
大模型智能体一换会话就失忆。A-Mem 把记忆写成互相链接的笔记,新记忆进来时会自我改写。2025 年 NeurIPS 论文,全文免费在线阅读。
A-Mem: Agentic Memory for LLM Agents
A-Mem:面向LLM智能体的智能体化记忆
Wujiang ,Zujie Liang ,Kai Mei ,Hang Gao ,Juntao Tan ,Yongfeng Zhang 罗格斯大学 独立研究者 AIOS基金会 wujiang.xu@rutgers.edu
摘要
尽管大型语言模型(LLM)智能体能够有效利用外部工具完成复杂的现实世界任务,但它们需要记忆系统来利用历史经验。当前的记忆系统能够实现基本的存储和检索,但缺乏复杂的记忆组织,尽管近期已有尝试引入图数据库。此外,这些系统固定的操作和结构限制了它们在不同任务间的适应性。为解决这一局限,本文提出了一种面向LLM智能体的新型智能体记忆系统,能够以智能体方式动态组织记忆。遵循卡片盒笔记法(Zettelkasten method)的基本原则,我们设计的记忆系统通过动态索引和链接创建互联的知识网络。当添加新记忆时,我们生成一条包含多个结构化属性的综合笔记,包括上下文描述、关键词和标签。随后系统分析历史记忆以识别相关连接,在存在有意义相似性之处建立链接。此外,这一过程还实现了记忆演化——当新记忆被整合时,它们可以触发对已有历史记忆的上下文表征和属性的更新,使记忆网络能够持续精炼其理解。我们的方法将卡片盒笔记法的结构化组织原则与智能体驱动决策的灵活性相结合,实现了更具适应性和上下文感知的记忆管理。在六个基础模型上的实证实验表明,相较于现有SOTA基线取得了显著提升。
基准评估代码:https://github.com/WujiangXu/AgenticMemory 生产就绪的智能体记忆代码:https://github.com/WujiangXu/A- mem- sys
1 引言
大型语言模型(LLM)智能体已在各类任务中展现出卓越能力,近期的进展使其能够与环境交互、执行任务并自主做出决策[23, 33, 7]。它们将LLM与外部工具和精细的工作流相结合,以提升推理和规划能力。尽管LLM智能体具有强大的推理性能,但它仍然需要记忆系统来提供与外部环境的长期交互能力[35]。
面向LLM智能体的现有记忆系统[25, 39, 28, 21]提供基本的记忆存储功能。这些系统要求智能体开发者预定义记忆存储结构、在工作流中指定存储点并确定检索时机。同时,为改进结构化记忆组织,Mem0[8]遵循RAG[9, 18, 30]的原则,将图数据库纳入存储和检索过程。虽然图数据库为记忆系统提供了结构化组织,但其对预定义模式和关系的依赖从根本上限制了其适应性。这一局限在实际场景中表现得十分明显——当智能体学到一种新颖的数学解法时,当前系统只能在其预设框架内对该信息进行分类和链接,
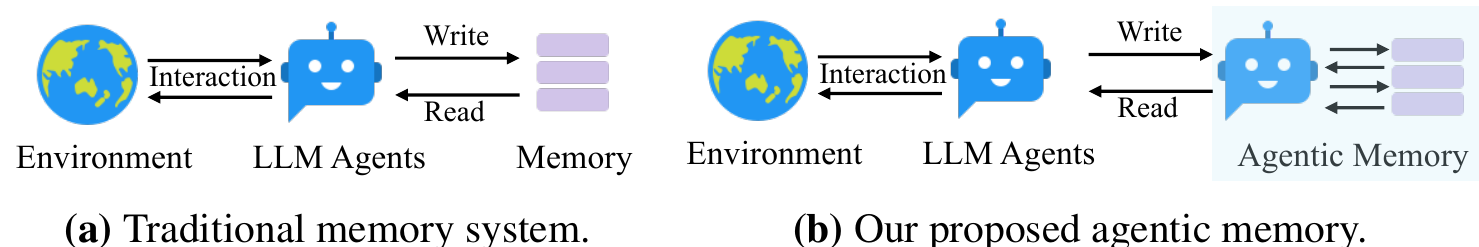
无法随着知识的演进而建立创新性连接或发展新的组织模式。这种僵化的结构,加之固定的智能体工作流,严重限制了这些系统在新环境中的泛化能力以及在长期交互中保持有效性的能力。随着LLM智能体处理更加复杂、开放式的任务,这一挑战变得愈发关键,因为灵活的知识组织和持续适应能力至关重要。因此,如何设计一个灵活且通用的记忆系统来支持LLM智能体的长期交互,仍然是一个关键挑战。
本文提出了一种面向LLM智能体的新型智能体记忆系统,命名为A- MEM,它能够实现动态记忆结构化,而不依赖于静态的、预先确定的记忆操作。我们的方法受卡片盒笔记法[15, 1]的启发,这是一种精密的知识管理系统,通过原子笔记和灵活的链接机制创建互联的信息网络。我们的系统引入了一种智能体记忆架构,为LLM智能体实现自主且灵活的记忆管理。对于每条新记忆,我们构建综合笔记,整合多种表征:包括多个属性的结构化文本属性以及用于相似性匹配的嵌入向量。随后A- MEM分析历史记忆库,基于语义相似性和共享属性建立有意义的连接。这一整合过程不仅创建新的链接,还实现了动态演化——当新记忆被纳入时,它们可以触发对现有记忆上下文表征的更新,使整个记忆能够随时间持续精炼并深化其理解。贡献总结如下:
- 我们提出了A-MEM,一种面向LLM智能体的智能体记忆系统,能够自主生成上下文描述、动态建立记忆连接,并基于新经验对现有记忆进行智能演化。该系统为LLM智能体赋予了长期交互能力,无需预先确定记忆操作。
- 我们设计了一种智能体记忆更新机制,新记忆会自动触发两项关键操作:链接生成和记忆演化。链接生成通过识别共享属性和相似的上下文描述,自动在记忆之间建立连接。记忆演化使现有记忆能够随着新经验的分析而动态适应,从而催生更高阶的模式和属性。
- 我们使用长期对话数据集对系统进行了全面评估,采用六种不同的评估指标比较六个基础模型的性能,展示了显著的改进。此外,我们提供了T-SNE可视化,以展示我们智能体记忆系统的结构化组织。
2 相关工作
2.1 LLM智能体的记忆
关于LLM智能体记忆系统的先前工作已探索了多种记忆管理和利用机制[23, 21, 8, 39]。一些方法实现了交互存储,通过稠密检索模型[39]或读写记忆结构[24]维护全面的历史记录。此外,MemGPT[25]利用类缓存架构来优先处理近期信息。类似地,SCM[32]提出了一种自控记忆(Self- Controlled Memory)框架,通过记忆流和控制器机制增强LLM维持长期记忆的能力。然而,这些方法在处理多样化的现实世界任务时面临显著局限。虽然它们能提供基本的记忆功能,但其操作通常受限于预定义的结构和固定的工作流。这些约束源于它们对僵化操作
模式的依赖,尤其是在记忆写入和检索过程中。这种不灵活性导致在新环境中泛化能力差,在长期交互中效果有限。因此,设计一个灵活且通用的记忆系统来支持智能体的长期交互仍然是一个关键挑战。
2.2 检索增强生成
检索增强生成(RAG)已成为一种通过引入外部知识源来增强LLM的强大方法[18, 6, 10]。标准RAG[37, 34]过程包括将文档索引为块、基于语义相似性检索相关块,并用检索到的上下文增强LLM的提示以进行生成。先进的RAG系统[20, 12]已发展到包含精密的检索前和检索后优化。在这些基础之上,近期研究引入了智能体RAG系统,在检索过程中展现出更加自主和自适应的行为。这些系统能够动态决定何时检索以及检索什么[4, 14],生成假设性响应以指导检索,并基于中间结果迭代精炼其搜索策略[31, 29]。
然而,尽管智能体RAG方法在检索阶段通过自主决定何时检索以及检索什么[4, 14, 38]展现了能动性,我们的智能体记忆系统则在更基础的层面上通过其记忆结构的自主演化展现了能动性。受卡片盒笔记法启发,我们的系统允许记忆主动生成自身的上下文描述、与相关记忆形成有意义的连接,并随着新经验的涌现而演化其内容和关系。这种在检索与存储和演化之间能动性的根本区别,使我们的方法与智能体RAG系统区分开来——后者尽管具有精密的检索机制,却维护着静态的知识库。
3 方法
我们提出的智能体记忆系统受卡片盒笔记法启发,实现了一个动态且自演化的记忆系统,使LLM智能体能够在无需预先确定操作的情况下维持长期记忆。该系统的设计强调原子笔记记录、灵活的链接机制以及知识结构的持续演化。
3.1 笔记构建
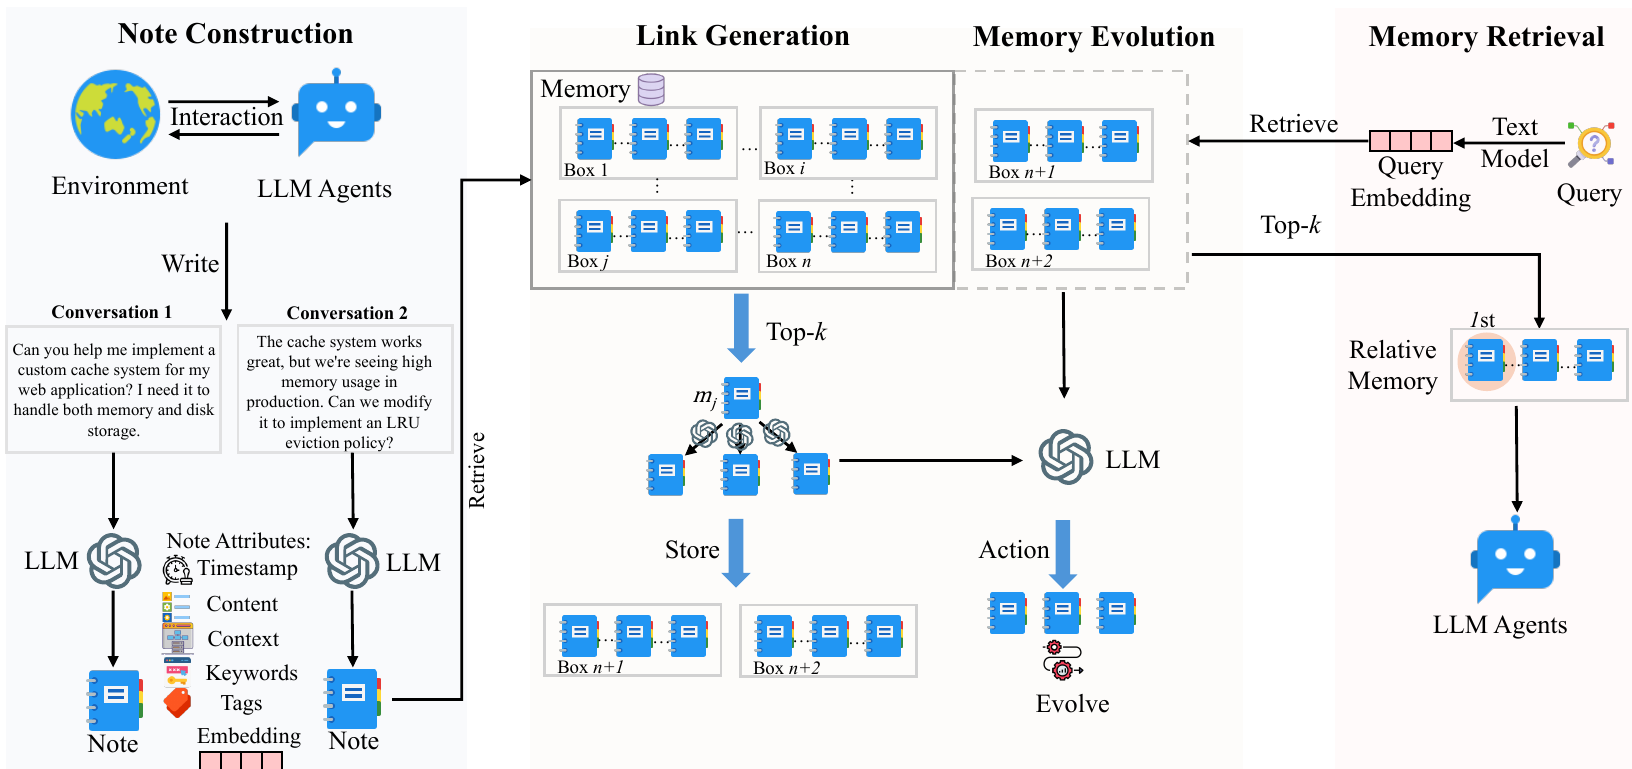
基于卡片盒笔记法的原子笔记记录和灵活组织原则,我们引入了一种由LLM驱动的记忆笔记构建方法。当智能体与其环境交互时,我们构建结构化的记忆笔记,既捕获显式信息,也捕获LLM生成的上下文理解。我们的集合 中的每条记忆笔记 表示为:
其中 表示原始交互内容, 是交互的时间戳, 表示LLM生成的关键词,用于捕获关键概念, 包含LLM生成的用于分类的标签, 表示LLM生成的上下文描述,提供丰富的语义理解, 维护共享语义关系的链接记忆集合。为了丰富每条记忆笔记,使其在基本内容和时间戳之外具有有意义的上下文,我们利用LLM分析交互并生成这些语义组件。笔记构建过程包括使用精心设计的模板 提示LLM:
遵循卡片盒笔记法的原子性原则,每条笔记捕获单一、自包含的知识单元。为实现高效检索和链接,我们通过文本编码器[27]计算一个稠密向量表示,封装笔记的所有文本组件:
通过使用LLM生成丰富的组件,我们能够从原始交互中自主提取隐含知识。多方面的笔记结构创建了丰富的表示,捕捉记忆的不同方面,促进细致入微的组织和检索。此外,LLM生成的语义组件与稠密向量表示相结合,既提供了上下文,又实现了计算高效的相似性匹配。
3.2 链接生成
我们的系统实现了一种自主链接生成机制,使新的记忆笔记无需预定义规则即可形成有意义的连接。当构造记忆笔记\(m_{n}\)被添加到系统中时,我们首先利用其语义嵌入进行基于相似性的检索。对于每个现有记忆笔记,我们计算相似度分数:
然后系统识别出前个最相关的记忆:
基于这些候选最近记忆,我们提示LLM根据其潜在共同属性分析潜在连接。形式上,记忆的链接集更新如下:
每个生成的链接\(l_{i}\)的结构为:。通过使用基于嵌入的检索作为初始过滤器,我们实现了高效的可扩展性,同时保持语义相关性。A-MEM即使在大型记忆集合中也能快速识别潜在连接,而无需进行穷举比较。更重要的是,LLM驱动的分析允许对关系进行细致入微的理解,超越了简单的相似性度量。语言模型可以识别仅凭嵌入相似性可能无法显现的微妙模式、因果关系和概念联系。我们在利用现代语言模型的同时,实现了Zettelkasten的灵活链接原则。由此产生的网络从记忆内容和上下文中有机涌现,实现了自然的知识组织。
3.3 记忆演化
在为新的记忆创建链接之后,A-MEM 会根据检索到的记忆的文本信息及其与新记忆的关系对其进行演化。对于最近邻集合 \(\mathcal{M}{\mathrm{near}}^{n}\) 中的每一条记忆 \(m{j}\),系统会判定是否更新其上下文、关键词和标签。这一演化过程可以形式化地表示为:
随后,演化后的记忆 \(m_{j}^{*}\) 会在记忆集合 \(\mathcal{M}\) 中替换原始记忆 \(m_{j}\)。这种演化式方法能够实现持续更新和新的连接,模拟人类的学习过程。随着系统随时间推移处理越来越多的记忆,它会发展出日益复杂的知识结构,在多个记忆之间发现更高阶的模式和概念。这为自主记忆学习奠定了基础,使得知识组织通过新经验与现有记忆之间持续不断的交互而逐步变得更加丰富。
3.4 检索相关记忆
在每次交互中,我们的 A-MEM 都会执行上下文感知的记忆检索,为智能体提供相关的历史信息。给定来自当前交互的查询文本 \(q\),我们首先使用与记忆笔记相同的文本编码器计算其稠密向量表示:
随后,系统使用余弦相似度计算查询嵌入与 \(\mathcal{M}\) 中所有现有记忆笔记之间的相似度分数:
然后,我们从历史记忆存储中检索出 k 条最相关的记忆,以构建上下文适宜的提示。
这些检索到的记忆提供了相关的历史上下文,帮助智能体更好地理解当前交互并作出回应。检索到的上下文通过将当前交互与记忆系统中存储的相关过往经验联系起来,丰富了智能体的推理过程。
4 实验
4.1 数据集与评估
为了评估指令感知推荐在长期对话中的有效性,我们使用了 LoCoMo 数据集 [22],与现有的对话数据集 [36, 13] 相比,它包含显著更长的对话。以往的数据集包含的对话大约为 1K 个 token、跨越 4-5 个会话,而 LoCoMo 的对话平均长达 9K 个 token,最多跨越 35 个会话,这使得它特别适合评估模型处理长程依赖关系以及在长时间对话中保持一致性的能力。LoCoMo 数据集包含多种问题类型,旨在全面评估模型理解的不同方面:(1) 单跳问题,可从单个会话中作答;(2) 多跳问题,需要跨会话综合信息;(3) 时间推理问题,测试对时间相关信息的理解;(4) 开放域知识问题,需要将对话上下文与外部知识相结合;(5) 对抗性问题,评估模型识别无法回答的查询的能力。总体而言,LoCoMo 在这些类别中共包含 7,512 个问答对。此外,我们使用一个名为 DialSim [16] 的新数据集来评估我们记忆系统的有效性。它是一个源自长期多方对话的问答数据集。该数据集源自热门电视节目(《老友记》《生活大爆炸》和《办公室》),涵盖跨越五年的 1,300 个会话,包含约 350,000 个 token,并且每个会话包含来自精心整理的粉丝问答网站问题的 1,000 多个问题,以及由时间知识图谱生成的复杂问题。
在对比基线方面,我们与 LoCoMo [22]、ReadAgent [17]、MemoryBank [39] 和 MemGPT [25] 进行比较。基线的详细介绍见附录 A.1。在评估方面,我们采用两个主要指标:F1 分数,通过平衡精确率和召回率来评估答案准确性;以及 BLEU-1 [26],通过衡量与真实答案的词语重叠来评估生成回复的质量。此外,我们还报告回答一个问题所需的平均 token 长度。除了报告使用另外四个指标(ROUGE-L、ROUGE-2、METEOR 和 SBERT 相似度)的实验结果外,我们还在附录 A.3 中展示了使用不同基础模型(包括 DeepSeek-R1-32B [11]、Claude 3.0 Haiku [2] 和 Claude 3.5 Haiku [3])的实验结果。
| 模型 | 方法 | 类别 | 平均 | ||||||||||
| 多跳 F1 | BLEU | 时序 F1 | 开放域 F1 | 单跳 F1 | BLEU | 对抗 F1 | BLEU | 排序 F1 | BLEU | Token 长度 | |||
| GPT | LoCoMo | 25.02 | 19.75 | 18.41 | 14.77 | 12.04 | 11.16 | 40.36 | 29.05 | 69.23 | 68.75 | 2.4 | 2.4 |
| READAGENT | 9.15 | 6.48 | 12.60 | 8.87 | 5.31 | 5.12 | 9.67 | 7.66 | 9.81 | 9.02 | 4.2 | 4.2 | |
| MEMORYBANK | 5.00 | 4.77 | 9.68 | 6.99 | 5.56 | 5.94 | 6.61 | 5.16 | 7.36 | 6.48 | 4.8 | 4.8 | |
| MEMGPT | 26.65 | 17.72 | 25.52 | 19.44 | 9.15 | 7.44 | 41.04 | 34.34 | 43.29 | 42.73 | 2.4 | 2.4 | |
| A-MEM | 27.02 | 20.09 | 45.85 | 36.67 | 12.14 | 12.00 | 44.65 | 37.06 | 50.03 | 49.47 | 1.2 | 1.2 | |
| GPT | LoCoMo | 28.00 | 18.47 | 9.09 | 5.78 | 16.47 | 14.80 | 61.56 | 54.19 | 52.61 | 51.13 | 2.0 | 2.0 |
| READAGENT | 14.61 | 9.95 | 4.16 | 3.19 | 8.84 | 8.37 | 12.46 | 10.29 | 6.81 | 6.13 | 4.0 | 4.0 | |
| MEMORYBANK | 6.49 | 4.69 | 2.47 | 2.43 | 6.43 | 5.30 | 8.28 | 7.10 | 4.42 | 3.67 | 5.0 | 5.0 | |
| MEMGPT | 30.36 | 22.83 | 17.29 | 13.18 | 12.24 | 11.87 | 60.16 | 53.35 | 34.96 | 34.25 | 2.4 | 2.4 | |
| A-MEM | 32.86 | 23.76 | 39.41 | 31.23 | 17.10 | 15.84 | 48.43 | 42.97 | 36.35 | 35.53 | 1.6 | 1.6 | |
| GPT | LoCoMo | 9.05 | 6.55 | 4.25 | 4.04 | 9.91 | 8.50 | 11.15 | 8.67 | 40.38 | 40.23 | 3.4 | 3.4 |
| READAGENT | 6.61 | 4.93 | 2.55 | 2.51 | 5.31 | 12.24 | 10.13 | 7.54 | 5.42 | 27.32 | 4.6 | 4.6 | |
| MEMORYBANK | 11.14 | 8.25 | 4.46 | 2.87 | 8.05 | 6.21 | 13.42 | 11.01 | 36.76 | 34.00 | 2.6 | 2.6 | |
| MEMGPT | 10.44 | 7.61 | 4.21 | 3.89 | 13.42 | 11.64 | 9.56 | 7.34 | 31.51 | 28.90 | 3.4 | 3.4 | |
| A-MEM | 18.23 | 11.94 | 24.32 | 19.74 | 16.48 | 14.31 | 23.63 | 19.23 | 46.00 | 43.26 | 1.0 | 1.0 | |
| GPT | LoCoMo | 4.61 | 4.29 | 3.11 | 2.71 | 4.55 | 5.97 | 7.03 | 5.69 | 16.95 | 14.81 | 3.2 | 3.2 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 3.60 | 3.39 | 1.97 | 1.67 | 6.63 | 6.58 | 4.11 | 3.32 | 13.07 | 10.30 | 4.2 | 4.2 | |
| MEMGPT | 5.07 | 4.31 | 2.94 | 2.95 | 7.04 | 7.10 | 7.26 | 5.52 | 14.47 | 12.39 | 2.4 | 2.4 | |
| A-MEM | 12.57 | 9.01 | 27.59 | 25.07 | 7.12 | 7.28 | 17.23 | 13.12 | 27.91 | 25.15 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 11.25 | 9.18 | 7.38 | 6.82 | 11.90 | 10.38 | 12.86 | 10.50 | 51.89 | 48.27 | 3.4 | 3.4 |
| READAGENT | 5.96 | 5.12 | 1.93 | 2.30 | 12.46 | 11.17 | 7.75 | 6.03 | 44.64 | 40.15 | 4.6 | 4.6 | |
| MEMORYBANK | 13.18 | 10.03 | 7.61 | 6.27 | 15.78 | 12.94 | 17.30 | 14.03 | 52.61 | 47.53 | 2.0 | 2.0 | |
| MEMGPT | 9.19 | 6.96 | 4.02 | 4.79 | 11.34 | 8.24 | 10.16 | 7.68 | 49.75 | 45.11 | 4.0 | 4.0 | |
| A-MEM | 19.06 | 11.71 | 17.80 | 10.28 | 17.55 | 14.67 | 28.51 | 24.13 | 58.81 | 54.28 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 6.88 | 5.77 | 4.37 | 4.40 | 10.65 | 9.29 | 8.37 | 6.93 | 30.25 | 28.46 | 2.8 | 2.8 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 6.19 | 4.47 | 3.49 | 3.13 | 4.07 | 4.57 | 7.61 | 6.03 | 18.65 | 17.05 | 3.2 | 3.2 | |
| MEMGPT | 5.32 | 3.99 | 2.68 | 2.72 | 5.64 | 5.54 | 4.32 | 3.51 | 21.45 | 19.37 | 3.8 | 3.8 | |
| A-MEM | 17.44 | 11.74 | 26.38 | 19.50 | 12.53 | 11.83 | 28.14 | 23.87 | 42.04 | 40.60 | 1.0 | 1.0 | |
4.2 实现细节
对于所有基线和我们的方法,我们通过采用附录 B 中详述的相同系统提示来保持一致。Qwen-1.5B/3B 和 Llama 3.2 1B/3B 模型通过使用 Ollama 1 进行本地实例化来部署,并由 LiteLLM 2 管理结构化输出生成。对于 GPT 模型,我们使用官方的结构化输出 API。在我们的记忆检索过程中,我们主要采用 \(k = 10\) 进行 top-\(k\) 记忆选择,以保持计算效率,同时针对特定类别调整该参数以优化性能。\(k\) 的详细配置见附录 A.5。对于文本嵌入,我们在所有实验中均采用 all-miniml-16-v2 模型。
4.3 实证结果
性能分析。在我们的实证评估中,我们在 LoCoMo 数据集上将 A-MEM 与四个具有竞争力的基线(包括 LoCoMo [22]、ReadAgent [17]、MemoryBank [39] 和 MemGPT [25])进行了比较。对于非 GPT 基础模型,我们的 A-MEM 在不同类别上始终优于所有基线,证明了我们智能体式记忆方法的有效性。对于基于 GPT 的模型,虽然 LoCoMo 和 MemGPT 由于其在简单事实检索方面强大的预训练知识,在开放域和对抗性等某些类别中表现出强劲性能,但我们的 A-MEM 在多跳任务中展现出更优越的性能,在需要复杂推理链的任务上取得了至少两倍于它们的表现。除了在 LoCoMo 数据集上的实验外,我们还在 DialSim 数据集上将我们的方法与 LoCoMo 和 MemGPT 进行了比较。A-MEM 在所有评估指标上始终优于所有基线,取得了 3.45 的 F1
| 方法 | F1 | BLEU-1 | ROUGE-L | ROUGE-2 | METEOR | SBERT 相似度 |
| LoCoMo | 2.55 | 3.13 | 2.75 | 0.90 | 1.64 | 15.76 |
| MemGPT | 1.18 | 1.07 | 0.96 | 0.42 | 0.95 | 8.54 |
| A-MEM | 3.45 | 3.37 | 3.54 | 3.60 | 2.05 | 19.51 |
| 方法 | 多跳 | 时间 | 类别 | 单跳 | 对抗 | |||||
| F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | |
| w/o LG & ME | 9.65 | 7.09 | 24.55 | 19.48 | 7.77 | 6.70 | 13.28 | 10.30 | 15.32 | 18.02 |
| w/o ME | 21.35 | 15.13 | 31.24 | 27.31 | 10.13 | 10.85 | 39.17 | 34.70 | 44.16 | 45.33 |
| A-MEM | 27.02 | 20.09 | 45.85 | 36.67 | 12.14 | 12.00 | 44.65 | 37.06 | 50.03 | 49.47 |
分数(比 LoCoMo 的 2.55 提高了 \(35\%\),比 MemGPT 的 1.18 高出 \(192\%\))。A-MEM 的有效性源于其新颖的智能体式记忆架构,该架构实现了动态且结构化的记忆管理。与使用静态记忆操作的传统方法不同,我们的系统通过带有丰富上下文描述的原子笔记创建相互连接的记忆网络,从而实现更有效的多跳推理。该系统能够基于共享属性动态地在记忆之间建立连接,并持续用新的上下文信息更新现有记忆描述,使其能够更好地捕捉和利用不同信息片段之间的关系。
成本效率分析。A-MEM 在展现强劲性能的同时,还表现出显著的计算和成本效率。该系统每次记忆操作大约需要 1,200 个 token,通过我们选择性的 top-k 检索机制,与基线方法(LoCoMo 和 MemGPT 为 16,900 个 token)相比,实现了 \(85-93\%\) 的 token 使用量减少。这一大幅度的 token 减少直接转化为更低的运营成本,每次记忆操作的成本低于 0.0003(当使用商业 API 服务时)——使得大规模部署在经济上可行。使用 GPT-4o-mini 时平均处理时间为 5.4 秒,而在单个 GPU 上使用本地托管的 Llama 3.2 1B 时仅需 1.1 秒。尽管在记忆处理过程中需要多次调用 LLM,A-MEM 仍能保持这种具有成本效益的资源利用,同时在所有测试的基础模型上始终优于基线方法,尤其是在复杂的多跳推理任务上将性能提升了一倍。这种低计算成本与卓越推理能力的平衡,凸显了 A-MEM 在现实世界中部署的实用优势。
4.4 消融研究
为了评估链接生成(LG)和记忆演化(ME)模块的有效性,我们通过系统地移除模型的关键组件来进行消融研究。当同时移除 LG 和 ME 模块时,系统表现出显著的性能下降,尤其是在多跳推理和开放域任务中。仅启用 LG 的系统(w/o ME)表现出中等性能水平,保持比同时缺少两个模块的版本显著更好的结果,这证明了链接生成在建立记忆连接方面的根本重要性。我们的完整模型 A-MEM 在所有评估类别中始终取得最佳性能,在复杂推理任务中尤为突出。这些结果表明,虽然链接生成模块是记忆组织的关键基础,但记忆演化模块为记忆结构提供了必要的完善。消融研究验证了我们的架构设计选择,并突出了这两个模块在构建有效记忆系统中的互补性。
4.5 超参数分析
我们进行了大量实验,以分析记忆检索参数 k 的影响,该参数控制每次交互检索的相关记忆数量。如图 3 所示,我们以 GPT-4o-mini 作为基础模型,在五类任务上评估了不同 k 值(10、20、30、40、50)下的性能。结果揭示了一个有趣的模式:虽然增大 k 通常会带来性能提升,但这种提升会逐渐趋于平缓,并且在较高的取值下有时会略有下降。这一趋势在多跳和开放域
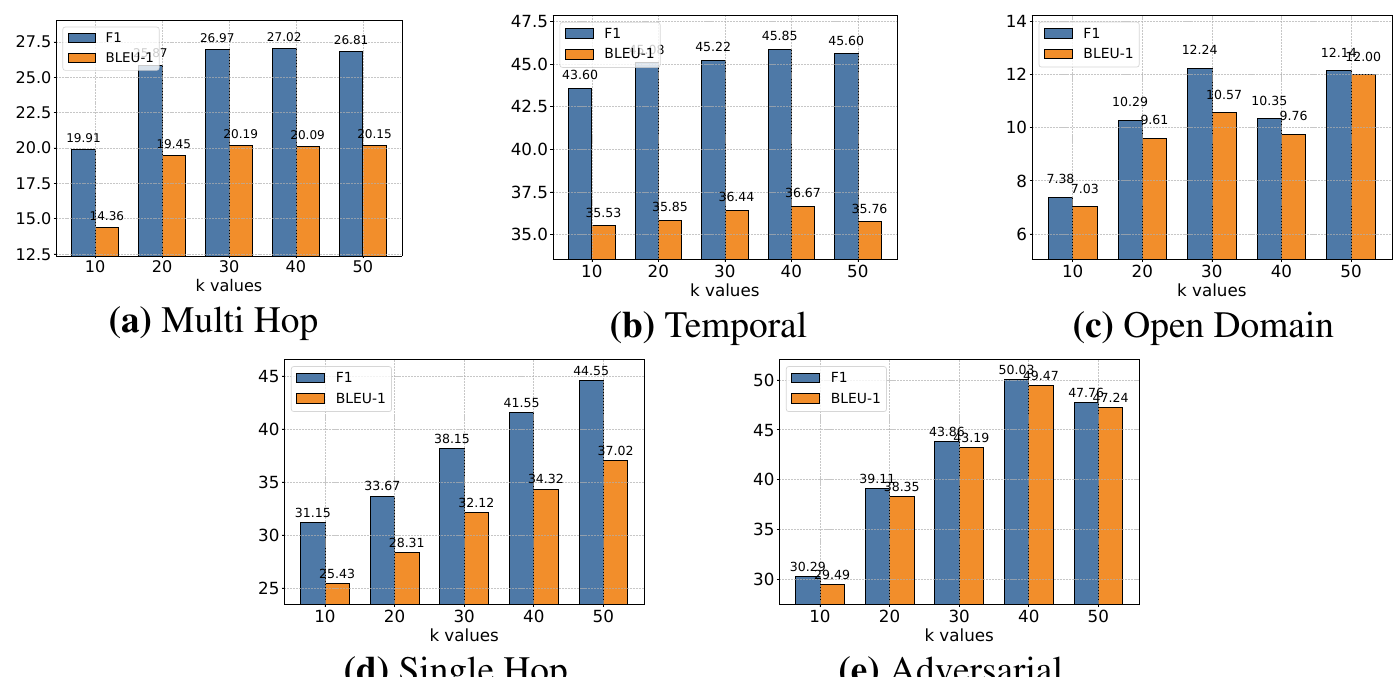
表 4:不同记忆方法和规模下内存使用量与检索时间的比较。
| 记忆大小 | 方法 | 内存使用量(MB) | 检索时间(μs) |
| 1,000 | A-MEM | 1.46 | 0.31 ± 0.30 |
| MemoryBank [39] | 1.46 | 0.24 ± 0.20 | |
| ReadAgent [17] | 1.46 | 43.62 ± 8.47 | |
| 10,000 | A-MEM | 14.65 | 0.38 ± 0.25 |
| MemoryBank [39] | 14.65 | 0.26 ± 0.13 | |
| ReadAgent [17] | 14.65 | 484.45 ± 93.86 | |
| 100,000 | A-MEM | 146.48 | 1.40 ± 0.49 |
| MemoryBank [39] | 146.48 | 0.78 ± 0.26 | |
| ReadAgent [17] | 146.48 | 6,682.22 ± 111.63 | |
| 1,000,000 | A-MEM | 1464.84 | 3.70 ± 0.74 |
| MemoryBank [39] | 1464.84 | 1.91 ± 0.31 | |
| ReadAgent [17] | 1464.84 | 120,069.68 ± 1,673.39 |
任务中尤为明显。这一观察表明记忆检索中存在一种微妙的平衡——较大的 k 值虽然能为推理提供更丰富的历史上下文,但也可能引入噪声,并对模型有效处理更长序列的能力构成挑战。我们的分析表明,适中的 k 值能够在上下文丰富性与信息处理效率之间取得最佳平衡。
4.6 规模扩展分析
为了评估记忆不断累积时的存储成本,我们考察了 A-MEM 系统与两种基线方法 MemoryBank [39] 和 ReadAgent [17] 中存储大小与检索时间之间的关系。我们在四个规模点上使用相同的记忆内容评估了这三种记忆系统,每一步将条目数量增加 10 倍(从 1,000 增加到 10,000、100,000,最终达到 1,000,000 条)。实验结果揭示了关于 A-MEM 系统扩展特性的关键洞见:在空间复杂度方面,三种系统均表现出相同的线性内存使用扩展 ,这符合基于向量的检索系统的预期。这证实了与基线方法相比,A-MEM 没有引入额外的存储开销。在检索时间方面,A-MEM 表现出优异的效率,随着记忆规模增长,检索时间的增加极小。即使扩展到 100 万条记忆,A-MEM 的检索时间也仅从 增加到 ,表现出卓越的性能。虽然 MemoryBank 的检索时间略快,但 A-MEM 在提供更丰富的记忆表示和功能的同时保持了相当的性能。基于我们对空间复杂度和检索时间的分析,我们得出结论:A-MEM 的检索机制即使在大规模下也保持了优异的效率。检索时间在不同记忆规模下的极小增长回应了人们对大规模记忆系统效率的担忧,表明 A-MEM 为长期对话管理提供了一种高度可扩展的解决方案。这种效率、可扩展性和增强记忆能力的独特结合,使 A-MEM 成为为 LLM 智能体构建强大长期记忆机制方面的一项重要进展。
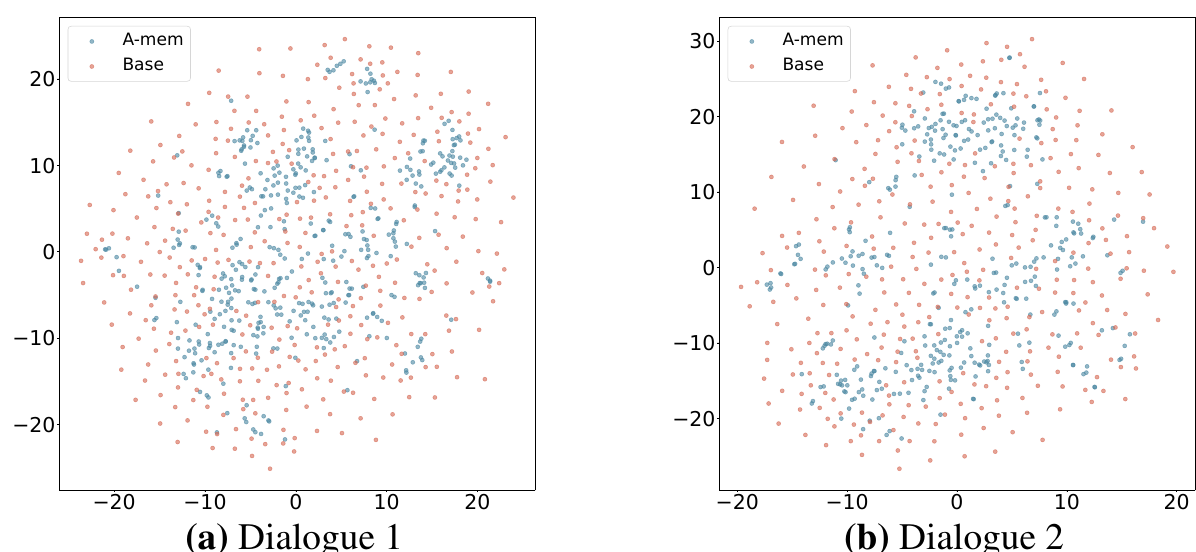
图4:记忆嵌入的t-SNE可视化,显示A-MEM(蓝色)相比基础记忆(红色)在不同对话中呈现出更有组织的分布。基础记忆表示不带链接生成和记忆演化的A-MEM。
4.7 记忆分析
我们在图4中呈现记忆嵌入的t-SNE可视化,以展示我们智能体记忆系统的结构优势。分析从LoCoMo [22]中长期对话采样的两个对话,我们观察到A-MEM(蓝色显示)相比基线系统(红色显示)始终表现出更连贯的聚类模式。这种结构组织在对话2中尤为明显,其中中心区域出现了定义良好的聚类,为我们的记忆演化机制和上下文描述生成的有效性提供了经验证据。相比之下,基线记忆嵌入显示出更分散的分布,表明在没有我们的链接生成和记忆演化组件的情况下,记忆缺乏结构组织。这些可视化结果验证了A-MEM能够通过动态演化和链接机制自主维护有意义的记忆结构。更多结果可见附录A.4。
5 结论
在这项工作中,我们介绍了A-MEM,一种新颖的智能体记忆系统,使LLM智能体能够动态组织和演化其记忆,而无需依赖预定义结构。受Zettelkasten方法的启发,我们的系统通过动态索引和链接机制创建了一个相互连接的知识网络,这些机制能够适应各种现实世界任务。该系统的核心架构特点是自主为新记忆生成上下文描述,并基于共享属性智能地与现有记忆建立连接。此外,我们的方法通过纳入新经验并通过持续交互发展高阶属性,使历史记忆能够持续演化。通过对六个基础模型的广泛实证评估,我们证明A-MEM在长期对话任务中相比现有最先进的基线取得了更优性能。可视化分析进一步验证了我们记忆组织方法的有效性。这些结果表明,智能体记忆系统可以显著增强LLM智能体在复杂环境中利用长期知识的能力。
6 局限性
尽管我们的智能体记忆系统取得了有前景的结果,但我们承认若干可供未来潜在探索的方面。首先,尽管我们的系统动态组织记忆,但这些组织的质量仍可能受到底层语言模型固有 capabilities 的影响。不同的LLM可能生成略有不同的上下文描述,或在记忆之间建立不同的连接。此外,虽然我们当前的实现聚焦于基于文本的交互,未来工作可以探索将该系统扩展到处理多模态信息,例如图像或音频,这可能提供更丰富的上下文表示。
参考文献
[1] Sönke Ahrens. How to Take Smart Notes: One Simple Technique to Boost Writing, Learning and Thinking. Amazon, 2017. Second Edition.
[2] Anthropic. The claude 3 model family: Opus, sonnet, haiku. Anthropic, Mar 2024. Accessed May 2025.
[3] Anthropic. Claude 3.5 sonnet model card addendum. Technical report, Anthropic, 2025. Accessed May 2025.
[4] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self- rag: Learning to retrieve, generate, and critique through self- reflection. arXiv preprint arXiv:2310.11511, 2023.
[5] Satanjeev Banerjee and Alon Lavie. Meteor: An automatic metric for mt evaluation with improved correlation with human judgments. In Proceedings of the acl workshop on intrinsic and extrinsic evaluation measures for machine translation and/or summarization, pages 65- 72, 2005.
[6] Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean- Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. Improving language models by retrieving from trillions of tokens. In International conference on machine learning, pages 2206- 2240. PMLR, 2022.
[7] Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Sam Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web. Advances in Neural Information Processing Systems, 36:28091- 28114, 2023.
[8] Khant Dev and Singh Taranjeet. mem0: The memory layer for ai agents. https://github.com/mem0ai/mem0, 2024.
[9] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From local to global: A graph rag approach to query- focused summarization. arXiv preprint arXiv:2404.16130, 2024.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, and Haofen Wang. Retrieval- augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2023.
[11] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[12] I. Ilin. Advanced rag techniques: An illustrated overview, 2023.
[13] Jihyoung Jang, Minseong Boo, and Hyounghun Kim. Conversation chronicles: Towards diverse temporal and relational dynamics in multi- session conversations. arXiv preprint arXiv:2310.13420, 2023.
[14] Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi- Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. arXiv preprint arXiv:2305.06983, 2023.
[15] David Kadavy. Digital Zettelkasten: Principles, Methods, & Examples. Google Books, May 2021.
[16] Jiho Kim, Woosog Chay, Hyeonji Hwang, Daeun Kyung, Hyunseung Chung, Eunbyeol Cho, Yohan Jo, and Edward Choi. Dialism: A real- time simulator for evaluating long- term multi- party dialogue understanding of conversational agents. arXiv preprint arXiv:2406.13144, 2024.
[17] Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. arXiv preprint arXiv:2402.09727, 2024.
[18] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen- tau Yih, Tim Rocktäschel, et al. Retrieval- augmented generation for knowledge- intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459- 9474, 2020.
[19] Chin- Yew Lin. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74- 81, 2004.
[20] Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra- dit: Retrieval- augmented dual instruction tuning. arXiv preprint arXiv:2310.01352, 2023.
[21] Zhiwei Liu, Weiran Yao, Jianguo Zhang, Liangwei Yang, Zuxin Liu, Juntao Tan, Prafulla K Choubey, Tian Lan, Jason Wu, Huan Wang, et al. Agentlite: A lightweight library for building and advancing task- oriented llm agent system. arXiv preprint arXiv:2402.15538, 2024.
[22] Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. arXiv preprint arXiv:2402.17753, 2024.
[23] Kai Mei, Zelong Li, Shuyuan Xu, Ruosong Ye, Yingqiang Ge, and Yongfeng Zhang. Aios: Llm agent operating system. arXiv e- prints, pp. arXiv- 2403, 2024.
[24] Ali Modarressi, Ayyob Imani, Mohsen Fayyaz, and Hinrich Schütze. Ret- llm: Towards a general read- write memory for large language models. arXiv preprint arXiv:2305.14322, 2023.
[25] Charles Packer、Sarah Wooders、Kevin Lin、Vivian Fang、Shishir G Patil、Ion Stoica 和 Joseph E Gonzalez。Memgpt:迈向将大语言模型作为操作系统。arXiv 预印本 arXiv:2310.08560,2023。
[26] Kishore Papineni、Salim Roukos、Todd Ward 和 Wei-Jing Zhu。Bleu:一种机器翻译自动评估方法。载于第40届计算语言学协会年会论文集,第311-318页,2002。
[27] Nils Reimers 和 Iryna Gurevych。Sentence-bert:使用孪生bert网络的句子嵌入。载于2019年自然语言处理经验方法会议论文集。计算语言学协会,2019年11月。
[28] Aymeric Roucher、Albert Villanova del Moral、Thomas Wolf、Leandro von Werra 和 Erik Kaunismaki。“smolagents”:一个用于构建出色智能体系统的smol库。https://github.com/huggingface/smolagents,2025。
[29] Zhihong Shao、Yeyun Gong、Yelong Shen、Minlie Huang、Nan Duan 和 Weizhu Chen。通过迭代检索-生成协同增强检索增强大语言模型。arXiv 预印本 arXiv:2305.15294,2023。
[30] Zeru Shi、Kai Mei、Mingyu Jin、Yongye Su、Chaoji Zuo、Wenyue Hua、Wujiang Xu、Yujie Ren、Zirui Liu、Mengnan Du 等。从命令到提示:面向aios的基于大语言模型的语义文件系统。arXiv 预印本 arXiv:2410.11843,2024。
[31] Harsh Trivedi、Niranjan Balasubramanian、Tushar Khot 和 Ashish Sabharwal。将检索与思维链推理交错用于知识密集型多步问题。arXiv 预印本 arXiv:2212.10509,2022。
[32] Bing Wang, Xinnian Liang, Jian Yang, Hui Huang, Shuangzhi Wu, Peihao Wu, Lu Lu, Zejun Ma, and Zhoujun Li. 使用自控记忆框架增强大型语言模型。arXiv预印本arXiv:2304.13343, 2023。
[33] Xingyao Wang, Boxuan Li, Yufan Song, Frank F Xu, Xiangru Tang, Mingchen Zhuge, Jiayi Pan, Yueqi Song, Bowen Li, Jaskirat Singh, 等. Openhands: 一个面向AI软件开发人员作为通用智能体的开放平台。arXiv预印本arXiv:2407.16741, 2024。
[34] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez, and Graham Neubig. 学习为检索增强生成过滤上下文。arXiv预印本arXiv:2311.08377, 2023。
[35] Lilian Weng. 由LLM驱动的自主智能体。lilianweng.github.io, 2023年6月。
[36] J Xu. 超越金鱼记忆:长期开放域对话。arXiv预印本arXiv:2107.07567, 2021。
[37] Wenhao Yu, Hongming Zhang, Xiaoman Pan, Kaixin Ma, Hongwei Wang, and Dong Yu. 笔记链:增强检索增强语言模型的鲁棒性。arXiv预印本arXiv:2311.09210, 2023。
[38] Zichun Yu, Chenyan Xiong, Shi Yu, and Zhiyuan Liu. 增强适配的检索器作为通用插件提高了语言模型的泛化能力。arXiv预印本arXiv:2305.17331, 2023。
[39] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, and Yanlin Wang. Memorybank: 使用长期记忆增强大型语言模型。载于《AAAI人工智能会议论文集》,第38卷,第19724-19731页,2024。
目录
1 引言 1
2 相关工作 2
2.1 LLM智能体的记忆 2
2.2 检索增强生成 3
3 方法论 3
3.1 笔记构建 4
3.2 链接生成 4
3.3 记忆演化 4
3.4 检索相关记忆 5
4 实验 5
4.1 数据集与评估 5
4.2 实现细节 6
4.3 实证结果 6
4.4 消融研究 7
4.5 超参数分析 7
4.6 缩放分析 8
4.7 记忆分析 9
5 结论 9
6 局限性 9
A 实验 14
A.1 详细基线介绍 14
A.2 评估指标 14
A.3 比较结果 15
A.4 记忆分析 16
A.5 超参数设置 17
B 提示模板与示例 19
B.1 笔记构建的提示模板 19
B.2 链接生成的提示模板 19
B.3 记忆演化的提示模板 20
B.4 使用A-MEM进行问答的示例 21
附录
A 实验
A.1 详细基线介绍
LoCoMo [22] 采取直接方法,利用基础模型而不使用记忆机制来完成问答任务。对于每个查询,它将完整的前置对话和问题纳入提示中,评估模型的推理能力。
ReadAgent [17] 通过复杂的三步方法处理长上下文文档:首先通过情节分页将内容分割成可管理的块,然后通过记忆摘要将每页提炼成简洁的记忆表示,最后通过交互式查找按需检索相关信息。
MemoryBank [39] 引入了一种创新的记忆管理系统,能够维护并高效检索历史交互。该系统具有基于艾宾浩斯遗忘曲线理论的动态记忆更新机制,可根据时间和重要性智能调整记忆强度。此外,它还包含一个用户画像构建系统,通过持续的交互分析逐步完善对用户个性的理解。
MemGPT [25] 提出了一种新颖的虚拟上下文管理系统,其灵感来源于传统操作系统的内存层次结构。该架构实现了双层结构:主上下文(类似于RAM)在LLM推理期间提供即时访问,外部上下文(类似于磁盘存储)则在固定上下文窗口之外维护信息。
A.2 评估指标
F1分数表示精确率和召回率的调和平均值,提供了一种将两种度量结合为单一值的平衡指标。当我们需要在完整响应和准确响应之间取得平衡时,该指标特别有价值:
其中
在问答系统中,F1分数在评估预测答案与参考答案之间的精确匹配方面起着关键作用。这对于基于片段的问答任务尤为重要,因为系统必须识别精确的文本片段,同时保持对答案的全面覆盖。BLEU-1 [26] 提供了一种评估系统输出与参考文本之间一元词匹配精确率的方法:
其中
这里, 是候选答案长度, 是参考答案长度, 是候选答案k中n元语法i的计数, 是任意参考答案中的最大计数。在问答中,BLEU-1评估生成答案的词汇精确率,对于生成式问答系统尤其有用,因为在这些系统中精确匹配可能过于严格。
ROUGE-L [19] 衡量生成文本与参考文本之间的最长公共子序列。
其中 是参考文本, 是候选文本,LCS 是最长公共子序列。
ROUGE- 2 [19] 计算生成文本与参考文本之间二元词组(bigram)的重叠程度。
ROUGE- L 和 ROUGE- 2 都特别适用于评估生成答案的流畅性和连贯性,其中 ROUGE- L 侧重于序列匹配,而 ROUGE- 2 侧重于局部词序。
METEOR [5] 基于候选文本与参考文本之间对齐的 unigram 计算得分,并考虑同义词与释义。
其中 为精确率, 为召回率,ch 为块(chunk)的数量, 为匹配的 unigram 数量。METEOR 对 QA 评估很有价值,因为它考虑了超出精确匹配的语义相似性,使其适合评估改述后的答案。
SBERT Similarity [27] 使用句子嵌入来衡量两个文本之间的语义相似度。
表示文本的句子嵌入。SBERT Similarity 对于评估 QA 系统中的语义理解特别有用,因为即使词汇重叠度很低,它也能捕捉到语义相似性。
A.3 比较结果
我们使用 ROUGE-2、ROUGE-L、METEOR 和 SBERT 指标进行的综合评估表明,A-MEM 在保持显著计算效率的同时实现了更优的性能。通过对各种模型规模和任务类别的广泛实证测试,我们确立了 A-MEM 相比现有基线是更有效的方法,并有若干有说服力的发现作为支持。在我们对非 GPT 模型(具体为 Qwen2.5 和 Llama 3.2)的分析中,A-MEM 在所有指标上始终优于所有基线方法。Multi-Hop 类别展示了尤为显著的结果,其中采用 A-MEM 的 Qwen2.5-15b 在 ROUGE-L 上达到 27.23 分,大幅超过 LoComo 的 4.68 和 ReadAgent 的 2.81——这代表着近六倍的提升。这种优越性模式在 METEOR 和 SBERT
| 模型 | 方法 | 类别 | ||||||||
| 多跳 RGE-2 | RGE-L | 时间 RGE-2 | RGE-L | 开放域 RGE-2 | RGE-L | 单跳 RGE-2 | RGE-L | 对抗 RGE-2 | ||
| GPT | LoCoMo | 9.64 | 23.92 | 2.01 | 18.09 | 3.40 | 11.58 | 26.48 | 40.20 | 60.46 |
| READAGENT | 2.47 | 9.45 | 0.95 | 13.12 | 0.55 | 5.76 | 2.99 | 9.92 | 6.66 | |
| MEMORYBANK | 1.18 | 5.43 | 0.52 | 9.64 | 0.97 | 5.77 | 1.64 | 6.63 | 4.55 | |
| MEMGPT | 10.58 | 25.60 | 4.76 | 25.22 | 0.76 | 9.14 | 28.44 | 42.24 | 36.62 | |
| A-MEM | 10.61 | 25.86 | 21.39 | 44.27 | 3.42 | 12.09 | 29.50 | 45.18 | 42.62 | |
| LoCoMo | 11.53 | 30.65 | 1.68 | 8.17 | 3.21 | 16.33 | 45.42 | 63.86 | 45.13 | |
| Qwen | READAGENT | 3.91 | 14.36 | 0.43 | 3.96 | 0.52 | 8.58 | 4.75 | 13.41 | 4.24 |
| MEMORYBANK | 1.84 | 7.36 | 0.36 | 2.29 | 2.13 | 6.85 | 3.02 | 9.35 | 1.22 | |
| MEMGPT | 11.55 | 30.18 | 4.66 | 15.83 | 3.27 | 14.02 | 43.27 | 62.75 | 28.72 | |
| A-MEM | 12.76 | 31.71 | 9.82 | 25.04 | 6.09 | 16.63 | 33.67 | 50.31 | 30.31 | |
| LoCoMo | 1.39 | 9.24 | 0.00 | 4.68 | 3.42 | 10.59 | 3.25 | 11.15 | 35.10 | |
| READAGENT | 0.74 | 7.14 | 0.10 | 2.81 | 3.05 | 12.63 | 1.47 | 7.88 | 20.73 | |
| Qwen | MEMORYBANK | 1.51 | 11.18 | 0.14 | 5.39 | 1.80 | 8.44 | 5.07 | 13.72 | 29.24 |
| MEMGPT | 1.16 | 11.35 | 0.00 | 7.88 | 2.87 | 14.62 | 2.18 | 9.82 | 23.96 | |
| A-MEM | 4.88 | 17.94 | 5.88 | 27.23 | 3.44 | 16.87 | 12.32 | 24.38 | 36.32 | |
| LoCoMo | 0.49 | 4.83 | 0.14 | 3.20 | 1.31 | 5.38 | 1.97 | 6.98 | 12.66 | |
| READAGENT | 0.08 | 4.08 | 0.00 | 1.96 | 1.26 | 6.19 | 0.73 | 4.34 | 7.35 | |
| MEMORYBANK | 0.43 | 3.76 | 0.05 | 1.61 | 0.24 | 6.32 | 1.03 | 4.22 | 9.55 | |
| Qwen | MEMGPT | 0.69 | 5.55 | 0.05 | 3.17 | 1.90 | 7.90 | 2.05 | 7.32 | 10.46 |
| A-MEM | 2.91 | 12.42 | 8.11 | 27.74 | 1.51 | 7.51 | 8.80 | 17.57 | 21.39 | |
| LoCoMo | 2.51 | 11.48 | 0.44 | 8.25 | 1.69 | 13.06 | 2.94 | 13.00 | 39.85 | |
| READAGENT | 0.53 | 6.49 | 0.00 | 4.62 | 5.47 | 14.29 | 1.19 | 8.03 | 34.52 | |
| MEMORYBANK | 2.96 | 13.57 | 0.23 | 10.53 | 4.01 | 18.38 | 6.41 | 17.66 | 41.15 | |
| MEMGPT | 1.82 | 9.91 | 0.06 | 6.56 | 2.13 | 11.36 | 2.00 | 10.37 | 38.59 | |
| Llama 2 | A-MEM | 4.82 | 19.31 | 1.84 | 20.47 | 5.99 | 18.49 | 14.82 | 29.78 | 46.76 |
| LoCoMo | 0.98 | 7.22 | 0.03 | 4.45 | 2.36 | 11.39 | 2.85 | 8.45 | 25.47 | |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.07 | 5.22 | 3.25 | 2.51 | 15.78 | |
| MEMORYBANK | 1.83 | 6.96 | 0.25 | 3.41 | 0.43 | 4.43 | 2.73 | 7.83 | 14.64 | |
| MEMGPT | 0.72 | 5.39 | 0.11 | 2.85 | 0.61 | 5.74 | 1.45 | 4.42 | 16.62 | |
| A-MEM | 6.02 | 17.62 | 7.93 | 27.97 | 5.38 | 13.00 | 16.89 | 28.55 | 35.48 | |
得分上也持续存在。在考察基于 GPT 的模型时,我们的结果揭示了一个有趣的模式。虽然 LoCoMo 和 MemGPT 在开放领域和对抗性任务中表现出强大的能力,但 A-MEM 在多跳推理任务中展现出显著的优越性。使用 GPT-4o-mini 时,A-MEM 在多跳任务中取得 44.27 的 ROUGE-L 得分,是 LoComo 的 18.09 的两倍多。这一显著优势在其他指标上也保持一致,METEOR 得分为 23.43 对 7.61,SBERT 得分为 70.49 对 52.30。A-MEM 出色的计算效率进一步放大了这些结果的重要性。我们的方法仅需 1,200-2,500 个 token,而 LoComo 和 MemGPT 需要大量的 16,900 个 token。这种效率源于两项关键的架构创新:第一,我们新颖的智能体记忆架构通过带有丰富上下文描述的原子笔记创建相互连接的记忆网络,从而能够更有效地捕获和利用信息关系。第二,我们的选择性 top-k 检索机制促进了动态记忆演化和结构化组织。这些创新的有效性在复杂推理任务中尤为明显,正如所有评估指标上持续强劲的多跳性能所证明的那样。此外,我们还展示了使用不同基础模型(包括 DeepSeek-R1-32B [11]、Claude 3.0 Haiku [2] 和 Claude 3.5 Haiku [3])的实验结果。
A.4 记忆分析
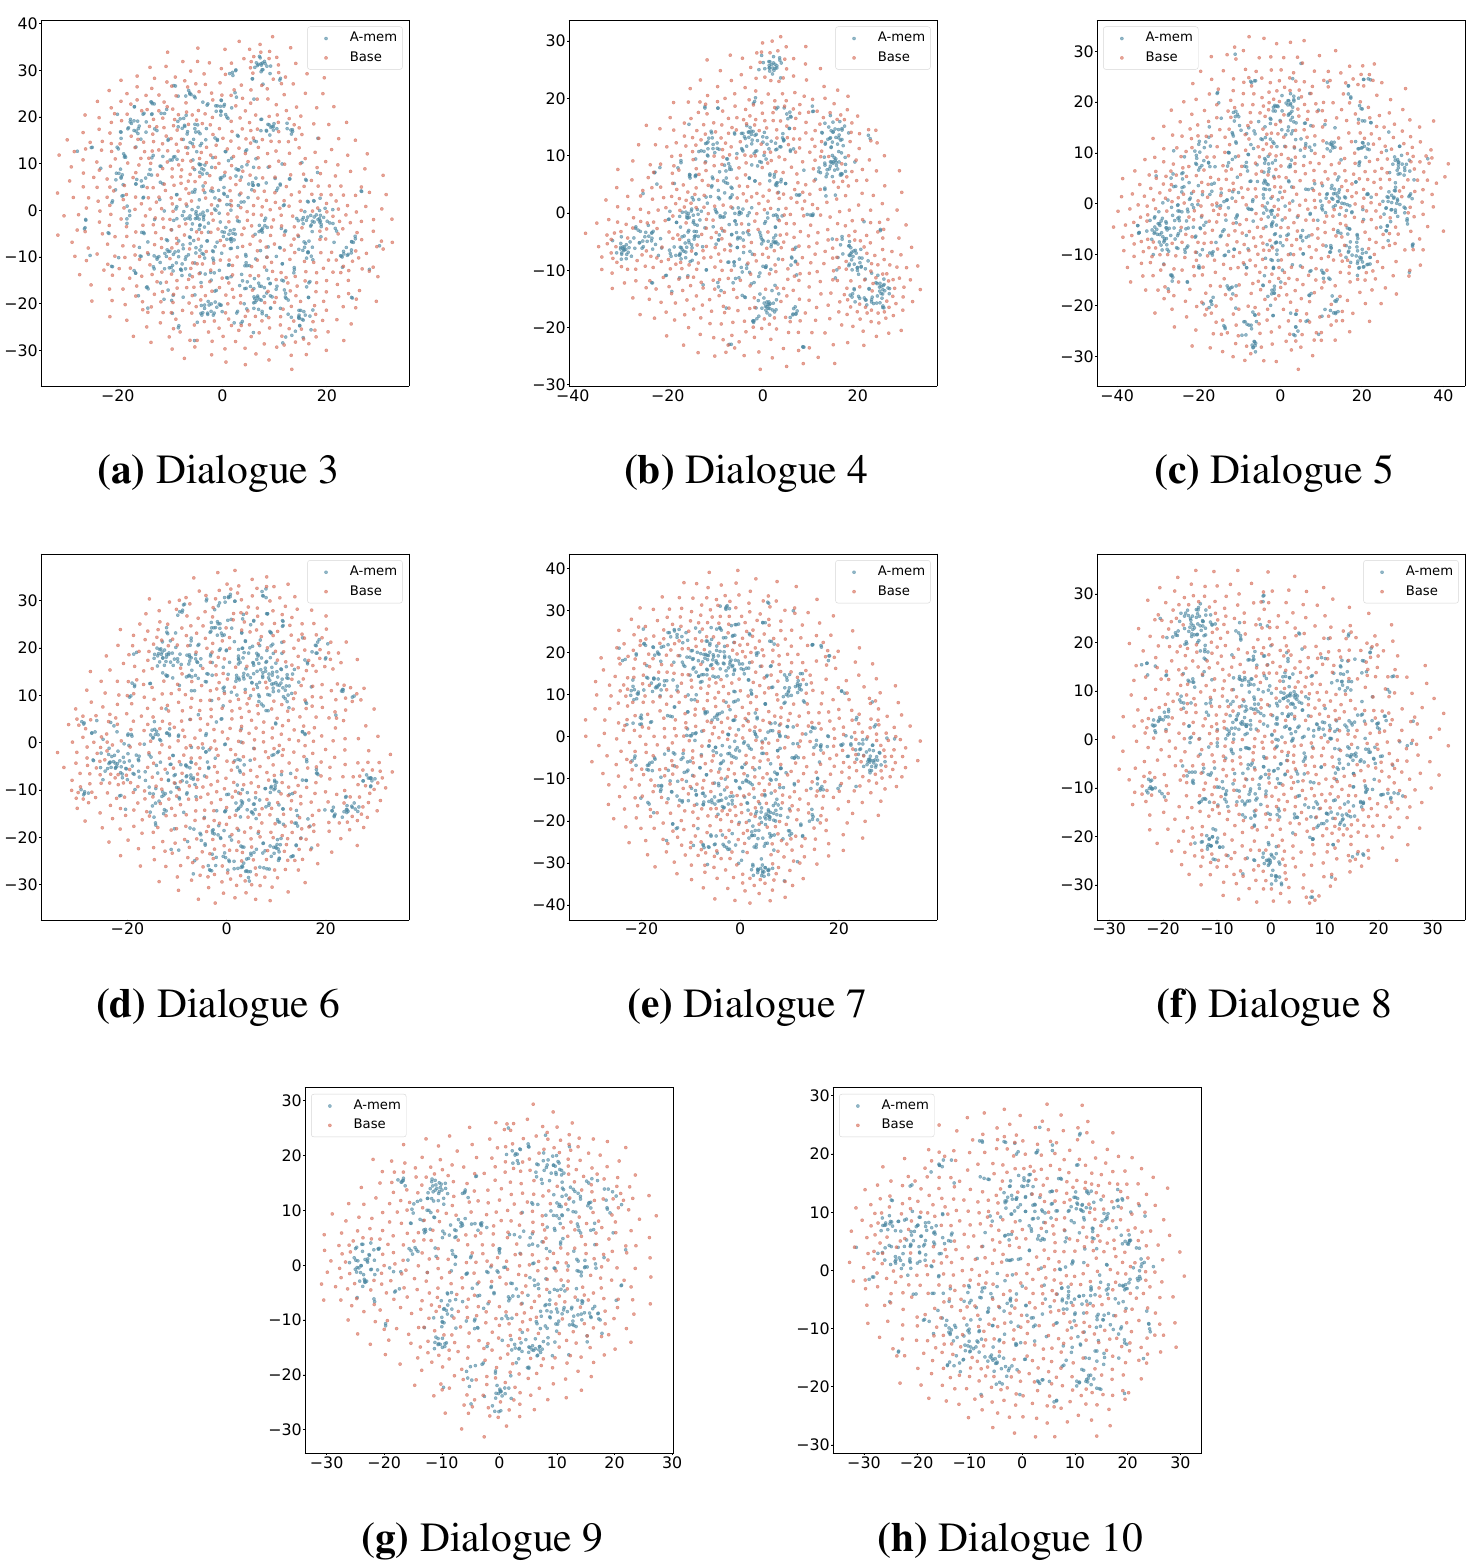
除了正文中展示的前两个对话的记忆可视化之外,我们在图 5 中提供了额外的可视化,以展示我们智能体记忆系统的结构优势。通过分析从 LoCoMo [22] 中的长期对话中采样的两个对话,我们观察到 A-MEM(以蓝色显示)相比基线系统(以红色显示)始终产生更连贯的聚类模式。这种结构组织在对话 2 中尤为明显,其中不同的聚类出现在中心区域,为我们的记忆演化机制和上下文描述生成的有效性提供了实证支持。相比之下,基线记忆嵌入呈现出更分散的分布,表明在没有我们的链接生成和记忆演化组件的情况下,记忆缺乏结构组织。
| 模型 | 方法 | 类别 | ||||||||||
| 多跳 ME | SBERT | 时序 ME | SBERT | 开放域 ME | SBERT | 单跳 ME | SBERT | 对抗 ME | ||||
| GPT | 4-hop | LoCoMo | 15.81 | 47.97 | 7.61 | 52.30 | 8.16 | 35.00 | 40.42 | 57.78 | 63.28 | 71.93 |
| ReadAgent | 5.46 | 28.67 | 4.76 | 45.07 | 3.69 | 26.72 | 8.01 | 26.78 | 8.38 | 15.20 | ||
| MEMORY BANK | 3.42 | 21.71 | 4.07 | 37.58 | 4.21 | 23.71 | 5.81 | 20.76 | 6.24 | 13.00 | ||
| MEMGPT | 15.79 | 49.33 | 13.25 | 61.53 | 4.59 | 32.77 | 41.40 | 58.19 | 39.16 | 47.24 | ||
| A-MEM | 16.36 | 49.46 | 23.43 | 70.49 | 8.36 | 38.48 | 42.32 | 59.38 | 45.64 | 53.26 | ||
| GPT | 4跳 | LoCoMo | 16.34 | 53.82 | 7.21 | 32.15 | 8.98 | 43.72 | 53.39 | 73.40 | 47.72 | 56.09 |
| ReadAgent | 7.86 | 37.41 | 3.76 | 26.22 | 4.42 | 30.75 | 9.36 | 31.37 | 5.47 | 12.34 | ||
| 记忆库 | 3.22 | 26.23 | 2.29 | 23.49 | 4.18 | 24.89 | 6.64 | 23.90 | 2.93 | 10.01 | ||
| MEMGPT | 16.64 | 55.12 | 12.68 | 35.93 | 7.78 | 37.91 | 52.14 | 72.83 | 31.15 | 39.08 | ||
| A-MEM | 17.53 | 55.96 | 13.10 | 45.40 | 10.62 | 38.87 | 41.93 | 62.47 | 32.34 | 40.11 | ||
| Open2.5 | 4跳 | LoCoMo | 4.99 | 32.23 | 2.86 | 34.03 | 5.89 | 35.61 | 8.57 | 29.47 | 40.53 | 50.49 |
| ReadAgent | 3.67 | 28.20 | 1.88 | 27.27 | 8.97 | 35.13 | 5.52 | 26.33 | 24.04 | 34.12 | ||
| MEMORY BANK | 5.57 | 35.40 | 2.80 | 32.47 | 4.27 | 33.85 | 10.59 | 32.16 | 32.93 | 42.83 | ||
| MEMGPT | 5.40 | 35.64 | 2.35 | 39.04 | 7.68 | 40.36 | 7.07 | 30.16 | 27.24 | 40.63 | ||
| A-MEM | 9.49 | 43.49 | 11.92 | 61.65 | 9.11 | 42.58 | 19.69 | 41.93 | 40.64 | 52.44 | ||
| Open2.5 | 4-hop | LoCoMo | 2.00 | 24.37 | 1.92 | 25.24 | 3.45 | 25.38 | 6.00 | 21.28 | 16.67 | 23.14 |
| ReadAgent | 1.78 | 21.10 | 1.69 | 20.78 | 4.43 | 25.15 | 3.37 | 18.20 | 10.46 | 17.39 | ||
| 记忆库 | 2.37 | 17.81 | 2.22 | 21.93 | 3.86 | 20.65 | 3.99 | 16.26 | 15.49 | 20.77 | ||
| MEMGPT | 3.74 | 24.31 | 2.25 | 27.67 | 6.44 | 29.59 | 6.24 | 22.40 | 13.19 | 20.83 | ||
| A-MEM | 6.25 | 33.72 | 14.04 | 62.54 | 6.56 | 30.60 | 15.98 | 33.98 | 27.36 | 33.72 | ||
| Llama 3.2 | 4-hop | LoCoMo | 5.77 | 38.02 | 3.38 | 45.44 | 6.20 | 42.69 | 9.33 | 34.19 | 46.79 | 60.74 |
| ReadAgent | 2.97 | 29.26 | 1.31 | 26.45 | 7.13 | 39.19 | 5.36 | 26.44 | 42.39 | 54.35 | ||
| 记忆库 | 6.77 | 39.33 | 4.43 | 45.63 | 7.76 | 42.81 | 13.01 | 37.32 | 50.43 | 60.81 | ||
| MEMGPT | 5.10 | 32.99 | 2.54 | 41.81 | 3.26 | 35.99 | 6.62 | 30.68 | 45.00 | 61.33 | ||
| A-MEM | 9.01 | 45.16 | 7.50 | 54.79 | 8.30 | 43.42 | 22.46 | 47.07 | 53.72 | 68.00 | ||
| Llama 3.2 | 4-hop | LoCoMo | 3.69 | 27.94 | 2.96 | 20.40 | 6.46 | 32.17 | 6.58 | 22.92 | 29.02 | 35.74 |
| ReadAgent | 1.21 | 17.40 | 2.33 | 12.02 | 3.39 | 19.63 | 2.46 | 14.63 | 14.37 | 21.25 | ||
| 记忆库 | 3.84 | 25.06 | 2.73 | 13.65 | 3.05 | 21.08 | 6.35 | 22.02 | 17.14 | 24.39 | ||
| MEMGPT | 2.78 | 22.06 | 2.21 | 14.97 | 3.63 | 23.18 | 3.47 | 17.81 | 20.50 | 26.87 | ||
| A-MEM | 9.74 | 39.32 | 13.19 | 59.70 | 8.09 | 32.27 | 24.30 | 42.86 | 39.74 | 46.76 | ||
| 方法 | 类别 | |||||
| 多跳 F1 | BLEU-1 | 时间 F1 | 开放域 F1 | 单跳 F1 | 对抗 F1 | |
| DeepSeek-R1-32B | ||||||
| LoCoMo | 8.58 | 6.48 | 4.79 | 4.35 | 12.96 | 12.52 |
| MEMGPT | 8.28 | 6.25 | 5.45 | 4.97 | 10.97 | 9.09 |
| A-MEM | 15.02 | 10.64 | 14.64 | 11.01 | 14.81 | 12.82 |
| Claude 3.0 Haiku | ||||||
| LoCoMo | 4.56 | 3.33 | 0.82 | 0.59 | 2.86 | 3.22 |
| MEMGPT | 7.65 | 6.36 | 1.65 | 1.26 | 7.41 | 6.64 |
| A-MEM | 19.28 | 14.69 | 16.65 | 12.23 | 11.85 | 9.61 |
| Claude 3.5 Haiku | ||||||
| LoCoMo | 11.34 | 8.21 | 3.29 | 2.69 | 3.79 | 3.58 |
| MEMGPT | 8.27 | 6.55 | 3.99 | 2.76 | 4.71 | 4.48 |
| A-MEM | 29.70 | 23.19 | 31.54 | 27.53 | 11.42 | 9.47 |
这些可视化验证了 A-MEM 能够通过其动态演化和链接机制自主维持有意义的记忆结构。
A.5 超参数设置
所有超参数 k 值均列于表 8 中。对于在 k=10 时已达到最先进(SOTA)性能的模型,我们保持该值而不进一步调优。
| 模型 | 多跳 | 时序 | 开放域 | 单跳 | 对抗性 |
| GPT-4o-mini | 40 | 40 | 50 | 50 | 40 |
| GPT-4o | 40 | 40 | 50 | 50 | 40 |
| Qwen2.5-1.5b | 10 | 10 | 10 | 10 | 10 |
| Qwen2.5-3b | 10 | 10 | 50 | 10 | 10 |
| Llama3.2-1b | 10 | 10 | 10 | 10 | 10 |
| Llama3.2-3b | 10 | 20 | 10 | 10 | 10 |
B 提示模板与示例
B.1 笔记构建的提示模板
笔记构建中的提示模板:
通过以下方式对以下内容生成结构化分析:
1. 识别最显著的关键词(关注名词、动词和关键概念)
2. 提取核心主题和上下文元素
3. 创建相关的分类标签
将响应格式化为 JSON 对象:{"keywords": [ // 若干具体、不同的关键词,用以捕捉关键概念和术语 // 按从最重要到最不重要排序 // 不要包含说话者姓名或时间的关键词 // 至少三个关键词,但不要过于冗余。 ], "context": // 一句话总结: // - 主要主题/领域 // - 关键论点/要点 // - 目标受众/目的 , "tags": [ // 若干用于分类的宽泛类别/主题 // 包含领域、格式和类型标签 // 至少三个标签,但不要过于冗余。 ]}
待分析内容:
B.2 链接生成的提示模板
链接生成中的提示模板:
你是一个 AI 记忆演化智能体,负责管理和演化知识库。根据关键词和上下文分析新记忆笔记,同时结合其若干最近邻记忆。新记忆上下文:{context} 内容:{content} 关键词:{keywords} 最近邻记忆:{nearest_neighbors_memories} 基于此信息,判断:该记忆是否应被演化?考虑其与其他记忆的关系。
B.3 记忆演化的提示模板
记忆演化中的提示模板:
你是一个 AI 记忆演化智能体,负责管理和演化知识库。根据关键词和上下文分析新记忆笔记,同时结合其若干最近邻记忆。
对其演化做出决策。
新记忆上下文:{context}
内容:{content}
关键词:{keywords}
最近邻记忆:{nearest_neighbors_memories}
基于此信息,判断:
1. 应采取哪些具体操作(strengthen、update_neighbor)?
1.1 如果选择加强连接,应连接到哪个记忆?你能给出该记忆更新后的标签吗?
1.2 如果选择更新邻居,你可以基于对这些记忆的理解更新这些记忆的上下文和标签。
标签应由这些记忆的特征内容决定,这些标签可用于后续检索和分类。
所有上述信息应按以下顺序以列表格式返回:[[new_memory],[neighbor_memory_1], ... [neighbor_memory_n]]
这些操作可以组合使用。
以 JSON 格式返回你的决策,结构如下:{{ "should_evolve": true/false,
“actions”:["strengthen", "merge", "prune"],
“suggested_connections”:["neighbor_memory_ids"],
“tags_to_update”:["tag_1", ... "tag_n"],
“new_context_neighborhood”:["new_context", ... "new_context"],
“new_tags_neighborhood":[["tag_1", ... "tag_n"], ... ["tag_1", ... "tag_n"]],
B.4 使用A-MEM进行问答的示例
示例:
问题686:Dave在2023年10月养成了什么爱好?
预测:摄影
参考:摄影
对话开始时间:2023年11月17日上午10:54
记忆内容:说话者Dave说:嘿,Calvin,好久没聊了!发生了很多事。我开始学习摄影了,感觉非常棒——一直在拍这附近的风景,真的很酷。
记忆上下文:主要话题是说话者新培养的摄影爱好,强调其拍摄当地风景的乐趣,目的是与朋友展开关于个人经历的对话。
记忆关键词:['photography', 'scenery', 'conversation', 'experience', 'hobby']
记忆标签:['hobby', 'photography', 'personal development', 'conversation', 'leisure']
对话开始时间:2023年7月21日下午6:38
记忆内容:说话者Calvin说:谢谢,Dave!拥有自己的工作空间感觉很棒。最近我一直在尝试不同流派,推动自己走出舒适区。在歌曲中加入电子元素给它们带来新鲜感。这是一个令人兴奋的自我发现和成长过程!
记忆上下文:说话者讨论其在音乐中的创作过程,强调对不同流派的尝试以及为个人成长和艺术演进融入电子元素。
记忆关键词:['space', 'experimentation', 'genres', 'electronic', 'self- discovery', 'growth']
记忆标签:['music', 'creativity', 'self- improvement', 'artistic expression']
NeurIPS论文检查清单
该检查清单旨在鼓励负责任的机器学习研究的最佳实践,涉及可复现性、透明度、研究伦理和社会影响等问题。请勿删除该检查清单:不包含该检查清单的论文将被直接拒稿。该检查清单应放在参考文献之后,并放在(可选的)补充材料之后。该检查清单不计入页数限制。
请仔细阅读检查清单指南,了解如何回答这些问题。对于检查清单中的每个问题:
您应回答[Yes]、[No]或[NA]。[NA]表示该问题对特定论文不适用,或相关信息不可用。请在回答后立即提供简短(1-2句)的理由说明(即使回答为NA也是如此)。
检查清单的答案是您论文投稿中不可或缺的一部分。审稿人、领域主席、高级领域主席和伦理审稿人都可以看到这些答案。您还将被要求在论文最终版本中(经过最终修改后)一并附上该清单,其最终版本将随论文一同发布。
您的论文审稿人将被要求将检查清单作为其评估的因素之一。虽然“[Yes]”通常比“[No]”更可取,但只要给出适当的理由(例如,“未报告误差棒,因为计算成本过高”或“我们无法找到所用数据集的许可证”),回答“[No]”是完全可以接受的。一般来说,回答“[No]”或“[NA]”并不构成拒稿理由。虽然问题的表述是二元的,但我们承认真实答案往往更为微妙,因此请仅使用您的最佳判断并撰写理由加以详述。所有支持性证据可以出现在正文或补充材料(以附录形式提供)中。如果您对某个问题回答[Yes],请在理由中指出可以找到该问题相关材料的章节。
重要,请:
- 删除此说明块,但保留章节标题“NeurIPS Paper Checklist”。- 保留以下检查清单的小节标题、问题/答案和指南。- 不要修改问题,并且仅使用提供的宏来回答。
1. 主张
问题:摘要和引言中提出的主要主张是否准确反映了论文的贡献和范围?
答案:[Yes]
理由:摘要和引言总结了我们的主要贡献。
指南:
- 答案NA表示摘要和引言不包含论文中提出的主张。- 摘要和/或引言应明确陈述所提出的主张,包括论文所作的贡献以及重要的假设和局限性。对这一问题回答No或NA不会给审稿人留下好印象。- 所提出的主张应与理论和实验结果相符,并反映结果在多大程度上可以预期推广到其他情境。- 只要明确这些目标并未由论文实现,将抱负性目标作为动机纳入是可以的。
2. 局限性
问题:论文是否讨论了作者所完成工作的局限性?
答案:[Yes]
理由:本文包含一个关于局限性的章节。
指南:
- 答案NA表示论文没有局限性,而答案No表示论文有局限性,但未在论文中讨论。
- 鼓励作者在论文中创建一个单独的“局限性”章节。
- 论文应指出任何强假设,以及结果在违反这些假设时有多稳健(例如,独立性假设、无噪声设定、模型良好设定、仅在局部成立的渐近近似)。作者应反思这些假设在实践中可能如何被违反,以及其影响会是什么。
- 作者应反思所提出主张的范围,例如,如果该方法仅在少数数据集上或仅进行了少数次运行测试。一般来说,实证结果往往依赖于隐含假设,这些假设应予以阐明。
- 作者应反思影响该方法性能的因素。例如,当图像分辨率低或在弱光下拍摄图像时,面部识别算法可能表现不佳。或者,语音转文字系统可能无法可靠地用于为在线讲座提供隐藏字幕,因为它无法处理技术术语。
- 作者应讨论所提出算法的计算效率以及它们如何随数据集规模扩展。
- 如果适用,作者应讨论其方法在解决隐私和公平问题方面可能存在的局限性。
- 虽然作者可能担心,对局限性完全诚实可能会被审稿人用作拒稿理由,但更糟的结果可能是审稿人发现了论文中未承认的局限性。作者应使用其最佳判断,并认识到有利于透明的个人行为在制定维护社区诚信的规范中发挥着重要作用。审稿人将被特别指示不要因对局限性的诚实而予以惩罚。
3. 理论假设和证明
问题:对于每个理论结果,论文是否提供了完整的假设集和完整(且正确)的证明?
答案:[NA]
理由:不适用
指南:
- 答案NA表示论文不包含理论结果。
- 论文中的所有定理、公式和证明都应编号并交叉引用。
- 所有假设都应在任何定理的陈述中明确说明或引用。
- 证明可以出现在正文或补充材料中,但如果出现在补充材料中,鼓励作者提供简短的证明概要以提供直觉。
- 反之,论文核心部分提供的任何非正式证明都应辅以附录或补充材料中提供的正式证明。
- 证明所依赖的定理和引理应被适当引用。
4. 实验结果可复现性
问题:论文是否充分披露了复现论文主要实验结果所需的全部信息,以至于影响到论文的主要主张和/或结论(无论是否提供代码和数据)?
答案:[Yes]
理由:代码和数据集均可获得。
指南:
- 答案NA表示论文不包含实验。
- 如果论文包含实验,对这一问题回答No不会给审稿人留下好印象:使论文可复现很重要,无论是否提供代码和数据。
- 如果贡献是数据集和/或模型,作者应描述为使结果可复现或可验证所采取的步骤。
- 取决于贡献的性质,可复现性可以通过多种方式实现。例如,如果贡献是一种新颖架构,完整描述该架构可能就足够了;或者,如果贡献是一个特定模型和实证评估,则可能需要使他人能够用相同数据集复现该模型,或提供对该模型的访问。一般来说,发布代码和数据通常是实现这一点的一种好方法,但可复现性也可以通过详细说明如何复现结果的指导、访问托管模型(例如,在大型语言模型的情况下)、发布模型检查点或其他适合所进行研究的方式来提供。
- 虽然NeurIPS不要求发布代码,但会议确实要求所有投稿提供某种合理的可复现性途径,这可能取决于贡献的性质。例如
(a) 如果贡献主要是一种新算法,论文应明确如何复现该算法。
(b) 如果贡献主要是一种新的模型架构,论文应清晰且完整地描述该架构。
(c) 如果贡献是一个新模型(例如,大型语言模型),则应要么有办法访问该模型以复现结果,要么有办法复现该模型(例如,使用开源数据集或关于如何构建该数据集的说明)。
(d) 我们认识到可复现性在某些情况下可能很棘手,在这种情况下,欢迎作者描述他们提供可复现性的特定方式。在闭源模型的情况下,对模型的访问可能在某种程度上受到限制(例如,限于注册用户),但其他研究人员应有可能拥有某种复现或验证结果的途径。
5. 数据和代码的开放获取
问题:论文是否提供对数据和代码的开放获取,并附有足够说明以忠实复现补充材料中描述的主要实验结果?
答案:[Yes]
理由:我们在摘要中提供了代码链接。
指南:
- 答案NA表示论文不包含需要代码的实验。
- 更多详情请参见NeurIPS代码和数据提交指南(https://nips.cc/public/guides/CodeSubmissionPolicy)。
- 虽然我们鼓励发布代码和数据,但我们理解这可能无法做到,因此“否”是可以接受的答案。论文不能仅仅因为没有包含代码而被拒稿,除非代码对论文贡献至关重要(例如,用于一个新的开源基准)。
- 说明中应包含复现结果所需的准确命令和运行环境。更多细节请参见NeurIPS代码和数据提交指南(https://nips.cc/public/guides/CodeSubmissionPolicy)。
- 作者应提供关于数据访问和数据准备的说明,包括如何访问原始数据、预处理数据、中间数据和生成数据等。
- 作者应提供脚本来复现新提出方法和基线方法的所有实验结果。如果只有一部分实验可复现,他们应说明哪些实验未包含在脚本中以及原因。
- 在提交时,为保护匿名性,作者应发布匿名版本(如适用)。
- 建议在补充材料(附于论文后)中提供尽可能多的信息,但允许包含数据和代码的URL。
6. 实验设置/细节
问题:论文是否明确说明了理解结果所需的所有训练和测试细节(例如,数据划分、超参数、如何选择超参数、优化器类型等)?
答案:[是]
理由:我们在论文中涵盖了所有细节。
指南:- 回答NA意味着论文不包含实验。- 实验设置应在论文核心部分呈现,其详细程度应足以让人理解结果并使其有意义。- 完整细节可以通过代码、附录或补充材料提供。
7. 实验统计显著性
问题:论文是否适当地报告了误差棒并正确定义了误差棒,或提供了关于实验统计显著性的其他适当信息?
回答:[否]
理由:实验使用了大语言模型的API。多次调用会显著增加成本。
指南:- 回答NA意味着论文不包含实验。- 如果结果附有误差棒、置信区间或统计显著性检验,至少对于支持论文主要主张的实验而言,作者应回答“是”。- 应清楚说明误差棒所捕捉的变异因素(例如,训练/测试划分、初始化、某个参数的随机抽取,或在给定实验条件下进行的整体运行)。- 应解释计算误差棒的方法(闭式公式、调用库函数、自助法等)。- 应给出所作假设(例如,误差呈正态分布)。- 应明确误差棒是标准差还是均值的标准误。- 报告1-sigma误差棒是可以的,但应说明这一点。如果误差呈正态分布的假设未经验证,作者最好报告2-sigma误差棒,而不是声称他们有96%的CI。- 对于非对称分布,作者应注意不要在表格或图中显示对称误差棒,从而产生超出范围的结果(例如负错误率)。- 如果表格或图中报告了误差棒,作者应在正文中解释它们是如何计算的,并在正文中引用相应的图或表。
8. 实验计算资源
问题:对于每个实验,论文是否提供了足够的信息,说明复现实验所需的计算机资源(计算工作节点的类型、内存、执行时间)?
回答:[是]
理由:可以在实验部分找到。
指南:- 回答NA意味着论文不包含实验。- 论文应说明计算工作节点的类型是CPU还是GPU、内部集群还是云服务提供商,包括相关内存和存储。
- 论文应提供每个单独实验运行所需的计算量,并估算总计算量。
- 论文应披露整个研究项目所需计算量是否多于论文中报告的实验(例如,未纳入论文的初步实验或失败实验)。
9. 伦理准则
问题:论文中进行的研究是否在各方面符合NeurIPS伦理准则 https://neurips.cc/public/EthicsGuidelines?
回答:[NA]
理由:N/A
指南:
- 回答NA意味着作者未审阅NeurIPS伦理准则。- 如果作者回答否,他们应解释需要偏离伦理准则的特殊情况。- 作者应确保保持匿名(例如,如果由于其管辖范围内的法律或法规而有特殊考虑)。
10. 更广泛的影响
问题:论文是否讨论了所进行工作的潜在积极社会影响和消极社会影响?
回答:[否]
理由:我们不讨论这一方面,因为我们只为LLM智能体提供了记忆系统。不同的LLM智能体可能产生不同的社会影响,这超出了我们工作的范围。
指南:
- 回答NA意味着所进行的工作没有社会影响。
- 如果作者回答NA或否,他们应解释为什么他们的工作没有社会影响,或为什么论文未涉及社会影响。
- 消极社会影响的例子包括潜在的恶意或非预期使用(例如,虚假信息、生成虚假个人资料、监控)、公平性考虑(例如,部署可能做出不公平影响特定群体决策的技术)、隐私考虑和安全考虑。
- 会议预计许多论文将是基础研究,并不与特定应用绑定,更不用说部署。然而,如果存在通往任何负面应用的直接路径,作者应指出这一点。例如,指出生成模型质量的提升可被用于生成深度伪造以传播虚假信息是合理的。另一方面,不需要指出用于优化神经网络的通用算法可以使人们更快地训练生成深度伪造的模型。
- 作者应考虑当技术按预期使用并正常运行时可能产生的危害、当技术按预期使用但给出错误结果时可能产生的危害,以及因(有意或无意)滥用技术而产生的危害。
- 如果存在消极社会影响,作者还可以讨论可能的缓解策略(例如,模型的门控发布、在攻击之外提供防御、监测滥用的机制、监测系统如何随时间从反馈中学习的机制、提高ML的效率和可及性)。
11. 保障措施
问题:论文是否描述了为负责任地发布具有高滥用风险的数据或模型(例如,预训练语言模型、图像生成器或抓取的数据集)而已实施的保障措施?
回答:[NA]
理由:N/A
指南:
指南:
12. 现有资产的许可证
问题:论文中使用的资产(例如,代码、数据、模型)的创建者或原始所有者是否得到了适当署名,并且许可证和使用条款是否被明确提及并得到适当遵守?
回答:[是]
理由:他们的贡献已被适当致谢和署名。
指南:
指南:
13. 新资产
问题:论文中引入的新资产是否有充分文档记录,并且文档是否与资产一起提供?
回答:[NA]
理由:N/A
指南:
指南:
14. 众包和涉及人类受试者的研究
问题:对于众包实验和涉及人类受试者的研究,论文是否包含提供给参与者的完整说明文本和截图(如适用),以及关于报酬的详细信息(如有)?
回答:[NA]
理由:N/A
指南:
- 回答NA意味着论文不涉及众包或涉及人类受试者的研究。- 将此信息包含在补充材料中是可以的,但如果论文的主要贡献涉及人类受试者,则应在主论文中包含尽可能多的细节。- 根据NeurIPS伦理准则,参与数据收集、整理或其他劳动的工作者应至少获得数据收集者所在国家的最低工资。
15. 机构审查委员会(IRB)批准或涉及人类受试者研究的同等批准
问题:论文是否描述了研究参与者可能承担的风险、这些风险是否已向受试者披露,以及是否获得了机构审查委员会(IRB)批准(或基于您所在国家或机构要求的同等批准/审查)?
回答:[NA]
理由:N/A
指南:
- 答案 NA 表示论文既不涉及众包,也不涉及以人类受试者为对象的研究。- 根据研究开展所在的国家,任何人类受试者研究都可能需要 IRB 批准(或同等批准)。如果你获得了 IRB 批准,应在论文中明确说明。- 我们认识到,这方面的程序可能因机构和地点而差异很大,我们期望作者遵守 NeurIPS 道德准则及其所在机构的指南。- 对于初次投稿,请勿包含任何会破坏匿名性的信息(如适用),例如负责评审的机构。
16. LLM 使用声明
问题:如果 LLM 是本研究中核心方法的重要、原创或非标准组成部分,论文是否描述了 LLM 的使用?请注意,如果 LLM 仅用于写作、编辑或格式化目的,且不影响研究的核心方法论、科学严谨性或原创性,则无需声明。
答案:[NA]
理由:不适用
指南:
- 回答“不适用”意味着本研究中的核心方法开发不涉及LLMs作为任何重要的、原创的或非标准的组成部分。- 请参阅我们的LLM政策(https://neurips.cc/Conferences/2025/LLM)以了解哪些内容应当或不应被描述。