
两千多个真实 GitHub issue,要从头改到尾,再由隐藏测试判定对错,是让编码智能体可被衡量的基准。2024 年 ICLR 论文,全文免费在线阅读。
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
SWE-BENCH:语言模型能否解决真实世界中的 GitHub 问题?
Carlos E. Jimenez John Yang Alexander Wettig
Shunyu Yao Kexin Pei Ofir Press Karthik Narasimhan
普林斯顿大学 普林斯顿语言与智能 芝加哥大学
摘要
语言模型的发展已经超出了我们有效评估它们的能力,但对其未来的发展而言,研究其能力前沿至关重要。我们发现,真实世界的软件工程是评估下一代语言模型的一个丰富、可持续且具有挑战性的测试平台。为此,我们引入了 SWE-bench,一个评估框架,包含 2,294 个软件工程问题,这些问题取自 12 个流行 Python 仓库中真实的 GitHub issue 及相应的 pull request。给定一个代码库以及待解决问题的描述,语言模型的任务是编辑代码库以解决该问题。解决 SWE-bench 中的问题通常需要理解并协调跨多个函数、类甚至多个文件的更改,这要求模型与执行环境交互、处理极长的上下文,并执行远远超出传统代码生成任务的复杂推理。我们的评估表明,无论是最先进的专有模型还是我们微调的模型 SWE-Llama,都只能解决最简单的问题。表现最好的模型 Claude 2 也仅能解决 \(1.96\%\) 的问题。SWE-bench 上的进展代表着朝着更实用、更智能、更自主的语言模型迈进的步伐。
1 引言
语言模型(LM)正迅速被部署到聊天机器人和编码助手等商业产品中。与此同时,现有的基准测试已经趋于饱和(Kiela et al., 2021; Ott et al., 2022),无法捕捉最先进语言模型能做什么和不能做什么的前沿。我们需要具有挑战性的基准测试,以更准确地反映语言模型在真实世界中的应用,从而帮助塑造其未来的发展和使用(Srivastava et al., 2023)。
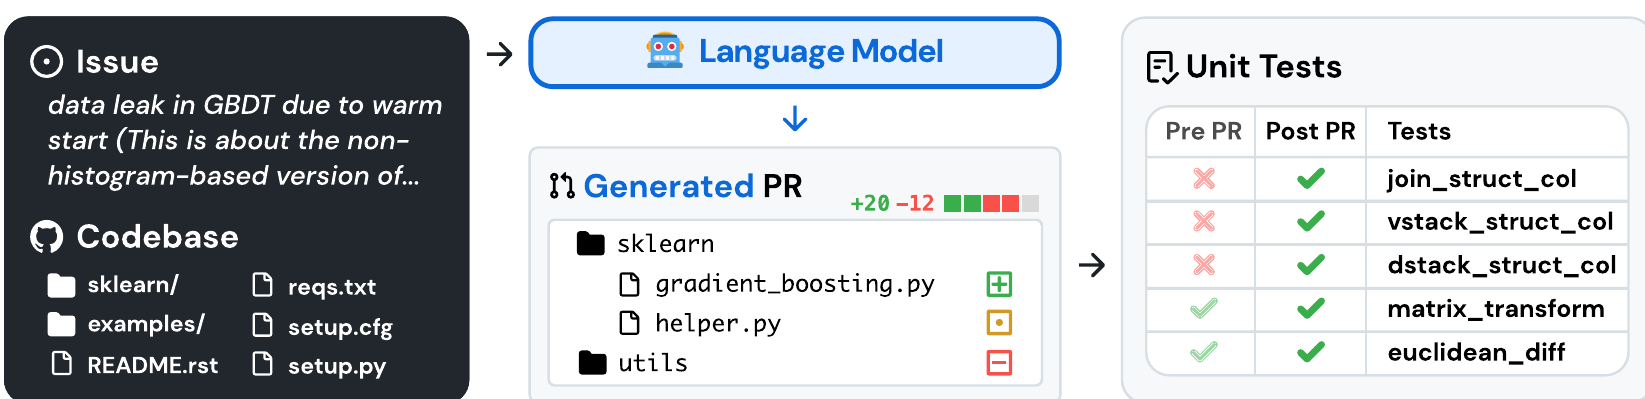
构建一个好的基准测试很困难,因为任务必须足够具有挑战性以难倒现有模型,但模型的预测也必须易于验证(Martinez-Plumed et al., 2021)。编码任务具有吸引力,因为它们对语言模型提出了具有挑战性的问题,而生成的解决方案可以通过运行单元测试轻松验证。然而,现有的编码基准测试,如 HumanEval(Chen et al., 2021),大多涉及可以用几行代码解决的自包含问题。
在现实世界中,软件工程并非如此简单。修复一个 bug 可能涉及浏览一个大型仓库、理解不同文件中函数之间的相互作用,或在复杂的代码中发现一个小错误。受此启发,我们引入了 SWE-bench,一个在现实软件工程环境中评估语言模型的基准测试。如图 1 所示,模型的任务是解决提交到流行 GitHub 仓库的问题(通常是 bug 报告或功能请求)。每个任务需要生成一个描述要应用于现有代码库的更改的补丁。然后使用仓库的测试框架评估修改后的代码库。
SWE-bench 相较于现有的语言模型编程基准测试具有若干优势。这些优势包括:利用用户提交的问题和解决方案的现实设置、包含来自 12 个仓库的独特代码问题的多样化输入、用于基于执行的评估的稳健框架,以及能够以最少的人工干预持续用新实例更新基准测试的能力。
我们在 SWE-bench 上评估了多个最先进的语言模型,发现它们除了最简单的问题外都无法解决。使用 BM25 检索器,Claude 2 仅能解决 \(1.96\%\) 的问题。
除 SWE-bench 外,我们的贡献还包括发布了一个训练数据集 SWE-bench-train,这对于在这一具有挑战性的领域推进开放模型的发展至关重要。该数据集包含 19,000 个非测试任务实例,取自 37 个仓库。利用 SWE-bench-train,我们发布了两个微调模型,SWE-Llama 7b 和 13b,基于 CodeLlama(Rozière et al., 2023)模型。我们发现,在某些设置下,SWE-Llama 13b 与 Claude 2 具有竞争力,并且能够处理超过 100,000 个 token 的上下文。
2 SWE-BENCH
SWE-bench 是一个基准测试,其特点是来自流行仓库的 GitHub issue(报告 bug 或请求新功能)以及为解决问题而对仓库进行更改的 pull request。任务是生成一个 pull request,解决给定的 issue 并通过与该 issue 相关的测试。
2.1 基准测试构建
GitHub 是软件开发的一个丰富数据源,但仓库、issue 和 pull request 可能充满噪声、临时拼凑,或文档和维护不佳。为了大规模地找到高质量的任务实例,我们使用如下 3 阶段流水线。
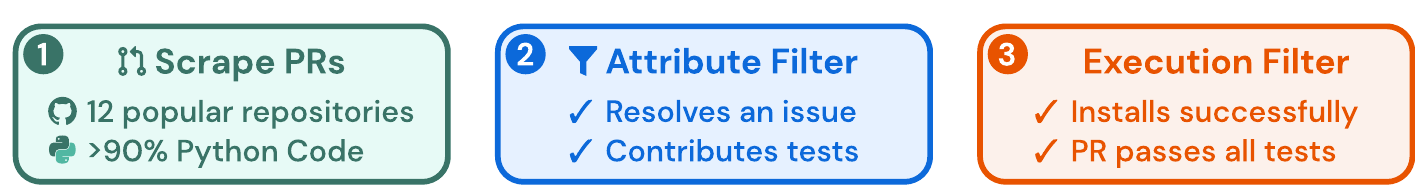
阶段 I:仓库选择和数据抓取。我们首先从 GitHub 上 12 个流行的开源 Python 仓库收集 pull request(PR),总共产生约 \(\sim 90,000\) 个 PR。我们关注流行仓库,因为它们往往维护得更好、有清晰的贡献者指南,并且测试覆盖率更高。每个 PR 都有一个由其基础提交指定的关联代码库。
阶段 II:基于属性的过滤。我们通过选择满足以下条件的已合并 PR 来创建候选任务:(1) 解决了一个 GitHub issue,并且 (2) 对仓库的测试文件进行了更改,这表明用户很可能贡献了测试以检查该 issue 是否已解决。
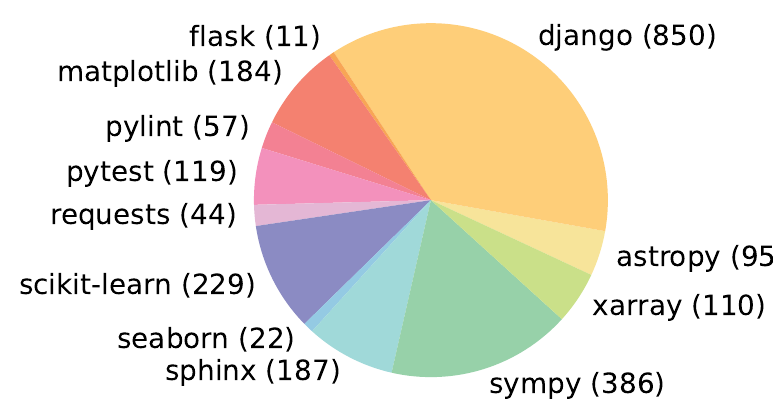
阶段 III:基于执行的过滤。对于每个候选任务,我们应用 PR 的测试内容,并记录在应用 PR 的其他内容之前和之后的相关测试结果。我们过滤掉那些没有至少一个测试的状态从失败变为通过(以下称为失败转通过测试)的任务实例。我们还过滤掉导致安装或运行时错误的实例。经过这些阶段的过滤,原始的 90,000 个 PR 被缩减为构成 SWE-bench 的 2,294 个任务实例。这些任务实例在各仓库间的最终分布如图 3 所示,表 1 突出了 SWE-bench 任务实例的关键特征。我们强调,代码库很大,包含数千个文件,而参考 pull request 通常一次对多个文件进行更改。有关 SWE-bench 构建流水线的技术细节在附录 A 中讨论。其他数据集统计信息在附录 A.5 中。
2.2 任务形式化
模型输入。模型被给予一个 issue 文本描述和一个完整的代码库。然后,模型的任务是对代码库进行编辑以解决该 issue。在实践中,我们将编辑表示为补丁文件,它指定了代码库中要修改哪些行以解决该 issue。
评估指标。为了评估一个提出的解决方案,我们使用 unix 的 patch 程序将生成的补丁应用于代码库,然后执行与该任务实例相关的单元测试和系统测试。如果补丁成功应用且所有这些测试都通过,我们认为所提出的解决方案成功解决了该 issue。我们的基准测试的指标是已解决任务实例的百分比。其他技术细节在附录 A.4 中。
2.3 SWE-BENCH 的特征
NLP 中的传统基准测试通常只涉及短的输入和输出序列,并考虑专门为基准测试创建的有些“人为造作”的问题。相比之下,SWE-bench 的现实构建设置赋予了数据集独特的属性,我们将在下面讨论。
真实世界的软件工程任务。由于 SWE-bench 中的每个任务实例都包含一个大型且复杂的代码库以及一个相关 issue 的描述,解决 SWE-bench 需要展示经验丰富的软件工程师所拥有的、但在传统代码生成基准测试中不常被评估的高级技能和知识。
可持续更新。我们的收集过程可以轻松应用于 GitHub 上的任何 Python 仓库,并且需要最少的人工干预。因此,我们可以用持续供应的新任务实例来扩展 SWE-bench,并在语言模型训练日期之后创建的 issue 上评估它们,从而确保解决方案未包含在其训练语料中。
多样化的长输入。issue 描述通常冗长而详细(平均 195 个词),代码库通常包含数千个文件。解决 SWE-bench 需要在大量上下文中识别出解决 issue 所需的相对少量的需要编辑的行。
稳健的评估。对于每个任务实例,至少有一个用于测试参考解决方案的失败转通过测试,且 \(40\%\) 的实例至少有两个失败转通过测试。这些测试评估模型是否解决了 issue 中的问题。此外,还会运行中位数为 51 个的额外测试,以检查先前的功能是否得到正确维护。
跨上下文代码编辑。与先前可能将编辑范围限制在单个函数或类(例如 Chen 等,2021;Cassano 等,2022)或提供完形填空式填空(例如 Lu 等,2021;Fried 等,2023)的设置不同,SWE-bench 不提供这种明确的指导。我们的基准不是仅仅要求生成一小段代码,而是挑战模型在大型代码库的多个位置生成修订。SWE-bench 的参考解决方案平均编辑 1.7 个文件、3.0 个函数和 32.8 行(新增或删除)。
可能解决方案的广泛范围。仓库级代码编辑任务可以作为一个公平的竞技场,用于比较从检索模型和长上下文模型到可在代码中推理和行动的决策智能体等各种方法。SWE-bench 还允许创作自由,因为模型可以生成可能偏离参考 PR 的新颖解决方案。
2.4 SWE-BENCH LITE
在 SWE-bench 上评估语言模型可能耗时,并且视模型而定,可能需要花费大量计算资源或 API 额度。鉴于第 5 节中呈现的初始性能回报相当低,SWE-bench 的难度使其有助于长期衡量语言模型的进展,但对于试图在短期内取得进展的初始系统而言,可能令人望而生畏。
| 均值 | 最大值 | ||
| 问题文本 | 长度(词数) | 195.1 | 4477 |
| 代码库 | 文件数(非测试) | 3,010 | 5,890 |
| 行数(非测试) | 438K | 886K | |
| 黄金补丁 | 编辑行数 | 32.8 | 5888 |
| 编辑文件数 | 1.7 | 31 | |
| 编辑函数数 | 3 | 36 | |
| 测试 | 失败转通过 | 9.1 | 1633 |
| 总数 | 120.8 | 9459 |
为鼓励采用 SWE-bench,我们创建了一个由 300 个实例组成的 Lite 子集,这些实例从 SWE-bench 中采样而来,更加自包含,重点是评估功能性错误修复。完整的筛选标准和数据集信息包含在 SWE-bench Lite 中,覆盖原始 12 个仓库中的 11 个,其任务实例在各仓库间的多样性和分布与原始版本相似。Lite 划分和筛选细节的完整信息见附录 A.7。
3 SWE-LLAMA:为 SWE-BENCH 微调 CODELLAMA
在 SWE-bench 上将开放模型的性能与专有模型一起进行基准测试很重要。在撰写本文时,只有 CodeLlama 模型(Rozière 等,2023)能够处理所需的长上下文。然而,我们观察到,现成的 CodeLlama 变体无法遵循详细指令来生成仓库范围的代码编辑,并且通常输出占位符响应或无关代码。为更好地评估这些模型的能力,我们对 70 亿和 130 亿参数的 CodeLlama-Python 模型进行监督微调。所得模型是专门的仓库编辑器,可以在消费级硬件上运行并解决 GitHub 问题。
训练数据。我们遵循数据收集流程,从另外 37 个流行的 Python 包仓库中收集了 19,000 个 issue-PR 对。与第 2.1 节不同,我们不要求 pull request 必须包含测试变更。这使我们能够创建一个更大的训练集,用于监督微调。为消除数据污染的风险,训练数据中的仓库集合与评估基准中包含的仓库集合不相交。
训练细节。给定指令、来自 GitHub 的 issue 文本以及相关代码文件作为提示,我们对 SWE-Llama 进行微调,使其生成解决给定 issue 的补丁(即“gold patch”)。为节省内存,我们仅使用 LoRA Hu et al. (2022) 微调注意力子层的权重,并排除超过 30,000 个 token 的训练序列,从而将训练语料的有效规模缩减至 10,000 个实例。更多细节见附录 B。
4 实验设置
在本节中,我们说明如何构建输入以运行 SWE-bench 评估。此外,我们回顾了本文中评估的模型。
4.1 基于检索的方法
SWE-bench 实例向模型提供 issue 描述和代码库作为输入。虽然 issue 描述通常较短(如表 1 所示,平均 195 个词),但代码库包含的 token 数量(平均 438K 行)远超通常能够放入 LM 上下文窗口的规模。那么问题依然存在:究竟应该如何选择相关上下文提供给模型?
为解决基线中的这一问题,我们简单地使用一个通用检索系统来选择要作为上下文插入的文件。具体而言,我们在两种相关上下文设置下评估模型:1)稀疏检索和 2)oracle 检索。
稀疏检索。稠密检索方法不适合我们的场景,原因在于键和查询的长度非常长,尤其是用自然语言查询检索代码文档这一不寻常的设置。因此,我们选择使用 BM25 检索(Robertson et al., 2009)来检索相关文件,作为每个任务实例的上下文。我们尝试了三种不同的最大上下文限制,并简单地检索在指定限制内能够容纳的尽可能多的文件。我们在适合其上下文窗口的所有限制上评估每个模型,并报告最佳性能。从观察来看,模型在最短的上下文窗口上表现最佳,如表 2 所示。
“Oracle”检索。出于分析目的,我们还考虑了一种设置,即我们“检索”由解决 GitHub 上该 issue 的参考补丁所编辑的文件。这种“oracle”设置不太现实,因为处理某个 issue 的工程师可能事先并不知道哪些文件需要修改。此外,这种设置也不一定全面,因为仅凭被编辑的文件可能并不包含理解软件在与代码中未见部分交互时究竟会如何表现所需的全部上下文。
我们将 BM25 检索结果与“oracle”检索设置的结果进行比较,如表 3 所示。我们观察到,在约 的实例中,对于 27,000 token 的上下文限制,BM25 检索到了 oracle 文件的超集。然而,在 27,000 token 限制下近一半的实例中,它没有检索到“oracle”上下文中的任何文件。
4.2 输入格式
一旦使用上述两种方法之一选定了检索文件,我们就构建模型输入,包括任务指令、issue 文本、检索到的文件和文档,最后是一个示例补丁文件以及用于生成补丁文件的提示。实例示例及关于此构建方式的更多细节见附录 D。
4.3 模型
由于需要处理长序列长度,目前只有少数模型适合 SWE-bench。因此,我们评估 ChatGPT-3.5(gpt-3.5-turbo-16k-0613)、GPT-4(gpt-4-32k-0613)、Claude 2 和 SWE-Llama,其上下文限制如表 4 所示。
| 模型 | 最大内容长度 | ||
| 13k | 27k | 50k | |
| Claude 2 | 1.96 | 1.87 | 1.22 |
| SWE-Llama 7b | 0.70 | 0.31 | 0.00 |
| SWE-Llama 13b | 0.70 | 0.48 | 0.00 |
| BM25 召回率 | |||
| 13k | 27k | 50k | |
| 平均 | 29.58 | 44.41 | 51.06 |
| 全部 | 26.09 | 39.83 | 45.90 |
| 任意 | 34.77 | 51.27 | 58.38 |
表 4:我们比较了不同的上下文长度以及“oracle”检索设置的覆盖比例。因此,上下文长度较短的模型天然处于劣势。请注意,token 长度的描述是一种相对的非标准度量(例如,Llama 分词后的序列平均比等效序列经 GPT-4 分词后长 )。
| 用于理解的只读背景(非待翻译源文本): | 表4:我们比较了不同的上下文长度以及“oracle”检索设置所覆盖的比例。因此,上下文长度较短的模型天然处于劣势。请注意,关于token长度的描述是一种相对的非标准度量(例如,Llama分词后的序列平均比等效序列为GPT-4分词时长约42%)。 | 待翻译文本: | ChatGPT-3.5 | |
| GPT-4 | Claude 2 | SWE-Llama | 最大Token数 | 16,385 |
| 32,768 | 100,000 | ≥100,000 | 实例占比 | 58.1% 84.1% 96.4% ≥94.8% |
| 模型 | SWE-bench | SWE-bench Lite | ||
| % 已解决 | % 应用 | % 已解决 | % 应用 | |
| Claude 3 Opus | 3.79 | 46.56 | 4.33 | 51.67 |
| Claude 2 | 1.97 | 43.07 | 3.00 | 33.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 | 10.00 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 | 29.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 | 38.00 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 | 38.00 |
5 结果
我们报告使用不同检索机制和提示风格的模型结果,然后对模型性能和难度提供一些分析与见解。我们在表 5 中总结了模型使用 BM25 检索的性能。总体而言,模型在解决 issue 方面存在显著困难。表现最好的模型 Claude 2 也仅能解决 的 issue。
为分析检索器对整体系统结果的重要性,我们在附录表 18 中呈现“oracle”检索结果。在那里,Claude 2 使用“oracle”检索器能够解决 的 issue。我们在下文的讨论中进一步分析上下文的重要性。
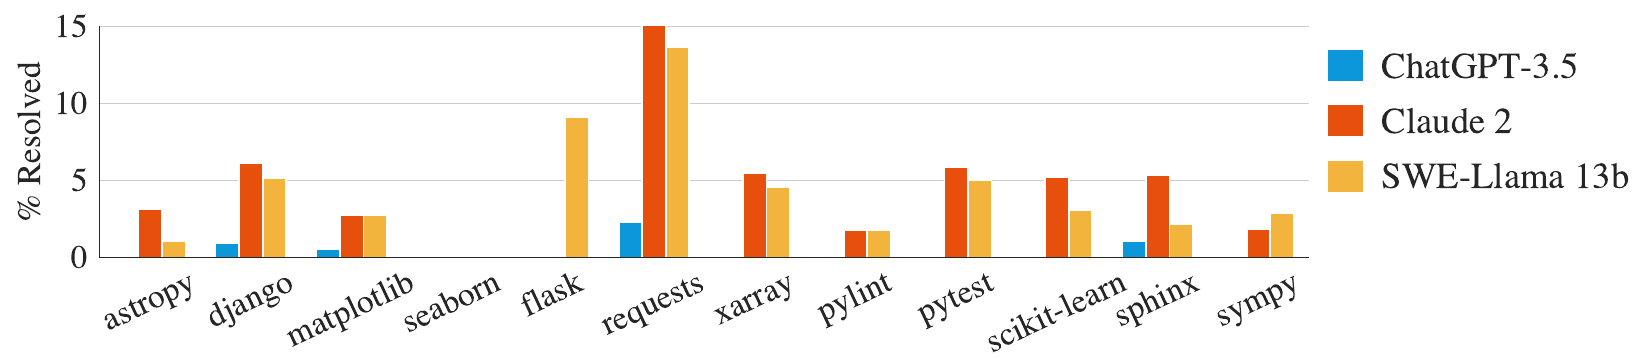
不同仓库之间的难度存在差异。当按仓库细分性能时,所有模型在不同仓库上的趋势相似,如图 4 所示。尽管如此,各模型解决的 issue 并不一定大量重叠。例如,在“oracle”设置下,Claude 2 和 SWE-Llama 13b 表现相当,分别解决了 110 和 91 个实例。然而在这些实例中,Claude 2 仅解决了 SWE-Llama 所解决实例的 。
这也可能与 issue 中存在图像有关,图像可以通过嵌入图像链接(即 ![image][https://...])编码到 issue markdown 中。一些仓库天然拥有更多包含图像的实例;例如, 的 matplotlib 实例和 的 seaborn 实例在其 issue 文本中包含嵌入图像,而所有实例中这一比例仅为 。解决这些实例可能需要多模态 LM 或某种外部工具使用来处理图像。
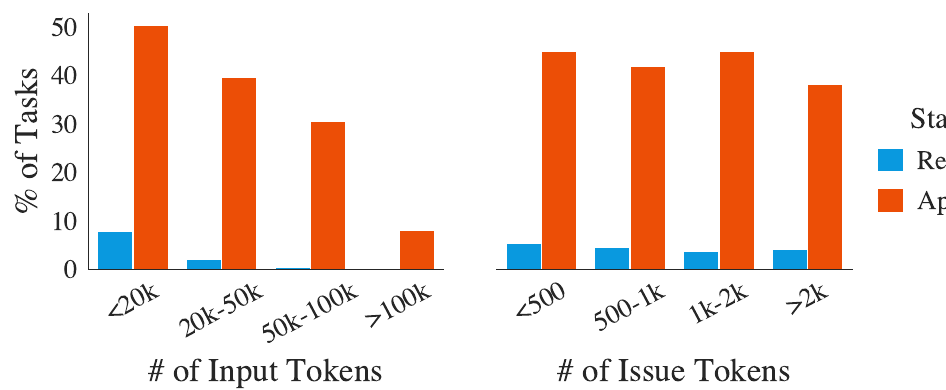
难度与上下文长度相关。聊天模型可能已在长代码序列上预训练,但通常被要求生成较短的代码片段,且用于框定问题的上下文有限。如图 5 所示,我们看到随着总上下文长度增加,Claude 2 的性能显著下降;这一行为在其他模型中也有观察到。在我们的评估设置中,模型看到大量可能与解决当前 issue 不直接相关的代码,它们似乎经常难以定位需要更新的问题代码。这一结果印证了其他研究,表明模型会被额外上下文分散注意力,并可能对目标序列的相对位置敏感(Liu et al., 2023b)。即使增加 BM25 的最大上下文大小会提高相对于 oracle 文件的召回率,性能仍会下降,如表 2 所示,因为模型在定位问题代码方面根本无效。 进一步研究这一点,我们在表 6 中提供了对“oracle”检索上下文的输入消融实验,即“oracle”-collapsed,其中检索到的文件被完全折叠,仅保留真实 pull request 实际编辑的行(带
| 模型 | “Oracle”折叠 | |
| 已解决 | 已应用 | |
| Claude 3 Opus | 9.39 | 48.00 |
| Claude 2 | 5.93 | 68.18 |
| GPT-4 | 3.40 | 48.65 |
| ChatGPT-3.5 | 1.09 | 40.93 |
行缓冲)。在此设置下,我们看到性能提升,GPT-4 从 跃升至 ,Claude 2 从 升至 。
难度与 issue 解决日期不相关。在表 7 中,我们展示了“oracle”检索设置下按日期分区的模型结果,针对 2023 年之前或之后创建的 PR。我们发现对于大多数模型而言,该日期前后的性能差异很小,GPT-4 除外。我们认为这一结果在很大程度上是令人乐观的,因为它表明尽管模型已接触过某仓库代码库的某些版本,它们不太可能仅仅通过生成仓库的较新版本而“作弊”来解决 issue。
| Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| 2023年之前 | 4.87 | 0.49 | 1.96 | 2.95 |
| 2023年之后 | 4.23 | 0.77 | 0.0 | 3.46 |
微调模型对上下文分布偏移敏感。微调模型 SWE-Llama 7b 和 13b 在 BM25 检索上下文下表现出乎意料地差。由于这些模型是使用“oracle”检索作为上下文进行微调的,我们怀疑这种上下文偏移使模型难以可靠地表现。例如,SWE-Llama 被训练为编辑作为上下文包含的每个文件,而在 BM25 设置下,上下文中提供的许多文件并不预期会被更改。
生成补丁比生成整个文件更容易。模型通常使用标准代码文件进行训练,很可能很少见到补丁文件。我们通常将任务设计为让模型生成补丁文件,而不是用其提议的更改重新创建整个文件,因为补丁文件通常是文件更改更为高效的表示。如表 5 所示,我们观察到模型在生成格式良好的补丁文件方面仍然存在困难。因此我们尝试要求模型改为重新生成整个文件及其提议的更改以解决 issue。在此设置下,我们发现模型在此任务上的表现通常不如生成补丁文件时;例如,Claude 2 在“oracle”检索下的得分为 ,而主表中为 。即使在控制实例长度的情况下,按输入 token 在任务实例较短的一半上生成时,Claude 2 的得分为 ,而生成补丁时为 。
语言模型倾向于生成更短、更简单的编辑。模型生成的补丁文件往往比对应的黄金补丁增加和删除的行数更少。如表8所示,与平均黄金补丁相比,能够正确应用的模型生成补丁文件总长度不到黄金编辑补丁文件的一半(74.5行对30.1行),并且很少编辑超过单个文件。
5.1 SWE-LLAMA生成结果的定性分析
我们从SWE-Llama和Claude 2中选取了11个生成结果,以更好地理解在“oracle”检索设置下任务和生成补丁的质量。在此我们讨论一个来自SWE-Llama的示例以及我们的总体发现,其他示例的深入分析见附录F。
| 模型 | 总行数 | 新增 | 删除 | 函数 | 文件 |
| Claude 2 | 19.6 | 4.2 | 1.9 | 1.1 | 1.0 |
| Gold | 44.1 | 12.0 | 5.8 | 2.1 | 1.2 |
| ChatGPT-3.5 | 30.1 | 3.8 | 2.7 | 1.6 | 1.0 |
| Gold | 39.6 | 9.5 | 6.1 | 1.9 | 1.2 |
| GPT-4 | 20.9 | 4.4 | 1.5 | 1.0 | 1.0 |
| Gold | 33.6 | 8.4 | 3.8 | 1.9 | 1.1 |
| SWE-Llama 13b | 17.6 | 1.6 | 1.2 | 1.2 | 1.1 |
| Gold | 37.8 | 10.0 | 4.4 | 1.9 | 1.1 |
| SWE-Llama 7b | 16.7 | 1.3 | 1.2 | 1.2 | 1.1 |
| Gold | 40.2 | 11.3 | 4.9 | 1.9 | 1.1 |
| 平均黄金 | 39.1 | 10.2 | 5.0 | 1.9 | 1.1 |
| 全部黄金 | 74.5 | 22.3 | 10.5 | 3.0 | 1.7 |
表8:“oracle”检索设置下成功应用的补丁中模型生成补丁的平均编辑量。对于各模型特定的任务实例,我们在对应的黄金补丁上计算相同的统计量。Avg Gold显示的是各模型各自黄金补丁的宏平均统计量。All Gold显示的是所有黄金补丁的统计量,不以模型表现为条件。
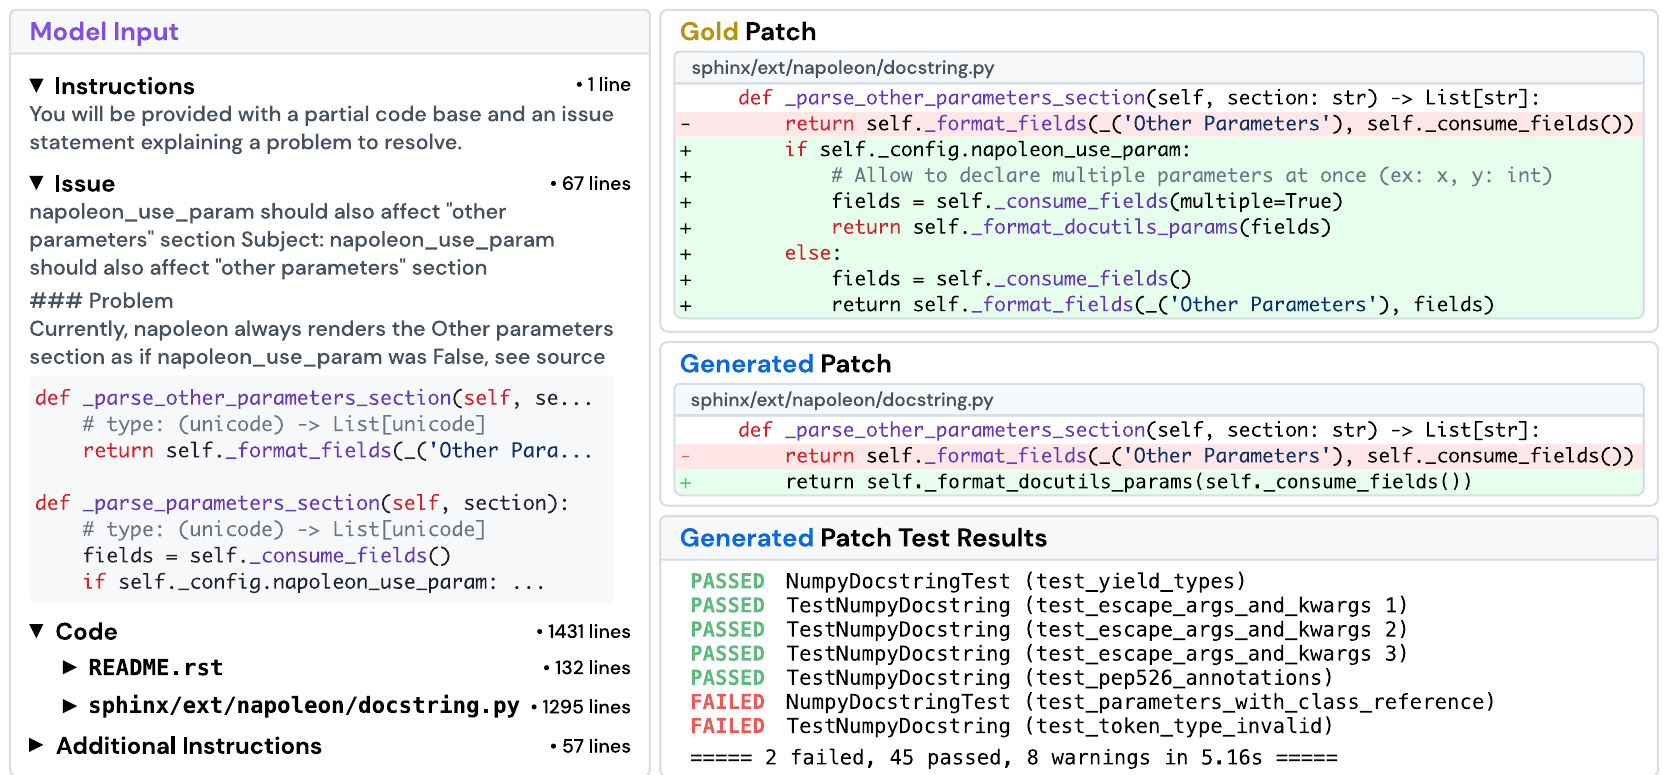
我们考虑来自Sphinx文档生成器的任务实例sphinx-doc_sphinx-8713,如图6所示。该问题指出,当配置设置napoleon.use_param设为True时,Sphinx的napoleon扩展未能正确格式化文档关键词“Other Parameters”。问题文本还提供了疑似问题源代码所在位置的详细代码片段,以及一些用于复现错误的代码示例和与包版本相关的附加信息。对于这个特定实例,模型未能解决该任务,未能通过黄金解决方案所通过的一些测试。
在“oracle”检索设置下,模型输入提供了该问题文本以及一些指令、黄金补丁所编辑文件的完整内容,以及我们期望答案所采用的diff格式示例。模型输入总计包含1,558行上下文,即20,882个token。在比较黄金补丁和模型补丁时,我们发现了一个明显的错误。虽然模型编辑了正确的函数,即sphinx/ext/napoleon/docstring.py第684行的_parse_other_parameters_section,但它将该函数改为表现得好像napoleon.use_param始终为True,而不是像黄金补丁那样先检查配置设置并复制_parse_parameters_section的做法。在测试中,test_parameters_with_class_reference直接比较了在napoleon_use_param设为False的配置下生成的文档,这立即捕获了模型的错误。
比较我们所考虑的所有示例的结果,我们注意到行为上一些突出的趋势。模型倾向于编写原始的Python代码,不利用现有的第三方库或代码库的其余部分来提供解决方案。模型的生成结果也反映了一种“贪婪”的方法,即精确地解决问题,很少考虑代码风格或代码库可能反映的逻辑约束(即使用相对导入而非绝对导入)。相比之下,我们观察到许多黄金补丁会做出结构性改进,覆盖代码库更大的范围;这些编辑不仅解决了问题,还预见并解决了未来可能的问题。
6 相关工作
语言模型的评估。近期几项评估语言模型的工作要么提出了一组跨越多个领域的互不相同的任务(Hendrycks et al., 2021; Liang et al., 2022; Srivastava et al., 2023),要么转向网络作为交互式环境,以需要多步才能解决的任务为特色(Yao et al., 2022; Zhou et al., 2023; Deng et al., 2023; Liu et al., 2023d)。这种“大杂烩”式的设置存在若干缺点。首先,每个任务往往狭隘地聚焦于一项或少数几项技能,导致挑战通常过于简单,将模型局限在缩减的角色中,无法为模型提供发挥其多面性或潜在展示新能力的空间(Srivastava et al., 2023)。因此,模型在此类任务集合上的表现可能无法产生关于其能力及如何改进的有可操作性的深刻见解(Schlangen, 2019; Martínez-Plumed et al., 2021; Bowman & Dahl, 2021)。SWE-bench解决了这些不足,因为我们的工作表明它具有显著的挑战性,为改进语言模型以解决该任务提供了广泛的可能性,并且易于随时间推移用新的任务实例进行更新,每个新实例都引入新颖、细微且实际的挑战。
代码生成基准。HumanEval(Chen et al., 2021)是长期以来从自然语言描述合成代码的努力中的当前标准(Yu et al., 2018; Austin et al., 2021; Hendrycks et al., 2021; Li et al., 2022a; Zan et al., 2023)。在过去一年中,后续基准试图通过扩展到不同语言(Cassano et al., 2022; Athiwaratkun et al., 2023; Orlanski et al., 2023)、编辑范围的变化(Yu et al., 2023; Du et al., 2023)、相似但新颖的代码补全任务(Muennighoff et al., 2023)以及更多测试(Liu et al., 2023a)来扩充HumanEval。同时,另一些工作试图引入新的编程范式(Yin et al., 2022; Yang et al., 2023)或设计特定于库的问题(Lai et al., 2022; Zan et al., 2022)。SWE-bench的收集流程并不将问题分割为孤立的数据集并为了简单起见而缩减它们,而是以最少的后处理转换源代码,保留了远超封闭形式补全的、根植于现实世界软件工程的更广泛挑战,例如补丁生成、长上下文推理、在代码库目录中导航以及捕获模块之间基于依赖的关系。
软件工程的机器学习。为了克服可能无法扩展或无法纳入自然语言的传统程序分析技术,当前软件工程研究的一个方向是使用神经网络(包括语言模型)来自动化现实世界的软件开发流程(Maniatis et al., 2023; Zheng et al., 2023; Hou et al., 2023)。用例包括自动化提交生成(Jung, 2021; Liu et al., 2023c)、PR审查(Yang et al., 2016; Li et al., 2022b; Tufano et al., 2021)、缺陷定位(Kim et al., 2019; Chakraborty et al., 2018)、测试(Kang et al., 2023; Xia et al., 2023; Wang et al., 2023)以及程序修复(Gupta et al., 2017; Allamanis et al., 2017; Monperrus, 2018; Jiang et al., 2018; Goues et al., 2019; Gao et al., 2022; Dinh et al., 2023; Motwani & Brun, 2023)。与SWE-bench最相关的是那些试图将语言模型应用于自动化程序修复(Xia & Zhang, 2022; 2023; Fan et al., 2023; Sobania et al., 2023)、利用提交指导代码编辑(Chakraborty & Ray, 2021; Zhang et al., 2022; Fakhoury et al., 2023)的工作。然而,现有数据集(Just et al., 2014; Karampatsis & Sutton, 2019)均未在SWE-bench的规模上呈现代码上下文。此外,SWE-bench可以轻松扩展到新的编程语言和仓库,并且它提供了一个显著更真实且更具挑战性的舞台,用于开展旨在用软件工程工具和实践增强语言模型的实验。
7 讨论
局限性与未来方向。SWE-bench任务实例全部使用Python;我们希望应用SWE-bench的任务实例收集流程,将其覆盖范围扩展到更多编程语言和领域。其次,我们的实验旨在为该任务建立最简单、最直接方法的基线;我们无意将未来方法学限制为相同类型的方法,并鼓励未来工作研究不同的方法(例如,基于智能体的方法、工具增强的语言模型)。
最后,虽然本工作使用基于执行的代码测试来评估模型,但仅依赖这种方法不足以保证模型生成结果的可靠性能,因为我们发现语言模型的自动化代码生成与人类编写的解决方案相比,往往在全面性、效率或可读性上有所不足。
结论。现实世界软件开发流程的复杂性远远超出代码补全。通过借鉴开源协作流水线,SWE-bench创建了真实世界编码环境的忠实镜像。这种更真实的环境鼓励能够立即应用于开源软件开发的创造性解决方案。我们希望该基准和我们的其他贡献能够在未来开发更实用、更智能、更自主的语言模型方面充当宝贵的资产。
8 伦理声明
8 伦理声明SWE-bench完全从允许软件使用的许可证的公共仓库中收集,我们的贡献符合这些许可证。许可证的详细信息包含在表12中。在收集或评估过程中,我们不收集关于GitHub用户的信息,SWE-bench任务实例不使用超出公共API和网站所提供范围之外的GitHub数据。我们的贡献不涉及任何人类受试者参与;我们不进行众包,也不为SWE-bench的任何部分(包括其收集和评估流程以及实验)招募人工任务工作者。SWE-bench基于流行度对GitHub仓库的筛选标准不隐式或显式地依赖任何具有歧视性或偏见的仓库选择启发式方法。对于数据集发布,我们计划开源SWE-bench任务实例、收集和评估基础设施、实验结果、用于微调SWE-Llama模型的训练数据以及SWE-Llama模型权重。遵循最佳实践先例,我们还将提供充足的文档来描述每个组件及其使用,并且我们还将建立便捷的沟通渠道以征求反馈以改进SWE-bench。SWE-bench不提出任何具有直接危害性的见解。我们在附录E中简要讨论了SWE-bench使用的潜在影响。
9 可复现性声明
9 可复现性声明对于我们的提交,我们已上传全部源代码的压缩文件,并已进行适当的匿名化处理。我们组织了代码库,使得不同的目录对应主论文中的不同贡献(即数据集收集、评估、开源模型推理、SWE-Llama训练等)。源代码包含内联文档,详细说明代码库不同部分的目的和用法。此外,我们还包含完整的2294个SWE-bench任务实例集,其中包含主论文中讨论的所有组件。除源代码中的文档外,我们在A.2节和A.4节中包含了收集流水线和评估流程的详尽技术细节,以补充主论文第2节中的原始细节。这些章节完全覆盖了代码中呈现的逻辑,有助于理解代码。今后,如伦理声明中所述,我们计划更正式地将SWE-bench作为开源仓库向公众发布,并提供详尽细节,描述基准、概述代码并详述其用法。SWE-bench的一个主要组件是收集框架,它将成为开源代码的一部分。由于其易于维护的设计(如主论文中所讨论),我们希望并相信SWE-bench应具有高度的可复现性。
10 致谢
10 致谢我们感谢Danqi Chen、Tri Dao、Zexuan Zhong、Tianyu Gao、Will Merrill、Mengzhou Xia、Dan Friedman、Adithya Bhaskar、Austin Watkins、Atamik Gupta和Richard Zhu的宝贵反馈和建议。我们感谢美国国家科学基金会根据拨款号2239363以及Oracle Collaborative Research奖的支持。本材料中表达的任何意见、发现、结论或建议均为作者的观点,不一定反映美国国家科学基金会的观点。
参考文献
Miltiadis Allamanis, Marc Brockschmidt, and Mahmoud Khademi. Learning to represent programs with graphs. arXiv preprint arXiv:1711.00740, 2017.
Ben Athiwaratkun, Sanjay Krishna Gouda, Zijian Wang, Xiaopeng Li, and Yuchen Tian et. al. Multilingual evaluation of code generation models, 2023.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, and Charles Sutton. Program synthesis with large language models, 2021.
Samuel R. Bowman and George E. Dahl. What will it take to fix benchmarking in natural language understanding?, 2021.
Federico Cassano, John Gouwar, Daniel Nguyen, Sydney Nguyen, Luna Phipps-Costin, Donald Pinckney, Ming-Ho Yee, Yangtian Zi, Carolyn Jane Anderson, Molly Q Feldman, Arjun Guha, Michael Greenberg, and Abhinav Jangda. Multiple:一种可扩展且可拓展的神经代码生成基准测试方法,2022。
Saikat Chakraborty and Baishakhi Ray. 关于编辑源代码的多模态学习,2021。
Saikat Chakraborty, Yujian Li, Matt Irvine, Ripon Saha, and Baishakhi Ray. 基于统计语言模型的熵引导频谱错误定位。arXiv预印本arXiv:1802.06947,2018。
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, and Jared Kaplan et. al. 评估在代码上训练的大型语言模型,2021。
Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention:具有IO感知的快速且内存高效精确注意力。神经信息处理系统进展,35:16344-16359,2022。
Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Samuel Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web, 2023.
Tuan Dinh, Jinman Zhao, Samson Tan, Renato Negrinho, Leonard Lausen, Sheng Zha, and George Karypis. Large language models of code fail at completing code with potential bugs. arXiv preprint arXiv:2306.03438, 2023.
Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng, and Yiling Lou. Classeval: A manually- crafted benchmark for evaluating llms on class- level code generation, 2023.
Sarah Fakhoury, Saikat Chakraborty, Madan Musuvathi, and Shuvendu K. Lahiri. Towards generating functionally correct code edits from natural language issue descriptions, 2023.
Zhiyu Fan, Xiang Gao, Martin Mirchev, Abhik Roychoudhury, and Shin Hwei Tan. Automated repair of programs from large language models, 2023.
Daniel Fried, Armen Aghajanyan, Jessy Lin, Sida Wang, Eric Wallace, Freda Shi, Ruiqi Zhong, Wen tau Yih, Luke Zettlemoyer, and Mike Lewis. Incoder: A generative model for code infilling and synthesis, 2023.
Xiang Gao, Yannic Noller, and Abhik Roychoudhury. Program repair, 2022.
Claire Le Goues, Michael Pradel, and Abhik Roychoudhury. Automated program repair. Communications of the ACM, 62(12):56- 65, 2019.
David Gros, Prem Devanbu, and Zhou Yu. Ai safety subproblems for software engineering researchers, 2023.
Rahul Gupta, Soham Pal, Aditya Kanade, and Shirish Shevade. Deepfix: Fixing common c language errors by deep learning. In Proceedings of the aaai conference on artificial intelligence, volume 31, 2017.
Maurice H. Halstead. Elements of Software Science (Operating and programming systems series). Elsevier Science Inc., USA, 1977. ISBN 0444002057.
Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song, and Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
Xinyi Hou, Yanjie Zhao, Yue Liu, Zhou Yang, Kailong Wang, Li Li, Xiapu Luo, David Lo, John Grundy, and Haoyu Wang. Large language models for software engineering: A systematic literature review, 2023.
Edward J Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen- Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. LoRA: Low- rank adaptation of large language models. In International Conference on Learning Representations, 2022. URL https://openreview.net/forum?id=nZeVKeeFYf9.
Sam Ade Jacobs, Masahiro Tanaka, Chengming Zhang, Minjia Zhang, Leon Song, Samyam Rajbhandari, and Yuxiong He. Deepspeed ulysses: System optimizations for enabling training of extreme long sequence transformer models, 2023.
Jiajun Jiang, Yingfei Xiong, Hongyu Zhang, Qing Gao, and Xiangqun Chen. Shaping program repair space with existing patches and similar code. In Proceedings of the 27th ACM SIGSOFT international symposium on software testing and analysis, pp. 298- 309, 2018.
Tae- Hwan Jung. Committer: Commit message generation using pre- trained programming language model, 2021.
René Just, Darioush Jalali, and Michael D. Ernst. Defects4J: A Database of existing faults to enable controlled testing studies for Java programs. In ISSTA 2014, Proceedings of the 2014 International Symposium on Software Testing and Analysis, pp. 437- 440, San Jose, CA, USA, July 2014. Tool demo.
Sungmin Kang, Juyeon Yoon, and Shin Yoo. Large language models are few- shot testers: Exploring llm- based general bug reproduction, 2023.
Rafael- Michael Karampatsis and Charles Sutton. How often do single- statement bugs occur? the manysstubs4j dataset. 2020 IEEE/ACM 17th International Conference on Mining Software Repositories (MSR), pp. 573- 577, 2019. URL https://api.semanticscholar.org/CorpusID:173188438.
Douwe Kiela, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger, and Zhengxuan Wu et. al. Dynabench: Rethinking benchmarking in nlp, 2021.
Yunho Kim, Seokhyeon Mun, Shin Yoo, and Moonzoo Kim. Precise learn- to- rank fault localization using dynamic and static features of target programs. ACM Transactions on Software Engineering and Methodology (TOSEM), 28(4):1- 34, 2019.
Yuhang Lai, Chengxi Li, Yiming Wang, Tianyi Zhang, Ruiqi Zhong, Luke Zettlemoyer, Scott Wen tau Yih, Daniel Fried, Sida Wang, and Tao Yu. Ds- 1000: A natural and reliable benchmark for data science code generation, 2022.
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, and Ré mi Leblond et. al. Competition- level code generation with AlphaCode. Science, 378(6624):1092- 1097, dec 2022a. doi: 10.1126/science.abq1158. URL https://doi.org/10.1126%2Fscience.abq1158.
Zhiyu Li, Shuai Lu, Daya Guo, Nan Duan, Shailesh Jannu, Grant Jenks, Deep Majumder, Jared Green, Alexey Svyatkovskiy, Shengyu Fu, and Neel Sundaresan. Automating code review activities by large- scale pre- training, 2022b.
Percy Liang, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu, and Michihiro Yasunaga et. al. Holistic evaluation of language models, 2022.
Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang, and Lingming Zhang. Is your code generated by chatgpt really correct? rigorous evaluation of large language models for code generation. arXiv preprint arXiv:2305.01210, 2023a.
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, and Percy Liang. Lost in the middle: How language models use long contexts, 2023b. arXiv:2307.03172.
Shangqing Liu, Yanzhou Li, Xiaofei Xie, and Yang Liu. Commitbart: A large pre- trained model for github commits, 2023c.
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, and Hanyu Lai et. al. Agentbench: Evaluating llms as agents, 2023d.
Shuai Lu, Daya Guo, Shuo Ren, Junjie Huang, Alexey Svyatkovskiy, and Ambrosio Blanco et. al. Codexglue: A machine learning benchmark dataset for code understanding and generation. CoRR, abs/2102.04664, 2021.
Petros Maniatis, Daniel Tarlow, and Google DeepMind. Large sequence models for software development activities, 2023. URL https://blog.research.google/2023/05/large- sequence- models- for- software.html.
Fernando Martinez- Plumed, Pablo Barredo, Seán Ó hEigeartaigh, and José Hernández- Orallo. Research community dynamics behind popular ai benchmarks. Nature Machine Intelligence, 3:581 - 589, 2021. URL https://api.semanticscholar.org/CorpusID:236610014.
Thomas J. McCabe. A complexity measure. IEEE Transactions on Software Engineering, SE- 2(4): 308- 320, 1976. doi: 10.1109/TSE.1976.233837.
Martin Monperrus. Automatic software repair. ACM Computing Surveys, 51(1):1- 24, jan 2018. doi: 10.1145/3105906. URL https://doi.org/10.1145%2F3105906.
Manish Motwani and Yuriy Brun. Better automatic program repair by using bug reports and tests together, 2023.
Niklas Muennighoff、Qian Liu、Armel Zebaze、Qinkai Zheng、Binyuan Hui、Terry Yue Zhuo、Swayam Singh、Xiangru Tang、Leandro von Werra 和 Shayne Longpre。Octopack:指令微调代码大语言模型,2023。
Gabriel Orlanski、Kefan Xiao、Xavier Garcia、Jeffrey Hui、Joshua Howland、Jonathan Malmaud、Jacob Austin、Rishabh Singh 和 Michele Catasta。衡量编程语言分布的影响,2023。
Simon Ott、Adriano Barbosa-Silva、Kathrin Blagec、Janina Brauner 和 Matthias Samwald。绘制人工智能中基准创建与饱和的全球动态。Nature Communications,13,2022。URL https://api.semanticscholar.org/CorpusID:247318891。
Stephen Robertson、Hugo Zaragoza 等。概率相关性框架:Bm25 及其扩展。Foundations and Trends® in Information Retrieval,3(4):333-389,2009。
Baptiste Rozière、Jonas Gehring、Fabian Gloeckle、Sten Sootla、Itai Gat 和 Xiaoqing Ellen Tan 等。Code llama:面向代码的开放基础模型,2023。
David Schlangen。语言任务与语言游戏:论当前自然语言处理研究中的方法论,2019。
Dominik Sobania、Martin Briesch、Carol Hanna 和 Justyna Petke。ChatGPT 自动缺陷修复性能分析,2023。
Aarohi Srivastava、Abhinav Rastogi、Abhishek Rao 和 Abu Awal Md Shoeb 等。超越模仿游戏:量化并外推语言模型的能力,2023。
Rosalia Tufano、Luca Pascarella、Michele Tufano、Denys Poshyvanyk 和 Gabriele Bavota。迈向代码审查活动的自动化,2021。
Junjie Wang、Yuchao Huang、Chunyang Chen、Zhe Liu、Song Wang 和 Qing Wang。使用大语言模型进行软件测试:综述、全景与愿景,2023。
Chunqiu Steven Xia 和 Lingming Zhang。少训练,多修复:通过零样本学习重新审视自动化程序修复。载于第30届ACM欧洲软件工程联合会议暨软件工程基础研讨会论文集,第959-971页,2022年。
Chunqiu Steven Xia 和 Lingming Zhang。对话式自动化程序修复,2023年。
Chunqiu Steven Xia、Matteo Paltenghi、Jia Le Tian、Michael Pradel 和 Lingming Zhang。通过大型语言模型实现通用模糊测试。arXiv预印本 arXiv:2308.04748,2023年。
John Yang、Akshara Prabhakar、Karthik Narasimhan 和 Shunyu Yao。Intercode:用执行反馈标准化和基准测试交互式编码,2023年。
Xin Yang、Raula Gaikovina Kula、Norihiro Yoshida 和 Hajimu Iida。挖掘现代代码审查仓库:一个关于人员、过程和产品的数据集。载于第13届挖掘软件仓库国际会议论文集,第460-463页,2016年。
Shunyu Yao、Howard Chen、John Yang 和 Karthik Narasimhan。Webshop:面向具有接地语言智能体的可扩展真实世界网络交互,2022年。
Pengcheng Yin、Wen-Ding Li、Kefan Xiao、Abhishek Rao、Yeming Wen、Kensen Shi、Joshua Howland、Paige Bailey、Michele Catasta、Henryk Michalewski、Alex Polozov 和 Charles Sutton。交互式数据科学笔记本中的自然语言到代码生成,2022年。
Hao Yu、Bo Shen、Dezhi Ran、Jiaxin Zhang、Qi Zhang、Yuchi Ma、Guangtai Liang、Ying Li、Tao Xie 和 Qianxiang Wang。Codereval:使用生成式预训练模型的实用代码生成基准,2023年。
Tao Yu、Rui Zhang、Kai Yang、Michihiro Yasunaga、Dongxu Wang、Zifan Li、James Ma、Irene Li、Qingning Yao、Shanelle Roman、Zilin Zhang 和 Dragomir Radev。Spider:一个用于复杂和跨域语义解析及文本到SQL任务的大规模人工标注数据集。载于2018年自然语言处理经验方法会议论文集,第3911-3921页,比利时布鲁塞尔,2018年10月-11月。计算语言学协会。doi: 10.18653/v1/D18-1425。URL https://aclanthology.org/D18-1425。
Daoguang Zan、Bei Chen、Dejian Yang、Zeqi Lin、Minsu Kim、Bei Guan、Yongji Wang、Weizhu Chen 和 Jian-Guang Lou。Cert:面向库导向代码生成的草图持续预训练,2022年。
Daoguang Zan、Bei Chen、Fengji Zhang、Dianjie Lu、Bingchao Wu、Bei Guan、Yongji Wang 和 Jian-Guang Lou。大型语言模型遇上n1code:综述,2023年。
Jiyang Zhang、Sheena Panthaplackel、Pengyu Nie、Junyi Jessy Li 和 Milos Gligoric。Coditt5:面向源代码和自然语言编辑的预训练,2022年。
Zibin Zheng、Kaiwen Ning、Jiachi Chen、Yanlin Wang、Wenqing Chen、Lianghong Guo 和 Weicheng Wang。理解软件工程任务中的大型语言模型。arXiv预印本 arXiv:2308.11396,2023年。
Shuyan Zhou、Frank F. Xu、Hao Zhu、Xuhui Zhou、Robert Lo、Abishek Sridhar、Xianyi Cheng、Yonatan Bisk、Daniel Fried、Uri Alon 和 Graham Neubig。Webarena:用于构建自主智能体的真实网络环境,2023年。
附录
在附录中,我们提供了关于数据集构建过程、评估流程以及SWE-bench基准特征的更详细说明。
A 基准详情
本节作为第2节的补充,提供关于数据收集、基于执行的验证和评估流程的更技术性、更细粒度的总结,以及对任务实例更全面的刻画。
A.1 高层概览
拉取请求抓取。从2023年8月下载量最高的5,000个PyPI库列表中,我们选择前100个包,识别每个库对应的开源GitHub仓库,验证哪些包具有允许自由软件使用的许可证,并通过GitHub开发者API收集这些仓库的所有PR。我们选择从访问量高的仓库中获取问题,因为广泛使用通常表明该仓库具有详尽的文档、结构化的开源开发指南以及可运行且格式良好的代码。
任务实例构建。我们从满足三个条件的PR构建候选任务实例。第一,PR的状态必须为Merged。Merged状态表明PR关联的代码更改已被接受并并入其父仓库。第二,PR解决其仓库中的一个或多个issue。Issue根据其在GitHub中的规范用法定义,即用于跟踪软件项目缺陷、增强或任何一般开发目标的数字工单。我们扫描PR的标题、正文和提交消息以查找链接的issue(即“fixes #24”)。第三,PR必须引入一个或多个新测试。当PR的代码更改编辑了包含测试相关关键词(例如“test”、“testing”)的文件路径时,即计为一个新测试。
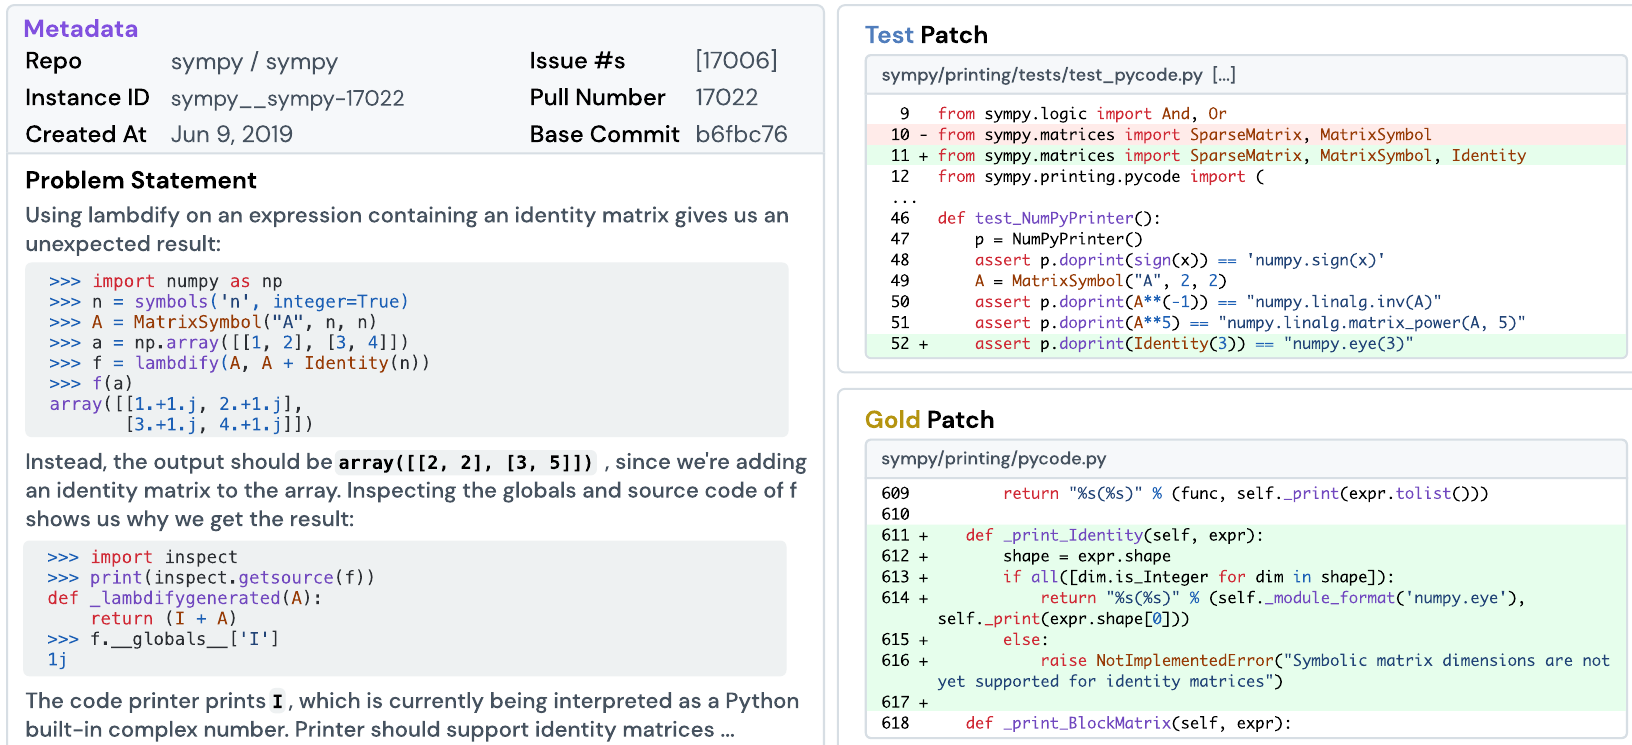
满足这些标准的PR随后被转换为候选任务实例,例如图7中的示例。代码库由仓库的owner/name标识符和拉取请求的基础提交标识。从此信息恢复实际代码库是直接的。我们创建原始GitHub仓库的镜像,每个镜像唯一标识为owner_name。克隆仓库对应的镜像并检出基础提交即可得到处于PR前状态的。问题陈述是所有相关issue的标题和描述以及在PR初始提交时间戳之前撰写的任何后续评论的聚合,以避免解决方案细节泄露。PR的代码更改被分为测试补丁和黄金补丁。由测试补丁中编辑的文件中的所有测试组成。如图7所示,和均存储为补丁文件。关于解析PR和语义数据的更多细节见附录A.2。
基于执行的验证。我们通过执行验证任务实例的可用性。对于每个候选实例,我们首先定义一个虚拟环境作为执行上下文,然后在应用任何补丁之前安装,最后在应用解决方案之前和之后各运行一次。如果验证过程中的任何步骤失败,则该候选实例将从最终数据集中移除。此外,为确保解决方案是非平凡的,我们比较解决方案前和解决方案后的验证日志,以检查中是否存在一个或多个测试的状态从失败变为通过。最后,我们排除其测试调用解决方案中首次引入的新创建函数或类的任务实例。由于对此类构造命名通常是任意过程,且通常未在问题陈述中明确指定,因此解决此类测试即使对人类开发者来说也可能是一项不可能完成的任务。关于执行上下文、代码库安装、从日志确定测试状态等的信息见附录A.3。
持续更新。SWE-bench的收集过程易于扩展到任何开源代码仓库,从而能够以低维护成本轻松扩展到新的编程语言和代码领域。这一设计还为SWE-bench提供了时间鲁棒性;随着基于更新源代码训练的新语言模型随时间发布,SWE-bench可以简单地更新,以基于任何LM训练日期之后创建的PR生成新的任务实例。
A.2 构建过程
我们讨论关于将拉取请求对象转换为候选任务实例的更多细节。在高层次上,此转换的主要目标是获取相关信息,以组合第2节中介绍的代码库、问题陈述、单元测试和解决方案组件。为此,一个SWE-bench任务实例由以下字段组成,列于下表9中。这些字段共同对应四个任务实例模块。
| 字段 | 描述 |
| base.commit | (str) 原始 PR 所应用在其之上的提交 ID |
| created.at | (date) PR 首次创建时的日期时间对象(非合并时间) |
| hints.text | (str) 关于如何解决问题的自然语言建议 |
| instance.id | (str) 由 repo 和 pull_number 创建的唯一标识符 |
| issue.numbers | (list) 原始拉取请求所解决的 issue 编号列表 |
| patch | (str) .patch 格式风格的字符串,是问题的参考解决方案,提取自原始 PR 的代码更改 |
| problem.statement | (str) 对代码库所需更改的自然语言描述 |
| pull.number | (int) 原始拉取请求的拉取编号 |
| test.patch | (str) .patch 格式风格的字符串,包含用于检查任务是否已解决的未见测试,提取自原始 PR 的代码更改 |
| version | (str) PR 创建期间(相对于 repo)的发布版本 |
| repo | (str) 任务实例来源的代码仓库 |
| FAIL_TO_PASS | (list) 状态从失败变为通过的测试列表 |
| PASS_TO_PASS | (list) 状态从通过变为通过的测试列表 |
| env.install.commit | (str) 用于安装运行任务实例所需依赖的基础提交。 |
问题陈述。每个任务实例的问题陈述 \(P\) 都可以直接通过 problem_statement 字段获取。问题陈述是对所有问题的首条评论以及这些问题上在 PR 初始提交的创建日期之前所创建的评论的汇总。我们从 PR 的标题、正文和提交信息中爬取问题引用。在拼接这些组成部分的文本数据之后,我们首先移除所有 Markdown 风格的注释,然后在剩余文本中查找对问题编号的引用(一个井号 # 后跟一个数字),并检查问题编号引用之前的单词是否包含在一组关键词中,这些关键词表明该问题已被该 PR 解决(例如 “closes”、“fixes”、“resolves”)。找到的问题记录在 issue_number 字段中,随后分别发起网络请求以检索每个问题的数据。为形成 problem_statement,每个问题的标题和正文被相加,如果有多个问题,则再与下一个问题的内容拼接。也正是在这一步骤中,hints_text 字段被创建并从 PR 的评论区收集,其中文本来自在 PR 初始提交之前创建的评论。这种收集方法的直觉是,此类 PR 评论很可能包含自然语言和伪代码建议,向原始人类任务工作者说明如何完成手头的问题。本工作中展示的实验并未使用 hints_text,但我们相信这一信息可能对未来的研究有价值。
代码库。代码库 的内容并非为每个任务实例以明文形式存储。相反,任务实例通过 repo 和 base_commit 字段包含对相关代码库的引用。这两个字段均可在原始 PR 的数据中获得。为使从这两个元素检索代码库 \(C\) 的过程可复现且可靠,我们创建了原始仓库的镜像。构成评估数据和微调数据的仓库的镜像被收集并以开源形式发布在 SWE-bench GitHub 组织下。由于原始仓库的代码可能会在其提交和编辑历史中发生作者无法控制的变化,我们选择创建镜像仓库,以确保对代码库的后续修改不会因相关 base_commit 的损坏或移除而可能使任务实例变得不可用。此外,我们创建镜像,而不是克隆并存储仓库的最新版本。这是因为镜像保留了原始的提交哈希、历史、分支和标签,作为原始仓库技术细节的忠实且完整的历史记录。镜像不保留原始仓库的 star、watcher、issue 或拉取请求。
我们在收集任务实例之后且在同一天之内从仓库创建镜像。镜像保留原始仓库的“owner/name”名称,只是将“/”字符转换为“_”以符合 GitHub 命名约定。基于这一基础设施,检索任务实例的代码库非常直接。首先,可以使用 repo 从 SWE-bench 组织克隆正确的镜像。接下来,在镜像的本地副本中,检出 base_commit 会将仓库重置为代码库 。要继续处理同一仓库中的另一个任务实例,使用 git 版本控制自动移除与当前任务实例相关的任何修改,然后再检出下一个任务实例的 base commit。
解决方案、测试补丁。解决方案 和测试 从 PR 的文件变更数据(即 diff)中导出。如第 2.1 节所述,原始 diff 连同解决方案 和测试 被表示为 .patch 文件,这是一种用于高效指定基于行的文本文件转换的格式。一般来说,.patch 被结构化为一个块列表,其中每个块由一个头部和一个或多个 hunk 组成,这些 hunk 共同对应于对单个文件的更改。头部包含指定文件路径和行号的元数据,而对目标文件的实际修改被编码为以“+”和“-”为前缀的多行,以指示添加和删除。为了创建测试 ,我们首先识别补丁中的每一个唯一块,然后挑出并合并文件路径包含测试相关关键词(例如“tests”、“testing”)的块。其余块被合并以形成解决方案 。我们通过将两个补丁应用到相应的代码库 并运行测试来验证用于正确解析 和 的脚本的稳健性;然后我们检查结果是否复现了基础 PR 的 diff 数据的行为。解决方案 保存为 patch 字段,而测试 保存为 test_patch 字段。
剩余字段。created_at 字段是一个时间戳,指定基础 PR 的创建时间。我们保留原始数据中的 created_at 字段,并使用该字段对模型性能进行时间分析。version 字段是一个字符串,对应于该 PR 发布时该仓库的发布版本。根据可用性和每种方法所需的工作量,我们通过以下方式创建 version 字段:直接从源代码中检索信息、在本地构建仓库并调用代码将版本显示到标准输出,或将 created_at 字段与仓库网页上的发布版本时间线进行比较。我们为仓库的每个版本创建可执行上下文,如 § A.3 中更详细讨论的那样。
使用 GitHub 创建镜像仓库的文档
A.3 基于执行的验证
在筛选完仓库中的所有 PR 并将满足上述标准的 PR 转换为候选任务实例之后,下一步是通过执行来验证每个任务实例的可用性。此过程分为三个步骤。首先,我们为仓库的每个发布版本创建可执行上下文。接下来,我们检查解决方案 和测试 是否能够在代码库 之上成功应用、安装和运行。最后,我们检查每个任务实例的执行日志,以验证一组特定的行为,从而确保该任务可用于且公平地用于模型评估。
可执行上下文。在尝试了关于为虚拟环境定义何种定义级别的各种粒度之后,我们选择为每个发布版本创建可执行上下文。定义任务实例特定的上下文最有利于确保端到端安装成功,但代价是费力的手动制作。另一方面,基于仓库最新版本的仓库特定上下文通常定义过于粗糙,与旧版本的要求不兼容。我们发现发布版本是捕获一部分任务实例依赖要求的一个良好代理,在安装成功与手动工作量之间取得了可管理的平衡。我们通过检查每个版本的最新任务实例的代码库来手动创建每个可执行上下文。基于通常可在仓库的 README 和 CONTRIBUTING 指南中找到的源代码和文档,我们找出 Python 版本、必要依赖和安装命令。
验证引擎。验证引擎的目的是验证候选任务实例。具体而言,此步骤首先检查解决方案 和测试 是否可以应用到代码库 ,其次检查代码库是否可以在相应的虚拟环境中正确安装和运行。为此,我们逐仓库执行验证,其中对于每个仓库的任务实例集,我们执行以下过程:
1. 基于每个版本的最新任务实例,创建作为 conda 环境的可执行上下文。
2. 按版本对任务实例进行分组。
3. 遍历每个任务实例组,其中对于每个任务实例,我们在相应的 conda 环境中执行以下操作。
(a) 移除任何文件更改并检出任务实例的 base_commit。这将仓库设置为代码库
(b) 运行安装命令以实例化代码库
(c) 将测试补丁 应用到代码库
(d) 运行由测试补丁 确定的测试脚本,以生成测试结果日志
(e) 将解决方案 补丁连同测试 应用到代码库
(f) 再次运行 (d) 部分中的测试脚本,以生成测试结果日志
测试命令由仓库所使用的测试框架(例如 pytest、tox)以及附加的 中指定的路径组成。测试命令将运行每个文件路径内容中指定的任何及所有测试。如果步骤 到 中的任何一步失败,则候选任务实例将从考虑中丢弃。在仓库之间存在适度差异的情况下,我们观察到此步骤通常移除一半的候选任务实例。
检查验证日志。最后但同样重要的是,我们检查验证引擎创建的日志 和 的特定属性。首先,为了防止任意命名选择,我们检查 中是否出现 ImportError 和 AttributeError,这可能表明依赖命名相关错误,这类错误将是琐碎且几乎不可能正确解决的。为此,我们移除 中存在此类错误的所有任务实例,不再予以考虑。接下来,我们比较测试结果,以检查任务实例是否非平凡,即至少有一个或多个测试在应用解决方案 之前具有 fail 状态,之后具有 pass 状态。为了检查这一点,我们首先定义若干仓库特定的解析器,以将 和 转换为测试 到状态 的映射。给定这两个数据结构,我们然后检查
| 仓库 | 抓取的 PR 总数 | 转换后 | 验证后(最终) |
| astropy | 9,469 | 1,016 | 95 |
| django | 16,914 | 2,880 | 850 |
| flask | 2,434 | 107 | 11 |
| matplotlib | 16,545 | 1,057 | 184 |
| pylint | 3,848 | 787 | 57 |
| pytest | 5,147 | 750 | 119 |
| requests | 2,344 | 84 | 44 |
| scikit-learn | 15,159 | 1,169 | 229 |
| seaborn | 1,004 | 203 | 22 |
| sphinx | 4,931 | 645 | 187 |
| sympy | 11,928 | 1,897 | 386 |
| xarray | 3,416 | 812 | 110 |
| 总计 | 93,139 | 11,407 | 2,294 |
是否存在至少一个 ,其中 从 fail 变为 pass。如果未找到此类测试,则该任务实例从考虑中移除。
如果任务实例满足这两个标准,则将其包含在评估数据集中。表 10 显示了在构建过程和基于执行的验证步骤中,有多少任务实例被从考虑中移除的摘要。我们将所有最终确定的任务实例保存到一个单独的 .json 文件中,该文件已开源并可供下载。
除任务实例外,我们还创建一个相应的文件夹,其中包含真实测试结果。对于每个任务实例,根据其各自的 和 测试到状态映射,我们创建一个测试结果数据结构,其中键为 FAIL_TO_FAIL、FAIL_TO_PASS、PASS_TO_FAIL 和 PASS_TO_PASS,值为测试列表。通过“缓存”这些结果,我们消除了在评估时重新运行解决方案 的需要(尽管重新运行是一个可用选项)。我们使用此数据结构来验证任务完成情况,如第 A.4 节所述。
A.4 评估程序
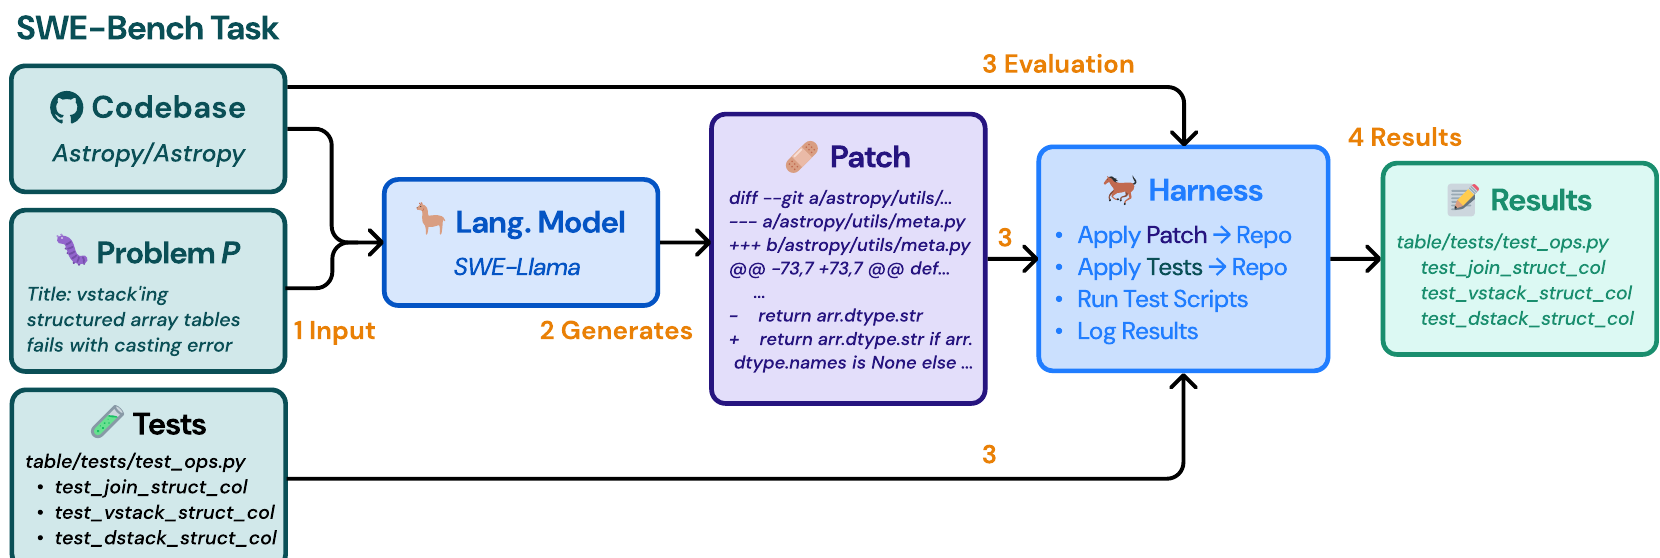
我们在图 8 中提供了评估程序的可视化。评估程序根据解决方案 的行为对模型的 .patch 生成进行评分。在更细粒度的层面上,评估程序可以分解为四个独立步骤,由图 8 中的编号步骤突出显示。首先,代码库和问题陈述可见并提供给LM;然后 LM 生成一个 .patch 预测 。在评估步骤中,针对目标任务实例的每个预测执行以下步骤:
1. 移除任何文件更改,并检出任务实例的基础提交。这将仓库设置为代码库。
2. 激活与任务实例版本对应的可执行环境。
3. 运行安装命令以实例化代码库。
4. 将测试补丁应用于代码库。
5. 将预测补丁连同测试应用于代码库。
6. 如果上一步失败,我们会尝试自动修复预测补丁并重新应用它。
7. 运行由测试补丁确定的测试脚本,以生成测试结果日志。
步骤1到4在任务实例验证过程中不会因验证而可靠地失败。如果应用预测补丁(步骤5)失败,我们会尝试通过移除不必要的上下文行并重新计算头部值来修复预测补丁文件(步骤6)。如果剩余补丁再次失败,或者运行测试命令(步骤7)失败,则预测会被自动赋予0分。假设这些步骤成功,输出日志随后可以通过§ A.3中引入的适当的、仓库特定的解析器转换为测试到状态的映射,其结构与前者相同。
评估指标计算。为了确定任务完成情况,我们将从解析出的测试到状态映射与对应于真实测试结果数据结构中FAIL-TO-PASS和PASS-TO-PASS键的测试列表进行比较。确定任务完成情况很直接;我们检查所有FAIL-TO-PASS和PASS-TO-PASS测试是否都能在评估测试到状态映射中找到并具有通过状态。如果某个测试缺失或具有非通过状态,则被视为失败状态。正如主论文中所定义和使用的那样,如果FAIL-TO-PASS和PASS-TO-PASS中的所有测试都通过,则认为任务已解决。
A.5 评估测试集特征描述
我们在表11中包含了表1的扩展形式,其中包含仓库特定的统计数据。表12提供了从仓库文档中提取的每个仓库的简要描述,以及仓库相关的开源许可证。相关许可证均允许对原始库源代码进行非商业用途使用,只要原始许可证中的权限得到遵守和保留。除了表1中呈现的原始统计数据外,我们还引入了三个新值。新增行数和删除行数合计为编辑行数。“新增”指的是引入的新行数,而“删除”是解决方案移除的既有行。(通过到通过)统计指的是在验证流水线中应用解决方案之前通过的测试数量。与旨在描述问题陈述并确定修订是否解决问题的失败到通过测试不同,通过到通过测试的加入是为了确保修订不会破坏或违反任何现有预期行为。这些测试是在§ A.3中讨论的验证日志检查阶段提取的。我们注意到,失败到失败测试和通过到失败测试在评估中不被考虑,这些统计数据也未反映在上表中。
任务实例问题类别。为了更好地了解SWE-bench任务实例所包含的问题类型,我们对每个任务实例的问题(由issue_numbers字段标识)进行了简单分析。对于每个问题,我们检查元数据,特别是标签,以描述PR所提出的贡献类型。表13分组并展示了我们在所有问题中找到的2,289个标签中的几个示例。虽然绝大多数问题与错误修复相关,但SWE-bench的任务实例与多样化的代码更改相关,其目的超出了调试和错误纠正。
属性分布。在图9中,我们展示了表1中所引入属性的累积分布函数图。从这些图中可以看出,SWE-bench任务实例的中位数问题描述为140个词,且涉及的代码库包含略少于1900个文件和40万行代码。相应的参考解决方案通常会编辑文件中的单个函数,
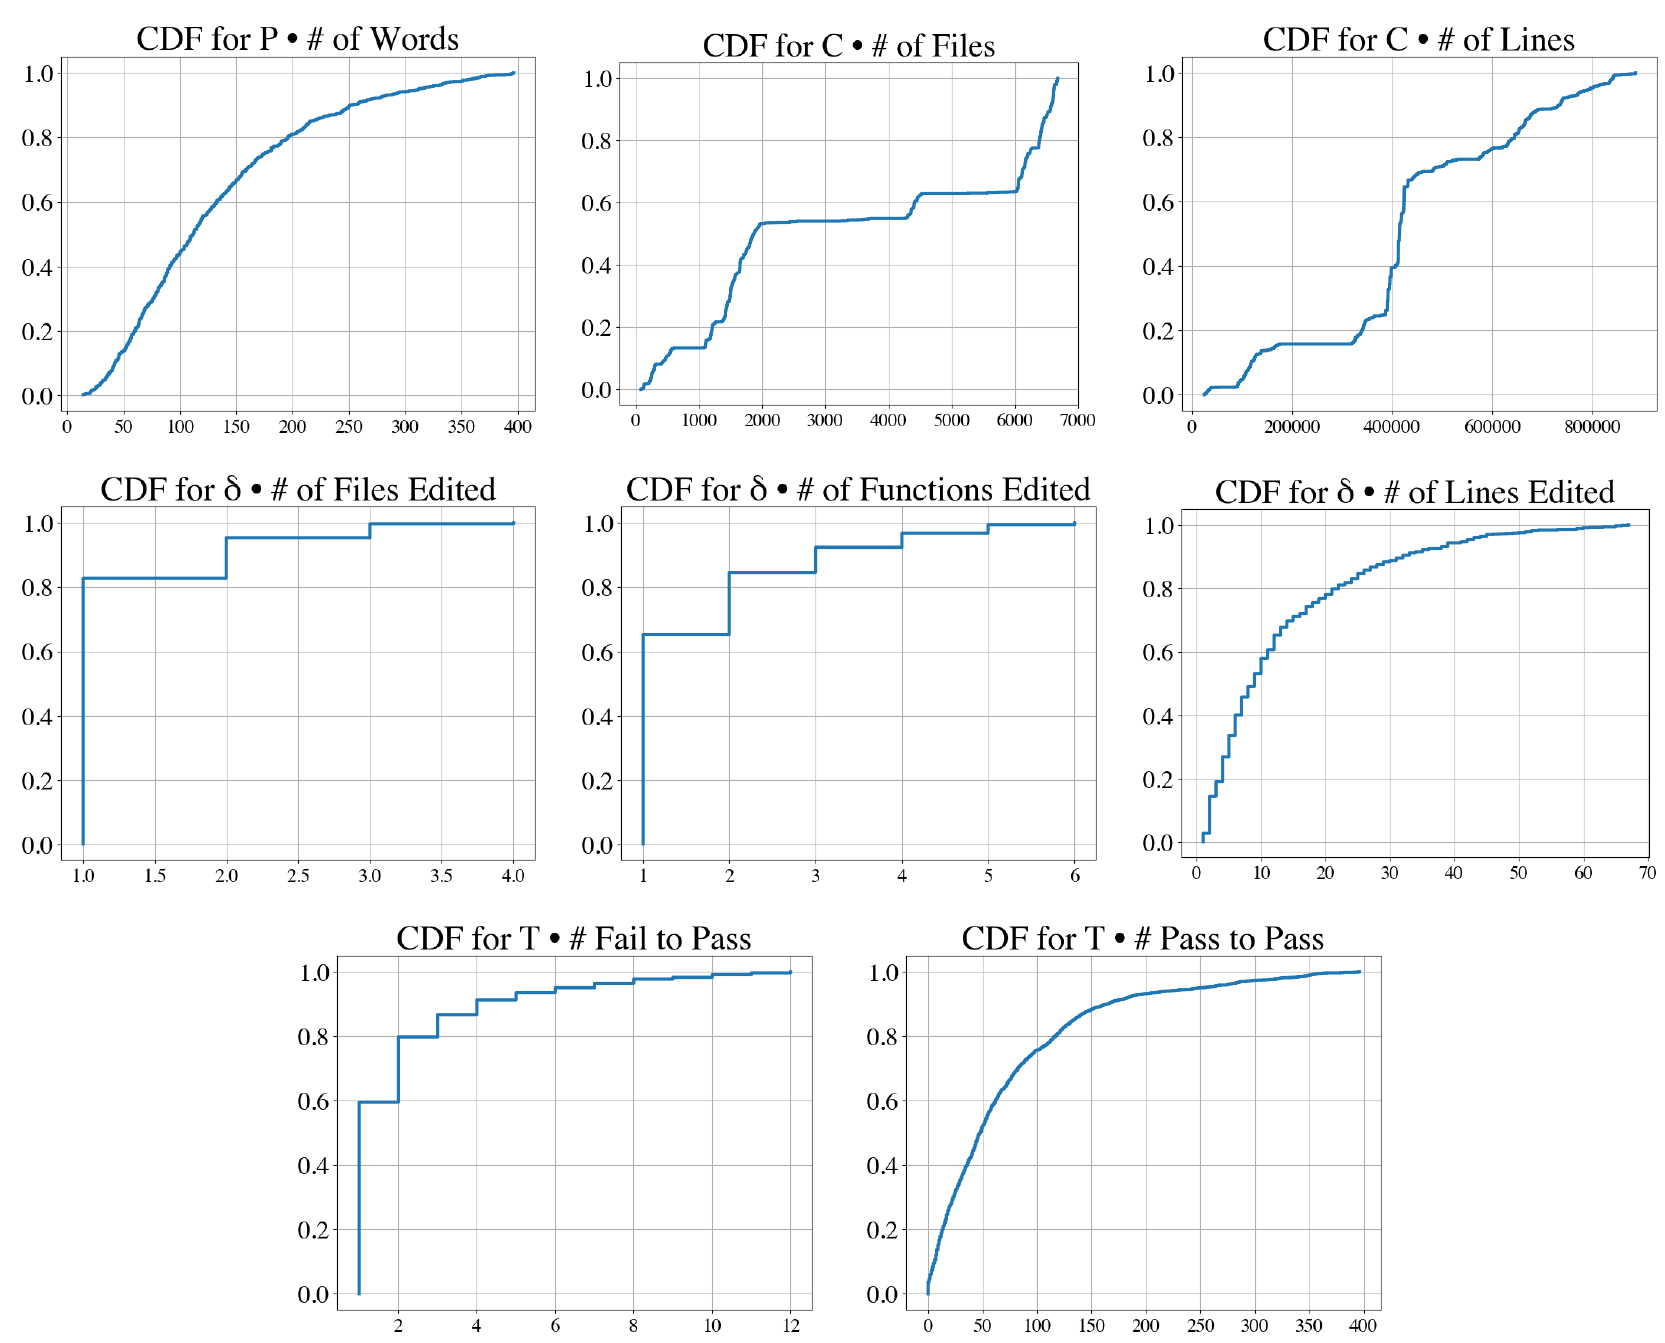
| 仅用于理解原文的只读背景(非待翻译源文本): 属性分布。在图9中,我们展示了表1中引入的属性的累积分布函数图。从这些图中可以看出,SWE-bench任务实例的中位数问题描述为140个单词,并且将在一个包含略少于1900个文件和40万行的代码库中进行。相应的参考解决方案\delta通常会编辑一个文件中的单个函数,修改约15行,并且有一个失败转通过的测试 待翻译文本: astropy | django | flask | matplotlib | pylint | pytest | |
| P 长度(字符) | 2,742 | 1,307 | 1,185 | 2,381 | 2,011 | |
| 2,948 | C 文件数 | 1,811 | 6,356 | 225 | 4,395 | 2,426 |
| 497 | C 行数 | 804k | 407k | 35k | 646k | 109k |
| 111k | δ 编辑文件数 | 1.5 | 1.5 | 1.6 | 1.5 | 1.8 |
| 1.4 | δ 编辑函数数 | 2.5 | 2.0 | 2.4 | 2.2 | 1.8 |
| 1.7 | δ 编辑行数 | 36.0 | 18.5 | 35.4 | 58.9 | 36.0 |
| 24.5 | δ 新增行数 | 25.0 | 12.8 | 23.7 | 35.7 | 26.6 |
| 18.2 | δ 删除行数 | 10.9 | 5.7 | 11.6 | 23.2 | 9.5 |
| 6.4 | |T|(失败转通过) 21.7 | 8.8 | 1.4 | 2.4 | 6.8 | 4.1 |
| |T|(通过到通过) | 191.0 | 85.9 | 32.5 | 242.4 | 47.0 | 60.7 |
| |T|(全部) | 212.8 | 94.6 | 33.9 | 244.8 | 53.7 | 64.8 |
| requests | scikit-learn | seaborn | sphinx | sympy | xarray | |
| P 长度(字符) | 1,654 | 2,239 | 1,667 | 1,888 | 1,213 | 3,515 |
| C # 文件数 | 119 | 1,224 | 273 | 1,483 | 1,666 | 260 |
| C # 行数 | 30k | 361k | 105k | 423k | 678k | 137k |
| δ # 编辑的文件数 | 1.64 | 1.68 | 1.77 | 1.51 | 1.9 | 2.45 |
| δ # 编辑的函数数 | 1.59 | 2.24 | 1.41 | 2.72 | 3.22 | 3.16 |
| δ # 编辑的行数 | 25.5 | 44.0 | 30.1 | 30.6 | 36.3 | 124.8 |
| δ 添加行数 | 19.2 | 32.7 | 24.9 | 22.0 | 24.2 | 95.6 |
| δ 删除行数 | 6.2 | 11.3 | 5.2 | 8.6 | 12.1 | 29.2 |
| |T|(失败转通过) | 7.6 | 7.5 | 12.9 | 2.3 | 2.2 | 58.5 |
| |T|(通过转通过) | 87.1 | 150.7 | 86.8 | 45.1 | 74.5 | 297.5 |
| |T|(全部) | 94.7 | 158.2 | 99.7 | 47.4 | 76.8 | 356.1 |
| 仓库 | 摘要 | 许可证 |
| astropy/astropy | 天文学与天体物理学核心库 | BSD 3-Clause |
| django/django | 用于构建 Web 应用程序的 Web 框架 | BSD 3-Clause |
| pallets/flask | 用于小型 Web 应用程序的轻量级框架 | BSD 3-Clause |
| matplotlib/matplotlib | 用于创建可视化图表的绘图库 | 自定义 |
| pylint-dev/pylint | 用于 Python 2 或 3 的静态代码分析器 | GPL 2.0 |
| pytest-dev/pytest | 用于 Python 的测试框架 | MIT |
| psf/requests | 用于编写 HTTP 请求的简单、优雅的库 | Apache-2.0 |
| scikit-learn/scikit-learn | Python 中的机器学习 | BSD 3-Clause |
| mwaskom/seaborn | Python 中的统计数据可视化 | BSD 3-Clause |
| sphinx-doc/sphinx | 用于创建文档的库 | 自定义 |
| sympy/sympy | 用 Python 编写的计算机代数系统 | 自定义 |
| pydata/xarray | N 维带标签数组和数据集 | Apache-2.0 |
修改约15行代码,并包含一个fail to pass测试来验证修改的正确性,以及51个pass to pass测试来检查现有行为是否被保持。
补丁修复率。我们在表14中展示了各模型生成补丁的任务实例数量(共2294个)、其中成功应用的补丁数量,以及成功应用的补丁中需要经过附录A.4所引入的补丁修复流程的比例的汇总统计。我们发现,修复后的补丁在SWE-Llama成功应用的补丁中所占比例较小,这表明SWE-Llama的微调过程对生成格式良好的补丁有积极影响。对于闭源模型,成功应用的补丁较少,而在成功应用的补丁中,需要生成后修复的比例更高,这表明模型在补丁生成和结构化输出方面仍存在困难。
| 类别 | 数量 | 示例 |
| Bug | 442 | “Bug”(179);“type:bug”(114);“bug”(57);“type: bug”(48);“Bug:beetle:”(23);“status: confirmed bug”(20); |
| Feature | 167 | “type:enhancement”(47);“Enhancement”(25);“New feature”(24);“Feature Request”(22);“type: enhancement”(19);“Enhancement:star:”(15);“New Feature”(7);“enhancement”(6);“type: regression”(14);“Regression”(14);“regression”(8);“help wanted”(71);“good first issue”(66);“printing”(58);“extensions:autodoc”(58);“Easy”(57);“Easy to Fix”(54);“domains:py”(27);“core”(26);“sets”(23);“Wrong Result”(23);“units”(22);“Good first issue”(21); |
| 模型 | 检索设置 | 生成数量 | 应用成功 | 已修复 | 补丁修复率 |
| ChatGPT-3.5 | BM25 13k | 2,270 | 604 | 363 | 60.1% |
| ChatGPT-3.5 | “Oracle” | 1,262 | 500 | 222 | 44.4% |
| ChatGPT-3.5 | “Oracle”-collapsed | 1,811 | 939 | 420 | 44.73% |
| Claude 2 | BM25 13k | 2,281 | 988 | 302 | 30.57% |
| Claude 2 | “Oracle” | 2,138 | 1,441 | 360 | 24.98% |
| Claude 2 | “Oracle”-collapsed | 2,242 | 1,564 | 465 | 29.73% |
| GPT-4 | BM25 27k | 573 | 85 | 59 | 69.41% |
| GPT-4 | “Oracle” | 462 | 195 | 121 | 62.05% |
| GPT-4 | “Oracle”-collapsed | 2,292 | 1,116 | 684 | 61.29% |
| SWE-Llama 13b | BM25 13k | 2,010 | 1,230 | 369 | 30.0% |
| SWE-Llama 13b | “Oracle” | 2,125 | 1,532 | 378 | 24.67% |
| SWE-Llama 7b | BM25 13k | 2,139 | 1,187 | 340 | 28.64% |
| SWE-Llama 7b | “Oracle” | 2,119 | 1,503 | 298 | 19.83% |
A.6 开发集特征描述
除了评估测试集之外,我们还提供了一个开发集,用于在最终测试集上运行之前评估模型和调优超参数。沿用之前的表格和图表风格,我们展示了类似的统计数据来描述225个开发任务实例(略多于主评估集的),这些实例采集自6个允许此类使用的开源代码库。开发集的采集遵循与主评估集完全相同的方法和过滤条件。除已有步骤外,我们还对开发集进行过滤,仅保留2019年1月1日之后创建的任务实例。与表12类似,在表15中我们简要总结了6个所选代码库的用途和许可证。
沿用表13,我们还在表16中列出了与开发集任务相关的标签,再次展示了修复缺陷之外任务类型的多样性和覆盖范围。与主评估任务相比,我们还可以看到一些标签(例如“Crash :collision:”、“io”)指向开发集中代码库所特有的问题。
沿用表1,我们在表17中展示了开发集中6个代码库的相同代码库特定平均统计数据。在整个开发集中,每个任务实例平均有19.9个/中位数2个F2P测试。每个任务实例平均有171.3个/中位数79.0个P2P测试,总计平均191.2个/中位数101.0个测试。
| 仓库 | 摘要 | 数量 | 许可证 |
| marshmallow-code/marshmallowpylint-dev/astroidpydicom/pydicompvlib/pvlib-pythonpyvista/pyvistasqlfluff/sqlfluff | 解析复杂对象与Python数据类型之间的转换用于AST解析、静态分析/推断的库使用Python读取/修改/写入DICOM文件模拟光伏能源系统性能通过接口进行3D绘图、网格分析SQL linter,支持多种方言、模板 | 93156631650 | MITLGPL-2.1CustomCustomMITMIT |
| 类别 | 数量 | 示例 |
| 缺陷 | 127 | “bug”(111);“Bug :cookreach:”(10);“rule bug”(6); |
| 功能 | 55 | “enhancement”:46;“Enhancement :star:”5;“feature-request”:2; |
| 回归 | 4 | “Regression”(4); |
| 其他 | 95 | “api”:11,“documentation”:7,“help wanted”:6,“config options”:5,“io”:5,“jinja”:4,“good first issue”:4,“parser”3 |
A.7 SWE-BENCH LITE特征描述
SWE-bench Lite是一个规范子集,用于更高效地在SWE-bench任务上评估语言模型。SWE-bench是
B 训练SWE-LLAMA的补充细节
B.1 训练细节
**优化。**我们使用LoRA(Hu et al., 2022)进行微调,,,dropout ,应用于每个注意力子层的查询、键、值和输出投影矩阵。我们以的学习率和每个梯度步32个序列的批量大小进行训练,最多训练4个epoch。训练期间,我们每50步保存一次检查点,训练结束后,根据100个留出实例上的验证损失选择最佳检查点。SWE-Llama 7b以CodeLlama-Python 7b初始化,在4块NVIDIA A100上训练了20小时。SWE-Llama 13b以CodeLlama-Python 13b初始化,在8块NVIDIA A100上训练了47小时。我们使用了DeepSpeed Ulysses(Jacobs et al., 2023)和Flash Attention(Dao et al., 2022)来支持长上下文训练。
C 补充结果
C.1 “ORACLE”检索的结果
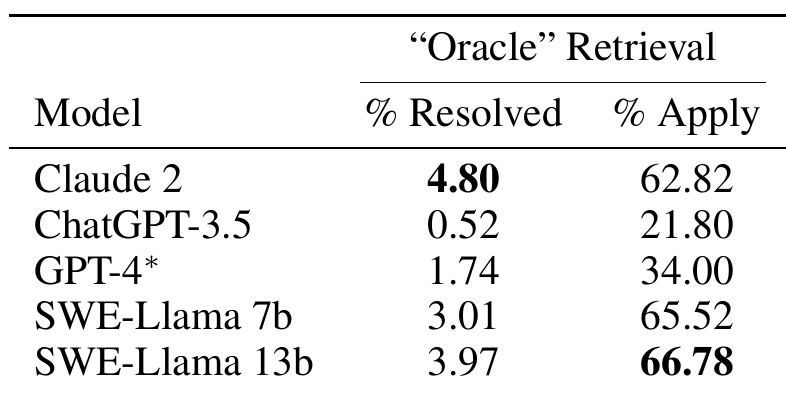
使用第4.1节中描述的“oracle”检索方法,我们在表18中展示了总体性能结果。自然地,仅提供参考解决方案的pull request所编辑的文件时,模型性能相比噪声更多的BM25检索设置有所提升。
C.2 评估测试集
我们在表19中包含了与主论文中图4相对应的按代码库划分的模型性能细分。正如主论文中所讨论的,不同代码库之间的性能差异很大。
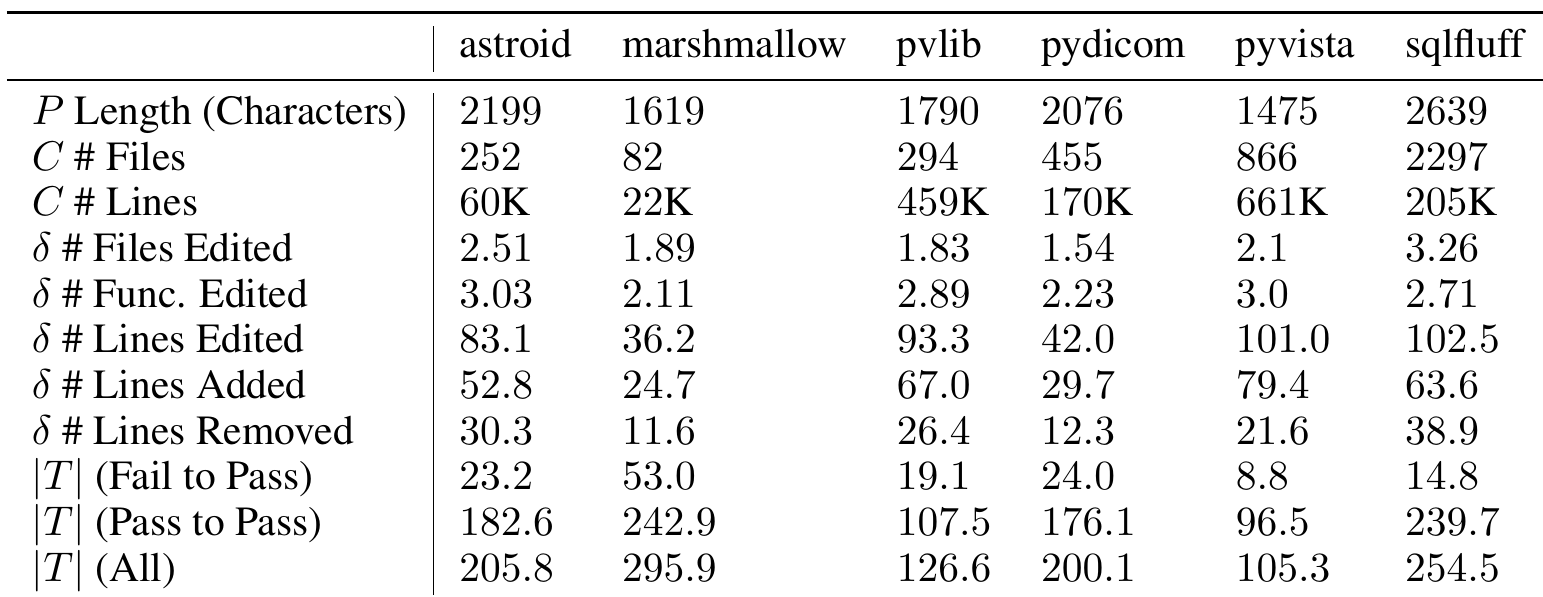
| astroid | marshmallow | pvlib | pydicom | pyvista | sqlfluff | |
| P 长度(字符) | 2199 | 1619 | 1790 | 2076 | 1475 | 2639 |
| C # 文件 | 252 | 82 | 294 | 455 | 866 | 2297 |
| C # 行数 | 60K | 22K | 459K | 170K | 661K | 205K |
| δ # 编辑的文件 | 2.51 | 1.89 | 1.83 | 1.54 | 2.1 | 3.26 |
| δ # 编辑的函数 | 3.03 | 2.11 | 2.89 | 2.23 | 3.0 | 2.71 |
| δ # 编辑的行数 | 83.1 | 36.2 | 93.3 | 42.0 | 101.0 | 102.5 |
| δ # 新增的行数 | 52.8 | 24.7 | 67.0 | 29.7 | 79.4 | 63.6 |
| δ # 删除的行数 | 30.3 | 11.6 | 26.4 | 12.3 | 21.6 | 38.9 |
| |T|(失败转为通过) | 23.2 | 53.0 | 19.1 | 24.0 | 8.8 | 14.8 |
| |T|(Pass 到 Pass) | 182.6 | 242.9 | 107.5 | 176.1 | 96.5 | 239.7 |
| |T|(全部) | 205.8 | 295.9 | 126.6 | 200.1 | 105.3 | 254.5 |
表 17:按开发数据集中各仓库分组后,刻画 SWE-bench 任务实例不同属性的平均数值。表 11 中呈现的相同统计量也在此展示。
| 模型 | “Oracle”检索 | |
| % 已解决 | % 应用 | |
| Claude 2 | 4.80 | 62.82 |
| ChatGPT-3.5 | 0.52 | 21.80 |
| GPT-4* | 1.74 | 34.00 |
| SWE-Llama 7b | 3.01 | 65.52 |
| SWE-Llama 13b | 3.97 | 66.78 |
表 18:我们按照第 4 节所述,使用 oracle 检索设置对模型进行相互比较。主结果表(表 5)展示了不同模型仅使用 BM25 时的结果。\*由于预算限制,我们仅在 SWE-bench 的 随机子集上,在“Oracle”和 BM25 27K 检索器设置下评估 GPT-4。
C.3 GPT-4 评估子集结果
在本节中,我们展示表 5 中的统计量在 GPT-4 所测试的 随机子集上的结果,见表 20。由于子集的选择是随机的,我们发现 已解决率和 应用率与主结果一致,且并未显著偏向于比一般评估集更简单或更困难。
C.4 扩展时间分析
在本节中,我们按年份对已解决的任务实例进行扩展时间分析,延续主论文评估部分表 7 所示的分析。在表 21 中,我们展示了在“Oracle”检索设置下,各模型在 6 个不同时间分区上的 已解决统计量;这些分区按问题创建年份对任务进行分组。从表中可以明显看出,模型性能与年份之间不存在一致的相关性,这支持了我们的结论:尽管模型在其预训练数据集中可能见过较旧版本的代码,但理解和实施 SWE-bench 中的修复是一项困难的任务,需要理解,无法通过记忆观察到的数据来可行或一致地完成。
C.5 F2P、P2P 比率分析
在主论文结果中,我们展示了“ 已解决”统计量,它表示不同模型完全解决了多少任务实例。在本节中,我们更细致地分析以下任务实例之间的差距:1. 模型生成的补丁被成功应用,且 2. 任务实例未被解决。假设补丁被成功应用,我们在表 22 中定义了 6 种情况,这些情况完全涵盖了基于 F2P 和 P2P 测试通过/失败结果的所有可能结果分布。除了“已解决”结果之外,还有
| 仓库 | Claude 2 | ChatGPT-3.5 | GPT-4 | SWE-Llama 13b | SWE-Llama 7b |
| astropy/astropy | 3.23 | 0.00 | 0.00 | 1.06 | 3.16 |
| django/django | 6.15 | 1.32 | 2.50 | 5.19 | 4.00 |
| matplotlib/matplotlib | 3.05 | 3.33 | 0.00 | 3.12 | 1.11 |
| mwaskom/seaborn | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| pallets/flask | 0.00 | 0.00 | 0.00 | 9.09 | 0.00 |
| psf/requests | 15.91 | 2.33 | 8.33 | 13.64 | 18.18 |
| pydata/xarray | 6.90 | 0.00 | 0.00 | 5.81 | 3.00 |
| pylint-dev/pylint | 1.75 | 0.00 | 0.00 | 1.75 | 1.75 |
| pytest-dev/pytest | 5.93 | 0.00 | 0.00 | 5.04 | 4.20 |
| scikit-learn/scikit-learn | 5.41 | 0.00 | 0.00 | 3.12 | 0.88 |
| sphinx-doc/sphinx | 5.65 | 1.83 | 0.00 | 2.25 | 2.69 |
| sympy/sympy | 1.94 | 0.00 | 0.00 | 3.01 | 1.59 |
表19:在SWE-bench中按仓库表示的模型的\(\%\)已解决率。
| 模型 | BM25 检索 | “Oracle” 检索 | ||
| % 解决 | % 应用 | % 解决 | % 应用 | |
| Claude 2 | 2.27 ↑ 0.31 | 45.72 ↑ 2.65 | 4.01 ↓ 0.79 | 62.65 ↓ 0.17 |
| ChatGPT-3.5 | 0.17 - 0.00 | 26.53 ↑ 0.02 | 0.70 ↑ 0.18 | 21.64 ↓ 0.16 |
| GPT-4 | 0.00 - 0.00 | 14.82 - 0.00 | 1.74 - 0.00 | 34.00 - 0.00 |
| SWE-Llama 7b | 0.35 ↑ 0.35 | 49.04 ↓ 2.70 | 1.92 ↓ 1.09 | 63.70 ↓ 1.82 |
| SWE-Llama 13b | 0.70 - 0.00 | 56.54 ↑ 2.92 | 4.54 ↑ 0.57 | 66.67 ↓ 0.11 |
表20:我们在SWE-bench的一个\(25\%\)随机子集(574个实例)上,仅在“oracle”和BM25 27K检索器设置下,使用第4节中描述的BM25和oracle检索设置对模型进行相互比较。这与表5中提到的GPT-4所评估的同一子集相同。相对于表5和表18中百分比的差异以 subscript 形式列出。在确立之后,我们引入五个新术语。“Breaking Resolved”结果指的是问题的期望行为已实现(所有F2P测试通过),但并非所有先前行为都得到保持(并非所有P2P测试通过)。“Partially Resolved”指的是代码库的先前行为得到保持(所有P2P测试通过);然而,期望行为未完全实现(并非所有F2P测试通过)。“Work in Progress”情况是指期望行为未完全实现(并非所有F2P测试通过),且代码库的先前行为未得到保持(并非所有P2P测试通过)。“No-Op”是指代码更改对原始代码库没有任何影响;先前行为得到保持(所有P2P测试通过),但问题完全未解决(0个F2P测试通过)。最后,如果问题未解决(0个F2P测试通过)且先前正常工作的行为被回退(部分P2P测试失败),则代码库处于更差的状态,我们将其定义为“Regression”。
在表23中,我们根据这六种情况对成功应用的补丁生成进行分类。我们发现,在非“Resolved”问题中,模型提出的大多数补丁生成未能解决对应任务实例中的任何一个F2P测试用例(“No-Op”和“Regression”)。在这些情况的子集中,大多数(至)情况为No-Op,而模型在其余这些情形中破坏了现有行为。
总体而言,模型生成通过部分但并非全部测试的情况(“Breaking Resolved”、“Partially Resolved”、“Work in Progress”)相对于其他三个类别累计代表的问题子集较小。通过对其中若干案例的人工检查,可以清楚地看出模型展示了对任务需求的一定理解。然而,由于基线方法对代码库的有限视图不包含诸如文件间依赖关系和函数关系等信息,许多这些任务实例经常失败,因为正确解决当前问题的更改未考虑使用受更改实体影响的其他模块。我们在F节中包含了若干直接突出这些缺点的案例研究。总体而言,这些结果不仅突出了SWE-bench的难度,还指出了
| 年份 | 总数 | 25% | Claude 2 | GPT-3.5 | GPT-4* | SWE-Llama 13b | SWE-Llama 7b |
| 2023 | 244 | 61 | 4.51 | 1.56 | 0.00 | 4.07 | 3.50 |
| 2022 | 395 | 117 | 4.05 | 0.85 | 3.42 | 2.80 | 2.46 |
| 2021 | 383 | 102 | 4.18 | 0.00 | 2.94 | 4.45 | 2.56 |
| 2020 | 427 | 109 | 5.15 | 0.71 | 0.00 | 3.96 | 3.43 |
| 2019 | 437 | 112 | 5.72 | 1.49 | 1.79 | 4.55 | 2.21 |
| 2018 | 165 | 37 | 5.45 | 0.00 | 0.00 | 3.57 | 2.94 |
| < 2018 | 89 | 36 | 4.49 | 0.00 | 2.78 | 3.37 | 1.09 |
表21:我们在此表中呈现扩展的时间分析,展示在“Oracle”检索设置下各模型任务实例的已解决率,并按不同截止日期分开。Year列指的是在指定日历年内创建的任务子集。在Total列中,我们列出属于给定年份的任务数量。列是GPT-4所评估子集的相同信息。其余模型特定列包含已解决指标。
| P2P 测试通过 | F2P 测试通过 | ||
| 全部 | 部分 | 无 | |
| 全部 | 已解决 | 部分解决 | 空操作 |
| 部分 | 破坏性已解决 | 进行中 | 回归 |
| 无 | 破坏性已解决 | 进行中 | 回归 |
表22:我们呈现成功应用并执行后的补丁生成的6种可能结果。这些结果通过通过的F2P和P2P测试数量加以区分。通过执行环境提供反馈的潜在价值,该环境允许模型针对现有测试运行修复,然后决定是继续编辑还是提交补丁以供审查。
C.6 补丁生成扩展分析
在本节中,我们按照表8中列出的指标呈现量化补丁生成各个方面的统计数据。在表24中,我们针对所有模型在oracle检索设置下的所有补丁生成重新计算这些值,无论补丁是否成功应用。在所有指标上,我们发现各模型的补丁生成在规模上更接近平均黄金编辑的特征。虽然一些模型相对于相应的Gold编辑仍生成较少的行数(例如Claude-2、ChatGPT-3.5、GPT-4),但SWE-Llama模型的编辑在大多数方面平均更长。当同时考虑表8和表24时,可以明显看出模型在生成长输出序列并将其正确格式化为补丁方面存在困难。对此类情况的进一步检查,如我们在F节中的案例研究所示,表明幻觉、遵循现有代码风格/结构以及正确引用长距离依赖是较长生成中更频繁出现的常见错误。
C.7 软件工程指标
我们进行初步评估,探索使用软件工程指标来评估集成在复杂代码库中的大型代码块的效率和复杂性。不同于传统NLP基准中流行并已被用于代码生成的、用于评估流畅性和表面形式相似性的语义相似度评分函数,诸如Cyclomatic复杂度McCabe (1976)和Halstead复杂度度量Halstead (1977)等指标建立在逻辑抽象(例如抽象语法树)和软件原则之上,以标量值量化代码的复杂性、效率和可读性。补丁生成和SWE-bench评估日志是软件工程指标和静态分析器可 readily 应用的丰富信息来源。不同于小型代码竞赛基准,由于目标功能的微小范围,软件工程指标的洞见在其中没有意义,SWE-bench的任务足够复杂,实践者可以使用这些工具获得关于补丁生成更改的复杂性及其对代码库其余部分影响的结构良好、
| 模型 | Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| 已应用 | 1078 | 284 | 76 | 1257 | 1196 |
| 已解决 | 110 | 12 | 10 | 69 | 91 |
| 破坏性解决 | 26 | 2 | 3 | 17 | 10 |
| 部分解决 | 15 | 4 | 3 | 17 | 10 |
| 进行中 | 20 | 2 | 1 | 17 | 16 |
| 无操作 | 471 | 174 | 30 | 716 | 672 |
| 回归 | 436 | 90 | 29 | 421 | 397 |
| 模型 | 总行数 | 新增 | 删除 | 函数 | 文件 |
| Claude 2 | 27.2 | 6.6 | 3.3 | 1.2 | 1.1 |
| Gold | 61.6 | 17.8 | 8.6 | 2.6 | 1.4 |
| ChatGPT-3.5 | 42.0 | 6.1 | 3.9 | 1.7 | 1.0 |
| Gold | 44.5 | 12.7 | 5.5 | 2.1 | 1.2 |
| GPT-4 | 22.4 | 4.4 | 1.8 | 0.8 | 0.9 |
| Gold | 50.3 | 14.0 | 6.5 | 2.3 | 1.3 |
| SWE-Llama 13b | 68.9 | 9.5 | 4.3 | 2.5 | 1.6 |
| Gold | 61.5 | 17.8 | 8.6 | 2.6 | 1.4 |
| SWE-Llama 7b | 78.9 | 10.1 | 7.6 | 2.5 | 1.5 |
| Gold | 65.1 | 18.8 | 9.0 | 2.7 | 1.5 |
严谨且广泛的反馈信号。
我们在此包含我们的探索性工作,展示软件工程指标如何可靠地捕捉代码质量特征,以及比较两个补丁之间的这些统计数据如何能够提供关于模型能力的自动观察。我们使用Radon包,这是一个直接从源代码计算不同软件工程指标的库。
我们特别关注在“Oracle”检索设置下,针对psf/requests仓库成功应用的Claude 2补丁预测,如图4所反映,若干模型在该仓库上表现最佳。对于每个预测,我们将补丁应用到代码库,然后计算修改后函数的Cyclomatic复杂度和Halstead复杂度分数。Cyclomatic复杂度量化函数的控制流,计算通过源代码的独立执行路径数量(McCabe, 1976)。更高的Cyclomatic复杂度分数表明函数更复杂,具有更高的缺陷可能性,通常表明可维护性困难。Halstead复杂度计算程序中运算符和操作数的数量(Halstead, 1977)。对于每个预测,我们还对相应的黄金补丁执行相同的步骤。
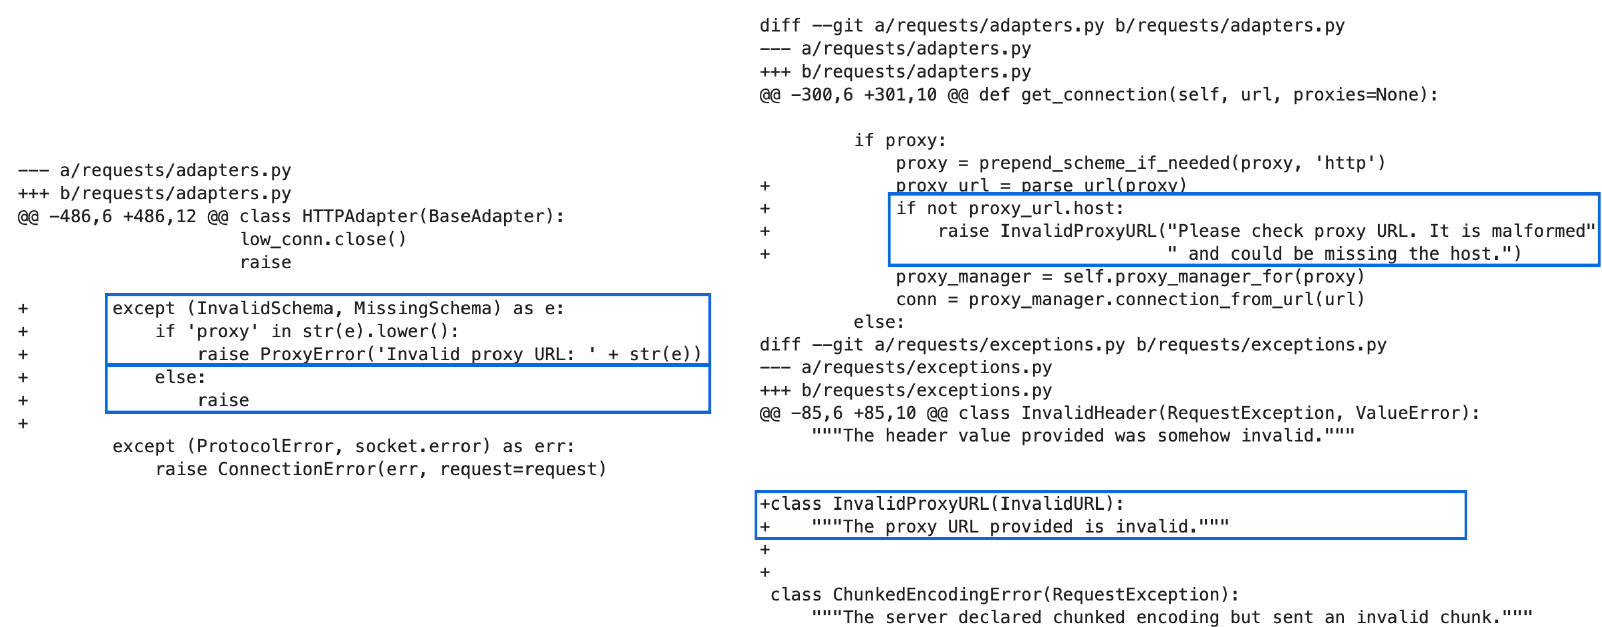
我们发现软件工程指标为模型性能提供了自动的定性洞见。考虑图10中的以下简单案例研究。虽然模型补丁预测(左侧)与黄金参考解决方案(右侧)相比行数更少(6行而非11行),修改的文件更少(1个而非2个),但模型的编辑在一个相对复杂且广泛使用的HTTPAdapter类中放置了一个条件。这引入了两个新的潜在执行结果,将HTTPAdapter的Cyclomatic复杂度从3提高到5。相比之下,参考解决方案虽然更长,但导入了模块内依赖,修改了get_connection中逻辑上更简单的函数,并定义了一个新的错误类型InvalidProxyURL以捕捉问题所描述的新颖缺陷。
Radon文档,开源代码库
问题陈述:代理变量中无效协议导致的误导性异常。当https_proxy或HTTPS_PROXY变量的值意外遗漏协议中的一个'?'时,会向用户抛出回溯,但并未指出问题出在代理配置上……
D 额外实验细节
D.1 检索细节
稀疏检索。在检索过程中,我们对文档做轻微增强,将文件内容前置其文件路径,以更好地支持基于问题中可能直接提及的文件名的检索。
Oracle检索。Oracle检索文件路径 simply 直接从参考解决方案的补丁文件中提取,排除测试文件。
D.2 推理设置
由于生成相对昂贵,我们每个实例仅生成单个补丁文件。遵循Pass@1代码生成评估的先例(Chen et al., 2021; Rozière et al., 2023),我们对所有模型简单地使用贪婪解码。
D.3 提示模板示例
模型使用以下通用模板进行提示,具体取决于所用模型略有变化。
你将获得一个部分代码库和一个解释待解决问题的问题陈述。<issue> {ISSUE TEXT} </issue>{start of README.md} {README.md text} {end of README.md} {start of file_1. py}...{file_1. py text}[end of file_1. py]...</code>
这是一个补丁文件的示例。它由对代码库的更改组成。它指定了文件名、每次更改的行号,以及删除和添加的行。
单个补丁文件可以包含对多个文件的更改。<patch>-- a/file.py+++ b/file.py@@ -1,27 +1,35 @@def euclidean(a, b):- while b:- a, b = b, a % b- return a + if b == 0: + return a + return euclidean(b, a % b) def bresenham(x0, y0, x1, y1): points = [] dx = abs(x1 - x0) dy = abs(y1 - y0)- sx = 1 if x0 < x1 else -1- sy = 1 if y0 < y1 else -1- err = dx - dy + x, y = x0, y0 + sx = -1 if x0 > x1 else 1 + sy = -1 if y0 > y1 else 1- while True: points.append((x0, y0))- if x0 == x1 and y0 == y1:- break e2 = 2 * err- if e2 > -dy: + if dx > dy: + err = dx / 2.0 + while x != x1: points.append((x, y)) err = dy- x0 += sx- if e2 < dx:- err += dx- y0 += sy + if err < 0: + y += sy + err += dx + x += sx + else: + err = dy / 2.0 + while y != y1: + points.append((x, y)) + err -= dx + if err < 0: + x += sx + err += dy + y += sy + points.append((x, y)) return points
</patch>
我需要你通过生成一个我可以直接使用 git apply 应用到该仓库的单个补丁文件来解决所提供的问题。请按照上述格式回复一个单独的补丁文件。
回复如下:
使用略多或略少几行指令或示例的实验似乎并未对整体性能产生实质性影响,但第5节所述实验的发现除外。
E 社会影响
随着代码推理已成为许多语言模型能力背后的基础技能,机器自动化软件工程的潜在未来引发了许多重要问题,并在AI安全方面具有重要的潜在影响(Gros等,2023)。重要的是要解决如何确保AI生成的代码忠实于人类意图的问题,以及在代码代理误解人类目标并随后执行任务时可能设置哪些防护措施。为了在受控环境中观察此类问题并展现其解决方案,我们希望SWE-bench能够作为一个测试平台,用于设计安全、稳健的措施,以实现对齐、可验证且安全的AI驱动软件工程。
F SWE-LLAMA生成结果的深入分析
在本节中,我们按照第5.1节的风格,提供五项额外的定性分析,涵盖Claude 2和SWE-Llama的生成结果(Oracle检索设置)。
Claude 2的定性研究可见于表25和表26。表27、28和29是Claude 2未能正确解决的任务实例。SWE-Llama的定性研究涵盖在表30、31、32、33、34中。对于表30、31和32,我们展示了SWE-Llama 13b正确解决的任务实例。在表33和34中,我们展示了SWE-Llama 13b未能正确解决问题的两个任务实例,指出了模型可能不够熟练以完成当前任务的部分推理和生成技能。
我们在这些部分中做出的观察与主论文中陈述的观点相吻合,即模型往往难以处理多行和多文件更改,当所需修复相对较短时表现更为擅长,并且在高效理解代码库方面需要帮助。
表25:在此示例中,Claude 2正确解决了scikit-learn/scikit-learn中的一个问题。然而,如讨论中所展示的,虽然解决方案是正确的,但它展示了模型倾向于编写原始Python代码而不使用代码库中已有的方法。
设置-模型:Claude 2配合Oracle检索-任务实例:scikit-learn_scikit-learn-13328-问题链接:https://github.com/scikit-learn/scikit-learn/pull/13314-PR链接:https://github.com/scikit-learn/scikit-learn/issues/13328
问题 向HuberRegressor fit提供布尔型X时出现TypeError### 描述 使用布尔预测变量拟合'HuberRegressor'时出现'TypeError'。
复现步骤/代码import numpy as np from sklearn.datasets import make_regression from sklearn.linear_model import HuberRegressor# 随机数据 X, y, coef = make_regression(n_samples=200, n_features=2, noise=4.0, coef =True, random_state=0) X_bool = X > 0 X_bool_as_float = np.asarray(X_bool, dtype=float)# 正常工作 huber = HuberRegressor().fit(X, y) # 失败 (!) huber = HuberRegressor().fit(X_bool, y) # 也正常工作 huber = HuberRegressor().fit(X_bool_as_float, y)
预期结果 当'X'的'dtype'为'bool'时不抛出错误(上述代码片段中第二行代码,.fit(X_bool, y))。布尔数组预期由'HuberRegressor.fit'转换为'float',正如'LinearRegression'等所做的那样。
实际结果 抛出'TypeError':(其余行省略)
金标准补丁diff --git a/sklearn/linear_model/huber.py b/sklearn/linear_model/huber.py -- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ - 251,7 +251,8 @@ def fit(self, X, y, sample_weight=None): self : object"
模型生成的补丁
- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ -231,6 +231,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self.tol = tol + def _validate_data(self, X, y=None): + return X.astype(np.float64) if X.dtype == np.bool else X + def fit(self, X, y, sample_weight=None): """Fit the model according to the given training data.
@@ -250,7 +253,7 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self : object """ X, y = check_X_y( X, y = check_X_y( X, y, copy=False, accept_sparse=['csr'], y_numeric=True) if sample_weight is not None: sample_weight = np.array(sample_weight) @@ -262,6 +265,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): raise ValueError( "epsilon_should_be_greater_than_or_equal_to_1.0,got_%f" % self.epsilon) + X = self._validate_data(X)
测试
失败转通过(1)
sklearn/linear_model/tests/test_huber.py::test_huber_bool
通过转通过(9)
sklearn/linear_model/tests/test_huber.py::test_huber_max_iter sklearn/linear_model/tests/test_huber.py::test_huber_gradient sklearn/linear_model/tests/test_huber.py::test_huber_sample_weights sklearn/linear_model/tests/test_huber.py::test_huber_sparse sklearn/linear_model/tests/test_huber.py::test_huber_scaling_invariant
其他通过转通过测试省略...
讨论。在此任务实例中,该问题描述了关于类型如何转换的问题。具体而言,当使用布尔预测变量(如X_bool)拟合HuberRegressor模型时,会出现TypeError。此问题出现的原因是HuberRegressor不会像其他一些模型(如LinearRegression)那样自动将布尔数组转换为浮点数,从而导致类型不匹配错误。对于其修复,模型定义了自己的_validate_data函数,该函数封装了类型转换逻辑,并将其应用于X。虽然它通过了测试,但此修复可以更高效,并可能引入风格和组织上的不一致。如参考解决方案所示,有一种更简单的解决方案,即传入dtype参数,利用check_X_y函数调用现有的标志来更干净地解决此问题。由于上下文窗口限制,其他文件的内容未包含在oracle检索设置中。
表26:我们提供另一个示例,其中Claude-2正确解决了问题并开发了与金标准补丁相似的解决方案。然而,金标准补丁的解决方案更注重避免未来可能与此代码相关的潜在问题。
设置
- 模型:Claude 2配合Oracle检索-任务实例:matplotlib_matplotlib-24362 - 问题链接:https://github.com/matplotlib/matplotlib/issues/24349 - PR链接:https://github.com/matplotlib/matplotlib/pull/24362
问题
[Bug]:sharex和sharey不接受0和1作为布尔值
Bug摘要
当在'pyplot.subplots'的'sharex'或'sharex'参数中使用'0'或'1'代替'False'或'True'时,会引发错误。
复现代码
import matplotlib.pyplot as plt
fig, ax = plt.subplots(ncols=2, sharey=1)
实际结果
我们得到以下错误:
Traceback (most recent call last):
(前面行省略) File "/\\\/matplotlib/lib/matplotlib/gridspec.py", line 293, in subplots _api.check_in_list(["all", "row", "col", "none"], File "/\\\/matplotlib/lib/matplotlib/_api/init.py", line 131, in check_in_list raise ValueError(msg)
ValueError: 1 is not a valid value for sharey; supported values are 'all', 'row', 'col', 'none'
使用“sharex”而不是“sharey”会产生同样的错误(尽管会出现以下警告:
UserWarning: sharex argument to subplots() was an integer. Did you intend to use subplot() (without 's')?
但这是预期之中的,不属于当前问题的一部分)
预期结果
我期望值 1 和 0 被理解为 bool。
模型生成的补丁
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py
index 06dd3f19f6.32ee7c306e 100644
-- a/lib/matplotlib/gridspec.py
+++ b/lib/matplotlib/gridspec.py
@@ - 276, 9 +276, 9 @@ class GridSpecBase:
raise ValueError("GridSpec.subplots().only_works_for_GridSpecs_"
"created_with_a_parent_figure")
if isinstance(sharex, bool):
+ if isinstance(sharex, bool) or sharex == 1 or sharex == 0:
sharex = "all" if sharex else "none"
if isinstance(sharey, bool):
+ if isinstance(sharey, bool) or sharey == 1 or sharey == 0:
sharey = "all" if sharey else "none"
This check was added because it is very easy to type
'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.
Gold Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py - - - a/lib/matplotlib/gridspec.py +++ b/lib/matplotlib/gridspec.py @@ -276,21 +276,12 @@ def subplots(self, \*, sharex=False, sharey=False, squeeze=True,- if isinstance(sharex, bool):+ if not isinstance(sharex, str):sharex = "all" if sharex else "none"- if isinstance(sharey, bool):+ if not isinstance(sharey, str):sharey = "all" if sharey else "none"- # This check was added because it is very easy to type# 'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.- # In most cases, no error will ever occur, but mysterious behavior# will result because what was intended to be the subplot index is# instead treated as a bool for sharex. This check should go away# once sharex becomes knownly.- if isinstance(sharex, Integral):- api.warn_external("sharex_argument_to_subplots()_was_an_integer.__Did_you""intend_to_use_subplot()_without's')?"- api.check_in_list(["all", "row", "col", "none"],+ api.check_in_list(["all", "row", "col", "none", False, True],sharex=sharex, sharey=sharey)
Tests
Fail to Pass (1)
lib/matplotlib/tests/test_subplots.py::test_shared
Pass to Pass (39)
lib/matplotlib/tests/test_subplots.py::test_label_outer_span lib/matplotlib/tests/test_subplots.py::test_label_outer_non_gridspec lib/matplotlib/tests/test_subplots.py::test_shared_and_moved lib/matplotlib/tests/test_subplots.py::test_exceptions lib/matplotlib/tests/test_subplots.py::test_subplots_offsettext.png)
Additional Pass to Pass Tests omitted...
讨论。本示例要求将 1 和 0 视为 pyplot.subplots 函数 sharex 和 sharey 参数的布尔值。当前代码会引发错误。在生成的补丁中,模型将 1 和 0 添加为可接受的值。然而,黄金补丁将可接受的值添加到列表 ["all", "row", "col", "none", False, True] 中。它还移除了与此问题相关的 Integral 相关警告。这种清理以及对 check_in_list 参数的清晰性使代码更加简洁和可读。
表 27:在本示例中,我们展示了 astropy/astropy 中的一个问题,Claude 2 未能正确解决。该错误主要是由于补丁生成尝试直接解决该问题。
设置
- 模型:带 Oracle 检索的 Claude 2- 任务实例:astropy_astropy-14365- 问题链接:https://github.com/astropy/astropy/issues/14363- PR 链接:https://github.com/astropy/astropy/pull/14365
问题
ascii.qdp Table 格式假定 QDP 命令为大写
描述
ascii.qdp 假定 QDP 文件中的命令为大写,例如,对于错误它们必须是 "READ SERR 1 2",而 QDP 本身不区分大小写,并且可以使用 "read serr 1 2"。由于许多 QDP 文件是手工创建的,因此应移除所有命令都必须全部大写的预期。
预期行为
以下 qdp 文件应读入带错误的 'Table',而不是崩溃。
read serr 1 2 1 0.5 1 0.5
如何复现 创建一个 QDP 文件:
cat > test.qdp read serr 1 2 1 0.5 1 0.5 <EOF>
python Python 3.10.9 (main, Dec 7 2022, 02:03:23) [Clang 13.0.0 (clang - 1300.0.29.30)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> from astropy.table import Table >>> Table.read('test.qdp', format='ascii.qdp') WARNING: table_id not specified. Reading the first available table [ astropy.io.ascii.qdp] Traceback (most recent call last): raise ValueError(f'Unrecognized_QDP_line: {line}') ValueError: Unrecognized QDP line: read serr 1 2
运行 "qdp test.qdp" 可以正常工作。
模型生成的补丁
- a/astropy/io/ascii/qdp.py - b/astropy/io/ascii/qdp.py - @ -60,7 +60,7 @@ ValueError: Unrecognized QDP line... """ _decimal_re = r"[-?(\d+(\. \d+)?\.\d+)([eE][+-]?\d+)?" _command_re = r"READ [TS]ERR(\s+[0-9]+)+" _command_re = r"read [ts]err(\s+[0-9]+)+" sep = delimiter if delimiter is None:
Gold Patch
diff - - git a/astropy/io/ascii/qdp.py b/astropy/io/ascii/qdp.py - - - a/astropy/io/ascii/qdp.py +++ b/astropy/io/ascii/qdp.py @@ - 68,7 + 68,7 @@ def _line_type (line, delimiter=None): _new_re = rf"NO((sep)NO)+" _data_re = rf"((_decimal_re) | NO | [- + ]?nan) ((sep) ((_decimal_re) | NO | [- + ]?nan)) +" _type_re = rf"\s*((?P<command>|_command_re)) | (?P<new>[_new_re]) | (?P< data>[_data_re])?\s*(\!|(?P<comment>.*))?\s+$" - _line_type_re = re.compile(_type_re) + _line_type_re = re.compile(_type_re, re.IGNORECASE) line = line.strip() if not line: return "comment" @@ - 306,7 + 306,7 @@ def _get_tables_from_qdp_file(qdp_file, input_colnames=None, delimiter=None): values = [] for v in line.split (delimiter): - if v == "NO": + if v.upper() == "NO": values.append(np.max. masked) else: # Understand if number is int or float
测试
失败到通过 (1)
X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[True]
通过到通过 (8)
X astropy/io/ascii/tests/test_qdp.py::test_get_tables_from_qdp_file X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[False] X astropy/io/ascii/tests/test_qdp.py::test_read_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example_comma X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple_specify_name X astropy/io/ascii/tests/test_qdp.py::test_get_lines_from_qdp
讨论。该问题要求修复对 QDP 文件的处理;具体而言,它要求移除对命令必须为大写的期望。在模型生成的补丁中,模型在正则表达式中定位了问题描述中提到的 READ 和 ERR 命令,并直接对其进行了编辑。然而,在同一文件中可以清楚地看到,该正则表达式还被用于其他模式,例如 _type_re,因此对“根”正则表达式进行修复可能并不合适。此外,在多个正则表达式变量中,要确定正确的修改对象,需要进行推理,而执行有可能为这种推理提供帮助。该解决方案中的这一错误体现在:它不仅未能通过给定的单元测试,而且还未能通过强制先前行为的现有测试。
表 28:对于这个来自 mwaskom/seaborn 仓库的问题,问题陈述中包含了指向图像的超链接。正如第 5 节所讨论的,SWE-bench 任务中有一小部分包含图像,这使得图像理解成为解决问题的一个虽小但重要的组成部分,而初始基线并未对此进行探索。
设置
- 模型:Claude 2 配合 Oracle 检索 - 任务实例:mwaskom_seaborn-3217 - 问题链接:https://github.com/mwaskom/seaborn/issues/2907 - PR 链接:https://github.com/mwaskom/seaborn/pull/3217
问题
使用对数刻度时,直方图后的宽度计算略有错误 请注意此处轻微的重叠:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image 当分箱数量更多时,这种重叠几乎变得不可察觉:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image 这与“Bars”无关;“Bar”也有同样的问题:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth , width ), so.Hist(bins ) .scale
image
模型生成的补丁
- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1327,9 +1327,7 @@ elif "width" in df: view_width = view_df["width"] else: - view_width = 0.8 # TODO what default? - spacing = scales[orient]._spacing(view_df.loc[view_idx, - width.loc[view_idx] = view_width + spacing + width.loc[view_idx] = view_width df["width"] = width if "baseline" in mark._mappable_props:
黄金补丁
diff - - git a/seaborn/_core/plot.py b/seaborn/_core/plot.py - - - a/seaborn/_core/plot.py ++ b/seaborn/_core/plot.py @@ - 1377,10 + 1377,9 @@ def _unscale_coords( - drop_cols = [\*coord_cols, "width"] if "width" in df else coord_cols out_df = ( df - .drop(drop_cols, axis=1) + .drop(coord_cols, axis=1) .reindex(df.columns, axis=1) # So unscaled columns retain their place @@ - 1396,12 + 1395,6 @@ def _unscale_coords( - if var == orient and "width" in view_df: - width = view_df["width"] - out_df.loc[values.index, "width"] = ( - transform(values + width / 2) - transform(values - width / 2) ) - return out_df diff - - git a/seaborn/_marks/bar.py b/seaborn/_marks/bar.py - - - a/seaborn/_marks/bar.py +++ b/seaborn/_marks/bar.py @@ - 29,17 + 29,23 @@ class BarBase(Mark): + transform = scales[orient]._matplotlib_scale.get_transform() + forward = transform.transform + reverse = transform.inverted().transform + + other = {"x": "y", "y": "x"} [orient] + + pos = reverse(forward(data[orient]) - data["width"] / 2) + width = reverse(forward(data[orient]) + data["width"] / 2) - pos + + val = (data[other] - data["baseline"]).to_numpy() + base = data["baseline"].to_numpy() + (Remaining lines omitted...)
测试
失败转通过(1)
X tests/_marks/test_bar.py::TestBars::test_log_scale
通过转通过(8)
X tests/_marks/test_bar.py::TestBar::test_categorical_positions_vertical X tests/_marks/test_bar.py::TestBar::test_categorical_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_numeric_positions_vertical X tests/_marks/test_bar.py::TestBar::test_numeric_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_set_properties
其他通过转通过测试省略...
讨论。基线模型无法解决此问题可直接归因于缺乏图像输入。我们纳入此示例是为了说明,调试真实软件问题可能涉及对图像的消化;这带来了一整套独立的与理解和推理相关的挑战。除 SWE-bench 任务之外,软件工程中的其他问题,例如解读系统设计图、用户界面规范和用户反馈,也带来了有趣的视觉-语言挑战。
表 29:在这个 Claude 2 生成的最后一个示例中,模型必须解决一个与解决循环依赖错误相关的错误。Claude 2 的解决方案在一个本就复杂的问题上交付不足。
设置
- 模型:Claude 2 配合 Oracle 检索- 任务实例:sympy_sympy-18211- 问题链接:https://github.com/pylint-dev/pylint/issues/3525- PR 链接:https://github.com/pylint-dev/pylint/pull/4703
问题
TYPE.CHECKING 内的导入可能引发“cyclic-import”
假设你有两个模块:a.py 和 b.py。'a' 导入 'b',但 'b' 需要 'a' 才能进行类型注解,那么这通常通过在 'TYPE.CHECKING' 块内导入 'a' 来完成。不幸的是,这会导致 pylint 报告“cyclic-import”。
可能与 https://github.com/PyCQA/pylint/issues/3285 相关
黄金补丁
diff --git a/pylint/checkers/imports.py b/pylint/checkers/imports.py-- a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py@@ - 813,7 + 813,9 @@ def _get_imported_module(self, importnode, modname):- def _add_imported_module(self, node, importedmodname): + def _add_imported_module(+ self, node: Union[astroid.Import, astroid.ImportFrom], importedmodname: str + ) -> None:"""notify an imported module, used to analyze dependencies""" module_file = node.root().file context_name = node.root().name@@ - 826,6 + 828,10 @@ def _add_imported_module(self, node, importedmodname): except ImportError: pass + in_type_checking_block = (+ isinstance(node.parent, astroid.If) and node.parent. is_type_guard() + ) if context_name == importedmodname: self.add_message("import- self", node=node)@@ - 845,7 + 851,10 @@ def _add_imported_module(self, node, importedmodname): # update import graph self.import_graph[context_name].add(importedmodname)- if not self.linter.is_message_enabled("cyclic-import", line= node.lineno): + if + not self.linter.is_message_enabled("cyclic-import", line= node.lineno) + or in_type_checking_block + ) self.excluded_edges[context_name].add(importedmodname)ްމައްސަލައިގެންނަށްޓަކ
模型生成的补丁
diff - - git a/pylint/checkers/imports.py b/pylint/checkers/imports.py index 4f3eed2. .2b74a8d 100644 - - - a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py @@ -49,6 +49,7 @@ import copy import os import sys from distutils import sysconfig +from typing import TYPE_CHECKING from typing import Dict, List, Union
import astroid @@ -61,6 +62,9 @@ from pylint.checkers.utils import ( node_ignores_exception, ) from pylint.exceptions import EmptyReportError +if TYPE_CHECKING: + from pylint.lint import PyLinter + from pylint.graph import DotBackend, get_cycles from pylint.interfaces import IASTroidChecker from pylint.reporters.ureports.nodes import Paragraph, VerbatimText, VNode
测试
失败转通过(1)
X tests/marks/test_bar.py::TestBars::test_log_scale
通过转通过(11)
tests/test_func.py::test_functionality[func_w0401_disabled_in_func.py] tests/test_func.py::test_functionality[func_i0022. py] tests/test_func.py::test_functionality[func_w0401. py] tests/test_func.py::test_functionality[func_w0801. py] tests/test_func.py::test_functionality[func_w0401_package]
额外通过的测试已省略……
讨论。在这个问题中,模型被要求提供基于TYPE_CHECKING的处理方式,以解决pylint目前会报错的循环导入问题。黄金补丁有一个详细的解决方案,涉及在TYPE_CHECKING块内进行条件处理,排除循环导入消息,并且通常具有更具体的处理方式。模型生成的补丁采用了类似“Stack Overflow”的解决方案;虽然创建TYPE_CHECKING块是解决导入问题的一种流行方案,但针对该代码库解决这个特定问题,需要的是一种比网上可能找到的通用答案更细致的解决方案。
表30:SWE-Llama 13b生成正确解决SWE-bench任务实例的示例。在这个例子中,SWE-Llama的生成与解决方案完全一致。
设置
- 模型:使用Oracle检索的SWE-Llama 13B- 任务实例:pydata_xarray-5131- 问题链接:https://github.com/pydata/xarray/pull/5130- PR链接:https://github.com/pydata/xarray/pull/5131
问题
在交互式Python会话中显示DatasetGroupBy时,输出的第一行包含尾随空白。文档中的第一个示例展示了这一点:
import xarray as xr, numpy as np >>> ds = xr.Dataset( ... {"foo": (("x", "y"), np.random.rand(4, 3)), ... coords={"x": [10, 20, 30, 40], "letters": ("x", list("abba")), ... >>> ds.groupby("letters") DatasetGroupBy, grouped over 'letters' 2 groups with labels 'a', 'b'.
输出的第一行“DatasetGroupBy, grouped over 'letters' ”中存在尾随空白。通过将对象转换为字符串可以更清楚地看到这一点(注意n前的空白):
str(ds.groupby("letters")) "DatasetGroupBy, grouped_over_'letters'\n2_groups_with_labels'a', 'b'."
虽然这本身不是问题,但它给我们带来了一个麻烦,因为我们在持续集成中使用flake8来验证代码格式是否正确……[还有20行]
黄金补丁
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 +436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
模型生成的补丁
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 +436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
测试
失败转通过(10)
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj0]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj1]
通过到通过(16)
✓ xarray/tests/test_groupby.py::test_consolidate_slices
✓ xarray/tests/test_groupby.py::test_groupby_da_datetime
✓ xarray/tests/test_groupby.py::test_groupby_duplicate_coordinate_labels
✓ xarray/tests/test_groupby.py::test_groupby_input_mutation
✓ xarray/tests/test_groupby.py::test_groupby_map_shrink_groups[obj0]
其他通过到通过测试已省略……
讨论。 在这个问题中,模型被要求修正一个尾部空白问题,问题描述展示了使用过程中出现的错误演示,但没有明确指出模型中需要修复的函数。在 oracle 检索设置中,模型被直接给予 xarray/core/groupby.py 文件进行编辑,但大多数情况下需要定位要编辑的行。在这种情况下,模型成功推理出在交互式 Python 设置中,实际被调用的底层函数是 __repr__ 函数。定位到该函数后,它必须弄清楚空白位于 return 语句中的哪个位置。此时,修复相当明显,因为存在一个显式的空格,模型将其移除。在这个案例中,模型成功通过了所有验证此修复正确性的测试(10 个失败到通过测试),同时还保持了文件的现有行为(16 个通过到通过测试)。
表 31:SWE-Llama 13b 生成正确解决 SWE-bench 任务实例的示例。在此示例中,SWE-Llama 的生成与黄金补丁不同。
设置
- 模型:SWE-Llama 13B 配合 Oracle 检索- 任务实例:psf_-requests-1724- 问题链接:https://github.com/psf/requests/issues/1723- PR 链接:https://github.com/psf/requests/pull/1724
问题
Unicode 方法名在 Python 2.7.2 中导致某些请求出现 UnicodeDecodeError。以下示例正常工作:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
但以下示例(使用 'method 'POST' 而非 'method 'POST')会产生 UnicodeDecodeError:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Traceback (most recent call last): [完整堆栈跟踪已隐藏] File "/System/Library/Frameworks/Python.framework/Versions/2.7/... msg_+=_message_body UnicodeDecodeError: 'ascii'_codec_can't_decode_byte_0xcf_in_position_140: ordinal_not_in_range (128)
我的猜测是 'u'POST' 在头部注入了 unicode,而它本应是字符串。这是因为 'sessions.py:313' 仅仅是:
req.method method.upper()
[其他行已隐藏……]
黄金补丁
diff --git a/requests/sessions.py b/requests/sessions.py-- a/requests/sessions.py +++ b/requests/sessions.py@@ - 12,7 + 12,7 @@from collections import Mapping from datetime import datetime-from .compact import cookielib, OrderedDict, [3 more omitted] +from .compact import cookielib, OrderedDict, [3 omitted, + builtin_str from .cookies import cookiejar_from_dict, extract_cookies_to_jar, RequestsCookieJar from .models import Request, PreparedRequest from .hooks import default_ hooks, dispatch_hook@@ - 309,6 + 309,6 @@ def request(self, method, url,:param cert: (optional) if String, path to ssl client cert file (.pem). If Tuple, ('cert', 'key') pair.\\\*
+ method builtin_str(method)
模型生成的补丁
diff - - git a/requests/sessions.py b/requests/sessions.py - - - a/requests/sessions.py +++ b/requests/sessions.py @@ -254,7 +254,7 @@ def prepare_request(self, request):
p = PreparedRequest() p.prepare( method=request.method.upper(), + method=str(request.method).upper(), url=request.url, files=request.files, data=request.data,
测试
失败到通过(6)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_RETURNS_COOKIE test_requests.py::RequestsTestCase::test_DIGEST_HTTP_200_OK_GET test_requests.py::RequestsTestCase::test_different_encodings_dont_break test_requests.py::RequestsTestCase::test_generic_cookiejar_works test_requests.py::RequestsTestCase::test_uppercase_scheme_redirect
通过到通过(75)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_SETS_SESSION_COOKIES test_requests.py::RequestsTestCase::test_DIGEST_STREAM test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_ALTERNATIVE test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_WITH_PARAMS test_requests.py::RequestsTestCase::test_HTTP_200_OK_HEAD
其他通过到通过测试已省略……
讨论。与表30中呈现的问题不同,这里不是交互式 Python 输入,而是向模型提供一个函数调用的错误追踪,其中提供了从用户角度重现问题的步骤。此外,该问题还在最后一行提供了关于问题潜在修复方案的建议。同样在 oracle 设置下,模型利用了自然语言建议,将更改定位到与建议语义非常相似的一行(req.method = method.upper() 与 method=str(request.method).upper())。模型正确地解决了该问题,所有通过的测试都反映了这一点。然而,在这种情况下,我们可以看出模型的成功实际上相当“幸运”。首先,尽管黄金补丁利用了用于统一处理字符串格式化的内置函数,但模型决定使用更原始的 Python 来解决此问题,这可能不会受到人类评审者的欢迎,因为它与代码库的其余部分不一致。进一步检查 builtin_str 函数(图中未显示)还揭示出,它处理了问题中所描述的之外的额外字符串格式化情况。虽然模型这次解决了任务,但该解决方案是否对未来的问题具有鲁棒性仍值得怀疑。
表32:这是 SWE-Llama13b 成功解决任务的另一个示例。这个示例很有趣,因为与参考方案相比,模型开发出了一种有些新颖的解决方案,可以说更高效、更简洁。
设置
- 模型:SWE-Llama 13B,使用 Oracle 检索- 任务实例:djang0. djang0-11727- 问题链接:https://code.djangoproject.com/ticket/29376- PR 链接:https://github.com/djang0/djang0/pull/11727
问题
允许通过 show_save_and_add_another 上下文变量隐藏“保存并添加另一个”按钮
为了提供更好的可调整性,引入新的上下文变量——show_save_and_add_another。例如,如果我想隐藏“保存并添加另一个”按钮,我只需修改 extra_context——将 False 写入该变量即可。对于其他按钮——“保存”和“保存并继续编辑”,这已经以完全相同的方式工作。
黄金补丁
diff --git a/djang0/contrib/admin/templateTags/admin_modify.py b/djang0 /... - - a/djang0/contrib/admin/templateTags/admin_modify.py +++ b/djang0/contrib/admin/templateTags/admin_modify.py @@ -54,12 +54,20 @@ def submit_row(context): is_popup = context['is_popup'] save_as = context['save_as'] show_save = context.get('show_save', True) + show_save_and_add_another = context.get('show_save_and_add_another', True)
(省略7行……) or (has_add_permission and add) or has_editable_inline_admin_formset + can_save_and_add_another = ( + has_add_permission and + not is_popup and + (not save_as or add) and + can_save and + show_save_and_add_another + ) can_save_and_continue = not is_popup and can_save and has_view_permission and show_save_and_continue can_change = has_change_permission or has_editable_inline_admin_formset ctx = Context(context) @@ -70,10 +78,7 @@ def submit_row(context): change and context.get('show_delete', True) ), 'show_save_as_new': not is_popup and has_change_permission and change and save_as, - 'show_save_and_add_another': ( - has_add_permission and not is_popup and - (not save_as or add) and can_save - ), 'show_save_and_add_another': can_save_and_add_another, 'show_save_and_continue': can_save_and_continue, 'show_save': show_save and can_save,
模型生成的补丁
diff --git a/django/contrib/admin/templateTags/admin_modify.py b/django/...-- a/django/contrib/admin/templateTags/admin_modify.py +++ b/django/contrib/admin/templateTags/admin_modify.py@@ - 72,7 + 72,7 @@ def submit_row(context):' show_save_as_new': not is_popup and has_change_permission and change and save_as,' show_save_and_add_another': has_add_permission and not is_popup and- (not save_as or add) and can_save + (not save_as or add) and can_save and context. get('show_save_and_add_another', True)),' show_save_and_continue': can_save_and_continue,' show_save': show_save and can_save,
测试
失败转为通过(2)
test_override_show_save_and_add_another
test_submit_row (admin_views.test_templateTags.Admin...)
通过转为通过(3)
test_choice_links (admin_views.test_templateTags.DateHierarchyTests)
test_override_change_form_template_tags
test_override_change_list_template_tags
讨论。对于这个来自 django/django 仓库的任务实例,模型被要求引入一个上下文变量,使用户能够通过上下文变量隐藏“保存并添加另一个”按钮,类似于对另外两个现有按钮的处理方式。与之前两个设置相比,这项任务稍难一些,因为没有提供明确的堆栈跟踪或对问题的程序化演示。在这种相对欠明确的设置中,没有提供关于正确定位函数的建议,模型成功推理出它应当调整现有的 show_save_and_add_another 键/值对。在比较黄金补丁解决方案时,可以说模型生成的补丁在编辑行数方面产生了更高效的解决方案,因为它做出了纳入上下文作为设置 show_save_and_add_another 隐藏状态标志所需的最小编辑。然而,与表 31 中的讨论类似,从风格上看,黄金补丁的编辑与代码库更加一致,并且还进行了问题中未明确讨论的额外更改,以遵循代码库中已有的做法(即添加 can_save_and_add_another 字段)。这个任务是这样一个潜在令人兴奋的方向的示例:通过人类指导或对代码库整体更好的理解,模型将调整其生成内容,不仅做出功能上正确的更改,也做出风格上正确的更改。
表 33:这是一个 SWE-Llama13b 写出错误解决方案,但成功保持先前行为的示例。这里模型生成内容与黄金补丁之间的差异展示了模型往往倾向于少生成必要的修复。
设置
- 模型:带 Oracle 检索的 SWE-Llama 13B- 任务实例:sphinx-doc_sphinx-11445- 问题链接:https://github.com/sphinx-doc/sphinx/issues/11437- PR 链接:https://github.com/sphinx-doc/sphinx/pull/11445
问题
使用 rst_prolog 会移除包含域指令的顶级标题
描述该缺陷
如果设置了 rst_prolog,那么任何包含域指令作为第一个标题(例如 :mod:)的文档都不会正确渲染该标题,也不会将该标题包含在 toctree 中。在下面的示例中,如果 docs/mypackage.rst 的标题是 mypackage2 而不是 :mod:mypackage2,那么标题会正确显示。同样,如果你不设置 rst_prolog,那么标题也会正确显示。这个问题似乎已经存在一段时间了,因为我可以在 Sphinx v4.0.0 中复现它。
如何复现
$ sphinx-quickstart --no-sep --project mypackage --author me - v 0.1.0 --release 0.1.0 --language en docs $ echo - e 'Welcome\n=========\n\n...\tctree::\n\n\_mypackage\n' > docs/index_rst $ echo - e ':mod:'mypackage2\n=========\n\nContent\n\n Subheading\n-
logger = logging.getLogger(name) - docinfo_re = re.compile(r'\w+.?') + docinfo_re = re.compile(r'\w+.?n') symbols_re = re.compile(r'([-]-\/-\@[\-]') SECTIONING_CHARS = ['=', '-', '-']
测试
失败转通过(2)
X tests/test_util_rst.py::test_prepend_prolog_with_roles_with_newline tests/test_util_rst.py::test_prepend_prolog_with_roles_without_newline
通过转通过(8)
X tests/test_util_rst.py::test_prepend_prolog tests/test_util_rst.py::test_prepend_prolog_with_CR tests/test_util_rst.py::test_prepend_prolog_without_CR
其他通过转通过测试省略……
黄金补丁
diff --git a/sphinx/util/rst.py b/sphinx/util/rst.py -- a/sphinx/util/rst.py ++ b/sphinx/util/rst.py @@ - 10,22 +10,17 @@
from docutils.parsers.rst import roles from docutils.parsers.rst.languages import en as english +from docutils.parsers.rst.states import Body from docutils.statemachine import StringList from docutils.utils import Reporter - from jinja2 import Environment +from jinja2 import Environment, pass_environment from sphinx.locale import from sphinx.util import docutils, logging- try: - from jinja2.utils import pass_environment - except ImportError: - from jinja2 import environmentfilter as pass_environment - logger = logging.getLogger(name) - docinfo_re = re.compile('\w+.*?') +FIELD_NAME_RE = re.compile(Body.patterns['field_marker']) symbols_re = re.compile(r'([-\-/:-@\[-\{-]})' # symbols without dot(0 x2e) SECTIONING_CHARS = ['=', '-', '~']
@@ - 80,7 +75,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: if prolog: pos = 0 for line in content: if docinfo_re.match(line): + if FIELD_NAME_RE.match(line): pos += 1 else: break @@ - 91,6 +86,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: pos += 1 # insert prolog (after docinfo if exists) + lineno = 0 for lineno, line in enumerate(prolog.splitlines()): content.insert(pos + lineno, line, 'rst_prolog>', lineno)
讨论。对于这个来自 sphinx-doc/sphinx 仓库的任务实例,模型被要求编写逻辑来修复标题被错误渲染的情况。仅仅理解所使用的术语并将这些词语映射到代码库中的逻辑,就是模型面临的一项重大挑战。模型得到了一个命令行调用,这可能有所帮助,但将问题中呈现的术语落实到代码库中至关重要。从比较黄金补丁和模型生成的补丁可以清楚看出,模型远未解决该任务。模型确实大体上识别出修复正则表达式模式是正确的操作,因为黄金补丁也是这样做的。然而,模型和 Oracle 检索设置共同不足之处,主要在于大量使用了来自代码库本身和第三方库的额外模块。这个示例凸显了训练语言模型以及设计推理流程的重要性和潜力,这些流程应能够自动发现此类信息。
表 34:在这个最后的示例中,SWE-Llama 13b 不仅没有解决任务,而且还破坏了模型中现有的行为。这个示例表明模型需要理解所需编辑范围之外的代码库。
设置
- 任务实例:scikit-learn_ scikit-learn-13241
- 问题链接:https://github.com/scikit-learn/scikit-learn/issues/8798
- PR 链接:https://github.com/scikit-learn/scikit-learn/pull/13241
问题
rbf 核 KernelPCA 结果之间的差异
描述
当我针对相同数据集运行 KernelPCA 进行降维时,结果的符号不同。
复现步骤/代码
只是为了使用 rbf 核将维度降到 7:
pca = KernelPCA(n_components=7, kernel='rbf', copy_X=False, n_jobs=- 1) pca.fit_transform(X)
预期结果
相同的结果。
实际结果
除了符号之外,结果相同:
[[- 0.44457 - 0.18155 - 0.10873 0.13548 - 0.14371 - 0.05746 0.18124]] [[0.44457 0.18155 0.10873 - 0.13548 - 0.14371 - 0.05746 - 0.18124]] [[- 0.44457 - 0.18155 0.10873 0.13548 0.14371 0.057469 0.18124]]
黄金补丁
diff --git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos...
-- a/sklearn/decomposition/kernel_pca.py
+++ b/sklearn/decomposition/kernel_pca.py
@@ - 8,6 + 8,7 @@
from scipy.sparse.linalg import eighs
from .utils import check_random_state
+from .utils.extmath import svd_flip
from .utils.validation import check_is_fitted, check_array
from .exceptions import NotFittedError from .base import BaseEstimator, TransformerMixin, _UnstableOn32BitMixin
@@ - 210,6 + 211,10 @@ def _fit_transform(self, K): maxiter=self.max_iter, v0=v0)
+ # 翻转特征向量的符号以强制实现确定性输出
+ self.alphas_, _ = svd_flip(self.alphas_, + np.empty_like(self.alphas_).T) + # 按降序对特征向量进行排序 indices = self.lambdas_.argsort() [::- 1] self.lambdas_ = self.lambdas_[indices]
模型生成的补丁
diff - - git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos... - - a/sklearn/decomposition/kernel_pca.py +++ b/sklearn/decomposition/kernel_pca.py @@ -220,7 +220,7 @@ def fit_transform(self, K): self.alphas = self.alphas_[:, self.lambdas_ > 0] self.lambdas_ = self.lambdas_[self.lambdas_ > 0]
return K return K / self.lambdas_
def _fit_inverse_transform(self, X_transformed, X): if hasattr(X, "tocstr"):
测试
失败转通过(1)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output
通过转通过(54)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca sklearn/tests/test_kernel_pca.py::test_kernel_pca_consistent_transform sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output sklearn/tests/test_kernel_pca.py::test_kernel_pca_sparse sklearn/tests/test_kernel_pca.py::test_kernel_pca_linear_kernel sklearn/tests/test_kernel_pca.py::test_kernel_pca_n_components sklearn/tests/test_kernel_pca.py::test_remove_zero_eig sklearn/tests/test_kernel_pca.py::test_kernel_pca_precomputed sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline_precomputed sklearn/tests/test_pca.py::test_pca_dtype_preservation[randomized] sklearn/tests/test_pca.py::test_pca_dtype_preservation[auto] sklearn/tests/test_pca.py::test_pca_deterministic_output
其他通过转通过测试从略……
讨论。在这个来自 scikit-learn/scikit-learn 库的示例中,模型收到一个观察结果:调用 fit_transform 函数的输出奇偶性被翻转了。模型还收到了可以重现该问题的 Python 代码行及其标准输出。黄金补丁导入并使用 svd_flip 函数,在 _fit_transform 函数的另一行中解决了该问题。模型在此任务中失败与表 33 示例中所讨论要点不同之处在于,除了理解其编辑所依赖的第三方依赖项之外,模型还必须理解代码库中还有哪些其他部分反过来依赖于它正在更改的函数。这个示例展示了另一个侧面,说明为什么处理超出局部编辑范围的长上下文是一项困难但值得的挑战。