
对 PPO 做了四处修正,让 32B 模型在 AIME 2024 上拿到 50 分,代码与数据全部开源。2025 年论文,全文免费在线阅读。
DAPO: An Open-Source LLM Reinforcement Learning System at Scale
DAPO:一个大规模开源LLM强化学习系统
字节跳动Seed 清华大学智能产业研究院(AIR) 香港大学 清华大学AIR与字节跳动Seed联合实验室(SIA-Lab)
完整作者列表见贡献部分
摘要
推理扩展赋予LLM前所未有的推理能力,而强化学习是激发复杂推理的核心技术。然而,最先进推理LLM的关键技术细节并未公开(例如OpenAI o1博客和DeepSeek R1技术报告中),因此社区仍难以复现其RL训练结果。我们提出了解耦裁剪与动态采样策略优化(DAPO)算法,并完全开源了一个最先进的大规模RL系统,使用Qwen2.5-32B基础模型在AIME 2024上达到50分。与以往隐瞒训练细节的工作不同,我们介绍了使大规模LLM RL取得成功的关键算法技术。此外,我们开源了基于verl框架构建的训练代码,以及精心整理和处理的数据集。我们开源系统的这些组件增强了可复现性,并支持大规模LLM RL的未来研究。
日期:2025年3月17日 通讯作者:zhouhao@air.tsinghua.edu.cn, wangmingxuan.89@bytedance.com 项目主页:https://dapo-sia.github.io/ "https://github.com/volcengine/verl
1 引言
OpenAI的o1 [1]和DeepSeek的R1 [2]等测试时扩展为大语言模型(LLM)[3-7]带来了深刻的范式转变。测试时扩展支持更长的思维链思考并诱导复杂的推理行为,使模型在AIME和Codeforces等竞争性数学和编程任务中表现优异。
推动这一革命的核心技术是大规模强化学习(RL),它激发出自我验证和迭代优化等复杂推理行为。然而,可扩展RL训练的实际算法和关键配方仍然是个谜,隐藏于现有推理模型的技术报告中[1, 2, 8-11]。在本文中,我们揭示大规模RL训练中的重大障碍,并开源一个可扩展的RL系统,其算法、训练代码和数据集完全开源,提供民主化的解决方案和工业级RL结果。
我们以Qwen2.5-32B [12]作为RL的预训练模型进行实验。在最初的GRPO运行中,我们在AIME上仅达到30分——显著低于DeepSeek的RL(47分)。深入分析表明,朴素的GRPO基线存在若干关键问题,如熵崩溃、奖励噪声和训练不稳定性。更广泛的社区在复现DeepSeek结果时也遇到了类似挑战[13-19],这表明R1论文中可能遗漏了开发工业级、大规模、可复现RL系统所需的关键训练细节。
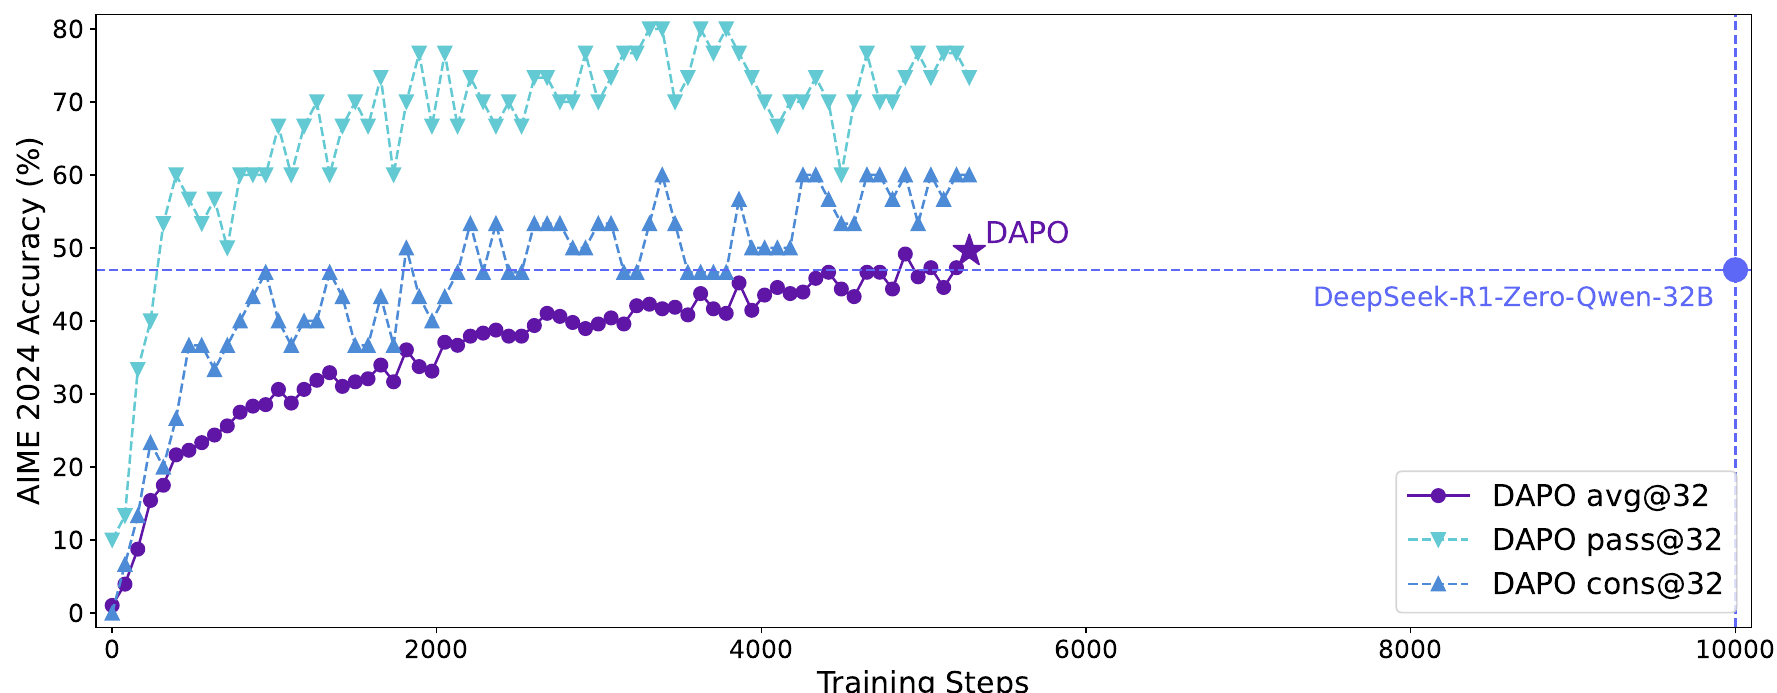
为弥补这一差距,我们发布了一个开源的最先进大规模LLM RL系统,基于Qwen2.5-32B模型在AIME 2024上达到50分,以50%的训练步数超越了DeepSeek-R1-Zero-Qwen-32B [2]此前取得的最先进结果(47分)(图1)。我们提出了解耦裁剪与动态采样策略优化(DAPO)算法,并引入4项关键技术使RL在长CoT RL场景中发挥出色表现。详情见第3节。
1. 高裁剪(Clip-Higher),促进系统多样性并避免熵崩溃;
2. 动态采样(Dynamic Sampling),提高训练效率和稳定性;
3. Token级策略梯度损失(Token-Level Policy Gradient Loss),在长CoT RL场景中至关重要;
4. 超长奖励塑形(Overlong Reward Shaping),减少奖励噪声并稳定训练。
我们的实现基于verl [20]。通过完全发布我们最先进的RL系统(包括训练代码和数据),我们旨在揭示对大规模LLM RL有价值的见解,惠及更广泛的社区。
2 预备知识
2.1 近端策略优化(PPO)
PPO [21]引入了用于策略优化的裁剪替代目标。通过使用裁剪将策略更新约束在前一策略的近端区域内,PPO稳定了训练并提高了样本效率。具体而言,PPO通过最大化以下目标来更新策略:
其中是来自数据分布的问答对,是重要性采样比的裁剪范围,是时间步的优势估计。给定价值函数和奖励函数,使用广义优势估计(GAE)[22]计算:
其中
2.2 组相对策略优化(GRPO)
与PPO相比,GRPO消除了价值函数,并以组相对方式估计优势。对于特定的问答对,行为策略采样一组个独立响应。然后,第个响应的优势通过归一化组级奖励计算:
与PPO类似,GRPO采用裁剪目标,并直接施加KL惩罚项:
其中
同样值得注意的是,GRPO 在样本级别计算目标函数。确切地说,GRPO 首先计算每个生成序列内的平均损失,然后再对不同样本的损失取平均。正如我们将在第 3.3 节中讨论的那样,这种差异可能会对算法的性能产生影响。
2.3 移除 KL 散度
KL 惩罚项用于调节在线策略与冻结参考策略之间的散度。在 RLHF 场景 [23] 中,RL 的目标是在使模型行为对齐的同时,不至于偏离初始模型太远。然而,在训练长 CoT 推理模型时,模型分布可能会显著偏离初始模型,因此这一限制并不必要。因此,我们将从所提出的算法中排除 KL 项。
2.4 基于规则的奖励建模
使用奖励模型通常会遭遇奖励黑客问题 [24-29]。相反,我们直接使用可验证任务的最终准确率作为结果奖励,并按以下规则计算:
其中 是真实答案, 是预测答案。这已被证明是激活基础模型推理能力的有效方法,如在自动定理证明 [30-33]、计算机编程 [34-37] 和数学竞赛 [2] 等多个领域中所示。
3 DAPO
我们提出了 ecouple Clip 与 ynamic sAmpling 策略 ptimization(DAPO)算法。DAPO 为每个与答案 配对的问题 采样一组输出 ,并通过以下目标函数优化策略:
其中
完整算法见算法1。在本节中,我们将介绍与DAPO相关的关键技术。
3.1 提高上限:Clip-Higher
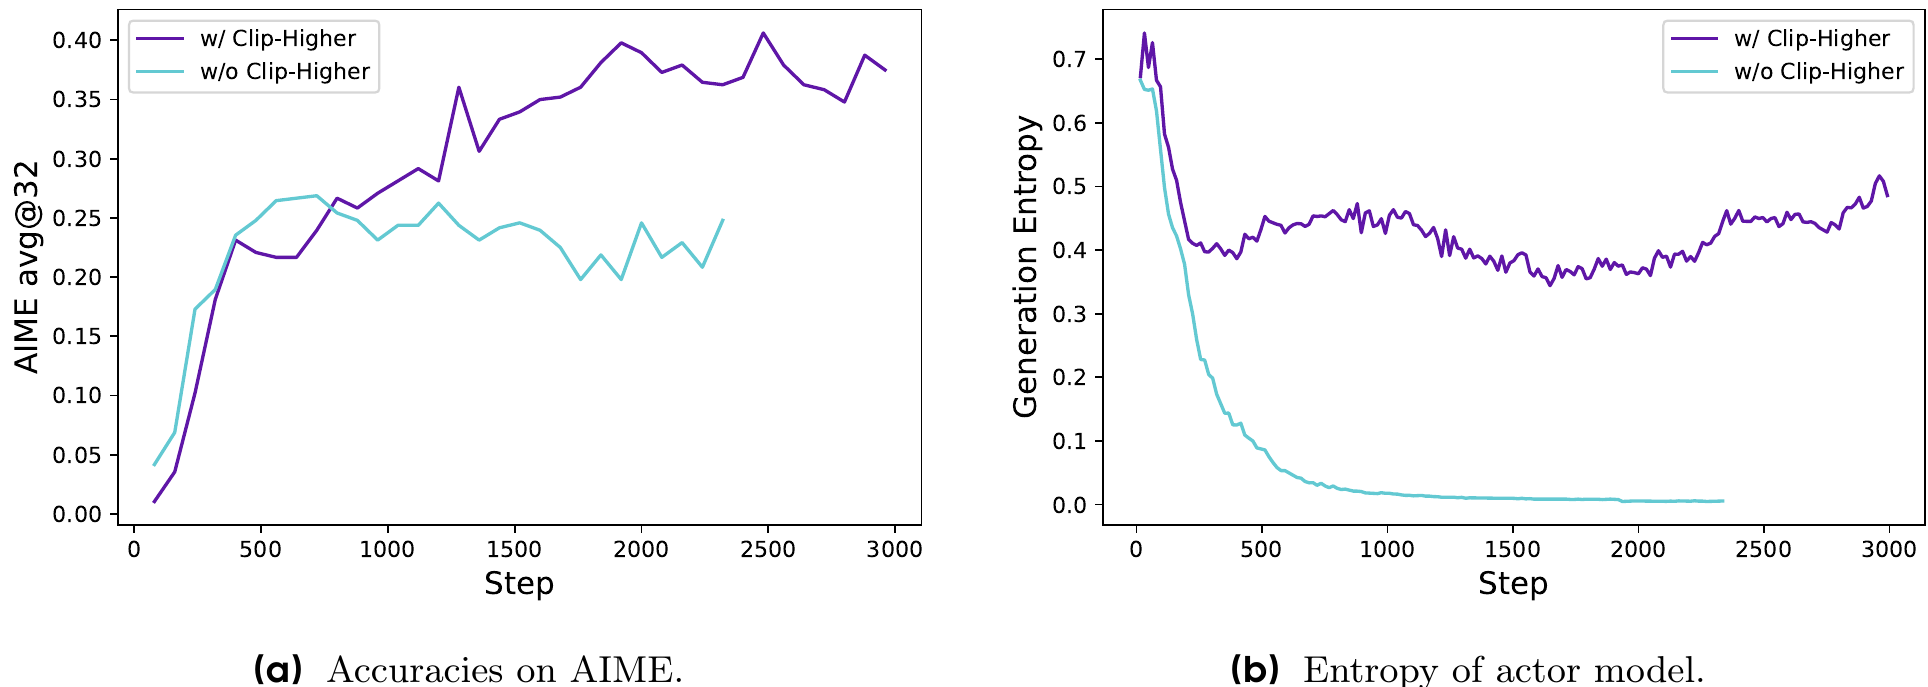
在我们使用朴素PPO [21]或GRPO [38]的初始实验中,我们观察到了熵坍缩现象:策略的熵随着训练的推进而迅速下降(图2b)。某些组的采样回复往往几乎完全相同。这表明探索有限且策略过早确定化,从而可能阻碍扩展过程。
我们提出Clip-Higher策略来解决这一问题。在裁剪近端策略优化(PPO-Clip)[21]中引入了对重要性采样比的裁剪,以限制信任域并增强强化学习的稳定性。我们发现,上裁剪会限制策略的探索,其中让一个“利用”token变得更可能要容易得多,而一个不太可能的“探索”token的概率则被限制得过紧,无法被提升。
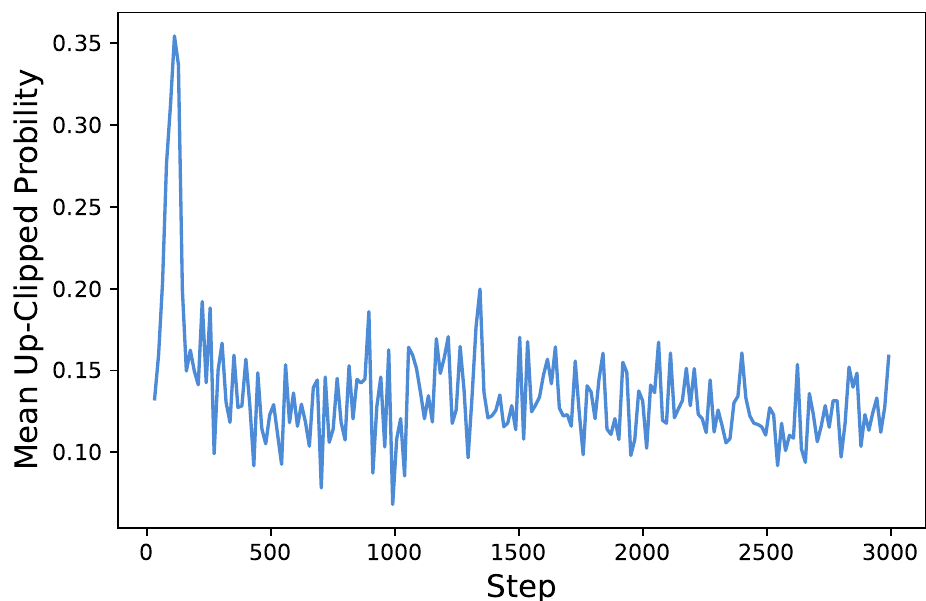
具体而言,当(大多数算法的默认值)且(系统试图提高概率)时,考虑两个概率为和0.9的动作。提高后的概率的上界分别为0.012和1.08()。这意味着,概率较高的“利用”token(例如0.9)不受约束,甚至可以变得极其更大,如0.999。相反,对于低概率的“探索”token,实现非平凡的概率提升要困难得多。根据经验,我们还观察到被上裁剪的token的平均概率很低:(图3a)。这一发现支持了我们的直觉,即上裁剪阈值确实限制了低概率“探索”token的概率提升,从而可能限制系统的探索。
遵循Clip-Higher策略,我们将下裁剪范围和上裁剪范围解耦为和,如公式10所示:
我们增大的值,为低概率token的提升留出更多空间。如图2所示,这一调整有效增强了策略的熵,并促进了更多样化样本的生成。我们保持不变,因为增大它会把这些token的概率抑制到0,导致采样空间坍缩。
3.2 多多益善:动态采样
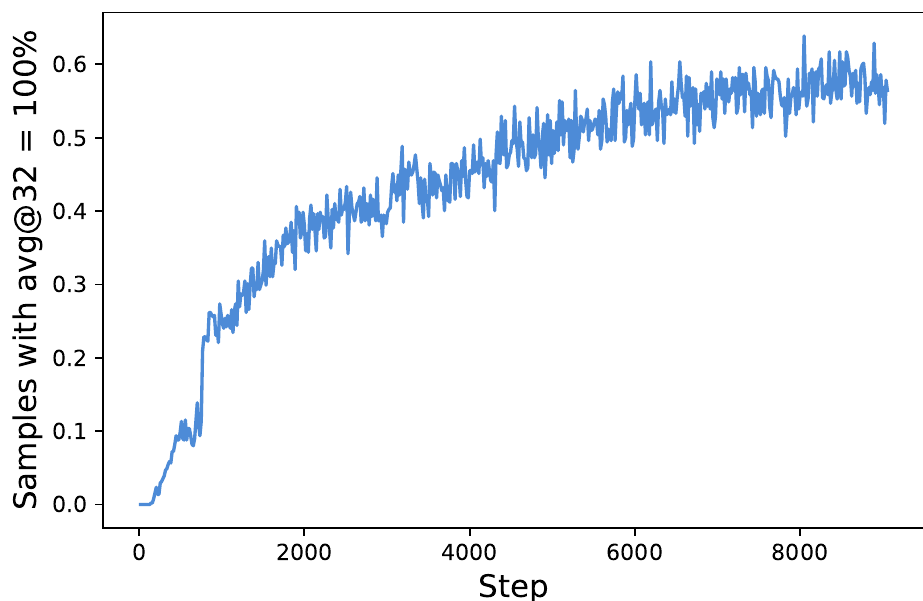
现有RL算法在某些提示的准确率等于1时会遭遇梯度递减问题。例如对于GRPO,如果某个特定提示的所有输出都正确并收到相同奖励,则该组得到的优势为零。零优势导致零策略梯度,缩小批量梯度的幅度并增加其对噪声的敏感性,从而降低样本效率。根据经验,准确率等于1的样本数量持续增加,如图3b所示。这意味着每个批次中有效提示的数量不断减少,这可能导致梯度方差增大,并削弱模型训练的梯度信号。
为此,我们提出过采样并过滤掉准确率等于1和0的提示,如公式11所示,使批次中的所有提示都具有有效梯度,并保持提示数量一致。每个批次的采样成本是动态的。在训练之前,我们持续采样,直到批次被准确率既不为0也不为1的样本完全填满。
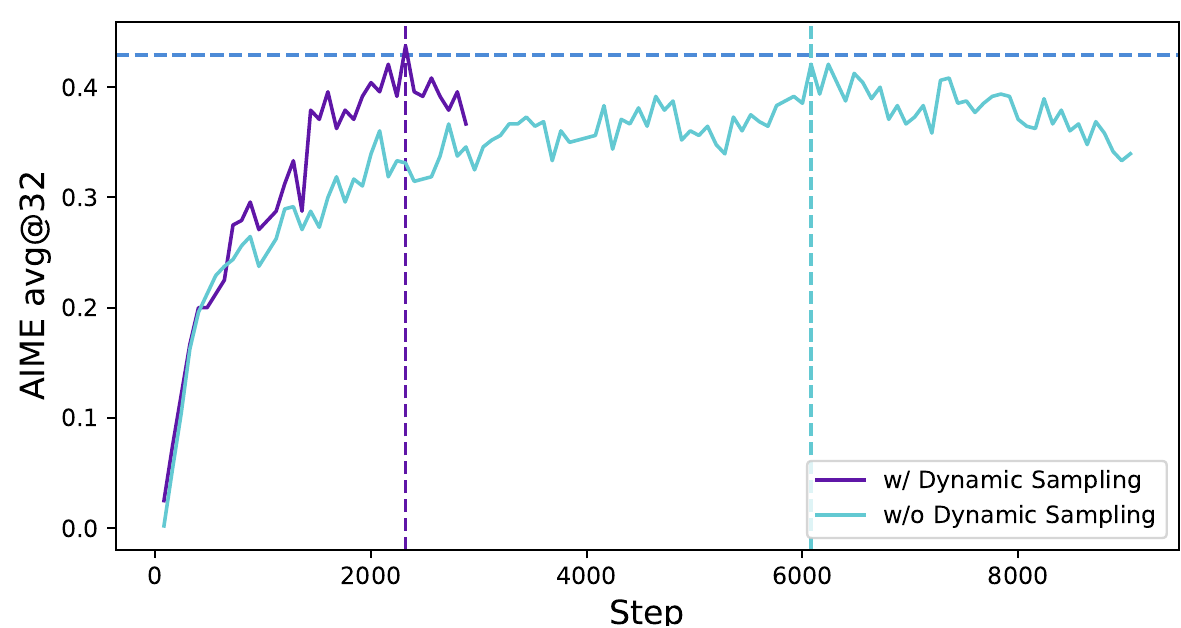
请注意,这一策略不一定会妨碍训练效率,因为如果RL系统是同步的且生成阶段未流水线化,生成时间通常由长尾样本的生成主导。此外,我们发现采用动态采样后,实验以更快的速度达到了相同性能,如图6所示。
3.3 再平衡之举:Token级策略梯度损失
原始GRPO算法采用样本级损失计算,即先对每个样本内的损失按token求平均,再跨样本聚合损失。在这种方法中,每个样本在最终损失计算中被赋予相同权重。然而,我们发现这种损失归约方式在长CoT强化学习场景中引入了若干挑战。
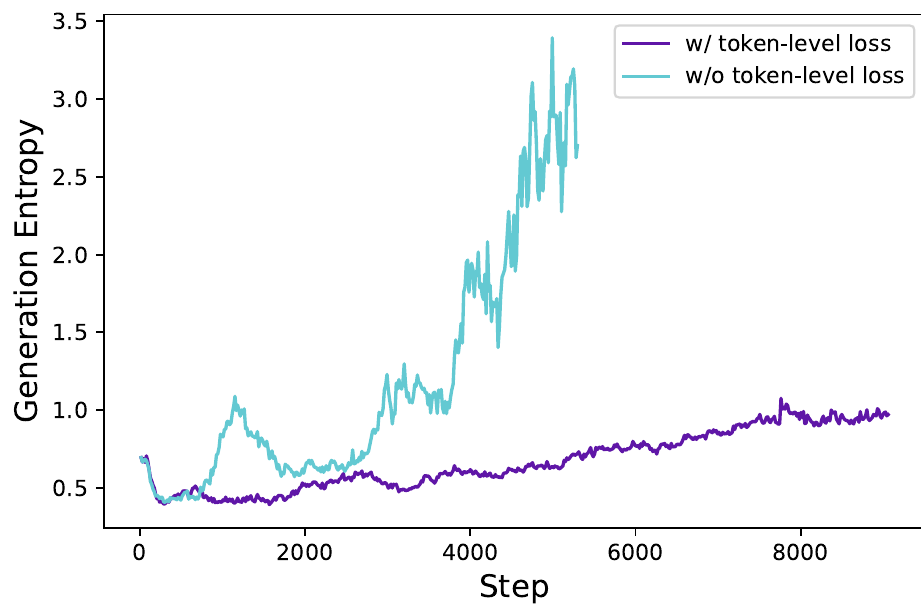
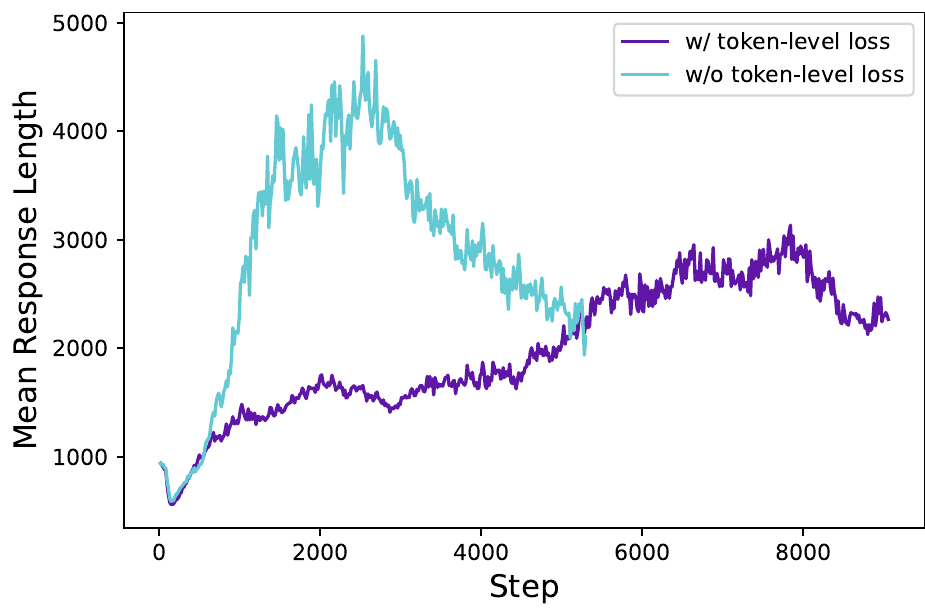
由于所有样本在损失计算中被赋予相同权重,较长回复(包含更多token)中的token对总体损失的贡献可能不成比例地偏低,这可能导致两个不利影响。首先,对于高质量的长样本,这种效应会妨碍模型学习其中与推理相关的模式。其次,我们观察到过长的样本往往表现出低质量模式,例如胡言乱语和重复词语。因此,样本级损失计算由于无法有效惩罚长样本中的这些不良模式,导致熵和回复长度出现不健康的增长,如图4a和图4b所示。
我们在长CoT强化学习场景中引入Token级策略梯度损失,以解决上述局限:
在此设置下,与较短序列相比,较长序列可以对整体梯度更新产生更大影响。此外,从单个token的角度来看,如果某种特定的生成模式能够导致奖励增加或减少,那么无论其所在回复的长度如何,它都会被同等程度地促进或抑制。
3.4 捉迷藏:过长奖励塑形
在强化学习训练中,我们通常为生成设定最大长度,超长样本会相应地被截断。我们发现,对截断样本进行不当的奖励塑造会引入奖励噪声,并严重干扰训练过程。
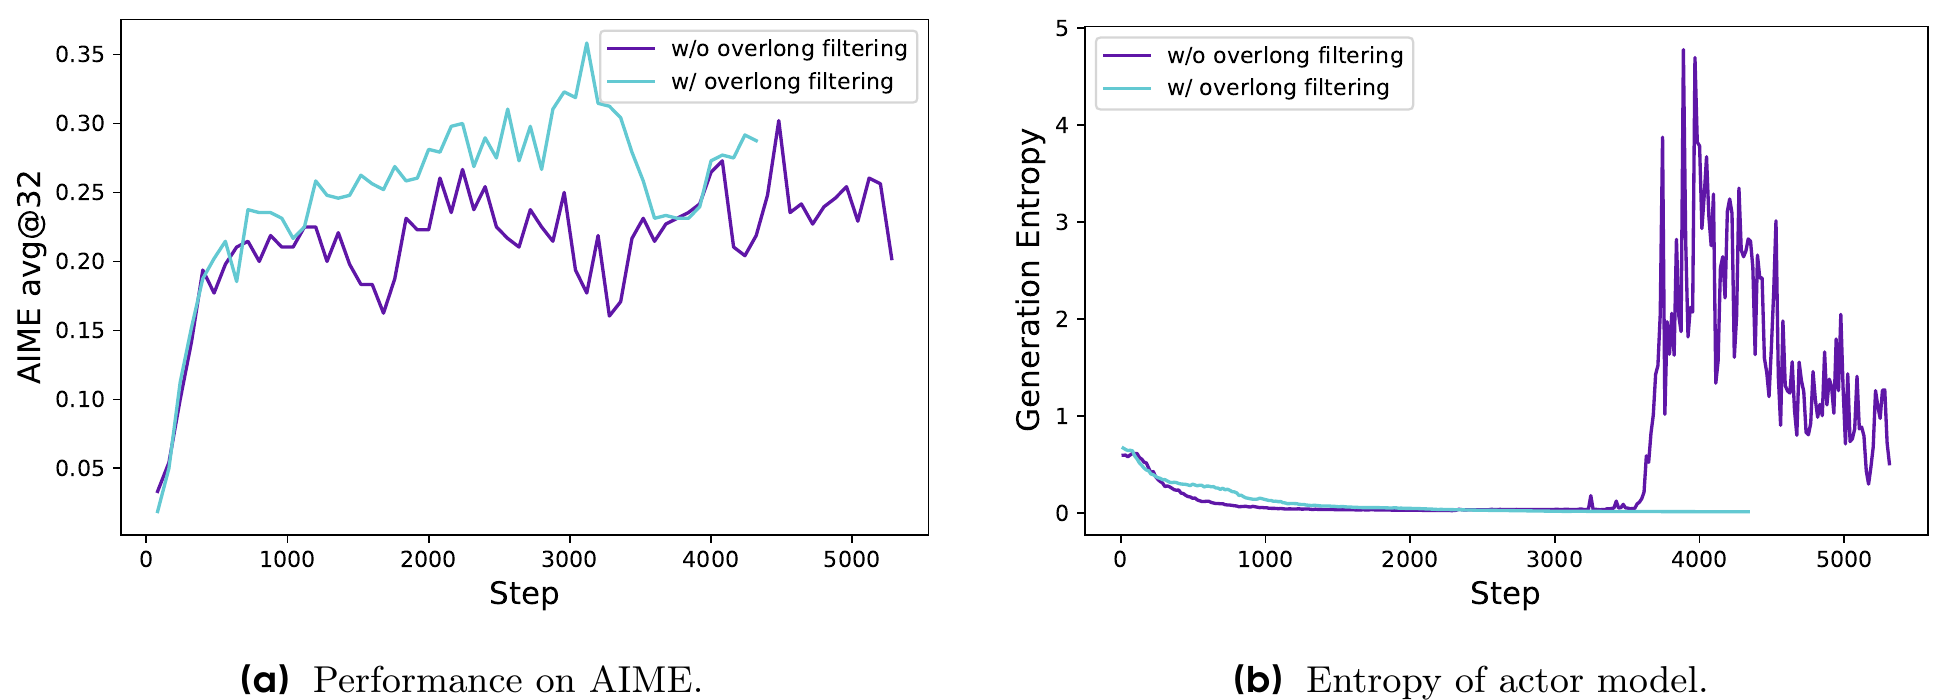
默认情况下,我们对截断样本赋予惩罚性奖励。这种做法可能会给训练过程引入噪声,因为一个合理的推理过程可能仅仅因为长度过长而受到惩罚。此类惩罚可能会使模型对其推理过程的有效性产生困惑。
为了研究这种奖励噪声的影响,我们首先采用了一种超长过滤(Overlong Filtering)策略,该策略会屏蔽截断样本的损失。我们发现,这种方法显著稳定了训练并提升了性能,如图5所示。
| 算法1 | DAPO:解耦裁剪与动态采样策略优化 |
| 输入 初始策略模型 πθ;奖励模型 R;任务提示 D;超参数 ε1ow、εhigh | |
| 1: for step = 1,...,M do | |
| 2: 从 D 中采样一个批次 Db | |
| 3: 更新旧策略模型 πθold ← πθ | |
| 4: 对每个问题 q ∈ Db,采样 G 个输出 {oi}i=1G ~ πθold(·|q) | |
| 5: 通过运行 R 为每个采样输出 oi 计算奖励 {ri}i=1G | |
| 6: 过滤掉 oi,并将剩余项加入动态采样缓冲区(动态采样公式 (11)) | |
| 7: if 缓冲区大小 nb < N: | |
| 8: continue | |
| 9: 对于缓冲区中的每个 oi,计算 oi 第 t 个 token 的 Ait,t(公式 (9)) | |
| 10: for iteration = 1, ..., μ do | |
| 11: 通过最大化 DAPO 目标(公式 (8))更新策略模型 πθ | |
| 输出 πθ |
此外,我们提出了软超长惩罚(Soft Overlong Punishment,公式13),这是一种长度感知的惩罚机制,旨在对截断样本的奖励进行塑造。具体而言,当响应长度超过预定义的最大值时,我们定义一个惩罚区间。在该区间内,响应越长,受到的惩罚越大。该惩罚被加到原始的基于规则的正确性奖励上,从而向模型发出信号,使其避免过长的响应。
3.5 数据集转换
我们的数据集通过网页抓取与人工标注相结合的方式,来源于网络和官方竞赛主页。数学数据集的答案通常以多种格式呈现,例如表达式、公式和数字,这使得设计全面的规则来解析它们颇具挑战性。为了使用规则提供准确的奖励信号,并尽量减少公式解析器引入的错误,受AIME启发,我们选择并将答案转换为易于解析的整数。例如,如果原始答案以的形式表示,我们会指示大语言模型修改题目,使预期答案变为。经过筛选和转换后,我们得到了DAPO-Math-17K数据集,该数据集包含17K个提示,每个提示都配有一个整数作为答案。
4 实验
4.1 训练细节
在本工作中,我们专门聚焦于数学任务来评估我们的算法,该算法可以很容易地迁移到其他任务。我们采用 veri 框架 [20] 进行训练。我们使用基础的 GRPO [38] 作为基线算法,并使用组奖励归一化来估计优势。
对于超参数,我们使用 AdamW [39] 优化器,恒定学习率为 ,并在 20 个 rollout 步骤上进行线性预热。对于 rollout,提示批次大小为 512,我们为每个提示采样 16 个响应。对于训练,小批次大小设置为 512,即每个 rollout 步骤进行 16 次梯度更新。对于超长奖励塑形,我们将预期最大长度设置为 16,384 个 token,并额外分配 4,096 个 token 作为软惩罚缓存。因此,生成的最大 token 数设置为 20,480 个 token。至于 Clip-Higher 机制,我们将裁剪参数 设置为 0.2,将 设置为 0.28,这有效地平衡了探索与利用之间的权衡。对于 AIME 上的评估,我们将评估集重复 32 次,并报告 avg@32 以保证结果稳定性。评估的推理超参数设置为温度 1.0 和 topp 0.7。
4.2 主要结果
在 AIME 2024 上的实验表明,DAPO 已成功地将 Qwen-32B Base 模型训练为一个强大的推理模型,其性能优于 DeepSeek 使用 R1 方法在 Qwen2.5-32B 上进行的实验。在图 1 中,我们观察到 AIME 2024 上的性能有显著提升,准确率从接近 0% 提高到 50%。值得注意的是,这一提升仅使用了 DeepSeek-R1-Zero-Qwen-32B 所需训练步骤的 50%。
我们在表 1 中详细分析了方法中每种训练技术的贡献。观察到的改进证明了这些技术在 RL 训练中的有效性,每一项都在 AIME 2024 中贡献了
| 模型 | AIME24 avg@32 |
| DeepSeek-R1-Zero-Qwen-32B | 47 |
| 朴素GRPO | 30 |
| + 超长过滤 | 36 |
| + 更高裁剪 | 38 |
| + 软超长惩罚 | 41 |
| + Token级损失 | 42 |
| + 动态采样(DAPO) | 50 |
若干准确率点。值得注意的是,在基础 GRPO 设置下,从 Qwen2.5-32B 基础模型开始训练只能达到 的准确率。
对于 token 级损失,尽管它带来的性能提升较小,但我们发现它增强了训练稳定性,并使长度增长更加健康。
当应用动态采样时,尽管由于过滤零梯度数据需要采样更多数据,但整体训练时间并未受到显著影响。如图 6 所示,尽管采样实例数量增加,但由于所需训练步骤减少,模型的收敛时间甚至缩短了。
4.3 训练动态
大型语言模型上的强化学习不仅是一个前沿研究方向,而且本质上是一个复杂的系统工程挑战,其特征是各子系统之间相互依赖。对任何单个子系统的修改都可能在整个系统中传播,由于这些组件之间错综复杂的相互作用,从而导致不可预见的后果。即使是初始条件中看似微小的变化,例如数据和超参数的变化,也可能通过迭代强化学习过程被放大,从而在结果中产生巨大偏差。这种复杂性常常使研究人员面临两难境地:即使经过细致分析和有充分依据的预期,认为某项修改会改善训练过程的特定方面,实际结果也常常偏离预期轨迹。因此,在实验过程中监测关键中间结果对于迅速识别差异来源并最终改进系统至关重要。
- 生成响应的长度是与训练稳定性和性能密切相关的指标,如图 7a 所示。长度的增加为模型提供了更大的探索空间,使更复杂的推理行为能够被采样,并通过训练逐步得到强化。然而,需要注意的是,长度在训练过程中并不总是保持持续上升趋势。在一些相当长的时期内,它可能呈现停滞甚至下降的趋势,这一点也在 [2] 中得到了证明。我们通常将长度与验证准确率结合使用,作为判断实验是否恶化的指标。
- 训练过程中奖励的动态一直是强化学习中关键的监测指标之一,如图 7b 所示。在我们的大多数实验中,奖励上升的趋势相对稳定,并不会因实验设置的调整而显著波动或下降。这表明,在给定可靠奖励信号的情况下,语言模型能够稳健地拟合训练集的分布。然而,我们发现训练集上的最终奖励通常与验证集上的准确率相关性很小,这表明对训练集存在过拟合。
- Actor 模型的熵和生成概率与模型的探索能力有关,是我们在实验中密切监测的关键指标。直观上,模型的熵需要保持在适当范围内。熵过低表明概率分布过于尖锐,导致探索能力丧失。相反,
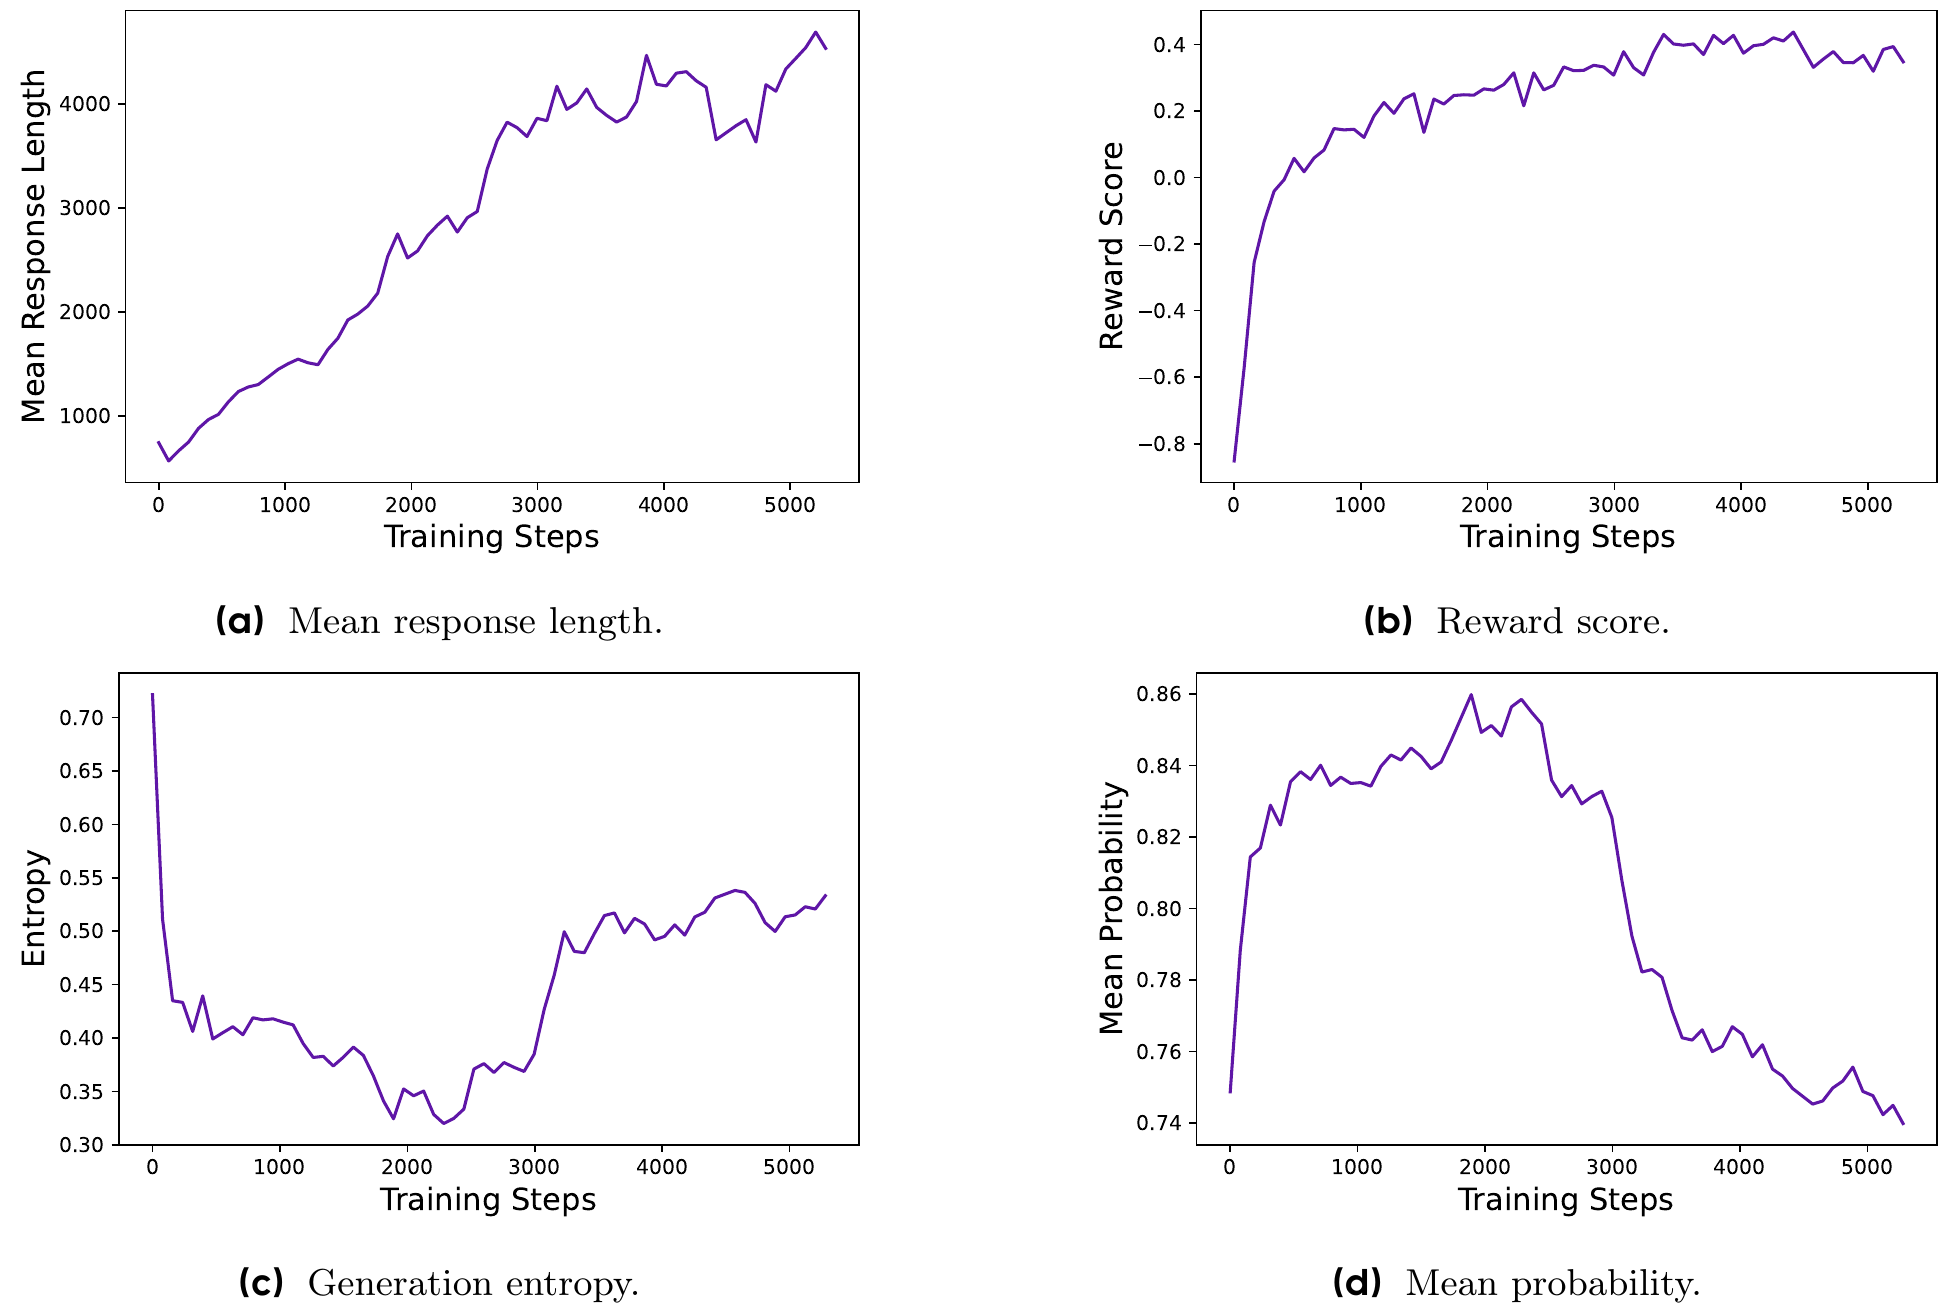
熵过高通常与过度探索的问题相关,例如乱码和重复生成。对于生成概率,情况正好相反。如第 3.1 节所示,通过应用 Clip-Higher 策略,我们有效解决了熵崩溃的问题。在后续实验中,我们发现保持熵缓慢上升的趋势有利于模型性能的提升,如图 7c 和图 7d 所示。
4.4 案例研究
在 RL 训练过程中,我们观察到一个有趣的现象:actor 模型的推理模式会随时间动态演化。具体而言,该算法不仅强化了有助于正确解决问题的现有推理模式,还逐渐产生了最初并不存在的全新推理模式。这一发现揭示了 RL 算法的适应性和探索能力,并为模型的学习机制提供了新的见解。
例如,在模型训练的早期阶段,几乎不存在对先前推理步骤进行检查和反思的情况。然而,随着训练推进,模型表现出明显的反思和回溯行为,如表 2 所示。这一观察为进一步探索解释 RL 过程中推理能力的涌现提供了启示,我们将其留待未来研究。
5 结论
在本文中,我们发布了一个用于大规模 LLM RL 的完全开源系统,包括算法、代码基础设施和数据集。该系统实现了最先进的大规模 LLM RL 性能(使用 Qwen-32B 预训练模型在 AIME 上达到 50)。我们提出了解耦裁剪与动态采样策略
问题:
已知四面体 的底面 是等边三角形,点 在面 上的投影 是 的垂心,二面角 为 ,且 ,求该四面体的体积。答案的形式为 ,因此给出 的值。
回答:
让我们考虑给定问题:我们需要确定……接下来,设 的坐标为 。由于 ,距离公式给出 ,因此我们可以写出 。现在,记住 是……的正交投影。然而,等一下,让我们以更有思考性的几何方式重新思考涉及平面的二面角。考虑平面 ,它完全位于 xy 坐标平面上(因为 )。设平面 。点 垂直投影到平面 上落在 。直线 ……
表2 强化学习优化(DAPO)算法中反思行为的涌现,并引入4项关键技术,使强化学习在长链式思维(long-CoT)强化学习场景中强大有效且高效。此外,通过开源训练代码和数据集,我们为更广泛的研究社区和社会提供了可扩展强化学习解决方案的实用访问途径,使所有人都能从中受益。
贡献
项目负责人
Qiying
算法
Qiying 、 Zheng Zhang 、 Ruofei Zhu 、 Yufeng Yuan 、 Xiaochen Zuo 、 Yu Yue
基础设施\*
Weinan Dai 、 Tiantian Fan 、 Gaohong Liu 、 Juncai Liu 、 Lingjun Liu 、 Xin Liu 、 Haibin Lin 、 Zhiqi Lin 、 Bole Ma 、 Guangming Sheng 、 Yuxuan Tong 、 Qiying Yu 、 Chi Zhang 、 Mofan Zhang 、 Ru Zhang 、 Wang Zhang 、 Hang Zhu 、 Jinhua Zhu
\*姓氏按字母顺序排列
数据集
Jiaze Chen 、 Jiangjie Chen 、 Chengyi Wang 、 Hongli Yu 、 Yuxuan Song 、 Xiangpeng Wei 、 Qiying
监督
Hao Zhou 、 Jingjing Liu 、 Wei- Ying Ma 、 Ya- Qin Zhang 、 Lin Yan 、 Mu Qiao 、 Yonghui Wu 、 Mingxuan Wang
所属机构
ByteDance Seed
清华大学智能产业研究院(AIR)
香港大学
清华大学AIR与ByteDance Seed联合实验室(SIA- Lab)
致谢
我们感谢Zhengyin Du、Shengding Hu、Kai Shen、Tianyang Zhan、Zhen Xiao、Renjie Zheng、Li Han、Kaihua Jiang以及ByteDance的其他同事对DAPO项目的支持。
参考文献
[1] OpenAI. Learning to reason with llms, 2024.
[2] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[3] OpenAI。GPT4技术报告。arXiv预印本arXiv:2303.08774,2023。
[4] Anthropic。Claude 3.5 sonnet,2024。
[5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, 等。语言模型是少样本学习器。Advances in neural information processing systems,33:1877-1901,2020。
[6] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, 等。Palm:使用Pathways扩展语言建模。Journal of Machine Learning Research,24(240):1-113,2023。
[7] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, 等。Deepseek-v3技术报告。arXiv预印本arXiv:2412.19437,2024。
[8] XAI。Grok 3 beta——推理智能体时代,2024。
[9] Google DeepMind。Gemini 2.0 flash thinking,2024。
[10] Qwen。Qwq-32b:拥抱强化学习的力量,2024。
[11] Kimi Team, Angang Du, Bofei Gao, Bowei Xing, Changjiu Jiang, Cheng Chen, Cheng Li, Chenjun Xiao, Chenzhuang Du, Chonghua Liao, 等。Kimi k1.5:使用LLM扩展强化学习。arXiv预印本arXiv:2501.12599,2025。
[12] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, 等。Qwen2.5技术报告。arXiv预印本arXiv:2412.15115,2024。
[13] Zhipeng Chen, Yingqian Min, Beichen Zhang, Jie Chen, Jinhao Jiang, Daixuan Cheng, Wayne Xin Zhao, Zheng Liu, Xu Miao, Yang Lu, 等。关于激发和改进类RL推理模型的实证研究。arXiv预印本arXiv:2503.04548,2025。
[14] Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, and Heung-Yeung Shum Xiangyu Zhang。Open-reasoner-zero:一种在基础模型上扩展强化学习的开源方法。https://github.com/Open-Reasoner-Zero/Open-Reasoner-Zero,2025。
[15] Jian Hu。Reinforce++:一种简单高效的对齐大语言模型方法。arXiv预印本arXiv:2501.03262,2025。
[16] Ganqu Cui, Lifan Yuan, Zefan Wang, Hanbin Wang, Wendi Li, Bingxiang He, Yuchen Fan, Tianyu Yu, Qixin Xu, Weize Chen, 等。通过隐式奖励进行过程强化。arXiv预印本arXiv:2502.01456,2025。
[17] Jung Hyun Lee, June Yong Yang, Byeongho Heo, Dongyoon Han, and Kang Min Yoo。用于增强大语言模型数学推理能力的 token 监督价值模型。arXiv预印本arXiv:2407.12863,2024。
[18] Amirhossein Kazemnejad, Milad Aghajohari, Eva Portelance, Alessandro Sordoni, Siva Reddy, Aaron Courville, and Nicolas Le Roux。Vineppo:通过精细化的信用分配释放LLM推理的RL潜力。arXiv预印本arXiv:2410.01679,2024。
[19] Yufeng Yuan, Yu Yue, Ruofei Zhu, Tiantian Fan, and Lin Yan。PPO在长CoT中崩溃的背后是什么?价值优化掌握着秘密。arXiv预印本arXiv:2503.01491,2025。
[20] Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, and Chuan Wu。Hybridflow:一个灵活高效的RLHF框架。arXiv预印本arXiv:2409.19256,2024。
[21] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov。近端策略优化算法。arXiv预印本arXiv:1707.06347,2017。
[22] John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, and Pieter Abbeel。使用广义优势估计的高维连续控制,2018。
[23] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F Christiano, Jan Leike, and Ryan Lowe。通过人类反馈训练语言模型遵循指令。In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, and A. Oh, editors, Advances in Neural Information Processing Systems,volume 35,pages 27730-27744。Curran Associates, Inc.,2022。
[24] Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, and Dan Mane。AI安全中的具体问题,2016。
[25] Tom Everitt, Victoria Krakovna, Laurent Orseau, Marcus Hutter, and Shane Legg。带有 corrupted reward channel 的强化学习,2017。
[26] Victoria Krakovna, Jonathan Uesato, Vladimir Mikulik, Matthew Rahtz, Tom Everitt, Ramana Kumar, Zac Kenton, Jan Leike, and Shane Legg。规范博弈:AI创造力的另一面,2020。
[27] Tom Everitt, Marcus Hutter, Ramana Kumar, and Victoria Krakovna。强化学习中的奖励篡改问题与解决方案:因果影响图视角,2021。
[28] Leo Gao, John Schulman, and Jacob Hilton。奖励模型过度优化的缩放定律,2022。
[29] Lilian Weng。强化学习中的奖励黑客。lilianweng.github.io,Nov 2024。
[30] Stanislas Polu and Ilya Sutskever。用于自动定理证明的生成式语言建模,2020。
[31] Trieu H Trinh, Yuhuai Wu, Quoc V Le, He He, and Thang Luong。无需人类演示求解奥林匹克几何问题。Nature,625(7995):476-482,2024。
[32] Trieu Trinh and Thang Luong。Alphageometry:一个奥林匹克级别的几何AI系统,2024。
[33] AlphaProof and AlphaGeometry Teams。AI达到银牌标准解决国际数学奥林匹克问题,2024。
[34] Hung Le, Yue Wang, Akhilesh Deepak Gotmare, Silvio Savarese, and Steven Chu Hong Hoi。Coderl:通过预训练模型和深度强化学习掌握代码生成。Advances in Neural Information Processing Systems,35:21314-21328,2022。
[35] Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao。Reflexion:具有言语强化学习的语言智能体,2023。
[36] Xinyun Chen, Maxwell Lin, Nathanael Schärli, and Denny Zhou。教导大语言模型自我调试,2023。
[37] Jonas Gehring, Kunhao Zheng, Jade Copet, Vegard Mella, Quentin Carbonneaux, Taco Cohen, and Gabriel Synnaeve。Rlcf:通过强化学习将代码LLM建立在执行反馈之上,2025。
[38] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, YK Li, Y Wu, and Daya Guo。Deepseekmath:推动开放语言模型数学推理的极限。arXiv预印本arXiv:2402.03300,2024。
[39] Ilya Loshchilov and Frank Hutter. 解耦权重衰减正则化。见 International Conference on Learning Representations,2019。
附录
A 数据集变换
这里是一个数据变换的示例,我们展示了原始问题、变换后的问题以及变换过程中的模型输出(原始内容为 markdown 文本,已为可读性进行渲染)。
为确保模型能够高精度地完成此任务,我们的目标是让它在避免幻觉的同时进行全面的推理。我们通过提供一个清晰的思维框架来鼓励周密推理,从而实现这一目标。具体而言,我们采用思维链(Chain of Thought,CoT)推理以及四个明确定义的步骤:提取答案格式、改写问题陈述、求解修改后的问题并提供整数作为最终答案。对于每一步,我们提供少样本解决方案或详细指南来引导模型的推理。
通过这种方法,我们观察到在大多数情况下,LLM 能够生成格式和质量均令人满意的重构。
原始问题
设 和 为实数,使得 。求 的最小可能值。答案:
变换后的问题
设 和 为实数,使得 。求 的最小可能值。原始答案的形式为 ,其中 、 和 为整数。请找出 的值。答案:19
模型输出(Markdown 文本)
变换思考过程
该问题的原始答案是代数表达式 。我们需要将其转换为整数形式。首先,注意该答案由一个整数部分和一个平方根项组成。根据给定规则,我们用待定系数替换整数和平方根分量。原始问题使用 和 作为变量,因此我们选择其他字母作为待定系数。我们将答案表示为 的形式,并要求学生求出 。
答案格式
转化后的问题
设 和 为实数,使得 。求 的最小可能值。原答案的形式为 ,其中 、 和 为整数。请找出 的值。
转化后问题的答案计算
原答案为:。要求的形式为:。匹配系数得:,,。最终结果为:。
最终答案
B 补充案例
问题:
在 Aimeville 的 900 名居民中,有 195 人拥有一枚钻石戒指,367 人拥有一套高尔夫球杆,562 人拥有一把园艺铲。此外,这 900 名居民每人都拥有一袋糖果心。有 437 名居民恰好拥有这些东西中的两样,有 234 名居民恰好拥有这些东西中的三样。求 Aimeville 中拥有这四样东西的居民人数。
回答:
逐步解答:
1. 让我们定义以下变量:
设 为拥有钻石戒指的居民集合。
设 为拥有一套高尔夫球杆的居民集合。
设 为拥有一把园艺铲的居民集合。
设 为拥有一袋糖果心的居民集合。由于全部 900 名居民都拥有一袋糖果心,
设 表示恰好拥有 4 件物品中 件的居民人数。
让我们对 4 个集合 的并集使用容斥原理
...
由于 ,即拥有全部四件物品的人数,必须是整数,我们当前的方法需要从拥有不同物品组合的人数的组合计数角度重新考虑。
我们可以不使用容斥原理直接计算,而是使用另一种方法,涉及拥有物品 、、 和 组合的人数。
设 为在 、、 中恰好拥有 件物品的人数(不包括每个人都拥有的物品 )。
那么,在 、、 和 中恰好拥有 件物品的总人数可以分解为:
...
表 3 反思性行为出现的一个案例。