用自注意力取代循环与卷积,Transformer 由此诞生。这篇 2017 年 NIPS 论文开启了现代大语言模型,全文免费在线阅读。
Attention Is All You Need
在提供适当署名的情况下,Google特此授予许可,允许复制本文中的表格和图片,仅用于新闻或学术作品。
注意力就是你所需要的一切
*Ashish Vaswani Google Brain avaswani@google.com
*Noam Shazeer Google Brain noam@google.com
*Niki Parmar Google Research nikip@google.com
*Jakob Uszkoreit Google Research usz@google.com
*Llion Jones Google Research llion@google.com
*Aidan N. Gomez† University of Toronto aidan@cs.toronto.edu
*Lukasz Kaiser Google Brain lukaszkaiser@google.com
*Illia Polosukhin† illia.polosukhin@gmail.com
摘要
主流的序列转导模型基于复杂的循环或卷积神经网络,包含编码器和解码器。性能最佳的模型还通过注意力机制连接编码器和解码器。我们提出了一种新的简单网络架构——Transformer,它完全基于注意力机制,彻底摒弃了循环和卷积。在两个机器翻译任务上的实验表明,这些模型在质量上更优,同时更具并行性,并且所需的训练时间显著减少。我们的模型在 WMT 2014 英德翻译任务上达到 28.4 BLEU,比现有最佳结果(包括集成模型)高出 2 BLEU 以上。在 WMT 2014 英法翻译任务上,我们的模型在八块 GPU 上训练 3.5 天后,建立了新的单模型最优 BLEU 分数 41.8,仅为文献中最佳模型训练成本的一小部分。我们通过将 Transformer 成功应用于大规模和有限训练数据下的英语成分句法分析,表明它能很好地泛化到其他任务。
1 引言
循环神经网络,特别是长短期记忆网络 [13] 和门控循环 [7] 神经网络,已被牢固确立为序列建模和转导问题(如语言建模和机器翻译)中的最先进方法 [35] [2] [5]。此后,大量工作不断推动循环语言模型和编码器-解码器架构的边界 [38] [24] [15]。
循环模型通常沿输入和输出序列的符号位置来分解计算。将位置与计算时间步对齐,它们生成隐藏状态序列 ,作为前一隐藏状态 和位置 的输入的函数。这种固有的顺序性阻碍了训练样本内的并行化,这在序列较长时变得至关重要,因为内存限制限制了跨样本的批处理。近期工作通过因子分解技巧 [21] 和条件计算 [32] 在计算效率上取得了显著改进,后者同时还提升了模型性能。然而,顺序计算的根本性约束依然存在。
注意力机制已成为各种任务中引人注目的序列建模和转导模型不可或缺的一部分,它允许对依赖关系进行建模,而不论其在输入或输出序列中的距离 [2] [19]。然而,除少数情况外 [27],这种注意力机制都是与循环网络结合使用的。
在这项工作中,我们提出 Transformer,这是一种摒弃循环、转而完全依赖注意力机制来绘制输入和输出之间全局依赖关系的模型架构。Transformer 允许显著更多的并行化,并且在八块 P100 GPU 上仅训练十二小时即可达到翻译质量的新最先进水平。
2 背景
减少顺序计算的目标也构成了扩展神经 GPU [16]、ByteNet [18] 和 ConvS2S [9] 的基础,它们都使用卷积神经网络作为基本构建块,为所有输入和输出位置并行计算隐藏表示。在这些模型中,关联来自两个任意输入或输出位置的信号所需的操作数随位置之间的距离增长,ConvS2S 为线性增长,ByteNet 为对数增长。这使得学习远距离位置之间的依赖关系更加困难 [12]。在 Transformer 中,这被减少为常数数量的操作,尽管代价是由于对注意力加权位置取平均而降低了有效分辨率,我们通过第 [3.2] 节中描述的多头注意力来抵消这一效应。
自注意力,有时称为内部注意力,是一种将单个序列的不同位置关联起来以计算序列表示的注意力机制。自注意力已成功应用于多种任务,包括阅读理解、抽象摘要、文本蕴涵以及学习任务无关的句子表示 [4] [27] [28] [22]。
端到端记忆网络基于循环注意力机制而非序列对齐的循环,并已被证明在简单语言问答和语言建模任务上表现良好 [34]。
然而,据我们所知,Transformer 是第一个完全依赖自注意力来计算其输入和输出表示、而不使用序列对齐的 RNN 或卷积的转导模型。在以下各节中,我们将描述 Transformer,阐述自注意力的动机,并讨论其相对于 [17] [18] 和 [9] 等模型的优势。
3 模型架构
大多数具有竞争力的神经序列转导模型都具有编码器-解码器结构 [5] [2] [35]。这里,编码器将符号表示的输入序列 映射为连续表示序列 。给定 ,解码器随后逐个元素地生成符号的输出序列 。在每一步,模型都是自回归的 [10],在生成下一个符号时,将先前生成的符号作为额外输入消耗。
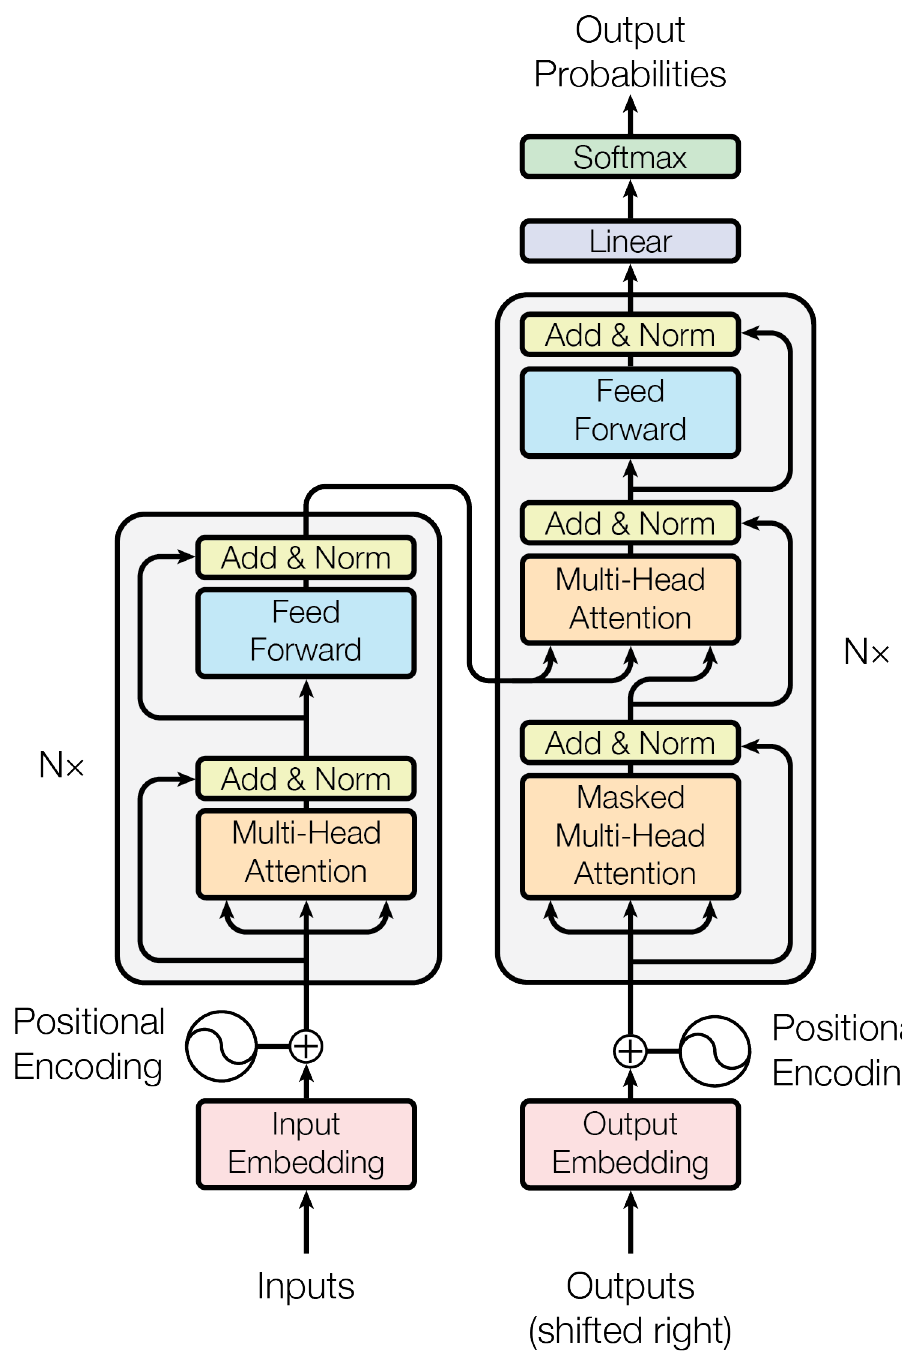
Transformer 遵循这一整体架构,对编码器和解码器均使用堆叠的自注意力和逐点全连接层,分别如图 [1] 的左半部分和右半部分所示。
3.1 编码器和解码器堆栈
编码器:编码器由 个相同层组成的堆栈构成。每层有两个子层。第一个是多头自注意力机制,第二个是简单的逐位置全连接前馈网络。我们对这两个子层中的每一个都采用残差连接 [11],随后进行层归一化 [1]。也就是说,每个子层的输出为 ,其中 是子层本身实现的函数。为了便于这些残差连接,模型中的所有子层以及嵌入层都产生维度为 的输出。
解码器:解码器同样由 个相同层组成的堆栈构成。除了每个编码器层中的两个子层外,解码器还插入了第三个子层,该子层对编码器堆栈的输出执行多头注意力。与编码器类似,我们对每个子层都采用残差连接,随后进行层归一化。我们还修改了解码器堆栈中的自注意力子层,以防止位置关注后续位置。这种掩码,加上输出嵌入偏移一个位置这一事实,确保了对位置 的预测只能依赖于位置小于 的已知输出。
3.2 注意力
注意力函数可以描述为将查询和一组键-值对映射到输出,其中查询、键、值和输出都是向量。输出被计算为
值的加权和,其中分配给每个值的权重由查询与相应键的兼容性函数计算。
3.2.1 缩放点积注意力
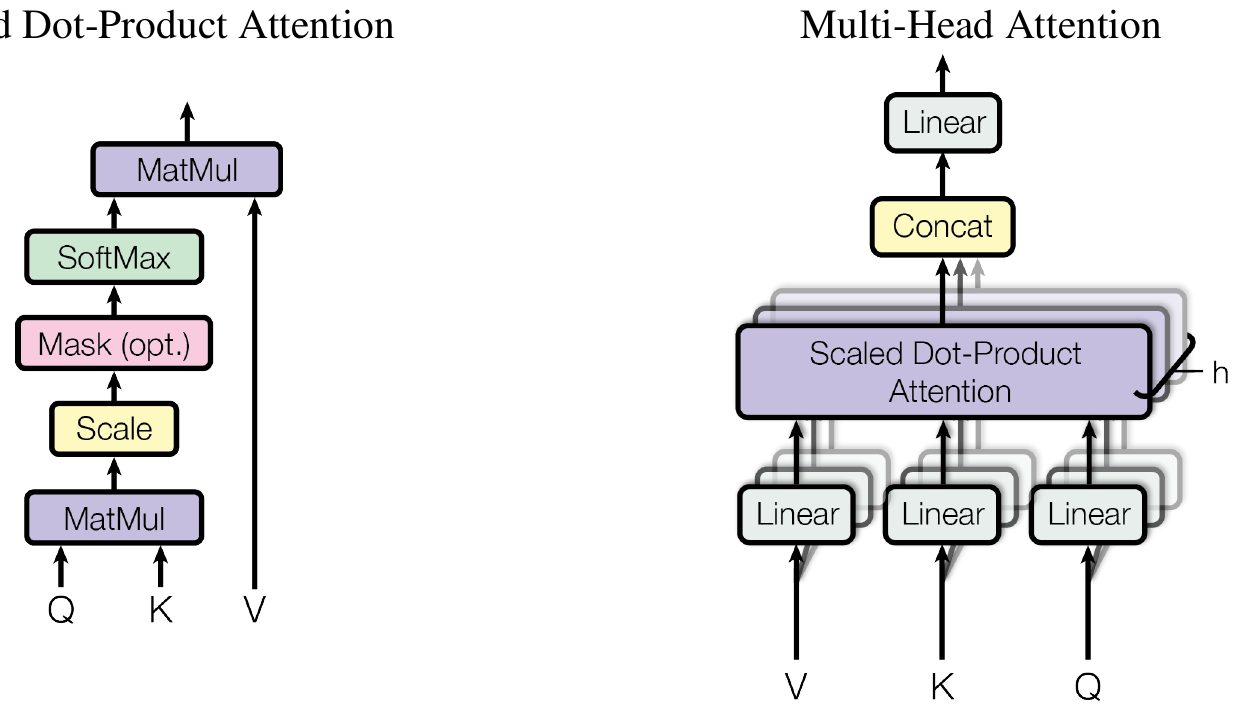
我们将我们的特定注意力称为“缩放点积注意力”(图 2)。输入由维度为 的查询和键,以及维度为 的值组成。我们计算查询与所有键的点积,将每个点积除以 ,并应用 softmax 函数以获得值上的权重。
在实践中,我们同时对一组查询计算注意力函数,将这些查询打包成一个矩阵 。键和值也分别打包成矩阵 和 。我们将输出矩阵计算为:
两种最常用的注意力函数是加性注意力²和点积(乘性)注意力。点积注意力与我们的算法相同,只是缺少了缩放因子 。加性注意力使用一个具有单隐藏层的前馈网络来计算兼容性函数。虽然两者在理论复杂度上相似,但在实践中,点积注意力要快得多且更加节省空间,因为它可以使用高度优化的矩阵乘法代码来实现。
对于较小的 值,两种机制的表现相似,而对于较大的 值,加性注意力在没有缩放的情况下优于点积注意力[3]。我们推测,对于较大的 值,点积的幅值会变大,将softmax函数推入其梯度极小的区域。为了抵消这一效应,我们将点积缩放 。
3.2.2 多头注意力
我们没有使用 维的键、值和查询来执行单一的注意力函数,而是发现将查询、键和值分别用不同的、可学习的线性投影线性投影 次到 、 和 维是有益的。然后,在这些投影后的查询、键和值版本上,我们并行地执行注意力函数,产生 维的输出值。这些输出值被拼接起来并再次进行投影,得到最终的值,如图2所示。
多头注意力允许模型在不同位置联合关注来自不同表示子空间的信息。使用单个注意力头时,平均化会抑制这一点。
其中投影为参数矩阵 、、 和
在这项工作中,我们采用个并行注意力层,或称注意力头。对于每个注意力头,我们使用。由于每个头的维度降低,总计算成本与全维度的单头注意力相似。
3.2.3 注意力在我们模型中的应用
Transformer以三种不同方式使用多头注意力:
- 在“编码器-解码器注意力”层中,查询来自前一个解码器层,而记忆键和值来自编码器的输出。这允许解码器中的每个位置关注输入序列中的所有位置。这模仿了序列到序列模型(如[38] [2] [9])中典型的编码器-解码器注意力机制。
- 编码器包含自注意力层。在自注意力层中,所有键、值和查询都来自同一位置,在此情况下,即编码器中前一层的输出。编码器中的每个位置可以关注编码器前一层中的所有位置。
- 类似地,解码器中的自注意力层允许解码器中的每个位置关注解码器中直到并包括该位置的所有位置。我们需要防止解码器中的向左信息流,以保持自回归特性。我们通过在缩放点积注意力内部实现这一点,即屏蔽掉(设置为)softmax输入中对应于非法连接的所有值。参见图[2]
3.3 逐位置前馈网络
除了注意力子层之外,我们编码器和解码器中的每一层都包含一个全连接前馈网络,该网络分别且相同地应用于每个位置。这由两个线性变换组成,中间有一个ReLU激活。
虽然线性变换在不同位置上是相同的,但它们在层与层之间使用不同的参数。另一种描述方式是将其视为两个核大小为1的卷积。输入和输出的维度为,内层维度为。
3.4 嵌入与Softmax
与其他序列转导模型类似,我们使用学习到的嵌入将输入标记和输出标记转换为维度为的向量。我们还使用通常的学习线性变换和softmax函数将解码器输出转换为预测的下一个标记概率。在我们的模型中,我们在两个嵌入层和softmax前的线性变换之间共享相同的权重矩阵,类似于[30]。在嵌入层中,我们将这些权重乘以。
| 层类型 | 每层复杂度 | 顺序操作数 | 最大路径长度 |
| 自注意力 | O(n²·d) | O(1) | O(1) |
| 循环 | O(n·d²) | O(n) | O(n) |
| 卷积 | O(k·n·d²) | O(1) | O(logk(n)) |
| 自注意力(受限) | O(r·n·d) | O(1) | O(n/r) |
3.5 位置编码
由于我们的模型不包含循环和卷积,为了使模型能够利用序列的顺序,我们必须注入一些关于序列中标记的相对或绝对位置的信息。为此,我们在编码器和解码器堆栈底部的输入嵌入中添加“位置编码”。位置编码与嵌入具有相同的维度,以便两者可以相加。位置编码有许多选择,包括学习的和固定的[9]。
在这项工作中,我们使用不同频率的正弦和余弦函数:
其中是位置,是维度。也就是说,位置编码的每个维度对应一个正弦波。波长形成从到的几何级数。我们选择这个函数是因为我们假设它能让模型容易地学习按相对位置进行关注,因为对于任何固定偏移,可以表示为的线性函数。
我们还尝试使用学习的位置嵌入[9],并发现两个版本产生了几乎相同的结果(见表3第(E)行)。我们选择正弦版本,因为它可能允许模型外推到比训练期间遇到的序列长度更长的序列。
4 为什么使用自注意力
在本节中,我们将自注意力层的各个方面与常用于将一个变长符号表示序列映射到另一个等长序列的循环层和卷积层进行比较,其中,例如典型序列转导编码器或解码器中的隐藏层。为了说明我们使用自注意力的动机,我们考虑三个 desiderata。
一个是每层的总计算复杂度。另一个是可以并行化的计算量,以所需的最小顺序操作数来衡量。
第三个是网络中长距离依赖之间的路径长度。学习长距离依赖是许多序列转导任务中的关键挑战。影响学习此类依赖能力的一个关键因素是前向和后向信号必须在网络中遍历的路径长度。输入和输出序列中任意位置组合之间的这些路径越短,就越容易学习长距离依赖[12]。因此,我们还比较了由不同层类型组成的网络中任意两个输入和输出位置之间的最大路径长度。
如表1所述,自注意力层用常数数量的顺序执行操作连接所有位置,而循环层需要个顺序操作。在计算复杂度方面,当序列长度小于表示维度时,自注意力层比循环层更快,这在机器翻译中最先进模型所使用的句子表示(如词片[38]和字节对[31]表示)中通常是这种情况。为了提高涉及非常长序列的任务的计算性能,可以将自注意力限制为仅考虑输入序列中以相应输出位置为中心、大小为的邻域。这将使最大路径长度增加到。我们计划在未来的工作中进一步研究这种方法。
核宽度为的单个卷积层不会连接所有输入和输出位置对。要做到这一点,在连续核的情况下需要个卷积层的堆叠,或在膨胀卷积[18]的情况下需要,这增加了网络中任意两个位置之间最长路径的长度。卷积层通常比循环层更昂贵,高出倍。然而,可分离卷积[6]将复杂度大大降低到。然而,即使,可分离卷积的复杂度也等于自注意力层和逐点前馈层的组合,这就是我们模型中采用的方法。
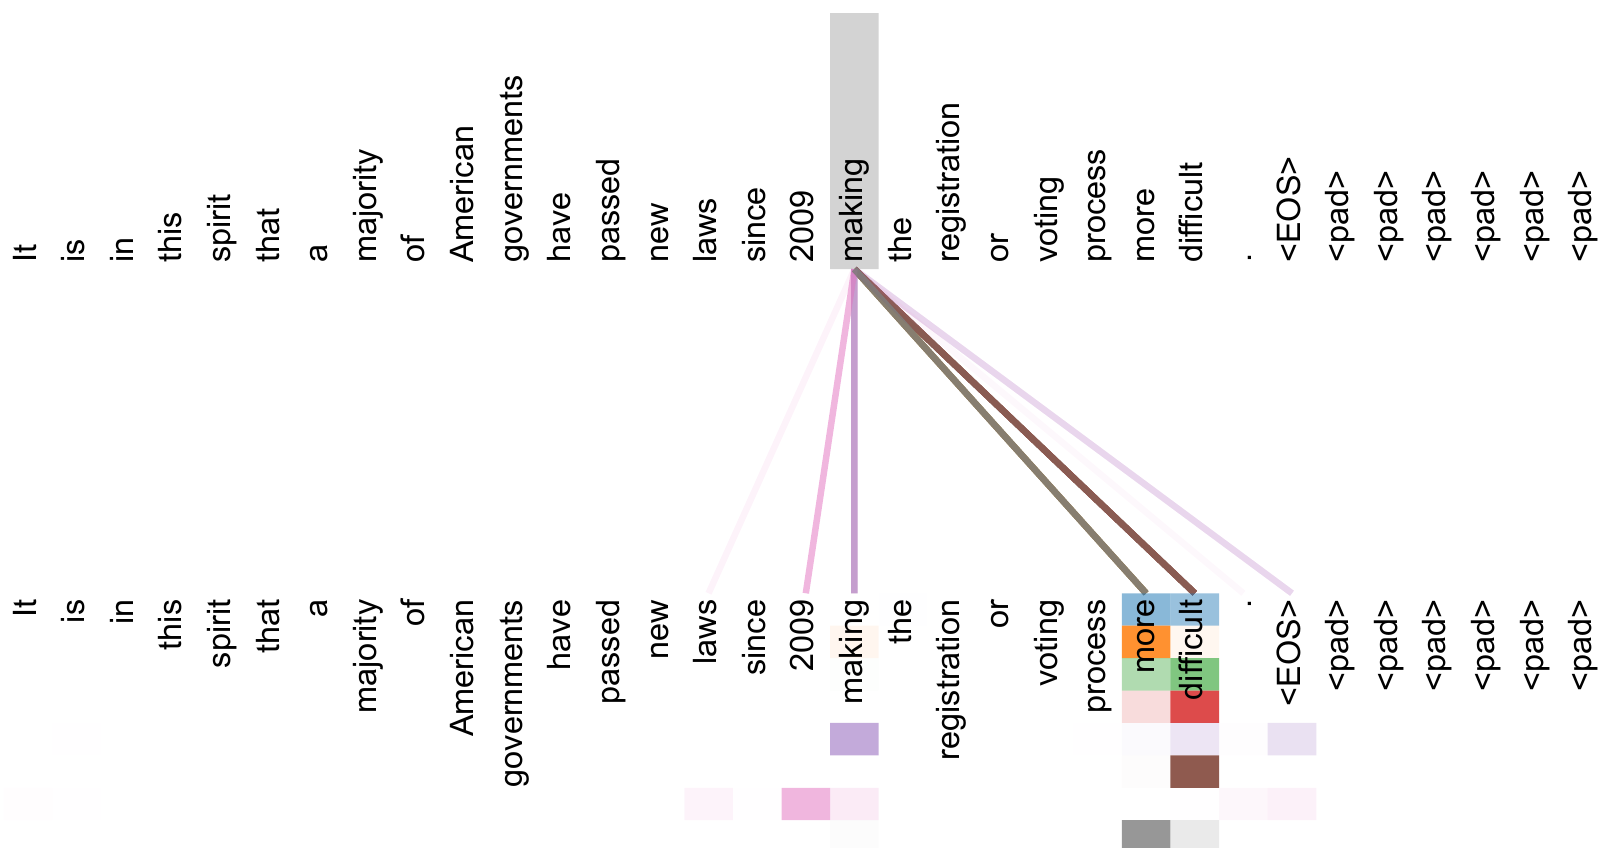
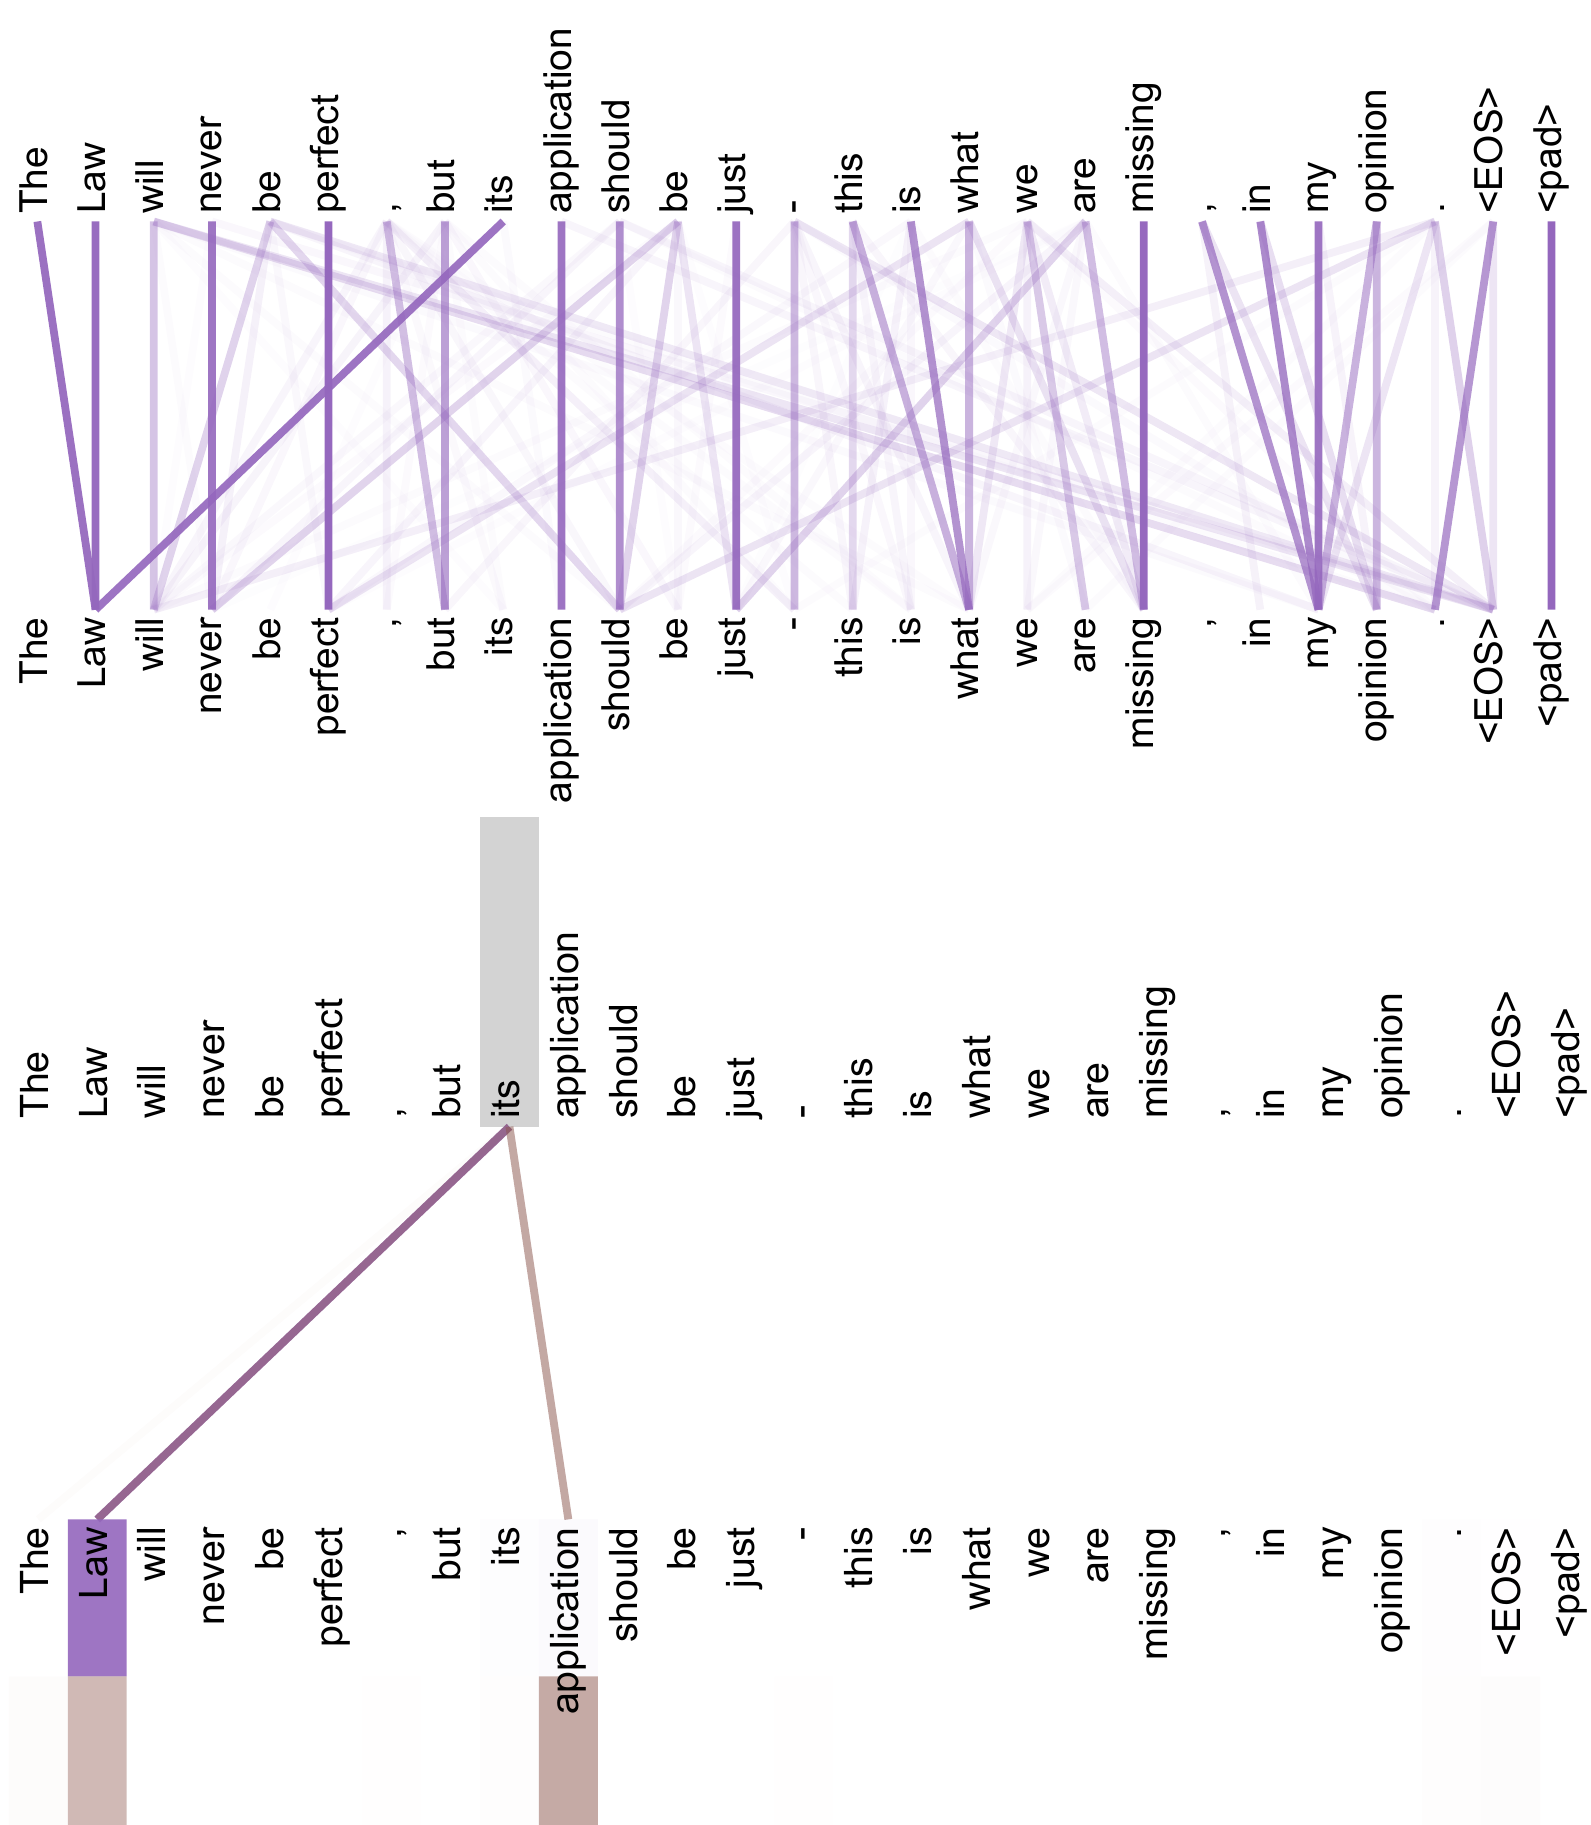
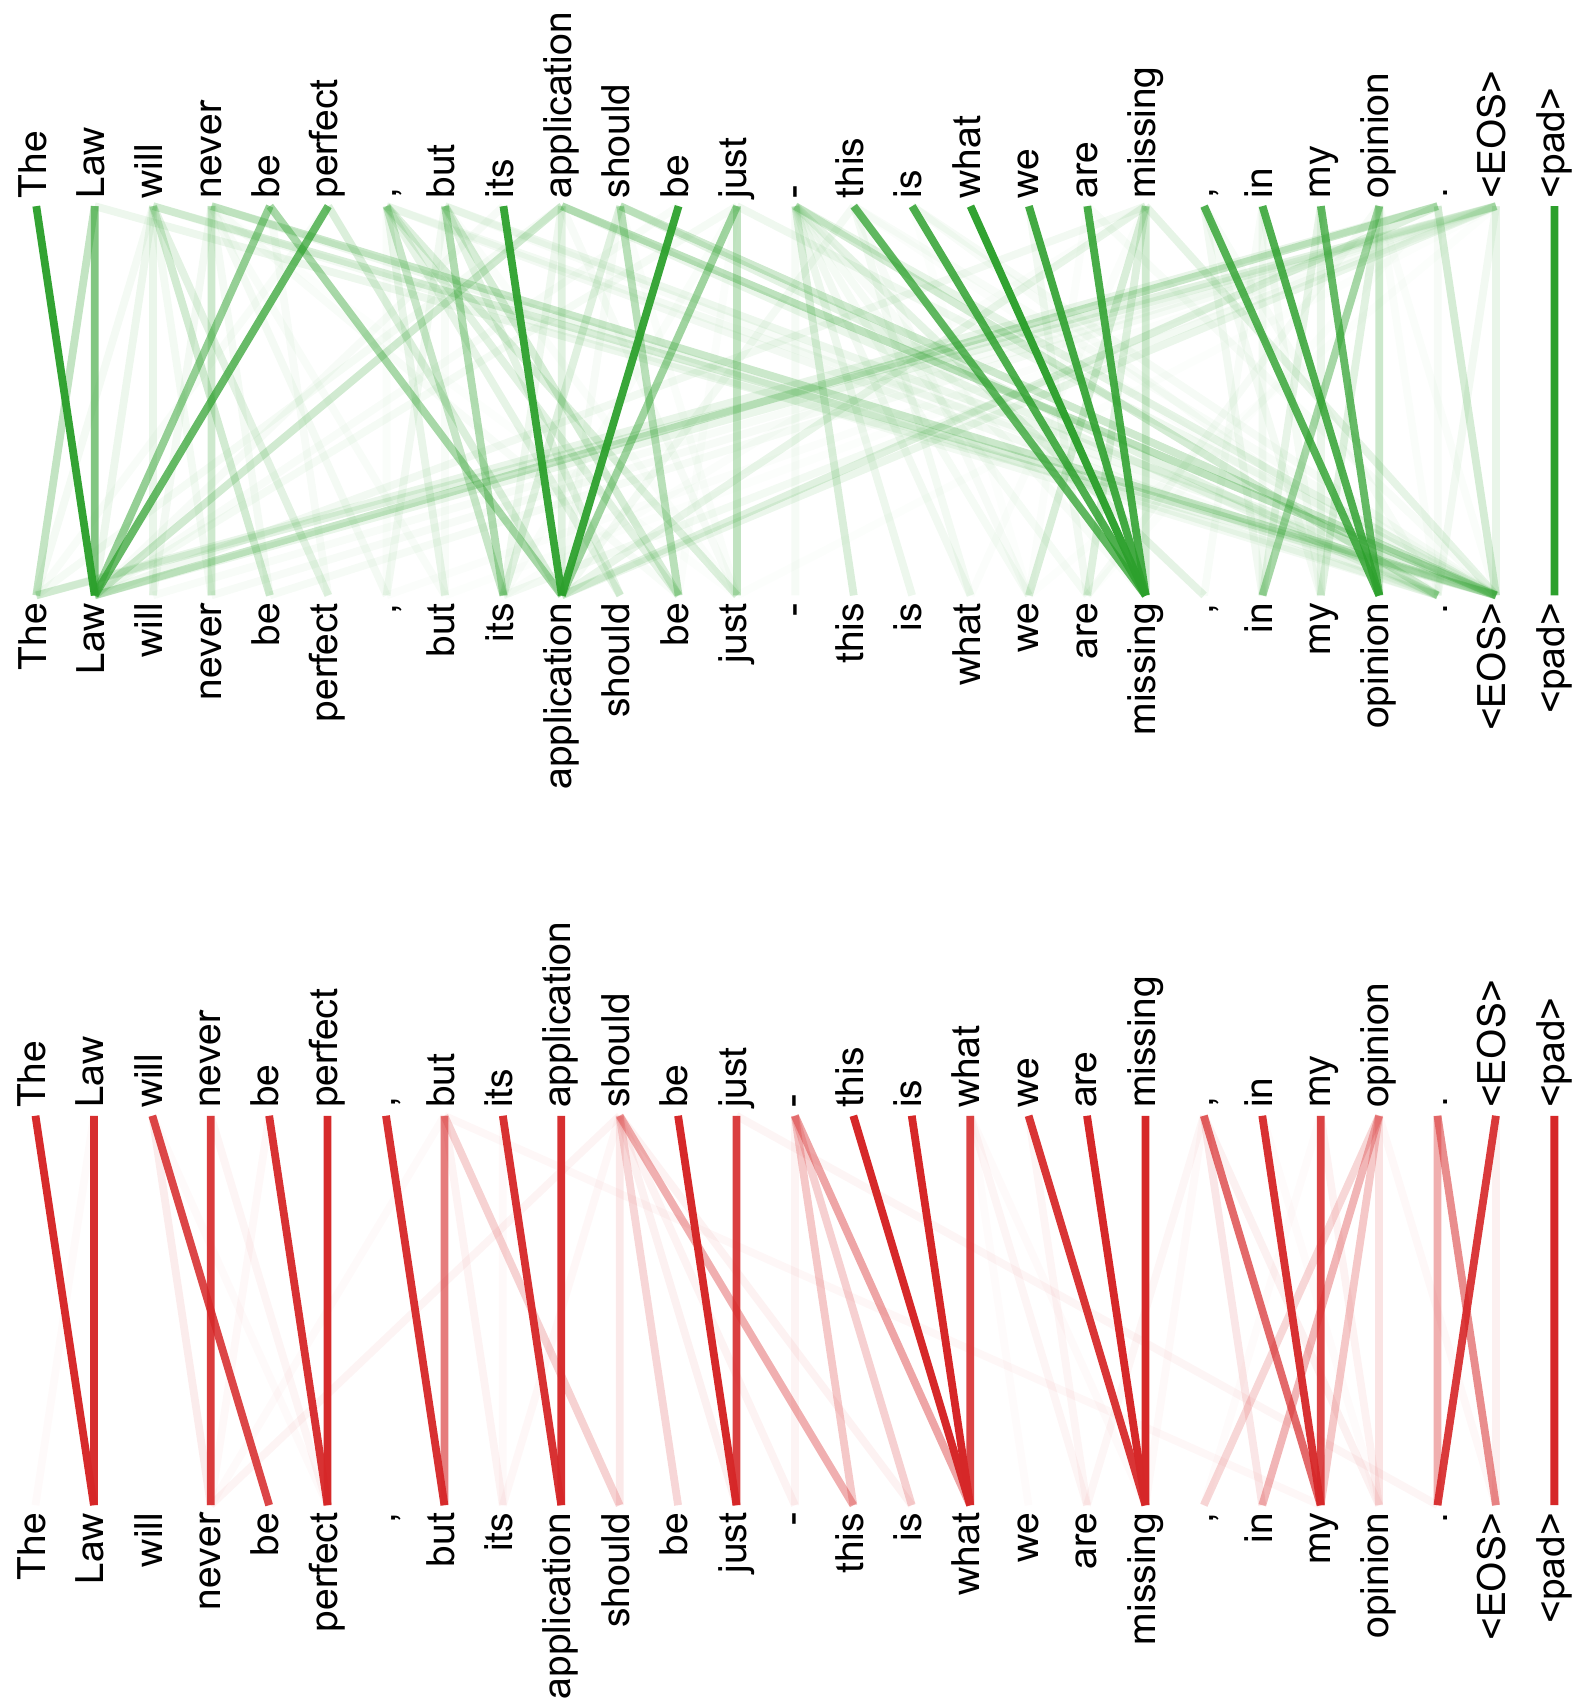
作为额外的好处,自注意力可以产生更具可解释性的模型。我们检查了模型中的注意力分布,并在附录中展示和讨论了示例。不仅各个注意力头清楚地学会了执行不同的任务,许多似乎表现出与句子的句法和语义结构相关的行为。
5 训练
本节描述我们模型的训练方案。
5.1 训练数据和批处理
我们在标准的WMT 2014英语-德语数据集上进行训练,该数据集由约450万个句子对组成。句子使用字节对编码[3]进行编码,其共享的源-目标词汇表约有37000个词元。对于英语-法语,我们使用了规模显著更大的WMT 2014英语-法语数据集,该数据集由3600万个句子组成,并将词元切分为32000个word-piece词汇表[38]。句子对按近似序列长度分批组合。每个训练批次包含一组句子对,其中约有25000个源词元和25000个目标词元。
5.2 硬件与时间安排
我们在一台配备8块NVIDIA P100 GPU的机器上训练模型。对于使用本文所述超参数的基准模型,每个训练步耗时约0.4秒。我们将基准模型总共训练了100,000步,即12小时。对于我们的big模型(见表[3]底行所述),每步时间为1.0秒。big模型训练了300,000步(3.5天)。
5.3 优化器
我们使用了Adam优化器[20],其中、且。我们在训练过程中根据以下公式改变学习率:
这对应于在前warmup个训练步中线性增加学习率,此后按步数的平方根反比递减。我们使用了warmup steps = 4000。
5.4 正则化
我们在训练期间采用了三种类型的正则化:
| 模型 | BLEU | 训练成本(FLOPs) | ||
| 英德 | 英法 | 英德 | 英法 | |
| ByteNet [18] | 23.75 | |||
| Deep-Att + PosUnk [39] | 39.2 | 1.0·1020 | ||
| GNMT + RL [38] | 24.6 | 39.92 | 2.3·1019 | 1.4·1020 |
| ConvS2S [9] | 25.16 | 40.46 | 9.6·1018 | 1.5·1020 |
| MoE [32] | 26.03 | 40.56 | 2.0·1019 | 1.2·1020 |
| Deep-Att + PosUnk 集成 [39] | 40.4 | 8.0·1020 | ||
| GNMT + RL 集成 [38] | 26.30 | 41.16 | 1.8·1020 | 1.1·1021 |
| ConvS2S 集成 [9] | 26.36 | 41.29 | 7.7·1019 | 1.2·1021 |
| Transformer(基础模型) | 27.3 | 38.1 | 3.3·1018 | |
| Transformer(大模型) | 28.4 | 41.8 | 2.3·1019 | |
残差Dropout 我们对每个子层的输出应用dropout[33],然后将其与子层输入相加并进行归一化。此外,我们对编码器和解码器堆栈中嵌入与位置编码的和应用dropout。对于基准模型,我们使用的丢弃率为。
标签平滑 在训练期间,我们采用了值为的标签平滑[36]。这会损害困惑度,因为模型会学会更加不确定,但会提高准确率和BLEU分数。
6 结果
6.1 机器翻译
在WMT 2014英语到德语翻译任务上,big transformer模型(表2中的Transformer (big))比之前报告的最佳模型(包括集成模型)高出2.0 BLEU以上,创造了28.4的新最先进BLEU分数。该模型的配置列于表3的底行。训练在8块P100 GPU上耗时3.5天。即使我们的基准模型也超越了所有先前发表的模型和集成模型,而训练成本仅为任何竞争模型的一小部分。
在WMT 2014英语到法语翻译任务上,我们的big模型取得了41.0的BLEU分数,超越了所有先前发表的单一模型,而训练成本不到先前最先进模型的。为英语到法语训练的Transformer (big)模型使用了丢弃率,而不是0.3。
对于基础模型,我们使用了将最后5个检查点取平均得到的单一模型,这些检查点以10分钟为间隔写入。对于大型模型,我们对最后20个检查点取平均。我们使用了束搜索,束大小为4,长度惩罚 [38]。这些超参数是在开发集上实验后选定的。我们将推理时的最大输出长度设为输入长度,但在可能时提前终止[38]。
表2总结了我们的结果,并将我们的翻译质量和训练成本与文献中的其他模型架构进行了比较。我们通过将训练时间、使用的GPU数量以及每个GPU持续单精度浮点容量的估计值相乘,来估算训练模型所使用的浮点运算次数。
6.2 模型变体
为了评估Transformer不同组件的重要性,我们以不同方式改变基础模型,测量在开发集
| N | dmodel | dff | h | dk | dv | Pdrop | εls | 训练步数 | PPL(开发集) | BLEU(开发集) | 参数量 ×10^6 | |
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0.1 | 0.1 | 100K | 4.92 | 25.8 | 65 |
| 1 | 512 | 512 | 5.29 | 24.9 | ||||||||
| 4 | 128 | 128 | 5.00 | 25.5 | ||||||||
| 16 | 32 | 32 | 4.91 | 25.8 | ||||||||
| (A) | 32 | 16 | 16 | 5.01 | 25.4 | |||||||
| 16 | 5.16 | 25.1 | 58 | |||||||||
| (B) | 32 | 5.01 | 25.4 | 60 | ||||||||
| 6.11 | 23.7 | 36 | ||||||||||
| (C) | 2 | 5.19 | 25.3 | 50 | ||||||||
| 4 | 4.88 | 25.5 | 80 | |||||||||
| 8 | 5.75 | 24.5 | 28 | |||||||||
| 256 | 32 | 32 | 4.66 | 26.0 | 168 | |||||||
| 1024 | 128 | 128 | 5.12 | 25.4 | 53 | |||||||
| 1024 | 4.75 | 26.2 | 90 | |||||||||
| (D) | 0.0 | 5.77 | 24.6 | |||||||||
| 0.2 | 4.95 | 25.5 | ||||||||||
| 0.0 | 4.67 | 25.3 | ||||||||||
| 0.2 | 5.47 | 25.7 | ||||||||||
| (E) | 4.92 | 25.7 | ||||||||||
| big | 6 | 1024 | 4096 | 16 | 0.3 | 300K | 4.33 | 26.4 | 213 |
newstest2013上英德翻译性能的变化。我们使用了上一节所述的束搜索,但不进行检查点平均。我们在表3中呈现这些结果。
在表3的(A)行中,我们改变注意力头的数量以及注意力键和值的维度,同时按照第3.2.2节所述保持计算量不变。虽然单头注意力比最佳设置差0.9 BLEU,但头数过多时质量也会下降。
在表3的(B)行中,我们观察到减小注意力键大小会损害模型质量。这表明确定兼容性并不容易,并且比点积更复杂的兼容性函数可能是有益的。我们在(C)和(D)行中进一步观察到,正如预期的那样,更大的模型更好,而dropout在避免过拟合方面非常有帮助。在(E)行中,我们用学习到的位置嵌入[2]替换正弦位置编码,并观察到与基础模型几乎相同的结果。
6.3 英语成分句法分析
为了评估Transformer能否泛化到其他任务,我们在英语成分句法分析上进行了实验。这项任务提出了特定挑战:输出受到强结构约束,并且显著长于输入。此外,RNN序列到序列模型在小数据情形下未能达到最先进的结果[37]。
我们在Penn Treebank [25]的《华尔街日报》(WSJ)部分上训练了一个的4层Transformer,约40K个训练句子。我们还在半监督设置中训练了它,使用来自更大高置信度和BerkleyParker语料库的约17M个句子[37]。对于仅WSJ设置,我们使用了16K词元的词汇表;对于半监督设置,我们使用了32K词元的词汇表。
我们仅进行了少量实验,在第22节开发集上选择dropout(注意力和残差,见第[5.4]节)、学习率和束大小,所有其他参数保持与英德基础翻译模型不变。在推理期间,我们
| 解析器 | 训练 | WSJ 23 F1 |
| Vinyals & Kaiser el al. (2014) [37] | 仅WSJ,判别式 | 88.3 |
| Petrov et al. (2006) [29] | 仅WSJ,判别式 | 90.4 |
| Zhu et al. (2013) [40] | 仅WSJ,判别式 | 90.4 |
| Dyer et al. (2016) [8] | 仅WSJ,判别式 | 91.7 |
| Transformer(4层) | 仅WSJ,判别式 | 91.3 |
| Zhu et al. (2013) [40] | 半监督 | 91.3 |
| Huang & Harper (2009) [14] | 半监督 | 91.3 |
| McClosky et al. (2006) [26] | 半监督 | 92.1 |
| Vinyals & Kaiser el al. (2014) [37] | 半监督 | 92.1 |
| Transformer(4层) | 半监督 | 92.7 |
| Luong et al. (2015) [23] | 多任务 | 93.0 |
| Dyer et al. (2016) [8] | 生成式 | 93.3 |
将最大输出长度增加到输入长度。对于仅WSJ和半监督设置,我们都使用了束大小21和。
我们在表4中的结果表明,尽管缺乏任务特定调优,我们的模型表现得出奇地好,除循环神经网络语法[8]外,优于所有先前报告的模型。
与RNN序列到序列模型[37]相比,即使仅在40K句子的WSJ训练集上训练,Transformer也优于Berkeley-Parser [29]。
7 结论
在这项工作中,我们提出了Transformer,这是第一个完全基于注意力的序列转导模型,用多头自注意力取代了编码器-解码器架构中最常用的循环层。
对于翻译任务,Transformer的训练速度可以显著快于基于循环层或卷积层的架构。在WMT 2014英德和WMT 2014英法翻译任务上,我们都取得了新的最先进结果。在前一项任务中,我们的最佳模型甚至优于所有先前报告的集成模型。
我们对基于注意力的模型的未来感到兴奋,并计划将其应用于其他任务。我们计划将Transformer扩展到涉及文本以外的输入和输出模态的问题,并研究局部、受限的注意力机制,以高效处理图像、音频和视频等大型输入和输出。使生成过程更少顺序化是我们的另一个研究目标。
我们用于训练和评估模型的代码可在https://github.com/tensorflow/tensor2tensor获取。
致谢 我们感谢Nal Kalchbrenner和Stephan Gouws富有成果的评论、修正和启发。
参考文献
[1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
[7] Junyoung Chung, Caglar Gulcehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122, 2017.
[10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, and Jürgen Schmidhuber. Gradient flow in recurrent nets: the difficulty of learning long-term dependencies, 2001.
[13] Sepp Hochreiter and Jürgen Schmidhuber. Long short-term memory. Neural computation, 9(8):1735-1780, 1997.
[14] Zhongqiang Huang and Mary Harper. Self-training PCFG grammars with latent annotations across languages. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, pages 832-841. ACL, August 2009.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer, and Yonghui Wu. Exploring the limits of language modeling. arXiv preprint arXiv:1602.02410, 2016.
[16] Łukasz Kaiser and Samy Bengio. Can active memory replace attention? In Advances in Neural Information Processing Systems, (NIPS), 2016.
[17] Łukasz Kaiser and Ilya Sutskever. Neural GPUs learn algorithms. In International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves, 和 Koray Kavukcuoglu。线性时间内的神经机器翻译。arXiv预印本arXiv:1610.10099, 2017。
[19] Yoon Kim, Carl Denton, Luong Hoang, 和 Alexander M. Rush。结构化注意力网络。在国际学习表征会议,2017。
[20] Diederik Kingma 和 Jimmy Ba。Adam: 一种随机优化方法。在ICLR, 2015。
[21] Oleksii Kuchaiev 和 Boris Ginsburg。LSTM网络的因子分解技巧。arXiv预印本arXiv:1703.10722, 2017。
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou, 和 Yoshua Bengio。一种结构化自注意力句子嵌入。arXiv预印本arXiv:1703.03130, 2017。
[23] Minh-Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals, 和 Lukasz Kaiser。多任务序列到序列学习。arXiv预印本arXiv:1511.06114, 2015。
[24] Minh-Thang Luong, Hieu Pham, 和 Christopher D Manning。基于注意力的神经机器翻译的有效方法。arXiv预印本arXiv:1508.04025, 2015。
[25] Mitchell P Marcus, Mary Ann Marcinkiewicz, 和 Beatrice Santorini。构建大型标注英语语料库:宾州树库。计算语言学,19(2):313-330, 1993。
[26] David McClosky, Eugene Charniak, 和 Mark Johnson。有效的自训练句法分析。在NAACL人类语言技术会议论文集,主会议,第152-159页。ACL,2006年6月。
[27] Ankur Parikh, Oscar Tackström, Dipanjan Das, 和 Jakob Uszkoreit。一种可分解的注意力模型。在自然语言处理经验方法,2016。
[28] Romain Paulus, Caiming Xiong, 和 Richard Socher。一种用于抽象摘要的深度强化模型。arXiv预印本arXiv:1705.04304, 2017。
[29] Slav Petrov, Leon Barrett, Romain Thibaux, 和 Dan Klein。学习准确、紧凑且可解释的树标注。在第21届国际计算语言学会议暨第44届ACL年会论文集,第433-440页。ACL,2006年7月。
[30] Ofir Press 和 Lior Wolf。利用输出嵌入改进语言模型。arXiv 预印本 arXiv:1608.05859,2016。
[31] Rico Sennrich、Barry Haddow 和 Alexandra Birch。使用子词单元对稀有词进行神经机器翻译。arXiv 预印本 arXiv:1508.07909,2015。
[32] Noam Shazeer、Azalia Mirhoseini、Krzysztof Maziarz、Andy Davis、Quoc Le、Geoffrey Hinton 和 Jeff Dean。极其庞大的神经网络:稀疏门控混合专家层。arXiv 预印本 arXiv:1701.06538,2017。
[33] Nitish Srivastava、Geoffrey E Hinton、Alex Krizhevsky、Ilya Sutskever 和 Ruslan Salakhutdinov。Dropout:一种防止神经网络过拟合的简单方法。Journal of Machine Learning Research,15(1):1929-1958,2014。
[34] Sainbayar Sukhbaatar、Arthur Szlam、Jason Weston 和 Rob Fergus。端到端记忆网络。收录于 C. Cortes、N. D. Lawrence、D. D. Lee、M. Sugiyama 和 R. Garnett 编,Advances in Neural Information Processing Systems 28,第 2440-2448 页。Curran Associates, Inc.,2015。
[35] Ilya Sutskever、Oriol Vinyals 和 Quoc VV Le。使用神经网络的序列到序列学习。收录于 Advances in Neural Information Processing Systems,第 3104-3112 页,2014。
[36] Christian Szegedy、Vincent Vanhoucke、Sergey Ioffe、Jonathon Shlens 和 Zbigniew Wojna。重新思考用于计算机视觉的 Inception 架构。CoRR,abs/1512.00567,2015。
[37] Vinyals & Kaiser、Koo、Petrov、Sutskever 和 Hinton。语法作为外语。收录于 Advances in Neural Information Processing Systems,2015。
[38] Yonghui Wu、Mike Schuster、Zhifeng Chen、Quoc V Le、Mohammad Norouzi、Wolfgang Macherey、Maxim Krikun、Yuan Cao、Qin Gao、Klaus Macherey 等。Google 的神经机器翻译系统:弥合人类翻译与机器翻译之间的差距。arXiv 预印本 arXiv:1609.08144,2016。
[39] Jie Zhou、Ying Cao、Xuguang Wang、Peng Li 和 Wei Xu。用于神经机器翻译的带前馈连接的深度循环模型。CoRR,abs/1606.04199,2016。
[40] Muhua Zhu、Yue Zhang、Wenliang Chen、Min Zhang 和 Jingbo Zhu。快速而准确的移进-归约成分句法分析。收录于 Proceedings of the 51st Annual Meeting of the ACL (Volume 1: Long Papers),第 434-443 页。ACL,2013 年 8 月。