
antiSMASH 8.0 rastrea genomas microbianos en busca de clústeres biosintéticos: de 81 a 101 tipos detectables. Artículo 2025, lectura gratuita.
antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation
antiSMASH 8.0: capacidades ampliadas de detección de grupos génicos y análisis de química, enzimología y regulación
Blin, K.; Shaw, S.; Vader, L.; Szenei, J.; Reitz, Z.L.; Augustijn, H.E.; ...; Weber, T.
Cita
Blin, K., Shaw, S., Vader, L., Szenei, J., Reitz, Z. L., Augustijn, H. E., ... Weber, T. (2025). antiSMASH 8.0: capacidades ampliadas de detección de grupos génicos y análisis de química, enzimología y regulación. Nucleic Acids Research, 53(W1), W32- W38. doi:10.1093/nar/gkaf334
Versión: Versión del editor Licencia: Licencia Creative Commons CC BY 4.0 Descargado de: https://hdl.handle.net/1887/4285886
Nota: Para citar esta publicación, utilice por favor la versión final publicada (si procede).
antiSMASH 8.0: capacidades ampliadas de detección de grupos génicos y análisis de química, enzimología y regulación
Kai Blin , Simon Shaw , Lisa Vader , Judit Szenei , Zachary L. Reitz , Hannah E. Augustijn , José D.D. Cédiel- Becerra , Valérie de Crécy- Lagard , Robert A. Koetsier , Sam E. Williams , Pablo Cruz- Morales , Sopida Wongwas , Alejandro E. Segurado Luchsinger , Friederike Biermann , Aleksandra Korenskaia , Mitja M. Zdouc , David Meijer , Barbara R. Terlouw , Justin J.J. van der Hooft , Nadine Ziemert , Eric J.N. Helfrich , Joleen Masschelein , Christophe Corre , Marc G. Chevrette , Gilles P. van Wezel , Marnix H. Medema , Tilmann Weber
Autor para correspondencia. Correo electrónico: kblin@biosustain.dtu.dk La correspondencia también puede dirigirse a Marnix H. Medema. Correo electrónico: marnix.medema@wur.nl La correspondencia también puede dirigirse a Tilmann Weber. Correo electrónico: tiwe@biosustain.dtu.dk
Resumen
Los microorganismos sintetizan compuestos bioactivos pequeños a través de su metabolismo secundario o especializado. Dichos compuestos desempeñan un papel importante en las interacciones microbianas y la salud del suelo, pero también son cruciales para el desarrollo de fármacos o agroquímicos. Durante las últimas décadas, los avances en la secuenciación de genomas han permitido la identificación de un gran número de grupos génicos biosintéticos directamente a partir de genomas microbianos. Desde su creación en 2011, antiSMASH (https://antismash. secondarymetabolites.org/), se ha convertido en la herramienta líder para detectar y caracterizar estos grupos génicos en bacterias y hongos. Este artículo presenta las versiones 8 de antiSMASH, que ha aumentado el número de tipos de grupos detectables de 81 a 101, y ha mejorado el soporte de análisis para terpenoides y enzimas de modificación, así como mejoras en el análisis de enzimas modulares como las policétido sintasas y las peptídico sintetasas no ribosomales. Estas modificaciones mantienen antiSMASH actualizado con los desarrollos en el campo y amplían sus capacidades predictivas generales para la minería genómica de productos naturales.
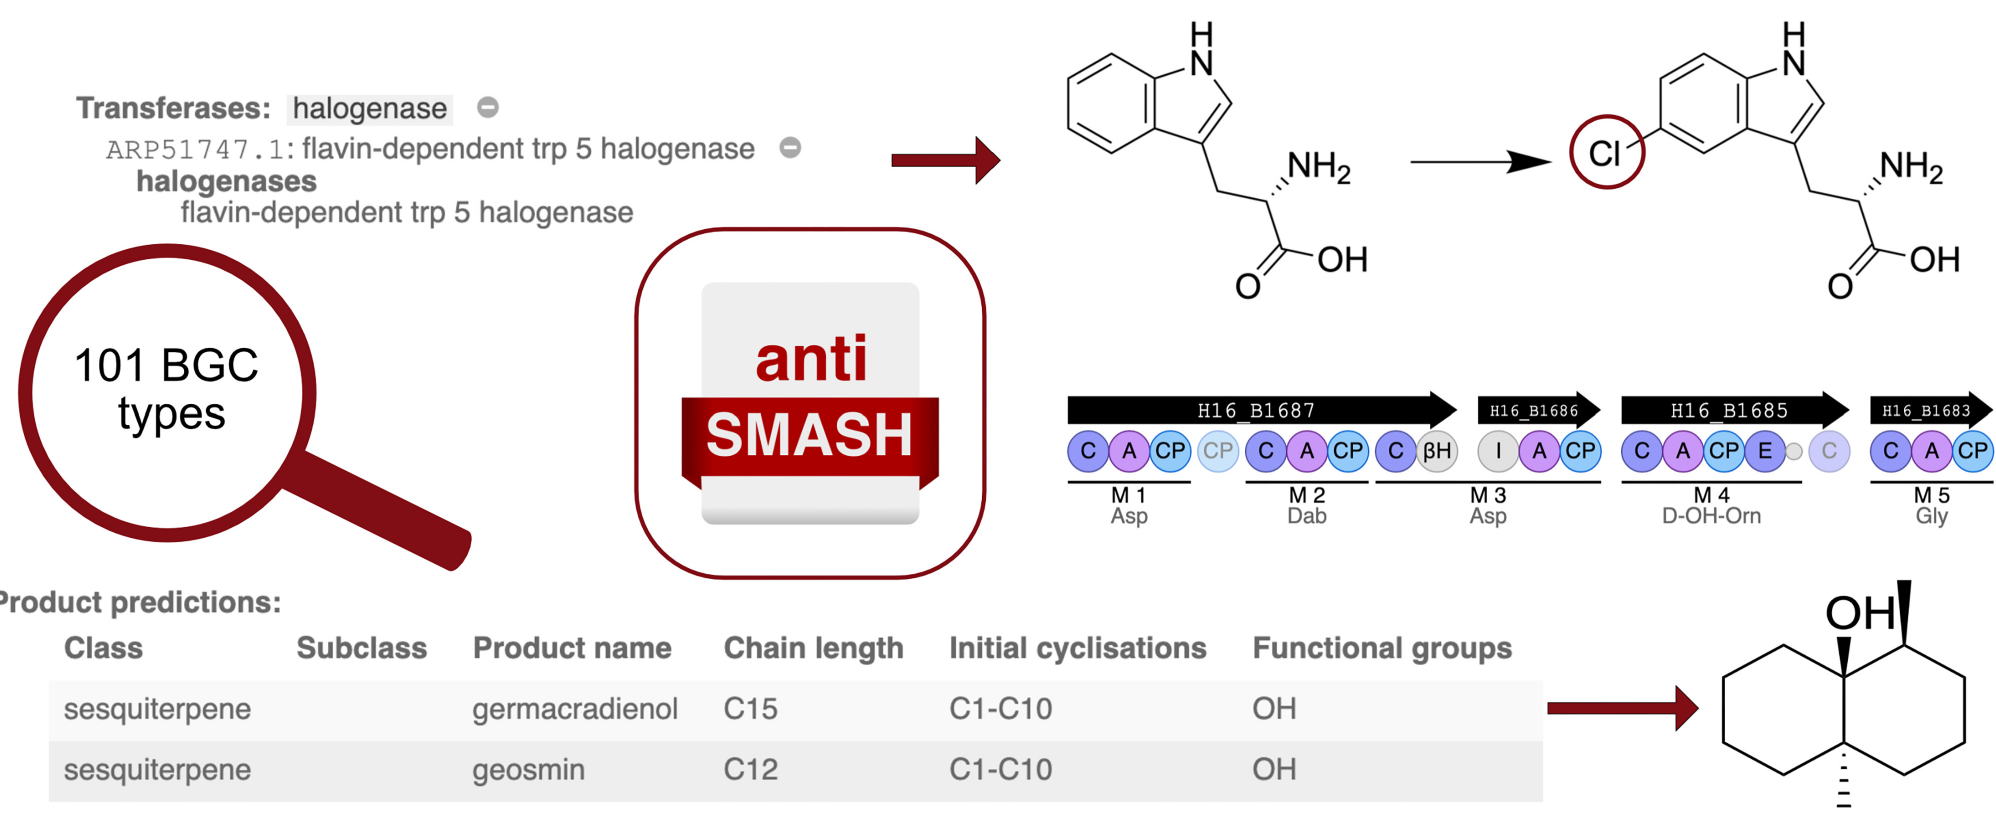
Resumen gráfico
Introducción
Las moléculas bioactivas pequeñas producidas por microorganismos son una fuente importante de fármacos [1] y agroquímicos [2], y desempeñan papeles importantes en las interacciones microbianas y la salud del suelo. Durante los últimos 20- 25 años, la abundancia de datos genómicos disponibles ha permitido mejorar los flujos de trabajo tradicionales de aislamiento de cepas microbianas, extracción de compuestos y posterior cribado de actividades deseadas mediante la búsqueda de grupos génicos biosintéticos (BGCs) que codifican la biosíntesis de estas moléculas en genomas microbianos [3]. Existen herramientas de software para buscar en genomas estos BGCs productores de metabolitos secundarios/especializados desde hace más de una década [4- 7].
Desde su lanzamiento inicial en 2011, antiSMASH [8- 14] se ha convertido en la herramienta líder en el campo. Alrededor de antiSMASH ha evolucionado un amplio ecosistema de herramientas relacionadas que incorporan o dependen de las predicciones de antiSMASH. Ejemplos incluyen la herramienta de minería basada en resistencia ARTS [15], Seq2PKS guiada por espectrometría de masas [16], la herramienta de ingeniería genómica StreptoCAD [17], la herramienta de redes y agrupamiento de BGCs BiG- SCAPE [18], y la herramienta de análisis de ómicas emparejadas NPLinker [19]. A su vez, antiSMASH también puede incorporar predicciones de BGCs de otras herramientas [13]. Originalmente construida para DeepBGC [20], otras herramientas basadas en aprendizaje automático como GECCO [21] también proporcionan sus resultados en el formato requerido. Las predicciones de BGCs de antiSMASH también se utilizan en muchas bases de datos genómicas y relacionadas con BGCs, como el Secondary Metabolite Collaboratory del Joint Genome Institute [22], la plataforma MicroScope para anotación y análisis de genomas [23], la base de datos MIBiG de BGCs curados manualmente [24], la base de datos de familias de BGCs BiG- FAM [25], la base de datos de metagenomas de diversidad química BGC Atlas [26], y la base de datos antiSMASH [27]. Además, antiSMASH forma parte de varios flujos de trabajo sistemáticos para análisis a gran escala de datos genómicos, p. ej., BGCFlow [28] o el MicroOrganisms Pipelines Service [29] de la Autoridad Europea de Seguridad Alimentaria (EFSA).
Aquí presentamos la versión 8 de antiSMASH. Esta versión aumenta el número de tipos de rutas biosintéticas detectables de 81 a 101, añade un módulo de análisis para BGCs de terpenoides y proporciona un análisis en profundidad de enzimas de modificación.
Además, los conjuntos de datos KnownClusterBlast y ClusterCompare se actualizaron para reflejar los datos de la versión 4 de MIBiG, añadimos soporte adecuado para BGCs que abarcan el origen de replicación en genomas circulares, y las predicciones de sitios de unión de factores de transcripción se ampliaron con conjuntos de datos de la base de datos CollecTF [30]. En BGCs que contienen peptídico sintetasas no ribosomales (NRPSs) o policétido sintasas de tipo I (PKSs), se detectan y analizan más dominios biosintéticos.
Nuevas características y actualizaciones
Actualizaciones en la detección de BGCs
antiSMASH utiliza reglas curadas manualmente para definir qué funciones biosintéticas deben existir en una región genómica para poder definir un BGC. Para identificar estas funciones biosintéticas, antiSMASH hace uso tanto de modelos ocultos de Markov de perfil (pHMM) como, en menor medida, de perfiles dinámicos especificados en archivos de código Python. Los pHMM provienen de conjuntos de datos públicos como PFAM [31], TIGRFAMS [32], SMART [33], BAGEL [34], Yadav et al. [35], o se crean específicamente para su uso en antiSMASH. antiSMASH 7 contenía 81 de tales reglas de BGC [14]; este número ha aumentado a 101 en esta versión, y se han refinado varias reglas existentes. Debido al gran solapamiento en las enzimas biosintéticas, es difícil diferenciar entre los péptidos lineales que contienen azol y los tiopéptidos circularizados con enlaces tio. En la base de datos actual de antiSMASH [27], de las llamadas de BGC de tiopéptidos y de las de péptidos lineales que contienen azol se solapan, y no está claro cuántas de las asignaciones restantes son correctas. Para abordar esta incertidumbre y evitar posibles confusiones, las reglas de detección para ambos tipos de BGC se fusionaron en una nueva «regla de RiPPs que contienen azol». También se actualizaron las reglas de detección para terpenos, micosporinas, sideróforos independientes de NRPS, PKS de trans-AT, NRPS, clústeres similares a NRPS y ácidos grasos. Además, se añadieron nuevas reglas para péptidos ribosómicamente sintetizados y modificados postraduccionalmente (RiPPs) de arqueas, atropopéptidos, ácido nitropropanoico, compuestos que contienen azoxi, polienos, desazapurinas, pirroles polihalogenados, hidroxitropolonas, cianuros de hidrógeno, darobactinas, isocianuros, dicetopiperazinas cíclicas bacterianas y fúngicas, tricéptidos, PKS de tipo II altamente reductoras y biosíntesis de lisina similar a NRPS fúngica.
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
::
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
I'm ready to translate, but it looks like the source text didn't come through—your message only contains a colon (":") and no actual content to translate. Could you paste the text you'd like me to translate into Spanish? Once you provide it, I'll translate it faithfully, preserving the meaning, details, voice, terminology, and any LaTeX notation.
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:: antiSMASH proporciona un análisis detallado de los dominios proteicos codificados en los BGC de NRPS/PKS. Para ofrecer una visión más completa de los dominios presentes, añadimos perfiles para las -hidroxilasas asociadas a sideróforos y los dominios de interfaz (véase [37] para una discusión detallada) y un - más genérico
Para cubrir los casos en los que secciones contiguas de algunos genes centrales estaban demasiado lejos de otros genes centrales, se añadió una nueva condición "EXTENDS" a la definición de reglas para garantizar que todos los genes centrales estén debidamente marcados. Las reglas de PKS trans-AT utilizan esto para garantizar que todos los genes que contienen módulos se detecten correctamente, incluso cuando el dominio aciltransferasa (AT) trans-actuante único está muy lejos.
Análisis de terpenos
Si bien antiSMASH ha estado detectando clústeres génicos de terpenos desde la versión 1 [8], faltaba un análisis más detallado de las terpeno sintasas/ciclasas. La versión 4 de antiSMASH [11] añadió un módulo de análisis inicial, pero debido a limitaciones en el rendimiento del algoritmo de colocación filogenética y a desafíos de mantenibilidad, este se eliminó de nuevo en antiSMASH 5 [12]. Para la versión 8, vemos un retorno del análisis de terpenos basado en pHMM cuidadosamente curados (véase la Fig. 1A). Para cada región que contiene un BGC de terpenos, se muestra una lista de posibles tipos de productos. Cada predicción incluye la clase terpenoide (p. ej., diterpeno, sesquiterpeno, etc.) y la longitud de la cadena del producto predicho. Para las subfamilias de terpeno sintasas mejor comprendidas, la predicción también puede contener la subclase terpenoide (p. ej., diterpenoide de indol), las ciclaciones iniciales (p. ej., C1-C15) y el nombre del producto.
Análisis de la función génica
Durante el gran impulso comunitario para anotar mejor las enzimas de modificación en las entradas de MIBiG durante las anotaciones de MIBiG del año pasado (véase [24] para una descripción), notamos que se necesitaba una interfaz más fácil de usar para acceder a las reacciones de las enzimas de modificación en antiSMASH. Utilizando la colección de enzimas de modificación de la base de datos MITE (https://mite.bioinformatics. nl/) [36] anotadas durante esos annotathons, así como nuestras anotaciones smCOG existentes, ahora presentamos información sobre enzimas de modificación en una pestaña dedicada de "tailoring" (véase la Fig. 1B). Esto también nos dio la oportunidad de informar sobre las especificidades de sustrato de muchas halogenasas dependientes de flavina, también añadidas en esta versión. Utilizando pHMM personalizados y firmas de motivos conservados, las predicciones varían en detalle desde "pirrol halogenado" hasta la regioselectividad de, p. ej., triptófano halogenasas, dependiendo de la disponibilidad de datos.
En la pestaña de tailoring, las enzimas de modificación se organizan por categoría de la Comisión de Enzimas, es decir, oxidorreductasas, transferasas, hidrolasas, liasas, isomerasas y ligasas. Solo se muestran las categorías con aciertos en la región. Al hacer clic en los iconos de más se expande la categoría para mostrar los genes con aciertos relevantes y un breve resumen de la predicción más detallada posible de la función de modificación. Al hacer clic en el icono de más de un gen de interés se expande toda la información que antiSMASH proporciona sobre una enzima de modificación. Si una enzima de modificación muestra al menos un de identidad de secuencia de aminoácidos con cualquier entrada de la base de datos MITE, se proporciona un enlace cruzado a esa entrada de MITE.
Mejoras en NRPS y PKS
Los dominios CoA-ligasa (CAL) a menudo participan en la carga de unidades iniciadoras derivadas de ácidos grasos en los BGC de lipopéptidos, pero anteriormente no se consideraban módulos iniciadores en la detección de módulos de antiSMASH. Junto con las -hidroxilasas y los dominios de interfaz mencionados anteriormente, ahora pueden detectarse como parte de los módulos.
Siguiendo la información recopilada en [38], ahora se comprueba la presencia de residuos catalíticos en los sitios activos de los dominios de condensación (C) y epimerización (E) de NRPS y se marcan como inactivos cuando faltan dichos residuos. Para complementar las predicciones de especificidad de sustrato del dominio de adenilación (A) de NRPS ya realizadas en antiSMASH, ahora también proporcionamos un enlace al predictor externo de especificidad de sustrato PARAS [39] para ofrecer a los investigadores aún más opciones de análisis.
Cambios misceláneos
Muchos otros cambios menores se han incluido en la versión 8. La vista de la página de resumen que muestra los clústeres conocidos más similares se ha simplificado para abordar algunas fuentes de confusión de los usuarios. En lugar de mostrar directamente la similitud del clúster en "porcentaje de los genes que tienen una similitud de secuencia de al menos ", ahora mostramos la similitud en tres niveles de confianza: "alta" para una similitud de clúster mayor o igual a , "media" para una similitud de clúster entre y , y "baja" para una similitud de clúster entre y . Las similitudes de clúster de ya no se consideran suficientemente similares y ya no se muestran en el resumen. Known ClusterBlast, ClusterCompare y CompaRiPPson se han actualizado a los datos proporcionados en la versión MIBiG 4.0 [24]. La generación de SVG de ClusterBlast se trasladó a JavaScript para reducir el tamaño de los archivos y mejorar la experiencia del usuario al visualizar los resultados de antiSMASH abiertos localmente. Históricamente, antiSMASH ha tenido dificultades con los BGC que abarcan el origen en genomas circulares. En el mejor de los casos, esos BGC se dividían en dos; en el peor, una o ambas partes en los lados opuestos del origen podían pasarse por alto por completo. En antiSMASH 8.0, hemos revisado completamente nuestro manejo de coordenadas para genomas circulares para que se detecten y notifiquen correctamente.
Históricamente, antiSMASH se ha basado en GlimmerHMM [40] para la llamada de genes fúngicos, ya que podía ejecutarse sin seleccionar manualmente el modelo génico correcto. Desafortunadamente, con cada vez más genomas fúngicos disponibles, se hizo evidente que esta selección del modelo génico es crucial para una llamada de genes de alta calidad. Como no podemos seleccionar fácilmente el modelo génico correcto para genomas subidos de taxones desconocidos, hemos decidido eliminar la funcionalidad de llamada de genes fúngicos de antiSMASH. Recomendamos a los usuarios ejecutar una herramienta dedicada de llamada de genes como AUGUSTUS [41] y luego proporcionar a antiSMASH las anotaciones génicas. Debido a incompatibilidades de software en sistemas modernos, también hemos depreciado nuestro soporte para la suite de herramientas MEME, específicamente MEME [42] y FIMO [43]. Los usuarios de la versión independiente de antiSMASH aún pueden proporcionar esos binarios ellos mismos, pero ya no forman parte de los contenedores que proporcionamos ni del servicio web. Esto desactiva efectivamente la detección de bordes de BGC fúngicos de CASSIS [44] y podría afectar la puntuación de RODEO [45] para lantipéptidos, sactipéptidos, péptidos lazo y precursores de RiPP que contienen azol.
A
Predicciones detalladas de terpenos
| Predictions de productos: | |||||
| Clase | Subclase | Nombre del producto | Longitud de la cadena | Ciclaciones iniciales | Grupos funcionales |
| sesquiterpeno | germacradienol | C15 | C1-C10 | OH | |
| sesquiterpeno | geosmina | C12 | C1-C10 | OH |
Genes con dominios de terpeno:
scO6073: T1TS + T1TS
Dominio 1 (0 - 326): Terpeno sintasa de tipo 1 Subtipo: Geosmina sintasa, dominio N terminal Reacciones: FPP → germacradienol
Dominio 2 (326 - 695): Terpeno sintasa de tipo 1
Subtipo: Geosmina sintasa, dominio C terminal Reacciones: germacradienol → geosmina
B
Funciones de modificación
Oxidorreductasas: oxigenasa
oxyA: Ciclación
oxyB: Ciclación
oxyC: Ciclación
oxyD: citocromo P450
Transferasas: aminotransferasa glicosiltransferasa halogenasa metiltransferasa
bgtFA: Glicosilación
bgtFB: Glicosilación
bgtFC: Glicosilación
bhaA: halogenasa de hpg de tipo tirosina dependiente de flavina halogenasas halogenasa de hpg de tipo tirosina dependiente de flavina
MITF
MITEO000028 Halogenación (identidad: 100.00%) smcogs SMCOG1119: halogenasa
bmt: Metilación
dvaB: DegT/DnrJ/ErYC1/StrS aminotransferasa
pgaT: aminotransferasa
Hidrolasas: hidrolasa
bhp: proteína con plegamiento de hidrolasa alfa/beta
Liasas: hidratasa
dpgC: enoil-CoA hidratasa
dpgD: enoil-CoA hidratasa
Ligasas: ligasa sintasa
Conclusión y perspectiva futura
Conclusión y perspectiva futuraLas tecnologías de minería genómica como antiSMASH constituyen una pieza importante del rompecabezas del descubrimiento de productos naturales. Durante los últimos 14 años, antiSMASH ha recibido actualizaciones y mejoras continuas, asegurando que se mantenga a la vanguardia de las herramientas de minería genómica de productos naturales. Como evidencian las numerosas contribuciones externas al equipo central de desarrollo, el modelo de Código Abierto y Ciencia Abierta del proyecto antiSMASH sigue siendo exitoso. Es una herramienta importante de la que dependen muchas otras herramientas, flujos de trabajo y bases de datos más especializadas. Sirve como plataforma tecnológica para varias otras herramientas de minería genómica actualmente en desarrollo. En futuras actualizaciones, continuaremos nuestro trabajo en nuevos algoritmos y módulos de análisis para descifrar las vías de biosíntesis completas de los clústeres detectados. Construiremos sobre la base de las mejoras en la predicción de enzimas de tailoring de esta versión y abarcaremos aún más familias de enzimas. De manera similar, continuará nuestro trabajo sobre la detección de reguladores y sitios de unión de reguladores. Como siempre, también integraremos, o nos integraremos con, nuevas herramientas que se desarrollen en el ecosistema.
Agradecimientos
AgradecimientosContribuciones de los autores: Kai Blin (Conceptualización [líder], Curación de datos [líder], Adquisición de financiación [igual], Metodología [líder], Administración del proyecto [líder], Software [igual], Supervisión [igual], Redacción—borrador original [líder], Redacción—revisión y edición [líder], Simon Shaw (Curación de datos [igual], Metodología [igual], Software [líder], Visualización [líder], Lisa Vader (Curación de datos [de apoyo], Software [de apoyo], Visualización [de apoyo], Judit Szenei (Curación de datos [de apoyo], Software [de apoyo], Visualización [de apoyo], Zachary L. Reitz (Curación de datos [de apoyo], Software [de apoyo], Hannah E. Augustin (Curación de datos [de apoyo], Software [de apoyo]), José D.D. Cediel- Becerra (Curación de datos [de apoyo], Software [de apoyo], Valérie de Crécy- Lagard (Curación de datos [de apoyo], Robert A. Koetsier (Curación de datos [de apoyo], Software [de apoyo]), Sam E. Williams (Curación de datos [de apoyo], Pablo Cruz- Morales (Curación de datos [de apoyo]), Sopida Wongwas (Curación de datos [de apoyo]), Alejandro E. Segurado Luchsinger (Curación de datos [de apoyo]), Friederike Biermann (Curación de datos [de apoyo]), Aleksandra Korenskaia (Curación de datos [de apoyo]), Mitja M. Zdouc (Curación de datos [de apoyo], Redacción—borrador original [de apoyo]), David Meijer (Curación de datos [de apoyo]), Barbara R. Terlouw (Curación de datos [de apoyo]), Justin J.J. van der Hooft (Adquisición de financiación [igual], Redacción—borrador original [de apoyo]), Nadine Ziemert (Adquisición de financiación [igual], Supervisión [igual]), Eric J.N. Helfrich (Adquisición de financiación [igual], Supervisión [igual], Redacción—borrador original [de apoyo]), Joleen Masschelein (Curación de datos [de apoyo], Adquisición de financiación [igual], Supervisión [igual]), Christophe Corre (Adquisición de financiación [igual], Supervisión [igual]), Marc G. Chevrette (Adquisición de financiación [igual], Supervisión [igual]), Gilles P. van Wezel (Adquisición de financiación [igual], Supervisión [igual]), Marnix H. Medema (Conceptualización [de apoyo], Adquisición de financiación [igual], Supervisión [igual], Redacción—borrador original [de apoyo]), y Tilmann Weber (Conceptualización [de apoyo], Adquisición de financiación [igual], Supervisión [igual], Validación [de apoyo], Redacción—borrador original [de apoyo])
Conflicto de intereses
J.J.vdH. es miembro del Consejo Asesor Científico de NAICONS Srl, Milán, Italia, y presta consultoría para Corteva Agriscience, Indianápolis, IN, EE. UU. M.H.M. es miembro del Consejo Asesor Científico de Hexagon Bio. Todos los demás autores declaran no tener conflictos de intereses.
Financiación
Financiación: Fundación Novo Nordisk [NNF20CC0035580 para T.W., K.B. y P.C.-M., NNF22OC0079021 para S.E.W.]; Centro de Metabolitos Secundarios Microbianos (CeMiSt), Fundación Nacional Danesa de Investigación [DNRF137 para T.W.]; Programa Horizonte Europa de la UE MAGic-MOLFUN [MSC 101072485 para T.W., K.B., M.H.M., N.Z., A.K. y J.J.vdH.]; Horizonte 2020 de la UE MARBLES [101000392 para M.M.Z., J.J.vdH., M.H.M. y G.P.vW.]; NWO [KICH1.LWV04.21.013 para M.M.Z., J.J.vdH. y M.H.M.]; Comunidad ERC de la UE [101055020 para G.P.vW.]; NWO-XL [OCENW.XL21.XL21.088 para R.A.K.]; Institutos Nacionales de Salud [RM1GM145426 para VdC.-L.]; Centro Alemán de Investigación de Infecciones (DZIF) [TTU09.716 para N.Z.]; Horizonte 2020 de la UE DECIPHER [948770 para D.M. y M.H.M.]; El Gobierno Real de Tailandia [financiación de doctorado para S.W.]; Programa Emmy Noether de la Fundación Alemana de Investigación [504947087 para E.J.N.H.], Ministerio de Ciencia y Artes de Hesse [Centro LOEWE de Genómica de la Biodiversidad Traslacional para E.J.N.H.]; FWO [1008520N y G061821N para J.M.]. La financiación para cubrir los cargos por publicación de acceso abierto de este artículo fue proporcionada por el Programa Horizonte Europa de la UE MAGic-MOLFUN.
Disponibilidad de datos
Se puede acceder libremente a las versiones bacteriana y fúngica de antiSMASH 8.0 en https://antismash.secondarymetabolites.org y https://fungismash.secondarymetabolites.org, respectivamente.
La documentación de antiSMASH está disponible en https://docs.antismash.secondarymetabolites.org/.
El código fuente de antiSMASH está licenciado bajo la Licencia Pública General Affero de GNU (AGPL), versión 3.0. antiSMASH también está disponible a través de Docker. Consulte el sitio web de documentación para obtener detalles sobre cómo descargar e instalar antiSMASH.
Referencias
1. Newman DJ, Cragg GM. Los productos naturales como fuentes de nuevos fármacos durante casi cuatro décadas, desde 01/1981 hasta 09/2019. BMC Genomics 2020;83:1138-43. https://doi.org/10.1021/acs.jnatprod.9b01285 2. Sparks TC, Bryant RJ. Impacto de los productos naturales en el descubrimiento y la innovación de compuestos para la protección de cultivos. Pest Manag Sci 2022;78:399-408. https://doi.org/10.1002/ps.6653 3. Ziemert N, Alanjary M, Weber T. La evolución de la minería genómica en microorganismos: una revisión. Nat Prod Rep 2016;33:988-1005. https://doi.org/10.1039/C6NP00025H 4. Weber T. Herramientas in silico para el análisis de las rutas de biosíntesis de antibióticos. Int J Med Microbiol 2014;304:230-5. https://doi.org/10.1016/j.ijmm.2014.02.001 5. Medema MH, Fischbach MA. Enfoques computacionales para el descubrimiento de productos naturales. Nat Chem Biol 2015;11:639-48. https://doi.org/10.1038/nchembio.1884 6. Weber T, Kim HU. El portal de bioinformática de metabolitos secundarios: herramientas computacionales para facilitar la biología sintética de la producción de metabolitos secundarios. Synth Syst Biotechnol 2016;1:69- 79. https://doi.org/10.1016/j.synbio.2015.12.0027. Blin K, Kim HU, Medema MH et al. Desarrollo reciente de antiSMASH y otros enfoques computacionales para minar grupos de genes biosintéticos de metabolitos secundarios. Brief Bioinform 2019;20:1103- 13. https://doi.org/10.1093/bib/bbx1468. Medema MH, Blin K, Cimermancic P et al. antiSMASH: identificación, anotación y análisis rápidos de grupos de genes de biosíntesis de metabolitos secundarios en secuencias genómicas bacterianas y fúngicas. Nucleic Acids Res 2011;39:W339- 46. https://doi.org/10.1093/nar/gkr4669. Blin K, Medema MH, Kazempour D et al. antiSMASH 2.0- una plataforma versátil para la minería genómica de productores de metabolitos secundarios. Nucleic Acids Res 2013;41:W204- 12. https://doi.org/10.1093/nar/gkt44910. Weber T, Blin K, Duddela S et al. antiSMASH 3.0- un recurso integral para la minería genómica de grupos de genes biosintéticos. Nucleic Acids Res 2015;43:W237- 43. https://doi.org/10.1093/nar/gkv43711. Blin K, Wolf T, Chevrette MG et al. antiSMASH 4.0- mejoras en la predicción química y la identificación de límites de grupos de genes. Nucleic Acids Res 2017;45:W36- 411. https://doi.org/10.1093/nar/gkx31912. Blin K, Shaw S, Steinke K et al. antiSMASH 5.0: actualizaciones del pipeline de minería genómica de metabolitos secundarios. Nucleic Acids Res 2019;47:W81- 7. https://doi.org/10.1093/nar/gkz31013. Blin K, Shaw S, Kloosterman AM et al. antiSMASH 6.0: mejora de las capacidades de detección y comparación de grupos. Nucleic Acids Res 2021;49:W29- 35. https://doi.org/10.1093/nar/gkab33514. Blin K, Shaw S, Augustijn HE et al. antiSMASH 7.0: predicciones nuevas y mejoradas para la detección, regulación, estructuras químicas y visualización. Nucleic Acids Res 2023;51:W46- 50. https://doi.org/10.1093/nar/gkad34415. Mungan MD, Alanjary M, Blin K et al. ARTS 2.0: actualizaciones de características y expansión del Antibiotic Resistant Target Seeker para la minería genómica comparativa. Nucleic Acids Res 2020;48:W546- 52. https://doi.org/10.1093/nar/gkaa37416. Yan D, Zhou M, Adduri A et al. Descubrimiento de policétidos tipo I cis- AT mediante espectrometría de masas computacional y minería genómica con Seq2PKS. Nat Commun 2024;15:5356. https://doi.org/10.1038/s41467- 024- 49587- 117. Levasor L, Whitford CM, Petersen SD et al. StreptoCAD: una caja de herramientas de software de código abierto que automatiza los flujos de trabajo de ingeniería genómica en estreptomicetos. bioRxiv, https://doi.org/10.1101/2024.12.19.629370, 20 de diciembre de 2024, preprint: no revisado por pares.18. Navarro- Munoz JC, Selem- Mojica N, Mullowney MW et al. Un marco computacional para explorar la diversidad biosintética a gran escala. Nat Chem Biol 2020;16:60- 8. https://doi.org/10.1038/s41589- 019- 0400- 919. Eldjarn GH, Ramsay A, Hooft JJJvd et al. Clasificación de vínculos metabolómicos y genómicos microbianos en el marco NPLinker utilizando funciones de puntuación complementarias. PLOS Comput Biol 2021;17:e1008920. https://doi.org/10.1371/journal.pcbi.100892020. Hannigan GD, Prihoda D, Palicka A et al. Una estrategia de minería genómica mediante aprendizaje profundo para la predicción de grupos de genes biosintéticos. Nucleic Acids Res 2019;47:e110. https://doi.org/10.1093/nar/gkz65421. Carroll LM, Larralde M, Fleck JS et al. Identificación de novo precisa de grupos de genes biosintéticos con GECCO. bioRxiv, https://doi.org/10.1101/2021.05.03.442509, 4 de mayo de 2021, preprint: no revisado por pares.22. Udwary DW, Doering DT, Foster B et al. El consorcio de metabolismo secundario: una base de datos y portal de discusión web para grupos de genes biosintéticos de metabolitos secundarios. Nucleic Acids Res 2025;53:D717- 23. https://doi.org/10.1093/nar/gkae106023. Vallenet D, Calteau A, Dubois M et al. MicroScope: una plataforma integrada para la anotación y exploración de funciones génicas microbianas mediante genómica, pangenómica y metabólicaanálisis comparativo. Nucleic Acids Res 2020;48: D579- 89. https://doi.org/10.1093/nar/gkz92624. Zdouc MM, Blin K, Louwen NLL et al. MIBiG 4.0: avanzando en la curación de grupos de genes biosintéticos mediante la colaboración global. Nucleic Acids Res 2025;53:D678- 90. https://doi.org/10.1093/nar/gkae111525. Kautsar SA, Blin K, Shaw S et al. BiG- FAM: la base de datos de familias de grupos de genes biosintéticos. Nucleic Acids Res 2021;49: D490- 7. https://doi.org/10.1093/nar/gkaa81226. Bagci C, Nuhamunada M, Goyat H et al. BGC Atlas: un recurso web para explorar la diversidad química global codificada en genomas bacterianos. Nucleic Acids Res 2025;53:D618- 24. https://doi.org/10.1093/nar/gkae95327. Blin K, Shaw S, Medema MH et al. La base de datos antiSMASH versión 4: genomas y BGC adicionales, nuevas búsquedas basadas en secuencias y más. Nucleic Acids Res 2024;52:D586- 9. https://doi.org/10.1093/nar/gkad98428. Nuhamunada M, Mohite OS, Phaneuf PV et al. BGCFlow: flujo de trabajo sistemático de pangenoma para el análisis de grupos de genes biosintéticos en grandes conjuntos de datos genómicos. Nucleic Acids Res 2024;52:5478- 95. https://doi.org/10.1093/nar/gkae31429. Yolanda GC. Servicio de pipelines de microorganismos (MOPS): documentación de pipelines. Informe técnico.30. Kilu S, White ER, Sagitova DM et al. CollecTF: una base de datos de sitios de unión de factores de transcripción validados experimentalmente en bacterias. Nucleic Acids Res 2014;42:D156- 6030. https://doi.org/10.1093/nar/gkt112331. Mistry J, Chugarunsky S, Williams L et al. Pfam: la base de datos de familias de proteínas en 2021. Nucleic Acids Res 2021;49: D412- 9. https://doi.org/10.1093/nar/gkaa91332. Haft DH, Selengut JD, Richter RA et al. TIGRFAMs y propiedades del genoma en 2013. Nucleic Acids Res 2013;41: D387- 953. https://doi.org/10.1093/nar/gks123433. Letunic I, Khedkar S, Bork P. SMART: actualizaciones recientes, nuevos desarrollos y estado en 2020. Nucleic Acids Res 2021;49: D458- 60. https://doi.org/10.1093/nar/gkaa93734. van Heel AJ, de Jong A, Song C et al. BAGEL4: un servidor web fácil de usar para minar a fondo RiPPs y bacteriocinas. Nucleic Acids Res 2018;46: W278- 81. https://doi.org/10.1093/nar/gky38335. Yadav G, Gokhale RS, Mohanty D. Hacia la predicción de productos metabólicos de policétido sintasas: un análisis in silico. PLOS Comput Biol 2009;5:e1000351. https://doi.org/10.1371/journal.pcbi.100035136. Zdouc MM, Meijer D, Biermann F et al. El estándar de datos de información mínima sobre una enzima de modificación/mutarasa para capturar la biosíntesis de productos naturales. ChemRxiv, https://doi.org/10.26434/chemrxiv- 2024- 78mtl, 9 de abril de 2024, preprint: no revisado por pares.37. Reitz ZL, Hardy CD, Suk J et al. El análisis genómico de - hidroxilasas de sideróforos revela un estereocontrol divergente y amplía la familia de dominios de condensación. Proc Natl Acad Sci USA 2019;116:19805- 14. https://doi.org/10.1073/pnas.190316111628. Bloudoff K, Schmeng TM. Aspectos estructurales y funcionales de la superfamilia del dominio de condensación de la sintetasa de péptidos no ribosomales: descubrimiento, disección y diversidad. Biochim Biophys Acta Proteins Proteom 2017;1865:1587- 604. https://doi.org/10.1016/j.bbapap.2017.05.01039. Terlouw BR, Huang C, Meijer D et al. PARAS: aprendizaje automático de alta precisión de especificidades de sustrato en sintetasas de péptidos no ribosomales. bioRxiv, https://doi.org/10.1101/2025.01.08.631717, 10 de enero de 2025, preprint: no revisado por pares.40. Majoros WH, Pertea M, Salzberg SL. TigrScan y GlimmerHMM: dos buscadores de genes eucariotas ab initio de código abierto. Bioinformatics 2004;20:2878- 9. https://doi.org/10.1093/bioinformatics/bth31541. Stanke M, Morgenstern B. AUGUSTUS: un servidor web para la predicción de genes en eucariotas que permite restricciones definidas por el usuario. Nucleic Acids Res 2005;33:W465- 7. https://doi.org/10.1093/nar/gk14858 42. Bailey TL, Elkan C. Ajuste de un modelo de mezcla mediante maximización de expectativas para descubrir motivos en biopolímeros. Proc Int Conf Intell Syst Mol Biol 1994;2:28-36. 43. Grant CE, Bailey TL, Noble WS. FIMO: escaneo en busca de ocurrencias de un motivo dado. Bioinformatics 2011;27:1017-8. https://doi.org/10.1093/bioinformatics/br064 44. Wolf T, Shelest V, Nath N et al. CASSIS y SMIPS: predicción basada en promotores de grupos de genes de metabolitos secundarios en genomas eucariotas. Bioinformatics 2016;32:1138- 43. https://doi.org/10.1093/bioinformatics/btv713 45. Walker MC, Eslami SM, Hetrick KJ et al. La minería dirigida a péptidos precursores de más de cien mil genomas amplía la familia de productos naturales de lantipéptidos. BMC Genomics 2020;21:387. https://doi.org/10.1186/s12864-020-06785-7