
NSA hace que la atención sea dispersa y entrenable de extremo a extremo, bajando el coste en contextos de 64k sin perder precisión. ACL 2025, gratis.
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
Atención Dispersa Nativa: Atención Dispersa Alineada con el Hardware y Entrenable de Forma Nativa
Jingyang Yuan , Huazuo Gao , Damai Dai , Junyu Luo , Liang Zhao , Zhengyan Zhang , Zhenda Xie , Y. X. Wei , Lean Wang , Zhiping Xiao , Yuqing Wang , Chong Ruan , Ming Zhang , Wenfeng Liang , Wangding Zeng
DeepSeek- AI Key Laboratory for Multimedia Information Processing, School of Computer Science, Peking University, PKU- Anker LLM Lab University of Washington {yuanjy, mzhang_cs}@pku.edu.cn, {zengwangding, wenfeng.liang}@deepseek.com
Resumen
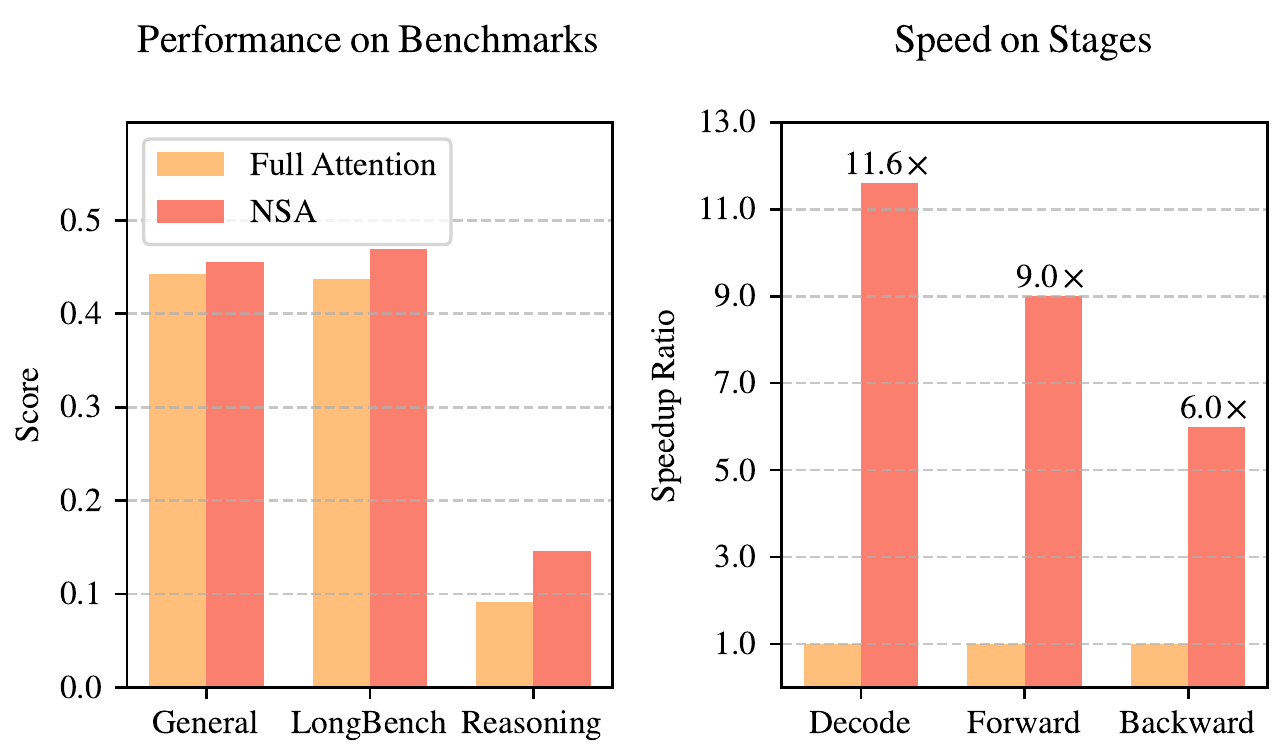
El modelado de contextos largos es crucial para los modelos de lenguaje de próxima generación; sin embargo, el alto costo computacional de los mecanismos de atención estándar plantea desafíos computacionales significativos. La atención dispersa ofrece una dirección prometedora para mejorar la eficiencia mientras se mantienen las capacidades del modelo. Presentamos NSA, un mecanismo de Atención Dispersa entrenable de forma nativa que integra innovaciones algorítmicas con optimizaciones alineadas con el hardware para lograr un modelado eficiente de contextos largos. NSA emplea una estrategia dispersa jerárquica dinámica, que combina compresión de tokens de grano grueso con selección de tokens de grano fino para preservar tanto la conciencia del contexto global como la precisión local. Nuestro enfoque avanza en el diseño de atención dispersa con dos innovaciones clave: (1) Logramos aceleraciones sustanciales mediante un diseño algorítmico equilibrado en intensidad aritmética, con optimizaciones de implementación para hardware moderno. (2) Habilitamos el entrenamiento de extremo a extremo, reduciendo la computación de preentrenamiento sin sacrificar el rendimiento del modelo. Como se muestra en la Figura [1], los experimentos muestran que el modelo preentrenado con NSA mantiene o supera a los modelos de Atención Completa en benchmarks generales, tareas de contexto largo y razonamiento basado en instrucciones. Mientras tanto, NSA logra aceleraciones sustanciales sobre la Atención Completa en secuencias de longitud 64k en decodificación, propagación hacia adelante y propagación hacia atrás, validando su eficiencia a lo largo del ciclo de vida del modelo.
1. Introducción
La comunidad investigadora reconoce cada vez más el modelado de contextos largos como una capacidad crucial para los modelos de lenguaje grandes de próxima generación, impulsada por diversas aplicaciones del mundo real que van desde el razonamiento profundo (DeepSeek- AI, 2025; Zelikman et al., 2022), la generación de código a nivel de repositorio (Zhang et al., 2023a; Zhang et al.) y los sistemas de agentes autónomos multiturno (Park et al., 2023). Avances recientes, incluidos los modelos de la serie o de OpenAI, DeepSeek- R1 (DeepSeek- AI, 2025) y Gemini 1.5 Pro (Google et al., 2024), permiten a los modelos procesar bases de código completas, documentos extensos, mantener conversaciones multiturno coherentes a lo largo de miles de tokens y realizar razonamientos complejos a través de dependencias de largo alcance. Sin embargo, la alta complejidad (Zaheer et al., 2020) de los mecanismos de Atención vanilla (Vaswani et al., 2017) emerge como un cuello de botella crítico de latencia a medida que aumenta la longitud de la secuencia. Las estimaciones teóricas indican que la computación de atención con arquitecturas softmax representa del \(70 - 80\%\) de la latencia total al decodificar contextos de longitud 64k, lo que subraya la necesidad urgente de mecanismos de atención más eficientes.
Un enfoque natural para el modelado eficiente de contextos largos es aprovechar la dispersión inherente de la atención softmax (Ge et al., 2023; Jiang et al., 2023), donde calcular selectivamente pares críticos consulta- clave puede reducir significativamente la sobrecarga computacional mientras se preserva el rendimiento. Avances recientes demuestran este potencial mediante diversas estrategias: métodos de expulsión de caché KV (Li et al., 2024; Zhang et al., 2023b; Zhou et al., 2024), métodos de selección de caché KV por bloques (Gao et al., 2024; Tang et al., 2024; Xiao et al., 2024a), y métodos de selección basados en muestreo, agrupamiento o hashing (Chen et al., 2024b; Desai et al., 2024; Liu et al., 2024). A pesar de estas estrategias prometedoras, los métodos de atención dispersa existentes a menudo se quedan cortos en implementaciones prácticas. Muchos enfoques no logran aceleraciones comparables a sus ganancias teóricas; además, la mayoría de los métodos carecen de soporte efectivo en tiempo de entrenamiento para explotar plenamente los patrones de dispersión de la atención.
Para abordar estas limitaciones, el despliegue de una atención dispersa efectiva debe enfrentar dos desafíos clave: (1) Aceleración de inferencia alineada con el hardware: Convertir reducciones computacionales teóricas en mejoras reales de velocidad requiere un diseño algorítmico amigable con el hardware durante las etapas de perfilado y decodificación para mitigar los cuellos de botella de acceso a memoria y programación del hardware; (2) Diseño algorítmico consciente del entrenamiento: Permitir la computación de extremo a extremo con operadores entrenables para reducir los costos de entrenamiento mientras se mantiene el rendimiento del modelo. Estos requisitos son cruciales para las aplicaciones del mundo real para lograr una inferencia o entrenamiento rápidos de contextos largos. Al considerar ambos aspectos, los métodos existentes aún exhiben una brecha notable.
Para lograr una atención dispersa más efectiva y eficiente, presentamos NSA, una arquitectura de Atención Dispersa entrenable de forma nativa que integra modelado jerárquico de tokens. Como se muestra en la Figura 2, NSA reduce la computación por consulta organizando claves y valores en bloques temporales y procesándolos a través de tres rutas de atención: tokens comprimidos de grano grueso, tokens de grano fino retenidos selectivamente y ventanas deslizantes para información contextual local. Luego
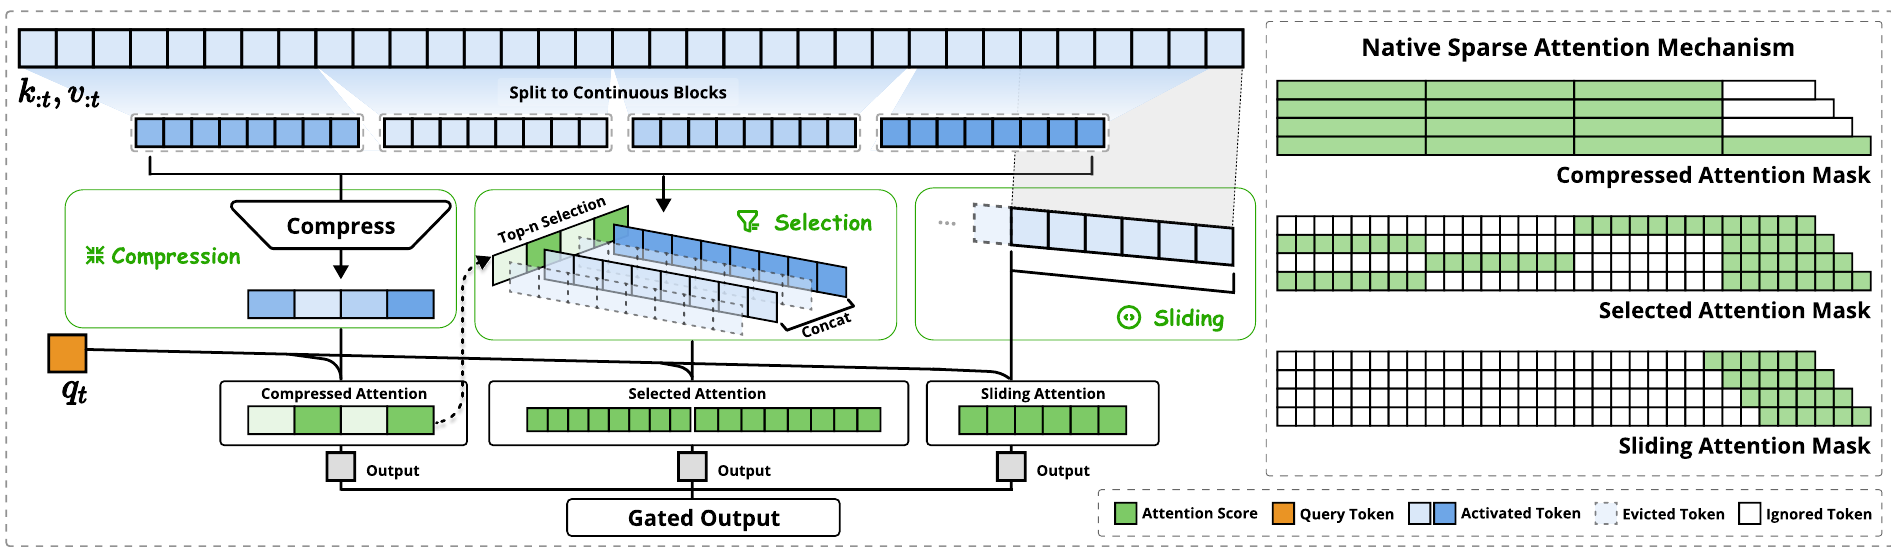
implementamos kernels especializados para maximizar su eficiencia práctica. NSA introduce dos innovaciones centrales correspondientes a los requisitos clave anteriores: (1) Sistema alineado con el hardware: Optimizar la atención dispersa por bloques para la utilización de Tensor Core y el acceso a memoria, asegurando una intensidad aritmética equilibrada. (2) Diseño consciente del entrenamiento: Permitir un entrenamiento estable de extremo a extremo mediante algoritmos eficientes y operadores hacia atrás. Esta optimización permite que NSA soporte tanto un despliegue eficiente como un entrenamiento de extremo a extremo.
Evaluamos NSA mediante experimentos integrales en corpus de lenguaje del mundo real. Con preentrenamiento en un backbone transformer de 27B parámetros con 260B tokens, evaluamos el rendimiento de NSA en evaluaciones generales de lenguaje, evaluaciones de contexto largo y evaluación de razonamiento de cadena de pensamiento. Además, comparamos la velocidad del kernel en GPUs A100 con implementaciones optimizadas de Triton (Tillet et al., 2019). Los resultados experimentales demuestran que NSA logra un rendimiento comparable o superior al baseline de atención completa, mientras supera a los enfoques de atención dispersa existentes. Además, NSA ofrece aceleraciones sustanciales en las etapas de decodificación, avance y retroceso en comparación con la Atención Completa, con la relación de aceleración aumentando para secuencias más largas. Estos resultados validan que nuestro diseño de atención dispersa jerárquica equilibra efectivamente la capacidad del modelo y la eficiencia computacional.
2. Repensando los Métodos de Atención Dispersa
Los métodos modernos de atención dispersa han logrado avances significativos en la reducción de la complejidad computacional teórica de los modelos transformer. Sin embargo, la mayoría de los enfoques aplican predominantemente la dispersión durante la inferencia mientras retienen un backbone de Atención Completa preentrenado, lo que potencialmente introduce un sesgo arquitectónico que limita su capacidad para explotar plenamente las ventajas de la atención dispersa. Antes de introducir nuestra arquitectura dispersa nativa, analizamos sistemáticamente estas limitaciones a través de dos lentes críticas.
2.1. La Ilusión de la Inferencia Eficiente
A pesar de lograr dispersión en la computación de atención, muchos métodos no logran reducciones correspondientes en la latencia de inferencia, principalmente debido a dos desafíos:
Dispersión Restringida por Fase. Métodos como H2O (Zhang et al., 2023b) aplican dispersión durante la decodificación autorregresiva mientras requieren un preprocesamiento computacionalmente intensivo (por ejemplo, cálculo del mapa de atención, construcción de índices) durante el perfilado. En contraste, enfoques como MInference (Jiang et al., 2024) se centran únicamente en la dispersión durante el perfilado. Estos métodos no logran aceleración en todas las etapas de inferencia, ya que al menos una fase mantiene costos computacionales comparables a la Atención Completa. La especialización por fase reduce la capacidad de aceleración de estos métodos en cargas de trabajo dominadas por perfilado, como el resumen de libros y la finalización de código, o cargas de trabajo dominadas por decodificación, como el razonamiento de cadena de pensamiento largo (Wei et al., 2022).
Incompatibilidad con Arquitecturas de Atención Avanzadas. Algunos métodos de atención dispersa no logran adaptarse a arquitecturas modernas eficientes en decodificación como Multiple- Query Attention (MQA) (Shazeer, 2019) y Grouped- Query Attention (GQA) (Ainslie et al., 2023), que reducen significativamente el cuello de botella de acceso a memoria durante la decodificación al compartir KV entre múltiples cabezas de consulta. Por ejemplo, en enfoques como Quest (Tang et al., 2024), cada cabeza de atención selecciona independientemente su subconjunto de caché KV. Aunque demuestra una dispersión computacional y una dispersión de acceso a memoria consistentes en modelos de Multi- Head Attention (MHA), presenta un escenario diferente en modelos basados en arquitecturas como GQA, donde el volumen de acceso a memoria de la caché KV corresponde a la unión de las selecciones de todas las cabezas de consulta dentro del mismo grupo GQA. Esta característica arquitectónica significa que, aunque estos métodos pueden reducir las operaciones de cómputo, el acceso a memoria de la caché KV requerido sigue siendo relativamente alto. Esta limitación obliga a una elección crítica: mientras algunos métodos de atención dispersa reducen la computación, su patrón de acceso a memoria disperso entra en conflicto con el diseño eficiente de acceso a memoria de las arquitecturas avanzadas.
Estas limitaciones surgen porque muchos métodos de atención dispersa existentes se centran en la reducción de la caché KV o en la reducción computacional teórica, pero luchan por lograr una reducción significativa de la latencia en frameworks o backends avanzados. Esto nos motiva a desarrollar algoritmos que combinen tanto arquitecturas avanzadas como implementaciones eficientes en hardware para aprovechar plenamente la dispersión y mejorar la eficiencia del modelo.
2.2. El Mito de la Dispersión Entrenable
Nuestra búsqueda de una atención dispersa nativa entrenable está motivada por dos ideas clave del análisis de los enfoques de solo inferencia: (1) Degradación del rendimiento: aplicar dispersión a posteriori obliga a los modelos a desviarse de su trayectoria de optimización preentrenada. Como demuestran Chen et al. (2024b), el superior de atención solo puede cubrir el de las puntuaciones de atención totales, lo que hace que estructuras como las cabezas de recuperación en modelos preentrenados sean vulnerables a la poda durante la inferencia. (2) Demandas de eficiencia de entrenamiento: el manejo eficiente del entrenamiento con secuencias largas es crucial para el desarrollo moderno de LLM. Esto incluye tanto el preentrenamiento con documentos más largos para mejorar la capacidad del modelo, como las fases de adaptación posteriores, tales como el ajuste fino de contexto largo y el aprendizaje por refuerzo. Sin embargo, los métodos existentes de atención dispersa se orientan principalmente a la inferencia, dejando en gran medida sin abordar los desafíos computacionales del entrenamiento. Esta limitación obstaculiza el desarrollo de modelos de contexto largo más capaces mediante un entrenamiento eficiente. Además, los esfuerzos por adaptar la atención dispersa existente para el entrenamiento también exponen desafíos:
Componentes no entrenables. Las operaciones discretas en métodos como ClusterKV (Liu et al., 2024) (incluye agrupamiento k-means) y MagicPIG (Chen et al., 2024b) (incluye selección basada en SimHash) crean discontinuidades en el grafo computacional. Estos componentes no entrenables impiden el flujo de gradientes a través del proceso de selección de tokens, limitando la capacidad del modelo para aprender patrones dispersos óptimos.
Retropropagación ineficiente. Algunos métodos de atención dispersa teóricamente entrenables sufren ineficiencias prácticas de entrenamiento. La estrategia de selección con granularidad de token usada en enfoques como HashAttention (Desai et al., 2024) conduce a la necesidad de cargar un gran número de tokens individuales desde la caché KV durante el cálculo de atención. Este acceso a memoria no contiguo impide la adaptación eficiente de técnicas de atención rápidas como FlashAttention, que dependen del acceso a memoria contiguo y del cálculo por bloques para lograr un alto rendimiento. Como resultado, las implementaciones se ven obligadas a recurrir a una baja utilización del hardware, lo que degrada significativamente la eficiencia del entrenamiento.
2.3. La dispersión nativa como imperativo
Estas limitaciones en la eficiencia de inferencia y la viabilidad del entrenamiento motivan nuestro rediseño fundamental de los mecanismos de atención dispersa. Proponemos NSA, un marco de atención nativamente dispersa que aborda tanto la eficiencia computacional como los requisitos de entrenamiento. En las siguientes secciones, detallamos el diseño algorítmico y la implementación del operador de NSA.
3. Metodología
Nuestro enfoque técnico abarca el diseño de algoritmos y la optimización de kernels. En las siguientes subsecciones, primero presentamos los antecedentes de nuestra metodología. Luego presentamos el marco general de NSA, seguido de sus componentes algorítmicos clave. Finalmente, detallamos nuestro diseño de kernel optimizado para hardware que maximiza la eficiencia práctica.
3.1. Antecedentes
El mecanismo de atención se utiliza ampliamente en el modelado de lenguaje, donde cada token de consulta calcula puntuaciones de relevancia frente a todas las claves precedentes para generar una suma ponderada de valores . Formalmente, para una secuencia de entrada de longitud , la operación de atención se define como:
donde Attn denota la función de atención:
Aquí, representa el peso de atención entre y , y es la dimensión de características de las claves. A medida que aumenta la longitud de la secuencia, el cálculo de atención se vuelve cada vez más dominante en el costo computacional total, lo que presenta desafíos significativos para el procesamiento de contextos largos.
La intensidad aritmética es la relación entre las operaciones de cómputo y los accesos a memoria. Esta determina intrínsecamente la optimización de algoritmos sobre el hardware. Cada GPU tiene una intensidad aritmética crítica determinada por su capacidad de cómputo máxima y su ancho de banda de memoria, calculada como la relación entre estos dos límites del hardware. Para las tareas de cómputo, una intensidad aritmética por encima de este umbral crítico pasa a estar limitada por cómputo (limitada por los FLOPS de la GPU), mientras que por debajo de él pasa a estar limitada por memoria (limitada por el ancho de banda de memoria).
Específicamente, para el mecanismo de autoatención causal, durante las fases de entrenamiento y perfilado, las multiplicaciones de matrices por lotes y los cálculos de atención exhiben una alta intensidad aritmética, lo que hace que estas etapas estén limitadas por cómputo en los aceleradores modernos. En contraste, la decodificación autorregresiva pasa a estar restringida por el ancho de banda de memoria porque genera un token por cada pasada hacia adelante mientras requiere cargar toda la caché de clave-valor, lo que resulta en una baja intensidad aritmética.Esto conduce a diferentes objetivos de optimización: reducir el costo computacional durante el entrenamiento y el prellenado, mientras se reduce el acceso a memoria durante la decodificación.
3.2. Marco general
Para aprovechar el potencial de la atención con un patrón de dispersión natural, proponemos reemplazar los pares clave-valor originales en la Ecuación (1) con un conjunto más compacto y denso en información de pares clave-valor de representación dado cada consulta . Específicamente, definimos formalmente la salida de atención optimizada de la siguiente manera:
donde se construyen dinámicamente en función de la consulta actual y la memoria contextual . Podemos diseñar diversas estrategias de mapeo para obtener diferentes categorías de , y combinarlas de la siguiente manera:
Como se ilustra en la Figura 2, NSA tiene tres estrategias de mapeo , que representan compresión, selección y ventana deslizante para claves y valores. es la puntuación de compuerta para la estrategia correspondiente , derivada de las características de entrada mediante un MLP y activación sigmoide. Sea el número total de claves/valores remapeados:
Mantenemos una alta tasa de dispersión asegurando .
3.3. Diseño del algoritmo
En esta subsección, presentamos el diseño de nuestras estrategias de remapeo y : compresión de tokens, selección de tokens y ventana deslizante.
3.3.1. Compresión de tokens
Al agregar bloques secuenciales de claves o valores en representaciones a nivel de bloque, obtenemos claves y valores comprimidos que capturan la información del bloque completo. Formalmente, la representación de clave comprimida se define como:
donde es la longitud del bloque, es el paso deslizante entre bloques adyacentes, y es un MLP entrenable con codificación de posición intra-bloque para mapear las claves de un bloque a una única clave comprimida. es un tensor compuesto por claves de compresión. Normalmente, adoptamos para mitigar la fragmentación de la información. Una formulación análoga se cumple para la representación de valor comprimida . Las representaciones comprimidas capturan información semántica de nivel superior de grano más grueso y reducen la carga computacional de la atención.
3.3.2. Selección de tokens
Usar solo claves y valores comprimidos podría perder información importante de grano fino, lo que nos motiva a preservar selectivamente claves y valores individuales. A continuación describimos nuestro mecanismo eficiente de selección de tokens que identifica y preserva los tokens más relevantes con bajo costo computacional.
Selección por bloques. Nuestra estrategia de selección procesa secuencias de claves y valores en bloques espacialmente continuos, motivada por dos factores clave: consideraciones de eficiencia de hardware y patrones de distribución inherentes de las puntuaciones de atención. La selección por bloques es crucial para lograr un cálculo eficiente en las GPU modernas. Esto se debe a que las arquitecturas de GPU modernas exhiben un rendimiento significativamente mayor para accesos a bloques continuos en comparación con lecturas aleatorias basadas en índices. Además, el cálculo por bloques permite una utilización óptima de los Tensor Cores. Esta característica arquitectónica ha establecido el acceso a memoria y el cálculo por bloques como un principio fundamental en las implementaciones de atención de alto rendimiento, como lo ejemplifica el diseño basado en bloques de FlashAttention. La selección por bloques sigue los patrones de distribución inherentes de las puntuaciones de atención. Trabajos previos (Jiang et al., 2024) han demostrado que las puntuaciones de atención a menudo exhiben continuidad espacial, lo que sugiere que las claves vecinas tienden a compartir niveles de importancia similares. Nuestra visualización en la Sección 6.2 también muestra este patrón de continuidad espacial.
Para implementar la selección por bloques, primero dividimos las secuencias de claves y valores en bloques de selección. Para identificar los bloques más importantes para el cálculo de atención, necesitamos asignar puntuaciones de importancia a cada bloque. A continuación presentamos nuestro método para calcular estas puntuaciones de importancia a nivel de bloque.
Cálculo de la puntuación de importancia. Calcular las puntuaciones de importancia de los bloques podría introducir una sobrecarga significativa. Afortunadamente, el cálculo de atención de los tokens de compresión produce puntuaciones de atención intermedias que podemos aprovechar para inducir las puntuaciones de importancia de los bloques de selección, formulado como:
donde son las puntuaciones de atención entre y las claves de compresión . Sea el tamaño del bloque de selección. Cuando los bloques de compresión y los bloques de selección comparten el mismo esquema de bloqueo, es decir, , podemos obtener directamente las puntuaciones de importancia de los bloques de selección mediante de forma directa. Para los casos en que los esquemas de bloqueo difieren, derivamos las puntuaciones de importancia para los bloques de selección de acuerdo con su relación espacial. Dado , y , tenemos:
donde denota el operador de indexación para acceder a un elemento de un vector. Para los modelos que emplean GQA o MQA, en los que las cachés de clave-valor se comparten entre las cabezas de consulta, debe garantizarse una selección de bloques consistente entre estas cabezas para minimizar la carga de la caché KV durante la decodificación. Las puntuaciones de importancia compartidas entre las cabezas de un grupo se definen formalmente como:
donde en el superíndice denota el índice de la cabeza, y es el número de cabezas de consulta en cada grupo. Esta agregación garantiza una selección de bloques consistente entre las cabezas dentro de un mismo grupo.
Selección de los \(n\) mejores bloques. Después de obtener las puntuaciones de importancia de los bloques de selección, conservamos los tokens dentro de los \(n\) bloques dispersos mejores clasificados según las puntuaciones de importancia de los bloques, formulado como:
donde rank denota la posición de clasificación en orden descendente, con rank correspondiente a la puntuación más alta, es el conjunto de índices de los bloques seleccionados, Cat denota la operación de concatenación. es un tensor compuesto por claves de compresión. Una formulación análoga se aplica al valor de grano fino . Las claves y los valores seleccionados participan entonces en el cálculo de la atención con como se define en la Ecuación (5).
3.3.3. Ventana deslizante
En los mecanismos de atención, los patrones locales suelen adaptarse más rápido y pueden dominar el proceso de aprendizaje, lo que potencialmente impide que el modelo aprenda eficazmente a partir de los tokens de compresión y selección. Para abordar este problema, introducimos una rama dedicada de ventana deslizante que maneja explícitamente el contexto local, permitiendo que las otras ramas (compresión y selección) se centren en aprender sus respectivas características sin ser atajadas por los patrones locales. Específicamente, mantenemos los tokens recientes en una ventana , y aislamos los cálculos de atención de las diferentes fuentes de información (tokens de compresión y tokens seleccionados, ventana deslizante) en ramas separadas. Las salidas de estas ramas se agregan luego mediante un mecanismo de compuerta aprendido. Para prevenir además el aprendizaje de atajos entre las ramas de atención con una sobrecarga computacional marginal, proporcionamos claves y valores independientes para las tres ramas. Este diseño arquitectónico permite un aprendizaje estable al prevenir la interferencia de gradientes entre el reconocimiento de patrones locales y de largo alcance, mientras introduce una sobrecarga mínima.
Después de obtener las tres categorías de claves y valores , calculamos la salida de atención final siguiendo la Ecuación (5). Junto con los mecanismos de compresión, selección y ventana deslizante descritos anteriormente, esto forma el marco algorítmico completo de NSA.
3.4. Diseño del kernel
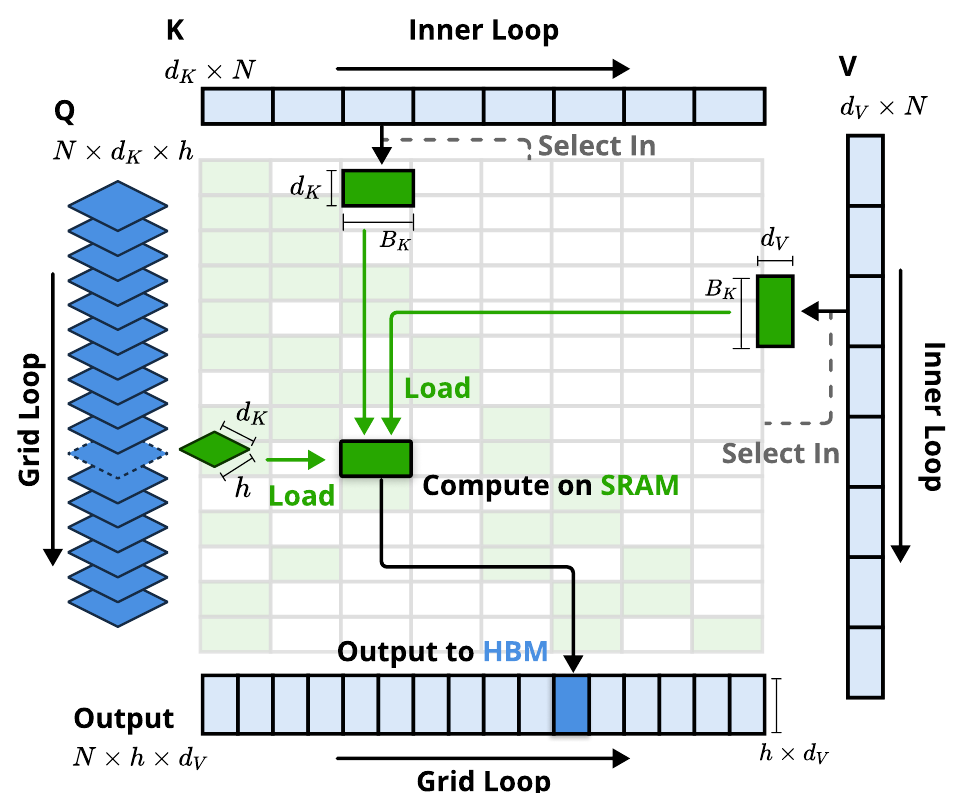
Para lograr una aceleración a nivel de FlashAttention durante el entrenamiento y la creación de perfiles, implementamos kernels de atención dispersa alineados con el hardware sobre Triton. Dado que MHA consume mucha memoria y es ineficiente para la decodificación, nos centramos en arquitecturas con cachés KV compartidas como GQA y MQA, siguiendo a los LLM de vanguardia actuales. Mientras que los cálculos de atención de compresión y ventana deslizante son fácilmente compatibles con los kernels existentes de FlashAttention-2, introducimos el diseño de kernel especializado para la atención de selección dispersa. Si siguiéramos la estrategia de FlashAttention de cargar bloques de consulta temporalmente continuos en la SRAM, esto resultaría en un acceso a memoria ineficiente, ya que las consultas dentro de un bloque podrían requerir bloques KV disjuntos. Para abordar esto, nuestra optimización clave radica en una estrategia diferente de agrupación de consultas: para cada posición en la secuencia de consultas, cargamos todas las cabezas de consulta dentro de un grupo GQA (que comparten los mismos bloques KV dispersos) en la SRAM. La Figura 3 ilustra nuestra implementación del paso hacia adelante. La arquitectura de kernel propuesta se caracteriza por las siguientes características clave:
1. Carga de datos centrada en grupos. Para cada bucle interno, cargamos las consultas de todas las cabezas en el grupo en la posición y sus índices de bloques clave/valor dispersos compartidos .
2. Obtención compartida de KV. En el bucle interno, cargamos secuencialmente bloques continuos de clave/valor indexados por en la SRAM como , para minimizar la carga de memoria, donde es el tamaño del bloque del kernel que satisface .
3. Bucle externo sobre la cuadrícula. Dado que la longitud del bucle interno (proporcional al número de bloques seleccionados ) permanece casi idéntica para diferentes bloques de consulta, colocamos los bucles de consulta/salida en el planificador de cuadrícula de Triton para simplificar y optimizar el kernel.
Este diseño logra una intensidad aritmética casi óptima al (1) eliminar las transferencias KV redundantes mediante el uso compartido por grupos, y (2) equilibrar las cargas de trabajo computacionales entre los multiprocesadores de transmisión de la GPU.
4. Experimentos
Evaluamos NSA a través de tres perspectivas: (1) rendimiento en benchmarks generales, (2) rendimiento en benchmarks de contexto largo, y (3) rendimiento en razonamiento de cadena de pensamiento, comparando con la línea base de Atención Completa y los métodos de atención dispersa de vanguardia. Diferimos el análisis de eficiencia de nuestro paradigma de computación dispersa a la Sección 5, donde proporcionamos discusiones detalladas sobre la velocidad de entrenamiento e inferencia.
4.1. Configuración de preentrenamiento
Siguiendo la práctica común en los LLM de vanguardia, nuestros experimentos adoptan una arquitectura troncal que combina Grouped-Query Attention (GQA) y Mixture-of-Experts (MoE), con 27B parámetros totales y 3B parámetros activos. El modelo consta de 30 capas con una dimensión oculta de 2560. Para GQA, establecemos el número de grupos en 4, con un total de 64 cabezas de atención. Para cada cabeza, las dimensiones ocultas de la consulta, la clave y el valor se configuran como y , respectivamente. Para MoE, utilizamos la estructura DeepSeekMoE (Dai et al., 2024; DeepSeek-AI, 2024), con 72 expertos enrutados y 2 expertos compartidos, y establecemos los expertos top-k en 6. Para garantizar la estabilidad del entrenamiento, el MoE en la primera capa se reemplaza por un MLP en forma de SwiGLU.
| Modelo | MMLU Acc. 5-shot | MMLU-PRO Acc. 5-shot | CMMLU Acc. 5-shot | BBH Acc. 3-shot | GSM8K Acc. 8-shot | MATH Acc. 4-shot | DROP F1 1-shot | MBPP Pass@1 3-shot | HumanEval Pass@1 0-shot | Prom. |
| Full Attn | 0.567 | 0.279 | 0.576 | 0.497 | 0.486 | 0.263 | 0.503 | 0.482 | 0.335 | 0.443 |
| NSA | 0.565 | 0.286 | 0.587 | 0.521 | 0.520 | 0.264 | 0.545 | 0.466 | 0.348 | 0.456 |
Tabla 1 | Comparación del rendimiento de preentrenamiento entre la línea base de atención completa y NSA en benchmarks generales, a través de tareas de conocimiento (MMLU, MMLU-PRO, CMMLU), razonamiento (BBH, GSM8K, MATH, DROP) y codificación (MBPP, HumanEval). NSA logra un rendimiento promedio superior en la mayoría de los benchmarks a pesar de la alta dispersión.
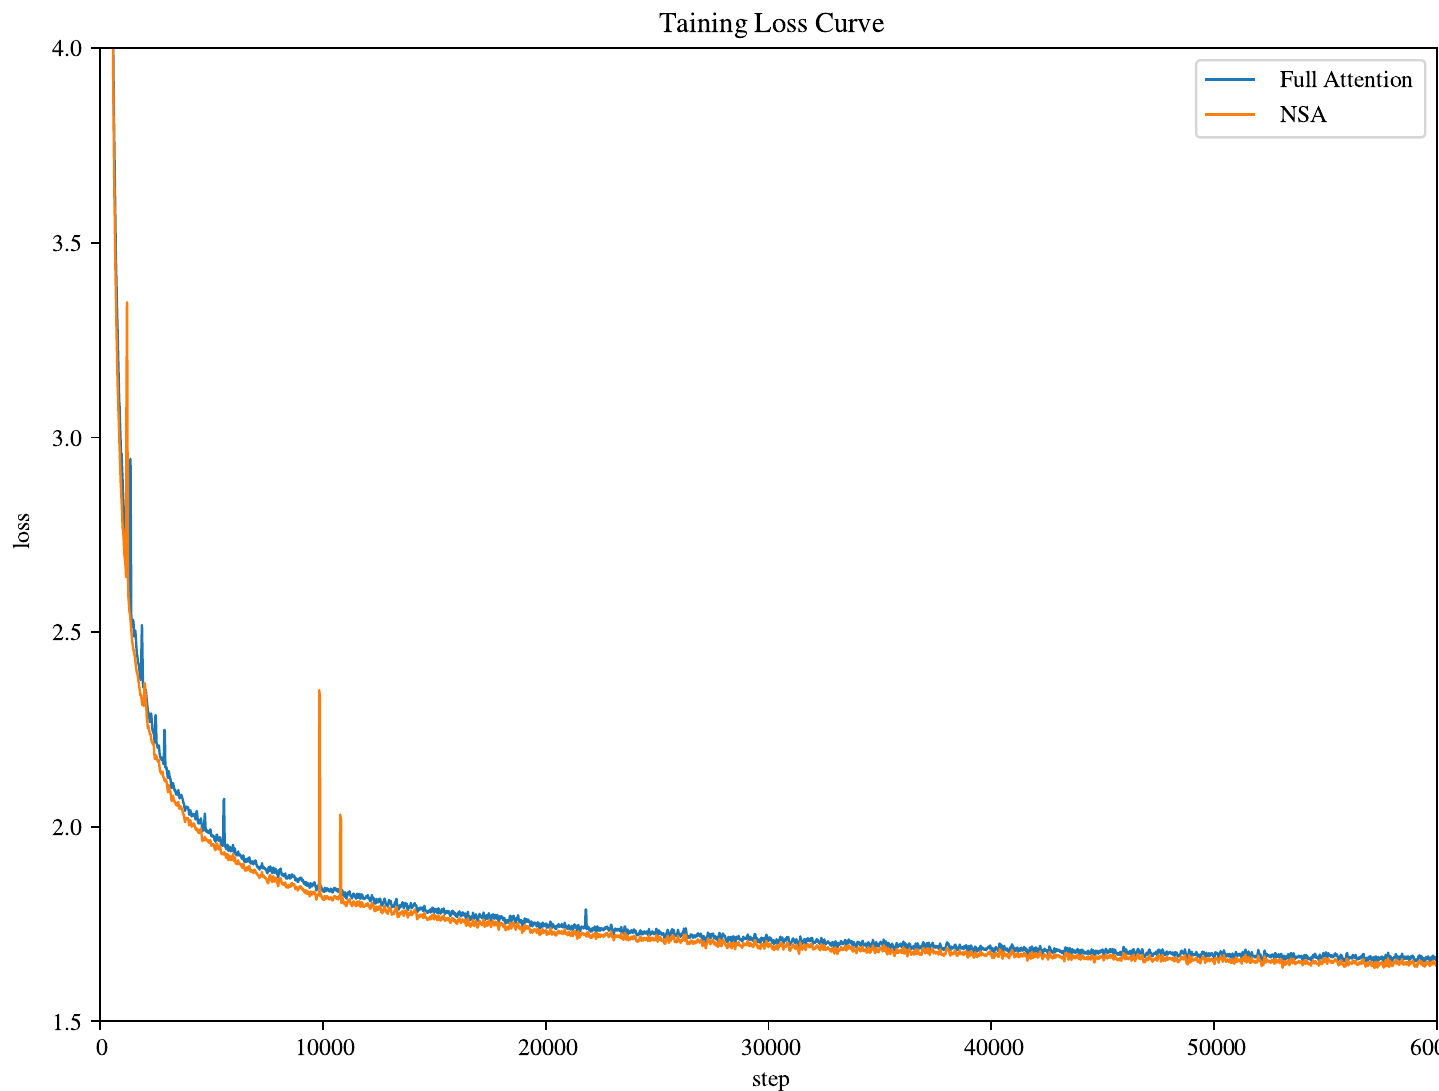
La arquitectura propuesta logra un equilibrio efectivo entre el costo computacional y el rendimiento del modelo. Para NSA, establecemos el tamaño del bloque de compresión , el paso deslizante , el tamaño del bloque seleccionado , el número de bloques seleccionados (incluyendo la activación fija del 1 bloque inicial y 2 bloques locales), y el tamaño de la ventana deslizante . Tanto los modelos de Atención Completa como los de atención dispersa se preentrenan con 270B tokens de textos de longitud 8k, seguido de un entrenamiento continuado y un ajuste fino supervisado en textos de longitud 32k con YaRN (Peng et al., 2024) para lograr la adaptación a contexto largo. Ambos modelos se entrenan hasta la convergencia completa para garantizar una comparación justa. Como se muestra en la Figura 4, la curva de pérdida de preentrenamiento de nuestro NSA y la línea base de Atención Completa demuestra un descenso estable y suave, con NSA superando consistentemente al modelo de Atención Completa.
4.2. Métodos de línea base
Además de comparar con Atención Completa, evaluamos varios métodos de atención dispersa de vanguardia en la etapa de inferencia: H2O (Zhang et al., 2023b), infLLM (Xiao et al., 2024a), Quest (Tang et al., 2024) y Exact-Top, que primero calcula la puntuación de atención completa y selecciona las claves top- correspondientes a cada consulta y luego calcula la atención en estas posiciones. Estos
| Modelo | SQA | MQA | Synthetic | CodeLCC | Prom. | ||||||
| MFQA-en | MFQA-zh | Qasper | HPQ | 2Wiki | GovRpt | Dur | PassR-en | PassR-zh | |||
| H2O | 0.428 | 0.429 | 0.308 | 0.112 | 0.101 | 0.231 | 0.208 | 0.704 | 0.421 | 0.092 | 0.303 |
| InfLLM | 0.474 | 0.517 | 0.356 | 0.306 | 0.250 | 0.277 | 0.257 | 0.766 | 0.486 | 0.143 | 0.383 |
| Quest | 0.495 | 0.561 | 0.365 | 0.295 | 0.245 | 0.293 | 0.257 | 0.792 | 0.478 | 0.135 | 0.392 |
| Exact-Top | 0.502 | 0.605 | 0.397 | 0.321 | 0.288 | 0.316 | 0.291 | 0.810 | 0.548 | 0.156 | 0.423 |
| Full Attn | 0.512 | 0.623 | 0.409 | 0.350 | 0.305 | 0.324 | 0.294 | 0.830 | 0.560 | 0.163 | 0.437 |
| NSA | 0.503 | 0.624 | 0.432 | 0.437 | 0.356 | 0.307 | 0.341 | 0.905 | 0.550 | 0.232 | 0.469 |
Tabla 2 | Comparación de rendimiento entre nuestro NSA y las líneas base en LongBench, incluyendo subconjuntos en QA de documento único, QA de múltiples documentos, tareas sintéticas y de código. NSA superó a la mayoría de las líneas base, incluida Atención Completa.métodos abarcan diversos paradigmas de atención dispersa, incluyendo la expulsión de caché KV, la selección consciente de consultas y la selección dispersa exacta top-.
Para la evaluación general, donde la mayoría de las muestras tienen longitudes dentro de la ventana de contexto local de las líneas base de atención dispersa, estos métodos son efectivamente equivalentes a la Atención Completa. Por lo tanto, presentamos solo los resultados de comparación entre NSA y la línea base de Atención Completa en esta configuración. En la evaluación de contexto largo, realizamos comparaciones entre todos los métodos de línea base, con la dispersión de todos los métodos de atención dispersa establecida igual para garantizar una comparación justa. Para la evaluación de razonamiento de cadena de pensamiento, que requiere un ajuste fino supervisado de texto largo, limitamos nuestra comparación a Atención Completa, ya que las líneas base de atención dispersa no admiten entrenamiento.
4.3. Comparación de rendimiento
Evaluación general. Evaluamos el NSA preentrenado y la línea base de Atención Completa en un conjunto integral de benchmarks que abarcan capacidades de conocimiento, razonamiento y codificación, incluyendo MMLU (Hendrycks et al., 2020), MMLU-PRO (Wang et al., 2024), CMMLU (Li et al., 2023), BBH (Suzgun et al., 2022), GSM8K (Cobbe et al., 2021), MATH (Hendrycks et al., 2020), DROP (Dua et al., 2019), MBPP (Austin et al., 2021) y HumanEval (Chen et al., 2021). Los resultados se muestran en la Tabla 1. A pesar de su dispersión, NSA logra un rendimiento general superior, superando a todas las líneas base, incluida Atención Completa, en 7 de 9 métricas. Esto indica que aunque NSA puede no aprovechar plenamente sus ventajas de eficiencia en secuencias más cortas, muestra un rendimiento sólido. Notablemente, NSA demuestra ganancias significativas en benchmarks relacionados con el razonamiento (DROP: , GSM8K: ), lo que sugiere que nuestro preentrenamiento ayuda a los modelos a desarrollar mecanismos de atención especializados. Este mecanismo de preentrenamiento con atención dispersa obliga al modelo a centrarse en la información más importante, mejorando potencialmente el rendimiento al filtrar el ruido de las vías de atención irrelevantes. El rendimiento consistente en diversas evaluaciones también valida la robustez de NSA como arquitectura de propósito general.
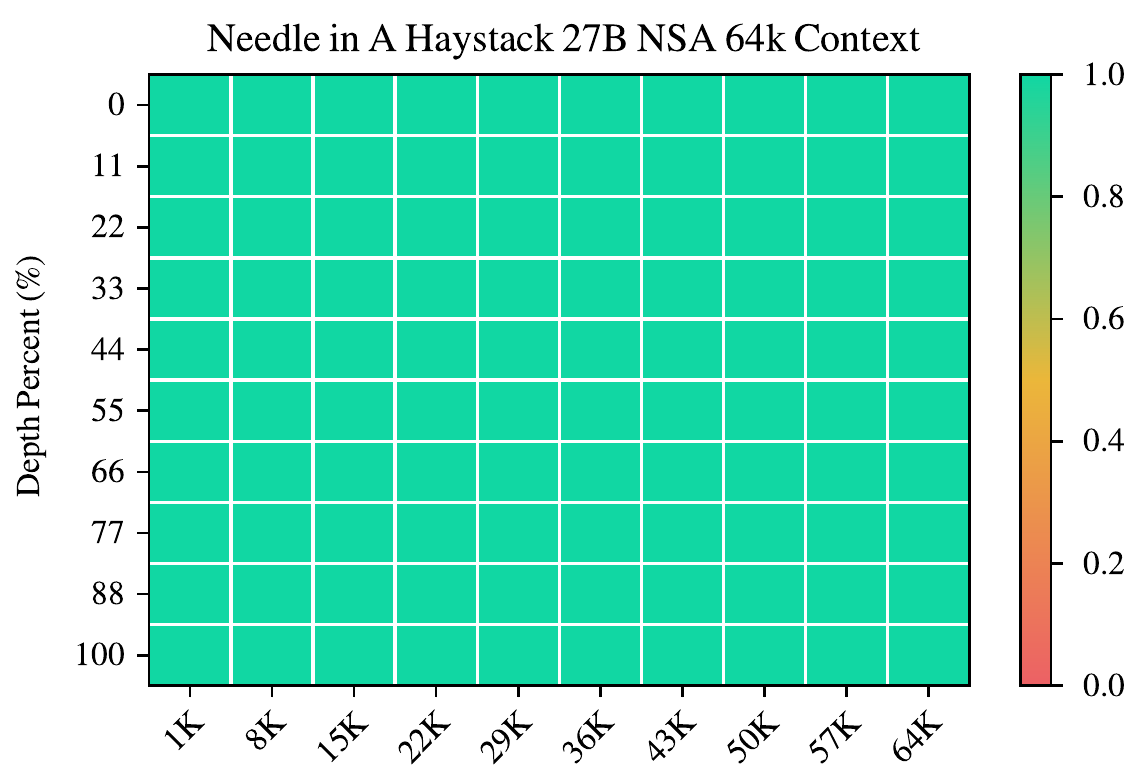
Evaluación de contexto largo. Como se muestra en la Figura 5, NSA logra una precisión de recuperación perfecta en todas las posiciones en la prueba de aguja en un pajar con contexto de 64k (Kamradt, 2023). Este rendimiento se deriva de nuestro diseño de atención dispersa jerárquica, que combina tokens de compresión para un escaneo eficiente del contexto global y tokens de selección para una recuperación precisa de información local. La compresión de grano grueso identifica bloques de contexto relevantes con bajo costo computacional, mientras que la atención a nivel de token sobre los tokens seleccionados garantiza la preservación de información crítica de grano fino. Este diseño permite a NSA mantener tanto conciencia global como precisión local.
También evaluamos NSA en LongBench (Bai et al., 2023) frente a métodos de atención dispersa de última generación
y una línea base de Atención Completa. Para garantizar una dispersión consistente, fijamos el número de tokens activados por cada consulta en todas las líneas base de atención dispersa en 2560 tokens, lo que corresponde al número promedio de tokens activados en NSA al manejar longitudes de secuencia de 32k. Siguiendo a Stream-LLM (Xiao et al., 2023), este presupuesto de tokens incluye los 128 tokens iniciales y 512 tokens locales. Excluimos ciertos subconjuntos de LongBench debido a sus bajas puntuaciones en todos los modelos, lo que podría no proporcionar comparaciones significativas. Como se muestra en la Tabla 2, NSA logra la puntuación promedio más alta, 0.469, superando a todas las líneas base (+0.032 sobre Atención Completa y +0.046 sobre Exact-Top). Esta mejora surge de dos innovaciones clave: (1) nuestro diseño nativo de atención dispersa, que permite la optimización de extremo a extremo de los patrones dispersos durante el preentrenamiento, facilita la adaptación sincronizada entre el módulo de atención dispersa y otros componentes del modelo; y (2) el mecanismo de atención dispersa jerárquica logra un equilibrio entre el procesamiento de información local y global.
Notablemente, NSA demuestra un rendimiento excepcional en tareas que requieren razonamiento complejo sobre contextos largos, logrando mejoras de +0.087 y +0.051 sobre Atención Completa en tareas de QA de múltiples saltos (HPQ y 2Wiki), superando el rendimiento de las líneas base en comprensión de código (LCC: +0.069), y superando a otros métodos en recuperación de pasajes (PassR-en: +0.075). Estos resultados validan la capacidad de NSA para manejar diversos desafíos de contexto largo, con su atención dispersa preentrenada de forma nativa proporcionando beneficios adicionales en el aprendizaje de patrones óptimos para las tareas.
Evaluación de razonamiento de cadena de pensamiento. Para evaluar la compatibilidad de NSA con paradigmas avanzados de entrenamiento posterior, investigamos su capacidad para adquirir habilidades de razonamiento matemático de cadena de pensamiento mediante post-entrenamiento. Dada la limitada efectividad del aprendizaje por refuerzo en modelos de menor escala, empleamos destilación de conocimiento de DeepSeek-R1, realizando un ajuste fino supervisado (SFT) con 10B tokens de trazas de razonamiento matemático de 32k de longitud. Esto produce dos modelos comparables: Full Attention-R (línea base de Atención Completa) y NSA-R (nuestra variante dispersa). Evaluamos ambos modelos en el desafiante benchmark del Examen de Matemáticas Invitacional Estadounidense (AIME 24). Usamos una temperatura de muestreo de 0.7 y un valor de top- de 0.95 para generar 16 respuestas por cada pregunta y obtener la puntuación promedio. Para validar el impacto de la profundidad de razonamiento, realizamos experimentos con dos límites de contexto de generación: 8k y 16k tokens, midiendo si las cadenas de razonamiento extendidas mejoran la precisión. En el Apéndice A se proporcionan ejemplos de comparaciones de predicciones de los modelos.
| Límite de tokens de generación | 8192 | 16384 |
| Full Attention-R | 0,046 | 0,092 |
| NSA-R | 0,121 | 0,146 |
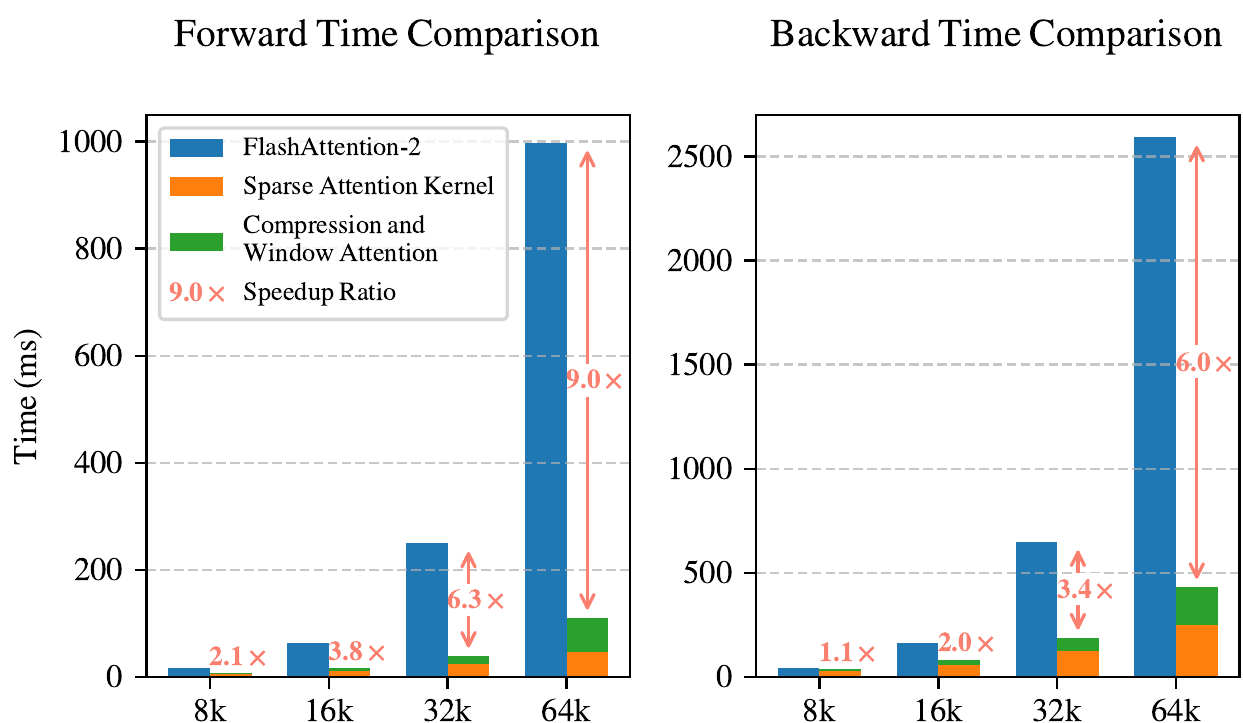
Figura 6 | Comparación del kernel NSA basado en Triton con el kernel FlashAttention-2 basado en Triton. Nuestra implementación reduce significativamente la latencia en todas las longitudes de contexto, y la mejora se vuelve más pronunciada a medida que aumenta la longitud de entrada.
Como se muestra en la Tabla 3, NSA-R logra una precisión significativamente mayor que Full Attention-R en el ajuste de contexto de 8k (+0,075), y esta ventaja persiste en contextos de 16k (+0,054). Estos resultados validan dos beneficios clave de la atención dispersa nativa: (1) Los patrones de atención dispersa preentrenados permiten capturar eficientemente dependencias lógicas de largo alcance, críticas para derivaciones matemáticas complejas; (2) El diseño de nuestra arquitectura, alineado con el hardware, mantiene una densidad de contexto suficiente para soportar una profundidad de razonamiento creciente sin olvido catastrófico. El rendimiento superior constante en distintas longitudes de contexto confirma la viabilidad de la atención dispersa para tareas de razonamiento avanzado cuando se integra de forma nativa en el pipeline de entrenamiento.
5. Análisis de eficiencia
Evaluamos la eficiencia computacional de NSA frente a Full Attention en un sistema de 8 GPU A100. En el análisis de eficiencia, también configuramos el modelo con grupo GQA , cabezas por grupo , dimensión de query/key y dimensión de value . Siguiendo los mismos ajustes de la Sección 4, establecemos el tamaño de bloque de compresión de NSA , el paso deslizante , el tamaño de bloque seleccionado , el número de bloques seleccionados y el tamaño de ventana deslizante .
5.1. Velocidad de entrenamiento
Comparamos las implementaciones basadas en Triton de nuestra atención NSA y Full Attention con FlashAttention-2 basado en Triton para garantizar una comparación de velocidad justa con el mismo backend. Como se muestra en la Figura 6, nuestra NSA logra aceleraciones progresivamente mayores a medida que aumenta la longitud de contexto, hasta en forward y en backward con una longitud de contexto de 64k. En particular, la ventaja de velocidad se vuelve más pronunciada con secuencias más largas. Esta aceleración proviene de nuestro
| Longitud del contexto | 8192 | 16384 | 32768 | 65536 |
| Full Attention | 8192 | 16384 | 32768 | 65536 |
| NSA | 2048 | 2560 | 3584 | 5632 |
| Aceleración esperada | 4× | 6.4× | 9.1× | 11.6× |
diseño de algoritmo alineado con el hardware para maximizar la eficiencia de la arquitectura de atención dispersa: (1) El patrón de acceso a memoria por bloques maximiza la utilización de los Tensor Cores mediante cargas coalescentes, (2) La delicada planificación de bucles en el kernel elimina las transferencias KV redundantes.
5.2. Velocidad de decodificación
La velocidad de decodificación de Attention está determinada principalmente por el cuello de botella de acceso a memoria, que está estrechamente ligado a la cantidad de carga de la caché KV. En cada paso de decodificación, nuestra NSA solo necesita cargar como máximo tokens de compresión, tokens seleccionados y tokens vecinos, donde es la longitud de la secuencia en caché. Como se muestra en la Tabla 4, nuestro método exhibe una reducción significativa de la latencia a medida que aumenta la longitud de decodificación, logrando hasta de aceleración con una longitud de contexto de 64k. Esta ventaja en eficiencia de acceso a memoria también se amplifica con secuencias más largas.
6. Discusión
En esta sección, reflexionamos sobre el proceso de desarrollo de NSA y discutimos ideas clave obtenidas de nuestra exploración de diferentes estrategias de atención dispersa. Aunque nuestro enfoque demuestra resultados prometedores, comprender los desafíos encontrados con estrategias alternativas y analizar los patrones de atención proporciona un contexto valioso para futuras direcciones de investigación. Primero examinamos los desafíos con estrategias alternativas de selección de tokens que motivaron nuestras elecciones de diseño, seguidas de visualizaciones que ofrecen ideas sobre los patrones de distribución de atención.
6.1. Desafíos con estrategias alternativas de selección de tokens
Antes de diseñar NSA, exploramos la adaptación de métodos existentes de atención dispersa a la etapa de entrenamiento. Sin embargo, estos intentos encontraron diversos desafíos, lo que nos llevó a diseñar una arquitectura de atención dispersa diferente:
Estrategias basadas en agrupamiento de Keys. Examinamos estrategias basadas en agrupamiento como ClusterKV (Liu et al., 2024). Estos métodos almacenan Keys y Values del mismo clúster en regiones de memoria contiguas. Aunque teóricamente factibles para entrenamiento e inferencia, enfrentan tres desafíos significativos: (1) La sobrecarga computacional no trivial introducida por los mecanismos de agrupamiento dinámico; (2) Las dificultades de optimización de operadores exacerbadas por los desequilibrios entre clústeres, especialmente en sistemas de Mixture-of-Experts (MoE), donde los tiempos de ejecución sesgados de los grupos de Expert Parallelism (EP) conducen a desequilibrios de carga persistentes; (3) Las restricciones de implementación derivadas de la necesidad de reagrupamiento periódico obligatorio y protocolos de entrenamiento secuencial por chunks. Estos factores combinados crean cuellos de botella sustanciales, limitando significativamente su efectividad para el despliegue en el mundo real.
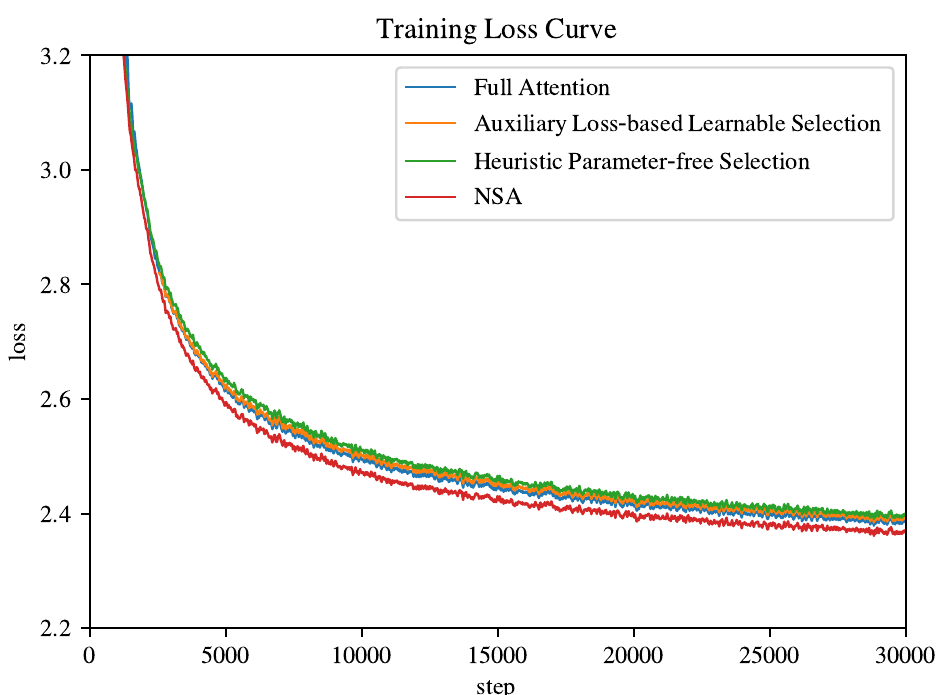
Otras estrategias de selección por bloques. También consideramos estrategias de selección de key, value por bloques diferentes de NSA, como Quest (Tang et al. [2024]) e InfLLM (Xiao et al. [2024a]). Estos métodos se basan en calcular una puntuación de importancia para cada bloque KV y seleccionar los bloques principales según su similitud con . Sin embargo, los métodos existentes enfrentan dos problemas críticos: (1) Dado que la operación de selección no es diferenciable, el cálculo de la puntuación de importancia basado en redes neuronales depende de una pérdida auxiliar, lo que aumenta la sobrecarga del operador y a menudo degrada el rendimiento del modelo; (2) La estrategia heurística de cálculo de puntuación de importancia sin parámetros sufre de bajas tasas de recall, lo que lleva a un rendimiento subóptimo. Evaluamos ambos enfoques en un modelo de 3B de parámetros con arquitectura similar y comparamos su curva de pérdida con NSA y Full Attention. Para el método de selección basado en pérdida auxiliar, introducimos queries adicionales para cada token y keys representativas para cada bloque para estimar las puntuaciones de importancia de los bloques. Calculamos las señales de supervisión a nivel de bloque mediante mean-pooling de las puntuaciones de atención dentro de cada bloque de keys, y usamos la divergencia KL para supervisar la predicción de importancia de bloques. Mantenemos la granularidad individual de query en lugar de queries promediadas por bloque para acomodar una decodificación eficiente. Esta estimación de importancia basada en pérdida auxiliar comparte similitud conceptual con SeerAttention (Gao et al. [2024]). Para el método heurístico de selección sin parámetros, siguiendo la estrategia de Quest, implementamos la selección directa usando el producto entre las queries y el mínimo-máximo por coordenadas de los chunks de keys, sin introducir parámetros adicionales. También exploramos un enfoque de entrenamiento con arranque en frío en el que se aplica Full Attention durante los primeros 1000 pasos antes de pasar a la selección heurística por bloques. Como se muestra en la Figura 7, ambos métodos exhibieron una pérdida inferior.
6.2. Visualización
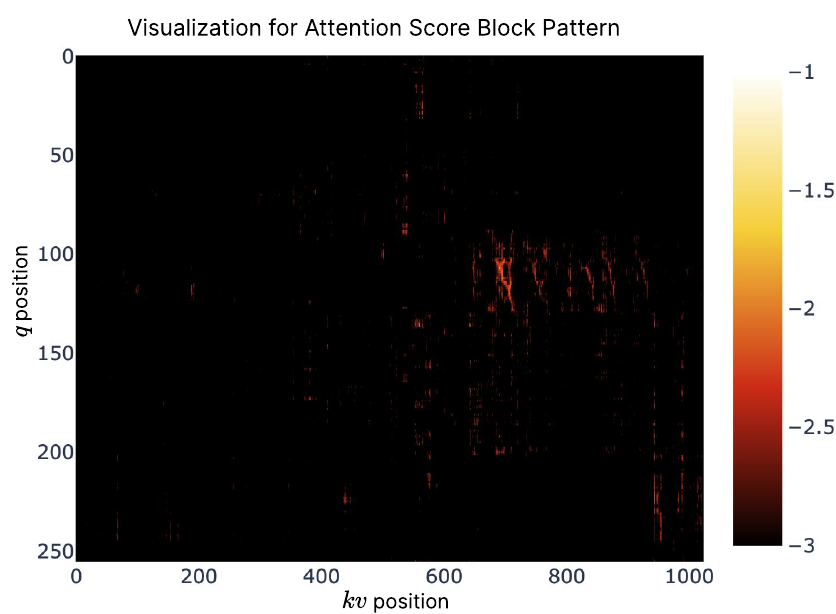
Para explorar posibles patrones en las distribuciones de atención de los transformers y buscar inspiración para nuestro diseño, visualizamos el mapa de atención de nuestro modelo Full Attention preentrenado de 27B en la Figura 8. La visualización revela patrones interesantes en los que las puntuaciones de atención tienden a exhibir características de agrupamiento por bloques, con keys cercanas que a menudo muestran puntuaciones de atención similares. Esta observación inspiró nuestro diseño de NSA, sugiriendo que seleccionar bloques de keys basándose en la continuidad espacial podría ser un enfoque prometedor. El fenómeno de agrupamiento por bloques indica que los tokens adyacentes en la secuencia pueden compartir ciertas relaciones semánticas con los tokens de query, aunque la naturaleza exacta de estas relaciones requiere más investigación. Estaobservación nos motivó a explorar un mecanismo de atención dispersa que opera sobre bloques continuos de tokens en lugar de tokens individuales, con el objetivo de mejorar la eficiencia computacional y preservar los patrones de alta atención.
7. Trabajos relacionados
Revisamos los enfoques existentes que mejoran la eficiencia del cálculo de atención mediante atención dispersa. Estos métodos pueden clasificarse ampliamente en tres grupos según sus estrategias centrales: (1) patrón disperso fijo, (2) poda dinámica de tokens y (3) selección consciente de la query. Presentamos varios trabajos representativos de cada categoría.
7.1. Patrón disperso fijo
SlidingWindow es un enfoque de uso común que permite a la query calcular atención solo dentro de una ventana fija. StreamingLLM (Xiao et al., 2023) combina attention sinks con ventanas locales para procesar flujos continuos de texto. MoA (Fu et al., 2024a) y DuoAttention (Xiao et al., 2024b) también adoptan información local y de sink similar para el modelado de secuencias largas. Longformer (Beltagy et al., 2020) intercala atención local por ventanas con tokens globales para procesar secuencias largas. En comparación con ellos, nuestra NSA no depende de patrones dispersos predefinidos, sino que aprende los patrones automáticamente, desbloqueando el potencial de utilizar el contexto completo.
7.2. Poda dinámica de tokens
Algunos métodos están diseñados para reducir los costos de memoria y computación durante la inferencia mediante la poda dinámica de la caché KV. H2O (Zhang et al., 2023b), BUZZ (Zhao et al., 2024) y SepLLM (Chen et al., 2024a) implementan enfoques adaptativos para reducir el uso de memoria de la caché KV durante la decodificación. Estos métodos desalojan dinámicamente los tokens considerados menos importantes para predicciones futuras. FastGen (Ge et al., 2023) y HeadKV (Fu et al., 2024b) optimizan la computación asignando diferentes estrategias a cabezas de atención individuales. SnapKV (Li et al., 2024) introduce una estrategia de poda de tokens que reduce la caché KV reteniendo selectivamente solo las características más cruciales, permitiendo un uso eficiente de la memoria. A diferencia de estos enfoques centrados en la inferencia, nuestra NSA incorpora la dispersión de forma nativa durante la fase de entrenamiento.
7.3. Selección consciente de la query
Otros trabajos se centran en métodos de selección de tokens dependientes de la consulta para reducir el cómputo de atención preservando la calidad de la atención. Quest (Tang et al., 2024) emplea una estrategia de selección por bloques en la que la importancia de cada fragmento se estima mediante el producto entre la consulta y el mínimo-máximo por coordenadas de los bloques de claves. InfLLM (Xiao et al., 2024a) combina patrones fijos con recuperación manteniendo sumideros de atención, contexto local y fragmentos recuperables. Este método selecciona claves representativas de cada fragmento para estimar la importancia del fragmento. HashAttention (Desai et al., 2024) formula la identificación de tokens fundamentales como un problema de recomendación al mapear consultas y claves al espacio de Hamming usando funciones aprendidas. ClusterKV (Liu et al., 2024) logra dispersión al agrupar primero las claves y luego seleccionar los clústeres más relevantes para el cómputo de atención según la similitud consulta-clúster. MInference (Jiang et al., 2024) y TokenSelect (Wu et al., 2024) seleccionan pares KV para el cómputo basándose en una puntuación de importancia a nivel de token. SeerAttention (Gao et al., 2024) separa consultas y claves en bloques espaciales y realiza una selección por bloques para un cómputo eficiente. En comparación con estos métodos, nuestro NSA logra un cómputo de atención disperso alineado con el hardware a lo largo de todo el ciclo de vida del modelo, incluyendo entrenamiento, prellenado y decodificación.
8. Conclusión
Presentamos NSA, una arquitectura de atención dispersa alineada con el hardware para el modelado eficiente de contextos largos. Al integrar compresión jerárquica de tokens con selección de tokens por bloques dentro de una arquitectura entrenable, nuestra arquitectura logra entrenamiento e inferencia acelerados mientras mantiene el rendimiento de Atención Completa. NSA avanza el estado del arte al demostrar que el rendimiento en benchmarks generales coincide con las líneas base de atención completa, superando la capacidad de modelado en evaluaciones de contexto largo y mejorando la capacidad de razonamiento, todo ello acompañado de reducciones medibles en la latencia computacional y logrando una aceleración significativa.
Referencias
J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón, and S. Sanghai. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. arXiv preprint arXiv:2305.13245, 2023. J. Austin, A. Odena, M. Nye, M. Bosma, H. Michalewski, D. Dohan, E. Jiang, C. Cai, M. Terry, Q. Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021. Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Zeng, L. Hou, et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508, 2023. I. Beltagy, M. E. Peters, and A. Cohan. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150, 2020. G. Chen, H. Shi, J. Li, Y. Gao, X. Ren, Y. Chen, X. Jiang, Z. Li, W. Liu, and C. Huang. Sepllm: Accelerate large language models by compressing one segment into one separator. arXiv preprint arXiv:2412.12094, 2024a. M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. D. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. Z. Chen, R. Sadhukhan, Z. Ye, Y. Zhou, J. Zhang, N. Nolte, Y. Tian, M. Douze, L. Bottou, Z. Jia, et al. Magicpig: Lsh sampling for efficient llm generation. arXiv preprint arXiv:2410.16179, 2024b. K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. Training verifiers to solve math word problems, 2021. URL https://arxiv.org/abs/2110.14168, 2021. D. Dai, C. Deng, C. Zhao, R. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv preprint arXiv:2401.06066, 2024. DeepSeek- AI. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model. 2024. URL https://arxiv.org/abs/2405.04434 DeepSeek- AI. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948
A. Desai, S. Yang, A. Cuadron, A. Klimovic, M. Zaharia, J. E. Gonzalez e I. Stoica. Hashattention: Semantic sparsity for faster inference. arXiv preprint arXiv:2412.14468, 2024.
D. Dua, Y. Wang, P. Dasigi, G. Stanovsky, S. Singh y M. Gardner. Drop: A reading comprehension benchmark requiring discrete reasoning over paragraphs. arXiv preprint arXiv:1903.00161, 2019.
T. Fu, H. Huang, X. Ning, G. Zhang, B. Chen, T. Wu, H. Wang, Z. Huang, S. Li, S. Yan, et al. Moa: Mixture of sparse attention for automatic large language model compression. arXiv preprint arXiv:2406.14909, 2024a.
Y. Fu, Z. Cai, A. Asi, W. Xiong, Y. Dong y W. Xiao. Not all heads matter: A head-level kv cache compression method with integrated retrieval and reasoning. arXiv preprint arXiv:2410.19258, 2024b.
Y. Gao, Z. Zeng, D. Du, S. Cao, H. K.-H. So, T. Cao, F. Yang y M. Yang. Seerattention: Learning intrinsic sparse attention in your llms. arXiv preprint arXiv:2410.13276, 2024.
S. Ge, Y. Zhang, L. Liu, M. Zhang, J. Han y J. Gao. Model tells you what to discard: Adaptive kv cache compression for llms. arXiv preprint arXiv:2310.01801, 2023.
G. T. Google, P. Georgiev, V. I. Lei, R. Burnell, L. Bai, A. Gulati, G. Tanzer, D. Vincent, Z. Pan, S. Wang, et al. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv preprint arXiv:2403.05530, 2024.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song y J. Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
H. Jiang, Q. Wu, C.-Y. Lin, Y. Yang y L. Qiu. Llmlingua: Compressing prompts for accelerated inference of large language models. arXiv preprint arXiv:2310.05736, 2023.
H. Jiang, Y. Li, C. Zhang, Q. Wu, X. Luo, S. Ahn, Z. Han, A. H. Abdi, D. Li, C.-Y. Lin, et al. Minference 1.0: Accelerating pre-filling for long-context llms via dynamic sparse attention. arXiv preprint arXiv:2407.02490, 2024.
G. Kamradt. LLMTest NeedleInAHaystack. Repositorio de GitHub, 2023. URL https://github.com/gkamradt/LLMTest_NeedleInAHaystack Consultado: [Insertar fecha de consulta aquí].
.
.
H. Li, Y. Zhang, F. Koto, Y. Yang, H. Zhao, Y. Gong, N. Duan y T. Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
Y. Li, Y. Huang, B. Yang, B. Venkitesh, A. Locatelli, H. Ye, T. Cai, P. Lewis y D. Chen. Snapkv: Llm knows what you are looking for before generation. arXiv preprint arXiv:2404.14469, 2024.
.
G. Liu, C. Li, J. Zhao, C. Zhang y M. Guo. Clusterkv: Manipulating llm kv cache in semantic space for recallable compression. arXiv preprint arXiv:2412.03213, 2024.
J. S. Park, J. C. O'Brien, C. J. Cai, M. R. Morris, P. Liang y M. S. Bernstein. Generative agents: Interactive simulacra of human behavior. En S. Follmer, J. Han, J. Steimle y N. H. Riche, editores, Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology, UIST 2023, San Francisco, CA, USA, 29 de octubre de 2023–1 de noviembre de 2023, páginas 2:1–2:22. ACM, 2023.
.
.
B. Peng, J. Quesnelle, H. Fan y E. Shippole. Yarn: Efficient context window extension of large language models. En ICLR. OpenReview.net, 2024.
N. Shazeer. Fast transformer decoding: One write-head is all you need. CoRR, abs/1911.02150, 2019.
M. Suzgun, N. Scales, N. Schärli, S. Gehrmann, Y. Tay, H. W. Chung, A. Chowdhery, Q. V. Le, E. H. Chi, D. Zhou, et al. Challenging big-bench tasks and whether chain-of-thought can solve them. arXiv preprint arXiv:2210.09261, 2022.
J. Tang, Y. Zhao, K. Zhu, G. Xiao, B. Kasikci y S. Han. Quest: Query-aware sparsity for efficient long-context llm inference. arXiv preprint arXiv:2406.10774, 2024.
P. Tillet, H.-T. Kung y D. Cox. Triton: an intermediate language and compiler for tiled neural network computations. En Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, páginas 10-19, 2019.
A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. u. Kaiser e I. Polosukhin. Attention is all you need. Advances in Neural Information Processing Systems, 2017.
Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. Mmlu-pro: A more robust and challenging multi-task language understanding benchmark. arXiv preprint arXiv:2406.01574, 2024.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824-24837, 2022.
W. Wu, Z. Pan, C. Wang, L. Chen, Y. Bai, K. Fu, Z. Wang y H. Xiong. Tokenselect: Efficient long-context inference and length extrapolation for llms via dynamic token-level kv cache selection. arXiv preprint arXiv:2411.02886, 2024.
C. Xiao, P. Zhang, X. Han, G. Xiao, Y. Lin, Z. Zhang, Z. Liu y M. Sun. Infllm: Training-free long-context extrapolation for llms with an efficient context memory. En The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024a.
G. Xiao, Y. Tian, B. Chen, S. Han y M. Lewis. Efficient streaming language models with attention sinks. arXiv preprint arXiv:2309.17453, 2023.
G. Xiao, J. Tang, J. Zuo, J. Guo, S. Yang, H. Tang, Y. Fu y S. Han. Duoattention: Efficient long-context llm inference with retrieval and streaming heads. arXiv preprint arXiv:2410.10819, 2024b.
M. Zaheer, G. Guruganesh, K. A. Dubey, J. Ainslie, C. Alberti, S. Ontanon, P. Pham, A. Ravula, Q. Wang, L. Yang, et al. Big bird: Transformers for longer sequences. Advances in neural information processing systems, 33:17283-17297, 2020.
E. Zelikman, Y. Wu, J. Mu y N. D. Goodman. Star: Bootstrapping reasoning with reasoning. En S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho y A. Oh, editores, Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, New Orleans, LA, USA, November 28 - December 9, 2022, 2022.
F. Zhang, B. Chen, Y. Zhang, J. Keung, J. Liu, D. Zan, Y. Mao, J. Lou y W. Chen. Repocoder: Repository-level code completion through iterative retrieval and generation. En H. Bouamor, J. Pino y K. Bali, editores, Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapore, December 6-10, 2023, páginas 2471-2484. Association for Computational Linguistics, 2023a.K. Zhang, J. Li, G. Li, X. Shi y Z. Jin. Codeagent: Enhancing code generation with tool-integrated agent systems for real-world repo-level coding challenges. En L. Ku, A. Martins y V. Srikumar, editores, Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thailand, August 11-16, 2024, páginas 13643-13658.Z. Zhang, Y. Sheng, T. Zhou, T. Chen, L. Zheng, R. Cai, Z. Song, Y. Tian, C. Ré, C. Barrett, et al. H2o: Heavy-hitter oracle for efficient generative inference of large language models. Advances in Neural Information Processing Systems, 36:34661-34710, 2023b.J. Zhao, Z. Fang, S. Li, S. Yang y S. He. Buzz: Beehive-structured sparse kv cache with segmented heavy hitters for efficient llm inference. arXiv preprint arXiv:2410.23079, 2024.Z. Zhou, C. Li, X. Chen, S. Wang, Y. Chao, Z. Li, H. Wang, R. An, Q. Shi, Z. Tan, et al. Llm × mapreduce: Simplified long-sequence processing using large language models. arXiv preprint arXiv:2410.09342, 2024.
A. Ejemplo de resultados de AIME
Prompt:
"| Usuario | Sean y números reales positivos que satisfacen el siguiente sistema de ecuaciones:
Entonces el valor de es , donde y son enteros positivos relativamente primos. Halle . Razone paso a paso y coloque su respuesta final dentro de . | Asistente | "
Nuestro resultado:
(2275 tokens)
Dado el sistema de ecuaciones:
Convertimos estas ecuaciones logarítmicas a sus formas exponenciales:
Expresando cada variable en términos de y :
Sustituyendo estas expresiones entre sí, encontramos:- De y , obtenemos , lo que lleva a . - Sustituyendo en la ecuación para , obtenemos . - Sustituyendo y en la ecuación para , obtenemos .
A continuación, calculamos :
Multiplicando estos resultados:
Tomando el logaritmo en base 2:
El valor absoluto es:
Por lo tanto, y , lo que da .
33
Resultado de referencia:
(think)...(/think) (9392 tokens)
Dado el sistema de ecuaciones logarítmicas:
Convertimos estas ecuaciones a forma exponencial:
Sustituyendo estas entre sí, encontramos:
Resolviendo estas ecuaciones paso a paso, encontramos:
Sin embargo, al verificar la tercera ecuación, nos damos cuenta de que el sistema podría no tener solución. Por lo tanto, usamos inversión de matrices para resolver el sistema:
Sea , , . El sistema se convierte en:
Resolvemos este sistema usando la regla de Cramer y la inversión de matrices. El determinante de la matriz es - 2, y las soluciones son:
Por lo tanto, tenemos:
Necesitamos encontrar :
Convirtiendo a un denominador común (48):
Sumando estos:
La fracción está en su forma más simple, así que y . Por lo tanto, .
Prompt:
"| Usuario | Los números reales y con satisfacen . ¿Cuál es el valor de ? Por favor, razona paso a paso y coloca tu respuesta final dentro de . | Asistente | "
Nuestro resultado:
(15147 tokens)
Dadas las ecuaciones:
1. 2.
Empezamos aplicando la regla de la potencia de los logaritmos a ambas ecuaciones.
Para la primera ecuación:
Sea . Entonces, . Sustituyendo esto en la ecuación, obtenemos:
Para la segunda ecuación:
Usando la regla de la potencia, obtenemos:
Dado que , esto se simplifica a:
Ahora tenemos dos expresiones:
1. 2.
Sustituyendo y en el producto , obtenemos:
Así, el valor de es .
Resultado de referencia:
(16223 tokens)
Dado el problema en el que los números reales e con satisfacen las ecuaciones y , necesitamos encontrar el valor de .
Primero, convertimos las ecuaciones logarítmicas a sus formas exponenciales usando la fórmula de cambio de base.
1.
Usando la fórmula de cambio de base, . Dado que , tenemos . Así,
2.
De nuevo, usando la fórmula de cambio de base, .
A continuación, expresamos e en términos de la otra:
Luego calculamos el producto :
Sin embargo, al reevaluar y usar otro enfoque estableciendo e , encontramos:
Finalmente, encontramos que el producto se simplifica a: