
Una plataforma abierta donde los agentes escriben código, ejecutan comandos y navegan, evaluada en 15 benchmarks. ICLR 2025, gratis online.
OpenHands: An Open Platform for AI Software Developers as Generalist Agents
OPENHANDS: UNA PLATAFORMA ABIERTA PARA DESARROLLADORES DE SOFTWARE DE IA COMO AGENTES GENERALISTAS
Xingyao Wang , Boxuan Li , Yufan Song , Frank F. Xu , Xiangru Tang , Mingchen Zhuge , Jiayi Pan , Yueqi Song , Bowen Li, Jaskirat Singh , Hoang H. Tran , Fuqiang Li, Ren Ma, Mingzhang Zheng, Bill Qian , Yanjun Shao , Niklas Muennighoff , Yizhe Zhang, Binyuan Hui , Junyang Lin , Robert Brennan , Hao Peng , Heng Ji , Graham Neubig UIUC CMU Yale UC Berkeley Contextual AI KAUST ANU HCMUT Alibaba All Hands AI xingyao6@illinois.edu, gneubig@cs.cmu.edu
RESUMEN
El software es una de las herramientas más poderosas de las que disponemos los humanos; permite a un programador experto interactuar con el mundo de formas complejas y profundas. Al mismo tiempo, gracias a las mejoras en los grandes modelos de lenguaje (LLM), también ha habido un rápido desarrollo de agentes de IA que interactúan con sus entornos circundantes y provocan cambios en ellos. En este artículo presentamos OpenHands (antes OpenDevin), una plataforma para el desarrollo de agentes de IA potentes y flexibles que interactúan con el mundo de manera similar a como lo hace un desarrollador humano: escribiendo código, interactuando con una línea de comandos y navegando por la web. Describimos cómo la plataforma permite la implementación de nuevos agentes, la interacción segura con entornos sandbox para la ejecución de código, la coordinación entre múltiples agentes y la incorporación de benchmarks de evaluación. Basándonos en los benchmarks actualmente incorporados, realizamos una evaluación de agentes en más de 15 tareas desafiantes, incluyendo ingeniería de software (p. ej., SWE-BENCH) y navegación web (p. ej., WEBARENA), entre otras. Publicado bajo la permisiva licencia MIT, OpenHands es un proyecto comunitario que abarca la academia y la industria, con más de 2,1K contribuciones de más de 188 contribuyentes.
Código https://github.com/All-Hands-AI/OpenHands Slack http://bit.ly/OpenHands-Slack
1 INTRODUCCIÓN
Impulsados por los grandes modelos de lenguaje (LLM; OpenAI 2024b; Team et al. 2023; Jiang et al. 2024; Chang et al. 2024), los sistemas de IA orientados al usuario (como ChatGPT) se han vuelto cada vez más capaces de realizar tareas complejas, como responder con precisión a las consultas de los usuarios, resolver problemas matemáticos y generar código. En particular, los agentes de IA, sistemas que pueden percibir y actuar sobre el entorno externo, han recibido recientemente un interés investigador cada vez mayor. Están avanzando hacia la realización de tareas complejas como desarrollar software (Jimenez et al., 2024), navegar por sitios web del mundo real (Zhou et al., 2023a), realizar tareas domésticas (Ahn et al., 2022) o incluso llevar a cabo investigación científica (Boiko et al., 2023; Tang et al., 2024a).
X
A medida que los agentes de IA se vuelven capaces de abordar problemas complejos, su desarrollo y evaluación también se han vuelto desafiantes. Recientemente existen numerosos esfuerzos por crear frameworks de código abierto que faciliten el desarrollo de agentes (Hong et al., 2023; Chen et al., 2024; Wu et al., 2023). Estos frameworks de agentes generalmente incluyen: 1) interfaces a través de las cuales los agentes interactúan con el mundo (como llamadas a funciones basadas en JSON o ejecución de código), 2) entornos en los que operan los agentes, y 3) mecanismos de interacción para la comunicación humano-agente o agente-agente. Estos frameworks agilizan y facilitan el proceso de desarrollo de diversas maneras (Tab. 1, §C).
Al diseñar agentes de IA, también podemos considerar cómo interactúa el humano con el mundo. La forma más poderosa en que los humanos interactúan actualmente con el mundo es mediante el software: el software
impulsa todos los aspectos de nuestra vida, sustentando desde la logística para las necesidades básicas hasta el avance de la ciencia, la tecnología y la propia IA. Dado el poder del software, así como las herramientas existentes en torno a su desarrollo, uso y despliegue eficientes, este proporciona la interfaz ideal para que los agentes de IA interactúen con el mundo de formas complejas. Sin embargo, construir agentes que puedan desarrollar software de manera efectiva conlleva sus propios desafíos únicos. ¿Cómo podemos permitir que los agentes creen y modifiquen código de manera efectiva en sistemas de software complejos? ¿Cómo podemos proporcionarles herramientas para recopilar información sobre la marcha para depurar problemas o reunir la información requerida por la tarea? ¿Cómo podemos garantizar que el desarrollo sea seguro y evite efectos secundarios negativos en los sistemas de los usuarios?
En este artículo presentamos OpenHands (antes OpenDevin), una plataforma impulsada por la comunidad diseñada para el desarrollo de agentes de IA generalistas y especialistas que interactúan con el mundo a través del software.1 Presenta:
(1) Un mecanismo de interacción que permite que las interfaces de usuario, los agentes y los entornos interactúen mediante una arquitectura de flujo de eventos potente y flexible (§2.1). (2) Un entorno de ejecución que consiste en un sistema operativo en sandbox de Docker con un shell bash, un navegador web y un servidor IPython con el que los agentes pueden interactuar (§2.2). (3) Una interfaz que permite al agente interactuar con el entorno de manera similar a los ingenieros de software reales (§2.3). Proporcionamos la capacidad para que los agentes a) creen y editen software complejo, b) ejecuten código arbitrario en el sandbox y c) naveguen por sitios web para recopilar información. (4) Delegación multiagente, que permite que múltiples agentes especializados trabajen juntos (§2.4). (5) Framework de evaluación, que facilita la evaluación de agentes en una amplia gama de tareas (§4).
Es importante destacar que OpenHands no es solo un framework conceptual, sino que también incluye una implementación integral e inmediatamente utilizable de agentes, entornos y evaluaciones. Al momento de escribir esto, OpenHands incluye un hub de agentes con más de 10 agentes implementados (§3), incluido un agente generalista sólido implementado con base en la arquitectura CodeAct (Wang et al., 2024a), con adiciones para la navegación web (ServiceNow) y especialistas en edición de código (Yang et al., 2024). La interacción con los usuarios se implementa mediante una interfaz de usuario basada en chat que visualiza las acciones actuales del agente y permite
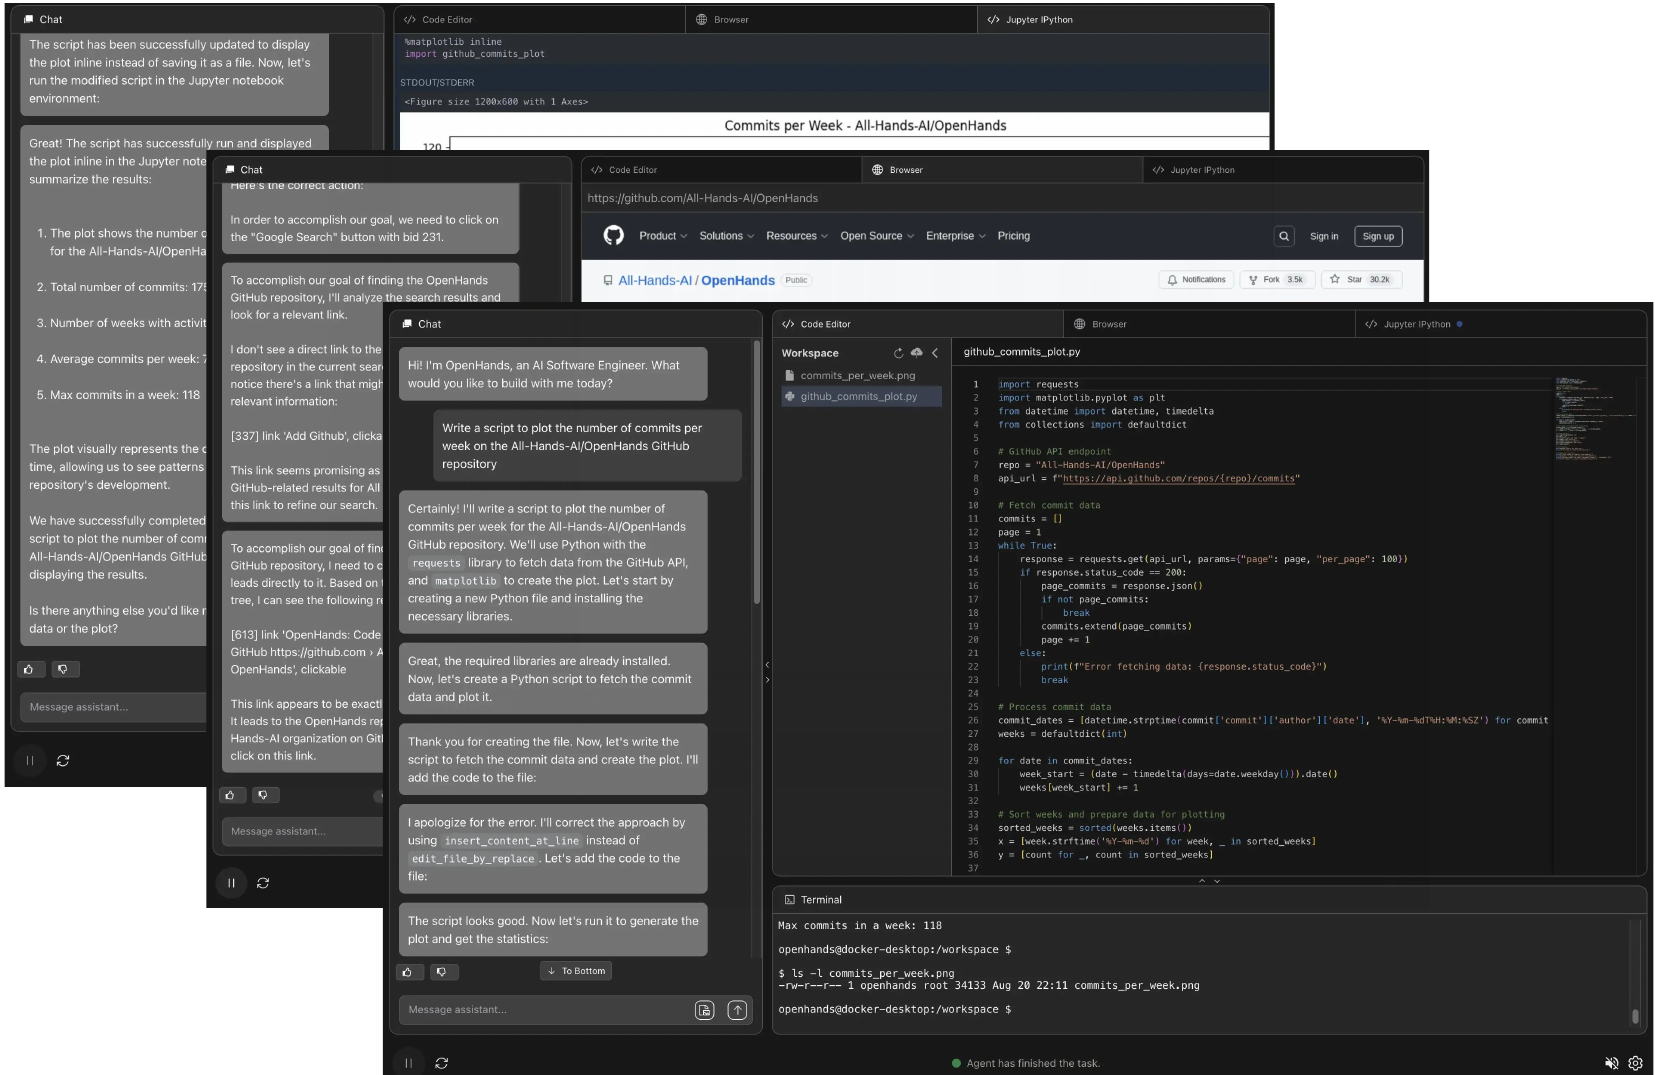
retroalimentación en tiempo real (Fig. 1, §D). Además, el framework de evaluación actualmente admite 15 benchmarks, que utilizamos para evaluar nuestros agentes (§4).
Publicado bajo una permisiva licencia MIT que permite el uso comercial, OpenHands está preparado para respaldar una diversa gama de investigaciones y aplicaciones del mundo real en la academia y la industria. OpenHands ha ganado una tracción significativa, con 32K estrellas en GitHub y más de 2,1K contribuciones de más de 188 contribuyentes. Concebimos OpenHands como un catalizador para futuras innovaciones en investigación y aplicaciones diversas impulsadas por una amplia comunidad de profesionales.
2 ARQUITECTURA DE OPENHANDS
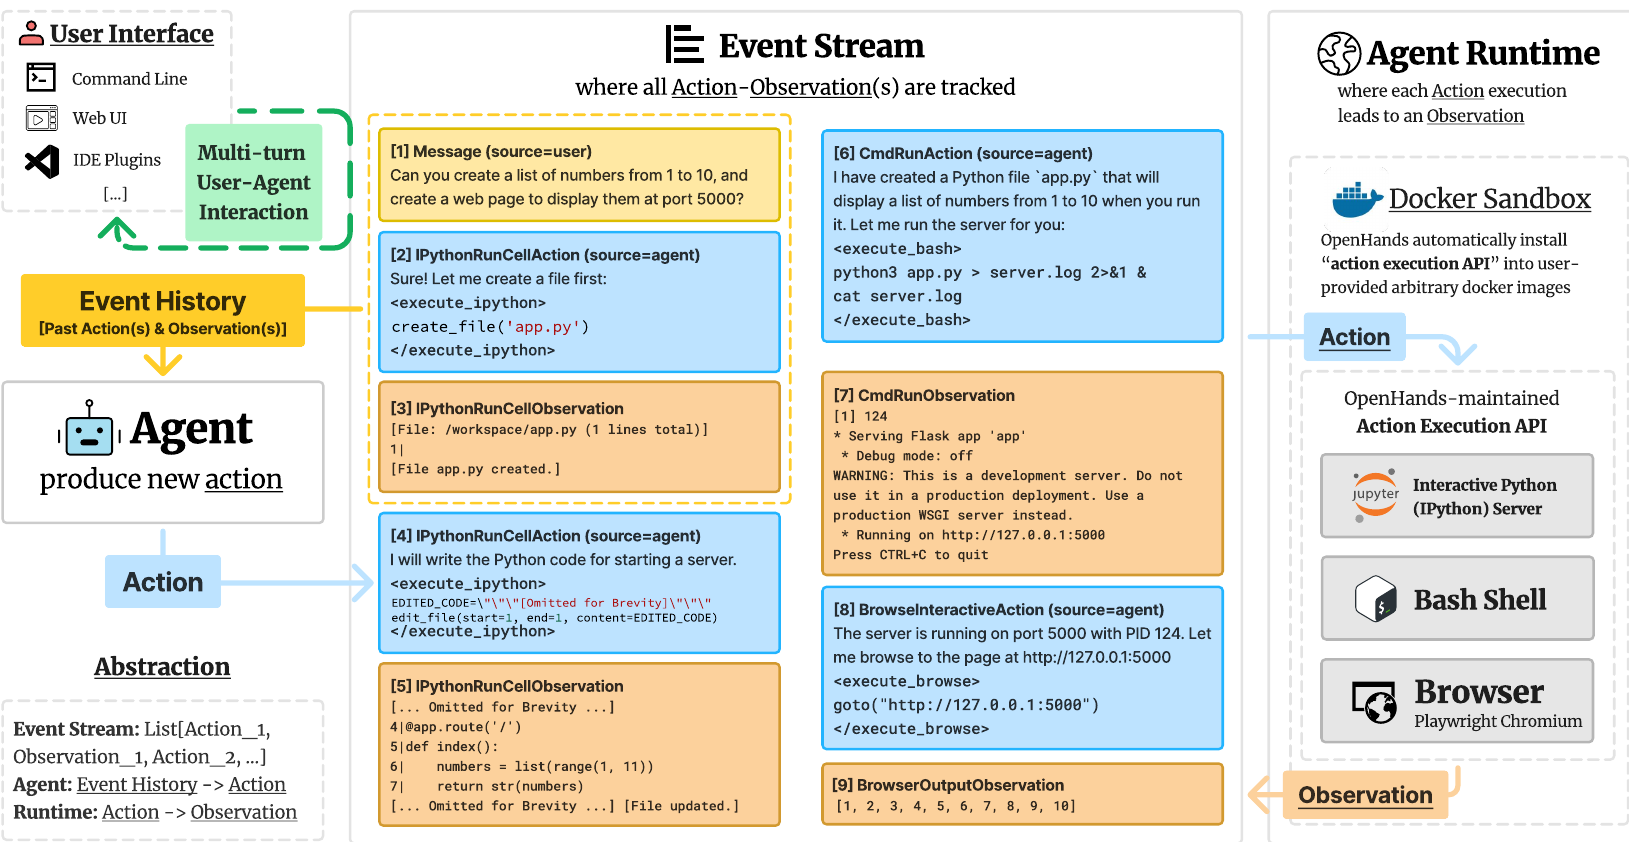
A continuación describimos el uso de OpenHands en detalle. En particular, discutimos 1) cómo definir e implementar un agente (§2.1), 2) cómo cada ejecución de acción conduce a una observación (§2.2), 3) cómo gestionar y extender de manera confiable las habilidades de uso común para los agentes (§2.3), y 4) cómo componer múltiples agentes juntos para la resolución de tareas (§2.4). La Fig. 2 proporciona una visión general.
2.1 DEFINICIÓN E IMPLEMENTACIÓN DEL AGENTE
Un agente puede percibir el estado del entorno (p. ej., acciones y observaciones previas) y producir una acción para su ejecución mientras resuelve una tarea especificada por el usuario.
El Estado y el Flujo de Eventos. En OpenHands, el estado es una estructura de datos que encapsula toda la información relevante para la ejecución del agente. Un componente clave de este estado es el flujo de eventos, que es una colección cronológica de acciones y observaciones pasadas, incluidas las propias acciones del agente y las interacciones del usuario (p. ej., instrucciones, retroalimentación). Además del flujo de eventos, el estado incorpora información auxiliar para el funcionamiento del agente, como el costo acumulativo de las llamadas al LLM, metadatos para rastrear la delegación multiagente (§2.4) y otros parámetros relacionados con la ejecución.
Acciones. Inspirado por CodeAct (Wang et al., 2024a), OpenHands conecta a un agente con el entorno a través de un conjunto central de acciones generales. Las acciones IPythonRunCellAction y CmdRunAction permiten al agente ejecutar código Python arbitrario y comandos bash dentro del entorno de sandbox (por ejemplo, un sistema operativo Linux aislado de forma segura). BrowserInteractiveAction permite la interacción con un navegador web con un lenguaje específico de dominio para la navegación introducido por BrowserGym (Drouin et al., 2024). Se eligieron estas acciones para proporcionar un conjunto de primitivas completo pero flexible que cubra la mayoría de las tareas realizadas por ingenieros de software y analistas humanos. El espacio de acciones basado en lenguajes de programación (PL) es lo suficientemente potentey flexible como para realizar cualquier tarea con herramientas de diferentes formas (por ejemplo, función de Python, API REST, etc.) al tiempo que es fiable y fácil de mantener (Wang et al., 2024a).
Este diseño también es compatible con los agentes de llamada a herramientas existentes que requieren una lista de herramientas predefinidas (Chase, 2022). Es decir, los usuarios pueden definir fácilmente herramientas usando PL soportados en acciones primitivas (por ejemplo, escribir una función de Python para una calculadora) y poner esas herramientas a disposición del agente mediante experiencias de llamada a funciones al estilo JSON (Qin et al., 2023). Además, las potentes primitivas basadas en PL del framework hacen posible que los agentes creen herramientas por sí mismos (por ejemplo, generando funciones de Python, Yuan et al. 2023) cuando la API para completar la tarea no está disponible. Consulte §2.3 para ver cómo estas acciones centrales basadas en PL pueden componerse en un conjunto diverso de herramientas.
Observaciones. Las observaciones describen los cambios del entorno (por ejemplo, el resultado de la ejecución de acciones previas, mensajes de texto del usuario humano, etc.) que el agente observa.
Figura 3: Ejemplo mínimo de implementación de un agente en OpenHands.
class MinimalAgent: def reset(self) -> None: self.system_message "You are a helpful assistant ..." def step(self, state: State): messages: list[dict[str, str]] = [ {'role': 'system', 'content': self.system_message] ] for prev_action, obs in state.history: action_message get_action_message(prev_action) messages.append(action_message) obs_message get_observation_message(obs) messages.append(obs_message) # use lim to generate response (e.g., thought, action) response self.lim.do_completion(messages) # parse and execute action in the runtime action self.parse_response(response) if self.is_finish_command(action): return AgentFinishAction() elif self.is_bash_command(action): return CmdRunAction(command=action.command) elif self.is_python_code(action): return IPythonRunCallAction(code=action.code) elif self.is_browser_action(action): return BrowseInteractiveAction(code=action.code) else: return MessageAction(content=action.message)
Implementar un nuevo agente. La abstracción de agente está diseñada para ser simple pero potente, permitiendo a los usuarios crear y personalizar agentes para diversas tareas fácilmente. El núcleo de la abstracción de agente reside en la función step, que toma el estado actual como entrada y genera una acción apropiada según la lógica del agente. En la Fig. 3 se ilustra un ejemplo de código simplificado para la abstracción de agente. Al proporcionar esta abstracción, OpenHands permite a los usuarios centrarse en definir el comportamiento y la lógica deseados del agente sin preocuparse por los detalles de bajo nivel de cómo se ejecutan las acciones (§2.2).
2.2 ENTORNO DE EJECUCIÓN DEL AGENTE: CÓMO LA EJECUCIÓN DE ACCIONES DA LUGAR A OBSERVACIONES
El Entorno de Ejecución del Agente proporciona un entorno general que equipa al agente con un espacio de acciones comparable al de los desarrolladores de software humanos, permitiendo a los agentes de OpenHands abordar una amplia gama de tareas de desarrollo de software y basadas en la web, incluyendo flujos de trabajo complejos de desarrollo de software, proyectos de análisis de datos, tareas de navegación web y más. Permite al agente acceder a un terminal bash para ejecutar código y herramientas de línea de comandos, utilizar un cuaderno Jupyter para escribir y ejecutar código sobre la marcha, e interactuar con un navegador web para tareas basadas en la web (por ejemplo, búsqueda de información).
Sandbox de Docker. Para cada sesión de tarea, OpenHands levanta un sandbox de contenedor Docker aislado de forma segura, donde se ejecutan todas las acciones del flujo de eventos. OpenHands se conecta al sandbox a través de un servidor API REST que se ejecuta dentro de él (es decir, la API de ejecución de acciones de OpenHands), ejecuta acciones arbitrarias (por ejemplo, comando bash, código Python) del flujo de eventos y devuelve los resultados de la ejecución como observaciones. Un directorio de trabajo configurable que contiene los archivos sobre los que el usuario desea que el agente trabaje se monta en ese sandbox seguro para que los agentes de OpenHands puedan acceder a él.
API de Ejecución de Acciones de OpenHands. OpenHands mantiene un servidor API que se ejecuta dentro del sandbox de Docker para escuchar las solicitudes de ejecución de acciones provenientes del flujo de eventos. El servidor API mantiene:
(1) Un shell bash que se conecta con el entorno del sistema operativo (especificado por la imagen de Docker) para la ejecución de comandos. (2) Un servidor Jupyter IPython para manejar solicitudes de ejecución de código Python interactivo (IPython) y devolver los resultados de la ejecución al flujo de eventos. (3) Un navegador Chromium basado en Playwright. El proveedor proporciona un conjunto de primitivas de acción definidas por BrowserGym (ServiceNow; Drouin et al., 2024), como navegación, clic, escritura y desplazamiento. El conjunto completo de acciones se detalla en §J. Después de ejecutar estas acciones, el entorno de ejecución del navegador proporciona un rico conjunto de observaciones sobre el estado actual del navegador, incluyendo HTML, DOM, árbol de accesibilidad (Mozilla), captura de pantalla, pestañas abiertas, etc.
Soporte de Imágenes Docker Arbitrarias. OpenHands permite a los agentes ejecutarse en sistemas operativos arbitrarios con diferentes entornos de software al admitir un entorno de ejecución basado en imágenes Docker arbitrarias. OpenHands implementa un mecanismo de construcción que toma una imagen Docker arbitraria proporcionada por el usuario e instala la API de ejecución de acciones de OpenHands en esa imagen para permitir las interacciones del agente. Incluimos una descripción detallada del entorno de ejecución del agente de OpenHands en §F.
2.3 HABILIDADES DEL AGENTE: LA INTERFAZ EXTENSIBLE AGENTE-COMPUTADORA
SWE-Agent (Yang et al., 2024) destaca la importancia de una Interfaz Agente-Computadora (ACI, es decir, herramientas especializadas para tareas particulares) cuidadosamente diseñada para resolver con éxito tareas complejas. Sin embargo, crear, mantener y distribuir una amplia variedad de herramientas puede ser un desafío de ingeniería abrumador, especialmente cuando queremos poner estas herramientas a disposición de diferentes implementaciones de agentes (§3). Para abordar esto, construimos una biblioteca AgentSkills, una caja de herramientas diseñada para mejorar las capacidades de los agentes, ofreciendo utilidades que no están fácilmente disponibles a través de comandos bash básicos o código Python.
Fácil de crear y extender herramientas. AgentSkills está diseñado como un paquete de Python que consiste en diferentes funciones de utilidad (es decir, herramientas) que se importan automáticamente en el entorno Jupyter IPython (§2.2). La facilidad de definir una función de Python como una herramienta reduce la barrera para que los miembros de la comunidad contribuyan con nuevas herramientas a la biblioteca. La generalidad de los paquetes de Python también permite que diferentes implementaciones de agentes aprovechen fácilmente estas herramientas a través de una de nuestras acciones principales IPythonRunCellAction (§2.1).
Criterios de inclusión y filosofía. En la biblioteca AgentSkills, no pretendemos envolver cada paquete de Python posible y re-enseñar a los agentes su uso (por ejemplo, el LLM ya conoce la biblioteca pandas que puede leer archivos CSV, por lo que no necesitamos recrear una herramienta que enseñe al agente a leer el mismo formato de archivo). Solo añadimos una nueva habilidad cuando: (1) no es fácilmente alcanzable para el LLM escribir código directamente (por ejemplo, editar código y reemplazar ciertas líneas), y/o (2) implica llamar a un modelo externo (por ejemplo, llamar a un modelo de voz a texto, o modelo para edición de código (Sanger)).
Habilidades actualmente soportadas. La biblioteca AgentSkills incluye utilidades de edición de archivos adaptadas de SWE-Agent (Yang et al., 2024) y Aider (Gauthier) como edit_file, que permite modificar un archivo existente desde una línea especificada; funciones de desplazamiento scroll_up y scroll_down para ver una parte diferente de los archivos. También contiene herramientas que soportan la lectura de documentos multimodales, como parse_image y parse_pdf para extraer información de imágenes usando modelos de visión-lenguaje (por ejemplo, GPT-4V) y leer texto de PDFs, respectivamente. Una lista completa de las habilidades soportadas se puede encontrar en §1.
2.4 DELEGACIÓN DE AGENTES: INTERACCIÓN MULTIAGENTE COOPERATIVA
OpenHands también permite interacciones entre múltiples agentes. Con este fin, utilizamos un tipo de acción especial AgentDelegateAction, que permite a un agente delegar una subtarea específica a otro agente. Por ejemplo, el agente generalista CodeActAgent, con soporte limitado para la navegación web, puede usar AgentDelegateAction para delegar tareas de navegación web al especializado BrowsingAgent para realizar actividades de navegación más complejas (por ejemplo, navegar por la web, hacer clic en botones, enviar formularios, etc.).
3 AGENTHUB: UN HUB DE AGENTES CONTRIBUIDOS POR LA COMUNIDAD
Basándose en nuestra abstracción de agente (§2.1), OpenHands soporta una amplia gama de implementaciones de agentes contribuidas por la comunidad para que los usuarios finales elijan y actúen como líneas base para diferentes tareas de agentes.
Agente CodeAct. CodeActAgent es el agente generalista predeterminado basado en el marco CodeAct (Wang et al., 2024a). En cada paso, el agente puede (1) conversar para comunicarse con humanos en lenguaje natural para solicitar aclaraciones, confirmación, etc., o (2) realizar la tarea ejecutando código (también conocido como CodeAct), incluyendo la ejecución de comandos bash, código Python o lenguaje de programación específico del navegador (§2.2). Este espacio de acciones general permite al agente (v1.5 y superior) realizar diversas tareas, incluyendo edición de archivos, navegación por la web, ejecución de programas, etc.
Tabla 1: Comparación de diferentes marcos de agentes de IA (§C). SWE se refiere a 'ingeniería de software'. Biblioteca de herramientas estandarizada: si el marco contiene herramientas reutilizables para diferentes implementaciones de agentes (§2.3); Sandbox integrado y ejecución de código: si soporta la ejecución en sandbox de código arbitrario generado por el agente; Navegador web integrado: si proporciona a los agentes acceso a un navegador web completamente funcional; Colaboración humano-IA: si permite la colaboración humano-IA de múltiples turnos (por ejemplo, el humano puede interrumpir al agente durante la ejecución de la tarea y/o proporcionar retroalimentación e instrucciones adicionales); AgentHub: si aloja implementaciones de varios agentes (§3); Marco de Evaluación: si ofrece una evaluación sistemática de los agentes implementados en benchmarks desafiantes (§4); Agent QC (Control de Calidad): si el marco integra pruebas (§E) para garantizar la calidad general del software del marco.
| Framework | Dominio | Interfaz gráfica de usuario | Biblioteca de herramientas estandarizada | Entorno de ejecución aislado y ejecución de código integrados | Navegador web integrado | Colaboración multiagente | Colaboración humano-IA | AgentHub | Marco de evaluación | Control de calidad de agentes |
| AutoGPT Gravitas (2023) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| LangChain (Chase, 2022) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| MetaGPT (Hong et al., 2023) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoGen (Wu et al., 2023) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoAgents (Chen et al., 2024) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Agents (Zhou et al., 2023b) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Xagents (Team, 2023) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenAgents (Xie et al., 2023) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| GPT5Warm (Zhuge et al., 2024) | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoCodeRover (Zhang et al., 2024b) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| SWE-Agent (Yang et al., 2024) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenHands | General | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
\* Sin soporte nativo. Hay disponibles opciones comerciales de terceros.
Agente Browsing. Implementamos un agente web generalista llamado Browsing Agent, para servir como una línea base simple pero efectiva para tareas de agentes web. El agente es similar al de WebArena (Zhou et al., 2023a), pero con observaciones y acciones mejoradas, con solo prompting zero-shot. Los prompts completos están en .
Agente GPT5Warm. GPT5Warm (Zhuge et al., 2024) es pionero en el uso de grafos optimizables para construir sistemas de agentes, unificando marcos de agentes de lenguaje a través de la modularidad. Cada nodo representa una operación distinta, mientras que las aristas definen vías de colaboración y comunicación. Este diseño permite la optimización automática de nodos y aristas, impulsando avances en la creación de sistemas multiagente.
Micro Agente(s). Además, OpenHands permite la creación de micro agentes, un agente especializado en una tarea particular. Un micro agente reutiliza la mayoría de las implementaciones de un agente generalista existente (por ejemplo, CodeAct Agent). Está diseñado para reducir la barrera al desarrollo de agentes, donde los miembros de la comunidad pueden compartir prompts especializados que funcionan bien para sus casos de uso particulares.
4 EVALUACIÓN
Para rastrear sistemáticamente el progreso en la construcción de agentes digitales generalistas, como se enumera en la Tabla 2, integramos 15 benchmarks establecidos en OpenHands. Estos benchmarks cubren ingeniería de software, navegación web y asistencia miscelánea. En esta sección, comparamos OpenHands con líneas base reproducibles de código abierto que no realizan ingeniería de prompts manual específicamente basada en el contenido del benchmark. Tenga en cuenta que usamos 'OH' como abreviatura de OpenHands para el resto de esta sección por razones de brevedad.
| Categoría | Benchmark | Capacidad requerida |
| Software | SWE-Bench (Jimenez et al., 2024) | Corrección de issues de Github |
| HumanEvalFix (Muennighoff et al., 2024) | Corrección de errores | |
| BIRD (Li et al., 2023b) | Texto a SQL | |
| BioCoder (Tang et al., 2024c) | Programación en bioinformática | |
| Web | ML-Bench (Tang et al., 2024b) | Programación de aprendizaje automático |
| Gorilla APIBench (Patil et al., 2023) | Llamada a API de software | |
| ToolQA (Zhuang et al., 2024) | Uso de herramientas | |
| Asistencia miscelánea | WebArena (Zhou et al., 2023a) | Planificación de objetivos y navegación realista |
| MiniWoB++ (Liu et al., 2018) | Trayectoria corta en web sintética | |
| GAI (Mialon et al., 2023) | Uso de herramientas, navegación, multimodalidad | |
| GPQA (Rein et al., 2023) | Preguntas y respuestas de nivel de posgrado a prueba de Google | |
| AgentBench (Liu et al., 2023) | Interacción con el sistema operativo (bash) | |
| MINT (Wang et al., 2024b) | Problemas de matemáticas y código de múltiples turnos | |
| Entity Deduction Arena (Zhang et al., 2024a) | Seguimiento de estados y planificación estratégica | |
| ProofWriter (Tajford et al., 2021) | Razonamiento lógico deductivo |
4.1 RESUMEN DE RESULTADOS
En OpenHands, nuestro objetivo es desarrollar agentes digitales generalistas capaces de interactuar con el mundo a través de interfaces de software (como lo ejemplifican las acciones de código descritas en §2.1). Reconocemos que un agente de software debería sobresalir no solo en la edición de código sino también en la navegación web y diversas tareas auxiliares, como responder preguntas sobre repositorios de código o realizar investigación en línea.
| Agente | Modelo | Software ('$4.2)</td><td rowspan="2">Web ('$4.3) | Varios ('$4.4) | ||
| SWE-Bench Lite | WebArena | ||||
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 18.0 | - | - | |
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-0125-preview | 19.0 | - | - | |
| Aider (Gauthier) | gpt-4o &amp; claude-3-opus | 26.3 | - | - | |
| Moatless Tools (Orwall) | claude-3.5-sonnet | 26.7 | - | - | |
| Agentless (Xia et al., 2024) | gpt-4o | 27.3 | - | - | |
| Agentes de navegación web | |||||
| Lemur (Xu et al., 2023) | Lemur-chat-70b | - | 5.3 | - | - |
| Patel et al. (2024) | Entrenado 72B con datos sintéticos | - | 9.4 | - | - |
| AutoWebGLM (Lai et al., 2024) | Entrenado 7B con anotación humana/agente | - | 18.2 | - | - |
| Auto Eval &amp; Refine (Pan et al., 2024) | GPT-4 + Reflexion con GPT-4V | - | 20.2 | - | - |
| WebArena Agent (Zhou et al., 2023a) | gpt-4-turbo | - | 14.4 | - | - |
| Agentes de asistencia varios | |||||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | - | - | - | 13,2 |
| Aprendizaje con pocos ejemplos + Cadena de Pensamiento (Rein et al., 2023) | Llama-2-70b-chat | - | - | 28,1 | - |
| gpt-4 | gpt-3.5-turbo-16k | - | - | 29,6 | - |
| gpt-4 | gpt-4 | - | - | 38,8 | - |
| Agentes OpenHands | |||||
| CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 6,3 | 8,3 | - | - |
| gpt-4o-2024-05-13 | gpt-4o-2024-05-13 | 22,0 | 14,5 | *53,1 | - |
| claude-3-5-sonnet | claude-3-5-sonnet | 26,0 | 15,3 | 52,0 | - |
| GPTSwarm v1.0 | gpt-4o-2024-05-13 | - | - | - | 32,1 |
\* Los números se reportan de CodeActAgent v1.5.
La Tabla 3 muestra un conjunto curado de resultados de evaluación. Si bien los agentes de OpenHands pueden no alcanzar el máximo rendimiento en cada categoría, están diseñados con la generalidad en mente. Notablemente, el mismo agente CodeAct, sin ninguna modificación a su prompt de sistema, demuestra un rendimiento competitivo en tres categorías principales de tareas: desarrollo de software, interacción web y tareas misceláneas. Esto es particularmente significativo en comparación con los agentes de línea base, que típicamente están diseñados y optimizados para categorías de tareas específicas.
4.2 INGENIERÍA DE SOFTWARE
A continuación, presentamos resultados específicos para los benchmarks de ingeniería de software en la Tabla 4.
SWE-Bench (Jimenez et al., 2024) está diseñado para evaluar las habilidades de los agentes para resolver problemas reales de GitHub, como informes de errores o solicitudes de funcionalidades. El agente interactúa con el repositorio e intenta solucionar el problema proporcionado mediante la edición de archivos y la ejecución de código. El repositorio de código modificado por el agente se somete a pruebas contra una suite de pruebas que incorpora nuevas pruebas añadidas a partir de las correcciones de los desarrolladores humanos para el mismo problema. Cada instancia de prueba incluye un fragmento de «texto de sugerencia» que consiste en sugerencias en lenguaje natural sobre cómo resolver el problema. A lo largo de este artículo, reportamos todos los resultados sin utilizar el texto de sugerencia. Se creó un subconjunto canónico, SWE-bench Lite, para facilitar pruebas accesibles y eficientes. Por defecto utilizamos este subconjunto para las pruebas por consideraciones de ahorro de costes.2 Resultado. Como se muestra en la Tabla 4, nuestra versión más reciente de CodeActAgent v1.8, usando claude-3.5-sonnet, alcanza una tasa de resolución competitiva del en comparación con otros especialistas en SWE de código abierto.
4.2.1 HUMANEVALFIX
HumanEvalFix (Muennighoff et al., 2024) encarga a los agentes corregir un error en una función proporcionada con la ayuda de casos de prueba proporcionados. Los errores se crean para garantizar que uno o más casos de prueba fallen. Nos centramos en el subconjunto de Python del benchmark y permitimos que los modelos resuelvan los errores mediante autodepuración a lo largo de múltiples turnos, incorporando retroalimentación de la ejecución de las pruebas. Seguimos la configuración de Muennighoff et al. (2024) usando pass@k (Chen et al., 2021). Resultados. En la Tabla 4, OpenHands CodeActAgent corrige con éxito el de los errores en la división de Python. Esto es significativamente mejor que todos los enfoques no agénticos, casi duplicando el rendimiento de StarCoder2-15B (Lozhkov et al., 2024; Li et al., 2023c). Si bien SWE-Agent alcanza el , Yang et al. (2024) proporciona al modelo una demostración completa de una trayectoria de muestra exitosa que corrige uno de los errores en el conjunto de datos de prueba («1-shot»), mientras que nuestra evaluación de OpenHands es 0-shot. Dado que HumanEvalFix ha sido creado por humanos y todos los errores
| Agente | Modelo | Tasa de éxito (%) | $ Coste medio |
| SWE-Agent (Yang et al., 2024) | SWE-Bench Lite (Jimenez et al., 2024), 300 instancias, sin pista | ||
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-1106-preview | 18,0 | 1,67 |
| Aider (Gauthier) | gpt-4-0125-preview | 19,0 | - |
| gpt-4-0&amp; claude-3-opus | 26,3 | - | |
| OH CodeActAgent v1.8 | gpt-4-0-mini-2024-07-18 | 7,0 | 0,01 |
| gpt-4-0-2024-05-13 | 22,0 | 1,72 | |
| claude-3-5-sonnet@20240620 | 26,0 | 1,10 | |
| HumanEvalFix (Muennighoff et al., 2024), 164 instancias | |||
| Prompting, 0-shot | BLOOMZ-176B | 16,6 | - |
| OctoCoder-15B | 30,4 | - | |
| DeepSeekCoder-33B-Instruct | 47,5 | - | |
| StarCoder2-15B | 48,6 | - | |
| SWE-agent, 1-shot (Yang et al., 2024) | gpt-4-turbo | 87,7 | - |
| gpt-3.5-turbo-16k-0613 | 20,1 | 0,11 | |
| OH CodeActAgent v1.5, Generalist, 0-shot. | gpt-4-0-2024-05-13 | 79,3 | 0,14 |
| BIRD (Li et al., 2023b), 300 instancias | |||
| Prompting, 0-shot | CodeLlama-7B-Instruct | 18,3 | - |
| CodeQwen-7B-Chat | 31,3 | - | |
| OH CodeActAgent v1.5 | gpt-4-1106-preview | 42,7 | 0,19 |
| gpt-4-0-2024-05-13 | 47,3 | 0,11 | |
| ML-Bench (Tang et al., 2024b), 68 instancias | |||
| prompting + BM25, 0-shot | gpt-3.5-turbo | 11,0 | - |
| gpt-4-1106-preview | 22,1 | - | |
| gpt-4-0-2024-05-13 | 26,2 | - | |
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 42,6 | 1,91 |
| Aider (Gauthier) | gpt-4-0-2024-05-13 | 64,4 | - |
| gpt-4-0-2024-05-13 | 76,5 | 0,25 | |
| gpt-4-1106-preview | 58,8 | 1,22 | |
| gpt-3.5-turbo-16k-0613 | 13,2 | 0,12 | |
| BioCoder (Python) (Tang et al., 2024b), 157 instancias | |||
| prompting, 0-shot | gpt-3.5-turbo | 11,0 | - |
| gpt-4-1106-preview | 12,7 | - | |
| OH CodeActAgent v1.5 | gpt-4-0-2024-05-13 | 27,5 | 0,13 |
| gpt-4-0-2024-05-13 | 8,7 | - | |
| gpt-4-0-2014 | 21,2 | - | |
| gpt-3.5-turbo-0301 | 29,7 | - | |
| llama-7b | 75,0 | - | |
| gpt-3.5-turbo-0125 | 21,6 | 0,002 | |
| gpt-4-0-2024-05-13 | 36,4 | 0,04 | |
| ToolQA (Zhuang et al., 2024), 800 instancias | |||
| Prompting, 0-shot | ChatGPT + CoT | 5.1 | - |
| ChatGPT | 5.6 | - | |
| Chameleon | 10.6 | - | |
| ReAct, 0-shot (Yao et al., 2023; OpenAI, 2024a) | gpt-3.5-turbo | 36.8 | - |
| gpt-3 | 43.1 | - | |
| gpt-3.5-turbo-0125 | 2.3 | 0.03 | |
| gpt-4-0-2024-05-13 | 47.2 | 0.91 |
han sido validados cuidadosamente, alcanzar el en este benchmark es totalmente factible, lo cual buscamos lograr en futuras iteraciones de OpenHands.
ML-Bench (Tang et al., 2024b) evalúa la capacidad de los agentes para resolver tareas de aprendizaje automático en 18 repositorios de GitHub. El benchmark comprende 9.641 tareas que abarcan 169 problemas diversos de ML, y requiere que los agentes generen scripts de bash o código Python en respuesta a las instrucciones del usuario. En el entorno de sandbox, los agentes pueden ejecutar comandos iterativamente y recibir retroalimentación, lo que les permite comprender el contexto del repositorio y satisfacer los requisitos del usuario de forma progresiva. Siguiendo la configuración del artículo original, realizamos la evaluación de los agentes sobre el subconjunto de un cuarto de ML-Bench.
Gorilla APIBench (Patil et al., 2023) evalúa la capacidad de los agentes para usar APIs. Incorpora tareas sobre TorchHub, TensorHub y HuggingFace. Durante la evaluación, se proporciona a los modelos una pregunta relacionada con el uso de APIs, como «identificar una API capaz de convertir el lenguaje hablado en una grabación a texto». La corrección se evalúa en función de si la llamada a la API del modelo está en el dominio correcto.
ToolQA (Zhuang et al., 2024) evalúa la capacidad de los agentes para usar herramientas externas. Este benchmark incluye tareas sobre diversos temas como el estado de los vuelos, el precio del café, datos de Yelp y datos de Airbnb, y requiere el uso de diversas herramientas como herramientas de texto, herramientas de bases de datos, herramientas matemáticas, herramientas de grafos, herramientas de código y herramientas de sistema. Presenta dos niveles: fácil y difícil. Las preguntas fáciles se centran más en el uso de una sola herramienta, mientras que las preguntas difíciles hacen hincapié en el razonamiento. Adoptamos el subconjunto fácil para la evaluación.
BioCoder (Tang et al., 2024c) es un benchmark de generación de código a nivel de repositorio que evalúa el rendimiento de los agentes en tareas relacionadas con la bioinformática, específicamente la capacidad de recuperar y utilizar con precisión el contexto. Los prompts originales contienen el contexto relevante del código; sin embargo, en este estudio los hemos eliminado para demostrar la capacidad de OpenHands de realizar recuperación de contexto,
| Agente | Modelo | Tasa de éxito (%) | $ Coste promedio |
| Lemur (Xu et al., 2023) | WebArena (Zhou et al., 2023a), 812 instancias | ||
| Patel et al. (2024) | Lemur-chat-70b | 5,3 | - |
| AutoWebGLM (Lai et al., 2024) | Entrenado 72B con datos sintéticos de auto-mejora | 9,4 | - |
| Auto Eval & Refine (Pan et al., 2024) | Entrenado 7B con anotación híbrida humano/agente | 18,2 | - |
| GPT-4 + Reflexion con modelo de recompensa GPT-4V | 20,2 | - | |
| WebArena Agent (Zhou et al., 2023a) | gpt-3.5-turbo | 6,2 | - |
| gpt-4-turbo | 14,4 | - | |
| OH BrowsingAgent v1.0 | gpt-4o-mini-2024-07-18 | 8,5 | 0,01 |
| gpt-4o-2024-05-13 | 14,8 | 0,15 | |
| claude-3-5-sonnet-20240620 | 15,5 | 0,10 | |
| OH CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 8,3 | - |
| mediante delegación a BrowsingAgent v1.0 | gpt-4o-2024-05-13 | 14,5 | - |
| claude-3-5-sonnet-20240620 | 15,3 | - | |
| MiniWoB++ (Liu et al., 2018), 125 entornos | |||
| Workflow Guided Exploration (Liu et al., 2018) | Modelo especialista entrenado con exploración del entorno | 34,6 | - |
| CC-NET (Humphreys et al., 2022) | Modelo especialista entrenado con RL y BC anotado por humanos | 91,1 | - |
| OH BrowsingAgent v1.0 | gpt-3.5-turbo-0125 | 27,2 | 0,01 |
| gpt-4o-2024-05-13 | 40,8 | 0,05 | |
| OH CodeActAgent v1.8 | gpt-4o-2024-05-13 | 39,8 | - |
autodepuración y razonamiento en interacciones de múltiples turnos. BioCoder consta de 157 funciones en Python y 50 en Java, cada una dirigida a un área específica de la bioinformática, como proteómica, genómica y otros dominios especializados. El benchmark se orienta a código del mundo real generando código en repositorios existentes donde el código relevante ha sido enmascarado.
BIRD (Li et al., 2023b) es un benchmark para tareas de texto-a-SQL (es decir, traducir lenguaje natural a SQL ejecutable) orientado a entornos de bases de datos realistas y a gran escala. Seleccionamos 300 muestras del conjunto de desarrollo para integrarlas en OpenHands y evaluamos la precisión de ejecución. Además, ampliamos la configuración permitiendo al agente participar en interacciones de múltiples turnos para llegar a la consulta SQL final, lo que le permite corregir resultados históricos observando los resultados de la ejecución de SQL.
4.3 NAVEGACIÓN WEB
Reportamos los resultados de evaluación para los benchmarks de navegación web en la Tabla 5.
WebArena (Zhou et al., 2023a) es un benchmark de agentes web autohostil y basado en ejecución que permite a los agentes elegir libremente qué camino tomar para completar las tareas asignadas. WebArena comprende 812 instrucciones de tareas curadas por humanos en diversos dominios, incluidos compras, foros, plataformas para desarrolladores y sistemas de gestión de contenido. Resultados. En la Tabla 5, podemos ver que nuestro BrowsingAgent logra un rendimiento competitivo entre los agentes que utilizan LLMs con técnicas de prompting de dominio general.
MiniWoB++ (Liu et al., 2018) es un benchmark web interactivo con funciones de recompensa integradas. Las tareas se inicializan de forma sintética en 125 interfaces web minimalistas diferentes. A diferencia de WebArena, las tareas son más fáciles sin cambios de página, requieren menos pasos y proporcionan indicaciones de tareas paso a paso de bajo nivel. Nótese que contiene una porción de entornos que requieren capacidad de visión para abordarse con éxito, y muchos trabajos existentes optan por centrarse solo en un subconjunto de las tareas (Kim et al., 2024; Li et al., 2023d; Shaw et al., 2023). Aun así, reportamos el rendimiento sobre el conjunto completo e incluimos solo las líneas base que se evalúan sobre el conjunto completo.
4.4 ASISTENCIA VARIADA
Los resultados de los benchmarks de asistencia variada se reportan en la Tabla 6.
GAIA (Mialon et al., 2023) evalúa las habilidades generales de resolución de tareas de los agentes, cubriendo diferentes escenarios del mundo real. Requiere diversas capacidades de los agentes, incluidos razonamiento, comprensión multimodal, navegación web y programación. GAIA consta de 466 tareas curadas en tres niveles. Configurar GAIA es tradicionalmente difícil debido a la complejidad de integrar diversas herramientas con el agente, pero la infraestructura de OpenHands (p. ej., runtime §2.2, herramientas §2.3) simplifica significativamente la integración.
GPQA (Rein et al., 2023) evalúa la capacidad de los agentes para el uso coordinado de herramientas al resolver problemas desafiantes de nivel de posgrado. El uso de herramientas (p. ej., python) y la búsqueda web suelen ser útiles para ayudar a los agentes a responder estas preguntas, ya que proporcionan cálculos precisos que los LLMs a menudo son incapaces de realizar y acceso a información fuera de la base de conocimiento paramétrico del LLM.
| Agente | Modelo | Tasa de éxito (%) | $ Coste prom. |
| GAIA (Mialon et al., 2023), conjunto de validación L1, 53 instancias | |||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | 13,2 | - |
| OH GPTSwarm v1.0 | gpt-4-0125-preview | 30,2 | 0,110 |
| gpt-4-2024-05-13 | 32,1 | 0,050 | |
| GPQA (Rein et al., 2023), conjunto diamond, 198 instancias (consúltese §G, Tab. 7 para otros subconjuntos) | |||
| Humano (Rein et al., 2023) | Humano experto | 81,3 | - |
| Humano no experto | 21,9 | - | |
| Few-shot Prompting + Chain-of-Thought (Rein et al., 2023) | gpt-3.5-turbo-16k | 29,6 | - |
| gpt-4 | 38,8 | - | |
| OH CodeActAgent v1.8 | claude-3-5-sonnet-20240620 | 52,0 | 0,065 |
| AgentBench (Liu et al., 2023), subconjunto OS (bash), 144 instancias | |||
| Agente de referencia de AgentBench (Liu et al., 2023) | gpt-4 | 42,4 | - |
| gpt-3.5-turbo | 32,6 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 57,6 | 0,085 |
| gpt-3.5-turbo-0125 | 11,8 | 0,006 | |
| MINT (Wang et al., 2024b): subconjunto de matemáticas, 225 instancias | |||
| Agente de referencia de MINT | gpt-4-0613 | 65,8 | - |
| gpt-4-2024-05-13 | 77,3 | 0,070 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 33,8 | 0,048 |
| MINT (Wang et al., 2024b): subconjunto de código, 136 instancias | |||
| Agente de referencia de MINT | gpt-4-0613 | 59,6 | - |
| gpt-4-2024-05-13 | 50,0 | 0,087 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 5,2 | 0,030 |
| ProofWriter (Tafjord et al., 2021), 600 instancias | |||
| Few-shot Prompting + Chain-of-Thought (Pan et al., 2023) | gpt-4 | 68,1 | - |
| Logic-LM (Pan et al., 2023) | gpt-4 + solucionador simbólico | 79,6 | - |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 78,8 | - |
| Entity Deduction Arena (Zhang et al., 2024a), 200 instancias | |||
| Zero-shot Prompting (Zhang et al., 2024a) | gpt-4-0314 | 40,0 | - |
| gpt-3.5-turbo-0613 | 27,0 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 38,0 | - |
| gpt-3.5-turbo-16k-0613 | 24,0 | - |
AgentBench (Liu et al., 2023) evalúa las capacidades de razonamiento y toma de decisiones de los agentes en un entorno de generación abierta de múltiples turnos. Seleccionamos el subconjunto de sistema operativo (OS) basado en código con 144 tareas. Los agentes de OpenHands interactúan directamente con el OS específico de la tarea usando comandos bash de manera multi-turno, combinando interacción y razonamiento para automatizar la finalización de tareas.
MINT (Wang et al., 2024b) es un benchmark diseñado para evaluar la capacidad de los agentes para resolver tareas desafiantes mediante interacciones de múltiples turnos usando herramientas y retroalimentación en lenguaje natural simulada por GPT-4. Utilizamos los subconjuntos de programación y matemáticas empleados en Yuan et al. (2024). Seguimos el artículo original y permitimos al agente interactuar hasta cinco iteraciones con dos oportunidades para proponer soluciones.
ProofWriter (Tafjord et al., 2021) es un conjunto de datos sintético creado para evaluar las capacidades de razonamiento deductivo de los LLMs. Al igual que Logic-LM (Pan et al., 2023), nos centramos en el subconjunto más desafiante, que contiene 600 instancias que requieren razonamiento de 5 saltos. Para minimizar el impacto de posibles errores en el análisis semántico, utilizamos las formas lógicas proporcionadas por Logic-LM.
Entity Deduction Arena (EDA) (Zhang et al., 2024a) evalúa la capacidad de los agentes para deducir entidades desconocidas mediante preguntas estratégicas, de manera similar al juego de las 20 preguntas. Este benchmark pone a prueba las capacidades de seguimiento de estado, planificación estratégica y razonamiento inductivo del agente a lo largo de conversaciones de múltiples turnos. Evaluamos dos conjuntos de datos, «Things» y «Celebrities», cada uno con 100 instancias, y reportamos la tasa de éxito promedio sobre estos dos conjuntos de datos.
5 CONCLUSIÓN
Presentamos OpenHands, una plataforma impulsada por la comunidad que permite el desarrollo de agentes que interactúan con el mundo a través de interfaces de software. Al proporcionar un mecanismo de interacción potente, un entorno de sandbox seguro, habilidades esenciales para agentes, capacidades de colaboración multiagente y un marco de evaluación integral, OpenHands acelera las innovaciones en investigación y las aplicaciones reales de sistemas de IA agéntica. A pesar de los desafíos en el desarrollo de agentes seguros y fiables (\$A), nos entusiasma nuestra vibrante comunidad y esperamos con interés la evolución continua de OpenHands.
REFERENCIAS
Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Omar Cortes, Byron David, Chelsea Finn, Chuyuan Fu, Keerthana Gopalakrishnan, Karol Hausman, et al. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022. 1
Daniil A Boiko, Robert MacKnight, Ben Kline, and Gabe Gomes. Autonomous chemical research with large language models. Nature, 624(7992):570- 578, 2023. 1
Yupeng Chang, Xu Wang, Jindong Wang, Yuan Wu, Linyi Yang, Kaijie Zhu, Hao Chen, Xiaoyuan Yi, Cunxiang Wang, Yidong Wang, et al. A survey on evaluation of large language models. ACM Transactions on Intelligent Systems and Technology, 15(3):1- 45, 2024. 1
Harrison Chase. LangChain, October 2022. URL https://github.com/langchain- ai/langchain. 4, 6, 18
Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Jaward Sesay, Borje F. Karlsson, Jie Fu, and Yemin Shi. Autoagents: A framework for automatic agent generation, 2024. 1, 6, 18
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. 7
Cognition.ai. Introducing devin, the first ai software engineer. URL https://www.cognition.ai/blog/introducing- devin. 2
CrewAI. CrewAI, October 2024. URL https://github.com/crewAIInc/crewAI. 18
Jiaxi Cui, Zongjian Li, Yang Yan, Bohua Chen y Li Yuan. Chatlaw: Modelo de lenguaje grande legal de código abierto con bases de conocimiento externas integradas, 2023. 18
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados y Alexandre Lacoste. Workarena: ¿Qué tan capaces son los agentes web para resolver tareas comunes de trabajo del conocimiento?, 2024. 3, 4
Paul Gauthier. Cómo aider obtuvo un SOTA del 26.3% en swe bench lite i aider. https://aider.chat/2024/05/22/ swe- bench- lite.html. Accedido: 2024- 06- 05. 5, 7, 8
Significant Gravitas. Auto- gpt: Un experimento autónomo de gpt- 4, 2023. URL https://github.com/Significant- Gravitas/Auto- GPT, 2023. 6, 7, 10, 18
Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, et al. Metagpt: Meta programación para un marco colaborativo multi- agente. En The Twelfth International Conference on Learning Representations, 2023. 1, 6, 18
Dong Huang, Qingwen Bu, Jie M. Zhang, Michael Luck y Heming Cui. Agentcoder: Generación de código basada en multi- agentes con pruebas y optimización iterativas, 2024. 19
Peter C Humphreys, David Raposo, Tobias Pohlen, Gregory Thornton, Rachita Chhaparia, Alistair Muldal, Josh Abramson, Petko Georgiev, Adam Santoro y Timothy Lillicrap. Un enfoque basado en datos para aprender a controlar computadoras. En International Conference on Machine Learning, pp. 9466- 9482. PMLR, 2022. 9
IPython. Jupyter y el futuro de IPython — IPython. URL https://ipython.org. 4
Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024. 1
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press y Karthik R Narasimhan. SWE- bench: ¿Pueden los modelos de lenguaje resolver problemas reales de Github? En The Twelfth International Conference on Learning Representations, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. 1, 6, 7, 8, 17, 19
Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia y Christopher Potts. Dspy: Compilando llamadas declarativas a modelos de lenguaje en pipelines de auto- mejora. 2024. 18
Geunwoo Kim, Pierre Baldi y Stephen McAleer. Los modelos de lenguaje pueden resolver tareas computacionales. Advances in Neural Information Processing Systems, 36, 2024. 9
Hanyu Lai, Xiao Liu, Iat Long Iong, Shuntian Yao, Yuxuan Chen, Pengbo Shen, Hao Yu, Hanchen Zhang, Xiaohan Zhang, Yuxiao Dong, et al. Autowebglm: Bootstrap y refuerzo de un agente de navegación web basado en un modelo de lenguaje grande. arXiv preprint arXiv:2404.03648, 2024. 7, 9
Hareton K. N. Leung y Lee J. White. Un estudio de pruebas de integración y regresión de software a nivel de integración. En Proceedings of the Conference on Software Maintenance, ICSM 1990, San Diego, CA, USA, 26- 29 November, 1990, pp. 290- 301. IEEE, 1990. doi: 10.1109/ICSM.1990.131377. URL https://doi.org/10.1109/ICSM.1990.131377. 19
Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin y Bernard Ghanem. Camel: Agentes comunicativos para la exploración de la "mente" de una sociedad de modelos de lenguaje a gran escala. arXiv preprint arXiv:2303.17760, 2023a. 18
Jinyang Li, Binyuan Hui, GE QU, Jiaxi Yang, Binhua Li, Bowen Li, Bailin Wang, Bowen Qin, Ruiying Geng, Nan Huo, Xuanhe Zhou, Chenhao Ma, Guoliang Li, Kevin Chang, Fei Huang, Reynold Cheng y Yongbin Li. ¿Puede LLM ya servir como una interfaz de base de datos? un Blg bench para text- to- SQLs fundamentados en bases de datos a gran escala. En Thirty- seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023b. 6, 8, 9, 17
Raymond Li, Loubna Ben Allal, Yangtian Zi, Niklas Muennighoff, Denis Kocetkov, Chenghao Mou, Marc Marone, Christopher Akiki, Jia Li, Jenny Chim, Qian Liu, Evgenii Zheltonozhskii, Terry Yue Zhuo, Thomas Wang, Olivier Dehaene, Mishig Davaadorj, Joel Lamy- Poirier, Joao Monteiro, Oleh Shliazhko, Nicolas Gontier, Nicholas Meade, Armel Zebaze, Ming- Ho Yee, Logesh Kumar Umapathi, Jian Zhu, Benjamin Lipkin, Muhtasham Oblokulov, Zhiruo Wang, Rudra Murthy, Jason Stillerman, Siva Sankalp Patel, Dmitry Abulkhanov, Marco Zocca, Manan Dey, Zhihan Zhang, Nour Fahmy, Urvashi Bhattacharyya, Wenhao Yu, Swayam Singh, Sasha Luccioni, Paulo Villegas, Maxim Kunakov, Fedor Zhdanov, Manuel Romero, Tony Lee, Nadav Timor, Jennifer Ding, Claire Schlesinger, Hailey Schoelkopf, Jan Ebert, Tri Dao, Mayank Mishra, Alex Gu, Jennifer Robinson, Carolyn Jane Anderson, Brendan Dolan- Gavitt, Danish Contractor, Siva Reddy, Daniel Fried, Dzmitry Bahdanau, Yacine Jernite, Carlos Munoz Ferrandis, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra y Harm de Vries. Starcoder: ¡que la fuente te acompañe!, 2023c. URL https://arxiv.org/abs/2305.06161. 7
Tao Li, Gang Li, Zhiwei Deng, Bryan Wang y Yang Li. Un agente de lenguaje de cero disparos para el control de computadoras con reflexión estructurada. arXiv preprint arXiv:2310.08740, 2023d. 9
Evan Zheran Liu, Kelvin Guu, Panupong Pasupat, Tianlin Shi y Percy Liang. Aprendizaje por refuerzo en interfaces web usando exploración guiada por flujos de trabajo. En International Conference on Learning Representations (ICLR), 2018. URL https://arxiv.org/abs/1802.08802. 6, 9, 17
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, Shudan Zhang, Xiang Deng, Aohan Zeng, Zhengxiao Du, Chenhui Zhang, Sheng Shen, Tianjun Zhang, Yu Su, Huan Sun, Minlie Huang, Yuxiao Dong y Jie Tang. Agentbench: Evaluando llms como agentes. arXiv preprint arXiv: 2308.03688, 2023. 6, 10, 17
Anton Lozhkov, Raymond Li, Loubna Ben Allal, Federico Cassano, Joel Lamy- Poirier, Nouamane Tazi, Ao Tang, Dmytro Pykhtar, Jiawei Liu, Yuxiang Wei, Tianyang Liu, Max Tian, Denis Kocetkov, Arthur Zucker, Younes Belkada, Zijian Wang, Qian Liu, Dmitry Abulkhanov, Indraneil Paul, Zhuang Li, Wen- Ding Li, Megan Risdal, Jia Li, Jian Zhu, Terry Yue Zhuo, Evgenii Zheltonozhskii, Nii Osae Osae Dade, Wenhao Yu, Lucas Krauß, Naman Jain, Yixuan Su, Xuanli He, Manan Dey, Edoardo Abati, Yekun Chai, Niklas Muennighoff, Xiangru Tang, Muhtasham Oblokulov, Christopher Akiki, Marc Marone, Chenghao Mou, Mayank Mishra, Alex Gu, Binyuan Hui, Tri Dao, Armel Zebaze, Olivier Dehaene, Nicolas Patry, Canwen Xu, Julian McAuley, Han Hu, Torsten Scholak, Sebastien Paquet, Jennifer Robinson, Carolyn Jane Anderson, Nicolas Chapados, Mostofa Patwary, Nima Tajbakhsh, Yacine Jernite, Carlos Muñoz Ferrandis, Lingming Zhang, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra y Harm de Vries. Starcoder 2 y the stack v2: La próxima generación, 2024. URL https://arxiv.org/abs/2402.19173. 7
Grégoire Mialon, Clémentine Fourrier, Craig Swift, Thomas Wolf, Yann LeCun y Thomas Scialom. GAIA: a benchmark for general AI assistants. CoRR, abs/2311.12983, 2023. doi: 10.48550/ARXIV.2311.12983. URL https://doi.org/10.48550/arXiv.2311.12983. 6, 9, 10, 17
Mozilla. Accessibility tree - MDN Web Docs Glossary: Definitions of Web- related terms | MDN. URL https://developer.mozilla.org/en-US/docs/Glossary/Accessibility_tree. 5
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra y Shayne Longpre. Octopack: Instruction tuning code large language models, 2024. 6, 7, 8, 17
Y Nakajima. Babyagi. URL https://github.com/yoheinakajima/babyagi, 2023. 18
OpenAI. Chatgpt: May 2024 version. https://www.openai.com/chatgpt, 2024a. Consultado: 2024- 05- 29. 8, 18
OpenAI. Hello gpt- 4o. https://openai.com/index/hello- gpt- 4o/, 2024b. Consultado: 2024- 05- 15. 1
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. Consultado: 2024-05-15. 1OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, Red Avila, Igor Babuschkin, Suchir Balaji, Valerie Balcom, Paul Baltescu, Haiming Bao, Mohammad Bavarian, Jeff Belgum, Irwan Bello, Jake Berdine, Gabriel Bernadett-Shapiro, Christopher Berner, Lenny Bogdonoff, Oleg Boiko, Madelaine Boyd, Anna-Luisa Brakman, Greg Brockman, Tim Brooks, Miles Brundage, Kevin Button, Trevor Cai, Rosie Campbell, Andrew Cann, Brittany Carey, Chelsea Carlson, Rory Carmichael, Brooke Chan, Che Chang, Fotis Chantzis, Derek Chen, Sully Chen, Ruby Chen, Jason Chen, Mark Chen, Ben Chess, Chester Cho, Casey Chu, Hyung Won Chung, Dave Cummings, Jeremiah Currier, Yunxing Dai, Cory Decareaux, Thomas Degry, Noah Deutsch, Damien Deville, Arka Dhar, David Dohan, Steve Dowling, Sheila Dunning, Adrien Ecoffet, Atty Eleti, Tyna Eloundou, David Farhi, Liam Fedus, Niko Felix, Simón Posada Fishman, Juston Forte, Isabella Fulford, Leo Gao, Elie Georges, Christian Gibson, Vik Goel, Tarun Gogineni, Gabriel Goh, Rapha Gontijo-Lopes, Jonathan Gordon, Morgan Grafstein, Scott Gray, Ryan Greene, Joshua Gross, Shixiang Shane Gu, Yufei Guo, Chris Hallacy, Jesse Han, Jeff Harris, Yuchen He, Mike Heaton, Johannes Heidecke, Chris Hesse, Alan Hickey, Wade Hickey, Peter Hoeschele, Brandon Houghton, Kenny Hsu, Shengli Hu, Xin Hu, Joost Huizinga, Shantanu Jain, Shawn Jain, Joanne Jang, Angela Jiang, Roger Jiang, Haozhun Jin, Denny Jin, Shino Jomoto, Billie Jonn, Heewoo Jun, Tomer Kaftan, Łukasz Kaiser, Ali Kamali, Ingmar Kanitscheider, Nitish Shirish Keskar, Tabarak Khan, Logan Kilpatrick, Jong Wook Kim, Christina Kim, Yongjik Kim, Jan Hendrik Kirchner, Jamie Kiros, Matt Knight, Daniel Kokotajlo, Łukasz Kondraciuk, Andrew Kondrich, Aris Konstantinidis, Kyle Kosic, Gretchen Krueger, Vishal Kuo, Michael Lampe, Iki Lan, Teddy Lee, Jan Leike, Jade Leung, Daniel Levy, Chak Ming Li, Rachel Lim, Molly Lin, Stephanie Lin, Mateusz Litwin, Theresa Lopez, Ryan Lowe, Patricia Lue, Anna Makanju, Kim Malfacini, Sam Manning, Todor Markov, Yaniv Markovski, Bianca Martin, Katie Mayer, Andrew Mayne, Bob McGrew, Scott Mayer McKinney, Christine McLeavey, Paul McMillan, Jake McNeil, David Medina, Aalok Mehta, Jacob Menick, Luke Metz, Andrey Mishchenko, Pamela Mishkin, Vinnie Monaco, Evan Morikawa, Daniel Mossing, Tong Mu, Mira Murati, Oleg Murk, David Mély, Ashvin Nair, Reiichiro Nakano, Rajeev Nayak, Arvind Neelakantan, Richard Ngo, Hyeonwoo Noh, Long Ouyang, Cullen O'Keefe, Jakub Pachocki, Alex Paino, Joe Palermo, Ashley Pantuliano, Giambattista Parascandolo, Joel Parish, Emy Parparita, Alex Passos, Mikhail Pavlov, Andrew Peng, Adam Perelman, Filipe de Avila Belbute Peres, Michael Petrov, Henrique Ponde de Oliveira Pinto, Michael, Pokorny, Michelle Pokrass, Vitchyr H. Pong, Tolly Powell, Alethea Power, Boris Power, Elizabeth Proehl, Raul Puri, Alec Radford, Jack Rae, Aditya Ramesh, Cameron Raymond, Francis Real, Kendra Rimbach, Carl Ross, Bob Rotsted, Henri Roussez, Nick Ryder, Mario Saltarelli, Ted Sanders, Shibani Santurkar, Girish Sastry, Heather Schmidt, David Schnurr, John Schulman, Daniel Selsam, Kyla Sheppard, Toki Sherbakov, Jessica Shieh, Sarah Shoker, Pranav Shyam, Szymon Sidor, Eric Sigler, Maddie Simens, Jordan Sitkin, Katarina Slama, Ian Sohl, Benjamin Sokolowsky, Yang Song, Natalie Staudacher, Felipe Petroski Such, Natalie Summers, Ilya Sutskever, Jie Tang, Nikolas Tezak, Madeleine B. Thompson, Phil Tillet, Amin Tootoonchian, Elizabeth Tseng, Preston Tuggle, Nick Turley, Jerry Tworek, Juan Felipe Cerón Uribe, Andrea Vallone, Arun Vijayvergiya, Chelsea Voss, Carroll Wainwright, Justin Jay Wang, Alvin Wang, Ben Wang, Jonathan Ward, Jason Wei, CJ Weinmann, Akila Welihinda, Peter Welinder, Jiayi Weng, Lilian Weng, Matt Wiethoff, Dave Willner, Clemens Winter, Samuel Wolrich, Hannah Wong, Lauren Workman, Sherwin Wu, Jeff Wu, Michael Wu, Kai Xiao, Tao Xu, Sarah Yoo, Kevin Yu, Qiming Yuan, Wojciech Zaremba, Rowan Zellers, Chong Zhang, Marvin Zhang, Shengjia Zhao, Tianhao Zheng, Juntang Zhuang, William Zhuk, and Barret Zoph. Gpt-4 technical report, 2024. 18
Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine, and Alane Suhr. Autonomous evaluation and refinement of digital agents. arXiv preprint arXiv:2404.06474, 2024. 7, 9, 18
Liangming Pan, Alon Albalak, Xinyi Wang, and William Yang Wang. Logic-Im: Empowering large language models with symbolic solvers for faithful logical reasoning. arXiv preprint arXiv:2305.12295, 2023. 10
Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior, 2023. 18
Ajay Patel, Markus Hofmarcher, Claudiu Leoveanu-Condrei, Marius-Constantin Dinu, Chris Callison-Burch, and Sepp Hochreiter. Large language models can self-improve at web agent tasks. arXiv preprint arXiv:2405.20309, 2024. 7, 9
Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023. 6, 8, 17
Playwright. Fast and reliable end-to-end testing for modern web apps | Playwright. URL https://playwright.dev/. 4
Chen Qian, Xin Cong, Wei Liu, Cheng Yang, Weize Chen, Yusheng Su, Yufan Dang, Jiahao Li, Juyuan Xu, Dahai Li, Zhiyuan Liu, and Maosong Sun. Communicative agents for software development, 2023. 18, 19
Yujia Qin, Shihao Liang, Yining Ye, Kunlun Zhu, Lan Yan, Yaxi Lu, Yankai Lin, Xin Cong, Xiangru Tang, Bill Qian, Sihan Zhao, Runchu Tian, Ruobing Xie, Jie Zhou, Mark Gerstein, Dahai Li, Zhiyuan Liu, and Maosong Sun. Toolllm: Facilitating large language models to master 16000+ real-world apis. CoRR, abs/2307.16789, 2023. doi: 10.48550/ARXIV.2307.16789. URL https://doi.org/10.48550/arXiv.2307.16789. 4
David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R Bowman. GPQA: A Graduate-Level Google-Proof Q&A Benchmark. arXiv preprint arXiv:2311.12022, 2023. 6, 7, 9, 10, 17, 23
Aman Sanger. Near-instant full-file edits. https://www.cursor.com/blog/instant-apply. Consultado: 2024-06-05. 5
ServiceNow. BrowserGym: a Gym Environment for Web Task Automation. URL https://github.com/ServiceNow/BrowserGym. 2, 4, 18
Peter Shaw, Mandar Joshi, James Cohan, Jonathan Berant, Panupong Pasupat, Hexiang Hu, Urvashi Khandelwal, Kenton Lee, and Kristina N Toutanova. From pixels to ui actions: Learning to follow instructions via graphical user interfaces. Advances in Neural Information Processing Systems, 36: 34354-34370, 2023. 9
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36, 2024. 18
Oyvind Tafjord, Bhavana Dalvi y Peter Clark. ProofWriter: Generating implications, proofs, and abductive statements over natural language. En Chengqing Zong, Fei Xia, Wenjie Li y Roberto Navigli (eds.), Findings of the Association for Computational Linguistics: ACL-IJCNLP 2021, pp. 3621-3634, Online, agosto de 2021. Association for Computational Linguistics. doi: 10.18653/v1/2021.findings-acl.317. URL https://aclanthology.org/2021.findings-acl.317. 6, 10, 17
Xiangru Tang, Qiao Jin, Kunlun Zhu, Tongxin Yuan, Yichi Zhang, Wangchunshu Zhou, Meng Qu, Yilun Zhao, Jian Tang, Zhuosheng Zhang, et al. Prioritizing safeguarding over autonomy: Risks of llm agents for science. arXiv preprint arXiv:2402.04247, 2024a. 1
Xiangru Tang, Yuliang Liu, Zefan Cai, Yanjun Shao, Junjie Lu, Yichi Zhang, Zexuan Deng, Helan Hu, Kaikai An, Ruijun Huang, Shuzheng Si, Sheng Chen, Haozhe Zhao, Liang Chen, Yan Wang, Tianyu Liu, Zhiwei Jiang, Baobao Chang, Yin Fang, Yujia Qin, Wangchunshu Zhou, Yilun Zhao, Arman Cohan y Mark Gerstein. ML-Bench: Evaluating large language models and agents for machine learning tasks on repository-level code, 2024b. URL https://arxiv.org/abs/2311.09835. 6, 8, 17
Xiangru Tang, Bill Qian, Rick Gao, Jiakang Chen, Xinyun Chen y Mark B Gerstein. BioCoder: un benchmark para la generación de código bioinformático con grandes modelos de lenguaje. Bioinformatics, 40 (Supplement_1):i266- i276, 06 2024c. ISSN 1367- 4811. 6, 8, 17
Xiangru Tang, Anni Zou, Zhuosheng Zhang, Ziming Li, Yilun Zhao, Xingyao Zhang, Arman Cohan y Mark Gerstein. Medagents: grandes modelos de lenguaje como colaboradores para el razonamiento médico de disparo cero, 2024d. 18
Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean- Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: una familia de modelos multimodales altamente capaces. arXiv preprint arXiv:2312.11805, 2023. 1
XAgent Team. Xagent: un agente autónomo para la resolución de tareas complejas, 2023. 6, 18
Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie- Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, Aurelien Rodriguez, Armand Joulin, Edouard Grave y Guillaume Lample. Llama: modelos de lenguaje fundamentales abiertos y eficientes. arXiv preprint arXiv:2302.13971, 2023. 8
Xingyao Wang, Yangyi Chen, Lifan Yuan, Yizhe Zhang, Yunzhu Li, Hao Peng y Heng Ji. Las acciones de código ejecutables elicitan mejores agentes LLM. En ICML, 2024a. 2, 3, 4, 5, 17
Xingyao Wang, Zihan Wang, Jiateng Liu, Yangyi Chen, Lifan Yuan, Hao Peng y Heng Ji. MINT: evaluación de LLM en interacción multiturno con herramientas y retroalimentación lingüística. En ICLR, 2024b. 6, 10, 17
Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang y Chi Wang. Autogen: habilitando aplicaciones LLM de próxima generación mediante un marco de conversación multiagente. arXiv preprint arXiv:2308.08155, 2023. 1, 6, 18
Chunqiu Steven Xia, Yinlin Deng, Soren Dunn y Lingming Zhang. Agentless: desmitificando los agentes de ingeniería de software basados en LLM. arXiv preprint, 2024. 7
Tianbao Xie, Fan Zhou, Zhoujun Cheng, Peng Shi, Luoxuan Weng, Yitao Liu, Toh Jing Hua, Junning Zhao, Qian Liu, Che Liu, et al. Openagents: una plataforma abierta para agentes lingüísticos en entornos reales. arXiv preprint arXiv:2310.10634, 2023. 6
Yiheng Xu, Hongjin Su, Chen Xing, Boyu Mi, Qian Liu, Weijia Shi, Binyuan Hui, Fan Zhou, Yitao Liu, Tianbao Xie, et al. Lemur: armonizando lenguaje natural y código para agentes lingüísticos. arXiv preprint arXiv:2310.06830, 2023. 7, 9
John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan y Ofir Press. Swe- agent: las interfaces agente- computadora permiten la ingeniería de software automatizada, 2024. 2, 5, 6, 7, 8, 19
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan y Yuan Cao. React: sinergizando razonamiento y actuación en modelos de lenguaje. En The Eleventh International Conference on Learning Representations, 2023. URL https://openreview.net/forum?id=WE_vluYUL- X. 8
Yining Ye, Xin Cong, Shizuo Tian, Jiannan Cao, Hao Wang, Yujia Qin, Yaxi Lu, Heyang Yu, Huadong Wang, Yankai Lin, et al. Proagent: de la automatización de procesos robóticos a la automatización de procesos agénticos. arXiv preprint arXiv:2311.10751, 2023. 18.
Lifan Yuan, Yangyi Chen, Xingyao Wang, Yi R. Fung, Hao Peng y Heng Ji. CRAFT: personalizando LLM mediante la creación y recuperación desde conjuntos de herramientas especializados. CoRR, abs/2309.17428, 2023. doi: 10.48550/ARXIV.2309.17428. URL https://doi.org/10.48550/arXiv.2309.17428. 4
Lifan Yuan, Ganqu Cui, Hanbin Wang, Ning Ding, Xingyao Wang, Jia Deng, Boji Shan, Huimin Chen, Ruobing Xie, Yankai Lin, Zhenghao Liu, Bowen Zhou, Hao Peng, Zhiyuan Liu y Maosong Sun. Avanzando en generalistas del razonamiento LLM con árboles de preferencia, 2024. 10
Yizhe Zhang, Jiarui Lu y Navdeep Jaitly. Sondeando las capacidades de planificación multiturno de los LLM mediante juegos de 20 preguntas. 2024a. 6, 10, 17
Yuntong Zhang, Haifeng Ruan, Zhiyu Fan y Abhik Roychoudhury. Autocoderover: mejora autónoma de programas, 2024b. 6, 7, 8, 19
Shuyan Zhou, Frank F Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried, et al. Webarena: un entorno web realista para construir agentes autónomos. En The Twelfth International Conference on Learning Representations, 2023a. 1, 6, 7, 9, 17
Wangchunshu Zhou, Yuchen Eleanor Jiang, Long Li, Jialong Wu, Tiannan Wang, Shi Qiu, Jintian Zhang, Jing Chen, Ruipu Wu, Shuai Wang, Shiding Zhu, Jiyu Chen, Wentao Zhang, Xiangru Tang, Ningyu Zhang, Huajun Chen, Peng Cui y Mrinmaya Sachan. Agents: un marco de código abierto para agentes lingüísticos autónomos, 2023b. 6, 18
Yuchen Zhuang, Yue Yu, Kuan Wang, Haotian Sun y Chao Zhang. Toolqa: un conjunto de datos para la respuesta a preguntas de LLM con herramientas externas. Advances in Neural Information Processing Systems, 36, 2024. 6, 8, 17
Mingchen Zhuge, Haozhe Liu, Francesco Faccio, Dylan R Ashley, Robert Csordás, Anand Gopalakrishnan, Abdullah Hamdi, Hasan Abed Al Kader Hammoud, Vincent Herrmann, Kazuki Irie, et al. Mindstorms en sociedades de la mente basadas en lenguaje natural. arXiv preprint arXiv:2305.17066, 2023. 18
Mingchen Zhuge, Wenyi Wang, Louis Kirsch, Francesco Faccio, Dmitrii Khizbullin y Jurgen Schmidhuber. Agentes lingüísticos como grafos optimizables. arXiv preprint arXiv:2402.16823, 2024. 6, 17, 18
Albert Örwall. Moatless tools. URL https://github.com/aorwall/moatless- tools. 7
CONTRIBUCIONES DE LOS AUTORES
Este trabajo fue un esfuerzo colaborativo de código abierto entre múltiples instituciones. Empleamos un sistema basado en puntos para determinar las contribuciones y otorgar autorías, con las contribuciones técnicas registradas y medidas en unidades de pull requests (PR)'. Xingyao Wang lideró el proyecto, coordinando los esfuerzos generales de desarrollo y redacción del artículo. Las contribuciones detalladas fueron las siguientes:
- Desarrollo de agentes (§3): Xingyao Wang lideró la implementación de los agentes CodeAct Wang et al. (2024a) y CodeActSWE. Frank F. Xu lideró el desarrollo de los agentes de navegación web Zhou et al. (2023a). Mingchen Zhuge orquestó la integración del agente GPTSwarm Zhuge et al. (2024). Robert Brennan y Boxuan Li lideran el desarrollo del Micro Agent.
- Desarrollo arquitectónico (Fig. 2): Robert Brennan inició el diseño de la arquitectura. Boxuan Li, Frank F. Xu, Xingyao Wang, Yufan Song y Mingzhang Zheng refinaron y ampliaron aún más la arquitectura. Boxuan Li implementó la versión inicial de las pruebas de integración (§E), mantuvo la biblioteca agentskills (§2.3), gestionó las configuraciones y resolvió fugas de recursos en la evaluación. Frank F. Xu desarrolló el entorno de navegación web (§J) tanto para la ejecución de agentes como para la evaluación y lo integró con las interfaces de usuario del agente y del front-end. Xingyao Wang escribió el código inicial para la biblioteca agentskills y el sandbox de Docker. Yufan Song implementó el seguimiento de costos para la evaluación, mientras que Mingzhang Zheng desarrolló un sandbox de Docker independiente de la imagen para una evaluación más estable de SWE-Bench.
- Evaluación comparativa, integración y revisión de código: Boxuan Li y Yufan Song lideraron los esfuerzos de integración de benchmarks, incluida la coordinación, la evaluación y la revisión de código. Yufan Song también ayudó a realizar el seguimiento de las contribuciones de PR. Graham Neubig, Xingyao Wang, Mingzhang Zheng, Robert Brennan, Hoang H. Tran, Frank F. Xu, Xiangru Tang, Fuqiang Li y Yanjun Shao brindaron apoyo adicional en la integración y las revisiones de código. Las contribuciones específicas a benchmarks incluyeron:
- SWE-Bench Jimenez et al. (2024): Bowen Li y Xingyao Wang- WebArena Zhou et al. (2023a) y MiniWob++ Liu et al. (2018): Frank F. Xu- GAIA Mialon et al. (2023): Jiayi Pan (integración) y Mingchen Zhuge (evaluación de GPTSwarm)- API-Bench Patil et al. (2023) y ToolQA Zhuang et al. (2024): Yueqi Song- HumanEvalFix Muennighoff et al. (2024): Niklas Muennighoff y Xiangru Tang- ProofWriter Tafjord et al. (2021): Ren Ma- MINT Wang et al. (2024b): Hoang H. Tran- AgentBench Liu et al. (2023): Fuqiang Li- BIRD Li et al. (2023b): Binyuan Hui- GPQA Rein et al. (2023): Jaskirat Singh- BioCoder Tang et al. (2024c): Xiangru Tang y Bill Qian- ML-Bench Tang et al. (2024b): Xiangru Tang y Yanjun Shao- Entity-Deduction-Arena Zhang et al. (2024a): Yizhe Zhang
- Asesoramiento: Graham Neubig asesoró el proyecto, proporcionando orientación, recursos y ediciones sustanciales del artículo. Heng Ji y Hao Peng ofrecieron asesoramiento adicional sobre el proyecto y ayudaron con la redacción del artículo. Junyang Lin contribuyó con apoyo de asesoramiento y patrocinó recursos.
A LIMITACIONES Y TRABAJO FUTURO
Nos entusiasman los fundamentos que nuestra vibrante comunidad ha establecido en OpenHands y esperamos con interés su continua evolución. Identificamos varias direcciones para el trabajo futuro:
Soporte mejorado para la multimodalidad. Aunque nuestra implementación actual ya admite una amplia gama de formatos de archivo mediante habilidades de agente predefinidas, nos interesa habilitar la multimodalidad de manera fundamentada a través de la integración estándar de IPython y del navegador, como visualizar imágenes y videos usando un modelo de lenguaje y visión a través de un navegador o procesar archivos XLSX con código.
Agentes más potentes. Los agentes actuales todavía tienen dificultades con tareas complejas, y nos interesa construir mejores agentes tanto mediante técnicas de entrenamiento como de inferencia.
Mejoras en la edición de agentes. El agente actual sufre mucho al editar archivos largos, y nos interesa explorar diferentes enfoques para mejorar el rendimiento de edición de archivos de los agentes.
Mejoras en la navegación web. Debido a la naturaleza extensible de OpenHands, los componentes ortogonales que podrían mejorar a los agentes se pueden integrar fácilmente. Por ejemplo, gracias a la arquitectura extensible de OpenHands, Auto Eval & Refine Pan et al. (2024), una estrategia de reintento ante errores del agente con prompts de Reflexion Shinn et al. (2024) y modelos de recompensa por finalización de tareas, se integrará como un componente opcional adjunto a nuestro agente de navegación.
Generación automática de flujos de trabajo. Actualmente, el flujo de trabajo de OpenHands todavía requiere una carga de trabajo sustancial hecha a mano. Creemos que los marcos basados en grafos como GPTSwarm Zhuge et al. (2024) y LangGraph Chase (2022) podrían servir como soluciones alternativas para construir agentes. Particularmente en GPTSwarm, cuando los agentes se construyen usando grafos, se vuelve más fácil incorporar diversos métodos de optimización (por ejemplo, aprendizaje por refuerzo, meta-prompting). OpenHands considera que estos métodos sientan las bases para soluciones prometedoras en la generación automática de flujos de trabajo en futuras versiones.
B DECLARACIÓN DE ÉTICA
La mayoría de los agentes de IA actuales siguen siendo artefactos de investigación y carecen de la capacidad de realizar tareas complejas de horizonte largo en el mundo real de manera confiable. Sin embargo, a medida que su rendimiento continúa mejorando y se despliegan cada vez más en el mundo real, tienen el potencial de impulsar la productividad y, al mismo tiempo, plantear riesgos de seguridad significativos para la sociedad. OpenHands ayuda a mitigar los riesgos al:
(1) Permitir la evaluación sistemática de estos agentes, lo que puede identificar y abordar riesgos antes de que se desplieguen ampliamente. (2) Facilitar la interacción humano-agente en lugar de permitir que los agentes operen de forma autónoma sin supervisión. (3) Más importante aún, esperamos que OpenHands permita a investigadores de todo el mundo acceder a los mejores conjuntos de agentes para llevar a cabo investigación de seguridad de frontera orientada a construir agentes seguros y útiles.
C TRABAJO RELACIONADO
Los avances en los modelos de lenguaje grandes (LLM) como ChatGPT OpenAI (2024a) y GPT4 OpenAI et al. (2024) han mejorado significativamente las capacidades de los agentes autónomos en diversos dominios Ye et al. (2023); Tang et al. (2024d); Park et al. (2023); Cui et al. (2023). Estos avances han impulsado una multitud de propuestas de agentes generalistas Gravitas (2023); Nakajima (2023); Wu et al. (2023) orientadas a realizar diversas tareas del usuario y han captado la atención tanto de desarrolladores como de audiencias más amplias. Trabajos notables como Auto-GPT Gravitas (2023) aprovechan los LLM para completar tareas descomponiendo los objetivos del usuario en pasos ejecutables. Los sistemas de colaboración multiagente aprovechan los LLM para elementos como la interpretación de roles y las capacidades de resolución de tareas Zhuge et al. (2023); Li et al. (2023a); Zhou et al. (2023b); Team (2023), con MetaGPT Hong et al. (2023) enfatizando procedimientos operativos estandarizados, y AutoGen Wu et al. (2023) proporcionando un marco de conversación para sistemas interactivos. AGENTS Zhou et al. (2023b) y AutoAgents Chen et al. (2024) ofrecen nuevos paradigmas para una arquitectura de agentes personalizable, mientras que XAgent Team (2023) y GPTSwarm Zhuge et al. (2024) introducen sistemas de gestión complejos y grafos optimizables, respectivamente, para mejorar las operaciones de los agentes.
Este auge en el desarrollo de agentes ha dado lugar a marcos especializados orientados a agilizar la implementación de agentes. LangChain y LangGraph Chase (2022) proporcionan bloques de construcción fundamentales con soporte básico en tiempo de ejecución, mientras que CrewAI CrewAI (2024) se centra en orquestar las comunicaciones multiagente. BrowserGym ServiceNow se dirige específicamente a las capacidades de navegación web, y DSPy Khattab et al. (2024) enfatiza la optimización de prompts de extremo a extremo. AutoGen Wu et al. (2023) avanza más allá de los marcos básicos al implementar capacidades de ejecución de Python y bash, aunque con ejecución de comandos sin estado, mientras que marcos como CrewAI ofrecen características de intérprete de código en sandbox pero limitadas.
El desarrollo de software, un pionero en la aplicación de agentes basados en LLM, ha visto avances en marcos para facilitar los procesos de desarrollo Hong et al. (2023); Qian et al. (2023). Innovaciones como ChatDev Qian et al. (2023) automatizan el ciclo de vida del desarrollo de software de manera similar al modelo en cascada, y AutoCodeRover Zhang et al. (2024b) aborda los problemas de GitHub mediante búsqueda de código y manipulación de árboles de sintaxis abstracta.AgentCoder Huang et al. (2024) refina iterativamente la generación de código con pruebas y retroalimentación integradas, mientras que SWE-Agent Yang et al. (2024) integra LLM para la corrección automatizada de problemas de GitHub, agilizando la ingeniería de software.
D INTERFAZ GRÁFICA DE USUARIO
Además de ejecutarse desde la línea de comandos, OpenHands cuenta con una rica interfaz gráfica de usuario que visualiza las acciones actuales del agente (por ejemplo, navegar por la web, ejecutar comandos básicos o código Python, etc.) y permite la retroalimentación del usuario en tiempo real. En la Fig. 1 se muestran capturas de pantalla de la interfaz de usuario. El usuario puede interrumpir al agente en cualquier momento para proporcionar retroalimentación, comentarios o instrucciones adicionales mientras el agente está trabajando. Esta interfaz de usuario se conecta directamente con los flujos de eventos (§2.1) para controlar y visualizar los agentes y el entorno de ejecución, lo que la hace independiente del agente y del entorno de ejecución.
E CONTROL DE CALIDAD: PRUEBAS DE INTEGRACIÓN PARA AGENTES
Las pruebas de integración Leung & White (1990) han sido utilizadas durante mucho tiempo por los desarrolladores de software para garantizar la calidad del software. A diferencia de los modelos de lenguaje grandes con un esquema simple de entrada-salida, los agentes suelen ser piezas de software complejas en las que se pueden introducir fácilmente errores menores durante el proceso de desarrollo y perjudicar el rendimiento final de la tarea. Si bien ejecutar una suite de evaluación completa (§4) es la medida definitiva de la degradación del rendimiento, ejecutarlas para cada cambio de código puede ser prohibitivamente lento y costoso. \(^{}\)4\(\) . En OpenHands, somos pioneros en un marco de pruebas de agentes de extremo a extremo que prueba la regresión de prompts, las acciones y los entornos sandbox. Combina las pruebas de integración de la ingeniería de software y el mocking de modelos fundacionales para lograr un comportamiento determinista y así prevenir la introducción accidental de errores durante el desarrollo de agentes.
Definición de una prueba de integración. El marco de pruebas de integración para OpenHands está estructurado para validar la funcionalidad de extremo a extremo mediante la automatización de la ejecución de tareas y la verificación de resultados. Los desarrolladores definen tareas y resultados esperados; por ejemplo, una tarea podría implicar corregir errores tipográficos en un documento llamado "bad.txt". Tras la ejecución de la tarea a través de OpenHands, las salidas se comparan con un "archivo de referencia" predefinido para garantizar la precisión.
Mocking de LLM para un comportamiento determinista. Para abordar el desafío de la no determinación en los modelos de lenguaje grandes (LLM) y los altos costos asociados, el marco intercepta todas las llamadas a LLM y proporciona respuestas predefinidas basadas en coincidencias exactas de prompts. Este método no solo garantiza la consistencia en los resultados de las pruebas, sino que también reduce los costos operativos al minimizar la dependencia de LLM reales.
Regenerar las respuestas de LLM ante cambios disruptivos. Los pares prompt-respuesta se gestionan mediante un script que genera y almacena estos pares cuando se introducen nuevas pruebas o se modifican prompts existentes. Para las pruebas rutinarias, el marco intenta reutilizar las respuestas de LLM existentes ajustando ligeramente los prompts. Los cambios sustanciales que afectan el manejo de tareas requieren la regeneración de estos pares usando LLM reales.
Beneficios de las pruebas de integración. El marco ofrece varias ventajas, entre ellas: 1) Pruebas de regresión de prompts: los pares prompt-respuesta almacenados facilitan el seguimiento de cambios y proporcionan una referencia para que los nuevos miembros del equipo comprendan las interacciones con el LLM; 2) Soporte multiplataforma: las pruebas se programan automáticamente para cada pull request y commit en la rama principal, ejecutándose en múltiples plataformas, entornos y agentes, incluidos Linux y Mac, y en sandboxes locales, SSH y exec; y 3) Detección integral de errores: captura errores en la generación de prompts, el paso de mensajes y la ejecución en sandbox, manteniendo así una alta cobertura de pruebas.
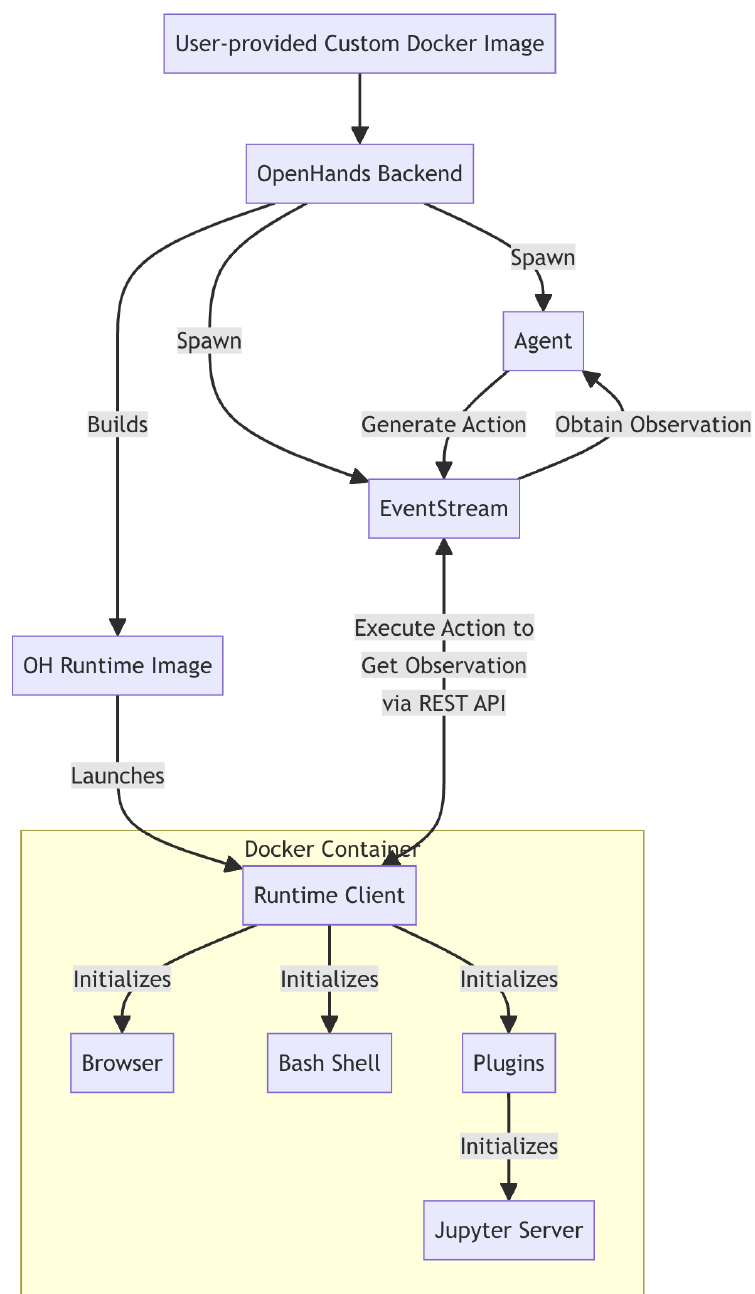
F CÓMO FUNCIONA EL ENTORNO DE EJECUCIÓN DE OPENHANDS
F.1 FLUJO DE TRABAJO
El sistema Runtime de OpenHands utiliza una arquitectura cliente-servidor implementada con contenedores Docker. Véase la Fig. 4 para una descripción general de cómo funciona.
(1) Entrada del usuario: el usuario proporciona una imagen Docker base personalizada.
(2) Construcción de la imagen: OpenHands construye una nueva imagen Docker (la "imagen de ejecución OH") basada en la imagen proporcionada por el usuario. Esta nueva imagen incluye código específico de OpenHands, principalmente el "cliente de ejecución" (es decir, el servidor de API de ejecución descrito en §2.2).
(3) Lanzamiento del contenedor: cuando OpenHands se inicia, lanza un contenedor Docker usando la imagen de ejecución OH.
(4) Comunicación: el backend de OpenHands (runtime.py) se comunica con el cliente de ejecución a través de una API RESTful, enviando acciones y recibiendo observaciones.
(5) Ejecución de acciones: el cliente de ejecución recibe acciones del backend, las ejecuta en el entorno sandbox y devuelve observaciones.
(6) Devolución de observaciones: el cliente envía los resultados de ejecución de vuelta al flujo de eventos del backend de OpenHands como observaciones.
El rol del cliente:- Actúa como intermediario entre el backend de OpenHands y el entorno en sandbox - Ejecuta diversos tipos de acciones (comandos de shell, operaciones de archivos, código Python, etc.) de forma segura dentro del contenedor - Gestiona el estado del entorno en sandbox, incluidos el directorio de trabajo actual y los plugins cargados- Formatea y devuelve observaciones al backend, garantizando una interfaz coherente para procesar los resultados
F.2 CÓMO OPENHANDS CONSTRUYE Y MANTIENE LAS IMÁGENES DE TIEMPO DE EJECUCIÓN
El enfoque de OpenHands para construir y gestionar imágenes de tiempo de ejecución garantiza eficiencia, coherencia y flexibilidad en la creación y el mantenimiento de imágenes de Docker tanto para entornos de producción como de desarrollo.
F.2.1 SISTEMA DE ETIQUETADO DE IMÁGENES
OpenHands utiliza un sistema de etiquetado doble para sus imágenes de tiempo de ejecución con el fin de equilibrar la reproducibilidad con la flexibilidad:
(1) Etiqueta basada en hash: {target_image_repo}:{target_image_hash_tag}. Ejemplo: runtime:abc123def456
- Esta etiqueta se basa en el hash MD5 de la carpeta de compilación de Docker, que incluye el código fuente (del cliente de tiempo de ejecución y las dependencias relacionadas) y el Dockerfile - Etiquetas hash idénticas garantizan que las imágenes se construyeron con exactamente el mismo código fuente y Dockerfile - Esto asegura la reproducibilidad; el mismo hash siempre significa el mismo contenido de imagen
(2) Etiqueta genérica: {target_image_repo}:{target_image_tag}. Ejemplo: runtime:oh_v0.9.3_ubuntu_tag_22.04
- Esta etiqueta sigue el formato: runtime:oh_v{VERSION}{BASE_IMAGE_tag{IMAGE_TAG}}
- Representa la última compilación para una combinación particular de imagen base y versión de OpenHands
- Esta etiqueta se actualiza cada vez que se construye una nueva imagen a partir de la misma imagen base, incluso si el código fuente cambia
La etiqueta basada en hash garantiza la reproducibilidad, mientras que la etiqueta genérica proporciona una referencia estable a la última versión de una configuración particular. Este enfoque de etiquetado doble permite a OpenHands gestionar eficientemente tanto los entornos de desarrollo como los de producción.
F.2.2 PROCESO DE COMPILACIÓN
(1) Convención de nomenclatura de imágenes:
- Etiqueta basada en hash: target_image_repo:target_image_hash_tag. Ejemplo: runtime:abc123def456
- Etiqueta genérica: target_image_repo:target_image_tag. Ejemplo: runtime:oh_v0.9.3_ubuntu_tag_22.04
(2) Proceso de compilación:
a. Convierte el nombre de la imagen base en un nombre de imagen de entorno de ejecución OH. Ejemplo: ubuntu:22.04-> runtime:oh_v0.9.3_ubuntu_tag_22.04
b. Genera un contexto de compilación (Dockerfile y código fuente de OpenHands) y calcula su hash
c. Busca una imagen existente con el hash calculado
d. Si no se encuentra, busca una imagen compatible reciente para usarla como base
e. Si no existe ninguna imagen compatible, compila desde cero usando la imagen base original
f. Etiqueta la nueva imagen con etiquetas basadas en hash y genéricas
(3) Lógica de reutilización y recompilación de imágenes: El sistema sigue estos pasos para determinar si debe compilar una nueva imagen o usar una existente a partir de una imagen (base) proporcionada por el usuario (p. ej., ubuntu:22.04):
a. Si existe una imagen con el mismo hash (p. ej., runtime:abc123def456), se reutilizará tal cual
b. Si no se encuentra el hash exacto, el sistema intentará recompilar usando la última imagen genérica (p. ej., runtime:oh_v0.9.3_ubuntu_tag_22.04) como base. Esto ahorra tiempo al aprovechar las dependencias existentes
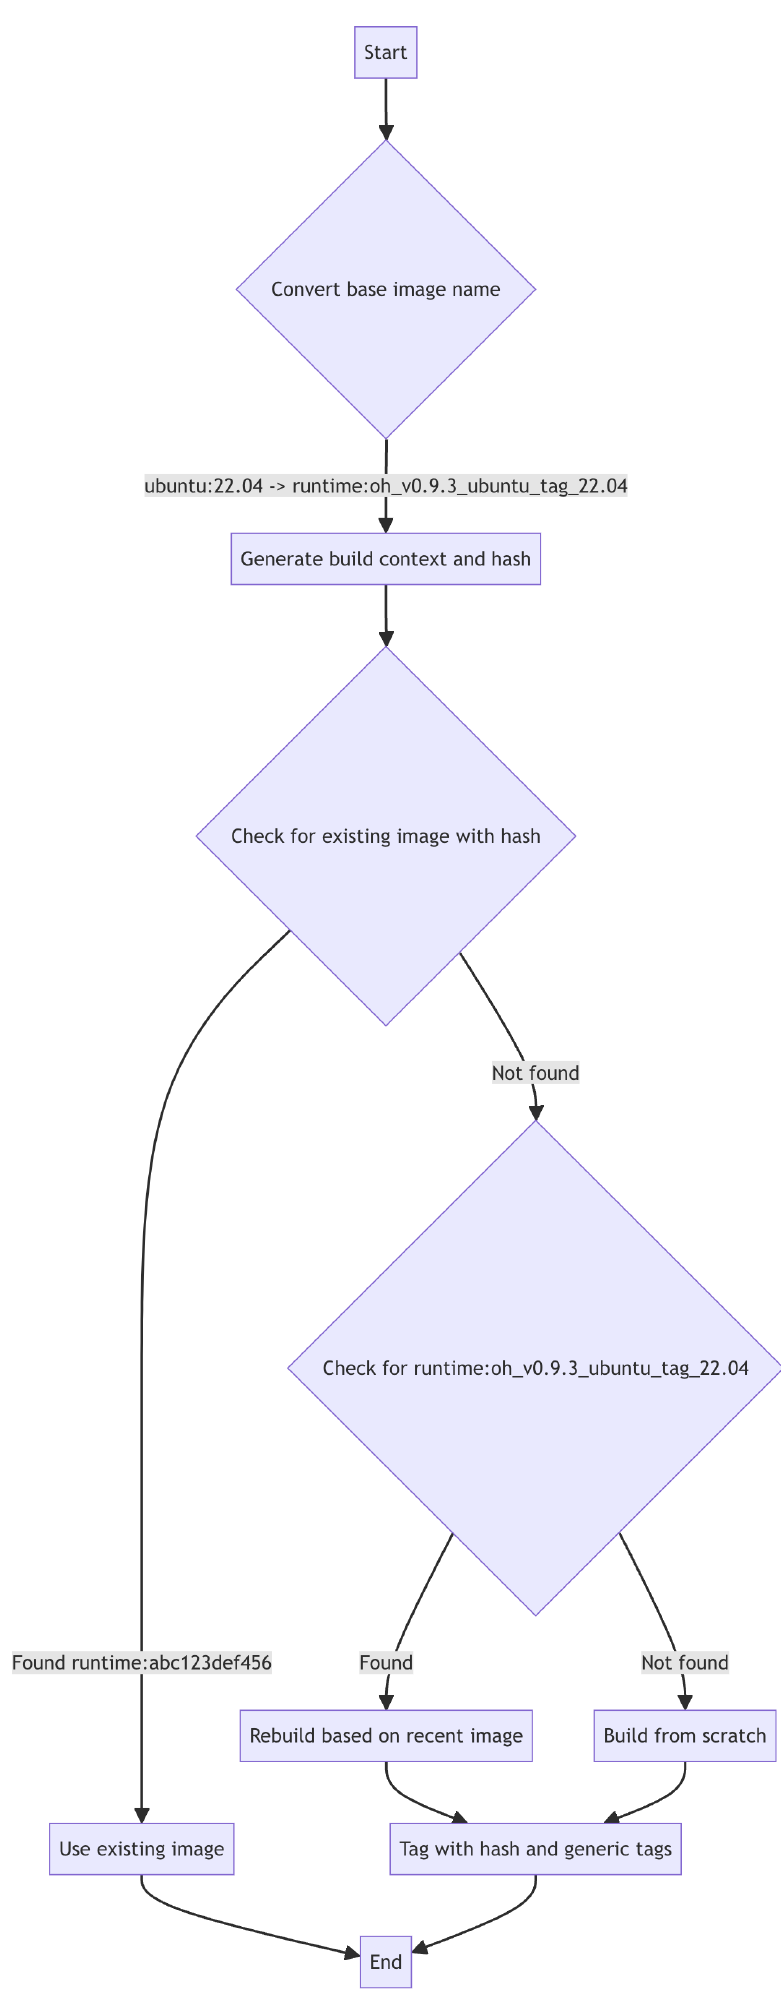
c. Si no se encuentra ni la imagen etiquetada con hash ni la etiquetada como genérica, el sistema compilará la imagen completamente desde cero
Almacenamiento en caché y eficiencia. El sistema intenta reutilizar imágenes existentes cuando es posible para ahorrar tiempo de compilación. Si se encuentra una coincidencia exacta (por hash), se usa sin recompilar. Si se encuentra una imagen compatible, se usa como base para recompilar, lo que ahorra tiempo en la instalación de dependencias.
En la Fig. 5 se muestra un diagrama de flujo que ilustra el proceso de compilación.
G RESULTADOS ADICIONALES PARA EL BENCHMARK GPQA
Mostramos resultados más detallados, incluido el rendimiento en otros subconjuntos del benchmark GPQA, en la Tab. 7.
| Contexto de solo lectura para comprender la fuente (no es texto fuente para traducir): Mostramos resultados más detallados, incluido el rendimiento en otros subconjuntos para el benchmark GPQA en la Tab. 7. Texto a traducir: Método de evaluación y modelo | Precisión por subconjunto (%) | Costo promedio ($) | ||
| Conjunto Diamond | Conjunto principal | Conjunto extendido | ||
| Validadores humanos expertos | 81.2 | 72.5 | 65.4 | N/A |
| Validadores humanos no expertos | 21.9 | 30.5 | 33.9 | N/A |
| Few-Shot CoT Llama-2-70B-chat | 28.1 | 29.1 | 30.4 | N/A |
| Few-Shot CoT GPT-3.5-turbo-16k | 29.6 | 28.0 | 28.2 | N/A |
| Few-Shot CoT GPT-4 | 38.8 | 39.7 | 38.7 | N/A |
| GPT-4 con búsqueda (retroceso a CoT en caso de abstención) | 38.8 | 41.0 | 39.4 | N/A |
| OpenHands + CodeActAgent v1.5 + GPT3.5-turbo | 27.9 | 23.4 | 26.1 | 0.012 |
| OpenHands + CodeActAgent v1.5 + GPT4-turbo | 51.8 | 47.4 | 42.4 | 0.501 |
| OpenHands + CodeActAgent v1.5 + GPT4o | 53.1 | 49.3 | 52.8 | 0.054 |
H DEMOSTRACIÓN EN CONTEXTO PARA CODEACTSWEAGENT
El prompt se vuelve a adoptar a partir de la trayectoria publicada del agente SWE (https://github.com/princeton-nlp/SWE-agent/tree/main/trajectories/demonstrations). El prompt se puede encontrar en https://github.com/All-Hands-AI/OpenHands/blob/main/agenthub/codeact_swe_agent/prompt.py.
I AGENTSKILLS COMPATIBLES
A partir de OpenHands v0.6, admitimos la siguiente lista de habilidades. Consulte el código fuente para obtener la lista más actualizada de habilidades: https://github.com/All-Hands-AI/OpenHands/blob/main/OpenHands/runtime/plugins/agent_skills/agentskills.py
def open_file(path: str, line_number: Optional[int] = None) -> None:\\\* Abre el archivo en la ruta indicada en el editor. Si se proporciona line_number, la ventana se desplazará para incluir esa línea.Args: path: str: La ruta del archivo que se va a abrir. line_number: Optional[int]: El número de línea al que desplazarse.\\\*
def goto_line(line_number: int) -> None:\\\* Desplaza la ventana para mostrar el número de línea especificado.Args: line_number: int: El número de línea al que desplazarse.pass
def scroll_down() -> None: """Desplaza la ventana hacia abajo 100 líneas.Args: None\\\*pass
def scroll_up() -> None: """Desplaza la ventana hacia arriba 100 líneas.Args: None pass
def create_file(filename: str) -> None: """Crea y abre un nuevo archivo con el nombre indicado.Args: filename: str: El nombre del archivo que se va a crear.pass
def edit_file(start: int, end: int, content: str) -> None: """Edita un archivo.Reemplaza las líneas 'start' hasta 'end' (inclusive) con el texto 'content' proporcionado en el archivo abierto. Recuerde que el archivo debe estar abierto antes de editarlo.Args: start: int: El número de línea inicial. Debe cumplir start >= 1. end: int: El número de línea final. Debe cumplir start <= end <= número de líneas del archivo. content: str: El contenido con el que se reemplazarán las líneas.pass
def search_dir(search_term: str, dir_path: str = './') -> None: """Busca search_term en todos los archivos de dir. Si no se proporciona dir, busca en el directorio actual.Args: search_term: str: El término que se va a buscar. dir_path: Optional[str]: La ruta del directorio en el que se va a buscar.pass
def search_file(search_term: str, file_path: Optional[str] = None) -> None: """Busca search_term en un archivo. Si no se proporciona file_path, busca en el archivo abierto actual.Args: search_term: str: El término que se va a buscar. file_path: Optional[str]: La ruta del archivo en el que se va a buscar.pass
def find_file(file_name: str, dir_path: str = './') -> None: """Encuentra todos los archivos con el nombre indicado en el directorio especificado.Args:file_name: str: El nombre del archivo que se va a encontrar. dir_path: Optional[str]: La ruta del directorio en el que se va a buscar.
pass
def parse_pdf(file_path: str) -> None:
"\\\*Analiza el contenido de un archivo PDF y lo imprime.
Args:
file_path: str: La ruta del archivo que se va a abrir.
pass
def parse_docx(file_path: str) -> None:
Analiza el contenido de un archivo DOCX y lo imprime.
Args:
file_path: str: La ruta del archivo que se va a abrir.
pass
def parse_latex(file_path: str) -> None:
Analiza el contenido de un archivo LaTeX y lo imprime.
Args:
file_path: str: La ruta al archivo que se va a abrir.
pass
def parse_audio(file_path: str, model: str = 'whisper- 1') -> None:
Analiza el contenido de un archivo de audio y lo imprime.
Args:
file_path: str: La ruta al archivo de audio que se va a transcribir. model: Optional[str]: El modelo de audio que se utilizará para la transcripción. Por defecto es 'whisper- 1'.
pass
def parse_image(
file_path: str, task: str = 'Describe this image as detail as possible.'
) -> None:
Analiza el contenido de un archivo de imagen e imprime la descripción.
Args:
file_path: str: La ruta al archivo que se va a abrir. task: Optional[str]: La descripción de la tarea para la llamada a la API. Por defecto es 'Describe this image as detail as possible.'
pass
def parse_video( file_path: str, task: str = 'Describe this image as detail as possible.', frame_interval: int = 30, ) -> None:
Analiza el contenido de un archivo de imagen e imprime la descripción.
Args: file_path: str: La ruta al archivo de video que se va a abrir. task: Optional[str]: La descripción de la tarea para la llamada a la API. Por defecto es 'Describe this image as detail as possible.' frame_interval: Optional[int]: El intervalo entre fotogramas que se van a analizar. Por defecto es 30.
pass
def parse_pptx(file_path: str) -> None:
Analiza el contenido de un archivo pptx y lo imprime.
Args: file_path: str: La ruta al archivo que se va a abrir.
pass
ACCIONES DE BROWSERGYM
Las siguientes son todas las acciones compatibles definidas en BrowserGym hasta la versión v0.3.4. Las acciones se pueden clasificar en varios tipos y se pueden configurar para usar solo un subconjunto de la funcionalidad. Hay acciones de control del agente, acciones de navegación, acciones basadas en elementos de la página, acciones basadas en coordenadas, así como acciones relacionadas con pestañas. Usamos estas acciones de la biblioteca BrowserGym como nuestras principales primitivas de acciones de navegación.5
def send_msg_to_user(text: str):
Envía un mensaje al usuario.
Ejemplos:
send_msg_to_user("Based on the results of my search, the city was built in 1751.")
\\\*
pass
def report_infeasible(reason: str):
\\\*
Notifica al usuario que sus instrucciones son inviables.
Ejemplos:
report_infeasible("I cannot follow these instructions because there is no email field in this form.") pass
def noop(wait_ms: float = 1000):\\\*
No hacer nada y, opcionalmente, esperar el tiempo indicado (en milisegundos).
Ejemplos: noop() noop(500) pass
https://playwright.dev/docs/input#text- input
def fill(bid: str, value: str):\\\*
Rellenar un campo de formulario. Enfoca el elemento y desencadena un evento de entrada con el texto introducido. Funciona para elementos <input>, <textarea> y [contenteditable] .
Ejemplos:
fill('237', 'example value')
fill('45', "multi- line\nexample")
fill('a12', "example with \\""quotes\\""\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- check
def check(bid: str):\\\*
Asegurarse de que una casilla de verificación o un elemento de tipo radio esté marcado.
Ejemplos:
check('55')\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- uncheck
def uncheck(bid: str):\\\*
Asegurarse de que una casilla de verificación o un elemento de tipo radio esté desmarcado.
Ejemplos:
uncheck('a5289')\\\* pass
https://playwright.dev/docs/input#select- options
def select_option(bid: str, options: str | list[str]):\\\* Seleccionar una o varias opciones en un elemento <select>. Puede especificar el valor o la etiqueta de la opción que desea seleccionar. Se pueden seleccionar varias opciones.
Ejemplos: select_option('a48', "blue") select_option('c48', ["red", "green", "blue"]) pass
https://playwright.dev/python/docs/api/class- locator#locator- click def click( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : Hacer clic en un elemento. Ejemplos: click('a51') click('b22', button="right") click('48', button="middle", modifiers=["Shift"]) pass
https://playwright.dev/python/docs/api/class- locator#locator- dblclick def dblclick( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : Hacer doble clic en un elemento.
Ejemplos: dblclick('12') dblclick('ca42', button="right") dblclick('178', button="middle", modifiers=["Shift"]) pass
https://playwright.dev/python/docs/api/class- locator#locator- hover def hover(bid: str): pasar el cursor sobre un elemento.
Ejemplos: hover('b8') pass
https://playwright.dev/docs/input#keys- and- shortcuts def press (bid: str, key_comb: str): """ Enfocar el elemento correspondiente y pulsar una combinación de teclas. Acepta los nombres lógicos de teclas que se emiten en la propiedad keyboardEvent.key de los eventos de teclado: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. Alternativamente, puede especificar un único carácter que desee producir, como "a" o "#". También se admiten los siguientes atajos de modificación: Shift, Control, Alt, Meta.
Ejemplos: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t') pass
https://playwright.dev/python/docs/api/class- locator#locator- focus def focus (bid: str): """ Enfoca el elemento coincidente. Ejemplos: focus('b455') """ pass
https://playwright.dev/python/docs/api/class- locator#locator- clear def clear (bid: str): """ Borra el campo de entrada. Ejemplos: clear('996') """ pass
https://playwright.dev/python/docs/input#drag- and- drop def drag_and_drop(from_bid: str, to_bid: str): """ Realiza un arrastrar y soltar. Pasa el cursor sobre el elemento que se va a arrastrar. """ Presiona el botón izquierdo del ratón. Mueve el ratón al elemento que recibirá \(\leftrightarrow\) el soltar. Suelta el botón izquierdo del ratón.
Ejemplos: drag_and_drop('56', '498')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- wheel def scroll(delta_x: float, delta_y: float):
Desplaza horizontal y verticalmente. Cantidades en píxeles, positivas para desplazamiento a la derecha o hacia abajo, negativas para desplazamiento a la izquierda o hacia arriba. Despacha un evento de rueda.
Ejemplos: scroll(0, 200) scroll(- 50.2, - 100.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- move def mouse_move(x: float, y: float):
\\\*
Mueve el ratón a una ubicación. Usa coordenadas de cliente absolutas en píxeles. Despacha un evento de movimiento del ratón.
Ejemplos: mouse_move(65.2, 158.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- up def mouse_up(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Mueve el ratón a una ubicación y luego suelta un botón del ratón. Despacha eventos de movimiento del ratón y mouseup.
Ejemplos: mouse_up(250, 120) mouse_up(47, 252, 'right')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- down def mouse_down(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Mueve el ratón a una ubicación y luego presiona y mantiene un botón del ratón. Despacha eventos de movimiento del ratón y mousedown. Ejemplos: mouse_down(140.2, 580.1) mouse_down(458, 254.5, 'middle') pass
https://playwright.dev/python/docs/api/class- mouse#mouse- click def mouse_click(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Mueve el ratón a una ubicación y haz clic en un botón del ratón. Envía los eventos mousemove, mousedown y mouseup.
Ejemplos: mouse_click(887.2, 68) mouse_click(56, 712.56, 'right') pass #
https://playwright.dev/python/docs/api/class- mouse#mouse- dblclick def mouse_dblclick(x: float, y: float, button: Literal["left", "middle", "right"] = "left"): Mueve el ratón a una ubicación y haz doble clic en un botón del ratón. Envía los eventos mousemove, mousedown y mouseup.
Ejemplos: mouse_dblclick(5, 236) mouse_dblclick(87.5, 354, 'right') pass
def mouse_drag_and_drop(from_x: float, from_y: float, to_x: float, to_y: float): "middle", "right"] = "left"):
Arrastrar y soltar desde una ubicación a otra. Usa coordenadas de cliente absolutas en píxeles. Envía los eventos mousemove, mousedown y mouseup.
Ejemplos: mouse_drag_and_drop(10.7, 325, 235.6, 24.54) pass #
https://playwright.dev/python/docs/api/class- keyboard#keyboard- press def keyboard_press(key: str): Pulsa una combinación de teclas. Acepta los nombres lógicos de teclas que se emiten en la propiedad keyboardEvent.key de los eventos de teclado: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. También puedes especificar un único carácter que desees producir como "a" o "#". También se admiten los siguientes atajos de modificación: Shift, Control, Alt, Meta.
Ejemplos: keyboard_press('Backspace') keyboard_press('Control+a') keyboard_press('Meta+Shift+t') page.keyboard.press("PageDown")\\\*pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- up def keyboard_up(key: str): Libera una tecla del teclado. Envía un evento keyup. Acepta los nombres lógicos de teclas que se emiten en la propiedad keyboardEvent.key de los eventos de teclado: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. También puedes especificar un único carácter que desees producir como "a" o "#".
Ejemplos: keyboard_up('Shift') keyboard_up('c') pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- down def keyboard_down(key: str): Pulsa y mantiene pulsada una tecla del teclado. Envía un evento keydown. Acepta los nombres lógicos de teclas que se emiten en la propiedad keyboardEvent.key de los eventos de teclado: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, etc. También puedes especificar un único carácter como "a" o "#".
Ejemplos: keyboard_up('Shift') keyboard_up('c')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- type def keyboard_type(text: str): """ Escribe una cadena de texto mediante el teclado. Envía un evento keydown, keypress/input y keyup para cada carácter del texto. Las teclas modificadoras NO afectan a keyboard_type. Mantener pulsada Shift no escribirá el texto en mayúsculas.
Ejemplos: keyboard_type('Hello world!')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- insert- text def keyboard_insert_text(text: str): """ Inserta una cadena de texto en el elemento que tiene el foco actualmente. Envía solo el evento input, no emite los eventos keydown, keyup ni keypress. Las teclas modificadoras NO afectan a keyboard_insert_text. Mantener pulsada Shift no escribirá el texto en mayúsculas.
Ejemplos: keyboard_insert_text('Hello world!')
pass
https://playwright.dev/python/docs/api/class- page#page- goto def goto(url: str):
Navega a una url.
Ejemplos: goto('http://www.example.com')
pass
https://playwright.dev/python/docs/api/class- page#page- go- back
\\\\
Navega a la página anterior en el historial.
Ejemplos: go_back()
pass
https://playwright.dev/python/docs/api/class- page#page- go- forward go_forward(): Navega a la página siguiente en el historial. Ejemplos: go_forward()
pass
\*
https://playwright.dev/python/docs/api/class- browsercontext#browser- context- new- def new_tab():
\\\\
Abre una nueva pestaña. Se convertirá en la activa.
Ejemplos: new_tab()
global page
set the new page as the active page
page page.context.new_page()
trigger the callback that sets this page as active in
browsergym
pass
https://playwright.dev/python/docs/api/class- page#page- close
def tab_close():
\\\\
Cerrar la pestaña actual.
Ejemplos:
tab_close()
\\\\
pass
\\\\
https://playwright.dev/python/docs/api/class- page#page- bring- to- front def tab_focus(index: int):
\\\\\*
Traer pestaña al frente (activar pestaña).
Ejemplos:
tab_focus(2)\\\* pass
\\\* pass# https://playwright.dev/python/docs/input#upload- filesdef upload_file(bid: str, file: str | list[str]): """Haz clic en un elemento y espera un evento "filechooser", luego → selecciona uno o varios archivos de entrada para subir. Las rutas de archivo relativas se → resuelven en relación con el directorio de trabajo actual. Una lista vacía → borra los archivos seleccionados.
Ejemplos: upload_file("572", "my_receipt.pdf") upload_file("63", ["/home/bob/Documents/image.jpg", "/home/bob/Documents/file.zip"])
pass
\\\* https://playwright.dev/python/docs/input#upload- filesdef mouse_upload_file(x: float, y: float, file: str | list[str]): """Haz clic en una ubicación y espera un evento "filechooser", luego → selecciona uno o varios archivos de entrada para subir. Las rutas de archivo relativas se → resuelven en relación con el directorio de trabajo actual. Una lista vacía → borra los archivos seleccionados.
Ejemplos: mouse_upload_file(132.1, 547, "my_receipt.pdf") mouse_upload_file(328, 812, → ["/home/bob/Documents/image.jpg", → "/home/bob/Documents/file.zip"])
pass
DETALLES DEL AGENTE DE NAVEGACIÓN K
DETALLES DEL AGENTE DE NAVEGACIÓN K A continuación se muestra un ejemplo de prompt que contiene toda la información requerida para el paso actual para hacer una predicción sobre las próximas acciones de navegación. Ten en cuenta que también instruimos al agente a predecir múltiples acciones en un turno si el agente piensa que están destinadas a ejecutarse secuencialmente sin ninguna retroalimentación de la página. Esto podría ahorrar turnos para flujos de trabajo comunes que consisten en una secuencia de acciones en la misma página sin ningún cambio de observación, como rellenar el nombre de usuario y la contraseña y enviar en una página de inicio de sesión.
Instrucciones
Revisa el estado actual de la página y toda la demás información para → encontrar la mejor acción posible para lograr tu objetivo. → Tu respuesta será interpretada y ejecutada por un programa, → asegúrate de seguir las instrucciones de formato.
Objetivo: Navega por localhost:8000 y dime la respuesta definitiva a la vida. No me pidas confirmación en ningún momento.
Espacio de Acciones
16 tipos diferentes de acciones están disponibles.
noop(wait_ms: float = 1000)
Ejemplos:
noop()
noop(500)
send_msg_to_user(text: str)
Ejemplos:
send_msg_to_user('Basado en los resultados de mi búsqueda, la ciudad fue construida en 1751. ')
scroll(delta_x: float, delta_y: float)
Ejemplos:
scroll(0, 200)
scroll(- 50.2, - 100.5)
fill(bid: str, value: str)
Ejemplos:
fill('237', 'valor de ejemplo')
fill('45', 'ejemplo de varias\nlíneas')
fill('a12', 'ejemplo con "comillas')
select_option(bid: str, options: str | list[str])
Ejemplos:
select_option('48', 'azul')
select_option('48', ['rojo', 'verde', 'azul'])
click(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
Ejemplos:
click('51')
click('b22', button='right')
click('48', button='middle', modifiers=['Shift'])
dblclick(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
Ejemplos:
dblclick('12')
dblclick('ca42', button='right')
dblclick('178', button='middle', modifiers=['Shift'])
hover(bid: str) Ejemplos: hover('b8')
press(bid: str, key_comb: str) Ejemplos: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')
focus(bid: str) Ejemplos: focus('b455')
clear(bid: str) Ejemplos: clear('996')
drag_and_drop(from_bid: str, to_bid: str) Ejemplos: drag_and_drop('56', '498')
upload_file(bid: str, file: str | list[str]) Ejemplos: upload_file('572', 'my_receipt.pdf')
upload_file('63', ['/home/bob/Documents/image.jpg', ' /home/bob/Documents/file.zip'])
go_back() Ejemplos: go_back()
go_forward() Ejemplos: go_forward()
goto(url: str) Ejemplos: goto('http://www.example.com')
Se pueden proporcionar varias acciones a la vez. Ejemplo: fill('a12', 'ejemplo con "comillas"') click('51')
click('48', button='middle', modifiers=['Shift']) Las acciones múltiples están pensadas para ejecutarse secuencialmente sin ninguna retroalimentación de la página. No ejecutes varias acciones a la vez si necesitas retroalimentación de la página.
Árbol de accesibilidad actual: RootWebArea 'La respuesta definitiva', enfocado [8] heading 'La respuesta definitiva' [9] paragraph ' StaticText 'Haz clic en el botón para revelar la respuesta a la vida, el universo y todo lo demás.' [10] button 'Haz clic en mí', clickable
Acciones previas goto('http://localhost:8000')
Aquí tienes un ejemplo con cadena de pensamiento de una acción válida al hacer clic en un botón:
Para lograr mi objetivo, necesito hacer clic en el botón con bid 12 "click("12")"
Y un ejemplo de respuesta al mensaje anterior es:
Para lograr mi objetivo, necesito hacer clic en el botón con bid 10 para revelar la respuesta a la vida, el universo y todo. "click("10")"
Para la evaluación en el benchmark WebArena, dado que algunas de las tareas requieren comprobar la coincidencia exacta de la respuesta en el mensaje del agente al usuario, añadimos la siguiente instrucción para que el agente responda solo con una cadena de respuesta concisa al enviar mensajes al usuario, a fin de evitar que el agente falle la prueba debido a texto adicional:
Aquí hay otro ejemplo con cadena de pensamiento de una acción válida al proporcionar una respuesta concisa al usuario:
Para lograr mi objetivo, necesito enviar al usuario la información solicitada. Esta página enumera la información de la HP Inkjet Fax Machine, que es el producto identificado en el objetivo. Su precio es 279,49\(. Enviaré un mensaje de vuelta al usuario con la respuesta. "send_msg_to_user("\) \ "