
En vez de predecir token a token, LLaDA rellena texto enmascarado como un modelo de difusión e iguala a LLaMA-3 8B. ICML 2025, gratis.
Large Language Diffusion Models
Modelos de Difusión para Lenguaje a Gran Escala
Shen Fengqi Zhu Zebin You Xiaolu Zhang Jingyang Jun Jun Zhou Yankai Ji- Rong Wen Chongxuan Gaoling School of Artificial Intelligence, Renmin University of China Beijing Key Laboratory of Research on Large Models and Intelligent Governance Engineering Research Center of Next- Generation Intelligent Search and Recommendation, MOE Ant Group {nieshen,fengqizhu,chongxuanli}@ruc.edu.cn {nie shen, fengqizhu, chongxuanli}@ruc.edu.cn
Resumen
Se considera ampliamente que las capacidades de los modelos de lenguaje a gran escala (LLMs) dependen de los modelos autorregresivos (ARMs). Cuestionamos esta noción introduciendo LLaDA, un modelo de difusión entrenado desde cero bajo el paradigma de preentrenamiento y ajuste fino supervisado (SFT). LLaDA emplea un proceso de enmascaramiento de datos hacia adelante y un proceso de generación inverso, parametrizado por un Transformer para predecir tokens enmascarados. Proporciona un enfoque generativo fundamentado para la inferencia probabilística mediante la optimización de una cota inferior de la verosimilitud. A través de extensos benchmarks en tareas generales, matemáticas, código, etc., LLaDA demuestra una fuerte escalabilidad y se desempeña de manera comparable a nuestras líneas base ARM construidas por nosotros mismos. Notablemente, LLaDA 8B es competitivo con LLMs fuertes como LLaMA3 8B en aprendizaje en contexto y, tras el SFT, exhibe impresionantes habilidades de seguimiento de instrucciones en estudios de caso como el diálogo multiturno. Además, LLaDA aborda la maldición de la reversión, superando a GPT- 4o en una tarea de completación de poemas invertidos. Nuestros hallazgos muestran la promesa de los modelos de difusión para el modelado del lenguaje a escala y cuestionan la suposición común de que las capacidades centrales de los LLMs discutidas anteriormente dependen inherentemente de los ARMs. Página del proyecto y códigos: https://ml- gsai.github.io/LLaDA- demo/
1 Introducción
Los modelos de lenguaje a gran escala (LLMs) [1] se enmarcan enteramente dentro del marco del modelado generativo. Específicamente, los LLMs tienen como objetivo capturar la distribución verdadera pero desconocida del lenguaje optimizando una distribución del modelo mediante estimación de máxima verosimilitud, o equivalentemente, minimización de la divergencia KL entre las dos distribuciones:
El enfoque predominante se basa en el modelado autorregresivo (ARM)—comúnmente denominado paradigma de "predicción del siguiente token"—para definir la distribución del modelo:
Formulación autorregresiva
\*Contribución equitativa.
Trabajo realizado durante una pasantía en Ant Group.
Líderes del proyecto.
Correspondencia a Chongxuan Li.
donde es una secuencia de longitud , y es el -ésimo token. Este paradigma ha demostrado ser notablemente efectivo [2][5] y se ha convertido en la base de los LLMs actuales. A pesar de su adopción generalizada, queda sin responder una pregunta fundamental: ¿Es el paradigma autorregresivo el único camino para lograr las capacidades centrales de los LLMs, como la escalabilidad, el aprendizaje en contexto y el seguimiento de instrucciones?
Sostenemos que la respuesta no es un simple "sí". La idea clave previamente pasada por alto es: son los principios del modelado generativo (es decir, la Ec. (1)), y no la formulación autorregresiva (es decir, la Ec. (2)) en sí misma, los que fundamentalmente sustentan las propiedades esenciales de los LLMs.
En particular, sostenemos que la escalabilidad es principalmente una consecuencia de la interacción entre los Transformers [7], el tamaño del modelo, el tamaño de los datos y la consistencia de Fisher [5][8] inducida por los principios generativos en la Ec. (1), y no un resultado exclusivo de los ARMs en la Ec. (2). El éxito de los transformers de difusión [9][10] en datos visuales [11] respalda esta afirmación. Además, las capacidades de seguimiento de instrucciones y aprendizaje en contexto [4] parecen ser propiedades intrínsecas de todos los modelos generativos condicionales en tareas lingüísticas estructuralmente consistentes, y no ventajas exclusivas de los ARMs. Adicionalmente, si bien los ARMs pueden interpretarse como un compresor de datos sin pérdida [12][13], cualquier modelo probabilístico suficientemente expresivo puede lograr capacidades similares [14].
Sin embargo, ciertas limitaciones inherentes de los LLMs pueden atribuirse directamente a su naturaleza autorregresiva. Por ejemplo, el proceso de generación de izquierda a derecha restringe su capacidad para manejar tareas de razonamiento de reversión [15], destacando un fallo representativo en las capacidades de generalización de los modelos actuales.
Motivados por estas ideas, presentamos LLaDA (Large Language Diffusion with mAsking) para investigar si las capacidades exhibidas por los LLMs pueden emerger de principios de modelado generativo más allá de los ARMs, abordando así la pregunta fundamental planteada anteriormente. En contraste con los ARMs tradicionales, LLaDA aprovecha un modelo de difusión enmascarado (MDM) [16][20], que incorpora un proceso de enmascaramiento de datos hacia adelante y entrena un predictor de máscaras para aproximar su proceso inverso. Este diseño permite a LLaDA construir una distribución del modelo con dependencias bidireccionales y optimizar una cota inferior variacional de su log- verosimilitud, ofreciendo una perspectiva fundamentada y previamente inexplorada sobre las capacidades centrales de los LLMs discutidas anteriormente.
Adoptamos el pipeline estándar de preparación de datos, preentrenamiento, ajuste fino supervisado (SFT) y evaluación, escalando LLaDA a una difusión de lenguaje de tamaño 8B sin precedentes. En particular, LLaDA 8B fue preentrenado desde cero en 2,3 billones de tokens utilizando 0,13 millones de horas de GPU H800, seguido de SFT en 4,5 millones de pares. A través de diversas tareas, incluyendo comprensión del lenguaje, matemáticas, código y chino, LLaDA demuestra las siguientes contribuciones:
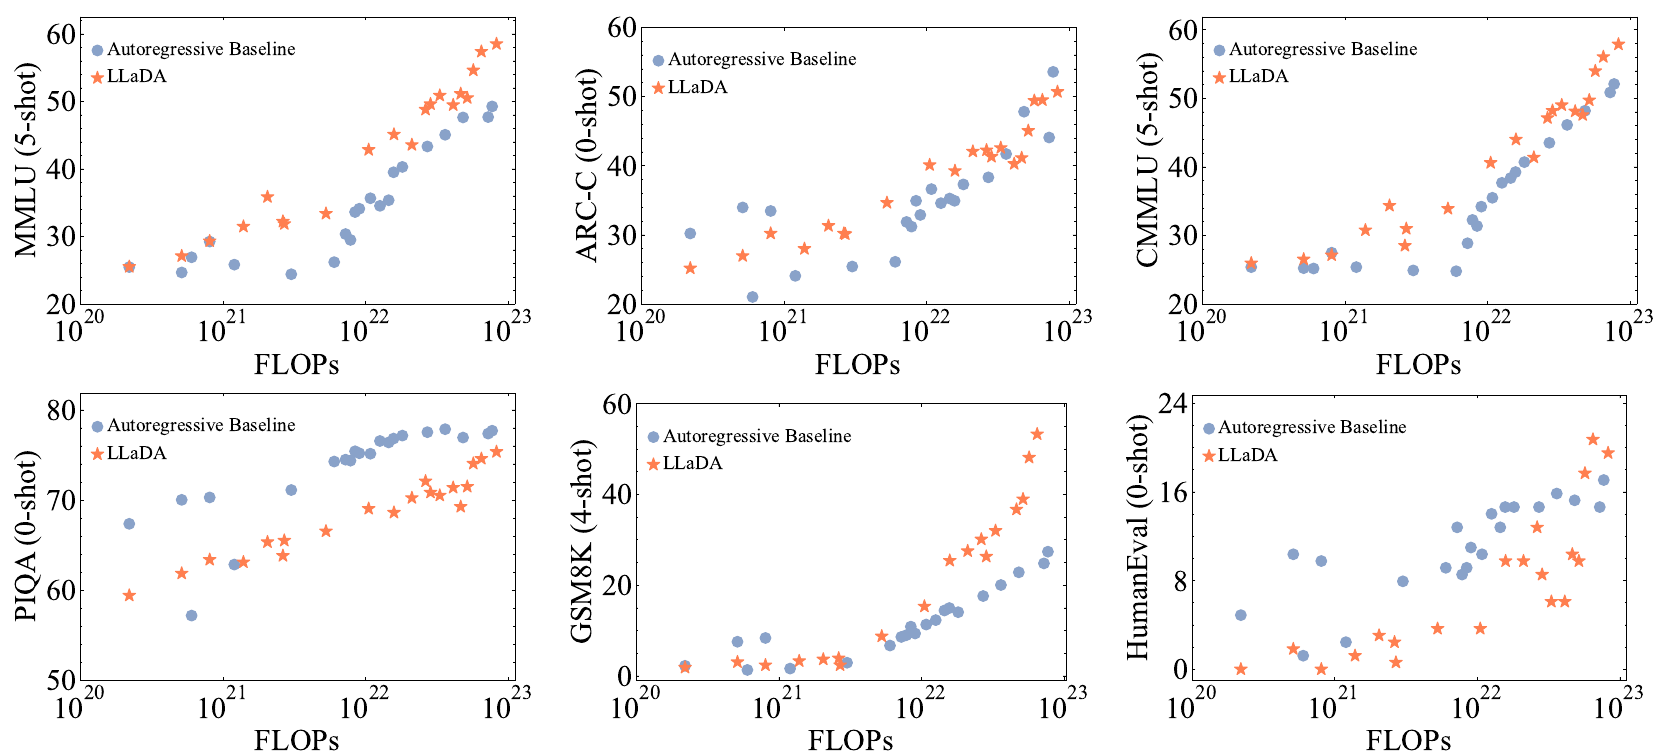
- LLaDA escala efectivamente a un presupuesto de cómputo de FLOPs, logrando resultados comparables a las líneas base ARM entrenadas con los mismos datos en seis tareas, por ejemplo, MMLU y GSM8K.
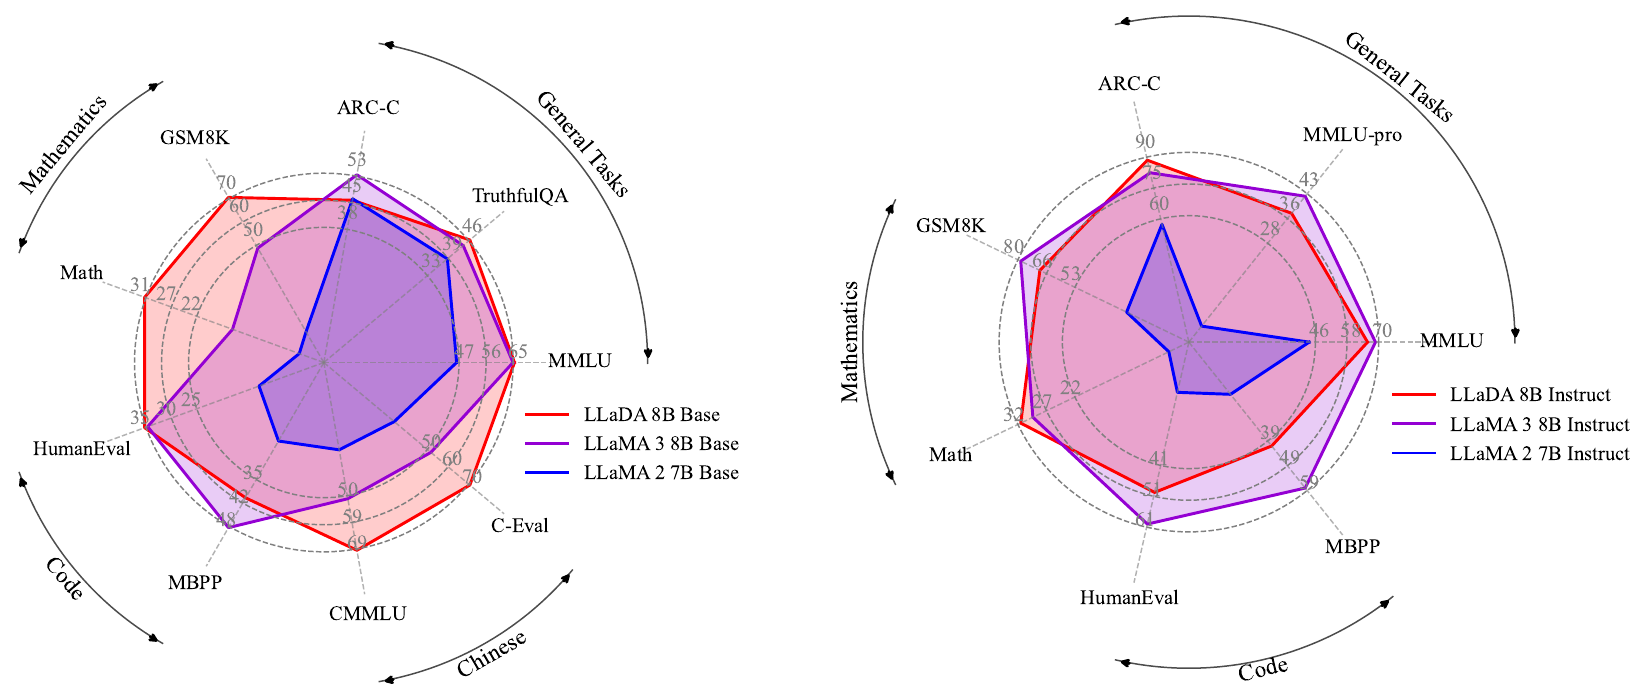
- LLaDA 8B Base preentrenado supera a LLaMA2 7B Base [21] en casi todas las 15 tareas estándar de aprendizaje de cero/pocos ejemplos, mientras que se desempeña a la par de LLaMA3 8B Base [6], mostrando una capacidad efectiva de aprendizaje en contexto.
- LLaDA mejora significativamente la capacidad de seguir instrucciones tras el SFT, como se demuestra en estudios de caso como el diálogo multiturno.
- LLaDA rompe efectivamente la maldición de la reversión [15] con un rendimiento consistente en tareas directas e inversas. Notablemente, supera a GPT-4o en una tarea de completación de poemas invertidos.
2 Enfoque
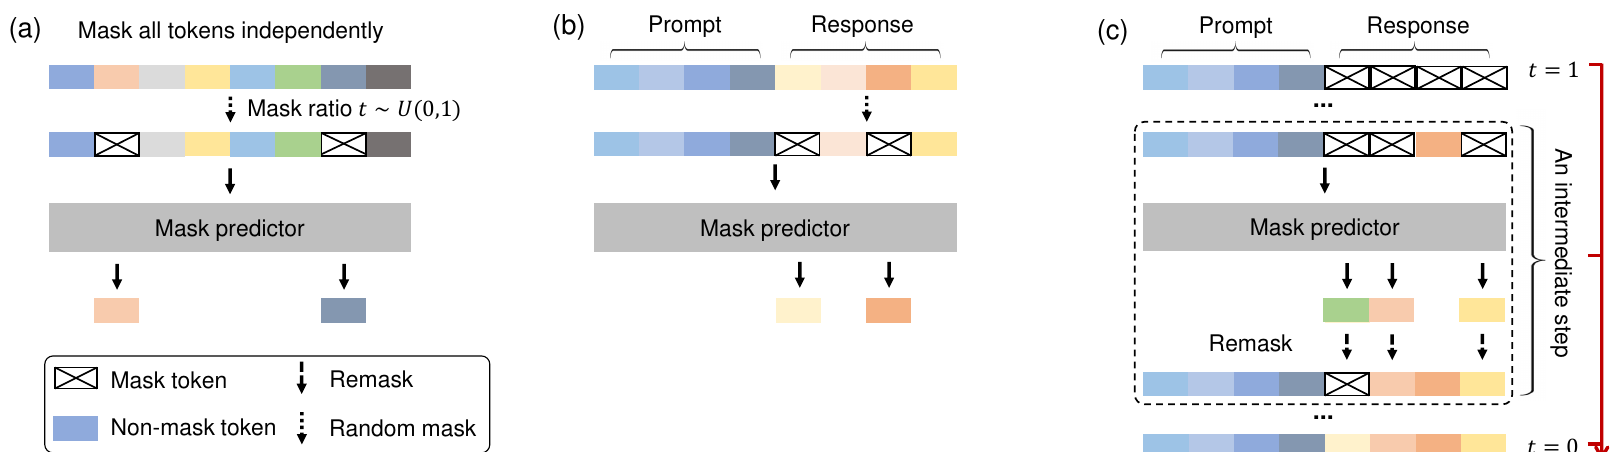
En esta sección, presentamos la formulación probabilística[6] junto con los procedimientos de preentrenamiento, ajuste fino supervisado e inferencia para LLaDA, como se ilustra en la Fig. [2]
2.1 Formulación Probabilística
A diferencia de los ARMs en la Ec. (2), LLaDA define una distribución del modelo mediante un proceso hacia adelante y un proceso inverso [16][20]. El proceso hacia adelante enmascara gradualmente los tokens de forma independiente en hasta que la secuencia está completamente enmascarada en . Para , la secuencia está parcialmente enmascarada, con cada uno siendo enmascarado con probabilidad o permaneciendo sin enmascarar con probabilidad . El proceso inverso recupera la distribución de los datos prediciendo iterativamente los tokens enmascarados a medida que pasa de 1 a 0.
El núcleo de LLaDA es un predictor de máscaras, un modelo paramétrico que toma como entrada y predice todos los tokens enmascarados (denotados como M) simultáneamente. Se entrena utilizando una pérdida de entropía cruzada calculada únicamente sobre los tokens enmascarados [18][20]:
donde es una muestra de entrenamiento, es una variable aleatoria continua extraída uniformemente de , se muestrea del proceso directo y es la longitud de la secuencia. La función indicadora garantiza que la pérdida se calcule solo para los tokens enmascarados.
Una vez entrenado, podemos simular un proceso inverso (véase la Sec. [2.4] para más detalles) parametrizado por el predictor de máscaras y definir la distribución del modelo como la distribución marginal inducida en . Se ha demostrado que la función de pérdida de la Ec. (3) es una cota superior de la log-verosimilitud negativa de la distribución del modelo, lo que la convierte en un objetivo fundamentado para el modelado generativo:
Cabe destacar que LLaDA emplea una tasa de enmascaramiento que varía aleatoriamente entre 0 y 1, mientras que BERT [22] utiliza una tasa fija. Las sutiles diferencias tienen implicaciones significativas, especialmente a escala: como se muestra en la Ec. (4), LLaDA es un modelo generativo fundamentado con el potencial de realizar aprendizaje en contexto y seguimiento de instrucciones de forma natural, de manera similar a los LLM. Además, su perspectiva generativa implica una fuerte escalabilidad con grandes datos y modelos, como se analiza en la Sec. [1]. Asimismo, MaskGIT [23] adopta un objetivo de entrenamiento heurístico, que omite el término en comparación con la Ec. (3), y carece de una conexión teórica con la máxima verosimilitud. Enfatizamos que es precisamente el fundamento teórico de la estimación por máxima verosimilitud lo que nos motivó a escalar los modelos de difusión discreta para el modelado del lenguaje.
2.2 Pre-entrenamiento
LLaDA emplea un Transformer [7] como predictor de máscaras, de forma similar a los LLM existentes. Sin embargo, LLaDA no utiliza una máscara causal, ya que su formulación le permite ver toda la entrada para realizar predicciones.
Entrenamos dos variantes de LLaDA con diferentes tamaños: 1B y 8B. Resumimos aquí la arquitectura del modelo de LLaDA 8B y LLaMA3 8B [6], y los detalles se proporcionan en el Apéndice [B.2]. Hemos garantizado la consistencia en la mayoría de los hiperparámetros mientras realizábamos varias modificaciones necesarias. Utilizamos atención multi-cabeza estándar en lugar de atención de consultas agrupadas [24] por simplicidad, ya que LLaDA es incompatible con el almacenamiento en caché de KV, lo que resulta en un número diferente de cabezas de clave y valor. En consecuencia, la capa de atención tiene más parámetros, y reducimos la dimensión de la FFN para mantener un tamaño de modelo comparable. Además, el tamaño del vocabulario difiere debido a un tokenizador [4] adaptado a nuestros datos.
El modelo LLaDA se preentrena en un conjunto de datos que comprende 2,3 billones (T) de tokens, siguiendo un protocolo de datos que se alinea estrechamente con los LLM existentes [25] [26], sin la incorporación de ninguna técnica especial. Los datos provienen de corpus en línea, con contenido de baja calidad filtrado mediante reglas diseñadas manualmente y enfoques basados en LLM. Además de texto general, el conjunto de datos abarca código de alta calidad, matemáticas y datos multilingües. Consúltese el Apéndice [B.1] para más detalles sobre los conjuntos de datos. La mezcla de fuentes de datos y dominios está guiada por ARMs de escala reducida. El proceso de preentrenamiento utiliza una longitud de secuencia fija de 4096 tokens, incurriendo en un coste computacional total de 0,13 millones de horas de GPU H800, similar a los ARMs de la misma escala y tamaño de conjunto de datos.
Para una secuencia de entrenamiento , muestreamos aleatoriamente , enmascaramos cada token de forma independiente con la misma probabilidad para obtener (véase la Fig. 2) y estimamos la Ec. (3) mediante el método de Monte Carlo para el entrenamiento con descenso de gradiente estocástico. Además, siguiendo a Nie et al. [27], para mejorar la capacidad de LLaDA de manejar datos de longitud variable, establecemos el de los datos de preentrenamiento a una longitud aleatoria que se muestrea uniformemente del rango .
Adoptamos el planificador de tasa de aprendizaje Warmup-Stable-Decay [28] para monitorizar el progreso del entrenamiento sin interrumpir el entrenamiento continuo. Específicamente, aumentamos linealmente la tasa de aprendizaje de 0 a durante las primeras 2000 iteraciones y la mantuvimos en . Tras procesar 1,2T tokens, decaímos la tasa de aprendizaje a y la mantuvimos constante durante los siguientes 0,8T tokens para garantizar un entrenamiento estable. Finalmente, redujimos linealmente la tasa de aprendizaje de a durante los últimos 0,3T tokens. Además, utilizamos el optimizador AdamW [29] con un decaimiento de peso de 0,1, un tamaño de lote de 1280 y un tamaño de lote local de 4 por GPU. El experimento de 8B se ejecutó una vez, sin ningún ajuste de hiperparámetros.
2.3 Ajuste Fino Supervisado
Mejoramos la capacidad de LLaDA de seguir instrucciones mediante ajuste fino supervisado (SFT) con datos emparejados , donde es el prompt y denota la respuesta. Este es el método de post-entrenamiento más simple y básico para los LLM. Técnicamente, esto requiere modelar la distribución condicional en lugar de en el preentrenamiento.
La implementación es similar al preentrenamiento. Como se muestra en la Fig. 2, dejamos el prompt sin cambios y enmascaramos los tokens en la respuesta de forma independiente, como se hizo para . Luego, alimentamos tanto el prompt como la respuesta enmascarada al predictor de máscaras preentrenado para calcular la pérdida para el SFT:
donde denota una longitud dinámica especificada más adelante, y todas las demás notaciones permanecen igual que antes. Nótese que este enfoque es totalmente compatible con el preentrenamiento. Esencialmente, la concatenación de y puede tratarse como datos de preentrenamiento limpios , mientras que la concatenación de y sirve como la versión enmascarada . El proceso es idéntico al preentrenamiento, con la única diferencia de que todos los tokens enmascarados resultan aparecer en la porción .
El modelo LLaDA 8B se somete a SFT en un conjunto de datos que comprende 4,5 millones de pares. De forma consistente con el proceso de preentrenamiento, tanto la preparación de datos como el entrenamiento siguen los protocolos de SFT utilizados en los LLM existentes [25] [26], sin introducir ninguna técnica adicional para optimizar el rendimiento de LLaDA. El conjunto de datos abarca múltiples dominios, incluyendo código, matemáticas y seguimiento de instrucciones. Añadimos tokens |EOS| al final de los pares cortos en cada mini-lote para garantizar longitudes iguales en todos los datos. Tratamos |EOS| como un token normal durante el entrenamiento y lo eliminamos durante el muestreo, lo que permite a LLaDA controlar la longitud de la respuesta automáticamente. Consúltese el Apéndice B.1 para más detalles.
Entrenamos durante 3 épocas en los datos de SFT usando un plan similar al de la fase de preentrenamiento. La tasa de aprendizaje se aumenta linealmente de 0 a durante las primeras 50 iteraciones y luego se mantiene constante. Durante el final de las iteraciones, se reduce linealmente a . Además, establecemos el decaimiento de peso en 0,1, el tamaño de lote global en 256 y el tamaño de lote local en 2 por GPU. El experimento de SFT se ejecutó una vez, sin ningún ajuste de hiperparámetros.
2.4 Inferencia
Como modelo generativo, LLaDA puede muestrear nuevo texto y evaluar la verosimilitud de texto candidato de manera difusiva en lugar de la forma autorregresiva de izquierda a derecha.
Comenzamos con el proceso de generación inverso. Como se ilustra en la Fig. 2, dado un prompt , discretizamos el proceso inverso para muestrear de la distribución del modelo , comenzando desde una respuesta completamente enmascarada. El número total de pasos de muestreo es un hiperparámetro, que naturalmente proporciona a LLaDA un compromiso entre eficiencia y calidad de muestra, como se analiza en la Sec. [3.3]. Empleamos pasos de tiempo distribuidos uniformemente por defecto. Además, la longitud de generación también se trata como un hiperparámetro, especificando la longitud de la oración completamente enmascarada al inicio del proceso de muestreo. Tras la generación, los tokens que aparecen después del token |EOS| se descartan. Como se detalla en el Apéndice [B.5], dado que tanto el preentrenamiento como el SFT se realizan utilizando conjuntos de datos con longitudes variables, los resultados finales son insensibles a este hiperparámetro de longitud.
En un paso intermedio desde el tiempo a , alimentamos tanto como al predictor de máscaras y predecimos todos los tokens enmascarados simultáneamente. Posteriormente, volvemos a enmascarar de los tokens predichos en expectativa para obtener , asegurando que la transición del proceso inverso se alinee con el proceso directo para un muestreo preciso [18] [20]. En principio, la estrategia de reenmascaramiento debería ser puramente aleatoria. Sin embargo, inspirados por los trucos de annealing del muestreo en LLM [4] [30], adoptamos una estrategia de reenmascaramiento de baja confianza, donde de los tokens predichos con la menor confianza se vuelven a enmascarar basándose en las predicciones, igual que el enfoque de Chang et al. [23].
Mencionamos que LLaDA permite un muestreo flexible. En particular, admite muestreo autorregresivo y de difusión por bloques [31] directamente después de los procesos de preentrenamiento o SFT descritos anteriormente, sin requerir ninguna modificación o entrenamiento adicional. Proporcionamos un análisis detallado en el Apéndice [B.4]. No obstante, el muestreo por difusión (es decir, el proceso de generación inverso) produce el mejor rendimiento y se adopta como predeterminado a lo largo de este artículo, especialmente para todos los experimentos presentados en la Sec. [3].
Para la evaluación de la verosimilitud condicional, podemos utilizar naturalmente la cota superior de la Ec. [5]. Sin embargo, encontramos que la siguiente forma equivalente [20] presenta menor varianza y es más estable:
donde es la longitud de la secuencia de , se muestrea uniformemente de , y se obtiene muestreando uniformemente tokens de sin reemplazo para el enmascaramiento.
Presentamos los algoritmos de entrenamiento e inferencia, junto con los detalles teóricos, en el Apéndice [A]
3 Experimentos
Evaluamos las capacidades de escalabilidad, seguimiento de instrucciones y aprendizaje en contexto de LLaDA en benchmarks estándar, seguidas de análisis y estudios de caso para proporcionar una evaluación integral.
3.1 Escalabilidad de LLaDA en tareas de lenguaje
Primero investigamos la escalabilidad de LLaDA en tareas downstream en comparación con las baselines ARM que construimos. Específicamente, a la escala de 1B, aseguramos que LLaDA y ARM compartieran la misma arquitectura, datos y todas las demás configuraciones. A escalas mayores, también reportamos resultados para modelos LLaDA y ARM de tamaños ligeramente diferentes entrenados con los mismos datos debido a limitaciones de recursos. Consulte el Apéndice [B.2] para más detalles. Utilizamos el costo computacional de preentrenamiento como métrica de escalabilidad unificada. Para la evaluación, nos centramos en seis tareas estándar y diversas.
La Fig. 3 muestra que LLaDA demuestra una escalabilidad impresionante, con su tendencia general altamente competitiva frente a las ARM. Notablemente, en tareas como MMLU y GSM8K, LLaDA exhibe una escalabilidad aún más fuerte. Incluso en tareas relativamente más débiles como PIQA, la brecha de rendimiento con las ARM se reduce a medida que aumenta la escala. Para tener en cuenta la influencia de valores atípicos, optamos por no ajustar curvas cuantitativas, evitando posibles interpretaciones erróneas. No obstante, los resultados demuestran claramente la escalabilidad de LLaDA.
Considerando las ventajas de LLaDA en ciertos benchmarks, planteamos la hipótesis de que esta mejora en el rendimiento proviene de una diferencia arquitectónica clave: mientras que los modelos autorregresivos optimizan únicamente probabilidades condicionales de izquierda a derecha, LLaDA se entrena para considerar múltiples direcciones de condicionamiento, como se detalla en el Apéndice [A.2], lo que puede ofrecer mayor flexibilidad y conducir a una mejor generalización. Esta hipótesis está motivada por el fuerte rendimiento de LLaDA en razonamiento de reversión en la Sec. [3.3] y los estudios de ablación sobre estrategias de muestreo en el Apéndice [B.4]
Nie et al. [27] sugiere que MDM requiere 16 veces más cómputo que ARM para alcanzar la misma verosimilitud. Sin embargo, diferencias clave hacen que nuestros hallazgos sean más ampliamente aplicables. En particular, la verosimilitud es una métrica relativamente indirecta para el rendimiento en tareas downstream, y la difusión optimiza una cota de la verosimilitud, lo que la hace no directamente comparable con ARM. Además, extendimos el rango de escalado de FLOPs en Nie et al. [27] a FLOPs en este trabajo.
3.2 Resultados en benchmarks
Para evaluar de manera integral las capacidades de aprendizaje en contexto y seguimiento de instrucciones de LLaDA 8B, realizamos comparaciones detalladas con LLMs existentes [6,21,25,26,32,33] de escala similar. La selección de tareas y los protocolos de evaluación siguieron estudios existentes, cubriendo benchmarks populares en tareas generales, matemáticas, código y chino. Se proporcionan más detalles en el Apéndice [B.6]. Para una comparación más directa, reevaluamos LLMs representativos [6,21] en nuestra implementación.
Como se muestra en la Tab. [1], después del preentrenamiento con 2.3T tokens, LLaDA 8B Base demuestra un rendimiento notable, superando a LLaMA2 7B Base en casi todas las tareas, y es en general competitivo con LLaMA3 8B Base. LLaDA muestra ventajas en tareas de matemáticas y chino. Conjeturamos que las
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Mistral 7B† | Deepseek 7B† | |
| Tokens de entrenamiento del modelo | Difusión 2,3T | AR 15T | AR 2T | AR 7T | AR 18T | AR - | AR 2T |
| Tareas generales | |||||||
| MMLU | 65,9 (5) | 65,4 (5) | 45,9 (5) | 70,3 (5) | 74,2 (5) | 64,2 (5) | 48,2 (5) |
| BBH | 49,7 (3) | 62,1 (3) | 39,4 (3) | 62,3 (3) | 70,4 (3) | 56,1 (3) | 39,5 (3) |
| ARC-C | 45,9 (0) | 53,1 (0) | 46,3 (0) | 60,6 (25) | 63,7 (25) | 60,0 (25) | 48,1 (0) |
| Hellaswag | 70,5 (0) | 79,1 (0) | 76,0 (0) | 80,7 (10) | 80,2 (10) | 83,3 (10) | 75,4 (0) |
| TruthfulQA | 46,1 (0) | 44,0 (0) | 39,0 (0) | 54,2 (0) | 56,4 (0) | 42,2 (0) | - |
| WinoGrande | 74,8 (5) | 77,3 (5) | 72,5 (5) | 77,0 (5) | 75,9 (5) | 78,4 (5) | 70,5 (0) |
| PIQA | 73,6 (0) | 80,6 (0) | 79,1 (0) | - | - | - | 79,2 (0) |
| Matemáticas y Ciencias | |||||||
| GSM8K | 70,3 (4) | 48,7 (4) | 13,1 (4) | 80,2 (4) | 85,4 (4) | 36,2 (4) | 17,4 (8) |
| Matemáticas | 31,4 (4) | 16,0 (4) | 4,3 (4) | 43,5 (4) | 49,8 (4) | 10,2 (4) | 6,0 (4) |
| GPQA | 25,2 (5) | 25,9 (5) | 25,7 (5) | 30,8 (5) | 36,4 (5) | 24,7 (5) | - |
| Código | |||||||
| HumanEval | 35,4 (0) | 34,8 (0) | 12,8 (0) | 51,2 (0) | 57,9 (0) | 29,3 (0) | 26,2 (0) |
| HumanEval-FIM | 73,8 (2) | 73,3 (2) | 26,9 (2) | - | - | - | - |
| MBPP | 40,0 (4) | 48,8 (4) | 23,2 (4) | 64,2 (0) | 74,9 (0) | 51,1 (0) | 39,0 (3) |
| Chino | |||||||
| CMMLU | 69,9 (5) | 50,7 (5) | 32,5 (5) | 83,9 (5) | - | - | 47,2 (5) |
| C-Eval | 70,5 (5) | 51,7 (5) | 34,0 (5) | 83,2 (5) | - | - | 45,0 (5) |
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Gemma2 9B† | Deepseek 7B† | |
| Tokens de entrenamiento del modelo | Difusión 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR 8T | AR 2T |
| Pares de alineación post-entrenamiento | SFT 4.5M | SFT+RL - | SFT+RL - | SFT+RL 0.5M + - | SFT+RL 1M + 0.15M - | SFT+RL - | SFT+RL 1.5M + - |
| Tareas generales | |||||||
| MMLU | 65.5 (5) | 68.4 (5) | 44.1 (5) | - | - | - | 49.4 (0) |
| MMLU-pro | 37.0 (0) | 41.9 (0) | 4.6 (0) | 44.1 (5) | 56.3 (5) | 52.1 (5) | - |
| Hellaswag | 74.6 (0) | 75.5 (0) | 51.5 (0) | - | - | - | 68.5 (-) |
| ARC-C | 88.5 (0) | 82.4 (0) | 57.3 (0) | - | - | - | 49.4 (-) |
| Matemáticas y Ciencias | |||||||
| GSM8K | 69.4 (4) | 78.3 (4) | 29.0 (4) | 85.7 (0) | 91.6 (0) | 76.7 (0) | 63.0 (0) |
| Matemáticas | 31.9 (0) | 29.6 (0) | 3.8 (0) | 52.9 (0) | 75.5 (0) | 44.3 (0) | 15.8 (0) |
| GPQA | 33.3 (5) | 31.9 (5) | 28.4 (5) | 34.3 (0) | 36.4 (0) | 32.8 (0) | - |
| Código | |||||||
| HumanEval | 49.4 (0) | 59.8 (0) | 16.5 (0) | 79.9 (0) | 84.8 (0) | 68.9 (0) | 48.2 (-) |
| MBPP | 41.0 (4) | 57.6 (4) | 20.6 (4) | 67.2 (0) | 79.2 (0) | 74.9 (0) | 35.2 (-) |
fortalezas provienen de los mismos factores que su rendimiento relativamente más débil en algunas tareas: diferencias en la calidad y distribución de los datos, en gran medida debido a la situación de código cerrado de los conjuntos de datos de LLM.
Cabe destacar que hemos descartado cuidadosamente la posibilidad de fuga de datos tomando GSM8K como ejemplo. En primer lugar, como se muestra en la Fig. [3], LLaDA superó a las líneas base ARM en GSM8K. Además, la conclusión se mantiene en una tarea completamente no vista similar a GSM8K [34] en el Apéndice B.8.
Además, la Tab. [2] compara el rendimiento de LLaDA 8B Instruct con los LLM existentes. El SFT mejoró el rendimiento de LLaDA en la mayoría de las tareas posteriores. Algunas métricas, como MMLU, mostraron descensos, posiblemente debido a la calidad subóptima de los datos de SFT. En general, dado que no realizamos alineación
| Proceso de muestreo | |
| Usuario | Lily puede correr 12 kilómetros por hora durante 4 horas. Después de eso, corre 6 kilómetros por hora. ¿Cuántos kilómetros puede correr en 8 horas? |
| LLaDA | En 4 horas, Lily corre 12 * 4 = 48 kilómetros. Después de 4 horas, corre 6 * 4 = 24 kilómetros. En total, corre 48 + 24 = 72 kilómetros en 8 horas. Resultado: 72 |
| Caso de diálogo de múltiples rondas | |
| Usuario | ¿Podrías compartir conmigo cuáles son los dos primeros versos del famoso poema «The Road Not Taken»? |
| LLaDA | ¡Por supuesto! Los dos primeros versos del famoso poema «The Road Not Taken» de Robert Frost son: «Two roads diverged in a yellow wood, And sorry I could not travel both». Estos versos preparan el escenario para el poema, introduciendo la idea de un hablante que se enfrenta a una elección entre dos caminos. |
| Usuario | Por favor, ayúdame a traducirlo al chino. |
| LLaDA | ¡Claro! Los dos primeros versos de «The Road Not Taken» de Robert Frost pueden traducirse al chino así: «两条路分岔在黄色的树林中,遗憾我不能同时走» |
| Usuario | Por favor, traduce al alemán. |
| LLaDA | ¡Claro! Los dos primeros versos de «The Road Not Taken» de Robert Frost pueden traducirse al alemán así: «Zwei Wege trennten sich im gelben Wald, und leider konnte ich nicht beide tun.» |
| Usuario | Por favor, escribe también un poema sobre las elecciones de la vida. Requiero 5 oraciones, y la primera palabra de cada oración debe empezar con C como primera letra. |
| LLaDA | ¡Por supuesto! Aquí tienes un poema sobre las elecciones de la vida, con cada oración empezando por la letra «C»: Choices cascade through life’s journey, Creating connections with each decision, Careful consideration leads to better paths, Courageous choices shape our destiny, Choosing wisely guides us through the years. |
con aprendizaje por refuerzo (RL), nuestros resultados están ligeramente por detrás de LLaMA3 8B Instruct, aunque las brechas en muchas métricas siguen siendo pequeñas. Cabe destacar que, incluso solo con SFT, LLaDA demuestra impresionantes habilidades de seguimiento de instrucciones, como se detalla en la Sec. [3.4]. Dejamos la alineación basada en RL para trabajos futuros.
Todos los resultados de la Sec. [3] se basan en métodos de difusión pura, ya que logran un mejor rendimiento general que los enfoques que incorporan componentes autorregresivos. Específicamente, utilizamos la Eq. (6) para la estimación de verosimilitud condicional y aplicamos el remasking de baja confianza para el muestreo. Para LLaDA 8B Instruct, el muestreo estilo difusión por bloques funciona mejor en GSM8K y Math, con puntuaciones de 78.6 y 42.2, en comparación con 69.4 y 31.9 en la Tab. [2]. Esta ganancia se debe al extenso relleno con el token |EOS| en los datos de SFT, lo que provoca una terminación temprana en el remasking de baja confianza. Consúltese el Apéndice [B.4] para más detalles.
En general, a pesar de la falta de transparencia de los datos, hemos hecho todo lo posible por adoptar procedimientos estandarizados e introducir tareas diversas; creemos que demuestran suficientemente las extraordinarias capacidades de LLaDA, que es el único modelo no autorregresivo competitivo hasta donde sabemos.
3.3 Razonamiento inverso y análisis
Para cuantificar la capacidad de razonamiento inverso [15] de los modelos, seguimos el protocolo establecido en Allen-Zhu y Li [35]. Específicamente, construimos un conjunto de datos de 496 pares de versos de poemas chinos famosos. Dado un verso de un poema, se encarga a los modelos generar el verso siguiente (hacia adelante) o el verso anterior (inverso) sin ajuste fino adicional. Pueden encontrarse ejemplos en la Sección [B.9]. Esta configuración proporciona una evaluación sencilla y más realista en comparación con estudios previos [27, 36].
Como se muestra en la Tab. [4], LLaDA aborda eficazmente la maldición de la inversión [15], demostrando un rendimiento consistente en zero-shot tanto en las tareas hacia adelante como en las inversas. En contraste, tanto Qwen 2.5 como GPT-4o exhiben una brecha significativa entre ambas. Los resultados en la generación hacia adelante confirman que ambos ARM son fuertes, beneficiándose de conjuntos de datos significativamente más grandes y mayores recursos computacionales que LLaDA. Sin embargo, LLaDA supera a ambos por un amplio margen en la tarea inversa.
No diseñamos nada especial para las tareas inversas. Intuitivamente, LLaDA trata los tokens de manera uniforme sin sesgo inductivo, lo que conduce a un rendimiento equilibrado. Véase el Apéndice A.2 para más detalles.
También analizamos el efecto de diferentes estrategias de muestreo para LLaDA, incluyendo el muestreo autorregresivo, el muestreo por difusión de bloques [31] y el muestreo por difusión pura, mostrando que el muestreo por difusión pura logra el mejor rendimiento general, como se detalla en el Apéndice B.4.
| Adelante | Inversión | |
| GPT-4o (2024-08-06) | 82,7 | 34,3 |
| Qwen2.5-7B Instruct | 75,9 | 38,0 |
| LLaDA-8B Instruct | 51,8 | 45,6 |
Además, examinamos la velocidad de muestreo y el consumo de memoria de LLaDA, mostrando que permite un equilibrio flexible entre la calidad y la velocidad de generación. Véase el Apéndice B.7 para más detalles.
La guía libre de clasificador (CFG) [37] [27] es una técnica ampliamente utilizada en modelos de difusión para mejorar la calidad de la generación. Para garantizar una comparación justa con los ARM, no aplicamos CFG a LLaDA en el texto principal. Sin embargo, mostramos que LLaDA es compatible con CFG y se beneficia consistentemente de su aplicación. Véase el Apéndice B.3 para más detalles.
3.4 Estudios de caso
Presentamos muestras generadas por LLaDA 8B Instruct en la Tab. 3, mostrando sus capacidades de seguimiento de instrucciones. En primer lugar, la tabla ilustra la capacidad de LLaDA para generar texto coherente, fluido y extenso de manera no autorregresiva. En segundo lugar, destaca la capacidad de diálogo multiturno del modelo, reteniendo eficazmente el historial de conversación y produciendo respuestas contextualmente apropiadas en múltiples idiomas. Tales capacidades de chat de LLaDA son impresionantes, ya que se aparta de los ARM convencionales por primera vez, hasta donde sabemos. Véanse más estudios de caso en el Apéndice B.10.
4 Trabajo relacionado
Los modelos de difusión [38,40] han logrado un éxito notable en dominios visuales, pero siguen sin verificarse para el modelado del lenguaje a gran escala (p. ej., modelos entrenados con más de FLOPs), a pesar del creciente interés y los extensos esfuerzos de investigación.
Un enfoque simple consiste en continuizar los datos de texto y aplicar directamente modelos de difusión continua [41-51]. Alternativamente, algunos métodos modelan en su lugar parámetros continuos de distribuciones discretas [52-56]. Sin embargo, la escalabilidad sigue siendo un desafío significativo para estos enfoques. Por ejemplo, un modelo de 1B puede requerir 64 veces el cómputo de un ARM para lograr un rendimiento comparable [57].
Otro enfoque reemplaza la difusión continua por procesos discretos que presentan nuevas dinámicas directas e inversas, dando lugar a numerosas variantes [58,71]. El artículo original del modelo de difusión [38] introdujo tanto núcleos de transición de estado continuo como de estado discreto bajo un marco de difusión unificado. Austin et al. [16] fue uno de los trabajos pioneros en introducir los modelos de difusión discreta en el modelado del lenguaje, demostrando la viabilidad de este enfoque. Lou et al. [17] mostraron que la difusión enmascarada, como caso especial de la difusión discreta, logra una perplejidad comparable o superior a los ARM a escala de GPT-2. Shi et al. [18], Sahoo et al. [19], Ou et al. [20] establecieron resultados teóricos fundamentales, que motivaron el diseño, entrenamiento e inferencia de nuestro modelo (véase el Apéndice A para más detalles). Nie et al. [27] introdujeron las leyes de escalado para los MDM en el modelado del lenguaje y exploraron cómo se pueden aprovechar los MDM para tareas de lenguaje como la respuesta a preguntas a escala de GPT-2. Gong et al. [72] demostraron el potencial de ajustar finamente un ARM dentro del marco de los MDM. Sin embargo, las mejoras observadas por Gong et al. [72] se limitan a métricas específicas, y su enfoque no aborda el rendimiento alcanzable mediante entrenamiento basado en difusión pura. Un trabajo concurrente [73] demuestra el potencial de los modelos de lenguaje de difusión en la generación de código y destaca sus ventajas en eficiencia de inferencia. No obstante, al ser un producto de código cerrado, detalles específicos como los procedimientos de entrenamiento y los métodos de muestreo siguen siendo desconocidos.
En comparación, este estudio escala los MDM a un tamaño sin precedentes de 8B parámetros desde cero, logrando un rendimiento comparable al de LLM líderes como LLaMA 3.
Además, una línea paralela de trabajo sobre generación de imágenes [23,74,75] concuerda bien con la aplicación de los MDM a datos de texto. Asimismo, los MDM también han mostrado potencial en otros dominios como la generación de proteínas [76][77], donde han logrado resultados prometedores. Cabe destacar que una serie de estudios [31][78][87] han explorado técnicas como la optimización arquitectónica, la destilación y el diseño de algoritmos de muestreo para acelerar el muestreo de los MDM.
5 Conclusión y discusión
Presentamos LLaDA, un modelo de lenguaje de difusión entrenado desde cero con una escala sin precedentes de 8B parámetros. LLaDA demuestra sólidas capacidades en escalabilidad, aprendizaje en contexto y seguimiento de instrucciones, logrando un rendimiento comparable al de LLM fuertes como LLaMA3. Además, LLaDA ofrece ventajas únicas, como el modelado bidireccional y una robustez mejorada, abordando eficazmente las limitaciones relevantes de los LLM existentes. Nuestros hallazgos muestran la promesa de los modelos de difusión para el modelado del lenguaje a escala y cuestionan la suposición común de que estas capacidades esenciales están inherentemente ligadas a los ARM. Estos resultados representan un nuevo paradigma para el modelado del lenguaje y descubren nuevas perspectivas, demostrando un alto grado de innovación científica.
Limitaciones. Aunque prometedor, el pleno potencial de los modelos de difusión aún está por explorarse completamente. Varias limitaciones de este trabajo presentan oportunidades significativas para investigaciones futuras. La longitud de generación es un hiperparámetro especificado por el usuario. Aunque LLaDA es insensible a este hiperparámetro, como se detalla en el Apéndice [B.5], creemos que adoptar una longitud de generación adaptativa ofrecería una solución más eficiente. Debido a restricciones computacionales, las comparaciones directas entre LLaDA y los ARM —como el entrenamiento con conjuntos de datos idénticos— se limitaron a un presupuesto computacional inferior a FLOPs. Para asignar recursos al entrenamiento del mayor modelo LLaDA posible y mostrar su potencial, no pudimos escalar la línea base ARM en la misma medida. Además, no se diseñaron mecanismos de atención ni embeddings de posición especializados para LLaDA, ni se aplicaron optimizaciones arquitectónicas a nivel de sistema como la caché KV. En el lado de la inferencia, los algoritmos de muestreo más eficientes y controlables [37][88][89] siguen siendo preliminares. Además, LLaDA aún no ha pasado por alineación con aprendizaje por refuerzo [90][91], lo cual es crucial para mejorar su rendimiento y su alineación con la intención humana.
De cara al futuro, tanto la escala del modelo como la cantidad de datos de entrenamiento de LLaDA siguen siendo menores que las de las contrapartes ARM líderes [6][26][92][95], lo que resalta la necesidad de un mayor escalado para evaluar plenamente sus capacidades. Además, la capacidad de LLaDA para procesar datos multimodales sigue sin explorarse. Su impacto en las técnicas de ajuste de prompts [96] y su integración en sistemas basados en agentes [97][98] aún no se comprenden del todo. Finalmente, se necesita una investigación sistemática sobre el post-entrenamiento de LLaDA (p. ej., sistemas similares a O1 [99][100]) para desbloquear aún más el potencial de los modelos de lenguaje de difusión.
Agradecimientos
Este trabajo fue financiado por la Fundación Nacional de Ciencias Naturales de China (No. 92470118); la Fundación de Ciencias Naturales de Beijing (No. L247030); el Programa Beijing Nova (No. 20220484044); y el Fondo de Investigación de Ant Group.
Referencias
[1] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. A survey of large language models. arXiv preprint arXiv:2303.18223, 2023. [2] Alec Radford. Improving language understanding by generative pre- training, 2018. [3] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, et al. Language models are unsupervised multitask learners. OpenAI blog, 1(8):9, 2019. [4] Tom B Brown. Language models are few- shot learners. arXiv preprint arXiv:2005.14165, 2020. [5] OpenAI. ChatGPT: Optimizing Language Models for Dialogue. OpenAI blog, November 2022. URL https://openai.com/blog/chatgpt/[6] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al- Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, et al. The llama 3 herd of models. arXiv preprint arXiv:2407.21783, 2024.
[7] Ashish Vaswani. Attention is all you need. arXiv preprint arXiv:1706.03762, 2017.
[8] Ronald A Fisher. On the mathematical foundations of theoretical statistics. Philosophical transactions of the Royal Society of London. Series A, containing papers of a mathematical or physical character, 222(594- 604):309- 368, 1922.
[9] Fan Bao, Shen Nie, Kaiwen Xue, Yue Cao, Chongxuan Li, Hang Su y Jun Zhu. All are worth words: A vit backbone for diffusion models. En Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, páginas 22669-22679, 2023.
[10] William Peebles y Saining Xie. Scalable diffusion models with transformers. En Proceedings of the IEEE/CVF International Conference on Computer Vision, páginas 4195-4205, 2023.
[11] Tim Brooks, Bill Peebles, Connor Holmes, Will DePue, Yufei Guo, Li Jing, David Schnurr, Joe Taylor, Troy Luhman, Eric Luhman, Clarence Ng, Ricky Wang y Aditya Ramesh. Video generation models as world simulators. 2024. URL https://openai.com/research/video-generation-models-as-world-simulators
[12] Gregoire Deletang, Anian Ruoss, Paul-Ambroise Duquenne, Elliot Catt, Tim Genewein, Christopher Mattern, Jordi Grau-Moya, Li Kevin Wenliang, Matthew Aitchison, Laurent Orseau, et al. Language modeling is compression. En The Twelfth International Conference on Learning Representations.
[13] Yuzhen Huang, Jinghan Zhang, Zifei Shan y Junxian He. Compression represents intelligence linearly. arXiv preprint arXiv:2404.09937, 2024.
[14] Claude Elwood Shannon. A mathematical theory of communication. The Bell system technical journal, 27(3):379-423, 1948.
[15] Lukas Berglund, Meg Tong, Max Kaufmann, Mikita Balesni, Asa Cooper Stickland, Tomasz Korbak y Owain Evans. The reversal curse: Llms trained on" a is b" fail to learn" b is a". arXiv preprint arXiv:2309.12288, 2023.
[16] Jacob Austin, Daniel D Johnson, Jonathan Ho, Daniel Tarlow y Rianne Van Den Berg. Structured denoising diffusion models in discrete state-spaces. Advances in Neural Information Processing Systems, 34:17981-17993, 2021.
[17] Aaron Lou, Chenlin Meng y Stefano Ermon. Discrete diffusion language modeling by estimating the ratios of the data distribution. arXiv preprint arXiv:2310.16834, 2023.
[18] Jiaxin Shi, Kehang Han, Zhe Wang, Arnaud Doucet y Michalis K Titsias. Simplified and generalized masked diffusion for discrete data. arXiv preprint arXiv:2406.04329, 2024.
[19] Subham Sekhar Sahoo, Marianne Arriola, Yair Schiff, Aaron Gokaslan, Edgar Marroquin, Justin T Chiu, Alexander Rush y Volodymyr Kuleshov. Simple and effective masked diffusion language models. arXiv preprint arXiv:2406.07524, 2024.
[20] Jingyang Ou, Shen Nie, Kaiwen Xue, Fengqi Zhu, Jiacheng Sun, Zhenguo Li y Chongxuan Li. Your absorbing discrete diffusion secretly models the conditional distributions of clean data. arXiv preprint arXiv:2406.03736, 2024.
[21] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: Open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
[22] Jacob Devlin. Bert: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805, 2018.
[23] Huiwen Chang, Han Zhang, Lu Jiang, Ce Liu y William T Freeman. Maskgit: Masked generative image transformer. En Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, páginas 11315-11325, 2022.
[24] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron y Sumit Sanghai. Gqa: Training generalized multi-query transformer models from multihead checkpoints. En Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, páginas 4895-4901, 2023.
[25] An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, Guanting Dong, Haoran Wei, Huan Lin, Jialong Tang, Jialin Wang, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Ma, Jianxin Yang, Jin Xu, Jingren Zhou, Jinze Bai, Jinzheng He, Junyang Lin, Kai Dang, Keming Lu, Keqin Chen, Kexin Yang, Mei Li, Mingfeng Xue, Na Ni, Pei Zhang, Peng Wang, Ru Peng, Rui Men, Ruize Gao, Runji Lin, Shijie Wang, Shuai Bai, Sinan Tan, Tianhang Zhu, Tianhao Li, Tianyu Liu, Wenbin Ge, Xiaodong Deng, Xiaohuan Zhou, Xingzhang Ren, Xinyu Zhang, Xipin Wei, Xuancheng Ren, Xuejing Liu, Yang Fan, Yang Yao, Yichang Zhang, Yu Wan, Yunfei Chu, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zhifang Guo y Zhihao Fan. Qwen2 technical report, 2024. URL https://arxiv.org/abs/2407.10671
[26] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, Huan Lin, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Yang, Jiaxi Yang, Jingren Zhou, Junyang Lin, Kai Dang, Keming Lu, Keqin Bao, Kexin Yang, Le Yu, Mei Li, Mingfeng Xue, Pei Zhang, Qin Zhu, Rui Men, Runji Lin, Tianhao Li, Tingyu Xia, Xingzhang Ren, Xuancheng Ren, Yang Fan, Yang Su, Yichang Zhang, Yu Wan, Yuqiong Liu, Zeyu Cui, Zhenru Zhang y Zihan Qiu. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
[27] Shen Nie, Fengqi Zhu, Chao Du, Tianyu Pang, Qian Liu, Guangtao Zeng, Min Lin y Chongxuan Li. Scaling up masked diffusion models on text. arXiv preprint arXiv:2410.18514, 2024.
[28] Shengding Hu, Yuge Tu, Xu Han, Chaoqun He, Ganqu Cui, Xiang Long, Zhi Zheng, Yewei Fang, Yuxiang Huang, Weilin Zhao, et al. Minicpm: Unveiling the potential of small language models with scalable training strategies. arXiv preprint arXiv:2404.06395, 2024.
[29] I Loshchilov. Decoupled weight decay regularization. arXiv preprint arXiv:1711.05101, 2017.
[30] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes y Yejin Choi. The curious case of neural text degeneration. arXiv preprint arXiv:1904.09751, 2019.
[31] Marianne Arriola, Aaron Gokaslan, Justin T Chiu, Zhihan Yang, Zhixuan Qi, Jiaqi Han, Subham Sekhar Sahoo y Volodymyr Kuleshov. Block diffusion: Interpolating between autoregressive and diffusion language models. arXiv preprint arXiv:2503.09573, 2025.
[32] Xiao Bi, Deli Chen, Guanting Chen, Shanhuang Chen, Damai Dai, Chengqi Deng, Honghui Ding, Kai Dong, Qiushi Du, Zhe Fu, et al. Deepseek llm: Scaling open-source language models with longtermism. arXiv preprint arXiv:2401.02954, 2024.
[33] Albert Q Jiang, Alexandre Sablayrolles, Arthur Mensch, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Florian Bressand, Gianna Lengyel, Guillaume Lample, Lucile Saulnier, et al. Mistral 7b. arXiv preprint arXiv:2310.06825, 2023.
[34] Tian Ye, Zicheng Xu, Yuanzhi Li y Zeyuan Allen-Zhu. Physics of Language Models: Part 2.1, Grade-School Math and the Hidden Reasoning Process. arXiv e-prints, abs/2407.20311, julio de 2024. Versión completa disponible en http://arxiv.org/abs/2407.20311
[35] Zeyuan Allen-Zhu y Yuanzhi Li. Physics of Language Models: Part 3.2, Knowledge Manipulation. ArXiv e-prints, abs/2309.14402, septiembre de 2023. Versión completa disponible en http://arxiv.org/abs/2309.14402
[36] Ouaïl Kitouni, Niklas Nolte, Diane Bouchacourt, Adina Williams, Mike Rabbat y Mark Ibrahim. La maldición de la factorización: qué tokens predices subyace a la maldición de la inversión y más. Preimpresión de arXiv arXiv:2406.05183, 2024.
[37] Jonathan Ho y Tim Salimans. Guía de difusión libre de clasificador. Preimpresión de arXiv arXiv:2207.12598, 2022.
[38] Jascha Sohl-Dickstein, Eric Weiss, Niru Maheswaranathan y Surya Ganguli. Aprendizaje profundo no supervisado mediante termodinámica de no equilibrio. En Conferencia Internacional sobre Aprendizaje Automático, páginas 2256-2265. PMLR, 2015.
[39] Jonathan Ho, Ajay Jain y Pieter Abbeel. Modelos probabilísticos de difusión con eliminación de ruido. Advances in neural information processing systems, 33:6840-6851, 2020.
[40] Yang Song, Jascha Sohl-Dickstein, Diederik P Kingma, Abhishek Kumar, Stefano Ermon y Ben Poole. Modelado generativo basado en puntuaciones mediante ecuaciones diferenciales estocásticas. Preimpresión de arXiv arXiv:2011.13456, 2020.
[41] Xiang Li, John Thickstun, Ishaan Gulrajani, Percy S Liang y Tatsunori B Hashimoto. Diffusion-LM mejora la generación de texto controlable. Advances in Neural Information Processing Systems, 35:4328-4343, 2022.
[42] Shansan Gong, Mukai Li, Jiangtao Feng, Zhiyong Wu y LingPeng Kong. Diffuseq: Generación de texto de secuencia a secuencia con modelos de difusión. arXiv preprint arXiv:2210.08933, 2022.
[43] Xiaochuang Han, Sachin Kumar y Yulia Tsvetkov. Ssd-lm: Modelo de lenguaje de difusión basado en símplex semiautorregresivo para la generación de texto y el control modular. arXiv preprint arXiv:2210.17432, 2022.
[44] Robin Strudel, Corentin Tallec, Florent Altché, Yilun Du, Yaroslav Ganin, Arthur Mensch, Will Grathwohl, Nikolay Savinov, Sander Dieleman, Laurent Sifre, et al. Difusión de incrustaciones autoconducida para la generación de texto. arXiv preprint arXiv:2211.04236, 2022.
[45] Ting Chen, Ruixiang Zhang y Geoffrey Hinton. Analog bits: Generación de datos discretos mediante modelos de difusión con autoconducción. arXiv preprint arXiv:2208.04202, 2022.
[46] Sander Dieleman, Laurent Sartran, Arman Roshannai, Nikolay Savinov, Yaroslav Ganin, Pierre H Richemond, Arnaud Doucet, Robin Strudel, Chris Dyer, Conor Durkan, et al. Difusión continua para datos categóricos. arXiv preprint arXiv:2211.15089, 2022.
[47] Pierre H. Richemond, Sander Dieleman y Arnaud Doucet. EDE categóricas con difusión en símplex, 2022.
[48] Tong Wu, Zhihao Fan, Xiao Liu, Yeyun Gong, Yelong Shen, Jian Jiao, Hai-Tao Zheng, Juntao Li, Zhongyu Wei, Jian Guo, Nan Duan y Weizhu Chen. Ar-diffusion: Modelo de difusión autorregresivo para la generación de texto, 2023.
[49] Rabeeh Karimi Mahabadi, Hamish Ivison, Jaesung Tae, James Henderson, Iz Beltagy, Matthew E. Peters y Arman Cohan. Tess: Difusión en símplex autoconducida de texto a texto, 2024.
[50] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian y Mingxuan Wang. Dinoiser: Aprendizaje de secuencias condicionales difundido mediante la manipulación de ruidos. arXiv preprint arXiv:2302.10025, 2023.
[51] Yizhe Zhang, Jiatao Gu, Zhuofeng Wu, Shuangfei Zhai, Joshua Susskind y Navdeep Jaitly. Planner: Generación de párrafos diversificados mediante un modelo de difusión de lenguaje latente. Advances in Neural Information Processing Systems, 36:80178-80190, 2023.
[52] Aaron Lou y Stefano Ermon. Modelos de difusión reflejados, 2023.
[53] Alex Graves, Rupesh Kumar Srivastava, Timothy Atkinson y Faustino Gomez. Redes de flujo bayesiano. arXiv preprint arXiv:2308.07037, 2023.
[54] Zhenghao Lin, Yeyun Gong, Yelong Shen, Tong Wu, Zhihao Fan, Chen Lin, Nan Duan y Weizhu Chen. Generación de texto con modelos de lenguaje de difusión: Un enfoque de preentrenamiento con eliminación de ruido de párrafos continuos. In International Conference on Machine Learning, pages 21051-21064. PMLR, 2023.
[55] Kaiwen Xue, Yuhao Zhou, Shen Nie, Xu Min, Xiaolu Zhang, Jun Zhou y Chongxuan Li. Unificación de redes de flujo bayesiano y modelos de difusión mediante ecuaciones diferenciales estocásticas. arXiv preprint arXiv:2404.15766, 2024.
[56] Ruixiang Zhang, Shuangfei Zhai, Yizhe Zhang, James Thornton, Zijing Ou, Joshua Susskind y Navdeep Jaitly. Target concrete score matching: Un marco holístico para la difusión discreta. arXiv preprint arXiv:2504.16431, 2025.
[57] Ishaan Gulrajani y Tatsunori B Hashimoto. Modelos de lenguaje de difusión basados en verosimilitud. Advances in Neural Information Processing Systems, 36, 2024.
[58] Emiel Hoogeboom, Didrik Nielsen, Priyank Jaini, Patrick Forré y Max Welling. Flujos argmax y difusión multinomial: Aprendizaje de distribuciones categóricas. Advances in Neural Information Processing Systems, 34:12454-12465, 2021.
[59] Emiel Hoogeboom, Alexey A Gritsenko, Jasmijn Bastings, Ben Poole, Rianne van den Berg y Tim Salimans. Modelos de difusión autorregresivos. arXiv preprint arXiv:2110.02037, 2021.
[60] Zhengfu He, Tianxiang Sun, Kuanning Wang, Xuanjing Huang y Xipeng Qiu. Diffusion-bert: Mejora de los modelos de lenguaje enmascarados generativos con modelos de difusión. arXiv preprint arXiv:2211.15029, 2022.
[61] Andrew Campbell, Joe Benton, Valentin De Bortoli, Thomas Rainforth, George Deligiannidis y Arnaud Doucet. Un marco de tiempo continuo para modelos de eliminación de ruido discretos. Advances in Neural Information Processing Systems, 35:28266-28279, 2022.
[62] Chenlin Meng, Kristy Choi, Jiaming Song y Stefano Ermon. Concrete score matching: Emparejamiento de puntuaciones generalizado para datos discretos. Advances in Neural Information Processing Systems, 35:34532-34545, 2022.
[63] Machel Reid, Vincent J. Hellendoorn y Graham Neubig. Diffuser: Difusión discreta mediante reconstrucción basada en ediciones, 2022.
[64] Haoran Sun, Lijun Yu, Bo Dai, Dale Schuurmans y Hanjun Dai. Modelos de difusión discreta de tiempo continuo basados en puntuaciones. arXiv preprint arXiv:2211.16750, 2022.
[65] Ouaif Kitouni, Niklas Nolte, James Hensman y Bhaskar Mitra. Disk: Un modelo de difusión para conocimiento estructurado. arXiv preprint arXiv:2312.05253, 2023.
[66] Lin Zheng, Jianbo Yuan, Lei Yu y Lingpeng Kong. Un modelo de difusión discreta reparametrizado para la generación de texto. ArXiv, abs/2302.05737, 2023.
[67] Zixiang Chen, Huizhuo Yuan, Yongqian Li, Yiwen Kou, Junkai Zhang y Quanquan Gu. Muestreo rápido mediante desaleatorización para modelos de difusión discretos. arXiv preprint arXiv:2312.09193, 2023.
[68] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian y Quanquan Gu. Los modelos de lenguaje de difusión pueden realizar muchas tareas con escalado y ajuste fino por instrucciones. arXiv preprint arXiv:2308.12219, 2023.
[69] Itai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky TQ Chen, Gabriel Synnaeve, Yossi Adi y Yaron Lipman. Emparejamiento de flujos discretos. arXiv preprint arXiv:2407.15595, 2024.
[70] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu y Qinsheng Zhang. Los modelos de difusión enmascarados son en secreto modelos enmascarados independientes del tiempo y explotan un muestreo categórico inexacto, 2024. URL https://arxiv.org/abs/2409.02908
[71] Shreyas Kapur, Erik Jenner y Stuart Russell. Difusión sobre árboles de sintaxis para la síntesis de programas. arXiv preprint arXiv:2405.20519, 2024.
[72] Shansan Gong, Shivam Agarwal, Yizhe Zhang, Jiacheng Ye, Lin Zheng, Mukai Li, Chenxin An, Peilin Zhao, Wei Bi, Jiawei Han, et al. Escalado de modelos de lenguaje de difusión mediante adaptación a partir de modelos autorregresivos. arXiv preprint arXiv:2410.17891, 2024.
[73] Samar Khanna, Siddhant Kharbanda, Shufan Li, Harshit Varma, Eric Wang, Sawyer Birnbaum, Ziyang Luo, Yanis Miraoui, Akash Palrecha, Stefano Ermon, et al. Mercury: Modelos de lenguaje ultrarrápidos basados en difusión. arXiv preprint arXiv:2506.17298, 2025.
[74] Huiwen Chang, Han Zhang, Jarred Barber, AJ Maschinot, Jose Lezama, Lu Jiang, Ming-Hsuan Yang, Kevin Murphy, William T Freeman, Michael Rubinstein, et al. Muse: Generación de texto a imagen mediante transformadores generativos enmascarados. arXiv preprint arXiv:2301.00704, 2023.
[75] Zebin You, Jingyang Ou, Xiaolu Zhang, Jun Hu, Jun Zhou y Chongxuan Li. Effective and efficient masked image generation models. arXiv preprint arXiv:2503.07197, 2025.
[76] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang y Quanquan Gu. Diffusion language models are versatile protein learners. arXiv preprint arXiv:2402.18567, 2024.
[77] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang y Quanquan Gu. Dplm- 2: A multimodal diffusion protein language model. arXiv preprint arXiv:2410.13782, 2024.
[78] Siqi Kou, Lanxiang Hu, Zhezhi He, Zhijie Deng y Hao Zhang. Clims: Consistency large language models. arXiv preprint arXiv:2403.00835, 2024.
[79] Chenkai Xu, Xu Wang, Zhenyi Liao, Yishun Li, Tianqi Hou y Zhijie Deng. Show- o turbo: Towards accelerated unified multimodal understanding and generation. arXiv preprint arXiv:2502.05415, 2025.
[80] Sulin Liu, Juno Nam, Andrew Campbell, Hannes Stärk, Yilun Xu, Tommi Jaakkola y Rafael Gómez- Bombarelli. Think while you generate: Discrete diffusion with planned denoising. arXiv preprint arXiv:2410.06264, 2024.
[81] Yuanzhi Zhu, Xi Wang, Stéphane Lathuilière y Vicky Kalogeiton. Dimo: Distilling masked diffusion models into one- step generator. arXiv preprint arXiv:2503.15457, 2025.
[82] Yinuo Ren, Haoxuan Chen, Yuchen Zhu, Wei Guo, Yongxin Chen, Grant M Rotskoff, Molei Tao, and Lexing Ying. Solvers rápidos para modelos de difusión discreta: Teoría y aplicaciones de algoritmos de alto orden. arXiv preprint arXiv:2502.00234, 2025.
[83] Satoshi Hayakawa, Yuhta Takida, Masaaki Imaizumi, Hiromi Wakaki, and Yuki Mitsufuji. Destilación de difusión discreta mediante correlaciones dimensionales. arXiv preprint arXiv:2410.08709, 2024.
[84] Yixiu Zhao, Jiaxin Shi, Feng Chen, Shaul Druckmann, Lester Mackey, and Scott Linderman. Correctores informados para modelos de difusión discreta. arXiv preprint arXiv:2407.21243, 2024.
[85] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming- Yu Liu, Jun Zhu, and Qinsheng Zhang. Los modelos de difusión enmascarada son en secreto modelos enmascarados independientes del tiempo y explotan un muestreo categórico inexacto. arXiv preprint arXiv:2409.02908, 2024.
[86] Yong- Hyun Park, Chieh- Hsin Lai, Satoshi Hayakawa, Yuhta Takida, and Yuki Mitsufuji. Salta tus pasos: Optimización del calendario de muestreo de modelos de difusión discreta. In The Thirteenth International Conference on Learning Representations, 2024.
[87] Justin Deschenaux and Caglar Gulcehre. Más allá de la autorregresión: LLMs rápidos mediante autodestilación a través del tiempo. arXiv preprint arXiv:2410.21035, 2024.
[88] Prafulla Dhariwal and Alexander Nichol. Los modelos de difusión superan a las GAN en síntesis de imágenes. Advances in neural information processing systems, 34:8780- 8794, 2021.
[89] Yair Schiff, Subham Sekhar Sahoo, Hao Phung, Guanghan Wang, Sam Boshar, Hugo Dallatorre, Bernardo P de Almeida, Alexander Rush, Thomas Pierrot, and Volodymyr Kuleshov. Mecanismos de guía simples para modelos de difusión discreta. arXiv preprint arXiv:2412.10193, 2024.
[90] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Entrenamiento de modelos de lenguaje para seguir instrucciones con retroalimentación humana. Advances in neural information processing systems, 35:27730- 27744, 2022.
[91] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, and Chelsea Finn. Optimización de preferencias directa: Tu modelo de lenguaje es en secreto un modelo de recompensa. Advances in Neural Information Processing Systems, 36, 2024.
[92] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Informe técnico de GPT- 4. arXiv preprint arXiv:2303.08774, 2023.
[93] Google. Nuestro modelo de próxima generación: Gemini 1.5, 2024. URL https://blog.google/technology/ai/google- gemini- next- generation- model- february- 2024
[94] Anthropic. Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude- 3- 5- sonnet
[95] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Informe técnico de Deepseek- v3. arXiv preprint arXiv:2412.19437, 2024.
[96] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. El prompting de cadena de pensamiento elicita razonamiento en modelos de lenguaje grandes. Advances in neural information processing systems, 35:24824- 24837, 2022.
[97] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang, and Michael S Bernstein. Agentes generativos: Simulacros interactivos del comportamiento humano. In Proceedings of the 36th annual acm symposium on user interface software and technology, pages 1- 22, 2023.
[98] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, et al. Una encuesta sobre agentes autónomos basados en modelos de lenguaje grandes. Frontiers of Computer Science, 18(6):186345, 2024.
[99] OpenAI. Aprender a razonar con LLMs, 2024. URL https://openai.com/index/learning- to- reason- with- llms/
[100] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivando la capacidad de razonamiento en LLMs mediante aprendizaje por refuerzo. arXiv preprint arXiv:2501.12948, 2025.
[101] Benigno Uria, Iain Murray, and Hugo Larochelle. Un estimador de densidad profundo y tratable. In Proceedings of the 31th International Conference on Machine Learning, 2014.
[102] Andy Shih, Dorsa Sadigh, and Stefano Ermon. Entrenamiento e inferencia en modelos autorregresivos de cualquier orden de la manera correcta. In Proceedings of the 31th International Conference on Machine Learning, 2022.
[103] Zhangchen Xu, Fengqing Jiang, Luyao Niu, Yuntian Deng, Radha Poovendran, Yejin Choi, and Bill Yuchen Lin. Magpie: Síntesis de datos de alineación desde cero mediante el prompting de LLMs alineados sin nada. arXiv preprint arXiv:2406.08464, 2024.
[104] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding, and Lingming Zhang. Magicoder: Potenciando la generación de código con oss- instruct. arXiv preprint arXiv:2312.02120, 2023.
[105] Biao Zhang and Rico Sennrich. Normalización de capas con raíz del error cuadrático medio. Advances in Neural Information Processing Systems, 32, 2019.
[106] Noam Shazeer. Las variantes de GLU mejoran el transformer. arXiv preprint arXiv:2002.05202, 2020.
[107] Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo, and Yunfeng Liu. Roformer: Transformer mejorado con incrustación de posición rotatoria. Neurocomputing, 568:127063, 2024.
[108] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. Leyes de escalado para modelos de lenguaje neuronales. arXiv preprint arXiv:2001.08361, 2020.
.
[109] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. Entrenamiento de modelos de lenguaje grandes con cómputo óptimo. arXiv preprint arXiv:2203.15556, 2022.
[110] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Medición de la comprensión del lenguaje multitarea masiva. arXiv preprint arXiv:2009.03300, 2020.
[111] Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, et al. Desafiando tareas de big- bench y si la cadena de pensamiento puede resolverlas. arXiv preprint arXiv:2210.09261, 2022.
[112] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. ¿Crees que has resuelto la respuesta a preguntas? Prueba arc, el desafío de razonamiento de ai2. arXiv preprint arXiv:1803.05457, 2018.
[113] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi. Hellaswag: ¿Puede realmente una máquina terminar tu oración? arXiv preprint arXiv:1905.07830, 2019.
[114] Stephanie Lin, Jacob Hilton y Owain Evans. Truthfulqa: Measuring how models mimic human falsehoods. arXiv preprint arXiv:2109.07958, 2021.
[115] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula y Yejin Choi. Winogrande: An adversarial winograd schema challenge at scale. Communications of the ACM, 64(9):99- 106, 2021.
[116] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. Piqa: Reasoning about physical commonsense in natural language. In Proceedings of the AAAI conference on artificial intelligence, 2020.
[117] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, et al. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021.
[118] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song y Jacob Steinhardt. Measuring mathematical problem solving with the math dataset. arXiv preprint arXiv:2103.03874, 2021.
[119] David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael y Samuel R Bowman. Gpqa: A graduate- level google- proof q&a benchmark. arXiv preprint arXiv:2311.12022, 2023.
[120] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
[121] Mohammad Bavarian, Heewoo Jun, Nikolas Tezak, John Schulman, Christine McLeavey, Jerry Tworek y Mark Chen. Efficient training of language models to fill in the middle. arXiv preprint arXiv:2207.14255, 2022.
[122] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
[123] Haonan Li, Yixuan Zhang, Fajri Koto, Yifei Yang, Hai Zhao, Yeyun Gong, Nan Duan y Timothy Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
[124] Yuzhen Huang, Yuzhuo Bai, Zhihao Zhu, Junlei Zhang, Jinghan Zhang, Tangjun Su, Junteng Liu, Chuancheng Lv, Yikai Zhang, Yao Fu, et al. C- eval: A multi- level multi- discipline chinese evaluation suite for foundation models. Advances in Neural Information Processing Systems, 36, 2024.
[125] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang y Andy Zou. A framework for few- shot language model evaluation, 07 2024. URL https://zenodo.org/records/12608602
Algoritmo 1 Preentrenamiento de LLaDA
Requiere: predictor de máscaras , distribución de datos
1: repetir
2: # con una probabilidad del , la longitud de secuencia de sigue U[1, 4096]
3:
4: # se define en la Ec. (7)
5: Calcular # es la longitud de secuencia de
6: Calcular y ejecutar el optimizador.
7: hasta que converja
8: Devolver
Algoritmo 2 Ajuste fino supervisado de LLaDA
Requiere: predictor de máscaras , distribución de datos de pares
1: repetir
2: # consulte el Apéndice B.1 para obtener detalles sobre los datos de SFT
3:
4: # se define en la Ec. (7)
5: Calcular # es la longitud de secuencia de
6: Calcular y ejecutar el optimizador.
7: hasta que converja
8: Devolver
Algoritmo 3 Evaluación de log-verosimilitud condicional de LLaDA
Requiere: predictor de máscaras , indicación , respuesta , el número de estimaciones de Monte Carlo
1: log_likelihood
2: para hasta hacer
3: # es la longitud de secuencia de
4: Obtener muestreando uniformemente tokens de sin reemplazo para enmascararlos
5:
6: fin para
7: log_likelihood
8: Devolver log_likelihood
A Formulación de los modelos de difusión enmascarada
A.1 Entrenamiento
Los MDM [16|20] definen la distribución del modelo de una manera distinta a los modelos autorregresivos.
Estos modelos introducen un proceso directo indexado por un tiempo . Este proceso enmascara gradual e independientemente todos los tokens en la secuencia . En el tiempo , el punto de datos se observa completamente sin máscaras, mientras que para , representa variables latentes con proporciones de máscara variables en expectativa.
Formalmente, la distribución condicional de dado se define mediante una forma totalmente factorizada:
donde la distribución condicional para cada token está dada por:
Aquí, M denota el token de máscara. Intuitivamente, cada token permanece sin cambios o se enmascara, con la probabilidad de ser enmascarado aumentando linealmente a medida que avanza de 0 a 1. En , todos
Requiere: predictor de máscara , prompt , longitud de respuesta , pasos de muestreo 1: Sea una secuencia completamente enmascarada de longitud .2: for hasta paso do3: 4: # empleamos muestreo voraz al predecir tokens enmascarados5: for hasta do6: if then7: 8: else9: con probabilidad , se establece en 10: end if11: end for12: 13: end for14: Devolver los tokens están garantizados de estar enmascarados, lo que significa que sigue una distribución de Dirac concentrada en una secuencia de tokens completamente enmascarados. En particular, la probabilidad de enmascaramiento lineal es análoga, pero distinta, al calendario de ruido en los modelos de difusión continua [38,40]. Esta linealidad está motivada por el supuesto de que la información en el texto es proporcional al número de tokens en promedio, lo que hace razonable perder información linealmente durante el proceso directo.
El proceso directo no solo es reversible, sino que también corresponde a un proceso inverso que está completamente factorizado en todos los tokens. El proceso inverso, desde el tiempo hasta 0, genera nuevos datos a partir de secuencias de tokens completamente enmascarados. La distribución condicional para el proceso inverso, para , se factoriza como:
donde la distribución condicional para cada token es:
Por lo tanto, la función clave a estimar es la distribución condicional , que predice el token original si está enmascarado en la entrada . Esto es análogo a la forma de predicción de datos en los modelos de difusión continua.
Como se demuestra en [20], se puede derivar una parametrización equivalente pero libre de tiempo como:
donde denota la colección de tokens no enmascarados en , que es idéntica a los tokens correspondientes en los datos originales , ya que los tokens no enmascarados están determinados únicamente por y son independientes del tiempo . Intuitivamente, esto implica que estimar la función de predicción de datos es equivalente a estimar las distribuciones condicionales sobre datos limpios, lo cual es invariante en el tiempo. En consecuencia, el tiempo no necesita proporcionarse como entrada al modelo paramétrico.
Aunque el desarrollo de la difusión enmascarada no es trivial, la implementación es sencilla. Primero introducimos el predictor de máscaras, un modelo paramétrico (por ejemplo, un Transformer sin máscara causal), que toma para cualquier como entrada y predice todos los tokens enmascarados simultáneamente. Luego, definimos la distribución del modelo de la siguiente manera: comenzando con como una secuencia de tokens completamente enmascarados, simulamos un proceso inverso aproximado parametrizado por desde hasta 0. La distribución marginal inducida en representa entonces la distribución del modelo .
Requiere: predictor de máscaras , prompt , longitud de la respuesta , pasos de muestreo
1: Sea una secuencia completamente enmascarada de longitud .
2: for hasta paso do
3:
4: for hasta do
5: if then
6:
7: else
8:
9:
10: end if
11: end for
12: # el número de tokens desenmascarados es en el paso temporal
13: for hasta do
14: if then
15: # las posiciones con menor confianza se seleccionan para reenmascarar.
16: end if
17: end for
18:
19: end for
20: Return
Formalmente, el predictor de máscaras se entrena utilizando una pérdida de entropía cruzada con enmascaramiento:
donde se muestrea de los datos de entrenamiento, se muestrea uniformemente de , y se muestrea de . La función indicadora asegura que la pérdida de entropía cruzada se calcule solo para los tokens enmascarados. En Shi et al. [18], Sahoo et al. [19], Ou et al. [20], se ha demostrado que la función de pérdida es una cota superior de la log-verosimilitud negativa de la distribución del modelo:
En resumen, este enfoque fundamentado entrena un modelo generativo enmascarando progresivamente tokens durante un proceso directo y aprendiendo a recuperar la distribución de datos durante un proceso inverso, todo ello bajo el marco de estimación de máxima verosimilitud (aproximada).
A.2 Inferencia
La pérdida de entropía cruzada en la Ec. [12] tiene varias formas equivalentes [20]. La primera viene dada por
donde se muestrea uniformemente de , y se obtiene muestreando uniformemente tokens de sin reemplazo para enmascararlos. Aunque enmascarar exactamente tokens es diferente de enmascarar cada token de forma independiente con probabilidad , estos dos métodos de enmascaramiento conducen a resultados equivalentes en esperanza [20].
Los modelos autorregresivos de cualquier orden (AO- ARM) [59][101][102] caracterizan la distribución conjunta de forma autorregresiva para todos los órdenes posibles de las variables. Para aprender dicha distribución, un AO- ARM utiliza una red neuronal con pesos compartidos para modelar todas las condicionales univariadas y emplea tokens de máscara para representar las variables ausentes. Durante el entrenamiento, se minimiza la log-verosimilitud negativa esperada sobre la distribución uniforme de todos los órdenes :
Intuitivamente, puede entenderse como un token enmascarado con índice en que está enmascarado. Se puede demostrar además que la Ec. (15) es equivalente a la Ec. (12). Esta conexión explica las capacidades de razonamiento bidireccional de LLaDA, aunque nunca se usó explícitamente en el procedimiento de inferencia.
Además, Nie et al. [27] introduce la guía sin clasificador no supervisada (CFG), una técnica plug- and- play que equilibra la alineación con los prompts y la diversidad del texto. Específicamente, la CFG no supervisada emplea el siguiente predictor de máscaras modificado para la inferencia:
donde es una secuencia de máscara de la misma longitud que y es un hiperparámetro ajustable que controla la fuerza de . Para garantizar una comparación justa con los ARM, no aplicamos CFG a LLaDA en el texto principal. Sin embargo, como se demuestra en el Apéndice [B.3], LLaDA es totalmente compatible con CFG y exhibe consistentemente un mejor rendimiento cuando se aplica.
A.3 Algoritmos
En esta sección, presentamos los algoritmos de entrenamiento e inferencia. Específicamente, introducimos los algoritmos de preentrenamiento y de ajuste fino supervisado en el Algoritmo [1] y el Algoritmo [2], respectivamente. Además, el algoritmo de evaluación de verosimilitud se proporciona en el Algoritmo [3]. Finalmente, presentamos el proceso de generación inversa en el Algoritmo [4] y el Algoritmo [5], que corresponden a la estrategia de remascarado aleatorio y de remascarado de baja confianza [23], respectivamente.
B Experimentos
B.1 Recopilación y preprocesamiento de datos
En esta sección, primero presentamos los procesos de recopilación y filtrado de datos tanto para el preentrenamiento como para el SFT. Luego describimos cómo LLaDA aprovecha estos conjuntos de datos durante el entrenamiento.
Nuestro corpus de preentrenamiento se construye a partir de diversas fuentes públicas disponibles, incluyendo datos web, libros, artículos académicos, redes sociales, enciclopedias, matemáticas y código, con aproximadamente de chino, de inglés y de código. El proceso de limpieza de datos implica la extracción de texto de PDF, la deduplicación y el filtrado de contenido dañino. Para garantizar aún más la calidad, ajustamos finamente un modelo BERT [22] para la anotación automatizada de la calidad de los datos, lo que permite seleccionar muestras de mayor calidad. Nuestro conjunto de datos de SFT consta de 1 millón de muestras anotadas por humanos y 3.5 millones de muestras sintéticas, generadas utilizando métodos similares a los propuestos en Xu et al. [103], Wei et al. [104].
Concatenamos los documentos recopilados en el corpus de preentrenamiento y segmentamos el texto en secuencias de longitud fija según la longitud de secuencia predefinida.
Para el SFT, se emplea una estrategia de longitud de secuencia dinámica, en la que se añaden tokens |EOS| al final de los pares más cortos para garantizar longitudes de secuencia uniformes en todas las muestras dentro de cada mini-lote. En particular, los tokens |EOS| de relleno se tratan como parte de la respuesta, es decir, se enmascaran y se incluyen en el objetivo de entrenamiento. Los tokens |EOS| se eliminan de las salidas generadas durante el muestreo. Esta estrategia garantiza que el modelo aprenda a controlar la longitud de sus respuestas mediante la generación de |EOS|, lo que permite que la longitud de la respuesta se alinee eficazmente con el prompt dado.
Además, para diálogos de turnos , lo tratamos como pares de diálogo de un solo turno, es decir, y muestreamos uno aleatoriamente. Esta estrategia de partición de datos no solo dota a LLaDA de capacidades de diálogo multiturno, sino que también se alinea con la estrategia de relleno con |EOS| anterior.
| Nuestro ARM Baseline 1B | LLaDA 1B | Nuestro ARM Baseline 7B | LLaDA 8B | LLaMA3 8B | |
| Capas | 22 | 22 | 28 | 32 | 32 |
| Dimensión del modelo | 2048 | 2048 | 4096 | 4096 | 4096 |
| Cabezas de atención | 32 | 32 | 32 | 32 | 32 |
| Tamaño del vocabulario | 126,464 | 126,464 | 126,464 | 126,464 | 128,000 |
| Dimensión de la FFN | 5634 | 5634 | 13,440 | 12,288 | 14,336 |
| Cabezas Key/Value | 4 | 4 | 8 | 32 | 8 |
| Parámetros totales | 1.49 B | 1.49 B | 6.83 B | 8.02 B | 8.03 B |
| Parámetros no de embedding | 0.97 B | 0.97 B | 5.80 B | 6.98 B | 6.98 B |
| ARC-C | Hellaswag | TruthfulQA | WinoGrande | GPQA | PIQA | |
| sin CFG | 45,9 | 70,5 | 46,1 | 74,8 | 25,2 | 73,6 |
| con CFG | 47,9 | 72,5 | 46,4 | 74,8 | 26,1 | 74,4 |
B.2 Detalles sobre el entrenamiento del modelo
Esta sección proporciona los detalles de entrenamiento de LLaDA y las líneas base ARM correspondientes.
En primer lugar, por eficiencia, entrenamos un ARM y un MDM, ambos con 1.5B parámetros y arquitecturas idénticas. Además, escalamos el MDM a 8B parámetros. Debido a restricciones de recursos computacionales, no entrenamos un modelo autorregresivo de 8B con la misma arquitectura. En su lugar, utilizamos nuestro modelo autorregresivo de 7B previamente entrenado para la comparación. Estos cuatro modelos se utilizan en el análisis de escalabilidad de la Sec. [3.1].
Adoptamos una arquitectura Transformer similar a LLaMA [6] [21] para los ARM y MDM que entrenamos. Específicamente, empleamos RMSNorm [105] para estabilizar el entrenamiento, usamos SwiGLU [106] como función de activación para mejorar la no linealidad e integramos RoPE [107] para una codificación posicional más expresiva. La Tab. [5] proporciona una visión general de las arquitecturas de los modelos.
Para las líneas base ARM de 1B y 7B, así como para los modelos LLaDA de 1B y 8B, utilizamos el optimizador AdamW [29] con una decaída de peso de 0.1 y adoptamos el planificador de tasa de aprendizaje Warmup-Stable-Decay [28]. La tasa de aprendizaje se incrementó linealmente de 0 a el valor máximo durante las primeras 2000 iteraciones y luego se mantuvo constante. Para LLaDA 8B, para garantizar un entrenamiento estable, la tasa de aprendizaje se redujo una vez durante el preentrenamiento, como se detalla en la Sec. [2.2]. Para la línea base ARM de 1B y tanto para los modelos LLaDA de 1B como de 8B, la tasa de aprendizaje máxima se establece en con un tamaño de lote de 1280, sin ningún ajuste de hiperparámetros. Para la línea base ARM de 7B, la tasa de aprendizaje máxima se establece en con un tamaño de lote de 4224, ambos seleccionados mediante búsqueda en cuadrícula.
Además, empleamos la formulación ampliamente utilizada [108] [109] para calcular los FLOPs de entrenamiento en la Fig. [3], donde representa el número de parámetros no de embedding, y denota el número total de tokens de entrenamiento. Los resultados detallados correspondientes a la Fig. [3] se proporcionan en la Tab. [18] y la Tab. [19].
B.3 Ablación sobre la guía libre de clasificador
Esta sección presenta un estudio de ablación sobre la guía libre de clasificador (CFG). Los detalles teóricos sobre CFG se pueden encontrar en el Apéndice [A.2].
Por simplicidad, seleccionamos seis benchmarks representativos, incluidos ARC-C, HellaSwag, TruthfulQA, WinoGrande, PIQA y GPQA, y realizamos experimentos utilizando LLaDA 8B Base. Buscamos la escala de CFG en para cada tarea y reportamos el mejor resultado. Como se muestra en la Tab. [6], CFG mejora consistentemente el rendimiento de LLaDA. Enfatizamos que, para garantizar una comparación justa con los ARMs, no se utiliza CFG en los resultados principales reportados en el artículo.
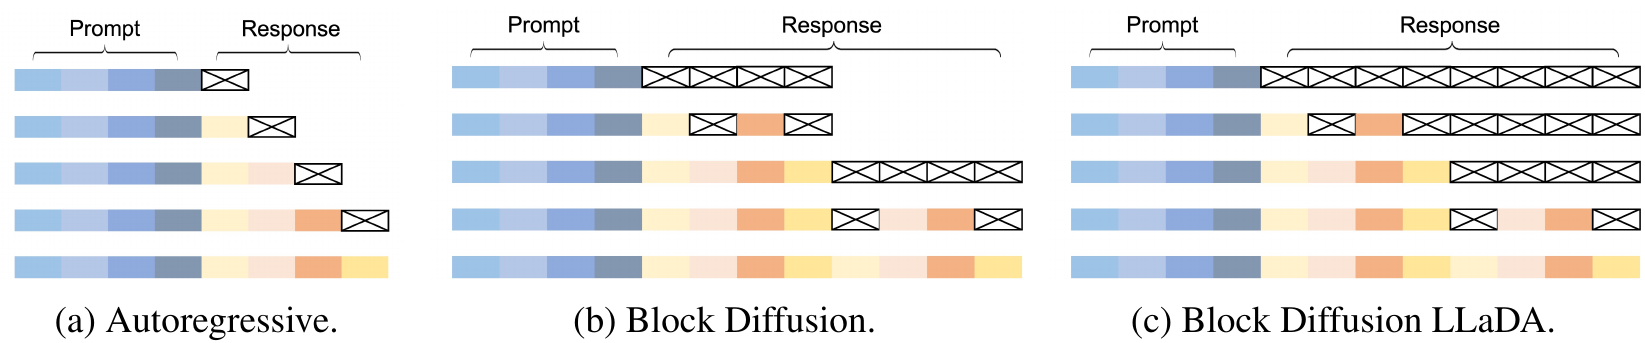
| BBH | GSM8K | Math | HumanEval | MBPP | ||
| Autorregresivo | 38,1 | 63,1 | 23,6 | 18,3 | 33,4 | |
| L' = 2 | 37,3 | 62,6 | 25,2 | 14,6 | 33,6 | |
| L' = 4 | 40,0 | 65,7 | 26,6 | 15,9 | 36,0 | |
| L' = 8 | 42,0 | 68,2 | 27,7 | 19,5 | 39,2 | |
| L' = 32 | 45,7 | 68,6 | 29,7 | 29,9 | 37,4 | |
| Difusión por bloques LLaDA | L' = 2 | 48,0 | 70,0 | 30,8 | 26,2 | 40,0 |
| L' = 4 | 48,5 | 70,3 | 31,3 | 27,4 | 38,8 | |
| L' = 8 | 48,6 | 70,2 | 30,9 | 31,1 | 39,0 | |
| L' = 32 | 48,3 | 70,3 | 31,2 | 32,3 | 40,0 | |
| Difusión pura | 49,7 | 70,3 | 31,4 | 35,4 | 40,0 |
| GSM8K | Matemáticas | HumanEval | MBPP | GPQA | MMLU-Pro | ARC-C | |
| Autorregresivo | 0 | 9,5 | 0 | 0 | 0 | 0 | 84,4 |
| Difusión por bloques | 24,6 | 23,5 | 17,1 | 21,2 | 29,3 | 32,5 | 88,1 |
| Difusión por bloques LLaDA | 77,5 | 42,2 | 46,3 | 34,2 | 31,3 | 34,8 | 85,4 |
| Difusión pura | 69,4 | 31,9 | 49,4 | 41,0 | 33,3 | 37,0 | 88,5 |
B.4 Detalles y ablación sobre estrategias de muestreo
En esta sección, primero presentamos las diferentes estrategias de muestreo soportadas por LLaDA. Luego presentamos estudios de ablación para evaluar el rendimiento de estas estrategias de muestreo.
Estrategias de muestreo flexibles. En la Sec. 2.4, la Fig. 2(c) ilustra el proceso de generación inversa de LLaDA. Como se muestra en la Fig. 4, además del proceso de generación inversa, LLaDA también soporta directamente muestreo autorregresivo y de difusión por bloques [31] después de las etapas de preentrenamiento o SFT, sin requerir ninguna modificación adicional ni reentrenamiento. El muestreo de difusión por bloques aplica el proceso inverso original dentro de cada bloque y el muestreo autorregresivo entre bloques. En el proceso original de difusión por bloques, la longitud de la secuencia varía dinámicamente. Como se muestra en la Fig. 4(c), LLaDA también puede adoptar una estrategia de difusión por bloques de longitud fija, a la que nos referimos como difusión por bloques LLaDA, también conocida como remasking semiautorregresivo.
Configuración experimental. Evaluamos diferentes estrategias de muestreo utilizando tanto LLaDA 8B Base como LLaDA 8B Instruct para un análisis exhaustivo. Para LLaDA 8B Base, utilizamos los cinco benchmarks de la Tab. 1 que se evalúan basándose en muestreo en lugar de estimación de verosimilitud. Para LLaDA 8B Instruct, utilizamos las siete métricas de la Tab. 2 excluyendo MMLU y HellaSwag, ya que estas dos tareas solo requieren que el modelo genere un único token (es decir, A, B, C o D). En todas las configuraciones, se genera un token por paso de muestreo. Para el muestreo autorregresivo y de difusión por bloques, la generación termina cuando se produce el token |EOS|. Para difusión por bloques LLaDA (es decir, remasking semiautorregresivo) y muestreo de difusión pura, la longitud de generación se fija en 1024 para LLaDA 8B Base, mientras que para LLaDA 8B Instruct, se ajusta entre {64, 256, 512} para equilibrar eficiencia y rendimiento. Se aplica remasking de baja confianza al muestreo de difusión intrabloque tanto en difusión por bloques como en difusión por bloques LLaDA, así como al muestreo de difusión pura. También probamos diferentes longitudes de bloque para LLaDA 8B Base. Para LLaDA 8B Instruct, solo evaluamos la longitud de bloque 32 por eficiencia, ya que produce los mejores resultados en LLaDA 8B Base.
| Longitud | BBH | GSM8K | Math | HumanEval | MBPP |
| Remasking aleatorio | 32.1 | 21.3 | 9.2 | 11.6 | 21.0 |
| Remasking de baja confianza | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| Longitud | BBH | GSM8K | Math | HumanEval | MBPP |
| 256 | 45,0 | 70,0 | 30,3 | 32,9 | 40,2 |
| 512 | 50,4 | 70,8 | 30,9 | 32,9 | 39,2 |
| 1024 | 49,7 | 70,3 | 31,4 | 35,4 | 40,0 |
Además, para LLaDA 8B Instruct, debido al gran relleno de tokens |EOS| en los datos de SFT (como se detalla en la Sec. [B.1]), observamos que bajo muestreo de difusión pura, la proporción de tokens |EOS| en las salidas del modelo se vuelve muy alta. Esto conduce a generaciones extremadamente cortas y degrada el rendimiento del modelo. Para mitigar este problema, para HumanEval, MBPP, GSM8K, Math y GPQA, establecemos la puntuación de confianza del token |EOS| en cero durante el muestreo de difusión pura. Este ajuste ayuda a mantener una proporción apropiada de tokens |EOS| durante la generación.
Finalmente, realizamos estudios de ablación para analizar los efectos de las estrategias de remasking aleatorio y de baja confianza utilizando el muestreo de difusión pura. Por eficiencia, utilizamos LLaDA 8B Base con longitud de generación y pasos de muestreo establecidos en 256 en este análisis.
Resultados. Como se muestra en la Tab. [7], para el muestreo de difusión por bloques, el rendimiento general mejora a medida que aumenta la longitud del bloque. Además, tanto la Tab. [7] como la Tab. [8] muestran que el muestreo de difusión por bloques supera consistentemente al muestreo autorregresivo, y el muestreo de difusión por bloques LLaDA mejora aún más el muestreo de difusión por bloques estándar. Finalmente, el muestreo de difusión pura logra el mejor rendimiento general.
Además, la Tab. [9] muestra que la estrategia de remasking de baja confianza supera consistentemente a la estrategia de remasking aleatorio. Hipotetizamos que el remasking de baja confianza funciona de manera similar al método de muestreo recocido utilizado por defecto en los ARMs, mejorando la precisión al reducir la diversidad de las oraciones generadas.
Descubrimos que el muestreo autorregresivo conduce a un rendimiento muy pobre para LLaDA 8B Instruct. Esto se debe a que cada dato de SFT es una oración completa, por lo que dada una longitud de secuencia, LLaDA 8B Instruct tiende a generar una oración completa dentro de esa longitud. En contraste, LLaDA 8B Base no sufre de este problema, ya que los datos de preentrenamiento consisten en documentos truncados (como se detalla en el Apéndice [B.1]) y el modelo se entrena con longitudes de secuencia aleatorias (como se detalla en la Sec. [2.2]). Como resultado, cuando se le da una longitud de secuencia corta, LLaDA 8B Base tiende a generar solo parte de una oración, que luego puede usarse como prefijo para continuar la generación.
Establecer la longitud de bloque en 8 en la Tab. [8] mejora aún más la puntuación de GSM8K de 77.5 a 78.6.
B.5 Ablación sobre la longitud generada
En esta sección, realizamos estudios de ablación sobre la longitud generada.
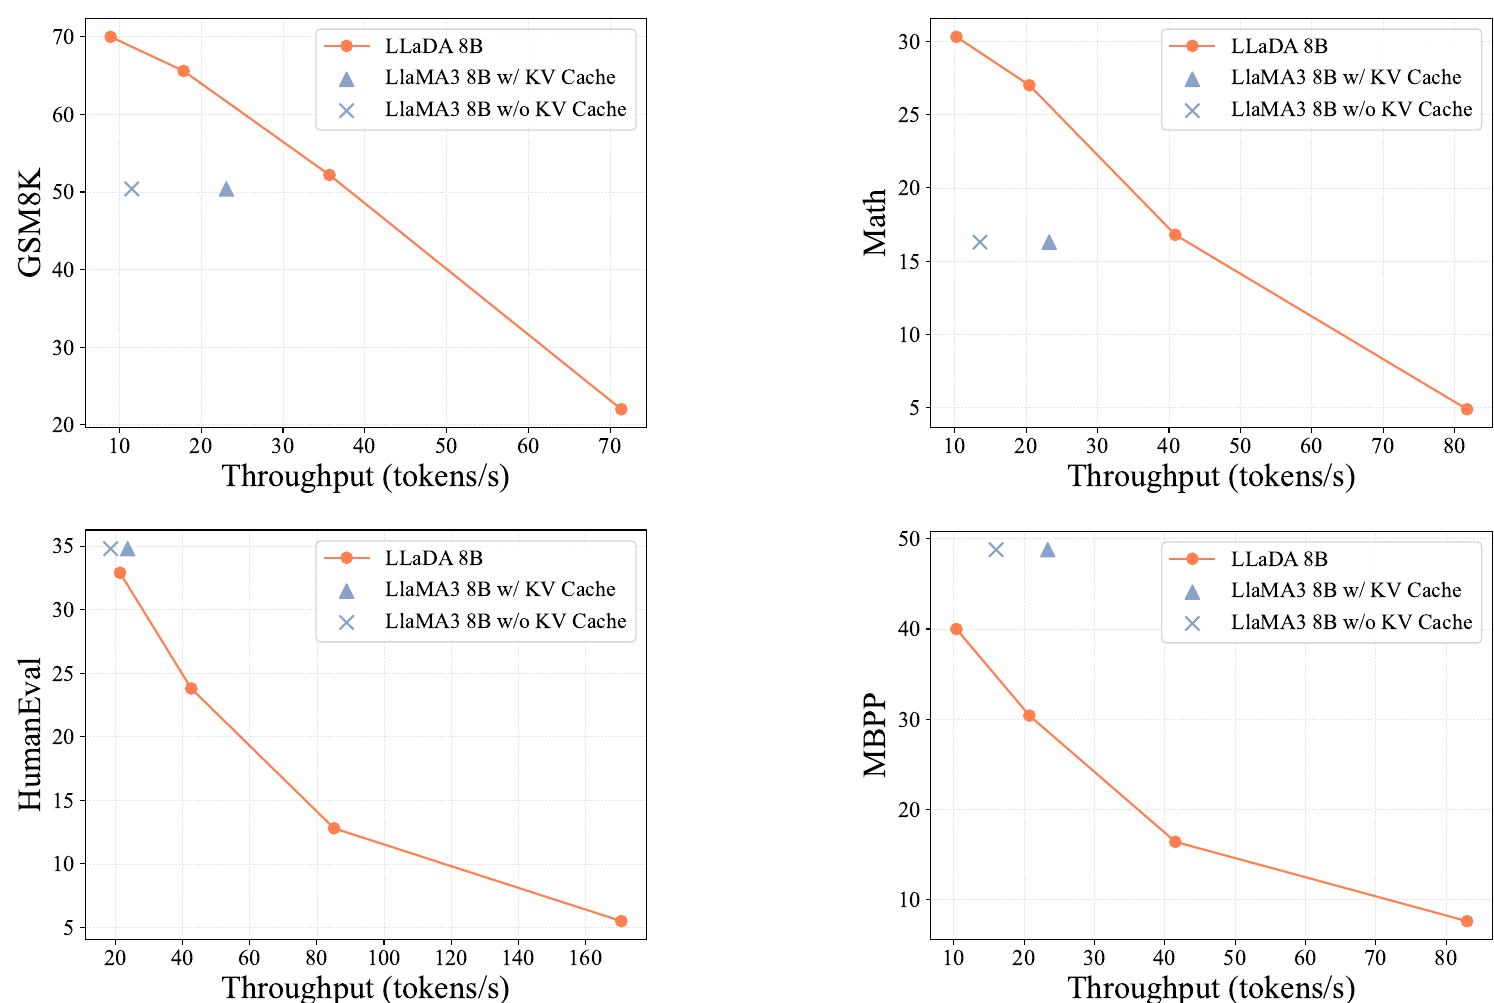
Para garantizar la equidad, para cada configuración, establecemos el número de pasos de muestreo igual a la longitud generada, asegurando que en cada paso de muestreo, solo un token se transfiera de la máscara al texto. Realizamos experimentos utilizando LLaDA 8B Base.
Como se reporta en la Tab. [10], los resultados no son sensibles al hiperparámetro de longitud.
B.6 Benchmarks estándar y detalles de evaluación
En esta sección, presentamos los benchmarks que utilizamos y presentamos los detalles de nuestro proceso de evaluación.
Siguiendo las prácticas estándar de evaluación de LLMs [25] [26], evaluamos LLaDA en cuatro dimensiones:
Capacidad general: MMLU [110], BBH [111], ARC-C [112], Hellaswag [113], TruthfulQA [114], WinoGrande [115] y PIQA [116].
Capacidad matemática y científica: GSM8K [117], Math [118] y GPQA [119].
Generación de código: HumanEval [120], HumanEval-FIM [121] y MBPP [122].
Comprensión del chino: CMMLU [123] y C-Eval [124].
Para todos los benchmarks mencionados anteriormente, seguimos el proceso de evaluación ampliamente adoptado [125] utilizado en las evaluaciones de LLMs, empleando principalmente la estimación de verosimilitud condicional y la generación condicional. Específicamente, para ciertos benchmarks, se proporciona un prompt y múltiples respuestas candidatas, y se requiere que el modelo calcule la verosimilitud condicional de cada candidata. Luego se selecciona la candidata con la mayor verosimilitud como la respuesta final del modelo, y se utiliza la precisión como métrica de evaluación. Para los benchmarks restantes, el modelo genera respuestas basándose en el prompt dado, y el rendimiento se evalúa utilizando métricas como coincidencia exacta y otros criterios relevantes.
Para el modelo base, utilizamos estimación de verosimilitud condicional para MMLU, CMMLU, C-Eval, ARC-C, Hellaswag, TruthfulQA, WinoGrande, PIQA y GPQA, mientras que los benchmarks restantes se evalúan utilizando generación condicional. Para el modelo instruct, evaluamos todos los benchmarks utilizando generación condicional. Para el modelo base, utilizamos el framework de evaluación de código abierto ampliamente adoptado lm-evaluation-harness [125], excepto para la métrica HumanEval-FIM, que no está soportada por el framework. Para HumanEval-FIM en el modelo base y todas las métricas de evaluación en el modelo instruct, utilizamos una biblioteca de evaluación interna. Elegimos la biblioteca interna ya que lm-evaluation-harness muestra una mayor desviación respecto a los resultados de LLaMA3 reportados por Yang et al. [25], en relación con nuestra evaluación interna.
| Longitud de entrada | Longitud de salida | LLaDA 8B | LLaMA3 8B sin KV-Cache | LLaMA3 8B con KV-Cache |
| 512 | 512 | 17,03 | 16,70 | 16,32 |
| 1024 | 17,53 | 17,49 | 16,43 | |
| 2048 | 18,52 | 20,00 | 16,73 | |
| 1024 | 512 | 17,53 | 17,16 | 16,36 |
| 1024 | 18,01 | 18,26 | 16,41 | |
| 2048 | 19,02 | 21,39 | 16,74 |
Para los benchmarks evaluados mediante estimación de verosimilitud condicional, utilizamos estimación de Monte Carlo para aproximar la Eq. [6] para LLaDA. Dado que MMLU, CMMLU y C-EVAL solo requieren la verosimilitud de un único token, una sola estimación de Monte Carlo es suficiente para estos benchmarks. Para todos los demás benchmarks, encontramos que 128 muestras de Monte Carlo son adecuadas para producir resultados estables.
Para los benchmarks evaluados utilizando generación condicional, aplicamos muestreo de difusión pura con una estrategia de remasking de baja confianza tanto a LLaDA Base como a LLaDA Instruct. Para LLaDA Base, establecemos tanto la longitud de generación como el número de pasos de muestreo en 1024. Para LLaDA Instruct, el número de pasos de muestreo se establece igual a la longitud de la respuesta, que se configura de la siguiente manera: 3 para MMLU y HellaSwag, 64 para GPQA, 256 para MBPP y MMLU-Pro, y 512 para HumanEval, GSM8K, Math y ARC-C. Como se detalla en el Apéndice [B.4], para HumanEval, MBPP, GSM8K, Math y GPQA, establecemos la confianza del token |EOS| en cero durante el muestreo para LLaDA Instruct.
B.7 Análisis de la eficiencia de muestreo
En esta sección, primero analizamos la eficiencia de muestreo de LLaDA, incluyendo tanto la velocidad de muestreo como el consumo de memoria. Luego discutimos posibles optimizaciones para mejorar aún más su eficiencia.
Utilizamos cuatro benchmarks representativos de generación abierta para el análisis de la velocidad de muestreo: GSM8K, Math, HumanEval y MBPP. Usamos la métrica de throughput ampliamente adoptada para medir la velocidad de generación, definida como el número de tokens generados por segundo. Comparamos LLaDA 8B Base y LLaMA3 8B Base, ambos usando precisión bfloat16. Todos los experimentos de esta sección se realizaron en una única GPU A100-80GB con un tamaño de lote de 1. Para LLaDA, la longitud de salida se fija en 256 tokens en los cuatro benchmarks.
La Fig. 5 muestra que LLaDA permite un trade-off flexible entre calidad de generación y velocidad mediante el ajuste del número de pasos de muestreo. Específicamente, en los conjuntos de datos GSM8K y Math, LLaDA 8B Base logra un rendimiento comparable al de LLaMA3 8B Base mientras ofrece un throughput 1.5 y 1.8 veces mayor, incluso aunque LLaMA3 usa KV Cache y LLaDA opera sin ninguna técnica de optimización de inferencia. Para el benchmark HumanEval, LLaDA 8B Base se desempeña de manera comparable a LLaMA3 8B Base cuando el throughput coincide. En el benchmark MBPP, LLaDA 8B Base queda por detrás de LLaMA3 8B Base.
Para LLaMA3, el beneficio de aceleración proporcionado por el almacenamiento en caché KV es notablemente más débil en el conjunto de datos HumanEval, lo que puede atribuirse a sus longitudes de prompt relativamente cortas. Específicamente, las longitudes promedio de prompt para GSM8K, Math, MBPP y HumanEval son 894, 680, 628 y 132 tokens, respectivamente.
La Tab. [1] compara el consumo de memoria entre LLaDA 8B Base y LLaMA3 8B Base. Para evitar variaciones en la longitud de generación causadas por diferencias en los datos de entrenamiento, fijamos tanto las longitudes de los tokens de entrada como de salida durante el análisis de memoria. Para LLaDA, el uso de memoria permanece constante independientemente del número de pasos de muestreo. Su consumo de memoria es comparable al de LLaMA3 8B Base sin caché KV, pero ligeramente superior al de este con caché KV.
| 4 pasos | 5 pasos | 6 pasos | |
| LLaMA3 8B Base | 38.0 | 35.0 | 34.0 |
| LLaDA 8B Base | 64.0 | 41.0 | 44.0 |
Destacamos que el objetivo de este estudio no es proponer un modelo que sea más rápido que los ARMs. En cambio, nuestro objetivo es mostrar el potencial de los modelos de difusión para el modelado del lenguaje a escala y desafiar la suposición común de que capacidades centrales de los LLM, como la escalabilidad, el aprendizaje en contexto y el seguimiento de instrucciones, dependen inherentemente de los ARMs. Un cuerpo sustancial de investigación [31, 79, 87] se ha centrado en mejorar la eficiencia de generación de los MDMs mediante innovaciones algorítmicas o arquitectónicas. Dejamos una exploración similar orientada a la eficiencia para LLaDA como trabajo futuro.
B.8 Evaluación en el conjunto de datos iGSM
Para evaluar más a fondo las capacidades matemáticas de LLaDA, probamos su rendimiento en iGSM [34], un conjunto de datos sintético e infinito similar a GSM8K. iGSM se genera mediante reglas específicas, con parámetros que controlan la dificultad de los problemas (es decir, el número de pasos de solución). Para mantener la coherencia en la evaluación, añadimos "#### Sanswer" a la solución final, siguiendo el formato de GSM8K. A continuación se muestra un ejemplo con pasos de solución establecidos en 4:
(Pregunta) El número de cada Aula de Estudios Culturales de North Star Elementary es igual a 1. El número de cada Estudio de Danza de Westridge Elementary es igual a 3 veces la suma de cada Aula de North Star Elementary y cada Aula de Estudios Culturales de North Star Elementary. ¿Cuántos Estudios de Danza tiene Westridge Elementary? (Solución) Definamos el Aula de Estudios Culturales de North Star Elementary como ; entonces . Definamos el Aula de North Star Elementary como ; entonces . Definamos el Estudio de Danza de Westridge Elementary como ; ; entonces #### 1
Dado que existen ligeras diferencias entre GSM8K e iGSM (por ejemplo, el uso de un sistema algorítmico módulo 5), seguimos [34] y proporcionamos un mensaje de sistema junto con pares pregunta-respuesta de cuatro ejemplos para cada problema.
(Prompt) Eres un experto en resolver problemas matemáticos elementales que implican suma, resta y multiplicación. Resuelves todos los problemas en un formato uniforme. Todos los cálculos se realizan módulo 5. Por ejemplo, es igual a 3, es igual a 1, es igual a 4, es igual a 4, y es igual a 4. Al proporcionar tu solución, termina con '#### x.' donde x es tu respuesta final, un entero entre 0 y 4. Debes resolver todos los problemas usando el mismo formato de solución. Nuestros escenarios involucran hasta cuatro categorías de objetos: escuelas, aulas, mochilas y papelería. Cada escuela puede contener aulas, cada aula puede contener mochilas, y cada mochila puede contener papelería. Podemos especificar cantidades, como el número de estudios de danza en cada Lakeshore High. Supón que toda entidad con el mismo nombre tiene una configuración idéntica; por ejemplo, cada Lakeshore High contiene el mismo número de estudios de danza. Otro principio rector es que lo que no se menciona no existe: cuando nos referimos a las aulas de Lakeshore High, solo estamos discutiendo las aulas mencionadas explícitamente en nuestro escenario. Además, si Lakeshore High ni siquiera se menciona, cualquier aula dentro de ella se considera automáticamente inexistente (es decir, 0).
Para pasos de solución que van de 4 a 6, generamos 100 preguntas para cada caso y reportamos la precisión correspondiente en la Tabla [2]. Como se muestra en la tabla, LLaDA 8B Base demuestra ventajas significativas y consistentes sobre LLaMA3 8B Base en problemas matemáticos no vistos, en línea con los resultados de la Tabla [1].
| Usuario LLaDA | ¿Cuáles son los beneficios del ejercicio regular para la salud física y mental? | ||||||||||
| El ejercicio regular | puede | mejorar | la | salud | física | al | fortalecer | los músculos | y | los huesos | |
| , | mejorar | la | salud | cardiovascular | , | y | reducir | el | riesgo | de | |
| enfermedades | crónicas | diabetes | y | enfermedades cardíacas | . | También | puede | mejorar | la | salud | |
| mental | y | la ansiedad | , | mejorar | el estado de ánimo | , | y | potenciar | la función | cognitiva | |
| Además | el ejercicio | puede | mejorar | la calidad | del sueño | y | aumentar | los niveles | de energía. | ||
B.9 Tareas de finalización de poemas
En esta sección, presentamos ejemplos de nuestro conjunto de datos de finalización de poemas como sigue.
Ejemplo 1:
Prompt: 窈窕淑女的下一句是什么? 直接输出句子即可。
Respuesta: 君子好逑。
Ejemplo 2:
Prompt: 不拘一格降人才的上一句是什么? 直接输出句子即可。
Respuesta: 我劝天公重抖擞。
B.10 Más estudios de casos
En esta sección, presentamos estudios de casos adicionales de LLaDA 8B Instruct. Primero, la Tabla [13] muestra el proceso de muestreo del muestreo de difusión por bloques de LLaDA, mientras que la Tabla [14] describe el proceso de muestreo para diálogos de múltiples turnos con remascarado aleatorio. Además, la Tabla [15] y la Tabla [16] proporcionan más ejemplos de diálogos de un solo turno y de múltiples turnos. Finalmente, la Tabla [17] presenta ejemplos de finalizaciones inversas de poemas en los que el modelo LLaDA 8B Instruct tiene éxito, en contraste con el fallo de GPT-4o.
C Declaración de impacto
Nuestro trabajo muestra el potencial de los modelos de difusión para el modelado del lenguaje a escala y desafía la suposición común de que capacidades centrales de los LLM, como la escalabilidad, el aprendizaje en contexto y el seguimiento de instrucciones, dependen inherentemente de los ARMs. Nuestros hallazgos abren nuevas vías para explorar paradigmas probabilísticos alternativos en el procesamiento del lenguaje natural, con posibles aplicaciones en IA conversacional, generación de código y tareas de razonamiento complejo.
Sin embargo, los modelos de difusión, al igual que los LLM tradicionales, plantean preocupaciones sociales similares. Estas incluyen el impacto ambiental del entrenamiento a gran escala, el posible uso indebido para generar contenido dañino y la amplificación de sesgos presentes en los datos de entrenamiento. Abordar estos desafíos es fundamental para garantizar el desarrollo y despliegue responsables de los modelos de lenguaje de difusión.
Tabla 14: Visualización del diálogo de múltiples turnos. Empleamos una estrategia de remascarado aleatorio. En la respuesta de LLaDA, los colores más oscuros indican tokens predichos en las etapas posteriores del muestreo, mientras que los colores más claros corresponden a predicciones anteriores.
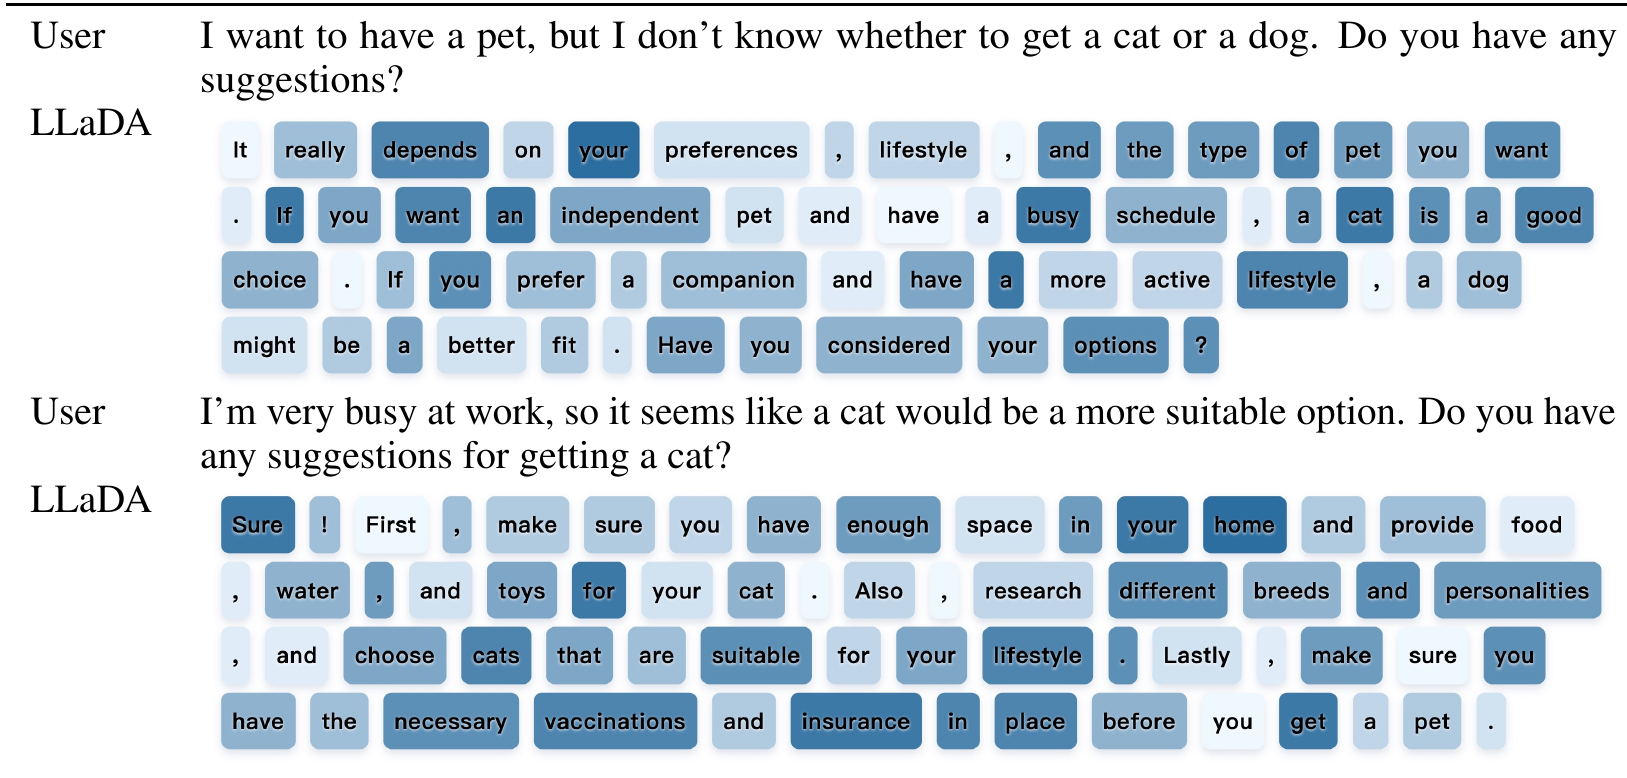
| Vida cotidiana Usuario LLaDA | ¿Cuál es un consejo que hayas recibido que te haya resultado útil? Un consejo útil que he recibido es estar siempre abierto al aprendizaje y al crecimiento. He descubierto que estar dispuesto a explorar nuevas ideas y experiencias me ha ayudado a ser más resiliente y adaptable. Al adoptar una mentalidad de crecimiento, he podido identificar oportunidades de mejora y desarrollo, tanto personal como profesionalmente. |
| Vida cotidiana Usuario LLaDA | Por favor, recomiéndame tres películas famosas ¡Claro! Aquí tienes tres películas famosas que han alcanzado una gran popularidad y aclamación de la crítica: 1. The Shawshank Redemption (1994) - Inspirada en una novela corta y dirigida por Frank Darabont, esta película cuenta la historia de Andy Dufresne, un hombre condenado por asesinar a su esposa, que afronta su dura vida en la prisión de Shawshank y forma una amistad improbable con un compañero recluso. 2. The Godfather (1972) - Dirigida por Francis Ford Coppola, esta película está basada en la novela homónima de Mario Puzo. Sigue la historia de la familia Corleone, en particular de Michael Corleone, quien asciende al poder y toma el control del imperio criminal de la familia. 3. The Empire Strikes Back (1980) - Dirigida por George Lucas, esta película continúa la historia de un joven Skywalker en la saga de Star Wars. Sigue a Luke Skywalker mientras ayuda a la Alianza Rebelde a luchar contra el Imperio Galáctico y destruir el poderoso arma, la Estrella de la Muerte. Todas estas películas son celebradas por sus logros cinematográficos, su poderosa narrativa y sus memorables personajes. |
| Traducción Usuario LLaDA | Por favor, ayúdame a traducir al chino: 'What is now proved was once only imagined' 现在被证明的曾经只是想象 |
| Traducción Usuario LLaDA | Por favor, ayúdame a traducir al alemán: 'What is now proved was once only imagined' 我把他去查查过,我其实没再问啊。 |
| Matemáticas Usuario LLaDA | Emma decide correr 4 sprints 5 veces por semana. Corre 75 metros en cada sprint. ¿Cuántos metros totales corre a la semana? Emma corre 4 sprints cada vez, así que corre un total de 4 x 5 = 20 sprints a la semana. Cada sprint tiene 75 metros de longitud, así que Emma corre un total de 20 x 75 = 1500 metros a la semana. El resultado final es 1500 |
| Código Usuario LLaDA | Estoy escribiendo código en python, tengo un arreglo, por favor ayúdame a ordenarlo de mayor a menor ¡Claro! Puedes ordenar un arreglo de mayor a menor en Python usando el método 'sort()' o la función 'sorted()'. Aquí tienes un ejemplo: ### Usando el método 'sort()': my_array = [3, 1, 4, 1, 5, 2] my_array.sort(reverse=True) print(my_array) |
| Vida cotidiana | |
| Usuario | ¿Cómo me preparo para una entrevista de trabajo? |
| LLaDA | Para prepararte para una entrevista de trabajo, debes investigar sobre la empresa y el puesto, practicar las preguntas comunes de entrevista y vestirte de manera apropiada. |
| Usuario | ¿Cuáles son algunas preguntas comunes de entrevista? |
| LLaDA | Algunas preguntas comunes de entrevista incluyen "Háblame de ti" y "¿Por qué quieres trabajar con nosotros"? |
| Vida cotidiana | |
| Usuario | ¿Cómo empiezo a aprender programación? |
| LLaDA | Para aprender programación, puedes empezar eligiendo un lenguaje de programación que te interese. Algunos lenguajes populares incluyen Python, Java y C++. |
| Usuario | ¿Qué lenguaje de programación debería aprender primero? |
| LLaDA | Depende de tus intereses y metas. Python es un gran lenguaje para principiantes por su simplicidad y versatilidad. |
| Usuario | ¿Cuánto tiempo se tarda en aprender Python? |
| LLaDA | Aprender Python puede tardar desde unas pocas semanas hasta varios meses. |
| Usuario | ¿Cuáles son algunos buenos proyectos de Python para principiantes? |
| LLaDA | Algunos buenos proyectos de Python para principiantes incluyen construir una calculadora simple, un juego y una aplicación web. |
| Matemáticas | |
| Usuario | Natalia vendió clips a 48 de sus amigos en abril, y luego vendió la mitad de clips en mayo. ¿Cuántos clips vendió Natalia en total en abril y mayo? |
| LLaDA | Natalia vendió clips a 48 amigos en abril. Vendió la mitad de clips en mayo, así que vendió 48/2 = 24 clips en mayo. En total, Natalia vendió 48 + 24 = 72 clips en abril y mayo. El resultado final es 72. |
| Usuario | Natalia vendió tres veces más artículos en junio que en mayo. ¿Cuántos clips vendió Natalia en total en estos tres meses? |
| LLaDA | Natalia vendió clips a 48 amigos en abril. Vendió la mitad de clips en mayo, así que vendió 48/2 = 24 clips en mayo. Natalia vendió tres veces más artículos en junio que en mayo, así que vendió 24 * 3 = 72 clips en junio. En total, Natalia vendió 48 + 24 + 72 = 144 clips en estos tres meses. El resultado final es 144. |
| Pregunta 1 | |
| Usuario | ¿Cuál es el verso anterior a «但闻人语响»? |
| GPT-4o | El verso anterior a «但闻人语响» es «无可奈何花落去»; estos dos versos provienen de la poeta de la dinastía Tang Li Qingzhao (Wu Ling Chun, Fin de primavera: 无可奈何花落去,但闻人语响. Este poema expresa la soledad y la tristeza de la autora en la época primaveral y, mediante la descripción de la caída de las flores y el sonido de las voces humanas, refleja la impotencia y la pérdida interior de la poeta. |
| LLaDA | El verso anterior a «但闻人语响» es «空山不见人». |
| Pregunta 2 | |
| Usuario | ¿Cuál es el verso anterior a «夜静春山空»? |
| GPT-4o | El verso anterior a «夜静春山空» es «空山新雨后»; estos dos versos provienen del poeta de la dinastía Tang Wang Wei (Vivienda en la montaña durante el otoño 膜): 空山新雨后,夜静春山空. Este poema describe la quietud y la etherealidad de la montaña en primavera después de la lluvia, y muestra la tranquilidad y la belleza armoniosa de la naturaleza. |
| LLaDA | El verso anterior a «夜静春山空» es «人闲桂花落». |
| Modelo | Tokens de entrenamiento | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| LLaDA 1B | 37.75B | 2.20e20 | 25.52 | 25.95 | 25.17 | 59.41 | 1.82 | 0.00 |
| LLaDA 1B | 88.08B | 5.13e20 | 27.11 | 26.52 | 26.96 | 61.86 | 3.03 | 1.83 |
| LLaDA 1B | 138.41B | 8.06e20 | 29.32 | 27.13 | 30.20 | 63.38 | 2.35 | 0.00 |
| LLaDA 1B | 239.08B | 1.39e21 | 31.48 | 30.77 | 27.99 | 63.11 | 3.26 | 1.22 |
| LLaDA 1B | 352.32B | 2.05e21 | 35.86 | 34.35 | 31.31 | 65.34 | 3.64 | 3.05 |
| LLaDA 1B | 461.37B | 2.69e21 | 31.86 | 30.98 | 30.12 | 65.51 | 2.35 | 0.61 |
| LLaDA 8B | 62,91B | 2,63e21 | 32,22 | 28,5 | 30,20 | 63,82 | 3,87 | 2,44 |
| LLaDA 8B | 125,83B | 5,27e21 | 33,39 | 33,9 | 34,64 | 66,54 | 8,72 | 3,66 |
| LLaDA 8B | 251,66B | 1,05e22 | 42,84 | 40,59 | 40,10 | 69,04 | 15,31 | 3,66 |
| LLaDA 8B | 377,49B | 1,58e22 | 45,11 | 43,99 | 39,25 | 68,61 | 25,40 | 9,76 |
| LLaDA 8B | 503,32B | 2,11e22 | 43,57 | 41,38 | 42,06 | 70,24 | 27,52 | 9,76 |
| LLaDA 8B | 629,14B | 2,63e22 | 48,80 | 47,13 | 42,24 | 72,09 | 30,10 | 12,80 |
| LLaDA 8B | 679,48B | 2,85e22 | 49,61 | 48,19 | 41,30 | 70,84 | 26,31 | 8,54 |
| LLaDA 8B | 792,72B | 3,31e22 | 50,88 | 49,01 | 42,58 | 70,51 | 31,99 | 6,10 |
| LLaDA 8B | 981,47B | 4,11e22 | 49,47 | 48,10 | 40,27 | 71,38 | - | 6,10 |
| LLaDA 8B | 1107,30B | 4,64e22 | 51,13 | 47,57 | 41,13 | 69,26 | 36,69 | 10,37 |
| LLaDA 8B | 1233,13B | 5,16e22 | 50,52 | 49,72 | 45,05 | 71,49 | 38,97 | 9,76 |
| LLaDA 8B | 1358,95B | 5,69e22 | 54,61 | 53,97 | 49,40 | 74,05 | 48,14 | 17,68 |
| LLaDA 8B | 1547,70B | 6,48e22 | 57,38 | 56,04 | 49,49 | 74,59 | 53,30 | 20,73 |
| LLaDA 8B | 1975,52B | 8,27e22 | 58,52 | 57,87 | 50,68 | 75,35 | - | 19,51 |
| Modelo | Tokens de entrenamiento | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| ARM 1B | 37,75B | 2,20e20 | 25,47 | 25,38 | 30,20 | 67,36 | 2,20 | 4,88 |
| ARM 1B | 88,08B | 5,13e20 | 24,67 | 25,23 | 33,96 | 70,02 | 7,51 | 10,37 |
| ARM 1B | 138,41B | 8,06e20 | 29,25 | 27,48 | 33,45 | 70,29 | 8,34 | 9,76 |
| ARM 7B | 17,30B | 6,02e20 | 26,92 | 25,18 | 21,02 | 57,18 | 1,29 | 1,22 |
| ARM 7B | 34,60B | 1,20e21 | 25,83 | 25,38 | 24,07 | 62,84 | 1,59 | 2,44 |
| ARM 7B | 86,50B | 3,01e21 | 24,41 | 24,90 | 25,42 | 71,11 | 2,88 | 7,93 |
| ARM 7B | 173,02B | 6,02e21 | 26,20 | 24,78 | 26,10 | 74,27 | 6,67 | 9,15 |
| ARM 7B | 207,62B | 7,23e21 | 30,36 | 28,86 | 31,86 | 74,48 | 8,57 | 12,80 |
| ARM 7B | 224,92B | 7,83e21 | 29,49 | 32,26 | 31,19 | 74,37 | 8,95 | 8,54 |
| ARM 7B | 242,22B | 8,43e21 | 33,62 | 31,38 | 34,92 | 75,41 | 10,84 | 9,15 |
| ARM 7B | 259,52B | 9,03e21 | 34,11 | 34,20 | 32,88 | 75,19 | 9,33 | 10,98 |
| ARM 7B | 311,43B | 1,08e22 | 35,66 | 35,49 | 36,61 | 75,14 | 11,30 | 10,37 |
| ARM 7B | 363,33B | 1,26e22 | 34,54 | 37,67 | 34,58 | 76,55 | 12,28 | 14,02 |
| ARM 7B | 415,24B | 1,45e22 | 35,37 | 38,37 | 35,25 | 76,39 | 14,40 | 12,80 |
| ARM 7B | 449,84B | 1,57e22 | 39,51 | 39,24 | 34,92 | 76,82 | 14,94 | 14,63 |
| ARM 7B | 519,09B | 1,81e22 | 40,30 | 40,69 | 37,29 | 77,15 | 14,03 | 14,63 |
| ARM 7B | 778,57B | 2,71e22 | 43,33 | 43,50 | 38,31 | 77,53 | 17,59 | 14,63 |
| ARM 7B | 1038,09B | 3,61e22 | 45,06 | 46,12 | 41,69 | 77,86 | 20,02 | 15,85 |
| ARM 7B | 1384,12B | 4,82e22 | 47,63 | 48,18 | 47,80 | 76,93 | 22,82 | 15,24 |
| ARM 7B | 2076,18B | 7,23e22 | 47,68 | 50,85 | 44,07 | 77,37 | 24,79 | 14,63 |
| ARM 7B | 2214,59B | 7,71e22 | 49,26 | 52,08 | 53,56 | 77,69 | 27,37 | 17,07 |