
Muestrear el mismo prompt miles de veces: la cobertura sigue subiendo y un verificador la convierte en precisión. Papel de 2024, gratis online.
Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
Los monos del lenguaje a gran escala: escalar la computación de inferencia mediante muestreo repetido
Bradley Brown\†‡, Jordan Juravsky\†, Ryan Ehrlich\*†, Ronald Clark‡, Quoc V. Le§, Christopher Ré† y Azalia Mirhoseini†§
†Departamento de Ciencias de la Computación, Universidad de Stanford ‡Universidad de Oxford §Google DeepMind
bradley.brown@cs.ox.ac.uk, jbj@stanford.edu, ryanehrlich@cs.stanford.edu, ronald.clark@cs.ox.ac.uk, qvl@google.com, chrismre@stanford.edu, azalia@stanford.edu
Resumen
Escalar la cantidad de computación utilizada para entrenar modelos de lenguaje ha mejorado drásticamente sus capacidades. Sin embargo, en lo que respecta a la inferencia, a menudo limitamos los modelos a hacer un solo intento en un problema. Aquí exploramos la computación de inferencia como otro eje para el escalado, utilizando la técnica simple de muestrear repetidamente soluciones candidatas de un modelo. A través de múltiples tareas y modelos, observamos que la cobertura —la fracción de problemas que se resuelven con cualquier muestra generada— escala con el número de muestras a lo largo de cuatro órdenes de magnitud. De manera interesante, la relación entre la cobertura y el número de muestras suele ser log-lineal y puede modelarse con una ley de potencias exponenciada, lo que sugiere la existencia de leyes de escalado en el tiempo de inferencia. En dominios como la programación y las pruebas formales, donde las respuestas pueden verificarse automáticamente, estos aumentos en la cobertura se traducen directamente en un mejor rendimiento. Cuando aplicamos muestreo repetido a SWE-bench Lite, la fracción de problemas resueltos con DeepSeek-Coder-V2-Instruct aumenta del 15.9% con una muestra al 56% con 250 muestras, superando el estado del arte de una sola muestra del 43%. En dominios sin verificadores automáticos, encontramos que los métodos comunes para elegir a partir de una colección de muestras (votación mayoritaria y modelos de recompensa) se estancan más allá de varios cientos de muestras y no logran escalar plenamente con el presupuesto de muestras.
1 Introducción
La capacidad de los modelos de lenguaje grandes (LLM) para resolver tareas de programación, matemáticas y otros razonamientos ha mejorado drásticamente en los últimos años [47, 11, 2, 4]. Escalar la cantidad de computación de entrenamiento mediante modelos más grandes, ejecuciones de preentrenamiento más largas y conjuntos de datos más grandes ha sido un impulsor constante de estas ganancias [27, 37, 28].
En contraste, se ha realizado una inversión comparativamente limitada en escalar la cantidad de computación utilizada durante la inferencia. Los modelos más grandes sí requieren más computación de inferencia que los más pequeños, y técnicas de prompting como la cadena de pensamiento [61] pueden aumentar la calidad de las respuestas a costa de salidas más largas (y, por lo tanto, computacionalmente más costosas). Sin embargo, al interactuar con los LLM, los usuarios y desarrolladores a menudo restringen los modelos a hacer un solo intento al resolver un problema.
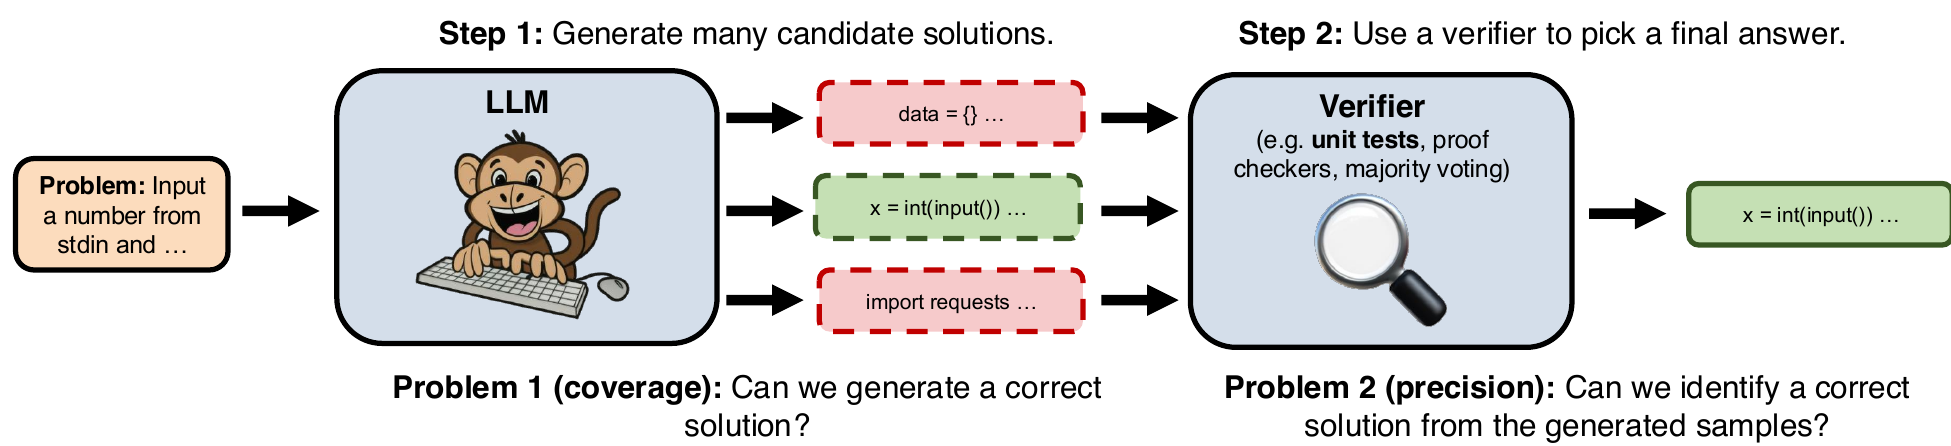
En este trabajo, exploramos el muestreo repetido (Figura 1) como un enfoque simple para escalar la computación de inferencia con el fin de mejorar el rendimiento en razonamiento. Trabajos existentes proporcionan ejemplos alentadores de que el muestreo repetido puede ser beneficioso en contextos de matemáticas, programación y resolución de acertijos [60, 48, 23]. En particular, AlphaCode [41], un sistema de vanguardia para programación competitiva, encuentra que el rendimiento continúa mejorando con un millón de muestras por problema. Nuestro objetivo es caracterizar sistemáticamente estos beneficios a través de una variedad de tareas, modelos y presupuestos de muestras.
La efectividad del muestreo repetido está determinada por dos propiedades clave:
1. Cobertura: A medida que aumenta el número de muestras, ¿qué fracción de problemas podemos resolver utilizando cualquier muestra que se haya generado?
2. Precisión: ¿Con qué frecuencia podemos identificar muestras correctas de nuestra colección de generaciones?
Ambas propiedades son necesarias para lograr un sólido rendimiento en el mundo real. Con muestras ilimitadas, cualquier modelo que asigne una probabilidad distinta de cero a cada secuencia alcanzará una cobertura perfecta. Sin embargo, el muestreo repetido solo es práctico si podemos mejorar la cobertura con un presupuesto factible. De manera similar, generar grandes colecciones de muestras solo es útil si se pueden identificar las muestras correctas dentro de una colección. La dificultad del problema de precisión puede variar según la tarea. En algunos contextos, herramientas existentes como verificadores de pruebas y pruebas unitarias pueden verificar automáticamente cada muestra. En otros casos, como al resolver problemas de palabras, se necesitan otros métodos de verificación.
Explorando primero la cobertura, encontramos que muestrear hasta 10,000 veces por problema puede aumentar significativamente la cobertura en tareas de matemáticas y programación (Sección 2). Al resolver problemas de programación de CodeContests [41] usando Gemma-2B [52], aumentamos la cobertura en más de 300x, del 0.02% con una muestra al 7.1% con 10,000 muestras. De manera interesante, la relación entre log(cobertura) y el número de muestras a menudo sigue una ley de potencias aproximada (Sección 3). Con los modelos Llama-3 [3] y Gemma, esto lleva a que la cobertura crezca casi log-linealmente con el número de muestras a lo largo de varios órdenes de magnitud.
En contextos con herramientas de verificación automática, los aumentos en la cobertura se traducen directamente en un mejor rendimiento en la tarea. Al aplicar muestreo repetido a programación competitiva y a la escritura de pruebas en Lean, modelos como Llama-3-8B-Instruct pueden superar el rendimiento de una sola muestra de modelos mucho más fuertes como GPT-4o [2]. Esta capacidad de amplificar modelos más débiles se extiende al desafiante conjunto de datos SWE-bench Lite de problemas reales de GitHub [32], donde el actual estado del arte (SOTA) de una sola muestra, logrado por una mezcla de GPT-4o y Claude 3.5 Sonnet, es del 43% [1]. Cuando se restringe a una sola muestra, DeepSeek-Coder-V2-Instruct [20] resuelve solo el 15.9% de los problemas. Al simplemente aumentar el número de muestras a 250, incrementamos la fracción de problemas resueltos al 56%, superando el estado del arte en un 13%.
Además de mejorar la calidad del modelo, el muestreo repetido proporciona un nuevo mecanismo para minimizar los costos de inferencia de LLM (Sección 2.3). Al mantener constante el número total de FLOPs de inferencia,encontramos que en algunos conjuntos de datos (p. ej., MATH), la cobertura se maximiza con un modelo más pequeño y más muestras, mientras que en otros (p. ej., CodeContests) es mejor muestrear menos veces de un modelo más grande. También comparamos los precios de API entre DeepSeek-Coder-V2-Instruct, GPT-4o y Claude Sonnet 3.5 en el contexto de la resolución de problemas de SWE-bench Lite. Al mantener constante el marco de agente (Moatless Tools [67]), muestrear cinco veces del modelo DeepSeek más débil y más barato resuelve más problemas que muestras únicas de Claude o GPT, además de ser más de 3 veces más barato.
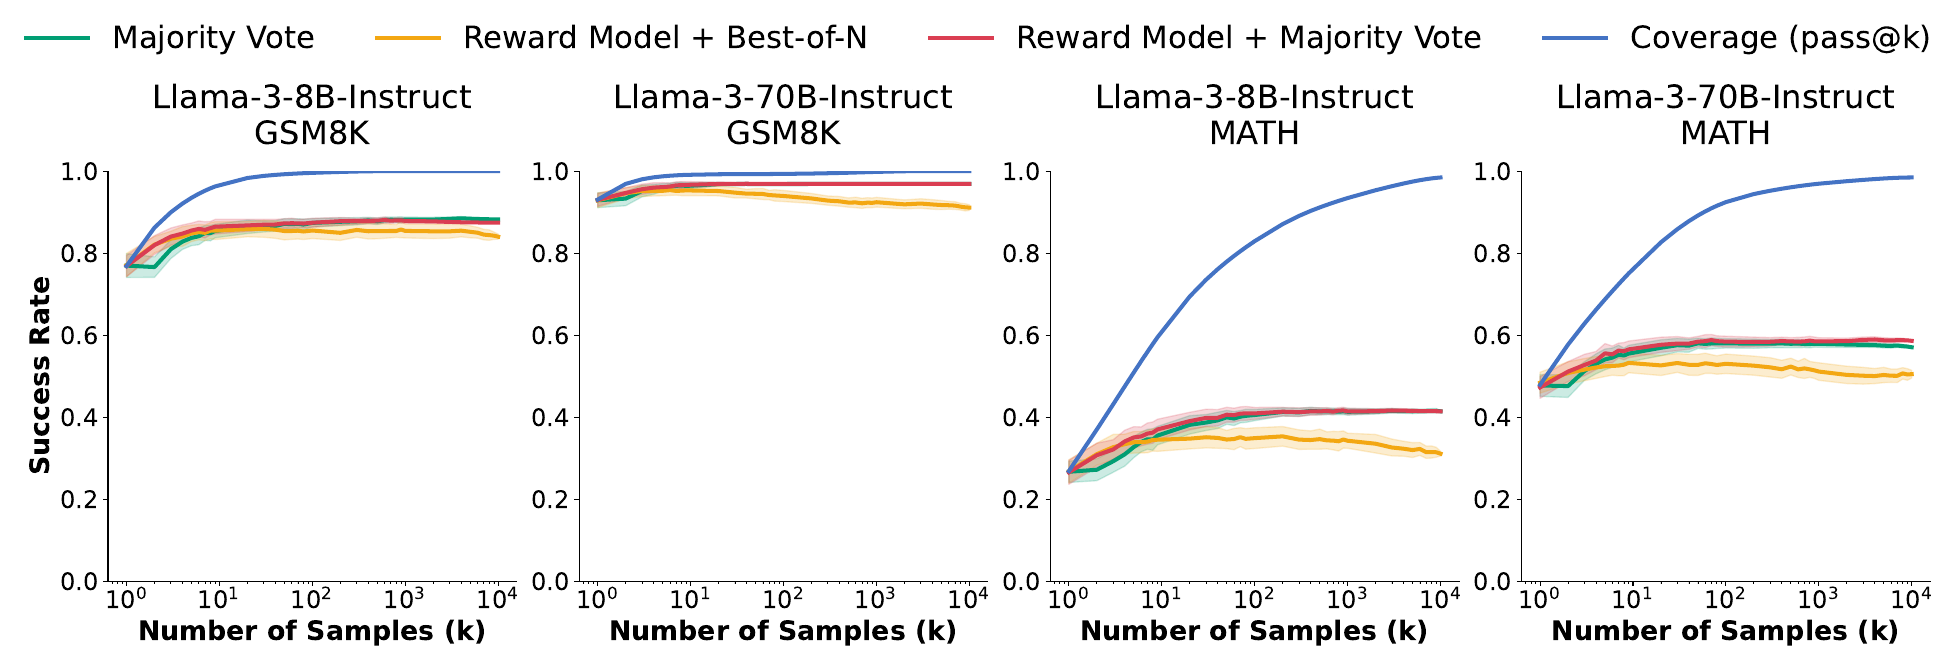
Finalmente, demostramos que la verificación escalable es necesaria para beneficiarse plenamente del muestreo repetido. A medida que aumenta el número de muestras, la cobertura mejora gracias a que los modelos generan soluciones correctas para problemas que no habían resuelto previamente. Sin embargo, estas generaciones correctas cada vez más raras solo son beneficiosas si los verificadores pueden "encontrar la aguja en el pajar" e identificarlas dentro de colecciones de muestras mayormente incorrectas. En contextos de problemas matemáticos de palabras, encontramos que dos métodos comunes de verificación (votación mayoritaria y modelos de recompensa) no poseen esta capacidad. Al resolver problemas de MATH [26] con Llama-3-8B-Instruct, la cobertura aumenta del 82.9% con 100 muestras al 98.44% con 10,000 muestras. Sin embargo, al usar votación mayoritaria o modelos de recompensa para seleccionar las respuestas finales, el mayor aumento de rendimiento es solo del 40.50% al 41.41% en el mismo rango de muestras. A medida que aumenta el número de muestras, la brecha entre la cobertura (es decir, el rendimiento con un verificador perfecto) y el rendimiento de estos métodos también aumenta (Figura [7]).
En resumen, nuestras observaciones principales son:
1. Demostramos que escalar la computación de inferencia mediante muestreo repetido conduce a grandes mejoras en la cobertura a través de una variedad de tareas y modelos. Esto hace posible, y a veces rentable, amplificar modelos más débiles con muchas muestras y superar el rendimiento de muestras únicas de modelos más capaces.
2. Mostramos que la relación entre la cobertura y el número de muestras a menudo puede modelarse usando una ley de potencias exponenciada, lo que sugiere una forma de leyes de escalado para la computación en tiempo de inferencia.
3. En dominios sin verificadores automáticos, mostramos que los enfoques comunes de verificación se estancan más allá de aproximadamente 100 muestras. Esto conduce a una brecha creciente entre el rendimiento alcanzado con estos métodos y el límite superior de cobertura.
2 Escalado del muestreo repetido
Nos centramos en tareas de aprobado-reprobado en las que una solución candidata puede puntuarse como correcta o incorrecta. La métrica principal de interés para estas tareas es la tasa de éxito: la fracción de problemas que somos capaces de resolver. Con el muestreo repetido, consideramos una configuración en la que un modelo puede generar muchas soluciones candidatas mientras intenta resolver un problema. Por lo tanto, la tasa de éxito está influenciada tanto por la capacidad de generar muestras correctas para muchos problemas (es decir, la cobertura), como por la capacidad de identificar estas muestras correctas (es decir, la precisión).
La dificultad del problema de precisión depende de la disponibilidad de herramientas para la verificación de muestras. Al demostrar afirmaciones formales en Lean, los verificadores de pruebas pueden identificar rápidamente si una solución candidata es correcta. De manera similar, las pruebas unitarias pueden usarse para verificar soluciones candidatas a tareas de programación. En estos casos, la precisión se maneja automáticamente, y mejorar la cobertura se traduce directamente en tasas de éxito más altas. En contraste, las herramientas disponibles para verificar soluciones a problemas matemáticos de palabras de GSM8K y MATH son limitadas, lo que exige métodos de verificación adicionales que decidan una única respuesta final a partir de muchas muestras (a menudo conflictivas).
Consideramos las siguientes cinco tareas:
1. GSM8K: Un conjunto de datos de problemas matemáticos de palabras de nivel escolar [18]. Evaluamos en un subconjunto aleatorio de 128 problemas del conjunto de prueba de GSM8K.
2. MATH: Otro conjunto de datos de problemas matemáticos planteados en palabras que generalmente son más difíciles que los de GSM8K [13]. De manera similar, evaluamos con 128 problemas aleatorios del conjunto de prueba de este conjunto de datos.
3. MiniF2F-MATH: Un conjunto de datos de problemas matemáticos que han sido formalizados en lenguajes de verificación de demostraciones [65]. Usamos Lean4 como nuestro lenguaje y evaluamos con los 130 problemas del conjunto de prueba que están formalizados a partir del conjunto de datos MATH.
4. CodeContests: Un conjunto de datos de problemas de programación competitiva [41]. Cada problema tiene una descripción textual, junto con un conjunto de casos de prueba de entrada-salida (ocultos para el modelo) que pueden usarse para verificar la corrección de una solución candidata. Exigimos que los modelos escriban sus soluciones usando Python3.
5. SWE-bench Lite: Un conjunto de datos de problemas reales de Github, donde cada problema consiste en una descripción y una instantánea de un repositorio de código [32]. Para resolver un problema, los modelos deben editar archivos en la base de código (en el subconjunto Lite de SWE-bench que usamos, solo es necesario cambiar un único archivo). Las soluciones candidatas pueden verificarse automáticamente usando la suite de pruebas unitarias del repositorio.
Entre estas tareas, MiniF2F-MATH, CodeContests y SWE-bench Lite tienen verificadores automáticos (en forma del verificador de demostraciones Lean4, casos de prueba y suites de pruebas unitarias, respectivamente). Comenzamos investigando cómo el muestreo repetido mejora la cobertura del modelo. Las mejoras de cobertura se corresponden directamente con mayores tasas de éxito para tareas con verificadores automáticos y, en el caso general, proporcionan una cota superior sobre la tasa de éxito. En entornos de programación, nuestra definición de cobertura es equivalente a la métrica comúnmente usada pass@k [15], donde denota el número de muestras por problema. Usamos esta métrica directamente al evaluar en CodeContests y SWE-bench Lite. Para MiniF2F la métrica es similar, con un "pass" definido según el verificador de demostraciones Lean4. Para GSM8K y MATH, la cobertura corresponde al uso de un verificador oráculo que comprueba si alguna muestra "pasa" al producir la respuesta final correcta. Para reducir la varianza al calcular la cobertura, adoptamos la fórmula de estimación insesgada de Chen et al. [15]. En cada experimento, primero generamos muestras para cada índice de problema y calculamos el número de muestras correctas . Luego calculamos las puntuaciones pass@k en cada de interés según:
Utilizamos la implementación numéricamente estable de la fórmula anterior sugerida en Chen et al. [15]. Los datos y el código están disponibles en https://scalingintelligence.stanford.edu/pubs/large_language_monkeys/.
2.1 El muestreo repetido es efectivo en todas las tareas
Aquí establecemos que el muestreo repetido mejora la cobertura en múltiples tareas y en un rango de presupuestos de muestras. Evaluamos Llama-3-8B-Instruct y Llama-3-70B-Instruct en CodeContests, MiniF2F, GSM8K y MATH, generando 10.000 muestras independientes por problema. Para SWE-bench Lite, utilizamos DeepSeek-Coder-V2-Instruct [20], ya que la longitud de contexto requerida para esta tarea excede los límites de los modelos Llama-3. Como es estándar al resolver problemas de SWE-bench, equipamos nuestro LLM con un marco de software que proporciona al modelo herramientas para navegar y editar bases de código. En nuestro trabajo, utilizamos la biblioteca de código abierto Moatless Tools [67]. Nótese que resolver un problema de SWE-bench implica un intercambio de ida y vuelta entre el LLM y Moatless Tools. Una muestra/intento para este benchmark se refiere a una trayectoria completa de múltiples turnos. Para minimizar los costos, restringimos el número de intentos por problema a 250, con todos los intentos realizados de forma independiente unos de otros.
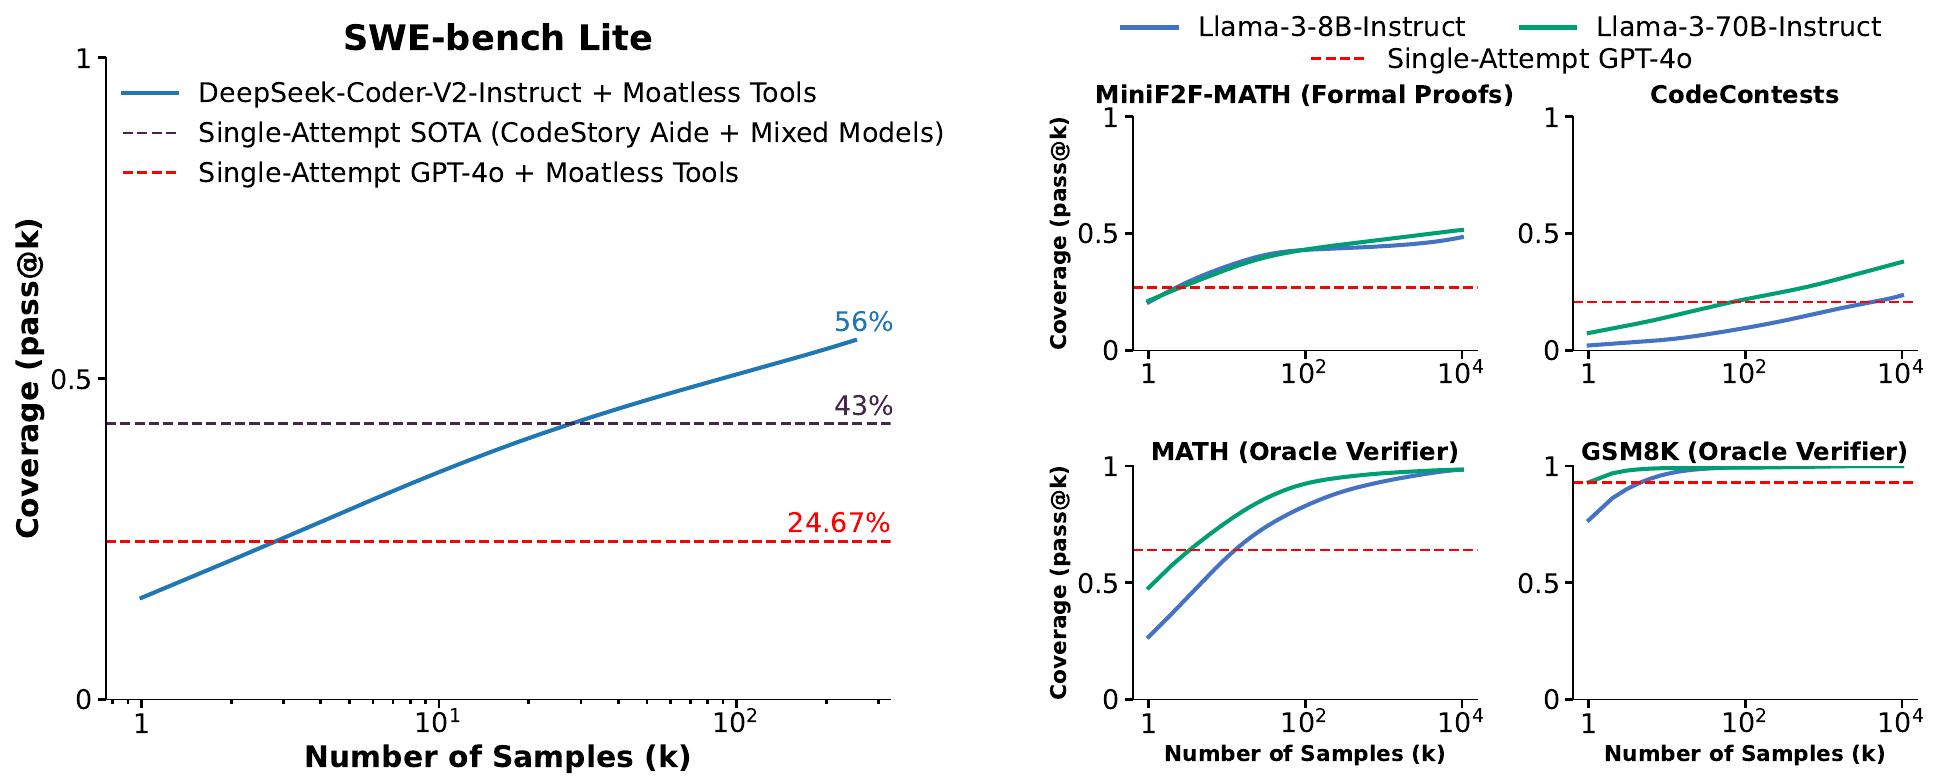
Reportamos nuestros resultados en la Figura 2. También incluimos el rendimiento de un solo intento de GPT-4o en cada tarea, así como el estado del arte de un solo intento para SWE-bench Lite (CodeStory Aide 1, que utiliza una combinación de GPT-4o y Claude 3.5 Sonnet). En las cinco tareas, encontramos que la cobertura mejora de manera fluida a medida que aumenta el presupuesto de muestras. Cuando a todos los LLM se les da un solo intento, GPT-4o supera a los modelos Llama y DeepSeek en todas las tareas. Sin embargo, a medida que aumenta el número de muestras, los tres modelos más débiles superan el rendimiento de un solo intento de GPT-4o. En el caso de SWE-bench Lite, resolvemos el de los problemas, superando el SOTA de un solo intento del .
2.2 El muestreo repetido es efectivo en distintos tamaños y familias de modelos
Los resultados de la Sección 2.1 indican que el muestreo repetido mejora la cobertura. Sin embargo, solo mostramos esta tendencia para tres modelos recientes ajustados por instrucciones con 8B o más parámetros. Ahora mostramos que estas tendencias se mantienen en otros tamaños de modelo, familias y niveles de post-entrenamiento. Ampliamos nuestra evaluación para incluir un conjunto más amplio de modelos:
- Llama 3: Llama-3-8B, Llama-3-8B-Instruct, Llama-3-70B-Instruct.
- Gemma: Gemma-2B, Gemma-7B [52].
- Pythia: Pythia-70M hasta Pythia-12B (ocho modelos en total) [9].
Restringimos la evaluación a los conjuntos de datos MATH y CodeContests para minimizar los costos de inferencia, reportando los resultados en la Figura 3. La cobertura aumenta en casi todos los modelos que probamos, y los modelos más pequeños muestran algunos de los aumentos más pronunciados en cobertura cuando se aplica muestreo repetido. En CodeContests, la cobertura de Gemma-2B aumenta en más de , de un pass@1 de a un
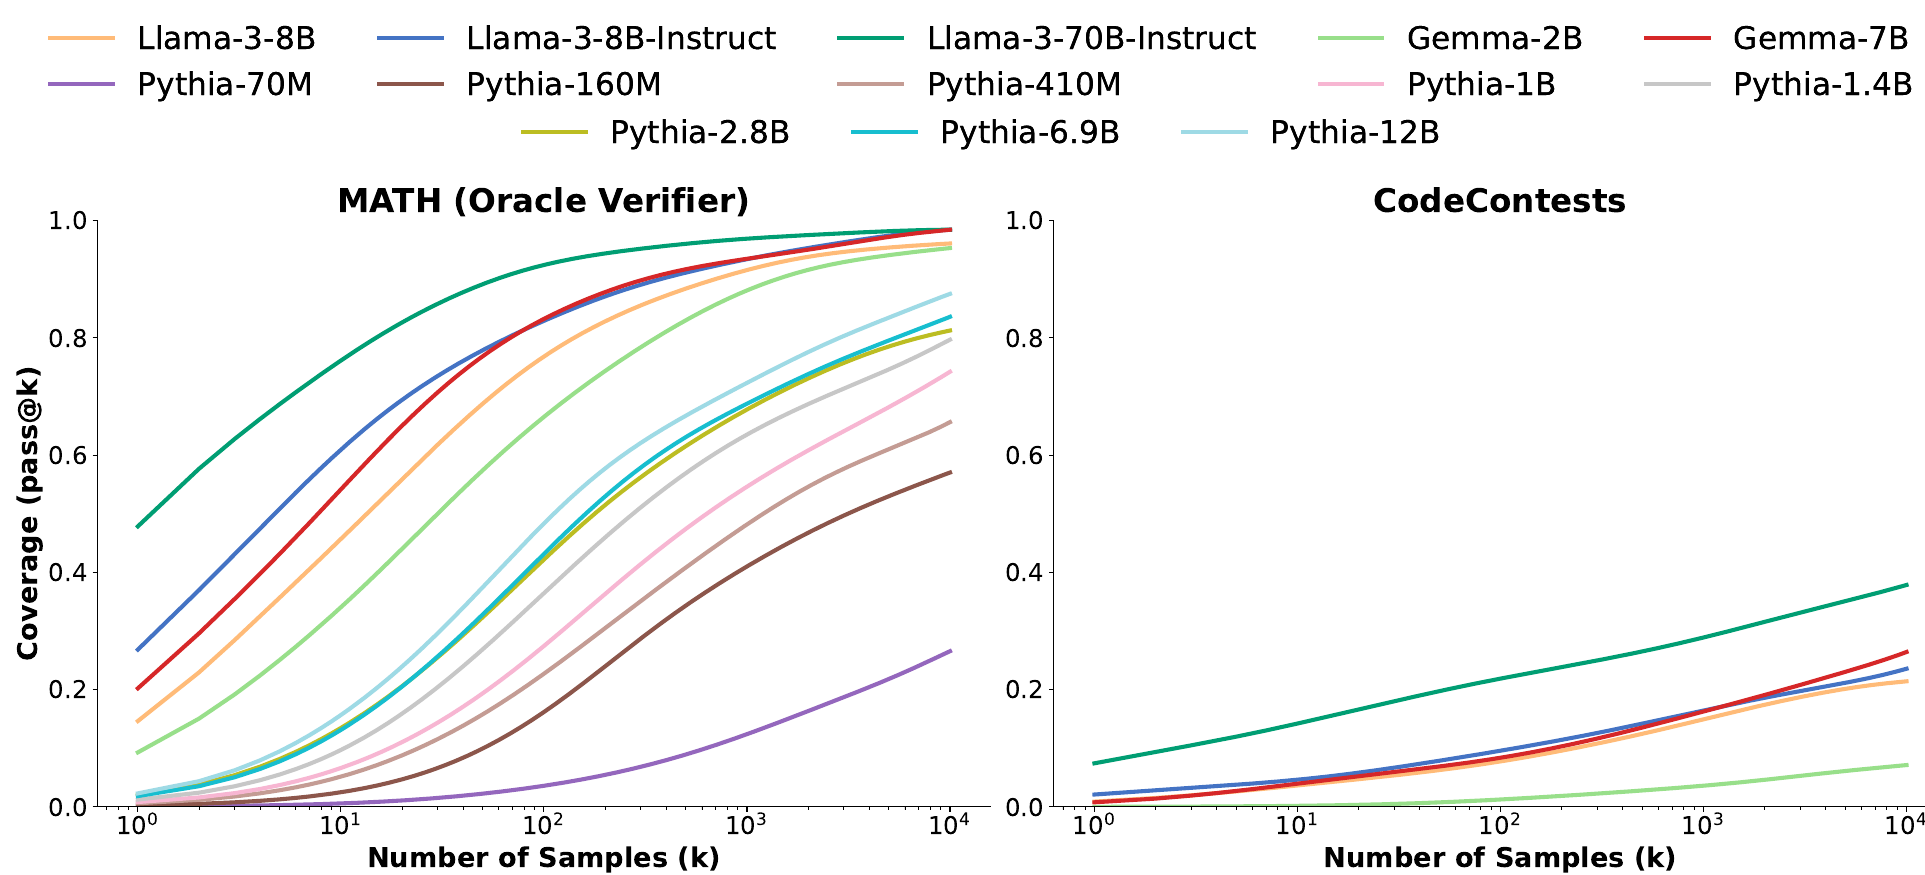
pass@10k de . De manera similar, al resolver problemas de MATH con Pythia-160M, la cobertura aumenta de un pass@1 de a un pass@10k de .
La excepción a este patrón de cobertura creciente en los modelos es la familia Pythia evaluada en CodeContests. Todos los modelos Pythia logran una cobertura cero en este conjunto de datos, incluso con un presupuesto de 10.000 muestras. Especulamos que esto se debe a que Pythia fue entrenado con menos datos específicos de programación que Llama y Gemma.
2.3 El muestreo repetido puede ayudar a equilibrar rendimiento y costo
Una conclusión de los resultados de las Secciones 2.1 y 2.2 es que el muestreo repetido hace posible amplificar las capacidades de un modelo más débil y superar las muestras únicas de modelos más fuertes. Aquí, demostramos que esta amplificación puede ser más rentable que usar un modelo más fuerte y más caro, proporcionando a los profesionales un nuevo grado de libertad al intentar optimizar conjuntamente el rendimiento y los costos.
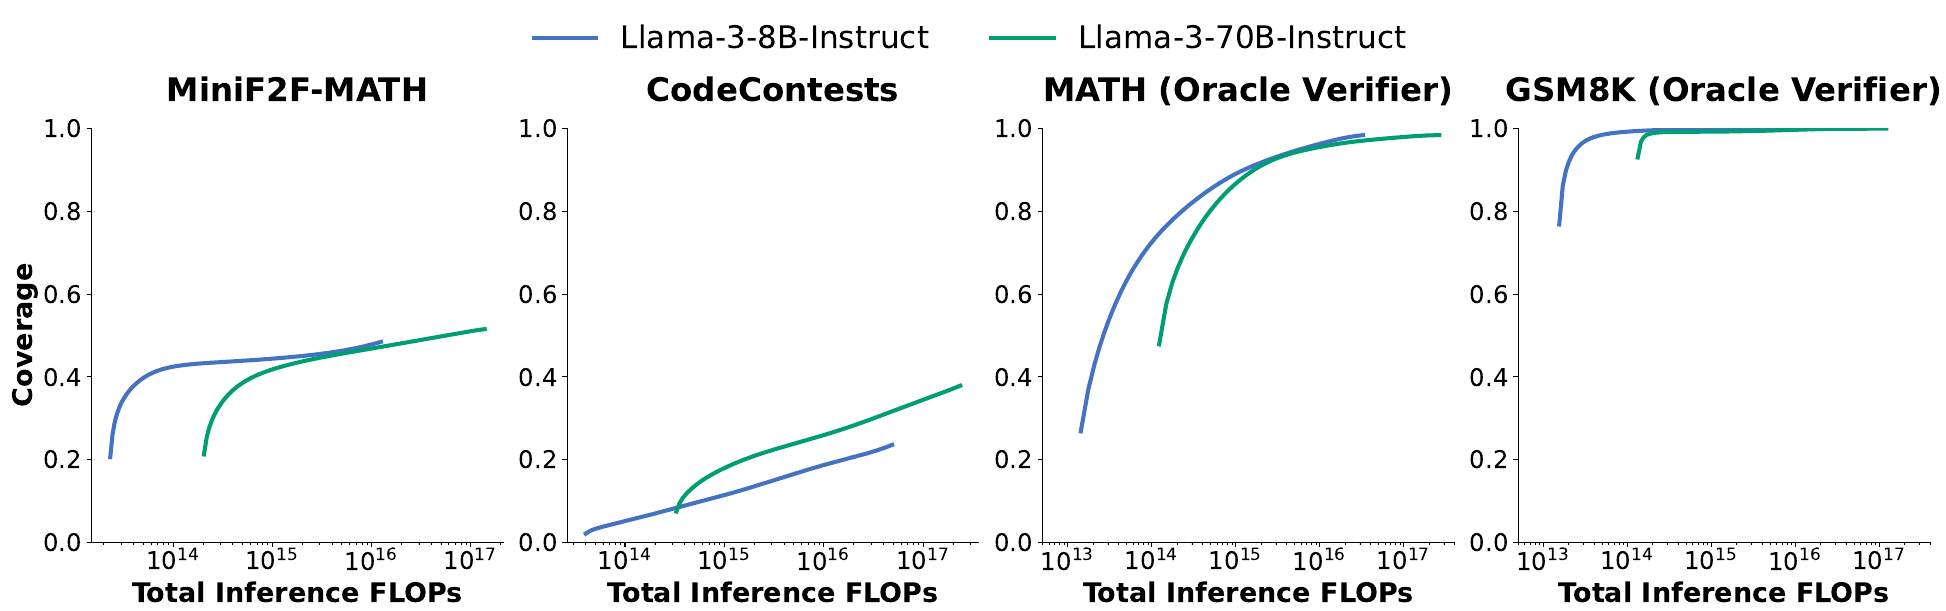
Primero consideramos los FLOPs como métrica de costo, examinando los resultados de Llama-3 de la Sección 2.1. Volvemos a trazar nuestros resultados de la Figura 2 visualizando ahora la cobertura en función de los FLOPs totales de inferencia en lugar del presupuesto de muestras. Dado que los modelos Llama-3 son transformers densos donde la mayoría de los parámetros se utilizan en multiplicaciones de matrices, aproximamos los FLOPs de inferencia con la fórmula:
Presentamos nuestros resultados reescalados para MiniF2F, CodeContests, MATH y GSM8K en la Figura 4. De manera interesante, el modelo que maximiza la cobertura varía según el presupuesto de cómputo y la tarea. En MiniF2F, GSM8K y MATH, Llama-3-8B-Instruct siempre obtiene una cobertura mayor que el modelo de 70B, más grande (y más caro), cuando el presupuesto de FLOPs es fijo. Sin embargo, para CodeContests, el modelo de 70B es casi siempre más rentable. Señalamos que examinar solo los FLOPs puede ser una métrica de costo burda que ignora otros aspectos de la eficiencia del sistema [21]. En particular, el muestreo repetido puede aprovechar tamaños de lote grandes y optimizaciones especializadas que mejoran el rendimiento del sistema en relación con las cargas de trabajo de inferencia de un solo intento [34] [6] [66]. Analizamos esto con más detalle en la Sección [5]
| Modelo | Costo por intento (USD) | Número de intentos | Problemas resueltos (%) | Costo total (USD) | Costo total relativo |
| DeepSeek-Coder-V2-Instruct | 0.0072 | 5 | 29.62 | 10.8 | 1x |
| GPT-4o | 0.13 | 1 | 24.00 | 39 | 3.6x |
| Claude 3.5 Sonnet | 0.17 | 1 | 26.70 | 51 | 4.7x |
Tabla 1: Comparación del costo de API (en dólares estadounidenses) y el rendimiento de varios modelos en el conjunto de datos SWE-bench Lite utilizando el marco de agente Moatless Tools. Cuando se muestrea más, el modelo de código abierto DeepSeek-Coder-V2-Instruct puede lograr la misma tasa de resolución de problemas que los modelos frontera de código cerrado por menos de un tercio del precio.
También examinamos los costos en dólares del muestreo repetido al resolver problemas de SWE-bench Lite utilizando los precios actuales de la API. Manteniendo constante el marco del agente (Moatless Tools), consideramos hacer un único intento por problema con Claude 3.5 Sonnet y GPT-4o, así como también muestreo repetido usando DeepSeek-Coder-V2-Instruct. Reportamos el costo promedio por problema y la tasa de resolución de problemas con cada enfoque en la Tabla [1]. Si bien el modelo DeepSeek es más débil que los modelos GPT y Claude, también es más de 10 veces más económico. En este caso, el muestreo repetido proporciona una alternativa más barata que pagar una prima por acceder a modelos fuertes, al tiempo que logra una tasa de resolución de problemas superior.
3 Caracterización de los beneficios del muestreo repetido
La relación entre la pérdida de un LLM y su cómputo de entrenamiento ha sido bien caracterizada con leyes de escalado de entrenamiento [27] [36] [28]. Estas leyes se han mantenido empíricamente a lo largo de muchos órdenes de magnitud e inspiran confianza en los desarrolladores de modelos de que las grandes inversiones en entrenamiento valdrán la pena. Inspirados por las leyes de escalado de entrenamiento, aquí buscamos caracterizar mejor la relación entre la cobertura y el presupuesto de muestras (es decir, la cantidad de cómputo de inferencia), presentando dos observaciones interesantes:
1. La relación entre la cobertura y el número de muestras a menudo puede modelarse con una ley de potencia exponenciada.
2. Para una tarea dada, las curvas de cobertura de diferentes modelos de la misma familia se asemejan a curvas S con pendientes similares pero desplazamientos horizontales distintos.
3.1 Leyes de escalado para el muestreo repetido
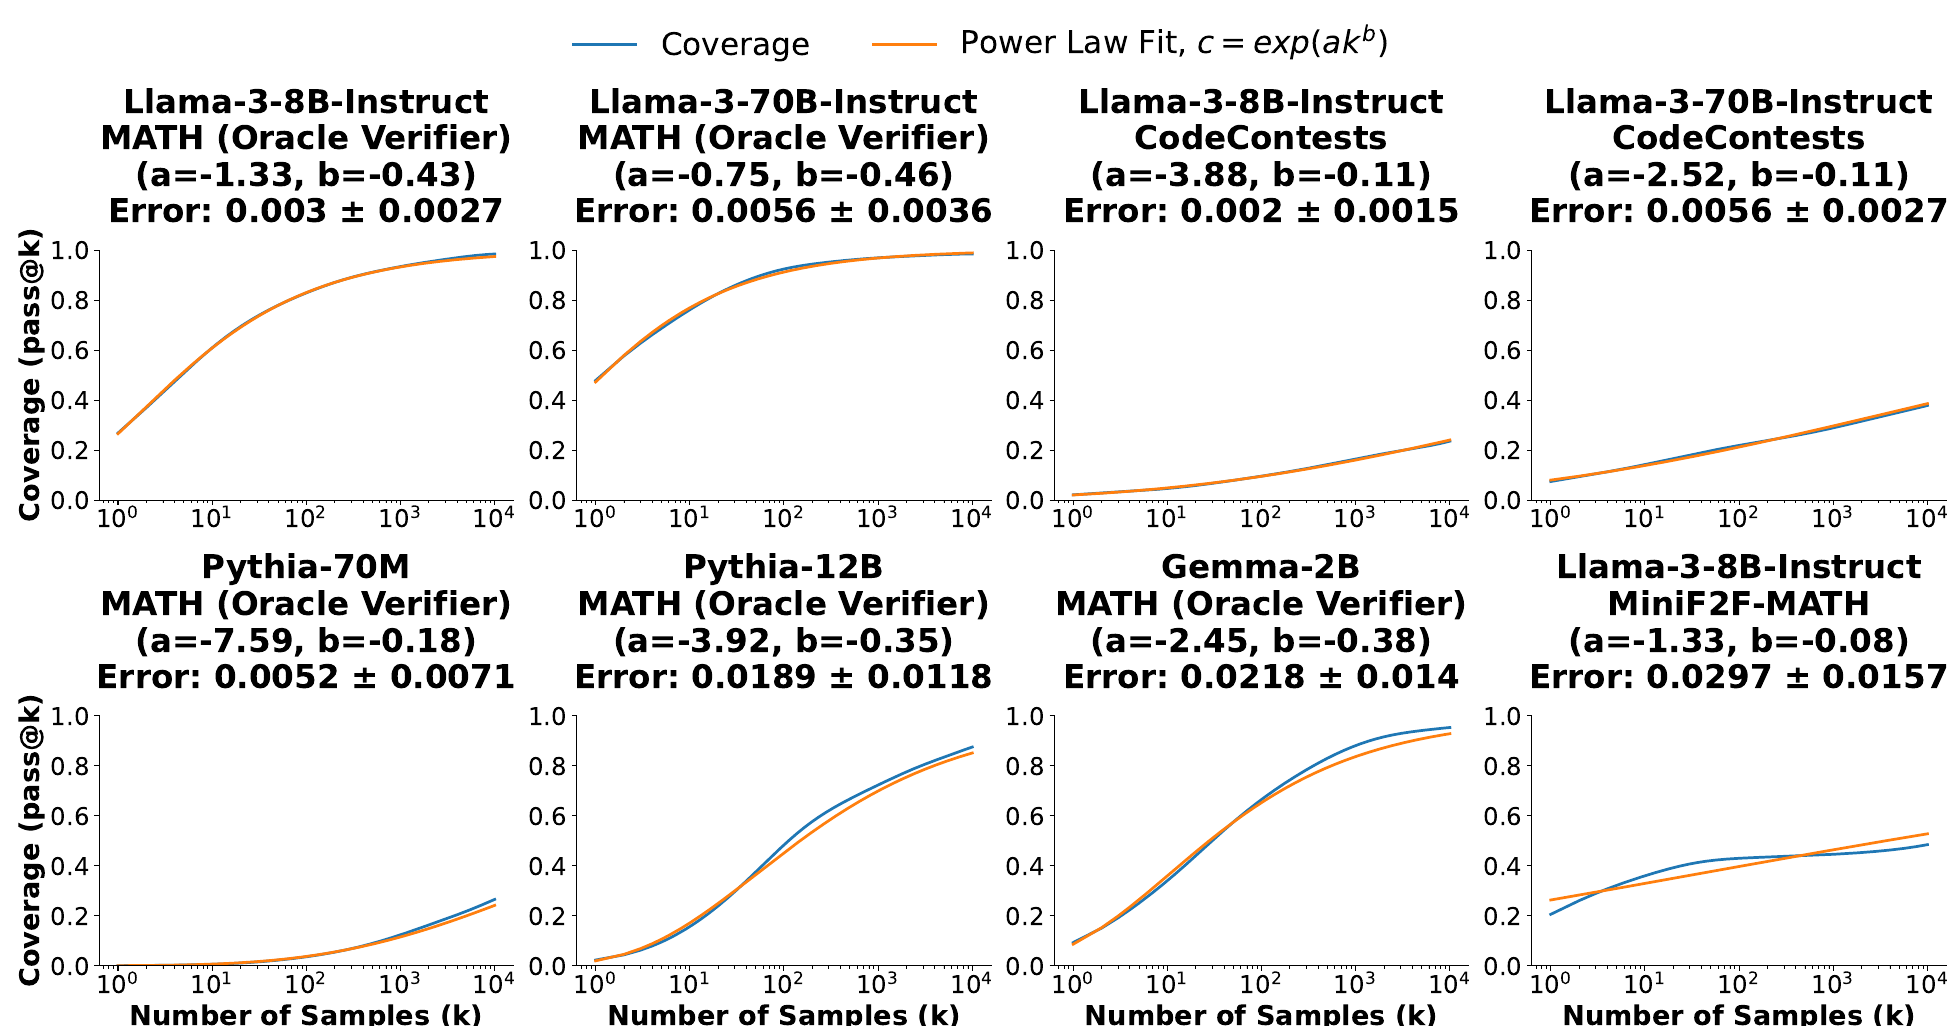
Aquí desarrollamos un modelo explícito para la relación entre la cobertura y el número de muestras. El informe técnico de GPT-4 [46] encuentra que la relación entre la tasa media de log-pass-rate de un modelo en problemas de programación y su cómputo de entrenamiento puede modelarse bien usando una ley de potencia. Comenzamos adoptando la misma clase de función, pero ahora modelando el logaritmo de la cobertura como función del número de muestras :
donde son parámetros ajustados del modelo. Para predecir directamente la cobertura, exponenciamos ambos lados, llegando al modelo final de:
Proporcionamos ejemplos de curvas de cobertura ajustadas en la Figura [5] y curvas adicionales en el Apéndice [C.2]. Si bien estas leyes no son tan exactas como las leyes de escalado de entrenamiento (de manera más llamativa en MiniF2F-MATH), proporcionan evidencia temprana alentadora de que los beneficios del escalado de inferencia pueden caracterizarse.
3.2 Similitudes en las curvas de cobertura entre modelos
De manera interesante, al comparar las curvas de cobertura (con un eje x logarítmico) de diferentes modelos de la misma familia en la misma tarea (véase la Figura [3]), parece que las curvas S trazadas tienen la misma pendiente, pero desplazamientos horizontales únicos. Para investigar esto más a fondo, superponemos las curvas de cobertura de diferentes modelos de la misma familia en la Figura [6]. Hacemos esto eligiendo un valor de cobertura ancla , y desplazando cada curva hacia la izquierda (en espacio logarítmico) de modo que cada una pase por el punto . Esto corresponde a un desplazamiento hacia la izquierda de
-
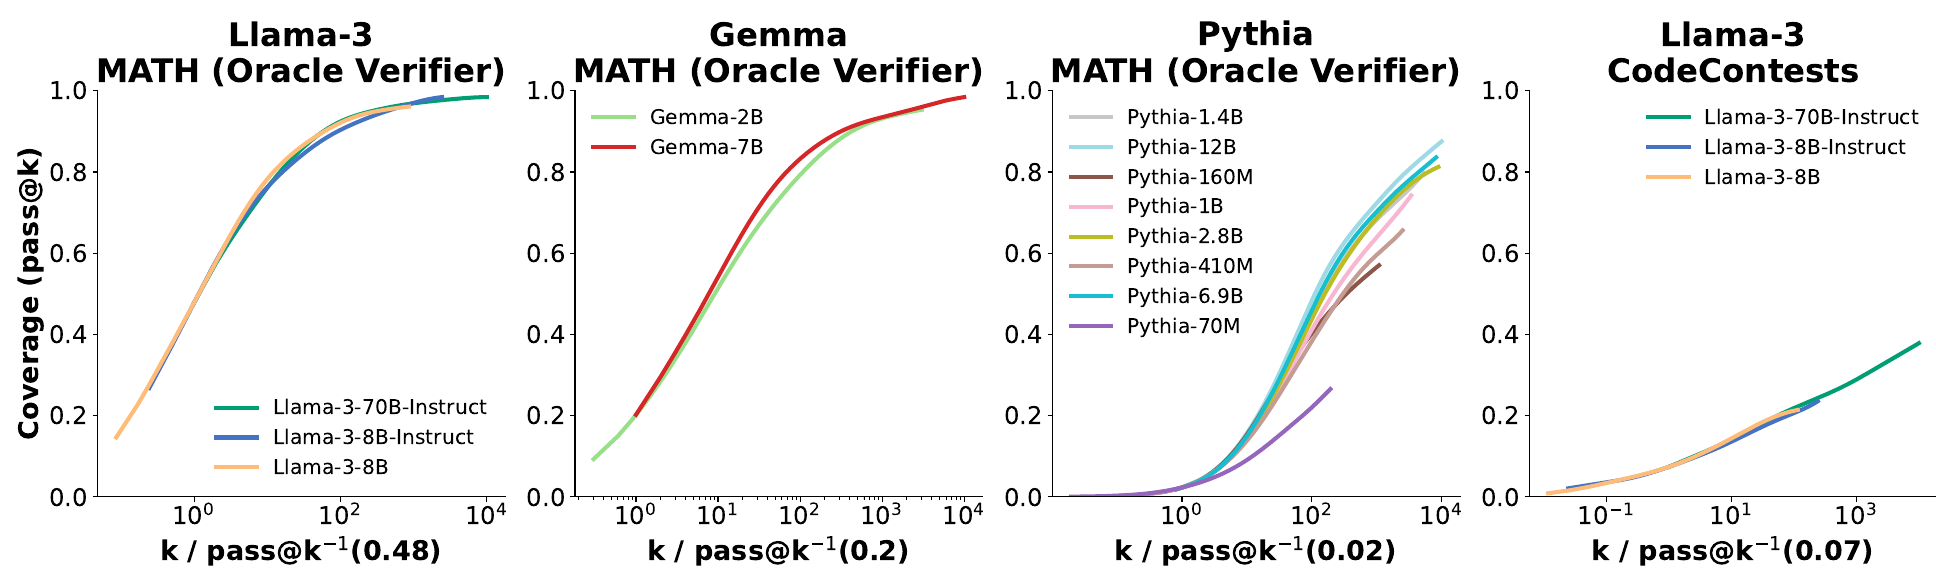
, donde denota el número natural más cercano tal que . Elegimos como la puntuación máxima de pass@1 sobre todos los modelos de la misma familia. Estas similitudes demuestran que, entre modelos de la misma familia, el aumento en el logaritmo del presupuesto de muestras (o, de manera equivalente, el aumento multiplicativo en el presupuesto de muestras) necesario para mejorar la cobertura de a es aproximadamente constante.
4 Aprovechar el muestreo repetido requiere precisión
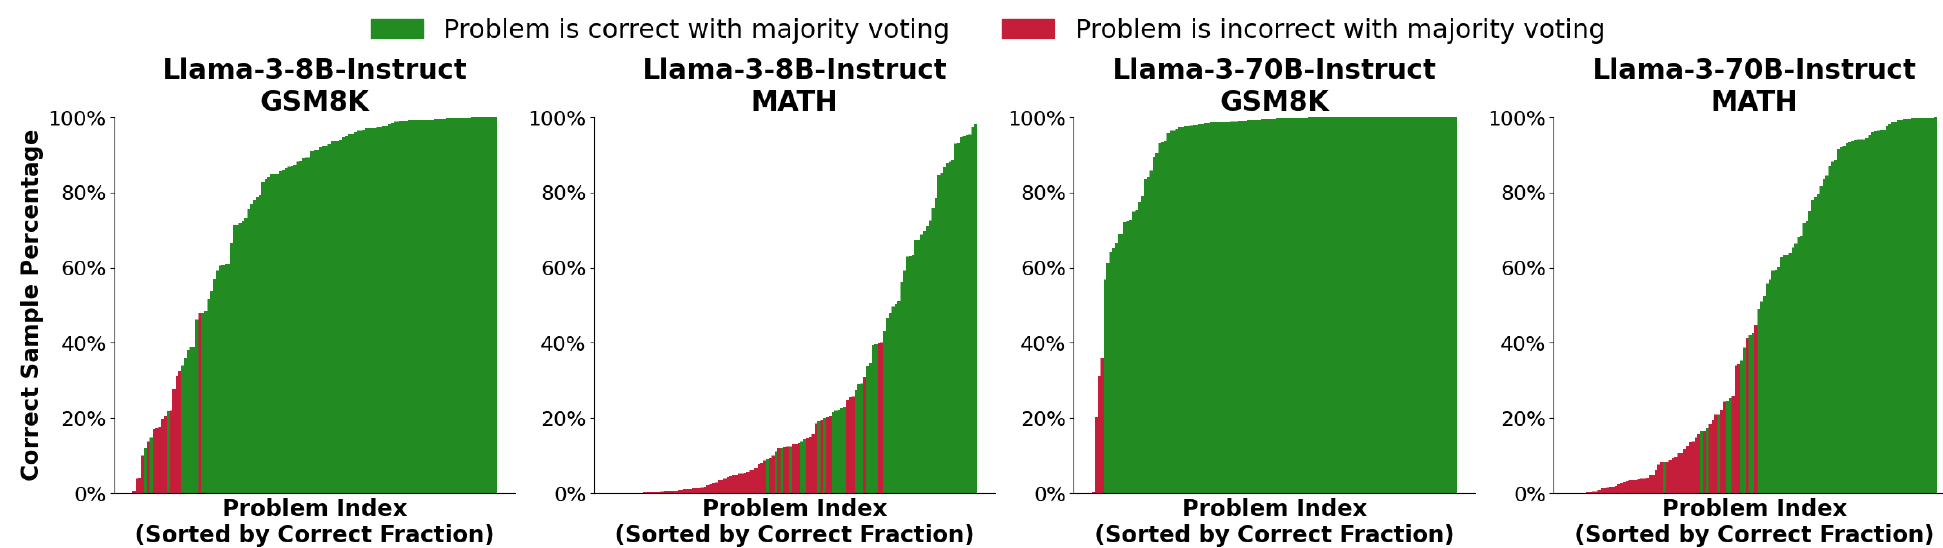
Hasta ahora, nos hemos centrado en medir la cobertura del modelo, caracterizando los beneficios del muestreo repetido en el escenario donde siempre podemos identificar muestras correctas del modelo. Ahora pasamos al problema complementario de la precisión: dada una colección de muestras del modelo, ¿con qué frecuencia podemos identificar las correctas? En particular, nos interesa el rendimiento de los verificadores a medida que aumentamos el número de muestras. Para algunos problemas, las soluciones correctas se muestrean del modelo con probabilidades bajas (p. ej., o menos, véase la Figura 8). A medida que aumenta el número de muestras y se generan soluciones correctas poco frecuentes para más problemas, la cobertura del modelo mejora. Para convertir estas mejoras de cobertura en tasas de éxito más altas, los verificadores deben ser capaces de encontrar la "aguja en el pajar" e identificar muestras correctas poco frecuentes.
4.1 Los métodos de verificación comunes no siempre escalan con el presupuesto de muestras
De las cinco tareas que evaluamos, solo GSM8K y MATH carecen de herramientas para verificar automáticamente las soluciones. Probamos tres enfoques de verificación simples y de uso común en su capacidad para identificar soluciones correctas a partir de estos conjuntos de datos:
1. Voto mayoritario: Elegimos la respuesta final más común [60].
2. Modelo de recompensa + Best-of-N: Usamos un modelo de recompensa [17] para puntuar cada solución y elegimos la respuesta de la muestra con mayor puntuación.
3. Modelo de recompensa + Voto mayoritario: Calculamos un voto mayoritario donde cada muestra se pondera por su puntuación del modelo de recompensa.
Reutilizamos las colecciones de 10,000 muestras que generamos con Llama-3-8B-Instruct y Llama-3-70B-Instruct en la Sección 2. Usamos ArmoRM-Llama3-8B-v0.1 [57] como modelo de recompensa, que obtiene puntuaciones altas en la sección de razonamiento de la tabla de clasificación RewardBench [39]. Reportamos nuestros resultados en la Figura 7 a medida que aumentamos el número de muestras. Si bien las tasas de éxito aumentan inicialmente con el número de muestras para los tres métodos, se estabilizan alrededor de las 100 muestras. Mientras tanto, la cobertura continúa aumentando con el número de muestras y eventualmente supera el 95%. En el caso del voto mayoritario, esta saturación de la tasa de éxito es intuitiva, ya que la aparición de soluciones correctas poco frecuentes no afecta la respuesta más común que elige el voto mayoritario.
Dado el pobre rendimiento de estos verificadores (en particular el modelo de recompensa), es razonable preguntarse qué tan "difícil" es verificar una solución candidata. Con GSM8K y MATH, solo la respuesta final de una muestra se usa para evaluar la corrección, descartándose las cadenas de pensamiento intermedias. Si los modelos generaran solo cadenas de pensamiento sin sentido antes de adivinar una respuesta final correcta, la verificación podría no ser más fácil que resolver el problema en primer lugar. Investigamos esta cuestión evaluando manualmente 105 cadenas de pensamiento de muestras correctas de Llama-3-8B-Instruct para problemas de GSM8K, reportando nuestros resultados en la Tabla 2. Encontramos que más del de las cadenas de pensamiento que calificamos son fieles, incluso entre problemas donde las respuestas correctas se generan con poca frecuencia. Estos pasos de razonamiento correctos indican que hay señal para que un verificador la explote al identificar muestras correctas. De manera interesante, durante este proceso también identificamos un problema de GSM8K que tiene una respuesta de referencia incorrecta (véase el Apéndice E). Este problema incorrecto de GSM8K es también el único para el que Llama-3-70B-Instruct no generó una muestra "correcta" en 10,000 intentos.
| Pass@1 | Problemas | CoT calificado | CoT correcto | CoT incorrecto | Verdad fundamental incorrecta |
| 0-10% | 5 | 15 | 11 | 1 | 1 problema, 3 CoT |
| 10-25% | 10 | 30 | 27 | 3 | 0 problemas |
| 25-75% | 29 | 30 | 28 | 2 | 0 problemas |
| 75-100% | 84 | 30 | 30 | 0 | 0 problemas |
Tabla 2: Evaluación humana de la validez del razonamiento de la cadena de pensamiento en respuestas de Llama-3-8B-Instruct a problemas de GSM8K. Se calificaron 3 cadenas de pensamiento por problema. Incluso para preguntas difíciles, donde el modelo solo acierta de las muestras, las CoT casi siempre siguen pasos lógicos válidos. Para las generaciones del modelo y las etiquetas humanas, véase aquí.
4.2 Verificadores y tareas de software: dos relatos con advertencia
Las tareas de desarrollo de software pueden ocupar un punto intermedio con respecto a las herramientas de verificación disponibles. Por un lado, la capacidad de ejecutar y probar código permite un mayor grado de verificación automática que el posible con tareas de lenguaje no estructurado. Sin embargo, herramientas como las pruebas unitarias adoptan un enfoque de caja negra para verificar un fragmento de código y no son tan exhaustivas como métodos como los verificadores de pruebas. Estas imperfecciones en el proceso de verificación pueden conducir a falsos positivos y/o falsos negativos que es importante considerar al aplicar muestreo repetido. A continuación proporcionamos dos ejemplos de imperfecciones de verificadores de software que
encontramos al generar nuestros resultados de la Sección 2.1
4.2.1 Pruebas inestables en SWE-bench Lite
Al producir nuestros resultados en SWE-bench Lite, identificamos que de los problemas tienen conjuntos de pruebas inestables que no producen resultados consistentes al ejecutarlos sobre una misma solución candidata. Estas pruebas inestables ocasionalmente clasifican incluso las soluciones de referencia del conjunto de datos como incorrectas. Además, los conjuntos de pruebas de algunos problemas pueden ser no deterministas dependiendo de la solución candidata. Por ejemplo, dos problemas de SWE-bench Lite implican la manipulación de conjuntos de Python, que son naturalmente no ordenados. Las soluciones de referencia para estos problemas ordenan explícitamente los elementos del conjunto y pasan los conjuntos de pruebas de manera fiable. Sin embargo, algunas soluciones candidatas generadas por el modelo no imponen tal ordenamiento y, por lo tanto, pasan las pruebas en algunas ejecuciones "afortunadas" y no en otras. En el Apéndice B enumeramos todos los ID de problemas en los que identificamos pruebas inestables. También reportamos nuestros resultados de SWE-bench Lite de la Figura 2 con los problemas problemáticos eliminados, encontrando resultados similares a nuestras evaluaciones sobre el conjunto de datos completo.
4.2.2 Falsos negativos en CodeContests
Cada problema del conjunto de datos CodeContests viene con un conjunto de casos de prueba de entrada-salida utilizados para evaluar la corrección de las soluciones. Estos casos de prueba son más exhaustivos que los de benchmarks de programación anteriores como APPS [25], lo que reduce la frecuencia de soluciones falsas positivas que pasan todos los casos de prueba pero no resuelven completamente el problema descrito. Sin embargo, la construcción de los conjuntos de pruebas de CodeContests conduce a soluciones falsas negativas que son correctas pero fallan las pruebas.
Para algunos problemas de CodeContests, la descripción del problema permite múltiples salidas correctas distintas para una entrada de prueba dada. Sin embargo, los casos de prueba correspondientes no manejan estos escenarios, sino que requieren que se emita una salida correcta particular. Además, muchos casos de prueba de CodeContests han sido generados programáticamente mediante la mutación de casos de prueba originales del problema. Algunas entradas mutadas violan las especificaciones de entrada del problema (por ejemplo, una entrada mutada es cero cuando la descripción promete un entero positivo). Estos casos de prueba malformados pueden llevar a un comportamiento inconsistente entre diferentes soluciones correctas.
Evaluamos la prevalencia de estos problemas ejecutando el conjunto de pruebas de cada problema sobre la lista de soluciones correctas que proporciona CodeContests. De los 122 problemas en el conjunto de prueba que tienen soluciones en Python3, encontramos que 35 problemas tienen soluciones "correctas" que fallan las pruebas correspondientes. Dado que no permitimos que los modelos vean todos los casos de prueba de un problema (y sus peculiaridades), aplicar muestreo repetido a estos problemas contiene un elemento de "lanzar los dados" para generar una solución que no solo sea correcta, sino que emita las salidas particulares que pasan las pruebas.
5 Discusión y limitaciones
En este trabajo, exploramos el muestreo repetido como un eje para escalar el cómputo en el momento de la inferencia con el fin de mejorar el rendimiento del modelo. A través de una variedad de modelos y tareas, el muestreo repetido puede mejorar significativamente la fracción de problemas resueltos usando cualquier muestra generada (es decir, la cobertura). Cuando se pueden identificar soluciones correctas (ya sea con herramientas de verificación automática u otros algoritmos de verificación), el muestreo repetido puede amplificar las capacidades del modelo durante la inferencia. Esta amplificación puede hacer que la combinación de un modelo más débil y muchas muestras sea más eficaz y rentable que usar menos intentos de un modelo más fuerte y más costoso.
Mejorar el muestreo repetido: En nuestros experimentos, exploramos solo una versión simple del muestreo repetido en la que todos los intentos de un problema se generan independientemente unos de otros usando exactamente el mismo prompt y los mismos hiperparámetros. Creemos que esta configuración puede refinarse para mejorar el rendimiento, particularmente en las siguientes direcciones:
1. Diversidad de soluciones: Actualmente dependemos de una temperatura de muestreo positiva como único mecanismo para crear diversidad entre las muestras. Combinar este muestreo a nivel de token con otros enfoques de nivel superior podría aumentar aún más la diversidad. Por ejemplo, AlphaCode condiciona diferentes muestras con diferentes etiquetas de metadatos.
2. Interacciones multiturno: A pesar de que las herramientas de verificación automática están disponibles al resolver problemas de Code-Contests y MiniF2F, utilizamos únicamente una configuración de un solo turno en la que los modelos generan una solución sin ninguna capacidad de iterar sobre ella. Proporcionar a los modelos retroalimentación de ejecución de estas herramientas debería mejorar la calidad de las soluciones. Nos interesan las compensaciones asociadas con las interacciones multiturno, ya que cada intento se vuelve más costoso, pero también puede tener más probabilidades de éxito.
3. Aprender de intentos previos: Actualmente, nuestros experimentos aíslan completamente los intentos entre sí. El acceso a muestras existentes, particularmente si las herramientas de verificación pueden proporcionar retroalimentación sobre ellas, podría ser útil al generar intentos futuros.
Muestreo repetido y sistemas de inferencia: El muestreo repetido es una carga de trabajo de inferencia de LLM distinta de servir solicitudes de chatbots. Los despliegues de chatbots en producción hacen énfasis en bajas latencias de respuesta, y adherirse a los objetivos de latencia puede forzar un menor tamaño de lote por dispositivo y reducir la utilización del hardware. En contraste, al muestrear muchas completaciones para un único prompt, se puede poner un mayor énfasis en el rendimiento global y en maximizar la utilización del hardware. Además, el muestreo repetido puede beneficiarse de optimizaciones de atención especializadas que explotan los solapamientos en los prompts entre secuencias [34] [6] [66]. Por lo tanto, la inferencia con muestreo repetido puede lograrse a un costo menor que hacer ingenuamente muchas solicitudes paralelas a una API orientada a chatbots. Estos ahorros de costos pueden motivar aún más la elección de muestrear muchas veces de un modelo más barato en lugar de menos veces de uno más caro.
Verificadores: Nuestros resultados de la Sección 4 resaltan la importancia de mejorar los métodos de verificación de muestras cuando las herramientas para hacerlo automáticamente no están disponibles. Dotar a los modelos de la capacidad de evaluar sus propias salidas permitirá escalar el muestreo repetido a muchas más tareas. De particular interés es aplicar el muestreo repetido a tareas no estructuradas como la escritura creativa, que puede requerir una comparación más subjetiva entre diferentes muestras que las tareas de aprobado/reprobado que consideramos. Una dirección alternativa al desarrollo de verificadores basados en modelos es diseñar convertidores que puedan hacer verificable una tarea no estructurada, por ejemplo, formalizando un enunciado matemático informal en un lenguaje como Lean para que se puedan aplicar verificadores de pruebas.
6 Trabajo relacionado
Escalado del cómputo de inferencia: Los métodos que realizan cómputo adicional durante la inferencia han tenido éxito en muchas áreas del aprendizaje profundo. En una variedad de entornos de juegos, los métodos de vanguardia aprovechan la búsqueda en tiempo de inferencia para examinar muchos estados futuros posibles del juego antes de decidir un movimiento [12] [50] [10]. Los métodos similares basados en árboles también pueden ser efectivos en combinación con los LLM, permitiendo a los modelos planificar mejor y explorar diferentes enfoques [63, 8, 53, 54]. Otro eje para aumentar el cómputo de inferencia de los LLM permite a los modelos gastar tokens deliberando sobre un problema antes de llegar a una solución [62, 61, 64]. Además, se pueden ensamblar múltiples modelos juntos en tiempo de inferencia para combinar sus fortalezas [58, 14, 45, 56, 31]. Aún otro enfoque implica usar LLM para criticar y refinar sus propias respuestas [43, 7].
Muestreo repetido: Trabajos previos han demostrado que el muestreo repetido puede mejorar las capacidades de los LLM en múltiples dominios. Uno de los casos de uso más efectivos es la programación [48, 15, 38], donde el rendimiento continúa escalando hasta un millón de muestras y las herramientas de verificación (por ejemplo, pruebas unitarias) a menudo están disponibles para puntuar automáticamente cada solución candidata. Recientemente, Greenblatt [23] muestra que el muestreo repetido es efectivo al resolver acertijos del desafío ARC [16], observando un escalado log-lineal a medida que aumenta el número de muestras. En esa aplicación, el muestreo repetido combinado con la clasificación best-of-N con un modelo de recompensa puede superar al muestreo voraz de una única respuesta [30]. En dominios sin herramientas de verificación automática, el trabajo existente muestra que usar votación por mayoría [60], solicitar a un LLM [19], o entrenar un verificador basado en modelo [18, 42, 29, 59, 35], para decidir una respuesta final puede mejorar el rendimiento en tareas de razonamiento en relación con tomar una única muestra. Nguyen et al. [44] halla que realizar votación por mayoría sobre respuestas que exceden una longitud umbral puede superar a la votación sobre todas las respuestas. Concurrente con nuestro trabajo, Song et al. [51] halla que usar la mejor muestra disponible mejora el rendimiento de los LLM en tareas de chat, matemáticas y código, abarcando hasta un máximo de 128 muestras. Además, Hassid et al. [24] halla que al resolver tareas de programación, puede ser más efectivo extraer más muestras de un modelo más pequeño que extraer menos muestras de uno más grande.
Leyes de escalado: Caracterizar cómo el escalado afecta el rendimiento de los modelos puede conducir a decisiones más informadas sobre cómo asignar recursos. Las leyes de escalado para el entrenamiento de LLM encuentran una relación de ley de potencia entre la pérdida y la cantidad de cómputo de entrenamiento y proporcionan estimaciones para el tamaño óptimo del modelo y del conjunto de datos dado un presupuesto de cómputo fijo [27, 36, 28]. Jones [33] encuentra leyes de escalado en el contexto del juego de mesa Hex, observando que el rendimiento escala de manera predecible con el tamaño del modelo y la dificultad del problema. Curiosamente, también muestran que el rendimiento escala con la cantidad de cómputo en tiempo de prueba gastado mientras se realiza la búsqueda en árbol. Recientemente, Shao et al. [49] observan leyes de escalado al aumentar los LLM con conjuntos de datos de recuperación externos, hallando que el rendimiento en tareas de recuperación escala suavemente con el tamaño del corpus de recuperación.
7 Agradecimientos
Agradecemos a Together AI por patrocinar parcialmente el cómputo para este proyecto, así como a Rahul Chalamala y Ben Athiwaratkun por su ayuda gestionando esta infraestructura. Agradecemos a John Yang por su consejo y apoyo al ejecutar nuestros experimentos de SWE-bench. Finalmente, estamos agradecidos con Mayee Chen, Neel Guha, Quinn McIntyre, Jon Saad-Falcon y Benjamin Spector por sus útiles discusiones y retroalimentación a lo largo de este proyecto.
Agradecemos con gratitud el apoyo de NIH bajo el No. U54EB020405 (Mobilize), NSF bajo los Nos. CCF2247015 (Hardware-Aware), CCF1763315 (Beyond Sparsity), CCF1563078 (Volume to Velocity) y 1937301 (RTML); US DEVCOM ARL bajo los Nos. W911NF-23-2-0184 (Long-context) y W911NF-21-2-0251 (Interactive Human-AI Teaming); ONR bajo el No. N000142312633 (Deep Signal Processing); Stanford HAI bajo el No. 247183; NXP, Xilinx, LETI-CEA, Intel, IBM, Microsoft, NEC, Toshiba, TSMC, ARM, Hitachi, BASF, Accenture, Ericsson, Qualcomm, Analog Devices, Google Cloud, Salesforce, Total, el programa HAI-GCP Cloud Credits for Research, la Stanford Data Science Initiative (SDSI), y miembros del proyecto Stanford DAWN: Meta, Google y VMWare. El Gobierno de los Estados Unidos está autorizado a reproducir y distribuir reimpresiones para propósitos gubernamentales independientemente de cualquier notación de derechos de autor al respecto. Cualquier opinión, hallazgo y conclusión o recomendación expresada en este material son las de los autores y no necesariamente reflejan las opiniones, políticas o respaldos, ya sean expresados o implícitos, de NIH, ONR o el Gobierno de los Estados Unidos.
Este trabajo se completó con el apoyo de las Becas del Clarendon Fund.
Referencias
[1] Aide.dev, 2024. URL https://aide.dev/
[2] Hello gpt-4o, 2024. URL https://openai.com/index/hello-gpt-4o/
[3] Meta llama 3, 2024. URL https://llama.meta.com/llama3/
[4] Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[5] Voyage ai, 2024. URL https://www.voyageai.com/
[6] Ben Athiwaratkun, Sujan Kumar Gonugondla, Sanjay Krishna Gouda, Haifeng Qian, Hantian Ding, Qing Sun, Jun Wang, Jiacheng Guo, Liangfu Chen, Parminder Bhatia, Ramesh Nallapati, Sudipta Sengupta, and Bing Xiang. Bifurcated attention: Accelerating massively parallel decoding with shared prefixes in llms, 2024. URL https://arxiv.org/abs/2403.08845
[7] Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, Andy Jones, Anna Chen, Anna Goldie, Azalia Mirhoseini, Cameron McKinnon, Carol Chen, Catherine Olsson, Christopher Olah, Danny Hernandez, Dawn Drain, Deep Ganguli, Dustin Li, Eli Tran-Johnson, Ethan Perez, Jamie Kerr, Jared Mueller, Jeffrey Ladish, Joshua Landau, Kamal Ndousse, Kamile Lukosuite, Liane Lovitt, Michael Sellitto, Nelson Elhage, Nicholas Schiefer, Noemi Mercado, Nova DasSarma, Robert Lasenby, Robin Larson, Sam Ringer, Scott Johnston, Shauna Kravec, Sheer El Showk, Stanislav Fort, Tamera Lanham, Timothy Telleen-Lawton, Tom Conerly, Tom Henighan, Tristan Hume, Samuel R. Bowman, Zac Hatfield-Dodds, Ben Mann, Dario Amodei, Nicholas Joseph, Sam McCandlish, Tom Brown, and Jared Kaplan. Constitutional ai: Harmlessness from ai feedback, 2022.
[8] Maciej Besta, Nils Blach, Ales Kubicek, Robert Gerstenberger, Michal Podstawski, Lukas Gianinazzi, Joanna Gajda, Tomasz Lehmann, Hubert Niewiadomski, Piotr Nyczyk, and Torsten Hoefler. Graph of thoughts: Solving elaborate problems with large language models. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16):17682-17690, March 2024. ISSN 2159-5399. doi: 10.1609/aaai.v38i16.29720. URL http://dx.doi.org/10.1609/aaai.v38i16.29720
[9] Stella Biderman, Hailey Schoelkopf, Quentin Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, Aviya Skowron, Lintang Sutawika y Oskar van der Wal. Pythia: A suite for analyzing large language models across training and scaling, 2023. URL https://arxiv.org/abs/2304.01373
[10] Noam Brown, Anton Bakhtin, Adam Lerer y Qucheng Gong. Combining deep reinforcement learning and search for imperfect-information games. En Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS '20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
[11] Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert-Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever y Dario Amodei. Language models are few-shot learners, 2020. URL https://arxiv.org/abs/2005.14165
[12] Murray Campbell, A. Joseph Hoane y Feng-hsiung Hsu. Deep blue. Artif. Intell., 134(1-2):57-83, ene 2002. ISSN 0004-3702. doi: 10.1016/S0004-3702(01)00129-1. URL https://doi.org/10.1016/S0004-3702(01)00129-1
[13] Guoxin Chen, Minpeng Liao, Chengxi Li y Kai Fan. Alphamath almost zero: process supervision without process, 2024.
[14] Lingjiao Chen, Jared Quincy Davis, Boris Hanin, Peter Bailis, Ion Stoica, Matei Zaharia y James Zou. Are more llm calls all you need? towards scaling laws of compound inference systems, 2024. URL https://arxiv.org/abs/2403.02419
[15] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, Alex Ray, Raul Puri, Gretchen Krueger, Michael Petrov, Heidy Khlaaf, Girish Sastry, Pamela Mishkin, Brooke Chan, Scott Gray, Nick Ryder, Mikhail Pavlov, Alethea Power, Lukasz Kaiser, Mohammad Bavarian, Clemens Winter, Philippe Tillet, Felipe Petroski Such, Dave Cummings, Matthias Plappert, Fotios Chantzis, Elizabeth Barnes, Ariel Herbert-Voss, William Hebgen Guss, Alex Nichol, Alex Paino, Nikolas Tezak, Jie Tang, Igor Babuschkin, Suchir Balaji, Shantanu Jain, William Saunders, Christopher Hesse, Andrew N. Carr, Jan Leike, Josh Achiam, Vedant Misra, Evan Morikawa, Alec Radford, Matthew Knight, Miles Brundage, Mira Murati, Katie Mayer, Peter Welinder, Bob McGrew, Dario Amodei, Sam McCandlish, Ilya Sutskever y Wojciech Zaremba. Evaluating large language models trained on code, 2021. URL https://arxiv.org/abs/2107.03374
[16] François Chollet. On the measure of intelligence, 2019. URL https://arxiv.org/abs/1911.01547
[17] Paul Christiano, Jan Leike, Tom B. Brown, Miljan Martic, Shane Legg y Dario Amodei. Deep reinforcement learning from human preferences, 2017. URL https://arxiv.org/abs/1706.03741
[18] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse y John Schulman. Training verifiers to solve math word problems, 2021.
[19] Jared Quincy Davis, Boris Hanin, Lingjiao Chen, Peter Bailis, Ion Stoica y Matei Zaharia. Networks of networks: Complexity class principles applied to compound ai systems design, 2024. URL https://arxiv.org/abs/2407.16831
[20] DeepSeek-AI et al. Deepseek-v2: A strong, economical, and efficient mixture-of-experts language model, 2024. URL https://arxiv.org/abs/2405.04434
[21] Mostafa Dehghani, Anurag Arnab, Lucas Beyer, Ashish Vaswani y Yi Tay. The efficiency misnomer, 2022. URL https://arxiv.org/abs/2110.12894
[22] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang y Andy Zou. A framework for few-shot language model evaluation, 12 2023. URL https://zenodo.org/records/10256836
[23] Ryan Greenblatt. Getting 50 https://www.lesswrong.com/posts/Rdwui3wHxCeKb7feK/ getting-50-sota-on-arc-agi-with-gpt-40 2024.
[24] Michael Hassid, Tal Remez, Jonas Gehring, Roy Schwartz y Yossi Adi. The larger the better? improved llm code-generation via budget reallocation, 2024. URL https://arxiv.org/abs/2404.00725
[25] Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song y Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
[26] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song y Jacob Steinhardt. Measuring mathematical problem solving with the math dataset, 2021.
[27] Joel Hestness, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang y Yanqi Zhou. Deep learning scaling is predictable, empirically, 2017. URL https://arxiv.org/abs/1712.00409
[28] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, Tom Hennigan, Eric Noland, Katie Millican, George van den Driessche, Bogdan Damoc, Aurelia Guy, Simon Osindero, Karen Simonyan, Erich Elsen, Jack W. Rae, Oriol Vinyals y Laurent Sifre. Training compute-optimal large language models, 2022. URL https://arxiv.org/abs/2203.15556
[29] Arian Hosseini, Xingdi Yuan, Nikolay Malkin, Aaron Courville, Alessandro Sordoni y Rishabh Agarwal. V-star: Training verifiers for self-taught reasoners, 2024.
[30] Robert Irvine, Douglas Boubert, Vyas Raina, Adian Liusie, Ziyi Zhu, Vineet Mudupalli, Aliaksei Korshuk, Zongyi Liu, Fritz Cremer, Valentin Assassi, Christie-Carol Beauchamp, Xiaoding Lu, Thomas Rialan y William Beauchamp. Rewarding chatbots for real-world engagement with millions of users, 2023. URL https://arxiv.org/abs/2303.06135
[31] Dongfu Jiang, Xiang Ren y Bill Yuchen Lin. Llm-blender: Ensembling large language models with pairwise ranking and generative fusion, 2023. URL https://arxiv.org/abs/2306.02561
[32] Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press y Karthik Narasimhan. Swe-bench: Can language models resolve real-world github issues?, 2024. URL https://arxiv.org/abs/2310.06770
[33] Andy L. Jones. Scaling scaling laws with board games, 2021. URL https://arxiv.org/abs/2104.03113
[34] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré y Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[35] Jikun Kang, Xin Zhe Li, Xi Chen, Amirreza Kazemi, Qianyi Sun, Boxing Chen, Dong Li, Xu He, Quan He, Feng Wen, Jianye Hao y Jun Yao. Mindstar: Enhancing math reasoning in pre-trained llms at inference time, 2024. URL https://arxiv.org/abs/2405.16265
[36] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu y Dario Amodei. Scaling laws for neural language models, 2020.
[37] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu y Dario Amodei. Scaling laws for neural language models, 2020. URL https://arxiv.org/abs/2001.08361
[38] Sumith Kulal, Panupong Pasupat, Kartik Chandra, Mina Lee, Oded Padon, Alex Aiken y Percy Liang. Spoc: Search-based pseudocode to code, 2019. URL https://arxiv.org/abs/1906.04908
[39] Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, Noah A. Smith y Hannaneh Hajishirzi. Reward-bench: Evaluating reward models for language modeling, 2024. URL https://arxiv.org/abs/2403.13787
[40] Aitor Lewkowycz, Anders Andreassen, David Dohan, Ethan Dyer, Henryk Michalewski, Vinay Ramasesh, Ambrose Slone, Cem Anil, Imanol Schlag, Theo Gutman-Solo, Yuhuai Wu, Behnam Neyshabur, Guy Gur-Ari y Vedant Misra. Solving quantitative reasoning problems with language models, 2022. URL https://arxiv.org/abs/2206.14858
[41] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, Thomas Hubert, Peter Choy, Cyprien de Masson d'Autume, Igor Babuschkin, Xinyun Chen, Po-Sen Huang, Johannes Welbl, Sven Gowal, Alexey Cherepanov, James Molloy, Daniel J. Mankowitz, Esme Sutherland Robson, Pushmeet Kohli, Nando de Freitas, Koray Kavukcuoglu y Oriol Vinyals. Competition-level code generation with alphacode. Science, 378(6624):1092-1097, diciembre de 2022. ISSN 1095-9203. doi: 10.1126/science.abq1158. URL http://dx.doi.org/10.1126/science.abq1158
[42] Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever y Karl Cobbe. Vamos a verificar paso a paso, 2023.
[43] Aman Madaan, Niket Tandon, Prakhar Gupta, Skyler Hallinan, Luyu Gao, Sarah Wiegreffe, Uri Alon, Nouha Dziri, Shrimai Prabhumoye, Yiming Yang, Shashank Gupta, Bodhisattwa Prasad Majumder, Katherine Hermann, Sean Welleck, Amir Yazdanbakhsh y Peter Clark. Self-refine: Refinamiento iterativo con autoretroalimentación, 2023. URL https://arxiv.org/abs/2303.17651
[44] Alex Nguyen, Dheeraj Mekala, Chengyu Dong y Jingbo Shang. ¿Cuándo es probable que la predicción consistente sea una predicción correcta?, 2024. URL https://arxiv.org/abs/2407.05778
[45] Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E. Gonzalez, M Waleed Kadous e Ion Stoica. Routellm: Aprendiendo a enrutar LLM con datos de preferencia, 2024. URL https://arxiv.org/abs/2406.18665
[46] OpenAI et al. Informe técnico de GPT-4, 2024. URL https://arxiv.org/abs/2303.08774
[47] Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei e Ilya Sutskever. Los modelos de lenguaje son aprendices multitarea no supervisados. 2019.
[48] Baptiste Roziere, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat, Xiaoqing Ellen Tan, Yossi Adi, Jingyu Liu, Romain Sauvestre, Tal Remez, Jérémy Rapin, Artyom Kozhevnikov, Ivan Evtimov, Joanna Bitton, Manish Bhatt, Cristian Canton Ferrer, Aaron Grattafiori, Wenhan Xiong, Alexandre Défossez, Jade Copet, Faisal Azhar, Hugo Touvron, Louis Martin, Nicolas Usunier, Thomas Scialom y Gabriel Synnaeve. Code llama: Modelos fundacionales abiertos para código, 2023. URL https://arxiv.org/abs/2308.12950
[49] Rulin Shao, Jacqueline He, Akari Asai, Weijia Shi, Tim Dettmers, Sewon Min, Luke Zettlemoyer y Pang Wei Koh. Escalando modelos de lenguaje basados en recuperación con un almacén de datos de un billón de tokens, 2024. URL https://arxiv.org/abs/2407.12854
[50] David Silver, Thomas Hubert, Julian Schrittwieser, Ioannis Antonoglou, Matthew Lai, Arthur Guez, Marc Lanctot, Laurent Sifre, Dharshan Kumaran, Thore Graepel, Timothy Lillicrap, Karen Simonyan y Demis Hassabis. Dominando el ajedrez y el shogi mediante autojuego con un algoritmo general de aprendizaje por refuerzo, 2017.
[51] Yifan Song, Guoyin Wang, Sujian Li y Bill Yuchen Lin. Lo bueno, lo malo y lo codicioso: La evaluación de los LLM no debería ignorar la no determinación, 2024. URL https://arxiv.org/abs/2407.10457
[52] Gemma Team et al. Gemma: Modelos abiertos basados en la investigación y tecnología de Gemini, 2024. URL https://arxiv.org/abs/2403.08295
[53] Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi y Dong Yu. Hacia la automejora de los LLM mediante imaginación, búsqueda y crítica, 2024. URL https://arxiv.org/abs/2404.12253
[54] Trieu H. Trinh, Yuhuai Wu, Quoc V. Le, He He y Thang Luong. Resolviendo geometría de olimpiada sin demostraciones humanas. Nature, 625(7995):476-482, 2024. ISSN 1476-4687. doi: 10.1038/s41586-023-06747-5. URL https://doi.org/10.1038/s41586-023-06747-5
[55] Pauli Virtanen, Ralf Gommers, Travis E. Oliphant, Matt Haberland, Tyler Reddy, David Cournapeau, Evgeni Burovski, Pearu Peterson, Warren Weckesser, Jonathan Bright, Stéfan J. van der Walt, Matthew Brett, Joshua Wilson, K. Jarrod Millman, Nikolay Mayorov, Andrew R. J. Nelson, Eric Jones, Robert Kern, Eric Larson, C J Carey, Ilhan Polat, Yu Feng, Eric W. Moore, Jake VanderPlas, Denis Laxalde, Josef Perktold, Robert Cimrman, Ian Henriksen, E. A. Quintero, Charles R. Harris, Anne M. Archibald, António H. Ribeiro, Fabian Pedregosa, Paul van Mulbregt y SciPy 1.0 Contributors. SciPy 1.0: Algoritmos fundamentales para la computación científica en Python. Nature Methods, 17:261-272, 2020. doi: 10.1038/s41592-019-0686-2.
[56] Fanqi Wan, Xinting Huang, Deng Cai, Xiaojun Quan, Wei Bi y Shuming Shi. Fusión de conocimiento de modelos de lenguaje grandes, 2024. URL https://arxiv.org/abs/2401.10491
[57] Haoxiang Wang, Wei Xiong, Tengyang Xie, Han Zhao y Tong Zhang. Preferencias interpretables mediante modelado de recompensas multiobjetivo y mezcla de expertos, 2024. URL https://arxiv.org/abs/2406.12845
[58] Junlin Wang, Jue Wang, Ben Athiwaratkun, Ce Zhang y James Zou. La mezcla de agentes mejora las capacidades de los modelos de lenguaje grandes, 2024. URL https://arxiv.org/abs/2406.04692
[59] Peiyi Wang, Lei Li, Zhihong Shao, R. X. Xu, Damai Dai, Yifei Li, Deli Chen, Y. Wu y Zhifang Sui. Math-shepherd: Verificar y reforzar los LLM paso a paso sin anotaciones humanas, 2024. URL https://arxiv.org/abs/2312.08935
[60] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi, Sharan Narang, Aakanksha Chowdhery y Denny Zhou. La autocoherencia mejora el razonamiento de cadena de pensamiento en modelos de lenguaje, 2023.
[61] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed Chi, Quoc Le y Denny Zhou. El prompting de cadena de pensamiento elicita razonamiento en modelos de lenguaje grandes, 2023.
[62] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan y Yuan Cao. React: Sinergizando razonamiento y actuación en modelos de lenguaje, 2022. URL https://arxiv.org/abs/2210.03629
[63] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao y Karthik Narasimhan. Árbol de pensamientos: Resolución deliberada de problemas con modelos de lenguaje grandes, 2023. URL https://arxiv.org/abs/2305.10601
[64] Eric Zelikman, Georges Harik, Yijia Shao, Varuna Jayasiri, Nick Haber y Noah D. Goodman. Quiet-star: Los modelos de lenguaje pueden enseñarse a sí mismos a pensar antes de hablar, 2024. URL https://arxiv.org/abs/2403.09629
[65] Kunhao Zheng, Jesse Michael Han y Stanislas Polu. Minif2f: un benchmark entre sistemas para matemáticas formales de nivel de olimpiada. arXiv preprint arXiv:2109.00110, 2021.
[66] Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Chuyue Sun, Jeff Huang, Cody Hao Yu, Shiyi Cao, Christos Kozyrakis, Ion Stoica, Joseph E. Gonzalez, Clark Barrett y Ying Sheng. Sglang: Ejecución eficiente de programas de modelos de lenguaje estructurados, 2024. URL https://arxiv.org/abs/2312.07104
[67] Albert Orwall. Herramientas moatless. https://github.com/aorwall/moatless-tools/tree/a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6, 2024.
A Configuración experimental de muestreo
Reportamos resultados sobre las 130 preguntas en el conjunto de prueba del conjunto de datos lean4 MiniF2F que corresponden a problemas de MATH formalizados. Este conjunto de datos se deriva de la versión corregida del conjunto de datos original MiniF2F creado por Zheng et al. [65]. Muestreamos con una temperatura de 0.5 y no utilizamos muestreo de núcleo. Generamos 10,000 muestras por problema. Utilizamos demostraciones de los siguientes 5 teoremas del conjunto de validación como ejemplos de pocos disparos:
mathd_algebra_116 amc12_2000_p5 mathd_algebra_132 mathd_algebra_11 mathd_numbertheory_84
Nuestro prompt consiste en:
1. Ejemplos de pocas tomas (few shot).
2. Importaciones de encabezado presentes en cada problema del dataset cat-searcher/minif2f-lean4 de HuggingFace, una carga del dataset lean4 MiniF2F.
3. La definición del teorema. Para evitar filtrar información sobre cómo resolver el teorema a partir de su nombre, reemplazamos el nombre del teorema con theorem_i. para los ejemplos de pocas tomas e para el problema actual.
Establecemos 200 como la longitud máxima de tokens para la solución generada. Para calificar las soluciones, usamos la biblioteca lean-dojo 1.1.2 con la versión de lean 4.3.0- rc2. Establecemos un tiempo de espera de 10 segundos para cada paso de táctica.
Ejemplo de pocas tomas
Escribe una prueba en lean4 para el enunciado formal proporcionado. Tienes acceso a la biblioteca estándar mathlib4.
import Mathlib.Algebra.BigOperators.Basic
import Mathlib.Data.Real.Basic
import Mathlib.Data.Complex.Basic
import Mathlib.Data.Nat.Log
import Mathlib.Data.Complex.Exponential
import Mathlib.NumberTheory.Divisors
import Mathlib.Data.ZMod.Defs
import Mathlib.Data.ZMod.Basic
import Mathlib.Topology.Basic
import Mathlib.Data.Nat.Digits
open BigOperators
open Real
open Nat
open Topology
theorem theorem1
Int.floor ((9: ) / 160 \* 100) = 5 :=
by (
rw [Int.floor_eq_iff]
constructor
all.goals norm_num
)
Ejemplo de instrucción
Escribe una prueba en lean4 para el enunciado formal proporcionado. Tienes acceso a la biblioteca estándar mathlib4.
\\\`pythonimport Mathlib.Algebra.BigOperators.Basic import Mathlib.Data.Real.Basic import Mathlib.Data.Complex.Basic import Mathlib.Data.Nat.Log import Mathlib.Data.Complex.Exponential import Mathlib.NumberTheory.Divisors import Mathlib.Data.ZMod.Defs import Mathlib.Data.ZMod.Basic import Mathlib.Topology.Basic import Mathlib.Data.Nat.Digits open BigOperators open Real open Nat open Topology theorem theorem6 (b h v : R) (h_0 : 0 < b \land 0 < h \land 0 < v) (h_1 : v = 1 / 3 * (b * h)) (h_2 : b = 30) (h_3 : h = 13 / 2) v = 65 := by (
A.2 CodeContests
Informamos los resultados sobre las 140 preguntas del conjunto de prueba que no incluyen etiquetas de imagen en la descripción del problema. Muestreamos con una temperatura de 0.6 y un valor top-p de 0.95 siguiendo los experimentos en CodeLlama [48]. Generamos 10,000 muestras por problema. Usamos dos ejemplos few-shot del conjunto de entrenamiento que se muestrean aleatoriamente por problema. Establecemos 1024 como la longitud máxima de tokens para la solución generada. Usamos la misma función de comparación de respuestas que [41] y usamos la concatenación de pruebas públicas, privadas y generadas para validar la corrección de las soluciones.
Ejemplo few-shot
P: Escribe código en python para resolver el siguiente problema de programación que cumpla con las restricciones y pase los casos de prueba de ejemplo. El código de salida debe leer de y escribir a la E/S estándar. Por favor, envuelve tu respuesta de código usando Petya tiene igual... (Resto de la pregunta y ejemplos de entrada/salida)...
R:
while cnt .
if :
while cnt :
print(ans)...
Ejemplo de prompt
P: Escribe código de Python para resolver el siguiente problema de programación que cumpla con las restricciones y pase los casos de prueba de ejemplo. El código de salida debe leer de la entrada estándar y escribir en la salida estándar. Por favor, envuelve tu respuesta de código usandoEsto es el......(Resto de la pregunta y ejemplos de entrada/salida)...
R:
A.3 MATH
Reportamos resultados en 128 problemas del conjunto de prueba seleccionados aleatoriamente. Muestreamos con una temperatura de 0,6 y no usamos muestreo de núcleo. Usamos los 5 ejemplos fijos de few-shot de [40] para cada problema. Generamos 10.000 muestras por problema. Establecemos 512 como la longitud máxima de tokens para la solución generada. Para calificar las soluciones, usamos las funciones minerva_math de LMEval [22] para extraer la respuesta final del modelo. Luego verificamos la corrección si la respuesta extraída coincide exactamente como cadena con la verdad de referencia, o si la función is_equiv de minerva_math en LMEval evalúa como verdadera.
Ejemplo de few-shot
Problema: Si y , entonces encuentra
Solución: Tenemos que . Respuesta final: La respuesta final es 24. Espero que sea correcta.
Ejemplo de prompt
Problema: ¿Cuál es el dominio de la función f(x) = \frac{(2x - 3)(2x + 5)}{(3x - 9)(3x + 6)}? Expresa tu respuesta como un intervalo o como una unión de intervalos.
Solución:
A.4 GSM8K
Reportamos resultados en 128 problemas del conjunto de prueba muestreados aleatoriamente. Muestreamos con una temperatura de 0,6 y no usamos muestreo de núcleo. Usamos 5 ejemplos de few-shot del conjunto de entrenamiento que se muestrean aleatoriamente por problema. Generamos 10.000 muestras por problema. Establecemos 512 como la longitud máxima de tokens para la solución generada. Para calificar las soluciones, seguimos LMEval [22] y extraemos respuestas usando una expresión regular que extrae la cadena después de los cuatro numerales. De manera similar a MATH, luego evaluamos la corrección comprobando si la respuesta extraída coincide exactamente como cadena con la verdad de referencia o si is_equiv evalúa como verdadera.
Ejemplo de few-shot
Pregunta: James decide reemplazar su auto. Vendió su auto de \(20.000\) dólares por el de su valor y luego logró regatear para comprar un auto con precio de etiqueta de \(30.000\) dólares por el de su valor. ¿Cuánto dinero tuvo que pagar de su bolsillo? Respuesta: Vendió su auto por Compró el auto nuevo por Eso significa que tuvo que pagar de su bolsillo
Ejemplo de prompt
Pregunta: Mary tiene 6 frascos de chispas de colores en su despensa. Cada frasco de chispas puede decorar 8 cupcakes. Mary quiere hornear suficientes cupcakes para usar todas sus chispas. Si cada bandeja contiene 12 cupcakes, ¿cuántas bandejas de cupcakes debería hornear?
Respuesta:
B SWE-bench Lite
B.1 Configuración experimental
Para nuestros experimentos, usamos DeepSeek-Coder-V2-Instruct con el framework de agente Moatless Tools (en el commit a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6). Usamos embeddings de Voyage AI 5 para la recuperación, el valor predeterminado usado por Moatless Tools. No hacemos modificaciones al modelo ni al framework, usándolos completamente como componentes listos para usar.
Con esta configuración, muestreamos 250 completaciones independientes para cada problema usando muestreo estándar basado en temperatura. Para determinar la temperatura de muestreo óptima, realizamos un barrido sobre un subconjunto aleatorio de 50 problemas del conjunto de prueba, probando temperaturas de 1,0, 1,4, 1,6 y 1,8. Con base en estos resultados, seleccionamos una temperatura de 1,6 para nuestros experimentos principales.
B.2 Inestabilidad de la suite de pruebas
Durante nuestro análisis, identificamos 34 problemas en SWE-bench Lite cuyas suites de pruebas tenían pruebas inestables. Usando el arnés de pruebas de SWE-bench proporcionado por los autores de SWE-bench, probamos cada solución repetidamente: para algunas soluciones, a veces la solución se marcaba como correcta y otras veces se marcaba como incorrecta. En 30 de estos 34 casos, observamos inestabilidad incluso en las soluciones correctas proporcionadas por los autores del conjunto de datos. La Tabla 3 enumera los ID de los 34 casos con pruebas inestables.
| Repositorio | ID de instancia |
| django | django_django-13315, django_django-13447, django_django-13590, django_django-13710, django_django-13757, django_django-13933, django_django-13964, django_django-14017, django_django-14238, django_django-14382, django_django-14608, django_django-14672, django_django-14752, django_django-14915, django_django-14997, django_django-14999, django_django-15320, django_django-15738, django_django-15790, django_django-15814, django_django-15819, django_django-16229, django_django-16379, django_django-16400, django_django-17051 |
| sympy | sympy_sympy-13146, sympy_sympy-13177, sympy_sympy-16988 |
| requests | psf_requests-863, psf_requests-2317, psf_requests-2674, psf_requests-3362 |
| scikit-learn | scikit-learn_scikit-learn-13241 |
| matplotlib | matplotlib_matplotlib-23987 |
Tabla 3: IDs de instancias de problemas de SWE-bench Lite que tienen pruebas inestables.
Una instancia adicional, astropy_astropy-6938, era inestable en algunas máquinas y no en otras. Los autores de SWE-bench pudieron reproducir la inestabilidad; sin embargo, nosotros no pudimos. Nuestra investigación preliminar indica que este problema específico se debe a versiones no fijadas de dependencias en los entornos de Docker que ejecutan las pruebas unitarias.
Aquí incluimos resultados sobre un subconjunto con los problemas de la Tabla 3 eliminados (266 problemas). Para la evaluación del conjunto de datos completo, en cualquier problema que tenga pruebas inestables, ejecutamos la suite de pruebas 11 veces y usamos votación por mayoría para determinar si una solución pasó o falló. Para la evaluación sobre el subconjunto sin pruebas inestables, todos los baselines con los que comparamos publican qué problemas resuelven correctamente, así que simplemente eliminamos los problemas con pruebas inestables y recalculamos sus puntuaciones.
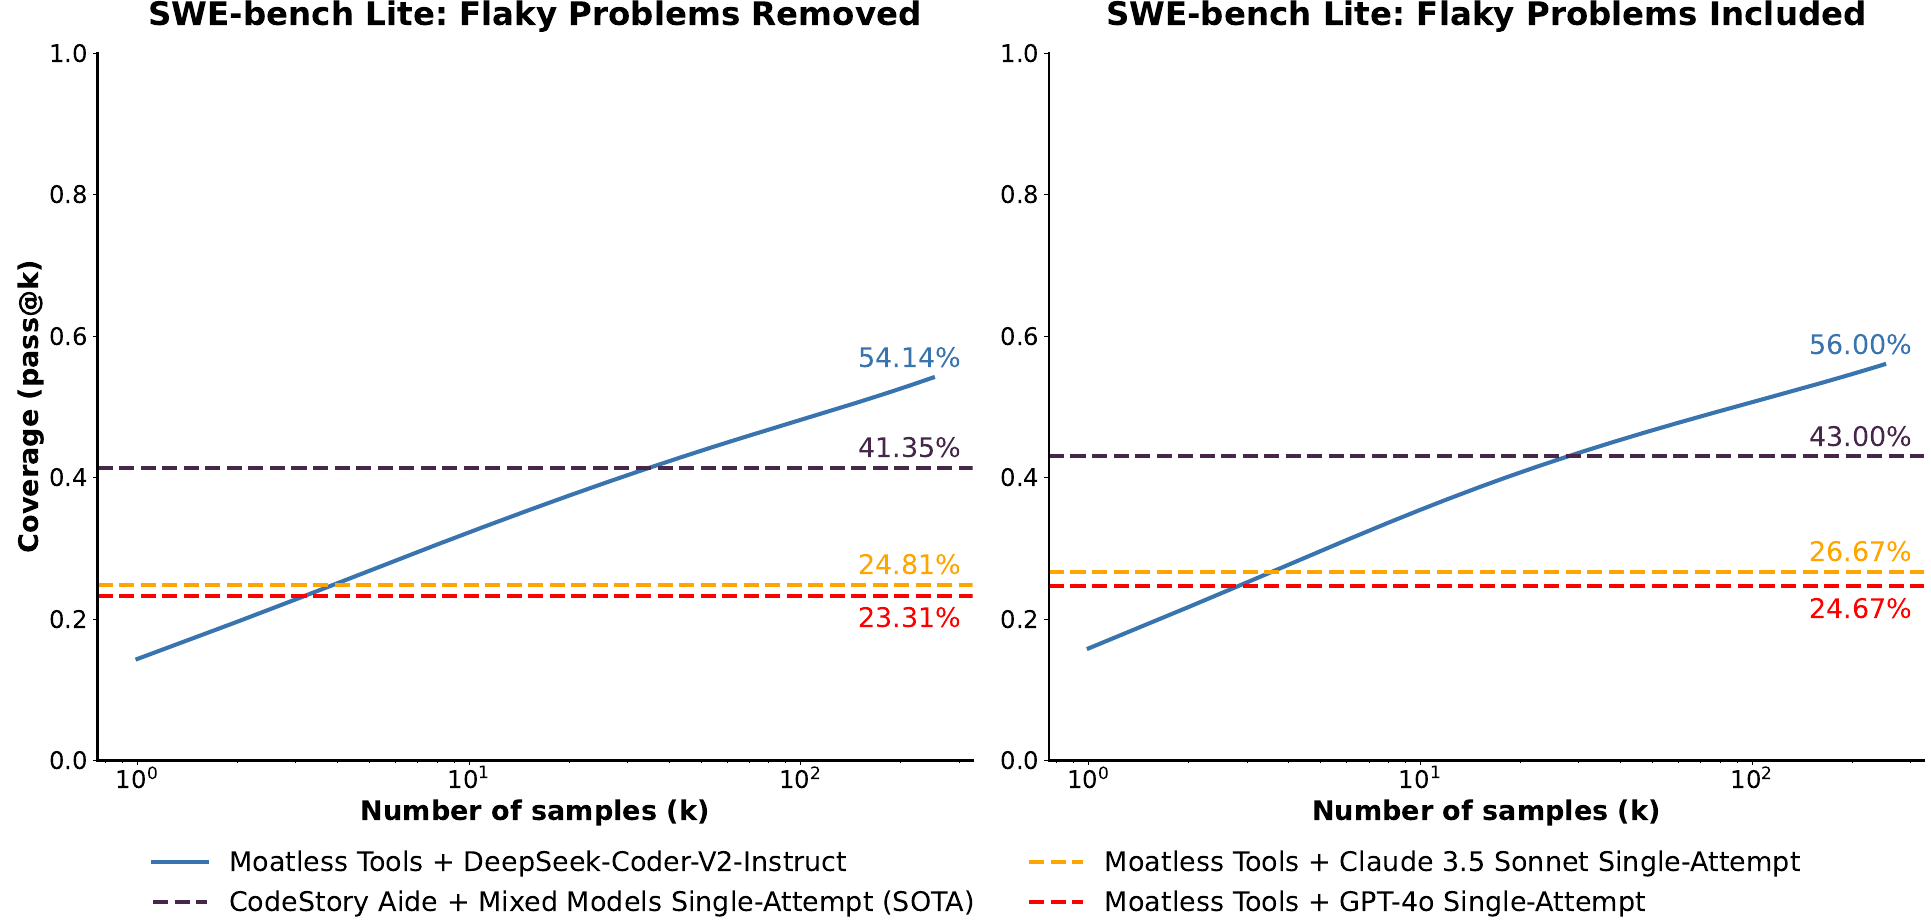
C Detalles de la ley de escalamiento
C.1 Detalles experimentales
Para ajustar leyes de potencia exponenciadas a las curvas de cobertura, primero muestreamos 40 puntos espaciados uniformemente en una escala logarítmica de 0 a 10,000 y eliminamos los duplicados. Luego usamos la función 55 curve_fit de SciPy para encontrar los parámetros y de la Ecuación 3 que mejor se ajustan a estos puntos.
C.2 Resultados adicionales
En la Figura 10 mostramos resultados adicionales del ajuste de leyes de potencia a las curvas de cobertura para un conjunto ampliado de conjuntos de datos y modelos.
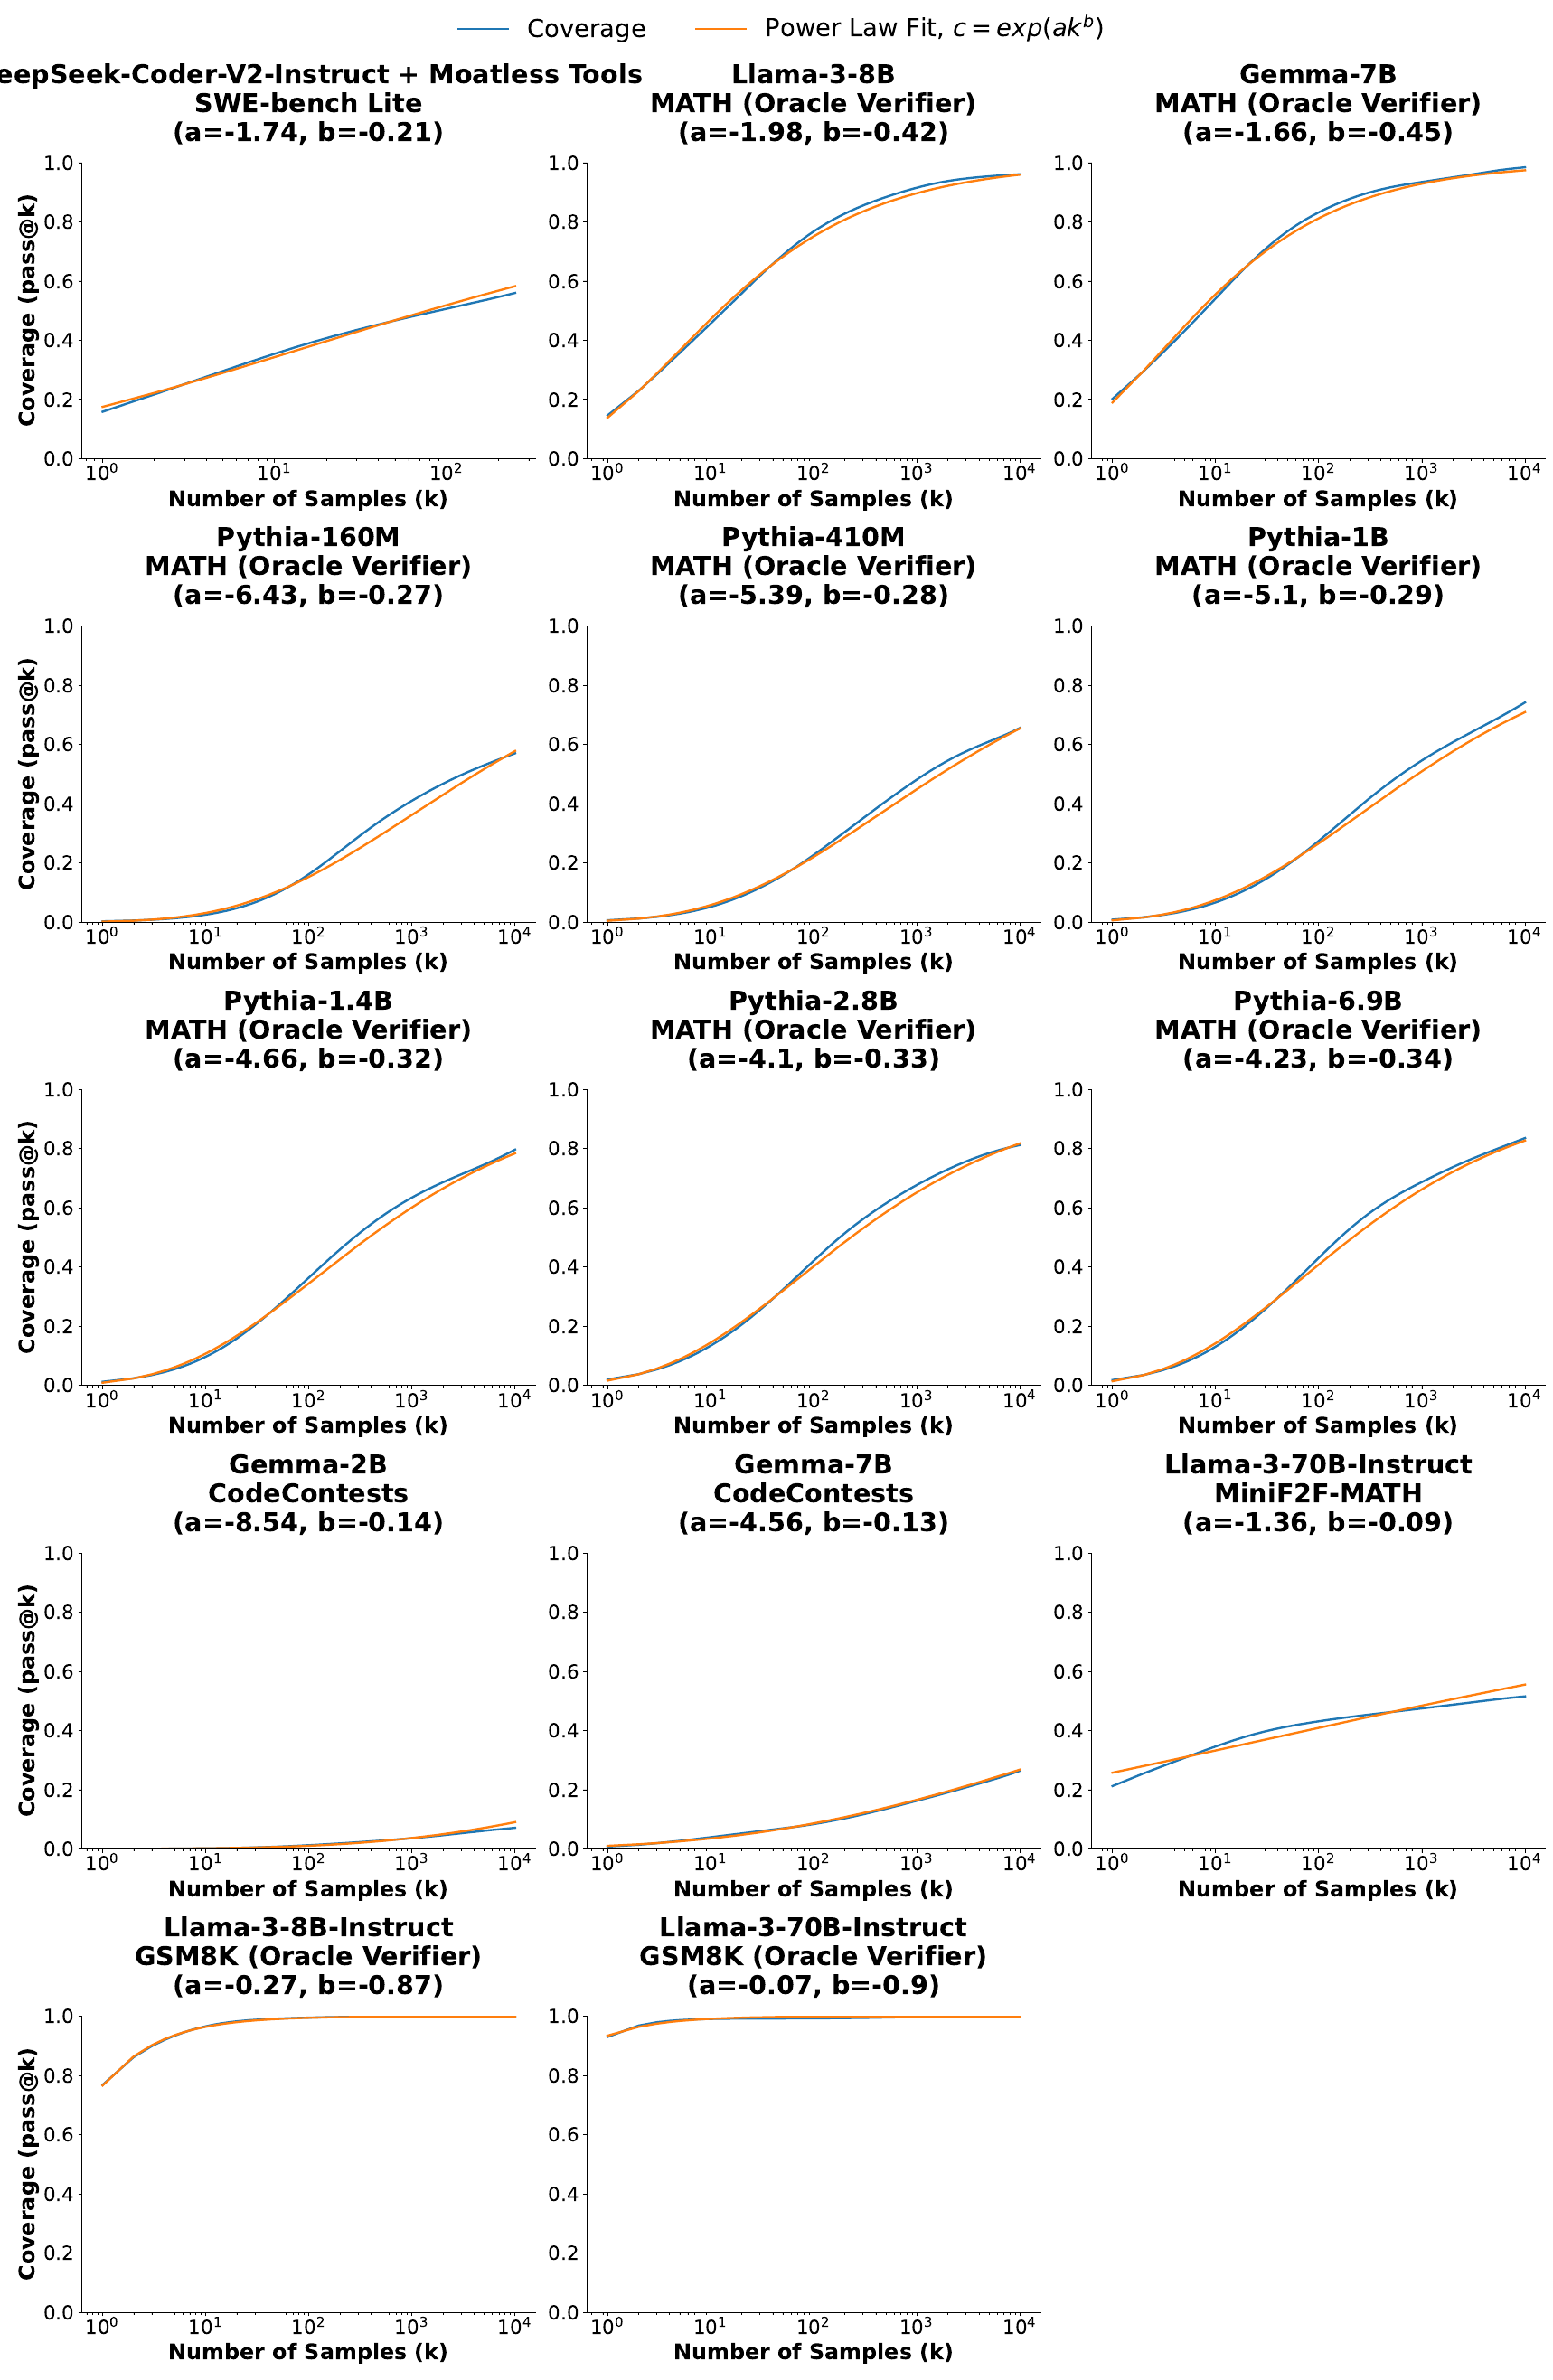
D Detalles de precisión
D Detalles de precisiónPara calcular las métricas de Votación por Mayoría, Modelo de Recompensa + Best-of-N y Modelo de Recompensa + Votación por Mayoría, usamos los mismos 128 subconjuntos de problemas tanto para los conjuntos de datos MATH como GSM8K presentados en la Sección 2. Cada problema corresponde a 10,000 muestras para cada modelo que evaluamos. Para cada método de verificación, tomamos 100 subconjuntos aleatorios de tamaño y calculamos la tasa de éxito usando cada subconjunto. Reportamos la media y la desviación estándar entre subconjuntos en la Figura 7. Para calcular la respuesta de Votación por Mayoría, tomamos la respuesta plural en cada subconjunto (nótese que dos respuestas se consideran equivalentes si son coincidencias exactas de cadena o si is_equiv evalúa como verdadero). Para el Modelo de Recompensa + Best-of-N, tomamos la respuesta con la puntuación más alta asignada por el modelo de recompensa. Para la métrica Modelo de Recompensa + Votación por Mayoría, sumamos la puntuación del modelo de recompensa sobre todas las muestras con la misma respuesta final, y usamos la respuesta final con la suma más alta.
E Respuesta incorrecta de GSM8K
Como se discutió en 4.1, identificamos que un problema en el conjunto de prueba de GSM8K (índice 1042 en HuggingFace) tiene una solución de referencia incorrecta.
Pregunta
El papá de Johnny lo llevó a ver una carrera de caballos y su papá apostó dinero. En la primera carrera, perdió 5 \ más del doble de la cantidad que había perdido previamente. En la tercera carrera, perdió 1.5 veces lo que ganó en la segunda carrera. ¿Cuánto perdió en promedio ese día?
Respuesta
En la segunda carrera ganó 11 1+5\times 2=<<1+52=11>>11 \ porque Perdió un total de 20 15+5=<<15+5=20>>20 \ ese día porque Perdió un promedio de 3 9/3=<<9/3=3>>3\#\#\#\#3$
El error está en la segunda línea de la respuesta: en la tercera carrera, el papá de Johnny perdió 16.5 \ , lo que significa que ganó 11 \ \ \ . Por lo tanto, la respuesta es una pérdida promedio de 3.5 \ por carrera (la respuesta en el conjunto de datos).