
Casi todos los modelos aciertan la aguja en el pajar. RULER añade 13 tareas más duras y muestra que el contexto real es mucho más corto. COLM 2024.
RULER: What's the Real Context Size of Your Long-Context Language Models?
RULER: ¿Cuál es el tamaño de contexto real de tus modelos de lenguaje de contexto largo?
Cheng-Ping Hsieh*, Simeng Sun*, Samuel Kriman, Shantanu Acharya Dima Rekesh, Fei Jia, Yang Zhang, Boris Ginsburg
NVIDIA
{chsieh, simengs}@nvidia.com
Resumen
La prueba de la aguja en el pajar (NIAH), que examina la capacidad de recuperar un fragmento de información (la "aguja") de textos largos con distracciones (el "pajar"), ha sido ampliamente adoptada para evaluar modelos de lenguaje (LM, por sus siglas en inglés) de contexto largo. Sin embargo, esta simple prueba basada en recuperación solo es indicativa de una forma superficial de comprensión de contexto largo. Para proporcionar una evaluación más completa de los LM de contexto largo, creamos un nuevo benchmark sintético, RULER, con configuraciones flexibles para personalizar la longitud de secuencia y la complejidad de la tarea. RULER amplía la prueba NIAH original para abarcar variaciones con diversos tipos y cantidades de agujas. Además, RULER introduce nuevas categorías de tareas, rastreo de múltiples saltos y agregación, para probar comportamientos más allá de la búsqueda en el contexto. Evaluamos 17 LM de contexto largo con 13 tareas representativas en RULER. A pesar de alcanzar una precisión casi perfecta en la prueba NIAH original, casi todos los modelos muestran grandes caídas de rendimiento a medida que aumenta la longitud del contexto. Si bien todos estos modelos afirman tener tamaños de contexto de 32K tokens o más, solo la mitad de ellos puede mantener un rendimiento satisfactorio a la longitud de 32K. Nuestro análisis de Yi-34B, que admite una longitud de contexto de 200K, revela un gran margen de mejora a medida que aumentamos la longitud de entrada y la complejidad de la tarea. Publicamos RULER como código abierto para impulsar una evaluación integral de los LM de contexto largo.
1 Introducción
Los avances recientes en la ingeniería de sistemas de IA (Dao et al., 2022; Jacobs et al., 2023; Fu et al., 2024) y en los diseños de modelos de lenguaje (Chen et al., 2023; Xiong et al., 2023) han permitido escalar de manera eficiente la longitud de contexto de los modelos de lenguaje (Liu et al., 2024a; Young et al., 2024). Trabajos previos (AI21, 2024; X.AI, 2024; Reid et al., 2024; Anthropic, 2024) adoptan comúnmente tareas sintéticas, como la recuperación de contraseñas (Mohtashami & Jaggi, 2023) y la aguja en el pajar (Kamradt, 2023), para evaluar los LM de contexto largo. Sin embargo, estas evaluaciones se usan de manera inconsistente entre trabajos y revelan únicamente la capacidad de recuperación, sin lograr medir otras formas de comprensión de contexto largo.
En este trabajo, proponemos RULER, un nuevo benchmark para evaluar las capacidades de modelado de contexto largo en modelos de lenguaje. RULER contiene cuatro categorías de tareas para probar comportamientos (Ribeiro et al., 2020) más allá de la simple recuperación desde el contexto:
1. Recuperación: ampliamos la prueba de la aguja en el pajar (Kamradt, 2023; NIAH) para evaluar la capacidad de recuperación con diversos tipos y cantidades de agujas. 2. Rastreo de múltiples saltos: proponemos el rastreo de variables, una tarea proxy mínima para la resolución de cadenas de correferencia, con el fin de comprobar el comportamiento de rastreo de entidades con conexiones de múltiples saltos. 3. Agregación: proponemos la extracción de palabras comunes/frecuentes, tareas proxy para la summarización, para probar la capacidad de agregar información relevante que abarca un contexto de largo alcance.
| Referencia y tarea | Longitud promedio | Tipo | Tareas diversas | Conocimiento paramétrico mínimo | Contexto controlable |
| ZeroSCROLLS | ~10k | realista | ✓ | X | X |
| L-Eval | ~8k | realista | ✓ | X | X |
| BAMBOO | ~16k | realista | ✓ | ✓ | X |
| LongBench | ~8k | híbrido | ✓ | X | X |
| LooGLE | ~20k | híbrido | ✓ | ✓ | X |
| InfiniteBench | ~200k | híbrido | ✓ | ✓ | X |
| Aguja en un pajar (NIAH) | cualquiera | sintético | X | ✓ | ✓ |
| Recuperación de Passkey / Line / KV | cualquiera | sintético | X | ✓ | ✓ |
| RULER (Nuestro) | cualquiera | sintético | ✓ | ✓ | ✓ |
4. Preguntas y respuestas: añadimos información distractora a la entrada de conjuntos de datos existentes de QA de contexto corto para evaluar la capacidad de respuesta a preguntas en varios tamaños de contexto.
En comparación con los benchmarks realistas existentes (Tabla 1), RULER consta únicamente de tareas sintéticas, que ofrecen la flexibilidad de controlar la longitud de secuencia y la complejidad de la tarea. La entrada sintética en RULER reduce la dependencia del conocimiento paramétrico, que interfiere con la utilización de la entrada de contexto largo en tareas realistas (Shaham et al., [2023]; Bai et al., [2023]).
Usando RULER, evaluamos Gemini-1.5 (Reid et al., [2024], GPT-4 (OpenAI: Josh Achiam et al., [2023]), y 15 modelos de código abierto con longitudes de contexto que van de 4k a 128k. A pesar de alcanzar un rendimiento casi perfecto en la prueba NIAH original, casi todos los modelos exhiben una gran degradación en las tareas más complejas de RULER a medida que aumenta la longitud de secuencia. Si bien todos los modelos afirman tener un tamaño de contexto de 32k tokens o más, nuestros resultados indican que solo la mitad de ellos puede manejar eficazmente una longitud de secuencia de 32K al superar un umbral cualitativo. Además, casi todos los modelos caen por debajo del umbral antes de alcanzar las longitudes de contexto declaradas. Para obtener comparaciones detalladas entre modelos, agregamos el rendimiento de 4k a 128k con dos puntuaciones promedio ponderadas, donde los pesos simulan la distribución de longitudes de casos de uso del mundo real. Los dos modelos principales —Gemini-1.5 y GPT-4— superan consistentemente a los demás modelos independientemente del esquema de ponderación elegido.
Analizamos además Yi-34B, que afirma tener una longitud de contexto de 200K y logra un rendimiento razonablemente bueno en RULER entre los modelos de código abierto. Nuestros resultados demuestran una gran degradación en el rendimiento de Yi a medida que aumentamos la longitud de entrada y la complejidad de la tarea. En tamaños de contexto grandes, Yi-34B a menudo devuelve respuestas incompletas y no logra localizar con precisión la información relevante. Además, observamos dos comportamientos que emergen con el escalado del tamaño de contexto en múltiples modelos: la mayor dependencia del conocimiento paramétrico y la mayor tendencia a copiar del contexto en tareas que no son de recuperación. Nuestras ablaciones adicionales demuestran que el entrenamiento con secuencias más largas no siempre conduce a un mejor rendimiento en RULER, y que tamaños de modelo más grandes se correlacionan positivamente con mejores capacidades de contexto largo. Finalmente, mostramos que las arquitecturas no Transformer, como RWKV y Mamba, todavía están muy por detrás de Transformer en RULER.
Nuestras contribuciones son las siguientes:
- Proponemos un nuevo benchmark, RULER, para evaluar modelos de lenguaje de contexto largo mediante tareas sintéticas con configuraciones flexibles.- Introducimos nuevas categorías de tareas, específicamente el rastreo de múltiples saltos y la agregación, para probar comportamientos distintos de la recuperación desde contexto largo.- Evaluamos 17 LM de contexto largo usando RULER y realizamos análisis entre modelos y complejidades de tarea.
Publicamos RULER como código abierto para impulsar la investigación futura en modelos de lenguaje de contexto largo.
2 Trabajo relacionado
Modelos de lenguaje de contexto largo. Numerosos modelos de lenguaje de contexto largo se han introducido recientemente debido al progreso en diseños de ingeniería, arquitectura y algoritmos. Flash attention (Dao et al., 2022; Dao, 2023) y Ring attention (Liu et al., 2023) reducen significativamente el consumo de memoria requerido para procesar contextos largos. Se emplearon diversos mecanismos de atención dispersa (Child et al., 2019; Jaszczur et al., 2021), como la atención dispersa desplazada (Chen et al., 2024), la atención dilatada (Ding et al., 2023) y los sumideros de atención (Han et al., 2023; Xiao et al., 2024b), para permitir un escalado eficiente del contexto. Se propusieron nuevos métodos de incrustación posicional para mejorar la extrapolación de longitud en Transformers (Vaswani et al., 2017), incluidos ALiBi (Press et al., 2022), xPOS (Sun et al., 2023b) y variantes de RoPE (Su et al., 2023) (Chen et al., 2023; Xiong et al., 2023; Peng et al., 2024; Liu et al., 2024b; Ding et al., 2024; Zhu et al., 2024). Otra línea de investigación se centra en reducir el tamaño del contexto. Esto puede lograrse almacenando en caché el contexto previo mediante un mecanismo de recurrencia (Zhang et al., 2024a; Bulatov et al., 2023; Martins et al., 2022; Wu et al., 2022), recuperando información relevante del contexto (Xu et al., 2024a; Mohtashami & Jaggi, 2023; Wang et al., 2024; Tworkowski et al., 2024; Xiao et al., 2024a), o preservando la información sobresaliente mediante compresión (Jiang et al., 2023). Finalmente, también se han propuesto arquitecturas novedosas (Gu et al., 2022; Fu et al., 2023a; Poli et al., 2023; Fu et al., 2023b; Sun et al., 2023a; Beck et al., 2024; Sun et al., 2024), como Mamba (Gu & Dao, 2023) y RWKV (Peng et al., 2023), para manejar eficientemente entradas de contexto largo.
Benchmarks y tareas de contexto largo. Nuestro trabajo está estrechamente relacionado con otros trabajos sobre la evaluación de modelos de lenguaje de contexto largo. ZeroSCROLLS (Shaham et al., 2023) abarca diez tareas realistas de lenguaje natural, como QA sobre documentos largos y summarización (basada en consultas). L-Eval (An et al., 2024) también utiliza datos realistas, que fueron filtrados manualmente para garantizar la calidad. LongBench (Bai et al., 2023) contiene tareas en un entorno bilingüe. InfiniteBench (Zhang et al., 2024b) incluye tareas con una longitud superior a 100K tokens. LTM (Castillo et al., 2024) se orienta a la evaluación de conversaciones de largo plazo. Para aislar el efecto del conocimiento paramétrico, trabajos previos (Dong et al., 2023; Li et al., 2023b) también proponen usar documentos publicados en línea después de cierta fecha de corte, o aprovechar materiales de muy bajos recursos (Tanzer et al., 2024). En comparación con los benchmarks realistas, las tareas sintéticas son más flexibles para controlar la configuración (p. ej., longitud de secuencia y complejidad de la tarea) y se ven menos afectadas por el conocimiento paramétrico. Trabajos recientes se han centrado principalmente en tareas sintéticas basadas en recuperación (Kamradt, 2023; Mohtashami & Jaggi, 2023; Li et al., 2023a; Liu et al., 2024d; Lee et al., 2024), con unos pocos que investigan otros aspectos, incluido el razonamiento sobre hechos (Kuratov et al., 2024; Karpinska et al., 2024), el modelado del discurso de largo alcance (Sun et al., 2022), las preguntas y respuestas (Levy et al., 2024; Yuan et al., 2024), el aprendizaje en contexto con muchos ejemplos (Agarwal et al., 2024; Bertsch et al., 2024; Xu et al., 2024b) y la comprensión de código (Liu et al., 2024c).
3 El benchmark RULER
RULER comprende tareas en cuatro categorías: recuperación, rastreo multi-salto, agregación y respuesta a preguntas. Los ejemplos de evaluación en RULER se generan automáticamente a partir de configuraciones de entrada (véase la Tabla 2) que definen la longitud y la complejidad de cada entrada. Dentro de un dominio restringido como en RULER, la complejidad de la tarea puede concebirse como una función del número de tokens de salida objetivo y de la relación señal-ruido en el contexto. Remitimos a los lectores a (Goldman et al., 2024) para una discusión más exhaustiva sobre el diseño de tareas de evaluación para modelos de lenguaje de contexto largo.
3.1 Recuperación: aguja en un pajar (NIAH)
Trabajos recientes (Reid et al., 2024; Anthropic, 2023) emplean comúnmente la prueba de la aguja en un pajar (Kamradt, 2023; NIAH) para evaluar la capacidad de modelado de contexto largo. La prueba NIAH recuerda a las tareas de recuerdo asociativo ampliamente estudiadas (Hopfield, 1982; Graves et al., 2014; Olsson et al., 2022; Arora et al., 2024), en las que es necesario recuperar información relevante del contexto dada una consulta suficiente. En RULER, incluimos múltiples tareas basadas en recuperación, extendiendo la prueba NIAH original para evaluar modelos con base en tres criterios.
| Tarea | Configuración | Ejemplo |
SingleNIAH (S-NIAH) | type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (ensayos) Uno de los números mágicos especiales para long-context es: 12345. ¿Cuál es el número mágico especial para long-context mencionado en el texto proporcionado? Respuesta: 12345 |
Multi-keysNIAH (MK-NIAH) | num_keys = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (ensayos) Uno de los números mágicos especiales para long-context es: 12345. Uno de los números mágicos especiales para large-model es: 54321. ¿Cuál es el número mágico especial para long-context mencionado en el texto proporcionado? Respuesta: 12345 |
Multi-valuesNIAH (MV-NIAH) | num_values = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (ensayos) Uno de los números mágicos especiales para long-context es: 12345. Uno de los números mágicos especiales para long-context es: 54321. ¿Cuáles son todos los números mágicos especiales para long-context mencionados en el texto proporcionado? Respuesta: 12345 54321 |
Multi-queriesNIAH (MQ-NIAH) | num_queries = 2type_key = wordtype_value = numbertype_haystack = essaysize_haystack < context length | (ensayos) Uno de los números mágicos especiales para long-context es: 12345. Uno de los números mágicos especiales para large-model es: 54321. ¿Cuáles son todos los números mágicos especiales para long-context y large-model mencionados en el texto proporcionado? Respuesta: 12345 54321 |
VariableTracking (VT) | num_chains = 2num_hops = 2size_noises < context length | (ruidos) VAR X1 = 12345 .... VAR Y1 = 54321 .... VAR X2 = X1 .... VAR Y2 = Y1 .... VAR X3 = X2 .... VAR Y3 = Y2 .... Encuentre todas las variables a las que se les asigna el valor 12345. Respuesta: X1 X2 X3 |
Common WordsExtraction (CWE) | freq_cw = 2, freq_ucw = 1num_cw = 10num_ucw < context length | aaa bbb cca aaa ddd eee ccc fff ggg hhh iii iii .... ¿Cuáles son las 10 palabras más comunes en la lista anterior? Respuesta: aaa ccc iii .... |
Frequent WordsExtraction (FWE) | α = 2num_word < context length | aaa bbb cca aaa ddd eee ccc fff ggg aaa hhh aaa ccc iii iii .... ¿Cuáles son las 3 palabras que aparecen con más frecuencia en el texto codificado anterior? Respuesta: aaa ccc iii |
QuestionAnswering (QA) | dataset = SQuADnum_document < context length | Documento 1: .... aaa .... Documento 2: .... bbb .... Documento 3: .... ccc .... Pregunta: question Respuesta: bbb |
Concretamente, la capacidad de recuperación debe ser (1) independiente del tipo de "aguja" y del "pajar", (2) lo suficientemente fuerte como para ignorar distractores difíciles y (3) de alto recuerdo cuando es necesario recuperar múltiples elementos. Con base en estos criterios, desarrollamos cuatro tareas NIAH. La "aguja" en cada una de estas tareas es un par clave-valor insertado en el "pajar" (textos largos distractores). La consulta se ubica al final de la secuencia y sirve como señal para hacer coincidir las claves en el contexto y posteriormente recuperar los valores asociados.
- NIAH simple (S-NIAH): Esta es la prueba NIAH original donde se debe recuperar una única "aguja" del "pajar". La consulta/clave/valor puede tomar la forma de palabras, números (7 dígitos) o UUID (32 dígitos). El "pajar" puede ser oraciones de ruido repetidas o ensayos de Paul Graham (Kamradt, 2023).- NIAH de múltiples claves (MK-NIAH): Se insertan múltiples "agujas" en el "pajar", y solo es necesario recuperar una de ellas. Las "agujas" adicionales son distractores difíciles. La configuración más desafiante es una versión en la que el "pajar" está lleno de agujas distractorias.
- NIAH de múltiples valores (MV-NIAH): Se insertan múltiples "agujas" que comparten la misma clave en el "pajar". Es necesario recuperar todos los valores asociados con la misma clave.- NIAH de múltiples consultas (MQ-NIAH): Se insertan múltiples "agujas" en el "pajar". Es necesario recuperar todas las "agujas" con claves distintas. Esta es la misma configuración de tarea de recuerdo asociativo de múltiples consultas usada por Arora et al. (2024). Junto con MV-NIAH, estas dos tareas evalúan la capacidad de recuperación sin omitir ninguna información crítica.
3.2 Rastreo de múltiples saltos: Seguimiento de variables (VT)
La comprensión efectiva del discurso (van Dijk & Kintsch, 1983) depende del reconocimiento exitoso de entidades recién mencionadas y del establecimiento de la cadena de referencias que correfieren a la misma entidad (Karttunen, 1969) a lo largo del contexto largo. Desarrollamos una nueva tarea de seguimiento de variables para emular una tarea mínima de resolución de cadenas de correferencia (Ng, 2010). Esta tarea verifica el comportamiento de rastrear patrones de coocurrencia relevantes y establecer conexiones saltadas dentro de una entrada larga. Específicamente, una variable se inicializa con un valor , seguida de una cadena lineal de declaraciones de vinculación de nombres de variables (p. ej., , , ...), que se insertan en diversas posiciones de la entrada. El objetivo es devolver todos los nombres de variables que apuntan al mismo valor . La complejidad de la tarea puede aumentarse agregando más saltos (es decir, el número de vinculaciones de nombres) o más cadenas, de forma similar a agregar distractores difíciles en MK- NIAH.
3.3 Agregación: Palabras comunes (CWE) y Extracción de palabras frecuentes (FWE)
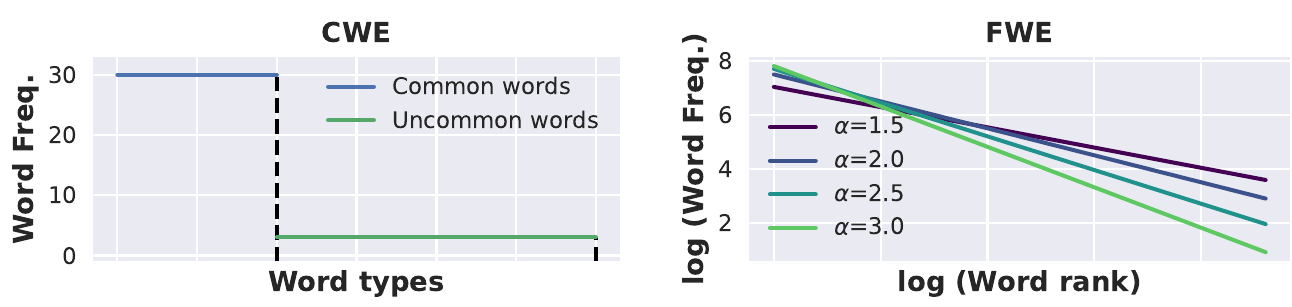
En RULER, introducimos una nueva categoría como aproximación a las tareas de resumen, donde la información relevante constituye una porción mucho mayor del contexto y la salida objetivo depende de una agregación precisa de la entrada relevante. Concretamente, construimos una secuencia de entrada muestreando palabras de una lista de palabras (sintética) predefinida. En la tarea de extracción de palabras comunes (CWE), las palabras se muestrean de distribuciones uniformes discretas, con el número de palabras comunes fijo mientras que el número de palabras poco comunes aumenta con la longitud de la secuencia. En la tarea de extracción de palabras frecuentes (FWE), las palabras se muestrean de una distribución Zeta. La Figura 1 muestra una ilustración de la frecuencia de palabras en la entrada construida. Un modelo debe devolver las palabras más frecuentes en el contexto. En CWE, es igual al número de palabras comunes. En FWE, fijamos en 3, ya que aumentar conduce a un rendimiento deficiente incluso en tamaños de contexto pequeños para la mayoría de los modelos. La complejidad de la tarea puede ajustarse variando el número de palabras comunes o el parámetro de la distribución Zeta.4
3.4 Responder preguntas (QA)
La mayoría de los conjuntos de datos de QA existentes (Rajpurkar et al., 2018; Yang et al., 2018; Trivedi et al., 2022) están diseñados para responder preguntas con base en pasajes cortos. Estos conjuntos de datos pueden extenderse para simular una entrada de contexto largo agregando información distractora. En esta categoría de tareas, insertamos los párrafos dorados (es decir, los párrafos que contienen respuestas) en párrafos muestreados aleatoriamente del mismo conjunto de datos. Esta categoría es una adaptación del mundo real (Ivgi et al., 2023) de NIAH, donde la pregunta sirve como consulta, los párrafos dorados son las "agujas" y los párrafos distractores forman el "pajar".
4 Experimentos y resultados
Modelos y configuración de inferencia Seleccionamos 17 LLM de contexto largo, incluidos 15 modelos de código abierto y dos modelos de código cerrado (Gemini- 1.5- Pro y GPT- 4), que cubren diversos tamaños de modelo (7B a 8x22B con arquitectura MoE) y longitudes de contexto declaradas (32K a 1M). La información completa sobre estos modelos se incluye en el Apéndice A. Evaluamos todos los modelos usando vLLM (Kwon et al., 2023), un sistema de servicio de LLM con gestión eficiente de memoria de caché KV. Para todos los modelos, ejecutamos la inferencia en BFloat16 en 8 GPU NVIDIA A100 con decodificación voraz.
Configuraciones de las tareas Evaluamos todos los modelos en 13 tareas que abarcan diversas complejidades de las cuatro categorías de RULER. Las configuraciones de prueba se han seleccionado (mostradas en el Apéndice B con base en un estudio de correlación de tareas descrito en el Apéndice C). Seleccionamos estas tareas porque la mayoría de los modelos se desempeñan decentemente en un tamaño de contexto corto de 4K tokens. Nuestro objetivo principal es ver si los modelos pueden mantener ese buen rendimiento con el escalado de la longitud del contexto. Para cada tarea, evaluamos cada modelo con 500 ejemplos generados para cada longitud de la serie (4K, 8K, 16K, 32K, 64K, 128K), respetando la plantilla de chat necesaria de cada modelo. Para evitar que el modelo se niegue a responder una consulta o genere explicaciones, agregamos a la entrada de la tarea un prefijo de respuesta y verificamos la presencia de la salida objetivo con una precisión basada en el recuerdo.
Tamaño de contexto efectivo Observamos una gran degradación del rendimiento en todos los modelos a medida que aumentamos la longitud de entrada en RULER. Para determinar el tamaño de contexto máximo que un modelo puede manejar efectivamente, calificamos cada modelo con un umbral fijo; superarlo indica un rendimiento satisfactorio en la longitud de evaluación. Usamos el rendimiento del modelo Llama2- 7b en la longitud de contexto de 4K como umbral. En la Tabla 3 reportamos la longitud máxima que supera el umbral como la "longitud efectiva", junto con la "longitud declarada".
Criterios de clasificación de modelos Si bien la calificación basada en umbrales revela la discrepancia entre la longitud declarada y la efectiva, carece de detalles para comparaciones detalladas entre modelos. Por ello, usamos una puntuación promedio ponderada para agregar el rendimiento de los modelos en varios tamaños de contexto. Clasificamos los modelos bajo dos esquemas de ponderación: wAvg. (inc) y wAvg. (dec), donde el peso aumenta y disminuye linealmente con la longitud de la secuencia, respectivamente. Idealmente, el peso para cada longitud debería determinarse por la distribución de longitudes de uso del modelo; aquí elegimos los dos esquemas para simular los escenarios en los que las secuencias más largas (inc) o las más cortas (dec) dominan la distribución.
Resultados principales Incluimos los resultados de 17 LM de contexto largo en comparación con la línea base Llama2-7B en la Tabla 3. El rendimiento a una longitud determinada es el promedio de las 13 tareas de RULER. El modelo de código cerrado Gemini-1.5-Pro supera al resto de los modelos por un amplio margen, con una longitud efectiva mayor que la longitud máxima que hemos probado. Someter a prueba este modelo con una versión más difícil de RULER puede ser interesante para dar seguimiento en el futuro. Para el resto de los modelos, si bien alcanzan un rendimiento casi perfecto en la recuperación de passkey y en la tarea NIAH vanilla (mostrada en el Apéndice E), todos ellos exhiben una gran degradación en RULER a medida que aumenta la longitud de la secuencia y no logran mantener un rendimiento superior a la línea base Llama2-7B en la longitud que declaran. Los modelos de código abierto mejor clasificados (Llama3.1, Qwen2 y Command-R-plus) comparten configuraciones comunes, como tener mayores tamaños de modelo y usar frecuencias base más grandes en
| Modelos | Longitud declarada | Longitud efectiva | 4K | 8K | 16K | 32K | 64K | 128K | Prom. | wProm. (inc) | wProm. (dec) |
| Llama2 (7B) | 4K | - | 85.6 | ||||||||
| Gemini-1.5-Pro | 1M | >128K | 96.7 | 95.8 | 96.0 | 95.9 | 95.9 | 94.4 | 95.8 | 95.5(1.º) | 96.1(1.º) |
| GPT-4 | 128K | 64K | 96.6 | 95.3 | 95.2 | 93.2 | 87.0 | 81.2 | 91.6 | 89.0(2.º) | 94.1(2.º) |
| Llama3.1 (70B) | 128K | 64K | 96.5 | 95.8 | 95.4 | 94.8 | 88.4 | 66.6 | 89.6 | 85.5(4.º) | 93.7(3.º) |
| Qwen2 (72B) | 128K | 32K | 96.9 | 96.1 | 94.9 | 94.1 | 79.8 | 53.7 | 85.9 | 79.6(9.º) | 92.3(4.º) |
| Contexto de solo lectura para comprender la fuente (no es texto fuente para traducir): 4 Experimentos y resultados Resultados principales Incluimos los resultados de 17 LM de contexto largo en comparación con la línea base Llama2-7B en la Tabla 3. El rendimiento a una determinada longitud es el promedio de las 13 tareas en RULER. El modelo de código cerrado Gemini-1.5-Pro supera al resto de los modelos por un amplio margen, con una longitud efectiva mayor que la longitud máxima que hemos probado. Someter a prueba este modelo con una versión más difícil de RULER puede ser interesante para continuar en Texto a traducir: Command-R-plus (104B) | 128K | 32K | 95.6 | 95.2 | 94.2 | 92.0 | 84.3 | 63.1 | 87.4 | 82.7(7.º) | 92.1(5.º) |
| GLM4 (9B) | 1M | 64K | 94.7 | 92.8 | 92.1 | 89.9 | 86.7 | 83.1 | 89.9 | 88.0(3.º) | 91.7(6.º) |
| Llama3.1 (8B) | 128K | 32K | 95.5 | 93.8 | 91.6 | 87.4 | 84.7 | 77.0 | 88.3 | 85.4(5.º) | 91.3(7.º) |
| GradientAI/Llama3 (70B) | 1M | 16K | 95.1 | 94.4 | 90.8 | 85.4 | 80.9 | 72.1 | 86.5 | 82.6(8.º) | 90.3(8.º) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 95.6 | 94.9 | 93.4 | 90.9 | 84.7 | 31.7 | 81.9 | 73.5(11.º) | 90.3(9.º) |
| Yi (34B) | 200K | 32K | 93.3 | 92,2 | 91,3 | 87,5 | 83,2 | 77,3 | 87,5 | 84,8 (6.º) | 90,1 (10.º) |
| Phi3-medium (14B) | 128K | 32K | 93,3 | 93,2 | 91,1 | 86,8 | 78,6 | 46,1 | 81,5 | 74,8 (10.º) | 88,3 (11.º) |
| Mixtral-v0.2 (7B) | 32K | 16K | 93,6 | 91,2 | 87,2 | 75,4 | 49,0 | 13,8 | 68,4 | 55,6 (13.º) | 81,2 (12.º) |
| LWM (7B) | 1M | <4K | 82,3 | 78,4 | 73,7 | 69,1 | 68,1 | 65,0 | 72,8 | 69,9 (12.º) | 75,7 (13.º) |
| DBRX (36B/132B) | 32K | 8K | 95,1 | 93,8 | 83,6 | 63,1 | 2,4 | 0,0 | 56,3 | 38,0 (14.º) | 74,7 (14.º) |
| Together (7B) | 32K | 4K | 88,2 | 81,1 | 69,4 | 63,0 | 0,0 | 0.0 | 50,3 | 33,8 (15.º) | 66,7 (15.º) |
| LongChat (7B) | 32K | <4K | 84,7 | 79,9 | 70,8 | 59,3 | 0.0 | 0.0 | 49,1 | 33,1 (16.º) | 65,2 (16.º) |
| LongAlpaca (13B) | 32K | <4K | 60,6 | 57,0 | 56,6 | 43,6 | 0.0 | 0.0 | 36,3 | 24,7 (17.º) | 47,9 (17.º) |
RoPE (Xiong et al., 2023). Una ventana de contexto de entrenamiento grande no siempre es necesaria para un buen rendimiento en contexto largo: los modelos de código abierto mejor clasificados incluyen tanto escalado de contexto por fuerza bruta (Llama3.1 entrenado con una longitud de contexto de 128K) como extrapolación de longitud en tiempo de inferencia (Qwen2 entrenado con una longitud de contexto de 32K). Los modelos con menor rendimiento también incluyen aquellos entrenados con un tamaño de contexto mucho mayor (p. ej., LWM y GradientAI/Llama3, ambos con una longitud de contexto de 1M). Aunque LWM alcanza un rango superior al de Mistral-v0.2 cuando las secuencias más largas reciben mayor peso (wAvg. inc) y muestra menos degradación a medida que aumenta el tamaño del contexto, su rendimiento es peor que el de Llama2-7B incluso a 4K. Este resultado sugiere un compromiso en la evaluación entre el rendimiento absoluto en secuencias cortas y la degradación relativa con el escalado del tamaño del contexto. Proporcionamos más análisis sobre el tamaño del modelo y la longitud máxima de entrenamiento en la sección 6
5 Análisis de errores por tarea
Evaluamos Yi-34B-200K con longitudes de entrada incrementadas (hasta 256K) en tareas más complejas para comprender el efecto de las configuraciones de las tareas y los modos de fallo en RULER.
Falta de robustez a los tipos de "aguja". La Figura 2 (izquierda) muestra que, si bien Yi alcanza un rendimiento casi perfecto cuando se usa una aguja de par palabra-número en la recuperación de passkey estándar y en NIAH vanilla, el rendimiento se degrada cuando la aguja adopta otras formas. Observamos la mayor degradación en la tarea de recuperación de UUID, para la cual Yi a veces no logra devolver los 32 dígitos completos dado un contexto de entrada largo ().
Fallo al ignorar los distractores. La Figura 2 (centro-izquierda) muestra que aumentar el número de agujas distractoras reduce constantemente el rendimiento, con Yi cayendo puntos a 256K en la versión extrema, donde el contexto está lleno de agujas irrelevantes (#K=FULL). El análisis de errores revela que Yi falla al ignorar eficazmente los distractores difíciles dado un contexto de entrada largo, por lo que recupera incorrectamente valores asociados con las claves distractoras. En la versión extrema, Yi a menudo devuelve valores de la vecindad del objetivo, lo que sugiere una coincidencia gruesa del rango pero la falta de precisión para localizar la clave cuando el objetivo está en la distribución de los ruidos.
Devolver información incompleta. En consonancia con trabajos anteriores (Liu et al., 2024a; Reid et al., 2024), notamos una degradación significativa en el rendimiento cuando el modelo necesitarecuperar múltiples elementos de una entrada larga. Por ejemplo, aumentar el número de consultas de 1 a 8 reduce el rendimiento en puntos (Figura 2 derecha). Cuando el modelo necesita recuperar múltiples valores asociados con la misma clave (Figura 2 centro-derecha), Yi a menudo produce respuestas duplicadas sin devolver el conjunto completo de valores, lo que implica asociaciones desiguales entre la clave y cada uno de sus valores.
Tendencia a copiar del contexto. Notamos que Yi tiene una fuerte tendencia a copiar textualmente del contexto cuando se escala la longitud de la entrada. Esta tendencia es más notable en el seguimiento de variables (VT) y la extracción de palabras comunes (CWE), donde incluimos una demostración en contexto al inicio de la secuencia. Más del de la salida de Yi en la tarea CWE a 128K es simplemente una cadena copiada del ejemplo one-shot, mientras que la copia es inexistente para secuencias cortas. Este comportamiento de copia también está presente en el modelo LWM y LongAlpaca; sin embargo, es menos prevalente en otros modelos, como Mixtral. Este hallazgo refuerza aún más la necesidad de probar comportamientos distintos a la recuperación dada una entrada de contexto larga.
Seguimiento poco fiable dentro del contexto. Para la tarea de seguimiento de variables, tanto añadir más cadenas como más saltos contribuyen a una gran degradación en el rendimiento de Yi. Yi se degrada consistentemente en la configuración de más saltos a medida que aumentamos el tamaño del contexto (Figura 3 izquierda), mientras que la degradación en la configuración de más cadenas es más significativa para longitudes mayores a 128K (Figura 3 centro-izquierda). Además del problema de copia mencionado anteriormente, Yi comete errores debido a devolver incorrectamente cadenas vacías o variables de otras cadenas, lo que implica una falta de capacidad para rastrear de manera fiable la misma entidad dentro de un contexto largo. Estos errores también se observan con frecuencia en modelos que no exhiben el comportamiento de copia.
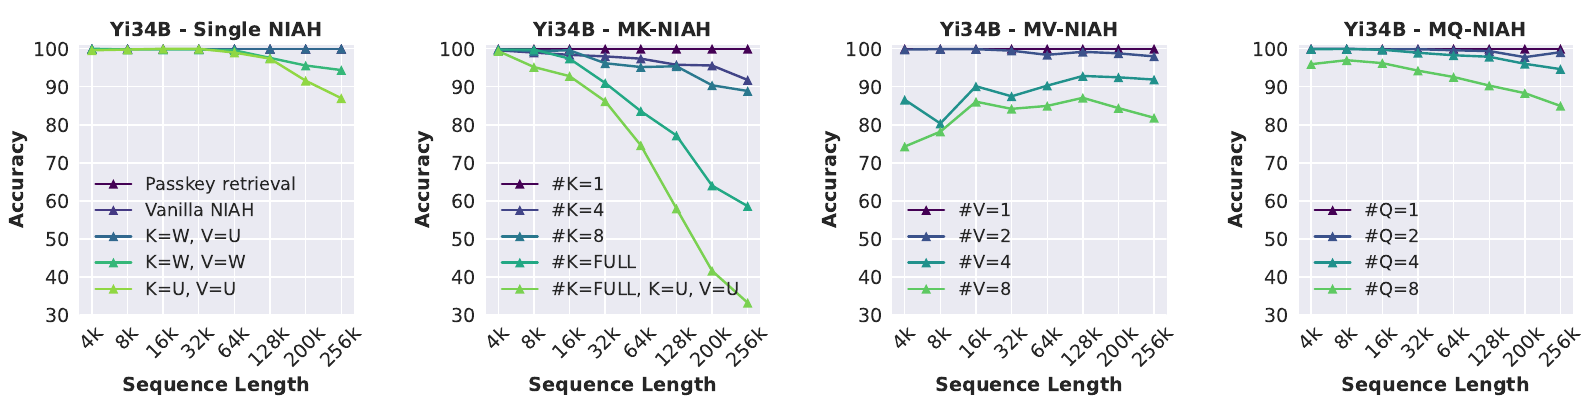
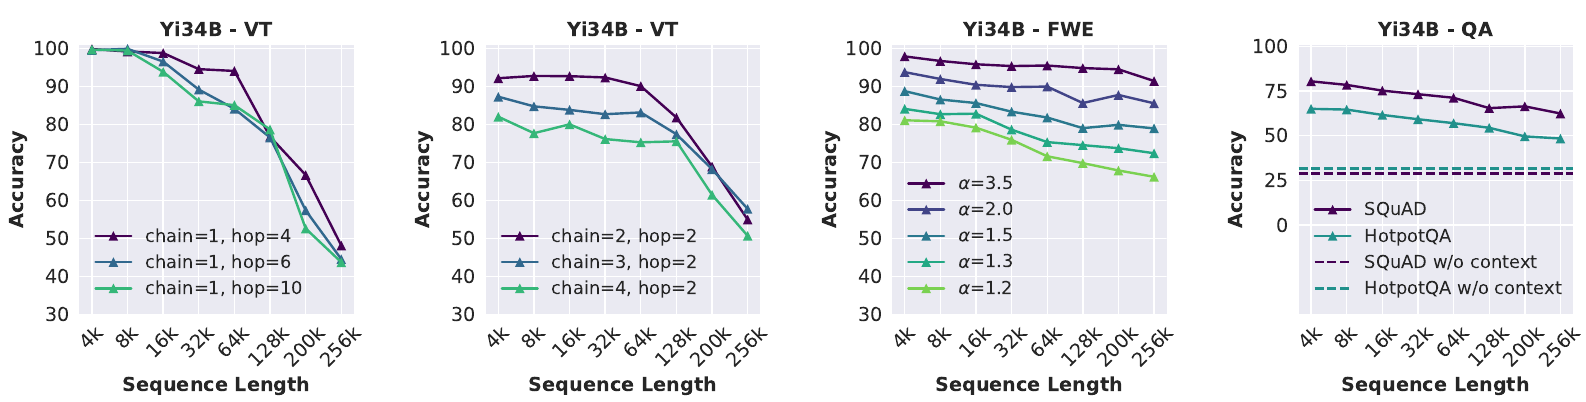
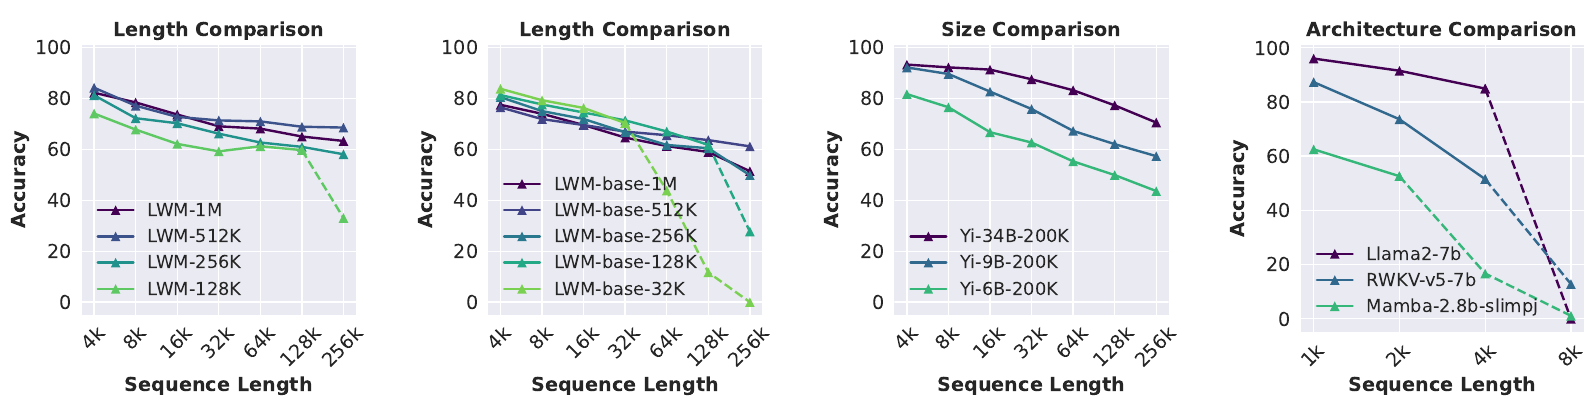
Figura 4: (Izquierda y centro-izquierda): Comparación de la serie LargeWorldModel (LWM) entrenada hasta varios tamaños de contexto con un tamaño de parámetros fijo de 7B. (Centro-derecha): Comparación de los modelos de la suite Yi con diferentes tamaños de parámetros con una longitud de contexto de entrenamiento controlada de 200K. (Derecha): El rendimiento de arquitecturas no Transformer queda rezagado respecto a la línea base Transformer Llama2-7B por un amplio margen. La extrapolación de longitud se presenta con líneas discontinuas.
Fallo en agregar con precisión. Observamos dos modos comunes de fallo en las tareas de agregación: uso incorrecto del conocimiento paramétrico y agregación inexacta. Los modelos que no exhiben el problema de copia en la tarea CWE a veces ignoran la información contextual y, en su lugar, utilizan conocimiento paramétrico para responder a la consulta, especialmente en tamaños de contexto grandes. Por ejemplo, Mistral (7b-instruct-v0.2) devuelve palabras de alta frecuencia, como "the", "an", "a", como salida sin contar las palabras en el contexto. Para la tarea FWE, que muestra menos el problema de copia, Yi falla en producir correctamente las palabras más frecuentes a medida que disminuimos el en la distribución Zeta (Figura 3 centro-derecha). Disminuir conduce a una menor diferencia en frecuencia entre las palabras, lo que aumenta la dificultad para distinguir las palabras más frecuentes.
Alucinación frecuente en QA de contexto largo. Para las tareas de QA, el rendimiento de Yi se aproxima a su línea base sin contexto a medida que extendemos el contexto con párrafos distractores (Figura 3 derecha). La degradación proviene principalmente de la alucinación y de una menor dependencia de la información contextual. Notamos que, en tamaños de contexto grandes, las predicciones del modelo a veces son irrelevantes para la pregunta y pueden coincidir con las respuestas de su línea base sin contexto. El peor rendimiento general en las tareas de QA confirma que la coincidencia difusa entre una consulta y un párrafo relevante en contexto largo es una configuración más desafiante que las pruebas simplistas de NIAH, donde las claves pueden localizarse exactamente en el contexto.
6 Análisis del modelo
Efecto de la longitud del contexto de entrenamiento. ¿Los modelos entrenados con tamaños de contexto mayores rinden mejor en RULER? Evaluamos la suite de LargeWorldModels (Liu et al. [2024a] LWM) de igual tamaño de parámetros y entrenados hasta varias longitudes de contexto. La Figura 4 (izquierda y centro-izquierda) muestra que tamaños de contexto mayores en general conducen a un mejor rendimiento, pero el ranking puede ser inconsistente para secuencias largas. Por ejemplo, el modelo entrenado con un tamaño de contexto de 1M (LWM-1M) es peor que el de 512K a una longitud de 256K, probablemente debido a un entrenamiento insuficiente para ajustarse a la nueva frecuencia base en RoPE. Además, observamos caídas abruptas en el rendimiento cuando los modelos necesitan extrapolar a longitudes no vistas (p. ej., LMW-128K dada una entrada de 256K), y una degradación casi lineal con la longitud de entrada en escala logarítmica dentro del tamaño máximo de contexto de entrenamiento.
Efecto del tamaño del modelo Los mejores modelos en nuestros resultados principales son mucho más grandes que otros modelos. Para ablacionar el efecto del tamaño del modelo, evaluamos Yi-34B-200k, Yi-9B-200k y Yi-6B-200k, todos entrenados hasta la misma longitud de contexto usando la misma mezcla de datos. La Figura 4 (centro-derecha) muestra que el modelo de 34B es significativamente mejor que el modelo de 6B en RULER tanto en rendimiento a una longitud de 4K como en la degradación relativa, lo que sugiere el beneficio de escalar los tamaños de modelo para un mejor modelado de contexto largo.
Efecto de la arquitectura Evaluamos la longitud de contexto efectiva para dos modelos con arquitecturas no Transformer: RWKV-v5 (Peng et al. [2023] y Mamba-2.8B-slimpj (Gu &Dao|2023). Encontramos que ambos modelos demuestran una degradación significativa al extender el tamaño de contexto a 8K, y ambos quedan por debajo de la línea base Transformer Llama2-7B por amplios márgenes hasta la longitud de 4K, más allá de la cual Llama2 muestra un pobre rendimiento de extrapolación de longitud (Figura 4 derecha).
7 Conclusión
Presentamos RULER, un benchmark sintético para evaluar modelos de lenguaje de contexto largo. RULER contiene diversas categorías de tareas: recuperación, rastreo multi-salto, agregación y respuesta a preguntas, lo que proporciona una evaluación flexible y completa de las capacidades de contexto largo de los LLM. Evaluamos 17 LM de contexto largo usando RULER con tamaños de contexto que van desde 4K hasta 128K. A pesar de lograr resultados perfectos en la prueba ampliamente utilizada de aguja en un pajar, casi todos los modelos fallan en mantener su rendimiento en otras tareas de RULER a medida que aumentamos la longitud de entrada. Observamos modos comunes de fallo en tamaños de contexto grandes, incluidos el fallo en ignorar distractores y la utilización ineficaz del contexto largo (p. ej., simplemente copiar del contexto o usar conocimiento paramétrico en su lugar). Mostramos que RULER es desafiante incluso para los modelos de código abierto mejor clasificados a medida que aumentamos la complejidad de las tareas. Nuestro análisis revela además el gran potencial de mejora en RULER y el beneficio de escalar los tamaños de modelo para lograr mejores capacidades de contexto largo.
8 Limitaciones
A pesar de cubrir más categorías de tareas que los benchmarks orientados a la recuperación, RULER está limitado de múltiples maneras, que describimos en detalle a continuación.
Falta de control de posición. El RULER actual reporta una única métrica numérica para cada longitud de entrada sin proporcionar el rendimiento a nivel de profundidad. El rendimiento a nivel de profundidad fue evaluado por la prueba NIAH (Kamradi|2023) y trabajos recientes como LV-Eval (Yuan et al. 2024) y puede ser efectivo para revelar el fenómeno de lost-in-the-middle (Liu et al. 2024d). Somos conscientes de este problema y planeamos admitir el control de posición de la información clave en nuestra base de código.
Falta de correlación con tareas realistas de contexto largo. Si bien tareas como el seguimiento de variables y la extracción de palabras frecuentes se propusieron para servir como proxies de tareas realistas de lenguaje natural de contexto largo, la falta de tareas realistas de contexto largo fáciles de evaluar nos impide verificar la validez de estos proxies. Debido a esta limitación, enfatizamos que RULER puede usarse como comprobaciones de comportamiento convenientes de modelos de lenguaje de contexto largo; sin embargo, no debería preferirse sobre configuraciones más realistas, como NoCHA (Karpinska et al. 2024), que también enfatiza otras capacidades como el razonamiento y el seguimiento de instrucciones.
Falta de evaluación en contexto corto. En la suite de tareas actual de RULER, incluimos tareas en las que la mayoría de los modelos se desempeñan razonablemente bien con un tamaño de contexto de 4k, y apuntamos a observar la degradación del rendimiento con el escalado del tamaño de contexto. Esto no debe interpretarse erróneamente como capacidades perfectas de LM con un tamaño de contexto de 4k. De hecho, trabajos recientes, como FlenQA (Levy et al. 2024), han demostrado un rendimiento decreciente al aumentar la longitud de entrada de su tarea a solo unos pocos miles de tokens. Si bien aumentar la complejidad de la tarea en RULER conduce a un rendimiento mucho peor en tamaños de contexto más cortos, no incluimos estos resultados en este artículo.
Falta de verificación de la robustez de los prompts. Los modelos de lenguaje pueden ser sensibles al formato del prompt; sin embargo, no extendimos un estudio exhaustivo sobre la robustez de los prompts más allá de pruebas preliminares en la etapa temprana de este trabajo. Tampoco experimentamos intensamente con algunos hiperparámetros fijos en las tareas existentes, como la longitud de los nombres de variables en el seguimiento de variables y el tamaño del vocabulario sintético en la extracción de palabras comunes y la extracción de palabras frecuentes.
Referencias
Marah Abdin, Sam Ade Jacobs, Ammar Ahmad Awan, Jyoti Aneja, Ahmed Awadallah, Hany Awadalla, Nguyen Bach, Amit Bahree, Arash Bakhtiari, Harkirat Behl, et al. Phi-3 technical report: A highly capable language model locally on your phone. arXiv preprint arXiv:2404.14219, 2024.
Rishabh Agarwal, Avi Singh, Lei M Zhang, Bernd Bohnet, Stephanie Chan, Ankesh Anand, Zaheer Abbas, Azade Nova, John D Co-Reyes, Eric Chu, et al. Many-shot in-context learning. arXiv preprint arXiv:2404.11018, 2024.
AI21. Presentamos jamba: el innovador modelo ssm-transformer de AI21, 2024. URL https://www.ai21.com/blog/announcing-jamba
Chenxin An, Shansan Gong, Ming Zhong, Mukai Li, Jun Zhang, Lingpeng Kong y Xipeng Qiu. L-eval: Instaurando una evaluación estandarizada para modelos de lenguaje de contexto largo. En ICLR, 2024.
Anthropic. Prompts de contexto largo para Claude 2.1. Blog, 2023. URL https://www.anthropic.com/index/claude-2-1-prompting
Anthropic. Presentamos la próxima generación de claude, 2024. URL https://www.anthropic.com/news/claude-3-family
Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra y Christopher Ré. Zoology: Medición y mejora del recall en modelos de lenguaje eficientes. En ICLR, 2024.
Yushi Bai et al. LongBench: Un benchmark bilingüe y multitarea para la comprensión de contexto largo. arXiv:2308.14508, 2023.
Maximilian Beck, Korbinian Pöppel, Markus Spanning, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter y Sepp Hochreiter. xlstm: Memoria a largo plazo extendida. Preprint de arXiv arXiv:2405.04517, 2024.
Amanda Bertsch, Maor Ivgi, Uri Alon, Jonathan Berant, Matthew R Gormley y Graham Neubig. In-context learning with long-context models: An in-depth exploration. arXiv preprint arXiv:2405.00200, 2024.
Aydar Bulatov, Yuri Kuratov y Mikhail S Burtsev. Scaling Transformer to 1M tokens and beyond with RMT. arXiv:2304.11062, 2023.
David Castillo, Joseph Davidson, Finlay Gray, José Solorzano y Marek Rosa. Introducing GoodAI LTM benchmark. Blog, 2024. URL https://www.goodai.com/introducing-goodai-ltm-benchmark/
Shouyuan Chen, Sherman Wong, Liangjian Chen y Yuandong Tian. Extending context window of large language models via positional interpolation. En ICLR, 2023.
Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han y Jiaya Jia. LongLoRA: Efficient fine-tuning of long-context large language models. En ICLR, 2024.
Rewon Child, Scott Gray, Alec Radford y Ilya Sutskever. Generating long sequences with sparse Transformers. arXiv:1904.10509, 2019.
Cohere. Command r, 2024. URL https://docs.cohere.com/docs/command-r-plus#model-details
Tri Dao. FlashAttention-2: Faster attention with better parallelism and work partitioning. arxiv:2307.08691, 2023.
Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra y Christopher Ré. FlashAttention: Fast and memory-efficient exact attention with IO-awareness. En NeurIPS, 2022.
.
Databricks. Introducing dbrx: A new state-of-the-art open llm, 2024. URL https://www databricks.com/blog/introducing-dbrx-new-state-art-open-llm
Jiayu Ding et al. LongNet: Scaling Transformers to 1,000,000,000 tokens. arXiv:2307.02486, 2023.
Yiran Ding et al. LongRoPE: Extending LLM context window beyond 2 million tokens. arXiv:2402.13753, 2024.
Zican Dong, Tianyi Tang, Junyi Li, Wayne Xin Zhao y Ji-Rong Wen. Bamboo: A comprehensive benchmark for evaluating long text modeling capacities of large language models. arXiv:2309.13345, 2023.
Daniel Y. Fu, Tri Dao, Khaled K. Saab, Armin W. Thomas, Atri Rudra y Christopher Ré. Hungry Hungry Hippos: Towards language modeling with state space models. En ICLR, 2023a.
Daniel Y. Fu et al. Simple hardware-efficient long convolutions for sequence modeling. ICML, 2023b.
Yao Fu et al. Data engineering for scaling language models to 128k context. arXiv:2402.10171, 2024.
Team GLM, Aohan Zeng, Bin Xu, Bowen Wang, Chenhui Zhang, Da Yin, Diego Rojas, Guanyu Feng, Hanlin Zhao, Hanyu Lai, Hao Yu, Hongning Wang, Jiadai Sun, Jiajie Zhang, Jiale Cheng, Jiayi Gui, Jie Tang, Jing Zhang, Juanzi Li, Lei Zhao, Lindong Wu, Lucen Zhong, Mingdao Liu, Minlie Huang, Peng Zhang, Qinkai Zheng, Rui Lu, Shuaiqi Duan, Shudan Zhang, Shulin Cao, Shuxun Yang, Weng Lam Tam, Wenyi Zhao, Xiao Liu, Xiao Xia, Xiaohan Zhang, Xiaotao Gu, Xin Lv, Xinghan Liu, Xinyi Liu, Xinyue Yang, Xixuan Song, Xunkai Zhang, Yifan An, Yifan Xu, Yilin Niu, Yuantao Yang, Yueyan Li, Yushi Bai, Yuxiao Dong, Zehan Qi, Zhaoyu Wang, Zhen Yang, Zhengxiao Du, Zhenyu Hou y Zihan Wang. Chatglm: A family of large language models from glm-130b to glm-4 all tools, 2024.
Omer Goldman, Alon Jacovi, Aviv Slobodkin, Aviya Maimon, Ido Dagan y Reut Tsarfaty. Is it really long context if all you need is retrieval? towards genuinely difficult long context nlp. arXiv preprint arXiv:2407.00402, 2024.
Alex Graves, Greg Wayne e Ivo Danihelka. Neural Turing machines. arXiv:1410.5401, 2014.
Albert Gu y Tri Dao. Mamba: Linear-time sequence modeling with selective state spaces. arXiv:2312.00752, 2023.
Albert Gu, Karan Goel y Christopher Re. Efficiently modeling long sequences with structured state spaces. En ICLR, 2022.
Chi Han, Qifan Wang, Wenhan Xiong, Yu Chen, Heng Ji y Sinong Wang. Lm-infinite: Simple on-the-fly length generalization for large language models. arXiv:2308.16137, 2023.
John J. Hopfield. Neural networks and physical systems with emergent collective computational abilities. Proc of the National Academy of Sciences of the United States of America, 79 8: 2554-8, 1982.
Maor Ivgi, Uri Shaham y Jonathan Berant. Efficient long-text understanding with short-text models. Transactions of the ACL, 11:284-299, 2023.
Sam Ade Jacobs et al. DeepSpeed Ulysses: System optimizations for enabling training of extreme long sequence Transformer models. arXiv:2309.14509, 2023.
Sebastian Jaszczur et al. Sparse is enough in scaling transformers. En NeurIPS, 2021.
Albert Q Jiang et al. Mixtral of experts. arXiv:2401.04088, 2024.
Huiqiang Jiang et al. LongLlmLingua: Accelerating and enhancing LLMs in long context scenarios via prompt compression. arXiv:2310.06839, 2023.
Gregory Kamradt. Needle In A Haystack - pressure testing LLMs. Github, 2023. URL https://github.com/gkamradt/LLMTest.NeedleInAHaystack/tree/main
Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal y Mohit Iyyer. One thousand and one pairs: A" novel" challenge for long-context language models. arXiv preprint arXiv:2406.16264, 2024.
Lauri Karttunen. Discourse referents. En COLING, 1969.
George Kingsley Zipf. Selected studies of the principle of relative frequency in language. Harvard university press, 1932.
Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin y Mikhail Burtsev. Babilong: Testing the limits of llms with long context reasoning-in-a-haystack. arXiv preprint arXiv:2406.10149, 2024.
Woosuk Kwon et al. Efficient memory management for large language model serving with paged attention. En Proc. of the ACM SIGOPS 29th Symposium on Operating Systems Principles, 2023.
Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien MR Arnold, Vincent Perot, Siddharth Dalmia, et al. Can long-context language models subsume retrieval, rag, sql, and more? arXiv preprint arXiv:2406.13121, 2024.
Mosh Levy, Alon Jacoby y Yoav Goldberg. Same task, more tokens: the impact of input length on the reasoning performance of large language models. arXiv preprint arXiv:2402.14848, 2024.
Dacheng Li, Rulin Shao, et al. How long can open-source LLMs truly promise on context length?, 2023a. URL https://1msys.org/blog/2023-06-29-longchat
Jiaqi Li, Mengmeng Wang, Zilong Zheng y Muhan Zhang. Loogle: Can long-context language models understand long contexts? arXiv:2311.04939, 2023b.
Hao Liu, Matei Zaharia y Pieter Abbeel. Ring attention with blockwise Transformers for near-infinite context. En ICLR, 2023.
Hao Liu, Wilson Yan, Matei Zaharia y Pieter Abbeel. World model on million-length video and language with Ring Attention. arxiv:2402.08268, 2024a.
Jiaheng Liu et al. E2-LLM: Efficient and extreme length extension of large language models. arXiv:2401.06951, 2024b.
Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang y Lingming Zhang. Repoqa: Evaluating long context code understanding. arXiv preprint arXiv:2406.06025, 2024c.
Nelson F Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni y Percy Liang. Lost in the middle: How language models use long contexts. Transactions of the ACL, 12:157-173, 2024d.
Pedro Henrique Martins, Zita Marinho y Andre Martins. ∞-former: Infinite memory Transformer. En Proc. of the 60th Annual Meeting of the ACL (Volume 1: Long Papers), 2022.
Meta.AI. Llama 3 model card. 2024a. URL https://github.com/meta-llama/llama3/blob/main/MODEL_CARD.md
Meta.AI. Llama 3.1 model card. 2024b. URL https://github.com/meta-llama/llama-models/blob/main/models/llama3.1/MODEL_CARD.md
Mistral.AI. La plateforme, 2023. URL https://mistral.ai/news/la-plateforme/Amirkeivan Mohtashami y Martin Jaggi. Landmark attention: Random-access infinite context length for Transformers. En Workshop on Efficient Systems for Foundation Models @ ICML, 2023.
Vincent Ng. Supervised noun phrase coreference research: The first fifteen years. En Proc. of the 48th Annual Meeting of the ACL, 2010.
Catherine Olsson et al. Aprendizaje en contexto y cabezas de inducción. Transformer Circuits Thread, 2022. https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html.
OpenAI: Josh Achiam et al. Informe técnico de GPT-4. arXiv:2303.08774, 2023.
Bo Peng et al. RWKV: Reinventando las RNN para la era del transformer. En EMNLP, 2023.
Bowen Peng, Jeffrey Quesnelle, Honglu Fan y Enrico Shippole. YaRN: Extensión eficiente de la ventana de contexto de modelos de lenguaje grandes. En ICLR, 2024.
Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon y Christopher Ré. Jerarquía Hyena: Hacia modelos de lenguaje convolucionales más grandes. En ICML, 2023.
Ofir Press, Noah Smith y Mike Lewis. Entrenar corto, probar largo: La atención con sesgos lineales permite la extrapolación de la longitud de entrada. En ICLR, 2022.
Pranav Rajpurkar, Robin Jia y Percy Liang. Sabe lo que no sabes: Preguntas sin respuesta para SQuAD. En Proc. de la 56.ª Reunión Anual de la ACL (Volumen 2: Artículos cortos), 2018.
Machel Reid et al. Gemini 1.5: Desbloqueando la comprensión multimodal a través de millones de tokens de contexto. arXiv:2403.05530, 2024.
Marco Tulio Ribeiro, Tongshuang Wu, Carlos Guestrin y Sameer Singh. Más allá de la precisión: Pruebas de comportamiento de modelos NLP con CheckList. En Proc. de la 58.ª Reunión Anual de la ACL, 2020.
Uri Shaham, Maor Ivgi, Avia Efrat, Jonathan Berant y Omer Levy. ZeroSCROLLS: Un benchmark de cero disparos para la comprensión de textos largos. En EMNLP, 2023.
Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen y Yunfeng Liu. RoFormer: Transformer mejorado con incrustación de posición rotatoria. arXiv:2104.09864, 2023.
Simeng Sun, Katherine Thai y Mohit Iyyer. ChapterBreak: Un conjunto de datos de desafío para modelos de lenguaje de largo alcance. En Proc. de la Conferencia 2022 del Capítulo Norteamericano de la ACL: Tecnologías del Lenguaje Humano, 2022.
Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang y Furu Wei. Red retentiva: Un sucesor del Transformer para modelos de lenguaje grandes. arXiv:2307.08621, 2023a.
Yutao Sun, Li Dong, Barun Patra, Shuming Ma, Shaohan Huang, Alon Benhaim, Vishrav Chaudhary, Xia Song y Furu Wei. Un Transformer con extrapolación de longitud. En Proc. de la 61.ª Reunión Anual de la ACL (Volumen 1: Artículos largos), 2023b.
Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang y Furu Wei. Solo almacenas en caché una vez: Arquitecturas decodificador-decodificador para modelos de lenguaje. Preimpresión de arXiv arXiv:2405.05254, 2024.
Garrett Tanzer, Mirac Suzgun, Eline Visser, Dan Jurafsky y Luke Melas-Kyriazi. Un benchmark para aprender a traducir un nuevo idioma a partir de un libro de gramática. En ICLR, 2024.
Together.AI. Preparándose para la era del contexto de 32k: Aprendizajes y exploraciones tempranas, 2023a. URL https://www.together.ai/blog/llama-2-7b-32k
Together.AI. Llama-2-7b-32k-instruct — y ajuste fino para modelos llama-2 con la API de together, 2023b. URL https://www.together.ai/blog/llama-2-7b-32k-instruct
Hugo Touvron et al. Llama 2: Modelos base abiertos y modelos de chat ajustados. arXiv:2307.09288, 2023.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot y Ashish Sabharwal. Musique: Preguntas de múltiples saltos mediante composición de preguntas de un solo salto. Transactions of the ACL, 10: 539-554, 2022.
Szymon Tworkowski et al. Focused Transformer: Entrenamiento contrastivo para el escalado de contexto. NeurIPS, 36, 2024.
Teun A. van Dijk y Walter Kintsch. Estrategias de comprensión del discurso. En Academic Press, 1983.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, L ukasz Kaiser e Illia Polosukhin. La atención es todo lo que necesitas. En NeurIPS, 2017.
Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao y Furu Wei. Aumentando modelos de lenguaje con memoria a largo plazo. NeurIPS, 36, 2024.
Thomas Wolf et al. Transformers de Huggingface: Procesamiento de lenguaje natural de vanguardia. arXiv:1910.03771, 2019.
Qingyang Wu, Zhenzhong Lan, Kun Qian, Jing Gu, Alborz Geramifard y Zhou Yu. Memformer: Un Transformer aumentado con memoria para el modelado de secuencias. En Findings of the ACL: AACL-IJCNLP, 2022.
X.AI. Anunciando grok-1.5, 2024. URL https://x.ai/blog/grok-1.5
Chaojun Xiao et al. InfLLM: Desvelando la capacidad intrínseca de los LLM para comprender secuencias extremadamente largas con memoria sin entrenamiento. arXiv:2402.04617, 2024a.
Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han y Mike Lewis. Modelos de lenguaje de transmisión eficientes con sumideros de atención. En ICLR, 2024b.
Wenhan Xiong et al. Escalado efectivo de contexto largo de modelos fundacionales. arXiv:2309.16039, 2023.
Peng Xu, Wei Ping, Xianchao Wu, Lawrence McAfee, Chen Zhu, Zihan Liu, Sandeep Subramanian, Evelina Bakhturina, Mohammad Shoeybi y Bryan Catanzaro. La recuperación se encuentra con los modelos de lenguaje grandes de contexto largo. En ICLR, 2024a.
Xiaoyue Xu, Qinyuan Ye y Xiang Ren. Poniendo a prueba modelos de lenguaje de contexto largo con ICL de por vida y pajar de tareas. Preimpresión de arXiv arXiv:2407.16695, 2024b.
An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, et al. Informe técnico de Qwen2. Preimpresión de arXiv arXiv:2407.10671, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William Cohen, Ruslan Salakhutdinov y Christopher D. Manning. HotpotQA: Un conjunto de datos para responder preguntas de múltiples saltos diverso y explicable. En EMNLP, 2018.
Alex Young et al. Yi: Modelos fundacionales abiertos por 01.AI. arXiv:2403.04652, 2024.
Tao Yuan, Xuefei Ning, Dong Zhou, Zhijie Yang, Shiyao Li, Minghui Zhuang, Zheyue Tan, Zhuyu Yao, Dahua Lin, Boxun Li, et al. Lv-eval: Un benchmark equilibrado de contexto largo con 5 niveles de longitud de hasta 256k. Preimpresión de arXiv arXiv:2402.05136, 2024.
Peitian Zhang, Zheng Liu, Shitao Xiao, Ninglu Shao, Qiwei Ye y Zhicheng Dou. Elevándose de 4k a 400k: Extendiendo el contexto de los LLM con baliza de activación. arXiv:2401.03462, 2024a.
Xinrong Zhang, Yingfa Chen, Shengding Hu, Zihang Xu, Junhao Chen, Moo Khai Hao, Xu Han, Zhen Leng Thai, Shuo Wang, Zhiyuan Liu y Maosong Sun. obench: Extendiendo la evaluación de contexto largo más allá de 100k tokens. arXiv:2402.13718, 2024b.
Dawei Zhu, Nan Yang, Liang Wang, Yifan Song, Wenhao Wu, Furu Wei y Sujian Li. PoSE: Efficient context window extension of LLMs via positional skip-wise training. En ICLR, 2024.
A Modelos
Seleccionamos en total 37 modelos para evaluación y análisis. Nuestros resultados en el texto principal solo incluyen modelos alineados (GPT-4, Gemini-1.5 y 15 modelos de código abierto). Además de los modelos alineados, también evaluamos 7 modelos base de código abierto usando RULER. Usamos el rendimiento de Llama2-7b (base) y Llama2-7b (chat) con una longitud de contexto de 4K como umbral para determinar el tamaño de contexto efectivo. En nuestra sección de análisis, evaluamos en total 11 modelos, incluyendo las series de modelos Yi y LWM, así como modelos de arquitecturas novedosas, incluyendo Mamba y RWKV.
| Modelo | Alineado | Tamaño | Longitud de contexto | Huggingface [Wolf et al., 2019] / API |
| GPT-4 | OpenAI: Josh Achiam et al., 2023 | ✓ | - | 128K |
| Gemini-1.5 | Kred et al., 2024 | ✓ | - | 1M |
| Llama3.1 | Meta: AI, 2024b | ✓ | 70B | 128K |
| Llama3.1 | Meta: AI, 2024b | ✓ | 8B | 128K |
| Command-K-plus: Cohen, 2024 | ✓ | ✓ | 104B | 128K |
| Qwen2: Yang et al., 2024 | ✓ | ✓ | 72B | 128K |
| Yi: Young et al., 2024 | ✓ | ✓ | 34B | 200K |
| Mixtral-8x22B: Huang et al., 2024 | ✓ | ✓ | 39B/141B | 32K |
| Mixtral-v0.2: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| GLM4: GLM et al., 2024 | ✓ | ✓ | 9B | 1M |
| GradieHAT: Llama3: Meta, AI, 2024a | ✓ | ✓ | 70B | 1M |
| Phi3-medium: Abdin et al., 2024 | ✓ | ✓ | 14B | 128K |
| LWM: Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| DBRX: Tabatricks, 2024 | ✓ | ✓ | 36B/132B | 1M |
| Together: Together, AI, 2023b | ✓ | ✓ | 7B | 32K |
| LongChat: Li et al., 2023a | ✓ | ✓ | 7B | 32K |
| LongAlpaca: Chen et al., 2024 | ✓ | ✓ | 13B | 32K |
| Mixtral-base: Jiang et al., 2024 | ✓ | ✓ | 8x7B | 32K |
| Mixtral-base: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| LWM-base: Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| LongLoRA-base: Chen et al., 2024 | ✓ | ✓ | 7B | 100K |
| Yarn-base: Peng et al., 2024 | ✓ | ✓ | 7B | 128K |
| Together-base: Together, AI, 2023a | ✓ | ✓ | 7B | 32K |
| Jamba-base: AI, 2024 | ✓ | ✓ | 52B | 256K |
| Llama2 (chat): Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Llama2 (base): Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Serie Yi: Young et al., 2024 | ✓ | ✓ | 6B, 9B | 200K |
| Serie LWM: Liu et al., 2024a | ✓ | ✓ | 7B | 128K, 256K, 512K |
| Serie LWM-base: Liu et al., 2024a | ✓ | ✓ | 7B | 32K, 128K, 256K, 512K |
| Mamba: Gu & Dai, 2023 | ✓ | ✓ | 2.8B | 2K |
| RWKV: Peng et al., 2023 | ✓ | ✓ | 7B | 4K |
Tabla 4: Información de los modelos evaluados y analizados en RULER.
B Configuraciones de las tareas
RULER está diseñado para ser configurable, de modo que permita diversas longitudes de secuencia y complejidades de tarea. Para cada tarea, surge un número combinatoriamente grande de configuraciones que se pueden adoptar. En el texto principal, evaluamos los modelos con 13 tareas representativas que abarcan las cuatro categorías de RULER. Nuestro proceso de selección de tareas se describe en la siguiente sección del apéndice.
- Recuperación: En S-NIAH, incluimos la recuperación de passkey (Mohtashami & Jaggi, 2023) y el NIAH vanilla (Kamradt, 2023), ambos usan palabra-número como clave-valor y difieren solo en el texto de relleno de fondo. Además, cambiamos el tipo de valor a UUID, con el propósito de probar la robustez del modelo al recuperar cadenas largas del contexto. Para MK-NIAH, añadimos tres agujas distractoras al texto de relleno. También incluimos configuraciones existentes de trabajos previos: recuperación de líneas (Li et al., 2023a) y recuperación clave-valor (Liu et al., 2024d) con el texto de relleno llenado enteramente con agujas distractoras. Para MV-NIAH y MQ-NIAH, probamos 4 valores y consultas respectivamente.
- Rastreo multi-salto: Para VT, insertamos 1 cadena con 4 saltos de vinculación de nombres, en total deben devolverse 5 nombres de variables.
- Agregación: Para CWE, en total se deben devolver 10 palabras comunes, cada una aparece 30 veces, mientras que las palabras poco comunes aparecen 3 veces cada una. Para FWE, establecemos en 2.0 en la distribución Zeta para el muestreo de palabras sintéticas.
- QA: Para QA, aumentamos SQuAD (Rajpurkar et al., 2018) y HotpotQA (Yang et al., 2018) para simular un escenario de contexto largo. Son representativos de tareas de respuesta a preguntas de un solo salto y de múltiples saltos, respectivamente.
| Tarea | Configuraciones | ||
| Subtarea-1 | Subtarea-2 | Subtarea-3 | |
| NIAH simple | type_key = wordtype_value = numbertype_haystack = repeat~recuperación de passkey | type_key = wordtype_value = numbertype_haystack = essay~NIAH vanilla | type_key = wordtype_value = uuidtype_haystack = essay |
| MK-NIAH | num_keys = 4type_key = wordtype_value = numbertype_haystack = essay | num_keys = full haystacktype_key = wordtype_value = number~recuperación de línea | num_keys = full haystacktype_key = uuidtype_value = uuid~recuperación de KV |
| MV-NIAH | num_values = 4, type_key = word, type_value = number, type_haystack = essay | ||
| MQ-NIAH | num_queries = 4, type_key = word, type_value = number, type_haystack = essay | ||
| VT | num_chains = 1, num_hops = 4 | ||
| CWE | freq_cw = 30, freq_ucw = 3, num_cw = 10 | ||
| FWE | α = 2.0 | ||
| QA | dataset = SQuAD | dataset = HotpotQA | |
Tabla 5: Nuestras 13 configuraciones de tareas en total en RULER.
C Análisis de correlación entre tareas
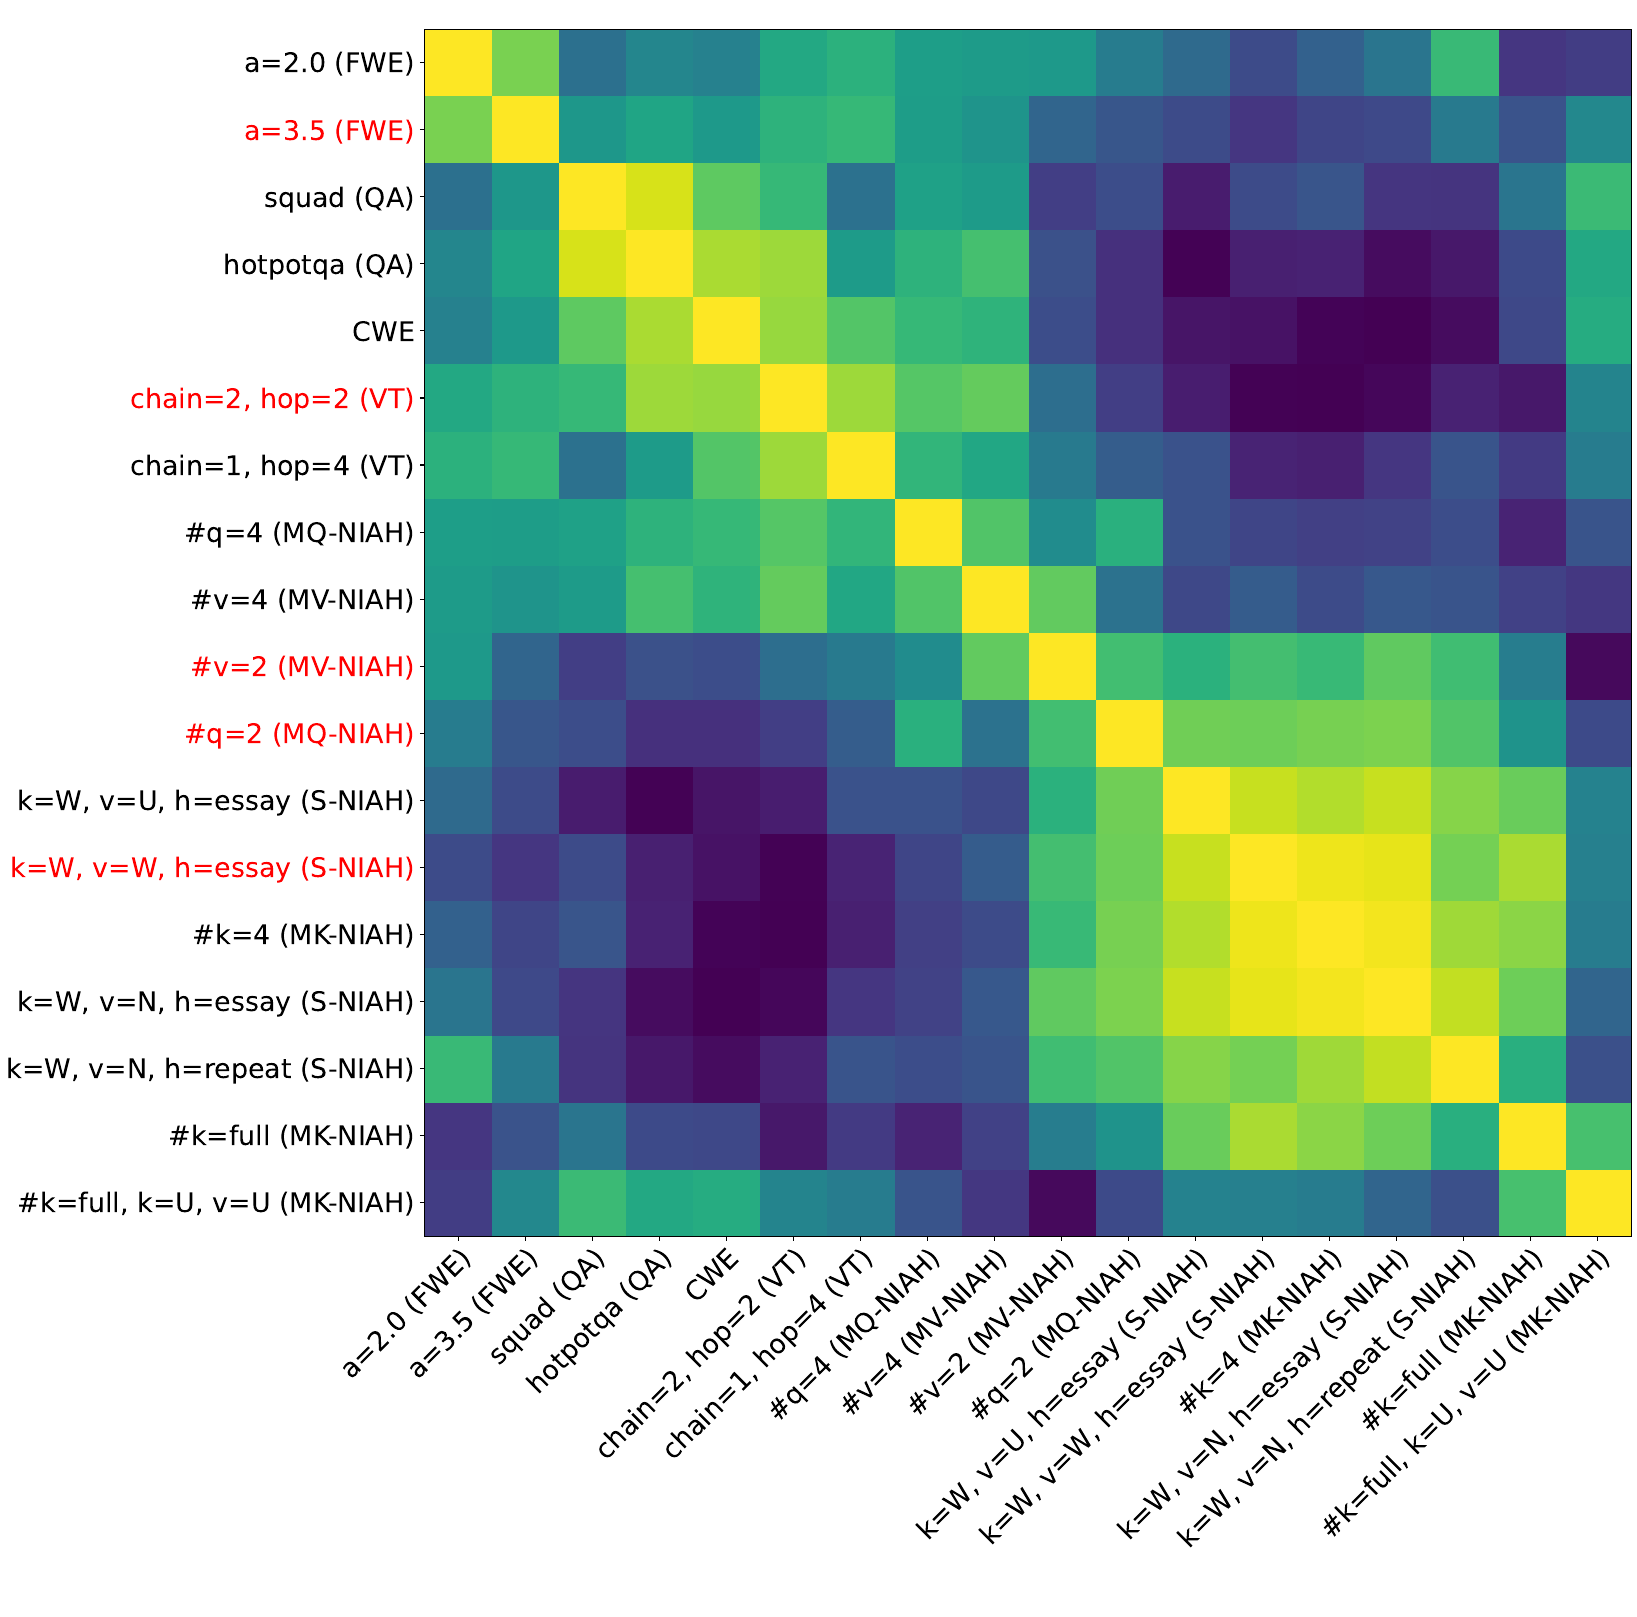
RULER está diseñado bajo el supuesto de que las tareas de diferentes categorías son capaces de revelar comportamientos distintos de los modelos. Realizamos un estudio correlacional preliminar para confirmar la validez de las categorías de tareas y guiar la selección de tareas representativas. Evaluamos ocho modelos de código abierto con varios tamaños de contexto en 18 configuraciones de tareas. Cada tarea puede entonces representarse con un vector de rendimiento del modelo en varios tamaños de contexto. Los 18 vectores de tareas se agrupan luego mediante un algoritmo de agrupamiento aglomerativo, usando el coeficiente de correlación como métrica de distancia. Como se muestra en la Figura 5, aunque ciertas tareas exhiben correlaciones moderadas con otras, las tareas de cada una de las cuatro categorías (NIAH, VT, AG, QA) forman grupos cohesivos propios sin redundancia. Además, eliminamos algunas tareas que correlacionan altamente con otras tareas dentro del mismo grupo y finalizamos 13 tareas para la evaluación a gran escala posterior.
D Plantillas de prompts
Descomponemos la plantilla de prompt de entrada en la plantilla de modelo en la Tabla 6 y la plantilla de tarea en la Tabla 7. La plantilla de modelo es el formato de chat del modelo, mientras que la plantilla de tarea combina instrucción, contexto y consulta. Para evitar que los modelos se nieguen a responder nuestras preguntas, añadimos a la entrada un prefijo de respuesta para elicitar las respuestas del modelo. Para VT y CWE, usamos una muestra de tarea como demostración en contexto.
| Modelo | Plantilla |
| GPT-4 | {task_template} No proporciones ninguna explicación. Por favor, dame directamente la respuesta. {task_answer_prefix} |
| Yi/Base | {task_template} {task_answer_prefix} |
Command-R | {BOS_TOKEN}{START_OF_TURN_TOKEN}{USER_TOKEN}{task_template}{END_OF_TURN_TOKEN}{START_OF_TURN_TOKEN}{CHATBOT_TOKEN}{task_answer_prefix} |
LWM/LongChat | {system_prompt} USER: {task_template} ASSISTANT:{task_answer_prefix} |
GLM | {gMASK} sop{user}{task_template} {assistant}{task_answer_prefix} |
Phi3 | {user}{task_template} {end}{assistant}{task_answer_prefix} |
Qwen/DBRX | {im_start} system{system_prompt} {im_end}{im_start} user{task_template} {im_end}{im_start} assistant{task_answer_prefix} |
| Llama3/Llama3.1 | {begin_of_text} {start_header_id} user {end_header_id} |
Llama2/Otros | {task_template} {eot_id}{start_header_id} assistant {end_header_id} |
| {task_answer_prefix} | |
| [INST] {task_template} [/INST] {task_answer_prefix} |
Tabla 6: Plantillas de chat de los modelos. Añadimos un prefijo de respuesta a la tarea en la respuesta del modelo para evitar que los modelos se nieguen a responder nuestras preguntas. La adición del prefijo de respuesta no rompe la plantilla de chat de los modelos.
Subtarea-1
Subtarea-2
Subtarea-3
Subtarea-1
Subtarea-2
Subtarea-3
Subtarea-4
Subtarea-5
Subtarea-6
Subtarea-7
Subtarea-8
Subtarea-9
Subtarea-10
Subtarea-11
Subtarea-12
Subtarea-13
Subtarea-14
Subtarea-15
Subtarea-16
Subtarea-17
Subtarea-18
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-19
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-20
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-21
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-22
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-23
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-24
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-25
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-26
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-27
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-28
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Tabla 6: Plantillas de chat del modelo. Añadimos un prefijo de respuesta de la tarea en la respuesta del modelo para evitar que los modelos se nieguen a responder nuestras preguntas. La adición del prefijo de respuesta no rompe la plantilla de chat de los modelos.
MK-NIAHSubtask-29
MK-NIAHSubtask-30
MK-NIAHSubtask-32
MK-NIAHSubtask-34
MK-NIAHSubtask-36
MK-NIAHSubtask-38
MK-NIAHSubtask-40
MK-NIAHSubtask-42
MK-NIAHSubtask-44
MK-NIAHSubtask-46
MK-NIAHSubtask-48
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-49
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-50
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-51
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-52
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-53
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-54
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-55
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-56
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-57
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-58
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtarea-59
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtarea-60
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré una prueba sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Tabla 6: Plantillas de chat de los modelos. Añadimos un prefijo de respuesta de la tarea en la respuesta del modelo para evitar que los modelos se nieguen a responder nuestras preguntas. La adición del prefijo de respuesta no rompe la plantilla de chat de los modelos.
Texto a traducir:
MK-NIAH
Subtask-61
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-62
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtask-63
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-64
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtask-65
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-66
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtask-67
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-68
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtask-69
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-70
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtask-71
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-72
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number-2}.
Uno de los números mágicos especiales para {word-3} es: {number-3}.
Uno de los números mágicos especiales para {word-4} es: {number-4}.
¿Cuál es el número mágico especial para {word-4} mencionado en el texto proporcionado?
Subtask-73
El número mágico especial para {word-4} mencionado en el texto proporcionado es
Subtask-74
Some special magic numbers are hidden within the following text. Make sure to memorize it. I will quiz you about the numbers afterwards.
One of the special magic numbers for {word-1} is: {number-1}.
Plantilla de la tarea:
Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.
Uno de los números mágicos especiales para {word-1} es: {number-1}.
Uno de los números mágicos especiales para {word-2} es: {number
| Plantilla de tarea: Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlos. Después te haré preguntas sobre los números. Ensayos de Paul Graham....... Uno de los números mágicos especiales para {word} es: {number-1}....... Uno de los números mágicos especiales para {word} es: {number-2}....... Uno de los números mágicos especiales para {word} es: {number-3}....... Uno de los números mágicos especiales para {word} es: {number-4}. ¿Cuáles son todos los números mágicos especiales para {word} mencionados en el texto proporcionado? |
Prefijo de respuesta de la tarea: Los números mágicos especiales para {word} mencionados en el texto proporcionado son | |
Plantilla de la tarea: Algunos números mágicos especiales están ocultos dentro del siguiente texto. Asegúrate de memorizarlo. Después te haré preguntas sobre los números.Paul Graham Essays....... Uno de los números mágicos especiales para {word-1} es: {number-1}....... Uno de los números mágicos especiales para {word-2} es: {number-2}....... Uno de los números mágicos especiales para {word-3} es: {number-3}....... Uno de los números mágicos especiales para {word-4} es: {number-4}.¿Cuáles son todos los números mágicos especiales para {word-1}, {word-2}, {word-3} y {word-4} mencionados en el texto proporcionado? |
| Prefijo de respuesta a la tarea: Los números mágicos especiales para {word-1}, {word-2}, {word-3} y {word-4} mencionados en el texto proporcionado son |
| Plantilla de tarea: {un ejemplo de tarea} Memoriza y rastrea la(s) cadena(s) de asignación de variables ocultas en el siguiente texto. La hierba es verde. El cielo es azul. El sol es amarillo. Aquí vamos. Ida y vuelta otra vez. ...... VAR {X1} = {número} ...... ...... VAR {X2} = {X1} ...... ...... VAR {X3} = {X2} ...... ...... VAR {X4} = {X3} ...... ...... VAR {X5} = {X4} ...... Pregunta: Encuentra todas las variables a las que se les asigna el valor {número} en el texto anterior. |
| Prefijo de respuesta a la tarea: Respuesta: Según la(s) cadena(s) de asignación de variables en el texto anterior, a 5 variables se les asigna el valor {number}, las cuales son: |
| Plantilla de tarea: {un ejemplo de tarea} A continuación se presenta una lista numerada de palabras. En estas palabras, algunas aparecen con más frecuencia que otras. Memoriza las que aparecen con más frecuencia. 1. palabra-a 2. palabra-b 3. palabra-c 4. palabra-d 5. palabra-d 6. palabra-a 7. palabra-e 8. palabra-f ...... Pregunta: ¿Cuáles son las 10 palabras más comunes en la lista anterior? |
| Prefijo de respuesta a la tarea: Respuesta: Las 10 palabras que aparecen con más frecuencia en la lista son: | |
| Plantilla de tarea: Lee el siguiente texto codificado y registra la frecuencia de cada palabra codificada. Encuentra las tres palabras codificadas que aparecen con más frecuencia. ... palabra-a ... palabra-b ... ... palabra-c ... palabra-a ...palabra-d palabra-e ... palabra-a ... palabra-f ... ... palabra-g ... palabra-h ... palabra-a ... palabra-i ....Pregunta: No proporciones ninguna explicación. Ignora los puntos suspensivos '...'. ¿Cuáles son las tres palabras que aparecen con más frecuencia en el texto codificado anterior? |
| Prefijo de respuesta a la tarea: Respuesta: Según el texto codificado anterior, las tres palabras que aparecieron con mayor frecuencia son: |
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Template:
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document y:
{document-y}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Plantilla de tarea:
Responde la pregunta basándote en los documentos proporcionados. Solo dame la respuesta y no emitas ninguna otra palabra.
A continuación se presentan los documentos proporcionados.
Documento 1:
{document-1}
......
Documento x:
{document-x}
......
Documento n:
{document-n}
Responde la pregunta basándote en los documentos proporcionados. Solo dame la respuesta y no emitas ninguna otra palabra.
Pregunta: pregunta
Prefijo de respuesta de la tarea:
Respuesta:
Plantilla de tarea:
Responde la pregunta basándote en los documentos proporcionados. Solo dame la respuesta y no emitas ninguna otra palabra.
A continuación se presentan los documentos proporcionados.
Documento 1:
{document-1}
......
Documento x:
{document-x}
......
Documento y:
{document-y}
......
Documento n:
{document-n}
Responde la pregunta basándote en los documentos proporcionados. Solo dame la respuesta y no emitas ninguna otra palabra.
Pregunta: pregunta
Prefijo de respuesta de la tarea:
Respuesta:
Prefijo de respuesta de la tarea:
Respuesta:
E Recuperación de passkey y resultados de NIAH vanilla
| Modelos | Longitud declarada | 4K | 8K | 16K | 32K | 64K | 128K | Prom. |
| Gemini-1.5 | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GPT-4 | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Llama3.1 (70B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 97,8 | 99,6 |
| Llama3.1 (8B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Qwen2 (72B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 96,6 | 99,4 |
| Command-R-plus (104B) | 128K | 100,0 | 100,0 | 99,8 | 99,8 | 100,0 | 97,2 | 99,5 |
| GLM4 (9B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GradientAI/LLama3 (70B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 93,6 | 98,9 |
| Mixtral-8x22B (39B/141B) | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 0,0 | 83,3 |
| Yi (34B) | 200K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Phi3-medium (14B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 88,0 | 98,0 |
| Mistral-v0.2 (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 69,6 | 94,9 |
| LWM (7B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| DBRX (36B/132B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 0,0 | 0,0 | 66,7 |
| Together (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 0,0 | 0,0 | 66,7 |
| LongChat (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,4 | 0,0 | 0,0 | 66,6 |
| LongAlpaca (13B) | 32K | 88,2 | 88,6 | 86,4 | 82,4 | 0,0 | 0,0 | 57,6 |
| Mixtral-base (8x7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 46,8 | 91,1 |
| Mixtral-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 70,8 | 95,1 |
| Jamba-base (52B) | 256K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| LWM-base (7B) | 1M | 99,8 | 99,6 | 99,6 | 98,2 | 96,0 | 98,9 | 98,9 |
| LongLoRA-base (7B) | 100K | 99,6 | 99,4 | 99,0 | 99,4 | 99,4 | 0,0 | 82,8 |
| Yarn-base (7B) | 128K | 100,0 | 100,0 | 99,0 | 100,0 | 99,2 | 39,6 | 89,6 |
| Together-base (7B) | 32K | 100,0 | 100,0 | 99,8 | 100,0 | 0,0 | 0,0 | 66,6 |
| Modelos | Longitud declarada | 4K | 8K | 16K | 32K | 64K | 128K | Prom. |
| Gemini-1.5 | 1M | 100,0 | 100,0 | 100,0 | 98,0 | 100,0 | 100,0 | 99,7 |
| GPT-4 | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Llama3.1 (70B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 |
| Llama3.1 (8B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 |
| Qwen2 (72B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,8 | 56,4 | 92,7 |
| Command-R-plus (35B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,8 | 86,0 | 97,6 |
| GLM4 (9B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GradientAI/LLama3 (70B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 97,8 | 99,4 |
| Mixtral-8x22B (39B/141B) | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 24,2 | 87,3 |
| Yi (34B) | 200K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Phi3-medium (14B) | 128K | 100,0 | 100,0 | 100,0 | 99,8 | 99,8 | 73,8 | 95,5 |
| Mixtral-v0.2 (7B) | 32K | 100,0 | 100,0 | 100,0 | 97,0 | 70,0 | 7,4 | 79,1 |
| LWM (7B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| DBRX (36B/132B) | 32K | 100,0 | 100,0 | 90,0 | 93,2 | 0,8 | 0,0 | 64,0 |
| Together (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,8 | 0,0 | 0,0 | 66,6 |
| LongChat (7B) | 32K | 100,0 | 100,0 | 97,6 | 98,4 | 0,0 | 0,0 | 66,0 |
| LongAlpaca (13B) | 32K | 90,2 | 90,2 | 88,4 | 83,4 | 0,0 | 0,0 | 58,7 |
| Mixtral-base (8x7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 85,2 | 34,8 | 86,7 |
| Mixtral-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 94,8 | 0,4 | 82,5 |
| Jamba-base (52B) | 256K | 100,0 | 100,0 | 98,8 | 99,8 | 99,8 | 86,4 | 97,5 |
| LWM-base (7B) | 1M | 100,0 | 99,4 | 97,8 | 98,6 | 98,2 | 98,6 | 98,8 |
| LongLoRA-base (7B) | 100K | 99,8 | 100,0 | 100,0 | 99,8 | 100,0 | 0,0 | 83,3 |
| Yarn-base (7B) | 128K | 97,4 | 97,8 | 91,4 | 85,4 | 86,6 | 20,0 | 79,8 |
| Together-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,8 | 0,0 | 0,0 | 66,6 |
Tabla 11: Rendimiento de modelos alineados y base seleccionados en longitudes de 4K a 128K en NIAH vanilla de RULER. Casi todos los modelos tienen una puntuación perfecta en la longitud que declaran.
.
F Resultados adicionales
| Modelos | Longitud declarada | Longitud efectiva | 4K | 8K | 16K | 32K | 64K | 128K | Prom. | wProm. (inc) | wProm. (dec) |
| Llama2-7B (base) | 4K | - | 79.4 | ||||||||
| Mixtral-base (8x7B) | 32K | 32K | 91.8 | 91.0 | 89.5 | 85.8 | 66.9 | 29.0 | 75.7 | 66.4(1.º) | 85.0(1.º) |
| Mixtral-base (7B) | 32K | 16K | 91.6 | 89.8 | 86.3 | 77.2 | 52.3 | 8.0 | 67.5 | 54.7(4.º) | 80.4(2.º) |
| Jamba-base (52B) | 256K | 4K | 81.2 | 75.4 | 68.8 | 65.3 | 61.0 | 51.4 | 67.2 | 62.5(3.º) | 71.8(4.º) |
| LWM-base (7B) | 1M | <4K | 77.5 | 74.0 | 69.6 | 64.6 | 61.3 | 59.0 | 67.7 | 64.4(2.º) | 70.9(5.º) |
| LongLoRA-base (7B) | 100K | 8K | 81.9 | 80.4 | 75.6 | 65.1 | 60.8 | 0.0 | 60.6 | 49.2(5.º) | 72.0(3.º) |
| Yarn-base (7B) | 128K | <4K | 77.3 | 67.5 | 59.0 | 47.3 | 38.6 | 13.9 | 50.6 | 40.7(6.º) | 60.5(7.º) |
| Together-base (7B) | 32K | 4K | 84.6 | 78.7 | 68.3 | 57.9 | 0.0 | 0.0 | 48.2 | 32.3(7.º) | 64.2(6.º) |
Tabla 12: Rendimiento de modelos base seleccionados en longitudes de 4K a 128K promediando las puntuaciones de 13 tareas en RULER.
| Modelos | Longitud declarada | Longitud efectiva | 4K | 8K | 16K | 32K | 64K | 128K | Prom. | wProm. (inc) | wProm. (dec) |
| Llama2-7B (chat) | 4K | - | 96.9 | ||||||||
| Gemini-1.5 | 1M | >128K | 99.8 | 99.9 | 99.6 | 99.7 | 99.7 | 99.6 | 99.7 | 99.7(1.º) | 99.7(1.º) |
| Llama3.1 (8B) | 128K | 64K | 99.9 | 99.9 | 99.8 | 99.6 | 98.7 | 92.6 | 98.4 | 97.5(3.º) | 99.4(2.º) |
| GLM4 (9B) | 1M | 64K | 99.4 | 99.2 | 99.5 | 99.4 | 97.3 | 94.4 | 98.2 | 97.5(2.º) | 98.9(3.º) |
| Llama3.1 (70B) | 128K | 64K | 100.0 | 100.0 | 99.9 | 99.6 | 98.5 | 78.9 | 96.1 | 93.5(5.º) | 98.8(4.º) |
| GPT-4 | 128K | 32K | 99,9 | 99,9 | 98,7 | 98,3 | 90,9 | 84,8 | 95,4 | 92,9 (6.º) | 97,9 (5.º) |
| Command-R-plus (104B) | 128K | 32K | 99,9 | 99,9 | 99,4 | 97,9 | 89,6 | 65,7 | 92,1 | 87,3 (8.º) | 96,9 (6.º) |
| GradientAI/Llama3 (70B) | 1M | 16K | 99,0 | 98,8 | 98,3 | 94,5 | 91,2 | 84,9 | 94,4 | 92,1 (7.º) | 96,8 (7.º) |
| Yi (34B) | 200K | 16K | 98,2 | 96,8 | 97,3 | 95,1 | 93,0 | 90,2 | 95,1 | 93,8 (4.º) | 96,4 (8.º) |
| Qwen2 (72B) | 128K | 32K | 100,0 | 99,9 | 99,9 | 99,4 | 84,5 | 48,0 | 88,6 | 81,3 (11.º) | 95,9 (9.º) |
| Phi3-medium (14B) | 128K | 8K | 98,7 | 98,5 | 96,6 | 95,4 | 91,9 | 51,3 | 88,7 | 82,6 (10.º) | 94,9 (10.º) |
| Mixtral-8x22B (39B/141B) | 64K | 16K | 99,3 | 99,1 | 97,7 | 96,7 | 89,9 | 23,8 | 84,4 | 74,8 (12.º) | 94,1 (11.º) |
| LWM (7B) | 1M | <4K | 92,5 | 92,1 | 87,6 | 83,7 | 84,1 | 83,4 | 87,2 | 85,5 (9.º) | 89,0 (12.º) |
| Mistral-v0.2 (7B) | 32K | 4K | 98,1 | 96,2 | 94,3 | 85,5 | 51,1 | 10,7 | 72,6 | 58,8 (13.º) | 86,5 (13.º) |
| DBRX (36B/132B) | 32K | 8K | 99,4 | 99,0 | 93,5 | 73,4 | 0,5 | 0,0 | 61,0 | 41,6 (14.º) | 80,3 (14.º) |
| Together (7B) | 32K | <4K | 96,2 | 89,9 | 82,3 | 80,2 | 0,0 | 0,0 | 58,1 | 40,2 (15.º) | 76,0 (15.º) |
| LongChat (7B) | 32K | <4K | 93,3 | 92,2 | 81,1 | 67,3 | 0,0 | 0,0 | 55,7 | 37,6 (16.º) | 73,7 (16.º) |
| LongAlpaca (13B) | 32K | <4K | 74,9 | 72,2 | 70,8 | 53,2 | 0,0 | 0,0 | 45,2 | 30,7 (17.º) | 59,7 (17.º) |
| Llama2-7B (base) | 4K | - | 90.9 | ||||||||
| Mixtral-base (8x7B) | 32K | 32K | 99.9 | 99.7 | 98.4 | 94.8 | 72.1 | 29.1 | 82.3 | 71.8(2.º) | 92.8(1.º) |
| Mixtral-base (7B) | 32K | 16K | 99.3 | 97.5 | 95.7 | 89.8 | 56.8 | 10.2 | 74.9 | 61.2(4.º) | 88.6(2.º) |
| Jamba-base (52B) | 256K | <4K | 86.4 | 80.5 | 73.7 | 72.3 | 68.1 | 56.9 | 73.0 | 68.5(3.º) | 77.4(5.º) |
| LWM-base (7B) | 1M | <4K | 88.5 | 87.7 | 84.5 | 79.6 | 76.1 | 74.2 | 81.8 | 79.1(1.º) | 84.4(4.º) |
| LongLoRA-base (7B) | 100K | 16K | 95.3 | 95.6 | 92.7 | 81.5 | 76.2 | 0.0 | 73.5 | 60.6(5.º) | 86.5(3.º) |
| Yarn-base (7B) | 128K | <4K | 89,9 | 86,1 | 78,4 | 59,0 | 49,5 | 17,5 | 63,4 | 51,7 (6.º) | 75,1 (7.º) |
| Together-base (7B) | 32K | 8K | 95,4 | 91,5 | 86,1 | 75,1 | 0,0 | 0,0 | 58,0 | 39,9 (7.º) | 76,2 (6.º) |
| Together-base (7B) | 32K | 8K | 95,4 | 91,5 | 86,1 | 75,1 | 0,0 | 0,0 | 58,0 | 39,9 (7.º) | 76,2 (6.º) |
Tabla 13: Rendimiento de modelos alineados y base seleccionados en longitudes de 4K a 128K promediando las puntuaciones de 8 tareas en Retrieval (NIAH) de RULER.
“”
| Modelos | Longitud declarada | Longitud efectiva | 4K | 8K | 16K | 32K | 64K | 128K | Prom. | wProm. (inc) | wProm. (dec) |
| Llama2-7B (chat) | 4K | - | 89,7 | ||||||||
| GPT-4 | 128K | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 | 99,9(2.º) | 100,0(1.º) |
| Gemini-1.5 | 1M | >128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 100,0 | 99,9 | 99,9(1.º) | 100,0(2.º) |
| Command-R-plus (104B) | 128K | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,9 | 97,2 | 99,5 | 99,2(3.º) | 99,8(3.º) |
| GLM4 (9B) | 1M | >128K | 99,9 | 99,6 | 99,8 | 99,8 | 99,6 | 97,7 | 99,4 | 99,1(4.º) | 99,7(4.º) |
| Contexto de solo lectura para comprender la fuente (no es texto fuente para traducir): "" Texto a traducir: Qwen2 (72B) | 128K | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 95.2 | 79.0 | 95.7 | 92.9(5.º) | 98.5(5.º) |
| Llama3.1 (70B) | 128K | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.9 | 59.2 | 93.2 | 88.3(8.º) | 98.0(6.º) |
| Llama3.1 (8B) | 128K | 64K | 99.9 | 99.7 | 99.7 | 98.8 | 97.6 | 70.4 | 94.4 | 90.7(6.º) | 98.0(7.º) |
| GradientAI/Llama3 (70B) | 1M | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.7 | 56.2 | 92.6 | 87.4(9.º) | 97.9(8.º) |
| Yi (34B) | 200K | 64K | 99.8 | 99.8 | 99.8 | 94.5 | 92.5 | 76.8 | 93.6 | 90.3(7.º) | 96.9(9.º) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 100.0 | 100,0 | 99,8 | 98,6 | 96,4 | 0,0 | 82,5 | 70,3 (10.º) | 94,7 (10.º) |
| Phi3-medium (14B) | 128K | 16K | 99,6 | 99,2 | 98,4 | 82,1 | 53,6 | 26,0 | 76,5 | 64,1 (11.º) | 88,9 (11.º) |
| Mixtral-v0.2 (7B) | 32K | 16K | 98,9 | 96,0 | 92,2 | 85,0 | 74,5 | 0,0 | 74,4 | 60,9 (12.º) | 87,9 (12.º) |
| LongChat (7B) | 32K | 8K | 97,6 | 93,5 | 83,4 | 62,4 | 0,0 | 0,0 | 56,2 | 37,4 (14.º) | 75,0 (13.º) |
| DBRX (36B/132B) | 32K | 8K | 100,0 | 99,0 | 72,5 | 45,8 | 0,0 | 0,0 | 52,9 | 33,3 (15.º) | 72,5 (14.º) |
| LWM (7B) | 1M | <4K | 84,4 | 80,1 | 67,2 | 52,2 | 45,9 | 15.2 | 57.5 | 46.5(13.º) | 68.6(15.º) |
| Together (7B) | 32K | <4K | 89.2 | 88.8 | 48.3 | 16.6 | 0.0 | 0.0 | 40.5 | 22.8(16.º) | 58.2(16.º) |
| LongAlpaca (13B) | 32K | <4K | 8.5 | 2.1 | 18.2 | 17.0 | 0.0 | 0.0 | 7.6 | 6.5(17.º) | 8.8(17.º) |
| Llama2-7B (base) | 4K | - | 58.8 | ||||||||
| Mixtral-base (8x7B) | 32K | 64K | 100.0 | 99.9 | 100.0 | 98.4 | 87.3 | 43.3 | 88.1 | 80.5(2.º) | 95.8(1.º) |
| Mixtral-base (7B) | 32K | 64K | 99.0 | 98.4 | 96.5 | 89.1 | 86.1 | 0.0 | 78.2 | 65.4(4.º) | 91.0(2.º) |
| Jamba-base (52B) | 256K | 128K | 87.5 | 87.6 | 86.2 | 88.1 | 86.0 | 77,8 | 85,5 | 84,3 (1.º) | 86,7 (3.º) |
| LWM-base (7B) | 1M | 128K | 80,2 | 82,7 | 79,3 | 76,4 | 70,7 | 66,1 | 75,9 | 73,3 (3.º) | 78,5 (4.º) |
| LongLoRA-base (7B) | 100K | 64K | 92,5 | 87,4 | 73,1 | 56,0 | 69,2 | 0,0 | 63,0 | 50,3 (5.º) | 75,8 (5.º) |
| Yarn-base (7B) | 128K | 4K | 84,6 | 43,6 | 24,8 | 43,0 | 20,9 | 0,0 | 36,1 | 24,9 (7.º) | 47,4 (7.º) |
| Together-base (7B) | 32K | 16K | 95,0 | 90,6 | 69,6 | 43,2 | 0,0 | 0,0 | 49,7 | 31,3 (6.º) | 68,1 (6.º) |
| Modelos | Longitud declarada | Longitud efectiva | 4K | 8K | 16K | 32K | 64K | 128K | Prom. (inc) | wProm. (dec) |
| Llama2-7B-chat | 4K | - | 84.8 | |||||||
| Gemini-1.5 | 1M | >128K | 97.7 | 97.7 | 97.6 | 98.6 | 97.3 | 90.9 | 96.6 | 95.8(1.º) |
| GPT-4 | 128K | 64K | 99.0 | 98.3 | 98.0 | 95.0 | 90.1 | 79.7 | 93.4 | 90.4(2.º) |
| Qwen2 (72B) | 128K | 32K | 99.3 | 98.0 | 93.1 | 97.4 | 78.5 | 70.3 | 89.4 | 84.7(3.º) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 97.8 | 96.9 | 94.8 | 88.2 | 83.3 | 69.7 | 88.5 | 84.0(4.º) |
| Command-R-plus (104B) | 128K | 32K | 98.2 | 96.9 | 95,2 | 90,3 | 82,5 | 59,5 | 87,1 | 81,3 (5.º) |
| Llama3.1 (70B) | 128K | 32K | 99,9 | 98,3 | 98,4 | 97,1 | 66,3 | 39,8 | 83,3 | 73,8 (6.º) |
| Phi3-medium (14B) | 128K | 16K | 90,8 | 95,1 | 90,3 | 82,4 | 62,1 | 43,8 | 77,4 | 69,3 (7.º) |
| Yi (34B) | 200K | 16K | 91,4 | 90,9 | 86,2 | 75,3 | 58,5 | 43,4 | 74,3 | 66,0 (8.º) |
| GLM4 (9B) | 1M | 8K | 93,5 | 85,2 | 78,5 | 68,1 | 58,3 | 49,7 | 72,2 | 64,8 (9.º) |
| GradientAI/Llama3 (70B) | 1M | 8K | 96,4 | 94,7 | 74,9 | 57,0 | 45,1 | 41,4 | 68,3 | 57,7 (10.º) |
| Llama3.1 (8B) | 128K | 8K | 97,0 | 90,1 | 79,2 | 54,1 | 43,5 | 36,2 | 66,7 | 55,5(11.º) |
| Mixtral-v0.2 (7B) | 32K | 8K | 94,3 | 90,4 | 77,4 | 48,5 | 42,4 | 33,7 | 64,4 | 53,1(12.º) |
| DBRX (36B/132B) | 32K | 8K | 94,5 | 94,7 | 73,7 | 48,7 | 4,1 | 0,0 | 52,6 | 34,3(13.º) |
| Together (7B) | 32K | <4K | 82,3 | 64,5 | 43,3 | 34,8 | 0,0 | 0,0 | 37,5 | 22,9(16.º) |
| LongChat (7B) | 32K | <4K | 74,3 | 50,7 | 46,7 | 51,1 | 0,0 | 0,0 | 37,1 | 24,8(15.º) |
| LWM (7B) | 1M | <4K | 61,3 | 43,6 | 38,3 | 32,8 | 29,1 | 29,1 | 39,0 | 34,0(14.º) |
| LongAlpaca (13B) | 32K | <4K | 33,0 | 27,0 | 26,0 | 23,2 | 0,0 | 0,0 | 18,2 | 12,3 (17.º) |
| Llama2-7B (base) | 4K | - | 73,1 | |||||||
| Mixtral-base (8x7B) | 32K | 32K | 96,5 | 94,8 | 93,1 | 87,8 | 68,6 | 24,3 | 77,5 | 66,9 (1.º) |
| Mixtral-base (7B) | 32K | 16K | 94,8 | 93,1 | 81,6 | 53,3 | 36,7 | 9,2 | 61,4 | 46,5 (2.º) |
| Jamba-base (52B) | 256K | 4K | 75,9 | 63,5 | 51,7 | 38,5 | 33,3 | 28,0 | 48,5 | 40,3 (3.º) |
| LWM-base (7B) | 1M | <4K | 67,1 | 48,4 | 36,0 | 26,3 | 21,5 | 18,7 | 36,3 | 28,4 (5.º) |
| LongLoRA-base (7B) | 100K | <4K | 70,3 | 64,4 | 50,7 | 39,9 | 29,4 | 0,0 | 42,4 | 31,3 (4.º) |
| Base Yarn (7B) | 128K | <4K | 70,6 | 49,2 | 28,9 | 20,5 | 17,0 | 2,1 | 31,4 | 20,7 (6.º) |
| Base Together (7B) | 32K | <4K | 69,1 | 53,0 | 19,9 | 20,6 | 0,0 | 0,0 | 27,1 | 15,1 (7.º) |
| Modelos | Longitud declarada | Longitud efectiva | 4K | 8K | 16K | 32K | 64K | 128K | Prom. | wProm. (inc) | wProm. (dec) |
| Llama2-7B (chat) | 4K | - | 49,7 | ||||||||
| Gemini-1.5 | 1M | >128K | 81,9 | 75,9 | 77,8 | 75,9 | 77,6 | 74,1 | 77,2 | 76,3(1.º) | 78,0(1.º) |
| GPT-4 | 128K | 128K | 79,0 | 78,0 | 76,0 | 68,0 | 61,6 | 59,0 | 70,3 | 66,5(4.º) | 74,0(2.º) |
| Qwen2 (72B) | 128K | 64K | 80,8 | 76,9 | 74,1 | 66,9 | 54,5 | 47,2 | 66,7 | 61,0(8.º) | 72,5(3.º) |
| GradientAI/LLama3 (70B) | 1M | >128K | 75,6 | 73,9 | 72,4 | 69,9 | 66,0 | 59,8 | 69,6 | 67,1(3.º) | 72,1(4.º) |
| Llama3.1 (70B) | 128K | 64K | 77,2 | 74,8 | 72,3 | 70,4 | 64,2 | 47,6 | 67,8 | 63,4 (7.º) | 72,1 (5.º) |
| GLM4 (9B) | 1M | >128K | 74,7 | 71,3 | 71,9 | 68,5 | 66,3 | 63,6 | 69,4 | 67,6 (2.º) | 71,1 (6.º) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 76,6 | 73,5 | 71,8 | 66,5 | 59,7 | 40,8 | 64,8 | 59,4 (9.º) | 70,2 (7.º) |
| Yi (34B) | 200K | >128K | 72,7 | 71,5 | 68,4 | 66,2 | 64,1 | 59,9 | 67,1 | 65,0 (5.º) | 69,2 (8.º) |
| Llama3.1 (8B) | 128K | 128K | 74,1 | 70,1 | 67,3 | 65,8 | 63,7 | 58,8 | 66,6 | 64,3 (6.º) | 68,9 (9.º) |
| Command-R-plus (104B) | 128K | 64K | 73,4 | 72,3 | 69,4 | 65,9 | 57,0 | 39,2 | 62,9 | 57,6 (10.º) | 68,1 (10.º) |
| Phi3-medium (14B) | 128K | 64K | 70,9 | 67,2 | 66,1 | 59,3 | 54,2 | 38,0 | 59,3 | 54,3 (12.º) | 64,3 (11.º) |
| Mixtral-v0.2 (7B) | 32K | 32K | 72,4 | 70,0 | 65,7 | 57,6 | 34,4 | 13,3 | 52,2 | 42,5 (13.º) | 62,0 (12.º) |
| LWM (7B) | 1M | >128K | 61,2 | 57,8 | 56,7 | 55,4 | 54,7 | 52,6 | 56,4 | 55,1 (11.º) | 57,7 (13.º) |
| DBRX (36B/132B) | 32K | 16K | 76,0 | 69,4 | 59,4 | 45,0 | 9,6 | 0,0 | 43,2 | 29,6 (14.º) | 56,9 (14.º) |
| Together (7B) | 32K | 16K | 61,1 | 58,3 | 54,2 | 45,6 | 0,0 | 0.0 | 36.5 | 24.9(15.º) | 48.2(15.º) |
| LongAlpaca (13B) | 32K | 16K | 57.2 | 53.5 | 49.7 | 39.0 | 0.0 | 0.0 | 33.2 | 22.3(16.º) | 44.1(16.º) |
| LongChat (7B) | 32K | 8K | 54.5 | 53.6 | 47.6 | 34.0 | 0.0 | 0.0 | 31.6 | 21.0(17.º) | 42.3(17.º) |
| Llama2-7B (base) | 4K | - | 48.6 | 47.7 | 45.3 | 41.3 | 34.4 | 26.4 | 41.0 | 37.0(3.º) | 44.9(3.º) |
| Mixtral-base (8x7B) | 32K | 4K | 50.8 | 47.7 | 45.3 | 41.3 | 34.4 | 26.4 | 41.0 | 37.0(3.º) | 44.9(3.º) |
| Mixtral-base (7B) | 32K | 8K | 53.5 | 51.0 | 48.4 | 44.7 | 32.8 | 2.2 | 38.8 | 31.3(4.º) | 46.3(2.º) |
| Jamba-base (52B) | 256K | 32K | 62,7 | 60,6 | 57,9 | 52,6 | 47,5 | 39,6 | 53,5 | 49,7(1.º) | 57,3(1.º) |
| LWM-base (7B) | 1M | <4K | 42,7 | 40,2 | 38,7 | 37,1 | 37,3 | 34,6 | 38,4 | 37,2(2.º) | 39,6(4.º) |
| LongLoRA-base (7B) | 100K | <4K | 34,5 | 32,1 | 33,6 | 29,4 | 26,1 | 0,0 | 26,0 | 21,3(6.º) | 30,6(6.º) |
| Yarn-base (7B) | 128K | <4K | 29,7 | 23,5 | 28,6 | 29,7 | 25,5 | 18,1 | 25,9 | 24,6(5.º) | 27,1(7.º) |
| Together-base (7B) | 32K | 4K | 52,0 | 47,5 | 44,6 | 33,6 | 0,0 | 0,0 | 29,6 | 19,8(7.º) | 39,5(5.º) |