
Servir prompts que comparten prefijo malgasta memoria de GPU. SGLang comparte la caché KV y logra 6,4x más rendimiento. NeurIPS 2024, gratis.
SGLang: Efficient Execution of Structured Language Model Programs
SGLang: Ejecución eficiente de programas estructurados de modelos de lenguaje
Lianmin Zheng * Liansheng Yin Zhiqiang Xie Chuyue Sun Jeff Huang Cody Hao Yu Shiyi Cao Christos Kozyrakis Ion Stoica Joseph E. Gonzalez Clark Barrett Ying Sheng *
Universidad de Stanford UC Berkeley Universidad Jiao Tong de Shanghái Universidad Texas A&M Investigador independiente
Resumen
Los modelos de lenguaje grandes (LLM, por sus siglas en inglés) se utilizan cada vez más para tareas complejas que requieren múltiples llamadas de generación, técnicas avanzadas de prompting, flujo de control y entradas/salidas estructuradas. Sin embargo, faltan sistemas eficientes para programar y ejecutar estas aplicaciones. Presentamos SGLang, un sistema para la ejecución eficiente de programas complejos de modelos de lenguaje. SGLang consta de un lenguaje frontend y un runtime. El frontend simplifica la programación con primitivas para la generación y el control del paralelismo. El runtime acelera la ejecución con optimizaciones novedosas como RadixAttention para la reutilización de la caché KV y máquinas de estados finitos comprimidas para una decodificación más rápida de salidas estructuradas. Los experimentos muestran que SGLang logra hasta mayor rendimiento en comparación con los sistemas de inferencia del estado del arte en diversos modelos grandes de lenguaje y multimodales en tareas que incluyen control de agentes, razonamiento lógico, benchmarks de aprendizaje con pocos ejemplos, decodificación JSON, pipelines de generación aumentada por recuperación y chat multiturno. El código está disponible públicamente en https://github.com/sgl-project/sglang.
1 Introducción
Los recientes aumentos en las capacidades de los LLM han ampliado su utilidad, permitiéndoles abordar una gama más amplia de tareas generales y actuar como agentes autónomos [35, 6, 36, 52, 46]. En tales aplicaciones, los LLM participan en planificación, razonamiento e interacción en múltiples rondas con entornos externos. Esto se logra mediante el uso de herramientas [41, 38], múltiples modalidades de entrada [47, 2] y una amplia gama de técnicas de prompting [30], como el aprendizaje con pocos ejemplos [5], la autocoherencia [53], el esqueleto de pensamiento [33] y el árbol de pensamiento [56]. Todos estos nuevos casos de uso requieren múltiples llamadas de generación de LLM, a menudo dependientes entre sí, lo que muestra una tendencia al uso de estructuras de múltiples llamadas para completar tareas complejas [57, 21].
La aparición de estos patrones significa un cambio en nuestra interacción con los LLM, pasando del chat simple a una forma más sofisticada de uso programático de los LLM, es decir, el uso de un programa para programar y controlar los procesos de generación de los LLM. Nos referimos a estos programas como "Programas de Modelos de Lenguaje" (Programas LM) [4, 20]. Las técnicas avanzadas de prompting y el flujo de trabajo agéntico mencionados anteriormente caen dentro del ámbito de los programas LM. Hay dos propiedades comunes de los programas LM: (1) los programas LM normalmente contienen múltiples llamadas a LLM intercaladas con flujo de control. Esto es necesario para completar tareas complejas y mejorar la calidad general. (2) los programas LM reciben entradas estructuradas y producen salidas estructuradas. Esto es necesario para permitir la composición de programas LM y para integrar programas LM en sistemas de software existentes.

A pesar del uso generalizado de los programas LM, los sistemas actuales para expresarlos y ejecutarlos siguen siendo ineficientes. Identificamos dos desafíos principales asociados con el uso eficiente de los programas LM: Primero, programar programas LM es tedioso y difícil debido a la naturaleza no determinista de los LLM. Desarrollar un programa LM a menudo requiere una extensa manipulación de cadenas, ajuste experimental de prompts, análisis frágil de salidas, manejo de múltiples modalidades de entrada e implementación de mecanismos de paralelismo. Esta complejidad reduce significativamente la legibilidad incluso de programas simples (Sec. 2).
En segundo lugar, y de manera importante, ejecutar programas LM es ineficiente debido al cómputo y uso de memoria redundantes. Los motores de inferencia del estado del arte (p. ej., vLLM [23], TGI [16] y TensorRT-LLM [34]) se han optimizado para reducir la latencia y mejorar el rendimiento sin conocimiento directo de la carga de trabajo. Esto hace que estos sistemas sean generales y robustos, pero también da lugar a ineficiencias significativas para cualquier carga de trabajo dada. Un ejemplo destacado es la reutilización de la caché de Clave-Valor (KV) (Sec. 3). La caché KV consiste en tensores intermedios reutilizables que son esenciales para la inferencia generativa. Durante las ejecuciones por lotes típicas de programas LM, existen numerosas oportunidades de reutilizar la caché KV entre múltiples llamadas a LLM diferentes que comparten un prefijo común. Sin embargo, los sistemas actuales carecen de mecanismos efectivos para facilitar esta reutilización, lo que resulta en cómputo innecesario y memoria desperdiciada. Otro ejemplo es la decodificación restringida para salidas estructuradas (p. ej., el modo JSON), donde la salida de los LLM se restringe para seguir reglas gramaticales específicas definidas por una expresión regular (Sec. 4). Bajo estas restricciones, a menudo se pueden decodificar múltiples tokens a la vez. Sin embargo, los sistemas existentes solo decodifican un token a la vez, lo que lleva a velocidades de decodificación subóptimas.
Para abordar estos desafíos, presentamos SGLang, un Lenguaje de Generación Estructurada para LLM. La idea central es explotar sistemáticamente la estructura de múltiples llamadas en los programas LM para una ejecución eficiente. Como se muestra en la Fig. 1, tiene dos partes: un lenguaje frontend y un runtime backend. El frontend simplifica la programación de programas LM, y el runtime acelera su ejecución. Las dos partes pueden trabajar juntas para un mejor rendimiento, pero también pueden funcionar de forma independiente.
Presentamos SGLang como un lenguaje específico de dominio embebido en Python. Proporciona primitivas para la generación (p. ej., extend, gen, select) y el control del paralelismo (p. ej., fork, join). SGLang es compatible con el flujo de control y las bibliotecas de Python, por lo que los usuarios pueden desarrollar flujos de trabajo avanzados de prompting fácilmente con la sintaxis nativa de Python. Proporcionamos un intérprete y un compilador para SGLang. El intérprete gestiona el estado del prompt como un flujo y envía operaciones primitivas al flujo para su ejecución asíncrona, garantizando un control adecuado sobre la sincronización y el paralelismo intraprograma. Además, el programa SGLang se puede rastrear y compilar para más optimizaciones.
En el lado del runtime, proponemos varias optimizaciones novedosas para acelerar la ejecución de los programas SGLang. La primera técnica, RadixAttention, permite la reutilización automática de la caché KV entre múltiples llamadas de generación. En los motores de inferencia existentes, la caché KV de una solicitud se descarta después de completar el procesamiento, lo que impide que la caché KV se reutilice entre múltiples llamadas y ralentiza significativamente la ejecución. En cambio, nuestro sistema mantiene una caché LRU de la caché KV para todas las solicitudes dentro de un árbol radix. Este enfoque gestiona la caché KV como una caché tradicional y utiliza un árbol radix para un emparejamiento, inserción y desalojo eficientes. Permite al runtime manejar varios patrones de reutilización con una política de planificación consciente de la caché de manera eficiente. La segunda técnica es una máquina de estados finitos comprimida, que permite una decodificación restringida más rápida para salidas estructuradas. Los sistemas existentes siguen las restricciones solo para el siguiente token enmascarando las probabilidades de los tokens no permitidos, lo que hace que solo puedan decodificar un token a la vez. En cambio, nuestro sistema analiza las restricciones y construye una máquina de estados finitos comprimida para representar la restricción. Este enfoque comprime una ruta de múltiples tokens en una ruta de un solo paso siempre que sea posible, permitiendo la decodificación de múltiples tokens a la vez para lograr una velocidad de decodificación más rápida. Por último, SGLang también admite modelos solo de API como GPT-4 de OpenAI, y presentamos la tercera técnica, ejecución especulativa de API, para optimizar programas de múltiples llamadas para modelos solo de API.
Usando SGLang, implementamos diversas aplicaciones de LLM, incluyendo control de agentes, razonamiento lógico, benchmarks de aprendizaje con pocos ejemplos, decodificación JSON, pipelines de generación aumentada por recuperación, chat multiturno y procesamiento multimodal. Probamos el rendimiento en modelos como Llama-7B/70B [49], Mistral-8x7B [17], LLaVA-v1.5-7B (imagen) [28] y LLaVA-NeXT-34B (video) [62] en GPUs NVIDIA A10G y A100. Los resultados experimentales muestran que SGLang logra hasta mayor rendimiento en una amplia gama de cargas de trabajo, modelos y configuraciones de hardware, en comparación con los sistemas de programación e inferencia existentes, incluidos Guidance [13], vLLM [23] y LMQL [4].
2 Modelo de programación
Esta sección presenta el modelo de programación de SGLang con un ejemplo práctico, describe sus primitivas de lenguaje y modos de ejecución, y esboza oportunidades de optimización del runtime. Este modelo de programación puede simplificar operaciones tediosas en flujos de trabajo de múltiples llamadas (p. ej., manipulación de cadenas, llamadas a API, especificación de restricciones, paralelismo) proporcionando primitivas flexibles y componibles.
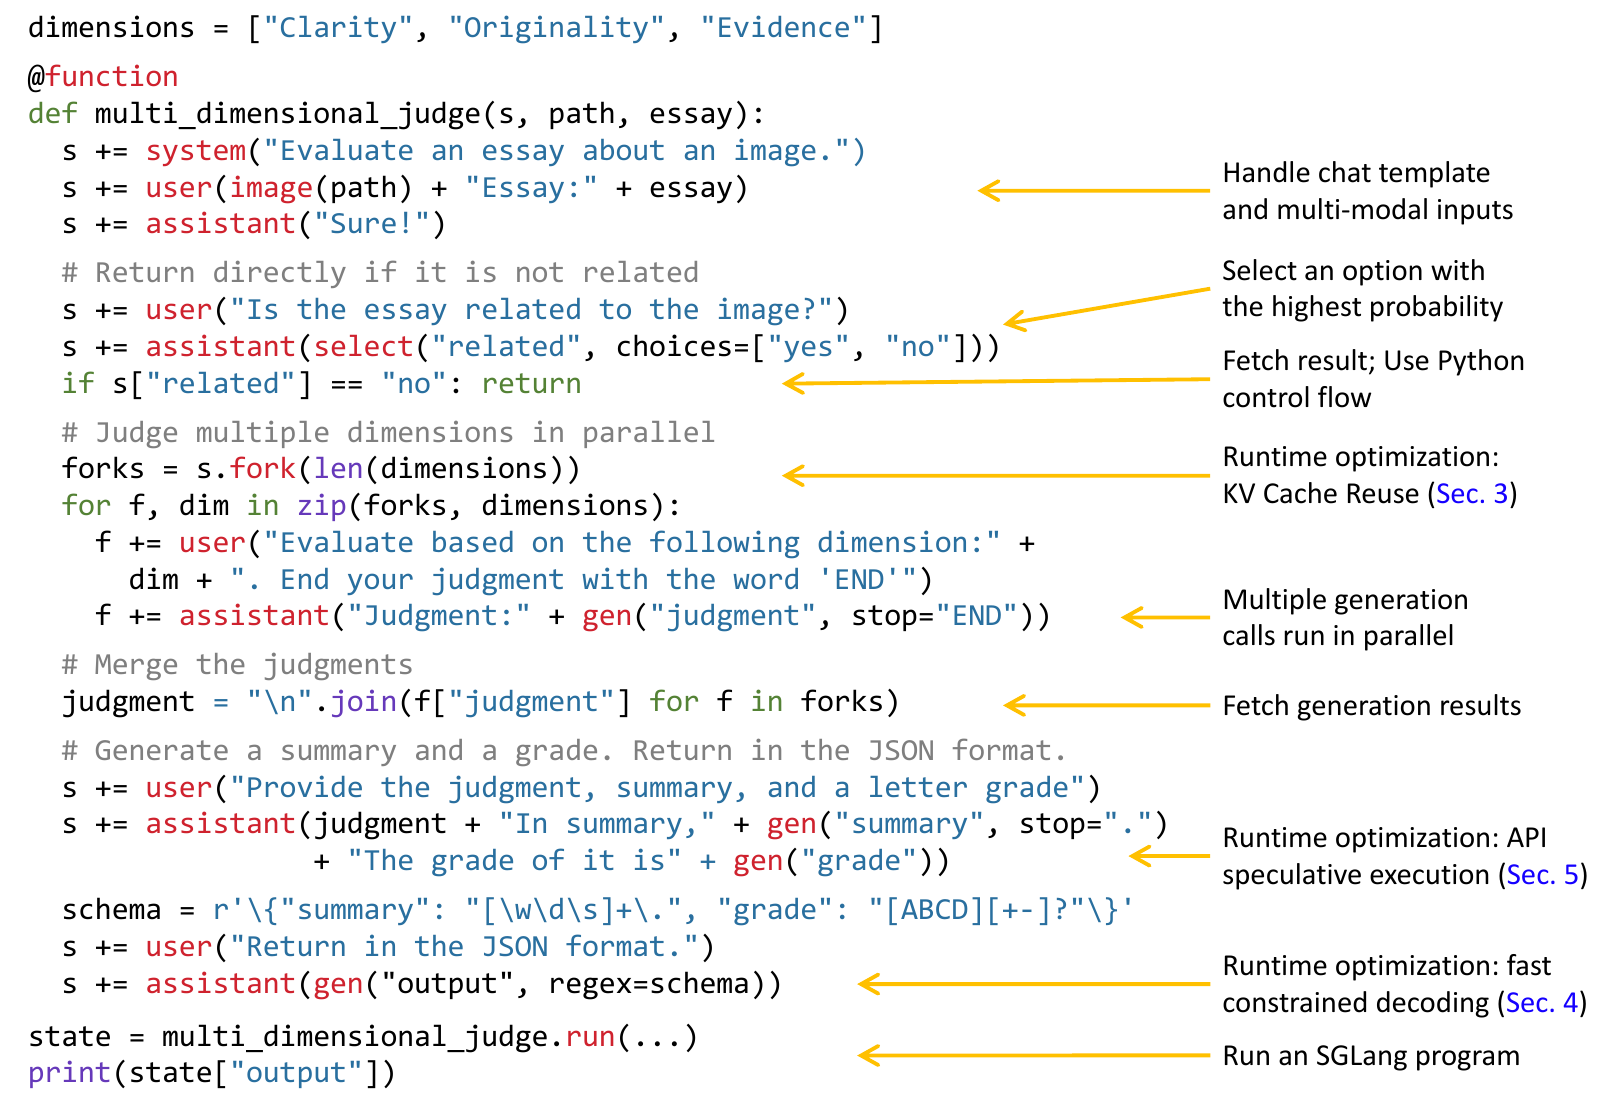
Un ejemplo práctico. El lenguaje es un lenguaje específico de dominio embebido en Python. La Fig. 2 muestra un programa que evalúa un ensayo sobre una imagen usando el método de prompting de ramificación-resolución-fusión [40]. La función multi_dimensional_judge toma tres argumentos: s, path y essay. s gestiona el estado del prompt, path es la ruta del archivo de imagen y essay es el texto del ensayo. Se pueden añadir nuevas cadenas y primitivas de SGLang al estado s para su ejecución usando el operador . Primero, la función añade la imagen y el ensayo al prompt. Luego comprueba si el ensayo está relacionado con la imagen usando select, almacenando el resultado en s["related"]. Si está relacionado, el prompt se bifurca en tres copias para una evaluación paralela desde diferentes dimensiones, usando gen para almacenar los resultados en f["judgment"]. A continuación, fusiona los juicios, genera un resumen y asigna una calificación con letra. Finalmente, devuelve los resultados en formato JSON, siguiendo un esquema definido por una restricción de expresión regular regex. SGLang simplifica enormemente este programa, ya que un programa equivalente usando una interfaz similar a la API de OpenAI requeriría tantas líneas de código debido a la manipulación manual de cadenas y al control del paralelismo.
Primitivas del lenguaje. SGLang proporciona primitivas para controlar el estado del prompt, la generación y el paralelismo. Se pueden usar junto con la sintaxis y las bibliotecas de Python. Estas son las primitivas: "gen" llama a un modelo para generar y almacena los resultados en una variable con el nombre especificado en su primer argumento. Admite un argumento "regex" para restringir la salida a seguir una gramática definida por una expresión regular (p. ej., un esquema JSON). "select" llama a un modelo para elegir la opción de mayor probabilidad de una lista. El operador "+=" o "extend" añade una cadena al prompt. El operador "[variable_name]" recupera los resultados de una generación. "fork" crea bifurcaciones paralelas del estado del prompt. "join" vuelve a unir el estado del prompt. "image" y "video" reciben entradas de imagen y video.
Modos de ejecución. La forma más sencilla de ejecutar un programa SGLang es mediante un intérprete, donde un prompt se trata como un flujo asíncrono. Primitivas como extend, gen y select se envían al flujo para su ejecución asíncrona. Estas llamadas no bloqueantes permiten que el código Python siga ejecutándose sin esperar a que finalice la generación. Esto es similar a lanzar kernels de CUDA de forma asíncrona. Cada prompt es gestionado por un ejecutor de flujo en un hilo en segundo plano, lo que permite el paralelismo intraprograma. La obtención de los resultados de la generación se bloqueará hasta que estén listos, lo que garantiza una sincronización correcta. Alternativamente, los programas SGLang se pueden compilar como grafos computacionales y
| Sistema | Sintaxis | Primitivas del lenguaje | Backends de ejecución |
| Guía de LMQL | Python personalizado | extend, gen, select extend, gen, select, image | HF Transformers, llama.cpp, OpenAI HF Transformers, llama.cpp, OpenAI |
| SGLang | Python | extend, gen, select, image, video, fork, join | SGLang Runtime (SRT), OpenAI |
ejecutar con un ejecutor de grafos, lo que permite más optimizaciones. Este artículo utiliza el modo intérprete de forma predeterminada y analiza los resultados del modo compilador en el Apéndice D. SGLang admite modelos de pesos abiertos con su propio SGLang Runtime (SRT), así como modelos de API como los modelos de OpenAI y Anthropic.
Comparación. Los sistemas de programación para LLM se pueden clasificar como de alto nivel (p. ej., LangChain, DSPy) y de bajo nivel (p. ej., LMQL, Guidance, SGLang). Los sistemas de alto nivel proporcionan prompts predefinidos o generados automáticamente, como el optimizador de prompts de DSPy. Los sistemas de bajo nivel normalmente no alteran los prompts, pero permiten la manipulación directa de prompts y primitivas. SGLang es un sistema de bajo nivel similar a LMQL y Guidance. La Tabla 1 compara sus características. SGLang se centra más en la eficiencia en tiempo de ejecución y viene con su propio runtime codiseñado, lo que permite optimizaciones novedosas introducidas posteriormente. Los lenguajes de alto nivel (p. ej., DSPy) se pueden compilar a lenguajes de bajo nivel (p. ej., SGLang). Demostramos la integración de SGLang como backend en DSPy para una mejor eficiencia en tiempo de ejecución en la Sec. 6.
Optimizaciones en tiempo de ejecución. La Fig. 2 muestra tres oportunidades de optimización en tiempo de ejecución: reutilización de la caché KV, decodificación restringida rápida y ejecución especulativa de API. Las discutiremos en las siguientes secciones.
3 Reutilización eficiente de la caché KV con RadixAttention
Los programas SGLang pueden encadenar múltiples llamadas de generación y crear copias paralelas con la primitiva "fork". Además, diferentes instancias de programas a menudo comparten algunas partes comunes (por ejemplo, prompts del sistema). Estos escenarios crean muchos prefijos de prompt compartidos durante la ejecución, lo que genera numerosas oportunidades para reutilizar la caché KV. Durante la inferencia del LLM, la caché KV almacena tensores intermedios de la pasada forward, reutilizados para decodificar tokens futuros. Reciben su nombre de los pares clave-valor del mecanismo de autoatención [51]. El cálculo de la caché KV depende únicamente de los tokens del prefijo. Por lo tanto, las solicitudes con el mismo prefijo de prompt pueden reutilizar la caché KV, reduciendo el cálculo redundante y el uso de memoria. En el Apéndice A se proporcionan más antecedentes y algunos ejemplos.
Dada la oportunidad de reutilización de la caché KV, un desafío clave en la optimización de programas SGLang es reutilizar la caché KV entre múltiples llamadas e instancias. Si bien algunos sistemas exploran ciertos casos de reutilización de la caché KV [23, 58, 18, 12], a menudo requieren configuraciones manuales y no pueden manejar todos los patrones de reutilización (por ejemplo, estructuras de árbol dinámicas). En consecuencia, la mayoría de los sistemas de inferencia del estado del arte recalculan la caché KV para cada solicitud. Discutiremos sus limitaciones y nuestras diferencias en la Sec. 7.
Esta sección presenta RadixAttention, una técnica novedosa para la reutilización automática y sistemática de la caché KV durante el tiempo de ejecución. A diferencia de los sistemas existentes que descartan la caché KV después de que finaliza una solicitud de generación, nuestro sistema conserva la caché para los prompts y los resultados de generación en un árbol radix, lo que permite una búsqueda eficiente de prefijos, reutilización, inserción y desalojo. Implementamos una política de desalojo LRU y una política de planificación consciente de la caché para mejorar la tasa de aciertos de caché. RadixAttention es compatible con técnicas como continuous batching [60], paged attention [23] y paralelismo de tensores [44]. Además, introduce una sobrecarga de memoria y tiempo insignificante cuando no hay aciertos de caché.
RadixAttention. Un árbol radix es una estructura de datos que sirve como alternativa eficiente en espacio a un trie clásico (árbol de prefijos). A diferencia de los árboles típicos, las aristas de un árbol radix pueden etiquetarse no solo con elementos individuales sino también con secuencias de elementos de longitudes variables, lo que mejora significativamente la eficiencia. En nuestro sistema, utilizamos un árbol radix para gestionar un mapeo entre secuencias de tokens y sus tensores de caché KV correspondientes. Estos tensores de caché KV se almacenan en un diseño paginado no contiguo, donde el tamaño de cada página equivale a un token. Debido a que la memoria de la GPU se llena rápidamente con la caché KV, introducimos una política de desalojo LRU simple que desaloja primero la hoja usada menos recientemente. Al desalojar primero las hojas, permitimos la reutilización de sus ancestros comunes hasta que esos ancestros se convierten en hojas y también son desalojados.
En el contexto de continuous batching, no podemos desalojar nodos utilizados por el lote en ejecución actual. Por lo tanto, cada nodo mantiene un contador de referencias que indica cuántas solicitudes en ejecución lo están utilizando. Un nodo es desalojable si su contador de referencias es cero. Nótese que no preasignamos un pool de memoria de tamaño fijo como caché. En su lugar, dejamos que los tokens en caché y las solicitudes en ejecución actuales compartan el mismo pool de memoria. Por lo tanto, el sistema asigna dinámicamente memoria para la caché y las solicitudes en ejecución. Cuando se ejecutan suficientes solicitudes en espera, el sistema desalojará todos los tokens en caché en favor de un tamaño de lote mayor. La Fig. 3 muestra cómo se mantiene el árbol radix para varias solicitudes entrantes. El
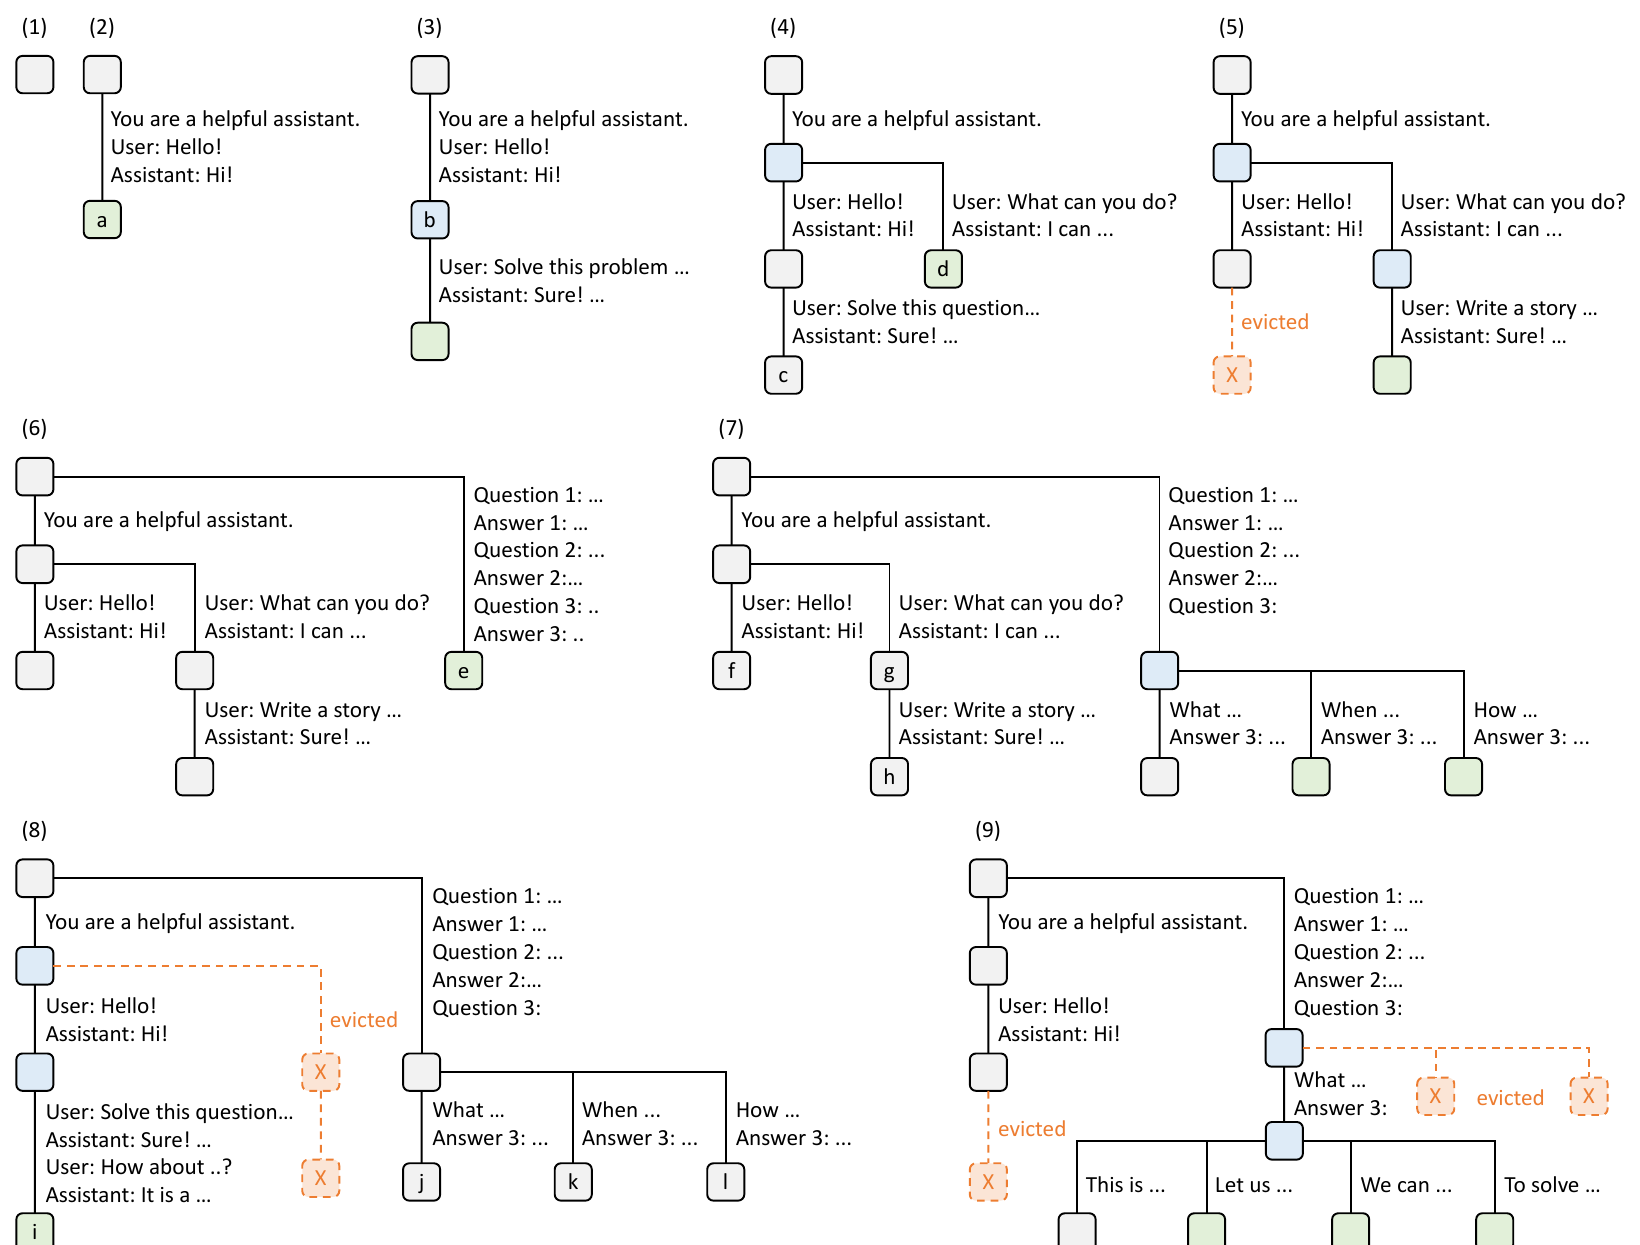
intérprete del frontend envía los prompts completos al runtime, y el runtime realiza la coincidencia de prefijos y la reutilización. La estructura del árbol se almacena en la CPU con una sobrecarga de mantenimiento insignificante. Durante la ejecución de la primitiva fork, el frontend envía primero el prefijo como pista, asegurando que el prefijo se inserte correctamente en el árbol. Luego envía los prompts restantes. Esta "pista del frontend" simplifica la planificación y la coincidencia en el runtime, ejemplificando los beneficios del codiseño frontend-runtime.
Planificación consciente de la caché. Definimos la tasa de aciertos de caché como el número de tokens de prompt en caché. Cuando hay muchas solicitudes en la cola de espera, el orden en que se ejecutan puede afectar significativamente la tasa de aciertos de caché. Por ejemplo, si el planificador de solicitudes cambia con frecuencia entre solicitudes diferentes y no relacionadas, puede provocar un thrashing de caché y una baja tasa de aciertos. Diseñamos un algoritmo de planificación consciente de la caché para aumentar la tasa de aciertos. En el contexto de procesamiento por lotes, ordenamos las
solicitudes por longitud de prefijo coincidente y priorizamos las solicitudes con prefijos coincidentes más largos en lugar de usar una planificación por orden de llegada. El Alg. 1 (Apéndice) muestra el pseudocódigo para la planificación consciente de la caché con batching contiguo. El algoritmo utiliza el orden de prefijo compartido más largo primero. En entornos más sensibles a la latencia, aún podríamos tolerar una reordenación de lotes limitada para mejorar la reutilización de la caché. Además, demostramos el siguiente teorema para la planificación óptima en el caso offline. 2
Teorema 3.1. Para un lote de solicitudes, podemos lograr una tasa de aciertos de caché óptima visitando el árbol radix de las solicitudes en orden de búsqueda en profundidad, con un tamaño de caché la longitud máxima de solicitud. El orden de prefijo compartido más largo primero es equivalente a un orden de búsqueda en profundidad.
La demostración está en la Sec. A.3 (Apéndice). En el caso online, el orden DFS se verá alterado, pero nuestra planificación aún aproxima el comportamiento DFS en la parte aumentada del árbol radix completo, como se describe en la Sec. A.3. Si bien la planificación consciente de la caché voraz puede lograr un alto rendimiento, puede provocar inanición. Dejamos su integración con otros métodos de planificación justa [42] como trabajo futuro.
Casos distribuidos. RadixAttention puede extenderse a múltiples GPU. Para el paralelismo de tensores, cada GPU mantiene una caché KV fragmentada. No se necesita sincronización adicional porque las operaciones del árbol son las mismas. El paralelismo de datos con múltiples workers se discute en la Sec. A.4 (Apéndice).
4 Decodificación restringida eficiente con máquina de estados finitos comprimida
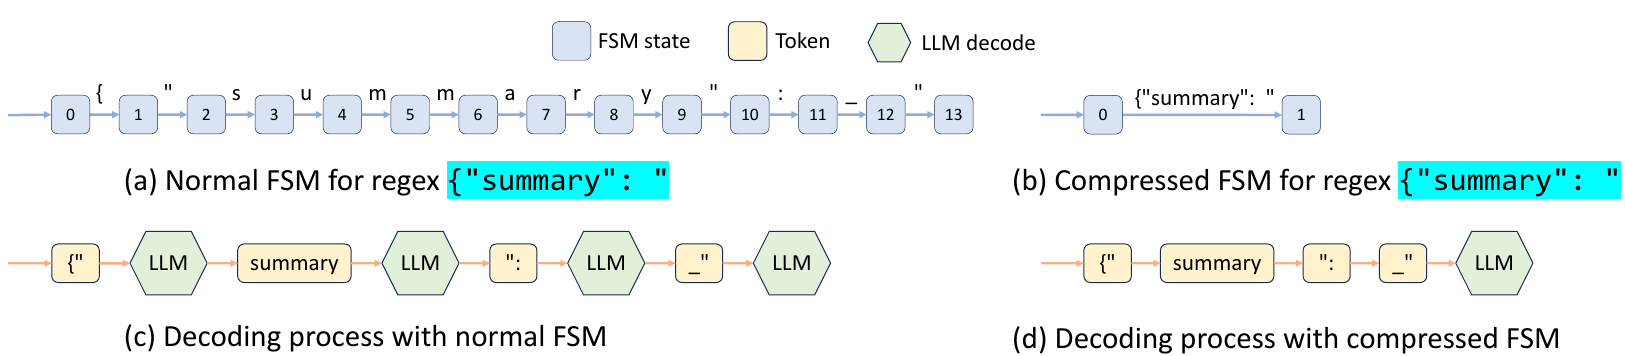
En los programas LM, los usuarios a menudo desean restringir la salida del modelo para que siga formatos específicos, como esquemas JSON. Esto puede mejorar la controlabilidad y la robustez, y facilitar el análisis de la salida. SGLang ofrece un argumento regex para imponer tales restricciones usando expresiones regulares, que son suficientemente expresivas para muchos escenarios prácticos. Los sistemas existentes lo admiten convirtiendo una expresión regular en una máquina de estados finitos (FSM) [54]. Durante la decodificación, mantienen el estado actual de la FSM, recuperan los tokens permitidos de los estados siguientes y ponen a cero la probabilidad de los tokens inválidos, decodificando token por token. Este enfoque token por token, sin embargo, es ineficiente cuando existen oportunidades de decodificar múltiples tokens a la vez. Por ejemplo, la secuencia constante {"summary": " en la Fig. 2 abarca múltiples tokens en el proceso de decodificación normal como se muestra en la Fig. 4 (c), requiriendo múltiples etapas de decodificación, aunque solo hay un token siguiente válido al decodificarla. Por lo tanto, toda la secuencia puede decodificarse en un solo paso (es decir, una pasada forward). Sin embargo, los sistemas existentes solo pueden decodificar un token a la vez porque la falta de integración entre la FSM y el ejecutor del modelo en los sistemas existentes impide el procesamiento de múltiples tokens, lo que resulta en una decodificación lenta.
SGLang supera esta limitación creando un runtime de decodificación restringida rápido con una FSM comprimida. Este runtime analiza la FSM y comprime las aristas adyacentes de transición singular en la FSM en aristas únicas como se demuestra en la Fig. 4 (b), lo que le permite reconocer cuándo se pueden decodificar múltiples tokens juntos. En la Fig. 4 (d), múltiples tokens en la arista de transición comprimida pueden decodificarse en una sola pasada forward, lo que acelera enormemente el proceso de decodificación. También es general y aplicable a todas las expresiones regulares. Más detalles sobre los antecedentes y la implementación están en el Apéndice B.
5 Llamadas eficientes a endpoints con ejecución especulativa de API
Las secciones anteriores introdujeron optimizaciones para modelos de pesos abiertos, que requieren modificaciones en el proceso de inferencia del modelo. Además, SGLang funciona con modelos accesibles solo mediante API, como GPT-4 de OpenAI. Sin embargo, para estos modelos, solo podemos llamar a un endpoint de API de caja negra.
Esta sección introduce una nueva optimización para modelos de API de caja negra que acelera la ejecución y reduce el costo de API de los programas SGLang con múltiples llamadas usando ejecución especulativa. Por ejemplo, un programa puede pedir al modelo que genere una descripción de un personaje con un patrón de múltiples llamadas:
context "name:" gen("name", stop="\n") "job:" gen("job", stop="\n"). De forma ingenua, las dos primitivas gen corresponden a dos llamadas de API, lo que significa que el usuario debe pagar dos veces la tarifa de tokens de entrada sobre el contexto. En SGLang, podemos habilitar la ejecución especulativa en la primera llamada y permitir que continúe la generación de algunos tokens más ignorando la condición de parada. El intérprete conserva las salidas de generación adicionales y las empareja y reutiliza con primitivas posteriores. En ciertos casos, con una ingeniería cuidadosa del prompt, el modelo puede emparejar correctamente la plantilla con alta precisión, ahorrándonos la latencia y los costos de entrada de una llamada de API.
6 Evaluación
Evaluamos el rendimiento de SGLang en diversas cargas de trabajo de LLM. Posteriormente, realizamos estudios de ablación y estudios de casos para demostrar la efectividad de componentes específicos. SGLang está implementado en PyTorch [37] con kernels CUDA personalizados de FlashInfer [59] y Triton [48].
6.1 Configuración
Modelos. Probamos modelos densos Llama-2 [49], modelos dispersos de mezcla de expertos Mixtral [17], modelos multimodales de imagen LLaVA [27] y de video [62], y el modelo de API GPT-3.5 de OpenAI. Para los modelos de pesos abiertos, el número de parámetros varía de 7 mil millones a 70 mil millones, y usamos precisión float16.
Hardware. Ejecutamos la mayoría de los experimentos en instancias AWS EC2 G5, que están equipadas con GPUs NVIDIA A10G (24GB). Ejecutamos modelos de 7B en una sola GPU A10G y modelos más grandes en múltiples GPUs A10G con paralelismo de tensores [44]. Ejecutamos algunos experimentos adicionales en GPUs A100G (80GB).
Baselines. Comparamos SGLang contra sistemas de programación de alto nivel con sus respectivos lenguajes y runtimes por defecto, así como contra motores de inferencia de bajo nivel con APIs estándar de Completion tipo OpenAI. A menos que se indique lo contrario, no activamos optimizaciones que cambien los resultados de los cálculos, de modo que todos los sistemas calculan los mismos resultados. Los baselines incluyen:
- Guidance [13], un lenguaje para controlar LLMs. Usamos Guidance v0.1.8 con el backend de llama.cpp. - vLLM [23], un motor de inferencia de alto rendimiento. Usamos vLLM v0.2.5 y su servidor API por defecto. - LMQL [4], un lenguaje de consulta. Usamos LMQL v0.7.3 con el backend de Hugging Face Transformers.
Cargas de trabajo. Probamos lo siguiente: benchmarks MMLU [14] de 5-shot y HellaSwag [61] de 20-shot. Decodificamos un token para MMLU y usamos la primitiva select para seleccionar la respuesta con mayor probabilidad para HellaSwag. Para el agente ReAct [57] y los agentes generativos [36], extraemos las trazas de los artículos originales y las reproducimos. Usamos el árbol de pensamiento (Tree-of-thought) [56] para los problemas de GSM-8K y el esqueleto de pensamiento (Skeleton-of-thought) [33] para la generación de tips. Usamos jueces LLM con la técnica branch-solve-merge [40]; decodificación JSON con un esquema especificado mediante una expresión regular; chat multiturno con 4 turnos, donde la entrada de cada turno se muestrea aleatoriamente entre 256-512 tokens. Chat multiturno (corto) significa salida corta (4-8 tokens) y chat multiturno (largo) significa salida larga (256-512 tokens); pipeline de generación aumentada por recuperación (RAG) de DSPy [20] en su ejemplo oficial.
Métricas. Reportamos dos métricas de rendimiento: throughput y latencia. Para el throughput, ejecutamos un lote suficientemente grande de instancias de programa para calcular el throughput máximo, comparando el número de instancias de programa ejecutadas por segundo (programas por segundo, p/s). Para la latencia, ejecutamos un único programa a la vez sin batching y reportamos la latencia promedio para múltiples instancias.
6.2 Rendimiento de extremo a extremo
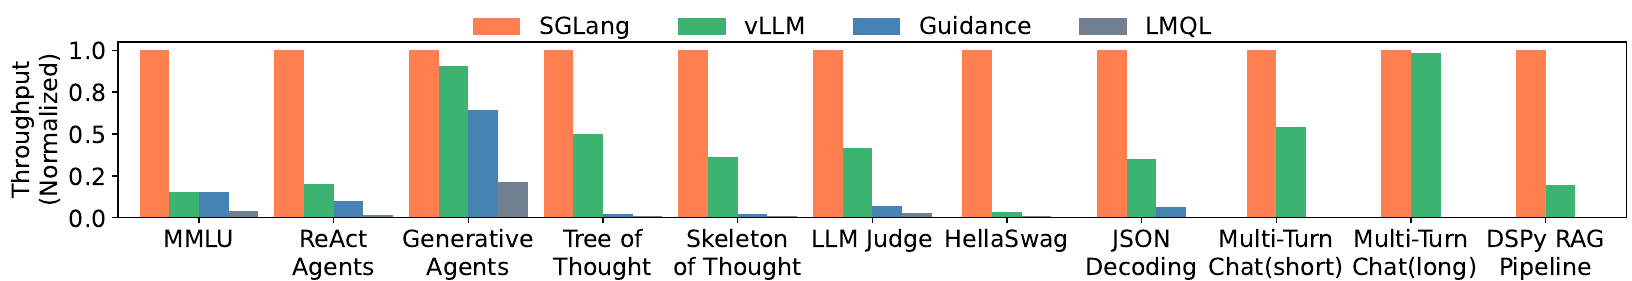
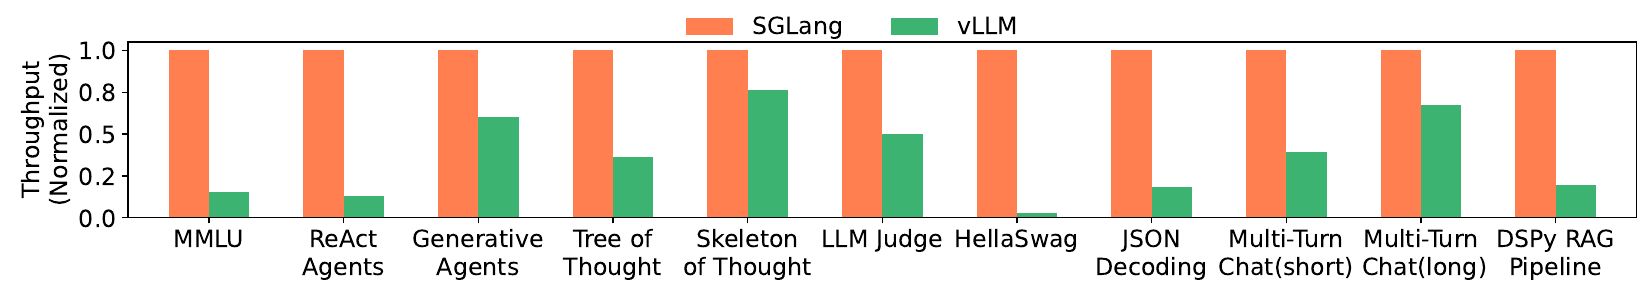
Resultados en modelos de pesos abiertos. Los resultados de latencia y throughput se muestran en la Fig. 5 y la Fig. 6. SGLang mejora el throughput hasta en y reduce la latencia hasta en . Estas mejoras
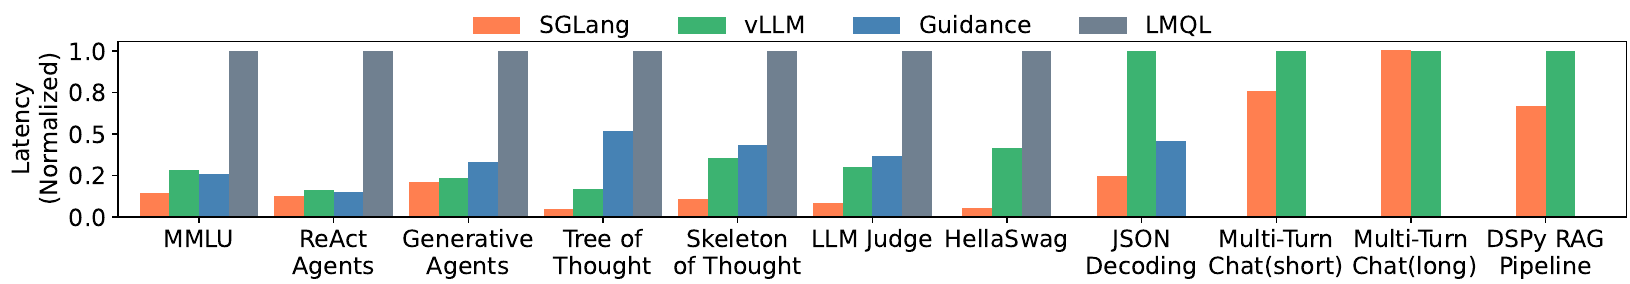
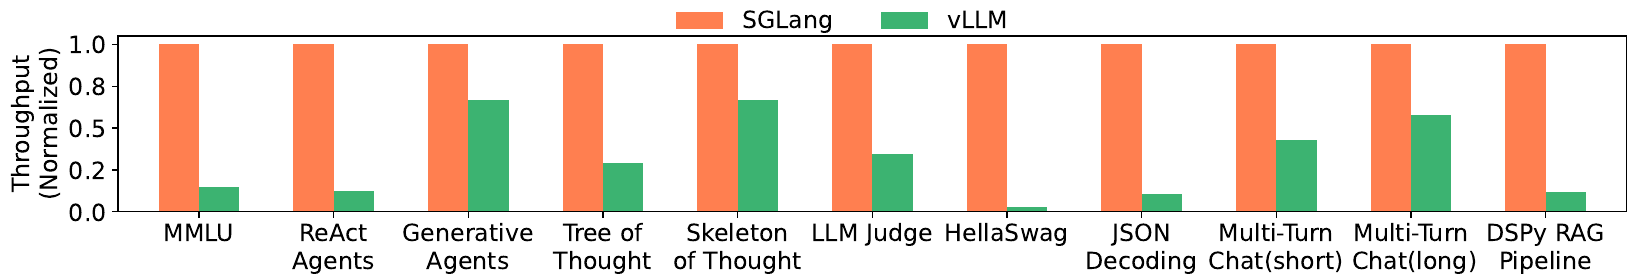
resultan de la reutilización de la caché KV, el aprovechamiento del paralelismo dentro de un único programa y una decodificación restringida más rápida. A continuación, explicamos las razones de la aceleración en cada benchmark.
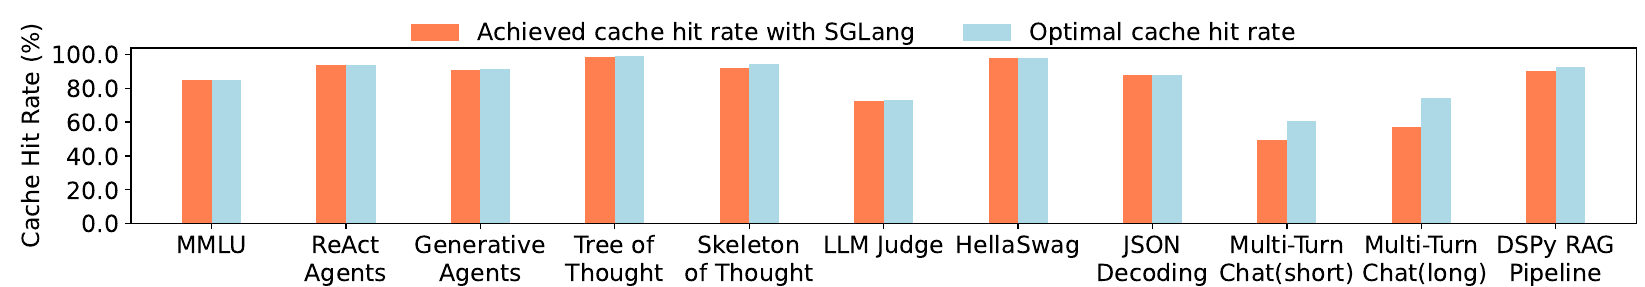
En MMLU, SGLang puede reutilizar la caché KV de los ejemplos de 5-shot con RadixAttention. RadixAttention beneficia tanto al throughput como a la latencia. RadixAttention reduce el uso total de memoria al compartir la caché KV, permitiendo un tamaño de lote mayor para mejorar el throughput máximo. RadixAttention también reduce la computación de prefill, disminuyendo así la latencia del primer token. En HellaSwag, SGLang reutiliza la caché KV tanto de los ejemplos few-shot como del prefijo común de la pregunta para múltiples opciones, lo que resulta en un uso compartido de dos niveles. Para los agentes ReAct y generativos, SGLang reutiliza la caché KV de la plantilla del agente y de las llamadas anteriores. En Tree-of-thought y Skeleton-of-thought, SGLang paraleliza las llamadas de generación dentro de un único programa y reutiliza la caché KV tanto como sea posible. En la decodificación JSON, SGLang acelera la decodificación decodificando múltiples tokens a la vez con una máquina de estados finitos comprimida. En el chat multiturno, SGLang reutiliza la caché KV del historial de chat. La aceleración es más notable para salidas cortas porque la reutilización de la caché KV ayuda principalmente a reducir el tiempo del prefijo. Para salidas largas, dado que no hay mucho uso compartido entre diferentes sesiones de chat y el tiempo de decodificación domina, casi no hay aceleración. En el pipeline RAG de DSPy, SGLang reutiliza la caché KV del ejemplo de contexto común. En estos benchmarks, la tasa de aciertos de caché varía del al . La Fig. 13 (Apéndice) enumera las tasas de aciertos de caché alcanzadas y óptimas para todos ellos, mostrando que nuestra planificación consciente de la caché se aproxima al de la tasa de aciertos óptima en promedio.
Excluimos LMQL y Guidance de algunos de los últimos cinco benchmarks debido a su rendimiento lento y a funcionalidades faltantes. Los problemas de LMQL provienen del procesamiento lento a nivel de token y de un backend no optimizado, mientras que Guidance carece de soporte de batching y paralelismo.
Resultados en modelos más grandes con paralelismo tensorial. Ejecutamos modelos más grandes, Mixtral-8x7B y Llama-70B, con paralelismo tensorial en el mismo conjunto de benchmarks y reportamos los resultados en la Fig. 7 y la Fig. 12 (Apéndice). La aceleración en modelos más grandes muestra una tendencia similar a la observada en modelos más pequeños, lo que indica que nuestra optimización generaliza bien a modelos más grandes. Omitimos Guidance y LMQL aquí porque carecen de implementaciones eficientes de paralelismo tensorial.
Resultados en modelos multimodales. SGLang tiene soporte nativo para modelos multimodales con las primitivas de imagen y video. Las optimizaciones de este artículo son compatibles con modelos multimodales. Para RadixAttention, calculamos el hash de las imágenes de entrada y lo usamos como clave en el árbol radix, lo que nos permite reutilizar la caché KV de los tokens de imagen de la misma imagen. Ejecutamos LLaVA-v1.5-7B (imagen) en llava-bench-in-the-wild y LLaVA-NeXT-34B (video) en ActivityNet. Debido a que estos modelos no están bien soportados por otros sistemas de referencia, usamos la implementación original de los autores del modelo en Hugging Face Transformers como referencia. Como se muestra en la Tabla 2, SGLang proporciona un throughput hasta mayor en estos benchmarks. En llava-bench-in-the-wild, hay múltiples preguntas sobre la misma imagen, y el runtime de SGLang reutiliza la caché KV en este caso.
Despliegue en producción. SGLang se ha desplegado en Chatbot Arena [8] para servir modelos de pesos abiertos. Debido al bajo tráfico de algunos modelos, solo un trabajador de SGLang sirve cada uno. Después de un mes, observamos una tasa de aciertos de caché de RadixAttention del para LLaVA-NeXT-34B [28] y del para Vicuna-33B [7]. Los aciertos de caché provienen de mensajes de sistema comunes, imágenes de ejemplo reutilizadas con frecuencia e historiales de chat multiturno. Esto reduce la latencia del primer token en un promedio de para Vicuna-33B.
| Modelo | LLaVA-v1.5-7B (imagen) | LLaVA-NEXT-34B (vídeo) |
| Implementación original del autor | 0,18 imagen/s | 0,02 fotograma/s |
| SGLang | 1,15 imagen/s | 0,10 fotograma/s |
Resultados en modelos de API. Probamos un prompt que extrae tres campos de una página de Wikipedia usando el modelo GPT-3.5 de OpenAI. Al usar few-shot prompting, la precisión de la ejecución especulativa de la API es alta, y reduce el costo de los tokens de entrada aproximadamente tres veces debido a la extracción de tres campos.
6.3 Estudio de ablación
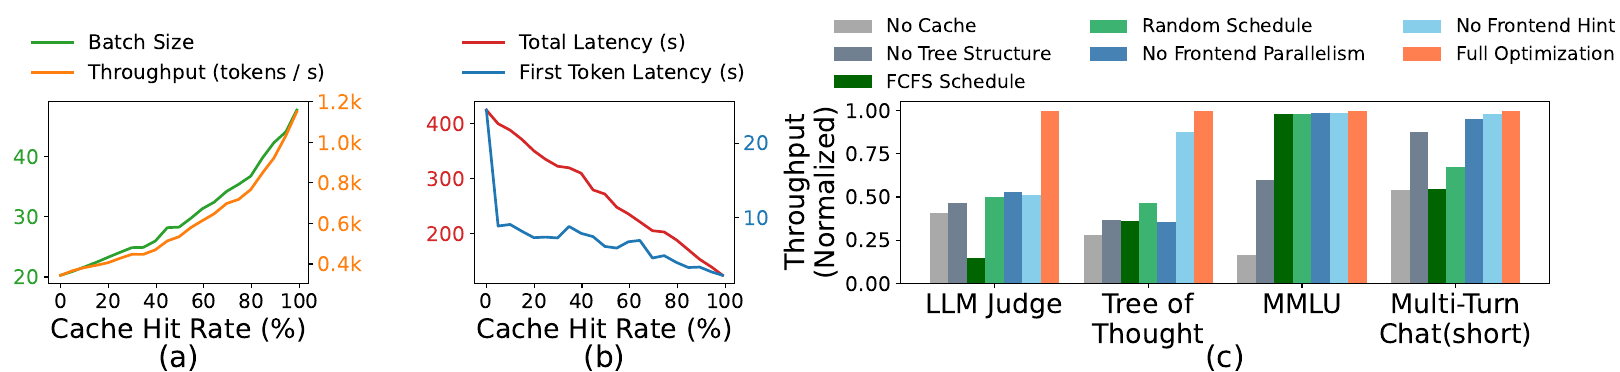
Tasa de aciertos de caché frente a latencia/throughput. La Fig. 8(a)(b) muestra la relación entre la tasa de aciertos de caché y las métricas de rendimiento (latencia del primer token, latencia total, tamaño de lote y throughput) en el benchmark tree-of-thought. La figura se obtiene deshabilitando parcialmente los tokens coincidentes en tiempo de ejecución. Muestra que una mayor tasa de aciertos de caché conduce a un tamaño de lote mayor, mayor throughput y menor latencia.
Eficacia de RadixAttention. Probamos la eficacia de RadixAttention y sus componentes en varios benchmarks representativos. Como se muestra en la Fig. 8(c), "No Cache" significa no usar ninguna caché, "No Tree-Structure" significa usar una caché simple basada en tabla en lugar de una caché estructurada en árbol, "FCFS Schedule" significa usar una política first-come-first-serve en lugar de nuestra planificación consciente de la caché, "Random Schedule" significa usar un orden aleatorio para planificar las solicitudes, "No Frontend Parallelism" significa deshabilitar el paralelismo en el intérprete, "No Frontend Hint" significa deshabilitar el envío de las pistas de bifurcación desde los intérpretes, y "Full optimizations" significa que activamos todas las optimizaciones. Los resultados experimentales muestran que cada uno de estos componentes es necesario para lograr el mejor rendimiento. Deshabilitar el paralelismo y las pistas del intérprete frontend también da como resultado un rendimiento subóptimo en tiempo de ejecución, lo que destaca la importancia del codiseño del lenguaje frontend y el runtime.
Sobrecarga de RadixAttention. Probamos la sobrecarga de RadixAttention en un benchmark sin ninguna oportunidad de reutilización de caché KV. El benchmark mide el throughput en el conjunto de datos ShareGPT. Se tarda 74.3 segundos en ejecutar 100 solicitudes; sin embargo, el tiempo utilizado para gestionar las estructuras de datos de RadixAttention es de solo 0.2 segundos, lo que es una sobrecarga despreciable de menos del 0.3%. Esto se debe a que la complejidad de las operaciones sobre el árbol es lineal y pequeña. Por lo tanto, podemos activar RadixAttention por defecto.
Eficacia de la máquina de estados finitos comprimida. Probamos la eficacia de la máquina de estados finitos comprimida y sus componentes en el benchmark de decodificación JSON. Los resultados experimentales muestran que la máquina de estados finitos comprimida aumenta el throughput en porque puede decodificar múltiples tokens a la vez. Además, necesitamos preprocesar la máquina de estados y reutilizarla para un lote de solicitudes. De lo contrario, rehacer el preprocesamiento para cada solicitud hace que el throughput sea menor.
7 Trabajo relacionado
Diversos trabajos han explorado la reutilización de la caché KV, y muchos de ellos son concurrentes con nuestro trabajo. De forma única, nuestra RadixAttention propone por primera vez tratar la caché KV como una caché LRU estructurada en árbol. Es la primera solución que admite uso compartido multinivel, planificación consciente de la caché, coplanificación frontend-runtime y casos distribuidos. vLLM [23] y ChunkedAttention [58] exploran algunos casos simples de reutilización (por ejemplo, uso compartido de prompts de sistema) pero no cubren el uso compartido multinivel estructurado en árbol ni el almacenamiento en caché LRU. PromptCache [12] propone la reutilización modular de la caché KV más allá del prefijo, pero puede impactar la precisión con una caída de hasta el . HydraGen [18], FlashInfer [59] y ChunkedAttention [58] se centran en optimizaciones de kernels CUDA y no incluyen el concepto de caché LRU. API Serve [1] y LLM-SQL [29] estudian la reutilización de la caché KV para aplicaciones específicas, como la intercalación con llamadas a API externas y bases de datos relacionales, pero no tienen nuestro árbol radix ni nuestra planificación consciente de la caché.
Existen varios frameworks de programación y agentes para LLM, como Guidance [13], LMQL [4], DSPy [20], LangChain [24], AutoGen [55] y LLM Compiler [21]. Guidance y LMQL son los más similares a SGLang, y los comparamos en la Sec. 2. Nuestra innovación radica en optimizaciones novedosas del runtime para acelerar el modelo de programación propuesto. SGLang es compatible con otros frameworks y puede acelerarlos (por ejemplo, el ejemplo de DSPy en nuestra evaluación). Además, SGLang es compatible con muchas otras optimizaciones comunes de inferencia [60, 39, 3, 23, 59, 10, 26, 15, 19, 32, 31, 11].
8 Direcciones futuras y conclusión
Direcciones futuras. A pesar del progreso realizado con SGLang, persisten varias limitaciones que revelan direcciones prometedoras para futuras investigaciones. Estas incluyen extender SGLang para admitir modalidades de salida adicionales, adaptar RadixAttention para operar a través de múltiples niveles de la jerarquía de memoria (por ejemplo, DRAM, Disco) [43], habilitar la coincidencia semántica difusa dentro de RadixAttention, proporcionar primitivas de nivel superior sobre SGLang, corregir la inanición en la planificación consciente de la caché [42] y mejorar el compilador de SGLang para realizar optimizaciones estáticas avanzadas como la planificación y la gestión de memoria.
Conclusión. Presentamos SGLang, un framework para programar y ejecutar de manera eficiente programas de modelos de lenguaje estructurados. SGLang mejora significativamente el rendimiento y la latencia de programas complejos de LM mediante optimizaciones novedosas como RadixAttention, máquinas de estados finitos comprimidas y un intérprete de lenguaje. Es una herramienta valiosa para desarrollar técnicas avanzadas de prompting y flujos de trabajo de agentes. El código fuente está disponible públicamente.
Agradecimientos
Este proyecto cuenta con el apoyo del Stanford Center for Automated Reasoning y de donaciones de Astronomer, Google, IBM, Intel, Lacework, Microsoft, Mohamed Bin Zayed University of Artificial Intelligence, Nexla, Samsung SDS, Uber y VMware. Lianmin Zheng cuenta con el apoyo de una Meta Ph.D. Fellowship. Agradecemos a Yuanhan Zhang y Bo Li por el soporte de LLaVA-NeXT (video).
Referencias
[1] Reyna Abhyankar, Zijian He, Vikranth Srivatsa, Hao Zhang, and Yiying Zhang. Apiserve: Efficient api support for large-language model inferencing. arXiv preprint arXiv:2402.01869, 2024. [2] Jean-Baptiste Alayrac, Jeff Donahue, Pauline Luc, Antoine Miech, Iain Barr, Yana Hasson, Karel Lenc, Arthur Mensch, Katherine Millican, Malcolm Reynolds, et al. Flamingo: a visual language model for few-shot learning. Advances in Neural Information Processing Systems, 35:23716–23736, 2022. [3] Reza Yazdani Aminabadi, Samyam Rajbhandari, Ammar Ahmad Awan, Cheng Li, Du Li, Elton Zheng, Olatunji Ruwase, Shaden Smith, Minjia Zhang, Jeff Rasley, et al. Deepspeed-inference: enabling efficient inference of transformer models at unprecedented scale. In SC22: International Conference for High Performance Computing, Networking, Storage and Analysis, pages 1–15. IEEE, 2022. [4] Luca Beurer-Kellner, Marc Fischer, and Martin Vechev. Prompting is programming: A query language for large language models. Proceedings of the ACM on Programming Languages, 7(PLDI):1946–1969, 2023. [5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877–1901, 2020. [6] Sébastien Bubeck, Varun Chandrasekaran, Ronen Eldan, Johannes Gehrke, Eric Horvitz, Ece Kamar, Peter Lee, Yin Tat Lee, Yuanzhi Li, Scott Lundberg, et al. Sparks of artificial general intelligence: Early experiments with gpt-4. arXiv preprint arXiv:2303.12712, 2023. [7] Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023.
[8] Wei-Lin Chiang, Lianmin Zheng, Ying Sheng, Anastasios Nikolas Angelopoulos, Tianle Li, Dacheng Li, Hao Zhang, Banghua Zhu, Michael Jordan, Joseph E Gonzalez, et al. Chatbot arena: An open platform for evaluating llms by human preference. arXiv preprint arXiv:2403.04132, 2024.
[9] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. arXiv preprint arXiv:2204.02311, 2022.
[10] Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
[11] Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, and Jianfeng Gao. Model tells you what to discard: Adaptive kv cache compression for llms. In The Twelfth International Conference on Learning Representations, 2023.
[12] In Gim, Guojun Chen, Seung-seob Lee, Nikhil Sarda, Anurag Khandelwal, and Lin Zhong. Prompt cache: Modular attention reuse for low-latency inference. arXiv preprint arXiv:2311.04934, 2023.
[13] Guidance AI. A guidance language for controlling large language models. https://github.com/guidance-ai/guidance. Accessed: 2023-11.
[14] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[15] Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, Michael W Mahoney, Yakun Sophia Shao, Kurt Keutzer, and Amir Gholami. Kvquant: Towards 10 million context length llm inference with kv cache quantization. arXiv preprint arXiv:2401.18079, 2024.
[16] Hugging Face. Text generation inference. https://github.com/huggingface/text-generation-inference. Accessed: 2023-11.
[17] Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024.
[18] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[19] Hao Kang, Qingru Zhang, Souvik Kundu, Geonhwa Jeong, Zaoxing Liu, Tushar Krishna, and Tuo Zhao. Gear: An efficient kv cache compression recipe for near-lossless generative inference of llm. arXiv preprint arXiv:2403.05527, 2024.
[20] Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: Compiling declarative language model calls into self-improving pipelines. arXiv preprint arXiv:2310.03714, 2023.
[21] Sehoon Kim, Suhong Moon, Ryan Tabrizi, Nicholas Lee, Michael W Mahoney, Kurt Keutzer, and Amir Gholami. An llm compiler for parallel function calling. arXiv preprint arXiv:2312.04511, 2023.
[22] Michael Kuchnik, Virginia Smith, and George Amvrosiadis. Validating large language models with relm. Proceedings of Machine Learning and Systems, 5, 2023.
[23] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. Efficient memory management for large language model serving with pagedattention. In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611-626, 2023.
[24] LangChain AI. Langchain. https://github.com/langchain-ai/langchain. Accessed: 2023-11.
[25] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. Competition-level code generation with alphacode. Science, 378(6624):1092-1097, 2022.
[26] Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Xingyu Dang, and Song Han. Awq: Activation-aware weight quantization for llm compression and acceleration. arXiv preprint arXiv:2306.00978, 2023.
[27] Haotian Liu, Chunyuan Li, Yuheng Li, and Yong Jae Lee. Improved baselines with visual instruction tuning. arXiv preprint arXiv:2310.03744, 2023.
[28] Haotian Liu, Chunyuan Li, Yuheng Li, Bo Li, Yuanhan Zhang, Sheng Shen, and Yong Jae Lee. Llava-next: Improved reasoning, ocr, and world knowledge, January 2024.
[29] Shu Liu, Asim Biswal, Audrey Cheng, Xiangxi Mo, Shiyi Cao, Joseph E Gonzalez, Ion Stoica, and Matei Zaharia. Optimizing llm queries in relational workloads. arXiv preprint arXiv:2403.05821, 2024.
[30] Xiaoxia Liu, Jingyi Wang, Jun Sun, Xiaohan Yuan, Guoliang Dong, Peng Di, Wenhai Wang, and Dongxia Wang. Prompting frameworks for large language models: A survey. arXiv preprint arXiv:2311.12785, 2023.
[31] Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, and Anshumali Shrivastava. Scissorhands: Exploiting the persistence of importance hypothesis for llm kv cache compression at test time. Advances in Neural Information Processing Systems, 36, 2024.
[32] Zirui Liu, Jiayi Yuan, Hongye Jin, Shaochen Zhong, Zhaozhuo Xu, Vladimir Braverman, Beidi Chen, and Xia Hu. Kivi: A tuning-free asymmetric 2bit quantization for kv cache. arXiv preprint arXiv:2402.02750, 2024.
[33] Xuefei Ning, Zinan Lin, Zixuan Zhou, Zifu Wang, Huazhong Yang, and Yu Wang. Skeleton-of-thought: Prompting LLMs for efficient parallel generation. In The Twelfth International Conference on Learning Representations, 2024.
[34] NVIDIA. Tensorrt-llm. https://github.com/NVIDIA/TensorRT-LLM. Accessed: 2023-11.
[35] OpenAI. Gpt-4 technical report, 2023.
[36] Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior. In In the 36th Annual ACM Symposium on User Interface Software and Technology (UIST '23), UIST '23, New York, NY, USA, 2023. Association for Computing Machinery.
[37] Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, et al. Pytorch: An imperative style, high-performance deep learning library. Advances in neural information processing systems, 32, 2019.
[38] Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023.
[39] Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. Efficiently scaling transformer inference. Proceedings of Machine Learning and Systems, 5, 2023.
[40] Swarnadeep Saha, Omer Levy, Asli Celikyilmaz, Mohit Bansal, Jason Weston y Xian Li. Branch-solve-merge improves large language model evaluation and generation. arXiv preprint arXiv:2310.15123, 2023.
[41] Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda y Thomas Scialom. Toolformer: Language models can teach themselves to use tools. arXiv preprint arXiv:2302.04761, 2023.
[42] Ying Sheng, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E Gonzalex y Ion Stoica. Fairness in serving large language models. arXiv preprint arXiv:2401.00588, 2023.
[43] Ying Sheng, Lianmin Zheng, Binhang Yuan, Zhuohan Li, Max Ryabinin, Beidi Chen, Percy Liang, Christopher Ré, Ion Stoica y Ce Zhang. Flexgen: high-throughput generative inference of large language models with a single gpu. En International Conference on Machine Learning, páginas 31094-31116. PMLR, 2023.
[44] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper y Bryan Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism. arXiv preprint arXiv:1909.08053, 2019.
[45] Vikranth Srivatsa, Zijian He, Reyna Abhyankar, Dongming Li y Yiying Zhang. Preble: Efficient distributed prompt scheduling for llm serving. 2024.
[46] Theodore Sumers, Shunyu Yao, Karthik Narasimhan y Thomas Griffiths. Arquitecturas cognitivas para agentes lingüísticos. Transactions on Machine Learning Research, 2023.
[47] Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: una familia de modelos multimodales altamente capaces. arXiv preprint arXiv:2312.11805, 2023.
[48] Philippe Tillet, Hsiang-Tsung Kung y David Cox. Triton: un lenguaje intermedio y compilador para cálculos de redes neuronales por mosaicos. En Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, páginas 10-19, 2019.
[49] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: modelos de chat abiertos fundacionales y ajustados. arXiv preprint arXiv:2307.09288, 2023.
[50] Vivien Tran-Thien. Decodificación rápida y de alta fidelidad de LLM con restricciones de regex, 2024.
[51] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser e Illia Polosukhin. La atención es todo lo que necesitas. Advances in neural information processing systems, 30, 2017.
[52] Guanzhi Wang, Yuqi Xie, Yunfan Jiang, Ajay Mandlekar, Chaowei Xiao, Yuke Zhu, Linxi Fan y Anima Anandkumar. Voyager: un agente encarnado abierto con grandes modelos de lenguaje. arXiv preprint arXiv: arXiv:2305.16291, 2023.
[53] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc V Le, Ed H Chi, Sharan Narang, Aakanksha Chowdhery y Denny Zhou. La autocon sistencia mejora el razonamiento de cadena de pensamiento en modelos de lenguaje. En The Eleventh International Conference on Learning Representations, 2022.
[54] Brandon T Willard y Rémi Louf. Generación guiada eficiente para grandes modelos de lenguaje. arXiv e-prints, páginas arXiv-2307, 2023.
[55] Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang y Chi Wang. Autogen: Habilitando aplicaciones LLM de próxima generación mediante un marco de conversación multiagente. arXiv preprint arXiv:2308.08155, 2023.
[56] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L Griffiths, Yuan Cao y Karthik Narasimhan. Árbol de pensamientos: resolución deliberada de problemas con grandes modelos de lenguaje. arXiv preprint arXiv:2305.10601, 2023.
[57] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan y Yuan Cao. React: Sinergizando razonamiento y actuación en modelos de lenguaje. En The Eleventh International Conference on Learning Representations, 2022.
[58] Lu Ye, Ze Tao, Yong Huang y Yang Li. Chunkattention: autoatención eficiente con caché KV consciente de prefijos y partición en dos fases. arXiv preprint arXiv:2402.15220, 2024.
[59] Zihao Ye, Lequn Chen, Ruihang Lai, Yilong Zhao, Size Zheng, Junru Shao, Bohan Hou, Hongyi Jin, Yifei Zuo, Liangsheng Yin, Tianqi Chen y Luis Ceze. Acelerando las autoatenciones para el servicio de LLM con flashinfer, febrero de 2024.
[60] Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim y Byung-Gon Chun. Orca: un sistema de servicio distribuido para modelos generativos {basados en Transformer}. En 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), páginas 521-538, 2022.
[61] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi y Yejin Choi. Hellaswag: ¿puede realmente una máquina terminar tu oración? En Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, páginas 4791-4800, 2019.
[62] Yuanhan Zhang, Bo Li, haotian Liu, Yong jae Lee, Liangke Gui, Di Fu, Jiashi Feng, Ziwei Liu y Chunyuan Li. Llava-next: un modelo sólido de comprensión de video zero-shot, abril de 2024.
A Detalles adicionales sobre RadixAttention
A.1 Antecedentes sobre la caché KV
La mayoría de los LLM en uso hoy en día, como GPT-3 [5], PaLM [9] y LLaMA [49], se basan en la arquitectura Transformer autorregresiva [51]. Estos modelos predicen la probabilidad del siguiente token en una secuencia basándose en los tokens precedentes. Durante la inferencia, el modelo primero procesa una secuencia de tokens de entrada mediante un pase hacia adelante (este proceso se denomina "prefill"). Luego decodifica secuencialmente los tokens de salida, con cada token dependiendo de los tokens anteriores (este proceso se denomina "decoding"). Nos referimos al proceso de tomar una secuencia de tokens de entrada y generar una secuencia de tokens de salida como una única llamada de generación. A lo largo de este proceso, cada token genera algunos tensores intermedios, que se utilizan para decodificar tokens posteriores. Estos tensores intermedios, conocidos como "KV Cache", reciben su nombre por los pares clave-valor en el mecanismo de autoatención. Una observación importante al discutir las optimizaciones en este artículo es que el cálculo de la caché KV solo depende de todos los tokens anteriores, por lo que diferentes secuencias con el mismo prefijo pueden reutilizar la caché KV de los tokens del prefijo y evitar cálculos redundantes.
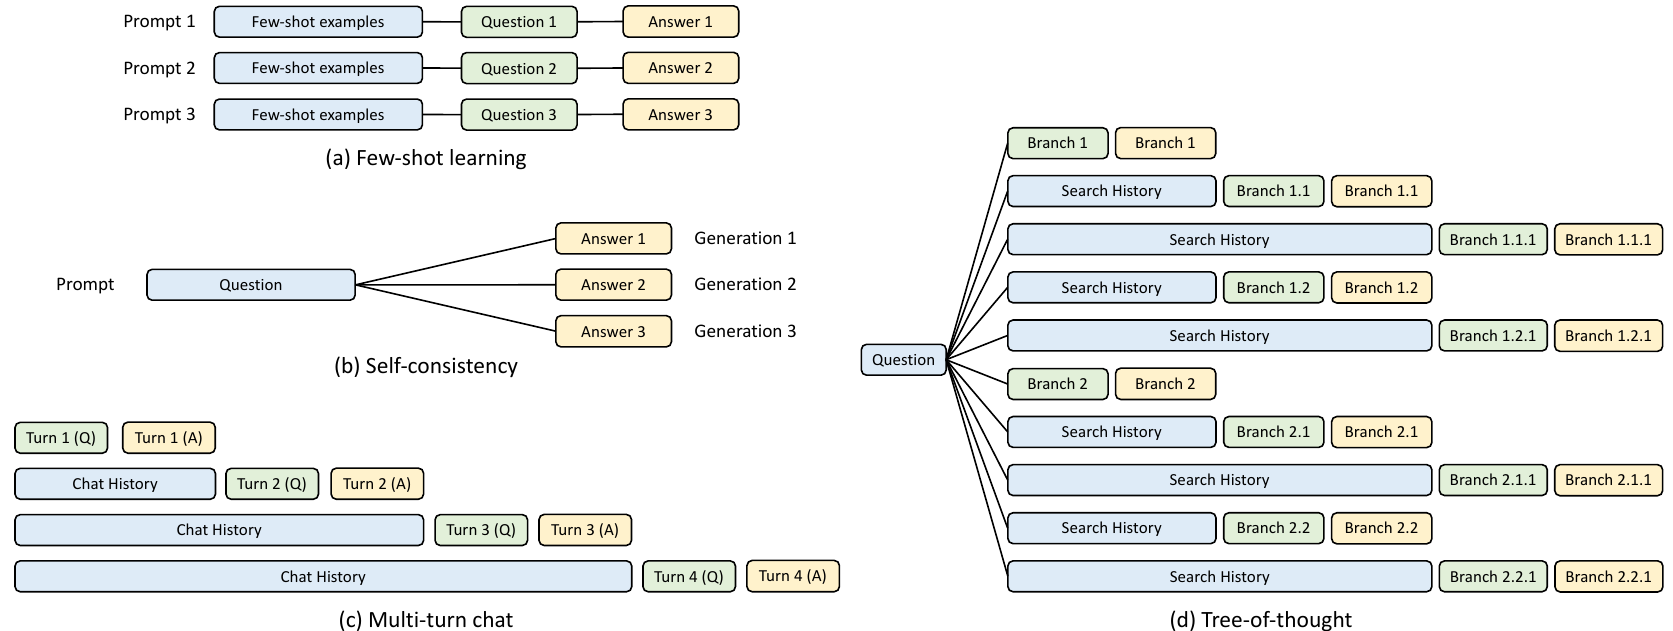
A menudo, en los programas LLM, múltiples segmentos de texto y llamadas de generación se añaden a un único prompt. Almacenar en caché la caché KV calculada para tokens anteriores a través de múltiples llamadas encadenadas puede reducir el cálculo redundante. Esta optimización, sin embargo, ni es gratuita ni trivial, ya que requiere almacenamiento adicional y una gestión de memoria más compleja. Además, es común en los programas LLM generar múltiples salidas a partir de un único prompt o bifurcar un nuevo prompt desde el estado actual [25]. La compartición básica de prefijos se ha investigado en vLLM [23]. También se pueden emplear patrones de compartición más avanzados, como la compartición con estructura de árbol irregular. La Fig. 9 muestra cuatro patrones típicos de compartición de caché KV entre múltiples llamadas; ninguno de los sistemas existentes puede manejar automáticamente todos ellos. Por el contrario, nuestro RadixAttention en la Sec. 3 puede manejarlos todos automáticamente en tiempo de ejecución.
A.2 Pseudocódigo para la planificación consciente de la caché
El Alg. 1 muestra el pseudocódigo de la planificación consciente de la caché para RadixAttention con batching continuo.
A.3 Demostración del Teorema 3.1
Teorema 3.1. Para un lote de solicitudes, podemos lograr una tasa óptima de aciertos de caché visitando el árbol radix de las solicitudes en el orden de búsqueda en profundidad, con un tamaño de caché la longitud máxima de solicitud. El orden de prefijo compartido más largo primero es equivalente a un orden de búsqueda en profundidad.
Demostración. Primero, mostramos que el orden de búsqueda en profundidad (DFS) logra una tasa óptima de aciertos de caché. Sea el conjunto de solicitudes en el lote, y el árbol radix construido a partir de . Para cada arista de , la caché KV asociada con debe calcularse al menos una vez. Sea el tamaño de la caché KV asociada con . Sea la complejidad computacional de la caché KV para .
Algoritmo 1 Programación consciente de la caché para RadixAttention con batching continuo. Entrada: El árbol radix , el pool de memoria , el lote en ejecución actual , la cola de espera . Salida: Solicitudes finalizadas y estado actualizado del sistema.// Obtener todas las solicitudes de la cola de espera requests .get_all_requests()// Buscar la coincidencia de prefijo para todas las solicitudes en espera for req requests do req.prefix_node, req.prefix_len .match_prefix(req.input_tokens) end for// Ordenar las solicitudes según las longitudes de prefijo coincidentes requests.sort()// Seleccionar solicitudes para el siguiente lote available_size .evitable_size() + .available_size() current_size new_batch for req requests do if req.size() + current_size available_size then new_batch.append(req) delta .increase_ref_counter(req.prefix_node) available_size available_size + delta end if end for Q.remove_requests(new_batch)// Insertar solicitudes en el lote en ejecución actual B.merge(new_batch)// Asignar nueva memoria y hacer desalojo si es necesario needed_size .needed_size() success,buffer .alloc(needed_size) if not success then T.evict(needed_size) success,buffer .alloc(needed_size) end if B.run(buffer)// Procesar solicitudes finalizadas finished_requests .drop_finished_requests() for req finished_requests do T.decrease_ref_counter(req.prefix_node) T.insert(req) end for return finished_requests Obtenemos la cota inferior
Consideremos que visitamos el árbol radix en orden DFS. Para cada arista de , la primera vez que calculamos la caché KV asociada con , calcularemos después todo el subárbol de . Durante el cálculo del subárbol de , la arista será alcanzada continuamente, por lo que no ocurrirá ningún cálculo adicional. Después de terminar el cálculo para el subárbol enraizado en , la arista no volverá a ser visitada. Nótese que, con un tamaño de caché la longitud máxima de solicitud, que es igual al camino más largo en el árbol radix , la arista no será desalojada durante el cálculo de su subárbol, ya que el prefijo común que incluye a del subárbol será alcanzado continuamente. Por lo tanto, la caché KV asociada con cada arista se calculará solo una vez. Así, alcanzamos la cota inferior
La tasa de aciertos de caché, definida como
que es igual a , alcanza su cota superior, proporcionando optimalidad.
A continuación, demostramos que el orden de longest-shared-prefix-first es equivalente a un orden DFS por inducción.
- (Base) Al principio, dado que no hay nada en caché, se procesará una solicitud aleatoria que corresponde a un nodo en . Todas las solicitudes que corresponden a los nodos en la ruta desde la raíz hasta no necesitan una recomputación. La complejidad de cómputo para las solicitudes correspondientes a los nodos está alineada con un DFS válido. La ruta desde la raíz hasta está en caché.
- (Inducción) Supongamos que acabamos de visitar un nodo en , y que los nodos visitados se alinean con un orden DFS. Sea la ruta desde la raíz hasta . Entonces, cada nodo que no ha sido visitado tiene su ancestro común más bajo con los nodos visitados en . Dado que los nodos en están en caché, un nodo que no ha sido visitado y cuyo ancestro común más bajo está en tendrá el prefijo compartido más largo. El orden longest-shared-prefix-first seleccionará , lo cual constituye un orden DFS válido. La ruta desde la raíz hasta estará en caché porque es la más reciente.
En el caso en línea, el orden DFS se verá interrumpido, pero la planificación por longest shared prefix aún aproxima el comportamiento de DFS sobre la parte aumentada del árbol de radix implícito. Mostramos esto considerando el paso de añadir un nuevo lote de solicitudes.
Sea la parte del árbol de radix que ha sido visitada hasta ahora, y sea el árbol de radix nuevo completo tras añadir el nuevo lote de solicitudes. Sea el conjunto de nodos en caché en . Sea longest el nodo en que tiene la ruta más larga desde la raíz y que tiene un subárbol en que no ha sido visitado por completo.
La planificación por longest shared prefix procesará entonces el subárbol en enraizado en longest en un orden DFS. Durante este proceso, podría ocurrir un desalojo, y los nodos restantes en caché de pasan a ser . A continuación, se realizará un DFS para el subárbol en enraizado en longest .
De manera similar, tendremos , hasta que contenga solo un nodo hoja en cuyo subárbol en no haya sido visitado por completo. En este punto, hemos alcanzado un estado DFS válido. La parte restante de se visitará en orden DFS como se describe en la prueba del Teorema 3.1.
A.4 RadixAttention distribuida con paralelismo de datos
Para adaptar RadixAttention a entornos distribuidos con múltiples workers de réplica (es decir, paralelismo de datos), desarrollamos un mecanismo en el que cada worker mantiene su propio subárbol, mientras que el router supervisa un metaárbol. Este metaárbol actúa como un trie que rastrea todos los subárboles y sus dispositivos asociados. Cuando llega un nuevo lote de solicitudes al router, se ejecuta la coincidencia de prefijos sobre el metaárbol. Implementamos diversas políticas basadas en la afinidad de cada solicitud —medida por la longitud del prefijo compartido con workers específicos y otras solicitudes del mismo grupo— para tomar decisiones de despacho eficientes que minimicen los cómputos redundantes. Cada vez que se procesan nuevas solicitudes, tanto el router como los workers actualizan de forma independiente sus respectivos árboles. Si ocurre un desalojo en un nodo worker, este confirma dicho desalojo en una cola, que el router procesa luego para actualizar el metaárbol durante periodos de baja actividad. Evaluamos esta configuración distribuida usando cuatro workers y el conjunto de datos MMLU, y observamos que logra un escalado lineal y una tasa óptima de aciertos de caché con una sobrecarga mínima de este diseño de caché distribuida débilmente consistente. Existe un compromiso entre maximizar la localidad de datos y la eficiencia del procesamiento paralelo. Explorar políticas de planificación avanzadas para optimizar este compromiso se designa como un área para investigación futura. Además, un trabajo concurrente de Preble [45] estudia la planificación con paralelismo de datos basada en una versión temprana de SGLang.
B Detalles adicionales sobre la máquina de estados finitos comprimida
Esta sección analiza los antecedentes y los detalles de implementación de la máquina de estados finitos comprimida para una decodificación restringida más rápida. Nuestro objetivo es que los LLM sigan una expresión regular (regex), que ofrece una mayor expresividad y puede usarse para representar formatos comunes como los esquemas JSON. Para lograrlo, convertimos la regex en una Máquina de Estados Finitos (FSM) para guiar el proceso de generación durante la decodificación [54]. Una FSM es esencialmente un grafo con nodos (estados) y aristas (transiciones con cadenas/caracteres). Partiendo de un estado inicial, cada transición añade la cadena de la arista para pasar al siguiente estado, usando un conjunto de estados finales para concluir el proceso. Este mecanismo guía la decodificación de un LLM, filtrando los tokens inválidos según las transiciones del estado actual de la FSM, como se ilustra en la Fig. 10. La decodificación puede implicar múltiples transiciones en la FSM hasta alcanzar un estado final.
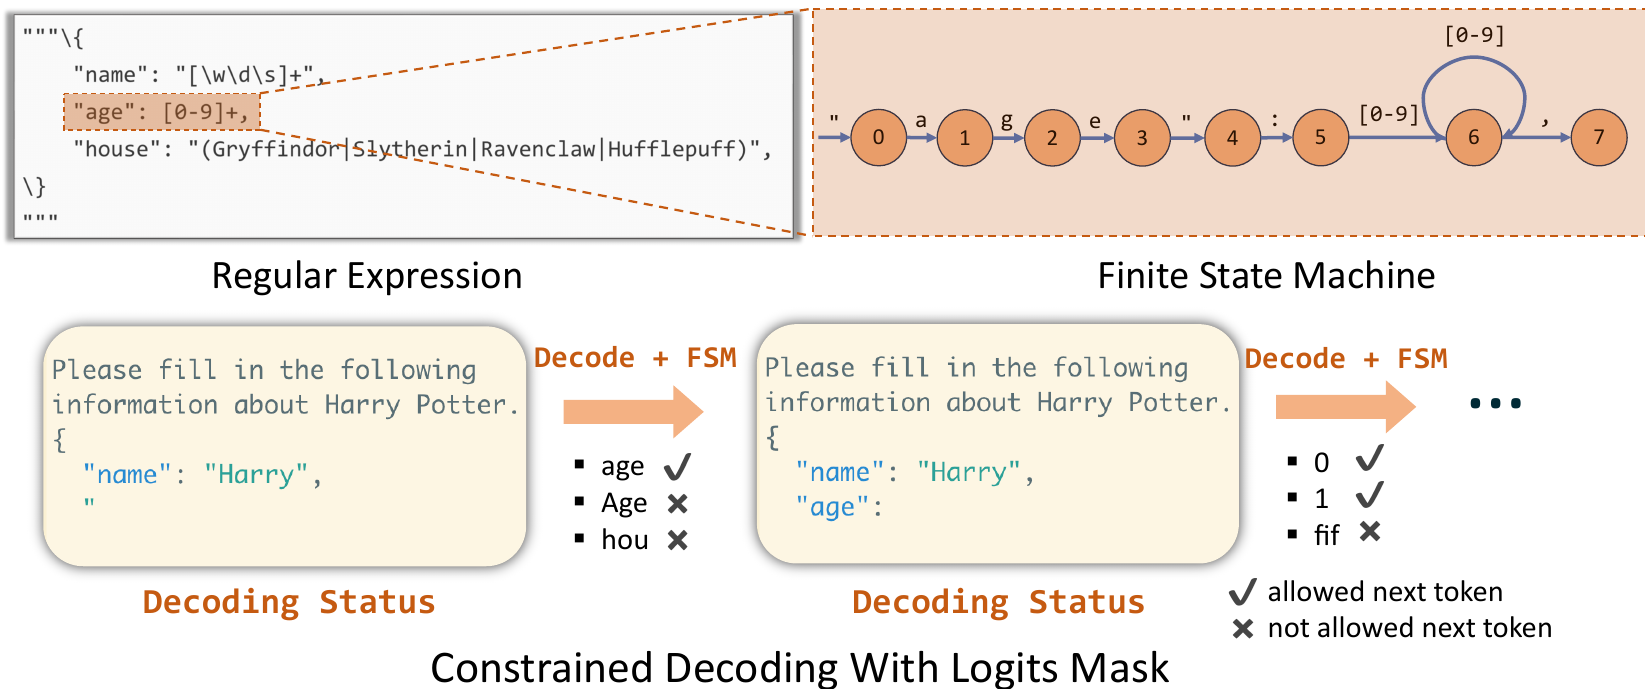
El desafío de la decodificación restringida surge del hecho de que las restricciones a menudo se expresan en formatos de lenguaje natural, es decir, la regex se representa mediante caracteres/cadenas, mientras que los LLM están diseñados para interpretar y procesar estos como tokens. Esto crea un escenario complejo, ya que la correspondencia entre cadenas y tokens es intrincada y carece de una correspondencia uno a uno [22].
Esta sección deriva de una entrada de blog anterior. También se anima a los lectores a leer la entrada de blog para obtener antecedentes adicionales y una comprensión más sencilla. 4
B.1 Detalles de implementación de la máquina de estados finitos comprimida
Para simplificar la construcción de la FSM comprimida, construimos la FSM original sobre caracteres/cadenas en lugar de sobre tokens. Definimos formalmente los conceptos de arista de transición singular y arista comprimida como sigue:
- Arista de transición singular: una arista es una arista de transición singular si 1) su nodo de origen tiene solo un nodo sucesor, y 2) solo hay un carácter/cadena aceptable en ella.- Arista comprimida: una arista comprimida por varias aristas adyacentes consecutivas si y solo si son aristas de transición singulares. El texto de la arista comprimida es la concatenación de los textos de .
Partiendo de una FSM basada en caracteres, fusionamos recursivamente las aristas de transición singulares en las precedentes hasta que una mayor compresión resulte inviable, lo que da como resultado una FSM comprimida. Este enfoque acelera el proceso de decodificación, como demuestra la eficiencia en tiempo de ejecución de SGLang con la FSM comprimida, mostrada en la Fig. 11.
B.2 Manejo de artefactos de tokenización con retokenización
Cuando se genera un nuevo token, obtenemos la cadena del token y buscamos en todas las aristas salientes del estado actual la que comience con la cadena recién decodificada, y luego avanzamos. Sin embargo, cuando la arista de transición es una bien comprimida y contiene una cadena muy larga, también podemos anticipar las cadenas decodificadas de las siguientes rondas. Aquí es donde ocurre la aceleración y llamamos a este proceso Jump Forward. No obstante, aún necesitamos convertir la cadena en tokens para las siguientes fases de decodificación, y esto no es sencillo debido al preentrenamiento y al método de tokenización específicos del LLM;
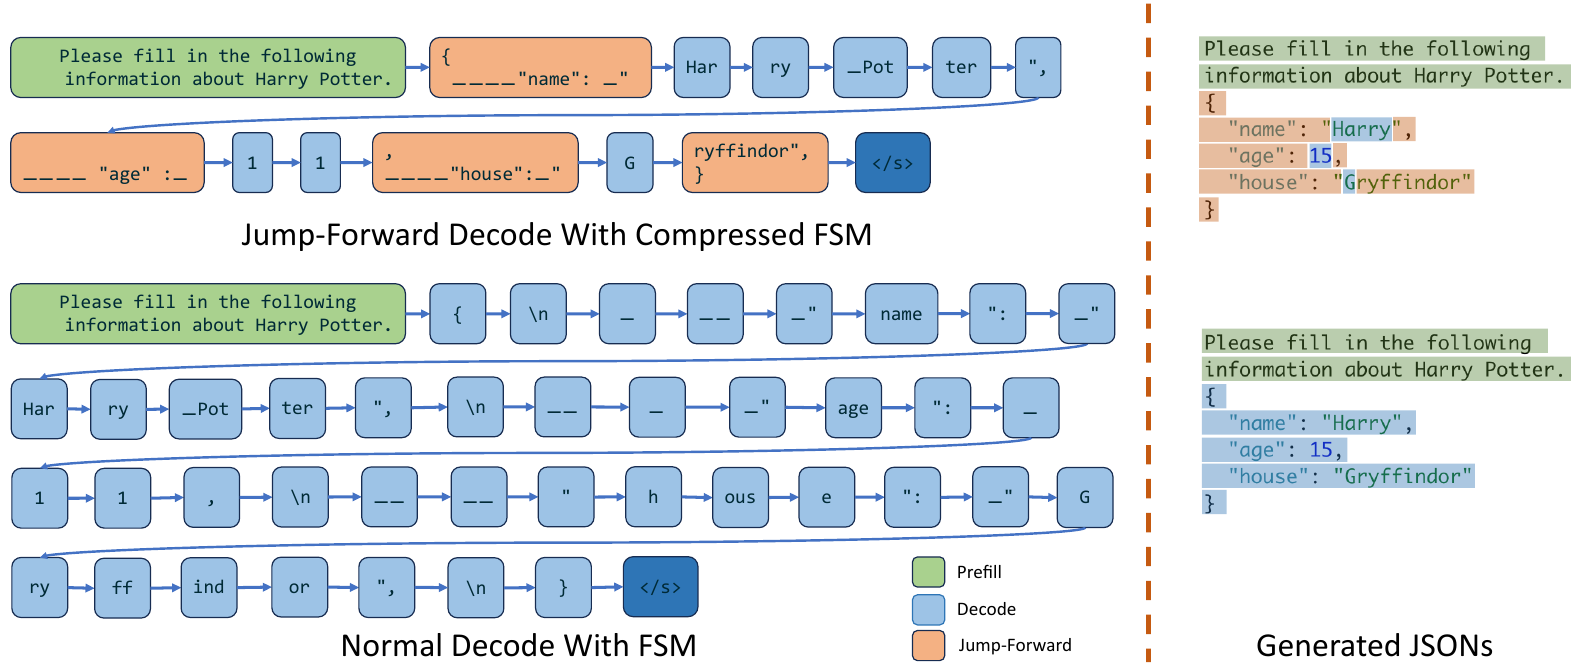
una partición directa podría alterar el significado previsto [50]. Por ejemplo, el texto comprimido en la regex de la Fig. 2 es {"summary": "que solo puede tokenizarse como {"summary,": y " según el tokenizador, en lugar de particionarlos aleatoriamente como {"summa, ry, y ".: Para abordar este problema, usamos el tokenizador original para retokenizar todo el texto anterior así como el texto de la arista comprimida, asegurando la alineación con el formato de entrada original de los LLM. Y solo conlleva una sobrecarga menor de retokenización.
B.3 Extensión futura: abordar la probabilidad distorsionada
La brecha entre cadenas y tokens también plantea el problema de una distribución de probabilidad sesgada [50]. Por ejemplo, en la Fig. 2, la expresión regular "[ABCD][+- ]?" sugiere calificaciones desde A+ hasta D-, pero si se reemplaza con términos más amplios como Excelente | Por encima de la media | Aceptable | Por debajo de la media, el tiempo de ejecución podría asignar incorrectamente una A a Por encima de la media debido a que el término Por encima de la media se encuentra en una transición comprimida, tergiversando la jerarquía de calificaciones. Esto ocurre porque el LLM no reconoce el rango específico de opciones, lo que da lugar a secuencias de tokens inapropiadas. Calcular probabilidades precisas para cada opción requiere sumar las probabilidades de todas las secuencias de tokens que dan como resultado cada opción, lo que complica la decodificación y añade sobrecarga. Una solución alternativa consiste en incluir las opciones o la expresión regular directamente en el prompt de prellenado, guiando al LLM para que sea consciente de sus opciones y emita la decisión en secuencias de tokens adecuadas. Sin embargo, este enfoque no resuelve el problema subyacente de las probabilidades distorsionadas, lo que pone de relieve la necesidad de seguir investigando para mejorar la precisión del FSM comprimido.
C Configuraciones y resultados experimentales adicionales
Configuraciones experimentales adicionales. La Fig. 5 y la Fig. 6 se obtienen ejecutando Llama-7B en una única GPU A10G (24 GB). La Fig. 7 se obtiene ejecutando Mixtral-8x7B en 8 GPU A10G (24 GB) con paralelismo de tensores. La Fig. 8(c) se obtiene ejecutando Llama-7B en una única GPU A10G (24 GB). La Fig. 12 se obtiene ejecutando Llama-70B en 4 GPU A100G (80 GB) con paralelismo de tensores. La Tabla 2 se obtiene ejecutando LLaVA-v1.5-7B en una única GPU A10G (24 GB) y ejecutando LLaVA-Next-34B en una única GPU A100G (80 GB). Cada barra de las figuras de referencia tarda desde varios minutos hasta una hora en ejecutarse.
Resultados experimentales adicionales. La Fig. 13 muestra las tasas de aciertos de caché alcanzadas y óptimas en los benchmarks enumerados en la Fig. 5. La Fig. 12 muestra el rendimiento en Llama-2-70B con paralelismo de tensores.
D Modo compilador
Además del modo intérprete utilizado en el cuerpo principal del artículo, otra forma de ejecutar programas SGLang es compilarlos como grafos computacionales y ejecutarlos con un ejecutor de grafos. Esto abre
oportunidades para más optimizaciones de compilación, ya que podemos reescribir el grafo y realizar una planificación más estática.
D.1 Diseño e implementación
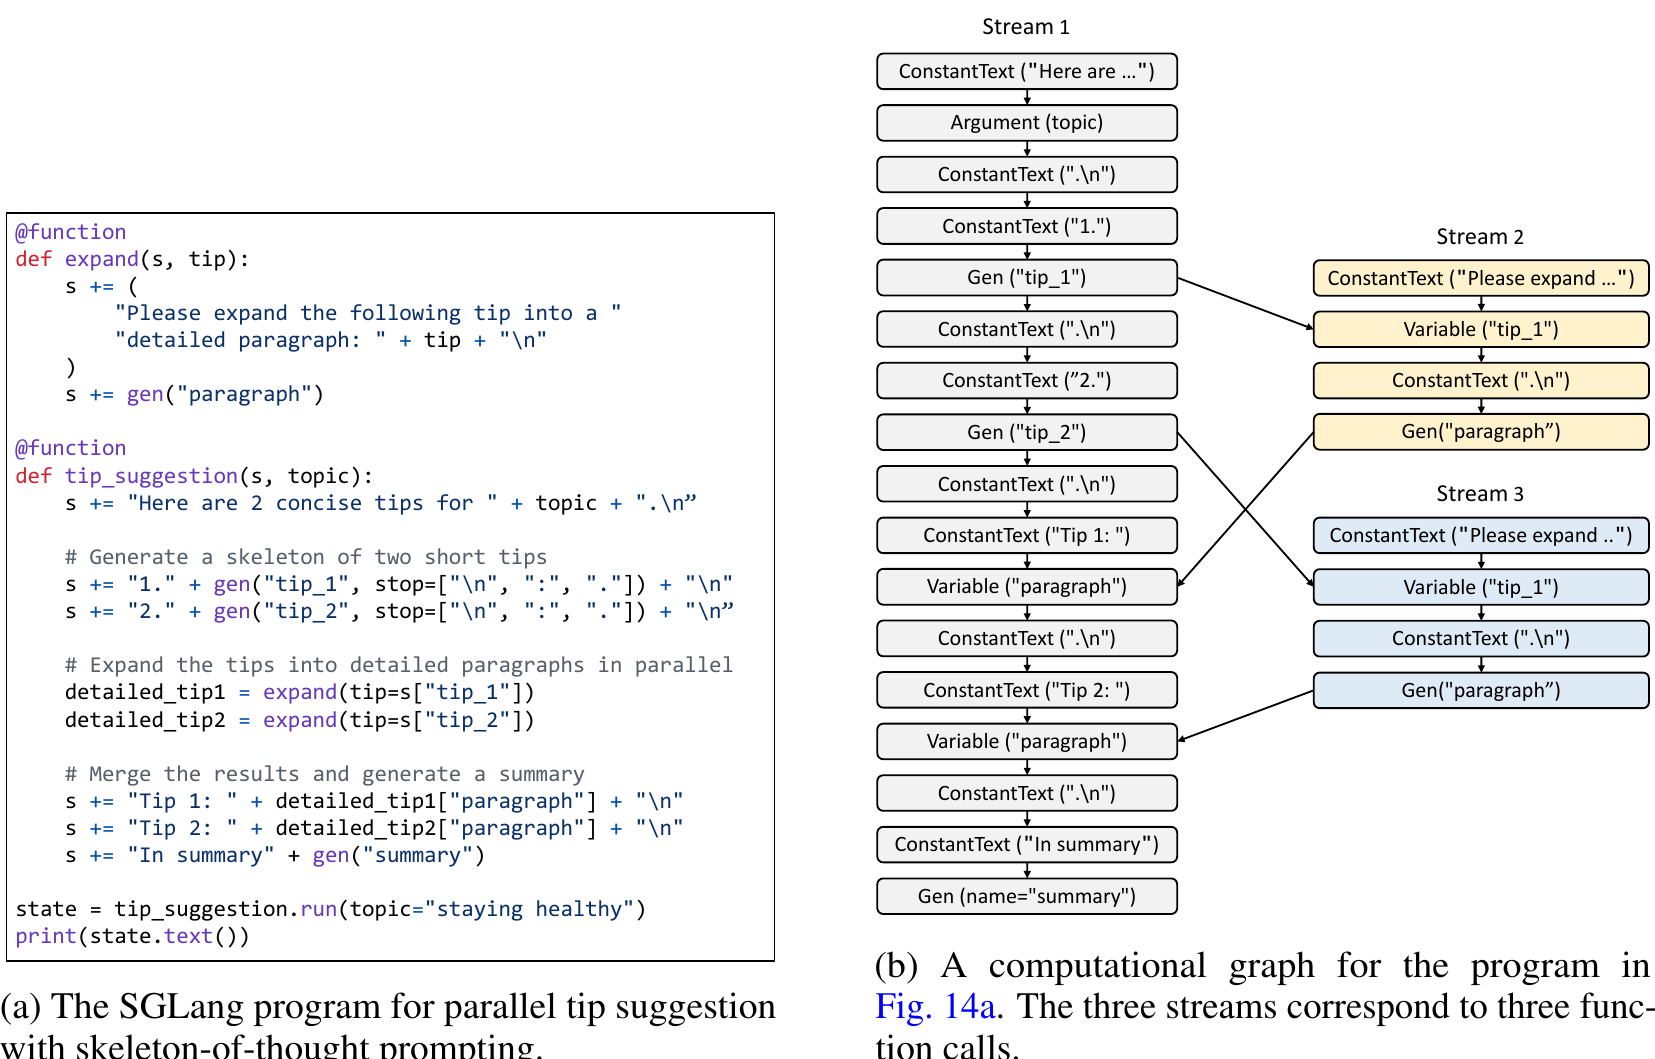
Diseñamos una representación intermedia (IR) para SGLang, que representa las estructuras y operaciones de los programas SGLang como un grafo computacional. Este grafo incluye nodos para operadores primitivos y aristas para dependencias. Véase la Fig. 14b para el grafo correspondiente al programa de la Fig. 14a. En el programa, cada llamada a una función decorada o a un fork crea un nuevo estado de prompt o un stream.
Hay varios tipos de nodos. Cada operando de los operadores y en un programa SGLang está representado por un nodo de la IR. Estos incluyen ConstantText, Argument, Gen, Select, Variable, Fork, GetForkItem y Join. Hay dos tipos de dependencias: la dependencia intra-stream, en la que las operaciones enviadas a un stream mediante deben ejecutarse después de todas las operaciones precedentes en ese stream, y la dependencia inter-stream, que ocurre cuando un stream necesita obtener valores de variables de otro stream, lo que exige sincronización. Operaciones como fork manipulan múltiples streams y, por tanto, introducen dependencias inter-stream.
Para generar el grafo, utilizamos el trazado para ejecutar el programa con argumentos abstractos y construir el grafo dinámicamente. Este método está limitado a programas sin flujo de control dependiente de datos, una limitación que planeamos abordar en trabajos futuros. Una vez construido, el grafo puede ejecutarse mediante un ejecutor de grafos, lo que elimina la necesidad de reinterpretar el programa Python original. Esto aporta beneficios como optimizaciones de reescritura del grafo, reducción de la sobrecarga en tiempo de ejecución y serialización del programa. Para la ejecución, se lanzan ejecutores de stream para cada flujo de datos, despachando los nodos de la IR a los streams en orden topológico.
D.2 Un estudio de caso de optimización de compilador: movimiento de código para mejorar el uso compartido de prefijos
Exploramos una optimización de compilación para SGLang IR: el movimiento de código para mejorar el uso compartido de prefijos. Anticipamos que también se pueden aplicar técnicas de compilador más clásicas, como la autotuning y la selección de instrucciones.
Esta optimización tiene como objetivo mejorar el uso compartido de prefijos reordenando los nodos del grafo para aumentar la longitud del prefijo constante. No preserva estrictamente el cálculo original, por lo que se clasifica como una optimización agresiva. Por ejemplo, cambiar el prompt de "Aquí hay una pregunta + {pregunta}. Por favor, actúa como un experto en matemáticas y resuelve la pregunta dada." a "Por favor, actúa como un experto en matemáticas y resuelve la pregunta dada. Aquí hay una pregunta + {pregunta}." da como resultado un prefijo compartible más largo. Esta optimización es interesante porque el análisis de programas tradicional no puede lograrla debido a la presencia de instrucciones en lenguaje natural en SGLang. En su lugar, solicitamos a GPT-4 que reordene los nodos del grafo. Escribimos un prompt con varios ejemplos para enseñar a GPT-4 los conceptos de SGLang IR, y encontramos que GPT-4 puede aplicar con éxito esta optimización para algunos programas sencillos de SGLang.
Evaluamos la eficacia de esta optimización. Recopilamos 20 plantillas de prompts de internet y las implementamos en SGLang. Utilizamos 5 de estas plantillas como ejemplos de few-shot y las 15 restantes como casos de prueba. Nuestra evaluación muestra que, para 12 de las 15 plantillas, GPT-4 reordena con éxito los nodos del grafo sin alterar la semántica, según lo confirmado mediante inspección manual de los prompts modificados. En promedio, esta optimización da como resultado un aumento de 60 tokens en la longitud del prefijo compartible, lo que demuestra la eficacia de GPT-4. Los fallos al crear un orden de prompt optimizado provienen de una comprensión incorrecta del significado semántico detrás de los nodos del grafo. Es demasiado agresivo y coloca todas las constantes al principio incluso cuando dicho orden cambia la semántica original. Este estudio de caso tiene como objetivo explorar el uso de GPT-4 para optimizaciones de compilador. Se necesita más trabajo para hacer que este tipo de optimizaciones sea confiable en el futuro.