
Un agente que lo olvida todo no ayuda. Mem0 guarda lo importante entre sesiones y baja la latencia p95 un 91 %. Papel de 2025, gratis online.
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
MemO: Construyendo agentes de IA listos para producción con memoria a largo plazo escalable
Prateek Chhikara, Dev Khant, Saket Aryan, Taranjeet Singh y Deshraj Yadavresearch@memO.ai
memO
Los Modelos de Lenguaje Grandes (LLM, por sus siglas en inglés) han demostrado una destreza notable en la generación de respuestas contextualmente coherentes; sin embargo, sus ventanas de contexto fijas plantean desafíos fundamentales para mantener la consistencia a lo largo de diálogos prolongados de múltiples sesiones. Presentamos MemO, una arquitectura escalable centrada en la memoria que aborda este problema extrayendo, consolidando y recuperando dinámicamente información relevante de conversaciones en curso. Sobre esta base, proponemos además una variante mejorada que aprovecha representaciones de memoria basadas en grafos para capturar estructuras relacionales complejas entre los elementos conversacionales. Mediante evaluaciones exhaustivas en el benchmark LOCOM0, comparamos sistemáticamente nuestros enfoques con seis categorías de referencia: (i) sistemas establecidos aumentados con memoria, (ii) generación aumentada por recuperación (RAG) con diversos tamaños de fragmento y valores de , (iii) un enfoque de contexto completo que procesa todo el historial de la conversación, (iv) una solución de memoria de código abierto, (v) un sistema de modelo propietario y (vi) una plataforma dedicada de gestión de memoria. Los resultados empíricos demuestran que nuestros métodos superan consistentemente a todos los sistemas de memoria existentes en cuatro categorías de preguntas: de un solo salto, temporales, de múltiples saltos y de dominio abierto. En particular, MemO logra mejoras relativas del en la métrica LLM-como-Juez frente a OpenAI, mientras que MemO con memoria de grafos alcanza una puntuación global aproximadamente superior a la configuración base de MemO. Más allá de las ganancias en precisión, también reducimos notablemente la sobrecarga computacional en comparación con el enfoque de contexto completo. En particular, MemO alcanza una latencia p95 un menor y ahorra más del del costo en tokens, ofreciendo así un equilibrio convincente entre capacidades de razonamiento avanzadas y restricciones prácticas de despliegue. Nuestros hallazgos destacan el papel crítico de los mecanismos de memoria estructurados y persistentes para la coherencia conversacional a largo plazo, allanando el camino hacia agentes de IA impulsados por LLM más confiables y eficientes.
El código se puede encontrar en: https://mem0. ai/research
1. Introducción
X
La memoria humana es un fundamento de la inteligencia: da forma a nuestra identidad, guía la toma de decisiones y nos permite aprender, adaptarnos y formar relaciones significativas (Craik y Jennings, 1992). Entre sus muchas funciones, la memoria es esencial para la comunicación: recordamos interacciones pasadas, inferimos preferencias y construimos modelos mentales en evolución de aquellos con quienes interactuamos (Assmann, 2011). Esta capacidad de retener y recuperar información durante períodos prolongados permite intercambios coherentes y contextualmente ricos que abarcan días, semanas o incluso meses. Los agentes de IA, impulsados por modelos de lenguaje grandes (LLM), han logrado avances notables en la generación de respuestas fluidas y contextualmente apropiadas (Yu et al., 2024, Zhang et al., 2024). Sin embargo, estos sistemas están fundamentalmente limitados por su dependencia de ventanas de contexto fijas, lo que restringe severamente su capacidad de mantener coherencia a lo largo de interacciones prolongadas (Bulatov et al., 2022, Liu et al., 2023). Esta limitación se deriva de la falta de mecanismos de memoria persistente en los LLM que puedan extenderse más allá de sus ventanas de contexto finitas. Mientras que los humanos acumulan y organizan naturalmente experiencias a lo largo del tiempo, formando una narrativa continua
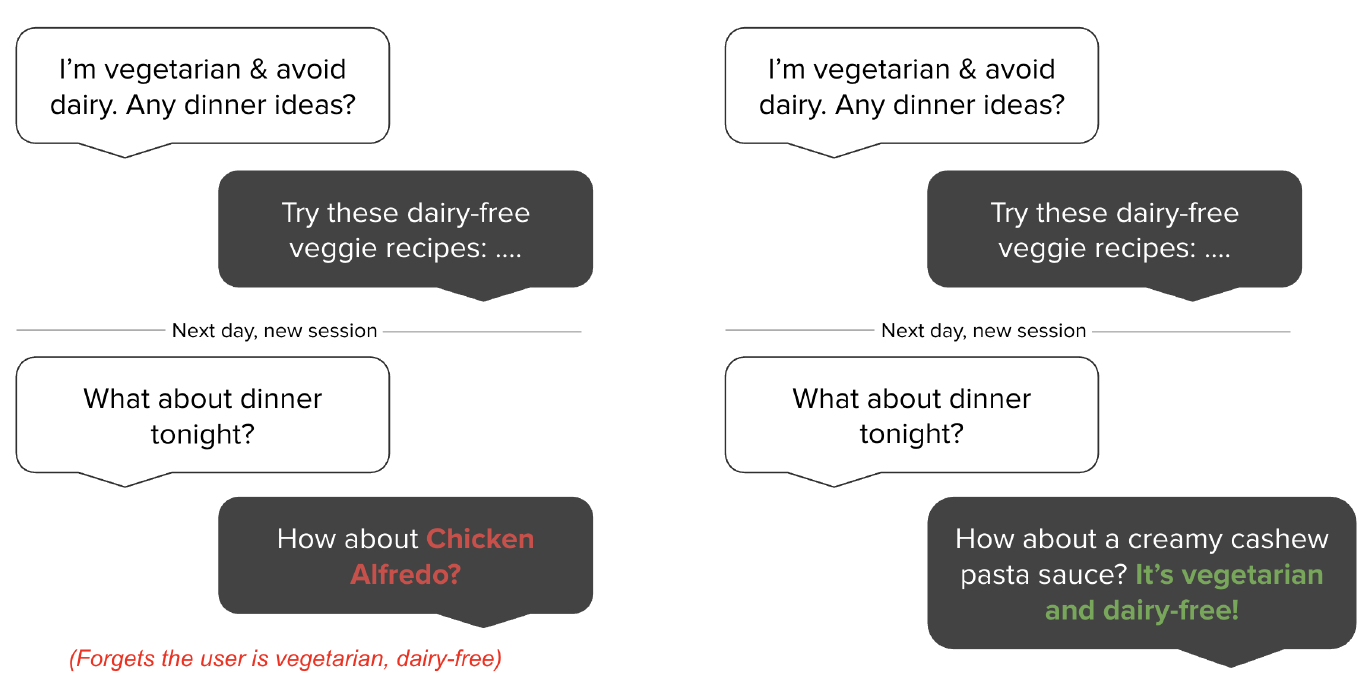
de interacciones, los sistemas de IA no pueden persistir información de forma inherente entre sesiones separadas o después del desbordamiento del contexto. La ausencia de memoria persistente crea una desconexión fundamental en la interacción humano-IA. Sin memoria, los agentes de IA olvidan las preferencias del usuario, repiten preguntas y contradicen hechos previamente establecidos. Considérese un ejemplo simple ilustrado en la Figura 1, donde un usuario menciona ser vegetariano y evitar los productos lácteos en una conversación inicial. En una sesión posterior, cuando el usuario pregunta sobre recomendaciones para la cena, un sistema sin memoria persistente podría sugerir pollo, contradiciendo completamente las preferencias dietéticas establecidas. En contraste, un sistema con memoria persistente mantendría esta información crítica del usuario a través de las sesiones y sugeriría opciones vegetarianas y sin lácteos apropiadas. Este escenario común destaca cómo las fallas de memoria pueden socavar fundamentalmente la experiencia del usuario y la confianza.
Más allá de los entornos conversacionales, se ha demostrado que los mecanismos de memoria mejoran drásticamente el rendimiento de los agentes en entornos interactivos (Majumder et al., Shinn et al., 2023). Los agentes equipados con memoria de experiencias pasadas pueden anticipar mejor las necesidades del usuario, aprender de errores previos y generalizar conocimiento entre tareas (Chhikara et al., 2023). La investigación demuestra que los agentes aumentados con memoria mejoran la toma de decisiones aprovechando las relaciones causales entre acciones y resultados, lo que conduce a una adaptación más efectiva en escenarios dinámicos (Rasmussen et al., 2025). Las arquitecturas de memoria jerárquicas (Packer et al., 2023, Sarthi et al., 2024) y los sistemas de memoria agénticos capaces de evolución autónoma (Xu et al., 2025) han demostrado además que la memoria permite un razonamiento más coherente y a largo plazo a través de múltiples sesiones de diálogo.
A diferencia de los humanos, que integran dinámicamente nueva información y revisan creencias desactualizadas, los LLM efectivamente se "reinician" una vez que la información queda fuera de su ventana de contexto (Zhang, 2024, Timoneda y Vera, 2025). Incluso cuando modelos como GPT-4 de OpenAI (128K tokens) (Hurst et al., 2024), o1 (contexto de 200K) (Jaech et al., 2024), Claude 3.7 Sonnet de Anthropic (200K tokens) (Anthropic, 2025) y Gemini de Google (al menos 10M tokens) (Team et al., 2024) amplían los límites de la longitud de contexto, estas mejoras apenas retrasan en lugar de resolver la limitación fundamental. En aplicaciones prácticas, incluso estas ventanas de contexto extendidas resultan insuficientes por dos razones críticas. Primero, a medida que las relaciones significativas humano-IA se desarrollan durante semanas o meses, el historial de conversación inevitablemente excede incluso los límites de contexto más generosos. Segundo, y quizás más importante, las conversaciones del mundo real rara vez mantienen continuidad temática. Un usuario podría mencionar preferencias dietéticas (ser vegetariano), luego participar durante horas en discusiones no relacionadas sobre tareas de programación, antes de volver a consultas relacionadas con la comida sobre opciones para la cena. En tales escenarios, un enfoque de contexto completo necesitaría razonar a través de montañas de información irrelevante, con las preferencias dietéticas críticas potencialmente enterradas entre miles de tokens de discusiones de programación. Además, simplemente presentar contextos más largos no garantiza una recuperación o utilización efectiva de la información pasada, ya que los mecanismos de atención se degradan sobre tokens distantes (Guo et al., 2024, Nelson et al., 2024). Esta limitación es particularmente problemática en dominios de alto riesgo como la atención médica, la educación y el soporte empresarial, donde mantener la continuidad y la confianza es crucial (Hatalis et al., 2023). Para abordar estos desafíos, los agentes de IA deben adoptar sistemas de memoria que vayan más allá de la extensión estática del contexto. Una memoria de IA robusta debería almacenar selectivamente información importante, consolidar conceptos relacionados y recuperar detalles relevantes cuando sea necesario, reflejando los procesos cognitivos humanos (He et al., 2024). Al integrar tales mecanismos, podemos desarrollar agentes de IA que mantengan personas consistentes, rastreen preferencias de usuario en evolución y construyan sobre intercambios previos. Este cambio transformará la IA de respondedores transitorios y olvidadizos en colaboradores confiables y a largo plazo, redefiniendo fundamentalmente el futuro de la inteligencia conversacional.
En este artículo, abordamos una limitación fundamental en los sistemas de IA: su incapacidad de mantener un razonamiento coherente a lo largo de conversaciones extendidas entre diferentes sesiones, lo que restringe severamente las interacciones significativas a largo plazo con los usuarios. Presentamos MemO (pronunciado mem-cero), una novela arquitectura de memoria que captura, organiza y recupera dinámicamente información relevante de conversaciones en curso. Sobre esta base, desarrollamos MemO8, que mejora la arquitectura base con representaciones de memoria basadas en grafos para modelar mejor las relaciones complejas entre los elementos conversacionales. Nuestros resultados experimentales en el benchmark LOCOM0 demuestran que nuestros enfoques superan consistentemente a los sistemas de memoria existentes —incluyendo arquitecturas aumentadas con memoria, métodos de generación aumentada por recuperación (RAG) y soluciones tanto de código abierto como propietarias— en diversos tipos de preguntas, mientras que simultáneamente requieren recursos computacionales significativamente menores. Las mediciones de latencia revelan además que MemO opera con tiempos de respuesta un 91% menores que los enfoques de contexto completo, logrando un equilibrio óptimo entre capacidades de razonamiento sofisticadas y restricciones prácticas de despliegue. Estas contribuciones representan un paso significativo hacia sistemas de IA que pueden mantener conversaciones coherentes y conscientes del contexto durante duraciones prolongadas, reflejando los patrones de comunicación humana y abriendo nuevas posibilidades para aplicaciones en tutoría personal, atención médica y asistencia personalizada.
2. Métodos propuestos
Introducimos dos arquitecturas de memoria para agentes de IA. (1) MemO implementa un novedoso paradigma que extrae, evalúa y gestiona información relevante de las conversaciones a través de módulos dedicados para la extracción y actualización de memoria. El sistema procesa un par de mensajes entre dos participantes usuarios o entre un usuario y un asistente. (2) MemO8 extiende esta base incorporando representaciones de memoria basadas en grafos, donde las memorias se almacenan como grafos dirigidos etiquetados con entidades como nodos y relaciones como aristas. Esta estructura permite una comprensión más profunda de las conexiones entre entidades. Al modelar explícitamente tanto las entidades como sus relaciones, MemO8 admite un razonamiento más avanzado a través de hechos interconectados, especialmente para consultas que requieren navegar por rutas relacionales complejas a través de múltiples memorias.
2.1. MemO
Nuestra arquitectura sigue un paradigma de procesamiento incremental, lo que le permite operar sin problemas dentro de conversaciones en curso. Como se ilustra en la Figura 2, la arquitectura completa del pipeline consta de dos fases: extracción y actualización.
La fase de extracción se inicia tras la ingesta de un nuevo par de mensajes , donde representa el mensaje actual y el precedente. Este par típicamente consiste en un mensaje de usuario y una respuesta del asistente, capturando una unidad de interacción completa. Para establecer el contexto apropiado para la extracción de memoria, el sistema emplea dos fuentes complementarias: (1) un resumen de la conversación recuperado de la base de datos que
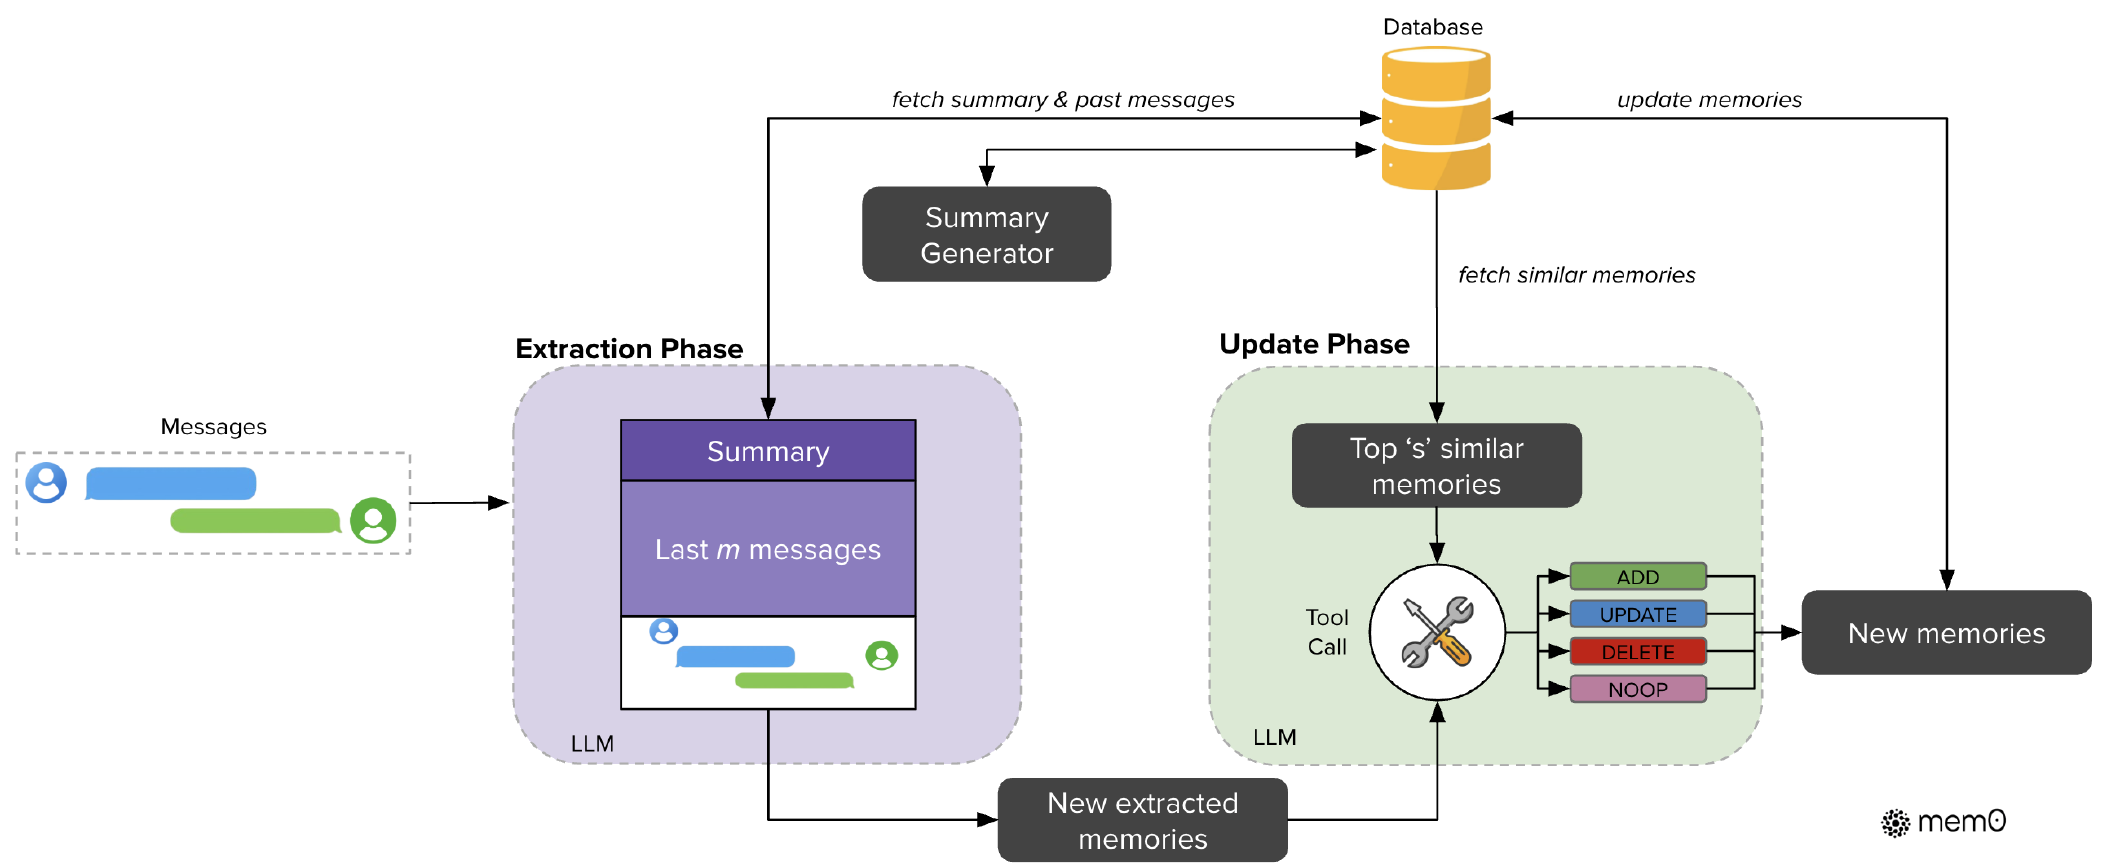
encapsula el contenido semántico de todo el historial de la conversación, y (2) una secuencia de mensajes recientes del historial de la conversación, donde es un hiperparámetro que controla la ventana de recencia. Para respaldar la extracción de memoria consciente del contexto, implementamos un módulo de generación de resúmenes asíncrono que actualiza periódicamente el resumen de la conversación. Este componente opera de forma independiente del flujo de procesamiento principal, garantizando que la extracción de memoria se beneficie de manera consistente de información contextual actualizada sin introducir retrasos de procesamiento. Mientras que 5 proporciona una comprensión temática global a lo largo de toda la conversación, la secuencia de mensajes recientes ofrece un contexto temporal granular que puede contener detalles relevantes no consolidados en el resumen. Esta información contextual dual, combinada con el nuevo par de mensajes, forma un prompt integral para una función de extracción implementada mediante un LLM. La función extrae entonces un conjunto de memorias destacadas específicamente del nuevo intercambio, manteniendo al mismo tiempo la conciencia del contexto más amplio de la conversación, lo que da como resultado hechos candidatos para su posible inclusión en la base de conocimiento.
Tras la extracción, la fase de actualización evalúa cada hecho candidato frente a las memorias existentes para mantener la consistencia y evitar la redundancia. Esta fase determina la operación de gestión de memoria apropiada para cada hecho extraído . El Algoritmo 1, mencionado en el Apéndice B, ilustra este proceso. Para cada hecho, el sistema primero recupera las memorias semánticamente más similares utilizando embeddings vectoriales de la base de datos. Estas memorias recuperadas, junto con el hecho candidato, se presentan entonces al LLM mediante una interfaz de llamada a funciones a la que nos referimos como una 'llamada a herramienta'. El propio LLM determina cuál de las cuatro operaciones distintas ejecutar: ADD para la creación de nuevas memorias cuando no existe ninguna memoria semánticamente equivalente; UPDATE para la ampliación de memorias existentes con información complementaria; DELETE para la eliminación de memorias contradichas por nueva información; y NOOP cuando el hecho candidato no requiere ninguna modificación de la base de conocimiento. En lugar de utilizar un clasificador separado, aprovechamos las capacidades de razonamiento del LLM para seleccionar directamente la operación apropiada en función de la relación semántica entre el hecho candidato y las memorias existentes. Tras esta determinación, el sistema ejecuta las operaciones proporcionadas, manteniendo así la coherencia de la base de conocimiento y la consistencia temporal.
En nuestra evaluación experimental, configuramos el sistema con ' mensajes previos para referencia contextual y ' memorias similares para análisis comparativo. Todas las operaciones del modelo de lenguaje utilizaron GPT- 4o- mini como motor de inferencia. La base de datos vectorial emplea embeddings densos para facilitar una búsqueda eficiente por similitud durante la fase de actualización.
2.2. Memo8
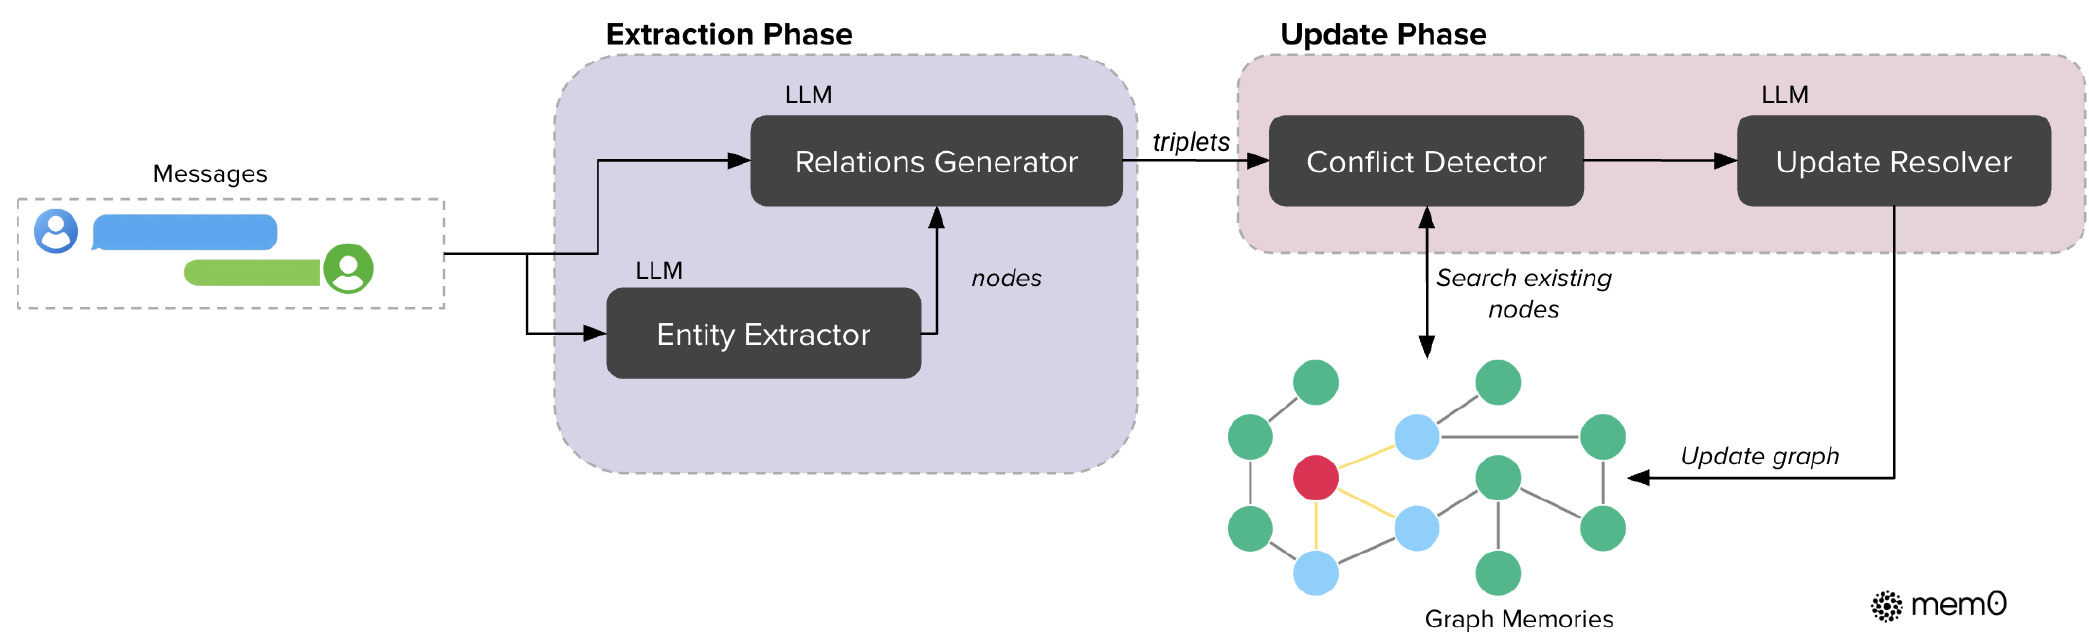
El pipeline Memo8, ilustrado en la Figura 3, implementa un enfoque de memoria basado en grafos que captura, almacena y recupera eficazmente información contextual a partir de interacciones en lenguaje natural (Zhang et al., 2022). En este marco, las memorias se representan como un grafo dirigido etiquetado , donde:
- Los nodos representan entidades (p. ej., ALICE, SAN_FRANCISCO)- Las aristas representan relaciones entre entidades (p. ej., LIVES_IN)- Las etiquetas asignan tipos semánticos a los nodos (p. ej., ALICE - Person, SAN_FRANCISCO - City)
Cada nodo de entidad contiene tres componentes: (1) una clasificación de tipo de entidad que categoriza la entidad (p. ej., Person, Location, Event), (2) un vector de embedding que captura el significado semántico de la entidad, y (3) metadatos que incluyen una marca temporal de creación . Las relaciones en nuestro sistema se estructuran como tripletas de la forma , donde y son los nodos de entidad origen y destino, respectivamente, y es la arista etiquetada que los conecta.
El proceso de extracción emplea un pipeline de dos etapas que aprovecha los LLM para transformar texto no estructurado en representaciones de grafo estructuradas. Primero, un módulo extractor de entidades procesa el texto de entrada para identificar un conjunto de entidades junto con sus tipos correspondientes. En nuestro marco, las entidades representan los elementos de información clave en las conversaciones—incluyendo personas, ubicaciones, objetos, conceptos, eventos y atributos que merecen representación en el grafo de memoria. El extractor de entidades identifica estas diversas unidades de información analizando la importancia semántica, la unicidad y la persistencia de los elementos en la conversación. Por ejemplo, en una conversación sobre planes de viaje, las entidades podrían incluir destinos (ciudades, países), modos de transporte, fechas, actividades y preferencias de los participantes—esencialmente cualquier información discreta que pudiera ser relevante para referencia o razonamiento futuros.
A continuación, un componente generador de relaciones deriva conexiones significativas entre estas entidades, estableciendo un conjunto de tripletas de relación que capturan la estructura semántica de la información. Este módulo basado en LLM analiza las entidades extraídas y su contexto dentro de la conversación para identificar conexiones semánticamente significativas. Funciona examinando patrones lingüísticos, señales contextuales y conocimiento del dominio para determinar cómo se relacionan las entidades entre sí. Para cada par potencial de entidades, el generador evalúa si existe una relación significativa y, de ser así, clasifica esta relación con una etiqueta apropiada (p. ej., 'lives_in', 'prefers', 'owns', 'happened_on'). El módulo emplea técnicas de ingeniería de prompts que guían al LLM a razonar tanto sobre declaraciones explícitas como sobre información implícita en el diálogo, resultando en tripletas de relación que forman las aristas en nuestro grafo de memoria y permiten razonamiento complejo a través de información interconectada. Al integrar nueva información, Memo8 emplea una estrategia sofisticada de almacenamiento y actualización. Para cada nueva tripleta de relación, calculamos embeddings para las entidades origen y destino, luego buscamos nodos existentes con similitud semántica por encima de un umbral definido 't'. Según la existencia de nodos, el sistema puede crear ambos nodos, crear solo un nodo o usar nodos existentes antes de establecer la relación con los metadatos apropiados. Para mantener un grafo de conocimiento consistente, implementamos un mecanismo de detección de conflictos que identifica relaciones existentes potencialmente conflictivas cuando llega nueva información. Un resolvedor de actualizaciones basado en LLM determina si ciertas relaciones deberían quedar obsoletas, marcándolas como inválidas en lugar de eliminarlas físicamente para permitir razonamiento temporal.
La funcionalidad de recuperación de memoria en Memo8 implementa una estrategia de doble enfoque para un acceso óptimo a la información. El método centrado en entidades primero identifica entidades clave dentro de una consulta, luego aprovecha la similitud semántica para localizar los nodos correspondientes en el grafo de conocimiento. Explora sistemáticamente tanto las relaciones entrantes como las salientes desde estos nodos ancla, construyendo un subgrafo integral que captura información contextual relevante. De forma complementaria, el enfoque de tripletas semánticas adopta una visión más holística al codificar la consulta completa como un vector de embedding denso. Esta representación de la consulta se compara luego con las codificaciones textuales de cada tripleta de relación en el grafo de conocimiento. El sistema calcula puntuaciones de similitud de grano fino entre la consulta y todas las tripletas disponibles, devolviendo solo aquellas que superan un umbral de relevancia configurable, clasificadas en orden de similitud decreciente. Este mecanismo de recuperación dual permite a Memo8 manejar tanto preguntas específicas centradas en entidades como consultas conceptuales más amplias con igual eficacia.
Desde una perspectiva de implementación, el sistema utiliza Neo4j1 como base de datos de grafos subyacente. Los extractores basados en LLM y el módulo de actualización aprovechan GPT-4o-mini con capacidades de llamada a funciones, permitiendo la extracción estructurada de información a partir de texto no estructurado. Al combinar representaciones basadas en grafos con embeddings semánticos y extracción de información basada en LLM, Memo8 logra tanto la riqueza estructural necesaria para el razonamiento complejo como la flexibilidad semántica requerida para la comprensión del lenguaje natural.
3. Configuración experimental
3.1. Conjunto de datos
El conjunto de datos LOCOM0 (Maharana et al., 2024) está diseñado para evaluar la memoria conversacional a largo plazo en sistemas de diálogo. Comprende 10 conversaciones extendidas, cada una con aproximadamente 600 diálogos y 26000 tokens en promedio, distribuidas en múltiples sesiones. Cada conversación captura a dos individuos discutiendo experiencias diarias o eventos pasados. Tras estos diálogos multi-sesión, cada conversación va acompañada de 200 preguntas en promedio con sus correspondientes respuestas de referencia. Estas preguntas se clasifican en múltiples tipos: de un salto, de múltiples saltos, temporales y de dominio abierto. El conjunto de datos incluía originalmente una categoría de preguntas adversarias, diseñada para probar la capacidad de los sistemas de reconocer preguntas sin respuesta. Sin embargo, esta categoría se excluyó de nuestra evaluación porque las respuestas de referencia no estaban disponibles, y el comportamiento esperado para este tipo de pregunta es que el agente las reconozca como no respondibles.
3.2. Métricas de evaluación
Nuestro marco de evaluación implementa un enfoque integral para evaluar las capacidades de memoria a largo plazo en sistemas de diálogo, considerando tanto la calidad de las respuestas como la eficiencia operativa. Categorizamos nuestras métricas en dos grupos distintos que, en conjunto, proporcionan una comprensión holística del rendimiento del sistema.
(1) Métricas de rendimiento Investigaciones previas en IA conversacional (Goswami, 2025, Soni et al., 2024, Singh et al., 2020) se han basado predominantemente en métricas de similitud léxica como F1 Score (F1) y BLEU-1 (B1). Sin embargo, estas métricas presentan limitaciones significativas al evaluar la precisión factual en contextos conversacionales. Consideremos un escenario en el que la respuesta de referencia es 'Alice nació en marzo' y un sistema genera 'Alice nace en julio'. A pesar de contener un error factual crítico respecto al mes de nacimiento, las métricas tradicionales asignarían puntuaciones relativamente altas debido a la superposición léxica en los tokens restantes ('Alice', 'nació', etc.). Esta limitación fundamental puede llevar a evaluaciones engañosas que no logran capturar la corrección semántica. Para abordar estas deficiencias, utilizamos LLM-as-a-Judge (J) como métrica de evaluación complementaria. Este enfoque aprovecha un LLM separado y más capaz para evaluar la calidad de las respuestas en múltiples dimensiones, incluyendo precisión factual, relevancia, completitud y adecuación contextual. El modelo juez analiza la pregunta, la respuesta de referencia y la respuesta generada, proporcionando una evaluación más matizada que se alinea mejor con el juicio humano. Debido a la naturaleza estocástica de las evaluaciones J, realizamos 10 ejecuciones independientes para cada método sobre el conjunto de datos completo y reportamos las puntuaciones medias junto con desviación estándar. Más detalles sobre J se presentan en el Apéndice A.
(2) Métricas de despliegue Más allá de la calidad de las respuestas, las consideraciones prácticas de despliegue son cruciales para las aplicaciones reales de la memoria a largo plazo en agentes de IA. Rastreamos sistemáticamente el Consumo de tokens, usando la codificación 'c1100k_base' de tiktoken, midiendo el número de tokens extraídos durante la recuperación que sirven como contexto para responder consultas. Para nuestros modelos basados en memoria, estos tokens representan las memorias recuperadas de la base de conocimiento, mientras que para los modelos basados en RAG, corresponden al número total de tokens en los fragmentos de texto recuperados. Esta distinción es importante ya que afecta directamente a los costes operativos y a la eficiencia del sistema—ya sea procesando hechos de memoria concisos o segmentos de texto sin procesar más grandes. Monitorizamos además la Latencia, (i) latencia de búsqueda: que captura el tiempo total necesario para buscar en la memoria (en soluciones basadas en memoria) o en el fragmento (en soluciones basadas en RAG) y (ii) latencia total: tiempo para generar las respuestas apropiadas, consistente tanto en el tiempo de recuperación (acceso a memorias o fragmentos) como en el tiempo de generación de respuestas usando el LLM.
La relación entre estas métricas revela compensaciones importantes en el diseño del sistema. Por ejemplo, arquitecturas de memoria más sofisticadas podrían lograr una mayor precisión factual pero a costa de un mayor consumo de tokens y latencia. Nuestra metodología de evaluación multidimensional permite a investigadores y profesionales tomar decisiones informadas basadas en sus requisitos específicos, ya sea priorizando la calidad de las respuestas para aplicaciones críticas o la eficiencia computacional para escenarios de despliegue en tiempo real.
3.3. Líneas base
Para evaluar exhaustivamente nuestro enfoque, lo comparamos con seis categorías distintas de líneas base que representan el estado actual de los sistemas de memoria conversacional. Estas diversas líneas base proporcionan colectivamente un marco robusto para evaluar la eficacia de diferentes arquitecturas de memoria a través de varias dimensiones, incluyendo precisión factual, eficiencia computacional y escalabilidad a conversaciones extendidas. Donde sea aplicable, salvo que se especifique lo contrario, establecemos la temperatura a 0 para garantizar que las ejecuciones sean lo más reproducibles posible.
Benchmarks establecidos de LOcOMO Primero establecemos una base comparativa evaluando métodos previamente utilizados como benchmark en el conjunto de datos LOcOMO. Estos incluyen cinco enfoques establecidos: LoCoMo (Maharana et al., 2024), ReadAgent (Lee et al., 2024), MemoryBank (Zhong et al., 2024), MemGPT (Packer et al., 2023) y A-Mem (Xu et al., 2025). Estos benchmarks establecidos no solo proporcionan puntos de comparación directos con resultados publicados, sino que también representan la evolución de las arquitecturas de memoria conversacional a través de diferentes paradigmas algorítmicos. Para nuestra evaluación, seleccionamos las métricas en las que se utilizó gpt-4o-mini para la evaluación. Más detalles sobre estos benchmarks se mencionan en el Apéndice C.
Soluciones de memoria de código abierto Nuestra segunda categoría consiste en arquitecturas de memoria de código abierto prometedoras como LangMem (Hot Path) que han demostrado eficacia en tareas conversacionales relacionadas pero que aún no han sido evaluadas en el conjunto de datos LOcOMO. Al adaptar estos sistemas a nuestro marco de evaluación, ampliamos el panorama comparativo e identificamos posibles enfoques alternativos que podrían ofrecer un rendimiento competitivo. Inicializamos el LLM con gpt-4o-mini y utilizamos text-embedding-small-3 como modelo de embeddings.2
Generación Aumentada por Recuperación (RAG) Como línea base, tratamos todo el historial de conversación como una colección de documentos y aplicamos un pipeline RAG estándar. Primero segmentamos cada conversación en fragmentos de longitud fija (128, 256, 512, 1024, 2048, 4096 y 8192 tokens), donde 8192 es el tamaño máximo de fragmento soportado por nuestro modelo de embeddings. Todos los fragmentos se embeben utilizando text-embedding-small-3 de OpenAI para garantizar una calidad vectorial consistente entre configuraciones. En el momento de la consulta, recuperamos los fragmentos principales por similitud semántica y los concatenamos como contexto para la generación de respuestas. A lo largo de nuestros experimentos establecimos : con solo se utiliza el fragmento más relevante, y con se concatenan los dos fragmentos más relevantes (hasta 16384 tokens). Evitamos ya que la longitud promedio de conversación (26000 tokens) quedaría completamente cubierta, anulando los beneficios de la recuperación selectiva. Al variar el tamaño de fragmento y , evaluamos sistemáticamente el rendimiento de RAG en tareas de memoria conversacional a largo plazo.
Procesamiento de Contexto Completo Adoptamos un enfoque directo pasando todo el historial de conversación dentro de la ventana de contexto del LLM. Este método aprovecha la capacidad inherente del modelo para procesar información secuencial sin componentes arquitectónicos adicionales. Aunque conceptualmente simple, este enfoque enfrenta limitaciones prácticas a medida que aumenta la longitud de la conversación, incrementando eventualmente el costo en tokens y la latencia. No obstante, establece un punto de referencia importante para comprender el valor de mecanismos de memoria más sofisticados en comparación con el procesamiento directo del contexto disponible.
Modelos Propietarios Evaluamos la función de memoria3 de OpenAI disponible en su interfaz ChatGPT, específicamente usando gpt-4o-mini para mantener la consistencia. Ingresamos conversaciones completas de LOcOMO con un prompt (véase el Apéndice A) en sesiones de chat individuales, solicitando la generación de memoria con marcas de tiempo, nombres de participantes y texto de la conversación. Estas memorias generadas se utilizan luego como contexto completo para responder preguntas sobre cada conversación, otorgando intencionalmente al enfoque de OpenAI acceso privilegiado a todas las memorias en lugar de solo aquellas relevantes a la pregunta. Esta metodología acomoda la falta de acceso a API externa para la recuperación selectiva de memorias en el sistema de OpenAI para fines de benchmarking.
| Método | Salto único | Multi-Salto | Dominio abierto | Temporal | ||||||||
| F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | |
| LoCoMo | 25,02 | 19,75 | - | 12,04 | 11,16 | - | 40,36 | 29,05 | - | 18,41 | 14,77 | - |
| ReadAgent | 9,15 | 6,48 | - | 5,31 | 5,12 | - | 9,67 | 7,66 | - | 12,60 | 8,87 | - |
| MemoryBank | 5,00 | 4,77 | - | 5,56 | 5,94 | - | 6,61 | 5,16 | - | 9,68 | 6,99 | - |
| MemGPT | 26,65 | 17,72 | - | 9,15 | 7,44 | - | 41,04 | 34,34 | - | 25,52 | 19,44 | - |
| A-Mem | 27,02 | 20,09 | - | 12,14 | 12,00 | - | 44,65 | 37,06 | - | 45,85 | 36,67 | - |
| A-Mem* | 20,76 | 14,90 | 39,79 ± 0,38 | 9,22 | 8,81 | 18,85 ± 0,31 | 33,34 | 27,58 | 54,05 ± 0,22 | 35,40 | 31,08 | 49,91 ± 0,31 |
| LangMem | 35,51 | 26,86 | 62,23 ± 0,75 | 26,04 | 22,32 | 47,92 ± 0,47 | 40,91 | 33,63 | 71,12 ± 0,20 | 30,75 | 25,84 | 23,43 ± 0,39 |
| Zep | 35,74 | 23,30 | 61,70 ± 0,32 | 19,37 | 14,82 | 41,35 ± 0,48 | 49,56 | 38,92 | 76,60 ± 0,13 | 42,00 | 34,53 | 49,31 ± 0,50 |
| OpenAI | 34,30 | 23,72 | 63,79 ± 0,46 | 20,09 | 15,42 | 42,92 ± 0,63 | 39,31 | 31,16 | 62,29 ± 0,12 | 14,04 | 11,25 | 21,71 ± 0,20 |
| MemO | 38,72 | 27,13 | 67,13 ± 0,65 | 28,64 | 21,58 | 51,15 ± 0,31 | 47,65 | 38,72 | 72,93 ± 0,11 | 48,93 | 40,51 | 55,51 ± 0,34 |
| MemO8 | 38,09 | 26,03 | 65,71 ± 0,45 | 24,32 | 18,82 | 47,19 ± 0,67 | 49,27 | 40,30 | 75,71 ± 0,21 | 51,55 | 40,28 | 58,13 ± 0,44 |
Proveedores de memoria Incorporamos Zep (Rasmussen et al., 2025), una plataforma de gestión de memoria diseñada para agentes de IA. Utilizando su versión de plataforma, llevamos a cabo evaluaciones sistemáticas en el conjunto de datos LOcOMO, manteniendo la fidelidad temporal al preservar la información de las marcas de tiempo junto con el contenido conversacional. Este anclaje temporal garantiza que las consultas sensibles al tiempo puedan abordarse mediante una recuperación de memoria contextualizada adecuadamente, lo cual es particularmente importante para evaluar preguntas que requieren conciencia cronológica. Esta línea base representa una implementación comercial importante de gestión de memoria diseñada específicamente para agentes de IA.
4. Resultados de la evaluación, análisis y discusión.
4.1. Comparación de rendimiento entre sistemas habilitados para memoria
La Tabla 1 reporta las puntuaciones , y J para nuestras dos arquitecturas —MemO y MemO— frente a un conjunto de líneas base competitivas, como se mencionó en la Sección 3, en preguntas de un solo salto, de múltiples saltos, de dominio abierto y temporales. En general, ambos modelos establecen nuevos récords de vanguardia en las tres métricas de evaluación para la mayoría de los tipos de preguntas.
Rendimiento en preguntas de un solo salto Las consultas de un solo salto implican localizar un único fragmento factual contenido dentro de un turno de diálogo. Aprovechando sus memorias densas en texto en lenguaje natural, MemO obtiene los mejores resultados: , y . Aumentar las memorias en lenguaje natural con memoria de grafo (MemO8) produce una caída marginal del rendimiento en comparación con MemO, lo que indica que la estructura relacional proporciona una utilidad limitada cuando el objetivo de recuperación ocupa un único turno. Entre las líneas base existentes, la ejecución de OpenAI con contexto completo alcanza la siguiente mejor puntuación J, lo que refleja los beneficios de retener toda la conversación en el contexto, mientras que LangMem y Zep obtienen ambos alrededor de un 8% relativamente menos frente a nuestros modelos en la puntuación J. Líneas base previas de LOcOMO , como A-mem, quedan más de 25 puntos por detrás en J, lo que subraya la necesidad de una indexación de memoria estructurada y de grano fino incluso para tareas de recuperación simples.
Rendimiento en preguntas de múltiples saltos Las consultas de múltiples saltos requieren sintetizar información dispersa a través de múltiples sesiones de conversación, lo que plantea desafíos significativos en la integración y recuperación de memoria. MemO supera claramente a otros métodos con una puntuación de 28.64 y una puntuación J de 51.15, lo que refleja su capacidad para recuperar e integrar eficientemente información dispar almacenada a través de sesiones. Curiosamente, la adición de memoria de grafo en MemO8 no proporciona ganancias de rendimiento aquí, lo que indica posibles ineficiencias o redundancias en las representaciones estructuradas de grafo para tareas integradoras complejas en comparación con la memoria densa en lenguaje natural sola. Líneas base como LangMem muestran rendimientos competitivos, pero sus puntuaciones quedan sustancialmente por detrás de las de MemO, lo que enfatiza la ventaja de nuestros refinados mecanismos de indexación y recuperación de memoria para el procesamiento de consultas complejas.
Rendimiento en dominio abierto En entornos de dominio abierto, la línea base Zep alcanza las puntuaciones más altas de (49.56) y J (76.60), superando a nuestros métodos por un margen estrecho. En particular, la puntuación J de Zep de 76.60 supera la de MemO8 de 75.71 por solo 0.89 puntos porcentuales y supera la de MemO de 72.93 por 3.67 puntos, lo que destaca una ventaja consistente, aunque ligera, en la integración de la memoria conversacional con conocimiento externo. MemO8 sigue siendo un fuerte subcampeón, con un J de 75.71 que refleja una alta precisión de recuperación factual, mientras que MemO le sigue con 72.93, demostrando una coherencia robusta. Estos resultados subrayan que, aunque las memorias relacionales estructuradas (como en MemO y MemO8) mejoran sustancialmente la recuperación en dominio abierto, Zep mantiene una ventaja pequeña pero significativa.
Rendimiento en razonamiento temporal Las tareas de razonamiento temporal dependen de un modelado preciso de las secuencias de eventos, su orden relativo y sus duraciones dentro del historial conversacional. Nuestras arquitecturas demuestran mejoras sustanciales en todas las métricas, con MemO8 alcanzando el (51.55) y el J (58.13) más altos, lo que sugiere que las representaciones relacionales estructuradas, además de las memorias en lenguaje natural, ayudan significativamente en los juicios con fundamento temporal. Cabe destacar que la variante base, MemO, también proporciona una puntuación J decente (55.51), lo que sugiere que el lenguaje natural por sí solo puede ayudar en los juicios con fundamento temporal. Entre las líneas base, OpenAI presenta un rendimiento notablemente inferior, con puntuaciones por debajo del 15%, principalmente debido a la falta de marcas de tiempo en la mayoría de las memorias generadas, a pesar de las indicaciones explícitas en OpenAI ChatGPT para extraer memorias con marcas de tiempo. Otras líneas base, como A-Mem, logran resultados respetables, pero nuestros modelos claramente avanzan el estado del arte, enfatizando la ventaja crítica de aprovechar con precisión tanto la contextualización en lenguaje natural como las representaciones estructuradas de grafo para el razonamiento temporal.
4.2. Análisis entre categorías
La evaluación integral a través de diversas categorías de preguntas revela que nuestras arquitecturas propuestas, MemO y MemO8, logran consistentemente un rendimiento superior en comparación con los sistemas de línea base. Para consultas de un solo salto, MemO demuestra un rendimiento particularmente fuerte, beneficiándose de su eficiente estructura de memoria densa en lenguaje natural. Aunque las representaciones basadas en grafo en MemO8 quedan ligeramente por detrás en las métricas de solapamiento léxico para estas consultas más simples, mejoran significativamente la coherencia semántica, como lo demuestran las puntuaciones J competitivas. Esto indica que las estructuras de grafo son más beneficiosas en escenarios que involucran un contexto relacional matizado en lugar de una recuperación directa. Para preguntas de múltiples saltos, MemO exhibe ventajas claras al sintetizar eficazmente información dispersa a través de múltiples sesiones, confirmando que las memorias en lenguaje natural proporcionan suficiente riqueza representacional para estas tareas integradoras. Sorprendentemente,
| Método | K | tamaño de fragmento / tokens de memoria | Latencia (segundos) | J general | |||
| Búsqueda | Total | ||||||
| RAG | 1 | 128 | 0,281 | 0,823 | 0,774 | 1,825 | 47,77 ± 0,23% |
| 256 | 0,251 | 0,710 | 0,745 | 1,628 | 50,15 ± 0,16% | ||
| 512 | 0,240 | 0,639 | 0,772 | 1,710 | 46,05 ± 0,14% | ||
| 1024 | 0,240 | 0,723 | 0,821 | 1,957 | 40,74 ± 0,17% | ||
| 2048 | 0,255 | 0,752 | 0,996 | 2,182 | 37,93 ± 0,12% | ||
| 8192 | 4096 | 0,254 | 0,719 | 1,093 | 2,711 | 36,84 ± 0,17% | |
| 812 | 0,279 | 0,838 | 1,396 | 4,416 | 44,53 ± 0,13% | ||
| 128 | 0,267 | 0,624 | 0,766 | 1,829 | 59,56 ± 0,19% | ||
| 256 | 0,255 | 0,699 | 0,802 | 1,907 | 60,97 ± 0,20% | ||
| 2 | 1024 | 512 | 0,247 | 0,746 | 0,829 | 1,729 | 58,19 ± 0,18% |
| 2048 | 0,238 | 0,702 | 0,860 | 1,850 | 50,68 ± 0,13% | ||
| 4096 | 0,261 | 0,829 | 1,101 | 2,791 | 48,57 ± 0,22% | ||
| 812 | 0,266 | 0,944 | 1,451 | 4,822 | 51,79 ± 0,15% | ||
| 8192 | 0,288 | 1,124 | 2,312 | 9,942 | 60,53 ± 0,16% | ||
| Contexto completo | 26031 | - | - | 9,870 | 17,117 | 72,90 ± 0,19% | |
| A-Mem | 2520 | 0,668 | 1,485 | 1,410 | 4,374 | 48,38 ± 0,15% | |
| LangMem | 127 | 17,99 | 59,82 | 18,53 | 60,40 | 58,10 ± 0,21% | |
| Zep | 3911 | 0,513 | 0,778 | 1,292 | 2,926 | 65,99 ± 0,16% | |
| OpenAI | 4437 | - | - | 0,466 | 0,889 | 52,90 ± 0,14 % | |
| Mem0 | 1764 | 0,148 | 0,200 | 0,708 | 1,440 | 66,88 ± 0,15 % | |
| Mem0^8 | 3616 | 0,476 | 0,657 | 1,091 | 2,590 | 68,44 ± 0,17 % | |
las ventajas relacionales esperadas de no se traducen en mejores resultados aquí, lo que sugiere una posible sobrecarga o redundancia al navegar por estructuras de grafo más intrincadas en escenarios de razonamiento de múltiples pasos.
En razonamiento temporal, supera sustancialmente a otros métodos, validando que los grafos relacionales estructurados sobresalen en la captura de relaciones cronológicas y secuencias de eventos. La presencia de un contexto relacional explícito mejora significativamente la coherencia temporal de , superando el almacenamiento de memoria densa de y destacando la importancia de representaciones relacionales precisas al rastrear información sensible al tiempo. El rendimiento en dominio abierto refuerza aún más el valor del modelado relacional. , beneficiándose de la claridad relacional de la memoria basada en grafo, compite estrechamente con la línea base de mejor rendimiento (Zep). Este resultado competitivo subraya la robustez de en la integración de conocimiento externo mediante la claridad relacional, lo que sugiere una sinergia óptima entre la memoria estructurada y la síntesis de información en dominio abierto.
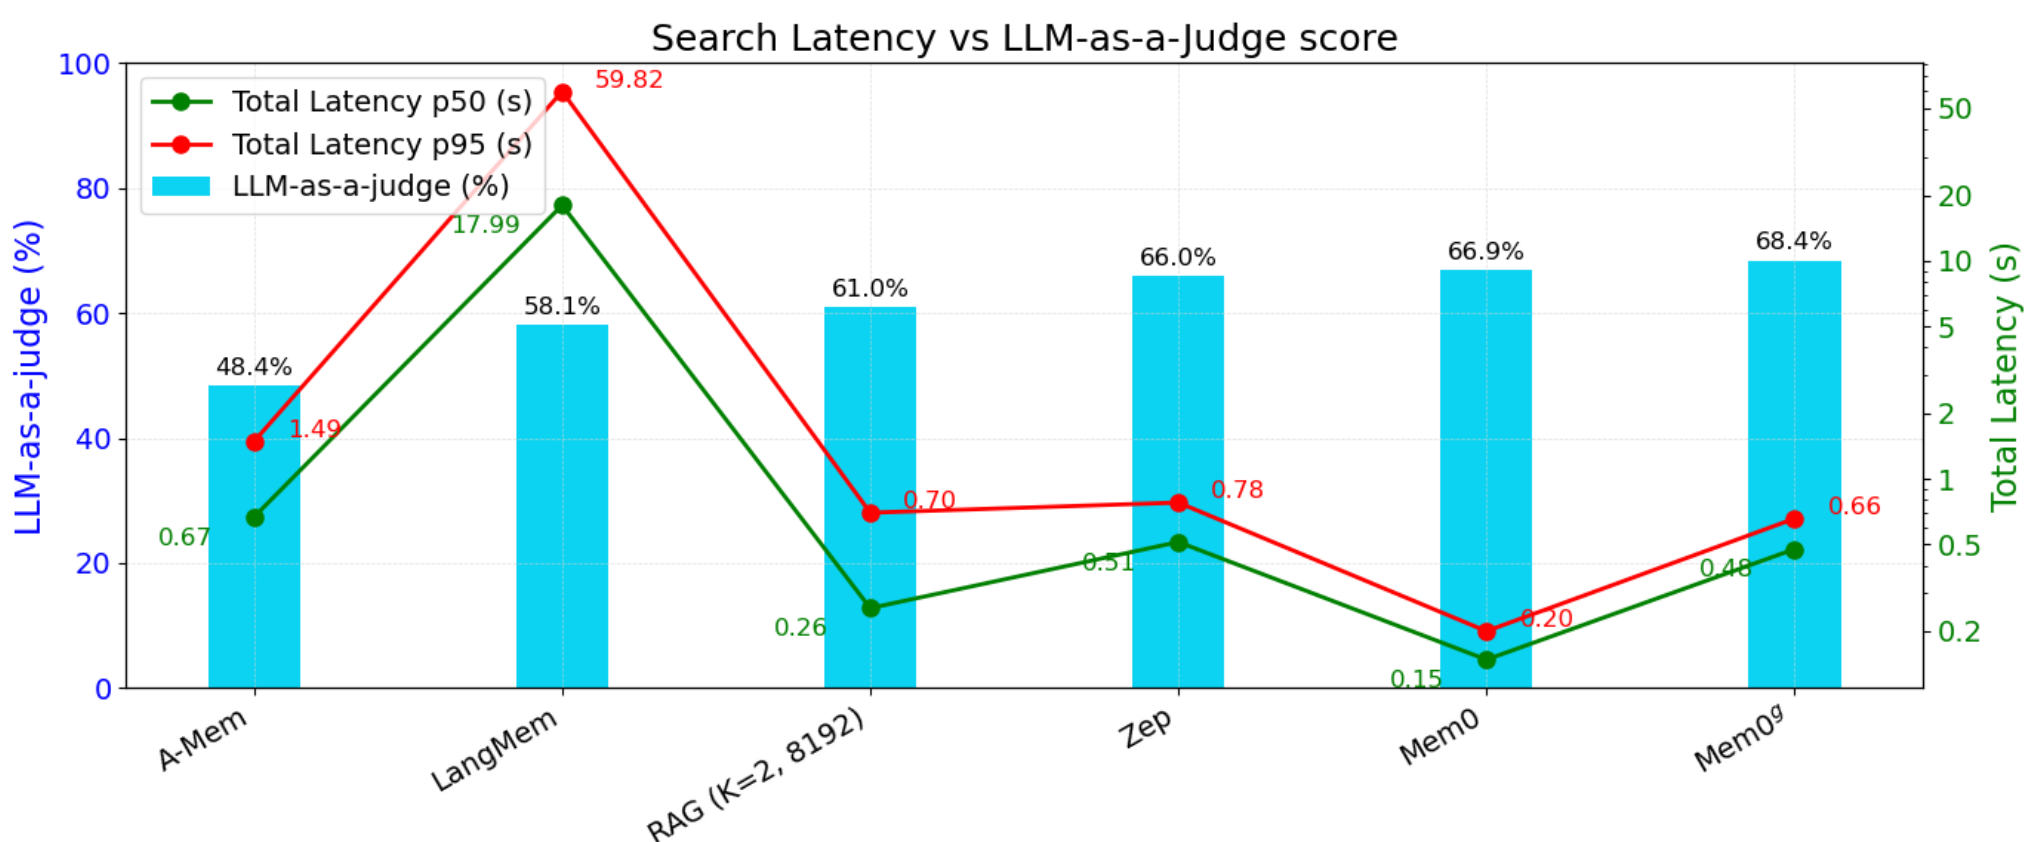
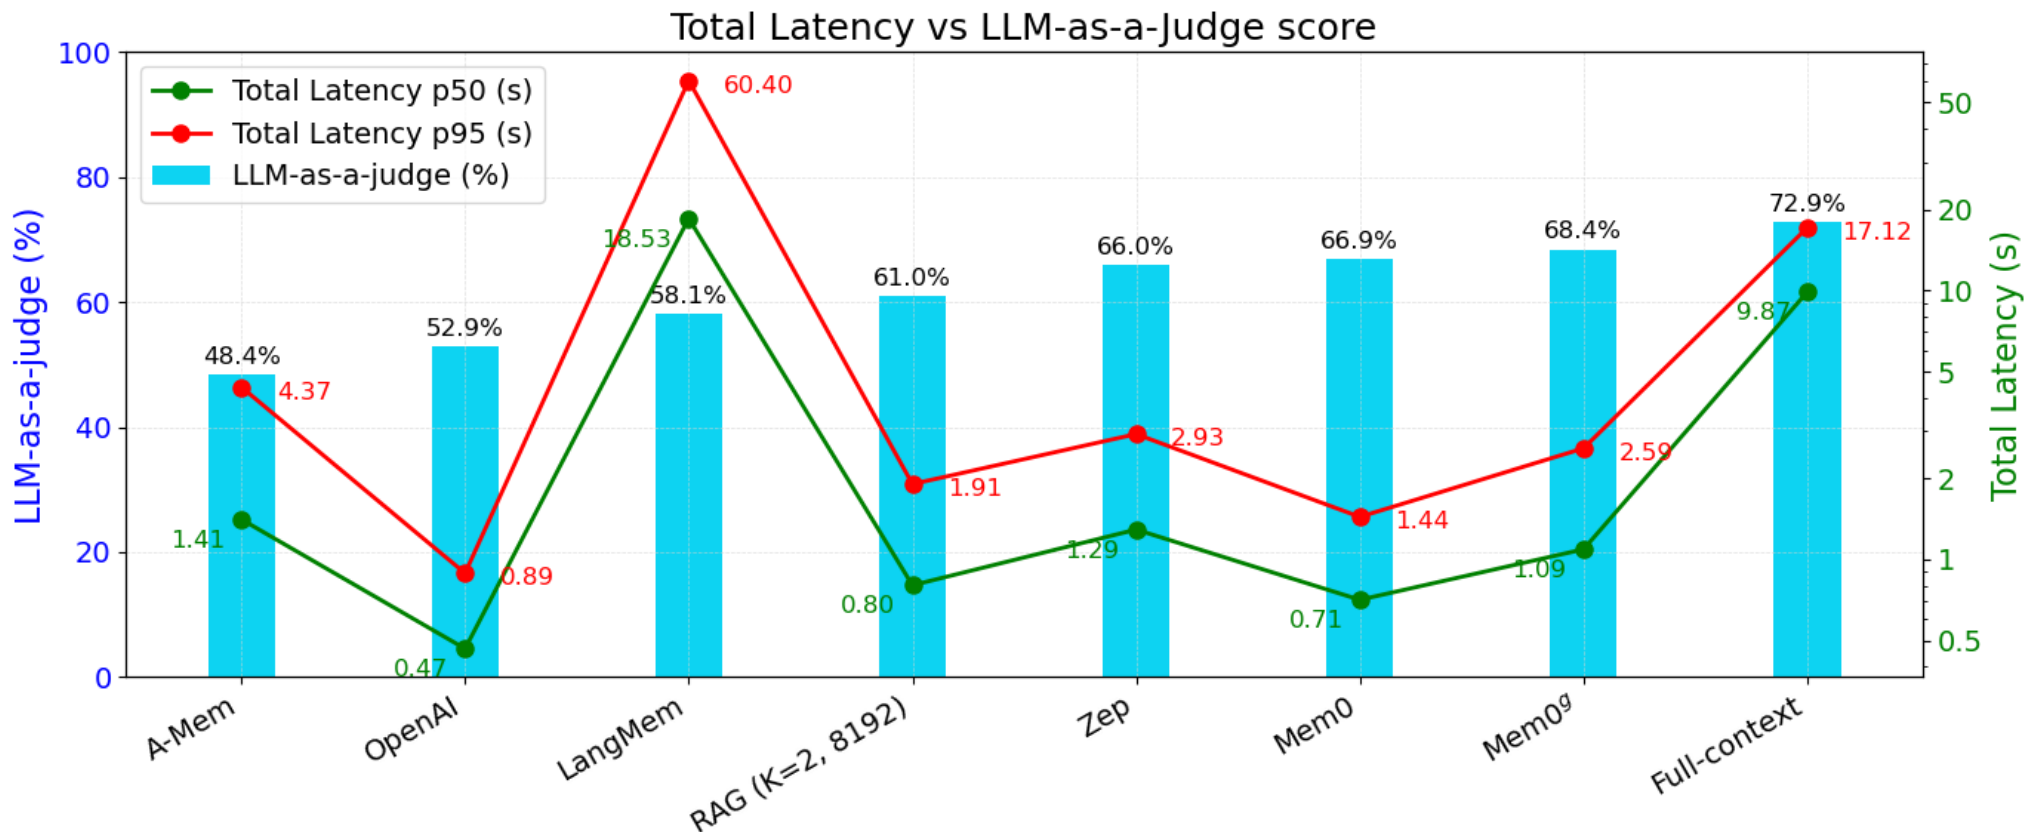
Figura 4: Análisis de latencia de diferentes enfoques de memoria. Estas subfiguras ilustran las puntuaciones J y la comparación de latencia de varios métodos seleccionados de la Tabla 2. La subfigura (a) destaca la latencia de búsqueda/recuperación previa a la generación de la respuesta, mientras que la subfigura (b) muestra la latencia total (incluida la inferencia del LLM). Ambas gráficas superponen la puntuación J de cada método para una visión holística de su precisión y eficiencia.
En general, nuestro análisis indica fortalezas complementarias de Mem0 y Mem08 en diversas demandas de tareas: la memoria densa basada en lenguaje natural ofrece una eficiencia significativa para consultas más simples, mientras que el modelado relacional explícito se vuelve esencial para tareas que exigen una integración matizada de aspectos temporales y contextuales. Estos hallazgos refuerzan la importancia de estructuras de memoria adaptables, adaptadas a contextos de razonamiento específicos, en los despliegues de agentes de IA.
4.3. Comparación de rendimiento de MemO y MemO frente a enfoques RAG y al modelo de contexto completo
Las comparaciones en la Tabla 2, centradas en la columna 'Overall J', revelan que tanto MemO como MemO superan consistentemente todas las configuraciones RAG, que varían los tamaños de fragmento (128-8192 tokens) y recuperan uno o dos fragmentos. Incluso el enfoque RAG más fuerte alcanza un máximo de alrededor del en la métrica J, mientras que MemO llega al —aproximadamente una mejora relativa del — y MemO supera el , logrando una ganancia relativa de alrededor del . Estos avances subrayan la ventaja de capturar únicamente los hechos más relevantes en la memoria, en lugar de recuperar grandes fragmentos del texto original. Al convertir el historial de conversación en representaciones concisas y estructuradas, MemO y MemO mitigan el ruido y exponen al LLM señales más precisas, lo que conduce a mejores respuestas según la evaluación de un LLM externo (J).
A pesar de estas mejoras, un método de contexto completo que ingiere un fragmento de aproximadamente 26.000 tokens sigue logrando la puntuación J más alta (aproximadamente ). Sin embargo, como se muestra en la Figura 4b, también incurre en una latencia total p95 muy alta —alrededor de 17 segundos—, ya que el modelo debe leer toda la conversación en cada consulta. En contraste, MemO y MemO reducen significativamente el uso de tokens y, por lo tanto, logran latencias p95 más bajas de alrededor de 1,44 segundos (una reducción del ) y 2,6 segundos (una reducción del ), respectivamente, frente al enfoque de contexto completo. Aunque el enfoque de contexto completo puede proporcionar una ligera ventaja en precisión, los sistemas basados en memoria ofrecen un compromiso más práctico, manteniendo una calidad casi competitiva mientras imponen solo una fracción del costo en tokens y latencia. A medida que aumenta la longitud de la conversación, los enfoques de contexto completo sufren un crecimiento exponencial en la sobrecarga computacional (evidente en la Tabla 2, donde la latencia total p95 aumenta significativamente con valores mayores de o tamaños de fragmento mayores). Este aumento en los fragmentos de entrada conduce a tiempos de respuesta más largos y mayores costos de consumo de tokens. En contraste, los enfoques centrados en la memoria como MemO y MemO mantienen un rendimiento constante independientemente de la longitud de la conversación, lo que los hace sustancialmente más viables para despliegues a escala de producción, donde la eficiencia y la capacidad de respuesta son críticas.
4.4. Análisis de latencia
La Tabla 2 proporciona una comparación exhaustiva del rendimiento de diversas metodologías de recuperación y memoria, presentando las latencias medianas (p50) y de cola (p95) tanto para la fase de búsqueda como para la generación total de respuestas en el conjunto de datos LOCOM0. Nuestro análisis revela patrones de rendimiento distintos gobernados por las elecciones arquitectónicas. Las arquitecturas centradas en memoria demuestran características de rendimiento diferentes. A-Mem, a pesar de su mayor almacén de memoria, incurre en una sobrecarga de búsqueda sustancial (p50: 0,668 s), lo que resulta en latencias medianas totales de 1,410 s. LangMem exhibe latencias de búsqueda aún mayores (p50: 17,99 s, p95: 59,82 s), lo que lo hace poco práctico para aplicaciones interactivas. Zep logra un rendimiento moderado (p50 total: 1,292 s). La línea base de contexto completo, que procesa todo el historial de conversación sin recuperación, difiere fundamentalmente de los enfoques basados en recuperación. Al pasar todo el contexto de la conversación (26000 tokens) directamente al LLM, elimina la sobrecarga de búsqueda pero incurre en latencias totales extremas (p50: 9,870 s, p95: 17,117 s). De manera similar, la implementación de OpenAI no realiza búsqueda en memoria, ya que procesa memorias extraídas manualmente desde su playground. Si bien este enfoque logra tiempos de generación de respuestas impresionantes (p50: 0,466 s, p95: 0,889 s), requiere la extracción previa del contexto relevante, lo cual no se refleja en las métricas reportadas.
Nuestro enfoque propuesto MemO logra la latencia de búsqueda más baja entre todos los métodos (p50: 0,148 s, p95: 0,200 s), como se ilustra en la Figura 4a. Esta eficiencia se deriva de nuestro mecanismo de recuperación selectiva de memoria y de mejoras en la infraestructura que identifican y recuperan dinámicamente solo la información más relevante en lugar de fragmentos de tamaño fijo. En consecuencia, MemO mantiene la latencia mediana total más baja (0,708 s) con valores p95 notablemente contenidos (1,440 s), lo que lo hace particularmente adecuado para aplicaciones sensibles a la latencia, como los agentes de IA interactivos. La variante mejorada con grafos MemO introduce capacidades adicionales de modelado relacional a un costo de latencia moderado, con tiempos de búsqueda (0,476 s) que aún superan a todas las soluciones de memoria y líneas base existentes. A pesar de este aumento, Memo8 mantiene latencias totales competitivas (p50: 1,091 s, p95: 2,590 s) mientras logra la puntuación J más alta (68,44%) entre todos los métodos, solo por detrás del enfoque de contexto completo, computacionalmente prohibitivo. Este perfil de rendimiento demuestra la capacidad de nuestros métodos para equilibrar la calidad de las respuestas y la eficiencia computacional, ofreciendo una solución convincente para agentes de IA en producción, donde ambos factores son restricciones críticas.
4.5. Sobrecarga del sistema de memoria: análisis de tokens y tiempo de construcción
Medimos el presupuesto medio de tokens requerido para materializar el almacén de memoria a largo plazo de cada sistema. Memo codifica turnos completos de diálogo en una representación en lenguaje natural y, por lo tanto, ocupa solo 7k tokens por conversación en promedio. Mientras que Memo8 aproximadamente duplica la huella a 14k tokens, debido a la introducción de memorias en grafo que incluyen nodos y las relaciones correspondientes. En marcado contraste, el grafo de memoria de Zep consume más de 600k tokens. La inflación surge de la elección de diseño de Zep de almacenar en caché un resumen abstractivo completo en cada nodo mientras también almacena hechos en las aristas de conexión, lo que genera una gran redundancia en todo el grafo. A modo de perspectiva, proporcionar todo el contexto de la conversación en bruto al modelo de lenguaje —sin ninguna abstracción de memoria— asciende a aproximadamente 26k tokens en promedio, 20 veces menos en relación con el grafo de Zep. Más allá de la ineficiencia en tokens, nuestros experimentos revelaron cuellos de botella operativos significativos con Zep. Después de añadir memorias al sistema de Zep, observamos que los intentos de recuperación inmediata de memoria a menudo no lograban responder correctamente a nuestras consultas. Curiosamente, volver a ejecutar búsquedas idénticas tras un retraso de varias horas produjo resultados considerablemente mejores. Esta latencia sugiere que la construcción del grafo de Zep implica múltiples llamadas asíncronas al LLM y un extenso procesamiento en segundo plano, lo que hace que el sistema de memoria sea poco práctico para aplicaciones en tiempo real. En contraste, la construcción del grafo de Memo se completa en menos de un minuto incluso en los peores escenarios, lo que permite a los usuarios aprovechar inmediatamente las memorias recién añadidas para la generación de respuestas a consultas.
Estos hallazgos destacan que Zep no solo replica fragmentos de conocimiento idénticos en múltiples nodos, sino que también introduce retrasos operativos significativos. Nuestras arquitecturas —MemO y Memo8— preservan la misma información con una fracción del costo en tokens y con una disponibilidad de memoria sustancialmente más rápida, ofreciendo una representación más eficiente en memoria y operativamente más ágil.
5. Conclusión y trabajo futuro
Hemos presentado MemO y Memo8, dos arquitecturas de memoria complementarias que superan las limitaciones intrínsecas de las ventanas de contexto fijas en los LLM. Al extraer, consolidar y recuperar dinámicamente representaciones de memoria compactas, MemO logra un rendimiento de vanguardia en razonamiento de un solo salto y de múltiples saltos, mientras que las extensiones basadas en grafos de Memo desbloquean ganancias significativas en tareas temporales y de dominio abierto. En el benchmark LOCOMO, nuestros métodos ofrecen mejoras relativas del 5%, 11% y 7% en tipos de preguntas de razonamiento de un solo salto, temporal y de múltiples saltos, respectivamente, sobre los métodos de mejor rendimiento en cada tipo de pregunta, y reducen la latencia p95 en más del 91% en comparación con las líneas base de contexto completo, lo que demuestra un poderoso equilibrio entre precisión y capacidad de respuesta. El pipeline de memoria densa de Memo sobresale en la recuperación rápida para consultas sencillas, minimizando el uso de tokens y la sobrecarga computacional. En contraste, las representaciones estructuradas en grafo de Memo proporcionan una claridad relacional matizada, permitiendo una compleja secuenciación de eventos y una rica integración de contexto sin sacrificar la eficiencia práctica. Juntas, forman un conjunto de herramientas de memoria versátil que se adapta a diversas demandas conversacionales y sigue siendo desplegable a escala.
Las direcciones de investigación futura incluyen optimizar las operaciones de grafo para reducir la sobrecarga de latencia en Memo8, explorar arquitecturas de memoria jerárquicas que combinen eficiencia con representación relacional, y desarrollar mecanismos de consolidación de memoria más sofisticados inspirados en los procesos cognitivos humanos.
Además, extender nuestros marcos de memoria a dominios más allá de los escenarios conversacionales, como el razonamiento procedimental y las interacciones multimodales, validaría aún más su aplicabilidad más amplia. Al abordar las limitaciones fundamentales de las ventanas de contexto fijas, nuestro trabajo representa un avance significativo hacia sistemas de IA conversacional capaces de mantener interacciones coherentes y contextualmente ricas durante períodos prolongados, de manera muy similar a sus homólogos humanos.
6. Agradecimientos
Deseamos expresar nuestra sincera gratitud a Harsh Agarwal, Shyamal Anadkat, Prithvijit Chattopadhyay, Siddesh Choudhary, Rishabh Jain y Vaibhav Pandey por sus invaluables perspectivas y minuciosas revisiones de los primeros borradores. Sus comentarios constructivos y sugerencias detalladas ayudaron a refinar el manuscrito, mejorando tanto su claridad como su calidad general. Agradecemos profundamente su generosidad al dedicar tiempo y experiencia a este trabajo.
Referencias
Anthropic. Model card and evaluations for claude models. Technical report, Anthropic, February 2025. URL https://www.anthropic.com/news/claude-3-7-sonnet.
Jan Assmann. Memoria comunicativa y cultural. En Cultural memories: The geographical point of view, páginas 15-27. Springer, 2011.
Aydar Bulatov, Yury Kuratov y Mikhail Burtsev. Recurrent memory transformer. Advances in Neural Information Processing Systems, 35:11079-11091, 2022.
Prateek Chhikara, Jiarui Zhang, Filip Ilievski, Jonathan Francis y Kaixin Ma. Knowledge-enhanced agents for interactive text games. En Proceedings of the 12th Knowledge Capture Conference 2023, páginas 157-165, 2023.
Fergus IM Craik y Janine M Jennings. Human memory. 1992.
Gaurav Goswami. Dissecting the metrics: How different evaluation approaches yield diverse results for conversational ai. Authorea Preprints, 2025.
Tianyu Guo, Druv Pai, Yu Bai, Jiantao Jiao, Michael Jordan y Song Mei. Active-dormant attention heads: Mechanistically demystifying extreme-token phenomena in llms. En NeurIPS 2024 Workshop on Mathematics of Modern Machine Learning, 2024.
Kostas Hatalis, Despina Christou, Joshua Myers, Steven Jones, Keith Lambert, Adam Amos-Binks, Zohreh Dannenhauer y Dustin Dannenhauer. Memory matters: The need to improve long-term memory in llm-agents. En Proceedings of the AAAI Symposium Series, volumen 2, páginas 277-280, 2023.
Zihong He, Weizhe Lin, Hao Zheng, Fan Zhang, Matt W Jones, Laurence Aitchison, Xuhai Xu, Miao Liu, Per Ola Kristensson y Junxiao Shen. Human-inspired perspectives: A survey on ai long-term memory. arXiv preprint arXiv:2411.00489, 2024.
Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt-4o system card. arXiv preprint arXiv:2410.21276, 2024.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Tarjeta de sistema de Openai o1. Preimpresión de arXiv arXiv:2412.16720, 2024.
Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny e Ian Fischer. Un agente de lectura inspirado en humanos con memoria de esencia de contextos muy largos. En Conferencia Internacional sobre Aprendizaje Automático, páginas 26396-26415. PMLR, 2024.
Lei Liu, Xiaoyan Yang, Yue Shen, Binbin Hu, Zhiqiang Zhang, Jinjie Gu y Guannan Zhang. Think-in-memory: Recordar y post-pensar permiten a los LLM tener memoria a largo plazo. Preimpresión de arXiv arXiv:2311.08719, 2023.
Adyasha Maharana, Dong-Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri y Yuwei Fang. Evaluación de la memoria conversacional a muy largo plazo de agentes LLM. En Actas de la 62.ª Reunión Anual de la Asociación de Lingüística Computacional (Volumen 1: Artículos largos), páginas 13851-13870, 2024.
Bodhisattwa Prasad Majumder, Bhavana Dalvi Mishra, Peter Jansen, Oyvind Tafjord, Niket Tandon, Li Zhang, Chris Callison-Burch y Peter Clark. Clin: Un agente de lenguaje con aprendizaje continuo para la adaptación y generalización rápida de tareas. En Primera Conferencia sobre Modelado del Lenguaje.
Elliot Nelson, Georgios Kollias, Payel Das, Subhajit Chaudhury y Soham Dan. Aguja en el pajar para modelos de lenguaje grandes basados en memoria. Preimpresión de arXiv arXiv:2407.01437, 2024.
Charles Packer, Vivian Fang, Shishir G Patil, Kevin Lin, Sarah Wooders y Joseph E Gonzalez. Memgpt: Hacia LLM como sistemas operativos. 2023.
Preston Rasmussen, Pavlo Paliychuk, Travis Beauvais, Jack Ryan y Daniel Chalef. Zep: Una arquitectura de grafo de conocimiento temporal para la memoria de agentes. Preimpresión de arXiv arXiv:2501.13956, 2025.
Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie y Christopher D Manning. Raptor: Procesamiento abstractivo recursivo para recuperación organizada en árbol. En La Duodécima Conferencia Internacional sobre Representaciones del Aprendizaje, 2024.
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan y Shunyu Yao. Reflexion: Agentes de lenguaje con aprendizaje por refuerzo verbal. Avances en Sistemas de Procesamiento de Información Neuronal, 36:8634-8652, 2023.
Prabhijot Singh, Prateek Chhikara y Jasmeet Singh. Un enfoque de conjunto para la summarización extractiva de texto. En Conferencia Internacional 2020 sobre Tendencias Emergentes en Tecnología de la Información e Ingeniería (ic-ETTE), páginas 1-7. IEEE, 2020.
Arpita Soni, Rajeev Arora, Anoop Kumar y Dheerendra Panwar. Evaluación de la cobertura de dominio en chatbots generativos de bajos recursos: Un estudio comparativo de enfoques de dominio abierto y dominio cerrado usando puntuaciones bleu. En Conferencia Internacional 2024 sobre Tecnologías Eléctricas, Electrónicas y de Computación (ICEECT), volumen 1, páginas 1-6. IEEE, 2024.
Equipo Gemini, Petko Georgiev, Ving Ian Lei, Ryan Burnell, Libin Bai, Anmol Gulati, Garrett Tanzer, Damien Vincent, Zhufeng Pan, Shibo Wang, et al. Gemini 1.5: Desbloqueando la comprensión multimodal a través de millones de tokens de contexto. Preimpresión de arXiv arXiv:2403.05530, 2024.
Joan C Timoneda y Sebastián Vallejo Vera. La memoria es todo lo que necesitas: Probando cómo la memoria del modelo afecta el rendimiento de los LLM en tareas de anotación. Preimpresión de arXiv arXiv:2503.04874, 2025.
Wujiang Xu, Zujie Liang, Kai Mei, Hang Gao, Juntao Tan y Yongfeng Zhang. A-mem: Memoria agéntica para agentes LLM. Preimpresión de arXiv arXiv:2502.12110, 2025.
Yangyang Yu, Haohang Li, Zhi Chen, Yuechen Jiang, Yang Li, Denghui Zhang, Rong Liu, Jordan W Suchow y Khaldoun Khashanah. Finmem: Un agente de trading LLM con rendimiento mejorado y con memoria por capas y diseño de personaje. En Actas de la Serie de Simposios de la AAAI, volumen 3, páginas 595-597, 2024.
Jiarui Zhang. La generación guiada de perfiles mejora la personalización con modelos de lenguaje grandes. En Hallazgos de la Asociación de Lingüística Computacional: EMNLP 2024, páginas 4005-4016, 2024.
Jiarui Zhang, Filip Ilievski, Kaixin Ma, Jonathan Francis y Alessandro Oltramari. Un estudio de adaptación de zero-shot con conocimiento de sentido común. En AKBC, 2022.
Zeyu Zhang, Xiaohe Bo, Chen Ma, Rui Li, Xu Chen, Quanyu Dai, Jieming Zhu, Zhenhua Dong y Ji-Rong Wen. Una encuesta sobre el mecanismo de memoria de agentes basados en modelos de lenguaje grandes. Preimpresión de arXiv arXiv:2404.13501, 2024.
Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye y Yanlin Wang. Memorybank: Mejorando los modelos de lenguaje grandes con memoria a largo plazo. En Actas de la Conferencia AAAI sobre Inteligencia Artificial, volumen 38, páginas 19724-19731, 2024.
Apéndice
A. Prompts
Al desarrollar nuestro prompt de LLM-como-Juez, adaptamos elementos del prompt publicado por Packer et al. (2023).
PLANTILLA DE PROMPT PARA LLM COMO JUEZ
Tu tarea es etiquetar una respuesta a una pregunta como "CORRECTA" o "INCORRECTA". Se te darán los siguientes datos: (1) una pregunta (planteada por un usuario a otro usuario), (2) una respuesta 'gold' (verdad fundamental), (3) una respuesta generada que puntuarás como CORRECTA/INCORRECTA.
El objetivo de la pregunta es preguntar sobre algo que un usuario debería saber sobre el otro usuario según sus conversaciones previas. La respuesta gold suele ser una respuesta concisa y breve que incluye el tema referenciado, por ejemplo:
Pregunta: ¿Recuerdas lo que obtuve la última vez que fui a Hawái?
Respuesta gold: Un collar de conchas
La respuesta generada puede ser mucho más larga, pero debes ser generoso con tu calificación; siempre que toque el mismo tema que la respuesta gold, debe contarse como CORRECTA.
Para preguntas relacionadas con el tiempo, la respuesta gold será una fecha, mes, año específicos, etc. La respuesta generada puede ser mucho más larga o usar referencias temporales relativas (como 'el martes pasado' o 'el próximo mes'), pero debes ser generoso con tu calificación; siempre que se refiera a la misma fecha o período de tiempo que la respuesta gold, debe contarse como CORRECTA. Incluso si el formato difiere (p. ej., '7 de mayo' vs 'mayo 7'), considéralo CORRECTO si es la misma fecha.
Ahora es el momento de la pregunta real: Pregunta: {question}
Respuesta gold: {gold_answer}
Respuesta generada: {generated_answer}
Primero, proporciona una explicación breve (una frase) de tu razonamiento, luego termina con CORRECTA o INCORRECTA. NO incluyas tanto CORRECTA como INCORRECTA en tu respuesta, o romperás el script de evaluación.
Solo devuelve la etiqueta CORRECTA o INCORRECTA en formato json con la clave como "label".
PLANTILLA DE PROMPT PARA LA GENERACIÓN DE RESULTADOS (MEMO)
Eres un asistente de memoria inteligente encargado de recuperar información precisa de las memorias de conversación.
CONTEXTO:
Tienes acceso a las memorias de dos hablantes en una conversación. Estas memorias contienen información con marcas de tiempo que puede ser relevante para responder la pregunta.
INSTRUCCIONES:
1. Analiza cuidadosamente todos los recuerdos proporcionados de ambos hablantes 2. Presta especial atención a las marcas de tiempo para determinar la respuesta 3. Si la pregunta trata sobre un evento o hecho específico, busca evidencia directa en los recuerdos 4. Si los recuerdos contienen información contradictoria, prioriza el recuerdo más reciente 5. Si hay una pregunta sobre referencias temporales (como "el año pasado", "hace dos meses", etc.), calcula la fecha real basándote en la marca de tiempo del recuerdo. Por ejemplo, si un recuerdo del 4 de mayo de 2022 menciona "fui a India el año pasado", entonces el viaje ocurrió en 2021. 6. Convierte siempre las referencias temporales relativas a fechas, meses o años específicos. Por ejemplo, convierte "el año pasado" a "2022" o "hace dos meses" a "marzo de 2023" basándote en la marca de tiempo del recuerdo. Ignora la referencia al responder la pregunta. 7. Céntrate solo en el contenido de los recuerdos de ambos hablantes. No confundas los nombres de personajes mencionados en los recuerdos con los usuarios reales que crearon esos recuerdos. 8. La respuesta debe tener menos de 5-6 palabras.
ENFOQUE (Piensa paso a paso):
1. Primero, examina todos los recuerdos que contengan información relacionada con la pregunta 2. Examina cuidadosamente las marcas de tiempo y el contenido de estos recuerdos 3. Busca menciones explícitas de fechas, horas, lugares o eventos que respondan a la pregunta 4. Si la respuesta requiere cálculo (por ejemplo, convertir referencias temporales relativas), muestra tu trabajo 5. Formula una respuesta precisa y concisa basada únicamente en la evidencia de los recuerdos 6. Verifica dos veces que tu respuesta aborde directamente la pregunta formulada 7. Asegúrate de que tu respuesta final sea específica y evite referencias temporales vagas
Recuerdos para el usuario {speaker_1_user_id}: {speaker_1_memories}
Recuerdos para el usuario {speaker_2_user_id}: {speaker_2_memories}
Pregunta: {question}
Respuesta:
PLANTILLA DE PROMPT PARA LA GENERACIÓN DE RESULTADOS (MEMO'S)
(igual que antes)
ENFOQUE (Piensa paso a paso):
1. Primero, examina todos los recuerdos que contengan información relacionada con la pregunta 2. Examina cuidadosamente las marcas de tiempo y el contenido de estos recuerdos 3. Busca menciones explícitas de fechas, horas, lugares o eventos que respondan a la pregunta 4. Si la respuesta requiere cálculo (por ejemplo, convertir referencias temporales relativas), muestra tu trabajo 5. Analiza las relaciones del grafo de conocimiento para entender el contexto de conocimiento del usuario 6. Formula una respuesta precisa y concisa basada únicamente en la evidencia de los recuerdos 7. Verifica dos veces que tu respuesta aborde directamente la pregunta formulada 8. Asegúrate de que tu respuesta final sea específica y evite referencias temporales vagas
Recuerdos para el usuario {speaker_1_user_id}: {speaker_1_memories}
Relaciones para el usuario {speaker_1_user_id}: {speaker_1_graph_memories}
Recuerdos para el usuario {speaker_2_user_id}: {speaker_2_memories}
Relaciones para el usuario {speaker_2_user_id}: {speaker_2_graph_memories}
Pregunta: {question}
Respuesta:
PLANTILLA DE PROMPT PARA OPENAI CHATGPT
¿Puedes extraer la información relevante de esta conversación y crear entradas de memoria para cada usuario mencionado? Por favor, almacena estas memorias en tu base de conocimiento además de la marca temporal proporcionada para futuras referencias e interacciones personalizadas.
(1:56 pm del 8 de mayo de 2023) Caroline: ¡Hola Mel! ¡Qué bueno verte! ¿Cómo has estado? (1:56 pm del 8 de mayo de 2023) Melanie: ¡Hola Caroline! ¡Qué bueno verte! Estoy desbordada con los niños y el trabajo. ¿Qué hay de ti? ¿Algo nuevo? (1:56 pm del 8 de mayo de 2023) Caroline: Ayer fui a un grupo de apoyo LGBTQ y fue muy poderoso.
B. Algoritmo
Algoritmo 1 Sistema de Gestión de Memoria: Operaciones de Actualización
1: Entrada: Conjunto de memorias recuperadas , Almacén de memoria existente
2: Salida: Almacén de memoria actualizado
3: procedimiento UPDATE MEMORY(F, M)
4: para cada hecho hacer
5: operación CLASSIFYOPERATION
Ejecutar la operación apropiada según la
clasificación
6: si operación ADD entonces
7: GenerateUniqueID()
8:
Añadir nuevo hecho con identificador único
9: si no, si operación UPDATE entonces
10: FindRelatedMemory
11: si InformationContent InformationContent entonces
12: Reemplazar con información más rica
13: fin si
14: si no, si operación DELETE entonces
15: FindContradictedMemory
16: Eliminar información contradicha
17: si no, si operación NOOP entonces
18: Ninguna operación realizada El hecho ya existe o es irrelevante
19: fin si
20: fin para
21: devolver M
22: fin procedimiento
23: función CLASSIFYOPERATION
24: si SemanticallySimilar entonces
25: devolver ADD
26: si no, si Contradicts entonces
27: devolver DELETE
28: si no, si Augments entonces
29: devolver UPDATE
30: si no
31: devolver NOOP
32: fin si
33: fin función
Nueva información no presente en la memoria
La información entra en conflicto con la memoria existente
Mejora la información existente en la memoria
No se requiere cambio
C. Líneas base seleccionadas
LoCoMo El marco LoCoMo implementa un sofisticado pipeline de memoria que permite a los agentes LLM mantener conversaciones coherentes y de largo plazo. En su núcleo, el sistema divide la memoria en componentes de corto y largo plazo. Después de cada sesión de conversación, los agentes generan resúmenes (almacenados como memoria de corto plazo) que destilan la información clave de esa interacción. Simultáneamente, los turnos individuales de conversación se transforman en 'observaciones': declaraciones fácticas sobre la persona y los eventos de vida de cada hablante, que se almacenan en la memoria de largo plazo con referencias a los turnos específicos del diálogo que las produjeron. Al generar nuevas respuestas, los agentes aprovechan tanto el resumen de la sesión más reciente como la recuperación selectiva de observaciones relevantes de su memoria de largo plazo. Este enfoque de doble memoria se ve además reforzado por la incorporación de un grafo temporal de eventos que rastrea eventos de vida causalmente conectados que ocurren entre sesiones de conversación. Al condicionar las respuestas a las memorias recuperadas, el contexto de la conversación actual, la información de la persona y los eventos de vida intermedios, el sistema permite a los agentes mantener personalidades consistentes y recordar detalles importantes a través de conversaciones que abarcan cientos de turnos y docenas de sesiones.
ReadAgent ReadAgent aborda las limitaciones fundamentales de los LLM emulando cómo los humanos procesan textos extensos mediante un sofisticado pipeline de tres etapas. Primero, en la Paginación de Episodios, el sistema segmenta inteligentemente el texto en límites cognitivos naturales en lugar de cortes arbitrarios. A continuación, durante la Destilación en Memoria (Memory Gisting), destila cada segmento en resúmenes concisos que preservan el significado esencial mientras reducen drásticamente el recuento de tokens, de forma similar a cómo la memoria humana retiene la sustancia de la información sin recordarla literalmente. Finalmente, cuando se le encarga responder preguntas, el mecanismo de Búsqueda Interactiva examina estos resúmenes y recupera estratégicamente solo los segmentos de texto original más relevantes para un procesamiento detallado. Este enfoque inspirado en los humanos permite a los LLM gestionar eficazmente documentos hasta 20 veces más largos que sus ventanas de contexto normales. Al equilibrar la comprensión global mediante resúmenes con la atención selectiva a los detalles, ReadAgent logra tanto eficiencia computacional como una mejor comprensión, demostrando que imitar los procesos cognitivos humanos puede mejorar significativamente las capacidades de procesamiento de texto de la IA.
MemoryBank El sistema MemoryBank mejora los LLM con memoria de largo plazo mediante un sofisticado pipeline de tres partes. En su núcleo, el componente de Almacenamiento de Memoria almacena registros detallados de conversaciones, resúmenes jerárquicos de eventos y perfiles de personalidad de usuario en evolución. Cuando ocurre una nueva interacción, el mecanismo de Recuperación de Memoria emplea un modelo de recuperación densa de doble torre para extraer información pasada contextualmente relevante. El componente de Actualización de Memoria proporciona un mecanismo de olvido similar al humano, donde las memorias se fortalecen cuando se recuerdan y decaen naturalmente con el tiempo si no se usan. Este enfoque integral permite a los compañeros de IA recordar información pertinente, mantener conciencia contextual a través de interacciones prolongadas y desarrollar retratos de usuario cada vez más precisos, lo que resulta en conversaciones de largo plazo más personalizadas y naturales.
MemGPT El sistema MemGPT introduce un enfoque inspirado en los sistemas operativos para superar las limitaciones de la ventana de contexto inherentes a los LLM. En su núcleo, MemGPT emplea un sofisticado pipeline de gestión de memoria que consta de tres componentes clave: un sistema de memoria jerárquico, operaciones de memoria autodirigidas y un mecanismo de flujo de control basado en eventos. El sistema divide la memoria disponible en 'contexto principal' (análogo a la RAM en los sistemas operativos tradicionales) y 'contexto externo' (análogo al almacenamiento en disco). El contexto principal —que está limitado por la ventana de contexto del LLM— contiene instrucciones del sistema, historial reciente de conversación y memoria de trabajo que puede ser modificada por el modelo. El contexto externo almacena información ilimitada fuera de la ventana de contexto inmediata del modelo, incluidos historiales completos de conversación y datos de archivo. Cuando el LLM necesita información que no está presente en el contexto principal, puede iniciar llamadas a funciones para buscar, recuperar o modificar contenido entre estos niveles de memoria, 'paginando' eficazmente la información relevante dentro y fuera de su limitada ventana de contexto. Esta arquitectura inspirada en los sistemas operativos permite a MemGPT mantener coherencia conversacional a través de interacciones prolongadas, gestionar documentos que exceden los límites de contexto estándar y realizar tareas de recuperación de información de múltiples saltos, todo mientras opera con modelos de contexto fijo. La capacidad del sistema para gestionar inteligentemente sus propios recursos de memoria proporciona la ilusión de un contexto infinito, extendiendo significativamente lo que es posible con la tecnología LLM actual.
A- Mem El modelo A- Mem introduce un sistema de memoria agéntica diseñado para agentes LLM. Este sistema estructura y evoluciona dinámicamente las memorias mediante notas interconectadas. Cada nota captura interacciones enriquecidas con atributos estructurados como palabras clave, descripciones contextuales y etiquetas generadas por el LLM. Al crear una nueva memoria, A- MEM utiliza embeddings semánticos para recuperar notas existentes relevantes, y luego emplea un enfoque impulsado por LLM para establecer vínculos significativos basados en similitudes y atributos compartidos. De manera crucial, el mecanismo de evolución de la memoria actualiza dinámicamente las notas existentes, refinando su información contextual y sus atributos siempre que se integran nuevas memorias relevantes. Así, la estructura de la memoria evoluciona continuamente, permitiendo conexiones más ricas y contextualmente más profundas entre las memorias. La recuperación desde la memoria se realiza mediante similitud semántica, proporcionando contexto histórico relevante durante las interacciones del agente.