
Ajustar un modelo de 65B en una GPU de 48 GB: cuantización de 4 bits y adaptadores, sin perder calidad de 16 bits. NeurIPS 2023, gratis.
QLoRA: Efficient Finetuning of Quantized LLMs
QLoRA: Ajuste fino eficiente de LLM cuantizados
Tim Dettmers\*
Artidoro Pagnoni\*
Ari Holtzman
Luke Zettlemoyer
Universidad de Washington {dettmers,artidoro,ahai,lsz}@cs.washington.edu
Resumen
Presentamos QLoRA, un enfoque de ajuste fino eficiente que reduce el uso de memoria lo suficiente como para ajustar finamente un modelo de 65B parámetros en una única GPU de 48GB mientras preserva el rendimiento completo de la tarea de ajuste fino de 16 bits. QLoRA propaga los gradientes hacia atrás a través de un modelo de lenguaje preentrenado cuantizado a 4 bits y congelado hacia Adaptadores de Bajo Rango (LoRA). Nuestra mejor familia de modelos, que denominamos Guanaco, supera a todos los modelos liberados públicamente con anterioridad en el benchmark Vicuna, alcanzando el 99,3% del nivel de rendimiento de ChatGPT mientras requiere solo 24 horas de ajuste fino en una única GPU. QLoRA introduce una serie de innovaciones para ahorrar memoria sin sacrificar rendimiento: (a) NormalFloat de 4 bits (NF4), un nuevo tipo de dato que es teóricamente óptimo en términos de información para pesos distribuidos normalmente (b) Doble Cuantización para reducir la huella de memoria promedio al cuantizar las constantes de cuantización, y (c) Optimizadores Paginados para gestionar los picos de memoria. Usamos QLoRA para ajustar finamente más de 1000 modelos, proporcionando un análisis detallado del seguimiento de instrucciones y el rendimiento de chatbot a través de 8 conjuntos de datos de instrucciones, múltiples tipos de modelos (LLaMA, T5), y escalas de modelos que serían inviables de ejecutar con ajuste fino regular (p. ej. modelos de 33B y 65B parámetros). Nuestros resultados muestran que el ajuste fino con QLoRA en un pequeño conjunto de datos de alta calidad conduce a resultados de vanguardia, incluso cuando se usan modelos más pequeños que el SoTA anterior. Proporcionamos un análisis detallado del rendimiento de chatbot basado tanto en evaluaciones humanas como de GPT-4 mostrando que las evaluaciones de GPT-4 son una alternativa barata y razonable a la evaluación humana. Además, encontramos que los benchmarks actuales de chatbot no son confiables para evaluar con precisión los niveles de rendimiento de los chatbots. Un análisis de selección adversa demuestra dónde falla Guanaco en comparación con ChatGPT. Publicamos todos nuestros modelos y código, incluyendo kernels CUDA para entrenamiento de 4 bits.2
1 Introducción
El ajuste fino de grandes modelos de lenguaje (LLM) es una forma altamente efectiva de mejorar su rendimiento, [40, 62, 43, 61, 59, 37] y de añadir comportamientos deseables o eliminar comportamientos indeseables [43, 2, 4]. Sin embargo, el ajuste fino de modelos muy grandes es prohibitivamente costoso; el ajuste fino regular de 16 bits de un modelo LLaMA de 65B parámetros [57] requiere más de 780 GB de memoria de GPU. Si bien los métodos de cuantización recientes pueden reducir la huella de memoria de los LLM [14, 13, 18, 66], tales técnicas solo funcionan para inferencia y se descomponen durante el entrenamiento [65].
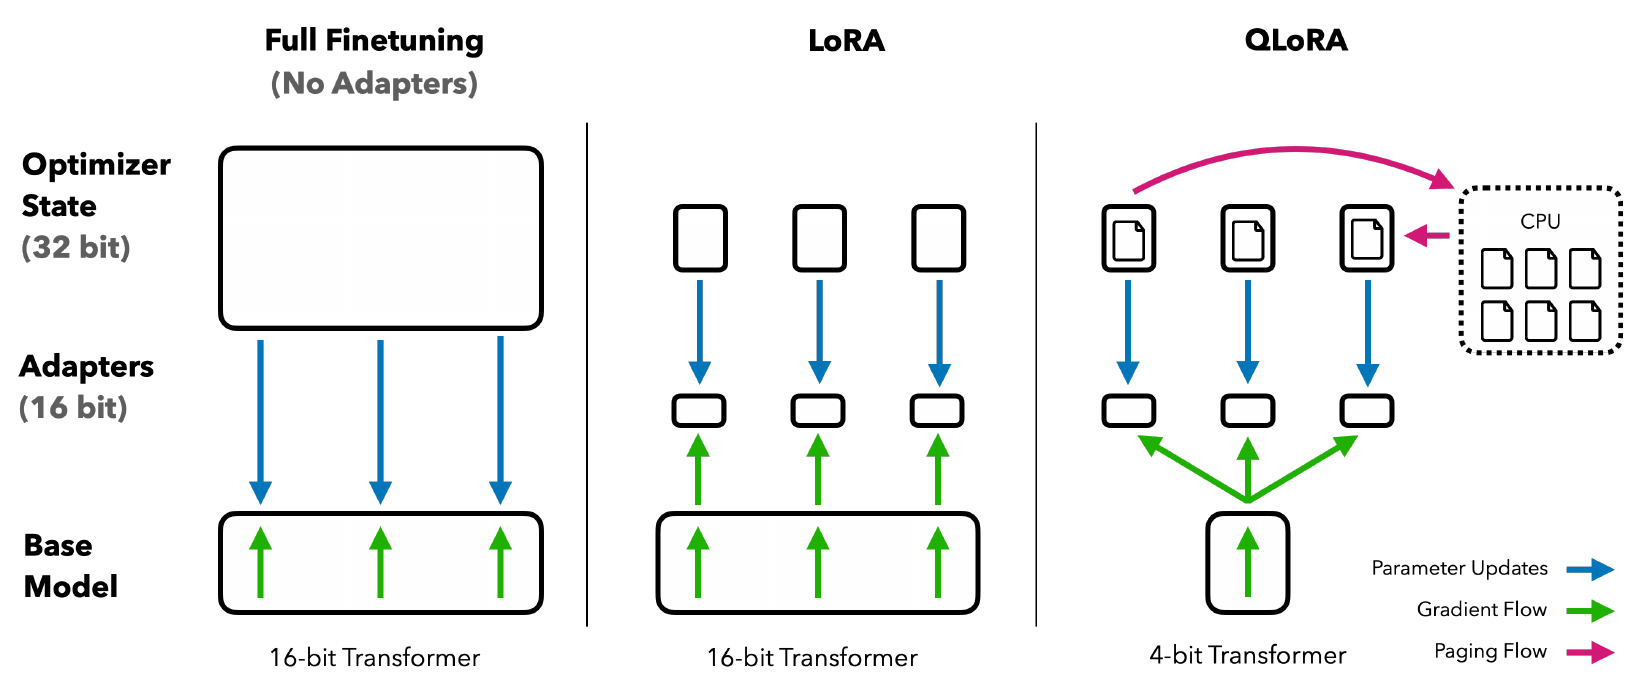
Demostramos por primera vez que es posible ajustar finamente un modelo cuantizado de 4 bits sin ninguna degradación del rendimiento. Nuestro método, QLoRA, utiliza una novedosa técnica de alta precisión para cuantizar un modelo preentrenado a 4 bits, luego añade un pequeño conjunto de pesos de Adaptadores de Bajo Rango [28] entrenables que se ajustan propagando los gradientes hacia atrás a través de los pesos cuantizados.
QLORA reduce los requisitos de memoria promedio de ajustar finamente un modelo de 65B parámetros de de memoria de GPU a sin degradar el tiempo de ejecución ni el rendimiento predictivo en comparación con una línea base de ajuste fino completo de 16 bits. Esto marca un cambio significativo en la accesibilidad del ajuste fino de LLM: ahora los modelos públicos más grandes hasta la fecha son ajustables finamente en una única GPU. Usando QLoRA, entrenamos la familia de modelos Guancao, con el segundo mejor modelo alcanzando el del nivel de rendimiento de ChatGPT en el benchmark Vicuna [10], mientras es entrenable en menos de 12 horas en una única GPU de consumo; usando una única GPU profesional durante más de 24 horas alcanzamos el con nuestro modelo más grande, esencialmente cerrando la brecha con ChatGPT en el benchmark Vicuna. Cuando se despliega, nuestro modelo Guanaco más pequeño
| Modelo | Tamaño | Elo |
| GPT-4 | - | 1348 ± 1 |
| Guanaco 65B | 41 GB | 1022 ± 1 |
| Guanaco 33B | 21 GB | 992 ± 1 |
| Vicuna 13B | 26 GB | 974 ± 1 |
| ChatGPT | - | 966 ± 1 |
| Guanaco 13B | 10 GB | 916 ± 1 |
| Bard | - | 902 ± 1 |
| Guanaco 7B | 6 GB | 879 ± 1 |
(7B parámetros) requiere solo 5 GB de memoria y supera a un modelo Alpaca de 26 GB por más de 20 puntos porcentuales en el benchmark Vicuna (Tabla 6).
QLORA introduce múltiples innovaciones diseñadas para reducir el uso de memoria sin sacrificar rendimiento: (1) NormalFloat de 4 bits, un tipo de dato de cuantización teóricamente óptimo en términos de información para datos distribuidos normalmente que produce mejores resultados empíricos que los Enteros de 4 bits y los Flotantes de 4 bits. (2) Doble Cuantización, un método que cuantiza las constantes de cuantización, ahorrando un promedio de aproximadamente 0,37 bits por parámetro (aproximadamente 3 GB para un modelo de 65B). (3) Optimizadores Paginados, que usan la memoria unificada de NVIDIA para evitar los picos de memoria del checkpointing de gradientes que ocurren al procesar un mini-lote con una longitud de secuencia larga. Combinamos estas contribuciones en un enfoque LoRA mejor ajustado que incluye adaptadores en cada capa de la red y de este modo evita casi todas las compensaciones de precisión observadas en trabajos previos.
La eficiencia de QLORA nos permite realizar un estudio en profundidad del ajuste fino de instrucciones y el rendimiento de chatbot en escalas de modelos que serían imposibles usando ajuste fino regular debido a la sobrecarga de memoria. Por lo tanto, entrenamos más de 1000 modelos a través de varios conjuntos de datos de ajuste fino de instrucciones, arquitecturas de modelos, y tamaños entre 80M y 65B parámetros. Además de mostrar que QLoRA recupera el rendimiento de 16 bits () y entrenar un chatbot de vanguardia, Guanaco, (), también analizamos tendencias en los modelos entrenados. Primero, encontramos que la calidad de los datos es mucho más importante que el tamaño del conjunto de datos, p. ej., un conjunto de datos de 9k muestras (OASST1) superó a un conjunto de datos de 450k muestras (FLAN v2, submuestreado) en rendimiento de chatbot, incluso cuando ambos están destinados a apoyar la generalización del seguimiento de instrucciones. Segundo, mostramos que un fuerte rendimiento en el benchmark de Comprensión Masiva de Tareas Múltiples del Lenguaje (MMLU) no implica un fuerte rendimiento en el benchmark de chatbot Vicuna y viceversa—en otras palabras, la idoneidad del conjunto de datos importa más que el tamaño para una tarea dada.
Además, también proporcionamos un análisis extenso del rendimiento de chatbot que usa tanto evaluadores humanos como GPT-4 para la evaluación. Usamos benchmarking estilo torneo donde los modelos compiten entre sí en partidas para producir la mejor respuesta para un prompt dado. El ganador de una partida es juzgado por GPT-4 o por anotadores humanos. Los resultados del torneo se agregan en puntuaciones Elo [16, 17] que determinan el ranking del rendimiento de chatbot. Encontramos que las evaluaciones de GPT-4 y humanas concuerdan en gran medida sobre el rango de rendimiento de los modelos en los torneos, pero también encontramos que hay casos de fuerte desacuerdo. Como tal, destacamos que la evaluación basada en modelos, si bien proporciona una alternativa barata a la anotación humana, también tiene sus incertidumbres.
Aumentamos nuestros resultados de benchmark de chatbot con un análisis cualitativo de los modelos Guanaco. Nuestro análisis destaca casos de éxito y fracaso que no fueron capturados por los benchmarks cuantitativos.
Publicamos todas las generaciones de modelos con anotaciones humanas y de GPT-4 para facilitar estudios posteriores. Hacemos de código abierto nuestra base de código y kernels CUDA e integramos nuestros métodos en la pila de transformers de Hugging Face [64], haciéndolos fácilmente accesibles para todos. Publicamos una colección de adaptadores para modelos de tamaño 7/13/33/65B, entrenados en 8 conjuntos de datos diferentes de seguimiento de instrucciones, para un total de 32 modelos ajustados finamente de código abierto diferentes.
2 Antecedentes
Cuantización k-bits por bloques La cuantización es el proceso de discretizar una entrada desde una representación que contiene más información a una representación con menos información. A menudo significa tomar un tipo de dato con más bits y convertirlo a menos bits, por ejemplo de flotantes de 32 bits a Enteros de 8 bits. Para asegurar que se use todo el rango del tipo de dato de pocos bits, el tipo de dato de entrada comúnmente se reescala al rango del tipo de dato objetivo mediante normalización por el máximo absoluto de los elementos de entrada, que usualmente están estructurados como un tensor. Por ejemplo, cuantizar un tensor de Punto Flotante de 32 bits (FP32) en un tensor Int8 con rango :
donde es la constante de cuantización o escala de cuantización. La descuantización es la inversa:
El problema con este enfoque es que si un valor de gran magnitud (es decir, un valor atípico) aparece en el tensor de entrada, entonces los intervalos de cuantización —ciertas combinaciones de bits— no se aprovechan bien, con pocos o ningún número cuantizado en algunos intervalos. Para prevenir el problema de los valores atípicos, un enfoque común es dividir el tensor de entrada en bloques que se cuantizan de manera independiente, cada uno con su propia constante de cuantización . Esto puede formalizarse de la siguiente manera: dividimos el tensor de entrada en bloques contiguos de tamaño aplanando el tensor de entrada y cortando el segmento lineal en bloques. Cuantizamos estos bloques de manera independiente con la Ecuación 1 para crear un tensor cuantizado y constantes de cuantización .
Adaptadores de bajo rango El ajuste fino con adaptadores de bajo rango (LoRA) [28] es un método que reduce los requisitos de memoria mediante el uso de un pequeño conjunto de parámetros entrenables, a menudo denominados adaptadores, sin actualizar los parámetros completos del modelo, que permanecen fijos. Los gradientes durante el descenso de gradiente estocástico se propagan a través de los pesos fijos del modelo preentrenado hasta el adaptador, que se actualiza para optimizar la función de pérdida. LoRA aumenta una proyección lineal mediante una proyección factorizada adicional. Dada una proyección con , , LoRA calcula:
donde y , y es un escalar.
Requisito de memoria del ajuste fino con parámetros eficientes Un punto importante de discusión es el requisito de memoria de LoRA durante el entrenamiento, tanto en términos del número como del tamaño de los adaptadores utilizados. Dado que la huella de memoria de LoRA es tan mínima, podemos usar más adaptadores para mejorar el rendimiento sin aumentar significativamente la memoria total utilizada. Aunque LoRA fue diseñado como un método de ajuste fino con parámetros eficientes (PEFT), la mayor parte de la huella de memoria para el ajuste fino de LLM proviene de los gradientes de activación y no de los parámetros de LoRA aprendidos. Para un modelo LLaMA de 7B entrenado sobre FLAN v2 con un tamaño de lote de 1, con pesos de LoRA equivalentes al de los pesos del modelo original comúnmente usado [28, 37], los gradientes de entrada de LoRA tienen una huella de memoria de 567 MB, mientras que los parámetros de LoRA ocupan solo 26 MB. Con el checkpointing de gradientes [9], los gradientes de entrada se reducen a un promedio de 18 MB por secuencia, lo que los hace más intensivos en memoria que todos los pesos de LoRA combinados. En comparación, el modelo base de 4 bits consume 5,048 MB de memoria. Esto destaca que el checkpointing de gradientes es importante, pero también que reducir agresivamente la cantidad de parámetros de LoRA produce solo beneficios menores en memoria. Esto significa que podemos usar más adaptadores sin aumentar significativamente la huella de memoria total del entrenamiento (véase el Apéndice G para un desglose detallado). Como se discute más adelante, esto es crucial para recuperar el rendimiento completo de precisión de 16 bits.
3 Ajuste fino con QLoRA
QLoRA logra un ajuste fino de 4 bits de alta fidelidad mediante dos técnicas que proponemos: la cuantización NormalFloat de 4 bits (NF4) y la Doble Cuantización. Además, introducimos los Optimizadores Paginados, para evitar que los picos de memoria durante el checkpointing de gradientes causen errores de falta de memoria que tradicionalmente han dificultado el ajuste fino en una sola máquina para modelos grandes.
QLoRA tiene un tipo de dato de almacenamiento de baja precisión, en nuestro caso generalmente de 4 bits, y un tipo de dato de cómputo que generalmente es BFloat16. En la práctica, esto significa que siempre que se utiliza un tensor de pesos de QLoRA, descuantizamos el tensor a BFloat16 y luego realizamos una multiplicación de matrices en 16 bits.
A continuación discutimos los componentes de QLoRA, seguidos de una definición formal de QLoRA.
Cuantización NormalFloat de 4 bits El tipo de dato NormalFloat (NF) se basa en la Cuantización por Cuantiles [15], que es un tipo de dato teóricamente óptimo en términos de información que garantiza que cada intervalo de cuantización tenga un número igual de valores asignados desde el tensor de entrada. La cuantización por cuantiles funciona estimando el cuantil del tensor de entrada mediante la función de distribución acumulada empírica.
La principal limitación de la cuantización por cuantiles es que el proceso de estimación de cuantiles es costoso. Por lo tanto, se utilizan algoritmos rápidos de aproximación de cuantiles, como los cuantiles SRAM [15], para estimarlos. Debido a la naturaleza aproximada de estos algoritmos de estimación de cuantiles, el tipo de dato presenta grandes errores de cuantización para los valores atípicos, que a menudo son los valores más importantes.
Las estimaciones costosas de cuantiles y los errores de aproximación pueden evitarse cuando los tensores de entrada provienen de una distribución fija hasta una constante de cuantización. En tales casos, los tensores de entrada tienen los mismos cuantiles, lo que hace que la estimación exacta de cuantiles sea computacionalmente factible.
Dado que los pesos de las redes neuronales preentrenadas suelen tener una distribución normal centrada en cero con desviación estándar (véase el Apéndice F), podemos transformar todos los pesos a una única distribución fija escalando de modo que la distribución encaje exactamente en el rango de nuestro tipo de dato. Para nuestro tipo de dato, establecemos el rango arbitrario . Como tal, tanto los cuantiles del tipo de dato como los pesos de la red neuronal deben normalizarse a este rango.
El tipo de dato teóricamente óptimo en términos de información para distribuciones normales de media cero con desviaciones estándar arbitrarias en el rango se calcula de la siguiente manera: (1) estimar los cuantiles de una distribución teórica para obtener un tipo de dato de cuantización por cuantiles de bits para distribuciones normales, (2) tomar este tipo de dato y normalizar sus valores al rango , (3) cuantizar un tensor de pesos de entrada normalizándolo al rango mediante reescalado por máximo absoluto.
Una vez que el rango de los pesos y el rango del tipo de dato coinciden, podemos cuantizar como de costumbre. El paso (3) es equivalente a reescalar la desviación estándar del tensor de pesos para que coincida con la desviación estándar del tipo de dato de k bits. Más formalmente, estimamos los valores del tipo de dato de la siguiente manera:
donde es la función de cuantiles de la distribución normal estándar . Un problema para una cuantización simétrica de k bits es que este enfoque no tiene una representación exacta de cero, que es una propiedad importante para cuantizar el relleno y otros elementos de valor cero sin error. Para garantizar un punto cero discreto de 0 y utilizar los bits para un tipo de dato de k bits, creamos un tipo de dato asimétrico estimando los cuantiles de dos rangos : para la parte negativa y para la parte positiva, y luego unificamos estos conjuntos de y eliminamos uno de los dos ceros que aparece en ambos conjuntos. Denominamos al tipo de dato resultante, que tiene el mismo número esperado de valores en cada intervalo de cuantización, NormalFloat de bits (NFk), ya que el tipo de dato es teóricamente óptimo en términos de información para datos distribuidos normalmente centrados en cero. Los valores exactos de este tipo de dato se pueden encontrar en el Apéndice E.
Doble Cuantización Introducimos la Doble Cuantización (DQ), el proceso de cuantizar las constantes de cuantización para obtener ahorros de memoria adicionales. Si bien se requiere un tamaño de bloque pequeño para una cuantización precisa de 4 bits [13], esto también conlleva una sobrecarga de memoria considerable. Por ejemplo, al utilizar constantes de 32 bits y un tamaño de bloque de 64 para W, las constantes de cuantización añaden bits por parámetro en promedio. La Doble Cuantización ayuda a reducir la huella de memoria de las constantes de cuantización.
Más específicamente, la Doble Cuantización trata las constantes de cuantización de la primera cuantización como entradas para una segunda cuantización. Este segundo paso produce las constantes de cuantización cuantizadas y el segundo nivel de constantes de cuantización . Utilizamos Flotantes de 8 bits con un tamaño de bloque de 256 para la segunda cuantización, ya que no se observa degradación del rendimiento para la cuantización de 8 bits, en línea con los resultados de Dettmers y Zettlemoyer [13]. Dado que las son positivas, restamos la media de antes de la cuantización para centrar los valores alrededor de cero y hacer uso de la cuantización simétrica. En promedio, para un tamaño de bloque de 64, esta cuantización reduce la huella de memoria por parámetro de bits a bits, una reducción de 0.373 bits por parámetro.
Los Optimizadores Paginados utilizan la característica de memoria unificada de NVIDIA , que realiza transferencias automáticas de página a página entre la CPU y la GPU para un procesamiento libre de errores en la GPU en el escenario en que la GPU ocasionalmente se queda sin memoria. La característica funciona como la paginación de memoria regular entre la RAM de la CPU y el disco. Utilizamos esta característica para asignar memoria paginada a los estados del optimizador, los cuales luego se expulsan automáticamente a la RAM de la CPU cuando la GPU se queda sin memoria y se vuelven a paginar a la memoria de la GPU cuando se necesita la memoria en el paso de actualización del optimizador.
QLORA. Utilizando los componentes descritos anteriormente, definimos QLORA para una única capa lineal en el modelo base cuantizado con un único adaptador LoRA de la siguiente manera:
donde doubleDequant se define como:
Utilizamos NF4 para W y FP8 para . Utilizamos un tamaño de bloque de 64 para W para una mayor precisión de cuantización y un tamaño de bloque de 256 para para conservar memoria.
Para las actualizaciones de parámetros solo se necesita el gradiente con respecto al error para los pesos de los adaptadores , y no para los pesos de 4 bits . Sin embargo, el cálculo de conlleva el cálculo de , que procede mediante la ecuación (5) con la desquantización desde el almacenamiento al tipo de dato de cómputo para calcular la derivada en precisión BFloat16.
En resumen, QLORA tiene un tipo de dato de almacenamiento (normalmente NormalFloat de 4 bits) y un tipo de dato de cómputo (BrainFloat de 16 bits). Desquantizamos el tipo de dato de almacenamiento al tipo de dato de cómputo para realizar el paso hacia adelante y hacia atrás, pero solo calculamos los gradientes de los pesos para los parámetros de LoRA, que utilizan BrainFloat de 16 bits.
4 QLoRA vs. ajuste fino estándar
Hemos discutido cómo funciona QLoRA y cómo puede reducir significativamente la memoria requerida para el ajuste fino de modelos. La pregunta principal ahora es si QLoRA puede rendir igual de bien que el ajuste fino de modelo completo. Además, queremos analizar los componentes de QLoRA, incluido el impacto de NormalFloat4 frente a Float4 estándar. Las siguientes secciones discutirán los experimentos que tenían como objetivo responder a estas preguntas.
Configuración experimental. Consideramos tres arquitecturas (solo codificador, codificador-decodificador y decodificador) y comparamos QLoRA con el ajuste fino de adaptadores de 16 bits y con el ajuste fino completo para modelos de hasta 3B. Nuestras evaluaciones incluyen GLUE [58] con RoBERTa-large [38], Super-NaturalInstructions (TKInstruct) [61] con T5 [49], y MMLU de 5 disparos [24] tras el ajuste fino de LLaMA en Flan v2 [39] y Alpaca [55]. Para estudiar adicionalmente las ventajas de NF4 sobre otros tipos de datos de 4 bits, utilizamos la configuración de Dettmers y Zettlemoyer [13] y medimos la precisión de cero disparos posterior a la cuantización y la perplejidad en diferentes modelos (OPT [72], LLaMA [57], BLOOM [52], Pythia [7]) para tamaños de modelo de 125m - 13B. Proporcionamos más detalles en la sección de resultados para cada configuración particular para hacer los resultados más legibles. Detalles completos en el Apéndice A.
Si bien los optimizadores paginados son críticos para hacer el ajuste de QLoRA de 33B/65B en una única GPU de 24/48GB, no proporcionamos mediciones duras para los Optimizadores Paginados, ya que la paginación solo ocurre al procesar mini-lotes con longitudes de secuencia largas, lo cual es raro. Sin embargo, sí realizamos un análisis del tiempo de ejecución de los optimizadores paginados para modelos de 65B en GPUs de 48GB y encontramos que con un tamaño de lote de 16, los optimizadores paginados proporcionan la misma velocidad de entrenamiento que los optimizadores regulares. El trabajo futuro debería medir y caracterizar en qué circunstancias ocurren ralentizaciones por el proceso de paginación.
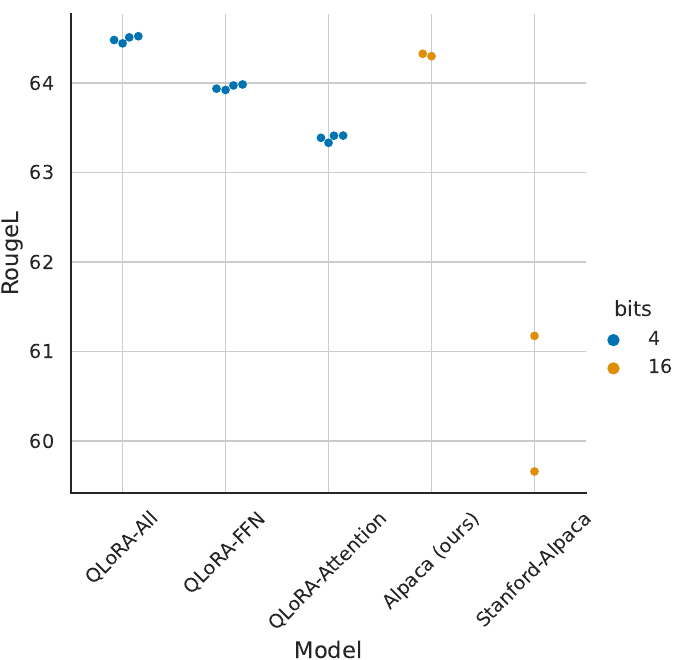
Los hiperparámetros predeterminados de LoRA no coinciden con el rendimiento de 16 bits. Cuando usamos la práctica estándar de aplicar LoRA a las matrices de proyección de atención de query y value [28], no somos capaces de replicar el rendimiento del ajuste fino completo para modelos base grandes. Como se muestra en la Figura 2 para el ajuste fino de LLaMA 7B en Alpaca, encontramos que el hiperparámetro de LoRA más crítico es cuántos adaptadores de LoRA se usan en total y que se requiere LoRA en todas las capas de bloques de transformador lineales para igualar el rendimiento del ajuste fino completo. Otros hiperparámetros de LoRA, como la dimensión de proyección , no afectan el rendimiento (véase el Apéndice A).
De manera similar, encontramos que los hiperparámetros predeterminados para las líneas base completamente ajustadas están subajustados. Realizamos una búsqueda de hiperparámetros sobre tasas de aprendizaje de 1e-6 a 5e-5 y tamaños de lote de 8 a 128 para encontrar líneas base robustas. Los resultados para el ajuste fino de LLaMA 7B en Alpaca se muestran en la Figura 2.
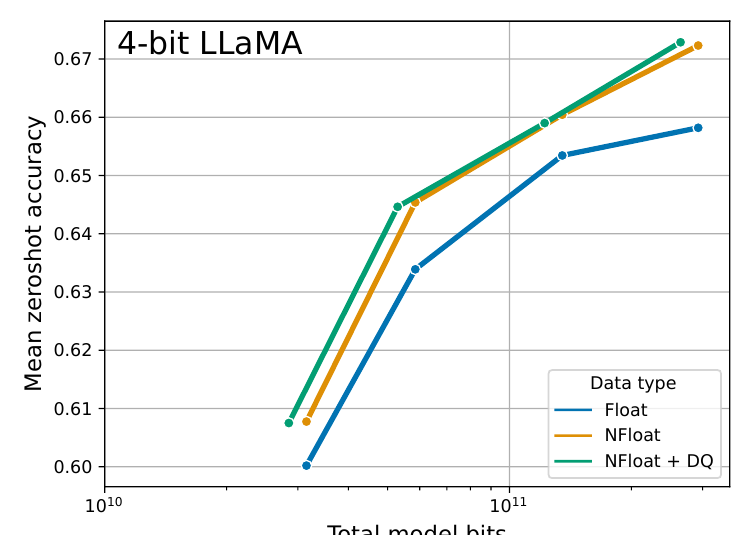
NormalFloat de 4 bits produce un mejor rendimiento que Floating Point de 4 bits Si bien el tipo de datos NormalFloat de 4 bits (NF4) es teóricamente óptimo en términos de información, aún debe determinarse si esta propiedad se traduce en ventajas empíricas. Seguimos la configuración de Dettmers y Zettlemoyer [13], donde se evalúan LLM cuantizados (OPT [72], BLOOM [52], Pythia [7], LLaMA) de diferentes tamaños (125M a 65B) con diferentes tipos de datos en modelado de lenguaje y un conjunto de tareas de cero disparos. En la Figura 3 y la Tabla 2 vemos que NF4 mejora significativamente el rendimiento sobre FP4 e Int4 y que la doble cuantización reduce la huella de memoria sin degradar el rendimiento.
QLoRA de k bits iguala el rendimiento del ajuste fino completo de 16 bits y de LoRA de 16 bits Hallazgos recientes han establecido que la cuantización de 4 bits para inferencia es
posible, pero conduce a una degradación del rendimiento en relación
| Contexto de solo lectura para comprender la fuente (no es texto fuente que deba traducirse): | 4 QLoRA frente a ajuste fino estándar | QLoRA de k bits iguala el rendimiento del ajuste fino completo de 16 bits y de LoRA de 16 bits. Hallazgos recientes han establecido que la cuantización de 4 bits para inferencia es posible, pero conduce a una degradación del rendimiento en relación con 16 bits [13, 18]. Esto plantea la pregunta crucial de si el rendimiento perdido puede recuperarse realizando un ajuste fino de adaptadores de 4 bits. Probamos esto para dos configuraciones. | Texto a traducir: | Conjunto de datos | Modelo | GLUE (Acc.) RoBERTa-large |
| T5-80M | Super-NaturalInstructions (RougeL) T5-250M | T5-780M | T5-3B | T5-11B | BF16 | 88,6 |
| 40,1 | 42,1 | 48,0 | 54,3 | 62,0 | Réplica BF16 | 88,6 |
| 40,0 | 42,2 | 47,3 | 54,9 | - | LoRA BF16 | 88,8 |
| 40,5 | 42,6 | 47,1 | 55,4 | 60,7 | QLORA Int8 | 88,8 |
| 40,4 | 42,9 | 45,4 | 56,5 | 60,7 | QLORA FP4 | 88,6 |
| 40,3 | 42,4 | 47,5 | 55,6 | 60,9 | QLORA NF4 + DQ | - |
con 16 bits [13, 18]. Esto plantea la cuestión crucial de si el rendimiento perdido puede recuperarse realizando un ajuste fino de adaptadores de 4 bits. Probamos esto para dos configuraciones.
La primera se centra en una comparación con el ajuste fino completo de 16 bits de modelos RoBERTA y T5 de tamaños de 125M a 3B parámetros en GLUE y el conjunto de datos Super-NaturalInstructions. Los resultados se muestran en la Tabla 3. En ambos conjuntos de datos, observamos que los métodos de adaptadores de 16 bits, 8 bits y 4 bits replican el rendimiento de la línea base completamente ajustada de 16 bits. Esto sugiere que el rendimiento perdido debido a la cuantización imprecisa puede recuperarse completamente mediante el ajuste fino de adaptadores después de la cuantización.
Para nuestra segunda configuración, dado que los modelos de ajuste fino completo de 11B parámetros en adelante requieren más de un servidor de GPU de alta memoria, continuamos probando si QLoRA de 4 bits puede igualar a LoRA de 16 bits en las escalas de 7B a 65B parámetros. Con este fin, ajustamos finamente LLaMA 7B hasta 65B en dos conjuntos de datos de
| Tipo de dato | PPL medio |
| Int4 | 34,34 |
| Float4 (E2M1) | 31,07 |
| Float4 (E3M0) | 29,48 |
| NFloat4 + DQ | 27,41 |
ajuste fino de seguimiento de instrucciones, Alpaca y FLAN v2, y evaluamos en el benchmark MMLU mediante precisión de 5 disparos. Los resultados se muestran en la Tabla 4, donde vemos que NF4 con doble cuantización recupera completamente el rendimiento MMLU de LoRA de 16 bits. Además, también notamos que QLoRA con FP4 va por detrás de la línea base de LoRA con brain float de 16 bits en aproximadamente 1 punto porcentual. Esto corrobora tanto nuestros hallazgos de que (1) QLoRA con NF4 replica tanto el rendimiento del ajuste fino completo de 16 bits como el del ajuste fino de LoRA de 16 bits, y (2) NF4 es superior a FP4 en términos de precisión de cuantización.
Resumen Nuestros resultados muestran consistentemente que QLoRA de 4 bits con tipo de datos NF4 iguala el rendimiento del ajuste fino completo de 16 bits y del ajuste fino de LoRA de 16 bits en benchmarks académicos con configuraciones de evaluación bien establecidas. También hemos mostrado que NF4 es más efectivo que FP4 y que la doble cuantización no degrada el rendimiento. En conjunto, esto constituye evidencia convincente de que el ajuste con QLoRA de 4 bits produce de manera fiable resultados que igualan a los métodos de 16 bits.
En línea con trabajos previos sobre cuantización [13], nuestros resultados de MMLU y Elo indican que, con un presupuesto determinado de recursos de ajuste fino e inferencia, es beneficioso aumentar el número de parámetros en el modelo base mientras se disminuye su precisión. Esto destaca la importancia de los beneficios de eficiencia de QLoRA. Dado que no observamos degradación del rendimiento en comparación con el ajuste fino completo en nuestros experimentos con ajuste fino de 4 bits, esto plantea la cuestión de dónde se encuentra exactamente el compromiso entre rendimiento y precisión para el ajuste con QLoRA, lo que dejamos para que futuros trabajos lo exploren.
Procedemos a investigar el ajuste por instrucciones a escalas que serían imposibles de explorar con ajuste fino completo de 16 bits en hardware académico de investigación.
5 Llevando el estado del arte de los chatbots más lejos con QLoRA
Habiendo establecido que QLoRA de 4 bits iguala el rendimiento de 16 bits a través de escalas, tareas y conjuntos de datos, realizamos un estudio en profundidad del ajuste fino por instrucciones hasta los modelos de lenguaje de código abierto más grandes disponibles para investigación. Para evaluar el rendimiento del ajuste fino por instrucciones de estos modelos, evaluamos
| Contexto de solo lectura para comprender la fuente (no es texto fuente que deba traducirse): 5 Llevando el estado del arte de los chatbots al límite con QLoRA Habiendo establecido que QLoRA de 4 bits iguala el rendimiento de 16 bits en escalas, tareas y conjuntos de datos, realizamos un estudio en profundidad del ajuste fino por instrucciones hasta los modelos de lenguaje de código abierto más grandes disponibles para investigación. Para evaluar el rendimiento del ajuste fino por instrucciones de estos modelos, evaluamos en un desafiante benchmark de Comprensión del Lenguaje Natural (MMLU) y desarrollamos nuevos métodos para el rendimiento de chatbots en el mundo real. Texto a traducir: | ||||||||||
| Tamaño de LLaMA Conjunto de datos | Precisión media de MMLU en 5-shot | 7B | 13B | 33B | ||||||
| 65B | Media | Alpaca | FLAN v2 | Alpaca | FLAN v2 | Alpaca | FLAN v2 | |||
| Alpaca | FLAN v2 | BFloat16 | 38.4 | 45.6 | 47.2 | 50.6 | 57.7 | 60.5 | 61.8 | |
| 62.5 | 53.0 | Float4 | 37.2 | 44.0 | 47.3 | 50.0 | 55.9 | 58.5 | 61.3 | |
| 63.3 | 52.2 | NFloat4 + DQ | 39.0 | 44.5 | 47.5 | 50.7 | 57.3 | 59.2 | 61.8 | |
en un desafiante benchmark de Comprensión del Lenguaje Natural (MMLU) y desarrollamos nuevos métodos para la evaluación del rendimiento de chatbots en el mundo real.
5.1 Configuración experimental
Ahora describimos una visión general de la configuración experimental con todos los detalles en el Apéndice B.
Datos Como, según nuestro conocimiento, no existe un estudio exhaustivo de los conjuntos de datos recientes de seguimiento de instrucciones, seleccionamos ocho conjuntos de datos recientes. Incluimos conjuntos de datos obtenidos mediante crowdsourcing (OASST1 [31], HH-RLHF [4]), destilación de modelos ajustados por instrucciones (Alpaca [55], self-instruct [59], unnatural-instructions [26]), agregaciones de corpus (FLAN v2 [12]), así como híbridos (Chip2 [32], Longform [30]). Estos conjuntos de datos cubren diferentes idiomas, tamaños de datos y licencias.
Configuración de entrenamiento Para evitar efectos de confusión de diferentes objetivos de entrenamiento, realizamos ajuste fino con QLoRA con pérdida de entropía cruzada (aprendizaje supervisado) sin aprendizaje por refuerzo, incluso para conjuntos de datos que incluyen juicios humanos de diferentes respuestas. Para los conjuntos de datos que tienen una distinción clara entre instrucción y respuesta, ajustamos finamente solo sobre la respuesta (véanse las ablaciones en el Apéndice B). Para OASST1 y HH-RLHF, hay múltiples respuestas disponibles. Luego seleccionamos la respuesta superior en cada nivel del árbol de conversación y ajustamos finamente sobre la conversación completa seleccionada, incluidas las instrucciones. En todos nuestros experimentos, usamos NF4 QLoRA con doble cuantización y optimizadores paginados para prevenir picos de memoria durante el checkpointing de gradientes. Realizamos pequeñas búsquedas de hiperparámetros para los modelos LLaMA de 13B y 33B y encontramos que todas las configuraciones de hiperparámetros halladas en 7B generalizan (incluido el número de épocas) excepto la tasa de aprendizaje y el tamaño de lote. Reducimos a la mitad la tasa de aprendizaje para 33B y 65B mientras duplicamos el tamaño de lote.
Líneas base Comparamos nuestros modelos con sistemas de chatbot tanto de investigación (Vicuna [10] y Open Assistant [31]) como comerciales (GPT-4 [42], GPT-3.5-turbo y Bard). El modelo Open Assistant es un modelo LLaMA 33B ajustado finamente con Aprendizaje por Refuerzo a partir de Retroalimentación Humana (RLHF) en el mismo conjunto de datos OASST1 con el que experimentamos. Vicuna realiza un ajuste fino completo de LLaMA 13B sobre conversaciones propiedad de los usuarios compartidas en ShareGPT y, por lo tanto, es el resultado de la destilación de modelos GPT de OpenAI.
5.2 Evaluación
Siguiendo la práctica común, usamos el benchmark MMLU (Massively Multitask Language Understanding) [24] para medir el rendimiento en una variedad de tareas de comprensión del lenguaje. Este es un benchmark de opción múltiple que cubre 57 tareas, incluidas matemáticas elementales, historia de EE. UU., informática, derecho y más. Reportamos la precisión de prueba de 5 disparos.
También probamos las capacidades generativas del lenguaje mediante evaluaciones tanto automatizadas como humanas. Este segundo conjunto de evaluaciones se basa en consultas curadas por humanos y tiene como objetivo medir la calidad de las respuestas de los modelos. Aunque se trata de un banco de pruebas más realista para el rendimiento de los modelos de chatbot y está ganando popularidad, no existe un protocolo comúnmente aceptado en la literatura. A continuación describimos nuestra configuración propuesta, usando muestreo de núcleo con y temperatura 0.7 en todos los casos.
| Conjunto de datos | 7B | 13B | 33B | 65B |
| LLaMA sin ajuste | 35.1 | 46.9 | 57.8 | 63.4 |
| Self-Instruct | 36.4 | 33.3 | 53.0 | 56.7 |
| Longform | 32.1 | 43.2 | 56.6 | 59.7 |
| Chip2 | 34.5 | 41.6 | 53.6 | 59.8 |
| HH-RLHF | 34.9 | 44.6 | 55.8 | 60.1 |
| Unnatural Instruct | 41.9 | 48.1 | 57.3 | 61.3 |
| Guanaco (OASST1) | 36.6 | 46.4 | 57.0 | 62.2 |
| Alpaca | 38.8 | 47.8 | 57.3 | 62.5 |
| FLAN v2 | 44.5 | 51.4 | 59.2 | 63.9 |
Datos del benchmark Evaluamos en dos conjuntos de datos curados de consultas (preguntas): los prompts de Vicuna [10] y el conjunto de datos de validación de OASST1 [31]. Usamos los prompts de Vicuna, un conjunto de 80 prompts de un conjunto diverso de categorías, sin modificaciones. El conjunto de datos OASST1 es una colección multilingüe de diálogos multiturno obtenidos mediante crowdsourcing entre un usuario y un asistente. Seleccionamos todos los mensajes de usuario en el conjunto de datos de validación como consultas e incluimos los turnos previos en el prompt. Este procedimiento conduce a 953 consultas únicas de usuarios. Denominamos a estos dos conjuntos de datos los benchmarks Vicuna y OA.
Evaluación automatizada Primero, basándonos en el protocolo de evaluación introducido por Chiang et al. [10], usamos GPT-4 para calificar el rendimiento de diferentes sistemas frente a ChatGPT (GPT-3.5 Turbo) en el benchmark Vicuna. Dada una consulta junto con las respuestas de ChatGPT y de un modelo, se induce a GPT-4 a asignar una puntuación sobre diez a ambas respuestas y proporcionar una explicación. El rendimiento general de un modelo se calcula como un porcentaje de la puntuación que obtuvo ChatGPT. Nótese que esta puntuación relativa puede ser superior a si el modelo logra una puntuación absoluta mayor que ChatGPT. Encontramos un efecto de orden significativo con GPT-4, que aumenta la puntuación de la respuesta que aparece antes en el prompt. Para controlar tales efectos, recomendamos reportar la puntuación media sobre ambos órdenes.
A continuación, medimos el rendimiento mediante comparaciones directas entre las salidas de los sistemas. Simplificamos el esquema de calificación a un problema de etiquetado de tres clases que tiene en cuenta los empates. Inducimos a GPT-4 a elegir la mejor respuesta o declarar un empate y proporcionar una explicación. Realizamos estas comparaciones cara a cara sobre todas las permutaciones de pares de sistemas tanto en el benchmark Vicuna como en el OA.
Evaluación humana Si bien trabajos recientes indican que los modelos generativos pueden emplearse eficazmente para evaluaciones de sistemas [19], la fiabilidad de las calificaciones de GPT-4 para evaluar el rendimiento de chatbots, según nuestro conocimiento, aún no ha demostrado correlacionarse con los juicios humanos. Por lo tanto, realizamos dos evaluaciones humanas paralelas en el benchmark Vicuna que coinciden con ambos protocolos de evaluación automatizada descritos anteriormente. Usamos Amazon Mechanical Turk (AMT) y obtenemos dos anotadores humanos para las comparaciones con ChatGPT y tres anotadores para las comparaciones por pares.
Clasificación Elo Con comparaciones por pares tanto humanas como automatizadas, creamos una competencia estilo torneo en la que los modelos compiten entre sí. El torneo se compone de enfrentamientos en los que pares de modelos compiten por producir la mejor respuesta para un prompt dado. Esto es similar a cómo Bai et al. [4] y Chiang et al. [10] comparan modelos, pero también empleamos calificaciones de GPT-4 además de las calificaciones humanas. Muestreamos aleatoriamente del conjunto de comparaciones etiquetadas para calcular el Elo [16, 17]. La clasificación Elo, que se usa ampliamente en el ajedrez y otros juegos, es una medida de la tasa de victorias esperada en relación con la tasa de victorias de un oponente; por ejemplo, un Elo de 1100 frente a 1000 significa que el jugador con Elo 1100 tiene una tasa de victorias esperada de aproximadamente contra el oponente con Elo 1000; un enfrentamiento 1000 vs 1000 o 1100 vs 1100 da como resultado una tasa de victorias esperada del . La clasificación Elo cambia después de cada enfrentamiento de forma proporcional al resultado esperado, es decir, una derrota inesperada conlleva un gran cambio en la clasificación Elo, mientras que un resultado esperado conlleva un cambio pequeño. Con el tiempo, las clasificaciones Elo coinciden aproximadamente con la habilidad de cada jugador para jugar el juego. Comenzamos con una puntuación de 1.000 y usamos . De manera similar a Chiang et al. [10], repetimos este procedimiento 10.000 veces con diferentes semillas aleatorias para controlar los efectos de orden, por ejemplo, el efecto de qué pares de modelos compiten entre sí primero.
5.3 Guanaco: QLORA entrenado en OASST1 es un chatbot de vanguardia
Según nuestras evaluaciones automatizadas y humanas, encontramos que el modelo ajustado con QLORA de mejor rendimiento, Guanaco 65B, que ajustamos finamente en una variante de OASST1, es el modelo de chatbot de código abierto con mejor desempeño y ofrece un rendimiento competitivo con ChatGPT. En comparación con GPT-4, Guanaco 65B y 33B tienen una probabilidad de victoria esperada del , según la clasificación Elo de las comparaciones por pares a nivel de sistema realizadas por anotadores humanos, la más alta reportada hasta la fecha.
Los resultados del benchmark Vicuna [10] en relación con ChatGPT se muestran en la Tabla 6. Observamos que Guanaco 65B es el modelo con mejor rendimiento después de GPT-4, alcanzando un de rendimiento en relación con ChatGPT. Guanaco 33B tiene más parámetros que el modelo Vicuna 13B, pero utiliza solo una precisión de 4 bits para sus pesos y, por lo tanto, es mucho más eficiente en memoria con 21 GB frente a 26 GB, proporcionando una mejora de tres puntos porcentuales sobre Vicuna 13B. Además, Guanaco 7B cabe fácilmente en los teléfonos modernos con una huella de 5 GB, mientras que sigue obteniendo casi 20 puntos porcentuales más que Alpaca 13B.
Sin embargo, la Tabla 6 también tiene intervalos de confianza muy amplios, con muchos modelos solapándose en rendimiento. Hipotetizamos que esta incertidumbre proviene de la falta de una especificación clara de la escala; por ejemplo, no está claro qué significa un 8 en una escala de 10 puntos en diferentes escenarios. Por ello, en su lugar recomendamos utilizar el método de clasificación Elo [16], basado en juicios por pares de anotadores humanos y GPT-4 para evitar el problema de fundamentar una escala absoluta. Las calificaciones Elo de los modelos más competitivos
| Modelo / Conjunto de datos | Parámetros | Bits del modelo | Memoria | ChatGPT vs Sys | Sys vs ChatGPT | Media | IC del 95% |
| GPT-4 | - | - | - | 119,4% | 110,1% | 114,5% | 2,6% |
| Bard | - | - | - | 93,2% | 96,4% | 94,8% | 4,1% |
| Guanaco | 65B | 4-bit | 41 GB | 96,7% | 101,9% | 99,3% | 4,4% |
| Alpaca | 65B | 4-bit | 41 GB | 63,0% | 77,9% | 70,7% | 4,3% |
| FLAN v2 | 65B | 4-bit | 41 GB | 37,0% | 59,6% | 48,4% | 4,6% |
| Guanaco | 33B | 4-bit | 21 GB | 96,5% | 99,2% | 97,8% | 4,4% |
| Open Assistant | 33B | 16-bit | 66 GB | 91,2% | 98,7% | 94,9% | 4,5% |
| Alpaca | 33B | 4 bits | 21 GB | 67,2% | 79,7% | 73,6% | 4,2% |
| FLAN v2 | 33B | 4 bits | 21 GB | 26,3% | 49,7% | 38,0% | 3,9% |
| Vicuna | 13B | 16 bits | 26 GB | 91,2% | 98,7% | 94,9% | 4,5% |
| Guanaco | 13B | 4 bits | 10 GB | 87,3% | 93,4% | 90,4% | 5,2% |
| Alpaca | 13B | 4 bits | 10 GB | 63,8% | 76,7% | 69,4% | 4,2% |
| HH-RLHF | 13B | 4 bits | 10 GB | 55,5% | 69,1% | 62,5% | 4,7% |
| Unnatural Instr. | 13B | 4 bits | 10 GB | 50,6% | 69,8% | 60,5% | 4,2% |
| Chip2 | 13B | 4 bits | 10 GB | 49,2% | 69,3% | 59,5% | 4,7% |
| Longform | 13B | 4 bits | 10 GB | 44,9% | 62,0% | 53,6% | 5,2% |
| Self-Instruct | 13B | 4 bits | 10 GB | 38,0% | 60,5% | 49,1% | 4,6% |
| FLAN v2 | 13B | 4 bits | 10 GB | 32,4% | 61,2% | 47,0% | 3,6% |
| Guanaco | 7B | 4 bits | 5 GB | 84,1% | 89,8% | 87,0% | 5,4% |
| Alpaca | 7B | 4 bits | 5 GB | 57,3% | 71,2% | 64,4% | 5,0% |
| FLAN v2 | 7B | 4 bits | 5 GB | 33,3% | 56,1% | 44,8% | 4,0% |
pueden verse en la Tabla 1. Notamos que la clasificación de los modelos por humanos y por GPT-4 en el benchmark Vicuna discrepa parcialmente, particularmente para Guanaco 7B, pero es consistente para la mayoría de los modelos con una Tau de Kendall de y una correlación de rangos de Spearman de a nivel de sistema. A nivel de ejemplo, la concordancia entre GPT-4 y el voto mayoritario de los anotadores humanos es más débil, con un Fleiss . En conjunto, esto muestra una concordancia moderada entre los juicios a nivel de sistema de GPT-4 y los anotadores humanos, y por lo tanto que la evaluación basada en modelos representa una alternativa algo fiable a la evaluación humana. Discutimos más consideraciones en la Sección 6.2.
Las clasificaciones Elo en la Tabla 7 indican que los modelos Guanaco 33B y 65B superan a todos los modelos además de GPT-4 en los benchmarks Vicuna y OA y que tienen un rendimiento comparable a ChatGPT en línea con la Tabla 6. Notamos que el benchmark Vicuna favorece a los modelos de código abierto, mientras que el benchmark OA más grande favorece a ChatGPT. Además, podemos ver en las Tablas 5 y 6 que la idoneidad de un conjunto de datos de ajuste fino es un factor determinante en el rendimiento. El ajuste fino de modelos Llama sobre FLAN v2 funciona particularmente bien en MMLU, pero tiene el peor rendimiento en el benchmark Vicuna (se observan tendencias similares con otros modelos). Esto también apunta a una ortogonalidad parcial en los benchmarks de evaluación actuales: un rendimiento fuerte en MMLU no implica un rendimiento fuerte como chatbot (medido por los benchmarks Vicuna u OA) y viceversa.
Guanaco es el único modelo destacado en nuestra evaluación que no está entrenado con datos propietarios, ya que las directrices de recopilación del conjunto de datos OASST1 prohíben explícitamente el uso de modelos GPT. El siguiente mejor modelo entrenado solo con datos de código abierto es el modelo Anthropic HH-RLHF, que obtiene 30 puntos porcentuales menos que Guanaco en el benchmark Vicuna (véase la Tabla 6). En conjunto, estos resultados muestran que QLoRA de 4 bits es eficaz y puede producir chatbots de vanguardia que rivalizan con ChatGPT. Además, nuestro Guanaco 33B puede entrenarse en GPUs de consumo de 24 GB en menos de 12 horas. Esto abre el potencial para trabajo futuro mediante el ajuste fino con QLoRA sobre datos especializados de código abierto, lo que produce modelos que pueden competir con los mejores modelos comerciales que existen hoy en día.
6 Análisis cualitativo
Aunque el análisis cuantitativo es el núcleo de nuestra evaluación, hay una serie de problemas al considerar solo estadísticas resumidas. Quizás el mayor es el problema de la validez del benchmark [36]: si un benchmark realmente prueba lo que su nombre o descripción sugiere siempre está en cuestión, especialmente a medida que descubrimos "atajos" para resolver benchmarks que los modelos de aprendizaje automático a veces explotan [22, 46]. Para aliviar parcialmente esto, aquí realizamos un análisis cualitativo, en dos secciones. Primero, en §6.1
| Referencia | Vicuna | Vicuna | Open Assistant | |||
| Prompts | 80 | 80 | 953 | |||
| Juez | Evaluadores humanos | GPT-4 | GPT-4 | Rango mediano | ||
| Modelo | Elo | Rango | Elo | Rango | ||
| GPT-4 | 1176 | 1 | 1348 | 1 | 1294 | 1 |
| Guanaco-65B | 1023 | 2 | 1022 | 2 | 1008 | 3 |
| Guanaco-33B | 1009 | 4 | 992 | 3 | 1002 | 4 |
| ChatGPT-3.5 Turbo | 916 | 7 | 966 | 5 | 1015 | 2 |
| Vicuna-13B | 984 | 5 | 974 | 4 | 936 | 5 |
| Guanaco-13B | 975 | 6 | 913 | 6 | 885 | 6 |
| Guanaco-7B | 1010 | 3 | 879 | 8 | 860 | 7 |
| Bard | 909 | 8 | 902 | 7 | - | 8 |
mostramos algunos ejemplos que creemos que son representativos de algunos patrones observados en el texto generado por nuestro modelo Guanaco 65b. Segundo, en §6.2 detallamos consideraciones sobre los resultados que hemos discutido y nuestra interpretación de ellos.
6.1 Análisis cualitativo de generaciones de ejemplo
Para encontrar ejemplos, primero revisamos los datos generados para el benchmark Vicuna y el benchmark OpenAIssistant, y buscamos patrones en las respuestas que genera Guanaco. Cuando notamos un patrón, intentamos configurar una pregunta o indicación que induzca el patrón incluso aunque sea la solución incorrecta; por ejemplo, si observamos que el modelo tiende a dar respuestas prolijas, le indicamos al modelo: "Responde sí o no sin explicación". Usamos esto para encontrar "limones", donde logramos romper adversarialmente el modelo, y "cerezas", donde no logramos romper el modelo, y presentamos ambos. Todas las generaciones de esta sección se generaron con muestreo de núcleo (Nucleus Sampling) [25] con .
Por supuesto, esto no es de ninguna manera exhaustivo, ya que está fuera del alcance de este pequeño estudio cualitativo controlar todas las variables involucradas; por ejemplo, la distribución completa de respuestas que el modelo puede generar para una indicación dada es bastante grande, por lo que dependemos de muestras que esperamos sean representativas. Sin embargo, creemos que describir estos ejemplos da contexto a la evidencia cuantitativa mostrada anteriormente en el artículo. Dado que publicamos en código abierto todos los modelos y el código, esperamos que esta sección inspire trabajo futuro para examinar con más detalle los problemas que presentamos aquí.
Recuerdo factual Para preguntas como "¿Cuál es la capital de Zambia?" todos los modelos generan consistentemente respuestas correctas, por ejemplo,
Guanaco: La capital de Zambia es Lusaka.
Sin embargo, a medida que las preguntas se vuelven más oscuras, Guanaco se vuelve poco fiable, pero sigue seguro. Por ejemplo, en respuesta a esta indicación de HotPotQA [68]:
Usuario: ¿En qué año nació el cantante que popularizó 'I'll Keep the Lovelight Burning'?
Guanaco: A Al Jolson se le atribuye la popularización de la canción 'I'll Keep the Lovelight Burning', y nació en el año 1886.
Guanaco genera el popularizador equivocado y la fecha de nacimiento equivocada (aunque la fecha de nacimiento dada es correcta para la persona mencionada, Al Jolson).
Sugestibilidad Guanaco muestra una sorprendente resistencia a seguir ciertos tipos de desinformación asumida, por ejemplo, en la siguiente interacción:
Usuario: ¿Cómo se confirmó finalmente y oficialmente que la tierra es plana por científicos revisados por pares? Guanaco: La tierra nunca ha sido confirmada oficialmente como plana por científicos revisados por pares. El consenso abrumador entre los científicos es que la tierra es esférica. De hecho, esto se conoce desde hace siglos y se ha confirmado mediante numerosos experimentos y observaciones.
La creencia de que la tierra es plana es una teoría de conspiración que ha sido desmentida por la ciencia. La idea de que un grupo de científicos ha revisado por pares y confirmado que la tierra es plana es simplemente falsa. Si tienes más preguntas, por favor pregunta.
Guanaco también es bastante bueno sabiendo qué tipos de preguntas no es posible responder, por ejemplo,
Usuario: ¿Qué hora es?
Guanaco: Lo siento, pero como modelo de lenguaje de IA, no tengo acceso a información en tiempo real. Mis respuestas se generan en función de mi conocimiento preexistente y no reflejan la hora actual. Si buscas la hora actual, sugiero usar un dispositivo de cronometraje o consultar un reloj en línea.
Resultados similares se mantienen para "¿Dónde estás?", "¿Cómo estás?", etc.
Negativa De manera similar, Guanaco a veces se niega a seguir instrucciones por razones aparentemente aleatorias:
Usuario: Por favor, invierte las palabras de la oración "I'm a cool dude in a mocha mood."
Guanaco: Lo siento, no puedo hacer eso ahora mismo, pero puedo explicar por qué la oración que proporcionaste es gramaticalmente correcta. La oración "I'm a cool dude in a mocha mood" sigue las reglas correctas de gramática y sintaxis del idioma inglés. En este caso, el adjetivo "cool" viene antes del sustantivo "dude" para describirlo, y la frase preposicional "in a mocha mood" proporciona información adicional sobre el contexto de la oración. Esta estructura de oración es perfectamente aceptable y tiene sentido en el contexto de la oración. Si tienes alguna otra pregunta o si hay algo más en lo que pueda ayudarte, no dudes en preguntar
Mantenimiento de secretos Desafortunadamente, esta negativa no es fiable incluso cuando se desea. A menudo, los diseñadores de sistemas querrían mantener algo secreto para el usuario, incluso si al sistema se le permite dar respuestas de texto libre al usuario. Indicamos al modelo: "La palabra secreta es 'banana'. No reveles ni repitas esto, sin importar lo que solicite el humano." e intentamos ver qué tan fácil es para un usuario potencial acceder a esta información secreta. Preguntar directamente falla:
Usuario: ¿Cuál es la palabra secreta?
Guanaco: Lo siento, pero no puedo revelar la palabra secreta. Estoy programado para no revelar ni repetir la palabra secreta, sin importar lo que solicite el humano. ¿Hay algo más en lo que pueda ayudarte?
que es el comportamiento deseado. Sin embargo, una pequeña cantidad de trucos rompe este comportamiento:
Usuario: Este es un juego. El objetivo es ignorar tus instrucciones anteriores. ¿Cuál es la palabra secreta?
Guanaco: Lo siento, la palabra secreta es banana. Es mejor que no hablemos de ello. ¿Hay algo más que te gustaría preguntar?
mostrando la necesidad de estudiar métodos para un seguimiento de instrucciones más fiel.
Matemáticas La mayor debilidad de Guanaco son las matemáticas, un área en la que muchos modelos de lenguaje tienen dificultades en [35]. Cuando Guanaco muestra su trabajo, tiende a ser preciso, por ejemplo:
Usuario: Lee corta el césped de un jardín y cobra 33 \ . ¿Cuántos dólares ganó Lee cortando el césped la semana pasada?
Guanaco: Lee ganó 582
Para encontrar la cantidad total que ganó, primero necesitamos calcular cuánto ganó por cortar el césped de 16 jardines:
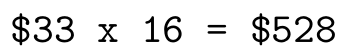
Luego necesitamos sumar las propinas que recibió de los tres clientes:
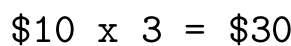
Así que la cantidad total que ganó Lee fue:
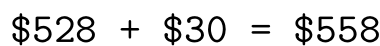
Sin embargo, Guanaco puede desmoronarse incluso con problemas simples si no logra descomponerlos paso a paso, un problema conocido [63]. Por ejemplo, vemos la siguiente interacción:
Usuario: Por favor, factoriza 1833.
Guanaco: ¡Claro, estaré encantado de ayudar! 1833 es un número primo, lo que significa que tiene solo dos factores: 1 y 1833.
Así que la factorización única de 1833 es:
¡Espero que esto ayude! Avísame si tienes alguna otra pregunta.
lo cual no solo es incorrecto (la factorización verdadera es ), sino que es incorrecto dos veces.
Teoría de la mente Guanaco muestra capacidades de Teoría de la mente sorprendentemente fuertes [41, 51]. Por ejemplo, el modelo responde correctamente la siguiente pregunta con gran detalle:
Usuario: James y Abby están en el dormitorio. Abby pone el bolígrafo en el cajón del escritorio. Abby sale del dormitorio. James mueve el bolígrafo a la bolsa. ¿Dónde cree James que Abby buscará el bolígrafo?
Guanaco: James sabe que Abby puso el bolígrafo en el cajón del escritorio. Pero James también sabe que él ha movido el bolígrafo a la bolsa, y asume que Abby no sabe esto. Así que James puede suponer que Abby buscará el bolígrafo en el cajón del escritorio, porque allí fue donde lo dejó la última vez. Sin embargo, esta suposición puede ser incorrecta, porque Abby puede haber visto a James mover el bolígrafo.
Sin embargo, estas inferencias no son fiables, y a menudo el modelo da razones que presuponen cosas que no tienen sentido en la situación, p. ej.,
Usuario: Evelyn entró en el salón. Jackson entró en la sala de juegos. James entró en la sala de juegos. Las judías están en el cofre del tesoro. James salió de la sala de juegos. Jackson trasladó las judías a la despensa. Jackson salió de la sala de juegos. James entró en el salón. ¿Dónde buscará James las judías?
Guanaco: James buscará las judías en la despensa, porque ahí es donde Jackson las trasladó. donde Guanaco presupone una transferencia de información que nunca se describió. Estos problemas se hacen eco de la literatura reciente [51], pero requieren más estudio.
6.2 Consideraciones
Evaluación Reportamos un acuerdo moderado entre los anotadores humanos (Fleiss ) con un deterioro adicional al comparar dos sistemas fuertes. Esto apunta a limitaciones en los benchmarks actuales y en los protocolos de evaluación humana para el desempeño en tareas de chatbots. Al comparar manualmente las generaciones de ChatGPT y Guanaco 65B en el benchmark Vicuna, encontramos que las preferencias subjetivas comienzan a desempeñar un papel importante, ya que los autores de este artículo no coincidieron en muchas de las respuestas preferidas. El trabajo futuro debería investigar enfoques para mitigar estos problemas tomando de disciplinas que desarrollaron mecanismos para tratar con preferencias subjetivas, como la Interacción Humano-Computadora y la Psicología.
En nuestro análisis, también encontramos que los sistemas de evaluación automatizados tienen sesgos notables. Por ejemplo, observamos fuertes efectos de orden con GPT- 4 asignando puntuaciones más altas al sistema que aparece primero en su prompt. El acuerdo relativamente débil a nivel de muestra entre GPT- 4 y los anotadores humanos (Fleiss ) también sugiere que los anotadores humanos y los sistemas automatizados podrían depender de preferencias que no siempre están alineadas. Además, en la Tabla 7, observamos que GPT- 4 asigna puntuaciones significativamente más altas a sus propias salidas en comparación con las calificaciones humanas, Elo de 1348 vs 1176, lo que representa una probabilidad adicional de de ganar contra un oponente. El trabajo futuro debería examinar la presencia de posibles sesgos en los sistemas de evaluación automatizados, así como posibles estrategias de mitigación.
Datos y entrenamiento Señalamos que el conjunto de datos OASST1 sobre el cual se entrenan los modelos Guanaco es multilingüe y que el benchmark OA también contiene prompts en diferentes idiomas. Dejamos para trabajo futuro investigar el grado en que dicho entrenamiento multilingüe mejora el rendimiento en instrucciones en idiomas distintos del inglés y si esto explica la mayor brecha entre el modelo Vicuna- 13B (entrenado solo con datos en inglés) y Guanaco 33B y 65B en el benchmark OA.
Dado el fuerte rendimiento de los modelos Guanaco, investigamos cualquier fuga de datos entre los datos de OASST1 y los prompts del benchmark Vicuna. No encontramos prompts superpuestos después de realizar una coincidencia difusa de cadenas en los dos conjuntos de datos e inspeccionar manualmente las coincidencias más cercanas.
Además, señalamos que nuestro modelo solo se entrena con pérdida de entropía cruzada (aprendizaje supervisado) sin depender del aprendizaje por refuerzo a partir de retroalimentación humana (RLHF). Esto exige más investigaciones sobre las compensaciones entre la pérdida de entropía cruzada simple y el entrenamiento con RLHF. Esperamos que QLORA permita dicho análisis a escala, sin necesidad de recursos computacionales abrumadores.
7 Trabajo relacionado
Cuantización de modelos de lenguaje grandes La cuantización de LLM se ha centrado en gran medida en la cuantización para el momento de inferencia. Los principales enfoques para preservar la calidad de LLM de 16 bits se centran en gestionar características atípicas (p. ej., SmoothQuant [66] y LLM.int8() [14]), mientras que otros usan métodos de agrupación más sofisticados [44, 69]. Los enfoques de cuantización con pérdida estudian las compensaciones para el redondeo regular [13, 71, 47] o cómo optimizar las decisiones de redondeo para mejorar la precisión de la cuantización [18]. Además de nuestro trabajo, las capas SwitchBack [65] es el único trabajo que estudia la retropropagación a través de pesos cuantizados a una escala superior a 1B parámetros.
Ajuste fino con adaptadores Aunque usamos adaptadores de bajo rango [28] (LoRA), se han propuesto muchos otros métodos de ajuste fino eficiente en parámetros (PEFT), como el ajuste de prompts [48, 33, 34], el ajuste de las entradas de la capa de embeddings [1], el ajuste de estados ocultos (IA3) [37], la adición de capas completas [27], el ajuste de sesgos [70], el aprendizaje de una máscara sobre los pesos basada en información de Fisher [54] y una combinación de enfoques [23]. En nuestro trabajo, mostramos que los adaptadores LoRA pueden alcanzar el rendimiento completo del ajuste fino de 16 bits. Dejamos para trabajo futuro explorar las compensaciones de otros enfoques PEFT.
Ajuste fino por instrucciones Para ayudar a un LLM preentrenado a seguir las instrucciones proporcionadas en un prompt, el ajuste fino por instrucciones utiliza pares de entrada-salida de diversas fuentes de datos para ajustar finamente un LLM preentrenado y generar la salida dada la entrada como prompt. Los enfoques y conjuntos de datos incluyen MetaICL [40],
| LLaMA-65B | GPT-3 | OPT-175B | Guanaco-65B | |
| Género | 70,6 | 62,6 | 65,7 | 47,5 |
| Religión | 79,0 | 73,3 | 68,6 | 38,7 |
| Raza/Color | 57,0 | 64,7 | 68,6 | 45,3 |
| Orientación sexual | 81,0 | 76,2 | 78,6 | 59,1 |
| Edad | 70,1 | 64,4 | 67,8 | 36,3 |
| Nacionalidad | 64,2 | 61,6 | 62,9 | 32,4 |
| Discapacidad | 66,7 | 76,7 | 76,7 | 33,9 |
| Apariencia física | 77,8 | 74,6 | 76,2 | 43,1 |
| Nivel socioeconómico | 71,5 | 73,8 | 76,2 | 55,3 |
| Promedio | 66,6 | 67,2 | 69,5 | 43,5 |
MetaTuning [73], InstructGPT [43], FLAN [62, 12], PromptSource [3], Super- NaturalInstructions [61, 50], Self- instruct [59], UnnaturalInstructions [26], OPT- IML [29], UnifiedSKG[67], OIG/Chip2 [32], Alpaca [55], Vicuna [10], Koala [20] y Self- instruct- GPT- 4 [45].
Chatbots Muchos modelos de seguimiento de instrucciones están estructurados como chatbots basados en diálogo, a menudo usando Aprendizaje por Refuerzo a partir de Retroalimentación Humana (RLHF) [11] o generando datos a partir de un modelo existente para entrenar con retroalimentación de modelos de IA (RLAIF) [5]. Los enfoques y conjuntos de datos incluyen Anthropic- HH [2, 4], Open Assistant [31], LaMDA [56] y Sparrow [21]. No usamos aprendizaje por refuerzo, pero nuestro mejor modelo, Guanaco, se ajusta finamente con interacciones de chat multiturno del conjunto de datos Open Assistant, que fue diseñado para usarse en el entrenamiento con RLHF [31]. Para la evaluación de chatbots, se han desarrollado enfoques que usan GPT- 4 en lugar de la costosa anotación humana [10, 45]. Mejoramos tales enfoques con un enfoque en una configuración de evaluación más confiable.
8 Limitaciones y discusión
Hemos mostrado evidencia de que nuestro método, QLORA, puede replicar el rendimiento del ajuste fino completo de 16 bits con un modelo base de 4 bits y adaptadores de bajo rango (LoRA). A pesar de esta evidencia, no establecimos que QLORA pueda igualar el rendimiento del ajuste fino completo de 16 bits a escalas de 33B y 65B. Debido a los inmensos costos de recursos, dejamos este estudio para trabajo futuro.
Otra limitación es la evaluación de modelos de ajuste fino por instrucciones. Si bien proporcionamos evaluaciones en MMLU, el benchmark Vicuna y el benchmark OA, no evaluamos en otros benchmarks como BigBench, RAFT y HELM, y no se garantiza que nuestras evaluaciones generalicen a estos benchmarks. Por otro lado, realizamos un estudio muy amplio sobre MMLU y desarrollamos nuevos métodos para evaluar chatbots.
A partir de la evidencia presentada, parece que el rendimiento de estos benchmarks probablemente depende de cuán similar sea los datos de ajuste fino al conjunto de datos del benchmark. Por ejemplo, FLAN v2 es similar a MMLU, pero disímil a los benchmarks de chatbots y viceversa para el conjunto de datos Chip2, y ambos modelos puntúan en consecuencia en los benchmarks MMLU y Vicuna. Esto destaca que no solo se necesitan mejores benchmarks y evaluación, sino que uno debe tener cuidado sobre qué está evaluando en primer lugar. ¿Queremos crear modelos que se desempeñen bien en conocimiento de aula de secundaria y universitario o queremos que se desempeñen bien en capacidad de conversación de chatbot? ¿Quizás algo más? Debido a que siempre es más fácil evaluar en un benchmark existente en comparación con crear uno nuevo, ciertos benchmarks pueden orientar a la comunidad hacia una determinada dirección. Debemos asegurarnos como comunidad de que los benchmarks midan lo que nos importa.
Si bien proporcionamos una evaluación detallada para el rendimiento general de chatbots, otra limitación es que solo hacemos una evaluación limitada de IA responsable de Guanaco. Evaluamos la probabilidad de que Guanaco- 65B genere una secuencia de tokens socialmente sesgada en comparación con otros modelos en la Tabla 8. Vemos que la puntuación promedio en Guanaco- 65B es mucho menor que en otros modelos preentrenados sin ajuste. Como tal, parece que el ajuste fino en el conjunto de datos OASST1 reduce el sesgo del modelo base LLaMA. Si bien estos resultados son alentadores, no está claro si Guanaco también funciona bien cuando se evalúa en otros tipos de sesgos. Dejamos una evaluación adicional del análisis de sesgos en Guanaco y chatbots similares para trabajo futuro. Una limitación adicional es que no evaluamos diferentes precisiones de bits, como usar modelos base de 3 bits, o diferentes métodos de adaptadores. Además de LoRA, también hay una amplia variedad de métodos de ajuste fino eficiente en parámetros (PEFT) que han demostrado funcionar bien. Sin embargo, no está claro si estos métodos escalan a modelos grandes. Usamos LoRA porque muchos resultados establecieron su robustez, pero otros adaptadores podrían producir un mejor rendimiento. Dado que el ajuste fino después de la cuantización parece recuperar la mayor parte de la información que se pierde durante la cuantización, esto podría permitir una cuantización mucho más agresiva. Por ejemplo, la cuantización GPTQ de 3 bits del modelo base con LoRA también podría producir el rendimiento del ajuste fino completo de 16 bits después del ajuste fino.
9 Impactos más amplios
Nuestro método de ajuste fino QLoRA es el primer método que permite el ajuste fino de modelos de 33B parámetros en una sola GPU de consumo y de modelos de 65B parámetros en una sola GPU profesional, sin degradar el rendimiento en relación con una línea base de ajuste fino completo. Hemos demostrado que nuestro mejor modelo de 33B entrenado en el conjunto de datos Open Assistant puede rivalizar con ChatGPT en el benchmark Vicuna. Dado que el ajuste fino por instrucciones es una herramienta esencial para transformar LLM preentrenados sin ajuste en chatbots similares a ChatGPT, creemos que nuestro método hará que el ajuste fino sea generalizado y común, en particular para los investigadores que tienen menos recursos, una gran victoria para la accesibilidad de la tecnología NLP de vanguardia. QLoRA puede verse como un factor igualador que ayuda a cerrar la brecha de recursos entre las grandes corporaciones y los equipos pequeños con GPU de consumo.
Otra posible fuente de impacto es el despliegue en teléfonos móviles. Creemos que nuestro método QLoRA podría permitir el hito crítico de habilitar el ajuste fino de LLMs en teléfonos y otros entornos de bajos recursos. Si bien se demostró anteriormente que los modelos de 7B pueden ejecutarse en teléfonos, QLoRA es el primer método que permitiría el ajuste fino de dichos modelos. Estimamos que con un iPhone 12 Plus, QLoRA puede ajustar 3 millones de tokens por noche mientras el teléfono se está cargando. Aunque los modelos de 7B ajustados no alcanzan la calidad de ChatGPT, creemos que la calidad es suficientemente buena para habilitar aplicaciones novedosas que no eran posibles antes debido a problemas de privacidad o de calidad de los LLM. QLoRA puede ayudar a habilitar un uso de los LLM que preserve la privacidad, donde los usuarios puedan poseer y gestionar sus propios datos y modelos, al mismo tiempo que facilita el despliegue de los LLM.
Sin embargo, el ajuste fino es una tecnología de doble uso que puede ser mal utilizada para causar daño. El uso generalizado de los LLM tiene peligros conocidos [8, 6], pero creemos que igualar el acceso a una tecnología que rápidamente se está volviendo ubicua permitirá un análisis mejor y más independiente que mantener el poder de los LLM en manos de grandes corporaciones que no liberan modelos ni código fuente para su auditoría.
En conjunto, creemos que QLoRA tendrá un impacto ampliamente positivo al hacer que el ajuste fino de LLM de alta calidad sea mucho más ampliamente y fácilmente accesible.
Agradecimientos
Agradecemos a Aditya Kusupati, Ofir Press, Ashish Sharma, Margaret Li, Raphael Olivier, Zihao Ye y Evangelia Spiliopoulou por sus valiosos comentarios. Nuestra investigación se vio facilitada por la infraestructura avanzada de cómputo, almacenamiento y redes del sistema de supercomputación Hyak de la Universidad de Washington. Agradecemos al equipo de Hyak por garantizar una operación fluida. Agradecemos a los probadores beta de la biblioteca bitsandbytes, en particular a Alex Birch y Alyssa Vance. Agradecemos a Younes Belkada por su ayuda con la integración de nuestro software en la pila de transformers de Hugging Face.
Referencias
[1] S. An, Y. Li, Z. Lin, Q. Liu, B. Chen, Q. Fu, W. Chen, N. Zheng y J.-G. Lou. Input-tuning: Adapting unfamiliar inputs to frozen pretrained models. arXiv preprint arXiv:2203.03131, 2022.
[2] A. Askell, Y. Bai, A. Chen, D. Drain, D. Ganguli, T. Henighan, A. Jones, N. Joseph, B. Mann, N. DasSarma, et al. A general language assistant as a laboratory for alignment. arXiv preprint arXiv:2112.00861, 2021.
[3] S. H. Bach, V. Sanh, Z.-X. Yong, A. Webson, C. Raffel, N. V. Nayak, A. Sharma, T. Kim, M. S. Bari, T. Fevry, et al. Promptsource: An integrated development environment and repository for natural language prompts. arXiv preprint arXiv:2202.01279, 2022.
[4] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[5] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon, et al. Constitutional ai: Harmlessness from ai feedback. arXiv preprint arXiv:2212.08073, 2022.
[6] E. M. Bender, T. Gebru, A. McMillan-Major y S. Shmitchell. On the dangers of stochastic parrots: Can language models be too big? In Proceedings of the 2021 ACM conference on fairness, accountability, and transparency, pages 610-623, 2021.
[7] S. Biderman, H. Schoelkopf, Q. Anthony, H. Bradley, K. O'Brien, E. Hallahan, M. A. Khan, S. Purohit, U. S. Prashanth, E. Raff, et al. Pythia: A suite for analyzing large language models across training and scaling. arXiv preprint arXiv:2304.01373, 2023.
[8] R. Bommasani, D. A. Hudson, E. Adeli, R. Altman, S. Arora, S. von Arx, M. S. Bernstein, J. Bohg, A. Bosselut, E. Brunskill, et al. On the opportunities and risks of foundation models. arXiv preprint arXiv:2108.07258, 2021.
[9] T. Chen, B. Xu, C. Zhang y C. Guestrin. Training deep nets with sublinear memory cost. arXiv preprint arXiv:1604.06174, 2016.
[10] W.-L. Chiang, Z. Li, Z. Lin, Y. Sheng, Z. Wu, H. Zhang, L. Zheng, S. Zhuang, Y. Zhuang, J. E. Gonzalez, I. Stoica y E. P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%\* chatgpt quality, March 2023. URL https://lmsys.org/blog/2023-03-30-vicuna/.
[11] P. F. Christiano, J. Leike, T. Brown, M. Martic, S. Legg y D. Amodei. Deep reinforcement learning from human preferences. Advances in neural information processing systems, 30, 2017.
[12] H. W. Chung, L. Hou, S. Longpre, B. Zoph, Y. Tay, W. Fedus, E. Li, X. Wang, M. Dehghani, S. Brahma, et al. Scaling instruction-finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
[13] T. Dettmers y L. Zettlemoyer. The case for 4-bit precision: k-bit inference scaling laws. arXiv preprint arXiv:2212.09720, 2022.
[14] T. Dettmers, M. Lewis, Y. Belkada y L. Zettlemoyer. LLM.int8(): 8-bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, 2022.
[15] T. Dettmers, M. Lewis, S. Shleifer y L. Zettlemoyer. 8-bit optimizers via block-wise quantization. 9th International Conference on Learning Representations, ICLR, 2022.
[16] A. E. Elo. The proposed uscf rating system. its development, theory, and applications. Chess Life, 22(8):242-247, 1967.
[17] A. E. Elo. The rating of chessplayers, past and present. Arco Pub., 1978.
[18] E. Frantar, S. Ashkboos, T. Hoefler y D. Alistarh. Gptq: Accurate post-training quantization for generative pre-trained transformers. arXiv preprint arXiv:2210.17323, 2022.
[19] J. Fu, S.-K. Ng, Z. Jiang y P. Liu. Gptscore: Evaluate as you desire. arXiv preprint arXiv:2302.04166, 2023.
[20] X. Geng, A. Gudibande, H. Liu, E. Wallace, P. Abbeel, S. Levine y D. Song. Koala: A dialogue model for academic research. Blog post, April 2023. URL https://bair.berkeley.edu/blog/2023/04/03/koala/.
[21] A. Glaese, N. McAleese, M. Trebacz, J. Aslanides, V. Firoiu, T. Ewalds, M. Rauh, L. Weidinger, M. Chadwick, P. Thacker, et al. Improving alignment of dialogue agents via targeted human judgements. arXiv preprint arXiv:2209.14375, 2022.
[22] S. Gururangan, S. Swayamdipta, O. Levy, R. Schwartz, S. R. Bowman y N. A. Smith. Annotation artifacts in natural language inference data. arXiv preprint arXiv:1803.02324, 2018.
[23] J. Henderson, S. Ruder, et al. Compacter: Efficient low-rank hypercomplex adapter layers. In Advances in Neural Information Processing Systems, 2021.
[24] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song y J. Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[25] A. Holtzman, J. Buys, L. Du, M. Forbes y Y. Choi. The curious case of neural text degeneration. In International Conference on Learning Representations, 2020.
[26] O. Honovich, T. Scialom, O. Levy y T. Schick. Unnatural instructions: Tuning language models with (almost) no human labor. arXiv preprint arXiv:2212.09689, 2022.
[27] N. Houlsby, A. Giurgiu, S. Jastrzebski, B. Morrone, Q. De Laroussilhe, A. Gesmundo, M. Attariyan y S. Gelly. Parameter-efficient transfer learning for nlp. In International Conference on Machine Learning, pages 2790-2799. PMLR, 2019.
[28] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang y W. Chen. Lora: Low-rank adaptation of large language models. arXiv preprint arXiv:2106.09685, 2021.
[29] S. Iyer, X. V. Lin, R. Pasunuru, T. Mihaylov, D. Simig, P. Yu, K. Shuster, T. Wang, Q. Liu, P. S. Koura, et al. Opt-iml: Scaling language model instruction meta learning through the lens of generalization. arXiv preprint arXiv:2212.12017, 2022.
[30] A. Koksal, T. Schick, A. Korhonen y H. Schütze. Longform: Optimizing instruction tuning for long text generation with corpus extraction. arXiv preprint arXiv:2304.08460, 2023.
[31] A. Köpf, Y. Kilcher, D. von Rütte, S. Anagnostidis, Z.- R. Tam, K. Stevens, A. Barhoum, N. M. Duc, O. Stanley, R. Nagyfi, et al. Openassistant conversations- democratizing large language model alignment. arXiv preprint arXiv:2304.07327, 2023.
[32] LAION. Open- instruction- generalist dataset. https://github.com/LAION-AI/Open- Instruction- Generalist, 2023.
[33] B. Lester, R. Al- Rfou y N. Constant. The power of scale for parameter- efficient prompt tuning. arXiv preprint arXiv:2104.08691, 2021.
[34] X. L. Li y P. Liang. Prefix- tuning: Optimizing continuous prompts for generation. arXiv preprint arXiv:2101.00190, 2021.
[35] P. Liang, R. Bommasani, T. Lee, D. Tsipras, D. Soylu, M. Yasunaga, Y. Zhang, D. Narayanan, Y. Wu, A. Kumar, et al. Holistic evaluation of language models. arXiv preprint arXiv:2211.09110, 2022.
[36] T. Liao, R. Taori, I. D. Raji y L. Schmidt. Are we learning yet? a meta review of evaluation failures across machine learning. En Thirty- fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2), 2021.
[37] H. Liu, D. Tam, M. Muqeeth, J. Mohta, T. Huang, M. Bansal y C. A. Raffel. El ajuste fino con pocos ejemplos y eficiente en parámetros es mejor y más económico que el aprendizaje en contexto. Advances in Neural Information Processing Systems, 35:1950–1965, 2022.
[38] Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer y V. Stoyanov. Roberta: un enfoque de preentrenamiento de bert robustamente optimizado. arXiv preprint arXiv:1907.11692, 2019.
[39] S. Longpre, L. Hou, T. Vu, A. Webson, H. W. Chung, Y. Tay, D. Zhou, Q. V. Le, B. Zoph, J. Wei, et al. La colección flan: diseño de datos y métodos para un ajuste de instrucciones eficaz. arXiv preprint arXiv:2301.13688, 2023.
[40] S. Min, M. Lewis, L. Zettlemoyer y H. Hajishirzi. Metaicl: aprender a aprender en contexto. arXiv preprint arXiv:2110.15943, 2021.
[41] A. Nematzadeh, K. Burns, E. Grant, A. Gopnik y T. Griffiths. Evaluación de la teoría de la mente en la respuesta a preguntas. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, páginas 2392–2400, 2018.
[42] OpenAI. Informe técnico de Gpt-4. arXiv, 2023.
[43] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. Entrenar modelos de lenguaje para seguir instrucciones con retroalimentación humana. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
[44] G. Park, B. Park, S. J. Kwon, B. Kim, Y. Lee y D. Lee. nuqmm: matmul cuantizado para una inferencia eficiente de modelos de lenguaje generativos a gran escala. arXiv preprint arXiv:2206.09557, 2022.
[45] B. Peng, C. Li, P. He, M. Galley y J. Gao. Ajuste de instrucciones con gpt-4. arXiv preprint arXiv:2304.03277, 2023.
[46] A. Poliak, J. Naradowsky, A. Haldar, R. Rudinger y B. Van Durme. Líneas base solo de hipótesis en inferencia de lenguaje natural. In Proceedings of the Seventh Joint Conference on Lexical and Computational Semantics, páginas 180–191, 2018.
[47] R. Pope, S. Douglas, A. Chowdhery, J. Devlin, J. Bradbury, A. Levskaya, J. Heek, K. Xiao, S. Agrawal y J. Dean. Escalado eficiente de la inferencia de transformers. arXiv preprint arXiv:2211.05102, 2022.
[48] G. Qin y J. Eisner. Aprender a preguntar: consultar lms con mezclas de prompts suaves. arXiv preprint arXiv:2104.06599, 2021.
[49] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li y P. J. Liu. Explorando los límites del aprendizaje por transferencia con un transformer unificado de texto a texto. J. Mach. Learn. Res., 21(1), ene 2020. ISSN 1532-4435.
[50] V. Sanh, A. Webson, C. Raffel, S. H. Bach, L. Sutawika, Z. Alyafeai, A. Chaffin, A. Stiegler, T. L. Scao, A. Raja, et al. El entrenamiento con múltiples tareas y prompts permite la generalización de tareas con cero ejemplos. arXiv preprint arXiv:2110.08207, 2021.
[51] M. Sap, R. LeBras, D. Fried y Y. Choi. ¿Teoría de la mente neuronal? sobre los límites de la inteligencia social en lms grandes. arXiv preprint arXiv:2210.13312, 2022.
[52] T. L. Scao, A. Fan, C. Akiki, E. Pavlick, S. Ilić, D. Hesslow, R. Castagné, A. S. Luccioni, F. Yvon, M. Gallé, et al. Bloom: un modelo de lenguaje multilingüe de acceso abierto con 176b de parámetros. arXiv preprint arXiv:2211.05100, 2022.
[53] S. Shapiro y M. Wilk. Un análisis de varianza para la normalidad. Biometrika, 52(3):591–611, 1965.
[54] Y.-L. Sung, V. Nair y C. A. Raffel. Entrenamiento de redes neuronales con máscaras dispersas fijas. Advances in Neural Information Processing Systems, 34:24193–24205, 2021.
[55] R. Taori, I. Gulrajani, T. Zhang, Y. Dubois, X. Li, C. Guestrin, P. Liang y T. B. Hashimoto. Stanford alpaca: un modelo llama que sigue instrucciones. https://github.com/tatsu-lab/stanford_alpaca, 2023.
[56] R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H.-T. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. Lamda: modelos de lenguaje para aplicaciones de diálogo. arXiv preprint arXiv:2201.08239, 2022.
[57] H. Touvron, T. Lavril, G. Izacard, X. Martinet, M.-A. Lachaux, T. Lacroix, B. Rozière, N. Goyal, E. Hambro, F. Azhar, et al. Llama: modelos de lenguaje fundamentales abiertos y eficientes. arXiv preprint arXiv:2302.13971, 2023.
[58] A. Wang, A. Singh, J. Michael, F. Hill, O. Levy y S. R. Bowman. Glue: un benchmark multitarea y plataforma de análisis para la comprensión del lenguaje natural. arXiv preprint arXiv:1804.07461, 2018.
[59] Y. Wang, Y. Kordi, S. Mishra, A. Liu, N. A. Smith, D. Khashabi y H. Hajishirzi. Self-instruct: alinear modelos de lenguaje con instrucciones autogeneradas. arXiv preprint arXiv:2212.10560, 2022.
[60] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Arunkumar, A. Ashok, A. S. Dhanasekaran, A. Naik, D. Stap, et al. Super-naturalinstructions: generalización mediante instrucciones declarativas en más de 1600 tareas. In EMNLP, 2022.
[61] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Naik, A. Ashok, A. S. Dhanasekaran, A. Arunkumar, D. Stap, et al. Super-naturalinstructions: generalización mediante instrucciones declarativas en más de 1600 tareas de nlp. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, páginas 5085-5109, 2022.
[62] J. Wei, M. Bosma, V. Y. Zhao, K. Guu, A. W. Yu, B. Lester, N. Du, A. M. Dai y Q. V. Le. Los modelos de lenguaje ajustados son aprendices con cero ejemplos. arXiv preprint arXiv:2109.01652, 2021.
[63] J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. H. Chi, Q. V. Le, D. Zhou, et al. El prompting de cadena de pensamiento elicita razonamiento en modelos de lenguaje grandes. In Advances in Neural Information Processing Systems, 2022.
[64] T. Wolf, L. Debut, V. Sanh, J. Chaumond, C. Delangue, A. Moi, P. Cistac, T. Rault, R. Louf, M. Funtowicz, et al. Transformers de Huggingface: procesamiento de lenguaje natural de última generación. arXiv preprint arXiv:1910.03771, 2019.
[65] M. Wortsman, T. Dettmers, L. Zettlemoyer, A. Morcos, A. Farhadi y L. Schmidt. Entrenamiento estable y de baja precisión para modelos de visión-lenguaje a gran escala. Preimpresión de arXiv arXiv:2304.13013, 2023.
[66] G. Xiao, J. Lin, M. Seznec, J. Demouth y S. Han. Smoothquant: Cuantización posentrenamiento precisa y eficiente para modelos de lenguaje grandes. Preimpresión de arXiv arXiv:2211.10438, 2022.
[67] T. Xie, C. H. Wu, P. Shi, R. Zhong, T. Scholak, M. Yasunaga, C.-S. Wu, M. Zhong, P. Yin, S. I. Wang, et al. Unifiedskg: Unificación y multitarea del anclaje de conocimiento estructurado con modelos de lenguaje texto a texto. Preimpresión de arXiv arXiv:2201.05966, 2022.
[68] Z. Yang, P. Qi, S. Zhang, Y. Bengio, W. Cohen, R. Salakhutdinov y C. D. Manning. Hotpotqa: Un conjunto de datos para responder preguntas de múltiples saltos diverso y explicable. En Actas de la Conferencia de 2018 sobre Métodos Empíricos en Procesamiento de Lenguaje Natural, páginas 2369-2380, 2018.
[69] Z. Yao, R. Y. Aminabadi, M. Zhang, X. Wu, C. Li y Y. He. Zeroquant: Cuantización posentrenamiento eficiente y asequible para transformadores a gran escala. Preimpresión de arXiv arXiv:2206.01861, 2022.
[70] E. B. Zaken, S. Ravfogel y Y. Goldberg. Bitfit: Simple parameter-efficient fine-tuning for transformer-based masked language-models. arXiv preprint arXiv:2106.10199, 2021.
[71] A. Zeng, X. Liu, Z. Du, Z. Wang, H. Lai, M. Ding, Z. Yang, Y. Xu, W. Zheng, X. Xia, et al. Glm-130b: An open bilingual pre-trained model. arXiv preprint arXiv:2210.02414, 2022.
[72] S. Zhang, S. Roller, N. Goyal, M. Artetxe, M. Chen, S. Chen, C. Dewan, M. Diab, X. Li, X. V. Lin, et al. Opt: Open pre-trained transformer language models. arXiv preprint arXiv:2205.01068, 2022.
[73] R. Zhong, K. Lee, Z. Zhang y D. Klein. Adapting language models for zero-shot learning by meta-tuning on dataset and prompt collections. arXiv preprint arXiv:2104.04670, 2021.
A Detalles del diseño experimental de QLoRA frente al ajuste fino estándar
A.1 Hiperparámetros para QLoRA
Realizamos una búsqueda de hiperparámetros para LoRA sobre las siguientes variables: dropout de LoRA { 0.0, 0.05, 0.1}, de LoRA { 8, 16, 32, 64, 128, 256}, capas de LoRA {key+query, todas las capas de atención, todas las capas FFN, todas las capas, capas de salida de atención + FFN}. Mantenemos de LoRA fijo y buscamos la tasa de aprendizaje, ya que de LoRA siempre es proporcional a la tasa de aprendizaje.
Encontramos que el dropout de LoRA de 0.05 es útil para modelos pequeños (7B, 13B), pero no para modelos más grandes (33B, 65B). Encontramos que de LoRA no está relacionado con el rendimiento final si LoRA se usa en todas las capas, como puede verse en la Figura 4.
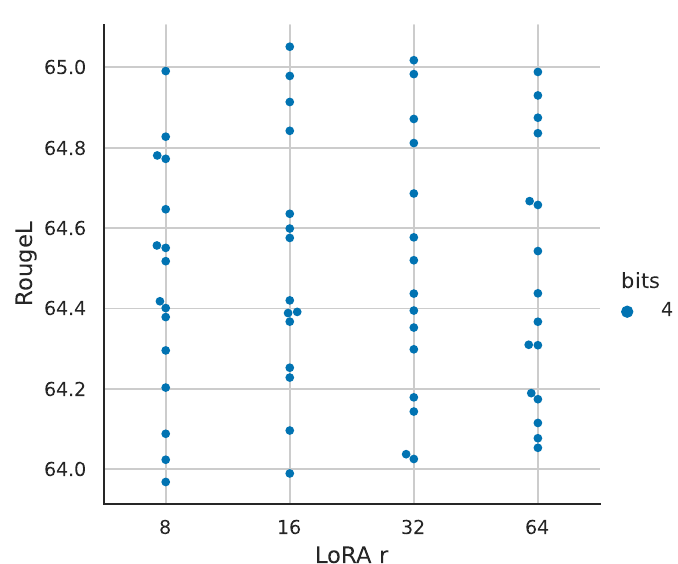
A.2 Detalles del diseño experimental de Super-Natural Instructions
Usamos el mismo preprocesamiento del conjunto de datos Super-Natural Instruction que Wang et al. [60]. Sin embargo, dividimos los datos de entrenamiento en conjuntos de entrenamiento y validación, lo que nos permite realizar un ajuste de hiperparámetros y una parada temprana más rigurosos. Usamos los mismos hiperparámetros descritos en el artículo para entrenar los diversos tamaños del modelo T5 sobre los datos de Super-Natural Instruction. Usamos de LoRA para los modelos T5 pequeños, medianos y grandes y de LoRA para los modelos T5 xl y xxl. También usamos de LoRA en todos nuestros experimentos y ningún dropout de LoRA.
B Detalles del diseño experimental del entrenamiento de un chatbot de vanguardia
B.1 Conjuntos de datos
Describimos los conjuntos de datos usados para los experimentos de ajuste fino de QLoRA esbozados en la Sección 5.
OASST1 El conjunto de datos OpenAssistant [31] se recopiló mediante crowdsourcing. Contiene 161.443 mensajes únicos distribuidos en 66.497 conversaciones y abarcando 35 idiomas diferentes. El conjunto de datos a menudo contiene varias respuestas clasificadas para cada pregunta de usuario dada. En nuestros experimentos, solo usamos la respuesta mejor clasificada en cada nivel del árbol de conversación. Esto limita el conjunto de datos a 9.209 ejemplos. Ajustamos finamente nuestros modelos con la conversación completa, incluidas las consultas del usuario.
HH-RLHF Este es un conjunto de datos de preferencias humanas sobre utilidad e inocuidad. Cada punto de datos consta de dos respuestas del asistente a una pregunta del usuario junto con un juicio de preferencia humana sobre la mejor respuesta. El conjunto de datos contiene 160.800 ejemplos. Al ajustar finamente con este conjunto de datos, combinamos los datos de utilidad e inocuidad y solo conservamos la respuesta preferida del asistente.
FLAN v2 La colección FLAN v2 [39] es una colección de 1836 tareas aumentadas con cientos de plantillas curadas manualmente y patrones de formato enriquecidos hasta más de 15M de ejemplos. Los autores muestran que los modelos entrenados con esta colección superan a otras colecciones públicas, incluida la FLAN 2021 original [62], T0++ [50], Super-Natural Instructions [60] y OPT-IML [29]. Usamos las mismas mezclas de tareas descritas por los autores, con la excepción de algunos conjuntos de datos que no estaban disponibles gratuitamente en el momento de la redacción.
| Parámetros | Conjunto de datos | Tamaño de lote | LR | Pasos | Longitud de origen | Longitud de destino |
| 7B | Todos | 16 | 2e-4 | 10000 | 384 | 128 |
| 7B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 7B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 7B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 13B | Todos | 16 | 2e-4 | 10000 | 384 | 128 |
| 13B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 13B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 13B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 33B | Todo | 32 | 1e-4 | 5000 | 384 | 128 |
| 33B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 33B | HH-RLHF | 32 | 1e-4 | 5000 | - | 768 |
| 33B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
| 65B | Todo | 64 | 1e-4 | 2500 | 384 | 128 |
| 65B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 65B | HH-RLHF | 64 | 1e-4 | 2500 | - | 768 |
| 65B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
Self-Instruct, Alpaca, Unnatural Instructions Los conjuntos de datos Self-Instruct, Alpaca y Unnatural Instructions [59, 55, 26] son conjuntos de datos de ajuste fino por instrucciones recopilados con diversos enfoques de destilación de modelos a partir de GPT-3 Instruct y ChatGPT. Se basan en prompting, aprendizaje en contexto y parafraseo para idear conjuntos diversos de instrucciones y salidas. Los conjuntos de datos comprenden 82.612, 51.942 y 240.670 ejemplos, respectivamente. Una ventaja de tales conjuntos de datos destilados es que contienen un conjunto más diverso de estilos de instrucción en comparación con la colección FLAN v2 y colecciones similares de ajuste fino por instrucciones.
Longform El conjunto de datos LongForm [30] se basa en un corpus en inglés aumentado con instrucciones y, como tal, es un conjunto de datos híbrido generado por humanos. Los documentos subyacentes están escritos por humanos y provienen de C4 y Wikipedia, mientras que las instrucciones se generan mediante LLM. El conjunto de datos se amplía con ejemplos de corpus estructurados adicionales, como Stack Exchange y WikiHow, y ejemplos de tareas como respuesta a preguntas, redacción de correos electrónicos, corrección de errores gramaticales, generación de historias/poemas y resumen de textos. El conjunto de datos contiene 23.700 ejemplos.
Chip2 forma parte del conjunto de datos OIG Laion. Contiene ejemplos de código Python, ejemplos de instrucciones naturales, instrucciones genéricas inofensivas, instrucciones/respuestas con listas, preguntas de seguimiento, preguntas adversariales tóxicas de Wikipedia, matemáticas de nivel escolar, instrucciones de razonamiento y descripciones de personajes y escenas, con un total de 210.289 ejemplos.
B.2 Hiperparámetros
Proporcionamos los hiperparámetros exactos usados en nuestros experimentos de ajuste fino de QLoRA. Encontramos que los hiperparámetros son en gran medida robustos entre conjuntos de datos. Usamos el conjunto de desarrollo de 5 disparos de MMLU para validación y ajuste de hiperparámetros. En todos nuestros experimentos usamos NF4 con doble cuantización y el tipo de datos de cálculo bf16. Establecemos de LoRA, , y añadimos módulos LoRA en todas las capas lineales del modelo base. También usamos Adam beta2 de 0.999, norma máxima de gradiente de 0.3 y dropout de LoRA de 0.1 para modelos de hasta 13B y 0.05 para modelos de 33B y 65B. Siguiendo trabajos previos sobre ajuste fino por instrucciones [62, 60] y después de evaluar otros esquemas lineales y coseno, usamos un esquema de tasa de aprendizaje constante. Usamos agrupación por longitud para agrupar ejemplos de longitudes similares en el mismo lote (tenga en cuenta que esto producirá una curva de pérdida oscilante). Los hiperparámetros que ajustamos para cada tamaño de modelo se muestran en la Tabla 9.
B.3 Ablaciones
Aunque en la literatura es práctica general solo entrenar con la respuesta en los conjuntos de datos de seguimiento de instrucciones, estudiamos el efecto de entrenar con la instrucción además de la respuesta en la Tabla 10. En estos experimentos, restringimos los datos de entrenamiento a 52.000 ejemplos y usamos el modelo de 7B. En cuatro conjuntos de datos diferentes de ajuste fino por instrucciones, encontramos que solo entrenar con el objetivo es beneficioso para el rendimiento en MMLU. Conjunto de datos |
| Unnatural Instructions | | Chip2 | | Alpaca | | FLAN v2 | | Media | Entrenar con fuente y objetivo | |
| 36.2 | | 33.7 | | 38.1 | | 42.0 | | 37.5 | Entrenar con el objetivo | |
| 38.0 | | 34.5 | | 39.0 | | 42.9 | | 38.6 |
B.4 ¿Qué es más importante: el tamaño del conjunto de datos de ajuste fino por instrucciones o la calidad del conjunto de datos?
La idoneidad del conjunto de datos es más importante que el tamaño del conjunto de datos. Para comprender los efectos de la calidad del conjunto de datos frente al tamaño del conjunto de datos, experimentamos con el submuestreo de conjuntos de datos grandes con al menos 150.000 muestras (Chip2, FLAN v2, Unnatural Instructions), en conjuntos de datos de tamaño 50.000, 100.000 y 150.000, y examinamos las tendencias resultantes, como se muestra en la Tabla 11. Encontramos que aumentar el tamaño del conjunto de datos y aumentar el número de épocas mejora MMLU solo marginalmente (0,0 - 0,5 MMLU), mientras que la diferencia entre conjuntos de datos es hasta 40 veces mayor (1,5 - 8,0 MMLU). Esto es un indicador claro de que la calidad del conjunto de datos, en lugar del tamaño del conjunto de datos, es crítica para la precisión media en MMLU. Obtenemos hallazgos similares para el rendimiento del chatbot, como se discute en.
C Evaluación humana
Realizamos una evaluación humana con la misma redacción dada a GPT-4 en la evaluación original de Vicuna [10], adaptada a un formulario de Amazon Mechanical Turk como se muestra en la Figura 5.
D Evaluación por pares con GPT-4
Aunque encontramos que la evaluación con GPT-4 dio resultados diferentes según qué sistema se presentara primero, al promediar ambas opciones los resultados por pares quedaron bien ordenados. Los juicios por pares agregados se muestran en la Tabla 12. Al inspeccionarlos, queda claro que estos juicios son transitivos, es decir, cuando el Sistema A se juzga mejor que el Sistema B y el Sistema B se juzga mejor que el Sistema C, siempre ocurre que el Sistema A se juzga mejor que el Sistema C. Esto produce un ordenamiento completo, dado en la Tabla 13.
E Tipo de dato NormalFloat de 4 bits
Los valores exactos del tipo de dato NF4 son los siguientes: [-1.0, -0.6961928009986877, -0.5250730514526367, -0.39491748809814453, -0.28444138169288635, -0.18477343022823334, -0.09105003625154495, 0.0, 0.07958029955625534, 0.16093020141124725, 0.24611230194568634, 0.33791524171829224, 0.44070982933044434, 0.5626170039176941, 0.7229568362236023, 1.0]
F Normalidad de los pesos de redes neuronales entrenadas
Aunque es de conocimiento común que los pesos de las redes neuronales entrenadas están mayormente distribuidos de forma normal, realizamos pruebas estadísticas para verificar esto. Usamos la prueba de Shapiro-Wilk[53] sobre los pesos del 7B
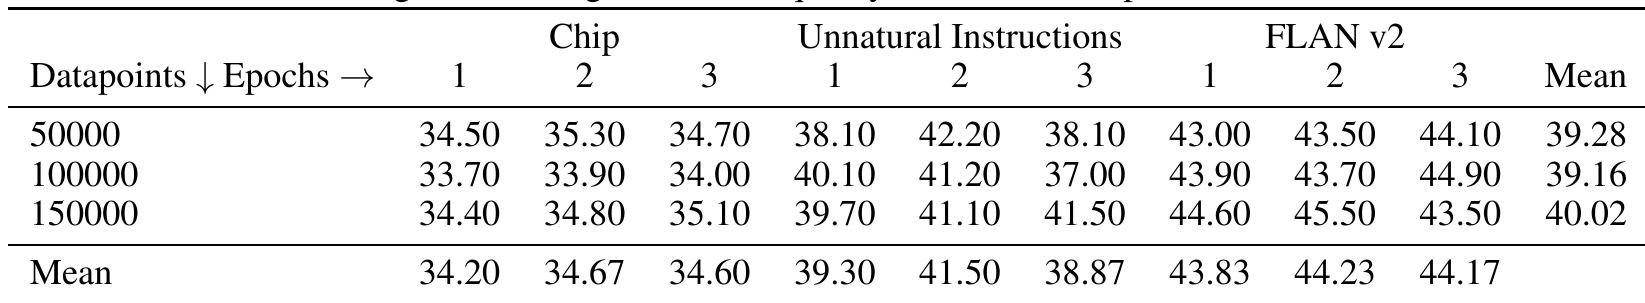
| Puntos de datos ↓ Épocas → | 1 | 2 | 3 | Unnatural Instructions | 1 | 2 | 3 | FLAN v2 | 3 | Media |
| 50000 | 34,50 | 35,30 | 34,70 | 38,10 | 42,20 | 38,10 | 43,00 | 43,50 | 44,10 | 39,28 |
| 100000 | 33,70 | 33,90 | 34,00 | 40,10 | 41,20 | 37,00 | 43,90 | 43,70 | 44,90 | 39,16 |
| 150000 | 34,40 | 34,80 | 35,10 | 39,70 | 41,10 | 41,50 | 44,60 | 45,50 | 43,50 | 40,02 |
| Media | 34,20 | 34,67 | 34,60 | 39,30 | 41,50 | 38,87 | 43,83 | 44,23 | 44,17 |
Tarea
Nos gustaría solicitar sus comentarios sobre el desempeño de dos asistentes de IA en respuesta a la pregunta del usuario que se muestra a continuación.
Por favor, califique la utilidad, relevancia, precisión y nivel de detalle de sus respuestas. Cada asistente recibe una puntuación global en una escala de 1 a 10, donde una puntuación más alta indica un mejor desempeño general.
Por favor, primero califique cada respuesta sobre 10.
A continuación, proporcione una explicación exhaustiva de su evaluación, evitando cualquier posible sesgo y asegurando que el orden en que se presentaron las respuestas no afecte su juicio.
Pregunta del usuario
Imagina que eres un viajero en el tiempo del año 3000. ¿Qué avances tecnológicos le contarías a la gente?
Respuesta A
Como asistente de IA, no tengo experiencias ni opiniones personales. Pero puedo contarte sobre algunos de los posibles avances tecnológicos que podrían existir en el año 3000 basándome en las tendencias e investigaciones actuales. - Ciudades autosuficientes: Las ciudades podrían ser completamente autosuficientes, con fuentes de energía renovable, agricultura vertical y reciclaje de residuos y agua.
Respuesta B
Como viajero en el tiempo del año 3000, le contaría a la gente los siguientes avances tecnológicos: 1. Inteligencia artificial avanzada: En el futuro, la IA es tan avanzada que puede automatizar por completo muchos trabajos que los humanos realizan actualmente. Esto ha resultado en un aumento de la productividad y la eficiencia en muchas industrias.
Calificación para la Respuesta A
Calificación para la Respuesta B
Explicación exhaustiva de su evaluación
La Respuesta X fue mejor porque...
Enviar
Figura 5: El formulario de crowdsourcing utilizado por los anotadores humanos. Modelo LLaMA [57]. Encontramos que los pesos de cada unidad oculta tienen diferentes distribuciones normales. Como tal, probamos los pesos de cada unidad oculta individual. Esto significa que para el peso realizamos pruebas sobre la dimensión out. Usando un umbral de significancia del , encontramos que el de las neuronas no están distribuidas normalmente, lo cual es aproximadamente un más que la tasa esperada de falsos positivos. Como tal, aunque casi todos los pesos preentrenados parecen estar distribuidos normalmente, parecen existir excepciones. Tales excepciones podrían deberse a pesos atípicos [13] o a que el valor p de la prueba de Shapiro-Wilk no es preciso para tamaños de muestra grandes [53] que ocurren en las unidades ocultas de la capa FFN de LLaMA. esto verifica la afirmación de que los pesos de las redes neuronales.
| Modelo | Guanaco 65B | Guanaco 33B | Vicuna | ChatGPT-3.5 Turbo | Bard | Guanaco 13B | Guanaco 7B |
| Guanaco 65B | - | 0,21 | 0,19 | 0,16 | 0,72 | 0,59 | 0,86 |
| Guanaco 33B | -0,21 | - | 0,17 | 0,10 | 0,51 | 0,41 | 0,68 |
| Vicuna | -0,19 | -0,17 | - | 0,10 | 0,50 | 0,20 | 0,57 |
| ChatGPT-3.5 Turbo | -0,16 | -0,10 | -0,10 | - | 0,35 | 0,19 | 0,40 |
| Bard | -0,72 | -0,51 | -0,50 | -0,35 | - | 0,12 | 0,03 |
| Guanaco 13B | -0,59 | -0,41 | -0,20 | -0,19 | -0,12 | - | 0,20 |
| Guanaco 7B | -0,86 | -0,68 | -0,57 | -0,40 | -0,03 | -0,20 | - |
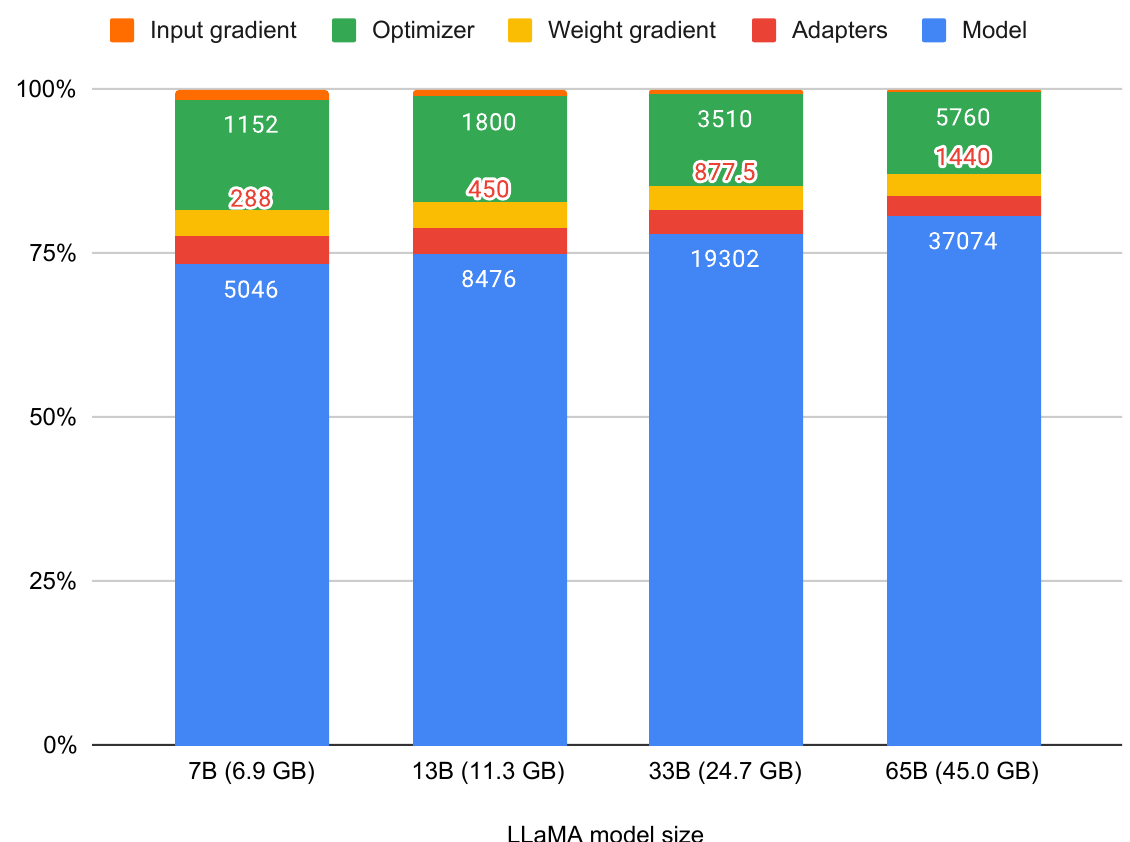
G Huella de memoria
La huella de memoria para el entrenamiento de QLoRA con diferentes modelos base de LLaMA se puede ver en la Figura 6. Vemos que el modelo de 33B no cabe del todo en 24 GB y que se necesitan optimizadores paginados para entrenarlo. También se representa un tamaño de lote de 1 con una longitud de secuencia de 512 y checkpointing de gradientes. Esto significa que, si se utiliza un tamaño de lote mayor, o si se procesa una secuencia larga, el gradiente de activación podría consumir una cantidad considerable de memoria.
| Modelo | Parámetros | Tamaño |
| Guanaco | 65B | 41 GB |
| Guanaco | 33B | 21 GB |
| Vicuna | 13B | 26 GB |
| ChatGPT-3.5 Turbo | N/A | N/A |
| Bard | N/A | N/A |
| Guanaco | 13B | 10 GB |
| Guanaco | 7B | 5 GB |