
Un modelo pequeño propone varios tokens, el grande los verifica en una pasada: la salida no cambia y la inferencia se acelera. ICML 2023, gratis online.
Fast Inference from Transformers via Speculative Decoding
Inferencia rápida a partir de Transformers mediante decodificación especulativa
Yaniv Leviathan \* 1 Matan Kalman \* 1 Yossi Matias 1
Resumen
La inferencia a partir de modelos autorregresivos grandes como los Transformers es lenta: decodificar tokens requiere ejecuciones en serie del modelo. En este trabajo presentamos la decodificación especulativa, un algoritmo para muestrear de modelos autorregresivos más rápido sin ningún cambio en las salidas, mediante el cómputo de varios tokens en paralelo. En el corazón de nuestro enfoque se encuentran las observaciones de que (1) las tareas difíciles de modelado del lenguaje a menudo incluyen subtareas más fáciles que pueden aproximarse bien mediante modelos más eficientes, y (2) usando ejecución especulativa y un novedoso método de muestreo, podemos hacer más rápida la decodificación exacta a partir de los modelos grandes, ejecutándolos en paralelo sobre las salidas de los modelos de aproximación, generando potencialmente varios tokens de forma concurrente, y sin cambiar la distribución. Nuestro método puede acelerar modelos existentes listos para usar sin reentrenamiento ni cambios de arquitectura. Lo demostramos en T5-XXL y mostramos una aceleración de 2X-3X en comparación con la implementación estándar de T5X, con salidas idénticas.
1. Introducción
Los modelos autorregresivos grandes, en particular los Transformers grandes (Vaswani et al., [2017]), son mucho más capaces que los modelos más pequeños, como se ha evidenciado innumerables veces en los últimos años, por ejemplo, en los dominios de texto o imágenes, como GPT-3 (Brown et al., [2020]), LaMDA (Thoppilan et al., [2022]), Parti (Yu et al., [2022]) y PaLM (Chowdhery et al., [2022]). Desafortunadamente, un único paso de decodificación de estos modelos más grandes es significativamente más lento que un paso de sus contrapartes más pequeñas y, para empeorar las cosas, estos pasos se realizan en serie: decodificar tokens requiere ejecuciones en serie del modelo.
Dada la importancia de los modelos autorregresivos grandes y específicamente de los Transformers grandes, se desarrollaron varios enfoques para hacer más rápida la inferencia a partir de ellos. Algunos enfoques buscan reducir el costo de inferencia para todas las entradas por igual (p. ej., Hinton et al., [2015], Jaszczur et al., [2021], Hubara et al., [2016], So et al., [2021], Shazeer [2019]). Otros enfoques parten de la observación de que no todos los pasos de inferencia son iguales: algunos requieren un modelo muy grande, mientras que otros pueden aproximarse bien mediante modelos más eficientes. Estos métodos de cómputo adaptativo (p. ej., Han et al., [2021], Sukhbaatar et al., [2019], Schuster et al., [2021], Scardapane et al., [2020], Bapna et al., [2020], Elbayad et al., [2019], Schwartz et al., [2020]) buscan usar menos recursos de cómputo para los pasos de inferencia más fáciles. Si bien muchas de estas soluciones han demostrado ser extremadamente efectivas en la práctica, por lo general requieren cambiar la arquitectura del modelo, cambiar el procedimiento de entrenamiento y reentrenar los modelos, y no mantienen salidas idénticas.
Contribución equitativa 1Google Research, Mountain View, CA, USA. Correspondencia a: Yaniv Leviathan leviathan@google.com.
La observación clave anterior, de que algunos pasos de inferencia son "más difíciles" y otros son "más fáciles", también es un motivador clave de nuestro trabajo. Además, observamos que la inferencia a partir de modelos grandes a menudo no tiene su cuello de botella en las operaciones aritméticas, sino en el ancho de banda de memoria y la comunicación, por lo que podrían estar disponibles recursos de cómputo adicionales. Por lo tanto, sugerimos aumentar la concurrencia como un enfoque complementario al uso de una cantidad adaptativa de cómputo. Específicamente, podemos acelerar la inferencia sin cambiar las arquitecturas de los modelos, sin cambiar los procedimientos de entrenamiento ni necesitar reentrenar los modelos, y sin cambiar la distribución de salida del modelo. Esto se logra mediante ejecución especulativa.
La ejecución especulativa (Burton, [1985], Hennessy & Patterson, [2012]) es una técnica de optimización, común en los procesadores, en la que una tarea se realiza en paralelo a la verificación de si realmente se necesita; el beneficio es una mayor concurrencia. Un ejemplo bien conocido de ejecución especulativa es la predicción de ramas. Para que la ejecución especulativa sea efectiva, necesitamos un mecanismo eficiente para sugerir tareas a ejecutar que probablemente se necesiten. En este trabajo, generalizamos la ejecución especulativa al entorno estocástico, donde una tarea podría necesitarse con cierta probabilidad. Aplicando esto a la decodificación a partir de modelos autorregresivos como los Transformers, muestreamos generaciones de modelos de aproximación más eficientes como prefijos especulativos para los modelos objetivo más lentos. Con un novedoso método de muestreo, el muestreo especulativo, maximizamos la probabilidad de que estas tareas especulativas
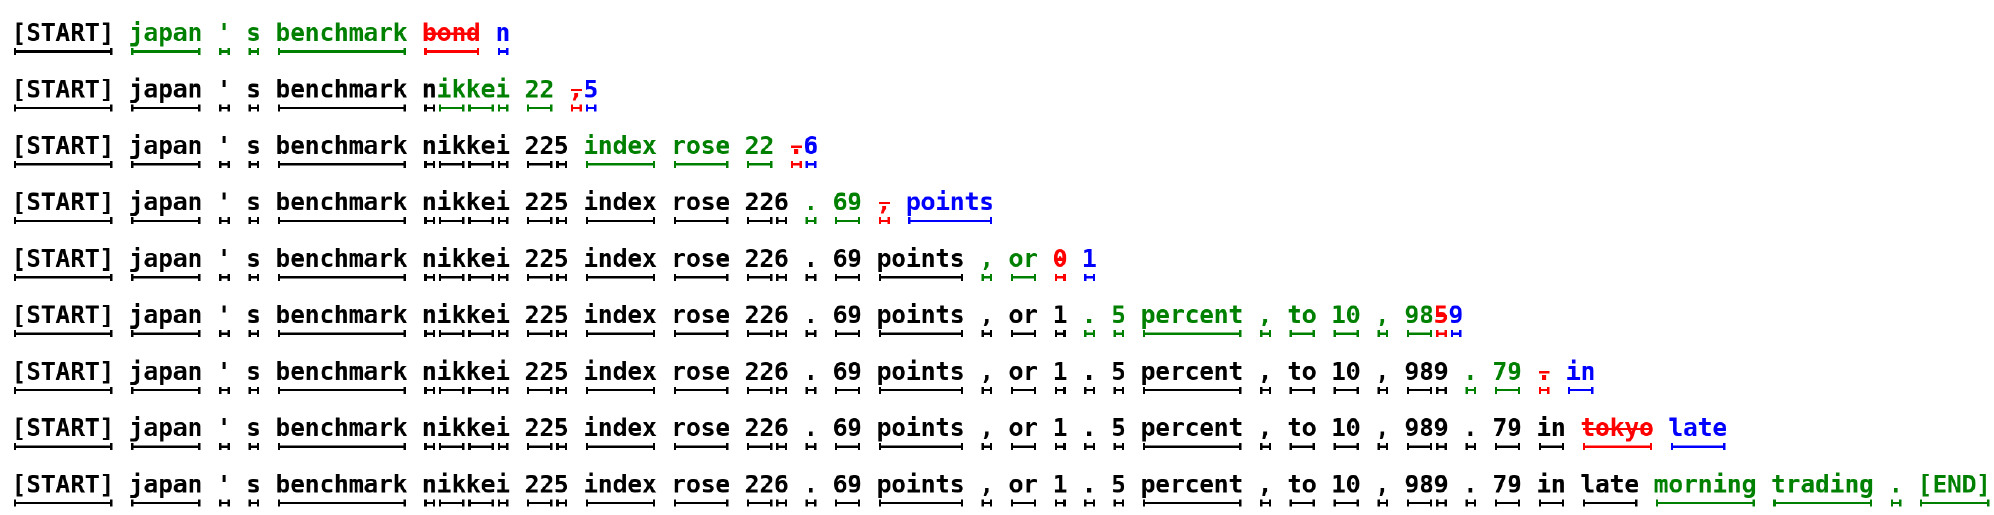
sean aceptadas, al tiempo que garantizamos que las salidas de nuestro sistema tengan la misma distribución que las del modelo objetivo por sí solo. Por ejemplo, la oración de la Figura 1, que consta de 38 tokens, fue generada por nuestro método con solo 9 ejecuciones en serie de un modelo objetivo más grande (97M parámetros) gracias a un modelo de aproximación más pequeño y eficiente (6M parámetros), mientras que la probabilidad de generarla no cambia.
Analizamos nuestro método en una variedad de tareas y tamaños de modelos: generación incondicional a partir de un modelo tipo GPT de 97M parámetros entrenado en 1m1b, traducción de inglés a alemán y resumen de artículos de noticias con un modelo T5-XXL de 11B parámetros, y una tarea de diálogo con un modelo LaMDA de 137B parámetros. Implementamos nuestro método y comparamos los tiempos de reloj reales para T5-XXL con los de la robusta implementación T5X (Roberts et al., 2022), mostrando una mejora de latencia lista para usar de 2X-3X, sin ningún cambio en las salidas (Sección 4).
Nuestro método es fácil de emplear en entornos de producción reales, no requiere entrenar nuevos modelos y no cambia las salidas. Por lo tanto, en situaciones comunes donde el ancho de banda de memoria es el cuello de botella y hay recursos de cómputo disponibles, puede ser una buena opción predeterminada para acelerar el muestreo de modelos autorregresivos como los Transformers.
En resumen, nuestras principales contribuciones son: (1) una generalización de la ejecución especulativa al entorno estocástico, con un novedoso método de muestreo que llamamos muestreo especulativo, y (2) un mecanismo de decodificación que llamamos decodificación especulativa que puede acelerar la decodificación a partir de modelos autorregresivos, sin ningún cambio en las arquitecturas de los modelos, los regímenes de entrenamiento y las distribuciones de salida.
2. Decodificación especulativa
2.1. Descripción general
Sea el modelo objetivo a partir del cual estamos intentando acelerar la inferencia, y la distribución que obtenemos del modelo para un prefijo . Sea un modelo de aproximación más eficiente para la misma tarea, y denotemos por la distribución que obtenemos del modelo para un prefijo . La idea central es (1) usar el modelo más eficiente para generar terminaciones (véase la Sección 3.5) sobre cómo elegir óptimamente este parámetro), luego (2) usar el modelo objetivo para evaluar todas las conjeturas y sus respectivas probabilidades de en paralelo, aceptando todas aquellas que puedan conducir a una distribución idéntica, y (3) muestrear un token adicional de una distribución ajustada para corregir el primero que fue rechazado, o para añadir uno adicional si todos son aceptados. De esta manera, cada ejecución en paralelo del modelo objetivo producirá al menos un token nuevo (por lo que el número de ejecuciones en serie del modelo objetivo nunca, ni siquiera en el peor de los casos, podrá ser mayor que el del método autorregresivo simple), pero potencialmente puede generar muchos tokens nuevos, hasta , dependiendo de cuán bien aproxima a .
2.2. Muestreo estandarizado
Primero, nótese que aunque existen muchos métodos y parámetros de muestreo, como argmax, top- k, núcleo, y el establecimiento de una temperatura, y las implementaciones populares suelen tratarlos de manera diferente a nivel de logits, todos pueden convertirse fácilmente en muestreo estándar a partir de una distribución de probabilidad ajustada. Por ejemplo, el muestreo argmax es equivalente a anular los elementos no máximos de la distribución y normalizar. Por lo tanto, podemos tratar únicamente con el muestreo estándar a partir de una distribución de probabilidad, y convertir todos los demás tipos de muestreo en ese marco. En adelante asumiremos que y son las distribuciones de y respectivamente, ajustadas según el método de muestreo.
2.3. Muestreo especulativo
Para muestrear , en su lugar muestreamos , conservándolo si , y en caso de que rechazamos la muestra con probabilidad y muestreamos de nuevo a partir de una distribución ajustada . Es fácil demostrar (véase el Apéndice [A.1]) que para cualesquiera distribuciones y , y muestreada de esta manera, efectivamente .
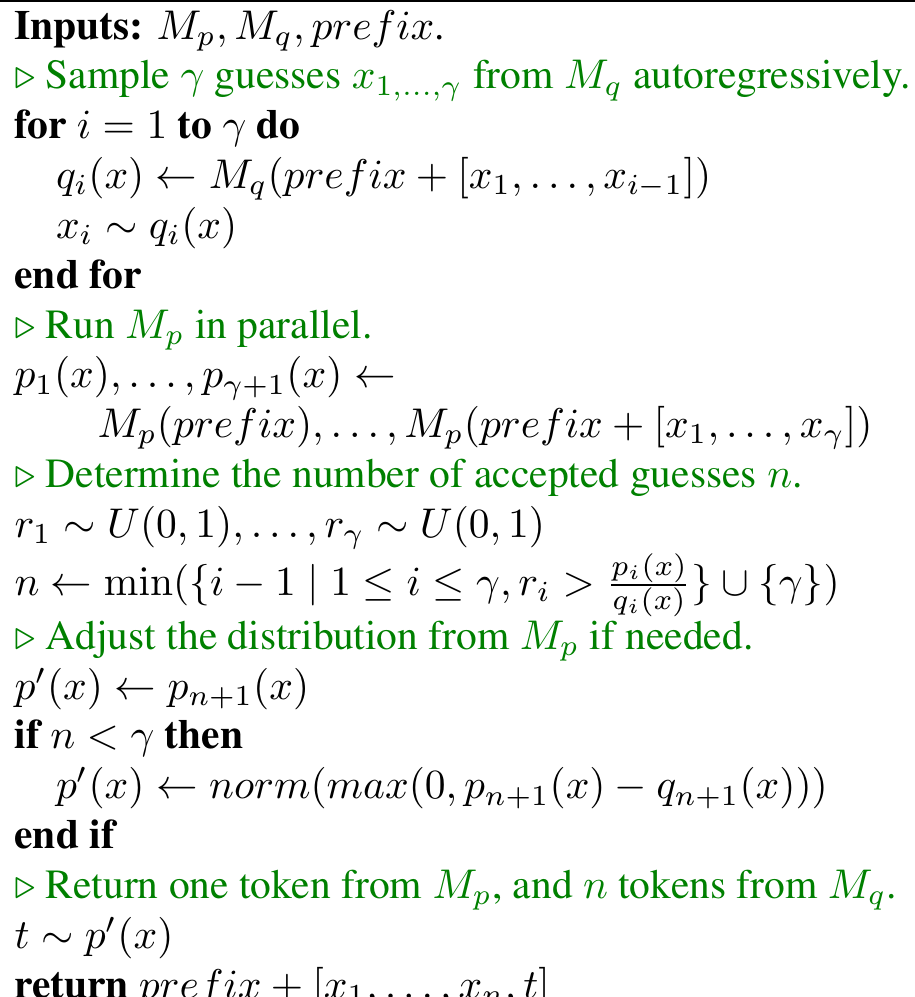
Dada la distribución obtenida al ejecutar sobre un de condicionamiento, podemos muestrear un token . Luego calculamos la distribución ejecutando sobre mientras, en paralelo, calculamos especulativamente la distribución del siguiente token ejecutando sobre . Una vez que ambos cálculos se completan, procedemos como se indicó anteriormente: si es rechazado, descartamos el cálculo de y volvemos a muestrear a partir de una distribución ajustada, y si es aceptado, conservamos ambos tokens. El Algoritmo [I] generaliza esta idea para muestrear entre 1 y tokens a la vez.
Algoritmo 1 SpeculativeDecodingStep
3. Análisis
3.1. Número de tokens generados
Analicemos el factor de reducción en el número de llamadas en serie al modelo objetivo, o equivalentemente, el número esperado de tokens producidos por una sola ejecución del Algoritmo [I]
Definición 3.1. La tasa de aceptación , dado un prefijo , es la probabilidad de aceptar mediante muestreo especulativo, según la Sección [2.3]:
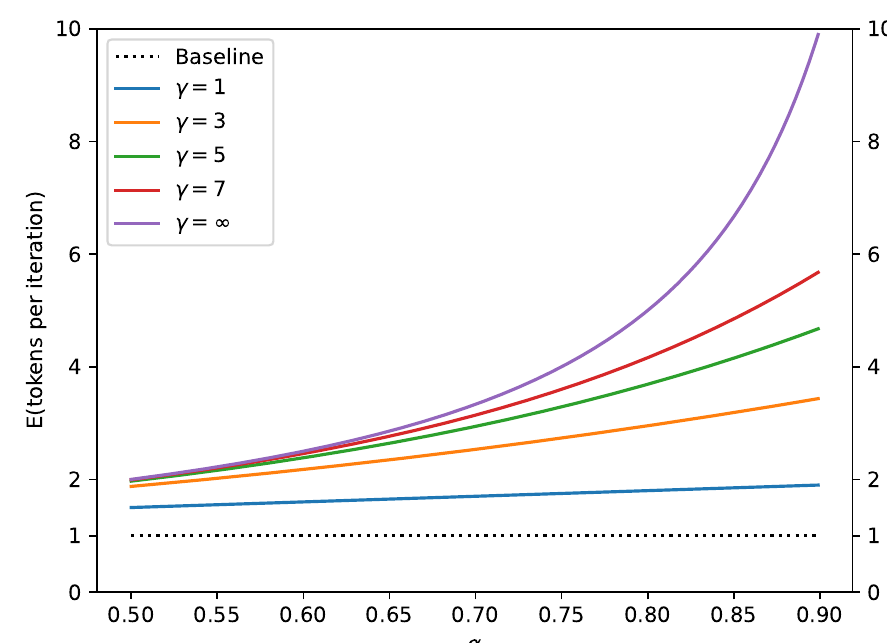
es entonces una medida natural de cuán bien aproxima a . Si hacemos el supuesto simplificador de que las son i.i.d., y denotamos , entonces el número de tokens producidos por una sola ejecución del Algoritmo [I] es una variable geométrica truncada, con probabilidad de éxito y tope , y el número esperado de tokens generados por el Algoritmo [I] satisface la Ecuación [I]. Véase la Figura [2]
3.2. Cálculo de
Ahora derivaremos una fórmula simple para calcular dado un prefijo y los dos modelos y . Comenzamos definiendo una divergencia natural :
Definición 3.2. donde .
Lema 3.3.
Demostración.
Del Lema [3.3] obtenemos inmediatamente los siguientes resultados: Corolario 3.4. es una divergencia simétrica en . . y tienen soporte disjunto.
Teorema 3.5.
Finalmente obtenemos:
Corolario 3.6.
Véase la Tabla 3 para los valores de observados empíricamente en nuestros experimentos.
3.3. Mejora del tiempo de ejecución
Hemos mostrado que, bajo el supuesto de i.i.d., nuestro algoritmo reduce el número de llamadas al modelo objetivo por un factor de . Nótese que la ejecución especulativa en general, y nuestro algoritmo en particular, suponen que disponemos de suficientes recursos de cómputo para soportar la concurrencia incrementada (Sección 3.4). Para el análisis del tiempo de ejecución, supondremos que podemos ejecutar evaluaciones concurrentes de en paralelo sin incrementar el tiempo de ejecución. Para obtener la mejora total del tiempo de ejecución, ahora consideramos el costo de ejecutar el modelo de aproximación .
Definición 3.7. Sea , el coeficiente de costo, la razón entre el tiempo de una sola ejecución de y el tiempo de una sola ejecución de .
Nótese que, a diferencia de , que es una propiedad intrínseca de los modelos y de la tarea, el valor de depende de la configuración de hardware y de los detalles de implementación del software. En nuestros experimentos, donde es típicamente un par de órdenes de magnitud más pequeño que , fue siempre menor que 0.05 y a menudo insignificantemente cercano a 0.
Teorema 3.8. El factor de mejora esperado en el tiempo de ejecución total por el Algoritmo 1 es .
Demostración. Denotemos por el costo de ejecutar un solo paso de . Ahora, cada ejecución del Algoritmo 1 cuesta (por ejecutar el modelo de aproximación veces y ejecutar una vez) y, de acuerdo con la Ecuación (1), produce tokens en promedio. Así, el costo esperado total de producir un token con el Algoritmo 1 es . Dado que el costo de producir un solo token con el algoritmo de decodificación estándar es , obtenemos el resultado deseado.
Nótese que el Teorema 3.8 supone generaciones suficientemente largas (por ejemplo, dado que ejecutamos al menos una vez, el factor de mejora está limitado por el número de tokens generados).
Corolario 3.9. Si , existe para el cual obtendremos una mejora, y el factor de mejora será al menos .
Demostración. Si obtenemos una mejora para , también obtendríamos una mejora para cualquier , así que para que nuestro método produzca una mejora, podemos evaluar el Teorema 3.8 para , lo que da .
3.4. Número de operaciones aritméticas
El Algoritmo 1 realiza ejecuciones de en paralelo, por lo que el número de operaciones aritméticas concurrentes crece por un factor de . Ahora, dado que el Algoritmo 1 produce como máximo tokens por ejecución, el número total de operaciones aritméticas podría ser mayor que el del algoritmo de decodificación estándar. Cuando aceptamos la muestra de , la concurrencia incrementada es "gratuita" y el número total de operaciones no aumenta. Sin embargo, cuando rechazamos una conjetura, la computación se desperdicia. Analicemos ahora el efecto de nuestro método sobre el número total de operaciones aritméticas.
Definición 3.10. Sea la razón entre las operaciones aritméticas por token del modelo de aproximación y las del modelo objetivo .
Teorema 3.11. El factor esperado de incremento en el número total de operaciones del Algoritmo 1 es .
Demostración. Denotemos por el número de operaciones aritméticas realizadas por una línea base de decodificación estándar por token, es decir, el número de operaciones de una sola ejecución de . Entonces, una sola iteración del Algoritmo 1 cuesta operaciones (por ejecuciones de y ejecuciones paralelas de ). Dividiendo por el número esperado de tokens producidos por el Algoritmo 1, es decir, la Ecuación (1), y por , obtenemos el resultado deseado.
Si es bajo, el aumento en el número de operaciones aritméticas es alto, y viceversa. Nótese que, para los decodificadores Transformer, el número total de operaciones aritméticas del Algoritmo 1 (sin contar las ejecuciones de ) puede acotarse superiormente por una sola ejecución de un codificador Transformer del mismo tamaño.
A diferencia del número total de operaciones aritméticas, el número total de accesos a memoria puede disminuir con nuestro método. Específicamente, los pesos del modelo objetivo y la caché KV pueden leerse una vez por cada ejecución del Algoritmo 1, por lo que el número de accesos a memoria para leerlos se reduce en un factor de , según la Ecuación (1).
3.5. Elección de
Dados y , y suponiendo suficientes recursos de cómputo (véase la Sección 3.4), el óptimo es el que maximiza la ecuación de mejora del tiempo de reloj
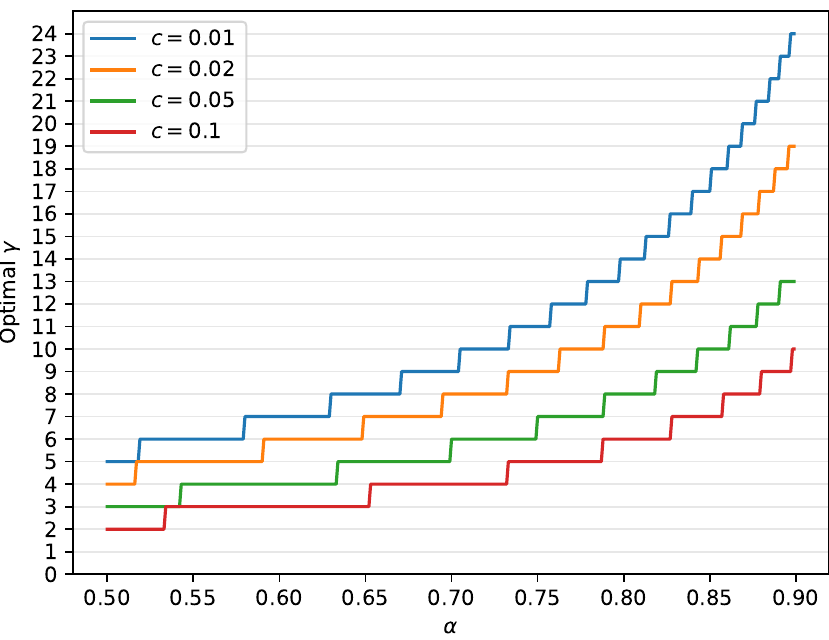
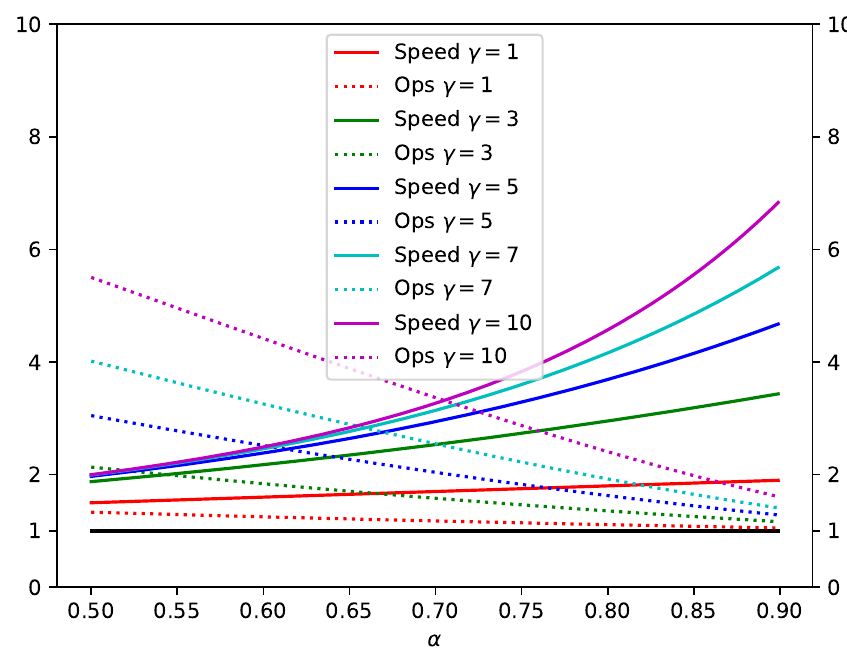
(Teorema 3.8): . Dado que es un entero, puede encontrarse fácilmente de forma numérica, véase la Figura 3.
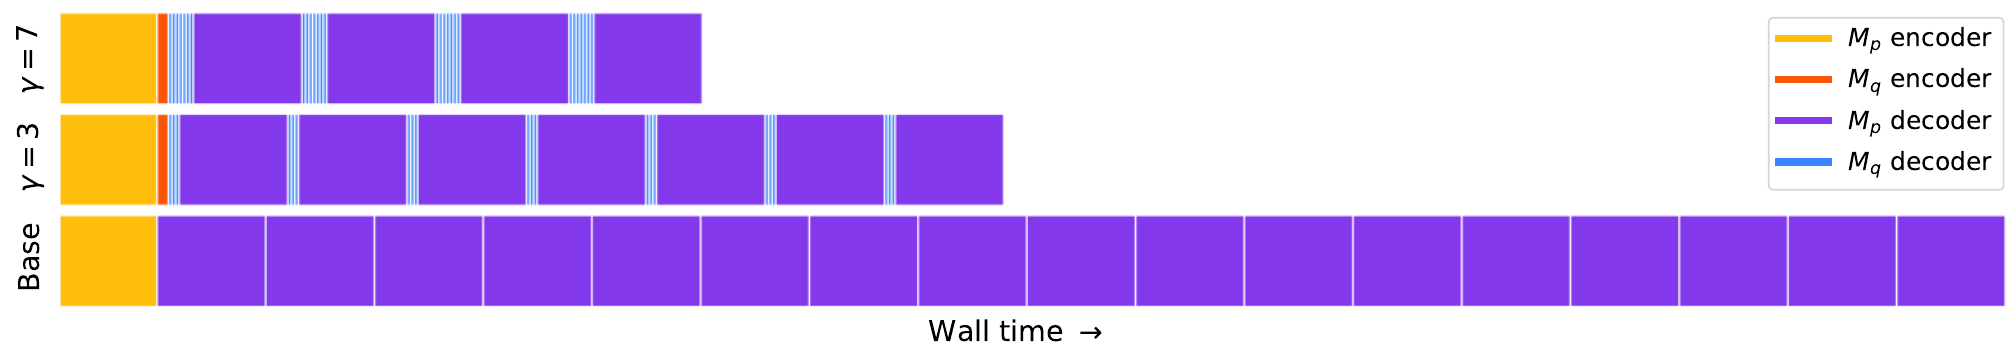
La Tabla 1 y la Figura 4 ilustran el compromiso entre la velocidad de inferencia y el número total de operaciones aritméticas para diversos valores de y , suponiendo . La Figura 5 muestra un diagrama de traza simplificado.
| α | γ | OPERACIONES | VELOCIDAD |
| 0,6 | 2 | 1,53X | 1,96X |
| 0,7 | 3 | 1,58X | 2,53X |
| 0,8 | 2 | 1,23X | 2,44X |
| 0,8 | 5 | 1,63X | 3,69X |
| 0,9 | 2 | 1,11X | 2,71X |
| 0,9 | 10 | 1,60X | 6,86X |
En lugar de elegir un único valor para basado en , dado que los no son constantes, podríamos obtener una mejora adicional prediciendo el valor de y variando en consecuencia el valor de durante la ejecución del Algoritmo 1. Para obtener una cota superior del factor de mejora adicional, supongamos que tuviéramos un oráculo para . Tendríamos entonces . Para valores típicos de y , y suponiendo recursos de cómputo ilimitados, el factor de mejora del tiempo de reloj mejorado puede ser hasta mayor que el factor de mejora con un fijo. Dejamos la exploración de esto para trabajo futuro.
3.6. Modelos de aproximación
El muestreo especulativo, y por tanto la decodificación especulativa, garantiza una distribución de salida idéntica para cualquier elección de modelo de aproximación sin restricción (véase el Apéndice [A.1]). En nuestros experimentos, probamos principalmente Transformers más pequeños ya existentes como modelos de aproximación. Además, solo probamos modelos de aproximación de la misma arquitectura que los modelos objetivo y que usan la misma estandarización de probabilidad. En esta configuración, elegir de alrededor de dos órdenes de magnitud más pequeño que generalmente funcionó mejor, equilibrando y (Teorema 3.8).
Otro tipo de modelos de aproximación, los modelos de costo despreciable, son aquellos para los cuales , es decir, modelos de aproximación con un costo despreciable en relación con el modelo objetivo. En este caso, obtenemos una mejora esperada del tiempo de reloj de , que está acotada superiormente por (nos acercamos a la igualdad si es grande). Un tipo interesante de modelos de aproximación de costo despreciable son los modelos de n-gramas, donde la evaluación se reduce a una consulta de tabla. Curiosamente, en pruebas empíricas (Sección 4.2) obtenemos distintos de cero incluso para estos modelos de n-gramas triviales. Por ejemplo, para la tarea de traducción inglés-alemán, con siendo T5-XXL 11B y siendo un modelo de bigramas trivial, obtenemos , lo que conduce a un factor de mejora de la velocidad de inferencia de con .
Otras heurísticas simples pueden usarse como modelos de aproximación de costo despreciable. Por ejemplo, en casos donde es probable que secuencias largas se repitan, como en tareas de resumen o interfaces tipo chat, un modelo de aproximación que simplemente
copie tokens del contexto en caso de que encontremos un prefijo coincidente podría producir valores altos de . Estos modelos de aproximación sin parámetros tienen la ventaja adicional de ser aún más simples de desplegar desde un punto de vista de producción.
Otro tipo de modelos de aproximación que pueden usarse con la decodificación especulativa son los modelos no autorregresivos, como los de Stern et al. [2018]. Entonces, en lugar del bucle autorregresivo del Algoritmo 1, simplemente llamaríamos una vez al modelo no autorregresivo.
Un ejemplo final, interesante principalmente desde una perspectiva teórica, es un modelo de aproximación que elige tokens al azar, lo que garantiza cierta mejora (aunque muy pequeña) para todos los modelos .
4. Experimentos
4.1. Mejora empírica del tiempo de reloj
Implementamos nuestro algoritmo y lo comparamos con la implementación en la base de código T5X para acelerar T5-XXL.
Configuración Probamos un modelo T5 versión 1.1 estándar de codificador-decodificador (Raffel et al., [2020) en dos tareas del artículo de T5: (1) traducción de inglés a alemán ajustada en WMT EnDe, y (2) resumen de texto ajustado en CCN/DM. Para ambas tareas, usamos T5-XXL (11B) para . Para el modelo de aproximación probamos varias configuraciones existentes, concretamente T5-large (800M), T5-base (250M) y T5-small (77M) (Raffel et al., [2020). Usamos los checkpoints existentes para todos los modelos. Medimos las mejoras del tiempo de reloj con un tamaño de lote de 1 en una única TPU-v4 tanto para el muestreo argmax (temp=0) como para el muestreo estándar (temp=1).
Resultados La Tabla 2 muestra los resultados empíricos de nuestro método. Vemos que T5-small (77M), con un buen equilibrio de y , proporciona la mayor aceleración entre los modelos deaproximación probados. Como era de esperar, vemos que aumenta con el tamaño del modelo de aproximación. Curiosamente, y la mejora del tiempo de reloj son mayores para el muestreo argmax (temp=0). Observamos aceleraciones de 2.6X (temp=1) y 3.4X (temp=0) en la tarea de traducción y aceleraciones ligeramente menores de 2.3X (temp=1) y 3.1X (temp=0) para la tarea de resumen. Estos resultados empíricos concuerdan bien con las predicciones teóricas, con cierta variación debida a detalles de implementación (véase el Apéndice A.3).
| Tarea | Mq | TEMP | γ | α | VELOCIDAD |
| ENDE | T5-SMALL ★ | 0 | 7 | 0.75 | 3.4X |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 2.8X |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 1.7X |
| ENDE | T5-SMALL ★ | 1 | 7 | 0.62 | 2.6X |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 2.4X |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 1.4X |
| CNNDM | T5-SMALL ★ | 0 | 5 | 0.65 | 3.1X |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 3.0X |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 2.2X |
| CNNDM | T5-SMALL ★ | 1 | 5 | 0,53 | 2,3X |
| CNNDM | T5-BASE | 1 | 3 | 0,55 | 2,2X |
| CNNDM | T5-LARGE | 1 | 3 | 0,56 | 1,7X |
4.2. Valores empíricos de
Aunque solo implementamos nuestro método para T5, medimos los valores de para diversas tareas, métodos de muestreo, modelos objetivo y modelos de aproximación . Específicamente, evaluamos la expectativa del Corolario 3.6 sobre 10K tokens generados por , para cada una de las configuraciones siguientes.
GPT- like (97M params) Probamos un modelo Transformer solo decodificador en generación de lenguaje incondicional, entrenado en lm1b (Chelba et al., [2013). El modelo aquí es un decodificador Transformer tipo GPT con activaciones Gelu (Hendrycks & Gimpel, [2016). Para experimentamos con un modelo decodificador Transformer con 6M de parámetros: dim 256, dim feed-forward 1024, 2 capas, 4 cabezas de atención, así como modelos simples de unigramas y bigramas. tiene 97M de parámetros: dim 768, dim feed-forward 3072, 12 capas, 12 cabezas de atención. Usamos la tokenización de Bert (Devlin et al., [2019]) con 8k tokens para todos los modelos.
LaMDA (137B params) Probamos un modelo LaMDA solo decodificador en una tarea de diálogo (Thoppilan et al., [2022]). Usamos checkpoints existentes de LaMDA 137B como y LaMDA 8B, LaMDA 2B y LaMDA 100M para .
Véase la Sección 4.1 para la configuración del modelo T5- XXL (11B params).
La Tabla 3 resume los valores de para los casos probados. Observamos que los modelos de aproximación que son un par de órdenes de magnitud más pequeños que el modelo objetivo tienden a producir valores de entre 0.5 y 0.9. Curiosamente, también notamos que para todos los modelos, cuanto más afilada es la distribución ajustada, mayores son los valores de . Finalmente, notamos que incluso las aproximaciones triviales de unigramas y bigramas producen valores de no despreciables. Por ejemplo, para el caso de traducción de inglés a alemán, el modelo de bigramas tiene un valor de de 0.2, y dado que en este caso, produce una mejora de velocidad de 1.25X, lo cual es sorprendentemente alto para este modelo de aproximación trivial (pero sigue siendo menor que la aceleración que obtenemos al usar T5- small como modelo de aproximación).
5. Trabajo relacionado
La eficiencia de la inferencia a partir de modelos grandes fue estudiada extensamente (Dehghani et al., [2021]). Muchos enfoques tienen como objetivo acelerar la inferencia a partir de modelos grandes en general, y de modelos autorregresivos como los Transformers en particular. Numerosas técnicas intentan hacer la inferencia más eficiente para todos los tokens, p. ej., destilación (Hinton et al., [2015]), sparcificación (Jaszczur et al., [2021]), cuantización (Hubara et al., [2016]) y modificación de la arquitectura (So et al., [2021]; Shazeer [2019]). Más cercanos a nuestro enfoque están los métodos de cómputo adaptativo que adaptan la cantidad de cómputo a la dificultad del problema (Han et al., [2021]). Los ejemplos incluyen atender a un subconjunto de las entradas (Sukhbaatar et al., [2019]), y salidas tempranas (Schuster et al., [2021]; Scardapane et al., [2020]; Bapna et al., [2020]; Elbayad et al., [2019]; Schwartz et al., [2020]). Notablemente, Wisdom of Committees (Schwartz et al., [2020]) aprovecha modelos más pequeños listos para usar, pero es un enfoque de cómputo adaptativo, y por lo tanto usa una heurística para determinar cuándo detenerse, perdiendo la garantía de salidas idénticas a las de los modelos objetivo. En general, los métodos de cómputo adaptativo usualmente aprenden, ya sea dentro del propio modelo o con un modelo auxiliar, cuándo se puede tomar un atajo de cómputo. Usualmente, estos métodos ahorran tanto en tiempo de inferencia como en operaciones aritméticas, pero requieren un cambio de arquitectura, un cambio del procedimiento de entrenamiento y el entrenamiento de modelos personalizados o el
| Mp | Mq | SMPL | α |
| GPT-LIKE (97M) | UNIGRAMO | T=0 | 0,03 |
| GPT-LIKE (97M) | BIGRAMO | T=0 | 0,05 |
| GPT-LIKE (97M) | GPT-LIKE (6M) | T=0 | 0,88 |
| GPT-LIKE (97M) | UNIGRAMO | T=1 | 0,03 |
| GPT-LIKE (97M) | BIGRAMO | T=1 | 0,05 |
| GPT-LIKE (97M) | GPT-LIKE (6M) | T=1 | 0,89 |
| T5-XXL (ENDE) | UNIGRAMO | T=0 | 0,08 |
| T5-XXL (ENDE) | BIGRAMO | T=0 | 0,20 |
| T5-XXL (ENDE) | T5-SMALL | T=0 | 0,75 |
| T5-XXL (ENDE) | T5-BASE | T=0 | 0,80 |
| T5-XXL (ENDE) | T5-LARGE | T=0 | 0,82 |
| T5-XXL (ENDE) | UNIGRAMO | T=1 | 0,07 |
| T5-XXL (ENDE) | BIGRAMO | T=1 | 0,19 |
| T5-XXL (ENDE) | T5-SMALL | T=1 | 0,62 |
| T5-XXL (ENDE) | T5-BASE | T=1 | 0,68 |
| T5-XXL (ENDE) | T5-LARGE | T=1 | 0,71 |
| T5-XXL (CNNDM) | UNIGRAM | T=0 | 0,13 |
| T5-XXL (CNNDM) | BIGRAM | T=0 | 0,23 |
| T5-XXL (CNNDM) | T5-SMALL | T=0 | 0,65 |
| T5-XXL (CNNDM) | T5-BASE | T=0 | 0,73 |
| T5-XXL (CNNDM) | T5-LARGE | T=0 | 0,74 |
| T5-XXL (CNNDM) | UNIGRAM | T=1 | 0,08 |
| T5-XXL (CNNDM) | BIGRAM | T=1 | 0,16 |
| T5-XXL (CNNDM) | T5-SMALL | T=1 | 0,53 |
| T5-XXL (CNNDM) | T5-BASE | T=1 | 0,55 |
| T5-XXL (CNNDM) | T5-LARGE | T=1 | 0,56 |
| LAMDA (137B) | LAMDA (100M) | T=0 | 0,61 |
| LAMDA (137B) | LAMDA (2B) | T=0 | 0,71 |
| LAMDA (137B) | LAMDA (8B) | T=0 | 0,75 |
| LAMDA (137B) | LAMDA (100M) | T=1 | 0,57 |
| LAMDA (137B) | LAMDA (2B) | T=1 | 0,71 |
| LAMDA (137B) | LAMDA (8B) | T=1 | 0.74 |
reentrenamiento de modelos existentes. Usualmente también cambian las salidas del modelo. Notamos que, si bien muchos de los métodos anteriores mejoran la relación entre memoria y operaciones aritméticas, en casos donde la relación sigue siendo alta, estos métodos y nuestro método de decodificación especulativa podrían ser efectivos en conjunto.
Dos métodos previos aprovechan la ejecución especulativa para acelerar la decodificación de modelos autorregresivos. Blockwise Parallel Decoding (Stern et al., [2018]) decodifica varios tokens en paralelo, de manera similar a nuestro trabajo. Sin embargo, solo admite decodificación voraz (temperatura ) y no la configuración estocástica general, requiere entrenamiento adicional de un modelo personalizado y se centra en preservar la calidad de la tarea posterior, en lugar de garantizar salidas idénticas. Shallow Aggressive Decoding (SAD) (Sun et al., [2021]) también decodifica varios tokens en paralelo, de manera similar a nuestro trabajo. A diferencia de nuestro trabajo, SAD solo admite la copia de la entrada a la salida, y no modelos de aproximación generales, lo que lo hace adecuado solo para los casos en que las entradas y las salidas son muy similares, como la corrección de errores gramaticales. Además, de manera similar a Blockwise Parallel Decoding, SAD no admite la configuración general de muestreo estocástico.
Después de que publicamos inicialmente nuestro trabajo, una implementación independiente de decodificación especulativa (Chen et al., [2023]) mostró mejoras similares de 2X-2.5X en Chinchilla 70B.
6. Discusión
Presentamos el muestreo especulativo, que permite una ejecución especulativa estocástica eficiente, es decir, la ejecución especulativa en el entorno estocástico. Analizamos su impacto en la decodificación a partir de modelos autorregresivos como Transformers mediante decodificación especulativa y hemos demostrado que, dadas suficientes recursos de cómputo, obtenemos aceleraciones significativas de 2X-3X en la práctica frente a T5X, una implementación optimizada popular.
Una limitación de la ejecución especulativa en general, y de la decodificación especulativa en particular, es que la latencia se mejora mediante una mayor concurrencia a costa de un mayor número de operaciones aritméticas. Por lo tanto, nuestro método no es útil para configuraciones en las que no se dispone de recursos de cómputo adicionales. Sin embargo, en los casos comunes en los que se dispone de recursos de cómputo adicionales (por ejemplo, cuando el ancho de banda de memoria es el cuello de botella), nuestro método proporciona la aceleración con beneficios significativos: la arquitectura del modelo no cambia, no se requiere reentrenamiento y, lo más importante, se garantiza que la distribución de salida permanezca igual. Nuestro método es fácil de implementar y puede usarse para acelerar la inferencia utilizando modelos listos para usar sin desarrollar y evaluar esquemas personalizados.
Hay varias direcciones para la investigación de seguimiento, en particular, investigar más a fondo la compatibilidad de la decodificación especulativa con la búsqueda por haces (véase el Apéndice[A.4]). Además, aunque nuestro método produce aceleraciones sustanciales con modelos de aproximación existentes listos para usar, podrían obtenerse mayores mejoras mediante modelos de aproximación personalizados (Sección[3.6], como aquellos con arquitecturas personalizadas (por ejemplo, tamaños personalizados, modelos no autorregresivos o diversas heurísticas) o con procedimientos de entrenamiento personalizados (por ejemplo, destilación estándar con objetivos suaves de , u optimización de para directamente). También podría ser interesante explorar una versión jerárquica del algoritmo, donde el modelo de aproximación es a su vez acelerado por un modelo aún más rápido, lo que podría permitir modelos de aproximación más capaces. En este trabajo fijamos el modelo de aproximación y el número de conjeturas durante toda la inferencia, pero variarlos durante la inferencia podría producir mejoras adicionales (Sección[3.5]). En nuestros experimentos siempre realizamos la misma estandarización sobre las distribuciones generadas por el modelo de aproximación que la deseada para el modelo objetivo (Sección[2.2]), pero podrían obtenerse mejoras adicionales aplicando transformaciones diferentes. Probamos la decodificación especulativa solo en la modalidad de texto, pero podría funcionar bien en otros dominios (por ejemplo, imágenes) con los que sería interesante experimentar.
Por último, señalamos que la ejecución especulativa estocástica y el muestreo especulativo pueden ser útiles fuera del ámbito de la decodificación especulativa a partir de modelos autorregresivos. Por ejemplo, dadas dos funciones lentas, y tales que genera una distribución de la cual se muestrea la entrada de , podríamos usar nuestro método para ejecutar y en paralelo. Esta configuración podría surgir, por ejemplo, en simulaciones físicas, o en aprendizaje por refuerzo donde es un modelo grande que produce una distribución sobre acciones, y es la simulación del mundo, lo que sería interesante explorar.
Agradecimientos
Nos gustaría extender un agradecimiento especial a YaGuang Li por su ayuda con todo lo relacionado con LaMDA y por calcular las figuras de LaMDA en el artículo, y a Blake Hechtman por sus grandes ideas y ayuda con XLA. También nos gustaría agradecer a los revisores por sus perspicaces comentarios, así como a Asaf Aharoni, Reiner Pope, Sasha Goldshtein, Nadav Sherman, Eyal Segalis, Eyal Molad, Dani Valevski, Daniel Wasserman, Valerie Nygaard, Danny Vainstein, los equipos de LaMDA y Theta Labs en Google, y a nuestras familias.
Referencias
Bapna, A., Arivazhagan, N., and Firat, O. Controlling computation versus quality for neural sequence models. ArXiv, abs/2002.07106, 2020.
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert- Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., Hesse, C., Chen, M., Sigler, E., Litwin, M., Gray, S., Chess, B., Clark, J., Berner, C., McCandlish, S., Radford, A., Sutskever, I., and Amodei, D. Language models are few- shot learners. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS'20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
Burton, F. W. Speculative computation, parallelism, and functional programming. IEEE Transactions on Computers, C- 34(12):1190- 1193, 1985. doi: 10.1109/TC.1985.6312218.
Chelba, C., Mikolov, T., Schuster, M., Ge, Q., Brants, T., Koehn, P. T., and Robinson, T. One billion word bench mark for measuring progress in statistical language modeling. In Interspeech, 2013.
Chen, C., Borgeaud, S., Irving, G., Lespiau, J.- B., Sifre, L., and Jumper, J. M. Accelerating large language model decoding with speculative sampling. ArXiv, abs/2302.01318, 2023.
Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N. M., Prabhakaran, V., Reif, E., Du, N., Hutchinson, B. C., Pope, R., Bradbury, J., Austin, J., Isard, M., Gur- Ari, G., Yin, P., Duke, T., Levskaya, A., Ghemawat, S., Dev, S., Michalewski, H., Garcia, X., Misra, V., Robinson, K., Fedus, L., Zhou, D., Ippolito, D., Luan, D., Lim, H., Zoph, B., Spiridonov, A., Sepassi, R., Dohan, D., Agrawal, S., Omernick, M., Dai, A. M., Pillai, T. S., Pelat, M., Lewkowycz, A., Moreira, E., Child, R., Polozov, O., Lee, K., Zhou, Z., Wang, X., Saeta, B., Diaz, M., Firat, O., Catasta, M., Wei, J., Meier- Hellstern, K. S., Eck, D., Dean, J., Petrov, S., and Fiedel, N. Palm: Scaling language modeling with pathways. ArXiv, abs/2204.02311, 2022.
Dehghani, M., Arnab, A., Beyer, L., Vaswani, A., and Tay, Y. The efficiency misnomer. ArXiv, abs/2110.12894, 2021.
Devlin, J., Chang, M.- W., Lee, K., and Toutanova, K. Bert: Pre- training of deep bidirectional transformers for language understanding. ArXiv, abs/1810.04805, 2019.
Elbayad, M., Gu, J., Grave, E., and Auli, M. Depth- adaptive transformer. ArXiv, abs/1910.10073, 2019.
Han, Y., Huang, G., Song, S., Yang, L., Wang, H., and Wang, Y. Dynamic neural networks: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence, 44: 7436- 7456, 2021.
Hendrycks, D. and Gimpel, K. Bridging nonlinearities and stochastic regularizers with gaussian error linear units. ArXiv, abs/1606.08415, 2016.
Hennessy, J. L. and Patterson, D. A. Computer Architecture: A Quantitative Approach. Morgan Kaufmann, Amsterdam, 5 edition, 2012. ISBN 978- 0- 12- 383872- 8.
Hinton, G. E., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. ArXiv, abs/1503.02531, 2015.
Hubara, I., Courbariaux, M., Soudry, D., El- Yaniv, R., and Bengio, Y. Quantized neural networks: Training neural networks with low precision weights and activations. ArXiv, abs/1609.07061, 2016.
Jaszczur, S., Chowdhery, A., Mohiuddin, A., Kaiser, L., Gajewski, W., Michalewski, H. y Kanerva, J. Sparse is enough in scaling transformers. En Neural Information Processing Systems, 2021.
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W. y Liu, P. J. Exploring the limits of transfer learning with a unified text-to-text transformer. The Journal of Machine Learning Research, 21(1):5485-5551, 2020.
Roberts, A., Chung, H. W., Levskaya, A., Mishra, G., Bradbury, J., Andor, D., Narang, S., Lester, B., Gaffney, C., Mohiuddin, A., Hawthorne, C., Lewkowycz, A., Salcianu, A., van Zee, M., Austin, J., Goodman, S., Soares, L. B., Hu, H., Tsvyashchenko, S., Chowdhery, A., Bastings, J., Bulian, J., Garcia, X., Ni, J., Chen, A., Kenealy, K., Clark, J., Lee, S., Garrette, D. H., Lee-Thorp, J., Raffel, C., Shazeer, N. M., Ritter, M., Bosma, M., Passos, A., Maitin-Shepard, J. B., Fiedel, N., Omernick, M., Saeta, B., Sepassi, R., Spiridonov, A., Newlan, J. y Gesmundo, A. Scaling up models and data with 5x and seqio. ArXiv, abs/2203.17189, 2022.
Scardapane, S., Scarpiniti, M., Baccarelli, E. y Uncini, A. Why should we add early exits to neural networks? Cognitive Computation, 12(5):954-966, 2020.
Schuster, T., Fisch, A., Jaakkola, T. y Barzilay, R. Consistent accelerated inference via confident adaptive transformers. En Conference on Empirical Methods in Natural Language Processing, 2021.
Schwartz, R., Stanovsky, G., Swayamdipta, S., Dodge, J., and Smith, N. A. The right tool for the job: Matching model and instance complexities. In Annual Meeting of the Association for Computational Linguistics, 2020.
Shazeer, N. M. Fast transformer decoding: One write- head is all you need. ArXiv, abs/1911.02150, 2019.
So, D. R., Ma'ake, W., Liu, H., Dai, Z., Shazeer, N. M., and Le, Q. V. Primer: Searching for efficient transformers for language modeling. ArXiv, abs/2109.08668, 2021.
Stern, M., Shazeer, N., and Uszkoreit, J. Blockwise parallel decoding for deep autoregressive models. Advances in Neural Information Processing Systems, 31, 2018.
Sukhbaatar, S., Grave, E., Bojanowski, P., and Joulin, A. Adaptive attention span in transformers. In Annual Meeting of the Association for Computational Linguistics, 2019.
Sun, X., Ge, T., Wei, F., and Wang, H. Instantaneous grammatical error correction with shallow aggressive decoding. ArXiv, abs/2106.04970, 2021.
Thoppilan, R., Freitas, D. D., Hall, J., Shazeer, N. M., Kulshreshtha, A., Cheng, H.- T., Jin, A., Bos, T., Baker, L., Du, Y., Li, Y., Lee, H., Zheng, H., Ghafouri, A., Menegali, M., Huang, Y., Krikun, M., Lepikhin, D., Qin, J., Chen, D., Xu, Y., Chen, Z., Roberts, A., Bosma, M., Zhou, Y., Chang, C.- C., Krivokon, I. A., Rusch, W. J., Pickett, M., Meier- Hellstern, K. S., Morris, M. R., Doshi, T., Santos, R. D., Duke, T., Soraker, J. H., Zevenbergen, B., Prabhakaran, V., Díaz, M., Hutchinson, B., Olson, K., Molina, A., Hoffman- John, E., Lee, J., Aroyo, L., Rajakumar, R., Butryna, A., Lamm, M., Kuzmina, V. O., Fenton, J., Cohen, A., Bernstein, R., Kurzweil, R., Aguera- Arcas, B., Cui, C., Croak, M., hsin Chi, E. H., and Le, Q. Lamda: Language models for dialog applications. ArXiv, abs/2201.08239, 2022.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., and Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Yu, J., Xu, Y., Koh, J. Y., Luong, T., Baid, G., Wang, Z., Vasudevan, V., Ku, A., Yang, Y., Ayan, B. K., Hutchinson, B. C., Han, W., Parekh, Z., Li, X., Zhang, H., Baldridge, J., and Wu, Y. Scaling autoregressive models for content-rich text- to- image generation. ArXiv, abs/2206.10789, 2022.
A. Apéndice
A.1. Correctitud del muestreo especulativo
Ahora mostraremos que para cualesquiera distribuciones y , los tokens muestreados mediante muestreo especulativo a partir de y se distribuyen de forma idéntica a los muestreados a partir de únicamente. Sea la probabilidad de aceptación (Definición 3.1).
Nótese que como , la constante de normalización para la distribución ajustada es , donde la última ecuación se sigue inmediatamente del Lema 3.3 y el Teorema 3.5.
Ahora:
Donde:
Y:
En conjunto:
Como se deseaba.
A.2. Muestreo especulativo frente a muestreo por rechazo
El muestreo por rechazo es el siguiente procedimiento de muestreo iterativo que parece superficialmente similar al nuestro:
1. Muestrear y .
2. Si , devolver .
3. Ir a 1.
Donde . Podríamos emplear una versión no iterativa del muestreo por rechazo en lugar del muestreo especulativo; específicamente, seguir los pasos 1 y 2 anteriores y, en caso contrario, muestrear directamente de una sin modificar. Sin embargo, eso sería mucho menos eficiente que nuestro método. Específicamente, la probabilidad de aceptación esperada aquí es , que es (potencialmente mucho) menor que la probabilidad de aceptación esperada en nuestro método .
A.3. Predicciones teóricas frente a tiempos de ejecución empíricos
La Tabla 4 compara las mejoras esperadas en el tiempo de ejecución basadas en el Teorema 3.8 con los tiempos de ejecución medidos empíricamente de la Tabla 2. Estimamos los valores de para los distintos modelos a partir de trazas del generador de perfiles. Podemos ver que las predicciones teóricas coinciden en su mayoría con los tiempos de ejecución medidos. Las diferencias mayores se deben a: (1) diferencias de optimización entre nuestra implementación y la línea base, y (2) el supuesto simplificador de que los son i.i.d. es solo una aproximación (véase la Sección 3.1).
| TAREA | MQ | TEMP | γ | α | c | EXP | EMP |
| ENDE | T5-SMALL | 0 | 7 | 0.75 | 0.02 | 3.2 | 3.4 |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 0.04 | 3.3 | 2.8 |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 0.11 | 2.5 | 1.7 |
| ENDE | T5-SMALL | 1 | 7 | 0.62 | 0.02 | 2.3 | 2.6 |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 0.04 | 2.4 | 2.4 |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 0.11 | 2.0 | 1.4 |
| CNNDM | T5-SMALL | 0 | 5 | 0.65 | 0.02 | 2.4 | 3.1 |
| CNNDM | T5-BASE | 0 | 5 | 0,73 | 0,04 | 2,6 | 3,0 |
| CNNDM | T5-LARGE | 0 | 3 | 0,74 | 0,11 | 2,0 | 2,2 |
| CNNDM | T5-SMALL | 1 | 5 | 0,53 | 0,02 | 1,9 | 2,3 |
| CNNDM | T5-BASE | 1 | 3 | 0,55 | 0,04 | 1,8 | 2,2 |
| CNNDM | T5-LARGE | 1 | 3 | 0,56 | 0,11 | 1,6 | 1,7 |
Tabla 4. Factor de mejora esperado (Exp) frente al factor de mejora medido empíricamente (EMP).
A.4. Aplicación a la búsqueda por haces
Nuestro método puede aplicarse, con cierta penalización en el rendimiento, al muestreo por búsqueda de haz. Dado el ancho de haz original , podemos realizar una búsqueda de haz con el modelo de aproximación y un ancho de haz durante pasos. Luego, podemos usar para verificar todos los candidatos en paralelo (con un costo de presupuesto de cómputo de ejecuciones de ). Finalmente, para cada paso, podemos aceptar las conjeturas de siempre que , para obtener resultados idénticos a la búsqueda de haz regular con sola (con un procedimiento más elaborado, también podríamos aceptar casos en los que los candidatos que obtuvimos resulten tener probabilidades más altas que las de sola). El análisis de nuestro método en este contexto es más complejo y lo dejamos para trabajo futuro.
A.5. Tolerancia
Una propiedad sólida del Algoritmo es que se garantiza que la distribución de salida permanece sin cambios. Dicho esto, si estamos dispuestos a permitir algunos cambios, con buenas garantías, podemos obtener mejoras adicionales en la velocidad de inferencia. Para motivar aún más esto, nótese que cuando entrenamos dos modelos con arquitecturas y tamaños idénticos sobre el mismo conjunto de datos, las distribuciones de probabilidad generadas no serán idénticas, por lo que cierta tolerancia podría tener sentido. Nótese que los resultados en este artículo, excepto en esta sección, usan la versión más estricta del Algoritmo y no permiten tolerancia de ningún tipo.
Podríamos incluir un parámetro de tolerancia y multiplicar por antes de comparar con en el Algoritmo Esto sigue manteniendo la buena garantía de que ningún token puede ser muestreado con una probabilidad mayor que . Esto significa, por ejemplo, que con ningún token puede ser muestreado con más de 10 veces su probabilidad real, por lo que podemos garantizar que los tokens extremadamente raros seguirán siendo extremadamente raros (no hay garantía sobre la probabilidad mínima, por lo que la tolerancia podría perjudicar la diversidad de las muestras).
Específicamente, con un factor de tolerancia tenemos \begin{array}{r l r}{{\alpha}~=}&{{}E_{x\sim q(x)}\left\{\begin{array}{l l}{1}&{l q(x)\leq p(x)}\\ {\frac{p(x)}{l q(x)}}&{l q(x)>p(x)}\end{array}\right.}&{{}=}&{{}E_{x\sim q(x)}\frac{p(x)}{m a x(p(x),l q(x))}}}\end{array}
La Tabla 5 muestra los valores de para diferentes valores de cuando es T5-XXL (11B) y es T5-small (77M). Con usando valores de tolerancia de 1, 0.5, 0.3 y 0.1 (lo que significa que ningún token puede ser muestreado con una probabilidad mayor que 1X, 2X, 3X y 10X de la real) obtenemos factores de mejora de 2.5X, 3.1X, 3.6X y 5X respectivamente.
| Contexto de solo lectura para comprender la fuente (no es texto fuente para traducir): La Tabla 5 muestra los valores de \alpha para diferentes valores de l cuando M_{p} es T5-XXL (11B) y M_{q} es T5-small (77M). Con c = 0.015 usando valores de indulgencia de 1, 0.5, 0.3 y 0.1 (lo que significa que ningún token puede muestrearse con una probabilidad mayor que 1X, 2X, 3X y 10X de la verdad fundamental), obtenemos factores de mejora de 2.5X, 3.1X, 3.6X y 5X, respectivamente. Tabla 5. Valores de \alpha para varios valores de l con muestreo estándar donde M_{p} es T5-XXL (11B) en la tarea de traducción EnDe. Texto a traducir: MQ | l = 1 | l = 0.5 | l = 0.3 | l = 0.1 |
| UNIGRAM | 0.07 | 0.1 | 0.11 | 0.16 |
| BIGRAM | 0.19 | 0.23 | 0.25 | 0.32 |
| T5-SMALL (77M) | 0.62 | 0.71 | 0.76 | 0.84 |
| T5-BASE (250M) | 0.68 | 0.8 | 0.83 | 0.90 |
Tabla 5. Valores de para varios valores de con muestreo estándar, donde es T5-XXL (11B) en la tarea de traducción EnDe.
Téngase en cuenta que, al usar temperatura (es decir, muestreo argmax), ya no podemos emplear la indulgencia como antes. En su lugar, podríamos permitir cierta indulgencia antes de estandarizar las distribuciones. Por ejemplo, podríamos aceptar el token muestreado de en caso de que . En este caso, medimos aumentos empíricos similares en los valores de a los obtenidos con temperatura . Por ejemplo, al usar valores de indulgencia de 1, 0.5, 0.3 y 0.1 para T5-XXL y T5-small en la traducción inglés-alemán, obtenemos valores de de 0.75, 0.75, 0.8 y 0.87. Tomando, por ejemplo, y , obtenemos factores de mejora de velocidad de 3.3X, 3.3X, 3.9X y 4.9X, respectivamente.7