
Un marco muestra que la atención y los modelos de espacio de estados son dos vistas de la misma matriz, y da una capa más rápida. ICML 2024, gratis.
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
Los Transformers son SSMs: Modelos Generalizados y Algoritmos Eficientes mediante la Dualidad de Espacios de Estados Estructurados
Departamento de Ciencias de la Computación, Universidad de Princeton Departamento de Aprendizaje Automático, Universidad Carnegie Mellon tri@tridao.me, agu@cs.cmu.edu
Resumen
Si bien los Transformers han sido la arquitectura principal detrás del éxito del aprendizaje profundo en el modelado del lenguaje, recientemente se ha demostrado que los modelos de espacios de estados (SSMs), como Mamba, igualan o superan a los Transformers a pequeña y mediana escala. Mostramos que estas familias de modelos están en realidad bastante estrechamente relacionadas, y desarrollamos un rico marco de conexiones teóricas entre los SSMs y variantes de la atención, conectadas a través de diversas descomposiciones de una clase bien estudiada de matrices semiseparables estructuradas. Nuestro marco de dualidad de espacios de estados (SSD) nos permite diseñar una nueva arquitectura (Mamba-2) cuya capa central es un refinamiento del SSM selectivo de Mamba que es de 2 a 8 veces más rápida, mientras continúa siendo competitiva con los Transformers en el modelado del lenguaje.
1 Introducción
Los Transformers, en particular los modelos solo-decodificador (p. ej., GPT (Brown et al. 2020), Llama (Touvron, Lavril, et al. 2023)) que procesan secuencias de entrada de manera causal, son uno de los principales impulsores del éxito del aprendizaje profundo moderno. Numerosos enfoques intentan aproximar la capa de atención central para abordar sus problemas de eficiencia (Tay et al. 2022), como el escalado cuadrático en la longitud de la secuencia durante el entrenamiento y la necesidad de una caché de tamaño lineal en la longitud de la secuencia durante la generación autorregresiva. En paralelo, ha surgido una clase de modelos de secuencia alternativos, los modelos de espacios de estados estructurados (SSMs), con escalado lineal en la longitud de la secuencia durante el entrenamiento y un tamaño de estado constante durante la generación. Muestran un fuerte rendimiento en tareas de largo alcance (p. ej., S4 (Gu, Goel y Ré 2022)) y recientemente igualaron o superaron a los Transformers en el modelado del lenguaje (p. ej., Mamba (Gu y Dao 2023)) a pequeña y moderada escala. Sin embargo, el desarrollo de los SSMs ha parecido disjunto del esfuerzo colectivo de la comunidad por mejorar los Transformers, como comprenderlos teóricamente así como optimizarlos en hardware moderno. Como resultado, es más difícil comprender y experimentar con los SSMs en comparación con los Transformers, y sigue siendo un desafío entrenar SSMs con la misma eficiencia que los Transformers tanto desde una perspectiva algorítmica como de sistemas.
Nuestro objetivo principal es desarrollar un rico cuerpo de conexiones teóricas entre los SSMs estructurados y las variantes de la atención. Esto nos permitirá transferir optimizaciones algorítmicas y de sistemas originalmente desarrolladas para Transformers a los SSMs, con el objetivo de construir modelos fundacionales que rindan mejor que los Transformers mientras escalan de manera más eficiente en la longitud de la secuencia. Una contribución destacada en esta dirección fue el marco de Atención Lineal (LA) (Katharopoulos et al. 2020), que derivó una conexión entre la atención autorregresiva y las RNN lineales al demostrar la equivalencia entre las "formas duales" de la atención kernelizada cuadrática y una recurrencia lineal particular. Esta dualidad permite nuevas capacidades, como la posibilidad de tener tanto un entrenamiento paralelizable eficiente como una inferencia autorregresiva eficiente. En el mismo espíritu, este artículo proporciona múltiples puntos de vista que conectan los SSMs de complejidad lineal con formas de complejidad cuadrática para combinar las fortalezas de los SSMs y la atención.
Dualidad de Espacios de Estados. Nuestro marco que conecta los SSMs estructurados y las variantes de la atención, al que llamamos dualidad de espacios de estados estructurados (SSD), se realiza mediante las abstracciones de matrices estructuradas: matrices con parámetros y complejidad de multiplicación subcuadráticos. Desarrollamos dos marcos amplios para representar modelos de secuencia, uno como transformaciones matriciales y otro como contracciones tensoriales, que revelan cada uno diferentes perspectivas de la dualidad. Nuestras contribuciones técnicas incluyen:
- Mostramos una equivalencia entre los modelos de espacios de estados y una familia bien estudiada de matrices estructuradas llamadas matrices semiseparables (Sección 3). Esta conexión está en el corazón de nuestro marco, revelando nuevas propiedades y algoritmos para los SSMs. Un mensaje central de este artículo es que los diferentes métodos de computar modelos de espacios de estados pueden reformularse como diversos algoritmos de multiplicación de matrices sobre matrices estructuradas.
- Mejoramos significativamente la teoría de la atención lineal (Katharopoulos et al. 2020). Primero proporcionamos una prueba incisiva de su forma recurrente a través del lenguaje de las contracciones tensoriales, y luego la generalizamos a una nueva familia de atención enmascarada estructurada (SMA) (Sección 4).
- Conectamos los SSMs y la SMA, mostrando que tienen una gran intersección que son duales entre sí, poseyendo tanto formas lineales tipo SSM como formas cuadráticas tipo atención (Sección 5). También demostramos que cualquier método de atención por kernel que posea una forma recurrente rápida debe ser un SSM.
Más allá de su valor teórico intrínseco, nuestro marco abre un amplio conjunto de direcciones para comprender y mejorar los modelos de secuencia.
Algoritmos Eficientes. Primero y más importante, nuestro marco expone nuevos algoritmos eficientes y fácilmente implementables para computar SSMs (Sección 6). Introducimos un nuevo algoritmo SSD, basado en descomposiciones por bloques de matrices semiseparables, que aprovecha tanto la recurrencia lineal del SSM como la forma dual cuadrática, obteniendo compensaciones óptimas en todos los ejes principales de eficiencia (p. ej., cómputo de entrenamiento e inferencia, uso de memoria y capacidad de aprovechar las unidades de multiplicación de matrices en hardware moderno). Una implementación dedicada de SSD es de veces más rápida que la implementación optimizada de escaneo selectivo de Mamba, mientras permite simultáneamente tamaños de estado recurrente mucho mayores ( el tamaño de Mamba o incluso mayor, con una desaceleración mínima). SSD es altamente competitivo con las implementaciones optimizadas de atención softmax (FlashAttention-2 (Dao 2024)), cruzándose en una longitud de secuencia de y siendo más rápido en una longitud de secuencia de 16K.
Diseño de Arquitectura. Un obstáculo importante para adoptar nuevas arquitecturas como los SSMs es el ecosistema adaptado a los Transformers, como las técnicas de optimización y paralelismo eficientes en hardware para el entrenamiento a gran escala. Nuestro marco permite usar convenciones y técnicas establecidas para la atención para construir un vocabulario de opciones de diseño de arquitectura para los SSMs, y mejorarlas aún más (Sección 7). Por ejemplo, introducimos el análogo de las cabezas de la atención multi-cabeza (MHA) para los SSMs. Mostramos que la arquitectura Mamba es un SSM multi-entrada (MIS) que resulta ser análogo a la atención multi-valor (MVA), y comparamos otras variantes de Mamba con diferentes estructuras de cabezas.
También usamos estas ideas para hacer ligeras modificaciones al bloque Mamba, lo que permite implementar el paralelismo tensorial (p. ej., al estilo de Megatron (Shoeybi et al. 2019)). Las ideas principales incluyen introducir la estructura de cabezas de atención de valores agrupados (GVA), y mover todas las proyecciones dependientes de datos para que ocurran en paralelo al inicio del bloque.
La combinación del bloque Mamba paralelo modificado, junto con el uso de SSD como la capa SSM interna, da como resultado la arquitectura Mamba-2. Investigamos las leyes de escalado de Chinchilla para Mamba-2 en el mismo entorno que Mamba, encontrando que domina en el sentido de Pareto a Mamba y Transformer++ tanto en perplejidad como en tiempo de reloj de pared. Además, entrenamos una familia demodelos Mamba-2 de tamaños variables sobre el Pile, mostrando que iguala o supera a Mamba y a los Transformers de código abierto en evaluaciones posteriores estándar. Por ejemplo, Mamba-2 con 2.7B parámetros entrenado sobre 300B tokens en el Pile supera a Mamba-2.8B, Pythia-2.8B e incluso a Pythia-6.9B entrenado sobre el mismo conjunto de datos.
Optimizaciones de Sistemas. El marco SSD conecta los SSMs y los Transformers, permitiéndonos aprovechar un rico cuerpo de trabajo sobre optimizaciones de sistemas desarrollado para Transformers (Sección 8).
- Por ejemplo, el Paralelismo Tensorial (TP) es una técnica importante de paralelismo de modelos para entrenar grandes modelos Transformer dividiendo cada capa entre GPUs en el mismo nodo. Diseñamos Mamba-2 para que sea amigable con TP, reduciendo a la mitad el número de puntos de sincronización por bloque.
- Para secuencias muy largas cuyas activaciones no caben en un solo dispositivo, se ha desarrollado el paralelismo de secuencia para los bloques de atención. Describimos cómo entrenar SSMs en general y Mamba-2 en particular con paralelismo de secuencia, pasando los estados recurrentes entre dispositivos.
- Para el ajuste fino con ejemplos de diferentes longitudes, para una mejor eficiencia, Transformer requiere técnicas sofisticadas para eliminar los tokens de relleno y realizar atención sobre secuencias de longitud variable. Mostramos cómo Mamba-2 puede entrenarse eficientemente con longitudes de secuencia variables, sin requerir tokens de relleno.
La Sección 9 valida empíricamente Mamba-2 en modelado del lenguaje, eficiencia de entrenamiento y una difícil tarea de recuperación asociativa multi-consulta (Arora, Eyuboglu, Zhang, et al. 2024). Finalmente, en la Sección 10, proporcionamos un trabajo relacionado extendido y discutimos posibles direcciones de investigación abiertas por nuestro marco.
El código del modelo y los checkpoints preentrenados están disponibles como código abierto en https://github.com/state-spaces/mamba.
2 Antecedentes y Visión General
2.1 Modelos de Espacios de Estados Estructurados
Los modelos de secuencia de espacios de estados estructurados (S4) son una clase reciente de modelos de secuencia para aprendizaje profundo que están ampliamente relacionados con las RNN, las CNN y los modelos de espacios de estados clásicos. Están inspirados en un sistema continuo particular (1) que mapea una secuencia unidimensional a través de un estado latente implícito .
Una forma discreta general de los SSM estructurados adopta la forma de la ecuación (1).
donde . Los SSM estructurados reciben ese nombre porque la matriz que controla la dinámica temporal debe estar estructurada para poder computar esta transformación de secuencia a secuencia de forma suficientemente eficiente como para ser utilizada en redes neuronales profundas. Las estructuras originales introducidas fueron diagonal más de bajo rango (DPLR, por sus siglas en inglés) (Gu, Goel, and Ré 2022) y diagonal (Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023), que sigue siendo la estructura más popular.
En este trabajo, utilizamos el término modelo de espacio de estados (SSM) para referirnos a los SSM estructurados. Existen muchas variantes de tales SSM, con profundos vínculos con varios paradigmas importantes de modelos neuronales de secuencia, como los modelos de tiempo continuo, recurrentes y convolucionales (Gu, Johnson, Goel, et al. 2021). Proporcionamos a continuación una breve descripción general, y remitimos a trabajos previos para más contexto y detalles (Gu 2023; Gu and Dao 2023).
Modelos de tiempo continuo. Los SSM estructurados originales surgieron como mapas de tiempo continuo sobre funciones , en lugar de operar directamente sobre secuencias. Desde la perspectiva del tiempo continuo, en la ecuación (1a) las matrices no se aprenden directamente, sino que se generan a partir de parámetros subyacentes , junto con un tamaño de paso parametrizado . Los "parámetros continuos" se convierten en "parámetros discretos" mediante fórmulas fijas y , donde el par se denomina regla de discretización.
Observación 1. Aunque nuestros modelos principales adoptan la misma parametrización y paso de discretización que trabajos previos (véase Gu y Dao (2023) para más detalles), por simplicidad de exposición y notación lo omitimos en el resto de este artículo. Señalamos que trabajos previos sobre SSMs estructurados se referían a los parámetros continuos \((\hat{A},\hat{B})\) y a los parámetros discretos \((A,B)\) como \((A,B)\) y \((\hat{A},\hat{B})\) en su lugar; hemos cambiado la notación para simplificar la presentación y centrarnos directamente en los parámetros discretos, que gobiernan la recurrencia principal del SSM.
Modelos recurrentes. Las ecuaciones (1) y (2) adoptan la forma de una recurrencia que es lineal en su entrada \(x\). Por lo tanto, los SSMs estructurados pueden considerarse como tipos de redes neuronales recurrentes (RNN), donde la linealidad les confiere propiedades adicionales y les permite evitar el cómputo secuencial de las RNN tradicionales. A la inversa, a pesar de esta simplificación, los SSMs siguen siendo plenamente expresivos como transformaciones de secuencias (en el sentido de aproximación universal) (Kaul 2020; Orvieto et al. 2023; Shida Wang y Xue 2023).
Modelos convolucionales. Cuando la dinámica del SSM es constante a lo largo del tiempo como en la ecuación (1), el modelo se denomina lineal e invariante en el tiempo (LTI). En este caso, son equivalentes a convoluciones. Así, los SSMs también pueden considerarse como tipos de CNN, pero donde (i) los núcleos de convolución están parametrizados implícitamente a través de los parámetros del SSM \((A,B,C)\) y (ii) los núcleos de convolución son generalmente globales en lugar de locales. A la inversa, mediante la teoría clásica del procesamiento de señales, todas las convoluciones suficientemente bien comportadas pueden representarse como SSMs.
Habitualmente, los SSMs LTI previos utilizaban el modo convolucional para un entrenamiento paralelizable eficiente (donde toda la secuencia de entrada se ve por adelantado), y cambiaban al modo recurrente (1) para una inferencia autorregresiva eficiente (donde las entradas se ven paso a paso).
Modelos de espacio de estados selectivos. La forma (2) donde los parámetros \((A,B,C)\) también pueden variar en el tiempo fue introducida en Mamba como el SSM selectivo. En comparación con la formulación LTI estándar (1), este modelo puede elegir selectivamente centrarse en las entradas o ignorarlas en cada paso temporal. Se demostró que funciona mucho mejor que los SSMs LTI en datos densos en información como el lenguaje, especialmente a medida que su tamaño de estado N aumenta, permitiendo una mayor capacidad de información. Sin embargo, solo puede computarse en modo recurrente en lugar de convolucional, y requiere una implementación cuidadosa consciente del hardware para ser eficiente. Aun así, sigue siendo menos eficiente que modelos amigables con el hardware como las CNN y los Transformers, porque no aprovecha las unidades de multiplicación de matrices, para las cuales los aceleradores modernos como las GPU y TPU están especializados.
Aunque los SSMs invariantes en el tiempo están estrechamente relacionados con modelos de secuencia continuos, recurrentes y convolucionales, no están directamente relacionados con la atención. En este artículo, mostramos una relación más profunda entre los SSMs selectivos y la atención, y la utilizamos para mejorar significativamente la velocidad de entrenamiento de los SSMs mientras permitimos simultáneamente tamaños de estado N mucho mayores.
SSMs estructurados como transformaciones de secuencias.
Definición 2.1. Usamos el término transformación de secuencias para referirnos a una aplicación parametrizada sobre secuencias \(Y = f_{\theta}(X)\) donde \(X,Y\in \mathbb{R}^{(\mathrm{T},\mathrm{P})}\) y \(\theta\) es una colección arbitraria de parámetros. T representa la secuencia o eje temporal; los subíndices indexan la primera dimensión, p. ej. \(X_{t},Y_{t}\in \mathbb{R}^{\mathrm{P}}\)
Las transformaciones de secuencias (p. ej. SSMs, o autoatención) son la piedra angular de los modelos profundos de secuencias, donde se incorporan en arquitecturas de redes neuronales (p. ej. Transformers). El SSM en (1) o (2) es una transformación de secuencias con \(\mathsf{P} = 1\); puede generalizarse a \(\mathsf{P} > 1\) simplemente difundiendo (broadcasting) a través de esta dimensión (en otras palabras, viendo la entrada como \(\mathsf{P}\) secuencias independientes y aplicando el SSM a cada una). Se puede pensar en \(\mathsf{P}\) como una dimensión de cabeza, que elaboraremos en la Sección 7.
Definición 2.2. Definimos el operador SSM \(\mathrm{SSM}(A,B,C) = \mathrm{SSM}(A_{0:T},B_{0:T},C_{0:T})\) como la transformación de secuencias \(X\in\) \(\mathbb{R}^{(\mathrm{T},\mathrm{P})}\mapsto Y\in \mathbb{R}^{(\mathrm{T},\mathrm{P})}\) definida por la ecuación (2).
En los SSMs, la dimensión N es un parámetro libre llamado tamaño de estado o dimensión de estado. También lo llamamos factor de expansión de estado, porque expande el tamaño de la entrada/salida por un factor de \(N\), con implicaciones para la eficiencia computacional de estos modelos.
Finalmente, observamos que muchos tipos de transformaciones de secuencias, como la atención, pueden representarse como una única multiplicación de matrices a través de la dimensión de secuencia.
Definición 2.3. Llamamos a una transformación de secuencias \(Y = f_{\theta}(X)\) una transformación matricial si puede escribirse en la forma \(Y = M_{\theta}X\) donde \(M\) es una matriz que depende de los parámetros \(\theta\). Identificamos la transformación de secuencias con la matriz \(M\), y a menudo omitimos la dependencia de \(\theta\) cuando está claro por el contexto.
2.2 Atención
La atención se refiere en términos generales a un tipo de cómputo que asigna puntuaciones a cada par de posiciones en una secuencia, permitiendo que cada elemento "atienda" al resto. Con diferencia, la variante de atención más común e importante es la autoatención softmax, que puede definirse como
para \(Q,K,V\in \mathbb{R}^{(\mathrm{T},\mathrm{P})}\). El mecanismo de comparaciones por pares (inducido al materializar \(Q K^{\top}\)) conduce al característico coste de entrenamiento cuadrático de la atención.
Se han propuesto muchas variantes de atención, pero todas comparten el núcleo subyacente de estas puntuaciones de atención, con diversas aproximaciones (Tay et al. 2022). La variante más importante para este trabajo es la atención lineal (Katharopoulos et al. 2020). En términos generales, esta familia de métodos elimina el softmax incorporándolo en un mapa de características kernel, y utiliza la asociatividad de la multiplicación de matrices para reescribir \((Q K^{\top})\cdot V = Q\cdot (K^{\top}V)\). Además, en el importante caso de la atención causal (autorregresiva), muestran que cuando la máscara causal se incorpora en el lado izquierdo como \((L\circ Q K^{\top})\cdot V\), donde \(L\) es la matriz triangular inferior de unos, entonces el lado derecho puede expandirse como una recurrencia. Varios trabajos recientes y concurrentes como RetNet (Y. Sun et al. 2023) y GateLoop (Katsch 2023) refuerzan esto a formas más generales de \(L\) (Sección 10). En este trabajo, nuestra formulación de la atención enmascarada estructurada generalizará fuertemente estas ideas.
2.3 Matrices estructuradas
Las matrices generales \(M\in \mathbb{R}^{(\mathrm{T},\mathrm{T})}\) requieren \(\mathrm{T}^{2}\) parámetros para representarse y \(O(\mathrm{T}^{2})\) tiempo para realizar operaciones básicas como la multiplicación matriz-vector. Las matrices estructuradas son aquellas que (i) pueden representarse en parámetros subcuadráticos (idealmente lineales) mediante una representación comprimida, y (ii) tienen algoritmos rápidos (lo más importante, multiplicación de matrices) al operar directamente sobre esta representación comprimida.
Quizás las familias más canónicas de matrices estructuradas son las matrices dispersas y de bajo rango. Sin embargo, existen muchas otras familias, como las matrices de Toeplitz, Cauchy, Vandermonde y mariposa (butterfly), que se han utilizado en aprendizaje automático para modelos eficientes (Dao, Gu, et al. 2019; D. Fu et al. 2024; Gu, Gupta, et al. 2022; Thomas et al. 2018). Las matrices estructuradas son una abstracción poderosa para representaciones y algoritmos eficientes. En este trabajo, mostraremos que los SSMs son equivalentes a otra clase de matrices estructuradas que no se han utilizado previamente en aprendizaje profundo, y usaremos esta conexión para derivar métodos y algoritmos eficientes.
2.4 Panorama general: Dualidad de espacios de estados estructurados
Aunque este artículo desarrolla un marco mucho más rico de conexiones entre los SSM, la atención y las matrices estructuradas, proporcionamos un breve resumen del método principal, que en realidad es bastante autocontenido y simple algorítmicamente.
Forma recurrente (lineal). La capa de dualidad de espacios de estados (SSD, por sus siglas en inglés) puede definirse como un caso especial del SSM selectivo (2). Puede aplicarse el cálculo estándar de un SSM como una recurrencia (o exploración paralela), que tiene complejidad lineal en la longitud de la secuencia. En comparación con la versión utilizada en Mamba, SSD tiene dos diferencias menores:
La estructura sobre se simplifica aún más, pasando de una estructura diagonal a una estructura escalar por identidad. Cada también puede identificarse con solo un escalar en este caso. Usamos una dimensión de cabeza mayor, en comparación con utilizado en Mamba. Normalmente se elige , lo cual es similar a las convenciones para los Transformers modernos.
En comparación con el SSM selectivo original, estos cambios pueden verse como una disminución leve de la capacidad expresiva a cambio de mejoras significativas en la eficiencia de entrenamiento. En particular, nuestros nuevos algoritmos permitirán el uso de unidades de multiplicación de matrices en los aceleradores modernos.
Forma dual (cuadrática). La forma dual de SSD es un cálculo cuadrático estrechamente relacionado con la atención, definido como
donde son escalares dependientes de la entrada acotados en [0, 1].
En comparación con la atención softmax estándar, hay dos diferencias principales:
- Se elimina el softmax.
- La matriz de atención se multiplica elemento por elemento por una matriz de máscara adicional .
Ambos cambios pueden verse como una manera de abordar problemas en la atención convencional. Por ejemplo, recientemente se ha observado que el softmax causa problemas en las puntuaciones de atención, como el fenómeno de "sumidero de atención" (Darcet et al. 2024; Xiao et al. 2024). Más importante aún, la matriz de máscara puede verse como un reemplazo de las incorporaciones posicionales heurísticas de los Transformers por una máscara posicional diferente, dependiente de los datos, que controla cuánta información se transfiere a lo largo del tiempo.
En términos más generales, esta forma es una instancia de nuestra generalización de atención enmascarada estructurada de la atención lineal, definida en la Sección 4.
Forma matricial y algoritmo SSD. Las diversas formas de SSD están conectadas mediante una representación matricial unificada, al mostrar que los SSM tienen una forma de transformación matricial para una matriz que depende de . En particular, la forma dual de SSD es equivalente a la multiplicación ingenua (de tiempo cuadrático) por la matriz , y la forma recurrente es un algoritmo eficiente particular (de tiempo lineal) que aprovecha la estructura en .
Yendo más allá de estas, se puede aplicar cualquier algoritmo para la multiplicación por . Nuestro algoritmo SSD propuesto, eficiente en hardware (Sección 6), es un nuevo método de multiplicación de matrices estructuradas que involucra descomposiciones en bloques de , el cual obtiene mejores compensaciones de eficiencia que las formas puramente lineal o cuadrática. Es relativamente simple y fácil de implementar en comparación con los SSM selectivos generales (Gu y Dao 2023); el Listado 1 proporciona una implementación completa en unas pocas líneas de código.
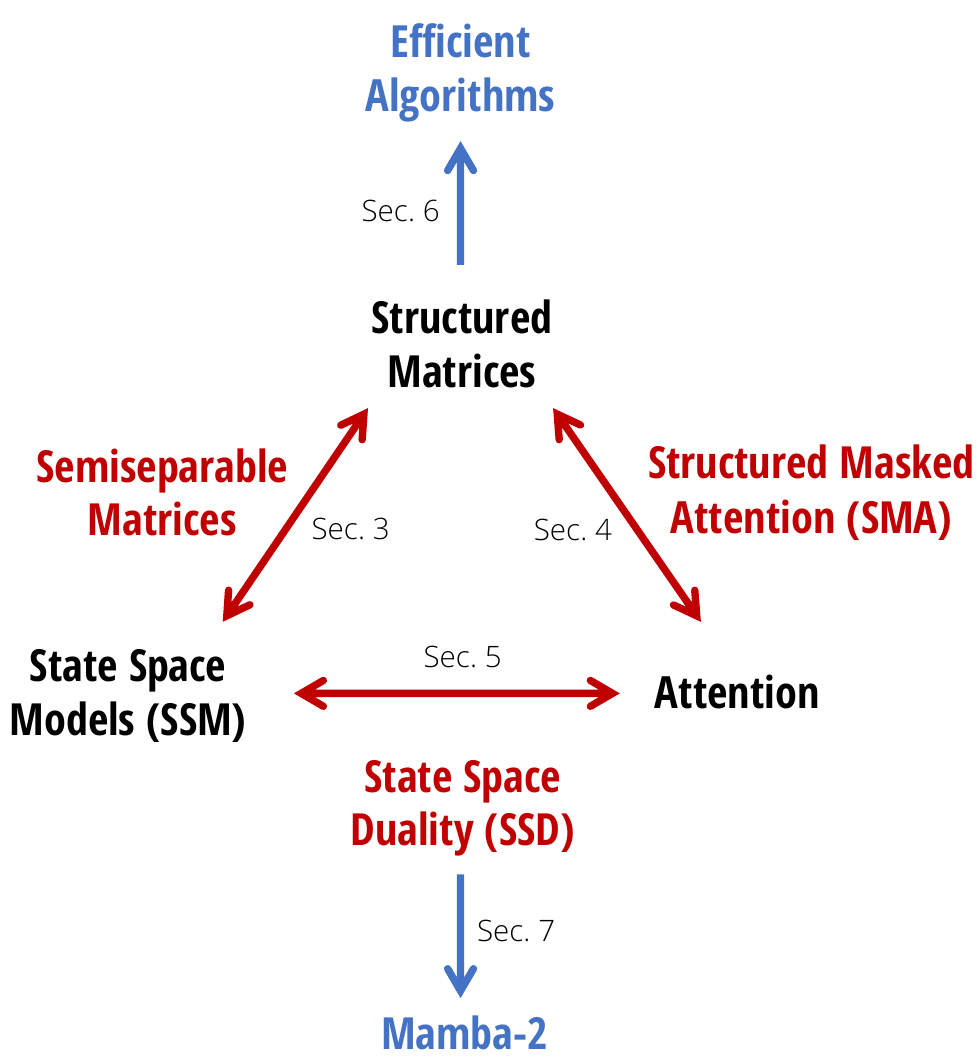
La figura 1 proporciona una hoja de ruta simple de las relaciones entre los conceptos presentados en este artículo.
2.5 Notación
A lo largo de este artículo, preferimos usar una notación precisa que pueda mapearse a código.
Matrices y vectores. Generalmente usamos minúsculas para denotar vectores (es decir, tensores con un solo eje) y mayúsculas para denotar matrices (es decir, tensores con más de un eje). En este trabajo no escribimos las matrices en negrita. A veces, si una matriz está ligada o repetida a lo largo de un eje (y por lo tanto también puede verse como un vector), podemos usar mayúsculas o minúsculas para ella. denota la multiplicación escalar o matricial, mientras que denota la multiplicación de Hadamard (elemento a elemento).
Indexación. Usamos indexación al estilo de Python; por ejemplo, se refiere al rango cuando y a cuando . Por ejemplo, para cualquier símbolo denotamos con para la secuencia . es equivalente a . Como abreviatura, también denotamos con el producto .
Dimensiones. Para distinguirlas de las matrices y los tensores, a menudo usamos letras mayúsculas en fuentes de máquina de escribir (por ejemplo, ) para denotar dimensiones y formas de tensores. En lugar de la notación tradicional , usamos con frecuencia para reflejar las formas de los tensores en el código.
Contracciones de tensores. Nos apoyaremos en gran medida en la notación de contracción de tensores o einsum, tanto por claridad como por ser una herramienta central para enunciar y demostrar nuestros resultados. Suponemos que el lector está familiarizado con esta notación, que se usa comúnmente en bibliotecas modernas de tensores como numpy. Por ejemplo, podemos usar contract para denotar el operador de multiplicación matriz-matriz, y en nuestra notación contract (que es equivalente a ) puede traducirse a código como numpy.einsum('mn,nk , X, Y).
En el apéndice A se incluye un glosario extenso de notación.
3 Los modelos de espacio de estados son matrices estructuradas
Esta sección explora diferentes perspectivas del modelo de espacio de estados como una transformación de secuencias, y describe propiedades y algoritmos de tales mapas. Los resultados principales de esta sección tratan sobre la equivalencia entre los modelos de espacio de estados y una familia de matrices estructuradas llamadas matrices semiseparables, lo que implica nuevos resultados de eficiencia (teoremas 3.5 y 3.7).
3.1 La forma de transformación matricial de los modelos de espacio de estados
Recordemos que nuestra definición de un SSM se define como un mapa parametrizado definido mediante (2). Nuestro marco teórico comienza simplemente escribiendo esta transformación como una multiplicación de matrices que mapea los vectores .
Por definición, . Por inducción,
Multiplicando por para producir y vectorizando la ecuación sobre , derivamos la forma de transformación matricial de los SSM.
3.2 Matrices semiseparables
en la ecuación (3) es una representación particular de una clase de matrices conocidas como matrices semiseparables. Las matrices semiseparables son una estructura matricial fundamental. Primero definimos estas matrices y sus propiedades.
Definición 3.1. Una matriz (triangular inferior) es N-semiseparable si toda submatriz contenida en la porción triangular inferior (es decir, sobre o por debajo de la diagonal) tiene rango como máximo N. Llamamos a N el orden o rango de la matriz semiseparable.
La definición 3.1, y otras formas de estructura relacionada "separable" (por ejemplo, matrices cuasiseparables y otras definiciones de matrices semiseparables) a veces se denominan matrices de rango estructurado (o matrices con estructura de rango) porque se caracterizan por condiciones de rango sobre sus submatrices. Las matrices semiseparables tienen muchas representaciones estructuradas, incluidas las formas jerárquicamente semiseparable (HSS), secuencialmente semiseparable (SSS) y de Bruhat (Pernet y Storjohann 2018). Usaremos principalmente la forma SSS.
3.2.1 La representación secuencialmente semiseparable (SSS)
Definición 3.2. Una matriz triangular inferior tiene una representación N-secuencialmente semiseparable (SSS) si puede escribirse de la forma
para vectores y matrices
Definimos el operador SSS de modo que
Un resultado fundamental de las matrices semiseparables es que son exactamente equivalentes a las matrices con representaciones SSS. Una dirección puede deducirse con una prueba constructiva simple.
Lema 3.3. Una matriz N-SSS con representación (4) es N-semiseparable.
Prueba. Considérese cualquier bloque fuera de la diagonal donde . Este tiene una factorización explícita de rango N como
Dado que las matrices diagonales son fáciles de manejar (por ejemplo, la multiplicación por una matriz diagonal es lo mismo que la multiplicación escalar elemento a elemento), podemos ignorar estos términos. Así, nuestra representación básica de una matriz 1-SS es o
La importancia de las matrices 1-SS radica en su equivalencia con la forma mínima de una recurrencia escalar: el caso de un SSM degenerado con dimensión de estado y sin proyecciones . Nótese que la multiplicación puede calcularse mediante la recurrencia
Por lo tanto, también nos referimos a la multiplicación de matrices por matrices 1-SS como la recurrencia SSM escalar o el operador cumprodsum (suma de productos acumulativos; una generalización del producto acumulativo y la suma acumulativa). Como forma fundamental de recurrencia, la multiplicación por matrices 1-SS es importante como bloque de construcción para nuestros algoritmos principales.
Enfatizamos que uno de los temas centrales de este artículo es que muchos algoritmos sobre modelos de secuencia pueden reducirse a algoritmos de multiplicación de matrices estructuradas. Las matrices 1-SS ejemplifican esta conexión: existen muchos algoritmos rápidos para calcular la recurrencia escalar primitiva o el operador cumprodsum, y todos ellos resultan ser equivalentes a diferentes factorizaciones estructuradas de matrices 1-SS. Dedicamos el Apéndice B a estos algoritmos para la multiplicación de matrices 1-SS.
3.3 Los modelos de espacio de estados son matrices semiseparables
Recordemos que nuestra definición de un SSM se define como una aplicación parametrizada definida mediante la Definición 2.1. La conexión entre los SSM y las matrices semiseparables se deduce simplemente escribiendo esta transformación como una multiplicación de matrices que aplica los vectores .
La ecuación (3) establece directamente el vínculo entre los modelos de espacio de estados y la representación secuencialmente semiseparable, que a su vez son equivalentes a matrices semiseparables en general (Lema 3.3 y Proposición 3.4).
Teorema 3.5. La transformación del modelo de espacio de estados con tamaño de estado es idéntica a la multiplicación de matrices por una matriz N-SS en representación secuencialmente semiseparable .
En otras palabras, el operador de transformación de secuencias SSM (Definición 2.2) coincide con el operador de construcción de matrices SSS (Definición 3.2), y los usamos indistintamente (o a veces SS como abreviatura). Además —por un giro del destino— los modelos de espacio de estados estructurados y las matrices secuencialmente semiseparables tienen las mismas siglas, ¡lo que subraya su equivalencia! Convenientemente, podemos usar cualquiera de estas siglas SSM (modelo de espacio de estados o matriz semiseparable), SSS (espacio de estados estructurado o secuencialmente semiseparable), o SS (espacio de estados o semiseparable) indistintamente para referirnos sin ambigüedad a cualquiera de los dos conceptos. Sin embargo, en general usaremos la convención de que SSM se refiere a modelo de espacio de estados, SS se refiere a semiseparable, y SSS se refiere a secuencialmente semiseparable.
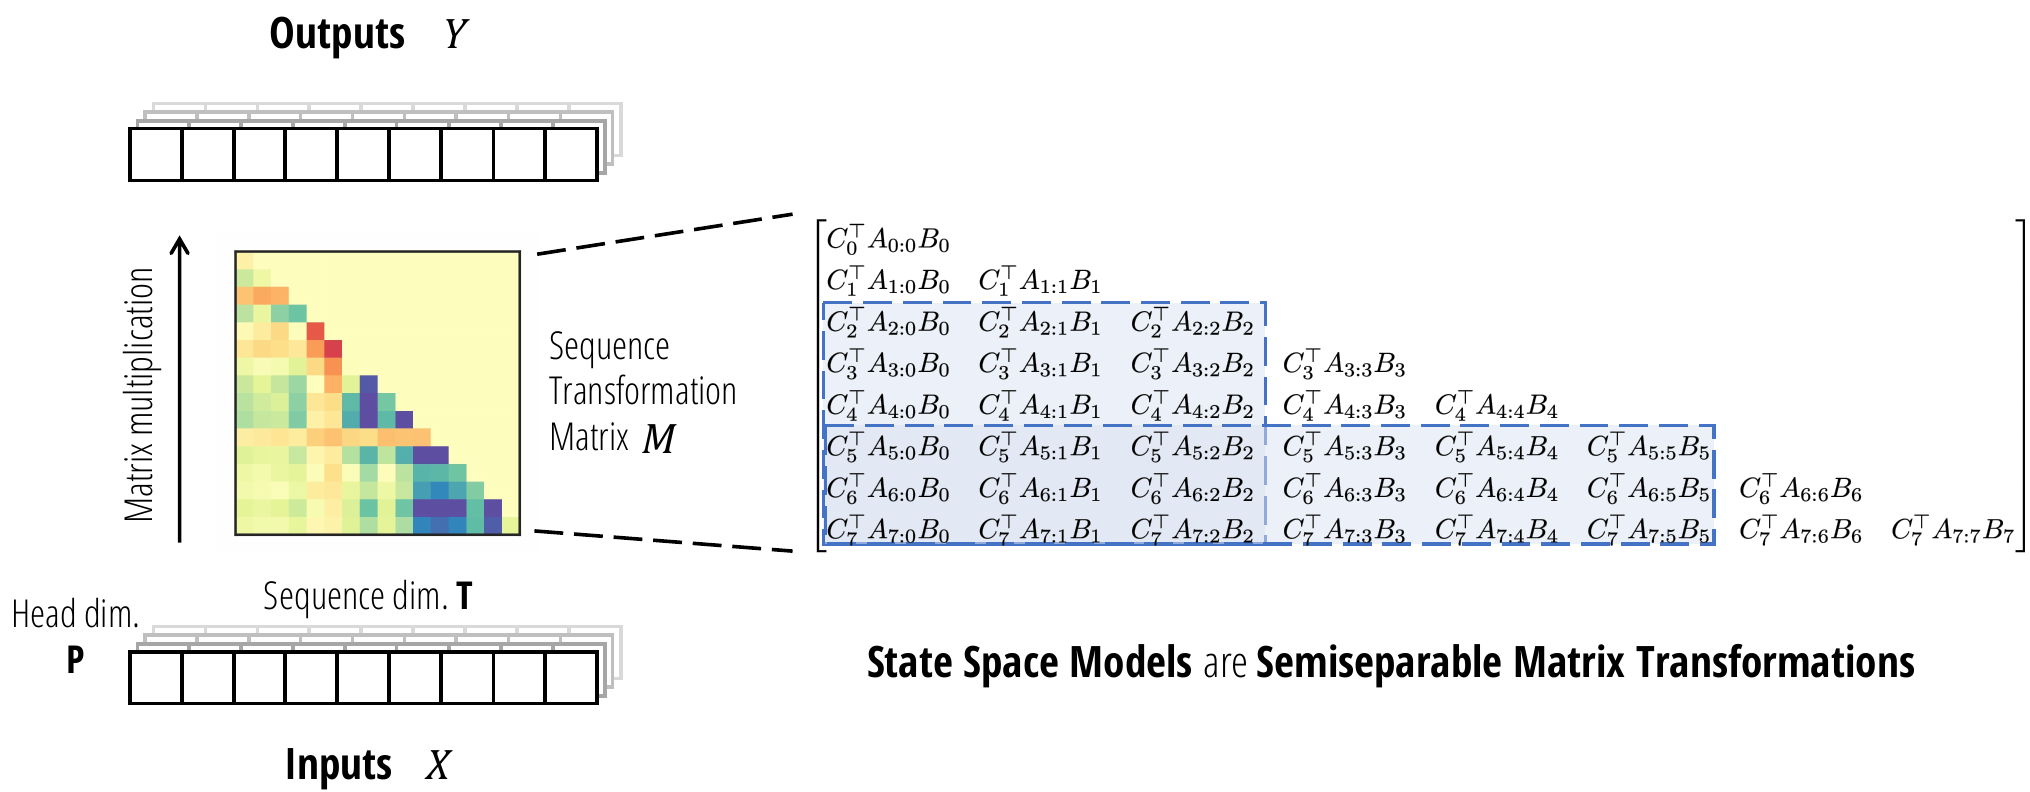
La Figura 2 ilustra la perspectiva de transformación de secuencias de los modelos de espacio de estados como matrices semiseparables.
3.4 Cálculo de modelos de espacio de estados mediante algoritmos de matrices estructuradas
La razón por la que el Teorema 3.5 es importante es que nos permitirá reducir el problema del cálculo eficiente de SSM (y otros modelos de secuencia) a algoritmos eficientes para la multiplicación de matrices estructuradas. Proporcionamos brevemente una visión general y posponemos nuestro principal algoritmo nuevo a la Sección 6, después de mostrar la equivalencia de los SSM con otros modelos de secuencia en las Secciones 4 y 5.
Como se definió previamente, las matrices semiseparables (es decir, matrices estructuradas por rango) son un tipo clásico de matriz estructurada:
(i) Tienen representaciones comprimidas como la forma SSS, que tiene solo en lugar de parámetros.
(ii) Tienen algoritmos rápidos que operan directamente sobre la representación comprimida.
Además, el costo de parametrización y de multiplicación de matrices puede ser ajustado en el orden semiseparable.
Proposición 3.6 (Pernet, Signargout y Villard (2023)). Una matriz N-SS de tamaño puede representarse con parámetros y tiene multiplicación matriz-vector en tiempo y espacio .
Por ejemplo, las matrices 1-SS ilustran la esencia de esta conexión. La matriz está definida por exactamente parámetros , y puede calcularse en tiempo siguiendo la recurrencia escalar (7).
3.4.1 El modo lineal (recurrente)
La Proposición 3.6 puede verse fácilmente en el caso de SSM estructurados diagonales (S4D (Gu, Gupta, et al. 2022)), simplemente aprovechando la formulación del modelo de espacio de estados (2) y desenrollando la recurrencia. Proporcionamos el algoritmo formal de contracción tensorial en (8), donde la dimensión S es igual a .
Aquí, se define como , o en otras palabras para . Este algoritmo involucra tres pasos correspondientes a (2):
(i) expandir la entrada mediante la matriz de entrada (8a),
(ii) desenrollar recurrencias SSM escalares independientes (8b), y
(iii) contraer el estado oculto mediante la matriz de salida (8c).
Nótese que hemos usado la equivalencia entre SSM escalares y matrices 1-SS en el paso (8b).
Observación 3. Señalamos que (8) es un caso especial del modelo Mamba (S6); sin embargo, una implementación ingenua es lenta debido a los tensores expandidos y de tamaño ; Gu y Dao (2023) introdujeron una implementación consciente del hardware para evitar materializar estos tensores.
Sorprendentemente, el Teorema 3.5 y la Proposición 3.6 implican inmediatamente que todos los SSM tienen la misma eficiencia asintótica que el algoritmo (8).
Teorema 3.7. Cualquier modelo de espacio de estados (Definición 2.2) de tamaño de estado N sobre longitud de secuencia T puede calcularse en tiempo (sin contar el posible preprocesamiento).
Notamos que este resultado es nuevo en la literatura de SSM estructurados. En particular, dadas matrices densas no estructuradas, la representación total por sí sola parece ser de tamaño . Por lo tanto, el Teorema 3.7 establece el resultado no trivial de que, con un paso de preprocesamiento, incluso un SSM no estructurado puede calcularse de manera óptimamente eficiente, con una cota superior que coincide con la cota inferior dada por el tamaño de y .
Observación 4. El Teorema 3.7 quizá no sea demasiado sorprendente a la luz del hecho de que casi todas las matrices densas sobre son diagonalizables sobre , lo que lleva al resultado de que casi todos los SSM reales densos son equivalentes a un SSM complejo diagonal. Este hecho subyace a la razón por la que los SSM diagonales son la forma más popular de SSM estructurado (Gu, Gupta, et al. 2022; Gupta, Gu y Berant 2022; J. T. Smith, Warrington y Linderman 2023). Sin embargo, el Teorema 3.7 implica el resultado mucho más fuerte para todos los SSM reales (no solo los diagonalizables), así como para SSM densos sobre otros cuerpos (incluido mismo).
En la práctica, los SSM computables eficientemente aún requieren estructura adicional en , particularmente para evitar el costoso paso de preprocesamiento (que tanto tiene N FLOPs adicionales como involucra operaciones ineficientes para el hardware, como las descomposiciones en valores singulares). Estas estructuras son el foco del trabajo previo sobre SSM estructurados (por ejemplo, S4(D) y Mamba), así como de nuestros nuevos algoritmos. En particular, cuando se impone una estructura ligeramente más fuerte sobre , diseñaremos algoritmos muy eficientes para el hardware mediante descomposiciones en bloques de la matriz SSM en la Sección 6.
3.4.2 El modo cuadrático (ingenuo)
Señalamos que hay otra forma de calcular un SSM expuesta por nuestro nuevo punto de vista matricial. Un cálculo ingenuo de la representación matricial SSM (3) implica simplemente materializar la matriz de transformación de secuencia . Esta es una matriz y, por lo tanto, este algoritmo ingenuo escalará cuadráticamente con la longitud de la secuencia. Sin embargo, cuando la longitud de la secuencia es corta, esto puede ser en realidad más eficiente que el algoritmo lineal debido a factores constantes y a la amigabilidad con el hardware del patrón de cómputo (por ejemplo, aprovechando multiplicaciones matriz-matriz). De hecho, para un caso particular de SSM estructurados, esto se parece mucho a un cálculo de atención cuadrático (Sección 5).
3.4.3 Resumen
Muchos modelos de secuencia están motivados o definidos explícitamente como transformaciones matriciales de secuencia, muy notablemente los Transformers, donde el mezclador matricial es la matriz de atención. Por otro lado, las RNN y los SSM no han sido descritos previamente de esta manera. Al proporcionar una forma explícita de transformación matricial de los modelos de espacio de estados, revelamos nuevas formas de entenderlos y usarlos. Desde una perspectiva computacional, cualquier método para calcular el pase forward de un modelo de espacio de estados puede verse como un algoritmo de multiplicación de matrices sobre matrices semiseparables. La perspectiva de matrices semiseparables proporciona una lente hacia la dualidad de espacio de estados (SSD), donde los modos duales se refieren respectivamente a un algoritmo de multiplicación de matrices semiseparables en tiempo lineal y a una multiplicación de matrices ingenua en tiempo cuadrático.
Además, aprovechar la rica estructura de las matrices semiseparables puede conducir a algoritmos aún mejores y a más ideas (por ejemplo, la Sección 6 y el Apéndice B). En el Apéndice C.1, describimos algunas propiedades adicionales de las matrices semiseparables.
4 Atención enmascarada estructurada: generalización de la atención lineal con matrices estructuradas
En esta sección revisamos el marco de atención lineal desde primeros principios. Los resultados principales de esta sección son una prueba simple basada en contracción tensorial de la atención lineal (Proposición 4.1), y nuestra abstracción generalizada de la atención enmascarada estructurada en la Definición 4.2. Señalamos que esta sección deriva los resultados principales de dualidad desde una dirección diferente a la de los modelos de espacio de estados y puede leerse de forma completamente independiente de la Sección 3.
- La sección 4.1 establece nuestro marco para variantes de atención, con especial énfasis en la atención por kernel y la atención por kernel enmascarada. - La sección 4.2 proporciona nuestro primer resultado principal sobre atención, una prueba simple de la atención lineal a través de la lente de las contracciones tensoriales. - La sección 4.3 define la atención enmascarada estructurada, nuestra generalización de variantes de atención previas mediante matrices estructuradas.
4.1 El marco de atención
4.1.1 Atención
La forma básica de la atención (de una sola cabeza) es una aplicación sobre tres secuencias de vectores
Usamos «anotaciones de forma» para indicar las dimensiones de los tensores, p. ej., . En esta forma general, S y T representan las longitudes de las secuencias fuente y objetivo, N representa la dimensión de características y P representa la dimensión de cabeza.
La variante más común de la atención softmax utiliza una activación softmax para normalizar las filas de la matriz .
4.1.2 Autoatención
Nuestro tratamiento está motivado por el caso más importante de autoatención, donde (i) las secuencias fuente y objetivo son la misma (es decir, ), (ii) normalmente las dimensiones de características y de cabeza son la misma (es decir, ), (iii) y se generan mediante proyecciones lineales sobre el mismo vector de entrada .
Sin embargo, nuestra presentación abstrae estas elecciones y comienza desde las matrices .
Observación 5. Nuestro enfoque está en el caso de autoatención con dimensiones de cabeza y de características iguales (es decir, y ), que debe usarse como el ejemplo recurrente. Definimos la formulación general de la atención no solo para que nuestro marco capture variantes como la atención cruzada, sino también porque separar la notación para las dimensiones (p. ej., S y T) hace más claras las pruebas mediante notación de contracciones de nuestros resultados principales en esta sección.
Observación 6. Si bien la atención suele plantearse como una operación sobre estas tres entradas que se ven de forma simétrica, las dimensiones de entrada y salida en (9) indican lo contrario. En particular, la dimensión de características N no está presente en la salida; por lo tanto, en el caso en que (p. ej., autoatención), consideramos como la entrada principal, de modo que (9) define una transformación de secuencia propiamente dicha (Definición 2.1).
4.1.3 Atención de kernel
El paso en el que se aplica la función softmax a la matriz de Gram puede descomponerse en dos partes:
1. Exponentiar la matriz .
2. Normalizar la matriz sobre el eje S.
Podemos ignorar el término de normalización por ahora, ya que equivale simplemente a introducir y dividir (lo revisamos en la Sección 7.3). El término de exponenciación puede verse como una transformación de kernel: existe un mapa de características (de dimensión infinita) tal que . Al abstraer el mapa de características dentro de la definición de y mismas (es decir, definir como las versiones post-transformadas), podemos ignorar la transformación softmax y suponer que son generadas arbitrariamente por mapas de características de kernel y potencialmente .
Se han propuesto muchas instanciaciones de la atención de kernel, entre ellas:
- La Linear Attention original (Katharopoulos et al. 2020) define el mapa de características de kernel como una función de activación puntual arbitraria, como .- Random Feature Attention (RFA) (H. Peng et al. 2021) elige el mapa de características de kernel para aproximar la atención softmax (es decir, el mapa de características exp) usando la aproximación de características aleatorias de Fourier de kernels gaussianos (Rahimi and Recht 2007). Esto implica proyecciones aleatorias (es decir, multiplicar y por una proyección aleatoria y aplicar la activación ).
- Performer (Choromanski et al. 2021) propone la fast attention via positive orthogonal random features (FAVOR+). La parte de positive random features (PRF) elige el mapa de características de kernel como una proyección aleatoria seguida del mapa de características . Esta elección está motivada para que los elementos del kernel sean de valor positivo y aproxima de manera demostrable la atención softmax. [También propone elegir las proyecciones aleatorias en direcciones ortogonales, lo cual no consideramos.]
- cosFormer (Qin, Weixuan Sun, et al. 2022) aumenta RFA con un mecanismo de reponderación por coseno que incorpora información posicional para enfatizar la localidad. Esto efectivamente pasa por el mapa de características .
- Linear Randomized Attention (Zheng, C. Wang, and Kong 2022) generaliza RFA desde la perspectiva del muestreo por importancia, y lo generaliza para proporcionar mejores estimaciones del kernel softmax completo (en lugar de solo el numerador transformado por exp).
Otras variantes de atención relacionadas incluyen Linformer (Sinong Wang et al. 2020) y Nyströmmer (Xiong et al. 2021), que usan ambas aproximaciones de bajo rango de la matriz de atención (y por lo tanto son compatibles con la ecuación (9)), mediante proyecciones aleatorias (Johnson-Lindenstrauss) y aproximación de kernel (el método de Nyström), respectivamente.
4.1.4 Atención (de kernel) enmascarada
Sea una máscara de forma (T, S). Lo más habitual, en el caso de autoatención autorregresiva cuando , es que sea una matriz triangular inferior de 1's que representa una máscara causal. Además de imponer la causalidad, se pueden aplicar muchos otros tipos de máscaras, en particular diversos patrones de dispersión como bandas, dilatados o diagonal por bloques, que están motivados por reducir la complejidad de la atención densa.
La atención enmascarada suele escribirse en notación matricial como
Más precisamente, con anotaciones de forma y desglosando esto en la secuencia precisa de cálculos:
Nuestra derivación mejorada de las variantes de atención en esta sección comienza observando que esta fórmula puede escribirse como una única contracción:
y el algoritmo en (11) puede reformularse como el cálculo de (12) mediante un orden particular de contracciones por pares
4.2 Atención lineal
La atención lineal, y muchas otras variantes de atención eficiente, suele estar motivada por cambiar el orden de asociatividad matricial en el cálculo central de atención . Sin embargo, cuando se añade la máscara, la derivación es algo menos directa (por ejemplo, el artículo original (Katharopoulos et al. 2020) y las variantes (Y. Sun et al. 2023) enuncian la fórmula sin demostración).
A grandes rasgos, el método de atención lineal afirma que la siguiente fórmula es equivalente a (10), lo cual debe verificarse expandiendo la suma y siguiendo los índices con cuidado.
Proposición 4.1 ((Katharopoulos et al. 2020)). La atención de kernel autorregresiva, es decir, la atención de kernel enmascarada con la máscara causal, puede calcularse en tiempo mediante una recurrencia que requiere tiempo constante por paso.
4.2.1 Una demostración de la atención lineal mediante contracción tensorial
Presentamos una derivación simple y rigurosa de la atención lineal que además revelará de inmediato cómo generalizarla. La idea principal es realizar la contracción (12) en un orden alternativo. Evitamos la notación matricial ambigua y trabajamos directamente con notación de contracción:
Intuitivamente, interpretamos este orden de contracción de la siguiente manera.
El primer paso (15a) realiza una «expansión» hacia más características, por un factor de la dimensión de características N. El tercer paso (15c) contrae la dimensión de características expandida. Si se considera la entrada (Observación 6), entonces y realizan la expansión y la contracción, respectivamente.
El segundo paso es el más crítico y explica la parte lineal de la atención lineal. Primero observa que (15b) es simplemente una multiplicación directa de matrices por (dado que los ejes pueden aplanarse). También nota que este es el único término que involucra tanto los ejes T como S, por lo que debería tener complejidad (es decir, cuadrática en la longitud de la secuencia). Sin embargo, cuando la máscara es la máscara de atención causal estándar (1's en la triangular inferior), la multiplicación matriz-vector por es idéntica a una suma acumulativa por elementos
4.3 Atención enmascarada estructurada
Con la perspectiva de contracción tensorial de la atención enmascarada (15), podemos ver inmediatamente que el punto crucial de la atención lineal original es el hecho de que la multiplicación matriz-vector por la máscara causal es equivalente al operador de suma acumulativa.
Sin embargo, observamos que no hay ninguna razón por la que la máscara de atención tenga que ser todo 1's. Todo lo que se necesita para que la atención lineal sea rápida es que sea una matriz estructurada, que por definición son aquellas que tienen multiplicación de matrices rápida (Sección 2.3). En particular, podemos usar cualquier matriz de máscara que tenga multiplicación matriz-vector subcuadrática (idealmente lineal), lo que tendría la misma complejidad que la atención lineal estándar al acelerar la ecuación cuello de botella (15b).
Definición 4.2. La atención enmascarada estructurada (SMA) (o atención estructurada para abreviar) se define como una función sobre consultas/claves/valores , así como cualquier matriz estructurada (es decir, que tiene multiplicación de matrices subcuadrática), mediante la contracción tensorial de 4 vías
El algoritmo de modo cuadrático de SMA es la secuencia de contracciones por pares definida por (13), que corresponde al cálculo estándar de atención (enmascarada).
El algoritmo de modo lineal de SMA es la secuencia de contracciones por pares definida por (15), donde el paso (15b) se optimiza mediante la multiplicación de matrices estructurada subcuadrática.
Podemos instanciar la atención enmascarada estructurada para cualquier clase dada de estructura matricial. Algunos ejemplos incluyen (Figura 3):
- La atención lineal usa una máscara causal.
- RetNet (Y. Sun et al. 2023) usa una máscara de decaimiento para algún factor de decaimiento .
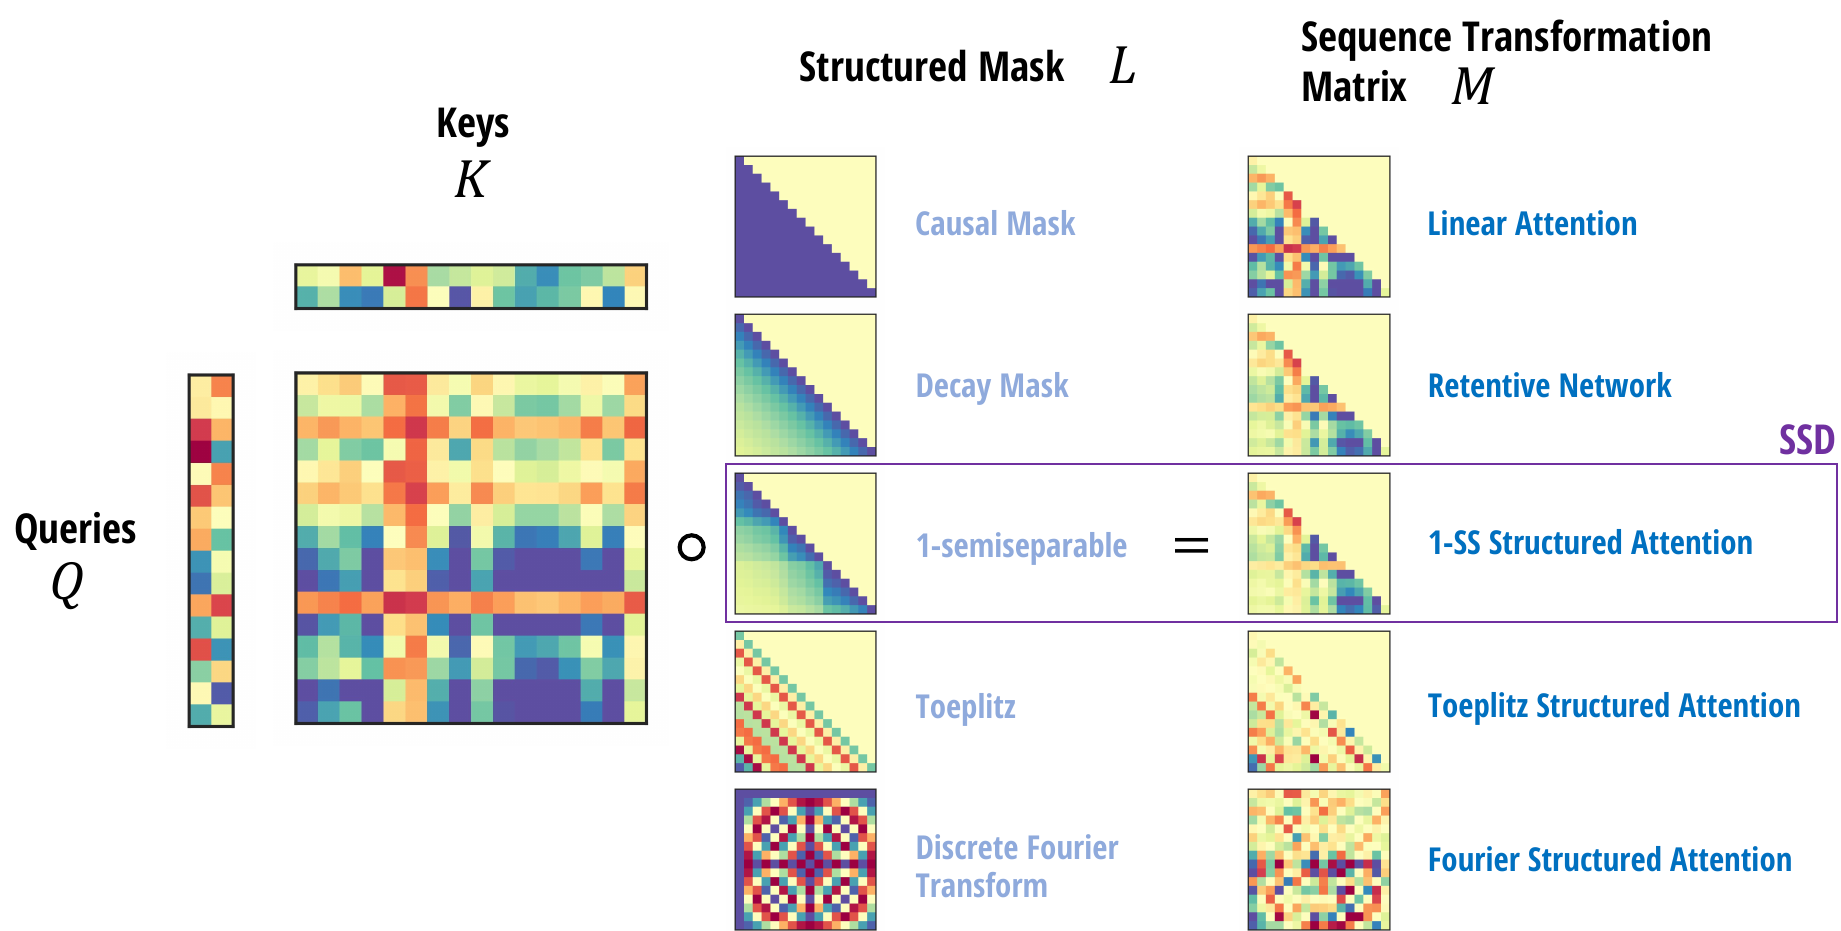
- La máscara de decaimiento podría generalizarse a una matriz de Toeplitz para algún conjunto de parámetros aprendible (o dependiente de la entrada) . Esto puede interpretarse como una forma de codificación posicional relativa, reminiscente de otros métodos como AliBi (Press, N. Smith, and Lewis 2022) pero multiplicativa en lugar de aditiva.- Otra variante podría usar una matriz de Fourier para codificar la estructura posicional de una manera diferente.
En la Sección 5, consideramos SMA semiseparable, que define nuestro modelo principal SSD.
4.3.1 Resumen: Las formas duales de la atención enmascarada
La atención estándar (kernel enmascarado) a menudo se confunde entre una función y un algoritmo. Separar esta distinción presenta una manera clara de entender las diferentes variantes de la atención.
- Vemos la atención enmascarada como una función particular (12).- El cálculo estándar de atención cuadrática (13) puede verse como un algoritmo para calcular la función.- La atención lineal (15) es un algoritmo alternativo para calcular la misma función.
Además, en este caso
- La función de atención enmascarada es simplemente una contracción particular sobre cuatro términos.- Los algoritmos de atención cuadrática y lineal son simplemente dos órdenes diferentes de realizar las contracciones.
Se sabe que los órdenes de contracción pueden producir grandes diferencias en la complejidad computacional, lo que lleva a la división entre cuadrática y lineal. Así como los modelos de espacio de estados son una transformación que puede calcularse de múltiples maneras, con formas duales cuadrática vs. lineal (Sección 3.4), la atención lineal tiene una dualidad similar que resulta de dos órdenes de contracción. De hecho, estas resultan ser perspectivas diferentes sobre la misma dualidad subyacente, que hacemos explícita en la Sección 5.
5 Dualidad de espacio de estados
En las Secciones 3 y 4, definimos modelos de espacio de estados estructurados y atención estructurada, discutimos sus propiedades y mostramos que ambos tienen un algoritmo cuadrático y un algoritmo lineal. Esta sección los conecta. Nuestro resultado principal es mostrar que un caso particular de los modelos de espacio de estados estructurados coincide con un caso particular de la atención estructurada, y que el algoritmo SSM de tiempo lineal y el algoritmo de atención por kernel de tiempo cuadrático son formas duales entre sí.
La Sección 5.1 especializa los modelos de espacio de estados a estructura escalar, donde el cálculo cuadrático ingenuo puede verse como una instancia de atención por kernel.
La Sección 5.2 especializa la atención enmascarada estructurada a SMA semiseparable, que caracteriza la atención enmascarada con autorregresión eficiente.
La Sección 5.3 resume la conexión entre la atención enmascarada estructurada y los modelos de espacio de estados estructurados, denominada dualidad de espacio de estados estructurados.
5.1 Modelos de espacio de estados estructurados con identidad escalar
En la Sección 3 mostramos que los modelos de espacio de estados son equivalentes a transformaciones matriciales semiseparables, lo que resulta tanto en una forma recurrente lineal como en una forma ingenua cuadrática.
Recordemos que los SSM se definen mediante , y la forma matricial de los SSM utiliza la representación SSS (secuencialmente semiseparable) donde (ecuación (3)).
Ahora consideremos el caso en que es simplemente un escalar; en otras palabras, una instanciación de un SSM estructurado donde las matrices están extremadamente estructuradas: para un escalar y la matriz identidad . Entonces podemos reordenar
Y esto puede vectorizarse como
donde
Usando esta formulación, la salida completa se calcula precisamente como
donde . ¡Pero esto es exactamente lo mismo que la definición original de la definición de atención por kernel enmascarada (13)!
Por lo tanto, como se aludió en la Sección 3.4, calcular ingenuamente el SSM estructurado escalar —materializando la matriz semiseparable y realizando una multiplicación matriz-vector cuadrática— es exactamente lo mismo que la atención por kernel enmascarada cuadrática.
5.2 Atención enmascarada estructurada 1-semiseparable
La atención enmascarada estructurada permite el uso de cualquier máscara estructurada . Cuando es la máscara causal, es atención lineal estándar. Nótese que la máscara causal es , es decir, la máscara 1-SS se genera mediante en la definición (6). Esto motiva generalizar a la clase de máscaras 1-semiseparables, o atención enmascarada estructurada 1-semiseparable (SMA 1-SS), donde la suma acumulada en la recurrencia de la atención lineal se reemplaza por una recurrencia más general: el escaneo SSM escalar, es decir, la multiplicación matricial 1-semiseparable (Sección 3.2.2).
Finalmente, la razón más importante por la que consideramos SMA 1-semiseparable es porque la forma lineal para calcularla es un caso especial del modelo de espacio de estados diagonal. La forma lineal de SMA es el algoritmo (15), donde el paso cuello de botella (15b) puede verse como una multiplicación matricial por la máscara 1-SS. En la Sección 3, también escribimos el cálculo para un SSM diagonal (8), donde el paso cuello de botella (8b) es una recurrencia SSM escalar que es equivalente a la multiplicación 1-SS. La única diferencia es que (8b) tiene una dimensión N extra en , porque la matriz es una matriz diagonal de tamaño N. Esta dimensión N desaparecería si todas las entradas diagonales de fueran iguales, lo que da como resultado el Corolario 5.1.
Corolario 5.1. La SMA 1-SS (atención enmascarada con matrices estructuradas 1-semiseparables ) (15) es un caso especial de un SSM diagonal (8) donde la matriz diagonal es un múltiplo escalar de la identidad.
Si bien el Corolario 5.1 dice que la SMA 1-SS tiene una forma recurrente eficiente, también podemos mostrar un resultado recíproco que caracteriza qué instancias de SMA tienen autorregresión eficiente.
Teorema 5.2. Para cualquier instanciación de atención enmascarada estructurada (Definición 4.2) que sea un proceso autorregresivo de orden acotado, la máscara estructurada debe ser una matriz semiseparable.
En otras palabras, la atención autorregresiva eficiente es SMA semiseparable general. El Teorema 5.2 se demuestra en el Apéndice C.2.
Observación 7. Si bien la SMA 1-semiseparable es un caso especial de un modelo de espacio de estados, la SMA semiseparable general es estrictamente más expresiva que la SMA 1-SS, y no puede describirse mediante un SSM estándar. Sin embargo, la multiplicación semiseparable por y la forma lineal de SMA (ecuación (15a)) involucran cada una un paso de expansión y contracción, y pueden absorberse en una instancia similar de SMA 1-SS con una única expansión (más grande).
En resumen, la atención estructurada 1-semiseparable es el caso más importante de SMA, porque es:
- una generalización natural de la atención lineal con una recurrencia dependiente de la entrada.
- el caso más simple de atención semiseparable general, que es equivalente a la atención autorregresiva eficiente.
- un caso especial de un modelo de espacio de estados diagonal.
5.3 Dualidad de espacio de estados estructurados (SSD)
Para resumir nuestros resultados:
- Los modelos de espacio de estados estructurados (Sección 3) son un modelo generalmente definido mediante una recurrencia de tiempo lineal. Sin embargo, al expandir la formulación matricial que caracteriza su transformación lineal de secuencia a secuencia, se puede derivar una forma cuadrática.
- Las variantes de atención (Sección 4) son un modelo definido mediante interacciones por pares de tiempo cuadrático. Sin embargo, al verlo como una contracción de tensor de cuatro vías y reducir en un orden diferente, se puede derivar una forma lineal.
- Un caso especial natural de cada uno —más precisamente, los modelos de espacio de estados con estructura escalar-identidad en las matrices , y la atención enmascarada estructurada con estructura 1-semiseparable en su máscara — son duales entre sí con exactamente las mismas formas lineales y cuadráticas.
La Figura 4 resume la dualidad entre estas dos representaciones.
Una sección extendida de trabajos relacionados y discusión (Sección 10) describe la relación entre SSD y los SSM generales / la atención con más detalle.
6 Un algoritmo hardware-eficiente para modelos SSD
Los beneficios de desarrollar el marco teórico SSD entre SSM, atención y matrices estructuradas radican en usar las conexiones para mejorar los modelos y algoritmos. En esta sección, mostramos cómo varios algoritmos para calcular modelos SSD de manera eficiente pueden derivarse de varios algoritmos para calcular la multiplicación de matrices estructuradas.
Nuestro principal resultado computacional es un algoritmo para calcular modelos SSD que combina tanto el modo lineal (recurrente) como el modo cuadrático (atención). Este algoritmo es tan eficiente en cómputo como los SSM (escalado lineal en la longitud de la secuencia) y tan amigable para el hardware como la atención (utiliza principalmente multiplicaciones de matrices).
Teorema 6.1. Considérese un modelo SSD con factor de expansión de estado y dimensión de cabeza . Existe un algoritmo para calcular el modelo sobre cualquier entrada que solo requiere FLOPs de entrenamiento, FLOPs de inferencia, memoria de inferencia, y cuyo trabajo está dominado por multiplicaciones de matrices.
| Modelo de Espacio de Estados Estructurado | Atención Enmascarada Estructurada | ||||
| C | (matriz de contracción) | Q | (consultas) | S4 | Modelo de Espacio de Estados Diagonal |
| B | (matriz de expansión) | K | (claves) | ||
| X | (secuencia de entrada) | V | (valores) | DSS | SSM de Identidad Escalar |
| Aij | (matriz de estado) | Lji | (máscara) | S4D | RetNet GateLoop |
| N | (dim. de expansión de estado) | N | (dim. de características del kernel) | S5 | TransNormer |
| H | (estados ocultos (8b)) | Dual lineal de SMA (15) | S6 | Atención Lineal | |
| = L·XB | (modo lineal) | SMA 1-Semiseparable | |||
| Dual cuadrático de SSM (16) | G | (matriz de Gram (13a)) | Atención Autoregresiva Eficiente | ||
| = Q·K | (modo cuadrático) | SMA Semiseparable |
Nótese que todas estas cotas son ajustadas, porque un modelo de espacio de estados con expansión de estado N operando sobre un tamaño de cabeza de N tiene un tamaño de estado total (lo que produce las cotas inferiores para los FLOPs de entrenamiento e inferencia de y respectivamente). Además, la entrada misma tiene TN elementos, lo que produce la cota inferior de memoria.
La idea principal detrás del Teorema 6.1 es, una vez más, ver el problema de calcular un modelo de espacio de estados como una multiplicación de matrices semiseparables, pero aprovechando su estructura de una manera nueva. En lugar de calcular la matriz completa en modo recurrente o de atención, realizamos una descomposición por bloques de la matriz. Los bloques diagonales pueden calcularse usando el modo dual de atención, que puede hacerse eficientemente con multiplicaciones de matrices, mientras que los bloques fuera de la diagonal pueden factorizarse por la estructura de rango de las matrices semiseparables y reducirse a una recurrencia más pequeña. Destacamos que el Listado 1 proporciona una implementación autocontenida del algoritmo SSD. En comparación con el SSM selectivo general de Gu y Dao (2023), esta implementación es mucho más simple, y relativamente eficiente incluso en PyTorch nativo sin requerir kernels especiales de bajo nivel.
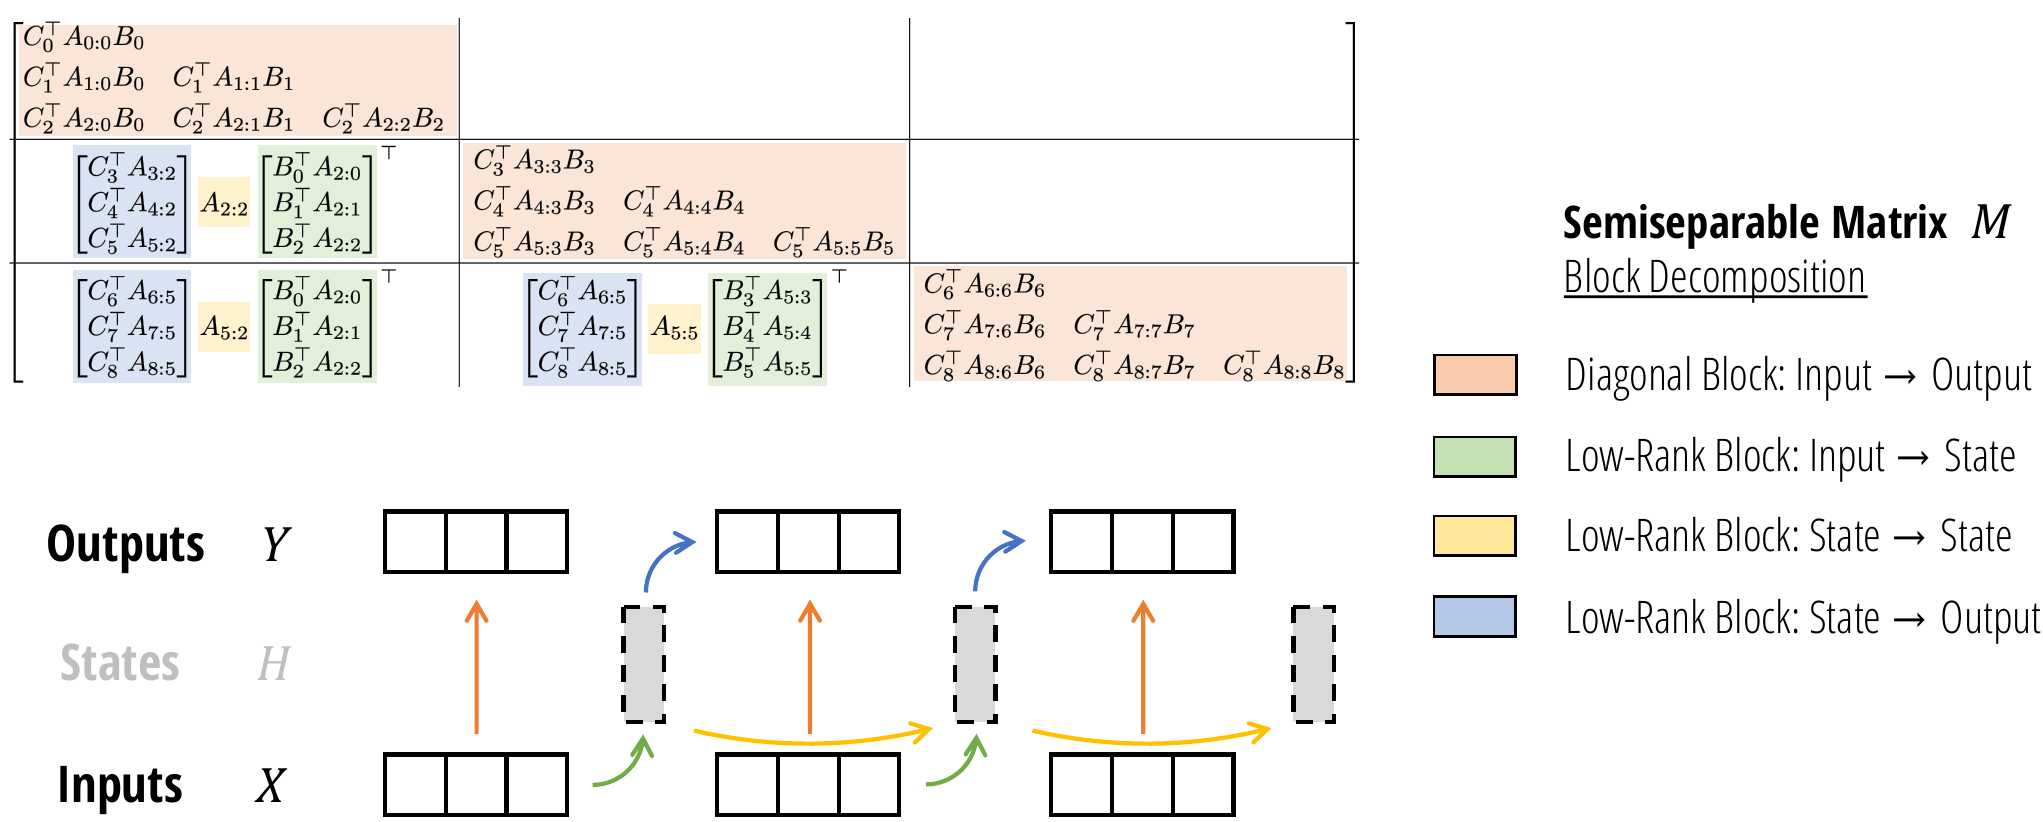
Para comenzar, dividimos la matriz en una cuadrícula de submatrices de tamaño , para algún tamaño de bloque . Nótese que los bloques fuera de la diagonal son de bajo rango por la propiedad definitoria de las matrices semiseparables (Definición 3.1).5
Esto se ilustra más fácilmente mediante un ejemplo, p. ej. para y descomponiendo en bloques de longitud . Las celdas sombreadas son factorizaciones de bajo rango de los bloques fuera de la diagonal de la matriz semiseparable.
Estos subproblemas pueden interpretarse como: cuál es la salida por fragmento suponiendo que el estado inicial (para el fragmento) es 0. En otras palabras, para el fragmento , esto calcula las salidas correctas teniendo en cuenta únicamente las entradas del fragmento .
6.2 Bloques de rango bajo
Las factorizaciones de rango bajo constan de 3 términos, y correspondientemente hay tres piezas del cálculo. En esta factorización, usaremos la terminología
Los términos como se denominan factores derechos o factores de bloque .
Los términos como se denominan factores centrales o factores de bloque .
Los términos como se denominan factores izquierdos o factores de bloque .
Factores derechos. Este paso calcula la multiplicación por los factores de bloque derechos de la factorización de rango bajo. Nótese que para cada fragmento, esto es una multiplicación de matrices por , donde es la dimensión del estado y es la dimensión de la cabeza. El resultado es un tensor para cada fragmento, que tiene la misma dimensionalidad que el estado oculto expandido .
Esto puede interpretarse como: cuál es el estado final por fragmento suponiendo que el estado inicial (para el fragmento) es 0. En otras palabras, esto calcula suponiendo que .
Factores centrales. Este paso calcula el efecto de los términos de los factores de bloque centrales en la factorización de rango bajo. En el paso anterior, los estados finales por fragmento tienen forma total . Ahora esto se multiplica por una matriz 1-SS generada por .
Este paso puede calcularse mediante cualquier algoritmo para calcular la multiplicación 1-SS (también conocido como el escaneo SSM escalar u operador cumprodsum).
Esto puede interpretarse como: cuál es el estado final real por fragmento teniendo en cuenta todas las entradas previas; en otras palabras, esto calcula el estado oculto verdadero teniendo en cuenta todo .
Factores izquierdos. Este paso calcula la multiplicación por los factores de bloque izquierdos de la factorización de rango bajo. Para cada fragmento, esto puede representarse mediante un contrato de multiplicación de matrices .
Esto puede interpretarse como: cuál es la salida por fragmento teniendo en cuenta el estado inicial correcto , y suponiendo que las entradas son 0. En otras palabras, para el fragmento , esto calcula las salidas correctas teniendo en cuenta únicamente las entradas previas .
6.3 Coste computacional
Definimos la notación para definir un contrato de multiplicación de matrices por lotes con dimensión de lote . A partir de esta notación podemos inferir tres aspectos de la eficiencia:- Coste de computación: total de FLOPs.- Coste de memoria: total de \(O(\mathsf{B}(\mathsf{MK} + \mathsf{KN} + \mathsf{MN}))\) espacio.
Listado 1 Ejemplo completo en PyTorch del modelo de espacio de estados dual (SSD).
def segsum(x):
Cálculo ingenuo de la suma por segmentos. exp(segsum(A)) produce una matriz 1-SS,
que es equivalente a un SSM escalar.
T = x.size(- 1)
x_cumsum = torch.cumsum(x, dim=- 1)
x_segsum = x_cumsum[..., None] - x_cumsum[..., None, :]
mask = torch.tri1(torch.ones(T, T, device=x.device, dtype=bool), diagonal=0)
x_segsum = x_segsum.masked_fill(- mask, - torch.inf)
return x_segsum
def ssd(X, A, B, C, block_len=64, initial_states=None):
Argumentos:
X: (batch, length, n_heads, d_head)
A: (batch, length, n_heads)
B: (batch, length, n_heads, d_state)
C: (batch, length, n_heads, d_state)
Devuelve:
Y: (batch, length, n_heads, d_head)
\*
4. Compute state -> output conversion per chunk # (left term of low-rank factorization of off-diagonal blocks; C terms) state_decay_out = torch.exp(A_cumsum) Y_off = torch.einsum('bclhn, bchpn, bhl->bclhp', C, states, state_decay_out)
Add output of intra-chunk and inter-chunk terms (diagonal and off-diagonal blocks) Y = rearrange(Y_diag+Y_off, "b c l h p -> b (c l) h p") return Y, final_state
- Paralelización: los términos M, N, K más grandes pueden aprovechar las unidades especializadas de multiplicación de matrices en los aceleradores modernos.
Bloques centrales. El coste del cálculo cuadrático de SMA consta de tres pasos (ecuación (16)):
- Calcular la matriz del núcleo , que tiene un coste .
- Multiplicar por la matriz de máscara, que es una operación elemento a elemento sobre tensores de forma .
- Multiplicando por los valores , lo cual tiene un coste
Bloques de bajo rango: Factores derechos. Este paso es una única multiplicación de matrices con coste .
Bloques de bajo rango: Factores centrales. Este paso es un escaneo SSM escalar (o multiplicación 1-SS) de longitud sobre canales independientes. El trabajo de este escaneo es , lo cual es despreciable en comparación con los otros factores.
Nótese que, debido al bloqueo que reduce la longitud de la secuencia de a , este escaneo tiene un coste veces menor que un escaneo SSM puro (por ejemplo, el escaneo selectivo de Mamba). Así, observamos que en la mayoría de las longitudes de problema, otros algoritmos (Apéndice B) pueden ser más eficientes o mucho más fáciles de implementar sin una ralentización significativa. Por ejemplo, una implementación ingenua de esto mediante multiplicación de matrices 1-SS tiene coste , lo cual es mucho más fácil de implementar y puede ser más eficiente que una implementación ingenua de recurrencia/escaneo.
Bloques de bajo rango: Factores izquierdos. Este paso es una única multiplicación de matrices con coste .
Coste total. Si establecemos (en otras palabras, la dimensión de estado, la dimensión de cabeza y la longitud de bloque son iguales), entonces todos los términos BMM anteriores se convierten en . Las características computacionales de esto son:
- Conteo total de FLOPs de .- Memoria total de .- El trabajo consiste principalmente en multiplicaciones de matrices sobre matrices de forma .
Nótese que el consumo de memoria es ajustado; las entradas y salidas tienen forma . Mientras tanto, el conteo de flops refleja un factor extra de , que es el coste incurrido por el tamaño de estado autorregresivo y es común a todos los modelos.
Aparte de las multiplicaciones de matrices, hay un escaneo SSM escalar sobre características y longitud de secuencia . Esto tiene un coste de FLOPs y de profundidad. Aunque no utiliza multiplicaciones de matrices, sigue siendo paralelizable y el trabajo total realizado es despreciable en comparación con los otros pasos; esto tiene un coste despreciable en nuestra implementación en GPU.
Comparación con modelos SSM puros y modelos de atención. La atención cuadrática también es muy eficiente en hardware al aprovechar únicamente multiplicaciones de matrices, pero tiene FLOPs totales. Su velocidad de cómputo más lenta tanto en entrenamiento como en inferencia puede verse directamente como consecuencia de tener un tamaño de estado mayor: la atención estándar tiene un tamaño de estado que escala con la longitud de secuencia porque almacena en caché su historial y no comprime su estado.
Los SSM lineales tienen FLOPs totales, que es lo mismo que SSD. Sin embargo, una implementación ingenua requiere una expansión de estado (15a) que materializa memoria extra, y una operación escalar (15b) que no aprovecha las multiplicaciones de matrices.
| Attention | SSM | SSD | |
| Tamaño del estado | T | N | N |
| FLOPs de entrenamiento | T²N | TN² | TN² |
| FLOPs de inferencia | TN | N² | N² |
| Memoria (ingenua) | T² | TN² | TN |
| Multiplicación de matrices | ✓ | ✓ |
Notamos que son posibles muchas otras descomposiciones matriciales (por ejemplo, véase el Apéndice B para un compendio de algoritmos para la multiplicación 1-SS mediante diferentes descomposiciones matriciales estructuradas), lo que puede dar lugar a más algoritmos para las SSD que podrían ser mejores para otros entornos especializados. Aún más ampliamente, observamos que las matrices semiseparables tienen una literatura rica y muchas más representaciones además de la forma SS que utilizamos (Definición 3.2), y podrían ser posibles algoritmos aún más eficientes.
7 La arquitectura Mamba-2
Al conectar los SSM y la atención, el marco SSD nos permite desarrollar un vocabulario y una biblioteca de técnicas compartidos para ambos. En esta sección discutimos algunos ejemplos de comprensión y modificación de las capas SSD utilizando ideas desarrolladas originalmente
para Transformers. Discutimos varias elecciones de diseño, que dan como resultado la arquitectura Mamba-2. Estos ejes de variación se abordan mediante ablación en la Sección 9.4.
7.1 Diseño del bloque
Primero discutimos modificaciones al bloque de red neuronal que son independientes de la capa interna de mezcla de secuencias (es decir, fuera de la capa SSD central).
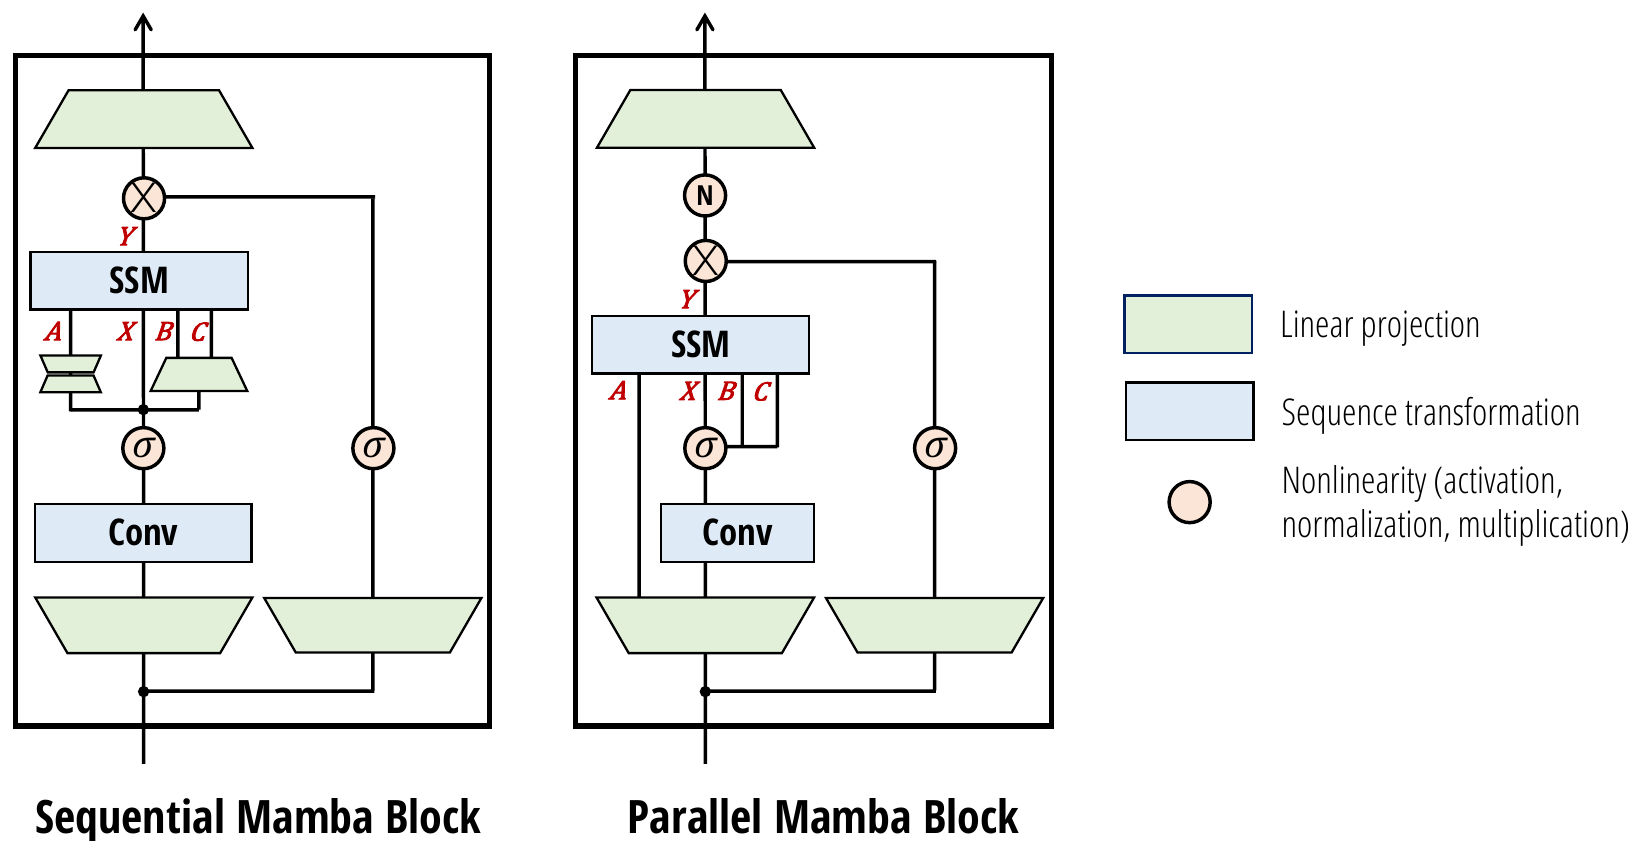
Proyecciones de parámetros en paralelo. Mamba-1 estaba motivado por un punto de vista centrado en el SSM, donde la capa SSM selectiva se ve como una aplicación de . Los parámetros del SSM se consideran subsidiarios y son funciones de la entrada del SSM . Por lo tanto, las proyecciones lineales que definen ocurren después de la proyección lineal inicial para crear .
En Mamba-2, la capa SSD se ve como una aplicación de . Por lo tanto, tiene sentido producir en paralelo con una única proyección al principio del bloque. Nótese la analogía con las arquitecturas de atención estándar, donde corresponden a las proyecciones que se crean en paralelo.
Nótese que adoptar proyecciones paralelas para las entradas al SSM reduce ligeramente los parámetros y, más importante aún, es más susceptible al paralelismo de tensores para modelos más grandes, al utilizar patrones de particionado estándar de Megatron (Shoeybi et al. 2019)).
Normalización adicional. En experimentos preliminares, encontramos que las inestabilidades eran propensas a surgir en modelos más grandes. Pudimos aliviar esto añadiendo una capa de normalización adicional (por ejemplo, LayerNorm, GroupNorm o RMSNorm) al bloque justo antes de la proyección de salida final. Este uso de una normalización está más directamente relacionado con la arquitectura NormFormer (Shleifer, Weston, and Ott 2021), que también añadió capas de normalización al final de los bloques MLP y MHA.
También notamos que este cambio es similar a otros modelos recientes relacionados con Mamba-2 que fueron derivados desde un punto de vista de atención lineal. La formulación original de la atención lineal normaliza mediante un término denominador que emula la normalización de la función softmax en la atención estándar. TransNormerLLM (Qin, Dong Li, et al. 2023) y RetNet (Y. Sun et al. 2023) encuentran que esta normalización es inestable y añaden un LayerNorm o GroupNorm adicional después de la capa de atención lineal. Nuestra capa de normalización adicional difiere ligeramente de estas, ya que ocurre después de la rama de compuerta multiplicativa en lugar de antes.
. . .
7.2 Patrones multicabeza para transformaciones de secuencias
Recuérdese que los SSM se definen como una transformación de secuencias (Definición 2.1) donde:
- Los parámetros tienen una dimensión de estado N.- Definen una transformación de secuencias , que por ejemplo puede representarse como una matriz .- Esta transformación opera sobre una secuencia de entrada , de forma independiente sobre el eje P.
Uno puede ver esto como la definición de una cabeza de la transformación de secuencias.
Definición 7.1 (Patrones multicabeza). Una transformación de secuencias multicabeza consta de H cabezas independientes, para una dimensión total del modelo de . Los parámetros pueden estar vinculados entre cabezas, lo que da lugar a un patrón de cabezas.
El tamaño de estado N y la dimensión de cabeza P son análogos a la dimensión de cabeza QK y a la dimensión de cabeza V de la atención, respectivamente. Al igual que en las arquitecturas Transformer modernas (Chowdhery et al. 2023; Touvron, Lavril, et al. 2023), en Mamba-2 generalmente elegimos que estas sean constantes alrededor de 64 o 128; cuando la dimensión del modelo D aumenta, incrementamos el número de cabezas mientras mantenemos fijas las dimensiones de cabeza N y P. Para describir cómo hacer esto, podemos transferir y generalizar ideas de la atención multicabeza para definir patrones similares para los SSM, o para cualquier transformación de secuencias general.
SSM multi-cabeza (Atención multi-cabeza) | SSM multicontracción (Atención multi-query) | SSM multiexpansión (Atención multi-key) | SSM multi-entrada (Atención multi-value) |
| X (T, H, P) | X (T, 1, P) | X (T, 1, P) | X (T, H, P) |
| A (T, H) | A (T, H) | A (T, H) | A (T, H) |
| B (T, H, N) | B (T, 1, N) | B (T, H, N) | B (T, 1, N) |
| C (T, H, N) | C (T, H, N) | C (T, 1, N) | C (T, 1, N) |
Patrón SSM multicabeza (MHS) / Atención multicabeza (MHA). El patrón MHA clásico asume que la dimensión de cabeza P divide la dimensión del modelo D. El número de cabezas se define como . Luego, se crean H copias de la transformación de secuencias central creando H copias independientes de cada parámetro. Nótese que, aunque el patrón MHA se describió por primera vez para la transformación de secuencias de atención, puede aplicarse a cualquier cosa compatible con la Definición 2.1. Por ejemplo, una capa SSD multicabeza aceptaría entradas con formas según la ecuación (17), donde el algoritmo SSD se difunde sobre la dimensión .
Patrón SSM multicontracción (MCS) / Atención multiconsulta (MQA). La atención multiconsulta (Shazeer 2019) es una optimización ingeniosa para la atención que puede mejorar drásticamente la velocidad de la inferencia autoregresiva, la cual depende de almacenar en caché los tensores y . Esta técnica simplemente evita dar a y la dimensión de cabeza adicional o, en otras palabras, difunde una única cabeza de a través de todas las cabezas de .
Usando la dualidad de espacio de estados, podemos definir una versión SSM equivalente de MQA como la ecuación (18). Aquí, y (los análogos en el SSM de y de la atención) se comparten entre las H cabezas. También llamamos a esto patrón de cabezas SSM multicontracción (MCS), porque el parámetro , que controla la contracción del estado del SSM, tiene copias independientes por cabeza.
Podemos definir de manera similar un patrón de cabezas de atención multiclave (MKA) o SSM multiexpansión (MES), donde (que controla la expansión del SSM) es independiente por cabeza, mientras que y se comparten entre cabezas.
Patrón SSM multimput (MIS) / Atención multivalor (MVA). Aunque MQA tiene sentido para la atención debido a su caché KV, no es la elección natural para los SSM. En Mamba, en cambio, se considera la entrada principal al SSM y, por lo tanto, y son parámetros que se comparten entre los canales de entrada. Definimos un nuevo patrón de atención multivalor (MVA) o SSM multimput (MIS) en la ecuación (20), que de nuevo puede aplicarse a cualquier transformación de secuencias, como SSD.
Armados con este vocabulario, podemos caracterizar la arquitectura Mamba original con mayor precisión.
Proposición 7.2. La capa SSM selectiva (S6) de la arquitectura Mamba (Gu and Dao 2023) puede considerarse como si tuviera:-- Dimensión de cabeza : cada canal tiene dinámicas SSM independientes .
- Estructura de cabezas SSM multimput (MIS) o atención multivalor (MVA): las matrices (que corresponden a en la dualidad de atención) se comparten entre todos los canales de la entrada (que corresponde a en atención).
También podemos ablacionar estas variantes de patrones de cabezas cuando se aplican a SSD (Sección 9.4.3). De manera interesante, a pesar de estar controladas en recuentos de parámetros y dimensión total del estado, existe una diferencia notable en el rendimiento downstream. Empíricamente encontramos que el patrón MVA, tal como se usa originalmente en Mamba, tiene el mejor rendimiento.
Patrones de Cabezas Agrupadas. Las ideas de la atención multi-query pueden extenderse a la atención grouped-query (Ainslie et al. 2023): en lugar de 1 cabeza K y V, se pueden crear G cabezas K y V independientes, donde y G divide a H. Esto está motivado tanto por cerrar la diferencia de rendimiento entre la atención multi-query y multi-head, como por permitir un paralelismo de tensores más eficiente al establecer G como un múltiplo del número de fragmentos (Sección 8).
De manera similar, el patrón de cabezas SSM multi-input usado en Mamba-2 puede extenderse fácilmente a SSM grouped-input (GIS), o, sinónimamente, atención grouped-value (GVA). La generalización es directa y omitimos los detalles por simplicidad.
7.3 Otras Extensiones de SSD desde Atención Lineal
Describimos aquí un ejemplo de modificaciones arquitectónicas a SSD motivadas por la atención lineal. Las ablacionamos en la Sección 9.4.3 como una forma de resultado negativo, encontrando que no mejoran significativamente el rendimiento lo suficiente como para adoptarlas como configuraciones predeterminadas. No obstante, estas ilustran cómo la vasta literatura sobre atención puede incorporarse para definir variantes de SSD. Tratamos la elección del mapa de características del kernel como un hiperparámetro en la arquitectura Mamba-2, y esperamos que también sean posibles otras modificaciones simples inspiradas en la atención.
Aproximaciones de Atención por Kernel a la Atención Softmax. Muchas variantes de atención lineal o atención por kernel están motivadas por ver las puntuaciones de atención como compuestas por
1. Un kernel exponencial , que puede aproximarse mediante para algún mapa de características del kernel. 2. Normalizar el kernel de modo que las filas sumen 1 mediante , donde la división ocurre elemento a elemento y 1 es el vector de unos.
Mapas de Características de Kernel Exponencial. En Mamba-2, incorporamos un mapa de características de kernel flexible y lo aplicamos a las ramas y (correspondientes a las ramas y en atención). El mapa de características también puede aplicarse opcionalmente a la rama ( ), por simplicidad y simetría. Esto está representado en la Figura 6 mediante una no linealidad arbitraria. Por defecto, simplemente elegimos como una función Swish / SiLU elemento a elemento (Hendrycks y Gimpel 2016; Ramachandran, Zoph y Le 2017). Exploramos otras opciones en las ablaciones de la Sección 9.4.3, incluidos mapas de características usados por Linear Attention, Performer, Random Feature Attention y cosFormer (Sección 4.1.3).
Incorporación de un Término de Normalización (Denominador). Para encontrar el término del denominador, simplemente tenemos que calcular . Pero recordemos que la salida final del modelo es simplemente (ecuación (16)). Por lo tanto, los términos de normalización pueden encontrarse simplemente aumentando con una columna adicional de 1, lo que resulta en un tensor de forma . Nótese que en este caso, el mapa de características del kernel debe ser positivo para que la suma sea positiva.
8 Optimización de Sistemas para SSMs
Describimos varias optimizaciones de sistemas para SSMs, en particular la arquitectura Mamba-2, para entrenamiento e inferencia eficientes a gran escala. En particular, nos centramos en tensor parallel y sequence parallel para entrenamiento a gran escala, así como en secuencias de longitud variable para finetuning e inferencia eficientes.
8.1 Paralelismo tensorial
El paralelismo tensorial (TP, por sus siglas en inglés) (Shoeybi et al. 2019) es una técnica de paralelismo de modelo que divide cada capa (p. ej., atención, MLP) para ejecutarse en múltiples aceleradores como GPUs. Esta técnica se usa ampliamente para entrenar la mayoría de los modelos grandes (Brown et al. 2020; Chowdhery et al. 2023; Touvron, Lavril, et al. 2023; Touvron, L. Martin, et al. 2023) en clústeres de GPUs donde cada nodo típicamente tiene 4-8 GPUs con redes rápidas como NVLink. TP se desarrolló originalmente para la arquitectura Transformer, y no es sencillo adaptarlo a otras arquitecturas. Primero mostramos el desafío de usar TP con la arquitectura Mamba, y luego mostramos cómo la arquitectura Mamba-2 está diseñada para hacer que TP sea eficiente.
Recordemos la arquitectura Mamba, con una única entrada (sin batching por simplicidad), matrices de proyección de entrada donde es el factor de expansión (típicamente 2), y matriz de proyección de salida :
Con TP, supongamos que queremos dividir el cómputo entre 2 GPUs. Es fácil dividir las matrices de proyección de entrada y en dos particiones de tamaño cada una. Entonces cada GPU tendría la mitad de de tamaño . Sin embargo, vemos que dado que son funciones de , necesitaríamos un all-reduce adicional entre las GPUs para obtener la totalidad de antes de calcular . Después de eso, las dos GPUs pueden calcular el SSM en paralelo, ya que son independientes a lo largo de . Al final, podemos dividir las matrices de proyección de salida en dos particiones de tamaño cada una, y hacer un all-reduce al final. En comparación con los Transformers, incurriríamos en dos all-reduces en lugar de uno, duplicando el tiempo dedicado a la comunicación. Para el entrenamiento de Transformers a gran escala, la comunicación ya podría llevar una fracción significativa del tiempo (p. ej., 10-20%), y duplicar la comunicación haría que Mamba no fuera tan eficiente para el entrenamiento a gran escala.
Con Mamba-2, nuestro objetivo es tener solo un all-reduce por bloque, similar a los bloques de atención o MLP en los Transformers. Como resultado, tenemos la proyección para obtener directamente desde en lugar de desde , lo que nos permite dividir estas matrices de proyección. Esto implica que tenemos diferentes conjuntos de en diferentes GPUs, lo cual es equivalente a tener varios "grupos" de en una "GPU lógica" más grande. Además, usamos GroupNorm dentro de cada bloque, con un número de grupos divisible por el grado de TP, de modo que las GPUs en un grupo de TP no tienen que comunicarse dentro del bloque:
Vemos que solo necesitamos dividir las matrices de proyección de entrada y las matrices de proyección de salida, y solo necesitamos hacer all-reduce al final del bloque. Esto es similar al diseño de TP para capas de atención y MLP. En particular, si tenemos grado de TP 2, dividiríamos con con ,
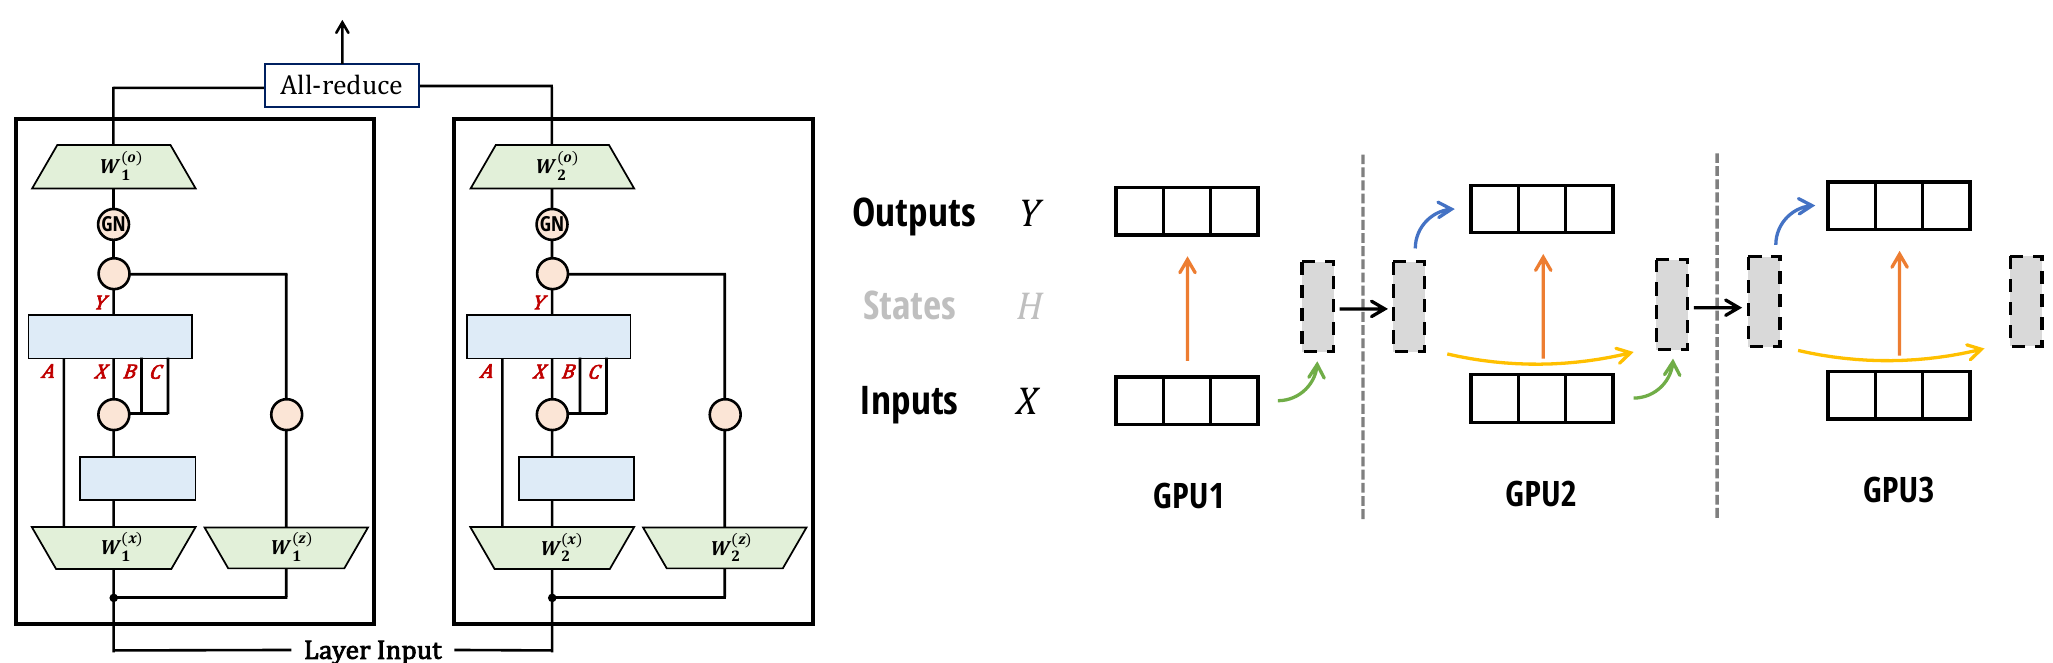
y con . Para , la capa Mamba-2 con TP se puede escribir como:
Ilustramos el paralelismo tensorial con Mamba-2 en la Figura 7 (Izquierda).
8.2 Paralelismo de secuencia
Para secuencias muy largas, podríamos necesitar dividir la entrada y la activación en diferentes GPUs a lo largo de la dimensión de longitud de secuencia. Hay dos técnicas principales:
1. Paralelismo de secuencia (SP, por sus siglas en inglés) para las operaciones residuales y de normalización: propuesto por primera vez por Korthikanti et al. (2023), esta técnica descompone el all-reduce en TP como reduce-scatter y all-gather. Observando que las operaciones residuales y de normalización se repiten sobre la misma entrada para todas las GPUs en el mismo grupo de TP, SP divide las activaciones a lo largo de la dimensión de longitud de secuencia realizando: reduce-scatter, residual y normalización, y luego all-gather.
Dado que la arquitectura Mamba-2 usa la misma estructura residual y de normalización, SP se aplica sin modificaciones.
2. Paralelismo de secuencia para las operaciones de mezcla de tokens (atención o SSM), también conocido como "paralelismo de contexto" (CP). Se han desarrollado varias técnicas para la capa de atención (p. ej., Ring attention (Liu, Yan, et al. 2024; Liu, Zaharia,
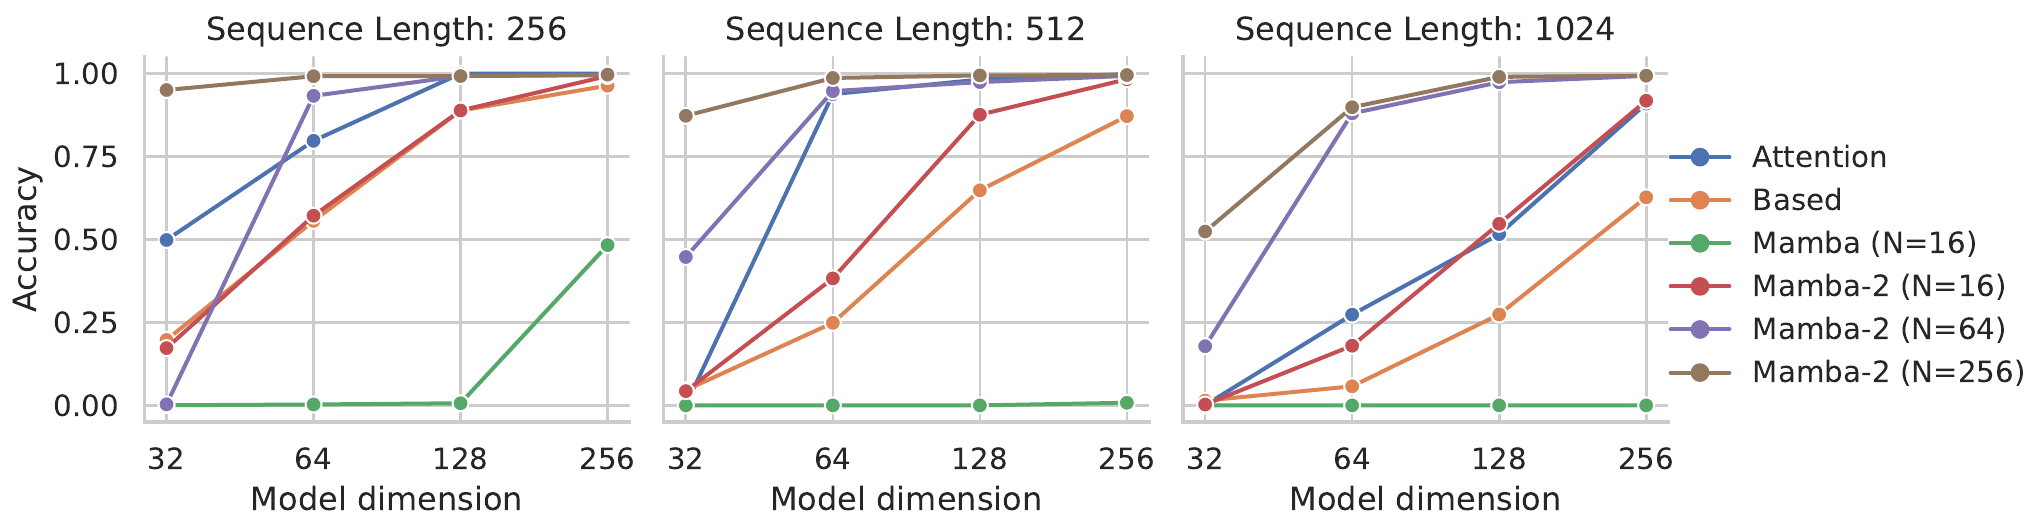
and Abbeel 2023)), con una sofisticada técnica de balanceo de carga (Brandon et al. 2023). La dificultad del paralelismo de secuencia en atención es que podemos dividir las consultas y las claves en bloques, pero cada bloque de consultas necesita interactuar con bloques de claves, lo que conlleva un ancho de banda de comunicación cuadrático en el número de trabajadores.
Con los SSM, podemos dividir la secuencia de manera simple: cada trabajador toma un estado inicial, calcula el SSM con respecto a sus entradas, devuelve el estado final y pasa ese estado final al siguiente trabajador. El ancho de banda de comunicación es lineal en el número de trabajadores. Esta descomposición es exactamente la misma que la descomposición en bloques del algoritmo SSD (Figura 5) para dividir en bloques / fragmentos. Ilustramos este paralelismo de contexto en la Figura 7 (Derecha).
8.3 Longitud variable
Aunque el preentrenamiento a menudo usa las mismas longitudes de secuencia para el lote, durante el ajuste fino o la inferencia, el modelo podría necesitar procesar diferentes secuencias de entrada de diferentes longitudes. Una forma ingenua de manejar este caso es rellenar por la derecha todas las secuencias del lote hasta la longitud máxima, pero esto puede ser ineficiente si las secuencias tienen longitudes muy diferentes. Para los transformers, se han desarrollado técnicas sofisticadas para evitar el relleno y hacer balanceo de carga entre GPUs (Zeng et al. 2022; Y. Zhai et al. 2023), o empaquetar múltiples secuencias en el mismo lote y ajustar la máscara de atención (Ding et al. 2024; Pouransari et al. 2024). Con los SSM y Mamba en particular, podemos manejar longitudes de secuencia variables simplemente tratando todo el lote como una sola secuencia larga, y evitar pasar los estados entre secuencias individuales. Esto es equivalente a simplemente establecer para los tokens al final de una secuencia para impedir que pase información al token , que pertenece a una secuencia diferente.
9 Validación empírica
Evaluamos empíricamente Mamba-2 en tareas sintéticas de recuerdo que han sido difíciles para los modelos recurrentes (Sección 9.1), y en preentrenamiento de modelado de lenguaje estándar y evaluaciones posteriores (Sección 9.2). Validamos que nuestro algoritmo SSD es mucho más eficiente que Mamba-1 (Sección 9.3) y comparable a la atención optimizada para longitudes de secuencia moderadas. Finalmente, realizamos ablaciones de diversas elecciones de diseño en la arquitectura Mamba-2 (Sección 9.4).
9.1 Sintéticos: recuerdo asociativo
Las tareas sintéticas de recuerdo asociativo han sido populares para evaluar la capacidad de los modelos de lenguaje de buscar información en su contexto. En términos generales, consisten en alimentar a modelos autorregresivos con pares de asociaciones clave-valor y luego pedirle al modelo que produzca la finalización correcta al mostrársele una clave vista previamente. La tarea de recuerdo asociativo de múltiples consultas (MQAR) es una formulación particular de esta tarea que requiere que el modelo memorice múltiples asociaciones (Arora, Eyuboglu, Timalsina, et al. 2024). El artículo original de Mamba reportó resultados en tareas sintéticas relacionadas, en particular Selective Copying (Gu y Dao 2023) e Induction Heads (Olsson et al. 2022), que pueden verse como tareas de recuerdo asociativo más fáciles. La tarea MQAR también está estrechamente relacionada con las tareas de "búsqueda en guía telefónica", que se ha demostrado que son difíciles para modelos recurrentes como los SSM, debido a su capacidad de estado finita (De et al. 2024; Jelassi et al. 2024).
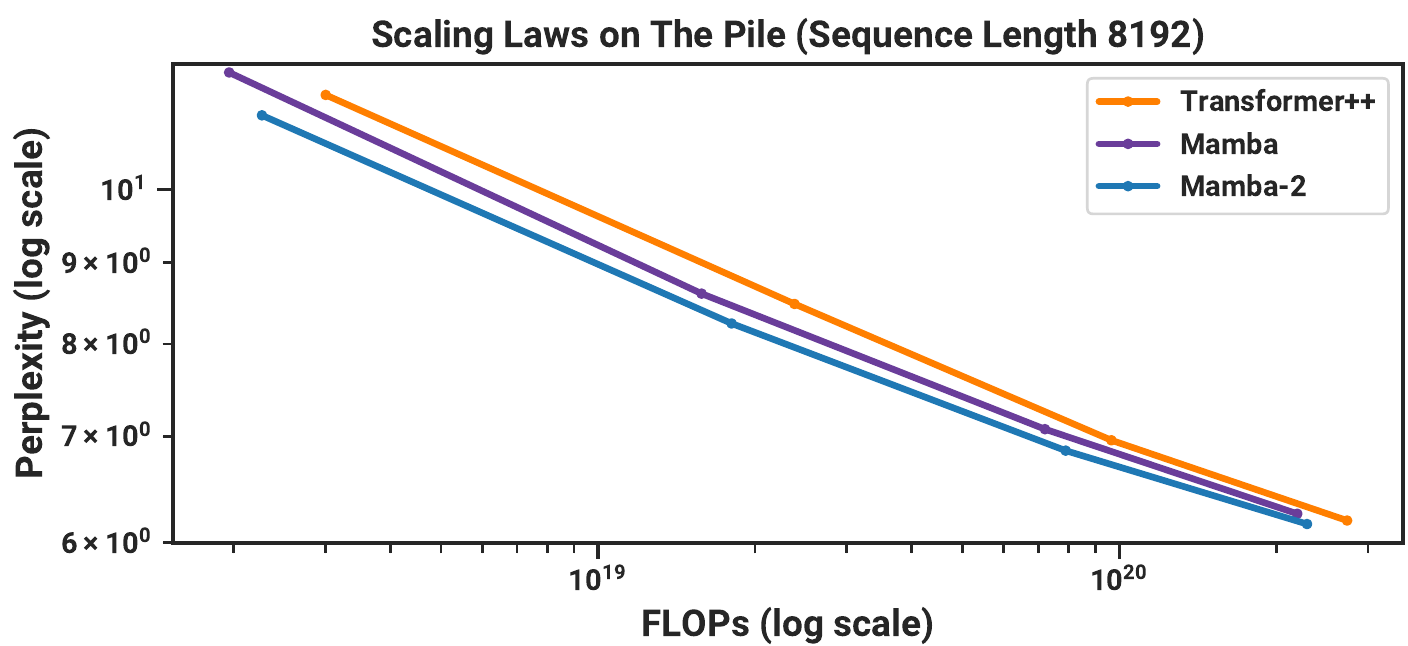
| MODELO | TOKEN. | PPL DE PILE ↓ | PPL DE LAMBADA ↓ | PREC. DE LAMBADA ↑ | PREC. DE HELLASWAG ↑ | PREC. DE PIQA ↑ | PREC. DE ARC-E ↑ | PREC. DE ARC-C ↑ | PREC. DE WINOGRANDE ↑ | PREC. DE OPENBOOKQA ↑ | PREC. MEDIA ↑ |
| Pythia-1B | NeoX | 7,82 | 7,92 | 56,1 | 47,2 | 70,7 | 57,0 | 27,1 | 53,5 | 31,4 | 49,0 |
| Mamba-790M | NeoX | 7,33 | 6,02 | 62,7 | 55,1 | 72,1 | 61,2 | 29,5 | 56,1 | 34,2 | 53,0 |
| Mamba-2-780M | NeoX | 7,26 | 5,86 | 61,7 | 54,9 | 72,0 | 61,0 | 28,5 | 60,2 | 36,2 | 53,5 |
| Hybrid H3-1.3B | GPT2 | — | 11,25 | 49,6 | 52,6 | 71,3 | 59,2 | 28,1 | 56,9 | 34,4 | 50,3 |
| Pythia-1.4B | NeoX | 7,51 | 6,08 | 61,7 | 52,1 | 71,0 | 60,5 | 28,5 | 57,2 | 30,8 | 51,7 |
| RWKV4-1.5B | NeoX | 7,70 | 7,04 | 56,4 | 52,5 | 72,4 | 60,5 | 29,4 | 54,6 | 34,0 | 51,4 |
| Mamba-1.4B | NeoX | 6,80 | 5,04 | 65,0 | 59,1 | 74,2 | 65,5 | 32,8 | 61,5 | 36,4 | 56,4 |
| Mamba-2-1.3B | NeoX | 6,66 | 5,02 | 65,7 | 59,9 | 73,2 | 64,3 | 33,3 | 60,9 | 37,8 | 56,4 |
| Hybrid H3-2.7B | GPT2 | — | 7,92 | 55,7 | 59,7 | 73,3 | 65,6 | 32,3 | 61,4 | 33,6 | 54,5 |
| Pythia-2.8B | NeoX | 6,73 | 5,04 | 64,7 | 59,3 | 74,0 | 64,1 | 32,9 | 59,7 | 35,2 | 55,7 |
| RWKV4-3B | NeoX | 7,00 | 5,24 | 63,9 | 59,6 | 73,7 | 67,8 | 33,1 | 59,6 | 37,0 | 56,4 |
| Mamba-2.8B | NeoX | 6,22 | 4,23 | 69,2 | 66,1 | 75,2 | 69,7 | 36,3 | 63,5 | 39,6 | 59,9 |
| Mamba-2-2.7B | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
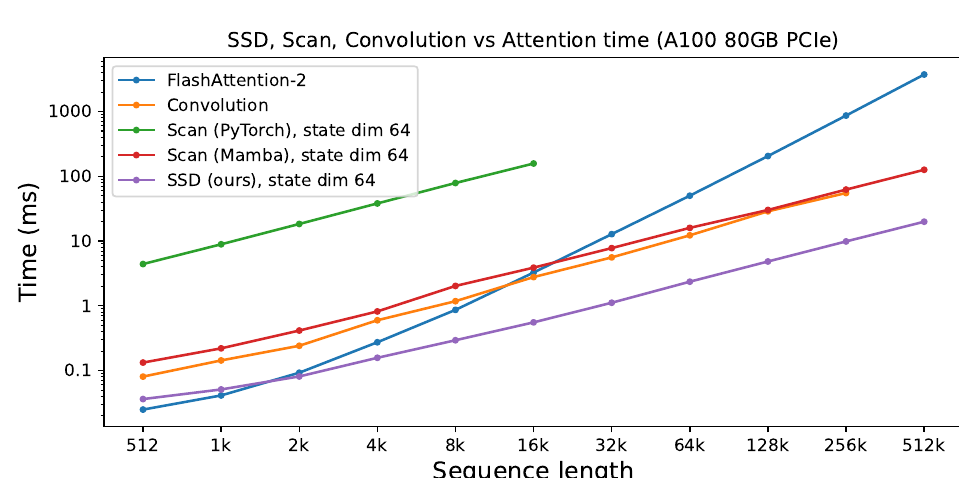
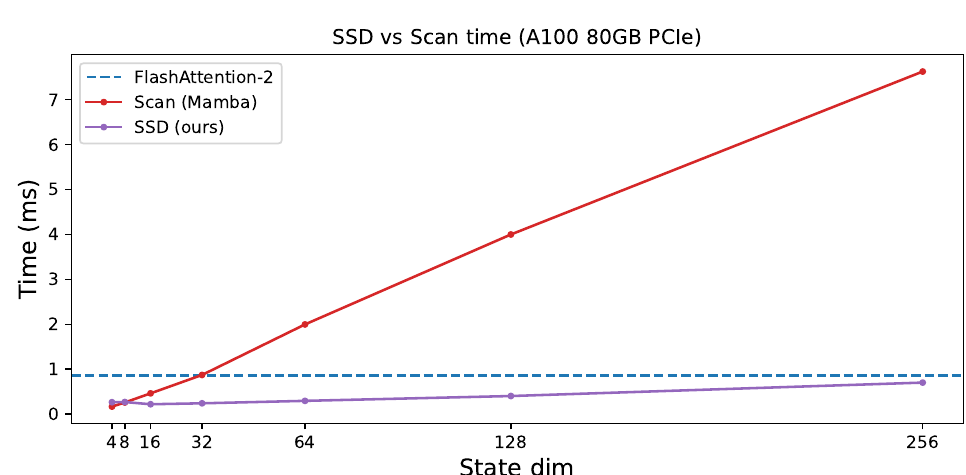
Figura 10: (Benchmarks de eficiencia). (Izquierda) Nuestro SSD es más rápido que un escaneo fusionado de Mamba para una gran expansión de estado y más rápido que FlashAttention-2 para longitudes de secuencia de y superiores. (Derecha) Longitud de secuencia : aumentar la expansión de estado ralentiza linealmente la implementación de escaneo optimizada de Mamba. SSD puede manejar factores de expansión de estado mucho mayores sin mucha ralentización.
Comparamos en una versión desafiante de la configuración MQAR de (Arora, Eyuboglu, Zhang, et al. 2024), usando una tarea más difícil, secuencias más largas y modelos más pequeños. Nuestras líneas base incluyen atención softmax multi-cabeza estándar, así como la arquitectura Based, que combina convoluciones, atención local y una variante de atención lineal.
Los resultados se muestran en la Figura 8. Mientras que Mamba-1 tiene dificultades en esta tarea, Mamba-2 funciona bien en todas las configuraciones. Sorprendentemente, es significativamente mejor que Mamba-1 incluso cuando los tamaños de estado están controlados (). (No estamos seguros de qué aspecto de la arquitectura es el factor predominante, lo que sigue siendo una cuestión a explorar en trabajos futuros). Además, esta tarea valida la importancia del tamaño de estado: aumentar de a y mejora consistentemente el rendimiento en MQAR, ya que el estado más grande permite memorizar más información (pares clave-valor).
9.2 Modelado de lenguaje
Siguiendo los protocolos estándar en los LLM, entrenamos y evaluamos la arquitectura Mamba-2 en modelado de lenguaje autorregresivo estándar frente a otras arquitecturas. Comparamos tanto las métricas de preentrenamiento (perplejidad) como las evaluaciones de zero-shot. Los tamaños de los modelos (profundidad y anchura) siguen las especificaciones de GPT3, desde hasta . Usamos el conjunto de datos Pile (L. Gao, Biderman, et al. 2020) y seguimos la receta de entrenamiento descrita en Brown et al. (2020). Esto sigue la misma configuración que la reportada en Mamba (Gu y Dao 2023); los detalles de entrenamiento están en el Apéndice D.
9.2.1 Leyes de escalado
Para las líneas base, comparamos tanto con Mamba como con su receta Transformer++ (Gu y Dao 2023), que se basa en las arquitecturas PaLM y LLaMa (p. ej., embedding rotatorio, MLP SwiGLU, RMSNorm en lugar de LayerNorm, sin sesgo lineal y tasas de aprendizaje más altas). Como Mamba ya ha demostrado que supera a la arquitectura Transformer estándar (arquitectura GPT3), así como a arquitecturas subcuadráticas recientes (H3 (Dao, D. Y. Fu, et al. 2023), Hyena (Poli et al. 2023), RWKV-4 (B. Peng, Alcaide, et al. 2023), RetNet (Y. Sun et al. 2023)), las omitimos en el gráfico por claridad (véase Gu y Dao (2023) para las comparaciones).
La Figura 9 muestra las leyes de escalado bajo el protocolo estándar de Chinchilla (Hoffmann et al. 2022), en modelos de a parámetros.
9.2.2 Evaluaciones posteriores
La Tabla 1 muestra el rendimiento de Mamba-2 en una variedad de tareas populares de evaluación zero-shot posteriores, en comparación con los modelos de código abierto más conocidos en estos tamaños, y de manera más importante Pythia (Biderman et al. 2023), que se entrenaron con el mismo tokenizador, conjunto de datos y longitud de entrenamiento (300B tokens) que nuestros modelos.
9.2.3 Modelos híbridos: combinación de la capa SSD con MLP y atención
Trabajos recientes y concurrentes (Dao, D. Y. Fu, et al. 2023; De et al. 2024; Glorioso et al. 2024; Lieber et al. 2024) sugieren que una arquitectura híbrida con capas tanto SSM como de atención podría mejorar la calidad del modelo respecto a la de un Transformer, o a la de un modelo puramente SSM (p. ej., Mamba), especialmente para el aprendizaje en contexto. Exploramos las diferentes formas en que las capas SSD pueden combinarse con atención y MLP para comprender los beneficios de cada una. Empíricamente encontramos que tener alrededor del del número total de capas siendo de atención rinde mejor. Combinar capas SSD, capas de atención y MLP también funciona mejor que un Transformer++ puro o Mamba-2.
SSD y atención Encontramos que las capas SSD y de atención son complementarias: por sí solas (p. ej., en la arquitectura Mamba-2 frente a Transformer++), su rendimiento (medido por perplejidad) es casi el mismo, pero una mezcla de capas SSD y de atención supera a la arquitectura pura Mamba-2 o Transformer++. Mostramos algunos resultados (Tabla 2) para el modelo de 350M (48 capas) entrenado hasta 7B tokens en el Pile con el tokenizador de GPT-2 (mismo número de parámetros, mismos hiperparámetros, mismo conjunto de entrenamiento y validación). Añadir solo unas pocas capas de atención ya produce una mejora notable y logra el mejor equilibrio entre calidad y eficiencia. Hipotetizamos que las capas SSM funcionan bien como un mapeo general de secuencia a secuencia, y las capas de atención actúan como un mecanismo de recuperación para referirse rápidamente a tokens anteriores en la secuencia en lugar de forzar al modelo a comprimir todo el contexto en su memoria (estados SSM).
| NÚM. DE BLOQUES DE ATENCIÓN | 0 (Mamba-2) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 9 | 11 | 15 | 24 | Transformer++ |
| PERPLEJIDAD ↓ | 8,60 | 8,38 | 8,32 | 8,29 | 8,29 | 8,28 | 8,26 | 8,27 | 8,28 | 8,30 | 8,34 | 8,50 | 8,68 |
Modelos híbridos con SSD, MLP y atención Comparamos diferentes formas en que SSD puede combinarse con las capas (con compuerta) MLP y de atención, y evaluamos a la escala de 2.7B (64 capas), entrenado hasta 300B tokens en el Pile (mismo número de parámetros, mismos hiperparámetros, mismo conjunto de entrenamiento y validación, mismo orden de datos):
1. Transformer++: 32 capas de atención y 32 MLP con compuerta, intercaladas.
2. Mamba-2: 64 capas SSD.
3. Mamba-2-MLP: 32 capas SSD y 32 capas MLP con compuerta, intercaladas.
4. Mamba-2-Attention: 58 capas SSD y 6 capas de atención (en los índices 9, 18, 27, 36, 45, 56)6.
5. Mamba-2-MLP-Attention: 28 capas SSD y 4 capas de atención, intercaladas con 32 capas MLP con compuerta.
Reportamos la perplejidad de validación en el Pile, así como la evaluación zero-shot, en la Tabla 3. En general, la calidad de los modelos Transformer++ y Mamba-2 es más o menos la misma. Vemos que añadir solo 6 capas de atención mejora notablemente respecto al modelo Mamba-2 puro (y respecto a Transformer++). Añadir capas MLP reduce la calidad del modelo, pero puede (i) acelerar el entrenamiento y la inferencia debido a la simplicidad y eficiencia en hardware de la capa MLP (ii) ser más fácil de actualizar a modelos MoE reemplazando las capas MLP con mezcla de expertos.
| MODELO | TOKEN. | PILE | LAMBADA | LAMBADA | HELLASWAG | PIQA | ARC-E | ARC-C | WINOGRANDE | OPENBOOKQA | PROMEDIO |
| PPL ↓ | PPL ↓ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ||
| Transformer++ | NeoX | 6.13 | 3.99 | 70.3 | 66.4 | 75.2 | 67.7 | 37.8 | 63.9 | 40.4 | 60.2 |
| Mamba-2 | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| Mamba-2-MLP | NeoX | 6.13 | 4.18 | 69.3 | 65.0 | 76.4 | 68.1 | 37.0 | 63.1 | 38.2 | 59.6 |
| Mamba-2-Attention | NeoX | 5.95 | 3.85 | 71.1 | 67.8 | 75,8 | 69,9 | 37,8 | 65,3 | 39,0 | 61,0 |
| Mamba-2-MLP-Attention | NeoX | 6,00 | 3,95 | 70,0 | 66,6 | 75,4 | 70,6 | 38,6 | 64,6 | 39,2 | 60,7 |
9.3 Benchmarks de velocidad
Evaluamos la velocidad del algoritmo SSD frente a la implementación de escaneo de Mamba y FlashAttention-2 (Figura 10). SSD, gracias a su reformulación para usar multiplicación de matrices como subrutina, puede aprovechar las unidades especializadas de multiplicación de matrices (matmul) en las GPU, también conocidas como tensor cores. Como resultado, es de 2 a 8 veces más rápido que el escaneo asociativo fusionado de Mamba, que no aprovecha las unidades matmul. Debido a su escalado lineal en la longitud de secuencia, SSD es más rápido que FlashAttention-2 a partir de una longitud de secuencia de .
Sin embargo, observamos que el modelo Mamba-2 en su conjunto podría no ser tan eficiente de entrenar como Transformer en longitudes de secuencia cortas (p. ej., en \(2K\)), ya que un Transformer con \(L\) capas tendría \(\frac{L}{2}\) capas MLP y \(\frac{L}{2}\) capas de atención, mientras que un modelo Mamba-2 tendría \(L\) capas SSD para el mismo número de parámetros. Generalmente, las capas MLP son muy eficientes en hardware, ya que consisten en una multiplicación de matrices simple y una linealidad puntual. Como se muestra en la Sección 9.2.3, también se pueden combinar \(\frac{L}{2}\) capas SSD y \(\frac{L}{2}\) capas MLP para acelerar el entrenamiento en longitudes de secuencia cortas.
| Bloque | Proyecciones ABCX | NORMALIZACIÓN EXTRA | PARÁMETROS | PERPLEJIDAD |
| Mamba-1 | Secuencial | × | 129,3M | 11,76 |
| Secuencial | ✓ | 129,3M | 11,54 | |
| Paralelo | × | 126,5M | 11,66 | |
| Paralelo | ✓ | 126,5M | 11,49 |
9.4 Ablaciones de arquitectura
9.4.1 Diseño del bloque
La Sección 7.1 presenta el bloque Mamba-2, que tiene pequeñas modificaciones respecto del bloque Mamba-1, motivadas en parte por la conexión con la atención y también para mejorar la escalabilidad de Mamba-2. La Tabla 4 realiza ablaciones de estos cambios de arquitectura en el bloque, que ocurren fuera de la capa SSM central.
Las ablaciones validan que las proyecciones paralelas para crear \((A,B,C,X)\) ahorran parámetros y tienen un rendimiento ligeramente mejor que las proyecciones secuenciales de Mamba. Más importante aún, esta modificación es compatible con el paralelismo de tensores en tamaños de modelo mayores (Sección 8). Además, la capa de normalización adicional también mejora ligeramente el rendimiento. Más importante aún, experimentos preliminares a mayores escalas observaron que también ayuda con la estabilidad del entrenamiento.
9.4.2 Estructura de cabezas
La Sección 7.2 describe cómo las dimensiones de las proyecciones \(B,C,X\) pueden verse como un hiperparámetro análogo a las nociones de atención multi-cabeza y atención multi-consulta. También mostramos cómo la arquitectura Mamba original es análoga a la atención multi-valor (Proposición 7.2), que fue una elección que se desarrolló naturalmente desde el punto de vista de los modelos de espacio de estados y que no había sido ablacionada previamente.
La Tabla 5 realiza ablaciones de las elecciones de la estructura multi-cabeza para la arquitectura Mamba-2. Sorprendentemente, encontramos una gran diferencia entre los patrones de cabezas multi-valor y multi-consulta o multi-clave, a pesar de que parecen muy similares. Nótese que esto no se explica por el tamaño total del estado, que es el mismo para todos ellos (igual a HPN o al producto del número de cabezas, la dimensión de cabeza y la dimensión de estado).
También comparamos con patrones multi-cabeza donde el número de cabezas \(C,B,X\) (análogas a \(Q,K,V\)) es igual. Comparamos con el patrón multi-cabeza estándar, así como con uno con compartición agresiva donde todas tienen solo 1 cabeza. Nótese que en el último caso, el modelo todavía tiene H mezcladores de secuencia diferentes \(M\), porque cada cabeza todavía tiene una \(A\) diferente. Cuando se igualan los parámetros, estos patrones multi-cabeza se comportan de manera similar entre sí, entre los patrones MVA y MQA/MKA.
9.4.3 Aproximaciones del kernel de atención
Sección 7.3 señaló cómo SSD puede combinarse con ideas de la literatura de atención lineal, tales como diversas formas de aproximaciones de kernel. Realizamos una ablación de varias variantes de estas sugeridas por trabajos previos en la Tabla 6. Estas incluyen cosFormer (Qin, Weixuan Sun, et al. 2022), Random Feature Attention H. Peng et al. 2021, y Positive Random Features (Performer) (Choromanski et al. 2021).
También realizamos una ablación añadiendo un término de normalización, similar al denominador de la función softmax en la atención estándar. Encontramos que esto introdujo inestabilidades en la mayoría de las variantes, pero mejoró ligeramente el rendimiento para la función de activación ReLU .
La Tabla 7 también prueba propuestas más recientes para mejorar la atención lineal que implican expandir la dimensión de características (Based (Arora, Eyuboglu, Zhang, et al. 2024) y ReBased (Aksenov et al. 2024)). Estas extensiones de atención lineal tienen como objetivo apropiarse del kernel exp con una aproximación cuadrática. ReBased también propone reemplazar la función de activación QK con una normalización de capa; desde una perspectiva centrada en SSM, aplicamos una normalización sobre antes de aplicar la función SSM.
| Patrón de cabeza SSM | ANÁLOGO DE ATENCIÓN | CABEZAS A | CABEZAS B | CABEZAS C | CABEZAS X | CAPAS | PARÁMS. | PPL. |
| Multi-entrada (MIS) | Multi-valor (MVA) | 24 | 1 | 1 | 24 | 24 | 126,5M | 11,66 |
| Multi-contracción (MCS) | Multi-consulta (MQA) | 24 | 1 | 24 | 1 | 24 | 126,5M | 12,62 |
| Multi-expansión (MES) | Multi-clave (MKA) | 24 | 24 | 1 | 1 | 24 | 126,5M | 12,59 |
| Multi-cabeza (MHS) | Multi-cabeza (MHA) | 24 | 24 | 24 | 24 | 15 | 127,6M | 12,06 |
| Multi-estado (MSS) | - | 24 | 1 | 1 | 1 | 36 | 129,6M | 12,00 |
| Multi-entrada (MIS) | Multi-valor (MVA) | 32 | 1 | 1 | 32 | 48 | 361,8M | 8,73 |
| Multi-contracción (MCS) | Consulta múltiple (MQA) | 32 | 1 | 32 | 1 | 48 | 361,8 M | 9,33 |
| Multiexpansión (MES) | Multiclave (MKA) | 32 | 32 | 1 | 1 | 48 | 361,8 M | 9,36 |
| Multicabezal (MHS) | Multicabezal (MHA) | 32 | 1 | 1 | 1 | 70 | 361,3 M | 9,01 |
| Multiestado (MSS) | - | 32 | 32 | 32 | 32 | 29 | 357,3 M | 9,04 |
| ACTIVACIÓN DEL KERNEL φ | PERPLEJIDAD |
| ninguna | 11.58 |
| Swish | 11.66 |
| Exp | 11.62 |
| ReLU | 11.73 |
| ReLU + normalización | 11.64 |
| cosFormer | 11.97 |
| Random Feature Attention | 11.57 |
| Positive Random Features (Performer) | 12.21 |
| ACTIVACIÓN DEL KERNEL φ | PERPLEJIDAD |
| Swish | 11.67 |
| Swish + Taylor (Based) | 12.19 |
| LayerNorm | 11.50 |
| LayerNorm + Square (ReBased) | 11.84 |
| Swish | 8.58 |
| Swish + Taylor (Based) | 8.71 |
| LayerNorm | 8.61 |
| LayerNorm + Square (ReBased) | 8.63 |
Notamos que esta técnica ha sido propuesta de forma independiente como la "QK-Norm" para atención softmax (Team 2024) y una "normalización interna" para Mamba (Lieber et al. 2024).
En general, las Tablas 6 y 7 encontraron que los métodos de aproximación de kernel que probamos no parecieron mejorar sobre funciones de activación no lineales puntuales simples para . Por lo tanto, nuestra configuración predeterminada para Mamba-2 usó para seguir a Mamba-1, pero sugerimos que eliminar esta activación por completo podría ser una opción más simple que no probamos exhaustivamente.
Sin embargo, enfatizamos que SSD y la atención lineal vanilla difieren en la inclusión de la máscara 1-semiseparable , mientras que los diversos métodos de atención lineal en la literatura fueron derivados para aproximar la atención softmax sin este término; por lo tanto, nuestros resultados negativos pueden no ser inesperados.
10 Trabajo relacionado y discusión
El marco de dualidad de espacio de estados tiende puentes entre las conexiones entre SSMs, matrices estructuradas y atención. Discutimos con mayor profundidad las relaciones entre SSD y estos conceptos de manera más amplia. Usando ideas de cada uno de los puntos de vista, también sugerimos algunas direcciones en las que el marco SSD puede extenderse en trabajos futuros.
10.1 Modelos de espacio de estados
Los modelos de espacio de estados estructurados pueden caracterizarse a lo largo de los ejes (i) si es invariante en el tiempo o variante en el tiempo.(ii) la dimensionalidad del sistema.(iii) la estructura sobre las transiciones recurrentes .
SSD puede describirse como un SSM selectivo con dimensiones SISO y estructura de identidad escalar.
Varianza temporal (selectividad). Los SSMs estructurados originales (S4) eran sistemas lineales invariantes en el tiempo (LTI) (Gu 2023; Gu, Goel, and Ré 2022) motivados por la memorización en línea en tiempo continuo (Gu, Dao, et al. 2020; Gu, Johnson, Goel, et al. 2021; Gu, Johnson, Timalsina, et al. 2023). Se han propuesto muchas variantes de SSMs estructurados (Dao, D. Y. Fu, et al. 2023; Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; Ma et al. 2023; J. T. Smith, Warrington, and Linderman 2023), incluidas varias que eliminan la recurrencia y se centran en la representación convolucional de SSMs LTI (D. Y. Fu et al. 2023; Y. Li et al. 2023; Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023).
SSD es un SSM estructurado variante en el tiempo, también conocido como SSM selectivo introducido en Mamba (Gu and Dao 2023). Los SSMs selectivos están estrechamente relacionados con los mecanismos de compuerta de las RNN, incluidas las RNN clásicas como LSTM (Hochreiter and Schmidhuber 1997) y GRU (J. Chung et al. 2014), así como variantes más modernas como QRNN (Bradbury et al. 2016), SRU (Lei 2021; Lei et al. 2017), RWKV (B. Peng, Alcaide, et al. 2023), HGRN (Qin, Yang, and Zhong 2023) y Griffin (Botev et al. 2024; De et al. 2024). Estas RNN difieren en sus parametrizaciones de diversas maneras, lo más importante en la falta de una expansión de estado.
Dimensionalidad y expansión de estado. Una característica importante de SSD, compartida por SSMs previos en su linaje (S4, H3, Mamba), es que es un sistema de una entrada y una salida (SISO) donde los canales de entrada se procesan independientemente. Esto conduce a un tamaño de estado efectivo mucho mayor de N0, donde N es el tamaño de estado del SSM (también llamado factor de expansión de estado) y D es la dimensión estándar del modelo. Las RNN tradicionales o bien tienen o son de múltiples entradas y múltiples salidas (MIMO) con matrices densas , cualquiera de las cuales conduce a un estado más pequeño. Aunque se ha demostrado que los SSMs MIMO funcionan bien en algunos dominios (Lu et al. 2023; Orvieto et al. 2023; J. T. Smith, Warrington, and Linderman 2023), Mamba mostró que la expansión de estado es crucial para dominios densos en información como el lenguaje. Una de las principales ventajas de SSD es permitir factores de expansión de estado aún mayores sin ralentizar el modelo. Muchos trabajos posteriores han adoptado desde entonces la expansión de estado (Sección 10.4).
Estructura. En comparación con SSMs estructurados previos, la principal restricción de SSD está en la expresividad de las transiciones de estado . Notamos que SSMs más generales, como el caso de diagonal, tienen la misma eficiencia teórica que SSD, pero son menos amigables para el hardware. Esto se debe a que la forma cuadrática dual pierde su interpretación tipo atención y se vuelve más difícil de calcular. Por lo tanto, en comparación con Mamba, SSD difiere solo en una forma ligeramente más restrictiva de diagonal, y compensa esta expresividad con una mejor eficiencia de hardware (y facilidad de implementación).
Hipótesis: puede ser posible refinar nuestros algoritmos de matrices estructuradas para mejorar también al caso general de SSM diagonal.
10.2 Matrices estructuradas
El primer punto de vista de la dualidad de espacio de estados adopta el punto de vista de estos modelos como transformaciones de secuencias matriciales o "mezcladores de matrices": transformaciones de secuencias (Definición 2.1) que pueden representarse como multiplicación de matrices (por una matriz ) a lo largo de la dimensión de secuencia T.
Se han propuesto varios de estos mezcladores de matrices antes, donde el eje principal de variación es la representación de la matriz. Estos incluyen MLP-Mixer (Tolstikhin et al. 2021) (matriz no estructurada), FNet (Lee-Thorp et al. 2021) (matriz de transformada de Fourier), M2 (Dao, B. Chen, et al. 2022; Dao, Gu, et al. 2019; Dao, Sohoni, et al. 2020; D. Fu et al. 2024) (matriz butterfly/monarch), matrices de Toeplitz (Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023), e incluso estructuras más exóticas (De Sa et al. 2018; Thomas et al. 2018).
Una caracterización importante es que las transformaciones de secuencias matriciales eficientes (subcuadráticas) son exactamente aquellas que tienen mezcladores de matrices estructuradas. Un resultado central del marco SSD es ver los SSMs como mezcladores de matrices con una estructura particular: matrices semiseparables (Sección 3). La dualidad lineal vs. cuadrática entonces toma la forma de multiplicación de matrices estructuradas vs. multiplicación de matrices ingenua.
La representación de matriz estructurada condujo a nuestro eficiente algoritmo SSD mediante descomposiciones en bloques de matrices semiseparables particulares (Sección 6). Notamos que las matrices semiseparables están bien estudiadas en la literatura de computación científica, e incorporar esas ideas puede ser una vía prometedora para más mejoras en los modelos de espacio de estados. También sugerimos que centrarse en el punto de vista del mezclador de matrices puede conducir a direcciones más fructíferas para los modelos de secuencia, como diseñar variantes no causales con principios de Mamba, o encontrar formas de caracterizar y cerrar la brecha entre la atención softmax y los modelos subcuadráticos mediante el análisis de su estructura de transformación matricial.
10.3 Atención (lineal)
En comparación con la atención estándar (causal), SSD tiene solo dos diferencias principales.
Primero, SSD no usa la activación softmax de la atención estándar (Bahdanau, Cho, and Bengio 2015; Vaswani et al. 2017), que es lo que le da a la atención su complejidad cuadrática. Cuando se elimina el softmax, la secuencia puede calcularse con escalado lineal a través del marco de atención lineal (Katharopoulos et al. 2020).
Segundo, SSD multiplica la matriz de logits por una máscara 1-semiseparable dependiente de la entrada. Por lo tanto, esta máscara puede verse como un reemplazo del softmax en la atención estándar.
Esta máscara semiseparable también puede verse como un mecanismo que proporciona información posicional. Los elementos actúan como «puertas» en el sentido de las RNN, o como un mecanismo de «selección» (véase la discusión en el artículo de Mamba), y sus productos acumulativos controlan cuánta interacción se permite entre las posiciones y . Las incrustaciones posicionales (p. ej., sinusoidal (Vaswani et al. 2017), Alibi (Press, N. Smith, and Lewis 2022) y RoPE (Su et al. 2021)) son un componente importante de los Transformers que a menudo se consideran heurísticas, y la máscara 1-SS de SSD puede verse como una forma más fundamentada de incrustaciones posicionales relativas. Señalamos que esta visión también fue postulada de forma concurrente por GateLoop (Katsch 2023).
La segunda perspectiva de la dualidad espacio de estados es un caso especial de nuestro marco más general de atención enmascarada estructurada (SMA, por sus siglas en inglés), donde la dualidad se revela como diferentes órdenes de contracción sobre una sencilla contracción tensorial de 4 vías. SMA es una fuerte generalización de la atención lineal que además es mucho más general que SSD; otras formas de máscaras estructuradas pueden dar lugar a más variantes de atención eficiente con propiedades diferentes a las de SSD.
Además de dar lugar a nuevos modelos, estas conexiones con la atención pueden abrir otras direcciones para comprender los SSM. Por ejemplo, nos preguntamos si el fenómeno de los sumideros de atención (attention sinks) (Darcet et al. 2024; Xiao et al. 2024) existe en los modelos Mamba y, de forma más amplia, si las técnicas de interpretabilidad pueden transferirse a los SSM (Ali, Zimerman, and Wolf 2024).
Por último, se han propuesto muchas otras variantes de atención lineal (Arora, Eyuboglu, Timalsina, et al. 2024; Arora, Eyuboglu, Zhang, et al. 2024; Choromanski et al. 2021; H. Peng et al. 2021; Qin, Han, Weixuan Sun, Dongxu Li, et al. 2022; Qin, Weixuan Sun, et al. 2022; Schlag, Irie, and Schmidhuber 2021; Zhang et al. 2024; Zheng, C. Wang, and Kong 2022) (véase la Sección 4.1.3 para descripciones de varias de ellas), y esperamos que muchas técnicas puedan transferirse a los SSM (p. ej., la Sección 7.3).
Destacamos que SSD no generaliza la atención softmax estándar, ni ninguna otra transformación sobre la matriz del núcleo de atención que no tenga un mapa de características finito \(\psi\). En comparación con la atención general, la ventaja de SSD es tener un factor de expansión de estado controlable \(N\) que comprime el historial, en comparación con el caché de la atención cuadrática de todo el historial que escala con la longitud de la secuencia \(T \gg N\). Trabajos concurrentes han comenzado a estudiar los compromisos de estas representaciones, por ejemplo en tareas de copiado y de aprendizaje en contexto (Akyürek et al. 2024; Grazzi et al. 2024; Jelassi et al. 2024; Park et al. 2024). Notamos que Mamba-2 mejora significativamente a Mamba en algunas de estas capacidades (por ejemplo, como se demuestra con los resultados de MQAR en la Sección 9.1), pero queda más por entender.
10.4 Modelos relacionados
Finalmente, destacamos un creciente conjunto de trabajos recientes y concurrentes que han desarrollado modelos de secuencia muy similares a Mamba y Mamba-2.
- RetNet (Y. Sun et al. 2023) y TransNormerLLM (Qin, Dong Li, et al. 2023) generalizan la Atención Lineal usando términos de decaimiento en lugar de una suma acumulativa, y proponen algoritmos duales paralelo/recurrente así como un modo híbrido "por bloques". Estos algoritmos pueden verse como una instanciación de SSD donde es invariante en el tiempo (constante para todo ); en la interpretación SMA, la matriz de máscara sería una matriz de decaimiento \(L_{i,j} = \gamma^{t - j}\). Estos modelos también difieren arquitectónicamente de diversas maneras. Por ejemplo, dado que se derivaron desde una perspectiva centrada en la atención, preservan el patrón de atención multi-cabeza (MHA); dado que Mamba-2 se derivó desde un patrón centrado en SSM, preserva el patrón de atención multi-valor (MVA) o SSM multi-expandido (MES), que mostramos que es mejor (Sección 9.4).
- GateLoop (Katsch 2023) propuso concurrentemente el uso de factores de decaimiento dependientes de la entrada \(A_{t}\), y desarrolló la misma forma cuadrática dual que en SSD, a la que llaman forma de "atención sustituta".
- Gated Linear Attention (GLA) (Yang et al. 2024) propuso una variante de atención lineal con compuertas dependientes de los datos, junto con algoritmos eficientes para computar un modo por bloques e implementaciones conscientes del hardware.
- HGRN (Qin, Yang, and Zhong 2023) introdujo una RNN con compuertas dependientes de la entrada, que fue mejorada para incorporar expansión de estado en HGRN2 (Qin, Yang, Weixuan Sun, et al. 2024).
- Griffin (De et al. 2024) y RecurrentGemma (Botev et al. 2024) mostraron que una RNN con compuertas dependientes de la entrada, combinada con atención local, puede ser muy competitiva con Transformers modernos fuertes. Jamba también mostró que combinar Mamba con unas pocas capas de atención funciona muy bien en modelado de lenguaje (Lieber et al. 2024).
- xLSTM (Beck et al. 2024) mejora la xLSTM adoptando la idea de expansión de estado y otras técnicas de compuertas, normalización y estabilización.
- RWKV(-4) (B. Peng, Alcaide, et al. 2023) es una RNN basada en una aproximación de atención lineal diferente (el Transformer libre de atención (S. Zhai et al. 2021)). Recientemente ha sido mejorada a las arquitecturas RWKV-5/6 (Eagle and Finch) (B. Peng, Goldstein, et al. 2024) adoptando las ideas de selectividad y expansión de estado.
11 Conclusión
Propuesto un marco teórico basado en clases bien estudiadas de matrices estructuradas que tiende un puente sobre la brecha conceptual entre los SSM y las variantes de atención. Este marco proporciona ideas sobre cómo los SSM recientes (por ejemplo, Mamba) funcionan tan bien como los Transformers en el modelado de lenguaje. Además, nuestras herramientas teóricas proporcionan nuevas ideas para mejorar los SSM (y potencialmente los Transformers) conectando los avances algorítmicos y de sistemas de ambos lados. Como demostración, el marco guía nuestro diseño de una nueva arquitectura (Mamba-2) en la intersección de los SSM y la atención estructurada.
Agradecimientos
Agradecemos a Angela Wu por la sugerencia sobre cómo computar eficientemente el gradiente de \(\Delta\) de manera numéricamente estable. Agradecemos a Sukjun Hwang y Aakash Lahoti por su asistencia con los experimentos de MQAR.
Referencias
[1] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints". In: arXiv preprint arXiv:2305.13245 (2023).
[2] Yaroslav Aksenov, Nikita Balagansky, Sofia Maria Lo Cicero Vaina, Boris Shaposhnikov, Alexey Gorbatovski, and Daniil Gavrilov. "Linear Transformers with Learnable Kernel Functions are Better In-Context Models". In: arXiv preprint arXiv:2402.10644 (2024).
[3] Ekin Akyürek, Bailin Wang, Yoon Kim, and Jacob Andreas. "In-Context Language Learning: Architectures and Algorithms". In: The International Conference on Machine Learning (ICML). 2024.
[4] Ameen Ali, Itamar Zimerman, and Lior Wolf. The Hidden Attention of Mamba Models. 2024. arXiv: 2403.01590 [cs.LG].
[5] Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. "Zoology: Measuring and Improving Recall in Efficient Language Models". In: The International Conference on Learning Representations (ICLR). 2024.
[6] Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, and Christopher Ré. "Simple Linear Attention Language Models Balance the Recall-Throughput Tradeoff". In: The International Conference on Machine Learning (ICML). 2024.
[7] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. "Neural Machine Translation by Jointly Learning to Align and Translate". In: The International Conference on Learning Representations (ICLR). 2015.
[8] George A Baker, George A Baker Jr, Peter Graves-Morris, and Susan S Baker. Pade Approximants: Encyclopedia of Mathematics and It's Applications, Vol. 59 George A. Baker, Jr., Peter Graves-Morris. Vol. 59. Cambridge University Press, 1996.
[9] Maximilian Beck, Korbinian Poppel, Markus Spanring, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, and Sepp Hochreiter. "xLSTM: Extended Long Short-Term Memory". In: arXiv preprint arXiv:2405.04517 (2024).
[10] Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, et al. "Pythia: A Suite for Analyzing Large Language Models across Training and Scaling". In: The International Conference on Machine Learning (ICML). PMLR. 2023, pp. 2397-2430.
[11] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. "PIQA: Reasoning about Physical Commonsense in Natural Language". In: Proceedings of the AAAI conference on Artificial Intelligence. Vol. 34. 2020.
[12] Sid Black, Stella Biderman, Eric Hallahan, Quentin Anthony, Leo Gao, Laurence Golding, Horace He, Connor Leahy, Kyle McDonell, Jason Phang, et al. "Gpt-NeoX-20B: An Open-source Autoregressive Language Model". In: arXiv preprint arXiv:2204.06745 (2022).
[13] Guy E Blelloch. "Prefix Sums and Their Applications". In: (1990).
[14] Aleksandar Botev, Soham De, Samuel L Smith, Anushan Fernando, George-Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, et al. "RecurrentGemma: Moving Past Transformers for Efficient Open Language Models". In: arXiv preprint arXiv:2404.07839 (2024).
[15] George EP Box, Gwilym M Jenkins, Gregory C Reinsel, and Greta M Ljung. Time Series Analysis: Forecasting and Control. John Wiley & Sons, 2015.
[16] James Bradbury, Stephen Merity, Caiming Xiong y Richard Socher. «Quasi-recurrent Neural Networks». En: arXiv preprint arXiv:1611.01576 (2016).
[17] William Brandon, Aniruddha Nrusimha, Kevin Qian, Zachary Ankner, Tian Jin, Zhiye Song y Jonathan Ragan-Kelley. «Striped attention: Faster ring attention for causal transformers». En: arXiv preprint arXiv:2311.09431 (2023).
[18] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. «Language Models are Few-shot Learners». En: Advances in Neural Information Processing Systems (NeurIPS) 33 (2020), pp. 1877-1901.
[19] Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, et al. «Rethinking Attention with Performers». En: The International Conference on Learning Representations (ICLR). 2021.
[20] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. «PaLM: Scaling Language Modeling with Pathways». En: Journal of Machine Learning Research 24.240 (2023), pp. 1-113. URL: http://jmlr.org/papers/v24/22-1144.html.
[21] Junyoung Chung, Caglar Gulcehre, KyungHyun Cho y Yoshua Bengio. «Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling». En: arXiv preprint arXiv:1412.3555 (2014).
[22] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick y Oyvind Tafjord. «Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge». En: arXiv preprint arXiv:1803.05457 (2018).
[23] Tri Dao. «FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning». En: The International Conference on Learning Representations (ICLR). 2024.
[24] Tri Dao, Beidi Chen, Nimit S Sohoni, Arjun Desai, Michael Poli, Jessica Grogan, Alexander Liu, Aniruddh Rao, Atri Rudra y Christopher Ré. «Monarch: Expressive structured matrices for efficient and accurate training». En: International Conference on Machine Learning. PMLR. 2022, pp. 4690-4721.
[25] Tri Dao, Daniel Y Fu, Khaled K Saab, Armin W Thomas, Atri Rudra y Christopher Ré. «Hungry Hungry Hippos: Towards Language Modeling with State Space Models». En: The International Conference on Learning Representations (ICLR). 2023.
[26] Tri Dao, Albert Gu, Matthew Eichhorn, Atri Rudra y Christopher Ré. «Learning Fast Algorithms for Linear Transforms Using Butterfly Factorizations». En: The International Conference on Machine Learning (ICML). 2019.
[27] Tri Dao, Nimit Sohoni, Albert Gu, Matthew Eichhorn, Amit Blonder, Megan Leszczynski, Atri Rudra y Christopher Ré. «Kaleidoscope: An Efficient, Learnable Representation for All Structured Linear Maps». En: The International Conference on Learning Representations (ICLR). 2020.
[28] Timothée Darcet, Maxime Oquab, Julien Mairal y Piotr Bojanowski. «Vision Transformers Need Registers». En: The International Conference on Learning Representations (ICLR). 2024.
[29] Soham De, Samuel L Smith, Anushan Fernando, Aleksandar Botev, George Cristian-Muraru, Albert Gu, Ruba Haroun, Leonard Berrada, Yutian Chen, Srivatsan Srinivasan, et al. «Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models». En: arXiv preprint arXiv:2402.19427 (2024).
[30] Christopher De Sa, Albert Gu, Rohan Puttagunta, Christopher Ré y Atri Rudra. «A Two-Pronged Progress in Structured Dense Matrix Vector Multiplication». En: Proceedings of the Twenty-Ninth Annual ACM-SIAM Symposium on Discrete Algorithms. SIAM. 2018, pp. 1060-1079.
[31] Hantian Ding, Zijian Wang, Giovanni Paolini, Varun Kumar, Anoop Deoras, Dan Roth y Stefano Soatto. «Fewer truncations improve language modeling». En: arXiv preprint arXiv:2404.10830 (2024).
[32] Yuli Eidelman e Israel Gohberg. «On a new class of structured matrices». En: Integral Equations and Operator Theory 34.3 (1999), pp. 293-324.
[33] Dan Fu, Simran Arora, Jessica Grogan, Isys Johnson, Evan Sabri Eyuboglu, Armin Thomas, Benjamin Spector, Michael Poli, Atri Rudra y Christopher Ré. «Monarch mixer: A simple sub-quadratic gemm-based architecture». En: Advances in Neural Information Processing Systems 36 (2024).
[34] Daniel Y Fu, Elliot L Epstein, Eric Nguyen, Armin W Thomas, Michael Zhang, Tri Dao, Atri Rudra y Christopher Ré. «Simple Hardware-efficient Long Convolutions for Sequence Modeling». En: The International Conference on Machine Learning (ICML) (2023).
[35] Leo Gao, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, Horace He, Anish Thite, Noa Nabeshima, Shawn Presser y Connor Leahy. «The Pile: An 800GB Dataset of Diverse Text for Language Modeling». En: arXiv preprint arXiv:2101.00027 (2020).
[36] Leo Gao, Jonathan Tow, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Kyle McDonell, Niklas Muennighoff, Jason Phang, Laria Reynolds, Eric Tang, Anish Thite, Ben Wang, Kevin Wang y Andy Zou. A Framework for Few-shot Language Model Evaluation. Versión v0.0.1. Sept. 2021. DOI: 10.5281/zenodo.5371628. URL: https://doi.org/10.5281/zenodo.5371628.
[37] Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim y Beren Millidge. «Zamba: A Compact 7B SSM Hybrid Model». En: arXiv preprint arXiv:2405.16712 (2024).
[38] Riccardo Grazzi, Julien Siems, Simon Schrodi, Thomas Brox y Frank Hutter. «Is Mamba Capable of In-Context Learning?». En: arXiv preprint arXiv:2402.03170 (2024).
[39] Albert Gu. «Modeling Sequences with Structured State Spaces». Tesis doctoral. Stanford University, 2023.
[40] Albert Gu y Tri Dao. «Mamba: Linear-Time Sequence Modeling with Selective State Spaces». En: arXiv preprint arXiv:2312.00752 (2023).
[41] Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra y Christopher Ré. «HIPPO: Recurrent Memory with Optimal Polynomial Projections». En: Advances in Neural Information Processing Systems (NeurIPS). 2020.
[42] Albert Gu, Karan Goel y Christopher Ré. «Efficiently Modeling Long Sequences with Structured State Spaces». En: The International Conference on Learning Representations (ICLR). 2022.
[43] Albert Gu, Ankit Gupta, Karan Goel y Christopher Ré. «On the Parameterization and Initialization of Diagonal State Space Models». En: Advances in Neural Information Processing Systems (NeurIPS). 2022.
[44] Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra y Christopher Ré. «Combining Recurrent, Convolutional, and Continuous-time Models with the Linear State Space Layer». En: Advances in Neural Information Processing Systems (NeurIPS). 2021.
[45] Albert Gu, Isys Johnson, Aman Timalsina, Atri Rudra y Christopher Ré. «How to Train Your HIPPO: State Space Models with Generalized Basis Projections». En: The International Conference on Learning Representations (ICLR). 2023.
[46] Ankit Gupta, Albert Gu y Jonathan Berant. «Diagonal State Spaces are as Effective as Structured State Spaces». En: Advances in Neural Information Processing Systems 35 (2022), pp. 22982-22994.
[47] Dan Hendrycks y Kevin Gimpel. «Gaussian Error Linear Units (GELUs)». En: arXiv preprint arXiv:1606.08415 (2016).
[48] W Daniel Hillis y Guy L Steele Jr. «Data Parallel Algorithms». En: Communications of the ACM 29.12 (1986), pp. 1170-1183.
[49] Sepp Hochreiter y Jürgen Schmidhuber. «Long Short-Term Memory». En: Neural Computation 9.8 (1997), pp. 1735-1780.
[50] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. "An Empirical Analysis of Compute Optimal Large Language Model Training". En: Advances in Neural Information Processing Systems (NeurIPS) 35 (2022), pp. 30016-30030. [51] Samy Jelassi, David Brandfonbrener, Sham M Kakade, and Eran Malach. "Repeat After Me: Transformers Are Better Than State Space Models at Copying". En: The International Conference on Machine Learning (ICML). 2024. [52] Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, and Francois Fleuret. "Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention". En: International Conference on Machine Learning. PMLR. 2020, pp. 5156-5165. [53] Tobias Katsch. "GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling". En: arXiv preprint arXiv:2311.01927 (2023). [54] Shiva Kaul. "Linear Dynamical Systems as a Core Computational Primitive". En: Advances in Neural Information Processing Systems 33 (2020), pp. 16808-16820. [55] Vijay Anand Korthikanti, Jared Casper, Sangkug Lynn, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi, and Bryan Catanzaro. "Reducing activation recomputation in large transformer models". En: Proceedings of Machine Learning and Systems 5 (2023). [56] James Lee-Thorp, Joshua Ainslie, Ilya Eckstein, and Santiago Ontanon. "Fnet: Mixing tokens with fourier transforms". En: arXiv preprint arXiv:2105.03824 (2021). [57] Tao Lei. "When Attention Meets Fast Recurrence: Training Language Models with Reduced Compute". En: Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing. 2021, pp. 7633-7648. [58] Tao Lei, Yu Zhang, Sida I Wang, Hui Dai, and Yoav Artzi. "Simple Recurrent Units for Highly Parallelizable Recurrence". En: arXiv preprint arXiv:1709.02755 (2017). [59] Yuhong Li, Tianle Cai, Yi Zhang, Deming Chen, and Debadeepta Dey. "What Makes Convolutional Models Great on Long Sequence Modeling?" En: The International Conference on Learning Representations (ICLR). 2023. [60] Opher Lieber, Barak Lenz, Hofit Bata, Gal Cohen, Jhonathan Osin, Itay Dalmedigos, Erez Safahi, Shaked Meirom, Yonatan Belinkov, Shai Shalev-Shwartz, et al. "Jamba: A Hybrid Transformer-Mamba Language Model". En: arXiv preprint arXiv:2403.19887 (2024). [61] Hao Liu, Wilson Yan, Matei Zaharia, and Pieter Abbeel. "World Model on Million-Length Video And Language With RingAttention". En: arXiv preprint arXiv:2402.08268 (2024). [62] Hao Liu, Matei Zaharia, and Pieter Abbeel. "Ring attention with blockwise transformers for near-infinite context". En: arXiv preprint arXiv:2310.01889 (2023). [63] Chris Lu, Yannick Schroecker, Albert Gu, Emilio Parisotto, Jakob Foerster, Satinder Singh, and Feryal Behbahani. "Structured State Space Models for In-Context Reinforcement Learning". En: Advances in Neural Information Processing Systems (NeurIPS). 2023. [64] Xuezhe Ma, Chunting Zhou, Xiang Kong, Junxian He, Liangke Gui, Graham Neubig, Jonathan May, and Luke Zettlemoyer. "Mega: Moving Average Equipped Gated Attention". En: The International Conference on Learning Representations (ICLR). 2023. [65] Eric Martin and Chris Cundy. "Parallelizing Linear Recurrent Neural Nets Over Sequence Length". En: The International Conference on Learning Representations (ICLR). 2018. [66] Todor Mihaylov, Peter Clark, Tushar Khot, and Ashish Sabharwal. "Can a Suit of Armor Conduct Electricity? A New Dataset for Open Book Question Answering". En: arXiv preprint arXiv:1809.02789 (2018). [67] Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, and Chris Olah. "In-context Learning and Induction Heads". En: Transformer Circuits Thread (2022). https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html. [68] Antonio Orvieto, Samuel L Smith, Albert Gu, Anushan Fernando, Caglar Gulcehre, Razvan Pascanu, and Soham De. "Resurrecting Recurrent Neural Networks for Long Sequences". En: The International Conference on Machine Learning (ICML). 2023. [69] Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Ngoc-Quan Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda, and Raquel Fernández. "The LAMBADA Dataset: Word Prediction Requiring a Broad Discourse Context". En: Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics. 2016, pp. 1525-1534. [70] Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee, and Dimitris Papailiopoulos. "Can Mamba Learn How to Learn? A Comparative Study on In-Context Learning Tasks". En: The International Conference on Machine Learning (ICML). 2024.
. html.
[71] Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, et al. «RWKV: Reinventing RNNs for the Transformer Era». En: arXiv preprint arXiv:2305.13048 (2023).
[72] Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Teddy Ferdinand, Haowen Hou, Przemyslaw Kazienko, et al. «Eagle and Finch: RWKV with matrix-valued states and dynamic recurrence». En: arXiv preprint arXiv:2404.05892 (2024).
[73] Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A Smith, and Lingpeng Kong. «Random Feature Attention». En: The International Conference on Learning Representations (ICLR). 2021.
[74] Clément Pernet. «Computing with Quasiseparable Matrices». En: Proceedings of the ACM on International Symposium on Symbolic and Algebraic Computation. 2016, pp. 389-396.
[75] Clément Pernet, Hippolyte Signargout, and Gilles Villard. «Exact computations with quasiseparable matrices». En: arXiv preprint arXiv:2302.04515 (2023).
[76] Clément Pernet and Arne Storjohann. «Time and space efficient generators for quasiseparable matrices». En: Journal of Symbolic Computation 85 (2018), pp. 224-246.
[77] Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. «Hyena Hierarchy: Towards Larger Convolutional Language Models». En: The International Conference on Machine Learning (ICML). 2023.
[78] Hadi Pouransari, Chun-Liang Li, Jen-Hao Rick Chang, Pavan Kumar Anasosalu Vasu, Cem Koc, Vaishaal Shankar, and Oncel Tuzel. «Dataset Decomposition: Faster LLM Training with Variable Sequence Length Curriculum». En: arXiv preprint arXiv:2405.13226 (2024).
[79] Ofir Press, Noah Smith, and Mike Lewis. «Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation». En: International Conference on Learning Representations. 2022.
[80] Zhen Qin, Xiaodong Han, Weixuan Sun, Bowen He, Dong Li, Dongxu Li, Yuchao Dai, Lingpeng Kong, and Yiran Zhong. «Toeplitz Neural Network for Sequence Modeling». En: The International Conference on Learning Representations (ICLR). 2023.
[81] Zhen Qin, Xiaodong Han, Weixuan Sun, Dongxu Li, Lingpeng Kong, Nick Barnes, and Yiran Zhong. «The devil in linear transformer». En: arXiv preprint arXiv:2210.10340 (2022).
[82] Zhen Qin, Dong Li, Weigao Sun, Weixuan Sun, Xuyang Shen, Xiaodong Han, Yunshen Wei, Baohong Lv, Xiao Luo, Yu Qiao, et al. «TransNormerLLM: A Faster and Better Large Language Model with Improved TransNormer». En: arXiv preprint arXiv:2307.14995 (2023).
[83] Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong. «CosFormer: Rethinking Softmax in Attention». En: The International Conference on Learning Representations (ICLR). 2022.
[84] Zhen Qin, Songlin Yang, Weixuan Sun, Xuyang Shen, Dong Li, Weigao Sun, and Yiran Zhong. «HGRN2: Gated Linear RNNs with State Expansion». En: arXiv preprint arXiv:2404.07904 (2024).
[85] Zhen Qin, Songlin Yang, and Yiran Zhong. «Hierarchically Gated Recurrent Neural Network for Sequence Modeling». En: Advances in Neural Information Processing Systems 36 (2023).
[86] Ali Rahimi and Benjamin Recht. «Random Features for Large-Scale Kernel Machines». En: Advances in Neural Information Processing Systems (NeurIPS) 20 (2007).
[87] Prajit Ramachandran, Barret Zoph, and Quoc V Le. «Swish: A Self-gated Activation Function». En: arXiv preprint arXiv:1710.05941 7.1 (2017), p. 5.
[88] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. «Winogrande: An Adversarial Winograd Schema Challenge at Scale». En: Communications of the ACM 64.9 (2021), pp. 99-106.
[89] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. «Linear Transformers are Secretly Fast Weight Programmers». En: The International Conference on Machine Learning (ICML). PMLR. 2021, pp. 9355-9366.
[90] Noam Shazeer. «Fast Transformer Decoding: One Write-head is All You Need». En: arXiv preprint arXiv:1911.02150 (2019).
[91] Sam Shleifer, Jason Weston, and Myle Ott. «NormFormer: Improved Transformer Pretraining with Extra Normalization». En: arXiv preprint arXiv:2110.09456 (2021).
[92] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. «Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism». En: arXiv preprint arXiv:1909.08053 (2019).
[93] Jimmy TH Smith, Andrew Warrington, and Scott W Linderman. «Simplified State Space Layers for Sequence Modeling». En: The International Conference on Learning Representations (ICLR). 2023.
[94] Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, and Yunfeng Liu. «Roformer: Enhanced Transformer with Rotary Position Embedding». En: arXiv preprint arXiv:2104.09864 (2021).
[95] Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei. «Retentive network: A successor to transformer for large language models». En: arXiv preprint arXiv:2307.08621 (2023).
[96] Yi Tay, Mostafa Dehghani, Dara Bahri, and Donald Metzler. «Efficient Transformers: A Survey». En: ACM Computing Surveys 55.6 (2022), pp. 1-28.
[97] Chameleon Team. «Chameleon: Mixed-Modal Early-Fusion Foundation Models». En: arXiv preprint arXiv:2405.09818 (2024).
[98] Anna Thomas, Albert Gu, Tri Dao, Atri Rudra, and Christopher Ré. «Learning Compressed Transforms with Low Displacement Rank». En: Advances in Neural Information Processing Systems (NeurIPS). 2018, pp. 9052-9060.
[99] Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al. «MLP-Mixer: An All-MLP Architecture for Vision». En: Advances in Neural Information Processing Systems (NeurIPS) 34 (2021), pp. 24261-24272.
[100] Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al. «Llama: Open and Efficient Foundation Language Models». En: arXiv preprint arXiv:2302.13971 (2023).
[101] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. «Llama 2: Open foundation and fine-tuned chat models». En: arXiv preprint arXiv:2307.09288 (2023).
[102] Raf Vandebril, M Van Barel, Gene Golub, and Nicola Mastronardi. «A bibliography on semiseparable matrices». En: Calcolo 42 (2005), pp. 249-270.
[103] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser e Illia Polosukhin. «Attention Is All You Need». En: Advances in Neural Information Processing Systems (NeurIPS). 2017.
[104] Shida Wang y Beichen Xue. «State-space Models with Layer-wise Nonlinearity are Universal Approximators with Exponential Decaying Memory». En: arXiv preprint arXiv:2309.13414 (2023).
[105] Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang y Hao Ma. «Linformer: Self-attention with Linear Complexity». En: arXiv preprint arXiv:2006.04768 (2020).
[106] Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han y Mike Lewis. «Efficient Streaming Language Models with Attention Sinks». En: The International Conference on Learning Representations (ICLR). 2024.
[107] Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li y Vikas Singh. «Nyströmformer: A Nyström-Based Algorithm for Approximating Self-Attention». En: Proceedings of the AAAI Conference on Artificial Intelligence. Vol. 35. 2021.
[108] Songlin Yang, Bailin Wang, Yikang Shen, Rameswar Panda y Yoon Kim. «Gated Linear Attention Transformers with Hardware-Efficient Training». En: The International Conference on Machine Learning (ICML). 2024.
[109] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi y Yejin Choi. «HellaSwag: Can a Machine Really Finish Your Sentence?». En: Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics. 2019.
[110] Jinle Zeng, Min Li, Zhihua Wu, Jiaqi Liu, Yuang Liu, Dianhai Yu, and Yanjun Ma. "Boosting distributed training performance of the unpadded bert model". En: arXiv preprint arXiv:2208.08124 (2022).
[111] Shuangfei Zhai, Walter Talbott, Nitish Srivastava, Chen Huang, Hanlin Goh, Ruixiang Zhang, and Josh Susskind. "An Attention Free Transformer". En: arXiv preprint arXiv:2105.14103 (2021).
[112] Yujia Zhai, Chengquan Jiang, Leyuan Wang, Xiaoying Jia, Shang Zhang, Zizhong Chen, Xin Liu, and Yibo Zhu. "Bytetransformer: A high- performance transformer boosted for variable- length inputs". En: 2023 IEEE International Parallel and Distributed Processing Symposium (IPDPS). IEEE. 2023, pp. 344- 355.
[113] Michael Zhang, Kush Bhatia, Hermann Kumbong, and Christopher Ré. "The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry". En: The International Conference on Learning Representations (ICLR). 2024.
[114] Lin Zheng, Chong Wang, and Lingpeng Kong. "Linear complexity randomized self- attention mechanism". En: International Conference on Machine Learning. PMLR. 2022, pp. 27011- 27041.
Apéndice A Glosario
| Glosario Texto a traducir: Notación | Descripción | Definición |
| T | Eje temporal o eje de la secuencia objetivo | Definición 2.1 |
| S | Eje de la secuencia fuente (en atención) | Ecuación (9) |
| D | Dimensión del modelo o d_model | Definición 7.1 |
| N | Dimensión de estado/característica o d_state | Ecuaciones (2) y (9) |
| P | Dimensión de cabeza o d_head | Definición 2.1 |
| H | Número de cabezas o n_head | Definición 7.1 |
| M | Matriz de transformación de secuencia | Definición 2.3 |
| A | Matriz recurrente (de estado) del SSM discreto | Ecuación (2) |
| B | Matriz de proyección (expansión) de entrada del modelo de espacio de estados | Ecuación (2) |
| C | Matriz de proyección (contracción) de salida del modelo de espacio de estados | Ecuación (2) |
| X | Matriz de entrada (forma (T,P)) | Ecuaciones (2) y (9) |
| Y | Matriz de salida (forma (T,P)) | Ecuaciones (2) y (9) |
| Q | Matriz de consulta de atención | Ecuación (9) |
| K | Matriz de clave de atención | Ecuación (9) |
| V | Matriz de valor de atención | Ecuación (9) |
| G | Matriz de Gram de atención | QK^T (o CB^T) |
| L | Matriz de máscara (estructurada) (triangular inferior en el contexto causal) | Definición 4.2 |
B Algoritmos eficientes para el escaneo de SSM escalar (multiplicación 1-SS)
En esta sección desarrollamos diversos algoritmos para calcular el escaneo de SSM escalar, a través de la lente de las descomposiciones de matrices estructuradas. El escaneo de SSM escalar se define como el cálculo de la parte recurrente del SSM discreto (7), en el caso en que (es decir, es un escalar). Esto se usa comúnmente para calcular SSM de forma recurrente; en particular, el caso de los SSM estructurados donde tiene estructura diagonal se reduce a esta operación, como en los modelos S5 (J. T. Smith, Warrington, and Linderman 2023) y S6 (Gu and Dao 2023).
El objetivo de esta sección es respaldar un tema central de este artículo: que los algoritmos eficientes para modelos de secuencia pueden verse como algoritmos de multiplicación de matrices estructuradas. Las diversas ideas de descomposición matricial que mostramos aquí están relacionadas con las ideas usadas para derivar algoritmos rápidos de SSM (Sección 6), así como también se usan directamente como subrutina.
B.1 Definición del problema
Sean y secuencias de escalares. El escaneo de SSM escalar se define como
Aquí puede ser un valor arbitrario que representa el estado oculto previo a la recurrencia del SSM; salvo que se especifique lo contrario, asumimos .
También llamamos a la ecuación (21) la cumprodsum (suma de productos acumulados). Nótese que la cumprodsum se reduce a la cumprod (producto acumulado) cuando es la identidad aditiva y se reduce a la cumsum (suma acumulada) cuando es la identidad multiplicativa. Finalmente, nótese que en forma vectorizada podemos escribir
En otras palabras, esto es simplemente el producto matriz- vector por una matriz 1- SS .
Por lo tanto, tenemos tres formas de ver esta operación primitiva fundamental que son todas equivalentes:
- Un escaneo de SSM (escalar).- Una cumprodsum.- Una multiplicación matriz-vector por una matriz 1-SS.
B.2 Algoritmos clásicos
Primero describimos las dos formas clásicas de calcular el escaneo de SSM (21), usadas previamente por trabajos anteriores.
B.2.1 Recurrencia secuencial
El modo recurrente simplemente calcula (21) un paso de tiempo a la vez. Desde la perspectiva de la multiplicación 1- SS, esto también se describió en la Sección 3.4.1.
B.2.2 Escaneo asociativo paralelo
Segundo, una observación importante es que esta recurrencia puede convertirse en un escaneo asociativo (E. Martin and Cundy 2018; J. T. Smith, Warrington, and Linderman 2023). Este hecho no es completamente obvio. Por ejemplo, S5 definió el operador de escaneo asociativo correcto y luego demostró la asociatividad del operador mediante cálculo mecánico.
Una forma un poco más limpia de ver que esto es computable con un escaneo asociativo es convertir la recurrencia de múltiples términos en una recurrencia de un solo término sobre un estado oculto de tamaño 2 en lugar de 1:
Entonces, calcular todos los es lo mismo que tomar los productos acumulados de estas matrices . Dado que la multiplicación de matrices es asociativa, esto puede calcularse con un escaneo asociativo. El operador binario asociativo es simplemente la multiplicación de matrices sobre estas matrices particulares:
Igualando la fila superior se obtiene el mismo operador de escaneo asociativo que el definido por S5:
La razón por la que los escaneos asociativos son importantes es que pueden paralelizarse usando un algoritmo de divide y vencerás (Blelloch 1990). Omitimos los detalles de este algoritmo y, en su lugar, mostramos que todo el algoritmo de escaneo asociativo de SSM puede derivarse desde cero mediante descomposiciones matriciales (Apéndice B.3.5).
B.3 Algoritmos eficientes mediante descomposiciones de matrices estructuradas
Discutimos varios algoritmos para calcular el escaneo de SSM, todos a través de la lente de encontrar descomposiciones de matrices estructuradas de la matriz 1- SS . Estos algoritmos o modos de cómputo incluyen Un modo dilatado donde la información se propaga 1, 2, 4, 8, ... pasos a la vez. Un modo de paso de estado donde la información se propaga hacia adelante en bloques. Un modo totalmente recurrente que incrementa un paso a la vez, que es un caso especial del modo de paso de estado. Un modo paralelo de descomposición en bloques donde se divide en bloques jerárquicos. Un modo de escaneo donde se divide en bloques de igual tamaño y se reduce recursivamente.
B.3.1 Modo dilatado
Este modo factoriza la matriz 1- SS de una manera particular que involucra "pasos" crecientes. Esto se ilustra mejor mediante un ejemplo concreto:
B.3.2 Modo de paso de estado (por bloques)
Este modo puede verse como una generalización del modo recurrente estándar, donde en lugar de propagar el estado recurrente un paso a la vez, calculamos la respuesta sobre bloques de longitud arbitraria y propagamos el estado a través del bloque. Esto también puede derivarse de una descomposición simple en bloques de la matriz 1-SS.
Observación 9. Aunque llamamos a esto "paso de estado" para referirnos a cómo los estados se pasan de un segmento local a otro, esto está relacionado con los algoritmos "chunkwise" propuestos por modelos relacionados (Y. Sun et al. 2023; Yang et al. 2024).
Consideremos el cálculo de en "bloques": para algún índice , queremos calcular o la salida hasta el índice , y tener una manera de reducir el problema a un problema más pequeño sobre los índices . Escribimos como
1. Calcular la mitad izquierda de la respuesta usando cualquier método deseado (es decir, cualquiera de los métodos para la multiplicación 1-SS de esta sección).
2. Calcular el estado final .
3. Incrementar el estado en un paso para modificar .
4. Calcular la mitad derecha de la respuesta usando cualquier método deseado.
En otras palabras, calculamos el subproblema izquierdo como una caja negra, pasamos su estado final al problema derecho y calculamos el subproblema derecho como una caja negra.
La utilidad de este método proviene de configuraciones más complicadas, como en el caso general -semiseparable, y cuando la entrada tiene una dimensión adicional de "lote" (o, en otras palabras, se trata de una multiplicación matriz-matriz en lugar de matriz-vector). En este caso, podemos usar un algoritmo alternativo para los bloques (correspondiente a la MM por y ) que no materializa los estados ocultos completos . En su lugar, omitimos los estados ocultos y calculamos directamente el estado final de una manera alternativa, y luego "pasamos" el estado al siguiente bloque.
Complejidad. Este método puede ser muy eficiente en términos de trabajo porque los pasos 2-3 solo toman tiempo constante. Por lo tanto, suponiendo que los dos subproblemas (pasos 1 y 4) son de tiempo lineal, el método completo toma tiempo lineal.
La desventaja es que esto también es secuencial.
B.3.3 Modo totalmente recurrente
Nótese que el modo totalmente recurrente, donde la recurrencia se evoluciona un paso a la vez (21), es simplemente una instanciación del modo de paso de estado con tamaño de bloque .
B.3.4 Modo de descomposición en bloques (paralelo)
Este usa la misma descomposición matricial que el modo de paso de estado, pero calcula los subproblemas en un orden diferente que intercambia computación por paralelización.
Como de costumbre, escribimos como
La observación clave es de nuevo que el cuadrante inferior izquierdo de es de rango 1. Aparte de la inspección, otra forma de ver esto es usando el lado derecho (RHS, por sus siglas en inglés), observando que su cuadrante inferior izquierdo es una matriz trivial de rango 1 (es todo 0 excepto la esquina superior derecha, que es ), y usando la fórmula de inversión de Woodbury para ver que la esquina inferior izquierda del lado izquierdo (LHS, por sus siglas en inglés) también debe ser de rango 1. Esto también proporciona una manera de deducir la factorización de rango 1, que puede verificarse mediante inspección:
Una segunda observación es que esta matriz es autosimilar: cualquier submatriz principal tiene la misma forma. En particular, los cuadrantes superior izquierdo e inferior derecho son ambos matrices 1-SS.
Esto proporciona una manera fácil de realizar la multiplicación de matrices por : recurrir en las dos mitades (es decir, superior izquierda e inferior derecha) en paralelo, y luego tener en cuenta la submatriz inferior izquierda. Este paso de "combinación" en el algoritmo de divide y vencerás es fácil ya que la submatriz es de rango 1. Esto conduce a un algoritmo paralelo.
Complejidad. Al igual que el algoritmo de paso de estado, este método utiliza las mismas descomposiciones en bloques de las matrices semiseparables con estructura de rango. La diferencia es que recurrimos en ambos subproblemas en paralelo, mientras que el algoritmo de paso de estado maneja primero el subproblema izquierdo y luego el derecho. Esto reduce la profundidad/span del algoritmo de lineal a . La contrapartida es que el paso de combinación (tener en cuenta la submatriz inferior izquierda de rango 1) requiere trabajo lineal en lugar de constante, por lo que el trabajo total es en lugar de lineal.
Nótese también que en la recursión podemos detenernos en cualquier momento y calcular los subproblemas de cualquier otra manera. Esta es una idea principal detrás del algoritmo SSD (Sección 6), donde cambiamos a la formulación dual de atención cuadrática en subproblemas pequeños.
B.3.5 Modo de escaneo asociativo
El algoritmo de paso de estado (por bloques) tiene trabajo lineal, pero también involucra operaciones secuenciales.
Los modos de reducción por matrices de bloques y dilatados son paralelizables: tienen profundidad/span . Sin embargo, realizan trabajo extra .
Como se señaló en el Apéndice B.2.2, existe un algoritmo que logra tanto profundidad como trabajo aprovechando el algoritmo de escaneo asociativo (también llamado escaneo de prefijos) (Baker et al. 1996). Este algoritmo se ve más fácilmente desde la vista de escaneo SSM o cumprodsum, e incluso entonces no es obvio: requiere derivar por separado un operador asociativo (22), y luego aprovechar el algoritmo de escaneo paralelo/asociativo/de prefijos como una caja negra (Blelloch 1990).
Aquí mostramos que en realidad es posible derivar este escaneo paralelo aprovechando una descomposición matricial diferente:
Etapa 2. Ahora consideremos cada uno de los bloques factorizados como una matriz de rango 1 en la parte estrictamente triangular inferior de la matriz. Nótese que cada uno de los vectores fila del lado derecho es el mismo que el vector fila inferior en el bloque diagonal de su columna: en particular las filas y .
Por lo tanto, ya tenemos las respuestas a estas desde la Etapa 1, que es el segundo elemento de todos los subproblemas en la Etapa 1. Si llamamos a este arreglo de elementos (de la mitad del tamaño de ), entonces necesitamos multiplicar por la matriz 1-SS generada por .
Etapa 3. Finalmente, cada una de las respuestas a la Etapa 2 puede difundirse en dos respuestas finales multiplicando por los vectores columna del lado izquierdo: en particular los vectores , y .
Nótese que esto puede modificarse ligeramente con algún desplazamiento de los índices por uno. Una manera equivalente de ver este algoritmo es como la factorización matricial en tres pasos
IUE (VUI, VUCI, AIU RCI, OULCI).
A su vez, estas implican propiedades de clausura de los modelos de espacio de estados.
Por ejemplo, la propiedad de adición dice que sumar dos modelos SSM paralelos sigue siendo un SSM. La propiedad de multiplicación dice que componer secuencialmente o encadenar dos SSMs todavía puede verse como un SSM, cuyo tamaño de estado total es aditivo, un hecho algo no trivial.
Finalmente, la propiedad de inversa nos permite relacionar los SSMs con otros tipos de modelos. Por ejemplo, uno puede notar que las matrices bandeadas son semiseparables, por lo que sus inversas son semiseparables. (De hecho, la familia de estructuras semiseparables a menudo está motivada por tomar inversas de matrices bandeadas (Vandebril et al. 2005)). Además, las propiedades de recurrencia rápida de las matrices semiseparables pueden verse como una consecuencia de que su inversa sea bandeada.
Observación 11. El hecho de que las matrices 1-SS sean recurrencias simples (7) es equivalente al hecho de que la inversa de una matriz 1-SS es una matriz 2-bandeada:
Por lo tanto , o
O elemento a elemento,
A la inversa, también usamos estos resultados de clausura para demostrar que la atención estructurada autorregresiva (bajo ciertas suposiciones) debe ser SSMs, lo que nos permite mostrar que familias más generales de modelos de secuencia eficientes, incluidas variantes de atención, pueden reducirse a modelos de espacio de estados (Apéndice C.2).
C.2 La atención enmascarada autorregresiva es una atención con estructura semiseparable
Demostramos el Teorema 5.2 de la Sección 5.2. En la Sección 4.3 definimos la atención estructurada como una generalización amplia de la atención enmascarada, donde la propiedad de eficiencia (es decir, una forma de tiempo lineal para la atención de kernel) se abstrae en la eficiencia de la multiplicación de matrices estructuradas. Sin embargo, más allá de la eficiencia computacional, la atención lineal estándar (Katharopoulos et al. 2020) también tiene dos propiedades importantes. Primero, es causal, lo cual es necesario para entornos como el modelado autorregresivo. Además, tiene una generación autorregresiva eficiente. En otras palabras, el costo de un paso autorregresivo —es decir, el costo incremental de calcular la salida al ver , dado que ya ha sido visto y preprocesado— requiere solo tiempo constante.
Aquí caracterizamos qué instancias de SMA tienen autorregresión eficiente.
En el marco de SMA, la causalidad es equivalente a la restricción de que la máscara sea una matriz triangular inferior.
Caracterizar el espacio de matrices que tienen autorregresión eficiente es más difícil. Usaremos una definición técnica estrecha de procesos autorregresivos, en el espíritu de las definiciones clásicas de la literatura de series temporales (p. ej., procesos ARIMA (Box et al. 2015)).
Definición C.2. Definimos una transformación autorregresiva de orden como aquella en la que cada salida depende solo de la entrada actual y de las últimas salidas:
Nótese que el caso en que es la matriz cumsum es un caso especial con y, por lo tanto, . Con esta definición, la caracterización del espacio de transformaciones lineales autorregresivas eficientes se sigue de las propiedades de las matrices semiseparables. El Teorema C.3 formaliza y demuestra el Teorema 5.2.
Teorema C.3. Sea una transformación autorregresiva eficiente de orden . Entonces es un modelo de espacio de estados de orden .
Demostración. Sean secuencias de entrada y salida, de modo que . Reordenando la definición (23),
Vectorizando sobre , esto puede expresarse como una transformación matricial
La matriz diagonal puede moverse a la izquierda y plegarse en la matriz de coeficientes , que sigue siendo una matriz triangular inferior con bandas. Pero también tenemos , así que es la inversa de esta matriz.
A continuación, obsérvese que las matrices con bandas son -semiseparables por la caracterización de rango de la semiseparabilidad (Definición 3.1). Por la Proposición C.1, la inversa es, por tanto, como mucho -semiseparable. Puede obtenerse una cota ligeramente más fuerte de debido a la estructura adicional de las matrices bandadas. Finalmente, la caracterización de como un modelo de espacio de estados de orden se sigue del Teorema 3.5.
En otras palabras, la atención autorregresiva eficiente es SMA semiseparable.
D Detalles experimentales
D.1 Detalles de MQAR
Usamos una versión más difícil de la tarea introducida en Based (Arora, Eyuboglu, Zhang, et al. 2024), donde los tokens que no son consulta/clave/valores se reemplazan con tokens aleatorios. También usamos más pares clave-valor, secuencias más largas y tamaños de modelo más pequeños que la variante habitual de MQAR usada por trabajos previos, todo lo cual hace la tarea más difícil.
Para cada longitud de secuencia , usamos pares clave-valor. El tamaño total del vocabulario es 8192.
Usamos una forma de entrenamiento con currículo en la que el entrenamiento recorre cíclicamente conjuntos de datos usando pares clave-valor, donde cada conjunto de datos tiene ejemplos, para un total de 8 épocas por cada conjunto de datos (total de ejemplos). El tamaño de lote total es tokens (p. ej., para , el tamaño de lote es 256).
Todos los métodos usan 2 capas con la configuración predeterminada; la línea base de atención recibe además incrustaciones posicionales. Para cada método, hacemos un barrido sobre dimensiones de modelo y tasas de aprendizaje . Usamos un esquema de decaimiento lineal que disminuye en cada época (p. ej., la última época tendría una tasa de aprendizaje de de la tasa de aprendizaje máxima/inicial).
D.2 Detalles de las leyes de escala
Todos los modelos se entrenaron con Pile. Para los experimentos de leyes de escala, usamos el tokenizador de GPT2.
Tamaños de modelo. La Tabla 9 especifica los tamaños de modelo que usamos para las leyes de escala siguiendo GPT3 (Brown et al. 2020). Primero, cambiamos el tamaño de lote del modelo de 1.3B de 1M tokens a 0.5M tokens para uniformidad. Segundo, cambiamos el número de pasos de entrenamiento y el total de tokens para coincidir aproximadamente con las leyes de escala de Chinchilla (Hoffmann et al. 2022), que especifican que los tokens de entrenamiento deben aumentar proporcionalmente al tamaño del modelo.
Recetas de entrenamiento. Todos los modelos usaron el optimizador AdamW con
- valor de recorte de gradiente 1.0- decaimiento de pesos 0.1- sin dropout- calentamiento lineal de la tasa de aprendizaje con decaimiento coseno
| PARÁMETROS | n_layers | d_model | n_heads / d_head | Pasos de entrenamiento | Tasa de aprendizaje | Tamaño de lote | Tokens |
| 125M | 12 | 768 | 12 / 64 | 4800 | 6e-4 | 0.5M tokens | 2.5B |
| 350M | 24 | 1024 | 16 / 64 | 13500 | 3e-4 | 0.5M tokens | 7B |
| 760M | 24 | 1536 | 16 / 96 | 29000 | 2.5e-4 | 0.5M tokens | 15B |
| 1.3B | 24 | 2048 | 32 / 64 | 50000 | 2e-4 | 0.5M tokens | 26B |
Por defecto, la tasa de aprendizaje máxima es la especificación de GPT3.
En comparación con la receta de GPT3, usamos una "receta mejorada", inspirada en los cambios adoptados por modelos de lenguaje grandes populares como PaLM (Chowdhery et al. 2023) y LLaMa (Touvron, Lavril, et al. 2023). Estos incluyen:
- calentamiento lineal de la tasa de aprendizaje con decaimiento coseno hasta , con un valor máximo de el valor de GPT3
- sin términos de sesgo lineales
- RMSNorm en lugar de LayerNorm
- hiperparámetro de AdamW (el valor de GPT3) en lugar del valor predeterminado de PyTorch de
D.3 Detalles de la evaluación downstream
Para evaluar el rendimiento downstream de modelos completamente entrenados, entrenamos Mamba-2 con 300B tokens en Pile, usando el tokenizador de GPT-NeoX (Black et al. 2022).
Usamos los mismos hiperparámetros que en los experimentos de escala, excepto con tamaño de lote de 1M para el modelo de 1.3B y el de 2.7B. Para el modelo de 2.7B, también seguimos la especificación de GPT3 (32 capas, dimensión 2560).
Para todos los modelos, usamos 5 veces la tasa de aprendizaje del modelo GPT3 correspondiente.
Para la evaluación downstream, usamos el arnés de evaluación de LM de EleutherAI (L. Gao, Tow, et al. 2021), en las mismas tareas que Mamba (Gu y Dao 2023) con una adicional:
- LAMBADA (Paperno et al. 2016)
- HellaSwag (Zellers et al. 2019)
- PIQA (Bisk et al. 2020)
- ARC-challenge (P. Clark et al. 2018)
- ARC-easy: un subconjunto fácil de ARC-challenge
- WinoGrande (Sakaguchi et al. 2021)
- OpenBookQA (Mihaylov et al. 2018)
D.4 Detalles de las ablaciones
Detalles de (Re)Based. Nuestras ablaciones en la Sección 9.4.3 consideraron los modelos Based (Arora, Eyuboglu, Zhang, et al. 2024) y ReBased (Aksenov et al. 2024).
Based aproxima el kernel exp con una expansión de Taylor cuadrática , lo cual puede lograrse mediante el mapa de características
ReBased propone utilizar la función de mapa de características más simple correspondiente a la transformación del kernel , pero también aplica una normalización de capa de antemano. Consideramos la normalización de capa como una activación no lineal alternativa a nuestra activación Swish predeterminada, y ablacionamos combinaciones de estas.
| MODELO | TOKEN. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | ACC MEDIA ↑ |
| Hybrid H3-130M | GPT2 | — | 89,48 | 25,8 | 31,7 | 64,2 | 44,4 | 24,2 | 50,6 | 27,0 | 38,2 |
| Pythia-160M | NeoX | 29,64 | 38,10 | 33,0 | 30,2 | 61,4 | 43,2 | 24,1 | 51,9 | 29,2 | 39,0 |
| Mamba-130M | NeoX | 10,56 | 16,07 | 44,3 | 35,2 | 64,5 | 48,0 | 24,2 | 51,9 | 28,8 | 42,4 |
| Mamba-2-130M | NeoX | 10,48 | 16,86 | 43,9 | 35,3 | 64,9 | 47,4 | 24,2 | 52,1 | 30,6 | 42,6 |
| Hybrid H3-360M | GPT2 | — | 12,58 | 48,0 | 41,5 | 68,1 | 51,4 | 24,7 | 54,1 | 31,6 | 45,6 |
| Pythia-410M | NeoX | 9,95 | 10,84 | 51,4 | 40,6 | 66,9 | 52,1 | 24,6 | 53,8 | 30,0 | 45,6 |
| Mamba-370M | NeoX | 8,28 | 8,14 | 55,6 | 46,5 | 69,5 | 55,1 | 28,0 | 55,3 | 30,8 | 48,7 |
| Mamba-2-370M | NeoX | 8,21 | 8,02 | 55,8 | 46,9 | 70,5 | 54,9 | 26,9 | 55,7 | 32,4 | 49,0 |
| Pythia-1B | NeoX | 7,82 | 7,92 | 56,1 | 47,2 | 70,7 | 57,0 | 27,1 | 53,5 | 31,4 | 49,0 |
| Mamba-790M | NeoX | 7,33 | 6,02 | 62,7 | 55,1 | 72,1 | 61,2 | 29,5 | 56,1 | 34,2 | 53,0 |
| Mamba-2-780M | NeoX | 7,26 | 5,86 | 61,7 | 54,9 | 72,0 | 61,0 | 28,5 | 60,2 | 36,2 | 53,5 |
| GPT-Neo 1.3B | GPT2 | — | 7,50 | 57,2 | 48,9 | 71,1 | 56,2 | 25,9 | 54,9 | 33,6 | 49,7 |
| Hybrid H3-1.3B | GPT2 | — | 11,25 | 49,6 | 52,6 | 71,3 | 59,2 | 28,1 | 56,9 | 34,4 | 50,3 |
| OPT-1.3B | OPT | — | 6,64 | 58,0 | 53,7 | 72,4 | 56,7 | 29,6 | 59,5 | 33,2 | 51,9 |
| Pythia-1.4B | NeoX | 7,51 | 6,08 | 61,7 | 52,1 | 71,0 | 60,5 | 28,5 | 57,2 | 30,8 | 51,7 |
| RWKV4-1.5B | NeoX | 7,70 | 7,04 | 56,4 | 52,5 | 72,4 | 60,5 | 29,4 | 54,6 | 34,0 | 51,4 |
| Mamba-1.4B | NeoX | 6,80 | 5,04 | 65,0 | 59,1 | 74,2 | 65,5 | 32,8 | 61,5 | 36,4 | 56,4 |
| Mamba-2-1.3B | NeoX | 6,66 | 5,02 | 65,7 | 59,9 | 73,2 | 64,3 | 33,3 | 60,9 | 37,8 | 56,4 |
| GPT-Neo 2.7B | GPT2 | — | 5,63 | 62,2 | 55,8 | 72,1 | 61,1 | 30,2 | 57,6 | 33,2 | 53,2 |
| Hybrid H3-2.7B | GPT2 | — | 7,92 | 55,7 | 59,7 | 73,3 | 65,6 | 32,3 | 61,4 | 33,6 | 54,5 |
| OPT-2.7B | OPT | — | 5,12 | 63,6 | 60,6 | 74,8 | 60,8 | 31,3 | 61,0 | 35,2 | 55,3 |
| Pythia-2.8B | NeoX | 6,73 | 5,04 | 64,7 | 59,3 | 74,0 | 64,1 | 32,9 | 59,7 | 35,2 | 55,7 |
| RWKV4-3B | NeoX | 7,00 | 5,24 | 63,9 | 59,6 | 73,7 | 67,8 | 33,1 | 59,6 | 37,0 | 56,4 |
| Mamba-2.8B | NeoX | 6,22 | 4,23 | 69,2 | 66,1 | 75,2 | 69,7 | 36,3 | 63,5 | 39,6 | 59,9 |
| Mamba-2-2.7B | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
| GPT-J-6B | GPT2 | — | 4,10 | 68,3 | 66,3 | 75,4 | 67,0 | 36,6 | 64,1 | 38,2 | 59,4 |
| OPT-6.7B | OPT | — | 4,25 | 67,7 | 67,2 | 76,3 | 65,6 | 34,9 | 65,5 | 37,4 | 59,2 |
| Pythia-6.9B | NeoX | 6,51 | 4,45 | 67,1 | 64,0 | 75,2 | 67,3 | 35,5 | 61,3 | 38,0 | 58,3 |
| RWKV4-7.4B | NeoX | 6,31 | 4,38 | 67,2 | 65,5 | 76,1 | 67,8 | 37,5 | 61,0 | 40,2 | 59,3 |
Nótese que, dado que estas expanden la dimensión de características, debemos proyectar a dimensiones más pequeñas; en la Tabla 7, utilícese un tamaño de estado para los modelos de 130M y para los modelos de 380M. Para los métodos (Re)Based, proyectamos a 8 y 16 dimensiones respectivamente antes de aplicar sus mapas de características; esto da como resultado un tamaño de estado total de para ReBased y para Based en el caso del modelo de 130M. Debido a que las proyecciones y son más pequeñas, estos métodos utilizan menos parámetros, y ajustamos el número de capas de manera apropiada.