
En vez de adivinar, el modelo aprende a lanzar una búsqueda en mitad del razonamiento e incorporar los resultados. Entrenado con refuerzo. COLM 2025, gratis.
Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning
Search-R1: Entrenamiento de LLM para razonar y aprovechar los motores de búsqueda con aprendizaje por refuerzo
Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon , Sercan Ö. Arik , Dong Wang , Hamed Zamani , Jiawei Han
Department of Computer Science, University of Illinois at Urbana- Champaign
Center for Intelligent Information Retrieval, University of Massachusetts Amherst
Google Cloud AI Research
{bowenj4, zhenrui3, dwang24, hanj}@illinois.edu, {hzeng, zamani}@cs.umass.edu {jinsungyoon, soarik}@google.com
Resumen
Adquirir de manera eficiente conocimiento externo e información actualizada es esencial para un razonamiento eficaz y la generación de texto en los modelos de lenguaje de gran tamaño (LLM). Solicitar a LLM avanzados con capacidades de razonamiento que utilicen motores de búsqueda durante la inferencia suele ser subóptimo, ya que el LLM podría no poseer plenamente la capacidad de interactuar de forma óptima con el motor de búsqueda. Este artículo presenta SEARCH- R1, una extensión del aprendizaje por refuerzo (RL) para marcos de razonamiento en los que el LLM aprende a generar de forma autónoma (múltiples) consultas de búsqueda durante el razonamiento paso a paso con recuperación en tiempo real. SEARCH- R1 optimiza las trayectorias de razonamiento del LLM con interacciones de búsqueda de múltiples turnos, aprovechando el enmascaramiento de tokens recuperados para un entrenamiento RL estable y una función de recompensa simple basada en resultados. Los experimentos en siete conjuntos de datos de respuesta a preguntas muestran que SEARCH- R1 mejora el rendimiento en (Qwen2.5- 7B) y (Qwen2.5- 3B) sobre varias líneas base de RAG bajo la misma configuración. Este artículo además proporciona ideas empíricas sobre los métodos de optimización de RL, las elecciones de LLM y la dinámica de la longitud de las respuestas en el razonamiento aumentado por recuperación. El código y los checkpoints del modelo están disponibles en https://github.com/PeterGriffinJin/Search- R1.
1 Introducción
Los modelos de lenguaje de gran tamaño (LLM) han demostrado capacidades notables en la comprensión y generación de lenguaje natural (Hendrycks et al., 2020; Clark et al., 2018). A pesar de estos logros, los LLM a menudo encuentran desafíos cuando se les encarga un razonamiento complejo (Wei et al., 2022) y la recuperación de información actualizada de fuentes externas (Jin et al., 2024). Abordar estas limitaciones requiere integrar habilidades de razonamiento avanzadas (Huang & Chang, 2022) y la capacidad de interactuar eficazmente con motores de búsqueda para aprovechar mejor la información externa actualizada (Schick et al., 2023).
Los enfoques existentes para integrar LLM con motores de búsqueda suelen dividirse en dos categorías: (1) generación aumentada por recuperación (RAG) (Gao et al., 2023; Lewis et al., 2020) y (2) tratar el motor de búsqueda como una herramienta (Yao et al., 2023; Schick et al., 2023). Los modelos RAG a menudo recuperan pasajes basados en la entrada del LLM como consulta y los incorporan al contexto del LLM para la generación (Lewis et al., 2020). Esto permite al LLM aprovechar conocimiento externo al responder preguntas. Aunque trabajos existentes (Trivedi et al., 2022a) solicitan al LLM recuperación de múltiples turnos y múltiples consultas, este enfoque es subóptimo porque el LLM no está optimizado para aprender cómo interactuar eficazmente con motores de búsqueda durante el entrenamiento. Alternativamente, se puede solicitar o entrenar a los LLM para utilizar herramientas, incluidos motores de búsqueda, como parte de su proceso de razonamiento (Qu et al., 2025; Trivedi et al., 2022a). Sin embargo, los enfoques basados en solicitudes a menudo tienen dificultades para generalizar, ya que ciertas tareas pueden no haber sido encontradas durante el preentrenamiento del LLM. Por otro lado, los enfoques basados en entrenamiento ofrecen mayor adaptabilidad, pero son difíciles de escalar eficazmente debido a su dependencia de trayectorias anotadas de alta calidad a gran escala y a la no diferenciabilidad inherente de la operación de búsqueda, lo que hace inaplicable la optimización de extremo a extremo basada en descenso de gradiente (Schick et al., 2023; Asai et al., 2024).
El aprendizaje por refuerzo (RL) (Sutton et al., 1999; Kaelbling et al., 1996) ha surgido como un paradigma potente para mejorar las capacidades de razonamiento de los LLM (Guo et al., 2025; Hou et al., 2025; Xie et al., 2025; Kumar et al., 2024). En particular, modelos como OpenAI- 01 (Jaech et al., 2024) y DeepSeek- R1 (Guo et al., 2025) han aprovechado técnicas de RL (p. ej., PPO (Schulman et al., 2017) y GRPO (Shao et al., 2024)) para mejorar la inferencia lógica y las habilidades de resolución de problemas aprendiendo de la experiencia y la retroalimentación. Con RL, incluso cuando se entrenan únicamente con recompensas basadas en resultados, los modelos aprenden capacidades de razonamiento complejas, incluida la autoverificación (Weng et al., 2022) y la autocorrección (Kumar et al., 2024). Sin embargo, aplicar RL a escenarios de búsqueda y razonamiento presenta tres desafíos clave: (1) Marco de RL y estabilidad – Sigue sin estar claro cómo integrar eficazmente el motor de búsqueda en los enfoques de RL para LLM mientras se garantiza una optimización estable, particularmente al incorporar contexto recuperado. (2) Razonamiento y búsqueda intercalados de múltiples turnos – Idealmente, el LLM debería ser capaz de realizar razonamiento iterativo y llamadas al motor de búsqueda, ajustando dinámicamente la estrategia de recuperación según la complejidad del problema. (3) Diseño de recompensa – Diseñar una función de recompensa eficaz para tareas de búsqueda y razonamiento sigue siendo un desafío fundamental, ya que no está claro si las recompensas simples basadas en resultados son suficientes para guiar al LLM a aprender comportamientos de búsqueda significativos y consistentes.
Para abordar los desafíos mencionados, presentamos SEARCH- R1, un novedoso marco de RL que permite a los LLM interactuar con motores de búsqueda de manera intercalada con su propio razonamiento. Específicamente, SEARCH- R1 introduce las siguientes innovaciones clave: (1) Modelamos el motor de búsqueda como parte del entorno, lo que permite secuencias de trayectorias muestreadas que intercalan la generación de tokens del LLM con recuperaciones del motor de búsqueda. SEARCH- R1 es compatible con diversos algoritmos de RL, incluidos PPO y GRPO, y aplicamos enmascaramiento de tokens recuperados para garantizar una optimización estable. (2) SEARCH- R1 admite recuperación y razonamiento de múltiples turnos, invocando llamadas de búsqueda cuando son activadas explícitamente por los tokens <search> y </search>. El contenido recuperado se encierra dentro de los tokens <information> y </information>, mientras que los pasos de razonamiento del LLM se envuelven dentro de los tokens <think> y </think>. La respuesta final se formatea usando los tokens <answer> y </answer>, lo que permite una toma de decisiones estructurada e iterativa. (3) Adoptamos una función de recompensa directa basada en resultados, evitando la complejidad de las recompensas basadas en procesos. Nuestros resultados demuestran que este diseño de recompensa mínimo es eficaz en escenarios de búsqueda y razonamiento. Como tal, SEARCH- R1 puede verse como una extensión de DeepSeek- R1 Zero (Guo et al., 2025), que se centra principalmente en el razonamiento paramétrico al introducir entrenamiento RL aumentado con búsqueda para una mejor toma de decisiones impulsada por recuperación.
En resumen, nuestras contribuciones clave son tres:
- Nuestro trabajo analiza los desafíos y proporciona perspectivas sobre la implementación de RL para mejorar cómo razonan los LLM usando resultados de motores de búsqueda.
- Proponemos SEARCH-R1, un novedoso marco de RL que admite rollouts de LLM y optimización directa con un motor de búsqueda, incluido el enmascaramiento de tokens recuperados para estabilizar el entrenamiento RL, razonamiento y búsqueda intercalados de múltiples turnos para apoyar la resolución de tareas complejas y una función de recompensa de resultados eficaz.
- Realizamos experimentos sistemáticos para demostrar la eficacia de SEARCH-R1, con dos LLM logrando mejoras relativas promedio respectivas del 41% y 20% sobre las líneas base de RAG bajo la misma configuración experimental (p. ej., el mismo modelo de recuperación, datos de entrenamiento y LLM preentrenados). Además, proporcionamos ideas sobre RL para configuraciones de razonamiento y búsqueda, incluida la selección del método de RL, diferentes elecciones de LLM y el estudio de la longitud de las respuestas..
2 Trabajos relacionados
2.1 Modelos de lenguaje de gran tamaño y recuperación
A pesar de demostrar capacidades notables de razonamiento (Guo et al., 2025) y programación (Guo et al., 2024), los LLM (Zhao et al., 2023; Team, 2024; Achiam et al., 2023) a menudo carecen de conocimiento específico del dominio (Peng et al., 2023; Li et al., 2023) y son propensos a las alucinaciones (Zhang et al., 2023). Para mitigar estas limitaciones, los motores de búsqueda (Zhao et al., 2024) se integran ampliamente para proporcionar información externa. Existen dos formas principales de integrar los motores de búsqueda con los LLM: (1) la generación aumentada por recuperación (RAG) (Gao et al., 2023) y (2) tratar los motores de búsqueda como herramientas (Schick et al., 2023). La RAG (Lewis et al., 2020; Yue et al., 2024; Xiong et al., 2025) normalmente sigue una ronda de recuperación y canalizaciones de generación secuencial, en las que un motor de búsqueda obtiene información relevante basándose en la consulta de entrada, que luego se concatena con la consulta y se introduce en el LLM. Sin embargo, esto podría enfrentarse a los desafíos de recuperar información irrelevante (Jin et al., 2024) y no proporcionar un contexto suficientemente útil (Jiang et al., 2023). Un enfoque alternativo es la búsqueda como herramienta, en la que se induce mediante indicaciones o se ajusta finamente a los LLM para interactuar con los motores de búsqueda. IRCoT (Trivedi et al., 2022a) y ReAct (Yao et al., 2023) utilizan indicaciones para guiar el razonamiento iterativo y las llamadas a los motores de búsqueda, mientras que Toolformer (Schick et al., 2023) aprovecha el ajuste fino supervisado para mejorar las capacidades de búsqueda. Sin embargo, tales métodos dependen de trayectorias etiquetadas de alta calidad, que son difíciles de obtener a escala. Trabajos recientes (Guo et al., 2025) sugieren que el RL puede permitir a los LLM desarrollar habilidades de razonamiento avanzadas utilizando únicamente recompensas de resultado, aunque su potencial en escenarios de llamadas a motores de búsqueda sigue estando poco explorado.
2.2 Grandes modelos de lenguaje y aprendizaje por refuerzo
El aprendizaje por refuerzo (RL) (Kaelbling et al., 1996) es un paradigma de aprendizaje en el que un agente aprende a tomar decisiones secuenciales interactuando con un entorno y recibiendo retroalimentación en forma de recompensas, con el objetivo de maximizar la recompensa acumulada a lo largo del tiempo (Sutton et al., 1999). El RL fue introducido en el ajuste de los LLM por Ouyang et al. (2022) mediante el RL a partir de retroalimentación humana (RLHF) (Kaufmann et al., 2023). Este enfoque primero entrena un modelo de recompensa utilizando datos de preferencias humanas (Lambert et al., 2024), que luego guía el ajuste basado en RL del LLM de política, normalmente mediante la Optimización de Política Proximal (PPO). Sin embargo, la PPO implica múltiples rondas de optimización del LLM, lo que dificulta su implementación. Para simplificar el ajuste basado en RL, se han propuesto métodos de optimización directa como la Optimización Directa de Preferencias (DPO) (Rafailov et al., 2023) y SimPO (Meng et al., 2024). Se emplea un enfoque similar en LeRet (Hsu et al., 2024), donde se entrena a los LLM para explorar consultas diversas con el fin de mejorar la eficacia de la recuperación de información. Si bien estos métodos ofrecen eficiencia computacional, adolecen de problemas de fuera de política (Pang et al., 2024) y no igualan de manera consistente el rendimiento de los enfoques de RL puro. Las soluciones alternativas incluyen la Optimización de Política Relativa de Grupo (GRPO) (Shao et al., 2024), que elimina la necesidad de un modelo crítico al estimar las líneas base a partir de las puntuaciones de grupo, y RLOO (Ahmadian et al., 2024), que introduce un marco de optimización simplificado al estilo REINFORCE (Williams, 1992). A pesar de estos avances, la aplicación del RL a las interacciones con motores de búsqueda y al razonamiento impulsados por LLM sigue estando en gran medida inexplorada.
3 Search-R1
En las siguientes secciones, presentamos el diseño detallado de los métodos de entrenamiento de SEARCH-R1, que abarcan (1) la extensión del RL para utilizar motores de búsqueda; (2) la generación de texto con una llamada intercalada al motor de búsqueda en múltiples turnos; (3) la plantilla de entrenamiento; y (4) el diseño del modelo de recompensa.
3.1 Aprendizaje por refuerzo con un motor de búsqueda
Formulamos la función objetivo del RL utilizando un motor de búsqueda de la siguiente manera:
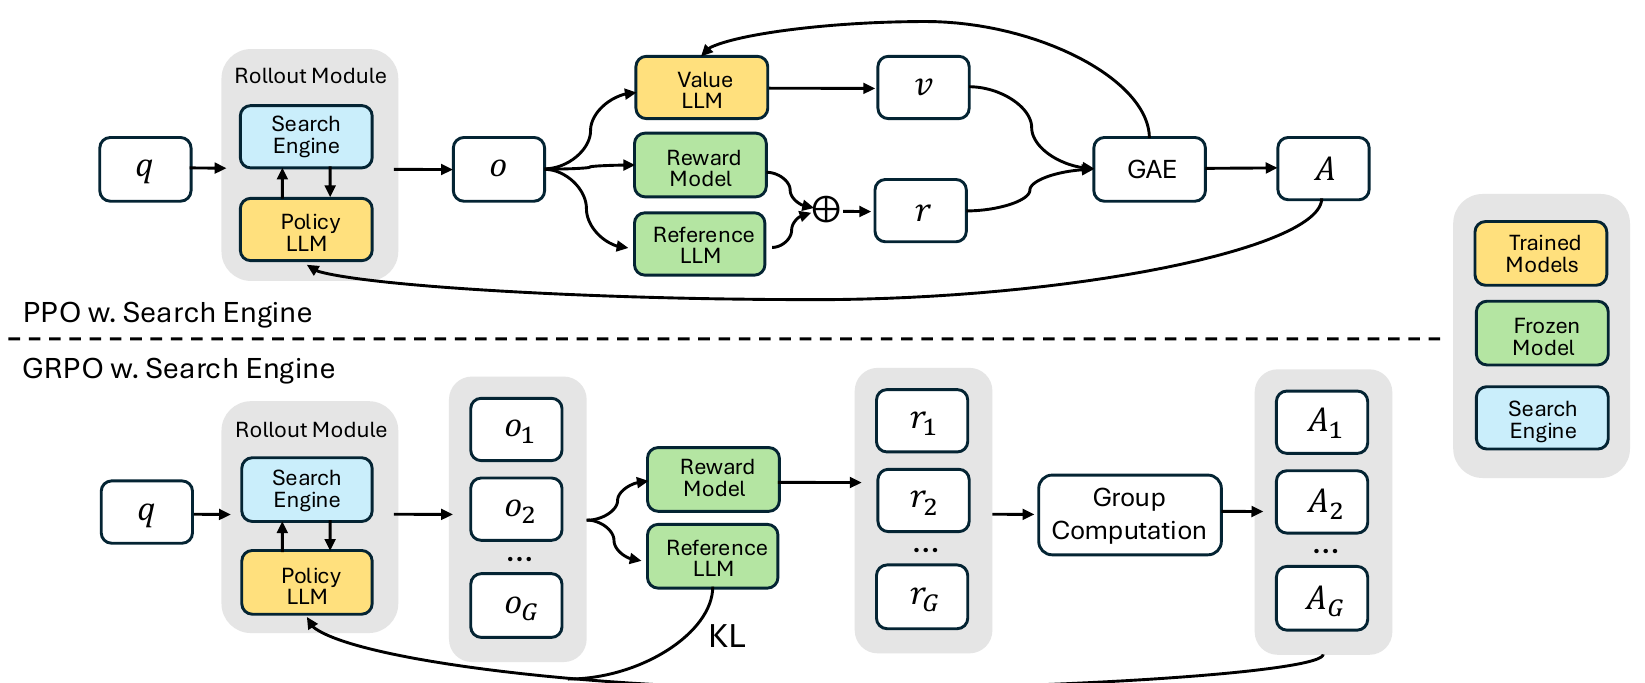
donde es el LLM de política, es el LLM de referencia, es la función de recompensa y es la medida de divergencia KL. denota las muestras de entrada extraídas del conjunto de datos , e representa las salidas generadas intercaladas con los resultados de las llamadas al motor de búsqueda, muestreadas de la política de referencia y recuperadas del motor de búsqueda . A diferencia de enfoques previos de RL que dependen principalmente del LLM de política para generar secuencias de rollout (Rafailov et al., 2023; Ouyang et al., 2022), nuestro marco incorpora explícitamente el razonamiento intercalado con recuperación mediante , lo que puede verse como , donde denota la recuperación y el razonamiento intercalados. Esto permite una toma de decisiones más eficaz en tareas intensivas en razonamiento que requieren recuperación de información externa. En la Sección 3.2 y el Apéndice A se proporciona una ilustración del proceso de rollout y una explicación de la Ec. 1.
Nuestro enfoque se basa en dos métodos de RL con gradiente de política bien establecidos: Proximal Policy Optimization (PPO) (Schulman et al., 2017) y Group Relative Policy Optimization (GRPO) (Shao et al., 2024; Guo et al., 2025), aprovechando sus respectivas ventajas para optimizar el razonamiento aumentado con recuperación.
Enmascaramiento de pérdidas para tokens recuperados. Tanto en PPO como en GRPO, las pérdidas a nivel de token se calculan sobre la secuencia de rollout completa. En SEARCH-R1, la secuencia de rollout consta tanto de tokens generados por el LLM como de tokens recuperados de pasajes externos. Mientras que optimizar los tokens generados por el LLM mejora la capacidad del modelo para interactuar con el motor de búsqueda y realizar razonamiento, aplicar la misma optimización a los tokens recuperados puede conducir a dinámicas de aprendizaje no deseadas. Para abordar esto, introducimos el enmascaramiento de pérdidas para los tokens recuperados, asegurando que el objetivo de gradiente de política se calcule solo sobre los tokens generados por el LLM, excluyendo el contenido recuperado del proceso de optimización. Este enfoque estabiliza el entrenamiento mientras preserva la flexibilidad de la generación aumentada con búsqueda.
PPO con motor de búsqueda. Proximal Policy Optimization (PPO) (Schulman et al., 2017) es un enfoque popular de RL actor-crítico comúnmente utilizado para LLMs (Ouyang et al., 2022). Para nuestros escenarios de razonamiento que implican llamadas al motor de búsqueda, optimiza los LLMs maximizando el siguiente objetivo:
donde y representan los modelos de política actual y anterior, respectivamente. es la operación de enmascaramiento de pérdida de token tal que si es un token generado por el LLM e si es un token recuperado. El término es un hiperparámetro relacionado con el recorte introducido en PPO para estabilizar el entrenamiento. La estimación de la ventaja se calcula utilizando Generalized Advantage Estimation (GAE) (Schulman et al., 2015), basándose en recompensas futuras y una función de valor aprendida .
GRPO con motor de búsqueda. Para mejorar la estabilidad de la optimización de la política y evitar la necesidad de una aproximación adicional de la función de valor, Group Relative Policy Optimization (GRPO) se introduce en Shao et al. (2024). GRPO difiere de PPO al aprovechar la recompensa promedio de múltiples salidas muestreadas como línea base en lugar de depender de una función de valor aprendida. Específicamente, para cada pregunta de entrada , GRPO muestrea un grupo de respuestas de la política de referencia . El modelo de política se optimiza entonces maximizando la siguiente función objetivo:
donde y son hiperparámetros, y representa la ventaja, calculada con base en las recompensas relativas de las salidas dentro de cada grupo. Este enfoque evita introducir complejidad adicional en el cálculo de . Además, en lugar de incorporar la divergencia KL como una penalización dentro de la función de recompensa, GRPO regulariza añadiendo directamente la divergencia KL entre la política entrenada y la política de referencia a la función de pérdida. El enmascaramiento de tokens recuperados también se aplica al calcular la pérdida de divergencia KL .
3.2 Generación con llamadas al motor de búsqueda en múltiples turnos
En esta sección, describimos el proceso de rollout para la generación de respuestas del LLM con llamadas intercaladas al motor de búsqueda en múltiples turnos, formulado como: .
Nuestro enfoque sigue un marco iterativo en el que el LLM alterna entre la generación de texto y las consultas a un motor de búsqueda externo. En concreto, la instrucción del sistema guía al LLM para que encierre su consulta de búsqueda entre dos tokens designados de llamada de búsqueda, <search> y </search>, siempre que se necesite una recuperación externa. Al detectar estos tokens en la secuencia generada, el sistema extrae la consulta de búsqueda, consulta el motor de búsqueda y recupera los resultados relevantes. A continuación, la información recuperada se encierra entre tokens especiales de recuperación, <information> y </information>, y se añade a la secuencia de rollout en curso, sirviendo como contexto adicional para el siguiente paso de generación. Este proceso continúa de forma iterativa hasta que se cumple una de las siguientes condiciones: (1) se alcanza el número máximo de acciones, o (2) el modelo genera una respuesta final, que se encierra entre los tokens de respuesta designados, <answer> y </answer>. El flujo de trabajo completo se describe en el Algoritmo 1.
3.3 Plantilla de entrenamiento
Para entrenar SEARCH- R1, comenzamos elaborando una plantilla sencilla que dirige al LLM inicial para que siga nuestras instrucciones predefinidas. Como se muestra en la Tabla 1, esta plantilla estructura la salida del modelo en tres partes de forma iterativa: primero, un proceso de razonamiento; después, una función de llamada al motor de búsqueda; y, finalmente, la respuesta. Limitamos deliberadamente nuestras restricciones a este formato estructural, evitando cualquier sesgo específico de contenido, como imponer un razonamiento reflexivo y la llamada al motor de búsqueda o respaldar enfoques específicos de resolución de problemas. Esto garantiza que la dinámica de aprendizaje natural del modelo durante el proceso de RL permanezca observable y sin sesgos.
Responde a la pregunta dada. Debes realizar el razonamiento dentro de <think> y </think> primero cada vez que obtengas nueva información. Después del razonamiento, si descubres que te falta algún conocimiento, puedes llamar a un motor de búsqueda mediante <search> query </search>, y este devolverá los mejores resultados buscados entre <information> y </information>. Puedes buscar tantas veces como quieras. Si consideras que no se necesita más conocimiento externo, puedes proporcionar directamente la respuesta dentro de <answer> y </answer> sin ilustraciones detalladas. Por ejemplo, <answer> xxx </answer>. Pregunta: question.
Tabla 1: Plantilla para SEARCH- R1. question se sustituirá por la pregunta específica durante el entrenamiento y la inferencia. Require: Consulta de entrada , modelo de política , motor de búsqueda , presupuesto máximo de acciones .
Ensure: Respuesta final .
1: Inicializar la secuencia de rollout
2: Inicializar el conteo de acciones
3: mientras hacer
4: Inicializar la secuencia de rollout de la acción actual del LLM
5: mientras Verdadero hacer
6: Generar token de respuesta
7: Añadir a la secuencia de rollout
8: si en [</search>,</answer>,<eos>] entonces romper
9: fin si
10: fin mientras
11:
12: si <search> </search> detectado en entonces
13: Extraer consulta de búsqueda
14: Recuperar resultados de búsqueda
15: Insertar en el rollout
16: si no, si <answer> </answer> detectado en entonces
17: devolver respuesta final generada
18: si no
19: Pedir reconsideración acción no es correcta. Déjame reconsiderar."
20: fin si
21: Incrementar el conteo de acciones
22: fin mientras
23: devolver la respuesta final generada
3.4 Modelado de recompensas
La función de recompensa sirve como la señal de entrenamiento principal, guiando el proceso de optimización en RL. Para entrenar SEARCH-R1, adoptamos un sistema de recompensas basado en reglas que consiste únicamente en recompensas por el resultado final, las cuales evalúan la corrección de la respuesta del modelo. Por ejemplo, en tareas de razonamiento factual, la corrección puede evaluarse utilizando criterios basados en reglas, como la coincidencia exacta de cadenas:
donde es la respuesta final extraída de la respuesta y es la respuesta de referencia. A diferencia de Guo et al. (2025), no incorporamos recompensas de formato, ya que nuestro modelo entrenado ya demuestra una fuerte adherencia estructural. Dejamos la exploración de recompensas de formato más complejas para trabajos futuros. Además, evitamos entrenar modelos de recompensa neuronales, siguiendo a Guo et al. (2025). Esta decisión está motivada por la sensibilidad de los LLM a formas específicas de recompensas en RL a gran escala, así como por el costo computacional y la complejidad adicionales que introduce el reentrenamiento de estos modelos.
4 Resultados principales
4.1 Conjuntos de datos
Evaluamos SEARCH-R1 en siete conjuntos de datos de referencia, categorizados de la siguiente manera: (1) Preguntas y respuestas generales: NQ (Kwiatkowski et al., 2019), TriviaQA (Joshi et al., 2017) y PopQA (Mallen et al., 2022). (2) Preguntas y respuestas de múltiples saltos: HotpotQA (Yang et al., 2018), 2WikiMultiHopQA (Ho et al., 2020), Musique (Trivedi et al., 2022b) y Bamboogle (Press et al., 2022). Estos conjuntos de datos abarcan una diversa gama de desafíos de búsqueda con razonamiento, lo que permite una evaluación integral de SEARCH-R1.
4.2 Líneas base
Para evaluar la efectividad de SEARCH-R1, lo comparamos con las siguientes líneas base: (1) Inferencia sin recuperación: inferencia directa y razonamiento en cadena de pensamiento (CoT) (Wei et al., 2022). (2) Inferencia con recuperación: generación aumentada por recuperación (RAG) (Lewis et al., 2020), IRCoT (Trivedi et al., 2022a) y Search-o1 (Li et al., 2025). (3) Métodos basados en ajuste fino: ajuste fino supervisado (SFT) (Chung et al., 2024), ajuste fino basado en RL sin un motor de búsqueda (R1) (Guo et al., 2025) y muestreo por rechazo (Ahn et al., 2024) con un motor de búsqueda. Para R1, entrenamos los LLM con los métodos de RL propuestos en Guo et al. (2025) con nuestros datos para tener una comparación justa con SEARCH-R1. Este solo contiene pasos de razonamiento y respuesta sin un motor de búsqueda. Para el muestreo por rechazo, generamos cinco respuestas candidatas por indicación de entrenamiento a partir del mismo conjunto de datos con los LLM instruidos y seleccionamos aquellas que conducen a respuestas finales correctas. Estas trayectorias seleccionadas se utilizan luego para construir un nuevo conjunto de entrenamiento que conserva el mismo mecanismo de despliegue de interacción multiturno entre LLM y motor de búsqueda propuesto en SEARCH-R1 para ajustar finamente los LLM.
Estas líneas base cubren un amplio espectro de enfoques de recuperación aumentada y ajuste fino, lo que permite una evaluación integral de SEARCH-R1 tanto en entornos de recuperación de cero disparos como aprendidos. Para hacer una comparación justa entre diferentes métodos, utilizamos el mismo recuperador, el mismo número de documentos recuperados, el mismo corpus de conocimiento, los mismos datos de entrenamiento y los mismos LLM preentrenados. Los detalles se pueden encontrar en el Apéndice B.
4.3 Configuración experimental
Realizamos experimentos utilizando dos tipos de modelos: Qwen-2.5-3B (Base/Instruct) y Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024). Para la recuperación, utilizamos el volcado de Wikipedia de 2018 (Karpukhin et al., 2020) como fuente de conocimiento y E5 (Wang et al., 2022) como recuperador. Para garantizar una comparación justa, seguimos a Lin et al. (2023) y establecemos el número de pasajes recuperados en 3 en todos los métodos basados en recuperación. Un estudio sobre el número de pasajes recuperados se puede encontrar en el Apéndice G.
Para el entrenamiento, fusionamos los conjuntos de entrenamiento de NQ y HotpotQA para formar un conjunto de datos unificado para SEARCH-R1 y otras líneas base basadas en ajuste fino. La evaluación se realiza en los conjuntos de prueba o validación de siete conjuntos de datos para evaluar tanto el rendimiento en dominio como fuera de dominio. Se utiliza la coincidencia exacta (EM) como métrica de evaluación, siguiendo a Yu et al. (2024). Para las líneas base de estilo inferencia, utilizamos modelos instruidos, ya que los modelos base no logran seguir instrucciones. Para los métodos de ajuste por RL, los experimentos se realizan tanto en modelos base como instruidos. Más detalles sobre la configuración experimental se pueden encontrar en el Apéndice B.
A menos que se indique lo contrario, se utiliza PPO como método de RL predeterminado, y se proporciona una comparación detallada entre PPO y GRPO en la Sección 5.1.
4.4 Rendimiento
Los resultados principales que comparan SEARCH-R1 con los métodos de línea base en los siete conjuntos de datos se presentan en la Tabla 2. A partir de los resultados, hacemos las siguientes observaciones clave: (1) SEARCH-R1 supera consistentemente a los métodos de línea base sólidos. Logramos una mejora relativa promedio del y con Qwen2.5-7B y Qwen2.5-3B, respectivamente. Estas ganancias se mantienen tanto en la evaluación en distribución (es decir, NQ y HotpotQA) como en la evaluación fuera de distribución (es decir, TriviaQA, PopQA, 2WikiMultiHopQA, Musique y Bamboogle). (2) SEARCH-R1 supera al entrenamiento basado en RL para el razonamiento de LLM sin recuperación (R1). Esto concuerda con lo esperado, ya que incorporar la búsqueda al razonamiento de LLM proporciona acceso a conocimiento externo relevante, mejorando el rendimiento general. (3) SEARCH-R1 es efectivo tanto para modelos base como para modelos ajustados con instrucciones. Esto demuestra que el RL estilo DeepSeek-R1-Zero con recompensas basadas en resultados (Guo et al., 2025) puede aplicarse con éxito al razonamiento con búsqueda, extendiendo su efectividad previamente establecida en escenarios de razonamiento puro. (4) Los modelos más grandes son mejores para aprender cómo realizar búsquedas. SEARCH-R1 en el modelo de 7B muestra una "brecha de rendimiento" mucho mayor en comparación con el modelo de 3B (por ejemplo, en comparación con el segundo mejor modelo: RAG).
| Métodos | QA general | QA multi-hop | ||||||
| NQ+ | TriviaQA+ | PopQA+ | HotpotQA+ | 2wiki+ | Musique+ | Bamboolle+ | Prom. | |
| Qwen2.5-7b-Base/Instruct | ||||||||
| Inferencia directa | 0,134 | 0,408 | 0,140 | 0,183 | 0,250 | 0,031 | 0,120 | 0,181 |
| CoT | 0,048 | 0,185 | 0,054 | 0,092 | 0,111 | 0,022 | 0,232 | 0,106 |
| IRCoT | 0,224 | 0,478 | 0,301 | 0,133 | 0,149 | 0,072 | 0,224 | 0,239 |
| Search-o1 | 0,151 | 0,443 | 0,131 | 0,187 | 0,176 | 0,058 | 0,296 | 0,206 |
| RAG | 0,349 | 0,585 | 0,392 | 0,299 | 0,235 | 0,058 | 0,208 | 0,304 |
| SFT | 0,318 | 0,354 | 0,121 | 0,217 | 0,259 | 0,066 | 0,112 | 0,207 |
| R1-base | 0,297 | 0,539 | 0,202 | 0,242 | 0,273 | 0,083 | 0,296 | 0,276 |
| R1-instruct | 0,270 | 0,537 | 0,199 | 0,237 | 0,292 | 0,072 | 0,293 | 0,271 |
| Muestreo de rechazo | 0,360 | 0,592 | 0,380 | 0,331 | 0,296 | 0,123 | 0,355 | 0,348 |
| Search-R1-base | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| Search-R1-instruct | 0,393 | 0,610 | 0,397 | 0,370 | 0,414 | 0,146 | 0,368 | 0,385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| Inferencia directa | 0,106 | 0,288 | 0,108 | 0,149 | 0,244 | 0,020 | 0,024 | 0,134 |
| CoT | 0,023 | 0,032 | 0,005 | 0,021 | 0,021 | 0,002 | 0,000 | 0,015 |
| IRCoT | 0,111 | 0,312 | 0,200 | 0,164 | 0,171 | 0,067 | 0,240 | 0,181 |
| Search-o1 | 0,238 | 0,472 | 0,262 | 0,221 | 0,218 | 0,054 | 0,320 | 0,255 |
| RAG | 0,348 | 0,544 | 0,387 | 0,255 | 0,226 | 0,047 | 0,080 | 0,270 |
| SFT | 0,249 | 0,292 | 0,104 | 0,186 | 0,248 | 0,044 | 0,112 | 0,176 |
| R1-base | 0,226 | 0,455 | 0,173 | 0,201 | 0,268 | 0,055 | 0,224 | 0,229 |
| R1-instruct | 0,210 | 0,449 | 0,171 | 0,208 | 0,275 | 0,060 | 0,192 | 0,224 |
| Rejection Sampling | 0,294 | 0,488 | 0,332 | 0,240 | 0,233 | 0,059 | 0,210 | 0,265 |
| Search-R1-base | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| Search-R1-instruct | 0,341 | 0,545 | 0,378 | 0,324 | 0,319 | 0,103 | 0,264 | 0,325 |
| Método | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolle | Prom. |
| Qwen2.5-7b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
| SEARCH-R1-instruct (GRPO) | 0.429 | 0.623 | 0.427 | 0.386 | 0.346 | 0.162 | 0.400 | 0.396 |
| SEARCH-R1-base (PPO) | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1-instruct (PPO) | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.421 | 0.583 | 0.413 | 0.297 | 0.274 | 0.066 | 0.128 | 0.312 |
| SEARCH-R1-instruct (GRPO) | 0.397 | 0.565 | 0.391 | 0.331 | 0.310 | 0.124 | 0.232 | 0,336 |
| SEARCH-R1-base (PPO) | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| SEARCH-R1-instruct (PPO) | 0,341 | 0,545 | 0,378 | 0,324 | 0,319 | 0,103 | 0,264 | 0,325 |
5 Análisis
5.1 Diferentes métodos de RL: PPO vs. GRPO
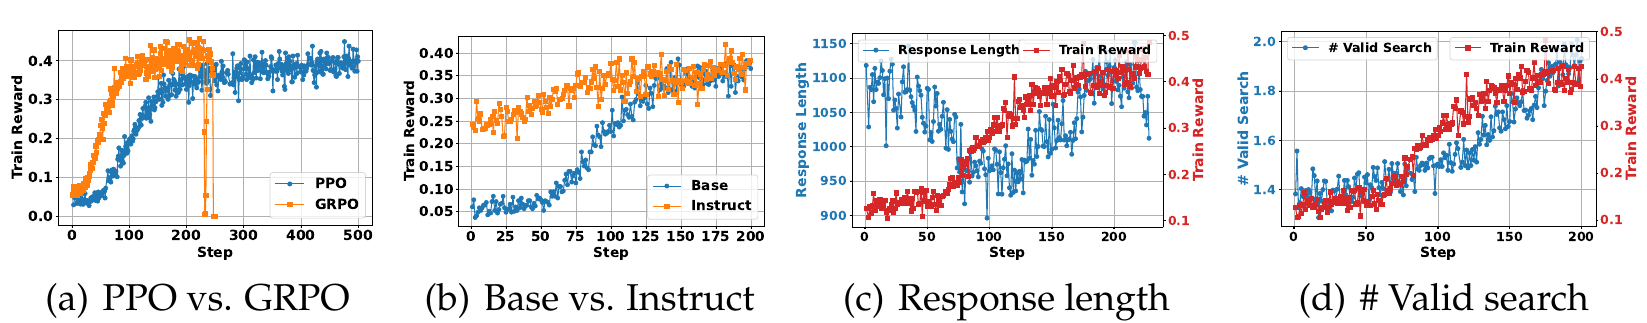
Evaluamos SEARCH-R1 utilizando tanto PPO como GRPO como método RL base, realizando experimentos con los modelos Qwen2.5-3B/7B. La comparación de la dinámica de entrenamiento se presenta en la Figura 2(a) y los resultados de la evaluación se presentan en la Tabla 3, revelando las siguientes observaciones: (1) GRPO converge más rápido que PPO en todos los casos. Esto se debe a que PPO depende de un modelo crítico, que requiere varios pasos de calentamiento antes de que comience el entrenamiento efectivo. (2) PPO demuestra una mayor estabilidad de entrenamiento. Como se muestra en la Figura 2(a), GRPO provoca un colapso de la recompensa tras entrenar durante muchos pasos, mientras que PPO permanece estable. (3) Las recompensas finales de entrenamiento de PPO y GRPO son comparables. A pesar de las diferencias en velocidad de convergencia y estabilidad, ambos métodos alcanzan una recompensa final de entrenamiento y un rendimiento similares, lo que indica que ambos son viables para optimizar SEARCH-R1. PPO exhibe una mayor estabilidad de entrenamiento, lo que lo convierte en una opción preferible en esta configuración. Más resultados se encuentran en el Apéndice F.
| Método | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bambooq | Prom. |
| SEARCH-R1 con máscara | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1 sin máscara | 0,388 | 0,567 | 0,391 | 0,325 | 0,321 | 0,108 | 0,304 | 0,343 |
5.2 LLM base vs. Instruct
Analizamos la dinámica de entrenamiento de SEARCH-R1 tanto en LLM base como en LLM ajustados por instrucciones. Los experimentos se realizan con dos variantes de modelo: Qwen2.5-3B y Qwen2.5-7B. Como se muestra en la Figura 2(b), observamos que los modelos ajustados por instrucciones convergen más rápido y parten de un rendimiento inicial más alto en comparación con los modelos base. Sin embargo, la recompensa final de entrenamiento de ambos tipos de modelo sigue siendo muy similar tras el entrenamiento. Este hallazgo sugiere que, si bien el post-entrenamiento general acelera el aprendizaje en escenarios de razonamiento más búsqueda, el RL puede cerrar eficazmente la brecha con el tiempo, permitiendo que los modelos base alcancen un rendimiento comparable. Se pueden encontrar más resultados en el Apéndice E.
5.3 Estudio de la longitud de respuesta y las búsquedas válidas
Realizamos un experimento utilizando SEARCH-R1 con el modelo Qwen2.5-7b-base para analizar la dinámica de la longitud de respuesta y el número de llamadas válidas al motor de búsqueda a lo largo del entrenamiento. El resultado de la longitud de respuesta se presenta en la Figura 2(c), revelando las siguientes tendencias clave: (1) Etapa temprana (primeros 100 pasos): la longitud de respuesta disminuye drásticamente, mientras que la recompensa de entrenamiento experimenta un ligero aumento. Durante esta fase, el modelo base aprende a eliminar palabras de relleno excesivas y comienza a adaptarse a los requisitos de la tarea. (2) Etapa posterior (después de 100 pasos): tanto la longitud de respuesta como la recompensa de entrenamiento aumentan significativamente. En este punto, el LLM aprende a llamar frecuentemente al motor de búsqueda, lo que da como resultado respuestas más largas debido a los pasajes recuperados. La recompensa de entrenamiento mejora sustancialmente, ya que el modelo se vuelve más eficaz a la hora de aprovechar los resultados de búsqueda. El resultado de búsquedas válidas se presenta en la Figura 2(d), mostrando que los LLM aprenden a llamar al motor de búsqueda más veces a medida que avanza el entrenamiento.
5.4 Estudio del enmascaramiento de la pérdida de tokens recuperados
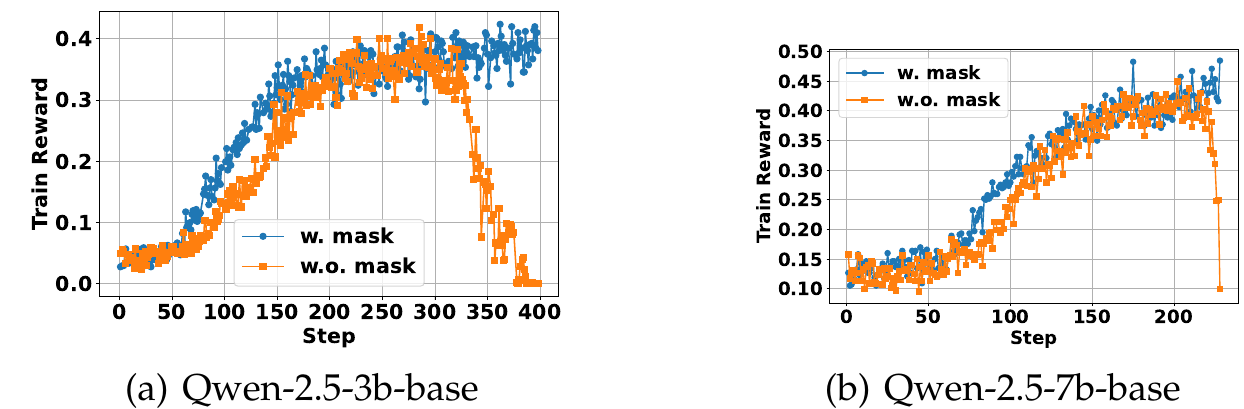
En la Sección 3.1, introdujimos el enmascaramiento de la pérdida para los tokens recuperados con el fin de prevenir comportamientos de optimización no deseados. Aquí, realizamos experimentos con el modelo Qwen2.5-7b-base, comparando la dinámica de entrenamiento con y sin enmascaramiento de la pérdida de tokens recuperados. Como se muestra en la Figura 3, aplicar el enmascaramiento de tokens recuperados da como resultado mayores mejoras del LLM, mitigando los efectos de optimización no deseados y garantizando un entrenamiento más estable. La comparación de rendimiento se proporciona en la Tabla 4, demostrando que SEARCH-R1 entrenado con enmascaramiento de la pérdida de tokens recuperados supera consistentemente a la variante sin enmascaramiento.
Se pueden encontrar más resultados experimentales sobre el enmascaramiento de la pérdida de tokens recuperados, LLM base vs. instruct, la comparación entre PPO/GRPO, el número de pasajes recuperados en el entrenamiento de SEARCH-R1, el estudio del tamaño de grupo en SEARCH-R1 (GRPO) y estudios de casos en los Apéndices D, E, G, H, I y J.
6 Conclusiones
En este trabajo, presentamos SEARCH-R1, un novedoso marco de RL que permite a los LLM intercalar el autorrazonamiento con interacciones en tiempo real con el motor de búsqueda. A diferencia de los enfoques existentes tipo RAG, que dependen de indicaciones extensas para la recuperación de múltiples turnos, o de los métodos de uso de herramientas que requieren datos de entrenamiento supervisado a gran escala, SEARCH-R1 optimiza las trayectorias de los LLM mediante RL, permitiendo la generación autónoma de consultas y la utilización estratégica de la información recuperada. Mediante extensos experimentos en siete conjuntos de datos, demostramos que SEARCH-R1 mejora significativamente la capacidad de los LLM para abordar tareas de razonamiento complejas que requieren conocimiento externo en tiempo real. Nuestro análisis también proporciona ideas clave sobre las estrategias de entrenamiento de RL para el razonamiento aumentado con búsqueda. De cara al futuro, el trabajo futuro puede explorar la ampliación de SEARCH-R1 para admitir estrategias de búsqueda más amplias, incluidos mecanismos de recompensa más sofisticados, ajustes dinámicos de recuperación basados en la incertidumbre, la combinación con un conjunto diverso de herramientas y la integración con diversas fuentes de información más allá de la búsqueda. También es prometedor investigar su aplicabilidad a tareas de razonamiento multimodal.
Agradecimientos
Esta investigación fue apoyada en parte por la Apple PhD Fellowship, en parte por el Programa INCAS de DARPA de EE. UU. No. HR0011-21-C0165 y el Programa BRIES No. HR0011-24-3-0325, en parte por el contrato número N000142412612 de la Office of Naval Research, en parte por las subvenciones de la NSF números IIS-19-56151 y 2402873, en parte por el Molecule Maker Lab Institute: un programa de AI Research Institutes apoyado por la NSF bajo el Award No. 2019897 y el Institute for Geospatial Understanding through an Integrative Discovery Environment (I-GUIDE) por la NSF bajo el Award No. 2118329, en parte por Cisco, y en parte por el Center for Intelligent Information Retrieval. Cualquier opinión, hallazgo y conclusión o recomendación expresada en este documento son de los autores y no representan necesariamente las opiniones, ya sean expresas o implícitas, de los patrocinadores o del Gobierno de EE. UU.
Referencias
Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, and Sara Hooker. Back to basics: Revisiting reinforce style optimization for learning from human feedback in llms. arXiv preprint arXiv:2402.14740, 2024.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, and Wenpeng Yin. Large language models for mathematical reasoning: Progresses and challenges. arXiv preprint arXiv:2402.00157, 2024.
Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. 2024.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1-53, 2024.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try arc, the ai2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Haofen Wang, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2, 2023.
Michael Glass, Gaetano Rossiello, Md Faisal Mahbub Chowdhury, Ankita Rajaram Naik, Pengshan Cai, and Alfio Gliozzo. Re2g: Retrieve, rerank, generate. arXiv preprint arXiv:2207.06300, 2022.
Daya Guo, Qihao Zhu, Dejian Yang, Zhenda Xie, Kai Dong, Wentao Zhang, Guanting Chen, Xiao Bi, Yu Wu, YK Li, et al. Deepseek-coder: When the large language model meets programming-the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. Constructing a multi-hop qa dataset for comprehensive evaluation of reasoning steps. arXiv preprint arXiv:2011.01060, 2020.
Zhenyu Hou, Xin Lv, Rui Lu, Jiajie Zhang, Yujiang Li, Zijun Yao, Juanzi Li, Jie Tang, and Yuxiao Dong. Advancing language model reasoning through reinforcement learning and inference scaling. arXiv preprint arXiv:2501.11651, 2025.
Sheryl Hsu, Omar Khattab, Chelsea Finn y Archit Sharma. Grounding by trying: Llms with reinforcement learning- enhanced retrieval. arXiv preprint arXiv:2410.23214, 2024.
Jie Huang y Kevin Chen- Chuan Chang. Towards reasoning in large language models: A survey. arXiv preprint arXiv:2212.10403, 2022.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El- Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi- Yu, Yiming Yang, Jamie Callan y Graham Neubig. Active retrieval augmented generation. En Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pp. 7969- 7992, 2023.
Bowen Jin, Jinsung Yoon, Jiawei Han y Sercan O Arik. Long- context llms meet rag: Overcoming challenges for long inputs in rag. En The Thirteenth International Conference on Learning Representations, 2024.
Mandar Joshi, Eunsol Choi, Daniel S Weld y Luke Zettlemoyer. Triviaqa: A large scale distantly supervised challenge dataset for reading comprehension. arXiv preprint arXiv:1705.03551, 2017.
Leslie Pack Kaelbling, Michael L Littman y Andrew W Moore. Reinforcement learning: A survey. Journal of artificial intelligence research, 4:237- 285, 1996.
Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick SH Lewis, Ledell Wu, Sergey Edunov, Danqi Chen y Wen- tau Yih. Dense passage retrieval for open- domain question answering. En EMNLP (1), pp. 6769- 6781, 2020.
Timo Kaufmann, Paul Weng, Viktor Bengs y Eyke Hullermeier. A survey of reinforcement learning from human feedback. arXiv preprint arXiv:2312.14925, 10, 2023.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, John D Co- Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, et al. Training language models to self- correct via reinforcement learning. arXiv preprint arXiv:2409.12917, 2024.
Tom Kwiatkowski, Jennimaria Palomaki, Olivia Redfield, Michael Collins, Ankur Parikh, Chris Alberti, Danielle Epstein, Illia Polosukhin, Jacob Devlin, Kenton Lee, et al. Natural questions: a benchmark for question answering research. Transactions of the Association for Computational Linguistics, 7:453- 466, 2019.
Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, et al. Rewardbench: Evaluating reward models for language modeling. arXiv preprint arXiv:2403.13787, 2024.
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen- tau Yih, Tim Rocktaschel, et al. Retrieval- augmented generation for knowledge- intensive nlp tasks. Advances in neural information processing systems, 33:9459- 9474, 2020.
Xiaoxi Li, Jiajie Jin, Yujia Zhou, Yongkang Wu, Zhonghua Li, Qi Ye y Zhicheng Dou. Retrollm: Empowering large language models to retrieve fine- grained evidence within generation. arXiv preprint arXiv:2412.11919, 2024.
Xiaoxi Li, Guanting Dong, Jiajie Jin, Yuyao Zhang, Yujia Zhou, Yutao Zhu, Peitian Zhang y Zhicheng Dou. Search- 01: Agentic search- enhanced large reasoning models. arXiv preprint arXiv:2501.05366, 2025.
Yinheng Li, Shaofei Wang, Han Ding y Hang Chen. Large language models in finance: A survey. En Proceedings of the fourth ACM international conference on AI in finance, pp. 374- 382, 2023.
Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Richard James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra- dit: Retrieval- augmented dual instruction tuning. En The Twelfth International Conference on Learning Representations, 2023.
Alex Mallen, Akari Asai, Victor Zhong, Rajarshi Das, Hannaneh Hajishirzi y Daniel Khashabi. When not to trust language models: Investigating effectiveness and limitations of parametric and non- parametric memories. arXiv preprint arXiv:2212.10511, 7, 2022.
Yu Meng, Mengzhou Xia y Danqi Chen. Simpo: Simple preference optimization with a reference- free reward. Advances in Neural Information Processing Systems, 37:124198- 124235, 2024.
Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Training language models to follow instructions with human feedback. Advances in neural information processing systems, 35:27730- 27744, 2022.
Richard Yuanzhe Pang, Weizhe Yuan, He He, Kyunghyun Cho, Sainbayar Sukhbaatar y Jason Weston. Iterative reasoning preference optimization. Advances in Neural Information Processing Systems, 37:116617- 116637, 2024.
Cheng Peng, Xi Yang, Aokun Chen, Kaleb E Smith, Nima PourNejatian, Anthony B Costa, Cheryl Martin, Mona G Flores, Ying Zhang, Tanja Magoc, et al. A study of generative large language model for medical research and healthcare. NPJ digital medicine, 6(1):210, 2023.
Ofir Press, Muru Zhang, Sewon Min, Ludwig Schmidt, Noah A Smith y Mike Lewis. Measuring and narrowing the compositionality gap in language models. arXiv preprint arXiv:2210.03350, 2022.
Changle Qu, Sunhao Dai, Xiaochi Wei, Hengyi Cai, Shuaiqiang Wang, Dawei Yin, Jun Xu y Ji- Rong Wen. Tool learning with large language models: A survey. Frontiers of Computer Science, 19(8):198343, 2025.
Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon y Chelsea Finn. Direct preference optimization: Your language model is secretly a reward model. Advances in Neural Information Processing Systems, 36:53728- 53741, 2023.
Timo Schick, Jane Dwivedi- Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Eric Hambro, Luke Zettlemoyer, Nicola Cancedda y Thomas Scialom. Toolformer: Language models can teach themselves to use tools. Advances in Neural Information Processing Systems, 36: 68539- 68551, 2023.
John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan y Pieter Abbeel. High- dimensional continuous control using generalized advantage estimation. arXiv preprint arXiv:1506.02438, 2015.
John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford y Oleg Klimov. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, YK Li, Y Wu, et al. Deepseekmath: Pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin y Chuan Wu. Hybridflow: A flexible and efficient rlhf framework. arXiv preprint arXiv:2409.19256, 2024.
Richard S Sutton, Andrew G Barto, et al. Reinforcement learning. Journal of Cognitive Neuroscience, 11(1):126- 134, 1999.
Gemini Team. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv preprint arXiv:2403.05530, 2024.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot y Ashish Sabharwal. Interleaving retrieval with chain-of-thought reasoning for knowledge-intensive multi-step questions. arXiv preprint arXiv:2212.10509, 2022a.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot y Ashish Sabharwal. Musique: Multihop questions via single-hop question composition. Transactions of the Association for Computational Linguistics, 10:539-554, 2022b.
Liang Wang, Nan Yang, Xiaolong Huang, Binxing Jiao, Linjun Yang, Daxin Jiang, Rangan Majumder y Furu Wei. Text embeddings by weakly-supervised contrastive pre-training. arXiv preprint arXiv:2212.03533, 2022.
Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824-24837, 2022.
Yixuan Weng, Minjun Zhu, Fei Xia, Bin Li, Shizhu He, Shengping Liu, Bin Sun, Kang Liu y Jun Zhao. Large language models are better reasoners with self-verification. arXiv preprint arXiv:2212.09561, 2022.
Ronald J Williams. Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine learning, 8:229-256, 1992.
Tian Xie, Zitian Gao, Qingnan Ren, Haoming Luo, Yuqian Hong, Bryan Dai, Joey Zhou, Kai Qiu, Zhirong Wu y Chong Luo. Logic-rl: Unleashing llm reasoning with rule-based reinforcement learning. arXiv preprint arXiv:2502.14768, 2025.
Guangzhi Xiong, Qiao Jin, Xiao Wang, Yin Fang, Haolin Liu, Yifan Yang, Fangyuan Chen, Zhixing Song, Dengyu Wang, Minjia Zhang, et al. Rag-gym: Optimizing reasoning and search agents with process supervision. arXiv preprint arXiv:2502.13957, 2025.
An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William W Cohen, Ruslan Salakhutdinov y Christopher D Manning. Hotpotqa: A dataset for diverse, explainable multi-hop question answering. arXiv preprint arXiv:1809.09600, 2018.
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan y Yuan Cao. React: Synergizing reasoning and acting in language models. In International Conference on Learning Representations (ICLR), 2023.
Yue Yu, Wei Ping, Zihan Liu, Boxin Wang, Jiaxuan You, Chao Zhang, Mohammad Shoeybi y Bryan Catanzaro. Rankrag: Unifying context ranking with retrieval-augmented generation in llms. Advances in Neural Information Processing Systems, 37:121156-121184, 2024.
Zhenrui Yue, Honglei Zhuang, Aijun Bai, Kai Hui, Rolf Jagerman, Hansi Zeng, Zhen Qin, Dong Wang, Xuanhui Wang y Michael Bendersky. Inference scaling for long-context retrieval augmented generation. arXiv preprint arXiv:2410.04343, 2024.
Yue Zhang, Yafu Li, Leyang Cui, Deng Cai, Lemao Liu, Tingchen Fu, Xinting Huang, Enbo Zhao, Yu Zhang, Yulong Chen, et al. Siren's song in the ai ocean: a survey on hallucination in large language models. arXiv preprint arXiv:2309.01219, 2023.
Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. A survey of large language models. arXiv preprint arXiv:2303.18223, 1(2), 2023.
Wayne Xin Zhao, Jing Liu, Ruiyang Ren y Ji-Rong Wen. Dense text retrieval based on pretrained language models: A survey. ACM Transactions on Information Systems, 42(4): 1-60, 2024.
Apéndice
A Formulación del aprendizaje por refuerzo con un motor de búsqueda
El marco clásico de aprendizaje por refuerzo (RL, por sus siglas en inglés) para entrenar modelos de lenguaje grandes (LLM) puede formularse de la siguiente manera (Rafailov et al., 2023; Ouyang et al., 2022):
donde denota un prompt muestreado de un conjunto de datos , es una respuesta generada por el modelo de política , y representa un modelo de referencia que sirve como ancla de regularización. La función de recompensa cuantifica la calidad de la respuesta generada, mientras que el término de divergencia KL restringe la política actualizada para que permanezca cercana al modelo de referencia, promoviendo así la estabilidad del entrenamiento.
Sin embargo, esta formulación asume que toda la secuencia de salida es generada únicamente por el LLM de política. Esta suposición no se cumple en nuestro entorno, donde el comportamiento del modelo incorpora tanto razonamiento interno como recuperación de información externa. Para dar cabida a esto, extendemos el objetivo de RL para incorporar un motor de búsqueda externo , lo que da lugar a la siguiente formulación:
En este objetivo revisado, la trayectoria incluye pasos de razonamiento intercalados y contenido recuperado, lo que refleja una interacción de múltiples turnos entre el LLM y el motor de búsqueda. La divergencia KL se calcula sobre la distribución conjunta de respuestas condicionada tanto al prompt como al contexto aumentado con recuperación, lo que garantiza que la política aprendida permanezca alineada con el modelo de referencia incluso en presencia de información externa.
B Configuraciones experimentales
B.1 Líneas base
Varios trabajos recientes han explorado canalizaciones de RAG, particularmente en benchmarks como Natural Questions (NQ) o HotpotQA, con el objetivo de mejorar el rendimiento mediante mecanismos de recuperación más elaborados. Por ejemplo, Re2G (Glass et al., 2022) y RetroLLM (Li et al., 2024) proponen marcos sofisticados de recuperar-reordenar-generar que emplean recuperadores potentes y estrategias de reordenación complejas para seleccionar evidencia de grano fino para la generación. Si bien estos enfoques demuestran resultados impresionantes, a menudo dependen de ingeniería específica de la tarea o de canalizaciones pesadas que limitan la generalizabilidad y la escalabilidad. En contraste, nuestro enfoque se centra en un método más ligero y general para el razonamiento aumentado con recuperación. Por lo tanto, no incluimos estos métodos como líneas base directas, aunque representan direcciones valiosas en el espacio más amplio del modelado de lenguaje mejorado con recuperación.
B.2 Configuraciones experimentales
Realizamos experimentos utilizando dos tipos de modelos: Qwen-2.5-3B (Base/Instruct) y Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024). Para la recuperación, utilizamos el volcado de Wikipedia de 2018 (Karpukhin et al., 2020) como fuente de conocimiento y E5 (Wang et al., 2022) como recuperador. Para garantizar una comparación justa, seguimos a Lin et al. (2023) y fijamos el número de pasajes recuperados en 3 en todos los métodos basados en recuperación.
Para el entrenamiento, fusionamos los conjuntos de entrenamiento de NQ y HotpotQA para formar un conjunto de datos unificado para SEARCH-R1 y otras líneas base basadas en ajuste fino. La evaluación se lleva a cabo en los conjuntos de prueba o validación de siete conjuntos de datos para evaluar el rendimiento tanto en dominio como fuera de dominio. Se utiliza Exact Match (EM) como métrica de evaluación, siguiendo a Yu et al. (2024). Para las líneas base de estilo inferencia, utilizamos modelos instruct, ya que los modelos base no logran seguir las instrucciones. Para los métodos de ajuste por RL, los experimentos se realizan tanto en modelos base como en modelos instruct. Pueden encontrarse más detalles sobre la configuración experimental en el Apéndice B.
Para la variante PPO de SEARCH-R1, establecemos la tasa de aprendizaje del LLM de política en 1e-6 y la del LLM de valor en 1e-5. El entrenamiento se realiza durante 500 pasos, con ratios de warm-up de 0.285 y 0.015 para los modelos de política y de valor, respectivamente. Utilizamos Generalized Advantage Estimation (GAE) con parámetros y .
El entrenamiento se realiza en un único nodo con 8 GPUs H100. Utilizamos un tamaño de lote total de 512, con un tamaño de mini-lote de 256 y un tamaño de micro-lote de 64. La longitud máxima de secuencia se establece en 4,096 tokens, con una longitud máxima de respuesta de 500 y una longitud máxima de 500 tokens para el contenido recuperado. Para optimizar el uso de la memoria de la GPU, habilitamos el gradient checkpointing y utilizamos Fully Sharded Data Parallel (FSDP) con descarga a CPU (CPU offloading).
Para rollouts eficientes del LLM, adoptamos vLLM1 con un tamaño de paralelismo tensorial de 1 y un ratio de utilización de memoria de GPU de 0.6. El muestreo de rollouts utiliza una temperatura de 1.0 y un valor de top-p de 1.0. El coeficiente de regularización de divergencia KL y el ratio de recorte se establecen en 0.001 y 0.2.
Para el entrenamiento con GRPO, establecemos la tasa de aprendizaje del LLM de política en 1e-6 y muestreamos 5 respuestas por prompt, siguiendo la implementación de GRPO en Verl (Sheng et al., 2024)1 . El modelo se entrena durante 500 pasos con un ratio de warm-up de la tasa de aprendizaje de 0.285. El entrenamiento se realiza en la misma configuración de 8xH100 con tamaños de lote y configuraciones de longitud de secuencia idénticos a los de PPO.
También utilizamos gradient checkpointing, descarga a CPU con FSDP y rollouts basados en vLLM con los mismos hiperparámetros que arriba. La temperatura de rollout y los valores de top-p se establecen ambos en 1.0, y el coeficiente de divergencia KL y el ratio de recorte se fijan en 0.001 y 0.2.
Para ambos métodos, los puntos de control del modelo se guardan cada 100 pasos. En los casos en que el entrenamiento diverge, evaluamos en el punto de control estable más reciente según la curva de recompensa del entrenamiento; en caso contrario, se utiliza el punto de control final para la evaluación. El presupuesto máximo de acciones se establece en 4, y recuperamos los 3 pasajes principales por defecto.
Calculamos las recompensas de resultado mediante coincidencia exacta (EM). Salvo que se indique lo contrario, se utiliza PPO como algoritmo de RL predeterminado, y en la Sección 5.1 se ofrece una comparación detallada con GRPO.
C Resultados principales en el LLM de 14B
Realizamos experimentos exhaustivos utilizando los modelos Qwen2.5-14B, y los resultados se presentan en la Tabla 5. Como se muestra, SEARCH-R1 supera consistentemente a todos los métodos de referencia en las métricas evaluadas. Además, observamos que aumentar el tamaño del modelo conduce a mejoras de rendimiento consistentes con SEARCH-R1, lo que destaca los beneficios del escalado del tamaño del LLM en nuestro enfoque.
D Estudio del enmascaramiento de la pérdida de tokens recuperados
En la Sección 3.1, introdujimos una estrategia de enmascaramiento de la pérdida para los tokens recuperados con el fin de mitigar comportamientos de optimización indeseables durante el entrenamiento. Para evaluar su impacto, realizamos experimentos utilizando el modelo Qwen2.5-3b/7b-base, comparando la dinámica de entrenamiento con y sin enmascaramiento de la pérdida de tokens recuperados. Como se ilustra en la Figura 3, incorporar el mecanismo de enmascaramiento conduce a una optimización más estable y a un mejor rendimiento del modelo. Los resultados cuantitativos de la Tabla 6 confirman además que SEARCH-R1, cuando se entrena con enmascaramiento de la pérdida en los tokens recuperados, supera consistentemente a su contraparte sin enmascaramiento.
E LLM base frente a LLM ajustados con instrucciones
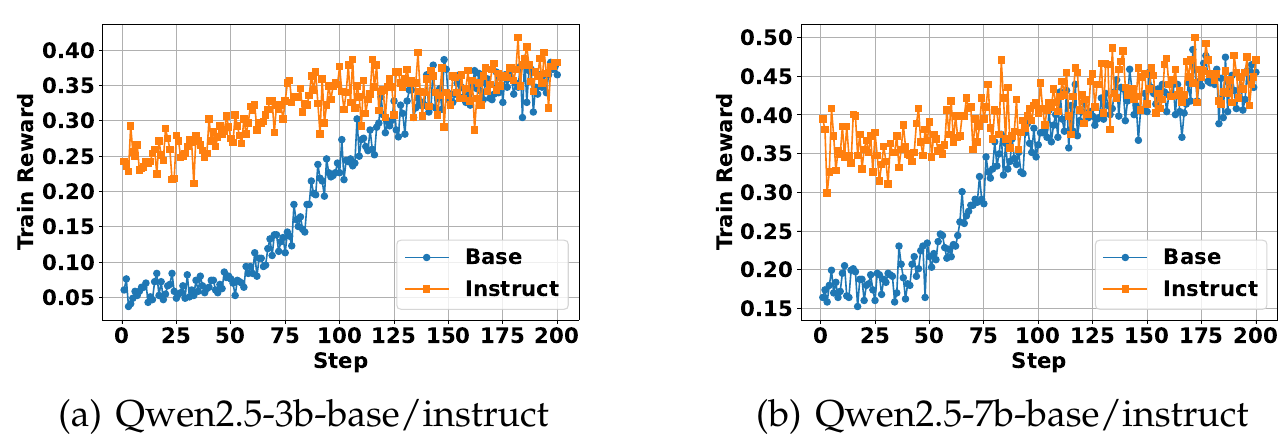
Investigamos la dinámica de entrenamiento de SEARCH-R1 tanto en LLM base como en LLM ajustados con instrucciones, utilizando dos escalas de modelo: Qwen2.5-3B y Qwen2.5-7B. Como se muestra en la Figura 4,
| Métodos | QA general | QA multirrespuesta | ||||||
| NQ† | TriviaQA* | PopQA* | HotpotQA† | 2wiki* | Musique* | Bamboolge* | Prom. | |
| Qwen2.5-14b-Base/Instruct | ||||||||
| Inferencia directa | 0,198 | 0,531 | 0,184 | 0,217 | 0,253 | 0,045 | 0,160 | 0,227 |
| CoT | 0,190 | 0,495 | 0,148 | 0,269 | 0,297 | 0,054 | 0,432 | 0,269 |
| IRCoT | 0,114 | 0,375 | 0,166 | 0,230 | 0,248 | 0,102 | 0,312 | 0,221 |
| Search-o1 | 0,347 | 0,635 | 0,241 | 0,268 | 0,161 | 0,099 | 0,416 | 0,310 |
| RAG | 0,327 | 0,585 | 0,376 | 0,279 | 0,160 | 0,051 | 0,192 | 0,281 |
| SFT | 0,361 | 0,467 | 0,150 | 0,248 | 0,278 | 0,089 | 0,160 | 0,250 |
| R1-base | 0,369 | 0,626 | 0,270 | 0,306 | 0,326 | 0,117 | 0,488 | 0,357 |
| R1-instruct | 0,334 | 0,628 | 0,253 | 0,294 | 0,325 | 0,108 | 0,432 | 0,339 |
| Search-R1-base | 0,486 | 0,676 | 0,480 | 0,468 | 0,470 | 0,241 | 0,528 | 0,479 |
| Search-R1-instruct | 0,424 | 0,660 | 0,442 | 0,436 | 0,379 | 0,210 | 0,480 | 0,433 |
los modelos ajustados con instrucciones exhiben una convergencia más rápida y se benefician de un rendimiento inicial más alto en relación con sus contrapartes base. A pesar de esta ventaja temprana, el rendimiento final de ambos tipos de modelo converge a un nivel similar tras el entrenamiento. Estos resultados indican que, si bien el ajuste con instrucciones facilita un aprendizaje temprano más eficiente en tareas de razonamiento más búsqueda, el aprendizaje por refuerzo es capaz de cerrar la brecha de rendimiento, permitiendo en última instancia que los modelos base alcancen resultados comparables.
F Comparación de PPO y GRPO en SEARCH-R1
Evaluamos la eficacia de SEARCH-R1 bajo dos algoritmos de aprendizaje por refuerzo: PPO y GRPO, utilizando tanto Qwen2.5-3B como Qwen2.5-7B como modelos subyacentes. La Figura 5 ilustra la dinámica de entrenamiento. Nuestro análisis arroja las siguientes observaciones clave: (1) GRPO exhibe una convergencia más rápida que PPO en todas las configuraciones, atribuido al hecho
| Método | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | Prom. |
| Qwen2.5-7b-Base | ||||||||
| SEARCH-R1 con máscara | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1 sin máscara | 0,388 | 0,567 | 0,391 | 0,325 | 0,321 | 0,108 | 0,304 | 0,343 |
| Qwen2.5-3b-Base | ||||||||
| SEARCH-R1 con máscara | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| SEARCH-R1 sin máscara | 0,346 | 0,484 | 0,365 | 0,241 | 0,244 | 0,053 | 0,104 | 0,262 |
Tabla 6: El rendimiento de SEARCH-R1 con y sin enmascaramiento de la pérdida de tokens recuperados. El LLM entrenado con enmascaramiento de la pérdida de tokens recuperados logra un rendimiento consistentemente mejor. (RL: PPO) de que PPO depende de una función de valor separada (crítico), que requiere una fase de calentamiento inicial antes de que se puedan realizar actualizaciones efectivas de la política. (2) PPO proporciona un comportamiento de entrenamiento más estable, como se evidencia en la Figura 5, donde GRPO experimenta un colapso de la recompensa a lo largo de pasos de entrenamiento prolongados, mientras que PPO mantiene la estabilidad en todo momento. (3) PPO y GRPO logran un rendimiento de recompensa final comparable, lo que sugiere que, a pesar de los compromisos entre velocidad de convergencia y estabilidad, ambos métodos son eficaces para optimizar SEARCH-R1.
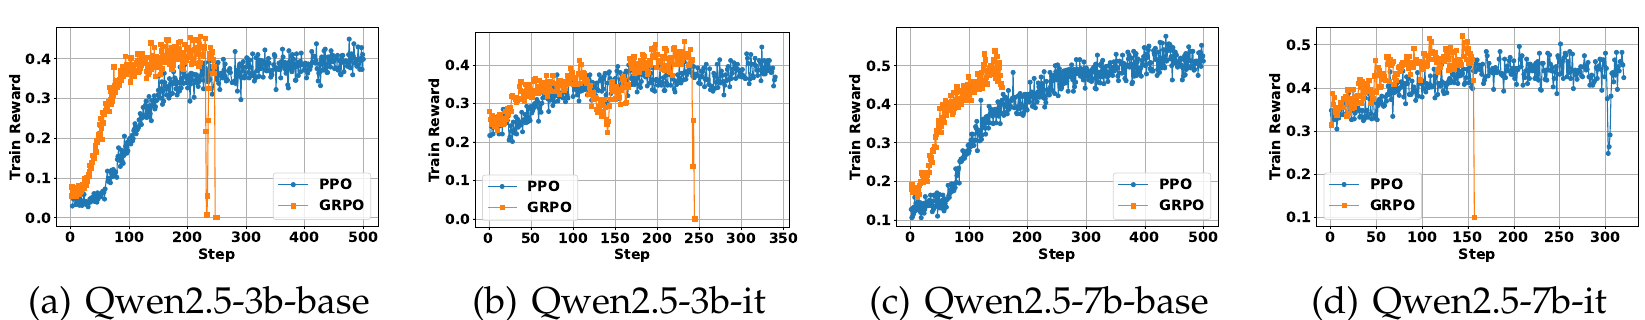
Figura 5: Dinámica de entrenamiento de SEARCH-R1 con PPO y GRPO como método de RL base en cuatro LLM. GRPO generalmente converge más rápido pero puede exhibir inestabilidad después de entrenarse durante un número de pasos, mientras que PPO proporciona una optimización más estable pero converge a un ritmo más lento. PPO y GRPO logran un rendimiento de recompensa final comparable.
G Estudio del número de pasajes recuperados en el entrenamiento de SEARCH-R1
Investigamos el impacto del número de pasajes recuperados (top-k) en la dinámica de entrenamiento de SEARCH-R1. Mientras que nuestros experimentos principales adoptan top-k = 3 siguiendo a Lin et al. (2023), realizamos estudios adicionales con top-k establecido en 1, 3 y 5 para comprender mejor su influencia.
La Figura 6 presenta las curvas de recompensa del entrenamiento bajo estas configuraciones. Observamos que las tres configuraciones exhiben trayectorias de entrenamiento generales similares. Notablemente, top-k = 5 logra la convergencia inicial más rápida, alcanzando la recompensa de entrenamiento más alta dentro de los primeros 200 pasos. Sin embargo, su recompensa disminuye gradualmente y se vuelve más inestable a medida que avanza el entrenamiento. En contraste, top-k = 1 y 3 demuestran mejoras más consistentes a lo largo del entrenamiento, con top-k = 3 alcanzando en última instancia la recompensa más alta después de 500 pasos.
Los resultados de la evaluación en el paso 500 se resumen en la Tabla 7, donde top-k = 3 produce el mejor rendimiento general. Hipotetizamos dos factores contribuyentes: (1) top-k = 1 probablemente sufre de un bajo recall de recuperación, limitando la capacidad de proporcionar información contextual relevante; (2) top-k = 5 introduce una menor precisión debido a la inclusión de pasajes ruidosos o irrelevantes (Jin et al., 2024), lo que no solo degrada el rendimiento de inferencia sino que también puede afectar negativamente el entrenamiento de RL—desalentando al modelo de aprovechar el contenido recuperado cuando aprende que el contexto adicional a menudo es inútil o engañoso.
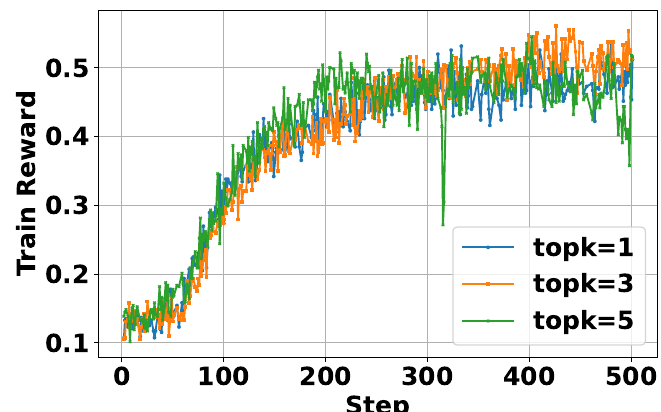
Figura 6: La dinámica de entrenamiento de SEARCH-R1 con un número diferente de pasajes recuperados. (LLM: Qwen2.5-7b-base, RL: PPO)
Tabla 7: Estudio del número de pasajes recuperados en el entrenamiento de SEARCH-R1. (LLM: Qwen2.5-7b-base; RL: PPO)
| Método | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolge | Prom. |
| topk=1 | 0,426 | 0,614 | 0,422 | 0,393 | 0,296 | 0,146 | 0,328 | 0,375 |
| topk=3 | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| topk=5 | 0,479 | 0,634 | 0,440 | 0,394 | 0,343 | 0,156 | 0,352 | 0,400 |
H Estudio del tamaño de grupo en el entrenamiento de SEARCH-R1 (GRPO)
En nuestro experimento principal, establecemos el tamaño de grupo para SEARCH-R1 (GRPO) en 5, siguiendo la configuración de Sheng et al. (2024). Para investigar más a fondo el impacto del tamaño de grupo en la dinámica de entrenamiento, realizamos un estudio de ablación con tamaños de grupo de 1, 3 y 5. Notablemente, cuando el tamaño de grupo se establece en 1, GRPO se reduce al algoritmo estándar REINFORCE (Williams, 1992).
Entrenamos los LLM durante 500 pasos, guardando puntos de control del modelo cada 100 pasos. Si el modelo colapsa durante el entrenamiento, utilizamos el último punto de control válido para la evaluación; en caso contrario, evaluamos el punto de control en el paso 500.
La dinámica de entrenamiento bajo diferentes configuraciones de tamaño de grupo se ilustra en la Figura 7. Observamos que un tamaño de grupo mayor generalmente conduce a una convergencia más rápida pero también puede aumentar el riesgo de colapso debido a la inestabilidad inherente del aprendizaje por refuerzo.
Los resultados de la evaluación en las diferentes configuraciones se resumen en la Tabla 8. Mientras que los tamaños de grupo más grandes pueden acelerar la convergencia y lograr recompensas de entrenamiento más altas, los tamaños de grupo más pequeños (p. ej., tamaño = 1) permiten un entrenamiento más estable y una mejor generalización. Esto se refleja en un rendimiento superior en tareas no vistas, destacando un compromiso entre velocidad de aprendizaje y estabilidad en el entrenamiento de GRPO.
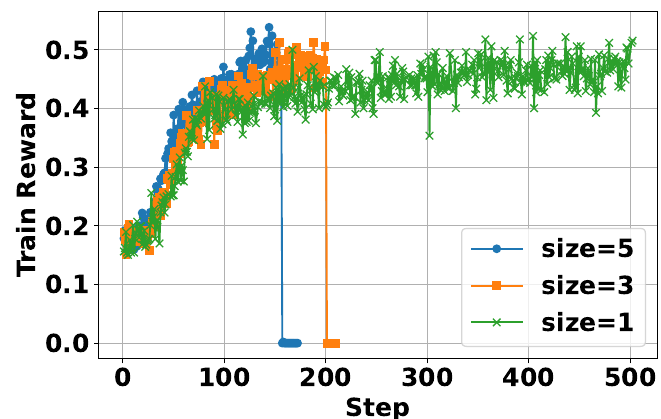
Figura 7: La dinámica de entrenamiento de SEARCH-R1 (GRPO) con diferente tamaño de grupo. (LLM: Qwen2.5-7b-base)
| Método | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | Prom. |
| size=1 | 0,463 | 0,605 | 0,449 | 0,392 | 0,413 | 0,163 | 0,384 | 0,410 |
| size=3 | 0,385 | 0,580 | 0,396 | 0,329 | 0,333 | 0,117 | 0,400 | 0,363 |
| size=5 | 0,395 | 0,560 | 0,388 | 0,326 | 0,297 | 0,125 | 0,360 | 0,350 |
Tabla 8: El estudio del tamaño de grupo de SEARCH-R1 (GRPO) en siete conjuntos de datos. (LLM: Qwen2.5-7b-base)
I Comparación entre R1 y SEARCH-R1: un estudio de caso
| Pregunta: Curious es una fragancia para mujer de una cantante nacida en qué ciudad y estado? | ||||||||
| Verdad de referencia: McComb, Mississippi | ||||||||
| R1: | ||||||||
| <l>La cantante es Beyoncé, que nació en Houston, Texas. </l> | ||||||||
| <l>Houston </l> | ||||||||
| <l>Necesito averiguar en qué ciudad y estado nació una cantante por quien se creó la fragancia para mujer "Curious". </l> | ||||||||
| <l>Información sobre la fragancia Curious </search> | ||||||||
| <l>Doc 1(Título: "Curious (fragrance)") Curious (fragrance) Curious es una fragancia para mujer de Britney Spears para Elizabeth Arden, y es el primer perfume respaldado por Britney Spears, anterior a "Fantasy". Según los informes, Spears ganó 52 millones de dólares con el respaldo. "Curious" se lanzó en septiembre de 2004 y fue muy exitosa internacionalmente. Fue la fragancia número uno de 2004 en tiendas departamentales, y en 2005, "Curious" fue honrada por la Fragrance Foundation como la Mejor Fragancia Femenina. La fragancia es una esencia floral blanca. Sus notas son magnolia de Luisiana, pera Anjou dorada, flor de loto, tuberosa, jazmín estrellado, ciclamen rosa, almizcle infusionado con vainilla, sándalo y maderas rubias. Elizabeth Arden... </information></td></tr><tr><td colspan="9"><l>Necesito averiguar en qué ciudad y estado nació Britney Spears, la cantante detrás de la fragancia "Curious". </l></td></tr><tr><td colspan="9"><l>Lugar de nacimiento de Britney Spears </search></td></tr><tr><td colspan="9"><l>Doc 1(Título: "Britney Spears") la artista femenina de álbumes más vendidos de la década de 2000. En 2004, lanzó una marca de perfumes con Elizabeth Arden, Inc., cuyas ventas superaron los 1.500 millones de dólares. Spears nació en McComb, Mississippi, la segunda hija de Lynne Irene Bridges y James Parnell Spears. Su abuela materna, Lillian Portell, era inglesa (nacida en Londres), y uno de los tatarabuelos maternos de Spears era maltés. Sus hermanos son Bryan James y Jamie Lynn. Britney nació en el Cinturón de la Biblia, donde el protestantismo evangélico socialmente conservador ejerce una influencia religiosa particularmente fuerte. Spears fue bautizada en la Convención Bautista del Sur, pero más adelante en su vida estudió... </information> | ||||||||
| <l>Dado que Britney Spears nació en McComb, Mississippi, necesito averiguar qué ciudad y estado es ese. </l> | ||||||||
| <l>Ubicación de McComb, Mississippi </search> | ||||||||
| <l>Doc 1(Título: "McComb, Mississippi") McComb, Mississippi McComb es una ciudad en el condado de Pike, Mississippi, Estados Unidos, aproximadamente al sur de Jackson. Según el censo de 2010, la ciudad tenía una población total de 12.790 habitantes. Es la ciudad principal del Área Estadística Micropolitana de McComb, Mississippi. McComb fue fundada en 1872 después de que Henry Simpson McComb, del Ferrocarril de Nueva Orleans, Jackson y Great Northern, un predecesor del Ferrocarril Central de Illinois (ahora parte del Ferrocarril Nacional Canadiense), decidiera trasladar los talleres de mantenimiento del ferrocarril lejos de Nueva Orleans, Luisiana, para evitar las atracciones de los salones de esa ciudad. El ferrocarril compró terrenos en el condado de Pike... </information> | ||||||||
| <l>He encontrado que Britney Spears nació en McComb, Mississippi. Dado que la pregunta pide la ciudad y el estado, solo necesito confirmar el estado, que ya conozco por la búsqueda anterior. </l> | ||||||||
| <l>McComb, Mississippi </answer> |
Tabla 9: Un estudio de caso de R1 y SEARCH-R1.
Para obtener una comprensión más profunda de SEARCH-R1, realizamos un estudio de caso utilizando Qwen2.5-7B-Base, comparando su comportamiento con RL sin un motor de búsqueda (Guo et al., 2025). Los resultados se presentan en la Tabla 20, revelando las siguientes observaciones clave: El razonamiento y la recuperación intercalados mejoran el análisis del problema: SEARCH-R1 permite al LLM realizar un razonamiento profundo con recuperación de múltiples turnos, mientras que el RL sin búsqueda se basa únicamente en el conocimiento interno de los modelos. Al incorporar pasajes recuperados, SEARCH-R1 permite al LLM refinar iterativamente su razonamiento, lo que conduce a respuestas más informadas y precisas.
Autoverificación mediante recuperación iterativa: Observamos que después de la segunda ronda de recuperación, el LLM ya ha reunido información suficiente para responder la pregunta. Sin embargo, SEARCH-R1 realiza un paso de recuperación adicional para autoverificar su conclusión, reforzando aún más su confianza en la respuesta final. Este fenómeno concuerda con los hallazgos del RL de razonamiento de LLM sin recuperación (Guo et al., 2025), destacando cómo el RL puede fomentar un razonamiento impulsado por la verificación incluso en entornos aumentados con búsqueda.
J Más estudios de caso de SEARCH-R1
Para obtener una comprensión más profunda del comportamiento y las capacidades del LLM entrenado, realizamos estudios de caso adicionales sobre SEARCH-R1. Específicamente, analizamos el modelo ajustado a partir de Qwen2.5-7B-Base utilizando Optimización de Política Proximal (PPO) como algoritmo de aprendizaje por refuerzo subyacente. Los resultados se muestran en las siguientes tablas.
Tabla 10: Estudio de caso 1 de SEARCH-R1 (exitoso): SEARCH-R1 realiza razonamiento de múltiples pasos, búsqueda, con autoverificación y finalmente responde la pregunta.
Pregunta: ¿Qué tipo de profesión tienen en común Chris Jericho y Gary Barlow? Verdad de referencia: músico BÚSQUEDA- R1: <think> Necesito encontrar el tipo de profesión que Chris Jericho y Gary Barlow tienen en común. Lo buscaré. </think><search> profesión de Chris Jericho y Gary Barlow </search> <information> Doc 2(Título: "Chris Jericho") "Do You Wanna Start a War" (2014) y "Judas" (2017) están compuestos enteramente o predominantemente por composiciones originales. También ha aparecido en numerosos programas de televisión a lo largo de los años, habiendo competido en la temporada 2011 de "Dancing With the Stars", durando hasta la sexta semana. Antes de eso, Jericho presentó el programa de concursos de ABC "Downfall" y los Revolver Golden Gods Awards. Christopher Keith Irvine nació el 9 de noviembre de 1970 en Manhasset, Nueva York, pero creció en Winnipeg. Su padre, el jugador de hockey sobre hielo Ted Irvine, había estado jugando para los New York Rangers en el momento de su nacimiento. ... </information>Necesito averiguar si Gary Barlow tiene alguna de estas profesiones en común. </think><search> profesión de Gary Barlow </search> <information> Doc 1(Título: "Gary Barlow") éxitos, doce sencillos número uno y siete álbumes número uno con Take That. Barlow ha recibido seis premios Ivor Novello de la British Academy of Songwriters, Composers and Authors, incluido el premio por Servicios Sobresalientes a la Música Británica. Ha vendido más de 50 millones de discos en todo el mundo. Barlow nació el 20 de enero de 1971 en Frodsham, Cheshire, el segundo hijo de Colin (fallecido el 15 de octubre de 2009) y Marjorie Barlow. En la autobiografía de Barlow, relata que su amor por la música comenzó a una edad temprana, y se describe a sí mismo como "uno de esos niños que siempre está bailando frente al televisor mirando a ... </information>Necesito averiguar si hay una profesión en común entre Chris Jericho y Gary Barlow. </think><search> profesión en común de Chris Jericho y Gary Barlow </search> <information> Doc 1(Título: "Gary Barlow") Gary Barlow Gary Barlow (nacido el 20 de enero de 1971) es un cantante, compositor, músico y productor discográfico inglés. Es mejor conocido como el vocalista principal del grupo de pop británico Take That. Barlow también se desempeñó como juez principal de "The X Factor UK" en 2011, 2012 y 2013 y de "Let It Shine" en 2017. Barlow es uno de los compositores más exitosos de Gran Bretaña, habiendo escrito catorce sencillos número uno y veinticuatro éxitos entre los 10 primeros. Como artista solista ha tenido tres sencillos número uno, seis sencillos entre los 10 primeros y dos álbumes número uno, y además ha tenido diecisiete entre los 5 primeros ... </information><think> Descubrí que Gary Barlow es cantante, compositor, músico y productor discográfico. Ahora necesito averiguar si Chris Jericho tiene alguna de estas profesiones en común. </think><search> profesión de Chris Jericho </search> <information> Doc 1(Título: "Chris Jericho") Chris Jericho Christopher Keith Irvine (nacido el 9 de noviembre de 1970), más conocido por su nombre de ring Chris Jericho, es un luchador profesional, músico, autor y actor nacido en Estados Unidos. Actualmente lucha para New Japan Pro-Wrestling (NJPW), donde es el actual Campeón Intercontinental de la IWGP en su primer reinado. Jericho también hace apariciones esporádicas para WWE en la marca SmackDown, con la que ha trabajado desde 1999. Dentro de la lucha libre profesional, es conocido por su excéntrica persona de estrella de rock. Jericho es considerado uno de los mejores luchadores profesionales de todos los tiempos. Durante la década de 1990, Jericho actuó para las organizaciones estadounidenses Extreme Championship ... </information><think> Descubrí que Chris Jericho es un luchador profesional, músico, autor y actor. Ahora puedo compararlo con las profesiones de Gary Barlow. Descubrí que Gary Barlow es cantante, compositor, músico y productor discográfico. La profesión en común entre Chris Jericho y Gary Barlow es músico. </think><answer> músico </answer>
| Pregunta: ¿Cuál era el título del álbum de estudio debut de Weezer que contenía los éxitos Buddy Holly y Undone – The Sweater Song? |
| Respuesta de referencia: The Blue Album |
| SEARCH-R1: |
| <think> Necesito encontrar el título del álbum de estudio debut de Weezer que contenía las canciones exitosas "Buddy Holly" y "Undone – The Sweater Song". Lo buscaré. </think> |
| <search> álbum de estudio debut de Weezer que contenía los éxitos Buddy Holly y Undone – The Sweater Song </search> |
| <information> Doc 1(Título: "Discografía de Weezer") Discografía de Weezer La discografía de Weezer, una banda de rock estadounidense, consta de 11 álbumes de estudio, dos álbumes recopilatorios, un álbum de vídeo, seis EP, 28 sencillos y 24 vídeos musicales. El álbum de estudio debut homónimo de Weezer, a menudo conocido como "The Blue Album", se publicó en mayo de 1994 a través de DGC Records. El álbum fue un enorme éxito comercial, alcanzó el puesto número 16 en el "Billboard" 200 de EE. UU. y dio lugar a los sencillos "Undone – The Sweater Song" y "Buddy Holly", ambos responsables de impulsar a Weezer hacia el éxito mainstream con la ayuda de los vídeos musicales dirigidos por Spike Jonze. ... <information> |
| <think> He descubierto que el álbum de estudio debut de Weezer que contenía las canciones exitosas "Buddy Holly" y "Undone – The Sweater Song" es el álbum homónimo, a menudo conocido como "The Blue Album". Ahora puedo proporcionar la respuesta. </think> |
| <answer> Weezer </answer> |
</think></search></search></information>
SEARCH-R1: <think> Necesito averiguar cuya muerte, dramatizada en una obra de teatro, ayudó a poner fin a la pena de muerte en Australia. Lo buscaré. </think>
<search> cuya muerte dramatizada en una obra de teatro ayudó a poner fin a la pena de muerte en Australia </search>
<information> Doc 3(Título: "Ronald Ryan") Ronald Ryan Ronald Joseph Ryan (21 de febrero de 1925 - 3 de febrero de 1967) fue la última persona ejecutada legalmente en Australia. Ryan fue declarado culpable de disparar y matar al guardia George Hodson durante una fuga de la prisión de Pentridge, Victoria, en 1965. El ahorcamiento de Ryan se enfrentó a algunas de las mayores protestas públicas en la historia de Australia y llevó al fin de la pena capital. La pena de muerte fue abolida en todos los estados para 1985. Ronald Edmond Thompson nació en el Royal Women's Hospital en el suburbio interior de Carlton, Melbourne, hijo de John Ronald Ryan y Cecilia Thompson (de soltera ... </information>
<think> Descubrí que la muerte de Ronald Ryan, dramatizada en una obra de teatro, ayudó a poner fin a la pena de muerte en Australia. Ahora puedo proporcionar la respuesta. </think>
<answer> Ronald Ryan </answer>
| Pregunta: ¿Dónde se encuentran el Parque Nacional del Teide y el Parque Nacional de Garajonay? |
| Verdad de referencia: Islas Canarias, España |
| SEARCH-R1: |
| <think> Necesito averiguar dónde se encuentran el Parque Nacional del Teide y el Parque Nacional de Garajonay. Lo buscaré. </think> |
| <search> ubicación del Parque Nacional del Teide y el Parque Nacional de Garajonay </search> |
| <information> Doc 1(Título: "Parque Nacional de Garajonay") decidieron quitarse la vida. Parque Nacional de Garajonay Parque Nacional de Garajonay (,) está situado en el centro y norte de la isla de La Gomera, una de las Islas Canarias (España). Fue declarado parque nacional en 1981 y Patrimonio de la Humanidad por la UNESCO en 1986. Ocupa 40 km (15 millas cuadradas) y se extiende por cada uno de los seis municipios de la isla. Casi 450.000 turistas visitan el parque cada año. Hay alojamiento para turistas justo fuera de los límites del parque. El parque lleva el nombre de la formación rocosa de Garajonay, el punto más alto ... </information> |
| <think> Descubrí que el Parque Nacional de Garajonay está situado en el centro y norte de la isla de La Gomera, una de las Islas Canarias (España). Ahora necesito encontrar la ubicación del Parque Nacional del Teide. </think> |
| <search> ubicación del Parque Nacional del Teide </search> |
| <information> Doc 1(Título: "Parque Nacional del Teide") Parque Nacional del Teide Parque Nacional del Teide (,) es un parque nacional situado en Tenerife (Islas Canarias, España). El parque nacional se centra en el Monte Teide, la montaña más alta de España (3.718 metros de altura), además, el volcán más alto de las islas del Océano Atlántico y el tercer volcán más alto del mundo desde su base en el fondo del océano (7.500 metros de altura). Su estatus de parque nacional se aprobó el 22 de enero de 1954, lo que lo convierte en el tercer parque nacional más antiguo de España. El Pico Viejo, también incluido dentro de los límites del parque nacional, es el segundo volcán más alto de las Islas Canarias con ... </information> |
| <think> Descubrí que el Parque Nacional del Teide está situado en Tenerife (Islas Canarias, España). Ahora tengo las ubicaciones tanto del Parque Nacional del Teide como del Parque Nacional de Garajonay. </think> |
| <answer> Islas Canarias, España </answer> |
| Pregunta: ¿Quién dirigió la película que protagonizaron Steve Cochran y el actor que interpretó al sheriff Roy Coffee en «Bonanza»? |
| Respuesta correcta: Louis King |
| SEARCH-R1: <think> Necesito averiguar quién dirigió la película que protagonizaron Steve Cochran y el actor que interpretó al sheriff Roy Coffee en «Bonanza». Lo buscaré. </think> <search> quién dirigió la película que protagonizaron Steve Cochran y el actor que interpretó al sheriff Roy Coffee en «Bonanza» </search> <information> Doc 2(Título: «Ray Teal») Ray Teal Ray Teal (12 de enero de 1902-2 de abril de 1976) fue un actor estadounidense que apareció en más de 250 películas y unos 90 programas de televisión en sus 37 años de carrera. Su papel más duradero fue el del sheriff Roy Coffee en la serie western de NBC «Bonanza» (1960-1972). También interpretó a un sheriff en la película «Ace in the Hole» (1951). Teal nació en Grand Rapids, Míchigan. Saxofonista, se costeó sus estudios en la Universidad de California, Los Ángeles, como director de banda antes de convertirse en actor. Tras más de 15 años actuando en películas y en la televisión temprana, Teal consiguió un papel recurrente... </information> <think> He descubierto que el actor que interpretó al sheriff Roy Coffee en «Bonanza» es Ray Teal. Ahora necesito encontrar la película que protagonizaron Steve Cochran y Ray Teal. </think> <search> película que protagonizaron Steve Cochran y Ray Teal </search> <information> Doc 1(Título: «Steve Cochran») en el clásico de gánsteres «White Heat» (1949). Apareció junto a Mayo. Warner Bros. acabaría haciéndose cargo de los contratos de Cochran y Mayo de Goldwyn. Cochran secundó a Joan Crawford en «The Damned Don't Cry» (1950), y luego recibió su primer papel protagonista en «Highway 301» (1950), interpretando a un gánster. Fue el villano frente al héroe de Gary Cooper en «Dallas» (1950), e interpretó a un miembro del Ku Klux Klan en «Storm Warning» (1951), con Ginger Rogers y Doris Day. Cochran fue el villano en «Canyon Pass» (1951), un western, y luego recibió el papel protagonista en «Inside the Walls of Folsom Prison» (1951), que inspiró... <information> <think> He descubierto que Steve Cochran protagonizó varias películas. Ahora necesito encontrar la película que también protagonizó Ray Teal. </think> <search> película que protagonizaron Steve Cochran y Ray Teal </search> <information> Doc 1(Título: «Steve Cochran») en el clásico de gánsteres «White Heat» (1949). Apareció junto a Mayo. Warner Bros. acabaría haciéndose cargo de los contratos de Cochran y Mayo de Goldwyn. Cochran secundó a Joan Crawford en «The Damned Don't Cry» (1950), y luego recibió su primer papel protagonista en «Highway 301» (1950), interpretando a un gánster. Fue el villano frente al héroe de Gary Cooper en «Dallas» (1950), e interpretó a un miembro del Ku Klux Klan en «Storm Warning» (1951), con Ginger Rogers y Doris Day. Cochran fue el villano en «Canyon Pass» (1951), un western, y luego recibió el papel protagonista en «Inside the Walls of Folsom Prison» (1951), que inspiró... <information> <think> He descubierto que Steve Cochran protagonizó varias películas. Ahora necesito encontrar la película que también protagonizó Ray Teal. Buscaré la película que protagonizaron tanto Steve Cochran como Ray Teal. </think> <search> película dirigida por Sam Peckinpah que protagonizaron Steve Cochran y Ray Teal </search> <information> Doc 1(Título: «Sam Peckinpah») Repleta de explosiones, persecuciones de coches y tiroteos intensos, la película se convirtió en el mayor éxito financiero de Peckinpah hasta la fecha, recaudando más de 25 millones de dólares en taquilla. Aunque estrictamente un producto comercial, los toques creativos de Peckinpah abundan por todas partes, sobre todo durante la intrincadamente editada secuencia inicial, cuando el personaje de McQueen sufre las presiones de la vida en prisión. La película sigue siendo popular y fue rehacida en 1994, protagonizada por Alec Baldwin y Kim Basinger. El año 1973 marcó el comienzo del período más difícil de la vida y carrera de Peckinpah. Mientras aún rodaba «The Getaway» en El Paso, Texas, Peckinpah cruzó clandestinamente la frontera... </information> <think> He descubierto que Sam Peckinpah dirigió la película «The Wild Bunch», que protagonizaron Steve Cochran y Ray Teal. </think> <answer> Sam Peckinpah </answer> |
| Pregunta: ¿Dónde tiene su sede la empresa que distribuyó el sencillo «Revenge» de XXXTentacion? |
| Respuesta correcta: San Francisco, California |
| SEARCH-R1: |
| <think> Necesito encontrar la empresa que distribuyó el sencillo «Revenge» de XXXTentacion. La buscaré. </think> |
| <search> empresa distribuidora del sencillo «Revenge» de XXXTentacion </search> |
| <information> Doc 1(Título: «Revenge (mixtape de XXXTentacion)») Revenge (mixtape de XXXTentacion) Revenge es un mixtape del rapero estadounidense XXXTentacion, lanzado el 16 de mayo de 2017 por Empire Distribution. Consta de ocho canciones previamente lanzadas que estaban disponibles para streaming en SoundCloud de XXXTentacion. Fue precedido por el sencillo principal «Look at Me», que alcanzó el puesto número 34 en el Billboard Hot 100 de EE. UU. El sencillo principal del mixtape, llamado «Look at Me», se estrenó el 31 de diciembre de 2015 en SoundCloud. La canción fue lanzada posteriormente en iTunes como sencillo el 29 de enero de 2016 hasta que más tarde fue relanzada para descarga digital nuevamente con una versión remasterizada y limpia... </information> |
| <think> Descubrí que la empresa que distribuyó el sencillo «Revenge» de XXXTentacion es Empire Distribution. Ahora necesito encontrar la ubicación de la empresa. </think> |
| <search> ubicación de Empire Distribution </search> |
| <information> Doc 1(Título: «Empire Distribution») Empire Distribution EMPIRE Distribution, Records and Publishing Inc. (comercializada como EMPIRE) es una empresa de distribución y sello discográfico estadounidense fundada en 2010 por Ghazi Shami y con sede central en San Francisco, California, con oficinas en la ciudad de Nueva York y Atlanta. Ha lanzado álbumes de diversos géneros como R&B, reggae, rock, gospel, latino, country y pop, pero se centra predominantemente en la música hip hop. Empresas y artistas como Top Dawg Entertainment (Kendrick Lamar, Schoolboy Q, Ab-Soul), Steel Wool (Anderson Paak, Watsky, Jez Dior), Jazz Anderson, Cody Wolfe, Kane Brown, Funk Volume (Dizzy Wright, Jarren Benton), ESGN (Freddie Gibbs),... </information> |
| <think> Descubrí que la empresa Empire Distribution tiene su sede en San Francisco, California. Ahora puedo proporcionar la respuesta. </think> |
| <answer> San Francisco, California </answer> |
| Pregunta: Esta expansión del artículo de revista de 2008 «Is Google Making Us Stoopid?» fue finalista de qué premio. |
| Verdad de referencia: Premio Pulitzer |
| SEARCH-R1: |
| <think>Necesito averiguar qué expansión del artículo de revista de 2008 «Is Google Making Us Stoopid?» fue finalista de qué premio. Lo buscaré. </think> |
| <search>Esta expansión del artículo de revista de 2008 «Is Google Making Us Stoopid?» fue finalista de qué premio </search> |
| <information>Doc 1(Título: «Is Google Making Us Stupid?») Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains (alternativamente Is Google Making Us Stupid?) es un artículo de revista del escritor de tecnología Nicholas G. Carr, y es muy crítico con el efecto de Internet sobre la cognición. Se publicó en la edición de julio/agosto de 2008 de la revista «The Atlantic» como reportaje de portada de seis páginas. El argumento principal de Carr es que Internet podría tener efectos perjudiciales sobre la cognición que disminuyen la capacidad de concentración y contemplación. A pesar del título, el artículo no está dirigido específicamente a Google, sino más bien al impacto cognitivo de... </information> |
| <think>Descubrí que la expansión del artículo de revista de 2008 «Is Google Making Us Stoopid?» fue finalista de un premio. Necesito averiguar de qué premio fue finalista. </think> |
| <search>de qué premio fue finalista la expansión del artículo de revista de 2008 «Is Google Making Us Stoopid?» </search> |
| <information>Doc 2(Título: «Is Google Making Us Stupid?») inconcluso y afirmó que «pasará tiempo antes de que esté claro si deberíamos lamentar las viejas formas, celebrar las nuevas o aprender a dejar de preocuparnos y amar la Red». Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains (alternativamente Is Google Making Us Stupid?) es un artículo de revista del escritor de tecnología Nicholas G. Carr, y es muy crítico con el efecto de Internet sobre la cognición. Se publicó en la edición de julio/agosto de 2008 de la revista «The Atlantic» como reportaje de portada de seis páginas. El argumento principal de Carr es que Internet podría tener efectos perjudiciales sobre la cognición que disminuyen la capacidad de concentración y contemplación. A pesar del título, el artículo no está dirigido específicamente a Google, sino más bien al impacto cognitivo de... </information> |
| <answer>National Magazine Award </answer> |
| Pregunta: ¿Quién fue pianista, Maro Ajemian o Richard C. Sarafian? |
| Respuesta correcta: Maro Ajemian |
| SEARCH-R1:<think>Necesito determinar si Maro Ajemian o Richard C. Sarafian fue pianista. Lo buscaré.</think><search> quién fue pianista, Maro Ajemian o Richard C. Sarafian </search><information> Doc 1(Título: "Maro Ajemian") Maro Ajemian Maro Ajemian (9 de julio de 1921 – 18 de septiembre de 1978) fue una pianista estadounidense. La carrera de Ajemian en la música contemporánea creció a partir de su herencia armenia. Se dio a conocer como pianista contemporánea tras interpretar el estreno en Estados Unidos del Concierto para piano de Aram Khachaturian, que eligió tocar por su herencia armenia compartida. Ajemian estudió en la Juilliard School of Music. El 14 de marzo de 1942, dio el estreno estadounidense del Concierto para piano en re bemol de Aram Khachaturian con la Juilliard Graduate Orchestra bajo la dirección de Albert Stoessel. Más tarde interpretó la pieza en una gira por todo el país. Tras sus interpretaciones de la ... </information><think> Descubrí que Maro Ajemian fue pianista. Ahora necesito comprobar si Richard C. Sarafian fue pianista o no. </think><search> quién fue Richard C. Sarafian </search><information> Doc 1(Título: "Richard C. Sarafian") Richard C. Sarafian Richard Caspar Sarafian (28 de abril de 1930 – 18 de septiembre de 2013) fue un director de televisión y cine y actor estadounidense. Acumuló una versátil carrera que abarcó más de cinco décadas como director, actor y guionista. Sarafian es conocido principalmente como el director de la película de 1971 "". Sarafian nació en la ciudad de Nueva York el 28 de abril de 1930, hijo de inmigrantes armenios. Estudió pre-derecho y pre-medicina en la Universidad de Nueva York y fue un estudiante mediocre, pero se cambió a estudiar cine, en lo que sobresalió. Dejó la universidad para unirse al Ejército de los Estados Unidos, en el que ... </information><think> Descubrí que Richard C. Sarafian fue un director de televisión y cine y actor. Ahora puedo compararlo con Maro Ajemian, que fue pianista. </think><answer> Maro Ajemian </answer> |
| Contexto de solo lectura para comprender la fuente (no es texto fuente para traducir): <answer> Ronald Ryan </answer> Tabla 20: Estudio de caso 11 de SEARCH-R1 (fallido): el LLM puede dejarse engañar por información recuperada irrelevante y proporcionar una respuesta incorrecta. Texto a traducir: Pregunta: ¿Quién es mayor, Jed Hoyer o John William Henry II? Verdad de referencia: John William Henry II |
| SEARCH-R1: <think> Necesito determinar si Jed Hoyer o John William Henry II es mayor. Buscaré sus edades.</think> <search> Jed Hoyer o John William Henry II </search> <information> Doc 1 (Título: "Jed Hoyer") récord de salvamentos en su carrera con Sam Elias y Nick Miceli. Durante su tiempo en la Universidad Wesleyan también fue iniciado en y es hermano de Delta Kappa Epsilon. Pasó el verano de 1995 en la plantilla de los Waterbury Barons de la New England Collegiate Baseball League viendo entradas en el montículo y en el campocorto. Hoyer trabajó en la oficina de admisiones y luego en la oficina de exalumnos/desarrollo, y también fue entrenador de béisbol en la universidad después de graduarse. Trabajó en el departamento de admisiones del Kenyon College antes de unirse a los Red Sox a los 28 años. Se casó con Merrill Muckerman en junio de 2010 en ... </information> <think> Descubrí que Jed Hoyer es una persona. Ahora necesito encontrar su edad y compararla con la edad de John William Henry II.</think> <search> John William Henry II </search> <information> Doc 1 (Título: "John W. Henry") la gestión de la firma había caído de 100 millones a finales de 2012. A julio de 2017, "Forbes" estimó su patrimonio neto en $2.6 mil millones. John William Henry II nació el 13 de septiembre de 1949 en Quincy, Illinois. Sus padres eran agricultores de soja, y dividió su tiempo al crecer entre Illinois y Arkansas. Su condición asmática a la edad de 15 años llevó a su familia a mudarse a Apple Valley, California. Después de graduarse de Victor Valley High School en Victorville, asistió a Victor Valley College, luego a la Universidad de California (en Riverside, ... </information> <think> Descubrí que John William Henry II nació el 13 de septiembre de 1949. Ahora necesito encontrar el año de nacimiento de Jed Hoyer para comparar.</think> <search> año de nacimiento de Jed Hoyer </search> <information> Doc 1 (Título: "Jed Hoyer") récord de salvamentos en su carrera con Sam Elias y Nick Miceli. Durante su tiempo en la Universidad Wesleyan también fue iniciado en y es hermano de Delta Kappa Epsilon. Pasó el verano de 1995 en la plantilla de los Waterbury Barons de la New England Collegiate Baseball League viendo entradas en el montículo y en el campocorto. Hoyer trabajó en la oficina de admisiones y luego en la oficina de exalumnos/desarrollo, y también fue entrenador de béisbol en la universidad después de graduarse. Trabajó en el departamento de admisiones del Kenyon College antes de unirse a los Red Sox a los 28 años. Se casó con Merrill Muckerman en junio de 2010 en ... </information> <think> Descubrí que Jed Hoyer nació el 7 de diciembre de 1973. Ahora puedo comparar su año de nacimiento con el año de nacimiento de John William Henry II.</think> <answer> John William Henry II </answer> |
| Pregunta: La antología de los más grandes superhéroes del mundo mostró a uno de los cuatro superhéroes conocidos por pronunciar la frase «¡SHAZAM!», ¿cuál era su nombre? |
| Verdad de referencia: Capitán Marvel |
| SEARCH-R1: |
| <think> Necesito encontrar el nombre de uno de los cuatro superhéroes conocidos por pronunciar la frase «SHAZAM». Lo buscaré. </think> |
| <search> La antología de los más grandes superhéroes del mundo mostró a uno de los cuatro superhéroes conocidos por pronunciar la frase «SHAZAM» </search> |
| <information> Doc 1(Título: «Shazam! (serie de televisión)») Shazam! (serie de televisión) Shazam! es un programa de televisión de acción real de media hora producido por Filmaton (el primer programa de este tipo del estudio), basado en el superhéroe Capitán Marvel, también conocido como Shazam, de la serie de cómics Whiz Comics de Fawcett Comics (ahora propiedad de DC Comics). El programa estaba protagonizado por Michael Gray como Billy Batson, un adolescente que puede transformarse en el superhéroe Capitán Marvel, interpretado originalmente por Jackson Bostwick y luego por John Davey, al pronunciar la palabra mágica «¡Shazam!». Con su guardián «Mentor» (Les Tremayne), Billy recorre el país en una autocaravana Dodge Open Road de 1973, buscando injusticias que resolver. ... </information> |
| <think> He descubierto que la antología de los más grandes superhéroes del mundo mostró a uno de los cuatro superhéroes conocidos por pronunciar la frase «SHAZAM». Ahora necesito encontrar sus nombres. </think> |
| <search> cuatro superhéroes conocidos por pronunciar la frase «SHAZAM» </search> |
| <information> Doc 1(Título: «Capitán Marvel (DC Comics)») Capitán Marvel (DC Comics) Capitán Marvel, también conocido como Shazam (), es un superhéroe ficticio de cómics que aparece en publicaciones de la editorial estadounidense DC Comics. El dibujante C. C. Beck y el escritor Bill Parker crearon el personaje en 1939. Capitán Marvel apareció por primera vez en «Whiz Comics» #2 (portada fechada en febrero de 1940), publicado por Fawcett Comics. Es el álter ego de Billy Batson, un niño que, al pronunciar la palabra mágica «SHAZAM» (acrónimo de seis «ancianos inmortales»: Solomon, Hercules, Atlas, Zeus, Achilles y Mercury), puede transformarse en un adulto con disfraz y los poderes de fuerza sobrehumana, velocidad, vuelo y otros ... </information> |
| <think> He descubierto que uno de los cuatro superhéroes conocidos por pronunciar la frase «SHAZAM» es Capitán Marvel (también conocido como Shazam). Ahora necesito encontrar a los otros tres superhéroes. </think> |
| <search> otros tres superhéroes conocidos por pronunciar la frase «SHAZAM» </search> |
| <information> Doc 2(Título: «Fawcett Comics») Fawcett Comics Fawcett Comics, una división de Fawcett Publications, fue una de las varias editoriales de cómics exitosas durante la Edad Dorada de los cómics en la década de 1940. Su personaje más popular era Capitán Marvel, el álter ego del reportero de radio Billy Batson, que se transformaba en el héroe siempre que decía la palabra mágica «¡Shazam!». Otros personajes publicados por Fawcett incluyen Captain Video, Hopalong Cassidy, Ibis the Invincible, Bulletman y Bulletgirl, Spy Smasher, Captain Midnight, Phantom Eagle, Mister Scarlet y Pinky, Minute-Man, Commando Yank y Golden Arrow. Aparte de los cómics de superhéroes más conocidos, Fawcett también publicó una línea de corta vida de ... </information> |
| <think> He descubierto que uno de los cuatro superhéroes conocidos por pronunciar la frase «SHAZAM» es Capitán Marvel (también conocido como Shazam). Ahora necesito encontrar a los otros tres superhéroes. Los buscaré. </think> |
| <search> otros tres superhéroes conocidos por pronunciar la frase «SHAZAM» </search> |
| <information> Doc 3(Título: «Capitán Marvel (DC Comics)») serie de eventos crossover. Es el álter ego superpoderoso de Alexander Luthor de Tierra-3. En la historia, el Crime Syndicate (análogos malvados de la Justice League de Tierra-3) ha traído a Alexander Luthor, su prisionero, con ellos a Prime Earth, donde residen la Justice League y otros héroes. Lex Luthor de Prime Earth y su equipo se infiltran en la Justice League Watchtower, donde el Syndicate tiene a Alexander como rehén, y le quitan la cinta adhesiva de la boca, permitiendo a Alexander pronunciar la palabra mágica «¡Mazahs!» y transformarse en su musculoso y muy poderoso álter ego. Mientras que el Shazam de Prime Earth es conocido por compartir sus poderes ... </information> |
| <think> He descubierto que uno de los cuatro superhéroes conocidos por pronunciar la frase «SHAZAM» es Capitán Marvel (también conocido como Shazam). Los otros tres superhéroes no se mencionan en el resultado de la búsqueda. Proporcionaré la respuesta basándome en la información que tengo. </think> |
| <answer> Capitán Marvel </answer> |
Tabla 20: Estudio de caso 11 de SEARCH-R1 (fallido): el LLM puede dejarse inducir a error por información recuperada irrelevante y proporcionar una respuesta incorrecta.
Pregunta: ¿Quién fue el ganador de la temporada de The Rap Game en la que una concursante llamada Lady Lesharr figuraba como una de sus influencias?
Verdad de referencia: Mani
SEARCH-R1: <think> Necesito encontrar al ganador de la temporada de The Rap Game en la que una concursante llamada Lady Lesharr figuraba como una de sus influencias. Lo buscaré. </think>
<search> quién fue el ganador de la temporada de The Rap Game en la que una concursante llamada Lady Lesharr figuraba como una de sus influencias </search>
<information> Doc 1(Título: "Lady Lesharr") Act. Lesharr se declaró pansexual en septiembre de 2018. Lesharr ha nombrado a Ashley Walters, Lisa Maffia, Missy Elliott y Lil Wayne como sus principales influencias. Lady Lesharr Melesha Katrina O'Garro (nacida el 15 de diciembre de 1989), conocida profesionalmente como Lady Lesharr (), es una rapera, cantante y productora británica de grime y hip hop de Kingshurst, Solihull, Reino Unido. Es conocida principalmente por su serie de freestyles ""Queen's Speech"", el cuarto de los cuales se hizo viral en 2016. La concursante de la temporada 2 de ""The Rap Game"" Nia Kay declaró que Lesharr era una de sus influencias debido a su singularidad y habilidad para el rap. Su freestyle posterior, ... </information>
<think> Descubrí que Lady Lesharr era una de las influencias de Nia Kay en la temporada 2 de The Rap Game. Ahora necesito encontrar al ganador de esa temporada. </think>
<search> ganador de la temporada 2 de The Rap Game </search> <information> Doc 1(Título: "Chandra Davis") Chandra Davis Chandra Davis (nacida el 2 de enero de 1978 en Detroit, Míchigan), también conocida como London Charles y Deelishis, es una modelo estadounidense y exconcursante de reality shows. Es conocida principalmente por ser la ganadora del exitoso reality show de VH1 ""Flavor of Love 2"". Davis fue concursante en la segunda temporada de Flavor of Love de VH1 (a los 29 años). Pasó a ganar la competencia cuando Flavor Flavor la eligió por encima de Tiffany 'New York' Pollard, quien regresó después de haber sido nombrada previamente subcampeona en la primera temporada del programa. Después de FOL, Davis anunció que actualmente no está saliendo con Flavor, mediante un especial de VH1, ... </information>
<think> Descubrí que el ganador de la temporada 2 de The Rap Game es London Charles (Chandra Davis). Ahora puedo proporcionar la respuesta. </think>
<answer> London Charles </answer>