
Mil ejemplos seleccionados y un tope duro de tokens de pensamiento bastan para superar a sistemas de razonamiento mayores. Artículo de 2025, gratis online.
s1: Simple test-time scaling
s1: Escalado simple en tiempo de prueba
Niklas Muennighoff Zitong Yang Weijia Shi Xiang Lisa Li Li Fei-Fei Hannaneh Hajishirzi Luke Zettlemoyer Percy Liang Emmanuel Candès Tatsunori Hashimoto
Resumen
El escalado en tiempo de prueba es un nuevo enfoque prometedor para el modelado del lenguaje que utiliza cómputo adicional en tiempo de prueba para mejorar el rendimiento. Recientemente, el modelo o1 de OpenAI mostró esta capacidad pero no compartió públicamente su metodología, lo que dio lugar a muchos esfuerzos de replicación. Buscamos el enfoque más simple para lograr el escalado en tiempo de prueba y un fuerte rendimiento en razonamiento. Primero, seleccionamos un pequeño conjunto de datos s1K de 1.000 preguntas emparejadas con trazas de razonamiento basándonos en tres criterios que validamos mediante ablaciones: dificultad, diversidad y calidad. Segundo, desarrollamos budget forcing para controlar el cómputo en tiempo de prueba terminando forzosamente el proceso de pensamiento del modelo o alargándolo añadiendo "Wait" varias veces a la generación del modelo cuando este intenta finalizar. Esto puede llevar al modelo a revisar su respuesta, corrigiendo a menudo pasos de razonamiento incorrectos. Tras el ajuste fino supervisado del modelo de lenguaje Qwen2.5-32B-Instruct sobre s1K y dotarlo de budget forcing, nuestro modelo s1-32B supera a o1-preview en preguntas de matemáticas de competición hasta en un (MATH y AIME24). Además, escalar s1-32B con budget forcing permite extrapolar más allá de su rendimiento sin intervención en tiempo de prueba: del al en AIME24. Nuestro modelo, datos y código son de código abierto en https://github.com/simplescaling/s1.
1. Introducción
Las mejoras de rendimiento de los modelos de lenguaje (LMs) en los últimos años se han basado en gran medida en escalar el cómputo en tiempo de entrenamiento mediante preentrenamiento autosupervisado a gran escala (Kaplan et al., 2020; Hoffmann et al., 2022). La creación de estos potentes modelos ha preparado el terreno para un nuevo paradigma de escalado construido sobre ellos: el escalado en tiempo de prueba. El objetivo
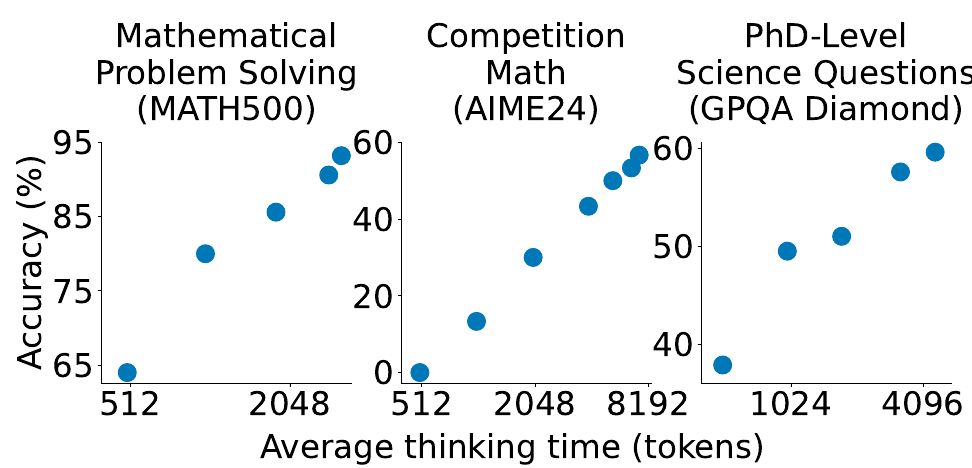
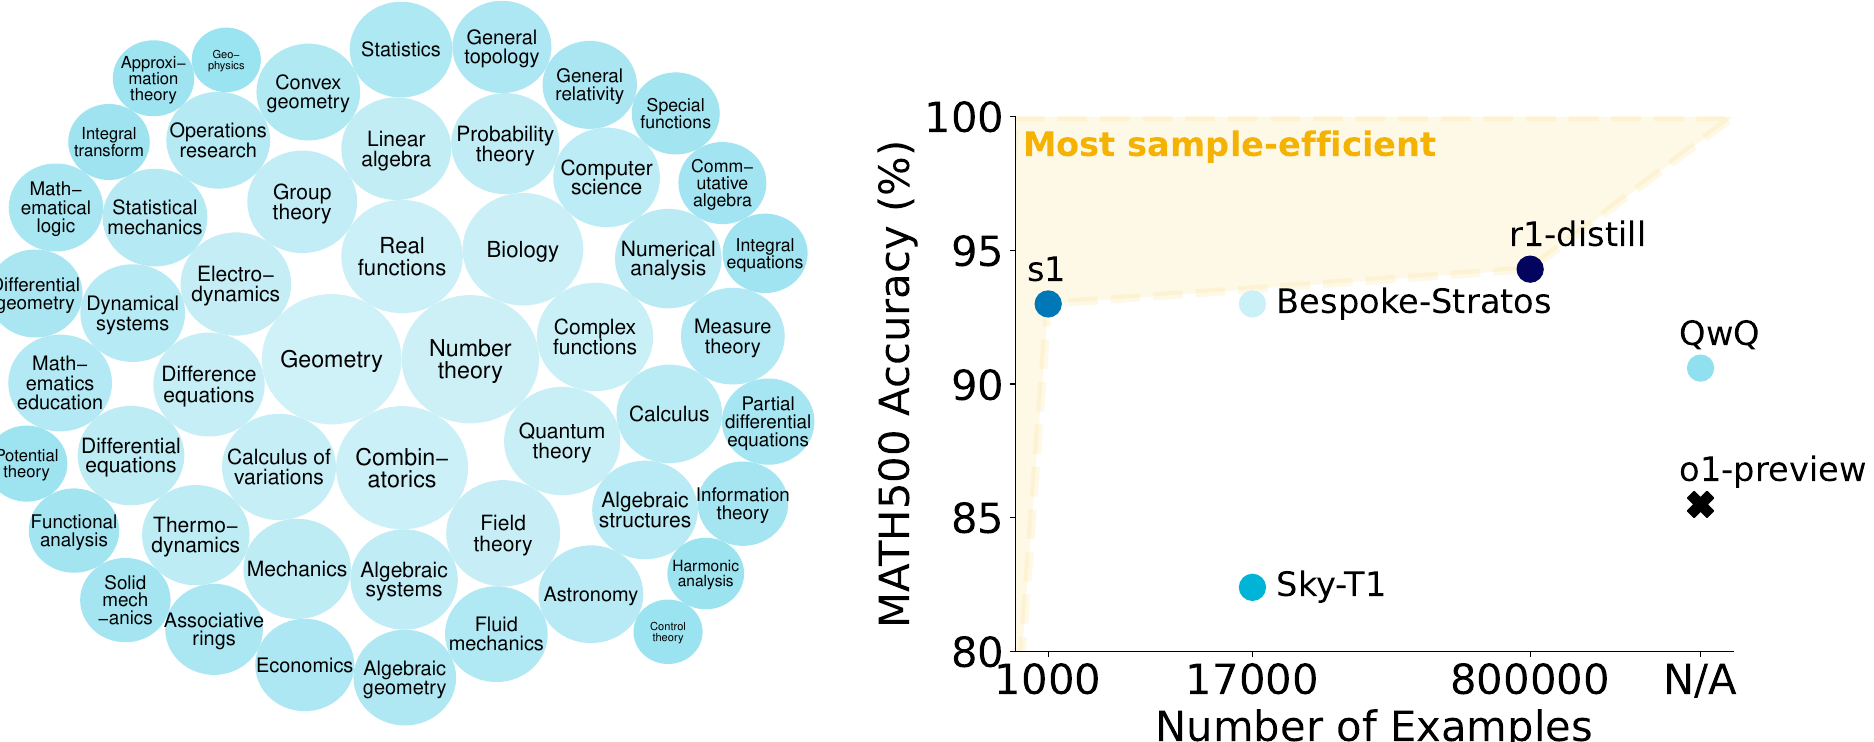
de este enfoque es aumentar el cómputo en tiempo de prueba para obtener mejores resultados. Ha habido mucho trabajo explorando esta idea (Snell et al., 2024; Welleck et al., 2024), y la viabilidad de este paradigma fue validada recientemente por OpenAI o1 (OpenAI, 2024). o1 ha demostrado un fuerte rendimiento en razonamiento con ganancias consistentes al escalar el cómputo en tiempo de prueba. OpenAI describe su enfoque como el uso de aprendizaje por refuerzo (RL) a gran escala, lo que implica el uso de cantidades considerables de datos (OpenAI, 2024). Esto ha llevado a diversos intentos de replicar sus modelos recurriendo a técnicas como la búsqueda de árbol de Monte Carlo (Gao et al., 2024b; Zhang et al., 2024a), enfoques multiagente (Qin et al., 2024) y otros (Wang et al., 2024a; Huang et al., 2024b; 2025). Entre estos enfoques, DeepSeek R1 (DeepSeek-AI et al., 2025) ha replicado con éxito el rendimiento de nivel o1, empleando también aprendizaje por refuerzo mediante millones de muestras y múltiples etapas de entrenamiento. Sin embargo, a pesar del gran número de intentos de replicación de o1, ninguno ha replicado abiertamente un comportamiento claro de escalado en tiempo de prueba. Por lo tanto, nos preguntamos: ¿cuál es el enfoque más simple para lograr tanto el escalado en tiempo de prueba como un fuerte rendimiento en razonamiento? Mostramos que entrenar con solo 1.000 muestras mediante predicción del siguiente token y controlar la duración del pensamiento mediante una simple técnica en tiempo de prueba a la que nos referimos como budget forcing conduce a un modelo de razonamiento fuerte cuyo rendimiento escala con más cómputo en tiempo de prueba. Específicamente, construimos s1K, que consta de 1.000 preguntas cuidadosamente seleccionadas emparejadas con trazas de razonamiento y respuestas destiladas de Gemini Thinking Experimental (Google, 2024). Realizamos un ajuste fino supervisado (SFT) de un modelo preentrenado listo para usar sobre nuestro pequeño conjunto de datos, lo que requiere solo 26 minutos de entrenamiento en 16 GPUs H100. Después del entrenamiento, controlamos la cantidad de cómputo en tiempo de prueba que nuestro modelo emplea mediante budget forcing: (I) Si el modelo genera más tokens de pensamiento que un límite deseado, terminamos forzosamente el proceso de pensamiento añadiendo un delimitador de token de fin de pensamiento. Terminar el pensamiento de esta manera hace que el modelo pase a generar su respuesta. (II) Si queremos que el modelo emplee más cómputo en tiempo de prueba en un problema, suprimimos la generación del delimitador de token de fin de pensamiento y, en su lugar, añadimos "Wait" a la traza de razonamiento actual del modelo para fomentar más exploración. Dotado de esta simple receta —SFT sobre 1.000 muestras y budget forcing en tiempo de prueba—, nuestro modelo s1-32B exhibe escalado en tiempo de prueba (Figura 1). Además, s1-32B es el modelo de razonamiento más eficiente en muestras y supera a modelos de código cerrado como o1-preview de OpenAI (Figura 2).
Realizamos extensos experimentos de ablación dirigidos a (a) nuestra selección de 1.000 (1K) muestras de razonamiento y (b) nuestro escalado en tiempo de prueba. Para (a), encontramos que incorporar conjuntamente medidas de dificultad, diversidad y calidad en nuestro algoritmo de selección es importante. La selección aleatoria, la selección de muestras con las trazas de razonamiento más largas o la selección únicamente de muestras máximamente diversas conducen todas a un rendimiento significativamente peor (alrededor de en AIME24 de media). Entrenar sobre nuestro conjunto completo de datos de 59K ejemplos, un superconjunto de s1K, no ofrece ganancias sustanciales sobre nuestra selección de 1K. Esto resalta la importancia de una selección cuidadosa de datos y se hace eco de hallazgos previos para el ajuste por instrucciones (Zhou et al., 2023). Para (b), definimos los requisitos deseables para los métodos de escalado en tiempo de prueba con el fin de comparar diferentes enfoques. Budget forcing conduce al mejor escalado, ya que tiene una controlabilidad perfecta con una clara pendiente positiva que conduce a un fuerte rendimiento.
En resumen, nuestras contribuciones son: Desarrollamos métodos simples para crear un conjunto de datos de razonamiento eficiente en muestras (§2) y escalado en tiempo de prueba (§3); Sobre esta base, construimos s1-32B, que es competitivo con o1-preview (§4); Realizamos ablaciones sobre sutilezas de los datos (§5.1) y del escalado en tiempo de prueba (§5.2). Terminamos con una discusión para motivar trabajo futuro sobre razonamiento simple (§6). Nuestro código, modelo y datos son de código abierto en https://github.com/simplescaling/s1.
2. Curación de datos de razonamiento para crear s1K
En esta sección, describimos nuestro proceso para crear un gran conjunto de datos primero en §2.1 y luego filtrarlo hasta s1K en §2.2.
2.1. Recopilación inicial de 59K muestras
Recopilamos una colección inicial de 59.029 preguntas de 16 fuentes siguiendo tres principios rectores. Calidad: Los conjuntos de datos deben ser de alta calidad; siempre inspeccionamos las muestras e ignoramos conjuntos de datos con, por ejemplo, formato deficiente; Dificultad: Los conjuntos de datos deben ser desafiantes y requerir un esfuerzo de razonamiento significativo; Diversidad: Los conjuntos de datos deben provenir de diversos campos para cubrir diferentes tareas de razonamiento. Recopilamos conjuntos de datos de dos categorías:
Curación de conjuntos de datos existentes Nuestra mayor fuente es NuminaMATH (LI et al., 2024) con 30.660 problemas matemáticos de sitios web en línea. También incluimos problemas históricos de AIME (1983-2021). Para mejorar la diversidad, añadimos OlympicArena (Huang et al., 2024a) con 4.250 preguntas que abarcan Astronomía, Biología, Química, Informática, Geografía, Matemáticas y Física de diversas Olimpiadas. OmniMath (Gao et al., 2024a) añade 4.238 problemas matemáticos de nivel de competición. También incluimos 2.385 problemas de AGIEval (Zhong et al., 2023), que presenta preguntas de exámenes estandarizados como el SAT y el LSAT, abarcando Inglés, Derecho y Lógica. Remitimos a la Tabla 7 en §C para nuestras otras fuentes.
Nuevos conjuntos de datos en razonamiento cuantitativo Para complementar estos conjuntos de datos existentes, creamos dos conjuntos de datos originales. s1-prob consta de 182 preguntas de la sección de probabilidad de los Exámenes de Calificación Doctoral del Departamento de Estadística de la Universidad de Stanford (https://statistics.stanford.edu), acompañadas de soluciones escritas a mano que abarcan demostraciones difíciles. El examen de calificación de probabilidad se celebra anualmente y requiere resolución de problemas matemáticos de nivel profesional. s1-teasers comprende 23 acertijos desafiantes comúnmente usados en preguntas de entrevista para puestos de trading cuantitativo. Cada muestra consta de un problema y una solución tomados de PuzzledQuant (https://www.puzzledquant.com/). Solo tomamos ejemplos con el nivel de dificultad más alto ("Hard").
Para cada pregunta, generamos una traza de razonamiento y una solución usando la API Google Gemini Flash Thinking (Google, 2024), extrayendo su traza de razonamiento y su respuesta. Esto produce 59K tripletas de una pregunta, una traza de razonamiento generada y una solución generada. Hay ejemplos de nuestro conjunto de datos en §D.2. Descontaminamos todas las muestras frente a nuestras preguntas de evaluación (MATH500, GPQA Diamond, AIME24; §C.5) usando 8-gramas y eliminamos los duplicados de los datos.
2.2. Selección final de 1K muestras
Podríamos entrenar directamente con nuestro conjunto de 59 000 preguntas; sin embargo, nuestro objetivo es encontrar el enfoque más sencillo con el mínimo de recursos. Por ello, pasamos por tres etapas de filtrado para llegar a un conjunto mínimo de 1000 muestras, basándonos en nuestros tres principios rectores de los datos: Calidad, Dificultad y Diversidad.
Calidad Primero eliminamos cualquier pregunta en la que hayamos encontrado algún error de API, lo que reduce nuestro conjunto de datos a 54 116 muestras. A continuación, filtramos los ejemplos de baja calidad comprobando si contienen patrones de cadena con problemas de formato, como diagramas de arte ASCII, referencias a imágenes inexistentes o numeración de preguntas inconsistente, lo que reduce nuestro conjunto de datos a 51 581 ejemplos.
De este conjunto, identificamos 384 muestras para nuestras 1000 muestras finales a partir de conjuntos de datos que percibimos como de alta calidad y que no necesitan más filtrado (véase §C.4 para más detalles).
Dificultad Para la dificultad, usamos dos indicadores: el rendimiento del modelo y la longitud de la traza de razonamiento. Evaluamos dos modelos en cada pregunta: Qwen2.5-7B-Instruct y Qwen2.5-32B-Instruct (Qwen et al., 2024), con la corrección evaluada por Claude 3.5 Sonnet comparando cada intento con la solución de referencia (véase §C.3 para el protocolo de calificación). Medimos la longitud en tokens de cada traza de razonamiento para indicar la dificultad del problema usando el tokenizador de Qwen2.5. Esto se basa en la suposición de que los problemas más difíciles requieren más tokens de pensamiento. Según la calificación, eliminamos las preguntas que Qwen2.5-7B-Instruct o Qwen2.5-32B-Instruct pueden resolver correctamente y que, por tanto, pueden ser demasiado fáciles. Al usar dos modelos reducimos la probabilidad de que una muestra fácil se cuele en nuestro filtrado debido a un error poco frecuente en una pregunta fácil de uno de los modelos. Esto reduce nuestro total de muestras a 24 496, preparando el terreno para la siguiente ronda de submuestreo basada en la diversidad. Aunque el filtrado con estos dos modelos puede estar optimizado para nuestra configuración, ya que también usaremos Qwen2.5-32B-Instruct como nuestro modelo para el ajuste fino, la idea del filtrado basado en modelos se generaliza a otras configuraciones.
Diversidad Para cuantificar la diversidad, clasificamos las preguntas en dominios usando Claude 3.5 Sonnet basándonos en el sistema de Clasificación por Materias Matemáticas (MSC) (p. ej., geometría, combinatoria, etc.) de la American Mathematical Society.1 La taxonomía se centra en temas de matemáticas, pero también incluye otras ciencias como biología, física y eco nomía. Para seleccionar nuestros ejemplos finales del conjunto de 24 496 preguntas, primero elegimos un dominio de manera uniforme al azar. Luego, muestreamos un problema de este dominio según una distribución que favorece las trazas de razonamiento más largas (véase §C.4 para más detalles), como se motivó en Dificultad. Repetimos este proceso hasta tener 1000 muestras totales que abarcan 50 dominios.
En la §5.1, mostraremos que usar nuestros tres criterios en combinación es importante, ya que depender únicamente de la calidad, la diversidad o la dificultad de forma aislada conduce a conjuntos de datos peores. Algunas generaciones destiladas son incorrectas, lo cual permitimos en nuestros datos, ya que nos centramos en capturar el proceso de razonamiento en lugar de soluciones totalmente correctas. Nuestro evaluador (§C.3) considera correcto el 53,6% en s1K y el 63,0% en nuestro s1K-1.1 de seguimiento (véase la §A).
3. Escalado en tiempo de prueba
3.1. Método
Clasificamos los métodos de escalado en tiempo de prueba en 1) Secuenciales, donde los cómputos posteriores dependen de los anteriores (p. ej., una larga traza de razonamiento), y 2) Paralelos, donde los cómputos se ejecutan de forma independiente (p. ej., votación por mayoría) (Snell et al., 2024; Brown et al., 2024). Nos centramos en el escalado secuencial, ya que intuitivamente creemos que debería escalar mejor, puesto que los cómputos posteriores pueden apoyarse en los resultados intermedios, lo que permite un razonamiento más profundo y un refinamiento iterativo. Proponemos nuevos métodos de escalado secuencial y formas de evaluarlos.
Forzado de presupuesto Proponemos una intervención simple en el momento de decodificación forzando un número máximo y/o mínimo de tokens de pensamiento. Específicamente, imponemos un conteo máximo de tokens simplemente añadiendo el delimitador del token de fin de pensamiento y, opcionalmente, "Final Answer:" para salir temprano
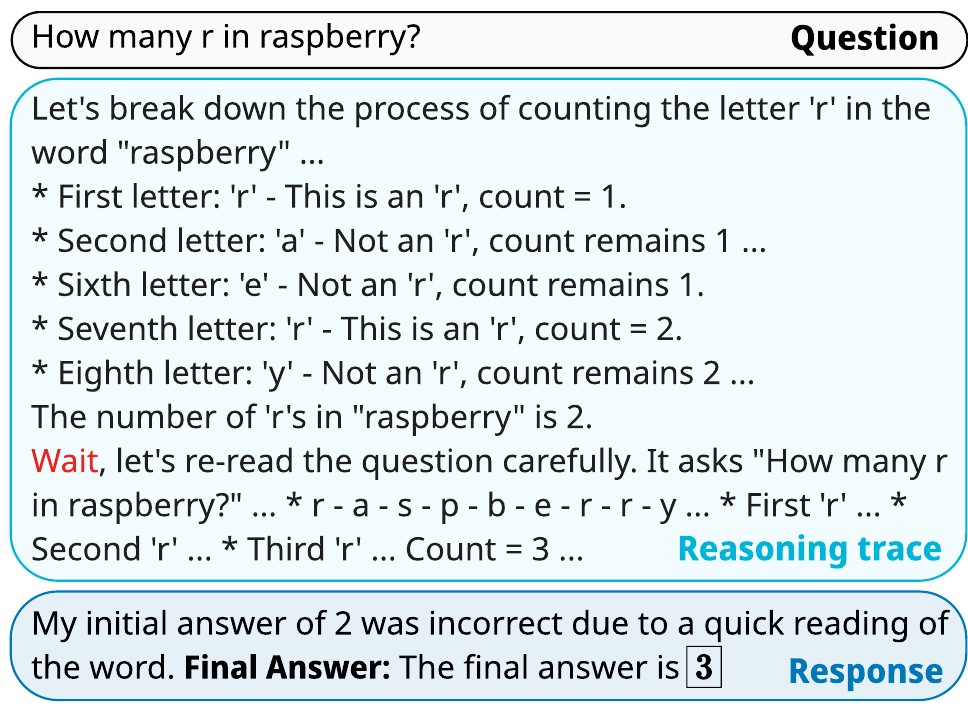
de la etapa de pensamiento y hacer que el modelo proporcione su mejor respuesta actual. Para imponer un mínimo, suprimimos la generación del delimitador del token de fin de pensamiento y, opcionalmente, añadimos la cadena "Wait" a la traza de razonamiento actual del modelo para animarlo a reflexionar sobre su generación actual. La Figura 3 contiene un ejemplo de cómo este enfoque simple puede llevar al modelo a llegar a una mejor respuesta.
Líneas base Evaluamos el forzado de presupuesto con: (I) Métodos de control condicional de la longitud, que consisten en indicar al modelo en el prompt durante cuánto tiempo debe generar. Los agrupamos por granularidad en (a) control condicional por tokens: especificamos un límite superior de tokens de pensamiento en el prompt; (b) control condicional por pasos: especificamos un límite superior de pasos de pensamiento, donde cada paso tiene alrededor de 100 tokens; (c) control condicional por clase: escribimos dos prompts genéricos que indican al modelo que piense durante un tiempo corto o largo (véase la §E.1 para más detalles). (II) Muestreo por rechazo, que muestrea hasta que una generación se ajusta a un presupuesto de cómputo predeterminado. Este oráculo captura la posterior sobre las respuestas condicionada a su longitud.
3.2. Métricas
Establecemos un conjunto de desiderata como métricas de evaluación para medir el escalado en tiempo de prueba entre métodos. Es importante destacar que no solo nos importa la precisión que un método puede alcanzar, sino también su controlabilidad y la pendiente de escalado en tiempo de prueba. Para cada método que consideramos, ejecutamos un conjunto de evaluaciones variando el cómputo en tiempo de prueba sobre un benchmark fijo, p. ej., AIME24. Esto produce una función lineal a trozos con el cómputo como eje x medido en tokens de pensamiento y la precisión como eje y (véase la Figura 1, donde el punto más a la derecha para AIME24 corresponde a ). Medimos tres métricas:
donde se refieren a una cantidad mínima y máxima de cómputo en tiempo de prueba preespecificadas; en nuestro caso, tokens de pensamiento. Normalmente solo restringimos . Como los tokens generados corresponden a la cantidad de cómputo en tiempo de prueba empleado, esta métrica mide en qué medida un método permite la controlabilidad sobre el uso de ese cómputo en tiempo de prueba. La reportamos como un porcentaje, siendo un control perfecto.
Scaling es la pendiente promedio de la función lineal a trozos. Debe ser positiva para que los métodos sean útiles y cuanto mayor, mejor.
Performance es simplemente el máximo rendimiento que el método alcanza en el benchmark. Un método con un escalado monótonamente creciente alcanza un de rendimiento en cualquier benchmark en el límite. Sin embargo, los métodos que investigamos eventualmente se estabilizan o el escalado adicional falla debido a limitaciones de control o de la ventana de contexto.
4. Resultados
4.1. Configuración
Entrenamiento Realizamos un ajuste fino supervisado sobre Qwen2.5-32B-Instruct usando s1K para obtener nuestro modelo s1-32B usando hiperparámetros básicos descritos en la §D. El ajuste fino tomó 26 minutos en 16 GPU NVIDIA H100 con PyTorch FSDP.
Evaluación Seleccionamos tres benchmarks de razonamiento representativos ampliamente usados en el campo: AIME24 (of America, 2024) tiene 30 problemas que se usaron en el Examen de Matemáticas Invitacional Estadounidense (AIME) de 2024, celebrado del 31 de enero al 1 de febrero de 2024. El AIME evalúa la resolución de problemas matemáticos con aritmética, álgebra, conteo, geometría, teoría de números, probabilidad y otros temas de matemáticas de secundaria. Los estudiantes de secundaria con puntuaciones altas en la prueba son invitados a participar en la Olimpiada Matemática de los Estados Unidos de América (USAMO). Todas las respuestas del AIME son números enteros que van de 000 a 999, inclusive. Algunos problemas del AIME dependen de figuras que proporcionamos a nuestro modelo usando el lenguaje de gráficos vectoriales Asymptote, ya que no puede recibir entradas de imagen. MATH500 (Hendrycks et al., 2021) es un benchmark de problemas de matemáticas de competición de dificultad variable. Evaluamos sobre las mismas 500 muestras seleccionadas por OpenAI en trabajos previos (Lightman et al., 2023). GPQA Diamond (Rein et al., 2023) consta de 198 preguntas de ciencia de nivel doctoral
de Biología, Química y Física. Los expertos con doctorados en los dominios correspondientes solo alcanzaron un en GPQA Diamond (OpenAI, 2024). Cuando escribimos "GPQA" en el contexto de la evaluación en este trabajo, siempre nos referimos al subconjunto Diamond. Nos basamos en el marco "lm-evaluation-harness" (Gao et al., 2021; Biderman et al., 2024). Salvo que se especifique lo contrario, evaluamos con una temperatura de 0 (codicioso) y medimos la precisión (equivalente a pass@1).
Otros modelos Evaluamos s1-32B frente a: la serie OpenAI o1 (OpenAI, 2024), modelos de código cerrado que popularizaron el escalado en tiempo de prueba; la serie DeepSeek r1 (DeepSeek-AI et al., 2025), modelos de razonamiento de pesos abiertos con rendimiento de hasta nivel o1; QwQ-32B-preview de Qwen (Team, 2024), un modelo de razonamiento de pesos abiertos de 32B sin metodología divulgada; Sky-T1-32B-Preview (Team, 2025) y Bespoke-32B (Labs, 2025), modelos abiertos con datos de razonamiento abiertos destilados de QwQ-32B-preview y r1; Google Gemini 2.0 Flash Thinking Experimental (Google, 2024), la API de la que destilamos. Como no tiene puntuaciones de evaluación oficiales, usamos la API de Gemini para evaluarlo nosotros mismos. Sin embargo, el "error de recitación" de la API de Gemini dificulta la evaluación.2 Evitamos esto insertando manualmente las 30 preguntas de AIME24 en su interfaz web, donde el error no aparece. Sin embargo, omitimos MATH500 (500 preguntas) y GPQA Diamond (198 preguntas), por lo que son N.A. en la Tabla 1. Nuestro modelo, s1-32B, es completamente abierto, incluyendo pesos, datos de razonamiento y código.
| Modelo | ej. | AIME 2024 | MATH 500 | GPQA Diamond |
| Solo API | ||||
| o1-preview | N.D. | 44,6 | 85,5 | 73,3 |
| o1-mini | N.D. | 70,0 | 90,0 | 60,0 |
| o1 | N.D. | 74,4 | 94,8 | 77,3 |
| Gemini 2.0 | N.D. | 60,0 | N.D. | N.D. |
| Flash Think. | ||||
| Pesos abiertos | ||||
| Qwen2.5-32B-Instruct | N.D. | 26,7 | 84,0 | 49,0 |
| QwQ-32B | N.D. | 50,0 | 90,6 | 54,5 |
| r1 | ≥800K | 79,8 | 97,3 | 71,5 |
| r1-distill | 800K | 72,6 | 94,3 | 62,1 |
| Pesos abiertos y datos abiertos | ||||
| Sky-T1 | 17K | 43,3 | 82,4 | 56,8 |
| Bespoke-32B | 17K | 63,3 | 93,0 | 58,1 |
| s1 sin BF | 1K | 50,0 | 92,6 | 56,6 |
| s1-32B | 1K | 56,7 | 93,0 | 59,6 |
| Qwen2.5-32B-Instruct | |||
| N.A. | 26.7 | 84.0 | QwQ-32B |
| N.A. | 50.0 | 90.6 | r1 |
| ≥800K | 79.8 | 97.3 | r1-distill |
| 800K | 72.6 | 94.3 | Pesos Abiertos y Datos Abiertos |
| Sky-T1 | |||
| 17K | 43.3 | 82.4 | Bespoke-32B |
| 17K | 63.3 | 93.0 | s1 sin BF |
| 1K | 50.0 | 92.6 | s1-32B |
| 1K | 56.7 | 93.0 | |
4.2. Rendimiento
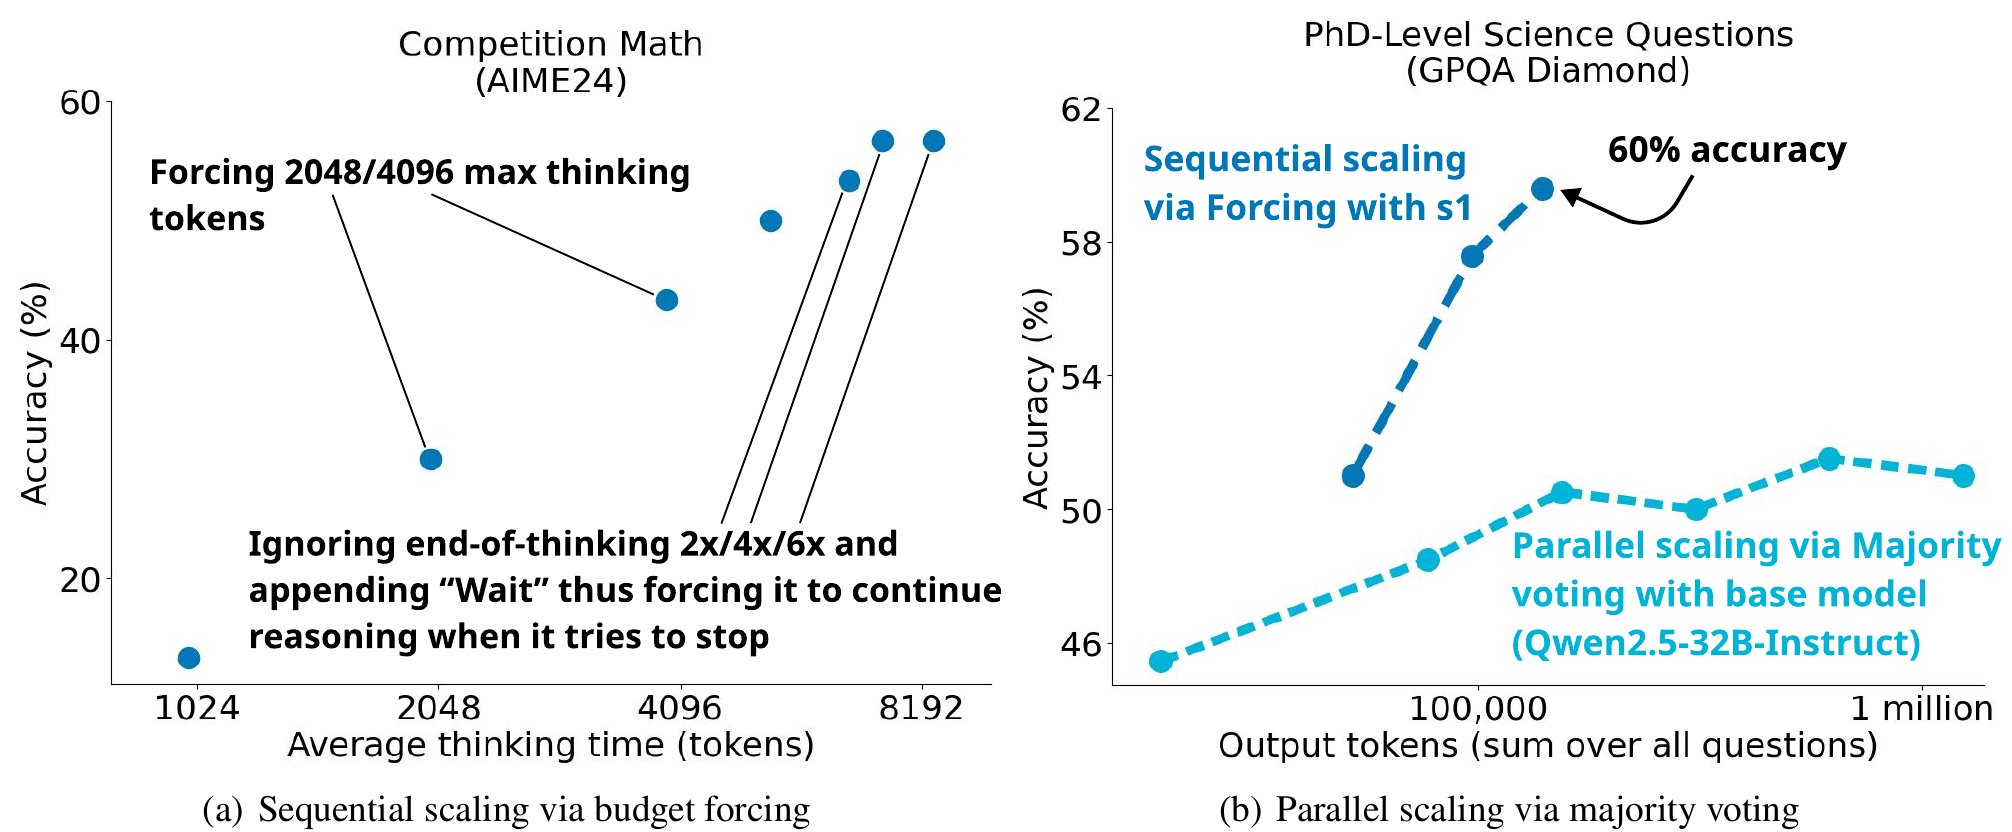
Escalado del cómputo en tiempo de prueba La Figura 1 muestra el rendimiento de s1-32B con budget forcing a medida que escala con más cómputo en tiempo de prueba. En la Figura 4 (izquierda), ampliamos el gráfico de la Figura 1 (centro) mostrando que, si bien podemos mejorar el rendimiento en AIME24 usando nuestra técnica de budget forcing (§3) y más cómputo en tiempo de prueba, este eventualmente se aplana a las seis veces. Suprimir el token delimitador de fin de pensamiento con demasiada frecuencia puede llevar al modelo a bucles repetitivos en lugar de continuar razonando. En la Figura 4 (derecha), mostramos que después de entrenar Qwen2.5-32B-Instruct con nuestras 1.000 muestras para producir s1-32B y equiparlo con la simple técnica de budget forcing, este opera en un paradigma de escalado diferente. Escalar el cómputo en tiempo de prueba en el modelo base mediante votación por mayoría no puede alcanzar el rendimiento de s1-32B, lo que valida nuestra intuición de §3 de que el escalado secuencial es más efectivo que el paralelo. Proporcionamos ejemplos de generaciones de s1-32B en la Figura 5.
Eficiencia de muestras En la Figura 2 (derecha) y la Tabla 1 comparamos s1-32B con otros modelos. Encontramos que s1-32B es el modelo de razonamiento con datos abiertos más eficiente en muestras. Rinde significativamente mejor que nuestro modelo base (Qwen2.5-32B-Instruct) a pesar de entrenarlo solo con 1.000 muestras adicionales. El r1-32B publicado simultáneamente muestra un rendimiento más fuerte que s1-32B mientras también usa solo SFT (DeepSeek-AI et al., 2025). Sin embargo, está entrenado con más muestras de razonamiento. Es una pregunta abierta si uno puede lograr su rendimiento con solo 1.000 muestras. Finalmente, nuestro modelo casi iguala a Gemini 2.0 Thinking en AIME24. Como los datos para s1-32B se destilan de Gemini 2.0, esto muestra que nuestro procedimiento de destilación probablemente fue efectivo.
5. Ablaciones
5.1. Cantidad, diversidad y dificultad de los datos
En §2 delineamos nuestros tres principios rectores en la curación de s1K: Calidad, Dificultad y Diversidad. Aquí ponemos a prueba la importancia de combinarlos y la eficacia general de nuestra selección. Solo calidad (1K-random): Después de obtener nuestras cadenas de razonamiento de alta calidad de Gemini, seleccionamos 1.000 muestras al azar; sin depender en absoluto de nuestro filtrado por dificultad y diversidad. La Tabla 2 muestra que este enfoque rinde mucho peor que s1K en todos los benchmarks. Solo diversidad (1K-diverse): Para este conjunto de datos, muestreamos uniformemente entre dominios para maximizar la diversidad, ignorando cualquier noción de dificultad. Este enfoque también conduce a un rendimiento deficiente similar a 1K-random. Solo dificultad (1K-longest): Aquí nos basamos en uno de nuestros indicadores de dificultad introducidos en §2 al seleccionar las 1.000 muestras con las trazas de razonamiento más largas. Este enfoque impulsa significativamente el rendimiento en GPQA, pero en general todavía queda por debajo del uso de s1K. Maximizar la cantidad:
| Modelo | AIME 2024 | MATH 500 | GPQA Diamond |
| 1K-aleatorio | 36,7 | 90,6 | 52,0 |
| [-26,7 %, -3,3 %] | [-4,8 %, 0,0 %] | [-12,6 %, 2,5 %] | |
| 1K-diverso | 26,7 | 91,2 | 54,6 |
| [-40,0 %, -10,0 %] | [-4,0 %, 0,2 %] | [-10,1 %, 5,1 %] | |
| 1K-más largo | 33,3 | 90,4 | 59,6 |
| [-36,7 %, 0,0 %] | [-5,0 %, -0,2 %] | [-5,1 %, 10,1 %] | |
| 59K-completo | 53,3 | 92,8 | 58,1 |
| [-13,3 %, 20,0 %] | [-2,6 %, 2,2 %] | [-6,6 %, 8,6 %] | |
| s1K | 50,0 | 93,0 | 57,6 |
Finalmente, comparamos con entrenar solo con todas nuestras 59K muestras, un superconjunto de todas las versiones de 1K muestras. Esto conduce a un modelo fuerte pero usa muchos más recursos. Para hacer fine-tuning con 59K muestras, usamos 394 horas de GPU H100, mientras que s1-32B solo requirió 7 horas de GPU H100. Además, depender solo de s1K es extremadamente competitivo, como se muestra en §2. En general, combinar los tres criterios —Calidad, Dificultad, Diversidad— mediante nuestra metodología en §2 es clave para un entrenamiento de razonamiento eficiente en muestras.
5.2. Métodos de escalado en tiempo de prueba
| Método | Control | Escalado | Rendimiento | |A| |
| BF | 100% | 15 | 56.7 | 5 |
| TCC | 40% | -24 | 40.0 | 5 |
| TCC + BF | 100% | 13 | 40.0 | 5 |
| SCC | 60% | 3 | 36.7 | 5 |
| SCC + BF | 100% | 6 | 36.7 | 5 |
| CCC | 50% | 25 | 36.7 | 2 |
| RS | 100% | -35 | 40.0 | 5 |
[AIME24]
Alice y Bob juegan el siguiente juego. Ante ellos hay una pila de fichas. Los jugadores se turnan y Alice empieza. En cada turno, el jugador retira 1 ficha o 4 fichas de la pila. Quien retira la última ficha gana. Halla el número de enteros positivos menores o iguales que 2024 para los cuales existe una estrategia para Bob que garantiza que Bob ganará el juego independientemente de cómo juegue Alice.
El problema pide el número de enteros positivos tales que Bob tiene una estrategia ganadora. Este es un juego imparcial típico que se puede analizar usando el teorema de Sprague-Grundy o encontrando directamente las posiciones ganadoras y perdedoras. Sea el conjunto de posiciones ganadoras (número de fichas tales que el jugador a quien le toca mover puede forzar una victoria) y sea el conjunto de posiciones perdedoras. [...]
Sea el enunciado «el jugador a quien le toca mover cuando hay fichas tiene una estrategia ganadora». es falso (el jugador a quien le toca mover y se enfrenta a 0 fichas ya ha perdido). Consideremos los valores pequeños de . .. : el jugador a quien le toca mover puede tomar 1 ficha y ganar. Así que es verdadero. . : el jugador a quien le toca mover puede tomar 1 ficha, dejando 1 ficha al oponente. Como , el oponente gana. Así que es falso. . : el jugador a quien le toca mover puede tomar 1 ficha, dejando 2 fichas al oponente. Como , el jugador a quien le toca mover gana. Así que es verdadero. ...]
Buscamos el número de enteros positivos para los cuales Bob tiene una estrategia ganadora. Esto significa que si el juego empieza con fichas y Alice mueve primero, Bob puede ganar. Esto ocurre si y solo si es una posición perdedora (porque si , entonces el primer movimiento de Alice debe llevar a una posición ganadora para Bob). [...]
Intentemos encontrar un patrón en las posiciones perdedoras . Diferencias entre términos consecutivos: 2,3,2,3,2,3,2,3,2, ... El patrón de diferencias es 2,3 alternados. [...] Las posiciones perdedoras son de la forma o , donde . Necesitamos hallar el número de enteros positivos que están en el conjunto de posiciones perdedoras ...]
Caso 1: , donde . , . Como es un entero, . El número de valores de es 404. Caso 2: , donde . , 5m\leq 2022\), \(m\leq 2022 / 5 = 404.4. Como es un entero, . El número de valores de es .
El número total de enteros positivos que son posiciones perdedoras es .
[MATH500]
Halla la proyección de sobre si .
La proyección del vector sobre el vector viene dada por la fórmula:
Se nos da y .
Primero, necesitamos hallar el cuadrado de la magnitud de , que es .
Ahora podemos sustituir los valores en la fórmula de la proyección:
Sustituye el vector :
Multiplica el escalar por cada componente del vector:
Respuesta final: La respuesta final es
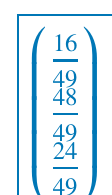
Una partícula mecánico-cuántica de masa se mueve en dos dimensiones en el siguiente potencial, como función de las coordenadas polares .
Halla el espectro de energía. Sugerencia: escribe el potencial en coordenadas cartesianas.
El problema pide el espectro de energía de una partícula en un potencial 2D dado. El potencial viene dado en coordenadas polares :
Podemos reescribir el potencial como:
El hamiltoniano para una partícula en 2D viene dado por:
En coordenadas polares , el operador laplaciano es:
Por lo tanto, el hamiltoniano en coordenadas polares es:
La ecuación de Schrödinger independiente del tiempo es . Podemos intentar separar variables suponiendo una solución de la forma . [...]
Esto confirma que el espectro de energía es:
Respuesta final:
Forzamiento de presupuesto En la Tabla 3 comparamos los métodos de escalado en tiempo de prueba que hemos introducido en . En general, encontramos que el forzamiento de presupuesto proporciona un control perfecto, un buen escalado y conduce a nuestra mejor puntuación en AIME24. Por lo tanto, este es el método que utilizamos para s1-32B en la Figura 1 y en . En la Tabla 4, comparamos diferentes cadenas para extrapolar el rendimiento. Encontramos que «Wait» generalmente da el mejor rendimiento.
Control condicionado por clase Proporcionamos puntuaciones de referencia para este método en y resumimos tres hallazgos aquí: (1) El control condicionado por token falla sin forzamiento de presupuesto, ya que nuestro modelo no puede contar tokens de manera fiable, incluso cuando se le entrena para hacerlo. (2) Bajo el control condicionado por paso, el modelo genera un número total de tokens similar cuando se le dan diferentes objetivos de pasos, ya que el modelo pasa de pocos pasos con muchos tokens por paso, a muchos pasos con pocos tokens en cada paso. Así, el modelo aprende a eludir la restricción de cómputo, lo que hace que la controlabilidad de este método sea mediocre. (3) El control condicionado por clase puede funcionar: decirle a un modelo que simplemente piense durante más tiempo puede aumentar su cómputo en tiempo de prueba y su rendimiento, lo que da lugar a un buen escalado en la Tabla 3.
| Modelo | AIME | MATH | GPQA |
| 2024 | 500 | Diamond | |
| Sin extrapolación | 50,0 | 93,0 | 57,6 |
| 2x sin cadena | 50,0 | 90,2 | 55,1 |
| 2x «Alternatively» | 50,0 | 92,2 | 59,6 |
| 2x «Hmm» | 50,0 | 93,0 | 59,6 |
| 2x «Wait» | 53,3 | 93,0 | 59,6 |
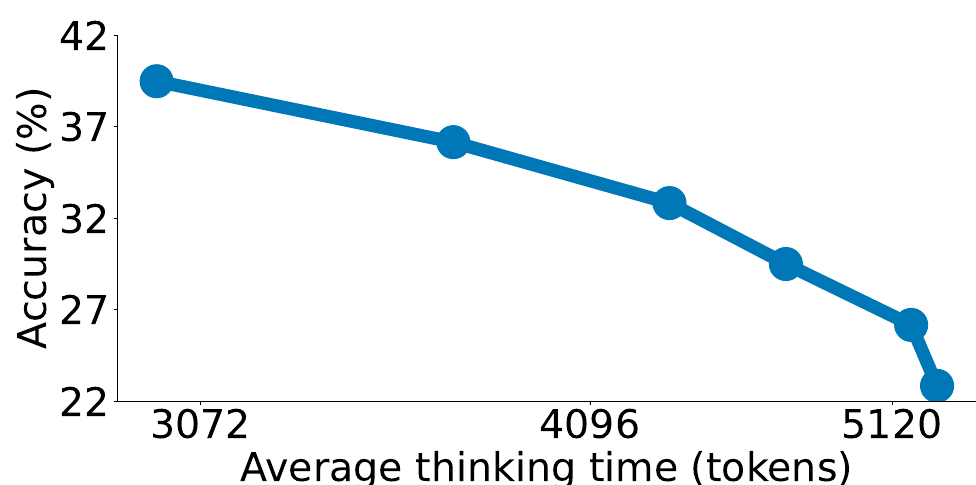
Muestreo por rechazo Sorprendentemente, encontramos que simplemente muestrear hasta que la generación se ajuste a una longitud específica conduce a una tendencia de escalado inversa, como se muestra en la Figura 6. En inspeccionamos una pregunta que el modelo respondió correctamente al hacer muestreo por rechazo para , pero no para la configuración de tokens. En la configuración de , el modelo salta directamente al enfoque correcto, mientras que en la configuración de retrocede mucho. Hipotetizamos que existe una correlación tal que las generaciones más cortas tienden a ser aquellas en las que el modelo iba por el buen camino desde el principio, mientras que las más largas tienden a ser aquellas en las que el modelo cometió errores y, por tanto, retrocede o se cuestiona a sí mismo. Esto hace que las muestras más largas a menudo sean incorrectas al aplicar muestreo por rechazo y, por tanto, que se produzca la tendencia de escalado inversa.
6. Discusión y trabajo relacionado
6.1. Razonamiento eficiente en muestras
Modelos Existen varios esfuerzos concurrentes para construir modelos que repliquen el rendimiento de o1 (OpenAI, 2024). Por ejemplo, DeepSeek-r1 y k1.5 (DeepSeek-AI et al., 2025; Team et al., 2025) se construyen con métodos de aprendizaje por refuerzo, mientras que otros dependen de SFT usando decenas de miles de ejemplos destilados (Team, 2025; Xu et al., 2025; Labs, 2025). Mostramos que el SFT con solo 1.000 ejemplos basta para construir un modelo de razonamiento competitivo que iguala a o1-preview y produce un modelo que se sitúa en la frontera de Pareto (Figura 2). Además, introducimos el forzamiento de presupuesto que, combinado con nuestro modelo de razonamiento, conduce a la primera reproducción de las curvas de escalado en tiempo de prueba de OpenAI (OpenAI, 2024). ¿Por qué el ajuste fino supervisado con solo 1.000 muestras conduce a tales mejoras de rendimiento? Hipotetizamos que el modelo ya está expuesto a grandes cantidades de datos de razonamiento durante el preentrenamiento, que abarca billones de tokens. Así, la capacidad de realizar razonamiento ya está presente en nuestro modelo. Nuestra etapa de ajuste fino eficiente en muestras simplemente la activa y la escalamos más en tiempo de prueba con forzamiento de presupuesto. Esto es similar a la «Hipótesis de Alineación Superficial» presentada en LIMA (Zhou et al., 2023), donde los autores encuentran que 1.000 ejemplos pueden ser suficientes para alinear un modelo para que se adhiera a las preferencias del usuario.
Referencias y métodos Para evaluar y ampliar los límites de estos modelos, se han introducido referencias cada vez más desafiantes, como competiciones científicas de nivel olímpico (He et al., 2024; Jain et al., 2024; Zhong et al., 2023) y otras (Srivastava et al., 2023; Glazer et al., 2024; Su et al., 2024; Kim et al., 2024; Phan et al., 2025). Para mejorar el rendimiento de los modelos en tareas relacionadas con el razonamiento, los investigadores han seguido varias estrategias: trabajos previos han explorado el entrenamiento continuado de modelos de lenguaje con corpus especializados relacionados con las matemáticas y las ciencias (Azerbayev et al., 2023; Yang et al., 2024), en ocasiones incluso con datos generados sintéticamente (Yu et al., 2024). Otros han desarrollado metodologías de entrenamiento orientadas específicamente al rendimiento en razonamiento (Zelikman et al., 2022; 2024; Luo et al., 2025; Yuan et al., 2025; Wu et al., 2024a). Otra línea de trabajo significativa se centra en métodos basados en prompting para elicitar y mejorar las capacidades de razonamiento, incluidos métodos como el prompting de Cadena de Pensamiento (Chain-of-Thought) (Wei et al., 2023; Yao et al., 2023a;b; Bi et al., 2023; Fu et al., 2023; Zhang et al., 2024b; Xiang et al., 2025; Hu et al., 2024; Diao et al., 2024). Estos esfuerzos combinados tienen como objetivo avanzar en la capacidad de razonamiento de los modelos de lenguaje, permitiéndoles manejar de manera efectiva tareas más complejas y abstractas.
6.2. Escalado en tiempo de prueba
Métodos Como presentamos en , diferenciamos dos métodos para escalar el cómputo en tiempo de prueba: paralelo y secuencial. El primero se basa en múltiples intentos de solución generados en paralelo y en la selección del mejor resultado mediante criterios específicos. Estos criterios incluyen elegir la respuesta más frecuente para el voto por mayoría o la mejor respuesta según una recompensa externa para Best-of-N (Brown et al., 2024; Irvine et al., 2023; Levi, 2024). A diferencia del muestreo repetido, los métodos de escalado secuencial previos permiten al modelo generar intentos de solución secuencialmente basándose en intentos anteriores, lo que le permite refinar cada intento a partir de los resultados previos (Snell et al., 2024; Hou et al., 2025; Lee et al., 2025). Los métodos de búsqueda basados en árboles (Gandhi et al., 2024; Wu et al., 2024b) ofrecen un enfoque híbrido entre el escalado secuencial y el paralelo, como la Búsqueda de Árbol de Montecarlo (MCTS) (Liu et al., 2024; Zhang et al., 2023; Zhou et al., 2024; Choi et al., 2023) y la búsqueda por haz guiada (Xie et al., 2023). REBASE (Wu et al., 2024b) emplea un modelo de recompensa de proceso para equilibrar la explotación y la poda durante la búsqueda en árbol. Empíricamente, se ha demostrado que REBASE supera a los métodos basados en muestreo y a MCTS (Wu et al., 2024b). Los modelos de recompensa (Lightman et al., 2023; Wang et al., 2024b;c) desempeñan un papel clave en estos métodos. Existen en dos variantes: modelos de recompensa de resultado y modelos de recompensa de proceso. Los modelos de recompensa de resultado (Xin et al., 2024; Ankner et al., 2024) asignan una puntuación a soluciones completas y son particularmente útiles en la selección Best-of-N, mientras que los modelos de recompensa de proceso (Lightman et al., 2023; Wang et al., 2024b; Wu et al., 2024b) evalúan pasos de razonamiento individuales y son eficaces para guiar métodos de búsqueda basados en árboles.
Límites para seguir escalando en tiempo de prueba Hemos mostrado que el forzamiento de presupuesto permite extrapolar el cómputo en tiempo de prueba en , por ejemplo, mejorando el rendimiento en AIME24 del al . Sin embargo, tiene dos limitaciones clave al escalar más: finalmente se aplana (Figura 4), y la ventana de contexto del modelo de lenguaje subyacente lo restringe. A pesar de estas restricciones, nuestro trabajo muestra el escalado en tiempo de prueba en un amplio rango de precisiones (Figura 1), en parte porque reducir el cómputo en tiempo de prueba se comporta de manera predecible y no sufre estas restricciones.
Continuar el escalado en tiempo de prueba requerirá enfoques que puedan extrapolar aún más el cómputo en tiempo de prueba. ¿Cómo podemos lograr
tal extrapolación? Puede haber mejoras al forzamiento de presupuesto, como rotar entre diferentes cadenas, no solo "Wait", o combinarlo con penalizaciones de frecuencia o una temperatura más alta para evitar bucles repetitivos. Una dirección emocionante para trabajo futuro es también investigar si aplicar el forzamiento de presupuesto a un modelo de razonamiento entrenado con aprendizaje por refuerzo produce una mejor extrapolación; o si el RL permite nuevas formas de escalado en tiempo de prueba más allá del forzamiento de presupuesto. Nuestro trabajo define las métricas correctas ( ) –Control, Escalado y Rendimiento– para permitir investigación y progreso futuros en la extrapolación del cómputo en tiempo de prueba.
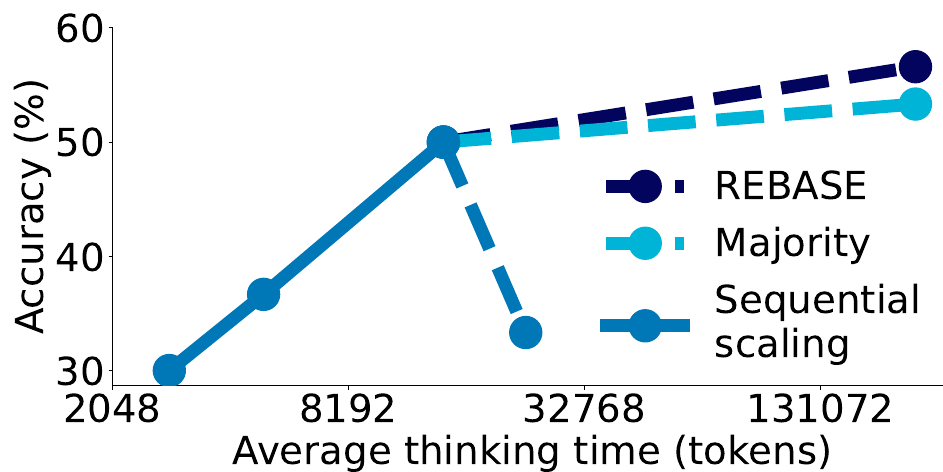
El escalado paralelo como solución El escalado paralelo ofrece una solución a los límites del escalado secuencial, por lo que aumentamos nuestro modelo escalado secuencialmente con dos métodos: (I) Voto por mayoría: después de generar soluciones, la solución final es la más frecuente entre las generaciones; (II) Búsqueda en árbol mediante REBASE: usamos el modelo de recompensa de proceso REBASE, que se inicializa a partir de LLaMA-34B y se ajusta finamente sobre un conjunto de datos sintético de modelado de recompensa de proceso (Wu et al., 2024b). Luego agregamos las soluciones generadas por REBASE mediante voto por mayoría. Como se muestra en la Figura 7, aumentar nuestro modelo con REBASE escala mejor que el voto por mayoría, e incluso que el escalado secuencial en este escenario. Sin embargo, REBASE requiere un pase hacia adelante adicional en cada paso para el modelo de recompensa, lo que añade cierta sobrecarga computacional. Para el escalado secuencial, cuando se le indica que use hasta 512 pasos, en 12 de las 30 preguntas de evaluación el modelo genera una respuesta que excede la ventana de contexto, lo que provoca una gran caída del rendimiento. En general, encontramos que estos métodos de escalado paralelo complementan el escalado secuencial, por lo que ofrecen una vía para escalar aún más el cómputo en tiempo de prueba; más allá de ventanas de contexto fijas.
Declaración de impacto
Declaración de impactoLos modelos de lenguaje con sólidas capacidades de razonamiento tienen el potencial de mejorar enormemente la productividad humana, desde ayudar en la toma de decisiones complejas hasta impulsar avances científicos. Sin embargo, los avances recientes en razonamiento, como o1 de OpenAI y r1 de DeepSeek, carecen de transparencia, lo que limita un progreso de investigación más amplio. Nuestro trabajo tiene como objetivo impulsar la frontera del razonamiento de manera totalmente abierta, fomentando la innovación y la colaboración para acelerar avances que en última instancia beneficien a la sociedad.
Agradecimientos
AgradecimientosAgradecemos a Ryan Marten por generar trazas a partir de DeepSeek r1 para s1.1 usando Bespoke Curator (Marten et al., 2025). Este trabajo se realizó en parte utilizando el clúster de GPU Stanford Marlowe (Kapfer et al., 2025), posible gracias al apoyo financiero de la Universidad de Stanford. Agradecemos a Alexander M. Rush, Andrew Ilyas, Banghua Zhu, Chenglei Si, Chunting Zhou, John Yang, Ludwig Schmidt, Samy Jelassi, Suhas Kotha, Tengyu Ma, Xuechen Li, Yu Sun y Yue Zhang por discusiones muy constructivas.
Referencias
Ankner, Z., Paul, M., Cui, B., Chang, J. D., and Ammanabrolu, P. Critique-out-loud reward models, 2024. URL https://arxiv.org/abs/2408.11791. Arora, D., Singh, H. G., and Mausam. Have llms advanced enough? a challenging problem solving benchmark for large language models, 2023. URL https://arxiv.org/abs/2305.15074. Azerbayev, Z., Schoelkopf, H., Paster, K., Santos, M. D., McAleer, S., Jiang, A. Q., Deng, J., Biderman, S., and Welleck, S. Llemma: An open language model for mathematics, 2023. Bi, Z., Zhang, N., Jiang, Y., Deng, S., Zheng, G., and Chen, H. When do program-of-thoughts work for reasoning?, 2023. URL https://arxiv.org/abs/2308.15452. Biderman, S., Schoelkopf, H., Sutawika, L., Gao, L., Tow, J., Abbasi, B., Aji, A. F., Ammanamanchi, P. S., Black, S., Clive, J., DiPofi, A., Etxaniz, J., Fattori, B., Forde, J. Z., Foster, C., Hsu, J., Jaiswal, M., Lee, W. Y., Li, H., Lovering, C., Muennighoff, N., Pavlick, E., Phang, J., Skowron, A., Tan, S., Tang, X., Wang, K. A., Winata, G. I., Yvon, F., and Zou, A. Lessons from the trenches on reproducible evaluation of language models, 2024. Brown, B., Juravsky, J., Ehrlich, R., Clark, R., Le, Q. V., Ré, C., and Mirhoseini, A. Large language monkeys: Scaling inference compute with repeated sampling, 2024. URL https://arxiv.org/abs/2407.21787.
Cesisita, F. L. Multimodal structured generation: Cvpr's 2nd mmfm challenge technical report, 2024. URL https://arxiv.org/abs/2406.11403. Chen, W., Yin, M., Ku, M., Lu, P., Wan, Y., Ma, X., Xu, J., Wang, X., and Xia, T. Theoremaqa: A theorem-driven question answering dataset, 2023. URL https://arxiv.org/abs/2305.12524. Choi, S., Fang, T., Wang, Z., and Song, Y. Kcts: Knowledge-constrained tree search decoding with token-level hallucination detection, 2023. URL https://arxiv.org/abs/2310.09044. DeepSeek-AI, Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., Liu, A., Xue, B., Wang, B., Wu, B., Feng, B., Lu, C., Zhao, C., Deng, C., Zhang, C., Ruan, C., Dai, D., Chen, D., Ji, D., Li, E., Lin, F., Dai, F., Luo, F., Hao, G., Chen, G., Li, G., Zhang, H., Bao, H., Xu, H., Wang, H., Ding, H., Xin, H., Gao, H., Qu, H., Li, H., Guo, J., Li, J., Wang, J., Chen, J., Yuan, J., Qiu, J., Li, J., Cai, J. L., Ni, J., Liang, J., Chen, J., Dong, K., Hu, K., Gao, K., Guan, K., Huang, K., Yu, K., Wang, L., Zhang, L., Zhao, L., Wang, L., Zhang, L., Xu, L., Xia, L., Zhang, M., Zhang, M., Tang, M., Li, M., Wang, M., Li, M., Tian, N., Huang, P., Zhang, P., Wang, Q., Chen, Q., Du, Q., Ge, R., Zhang, R., Pan, R., Wang, R., Chen, R. J., Jin, R. L., Chen, R., Lu, S., Zhou, S., Chen, S., Ye, S., Wang, S., Yu, S., Zhou, S., Pan, S., Li, S. S., Zhou, S., Wu, S., Ye, S., Yun, T., Pei, T., Sun, T., Wang, T., Zeng, W., Zhao, W., Liu, W., Liang, W., Gao, W., Yu, W., Zhang, W., Xiao, W. L., An, W., Liu, X., Wang, X., Chen, X., Nie, X., Cheng, X., Liu, X., Xie, X., Liu, X., Yang, X., Li, X., Su, X., Lin, X., Li, X. Q., Jin, X., Shen, X., Chen, X., Sun, X., Wang, X., Song, X., Zhou, X., Wang, X., Shan, X., Li, Y. K., Wang, Y. Q., Wei, Y. X., Zhang, Y., Xu, Y., Li, Y., Zhao, Y., Sun, Y., Wang, Y., Yu, Y., Zhang, Y., Shi, Y., Xiong, Y., He, Y., Piao, Y., Wang, Y., Tan, Y., Ma, Y., Liu, Y., Guo, Y., Ou, Y., Wang, Y., Gong, Y., Zou, Y., He, Y., Xiong, Y., Luo, Y., You, Y., Liu, Y., Zhou, Y., Zhu, Y. X., Xu, Y., Huang, Y., Li, Y., Zheng, Y., Zhu, Y., Ma, Y., Tang, Y., Zha, Y., Yan, Y., Ren, Z. Z., Ren, Z., Sha, Z., Fu, Z., Xu, Z., Xie, Z., Zhang, Z., Hao, Z., Ma, Z., Yan, Z., Wu, Z., Gu, Z., Zhu, Z., Liu, Z., Li, Z., Xie, Z., Song, Z., Pan, Z., Huang, Z., Xu, Z., Zhang, Z., and Zhang, Z. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948. Diao, S., Wang, P., Lin, Y., Pan, R., Liu, X., and Zhang, T. Active prompting with chain-of-thought for large language models, 2024. URL https://arxiv.org/abs/2302.12246.
Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al-Dahle, A., Letman, A., Mathur, A., Schelten, A., Yang, A., Fan, A., Goyal, A., Hartshorn, A., Yang, A., Mitra, A., Sravankumar, A., Korenev, A., Hinsvark, A., Rao, A., Zhang, A., Rodriguez, A., Gregerson, A., et al. The llama 3 herd of models, 2024. URL https://arxiv.org/abs/2407.21783.
Fu, Y., Peng, H., Sabharwal, A., Clark, P., and Khot, T. Complexity-based prompting for multi-step reasoning, 2023. URL https://arxiv.org/abs/2210.00720.
Gandhi, K., Lee, D., Grand, G., Liu, M., Cheng, W., Sharma, A., and Goodman, N. D. Stream of search (sos): Learning to search in language, 2024. URL https://arxiv.org/abs/2404.03683.
Gao, B., Song, F., Yang, Z., Cai, Z., Miao, Y., Dong, Q., Li, L., Ma, C., Chen, L., Xu, R., Tang, Z., Wang, B., Zan, D., Quan, S., Zhang, G., Sha, L., Zhang, Y., Ren, X., Liu, T., and Chang, B. Omni-math: A universal olympiad level mathematic benchmark for large language models, 2024a. URL https://arxiv.org/abs/2410.07985.
Gao, L., Tow, J., Biderman, S., Black, S., DiPofi, A., Foster, C., Golding, L., Hsu, J., McDonell, K., Muennighoff, N., Phang, J., Reynolds, L., Tang, E., Thite, A., Wang, B., Wang, K., and Zou, A. A framework for few-shot language model evaluation, September 2021. URL https://doi.org/10.5281/zenodo.5371628.
Gao, Z., Niu, B., He, X., Xu, H., Liu, H., Liu, A., Hu, X., and Wen, L. Interpretable contrastive monte carlo tree search reasoning, 2024b. URL https://arxiv.org/abs/2410.01707.
Glazer, E., Erdil, E., Besiroglu, T., Chicharro, D., Chen, E., Gunning, A., Olsson, C. F., Denain, J.-S., Ho, A., de Oliveira Santos, E., Järviniemi, O., Barnett, M., Sandler, R., Vrzala, M., Sevilla, J., Ren, Q., Pratt, E., Levine, L., Barkley, G., Stewart, N., Grechuk, B., Grechuk, T., Enugandla, S. V., and Wildon, M. Frontiermath: A benchmark for evaluating advanced mathematical reasoning in ai, 2024. URL https://arxiv.org/abs/2411.04872.
Google. Gemini 2.0 flash thinking mode (gemini-2.0-flash-thinking-exp-1219), December 2024. URL https://cloud.google.com/vertex-ai/generative-ai/docs/thinking-mode.
Groeneveld, D., Beltagy, I., Walsh, P., Bhagia, A., Kinney, R., Tafjord, O., Jha, A. H., Ivison, H., Magnusson, I.,
Wang, Y., Arora, S., Atkinson, D., Authur, R., Chandu, K. R., Cohan, A., Dumas, J., Elazar, Y., Gu, Y., Hessel, J., Khot, T., Merrill, W., Morrison, J., Muennighoff, N., Naik, A., Nam, C., Peters, M. E., Pyatkin, V., Ravichander, A., Schwenk, D., Shah, S., Smith, W., Strubell, E., Subramani, N., Wortsman, M., Dasigi, P., Lambert, N., Richardson, K., Zettlemoyer, L., Dodge, J., Lo, K., Soldaini, L., Smith, N. A., and Hajishirzi, H. Olmo: Accelerating the science of language models, 2024.
He, C., Luo, R., Bai, Y., Hu, S., Thai, Z. L., Shen, J., Hu, J., Han, X., Huang, Y., Zhang, Y., Liu, J., Qi, L., Liu, Z., and Sun, M. Olympiadbench: A challenging benchmark for promoting agi with olympiad-level bilingual multimodal scientific problems, 2024. URL https://arxiv.org/abs/2402.14008.
Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., and Steinhardt, J. Measuring mathematical problem solving with the math dataset, 2021. URL https://arxiv.org/abs/2103.03874.
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., Rae, J. W., Vinyals, O., and Sifre, L. Training compute-optimal large language models, 2022. URL https://arxiv.org/abs/2203.15556.
Hou, Z., Lv, X., Lu, R., Zhang, J., Li, Y., Yao, Z., Li, J., Tang, J., and Dong, Y. Advancing language model reasoning through reinforcement learning and inference scaling, 2025. URL https://arxiv.org/abs/2501.11651.
Hu, Y., Shi, W., Fu, X., Roth, D., Ostendorf, M., Zettlemoyer, L., Smith, N. A., and Krishna, R. Visual sketchpad: Sketching as a visual chain of thought for multimodal language models, 2024. URL https://arxiv.org/abs/2406.09403.
Huang, Z., Wang, Z., Xia, S., Li, X., Zou, H., Xu, R., Fan, R.-Z., Ye, L., Chern, E., Ye, Y., Zhang, Y., Yang, Y., Wu, T., Wang, B., Sun, S., Xiao, Y., Li, Y., Zhou, F., Chern, S., Qin, Y., Ma, Y., Su, J., Liu, Y., Zheng, Y., Zhang, S., Lin, D., Qiao, Y., and Liu, P. Olympicarena: Benchmarking multi-discipline cognitive reasoning for superintelligent ai, 2024a. URL https://arxiv.org/abs/2406.12753.
Huang, Z., Zou, H., Li, X., Liu, Y., Zheng, Y., Chern, E., Xia, S., Qin, Y., Yuan, W., and Liu, P. O1 replication journey - part 2: Surpassing o1-preview through simple distillation, big progress or bitter lesson?, 2024b. URL https://arxiv.org/abs/2411.16489.
Huang, Z., Geng, G., Hua, S., Huang, Z., Zou, H., Zhang, S., Liu, P., and Zhang, X. O1 replication journey - part 3: Inference-time scaling for medical reasoning, 2025. URL https://arxiv.org/abs/2501.06458.
Irvine, R., Boubert, D., Raina, V., Liusie, A., Zhu, Z., Mudupalli, V., Korshuk, A., Liu, Z., Cremer, F., Assassi, V., Beauchamp, C.-C., Lu, X., Rialan, T., and Beauchamp, W. Rewarding chatbots for real-world engagement with millions of users, 2023. URL https://arxiv.org/abs/2303.06135.
Jain, N., Han, K., Gu, A., Li, W.-D., Yan, F., Zhang, T., Wang, S., Solar-Lezama, A., Sen, K., and Stoica, I. Livecodebench: Holistic and contamination free evaluation of large language models for code, 2024. URL https://arxiv.org/abs/2403.07974.
Kapfer, C., Stine, K., Narasimhan, B., Mentzel, C., and Candes, E. Marlowe: Stanford's gpu-based computational instrument, January 2025. URL https://doi.org/10.5281/zenodo.14751899.
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., and Amodei, D. Scaling laws for neural language models, 2020. URL https://arxiv.org/abs/2001.08361.
Kim, E., Suk, J., Kim, S., Muennighoff, N., Kim, D., and Oh, A. Llm-as-an-interviewer: Beyond static testing through dynamic llm evaluation, 2024. URL https://arxiv.org/abs/2412.10424.
Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H. y Stoica, I. Efficient memory management for large language model serving with pagedattention, 2023. URL https://arxiv.org/abs/2309.06180.
Labs, B. Bespoke- stratos: The unreasonable effectiveness of reasoning distillation, 2025. URL https://hf.co/bespokelabs/Bespoke- Stratos- 32B. Consultado: 2025- 01- 22.
Lee, K.- H., Fischer, I., Wu, Y.- H., Marwood, D., Baluja, S., Schuurmans, D. y Chen, X. Evolving deeper llm thinking, 2025. URL https://arxiv.org/abs/2501.09891.
Levi, N. A simple model of inference scaling laws, 2024. URL https://arxiv.org/abs/2410.16377.
LI, J., Beeching, E., Tunstall, L., Lipkin, B., Soletskyi, R., Huang, S. C., Rasul, K., Yu, L., Jiang, A., Shen, Z., Qin, Z., Dong, B., Zhou, L., Fleureau, Y., Lample, G. y Polu, S. Numinnamath, 2024. URL https://github.com/project- numina/aimo- progress- prize/blob/main/report/ numina_dataset.pdf.
Lightman, H., Kosaraju, V., Burda, Y., Edwards, H., Baker, B., Lee, T., Leike, J., Schulman, J., Sutskever, I. y Cobbe, K. Let's verify step by step, 2023. URL https://arxiv.org/abs/2305.20050.
Ling, W., Yogatama, D., Dyer, C. y Blunsom, P. Program induction by rationale generation: Learning to solve and explain algebraic word problems, 2017. URL https://arxiv.org/abs/1705.04146.
Liu, J., Cui, L., Liu, H., Huang, D., Wang, Y. y Zhang, Y. Logiqa: A challenge dataset for machine reading comprehension with logical reasoning, 2020. URL https://arxiv.org/abs/2007.08124.
Liu, J., Cohen, A., Pasunuru, R., Choi, Y., Hajishirzi, H. y Celikyilmaz, A. Don't throw away your value model! generating more preferable text with value- guided monte- carlo tree search decoding, 2024. URL https://arxiv.org/abs/2309.15028.
Loshchilov, I. y Hutter, F. Decoupled weight decay regularization, 2019.
Luo, H., Sun, Q., Xu, C., Zhao, P., Lou, J., Tao, C., Geng, X., Lin, Q., Chen, S., Tang, Y. y Zhang, D. Wizardmath: Empowering mathematical reasoning for large language models via reinforced evol- instruct, 2025. URL https://arxiv.org/abs/2308.09583.
Marten, R., Vu, T., Ji, C. C.- J., Sharma, K., Pimpalgaonkar, S., Dimakis, A. y Sathiamoorthy, M. Curator: A tool for synthetic data creation. https://github.com/bespokelabsai/curator, enero de 2025.
Muennighoff, N., Soldaini, L., Groeneveld, D., Lo, K., Morrison, J., Min, S., Shi, W., Walsh, P., Tafjord, O., Lambert, N., Gu, Y., Arora, S., Bhagia, A., Schwenk, D., Wadden, D., Wettig, A., Hui, B., Dettmers, T., Kiela, D., Farhadi, A., Smith, N. A., Koh, P. W., Singh, A. y Hajishirzi, H. Olmoe: Open mixture- of- experts language models, 2024. URL https://arxiv.org/abs/2409.02060.
of America, M. A. Aime, febrero de 2024. URL https://artofproblemsolving.com/wiki/index.php/AIME_Problems_and_Solutions/.
OpenAI. Learning to reason with llms, septiembre de 2024. URL https://openai.com/index/learning- to- reason- with- llms/.
OpenAI. Openai o3- mini, 2025. URL https://openai.com/index/openai- o3- mini/. Consultado: 2025- 02- 24.
Phan, L., Gatti, A., Han, Z., Li, N., Hu, J., Zhang, H., Shi, S., Choi, M., Agrawal, A., Chopra, A., et al. Humanity's last exam, 2025. URL https://arxiv.org/abs/2501.14249.
Qin, Y., Li, X., Zou, H., Liu, Y., Xia, S., Huang, Z., Ye, Y., Yuan, W., Liu, H., Li, Y. y Liu, P. O1 replication journey: A strategic progress report - part 1, 2024. URL https://arxiv.org/abs/2410.18982.
Qwen, : Yang, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Li, C., Liu, D., Huang, F., Wei, H., Lin, H., Yang, J., Tu, J., Zhang, J., Yang, J., Yang, J., Zhou, J., Lin, J., Dang, K., Lu, K., Bao, K., Yang, K., Yu, L., Li, M., Xue, M., Zhang, P., Zhu, Q., Men, R., Lin, R., Li, T., Xia, T., Ren, X., Ren, X., Fan, Y., Su, Y., Zhang, Y., Wan, Y., Liu, Y., Cui, Z., Zhang, Z. y Qiu, Z. Qwen2.5 technical report, 2024. URL https://arxiv.org/abs/2412.15115.
Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J. y Bowman, S. R. Gpqa: A graduate- level google- proof q&a benchmark, 2023. URL https://arxiv.org/abs/2311.12022.
Shi, Q., Tang, M., Narasimhan, K. y Yao, S. Can language models solve olympiad programming?, 2024. URL https://arxiv.org/abs/2404.10952.
Snell, C., Lee, J., Xu, K. y Kumar, A. Scaling llm test- time compute optimally can be more effective than scaling model parameters, 2024. URL https://arxiv.org/abs/2408.03314.
Srivastava, A., Rastogi, A., Rao, A., Shoeb, A. A. M., Abid, A., Fisch, A., Brown, A. R., Santoro, A., Gupta, A., Garriga- Alonso, A., et al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models, 2023.
Su, H., Yen, H., Xia, M., Shi, W., Muennighoff, N., yu Wang, H., Liu, H., Shi, Q., Siegel, Z. S., Tang, M., Sun, R., Yoon, J., Arik, S. O., Chen, D. y Yu, T. Bright: A realistic and challenging benchmark for reasoning- intensive retrieval, 2024. URL https://arxiv.org/abs/2407.12883.
Sun, L., Han, Y., Zhao, Z., Ma, D., Shen, Z., Chen, B., Chen, L. y Yu, K. Scieval: A multi- level large language model evaluation benchmark for scientific research, 2024. URL https://arxiv.org/abs/2308.13149.
Team, K., Du, A., Gao, B., Xing, B., Jiang, C., Chen, C., Li, C., Xiao, C., Du, C., Liao, C., Tang, C., Wang, C., Zhang, D., Yuan, E., Lu, E., Tang, F., Sung, F., Wei, G., Lai, G., Guo, H., Zhu, H., Ding, H., Hu, H., Yang, H., Zhang, H., Yao, H., Zhao, H., Lu, H., Li, H., Yu, H., Gao, H., Zheng, H., Yuan, H., Chen, J., Guo, J., Su, J., Wang, J., Zhao, J., Zhang, J., Liu, J., Yan, J., Wu, J., Shi, L., Ye, L., Yu, L., Dong, M., Zhang, N., Ma, N., Pan, Q., Gong, Q., Liu, S., Ma, S., Wei, S., Cao, S., Huang, S., Jiang, T., Gao, W., Xiong, W., He, W., Huang, W., Wu, W., He, W., Wei, X., Jia, X., Wu, X., Xu, X., Zu, X., Zhou, X., Pan, X., Charles, Y., Li, Y., Hu, Y., Liu, Y., Chen, Y., Wang, Y., Liu, Y., Qin, Y., Liu, Y., Yang, Y., Bao, Y., Du, Y., Wu, Y., Wang, Y., Zhou, Z., Wang, Z., Li, Z., Zhu, Z., Zhang, Z., Wang, Z., Yang, Z., Huang, Z., Huang, Z., Xu, Z. y Yang, Z. Kimi k1.5: Scaling reinforcement learning with llms, 2025. URL https://arxiv.org/abs/2501.12599.
Team, N. Sky- tl: Fully open- source reasoning model with o1- preview performance in 450\(presupuesto, 2025. URL https://novasky- ai.github.io/posts/sky- tl. Consultado: 2025- 01- 09.
Team, Q. Qwq: Reflect deeply on the boundaries of the unknown, noviembre de 2024. URL https://qwenlm.github.io/blog/qwq- 32b- preview/.
Wang, J., Meng, F., Liang, Y. y Zhou, J. Drt- o1: Optimized deep reasoning translation via long chain- of- thought, 2024a. URL https://arxiv.org/abs/2412.17498.
Wang, P., Li, L., Shao, Z., Xu, R. X., Dai, D., Li, Y., Chen, D., Wu, Y. y Sui, Z. Math- shepherd: Verify and reinforce llms step- by- step without human annotations, 2024b. URL https://arxiv.org/abs/2312.08935.
Wang, S., Liu, Z., Zhong, W., Zhou, M., Wei, Z., Chen, Z. y Duan, N. From Isat: The progress and challenges of complex reasoning, 2021. URL https://arxiv.org/abs/2108.00648.
Wang, Z., Dong, Y., Delalleau, O., Zeng, J., Shen, G., Egert, D., Zhang, J. J., Sreedhar, M. N. y Kuchaiev, O. Help-steer2: Open-source dataset for training top-performing reward models, 2024c. URL https://arxiv.org/abs/2406.08673.
Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q. y Zhou, D. Chain-of-thought prompting elicits reasoning in large language models, 2023. URL https://arxiv.org/abs/2201.11903.
Welleck, S., Bertsch, A., Finlayson, M., Schoelkopf, H., Xie, A., Neubig, G., Kulikov, I. y Harchaoui, Z. From decoding to meta-generation: Inference-time algorithms for large language models, 2024. URL https://arxiv.org/abs/2406.16838.
Wu, T., Lan, J., Yuan, W., Jiao, J., Weston, J. y Sukhbaatar, S. Thinking llms: General instruction following with thought generation, 2024a. URL https://arxiv.org/abs/2410.10630. Wu, Y., Sun, Z., Li, S., Welleck, S. y Yang, Y. Inference scaling laws: An empirical analysis of compute-optimal inference for problem-solving with language models, 2024b. URL https://arxiv.org/abs/2408.00724. Xiang, V., Snell, C., Gandhi, K., Albalak, A., Singh, A., Blagden, C., Phung, D., Rafailov, R., Lile, N., Mahan, D., Castricato, L., Franken, J.-P., Haber, N. y Finn, C. Towards system 2 reasoning in llms: Learning how to think with meta chain-of-thought, 2025. URL https://arxiv.org/abs/2501.04682. Xie, Y., Kawaguchi, K., Zhao, Y., Zhao, X., Kan, M.-Y., He, J. y Xie, Q. Self-evaluation guided beam search for reasoning, 2023. URL https://arxiv.org/abs/2305.00633. Xin, H., Guo, D., Shao, Z., Ren, Z., Zhu, Q., Liu, B., Ruan, C., Li, W. y Liang, X. Deepseek-prover: Advancing theorem proving in llms through large-scale synthetic data, 2024. URL https://arxiv.org/abs/2405.14333. Xu, H., Wu, X., Wang, W., Li, Z., Zheng, D., Chen, B., Hu, Y., Kang, S., Ji, J., Zhang, Y., Guo, Z., Yang, Y., Zhang, M. y Zhang, D. Redstar: Does scaling long-cot data unlock better slow-reasoning systems?, 2025. URL https://arxiv.org/abs/2501.11284. Yang, Z., Band, N., Li, S., Candès, E. y Hashimoto, T. Synthetic continued pretraining, 2024. URL https://arxiv.org/abs/2409.07431. Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T. L., Cao, Y. y Narasimhan, K. Tree of thoughts: Deliberate problem solving with large language models, 2023a. URL https://arxiv.org/abs/2305.10601. Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K. y Cao, Y. React: Synergizing reasoning and acting in language models, 2023b. URL https://arxiv.org/abs/2210.03629. Ye, Y., Huang, Z., Xiao, Y., Chern, E., Xia, S. y Liu, P. Limo: Less is more for reasoning, 2025a. URL https://arxiv.org/abs/2502.03387. Ye, Y., Xiao, Y., Mi, T. y Liu, P. Aime-preview: A rigorous and immediate evaluation framework for advanced mathematical reasoning. https://github.com/GAIR-NLP/AIME-Preview, 2025b. Repositorio de GitHub.
Yu, L., Jiang, W., Shi, H., Yu, J., Liu, Z., Zhang, Y., Kwok, J. T., Li, Z., Weller, A., y Liu, W. Metamath: Bootstrap your own mathematical questions for large language models, 2024. URL https://arxiv.org/abs/2309.12284. Yuan, S., Chen, Z., Xi, Z., Ye, J., Du, Z., y Chen, J. Agent-r: Training language model agents to reflect via iterative self-training, 2025. URL https://arxiv.org/abs/2501.11425. Zelikman, E., Wu, Y., Mu, J., y Goodman, N. D. Star: Bootstrapping reasoning with reasoning, 2022. URL https://arxiv.org/abs/2203.14465. Zelikman, E., Harik, G., Shao, Y., Jayasiri, V., Haber, N., y Goodman, N. D. Quiet-star: Language models can teach themselves to think before speaking, 2024. URL https://arxiv.org/abs/2403.09629. Zhang, H. y Chen, C. Test-time compute scaling laws, 2024. URL https://github.com/hughbzhang/ol_inference_scaling_laws. Zhang, S., Chen, Z., Shen, Y., Ding, M., Tenenbaum, J. B., y Gan, C. Planning with large language models for code generation, 2023. URL https://arxiv.org/abs/2303.05510. Zhang, Y., Wu, S., Yang, Y., Shu, J., Xiao, J., Kong, C., y Sang, J. ol-coder: an ol replication for coding, 2024a. URL https://arxiv.org/abs/2412.00154. Zhang, Y., Yang, J., Yuan, Y., y Yao, A. C.-C. Cumulative reasoning with large language models, 2024b. URL https://arxiv.org/abs/2308.04371. Zhong, H., Xiao, C., Tu, C., Zhang, T., Liu, Z., y Sun, M. Jec-qa: A legal-domain question answering dataset, 2019. URL https://arxiv.org/abs/1911.12011. Zhong, W., Cui, R., Guo, Y., Liang, Y., Lu, S., Wang, Y., Saied, A., Chen, W., y Duan, N. Agieval: A human-centric benchmark for evaluating foundation models, 2023. URL https://arxiv.org/abs/2304.06364. Zhou, A., Yan, K., Shlapentokh-Rothman, M., Wang, H., y Wang, Y.-X. Language agent tree search unifies reasoning acting and planning in language models, 2024. URL https://arxiv.org/abs/2310.04406. Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., Ma, X., Efrat, A., Yu, P., Yu, L., Zhang, S., Ghosh, G., Lewis, M., Zettlemoyer, L., y Levy, O. Lima: Less is more for alignment, 2023. URL https://arxiv.org/abs/2305.11206.
Contenido
1 Introducción 1
2 Curación de datos de razonamiento para crear s1K 2
2.1 Colección inicial de 59K muestras 2
2.2 Selección final de 1K muestras 2
3 Escalado en tiempo de prueba 3
3.1 Método 3
3.2 Métricas 4
4 Resultados 4
4.1 Configuración 4
4.2 Rendimiento 6
5 Ablaciones 6
5.1 Cantidad, diversidad y dificultad de los datos 6
5.2 Métodos de escalado en tiempo de prueba 6
6 Discusión y trabajo relacionado 8
6.1 Razonamiento eficiente en muestras 8
6.2 Escalado en tiempo de prueba 9
A s1.1 16
B Determinismo de la evaluación 16
C Detalles de s1K 17
C.1 Resumen de s1K 17
C.2 Composición del conjunto de datos para las 59K preguntas completas 17
C.3 Indicación de calificación de s1K 19
C.4 Selección de diversidad de s1K 19
C.5 Descontaminación 19
D Detalles de entrenamiento 21
D.1 Ablaciones de entrenamiento: longitud de secuencia 21
D.2 Muestras de entrenamiento 21
E Detalles del escalado en tiempo de prueba 35
E.1 Ablaciones de escalado secuencial 35
E.2 Ejemplos para la ablación de muestreo por rechazo 37
F Control de versiones 46
A. s1.1
A. s1.1Siete días después de nuestro lanzamiento de s1, lanzamos s1.1. Regeneramos las trazas para nuestras 1,000 muestras en s1K usando DeepSeek r1 (DeepSeek-AI et al., 2025) para crear s1K-1.1. Usamos el mismo procedimiento de entrenamiento para entrenar nuestro modelo s1.1. Otras actualizaciones desde nuestro lanzamiento incluyen el lanzamiento de o3 (OpenAI, 2025), LIMO (Ye et al., 2025a) y AIME 2025. Consideramos todos estos nuevos desarrollos en la Tabla 5. Encontramos que s1.1 se desempeña significativamente mejor que s1. También intentamos destilar de Claude 3.7, lo que llevó a un rendimiento peor que el de r1 (no reportado).
| Modelo | Ejemplos | MATH500 | GPQA | AIME 2024 | AIME 2025 |
| Solo API | |||||
| o3-mini-low | N/A | 95.8 | 70.6 | 56.3 | 42.1 |
| o3-mini-medium | N/A | 97.3 | 76.8 | 75.8 | 70.4 |
| o3-mini-high | N/A | 97.9 | 79.7 | 83.8 | 80.9 |
| Pesos abiertos | |||||
| QwQ-32B | N.A. | 90.6 | 54.5 | 46.7 | 32.7 |
| r1 | ≥800K | 07.3 | 71.5 | 79.8 | 70.0 |
| r1-distill-Llama-70B | 800K | 94.5 | 65.2 | 57.1 | 56.3 |
| r1-distill-Qwen-14B | 800K | 93.9 | 59.1 | 61.7 | 48.0 |
| r1-distill-Qwen-32B | 800K | 94.3 | 62.1 | 58.3 | 49.6 |
| Pesos abiertos y datos abiertos | |||||
| LIMO | 817 | 94.8 | 66.7 | 56.3 | 44.6 |
| s1 sin BF | 1K | 92,6 | 56,6 | 50,0 | 26,7 |
| s1 con Budget Forcing «Wait» 1x | 1K | 92,8 | 59,6 | 53,3 | 30,0 |
| s1 con Budget Forcing «Wait» 2x | 1K | 93,0 | 59,6 | 53,3 | 33,3 |
| s1 con Budget Forcing «Wait» 4x | 1K | 92,2 | 58,6 | 56,7 | 36,7 |
| s1.1 sin BF | 1K | 94,4 | 60,6 | 56,7 | 50,0 |
| s1.1 con Budget Forcing «Wait» 1x | 1K | 95,4 | 62,6 | 56,7 | 50,0 |
| s1.1 con Budget Forcing «Wait» 2x | 1K | 95,4 | 63,6 | 56,7 | 50,0 |
B. Determinismo de la evaluación
Ejecutamos nuestras evaluaciones usando vLLM (Kwon et al., 2023), ya que es más rápido que las alternativas que probamos. Sin embargo, encontramos que incluso cuando se usan las mismas semillas aleatorias y muestreo voraz, las puntuaciones de evaluación pueden cambiar significativamente entre ejecuciones:
Diferentes tamaños de lote causan resultados diferentes, véase https://github.com/vllm-project/vllm/issues/5898 Generaciones continuas causan resultados diferentes, véase https://github.com/vllm-project/vllm/issues/11783 Cambios en el paralelismo de tensores causan resultados diferentes
Como nuestro modelo genera largas trazas de razonamiento antes de su respuesta, pequeños cambios numéricos pueden multiplicarse hasta producir grandes diferencias. Encontramos muchas generaciones que son exactamente iguales durante miles de tokens y luego de repente difieren en un token, terminando finalmente con una respuesta completamente diferente. Para contrarrestar en parte este problema, generalmente ejecutamos nuestras evaluaciones finales usando precisión completa, a menos que se indique lo contrario.
- .
C. Detalles de s1K
C.1. Resumen de s1K
| Dominio | #preguntas | Recuento total de tokens | Palabras clave |
| Geometría | 109 | 560,2K | Área, Triángulo, Distancia |
| Teoría de números | 98 | 522,5K | Sucesiones, Divisibilidad |
| Combinatoria | 75 | 384,7K | Permutaciones, Conteo |
| Funciones reales | 43 | 234,8K | Trigonometría, Cálculo |
| Biología | 41 | 120,9K | Reacciones orgánicas |
| Funciones complejas | 32 | 170,2K | Raíces complejas |
| Teoría cuántica | 32 | 127,9K | Partículas, Funciones de onda |
| Teoría de campos | 28 | 150,1K | Polinomios, Raíces |
| Cálculo de variaciones | 28 | 155,5K | Optimización, Control |
| Ecuaciones en diferencias | 24 | 132,5K | Recurrencia, Recursión |
| Teoría electromagnética | 23 | 95,8K | Óptica, Ondas, Difracción |
| Teoría de grupos | 22 | 100,0K | Grupos, Automorfismos |
| Álgebra lineal | 22 | 128,3K | Matrices, Determinantes |
| Teoría de la probabilidad | 20 | 114,6K | Camino aleatorio, Esperanza |
| Sistemas algebraicos | 19 | 109,9K | Ecuaciones funcionales |
| Mecánica | 19 | 103,6K | Fuerzas, movimiento, energía |
| Termodinámica | 19 | 74,2K | Máquinas térmicas, entropía |
| Ecuaciones diferenciales | 18 | 89,6K | Sustitución, existencia |
| Ciencias de la computación | 18 | 34,2K | Teoría de la complejidad, algoritmos |
| Análisis numérico | 18 | 76,5K | Análisis de errores, estabilidad |
| Cálculo | 17 | 96,3K | Convergencia, sumación |
| Estructuras algebraicas | 17 | 90,4K | Desigualdades, conjuntos |
| Astronomía | 16 | 37,7K | Poblaciones estelares, órbitas |
| 27 dominios restantes | 242 | 982,2K | Dominios con ≤ 16 preguntas |
| Todos los dominios (51) | 1000 | 4,7M | s1K |
C.2. Composición del conjunto de datos para las 59K preguntas completas
| Fuente | Descripción | n.º de muestras | Longitud media del razonamiento |
| NuminaMATH (LI et al., 2024) | Problemas de matemáticas de sitios web | 30660 | 4,1K |
| MATH (Hendrycks et al., 2021) | Problemas de matemáticas de competiciones | 11999 | 2,9K |
| OlympicArena (Huang et al., 2024a) | Preguntas de olimpiadas de Astronomía, Biología, Química, Informática, Geografía, Matemáticas y Física | 4250 | 3,2K |
| OmniMath (Gao et al., 2024a) | Problemas de matemáticas de competiciones | 4238 | 4,4K |
| AGIEval (Zhong et al., 2023; Ling et al., 2017; Hendrycks et al., 2021; Liu et al., 2020; Zhong et al., 2019; Wang et al., 2021) | Problemas de inglés, derecho, lógica y matemáticas de los exámenes SAT, LSAT y otros | 2385 | 1,2K |
| xword | Crucigramas | 999 | 0,7K |
| OlympiadBench (He et al., 2024) | Preguntas de olimpiadas de Matemáticas y Física | 896 | 3,9K |
| AIME (1983-2021) | American Invitational Mathematics Examination | 890 | 4,7K |
| TheoremQA (Chen et al., 2023) | Preguntas de nivel universitario de Informática, Finanzas, Matemáticas y Física relacionadas con teoremas | 747 | 2,1K |
| USACO (Shi et al., 2024) | Problemas de código de la USA Computing Olympiad | 519 | 3,6K |
| JEEBench (Arora et al., 2023) | Problemas de Química, Matemáticas y Física utilizados en el examen de acceso a la universidad del Instituto Indio de Tecnología | 515 | 2,9K |
| GPQA (Rein et al., 2023) | Preguntas científicas de nivel de doctorado | 348 | 2,9K |
| SciEval (Sun et al., 2024) | Problemas de Biología, Química y Física de diversas fuentes | 227 | 0,7K |
| s1-prob | Exámenes de calificación de estadística de Stanford | 182 | 4,0K |
| LiveCodeBench (Jain et al., 2024) | Problemas de código de sitios web de programación (LeetCode, AtCoder y CodeForces) | 151 | 3,5K |
| s1-teasers | Acertijos matemáticos extraídos de Internet | 23 | 4.1K |
| Las 59K preguntas completas | Composición de los conjuntos de datos anteriores con trazas de razonamiento y soluciones | 59029 | 3.6K |
C.3. Indicación de calificación de s1K
Para calificar si un ejemplo es correcto para nuestra selección de conjunto de datos en , usamos la indicación de la Figura 8. Calificamos usando Claude 3.5, excepto la corrección entre las 1,000 muestras finales, que calificamos con Claude 3.7.
Eres un asistente de IA para calificar un problema de ciencias. El usuario te proporcionará la pregunta en sí, un intento realizado por un estudiante y la respuesta correcta al problema. Tu trabajo es juzgar si el intento es correcto comparándolo con la respuesta correcta. Si la solución esperada concluye con un número o una opción, no debe haber ambigüedad. Si la solución esperada implica recorrer todo el proceso de razonamiento, debes juzgar el intento en función de si el proceso de razonamiento es correcto con la respuesta correcta, si es útil.
El usuario proporcionará el intento y la respuesta correcta en el siguiente formato:
Problema {problem}
Intento {attempt}
Respuesta correcta {solution}
Explica tu razonamiento y termina tu respuesta en una nueva línea con solo "Yes" o "No" (sin comillas).
C.4. Selección de diversidad de s1K
El algoritmo 1 proporciona nuestro algoritmo para seleccionar datos en nuestra etapa de selección por diversidad. Como se mencionó en \(\S 2\), también incluimos muestras de algunos benchmarks específicos que percibimos como de alta calidad. Ninguna de las muestras se solapa con nuestra evaluación final.
C.5. Descontaminación
Filtramos todas las muestras comprobando si hay un solapamiento de 8 gramos entre los ejemplos seleccionados y los benchmarks de evaluación: MATH500, GPTQA Diamond y AIME24. Excluimos las preguntas con un solapamiento de más de 8 gramos.
Algoritmo 1 Muestreo en dos etapas para s1K
1: Entrada: Conjunto de 24.496 preguntas con características 2: Salida: Conjunto de 1.000 preguntas seleccionadas 3: Inicializar el conjunto de salida (solo registra elementos únicos) 4: for do 5: if IsGeminiCorrect and (IsAIME or IsGPQA ) then 6: 7: Seleccionar todas las soluciones correctas de AIME/GPQA 8: else if IsGeminiCorrect and IsMATH and ThinkingLength then 9: 10: Seleccionar soluciones correctas de MATH500 con cadenas largas 11: end if 12: end for 13: Todos los dominios disponibles 14: Inicializar el conjunto de dominios 15: while do 16: RandomChoice 17: Seleccionar un dominio aleatoriamente 18: Preguntas del dominio 19: Obtener preguntas de este dominio 20: ranks RankByThinkingLength 21: Ordenar por longitud de pensamiento 22: weights ranks 23: Aplicar ponderación de ley de potencias 24: WeightedSample , weights) 25: Muestrear favoreciendo cadenas más largas 26: 27: Añadir la pregunta seleccionada 28: 29: if then 30: 31: Eliminar los dominios agotados 32: end if 33: end while
D. Detalles de entrenamiento
Tomamos un modelo que ya ha sido preentrenado y ajustado con instrucciones y lo ajustamos aún más para el razonamiento. En concreto, utilizamos Qwen2.5- 32B- Instruct (Qwen et al., 2024), que en tareas matemáticas generalmente iguala o supera al modelo más grande Qwen2.5- 72B- Instruct (Qwen et al., 2024) u otros modelos abiertos (Dubey et al., 2024; Groeneveld et al., 2024; Muennighoff et al., 2024). Usamos delimitadores de tokens para separar la etapa de pensamiento de la etapa de respuesta. Encerramos la etapa de pensamiento con <|im_start|>think y <|im_start|>answer; ambos precedidos y seguidos por un salto de línea. Las muestras de nuestro conjunto de datos están en . Usamos hiperparámetros básicos de ajuste fino: entrenamos durante 5 épocas con un tamaño de lote de 16 para un total de 315 pasos de gradiente. Entrenamos en precisión bfloat16 con una tasa de aprendizaje de con calentamiento lineal durante (16 pasos) y luego decaída a 0 durante el resto del entrenamiento (299 pasos) siguiendo un esquema coseno. Usamos el optimizador AdamW (Loshchilov & Hutter, 2019) con , y decaimiento de peso de . No calculamos la pérdida sobre las preguntas, solo sobre las trazas de razonamiento y las soluciones. Nos aseguramos de que la longitud de secuencia sea suficientemente grande para evitar truncar cualquier muestra; una configuración que analizamos mediante ablación en . El entrenamiento tarda solo 26 minutos en 16 GPU NVIDIA H100.
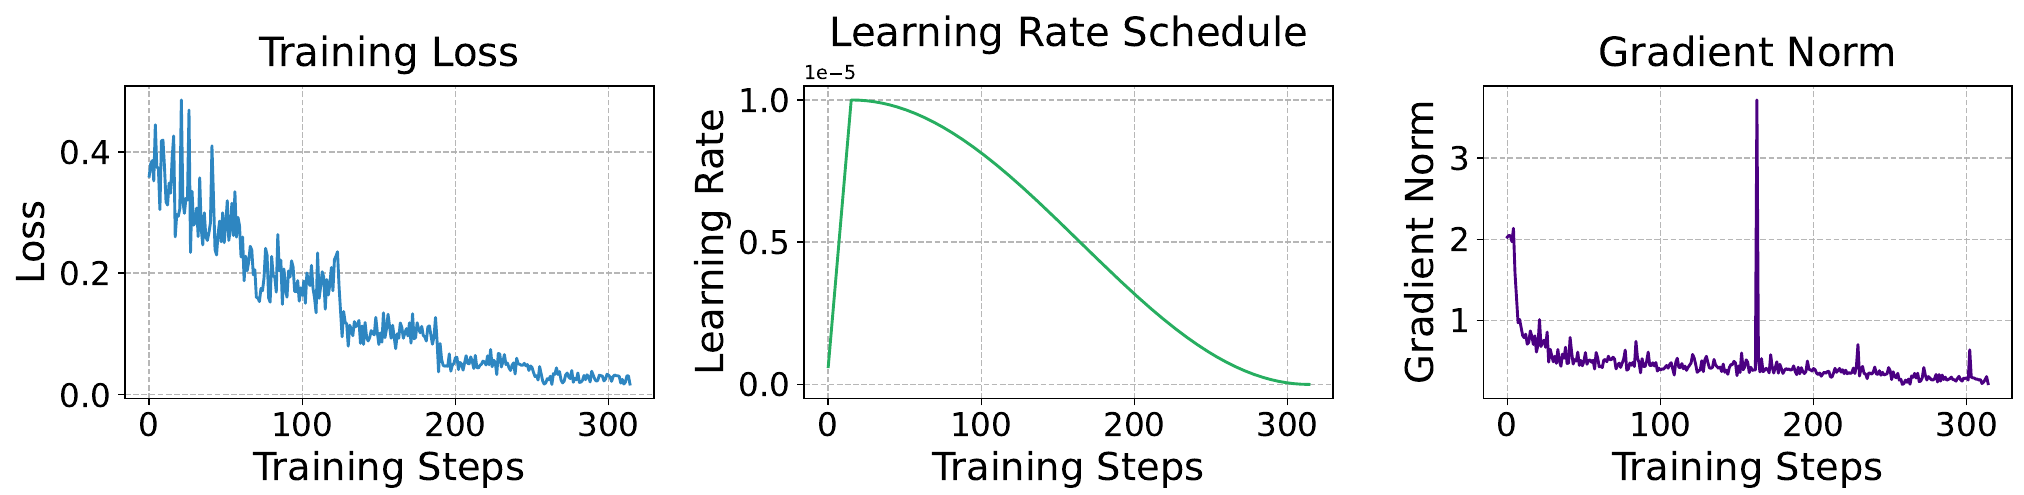
Figura 9. Dinámica de entrenamiento de s1-32B en s1K.
D.1. Ablaciones de entrenamiento: longitud de secuencia
| Contexto de solo lectura para comprender la fuente (no es texto fuente que deba traducirse): D.1. Ablaciones de entrenamiento: Longitud de secuencia Tabla 8. Ablación de longitud de secuencia de entrenamiento. Reportamos "precisión / promedio de tokens de pensamiento por muestra"; cuanto mayor es la precisión y menores son los tokens de pensamiento (coste de inferencia), mejor. Texto a traducir: Modelo A | Modelo B | |
| Longitud de secuencia de entrenamiento | 4096 | 32768 |
| % de muestras de entrenamiento truncadas | 74% | 0% |
| AIME24 | 30.0% / 20721 | 50.0% / 6984 |
| MATH500 | 90.0% / 5324 | 91.0% / 3268 |
| GPQA | 52.5% / 6841 | 53.0% / 3568 |
Tabla 8. Ablación de la longitud de secuencia de entrenamiento. Reportamos "precisión / promedio de tokens de pensamiento por muestra"; cuanto mayor sea la precisión y menores sean los tokens de pensamiento (costo de inferencia), mejor.
Además de nuestras ablaciones de escalado en , el principal hiperparámetro de entrenamiento que ablacionamos es la longitud de secuencia utilizada durante el entrenamiento. Encontramos que una longitud de secuencia de entrenamiento más corta conduce a trazas de razonamiento más largas en el momento de la prueba. Esto se debe a que, al entrenar con una longitud de secuencia más corta, la sección de respuesta de la muestra de entrenamiento se corta con mayor frecuencia. Inversamente, cuando la longitud de secuencia de entrenamiento es más larga, más muestras aparecen en su totalidad con la sección donde el modelo responde. Por lo tanto, el modelo recibe más actualizaciones de gradiente en las que aprende a generar una respuesta siguiendo su cadena. Esto, a su vez, conduce a una mayor probabilidad logarítmica de la sección de respuesta en cualquier punto durante la generación y, por ende, a trazas de razonamiento más cortas en el momento de la prueba. En términos de rendimiento, también encontramos que el modelo entrenado con una longitud de secuencia más larga se desempeña mejor. Por lo tanto, optamos por la longitud de secuencia de entrenamiento más larga, ya que conduce a un mejor rendimiento y hace que la inferencia sea más eficiente al generar trazas de razonamiento más cortas.
D.2. Muestras de entrenamiento
La Tabla 9, la Tabla 10 y la Tabla 11 contienen muestras de entrenamiento de s1K.
Tabla 9. Muestra de s1K proveniente de s1-prob. El texto negro es la pregunta y el texto amarillo es la solución. Basándonos únicamente en la pregunta, generamos la traza de razonamiento en azul claro y la respuesta en azul con Gemini, que utilizamos para el entrenamiento.
Se dan variables aleatorias integrables y en el mismo espacio de probabilidad , y dos -álgebras . Para , sea
(a) Demuestre que existen variables aleatorias integrables y tales que, cuando , tanto como . (b) Demuestre que casi seguramente .
1. Introduzcamos las notaciones, y , para todo y , . Claramente, ambas son filtraciones y, por definición, y , para todo . Así, (o ) es una martingala de Doob con respecto a la filtración (o ) y, por lo tanto, es U.I., siendo integrable. Ahora aplique el hecho de que una martingala es U.I. si y solo si converge en y concluya.
2. Proporcionamos dos demostraciones diferentes.
1. Observe la siguiente identidad que se deduce de la propiedad de la torre.
Note que y, por el teorema de convergencia hacia arriba de Lévy, donde . Es evidente que (dado que es el límite casi seguro de ) y, por lo tanto, casi seguramente. Combinando las observaciones anteriores, concluimos que . De manera similar, . Ahora invoque la ecuación (4) para concluir que casi seguramente.
2. Dado que es integrable, tenemos, por el teorema de convergencia hacia arriba de Lévy, . De manera similar, . Por otro lado, en la primera demostración hemos observado que y, por lo tanto, . Esto produce lo siguiente.
De manera similar, . Esto demuestra que casi seguramente.
Analicemos el problema. Se nos dan dos sucesiones de variables aleatorias y definidas mediante esperanzas condicionales. Necesitamos demostrar que estas sucesiones convergen en y que sus límites son iguales casi seguramente.
Parte (a): Convergencia en .
Las sigma-álgebras involucradas son crecientes:
Para la sucesión :
La sucesión de sigma-álgebras es creciente. Por el Teorema de Convergencia de Martingalas (para esperanzas condicionales), dado que es integrable, la sucesión converge casi seguramente y en a . Sea .
De manera similar, para la sucesión :
La sucesión de sigma-álgebras es creciente. Por el Teorema de Convergencia de Martingalas, la sucesión converge casi seguramente y en a . Sea .
Parte (b): Demostrar que casi seguramente .
Tenemos y .
Sea y .
Entonces y .
Considérese . .
. Dado que , .
. Dado que no está definido, supongamos que y están dados.
Consideremos el sigma-álgebra generado por todos los y .
Sea .
Tanto como son medibles con respecto a . Por lo tanto, y son medibles con respecto a .
Consideremos .
Consideremos .
Sea .
Consideremos .
Consideremos .
Consideremos los sigma-álgebras límite y .
Sabemos que es - medible y es - medible.
Sea .
Consideremos el caso en que y son independientes. Entonces y .
.
Consideremos el sigma-álgebra generado por toda la información. Sea .
Entonces tanto como son - medibles.
Tenemos y c.s. y en .
Consideremos y .
Sea .
Consideremos .
Intentemos demostrar que tanto como son iguales a . Esto parece demasiado simple.
Consideremos la definición de esperanza condicional. Para cualquier conjunto , .
Para cualquier conjunto , .
Consideremos donde .
Consideremos donde .
Consideremos el sigma-álgebra .
Sea .
Tenemos .
Dado que depende de que depende de etc., es complejo.
Consideremos el caso en que y .
Entonces .
Si este fuera el caso, entonces y , por lo que y .
Necesitamos c.s., es decir, c.s. Esto no es cierto en general.
Considérese la sigma-álgebra generada por todos los y , denotada por .
Entonces .
. Considérese . Esto significa que para cualquier
Considérese . Esto significa que para cualquier
Sea
Considérese
Considérese
Usemos el hecho de que es - medible y es - medible.
Considérese la sigma-álgebra más pequeña que contiene tanto como
Esta es
Intentemos mostrar que
Considérese la definición de y
Considérese
Dado que es medible con respecto a , esto no se simplifica fácilmente.
Supongamos que en un conjunto de medida positiva.
Considérese el caso en que y son triviales.
Entonces y
Texto a traducir: Sea
Considérese
Tenemos
Por las propiedades de la esperanza condicional,
Considérese la sigma-álgebra generada por todas las variables aleatorias involucradas.
Sea
Considérense los límites. Cuando
Cuando
Sean y
Tenemos y
Considérese
Considérese la sigma-álgebra
Sea
Considérese la sigma-álgebra límite generada por toda la información.
Sea
Entonces y
Tenemos y
Considérense y
Sea
Considérese
Considérese la sucesión de pares
Si los límites son iguales, entonces para cualquier función medible acotada ,
Considérese la sigma-álgebra
Entonces tanto como son medibles con respecto a
Considérese
Sea
Considérese
Entonces y Considérese la sigma-álgebra límite .
Tenemos y .
Sea .
Considérese .
Considérese la variable aleatoria . Entonces y \(Z{\infty} = \lim_{n} \mathbb{E}[X|\mathcal{G}_{n}]\).
Sea .
Considérese . Supóngase que .
Considérese la esperanza condicional con respecto a la unión de las sigma-álgebras.
Sea .
Considérese .
Entonces .
Y .
Así que y .
Sean y .
Considérese .
Entonces .
Y .
Esto significa que c.s. y c.s.
Por lo tanto, c.s.
Solución:
(a) Para la sucesión , las -álgebras son crecientes a medida que aumenta. Dado que es integrable, por el Teorema de Convergencia de Martingalas para esperanzas condicionales, la sucesión converge casi seguramente y en a . De manera similar, para la sucesión , las -álgebras son crecientes. Dado que es integrable, por el Teorema de Convergencia de Martingalas, la sucesión converge casi seguramente y en a .
(b) Sean \(\mathcal{F}{\infty} = \sigma (\mathcal{A}, Z{0}, Z_{1}, \ldots)\) y \(G_{\infty} = \sigma (B, Y_{0}, Y_{1}, \ldots)\) . Tenemos \(Y_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty}]\) y \(Z{\infty} = \mathbb{E}[X|G_{\infty}]\) . Consideremos la \(\sigma\) -álgebra \(\mathcal{H} = \mathcal{F}{\infty} \vee G{\infty} = \sigma (\mathcal{A}, B, Y_{0}, Z_{0}, Y_{1}, Z_{1}, \ldots)\) . Consideremos \(W = \mathbb{E}[X|\mathcal{H}]\) .
Tenemos \(\mathcal{F}{\infty} \subseteq \mathcal{H}\) , así que \(\mathbb{E}[W|\mathcal{F}{\infty}] = \mathbb{E}[\mathbb{E}[X|\mathcal{H}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty}\) .
Dado que \(W\) es \(\mathcal{H}\) - medible, \(\mathbb{E}[W|\mathcal{F}{\infty}] = Y{\infty}\) implica que \(Y_{\infty}\) es la esperanza condicional de \(W\) dada \(\mathcal{F}{\infty}\) . Pero como \(Y{\infty}\) ya es \(\mathcal{F}{\infty}\) - medible, tenemos \(\mathbb{E}[W|\mathcal{F}{\infty}] = W\) si \(W\) es \(\mathcal{F}_{\infty}\) - medible, lo cual no es necesariamente cierto.
Sin embargo, sabemos que \(\mathbb{E}[Y_{\infty}|\mathcal{F}{\infty}] = Y{\infty}\) y \(\mathbb{E}[Z_{\infty}|G_{\infty}] = Z_{\infty}\) .
Consideremos \(\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]\) .
Entonces \(\mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty}\) .
Esto implica que \(\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty}\) .
De manera similar, \(\mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty}\) .
Esto implica que \(\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] = Z_{\infty}\) casi seguramente.
Por lo tanto, \(Y_{\infty} = Z_{\infty}\) casi seguramente.
Respuesta final: La respuesta final es \(\left[Y_{\infty} = Z_{\infty}\right]\)
Tabla 10. muestra s1K derivada de s1- teasers. El texto en negro es la pregunta y el texto en amarillo es la solución. Basándonos únicamente en la pregunta, generamos el rastro de razonamiento en azul claro y la respuesta en azul con Gemini, que usamos para el entrenamiento.
Alice y Bob tienen cada uno una moneda y la lanzan hasta que obtienen cara. Si Bob lanzó su moneda más veces que Alice, ¿cuál es el número esperado de veces que Alice lanzó su moneda?
4/3
El problema pide el número esperado de veces que Alice lanzó su moneda, dado que Bob lanzó su moneda más veces que Alice.
Sea \(X\) el número de lanzamientos que hace Alice hasta obtener cara.
Sea \(Y\) el número de lanzamientos que hace Bob hasta obtener cara.
\(X\) e \(Y\) son variables aleatorias independientes que siguen una distribución geométrica con parámetro \(p = 0.5\) (probabilidad de obtener cara).
La función de masa de probabilidad para una distribución geométrica es \(P(K = k) = (1 - p)^{k - 1}p\) , para \(k = 1,2,\ldots\)
En este caso, \(p = 0.5\) , así que \(P(K = k) = (0.5)^{k - 1}(0.5) = (0.5)^{k} = \frac{1}{2^{k}}\) .
Se nos da la condición de que Bob lanzó su moneda más veces que Alice, lo que significa \(Y > X\) .
Queremos encontrar el valor esperado de \(X\) dado que \(Y > X\) , es decir, \(E[X|Y > X]\) .
La fórmula para la esperanza condicional es \(E[X|A] = \sum_{x}xP(X = x|A)\) .
Además, \(P(X = x|A) = \frac{P(X = x\cap A)}{P(A)}\) .
En nuestro caso, \(A\) es el evento \(Y > X\) .
Necesitamos encontrar \(P(Y > X)\) .
\(P(Y > X) = \sum_{x = 1}^{\infty}\sum_{y = x + 1}^{\infty}P(X = x,Y = y)\)
Dado que \(X\) e \(Y\) son independientes, \(P(X = x,Y = y) = P(X = x)P(Y = y) = \frac{1}{2^{x}}\frac{1}{2^{y}} = \frac{1}{2^{x + y}}\) .
\(P(Y > X) = \sum_{x = 1}^{\infty}\sum_{y = x + 1}^{\infty}\frac{1}{2^{x + y}} = \sum_{x = 1}^{\infty}\frac{1}{2^{x}}\sum_{y = x + 1}^{\infty}\frac{1}{2^{y}}\)
La suma interna es una serie geométrica: \(\sum_{y = x + 1}^{\infty}\left(\frac{1}{2}\right)^{y} = \left(\frac{1}{2}\right)^{x + 1} + \left(\frac{1}{2}\right)^{x + 2} + \ldots\)
Esta es una serie geométrica con primer término \(a = \left(\frac{1}{2}\right)^{x + 1}\) y razón común \(r = \frac{1}{2}\) .
La suma es .
Por lo tanto, .
Esta es otra serie geométrica con primer término y razón común .
La suma es .
Ahora, necesitamos encontrar .
, debido a la independencia.
.
Entonces, .
Ahora, podemos encontrar .
Finalmente, podemos calcular la esperanza condicional:
Consideremos la serie , donde .
Consideremos la serie geométrica .
Derivando con respecto a :
Entonces, , lo que significa .
En nuestro caso, .
Por lo tanto,
Enfoque alternativo: Simetría.
Consideremos los eventos , y .
debido a la simetría.
Tenemos .
. Esto confirma nuestro cálculo anterior.
Sea .
Buscamos el número esperado de lanzamientos que hizo Alice, dado que Bob lanzó más veces.
Consideremos el caso en que el primer lanzamiento de ambos es cruz. Entonces el proceso se reinicia y la condición se mantiene.
Sea el primer lanzamiento de Alice, el primer lanzamiento de Bob.
Caso 1: , por lo que es falso.
Caso 2: . Alice se detiene en 1, Bob continúa.
Caso 3: . Bob se detiene en 1, Alice continúa.
Caso 4: . Ambos continúan.
Consideremos las probabilidades condicionales dado .
Sea .
Si los primeros lanzamientos son HH, la condición no se cumple.
Si los primeros lanzamientos son HT, el número de lanzamientos de Alice es 1.
Si los primeros lanzamientos son TH, el número de lanzamientos de Bob es 1, el de Alice es al menos 2, por lo que .
Si los primeros lanzamientos son TT, el problema se reinicia, y el número esperado de lanzamientos adicionales para Alice sigue siendo .
Sea el número de lanzamientos que hace Alice, el número de lanzamientos que hace Bob.
Se nos da .
Consideremos los primeros lanzamientos:
HH (prob 1/4): La condición no se cumple.
HT (probabilidad 1/4): Alice lanza 1 vez.
TH (probabilidad 1/4): Bob lanza 1 vez, Alice , por lo que , condición no cumplida.
TT (probabilidad 1/4): Ambos continúan.
Sea el número esperado de lanzamientos de Alice dado que Bob lanzó más.
Si los primeros lanzamientos son HT, Alice lanzó 1 vez y se cumple la condición.
Si los primeros lanzamientos son TT, la situación es la misma que al principio, así que el número esperado de lanzamientos adicionales para Alice es .
Consideremos el evento .
Condicionando en los primeros lanzamientos:
depende de los lanzamientos futuros.
Usemos directamente la definición de esperanza condicional.
(1>λ)
Consideremos las probabilidades de los primeros lanzamientos dado .
Si los primeros lanzamientos son TT, el comportamiento futuro es el mismo, y la condición se cumple si Bob realiza más lanzamientos que Alice en los ensayos posteriores.
necesita más lanzamientos que Alice empezando desde cero
Suma de probabilidades condicionales:
Ahora consideremos las esperanzas condicionales de
: No es relevante, ya que
: Dado HT y , Alice lanzó 1 vez.
: No es relevante.
: Dado TT y , Alice ya lanzó una vez, y el número esperado de lanzamientos adicionales es . Por lo tanto, el número total de lanzamientos es .
indefinido
Esto confirma el resultado anterior.
Pensemos en la intuición. Si tenemos la condición , significa que Alice tuvo "suerte" y obtuvo una cara pronto, o que Bob tuvo "mala suerte".
Consideremos la variable aleatoria . Se nos da .
Queremos .
Sea .
El número de cruces antes de la primera cara sigue una distribución geométrica con parámetro .
, .
.
.
Consideremos la distribución conjunta de e .
Consideremos el evento , donde .
Si , entonces , .
Comprueba si .
Algo está mal aquí.
Recalculemos .
Suma interna: .
Si , . Correcto.
Ahora, encontremos .
(independencia)
(error en la potencia)
Sea . .
Si , .
Solución:
Sea el número de lanzamientos que hace Alice hasta obtener una cara, y el número de lanzamientos que hace Bob hasta obtener una cara. e son variables aleatorias geométricas independientes con parámetro . La función de masa de probabilidad es .
Nos interesa el número esperado de veces que Alice lanzó su moneda, dado que Bob lanzó su moneda más veces que Alice, es decir, .
Usando la definición de esperanza condicional, .
Primero, calculemos .
A continuación, calculemos .
Ahora, encontremos .
Finalmente, calculemos la esperanza condicional:
Usando la fórmula con :
Respuesta final: La respuesta final es
Tabla 11. Muestra s1K proveniente del subconjunto de astronomía de OlympicArena. El texto negro es la pregunta y el texto azul es la solución. Basándonos únicamente en la pregunta, generamos con Gemini el rastro de razonamiento en azul claro y la respuesta en azul, que usamos para el entrenamiento.
Un dato curioso que se repite a menudo es que los humanos producen más potencia por unidad de volumen que las estrellas. Si el sol tuviera el mismo tamaño, pero produjera la misma cantidad de potencia por unidad de volumen que un humano, ¿cuál sería su temperatura superficial? Supón que el "humano promedio" produce 100 vatios de potencia y tiene un volumen de 66400 centímetros cúbicos.
A: 3500 K B: 10000 K C: 25000 K D: 40000 K E: 50000 K
Usando los números del problema, el humano promedio produce
El volumen del sol es , por lo que su nueva potencia de salida sería . Para encontrar la temperatura de equilibrio, usamos
Despejando , obtenemos
El problema pide la temperatura superficial del sol si tuviera el mismo tamaño pero produjera potencia por unidad de volumen como un humano.
Primero, encontremos la densidad de potencia de un humano.
Potencia producida por un humano,
Volumen de un humano,
Convertir el volumen a metros cúbicos:
Densidad de potencia de un humano,
Ahora, consideremos el sol con el mismo tamaño que tiene actualmente, pero con una densidad de potencia igual a la de un humano.
Necesitamos el radio del sol para calcular su volumen. El radio promedio del sol es
Volumen del sol,
Si el sol tuviera la misma densidad de potencia que un humano, la potencia total producida por este sol modificado sería:
La temperatura superficial de una estrella está relacionada con su luminosidad (potencia total emitida) mediante la ley de Stefan-Boltzmann:
donde es la luminosidad (potencia total emitida), es el radio de la estrella, es la constante de Stefan-Boltzmann y es la temperatura superficial.
En este caso, la luminosidad del sol modificado es . El radio del sol modificado es el mismo que el del sol real, .
La constante de Stefan-Boltzmann, .
Calcular el término :
Ahora, sustituir esto de nuevo en la ecuación:
Despejar :
Despejar :
Calcular (1,9386) :Sea , entonces
Por lo tanto,
Sabemos que y , así que está entre 5 y 6.
Alternativamente,
Verifiquemos los cálculos.
Densidad de potencia del humano:
Volumen del sol:
Potencia del sol modificado:
Ley de Stefan-Boltzmann:
Calcular :Sea , entonces
El resultado es aproximadamente 66000 K. Este no está entre las opciones. Revisemos los supuestos y los cálculos.
Supuesto: El sol irradia como un cuerpo negro, lo cual es razonable para estimar la temperatura superficial.
Consideremos posibles errores en los cálculos.
Probemos un enfoque más simple estableciendo razones.
La potencia por unidad de volumen del sol modificado es igual a la de un humano.
También sabemos que
Sustituyamos los valores:
Calcular :
Sea , entonces
Esto se acerca a la opción E: 50000 K.
Revisemos cuidadosamente las unidades y los cálculos.
Densidad de potencia del humano:
La fórmula derivada fue .
Verificación de unidades:
Las unidades coinciden para .
Verificación del cálculo numérico:
Numerador:
Denominador:
Cociente:
Usemos logaritmos para mayor precisión.
Esto está muy cerca de 50000 K.
Posibles fuentes de discrepancias menores: errores de redondeo, precisión de las constantes.
Verifiquemos la derivación de la fórmula.
Potencia por unidad de volumen
Si el sol modificado tiene la densidad de potencia de un humano:
La derivación de la fórmula parece correcta.
Usemos valores aproximados para verificar el orden de magnitud.
Por lo tanto, entre 7 y 8.
El orden de magnitud parece consistente con el cálculo detallado.
El enunciado del problema es directo y no parece tener complejidades ocultas. Los supuestos realizados son estándar para este tipo de problemas.
Consideremos la precisión de los valores dados.
Potencia del humano: (exacto)
Volumen del humano: (exacto)
El resultado obtenido está muy cerca de la opción E. Dada la naturaleza de las preguntas de opción múltiple, la opción más cercana probablemente sea la respuesta prevista.
Si hubiera alguna interpretación errónea de la pregunta, probablemente estaría en el planteamiento. Sin embargo, la frase «Si el sol tuviera el mismo tamaño, pero produjera la misma cantidad de potencia por unidad de volumen que un humano» parece clara.
La temperatura superficial se calcula utilizando la ley de Stefan-Boltzmann, suponiendo radiación de cuerpo negro.
Verifica dos veces las opciones proporcionadas:
A: 3500 K
B: 10000 K
C: 25000 K
D: 40000 K
E: 50000 K
Nuestro valor calculado es aproximadamente 49800 K, que es el más cercano a 50000 K.
Si usáramos valores más precisos para las constantes, el resultado podría ser ligeramente distinto, pero probablemente no lo suficiente como para pasar a otra opción.
El dato curioso mencionado en la pregunta implica que la densidad de potencia de un humano es mayor que la del sol. Vamos a verificarlo.
Potencia emitida por el sol:
Volumen del sol:
Densidad de potencia del sol:
Densidad de potencia del humano:
En efecto, la densidad de potencia de un humano es significativamente mayor que la del sol.
Verificación final de los pasos de cálculo y de la lógica. El enfoque de igualar la densidad de potencia del sol modificado a la de un humano y luego usar la ley de Stefan-Boltzmann parece correcto.
Solución:
La potencia producida por un humano promedio es , y el volumen de un humano promedio es .
La densidad de potencia de un humano es .
Si el sol tuviera el mismo tamaño pero produjera la misma cantidad de potencia por unidad de volumen que un humano, su densidad de potencia sería .
El radio del sol es .
El volumen del sol es .
La densidad de potencia del sol modificado viene dada por .
También sabemos que , donde es la temperatura superficial del sol modificado.
Igualando la densidad de potencia:
Despejando :
Sustituyendo los valores:
Despejando :
Usando logaritmos:
Rehagamos el cálculo del exponente: .
- error en el paso anterior.
La temperatura superficial sería aproximadamente 49806 K, que es la más cercana a 50000 K.
Respuesta final: La respuesta final es
E. Detalles del escalado en tiempo de prueba
E.1. Ablaciones de escalado secuencial
| <lim_start>user | <lim_start>user |
| What is the answer to Life, the Universe and Everything? | What is the answer to Life, the Universe and Everything? |
| Think for up to 2048 tokens. | Think for up to 64 steps. |
| <lim_start>assistant | <lim_start>assistant |
| <lim_start>think | <lim_start>64 steps left |
| Let me break down this question into the three parts it is asking for: 1) Life 2) Universe 3) Everything | Let me break down this question into the three parts it is asking for: 1) Life 2) Universe 3) Everything |
| Let me start with life... | <lim_start>63 steps left |
| Let me start with life... | |
| <lim_start>answer | <lim_start>answer |
| The answer is... | The answer is... |
</lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start
Entonces la traza de razonamiento tiene entre 1024 y 2048 tokens. En la Tabla 12, mostramos que después del entrenamiento el modelo apenas sigue la instrucción de tokens. A veces genera más tokens cuando se le da un límite mayor, pero a menudo sobrepasa el límite. Esto puede no ser exclusivo de nuestro modelo, ya que trabajos previos sugieren que OpenAI o1-mini tampoco puede seguir instrucciones de tokens (Zhang & Chen, 2024). Para evitar exceder el límite, probamos forzar el presupuesto para terminar el pensamiento una vez alcanzado el límite. Esto conduce a un control perfecto (Tabla 12 (parte inferior)). Con el forzamiento de presupuesto, la tendencia de escalado también es más clara, ya que el modelo ya no puede sobrepasar el límite cuando se le da un presupuesto de pensamiento pequeño. Esto conduce a mejores valores de escalado en tiempo de prueba para Token Prompting + forzamiento de presupuesto en la Tabla 3. Para calcular Control reportado en la Tabla 3 para las variantes de control condicionado por tokens, dividimos el número de veces que los tokens de pensamiento en la Tabla 12 son menores que el límite superior por el total de evaluaciones (2/5 sin intervención; 5/5 con intervención).
Control condicionado por pasos Las instrucciones de tokens fallan porque los modelos actuales no pueden contar tokens. Para acomodar esta falta de capacidad, experimentamos haciendo el conteo más grueso. Dividimos las trazas de razonamiento en pasos y pedimos al modelo que piense durante un número específico de pasos en lugar de tokens. Dividimos nuestras trazas de razonamiento en dobles saltos de línea en pasos, que encontramos que actúan como separadores intuitivos según la inspección manual de muestras. Agrupamos nuestras muestras de entrenamiento en potencias de 2 dependiendo de su número de pasos y añadimos una instrucción de pasos correspondiente siguiendo el formato de la Figura 10 (derecha). Este formato se basa en experimentos tempranos, donde encontramos que el modelo era más propenso a adherirse al límite de pasos
| Pasos indicados | 16 | 32 | 64 | 128 | 256 |
| Sin intervención en el momento de la prueba | |||||
| Pasos utilizados | 123 | 90 | 80 | 82 | 136 |
| Tokens por paso | 60 | 70 | 69 | 66 | 56 |
| Tokens de pensamiento | 7252 | 6277 | 5396 | 5552 | 7551 |
| Tokens de respuesta | 665 | 653 | 735 | 777 | 754 |
| AIME24 | 33.3 | 23.3 | 33.3 | 36.7 | 33.3 |
| Forzar el fin del pensamiento cuando se alcanzan 0 pasos | |||||
| Pasos utilizados | 16 | 32 | 59 | 78 | 136 |
| Tokens por paso | 96 | 94 | 80 | 70 | 56 |
| Tokens de pensamiento | 1517 | 2963 | 4636 | 5409 | 7551 |
| Tokens de respuesta | 1111 | 788 | 799 | 794 | 754 |
| AIME24 | 23.3 | 23,3 | 33,3 | 36,7 | 33,3 |
Tabla 13. Escalado del tiempo de pensamiento mediante control condicionado por pasos. Todas las métricas se promedian sobre las 30 muestras en AIME24. Los recuentos de tokens ignoran los delimitadores de pensamiento y de pasos.
Tabla 14. Escalado del tiempo de pensamiento mediante control condicionado por clase. Reportamos "precisión / tokens de pensamiento promedio por muestra"; cuanto mayor sea la precisión y menos tokens de pensamiento (coste de inferencia), mejor.
| Contexto de solo lectura para comprender la fuente (no es texto fuente para traducir): Tabla 14. Escalado del tiempo de pensamiento mediante control condicional por clase. Informamos “precisión / promedio de tokens de pensamiento por muestra”; cuanto mayor es la precisión y menores son los tokens de pensamiento (coste de inferencia), mejor. al contar hacia atrás (“quedan 3 pasos... quedan 2 pasos”) en lugar de contar hacia adelante (“Paso2...Paso3...”). Esto probablemente se debe a que, si se cuenta hacia atrás, el paso final siempre es 1, lo que actuará como un prior fuerte para que el modelo termine su generación. Si se cuenta hacia adelante, el paso final se Texto a traducir: Prompt añadido a la pregunta después de dos saltos de línea | AIME24 | MATH500 | GPQA |
| Responde después de pensar durante un breve periodo de tiempo. No dediques un tiempo excesivo a revisar tu trabajo. | 30,0% 8033 | 90,4% 2537 | 56,6% 4177 |
| Responde después de pensar durante un largo periodo de tiempo. Si sientes que has terminado antes de tiempo, dedica el tiempo extra a intentar revisar tu trabajo hasta que estés absolutamente seguro de que tienes la respuesta correcta. | 36,7% 9651 | 91,4% 3875 | 51,0% 4827 |
| Sin añadir un prompt genérico | 50,0% 6109 | 93,0% 3298 | 57,6% 3510 |
al contar hacia atrás ("quedan 3 pasos... quedan 2 pasos") en lugar de contar hacia adelante ("Paso 2... Paso 3..."). Esto probablemente se debe a que, si se cuenta hacia atrás, el paso final siempre es 1, lo que actuará como un prior fuerte para que el modelo termine su generación. Si se cuenta hacia adelante, el paso final antes de la respuesta varía, por lo que si el modelo no recuerda la instrucción de pasos original, puede que no logre detenerse. Concluimos lo siguiente a partir de nuestros resultados en la Tabla 13: (1) El modelo todavía tiene dificultades para adherirse al límite de pasos. El modelo a veces simplemente continúa contando hacia pasos negativos, p. ej., "queda 1 paso". Para resolver este problema, detenemos automáticamente el proceso de pensamiento una vez que se alcanzan 0 pasos y luego forzamos al modelo a pasar al modo de respuesta añadiendo el delimitador de token de respuesta (§3). Esto conduce a una adherencia perfecta a los pasos (mitad inferior de la Tabla 13), pero aún quedan problemas. (2) El modelo compensa los menos pasos haciendo cada paso más largo. Por ejemplo, cuando se le fuerza a usar hasta 16 pasos frente a 256 pasos, el modelo genera un promedio de 96 tokens por paso frente a 56. A pesar de este problema, más pasos todavía se correlacionan claramente con más tokens de pensamiento totales en la Tabla 13 y con un mejor rendimiento, lo que conduce a una pendiente positiva. (3) Las instrucciones de pasos son más costosas que otros métodos. Los delimitadores de pasos requieren alrededor de 6 tokens cada uno, lo que para, p. ej., 64 pasos suma un total de alrededor de 380 tokens. Al ignorar los delimitadores de pasos en los recuentos de tokens como en la Tabla 13, el modelo todavía requiere 7551 tokens de pensamiento en promedio para lograr solo en AIME24. Para calcular Control reportado en la Tabla 3 para las variantes de control condicionado por pasos, primero decidimos que 100 tokens son un límite superior por paso y luego multiplicamos este número por los pasos indicados para llegar a un límite total de tokens aproximado, p. ej., 1600 para 16 pasos indicados. Luego verificamos si los tokens de pensamiento en la Tabla 13 encajan dentro del límite respectivo para cada ejecución de evaluación (3/5 sin intervención; 5/5 con intervención). Para el modelo en la Figura 7, usamos un modelo con control condicionado por pasos entrenado en una versión anterior de nuestros datos y usando una versión anterior de nuestra base de código de evaluación.
Control condicionado por clase OpenAI expone el control del cómputo en tiempo de prueba a los usuarios mediante un parámetro de API "reasoning_effort" con tres configuraciones posibles: bajo, medio y alto. La documentación de OpenAI también afirma que "Reducir el esfuerzo de razonamiento puede dar lugar a respuestas más rápidas y a un uso de menos tokens en el razonamiento de una respuesta", lo que sugiere que no pueden controlar el cómputo en tiempo de prueba con garantías. Por lo tanto, quizá OpenAI simplemente ajusta el prompt o la instrucción del sistema dependiendo del esfuerzo de razonamiento deseado. En la Tabla 14, mostramos que prompts separados para pensamiento corto y largo nos permiten controlar el tiempo de pensamiento hasta cierto punto: pedir al modelo que piense durante más tiempo conduce a un pensamiento más largo. Sin embargo, no mejora de forma fiable el rendimiento y el control no es preciso. La adherencia actual al control puede bastar cuando solo tenemos tres clases, pero podría no escalar a clases más finas. Para calcular Control reportado en la Tabla 3 para este método, asumimos que pedir al modelo que piense durante poco tiempo en la Tabla 14 debería producir menos tokens que el valor predeterminado para AIME24, mientras que el prompt largo debería producir más. Como y , uno de dos sigue nuestro control esperado, por lo que Control es .
E.2. Ejemplos para la ablación de muestreo por rechazo
3https://github.com/openai/openai-python/blob/44d6210f101abedeb2dd68507fcfcb329df70ea/src/openai/types/chat/completion_create_params.py#L172
Tabla 15. Respuestas generadas por una versión anterior de s1-32B al aplicar muestreo por rechazo en AIME24. El texto negro es la pregunta y el texto amarillo es la solución. Basándonos únicamente en la pregunta, generamos la traza de razonamiento en azul claro y la respuesta en azul con s1-32B usando una temperatura de 1. Generamos hasta que la traza de razonamiento tenga menos de 4000 tokens para el primer ejemplo y menos de 8000 tokens para el segundo. Se requirió un promedio de 199 (1) intentos por ejemplo hasta que el pensamiento fue ( tokens).
Sean , y puntos en el plano coordenado. Sea la familia de segmentos de longitud unitaria que yacen en el primer cuadrante con sobre el eje y sobre el eje . Hay un único punto sobre , distinto de y , que no pertenece a ningún segmento de distinto de . Entonces , donde y son enteros positivos relativamente primos. Encuentre .
23
[Generación correcta con 3981 tokens de pensamiento y 1055 tokens de respuesta]
El problema pide un punto sobre el segmento que no esté contenido en ningún otro segmento de la familia , excepto el propio .
Los puntos forman un triángulo en el primer cuadrante.
El segmento conecta y
La ecuación de la recta que contiene a se puede encontrar usando los dos puntos:
Pendiente
Usando la forma punto-pendiente con el punto
El segmento está en el primer cuadrante y conecta con
La familia consta de segmentos de longitud unitaria, donde está sobre el eje y está sobre el eje . Sean y .
La longitud de es .
Entonces .
Como está sobre el semieje positivo y está sobre el semieje positivo , tenemos y .
El segmento conecta y . La ecuación de la recta que contiene a es .
La región cubierta por la familia es el área delimitada por las rectas que contienen a estos segmentos. Los extremos y varían de modo que .
Considérese la parametrización , , donde .
El segmento conecta y . La ecuación de la recta es .
Buscamos un punto único sobre , distinto de y , que no pertenezca a ningún segmento de distinto de .
Sea un punto sobre . Podemos parametrizar los puntos sobre como para .
.
Como es distinto de y , tenemos .
Supongamos que el punto está sobre algún segmento , donde y .
El punto satisface la ecuación .
Sustituyendo las coordenadas de :
Multiplicando por 2:
Buscamos un punto sobre tal que el único segmento de que contiene a sea mismo. El segmento forma parte de la familia .
Para , y .
Aquí , .
El segmento de recta conecta y .
La ecuación de la recta es , que se simplifica a , o .
Esto coincide con la ecuación .
Considérese la envolvente de la familia de rectas .
Derivando con respecto a :
De la ecuación de la recta:
Sustituyendo
Sustituyendo de nuevo en la ecuación de la recta:
La envolvente de la familia es el astroide .
Los segmentos de son tangentes a este astroide.
El punto sobre que buscamos es el punto donde es tangente al astroide.
La ecuación de es .
Sustituyendo en la ecuación del astroide:
Sea y . El astroide es .
El punto se encuentra tanto sobre la recta como sobre el astroide.
Derivando implícitamente la ecuación del astroide:
.
La pendiente de la tangente al astroide en un punto es .
La pendiente de la recta es .
Entonces, en el punto de tangencia, .
El punto está sobre la recta y satisface .
Entonces .
Sustituyendo en la ecuación de la recta:
Luego .
El punto es .
Necesitamos verificar si este punto está sobre el segmento .
El punto es de la forma .
Así que está sobre .
Necesitamos asegurarnos de que , lo cual es cierto para .
Ahora, necesitamos verificar que este punto no pertenece a ningún otro segmento de .
El punto está sobre la astroide. El segmento es tangente a la astroide en .
Cualquier otro segmento de que contenga a tendría a como punto interior, no como punto de tangencia.
Consideremos la parametrización de la familia .
Un punto pertenece a algún segmento de si y solo si existe tal que .
Para el punto , tenemos:
Sabemos que está sobre , lo cual corresponde a algún segmento específico de .
El enunciado del problema asume la existencia y unicidad de tal punto .
El único punto sobre , distinto de y , que no pertenece a ningún segmento de distinto de .
Esto significa que si está sobre otro segmento , entonces .
El punto es el punto de tangencia de con la astroide.
Ahora necesitamos encontrar .
Aquí y .
y son coprimos.
.
Verificación final del razonamiento:
La familia consiste en segmentos de longitud unitaria con extremos sobre los ejes.
La envolvente de esta familia es la astroide .
Los segmentos de son tangentes a la astroide.
El segmento también es un miembro de la familia .
Buscamos un punto sobre que esté sobre la astroide.
Este punto es el punto de tangencia de con la astroide.
Si un punto sobre está sobre la astroide, pertenece al segmento tangente en ese punto. Dado que es el segmento tangente, este punto no pertenece a ningún otro segmento de .
Consideremos el caso en que el segmento interseca la astroide en dos puntos.
Si el segmento no es tangente al astroide, entonces hay dos puntos de intersección.
Sean los puntos de intersección y
Si está sobre , entonces la tangente al astroide en es el segmento
Si está sobre , entonces la tangente al astroide en es el segmento
La pendiente de es
Encontramos el punto sobre el astroide con pendiente de tangente
El enunciado del problema garantiza la unicidad de tal punto
El punto debe ser interior a , por lo que
El parámetro está en este rango.
El punto es distinto de y
Si , entonces ,
Si , entonces ,
El punto de tangencia es el único punto sobre (excluyendo los extremos) que está sobre el astroide.
Solución:
Sea la familia de segmentos definida por segmentos de longitud unitaria con sobre el semieje positivo y sobre el semieje positivo. Sean y . La condición de longitud da . El segmento está sobre la recta . Usando la parametrización , con , la ecuación de la recta es .
La envolvente de esta familia de rectas es el astroide
Los segmentos de son tangentes a este astroide.
El segmento conecta y . La ecuación de la recta que contiene a es . Este segmento es parte de la familia .
Buscamos un único punto sobre , distinto de y , que no pertenezca a ningún segmento de distinto de . Esto significa que es el punto donde es tangente al astroide.
La pendiente de la tangente al astroide en un punto es . La pendiente de es
Igualando las pendientes:
El punto está sobre la recta y satisface
Sustituyendo,
Entonces
El punto es
Necesitamos comprobar si está sobre . Los puntos sobre son para
Para
Para
Como , es un punto interior de
El punto es el único punto sobre (excluyendo los extremos) que yace sobre la astroide. La tangente a la astroide en es el segmento . Por lo tanto, no pertenece a ningún otro segmento de .
Finalmente, calculamos
Tenemos y . Estos son coprimos.
Respuesta final: La respuesta final es [23]
[Generación incorrecta con 5923 tokens de pensamiento y 754 tokens de respuesta]
El problema pide un punto sobre el segmento tal que no esté sobre ningún otro segmento de la familia , excepto mismo. La familia consiste en segmentos de longitud unitaria, con sobre el eje y sobre el eje en el primer cuadrante. Sea y , donde y . La longitud del segmento es 1, por lo que la distancia entre y es 1.
El segmento está en el primer cuadrante, por lo que y
La ecuación representa el cuarto de círculo en el primer cuadrante, con extremos en y . Los puntos sobre el segmento se pueden parametrizar como , donde .
El segmento conecta y .
La ecuación de la recta que contiene a se puede encontrar usando los dos puntos: Pendiente .
Usando la forma punto-pendiente con el punto :
El segmento está en el primer cuadrante, entre y .
Alternativamente, podemos parametrizar los puntos sobre . Sea un punto sobre . Entonces para algún .
Buscamos un punto único sobre , distinto de y , que no pertenezca a ningún segmento de distinto de . Consideremos un segmento de , con extremos y , donde . Un punto sobre este segmento es de la forma , donde . Queremos encontrar un punto sobre , , tal que si está sobre un segmento , entonces .
Sea , donde . Si está sobre un segmento de , entonces existen con , y tales que:
De la primera ecuación, . De la segunda ecuación, . Como , tenemos . Además, , por lo que , lo que implica , o . Esto es consistente con la condición para un punto sobre .
Tenemos y . Sumando estas ecuaciones:
Sabemos que . Si el punto pertenece al propio segmento , entonces los extremos del segmento son y . Así, el segmento va desde hasta . Aquí, y . Comprobemos si : . Por lo tanto, .
Si pertenece a otro segmento de , con extremos y , donde . Consideremos la interpretación geométrica. La familia está formada por segmentos de longitud unitaria con extremos sobre los ejes. Los puntos medios de estos segmentos se encuentran sobre la circunferencia . Sea el punto correspondiente a algún . Si está sobre , entonces . Así, y . Necesitamos encontrar un tal que la única solución de estas ecuaciones, con , , sea y . A partir de las ecuaciones, y . Sustituyamos estas en .
Probemos un enfoque diferente. Consideremos las tangentes a la familia de segmentos. Los segmentos están formados por los puntos y con . La ecuación de la recta que contiene al segmento es , o . La ecuación de la recta es .
Consideremos la ecuación del segmento en forma paramétrica: . Si un punto está sobre este segmento, entonces , donde y . Así, y . . Los segmentos de son partes de las rectas , donde , .
Consideremos el punto . Si está sobre un segmento de con extremos y , entonces:
Necesitamos encontrar un único tal que la única solución de esta ecuación, con , , sea .
Sustituyamos y en la ecuación:
Esto muestra que cualquier punto sobre está sobre el propio segmento .
Consideremos la recta que contiene : .
Si un punto sobre también está sobre otro segmento de con extremos y , entonces:
Sea el punto que divide en la razón , donde .
Si está sobre un segmento con extremos y , entonces:
Buscamos un punto tal que la recta que pasa por con la forma , donde , sea única.
Consideremos las tangentes a la circunferencia unitaria centrada en el origen. Las rectas de la forma son tangentes a la circunferencia .
Consideremos el problema dual. La familia de segmentos corresponde a puntos sobre el cuarto de circunferencia en el primer cuadrante.
Las rectas que contienen los segmentos son .
La envolvente de estas rectas es la curva cuyas tangentes son estas rectas.
La ecuación , con la restricción .
Sea , , donde .
Las ecuaciones de las rectas son .
La envolvente de la familia de rectas es la circunferencia .
Los segmentos de son partes de las tangentes a la circunferencia unitaria en el primer cuadrante.
El punto sobre que no pertenece a ningún otro segmento de significa que la tangente a la circunferencia unitaria que pasa por es única.
Consideremos el punto .
Las tangentes a la circunferencia unitaria que pasan por tienen la forma .
Si la tangente es única, entonces está sobre la circunferencia unitaria.
Resolver para :
Necesitamos .
Algo está mal. El punto está dentro de la circunferencia unitaria.
Reformulemos la condición. Hay un único punto sobre tal que si está sobre un segmento , entonces .
Sea el punto sobre igual a .
Consideremos un segmento de con extremos y , .
La forma paramétrica del segmento es .
Si está sobre este segmento, entonces para algún :
Si el segmento es único, entonces los valores de y son únicos.
La única solución de , con , , debería ser , .
Considérese la intersección de la recta que contiene a con la frontera de la región formada por los segmentos en .
Las fronteras son el eje , el eje y el cuarto de círculo .
Considérese de nuevo el problema dual. La familia de rectas , donde , .
La envolvente de estas rectas es el círculo .
Un punto pertenece a un único segmento de si está sobre el círculo .
El punto sobre satisface .
Consideremos el caso en que el segmento es . Aquí , .
El punto puede representarse como para .
Buscamos un punto sobre que no esté sobre ningún otro segmento de .
Considérese la geometría. La familia forma una región limitada por los ejes y el cuarto de círculo.
Los segmentos son cuerdas de círculos centrados sobre la recta , tangentes a los ejes.
Sean los extremos de un segmento y
Un punto sobre el segmento es
El punto
Si está sobre tal segmento, entonces y
Necesitamos un único tal que la única solución sea , lo que corresponde a
Considérese la función
Necesitamos
Si , entonces
Dividir por 2:
, o
, entonces
Si ,
Si ,
Si , el punto es
Este punto está sobre los segmentos correspondientes a y
El punto único significa que para otros valores de , hay más de una solución para
Considérese la tangente a la circunferencia unitaria que pasa por
Si la tangente es única, está sobre la circunferencia unitaria.
Esto conduce a , ninguno de los cuales está en
Considérese la interpretación geométrica de la familia . Los segmentos conectan puntos sobre los ejes de modo que la distancia es 1.
El lugar geométrico de los centros de estos segmentos es la circunferencia , en el primer cuadrante.
Si un punto está sobre un segmento de , entonces está sobre un segmento de recta que conecta y con
La recta que contiene al segmento es
Si pertenece a un único segmento, entonces hay una única recta de esta forma que pasa por
El punto sobre es
Necesitamos un único con , tal que
Sea el punto tal que la recta que pasa por con la forma sea única, sujeta a
Esta recta es tangente a la circunferencia unitaria.
El punto está sobre la intersección de la recta que contiene a y la circunferencia unitaria.
No encontramos solución para El punto único significa que si cualquier otro segmento pasa por , debe ser .
Considérese la pendiente de la recta que contiene al segmento que conecta y . La pendiente es .
La ecuación es .
Si está sobre el segmento, entonces .
Considérese la media geométrica.
Sea el punto de coordenadas . El segmento que une y pasa por . . Si está sobre , entonces . .
El punto es tangente a la envolvente de la familia de segmentos.
Solución: Sea la familia de segmentos . Los segmentos tienen extremos y con y . Los puntos sobre el segmento satisfacen . Los segmentos están contenidos en las rectas , donde , .
El segmento tiene extremos y . La ecuación de la recta que contiene a es .
Un punto sobre se puede parametrizar como , donde .
Si pertenece a un segmento de con extremos y , entonces .
Buscamos un punto único sobre , distinto de y , que no pertenezca a ningún segmento de distinto de . Esto significa que la única solución de la ecuación con , , es .
Los segmentos de son partes de las tangentes a la circunferencia unitaria. El punto debe ser tangente a la envolvente de la familia de segmentos. La envolvente es la propia circunferencia unitaria.
El único punto sobre , distinto de y , que yace sobre la circunferencia unitaria. Necesitamos resolver:
. El punto .
, así que , . y son coprimos. .
Respuesta final: La respuesta final es
F. Control de versiones
(2025- 03):
Se añadió
Se añadió el número de muestras correctas en
(2025- 02):
Se añadieron citas y otros pequeños cambios de redacción