
Un agente LLM olvida todo entre sesiones. A-Mem guarda recuerdos como notas enlazadas que se reescriben con cada nueva. Artículo de NeurIPS 2025, gratis online.
A-Mem: Agentic Memory for LLM Agents
A-Mem: Memoria agéntica para agentes LLM
Wujiang , Zujie Liang , Kai Mei , Hang Gao , Juntao Tan , Yongfeng Zhang Universidad de Rutgers Investigador independiente AIOS Foundation wujiang.xu@rutgers.edu
Resumen
Si bien los agentes de modelos de lenguaje grandes (LLM) pueden usar eficazmente herramientas externas para tareas complejas del mundo real, requieren sistemas de memoria para aprovechar las experiencias históricas. Los sistemas de memoria actuales permiten el almacenamiento y la recuperación básicos, pero carecen de una organización sofisticada de la memoria, a pesar de los intentos recientes de incorporar bases de datos de grafos. Además, las operaciones y estructuras fijas de estos sistemas limitan su adaptabilidad a través de diversas tareas. Para abordar esta limitación, este artículo propone un novedoso sistema de memoria agéntica para agentes LLM que puede organizar dinámicamente las memorias de manera agéntica. Siguiendo los principios básicos del método Zettelkasten, diseñamos nuestro sistema de memoria para crear redes de conocimiento interconectadas mediante indexación y enlace dinámicos. Cuando se añade una nueva memoria, generamos una nota integral que contiene múltiples atributos estructurados, incluidos descripciones contextuales, palabras clave y etiquetas. El sistema luego analiza las memorias históricas para identificar conexiones relevantes, estableciendo vínculos donde existan similitudes significativas. Además, este proceso permite la evolución de la memoria: a medida que se integran nuevas memorias, pueden desencadenar actualizaciones en las representaciones contextuales y los atributos de las memorias históricas existentes, permitiendo que la red de memoria refine continuamente su comprensión. Nuestro enfoque combina los principios de organización estructurada de Zettelkasten con la flexibilidad de la toma de decisiones impulsada por agentes, permitiendo una gestión de memoria más adaptativa y consciente del contexto. Experimentos empíricos en seis modelos fundacionales muestran una mejora superior frente a las líneas base SOTA existentes.
Código para la evaluación de referencia: https://github.com/WujiangXu/AgenticMemory Código para la memoria agéntica lista para producción: https://github.com/WujiangXu/A- mem- sys
1 Introducción
Los agentes de modelos de lenguaje grandes (LLM) han demostrado capacidades notables en diversas tareas, con avances recientes que les permiten interactuar con entornos, ejecutar tareas y tomar decisiones de forma autónoma [23, 33, 7]. Integran LLM con herramientas externas y flujos de trabajo delicados para mejorar las capacidades de razonamiento y planificación. Aunque el agente LLM tiene un fuerte rendimiento de razonamiento, todavía necesita un sistema de memoria para proporcionar capacidad de interacción a largo plazo con el entorno externo [35].
Los sistemas de memoria existentes [25, 39, 28, 21] para agentes LLM proporcionan funcionalidad básica de almacenamiento de memoria. Estos sistemas requieren que los desarrolladores de agentes predefinan estructuras de almacenamiento de memoria, especifiquen puntos de almacenamiento dentro del flujo de trabajo y establezcan el momento de recuperación. Mientras tanto, para mejorar la organización estructurada de la memoria, Mem0 [8], siguiendo los principios de RAG [9, 18, 30], incorpora bases de datos de grafos para los procesos de almacenamiento y recuperación. Aunque las bases de datos de grafos proporcionan una organización estructurada para los sistemas de memoria, su dependencia de esquemas y relaciones predefinidos limita fundamentalmente su adaptabilidad. Esta limitación se manifiesta claramente en escenarios prácticos: cuando un agente aprende una nueva solución matemática, los sistemas actuales solo pueden categorizar y vincular esta información dentro de su marco preestablecido,
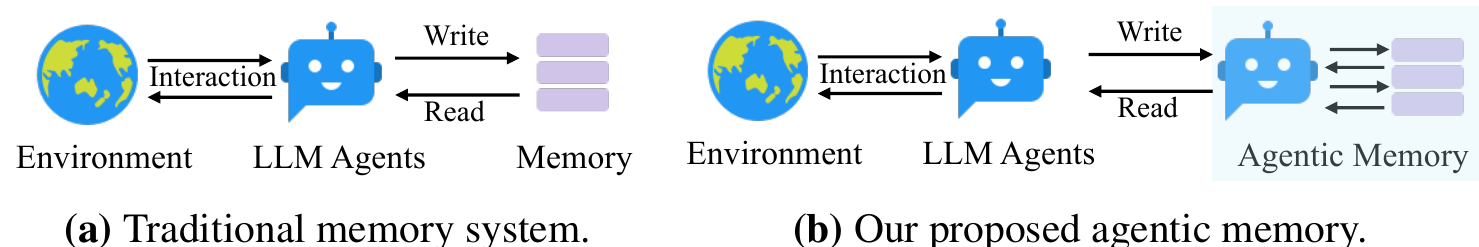
incapaces de forjar conexiones innovadoras o desarrollar nuevos patrones organizativos a medida que el conocimiento evoluciona. Tales estructuras rígidas, junto con flujos de trabajo de agentes fijos, restringen severamente la capacidad de estos sistemas para generalizar en nuevos entornos y mantener su eficacia en interacciones a largo plazo. El desafío se vuelve cada vez más crítico a medida que los agentes LLM abordan tareas más complejas y abiertas, donde la organización flexible del conocimiento y la adaptación continua son esenciales. Por lo tanto, cómo diseñar un sistema de memoria flexible y universal que apoye las interacciones a largo plazo de los agentes LLM sigue siendo un desafío crucial.
En este artículo, presentamos un novedoso sistema de memoria agéntica, denominado A- MEM, para agentes LLM que permite la estructuración dinámica de la memoria sin depender de operaciones de memoria estáticas y predeterminadas. Nuestro enfoque se inspira en el método Zettelkasten [15, 1], un sofisticado sistema de gestión del conocimiento que crea redes de información interconectadas mediante notas atómicas y mecanismos de enlace flexibles. Nuestro sistema introduce una arquitectura de memoria agéntica que permite una gestión de memoria autónoma y flexible para agentes LLM. Para cada nueva memoria, construimos notas integrales, que integran múltiples representaciones: atributos textuales estructurados que incluyen varios atributos y vectores de incrustación para la coincidencia por similitud. Luego A- MEM analiza el repositorio de memorias históricas para establecer conexiones significativas basadas en similitudes semánticas y atributos compartidos. Este proceso de integración no solo crea nuevos enlaces, sino que también permite la evolución dinámica: cuando se incorporan nuevas memorias, pueden desencadenar actualizaciones en las representaciones contextuales de las memorias existentes, permitiendo que el conjunto de memorias refine y profundice continuamente su comprensión con el tiempo. Las contribuciones se resumen a continuación:
- Presentamos A-MEM, un sistema de memoria agéntica para agentes LLM que permite la generación autónoma de descripciones contextuales, el establecimiento dinámico de conexiones de memoria y la evolución inteligente de las memorias existentes basada en nuevas experiencias. Este sistema dota a los agentes LLM de capacidades de interacción a largo plazo sin requerir operaciones de memoria predeterminadas.
- Diseñamos un mecanismo de actualización de memoria agéntica donde las nuevas memorias desencadenan automáticamente dos operaciones clave: generación de enlaces y evolución de la memoria. La generación de enlaces establece automáticamente conexiones entre memorias al identificar atributos compartidos y descripciones contextuales similares. La evolución de la memoria permite que las memorias existentes se adapten dinámicamente a medida que se analizan nuevas experiencias, lo que lleva a la aparición de patrones y atributos de orden superior.
- Realizamos evaluaciones exhaustivas de nuestro sistema utilizando un conjunto de datos conversacionales a largo plazo, comparando el rendimiento en seis modelos fundacionales usando seis métricas de evaluación distintas, demostrando mejoras significativas. Además, proporcionamos visualizaciones T-SNE para ilustrar la organización estructurada de nuestro sistema de memoria agéntica.
2 Trabajo relacionado
2.1 Memoria para agentes LLM
Trabajos previos sobre sistemas de memoria para agentes LLM han explorado varios mecanismos para la gestión y utilización de la memoria [23, 21, 8, 39]. Algunos enfoques completan el almacenamiento de interacciones, que mantiene registros históricos completos mediante modelos de recuperación densa [39] o estructuras de memoria de lectura-escritura [24]. Además, MemGPT [25] aprovecha arquitecturas similares a caché para priorizar la información reciente. De manera similar, SCM [32] propone un marco de Memoria Autocontrolada que mejora la capacidad de los LLM para mantener memoria a largo plazo mediante un flujo de memoria y un mecanismo controlador. Sin embargo, estos enfoques enfrentan limitaciones significativas al manejar diversas tareas del mundo real. Si bien pueden proporcionar funcionalidad básica de memoria, sus operaciones suelen estar limitadas por estructuras predefinidas y flujos de trabajo fijos. Estas restricciones provienen de su dependencia de
patrones operativos rígidos, particularmente en los procesos de escritura y recuperación de memoria. Tal inflexibilidad conduce a una pobre generalización en nuevos entornos y a una eficacia limitada en interacciones a largo plazo. Por lo tanto, diseñar un sistema de memoria flexible y universal que apoye las interacciones a largo plazo de los agentes sigue siendo un desafío crucial.
2.2 Generación Aumentada por Recuperación
La Generación Aumentada por Recuperación (RAG) ha surgido como un enfoque poderoso para mejorar los LLM mediante la incorporación de fuentes de conocimiento externas [18, 6, 10]. El proceso estándar de RAG [37, 34] implica indexar documentos en fragmentos, recuperar fragmentos relevantes basados en similitud semántica y aumentar el prompt del LLM con este contexto recuperado para la generación. Los sistemas RAG avanzados [20, 12] han evolucionado para incluir sofisticadas optimizaciones previas y posteriores a la recuperación. Sobre estas bases, investigaciones recientes han introducido sistemas RAG agénticos que demuestran comportamientos más autónomos y adaptativos en el proceso de recuperación. Estos sistemas pueden determinar dinámicamente cuándo y qué recuperar [4, 14], generar respuestas hipotéticas para guiar la recuperación y refinar iterativamente sus estrategias de búsqueda basadas en resultados intermedios [31, 29].
Sin embargo, mientras que los enfoques RAG agénticos demuestran agencia en la fase de recuperación al decidir autónomamente cuándo y qué recuperar [4, 14, 38], nuestro sistema de memoria agéntica exhibe agencia en un nivel más fundamental mediante la evolución autónoma de su estructura de memoria. Inspirado por el método Zettelkasten, nuestro sistema permite que las memorias generen activamente sus propias descripciones contextuales, formen conexiones significativas con memorias relacionadas y evolucionen tanto su contenido como sus relaciones a medida que surgen nuevas experiencias. Esta distinción fundamental en la agencia entre recuperación versus almacenamiento y evolución distingue nuestro enfoque de los sistemas RAG agénticos, que mantienen bases de conocimiento estáticas a pesar de sus sofisticados mecanismos de recuperación.
3 Metodología
Nuestro sistema de memoria agéntica propuesto se inspira en el método Zettelkasten, implementando un sistema de memoria dinámico y autoevolutivo que permite a los agentes LLM mantener memoria a largo plazo sin operaciones predeterminadas. El diseño del sistema enfatiza la toma de notas atómicas, los mecanismos de enlace flexibles y la evolución continua de las estructuras de conocimiento.
3.1 Construcción de notas
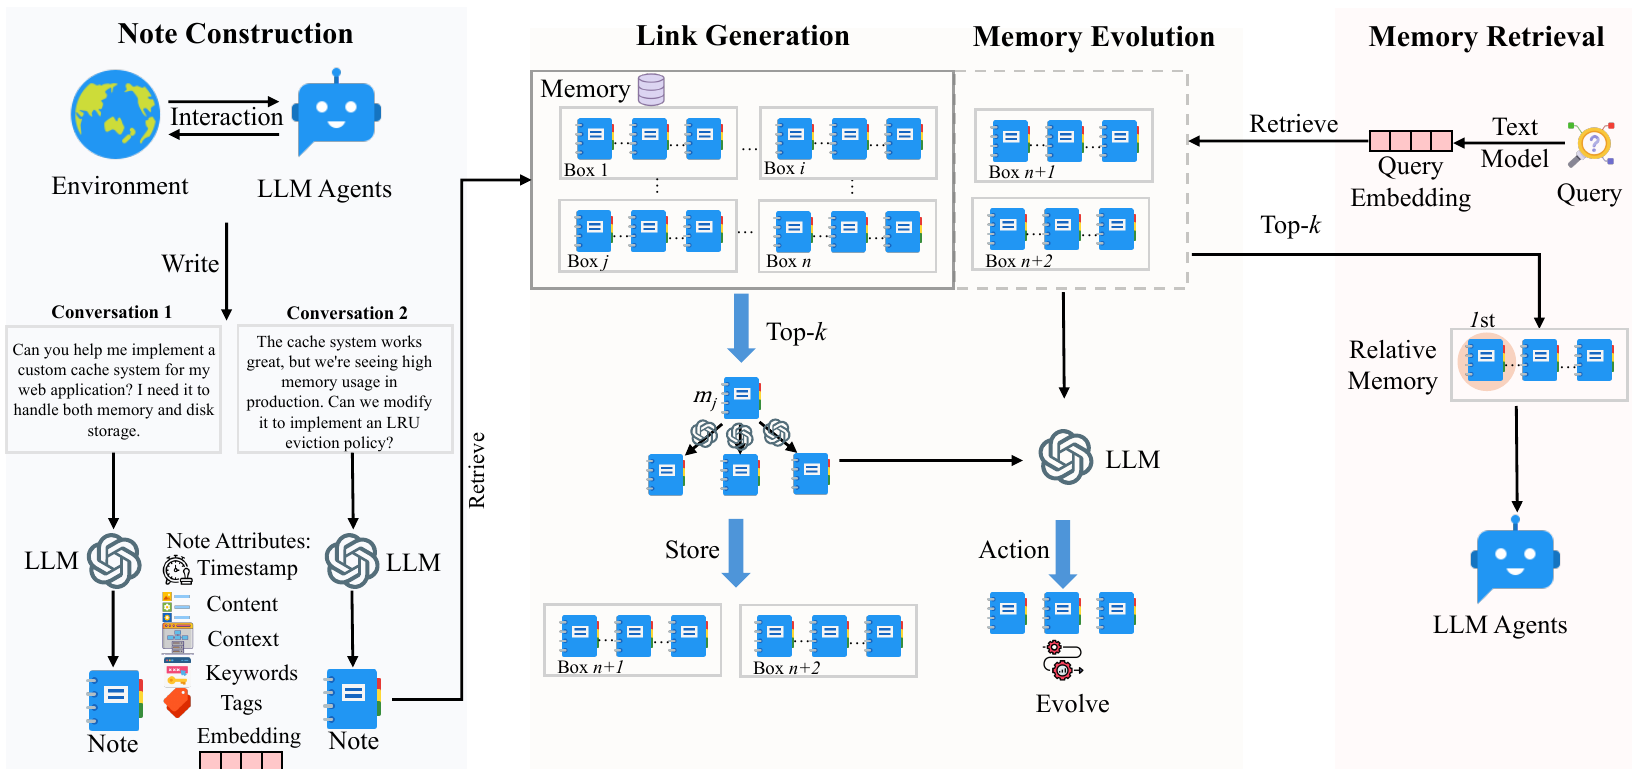
Sobre la base de los principios del método Zettelkasten de toma de notas atómicas y organización flexible, introducimos un enfoque impulsado por LLM para la construcción de notas de memoria. Cuando un agente interactúa con su entorno, construimos notas de memoria estructuradas que capturan tanto información explícita como la comprensión contextual generada por el LLM. Cada nota de memoria en nuestra colección se representa como:
donde representa el contenido original de la interacción, es la marca temporal de la interacción, denota las palabras clave generadas por el LLM que capturan los conceptos clave, contiene las etiquetas generadas por el LLM para la categorización, representa la descripción contextual generada por el LLM que proporciona una rica comprensión semántica, y mantiene el conjunto de memorias vinculadas que comparten relaciones semánticas. Para enriquecer cada nota de memoria con un contexto significativo más allá de su contenido básico y su marca temporal, aprovechamos un LLM para analizar la interacción y generar estos componentes semánticos. El proceso de construcción de la nota implica solicitar al LLM mediante plantillas cuidadosamente diseñadas :
Siguiendo el principio de atomicidad de Zettelkasten, cada nota captura una unidad de conocimiento única y autocontenida. Para permitir una recuperación y vinculación eficientes, calculamos una representación vectorial densa mediante un codificador de texto [27] que encapsula todos los componentes textuales de la nota:
Al utilizar LLM para generar componentes enriquecidos, permitimos la extracción autónoma de conocimiento implícito a partir de interacciones sin procesar. La estructura multifacética de la nota \((K_{i},G_{i},X_{i})\) crea representaciones ricas que capturan diferentes aspectos de la memoria, facilitando una organización y recuperación matizadas. Además, la combinación de componentes semánticos generados por el LLM con representaciones vectoriales densas proporciona tanto contexto como una coincidencia de similitud computacionalmente eficiente.
3.2 Generación de vínculos
Nuestro sistema implementa un mecanismo autónomo de generación de vínculos que permite a las nuevas notas de memoria formar conexiones significativas sin reglas predefinidas. Cuando la nota de memoria construida se añade al sistema, primero aprovechamos su incrustación semántica para la recuperación basada en similitud. Para cada nota de memoria existente , calculamos una puntuación de similitud:
El sistema entonces identifica las \(k\) memorias más relevantes:
Basándonos en estas memorias candidatas más cercanas, solicitamos al LLM que analice las posibles conexiones en función de sus posibles atributos comunes. Formalmente, el conjunto de vínculos de la memoria \(m_{n}\) se actualiza así:
Cada enlace generado se estructura como: . Al utilizar la recuperación basada en embeddings como filtro inicial, permitimos una escalabilidad eficiente mientras mantenemos la relevancia semántica. A-MEM puede identificar rápidamente conexiones potenciales incluso en grandes colecciones de memorias sin necesidad de comparaciones exhaustivas. Más importante aún, el análisis impulsado por el LLM permite una comprensión matizada de las relaciones que va más allá de las simples métricas de similitud. El modelo de lenguaje puede identificar patrones sutiles, relaciones causales y conexiones conceptuales que podrían no ser evidentes a partir de la similitud de embeddings únicamente. Implementamos el principio Zettelkasten de vinculación flexible mientras aprovechamos los modelos de lenguaje modernos. La red resultante emerge orgánicamente del contenido y el contexto de la memoria, permitiendo una organización natural del conocimiento.
3.3 Evolución de la memoria
Después de crear enlaces para la nueva memoria, A-MEM evoluciona las memorias recuperadas en función de su información textual y sus relaciones con la nueva memoria. Para cada memoria en el conjunto devecinos más cercanos , el sistema determina si actualizar su contexto, palabras clave y etiquetas. Este proceso de evolución puede expresarse formalmente como:
La memoria evolucionada reemplaza entonces a la memoria original en el conjunto de memorias . Este enfoque evolutivo permite actualizaciones continuas y nuevas conexiones, imitando los procesos de aprendizaje humano. A medida que el sistema procesa más memorias con el tiempo, desarrolla estructuras de conocimiento cada vez más sofisticadas, descubriendo patrones y conceptos de orden superior a través de múltiples memorias. Esto crea una base para el aprendizaje autónomo de la memoria, donde la organización del conocimiento se vuelve progresivamente más rica mediante la interacción continua entre nuevas experiencias y memorias existentes.
3.4 Recuperación de memoria relativa
En cada interacción, nuestro A-MEM realiza una recuperación de memoria consciente del contexto para proporcionar al agente información histórica relevante. Dado un texto de consulta de la interacción actual, primero calculamos su representación vectorial densa utilizando el mismo codificador de texto empleado para las notas de memoria:
El sistema entonces calcula las puntuaciones de similitud entre el embedding de la consulta y todas las notas de memoria existentes en utilizando la similitud del coseno:
Luego recuperamos las k memorias más relevantes del almacenamiento histórico de memorias para construir un prompt contextualmente apropiado.
Estas memorias recuperadas proporcionan un contexto histórico relevante que ayuda al agente a comprender y responder mejor a la interacción actual. El contexto recuperado enriquece el proceso de razonamiento del agente al conectar la interacción actual con experiencias pasadas relacionadas almacenadas en el sistema de memoria.
4 Experimentos
4.1 Conjunto de datos y evaluación
Para evaluar la efectividad de la recomendación consciente de las instrucciones en conversaciones a largo plazo, utilizamos el conjunto de datos LoCoMo [22], que contiene diálogos significativamente más largos en comparación con los conjuntos de datos conversacionales existentes [36, 13]. Mientras que los conjuntos de datos anteriores contienen diálogos con alrededor de 1K tokens a lo largo de 4-5 sesiones, LoCoMo presenta conversaciones mucho más largas que promedian 9K tokens y abarcan hasta 35 sesiones, lo que lo hace particularmente adecuado para evaluar la capacidad de los modelos de manejar dependencias de largo alcance y mantener la consistencia a lo largo de conversaciones extendidas. El conjunto de datos LoCoMo comprende diversos tipos de preguntas diseñadas para evaluar de manera integral diferentes aspectos de la comprensión del modelo: (1) preguntas de un solo salto que pueden responderse a partir de una sola sesión; (2) preguntas de múltiples saltos que requieren la síntesis de información entre sesiones; (3) preguntas de razonamiento temporal que ponen a prueba la comprensión de información relacionada con el tiempo; (4) preguntas de conocimiento de dominio abierto que requieren la integración del contexto de la conversación con conocimiento externo; y (5) preguntas adversariales que evalúan la capacidad de los modelos para identificar consultas sin respuesta. En total, LoCoMo contiene 7.512 pares pregunta-respuesta en estas categorías. Además, utilizamos un nuevo conjunto de datos, denominado DialSim [16], para evaluar la efectividad de nuestro sistema de memoria. Es un conjunto de datos de respuesta a preguntas derivado de diálogos multipartitos de largo plazo. El conjunto de datos se deriva de populares programas de televisión (Friends, The Big Bang Theory y The Office), abarcando 1.300 sesiones que se extienden a lo largo de cinco años, conteniendo aproximadamente 350.000 tokens e incluyendo más de 1.000 preguntas por sesión a partir de preguntas refinadas de sitios web de cuestionarios para fans y preguntas complejas generadas a partir de grafos de conocimiento temporal.
Para las líneas base de comparación, nos comparamos con LoCoMo [22], ReadAgent [17], MemoryBank [39] y MemGPT [25]. La introducción detallada de las líneas base puede encontrarse en el Apéndice A.1. Para la evaluación, empleamos dos métricas principales: la puntuación F1 para evaluar la precisión de las respuestas equilibrando precisión y exhaustividad, y BLEU-1 [26] para evaluar la calidad de las respuestas generadas midiendo la superposición de palabras
| Modelo | Método | Categoría | Promedio | ||||||||||
| F1 Multi Hop | BLEU | F1 Temporal | F1 Dominio Abierto | F1 Single Hop | BLEU | F1 Adversarial | BLEU | F1 Ranking | BLEU | Longitud de Tokens | |||
| GPT | LoCoMo | 25.02 | 19.75 | 18.41 | 14.77 | 12.04 | 11.16 | 40.36 | 29.05 | 69.23 | 68.75 | 2.4 | 2.4 |
| READAGENT | 9.15 | 6.48 | 12.60 | 8.87 | 5.31 | 5.12 | 9.67 | 7.66 | 9.81 | 9.02 | 4.2 | 4.2 | |
| MEMORYBANK | 5.00 | 4.77 | 9.68 | 6.99 | 5.56 | 5.94 | 6.61 | 5.16 | 7.36 | 6.48 | 4.8 | 4.8 | |
| MEMGPT | 26.65 | 17.72 | 25.52 | 19.44 | 9.15 | 7.44 | 41.04 | 34.34 | 43,29 | 42,73 | 2,4 | 2,4 | |
| A-MEM | 27,02 | 20,09 | 45,85 | 36,67 | 12,14 | 12,00 | 44,65 | 37,06 | 50,03 | 49,47 | 1,2 | 1,2 | |
| GPT | LoCoMo | 28,00 | 18,47 | 9,09 | 5,78 | 16,47 | 14,80 | 61,56 | 54,19 | 52,61 | 51,13 | 2,0 | 2,0 |
| READAGENT | 14,61 | 9,95 | 4,16 | 3,19 | 8,84 | 8,37 | 12,46 | 10,29 | 6,81 | 6,13 | 4,0 | 4,0 | |
| MEMORYBANK | 6,49 | 4,69 | 2,47 | 2,43 | 6,43 | 5,30 | 8,28 | 7,10 | 4,42 | 3,67 | 5,0 | 5,0 | |
| MEMGPT | 30,36 | 22,83 | 17,29 | 13,18 | 12,24 | 11,87 | 60,16 | 53,35 | 34,96 | 34,25 | 2,4 | 2,4 | |
| A-MEM | 32,86 | 23,76 | 39,41 | 31,23 | 17,10 | 15,84 | 48,43 | 42,97 | 36,35 | 35,53 | 1,6 | 1,6 | |
| GPT | LoCoMo | 9,05 | 6,55 | 4,25 | 4,04 | 9,91 | 8,50 | 11,15 | 8,67 | 40,38 | 40,23 | 3,4 | 3,4 |
| READAGENT | 6,61 | 4,93 | 2,55 | 2,51 | 5,31 | 12,24 | 10,13 | 7,54 | 5,42 | 27,32 | 4,6 | 4,6 | |
| MEMORYBANK | 11,14 | 8,25 | 4,46 | 2,87 | 8,05 | 6,21 | 13,42 | 11,01 | 36,76 | 34,00 | 2,6 | 2,6 | |
| MEMGPT | 10,44 | 7,61 | 4,21 | 3,89 | 13,42 | 11,64 | 9,56 | 7,34 | 31,51 | 28,90 | 3,4 | 3,4 | |
| A-MEM | 18,23 | 11,94 | 24,32 | 19,74 | 16,48 | 14,31 | 23,63 | 19,23 | 46,00 | 43,26 | 1,0 | 1,0 | |
| GPT | LoCoMo | 4,61 | 4,29 | 3,11 | 2,71 | 4,55 | 5,97 | 7,03 | 5,69 | 16,95 | 14,81 | 3,2 | 3,2 |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,57 | 5,22 | 3,25 | 2,51 | 15,78 | 14,01 | 4,2 | 4,2 | |
| MEMORYBANK | 3,60 | 3,39 | 1,97 | 1,67 | 6,63 | 6,58 | 4,11 | 3,32 | 13,07 | 10,30 | 4,2 | 4,2 | |
| MEMGPT | 5,07 | 4,31 | 2,94 | 2,95 | 7,04 | 7,10 | 7,26 | 5,52 | 14,47 | 12,39 | 2,4 | 2,4 | |
| A-MEM | 12,57 | 9,01 | 27,59 | 25,07 | 7,12 | 7,28 | 17,23 | 13,12 | 27,91 | 25,15 | 1,0 | 1,0 | |
| LLaMA 2 | LoCoMo | 11,25 | 9,18 | 7,38 | 6,82 | 11,90 | 10,38 | 12,86 | 10,50 | 51,89 | 48,27 | 3,4 | 3,4 |
| READAGENT | 5,96 | 5,12 | 1,93 | 2,30 | 12,46 | 11,17 | 7,75 | 6,03 | 44,64 | 40,15 | 4,6 | 4,6 | |
| MEMORYBANK | 13,18 | 10,03 | 7,61 | 6,27 | 15,78 | 12,94 | 17,30 | 14,03 | 52,61 | 47,53 | 2,0 | 2,0 | |
| MEMGPT | 9.19 | 6.96 | 4.02 | 4.79 | 11.34 | 8.24 | 10.16 | 7.68 | 49.75 | 45.11 | 4.0 | 4.0 | |
| A-MEM | 19.06 | 11.71 | 17.80 | 10.28 | 17.55 | 14.67 | 28.51 | 24.13 | 58.81 | 54.28 | 1.0 | 1.0 | |
| LLaMA 2 | LoCoMo | 6.88 | 5.77 | 4.37 | 4.40 | 10.65 | 9.29 | 8.37 | 6.93 | 30.25 | 28.46 | 2.8 | 2.8 |
| READAGENT | 2.47 | 1.78 | 3.01 | 3.01 | 5.57 | 5.22 | 3.25 | 2.51 | 15.78 | 14.01 | 4.2 | 4.2 | |
| MEMORYBANK | 6.19 | 4.47 | 3.49 | 3.13 | 4.07 | 4.57 | 7.61 | 6.03 | 18.65 | 17.05 | 3.2 | 3.2 | |
| MEMGPT | 5,32 | 3,99 | 2,68 | 2,72 | 5,64 | 5,54 | 4,32 | 3,51 | 21,45 | 19,37 | 3,8 | 3,8 | |
| A-MEM | 17,44 | 11,74 | 26,38 | 19,50 | 12,53 | 11,83 | 28,14 | 23,87 | 42,04 | 40,60 | 1,0 | 1,0 | |
con las respuestas de referencia. Además, reportamos la longitud media de tokens para responder una pregunta. Además de reportar los resultados experimentales con cuatro métricas adicionales (ROUGE-L, ROUGE-2, METEOR y Similitud SBERT), también presentamos los resultados experimentales utilizando diferentes modelos fundacionales, incluidos DeepSeek-R1-32B [11], Claude 3.0 Haiku [2] y Claude 3.5 Haiku [3], en el Apéndice A.3.
4.2 Detalles de implementación
Para todas las líneas base y nuestro método propuesto, mantenemos la consistencia empleando prompts de sistema idénticos, como se detalla en el Apéndice B. El despliegue de los modelos Qwen-1.5B/3B y Llama 3.2 1B/3B se realiza mediante instanciación local utilizando Ollama 1, con LiteLLM 2 gestionando la generación de salida estructurada. Para los modelos GPT, utilizamos la API oficial de salida estructurada. En nuestro proceso de recuperación de memoria, empleamos principalmente para la selección de las top- memorias con el fin de mantener la eficiencia computacional, mientras ajustamos este parámetro para categorías específicas para optimizar el rendimiento. Las configuraciones detalladas de pueden encontrarse en el Apéndice A.5. Para el embedding de texto, implementamos el modelo all-miniml-16-v2 en todos los experimentos.
4.3 Resultados empíricos
Análisis de rendimiento. En nuestra evaluación empírica, comparamos A-MEM con cuatro líneas base competitivas, incluidas LoCoMo [22], ReadAgent [17], MemoryBank [39] y MemGPT [25], en el conjunto de datos LoCoMo. Para los modelos fundacionales que no son GPT, nuestro A-MEM supera consistentemente a todas las líneas base en las diferentes categorías, lo que demuestra la efectividad de nuestro enfoque de memoria agéntica. Para los modelos basados en GPT, si bien LoCoMo y MemGPT muestran un fuerte rendimiento en ciertas categorías como Dominio Abierto y tareas Adversariales debido a su robusto conocimiento preentrenado en la recuperación de hechos simples, nuestro A-MEM demuestra un rendimiento superior en tareas de Múltiples Saltos, alcanzando al menos el doble de rendimiento en aquellas que requieren cadenas de razonamiento complejas. Además de los experimentos en el conjunto de datos LoCoMo, también comparamos nuestro método en el conjunto de datos DialSim frente a LoCoMo y MemGPT. A-MEM supera consistentemente a todas las líneas base en todas las métricas de evaluación, alcanzando una puntuación F1
| Método | F1 | BLEU-1 | ROUGE-L | ROUGE-2 | METEOR | Similitud SBERT |
| LoCoMo | 2,55 | 3,13 | 2,75 | 0,90 | 1,64 | 15,76 |
| MemGPT | 1,18 | 1,07 | 0,96 | 0,42 | 0,95 | 8,54 |
| A-MEM | 3,45 | 3,37 | 3,54 | 3,60 | 2,05 | 19,51 |
| Método | Multi Hop | Temporal | Categoría | Single Hop | Adversarial | |||||
| F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | |
| sin LG y ME | 9,65 | 7,09 | 24,55 | 19,48 | 7,77 | 6,70 | 13,28 | 10,30 | 15,32 | 18,02 |
| sin ME | 21,35 | 15,13 | 31,24 | 27,31 | 10,13 | 10,85 | 39,17 | 34,70 | 44,16 | 45,33 |
| A-MEM | 27,02 | 20,09 | 45,85 | 36,67 | 12,14 | 12,00 | 44,65 | 37,06 | 50,03 | 49,47 |
de 3,45 (una mejora del sobre 2,55 de LoCoMo y superior a 1,18 de MemGPT). La efectividad de A-MEM proviene de su novedosa arquitectura de memoria agéntica que permite una gestión dinámica y estructurada de la memoria. A diferencia de los enfoques tradicionales que utilizan operaciones de memoria estáticas, nuestro sistema crea redes de memoria interconectadas mediante notas atómicas con ricas descripciones contextuales, lo que permite un razonamiento de múltiples saltos más efectivo. La capacidad del sistema para establecer dinámicamente conexiones entre memorias basadas en atributos compartidos y actualizar continuamente las descripciones de memoria existentes con nueva información contextual le permite capturar y utilizar mejor las relaciones entre diferentes piezas de información.
Análisis de eficiencia de costos. A-MEM demuestra una importante eficiencia computacional y de costos junto con un sólido rendimiento. El sistema requiere aproximadamente 1.200 tokens por operación de memoria, logrando una reducción del en el uso de tokens en comparación con los métodos de línea base (LoCoMo y MemGPT con 16.900 tokens) mediante nuestro mecanismo de recuperación selectiva top-k. Esta reducción sustancial de tokens se traduce directamente en menores costos operativos, con cada operación de memoria costando menos de 0,0003\(cuando se utilizan servicios de API comerciales, lo que hace que los despliegues a gran escala sean económicamente viables. Los tiempos de procesamiento promedian 5,4 segundos usando GPT-4o-mini y solo 1,1 segundos con Llama 3.2 1B alojado localmente en una sola GPU. A pesar de requerir múltiples llamadas al LLM durante el procesamiento de la memoria, A-MEM mantiene esta utilización de recursos rentable mientras supera consistentemente a los enfoques de línea base en todos los modelos fundacionales probados, particularmente duplicando el rendimiento en tareas complejas de razonamiento de múltiples saltos. Este equilibrio entre bajo costo computacional y capacidad de razonamiento superior destaca la ventaja práctica de A-MEM para su despliegue en el mundo real.
4.4 Estudio de ablación
Para evaluar la efectividad de los módulos de Generación de Enlaces (LG, por sus siglas en inglés) y Evolución de la Memoria (ME, por sus siglas en inglés), realizamos el estudio de ablación eliminando sistemáticamente componentes clave de nuestro modelo. Cuando se eliminan ambos módulos, LG y ME, el sistema exhibe una degradación sustancial del rendimiento, particularmente en las tareas de Razonamiento Multi-Salto y Dominio Abierto. El sistema con solo LG activo (sin ME) muestra niveles de rendimiento intermedios, manteniendo resultados significativamente mejores que la versión sin ambos módulos, lo que demuestra la importancia fundamental de la generación de enlaces en el establecimiento de conexiones de memoria. Nuestro modelo completo, A-MEM, alcanza consistentemente el mejor rendimiento en todas las categorías de evaluación, con resultados particularmente sólidos en tareas de razonamiento complejo. Estos resultados revelan que, si bien el módulo de generación de enlaces sirve como fundamento crítico para la organización de la memoria, el módulo de evolución de la memoria proporciona refinamientos esenciales a la estructura de memoria. El estudio de ablación valida nuestras decisiones de diseño arquitectónico y destaca la naturaleza complementaria de estos dos módulos en la creación de un sistema de memoria efectivo.
4.5 Análisis de Hiperparámetros
Realizamos experimentos exhaustivos para analizar el impacto del parámetro de recuperación de memoria k, que controla el número de memorias relevantes recuperadas para cada interacción. Como se muestra en la Figura 3, evaluamos el rendimiento a través de diferentes valores de k (10, 20, 30, 40, 50) en cinco categorías de tareas utilizando GPT-4o-mini como nuestro modelo base. Los resultados revelan un patrón interesante: si bien aumentar k generalmente conduce a un mejor rendimiento, esta mejora se estabiliza gradualmente y en ocasiones disminuye ligeramente en valores más altos. Esta tendencia es particularmente evidente en las tareas de Razonamiento Multi-Salto y Dominio Abierto.
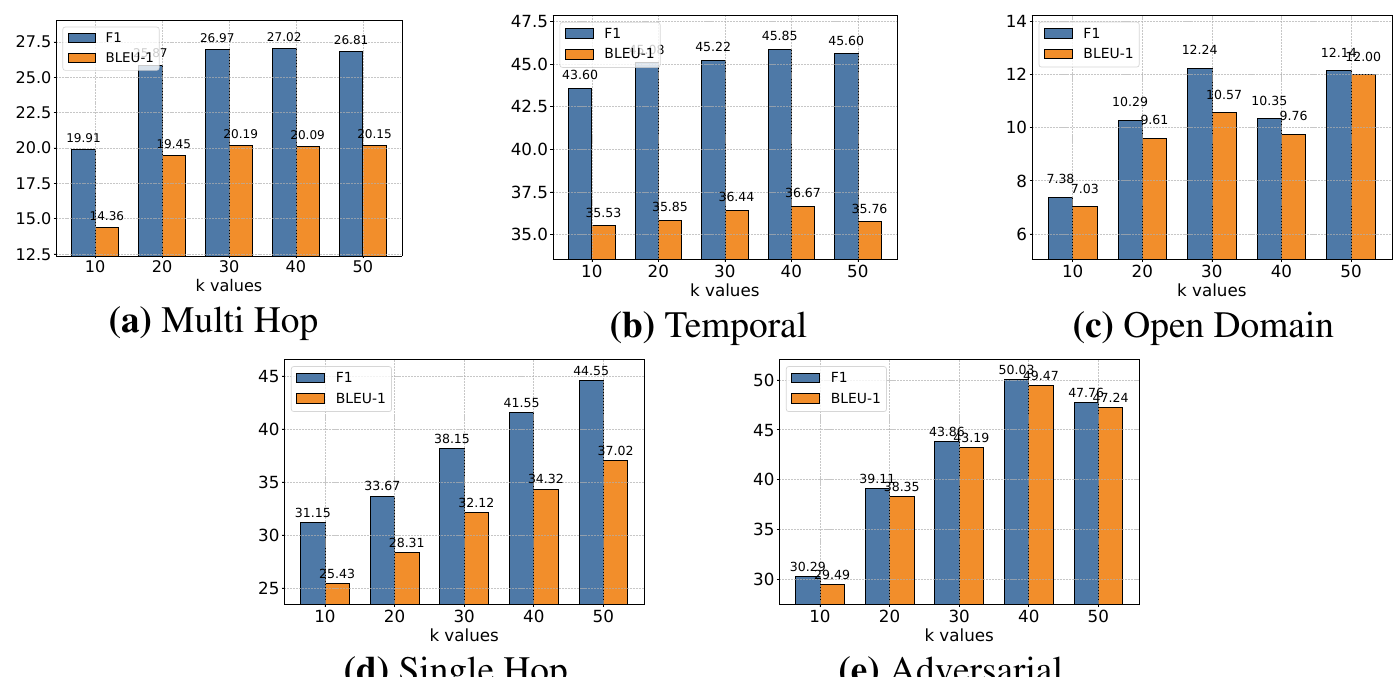
Tabla 4: Comparación del uso de memoria y el tiempo de recuperación entre diferentes métodos de memoria y escalas.
| Tamaño de memoria | Método | Uso de memoria (MB) | Tiempo de recuperación (μs) |
| 1.000 | A-MEM | 1,46 | 0,31 ± 0,30 |
| MemoryBank [39] | 1,46 | 0,24 ± 0,20 | |
| ReadAgent [17] | 1,46 | 43,62 ± 8,47 | |
| 10.000 | A-MEM | 14,65 | 0,38 ± 0,25 |
| MemoryBank [39] | 14,65 | 0,26 ± 0,13 | |
| ReadAgent [17] | 14,65 | 484,45 ± 93,86 | |
| 100.000 | A-MEM | 146,48 | 1,40 ± 0,49 |
| MemoryBank [39] | 146,48 | 0,78 ± 0,26 | |
| ReadAgent [17] | 146,48 | 6.682,22 ± 111,63 | |
| 1.000.000 | A-MEM | 1464,84 | 3,70 ± 0,74 |
| MemoryBank [39] | 1464,84 | 1,91 ± 0,31 | |
| ReadAgent [17] | 1464,84 | 120.069,68 ± 1.673,39 |
Las observaciones sugieren un equilibrio delicado en la recuperación de memoria: si bien valores de k más grandes proporcionan un contexto histórico más rico para el razonamiento, también pueden introducir ruido y desafiar la capacidad del modelo para procesar secuencias más largas de manera efectiva. Nuestro análisis indica que valores moderados de k logran un equilibrio óptimo entre la riqueza del contexto y la eficiencia del procesamiento de información.
4.6 Análisis de Escalabilidad
Para evaluar los costos de almacenamiento con memoria acumulativa, examinamos la relación entre el tamaño de almacenamiento y el tiempo de recuperación en nuestro sistema A-MEM y dos enfoques de referencia: MemoryBank [39] y ReadAgent [17]. Evaluamos estos tres sistemas de memoria con contenido de memoria idéntico en cuatro puntos de escala, incrementando el número de entradas por un factor de 10 en cada paso (de 1.000 a 10.000, 100.000 y finalmente 1.000.000 de entradas). Los resultados experimentales revelan ideas clave sobre las propiedades de escalabilidad de nuestro sistema A-MEM: En términos de complejidad espacial, los tres sistemas exhiben un escalamiento de uso de memoria lineal idéntico , como se espera para sistemas de recuperación basados en vectores. Esto confirma que A-MEM no introduce sobrecarga de almacenamiento adicional en comparación con los enfoques de referencia. En cuanto al tiempo de recuperación, A-MEM demuestra una excelente eficiencia con incrementos mínimos a medida que crece el tamaño de la memoria. Incluso al escalar a 1 millón de memorias, el tiempo de recuperación de A-MEM aumenta solo de a , lo que representa un rendimiento excepcional. Si bien MemoryBank muestra tiempos de recuperación ligeramente más rápidos, A-MEM mantiene un rendimiento comparable mientras proporciona representaciones de memoria y funcionalidad más ricas. Basándonos en nuestro análisis de complejidad espacial y tiempo de recuperación, concluimos que los mecanismos de recuperación de A-MEM mantienen una excelente eficiencia incluso a gran escala. El crecimiento mínimo en el tiempo de recuperación a través de los tamaños de memoria aborda las preocupaciones sobre la eficiencia en sistemas de memoria a gran escala, demostrando que A-MEM proporciona una solución altamente escalable para la gestión de conversaciones a largo plazo. Esta combinación única de eficiencia, escalabilidad y capacidades de memoria mejoradas posiciona a A-MEM como un avance significativo en la construcción de un mecanismo de memoria potente y a largo plazo para Agentes LLM.
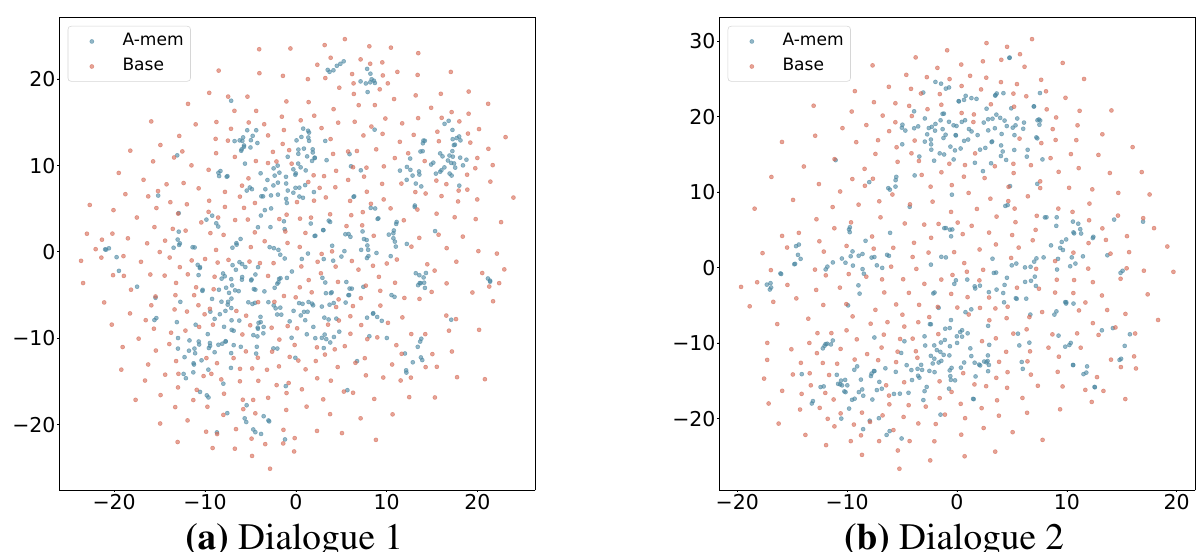
Figura 4: Visualización T-SNE de los embeddings de memoria que muestra una distribución más organizada con A-MEM (azul) en comparación con la memoria base (rojo) en diferentes diálogos. La memoria base representa A-MEM sin generación de enlaces ni evolución de la memoria.
4.7 Análisis de la memoria
Presentamos la visualización t-SNE en la Figura 4 de los embeddings de memoria para demostrar las ventajas estructurales de nuestro sistema de memoria agéntica. Al analizar dos diálogos muestreados de conversaciones a largo plazo en LoCoMo [22], observamos que A-MEM (mostrado en azul) exhibe consistentemente patrones de agrupamiento más coherentes en comparación con el sistema de referencia (mostrado en rojo). Esta organización estructural es particularmente evidente en el Diálogo 2, donde surgen agrupamientos bien definidos en la región central, lo que proporciona evidencia empírica de la eficacia de nuestro mecanismo de evolución de la memoria y de la generación de descripciones contextuales. En contraste, los embeddings de memoria del sistema de referencia muestran una distribución más dispersa, lo que demuestra que las memorias carecen de organización estructural sin nuestros componentes de generación de enlaces y evolución de la memoria. Estos resultados de visualización validan que A-MEM puede mantener autónomamente estructuras de memoria significativas mediante mecanismos de evolución dinámica y vinculación. Pueden verse más resultados en el Apéndice A.4.
5 Conclusiones
En este trabajo, presentamos A-MEM, un novedoso sistema de memoria agéntica que permite a los agentes LLM organizar y evolucionar dinámicamente sus memorias sin depender de estructuras predefinidas. Inspirándonos en el método Zettelkasten, nuestro sistema crea una red de conocimiento interconectada mediante mecanismos de indexación y vinculación dinámicos que se adaptan a diversas tareas del mundo real. La arquitectura central del sistema se caracteriza por la generación autónoma de descripciones contextuales para nuevas memorias y el establecimiento inteligente de conexiones con memorias existentes basadas en atributos compartidos. Además, nuestro enfoque permite la evolución continua de las memorias históricas al incorporar nuevas experiencias y desarrollar atributos de orden superior mediante interacciones continuas. Mediante una extensa evaluación empírica en seis modelos fundacionales, demostramos que A-MEM logra un rendimiento superior en comparación con las líneas base existentes del estado del arte en tareas de conversación a largo plazo. El análisis de visualización valida además la eficacia de nuestro enfoque de organización de la memoria. Estos resultados sugieren que los sistemas de memoria agéntica pueden mejorar significativamente la capacidad de los agentes LLM para utilizar conocimiento a largo plazo en entornos complejos.
6 Limitaciones
Si bien nuestro sistema de memoria agéntica logra resultados prometedores, reconocemos varias áreas para una posible exploración futura. Primero, aunque nuestro sistema organiza dinámicamente las memorias, la calidad de estas organizaciones aún puede verse influida por las capacidades inherentes de los modelos de lenguaje subyacentes. Diferentes LLM podrían generar descripciones contextuales ligeramente distintas o establecer conexiones variables entre memorias. Además, aunque nuestra implementación actual se centra en interacciones basadas en texto, el trabajo futuro podría explorar la extensión del sistema para manejar información multimodal, como imágenes o audio, lo que podría proporcionar representaciones contextuales más ricas.
Referencias
[1] Sönke Ahrens. How to Take Smart Notes: One Simple Technique to Boost Writing, Learning and Thinking. Amazon, 2017. Second Edition.
[2] Anthropic. The claude 3 model family: Opus, sonnet, haiku. Anthropic, Mar 2024. Accessed May 2025.
[3] Anthropic. Claude 3.5 sonnet model card addendum. Technical report, Anthropic, 2025. Accessed May 2025.
[4] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. arXiv preprint arXiv:2310.11511, 2023.
[5] Satanjeev Banerjee and Alon Lavie. Meteor: An automatic metric for mt evaluation with improved correlation with human judgments. In Proceedings of the acl workshop on intrinsic and extrinsic evaluation measures for machine translation and/or summarization, pages 65-72, 2005.
[6] Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean-Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. Improving language models by retrieving from trillions of tokens. In International conference on machine learning, pages 2206-2240. PMLR, 2022.
[7] Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Sam Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web. Advances in Neural Information Processing Systems, 36:28091-28114, 2023.
[8] Khant Dev and Singh Taranjeet. mem0: The memory layer for ai agents. https://github.com/mem0ai/mem0, 2024.
[9] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From local to global: A graph rag approach to query-focused summarization. arXiv preprint arXiv:2404.16130, 2024.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2023.
[11] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[12] I. Ilin. Advanced rag techniques: An illustrated overview, 2023.
[13] Jihyoung Jang, Minseong Boo, and Hyounghun Kim. Conversation chronicles: Towards diverse temporal and relational dynamics in multi-session conversations. arXiv preprint arXiv:2310.13420, 2023.
[14] Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. arXiv preprint arXiv:2305.06983, 2023.
[15] David Kadavy. Digital Zettelkasten: Principles, Methods, & Examples. Google Books, May 2021.
[16] Jiho Kim, Woosog Chay, Hyeonji Hwang, Daeun Kyung, Hyunseung Chung, Eunbyeol Cho, Yohan Jo, and Edward Choi. Dialism: A real-time simulator for evaluating long-term multi-party dialogue understanding of conversational agents. arXiv preprint arXiv:2406.13144, 2024.
[17] Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human-inspired reading agent with gist memory of very long contexts. arXiv preprint arXiv:2402.09727, 2024.
[18] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, et al. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459-9474, 2020.
[19] Chin-Yew Lin. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74-81, 2004.
[20] Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra-dit: Retrieval-augmented dual instruction tuning. arXiv preprint arXiv:2310.01352, 2023.
[21] Zhiwei Liu, Weiran Yao, Jianguo Zhang, Liangwei Yang, Zuxin Liu, Juntao Tan, Prafulla K Choubey, Tian Lan, Jason Wu, Huan Wang, et al. Agentlite: A lightweight library for building and advancing task-oriented llm agent system. arXiv preprint arXiv:2402.15538, 2024.
[22] Adyasha Maharana, Dong-Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long-term conversational memory of llm agents. arXiv preprint arXiv:2402.17753, 2024.
[23] Kai Mei, Zelong Li, Shuyuan Xu, Ruosong Ye, Yingqiang Ge, and Yongfeng Zhang. Aios: Llm agent operating system. arXiv e-prints, pp. arXiv-2403, 2024.
[24] Ali Modarressi, Ayyob Imani, Mohsen Fayyaz, and Hinrich Schütze. Ret-llm: Towards a general read-write memory for large language models. arXiv preprint arXiv:2305.14322, 2023.
[25] Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G Patil, Ion Stoica y Joseph E Gonzalez. Memgpt: Towards llms as operating systems. Preimpresión de arXiv arXiv:2310.08560, 2023.
[26] Kishore Papineni, Salim Roukos, Todd Ward y Wei-Jing Zhu. Bleu: a method for automatic evaluation of machine translation. En Proceedings of the 40th annual meeting of the Association for Computational Linguistics, páginas 311-318, 2002.
[27] Nils Reimers e Iryna Gurevych. Sentence-bert: Sentence embeddings using siamese bert-networks. En Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing. Association for Computational Linguistics, 11 2019.
[28] Aymeric Roucher, Albert Villanova del Moral, Thomas Wolf, Leandro von Werra y Erik Kaunismaki. 'smolagents': a smol library to build great agentic systems. https://github.com/huggingface/smolagents, 2025.
[29] Zhihong Shao, Yeyun Gong, Yelong Shen, Minlie Huang, Nan Duan y Weizhu Chen. Enhancing retrieval-augmented large language models with iterative retrieval-generation synergy. Preimpresión de arXiv arXiv:2305.15294, 2023.
[30] Zeru Shi, Kai Mei, Mingyu Jin, Yongye Su, Chaoji Zuo, Wenyue Hua, Wujiang Xu, Yujie Ren, Zirui Liu, Mengnan Du, et al. From commands to prompts: Llm-based semantic file system for aios. Preimpresión de arXiv arXiv:2410.11843, 2024.
[31] Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot y Ashish Sabharwal. Interleaving retrieval with chain-of-thought reasoning for knowledge-intensive multi-step questions. Preimpresión de arXiv arXiv:2212.10509, 2022.
[32] Bing Wang, Xinnian Liang, Jian Yang, Hui Huang, Shuangzhi Wu, Peihao Wu, Lu Lu, Zejun Ma y Zhoujun Li. Enhancing large language model with self-controlled memory framework. Preimpresión de arXiv arXiv:2304.13343, 2023.
[33] Xingyao Wang, Boxuan Li, Yufan Song, Frank F Xu, Xiangru Tang, Mingchen Zhuge, Jiayi Pan, Yueqi Song, Bowen Li, Jaskirat Singh, et al. Openhands: An open platform for ai software developers as generalist agents. Preimpresión de arXiv arXiv:2407.16741, 2024.
[34] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez y Graham Neubig. Learning to filter context for retrieval-augmented generation. Preimpresión de arXiv arXiv:2311.08377, 2023.
[35] Lilian Weng. Llm-powered autonomous agents. lilianweng.github.io, jun 2023.
[36] J Xu. Beyond goldfish memory: Long-term open-domain conversation. Preimpresión de arXiv arXiv:2107.07567, 2021.
[37] Wenhao Yu, Hongming Zhang, Xiaoman Pan, Kaixin Ma, Hongwei Wang y Dong Yu. Chain-of-note: Enhancing robustness in retrieval-augmented language models. Preimpresión de arXiv arXiv:2311.09210, 2023.
[38] Zichun Yu, Chenyan Xiong, Shi Yu y Zhiyuan Liu. Augmentation-adapted retriever improves generalization of language models as generic plug-in. Preimpresión de arXiv arXiv:2305.17331, 2023.
[39] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye y Yanlin Wang. Memorybank: Enhancing large language models with long-term memory. En Proceedings of the AAAI Conference on Artificial Intelligence, volumen 38, páginas 19724-19731, 2024.
Contenido
1 Introducción 1
2 Trabajo relacionado 2
2.1 Memoria para agentes LLM 2
2.2 Generación aumentada por recuperación 3
3 Metodología 3
3.1 Construcción de notas 4
3.2 Generación de enlaces 4
3.3 Evolución de la memoria 4
3.4 Recuperar memoria relativa 5
4 Experimento 5
4.1 Conjunto de datos y evaluación 5
4.2 Detalles de implementación 6
4.3 Resultados empíricos 6
4.4 Estudio de ablación 7
4.5 Análisis de hiperparámetros 7
4.6 Análisis de escalado 8
4.7 Análisis de memoria 9
5 Conclusiones 9
6 Limitaciones 9
A Experimento 14
A.1 Introducción detallada a las líneas base 14
A.2 Métrica de evaluación 14
A.3 Resultados comparativos 15
A.4 Análisis de memoria 16
A.5 Configuración de hiperparámetros 17
B Plantillas de prompts y ejemplos 19
B.1 Plantilla de prompt para la construcción de notas 19
B.2 Plantilla de prompt para la generación de enlaces 19
B.3 Plantilla de prompt para la evolución de la memoria 20
B.4 Ejemplos de P/R con A-MEM 21
APÉNDICE
A Experimento
A.1 Introducción detallada a las líneas base
LoCoMo [22] adopta un enfoque directo al aprovechar modelos fundacionales sin mecanismos de memoria para tareas de respuesta a preguntas. Para cada consulta, incorpora la conversación precedente completa y las preguntas en el prompt, evaluando las capacidades de razonamiento del modelo.
ReadAgent [17] aborda el procesamiento de documentos de contexto largo mediante una metodología sofisticada de tres pasos: comienza con la paginación de episodios para segmentar el contenido en fragmentos manejables, seguida de la síntesis de memoria para destilar cada página en representaciones de memoria concisas, y concluye con la búsqueda interactiva para recuperar información pertinente según sea necesario.
MemoryBank [39] introduce un innovador sistema de gestión de memoria que mantiene y recupera eficientemente interacciones históricas. El sistema presenta un mecanismo dinámico de actualización de la memoria basado en la teoría de la Curva del Olvido de Ebbinghaus, que ajusta inteligentemente la fuerza de la memoria según el tiempo y la importancia. Además, incorpora un sistema de construcción de retratos de usuario que refina progresivamente su comprensión de la personalidad del usuario mediante el análisis continuo de las interacciones.
MemGPT [25] presenta un novedoso sistema de gestión de contexto virtual inspirado en las jerarquías de memoria de los sistemas operativos tradicionales. La arquitectura implementa una estructura de dos niveles: un contexto principal (análogo a la RAM) que proporciona acceso inmediato durante la inferencia del LLM, y un contexto externo (análogo al almacenamiento en disco) que mantiene información más allá de la ventana de contexto fija.
A.2 Métrica de evaluación
La puntuación F1 representa la media armónica de la precisión y la exhaustividad, ofreciendo una métrica equilibrada que combina ambas medidas en un único valor. Esta métrica es particularmente valiosa cuando necesitamos equilibrar entre respuestas completas y precisas:
donde
En los sistemas de respuesta a preguntas, la puntuación F1 desempeña un papel crucial en la evaluación de coincidencias exactas entre las respuestas predichas y las de referencia. Esto es especialmente importante para las tareas de QA basadas en spans, donde los sistemas deben identificar segmentos de texto precisos mientras mantienen una cobertura integral de la respuesta. BLEU-1 [26] proporciona un método para evaluar la precisión de las coincidencias de unigramas entre las salidas del sistema y los textos de referencia:
donde
Aquí, es la longitud del candidato, es la longitud de la referencia, es el recuento del n-grama i en el candidato k, y es el recuento máximo en cualquier referencia. En QA, BLEU-1 evalúa la precisión léxica de las respuestas generadas, lo que resulta particularmente útil para los sistemas de QA generativos donde la coincidencia exacta podría ser demasiado estricta.
ROUGE-L [19] mide la subsecuencia común más larga entre los textos generados y de referencia.
donde es el texto de referencia, es el texto candidato, y LCS es la Subsecuencia Común Más Larga.
ROUGE- 2 [19] calcula la superposición de bigramas entre los textos generado y de referencia.
Tanto ROUGE- L como ROUGE- 2 son particularmente útiles para evaluar la fluidez y la coherencia de las respuestas generadas, con ROUGE- L enfocándose en la coincidencia de secuencias y ROUGE- 2 en el orden local de las palabras.
METEOR [5] calcula una puntuación basada en unigramas alineados entre los textos candidato y de referencia, considerando sinónimos y paráfrasis.
donde es la precisión, es la exhaustividad, ch es el número de fragmentos y es el número de unigramas coincidentes. METEOR es valioso para la evaluación de QA, ya que considera la similitud semántica más allá de la coincidencia exacta, lo que lo hace adecuado para evaluar respuestas parafraseadas.
La Similitud SBERT [27] mide la similitud semántica entre dos textos utilizando embeddings de oraciones.
representa el embedding de oración del texto. La Similitud SBERT es particularmente útil para evaluar la comprensión semántica en sistemas de QA, ya que puede capturar similitudes de significado incluso cuando la superposición léxica es baja.
A.3 Resultados de la comparación
Nuestra evaluación integral utilizando las métricas ROUGE-2, ROUGE-L, METEOR y SBERT demuestra que A-MEM logra un rendimiento superior mientras mantiene una notable eficiencia computacional. Mediante pruebas empíricas exhaustivas en varios tamaños de modelo y categorías de tareas, hemos establecido A-MEM como un enfoque más efectivo en comparación con las líneas base existentes, respaldado por varios hallazgos convincentes. En nuestro análisis de modelos no GPT, específicamente Qwen2.5 y Llama 3.2, A-MEM supera consistentemente a todos los enfoques de línea base en todas las métricas. La categoría Multi-Hop muestra resultados particularmente llamativos, donde Qwen2.5-15b con A-MEM alcanza una puntuación ROUGE-L de 27,23, superando drásticamente el 4,68 de LoComo y el 2,81 de ReadAgent, lo que representa una mejora de casi seis veces. Este patrón de superioridad se extiende consistentemente a las puntuaciones METEOR y SBERT. Al examinar los modelos basados en GPT, nuestros resultados revelan un patrón interesante. Mientras que LoCoMo y MemGPT demuestran fuertes capacidades en tareas de Dominio Abierto y Adversarias, A-MEM muestra una notable superioridad en tareas de razonamiento Multi-Hop. Utilizando GPT-4o-mini, A-MEM alcanza una puntuación ROUGE-L de 44,27 en tareas Multi-Hop, más del doble del 18,09 de LoComo. Esta ventaja significativa se mantiene consistente en otras métricas, con puntuaciones METEOR de 23,43 frente a 7,61 y puntuaciones SBERT de 70,49 frente a 52,30. La importancia de estos resultados se ve amplificada por la excepcional eficiencia computacional de A-MEM. Nuestro enfoque requiere solo entre 1.200 y 2.500 tokens, en comparación con los sustanciales 16.900 tokens que necesitan LoComo y MemGPT. Esta eficiencia proviene de dos innovaciones arquitectónicas clave: Primero, nuestra novedosa arquitectura de memoria agéntica crea redes de memoria interconectadas mediante notas atómicas con ricas descripciones contextuales, lo que permite capturar y utilizar de manera más efectiva las relaciones entre la información. Segundo, nuestro mecanismo de recuperación selectiva top-k facilita la evolución dinámica de la memoria y la organización estructurada. La efectividad de estas innovaciones es particularmente evidente en tareas de razonamiento complejo, como lo demuestra el consistentemente sólido rendimiento Multi-Hop en todas las métricas de evaluación. Además, también mostramos los resultados experimentales con diferentes modelos fundacionales, incluidos DeepSeek-R1-32B [11], Claude 3.0 Haiku [2] y Claude 3.5 Haiku [3].
| Modelo | Método | Categoría | ||||||||
| Multi Hop RGE-2 | RGE-L | Temporal RGE-2 | RGE-L | Dominio Abierto RGE-2 | RGE-L | Single Hop RGE-2 | RGE-L | Adversarial RGE-2 | ||
| GPT | LoCoMo | 9,64 | 23,92 | 2,01 | 18,09 | 3,40 | 11,58 | 26,48 | 40,20 | 60,46 |
| READAGENT | 2,47 | 9,45 | 0,95 | 13,12 | 0,55 | 5,76 | 2,99 | 9,92 | 6,66 | |
| MEMORYBANK | 1,18 | 5,43 | 0,52 | 9,64 | 0,97 | 5,77 | 1,64 | 6,63 | 4,55 | |
| MEMGPT | 10,58 | 25,60 | 4,76 | 25,22 | 0,76 | 9,14 | 28,44 | 42,24 | 36,62 | |
| A-MEM | 10,61 | 25,86 | 21,39 | 44,27 | 3,42 | 12,09 | 29,50 | 45,18 | 42,62 | |
| LoCoMo | 11,53 | 30,65 | 1,68 | 8,17 | 3,21 | 16,33 | 45,42 | 63,86 | 45,13 | |
| Qwen | READAGENT | 3,91 | 14,36 | 0,43 | 3,96 | 0,52 | 8,58 | 4,75 | 13,41 | 4,24 |
| MEMORYBANK | 1,84 | 7,36 | 0,36 | 2,29 | 2,13 | 6,85 | 3,02 | 9,35 | 1,22 | |
| MEMGPT | 11,55 | 30,18 | 4,66 | 15,83 | 3,27 | 14,02 | 43,27 | 62,75 | 28,72 | |
| A-MEM | 12,76 | 31,71 | 9,82 | 25,04 | 6,09 | 16,63 | 33,67 | 50,31 | 30,31 | |
| LoCoMo | 1,39 | 9,24 | 0,00 | 4,68 | 3,42 | 10,59 | 3,25 | 11,15 | 35,10 | |
| READAGENT | 0,74 | 7,14 | 0,10 | 2,81 | 3,05 | 12,63 | 1,47 | 7,88 | 20,73 | |
| Qwen | MEMORYBANK | 1,51 | 11,18 | 0,14 | 5,39 | 1,80 | 8,44 | 5,07 | 13,72 | 29,24 |
| MEMGPT | 1,16 | 11,35 | 0,00 | 7,88 | 2,87 | 14,62 | 2,18 | 9,82 | 23,96 | |
| A-MEM | 4,88 | 17,94 | 5,88 | 27,23 | 3,44 | 16,87 | 12,32 | 24,38 | 36,32 | |
| LoCoMo | 0,49 | 4,83 | 0,14 | 3,20 | 1,31 | 5,38 | 1,97 | 6,98 | 12,66 | |
| READAGENT | 0,08 | 4,08 | 0,00 | 1,96 | 1,26 | 6,19 | 0,73 | 4,34 | 7,35 | |
| MEMORYBANK | 0,43 | 3,76 | 0,05 | 1,61 | 0,24 | 6,32 | 1,03 | 4,22 | 9,55 | |
| Qwen | MEMGPT | 0,69 | 5,55 | 0,05 | 3,17 | 1,90 | 7,90 | 2,05 | 7,32 | 10,46 |
| A-MEM | 2,91 | 12,42 | 8,11 | 27,74 | 1,51 | 7,51 | 8,80 | 17,57 | 21,39 | |
| LoCoMo | 2,51 | 11,48 | 0,44 | 8,25 | 1,69 | 13,06 | 2,94 | 13,00 | 39,85 | |
| READAGENT | 0,53 | 6,49 | 0,00 | 4,62 | 5,47 | 14,29 | 1,19 | 8,03 | 34,52 | |
| MEMORYBANK | 2,96 | 13,57 | 0,23 | 10,53 | 4,01 | 18,38 | 6,41 | 17,66 | 41,15 | |
| MEMGPT | 1,82 | 9,91 | 0,06 | 6,56 | 2,13 | 11,36 | 2,00 | 10,37 | 38,59 | |
| Llama 2 | A-MEM | 4,82 | 19,31 | 1,84 | 20,47 | 5,99 | 18,49 | 14,82 | 29,78 | 46,76 |
| LoCoMo | 0,98 | 7,22 | 0,03 | 4,45 | 2,36 | 11,39 | 2,85 | 8,45 | 25,47 | |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,07 | 5,22 | 3,25 | 2,51 | 15,78 | |
| MEMORYBANK | 1,83 | 6,96 | 0,25 | 3,41 | 0,43 | 4,43 | 2,73 | 7,83 | 14,64 | |
| MEMGPT | 0,72 | 5,39 | 0,11 | 2,85 | 0,61 | 5,74 | 1,45 | 4,42 | 16,62 | |
| A-MEM | 6,02 | 17,62 | 7,93 | 27,97 | 5,38 | 13,00 | 16,89 | 28,55 | 35,48 | |
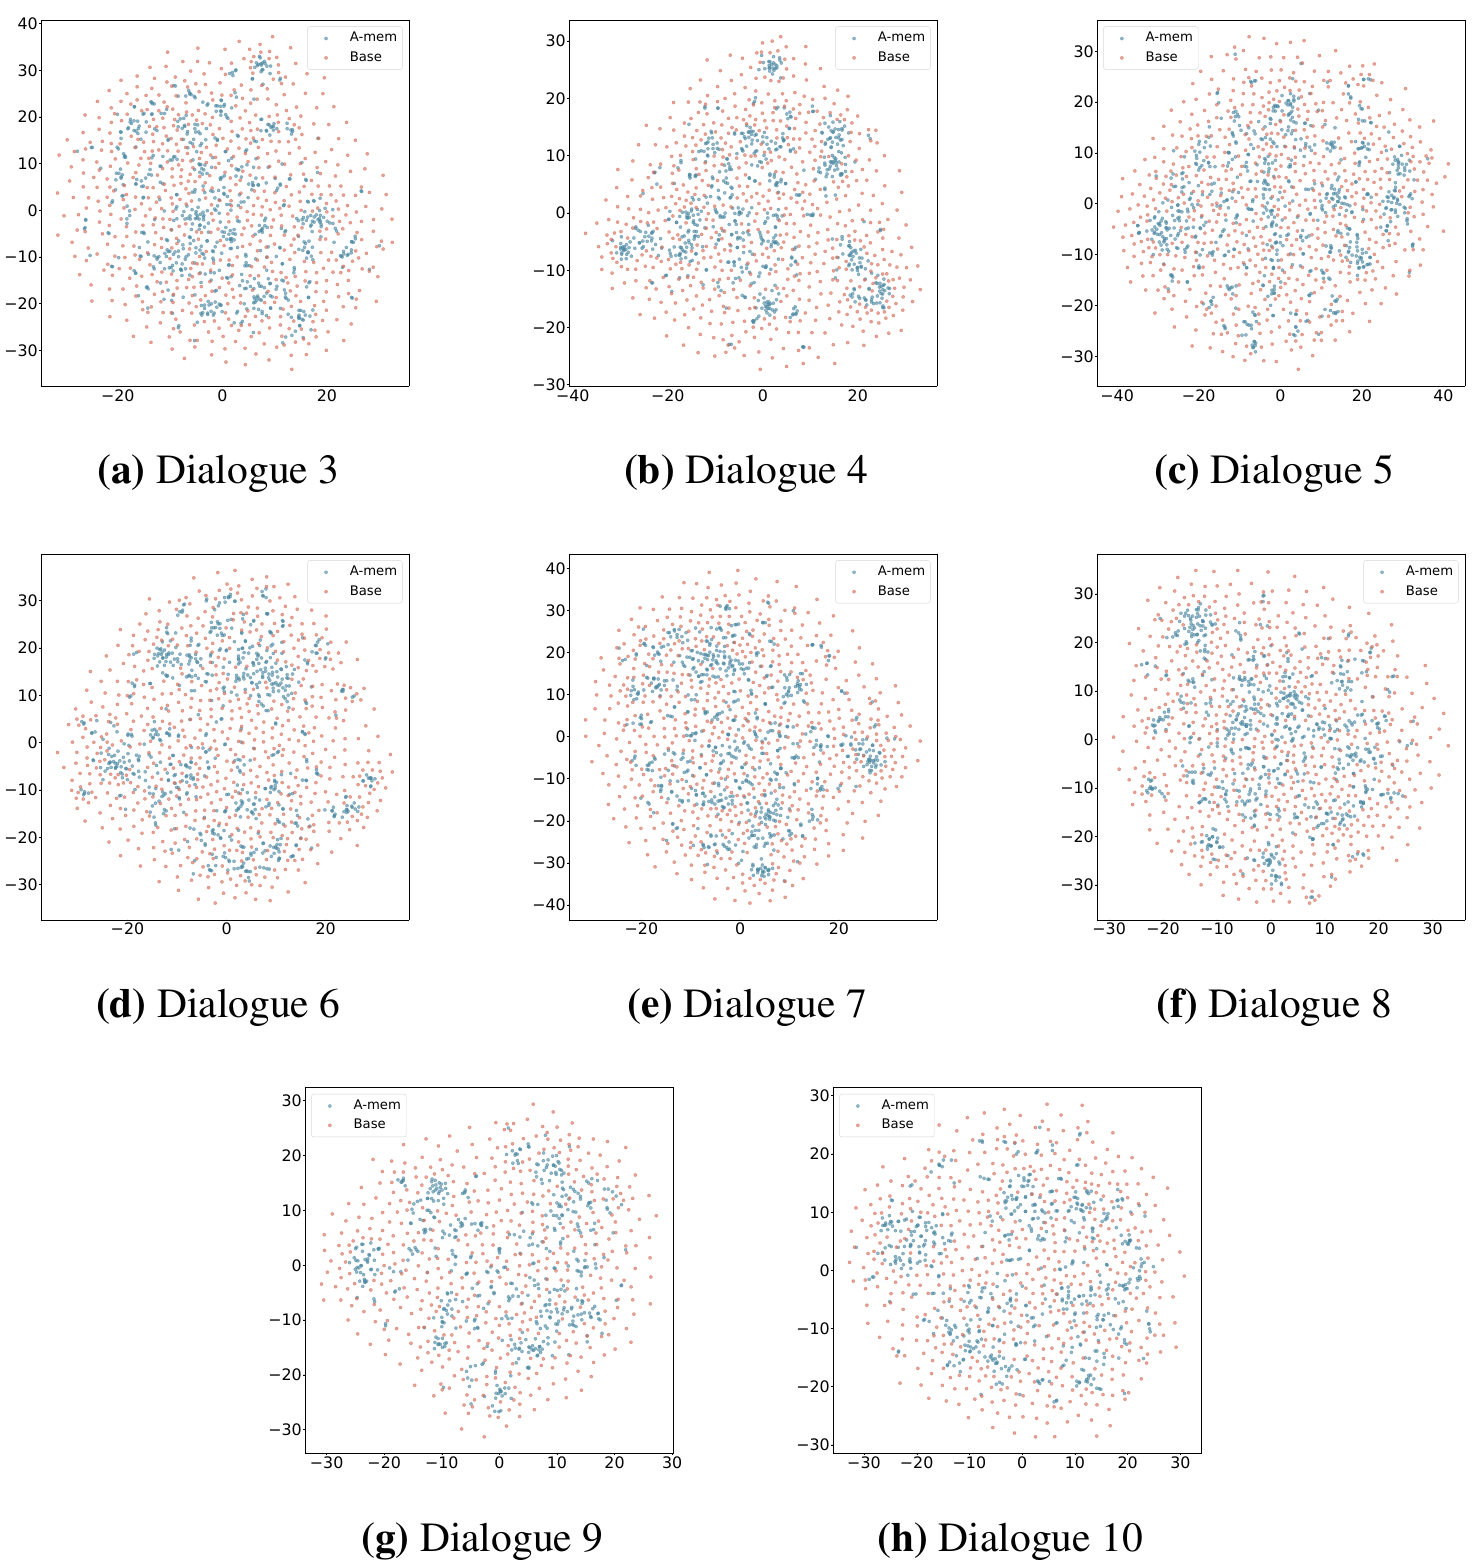
A.4 Análisis de la memoria
Además de las visualizaciones de memoria de los dos primeros diálogos mostrados en el texto principal, presentamos visualizaciones adicionales en la Fig. 5 que demuestran las ventajas estructurales de nuestro sistema de memoria agéntica. Mediante el análisis de dos diálogos muestreados de conversaciones de largo plazo en LoCoMo [22], observamos que A-MEM (mostrado en azul) produce consistentemente patrones de agrupamiento más coherentes en comparación con el sistema de línea base (mostrado en rojo). Esta organización estructural es particularmente evidente en el Diálogo 2, donde surgen grupos distintos en la región central, lo que proporciona apoyo empírico a la efectividad de nuestro mecanismo de evolución de la memoria y la generación de descripciones contextuales. En contraste, los embeddings de memoria de la línea base exhiben una distribución más dispersa, lo que indica que las memorias carecen de organización estructural sin nuestros componentes de generación de enlaces y evolución de la memoria. Estas visualizaciones validan que A-MEM puede mantener autónomamente estructuras de memoria significativas a través de sus mecanismos de evolución dinámica y enlace.
| Modelo | Método | Categoría | ||||||||||
| Multi Hop ME | SBERT | Temporal ME | SBERT | Open Domain ME | SBERT | Single Hop ME | SBERT | Adversial ME | ||||
| GPT | 4-hop | LoCoMo | 15,81 | 47,97 | 7,61 | 52,30 | 8,16 | 35,00 | 40,42 | 57,78 | 63,28 | 71,93 |
| ReadAgent | 5,46 | 28,67 | 4,76 | 45,07 | 3,69 | 26,72 | 8,01 | 26,78 | 8,38 | 15,20 | ||
| MEMORY BANK | 3,42 | 21,71 | 4,07 | 37,58 | 4,21 | 23,71 | 5,81 | 20,76 | 6,24 | 13,00 | ||
| MEMGPT | 15,79 | 49,33 | 13,25 | 61,53 | 4,59 | 32,77 | 41,40 | 58,19 | 39,16 | 47,24 | ||
| A-MEM | 16,36 | 49,46 | 23,43 | 70,49 | 8,36 | 38,48 | 42,32 | 59,38 | 45,64 | 53,26 | ||
| GPT | 4-hop | LoCoMo | 16,34 | 53,82 | 7,21 | 32,15 | 8,98 | 43,72 | 53,39 | 73,40 | 47,72 | 56,09 |
| ReadAgent | 7,86 | 37,41 | 3,76 | 26,22 | 4,42 | 30,75 | 9,36 | 31,37 | 5,47 | 12,34 | ||
| MEMORY BANK | 3,22 | 26,23 | 2,29 | 23,49 | 4,18 | 24,89 | 6,64 | 23,90 | 2,93 | 10,01 | ||
| MEMGPT | 16,64 | 55,12 | 12,68 | 35,93 | 7,78 | 37,91 | 52,14 | 72,83 | 31,15 | 39,08 | ||
| A-MEM | 17,53 | 55,96 | 13,10 | 45,40 | 10,62 | 38,87 | 41,93 | 62,47 | 32,34 | 40,11 | ||
| Open2.5 | 4-hop | LoCoMo | 4,99 | 32,23 | 2,86 | 34,03 | 5,89 | 35,61 | 8,57 | 29,47 | 40,53 | 50,49 |
| ReadAgent | 3,67 | 28,20 | 1,88 | 27,27 | 8,97 | 35,13 | 5,52 | 26,33 | 24,04 | 34,12 | ||
| BANCO DE MEMORIA | 5,57 | 35,40 | 2,80 | 32,47 | 4,27 | 33,85 | 10,59 | 32,16 | 32,93 | 42,83 | ||
| MEMGPT | 5,40 | 35,64 | 2,35 | 39,04 | 7,68 | 40,36 | 7,07 | 30,16 | 27,24 | 40,63 | ||
| A-MEM | 9,49 | 43,49 | 11,92 | 61,65 | 9,11 | 42,58 | 19,69 | 41,93 | 40,64 | 52,44 | ||
| Open2.5 | 4-hop | LoCoMo | 2,00 | 24,37 | 1,92 | 25,24 | 3,45 | 25,38 | 6,00 | 21,28 | 16,67 | 23,14 |
| ReadAgent | 1,78 | 21,10 | 1,69 | 20,78 | 4,43 | 25,15 | 3,37 | 18,20 | 10,46 | 17,39 | ||
| MEMORY BANK | 2,37 | 17,81 | 2,22 | 21,93 | 3,86 | 20,65 | 3,99 | 16,26 | 15,49 | 20,77 | ||
| MEMGPT | 3,74 | 24,31 | 2,25 | 27,67 | 6,44 | 29,59 | 6,24 | 22,40 | 13,19 | 20,83 | ||
| A-MEM | 6,25 | 33,72 | 14,04 | 62,54 | 6,56 | 30,60 | 15,98 | 33,98 | 27,36 | 33,72 | ||
| Llama 3.2 | 4-hop | LoCoMo | 5,77 | 38,02 | 3,38 | 45,44 | 6,20 | 42,69 | 9,33 | 34,19 | 46,79 | 60,74 |
| ReadAgent | 2,97 | 29,26 | 1.31 | 26.45 | 7.13 | 39.19 | 5.36 | 26.44 | 42.39 | 54.35 | ||
| BANCO DE MEMORIA | 6.77 | 39.33 | 4.43 | 45.63 | 7.76 | 42.81 | 13.01 | 37.32 | 50.43 | 60.81 | ||
| MEMGPT | 5.10 | 32.99 | 2.54 | 41.81 | 3.26 | 35.99 | 6.62 | 30.68 | 45.00 | 61.33 | ||
| A-MEM | 9.01 | 45.16 | 7.50 | 54.79 | 8.30 | 43.42 | 22.46 | 47.07 | 53.72 | 68.00 | ||
| Llama 3.2 | 4 saltos | LoCoMo | 3.69 | 27.94 | 2.96 | 20.40 | 6.46 | 32.17 | 6.58 | 22.92 | 29.02 | 35.74 |
| ReadAgent | 1.21 | 17.40 | 2.33 | 12.02 | 3.39 | 19.63 | 2.46 | 14.63 | 14.37 | 21,25 | ||
| BANCO DE MEMORIA | 3,84 | 25,06 | 2,73 | 13,65 | 3,05 | 21,08 | 6,35 | 22,02 | 17,14 | 24,39 | ||
| MEMGPT | 2,78 | 22,06 | 2,21 | 14,97 | 3,63 | 23,18 | 3,47 | 17,81 | 20,50 | 26,87 | ||
| A-MEM | 9,74 | 39,32 | 13,19 | 59,70 | 8,09 | 32,27 | 24,30 | 42,86 | 39,74 | 46,76 | ||
| Método | Categoría | |||||
| F1 Multi Hop | BLEU-1 | F1 Temporal | F1 Dominio Abierto | F1 Single Hop | F1 Adversarial | |
| DeepSeek-R1-32B | ||||||
| LoCoMo | 8,58 | 6,48 | 4,79 | 4,35 | 12,96 | 12,52 |
| MEMGPT | 8,28 | 6,25 | 5,45 | 4,97 | 10,97 | 9,09 |
| A-MEM | 15,02 | 10,64 | 14,64 | 11,01 | 14,81 | 12,82 |
| Claude 3.0 Haiku | ||||||
| LoCoMo | 4,56 | 3,33 | 0,82 | 0,59 | 2,86 | 3,22 |
| MEMGPT | 7,65 | 6,36 | 1,65 | 1,26 | 7,41 | 6,64 |
| A-MEM | 19,28 | 14,69 | 16,65 | 12,23 | 11,85 | 9,61 |
| Claude 3.5 Haiku | ||||||
| LoCoMo | 11,34 | 8,21 | 3,29 | 2,69 | 3,79 | 3,58 |
| MEMGPT | 8,27 | 6,55 | 3,99 | 2,76 | 4,71 | 4,48 |
| A-MEM | 29,70 | 23,19 | 31,54 | 27,53 | 11,42 | 9,47 |
A.5 Configuración de hiperparámetros
Todos los valores del hiperparámetro k se presentan en la Tabla 8. Para los modelos que ya han alcanzado un rendimiento de vanguardia (SOTA) con k=10, mantenemos este valor sin ajustes adicionales.
| Modelo | Multi Hop | Temporal | Dominio abierto | Single Hop | Adversarial |
| GPT-4o-mini | 40 | 40 | 50 | 50 | 40 |
| GPT-4o | 40 | 40 | 50 | 50 | 40 |
| Qwen2.5-1.5b | 10 | 10 | 10 | 10 | 10 |
| Qwen2.5-3b | 10 | 10 | 50 | 10 | 10 |
| Llama3.2-1b | 10 | 10 | 10 | 10 | 10 |
| Llama3.2-3b | 10 | 20 | 10 | 10 | 10 |
B Plantillas de prompts y ejemplos
B.1 Plantilla de prompt para la Construcción de Notas
La plantilla de prompt en la Construcción de Notas:
Genere un análisis estructurado del siguiente contenido mediante:
1. La identificación de las palabras clave más prominentes (centrándose en sustantivos, verbos y conceptos clave)
2. La extracción de temas centrales y elementos contextuales
3. La creación de etiquetas categóricas relevantes
Formatee la respuesta como un objeto JSON: {"keywords": [ // varias palabras clave específicas y distintas que capturen conceptos y terminología clave // Ordene de más a menos importante // No incluya palabras clave que sean el nombre del hablante o el tiempo // Al menos tres palabras clave, pero no sea demasiado redundante. ], "context": // una oración que resuma: // - Tema/dominio principal // - Argumentos/puntos clave // - Audiencia/propósito previsto , "tags": [ // varias categorías/temas amplios para la clasificación // Incluya etiquetas de dominio, formato y tipo // Al menos tres etiquetas, pero no sea demasiado redundante. ]}
Contenido para el análisis:
B.2 Plantilla de prompt para la Generación de Enlaces
La plantilla de prompt en la Generación de Enlaces:
Usted es un agente de evolución de memoria de IA responsable de gestionar y evolucionar una base de conocimiento. Analice la nueva nota de memoria según las palabras clave y el contexto, también junto con sus varios vecinos más cercanos en memoria. El contexto de la nueva memoria: {context} contenido: {content} palabras clave: {keywords} Las memorias de los vecinos más cercanos: {nearest_neighbors_memories} Basándose en esta información, determine: ¿Debería evolucionar esta memoria? Considere sus relaciones con otras memorias.
B.3 Plantilla de prompt para la Evolución de la Memoria
La plantilla de prompt en la Evolución de la Memoria:
Usted es un agente de evolución de memoria de IA responsable de gestionar y evolucionar una base de conocimiento. Analice la nueva nota de memoria según las palabras clave y el contexto, también junto con sus varios vecinos más cercanos en memoria.
Tome decisiones sobre su evolución.
El contexto de la nueva memoria: {context}
contenido: {content}
palabras clave: {keywords}
Las memorias de los vecinos más cercanos: {nearest_neighbors_memories}
Basándose en esta información, determine:
1. ¿Qué acciones específicas deben tomarse (strengthen, update_neighbor)?
1.1 Si elige fortalecer la conexión, ¿a qué memoria debería conectarse? ¿Puede proporcionar las etiquetas actualizadas de esta memoria?
1.2 Si elige actualizar el vecino, puede actualizar el contexto y las etiquetas de estas memorias según la comprensión de estas memorias.
Las etiquetas deben determinarse por el contenido de las características de estas memorias, que pueden utilizarse para recuperarlas posteriormente y categorizarlas.
Toda la información anterior debe devolverse en formato de lista según la secuencia: [[new_memory],[neighbor_memory_1], ... [neighbor_memory_n]]
Estas acciones pueden combinarse.
Devuelva su decisión en formato JSON con la siguiente estructura: {{ "should_evolve": true/false,
"actions": ["fortalecer", "fusionar", "podar"],
"suggested_connections": ["neighbor_memory_ids"],
"tags_to_update": ["tag_1", ... "tag_n"],
"new_context_neighborhood": ["new_context", ... "new_context"],
"new_tags_neighborhood": [["tag_1", ... "tag_n"], ... ["tag_1", ... "tag_n"]],
B.4 Ejemplos de preguntas/respuestas con A-MEM
Ejemplo:
Pregunta 686: ¿Qué pasatiempo adoptó Dave en octubre de 2023?
Predicción: fotografía
Referencia: fotografía
hora de inicio de la conversación: 10:54 a. m. del 17 de noviembre de 2023
contenido de la memoria: El hablante Dave dice: ¡Hola Calvin, cuánto tiempo sin hablar! Han pasado muchas cosas. He empezado con la fotografía y ha sido genial;he estado tomando fotos del paisaje de por aquí, lo cuales realmente genial.
contexto de la memoria: El tema principal es el nuevo pasatiempo del hablante, la fotografía,destacando su disfrute al capturar paisajeslocales, con el objetivo de involucrar a un amigo en una conversación sobre experiencias personales.
palabras clave de la memoria: ['photography', 'scenery', 'conversation','experience', 'hobby']
etiquetas de la memoria: ['hobby', 'photography', 'personal development','conversation', 'leisure']
hora de inicio de la conversación: 6:38 p. m. del 21 de julio de 2023
contenido de la memoria: El hablante Calvin dice: ¡Gracias, Dave! Se sientemuy bien tener mi propio espacio para trabajar. Últimamente he estado experimentandocon diferentes géneros, saliendo de mi zona de confort.Añadir elementos electrónicos a mis canciones les da una vibra fresca. ¡Ha sido un proceso emocionante de autodescubrimiento y crecimiento!
contexto de la memoria: El hablante analiza su proceso creativo enla música, destacando la experimentación con géneros y la incorporaciónde elementos electrónicos para el crecimiento personal y la evolución artística.
palabras clave de la memoria: ['space', 'experimentation', 'genres', 'electronic','self- discovery', 'growth']
etiquetas de la memoria: ['music', 'creativity', 'self- improvement', 'artisticexpression']
Lista de verificación para artículos de NeurIPS
La lista de verificación está diseñada para fomentar las mejores prácticas en la investigación responsable en aprendizaje automático, abordando cuestiones de reproducibilidad, transparencia, ética de la investigación e impacto social. No elimine la lista de verificación: los artículos que no incluyan la lista de verificación serán rechazados sin revisión. La lista de verificación debe ir después de las referencias y después del material complementario (opcional). La lista de verificación NO cuenta para el límite de páginas.
Lea atentamente las directrices de la lista de verificación para obtener información sobre cómo responder a estas preguntas. Para cada pregunta de la lista de verificación:
Debe responder [Sí], [No] o [NA]. [NA] significa que la pregunta No es Aplicable para ese artículo en particular o que la información pertinente No está Disponible. Proporcione una justificación breve (de 1 a 2 oraciones) inmediatamente después de su respuesta (incluso para NA).
Las respuestas de la lista de verificación son una parte integral del envío de su artículo. Son visibles para los revisores, los presidentes de área, los presidentes sénior de área y los revisores de ética. También se le pedirá que la incluya (tras las eventuales revisiones) con la versión final de su artículo, y su versión final se publicará junto con el artículo.
Se pedirá a los revisores de su artículo que utilicen la lista de verificación como uno de los factores en su evaluación. Aunque "[Yes]" es generalmente preferible a "[No]", es perfectamente aceptable responder "[No]" siempre que se dé una justificación adecuada (p. ej., "no se reportan barras de error porque sería demasiado costoso computacionalmente" o "no pudimos encontrar la licencia del conjunto de datos que utilizamos"). En general, responder "[No]" o "[NA]" no es motivo de rechazo. Aunque las preguntas están formuladas de manera binaria, reconocemos que la respuesta verdadera a menudo es más matizada, así que por favor use su mejor criterio y escriba una justificación para elaborar. Toda la evidencia de apoyo puede aparecer ya sea en el artículo principal o en el material suplementario, proporcionado en el apéndice. Si responde [Yes] a una pregunta, en la justificación por favor indique la(s) sección(es) donde se puede encontrar el material relacionado con la pregunta.
IMPORTANTE, por favor:
- Elimine este bloque de instrucciones, pero conserve el encabezado de la sección "NeurIPS Paper Checklist".- Conserve los subtítulos de las subsecciones de la lista de verificación, las preguntas/respuestas y las pautas a continuación.- No modifique las preguntas y solo utilice las macros proporcionadas para sus respuestas.
1. Claims
Pregunta: ¿Los principales afirmaciones hechas en el resumen y la introducción reflejan con precisión las contribuciones y el alcance del artículo?
Respuesta: [Yes]
Justificación: El resumen y la introducción resumen nuestras principales contribuciones.
Pautas:
- La respuesta NA significa que el resumen y la introducción no incluyen las afirmaciones hechas en el artículo.- El resumen y/o la introducción deben indicar claramente las afirmaciones hechas, incluidas las contribuciones realizadas en el artículo y los supuestos y limitaciones importantes. Una respuesta No o NA a esta pregunta no será percibida bien por los revisores.- Las afirmaciones hechas deben coincidir con los resultados teóricos y experimentales, y reflejar en qué medida se puede esperar que los resultados se generalicen a otros entornos.- Está bien incluir objetivos aspiracionales como motivación siempre que quede claro que el artículo no alcanza estos objetivos.
2. Limitations
Pregunta: ¿El artículo discute las limitaciones del trabajo realizado por los autores?
Respuesta: [Yes]
Justificación: Este artículo cubre una sección de las limitaciones.
Pautas:
- La respuesta NA significa que el artículo no tiene limitaciones, mientras que la respuesta No significa que el artículo tiene limitaciones, pero esas no se discuten en el artículo.
- Se anima a los autores a crear una sección separada de "Limitations" en su artículo.
- El artículo debe señalar cualquier supuesto fuerte y cuán robustos son los resultados a violaciones de estos supuestos (p. ej., supuestos de independencia, entornos sin ruido, especificación correcta del modelo, aproximaciones asintóticas que solo se cumplen localmente). Los autores deben reflexionar sobre cómo estos supuestos podrían ser violados en la práctica y cuáles serían las implicaciones.
- Los autores deben reflexionar sobre el alcance de las afirmaciones hechas, p. ej., si el enfoque fue probado solo en unos pocos conjuntos de datos o con unas pocas ejecuciones. En general, los resultados empíricos a menudo dependen de supuestos implícitos, que deberían articularse.
- Los autores deben reflexionar sobre los factores que influyen en el rendimiento del enfoque. Por ejemplo, un algoritmo de reconocimiento facial puede rendir mal cuando la resolución de la imagen es baja o las imágenes se toman con poca luz. O un sistema de conversión de voz a texto podría no usarse de manera confiable para proporcionar subtítulos para clases en línea porque no maneja la jerga técnica.
- Los autores deben discutir la eficiencia computacional de los algoritmos propuestos y cómo escalan con el tamaño del conjunto de datos.
- Si corresponde, los autores deben discutir posibles limitaciones de su enfoque para abordar problemas de privacidad y equidad.
- Aunque los autores podrían temer que la honestidad completa sobre las limitaciones sea utilizada por los revisores como motivo de rechazo, un resultado peor podría ser que los revisores descubran limitaciones que no se reconocen en el artículo. Los autores deben usar su mejor criterio y reconocer que las acciones individuales en favor de la transparencia desempeñan un papel importante en el desarrollo de normas que preservan la integridad de la comunidad. Se instruirá específicamente a los revisores para que no penalicen la honestidad en relación con las limitaciones.
3. Theory assumptions and proofs
Pregunta: Para cada resultado teórico, ¿el artículo proporciona el conjunto completo de supuestos y una prueba completa (y correcta)?
Respuesta: [NA]
Justificación: N/A
Pautas:
- La respuesta NA significa que el artículo no incluye resultados teóricos.
- Todos los teoremas, fórmulas y pruebas del artículo deben estar numerados y referenciados de forma cruzada.
- Todos los supuestos deben indicarse o referenciarse claramente en el enunciado de cualquier teorema.
- Las pruebas pueden aparecer en el artículo principal o en el material suplementario, pero si aparecen en el material suplementario, se anima a los autores a proporcionar un breve esbozo de la prueba para dar intuición.
- Inversamente, cualquier prueba informal proporcionada en el núcleo del artículo debe complementarse con pruebas formales proporcionadas en el apéndice o en el material suplementario.
- Los teoremas y lemas en los que se basa la prueba deben estar debidamente referenciados.
4. Experimental result reproducibility
Pregunta: ¿El artículo divulga completamente toda la información necesaria para reproducir los principales resultados experimentales del artículo en la medida en que afecta a las principales afirmaciones y/o conclusiones del artículo (independientemente de si se proporcionan o no el código y los datos)?
Respuesta: [Yes]
Justificación: Tanto el código como los conjuntos de datos están disponibles.
Pautas:
- La respuesta NA significa que el artículo no incluye experimentos.
- Si el artículo incluye experimentos, una respuesta No a esta pregunta no será percibida bien por los revisores: Hacer que el artículo sea reproducible es importante, independientemente de si se proporcionan o no el código y los datos.
- Si la contribución es un conjunto de datos y/o un modelo, los autores deben describir los pasos tomados para hacer que sus resultados sean reproducibles o verificables.
- Dependiendo de la contribución, la reproducibilidad puede lograrse de diversas maneras. Por ejemplo, si la contribución es una arquitectura novedosa, describir la arquitectura completamente podría ser suficiente, o si la contribución es un modelo específico y una evaluación empírica, puede ser necesario hacer posible que otros repliquen el modelo con el mismo conjunto de datos, o proporcionar acceso al modelo. En general, publicar el código y los datos suele ser una buena manera de lograrlo, pero la reproducibilidad también puede proporcionarse mediante instrucciones detalladas sobre cómo replicar los resultados, acceso a un modelo alojado (p. ej., en el caso de un modelo de lenguaje grande), publicación de un checkpoint del modelo u otros medios apropiados para la investigación realizada.
- Aunque NeurIPS no exige la publicación del código, la conferencia sí requiere que todos los envíos proporcionen alguna vía razonable para la reproducibilidad, lo que puede depender de la naturaleza de la contribución. Por ejemplo
(a) Si la contribución es principalmente un nuevo algoritmo, el artículo debe dejar claro cómo reproducir ese algoritmo.
(b) Si la contribución es principalmente una nueva arquitectura de modelo, el artículo debe describir la arquitectura de manera clara y completa.
(c) Si la contribución es un nuevo modelo (p. ej., un modelo de lenguaje grande), entonces debería haber ya sea una forma de acceder a este modelo para reproducir los resultados o una forma de reproducir el modelo (p. ej., con un conjunto de datos de código abierto o instrucciones sobre cómo construir el conjunto de datos).
(d) Reconocemos que la reproducibilidad puede ser complicada en algunos casos, en cuyo caso se invita a los autores a describir la forma particular en que la proporcionan. En el caso de modelos de código cerrado, puede ser que el acceso al modelo esté limitado de alguna manera (p. ej., a usuarios registrados), pero debería ser posible que otros investigadores tengan alguna vía para reproducir o verificar los resultados.
5. Open access to data and code
Pregunta: ¿El artículo proporciona acceso abierto a los datos y al código, con instrucciones suficientes para reproducir fielmente los principales resultados experimentales, como se describe en el material suplementario?
Respuesta: [Yes]
Justificación: Proporcionamos el enlace al código en el resumen.
Pautas:
- La respuesta NA significa que el artículo no incluye experimentos que requieran código.
- Consulte las pautas de envío de código y datos de NeurIPS (https://nips.cc/public/guides/CodeSubmissionPolicy) para más detalles.
- Si bien alentamos la publicación de código y datos, entendemos que esto podría no ser posible, por lo que "No" es una respuesta aceptable. Los artículos no pueden ser rechazados simplemente por no incluir código, a menos que esto sea central para la contribución (p. ej., para un nuevo benchmark de código abierto).
- Las instrucciones deben contener el comando exacto y el entorno necesarios para ejecutar y reproducir los resultados. Consulte las directrices de envío de código y datos de NeurIPS (https://nips.cc/public/guides/CodeSubmissionPolicy) para más detalles.
- Los autores deben proporcionar instrucciones sobre el acceso y la preparación de los datos, incluida la forma de acceder a los datos sin procesar, los datos preprocesados, los datos intermedios y los datos generados, etc.
- Los autores deben proporcionar scripts para reproducir todos los resultados experimentales del nuevo método propuesto y de las líneas base. Si solo un subconjunto de experimentos es reproducible, deben indicar cuáles se omiten del script y por qué.
- En el momento del envío, para preservar el anonimato, los autores deben publicar versiones anonimizadas (si corresponde).
- Se recomienda proporcionar la mayor cantidad de información posible en el material complementario (anexado al artículo), pero se permite incluir URL a los datos y al código.
6. Configuración/detalles experimentales
Pregunta: ¿El artículo especifica todos los detalles de entrenamiento y prueba (p. ej., divisiones de datos, hiperparámetros, cómo se eligieron, tipo de optimizador, etc.) necesarios para entender los resultados?
Respuesta: [Sí]
Justificación: Cubrimos todos los detalles en el artículo.
Directrices:- La respuesta NA significa que el artículo no incluye experimentos. - La configuración experimental debe presentarse en el núcleo del artículo con un nivel de detalle que sea necesario para apreciar los resultados y darles sentido. - Los detalles completos pueden proporcionarse ya sea con el código, en el apéndice o como material complementario.
7. Significancia estadística de los experimentos
Pregunta: ¿Reporta el artículo barras de error adecuadamente y correctamente definidas u otra información apropiada sobre la significancia estadística de los experimentos?
Respuesta: [No]
Justificación: Los experimentos utilizan la API de Modelos de Lenguaje Grandes. Múltiples llamadas incrementarán significativamente los costos.
Directrices:- La respuesta NA significa que el artículo no incluye experimentos. - Los autores deben responder "Sí" si los resultados están acompañados de barras de error, intervalos de confianza o pruebas de significancia estadística, al menos para los experimentos que respaldan las afirmaciones principales del artículo. - Los factores de variabilidad que capturan las barras de error deben indicarse claramente (por ejemplo, división entrenamiento/prueba, inicialización, extracción aleatoria de algún parámetro o ejecución general con condiciones experimentales dadas). - El método para calcular las barras de error debe explicarse (fórmula en forma cerrada, llamada a una función de biblioteca, bootstrap, etc.). - Deben darse los supuestos realizados (por ejemplo, errores distribuidos normalmente). - Debe quedar claro si la barra de error es la desviación estándar o el error estándar de la media. - Está bien reportar barras de error de 1 sigma, pero se debe indicar. Los autores preferiblemente deberían reportar una barra de error de 2 sigma que indicar que tienen un IC del 96%, si no se verifica la hipótesis de normalidad de los errores. - Para distribuciones asimétricas, los autores deben tener cuidado de no mostrar en tablas o figuras barras de error simétricas que producirían resultados fuera de rango (por ejemplo, tasas de error negativas). - Si se reportan barras de error en tablas o gráficos, los autores deben explicar en el texto cómo se calcularon y hacer referencia a las figuras o tablas correspondientes en el texto.
8. Recursos computacionales de los experimentos
Pregunta: Para cada experimento, ¿proporciona el artículo información suficiente sobre los recursos computacionales (tipo de trabajadores de cómputo, memoria, tiempo de ejecución) necesarios para reproducir los experimentos?
Respuesta: [Sí]
Justificación: Se puede encontrar en la parte experimental.
Directrices:- La respuesta NA significa que el artículo no incluye experimentos. - El artículo debe indicar el tipo de trabajadores de cómputo CPU o GPU, clúster interno o proveedor de nube, incluida la memoria y el almacenamiento relevantes.
- El artículo debe proporcionar la cantidad de cómputo requerido para cada una de las ejecuciones experimentales individuales, así como estimar el cómputo total.
- El artículo debe divulgar si el proyecto de investigación completo requirió más cómputo que los experimentos reportados en el artículo (por ejemplo, experimentos preliminares o fallidos que no llegaron al artículo).
9. Código de ética
Pregunta: ¿La investigación realizada en el artículo cumple, en todos los aspectos, con el Código de Ética de NeurIPS https://neurips.cc/public/EthicsGuidelines?
Respuesta: [NA]
Justificación: N/A
Directrices:
- La respuesta NA significa que los autores no han revisado el Código de Ética de NeurIPS. - Si los autores responden No, deben explicar las circunstancias especiales que requieren una desviación del Código de Ética. - Los autores deben asegurarse de preservar el anonimato (por ejemplo, si hay una consideración especial debido a leyes o regulaciones en su jurisdicción).
10. Impactos más amplios
Pregunta: ¿Discute el artículo tanto los posibles impactos sociales positivos como los negativos del trabajo realizado?
Respuesta: [No]
Justificación: No discutimos este aspecto porque solo proporcionamos el sistema de memoria para agentes LLM. Diferentes agentes LLM pueden crear impactos sociales variados, lo cual está fuera del alcance de nuestro trabajo.
Directrices:
- La respuesta NA significa que no hay impacto social del trabajo realizado.
- Si los autores responden NA o No, deben explicar por qué su trabajo no tiene impacto social o por qué el artículo no aborda el impacto social.
- Ejemplos de impactos sociales negativos incluyen usos potencialmente maliciosos o no intencionados (por ejemplo, desinformación, generación de perfiles falsos, vigilancia), consideraciones de equidad (por ejemplo, despliegue de tecnologías que podrían tomar decisiones que afecten injustamente a grupos específicos), consideraciones de privacidad y consideraciones de seguridad.
- La conferencia espera que muchos artículos sean investigación fundamental y no estén vinculados a aplicaciones particulares, y mucho menos a despliegues. Sin embargo, si existe un camino directo hacia cualquier aplicación negativa, los autores deben señalarlo. Por ejemplo, es legítimo señalar que una mejora en la calidad de los modelos generativos podría usarse para generar deepfakes para desinformación. Por otro lado, no es necesario señalar que un algoritmo genérico para optimizar redes neuronales podría permitir a las personas entrenar modelos que generen Deepfakes más rápido.
- Los autores deben considerar los posibles daños que podrían surgir cuando la tecnología se utiliza según lo previsto y funciona correctamente, los daños que podrían surgir cuando la tecnología se utiliza según lo previsto pero da resultados incorrectos, y los daños derivados del uso indebido (intencional o no intencional) de la tecnología.
- Si hay impactos sociales negativos, los autores también podrían discutir posibles estrategias de mitigación (por ejemplo, liberación controlada de modelos, proporcionar defensas además de ataques, mecanismos para monitorear el uso indebido, mecanismos para monitorear cómo un sistema aprende de la retroalimentación a lo largo del tiempo, mejorar la eficiencia y accesibilidad del ML).
11. Salvaguardas
Pregunta: ¿Describe el artículo las salvaguardas que se han implementado para la liberación responsable de datos o modelos que tienen un alto riesgo de uso indebido (por ejemplo, modelos de lenguaje preentrenados, generadores de imágenes o conjuntos de datos extraídos de la web)?
Respuesta: [NA]
Justificación: N/A
Directrices:
Directrices:
12. Licencias para activos existentes
Pregunta: ¿Los creadores o propietarios originales de los activos (por ejemplo, código, datos, modelos) utilizados en el artículo están debidamente acreditados y se mencionan y respetan explícitamente la licencia y los términos de uso?
Respuesta: [Sí]
Justificación: Su contribución ya ha sido debidamente reconocida y acreditada.
Directrices:
Directrices:
13. Nuevos activos
Pregunta: ¿Los nuevos activos introducidos en el artículo están bien documentados y la documentación se proporciona junto con los activos?
Respuesta: [NA]
Justificación: N/A
Directrices:
Directrices:
14. Crowdsourcing e investigación con sujetos humanos
Pregunta: Para experimentos de crowdsourcing e investigación con sujetos humanos, ¿incluye el artículo el texto completo de las instrucciones dadas a los participantes y capturas de pantalla, si corresponde, así como detalles sobre la compensación (si la hay)?
Respuesta: [NA]
Justificación: N/A
Directrices:
- La respuesta NA significa que el artículo no involucra crowdsourcing ni investigación con sujetos humanos. - Incluir esta información en el material complementario está bien, pero si la contribución principal del artículo involucra sujetos humanos, entonces se debe incluir la mayor cantidad de detalle posible en el artículo principal. - Según el Código de Ética de NeurIPS, los trabajadores involucrados en la recolección de datos, la curación u otro trabajo deberían recibir al menos el salario mínimo en el país del recolector de datos.
15. Aprobaciones del consejo de revisión institucional (IRB) o equivalentes para investigación con sujetos humanos
Pregunta: ¿Describe el artículo los posibles riesgos incurridos por los participantes del estudio, si dichos riesgos fueron divulgados a los sujetos y si se obtuvieron aprobaciones del Consejo de Revisión Institucional (IRB) (o una aprobación/revisión equivalente basada en los requisitos de su país o institución)?
Respuesta: [NA]
Justificación: N/A
Directrices:
- La respuesta NA significa que el artículo no implica crowdsourcing ni investigación con sujetos humanos.- Dependiendo del país en el que se realice la investigación, puede requerirse la aprobación del IRB (o su equivalente) para cualquier investigación con sujetos humanos. Si obtuvo la aprobación del IRB, debe indicarlo claramente en el artículo.- Reconocemos que los procedimientos para esto pueden variar significativamente entre instituciones y ubicaciones, y esperamos que los autores se adhieran al Código de Ética de NeurIPS y a las directrices de su institución.- Para los envíos iniciales, no incluya ninguna información que pueda romper el anonimato (si corresponde), como la institución que realiza la revisión.
16. Declaración del uso de LLM
Pregunta: ¿Describe el artículo el uso de LLM si es un componente importante, original o no estándar de los métodos centrales de esta investigación? Tenga en cuenta que si el LLM se utiliza únicamente con fines de redacción, edición o formato y no afecta la metodología central, el rigor científico o la originalidad de la investigación, no se requiere declaración.
Respuesta: [NA]
Justificación: N/A
Directrices:
- La respuesta NA significa que el desarrollo del método central en esta investigación no involucra LLM como componente importante, original o no estándar alguno.- Consulte nuestra política sobre LLM (https://neurips.cc/Conferences/2025/LLM) para saber qué debería o no describirse.