
Dos mil incidencias reales de GitHub resueltas de principio a fin, con tests ocultos: el benchmark de los agentes de código. ICLR 2024, gratis.
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
SWE-BENCH: ¿PUEDEN LOS MODELOS DE LENGUAJE RESOLVER PROBLEMAS REALES DE GITHUB?
Carlos E. Jimenez John Yang Alexander Wettig
Shunyu Yao Kexin Pei Ofir Press Karthik Narasimhan
Universidad de Princeton Princeton Language and Intelligence Universidad de Chicago
RESUMEN
Los modelos de lenguaje han superado nuestra capacidad de evaluarlos de manera efectiva, pero para su desarrollo futuro es esencial estudiar la frontera de sus capacidades. Consideramos que la ingeniería de software del mundo real constituye un banco de pruebas rico, sostenible y desafiante para evaluar la próxima generación de modelos de lenguaje. Con este fin, presentamos SWE-bench, un marco de evaluación que consta de 2.294 problemas de ingeniería de software extraídos de problemas reales de GitHub y sus correspondientes pull requests en 12 repositorios populares de Python. Dado un código base junto con la descripción de un problema a resolver, se encarga a un modelo de lenguaje que edite el código base para abordar el problema. Resolver los problemas de SWE-bench con frecuencia requiere comprender y coordinar cambios entre múltiples funciones, clases e incluso archivos simultáneamente, lo que exige que los modelos interactúen con entornos de ejecución, procesen contextos extremadamente largos y realicen razonamientos complejos que van mucho más allá de las tareas tradicionales de generación de código. Nuestras evaluaciones muestran que tanto los modelos propietarios de última generación como nuestro modelo ajustado SWE-Llama pueden resolver únicamente los problemas más simples. El modelo con mejor rendimiento, Claude 2, logra resolver apenas un de los problemas. Los avances en SWE-bench representan pasos hacia modelos de lenguaje más prácticos, inteligentes y autónomos.
1 INTRODUCCIÓN
Los modelos de lenguaje (LM, por sus siglas en inglés) se están desplegando rápidamente en productos comerciales como chatbots y asistentes de programación. Al mismo tiempo, los benchmarks existentes se han saturado (Kiela et al., 2021; Ott et al., 2022) y no logran capturar la frontera de lo que los LM de última generación pueden y no pueden hacer. Existe la necesidad de benchmarks desafiantes que reflejen con mayor precisión las aplicaciones reales de los LM para ayudar a moldear su desarrollo y uso futuros (Srivastava et al., 2023).
Construir un buen benchmark es difícil, ya que las tareas deben ser lo suficientemente desafiantes como para poner en aprietos a los modelos existentes, pero las predicciones de los modelos también deben ser fáciles de verificar (Martinez-Plumed et al., 2021). Las tareas de programaciónresultan atractivas porque plantean problemas desafiantes a los LM y, sin embargo, las soluciones generadas pueden verificarse fácilmente ejecutando pruebas unitarias. Sin embargo, los benchmarks de programación existentes, como HumanEval (Chen et al., 2021), involucran mayormente problemas autocontenidos que pueden resolverse en unas pocas líneas de código.
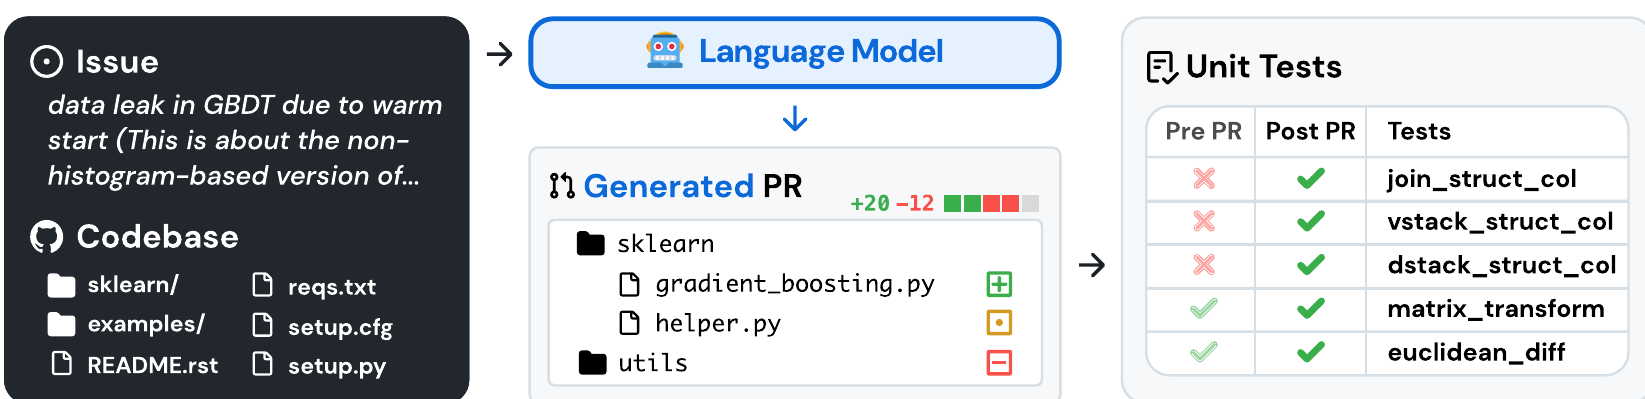
En el mundo real, la ingeniería de software no es tan simple. Corregir un error puede implicar navegar por un repositorio grande, comprender la interacción entre funciones en distintos archivos o detectar un pequeño error en código enrevesado. Inspirados por esto, presentamos SWE-bench, un benchmark que evalúa los LM en un entorno realista de ingeniería de software. Como se muestra en la Figura 1, se encarga a los modelos resolver problemas (típicamente un informe de error o una solicitud de funcionalidad) enviados a repositorios populares de GitHub. Cada tarea requiere generar un parche que describa los cambios a aplicar al código base existente. El código base revisado se evalúa luego utilizando el marco de pruebas del repositorio.
SWE-bench ofrece varias ventajas sobre los benchmarks de programación para LM existentes. Entre ellas, un entorno realista que utiliza problemas y soluciones enviados por usuarios, entradas diversas que presentan problemas de código únicos de 12 repositorios, un marco robusto para la evaluación basada en ejecución y la capacidad de actualizar continuamente el benchmark con nuevas instancias, requiriendo una intervención humana mínima.
Evaluamos múltiples LM de última generación en SWE-bench y encontramos que no logran resolver todos los problemas excepto los más simples. Usando un recuperador BM25, Claude 2 solo logra resolver el de los problemas.
Además de SWE-bench, nuestras contribuciones incluyen la publicación de un conjunto de datos de entrenamiento, SWE-bench-train, que es esencial para avanzar en el desarrollo de modelos abiertos en este dominio desafiante. Este conjunto de datos comprende una colección de 19.000 instancias de tareas no de prueba derivadas de 37 repositorios. Utilizando SWE-bench-train, publicamos dos modelos ajustados, SWE-Llama 7b y 13b, basados en el modelo CodeLlama (Rozière et al., 2023). Encontramos que en algunos entornos SWE-Llama 13b es competitivo con Claude 2 y es capaz de procesar contextos que superan los 100.000 tokens.
2 SWE-BENCH
SWE-bench es un benchmark que presenta problemas de GitHub de repositorios populares que informan errores o solicitan nuevas funcionalidades, y pull requests que realizan cambios en el repositorio para resolver estos problemas. La tarea consiste en generar un pull request que aborde un problema dado y pase las pruebas relacionadas con el problema.
2.1 CONSTRUCCIÓN DEL BENCHMARK
GitHub es una rica fuente de datos para el desarrollo de software, pero los repositorios, problemas y pull requests pueden ser ruidosos, ad hoc o estar mal documentados o mantenidos. Para encontrar instancias de tareas de alta calidad a escala, utilizamos un proceso de 3 etapas como se describe a continuación.
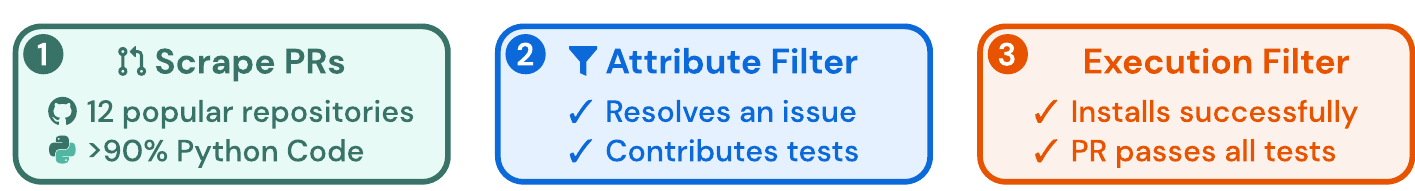
Etapa I: Selección de repositorios y extracción de datos. Comenzamos recopilando pull requests (PR) de 12 repositorios populares de Python de código abierto en GitHub, produciendo aproximadamente PR en total. Nos centramos en repositorios populares, ya que tienden a estar mejor mantenidos, tener pautas claras para contribuyentes y una mejor cobertura de pruebas. Cada PR tiene un código base asociado especificado por su commit base.
Etapa II: Filtrado basado en atributos. Creamos tareas candidatas seleccionando los PR fusionados que (1) resuelven un problema de GitHub y (2) realizan cambios en los archivos de prueba del repositorio, lo que indica que el usuario probablemente contribuyó con pruebas para verificar si el problema se ha resuelto.
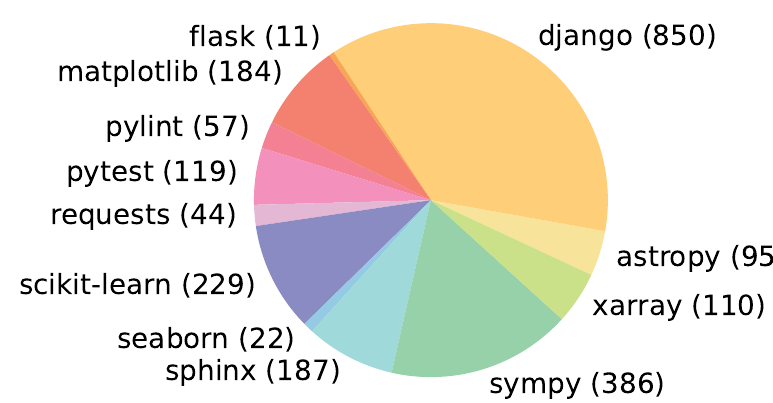
Etapa III: Filtrado basado en ejecución. Para cada tarea candidata, aplicamos el contenido de prueba del PR y registramos los resultados de las pruebas asociadas antes y después de aplicar el resto del contenido del PR. Filtramos las instancias de tareas que no tengan al menos una prueba en la que su estado cambie de fallo a aprobado (en adelante, prueba de fallo a aprobado). También filtramos las instancias que resultan en errores de instalación o de ejecución.A través de estas etapas de filtrado, los 90.000 PR originales se reducen a las 2.294 instancias de tareas que componen SWE-bench. En la Figura 3 se presenta un desglose final de estas instancias de tareas por repositorio, y la Tabla 1 destaca las características clave de las instancias de tareas de SWE-bench. Destacamos que los código bases son grandes, con miles de archivos, y que los pull requests de referencia a menudo realizan cambios en múltiples archivos a la vez. Los detalles técnicos sobre el proceso de construcción de SWE-bench se analizan en el Apéndice A. Las estadísticas adicionales del conjunto de datos se encuentran en el Apéndice A.5.
2.2 FORMULACIÓN DE LA TAREA
Entrada del modelo. Se proporciona a un modelo la descripción del texto de un problema y un código base completo. Luego se encarga al modelo que realice una edición en el código base para resolver el problema. En la práctica, representamos las ediciones como archivos de parche, que especifican qué líneas del código base modificar para resolver el problema.
Métricas de evaluación. Para evaluar una solución propuesta, aplicamos el parche generado, usando el programa patch de Unix, al código base y luego ejecutamos las pruebas unitarias y de sistema asociadas con la instancia de tarea. Si el parche se aplica correctamente y todas estas pruebas pasan, consideramos que la solución propuesta ha resuelto con éxito el problema. La métrica de nuestro benchmark es el porcentaje de instancias de tareas que se resuelven. Detalles técnicos adicionales en el Apéndice A.4.
2.3 CARACTERÍSTICAS DE SWE-BENCH
Los benchmarks tradicionales en PLN típicamente involucran solo secuencias de entrada y salida cortas y consideran problemas algo "artificiales" creados específicamente para el benchmark. En contraste, el entorno realista de construcción de SWE-bench dota al conjunto de datos de propiedades únicas, que discutimos a continuación.
Tareas de ingeniería de software del mundo real. Dado que cada instancia de tarea en SWE-bench consiste en un código base grande y complejo y la descripción de un problema relevante, resolver SWE-bench requiere demostrar habilidades y conocimientos sofisticados que poseen los ingenieros de software experimentados, pero que no se evalúan comúnmente en los benchmarks tradicionales de generación de código.
Actualizable continuamente. Nuestro proceso de recopilación puede aplicarse fácilmente a cualquier repositorio de Python en GitHub y requiere una intervención humana mínima. Por lo tanto, podemos ampliar SWE-bench con un suministro continuo de nuevas instancias de tareas y evaluar los LM en problemas creados después de su fecha de entrenamiento, lo que garantiza que la solución no estuviera incluida en su corpus de entrenamiento.
Entradas largas y diversas. Las descripciones de problemas son típicamente largas y detalladas (195 palabras en promedio), y los código bases contienen regularmente muchos miles de archivos. Resolver SWE-bench requiere identificar la relativamente pequeña cantidad de líneas que deben editarse para resolver un problema en medio de un mar de contexto.
Evaluación robusta. Para cada instancia de tarea, hay al menos una prueba de fallo a aprobado que se utilizó para probar la solución de referencia, y el de las instancias tienen al menos dos pruebas de fallo a aprobado. Estas pruebas evalúan si el modelo abordó el problema en la incidencia. Además, se ejecutan una mediana de 51 pruebas adicionales para verificar si la funcionalidad previa se mantiene adecuadamente.
Edición de código entre contextos. A diferencia de configuraciones previas que pueden restringir el alcance de la edición a una función o clase individual (p. ej., Chen et al., 2021; Cassano et al., 2022) o proporcionar espacios en blanco estilo cloze (p. ej., Lu et al., 2021; Fried et al., 2023), SWE-bench no ofrece dicha orientación explícita. En lugar de simplemente tener que producir un breve fragmento de código, nuestro benchmark desafía a los modelos a generar revisiones en múltiples ubicaciones de una base de código grande. Las soluciones de referencia de SWE-bench editan en promedio 1.7 archivos, 3.0 funciones y 32.8 líneas (añadidas o eliminadas).
Amplio alcance para posibles soluciones. La tarea de edición de código a escala de repositorio puede servir como un terreno de juego equitativo para comparar enfoques que van desde modelos de recuperación y de contexto largo hasta agentes de toma de decisiones, que podrían razonar y actuar en el código. SWE-bench también permite libertad creativa, ya que los modelos pueden generar soluciones novedosas que pueden desviarse del PR de referencia.
2.4 SWE-BENCH LITE
Evaluar LMs en SWE-bench puede llevar mucho tiempo y, dependiendo del modelo, requerir una cantidad costosa de cómputo o créditos de API. Dado que los rendimientos de rendimiento iniciales presentados en la Sección 5 son bastante bajos, la dificultad de SWE-bench lo hace útil para medir el progreso de los LM a largo plazo, pero potencialmente intimidante para sistemas iniciales que intentan avanzar a corto plazo.
| Media | Máx. | ||
| Texto del problema | Longitud (palabras) | 195,1 | 4477 |
| Base de código | N.º de archivos (no de prueba) | 3.010 | 5.890 |
| N.º de líneas (no de prueba) | 438K | 886K | |
| Parche de referencia | N.º de líneas editadas | 32,8 | 5888 |
| N.º de archivos editados | 1,7 | 31 | |
| N.º de funciones editadas | 3 | 36 | |
| Pruebas | N.º de fallos que pasan a éxito | 9,1 | 1633 |
| N.º total | 120,8 | 9459 |
Para fomentar la adopción de SWE-bench, creamos un subconjunto Lite de 300 instancias de SWE-bench que han sido muestreadas para ser más autocontenidas, con un enfoque en evaluar correcciones de errores funcionales. Los criterios de filtrado completos y la información del conjunto de datos se incluyen en SWE-bench Lite cubre 11 de los 12 repositorios originales, con una diversidad y distribución similares de instancias de tareas entre repositorios que el original. Los detalles completos de la división Lite y del filtrado se incluyen en el Apéndice A.7.
3 SWE-LLAMA: AJUSTE FINO DE CODELLAMA PARA SWE-BENCH
Es importante evaluar el rendimiento de los modelos abiertos en SWE-bench junto con los modelos propietarios. En el momento de escribir este documento, solo los modelos CodeLlama (Rozière et al., 2023) son capaces de manejar los contextos muy largos necesarios. Sin embargo, observamos que las variantes de CodeLlama listas para usar no son capaces de seguir las instrucciones detalladas para generar ediciones de código en todo el repositorio, y típicamente producen respuestas de marcador de posición o código no relacionado. Para evaluar mejor las capacidades de estos modelos, realizamos un ajuste fino supervisado en los modelos CodeLlama-Python de 7 mil millones y 13 mil millones de parámetros. Los modelos resultantes son editores de repositorio especializados que pueden ejecutarse en hardware de consumo y resolver problemas de GitHub.
Datos de entrenamiento. Seguimos nuestro procedimiento de recolección de datos y recopilamos 19.000 pares de issue-PR de otros 37 repositorios populares de paquetes de Python. A diferencia de la Sección 2.1, no exigimos que las pull requests aporten cambios en las pruebas. Esto nos permite crear un conjunto de entrenamiento mucho mayor para usar en el ajuste fino supervisado. Para eliminar el riesgo de contaminación de datos, el conjunto de repositorios de los datos de entrenamiento es disjunto de los incluidos en el benchmark de evaluación.
Detalles del entrenamiento. Dadas las instrucciones, un texto de issue de GitHub y los archivos de código relevantes como prompt, ajustamos SWE-Llama para generar el parche que resolvió la issue dada (el "parche gold"). Por eficiencia de memoria, ajustamos solo los pesos de la subcapa de atención usando LoRA Hu et al. (2022), y excluimos las secuencias de entrenamiento con más de 30.000 tokens, reduciendo el tamaño efectivo del corpus de entrenamiento a 10.000 instancias. Se proporcionan más detalles en el Apéndice B.
4 CONFIGURACIÓN EXPERIMENTAL
En esta sección explicamos cómo se construyen las entradas para ejecutar la evaluación de SWE-bench. Además, revisamos los modelos que evaluamos en este trabajo.
4.1 ENFOQUE BASADO EN RECUPERACIÓN
Las instancias de SWE-bench proporcionan una descripción de la issue y una base de código como entrada al modelo. Mientras que las descripciones de las issues suelen ser cortas (195 palabras en promedio, como se muestra en la Tabla 1), las bases de código constan de muchos más tokens (438K líneas en promedio) de los que normalmente caben en la ventana de contexto de un LM. Entonces surge la pregunta de exactamente cómo elegir el contexto relevante que se proporcionará al modelo.
Para abordar este problema en nuestros baselines, simplemente usamos un sistema de recuperación genérico para seleccionar los archivos que se insertarán como contexto. En particular, evaluamos los modelos bajo dos configuraciones de contexto relevantes: 1) recuperación dispersa y 2) una recuperación oracle.
Recuperación dispersa. Los métodos de recuperación densa son poco adecuados para nuestra configuración debido a las longitudes muy largas de claves y consultas, y especialmente a la configuración inusual de recuperar documentos de código con consultas en lenguaje natural. Por lo tanto, elegimos usar la recuperación BM25 (Robertson et al., 2009) para recuperar archivos relevantes que se proporcionarán como contexto para cada instancia de tarea. Experimentamos con tres límites máximos de contexto diferentes y simplemente recuperamos tantos archivos como quepan dentro del límite especificado. Evaluamos cada modelo en todos los límites que caben dentro de su ventana de contexto y reportamos el mejor rendimiento. Por observación, los modelos rinden mejor con la ventana de contexto más corta, como se muestra en la Tabla 2.
Recuperación "oracle". Con fines de análisis, también consideramos una configuración en la que "recuperamos" los archivos editados por el parche de referencia que resolvió la issue en GitHub. Esta configuración "oracle" es menos realista, ya que un ingeniero que trabaja en abordar una issue puede no saber a priori qué archivos deben modificarse. Además, esta configuración tampoco es necesariamente exhaustiva, ya que los archivos editados por sí solos pueden no incluir todo el contexto requerido para comprender exactamente cómo se comportará el software al interactuar con partes no vistas del código.
Comparamos los resultados de la recuperación BM25 con los de la configuración de recuperación "oracle", como se muestra en la Tabla 3. Observamos que en aproximadamente el de las instancias, BM25 recupera un superconjunto de los archivos oracle para el límite de contexto de 27.000 tokens. Sin embargo, en casi la mitad de las instancias con el límite de 27.000 tokens, no recupera ninguno de los archivos del contexto "oracle".
4.2 FORMATO DE ENTRADA
Una vez seleccionados los archivos recuperados usando uno de los dos métodos anteriores, construimos la entrada al modelo compuesta por las instrucciones de la tarea, el texto de la issue, los archivos recuperados y la documentación y, finalmente, un archivo de parche de ejemplo y un prompt para generar el archivo de parche. En el Apéndice D se proporcionan ejemplos de instancias y más detalles sobre esta formulación.
4.3 MODELOS
Debido a la necesidad de procesar longitudes de secuencia largas, actualmente solo hay unos pocos modelos adecuados para SWE-bench. Por lo tanto, evaluamos ChatGPT-3.5 (gpt-3.5-turbo-16k-0613), GPT-4 (gpt-4-32k-0613), Claude 2 y SWE-Llama con sus límites de contexto mostrados en la Tabla 4.
| Modelo | Contenido máx. | ||
| 13k | 27k | 50k | |
| Claude 2 | 1.96 | 1.87 | 1.22 |
| SWE-Llama 7b | 0.70 | 0.31 | 0.00 |
| SWE-Llama 13b | 0.70 | 0.48 | 0.00 |
| BM25 Recall | |||
| 13k | 27k | 50k | |
| Prom. | 29,58 | 44,41 | 51,06 |
| All | 26,09 | 39,83 | 45,90 |
| Any | 34,77 | 51,27 | 58,38 |
Tabla 4: Comparamos las diferentes longitudes de contexto y la proporción de la configuración de recuperación "oracle" cubierta. Los modelos con longitudes de contexto más cortas están, por tanto, inherentemente en desventaja. Nótese que la descripción de longitudes de tokens es una medida relativa no estándar (p. ej., las secuencias tokenizadas con Llama son más largas en promedio que la secuencia equivalente tokenizada para GPT-4).
| ChatGPT-3.5 | GPT-4 | Claude 2 | SWE-Llama | |
| Máx. de tokens | 16.385 | 32.768 | 100.000 | ≥100.000 |
| % de instancias | 58,1% | 84,1% | 96,4% | ≥94,8% |
| Modelo | SWE-bench | SWE-bench Lite | ||
| % Resuelto | % Aplicado | % Resuelto | % Aplicado | |
| Claude 3 Opus | 3,79 | 46,56 | 4,33 | 51,67 |
| Claude 2 | 1,97 | 43,07 | 3,00 | 33,00 |
| ChatGPT-3.5 | 0,17 | 26,33 | 0,33 | 10,00 |
| GPT-4-turbo | 1,31 | 26,90 | 2,67 | 29,67 |
| SWE-Llama 7b | 0,70 | 51,74 | 1,33 | 38,00 |
| SWE-Llama 13b | 0,70 | 53,62 | 1,00 | 38,00 |
5 RESULTADOS
Reportamos los resultados de los modelos usando diferentes mecanismos de recuperación y estilos de prompting, y luego proporcionamos algún análisis y perspectiva sobre el rendimiento y la dificultad de los modelos. Resumimos el rendimiento de los modelos usando recuperación BM25 en la Tabla 5. En general, los modelos tienen dificultades significativas para resolver las issues. El modelo con mejor rendimiento, Claude 2, solo es capaz de resolver el de las issues.
Para analizar la importancia del recuperador en los resultados generales del sistema, presentamos los resultados de la recuperación "oracle" en la Tabla 18 del Apéndice. Allí, Claude 2 es capaz de resolver el de las issues usando el recuperador "oracle". Además analizamos la importancia del contexto en la discusión a continuación.
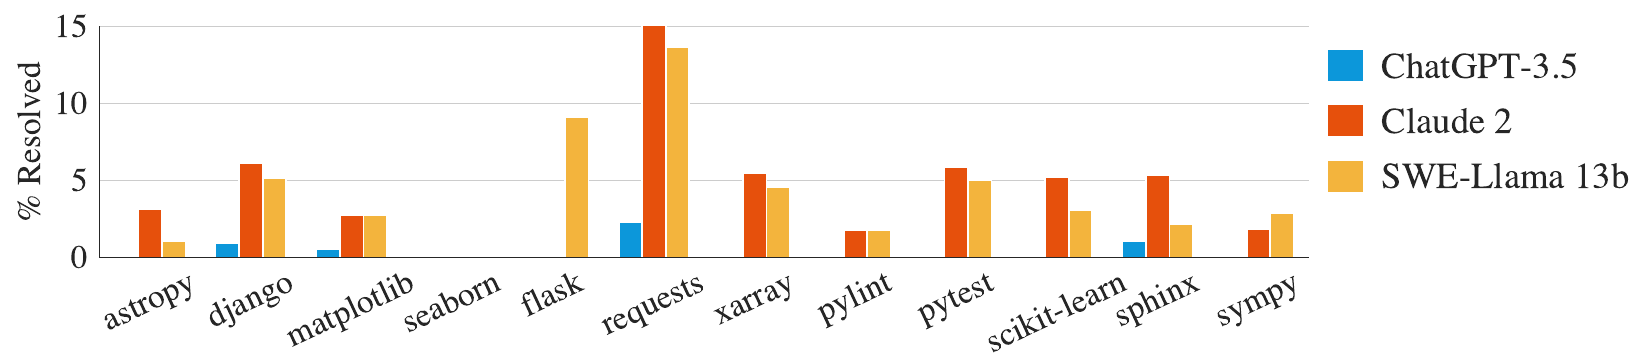
La dificultad difiere entre repositorios. Al desglosar el rendimiento por repositorio, todos los modelos tienden de manera similar entre los distintos repositorios, como se muestra en la Figura 4. A pesar de esto, las issues resueltas por cada modelo no necesariamente se solapan extensamente. Por ejemplo, en la configuración "oracle", Claude 2 y SWE-Llama 13b rinden de manera comparable, resolviendo cada modelo 110 y 91 instancias respectivamente. Sin embargo, de estas instancias, Claude 2 solo resuelve el de las instancias resueltas por SWE-Llama.
Esto también puede estar relacionado con la presencia de imágenes en las issues, que pueden codificarse en el markdown de la issue con enlaces de imágenes incrustados (es decir, ![image][https://...]). Algunos repositorios presentan naturalmente más instancias con imágenes; por ejemplo, el de las instancias de matplotlib y el de las de seaborn contienen imágenes incrustadas en el texto de su issue, en comparación con solo el de todas las instancias. Resolver estas instancias puede requerir LMs multimodales o algún tipo de uso de herramientas externas para procesar imágenes.
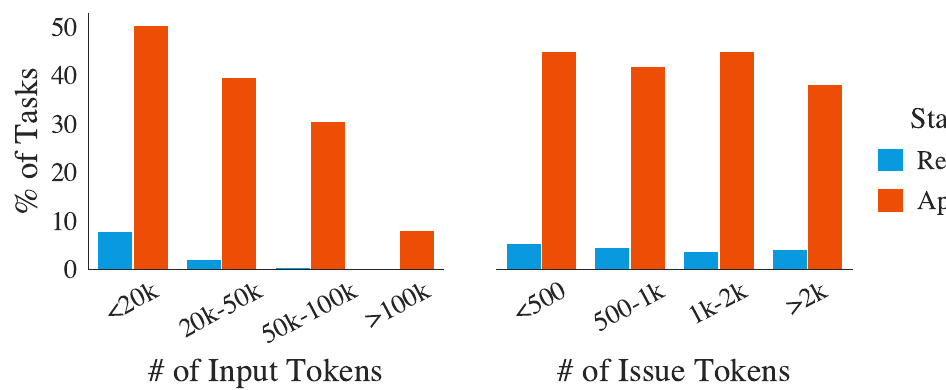
La dificultad se correlaciona con la longitud del contexto. Los modelos de chat pueden estar preentrenados con secuencias largas de código, pero normalmente se les pide generar fragmentos de código más cortos con un contexto limitado proporcionado para enmarcar la pregunta. Como se muestra en la Figura 5, vemos que a medida que aumenta la longitud total del contexto, el rendimiento de Claude 2 cae considerablemente; un comportamiento que también se observa en otros modelos. En nuestras configuraciones de evaluación, los modelos ven mucho código que puede no estar directamente relacionado con resolver la issue en cuestión, y parecen tener dificultades con frecuencia para localizar el código problemático que necesita ser actualizado. Este resultado corrobora otros estudios que muestran que los modelos se distraen con contexto adicional y pueden ser sensibles a la ubicación relativa de las secuencias objetivo (Liu et al., 2023b). Incluso cuando aumentar el tamaño máximo de contexto para BM25 incrementaría el recall con respecto a los archivos oracle, el rendimiento cae, como se muestra en la Tabla 2, ya que los modelos simplemente son ineficaces para localizar el código problemático. Para investigar más esto, proporcionamos una ablación de entrada sobre el contexto de recuperación "oracle", "oracle"-collapsed, donde los archivos recuperados se colapsan por completo, excepto las líneas realmente editadas por la
| Modelo | “Oracle” colapsado | |
| Resuelto | Aplicado | |
| Claude 3 Opus | 9,39 | 48,00 |
| Claude 2 | 5,93 | 68,18 |
| GPT-4 | 3,40 | 48,65 |
| ChatGPT-3.5 | 1,09 | 40,93 |
pull request verdadera (con líneas de margen), que se muestra en la Tabla 6. En esta configuración, vemos aumentos en el rendimiento, con GPT-4 saltando del al y Claude 2 del al .
La dificultad no se correlaciona con la fecha de resolución de la issue. En la Tabla 7 mostramos los resultados de los modelos en la configuración de recuperación "oracle", particionados por fecha, para PRs creadas antes o después de 2023. Encontramos que para la mayoría de los modelos hay poca diferencia en el rendimiento antes o después de esta fecha, con la excepción de GPT-4. Consideramos que este resultado es en gran medida prometedor, ya que sugiere que, a pesar de que los modelos han estado expuestos a alguna versión de la base de código de un repositorio, es poco probable que "hagan trampa" para abordar las issues simplemente generando una versión más reciente del repositorio.
| Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| Antes de 2023 | 4,87 | 0,49 | 1,96 | 2,95 |
| Después de 2023 | 4,23 | 0,77 | 0,0 | 3,46 |
Los modelos ajustados son sensibles a los cambios en la distribución del contexto. Los modelos ajustados SWE-Llama 7b y 13b rinden sorprendentemente mal con el contexto recuperado por BM25. Dado que estos modelos se ajustaron usando la recuperación "oracle" como contexto, sospechamos que este cambio en el contexto dificulta que el modelo funcione de manera fiable. Por ejemplo, SWE-Llama fue entrenado para editar cada archivo incluido como contexto, mientras que en la configuración de BM25 muchos archivos proporcionados en el contexto no se espera que se modifiquen.
Generar parches es más fácil que generar archivos completos. Los modelos a menudo se entrenan usando archivos de código estándar y probablemente rara vez ven archivos de parche. Generalmente formulamos nuestra tarea para que los modelos generen archivos de parche en lugar de recrear el archivo completo con su cambio propuesto, ya que los archivos de parche suelen ser una representación mucho más eficiente de un cambio en un archivo. Como se muestra en la Tabla 5, observamos que los modelos todavía tienen dificultades para generar archivos de parche bien formateados. Por ello, experimentamos pidiendo a los modelos que, en su lugar, regeneren archivos completos con sus cambios propuestos para resolver la issue. En esta configuración, encontramos que los modelos generalmente rinden peor en esta tarea que al generar archivos de parche; por ejemplo, Claude 2 obtiene un en comparación con el de la tabla principal para la recuperación "oracle". Incluso controlando por la longitud de la instancia, generar sobre la mitad más corta de las instancias de tarea según los tokens de entrada arroja un en comparación con el para generar parches con Claude 2.
Los modelos de lenguaje tienden a generar ediciones más cortas y simples. Los archivos de parche generados por el modelo tienden a añadir y eliminar menos líneas que su respectivo parche de referencia. Como se muestra en la Tabla 8, en comparación con un parche de referencia promedio, los archivos de parche generados por el modelo que se aplican correctamente tienen menos de la mitad de la longitud total (74,5 frente a 30,1 líneas) de los archivos de parche de edición de referencia, y rara vez editan más de un único archivo.
5.1 UN ANÁLISIS CUALITATIVO DE LAS GENERACIONES DE SWE-LLAMA
Seleccionamos 11 generaciones de SWE-Llama y Claude 2 para comprender mejor la calidad de la tarea y de los parches generados bajo el ajuste de recuperación "oracle". Aquí discutimos un ejemplo de SWE-Llama y nuestros hallazgos generales, con análisis en profundidad de otros ejemplos mostrados en el Apéndice F.
| Modelo | Líneas totales | Añadidas | Eliminadas | Funciones | Archivos |
| Claude 2 | 19.6 | 4.2 | 1.9 | 1.1 | 1.0 |
| Gold | 44.1 | 12.0 | 5.8 | 2.1 | 1.2 |
| ChatGPT-3.5 | 30.1 | 3.8 | 2.7 | 1.6 | 1.0 |
| Gold | 39.6 | 9.5 | 6.1 | 1.9 | 1.2 |
| GPT-4 | 20.9 | 4.4 | 1.5 | 1.0 | 1.0 |
| Gold | 33.6 | 8.4 | 3.8 | 1.9 | 1.1 |
| SWE-Llama 13b | 17.6 | 1.6 | 1.2 | 1.2 | 1.1 |
| Gold | 37.8 | 10.0 | 4.4 | 1.9 | 1.1 |
| SWE-Llama 7b | 16.7 | 1.3 | 1.2 | 1.2 | 1.1 |
| Gold | 40.2 | 11.3 | 4.9 | 1,9 | 1,1 |
| Promedio Gold | 39,1 | 10,2 | 5,0 | 1,9 | 1,1 |
| Todos Gold | 74,5 | 22,3 | 10,5 | 3,0 | 1,7 |
Tabla 8: Ediciones promedio de los parches generados por el modelo en el ajuste de recuperación "oracle" a través de los parches aplicados con éxito. Para las instancias de tarea específicas de cada modelo, calculamos las mismas estadísticas a través de los parches de referencia. Avg Gold muestra estadísticas promediadas macro sobre los respectivos parches de referencia de cada modelo. All Gold muestra estadísticas para todos los parches de referencia sin condicionar al rendimiento del modelo.
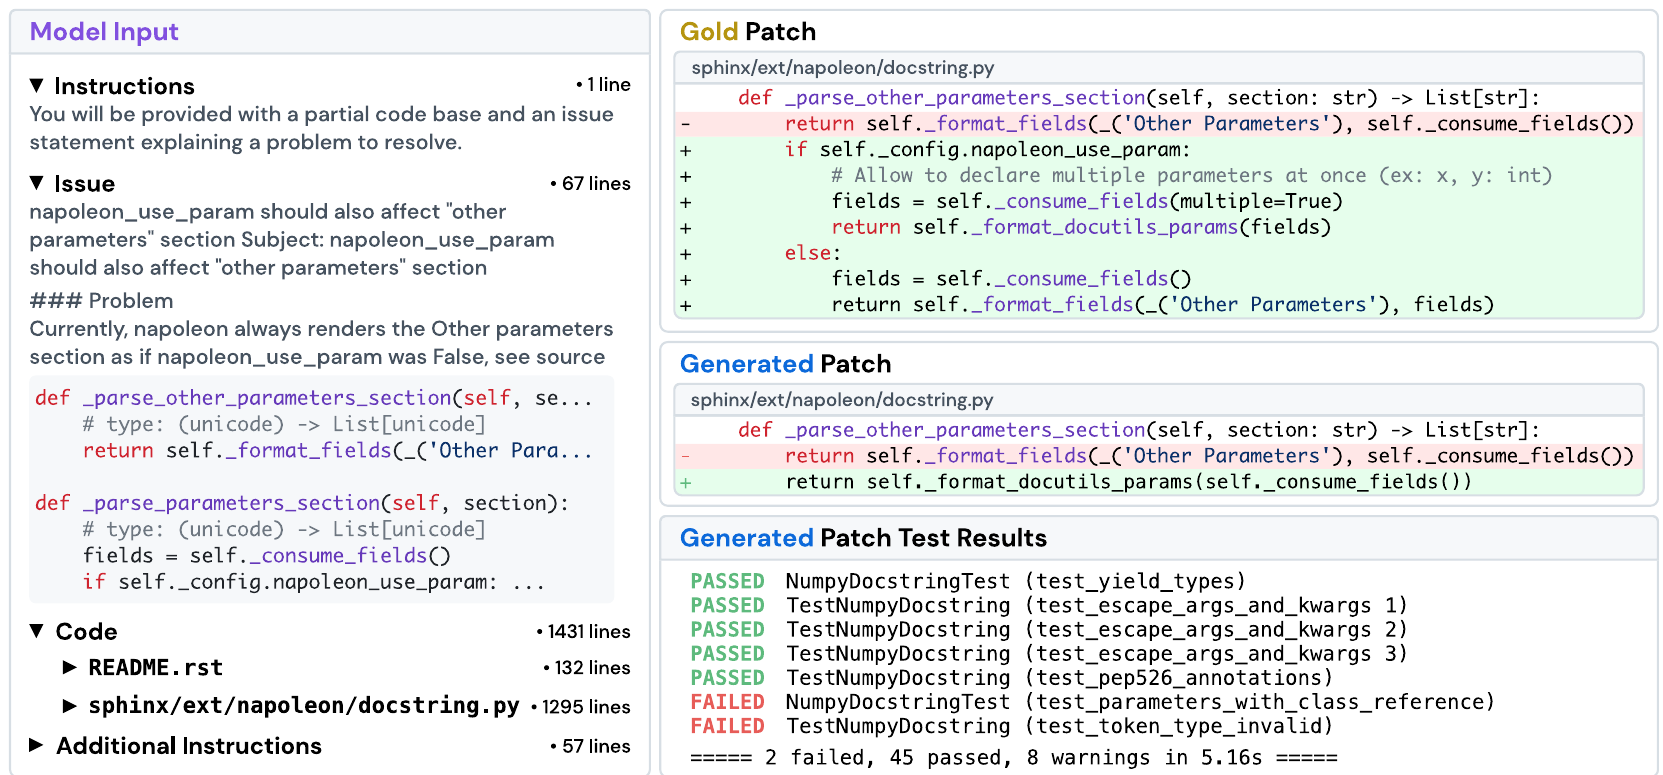
Consideraremos la instancia de tarea sphinx-doc_sphinx-8713 del generador de documentación Sphinx, mostrada en la Figura 6. El problema indica que la extensión napoleon de Sphinx no está formateando correctamente la palabra clave de documentación "Other Parameters" cuando la opción de configuración napoleon.use_param está establecida en True. El texto del problema además proporciona un fragmento de código detallado de dónde se sospecha que se encuentra el código fuente problemático, así como algunos ejemplos de código para reproducir el error e información adicional relacionada con las versiones del paquete. Para esta instancia en particular, el modelo no resolvió la tarea, al no pasar algunas de las pruebas resueltas por la solución de referencia.
En el ajuste de recuperación "oracle", la entrada del modelo proporciona este texto del problema junto con algunas instrucciones, el contenido completo de los archivos editados por el parche de referencia, y un ejemplo del formato diff en el que esperamos que esté la respuesta. La entrada total del modelo consiste en 1.558 líneas de contexto o 20.882 tokens. Al comparar el parche de referencia y el parche del modelo, encontramos un error obvio. Si bien el modelo edita la función correcta, _parse_other_parameters_section en la línea 684 en sphinx/ext/napoleon/docstring.py, cambia la función para que se comporte como si napoleon.use_param fuera siempre True en lugar de verificar primero la opción de configuración y copiar lo que hace _parse_parameters_section, como el parche de referencia. En las pruebas, test_parameters_with_class_reference compara directamente la documentación producida usando una configuración donde napoleon_use_param está establecido en False, lo que detecta el error del modelo inmediatamente.
Comparando los resultados de todos los ejemplos que consideramos, notamos algunas tendencias prominentes en el comportamiento. Los modelos tienden a escribir código Python primitivo y no aprovechan las bibliotecas de terceros existentes ni el resto de la base de código para sus soluciones. Las generaciones de los modelos también reflejan un enfoque "codicioso" de resolver el problema exactamente, con poca consideración por el estilo del código o las restricciones lógicas que podrían reflejarse en la base de código (es decir, usar importaciones relativas en lugar de absolutas). En contraste, observamos que muchos parches dorados harán mejoras estructurales que cubren un alcance mucho mayor de la base de código; estas ediciones no solo resuelven el problema, sino que también anticipan y resuelven posibles problemas futuros.
6 TRABAJO RELACIONADO
Evaluación de LMs. Varios trabajos recientes para evaluar LMs han propuesto una colección de tareas mutuamente distintas que abarcan múltiples dominios (Hendrycks et al., 2021; Liang et al., 2022; Srivastava et al., 2023) o han recurrido a la web como un entorno interactivo que presenta tareas que requieren múltiples pasos para resolverse (Yao et al., 2022; Zhou et al., 2023; Deng et al., 2023; Liu et al., 2023d). Hay varias desventajas con tal configuración de estilo "popurrí". Primero, cada tarea tiende a enfocarse estrechamente en una o unas pocas habilidades, lo que resulta en desafíos que son típicamente demasiado simples, encasillan al modelo en un rol reducido y no proporcionan a los modelos el ancho de banda para ejercer su versatilidad o potencialmente demostrar nuevas habilidades (Srivastava et al., 2023). En consecuencia, el rendimiento de un modelo en tales conglomerados de tareas puede no producir información procesable y profunda sobre sus capacidades y cómo mejorarlas (Schlangen, 2019; Martínez- Plumed et al., 2021; Bowman & Dahl, 2021). SWE- bench aborda estas deficiencias, ya que nuestro trabajo demuestra que es significativamente desafiante, presenta una amplia gama de posibilidades para mejorar los LMs para resolver esta tarea, y es fácil de actualizar con el tiempo con nuevas instancias de tareas, cada una de las cuales introduce desafíos novedosos, matizados y prácticos.
Benchmarks de Generación de Código. HumanEval (Chen et al., 2021) es el estándar actual en una búsqueda prolongada de sintetizar código a partir de descripciones en lenguaje natural (Yu et al., 2018; Austin et al., 2021; Hendrycks et al., 2021; Li et al., 2022a; Zan et al., 2023). En el último año, benchmarks posteriores han buscado aumentar HumanEval con extensiones a diferentes lenguajes (Cassano et al., 2022; Athiwaratkun et al., 2023; Orlanski et al., 2023), variaciones en el alcance de la edición (Yu et al., 2023; Du et al., 2023), tareas de finalización de código similares pero novedosas (Muennighoff et al., 2023), y más pruebas (Liu et al., 2023a). Simultáneamente, trabajos separados han buscado introducir nuevos paradigmas de codificación (Yin et al., 2022; Yang et al., 2023) o diseñar problemas específicos de bibliotecas (Lai et al., 2022; Zan et al., 2022). En lugar de dividir los problemas en conjuntos de datos aislados y reducirlos por simplicidad, el procedimiento de recopilación de SWE- bench transforma el código fuente con un posprocesamiento mínimo, preservando un conjunto mucho más amplio de desafíos basados en la ingeniería de software del mundo real más allá de la finalización de forma cerrada, como la generación de parches, el razonamiento sobre contextos largos, la navegación por un directorio de base de código y la captura de relaciones basadas en dependencias entre módulos.
ML para Ingeniería de Software. Para superar las técnicas tradicionales de análisis de programas que pueden no escalar o incorporar lenguaje natural, una dirección de la investigación actual en ingeniería de software es usar redes neuronales, incluidos los LMs, para automatizar procesos de desarrollo de software del mundo real (Maniatis et al., 2023; Zheng et al., 2023; Hou et al., 2023). Los casos de uso incluyen la automatización de la generación de commits (Jung, 2021; Liu et al., 2023c), la revisión de PR (Yang et al., 2016; Li et al., 2022b; Tufano et al., 2021), la localización de errores (Kim et al., 2019; Chakraborty et al., 2018), las pruebas (Kang et al., 2023; Xia et al., 2023; Wang et al., 2023), y la reparación de programas (Gupta et al., 2017; Allamanis et al., 2017; Monperrus, 2018; Jiang et al., 2018; Goues et al., 2019; Gao et al., 2022; Dinh et al., 2023; Motwani & Brun, 2023). Lo más relevante para SWE- bench son los trabajos que han buscado aplicar LMs a la reparación automatizada de programas (Xia & Zhang, 2022; 2023; Fan et al., 2023; Sobania et al., 2023), guiando la edición de código con commits (Chakraborty & Ray, 2021; Zhang et al., 2022; Fakhoury et al., 2023). Sin embargo, ninguno de los conjuntos de datos existentes (Just et al., 2014; Karampatsis & Sutton, 2019) presenta contexto de código a la escala de SWE- bench. Además, SWE- bench puede extenderse fácilmente a nuevos lenguajes de programación y repositorios, y proporciona una arena significativamente más realista y desafiante para llevar a cabo experimentos hacia la augmentación de LMs con herramientas y prácticas de ingeniería de software.
7 DISCUSIÓN
Limitaciones y direcciones futuras. Las instancias de tareas de SWE- bench están todas en Python; esperamos aplicar el procedimiento de recopilación de instancias de tareas de SWE- bench para expandir su cobertura a más lenguajes de programación y dominios. Segundo, nuestros experimentos tienen como objetivo establecer una línea base de los enfoques más simples y directos para esta tarea; no pretendemos restringir metodologías futuras al mismo tipo de enfoque y alentamos trabajos futuros a investigar diferentes métodos (p. ej., enfoques basados en agentes, LMs aumentados con herramientas).
Por último, aunque este trabajo evalúa modelos usando pruebas de código basadas en ejecución, depender únicamente de este método es insuficiente para garantizar un rendimiento confiable de las generaciones de modelos, ya que encontramos que las generaciones automatizadas de código de LMs pueden frecuentemente ser menos completas, eficientes o legibles en comparación con soluciones escritas por humanos.
Conclusión. La complejidad de los procesos de desarrollo de software del mundo real se extiende mucho más allá de la simple finalización de código. Al basarse en el pipeline colaborativo de código abierto, SWE- bench crea un espejo fiel de los entornos de codificación del mundo real. Este entorno más realista fomenta soluciones creativas que pueden tener aplicabilidad inmediata en el desarrollo de software de código abierto. Esperamos que este benchmark y nuestras otras contribuciones puedan servir como activos valiosos en el futuro desarrollo de LMs que sean más prácticos, inteligentes y autónomos.
8 DECLARACIÓN DE ÉTICA
8 DECLARACIÓN DE ÉTICASWE- bench se recopila completamente de repositorios públicos con licencias que permiten el uso de software y con las cuales nuestras contribuciones están en conformidad. Los detalles de las licencias se incluyen en la Tabla 12. Durante los procesos de recopilación o evaluación, no recopilamos información sobre usuarios de GitHub, y las instancias de tareas de SWE- bench no usan datos de GitHub más allá de lo que se ofrece a través de la API pública y el sitio web. Nuestras contribuciones no involucran ninguna participación de sujetos humanos; no realizamos crowdsourcing ni reclutamos trabajadores humanos para tareas de ninguna parte de SWE- bench, incluidos sus procedimientos de recopilación y evaluación junto con los experimentos. Los criterios de filtrado de SWE- bench para repositorios de GitHub basados en popularidad no dependen implícita o explícitamente de heurísticas discriminatorias o sesgadas para la selección de repositorios. Para el lanzamiento del conjunto de datos, planeamos hacer de código abierto las instancias de tareas de SWE- bench, la infraestructura de recopilación y evaluación, los resultados experimentales, los datos de entrenamiento usados para el ajuste fino de los modelos SWE- Llama, y los pesos del modelo SWE- Llama. Siguiendo precedentes de mejores prácticas, también presentaremos documentación amplia para describir cada componente y su uso, y también implementaremos canales de comunicación convenientes para solicitar comentarios para mejorar SWE- bench. SWE- bench no presenta ninguna información inmediatamente dañina. Discutimos brevemente el impacto potencial del uso de SWE- bench en la Sección E.
9 DECLARACIÓN DE REPRODUCIBILIDAD
9 DECLARACIÓN DE REPRODUCIBILIDADPara nuestra presentación, hemos subido la totalidad del código fuente como un archivo comprimido que ha sido debidamente anonimizado. Hemos organizado la base de código de manera que directorios separados correspondan a diferentes contribuciones dentro del artículo principal (es decir, recopilación de conjuntos de datos, evaluación, inferencia de modelos de código abierto, entrenamiento de SWE- Llama, etc.). El código fuente contiene documentación en línea que detalla el propósito y uso de diferentes partes de la base de código. Además, también incluimos el conjunto completo de 2294 instancias de tareas de SWE- bench que contiene todos los componentes discutidos en el artículo principal. Más allá de la documentación en el código fuente, incluimos detalles técnicos exhaustivos para el pipeline de recopilación y los procedimientos de evaluación en la Sección A.2 y la Sección A.4 que complementan los detalles originales en la Sección 2 del artículo principal. Estas secciones cubren completamente la lógica presentada en el código y pueden ser útiles para entenderlo. En adelante, como se discute en la declaración de ética, planeamos lanzar más formalmente SWE- bench al público como un repositorio de código abierto con detalles exhaustivos que describan el benchmark, describan el código y detallen su uso. Un componente principal de SWE- bench es el marco de recopilación, que será parte del código de código abierto. Debido a su diseño fácilmente mantenible, como se discute en el artículo principal, nuestra esperanza y creencia es que SWE- bench debería ser altamente reproducible.
10 AGRADECIMIENTOS
10 AGRADECIMIENTOSAgradecemos a Danqi Chen, Tri Dao, Zexuan Zhong, Tianyu Gao, Will Merrill, Mengzhou Xia, Dan Friedman, Adithya Bhaskar, Austin Watkins, Atamik Gupta y Richard Zhu por sus valiosos comentarios y consejos. Reconocemos el apoyo de la National Science Foundation bajo el Grant No. 2239363 y un premio de Oracle Collaborative Research. Cualquier opinión, hallazgo, conclusión o recomendación expresada en este material son de los autores y no reflejan necesariamente los puntos de vista de la National Science Foundation.
REFERENCIAS
Miltiadis Allamanis, Marc Brockschmidt, and Mahmoud Khademi. Learning to represent programs with graphs. arXiv preprint arXiv:1711.00740, 2017.
Ben Athiwaratkun, Sanjay Krishna Gouda, Zijian Wang, Xiaopeng Li, and Yuchen Tian et. al. Multilingual evaluation of code generation models, 2023.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, and Charles Sutton. Program synthesis with large language models, 2021.
Samuel R. Bowman and George E. Dahl. What will it take to fix benchmarking in natural language understanding?, 2021.
Federico Cassano, John Gouwar, Daniel Nguyen, Sydney Nguyen, Luna Phipps-Costin, Donald Pinckney, Ming-Ho Yee, Yangtian Zi, Carolyn Jane Anderson, Molly Q Feldman, Arjun Guha, Michael Greenberg y Abhinav Jangda. Multipl-e: A scalable and extensible approach to benchmarking neural code generation, 2022.
Saikat Chakraborty y Baishakhi Ray. On multi-modal learning of editing source code, 2021.
Saikat Chakraborty, Yujian Li, Matt Irvine, Ripon Saha y Baishakhi Ray. Entropy guided spectrum based bug localization using statistical language model. arXiv preprint arXiv:1802.06947, 2018.
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto y Jared Kaplan et. al. Evaluating large language models trained on code, 2021.
Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra y Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Samuel Stevens, Boshi Wang, Huan Sun y Yu Su. Mind2web: Towards a generalist agent for the web, 2023.
Tuan Dinh, Jinman Zhao, Samson Tan, Renato Negrinho, Leonard Lausen, Sheng Zha y George Karypis. Large language models of code fail at completing code with potential bugs. arXiv preprint arXiv:2306.03438, 2023.
Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng y Yiling Lou. Classeval: A manually-crafted benchmark for evaluating llms on class-level code generation, 2023.
Sarah Fakhoury, Saikat Chakraborty, Madan Musuvathi y Shuvendu K. Lahiri. Towards generating functionally correct code edits from natural language issue descriptions, 2023.
Zhiyu Fan, Xiang Gao, Martin Mirchev, Abhik Roychoudhury y Shin Hwei Tan. Automated repair of programs from large language models, 2023.
Daniel Fried, Armen Aghajanyan, Jessy Lin, Sida Wang, Eric Wallace, Freda Shi, Ruiqi Zhong, Wen tau Yih, Luke Zettlemoyer y Mike Lewis. Incoder: A generative model for code infilling and synthesis, 2023.
Xiang Gao, Yannic Noller y Abhik Roychoudhury. Program repair, 2022.
Claire Le Goues, Michael Pradel y Abhik Roychoudhury. Automated program repair. Communications of the ACM, 62(12):56-65, 2019.
David Gros, Prem Devanbu y Zhou Yu. Ai safety subproblems for software engineering researchers, 2023.
Rahul Gupta, Soham Pal, Aditya Kanade y Shirish Shevade. Deepfix: Fixing common c language errors by deep learning. En Proceedings of the aaai conference on artificial intelligence, volumen 31, 2017.
Maurice H. Halstead. Elements of Software Science (Operating and programming systems series). Elsevier Science Inc., USA, 1977. ISBN 0444002057.
Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song y Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
Xinyi Hou, Yanjie Zhao, Yue Liu, Zhou Yang, Kailong Wang, Li Li, Xiapu Luo, David Lo, John Grundy y Haoyu Wang. Large language models for software engineering: A systematic literature review, 2023.
Edward J Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang y Weizhu Chen. LoRA: Low-rank adaptation of large language models. En International Conference on Learning Representations, 2022. URL https://openreview.net/forum?id=nZeVKeeFYf9.
Sam Ade Jacobs, Masahiro Tanaka, Chengming Zhang, Minjia Zhang, Leon Song, Samyam Rajbhandari y Yuxiong He. Deepspeed ulysses: System optimizations for enabling training of extreme long sequence transformer models, 2023.
Jiajun Jiang, Yingfei Xiong, Hongyu Zhang, Qing Gao y Xiangqun Chen. Shaping program repair space with existing patches and similar code. En Proceedings of the 27th ACM SIGSOFT international symposium on software testing and analysis, pp. 298-309, 2018.
Tae-Hwan Jung. Committer: Commit message generation using pre-trained programming language model, 2021.
René Just, Darioush Jalali y Michael D. Ernst. Defects4J: A Database of existing faults to enable controlled testing studies for Java programs. En ISSTA 2014, Proceedings of the 2014 International Symposium on Software Testing and Analysis, pp. 437-440, San Jose, CA, USA, julio de 2014. Demostración de herramienta.
Sungmin Kang, Juyeon Yoon y Shin Yoo. Large language models are few-shot testers: Exploring llm-based general bug reproduction, 2023.
Rafael-Michael Karampatsis y Charles Sutton. How often do single-statement bugs occur? the manysstubs4j dataset. 2020 IEEE/ACM 17th International Conference on Mining Software Repositories (MSR), pp. 573-577, 2019. URL https://api.semanticscholar.org/CorpusID:173188438.
Douwe Kiela, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger y Zhengxuan Wu et. al. Dynabench: Rethinking benchmarking in nlp, 2021.
Yunho Kim, Seokhyeon Mun, Shin Yoo y Moonzoo Kim. Precise learn-to-rank fault localization using dynamic and static features of target programs. ACM Transactions on Software Engineering and Methodology (TOSEM), 28(4):1-34, 2019.
Yuhang Lai, Chengxi Li, Yiming Wang, Tianyi Zhang, Ruiqi Zhong, Luke Zettlemoyer, Scott Wen tau Yih, Daniel Fried, Sida Wang y Tao Yu. Ds-1000: A natural and reliable benchmark for data science code generation, 2022.
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser y Rémi Leblond et. al. Competition-level code generation with AlphaCode. Science, 378(6624):1092-1097, dic. 2022a. doi: 10.1126/science.abq1158. URL https://doi.org/10.1126%2Fscience.abq1158.
Zhiyu Li, Shuai Lu, Daya Guo, Nan Duan, Shailesh Jannu, Grant Jenks, Deep Majumder, Jared Green, Alexey Svyatkovskiy, Shengyu Fu y Neel Sundaresan. Automating code review activities by large-scale pre-training, 2022b.
Percy Liang, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu y Michihiro Yasunaga et. al. Holistic evaluation of language models, 2022.
Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang y Lingming Zhang. Is your code generated by chatgpt really correct? rigorous evaluation of large language models for code generation. arXiv preprint arXiv:2305.01210, 2023a.
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni y Percy Liang. Lost in the middle: How language models use long contexts, 2023b. arXiv:2307.03172.
Shangqing Liu, Yanzhou Li, Xiaofei Xie y Yang Liu. Commitbart: A large pre-trained model for github commits, 2023c.
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei y Hanyu Lai et. al. Agentbench: Evaluating llms as agents, 2023d.
Shuai Lu, Daya Guo, Shuo Ren, Junjie Huang, Alexey Svyatkovskiy y Ambrosio Blanco et. al. Codexglue: A machine learning benchmark dataset for code understanding and generation. CoRR, abs/2102.04664, 2021.
Petros Maniatis, Daniel Tarlow y Google DeepMind. Large sequence models for software development activities, 2023. URL https://blog.research.google/2023/05/large-sequence-models-for-software.html.
Fernando Martinez-Plumed, Pablo Barredo, Seán Ó hEigeartaigh y José Hernández-Orallo. Research community dynamics behind popular ai benchmarks. Nature Machine Intelligence, 3:581-589, 2021. URL https://api.semanticscholar.org/CorpusID:236610014.
Thomas J. McCabe. A complexity measure. IEEE Transactions on Software Engineering, SE-2(4):308-320, 1976. doi: 10.1109/TSE.1976.233837.
Martin Monperrus. Automatic software repair. ACM Computing Surveys, 51(1):1-24, ene. 2018. doi: 10.1145/3105906. URL https://doi.org/10.1145%2F3105906.
Manish Motwani y Yuriy Brun. Better automatic program repair by using bug reports and tests together, 2023.
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra y Shayne Longpre. Octopack: Instruction tuning code large language models, 2023.
Gabriel Orlanski, Kefan Xiao, Xavier Garcia, Jeffrey Hui, Joshua Howland, Jonathan Malmaud, Jacob Austin, Rishabh Singh y Michele Catasta. Measuring the impact of programming language distribution, 2023.
Simon Ott, Adriano Barbosa- Silva, Kathrin Blagec, Janina Brauner y Matthias Samwald. Mapping global dynamics of benchmark creation and saturation in artificial intelligence. Nature Communications, 13, 2022. URL https://api.semanticscholar.org/CorpusID:247318891.
Stephen Robertson, Hugo Zaragoza, et al. The probabilistic relevance framework: Bm25 and beyond. Foundations and Trends® in Information Retrieval, 3(4):333- 389, 2009.
Baptiste Rozière, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat y Xiaoqing Ellen Tan et. al. Code llama: Open foundation models for code, 2023.
David Schlangen. Language tasks and language games: On methodology in current natural language processing research, 2019.
Dominik Sobania, Martin Briesch, Carol Hanna y Justyna Petke. An analysis of the automatic bug fixing performance of chatgpt, 2023.
Aarohi Srivastava, Abhinav Rastogi, Abhishek Rao y Abu Awal Md Shoeb et. al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models, 2023.
Rosalia Tufano, Luca Pascarella, Michele Tufano, Denys Poshyvanyk y Gabriele Bavota. Towards automating code review activities, 2021.
Junjie Wang, Yuchao Huang, Chunyang Chen, Zhe Liu, Song Wang y Qing Wang. Software testing with large language model: Survey, landscape, and vision, 2023.
Chunqiu Steven Xia y Lingming Zhang. Menos entrenamiento, más reparación, por favor: revisitando la reparación automática de programas mediante aprendizaje de cero ejemplos. En Actas de la 30.ª Conferencia Conjunta Europea de Ingeniería de Software de la ACM y Simposio sobre los Fundamentos de la Ingeniería de Software, pp. 959-971, 2022.
Chunqiu Steven Xia y Lingming Zhang. Reparación automática de programas conversacional, 2023.
Chunqiu Steven Xia, Matteo Paltenghi, Jia Le Tian, Michael Pradel y Lingming Zhang. Fuzzing universal mediante grandes modelos de lenguaje. arXiv preprint arXiv:2308.04748, 2023.
John Yang, Akshara Prabhakar, Karthik Narasimhan y Shunyu Yao. Intercode: Estandarización y evaluación comparativa de la codificación interactiva con retroalimentación de ejecución, 2023.
Xin Yang, Raula Gaikovina Kula, Norihiro Yoshida y Hajimu Iida. Minería de los repositorios modernos de revisión de código: Un conjunto de datos de personas, procesos y productos. En Actas de la 13.ª Conferencia Internacional sobre Minería de Repositorios de Software, pp. 460-463, 2016.
Shunyu Yao, Howard Chen, John Yang y Karthik Narasimhan. Webshop: Hacia una interacción web escalable del mundo real con agentes de lenguaje fundamentados, 2022.
Pengcheng Yin, Wen-Ding Li, Kefan Xiao, Abhishek Rao, Yeming Wen, Kensen Shi, Joshua Howland, Paige Bailey, Michele Catasta, Henryk Michalewski, Alex Polozov y Charles Sutton. Generación de código a partir de lenguaje natural en cuadernos interactivos de ciencia de datos, 2022.
Hao Yu, Bo Shen, Dezhi Ran, Jiaxin Zhang, Qi Zhang, Yuchi Ma, Guangtai Liang, Ying Li, Tao Xie y Qianxiang Wang. Codereval: Un punto de referencia de generación pragmática de código con modelos generativos preentrenados, 2023.
Tao Yu, Rui Zhang, Kai Yang, Michihiro Yasunaga, Dongxu Wang, Zifan Li, James Ma, Irene Li, Qingning Yao, Shanelle Roman, Zilin Zhang y Dragomir Radev. Spider: Un conjunto de datos a gran escala etiquetado por humanos para análisis semántico complejo y entre dominios y la tarea de texto a SQL. En Actas de la Conferencia de 2018 sobre Métodos Empíricos en Procesamiento de Lenguaje Natural, pp. 3911-3921, Bruselas, Bélgica, octubre-noviembre de 2018. Association for Computational Linguistics. doi: 10.18653/v1/D18-1425. URL https://aclanthology.org/D18-1425.
Daoguang Zan, Bei Chen, Dejian Yang, Zeqi Lin, Minsu Kim, Bei Guan, Yongji Wang, Weizhu Chen y Jian-Guang Lou. Cert: Preentrenamiento continuo sobre esquemas para la generación de código orientada a bibliotecas, 2022.
Daoguang Zan, Bei Chen, Fengji Zhang, Dianjie Lu, Bingchao Wu, Bei Guan, Yongji Wang y Jian-Guang Lou. Los grandes modelos de lenguaje se encuentran con n1code: Una encuesta, 2023.
Jiyang Zhang, Sheena Panthaplackel, Pengyu Nie, Junyi Jessy Li y Milos Gligoric. Coditt5: Preentrenamiento para código fuente y edición de lenguaje natural, 2022.
Zibin Zheng, Kaiwen Ning, Jiachi Chen, Yanlin Wang, Wenqing Chen, Lianghong Guo y Weicheng Wang. Hacia una comprensión de los grandes modelos de lenguaje en tareas de ingeniería de software. arXiv preprint arXiv:2308.11396, 2023.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Yonatan Bisk, Daniel Fried, Uri Alon y Graham Neubig. Webarena: Un entorno web realista para construir agentes autónomos, 2023.
APÉNDICE
En el apéndice, proporcionamos detalles más exhaustivos sobre el proceso de construcción del conjunto de datos, el pipeline de evaluación y la caracterización del benchmark SWE-bench.
A DETALLES DEL BENCHMARK
Esta sección complementa la Sección 2 con un resumen más técnico y detallado de los procedimientos de recopilación de datos, validación basada en ejecución y evaluación, junto con una caracterización más completa de las instancias de tarea.
A.1 VISIÓN GENERAL DE ALTO NIVEL
Extracción de pull requests. De una lista de las 5.000 bibliotecas de PyPI más descargadas durante agosto de 2023, seleccionamos los 100 paquetes principales, identificamos el repositorio de GitHub de código abierto correspondiente a cada biblioteca, verificamos qué paquetes tienen licencias que permiten el uso libre de software y recopilamos todos los PR de estos repositorios mediante la API para desarrolladores de GitHub. Elegimos obtener problemas de repositorios con mucho tráfico porque el uso generalizado suele sugerir que el repositorio tiene documentación extensa, pautas estructuradas de desarrollo de código abierto y código funcional y bien formateado.
Construcción de instancias de tarea. Construimos instancias de tarea candidatas a partir de PR que satisfacen tres condiciones. Primero, el estado del PR debe ser Merged. Un estado Merged indica que los cambios de código asociados al PR fueron aceptados e incorporados en su repositorio padre. Segundo, el PR resuelve uno o más issues en su repositorio. Un issue se define según su uso canónico en GitHub como un ticket digital para rastrear errores, mejoras o cualquier objetivo general de desarrollo de un proyecto de software. Escaneamos el título, el cuerpo y los mensajes de commit de un PR en busca de issues vinculados (es decir, "fixes #24"). Tercero, el PR debe introducir una o más pruebas nuevas. Una prueba nueva se cuenta cuando los cambios de código de un PR editan una ruta de archivo que contiene una palabra clave relacionada con pruebas (p. ej., "test", "testing").
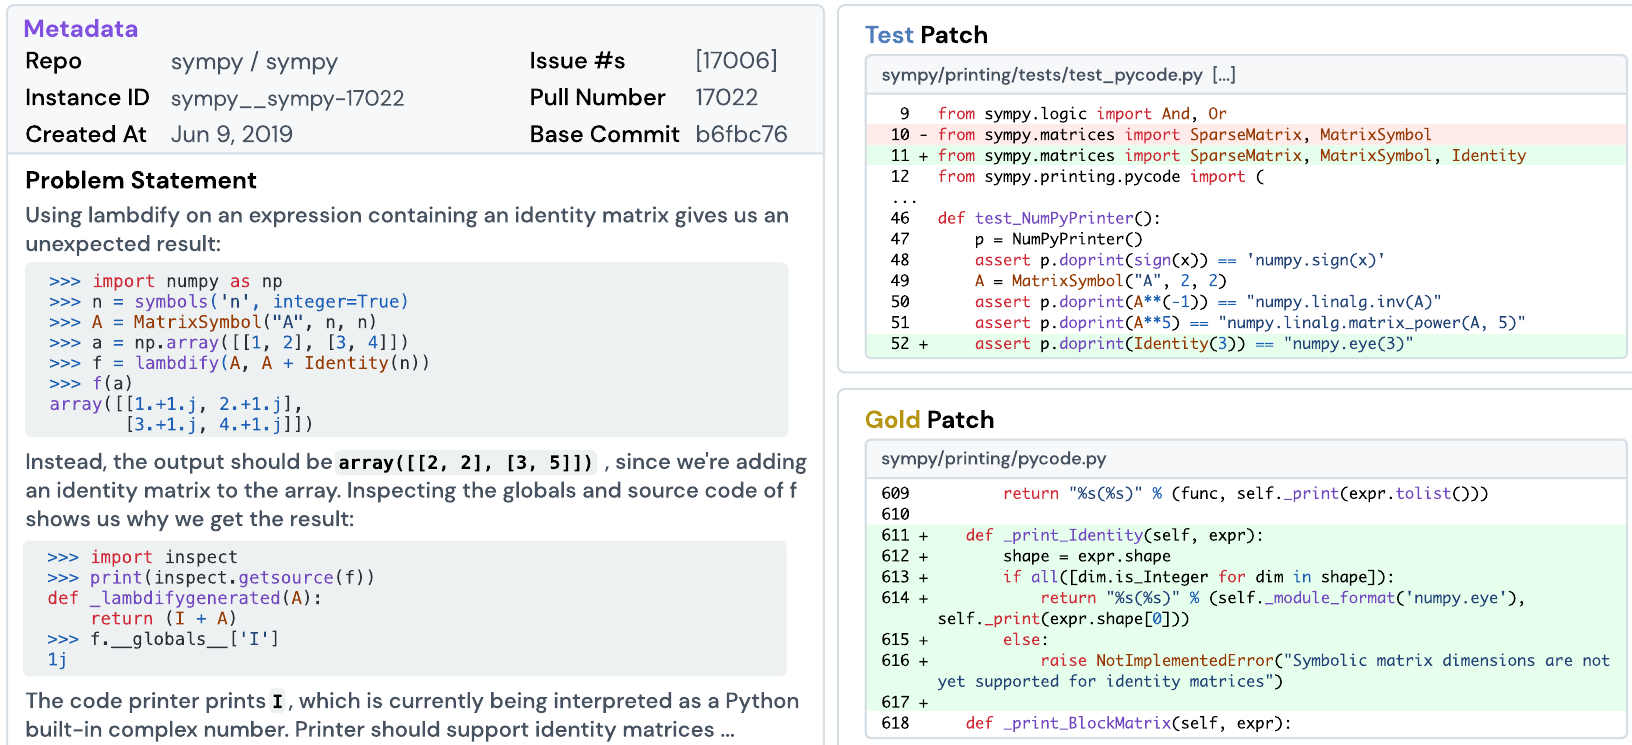
Un PR que satisface estos criterios se convierte entonces en una instancia de tarea candidata como el ejemplo de la Figura 7. El código base se identifica mediante el moniker propietario/nombre del repositorio y el commit base del pull request. Recuperar el código base real a partir de esta información es sencillo. Creamos espejos de los repositorios originales de GitHub, donde cada espejo se identifica de forma única como owner_name. Clonar el espejo correspondiente de un repositorio y hacer checkout del commit base produce en su estado previo al PR. El enunciado del problema es un agregado de los títulos y descripciones de todos los issues relacionados, junto con cualquier comentario posterior escrito antes de la marca temporal del commit inicial del PR para evitar la filtración de detalles de la solución. Los cambios de código de un PR se separan en un parche de prueba y un parche gold . consiste en todas las pruebas de los archivos editados en el parche de prueba. Como se muestra en la Figura 7, tanto como se almacenan como archivos de parche. Más detalles sobre el análisis de PR y datos semánticos se encuentran en el Apéndice A.2.
Validación basada en ejecución. Verificamos la usabilidad de una instancia de tarea mediante ejecución. Para cada candidata, primero definimos un entorno virtual que sirva como contexto de ejecución, luego instalamos antes de aplicar cualquier parche y, finalmente, ejecutamos una vez antes y una vez después de aplicar la solución . Un candidato se elimina de consideración para el conjunto de datos final si falla cualquier paso del proceso de verificación. Además, para asegurar que una solución no sea trivial, comparamos los registros de validación previos y posteriores a la solución para comprobar si hay una o más pruebas en cuyo estado cambia de fallo a éxito. Por último, excluimos las instancias de tarea con pruebas que invocan funciones o clases recién creadas introducidas por primera vez en la solución . Dado que nombrar tales constructos suele ser un proceso arbitrario y normalmente no se especifica explícitamente en el enunciado del problema, resolver pruebas como estas puede ser una tarea imposible incluso para desarrolladores humanos. La información sobre contextos de ejecución, instalación del código base, determinación de estados de prueba a partir de registros y más se encuentra en el Apéndice A.3.
Actualizaciones continuas. El proceso de recopilación de SWE-bench es fácilmente extensible a cualquier repositorio de código abierto, lo que permite una extensión fácil y de bajo mantenimiento a nuevos lenguajes de programación y dominios de código. Este diseño también proporciona a SWE-bench robustez temporal; a medida que se publiquen con el tiempo nuevos modelos de lenguaje entrenados con código fuente más reciente, SWE-bench puede simplemente actualizarse para producir nuevas instancias de tarea basadas en PR creados después de la fecha de entrenamiento de cualquier LM.
A.2 PROCESO DE CONSTRUCCIÓN
Analizamos detalles adicionales sobre la conversión de un objeto pull request en una instancia de tarea candidata. A alto nivel, el objetivo principal de esta conversión es adquirir información relevante para armar el código base , el enunciado del problema , las pruebas unitarias y los componentes de solución presentados en la Sección 2. Con este fin, una instancia de tarea de SWE-bench consta de los siguientes campos, presentados en la siguiente Tabla 9. En conjunto, los campos corresponden a los cuatro módulos de instancia de tarea.
| Campo | Descripción |
| base.commit | (str) El ID del commit sobre el cual se aplica el PR original |
| created.at | (fecha) Objeto datetime de cuándo se creó por primera vez el PR (no fusionado) |
| hints.text | (str) Sugerencias en lenguaje natural sobre cómo resolver el problema |
| instance.id | (str) Un identificador único creado a partir del repositorio y pull_number |
| issue.numbers | (lista) Lista de números de issues que el pull request original resuelve |
| patch | (str) Cadena con estilo de formato .patch que es una solución de referencia al problema, extraída de los cambios de código del PR original |
| problem.statement | (str) Descripción en lenguaje natural del cambio deseado al código base |
| pull.number | (int) El número de pull del pull request original |
| test.patch | (str) Cadena con estilo de formato .patch que contiene pruebas no vistas para verificar si una tarea fue resuelta, extraída de los cambios de código del PR original |
| version | (str) Versión de lanzamiento (con respecto al repositorio) durante la cual se creó el PR |
| repo | (str) El repositorio del cual proviene la instancia de tarea |
| FAIL_TO_PASS | (lista) Lista de pruebas que cambian de estado de fallo a aprobado |
| PASS_TO_PASS | (lista) Lista de pruebas que cambian de estado de aprobado a aprobado |
| env.install.commit | (str) Commit base en el cual instalar las dependencias necesarias para ejecutar la instancia de tarea. |
Enunciado del problema. El enunciado del problema para cada instancia de tarea está fácilmente disponible como el campo problem_statement. El enunciado del problema es un agregado de los primeros comentarios de todos los issues junto con cualquier comentario adjunto a esos issues que se haya creado antes de la fecha de creación del commit inicial del PR. Rastreamos issues a partir del título, el cuerpo y los mensajes de commit del PR. Tras concatenar los datos de texto de estos componentes, primero eliminamos cualquier comentario al estilo Markdown y luego examinamos el texto restante en busca de referencias a números de issue (un signo de almohadilla # seguido de un número) y comprobamos si la palabra que precede a la referencia del número de issue está incluida en un conjunto de palabras clave que sugieren que el PR resolvió el issue (p. ej., "closes", "fixes", "resolves"). Los issues encontrados se registran en los campos issue_number y, a continuación, se realizan solicitudes web separadas para recuperar los datos de cada issue. Para formar el problem_statement, el título y el cuerpo de cada issue se suman y luego se concatenan con los del siguiente issue si hay varios. Es también durante este paso cuando se crea y recopila el campo hints_text a partir de la sección de comentarios del PR, donde se toma el texto de los comentarios creados antes del commit inicial del PR. La intuición detrás de esta metodología de recopilación es que tales comentarios del PR probablemente contendrían lenguaje natural y sugerencias de pseudocódigo para el trabajador humano original de la tarea sobre cómo completar el problema en cuestión. Los experimentos presentados en este trabajo no hacen uso de hints_text, pero creemos que esta información puede ser interesante para investigaciones futuras.
Base de código. El contenido de la base de código no se almacena en texto plano para cada instancia de tarea. En su lugar, la instancia de tarea contiene una referencia a la base de código relevante mediante los campos repo y base_commit. Ambos campos están disponibles en los datos del PR original. Para hacer que la recuperación de la base de código a partir de estos dos elementos sea reproducible y fiable, creamos réplicas del repositorio original. Las réplicas del repositorio que constituye tanto los datos de evaluación como los de ajuste fino se recopilan y se publican como código abierto bajo la organización de GitHub SWE-bench. Dado que el código de un repositorio original puede estar sujeto a cambios en su historial de commits y ediciones fuera del control de los autores, optamos por crear un repositorio réplica para garantizar que modificaciones posteriores a la base de código no puedan potencialmente dejar inutilizable una instancia de tarea debido a una corrupción o eliminación del base_commit asociado. Además, creamos una réplica en lugar de clonar y almacenar la última versión de un repositorio. Esto se debe a que una réplica conserva los hashes de commit, el historial, las ramas y las etiquetas originales, sirviendo como un historial fiel y completo de los detalles técnicos del repositorio original. Una réplica no conserva las estrellas, los observadores, los issues ni las pull requests del repositorio original.
Creamos una réplica de un repositorio después y dentro del mismo día en que se recopilaron las instancias de tarea. La réplica conserva el moniker "owner/name" del repositorio original, excepto que el carácter "/" se convierte en "_" para ajustarse a las convenciones de nomenclatura de GitHub. Dada esta infraestructura, recuperar la base de código de una instancia de tarea es sencillo. Primero, la réplica correcta puede clonarse desde la organización SWE-bench usando repo. A continuación, dentro de la copia local de la réplica, hacer checkout del base_commit restablecerá el repositorio a la base de código . Para pasar a otra instancia de tarea del mismo repositorio, se utiliza el control de versiones git para eliminar automáticamente cualquier modificación asociada con la instancia de tarea actual antes de hacer checkout del commit base de la siguiente instancia de tarea.
Solución, parches de prueba. La solución y las pruebas se derivan de los datos de cambios de archivo, o diff, de un PR. Como se mencionó en la Sección 2.1, el diff original junto con la solución y las pruebas se representan como un archivo .patch, un formato para especificar de manera eficiente transformaciones a archivos de texto basados en líneas. En términos generales, un .patch está estructurado como una lista de bloques, donde cada bloque consta de una cabecera y uno o más hunks que en conjunto corresponden a cambios en un solo archivo. La cabecera contiene metadatos que especifican una ruta de archivo y números de línea, mientras que las modificaciones reales al archivo objetivo se codifican como múltiples líneas prefijadas con "+" y "-" para indicar adiciones y eliminaciones. Para crear las pruebas , primero identificamos cada bloque único dentro del parche, luego seleccionamos y conglomeramos los bloques con rutas de archivo que contienen palabras clave relacionadas con pruebas (p. ej., "tests", "testing"). Los bloques restantes se fusionan para formar la solución . Validamos la robustez del script escrito para analizar correctamente y aplicando ambos parches al código base correspondiente y ejecutando las pruebas; luego verificamos que los resultados reproduzcan el comportamiento de los datos de diff del PR base. La solución se guarda como el campo patch mientras que las pruebas se guardan como el campo test_patch.
Campos restantes. El campo created_at es una marca de tiempo que especifica cuándo se creó el PR base. Conservamos el campo created_at de los datos originales y usamos este campo para realizar un análisis temporal del rendimiento del modelo. El campo version es una cadena que corresponde a la versión de lanzamiento, con respecto al repositorio, durante la cual se publicó el PR. Dependiendo de la disponibilidad y la cantidad de esfuerzo requerido para cada método, creamos el campo version recuperando la información directamente del código fuente, construyendo el repositorio localmente e invocando código para mostrar la versión en la salida estándar, o comparando el campo created_at con una línea de tiempo de versiones de lanzamiento de la página web de un repositorio. Creamos contextos ejecutables para cada versión de un repositorio, como se discute con mayor detalle en § A.3.
Documentación para crear un repositorio espejo usando GitHub
A.3 VALIDACIÓN BASADA EN EJECUCIÓN
Después de filtrar todos los PRs de un repositorio y convertir aquellos que satisfacen los criterios antes mencionados en instancias de tarea candidatas, el siguiente paso es validar la usabilidad de cada instancia de tarea mediante ejecución. Este procedimiento se desglosa en tres pasos. Primero, creamos contextos ejecutables para cada versión de lanzamiento de un repositorio. A continuación, verificamos si la solución y las pruebas pueden aplicarse, instalarse y ejecutarse con éxito sobre el código base . Finalmente, examinamos el registro de ejecución de cada instancia de tarea para verificar un conjunto específico de comportamientos que aseguren que la tarea sea usable y justa para la evaluación del modelo.
Contextos ejecutables. Elegimos crear contextos ejecutables por versión de lanzamiento después de experimentar con varios grados de granularidad con respecto a qué nivel de definición definir los entornos virtuales. Definir contextos específicos por instancia de tarea es lo más propicio para asegurar el éxito de la instalación de extremo a extremo, pero tiene el costo de una laboriosa elaboración manual. Por otro lado, un contexto específico por repositorio basado en la última versión de un repositorio suele ser una definición demasiado gruesa que no es compatible con los requisitos de versiones anteriores. Encontramos que las versiones de lanzamiento son un buen proxy para capturar los requisitos de dependencias a través de un subconjunto de instancias de tarea, logrando un equilibrio manejable entre el éxito de la instalación y el esfuerzo manual. Creamos manualmente cada contexto ejecutable examinando el código base de la última instancia de tarea para cada versión. Basándonos en el código fuente y la documentación que suele encontrarse en el README y las guías CONTRIBUTING del repositorio, averiguamos la versión de Python, las dependencias necesarias y el comando de instalación.
Motor de validación. El propósito del motor de validación es verificar las instancias de tarea candidatas. Específicamente, este paso verifica primero que la solución y las pruebas puedan aplicarse al código base , y segundo, que el código base pueda instalarse y ejecutarse correctamente dentro del entorno virtual correspondiente. Para ello, realizamos la validación repositorio por repositorio, donde para cada conjunto de instancias de tarea de un repositorio, realizamos el siguiente procedimiento:
1. Crear contextos ejecutables como entornos conda basados en la última instancia de tarea por versión.
2. Agrupar las instancias de tarea por versión.
3. Iterar a través de cada grupo de instancias de tarea, donde para cada instancia de tarea, realizamos lo siguiente dentro del entorno conda correspondiente.
(a) Eliminar cualquier cambio de archivo y hacer checkout del base_commit de la instancia de tarea. Esto establece el repositorio en el código base
(b) Ejecutar el comando de instalación para instanciar el código base
(c) Aplicar el parche de prueba al código base
(d) Ejecutar el script de pruebas, determinado a partir del parche de prueba , para generar los registros de resultados de pruebas
(e) Aplicar el parche de la solución al código base con las pruebas
(f) Ejecutar el script de pruebas de la parte (d) nuevamente para generar los registros de resultados de pruebas
El comando de pruebas consiste en el framework de pruebas utilizado por el repositorio (p. ej., pytest, tox) con las rutas especificadas en añadidas. El comando de pruebas ejecutaría todas y cada una de las pruebas especificadas dentro del contenido de cada ruta de archivo. Si cualquiera de los pasos a falla, la instancia de tarea candidata se descarta de consideración. Con una variación moderada entre repositorios, observamos que este paso generalmente elimina la mitad de las instancias de tarea candidatas.
Examen de los registros de validación. Por último, pero no menos importante, verificamos los registros y creados por el motor de validación en busca de propiedades específicas. Primero, para protegernos contra elecciones arbitrarias de nombres, verificamos en busca de ocurrencias de ImportError y AttributeError, que son potencialmente indicativas de errores relacionados con el nombrado de dependencias que serían triviales y casi imposibles de abordar correctamente. Con este fin, eliminamos de consideración todas las instancias de tarea con tales errores en su . A continuación, comparamos los resultados de las pruebas para verificar que la instancia de tarea no sea trivial, indicado por al menos una o más pruebas que tienen un estado de fallo antes de que se aplique la solución , y luego un estado de aprobación después. Para verificar esto, primero definimos varios analizadores específicos por repositorio para convertir y en asignaciones de la prueba a un estado . Dadas estas dos estructuras de datos, verificamos entonces que
| Repo | PR totales rastreados | Post-conversión | Post-validación (final) |
| astropy | 9.469 | 1.016 | 95 |
| django | 16.914 | 2.880 | 850 |
| flask | 2.434 | 107 | 11 |
| matplotlib | 16.545 | 1.057 | 184 |
| pylint | 3.848 | 787 | 57 |
| pytest | 5.147 | 750 | 119 |
| requests | 2.344 | 84 | 44 |
| scikit-learn | 15.159 | 1.169 | 229 |
| seaborn | 1.004 | 203 | 22 |
| sphinx | 4.931 | 645 | 187 |
| sympy | 11.928 | 1.897 | 386 |
| xarray | 3.416 | 812 | 110 |
| Total | 93.139 | 11.407 | 2.294 |
existe al menos un donde cambia de fail a pass. Si no se encuentran tales pruebas, la instancia de tarea se elimina de consideración.
Si una instancia de tarea cumple estos dos criterios, entonces se incluye en el conjunto de datos de evaluación. La Tabla 10 muestra un resumen de cuántas instancias de tarea se eliminaron de consideración a lo largo del proceso de construcción y los pasos de validación basados en ejecución. Guardamos todas las instancias de tarea finalizadas en un único archivo .json que es de código abierto y está disponible para su descarga.
Junto con las instancias de tarea, también creamos una carpeta correspondiente que contiene los resultados de pruebas de referencia (ground truth). Para cada instancia de tarea, a partir de sus respectivas asignaciones de prueba-a-estado y , creamos una estructura de datos de resultados de pruebas donde las claves son FAIL_TO_FAIL, FAIL_TO_PASS, PASS_TO_FAIL y PASS_TO_PASS, y los valores son listas de pruebas. Al "almacenar en caché" estos resultados, eliminamos la necesidad de volver a ejecutar la solución en el momento de la evaluación (aunque volver a ejecutar es una opción disponible). Usamos esta estructura de datos para verificar la finalización de la tarea, como se discute en la Sección A.4.
A.4 PROCEDIMIENTO DE EVALUACIÓN
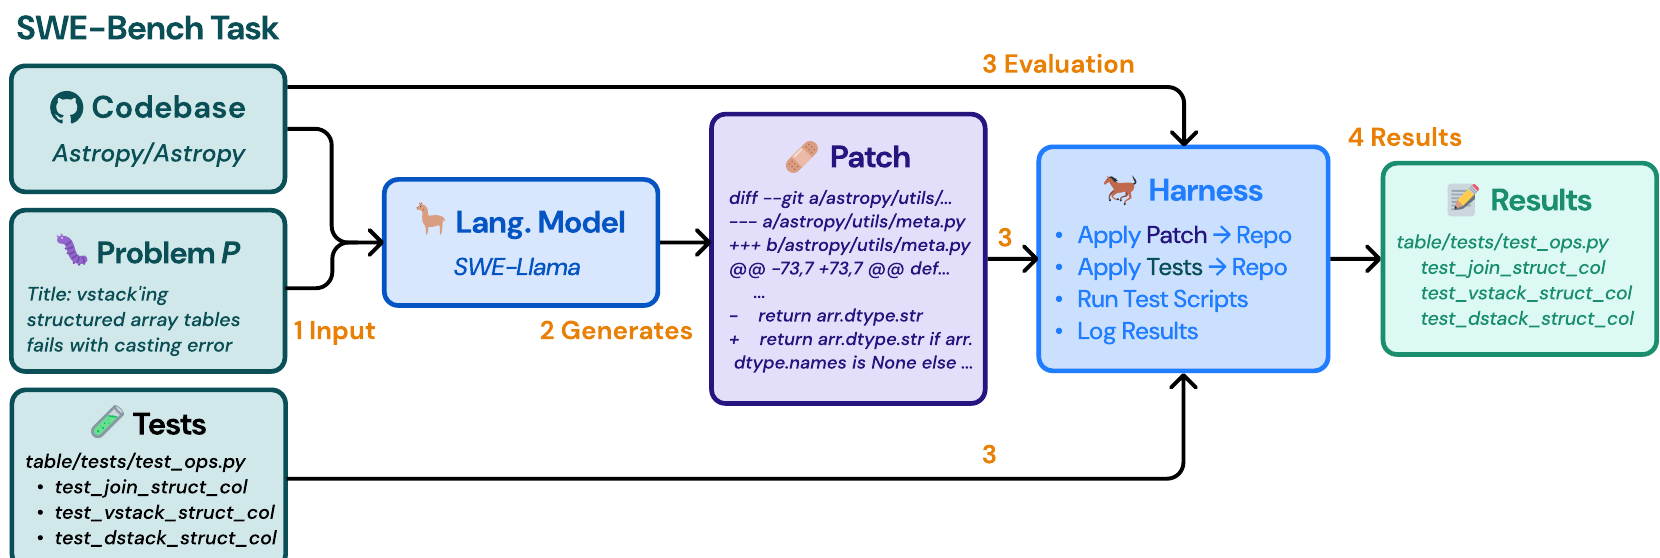
Proporcionamos una visualización del procedimiento de evaluación en la Figura 8. El procedimiento de evaluación puntúa la generación de .patch del modelo con respecto al comportamiento de la solución . A un nivel más fino, el procedimiento de evaluación se puede desglosar en cuatro pasos separados, resaltados por los pasos numerados en la Figura 8. Primero, el código base y el enunciado del problema son visibles y se proporcionan al LM; el LM luego genera una predicción de .patch . En el paso de evaluación, los siguientes pasos se realizan por predicción en la instancia de tarea objetivo:
1. Eliminar cualquier cambio en los archivos y hacer checkout del commit base de la instancia de tarea. Esto establece el repositorio al codebase .
2. Activar el contexto ejecutable correspondiente a la versión de la instancia de tarea.
3. Ejecutar el comando de instalación para instanciar el codebase .
4. Aplicar el parche de prueba al codebase .
5. Aplicar el parche de predicción al codebase con las pruebas .
6. Si el paso anterior falla, intentamos corregir el parche de predicción automáticamente y volver a aplicarlo.
7. Ejecutar el script de prueba, determinado a partir del parche de prueba , para generar los registros de resultados de prueba .
Los pasos 1 a 4 de manera confiable no fallan debido a la verificación durante el proceso de validación de la instancia de tarea. Si la aplicación del parche de predicción (Paso 5) falla, intentamos reparar el archivo del parche de predicción eliminando líneas de contexto innecesarias y recalculando los valores de encabezado (Paso 6). Si el parche restante falla nuevamente o la ejecución del comando de prueba (Paso 7) falla, entonces a la predicción se le asigna automáticamente una puntuación de 0. Suponiendo que estos pasos tienen éxito, el registro de salida puede entonces convertirse en un mapeo de test- to- status, idéntico en estructura al mediante el analizador apropiado y específico del repositorio introducido en § A.3.
Cálculo de métricas de evaluación. Para determinar la finalización de la tarea, comparamos el mapeo de test- to- status analizado a partir de con la lista de pruebas correspondientes a las claves FAIL- TO- PASS y PASS- TO- PASS de la estructura de datos de resultados de prueba de referencia. Determinar la finalización de la tarea es sencillo; verificamos que todas las pruebas FAIL- TO- PASS y PASS- TO- PASS se encuentren y tengan un estado de aprobación en el mapeo de test- to- status de evaluación. Si una prueba falta o tiene un estado no aprobado, se considera un estado de fallo. Tal como se define y se usa en el artículo principal, una tarea se considera resuelta si todas las pruebas de FAIL- TO- PASS y PASS- TO- PASS pasan.
A.5 CARACTERIZACIÓN DEL CONJUNTO DE PRUEBAS DE EVALUACIÓN
Incluimos una forma ampliada de la Tabla 1 que incluye estadísticas específicas del repositorio en la Tabla 11. La Tabla 12 presenta una breve descripción de cada repositorio extraída de la documentación del repositorio junto con la licencia de código abierto asociada al repositorio. Las licencias asociadas permiten todas el uso no comercial del código fuente original de la biblioteca siempre que se respeten y conserven los permisos de las licencias originales. Además de las estadísticas originales presentadas en la Tabla 1, introducimos tres nuevos valores. Lines Added y Lines Removed juntos suman Lines Edited. "Added" se refiere al número de líneas nuevas que se introducen, mientras que "Removed" son líneas preexistentes eliminadas por la solución. La estadística (Pass to Pass) se refiere al número de pruebas que pasaban antes de que la solución se aplicara durante el pipeline de validación. A diferencia de las pruebas fail to pass, que tienen como objetivo caracterizar el enunciado del problema y determinar si una revisión aborda el problema, las pruebas pass to pass se incluyen para garantizar que la revisión no rompa ni viole ningún comportamiento esperado existente. Estas pruebas se extraen durante la fase de examen del registro de validación, como se analiza en § A.3. Observamos que las pruebas fail to fail y pass to fail no se consideran durante la evaluación, y esas estadísticas no se reflejan en la tabla anterior.
Categorías de problemas de las instancias de tarea. Para proporcionar una mejor idea de los tipos de problemas que incluyen las instancias de tarea de SWE- bench, realizamos análisis simples sobre los issues, identificados por el campo issue_numbers, para cada instancia de tarea. Por issue, inspeccionamos los metadatos, específicamente las etiquetas, para caracterizar el tipo de contribución propuesta por el PR. La Tabla 13 agrupa y muestra varios ejemplos de las 2,289 etiquetas que encontramos en todos los issues. Si bien la mayoría absoluta de los issues están asociados con correcciones de errores, las instancias de tarea de SWE- bench están asociadas con un conjunto diverso de cambios de código con propósitos más allá de la depuración y la corrección de errores.
Distribuciones de atributos. En la Figura 9, presentamos gráficas de la función de distribución acumulada para los atributos introducidos en la Tabla 1. A partir de estas gráficas, observamos que la instancia de tarea mediana de SWE-bench tiene una descripción del problema de 140 palabras, y tendrá lugar dentro de una base de código que contiene poco menos de 1900 archivos y 400K líneas. La solución de referencia correspondiente normalmente editará una sola función
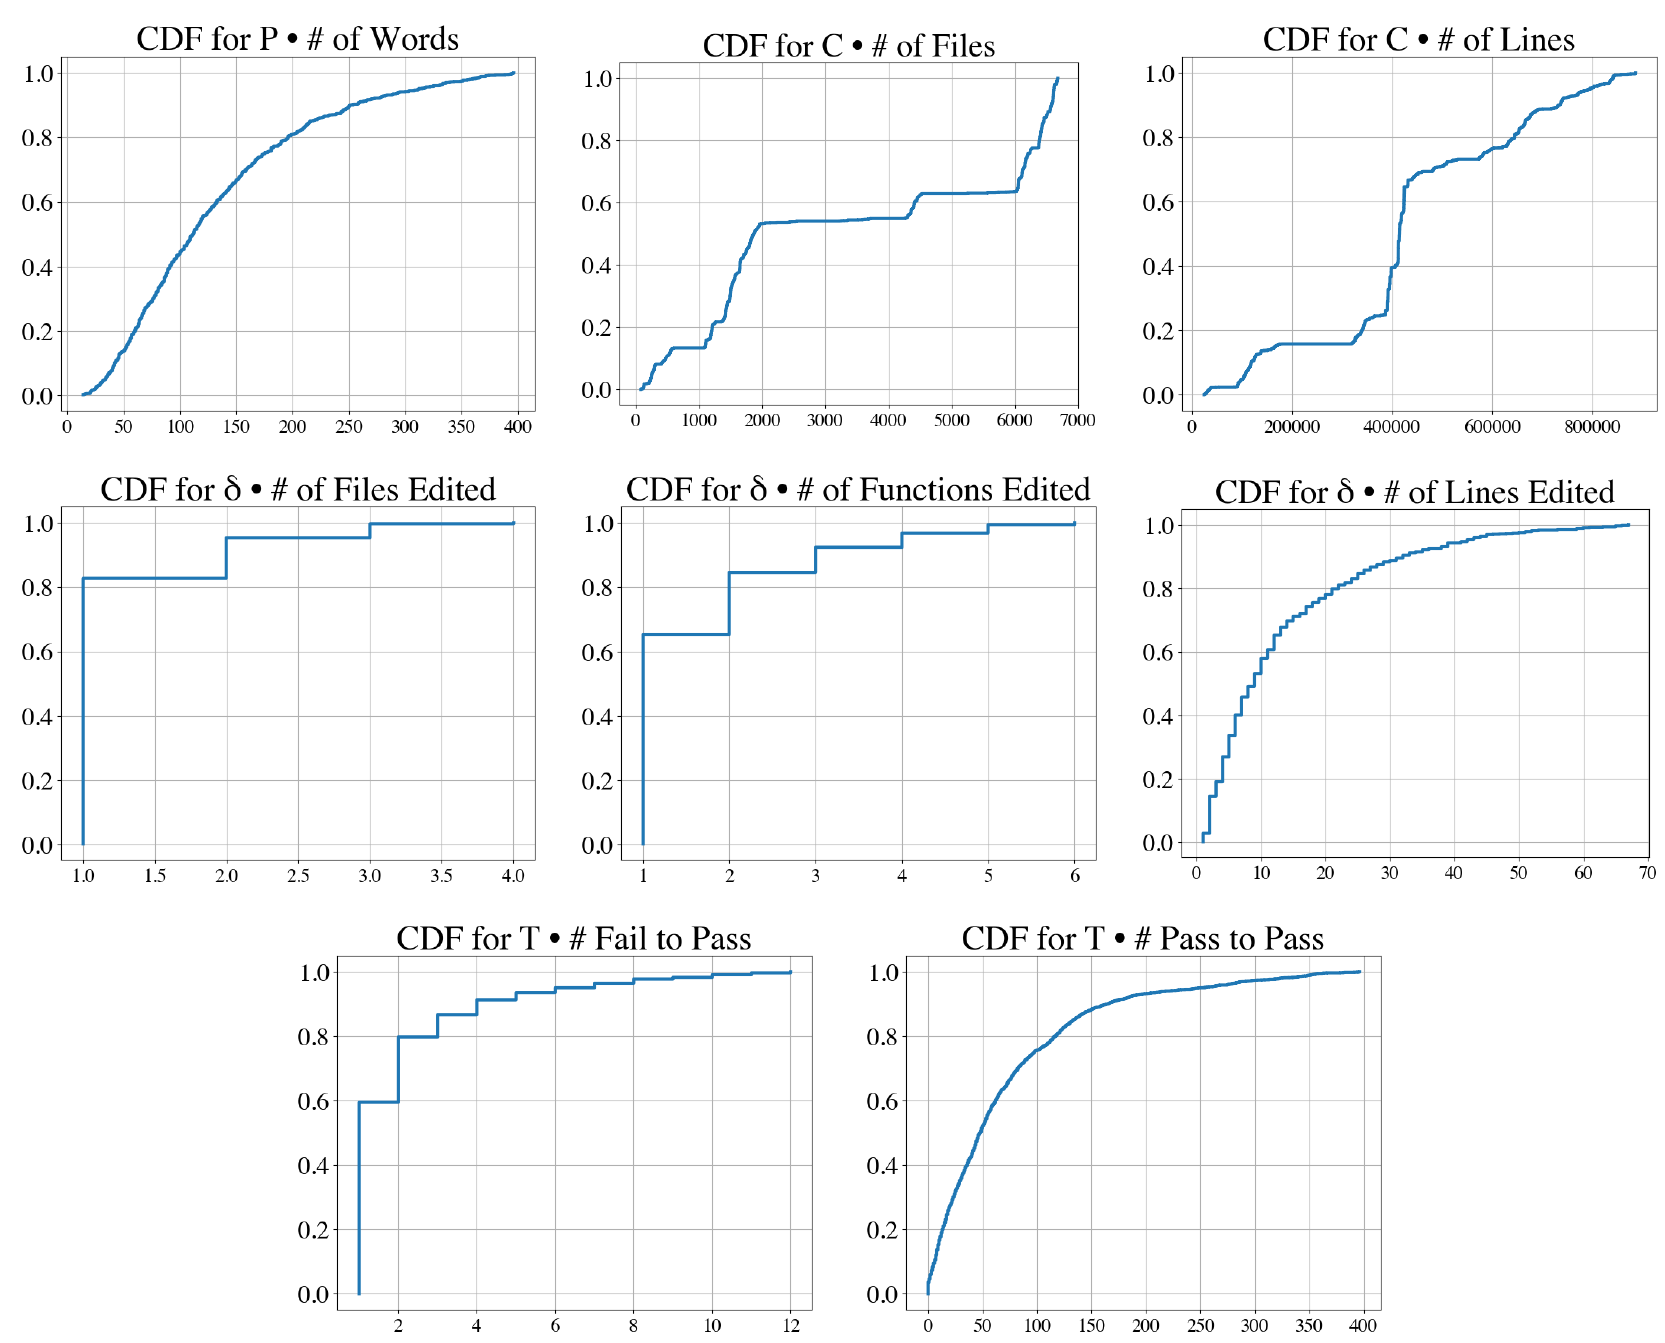
| astropy | django | flask | matplotlib | pylint | pytest | |
| Longitud de P (caracteres) | 2.742 | 1.307 | 1.185 | 2.381 | 2.011 | 2.948 |
| Cantidad de C # Archivos | 1.811 | 6.356 | 225 | 4.395 | 2.426 | 497 |
| Cantidad de C # Líneas | 804k | 407k | 35k | 646k | 109k | 111k |
| δ Cantidad de archivos editados | 1,5 | 1,5 | 1,6 | 1,5 | 1,8 | 1,4 |
| δ Cantidad de funciones editadas | 2,5 | 2,0 | 2,4 | 2,2 | 1,8 | 1,7 |
| δ Cantidad de líneas editadas | 36,0 | 18,5 | 35,4 | 58,9 | 36,0 | 24,5 |
| δ Cantidad de líneas añadidas | 25,0 | 12,8 | 23,7 | 35,7 | 26,6 | 18,2 |
| δ Cantidad de líneas eliminadas | 10,9 | 5,7 | 11,6 | 23,2 | 9,5 | 6,4 |
| |T| (fallo a aprobación) | 21,7 | 8,8 | 1,4 | 2,4 | 6,8 | 4,1 |
| |T| (Aprobado a aprobado) | 191,0 | 85,9 | 32,5 | 242,4 | 47,0 | 60,7 |
| |T| (Todos) | 212,8 | 94,6 | 33,9 | 244,8 | 53,7 | 64,8 |
| solicitudes | scikit-learn | seaborn | sphinx | sympy | xarray | |
| Longitud de P (caracteres) | 1.654 | 2.239 | 1.667 | 1.888 | 1.213 | 3.515 |
| Cantidad de archivos en C | 119 | 1.224 | 273 | 1.483 | 1.666 | 260 |
| Cantidad de líneas en C | 30k | 361k | 105k | 423k | 678k | 137k |
| Cantidad de archivos editados por δ | 1,64 | 1,68 | 1,77 | 1,51 | 1,9 | 2,45 |
| Cantidad de funciones editadas por δ | 1,59 | 2,24 | 1,41 | 2,72 | 3,22 | 3,16 |
| Cantidad de líneas editadas por δ | 25,5 | 44,0 | 30,1 | 30,6 | 36,3 | 124,8 |
| δ n.º de líneas añadidas | 19,2 | 32,7 | 24,9 | 22,0 | 24,2 | 95,6 |
| δ n.º de líneas eliminadas | 6,2 | 11,3 | 5,2 | 8,6 | 12,1 | 29,2 |
| |T| (fallo a aprobación) | 7,6 | 7,5 | 12,9 | 2,3 | 2,2 | 58,5 |
| |T| (aprobación a aprobación) | 87,1 | 150,7 | 86,8 | 45,1 | 74,5 | 297,5 |
| |T| (todas) | 94,7 | 158,2 | 99,7 | 47,4 | 76,8 | 356,1 |
| Repositorio | Resumen | Licencia |
| astropy/astropy | Biblioteca central de astronomía y astrofísica | BSD 3-Clause |
| django/django | Framework web para crear aplicaciones web | BSD 3-Clause |
| pallets/flask | Framework ligero para pequeñas aplicaciones web | BSD 3-Clause |
| matplotlib/matplotlib | Biblioteca de trazado para crear visualizaciones | Personalizada |
| pylint-dev/pylint | Analizador estático de código para Python 2 o 3 | GPL 2.0 |
| pytest-dev/pytest | Framework de pruebas para Python | MIT |
| psf/requests | Biblioteca simple y elegante para escribir solicitudes HTTP | Apache-2.0 |
| scikit-learn/scikit-learn | Aprendizaje automático en Python | BSD 3-Clause |
| mwaskom/seaborn | Visualización de datos estadísticos en Python | BSD 3-Clause |
| sphinx-doc/sphinx | Biblioteca para crear documentación | Personalizada |
| sympy/sympy | Sistema de álgebra computacional escrito en Python | Personalizada |
| pydata/xarray | Arreglos y conjuntos de datos etiquetados N-D | Apache-2.0 |
dentro de un archivo, cambiando líneas, y tiene una única prueba de fallo a aprobación para verificar la corrección del cambio, junto con 51 pruebas de aprobación a aprobación para comprobar si se preserva el comportamiento existente.
Tasa de corrección de parches. Presentamos la Tabla 14, que presenta estadísticas resumidas de cuántas instancias de tarea generaron parches para cada modelo (de 2294), cuántos de estos parches se aplicaron con éxito y cuántos de los parches aplicados con éxito requirieron someterse al procedimiento de corrección de parches introducido en el Apéndice A.4. Encontramos que los parches corregidos tienden a constituir un porcentaje menor de los parches de SWE-Llama que se aplicaron con éxito, lo que sugiere que el procedimiento de ajuste fino de SWE-Llama tiene un efecto positivo en la generación de parches bien formateados. Para los modelos de código cerrado, se aplican con éxito menos parches y, de los que sí se aplican, un mayor porcentaje requiere la corrección posterior a la generación, lo que sugiere que los modelos todavía tienen dificultades con la generación de parches y las salidas estructuradas en general.
| Categoría | Recuento | Ejemplos |
| Error | 442 | «Bug» (179); «type:bug» (114); «bug» (57); «type: bug» (48); «Bug:beetle:» (23); «status: confirmed bug» (20); |
| Funcionalidad | 167 | «type:enhancement» (47); «Enhancement» (25); «New feature» (24); «Feature Request» (22); «type: enhancement» (19); «Enhancement:star:» (15); «New Feature» (7); «enhancement» (6); «type: regression» (14); «Regression» (14); «regression» (8); «help wanted» (71); «good first issue» (66); «printing» (58); «extensions:autodoc» (58); «Easy» (57); «Easy to Fix» (54); «domains:py» (27); «core» (26); «sets» (23); «Wrong Result» (23); «units» (22); «Good first issue» (21); |
| Modelo | Configuración de recuperación | Generaciones | Aplicaciones | Corregidos | % de corrección de parches |
| ChatGPT-3.5 | BM25 13k | 2.270 | 604 | 363 | 60,1% |
| ChatGPT-3.5 | “Oracle” | 1.262 | 500 | 222 | 44,4% |
| ChatGPT-3.5 | “Oracle”-collapsed | 1.811 | 939 | 420 | 44,73% |
| Claude 2 | BM25 13k | 2.281 | 988 | 302 | 30,57% |
| Claude 2 | “Oracle” | 2.138 | 1.441 | 360 | 24,98% |
| Claude 2 | “Oracle”-collapsed | 2.242 | 1.564 | 465 | 29,73% |
| GPT-4 | BM25 27k | 573 | 85 | 59 | 69,41% |
| GPT-4 | “Oracle” | 462 | 195 | 121 | 62,05% |
| GPT-4 | “Oracle”-collapsed | 2.292 | 1.116 | 684 | 61,29% |
| SWE-Llama 13b | BM25 13k | 2.010 | 1.230 | 369 | 30,0% |
| SWE-Llama 13b | «Oracle» | 2.125 | 1.532 | 378 | 24,67% |
| SWE-Llama 7b | BM25 13k | 2.139 | 1.187 | 340 | 28,64% |
| SWE-Llama 7b | «Oracle» | 2.119 | 1.503 | 298 | 19,83% |
A.6 CARACTERIZACIÓN DEL CONJUNTO DE DESARROLLO
Además del conjunto de pruebas de evaluación, también proporcionamos un conjunto de desarrollo para evaluar modelos y ajustar hiperparámetros antes de ejecutar sobre el conjunto de pruebas final. Siguiendo el estilo de las tablas y gráficas anteriores, presentamos estadísticas similares para caracterizar las 225 instancias de tarea de desarrollo (ligeramente más del del conjunto de evaluación principal) recopiladas de 6 repositorios de código abierto con licencias que permiten dicho uso. El conjunto de desarrollo se recopiló siguiendo exactamente el mismo conjunto de metodologías y filtros que el conjunto de evaluación principal. Además de los pasos preexistentes, también filtramos el conjunto de desarrollo para conservar las instancias de tarea que fueron creadas después del 1 de enero de 2019. De manera similar a la Tabla 12, en la Tabla 15 resumimos brevemente el propósito y las licencias de los 6 repositorios seleccionados.
Siguiendo la Tabla 13, también enumeramos las etiquetas asociadas con las tareas del conjunto de desarrollo en la Tabla 16, mostrando nuevamente la diversidad y cobertura de tipos de tareas más allá de la corrección de errores. En comparación con las tareas de evaluación principal, también podemos ver etiquetas (p. ej., “Crash :collision:”, “io”) que se refieren a problemas que presentan dificultades únicas de los repositorios en el conjunto de desarrollo.
Siguiendo la Tabla 1, presentamos el mismo conjunto de estadísticas promedio específicas por repositorio para los 6 repositorios en el conjunto de desarrollo en la Tabla 17. En todo el conjunto de desarrollo, cada instancia de tarea tiene 19.9 pruebas F2P en promedio / 2 en mediana. Hay 171.3 pruebas P2P en promedio / 79.0 en mediana, y 191.2 pruebas en total en promedio / 101.0 en mediana por instancia de tarea.
| Repositorio | Resumen | Recuento | Licencia |
marshmallow-code/ marshmallowpylint-dev/astroidpydicom/pydicompvlib/pvlib-pythonpyvista/pyvistasqlfluff/sqlfluff | Analizar objetos complejos hacia/desde tipos de datos de PythonBiblioteca para análisis de AST, análisis estático/inferenciaLeer/modificar/escribir archivos DICOM con PythonSimular el rendimiento de sistemas de energía fotovoltaicaTrazado 3D, análisis de mallas mediante interfazLinter de SQL, admite múltiples dialectos, plantillas | 93156631650 | MITLGPL-2.1PersonalizadoPersonalizadoMITMIT |
| Categoría | Recuento | Ejemplos |
| Error | 127 | "bug"(111); "Bug :cookreach:"(10); "rule bug"(6); |
| Funcionalidad | 55 | "enhancement": 46; "Enhancement :star:" 5; "feature-request": 2; |
| Regresión | 4 | "Regression"(4); |
| Otro | 95 | "api": 11, "documentation": 7, "help wanted": 6, "config options": 5, "io": 5, "jinja": 4, "good first issue": 4, "parser" 3 |
A.7 CARACTERIZACIÓN DE SWE-BENCH LITE
SWE-bench Lite es un subconjunto canónico para una evaluación más eficiente de modelos de lenguaje en la tarea SWE-bench. SWE-bench es
B DETALLES ADICIONALES SOBRE EL ENTRENAMIENTO DE SWE-LLAMA
B.1 DETALLES DE ENTRENAMIENTO
Optimización. Realizamos ajuste fino usando LoRA (Hu et al., 2022) con , , dropout en las matrices de proyección de query, key, value y output de cada subcapa de atención. Entrenamos con una tasa de aprendizaje de y un tamaño de lote de 32 secuencias por paso de gradiente durante un máximo de 4 épocas. Durante el entrenamiento, guardamos checkpoints cada 50 pasos y, después del entrenamiento, seleccionamos el mejor checkpoint según la pérdida de validación en 100 instancias reservadas. SWE-Llama 7b se inicializó con CodeLlama-Python 7b y se entrenó en 20 horas en 4 NVIDIA A100s. SWE-Llama 13b se inicializó con CodeLlama-Python 13b y se entrenó en 47 horas en 8 NVIDIA A100s. Usamos DeepSpeed Ulysses (Jacobs et al., 2023) y Flash Attention (Dao et al., 2022) para permitir el entrenamiento con contexto largo.
C RESULTADOS ADICIONALES
C.1 RESULTADOS CON RECUPERACIÓN “ORACLE”
Usando el método de recuperación “oracle” descrito en la Sección 4.1, mostramos los resultados generales de rendimiento en la Tabla 18. Naturalmente, al proporcionar solo los archivos editados por el pull request de la solución de referencia, el rendimiento del modelo mejora en comparación con la configuración de recuperación BM25 más ruidosa.
C.2 CONJUNTO DE PRUEBAS DE EVALUACIÓN
Incluimos un desglose por repositorio del rendimiento del modelo en la Tabla 19 que corresponde a la Figura 4 del artículo principal. Como se discutió en el artículo principal, el rendimiento difiere enormemente entre repositorios.
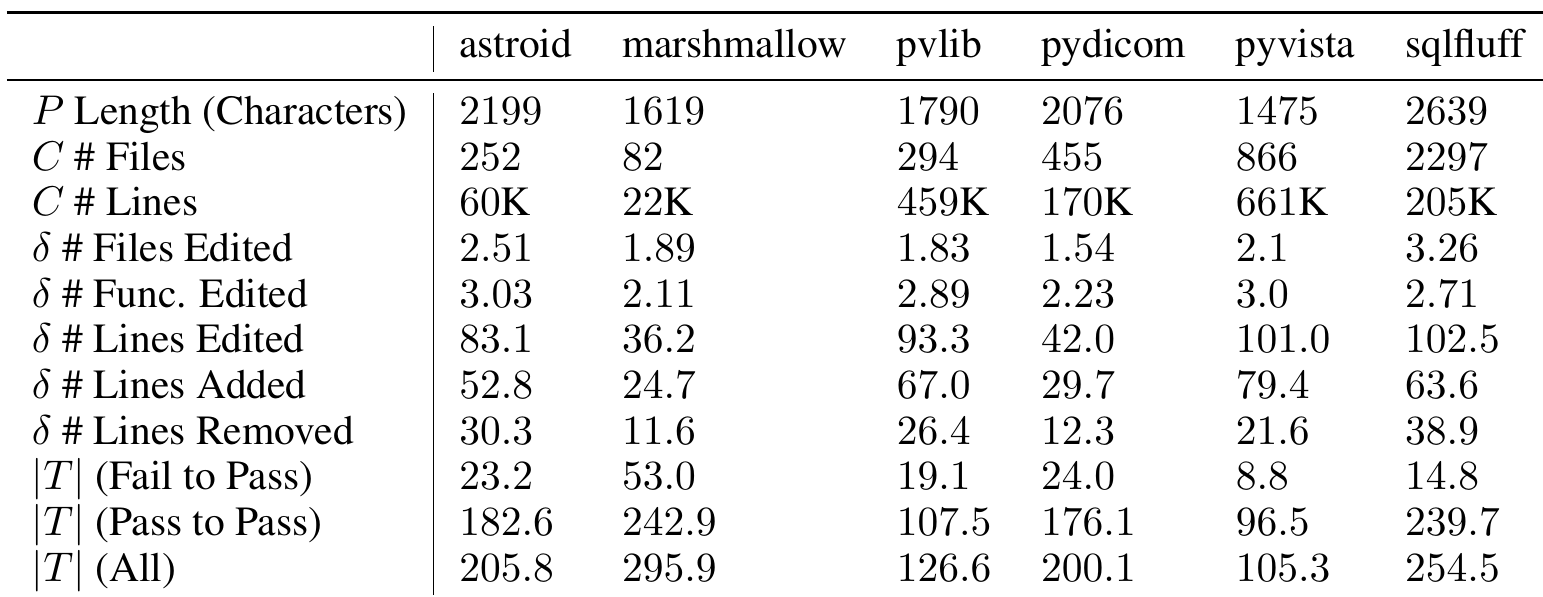
| astroid | marshmallow | pvlib | pydicom | pyvista | sqlfluff | |
| P Longitud (caracteres) | 2199 | 1619 | 1790 | 2076 | 1475 | 2639 |
| C # Archivos | 252 | 82 | 294 | 455 | 866 | 2297 |
| C # Líneas | 60K | 22K | 459K | 170K | 661K | 205K |
| δ # Archivos editados | 2.51 | 1.89 | 1.83 | 1.54 | 2.1 | 3.26 |
| δ # Func. editadas | 3.03 | 2.11 | 2.89 | 2.23 | 3.0 | 2.71 |
| δ # Líneas editadas | 83.1 | 36.2 | 93.3 | 42.0 | 101.0 | 102.5 |
| δ # Líneas añadidas | 52.8 | 24.7 | 67.0 | 29.7 | 79.4 | 63.6 |
| δ # Líneas eliminadas | 30.3 | 11.6 | 26.4 | 12.3 | 21.6 | 38.9 |
| |T| (Fallo a Aprobado) | 23.2 | 53.0 | 19.1 | 24.0 | 8.8 | 14.8 |
| |T| (Pass to Pass) | 182.6 | 242.9 | 107.5 | 176.1 | 96.5 | 239.7 |
| |T| (All) | 205.8 | 295.9 | 126.6 | 200.1 | 105.3 | 254.5 |
Tabla 17: Números promedio que caracterizan diferentes atributos de una instancia de tarea de SWE-bench agrupados por repositorio para los repositorios del conjunto de datos de desarrollo. Las mismas estadísticas presentadas en la Tabla 11 también se muestran aquí.
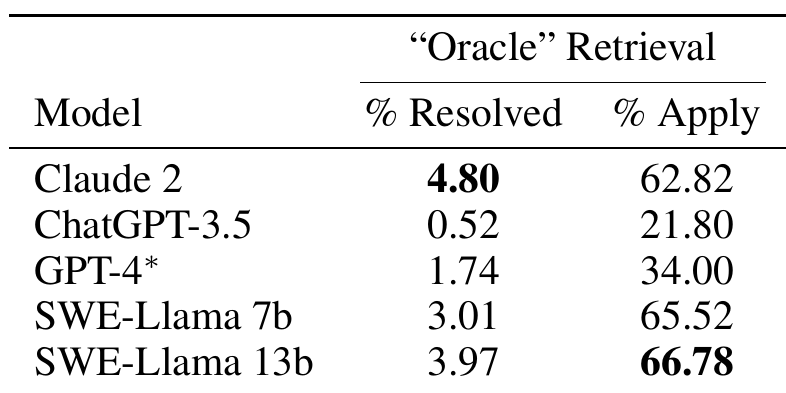
| Modelo | “Oracle” Retrieval | |
| % Resolved | % Apply | |
| Claude 2 | 4.80 | 62.82 |
| ChatGPT-3.5 | 0.52 | 21.80 |
| GPT-4* | 1.74 | 34.00 |
| SWE-Llama 7b | 3.01 | 65.52 |
| SWE-Llama 13b | 3.97 | 66.78 |
Tabla 18: Comparamos los modelos entre sí utilizando la configuración de recuperación oracle como se describe en la Sección 4. La tabla principal de resultados, la Tabla 5, presenta los resultados para los diferentes modelos cuando se utiliza únicamente BM25. \*Debido a restricciones presupuestarias, evaluamos GPT-4 en un subconjunto aleatorio del de SWE-bench únicamente en las configuraciones de recuperación "Oracle" y BM25 27K.
C.3 RESULTADOS DEL SUBCONJUNTO DE EVALUACIÓN DE GPT-4
En esta sección, presentamos las estadísticas mostradas en la Tabla 5 para el subconjunto aleatorio del en el que se probó GPT-4 en la Tabla 20. Dado que la selección del subconjunto es aleatoria, encontramos que las tasas de Resolved y Apply son consistentes con los resultados principales, y no están significativamente sesgadas hacia una mayor simplicidad o dificultad en comparación con el conjunto de evaluación general.
C.4 ANÁLISIS TEMPORAL EXTENDIDO
En esta sección, presentamos un análisis temporal extendido de las instancias de tarea resueltas por año que sigue el análisis mostrado en la Tabla 7 de la sección de evaluación del artículo principal. En la Tabla 21, presentamos la estadística Resolved entre modelos bajo la configuración de recuperación "Oracle" para 6 particiones temporales diferentes que agrupan las tareas según los años en que se crearon los issues. Es evidente a partir de la tabla que no existe una correlación consistente entre el rendimiento del modelo y el año, lo que respalda nuestra conclusión de que, a pesar de haber visto potencialmente versiones más antiguas del código dentro de sus conjuntos de datos de preentrenamiento, comprender e implementar correcciones en SWE-bench es una tarea difícil que requiere comprensión y no puede lograrse de manera factible o consistente mediante la memorización de los datos observados.
C.5 ANÁLISIS DE TASAS F2P, P2P
En los resultados del artículo principal, presentamos la estadística " Resolved" que indica cuántas instancias de tarea fueron resueltas completamente por los diferentes modelos. En esta sección, proporcionamos una visión más detallada de la brecha de instancias de tarea en las que 1. la generación de parche del modelo se aplicó con éxito y 2. la instancia de tarea no fue resuelta. Asumiendo que un parche se aplica con éxito, definimos 6 casos en la Tabla 22 que capturan completamente la distribución de todos los resultados posibles según los resultados de aprobado/fallido de las pruebas F2P y P2P. Además del resultado "Resolved" que se ha
| Repo | Claude 2 | ChatGPT-3.5 | GPT-4 | SWE-Llama 13b | SWE-Llama 7b |
| astropy/astropy | 3,23 | 0,00 | 0,00 | 1,06 | 3,16 |
| django/django | 6,15 | 1,32 | 2,50 | 5,19 | 4,00 |
| matplotlib/matplotlib | 3,05 | 3,33 | 0,00 | 3,12 | 1,11 |
| mwaskom/seaborn | 0,00 | 0,00 | 0,00 | 0,00 | 0,00 |
| pallets/flask | 0,00 | 0,00 | 0,00 | 9,09 | 0,00 |
| psf/requests | 15,91 | 2,33 | 8,33 | 13,64 | 18,18 |
| pydata/xarray | 6,90 | 0,00 | 0,00 | 5,81 | 3,00 |
| pylint-dev/pylint | 1,75 | 0,00 | 0,00 | 1,75 | 1,75 |
| pytest-dev/pytest | 5,93 | 0,00 | 0,00 | 5,04 | 4,20 |
| scikit-learn/scikit-learn | 5,41 | 0,00 | 0,00 | 3.12 | 0.88 |
| sphinx-doc/sphinx | 5.65 | 1.83 | 0.00 | 2.25 | 2.69 |
| sympy/sympy | 1.94 | 0.00 | 0.00 | 3.01 | 1.59 |
Tabla 19: Resolved para los modelos por repositorio representados en SWE-bench.
| Modelo | Recuperación BM25 | Recuperación "Oracle" | ||
| % Resuelto | % Aplicado | % Resuelto | % Aplicado | |
| Claude 2 | 2,27 ↑ 0,31 | 45,72 ↑ 2,65 | 4,01 ↓ 0,79 | 62,65 ↓ 0,17 |
| ChatGPT-3.5 | 0,17 - 0,00 | 26,53 ↑ 0,02 | 0,70 ↑ 0,18 | 21,64 ↓ 0,16 |
| GPT-4 | 0,00 - 0,00 | 14,82 - 0,00 | 1,74 - 0,00 | 34,00 - 0,00 |
| SWE-Llama 7b | 0,35 ↑ 0,35 | 49,04 ↓ 2,70 | 1,92 ↓ 1,09 | 63,70 ↓ 1,82 |
| SWE-Llama 13b | 0,70 - 0,00 | 56,54 ↑ 2,92 | 4,54 ↑ 0,57 | 66,67 ↓ 0,11 |
Tabla 20: Comparamos los modelos entre sí utilizando las configuraciones de recuperación BM25 y oracle como se describe en la Sección 4 en un subconjunto aleatorio del (574 instancias) de SWE-bench únicamente en las configuraciones de recuperación "oracle" y BM25 27K. Este es el mismo subconjunto en el que se evalúa GPT-4, como se menciona en la Tabla 5. La diferencia con respecto a los porcentajes en la Tabla 5 y la Tabla 18 se incluye como subíndice. establecido, introducimos cinco nuevos términos. El resultado "Breaking Resolved" se refiere a cuando el comportamiento deseado del issue se ha logrado (todas las pruebas F2P pasan), pero no se mantiene todo el comportamiento previo (no todas las pruebas P2P pasan). "Partially Resolved" se refiere a cuando se mantuvo el comportamiento previo de una base de código (todas las pruebas P2P pasan); sin embargo, el comportamiento deseado no se logra completamente (no todas las pruebas F2P pasan). El caso "Work in Progress" es cuando el comportamiento deseado no se logra completamente (no todas las pruebas F2P pasan) y el comportamiento previo de la base de código no se mantiene (no todas las pruebas P2P pasan). Un "No-Op" es cuando un cambio de código no tiene ningún efecto sobre la base de código original; el comportamiento previo se mantiene (todas las pruebas P2P pasan) pero el issue permanece completamente sin resolver (0 pruebas F2P pasan). Finalmente, si el issue no se resuelve (0 pruebas F2P pasan) y el comportamiento funcional previo se revierte (algunas pruebas P2P fallan), la base de código queda en un estado peor, lo que definimos como una "Regression".
En la Tabla 23, categorizamos las generaciones de parches que se aplicaron con éxito según estos seis casos. Encontramos que, de los issues no "Resolved", la mayoría de las generaciones de parches propuestas por el modelo no resuelven un solo caso de prueba F2P de la instancia de tarea correspondiente ("No-Op" y "Regression"). Dentro del subconjunto de estos casos, la mayoría ( a ) de los casos son un No-Op, mientras que el modelo rompe el comportamiento existente en el resto de estas situaciones.
En general, los casos en los que las generaciones del modelo pasan algunas, pero no todas, las pruebas ("Breaking Resolved", "Partially Resolved", "Work in Progress") representan acumulativamente un subconjunto más pequeño de problemas en relación con las otras tres categorías. A partir de la inspección manual de varios de estos casos, está claro que el modelo demuestra cierta comprensión de los requisitos de la tarea. Sin embargo, debido a la visión limitada de la base de código que tienen los métodos de referencia, que no incluye información como dependencias entre archivos y relaciones entre funciones, muchas de estas instancias de tarea a menudo fallan porque un cambio que resuelve correctamente el problema inmediato no tiene en cuenta otros módulos que usan y se ven afectados por la entidad modificada. Incluimos varios estudios de caso que destacan directamente estas deficiencias en la Sección F. En general, estos resultados destacan no solo la dificultad de SWE-bench, sino que también señalan la
| Año | Total | 25% | Claude 2 | GPT-3.5 | GPT-4* | SWE-Llama 13b | SWE-Llama 7b |
| 2023 | 244 | 61 | 4,51 | 1,56 | 0,00 | 4,07 | 3,50 |
| 2022 | 395 | 117 | 4,05 | 0,85 | 3,42 | 2,80 | 2,46 |
| 2021 | 383 | 102 | 4,18 | 0,00 | 2,94 | 4,45 | 2,56 |
| 2020 | 427 | 109 | 5,15 | 0,71 | 0,00 | 3,96 | 3,43 |
| 2019 | 437 | 112 | 5,72 | 1,49 | 1,79 | 4,55 | 2,21 |
| 2018 | 165 | 37 | 5,45 | 0,00 | 0,00 | 3,57 | 2,94 |
| < 2018 | 89 | 36 | 4,49 | 0,00 | 2,78 | 3,37 | 1,09 |
Tabla 21: Presentamos un análisis temporal extendido en esta tabla, mostrando el resuelto para instancias de tarea entre modelos en la configuración de recuperación "Oracle", separadas por diferentes fechas de corte. La columna Year se refiere al subconjunto de tareas que se crearon durante el año calendario especificado. En la columna Total, enumeramos el número de tareas que caen dentro del año dado. La columna es la misma información para el subconjunto en el que se evaluó GPT-4. Las columnas restantes específicas de cada modelo contienen la métrica resuelto.
| Pruebas P2P aprobadas | Pruebas F2P aprobadas | ||
| Todas | Parcial | Ninguna | |
| Todas | Resuelto | Parcialmente resuelto | Sin operación |
| Parcial | Resuelto con ruptura | Trabajo en curso | Regresión |
| Ninguna | Resuelto con ruptura | Trabajo en curso | Regresión |
Tabla 22: Presentamos los 6 resultados posibles para una generación de parche que se aplica con éxito y luego se ejecuta. Los resultados se distinguen por el número de pruebas F2P y P2P que pasan.valor potencial de proporcionar retroalimentación mediante un entorno de ejecución que permitiría a los modelos ejecutar correcciones contra las pruebas existentes, y luego decidir si continuar editando o enviar el parche para revisión.
C.6 ANÁLISIS EXTENDIDO DE GENERACIÓN DE PARCHES
En esta sección, presentamos una estadística para cuantificar diversas facetas de las generaciones de parches siguiendo las métricas establecidas en la Tabla 8. En la Tabla 24, recalculamos estos valores para todas las generaciones de parches en el entorno de recuperación oracle para todos los modelos, independientemente de si el parche se aplicó con éxito o no. En todas las métricas, encontramos que las generaciones de parches entre modelos están mucho más cerca en tamaño a las características de las ediciones gold promedio. Mientras que algunos modelos aún generan menos líneas en relación con la edición Gold correspondiente (p. ej., Claude- 2, ChatGPT- 3.5, GPT- 4), las ediciones de los modelos SWE- Llama son en promedio más largas en la mayoría de los aspectos. Al considerar tanto la Tabla 8 como la Tabla 24, resulta claro que los modelos tienen dificultades para generar secuencias de salida más largas que estén correctamente formateadas como parches. Un examen más detallado de tales ocurrencias, como se muestra en nuestros estudios de caso en la Sección F, indica que las alucinaciones, el apego al estilo/estructura de código existente y la referencia correcta a dependencias de largo alcance son errores comunes que surgen con mayor frecuencia en generaciones más largas.
C.7 MÉTRICAS DE INGENIERÍA DE SOFTWARE
Realizamos evaluaciones preliminares que exploran el uso de métricas de ingeniería de software para evaluar la eficiencia y complejidad de bloques de código grandes integrados dentro de una base de código compleja. A diferencia de las funciones de puntuación de similitud semántica para evaluar la fluidez y el parecido de la forma superficial que son populares en los benchmarks tradicionales de NLP y que se han adoptado para la generación de código, métricas como la complejidad Ciclomática McCabe (1976) y las medidas de complejidad de Halstead Halstead (1977) se fundamentan en abstracciones lógicas (p. ej., Árboles de Sintaxis Abstracta) y principios de software para cuantificar la complejidad, eficiencia y legibilidad del código como un valor escalar. Las generaciones de parches y los registros de evaluación de SWE- bench son ricas fuentes de información a las que se pueden aplicar fácilmente métricas de ingeniería de software y analizadores estáticos. A diferencia de los benchmarks pequeños de concursos de código donde las perspectivas de las métricas de ingeniería de software no son significativas debido al alcance minúsculo de la funcionalidad objetivo, la tarea de SWE- bench es lo suficientemente compleja como para que los profesionales puedan usar estas herramientas para obtener señales de retroalimentación bien estructuradas,
| Modelo | Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| Aplicado | 1078 | 284 | 76 | 1257 | 1196 |
| Resuelto | 110 | 12 | 10 | 69 | 91 |
| Resuelto con ruptura | 26 | 2 | 3 | 17 | 10 |
| Parcialmente resuelto | 15 | 4 | 3 | 17 | 10 |
| Trabajo en curso | 20 | 2 | 1 | 17 | 16 |
| Sin operación | 471 | 174 | 30 | 716 | 672 |
| Regresión | 436 | 90 | 29 | 421 | 397 |
| Modelo | Líneas totales | Añadidas | Eliminadas | Funciones | Archivos |
| Claude 2 | 27,2 | 6,6 | 3,3 | 1,2 | 1,1 |
| Gold | 61,6 | 17,8 | 8,6 | 2,6 | 1,4 |
| ChatGPT-3.5 | 42,0 | 6,1 | 3,9 | 1,7 | 1,0 |
| Gold | 44,5 | 12,7 | 5,5 | 2,1 | 1,2 |
| GPT-4 | 22,4 | 4,4 | 1,8 | 0,8 | 0,9 |
| Gold | 50,3 | 14,0 | 6,5 | 2,3 | 1,3 |
| SWE-Llama 13b | 68,9 | 9,5 | 4,3 | 2,5 | 1,6 |
| Gold | 61,5 | 17,8 | 8,6 | 2,6 | 1,4 |
| SWE-Llama 7b | 78,9 | 10,1 | 7,6 | 2,5 | 1,5 |
| Gold | 65,1 | 18,8 | 9,0 | 2.7 | 1,5 |
rigurosas y de amplio alcance sobre la complejidad del cambio de una generación de parche y su efecto en el resto de la base de código.
Incluimos aquí nuestro trabajo exploratorio que demuestra cómo las métricas de ingeniería de software pueden capturar de manera confiable características de la calidad del código, y cómo comparar estas estadísticas entre dos parches puede proporcionar observaciones automáticas sobre las capacidades del modelo. Usamos el paquete Radon, una biblioteca para calcular diferentes métricas de ingeniería de software directamente desde el código fuente.
Observamos específicamente las predicciones de parches de Claude 2 aplicadas con éxito en el entorno de recuperación "Oracle" para el repositorio psf/requests, en el que varios modelos tienen el mejor desempeño, como se refleja en la Figura 4. Por predicción, aplicamos el parche a la base de código, luego calculamos las puntuaciones de complejidad Ciclomática y de complejidad de Halstead para las funciones modificadas. La complejidad Ciclomática cuantifica el flujo de control de una función, contando el número de rutas de ejecución independientes a través del código fuente (McCabe, 1976). Una puntuación de complejidad Ciclomática más alta sugiere una función más compleja que tiene una mayor probabilidad de defectos y generalmente sugiere un mantenimiento difícil. La complejidad de Halstead cuenta el número de operadores y operandos en un programa (Halstead, 1977). Por predicción, también realizamos el mismo conjunto de pasos para el parche gold correspondiente.
Encontramos que las métricas de ingeniería de software proporcionan perspectivas cualitativas automáticas sobre el desempeño del modelo. Consideremos el siguiente estudio de caso simple en la Figura 10. Mientras que la predicción del parche del modelo (izquierda) tiene menos líneas (6 en lugar de 11) y modifica menos archivos (1 en lugar de 2) en comparación con la solución de referencia gold (derecha), la edición del modelo coloca un condicional dentro de una clase HTTPAdapter relativamente compleja y ampliamente utilizada. Esto introduce dos nuevos resultados de ejecución potenciales, elevando la complejidad Ciclomática de HTTPAdapter de 3 a 5. En contraste, aunque más larga, la solución de referencia importa dependencias intra- módulo, modifica una función lógicamente más simple en get_connection, y define un nuevo tipo de error InvalidProxyURL para capturar el novedoso bug descrito por el issue.
Documentación de Radon, base de código de código abierto
Declaración del problema: Excepción engañosa con protocolo inválido en la variable proxy. Cuando el valor de la(s) variable(s) https_proxy o HTTPS_PROXY pierde accidentalmente un '?' en el protocolo, se lanza al usuario un traceback que no señala que el problema está en la configuración del proxy...
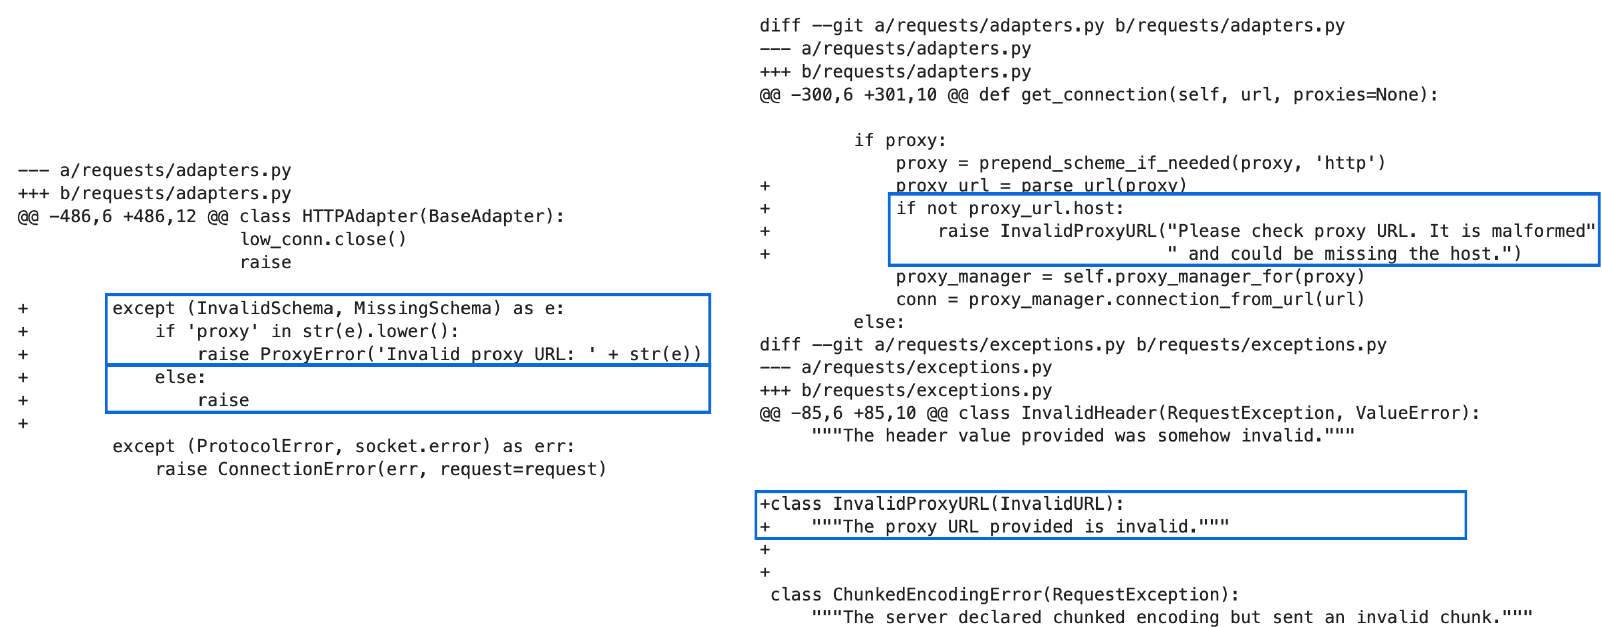
D DETALLES EXPERIMENTALES ADICIONALES
D.1 DETALLES DE RECUPERACIÓN
Recuperación dispersa. Durante la recuperación hacemos un ligero aumento a los documentos anteponiendo a los contenidos de los archivos sus rutas de archivo para habilitar mejor la recuperación basada en nombres de archivo que pueden mencionarse directamente en el issue.
Recuperación oracle. Las rutas de archivo de la recuperación oracle simplemente se extraen directamente del archivo de parche de la solución de referencia, excluyendo los archivos de prueba.
D.2 CONFIGURACIONES DE INFERENCIA
Dado que las generaciones son relativamente costosas, solo generamos un único archivo de parche por instancia. Siguiendo el precedente en la generación de código para evaluación en Pass@1 (Chen et al., 2021; Rozière et al., 2023), simplemente usamos decodificación greedy para todos los modelos.
D.3 EJEMPLO DE PLANTILLA DE PROMPT
Se solicita a los modelos con la siguiente plantilla general con ligeras variaciones dependiendo del modelo utilizado.
Se le proporcionará una base de código parcial y una declaración de problema que explica un problema a resolver. <issue> {ISSUE TEXT} </issue> {start of README.md} {README.md text} {end of README.md} {start of file_1. py}... {file_1. py text} [end of file_1. py]... </code>
Aquí hay un ejemplo de un archivo de parche. Consiste en cambios a la base de código. Especifica los nombres de archivo, los números de línea de cada cambio, y las líneas eliminadas y añadidas. Un único archivo de parche puede contener cambios a múltiples archivos.
<parche>-- a/file.py +++ b/file.py@@ -1,27 +1,35 @@def euclidean(a, b):- while b:- a, b = b, a % b- return a + if b == 0: + return a + return euclidean(b, a % b) def bresenham(x0, y0, x1, y1): points = [] dx = abs(x1 - x0) dy = abs(y1 - y0)- sx = 1 if x0 < x1 else -1- sy = 1 if y0 < y1 else -1- err = dx - dy + x, y = x0, y0 + sx = -1 if x0 > x1 else 1 + sy = -1 if y0 > y1 else 1- while True: points.append((x0, y0))- if x0 == x1 and y0 == y1:- break e2 = 2 * err- if e2 > -dy: + if dx > dy: + err = dx / 2.0 + while x != x1: points.append((x, y)) err = dy- x0 += sx- if e2 < dx:- err += dx- y0 += sy + if err < 0: + y += sy + err += dx + x += sx + else: + err = dy / 2.0 + while y != y1: + points.append((x, y)) + err -= dx + if err < 0: + x += sx + err += dy + y += sy + points.append((x, y)) return points </parche> Necesito que resuelvas el problema proporcionado generando un único archivo de parche que pueda aplicar directamente a este repositorio usando git apply. Por favor, responde con un único archivo de parche en el formato mostrado arriba. Responde a continuación: Los experimentos que usaban unas pocas líneas más o menos de instrucciones o ejemplos parecieron no afectar sustancialmente el rendimiento general, excepto por los hallazgos de los experimentos indicados en la Sección 5.
E IMPACTO SOCIAL
Dado que el razonamiento sobre código ha emergido como una habilidad fundamental subyacente a la capacidad de muchos LM, un futuro potencial de ingeniería de software automatizada por máquina plantea muchas preguntas importantes y tiene importantes ramificaciones potenciales en lo que respecta a la Seguridad de la IA (Gros et al., 2023). Es importante abordar preguntas sobre cómo garantizar que el código generado por IA sea fiel a las intenciones humanas y qué barreras de protección podrían existir cuando los objetivos humanos son malinterpretados por agentes de código que luego llevan a cabo la tarea. Para observar tales problemas en un entorno controlado y manifestar sus soluciones, esperamos que SWE-bench pueda servir como un banco de pruebas para diseñar medidas seguras y robustas hacia una ingeniería de software impulsada por IA alineada, verificable y segura.
F ANÁLISIS EN PROFUNDIDAD DE LAS GENERACIONES DE SWE-LLAMA
En esta sección, proporcionamos cinco análisis cualitativos adicionales de generaciones tanto de Claude 2 como de SWE-Llama (entorno de recuperación Oracle) siguiendo el estilo de la Sección 5.1.
Los estudios cualitativos de Claude 2 se pueden encontrar en las Tablas 25 y 26. Las Tablas 27, 28 y 29 son instancias de tareas que Claude 2 no abordó correctamente. Los estudios cualitativos de SWE-Llama se cubren en las Tablas 30, 31, 32, 33, 34. Para las Tablas 30, 31 y 32, presentamos instancias de tareas resueltas correctamente por SWE-Llama 13b. En la Tabla 33 y 34, presentamos dos instancias de tareas en las que SWE-Llama 13b no aborda el problema correctamente, señalando un subconjunto de las habilidades de razonamiento y generación que los modelos pueden no dominar lo suficiente como para lograr la tarea en cuestión.
Las observaciones que hacemos a lo largo de estas secciones corroboran los puntos expuestos en el artículo principal, que son que los modelos tienden a tener dificultades con cambios de varias líneas y de varios archivos, son más hábiles cuando la corrección requerida es relativamente corta, y necesitan ayuda para comprender la base de código de manera eficiente.
Tabla 25: En este ejemplo, Claude 2 aborda correctamente un problema de scikit-learn/scikit-learn. Sin embargo, como se demuestra en la discusión, aunque la solución es correcta, demuestra la tendencia de los modelos a escribir Python primitivo y no emplear métodos existentes dentro de la base de código.
Configuración- Modelo: Claude 2 con recuperación Oracle - Instancia de tarea: scikit-learn_scikit-learn-13328 - Enlace al problema: https://github.com/scikit-learn/scikit-learn/pull/13314 - Enlace al PR: https://github.com/scikit-learn/scikit-learn/issues/13328
Se produce un TypeError al proporcionar un X booleano al ajuste de HuberRegressor ### Descripción 'TypeError' al ajustar 'HuberRegressor' con predictores booleanos.
Pasos/Código para reproducir import numpy as np from sklearn.datasets import make_regression from sklearn.linear_model import HuberRegressor # Datos aleatorios X, y, coef = make_regression(n_samples=200, n_features=2, noise=4.0, coef =True, random_state=0) X_bool = X > 0 X_bool_as_float = np.asarray(X_bool, dtype=float) # Funciona huber = HuberRegressor().fit(X, y) # Falla (!) huber = HuberRegressor().fit(X_bool, y) # También funciona huber = HuberRegressor().fit(X_bool_as_float, y)
Resultados esperados No se lanza ningún error cuando el 'dtype' de 'X' es 'bool' (segunda línea de código en el fragmento anterior, .fit(X_bool, y)). Se espera que el array booleano se convierta a 'float' por 'HuberRegressor.fit' como lo hace, por ejemplo, 'LinearRegression'. Resultados reales Se lanza 'TypeError': (Líneas restantes omitidas)
Gold Patch diff --git a/sklearn/linear_model/huber.py b/sklearn/linear_model/huber. py -- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ - 251,7 +251,8 @@ def fit(self, X, y, sample_weight=None): self : object"
Model Generated Patch
- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ -231,6 +231,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self.tol = tol + def _validate_data(self, X, y=None): + return X.astype(np.float64) if X.dtype == np.bool else X + def fit(self, X, y, sample_weight=None): """Fit the model according to the given training data.
@@ -250,7 +253,7 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self : object """ X, y = check_X_y( X, y = check_X_y( X, y, copy=False, accept_sparse=['csr'], y_numeric=True) if sample_weight is not None: sample_weight = np.array(sample_weight) @@ -262,6 +265,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): raise ValueError( "epsilon_should_be_greater_than_or_equal_to_1.0,got_%f" % self.epsilon) + X = self._validate_data(X)
Tests
Fail to Pass (1)
sklearn/linear_model/tests/test_huber.py::test_huber_bool
Pass to Pass (9)
sklearn/linear_model/tests/test_huber.py::test_huber_max_iter sklearn/linear_model/tests/test_huber.py::test_huber_gradient sklearn/linear_model/tests/test_huber.py::test_huber_sample_weights sklearn/linear_model/tests/test_huber.py::test_huber_sparse sklearn/linear_model/tests/test_huber.py::test_huber_scaling_invariant
Additional Pass to Pass Tests omitted...
Discussion. In this task instance, the issue is describing an issue regarding how types are cast. Specifically, when When fitting the HuberRegressor model with boolean predictors, like X_bool, a TypeError occurs. This issue arises because the HuberRegressor does not automatically convert boolean arrays to floats as some other models do, such as LinearRegression, causing a type mismatch error. For its fix, the model defines its own _validate_data function, which encapsulates the type casting logic, and applies it to X. While it passes the tests, this fix could be more efficient and potentially introduces stylistic and organizational inconsistencies. As demonstrated in the reference solution, there is a much simpler solution of passing in dtype arguments that leverage the existing flags of the check_X_y function call to resolve this more cleanly. Other files' content was not included in the oracle retrieval setting due to the context window limitation.
Table 26: We provide another example where Claude- 2 solves the issue correctly and develops a solution similar to the gold patch. However, the gold patch solution is more cognizant of avoiding future potential issues that could be related to this code.
Setting
- Model: Claude 2 with Oracle retrieval- Task Instance: matplotlib_matplotlib-24362 - Link to Issue: https://github.com/matplotlib/matplotlib/issues/24349 - Link to PR: https://github.com/matplotlib/matplotlib/pull/24362
Issue
[Bug]: sharex and sharey don't accept 0 and 1 as bool values
Bug summary
When using '0' or '1' in place of 'False' or 'True' in 'sharex' or 'sharex' arguments of 'pyplot.subplots' an error is raised.
Code for reproduction
import matplotlib.pyplot as plt
fig, ax = plt.subplots(ncols=2, sharey=1)
Actual outcome
We get the following error:
Traceback (most recent call last):
(Earlier lines omitted) File "/\\\/matplotlib/lib/matplotlib/gridspec.py", line 293, in subplots _api.check_in_list(["all", "row", "col", "none"], File "/\\\/matplotlib/lib/matplotlib/_api/init.py", line 131, in check_in_list raise ValueError(msg)
ValueError: 1 is not a valid value for sharey; supported values are 'all', 'row', 'col', 'none'
Using 'sharex' instead of 'sharey' produces the same error (albeit with the following warning:
UserWarning: sharex argument to subplots() was an integer. Did you intend to use subplot() (without 's')?
but this is expected and not part of the present issue)
Expected outcome
I expected values 1 and 0 to be understood as bool.
Model Generated Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py
index 06dd3f19f6.32ee7c306e 100644
-- a/lib/matplotlib/gridspec.py
+++ b/lib/matplotlib/gridspec.py
@@ - 276, 9 +276, 9 @@ class GridSpecBase:
raise ValueError("GridSpec.subplots().only_works_for_GridSpecs_"
"created_with_a_parent_figure")
if isinstance(sharex, bool):
+ if isinstance(sharex, bool) or sharex == 1 or sharex == 0:
sharex = "all" if sharex else "none"
if isinstance(sharey, bool):
+ if isinstance(sharey, bool) or sharey == 1 or sharey == 0:
sharey = "all" if sharey else "none"
This check was added because it is very easy to type
'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.
Gold Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py - - - a/lib/matplotlib/gridspec.py +++ b/lib/matplotlib/gridspec.py @@ -276,21 +276,12 @@ def subplots(self, \*, sharex=False, sharey=False, squeeze=True,- if isinstance(sharex, bool):+ if not isinstance(sharex, str):sharex = "all" if sharex else "none"- if isinstance(sharey, bool):+ if not isinstance(sharey, str):sharey = "all" if sharey else "none"- # Esta comprobación se añadió porque es muy fácil escribir# 'subplots(1, 2, 1)' cuando se quería 'subplot(1, 2, 1)'.- # En la mayoría de los casos, nunca ocurrirá ningún error, pero se producirá# un comportamiento misterioso porque lo que se pretendía que fuera el índice de subplot# se trata en cambio como un booleano para sharex. Esta comprobación debería eliminarse# una vez que sharex sea conocido.- if isinstance(sharex, Integral):- api.warn_external("sharex_argument_to_subplots()_was_an_integer.__Did_you""intend_to_use_subplot()_without's')?"- api.check_in_list(["all", "row", "col", "none"],+ api.check_in_list(["all", "row", "col", "none", False, True],sharex=sharex, sharey=sharey)
Pruebas
Fallan a Pasan (1)
lib/matplotlib/tests/test_subplots.py::test_shared
Pasan a Pasan (39)
lib/matplotlib/tests/test_subplots.py::test_label_outer_span lib/matplotlib/tests/test_subplots.py::test_label_outer_non_gridspec lib/matplotlib/tests/test_subplots.py::test_shared_and_moved lib/matplotlib/tests/test_subplots.py::test_exceptions lib/matplotlib/tests/test_subplots.py::test_subplots_offsettext.png)
Pruebas adicionales de Pasan a Pasan omitidas...
Discusión. Este ejemplo pide que 1 y 0 se traten como valores booleanos para los argumentos sharex y sharey de la función pyplot.subplots. El código actual genera un error. En el parche generado, el modelo añade 1 y 0 como valores aceptables. Sin embargo, el parche de referencia añade los valores aceptables a una lista ["all", "row", "col", "none", False, True]. También elimina la advertencia relacionada con Integral vinculada a este problema. Esta limpieza, junto con la claridad del argumento de check_in_list, hace que el código sea más conciso y legible.
Tabla 27: En este ejemplo, mostramos un problema de astropy/astropy que Claude 2 no resuelve correctamente. El error se debe principalmente al intento de la generación del parche de resolver directamente el problema.
Configuración
- Modelo: Claude 2 con recuperación Oracle- Instancia de tarea: astropy_astropy-14365- Enlace al problema: https://github.com/astropy/astropy/issues/14363- Enlace al PR: https://github.com/astropy/astropy/pull/14365
Problema
El formato de tabla ascii.qdp asume que los comandos QDP están en mayúsculas
Descripción
ascii.qdp supone que los comandos en un archivo QDP están en mayúsculas; por ejemplo, para los errores deben ser "READ SERR 1 2", mientras que QDP en sí no distingue entre mayúsculas y minúsculas y puede usar "read serr 1 2". Como muchos archivos QDP se crean a mano, debería eliminarse la expectativa de que todos los comandos estén en mayúsculas.
Comportamiento esperado
El siguiente archivo qdp debería leerse en una 'Table' con errores, en lugar de fallar.
read serr 1 2 1 0.5 1 0.5
Cómo reproducirlo Crear un archivo QDP:
cat > test.qdp read serr 1 2 1 0.5 1 0.5 <EOF>
python Python 3.10.9 (main, Dec 7 2022, 02:03:23) [Clang 13.0.0 (clang - 1300.0.29.30)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> from astropy.table import Table >>> Table.read('test.qdp', format='ascii.qdp') WARNING: table_id not specified. Reading the first available table [ astropy.io.ascii.qdp] Traceback (most recent call last): raise ValueError(f'Unrecognized_QDP_line: {line}') ValueError: Unrecognized QDP line: read serr 1 2
Ejecutar "qdp test.qdp" funciona sin problemas.
Model Generated Patch
- a/astropy/io/ascii/qdp.py - b/astropy/io/ascii/qdp.py - @ -60,7 +60,7 @@ ValueError: Unrecognized QDP line... """ _decimal_re = r"[-?(\d+(\. \d+)?\.\d+)([eE][+-]?\d+)?" _command_re = r"READ [TS]ERR(\s+[0-9]+)+" _command_re = r"read [ts]err(\s+[0-9]+)+" sep = delimiter if delimiter is None:
Gold Patch
diff - - git a/astropy/io/ascii/qdp.py b/astropy/io/ascii/qdp.py - - - a/astropy/io/ascii/qdp.py +++ b/astropy/io/ascii/qdp.py @@ - 68,7 + 68,7 @@ def _line_type (line, delimiter=None): _new_re = rf"NO((sep)NO)+" _data_re = rf"((_decimal_re) | NO | [- + ]?nan) ((sep) ((_decimal_re) | NO | [- + ]?nan)) +" _type_re = rf"\s*((?P<command>|_command_re)) | (?P<new>[_new_re]) | (?P< data>[_data_re])?\s*(\!|(?P<comment>.*))?\s+$" - _line_type_re = re.compile(_type_re) + _line_type_re = re.compile(_type_re, re.IGNORECASE) line = line.strip() if not line: return "comment" @@ - 306,7 + 306,7 @@ def _get_tables_from_qdp_file(qdp_file, input_colnames=None, delimiter=None): values = [] for v in line.split (delimiter): - if v == "NO": + if v.upper() == "NO": values.append(np.max. masked) else: # Understand if number is int or float
Tests
Fail to Pass (1)
X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[True]
Pass to Pass (8)
X astropy/io/ascii/tests/test_qdp.py::test_get_tables_from_qdp_file X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[False] X astropy/io/ascii/tests/test_qdp.py::test_read_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example_comma X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple_specify_name X astropy/io/ascii/tests/test_qdp.py::test_get_lines_from_qdp
Discussion. This issue requests a fix for handling QDP files; specifically, it asks for the expectation of the commands to be uppercase to be removed. In the model generated patch, the model locates the READ and ERR commands mentioned in the issue description in a regex pattern and edits it directly. However, within the same file, it is clear that the regex pattern is used in additional patterns, such as _type_re, and so a fix to the "root" regex pattern may not be appropriate. In addition, amidst multiple regex pattern variables, identifying the correct one to modify requires reasoning that can potentially be helped by execution. This error in this solution is reflected in the fact that it not only fails to pass the given unit tests, but also fails existing tests enforcing prior behavior.
Table 28: For this issue from the mwaskom/seaborn repository, the problem statement includes hyperlinks to images. As discussed in Section 5, a minor subset of SWE- bench tasks include images in them, making image understanding a small but important component to resolving issues that is unexplored by the initial baselines.
Setting
- Model: Claude 2 with Oracle retrieval- Task Instance: mwaskom_seaborn-3217 - Link to Issue: https://github.com/mwaskom/seaborn/issues/2907 - Link to PR: https://github.com/mwaskom/seaborn/pull/3217
Issue
Width computation after histogram slightly wrong with log scale Note the slight overlap here:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image It becomes nearly imperceptible with more bins:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image This is not about 'Bars'; 'Bar' has it too:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth , width ), so.Hist(bins ) .scale
image
Model Generated Patch
- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1327,9 +1327,7 @@ elif "width" in df: view_width = view_df["width"] else: - view_width = 0.8 # TODO what default? - spacing = scales[orient]._spacing(view_df.loc[view_idx, - width.loc[view_idx] = view_width + spacing + width.loc[view_idx] = view_width df["width"] = width if "baseline" in mark._mappable_props:
Gold Patch
diff - - git a/seaborn/_core/plot.py b/seaborn/_core/plot.py - - - a/seaborn/_core/plot.py ++ b/seaborn/_core/plot.py @@ - 1377,10 + 1377,9 @@ def _unscale_coords( - drop_cols = [\*coord_cols, "width"] if "width" in df else coord_cols out_df = ( df - .drop(drop_cols, axis=1) + .drop(coord_cols, axis=1) .reindex(df.columns, axis=1) # Para que las columnas sin escalar conserven su lugar @@ - 1396,12 + 1395,6 @@ def _unscale_coords( - if var == orient and "width" in view_df: - width = view_df["width"] - out_df.loc[values.index, "width"] = ( - transform(values + width / 2) - transform(values - width / 2) ) - return out_df diff - - git a/seaborn/_marks/bar.py b/seaborn/_marks/bar.py - - - a/seaborn/_marks/bar.py +++ b/seaborn/_marks/bar.py @@ - 29,17 + 29,23 @@ class BarBase(Mark): + transform = scales[orient]._matplotlib_scale.get_transform() + forward = transform.transform + reverse = transform.inverted().transform + + other = {"x": "y", "y": "x"} [orient] + + pos = reverse(forward(data[orient]) - data["width"] / 2) + width = reverse(forward(data[orient]) + data["width"] / 2) - pos + + val = (data[other] - data["baseline"]).to_numpy() + base = data["baseline"].to_numpy() + (Líneas restantes omitidas...)
Pruebas
Fallan a Pasan (1)
X tests/_marks/test_bar.py::TestBars::test_log_scale
Pasan a Pasan (8)
X tests/_marks/test_bar.py::TestBar::test_categorical_positions_vertical X tests/_marks/test_bar.py::TestBar::test_categorical_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_numeric_positions_vertical X tests/_marks/test_bar.py::TestBar::test_numeric_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_set_properties
Pruebas adicionales de Pasan a Pasan omitidas...
Discusión. La incapacidad del modelo baseline para resolver este problema puede atribuirse directamente a la falta de una entrada de imagen. Incluimos este ejemplo para demostrar que la depuración de problemas reales de software puede implicar digerir imágenes; esto presenta todo un conjunto separado de desafíos relacionados con la comprensión y el razonamiento. Más allá de la tarea de SWE-bench, otros problemas en la ingeniería de software, como interpretar diagramas de diseño de sistemas, especificaciones de interfaz de usuario y comentarios de usuarios, presentan interesantes desafíos de visión-lenguaje.
Tabla 29: En este ejemplo final de una generación de Claude 2, el modelo debe resolver un error relacionado con la resolución de un error relativo a dependencias cíclicas. La solución de Claude 2 queda corta en un problema por lo demás complejo.
Configuración
- Modelo: Claude 2 con recuperación Oracle- Instancia de tarea: sympy_sympy-18211- Enlace al issue: https://github.com/pylint-dev/pylint/issues/3525- Enlace al PR: https://github.com/pylint-dev/pylint/pull/4703
Issue
Las importaciones dentro de TYPE.CHECKING pueden inducir un "cyclic-import"
Supongamos que tienes dos módulos: a.py y b.py. 'a' importa 'b', pero 'b' necesita 'a' para hacer anotaciones de tipo, entonces esto normalmente se hace importando 'a' dentro de un bloque 'TYPE.CHECKING'. Desafortunadamente, esto hace que pylint reporte 'cyclic-import'.
Posiblemente relacionado con https://github.com/PyCQA/pylint/issues/3285
Parche dorado
diff --git a/pylint/checkers/imports.py b/pylint/checkers/imports.py-- a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py@@ - 813,7 + 813,9 @@ def _get_imported_module(self, importnode, modname):- def _add_imported_module(self, node, importedmodname): + def _add_imported_module(+ self, node: Union[astroid.Import, astroid.ImportFrom], importedmodname: str + ) -> None:"""notifica un módulo importado, se usa para analizar dependencias""" module_file = node.root().file context_name = node.root().name@@ - 826,6 + 828,10 @@ def _add_imported_module(self, node, importedmodname): except ImportError: pass + in_type_checking_block = (+ isinstance(node.parent, astroid.If) and node.parent. is_type_guard() + ) if context_name == importedmodname: self.add_message("import- self", node=node)@@ - 845,7 + 851,10 @@ def _add_imported_module(self, node, importedmodname): # actualizar el grafo de importaciones self.import_graph[context_name].add(importedmodname)- if not self.linter.is_message_enabled("cyclic-import", line= node.lineno): + if + not self.linter.is_message_enabled("cyclic-import", line= node.lineno) + or in_type_checking_block + ) self.excluded_edges[context_name].add(importedmodname)ްމައްސަލައިގެންނަށްޓަކ
Parche generado por el modelo
diff - - git a/pylint/checkers/imports.py b/pylint/checkers/imports.py index 4f3eed2. .2b74a8d 100644 - - - a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py @@ -49,6 +49,7 @@ import copy import os import sys from distutils import sysconfig +from typing import TYPE_CHECKING from typing import Dict, List, Union
import astroid @@ -61,6 +62,9 @@ from pylint.checkers.utils import ( node_ignores_exception, ) from pylint.exceptions import EmptyReportError +if TYPE_CHECKING: + from pylint.lint import PyLinter + from pylint.graph import DotBackend, get_cycles from pylint.interfaces import IASTroidChecker from pylint.reporters.ureports.nodes import Paragraph, VerbatimText, VNode
Pruebas
Falla a Pasa (1)
X tests/marks/test_bar.py::TestBars::test_log_scale
Pasa a Pasa (11)
tests/test_func.py::test_functionality[func_w0401_disabled_in_func.py] tests/test_func.py::test_functionality[func_i0022. py] tests/test_func.py::test_functionality[func_w0401. py] tests/test_func.py::test_functionality[func_w0801. py] tests/test_func.py::test_functionality[func_w0401_package]
Pruebas adicionales de Pasa a Pasa omitidas...
Discusión. En este problema, se pide al modelo que proporcione un manejo basado en TYPE_CHECKING para resolver importaciones cíclicas, para las cuales pylint actualmente arroja un error. El parche dorado tiene una solución detallada que implica un manejo condicional dentro del bloque TYPE_CHECKING, excluye los mensajes de importación cíclica y, en general, tiene un manejo más específico. El parche generado por el modelo emplea una solución al estilo "Stack Overflow"; aunque crear un bloque TYPE_CHECKING es una solución popular para resolver importaciones, resolver este problema para el código base en particular requiere una solución más matizada que una respuesta general que pueda estar disponible en línea.
Tabla 30: Ejemplo de una generación de SWE- Llama 13b que resuelve correctamente una instancia de tarea de SWE- bench. En este ejemplo, la generación de SWE- Llama es exactamente igual a la solución.
Configuración
- Modelo: SWE-Llama 13B con recuperación Oracle- Instancia de tarea: pydata_xarray-5131- Enlace al problema: https://github.com/pydata/xarray/pull/5130- Enlace al PR: https://github.com/pydata/xarray/pull/5131
Problema
Al mostrar un DatasetGroupBy en una sesión interactiva de Python, la primera línea de salida contiene un espacio en blanco al final. El primer ejemplo en la documentación demuestra esto:
import xarray as xr, numpy as np >>> ds = xr.Dataset( ... {"foo": (("x", "y"), np.random.rand(4, 3)), ... coords={"x": [10, 20, 30, 40], "letters": ("x", list("abba")), ... >>> ds.groupby("letters") DatasetGroupBy, grouped over 'letters' 2 groups with labels 'a', 'b'.
Hay un espacio en blanco al final en la primera línea de salida, que es "DatasetGroupBy, grouped over 'letters' ". Esto se puede ver más claramente convirtiendo el objeto a una cadena (nótese el espacio en blanco antes de n):
str(ds.groupby("letters")) "DatasetGroupBy, grouped_over_'letters'\n2_groups_with_labels'a', 'b'."
Aunque esto no es un problema en sí mismo, nos causa un problema porque usamos flake8 en integración continua para verificar que nuestro código esté correctamente formateado... [20 líneas más]
Parche dorado
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
Parche generado por el modelo
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
Pruebas
Falla a Pasa (10)
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj0]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj1]
Pass to Pass (16)
✓ xarray/tests/test_groupby.py::test_consolidate_slices
✓ xarray/tests/test_groupby.py::test_groupby_da_datetime
✓ xarray/tests/test_groupby.py::test_groupby_duplicate_coordinate_labels
✓ xarray/tests/test_groupby.py::test_groupby_input_mutation
✓ xarray/tests/test_groupby.py::test_groupby_map_shrink_groups[obj0]
Additional Pass to Pass Tests omitted...
Discusión. En este problema, se pide al modelo que corrija un problema de espacio en blanco al final, y el problema muestra una demostración del error que surge durante el uso, pero no señala explícitamente la función que debe corregirse en el modelo. En la configuración de recuperación oracle, se proporciona al modelo el archivo xarray/core/groupby.py para editarlo directamente, pero la mayoría localiza la línea que debe editar. En esta situación, el modelo razona con éxito que, en el entorno interactivo de Python, la función subyacente que se está invocando es en realidad la función repr. Después de localizar la función, debe averiguar dónde se encuentra el espacio en blanco en la instrucción return. En este punto, la corrección es bastante evidente, ya que hay un espacio explícito que el modelo elimina. En este caso, el modelo supera con éxito todas las pruebas para verificar la corrección de esta corrección explícitamente (10 pruebas fail to pass) mientras también mantiene el comportamiento existente del archivo (16 pruebas pass to pass).
Tabla 31: Ejemplo de una generación de SWE- Llama 13b que resuelve correctamente una instancia de tarea de SWE- bench. En este ejemplo, la generación de SWE- Llama es diferente del parche gold.
Configuración
- Modelo: SWE-Llama 13B con recuperación Oracle- Instancia de tarea: psf_-requests-1724- Enlace al issue: https://github.com/psf/requests/issues/1723- Enlace al PR: https://github.com/psf/requests/pull/1724
Issue
Los nombres de métodos Unicode causan UnicodeDecodeError para algunas solicitudes en Python 2.7.2. El siguiente ejemplo funciona bien:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Pero el siguiente ejemplo (usando 'method 'POST' en lugar de 'method 'POST') produce un UnicodeDecodeError:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Traceback (most recent call last): [Traza completa oculta] File "/System/Library/Frameworks/Python.framework/Versions/2.7/... msg_+=_message_body UnicodeDecodeError: 'ascii'_codec_can't_decode_byte_0xcf_in_position_140: ordinal_not_in_range (128)
Mi conjetura es que 'u'POST' está infectando el encabezado con unicode cuando debería ser una cadena. Esto se debe a que 'sessions.py:313' es simplemente:
req.method method.upper()
[Líneas adicionales ocultas...]
Parche gold
diff --git a/requests/sessions.py b/requests/sessions.py-- a/requests/sessions.py +++ b/requests/sessions.py@@ - 12,7 + 12,7 @@from collections import Mappingfrom datetime import datetime-from .compact import cookielib, OrderedDict, [3 más omitidos]+from .compact import cookielib, OrderedDict, [3 omitidos,+ builtin_strfrom .cookies import cookiejar_from_dict, extract_cookies_to_jar, RequestsCookieJarfrom .models import Request, PreparedRequestfrom .hooks import default_ hooks, dispatch_hook@@ - 309,6 + 309,6 @@ def request(self, method, url,:param cert: (optional) if String, path to ssl client cert file (.pem). If Tuple, ('cert', 'key') pair.\\\*
+ method builtin_str(method)
Parche generado por el modelo
diff - - git a/requests/sessions.py b/requests/sessions.py - - - a/requests/sessions.py +++ b/requests/sessions.py @@ -254,7 +254,7 @@ def prepare_request(self, request):
p = PreparedRequest() p.prepare( method=request.method.upper(), + method=str(request.method).upper(), url=request.url, files=request.files, data=request.data,
Pruebas
Falla a Pasa (6)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_RETURNS_COOKIE test_requests.py::RequestsTestCase::test_DIGEST_HTTP_200_OK_GET test_requests.py::RequestsTestCase::test_different_encodings_dont_break test_requests.py::RequestsTestCase::test_generic_cookiejar_works test_requests.py::RequestsTestCase::test_uppercase_scheme_redirect
Pasa a Pasa (75)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_SETS_SESSION_COOKIES test_requests.py::RequestsTestCase::test_DIGEST_STREAM test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_ALTERNATIVE test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_WITH_PARAMS test_requests.py::RequestsTestCase::test_HTTP_200_OK_HEAD
Pruebas adicionales de Pasa a Pasa omitidas...
Discusión. A diferencia del problema presentado en la Tabla 30, en lugar de una entrada interactiva de python, al modelo se le proporciona un rastreo de error de una invocación de función, donde se ofrecen los pasos para recrear el problema desde el punto de vista del usuario. Además, el issue también proporciona una sugerencia durante la última línea sobre una posible solución para el problema. Una vez más, en el entorno oracle, el modelo aprovecha la sugerencia en lenguaje natural y localiza el cambio en una línea que es semánticamente bastante similar a la sugerencia ( req.method = method.upper() en comparación con method=str(request.method).upper() ). El modelo aborda correctamente el problema, como se refleja en todas las pruebas que pasan. Sin embargo, en esta situación, podemos ver que el modelo es en realidad bastante "afortunado" en su éxito. Primero, mientras que el parche gold aprovecha funciones integradas que se utilizan para la uniformidad en el manejo del formato de cadenas, la decisión del modelo de usar Python más primitivo para abordar este problema probablemente no sería bien recibida por un revisor humano debido a su inconsistencia con el resto del código base. Una inspección más detallada de la función builtin_str, no mostrada en esta figura, también revela que maneja casos adicionales de formato de cadenas más allá de lo que se retrató en el issue. Aunque el modelo resuelve la tarea esta vez, es cuestionable si esta solución es robusta frente a problemas futuros.
Tabla 32: Este es otro ejemplo donde SWE- Llama13b resuelve la tarea con éxito. Este ejemplo es interesante porque el modelo desarrolla una solución algo novedosa en comparación con la referencia que podría argumentarse que es más eficiente y limpia.
Configuración
- Modelo: SWE-Llama 13B con recuperación Oracle- Instancia de tarea: djang0. djang0-11727- Enlace al issue: https://code.djangoproject.com/ticket/29376- Enlace al PR: https://github.com/djang0/djang0/pull/11727
Issue
Permitir ocultar el botón "Guardar y añadir otro" con una variable de contexto show_save_and_add_another
Para proporcionar una mejor ajustabilidad, introducir una nueva variable de contexto - show_save_and_add_another. Por ejemplo, si quiero ocultar el botón "Guardar y añadir otro", puedo simplemente modificar extra_context - escribir False en la variable. Para otros botones - "Guardar" y "Guardar y continuar editando", esto ya funciona exactamente de esta manera.
Parche gold
diff --git a/djang0/contrib/admin/templateTags/admin_modify.py b/djang0 /... - - a/djang0/contrib/admin/templateTags/admin_modify.py +++ b/djang0/contrib/admin/templateTags/admin_modify.py @@ -54,12 +54,20 @@ def submit_row(context): is_popup = context['is_popup'] save_as = context['save_as'] show_save = context.get('show_save', True) + show_save_and_add_another = context.get('show_save_and_add_another', True)
(7 líneas omitidas...) or (has_add_permission and add) or has_editable_inline_admin_formset + can_save_and_add_another = ( + has_add_permission and + not is_popup and + (not save_as or add) and + can_save and + show_save_and_add_another + ) can_save_and_continue = not is_popup and can_save and has_view_permission and show_save_and_continue can_change = has_change_permission or has_editable_inline_admin_formset ctx = Context(context) @@ -70,10 +78,7 @@ def submit_row(context): change and context.get('show_delete', True) ), 'show_save_as_new': not is_popup and has_change_permission and change and save_as, - 'show_save_and_add_another': ( - has_add_permission and not is_popup and - (not save_as or add) and can_save - ), 'show_save_and_add_another': can_save_and_add_another, 'show_save_and_continue': can_save_and_continue, 'show_save': show_save and can_save,
Parche generado por el modelo
diff --git a/django/contrib/admin/templateTags/admin_modify.py b/django/...-- a/django/contrib/admin/templateTags/admin_modify.py +++ b/django/contrib/admin/templateTags/admin_modify.py@@ - 72,7 + 72,7 @@ def submit_row(context):' show_save_as_new': not is_popup and has_change_permission and change and save_as,' show_save_and_add_another': has_add_permission and not is_popup and- (not save_as or add) and can_save + (not save_as or add) and can_save and context. get('show_save_and_add_another', True)),' show_save_and_continue': can_save_and_continue,' show_save': show_save and can_save,
Pruebas
Falla a Pasa (2)
test_override_show_save_and_add_another
test_submit_row (admin_views.test_templateTags.Admin...)
Pasa a Pasa (3)
test_choice_links (admin_views.test_templateTags.DateHierarchyTests)
test_override_change_form_template_tags
test_override_change_list_template_tags
Discusión. Para esta instancia de tarea que proviene del repositorio django/django, se pide al modelo que introduzca una variable de contexto que permita a un usuario ocultar el botón "Guardar y añadir otro" mediante una variable de contexto, de forma similar a como se hace para otros dos botones existentes. La tarea es un poco más difícil en comparación con las dos configuraciones anteriores porque no se ofrece un rastreo de pila explícito ni una demostración programática del issue. En esta configuración relativamente poco especificada que no proporciona sugerencias con respecto a localizar la función correctamente, el modelo razona con éxito que debería ajustar el par clave/valor show_save_and_add_another existente. Al comparar con la solución del parche gold, se puede argumentar que el parche generado por el modelo produce una solución mucho más eficiente en términos de líneas editadas, ya que realiza la edición más pequeña necesaria para incorporar el contexto como una bandera para establecer el estado oculto de show_save_and_add_another. Sin embargo, de forma similar a la discusión en la Tabla 31, estilísticamente, las ediciones del parche gold son mucho más consistentes con el código base, y también se realizan cambios adicionales que no se discuten explícitamente en el issue para adherirse a lo que se ha hecho en el código base (es decir, la adición de un campo can_save_and_add_another. Esta tarea es un ejemplo de una dirección potencialmente emocionante donde, mediante la guía humana o una mejor comprensión de un código base en general, los modelos ajustarían entonces sus generaciones para no solo hacer los cambios funcionalmente correctos, sino también los estilísticamente correctos.
Tabla 33: Este es un ejemplo donde SWE- Llama13b escribe una solución incorrecta, pero mantiene con éxito el comportamiento previo. La diferencia en la generación del modelo y el parche gold aquí demuestra cómo los modelos tienden a generar de menos las correcciones necesarias.
Configuración
- Modelo: SWE-Llama 13B con recuperación Oracle- Instancia de tarea: sphinx-doc_sphinx-11445- Enlace al issue: https://github.com/sphinx-doc/sphinx/issues/11437- Enlace al PR: https://github.com/sphinx-doc/sphinx/pull/11445
Issue
Usar rst_prolog elimina los encabezados de nivel superior que contienen una directiva de dominio
Describir el error
Si se establece rst_prolog, entonces cualquier documento que contenga una directiva de dominio como primer encabezado (p. ej. :mod:) no renderiza el encabezado correctamente ni lo incluye en el toctree. En el ejemplo siguiente, si el encabezado de docs/mypackage.rst fuera mypackage2 en lugar de :mod:mypackage2, entonces el encabezado se muestra correctamente. De forma similar, si no se establece rst_prolog, entonces el encabezado se mostrará correctamente. Esto parece haber estado roto desde hace algún tiempo, porque puedo reproducirlo en la v4.0.0 de Sphinx.
Cómo reproducirlo
$ sphinx-quickstart --no-sep --project mypackage --author me - v 0.1.0 --release 0.1.0 --language en docs $ echo - e 'Welcome\n=========\n\n...\tctree::\n\n\_mypackage\n' > docs/index_rst $ echo - e ':mod:'mypackage2\n=========\n\nContent\n\n Subheading\n-
logger = logging.getLogger(name) - docinfo_re = re.compile(r'\w+.?') + docinfo_re = re.compile(r'\w+.?n') symbols_re = re.compile(r'([-]-\/-\@[\-]') SECTIONING_CHARS = ['=', '-', '-']
Pruebas
Falla a Pasa (2)
X tests/test_util_rst.py::test_prepend_prolog_with_roles_with_newline tests/test_util_rst.py::test_prepend_prolog_with_roles_without_newline
Pasa a Pasa (8)
X tests/test_util_rst.py::test_prepend_prolog tests/test_util_rst.py::test_prepend_prolog_with_CR tests/test_util_rst.py::test_prepend_prolog_without_CR
Pruebas adicionales Pasa a Pasa omitidas...
Parche dorado
diff --git a/sphinx/util/rst.py b/sphinx/util/rst.py -- a/sphinx/util/rst.py ++ b/sphinx/util/rst.py @@ - 10,22 +10,17 @@
from docutils.parsers.rst import roles from docutils.parsers.rst.languages import en as english +from docutils.parsers.rst.states import Body from docutils.statemachine import StringList from docutils.utils import Reporter - from jinja2 import Environment +from jinja2 import Environment, pass_environment from sphinx.locale import from sphinx.util import docutils, logging- try: - from jinja2.utils import pass_environment - except ImportError: - from jinja2 import environmentfilter as pass_environment - logger = logging.getLogger(name) - docinfo_re = re.compile('\w+.*?') +FIELD_NAME_RE = re.compile(Body.patterns['field_marker']) symbols_re = re.compile(r'([-\-/:-@\[-\{-]})' # symbols without dot(0 x2e) SECTIONING_CHARS = ['=', '-', '~']
@@ - 80,7 +75,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: if prolog: pos = 0 for line in content: if docinfo_re.match(line): + if FIELD_NAME_RE.match(line): pos += 1 else: break @@ - 91,6 +86,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: pos += 1 # insert prolog (after docinfo if exists) + lineno = 0 for lineno, line in enumerate(prolog.splitlines()): content.insert(pos + lineno, line, 'rst_prolog>', lineno)
Discusión. Para esta instancia de tarea del repositorio sphinx-doc/sphinx, se pide a un modelo que escriba lógica para corregir un caso en el que el título se está renderizando incorrectamente. Simplemente comprender la jerga utilizada y mapear dichas palabras a la lógica dentro del código base es un desafío significativo al que se enfrenta el modelo. Se proporciona al modelo una llamada de línea de comandos que puede ayudar con esto, pero fundamentar la terminología presentada en los issues dentro del código base es esencial. Al comparar el parche gold y el parche generado por el modelo, queda claro que el modelo no se acerca a resolver la tarea. El modelo generalmente sí identifica que corregir el patrón regex es la acción correcta, ya que esto es lo que hace también el parche gold. Sin embargo, donde el modelo y la configuración de recuperación oracle quedan cortos colectivamente se debe principalmente al uso significativo de módulos adicionales tanto del propio código base como de bibliotecas de terceros. Este ejemplo destaca la importancia y el potencial de entrenar modelos de lenguaje y diseñar procedimientos de inferencia que permitan el descubrimiento automatizado de dicha información.
Tabla 34: En este ejemplo final, SWE-Llama 13b no solo no resuelve la tarea, sino que también corrompe el comportamiento existente en el modelo. Este ejemplo demuestra la necesidad de que los modelos comprendan el código base más allá del alcance de las ediciones requeridas.
Configuración
- Instancia de tarea: scikit-learn_ scikit-learn-13241
- Enlace al issue: https://github.com/scikit-learn/scikit-learn/issues/8798
- Enlace al PR: https://github.com/scikit-learn/scikit-learn/pull/13241
Issue
Diferencias entre los resultados de KernelPCA con kernel rbf
Descripción
Cuando ejecuto KernelPCA para reducción de dimensionalidad para los mismos conjuntos de datos, los resultados son diferentes en signos.
Pasos/Código para reproducir
Solo para reducir la dimensión a 7 con kernel rbf:
pca = KernelPCA(n_components=7, kernel='rbf', copy_X=False, n_jobs=- 1) pca.fit_transform(X)
Resultados esperados
El mismo resultado.
Resultados reales
Los resultados son los mismos excepto por sus signos:
[[- 0.44457 - 0.18155 - 0.10873 0.13548 - 0.14371 - 0.05746 0.18124]] [[0.44457 0.18155 0.10873 - 0.13548 - 0.14371 - 0.05746 - 0.18124]] [[- 0.44457 - 0.18155 0.10873 0.13548 0.14371 0.057469 0.18124]]
Parche gold
diff --git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos...
-- a/sklearn/decomposition/kernel_pca.py
+++ b/sklearn/decomposition/kernel_pca.py
@@ - 8,6 + 8,7 @@
from scipy.sparse.linalg import eighs
from .utils import check_random_state
+from .utils.extmath import svd_flip
from .utils.validation import check_is_fitted, check_array
from .exceptions import NotFittedErrorfrom .base import BaseEstimator, TransformerMixin,_UnstableOn32BitMixin
@@ - 210,6 + 211,10 @@ def _fit_transform(self, K): maxiter=self.max_iter, v0=v0)
+ # voltear el signo de los autovectores para imponer una salida determinista
+ self.alphas_, _ = svd_flip(self.alphas_,+ np.empty_like(self.alphas_).T)+# ordenar los autovectores en orden descendenteindices = self.lambdas_.argsort() [::- 1]self.lambdas_ = self.lambdas_[indices]
Parche generado por el modelo
diff - - git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos... - - a/sklearn/decomposition/kernel_pca.py +++ b/sklearn/decomposition/kernel_pca.py @@ -220,7 +220,7 @@ def fit_transform(self, K): self.alphas = self.alphas_[:, self.lambdas_ > 0] self.lambdas_ = self.lambdas_[self.lambdas_ > 0]
return K return K / self.lambdas_
def _fit_inverse_transform(self, X_transformed, X): if hasattr(X, "tocstr"):
Pruebas
Falla a Pasa (1)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output
Pasa a Pasa (54)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca sklearn/tests/test_kernel_pca.py::test_kernel_pca_consistent_transform sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output sklearn/tests/test_kernel_pca.py::test_kernel_pca_sparse sklearn/tests/test_kernel_pca.py::test_kernel_pca_linear_kernel sklearn/tests/test_kernel_pca.py::test_kernel_pca_n_components sklearn/tests/test_kernel_pca.py::test_remove_zero_eig sklearn/tests/test_kernel_pca.py::test_kernel_pca_precomputed sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline_precomputed sklearn/tests/test_pca.py::test_pca_dtype_preservation[randomized] sklearn/tests/test_pca.py::test_pca_dtype_preservation[auto] sklearn/tests/test_pca.py::test_pca_deterministic_output
Pruebas adicionales Pasa a Pasa omitidas...
Discusión. En este ejemplo de la biblioteca scikit-learn/scikit-learn, se da a un modelo la observación de que las paridades de la salida de una llamada a la función fit_transform están invertidas. También se proporcionan al modelo líneas de código Python y su salida estándar que recrean el problema. El parche gold importa y usa la función svd_flip para resolver este problema dentro de una línea diferente de la función _fit_transform. Lo que diferencia el fallo del modelo para esta tarea, más allá de los puntos discutidos para el ejemplo de la Tabla 33, es que, además de comprender las dependencias de terceros de las que dependen sus ediciones, también es importante que un modelo comprenda de qué otras partes del código base depende a su vez la función que está modificando. Este ejemplo presenta una faceta diferente de por qué procesar contextos largos que se extienden más allá del alcance local de la edición es un desafío difícil pero valioso.