
Cuatro correcciones a PPO llevan un modelo de 32B a 50 puntos en AIME 2024, con código y datos abiertos. Artículo de 2025, gratis online.
DAPO: An Open-Source LLM Reinforcement Learning System at Scale
DAPO: Un sistema de aprendizaje por refuerzo para LLM de código abierto a gran escala
ByteDance Seed Institute for AI Industry Research (AIR), Universidad de Tsinghua La Universidad de Hong Kong SIA-Lab de Tsinghua AIR y ByteDance Seed
Lista completa de autores en Contribuciones
Resumen
El escalado en inferencia dota a los LLM de una capacidad de razonamiento sin precedentes, con el aprendizaje por refuerzo como técnica central para suscitar razonamiento complejo. Sin embargo, los detalles técnicos clave de los LLM de razonamiento de última generación están ocultos (como en el blog de OpenAI o1 y el informe técnico de DeepSeek R1), por lo que la comunidad aún lucha por reproducir sus resultados de entrenamiento con RL. Proponemos el algoritmo Decoupled Clip and Dynamic sAmpling Policy Optimization (DAPO), y liberamos completamente como código abierto un sistema de RL a gran escala de última generación que alcanza 50 puntos en AIME 2024 usando el modelo base Qwen2.5-32B. A diferencia de trabajos previos que retienen los detalles de entrenamiento, presentamos cuatro técnicas clave de nuestro algoritmo que hacen posible el éxito del RL a gran escala para LLM. Además, liberamos como código abierto nuestro código de entrenamiento, que se construye sobre el framework ver1 , junto con un conjunto de datos cuidadosamente curado y procesado. Estos componentes de nuestro sistema de código abierto mejoran la reproducibilidad y apoyan la investigación futura en RL a gran escala para LLM.
Fecha: 17 de marzo de 2025 Correspondencia: zhouhao@air.tsinghua.edu.cn, wangmingxuan.89@bytedance.com Página del proyecto: https://dapo-sia.github.io/"https://github.com/volcengine/ver1
1 Introducción
El escalado en tiempo de prueba, como el o1 de OpenAI [1] y el R1 de DeepSeek [2], aporta un profundo cambio de paradigma a los modelos de lenguaje de gran tamaño (LLM) [3-7]. El escalado en tiempo de prueba permite cadenas de pensamiento más largas e induce comportamientos de razonamiento sofisticados, lo que hace que los modelos sean superiores en tareas competitivas de matemáticas y programación como AIME y Codeforces.
La técnica central que impulsa la revolución es el aprendizaje por refuerzo (RL) a gran escala, que suscita comportamientos de razonamiento complejos como la autoverificación y el refinamiento iterativo. Sin embargo, el algoritmo real y la receta clave para el entrenamiento de RL escalable siguen siendo un mito, ocultos en los informes técnicos de los modelos de razonamiento existentes [1, 2, 8-11]. En este artículo, revelamos obstáculos significativos en el entrenamiento de RL a gran escala y liberamos como código abierto un sistema de RL escalable con algoritmo, código de entrenamiento y conjunto de datos completamente de código abierto, que ofrece soluciones democratizadas con resultados de RL de nivel industrial.
Experimentamos con Qwen2.5-32B [12] como modelo preentrenado para RL. En nuestra ejecución inicial de GRPO, logramos solo 30 puntos en AIME, un rendimiento significativamente inferior al RL de DeepSeek (47 puntos). Un análisis exhaustivo revela que la línea base ingenua de GRPO adolece de varios problemas clave, como el colapso de entropía, el ruido en la recompensa y la inestabilidad del entrenamiento. La comunidad en general ha encontrado desafíos similares al reproducir los resultados de DeepSeek [13-19], lo que sugiere que detalles críticos de entrenamiento pueden haberse omitido en el artículo de R1 y que son necesarios para desarrollar un sistema de RL de nivel industrial, a gran escala y reproducible.
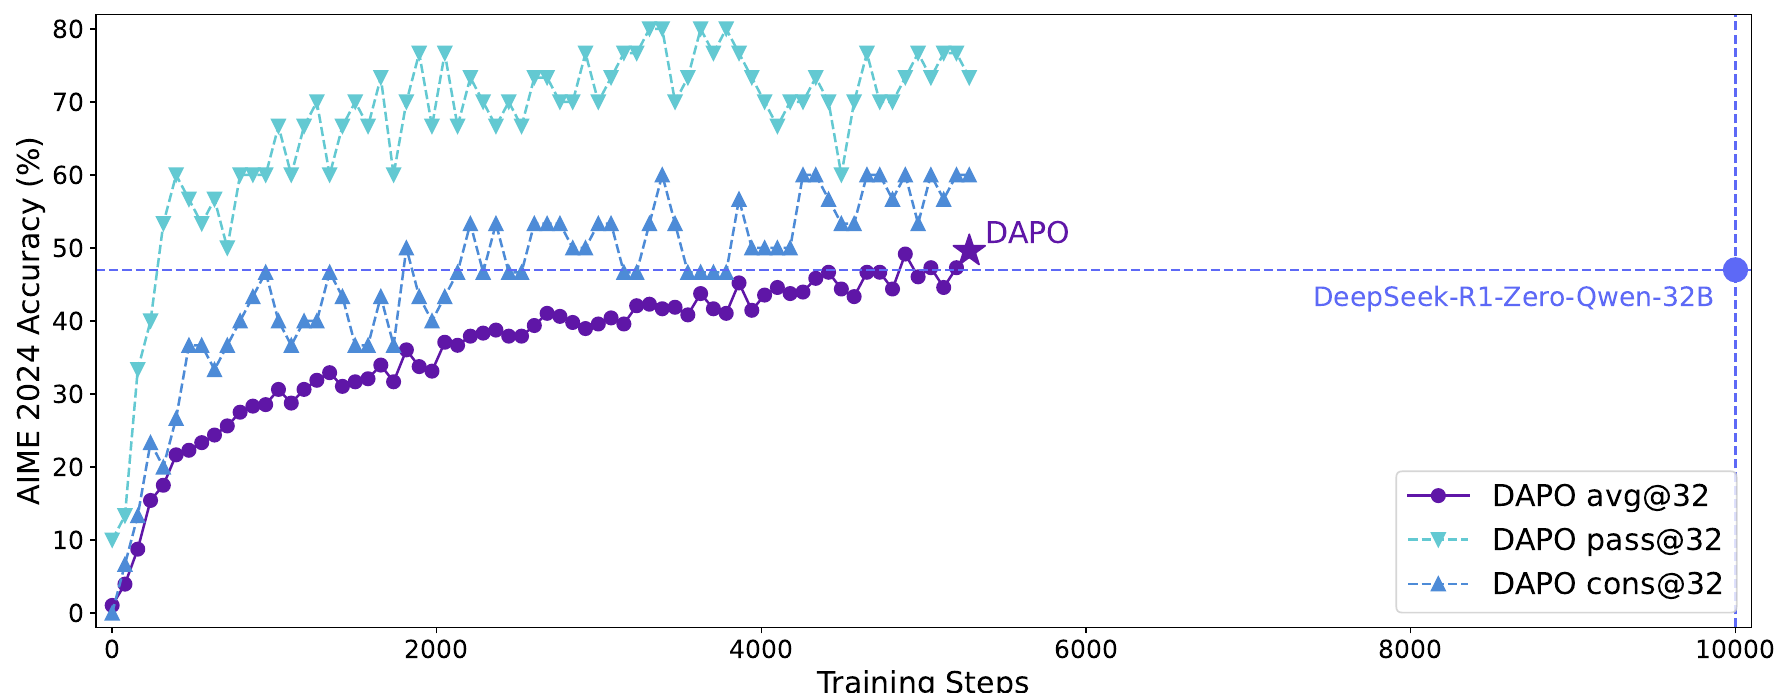
Para cerrar esta brecha, publicamos un sistema de código abierto de última generación para RL de LLM a gran escala, que alcanza 50 puntos en AIME 2024 basado en el modelo Qwen2.5-32B, superando resultados de última generación previos logrados por DeepSeek-R1-Zero-Qwen-32B [2] (47 puntos) usando el 50% de los pasos de entrenamiento (Figura 1). Proponemos el algoritmo Decoupled Clip and Dynamic Sampling Policy Optimization (DAPO), e introducimos 4 técnicas clave para hacer que el RL brille en el escenario de RL con CoT largas. Los detalles se presentan en la Sección 3.
1. Clip-Higher, que promueve la diversidad del sistema y evita el colapso de entropía;
2. Dynamic Sampling, que mejora la eficiencia y la estabilidad del entrenamiento;
3. Token-Level Policy Gradient Loss, que es crítica en escenarios de RL con CoT largas;
4. Overlong Reward Shaping, que reduce el ruido en la recompensa y estabiliza el entrenamiento.
Nuestra implementación se basa en verl [20]. Al liberar completamente nuestro sistema de RL de última generación, incluidos el código de entrenamiento y los datos, nuestro objetivo es revelar ideas valiosas sobre el RL a gran escala para LLM que beneficien a la comunidad en general.
2 Preliminares
2.1 Optimización de políticas proximal (PPO)
PPO [21] introduce un objetivo sustituto recortado para la optimización de políticas. Al restringir las actualizaciones de la política dentro de una región proximal de la política anterior usando clip, PPO estabiliza el entrenamiento y mejora la eficiencia de muestreo. Específicamente, PPO actualiza la política maximizando el siguiente objetivo:
donde es un par pregunta-respuesta de la distribución de datos , es el rango de recorte de la razón de muestreo por importancia, y es un estimador de la ventaja en el paso temporal . Dada la función de valor y la función de recompensa , se calcula usando la Estimación de Ventaja Generalizada (GAE) [22]:
donde
2.2 Optimización de políticas relativas a grupo (GRPO)
En comparación con PPO, GRPO elimina la función de valor y estima la ventaja de manera relativa al grupo. Para un par pregunta-respuesta específico , la política de comportamiento muestrea un grupo de respuestas individuales . Luego, la ventaja de la -ésima respuesta se calcula normalizando las recompensas a nivel de grupo :
De manera similar a PPO, GRPO adopta un objetivo recortado, junto con un término de penalización KL impuesto directamente:
donde
También vale la pena señalar que GRPO calcula el objetivo a nivel de muestra. Para ser exactos, GRPO primero calcula la pérdida media dentro de cada secuencia generada, antes de promediar la pérdida de las diferentes muestras. Como discutiremos en la Sección 3.3, tal diferencia puede tener un impacto en el rendimiento del algoritmo.
2.3 Eliminación de la divergencia KL
El término de penalización KL se utiliza para regular la divergencia entre la política en línea y la política de referencia congelada. En el escenario de RLHF [23], el objetivo del RL es alinear el comportamiento del modelo sin divergir demasiado del modelo inicial. Sin embargo, durante el entrenamiento del modelo de razonamiento CoT largo, la distribución del modelo puede divergir significativamente del modelo inicial, por lo que esta restricción no es necesaria. Por lo tanto, excluiremos el término KL de nuestro algoritmo propuesto.
2.4 Modelado de recompensas basado en reglas
El uso del modelo de recompensa suele sufrir el problema de la manipulación de la recompensa (reward hacking) [24-29]. En su lugar, utilizamos directamente la precisión final de una tarea verificable como recompensa de resultado, calculada mediante la siguiente regla:
donde es la respuesta de referencia y es la respuesta predicha. Se ha demostrado que este es un enfoque eficaz para activar la capacidad de razonamiento del modelo base, como se muestra en múltiples dominios tales como la demostración automática de teoremas [30-33], la programación de computadoras [34-37] y las competiciones de matemáticas [2].
3 DAPO
Proponemos el algoritmo ecouple Clip and ynamic sAmpling Policy ptimization (DAPO). DAPO muestrea un grupo de salidas para cada pregunta emparejada con la respuesta , y optimiza la política mediante el siguiente objetivo:
donde
El algoritmo completo se puede encontrar en el Algoritmo 1. En esta sección, presentaremos las técnicas clave asociadas con DAPO.
3.1 Elevar el techo: Clip-Higher
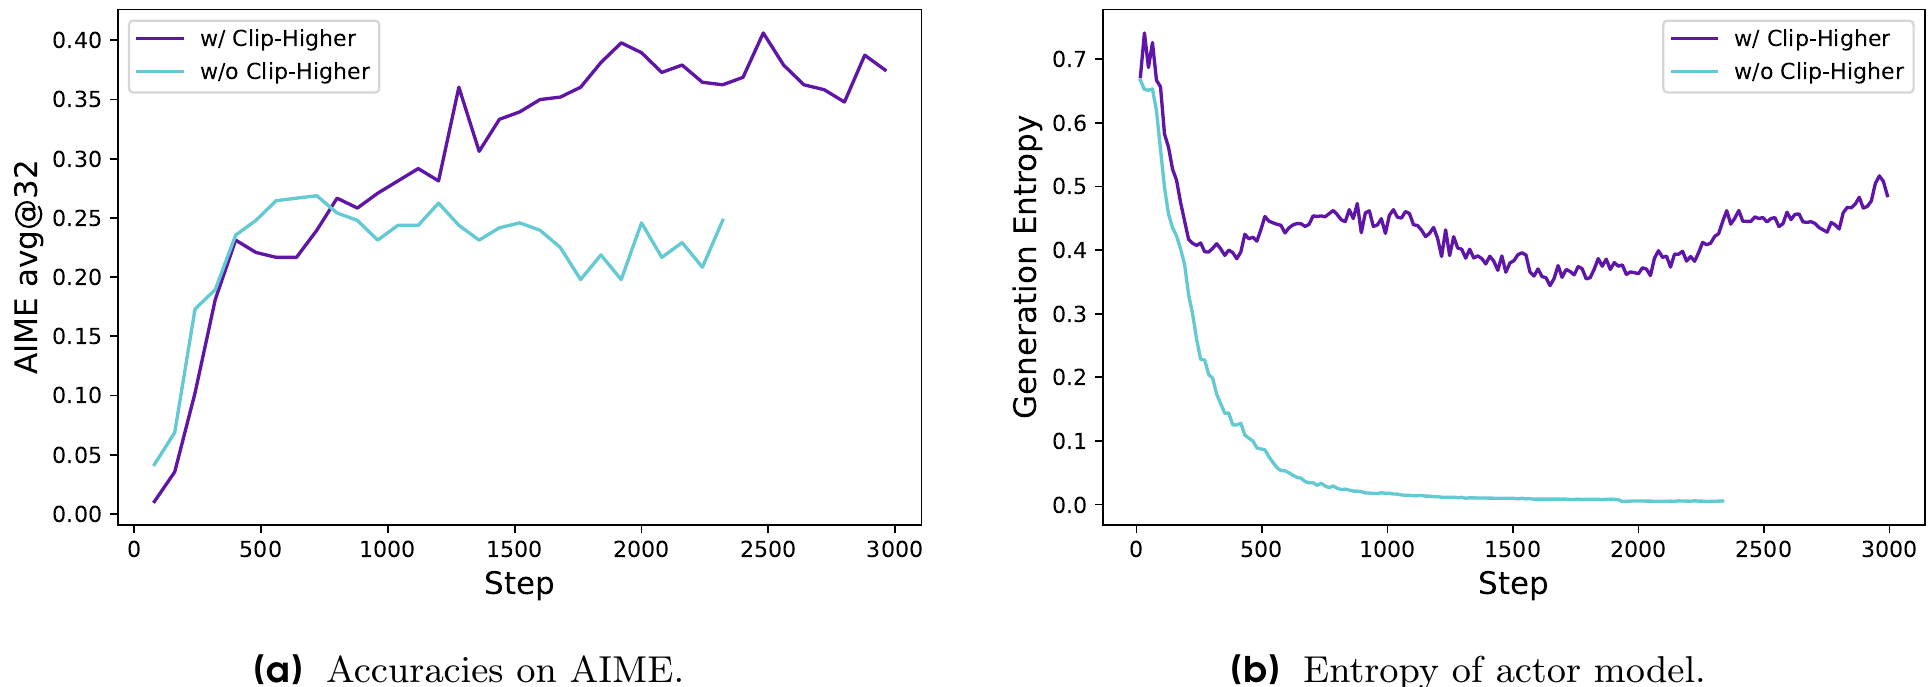
En nuestros experimentos iniciales usando PPO ingenuo [21] o GRPO [38], observamos el fenómeno de colapso de la entropía: la entropía de la política disminuye rápidamente a medida que avanza el entrenamiento (Figura 2b). Las respuestas muestreadas de ciertos grupos tienden a ser casi idénticas. Esto indica una exploración limitada y una política determinista temprana, lo que puede obstaculizar el proceso de escalado.
Proponemos la estrategia Clip-Higher para abordar este problema. El recorte sobre la razón de muestreo por importancia se introduce en Clipped Proximal Policy Optimization (PPO-Clip) [21] para restringir la región de confianza y mejorar la estabilidad del RL. Identificamos que el recorte superior puede restringir la exploración de la política, donde hacer que un token de "explotación" sea más probable es mucho más fácil, mientras que la probabilidad de un token de "exploración" poco probable está demasiado acotada para poder elevarla.
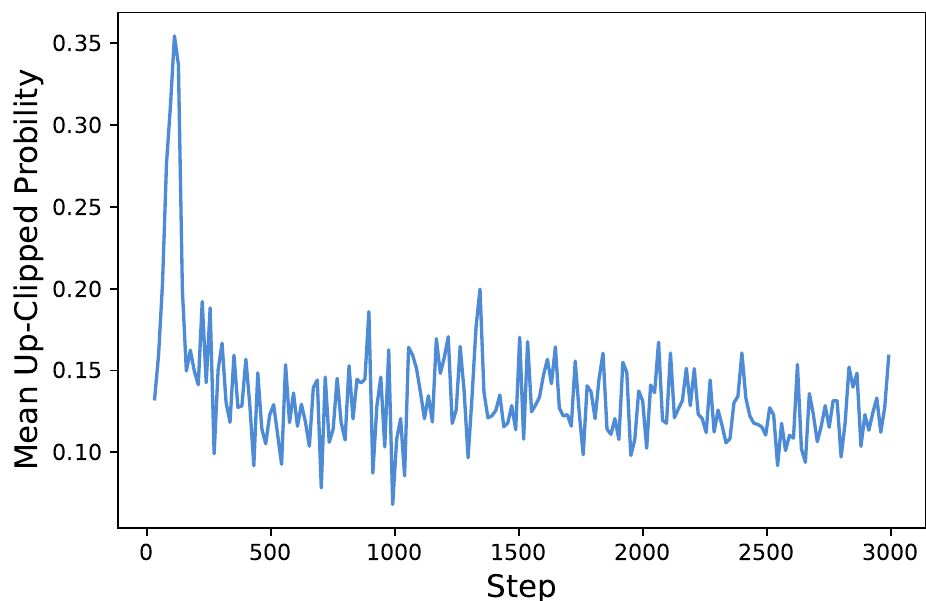
Concretamente, cuando (el valor predeterminado de la mayoría de los algoritmos) y (el sistema intenta aumentar la probabilidad), considere dos acciones con probabilidades y 0.9. Los límites superiores de las probabilidades incrementadas son 0.012 y 1.08, respectivamente ( ). Esto implica que los tokens de "explotación" con una probabilidad más alta (p. ej., 0.9) no están restringidos a obtener probabilidades aún extremadamente mayores como 0.999. A la inversa, para los tokens de "exploración" de baja probabilidad, lograr un aumento no trivial de la probabilidad es considerablemente más difícil. Empíricamente, también observamos que la probabilidad media de los tokens recortados por el límite superior es baja: (Figura 3a). Este hallazgo respalda nuestra intuición de que el umbral de recorte superior efectivamente restringe el aumento de probabilidad de los tokens de "exploración" de baja probabilidad, limitando así potencialmente la exploración del sistema.
Siguiendo la estrategia Clip-Higher, desacoplamos el rango de recorte inferior y superior como y , como se destaca en la Ecuación 10:
Aumentamos el valor de para dejar más espacio al aumento de los tokens de baja probabilidad. Como se muestra en la Figura 2, este ajuste mejora efectivamente la entropía de la política y facilita la generación de muestras más diversas. Mantenemos tal como está, porque aumentarlo suprimirá la probabilidad de estos tokens a 0, lo que provocaría el colapso del espacio de muestreo.
3.2 Cuantos más, mejor: Muestreo dinámico
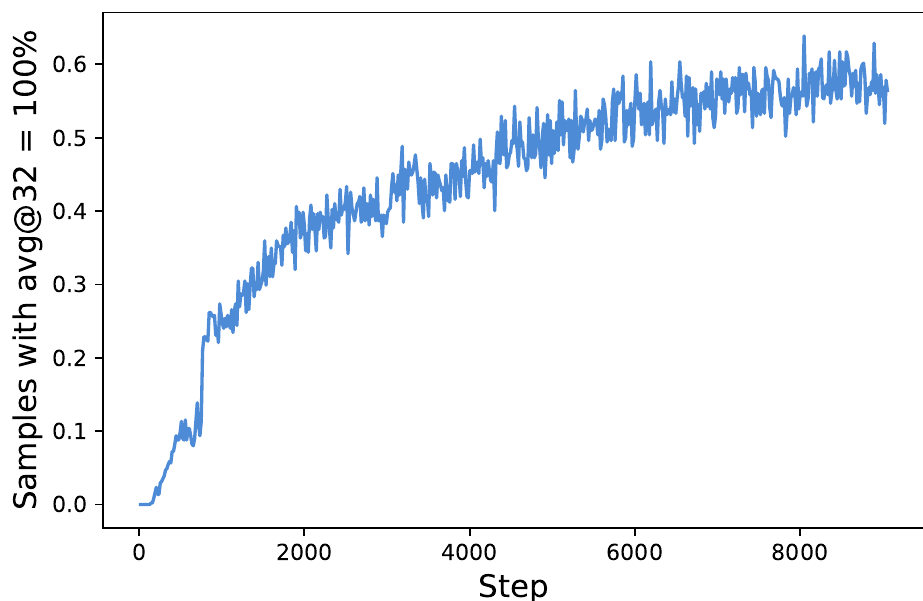
Los algoritmos de RL existentes sufren el problema de disminución del gradiente cuando algunas indicaciones tienen una precisión igual a 1. Por ejemplo, para GRPO, si todas las salidas de una indicación particular son correctas y reciben la misma recompensa, la ventaja resultante para este grupo es cero. Una ventaja cero da como resultado gradientes de política cero, reduciendo la magnitud y aumentando la sensibilidad al ruido del gradiente del lote, lo que degrada la eficiencia del muestreo. Empíricamente, el número de muestras con precisión igual a 1 continúa aumentando, como se muestra en la Figura 3b. Esto significa que el número efectivo de indicaciones en cada lote sigue disminuyendo, lo que puede llevar a una mayor varianza en el gradiente y amortigua las señales de gradiente para el entrenamiento del modelo.
Con este fin, proponemos sobremuestrear y filtrar las indicaciones con precisión igual a 1 y 0 como se ilustra en la Ecuación 11, dejando todas las indicaciones en el lote con gradientes efectivos y manteniendo un número consistente de indicaciones. El costo de muestreo para cada lote es dinámico. Antes del entrenamiento, seguimos muestreando hasta que el lote esté completamente lleno con muestras cuya precisión no sea ni 0 ni 1.
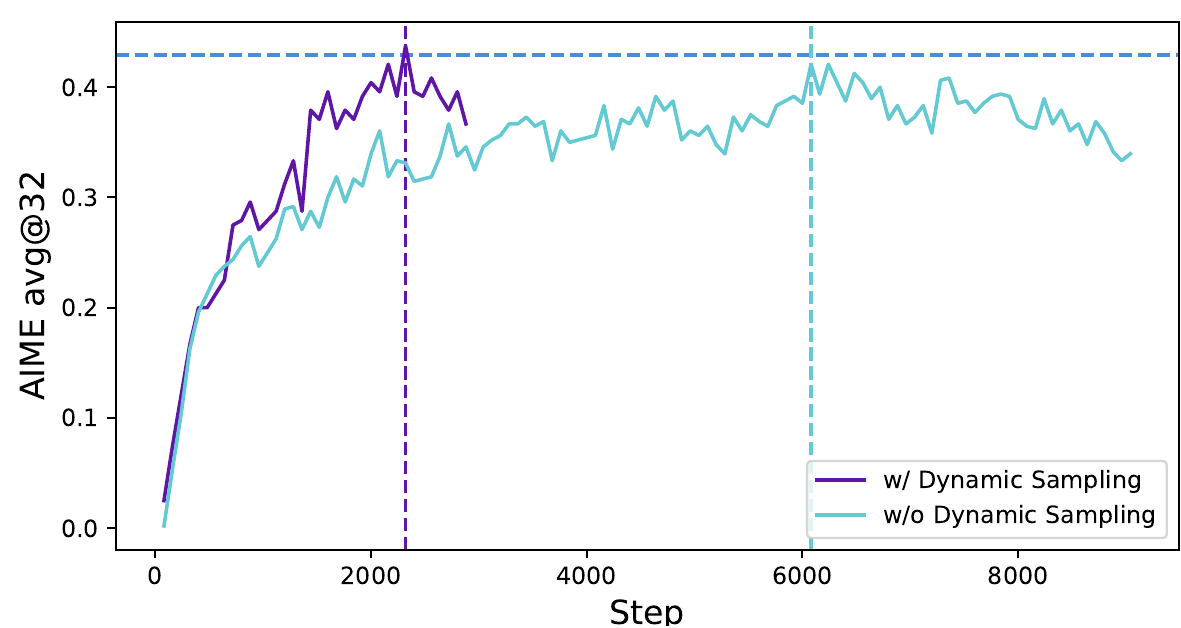
Tenga en cuenta que esta estrategia no necesariamente impide la eficiencia del entrenamiento, porque el tiempo de generación generalmente está dominado por la generación de muestras de cola larga si el sistema de RL está sincronizado y la etapa de generación no está canalizada. Además, encontramos que con el muestreo dinámico el experimento alcanza el mismo rendimiento más rápido, como se muestra en la Figura 6.
3.3 Acto de reequilibrio: Pérdida de gradiente de política a nivel de token
El algoritmo GRPO original emplea un cálculo de pérdida a nivel de muestra, que implica primero promediar las pérdidas por token dentro de cada muestra y luego agregar las pérdidas entre muestras. En este enfoque, a cada muestra se le asigna el mismo peso en el cálculo final de la pérdida. Sin embargo, encontramos que este método de reducción de pérdida introduce varios desafíos en el contexto de escenarios de RL con CoT largas.
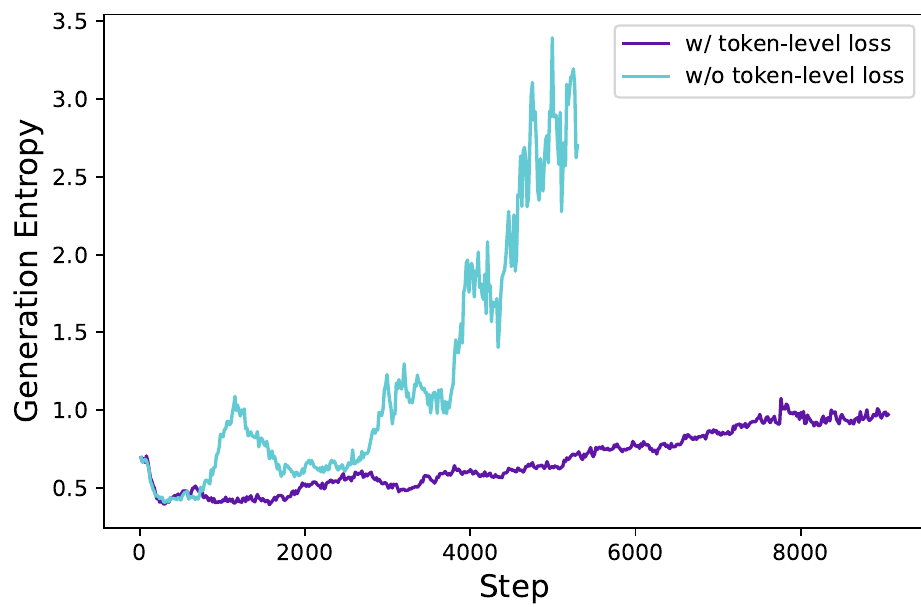
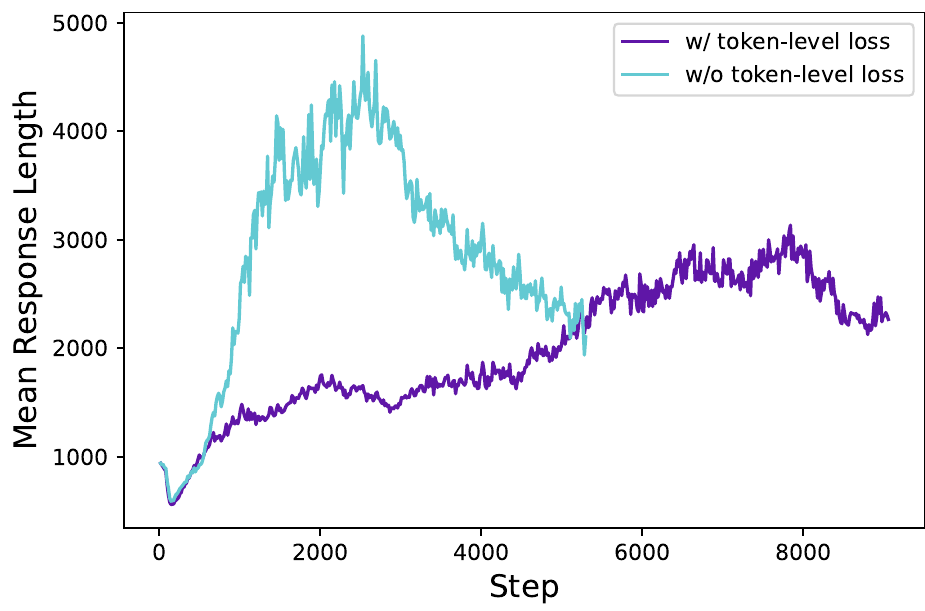
Dado que a todas las muestras se les asigna el mismo peso en el cálculo de la pérdida, los tokens dentro de respuestas más largas (que contienen más tokens) pueden tener una contribución desproporcionadamente menor a la pérdida general, lo que puede provocar dos efectos adversos. Primero, para muestras largas de alta calidad, este efecto puede impedir la capacidad del modelo de aprender patrones relevantes para el razonamiento dentro de ellas. Segundo, observamos que las muestras excesivamente largas a menudo exhiben patrones de baja calidad, como galimatías y palabras repetitivas. Por lo tanto, el cálculo de pérdida a nivel de muestra, debido a su incapacidad de penalizar efectivamente esos patrones indeseables en muestras largas, conduce a un aumento poco saludable de la entropía y la longitud de la respuesta, como se muestra en la Figura 4a y la Figura 4b.
Introducimos una Pérdida de gradiente de política a nivel de token en el escenario de RL con CoT largas para abordar las limitaciones anteriores:
En esta configuración, las secuencias más largas pueden tener más influencia en la actualización general del gradiente en comparación con las secuencias más cortas. Además, desde la perspectiva de tokens individuales, si un patrón de generación particular puede conducir a un aumento o disminución de la recompensa, se fomentará o suprimirá por igual, independientemente de la longitud de la respuesta en la que aparezca.
3.4 Escondite: Modelado de recompensas demasiado largas
En el entrenamiento con RL, normalmente establecemos una longitud máxima para la generación, truncando las muestras demasiado largas en consecuencia. Observamos que una configuración inadecuada de la recompensa para las muestras truncadas puede introducir ruido en la recompensa y perturbar significativamente el proceso de entrenamiento.
Por defecto, asignamos una recompensa punitiva a las muestras truncadas. Este enfoque puede introducir ruido en el proceso de entrenamiento, ya que un proceso de razonamiento sólido puede ser penalizado únicamente debido a su longitud excesiva. Tales penalizaciones pueden confundir potencialmente al modelo respecto a la validez de su proceso de razonamiento.
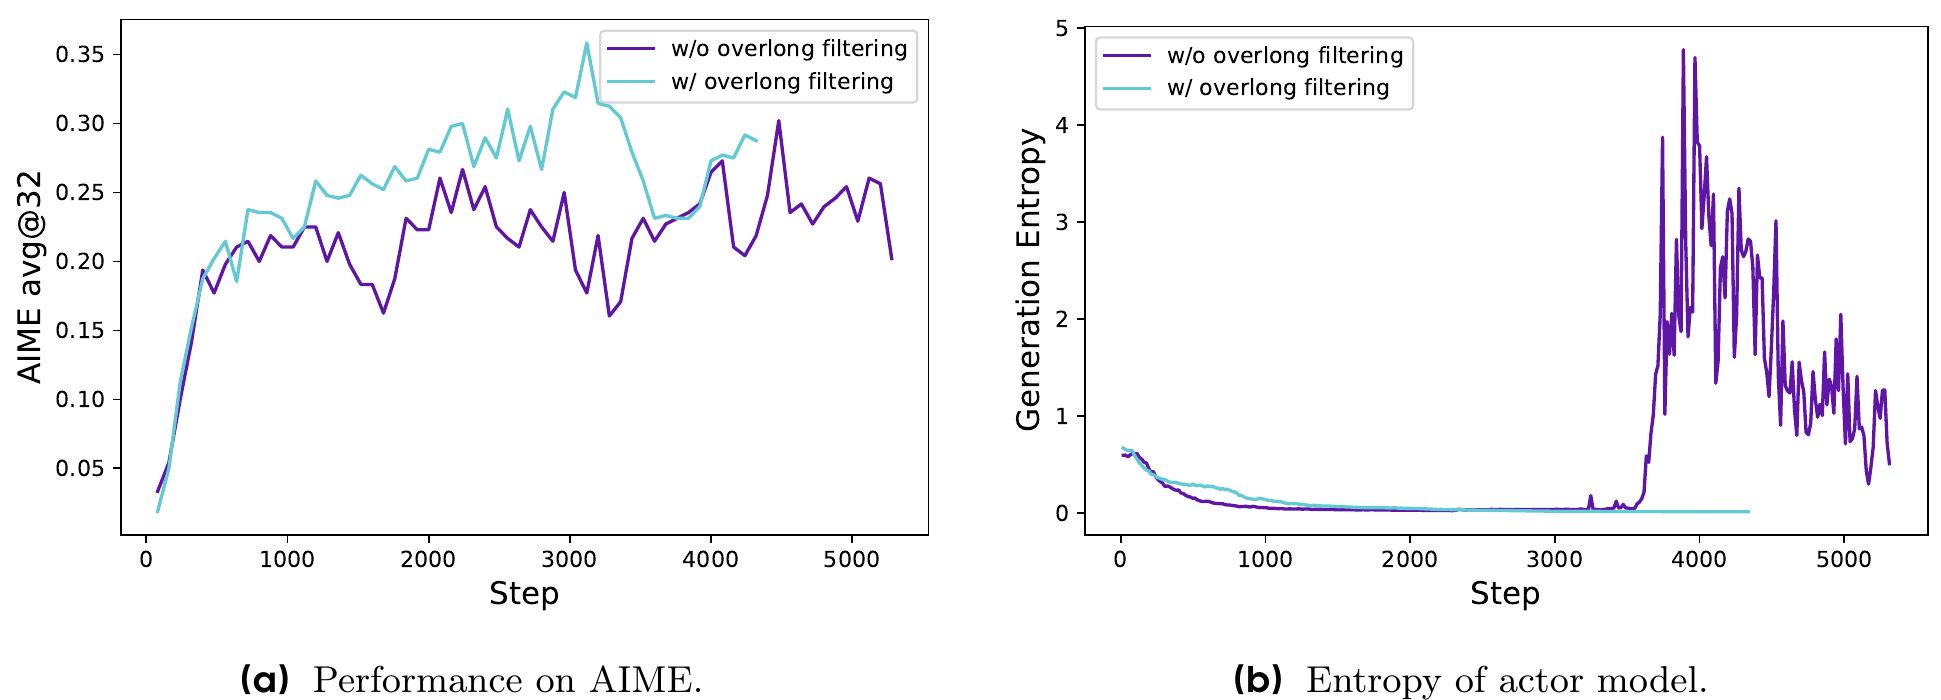
Para investigar el impacto de este ruido en la recompensa, primero aplicamos una estrategia de Filtrado de Muestras Demasiado Largas (Overlong Filtering) que enmascara la pérdida de las muestras truncadas. Encontramos que este enfoque estabiliza significativamente el entrenamiento y mejora el rendimiento, como se demuestra en la Figura 5.
| Algoritmo 1 | DAPO: Optimización de Política con Recorte Desacoplado y Muestreo Dinámico |
| Entrada: modelo de política inicial πθ; modelo de recompensa R; indicaciones de tarea D; hiperparámetros ε1ow, εhigh | |
| 1: para step = 1,...,M hacer | |
| 2: Muestrear un lote Db de D | |
| 3: Actualizar el modelo de política antiguo πθold ← πθ | |
| 4: Muestrear G salidas {oi}i=1G ~ πθold(·|q) para cada pregunta q ∈ Db | |
| 5: Calcular las recompensas {ri}i=1G para cada salida muestreada oi ejecutando R | |
| 6: Filtrar oi y añadir el resto al búfer de muestreo dinámico (Ecuación de Muestreo Dinámico (11)) | |
| 7: si tamaño del búfer nb < N: | |
| 8: continuar | |
| 9: Para cada oi en el búfer, calcular Ait,t para el t-ésimo token de oi (Ecuación (9)) | |
| 10: para iteration = 1, ..., μ hacer | |
| 11: Actualizar el modelo de política πθ maximizando el objetivo DAPO (Ecuación (8)) | |
| Salida: πθ |
Además, proponemos el Castigo Suave para Respuestas Demasiado Largas (Soft Overlong Punishment, Ecuación 13), un mecanismo de penalización consciente de la longitud diseñado para moldear la recompensa de las muestras truncadas. Específicamente, cuando la longitud de la respuesta excede el valor máximo predefinido, definimos un intervalo de castigo. Dentro de este intervalo, cuanto más larga es la respuesta, mayor es el castigo que recibe. Este castigo se suma a la recompensa original de corrección basada en reglas, señalando así al modelo que evite respuestas excesivamente largas.
3.5 Transformación del conjunto de datos
Nuestro conjunto de datos proviene de la web y de las páginas oficiales de competiciones, mediante una combinación de raspado web y anotación manual. Las respuestas del conjunto de datos matemáticos suelen presentarse en una variedad de formatos, como expresiones, fórmulas y números, lo que dificulta el diseño de reglas integrales para analizarlas. Para proporcionar señales de recompensa precisas utilizando reglas y minimizar los errores introducidos por los analizadores de fórmulas, inspirados en AIME, seleccionamos y transformamos las respuestas en números enteros, que son fáciles de analizar. Por ejemplo, si la respuesta original se expresa en la forma , instruimos al LLM a modificar la pregunta para que la respuesta esperada se convierta en . Tras la selección y transformación, obtuvimos el conjunto de datos DAPO-Math-17K, que consta de 17K prompts, cada uno emparejado con un número entero como respuesta.
4 Experimentos
4.1 Detalles de entrenamiento
En este trabajo, nos centramos específicamente en tareas matemáticas para evaluar nuestro algoritmo, lo cual puede transferirse fácilmente a otras tareas. Adoptamos el marco veri [20] para el entrenamiento. Utilizamos GRPO naive [38] como nuestro algoritmo de referencia y estimamos las ventajas mediante la normalización de recompensas por grupo.
En cuanto a los hiperparámetros, utilizamos el optimizador AdamW [39] con una tasa de aprendizaje constante de , incorporando un calentamiento lineal durante 20 pasos de rollout. Para el rollout, el tamaño de lote de prompts es 512 y muestreamos 16 respuestas por cada prompt. Para el entrenamiento, el tamaño de minilote se establece en 512, es decir, 16 actualizaciones de gradiente por cada paso de rollout. Para el Overlong Reward Shaping, establecemos la longitud máxima esperada en 16.384 tokens y asignamos 4.096 tokens adicionales como caché de castigo suave. Por lo tanto, el número máximo de tokens para la generación se establece en 20.480 tokens. En cuanto al mecanismo Clip-Higher, establecemos el parámetro de recorte en 0,2 y en 0,28, lo que equilibra eficazmente el compromiso entre exploración y explotación. Para la evaluación en AIME, repetimos el conjunto de evaluación 32 veces y reportamos avg@32 para la estabilidad de los resultados. Los hiperparámetros de inferencia de la evaluación se establecen con temperatura 1,0 y top-p 0,7.
4.2 Resultados principales
Los experimentos en AIME 2024 demuestran que DAPO ha entrenado con éxito el modelo Qwen-32B Base hasta convertirlo en un potente modelo de razonamiento, alcanzando un rendimiento superior a los experimentos de DeepSeek sobre Qwen2.5-32B usando el enfoque R1. En la Figura 1, observamos una mejora sustancial del rendimiento en AIME 2024, con la precisión aumentando desde cerca del 0% hasta el 50%. Notablemente, esta mejora se logra con solo el 50% de los pasos de entrenamiento requeridos por DeepSeek-R1-Zero-Qwen-32B.
Analizamos las contribuciones de cada técnica de entrenamiento en nuestra metodología, como se detalla en la Tabla 1. Las mejoras observadas demuestran la eficacia de estas técnicas en el entrenamiento de RL, cada una aportando
| Modelo | AIME24avg@32 |
| DeepSeek-R1-Zero-Qwen-32B | 47 |
| GRPO simple | 30 |
| + Filtrado de secuencias demasiado largas | 36 |
| + Clip-Higher | 38 |
| + Penalización suave por exceso de longitud | 41 |
| + Pérdida a nivel de token | 42 |
| + Muestreo dinámico (DAPO) | 50 |
varios puntos de precisión en AIME 2024. Notablemente, dado el ajuste vanilla de GRPO, solo se puede alcanzar un de precisión entrenando desde un modelo base Qwen2.5-32B.
Para la pérdida a nivel de token, aunque aporta una menor mejora de rendimiento, encontramos que aumenta la estabilidad del entrenamiento y hace que el aumento de longitud sea más saludable.
Al aplicar el Muestreo Dinámico, aunque es necesario muestrear más datos debido al filtrado de datos con gradiente cero, el tiempo total de entrenamiento no se ve significativamente afectado. Como se muestra en la Figura 6, aunque el número de instancias de muestreo aumenta, el tiempo de convergencia del modelo se reduce incluso, debido a que se requieren menos pasos de entrenamiento.
4.3 Dinámica de entrenamiento
El aprendizaje por refuerzo en modelos de lenguaje grandes no solo es una dirección de investigación de vanguardia, sino también un desafío de ingeniería de sistemas intrínsecamente complejo, caracterizado por la interdependencia de sus diversos subsistemas. Las modificaciones de cualquier subsistema individual pueden propagarse por el sistema, provocando consecuencias imprevistas debido a la intrincada interacción entre estos componentes. Incluso cambios aparentemente menores en las condiciones iniciales, como variaciones en los datos y los hiperparámetros, pueden amplificarse a través de procesos iterativos de aprendizaje por refuerzo, produciendo desviaciones sustanciales en los resultados. Esta complejidad a menudo enfrenta a los investigadores a un dilema: incluso después de un análisis meticuloso y expectativas bien fundamentadas de que una modificación mejorará aspectos específicos del proceso de entrenamiento, los resultados reales frecuentemente divergen de la trayectoria anticipada. Por lo tanto, la monitorización de resultados intermedios clave durante la experimentación es esencial para identificar rápidamente las fuentes de discrepancias y, en última instancia, para refinar el sistema.
- La Longitud de las Respuestas Generadas es una métrica estrechamente relacionada con la estabilidad del entrenamiento y el rendimiento, como se muestra en la Figura 7a. El aumento de longitud proporciona al modelo un mayor espacio para la exploración, permitiendo que se muestreen comportamientos de razonamiento más complejos y se refuercen gradualmente mediante el entrenamiento. Sin embargo, es importante señalar que la longitud no siempre mantiene una tendencia ascendente continua durante el entrenamiento. En algunos periodos considerables, puede presentar una tendencia de estancamiento o incluso de descenso, lo cual también se ha demostrado en [2]. Normalmente utilizamos la longitud junto con la precisión de validación como indicadores para evaluar si un experimento se está deteriorando.
- La Dinámica de la Recompensa durante el entrenamiento siempre ha sido uno de los indicadores de monitorización cruciales en el aprendizaje por refuerzo, como se muestra en la Figura 7b. En la mayoría de nuestros experimentos, la tendencia de aumento de la recompensa es relativamente estable y no fluctúa ni disminuye significativamente debido a ajustes en la configuración experimental. Esto indica que, dado una señal de recompensa fiable, los modelos de lenguaje pueden ajustarse robustamente a la distribución del conjunto de entrenamiento. Sin embargo, encontramos que la recompensa final en el conjunto de entrenamiento a menudo exhibe poca correlación con la precisión en el conjunto de validación, lo que indica sobreajuste al conjunto de entrenamiento.
- La Entropía del Modelo Actor y la Probabilidad de Generación están relacionadas con la capacidad de exploración del modelo y son métricas clave que monitorizamos de cerca en nuestros experimentos. Intuitivamente, la entropía del modelo debe mantenerse dentro de un rango apropiado. Una entropía excesivamente baja indica que la distribución de probabilidad es demasiado puntiaguda, lo que lleva a una pérdida de capacidad de exploración. Por el contrario, una
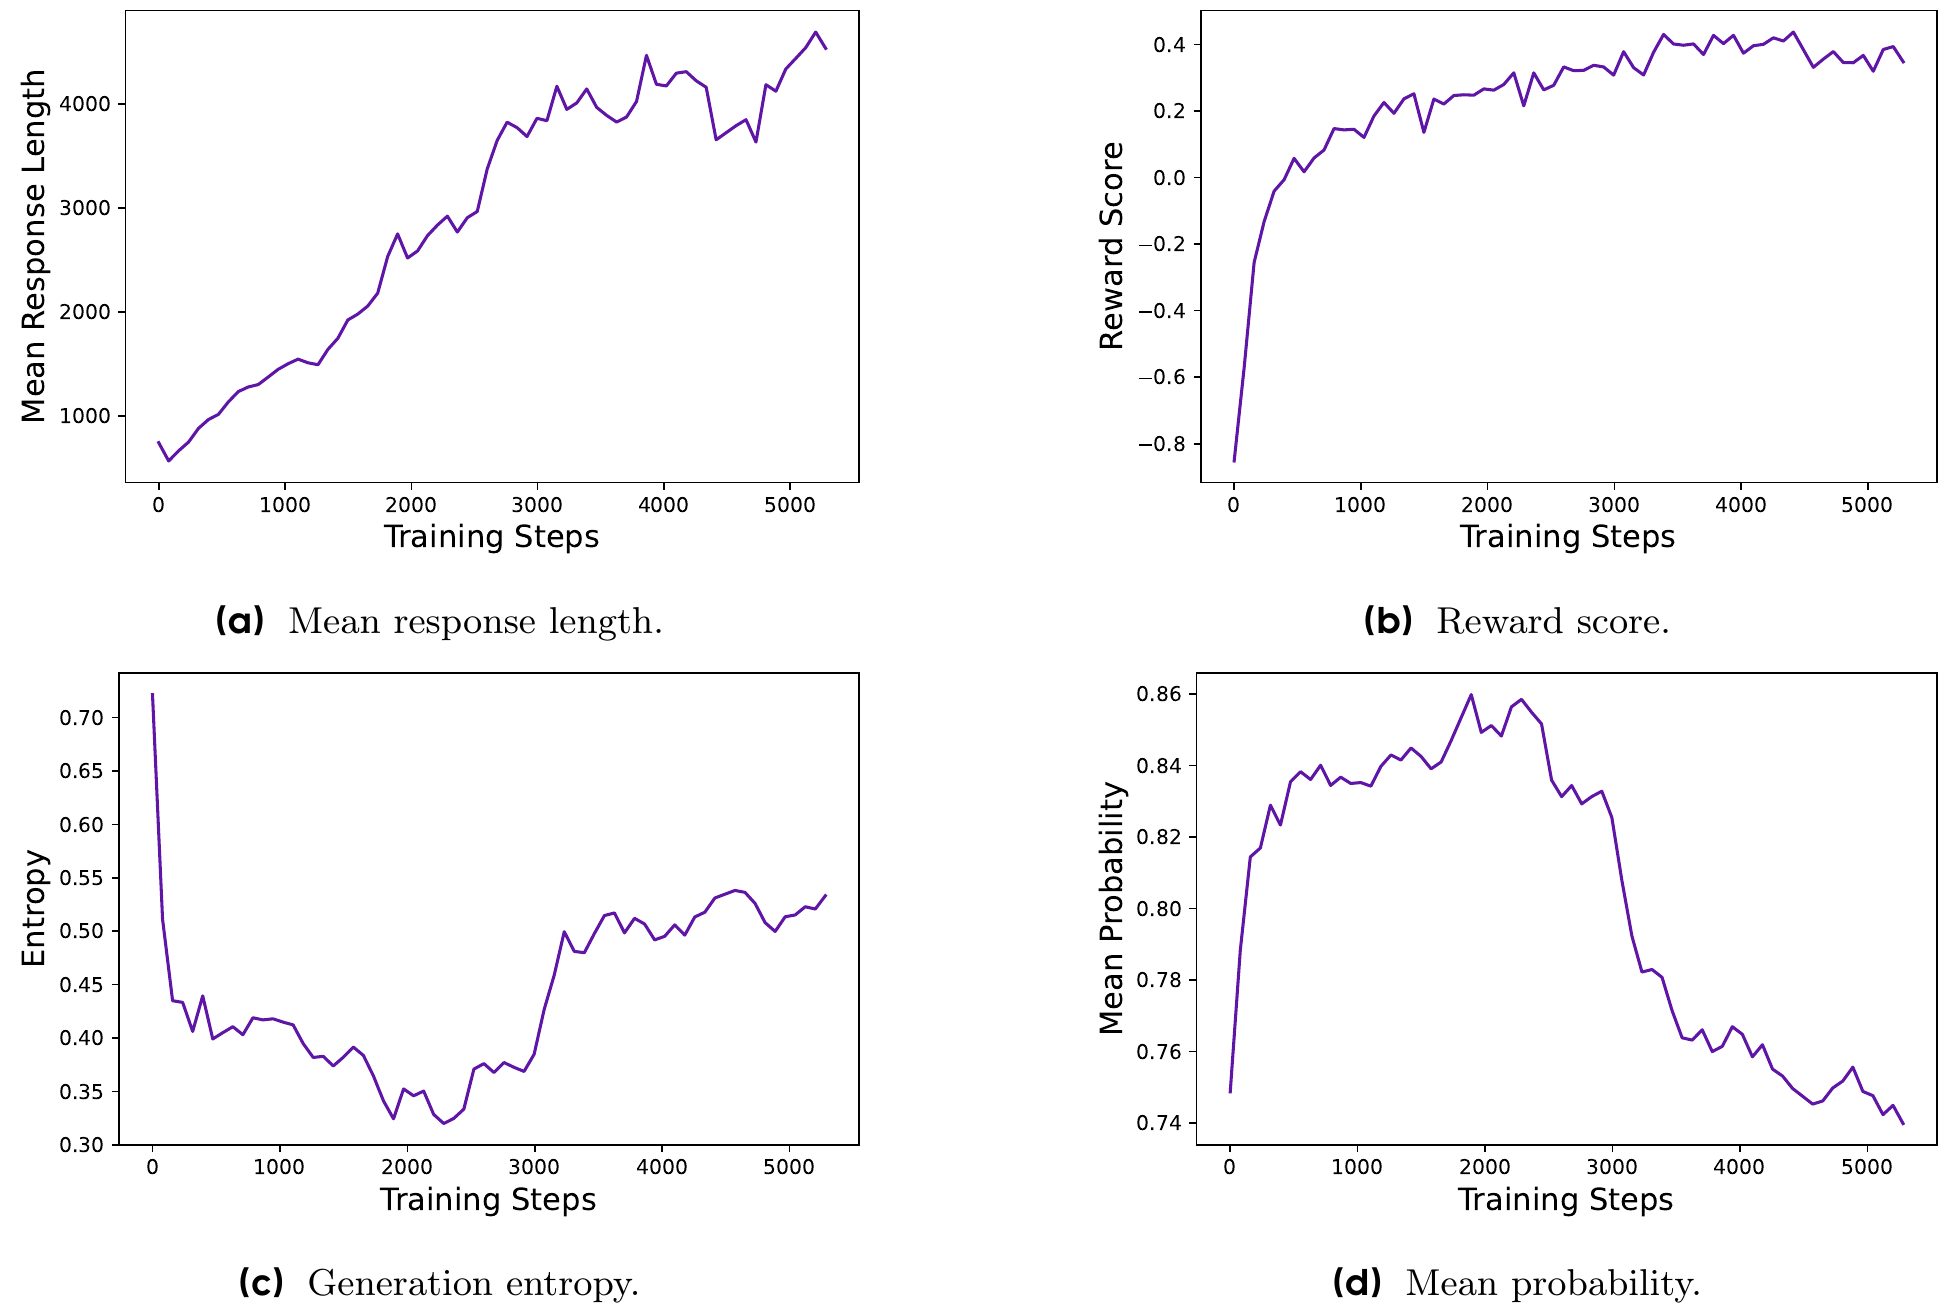
entropía excesivamente alta a menudo se asocia con problemas de sobreexploración, como la generación de galimatías y repeticiones. Para la probabilidad de generación, la situación es exactamente la opuesta. Como se demuestra en la Sección 3.1, al aplicar la estrategia Clip-Higher, abordamos eficazmente el problema del colapso de la entropía. En experimentos posteriores, encontramos que mantener una tendencia ascendente lenta en la entropía favorece la mejora del rendimiento del modelo, mostrado en la Figura 7c y la Figura 7d.
4.4 Estudio de caso
Durante el proceso de entrenamiento de RL, observamos un fenómeno interesante: los patrones de razonamiento del modelo actor evolucionan dinámicamente con el tiempo. Específicamente, el algoritmo no solo refuerza los patrones de razonamiento existentes que facilitan la resolución correcta de problemas, sino que también da lugar gradualmente a modos de razonamiento completamente nuevos que inicialmente estaban ausentes. Este hallazgo revela la adaptabilidad y la capacidad de exploración de los algoritmos de RL y ofrece nuevas perspectivas sobre los mecanismos de aprendizaje del modelo.
Por ejemplo, en las etapas tempranas del entrenamiento del modelo, prácticamente no había ocurrido la verificación y reflexión sobre pasos de razonamiento previos. Sin embargo, a medida que avanza el entrenamiento, el modelo exhibe comportamientos distintos de reflexión y retroceso, como se muestra en la Tabla 2. Esta observación arroja luz sobre una mayor exploración para interpretar la aparición de habilidades de razonamiento durante el RL, lo cual dejamos para investigaciones futuras.
5 Conclusión
En este artículo, publicamos un sistema completamente de código abierto para RL de LLM a gran escala, incluyendo algoritmo, infraestructura de código y conjunto de datos. El sistema alcanza un rendimiento de RL de LLM a gran escala de última generación (AIME 50 usando el modelo preentrenado Qwen-32B). Proponemos la Política de Recorte Desacoplado y Muestreo Dinámico
Pregunta:
Dado que la base del tetraedro es un triángulo equilátero, la proyección del punto sobre la cara es el ortocentro de , el ángulo diedro es y , encuentre el volumen del tetraedro. La respuesta tiene la forma , así que dé el valor de .
Respuesta:
Consideremos el problema dado: Necesitamos determinar... A continuación, sea con coordenadas . Dado que , la fórmula de distancia nos da , por lo que podemos escribir . Ahora, recordemos que es la proyección ortogonal de Sin embargo, esperemos un momento, reconsideremos el ángulo diedro que involucra planos de una manera geométrica más reflexiva. Consideremos el plano , que se encuentra completamente en el plano coordenado xy (como ). Sea el plano . El punto proyectado perpendicularmente al plano cae sobre . La recta ......
Tabla 2 Emergencia del comportamiento reflexivo en elalgoritmo de optimización del aprendizaje por refuerzo (DAPO), y presentamos 4 técnicas clave para hacer que el RL sea poderosa y eficazmente eficiente en el escenario de RL de CoT largo. Además, al abrir el código de entrenamiento y el conjunto de datos, proporcionamos a la comunidad investigadora y a la sociedad en general un acceso práctico a una solución de aprendizaje por refuerzo escalable, permitiendo que todos se beneficien de estos avances.
Contribuciones
Líder del proyecto
Qiying
Algoritmo
Qiying , Zheng Zhang , Ruofei Zhu , Yufeng Yuan , Xiaochen Zuo , Yu Yue
Infraestructura\*
Weinan Dai , Tiantian Fan , Gaohong Liu , Juncai Liu , Lingjun Liu , Xin Liu , Haibin Lin , Zhiqi Lin , Bole Ma , Guangming Sheng , Yuxuan Tong , Qiying Yu , Chi Zhang , Mofan Zhang , Ru Zhang , Wang Zhang , Hang Zhu , Jinhua Zhu
\*Apellido en orden alfabético
Conjunto de datos
Jiaze Chen , Jiangjie Chen , Chengyi Wang , Hongli Yu , Yuxuan Song , Xiangpeng Wei , Qiying
Supervisión
Hao Zhou , Jingjing Liu , Wei- Ying Ma , Ya- Qin Zhang , Lin Yan , Mu Qiao , Yonghui Wu , Mingxuan Wang
Afiliación
ByteDance Seed
Institute for AI Industry Research (AIR), Tsinghua University
The University of Hong Kong
SIA- Lab of Tsinghua AIR and ByteDance Seed
Agradecimientos
Agradecemos a Zhengyin Du, Shengding Hu, Kai Shen, Tianyang Zhan, Zhen Xiao, Renjie Zheng, Li Han, Kaihua Jiang, así como a otros colegas de ByteDance, por su apoyo al proyecto DAPO.
Referencias
[1] OpenAI. Learning to reason with llms, 2024.
[2] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[3] OpenAI. Informe técnico de GPT4. Preimpresión de arXiv arXiv:2303.08774, 2023.
[4] Anthropic. Claude 3.5 sonnet, 2024.
[5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Los modelos de lenguaje son aprendices con pocos ejemplos. Advances in neural information processing systems, 33:1877-1901, 2020.
[6] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Escalando el modelado de lenguaje con pathways. Journal of Machine Learning Research, 24(240):1-113, 2023.
[7] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Informe técnico de Deepseek-v3. Preimpresión de arXiv arXiv:2412.19437, 2024.
[8] XAI. Grok 3 beta — la era de los agentes de razonamiento, 2024.
[9] Google DeepMind. Gemini 2.0 flash thinking, 2024.
[10] Qwen. Qwq-32b: Abrazando el poder del aprendizaje por refuerzo, 2024.
[11] Kimi Team, Angang Du, Bofei Gao, Bowei Xing, Changjiu Jiang, Cheng Chen, Cheng Li, Chenjun Xiao, Chenzhuang Du, Chonghua Liao, et al. Kimi k1.5: Escalando el aprendizaje por refuerzo con LLM. Preimpresión de arXiv arXiv:2501.12599, 2025.
[12] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Informe técnico de Qwen2.5. Preimpresión de arXiv arXiv:2412.15115, 2024.
[13] Zhipeng Chen, Yingqian Min, Beichen Zhang, Jie Chen, Jinhao Jiang, Daixuan Cheng, Wayne Xin Zhao, Zheng Liu, Xu Miao, Yang Lu, et al. Un estudio empírico sobre la elicitación y mejora de modelos de razonamiento similares a RL. Preimpresión de arXiv arXiv:2503.04548, 2025.
[14] Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, and Heung-Yeung Shum Xiangyu Zhang. Open-reasoner-zero: Un enfoque de código abierto para escalar el aprendizaje por refuerzo sobre el modelo base. https://github.com/Open-Reasoner-Zero/Open-Reasoner-Zero, 2025.
[15] Jian Hu. Reinforce++: Un enfoque simple y eficiente para alinear grandes modelos de lenguaje. Preimpresión de arXiv arXiv:2501.03262, 2025.
[16] Ganqu Cui, Lifan Yuan, Zefan Wang, Hanbin Wang, Wendi Li, Bingxiang He, Yuchen Fan, Tianyu Yu, Qixin Xu, Weize Chen, et al. Refuerzo de procesos mediante recompensas implícitas. Preimpresión de arXiv arXiv:2502.01456, 2025.
[17] Jung Hyun Lee, June Yong Yang, Byeongho Heo, Dongyoon Han, and Kang Min Yoo. Modelos de valor supervisados por tokens para mejorar las capacidades de razonamiento matemático de grandes modelos de lenguaje. Preimpresión de arXiv arXiv:2407.12863, 2024.
[18] Amirhossein Kazemnejad, Milad Aghajohari, Eva Portelance, Alessandro Sordoni, Siva Reddy, Aaron Courville, and Nicolas Le Roux. Vineppo: Desbloqueando el potencial de RL para el razonamiento de LLM mediante una asignación de crédito refinada. Preimpresión de arXiv arXiv:2410.01679, 2024.
[19] Yufeng Yuan, Yu Yue, Ruofei Zhu, Tiantian Fan, and Lin Yan. ¿Qué hay detrás del colapso de PPO en cadenas de razonamiento largas? La optimización del valor guarda el secreto. Preimpresión de arXiv arXiv:2503.01491, 2025.
[20] Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, and Chuan Wu. Hybridflow: Un marco RLHF flexible y eficiente. Preimpresión de arXiv arXiv:2409.19256, 2024.
[21] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov. Algoritmos de optimización de políticas proximales. Preimpresión de arXiv arXiv:1707.06347, 2017.
[22] John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, and Pieter Abbeel. Control continuo de alta dimensionalidad usando estimación de ventaja generalizada, 2018.
[23] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F Christiano, Jan Leike, and Ryan Lowe. Entrenar modelos de lenguaje para seguir instrucciones con retroalimentación humana. In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, and A. Oh, editors, Advances in Neural Information Processing Systems, volume 35, pages 27730-27744. Curran Associates, Inc., 2022.
[24] Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, and Dan Mane. Problemas concretos en la seguridad de la IA, 2016.
[25] Tom Everitt, Victoria Krakovna, Laurent Orseau, Marcus Hutter, and Shane Legg. Aprendizaje por refuerzo con un canal de recompensa corrupto, 2017.
[26] Victoria Krakovna, Jonathan Uesato, Vladimir Mikulik, Matthew Rahtz, Tom Everitt, Ramana Kumar, Zac Kenton, Jan Leike, and Shane Legg. Especificación de juegos: el otro lado del ingenio de la IA, 2020.
[27] Tom Everitt, Marcus Hutter, Ramana Kumar, and Victoria Krakovna. Problemas y soluciones de manipulación de recompensas en el aprendizaje por refuerzo: Una perspectiva de diagramas de influencia causal, 2021.
[28] Leo Gao, John Schulman, and Jacob Hilton. Leyes de escala para la sobreoptimización de modelos de recompensa, 2022.
[29] Lilian Weng. Reward hacking en el aprendizaje por refuerzo. lilianweng.github.io, Nov 2024.
[30] Stanislas Polu and Ilya Sutskever. Modelado de lenguaje generativo para la demostración automatizada de teoremas, 2020.
[31] Trieu H Trinh, Yuhuai Wu, Quoc V Le, He He, and Thang Luong. Resolviendo geometría de olimpiadas sin demostraciones humanas. Nature, 625(7995):476-482, 2024.
[32] Trieu Trinh and Thang Luong. Alphageometry: Un sistema de IA de nivel olímpico para geometría, 2024.
[33] AlphaProof and AlphaGeometry Teams. La IA alcanza el estándar de medalla de plata resolviendo problemas de la Olimpiada Internacional de Matemáticas, 2024.
[34] Hung Le, Yue Wang, Akhilesh Deepak Gotmare, Silvio Savarese, and Steven Chu Hong Hoi. Coderl: Dominando la generación de código mediante modelos preentrenados y aprendizaje por refuerzo profundo. Advances in Neural Information Processing Systems, 35:21314-21328, 2022.
[35] Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Agentes de lenguaje con aprendizaje por refuerzo verbal, 2023.
[36] Xinyun Chen, Maxwell Lin, Nathanael Schärli, and Denny Zhou. Enseñando a grandes modelos de lenguaje a autodepurar, 2023.
[37] Jonas Gehring, Kunhao Zheng, Jade Copet, Vegard Mella, Quentin Carbonneaux, Taco Cohen, and Gabriel Synnaeve. Rlcf: Fundamentando LLM de código en retroalimentación de ejecución con aprendizaje por refuerzo, 2025.
[38] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, YK Li, Y Wu, and Daya Guo. Deepseekmath: Empujando los límites del razonamiento matemático en modelos de lenguaje abiertos. Preimpresión de arXiv arXiv:2402.03300, 2024.
[39] Ilya Loshchilov y Frank Hutter. Regularización de decaimiento de peso desacoplada. En Conferencia Internacional sobre Representaciones del Aprendizaje, 2019.
Apéndice
A Transformación del conjunto de datos
A continuación se muestra un ejemplo de transformación de datos, en el que demostramos el problema original, el problema transformado y las salidas del modelo durante el proceso de transformación (el original está en texto markdown, que ha sido renderizado para facilitar su lectura).
Para garantizar que el modelo pueda completar esta tarea con alta precisión, nuestro objetivo es que realice un razonamiento integral mientras evita las alucinaciones. Lo logramos proporcionando un marco de pensamiento claro que fomente un razonamiento exhaustivo. Específicamente, empleamos el razonamiento de Cadena de Pensamiento (CoT, por sus siglas en inglés) junto con cuatro pasos bien definidos: extraer el formato de la respuesta, reescribir el enunciado del problema, resolver el problema modificado y proporcionar un número entero como respuesta final. Para cada paso, proporcionamos soluciones de pocos ejemplos o pautas detalladas para guiar el razonamiento del modelo.
Mediante este enfoque, hemos observado que en la mayoría de los casos, el LLM puede generar reformulaciones tanto en formato como en calidad que resultan satisfactorias.
Problema original
Sean e números reales tales que . Determine el menor valor posible de . Respuesta:
Problema transformado
Sean e números reales tales que . Determine el menor valor posible de . La respuesta original tiene la forma , donde , y son números enteros. Halle el valor de . Respuesta: 19
Salida del modelo (texto Markdown)
Proceso de pensamiento de la transformación
La respuesta original al problema es una expresión algebraica . Necesitamos transformarla en una forma entera. Primero, observe que la respuesta consta de una parte entera y un término con raíz cuadrada. De acuerdo con la regla dada, reemplazamos los componentes entero y de raíz cuadrada con coeficientes indeterminados. El problema original utiliza e como variables, por lo que elegimos otras letras como coeficientes indeterminados. Expresamos la respuesta en la forma y pedimos al estudiante que halle .
Formato de respuesta
Problema transformado
Sean e números reales tales que . Determine el menor valor posible de . La respuesta original está en la forma , donde , y son enteros. Halle el valor de .
Cálculo de la respuesta para el problema transformado
La respuesta original es: . El formato requerido es: . Igualando los coeficientes: , , . El resultado final es: .
Respuesta final
B Caso complementario
Pregunta:
Entre los 900 residentes de Aimeville, hay 195 que poseen un anillo de diamantes, 367 que poseen un juego de palos de golf y 562 que poseen una pala de jardín. Además, cada uno de los 900 residentes posee una bolsa de corazones de caramelo. Hay 437 residentes que poseen exactamente dos de estas cosas, y 234 residentes que poseen exactamente tres de estas cosas. Halle el número de residentes de Aimeville que poseen las cuatro cosas.
Respuesta:
Solución paso a paso:
1. Definamos las siguientes variables:
Sea el conjunto de residentes que poseen un anillo de diamantes.
Sea el conjunto de residentes que poseen un juego de palos de golf.
Sea el conjunto de residentes que poseen una pala de jardín.
Sea el conjunto de residentes que poseen una bolsa de corazones de caramelo. Dado que los 900 residentes poseen una bolsa de corazones de caramelo,
Sea el número de residentes que poseen exactamente de los 4 artículos.
Usemos el principio de inclusión-exclusión para la unión de 4 conjuntos
...
Dado que , el número de personas que poseen los cuatro artículos, debe ser un número entero, nuestro enfoque actual debe reconsiderarse en términos del conteo combinatorio de personas que poseen diferentes combinaciones de los artículos.
En lugar de usar directamente el principio de inclusión-exclusión, podemos usar un enfoque diferente que involucre el número de personas que poseen combinaciones de los artículos , , y .
Sea el número de personas que poseen exactamente artículos entre , , (excluyendo el artículo que todos poseen).
Entonces el número total de personas que poseen exactamente artículos entre , , y puede desglosarse:
...
Tabla 3 Un caso de emergencia de comportamiento reflexivo.