La autoatención sustituye recurrencia y convolución: el Transformer. El artículo de NIPS 2017 que abrió los modelos de lenguaje actuales, gratis online.
Siempre que se proporcione la debida atribución, Google otorga por la presente permiso para reproducir las tablas y figuras de este artículo únicamente para su uso en trabajos periodísticos o académicos.
Attention Is All You Need
Ashish Vaswani* Google Brain avaswani@google.com
Noam Shazeer* Google Brain noam@google.com
Niki Parmar* Google Research nikip@google.com
Jakob Uszkoreit* Google Research usz@google.com
Llion Jones* Google Research llion@google.com
Aidan N. Gomez*† University of Toronto aidan@cs.toronto.edu
Lukasz Kaiser* Google Brain lukaszkaiser@google.com
Illia Polosukhin*† illia.polosukhin@gmail.com
Resumen
Los modelos dominantes de transducción de secuencias se basan en complejas redes neuronales recurrentes o convolucionales que incluyen un codificador y un decodificador. Los modelos con mejor rendimiento también conectan el codificador y el decodificador mediante un mecanismo de atención. Proponemos una nueva arquitectura de red simple, el Transformer, basada únicamente en mecanismos de atención, prescindiendo por completo de la recurrencia y las convoluciones. Los experimentos en dos tareas de traducción automática muestran que estos modelos son superiores en calidad, a la vez que son más paralelizables y requieren significativamente menos tiempo de entrenamiento. Nuestro modelo alcanza 28.4 BLEU en la tarea de traducción de inglés a alemán de WMT 2014, mejorando los mejores resultados existentes, incluidos los conjuntos, en más de 2 BLEU. En la tarea de traducción de inglés a francés de WMT 2014, nuestro modelo establece un nuevo puntaje BLEU de vanguardia para un solo modelo de 41.8 después de entrenar durante 3.5 días en ocho GPU, una pequeña fracción de los costos de entrenamiento de los mejores modelos de la literatura. Mostramos que el Transformer generaliza bien a otras tareas aplicándolo con éxito al análisis de constituyentes del inglés tanto con datos de entrenamiento abundantes como limitados.
1 Introducción
Las redes neuronales recurrentes, en particular la memoria a largo y corto plazo [13] y las redes neuronales recurrentes con compuertas [7], se han establecido firmemente como enfoques de vanguardia en el modelado de secuencias y los problemas de transducción, como el modelado de lenguaje y la traducción automática [35] [2] [5]. Numerosos esfuerzos han continuado desde entonces empujando los límites de los modelos de lenguaje recurrentes y las arquitecturas codificador-decodificador [38] [24] [15].
Los modelos recurrentes típicamente factorizan la computación a lo largo de las posiciones de símbolo de las secuencias de entrada y salida. Alineando las posiciones con los pasos en el tiempo de computación, generan una secuencia de estados ocultos , como función del estado oculto anterior y la entrada para la posición . Esta naturaleza inherentemente secuencial impide la paralelización dentro de los ejemplos de entrenamiento, lo que se vuelve crítico en longitudes de secuencia más largas, ya que las restricciones de memoria limitan el agrupamiento en lotes entre ejemplos. Trabajos recientes han logrado mejoras significativas en eficiencia computacional mediante trucos de factorización [21] y computación condicional [32], mientras que también mejoran el rendimiento del modelo en el caso de esta última. La restricción fundamental de la computación secuencial, sin embargo, permanece.
Los mecanismos de atención se han convertido en una parte integral de modelos convincentes de modelado de secuencias y transducción en diversas tareas, permitiendo modelar dependencias sin importar su distancia en las secuencias de entrada o salida [2] [19]. En todos los casos salvo unos pocos [27], sin embargo, dichos mecanismos de atención se utilizan junto con una red recurrente.
En este trabajo proponemos el Transformer, una arquitectura de modelo que evita la recurrencia y en su lugar se basa enteramente en un mecanismo de atención para extraer dependencias globales entre entrada y salida. El Transformer permite una paralelización significativamente mayor y puede alcanzar un nuevo estado del arte en calidad de traducción después de ser entrenado durante tan solo doce horas en ocho GPU P100.
2 Antecedentes
El objetivo de reducir la computación secuencial también constituye la base de la Extended Neural GPU [16], ByteNet [18] y ConvS2S [9], todas las cuales utilizan redes neuronales convolucionales como bloque de construcción básico, calculando representaciones ocultas en paralelo para todas las posiciones de entrada y salida. En estos modelos, el número de operaciones requeridas para relacionar señales de dos posiciones arbitrarias de entrada o salida crece con la distancia entre posiciones, linealmente para ConvS2S y logarítmicamente para ByteNet. Esto hace más difícil aprender dependencias entre posiciones distantes [12]. En el Transformer esto se reduce a un número constante de operaciones, aunque a costa de una reducción de la resolución efectiva debido al promedio de posiciones ponderadas por atención, un efecto que contrarrestamos con la Atención Multicabeza como se describe en la sección [3.2].
La autoatención, a veces llamada atención interna, es un mecanismo de atención que relaciona diferentes posiciones de una única secuencia para calcular una representación de la secuencia. La autoatención se ha utilizado con éxito en una variedad de tareas, incluida la comprensión lectora, la sumarización abstractiva, la implicación textual y el aprendizaje de representaciones de oraciones independientes de la tarea [4] [27] [28] [22].
Las redes de memoria de extremo a extremo se basan en un mecanismo de atención recurrente en lugar de recurrencia alineada con la secuencia y se ha demostrado que funcionan bien en tareas de respuesta a preguntas en lenguaje simple y modelado de lenguaje [34].
Hasta donde sabemos, sin embargo, el Transformer es el primer modelo de transducción que se basa enteramente en la autoatención para calcular representaciones de su entrada y salida sin usar RNN alineadas con la secuencia ni convolución. En las siguientes secciones, describiremos el Transformer, motivaremos la autoatención y discutiremos sus ventajas sobre modelos como [17] [18] y [9].
3 Arquitectura del modelo
La mayoría de los modelos neuronales competitivos de transducción de secuencias tienen una estructura codificador-decodificador [5] [2] [35]. Aquí, el codificador mapea una secuencia de entrada de representaciones de símbolos a una secuencia de representaciones continuas . Dado , el decodificador luego genera una secuencia de salida de símbolos un elemento a la vez. En cada paso el modelo es autorregresivo [10], consumiendo los símbolos generados previamente como entrada adicional al generar el siguiente.
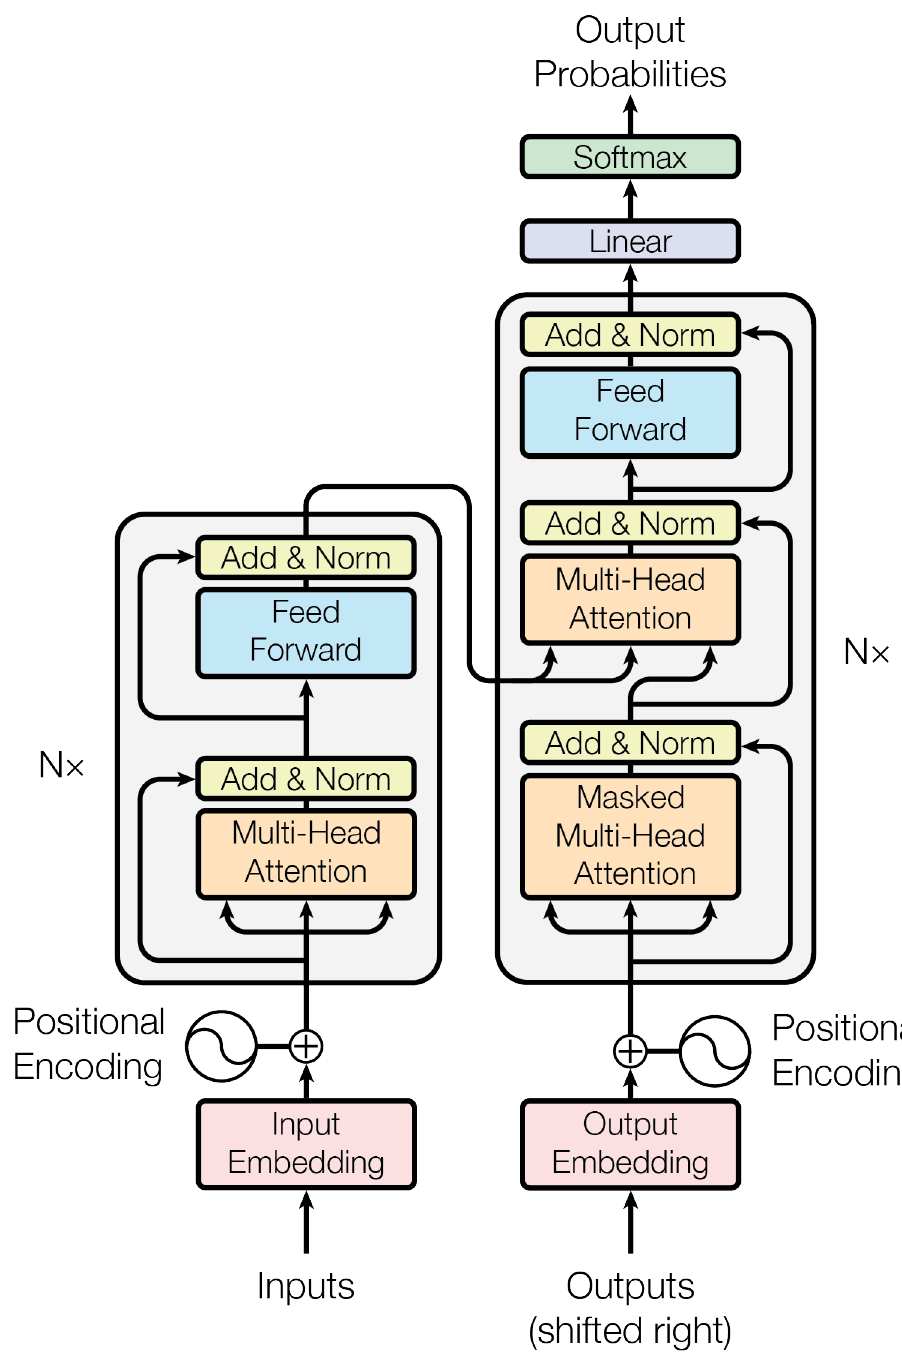
El Transformer sigue esta arquitectura general usando capas apiladas de autoatención y capas completamente conectadas puntuales tanto para el codificador como para el decodificador, mostradas en las mitades izquierda y derecha de la Figura [1] respectivamente.
3.1 Pilas del codificador y del decodificador
Codificador: El codificador está compuesto por una pila de capas idénticas. Cada capa tiene dos subcapas. La primera es un mecanismo de autoatención multicabeza, y la segunda es una red feed-forward simple, completamente conectada y puntual. Empleamos una conexión residual [11] alrededor de cada una de las dos subcapas, seguida de normalización de capa [1]. Es decir, la salida de cada subcapa es , donde es la función implementada por la propia subcapa. Para facilitar estas conexiones residuales, todas las subcapas del modelo, así como las capas de embedding, producen salidas de dimensión .
Decodificador: El decodificador también está compuesto por una pila de capas idénticas. Además de las dos subcapas en cada capa del codificador, el decodificador inserta una tercera subcapa, que realiza atención multicabeza sobre la salida de la pila del codificador. De manera similar al codificador, empleamos conexiones residuales alrededor de cada una de las subcapas, seguidas de normalización de capa. También modificamos la subcapa de autoatención en la pila del decodificador para evitar que las posiciones atiendan a posiciones posteriores. Este enmascaramiento, combinado con el hecho de que los embeddings de salida están desplazados en una posición, asegura que las predicciones para la posición puedan depender solo de las salidas conocidas en posiciones menores que .
3.2 Atención
Una función de atención puede describirse como el mapeo de una consulta y un conjunto de pares clave-valor a una salida, donde la consulta, las claves, los valores y la salida son todos vectores. La salida se calcula como una suma ponderada
de los valores, donde el peso asignado a cada valor se calcula mediante una función de compatibilidad de la consulta con la clave correspondiente.
3.2.1 Atención de producto punto escalada
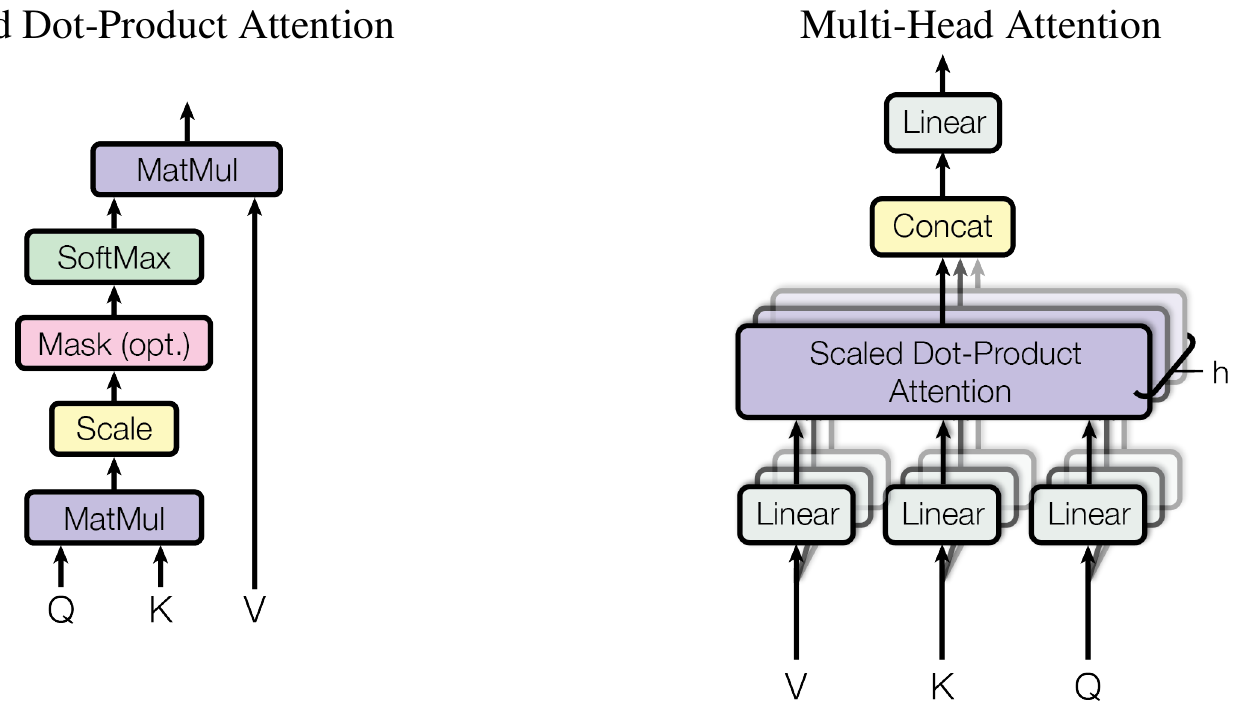
Llamamos a nuestra atención particular "atención de producto escalar escalado" (Figura 2). La entrada consiste en consultas y claves de dimensión , y valores de dimensión . Calculamos los productos escalares de la consulta con todas las claves, dividimos cada uno por , y aplicamos una función softmax para obtener los pesos sobre los valores.
En la práctica, calculamos la función de atención sobre un conjunto de consultas simultáneamente, empaquetadas juntas en una matriz . Las claves y los valores también se empaquetan juntos en matrices y . Calculamos la matriz de salidas como:
Las dos funciones de atención más comúnmente usadas son la atención aditiva 2, y la atención de producto escalar (multiplicativa). La atención de producto escalar es idéntica a nuestro algoritmo, excepto por el factor de escala de . La atención aditiva calcula la función de compatibilidad usando una red feed-forward con una sola capa oculta. Aunque las dos son similares en complejidad teórica, la atención de producto escalar es mucho más rápida y más eficiente en espacio en la práctica, ya que puede implementarse usando código de multiplicación de matrices altamente optimizado.
Mientras que para valores pequeños de los dos mecanismos se comportan de manera similar, la atención aditiva supera a la atención de producto escalar sin escalado para valores más grandes de [3]. Sospechamos que para valores grandes de , los productos escalares crecen en magnitud, empujando a la función softmax hacia regiones donde tiene gradientes extremadamente pequeños. Para contrarrestar este efecto, escalamos los productos escalares por .
3.2.2 Atención multi-cabeza
En lugar de realizar una única función de atención con claves, valores y consultas de dimensión , encontramos beneficioso proyectar linealmente las consultas, claves y valores veces con diferentes proyecciones lineales aprendidas, a dimensiones , y , respectivamente. Sobre cada una de estas versiones proyectadas de consultas, claves y valores realizamos entonces la función de atención en paralelo, produciendo valores de salida de dimensión .Estos se concatenan y se proyectan una vez más, resultando en los valores finales, como se representa en la Figura 2
La atención multi-cabeza permite al modelo atender conjuntamente a información de diferentes subespacios de representación en diferentes posiciones. Con una sola cabeza de atención, el promedio inhibe esto.
Donde las proyecciones son matrices de parámetros , , y
En este trabajo empleamos capas de atención paralelas, o cabezas. Para cada una de ellas usamos . Debido a la dimensión reducida de cada cabeza, el coste computacional total es similar al de la atención de una sola cabeza con dimensionalidad completa.
3.2.3 Aplicaciones de la atención en nuestro modelo
El Transformer utiliza atención multi-cabeza de tres formas diferentes:
- En las capas de "atención encoder-decoder", las consultas provienen de la capa anterior del decoder, y las claves y valores de memoria provienen de la salida del encoder. Esto permite que cada posición del decoder atienda sobre todas las posiciones de la secuencia de entrada. Esto imita los mecanismos típicos de atención encoder-decoder en modelos secuencia-a-secuencia como [38] [2] [9].
- El encoder contiene capas de autoatención. En una capa de autoatención, todas las claves, valores y consultas provienen del mismo lugar, en este caso, la salida de la capa anterior del encoder. Cada posición del encoder puede atender a todas las posiciones de la capa anterior del encoder.
- De forma similar, las capas de autoatención del decoder permiten que cada posición del decoder atienda a todas las posiciones del decoder hasta esa posición inclusive. Necesitamos impedir el flujo de información hacia la izquierda en el decoder para preservar la propiedad autorregresiva. Implementamos esto dentro de la atención de producto escalar escalada enmascarando (estableciendo a ) todos los valores en la entrada del softmax que corresponden a conexiones ilegales. Véase la Figura [2]
3.3 Redes feed-forward por posición
Además de las subcapas de atención, cada una de las capas de nuestro encoder y decoder contiene una red feed-forward totalmente conectada, que se aplica a cada posición de forma separada e idéntica. Esta consta de dos transformaciones lineales con una activación ReLU entre ellas.
Mientras que las transformaciones lineales son las mismas en las distintas posiciones, utilizan parámetros diferentes de una capa a otra. Otra forma de describir esto es como dos convoluciones con tamaño de núcleo 1. La dimensionalidad de la entrada y la salida es , y la capa interna tiene dimensionalidad .
3.4 Embeddings y Softmax
De forma similar a otros modelos de transducción de secuencias, utilizamos embeddings aprendidos para convertir los tokens de entrada y los tokens de salida en vectores de dimensión . También utilizamos la habitual transformación lineal aprendida y la función softmax para convertir la salida del decoder en probabilidades predichas del siguiente token. En nuestro modelo, compartimos la misma matriz de pesos entre las dos capas de embedding y la transformación lineal previa al softmax, de forma similar a [30]. En las capas de embedding, multiplicamos esos pesos por .
| Tipo de capa | Complejidad por capa | Operaciones secuenciales | Longitud máxima de la ruta |
| Autoatención | O(n²·d) | O(1) | O(1) |
| Recurrente | O(n·d²) | O(n) | O(n) |
| Convolucional | O(k·n·d²) | O(1) | O(logk(n)) |
| Autoatención (restringida) | O(r·n·d) | O(1) | O(n/r) |
3.5 Codificación posicional
Dado que nuestro modelo no contiene recurrencia ni convolución, para que el modelo pueda hacer uso del orden de la secuencia, debemos inyectar cierta información sobre la posición relativa o absoluta de los tokens en la secuencia. Con este fin, añadimos "codificaciones posicionales" a los embeddings de entrada en las bases de las pilas del encoder y del decoder. Las codificaciones posicionales tienen la misma dimensión que los embeddings, de modo que ambas pueden sumarse. Existen muchas elecciones de codificaciones posicionales, aprendidas y fijas [9].
En este trabajo, utilizamos funciones seno y coseno de diferentes frecuencias:
donde es la posición e es la dimensión. Es decir, cada dimensión de la codificación posicional corresponde a una sinusoide. Las longitudes de onda forman una progresión geométrica desde hasta . Elegimos esta función porque planteamos la hipótesis de que permitiría al modelo aprender fácilmente a atender por posiciones relativas, ya que para cualquier desplazamiento fijo , puede representarse como una función lineal de .
También experimentamos con el uso de embeddings posicionales aprendidos [9] en su lugar, y encontramos que las dos versiones producían resultados casi idénticos (véase la Tabla 3, fila (E)). Elegimos la versión sinusoidal porque puede permitir al modelo extrapolar a longitudes de secuencia mayores que las encontradas durante el entrenamiento.
4 Por qué la autoatención
En esta sección comparamos varios aspectos de las capas de autoatención con las capas recurrentes y convolucionales comúnmente utilizadas para mapear una secuencia de longitud variable de representaciones de símbolos a otra secuencia de igual longitud , con , como una capa oculta en un encoder o decoder típico de transducción de secuencias. Motivando nuestro uso de la autoatención, consideramos tres desiderata.
Una es la complejidad computacional total por capa. Otra es la cantidad de computación que puede paralelizarse, medida por el número mínimo de operaciones secuenciales requeridas.
La tercera es la longitud del camino entre dependencias de largo alcance en la red. Aprender dependencias de largo alcance es un desafío clave en muchas tareas de transducción de secuencias. Un factor clave que afecta la capacidad de aprender tales dependencias es la longitud de los caminos que las señales hacia adelante y hacia atrás tienen que recorrer en la red. Cuanto más cortos sean estos caminos entre cualquier combinación de posiciones en las secuencias de entrada y salida, más fácil será aprender dependencias de largo alcance [12]. Por lo tanto, también comparamos la longitud máxima del camino entre dos posiciones cualesquiera de entrada y salida en redes compuestas por los diferentes tipos de capas.
Como se señala en la Tabla 1, una capa de autoatención conecta todas las posiciones con un número constante de operaciones ejecutadas secuencialmente, mientras que una capa recurrente requiere operaciones secuenciales. En términos de complejidad computacional, las capas de autoatención son más rápidas que las capas recurrentes cuando la longitud de la secuencia es menor que la dimensionalidad de la representación , que es el caso más frecuente con las representaciones de oraciones utilizadas por los modelos de vanguardia en traducción automática, como las representaciones word-piece [38] y byte-pair [31]. Para mejorar el rendimiento computacional en tareas que involucran secuencias muy largas, la autoatención podría restringirse a considerar solo un vecindario de tamaño en la secuencia de entrada centrado alrededor de la posición de salida respectiva. Esto aumentaría la longitud máxima del camino a . Planeamos investigar este enfoque más a fondo en trabajos futuros.
Una sola capa convolucional con ancho de kernel no conecta todos los pares de posiciones de entrada y salida. Hacerlo requiere una pila de capas convolucionales en el caso de kernels contiguos, o en el caso de convoluciones dilatadas [18], lo que aumenta la longitud de los caminos más largos entre dos posiciones cualesquiera en la red. Las capas convolucionales son generalmente más costosas que las capas recurrentes, por un factor de . Las convoluciones separables [6], sin embargo, disminuyen la complejidad considerablemente, a . Incluso con , sin embargo, la complejidad de una convolución separable es igual a la combinación de una capa de self-attention y una capa feed-forward puntual, el enfoque que adoptamos en nuestro modelo.
Como beneficio secundario, la self-attention podría producir modelos más interpretables. Inspeccionamos las distribuciones de atención de nuestros modelos y presentamos y discutimos ejemplos en el apéndice. No solo las cabezas de atención individuales aprenden claramente a realizar tareas diferentes, sino que muchas parecen exhibir un comportamiento relacionado con la estructura sintáctica y semántica de las oraciones.
5 Entrenamiento
Esta sección describe el régimen de entrenamiento para nuestros modelos.
5.1 Datos de entrenamiento y batching
Entrenamos con el conjunto de datos estándar WMT 2014 inglés-alemán que consta de aproximadamente 4,5 millones de pares de oraciones. Las oraciones se codificaron usando codificación de pares de bytes [3], que tiene un vocabulario compartido de origen-destino de aproximadamente 37000 tokens. Para inglés-francés, utilizamos el conjunto de datos WMT 2014 inglés-francés significativamente más grande, que consta de 36M de oraciones, y dividimos los tokens en un vocabulario de 32000 word-pieces [38]. Los pares de oraciones se agruparon en lotes según la longitud aproximada de la secuencia. Cada lote de entrenamiento contenía un conjunto de pares de oraciones que contenían aproximadamente 25000 tokens de origen y 25000 tokens de destino.
5.2 Hardware y cronograma
Entrenamos nuestros modelos en una máquina con 8 GPU NVIDIA P100. Para nuestros modelos base usando los hiperparámetros descritos a lo largo del artículo, cada paso de entrenamiento tomó aproximadamente 0,4 segundos. Entrenamos los modelos base durante un total de 100.000 pasos o 12 horas. Para nuestros modelos grandes, (descritos en la línea inferior de la tabla [3], el tiempo por paso fue de 1,0 segundos. Los modelos grandes se entrenaron durante 300.000 pasos (3,5 días).
5.3 Optimizador
Usamos el optimizador Adam [20] con , y . Variamos la tasa de aprendizaje a lo largo del entrenamiento, de acuerdo con la fórmula:
Esto corresponde a aumentar la tasa de aprendizaje linealmente durante los primeros pasos de warmup del entrenamiento, y disminuirla thereafter proporcionalmente a la raíz cuadrada inversa del número de paso. Usamos warmup steps = 4000.
5.4 Regularización
Empleamos tres tipos de regularización durante el entrenamiento:
| Modelo | BLEU | Costo de entrenamiento (FLOPs) | ||
| EN-DE | EN-FR | EN-DE | EN-FR | |
| ByteNet [18] | 23,75 | |||
| Deep-Att + PosUnk [39] | 39,2 | 1,0·1020 | ||
| GNMT + RL [38] | 24,6 | 39,92 | 2,3·1019 | 1,4·1020 |
| ConvS2S [9] | 25,16 | 40,46 | 9,6·1018 | 1,5·1020 |
| MoE [32] | 26,03 | 40,56 | 2,0·1019 | 1,2·1020 |
| Deep-Att + PosUnk Ensemble [39] | 40,4 | 8,0·1020 | ||
| GNMT + RL Ensemble [38] | 26,30 | 41,16 | 1,8·1020 | 1,1·1021 |
| ConvS2S Ensemble [9] | 26,36 | 41,29 | 7,7·1019 | 1,2·1021 |
| Transformer (modelo base) | 27,3 | 38,1 | 3,3·1018 | |
| Transformer (grande) | 28,4 | 41,8 | 2,3·1019 | |
Dropout residual Aplicamos dropout [33] a la salida de cada subcapa, antes de que se agregue a la entrada de la subcapa y se normalice. Además, aplicamos dropout a las sumas de los embeddings y las codificaciones posicionales tanto en las pilas del encoder como del decoder. Para el modelo base, usamos una tasa de .
Suavizado de etiquetas Durante el entrenamiento, empleamos suavizado de etiquetas con valor [36]. Esto perjudica la perplejidad, ya que el modelo aprende a ser más inseguro, pero mejora la precisión y la puntuación BLEU.
6 Resultados
6.1 Traducción automática
En la tarea de traducción de inglés a alemán de WMT 2014, el modelo transformer grande (Transformer (big) en la Tabla 2) supera a los mejores modelos reportados previamente (incluidos los ensembles) por más de 2,0 BLEU, estableciendo una nueva puntuación BLEU de última generación de 28,4. La configuración de este modelo se enumera en la línea inferior de la Tabla 3 El entrenamiento tomó 3,5 días en 8 GPU P100. Incluso nuestro modelo base supera a todos los modelos y ensembles publicados previamente, a una fracción del costo de entrenamiento de cualquiera de los modelos competitivos.
En la tarea de traducción de inglés a francés de WMT 2014, nuestro modelo grande alcanza una puntuación BLEU de 41,0, superando a todos los modelos individuales publicados previamente, con menos de del coste de entrenamiento del modelo de vanguardia anterior. El modelo Transformer (grande) entrenado para inglés a francés utilizó una tasa de dropout , en lugar de 0,3.
Para los modelos base, utilizamos un único modelo obtenido promediando los últimos 5 checkpoints, que se escribieron a intervalos de 10 minutos. Para los modelos grandes, promediamos los últimos 20 checkpoints. Utilizamos búsqueda por haces con un tamaño de haz de 4 y una penalización de longitud [38]. Estos hiperparámetros se eligieron tras experimentar con el conjunto de desarrollo. Fijamos la longitud máxima de salida durante la inferencia a la longitud de entrada , pero terminamos antes cuando es posible [38].
La Tabla 2 resume nuestros resultados y compara nuestra calidad de traducción y costes de entrenamiento con otras arquitecturas de modelos de la literatura. Estimamos el número de operaciones en coma flotante utilizadas para entrenar un modelo multiplicando el tiempo de entrenamiento, el número de GPUs utilizadas y una estimación de la capacidad sostenida de coma flotante de precisión simple de cada GPU.
6.2 Variaciones del modelo
Para evaluar la importancia de los diferentes componentes del Transformer, variamos nuestro modelo base de diferentes maneras, midiendo el cambio en el rendimiento en la traducción de inglés a alemán en el
| N | dmodel | dff | h | dk | dv | Pdrop | εls | pasos de entrenamiento | PPL (dev) | BLEU (dev) | parámetros ×106 | |
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0.1 | 0.1 | 100K | 4.92 | 25.8 | 65 |
| 1 | 512 | 512 | 5.29 | 24.9 | ||||||||
| 4 | 128 | 128 | 5.00 | 25.5 | ||||||||
| 16 | 32 | 32 | 4.91 | 25.8 | ||||||||
| (A) | 32 | 16 | 16 | 5.01 | 25.4 | |||||||
| 16 | 5.16 | 25.1 | 58 | |||||||||
| (B) | 32 | 5.01 | 25.4 | 60 | ||||||||
| 6.11 | 23.7 | 36 | ||||||||||
| (C) | 2 | 5.19 | 25.3 | 50 | ||||||||
| 4 | 4,88 | 25,5 | 80 | |||||||||
| 8 | 5,75 | 24,5 | 28 | |||||||||
| 256 | 32 | 32 | 4,66 | 26,0 | 168 | |||||||
| 1024 | 128 | 128 | 5,12 | 25,4 | 53 | |||||||
| 1024 | 4,75 | 26,2 | 90 | |||||||||
| (D) | 0,0 | 5,77 | 24,6 | |||||||||
| 0,2 | 4,95 | 25,5 | ||||||||||
| 0,0 | 4,67 | 25,3 | ||||||||||
| 0,2 | 5,47 | 25,7 | ||||||||||
| (E) | 4,92 | 25,7 | ||||||||||
| grande | 6 | 1024 | 4096 | 16 | 0,3 | 300K | 4,33 | 26,4 | 213 |
conjunto de desarrollo, newstest2013. Utilizamos búsqueda por haces como se describe en la sección anterior, pero sin promediado de checkpoints. Presentamos estos resultados en la Tabla 3.
En las filas (A) de la Tabla 3, variamos el número de cabezas de atención y las dimensiones de clave y valor de la atención, manteniendo constante la cantidad de cómputo, como se describe en la Sección 3.2.2. Aunque la atención de una sola cabeza es 0,9 BLEU peor que la mejor configuración, la calidad también disminuye con demasiadas cabezas.
En las filas (B) de la Tabla 3, observamos que reducir el tamaño de la clave de atención perjudica la calidad del modelo. Esto sugiere que determinar la compatibilidad no es fácil y que una función de compatibilidad más sofisticada que el producto escalar podría ser beneficiosa. Observamos además en las filas (C) y (D) que, como era de esperar, los modelos más grandes son mejores, y que el dropout es muy útil para evitar el sobreajuste. En la fila (E) reemplazamos nuestra codificación posicional sinusoidal por embeddings posicionales aprendidos [2], y observamos resultados casi idénticos a los del modelo base.
6.3 Análisis sintáctico de constituyentes en inglés
Para evaluar si el Transformer puede generalizar a otras tareas, realizamos experimentos sobre el análisis sintáctico de constituyentes en inglés. Esta tarea presenta desafíos específicos: la salida está sujeta a fuertes restricciones estructurales y es significativamente más larga que la entrada. Además, los modelos de secuencia a secuencia basados en RNN no han podido alcanzar resultados de vanguardia en regímenes de pocos datos [37].
Entrenamos un transformer de 4 capas con en la porción del Wall Street Journal (WSJ) del Penn Treebank [25], con aproximadamente 40K frases de entrenamiento. También lo entrenamos en un entorno semisupervisado, utilizando los corpus más grandes de alta confianza y BerkleyParker con aproximadamente 17M de frases [37]. Utilizamos un vocabulario de 16K tokens para la configuración solo con WSJ y un vocabulario de 32K tokens para la configuración semisupervisada.
Realizamos solo un pequeño número de experimentos para seleccionar el dropout, tanto de atención como residual (sección [5.4]), las tasas de aprendizaje y el tamaño de haz en el conjunto de desarrollo de la Sección 22; todos los demás parámetros permanecieron sin cambios respecto al modelo base de traducción de inglés a alemán. Durante la inferencia,
| Parser | Entrenamiento | WSJ 23 F1 |
| Vinyals & Kaiser el al. (2014) [37] | Solo WSJ, discriminativo | 88,3 |
| Petrov et al. (2006) [29] | Solo WSJ, discriminativo | 90,4 |
| Zhu et al. (2013) [40] | Solo WSJ, discriminativo | 90,4 |
| Dyer et al. (2016) [8] | Solo WSJ, discriminativo | 91,7 |
| Transformer (4 capas) | Solo WSJ, discriminativo | 91,3 |
| Zhu et al. (2013) [40] | semisupervisado | 91,3 |
| Huang & Harper (2009) [14] | semisupervisado | 91,3 |
| McClosky et al. (2006) [26] | semisupervisado | 92,1 |
| Vinyals & Kaiser el al. (2014) [37] | semisupervisado | 92,1 |
| Transformer (4 capas) | semisupervisado | 92,7 |
| Luong et al. (2015) [23] | multitarea | 93,0 |
| Dyer et al. (2016) [8] | generativo | 93,3 |
aumentamos la longitud máxima de salida a la longitud de entrada . Utilizamos un tamaño de haz de 21 y tanto para la configuración solo con WSJ como para la semisupervisada.
Nuestros resultados en la Tabla 4 muestran que, a pesar de la falta de ajuste específico para la tarea, nuestro modelo rinde sorprendentemente bien, obteniendo mejores resultados que todos los modelos reportados previamente, con la excepción de la Recurrent Neural Network Grammar [8].
En contraste con los modelos de secuencia a secuencia basados en RNN [37], el Transformer supera al Berkeley-Parser [29] incluso cuando se entrena solo con el conjunto de entrenamiento WSJ de 40K frases.
7 Conclusión
En este trabajo, presentamos el Transformer, el primer modelo de transducción de secuencias basado enteramente en atención, reemplazando las capas recurrentes más comúnmente usadas en las arquitecturas codificador-decodificador por autoatención multicabeza.
Para tareas de traducción, el Transformer puede entrenarse significativamente más rápido que las arquitecturas basadas en capas recurrentes o convolucionales. Tanto en las tareas de traducción de inglés a alemán de WMT 2014 como de inglés a francés de WMT 2014, alcanzamos un nuevo estado de la cuestión. En la primera tarea, nuestro mejor modelo supera incluso a todos los conjuntos previamente reportados.
Estamos entusiasmados con el futuro de los modelos basados en atención y planeamos aplicarlos a otras tareas. Planeamos extender el Transformer a problemas que involucran modalidades de entrada y salida distintas del texto e investigar mecanismos de atención locales y restringidos para manejar eficientemente entradas y salidas grandes, como imágenes, audio y video. Hacer la generación menos secuencial es otro de nuestros objetivos de investigación.
El código que utilizamos para entrenar y evaluar nuestros modelos está disponible en https://github.com/tensorflow/tensor2tensor
Agradecimientos Agradecemos a Nal Kalchbrenner y Stephan Gouws por sus fructíferos comentarios, correcciones e inspiración.
Referencias
[1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
[7] Junyoung Chung, Caglar Gulcehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122, 2017.
[10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, and Jürgen Schmidhuber. Gradient flow in recurrent nets: the difficulty of learning long-term dependencies, 2001.
[13] Sepp Hochreiter and Jürgen Schmidhuber. Long short-term memory. Neural computation, 9(8):1735-1780, 1997.
[14] Zhongqiang Huang and Mary Harper. Self-training PCFG grammars with latent annotations across languages. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, pages 832-841. ACL, August 2009.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer y Yonghui Wu. Exploring the limits of language modeling. arXiv preprint arXiv:1602.02410, 2016.
[16] Łukasz Kaiser y Samy Bengio. Can active memory replace attention? En Advances in Neural Information Processing Systems, (NIPS), 2016.
[17] Łukasz Kaiser e Ilya Sutskever. Neural GPUs learn algorithms. En International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves y Koray Kavukcuoglu. Neural machine translation in linear time. arXiv preprint arXiv:1610.10099, 2017.
[19] Yoon Kim, Carl Denton, Luong Hoang y Alexander M. Rush. Structured attention networks. En International Conference on Learning Representations, 2017.
[20] Diederik Kingma y Jimmy Ba. Adam: A method for stochastic optimization. En ICLR, 2015.
[21] Oleksii Kuchaiev y Boris Ginsburg. Factorization tricks for LSTM networks. arXiv preprint arXiv:1703.10722, 2017.
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou y Yoshua Bengio. A structured self- attentive sentence embedding. arXiv preprint arXiv:1703.03130, 2017.
[23] Minh- Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals y Lukasz Kaiser. Multi- task sequence to sequence learning. arXiv preprint arXiv:1511.06114, 2015.
[24] Minh- Thang Luong, Hieu Pham y Christopher D Manning. Effective approaches to attention- based neural machine translation. arXiv preprint arXiv:1508.04025, 2015.
[25] Mitchell P Marcus, Mary Ann Marcinkiewicz y Beatrice Santorini. Building a large annotated corpus of english: The penn treebank. Computational linguistics, 19(2):313- 330, 1993.
[26] David McClosky, Eugene Charniak y Mark Johnson. Effective self- training for parsing. En Proceedings of the Human Language Technology Conference of the NAACL, Main Conference, páginas 152- 159. ACL, junio de 2006.
[27] Ankur Parikh, Oscar Tackström, Dipanjan Das y Jakob Uszkoreit. A decomposable attention model. En Empirical Methods in Natural Language Processing, 2016.
[28] Romain Paulus, Caiming Xiong y Richard Socher. A deep reinforced model for abstractive summarization. arXiv preprint arXiv:1705.04304, 2017.
[29] Slav Petrov, Leon Barrett, Romain Thibaux y Dan Klein. Learning accurate, compact, and interpretable tree annotation. En Proceedings of the 21st International Conference on Computational Linguistics and 44th Annual Meeting of the ACL, páginas 433-440. ACL, julio de 2006.
[30] Ofir Press y Lior Wolf. Using the output embedding to improve language models. arXiv preprint arXiv:1608.05859, 2016.
[31] Rico Sennrich, Barry Haddow y Alexandra Birch. Neural machine translation of rare words with subword units. arXiv preprint arXiv:1508.07909, 2015.
[32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton y Jeff Dean. Outrageously large neural networks: The sparsely-gated mixture-of-experts layer. arXiv preprint arXiv:1701.06538, 2017.
[33] Nitish Srivastava, Geoffrey E Hinton, Alex Krizhevsky, Ilya Sutskever y Ruslan Salakhutdinov. Dropout: a simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(1):1929-1958, 2014.
[34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston y Rob Fergus. End-to-end memory networks. En C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama y R. Garnett, editores, Advances in Neural Information Processing Systems 28, páginas 2440-2448. Curran Associates, Inc., 2015.
[35] Ilya Sutskever, Oriol Vinyals y Quoc VV Le. Sequence to sequence learning with neural networks. En Advances in Neural Information Processing Systems, páginas 3104-3112, 2014.
[36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens y Zbigniew Wojna. Rethinking the inception architecture for computer vision. CoRR, abs/1512.00567, 2015.
[37] Vinyals & Kaiser, Koo, Petrov, Sutskever y Hinton. Grammar as a foreign language. En Advances in Neural Information Processing Systems, 2015.
[38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey, et al. Google's neural machine translation system: Bridging the gap between human and machine translation. arXiv preprint arXiv:1609.08144, 2016.
[39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li y Wei Xu. Deep recurrent models with fast-forward connections for neural machine translation. CoRR, abs/1606.04199, 2016.
[40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang y Jingbo Zhu. Fast and accurate shift-reduce constituent parsing. En Proceedings of the 51st Annual Meeting of the ACL (Volume 1: Long Papers), páginas 434-443. ACL, agosto de 2013.