
antiSMASH 8.0 durchsucht mikrobielle Genome nach Biosynthese-Genclustern: 101 statt 81 Typen, feinere Enzymanalyse. 2025, kostenlos lesbar.
antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation
antiSMASH 8.0: Erweiterte Fähigkeiten zur Detektion von Genclustern und Analysen von Chemie, Enzymologie und Regulation
Blin, K.; Shaw, S.; Vader, L.; Szenei, J.; Reitz, Z.L.; Augustijn, H.E.; ...; Weber, T.
Zitierweise
Blin, K., Shaw, S., Vader, L., Szenei, J., Reitz, Z. L., Augustijn, H. E., ... Weber, T. (2025). antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation. Nucleic Acids Research, 53(W1), W32- W38. doi:10.1093/nar/gkaf334
Version: Publisher's Version License: Creative Commons CC BY 4.0 license Downloaded from: https://hdl.handle.net/1887/4285886
Hinweis: Um diese Publikation zu zitieren, verwenden Sie bitte die endgültig veröffentlichte Version (falls zutreffend).
antiSMASH 8.0: Erweiterte Fähigkeiten zur Detektion von Genclustern und Analysen von Chemie, Enzymologie und Regulation
Kai Blin , Simon Shaw , Lisa Vader , Judit Szenei , Zachary L. Reitz , Hannah E. Augustijn , José D.D. Cédiel- Becerra , Valérie de Crécy- Lagard , Robert A. Koetsier , Sam E. Williams , Pablo Cruz- Morales , Sopida Wongwas , Alejandro E. Segurado Luchsinger , Friederike Biermann , Aleksandra Korenskaia , Mitja M. Zdouc , David Meijer , Barbara R. Terlouw , Justin J.J. van der Hooft , Nadine Ziemert , Eric J.N. Helfrich , Joleen Masschelein , Christophe Corre , Marc G. Chevrette , Gilles P. van Wezel , Marnix H. Medema , Tilmann Weber
Korrespondenzadresse. E-Mail: kblin@biosustain.dtu.dk Korrespondenz kann auch an Marnix H. Medema gerichtet werden. E-Mail: marnix.medema@wur.nl Korrespondenz kann auch an Tilmann Weber gerichtet werden. E-Mail: tiwe@biosustain.dtu.dk
Zusammenfassung
Mikroorganismen synthetisieren kleine bioaktive Verbindungen durch ihren Sekundär- oder Spezialstoffwechsel. Diese Verbindungen spielen eine wichtige Rolle bei mikrobiellen Interaktionen und der Bodengesundheit, sind aber auch entscheidend für die Entwicklung von Arzneimitteln oder Agrochemikalien. In den vergangenen Jahrzehnten haben Fortschritte in der Genomsequenzierung die Identifizierung großer Zahlen biosynthetischer Gencluster direkt aus mikrobiellen Genomen ermöglicht. Seit seiner Einführung im Jahr 2011 hat sich antiSMASH (https://antismash. secondarymetabolites.org/) zum führenden Werkzeug für die Detektion und Charakterisierung dieser Gencluster in Bakterien und Pilzen entwickelt. Dieser Artikel stellt Version 8 von antiSMASH vor, die die Zahl der detektierbaren Clustertypen von 81 auf 101 erhöht hat und die Analyseunterstützung für Terpenoide und Tailoring-Enzyme verbessert hat, sowie Verbesserungen bei der Analyse modularer Enzyme wie Polyketidsynthasen und nichtribosomaler Peptidsynthetasen. Diese Änderungen halten antiSMASH mit den Entwicklungen auf dem Gebiet auf dem neuesten Stand und erweitern seine insgesamt prädiktiven Fähigkeiten für das Naturstoff-Genom-Mining.
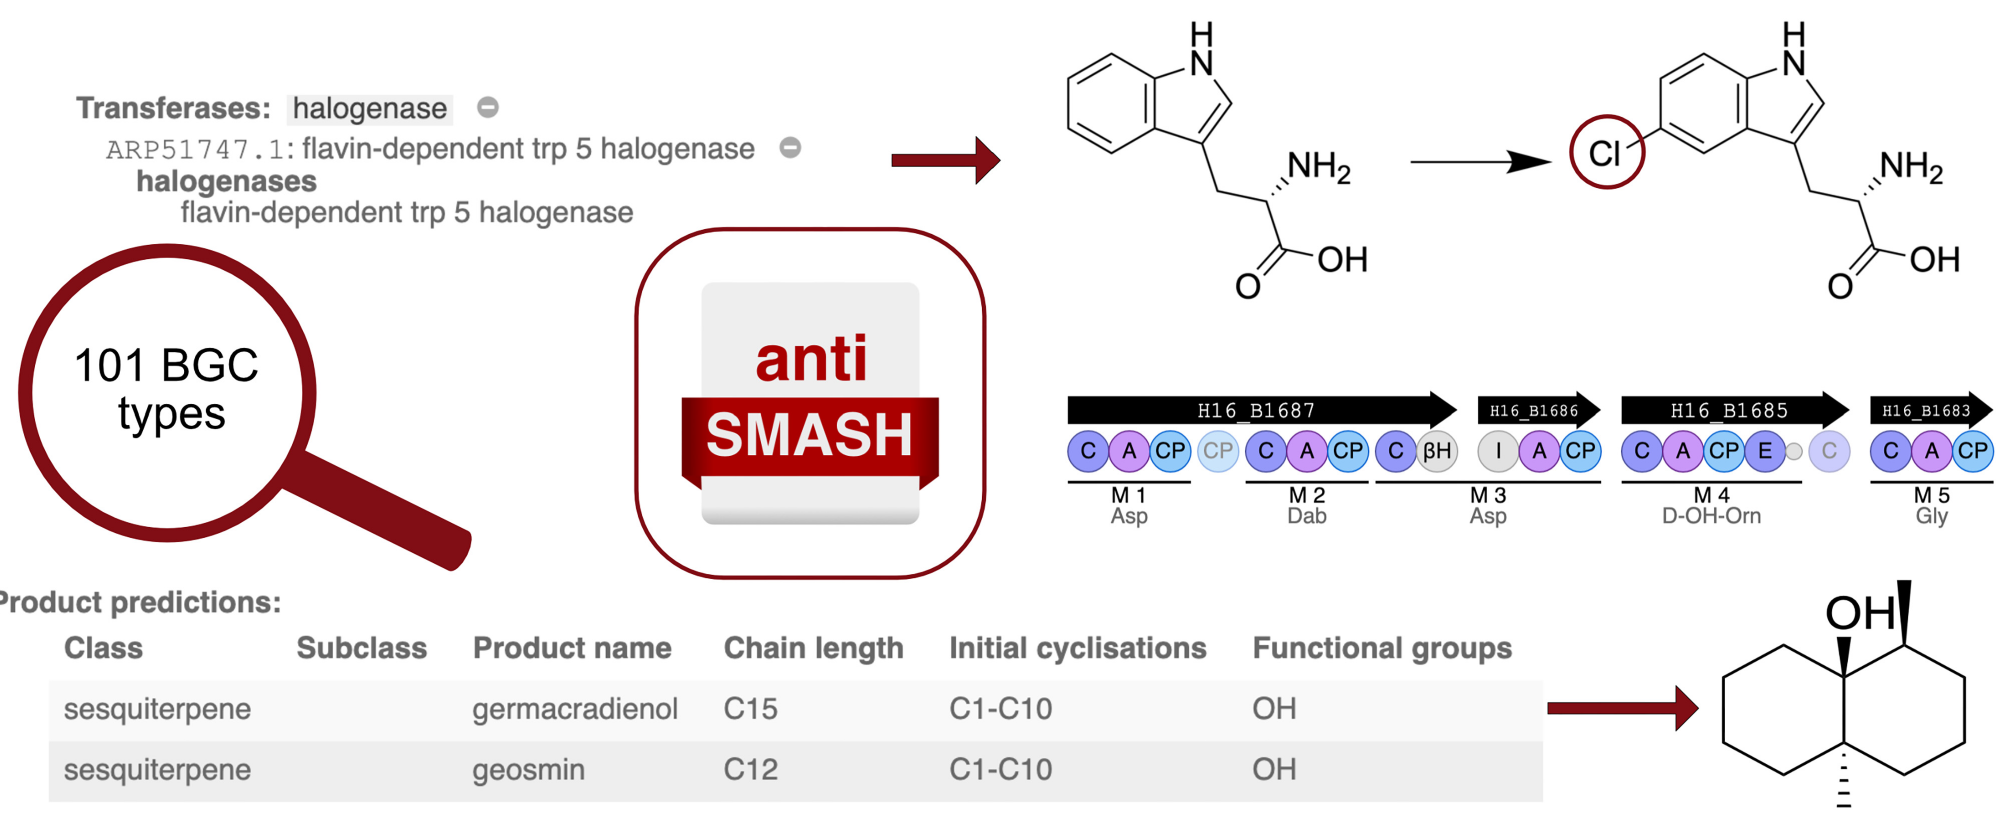
Grafische Zusammenfassung
Einleitung
Kleine, bioaktive Moleküle, die von Mikroorganismen produziert werden, sind eine wichtige Quelle für Arzneimittel [1] und Agrochemikalien [2] und spielen wichtige Rollen bei mikrobiellen Interaktionen und der Bodengesundheit. In den vergangenen 20–25 Jahren hat die Fülle verfügbarer Genomdaten es ermöglicht, die traditionellen Arbeitsabläufe der Isolierung mikrobieller Stämme, der Extraktion von Verbindungen und anschließender Screening-Verfahren auf gewünschte Aktivitäten zu verbessern, indem in mikrobiellen Genomen nach biosynthetischen Genclustern (BGCs) gesucht wird, die für die Biosynthese dieser Moleküle kodieren [3]. Softwarewerkzeuge zur Suche nach diesen sekundär-/spezialstoffproduzierenden BGCs in Genomen existieren seit über einem Jahrzehnt [4- 7].
Seit seiner ersten Veröffentlichung im Jahr 2011 hat sich antiSMASH [8- 14] zum führenden Werkzeug auf diesem Gebiet entwickelt. Rund um antiSMASH hat sich ein breites Ökosystem verwandter Werkzeuge entwickelt, die antiSMASH-Vorhersagen integrieren oder auf ihnen basieren. Beispiele hierfür sind das resistenzbasierte Mining-Werkzeug ARTS [15], das massenspektrometriegeführte Seq2PKS [16], das Werkzeug für Genom-Engineering StreptoCAD [17], das BGC-Netzwerk- und Clustering-Werkzeug BiG- SCAPE [18] und das Werkzeug für gekoppelte Omics-Analysen NPLinker [19]. Umgekehrt kann antiSMASH auch BGC-Vorhersagen anderer Werkzeuge integrieren [13]. Ursprünglich für DeepBGC [20] entwickelt, stellen auch andere maschinenlernbasierte Werkzeuge wie GECCO [21] ihre Ergebnisse im erforderlichen Format bereit. antiSMASH-BGC-Vorhersagen werden auch in vielen genomischen und BGC-bezogenen Datenbanken verwendet, wie dem Secondary Metabolite Collaboratory des Joint Genome Institute [22], der MicroScope-Plattform für Genomannotation und -analyse [23], der MIBiG-Datenbank manuell kuratierter BGCs [24], der BGC-Familien-Datenbank BiG- FAM [25], der Datenbank für chemische Diversität in Metagenomen BGC Atlas [26] und der antiSMASH-Datenbank [27]. Darüber hinaus ist antiSMASH Teil mehrerer systematischer Arbeitsabläufe für groß angelegte Analysen genomischer Daten, z. B. BGCFlow [28] oder des MicroOrganisms Pipelines Service [29] der Europäischen Behörde für Lebensmittelsicherheit (EFSA).
Hier stellen wir Version 8 von antiSMASH vor. Diese Veröffentlichung erhöht die Zahl der detektierbaren Typen biosynthetischer Pathways von 81 auf 101, fügt ein Analysemodul für terpenoide BGCs hinzu und bietet eine eingehende Analyse von Tailoring-Enzymen.
Darüber hinaus wurden die KnownClusterBlast- und ClusterCompare-Datensätze aktualisiert, um die Daten von MIBiG Release 4 widerzuspiegeln, wir haben eine ordnungsgemäße Unterstützung für BGCs hinzugefügt, die den Replikationsursprung in zirkulären Genomen überspannen, und die Vorhersagen von Transkriptionsfaktor-Bindungsstellen wurden um Datensätze aus der CollecTF-Datenbank [30] erweitert. In BGCs, die nichtribosomale Peptidsynthetasen (NRPSs) oder Typ-I-Polyketidsynthasen (PKSs) enthalten, werden mehr biosynthetische Domänen detektiert und analysiert.
Neue Funktionen und Aktualisierungen
Aktualisierungen der BGC-Detektion
antiSMASH verwendet manuell kuratierte Regeln, um festzulegen, welche biosynthetischen Funktionen in einer genomischen Region vorhanden sein müssen, um eine BGC zu definieren. Zur Identifizierung dieser biosynthetischen Funktionen nutzt antiSMASH sowohl Profil-Hidden-Markov-Modelle (pHMMs) als auch, in geringerem Umfang, dynamische Profile, die in Python-Codedateien spezifiziert sind. Die pHMMs stammen aus öffentlichen Datensätzen wie PFAM [31], TIGRFAMS [32], SMART [33], BAGEL [34], Yadav et al. [35] oder wurden speziell für die Verwendung in antiSMASH erstellt. antiSMASH 7 enthielt 81 solcher BGC-Regeln [14]; diese Zahl ist in dieser Version auf 101 gestiegen, wobei eine Reihe bestehender Regeln verfeinert wurde. Aufgrund der großen Überlappung bei biosynthetischen Enzymen ist es schwierig, zwischen linearen azolhaltigen Peptiden und den thio-verknüpften zyklisierten Thiopeptiden zu unterscheiden. In der aktuellen antiSMASH-Datenbank [27] überlappen sich der Thiopeptid- und der BGC-Aufrufe für lineare azolhaltige Peptide, und es ist unklar, wie viele der übrigen Zuordnungen korrekt sind. Um dieser Unsicherheit zu begegnen und mögliche Verwirrung zu vermeiden, wurden die Erkennungsregeln für beide Arten von BGCs zu einer neuen „Regel für azolhaltige RiPPs“ zusammengeführt. Die Erkennungsregeln für Terpene, Mycosporine, NRPS-unabhängige Siderophore, trans-AT PKSs, NRPSs, NRPS-ähnliche Cluster und Fettsäuren wurden ebenfalls aktualisiert. Zusätzlich wurden neue Regeln für archaelle ribosomale synthetisierte und posttranslational modifizierte Peptide (RiPPs), Atropopeptide, Nitropropansäure, azoxyhaltige Verbindungen, Polyine, Deazapurine, polyhalogenierte Pyrrole, Hydroxytropolone, Blausäuren, Darobactine, Isocyanide, bakterielle und pilzliche cyclische Dipeptide, Triceptide, stark reduzierende Typ-II-PKSs und pilzliche NRPS-ähnliche Lysin-Biosynthese hinzugefügt.
:
:
:
:
:
:
:
:
:
:
:
:
::
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
The text to translate is empty — only a colon (":") was provided, so there is nothing to translate into German. Please send the source text you'd like translated.
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:: antiSMASH bietet eine detaillierte Analyse der in NRPS/PKS-BGCs kodierten Proteindomänen. Um eine umfassendere Übersicht über die vorhandenen Domänen bereitzustellen, haben wir Profile für siderophor-assoziierte -Hydroxylasen und Interface-Domänen (siehe [37] für eine ausführliche Diskussion) sowie ein allgemeineres -
Um Fälle abzudecken, in denen zusammenhängende Abschnitte einiger Kerngene zu weit von anderen Kerngenen entfernt waren, wurde der Regeldefinition eine neue „EXTENDS“-Bedingung hinzugefügt, um sicherzustellen, dass alle Kerngene ordnungsgemäß markiert werden. Die trans-AT-PKS-Regeln nutzen dies, um sicherzustellen, dass alle Gene, die Module enthalten, korrekt erkannt werden, selbst wenn die einzelne trans-agierende Acyltransferase-(AT-)Domäne weit entfernt liegt.
Terpen-Analyse
Obwohl antiSMASH seit Version 1 [8] Terpen-Gencluster erkennt, fehlte eine detailliertere Analyse der Terpensynthasen/Cyclasen. antiSMASH Version 4 [11] fügte ein erstes Analysemodul hinzu, das jedoch aufgrund von Leistungsgrenzen des phylogenetischen Platzierungsalgorithmus und Herausforderungen bei der Wartbarkeit in antiSMASH 5 [12] wieder entfernt wurde. Für Version 8 sehen wir eine Rückkehr der Terpen-Analyse basierend auf sorgfältig kuratierten pHMMs (siehe Abb. 1A). Für jede Region, die ein Terpen-BGC enthält, wird eine Liste potenzieller Produkttypen angezeigt. Jede Vorhersage enthält die Terpenoidklasse (z. B. Diterpen, Sesquiterpen usw.) und die Kettenlänge des vorhergesagten Produkts. Für besser verstandene Subfamilien von Terpensynthasen kann die Vorhersage auch die Terpenoid-Unterklasse (z. B. Indol-Diterpenoid), initiale Cyclisierungen (z. B. C1-C15) und den Produktnamen enthalten.
Genfunktionsanalyse
Während der großen Community-Initiative zur besseren Annotation von Tailoring-Enzymen in MIBiG-Einträgen während der MIBiG-Annotationen des letzten Jahres (siehe [24] für eine Beschreibung) bemerkten wir, dass in antiSMASH eine benutzerfreundlichere Schnittstelle für den Zugriff auf Tailoring-Enzymreaktionen benötigt wurde. Unter Verwendung der Sammlung von Tailoring-Enzymen in der MITE-Datenbank (https://mite.bioinformatics.nl/) [36], die während dieser Annotathons annotiert wurden, sowie unserer bestehenden smCOG-Annotationen präsentieren wir nun Tailoring-Enzym-Informationen in einem eigenen „Tailoring“-Tab (siehe Abb. 1B). Dies gab uns auch die Gelegenheit, die Substratspezifitäten vieler Flavin-abhängiger Halogenasen zu berichten, die ebenfalls in dieser Version hinzugefügt wurden. Unter Verwendung maßgeschneiderter pHMMs und konservierter Motivsignaturen reichen die Vorhersagen je nach Datenverfügbarkeit von „halogeniertes Pyrrol“ bis hin zur Regioselektivität z. B. von Tryptophan-Halogenasen.
Im Tailoring-Tab sind Tailoring-Enzyme nach Enzyme-Commission-Kategorie organisiert, d. h. Oxidoreduktasen, Transferasen, Hydrolasen, Lyasen, Isomerasen und Ligasen. Es werden nur Kategorien mit Treffern in der Region angezeigt. Durch Klicken auf die Plus-Symbole wird die Kategorie erweitert, um die Gene mit relevanten Treffern und eine kurze Zusammenfassung der möglichst detailliertesten Vorhersage der Tailoring-Funktion anzuzeigen. Durch Klicken auf das Plus-Symbol eines Gens von Interesse werden alle Informationen erweitert, die antiSMASH über ein Tailoring-Enzym bereitstellt. Wenn ein Tailoring-Enzym mindestens Aminosäuresequenzidentität zu einem beliebigen Eintrag in der MITE-Datenbank aufweist, wird ein Querverweis zu diesem MITE-Eintrag bereitgestellt.
Verbesserungen bei NRPS und PKS
CoA-Ligase-(CAL-)Domänen sind häufig an der Beladung von von Fettsäuren abgeleiteten Startereinheiten in Lipopeptid-BGCs beteiligt, wurden jedoch zuvor in der antiSMASH-Modulerkennung nicht als Startmodule betrachtet. Zusammen mit den zuvor erwähnten -Hydroxylasen und Interface-Domänen können sie nun als Teil von Modulen erkannt werden.
Gemäß den in [38] gesammelten Informationen werden die aktiven Zentren von NRPS-Kondensations-(C-) und Epimerisierungs-(E-)Domänen nun auf das Vorhandensein katalytischer Reste geprüft und als inaktiv markiert, wenn diese Reste fehlen. Um die bereits in antiSMASH durchgeführten Substratspezifitätsvorhersagen der NRPS-Adenylierungs-(A-)Domäne zu ergänzen, stellen wir nun außerdem einen Link zum externen PARAS-Substratspezifitätsprädiktor [39] bereit, um Forschenden noch mehr Analysemöglichkeiten zu bieten.
Sonstige Änderungen
Viele weitere kleinere Änderungen wurden in Version 8 aufgenommen. Die Übersichtsseitenansicht, die die ähnlichsten bekannten Cluster zeigt, wurde vereinfacht, um einige Quellen von Benutzerverwirrung zu beseitigen. Anstatt die Cluster-Ähnlichkeit direkt in „Prozent der Gene mit einer Sequenzähnlichkeit von mindestens “ anzuzeigen, zeigen wir die Ähnlichkeit nun in drei Konfidenzstufen: „hoch“ für eine Cluster-Ähnlichkeit von größer oder gleich , „mittel“ für eine Cluster-Ähnlichkeit zwischen und und „niedrig“ für eine Cluster-Ähnlichkeit zwischen und . Cluster-Ähnlichkeiten von werden nicht mehr als ausreichend ähnlich betrachtet und nicht mehr in der Übersicht angezeigt. Known ClusterBlast, ClusterCompare und CompaRiPPson wurden auf die im MIBiG 4.0-Release [24] bereitgestellten Daten aktualisiert. Die ClusterBlast-SVG-Generierung wurde nach JavaScript verlagert, um Dateigrößen zu reduzieren und die Benutzererfahrung beim Anzeigen lokal geöffneter antiSMASH-Ergebnisse zu verbessern. Historisch gesehen hatte antiSMASH Schwierigkeiten mit BGCs, die den Ursprung in zirkulären Genomen überspannen. Im besten Fall wurden diese BGCs in zwei Teile aufgeteilt, im schlimmsten Fall konnte einer oder beide der Teile auf den gegenüberliegenden Seiten des Ursprungs vollständig übersehen werden. In antiSMASH 8.0 haben wir unsere Koordinatenverarbeitung für zirkuläre Genome vollständig überarbeitet, sodass diese ordnungsgemäß erkannt und berichtet werden.
Historisch gesehen hat antiSMASH für die pilzliche Genvorhersage auf GlimmerHMM [40] zurückgegriffen, da es ohne manuelle Auswahl des richtigen Genmodells ausgeführt werden konnte. Unglücklicherweise wurde, da immer mehr pilzliche Genome verfügbar wurden, deutlich, dass diese Genmodellauswahl entscheidend für eine hochwertige Genvorhersage ist. Da wir das richtige Genmodell für hochgeladene Genome unbekannter Taxa nicht ohne Weiteres auswählen können, haben wir beschlossen, die pilzliche Genvorhersagefunktionalität aus antiSMASH zu entfernen. Wir empfehlen Nutzenden, ein dediziertes Genvorhersagewerkzeug wie AUGUSTUS [41] auszuführen und antiSMASH anschließend die Genannotationen bereitzustellen. Aufgrund von Softwareinkompatibilitäten in modernen Systemen haben wir außerdem unsere Unterstützung für die MEME-Toolsuite, insbesondere MEME [42] und FIMO [43], eingestellt. Nutzende der Standalone-Version von antiSMASH können diese Binärdateien weiterhin selbst bereitstellen, aber sie sind nicht mehr Teil der von uns bereitgestellten Container oder des Webdienstes. Dies deaktiviert effektiv die pilzliche BGC-Grenzenerkennung von CASSIS [44] und könnte den RODEO-Score [45] für Lanthipeptid-, Sactipeptid-, Lassopeptid- und azolhaltige RiPP-Vorläufer beeinflussen.
A
Detaillierte Terpen-Vorhersagen
| Produktvorhersagen: | |||||
| Klasse | Unterklasse | Produktname | Kettenlänge | Erste Cyclisierungen | Funktionelle Gruppen |
| Sesquiterpen | Germacradienol | C15 | C1-C10 | OH | |
| Sesquiterpen | Geosmin | C12 | C1-C10 | OH |
Gene mit Terpendomänen:
scO6073: T1TS + T1TS
Domäne 1 (0 - 326): Typ-1-Terpensynthase Subtyp: Geosmin-Synthase, N-terminale Domäne Reaktionen: FPP → Germacradienol
Domäne 2 (326 - 695): Typ-1-Terpensynthase
Subtyp: Geosmin-Synthase, C-terminale Domäne Reaktionen: Germacradienol → Geosmin
B
Tailoring-Funktionen
Oxidoreduktasen: Oxygenase
oxyA: Cyclisierung
oxyB: Cyclisierung
oxyC: Cyclisierung
oxyD: Cytochrom P450
Transferasen: Aminotransferase Glycosyltransferase Halogenase Methyltransferase
bgtFA: Glycosylierung
bgtFB: Glycosylierung
bgtFC: Glycosylierung
bhaA: Flavin-abhängige Tyrosin-ähnliche hpg-Halogenase halogenasen Flavin-abhängige Tyrosin-ähnliche hpg-Halogenase
MITF
MITEO000028 Halogenierung (Identität: 100.00%) smcogs SMCOG1119: Halogenase
bmt: Methylierung
dvaB: DegT/DnrJ/ErYC1/StrS-Aminotransferase
pgaT: Aminotransferase
Hydrolasen: Hydrolase
bhp: Alpha/Beta-Hydrolase-Faltprotein
Lyasen: Hydratase
dpgC: Enoyl-CoA-Hydratase
dpgD: Enoyl-CoA-Hydratase
Ligasen: Ligase-Synthase
Fazit und Zukunftsperspektive
Fazit und ZukunftsperspektiveGenom-Mining-Technologien wie antiSMASH sind ein wichtiger Baustein im Puzzle der Naturstoffentdeckung. In den vergangenen 14 Jahren wurde antiSMASH kontinuierlich aktualisiert und verbessert, um sicherzustellen, dass es an der Spitze der Genom-Mining-Werkzeuge für Naturstoffe bleibt. Wie die zahlreichen Beiträge von außerhalb des Kerentwicklungsteams zeigen, bleibt das Open-Source- und Open-Science-Modell des antiSMASH-Projekts erfolgreich. Es ist ein wichtiges Werkzeug, auf das viele andere, spezialisiertere Werkzeuge, Workflows und Datenbanken angewiesen sind. Es dient als Technologieplattform für eine Reihe anderer Genom-Mining-Werkzeuge, die derzeit entwickelt werden. In zukünftigen Aktualisierungen werden wir unsere Arbeit an neuen Algorithmen und Analysemodulen fortsetzen, um die vollständigen Biosynthesewege der erkannten Cluster zu entschlüsseln. Wir werden auf der Grundlage der Verbesserungen der Vorhersage von Tailoring-Enzymen in dieser Version aufbauen und noch mehr Enzymfamilien abdecken. Ebenso wird unsere Arbeit zur Erkennung von Regulatoren und Regulator-Bindungsstellen fortgesetzt. Wie immer werden wir auch neue Werkzeuge, die sich im Ökosystem entwickeln, integrieren oder uns mit ihnen integrieren.
Danksagungen
DanksagungenAutorenbeiträge: Kai Blin (Konzeptualisierung [federführend], Datenkuration [federführend], Mittelakquise [gleichberechtigt], Methodik [federführend], Projektverwaltung [federführend], Software [gleichberechtigt], Supervision [gleichberechtigt], Verfassen—Originalentwurf [federführend], Verfassen—Überprüfung & Bearbeitung [federführend], Simon Shaw (Datenkuration [gleichberechtigt], Methodik [gleichberechtigt], Software [federführend], Visualisierung [federführend], Lisa Vader (Datenkuration [unterstützend], Software [unterstützend], Visualisierung [unterstützend], Judit Szenei (Datenkuration [unterstützend], Software [unterstützend], Visualisierung [unterstützend], Zachary L. Reitz (Datenkuration [unterstützend], Software [unterstützend], Hannah E. Augustin (Datenkuration [unterstützend], Software [unterstützend]), José D.D. Cediel-Becerra (Datenkuration [unterstützend], Software [unterstützend], Valérie de Crécy-Lagard (Datenkuration [unterstützend], Robert A. Koetsier (Datenkuration [unterstützend], Software [unterstützend]), Sam E. Williams (Datenkuration [unterstützend], Pablo Cruz-Morales (Datenkuration [unterstützend]), Sopida Wongwas (Datenkuration [unterstützend]), Alejandro E. Segurado Luchsinger (Datenkuration [unterstützend]), Friederike Biermann (Datenkuration [unterstützend]), Aleksandra Korenskaia (Datenkuration [unterstützend]), Mitja M. Zdouc (Datenkuration [unterstützend], Verfassen—Originalentwurf [unterstützend]), David Meijer (Datenkuration [unterstützend]), Barbara R. Terlouw (Datenkuration [unterstützend]), Justin J.J. van der Hooft (Mittelakquise [gleichberechtigt], Verfassen—Originalentwurf [unterstützend]), Nadine Ziemert (Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt]), Eric J.N. Helfrich (Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt], Verfassen—Originalentwurf [unterstützend]), Joleen Masschelein (Datenkuration [unterstützend], Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt]), Christophe Corre (Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt]), Marc G. Chevrette (Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt]), Gilles P. van Wezel (Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt]), Marnix H. Medema (Konzeptualisierung [unterstützend], Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt], Verfassen—Originalentwurf [unterstützend]), und Tilmann Weber (Konzeptualisierung [unterstützend], Mittelakquise [gleichberechtigt], Supervision [gleichberechtigt], Validierung [unterstützend], Verfassen—Originalentwurf [unterstützend])
Interessenkonflikt
J.J.vdH. ist Mitglied des Scientific Advisory Board von NAICONS Srl, Mailand, Italien, und ist als Berater für Corteva Agriscience, Indianapolis, IN, USA, tätig. M.H.M. ist Mitglied des Scientific Advisory Board von Hexagon Bio. Alle anderen Autoren erklären, keine Interessenkonflikte zu haben.
Förderung
FörderungNovo Nordisk Foundation [NNF20CC0035580 an T.W., K.B. und P.C.-M., NNF22OC0079021 an S.E.W.]; Center for Microbial Secondary Metabolites (CeMiSt), Danish National Research Foundation [DNRF137 an T.W.]; EU-Horizon-Europe-Programm MAGic-MOLFUN [MSC 101072485 an T.W., K.B., M.H.M., N.Z., A.K. und J.J.vdH.]; EU-Horizon-2020 MARBLES [101000392 an M.M.Z., J.J.vdH., M.H.M. und G.P.vW.]; NWO [KICH1.LWV04.21.013 an M.M.Z., J.J.vdH. und M.H.M.]; EU-ERC-Community [101055020 an G.P.vW.]; NWO-XL [OCENW.XL21.XL21.088 an R.A.K.]; National Institutes of Health [RM1GM145426 an VdC.-L.]; Deutsches Zentrum für Infektionsforschung (DZIF) [TTU09.716 an N.Z.]; EU-Horizon-2020 DECIPHER [948770 an D.M. und M.H.M.]; The Royal Thai Government [Promotionsförderung an S.W.]; Emmy-Noether-Programm der Deutschen Forschungsgemeinschaft [504947087 an E.J.N.H.], Hessisches Ministerium für Wissenschaft und Kunst [LOEWE-Zentrum für Translationale Biodiversitätsgenomik an E.J.N.H.]; FWO [1008520N und G061821N an J.M.]. Die Mittel zur Deckung der Open-Access-Publikationsgebühren für diesen Artikel wurden vom EU-Horizon-Europe-Programm MAGic-MOLFUN bereitgestellt.
Datenverfügbarkeit
Die bakteriellen und fungalen Versionen von antiSMASH 8.0 sind frei zugänglich unter https://antismash.secondarymetabolites.org bzw. https://fungismash.secondarymetabolites.org.
Die antiSMASH-Dokumentation ist verfügbar unter https://docs.antismash.secondarymetabolites.org/.
Der antiSMASH-Quellcode ist unter der GNU Affero General Public License (AGPL) Version 3.0 lizenziert. antiSMASH ist auch über Docker verfügbar. Einzelheiten zum Herunterladen und Installieren von antiSMASH finden Sie auf der Dokumentationswebsite.
Literatur
1. Newman DJ, Cragg GM. Natural products as sources of new drugs over the nearly four decades from 01/1981 to 09/2019. BMC Genomics 2020;83:1138-43. https://doi.org/10.1021/acs.jnatprod.9b01285 2. Sparks TC, Bryant RJ. Impact of natural products on discovery of, and innovation in, crop protection compounds. Pest Manag Sci 2022;78:399-408. https://doi.org/10.1002/ps.6653 3. Ziemert N, Alanjary M, Weber T. The evolution of genome mining in microbes—a review. Nat Prod Rep 2016;33:988-1005. https://doi.org/10.1039/C6NP00025H 4. Weber T. In silico tools for the analysis of antibiotic biosynthesis pathways. Int J Med Microbiol 2014;304:230-5. https://doi.org/10.1016/j.ijmm.2014.02.001 5. Medema MH, Fischbach MA. Computational approaches to natural product discovery. Nat Chem Biol 2015;11:639-48. https://doi.org/10.1038/nchembio.1884 6. Weber T, Kim HU. The secondary metabolite bioinformatics portal: computational tools to facilitate synthetic biology of secondary metabolite production. Synth Syst Biotechnol 2016;1:69- 79. https://doi.org/10.1016/j.synbio.2015.12.0027. Blin K, Kim HU, Medema MH et al. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Brief Bioinform 2019;20:1103- 13. https://doi.org/10.1093/bib/bbx1468. Medema MH, Blin K, Cimermancic P et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Res 2011;39:W339- 46. https://doi.org/10.1093/nar/gkr4669. Blin K, Medema MH, Kazempour D et al. antiSMASH 2.0- a versatile platform for genome mining of secondary metabolite producers. Nucleic Acids Res 2013;41:W204- 12. https://doi.org/10.1093/nar/gkt44910. Weber T, Blin K, Duddela S et al. antiSMASH 3.0- a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Res 2015;43:W237- 43. https://doi.org/10.1093/nar/gkv43711. Blin K, Wolf T, Chevrette MG et al. antiSMASH 4.0- improvements in chemistry prediction and gene cluster boundary identification. Nucleic Acids Res 2017;45:W36- 411. https://doi.org/10.1093/nar/gkx31912. Blin K, Shaw S, Steinke K et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Res 2019;47:W81- 7. https://doi.org/10.1093/nar/gkz31013. Blin K, Shaw S, Kloosterman AM et al. antiSMASH 6.0: improving cluster detection and comparison capabilities. Nucleic Acids Res 2021;49:W29- 35. https://doi.org/10.1093/nar/gkab33514. Blin K, Shaw S, Augustijn HE et al. antiSMASH 7.0: new and improved predictions for detection, regulation, chemical structures and visualisation. Nucleic Acids Res 2023;51:W46- 50. https://doi.org/10.1093/nar/gkad34415. Mungan MD, Alanjary M, Blin K et al. ARTS 2.0: feature updates and expansion of the Antibiotic Resistant Target Seeker for comparative genome mining. Nucleic Acids Res 2020;48:W546- 52. https://doi.org/10.1093/nar/gkaa37416. Yan D, Zhou M, Adduri A et al. Discovering type I cis- AT polyketides through computational mass spectrometry and genome mining with Seq2PKS. Nat Commun 2024;15:5356. https://doi.org/10.1038/s41467- 024- 49587- 117. Levasor L, Whitford CM, Petersen SD et al. StreptoCAD: an open- source software toolbox automating genome engineering workflows in streptomycetes. bioRxiv, https://doi.org/10.1101/2024.12.19.629370, 20 December 2024, preprint: not peer reviewed.18. Navarro- Munoz JC, Selem- Mojica N, Mullowney MW et al. A computational framework to explore large- scale biosynthetic diversity. Nat Chem Biol 2020;16:60- 8. https://doi.org/10.1038/s41589- 019- 0400- 919. Eldjarn GH, Ramsay A, Hooft JJJvd et al. Ranking microbial metabolomic and genomic links in the NPLinker framework using complementary scoring functions. PLOS Comput Biol 2021;17:e1008920. https://doi.org/10.1371/journal.pcbi.100892020. Hannigan GD, Prihoda D, Palicka A et al. A deep learning genome- mining strategy for biosynthetic gene cluster prediction. Nucleic Acids Res 2019;47:e110. https://doi.org/10.1093/nar/gkz65421. Carroll LM, Larralde M, Fleck JS et al. Accurate de novo identification of biosynthetic gene clusters with GECCO. bioRxiv, https://doi.org/10.1101/2021.05.03.442509, 4 May 2021, preprint: not peer reviewed.22. Udwary DW, Doering DT, Foster B et al. The secondary metabolism collaboratory: a database and web discussion portal for secondary metabolite biosynthetic gene clusters. Nucleic Acids Res 2025;53:D717- 23. https://doi.org/10.1093/nar/gkae106023. Vallenet D, Calteau A, Dubois M et al. MicroScope: an integrated platform for the annotation and exploration of microbial gene functions through genomic, pangenomic and metabolicVergleichende Analyse. Nucleic Acids Res 2020;48: D579-89. https://doi.org/10.1093/nar/gkz92624. Zdouc MM, Blin K, Louwen NLL et al. MIBiG 4.0: advancing biosynthetic gene cluster curation through global collaboration. Nucleic Acids Res 2025;53:D678-90. https://doi.org/10.1093/nar/gkae111525. Kautsar SA, Blin K, Shaw S et al. BiG-FAM: the biosynthetic gene cluster families database. Nucleic Acids Res 2021;49: D490-7. https://doi.org/10.1093/nar/gkaa81226. Bagci C, Nuhamunada M, Goyat H et al. BGC Atlas: a web resource for exploring the global chemical diversity encoded in bacterial genomes. Nucleic Acids Res 2025;53:D618-24. https://doi.org/10.1093/nar/gkae95327. Blin K, Shaw S, Medema MH et al. The antiSMASH database version 4: additional genomes and BGCs, new sequence-based searches and more. Nucleic Acids Res 2024;52:D586-9. https://doi.org/10.1093/nar/gkad98428. Nuhamunada M, Mohite OS, Phaneuf PV et al. BGCFlow: systematic pangenome workflow for the analysis of biosynthetic gene clusters across large genomic datasets. Nucleic Acids Res 2024;52:5478-95. https://doi.org/10.1093/nar/gkae31429. Yolanda GC. Microorganisms pipelines service (MOPS): pipelines documentation. Technical report.30. Kilu S, White ER, Sagitova DM et al. CollecTF: a database of experimentally validated transcription factor-binding sites in bacteria. Nucleic Acids Res 2014;42:D156-6030. https://doi.org/10.1093/nar/gkt112331. Mistry J, Chugarunsky S, Williams L et al. Pfam: the protein families database in 2021. Nucleic Acids Res 2021;49: D412-9. https://doi.org/10.1093/nar/gkaa91332. Haft DH, Selengut JD, Richter RA et al. TIGRFAMs and genome properties in 2013. Nucleic Acids Res 2013;41: D387-953. https://doi.org/10.1093/nar/gks123433. Letunic I, Khedkar S, Bork P. SMART: recent updates, new developments and status in 2020. Nucleic Acids Res 2021;49: D458-60. https://doi.org/10.1093/nar/gkaa93734. van Heel AJ, de Jong A, Song C et al. BAGEL4: a user-friendly web server to thoroughly mine RiPPs and bacteriocins. Nucleic Acids Res 2018;46: W278-81. https://doi.org/10.1093/nar/gky38335. Yadav G, Gokhale RS, Mohanty D. Towards prediction of metabolic products of polyketide synthases: an in silico analysis. PLOS Comput Biol 2009;5:e1000351. https://doi.org/10.1371/journal.pcbi.100035136. Zdouc MM, Meijer D, Biermann F et al. The minimum information about a tailoring enzyme/mutarease data standard for capturing natural product biosynthesis. ChemRxiv, https://doi.org/10.26434/chemrxiv-2024-78mtl, 9 April 2024, preprint: not peer reviewed.37. Reitz ZL, Hardy CD, Suk J et al. Genomic analysis of siderophore -hydroxylases reveals divergent stereocontrol and expands the condensation domain family. Proc Natl Acad Sci USA 2019;116:19805-14. https://doi.org/10.1073/pnas.190316111628. Bloudoff K, Schmeng TM. Structural and functional aspects of the nonribosomal peptide synthetase condensation domain superfamily: discovery, dissection and diversity. Biochim Biophys Acta Proteins Proteom 2017;1865:1587-604. https://doi.org/10.1016/j.bbapap.2017.05.01039. Terlouw BR, Huang C, Meijer D et al. PARAS: high-accuracy machine-learning of substrate specificities in nonribosomal peptide synthetases. bioRxiv, https://doi.org/10.1101/2025.01.08.631717, 10 January 2025, preprint: not peer reviewed.40. Majoros WH, Pertea M, Salzberg SL. TigrScan and GlimmerHMM: two open source ab initio eukaryotic gene-finders. Bioinformatics 2004;20:2878-9. https://doi.org/10.1093/bioinformatics/bth31541. Stanke M, Morgenstern B. AUGUSTUS: a web server for gene prediction in eukaryotes that allows user-defined constraints. Nucleic Acids Res 2005;33:W465-7. https://doi.org/10.1093/nar/gk14858 42. Bailey TL, Elkan C. Fitting a mixture model by expectation maximization to discover motifs in biopolymers. Proc Int Conf Intell Syst Mol Biol 1994;2:28-36. 43. Grant CE, Bailey TL, Noble WS. FIMO: scanning for occurrences of a given motif. Bioinformatics 2011;27:1017-8. https://doi.org/10.1093/bioinformatics/btr064 44. Wolf T, Shelest V, Nath N et al. CASSIS and SMIPS: promoter-based prediction of secondary metabolite gene clusters in eukaryotic genomes. Bioinformatics 2016;32:1138-43. https://doi.org/10.1093/bioinformatics/btv713 45. Walker MC, Eslami SM, Hetrick KJ et al. Precursor peptide-targeted mining of more than one hundred thousand genomes expands the lanthipeptide natural product family. BMC Genomics 2020;21:387. https://doi.org/10.1186/s12864-020-06785-7