
NSA macht die Attention selbst spärlich und durchgehend trainierbar, senkt Prefill- und Decode-Kosten bei 64k-Kontexten ohne Genauigkeitsverlust. ACL 2025.
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
Native Sparse Attention: Hardware-Aligned und nativ trainierbare Sparse Attention
Jingyang Yuan , Huazuo Gao , Damai Dai , Junyu Luo , Liang Zhao , Zhengyan Zhang , Zhenda Xie , Y. X. Wei , Lean Wang , Zhiping Xiao , Yuqing Wang , Chong Ruan , Ming Zhang , Wenfeng Liang , Wangding Zeng
DeepSeek- AI Key Laboratory for Multimedia Information Processing, School of Computer Science, Peking University, PKU- Anker LLM Lab University of Washington {yuanjy, mzhang_cs}@pku.edu.cn, {zengwangding, wenfeng.liang}@deepseek.com
Abstract
Die Modellierung langer Kontexte ist entscheidend für Sprachmodelle der nächsten Generation, doch die hohen Rechenkosten standardmäßiger Attention-Mechanismen stellen erhebliche rechnerische Herausforderungen dar. Sparse Attention bietet eine vielversprechende Richtung zur Effizienzsteigerung bei gleichbleibenden Modellfähigkeiten. Wir präsentieren NSA, einen nativ trainierbaren Sparse-Attention-Mechanismus, der algorithmische Innovationen mit hardware-ausgerichteten Optimierungen integriert, um eine effiziente Modellierung langer Kontexte zu erreichen. NSA verwendet eine dynamische hierarchische Sparse-Strategie, die grobkörnige Token-Kompression mit feinkörniger Token-Auswahl kombiniert, um sowohl globale Kontextwahrnehmung als auch lokale Präzision zu erhalten. Unser Ansatz bringt das Design von Sparse Attention mit zwei zentralen Innovationen voran: (1) Wir erzielen erhebliche Beschleunigungen durch ein algorithmisches Design mit ausgewogener arithmetischer Intensität, mit Implementierungsoptimierungen für moderne Hardware. (2) Wir ermöglichen End-to-End-Training und reduzieren den Vortrainingsaufwand, ohne die Modellleistung zu beeinträchtigen. Wie in Abbildung [1] gezeigt, behält das mit NSA vortrainierte Modell seine Leistung bei oder übertrifft Vollattentionsmodelle in allgemeinen Benchmarks, Long-Context-Aufgaben und instrukionsbasiertem Reasoning. Gleichzeitig erzielt NSA erhebliche Beschleunigungen gegenüber Full Attention bei Sequenzen der Länge 64k über Decoding, Vorwärtspropagation und Rückwärtspropagation hinweg und bestätigt damit seine Effizienz über den gesamten Modelllebenszyklus.
1. Einleitung
Die Forschungsgemeinschaft erkennt zunehmend, dass die Modellierung langer Kontexte eine entscheidende Fähigkeit für große Sprachmodelle der nächsten Generation ist, angetrieben durch vielfältige reale Anwendungen, die von tiefgehendem Reasoning (DeepSeek- AI, 2025; Zelikman et al., 2022), Codegenerierung auf Repository-Ebene (Zhang et al., 2023a; Zhang et al.) bis hin zu mehrstufigen autonomen Agentensystemen (Park et al., 2023) reichen. Jüngste Durchbrüche, darunter OpenAIs o-Serien-Modelle, DeepSeek- R1 (DeepSeek- AI, 2025) und Gemini 1.5 Pro (Google et al., 2024), ermöglichen es Modellen, gesamte Codebasen und umfangreiche Dokumente zu verarbeiten, kohärente mehrstufige Dialoge über Tausende von Token hinweg aufrechtzuerhalten und komplexes Reasoning über weitreichende Abhängigkeiten hinweg durchzuführen. Die hohe Komplexität (Zaheer et al., 2020) von Vanilla-Attention-Mechanismen (Vaswani et al., 2017) erweist sich jedoch als kritischer
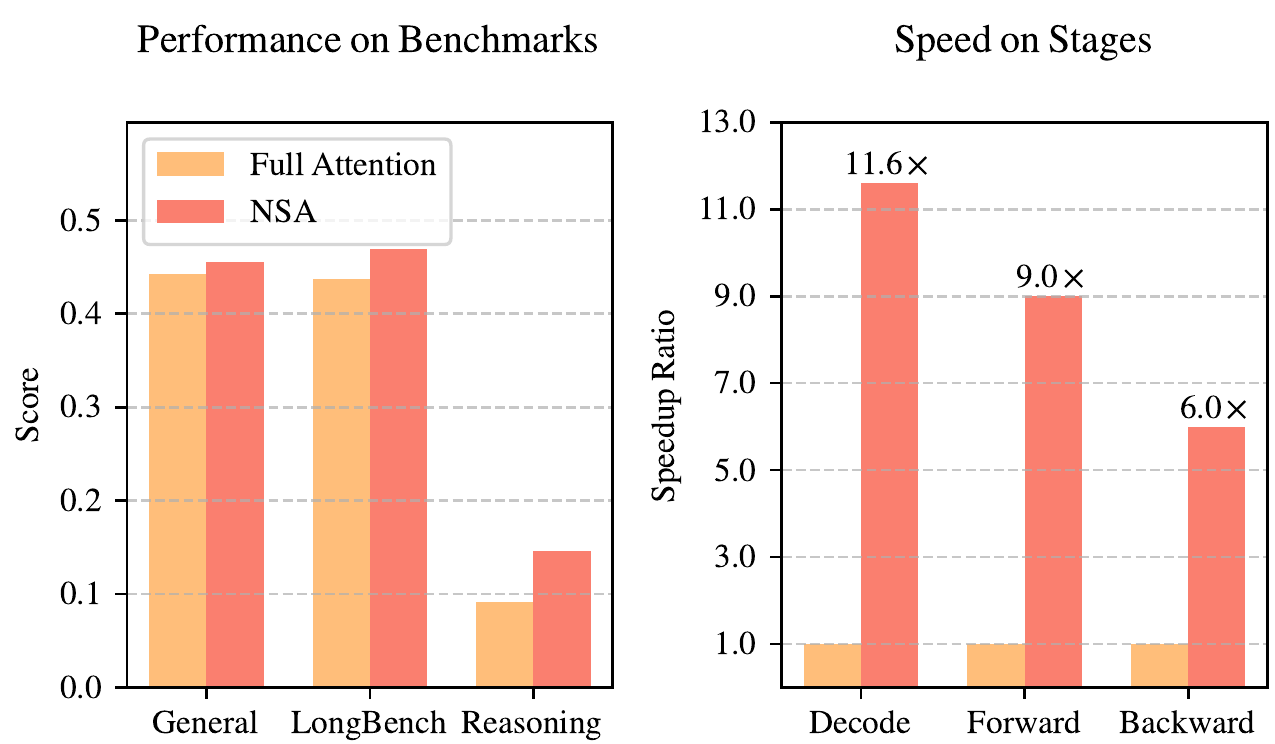
Abbildung 1 | Vergleich von Leistung und Effizienz zwischen dem Full-Attention-Modell und unserem NSA. Links: Obwohl NSA sparse ist, übertrifft es die Full-Attention-Baseline im Durchschnitt über allgemeine Benchmarks, Long-Context-Aufgaben und Reasoning-Evaluierung. Rechts: Bei der Verarbeitung von Sequenzen der Länge 64k erzielt NSA im Vergleich zu Full Attention in allen Phasen eine erhebliche rechnerische Beschleunigung: Decoding, Vorwärtspropagation und Rückwärtspropagation.Latenzengpass, wenn die Sequenzlänge zunimmt. Theoretische Schätzungen deuten darauf hin, dass die Attention-Berechnung mit Softmax-Architekturen der Gesamtlatenz beim Decoding von Kontexten der Länge 64k ausmacht, was den dringenden Bedarf an effizienteren Attention-Mechanismen unterstreicht.
Ein naheliegender Ansatz für effiziente Modellierung langer Kontexte besteht darin, die inhärente Sparsität von Softmax-Attention (Ge et al., 2023; Jiang et al., 2023) auszunutzen, wobei die selektive Berechnung kritischer Query-Key-Paare den Rechenaufwand erheblich reduzieren kann, während die Leistung erhalten bleibt. Jüngste Fortschritte demonstrieren dieses Potenzial durch verschiedene Strategien: KV-Cache-Eviction-Methoden (Li et al., 2024; Zhang et al., 2023b; Zhou et al., 2024), blockweise KV-Cache-Auswahlmethoden (Gao et al., 2024; Tang et al., 2024; Xiao et al., 2024a) sowie auf Sampling, Clustering oder Hashing basierende Auswahlmethoden (Chen et al., 2024b; Desai et al., 2024; Liu et al., 2024). Trotz dieser vielversprechenden Strategien bleiben bestehende Sparse-Attention-Methoden in praktischen Einsätzen oft hinter den Erwartungen zurück. Viele Ansätze erzielen keine mit ihren theoretischen Gewinnen vergleichbaren Beschleunigungen; darüber hinaus fehlt den meisten Methoden eine wirksame Unterstützung während des Trainings, um die Sparsitätsmuster der Attention vollständig auszunutzen.
Um diese Einschränkungen zu adressieren, muss der Einsatz effektiver Sparse Attention zwei zentrale Herausforderungen bewältigen: (1) Hardware-ausgerichtete Inferenzbeschleunigung: Die Umwandlung theoretischer Rechenreduktionen in tatsächliche Geschwindigkeitsverbesserungen erfordert hardwarefreundliches Algorithmusdesign sowohl in der Profiling- als auch in der Decoding-Phase, um Engpässe bei Speicherzugriffen und Hardware-Scheduling zu mildern; (2) Trainingsbewusstes Algorithmusdesign: Ermöglichung von End-to-End-Berechnungen mit trainierbaren Operatoren, um die Trainingskosten zu senken und gleichzeitig die Modellleistung zu erhalten. Diese Anforderungen sind entscheidend für reale Anwendungen, um schnelle Long-Context-Inferenz oder schnelles Training zu erreichen. Berücksichtigt man beide Aspekte, weisen bestehende Methoden noch eine merkliche Lücke auf.
Um eine effektivere und effizientere Sparse Attention zu erreichen, präsentieren wir NSA, eine nativ trainierbare Sparse-Attention-Architektur, die hierarchische Token-Modellierung integriert. Wie in Abbildung 2 gezeigt, reduziert NSA die Berechnung pro Query, indem Keys und Values in zeitliche Blöcke organisiert und durch drei Attention-Pfade verarbeitet werden: komprimierte grobkörnige Token, selektiv beibehaltene feinkörnige Token und Sliding Windows für lokale Kontextinformationen. Anschließend
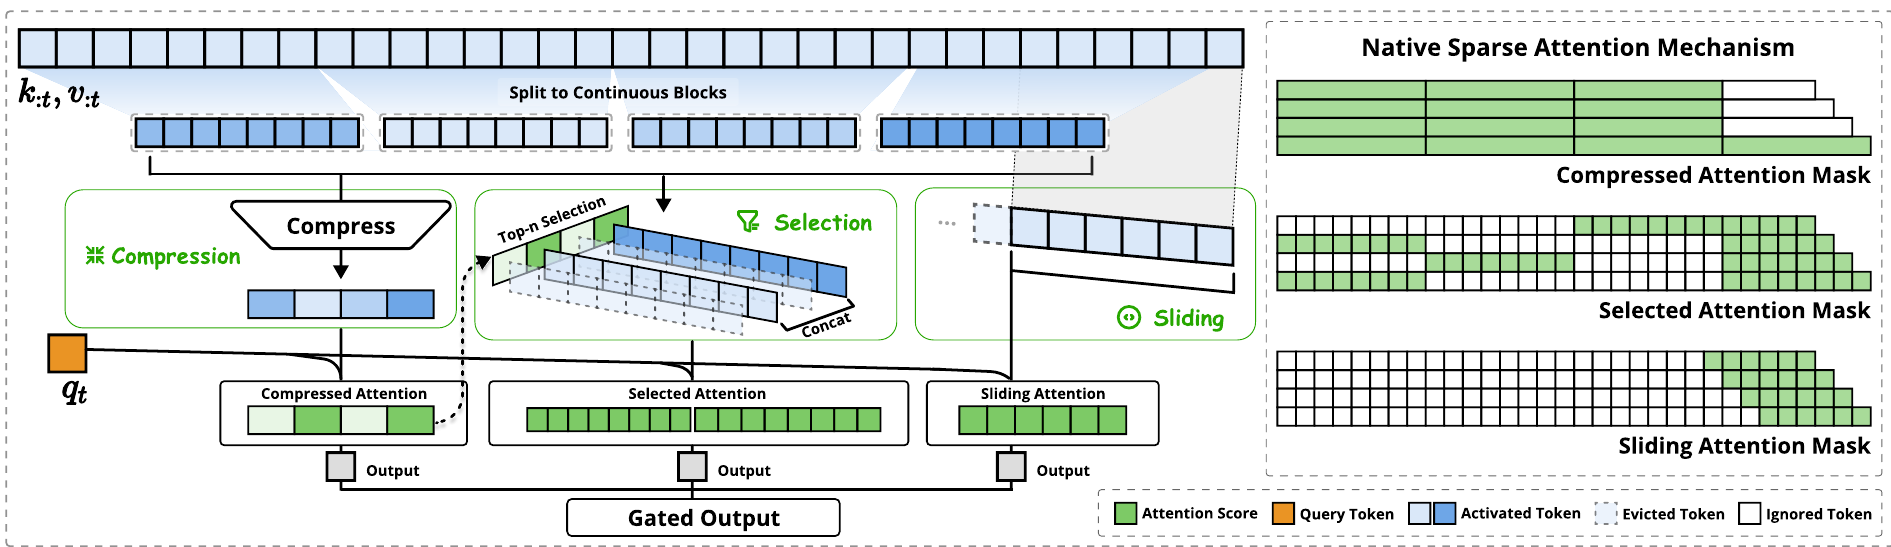
implementieren wir spezialisierte Kernel, um ihre praktische Effizienz zu maximieren. NSA führt zwei Kerninnovationen ein, die den oben genannten zentralen Anforderungen entsprechen: (1) Hardware-ausgerichtetes System: Optimierung blockweiser Sparse Attention für die Nutzung von Tensor Cores und Speicherzugriffe, wodurch eine ausgewogene arithmetische Intensität sichergestellt wird. (2) Trainingsbewusstes Design: Ermöglichung stabilen End-to-End-Trainings durch effiziente Algorithmen und Rückwärtsoperatoren. Diese Optimierung ermöglicht es NSA, sowohl effizienten Einsatz als auch End-to-End-Training zu unterstützen.
Wir evaluieren NSA durch umfassende Experimente auf realen Sprachkorpora. Nach dem Vortraining auf einem Transformer-Backbone mit 27B Parametern und 260B Token bewerten wir die Leistung von NSA in allgemeinen Sprachbewertungen, Long-Context-Bewertungen und Bewertungen des Chain-of-Thought-Reasonings. Darüber hinaus vergleichen wir die Kernel-Geschwindigkeit auf A100-GPUs mit optimierten Triton-Implementierungen (Tillet et al., 2019). Die experimentellen Ergebnisse zeigen, dass NSA eine vergleichbare oder überlegene Leistung gegenüber der Full-Attention-Baseline erzielt und dabei bestehende Sparse-Attention-Ansätze übertrifft. Zusätzlich liefert NSA erhebliche Beschleunigungen in den Decoding-, Vorwärts- und Rückwärtsphasen im Vergleich zu Full Attention, wobei das Beschleunigungsverhältnis für längere Sequenzen zunimmt. Diese Ergebnisse bestätigen, dass unser hierarchisches Sparse-Attention-Design Modellfähigkeit und Recheneffizienz wirksam ausbalanciert.
2. Sparse-Attention-Methoden neu überdenken
Moderne Sparse-Attention-Methoden haben bedeutende Fortschritte bei der Reduzierung der theoretischen Rechenkomplexität von Transformer-Modellen erzielt. Die meisten Ansätze wenden Sparsität jedoch überwiegend während der Inferenz an, während sie ein vortrainiertes Full-Attention-Backbone beibehalten, was potenziell einen architektonischen Bias einführt, der ihre Fähigkeit einschränkt, die Vorteile von Sparse Attention vollständig auszunutzen. Bevor wir unsere native Sparse-Architektur einführen, analysieren wir diese Einschränkungen systematisch aus zwei kritischen Perspektiven.
2.1. Die Illusion effizienter Inferenz
Trotz erreichter Sparsität in der Attention-Berechnung erzielen viele Methoden keine entsprechenden Reduktionen der Inferenzlatenz, hauptsächlich aufgrund von zwei Herausforderungen:
Phasenbeschränkte Sparsität. Methoden wie H2O (Zhang et al., 2023b) wenden Sparsität während des autoregressiven Decodings an, erfordern jedoch rechenintensive Vorverarbeitung (z. B. Attention-Map-Berechnung, Indexaufbau) während des Profilings. Im Gegensatz dazu konzentrieren sich Ansätze wie MInference (Jiang et al., 2024) ausschließlich auf Profiling-Sparsität. Diese Methoden erzielen keine Beschleunigung über alle Inferenzphasen hinweg, da mindestens eine Phase Rechenkosten vergleichbar mit Full Attention aufweist. Die Phasenspezialisierung verringert die Beschleunigungsfähigkeit dieser Methoden bei profiling-dominierten Arbeitslasten wie Buchzusammenfassung und Codevervollständigung oder bei decoding-dominierten Arbeitslasten wie langem Chain-of-Thought-Reasoning (Wei et al., 2022).
Inkompatibilität mit fortgeschrittenen Attention-Architekturen. Einige Sparse-Attention-Methoden lassen sich nicht an moderne decoding-effiziente Architekturen wie Multiple-Query Attention (MQA) (Shazeer, 2019) und Grouped-Query Attention (GQA) (Ainslie et al., 2023) anpassen, die den Engpass beim Speicherzugriff während des Decodings erheblich reduzierten, indem sie KV über mehrere Query-Heads hinweg teilen. Beispielsweise wählt in Ansätzen wie Quest (Tang et al., 2024) jeder Attention-Head unabhängig seine KV-Cache-Teilmenge aus. Obwohl dies in Multi-Head-Attention-(MHA-)Modellen konsistente Rechensparsität und Speicherzugriffssparsität zeigt, ergibt sich in Modellen auf Basis von Architekturen wie GQA ein anderes Szenario, in dem das Speicherzugriffsvolumen des KV-Cache der Vereinigung der Auswahlen aller Query-Heads innerhalb derselben GQA-Gruppe entspricht. Diese architektonische Eigenschaft bedeutet, dass diese Methoden zwar Rechenoperationen reduzieren können, der erforderliche KV-Cache-Speicherzugriff jedoch relativ hoch bleibt. Diese Einschränkung erzwingt eine kritische Entscheidung: Während einige Sparse-Attention-Methoden die Berechnung reduzieren, steht ihr verstreutes Speicherzugriffsmuster im Konflikt mit dem effizienten Speicherzugriffsdesign fortgeschrittener Architekturen.
Diese Einschränkungen entstehen, weil viele bestehende Sparse-Attention-Methoden auf KV-Cache-Reduktion oder theoretische Rechenreduktion abzielen, aber Schwierigkeiten haben, eine signifikante Latenzreduktion in fortgeschrittenen Frameworks oder Backends zu erreichen. Dies motiviert uns, Algorithmen zu entwickeln, die sowohl fortgeschrittene Architektur als auch hardwareeffiziente Implementierung kombinieren, um Sparsität zur Verbesserung der Modelleffizienz vollständig auszunutzen.
2.2. Der Mythos trainierbarer Sparsität
Unsere Suche nach nativer trainierbarer sparse Attention ist durch zwei zentrale Erkenntnisse aus der Analyse von Ansätzen motiviert, die ausschließlich auf Inferenz abzielen: (1) Leistungsverschlechterung: Die nachträgliche Anwendung von Sparsity zwingt Modelle, von ihrer vortrainierten Optimierungstrajektorie abzuweichen. Wie Chen et al. (2024b) zeigen, kann top Attention nur der gesamten Attention-Scores abdecken, wodurch Strukturen wie Retrieval Heads in vortrainierten Modellen während der Inferenz anfällig für Pruning werden. (2) Anforderungen an die Trainingseffizienz: Der effiziente Umgang mit Long-Sequence-Training ist entscheidend für die moderne LLM-Entwicklung. Dies umfasst sowohl das Pretraining auf längeren Dokumenten zur Erhöhung der Modellkapazität als auch nachfolgende Adaptionsphasen wie Long-Context-Fine-Tuning und Reinforcement Learning. Bestehende sparse-Attention-Methoden zielen jedoch primär auf Inferenz ab und lassen die rechnerischen Herausforderungen beim Training weitgehend unadressiert. Diese Einschränkung behindert die Entwicklung leistungsfähigerer Long-Context-Modelle durch effizientes Training. Darüber hinaus zeigen Bestrebungen, bestehende sparse Attention für das Training anzupassen, ebenfalls Herausforderungen:
Nicht trainierbare Komponenten. Diskrete Operationen in Methoden wie ClusterKV (Liu et al., 2024) (umfasst k-means-Clustering) und MagicPIG (Chen et al., 2024b) (umfasst SimHash-basiertes Auswählen) erzeugen Diskontinuitäten im Berechnungsgraphen. Diese nicht trainierbaren Komponenten verhindern den Gradientenfluss durch den Token-Auswahlprozess und schränken die Fähigkeit des Modells ein, optimale sparse Muster zu lernen.
Ineffiziente Back-propagation. Einige theoretisch trainierbare sparse-Attention-Methoden leiden unter praktischen Trainingseffizienzproblemen. Die Token-granulare Auswahlstrategie, die in Ansätzen wie HashAttention (Desai et al., 2024) verwendet wird, führt dazu, dass während der Attention-Berechnung eine große Anzahl einzelner Tokens aus dem KV-Cache geladen werden muss. Dieser nicht zusammenhängende Speicherzugriff verhindert die effiziente Anpassung schneller Attention-Techniken wie FlashAttention, die auf zusammenhängendem Speicherzugriff und blockweiser Berechnung basieren, um hohen Durchsatz zu erreichen. Infolgedessen sind Implementierungen gezwungen, auf geringe Hardwareauslastung zurückzufallen, was die Trainingseffizienz erheblich beeinträchtigt.
2.3. Native Sparsity als Imperativ
Diese Einschränkungen in Bezug auf Inferenzeffizienz und Trainierbarkeit motivieren unsere grundlegende Neugestaltung von sparse-Attention-Mechanismen. Wir schlagen NSA vor, ein natives sparse-Attention-Framework, das sowohl rechnerische Effizienz als auch Trainingsanforderungen adressiert. In den folgenden Abschnitten beschreiben wir das algorithmische Design und die Operator-Implementierung von NSA.
3. Methodik
Unser technischer Ansatz umfasst Algorithmusdesign und Kernel-Optimierung. In den folgenden Unterabschnitten führen wir zunächst den Hintergrund unserer Methodik ein. Dann präsentieren wir das Gesamtframework von NSA, gefolgt von seinen zentralen algorithmischen Komponenten. Schließlich beschreiben wir im Detail unser hardwareoptimiertes Kernel-Design, das die praktische Effizienz maximiert.
3.1. Hintergrund
Der Attention-Mechanismus wird in der Sprachmodellierung weit verbreitet eingesetzt, wobei jeder Query-Token Relevanzwerte gegen alle vorhergehenden Keys berechnet, um eine gewichtete Summe der Values zu erzeugen. Formal ist für eine Eingabesequenz der Länge die Attention-Operation definiert als:
wobei Attn die Attention-Funktion bezeichnet:
Hier repräsentiert das Attention-Gewicht zwischen und , und ist die Feature-Dimension der Keys. Mit zunehmender Sequenzlänge wird die Attention-Berechnung zunehmend dominierend in den gesamten Rechenkosten, was erhebliche Herausforderungen für die Verarbeitung langer Kontexte darstellt.
Die arithmetische Intensität ist das Verhältnis von Rechenoperationen zu Speicherzugriffen. Sie prägt intrinsisch die Algorithmusoptimierung auf Hardware. Jede GPU hat eine kritische arithmetische Intensität, die durch ihre Spitzenrechenleistung und Speicherbandbreite bestimmt wird und als Verhältnis dieser beiden Hardwaregrenzen berechnet wird. Für Rechenaufgaben wird die arithmetische Intensität oberhalb dieser kritischen Schwelle rechengebunden (begrenzt durch GPU-FLOPS), während sie unterhalb davon speichergebunden wird (begrenzt durch die Speicherbandbreite).
Speziell für den kausalen Self-Attention-Mechanismus weisen während der Trainings- und Profiling-Phasen gebatchte Matrixmultiplikationen und Attention-Berechnungen eine hohe arithmetische Intensität auf, wodurch diese Phasen auf modernen Beschleunigern rechengebunden sind. Im Gegensatz dazu wird die autoregressive Dekodierung durch die Speicherbandbreite eingeschränkt, da sie pro Vorwärtsdurchlauf einen Token erzeugt, während der gesamte Key-Value-Cache geladen werden muss, was zu einer niedrigen arithmetischen Intensität führt.Dies führt zu unterschiedlichen Optimierungszielen – Reduzierung der Rechenkosten während des Trainings und des Prefillings, während der Dekodierung hingegen Reduzierung der Speicherzugriffe.
3.2. Gesamtframework
Um das Potenzial von Attention mit natürlichem Sparse-Muster zu nutzen, schlagen wir vor, die ursprünglichen Key-Value-Paare in Gleichung (1) durch eine kompaktere und informationsdichtere Menge von Repräsentations-Key-Value-Paaren für jede Query zu ersetzen. Konkret definieren wir die optimierte Attention-Ausgabe formal wie folgt:
wobei dynamisch basierend auf der aktuellen Query und dem kontextuellen Gedächtnis konstruiert werden. Wir können verschiedene Mapping-Strategien entwerfen, um unterschiedliche Kategorien von zu erhalten, und diese wie folgt kombinieren:
Wie in Abbildung 2 dargestellt, hat NSA drei Mapping-Strategien , die Kompression, Selektion und gleitendes Fenster für Keys und Values repräsentieren. ist der Gate-Score für die entsprechende Strategie , der aus den Eingabefeatures über ein MLP und eine Sigmoid-Aktivierung abgeleitet wird. Sei die Gesamtzahl der neu gemappten Keys/Values:
Wir halten ein hohes Sparsity-Verhältnis aufrecht, indem wir sicherstellen.
3.3. Algorithmusdesign
In diesem Unterabschnitt stellen wir das Design unserer Remapping-Strategien und vor: Token-Kompression, Token-Selektion und gleitendes Fenster.
3.3.1. Token-Kompression
Durch die Aggregation sequenzieller Blöcke von Keys oder Values zu Block-Repräsentationen erhalten wir komprimierte Keys und Values, die die Information des gesamten Blocks erfassen. Formal ist die komprimierte Key-Repräsentation definiert als:
wobei die Blocklänge ist, die gleitende Schrittweite zwischen benachbarten Blöcken und ein lernbares MLP mit Intra-Block-Positionskodierung, um Keys in einem Block auf einen einzelnen komprimierten Key abzubilden. ist ein Tensor, der aus Kompressions-Keys besteht. Üblicherweise wählen wir , um Informationsfragmentierung zu mildern. Eine analoge Formulierung gilt für die komprimierte Value-Repräsentation . Komprimierte Repräsentationen erfassen gröbere semantische Informationen auf höherer Ebene und reduzieren den Rechenaufwand der Attention.
3.3.2. Token-Selektion
Durch die ausschließliche Verwendung komprimierter Keys und Values könnten wichtige feingranulare Informationen verloren gehen, was uns dazu motiviert, einzelne Keys und Values selektiv zu bewahren. Im Folgenden beschreiben wir unseren effizienten Token-Selektionsmechanismus, der die relevantesten Tokens mit geringem Rechenaufwand identifiziert und bewahrt.
Blockweise Selektion. Unsere Selektionsstrategie verarbeitet Key- und Value-Sequenzen in räumlich zusammenhängenden Blöcken, motiviert durch zwei Schlüsselfaktoren: Überlegungen zur Hardware-Effizienz und inhärente Verteilungsmuster der Attention-Scores. Die blockweise Selektion ist entscheidend, um eine effiziente Berechnung auf modernen GPUs zu erreichen. Das liegt daran, dass moderne GPU-Architekturen einen deutlich höheren Durchsatz für kontinuierliche Blockzugriffe im Vergleich zu zufälligen indexbasierten Lesezugriffen aufweisen. Außerdem ermöglicht die blockweise Berechnung eine optimale Nutzung von Tensor Cores. Diese architektonische Eigenschaft hat blockweisen Speicherzugriff und blockweise Berechnung zu einem Grundprinzip in leistungsfähigen Attention-Implementierungen gemacht, wie es das blockbasierte Design von FlashAttention exemplifiziert. Die blockweise Selektion folgt den inhärenten Verteilungsmustern der Attention-Scores. Frühere Arbeiten (Jiang et al., 2024) haben gezeigt, dass Attention-Scores oft räumliche Kontinuität aufweisen, was darauf hindeutet, dass benachbarte Keys dazu neigen, ähnliche Wichtigkeitsgrade zu teilen. Unsere Visualisierung in Abschnitt 6.2 zeigt ebenfalls dieses räumlich kontinuierliche Muster.
Um die blockweise Selektion zu implementieren, unterteilen wir Key- und Value-Sequenzen zunächst in Selektionsblöcke. Um die wichtigsten Blöcke für die Attention-Berechnung zu identifizieren, müssen wir jedem Block Wichtigkeitswerte zuweisen. Im Folgenden stellen wir unsere Methode zur Berechnung dieser blockweisen Wichtigkeitswerte vor.
Berechnung des Wichtigkeitswerts. Die Berechnung der Block-Wichtigkeitswerte könnte erheblichen Overhead verursachen. Glücklicherweise erzeugt die Attention-Berechnung der Kompressionstokens intermediäre Attention-Scores, die wir nutzen können, um Wichtigkeitswerte der Selektionsblöcke abzuleiten, formuliert als:
wobei die Attention-Scores zwischen und den Kompressionsschlüsseln sind. Sei die Selektionsblockgröße. Wenn Kompressionsblöcke und Selektionsblöcke dasselbe Blockierungsschema teilen, d. h. , können wir die Wichtigkeitswerte der Selektionsblöcke direkt durch unmittelbar erhalten. Für Fälle, in denen sich die Blockierungsschemata unterscheiden, leiten wir die Wichtigkeitswerte für Selektionsblöcke gemäß ihrer räumlichen Beziehung ab. Gegeben , und , gilt:
wobei den Indexierungsoperator für den Zugriff auf ein Vektorelement bezeichnet. Für Modelle, die GQA oder MQA verwenden, bei denen Key-Value-Caches über Query-Heads hinweg geteilt werden, muss eine konsistente Blockauswahl über diese Heads hinweg sichergestellt werden, um das Laden des KV-Caches während der Dekodierung zu minimieren. Die geteilten Wichtigkeitswerte über die Heads in einer Gruppe sind formal definiert als:
wobei im Superskript den Head-Index bezeichnet und die Anzahl der Query-Heads in jeder Gruppe ist. Diese Aggregation gewährleistet eine konsistente Blockauswahl über die Heads innerhalb derselben Gruppe.
Top-n-Blockauswahl. Nach Erhalt der Wichtigkeitswerte der Selektionsblöcke behalten wir Tokens innerhalb der Top-n-Sparse-Blöcke bei, die nach den Block-Wichtigkeitswerten geordnet sind, formuliert als:
wobei rank die Rangposition in absteigender Reihenfolge bezeichnet, wobei rank dem höchsten Wert entspricht, die Menge der Indizes der ausgewählten Blöcke ist und Cat die Verkettungsoperation bezeichnet. ist ein Tensor, der aus Kompressionsschlüsseln zusammengesetzt ist. Eine analoge Formulierung gilt für den feingranularen Value . Die ausgewählten Keys und Values nehmen dann an der Attention-Berechnung mit teil, wie in Gleichung (5) definiert.
3.3.3. Sliding Window
In Attention-Mechanismen passen sich lokale Muster typischerweise schneller an und können den Lernprozess dominieren, wodurch das Modell potenziell daran gehindert wird, effektiv aus Kompressions- und Selektionstoken zu lernen. Um dieses Problem zu adressieren, führen wir einen dedizierten Sliding-Window-Zweig ein, der explizit den lokalen Kontext verarbeitet und es den anderen Zweigen (Komprimierung und Selektion) ermöglicht, sich auf das Erlernen ihrer jeweiligen Merkmale zu konzentrieren, ohne durch lokale Muster abgekürzt zu werden. Konkret halten wir die jüngsten Token in einem Fenster und isolieren die Attention-Berechnungen der verschiedenen Informationsquellen (Komprimierungstoken, ausgewählte Token, Sliding Window) in separate Zweige. Diese Zweigausgaben werden dann über einen erlernten Gating-Mechanismus aggregiert. Um weiteres Shortcut-Lernen über Attention-Zweige hinweg mit marginalem Rechenaufwand zu verhindern, stellen wir unabhängige Keys und Values für drei Zweige bereit. Dieses architektonische Design ermöglicht stabiles Lernen, indem es Gradienteninterferenz zwischen lokaler und langreichweitiger Mustererkennung verhindert, während es nur minimalen Overhead einführt.
Nachdem wir alle drei Kategorien von Keys und Values erhalten haben , berechnen wir die finale Attention-Ausgabe gemäß Gleichung (5). Zusammen mit den oben beschriebenen Mechanismen für Komprimierung, Selektion und Sliding Window bildet dies das vollständige algorithmische Framework von NSA.
3.4. Kernel-Design
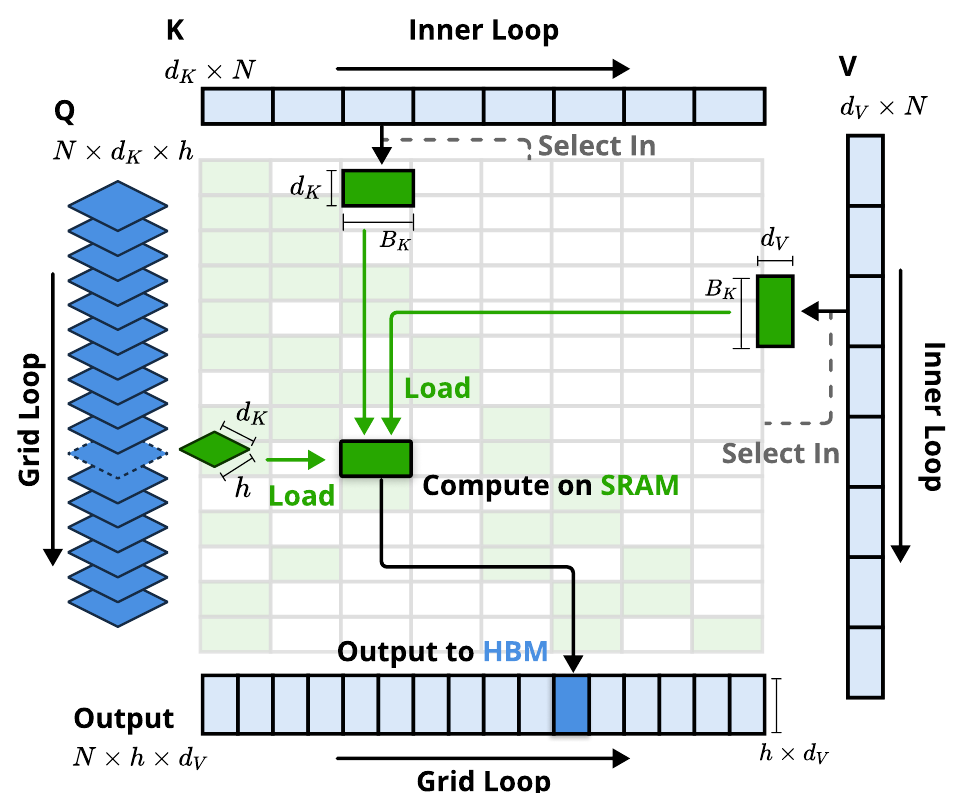
Um während des Trainings und Profilings eine Beschleunigung auf FlashAttention-Niveau zu erreichen, implementieren wir hardware-aligned Sparse-Attention-Kernel auf Basis von Triton. Da MHA speicherintensiv und für das Decoding ineffizient ist, konzentrieren wir uns auf Architekturen mit gemeinsam genutzten KV-Caches wie GQA und MQA, entsprechend dem aktuellen Stand der Technik bei LLMs. Während die Attention-Berechnungen für Komprimierung und Sliding Window problemlos mit bestehenden FlashAttention-2-Kernels kompatibel sind, führen wir das spezialisierte Kernel-Design für Sparse-Selection-Attention ein. Würden wir der Strategie von FlashAttention folgen, zeitlich kontinuierliche Query-Blöcke in den SRAM zu laden, würde dies zu ineffizienten Speicherzugriffen führen, da Queries innerhalb eines Blocks disjunkte KV-Blöcke benötigen können. Um dies zu adressieren, liegt unsere zentrale Optimierung in einer anderen Query-Gruppierungsstrategie: Für jede Position in der Query-Sequenz laden wir alle Query-Heads innerhalb einer GQA-Gruppe (die dieselben spärlichen KV-Blöcke teilen) in den SRAM. Abbildung 3 veranschaulicht unsere Forward-Pass-Implementierung. Die vorgeschlagene Kernel-Architektur zeichnet sich durch die folgenden zentralen Merkmale aus:
1. Group-Centric Data Loading. Für jede innere Schleife laden wir die Queries aller Heads in der Gruppe an Position und ihre gemeinsam genutzten spärlichen Key/Value-Blockindizes .
2. Shared KV Fetching. In der inneren Schleife laden wir sequenziell kontinuierliche Key/Value-Blöcke, indiziert durch , in den SRAM als , , um das Speicherladen zu minimieren, wobei die Kernel-Blockgröße ist, die erfüllt.
3. Outer Loop on Grid. Da die Länge der inneren Schleife (proportional zur Anzahl ausgewählter Blöcke ) für verschiedene Query-Blöcke nahezu identisch bleibt, legen wir die Query/Output-Schleifen in den Grid-Scheduler von Triton, um den Kernel zu vereinfachen und zu optimieren.
Dieses Design erreicht nahezu optimale arithmetische Intensität, indem es (1) redundante KV-Transfers durch gruppenweise gemeinsame Nutzung eliminiert und (2) die Rechenlasten über die Streaming-Multiprozessoren der GPU ausbalanciert.
4. Experimente
Wir evaluieren NSA unter drei Gesichtspunkten: (1) Leistung auf allgemeinen Benchmarks, (2) Leistung auf Long-Context-Benchmarks und (3) Leistung beim Chain-of-Thought-Reasoning, jeweils im Vergleich zur Full-Attention-Baseline und zu State-of-the-Art-Sparse-Attention-Methoden. Die Effizienzanalyse unseres Sparse-Berechnungsparadigmas verschieben wir auf Abschnitt 5, wo wir detaillierte Diskussionen zur Trainings- und Inferenzgeschwindigkeit bereitstellen.
4.1. Pretraining-Setup
Der gängigen Praxis bei State-of-the-Art-LLMs folgend, verwenden unsere Experimente ein Backbone, das Grouped-Query Attention (GQA) und Mixture-of-Experts (MoE) kombiniert, mit insgesamt 27B Parametern und 3B aktiven Parametern. Das Modell besteht aus 30 Schichten mit einer Hidden-Dimension von 2560. Für GQA setzen wir die Anzahl der Gruppen auf 4, mit insgesamt 64 Attention-Heads. Für jeden Head sind die Hidden-Dimensionen von Query, Key und Value als bzw. konfiguriert. Für MoE nutzen wir die DeepSeekMoE-Struktur (Dai et al., 2024; DeepSeek-AI, 2024) mit 72 gerouteten Experten und 2 geteilten Experten und setzen die Top-k-Experten auf 6. Um die Trainingsstabilität zu gewährleisten, wird das MoE in der ersten Schicht durch ein MLP in Form von SwiGLU ersetzt.
| Modell | MMLU Acc. 5-shot | MMLU-PRO Acc. 5-shot | CMMLU Acc. 5-shot | BBH Acc. 3-shot | GSM8K Acc. 8-shot | MATH Acc. 4-shot | DROP F1 1-shot | MBPP Pass@1 3-shot | HumanEval Pass@1 0-shot | Durchschn. |
| Full Attn | 0,567 | 0,279 | 0,576 | 0,497 | 0,486 | 0,263 | 0,503 | 0,482 | 0,335 | 0,443 |
| NSA | 0,565 | 0,286 | 0,587 | 0,521 | 0,520 | 0,264 | 0,545 | 0,466 | 0,348 | 0,456 |
Tabelle 1 | Pretraining-Leistungsvergleich zwischen der Full-Attention-Baseline und NSA auf allgemeinen Benchmarks, über Wissens- (MMLU, MMLU-PRO, CMMLU), Reasoning- (BBH, GSM8K, MATH, DROP) und Coding-Aufgaben (MBPP, HumanEval). NSA erzielt trotz hoher Sparsity eine überlegene durchschnittliche Leistung auf den meisten Benchmarks.
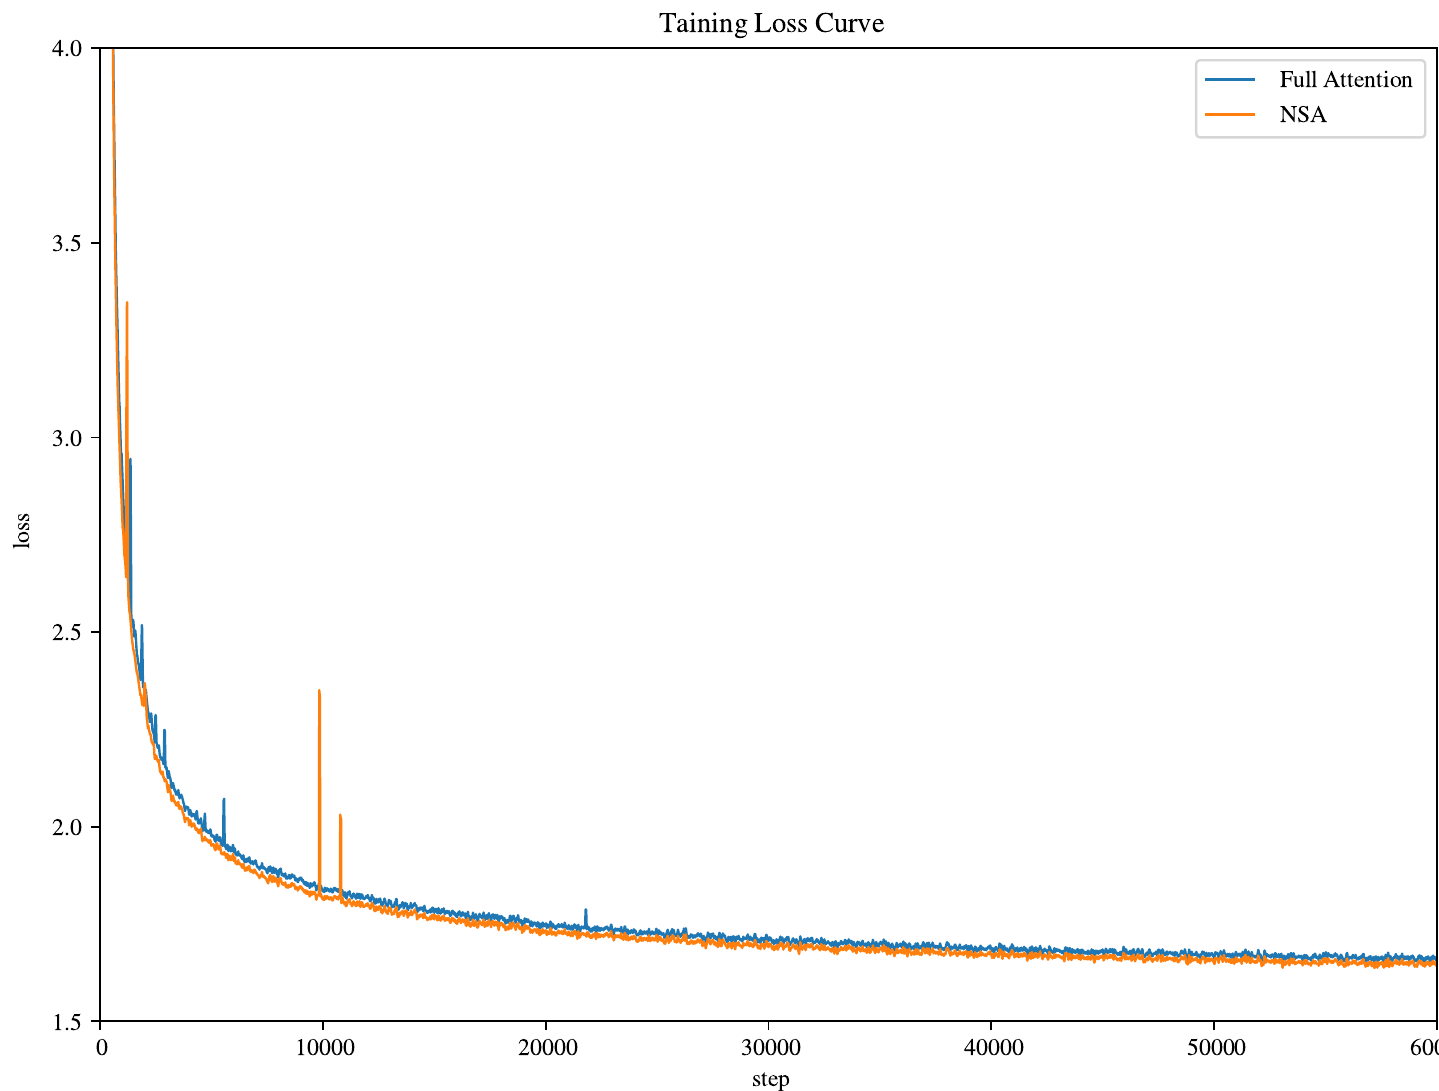
Die vorgeschlagene Architektur erreicht einen effektiven Kompromiss zwischen Rechenkosten und Modellleistung. Für NSA setzen wir die Komprimierungsblockgröße , die Sliding-Stride , die ausgewählte Blockgröße , die Anzahl ausgewählter Blöcke (einschließlich der festen Aktivierung des 1 initialen Blocks und 2 lokaler Blöcke) und die Sliding-Window-Größe . Sowohl Full-Attention- als auch Sparse-Attention-Modelle werden auf 270B Token aus Texten mit 8k-Länge vortrainiert, gefolgt von kontinuierlichem Training und überwachtem Finetuning auf Texten mit 32k-Länge mit YaRN (Peng et al., 2024), um eine Long-Context-Anpassung zu erreichen. Beide Modelle werden bis zur vollständigen Konvergenz trainiert, um einen fairen Vergleich zu gewährleisten. Wie in Abbildung 4 dargestellt, zeigt die Pretraining-Loss-Kurve unseres NSA und der Full-Attention-Baseline einen stabilen und gleichmäßigen Rückgang, wobei NSA das Full-Attention-Modell durchgängig übertrifft.
4.2. Baseline-Methoden
Neben dem Vergleich mit Full Attention evaluieren wir mehrere State-of-the-Art-Sparse-Attention-Methoden für die Inferenzphase: H2O (Zhang et al., 2023b), infLLM (Xiao et al., 2024a), Quest (Tang et al., 2024) und Exact-Top, das zunächst den vollständigen Attention-Score berechnet und die Top- Score-Keys entsprechend jeder Query auswählt und dann die Attention auf diesen Positionen berechnet. Diese
| Modell | SQA | MQA | Synthetic | CodeLCC | |||||||
| Avg. | MFQA-en | MFQA-zh | Qasper | HPQ | 2Wiki | GovRpt | Dur | PassR-en | |||
| PassR-zh | H2O | 0,428 | 0,429 | 0,308 | 0,112 | 0,101 | 0,231 | 0,208 | 0,704 | 0,421 | 0,092 |
| 0,303 | InfLLM | 0,474 | 0,517 | 0,356 | 0,306 | 0,250 | 0,277 | 0,257 | 0,766 | 0,486 | 0,143 |
| 0,383 | Quest | 0,495 | 0,561 | 0,365 | 0,295 | 0,245 | 0,293 | 0,257 | 0,792 | 0,478 | 0,135 |
| 0,392 | Exact-Top | 0,502 | 0,605 | 0,397 | 0,321 | 0,288 | 0,316 | 0,291 | 0,810 | 0,548 | 0,156 |
| 0,423 Full Attn | 0,512 | 0,623 | 0,409 | 0,350 | 0,305 | 0,324 | 0,294 | 0,830 | 0,560 | 0,163 | 0,437 |
| NSA | 0,503 | 0,624 | 0,432 | 0,437 | 0,356 | 0,307 | 0,341 | 0,905 | 0,550 | 0,232 | 0,469 |
Tabelle 2 | Leistungsvergleich zwischen unserem NSA und Baselines auf LongBench, einschließlich Teilmengen in den Kategorien Single-Document-QA, Multi-Document-QA, synthetische und Code-Aufgaben. NSA übertraf die meisten Baselines einschließlich Full Attention.Methoden umfassen diverse Sparse-Attention-Paradigmen, einschließlich KV-Cache-Eviction, query-bewusster Selektion und exakter Top- Sparse-Selektion.
Für die allgemeine Evaluation, bei der die meisten Samples Längen innerhalb des lokalen Kontextfensters der Sparse-Attention-Baselines aufweisen, sind diese Methoden effektiv äquivalent zu Full Attention. Daher präsentieren wir in diesem Setting nur die Vergleichsergebnisse zwischen NSA und der Full-Attention-Baseline. In der Long-Context-Evaluation führen wir Vergleiche über alle Baseline-Methoden durch, wobei die Sparsity aller Sparse-Attention-Methoden auf denselben Wert gesetzt wird, um einen fairen Vergleich zu gewährleisten. Für die Chain-of-Thought-Reasoning-Evaluation, die Long-Text-Supervised-Finetuning erfordert, beschränken wir unseren Vergleich auf Full Attention, da Sparse-Attention-Baselines kein Training unterstützen.
4.3. Leistungsvergleich
Allgemeine Evaluation. Wir evaluierten das vortrainierte NSA und die Full-Attention-Baseline auf einer umfassenden Suite von Benchmarks, die Wissens-, Reasoning- und Coding-Fähigkeiten abdecken, darunter MMLU (Hendrycks et al., 2020), MMLU-PRO (Wang et al., 2024), CMMLU (Li et al., 2023), BBH (Suzgun et al., 2022), GSM8K (Cobbe et al., 2021), MATH (Hendrycks et al., 2020), DROP (Dua et al., 2019), MBPP (Austin et al., 2021) und HumanEval (Chen et al., 2021). Die Ergebnisse sind in Tabelle 1 dargestellt. Trotz seiner Sparsity erzielt NSA eine überlegene Gesamtleistung und übertrifft alle Baselines einschließlich Full Attention bei 7 von 9 Metriken. Dies deutet darauf hin, dass NSA zwar auf kürzeren Sequenzen seine Effizienzvorteile möglicherweise nicht vollständig ausnutzt, aber dennoch starke Leistung zeigt. Bemerkenswert ist, dass NSA signifikante Zugewinne bei reasoning-bezogenen Benchmarks zeigt (DROP: , GSM8K: ), was nahelegt, dass unser Pretraining den Modellen hilft, spezialisierte Attention-Mechanismen zu entwickeln. Dieser Sparse-Attention-Pretraining-Mechanismus zwingt das Modell, sich auf die wichtigsten Informationen zu konzentrieren, und kann die Leistung potenziell durch das Herausfiltern von Rauschen aus irrelevanten Attention-Pfaden verbessern. Die konsistente Leistung über diverse Evaluationen hinweg bestätigt zudem die Robustheit von NSA als Allzweckarchitektur.
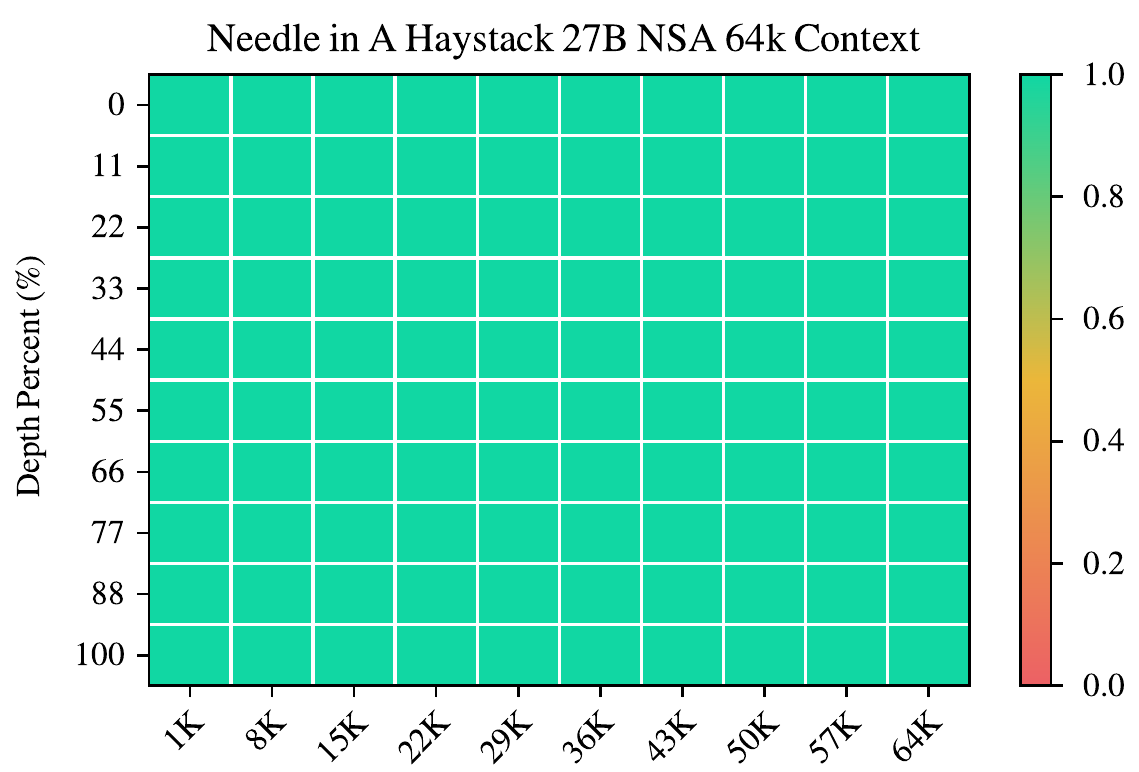
Langkontext-Evaluierung. Wie in Abbildung 5 gezeigt, erreicht NSA eine perfekte Retrieval-Genauigkeit über alle Positionen im 64k-Kontext-Needle-in-a-Haystack-Test (Kamradt, 2023). Diese Leistung resultiert aus unserem hierarchischen Sparse-Attention-Design, das Kompressionstoken für ein effizientes globales Kontext-Scanning und Selektionstoken für eine präzise lokale Informationsabfrage kombiniert. Die grobkörnige Kompression identifiziert relevante Kontextblöcke zu geringen Rechenkosten, während die Token-Level-Attention auf ausgewählten Token die Bewahrung kritischer feinkörniger Informationen gewährleistet. Dieses Design ermöglicht es NSA, sowohl globale Aufmerksamkeit als auch lokale Präzision aufrechtzuerhalten.
Wir evaluieren NSA außerdem auf LongBench (Bai et al., 2023) im Vergleich zu modernsten Sparse-Attention-
Methoden und einer Full-Attention-Baseline. Um eine konsistente Sparsity sicherzustellen, setzen wir die von jeder Query in allen Sparse-Attention-Baselines aktivierten Token auf 2560 Token, was der durchschnittlichen Anzahl von Token entspricht, die in NSA bei der Verarbeitung von Sequenzlängen von 32k aktiviert werden. In Anlehnung an Stream-LLM (Xiao et al., 2023) umfasst dieses Token-Budget die führenden 128 Token und 512 lokale Token. Wir schließen bestimmte Teilmengen aus LongBench aus, da sie über alle Modelle hinweg niedrige Scores erzielen, was möglicherweise keine aussagekräftigen Vergleiche ermöglicht. Wie in Tabelle 2 gezeigt, erreicht NSA den höchsten Durchschnittsscore von 0,469 und übertrifft alle Baselines (+0,032 gegenüber Full Attention und +0,046 gegenüber Exact-Top). Diese Verbesserung ergibt sich aus zwei zentralen Innovationen: (1) unser natives Sparse-Attention-Design, das eine End-to-End-Optimierung der Sparse-Muster während des Pretrainings ermöglicht und eine synchronisierte Anpassung zwischen dem Sparse-Attention-Modul und anderen Modellkomponenten erleichtert; und (2) der hierarchische Sparse-Attention-Mechanismus, der ein Gleichgewicht zwischen lokaler und globaler Informationsverarbeitung erreicht.
Bemerkenswerterweise zeigt NSA außergewöhnliche Leistung bei Aufgaben, die komplexes Reasoning über lange Kontexte erfordern, und erzielt +0,087 und +0,051 Verbesserungen gegenüber Full Attention bei Multi-Hop-QA-Aufgaben (HPQ und 2Wiki), übertrifft die Leistung der Baselines bei Code-Verständnis (LCC: +0,069) und übertrifft andere Methoden bei Passage-Retrieval (PassR-en: +0,075). Diese Ergebnisse validieren die Fähigkeit von NSA, vielfältige Langkontext-Herausforderungen zu bewältigen, wobei die nativ vortrainierte Sparse-Attention zusätzliche Vorteile beim Erlernen aufgabenoptimaler Muster bietet.
Chain-of-Thought-Reasoning-Evaluierung. Um die Kompatibilität von NSA mit fortgeschrittenen Downstream-Trainingsparadigmen zu evaluieren, untersuchen wir seine Fähigkeit, Chain-of-Thought-Fähigkeiten zum mathematischen Reasoning durch Post-Training zu erwerben. Angesichts der begrenzten Wirksamkeit von Reinforcement Learning bei kleineren Modellen setzen wir Wissen-Destillation von DeepSeek-R1 ein und führen Supervised Fine-Tuning (SFT) mit 10B Token mathematischer Reasoning-Traces der Länge 32k durch. Dies erzeugt zwei vergleichbare Modelle: Full Attention-R (Full-Attention-Baseline) und NSA-R (unsere Sparse-Variante). Wir bewerten beide Modelle auf dem anspruchsvollen Benchmark der American Invitational Mathematics Examination (AIME 24). Wir verwenden eine Sampling-Temperatur von 0,7 und einen Top--Wert von 0,95, um 16 Antworten pro Frage zu generieren, und ermitteln den Durchschnittsscore. Um die Auswirkung der Reasoning-Tiefe zu validieren, führen wir Experimente mit zwei Generierungskontextgrenzen durch: 8k und 16k Token, wobei wir messen, ob verlängerte Reasoning-Ketten die Genauigkeit verbessern. Beispielvergleiche der Modellvorhersagen sind in Anhang A bereitgestellt.
| Kontext (nicht zu übersetzen): Chain-of-Thought-Reasoning-Bewertung. Um die Kompatibilität von NSA mit fortgeschrittenen Downstream-Trainingsparadigmen zu bewerten, untersuchen wir seine Fähigkeit, mathematische Chain-of-Thought-Reasoning-Fähigkeiten durch Post-Training zu erlernen. Angesichts der begrenzten Wirksamkeit von Reinforcement Learning bei kleineren Modellen setzen wir Wissensdestillation von DeepSeek-R1 ein und führen überwachtes Feintuning (SFT) mit 10B Tokens mathematischer Reasoning-Spuren der Länge 32k durch. Dies erzeugt Zu übersetzender Text: | Generierungs-Token-Limit | |
| 8192 | 16384 | Full Attention-R |
| 0.046 | 0.092 | NSA-R |
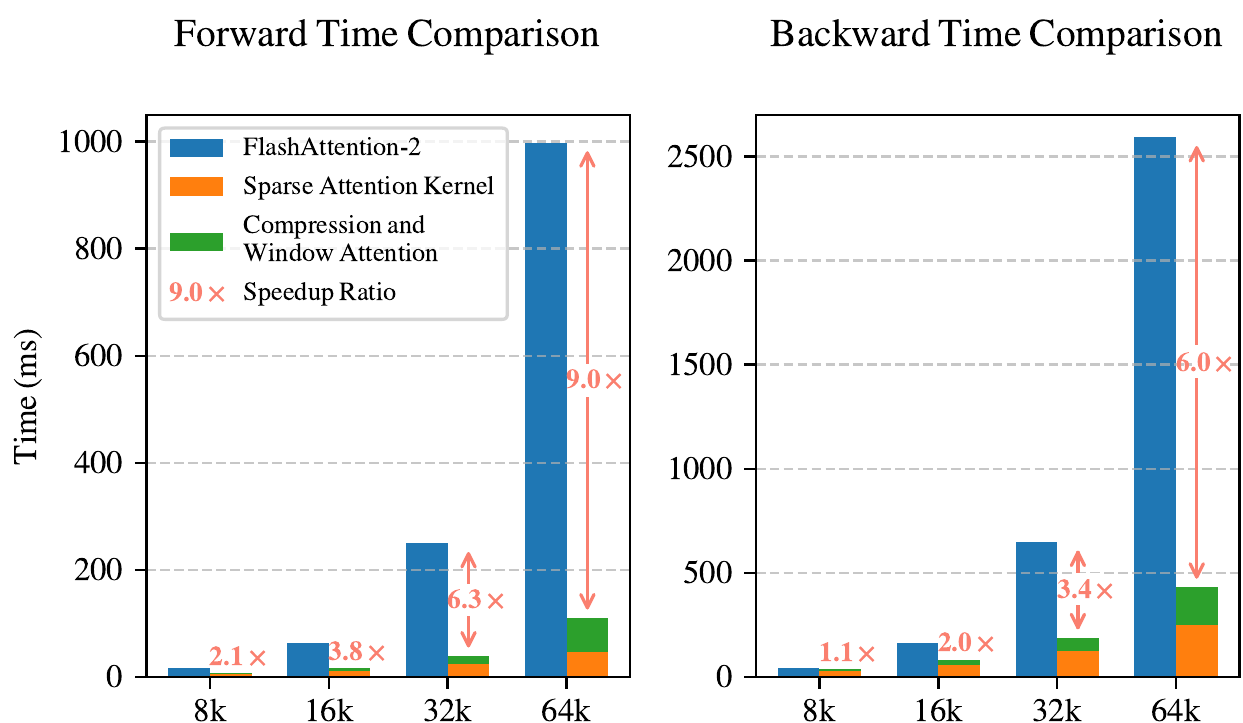
Abbildung 6 | Vergleich des Triton-basierten NSA-Kernels mit dem Triton-basierten FlashAttention-2-Kernel. Unsere Implementierung reduziert die Latenz über alle Kontextlängen hinweg erheblich, wobei die Verbesserung mit zunehmender Eingabelänge deutlicher wird.
Wie in Tabelle 3 gezeigt, erreicht NSA-R unter der 8k-Kontext-Einstellung eine deutlich höhere Genauigkeit als Full Attention-R (+0,075), wobei dieser Vorteil bei 16k-Kontexten bestehen bleibt (+0,054). Diese Ergebnisse bestätigen zwei zentrale Vorteile nativer Sparse Attention: (1) Die vortrainierten Sparse-Attention-Muster ermöglichen die effiziente Erfassung langreichweitiger logischer Abhängigkeiten, die für komplexe mathematische Herleitungen entscheidend sind; (2) Das hardware-angepasste Design unserer Architektur bewahrt eine ausreichende Kontextdichte, um zunehmende Inferenzierungstiefe ohne katastrophales Vergessen zu unterstützen. Die durchgängige Überlegenheit über verschiedene Kontextlängen hinweg bestätigt die Tragfähigkeit von Sparse Attention für fortgeschrittene Inferenzaufgaben, wenn sie nativ in die Trainingspipeline integriert wird.
5. Effizienzanalyse
Wir bewerten die Recheneffizienz von NSA im Vergleich zu Full Attention auf einem 8-GPU-A100-System. In der Effizienzanalyse konfigurieren wir das Modell außerdem mit der GQA-Gruppe , Köpfen pro Gruppe , Query-/Key-Dimension und Value-Dimension . Gemäß denselben Einstellungen wie in Abschnitt 4 setzen wir die NSA-Kompressionsblockgröße , die Sliding-Stride , die ausgewählte Blockgröße , die Anzahl ausgewählter Blöcke und die Sliding-Window-Größe .
5.1. Trainingsgeschwindigkeit
Wir vergleichen die Triton-basierten Implementierungen unserer NSA-Attention und Full Attention mit Triton-basiertem FlashAttention-2, um einen fairen Geschwindigkeitsvergleich über dasselbe Backend hinweg zu gewährleisten. Wie in Abbildung 6 gezeigt, erzielt unser NSA mit zunehmender Kontextlänge fortschreitend größere Speedups, bis zu Speedup im Vorwärtspass und im Rückwärtspass bei 64k Kontextlänge. Bemerkenswert ist, dass der Geschwindigkeitsvorteil bei längeren Sequenzen deutlicher wird. Dieser Speedup resultiert aus unserem
| Kontextlänge | 8192 | 16384 | 32768 | 65536 |
| Full Attention | 8192 | 16384 | 32768 | 65536 |
| NSA | 2048 | 2560 | 3584 | 5632 |
| Erwartete Beschleunigung | 4× | 6,4× | 9,1× | 11,6× |
hardware-angepassten Algorithmusdesign zur Maximierung der Effizienz der Sparse-Attention-Architektur: (1) Das blockweise Speicherzugriffsmuster maximiert die Tensor-Core-Auslastung durch zusammengefasste Ladevorgänge, (2) Die sorgfältige Schleifenplanung im Kernel eliminiert redundante KV-Transfers.
5.2. Dekodierungsgeschwindigkeit
Die Dekodierungsgeschwindigkeit von Attention wird primär durch den Speicherzugriffsengpass bestimmt, der eng mit der Menge des geladenen KV-Cache verbunden ist. In jedem Dekodierungsschritt muss unser NSA höchstens Kompressionstoken, ausgewählte Token und Nachbartoken laden, wobei die gecachte Sequenzlänge ist. Wie in Tabelle 4 gezeigt, weist unsere Methode mit zunehmender Dekodierungslänge eine signifikante Reduktion der Latenz auf und erreicht bis zu Speedup bei 64k Kontextlänge. Dieser Vorteil bei der Speicherzugriffseffizienz verstärkt sich ebenfalls mit längeren Sequenzen.
6. Diskussion
In diesem Abschnitt reflektieren wir über den Entwicklungsprozess von NSA und diskutieren zentrale Erkenntnisse aus unserer Untersuchung verschiedener Sparse-Attention-Strategien. Während unser Ansatz vielversprechende Ergebnisse zeigt, bietet das Verständnis der Herausforderungen bei alternativen Strategien und die Analyse von Attention-Mustern wertvollen Kontext für zukünftige Forschungsrichtungen. Wir untersuchen zunächst Herausforderungen bei alternativen Token-Auswahlstrategien, die unsere Designentscheidungen motivierten, gefolgt von Visualisierungen, die Einblicke in Attention-Verteilungsmuster bieten.
6.1. Herausforderungen bei alternativen Token-Auswahlstrategien
Vor der Entwicklung von NSA haben wir untersucht, wie bestehende Sparse-Attention-Methoden an die Trainingsphase angepasst werden können. Diese Versuche stießen jedoch auf verschiedene Herausforderungen, die uns dazu veranlassten, eine andere Sparse-Attention-Architektur zu entwerfen:
Key-Clustering-basierte Strategien. Wir untersuchten clustering-basierte Strategien wie ClusterKV (Liu et al., 2024). Diese Methoden speichern Keys und Values aus demselben Cluster in zusammenhängenden Speicherbereichen. Obwohl sie theoretisch für Training und Inferenz machbar sind, stehen sie vor drei erheblichen Herausforderungen: (1) Nicht unerheblicher Rechenaufwand durch dynamische Clustering-Mechanismen; (2) Operator-Optimierungsschwierigkeiten, die durch Ungleichgewichte zwischen Clustern verschärft werden, insbesondere in Mixture-of-Experts-(MoE-)Systemen, wo verzerrte Ausführungszeiten von Expert-Parallelism-(EP-)Gruppen zu anhaltenden Lastungleichgewichten führen; (3) Implementierungsbeschränkungen, die sich aus der Notwendigkeit obligatorischer periodischer Neu-Clusterung und chunk-sequenzieller Trainingsprotokolle ergeben. Diese kombinierten Faktoren schaffen erhebliche Engpässe, die ihre Wirksamkeit für den realen Einsatz deutlich einschränken.
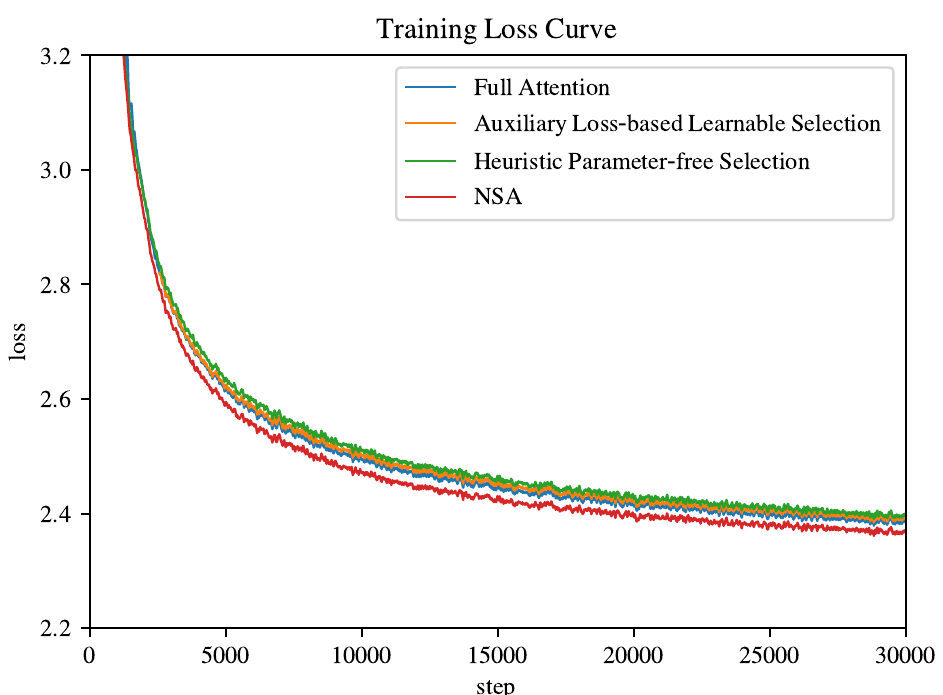
Andere blockweise Auswahlstrategien. Wir betrachteten auch blockweise Key-Value-Auswahlstrategien, die sich von NSA unterscheiden, wie Quest (Tang et al. [2024]) und InfLLM (Xiao et al. [2024a]). Diese Methoden beruhen auf der Berechnung eines Wichtigkeitswerts für jeden KV-Block und der Auswahl der obersten Blöcke basierend auf ihrer Ähnlichkeit mit . Bestehende Methoden stehen jedoch vor zwei kritischen Problemen: (1) Da die Auswahloperation nicht differenzierbar ist, hängt die auf neuronalen Netzen basierende Wichtigkeitswertberechnung von einer Hilfsverlustfunktion ab, was den Operator-Overhead erhöht und häufig die Modellleistung beeinträchtigt; (2) Heuristische parameterfreie Strategien zur Berechnung des Wichtigkeitswerts leiden unter niedrigen Recall-Raten, was zu suboptimaler Leistung führt. Wir evaluieren beide Ansätze auf einem 3B-Parameter-Modell mit ähnlicher Architektur und vergleichen ihre Verlustkurve mit NSA und Full Attention. Für die auf Hilfsverlust basierende Auswahlmethode führen wir zusätzliche Queries für jedes Token und repräsentative Keys für jeden Block ein, um die Block-Wichtigkeitswerte zu schätzen. Wir berechnen blockweise Überwachungssignale durch Mean-Pooling der Attention-Werte innerhalb jedes Key-Blocks und verwenden KL-Divergenz zur Überwachung der Block-Wichtigkeitsvorhersage. Wir behalten die individuelle Query-Granularität bei, anstatt blockgemittelte Queries zu verwenden, um eine effiziente Dekodierung zu ermöglichen. Diese auf Hilfsverlust basierende Wichtigkeitsschätzung weist konzeptionelle Ähnlichkeit mit SeerAttention (Gao et al. [2024]) auf. Für die heuristische parameterfreie Auswahlmethode implementieren wir gemäß der Strategie von Quest eine direkte Auswahl unter Verwendung des Produkts zwischen Queries und dem koordinatenweisen Min-Max der Key-Chunks, ohne zusätzliche Parameter einzuführen. Wir untersuchen auch einen Cold-Start-Trainingsansatz, bei dem Full Attention für die ersten 1000 Schritte angewendet wird, bevor auf die heuristische blockweise Auswahl übergegangen wird. Wie in Abbildung 7 gezeigt, wiesen beide Methoden einen schlechteren Verlust auf.
6.2. Visualisierung
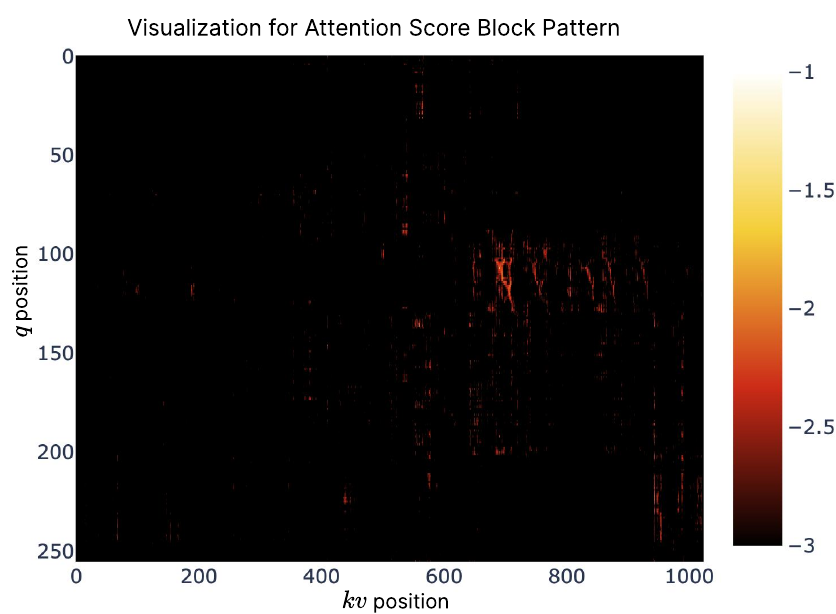
Um potenzielle Muster in den Attention-Verteilungen von Transformern zu untersuchen und Inspiration für unser Design zu finden, visualisieren wir die Attention-Map aus unserem vortrainierten 27B-Full-Attention-Modell in Abbildung 8. Die Visualisierung zeigt interessante Muster, bei denen Attention-Werte dazu neigen, blockweise Clustering-Eigenschaften aufzuweisen, wobei nahe gelegene Keys oft ähnliche Attention-Werte zeigen. Diese Beobachtung inspirierte unser Design von NSA und legte nahe, dass die Auswahl von Key-Blöcken basierend auf räumlicher Kontinuität ein vielversprechender Ansatz sein könnte. Das Phänomen des blockweisen Clusterings deutet darauf hin, dass in der Sequenz benachbarte Token bestimmte semantische Beziehungen mit Query-Token teilen könnten, wobei die genaue Natur dieser Beziehungen weitere Untersuchungen erfordert. DieseBeobachtung motivierte uns, einen Sparse-Attention-Mechanismus zu erforschen, der auf kontinuierlichen Token-Blöcken statt auf einzelnen Token operiert, mit dem Ziel, die Recheneffizienz zu verbessern und Muster mit hoher Attention zu bewahren.
7. Verwandte Arbeiten
Wir überprüfen bestehende Ansätze, die die Effizienz der Attention-Berechnung durch Sparse Attention verbessern. Diese Methoden lassen sich anhand ihrer Kernstrategien grob in drei Gruppen einteilen: (1) feste Sparse-Muster, (2) dynamisches Token-Pruning und (3) query-bewusste Auswahl. Wir stellen mehrere repräsentative Arbeiten aus jeder Kategorie vor.
7.1. Festes Sparse-Muster
SlidingWindow ist ein häufig verwendeter Ansatz, der es der Query ermöglicht, Attention nur innerhalb eines festen Fensters zu berechnen. StreamingLLM (Xiao et al., 2023) kombiniert Attention-Sinks mit lokalen Fenstern, um kontinuierliche Textströme zu verarbeiten. MoA (Fu et al., 2024a) und DuoAttention (Xiao et al., 2024b) übernehmen ebenfalls ähnliche lokale und Sink-Informationen für die Modellierung langer Sequenzen. Longformer (Beltagy et al., 2020) verschachtelt lokale fensterbasierte Attention mit globalen Token, um lange Sequenzen zu verarbeiten. Im Vergleich dazu stützt sich unser NSA nicht auf vordefinierte Sparse-Muster, sondern erlernt die Muster automatisch, wodurch das Potenzial zur Nutzung des vollständigen Kontexts erschlossen wird.
7.2. Dynamisches Token-Pruning
Einige Methoden sind darauf ausgelegt, Speicher- und Rechenkosten während der Inferenz durch dynamisches KV-Cache-Pruning zu reduzieren. H2O (Zhang et al., 2023b), BUZZ (Zhao et al., 2024) und SepLLM (Chen et al., 2024a) implementieren adaptive Ansätze zur Reduzierung des KV-Cache-Speicherverbrauchs während der Dekodierung. Diese Methoden entfernen dynamisch Token, die für zukünftige Vorhersagen als weniger wichtig erachtet werden. FastGen (Ge et al., 2023) und HeadKV (Fu et al., 2024b) optimieren die Berechnung durch die Zuweisung unterschiedlicher Strategien zu einzelnen Attention-Köpfen. SnapKV (Li et al., 2024) führt eine Token-Pruning-Strategie ein, die den KV-Cache durch selektive Beibehaltung nur der wichtigsten Merkmale reduziert und so eine effiziente Speichernutzung ermöglicht. Im Gegensatz zu diesen inferenzfokussierten Ansätzen integriert unser NSA die Sparsität nativ während der Trainingsphase.
7.3. Query-bewusste Auswahl
Andere Arbeiten konzentrieren sich auf query-abhängige Token-Auswahlverfahren, um die Attention-Berechnung zu reduzieren, während die Attention-Qualität erhalten bleibt. Quest (Tang et al., 2024) verwendet eine blockweise Auswahlstrategie, bei der die Wichtigkeit jedes Chunks durch das Produkt zwischen der Query und dem koordinatenweisen Min-Max der Key-Chunks geschätzt wird. InfLLM (Xiao et al., 2024a) kombiniert feste Muster mit Retrieval, indem es Attention-Sinks, lokalen Kontext und abrufbare Chunks beibehält. Diese Methode wählt repräsentative Keys aus jedem Chunk aus, um die Wichtigkeit des Chunks zu schätzen. HashAttention (Desai et al., 2024) formuliert die Identifikation zentraler Tokens als Empfehlungsproblem, indem es Queries und Keys mittels gelernter Funktionen in den Hamming-Raum abbildet. ClusterKV (Liu et al., 2024) erreicht Sparsität, indem es zunächst Keys clustert und dann die relevantesten Cluster für die Attention-Berechnung basierend auf der Query-Cluster-Ähnlichkeit auswählt. MInference (Jiang et al., 2024) und TokenSelect (Wu et al., 2024) wählen KV-Paare für die Berechnung basierend auf einer Bewertung der Wichtigkeit auf Token-Ebene aus. SeerAttention (Gao et al., 2024) unterteilt Queries und Keys in räumliche Blöcke und führt eine blockweise Auswahl für eine effiziente Berechnung durch. Im Vergleich zu diesen Methoden erreicht unser NSA eine hardware-aligned sparse Attention-Berechnung über den gesamten Modelllebenszyklus hinweg, einschließlich Training, Prefilling und Decoding.
8. Fazit
Wir präsentieren NSA, eine hardware-aligned sparse Attention-Architektur für eine effiziente Modellierung langer Kontexte. Durch die Integration hierarchischer Token-Kompression mit blockweiser Token-Auswahl innerhalb einer trainierbaren Architektur erreicht unsere Architektur beschleunigtes Training und beschleunigte Inferenz, während die Leistung von Full Attention erhalten bleibt. NSA bringt den Stand der Technik voran, indem es zeigt, dass die allgemeine Benchmark-Leistung mit Full-Attention-Baselines übereinstimmt, die Modellierungsfähigkeit in Long-Context-Evaluierungen übertroffen wird und die Reasoning-Fähigkeit verbessert ist – all dies begleitet von messbaren Reduktionen der Berechnungslatenz und einer signifikanten Beschleunigung.
Referenzen
J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón, and S. Sanghai. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. arXiv preprint arXiv:2305.13245, 2023. J. Austin, A. Odena, M. Nye, M. Bosma, H. Michalewski, D. Dohan, E. Jiang, C. Cai, M. Terry, Q. Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021. Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Zeng, L. Hou, et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508, 2023. I. Beltagy, M. E. Peters, and A. Cohan. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150, 2020. G. Chen, H. Shi, J. Li, Y. Gao, X. Ren, Y. Chen, X. Jiang, Z. Li, W. Liu, and C. Huang. Sepllm: Accelerate large language models by compressing one segment into one separator. arXiv preprint arXiv:2412.12094, 2024a. M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. D. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. Z. Chen, R. Sadhukhan, Z. Ye, Y. Zhou, J. Zhang, N. Nolte, Y. Tian, M. Douze, L. Bottou, Z. Jia, et al. Magicpig: Lsh sampling for efficient llm generation. arXiv preprint arXiv:2410.16179, 2024b. K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. Training verifiers to solve math word problems, 2021. URL https://arxiv.org/abs/2110.14168, 2021. D. Dai, C. Deng, C. Zhao, R. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv preprint arXiv:2401.06066, 2024. DeepSeek- AI. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model. 2024. URL https://arxiv.org/abs/2405.04434 DeepSeek- AI. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948
A. Desai, S. Yang, A. Cuadron, A. Klimovic, M. Zaharia, J. E. Gonzalez und I. Stoica. Hashattention: Semantische Sparsität für schnellere Inferenz. arXiv preprint arXiv:2412.14468, 2024.
D. Dua, Y. Wang, P. Dasigi, G. Stanovsky, S. Singh und M. Gardner. Drop: Ein Benchmark für Leseverständnis, der diskretes Schlussfolgern über Absätze erfordert. arXiv preprint arXiv:1903.00161, 2019.
T. Fu, H. Huang, X. Ning, G. Zhang, B. Chen, T. Wu, H. Wang, Z. Huang, S. Li, S. Yan, et al. Moa: Mischung aus sparsamer Attention zur automatischen Kompression großer Sprachmodelle. arXiv preprint arXiv:2406.14909, 2024a.
Y. Fu, Z. Cai, A. Asi, W. Xiong, Y. Dong und W. Xiao. Nicht alle Heads sind wichtig: Eine KV-Cache-Kompressionsmethode auf Head-Ebene mit integriertem Retrieval und Schlussfolgern. arXiv preprint arXiv:2410.19258, 2024b.
Y. Gao, Z. Zeng, D. Du, S. Cao, H. K.-H. So, T. Cao, F. Yang und M. Yang. Seerattention: Intrinsisch sparsame Attention in deinen LLMs lernen. arXiv preprint arXiv:2410.13276, 2024.
S. Ge, Y. Zhang, L. Liu, M. Zhang, J. Han und J. Gao. Das Modell sagt dir, was zu verwerfen ist: Adaptive KV-Cache-Kompression für LLMs. arXiv preprint arXiv:2310.01801, 2023.
G. T. Google, P. Georgiev, V. I. Lei, R. Burnell, L. Bai, A. Gulati, G. Tanzer, D. Vincent, Z. Pan, S. Wang, et al. Gemini 1.5: Multimodales Verständnis über Millionen von Kontext-Tokens hinweg erschließen. arXiv preprint arXiv:2403.05530, 2024.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song und J. Steinhardt. Messung umfassenden Multitask-Sprachverständnisses. arXiv preprint arXiv:2009.03300, 2020.
H. Jiang, Q. Wu, C.-Y. Lin, Y. Yang und L. Qiu. Llmlingua: Komprimierung von Prompts für beschleunigte Inferenz großer Sprachmodelle. arXiv preprint arXiv:2310.05736, 2023.
H. Jiang, Y. Li, C. Zhang, Q. Wu, X. Luo, S. Ahn, Z. Han, A. H. Abdi, D. Li, C.-Y. Lin, et al. Minference 1.0: Beschleunigung des Pre-Fillings für LLMs mit langem Kontext durch dynamische sparsame Attention. arXiv preprint arXiv:2407.02490, 2024.
G. Kamradt. LLMTest NeedleInAHaystack. GitHub-Repository, 2023. URL https://github.com/gkamradt/LLMTest_NeedleInAHaystack Zugriff: [Zugriffsdatum hier einfügen].
.
.
H. Li, Y. Zhang, F. Koto, Y. Yang, H. Zhao, Y. Gong, N. Duan und T. Baldwin. Cmmlu: Messung umfassenden Multitask-Sprachverständnisses auf Chinesisch. arXiv preprint arXiv:2306.09212, 2023.
Y. Li, Y. Huang, B. Yang, B. Venkitesh, A. Locatelli, H. Ye, T. Cai, P. Lewis und D. Chen. Snapkv: Das LLM weiß, wonach du suchst, bevor es generiert. arXiv preprint arXiv:2404.14469, 2024.
.
G. Liu, C. Li, J. Zhao, C. Zhang und M. Guo. Clusterkv: Manipulation des LLM-KV-Caches im semantischen Raum für wiederabrufbare Kompression. arXiv preprint arXiv:2412.03213, 2024.
J. S. Park, J. C. O'Brien, C. J. Cai, M. R. Morris, P. Liang und M. S. Bernstein. Generative Agents: Interaktive Simulakren menschlichen Verhaltens. In S. Follmer, J. Han, J. Steimle und N. H. Riche, Herausgeber, Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology, UIST 2023, San Francisco, CA, USA, 29. Oktober 2023–1. November 2023, Seiten 2:1–2:22. ACM, 2023.
.
.
B. Peng, J. Quesnelle, H. Fan und E. Shippole. Yarn: Effiziente Kontextfenstererweiterung großer Sprachmodelle. In ICLR. OpenReview.net, 2024.
N. Shazeer. Schnelles Transformer-Decoding: Ein Write-Head ist alles, was du brauchst. CoRR, abs/1911.02150, 2019.
M. Suzgun, N. Scales, N. Schärli, S. Gehrmann, Y. Tay, H. W. Chung, A. Chowdhery, Q. V. Le, E. H. Chi, D. Zhou, et al. Herausfordernde Big-Bench-Aufgaben und ob Chain-of-Thought sie lösen kann. arXiv preprint arXiv:2210.09261, 2022.
J. Tang, Y. Zhao, K. Zhu, G. Xiao, B. Kasikci und S. Han. Quest: Query-bewusste Sparsität für effiziente LLM-Inferenz mit langem Kontext. arXiv preprint arXiv:2406.10774, 2024.
P. Tillet, H.-T. Kung und D. Cox. Triton: eine Zwischensprache und ein Compiler für gekachelte neuronale Netzwerkberechnungen. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, Seiten 10-19, 2019.
A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. u. Kaiser und I. Polosukhin. Attention is all you need. Advances in Neural Information Processing Systems, 2017.
Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. Mmlu-pro: Ein robusteres und herausfordernderes Benchmark für Multitask-Sprachverständnis. arXiv preprint arXiv:2406.01574, 2024.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. Chi, Q. V. Le, D. Zhou, et al. Chain-of-Thought-Prompting ruft Schlussfolgern in großen Sprachmodellen hervor. Advances in neural information processing systems, 35:24824-24837, 2022.
W. Wu, Z. Pan, C. Wang, L. Chen, Y. Bai, K. Fu, Z. Wang und H. Xiong. Tokenselect: Effiziente Inferenz mit langem Kontext und Längenextrapolation für LLMs durch dynamische KV-Cache-Auswahl auf Token-Ebene. arXiv preprint arXiv:2411.02886, 2024.
C. Xiao, P. Zhang, X. Han, G. Xiao, Y. Lin, Z. Zhang, Z. Liu und M. Sun. Infllm: Trainingsfreie Long-Context-Extrapolation für LLMs mit einem effizienten Kontextspeicher. In The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024a.
G. Xiao, Y. Tian, B. Chen, S. Han und M. Lewis. Effiziente Streaming-Sprachmodelle mit Attention-Sinks. arXiv preprint arXiv:2309.17453, 2023.
G. Xiao, J. Tang, J. Zuo, J. Guo, S. Yang, H. Tang, Y. Fu und S. Han. Duoattention: Effiziente LLM-Inferenz mit langem Kontext mit Retrieval- und Streaming-Heads. arXiv preprint arXiv:2410.10819, 2024b.
M. Zaheer, G. Guruganesh, K. A. Dubey, J. Ainslie, C. Alberti, S. Ontanon, P. Pham, A. Ravula, Q. Wang, L. Yang, et al. Big Bird: Transformer für längere Sequenzen. Advances in neural information processing systems, 33:17283-17297, 2020.
E. Zelikman, Y. Wu, J. Mu und N. D. Goodman. Star: Bootstrapping reasoning with reasoning. In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho und A. Oh, Herausgeber, Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, New Orleans, LA, USA, 28. November - 9. Dezember 2022, 2022.
F. Zhang, B. Chen, Y. Zhang, J. Keung, J. Liu, D. Zan, Y. Mao, J. Lou und W. Chen. Repocoder: Repository-level code completion through iterative retrieval and generation. In H. Bouamor, J. Pino und K. Bali, Herausgeber, Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapur, 6.-10. Dezember 2023, Seiten 2471-2484. Association for Computational Linguistics, 2023a.K. Zhang, J. Li, G. Li, X. Shi und Z. Jin. Codeagent: Enhancing code generation with tool-integrated agent systems for real-world repo-level coding challenges. In L. Ku, A. Martins und V. Srikumar, Herausgeber, Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thailand, 11.-16. August 2024, Seiten 13643-13658.Z. Zhang, Y. Sheng, T. Zhou, T. Chen, L. Zheng, R. Cai, Z. Song, Y. Tian, C. Ré, C. Barrett, et al. H2o: Heavy-hitter oracle for efficient generative inference of large language models. Advances in Neural Information Processing Systems, 36:34661-34710, 2023b.J. Zhao, Z. Fang, S. Li, S. Yang und S. He. Buzz: Beehive-structured sparse kv cache with segmented heavy hitters for efficient llm inference. arXiv preprint arXiv:2410.23079, 2024.Z. Zhou, C. Li, X. Chen, S. Wang, Y. Chao, Z. Li, H. Wang, R. An, Q. Shi, Z. Tan, et al. Llm × mapreduce: Simplified long-sequence processing using large language models. arXiv preprint arXiv:2410.09342, 2024.
A. Beispiel für AIME-Ergebnisse
Prompt:
„| User | Seien und positive reelle Zahlen, die das folgende Gleichungssystem erfüllen:
Dann ist der Wert von gleich , wobei und teilerfremde positive ganze Zahlen sind. Finde . Bitte begründe Schritt für Schritt und setze deine endgültige Antwort in . | Assistant |“
Unser Ergebnis:
(2275 Tokens)
Gegeben ist das Gleichungssystem:
Wir wandeln diese logarithmischen Gleichungen in ihre Exponentialformen um:
Wir drücken jede Variable durch und aus:
Durch gegenseitiges Einsetzen dieser Ausdrücke finden wir:– Aus und erhalten wir , was zu führt. – Setzt man in die Gleichung für ein, erhalten wir . – Setzt man und in die Gleichung für ein, erhalten wir .
Als Nächstes berechnen wir :
Wenn wir diese miteinander multiplizieren:
Nimmt man den Logarithmus zur Basis 2:
Der Absolutwert ist:
Somit ist und , was ergibt.
33
Baseline-Ergebnis:
(think)...(/think) (9392 Tokens)
Gegeben ist das System logarithmischer Gleichungen:
Wir wandeln diese Gleichungen in Exponentialform um:
Durch gegenseitiges Einsetzen dieser Ausdrücke finden wir:
Indem wir diese Gleichungen Schritt für Schritt lösen, finden wir:
Bei der Überprüfung der dritten Gleichung stellen wir jedoch fest, dass das System möglicherweise keine Lösung hat. Daher verwenden wir zur Lösung des Systems die Matrixinversion:
Sei , , . Das System wird zu:
Wir lösen dieses System mit der Cramerschen Regel und Matrixinversion. Die Determinante der Matrix ist - 2, und die Lösungen sind:
Somit haben wir:
Wir müssen finden:
Umwandlung auf einen gemeinsamen Nenner (48):
Summierung dieser:
Der Bruch ist in einfachster Form, also und . Daher ist .
Prompt:
„| User | Reelle Zahlen und mit erfüllen . Wie lautet der Wert von ? Bitte begründe Schritt für Schritt und setze deine endgültige Antwort in . | Assistant |“
Unser Ergebnis:
(15147 Tokens)
Gegeben seien die Gleichungen:
1. 2.
Wir beginnen damit, die Logarithmus-Potenzregel auf beide Gleichungen anzuwenden.
Für die erste Gleichung:
Sei . Dann ist . Setzen wir dies in die Gleichung ein, erhalten wir:
Für die zweite Gleichung:
Unter Verwendung der Potenzregel erhalten wir:
Da ist, vereinfacht sich dies zu:
Wir haben nun zwei Ausdrücke:
1. 2.
Setzt man und in das Produkt ein, erhält man:
Somit ist der Wert von .
Basisergebnis:
(16223 Token)
Gegeben ist das Problem, bei dem reelle Zahlen und mit die Gleichungen und erfüllen; wir müssen den Wert von finden.
Zuerst wandeln wir die logarithmischen Gleichungen mit der Basiswechselformel in ihre Exponentialformen um.
1.
Mit der Basiswechselformel gilt . Da ist, haben wir . Somit gilt
2.
Wiederum gilt mit der Basiswechselformel .
Als Nächstes drücken wir und durcheinander aus:
Dann berechnen wir das Produkt :
Bei erneuter Auswertung und Verwendung eines anderen Ansatzes mit und finden wir jedoch:
Schließlich finden wir, dass sich das Produkt vereinfacht zu: