
Eine offene Plattform, auf der Agenten Code schreiben, Befehle ausführen und browsen, geprüft auf 15 Benchmarks. ICLR 2025, kostenlos.
OpenHands: An Open Platform for AI Software Developers as Generalist Agents
OPENHANDS: EINE OFFENE PLATTFORM FÜR KI-SOFTWAREENTWICKLER ALS GENERALISTISCHE AGENTEN
Xingyao Wang , Boxuan Li , Yufan Song , Frank F. Xu , Xiangru Tang , Mingchen Zhuge , Jiayi Pan , Yueqi Song , Bowen Li, Jaskirat Singh , Hoang H. Tran , Fuqiang Li, Ren Ma, Mingzhang Zheng, Bill Qian , Yanjun Shao , Niklas Muennighoff , Yizhe Zhang, Binyuan Hui , Junyang Lin , Robert Brennan , Hao Peng , Heng Ji , Graham Neubig UIUC CMU Yale UC Berkeley Contextual AI KAUST ANU HCMUT Alibaba All Hands AI xingyao6@illinois.edu, gneubig@cs.cmu.edu
KURZFASSUNG
Software ist eines der mächtigsten Werkzeuge, die uns Menschen zur Verfügung stehen; sie erlaubt es einem erfahrenen Programmierer, in komplexer und tiefgreifender Weise mit der Welt zu interagieren. Gleichzeitig hat dank der Verbesserungen großer Sprachmodelle (LLMs) auch die Entwicklung von KI-Agenten, die mit ihrer Umgebung interagieren und Veränderungen in ihr bewirken, rasant an Fahrt aufgenommen. In diesem Beitrag stellen wir OpenHands (früher OpenDevin) vor, eine Plattform für die Entwicklung leistungsfähiger und flexibler KI-Agenten, die in ähnlicher Weise mit der Welt interagieren wie ein menschlicher Entwickler: durch das Schreiben von Code, die Interaktion mit einer Kommandozeile und das Durchsuchen des Webs. Wir beschreiben, wie die Plattform die Implementierung neuer Agenten, die sichere Interaktion mit Sandbox-Umgebungen zur Codeausführung, die Koordination zwischen mehreren Agenten und die Einbindung von Evaluierungs-Benchmarks ermöglicht. Basierend auf den derzeit integrierten Benchmarks führen wir eine Evaluierung von Agenten über 15 anspruchsvolle Aufgaben durch, darunter Softwareentwicklung (z. B. SWe- BENCH) und Webbrowsing (z. B. WEBARENA) sowie weitere. OpenHands wird unter der permissiven MIT-Lizenz veröffentlicht und ist ein Gemeinschaftsprojekt aus Wissenschaft und Industrie mit mehr als 2,1K Beiträgen von über 188 Mitwirkenden.
Code https://github.com/All- Hands- AI/OpenHands Slack http://bit.ly/OpenHands- Slack
1 EINLEITUNG
Angetrieben durch große Sprachmodelle (LLMs; OpenAI 2024b; Team et al. 2023; Jiang et al. 2024; Chang et al. 2024) sind benutzerorientierte KI-Systeme (wie ChatGPT) zunehmend in der Lage, komplexe Aufgaben zu bewältigen, etwa Benutzeranfragen präzise zu beantworten, Mathematikaufgaben zu lösen und Code zu generieren. Insbesondere KI-Agenten, also Systeme, die die externe Umgebung wahrnehmen und auf sie einwirken können, haben in jüngster Zeit immer mehr Forschungsaufmerksamkeit erhalten. Sie bewegen sich auf die Bewältigung komplexer Aufgaben zu, wie die Entwicklung von Software (Jimenez et al., 2024), die Navigation auf realen Websites (Zhou et al., 2023a), die Erledigung von Hausarbeiten (Ahn et al., 2022) oder sogar die Durchführung wissenschaftlicher Forschung (Boiko et al., 2023; Tang et al., 2024a).
X
Da KI-Agenten zunehmend in der Lage werden, komplexe Probleme anzugehen, sind auch ihre Entwicklung und Evaluierung zu einer Herausforderung geworden. Es gibt zahlreiche aktuelle Bemühungen zur Schaffung von Open-Source-Frameworks, die die Entwicklung von Agenten erleichtern (Hong et al., 2023; Chen et al., 2024; Wu et al., 2023). Diese Agenten-Frameworks umfassen im Allgemeinen: 1) Schnittstellen, über die Agenten mit der Welt interagieren (etwa JSON-basierte Funktionsaufrufe oder Codeausführung), 2) Umgebungen, in denen Agenten operieren, und 3) Interaktionsmechanismen für die Kommunikation zwischen Mensch und Agent oder zwischen Agenten. Diese Frameworks rationalisieren und erleichtern den Entwicklungsprozess auf vielfältige Weise (Tab. 1, §C).
Bei der Gestaltung von KI-Agenten können wir auch betrachten, wie Menschen mit der Welt interagieren. Die derzeit mächtigste Art, in der Menschen mit der Welt interagieren, ist Software – Software
treibt jeden Aspekt unseres Lebens an und unterstützt alles von der Logistik für Grundbedürfnisse bis hin zum Fortschritt von Wissenschaft, Technologie und der KI selbst. Angesichts der Macht von Software sowie der vorhandenen Werkzeuge für ihre effiziente Entwicklung, Nutzung und Bereitstellung bietet sie die ideale Schnittstelle für KI-Agenten, um auf komplexe Weise mit der Welt zu interagieren. Der Aufbau von Agenten, die effektiv Software entwickeln können, bringt jedoch eigene einzigartige Herausforderungen mit sich. Wie können wir Agenten in die Lage versetzen, in komplexen Softwaresystemen effektiv Code zu erstellen und zu ändern? Wie können wir ihnen Werkzeuge an die Hand geben, um unterwegs Informationen zu sammeln, Probleme zu debuggen oder aufgabennotwendige Informationen zu beschaffen? Wie können wir sicherstellen, dass die Entwicklung sicher ist und negative Nebenwirkungen auf die Systeme der Nutzer vermeidet?
In diesem Beitrag stellen wir OpenHands (früher OpenDevin) vor, eine gemeinschaftsgetriebene Plattform, die für die Entwicklung generalistischer und spezialisierter KI-Agenten konzipiert ist, die über Software mit der Welt interagieren.1 Sie bietet:
(1) Einen Interaktionsmechanismus, der es Benutzeroberflächen, Agenten und Umgebungen ermöglicht, über eine leistungsfähige und flexible Event-Stream-Architektur zu interagieren (§2.1). (2) Eine Laufzeitumgebung, die aus einem docker-sandboxed Betriebssystem mit einer Bash-Shell, einem Webbrowser und einem IPython-Server besteht, mit denen die Agenten interagieren können (§2.2). (3) Eine Schnittstelle, die es dem Agenten ermöglicht, in einer Weise mit der Umgebung zu interagieren, die der tatsächlicher Softwareentwickler ähnelt (§2.3). Wir stellen die Fähigkeit bereit, dass Agenten a) komplexe Software erstellen und bearbeiten, b) beliebigen Code in der Sandbox ausführen und c) Websites durchsuchen, um Informationen zu sammeln. (4) Multi-Agenten-Delegation, die es mehreren spezialisierten Agenten ermöglicht, zusammenzuarbeiten (§2.4). (5) Ein Evaluierungs-Framework, das die Evaluierung von Agenten über eine breite Palette von Aufgaben erleichtert (§4).
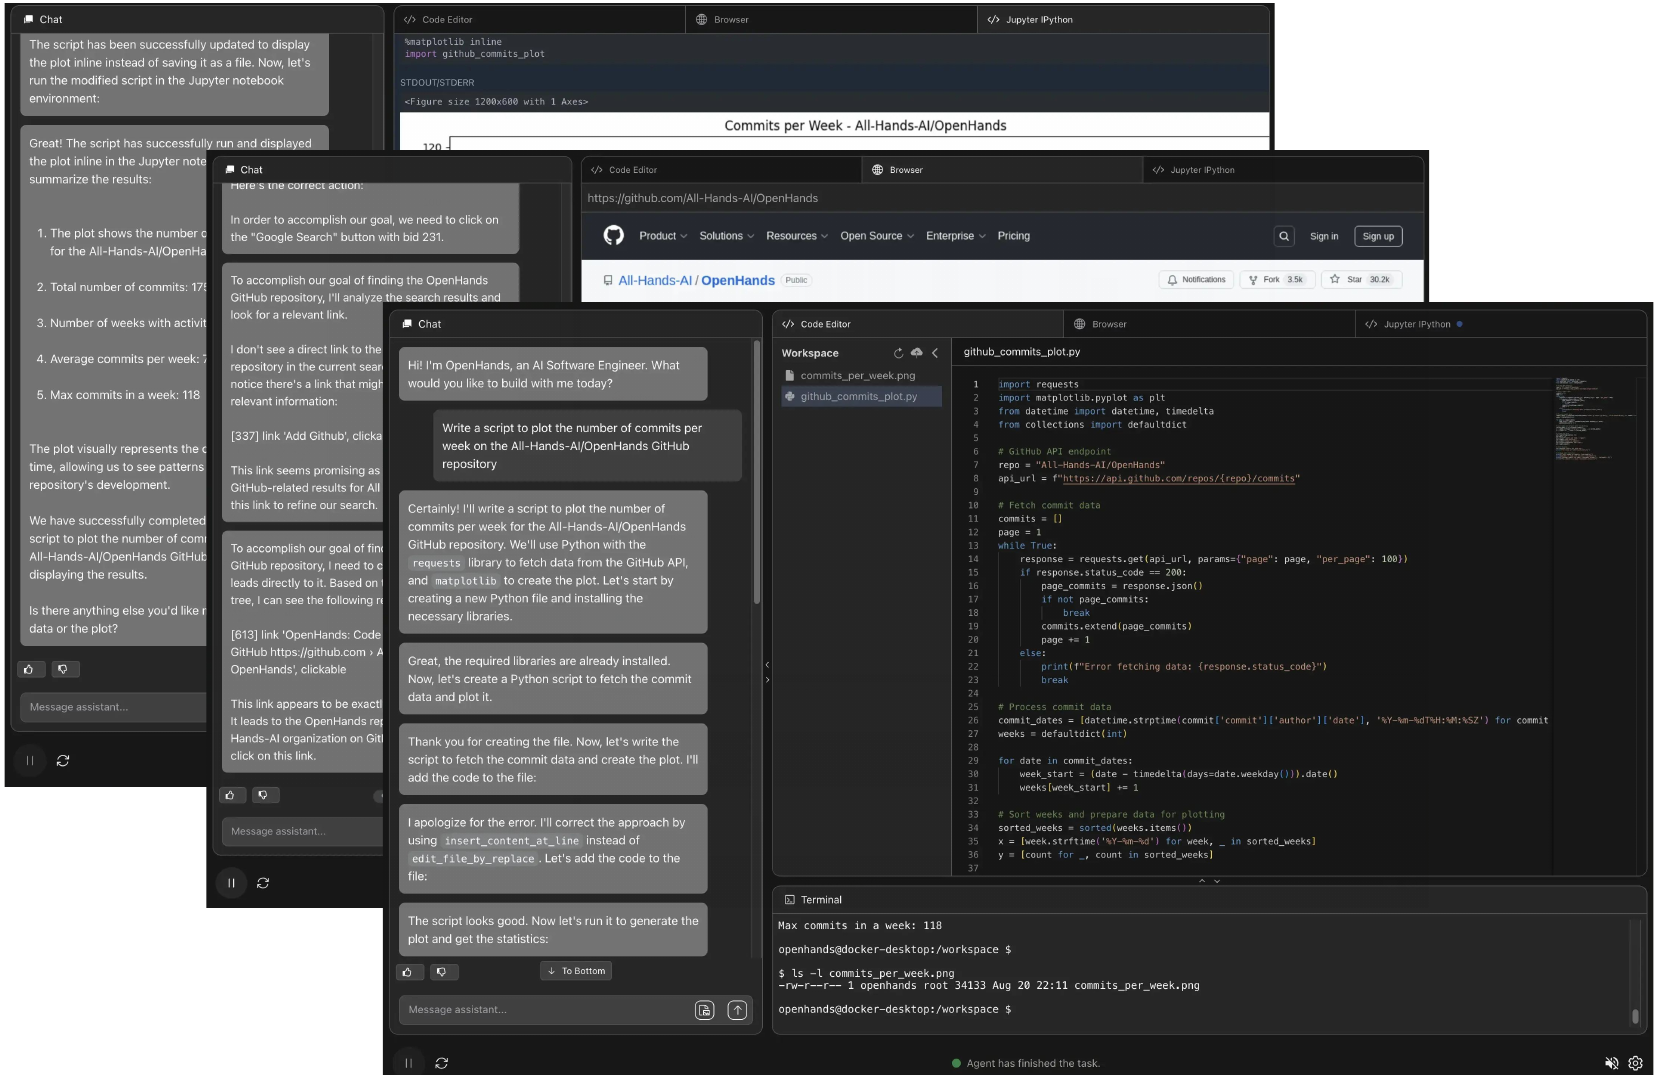
Wichtig ist, dass OpenHands nicht nur ein konzeptionelles Framework ist, sondern auch eine umfassende und sofort nutzbare Implementierung von Agenten, Umgebungen und Evaluierungen enthält. Zum Zeitpunkt dieses Schreibens umfasst OpenHands einen Agenten-Hub mit über 10 implementierten Agenten (§3), darunter ein starker generalistischer Agent, der auf Basis der CodeAct-Architektur (Wang et al., 2024a) implementiert wurde, mit Ergänzungen für Webbrowsing (ServiceNow) und Spezialisten für Codebearbeitung (Yang et al., 2024). Die Interaktion mit Benutzern ist über eine chatbasierte Benutzeroberfläche implementiert, die die aktuellen Aktionen des Agenten visualisiert und
Echtzeit-Feedback ermöglicht (Abb. 1, §D). Darüber hinaus unterstützt das Evaluierungs-Framework derzeit 15 Benchmarks, die wir zur Evaluierung unserer Agenten verwenden (§4).
OpenHands wird unter einer permissiven MIT-Lizenz veröffentlicht, die kommerzielle Nutzung erlaubt, und ist darauf ausgerichtet, ein vielfältiges Spektrum an Forschung und realen Anwendungen in Wissenschaft und Industrie zu unterstützen. OpenHands hat erhebliche Aufmerksamkeit gewonnen, mit 32K GitHub-Sternen und mehr als 2,1K Beiträgen von über 188 Mitwirkenden. Wir sehen OpenHands als Katalysator für zukünftige Forschungsinnovationen und vielfältige Anwendungen, angetrieben von einer breiten Gemeinschaft von Praktikern.
2 OPENHANDS-ARCHITEKTUR
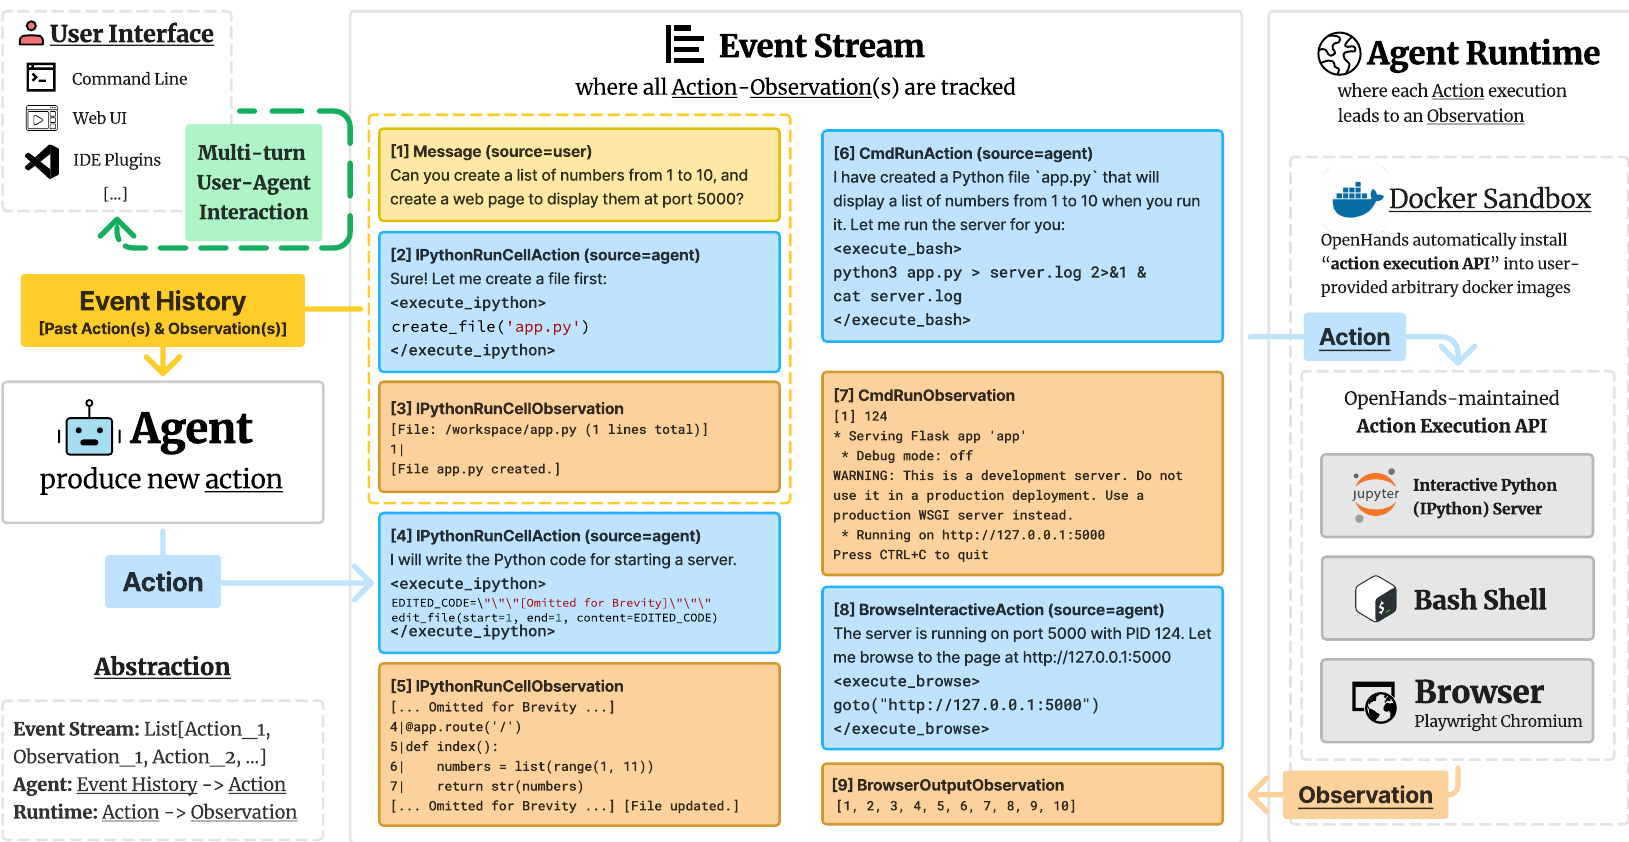
Als Nächstes beschreiben wir die Verwendung von OpenHands im Detail. Insbesondere diskutieren wir 1) wie ein Agent definiert und implementiert wird (§2.1), 2) wie jede Aktionsausführung zu einer Beobachtung führt (§2.2), 3) wie häufig verwendete Fähigkeiten für Agenten zuverlässig verwaltet und erweitert werden können (§2.3) und 4) wie mehrere Agenten zur Aufgabenlösung zusammengesetzt werden können (§2.4). Abb. 2 gibt einen Überblick.
2.1 AGENTENDEFINITION UND -IMPLEMENTIERUNG
Ein Agent kann den Zustand der Umgebung wahrnehmen (z. B. frühere Aktionen und Beobachtungen) und eine Aktion zur Ausführung erzeugen, während er eine vom Benutzer festgelegte Aufgabe löst.
Der Zustand und der Event-Stream. In OpenHands ist der Zustand eine Datenstruktur, die alle relevanten Informationen für die Ausführung des Agenten kapselt. Eine Schlüsselkomponente dieses Zustands ist der Event-Stream, eine chronologische Sammlung vergangener Aktionen und Beobachtungen, einschließlich der eigenen Aktionen des Agenten und der Benutzerinteraktionen (z. B. Anweisungen, Feedback). Neben dem Event-Stream enthält der Zustand zusätzliche Informationen für den Betrieb des Agenten, wie die kumulativen Kosten von LLM-Aufrufen, Metadaten zur Verfolgung der Multi-Agenten-Delegation (§2.4) und andere ausführungsbezogene Parameter.
Aktionen. Inspiriert von CodeAct (Wang et al., 2024a) verbindet OpenHands einen Agenten über eine Kernmenge allgemeiner Aktionen mit der Umgebung. Die Aktionen IPythonRunCellAction und CmdRunAction ermöglichen es dem Agenten, beliebigen Python-Code und Bash-Befehle innerhalb der Sandbox-Umgebung auszuführen (z. B. in einem sicher isolierten Linux-Betriebssystem). BrowserInteractiveAction ermöglicht die Interaktion mit einem Webbrowser über eine domänenspezifische Sprache zum Browsen, die von BrowserGym (Drouin et al., 2024) eingeführt wurde. Diese Aktionen wurden gewählt, um eine umfassende und zugleich flexible Menge von Primitiven bereitzustellen, die die meisten Aufgaben abdecken, die menschliche Softwareentwickler und Analysten ausführen. Der auf Programmiersprachen (PL) basierende Aktionsraum ist leistungsfähigund flexibel genug, um jede Aufgabe mit Werkzeugen in unterschiedlicher Form auszuführen (z. B. Python-Funktion, REST-API usw.), während er zugleich zuverlässig und einfach zu warten ist (Wang et al., 2024a).
Dieses Design ist auch mit bestehenden Tool-Calling-Agenten kompatibel, die eine Liste vordefinierter Werkzeuge erfordern (Chase, 2022). Das heißt, Benutzer können Werkzeuge einfach mithilfe von PL definieren, die in primitiven Aktionen unterstützt werden (z. B. eine Python-Funktion für einen Taschenrechner schreiben), und diese Werkzeuge dem Agenten über Funktionsaufruf-Erfahrungen im JSON-Stil verfügbar machen (Qin et al., 2023). Darüber hinaus machen die leistungsfähigen PL-basierten Primitive des Frameworks es den Agenten zusätzlich möglich, selbst Werkzeuge zu erstellen (z. B. durch Generieren von Python-Funktionen, Yuan et al. 2023), wenn keine API zur Erledigung der Aufgabe verfügbar ist. Siehe §2.3 dazu, wie diese zentralen PL-basierten Aktionen zu einer vielfältigen Menge von Werkzeugen zusammengesetzt werden können.
Beobachtungen. Beobachtungen beschreiben die Veränderungen der Umgebung (z. B. das Ausführungsergebnis vorheriger Aktionen, Textnachrichten des menschlichen Benutzers usw.), die der Agent wahrnimmt.
Abbildung 3: Minimalbeispiel für die Implementierung eines Agenten in OpenHands.
class MinimalAgent: def reset(self) -> None: self.system_message "You are a helpful assistant ..." def step(self, state: State): messages: list[dict[str, str]] = [ {'role': 'system', 'content': self.system_message] ] for prev_action, obs in state.history: action_message get_action_message(prev_action) messages.append(action_message) obs_message get_observation_message(obs) messages.append(obs_message) # use lim to generate response (e.g., thought, action) response self.lim.do_completion(messages) # parse and execute action in the runtime action self.parse_response(response) if self.is_finish_command(action): return AgentFinishAction() elif self.is_bash_command(action): return CmdRunAction(command=action.command) elif self.is_python_code(action): return IPythonRunCallAction(code=action.code) elif self.is_browser_action(action): return BrowseInteractiveAction(code=action.code) else: return MessageAction(content=action.message)
Einen neuen Agenten implementieren. Die Agentenabstraktion ist bewusst einfach und zugleich leistungsfähig gestaltet, sodass Benutzer leicht Agenten für verschiedene Aufgaben erstellen und anpassen können. Der Kern der Agentenabstraktion liegt in der step-Funktion, die den aktuellen Zustand als Eingabe nimmt und basierend auf der Logik des Agenten eine geeignete Aktion erzeugt. Ein vereinfachtes Beispiel für den Code der Agentenabstraktion ist in Abb. 3 dargestellt. Durch die Bereitstellung dieser Abstraktion ermöglicht es OpenHands den Benutzern, sich auf die Definition des gewünschten Agentenverhaltens und der gewünschten Logik zu konzentrieren, ohne sich um die niedrigstufigen Details der Ausführung von Aktionen kümmern zu müssen (§2.2).
2.2 AGENT-RUNTIME: WIE DIE AUSFÜHRUNG VON AKTIONEN ZU BEOBACHTUNGEN FÜHRT
Die Agent-Runtime stellt eine allgemeine Umgebung bereit, die den Agenten mit einem Aktionsraum ausstattet, der mit dem menschlicher Softwareentwickler vergleichbar ist, sodass OpenHands-Agenten eine breite Palette von Softwareentwicklungs- und webbasierten Aufgaben bewältigen können, darunter komplexe Softwareentwicklungs-Workflows, Datenanalyseprojekte, Webbrowsing-Aufgaben und mehr. Sie ermöglicht dem Agenten, auf ein Bash-Terminal zuzugreifen, um Code und Kommandozeilenwerkzeuge auszuführen, ein Jupyter-Notebook zu nutzen, um Code on-the-fly zu schreiben und auszuführen, und mit einem Webbrowser für webbasierte Aufgaben zu interagieren (z. B. Informationssuche).
Docker-Sandbox. Für jede Aufgabensitzung startet OpenHands eine sicher isolierte Docker-Container-Sandbox, in der alle Aktionen aus dem Ereignisstrom ausgeführt werden. OpenHands verbindet sich über einen im Inneren laufenden REST-API-Server (d. h. die OpenHands-Aktionsausführungs-API) mit der Sandbox, führt beliebige Aktionen (z. B. Bash-Befehl, Python-Code) aus dem Ereignisstrom aus und gibt die Ausführungsergebnisse als Beobachtungen zurück. Ein konfigurierbares Arbeitsverzeichnis, das Dateien enthält, an denen der Benutzer den Agenten arbeiten lassen möchte, wird in diese sichere Sandbox eingebunden, damit OpenHands-Agenten darauf zugreifen können.
OpenHands-Aktionsausführungs-API. OpenHands unterhält einen API-Server, der innerhalb der Docker-Sandbox läuft, um auf Aktionsausführungsanfragen aus dem Ereignisstrom zu warten. Der API-Server unterhält:
(1) Eine Bash-Shell, die mit der Betriebssystemumgebung (spezifiziert durch das Docker-Image) für die Befehlsausführung verbunden ist. (2) Einen Jupyter-IPython-Server, um Anfragen zur Ausführung interaktiven Python-Codes (IPython) zu bearbeiten und die Ausführungsergebnisse an den Ereignisstrom zurückzugeben. (3) Einen Chromium-Browser auf Basis von Playwright. Der Anbieter stellt eine Reihe von Aktionsprimitiven bereit, die von BrowserGym (ServiceNow; Drouin et al., 2024) definiert wurden, wie Navigation, Klicken, Tippen und Scrollen. Der vollständige Satz an Aktionen ist in §J detailliert beschrieben. Nach der Ausführung dieser Aktionen liefert die Browser-Runtime eine reichhaltige Menge an Beobachtungen über den aktuellen Zustand des Browsers, darunter HTML, DOM, Accessibility Tree (Mozilla), Screenshot, geöffnete Tabs usw.
Unterstützung beliebiger Docker-Images. OpenHands ermöglicht es Agenten, auf beliebigen Betriebssystemen mit unterschiedlichen Softwareumgebungen zu laufen, indem eine Runtime auf Basis beliebiger Docker-Images unterstützt wird. OpenHands implementiert einen Build-Mechanismus, der ein vom Benutzer bereitgestelltes beliebiges Docker-Image nimmt und die OpenHands-Aktionsausführungs-API in dieses Image installiert, um Agent-Interaktionen zu ermöglichen. Eine detaillierte Beschreibung der OpenHands-Agent-Runtime finden sich in §F.
2.3 AGENT-SKILLS: DIE ERWEITERBARE AGENT-COMPUTER-SCHNITTSTELLE
SWE-Agent (Yang et al., 2024) hebt die Bedeutung einer sorgfältig gestalteten Agent-Computer-Schnittstelle (ACI, d. h. spezialisierte Werkzeuge für bestimmte Aufgaben) für die erfolgreiche Lösung komplexer Aufgaben hervor. Allerdings kann das Erstellen, Warten und Verteilen einer breiten Palette von Werkzeugen eine gewaltige technische Herausforderung darstellen, insbesondere wenn wir diese Werkzeuge verschiedenen Agent-Implementierungen (§3) verfügbar machen wollen. Um dem zu begegnen, haben wir eine AgentSkills-Bibliothek entwickelt, einen Werkzeugkasten, der die Fähigkeiten von Agenten erweitern soll und Hilfsmittel bereitstellt, die über einfache Bash-Befehle oder Python-Code nicht ohne Weiteres verfügbar sind.
Einfach zu erstellende und zu erweiternde Werkzeuge. AgentSkills ist als Python-Paket konzipiert, das aus verschiedenen Hilfsfunktionen (d. h. Werkzeugen) besteht, die automatisch in die Jupyter-IPython-Umgebung (§2.2) importiert werden. Die Leichtigkeit, eine Python-Funktion als Werkzeug zu definieren, senkt die Hürde für Community-Mitglieder, neue Werkzeuge zur Bibliothek beizutragen. Die Allgemeinheit von Python-Paketen ermöglicht es zudem verschiedenen Agent-Implementierungen, diese Werkzeuge einfach über eine unserer zentralen Aktionen IPythonRunCellAction (§2.1) zu nutzen.
Aufnahmekriterien und Philosophie. In der AgentSkills-Bibliothek zielen wir nicht darauf ab, jedes mögliche Python-Paket zu umhüllen und Agenten deren Verwendung neu beizubringen (z. B. kennt das LLM bereits die pandas-Bibliothek, die CSV-Dateien lesen kann, sodass wir kein Werkzeug neu erstellen müssen, das dem Agenten beibringt, dasselbe Dateiformat zu lesen). Wir fügen eine neue Fähigkeit nur hinzu, wenn: (1) es für das LLM nicht ohne Weiteres machbar ist, Code direkt zu schreiben (z. B. Code bearbeiten und bestimmte Zeilen ersetzen), und/oder (2) es den Aufruf eines externen Modells beinhaltet (z. B. Aufruf eines Speech-to-Text-Modells oder eines Modells zur Codebearbeitung (Sanger)).
Derzeit unterstützte Fähigkeiten. Die AgentSkills-Bibliothek enthält Dateibearbeitungs-Hilfsmittel, die von SWE-Agent (Yang et al., 2024) und Aider (Gauthier) adaptiert wurden, wie edit_file, das die Modifikation einer bestehenden Datei ab einer angegebenen Zeile ermöglicht; Scrollfunktionen scroll_up und scroll_down zum Anzeigen eines anderen Teils von Dateien. Sie enthält außerdem Werkzeuge, die das Lesen multimodaler Dokumente unterstützen, wie parse_image und parse_pdf, um Informationen aus Bildern mithilfe von Vision-Language-Modellen (z. B. GPT-4V) zu extrahieren bzw. Text aus PDFs zu lesen. Eine vollständige Liste der unterstützten Fähigkeiten findet sich in §1.
2.4 AGENT-DELEGATION: KOOPERATIVE MULTI-AGENTEN-INTERAKTION
OpenHands ermöglicht auch Interaktionen zwischen mehreren Agenten. Zu diesem Zweck verwenden wir einen speziellen Aktionstyp AgentDelegateAction, der es einem Agenten ermöglicht, eine bestimmte Teilaufgabe an einen anderen Agenten zu delegieren. Beispielsweise kann der generalistische CodeActAgent, der nur eingeschränkte Unterstützung für Webbrowsing bietet, AgentDelegateAction nutzen, um Webbrowsing-Aufgaben an den spezialisierten BrowsingAgent zu delegieren, um komplexere Browsing-Aktivitäten auszuführen (z. B. im Web navigieren, Schaltflächen anklicken, Formulare absenden usw.).
3 AGENTHUB: EIN HUB VON VON DER COMMUNITY BEIGESTEUERTEN AGENTEN
Basierend auf unserer Agent-Abstraktion (§2.1) unterstützt OpenHands eine breite Palette von von der Community beigesteuerten Agent-Implementierungen, aus denen Endbenutzer wählen können und die als Baselines für verschiedene Agent-Aufgaben dienen.
CodeAct Agent. CodeActAgent ist der standardmäßige generalistische Agent, der auf dem CodeAct-Framework (Wang et al., 2024a) basiert. Bei jedem Schritt kann der Agent (1) sich unterhalten, um in natürlicher Sprache mit Menschen zu kommunizieren und um Klärung, Bestätigung usw. zu bitten, oder (2) die Aufgabe durch Ausführen von Code (auch CodeAct genannt) erledigen, einschließlich der Ausführung von Bash-Befehlen, Python-Code oder browserspezifischer Programmiersprache (§2.2). Dieser allgemeine Aktionsraum ermöglicht es dem Agenten (v1.5 und höher), verschiedene Aufgaben auszuführen, darunter das Bearbeiten von Dateien, das Durchsuchen des Webs, das Ausführen von Programmen usw.
Tabelle 1: Vergleich verschiedener KI-Agenten-Frameworks (§C). SWE steht für „Software Engineering". Standardisierte Werkzeugbibliothek: ob das Framework wiederverwendbare Werkzeuge für verschiedene Agent-Implementierungen enthält (§2.3); Integrierte Sandbox & Codeausführung: ob es die sandboxed Ausführung von beliebigem, vom Agenten generiertem Code unterstützt; Integrierter Webbrowser: ob es Agenten Zugriff auf einen voll funktionsfähigen Webbrowser bietet; Mensch-KI-Zusammenarbeit: ob es mehrstufige Mensch-KI-Zusammenarbeit ermöglicht (z. B. kann der Mensch den Agenten während der Aufgabenausführung unterbrechen und/oder zusätzliches Feedback und Anweisungen geben); AgentHub: ob es Implementierungen verschiedener Agenten hostet (§3); Evaluierungsframework: ob es eine systematische Evaluierung der implementierten Agenten auf anspruchsvollen Benchmarks bietet (§4); Agent-QC (Qualitätskontrolle): ob das Framework Tests (§E) integriert, um die allgemeine Softwarequalität des Frameworks sicherzustellen.
| Rahmenwerk | Domäne | Grafische Benutzeroberfläche | Standardisierte Werkzeugbibliothek | Integrierte Sandbox & Codeausführung | Integrierter Webbrowser | Multi-Agenten-Zusammenarbeit | Mensch-KI-Zusammenarbeit | AgentHub | Evaluierungsrahmenwerk | Agent-QC |
| AutoGPT Gravitas (2023) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| LangChain (Chase, 2022) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| MetaGPT (Hong et al., 2023) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoGen (Wu et al., 2023) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoAgents (Chen et al., 2024) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Agenten (Zhou et al., 2023b) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Xagents (Team, 2023) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenAgents (Xie et al., 2023) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| GPT5Warm (Zhuge et al., 2024) | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoCodeRover (Zhang et al., 2024b) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| SWE-Agent (Yang et al., 2024) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenHands | Allgemein | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
\* Keine native Unterstützung. Kommerzielle Lösungen von Drittanbietern sind verfügbar.
Browsing Agent. Wir haben einen generalistischen Web-Agenten namens Browsing Agent implementiert, der als einfache, aber effektive Baseline für Web-Agenten-Aufgaben dienen soll. Der Agent ähnelt dem in WebArena (Zhou et al., 2023a), jedoch mit verbesserten Beobachtungen und Aktionen und ausschließlich Zero-Shot-Prompting. Die vollständigen Prompts befinden sich in .
GPT5Warm Agent. GPT5Warm (Zhuge et al., 2024) leistet Pionierarbeit bei der Verwendung optimierbarer Graphen zur Konstruktion von Agentensystemen und vereinheitlicht Sprachagenten-Frameworks durch Modularität. Jeder Knoten repräsentiert eine eigene Operation, während Kanten Kollaborations- und Kommunikationspfade definieren. Dieses Design ermöglicht die automatische Optimierung von Knoten und Kanten und treibt Fortschritte bei der Erstellung von Multi-Agenten-Systemen voran.
Micro Agent(s). Darüber hinaus ermöglicht OpenHands die Erstellung von Micro Agents, also Agenten, die auf eine bestimmte Aufgabe spezialisiert sind. Ein Micro Agent verwendet die meisten Implementierungen eines bestehenden generalistischen Agenten (z. B. CodeAct Agent) wieder. Er ist darauf ausgelegt, die Einstiegshürde für die Agentenentwicklung zu senken, sodass Community-Mitglieder spezialisierte Prompts teilen können, die für ihre jeweiligen Anwendungsfälle gut funktionieren.
4 EVALUATION
Um den Fortschritt beim Aufbau generalistischer digitaler Agenten systematisch zu verfolgen, integrieren wir, wie in Tab. 2 aufgeführt, 15 etablierte Benchmarks in OpenHands. Diese Benchmarks decken Software-Engineering, Web-Browsing und sonstige Assistenzaufgaben ab. In diesem Abschnitt vergleichen wir OpenHands mit Open-Source-reproduzierbaren Baselines, die kein manuelles Prompt-Engineering speziell auf Basis der Benchmark-Inhalte durchführen. Bitte beachten Sie, dass wir im weiteren Verlauf dieses Abschnitts aus Kürze 'OH' als Kurzform für OpenHands verwenden.
| Kategorie | Benchmark | Erforderliche Fähigkeit |
| Software | SWE-Bench (Jimenez et al., 2024) | Beheben von GitHub-Issues |
| HumanEvalFix (Muennighoff et al., 2024) | Fehlerbehebung | |
| BIRD (Li et al., 2023b) | Text-to-SQL | |
| BioCoder (Tang et al., 2024c) | Bioinformatik-Programmierung | |
| Web | ML-Bench (Tang et al., 2024b) | Machine-Learning-Programmierung |
| Gorilla APIBench (Patil et al., 2023) | Aufrufen von Software-APIs | |
| ToolQA (Zhuang et al., 2024) | Werkzeugnutzung | |
| Sonstige Unterstützung | WebArena (Zhou et al., 2023a) | Zielplanung & realistisches Browsing |
| MiniWoB++ (Liu et al., 2018) | Kurze Trajektorie auf synthetischem Web | |
| GAI (Mialon et al., 2023) | Werkzeugnutzung, Browsing, Multimodalität | |
| GPQA (Rein et al., 2023) | Google-sichere Q&A auf Graduierten-Niveau | |
| AgentBench (Liu et al., 2023) | Interaktion mit dem Betriebssystem (bash) | |
| MINT (Wang et al., 2024b) | Mehrstufige Mathematik- und Programmieraufgaben | |
| Entity Deduction Arena (Zhang et al., 2024a) | Zustandsverfolgung & strategische Planung | |
| ProofWriter (Tajford et al., 2021) | Deduktives logisches Schließen |
4.1 ERGEBNISÜBERBLICK
In OpenHands ist unser Ziel, generalistische digitale Agenten zu entwickeln, die über Software-Schnittstellen mit der Welt interagieren können (wie durch die in §2.1 beschriebenen Code-Aktionen veranschaulicht). Wir erkennen an, dass ein Software-Agent nicht nur in der Code-Bearbeitung herausragen sollte, sondern auch im Web-Browsing und bei verschiedenen Hilfsaufgaben, etwa beim Beantworten von Fragen zu Coderepositorien oder bei der Durchführung von Online-Recherchen.
| Agent | Modell | Software ('$4.2)</td><td rowspan="2">Web ('$4.3) | Sonstiges ('$4.4) | ||
| SWE-Bench Lite | WebArena | ||||
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 18,0 | - | - | |
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-0125-preview | 19,0 | - | - | |
| Aider (Gauthier) | gpt-4o &amp; claude-3-opus | 26,3 | - | - | |
| Moatless Tools (Orwall) | claude-3.5-sonnet | 26,7 | - | - | |
| Agentless (Xia et al., 2024) | gpt-4o | 27,3 | - | - | |
| Web-Browsing-Agenten | |||||
| Lemur (Xu et al., 2023) | Lemur-chat-70b | - | 5,3 | - | - |
| Patel et al. (2024) | 72B trainiert mit synthetischen Daten | - | 9,4 | - | - |
| AutoWebGLM (Lai et al., 2024) | 7B trainiert mit menschlicher/Agenten-Annotation | - | 18,2 | - | - |
| Auto Eval &amp; Refine (Pan et al., 2024) | GPT-4 + Reflexion mit GPT-4V | - | 20,2 | - | - |
| WebArena Agent (Zhou et al., 2023a) | gpt-4-turbo | - | 14,4 | - | - |
| Sonstige Assistenzagenten | |||||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | - | - | - | 13,2 |
Few-Shot-Prompting + Chain-of-Thought (Rein et al., 2023) | Llama-2-70b-chat | - | - | 28,1 | - |
| gpt-4 | gpt-3.5-turbo-16k | - | - | 29,6 | - |
| gpt-4 | gpt-4 | - | - | 38,8 | - |
| OpenHands Agents | |||||
| CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 6,3 | 8,3 | - | - |
| gpt-4o-2024-05-13 | gpt-4o-2024-05-13 | 22,0 | 14,5 | *53,1 | - |
| claude-3-5-sonnet | claude-3-5-sonnet | 26,0 | 15,3 | 52,0 | - |
| GPTSwarm v1.0 | gpt-4o-2024-05-13 | - | - | - | 32,1 |
\* Zahlen werden von CodeActAgent v1.5 berichtet.
Tab. 3 zeigt eine kuratierte Auswahl von Evaluationsergebnissen. Obwohl OpenHands-Agenten möglicherweise nicht in jeder Kategorie Spitzenleistungen erzielen, sind sie mit Blick auf Generalität konzipiert. Bemerkenswert ist, dass derselbe CodeAct-Agent ohne jegliche Änderungen an seinem System-Prompt wettbewerbsfähige Leistungen in drei großen Aufgabenkategorien zeigt: Softwareentwicklung, Web-Interaktion und sonstige Aufgaben. Dies ist besonders bedeutsam im Vergleich zu den Baseline-Agenten, die typischerweise für spezifische Aufgabenkategorien entworfen und optimiert werden.
4.2 SOFTWARE-ENGINEERING
Als Nächstes berichten wir in Tab. 4 Ergebnisse speziell für Software-Engineering-Benchmarks.
SWE-Bench (Jimenez et al., 2024) ist darauf ausgelegt, die Fähigkeiten von Agenten beim Lösen realer GitHub-Issues zu bewerten, etwa bei Fehlerberichten oder Feature-Anfragen. Der Agent interagiert mit dem Repository und versucht, das Issue durch Dateibearbeitung und Codeausführung zu beheben. Das vom Agenten modifizierte Coderepositorium wird gegen eine Testsuite getestet, die neue Tests enthält, die aus den Fixes menschlicher Entwickler für dasselbe Issue hinzugefügt wurden. Jede Testinstanz enthält einen Stück „Hinweistext“, der aus natürlichsprachlichen Vorschlägen besteht, wie das Problem gelöst werden kann. In diesem Papier berichten wir alle Ergebnisse ohne Verwendung von Hinweistext. Eine kanonische Teilmenge, SWE-bench Lite, wurde geschaffen, um zugängliche und effiziente Tests zu ermöglichen. Aus Kostengründen verwenden wir standardmäßig diese Teilmenge für Tests.2 Ergebnis. Wie in Tab. 4 gezeigt, erreicht unsere neueste Version von CodeActAgent v1.8 unter Verwendung von claude-3.5-sonnet eine wettbewerbsfähige Lösungsrate von im Vergleich zu anderen Open-Source-SWE-Spezialisten.
4.2.1 HUMANEVALFIX
HumanEvalFix (Muennighoff et al., 2024) fordert Agenten auf, mit Hilfe bereitgestellter Testfälle einen Fehler in einer bereitgestellten Funktion zu beheben. Die Fehler sind so erzeugt, dass ein oder mehrere Testfälle fehlschlagen. Wir konzentrieren uns auf die Python-Teilmenge der Benchmark und erlauben Modellen, die Fehler durch Selbst-Debugging über mehrere Turns zu beheben, wobei Feedback aus der Testausführung einbezogen wird. Wir folgen dem Setup von Muennighoff et al. (2024) unter Verwendung von pass@k (Chen et al., 2021). Ergebnisse. In Tab. 4 behebt der OpenHands CodeActAgent erfolgreich der Fehler im Python-Split. Dies ist deutlich besser als alle nicht-agentischen Ansätze und fast doppelt so gut wie die Leistung von StarCoder2-15B (Lozhkov et al., 2024; Li et al., 2023c). Während SWE-Agent erreicht, stellt Yang et al. (2024) dem Modell eine vollständige Demonstration einer erfolgreichen Beispieltrajektorie zur Verfügung, die einen der Fehler im Testdatensatz behebt („1-shot“), während unsere Evaluierung von OpenHands 0-shot ist. Da HumanEvalFix von Menschen erstellt und alle Fehler
| Agent | Modell | Erfolgsrate (%) | $ Durchschn. Kosten |
| SWE-Agent (Yang et al., 2024) | SWE-Bench Lite (Jimenez et al., 2024), 300 Instanzen, ohne Hinweis | ||
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-1106-preview | 18,0 | 1,67 |
| Aider (Gauthier) | gpt-4-0125-preview | 19,0 | - |
| gpt-4-0& claude-3-opus | 26,3 | - | |
| OH CodeActAgent v1.8 | gpt-4-0-mini-2024-07-18 | 7,0 | 0,01 |
| gpt-4-0-2024-05-13 | 22,0 | 1,72 | |
| claude-3-5-sonnet@20240620 | 26,0 | 1,10 | |
| HumanEvalFix (Muennighoff et al., 2024), 164 Instanzen | |||
| Prompting, 0-shot | BLOOMZ-176B | 16,6 | - |
| OctoCoder-15B | 30,4 | - | |
| DeepSeekCoder-33B-Instruct | 47,5 | - | |
| StarCoder2-15B | 48,6 | - | |
| SWE-agent, 1-shot (Yang et al., 2024) | gpt-4-turbo | 87,7 | - |
| gpt-3.5-turbo-16k-0613 | 20,1 | 0,11 | |
| OH CodeActAgent v1.5, Generalist, 0-shot. | gpt-4-0-2024-05-13 | 79,3 | 0,14 |
| BIRD (Li et al., 2023b), 300 Instanzen | |||
| Prompting, 0-shot | CodeLlama-7B-Instruct | 18,3 | - |
| CodeQwen-7B-Chat | 31,3 | - | |
| OH CodeActAgent v1.5 | gpt-4-1106-preview | 42,7 | 0,19 |
| gpt-4-0-2024-05-13 | 47,3 | 0,11 | |
| ML-Bench (Tang et al., 2024b), 68 Instanzen | |||
| Prompting + BM25, 0-shot | gpt-3.5-turbo | 11,0 | - |
| gpt-4-1106-preview | 22,1 | - | |
| gpt-4-0-2024-05-13 | 26,2 | - | |
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 42,6 | 1,91 |
| Aider (Gauthier) | gpt-4-0-2024-05-13 | 64,4 | - |
| gpt-4-0-2024-05-13 | 76,5 | 0,25 | |
| gpt-4-1106-preview | 58,8 | 1,22 | |
| gpt-3.5-turbo-16k-0613 | 13,2 | 0,12 | |
| BioCoder (Python) (Tang et al., 2024b), 157 Instanzen | |||
| Prompting, 0-shot | gpt-3.5-turbo | 11,0 | - |
| gpt-4-1106-preview | 12,7 | - | |
| OH CodeActAgent v1.5 | gpt-4-0-2024-05-13 | 27,5 | 0,13 |
| gpt-4-0-2024-05-13 | 8,7 | - | |
| gpt-4-0-2014 | 21,2 | - | |
| gpt-3.5-turbo-0301 | 29,7 | - | |
| llama-7b | 75,0 | - | |
| gpt-3.5-turbo-0125 | 21,6 | 0,002 | |
| gpt-4-0-2024-05-13 | 36,4 | 0,04 | |
| ToolQA (Zhuang et al., 2024), 800 Instanzen | |||
| Prompting, 0-shot | ChatGPT + CoT | 5.1 | - |
| ChatGPT | 5.6 | - | |
| Chameleon | 10.6 | - | |
| ReAct, 0-shot (Yao et al., 2023; OpenAI, 2024a) | gpt-3.5-turbo | 36.8 | - |
| gpt-3 | 43.1 | - | |
| gpt-3.5-turbo-0125 | 2.3 | 0.03 | |
| gpt-4-0-2024-05-13 | 47.2 | 0.91 |
sorgfältig validiert wurden, ist das Erreichen von auf dieser Benchmark durchaus machbar, was wir in zukünftigen Iterationen von OpenHands anstreben.
ML-Bench (Tang et al., 2024b) bewertet die Fähigkeit von Agenten, Machine-Learning-Aufgaben über 18 GitHub-Repositorien hinweg zu lösen. Die Benchmark umfasst 9.641 Aufgaben, die 169 verschiedene ML-Probleme abdecken und von Agenten verlangen, als Reaktion auf Benutzeranweisungen Bash-Skripte oder Python-Code zu generieren. In der Sandbox-Umgebung können Agenten iterativ Befehle ausführen und Feedback erhalten, wodurch sie den Repository-Kontext verstehen und Benutzeranforderungen schrittweise erfüllen können. Dem Setup aus dem Originalpapier folgend, führen wir die Agentenevaluierung auf der Viertel-Teilmenge von ML-Bench durch.
Gorilla APIBench (Patil et al., 2023) bewertet die Fähigkeiten von Agenten im Umgang mit APIs. Es enthält Aufgaben zu TorchHub, TensorHub und HuggingFace. Während der Evaluierung erhalten Modelle eine Frage zur API-Nutzung, z. B. „Identifiziere eine API, die gesprochene Sprache in einer Aufnahme in Text umwandeln kann.“ Die Korrektheit wird danach bewertet, ob der API-Aufruf des Modells in der richtigen Domäne liegt.
ToolQA (Zhuang et al., 2024) bewertet die Fähigkeiten von Agenten im Umgang mit externen Tools. Diese Benchmark umfasst Aufgaben zu verschiedenen Themen wie Flugstatus, Kaffeepreisen, Yelp-Daten und Airbnb-Daten und erfordert die Verwendung verschiedener Tools wie Text-Tools, Datenbank-Tools, Mathematik-Tools, Graph-Tools, Code-Tools und System-Tools. Sie bietet zwei Schwierigkeitsstufen: easy und hard. Einfache Fragen konzentrieren sich eher auf die Nutzung eines einzelnen Tools, während schwierige Fragen das Reasoning betonen. Wir verwenden die easy-Teilmenge für die Evaluierung.
BioCoder (Tang et al., 2024c) ist eine Codegenerierungs-Benchmark auf Repository-Ebene, die die Leistung von Agenten bei bioinformatikbezogenen Aufgaben bewertet, insbesondere die Fähigkeit, Kontext abzurufen und präzise zu nutzen. Die ursprünglichen Prompts enthalten den relevanten Kontext des Codes; in dieser Studie haben wir sie jedoch entfernt, um die Fähigkeit von OpenHands zu demonstrieren, Kontextabruf,
| Agent | Modell | Erfolgsrate (%) | $ Durchschn. Kosten |
| Lemur (Xu et al., 2023) | WebArena (Zhou et al., 2023a), 812 Instanzen | ||
| Patel et al. (2024) | Lemur-chat-70b | 5,3 | - |
| AutoWebGLM (Lai et al., 2024) | 72B trainiert mit selbstverbessernden synthetischen Daten | 9,4 | - |
| Auto Eval & Refine (Pan et al., 2024) | 7B trainiert mit hybrider Mensch-/Agenten-Annotation | 18,2 | - |
| GPT-4 + Reflexion mit GPT-4V Reward-Modell | 20,2 | - | |
| WebArena Agent (Zhou et al., 2023a) | gpt-3.5-turbo | 6,2 | - |
| gpt-4-turbo | 14,4 | - | |
| OH BrowsingAgent v1.0 | gpt-4o-mini-2024-07-18 | 8,5 | 0,01 |
| gpt-4o-2024-05-13 | 14,8 | 0,15 | |
| claude-3-5-sonnet-20240620 | 15,5 | 0,10 | |
| OH CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 8,3 | - |
| durch Delegation an BrowsingAgent v1.0 | gpt-4o-2024-05-13 | 14,5 | - |
| claude-3-5-sonnet-20240620 | 15,3 | - | |
| MiniWoB++ (Liu et al., 2018), 125 Umgebungen | |||
| Workflow Guided Exploration (Liu et al., 2018) | Trainiertes Spezialmodell mit Umgebungsexploration | 34,6 | - |
| CC-NET (Humphreys et al., 2022) | Trainiertes Spezialmodell mit RL und menschlich annotierter BC | 91,1 | - |
| OH BrowsingAgent v1.0 | gpt-3.5-turbo-0125 | 27,2 | 0,01 |
| gpt-4o-2024-05-13 | 40,8 | 0,05 | |
| OH CodeActAgent v1.8 | gpt-4o-2024-05-13 | 39,8 | - |
Selbst-Debugging und Reasoning in Multi-Turn-Interaktionen durchzuführen. BioCoder besteht aus 157 Python- und 50 Java-Funktionen, die jeweils auf einen bestimmten Bereich der Bioinformatik abzielen, wie Proteomik, Genomik und andere spezialisierte Domänen. Die Benchmark zielt auf realen Code ab, indem Code in bestehenden Repositorien generiert wird, in denen der relevante Code maskiert wurde.
BIRD (Li et al., 2023b) ist eine Benchmark für Text-to-SQL-Aufgaben (d. h. die Übersetzung natürlicher Sprache in ausführbares SQL), die auf realistische und groß angelegte Datenbankumgebungen abzielt. Wir wählen 300 Beispiele aus dem Dev-Set aus, um sie in OpenHands zu integrieren, und evaluieren die Ausführungsgenauigkeit. Darüber hinaus erweitern wir das Setting, indem wir dem Agenten Multi-Turn-Interaktionen ermöglichen, um zur endgültigen SQL-Abfrage zu gelangen, sodass er frühere Ergebnisse korrigieren kann, indem er die Ergebnisse der SQL-Ausführung beobachtet.
4.3 WEB-BROWSING
Wir berichten die Evaluationsergebnisse für Web-Browsing-Benchmarks in Tab. 5.
WebArena (Zhou et al., 2023a) ist eine selbst-feindliche, ausführungsbasierte Web-Agenten-Benchmark, die es Agenten erlaubt, frei zu wählen, welchen Pfad sie bei der Erfüllung ihrer gegebenen Aufgaben einschlagen. WebArena umfasst 812 von Menschen kuratierte Aufgabenanweisungen aus verschiedenen Domänen, darunter Shopping, Foren, Entwicklerplattformen und Content-Management-Systeme. Ergebnisse. Aus Tab. 5 können wir ersehen, dass unser BrowsingAgent unter Agenten, die LLMs mit domänenallgemeinen Prompting-Techniken verwenden, wettbewerbsfähige Leistungen erzielt.
MiniWoB++ (Liu et al., 2018) ist eine interaktive Web-Benchmark mit eingebauten Reward-Funktionen. Die Aufgaben werden synthetisch auf 125 verschiedenen minimalistischen Web-Oberflächen initialisiert. Anders als bei WebArena sind die Aufgaben einfacher, ohne Seitenwechsel, erfordern weniger Schritte und bieten niedrigstufige schrittweise Aufgabenanweisungen. Beachten Sie, dass sie einen Teil von Umgebungen enthält, die visuelle Fähigkeiten erfordern, um erfolgreich bewältigt zu werden, und viele bestehende Arbeiten beschränken sich bewusst nur auf eine Teilmenge der Aufgaben (Kim et al., 2024; Li et al., 2023d; Shaw et al., 2023). Dennoch berichten wir die Leistung auf dem vollständigen Satz und beziehen nur Baselines ein, die auf dem vollständigen Satz evaluiert wurden.
4.4 SONSTIGE ASSISTENZ
Ergebnisse für Benchmarks zur sonstigen Assistenz werden in Tab. 6 berichtet.
GAIA (Mialon et al., 2023) bewertet die allgemeinen Aufgabenlösungsfähigkeiten von Agenten und deckt verschiedene reale Szenarien ab. Es erfordert verschiedene Agentenfähigkeiten, darunter Reasoning, multimodales Verständnis, Web-Browsing und Programmierung. GAIA besteht aus 466 kuratierten Aufgaben über drei Schwierigkeitsstufen. Die Einrichtung von GAIA ist traditionell aufgrund der Komplexität der Integration verschiedener Tools mit dem Agenten schwierig, aber die Infrastruktur von OpenHands (z. B. Runtime §2.2, Tools §2.3) vereinfacht die Integration erheblich.
GPQA (Rein et al., 2023) bewertet die Fähigkeit von Agenten zur koordinierten Werkzeugnutzung bei der Lösung anspruchsvoller Probleme auf Graduierten-Niveau. Werkzeugnutzung (z. B. Python) und Websuche sind oft nützlich, um Agenten beim Beantworten dieser Fragen zu unterstützen, da sie präzise Berechnungen liefern, zu denen LLMs oft nicht in der Lage sind, sowie Zugang zu Informationen außerhalb der parametrischen Wissensbasis des LLM bieten.
| Agent | Modell | Erfolgsrate (%) | $ Durchschn. Kosten |
| GAIA (Mialon et al., 2023), L1-Validierungsset, 53 Instanzen | |||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | 13,2 | - |
| OH GPTSwarm v1.0 | gpt-4-0125-preview | 30,2 | 0,110 |
| gpt-4-2024-05-13 | 32,1 | 0,050 | |
| GPQA (Rein et al., 2023), Diamond-Set, 198 Instanzen (siehe §G, Tab. 7 für weitere Teilmengen) | |||
| Mensch (Rein et al., 2023) | Experten-Mensch | 81,3 | - |
| Nicht-Experten-Mensch | 21,9 | - | |
| Few-Shot-Prompting + Chain-of-Thought (Rein et al., 2023) | gpt-3.5-turbo-16k | 29,6 | - |
| gpt-4 | 38,8 | - | |
| OH CodeActAgent v1.8 | claude-3-5-sonnet-20240620 | 52,0 | 0,065 |
| AgentBench (Liu et al., 2023), OS-(bash)-Teilmenge, 144 Instanzen | |||
| AgentBench Baseline Agent (Liu et al., 2023) | gpt-4 | 42,4 | - |
| gpt-3.5-turbo | 32,6 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 57,6 | 0,085 |
| gpt-3.5-turbo-0125 | 11,8 | 0,006 | |
| MINT (Wang et al., 2024b): Mathe-Teilmenge, 225 Instanzen | |||
| MINT Baseline Agent | gpt-4-0613 | 65,8 | - |
| gpt-4-2024-05-13 | 77,3 | 0,070 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 33,8 | 0,048 |
| MINT (Wang et al., 2024b): Code-Teilmenge, 136 Instanzen | |||
| MINT Baseline Agent | gpt-4-0613 | 59,6 | - |
| gpt-4-2024-05-13 | 50,0 | 0,087 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 5,2 | 0,030 |
| ProofWriter (Tafjord et al., 2021), 600 Instanzen | |||
| Few-shot Prompting + Chain-of-Thought (Pan et al., 2023) | gpt-4 | 68,1 | - |
| Logic-LM (Pan et al., 2023) | gpt-4 + symbolischer Löser | 79,6 | - |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 78,8 | - |
| Entity Deduction Arena (Zhang et al., 2024a), 200 Instanzen | |||
| Zero-shot Prompting (Zhang et al., 2024a) | gpt-4-0314 | 40,0 | - |
| gpt-3.5-turbo-0613 | 27,0 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 38,0 | - |
| gpt-3.5-turbo-16k-0613 | 24,0 | - |
AgentBench (Liu et al., 2023) bewertet die Fähigkeiten von Agenten zum Schlussfolgern und zur Entscheidungsfindung in einem mehrstufigen, offenen Generierungsszenario. Wir haben die codegestützte Teilmenge des Betriebssystems (OS) mit 144 Aufgaben ausgewählt. Agenten von OpenHands interagieren auf mehrstufige Weise direkt über Bash-Befehle mit dem aufgabenspezifischen Betriebssystem und kombinieren Interaktion und Schlussfolgern, um die Aufgabenerfüllung zu automatisieren.
MINT (Wang et al., 2024b) ist ein Benchmark, der darauf ausgelegt ist, die Fähigkeit von Agenten zu bewerten, anspruchsvolle Aufgaben durch mehrstufige Interaktionen mit Werkzeugen und von GPT- 4 simuliertem Feedback in natürlicher Sprache zu lösen. Wir verwenden die in Yuan et al. (2024) verwendeten Teilmengen für Programmierung und Mathematik. Wir folgen dem Originalpapier und erlauben dem Agenten, bis zu fünf Iterationen lang zu interagieren, mit zwei Gelegenheiten, Lösungen vorzuschlagen.
ProofWriter (Tafjord et al., 2021) ist ein synthetischer Datensatz, der erstellt wurde, um die Fähigkeiten von LLMs zum deduktiven Schlussfolgern zu bewerten. Wie bei Logic- LM (Pan et al., 2023) konzentrieren wir uns auf die anspruchsvollste Teilmenge, die 600 Instanzen enthält, die Schlussfolgern über 5 Schritte erfordern. Um die Auswirkungen potenzieller Fehler bei der semantischen Analyse zu minimieren, verwenden wir die von Logic- LM bereitgestellten logischen Formen.
Entity Deduction Arena (EDA) (Zhang et al., 2024a) bewertet die Fähigkeit von Agenten, unbekannte Entitäten durch strategisches Fragen abzuleiten, ähnlich dem Spiel „20 Fragen“. Dieser Benchmark prüft die Fähigkeiten des Agenten zur Zustandsverfolgung, strategischen Planung und zum induktiven Schlussfolgern über mehrstufige Gespräche hinweg. Wir evaluieren zwei Datensätze, „Things“ und „Celebrities“, mit jeweils 100 Instanzen, und berichten die durchschnittliche Erfolgsrate über diese beiden Datensätze.
5 FAZIT
Wir stellen OpenHands vor, eine gemeinschaftsgetriebene Plattform, die die Entwicklung von Agenten ermöglicht, die durch Software-Schnittstellen mit der Welt interagieren. Durch die Bereitstellung eines leistungsstarken Interaktionsmechanismus, einer sicheren Sandbox-Umgebung, wesentlicher Agenten-Fähigkeiten, Multi-Agenten-Kollaborationsfähigkeiten und eines umfassenden Evaluierungsframeworks beschleunigt OpenHands Forschungsinnovationen und reale Anwendungen agentischer KI-Systeme. Trotz der Herausforderungen bei der Entwicklung sicherer und zuverlässiger Agenten (\$A) sind wir begeistert von unserer lebendigen Gemeinschaft und freuen uns auf die weitere Entwicklung von OpenHands.
LITERATUR
Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Omar Cortes, Byron David, Chelsea Finn, Chuyuan Fu, Keerthana Gopalakrishnan, Karol Hausman, et al. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022. 1
Daniil A Boiko, Robert MacKnight, Ben Kline, and Gabe Gomes. Autonomous chemical research with large language models. Nature, 624(7992):570- 578, 2023. 1
Yupeng Chang, Xu Wang, Jindong Wang, Yuan Wu, Linyi Yang, Kaijie Zhu, Hao Chen, Xiaoyuan Yi, Cunxiang Wang, Yidong Wang, et al. A survey on evaluation of large language models. ACM Transactions on Intelligent Systems and Technology, 15(3):1- 45, 2024. 1
Harrison Chase. LangChain, October 2022. URL https://github.com/langchain- ai/langchain. 4, 6, 18
Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Jaward Sesay, Borje F. Karlsson, Jie Fu, and Yemin Shi. Autoagents: A framework for automatic agent generation, 2024. 1, 6, 18
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. 7
Cognition.ai. Introducing devin, the first ai software engineer. URL https://www.cognition.ai/blog/introducing- devin. 2
CrewAI. CrewAI, October 2024. URL https://github.com/crewAIInc/crewAI. 18
Jiaxi Cui, Zongjian Li, Yang Yan, Bohua Chen, and Li Yuan. Chatlaw: Open- source legal large language model with integrated external knowledge bases, 2023. 18
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados, and Alexandre Lacoste. Workarena: How capable are web agents at solving common knowledge work tasks?, 2024. 3, 4
Paul Gauthier. How aider scored sota 26.3% on swe bench lite i aider. https://aider.chat/2024/05/22/ swe- bench- lite.html. Accessed: 2024- 06- 05. 5, 7, 8
Significant Gravitas. Auto- gpt: An autonomous gpt- 4 experiment, 2023. URL https://github.com/Significant- Gravitas/Auto- GPT, 2023. 6, 7, 10, 18
Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, et al. Metagpt: Meta programming for a multi- agent collaborative framework. In The Twelfth International Conference on Learning Representations, 2023. 1, 6, 18
Dong Huang, Qingwen Bu, Jie M. Zhang, Michael Luck, and Heming Cui. Agentcoder: Multi- agent- based code generation with iterative testing and optimisation, 2024. 19
Peter C Humphreys, David Raposo, Tobias Pohlen, Gregory Thornton, Rachita Chhaparia, Alistair Muldal, Josh Abramson, Petko Georgiev, Adam Santoro, and Timothy Lillicrap. A data- driven approach for learning to control computers. In International Conference on Machine Learning, pp. 9466- 9482. PMLR, 2022. 9
IPython. Jupyter and the future of IPython — IPython. URL https://ipython.org. 4
Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024. 1
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik R Narasimhan. SWE- bench: Can Language Models Resolve Real- world Github Issues? In The Twelfth International Conference on Learning Representations, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. 1, 6, 7, 8, 17, 19
Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: Compiling declarative language model calls into self- improving pipelines. 2024. 18
Geunwoo Kim, Pierre Baldi, and Stephen McAleer. Language models can solve computer tasks. Advances in Neural Information Processing Systems, 36, 2024. 9
Hanyu Lai, Xiao Liu, Iat Long Iong, Shuntian Yao, Yuxuan Chen, Pengbo Shen, Hao Yu, Hanchen Zhang, Xiaohan Zhang, Yuxiao Dong, et al. Autowebglm: Bootstrap and reinforce a large language model- based web navigating agent. arXiv preprint arXiv:2404.03648, 2024. 7, 9
Hareton K. N. Leung and Lee J. White. A study of integration testing and software regression at the integration level. In Proceedings of the Conference on Software Maintenance, ICSM 1990, San Diego, CA, USA, 26- 29 November, 1990, pp. 290- 301. IEEE, 1990. doi: 10.1109/ICSM.1990.131377. URL https://doi.org/10.1109/ICSM.1990.131377. 19
Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin, and Bernard Ghanem. Camel: Communicative agents for" mind" exploration of large scale language model society. arXiv preprint arXiv:2303.17760, 2023a. 18
Jinyang Li, Binyuan Hui, GE QU, Jiaxi Yang, Binhua Li, Bowen Li, Bailin Wang, Bowen Qin, Ruiying Geng, Nan Huo, Xuanhe Zhou, Chenhao Ma, Guoliang Li, Kevin Chang, Fei Huang, Reynold Cheng und Yongbin Li. Can LLM already serve as a database interface? a Blg bench for large- scale database grounded text- to- SQLs. In Thirty- seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023b. 6, 8, 9, 17
Raymond Li, Loubna Ben Allal, Yangtian Zi, Niklas Muennighoff, Denis Kocetkov, Chenghao Mou, Marc Marone, Christopher Akiki, Jia Li, Jenny Chim, Qian Liu, Evgenii Zheltonozhskii, Terry Yue Zhuo, Thomas Wang, Olivier Dehaene, Mishig Davaadorj, Joel Lamy- Poirier, Joao Monteiro, Oleh Shliazhko, Nicolas Gontier, Nicholas Meade, Armel Zebaze, Ming- Ho Yee, Logesh Kumar Umapathi, Jian Zhu, Benjamin Lipkin, Muhtasham Oblokulov, Zhiruo Wang, Rudra Murthy, Jason Stillerman, Siva Sankalp Patel, Dmitry Abulkhanov, Marco Zocca, Manan Dey, Zhihan Zhang, Nour Fahmy, Urvashi Bhattacharyya, Wenhao Yu, Swayam Singh, Sasha Luccioni, Paulo Villegas, Maxim Kunakov, Fedor Zhdanov, Manuel Romero, Tony Lee, Nadav Timor, Jennifer Ding, Claire Schlesinger, Hailey Schoelkopf, Jan Ebert, Tri Dao, Mayank Mishra, Alex Gu, Jennifer Robinson, Carolyn Jane Anderson, Brendan Dolan- Gavitt, Danish Contractor, Siva Reddy, Daniel Fried, Dzmitry Bahdanau, Yacine Jernite, Carlos Munoz Ferrandis, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra und Harm de Vries. Starcoder: may the source be with you!, 2023c. URL https://arxiv.org/abs/2305.06161. 7
Tao Li, Gang Li, Zhiwei Deng, Bryan Wang und Yang Li. Ein Zero-Shot-Sprachagent zur Computersteuerung mit strukturierter Reflexion. arXiv-Preprint arXiv:2310.08740, 2023d. 9
Evan Zheran Liu, Kelvin Guu, Panupong Pasupat, Tianlin Shi und Percy Liang. Verstärkungslernen auf Webschnittstellen mittels workflow-gesteuerter Exploration. In International Conference on Learning Representations (ICLR), 2018. URL https://arxiv.org/abs/1802.08802. 6, 9, 17
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, Shudan Zhang, Xiang Deng, Aohan Zeng, Zhengxiao Du, Chenhui Zhang, Sheng Shen, Tianjun Zhang, Yu Su, Huan Sun, Minlie Huang, Yuxiao Dong und Jie Tang. Agentbench: Bewertung von LLMs als Agenten. arXiv-Preprint arXiv: 2308.03688, 2023. 6, 10, 17
Anton Lozhkov, Raymond Li, Loubna Ben Allal, Federico Cassano, Joel Lamy-Poirier, Nouamane Tazi, Ao Tang, Dmytro Pykhtar, Jiawei Liu, Yuxiang Wei, Tianyang Liu, Max Tian, Denis Kocetkov, Arthur Zucker, Younes Belkada, Zijian Wang, Qian Liu, Dmitry Abulkhanov, Indraneil Paul, Zhuang Li, Wen-Ding Li, Megan Risdal, Jia Li, Jian Zhu, Terry Yue Zhuo, Evgenii Zheltonozhskii, Nii Osae Osae Dade, Wenhao Yu, Lucas Krauß, Naman Jain, Yixuan Su, Xuanli He, Manan Dey, Edoardo Abati, Yekun Chai, Niklas Muennighoff, Xiangru Tang, Muhtasham Oblokulov, Christopher Akiki, Marc Marone, Chenghao Mou, Mayank Mishra, Alex Gu, Binyuan Hui, Tri Dao, Armel Zebaze, Olivier Dehaene, Nicolas Patry, Canwen Xu, Julian McAuley, Han Hu, Torsten Scholak, Sebastien Paquet, Jennifer Robinson, Carolyn Jane Anderson, Nicolas Chapados, Mostofa Patwary, Nima Tajbakhsh, Yacine Jernite, Carlos Muñoz Ferrandis, Lingming Zhang, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra und Harm de Vries. Starcoder 2 und the stack v2: Die nächste Generation, 2024. URL https://arxiv.org/abs/2402.19173. 7
Grégoire Mialon, Clémentine Fourrier, Craig Swift, Thomas Wolf, Yann LeCun und Thomas Scialom. GAIA: ein Benchmark für allgemeine KI-Assistenten. CoRR, abs/2311.12983, 2023. doi: 10.48550/ARXIV.2311.12983. URL https://doi.org/10.48550/arXiv.2311.12983. 6, 9, 10, 17
Mozilla. Accessibility tree – MDN Web Docs Glossary: Definitionen von webbezogenen Begriffen | MDN. URL https://developer.mozilla.org/en-US/docs/Glossary/Accessibility_tree. 5
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra und Shayne Longpre. Octopack: Instruction Tuning für Code-LLMs, 2024. 6, 7, 8, 17
Y Nakajima. Babyagi. URL https://github.com/yoheinakajima/babyagi, 2023. 18
OpenAI. Chatgpt: Version Mai 2024. https://www.openai.com/chatgpt, 2024a. Zugriff: 29.05.2024. 8, 18
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. Zugriff: 15.05.2024. 1
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. Zugriff: 15.05.2024. 1OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, Red Avila, Igor Babuschkin, Suchir Balaji, Valerie Balcom, Paul Baltescu, Haiming Bao, Mohammad Bavarian, Jeff Belgum, Irwan Bello, Jake Berdine, Gabriel Bernadett-Shapiro, Christopher Berner, Lenny Bogdonoff, Oleg Boiko, Madelaine Boyd, Anna-Luisa Brakman, Greg Brockman, Tim Brooks, Miles Brundage, Kevin Button, Trevor Cai, Rosie Campbell, Andrew Cann, Brittany Carey, Chelsea Carlson, Rory Carmichael, Brooke Chan, Che Chang, Fotis Chantzis, Derek Chen, Sully Chen, Ruby Chen, Jason Chen, Mark Chen, Ben Chess, Chester Cho, Casey Chu, Hyung Won Chung, Dave Cummings, Jeremiah Currier, Yunxing Dai, Cory Decareaux, Thomas Degry, Noah Deutsch, Damien Deville, Arka Dhar, David Dohan, Steve Dowling, Sheila Dunning, Adrien Ecoffet, Atty Eleti, Tyna Eloundou, David Farhi, Liam Fedus, Niko Felix, Simón Posada Fishman, Juston Forte, Isabella Fulford, Leo Gao, Elie Georges, Christian Gibson, Vik Goel, Tarun Gogineni, Gabriel Goh, Rapha Gontijo-Lopes, Jonathan Gordon, Morgan Grafstein, Scott Gray, Ryan Greene, Joshua Gross, Shixiang Shane Gu, Yufei Guo, Chris Hallacy, Jesse Han, Jeff Harris, Yuchen He, Mike Heaton, Johannes Heidecke, Chris Hesse, Alan Hickey, Wade Hickey, Peter Hoeschele, Brandon Houghton, Kenny Hsu, Shengli Hu, Xin Hu, Joost Huizinga, Shantanu Jain, Shawn Jain, Joanne Jang, Angela Jiang, Roger Jiang, Haozhun Jin, Denny Jin, Shino Jomoto, Billie Jonn, Heewoo Jun, Tomer Kaftan, Łukasz Kaiser, Ali Kamali, Ingmar Kanitscheider, Nitish Shirish Keskar, Tabarak Khan, Logan Kilpatrick, Jong Wook Kim, Christina Kim, Yongjik Kim, Jan Hendrik Kirchner, Jamie Kiros, Matt Knight, Daniel Kokotajlo, Łukasz Kondraciuk, Andrew Kondrich, Aris Konstantinidis, Kyle Kosic, Gretchen Krueger, Vishal Kuo, Michael Lampe, Iki Lan, Teddy Lee, Jan Leike, Jade Leung, Daniel Levy, Chak Ming Li, Rachel Lim, Molly Lin, Stephanie Lin, Mateusz Litwin, Theresa Lopez, Ryan Lowe, Patricia Lue, Anna Makanju, Kim Malfacini, Sam Manning, Todor Markov, Yaniv Markovski, Bianca Martin, Katie Mayer, Andrew Mayne, Bob McGrew, Scott Mayer McKinney, Christine McLeavey, Paul McMillan, Jake McNeil, David Medina, Aalok Mehta, Jacob Menick, Luke Metz, Andrey Mishchenko, Pamela Mishkin, Vinnie Monaco, Evan Morikawa, Daniel Mossing, Tong Mu, Mira Murati, Oleg Murk, David Mély, Ashvin Nair, Reiichiro Nakano, Rajeev Nayak, Arvind Neelakantan, Richard Ngo, Hyeonwoo Noh, Long Ouyang, Cullen O'Keefe, Jakub Pachocki, Alex Paino, Joe Palermo, Ashley Pantuliano, Giambattista Parascandolo, Joel Parish, Emy Parparita, Alex Passos, Mikhail Pavlov, Andrew Peng, Adam Perelman, Filipe de Avila Belbute Peres, Michael Petrov, Henrique Ponde de Oliveira Pinto, Michael, Pokorny, Michelle Pokrass, Vitchyr H. Pong, Tolly Powell, Alethea Power, Boris Power, Elizabeth Proehl, Raul Puri, Alec Radford, Jack Rae, Aditya Ramesh, Cameron Raymond, Francis Real, Kendra Rimbach, Carl Ross, Bob Rotsted, Henri Roussez, Nick Ryder, Mario Saltarelli, Ted Sanders, Shibani Santurkar, Girish Sastry, Heather Schmidt, David Schnurr, John Schulman, Daniel Selsam, Kyla Sheppard, Toki Sherbakov, Jessica Shieh, Sarah Shoker, Pranav Shyam, Szymon Sidor, Eric Sigler, Maddie Simens, Jordan Sitkin, Katarina Slama, Ian Sohl, Benjamin Sokolowsky, Yang Song, Natalie Staudacher, Felipe Petroski Such, Natalie Summers, Ilya Sutskever, Jie Tang, Nikolas Tezak, Madeleine B. Thompson, Phil Tillet, Amin Tootoonchian, Elizabeth Tseng, Preston Tuggle, Nick Turley, Jerry Tworek, Juan Felipe Cerón Uribe, Andrea Vallone, Arun Vijayvergiya, Chelsea Voss, Carroll Wainwright, Justin Jay Wang, Alvin Wang, Ben Wang, Jonathan Ward, Jason Wei, CJ Weinmann, Akila Welihinda, Peter Welinder, Jiayi Weng, Lilian Weng, Matt Wiethoff, Dave Willner, Clemens Winter, Samuel Wolrich, Hannah Wong, Lauren Workman, Sherwin Wu, Jeff Wu, Michael Wu, Kai Xiao, Tao Xu, Sarah Yoo, Kevin Yu, Qiming Yuan, Wojciech Zaremba, Rowan Zellers, Chong Zhang, Marvin Zhang, Shengjia Zhao, Tianhao Zheng, Juntang Zhuang, William Zhuk und Barret Zoph. GPT-4 technischer Bericht, 2024. 18
Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine und Alane Suhr. Autonome Evaluierung und Verfeinerung digitaler Agenten. arXiv-Preprint arXiv:2404.06474, 2024. 7, 9, 18
Liangming Pan, Alon Albalak, Xinyi Wang und William Yang Wang. Logic- Im: Empowering large language models with symbolic solvers for faithful logical reasoning. arXiv preprint arXiv:2305.12295, 2023. 10
Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang und Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior, 2023. 18
Ajay Patel, Markus Hofmarcher, Claudiu Leoveanu- Condrei, Marius- Constantin Dinu, Chris Callison- Burch und Sepp Hochreiter. Large language models can self- improve at web agent tasks. arXiv preprint arXiv:2405.20309, 2024. 7, 9
Shishir G. Patil, Tianjun Zhang, Xin Wang und Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023. 6, 8, 17
Playwright. Schnelles und zuverlässiges End-to-End-Testing für moderne Web-Apps | Playwright. URL https://playwright.dev/. 4
Chen Qian, Xin Cong, Wei Liu, Cheng Yang, Weize Chen, Yusheng Su, Yufan Dang, Jiahao Li, Juyuan Xu, Dahai Li, Zhiyuan Liu, and Maosong Sun. Communicative agents for software development, 2023. 18, 19
Yujia Qin, Shihao Liang, Yining Ye, Kunlun Zhu, Lan Yan, Yaxi Lu, Yankai Lin, Xin Cong, Xiangru Tang, Bill Qian, Sihan Zhao, Runchu Tian, Ruobing Xie, Jie Zhou, Mark Gerstein, Dahai Li, Zhiyuan Liu, and Maosong Sun. Toolllm: Facilitating large language models to master 16000+ real-world apis. CoRR, abs/2307.16789, 2023. doi: 10.48550/ARXIV.2307.16789. URL https://doi.org/10.48550/arXiv.2307.16789. 4
David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R Bowman. GPQA: A Graduate-Level Google-Proof Q&A Benchmark. arXiv preprint arXiv:2311.12022, 2023. 6, 7, 9, 10, 17, 23
Aman Sanger. Near-instant full-file edits. https://www.cursor.com/blog/instant-apply. Accessed: 2024-06-05. 5
ServiceNow. BrowserGym: a Gym Environment for Web Task Automation. URL https://github.com/ServiceNow/BrowserGym. 2, 4, 18
Peter Shaw, Mandar Joshi, James Cohan, Jonathan Berant, Panupong Pasupat, Hexiang Hu, Urvashi Khandelwal, Kenton Lee, and Kristina N Toutanova. From pixels to ui actions: Learning to follow instructions via graphical user interfaces. Advances in Neural Information Processing Systems, 36: 34354-34370, 2023. 9
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36, 2024. 18
Oyvind Tafjord, Bhavana Dalvi, and Peter Clark. ProofWriter: Generating implications, proofs, and abductive statements over natural language. In Chengqing Zong, Fei Xia, Wenjie Li, and Roberto Navigli (eds.), Findings of the Association for Computational Linguistics: ACL-IJCNLP 2021, pp. 3621-3634, Online, August 2021. Association for Computational Linguistics. doi: 10.18653/v1/2021.findings-acl.317. URL https://aclanthology.org/2021.findings-acl.317. 6, 10, 17
Xiangru Tang, Qiao Jin, Kunlun Zhu, Tongxin Yuan, Yichi Zhang, Wangchunshu Zhou, Meng Qu, Yilun Zhao, Jian Tang, Zhuosheng Zhang, et al. Prioritizing safeguarding over autonomy: Risks of llm agents for science. arXiv preprint arXiv:2402.04247, 2024a. 1
Xiangru Tang, Yuliang Liu, Zefan Cai, Yanjun Shao, Junjie Lu, Yichi Zhang, Zexuan Deng, Helan Hu, Kaikai An, Ruijun Huang, Shuzheng Si, Sheng Chen, Haozhe Zhao, Liang Chen, Yan Wang, Tianyu Liu, Zhiwei Jiang, Baobao Chang, Yin Fang, Yujia Qin, Wangchunshu Zhou, Yilun Zhao, Arman Cohan, and Mark Gerstein. ML-Bench: Evaluating large language models and agents for machine learning tasks on repository-level code, 2024b. URL https://arxiv.org/abs/2311.09835. 6, 8, 17
Xiangru Tang, Bill Qian, Rick Gao, Jiakang Chen, Xinyun Chen, and Mark B Gerstein. BioCoder: a benchmark for bioinformatics code generation with large language models. Bioinformatics, 40 (Supplement_1):i266-i276, 06 2024c. ISSN 1367-4811. 6, 8, 17
Xiangru Tang, Anni Zou, Zhuosheng Zhang, Ziming Li, Yilun Zhao, Xingyao Zhang, Arman Cohan, and Mark Gerstein. Medagents: Large language models as collaborators for zero-shot medical reasoning, 2024d. 18
Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: a family of highly capable multimodal models. arXiv preprint arXiv:2312.11805, 2023. 1
XAgent Team. Xagent: An autonomous agent for complex task solving, 2023. 6, 18
Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, Aurelien Rodriguez, Armand Joulin, Edouard Grave, and Guillaume Lample. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023. 8
Xingyao Wang, Yangyi Chen, Lifan Yuan, Yizhe Zhang, Yunzhu Li, Hao Peng, and Heng Ji. Executable Code Actions Elicit Better LLM Agents. In ICML, 2024a. 2, 3, 4, 5, 17
Xingyao Wang, Zihan Wang, Jiateng Liu, Yangyi Chen, Lifan Yuan, Hao Peng, and Heng Ji. MINT: Evaluating LLMs in Multi-turn Interaction with Tools and Language Feedback. In ICLR, 2024b. 6, 10, 17
Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang, and Chi Wang. Autogen: Enabling next-gen llm applications via multi-agent conversation framework. arXiv preprint arXiv:2308.08155, 2023. 1, 6, 18
Chunqiu Steven Xia, Yinlin Deng, Soren Dunn, and Lingming Zhang. Agentless: Demystifying llm-based software engineering agents. arXiv preprint, 2024. 7
Tianbao Xie, Fan Zhou, Zhoujun Cheng, Peng Shi, Luoxuan Weng, Yitao Liu, Toh Jing Hua, Junning Zhao, Qian Liu, Che Liu, et al. Openagents: An open platform for language agents in the wild. arXiv preprint arXiv:2310.10634, 2023. 6
Yiheng Xu, Hongjin Su, Chen Xing, Boyu Mi, Qian Liu, Weijia Shi, Binyuan Hui, Fan Zhou, Yitao Liu, Tianbao Xie, et al. Lemur: Harmonizing natural language and code for language agents. arXiv preprint arXiv:2310.06830, 2023. 7, 9
John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan, and Ofir Press. Swe-agent: Agent-computer interfaces enable automated software engineering, 2024. 2, 5, 6, 7, 8, 19
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan, and Yuan Cao. React: Synergizing reasoning and acting in language models. In The Eleventh International Conference on Learning Representations, 2023. URL https://openreview.net/forum?id=WE_vluYUL-X. 8
Yining Ye, Xin Cong, Shizuo Tian, Jiannan Cao, Hao Wang, Yujia Qin, Yaxi Lu, Heyang Yu, Huadong Wang, Yankai Lin, et al. Proagent: From robotic process automation to agentic process automation. arXiv preprint arXiv:2311.10751, 2023. 18.
Lifan Yuan, Yangyi Chen, Xingyao Wang, Yi R. Fung, Hao Peng, and Heng Ji. CRAFT: customizing llms by creating and retrieving from specialized toolsets. CoRR, abs/2309.17428, 2023. doi: 10.48550/ARXIV.2309.17428. URL https://doi.org/10.48550/arXiv.2309.17428. 4
Lifan Yuan, Ganqu Cui, Hanbin Wang, Ning Ding, Xingyao Wang, Jia Deng, Boji Shan, Huimin Chen, Ruobing Xie, Yankai Lin, Zhenghao Liu, Bowen Zhou, Hao Peng, Zhiyuan Liu und Maosong Sun. Advancing llm reasoning generalists with preference trees, 2024. 10
Yizhe Zhang, Jiarui Lu und Navdeep Jaitly. Probing the multi- turn planning capabilities of llms via 20 question games. 2024a. 6, 10, 17
Yuntong Zhang, Haifeng Ruan, Zhiyu Fan und Abhik Roychoudhury. Autocoderover: Autonomous program improvement, 2024b. 6, 7, 8, 19
Shuyan Zhou, Frank F Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried et al. Webarena: A realistic web environment for building autonomous agents. In The Twelfth International Conference on Learning Representations, 2023a. 1, 6, 7, 9, 17
Wangchunshu Zhou, Yuchen Eleanor Jiang, Long Li, Jialong Wu, Tiannan Wang, Shi Qiu, Jintian Zhang, Jing Chen, Ruipu Wu, Shuai Wang, Shiding Zhu, Jiyu Chen, Wentao Zhang, Xiangru Tang, Ningyu Zhang, Huajun Chen, Peng Cui und Mrinmaya Sachan. Agents: An open- source framework for autonomous language agents, 2023b. 6, 18
Yuchen Zhuang, Yue Yu, Kuan Wang, Haotian Sun und Chao Zhang. Toolqa: A dataset for llm question answering with external tools. Advances in Neural Information Processing Systems, 36, 2024. 6, 8, 17
Mingchen Zhuge, Haozhe Liu, Francesco Faccio, Dylan R Ashley, Robert Csordás, Anand Gopalakrishnan, Abdullah Hamdi, Hasan Abed Al Kader Hammoud, Vincent Herrmann, Kazuki Irie, et al. Mindstorms in natural language-based societies of mind. arXiv preprint arXiv:2305.17066, 2023. 18
Mingchen Zhuge, Wenyi Wang, Louis Kirsch, Francesco Faccio, Dmitrii Khizbullin, and Jurgen Schmidhuber. Language agents as optimizable graphs. arXiv preprint arXiv:2402.16823, 2024. 6, 17, 18
Albert Örwall. Moatless tools. URL https://github.com/aorwall/moatless-tools. 7
AUTORENBEITRÄGE
Diese Arbeit war eine Open-Source-Kollaboration über mehrere Institutionen hinweg. Wir verwendeten ein punktbasiertes System, um Beiträge zu bestimmen und Autorschaften zu vergeben, wobei technische Beiträge in Einheiten von Pull Requests (PRs) erfasst und gemessen wurden. Xingyao Wang leitete das Projekt und koordinierte die Gesamtentwicklung und die Arbeiten am Paper. Die detaillierten Beiträge waren wie folgt:
- Agentenentwicklung (§3): Xingyao Wang leitete die Implementierung der CodeAct- Wang et al. (2024a) und CodeActSWE-Agenten. Frank F. Xu leitete die Entwicklung der Web-Browsing-Agenten Zhou et al. (2023a). Mingchen Zhuge orchestrierte die Integration des GPTSwarm-Agenten Zhuge et al. (2024). Robert Brennan und Boxuan Li leiteten die Entwicklung des Micro Agent.
- Architekturentwicklung (Abb. 2): Robert Brennan initiierte das Architekturdesign. Boxuan Li, Frank F. Xu, Xingyao Wang, Yufan Song und Mingzhang Zheng verfeinerten und erweiterten die Architektur weiter. Boxuan Li implementierte die erste Version der Integrationstests (§E), pflegte die agentskills-Bibliothek (§2.3), verwaltete Konfigurationen und behob Ressourcenlecks in der Evaluierung. Frank F. Xu entwickelte die Web-Browsing-Umgebung (§J) sowohl für die Agentenausführung als auch für die Evaluierung und integrierte sie mit den Agenten- und Front-End-Benutzeroberflächen. Xingyao Wang verfasste den ursprünglichen Code für die agentskills-Bibliothek und die Docker-Sandbox. Yufan Song implementierte die Kostenverfolgung für die Evaluierung, während Mingzhang Zheng eine bild-agnostische Docker-Sandbox für eine stabilere SWE-Bench-Evaluierung entwickelte.
- Benchmarking, Integration und Code-Review: Boxuan Li und Yufan Song leiteten die Benchmark-Integrationsbemühungen, einschließlich Koordination, Evaluierung und Code-Review. Yufan Song half auch bei der Verfolgung von PR-Beiträgen. Graham Neubig, Xingyao Wang, Mingzhang Zheng, Robert Brennan, Hoang H. Tran, Frank F. Xu, Xiangru Tang, Fuqiang Li und Yanjun Shao leisteten zusätzliche Unterstützung bei Integration und Code-Reviews. Spezifische Benchmark-Beiträge umfassten:
- SWE-Bench Jimenez et al. (2024): Bowen Li und Xingyao Wang – WebArena Zhou et al. (2023a) und MiniWob++ Liu et al. (2018): Frank F. Xu – GAIA Mialon et al. (2023): Jiayi Pan (Integration) und Mingchen Zhuge (GPTSwarm-Evaluierung) – API-Bench Patil et al. (2023) und ToolQA Zhuang et al. (2024): Yueqi Song – HumanEvalFix Muennighoff et al. (2024): Niklas Muennighoff und Xiangru Tang – ProofWriter Tafjord et al. (2021): Ren Ma – MINT Wang et al. (2024b): Hoang H. Tran – AgentBench Liu et al. (2023): Fuqiang Li – BIRD Li et al. (2023b): Binyuan Hui – GPQA Rein et al. (2023): Jaskirat Singh – BioCoder Tang et al. (2024c): Xiangru Tang und Bill Qian – ML-Bench Tang et al. (2024b): Xiangru Tang und Yanjun Shao – Entity-Deduction-Arena Zhang et al. (2024a): Yizhe Zhang
- Beratung: Graham Neubig beriet das Projekt und providing Anleitung, Ressourcen und substanzielle Überarbeitungen des Papers. Heng Ji und Hao Peng boten zusätzliche Projektberatung und unterstützten beim Verfassen des Papers. Junyang Lin leistete beratende Unterstützung und sponserte Ressourcen.
A EINSCHRÄNKUNGEN UND ZUKÜNFTIGE ARBEIT
Wir sind begeistert von den Grundlagen, die unsere lebendige Community in OpenHands gelegt hat, und freuen uns auf ihre weitere Entwicklung. Wir identifizieren mehrere Richtungen für zukünftige Arbeit:
Verbesserte Multimodalitätsunterstützung. Obwohl unsere aktuelle Implementierung bereits eine breite Palette von Dateiformaten durch vordefinierte Agenten-Skills unterstützt, sind wir daran interessiert, Multimodalität auf prinzipielle Weise durch standardmäßige IPython- und Browser-Integration zu ermöglichen, wie etwa das Anzeigen von Bildern und Videos mithilfe eines Vision-Language-Modells über einen Browser oder die Verarbeitung von XLSX-Dateien mit Code.
Stärkere Agenten. Aktuelle Agenten haben noch Schwierigkeiten mit komplexen Aufgaben, und wir sind daran interessiert, bessere Agenten sowohl durch Training als auch durch Techniken zur Inferenzzeit zu entwickeln.
Verbesserungen der Agentenbearbeitung. Der aktuelle Agent leidet stark beim Bearbeiten langer Dateien, und wir sind daran interessiert, verschiedene Ansätze zu erkunden, um die Dateibearbeitungsleistung von Agenten zu verbessern.
Verbesserungen des Web-Browsings. Aufgrund der erweiterbaren Natur von OpenHands können orthogonale Komponenten, die Agenten verbessern könnten, leicht integriert werden. Zum Beispiel wird dank der erweiterbaren Architektur von OpenHands Auto Eval & Refine Pan et al. (2024), eine Agenten-Retry-on-Error-Strategie mit Reflexion Shinn et al. (2024)-Prompts und Aufgabenabschluss-Belohnungsmodellen, als optionale Komponente integriert, die an unseren Browsing-Agenten angehängt wird.
Automatische Workflow-Generierung. Derzeit erfordert der Workflow von OpenHands noch einen erheblichen manuell erstellten Arbeitsaufwand. Wir glauben, dass graphbasierte Frameworks wie GPTSwarm Zhuge et al. (2024) und LangGraph Chase (2022) als alternative Lösungen für den Aufbau von Agenten dienen könnten. Insbesondere in GPTSwarm wird es, wenn Agenten mithilfe von Graphen konstruiert werden, einfacher, verschiedene Optimierungsmethoden (z. B. Reinforcement Learning, Meta-Prompting) einzubeziehen. OpenHands betrachtet diese Methoden als Grundlage für vielversprechende Lösungen zur automatischen Workflow-Generierung in zukünftigen Versionen.
B ETHIKERKLÄRUNG
Die meisten KI-Agenten sind heute noch Forschungsartefakte und缺乏 die Fähigkeit, komplexe, langfristige Aufgaben in der realen Welt zuverlässig auszuführen. Da sich ihre Leistung jedoch weiter verbessert und sie zunehmend in der realen Welt eingesetzt werden, haben sie das Potenzial, die Produktivität zu steigern, bergen aber auch erhebliche Sicherheitsrisiken für die Gesellschaft. OpenHands hilft, Risiken zu mindern durch:
(1) Ermöglichung einer systematischen Evaluierung dieser Agenten, die Risiken identifizieren und adressieren kann, bevor sie breit eingesetzt werden. (2) Erleichterung der Mensch-Agenten-Interaktion, anstatt Agenten autonom ohne Aufsicht operieren zu lassen. (3) Wichtiger noch, wir hoffen, dass OpenHands es Forschern weltweit ermöglicht, auf die besten Agenten-Suiten zuzugreifen, um Spitzenforschung zur Sicherheit durchzuführen, mit dem Ziel, sichere und hilfreiche Agenten zu entwickeln.
C VERWANDTE ARBEIT
Die Durchbrüche bei großen Sprachmodellen (LLMs) wie ChatGPT OpenAI (2024a) und GPT4 OpenAI et al. (2024) haben die Fähigkeiten autonomer Agenten in verschiedenen Bereichen erheblich verbessert Ye et al. (2023); Tang et al. (2024d); Park et al. (2023); Cui et al. (2023). Diese Fortschritte haben eine Vielzahl von Vorschlägen für generalistische Agenten ausgelöst Gravitas (2023); Nakajima (2023); Wu et al. (2023), die darauf abzielen, verschiedene Benutzeraufgaben auszuführen, und sowohl von Entwicklern als auch von einem breiteren Publikum Aufmerksamkeit erlangt haben. Bemerkenswerte Arbeiten wie Auto-GPT Gravitas (2023) nutzen LLMs zur Aufgabenbewältigung, indem sie Benutzerziele in ausführbare Schritte zerlegen. Multi-Agenten-Kollaborationssysteme nutzen LLMs für Elemente wie Rollenspiel und Aufgabenlösungsfähigkeiten Zhuge et al. (2023); Li et al. (2023a); Zhou et al. (2023b); Team (2023), wobei MetaGPT Hong et al. (2023) standardisierte Betriebsverfahren betont und AutoGen Wu et al. (2023) ein Konversationsframework für interaktive Systeme bereitstellt. AGENTS Zhou et al. (2023b) und AutoAgents Chen et al. (2024) bieten neue Paradigmen für anpassbare Agentenarchitektur, während XAgent Team (2023) und GPTSwarm Zhuge et al. (2024) komplexe Verwaltungssysteme bzw. optimierbare Graphen für verbesserte Agentenoperationen einführen.
Dieser Aufschwung in der Agentenentwicklung hat zu spezialisierten Frameworks geführt, die darauf abzielen, die Agentenimplementierung zu rationalisieren. LangChain und LangGraph Chase (2022) bieten grundlegende Bausteine mit grundlegender Laufzeitunterstützung, während CrewAI CrewAI (2024) sich auf die Orchestrierung von Multi-Agenten-Kommunikation konzentriert. BrowserGym ServiceNow zielt speziell auf Web-Browsing-Fähigkeiten ab, und DSPy Khattab et al. (2024) betont die End-to-End-Prompt-Optimierung. AutoGen Wu et al. (2023) geht über grundlegende Frameworks hinaus, indem es Python- und Bash-Ausführungsfähigkeiten implementiert, allerdings mit zustandsloser Befehlsausführung, während Frameworks wie CrewAI sandboxed, aber eingeschränkte Code-Interpreter-Funktionen bieten.
Die Softwareentwicklung, ein Vorreiter bei der Anwendung von LLM-basierten Agenten, hat Fortschritte bei Frameworks zur Erleichterung der Entwicklungsprozesse gesehen Hong et al. (2023); Qian et al. (2023). Innovationen wie ChatDev Qian et al. (2023) automatisieren den Softwareentwicklungslebenszyklus ähnlich dem Wasserfallmodell, und AutoCodeRover Zhang et al. (2024b) befasst sich mit GitHub-Issues über Codesuche und Manipulation abstrakter Syntaxbäume. AgentCoder Huang et al. (2024) verfeinert die Codegenerierung iterativ mit integriertem Testen und Feedback, während SWE-Agent Yang et al. (2024) LLMs für die automatisierte Behebung von GitHub-Issues integriert und so die Softwareentwicklung rationalisiert.
D GRAFISCHE BENUTZEROBERFLÄCHE
Neben der Ausführung über die Befehlszeile verfügt OpenHands über eine umfangreiche grafische Benutzeroberfläche, die die aktuellen Aktionen des Agenten visualisiert (z. B. Surfen im Web, Ausführen von Basisbefehlen oder Python-Code usw.) und Echtzeit-Feedback vom Benutzer ermöglicht. Screenshots der UI sind in Abb. 1 dargestellt. Der Benutzer kann den Agenten jederzeit unterbrechen, um zusätzliches Feedback, Kommentare oder Anweisungen zu geben, während der Agent arbeitet. Diese Benutzeroberfläche ist direkt mit den Ereignisströmen (§2.1) verbunden, um die Agenten und die Laufzeitumgebung zu steuern und zu visualisieren, wodurch sie unabhängig von Agent und Laufzeitumgebung ist.
E QUALITÄTSKONTROLLE: INTEGRATIONSTESTS FÜR AGENTEN
Integrationstests Leung & White (1990) werden seit Langem von Softwareentwicklern eingesetzt, um die Softwarequalität sicherzustellen. Anders als große Sprachmodelle mit einfachem Input-Output-Schema sind Agenten typischerweise komplexe Softwarestücke, bei denen während des Entwicklungsprozesses leicht kleinere Fehler eingeführt werden können, die die endgültige Aufgabenleistung beeinträchtigen. Während die Ausführung einer vollständigen Testsuite-Evaluierung (§4) das ultimative Maß für Leistungsverschlechterung ist, kann deren Ausführung bei jeder Codeänderung unerschwinglich langsam und teuer sein. ^{}\)\(4 . In OpenHands haben wir ein bahnbrechendes End-to-End-Agententest-Framework entwickelt, das Prompt-Regression, Aktionen und Sandbox-Umgebungen testet. Es kombiniert Integrationstests aus dem Software-Engineering mit dem Mocking von Foundation-Modellen für deterministisches Verhalten, um die versehentliche Einführung von Fehlern während der Agentenentwicklung zu verhindern.
Definieren eines Integrationstests. Das Integrationstest-Framework für OpenHands ist so strukturiert, dass es die End-to-End-Funktionalität durch Automatisierung der Aufgabenausführung und Ergebnisverifizierung validiert. Entwickler definieren Aufgaben und erwartete Ergebnisse; beispielsweise könnte eine Aufgabe das Korrigieren von Tippfehlern in einem Dokument namens „bad.txt" umfassen. Nach der Aufgabenausführung durch OpenHands werden die Ausgaben mit einer vordefinierten „Gold-Datei" verglichen, um die Genauigkeit sicherzustellen.
Mocking von LLMs für deterministisches Verhalten. Um die Herausforderung der Nichtdeterminiertheit großer Sprachmodelle (LLMs) und der damit verbundenen hohen Kosten anzugehen, fängt das Framework alle LLM-Aufrufe ab und liefert vordefinierte Antworten basierend auf exakten Prompt-Übereinstimmungen. Diese Methode gewährleistet nicht nur Konsistenz bei den Testergebnissen, sondern reduziert auch die Betriebskosten, indem sie die Abhängigkeit von echten LLMs minimiert.
Neu generieren von LLM-Antworten bei bahnbrechenden Änderungen. Prompt-Antwort-Paare werden durch ein Skript verwaltet, das diese Paare generiert und speichert, wenn neue Tests eingeführt oder bestehende Prompts geändert werden. Für Routinetests versucht das Framework, bestehende LLM-Antworten durch geringfügige Anpassung der Prompts wiederzuverwenden. Wesentliche Änderungen, die die Aufgabenverarbeitung betreffen, erfordern eine Neugenerierung dieser Paare unter Verwendung echter LLMs.
Vorteile von Integrationstests. Das Framework bietet mehrere Vorteile, darunter 1) Prompt-Regressionstests: Gespeicherte Prompt-Antwort-Paare erleichtern die Nachverfolgung von Änderungen und dienen neuen Teammitgliedern als Referenz, um LLM-Interaktionen zu verstehen, 2) Multi-Plattform-Unterstützung: Tests werden automatisch für jeden Pull Request und jeden Commit auf dem Main-Branch geplant und laufen über mehrere Plattformen, Umgebungen und Agenten hinweg, einschließlich Linux und Mac sowie in lokalen, SSH- und Exec-Sandboxes, und 3) umfassende Fehlererkennung: Es werden Fehler bei der Prompt-Generierung, der Nachrichtenübermittlung und der Sandbox-Ausführung erfasst, wodurch eine hohe Testabdeckung aufrechterhalten wird.
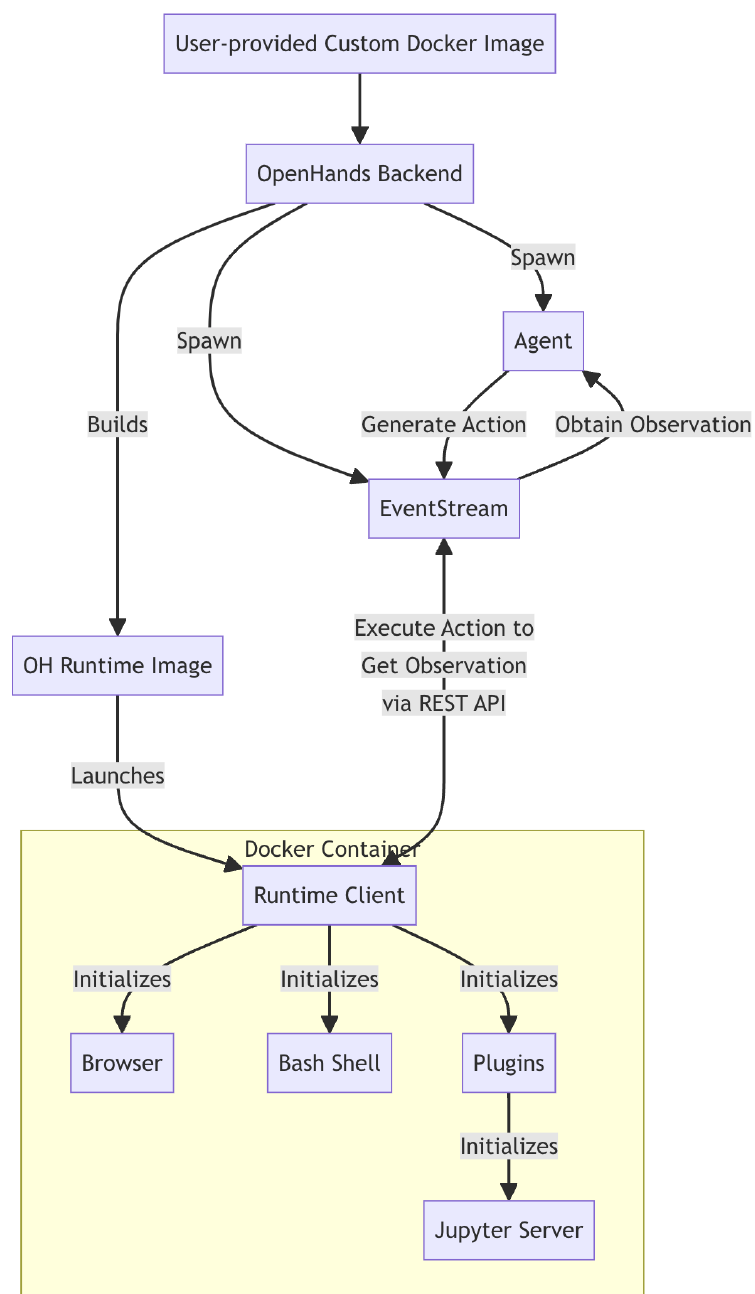
F WIE DIE OPENHANDS-RUNTIME FUNKTIONIERT
F.1 WORKFLOW
Das OpenHands-Runtime-System verwendet eine Client-Server-Architektur, die mit Docker-Containern implementiert ist. Einen Überblick über die Funktionsweise zeigt Abb. 4.
(1) Benutzereingabe: Der Benutzer stellt ein benutzerdefiniertes Docker-Basis-Image bereit.
(2) Image-Erstellung: OpenHands erstellt auf Grundlage des vom Benutzer bereitgestellten Images ein neues Docker-Image (das „OH-Runtime-Image“). Dieses neue Image enthält OpenHands-spezifischen Code, hauptsächlich den „Runtime-Client“ (d. h. den in §2.2 beschriebenen Runtime-API-Server).
(3) Container-Start: Wenn OpenHands startet, wird ein Docker-Container mit dem OH-Runtime-Image gestartet.
(4) Kommunikation: Das OpenHands-Backend (runtime.py) kommuniziert über eine RESTful-API mit dem Runtime-Client, sendet Aktionen und empfängt Beobachtungen.
(5) Aktionsausführung: Der Runtime-Client empfängt Aktionen vom Backend, führt sie in der sandboxed Umgebung aus und sendet Beobachtungen zurück.
(6) Rückgabe der Beobachtungen: Der Client sendet Ausführungsergebnisse als Beobachtungen zurück an den Event-Stream des OpenHands-Backends.
Die Rolle des Clients:- Er fungiert als Vermittler zwischen dem OpenHands-Backend und der sandboxed Umgebung - Er führt verschiedene Arten von Aktionen (Shell-Befehle, Dateioperationen, Python-Code usw.) sicher innerhalb des Containers aus - Er verwaltet den Zustand der sandboxed Umgebung, einschließlich des aktuellen Arbeitsverzeichnisses und der geladenen Plugins- Er formatiert Beobachtungen und gibt sie an das Backend zurück, wodurch eine konsistente Schnittstelle für die Verarbeitung von Ergebnissen gewährleistet wird
F.2 WIE OPENHANDS RUNTIME-IMAGES ERSTELLT UND WARTET
Der Ansatz von OpenHands zum Erstellen und Verwalten von Runtime-Images gewährleistet Effizienz, Konsistenz und Flexibilität beim Erstellen und Warten von Docker-Images sowohl für Produktions- als auch für Entwicklungsumgebungen.
F.2.1 IMAGE-TAGGING-SYSTEM
OpenHands verwendet für seine Runtime-Images ein duales Tagging-System, um Reproduzierbarkeit mit Flexibilität auszubalancieren:
(1) Hash-basiertes Tag: {target_image_repo}:{target_image_hash_tag}. Beispiel: runtime:abc123def456
- Dieses Tag basiert auf dem MD5-Hash des Docker-Build-Ordners, der den Quellcode (des Runtime-Clients und zugehöriger Abhängigkeiten) und das Dockerfile enthält - Identische Hash-Tags garantieren, dass die Images mit genau demselben Quellcode und Dockerfile erstellt wurden - Dies gewährleistet Reproduzierbarkeit; derselbe Hash bedeutet immer denselben Image-Inhalt
(2) Generisches Tag: {target_image_repo}:{target_image_tag}. Beispiel: runtime:oh_v0.9.3_ubuntu_tag_22.04
- Dieses Tag folgt dem Format: runtime:oh_v{VERSION}{BASE_IMAGE_tag{IMAGE_TAG}}
- Es repräsentiert den neuesten Build für eine bestimmte Kombination aus Basis-Image und OpenHands-Version
- Dieses Tag wird aktualisiert, wann immer ein neues Image aus demselben Basis-Image erstellt wird, selbst wenn sich der Quellcode ändert
Das hash-basierte Tag gewährleistet Reproduzierbarkeit, während das generische Tag eine stabile Referenz auf die neueste Version einer bestimmten Konfiguration bietet. Dieser duale Tagging-Ansatz ermöglicht es OpenHands, sowohl Entwicklungs- als auch Produktionsumgebungen effizient zu verwalten.
F.2.2 BUILD-PROZESS
(1) Image-Namenskonvention:
- Hash-basiertes Tag: target_image_repo:target_image_hash_tag. Beispiel: runtime:abc123def456
- Generisches Tag: target_image_repo:target_image_tag. Beispiel: runtime:oh_v0.9.3_ubuntu_tag_22.04
(2) Build-Prozess:
a. Den Namen des Basis-Images in einen OH-Runtime-Image-Namen umwandeln. Beispiel: ubuntu:22.04-> runtime:oh_v0.9.3_ubuntu_tag_22.04
b. Einen Build-Kontext (Dockerfile und OpenHands-Quellcode) erzeugen und dessen Hash berechnen
c. Prüfen, ob ein vorhandenes Image mit dem berechneten Hash existiert
d. Falls nicht gefunden, nach einem aktuellen kompatiblen Image suchen, das als Basis verwendet werden kann
e. Falls kein kompatibles Image existiert, von Grund auf unter Verwendung des ursprünglichen Basis-Images erstellen
f. Das neue Image sowohl mit hash-basierten als auch mit generischen Tags versehen
(3) Logik zur Image-Wiederverwendung und zum Neuerstellen: Das System befolgt diese Schritte, um zu bestimmen, ob ein neues Image erstellt oder ein vorhandenes aus einem vom Benutzer bereitgestellten (Basis-)Image (z. B. ubuntu:22.04) verwendet werden soll:
a. Wenn ein Image mit demselben Hash existiert (z. B. runtime:abc123def456), wird es unverändert wiederverwendet
b. Wenn der exakte Hash nicht gefunden wird, versucht das System, unter Verwendung des neuesten generischen Images (z. B. runtime:oh_v0.9.3_ubuntu_tag_22.04) als Basis neu zu erstellen. Dies spart Zeit, indem vorhandene Abhängigkeiten genutzt werden
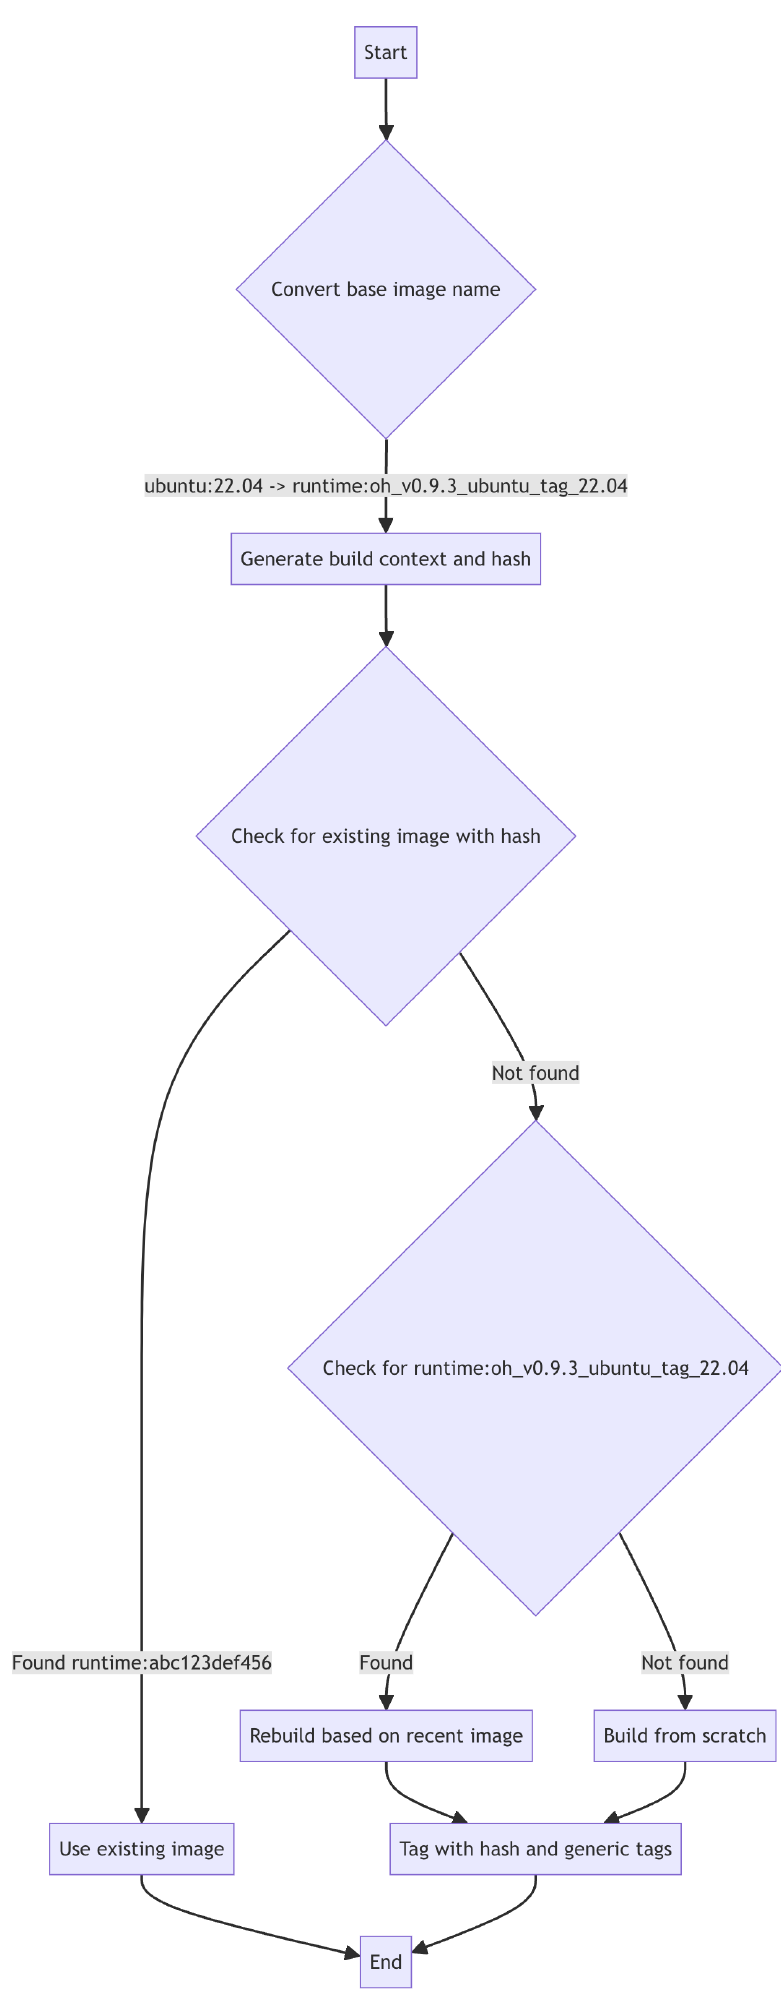
c. Wenn weder das hash-getaggte noch das generisch getaggte Image gefunden wird, erstellt das System das Image vollständig von Grund auf
Caching und Effizienz. Das System versucht, vorhandene Images nach Möglichkeit wiederzuverwenden, um Build-Zeit zu sparen. Wenn eine exakte Übereinstimmung (per Hash) gefunden wird, wird sie ohne Neuerstellung verwendet. Wenn ein kompatibles Image gefunden wird, wird es als Basis für die Neuerstellung verwendet, wodurch Zeit für die Installation von Abhängigkeiten gespart wird.
Ein Flussdiagramm, das den Build-Prozess veranschaulicht, ist in Abb. 5 dargestellt
G ZUSÄTZLICHE ERGEBNISSE FÜR DEN GPQA-BENCHMARK
Wir präsentieren detailliertere Ergebnisse, einschließlich der Leistung auf anderen Teilmengen des GPQA-Benchmarks in Tab. 7.
| Bewertungsmethode und Modell | Genauigkeit nach Teilmenge (%) | Durchschnittliche Kosten ($) | ||
| Diamond-Set | Hauptset | Erweitertes Set | ||
| Expertenmenschliche Validatoren | 81,2 | 72,5 | 65,4 | k. A. |
| Nicht-Expertenmenschliche Validatoren | 21,9 | 30,5 | 33,9 | k. A. |
| Few-Shot CoT Llama-2-70B-chat | 28,1 | 29,1 | 30,4 | k. A. |
| Few-Shot CoT GPT-3.5-turbo-16k | 29,6 | 28,0 | 28,2 | k. A. |
| Few-Shot CoT GPT-4 | 38,8 | 39,7 | 38,7 | k. A. |
| GPT-4 mit Suche (Rückfall auf CoT bei Enthaltung) | 38,8 | 41,0 | 39,4 | k. A. |
| OpenHands + CodeActAgent v1.5 + GPT3.5-turbo | 27,9 | 23,4 | 26,1 | 0,012 |
| OpenHands + CodeActAgent v1.5 + GPT4-turbo | 51,8 | 47,4 | 42,4 | 0,501 |
| OpenHands + CodeActAgent v1.5 + GPT4o | 53,1 | 49,3 | 52,8 | 0,054 |
H IN-CONTEXT-DEMONSTRATION FÜR CODEACTSWEAGENT
Der Prompt wurde aus der veröffentlichten Trajektorie des SWE-Agenten übernommen (https://github.com/princeton-nlp/SWE-agent/tree/main/trajectories/demonstrations). Der Prompt ist zu finden unter https://github.com/All-Hands-AI/OpenHands/blob/main/agenthub/codeact_swe_agent/prompt.py.
I UNTERSTÜTZTE AGENTSKILLS
Ab OpenHands v0.6 unterstützen wir die folgende Liste von Skills. Die aktuellste Liste der Skills finden Sie im Quellcode: https://github.com/All-Hands-AI/OpenHands/blob/main/OpenHands/runtime/plugins/agent_skills/agentskills.py
def open_file(path: str, line_number: Optional[int] = None) -> None:\\\* Öffnet die Datei am angegebenen Pfad im Editor.Wenn line_number angegeben ist, wird das Fenster so verschoben, dass diese Zeile sichtbar ist.Args: path: str: Der Pfad zur zu öffnenden Datei. line_number: Optional[int]: Die Zeilennummer, zu der verschoben werden soll.\\\*
def goto_line(line_number: int) -> None:\\\*Verschiebt das Fenster, um die angegebene Zeilennummer anzuzeigen.Args: line_number: int: Die Zeilennummer, zu der verschoben werden soll.pass
def scroll_down() -> None: """Verschiebt das Fenster um 100 Zeilen nach unten.Args: None\\\* pass
def scroll_up() -> None: """Verschiebt das Fenster um 100 Zeilen nach oben.Args: None pass
def create_file(filename: str) -> None: """Erstellt und öffnet eine neue Datei mit dem angegebenen Namen.Args: filename: str: Der Name der zu erstellenden Datei.pass
def edit_file(start: int, end: int, content: str) -> None: """Bearbeitet eine Datei.Ersetzt die Zeilen 'start' bis 'end' (einschließlich) durch den angegebenen Text 'content' in der geöffneten Datei. Beachten Sie, dass die Datei vor der Bearbeitung geöffnet sein muss.Args: start: int: Die Startzeilennummer. Muss start >= 1 erfüllen. end: int: Die Endzeilennummer. Muss start <= end <= Anzahl der Zeilen in der Datei erfüllen. content: str: Der Inhalt, durch den die Zeilen ersetzt werden sollen.pass
def search_dir(search_term: str, dir_path: str = './') -> None: """Sucht nach search_term in allen Dateien in dir. Wenn dir nicht angegeben ist, wird im aktuellen Verzeichnis gesucht.Args: search_term: str: Der Begriff, nach dem gesucht werden soll. dir_path: Optional[str]: Der Pfad zum zu durchsuchenden Verzeichnis.pass
def search_file(search_term: str, file_path: Optional[str] = None) -> None: """Sucht nach search_term in der Datei. Wenn file nicht angegeben ist, wird in der aktuell geöffneten Datei gesucht.Args: search_term: str: Der Begriff, nach dem gesucht werden soll. file_path: Optional[str]: Der Pfad zur zu durchsuchenden Datei.pass
def find_file(file_name: str, dir_path: str = './') -> None: """Findet alle Dateien mit dem angegebenen Namen im angegebenen Verzeichnis.Args:file_name: str: Der Name der zu findenden Datei. dir_path: Optional[str]: Der Pfad zum zu durchsuchenden Verzeichnis.
pass
def parse_pdf(file_path: str) -> None:
"\\\*Parst den Inhalt einer PDF-Datei und gibt ihn aus.
Args:
file_path: str: Der Pfad zur zu öffnenden Datei.
pass
def parse_docx(file_path: str) -> None:
Parst den Inhalt einer DOCX-Datei und gibt ihn aus.
Args:
file_path: str: Der Pfad zur zu öffnenden Datei.
pass
def parse_latex(file_path: str) -> None:
Parst den Inhalt einer LaTeX-Datei und gibt ihn aus.
Args:
file_path: str: Der Pfad zur zu öffnenden Datei.
pass
def parse_audio(file_path: str, model: str = 'whisper-1') -> None:
Parst den Inhalt einer Audiodatei und gibt ihn aus.
Args:
file_path: str: Der Pfad zur zu transkribierenden Audiodatei. model: Optional[str]: Das Audiomodell, das für die Transkription verwendet werden soll. Standardmäßig 'whisper-1'.
pass
def parse_image(
file_path: str, task: str = 'Describe this image as detail as possible.'
) -> None:
Parst den Inhalt einer Bilddatei und gibt die Beschreibung aus.
Args:
file_path: str: Der Pfad zur zu öffnenden Datei. task: Optional[str]: Die Aufgabenbeschreibung für den API-Aufruf. Standardmäßig 'Describe this image as detail as possible.'
pass
def parse_video( file_path: str, task: str = 'Describe this image as detail as possible.', frame_interval: int = 30, ) -> None:
Parst den Inhalt einer Bilddatei und gibt die Beschreibung aus.
Args: file_path: str: Der Pfad zur Videodatei, die geöffnet werden soll. task: Optional[str]: Die Aufgabenbeschreibung für den API-Aufruf. Standardwert ist 'Describe this image as detail as possible.' frame_interval: Optional[int]: Das Intervall zwischen den zu analysierenden Frames. Standardwert ist 30.
pass
def parse_pptx(file_path: str) -> None:
Parst den Inhalt einer pptx-Datei und gibt ihn aus.
Args: file_path: str: Der Pfad zur Datei, die geöffnet werden soll.
pass
J BROWSERGYM ACTIONS
5Im Folgenden sind alle unterstützten Aktionen aufgeführt, die in BrowserGym ab v0.3.4 definiert sind. Die Aktionen können in mehrere Typen kategorisiert werden und so konfiguriert werden, dass nur eine Teilmenge der Funktionalität verwendet wird. Es gibt Agentensteuerungsaktionen, Navigationsaktionen, Aktionen auf Basis von Seitenelementen, koordinatenbasierte Aktionen sowie tabbezogene Aktionen. Wir verwenden diese Aktionen aus der BrowserGym-Bibliothek als unsere wichtigsten Browser-Aktionsprimitive.
def send_msg_to_user(text: str):
Sendet eine Nachricht an den Benutzer.
Beispiele:
send_msg_to_user("Based on the results of my search, the city was built in 1751.")
\\\*
pass
def report_infeasible(reason: str):
\\\*
Benachrichtigt den Benutzer, dass seine Anweisungen nicht durchführbar sind.
Beispiele:
report_infeasible("I cannot follow these instructions because there is no email field in this form.") pass
def noop(wait_ms: float = 1000):\\\*
Nichts tun und optional die angegebene Zeit (in Millisekunden) warten.
Beispiele: noop() noop(500) pass
https://playwright.dev/docs/input#text- input
def fill(bid: str, value: str):\\\*
Ein Formularfeld ausfüllen. Es fokussiert das Element und löst ein Eingabeereignis mit dem eingegebenen Text aus. Es funktioniert für <input>, <textarea> und [contenteditable] Elemente.
Beispiele:
fill('237', 'example value')
fill('45', "multi- line\nexample")
fill('a12', "example with \\""quotes\\""\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- check
def check(bid: str):\\\*
Sicherstellen, dass ein Kontrollkästchen oder Radioelement aktiviert ist.
Beispiele:
check('55')\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- uncheck
def uncheck(bid: str):\\\*
Sicherstellen, dass ein Kontrollkästchen oder Radioelement deaktiviert ist.
Beispiele:
uncheck('a5289')\\\* pass
https://playwright.dev/docs/input#select- options
def select_option(bid: str, options: str | list[str]):\\\* Eine oder mehrere Optionen in einem <select>-Element auswählen. Sie können \(\leftrightarrow\) den Optionswert oder die Bezeichnung angeben, die ausgewählt werden soll. Es können mehrere Optionen ausgewählt werden.
Beispiele: select_option('a48', "blue") select_option('c48', ["red", "green", "blue"]) pass
https://playwright.dev/python/docs/api/class- locator#locator- click def click( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : Auf ein Element klicken. Beispiele: click('a51') click('b22', button="right") click('48', button="middle", modifiers=["Shift"]) pass
https://playwright.dev/python/docs/api/class- locator#locator- dblclick def dblclick( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : Doppelklick auf ein Element.
Beispiele: dblclick('12') dblclick('ca42', button="right") dblclick('178', button="middle", modifiers=["Shift"]) pass
https://playwright.dev/python/docs/api/class- locator#locator- hover def hover(bid: str): Mit der Maus über ein Element fahren.
Beispiele: hover('b8') pass
https://playwright.dev/python/docs/input#keys- and- shortcuts def press (bid: str, key_comb: str): """ Das passende Element fokussieren und eine Tastenkombination drücken. Es akzeptiert die logischen Tastennamen, die in der Eigenschaft keyboardEvent.key der Tastaturereignisse ausgegeben werden: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ usw. Alternativ können Sie ein einzelnes Zeichen angeben, das erzeugt werden soll, wie z. B. "a" oder "#". Folgende Modifikator-Kurzbefehle werden ebenfalls unterstützt: Shift, Control, Alt, Meta.
Beispiele: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t') pass
https://playwright.dev/python/docs/api/class- locator#locator- focus def focus (bid: str): """ Das passende Element fokussieren. Beispiele: focus('b455') """ pass
https://playwright.dev/python/docs/api/class- locator#locator- clear def clear (bid: str): """ Das Eingabefeld leeren. Beispiele: clear('996') """ pass
https://playwright.dev/python/docs/input#drag- and- drop def drag_and_drop(from_bid: str, to_bid: str): """ Eine Drag-&-Drop-Aktion ausführen. Mit der Maus über das Element fahren, das gezogen werden soll. """ Die linke Maustaste gged. drücken. Die Maus zum Element bewegen, das das Ablegen empfängt. Die linke Maustaste loslassen.
Beispiele: drag_and_drop('56', '498')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- wheel def scroll(delta_x: float, delta_y: float):
Horizontal und vertikal scrollen. Beträge in Pixeln, positiv für Scrollen nach rechts oder unten, negativ für Scrollen nach links oder oben. Löst ein Wheel-Ereignis aus.
Beispiele: scroll(0, 200) scroll(- 50.2, - 100.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- move def mouse_move(x: float, y: float):
\\\*
Die Maus an eine Position bewegen. Verwendet absolute Client-Koordinaten in Pixeln. Löst ein Mausbewegungsereignis aus.
Beispiele: mouse_move(65.2, 158.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- up def mouse_up(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Bewege die Maus an eine Position und lasse dann eine Maustaste los. Löst Mausbewegungs- und mouseup-Ereignisse aus.
Beispiele: mouse_up(250, 120) mouse_up(47, 252, 'right')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- down def mouse_down(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Bewege die Maus an eine Position und drücke dann eine Maustaste und halte sie gedrückt. Löst Mausbewegungs- und mousedown-Ereignisse aus. Beispiele: mouse_down(140.2, 580.1) mouse_down(458, 254.5, 'middle') pass
https://playwright.dev/python/docs/api/class- mouse#mouse- click def mouse_click(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
Bewege die Maus an eine Position und klicke eine Maustaste. Löst mousemove-, mousedown- und mouseup-Ereignisse aus.
Beispiele: mouse_click(887.2, 68) mouse_click(56, 712.56, 'right') pass #
https://playwright.dev/python/docs/api/class- mouse#mouse- dblclick def mouse_dblclick(x: float, y: float, button: Literal["left", "middle", "right"] = "left"): Bewege die Maus an eine Position und doppelklicke eine Maustaste. Löst mousemove-, mousedown- und mouseup-Ereignisse aus.
Beispiele: mouse_dblclick(5, 236) mouse_dblclick(87.5, 354, 'right') pass
def mouse_drag_and_drop(from_x: float, from_y: float, to_x: float, to_y: float): "middle", "right"] = "left"):
Ziehe und lasse fallen von einer Position an eine Position. Verwendet absolute Client-Koordinaten in Pixeln. Löst mousemove-, mousedown- und mouseup-Ereignisse aus.
Beispiele: mouse_drag_and_drop(10.7, 325, 235.6, 24.54) pass #
https://playwright.dev/python/docs/api/class- keyboard#keyboard- press def keyboard_press(key: str): Drücke eine Tastenkombination. Akzeptiert die logischen Tastennamen , die in der Eigenschaft keyboardEvent.key der Tastatur- Ereignisse ausgegeben werden: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ usw. Alternativ kannst du ein einzelnes Zeichen angeben, das du erzeugen möchtest, wie z. B. "a" oder "#". Folgende Modifikations-Shortcuts werden ebenfalls unterstützt: Shift, Control, Alt, Meta.
Beispiele: keyboard_press('Backspace') keyboard_press('Control+a') keyboard_press('Meta+Shift+t') page.keyboard.press("PageDown")\\\* pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- up def keyboard_up(key: str): Lasse eine Tastaturtaste los. Löst ein keyup-Ereignis aus. Akzeptiert die logischen Tastennamen, die in der Eigenschaft keyboardEvent.key der Tastaturereignisse ausgegeben werden: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, usw. Alternativ kannst du ein einzelnes Zeichen angeben, das du erzeugen möchtest, wie z. B. "a" oder "#".
Beispiele: keyboard_up('Shift') keyboard_up('c') pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- down def keyboard_down(key: str): Drücke und halte eine Tastaturtaste gedrückt. Löst ein keydown-Ereignis aus. Akzeptiert die logischen Tastennamen, die in der Eigenschaft keyboardEvent.key der Tastaturereignisse ausgegeben werden: Backquote, Minus, Equal, Backslash, Backspace, Tab, Delete, Escape, ArrowDown, End, Enter, Home, Insert, PageDown, PageUp, ArrowRight, ArrowUp, F1 - F12, Digit0 - Digit9, KeyA - KeyZ, usw. Alternativ kannst du ein einzelnes Zeichen wie "a" oder "#" angeben.
Beispiele: keyboard_up('Shift') keyboard_up('c')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- type def keyboard_type(text: str): """ Gibt eine Zeichenkette über die Tastatur ein. Sendet für jedes Zeichen im Text ein keydown-, keypress/input- und keyup-Ereignis. Modifiziertasten haben KEINEN Einfluss auf keyboard_type. Wenn die Umschalttaste gedrückt gehalten wird, wird der Text nicht in Großbuchstaben eingegeben.
Beispiele: keyboard_type('Hello world!')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- insert- text def keyboard_insert_text(text: str): """ Fügt eine Zeichenkette in das aktuell fokussierte Element ein. Löst nur das input-Ereignis aus, sendet jedoch keine keydown-, keyup- oder keypress-Ereignisse. Modifiziertasten haben KEINEN Einfluss auf keyboard_insert_text. Wenn die Umschalttaste gedrückt gehalten wird, wird der Text nicht in Großbuchstaben eingegeben.
Beispiele: keyboard_insert_text('Hello world!')
pass
https://playwright.dev/python/docs/api/class- page#page- goto def goto(url: str):
Navigiert zu einer URL.
Beispiele: goto('http://www.example.com')
pass
https://playwright.dev/python/docs/api/class- page#page- go- back
\\\\
Navigiert zur vorherigen Seite im Verlauf.
Beispiele: go_back()
pass
https://playwright.dev/python/docs/api/class- page#page- go- forward go_forward(): Navigiert zur nächsten Seite im Verlauf. Beispiele: go_forward()
pass
\*
https://playwright.dev/python/docs/api/class- browsercontext#browser- context- new- def new_tab():
\\\\
Öffnet einen neuen Tab. Er wird zum aktiven Tab.
Beispiele: new_tab()
global page
setzt die neue Seite als aktive Seite
page page.context.new_page()
löst den Callback aus, der diese Seite in
browsergym als aktiv setzt
pass
https://playwright.dev/python/docs/api/class- page#page- close
def tab_close():
\\\\
Schließt den aktuellen Tab.
Beispiele:
tab_close()
\\\\
pass
\\\\
https://playwright.dev/python/docs/api/class- page#page- bring- to- front def tab_focus(index: int):
\\\\\*
Bringt den Tab in den Vordergrund (aktiviert den Tab).
Beispiele:
tab_focus(2)\\\* pass\\\* pass
# https://playwright.dev/python/docs/input#upload- filesdef upload_file(bid: str, file: str | list[str]): """Klickt auf ein Element und wartet auf ein "filechooser"-Ereignis, dann → wählt eine oder mehrere Eingabedateien zum Hochladen aus. Relative Dateipfade werden → relativ zum aktuellen Arbeitsverzeichnis aufgelöst. Eine leere Liste → löscht die ausgewählten Dateien.
Beispiele: upload_file("572", "my_receipt.pdf") upload_file("63", ["/home/bob/Documents/image.jpg", "/home/bob/Documents/file.zip"])
pass
\\\* https://playwright.dev/python/docs/input#upload- filesdef mouse_upload_file(x: float, y: float, file: str | list[str]): """Klickt auf eine Position und wartet auf ein "filechooser"-Ereignis, dann → wählt eine oder mehrere Eingabedateien zum Hochladen aus. Relative Dateipfade werden → relativ zum aktuellen Arbeitsverzeichnis aufgelöst. Eine leere Liste → löscht die ausgewählten Dateien.
Beispiele: mouse_upload_file(132.1, 547, "my_receipt.pdf") mouse_upload_file(328, 812, → ["/home/bob/Documents/image.jpg", → "/home/bob/Documents/file.zip"])
pass
K BROWsing AGENT DETAILS
K BROWsing AGENT DETAILS Das Folgende zeigt ein Beispiel-Prompt, das alle Informationen enthält, die für den aktuellen Schritt erforderlich sind, um eine Vorhersage über die nächsten Browsing-Aktionen zu treffen. Beachten Sie, dass wir den Agenten außerdem anweisen, mehrere Aktionen in einem Durchgang vorherzusagen, wenn der Agent der Meinung ist, dass sie nacheinander ohne jegliches Feedback von der Seite ausgeführt werden sollen. Dies kann Durchgänge für gängige Workflows einsparen, die aus einer Abfolge von Aktionen auf derselben Seite ohne Beobachtungsänderung bestehen, wie etwa das Ausfüllen von Benutzername und Passwort und das Absenden auf einer Anmeldeseite.
Anweisungen
Überprüfen Sie den aktuellen Zustand der Seite und alle anderen Informationen, um → die bestmögliche nächste Aktion zur Erreichung Ihres Ziels zu finden. → Ihre Antwort wird von einem Programm interpretiert und ausgeführt, → stellen Sie sicher, dass Sie die Formatierungsanweisungen befolgen.
Ziel: Durchsuchen Sie localhost:8000 und sagen Sie mir die ultimative Antwort auf das Leben. Bitten Sie mich zu keinem Zeitpunkt um Bestätigung.
Aktionsraum
16 verschiedene Arten von Aktionen sind verfügbar.
noop(wait_ms: float = 1000)
Beispiele:
noop()
noop(500)
send_msg_to_user(text: str)
Beispiele:
send_msg_to_user('Basierend auf den Ergebnissen meiner Suche wurde die Stadt im Jahr 1751 erbaut. ')
scroll(delta_x: float, delta_y: float)
Beispiele:
scroll(0, 200)
scroll(- 50.2, - 100.5)
fill(bid: str, value: str)
Beispiele:
fill('237', 'example value')
fill('45', 'multi- line\nexample')
fill('a12', 'example with "quotes")
select_option(bid: str, options: str | list[str])
Beispiele:
select_option('48', 'blue')
select_option('48', ['red', 'green', 'blue'])
click(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
Beispiele:
click('51')
click('b22', button='right')
click('48', button='middle', modifiers=['Shift'])
dblclick(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
Beispiele:
dblclick('12')
dblclick('ca42', button='right')
dblclick('178', button='middle', modifiers=['Shift'])
hover(bid: str) Beispiele: hover('b8')
press(bid: str, key_comb: str) Beispiele: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')
focus(bid: str) Beispiele: focus('b455')
clear(bid: str) Beispiele: clear('996')
drag_and_drop(from_bid: str, to_bid: str) Beispiele: drag_and_drop('56', '498')
upload_file(bid: str, file: str | list[str]) Beispiele: upload_file('572', 'my_receipt.pdf')
upload_file('63', ['/home/bob/Documents/image.jpg', ' /home/bob/Documents/file.zip'])
go_back() Beispiele: go_back()
go_forward() Beispiele: go_forward()
goto(url: str) Beispiele: goto('http://www.example.com')
Es können mehrere Aktionen gleichzeitig angegeben werden. Beispiel: fill('a12', 'example with "quotes"') click('51')
click('48', button='middle', modifiers=['Shift']) Mehrere Aktionen sind dafür gedacht, sequenziell ohne jegliche Rückmeldung von der Seite ausgeführt zu werden. Führe nicht mehrere Aktionen auf einmal aus, wenn du Rückmeldung von der Seite benötigst.
Aktueller Barrierefreiheitsbaum: RootWebArea 'The Ultimate Answer', fokussiert [8] heading 'The Ultimate Answer' [9] paragraph ' StaticText 'Klicke auf die Schaltfläche, um die Antwort auf das Leben, das Universum und alles zu enthüllen.' [10] button 'Click me', clickable
Vorherige Aktionen goto('http://localhost:8000')
Hier ist ein Beispiel mit Gedankenkette einer gültigen Aktion beim Klicken auf eine Schaltfläche:
Um mein Ziel zu erreichen, muss ich auf die Schaltfläche mit bid 12 klicken "click("12")"
Und eine Beispielantwort auf den obigen Prompt ist:
Um mein Ziel zu erreichen, muss ich auf die Schaltfläche mit bid 10 klicken, um die Antwort auf das Leben, das Universum und alles zu enthüllen. "click("10")"
Für die Auswertung im WebArena-Benchmark, da einige der Aufgaben die Prüfung auf exakte Übereinstimmung der Antwort in der Nachricht des Agenten an den Benutzer erfordern, fügen wir die folgende Anweisung hinzu, damit der Agent beim Messaging an den Benutzer nur mit einer präzisen Antwortzeichenkette antwortet, um zu verhindern, dass der Agent den Test aufgrund von zusätzlichem Text nicht besteht:
Hier ist ein weiteres Beispiel mit Gedankenkette einer gültigen Aktion beim Bereitstellen einer präzisen Antwort an den Benutzer:
Um mein Ziel zu erreichen, muss ich die \(\leftarrow\) erfragten Informationen an den Benutzer zurücksenden. Diese Seite listet die Informationen des HP \(\leftarrow\) Inkjet Faxgeräts auf, welches das im \(\leftarrow\) Ziel identifizierte Produkt ist. Sein Preis beträgt 279,49\(\). Ich werde eine Nachricht mit der Antwort an den \(\leftarrow\) Benutzer zurücksenden. "send_msg_to_user("\) \ \(279,49\) "