
Statt Token für Token sagt LLaDA maskierten Text wie ein Diffusionsmodell voraus und hält mit LLaMA-3 8B mit. ICML 2025, kostenlos.
Large Language Diffusion Models
Große Sprachdiffusionsmodelle
Shen Fengqi Zhu Zebin You Xiaolu Zhang Jingyang Jun Jun Zhou Yankai Ji-Rong Wen Chongxuan Gaoling School of Artificial Intelligence, Renmin University of China Beijing Key Laboratory of Research on Large Models and Intelligent Governance Engineering Research Center of Next-Generation Intelligent Search and Recommendation, MOE Ant Group {nieshen,fengqizhu,chongxuanli}@ruc.edu.cn {nie shen, fengqizhu, chongxuanli}@ruc.edu.cn
Zusammenfassung
Die Fähigkeiten großer Sprachmodelle (LLMs) werden weithin als abhängig von autoregressiven Modellen (ARMs) angesehen. Wir stellen diese Auffassung infrage, indem wir LLaDA einführen, ein Diffusionsmodell, das von Grund auf unter dem Paradigma des Pre-Trainings und des überwachten Feintunings (SFT) trainiert wird. LLaDA verwendet einen Vorwärts-Datenmaskierungsprozess und einen Rückwärts-Generierungsprozess, parametrisiert durch einen Transformer zur Vorhersage maskierter Token. Es bietet einen prinzipienbasierten generativen Ansatz für probabilistische Inferenz durch Optimierung einer unteren Likelihood-Schranke. Über umfangreiche Benchmarks zu allgemeinen Aufgaben, Mathematik, Code und so weiter hinweg zeigt LLaDA eine starke Skalierbarkeit und erzielt vergleichbare Ergebnisse mit unseren selbst konstruierten ARM-Baselines. Bemerkenswert ist, dass LLaDA 8B im In-Context-Learning mit starken LLMs wie LLaMA3 8B konkurrenzfähig ist und nach SFT in Fallstudien wie mehrrundigen Dialogen beeindruckende Fähigkeiten zur Befehlsbefolgung zeigt. Darüber hinaus adressiert LLaDA den Umkehrfluch und übertrifft GPT-4o in einer Aufgabe zur Vervollständigung umgekehrter Gedichte. Unsere Ergebnisse zeigen das Potenzial von Diffusionsmodellen für die Sprachmodellierung im großen Maßstab und stellen die gängige Annahme infrage, dass die oben diskutierten Kernfähigkeiten von LLMs inhärent von ARMs abhängen. Projektseite und Codes: https://ml-gsai.github.io/LLaDA-demo/
1 Einleitung
Große Sprachmodelle (LLMs) [1] fallen vollständig in den Rahmen der generativen Modellierung. Konkret zielen LLMs darauf ab, die wahre, aber unbekannte Sprachverteilung zu erfassen, indem sie eine Modellverteilung durch Maximum-Likelihood-Schätzung optimieren, oder äquivalent dazu die KL-Divergenz zwischen den beiden Verteilungen minimieren:
Der vorherrschende Ansatz beruht auf der autoregressiven Modellierung (ARM) – gemeinhin als Paradigma der „Vorhersage des nächsten Tokens" bezeichnet –, um die Modellverteilung zu definieren:
Autoregressive Formulierung
\*Gleicher Beitrag.
Arbeit während eines Praktikums bei Ant Group entstanden.
Projektleiter.
Korrespondenz an Chongxuan Li.
wobei eine Sequenz der Länge ist und das -te Token. Dieses Paradigma hat sich als bemerkenswert effektiv erwiesen [2][5] und ist zur Grundlage der aktuellen LLMs geworden. Trotz seiner weiten Verbreitung bleibt eine grundlegende Frage unbeantwortet: Ist das autoregressive Paradigma der einzige Weg, um die Kernfähigkeiten von LLMs zu erreichen, wie etwa Skalierbarkeit, In-Context-Learning und Befehlsbefolgung?
Wir argumentieren, dass die Antwort nicht einfach „ja" lautet. Die zuvor übersehene zentrale Erkenntnis ist: Es sind die Prinzipien der generativen Modellierung (d. h. Gl. (1)) und nicht die autoregressive Formulierung (d. h. Gl. (2)) selbst, die den wesentlichen Eigenschaften von LLMs grundlegend zugrunde liegen.
Insbesondere argumentieren wir, dass Skalierbarkeit in erster Linie eine Folge des Zusammenspiels zwischen Transformern [7], Modellgröße, Datengröße und Fisher-Konsistenz [5][8] ist, die durch die generativen Prinzipien in Gl. (1) induziert wird, und nicht ein einzigartiges Resultat der ARMs in Gl. (2). Der Erfolg von Diffusions-Transformern [9][10] auf visuellen Daten [11] stützt diese Behauptung. Darüber hinaus scheinen die Fähigkeiten zur Befehlsbefolgung und zum In-Context-Learning [4] intrinsische Eigenschaften aller bedingten generativen Modelle bei strukturell konsistenten sprachlichen Aufgaben zu sein und keine ausschließlichen Vorteile von ARMs. Zudem können ARMs zwar als verlustfreier Datenkompressor interpretiert werden [12][13], doch jedes hinreichend ausdrucksstarke probabilistische Modell kann ähnliche Fähigkeiten erreichen [14].
Bestimmte inhärente Einschränkungen von LLMs lassen sich jedoch direkt auf ihre autoregressive Natur zurückführen. Beispielsweise beschränkt der von links nach rechts verlaufende Generierungsprozess ihre Fähigkeit, Aufgaben des Umkehrschlusses zu bewältigen [15], was ein repräsentatives Versagen der Generalisierungsfähigkeiten aktueller Modelle darstellt.
Motiviert durch diese Erkenntnisse führen wir LLaDA (Large Language Diffusion with mAsking) ein, um zu untersuchen, ob die von LLMs gezeigten Fähigkeiten aus generativen Modellierungsprinzipien jenseits von ARMs entstehen können, und damit die zuvor aufgeworfene grundlegende Frage zu beantworten. Im Gegensatz zu traditionellen ARMs nutzt LLaDA ein maskiertes Diffusionsmodell (MDM) [16][20], das einen Vorwärts-Datenmaskierungsprozess umfasst und einen Maskenprädiktor trainiert, um seinen Rückwärtsprozess anzunähern. Dieses Design ermöglicht es LLaDA, eine Modellverteilung mit bidirektionalen Abhängigkeiten zu konstruieren und eine Variations-Untergrenze ihrer Log-Likelihood zu optimieren, was eine prinzipienbasierte und zuvor unerforschte Perspektive auf die oben diskutierten Kernfähigkeiten von LLMs bietet.
Wir übernehmen die Standard-Pipeline aus Datenvorbereitung, Pre-Training, überwachtem Feintuning (SFT) und Evaluierung und skalieren LLaDA auf eine beispiellose Sprachdiffusion der Größe 8B. Insbesondere wurde LLaDA 8B von Grund auf auf 2,3 Billionen Token mit 0,13 Millionen H800-GPU-Stunden vortrainiert, gefolgt von SFT auf 4,5 Millionen Paaren. Über verschiedene Aufgaben hinweg, einschließlich Sprachverständnis, Mathematik, Code und Chinesisch, zeigt LLaDA die folgenden Beiträge:
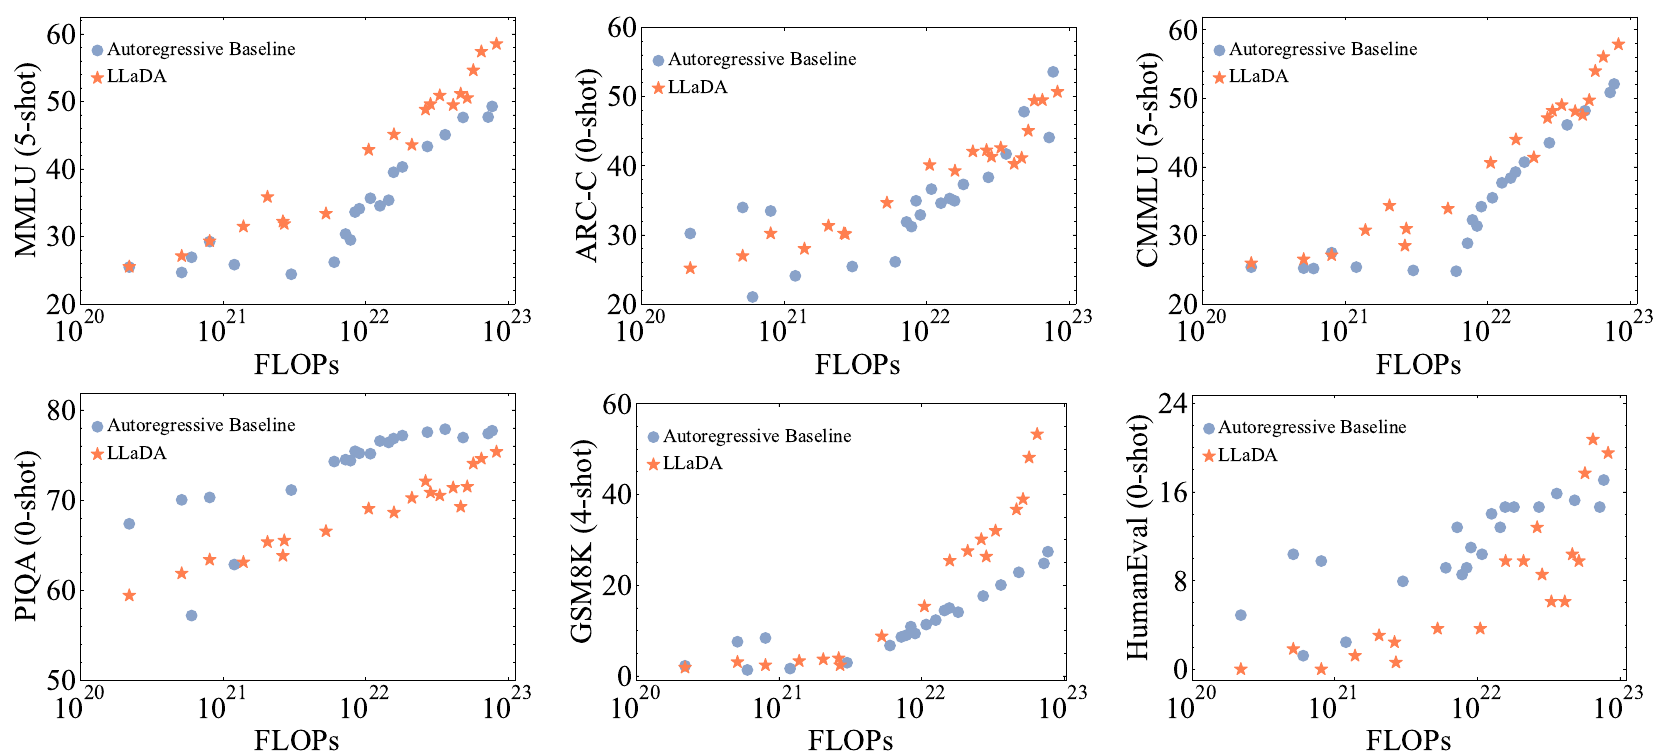
- LLaDA skaliert effektiv auf ein Rechenbudget von FLOPs und erzielt vergleichbare Ergebnisse mit ARM-Baselines, die auf denselben Daten über sechs Aufgaben trainiert wurden, z. B. MMLU und GSM8K.
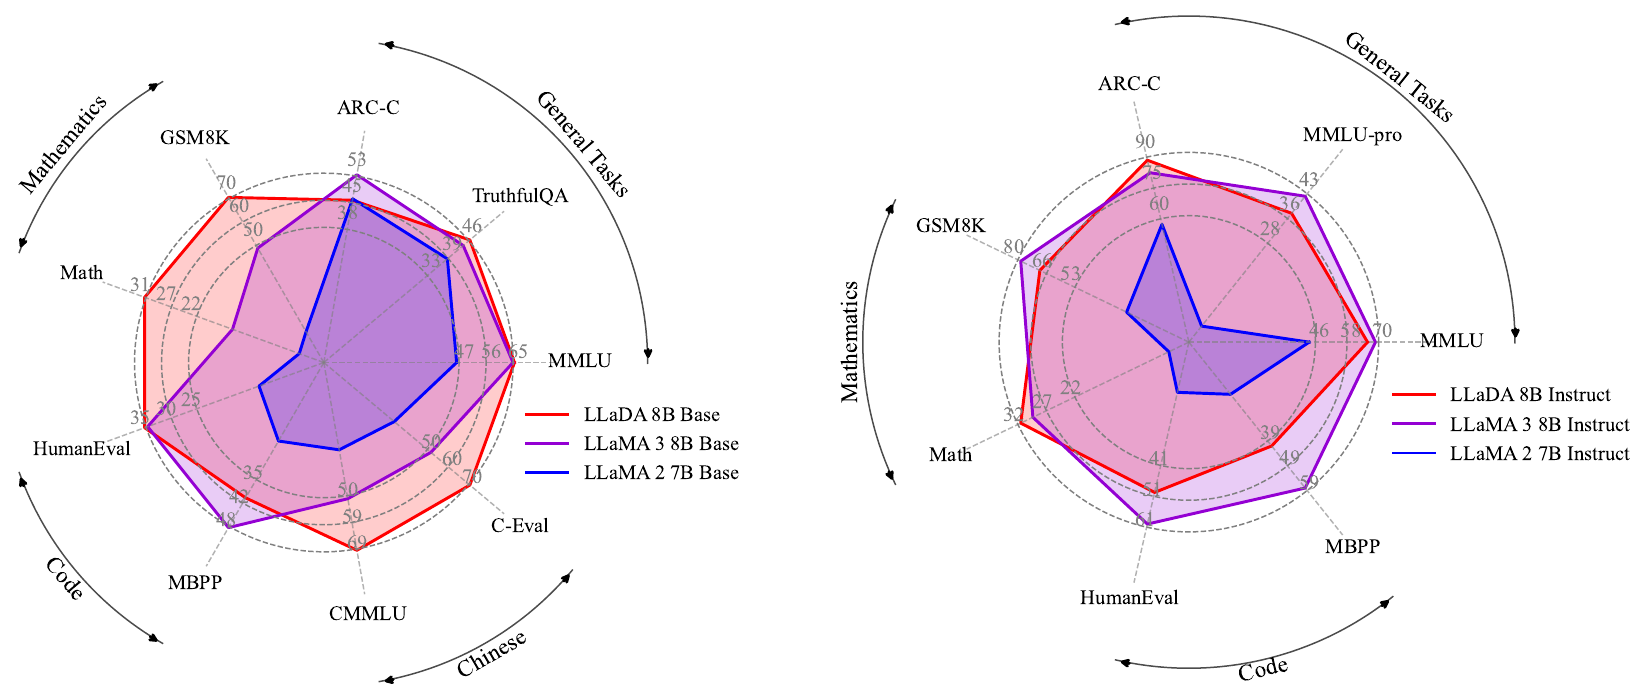
- Das vortrainierte LLaDA 8B Base übertrifft LLaMA2 7B Base [21] bei nahezu allen 15 standardmäßigen Zero-/Few-Shot-Lernaufgaben und schneidet gleichauf mit LLaMA3 8B Base [6] ab, was eine effektive In-Context-Learning-Fähigkeit zeigt.
- LLaDA verbessert nach SFT die Fähigkeit zur Befehlsbefolgung erheblich, wie in Fallstudien wie mehrrundigen Dialogen demonstriert wird.
- LLaDA durchbricht effektiv den Umkehrfluch [15] mit konsistenter Leistung bei Vorwärts- und Umkehraufgaben. Bemerkenswert ist, dass es GPT-4o in einer Aufgabe zur Vervollständigung umgekehrter Gedichte übertrifft.
2 Ansatz
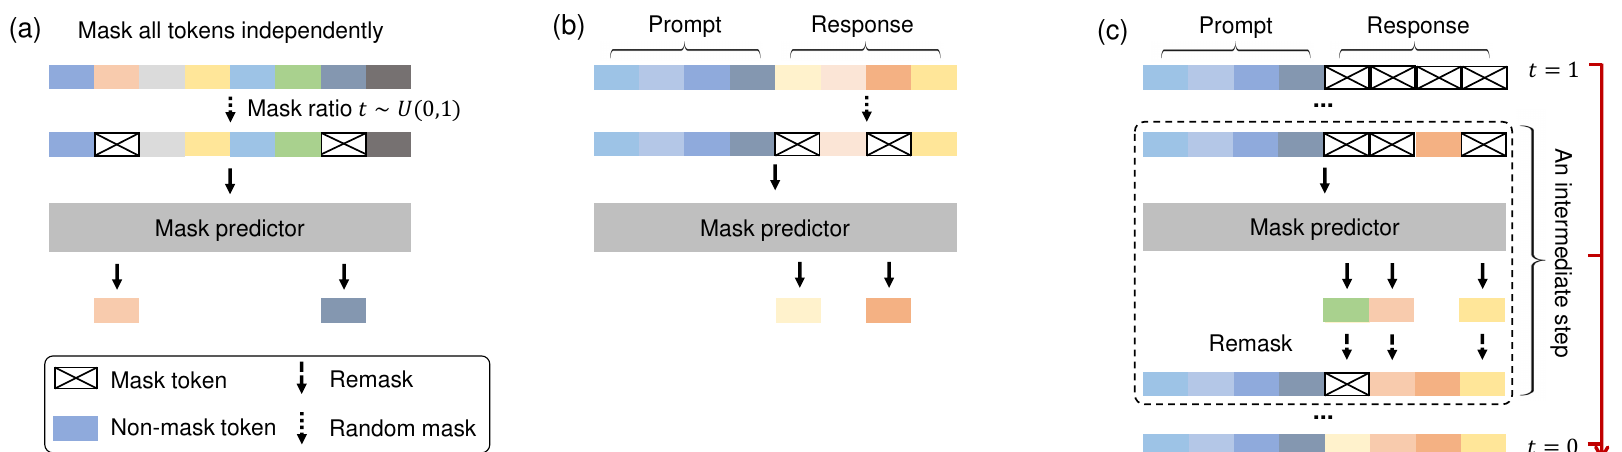
In diesem Abschnitt führen wir die probabilistische Formulierung[6] zusammen mit den Verfahren für Pre-Training, überwachtes Feintuning und Inferenz für LLaDA ein, wie in Abb. [2] dargestellt.
2.1 Probabilistische Formulierung
Anders als ARMs in Gl. (2) definiert LLaDA eine Modellverteilung durch einen Vorwärtsprozess und einen Rückwärtsprozess [16][20]. Der Vorwärtsprozess maskiert allmählich Token unabhängig voneinander in , bis die Sequenz bei vollständig maskiert ist. Für ist die Sequenz teilweise maskiert, wobei jedes Token mit Wahrscheinlichkeit maskiert oder mit Wahrscheinlichkeit unmaskiert bleibt. Der Rückwärtsprozess stellt die Datenverteilung wieder her, indem er maskierte Token iterativ vorhersagt, während von 1 nach 0 wandert.
Der Kern von LLaDA ist ein Maskenprädiktor, ein parametrisches Modell , das als Eingabe nimmt und alle maskierten Token (bezeichnet als M) gleichzeitig vorhersagt. Es wird mit einer Kreuzentropie-Verlustfunktion trainiert, die nur auf den maskierten Token berechnet wird [18][20]:
wobei ein Trainingsbeispiel ist, eine kontinuierliche Zufallsvariable, die gleichmäßig aus gezogen wird, aus dem Vorwärtsprozess gezogen wird und die Sequenzlänge ist. Die Indikatorfunktion stellt sicher, dass der Verlust nur für maskierte Token berechnet wird.
Nach dem Training können wir einen Umkehrprozess simulieren (siehe Abschnitt [2.4] für Details), der durch den Maskenprädiktor parametrisiert wird, und die Modellverteilung als die bei induzierte Randverteilung definieren. Die Verlustfunktion in Gl. (3) wurde als obere Schranke der negativen Log-Likelihood der Modellverteilung bewiesen, was sie zu einem prinzipientreuen Ziel für generative Modellierung macht:
Bemerkenswerterweise verwendet LLaDA ein Maskierungsverhältnis, das zufällig zwischen 0 und 1 variiert, während BERT [22] ein festes Verhältnis verwendet. Die subtilen Unterschiede haben erhebliche Auswirkungen, insbesondere im großen Maßstab: Wie in Gl. (4) gezeigt, ist LLaDA ein prinzipientreues generatives Modell mit dem Potenzial, In-Context-Lernen und Instruction-Following auf natürliche Weise durchzuführen, ähnlich wie LLMs. Darüber hinaus impliziert seine generative Perspektive eine starke Skalierbarkeit mit großen Daten und Modellen, wie in Abschnitt [1] diskutiert. Zusätzlich verwendet MaskGIT [23] ein heuristisches Trainingsziel, dem im Vergleich zu Gl. (3) der Term fehlt und das keine theoretische Verbindung zur Maximum-Likelihood aufweist. Wir betonen, dass es genau die theoretische Grundlage der Maximum-Likelihood-Schätzung war, die uns dazu motivierte, diskrete Diffusionsmodelle für die Sprachmodellierung zu skalieren.
2.2 Vor-training
LLaDA verwendet einen Transformer [7] als Maskenprädiktor, ähnlich wie bestehende LLMs. Allerdings verwendet LLaDA keine kausale Maske, da seine Formulierung es ermöglicht, die gesamte Eingabe für Vorhersagen zu sehen.
Wir haben zwei Varianten von LLaDA mit unterschiedlichen Größen trainiert: 1B und 8B. Wir fassen hier die Modellarchitektur von LLaDA 8B und LLaMA3 8B [6] zusammen, und Details werden in Anhang [B.2] bereitgestellt. Wir haben Konsistenz bei den meisten Hyperparametern sichergestellt und dabei mehrere notwendige Modifikationen vorgenommen. Wir verwenden Vanilla-Multi-Head-Attention anstelle von Grouped-Query-Attention [24] aus Einfachheitsgründen, da LLaDA mit KV-Caching inkompatibel ist, was zu einer unterschiedlichen Anzahl von Key- und Value-Heads führt. Folglich hat die Attention-Schicht mehr Parameter, und wir reduzieren die FFN-Dimension, um eine vergleichbare Modellgröße beizubehalten. Zusätzlich unterscheidet sich die Vokabulargröße aufgrund eines auf unseren Daten angepassten Tokenizers [4].
Das LLaDA-Modell wird auf einem Datensatz von 2,3 Billionen (T) Tokens vorab trainiert, wobei ein Datenprotokoll befolgt wird, das eng an bestehende LLMs [25] [26] angelehnt ist, ohne den Einsatz spezieller Techniken. Die Daten stammen aus Online-Korpora, wobei minderwertige Inhalte durch manuell entworfene Regeln und LLM-basierte Ansätze herausgefiltert werden. Neben allgemeinem Text umfasst der Datensatz hochwertigen Code, Mathematik- und mehrsprachige Daten. Weitere Details zu den Datensätzen finden Sie in Anhang [B.1]. Die Mischung der Datenquellen und Domänen wird durch verkleinerte ARMs gesteuert. Der Vorabtrainingsprozess verwendet eine feste Sequenzlänge von 4096 Tokens und verursacht einen gesamten Rechenaufwand von 0,13 Millionen H800-GPU-Stunden, ähnlich wie bei ARMs gleicher Größe und Datensatzgröße.
Für eine Trainingssequenz ziehen wir zufällig , maskieren jedes Token unabhängig mit derselben Wahrscheinlichkeit , um zu erhalten (siehe Abb. 2), und schätzen Gl. (3) über die Monte-Carlo-Methode für das stochastische Gradientenabstiegs-Training. Darüber hinaus setzen wir in Anlehnung an Nie et al. [27], um die Fähigkeit von LLaDA zum Umgang mit Daten variabler Länge zu verbessern, der Vorabtrainingsdaten auf eine zufällige Länge, die gleichmäßig aus dem Bereich gezogen wird.
Wir verwendeten den Lernraten-Scheduler Warmup-Stable-Decay [28], um den Trainingsfortschritt zu überwachen, ohne das kontinuierliche Training zu unterbrechen. Konkret erhöhten wir die Lernrate über die ersten 2000 Iterationen linear von 0 auf und hielten sie bei . Nach der Verarbeitung von 1,2T Tokens senkten wir die Lernrate auf und hielten sie für die nächsten 0,8T Tokens konstant, um ein stabiles Training zu gewährleisten. Schließlich reduzierten wir die Lernrate für die letzten 0,3T Tokens linear von auf . Darüber hinaus verwendeten wir den AdamW-Optimierer [29] mit einem Weight Decay von 0,1, einer Batch-Größe von 1280 und einer lokalen Batch-Größe von 4 pro GPU. Das 8B-Experiment wurde einmal durchgeführt, ohne jegliche Hyperparameter-Optimierung.
2.3 Überwachtes Feintuning
Wir verbessern die Fähigkeit von LLaDA, Anweisungen zu befolgen, durch überwachtes Feintuning (Supervised Fine-Tuning, SFT) mit Paardaten , wobei der Prompt und die Antwort ist. Dies ist die einfachste und grundlegendste Post-Training-Methode für LLMs. Technisch erfordert dies die Modellierung der bedingten Verteilung anstelle von im Vorabtraining.
Die Implementierung ähnelt dem Vorabtraining. Wie in Abb. 2 gezeigt, lassen wir den Prompt unverändert und maskieren die Tokens in der Antwort unabhängig voneinander, wie für durchgeführt. Anschließend speisen wir sowohl den Prompt als auch die maskierte Antwort in den vorab trainierten Maskenprädiktor ein, um den Verlust für das SFT zu berechnen:
wobei eine später spezifizierte dynamische Länge bezeichnet und alle anderen Notationen gleich bleiben wie zuvor. Beachten Sie, dass dieser Ansatz vollständig mit dem Vorabtraining kompatibel ist. Im Wesentlichen kann die Verkettung von und als saubere Vorabtrainingsdaten behandelt werden, während die Verkettung von und als maskierte Version dient. Der Prozess ist identisch mit dem Vorabtraining, mit dem einzigen Unterschied, dass alle maskierten Tokens zufällig im -Teil auftreten.
Das LLaDA 8B-Modell durchläuft SFT auf einem Datensatz von 4,5 Millionen Paaren. In Übereinstimmung mit dem Vorabtrainingsprozess folgen sowohl die Datenvorbereitung als auch das Training den SFT-Protokollen, die in bestehenden LLMs [25] [26] verwendet werden, ohne zusätzliche Techniken zur Optimierung der LLaDA-Leistung einzuführen. Der Datensatz umfasst mehrere Domänen, darunter Code, Mathematik und Instruction-Following. Wir hängen |EOS|-Tokens an das Ende kurzer Paare in jedem Mini-Batch an, um gleiche Längen über alle Daten hinweg sicherzustellen. Wir behandeln |EOS| während des Trainings als normales Token und entfernen es während des Samplings, wodurch LLaDA die Antwortlänge automatisch steuern kann. Weitere Details finden Sie in Anhang B.1.
Wir trainieren 3 Epochen auf den SFT-Daten unter Verwendung eines ähnlichen Zeitplans wie in der Vorabtrainingsphase. Die Lernrate wird über die ersten 50 Iterationen linear von 0 auf erhöht und dann konstant gehalten. Während der letzten der Iterationen wird sie linear auf reduziert. Darüber hinaus setzen wir den Weight Decay auf 0,1, die globale Batch-Größe auf 256 und die lokale Batch-Größe auf 2 pro GPU. Das SFT-Experiment wurde einmal durchgeführt, ohne jegliche Hyperparameter-Optimierung.
2.4 Inferenz
Als generatives Modell kann LLaDA neuen Text samplen und die Likelihood von Kandidatentext auf eine Diffusionsweise bewerten, anstatt in links-nach-rechts-autoregressiver Manier.
Wir beginnen mit dem umgekehrten Generierungsprozess. Wie in Abb. 2 dargestellt, diskretisieren wir den umgekehrten Prozess, um aus der Modellverteilung zu samplen, beginnend mit einer vollständig maskierten Antwort. Die Gesamtzahl der Sampling-Schritte ist ein Hyperparameter, der LLaDA auf natürliche Weise einen Kompromiss zwischen Effizienz und Sample-Qualität bietet, wie in Abschn. [3.3] analysiert. Standardmäßig verwenden wir gleichmäßig verteilte Zeitschritte. Darüber hinaus wird auch die Generierungslänge als Hyperparameter behandelt, der die Länge des vollständig maskierten Satzes zu Beginn des Sampling-Prozesses festlegt. Nach der Generierung werden Tokens, die nach dem |EOS|-Token auftreten, verworfen. Wie in Anhang [B.5] ausführlich dargelegt, sind die Endergebnisse unempfindlich gegenüber diesem Längen-Hyperparameter, da sowohl das Vorabtraining als auch das SFT mit Datensätzen variabler Länge durchgeführt werden.
Bei einem Zwischenschritt von Zeit zu speisen wir sowohl als auch in den Maskenprädiktor ein und sagen alle maskierten Tokens gleichzeitig voraus. Anschließend maskieren wir der vorhergesagten Tokens im Erwartungswert erneut, um zu erhalten, wodurch sichergestellt wird, dass der Übergang des umgekehrten Prozesses mit dem Vorwärtsprozess für eine akkurate Sampling-Prozedur übereinstimmt [18] [20]. Im Prinzip sollte die Remasking-Strategie rein zufällig sein. Inspiriert von den Annealing-Tricks beim Sampling in LLMs [4] [30] verwenden wir jedoch eine Remasking-Strategie mit geringer Konfidenz, bei der der vorhergesagten Tokens mit der geringsten Konfidenz basierend auf den Vorhersagen erneut maskiert werden, ebenso wie der Ansatz von Chang et al. [23].
Wir erwähnen, dass LLaDA ein flexibles Sampling ermöglicht. Insbesondere unterstützt es autoregressives und Block-Diffusions-Sampling [31] direkt nach den oben beschriebenen Vorabtrainings- oder SFT-Prozessen, ohne dass weitere Modifikationen oder Trainings erforderlich sind. Wir bieten eine detaillierte Analyse in Anhang [B.4]. Nichtsdestotrotz erzielt das Diffusions-Sampling (d. h. der umgekehrte Generierungsprozess) die beste Leistung und wird als Standard in dieser Arbeit verwendet, insbesondere für alle in Abschn. [3] vorgestellten Experimente.
Für die bedingte Likelihood-Bewertung können wir auf natürliche Weise die obere Schranke in Gl. [5] nutzen. Wir stellen jedoch fest, dass die folgende äquivalente Form [20] eine geringere Varianz aufweist und stabiler ist:
Hierbei ist die Sequenzlänge von , wird gleichmäßig aus gezogen, und wird erhalten, indem Token gleichmäßig ohne Zurücklegen aus gezogen werden, um sie zu maskieren.
Wir stellen die Trainings- und Inferenzalgorithmen zusammen mit theoretischen Details in Anhang [A] vor.
3 Experimente
Wir evaluieren die Skalierbarkeit, die Fähigkeit zur Instruktionsbefolgung und die In-Context-Lernfähigkeiten von LLaDA anhand standardisierter Benchmarks, gefolgt von Analysen und Fallstudien, um eine umfassende Bewertung zu ermöglichen.
3.1 Skalierbarkeit von LLaDA bei Sprachaufgaben
Wir untersuchen zunächst die Skalierbarkeit von LLaDA bei nachgelagerten Aufgaben im Vergleich zu den von uns konstruierten ARM-Baselines. Konkret haben wir im Maßstab von 1B sichergestellt, dass LLaDA und ARM dieselbe Architektur, dieselben Daten und alle anderen Konfigurationen teilten. In größeren Maßstäben berichten wir auch Ergebnisse für LLaDA- und ARM-Modelle leicht unterschiedlicher Größe, die aufgrund von Ressourcenbeschränkungen auf denselben Daten trainiert wurden. Weitere Details finden sich in Anhang [B.2]. Wir verwenden die Rechenkosten des Vortrainings als einheitliches Skalierungsmaß. Für die Evaluation konzentrierten wir uns auf sechs standardisierte und vielfältige Aufgaben.
Abb. 3 zeigt, dass LLaDA eine beeindruckende Skalierbarkeit aufweist, wobei sein Gesamttrend mit ARMs höchst konkurrenzfähig ist. Bemerkenswert ist, dass LLaDA bei Aufgaben wie MMLU und GSM8K sogar eine stärkere Skalierbarkeit zeigt. Selbst bei relativ schwächeren Aufgaben wie PIQA verringert sich die Leistungslücke zu ARMs mit zunehmendem Maßstab. Um den Einfluss von Ausreißern zu berücksichtigen, haben wir darauf verzichtet, quantitative Kurven anzupassen, um mögliche Fehlinterpretationen zu vermeiden. Dennoch zeigen die Ergebnisse eindeutig die Skalierbarkeit von LLaDA.
In Anbetracht der Vorteile von LLaDA bei bestimmten Benchmarks stellen wir die Hypothese auf, dass dieser Leistungsgewinn aus einem entscheidenden architektonischen Unterschied resultiert: Während autoregressive Modelle nur bedingte Wahrscheinlichkeiten von links nach rechts optimieren, wird LLaDA darauf trainiert, mehrere Konditionierungsrichtungen zu berücksichtigen, wie in Anhang [A.2] detailliert dargestellt, was größere Flexibilität bieten und zu besserer Generalisierung führen könnte. Diese Hypothese wird durch die starke Leistung von LLaDA beim Umkehrschluss in Abschnitt [3.3] und die Ablationsstudien zu Sampling-Strategien in Anhang [B.4] motiviert.
Nie et al. [27] legen nahe, dass MDM im Vergleich zu ARM 16-mal mehr Rechenaufwand benötigt, um dieselbe Likelihood zu erreichen. Jedoch machen entscheidende Unterschiede unsere Ergebnisse breiter anwendbar. Insbesondere ist die Likelihood eine relativ indirekte Metrik für die Leistung bei nachgelagerten Aufgaben, und Diffusion optimiert eine Schranke der Likelihood, was sie nicht direkt mit ARM vergleichbar macht. Darüber hinaus haben wir den Skalierungsbereich von FLOPs in Nie et al. [27] auf FLOPs in dieser Arbeit erweitert.
3.2 Benchmark-Ergebnisse
Um die In-Context-Lern- und Instruktionsbefolgungsfähigkeiten von LLaDA 8B umfassend zu evaluieren, haben wir detaillierte Vergleiche mit bestehenden LLMs [6,21,25,26,32,33] ähnlicher Größe durchgeführt. Aufgabenauswahl und Evaluationsprotokolle folgten bestehenden Studien und deckten populäre Benchmarks in allgemeinen Aufgaben, Mathematik, Code und Chinesisch ab. Weitere Details werden in Anhang [B.6] bereitgestellt. Für einen direkteren Vergleich haben wir repräsentative LLMs [6,21] in unserer Implementierung erneut evaluiert.
Wie in Tab. [1] gezeigt, demonstriert LLaDA 8B Base nach dem Vortraining auf 2,3T Token bemerkenswerte Leistung, übertrifft LLaMA2 7B Base bei nahezu allen Aufgaben und ist insgesamt konkurrenzfähig mit LLaMA3 8B Base. LLaDA zeigt Vorteile bei Mathematik- und Chinesisch-Aufgaben. Wir vermuten, dass die
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Mistral 7B† | Deepseek 7B† | |
| Modell-Trainings-Token | Diffusion 2,3T | AR 15T | AR 2T | AR 7T | AR 18T | AR - | AR 2T |
| Allgemeine Aufgaben | |||||||
| MMLU | 65,9 (5) | 65,4 (5) | 45,9 (5) | 70,3 (5) | 74,2 (5) | 64,2 (5) | 48,2 (5) |
| BBH | 49,7 (3) | 62,1 (3) | 39,4 (3) | 62,3 (3) | 70,4 (3) | 56,1 (3) | 39,5 (3) |
| ARC-C | 45,9 (0) | 53,1 (0) | 46,3 (0) | 60,6 (25) | 63,7 (25) | 60,0 (25) | 48,1 (0) |
| Hellaswag | 70,5 (0) | 79,1 (0) | 76,0 (0) | 80,7 (10) | 80,2 (10) | 83,3 (10) | 75,4 (0) |
| TruthfulQA | 46,1 (0) | 44,0 (0) | 39,0 (0) | 54,2 (0) | 56,4 (0) | 42,2 (0) | - |
| WinoGrande | 74,8 (5) | 77,3 (5) | 72,5 (5) | 77,0 (5) | 75,9 (5) | 78,4 (5) | 70,5 (0) |
| PIQA | 73,6 (0) | 80,6 (0) | 79,1 (0) | - | - | - | 79,2 (0) |
| Mathematik & Naturwissenschaften | |||||||
| GSM8K | 70,3 (4) | 48,7 (4) | 13,1 (4) | 80,2 (4) | 85,4 (4) | 36,2 (4) | 17,4 (8) |
| Math | 31,4 (4) | 16,0 (4) | 4,3 (4) | 43,5 (4) | 49,8 (4) | 10,2 (4) | 6,0 (4) |
| GPQA | 25,2 (5) | 25,9 (5) | 25,7 (5) | 30,8 (5) | 36,4 (5) | 24,7 (5) | - |
| Code | |||||||
| HumanEval | 35,4 (0) | 34,8 (0) | 12,8 (0) | 51,2 (0) | 57,9 (0) | 29,3 (0) | 26,2 (0) |
| HumanEval-FIM | 73,8 (2) | 73,3 (2) | 26,9 (2) | - | - | - | - |
| MBPP | 40,0 (4) | 48,8 (4) | 23,2 (4) | 64,2 (0) | 74,9 (0) | 51,1 (0) | 39,0 (3) |
| Chinesisch | |||||||
| CMMLU | 69,9 (5) | 50,7 (5) | 32,5 (5) | 83,9 (5) | - | - | 47,2 (5) |
| C-Eval | 70,5 (5) | 51,7 (5) | 34,0 (5) | 83,2 (5) | - | - | 45,0 (5) |
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Gemma2 9B† | Deepseek 7B† | |
| Modell-Trainings-Token | Diffusion 2,3T | AR 15T | AR 2T | AR 7T | AR 18T | AR 8T | AR 2T |
| Post-Training-Ausrichtungspaare | SFT 4,5M | SFT+RL - | SFT+RL - | SFT+RL 0,5M + - | SFT+RL 1M + 0,15M - | SFT+RL - | SFT+RL 1,5M + - |
| Allgemeine Aufgaben | |||||||
| MMLU | 65,5 (5) | 68,4 (5) | 44,1 (5) | - | - | - | 49,4 (0) |
| MMLU-pro | 37,0 (0) | 41,9 (0) | 4,6 (0) | 44,1 (5) | 56,3 (5) | 52,1 (5) | - |
| Hellaswag | 74,6 (0) | 75,5 (0) | 51,5 (0) | - | - | - | 68,5 (-) |
| ARC-C | 88,5 (0) | 82,4 (0) | 57,3 (0) | - | - | - | 49,4 (-) |
| Mathematik & Naturwissenschaften | |||||||
| GSM8K | 69,4 (4) | 78,3 (4) | 29,0 (4) | 85,7 (0) | 91,6 (0) | 76,7 (0) | 63,0 (0) |
| Mathematik | 31,9 (0) | 29,6 (0) | 3,8 (0) | 52,9 (0) | 75,5 (0) | 44,3 (0) | 15,8 (0) |
| GPQA | 33,3 (5) | 31,9 (5) | 28,4 (5) | 34,3 (0) | 36,4 (0) | 32,8 (0) | - |
| Code | |||||||
| HumanEval | 49,4 (0) | 59,8 (0) | 16,5 (0) | 79,9 (0) | 84,8 (0) | 68,9 (0) | 48,2 (-) |
| MBPP | 41,0 (4) | 57,6 (4) | 20,6 (4) | 67,2 (0) | 79,2 (0) | 74,9 (0) | 35,2 (-) |
Stärken aus denselben Faktoren stammen wie seine relativ schwächere Leistung bei einigen Aufgaben – Unterschiede in Datenqualität und -verteilung, die weitgehend auf die Closed-Source-Situation von LLM-Datensätzen zurückzuführen sind.
Insbesondere haben wir die Möglichkeit von Datenlecks sorgfältig ausgeschlossen, indem wir GSM8K als Beispiel herangezogen haben. Erstens übertrifft LLaDA, wie in Abb. [3] gezeigt, die ARM-Baselines in Bezug auf GSM8K. Darüber hinaus bleibt die Schlussfolgerung bei einer völlig ungesehenen GSM8K-ähnlichen Aufgabe [34] in Anhang B.8 bestehen.
Weiterhin vergleicht Tab. [2] die Leistung von LLaDA 8B Instruct mit bestehenden LLMs. SFT verbesserte die Leistung von LLaDA bei den meisten nachgelagerten Aufgaben. Einige wenige Metriken, wie MMLU, zeigten Rückgänge, möglicherweise aufgrund der suboptimalen Qualität der SFT-Daten. Insgesamt, da wir kein Alignment
| Sampling-Prozess | |
| Benutzer | Lily kann 12 Kilometer pro Stunde für 4 Stunden laufen. Danach läuft sie 6 Kilometer pro Stunde. Wie viele Kilometer kann sie in 8 Stunden laufen? |
| LLaDA | In 4 Stunden läuft Lily 12 * 4 = 48 Kilometer. Nach 4 Stunden läuft sie 6 * 4 = 24 Kilometer. Insgesamt läuft sie 48 + 24 = 72 Kilometer in 8 Stunden. Ergebnis 72 |
| Fall eines mehrrundigen Dialogs | |
| Benutzer | Könntest du mir bitte die ersten beiden Zeilen des berühmten Gedichts „The Road Not Taken“ mitteilen? |
| LLaDA | Gewiss! Die ersten beiden Zeilen des berühmten Gedichts „The Road Not Taken“ von Robert Frost lauten: „Two roads diverged in a yellow wood, And sorry I could not travel both.“ Diese Zeilen bereiten den Boden für das Gedicht und führen die Idee eines Sprechers ein, der vor der Wahl zwischen zwei Wegen steht. |
| Benutzer | Bitte hilf mir, es ins Chinesische zu übersetzen. |
| LLaDA | Gerne! Die ersten beiden Zeilen von „The Road Not Taken“ von Robert Frost lassen sich ins Chinesische übersetzen als: „两条路分岔在黄色的树林中,遗憾我不能同时走“ |
| Benutzer | Bitte übersetze ins Deutsche. |
| LLaDA | Gerne! Die ersten beiden Zeilen von „The Road Not Taken“ von Robert Frost lassen sich ins Deutsche übersetzen als: „Zwei Wege trennten sich im gelben Wald, und leider konnte ich nicht beide tun.“ |
| Benutzer | Bitte schreibe auch ein Gedicht über Lebensentscheidungen. Ich verlange 5 Sätze, und das erste Wort jedes Satzes beginnt mit C als erstem Buchstaben. |
| LLaDA | Gewiss! Hier ist ein Gedicht über Lebensentscheidungen, bei dem jeder Satz mit dem Buchstaben „C“ beginnt: Choices cascade through life’s journey, Creating connections with each decision, Careful consideration leads to better paths, Courageous choices shape our destiny, Choosing wisely guides us through the years. |
mit Reinforcement Learning (RL) durchgeführt haben, liegen unsere Ergebnisse etwas hinter LLaMA3 8B Instruct zurück, obwohl die Lücken bei vielen Metriken klein bleiben. Bemerkenswert ist, dass LLaDA selbst mit nur SFT beeindruckende Fähigkeiten zur Befehlsbefolgung zeigt, wie in Abschnitt [3.4] detailliert beschrieben. Wir überlassen RL-basiertes Alignment zukünftiger Arbeit.
Alle Ergebnisse in Abschnitt [3] basieren auf reinen Diffusionsmethoden, da sie eine bessere Gesamtleistung erzielen als Ansätze, die autoregressive Komponenten einbeziehen. Konkret verwenden wir Gl. (6) zur bedingten Likelihood-Schätzung und wenden Low-Confidence-Remasking für das Sampling an. Für LLaDA 8B Instruct erzielt das Sampling im Block-Diffusions-Stil bessere Ergebnisse bei GSM8K und Math, mit Werten von 78,6 und 42,2, verglichen mit 69,4 und 31,9 in Tab. [2]. Dieser Gewinn ist auf umfangreiches |EOS|-Token-Padding in den SFT-Daten zurückzuführen, das eine vorzeitige Beendigung beim Low-Confidence-Remasking verursacht. Weitere Details finden Sie in Anhang [B.4].
Insgesamt haben wir trotz der mangelnden Datentransparenz alle Anstrengungen unternommen, standardisierte Verfahren anzuwenden und vielfältige Aufgaben einzuführen; wir sind der Überzeugung, dass sie die außergewöhnlichen Fähigkeiten von LLaDA hinreichend demonstrieren, das unseres Wissens das einzige konkurrenzfähige nicht-autoregressive Modell ist.
3.3 Umkehrschlussfolgerung und Analysen
Um die Fähigkeit zum Umkehrschluss [15] von Modellen zu quantifizieren, folgen wir dem von Allen-Zhu und Li [35] etablierten Protokoll. Konkret konstruieren wir einen Datensatz aus 496 berühmten chinesischen Gedicht-Satzpaaren. Bei einem gegebenen Satz aus einem Gedicht besteht die Aufgabe der Modelle darin, die nachfolgende Zeile (vorwärts) oder die vorhergehende Zeile (umgekehrt) ohne zusätzliches Fine-Tuning zu generieren. Beispiele finden sich in Abschnitt [B.9]. Diese Einstellung bietet eine unkomplizierte und realistischere Bewertung im Vergleich zu früheren Studien [27, 36].
Wie in Tab. [4] gezeigt, adressiert LLaDA den Umkehrfluch [15] effektiv und demonstriert konsistente Zero-Shot-Leistung sowohl bei Vorwärts- als auch bei Umkehraufgaben. Im Gegensatz dazu zeigen sowohl Qwen 2.5 als auch GPT-4o eine erhebliche Lücke zwischen beiden. Die Ergebnisse bei der Vorwärtsgenerierung bestätigen, dass beide ARMs stark sind und von deutlich größeren Datensätzen und greateren Rechenressourcen als LLaDA profitieren. Jedoch übertrifft LLaDA beide bei der Umkehraufgabe um einen großen Abstand.
Wir haben nichts Besonderes für Umkehraufgaben entworfen. Intuitiv behandelt LLaDA Token gleichmäßig ohne induktiven Bias, was zu ausgewogener Leistung führt. Details finden Sie in Anhang A.2.
Wir analysieren auch die Auswirkung verschiedener Sampling-Strategien für LLaDA, einschließlich autoregressivem Sampling, Block-Diffusions-Sampling [31] und reinem Diffusions-Sampling, und zeigen, dass reines Diffusions-Sampling die beste Gesamtleistung erzielt, wie in Anhang B.4 detailliert beschrieben.
| Vorwärts | Umkehrung | |
| GPT-4o (2024-08-06) | 82,7 | 34,3 |
| Qwen2.5-7B Instruct | 75,9 | 38,0 |
| LLaDA-8B Instruct | 51,8 | 45,6 |
Darüber hinaus untersuchen wir die Sampling-Geschwindigkeit und den Speicherverbrauch von LLaDA und zeigen, dass es einen flexiblen Kompromiss zwischen Generierungsqualität und Geschwindigkeit ermöglicht. Weitere Details finden Sie in Anhang B.7.
Classifier-free Guidance (CFG) [37] [27] ist eine weit verbreitete Technik in Diffusionsmodellen zur Verbesserung der Generierungsqualität. Um einen fairen Vergleich mit ARMs zu gewährleisten, wenden wir CFG im Haupttext nicht auf LLaDA an. Wir zeigen jedoch, dass LLaDA mit CFG kompatibel ist und konsistent von seiner Anwendung profitiert. Weitere Details finden Sie in Anhang B.3.
3.4 Fallstudien
Wir präsentieren in Tab. 3 von LLaDA 8B Instruct generierte Beispiele, die seine Fähigkeiten zur Befehlsbefolgung veranschaulichen. Erstens veranschaulicht die Tabelle LLaDAs Fähigkeit, kohärenten, flüssigen und ausgedehnten Text auf nicht-autoregressive Weise zu generieren. Zweitens hebt sie die Mehrfachdialogfähigkeit des Modells hervor, die den Gesprächsverlauf effektiv beibehält und kontextuell angemessene Antworten in mehreren Sprachen erzeugt. Solche Chat-Fähigkeiten von LLaDA sind beeindruckend, da es unseres Wissens nach zum ersten Mal von konventionellen ARMs abweicht. Weitere Fallstudien finden Sie in Anhang B.10.
4 Verwandte Arbeiten
Diffusionsmodelle [38,40] haben im visuellen Bereich bemerkenswerte Erfolge erzielt, bleiben jedoch für die Sprachmodellierung im großen Maßstab (z. B. Modelle, die mit über FLOPs trainiert wurden) unverifiziert, trotz wachsendem Interesse und umfangreicher Forschungsbemühungen.
Ein einfacher Ansatz besteht darin, Textdaten zu kontinuisieren und kontinuierliche Diffusionsmodelle direkt anzuwenden [41-51]. Alternativ modellieren einige Methoden stattdessen kontinuierliche Parameter diskreter Verteilungen [52-56]. Allerdings bleibt die Skalierbarkeit für diese Ansätze eine erhebliche Herausforderung. Beispielsweise könnte ein 1B-Modell das 64-fache an Rechenleistung eines ARM benötigen, um vergleichbare Leistung zu erzielen [57].
Ein anderer Ansatz ersetzt kontinuierliche Diffusion durch diskrete Prozesse mit neuen Vorwärts- und Rückwärtsdynamiken, was zu zahlreichen Varianten führt [58,71]. Das ursprüngliche Diffusionsmodell-Papier [38] führte sowohl kontinuierliche als auch diskrete Zustandsübergangskerne unter einem einheitlichen Diffusionsrahmen ein. Austin et al. [16] gehörten zu den Pionierarbeiten, die diskrete Diffusionsmodelle in die Sprachmodellierung einführten und die Machbarkeit dieses Ansatzes demonstrierten. Lou et al. [17] zeigten, dass maskierte Diffusion als Spezialfall der diskreten Diffusion eine Perplexität erreicht, die mit ARMs auf GPT-2-Skala vergleichbar ist oder diese übertrifft. Shi et al. [18], Sahoo et al. [19], Ou et al. [20] etablierten grundlegende theoretische Ergebnisse, die unser Modell-Design, Training und Inferenz motivierten (siehe Anhang A für Details). Nie et al. [27] führten die Skalierungsgesetze für MDMs in der Sprachmodellierung ein und untersuchten, wie MDMs für Sprachaufgaben wie Fragebeantwortung auf GPT-2-Skala genutzt werden können. Gong et al. [72] demonstrierten das Potenzial des Fine-Tunings eines ARM innerhalb des MDM-Frameworks. Allerdings sind die von Gong et al. [72] beobachteten Verbesserungen auf spezifische Metriken beschränkt, und ihr Ansatz adressiert nicht die durch reines diffusionsbasiertes Training erreichbare Leistung. Eine parallele Arbeit [73] demonstriert das Potenzial von Diffusions-Sprachmodellen in der Codegenerierung und hebt ihre Vorteile in der Inferenzeffizienz hervor. Da es sich jedoch um ein Closed-Source-Produkt handelt, bleiben spezifische Details wie Trainingsverfahren und Sampling-Methoden unbekannt.
Im Vergleich dazu skaliert diese Studie MDM von Grund auf auf eine beispiellose Größe von 8B Parametern und erzielt eine Leistung, die mit führenden LLMs wie LLaMA 3 vergleichbar ist.
Darüber hinaus steht eine parallele Arbeitslinie zur Bildgenerierung [23,74,75] in gutem Einklang mit der Anwendung von MDMs auf Textdaten. Darüber hinaus haben MDMs auch in anderen Bereichen wie der Proteingenerierung [76][77] vielversprechende Ergebnisse erzielt. Bemerkenswert ist, dass eine Reihe von Studien [31][78][87] Techniken wie Architekturoptimierung, Destillation und Sampling-Algorithmus-Design untersucht haben, um das Sampling von MDMs zu beschleunigen.
5 Schlussfolgerung und Diskussion
Wir stellen LLaDA vor, ein Diffusions-Sprachmodell, das von Grund auf mit einer beispiellosen Größe von 8B Parametern trainiert wurde. LLaDA demonstriert starke Fähigkeiten in Skalierbarkeit, In-Context-Learning und Befehlsbefolgung und erreicht eine Leistung, die mit starken LLMs wie LLaMA3 vergleichbar ist. Darüber hinaus bietet LLaDA einzigartige Vorteile wie bidirektionale Modellierung und erhöhte Robustheit und adressiert effektiv die relevanten Einschränkungen bestehender LLMs. Unsere Ergebnisse zeigen das Versprechen von Diffusionsmodellen für die Sprachmodellierung im großen Maßstab und stellen die gängige Annahme in Frage, dass diese wesentlichen Fähigkeiten inhärent an ARMs gebunden sind. Diese Ergebnisse repräsentieren ein neues Paradigma für die Sprachmodellierung und eröffnen neuartige Erkenntnisse, die ein hohes Maß an wissenschaftlicher Innovation demonstrieren.
Einschränkungen. So vielversprechend sie sind, bleibt das volle Potenzial von Diffusionsmodellen noch zu erkunden. Mehrere Einschränkungen dieser Arbeit bieten bedeutende Möglichkeiten für zukünftige Forschung. Die Generierungslänge ist ein vom Benutzer festgelegter Hyperparameter. Obwohl LLaDA gegenüber diesem Hyperparameter unempfindlich ist, wie in Anhang [B.5] detailliert beschrieben, glauben wir, dass die Annahme einer adaptiven Generierungslänge eine effizientere Lösung bieten würde. Aufgrund von Rechenbeschränkungen waren direkte Vergleiche zwischen LLaDA und ARMs – wie etwa das Training auf identischen Datensätzen – auf ein Rechenbudget von weniger als FLOPs beschränkt. Um Ressourcen für das Training des größtmöglichen LLaDA-Modells und die Demonstration seines Potenzials zu allocieren, konnten wir die ARM-Baseline nicht im gleichen Umfang skalieren. Darüber hinaus wurden weder spezialisierte Attention-Mechanismen noch Positions-Embeddings für LLaDA entworfen, noch wurden systemische Architekturoptimierungen wie KV-Cache angewendet. Auf der Inferenzseite bleiben effizientere und kontrollierbarere [37][88][89] Sampling-Algorithmen vorläufig. Darüber hinaus hat LLaDA noch kein Alignment mit Reinforcement Learning [90][91] durchlaufen, was entscheidend für die Verbesserung seiner Leistung und die Ausrichtung an menschlichen Absichten ist.
Mit Blick auf die Zukunft bleiben sowohl die Modellgröße als auch die Menge der Trainingsdaten für LLaDA kleiner als die führender ARM-Gegenstücke [6][26][92][95], was die Notwendigkeit weiterer Skalierung unterstreicht, um seine Fähigkeiten vollständig zu evaluieren. Darüber hinaus ist LLaDAs Fähigkeit zur Verarbeitung multimodaler Daten noch unerforscht. Seine Auswirkung auf Prompt-Tuning-Techniken [96] und die Integration in agentenbasierte Systeme [97][98] ist noch nicht vollständig verstanden. Schließlich ist eine systematische Untersuchung des Post-Trainings für LLaDA (z. B. O1-ähnliche Systeme [99][100]) erforderlich, um das Potenzial von Diffusions-Sprachmodellen weiter zu erschließen.
Danksagungen
Diese Arbeit wurde unterstützt von der National Natural Science Foundation of China (Nr. 92470118); der Beijing Natural Science Foundation (Nr. L247030); dem Beijing Nova Program (Nr. 20220484044); und dem Ant Group Research Fund.
Literatur
[1] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. A survey of large language models. arXiv preprint arXiv:2303.18223, 2023. [2] Alec Radford. Improving language understanding by generative pre-training, 2018. [3] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, et al. Language models are unsupervised multitask learners. OpenAI blog, 1(8):9, 2019. [4] Tom B Brown. Language models are few-shot learners. arXiv preprint arXiv:2005.14165, 2020. [5] OpenAI. ChatGPT: Optimizing Language Models for Dialogue. OpenAI blog, November 2022. URL https://openai.com/blog/chatgpt/[6] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, et al. The llama 3 herd of models. arXiv preprint arXiv:2407.21783, 2024.
[7] Ashish Vaswani. Attention is all you need. arXiv preprint arXiv:1706.03762, 2017.
[8] Ronald A Fisher. On the mathematical foundations of theoretical statistics. Philosophical transactions of the Royal Society of London. Series A, containing papers of a mathematical or physical character, 222(594-604):309-368, 1922.
[9] Fan Bao, Shen Nie, Kaiwen Xue, Yue Cao, Chongxuan Li, Hang Su und Jun Zhu. All are worth words: A vit backbone for diffusion models. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, Seiten 22669–22679, 2023.
[10] William Peebles und Saining Xie. Scalable diffusion models with transformers. In Proceedings of the IEEE/CVF International Conference on Computer Vision, Seiten 4195–4205, 2023.
[11] Tim Brooks, Bill Peebles, Connor Holmes, Will DePue, Yufei Guo, Li Jing, David Schnurr, Joe Taylor, Troy Luhman, Eric Luhman, Clarence Ng, Ricky Wang und Aditya Ramesh. Video generation models as world simulators. 2024. URL https://openai.com/research/video-generation-models-as-world-simulators
[12] Gregoire Deletang, Anian Ruoss, Paul-Ambroise Duquenne, Elliot Catt, Tim Genewein, Christopher Mattern, Jordi Grau-Moya, Li Kevin Wenliang, Matthew Aitchison, Laurent Orseau, et al. Language modeling is compression. In The Twelfth International Conference on Learning Representations.
[13] Yuzhen Huang, Jinghan Zhang, Zifei Shan und Junxian He. Compression represents intelligence linearly. arXiv preprint arXiv:2404.09937, 2024.
[14] Claude Elwood Shannon. A mathematical theory of communication. The Bell system technical journal, 27(3):379–423, 1948.
[15] Lukas Berglund, Meg Tong, Max Kaufmann, Mikita Balesni, Asa Cooper Stickland, Tomasz Korbak und Owain Evans. The reversal curse: Llms trained on" a is b" fail to learn" b is a". arXiv preprint arXiv:2309.12288, 2023.
[16] Jacob Austin, Daniel D Johnson, Jonathan Ho, Daniel Tarlow und Rianne Van Den Berg. Structured denoising diffusion models in discrete state-spaces. Advances in Neural Information Processing Systems, 34:17981–17993, 2021.
[17] Aaron Lou, Chenlin Meng und Stefano Ermon. Discrete diffusion language modeling by estimating the ratios of the data distribution. arXiv preprint arXiv:2310.16834, 2023.
[18] Jiaxin Shi, Kehang Han, Zhe Wang, Arnaud Doucet und Michalis K Titsias. Simplified and generalized masked diffusion for discrete data. arXiv preprint arXiv:2406.04329, 2024.
[19] Subham Sekhar Sahoo, Marianne Arriola, Yair Schiff, Aaron Gokaslan, Edgar Marroquin, Justin T Chiu, Alexander Rush und Volodymyr Kuleshov. Simple and effective masked diffusion language models. arXiv preprint arXiv:2406.07524, 2024.
[20] Jingyang Ou, Shen Nie, Kaiwen Xue, Fengqi Zhu, Jiacheng Sun, Zhenguo Li und Chongxuan Li. Your absorbing discrete diffusion secretly models the conditional distributions of clean data. arXiv preprint arXiv:2406.03736, 2024.
[21] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: Open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
[22] Jacob Devlin. Bert: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805, 2018.
[23] Huiwen Chang, Han Zhang, Lu Jiang, Ce Liu und William T Freeman. Maskgit: Masked generative image transformer. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, Seiten 11315–11325, 2022.
[24] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron und Sumit Sanghai. Gqa: Training generalized multi-query transformer models from multihead checkpoints. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, Seiten 4895–4901, 2023.
[25] An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, Guanting Dong, Haoran Wei, Huan Lin, Jialong Tang, Jialin Wang, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Ma, Jianxin Yang, Jin Xu, Jingren Zhou, Jinze Bai, Jinzheng He, Junyang Lin, Kai Dang, Keming Lu, Keqin Chen, Kexin Yang, Mei Li, Mingfeng Xue, Na Ni, Pei Zhang, Peng Wang, Ru Peng, Rui Men, Ruize Gao, Runji Lin, Shijie Wang, Shuai Bai, Sinan Tan, Tianhang Zhu, Tianhao Li, Tianyu Liu, Wenbin Ge, Xiaodong Deng, Xiaohuan Zhou, Xingzhang Ren, Xinyu Zhang, Xipin Wei, Xuancheng Ren, Xuejing Liu, Yang Fan, Yang Yao, Yichang Zhang, Yu Wan, Yunfei Chu, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zhifang Guo und Zhihao Fan. Qwen2 technical report, 2024. URL https://arxiv.org/abs/2407.10671
[26] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, Huan Lin, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Yang, Jiaxi Yang, Jingren Zhou, Junyang Lin, Kai Dang, Keming Lu, Keqin Bao, Kexin Yang, Le Yu, Mei Li, Mingfeng Xue, Pei Zhang, Qin Zhu, Rui Men, Runji Lin, Tianhao Li, Tingyu Xia, Xingzhang Ren, Xuancheng Ren, Yang Fan, Yang Su, Yichang Zhang, Yu Wan, Yuqiong Liu, Zeyu Cui, Zhenru Zhang und Zihan Qiu. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
[27] Shen Nie, Fengqi Zhu, Chao Du, Tianyu Pang, Qian Liu, Guangtao Zeng, Min Lin und Chongxuan Li. Scaling up masked diffusion models on text. arXiv preprint arXiv:2410.18514, 2024.
[28] Shengding Hu, Yuge Tu, Xu Han, Chaoqun He, Ganqu Cui, Xiang Long, Zhi Zheng, Yewei Fang, Yuxiang Huang, Weilin Zhao, et al. Minicpm: Unveiling the potential of small language models with scalable training strategies. arXiv preprint arXiv:2404.06395, 2024.
[29] I Loshchilov. Decoupled weight decay regularization. arXiv preprint arXiv:1711.05101, 2017.
[30] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes und Yejin Choi. The curious case of neural text degeneration. arXiv preprint arXiv:1904.09751, 2019.
[31] Marianne Arriola, Aaron Gokaslan, Justin T Chiu, Zhihan Yang, Zhixuan Qi, Jiaqi Han, Subham Sekhar Sahoo und Volodymyr Kuleshov. Block diffusion: Interpolating between autoregressive and diffusion language models. arXiv preprint arXiv:2503.09573, 2025.
[32] Xiao Bi, Deli Chen, Guanting Chen, Shanhuang Chen, Damai Dai, Chengqi Deng, Honghui Ding, Kai Dong, Qiushi Du, Zhe Fu, et al. Deepseek llm: Scaling open-source language models with longtermism. arXiv preprint arXiv:2401.02954, 2024.
[33] Albert Q Jiang, Alexandre Sablayrolles, Arthur Mensch, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Florian Bressand, Gianna Lengyel, Guillaume Lample, Lucile Saulnier, et al. Mistral 7b. arXiv preprint arXiv:2310.06825, 2023.
[34] Tian Ye, Zicheng Xu, Yuanzhi Li und Zeyuan Allen-Zhu. Physics of Language Models: Part 2.1, Grade-School Math and the Hidden Reasoning Process. arXiv e-prints, abs/2407.20311, Juli 2024. Vollständige Version verfügbar unter http://arxiv.org/abs/2407.20311
[35] Zeyuan Allen-Zhu und Yuanzhi Li. Physics of Language Models: Part 3.2, Knowledge Manipulation. ArXiv e-prints, abs/2309.14402, September 2023. Vollständige Version verfügbar unter http://arxiv.org/abs/2309.14402
[36] Ouaïl Kitouni, Niklas Nolte, Diane Bouchacourt, Adina Williams, Mike Rabbat und Mark Ibrahim. The factorization curse: Which tokens you predict underlie the reversal curse and more. arXiv preprint arXiv:2406.05183, 2024.
[37] Jonathan Ho und Tim Salimans. Classifier-free diffusion guidance. arXiv preprint arXiv:2207.12598, 2022.
[38] Jascha Sohl-Dickstein, Eric Weiss, Niru Maheswaranathan und Surya Ganguli. Deep unsupervised learning using nonequilibrium thermodynamics. In International conference on machine learning, Seiten 2256-2265. PMLR, 2015.
[39] Jonathan Ho, Ajay Jain und Pieter Abbeel. Denoising diffusion probabilistic models. Advances in neural information processing systems, 33:6840-6851, 2020.
[40] Yang Song, Jascha Sohl-Dickstein, Diederik P Kingma, Abhishek Kumar, Stefano Ermon und Ben Poole. Score-based generative modeling through stochastic differential equations. arXiv preprint arXiv:2011.13456, 2020.
[41] Xiang Li, John Thickstun, Ishaan Gulrajani, Percy S Liang und Tatsunori B Hashimoto. Diffusion-lm improves controllable text generation. Advances in Neural Information Processing Systems, 35:4328-4343, 2022.
[42] Shansan Gong, Mukai Li, Jiangtao Feng, Zhiyong Wu und LingPeng Kong. Diffuseq: Sequenz-zu-Sequenz-Textgenerierung mit Diffusionsmodellen. arXiv preprint arXiv:2210.08933, 2022.
[43] Xiaochuang Han, Sachin Kumar und Yulia Tsvetkov. Ssd-lm: Halbautoregressives simplexbasiertes Diffusions-Sprachmodell für Textgenerierung und modulare Steuerung. arXiv preprint arXiv:2210.17432, 2022.
[44] Robin Strudel, Corentin Tallec, Florent Altché, Yilun Du, Yaroslav Ganin, Arthur Mensch, Will Grathwohl, Nikolay Savinov, Sander Dieleman, Laurent Sifre, et al. Selbstkonditionierte Einbettungsdiffusion für Textgenerierung. arXiv preprint arXiv:2211.04236, 2022.
[45] Ting Chen, Ruixiang Zhang und Geoffrey Hinton. Analog Bits: Generierung diskreter Daten mit Diffusionsmodellen und Selbstkonditionierung. arXiv preprint arXiv:2208.04202, 2022.
[46] Sander Dieleman, Laurent Sartran, Arman Roshannai, Nikolay Savinov, Yaroslav Ganin, Pierre H Richemond, Arnaud Doucet, Robin Strudel, Chris Dyer, Conor Durkan, et al. Kontinuierliche Diffusion für kategorische Daten. arXiv preprint arXiv:2211.15089, 2022.
[47] Pierre H. Richemond, Sander Dieleman und Arnaud Doucet. Kategorische SDEs mit Simplex-Diffusion, 2022.
[48] Tong Wu, Zhihao Fan, Xiao Liu, Yeyun Gong, Yelong Shen, Jian Jiao, Hai-Tao Zheng, Juntao Li, Zhongyu Wei, Jian Guo, Nan Duan und Weizhu Chen. Ar-Diffusion: Autoregressives Diffusionsmodell für Textgenerierung, 2023.
[49] Rabeeh Karimi Mahabadi, Hamish Ivison, Jaesung Tae, James Henderson, Iz Beltagy, Matthew E. Peters und Arman Cohan. Tess: Text-zu-Text selbstkonditionierte Simplex-Diffusion, 2024.
[50] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian und Mingxuan Wang. Dinoiser: Diffundiertes konditionales Sequenzlernen durch Manipulation von Rauschen. arXiv preprint arXiv:2302.10025, 2023.
[51] Yizhe Zhang, Jiatao Gu, Zhuofeng Wu, Shuangfei Zhai, Joshua Susskind und Navdeep Jaitly. Planner: Generierung diversifizierter Absätze mittels latentem Sprachdiffusionsmodell. Advances in Neural Information Processing Systems, 36:80178-80190, 2023.
[52] Aaron Lou und Stefano Ermon. Reflektierte Diffusionsmodelle, 2023.
[53] Alex Graves, Rupesh Kumar Srivastava, Timothy Atkinson und Faustino Gomez. Bayessche Flussnetzwerke. arXiv preprint arXiv:2308.07037, 2023.
[54] Zhenghao Lin, Yeyun Gong, Yelong Shen, Tong Wu, Zhihao Fan, Chen Lin, Nan Duan und Weizhu Chen. Textgenerierung mit Diffusions-Sprachmodellen: Ein Vor trainierungsansatz mit kontinuierlicher Absatzentrauschung. In International Conference on Machine Learning, Seiten 21051-21064. PMLR, 2023.
[55] Kaiwen Xue, Yuhao Zhou, Shen Nie, Xu Min, Xiaolu Zhang, Jun Zhou und Chongxuan Li. Vereinheitlichung bayesscher Flussnetzwerke und Diffusionsmodelle durch stochastische Differentialgleichungen. arXiv preprint arXiv:2404.15766, 2024.
[56] Ruixiang Zhang, Shuangfei Zhai, Yizhe Zhang, James Thornton, Zijing Ou, Joshua Susskind und Navdeep Jaitly. Target Concrete Score Matching: Ein ganzheitliches Framework für diskrete Diffusion. arXiv preprint arXiv:2504.16431, 2025.
[57] Ishaan Gulrajani und Tatsunori B Hashimoto. Likelihood-basierte Diffusions-Sprachmodelle. Advances in Neural Information Processing Systems, 36, 2024.
[58] Emiel Hoogeboom, Didrik Nielsen, Priyank Jaini, Patrick Forré und Max Welling. Argmax-Flüsse und multinomiale Diffusion: Lernen kategorischer Verteilungen. Advances in Neural Information Processing Systems, 34:12454-12465, 2021.
[59] Emiel Hoogeboom, Alexey A Gritsenko, Jasmijn Bastings, Ben Poole, Rianne van den Berg und Tim Salimans. Autoregressive Diffusionsmodelle. arXiv preprint arXiv:2110.02037, 2021.
[60] Zhengfu He, Tianxiang Sun, Kuanning Wang, Xuanjing Huang und Xipeng Qiu. Diffusion-BERT: Verbesserung generativer maskierter Sprachmodelle mit Diffusionsmodellen. arXiv preprint arXiv:2211.15029, 2022.
[61] Andrew Campbell, Joe Benton, Valentin De Bortoli, Thomas Rainforth, George Deligiannidis und Arnaud Doucet. Ein kontinuierliches Zeit-Framework für diskrete Entrauschungsmodelle. Advances in Neural Information Processing Systems, 35:28266-28279, 2022.
[62] Chenlin Meng, Kristy Choi, Jiaming Song und Stefano Ermon. Concrete Score Matching: Verallgemeinertes Score Matching für diskrete Daten. Advances in Neural Information Processing Systems, 35:34532-34545, 2022.
[63] Machel Reid, Vincent J. Hellendoorn und Graham Neubig. Diffuser: Diskrete Diffusion mittels bearbeitungsbasierter Rekonstruktion, 2022.
[64] Haoran Sun, Lijun Yu, Bo Dai, Dale Schuurmans und Hanjun Dai. Score-basierte kontinuierliche diskrete Diffusionsmodelle. arXiv preprint arXiv:2211.16750, 2022.
[65] Ouaif Kitouni, Niklas Nolte, James Hensman und Bhaskar Mitra. Disk: Ein Diffusionsmodell für strukturiertes Wissen. arXiv preprint arXiv:2312.05253, 2023.
[66] Lin Zheng, Jianbo Yuan, Lei Yu und Lingpeng Kong. Ein reparametrisiertes diskretes Diffusionsmodell für Textgenerierung. ArXiv, abs/2302.05737, 2023.
[67] Zixiang Chen, Huizhuo Yuan, Yongqian Li, Yiwen Kou, Junkai Zhang und Quanquan Gu. Schnelles Sampling mittels Entrandomisierung für diskrete Diffusionsmodelle. arXiv preprint arXiv:2312.09193, 2023.
[68] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian und Quanquan Gu. Diffusions-Sprachmodelle können viele Aufgaben durch Skalierung und Instruktions-Feintuning bewältigen. arXiv preprint arXiv:2308.12219, 2023.
[69] Itai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky TQ Chen, Gabriel Synnaeve, Yossi Adi und Yaron Lipman. Diskrete Flussanpassung. arXiv preprint arXiv:2407.15595, 2024.
[70] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu und Qinsheng Zhang. Maskierte Diffusionsmodelle sind heimlich zeitagnostische maskierte Modelle und nutzen ungenaue kategorische Stichprobenentnahme aus, 2024. URL https://arxiv.org/abs/2409.02908
[71] Shreyas Kapur, Erik Jenner und Stuart Russell. Diffusion auf Syntaxbäumen für Programmsynthese. arXiv preprint arXiv:2405.20519, 2024.
[72] Shansan Gong, Shivam Agarwal, Yizhe Zhang, Jiacheng Ye, Lin Zheng, Mukai Li, Chenxin An, Peilin Zhao, Wei Bi, Jiawei Han, et al. Skalierung von Diffusions-Sprachmodellen durch Anpassung von autoregressiven Modellen. arXiv preprint arXiv:2410.17891, 2024.
[73] Samar Khanna, Siddhant Kharbanda, Shufan Li, Harshit Varma, Eric Wang, Sawyer Birnbaum, Ziyang Luo, Yanis Miraoui, Akash Palrecha, Stefano Ermon, et al. Mercury: Ultraschnelle Sprachmodelle auf Diffusionsbasis. arXiv preprint arXiv:2506.17298, 2025.
[74] Huiwen Chang, Han Zhang, Jarred Barber, AJ Maschinot, Jose Lezama, Lu Jiang, Ming-Hsuan Yang, Kevin Murphy, William T Freeman, Michael Rubinstein, et al. Muse: Text-zu-Bild-Generierung mittels maskierter generativer Transformer. arXiv preprint arXiv:2301.00704, 2023.
[75] Zebin You, Jingyang Ou, Xiaolu Zhang, Jun Hu, Jun Zhou und Chongxuan Li. Effektive und effiziente maskierte Bildgenerierungsmodelle. arXiv-Preprint arXiv:2503.07197, 2025.
[76] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang und Quanquan Gu. Diffusions-Sprachmodelle sind vielseitige Protein-Lerner. arXiv-Preprint arXiv:2402.18567, 2024.
[77] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang und Quanquan Gu. Dplm-2: Ein multimodales Diffusions-Protein-Sprachmodell. arXiv-Preprint arXiv:2410.13782, 2024.
[78] Siqi Kou, Lanxiang Hu, Zhezhi He, Zhijie Deng und Hao Zhang. Clims: Konsistenz-Sprachmodelle für große Modelle. arXiv-Preprint arXiv:2403.00835, 2024.
[79] Chenkai Xu, Xu Wang, Zhenyi Liao, Yishun Li, Tianqi Hou und Zhijie Deng. Show-o Turbo: Hin zu beschleunigtem einheitlichem multimodalen Verständnis und Generierung. arXiv-Preprint arXiv:2502.05415, 2025.
[80] Sulin Liu, Juno Nam, Andrew Campbell, Hannes Stärk, Yilun Xu, Tommi Jaakkola und Rafael Gómez-Bombarelli. Denke, während du generierst: Diskrete Diffusion mit geplantem Entrauschen. arXiv-Preprint arXiv:2410.06264, 2024.
[81] Yuanzhi Zhu, Xi Wang, Stéphane Lathuilière und Vicky Kalogeiton. Dimo: Destillation maskierter Diffusionsmodelle in einen Ein-Schritt-Generator. arXiv-Preprint arXiv:2503.15457, 2025.
[82] Yinuo Ren, Haoxuan Chen, Yuchen Zhu, Wei Guo, Yongxin Chen, Grant M Rotskoff, Molei Tao und Lexing Ying. Schnelle Löser für diskrete Diffusionsmodelle: Theorie und Anwendungen von Algorithmen höherer Ordnung. arXiv preprint arXiv:2502.00234, 2025.
[83] Satoshi Hayakawa, Yuhta Takida, Masaaki Imaizumi, Hiromi Wakaki und Yuki Mitsufuji. Destillation diskreter Diffusion durch dimensionale Korrelationen. arXiv preprint arXiv:2410.08709, 2024.
[84] Yixiu Zhao, Jiaxin Shi, Feng Chen, Shaul Druckmann, Lester Mackey und Scott Linderman. Informierte Korrektoren für diskrete Diffusionsmodelle. arXiv preprint arXiv:2407.21243, 2024.
[85] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu und Qinsheng Zhang. Maskierte Diffusionsmodelle sind heimlich zeitagnostische maskierte Modelle und nutzen ungenaue kategorische Stichprobenentnahme aus. arXiv preprint arXiv:2409.02908, 2024.
[86] Yong-Hyun Park, Chieh-Hsin Lai, Satoshi Hayakawa, Yuhta Takida und Yuki Mitsufuji. Springe deine Schritte: Optimierung des Stichprobenplans diskreter Diffusionsmodelle. In The Thirteenth International Conference on Learning Representations, 2024.
[87] Justin Deschenaux und Caglar Gulcehre. Jenseits der Autoregression: Schnelle LLMs durch Selbst-Destillation über die Zeit. arXiv preprint arXiv:2410.21035, 2024.
[88] Prafulla Dhariwal und Alexander Nichol. Diffusionsmodelle schlagen GANs bei der Bildsynthese. Advances in neural information processing systems, 34:8780-8794, 2021.
[89] Yair Schiff, Subham Sekhar Sahoo, Hao Phung, Guanghan Wang, Sam Boshar, Hugo Dallatorre, Bernardo P de Almeida, Alexander Rush, Thomas Pierrot und Volodymyr Kuleshov. Einfache Lenkungsmechanismen für diskrete Diffusionsmodelle. arXiv preprint arXiv:2412.10193, 2024.
[90] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Training von Sprachmodellen zur Befolgung von Anweisungen mit menschlichem Feedback. Advances in neural information processing systems, 35:27730-27744, 2022.
[91] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon und Chelsea Finn. Direkte Präferenzoptimierung: Ihr Sprachmodell ist heimlich ein Belohnungsmodell. Advances in Neural Information Processing Systems, 36, 2024.
[92] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technischer Bericht. arXiv preprint arXiv:2303.08774, 2023.
[93] Google. Unser Modell der nächsten Generation: Gemini 1.5, 2024. URL https://blog.google/technology/ai/google-gemini-next-generation-model-february-2024
[94] Anthropic. Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[95] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Deepseek-v3 technischer Bericht. arXiv preprint arXiv:2412.19437, 2024.
[96] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. Chain-of-thought-Prompting ruft Schlussfolgern in großen Sprachmodellen hervor. Advances in neural information processing systems, 35:24824-24837, 2022.
[97] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang und Michael S Bernstein. Generative Agenten: Interaktive Simulakra menschlichen Verhaltens. In Proceedings of the 36th annual acm symposium on user interface software and technology, Seiten 1-22, 2023.
[98] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, et al. Eine Übersicht über autonome Agenten auf Basis großer Sprachmodelle. Frontiers of Computer Science, 18(6):186345, 2024.
[99] OpenAI. Lernen, mit LLMs zu schlussfolgern, 2024. URL https://openai.com/index/learning-to-reason-with-llms/
[100] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Förderung der Schlussfolgerungsfähigkeit in LLMs durch Verstärkungslernen. arXiv preprint arXiv:2501.12948, 2025.
[101] Benigno Uria, Iain Murray und Hugo Larochelle. Ein tiefer und handhabbarer Dichteschätzer. In Proceedings of the 31th International Conference on Machine Learning, 2014.
[102] Andy Shih, Dorsa Sadigh und Stefano Ermon. Training und Inferenz bei autoregressiven Modellen beliebiger Ordnung auf die richtige Weise. In Proceedings of the 31th International Conference on Machine Learning, 2022.
[103] Zhangchen Xu, Fengqing Jiang, Luyao Niu, Yuntian Deng, Radha Poovendran, Yejin Choi und Bill Yuchen Lin. Magpie: Alignment-Datensynthese von Grund auf durch Prompting ausgerichteter LLMs mit nichts. arXiv preprint arXiv:2406.08464, 2024.
[104] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding und Lingming Zhang. Magicoder: Befähigung zur Codegenerierung mit oss-instruct. arXiv preprint arXiv:2312.02120, 2023.
[105] Biao Zhang und Rico Sennrich. Root-Mean-Square-Layer-Normalisierung. Advances in Neural Information Processing Systems, 32, 2019.
[106] Noam Shazeer. GLU-Varianten verbessern den Transformer. arXiv preprint arXiv:2002.05202, 2020.
[107] Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo und Yunfeng Liu. Roformer: Verbesserter Transformer mit rotierendem Positionseinbettung. Neurocomputing, 568:127063, 2024.
[108] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu und Dario Amodei. Skalierungsgesetze für neuronale Sprachmodelle. arXiv preprint arXiv:2001.08361, 2020.
.
[109] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. Training rechenoptimaler großer Sprachmodelle. arXiv preprint arXiv:2203.15556, 2022.
[110] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song und Jacob Steinhardt. Messung massiven mehrstufigen Sprachverständnisses. arXiv preprint arXiv:2009.03300, 2020.
[111] Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, et al. Herausfordernde Big-Bench-Aufgaben und ob Chain-of-thought sie lösen kann. arXiv preprint arXiv:2210.09261, 2022.
[112] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick und Oyvind Tafjord. Denkst du, du hast Fragebeantwortung gelöst? Versuche ARC, die AI2-Reasoning-Herausforderung. arXiv preprint arXiv:1803.05457, 2018.
[113] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi und Yejin Choi. Hellaswag: Kann eine Maschine deinen Satz wirklich vervollständigen? arXiv preprint arXiv:1905.07830, 2019.
[114] Stephanie Lin, Jacob Hilton und Owain Evans. Truthfulqa: Measuring how models mimic human falsehoods. arXiv preprint arXiv:2109.07958, 2021.
[115] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula und Yejin Choi. Winogrande: An adversarial winograd schema challenge at scale. Communications of the ACM, 64(9):99–106, 2021.
[116] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi et al. Piqa: Reasoning about physical commonsense in natural language. In Proceedings of the AAAI conference on artificial intelligence, 2020.
[117] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano et al. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021.
[118] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song und Jacob Steinhardt. Measuring mathematical problem solving with the math dataset. arXiv preprint arXiv:2103.03874, 2021.
[119] David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael und Samuel R Bowman. Gpqa: A graduate-level google-proof q&a benchmark. arXiv preprint arXiv:2311.12022, 2023.
[120] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
[121] Mohammad Bavarian, Heewoo Jun, Nikolas Tezak, John Schulman, Christine McLeavey, Jerry Tworek und Mark Chen. Efficient training of language models to fill in the middle. arXiv preprint arXiv:2207.14255, 2022.
[122] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
[123] Haonan Li, Yixuan Zhang, Fajri Koto, Yifei Yang, Hai Zhao, Yeyun Gong, Nan Duan und Timothy Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
[124] Yuzhen Huang, Yuzhuo Bai, Zhihao Zhu, Junlei Zhang, Jinghan Zhang, Tangjun Su, Junteng Liu, Chuancheng Lv, Yikai Zhang, Yao Fu, et al. C- eval: A multi- level multi- discipline chinese evaluation suite for foundation models. Advances in Neural Information Processing Systems, 36, 2024.
[125] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang und Andy Zou. A framework for few- shot language model evaluation, 07 2024. URL https://zenodo.org/records/12608602
Algorithmus 1 Vortraining von LLaDA
Erfordert: Maskenprädiktor , Datenverteilung
1: wiederhole
2: # mit einer Wahrscheinlichkeit von folgt die Sequenzlänge von U[1, 4096]
3:
4: # ist in Gl. (7) definiert
5: Berechne # ist die Sequenzlänge von
6: Berechne und führe den Optimierer aus.
7: bis konvergiert
8: Gib zurück
Algorithmus 2 Überwachtes Feintuning von LLaDA
Erfordert: Maskenprädiktor , Paardatenverteilung
1: wiederhole
2: # Details zu den SFT-Daten finden Sie in Anhang B.1
3:
4: # ist in Gl. (7) definiert
5: Berechne # ist die Sequenzlänge von
6: Berechne und führe den Optimierer aus.
7: bis konvergiert
8: Gib zurück
Algorithmus 3 Bewertung der bedingten Log-Likelihood von LLaDA
Erfordert: Maskenprädiktor , Prompt , Antwort , die Anzahl der Monte-Carlo-Schätzungen
1: log_likelihood
2: für bis tue
3: # ist die Sequenzlänge von
4: Erhalte durch gleichmäßiges Ziehen von Tokens aus ohne Zurücklegen zum Maskieren
5:
6: Ende für
7: log_likelihood
8: Gib log_likelihood zurück
A Formulierung maskierter Diffusionsmodelle
A.1 Training
MDMs [16|20] definieren die Modellverteilung auf eine Weise, die sich von autoregressiven Modellen unterscheidet.
Diese Modelle führen einen Vorwärtsprozess ein, der durch eine Zeit indiziert wird. Dieser Prozess maskiert schrittweise und unabhängig alle Tokens in der Sequenz . Zum Zeitpunkt ist der Datenpunkt vollständig beobachtet und ohne Masken, während für latente Variablen mit im Erwartungswert variierenden Maskenverhältnissen darstellt.
Formal ist die bedingte Verteilung von gegeben durch eine vollständig faktorisierte Form definiert:
wobei die bedingte Verteilung für jedes Token gegeben ist durch:
Hierbei bezeichnet M das Masken-Token. Anschaulich gesprochen bleibt jedes Token entweder unverändert oder wird maskiert, wobei die Wahrscheinlichkeit, maskiert zu werden, linear zunimmt, während \(t\) von 0 auf 1 fortschreitet. Bei \(t = 1\) sind alle
Erforderlich: Maskenprädiktor \(p_{\theta}\) , Prompt \(p_{0}\) , Antwortlänge \(L\) , Sampling-Schritte \(N\) 1: Setze \(r_{1}\) als eine vollständig maskierte Sequenz der Länge \(L\) . 2: for \(t \leftarrow 1\) bis hinunter zu \(\frac{1}{N}\) mit Schrittweite \(\frac{1}{N}\) do 3: \(s = t - \frac{1}{N}\) 4: \(r_{0} = \arg \max_{r_{0}} p_{\theta}(r_{0}|p_{0},r_{t})\) # wir verwenden Greedy-Sampling bei der Vorhersage maskierter Token 5: for \(i \leftarrow 1\) bis \(L\) do 6: if \(r_{t}^{i} \neq \mathbf{M}\) then 7: \(r_{0}^{i} = r_{t}^{i}\) 8: else 9: mit Wahrscheinlichkeit \(\frac{s}{t}\) wird \(r_{0}^{i}\) auf \(\mathbf{M}\) gesetzt 10: end if 11: end for 12: \(r_{s} = r_{0}\) 13: end for 14: Gib \(r_{0}\) zurück. Token garantiert maskiert sind, was bedeutet, dass \(x_{1}\) einer Dirac-Verteilung folgt, die auf einer Sequenz vollständig maskierter Token konzentriert ist. Bemerkenswert ist, dass die lineare Maskierungswahrscheinlichkeit analog zum, aber verschieden vom Rauschplan in kontinuierlichen Diffusionsmodellen [38,40] ist. Diese Linearität ist durch die Annahme motiviert, dass die Information im Text im Durchschnitt proportional zur Anzahl der Token ist, wodurch es vernünftig ist, während des Vorwärtsprozesses linear Information zu verlieren.
Der Vorwärtsprozess ist nicht nur umkehrbar, sondern entspricht auch einem Rückwärtsprozess, der über alle Token vollständig faktorisiert ist. Der Rückwärtsprozess erzeugt von Zeit \(t = 1\) bis 0 neue Daten aus Sequenzen vollständig maskierter Token. Die bedingte Verteilung für den Rückwärtsprozess ist für \(0 \leq s < t \leq 1\) faktorisiert als:
wobei die bedingte Verteilung für jedes Token gegeben ist durch:
Somit ist die zentrale zu schätzende Funktion die bedingte Verteilung \(q_{0|t}(x_{s}^{i}|x_{t})\) , welche das ursprüngliche Token vorhersagt, falls es in der Eingabe \(x_{t}\) maskiert ist. Dies ist analog zur Datenvorhersageform in kontinuierlichen Diffusionsmodellen.
Wie in [20] bewiesen wurde, lässt sich eine äquivalente, aber zeitfreie Parametrisierung ableiten als:
wobei \(x_{t}^{\mathrm{UM}}\) die Sammlung der unmaskierten Token in \(x_{t}\) bezeichnet, die mit den entsprechenden Token in den ursprünglichen Daten \(x_{0}\) identisch ist, da unmaskierte Token ausschließlich durch \(x_{0}\) bestimmt werden und unabhängig von der Zeit \(t\) sind. Anschaulich bedeutet dies, dass die Schätzung der Datenvorhersagefunktion äquivalent zur Schätzung der bedingten Verteilungen auf sauberen Daten ist, welche zeitinvariant ist. Folglich muss die Zeit \(t\) nicht als Eingabe für das parametrische Modell bereitgestellt werden.
Obwohl die Entwicklung der maskierten Diffusion nicht trivial ist, ist die Implementierung unkompliziert. Zunächst führen wir den Maskenprädiktor ein, ein parametrisches Modell (z. B. einen Transformer ohne kausale Maske), das für jedes als Eingabe nimmt und alle maskierten Token gleichzeitig vorhersagt. Dann definieren wir die Modellverteilung wie folgt: Ausgehend von als einer Sequenz vollständig maskierter Token simulieren wir einen approximativen Umkehrprozess, parametrisiert durch , von bis 0. Die bei induzierte Randverteilung repräsentiert dann die Modellverteilung .
Erfordert: Maskenprädiktor , Prompt , Antwortlänge , Sampling-Schritte
1: Setze als eine vollständig maskierte Sequenz der Länge .
2: for bis hinunter zu mit Schrittweite do
3:
4: for bis do
5: if then
6:
7: else
8:
9:
10: end if
11: end for
12: # die Anzahl der unmaskierten Token ist im Zeitschritt
13: for bis do
14: if then
15: # die Positionen mit der geringsten Konfidenz werden zur erneuten Maskierung ausgewählt.
16: end if
17: end for
18:
19: end for
20: Gib zurück
Formal wird der Maskenprädiktor unter Verwendung einer Kreuzentropieverlustfunktion mit Maskierung trainiert:
wobei aus den Trainingsdaten gezogen wird, gleichmäßig aus gezogen wird und aus gezogen wird. Die Indikatorfunktion stellt sicher, dass die Kreuzentropieverlustfunktion nur für maskierte Token berechnet wird. In Shi et al. [18], Sahoo et al. [19], Ou et al. [20] wurde bewiesen, dass die Verlustfunktion eine obere Schranke für die negative Log-Likelihood der Modellverteilung ist:
Zusammenfassend trainiert dieser prinzipielle Ansatz ein generatives Modell, indem während eines Vorwärtsprozesses schrittweise Token maskiert werden und gelernt wird, die Datenverteilung während eines Umkehrprozesses wiederherzustellen, und zwar alles im Rahmen der (approximativen) Maximum-Likelihood-Schätzung.
A.2 Inferenz
Der Kreuzentropieverlust in Gl. [12] hat mehrere äquivalente Formen [20]. Die erste ist gegeben durch
wobei gleichmäßig aus gezogen wird und erhalten wird, indem Token gleichmäßig ohne Zurücklegen aus zur Maskierung gezogen werden. Obwohl das Maskieren von genau Token sich davon unterscheidet, jedes Token unabhängig mit Wahrscheinlichkeit zu maskieren, führen diese beiden Maskierungsmethoden im Erwartungswert zu äquivalenten Ergebnissen [20].
Any-order autoregressive Modelle (AO-ARM) [59][101][102] charakterisieren die gemeinsame Verteilung autoregressiv für alle möglichen Reihenfolgen der Variablen. Um eine solche Verteilung zu lernen, verwendet ein AO-ARM ein neuronales Netz mit geteilten Gewichten, um alle univariaten bedingten Verteilungen zu modellieren, und setzt Masken-Token ein, um fehlende Variablen darzustellen. Während des Trainings wird die erwartete negative Log-Likelihood über der Gleichverteilung aller Reihenfolgen minimiert:
Intuitiv kann als ein maskiertes Token verstanden werden, bei dem die Indizes in maskiert sind. Es kann weiter bewiesen werden, dass Gl. (15) äquivalent zu Gl. (12) ist. Diese Verbindung erklärt die bidirektionalen Argumentationsfähigkeiten von LLaDA, obwohl sie im Inferenzverfahren nie explizit genutzt wurden.
Darüber hinaus führt Nie et al. [27] unüberwachte Classifier-Free-Guidance (CFG) ein, eine Plug-and-Play-Technik, die die Ausrichtung an Prompts und die Textvielfalt ausbalanciert. Konkret verwendet unüberwachte CFG den folgenden modifizierten Maskenprädiktor für die Inferenz:
wobei eine Maskensequenz derselben Länge wie ist und ein abstimmbarer Hyperparameter, der die Stärke von steuert. Um einen fairen Vergleich mit ARMs zu gewährleisten, wenden wir CFG im Haupttext nicht auf LLaDA an. Wie jedoch in Anhang [B.3] gezeigt wird, ist LLaDA vollständig mit CFG kompatibel und weist durchgängig eine verbesserte Leistung auf, wenn es angewendet wird.
A.3 Algorithmen
In diesem Abschnitt stellen wir die Trainings- und Inferenzalgorithmen vor. Konkret führen wir die Algorithmen für das Vortraining und das überwachte Feintuning in Algorithmus [1] bzw. Algorithmus [2] ein. Darüber hinaus wird der Algorithmus zur Likelihood-Bewertung in Algorithmus [3] bereitgestellt. Schließlich präsentieren wir den umgekehrten Generierungsprozess in Algorithmus [4] und Algorithmus [5], die der Strategie des zufälligen Remaskings bzw. des Remaskings mit geringer Konfidenz [23] entsprechen.
B Experimente
B.1 Datenerhebung und Vorverarbeitung
In diesem Abschnitt führen wir zunächst die Datenerhebungs- und Filterprozesse sowohl für das Vortraining als auch für das SFT ein. Anschließend beschreiben wir, wie LLaDA diese Datensätze während des Trainings nutzt.
Unser Vortrainingskorpus wird aus diversen öffentlich verfügbaren Quellen zusammengestellt, darunter Webdaten, Bücher, wissenschaftliche Arbeiten, soziale Medien, Enzyklopädien, Mathematik und Code, mit etwa Chinesisch, Englisch und Code. Der Datenbereinigungsprozess umfasst die PDF-Textextraktion, Deduplizierung und Filterung schädlicher Inhalte. Um die Qualität weiter zu gewährleisten, feintunen wir ein BERT-Modell [22] für die automatisierte Annotation der Datenqualität, wodurch die Auswahl qualitativ hochwertigerer Stichproben ermöglicht wird. Unser SFT-Datensatz besteht aus 1 Million von Menschen annotierten Stichproben und 3,5 Millionen synthetischen Stichproben, die mit Methoden erzeugt wurden, die den in Xu et al. [103], Wei et al. [104] vorgeschlagenen ähneln.
Wir verketten die gesammelten Dokumente im Vortrainingskorpus und segmentieren den Text gemäß der vordefinierten Sequenzlänge in Sequenzen fester Länge.
Für das SFT wird eine Strategie mit dynamischer Sequenzlänge verwendet, bei der |EOS|-Token an das Ende kürzerer Paare angehängt werden, um einheitliche Sequenzlängen über alle Stichproben innerhalb jedes Mini-Batches hinweg sicherzustellen. Bemerkenswert ist, dass die Padding-|EOS|-Token als Teil der Antwort behandelt werden, d. h. maskiert und in das Trainingsziel einbezogen werden. Die |EOS|-Token werden beim Sampling aus den generierten Ausgaben entfernt. Diese Strategie stellt sicher, dass das Modell lernt, die Länge seiner Antworten durch die Generierung von |EOS| zu steuern, wodurch die Antwortlänge effektiv mit dem gegebenen Prompt abgestimmt werden kann.
Darüber hinaus behandeln wir für -Turn-Dialoge diese als Einzel-Turn-Dialogpaare, d. h. , und ziehen zufällig eines. Diese Datenpartitionierungsstrategie verleiht LLaDA nicht nur Fähigkeiten für Multi-Turn-Dialoge, sondern ist auch mit der oben genannten |EOS|-Padding-Strategie vereinbar.
| Unser ARM-Baseline 1B | LLaDA 1B | Unser ARM-Baseline 7B | LLaDA 8B | LLaMA3 8B | |
| Schichten | 22 | 22 | 28 | 32 | 32 |
| Modelldimension | 2048 | 2048 | 4096 | 4096 | 4096 |
| Attention-Köpfe | 32 | 32 | 32 | 32 | 32 |
| Vokabulargröße | 126.464 | 126.464 | 126.464 | 126.464 | 128.000 |
| FFN-Dimension | 5634 | 5634 | 13.440 | 12.288 | 14.336 |
| Key/Value-Köpfe | 4 | 4 | 8 | 32 | 8 |
| Gesamtparameter | 1,49 B | 1,49 B | 6,83 B | 8,02 B | 8,03 B |
| Nicht-Embedding-Parameter | 0,97 B | 0,97 B | 5,80 B | 6,98 B | 6,98 B |
| ARC-C | Hellaswag | TruthfulQA | WinoGrande | GPQA | PIQA | |
| ohne CFG | 45,9 | 70,5 | 46,1 | 74,8 | 25,2 | 73,6 |
| mit CFG | 47,9 | 72,5 | 46,4 | 74,8 | 26,1 | 74,4 |
B.2 Details zum Modelltraining
Dieser Abschnitt enthält die Trainingsdetails von LLaDA und den entsprechenden ARM-Baselines.
Erstens haben wir aus Effizienzgründen ein ARM und ein MDM trainiert, beide mit 1,5B Parametern und identischen Architekturen. Darüber hinaus haben wir das MDM auf 8B Parameter skaliert. Aufgrund begrenzter Rechenressourcen haben wir kein autoregressives Modell mit 8B Parametern und derselben Architektur trainiert. Stattdessen haben wir unser zuvor trainiertes autoregressives Modell mit 7B Parametern für den Vergleich verwendet. Diese vier Modelle werden in der Skalierbarkeitsanalyse in Abschn. [3.1] verwendet.
Für die von uns trainierten ARMs und MDMs haben wir eine Transformer-Architektur ähnlich LLaMA [6] [21] verwendet. Konkret setzen wir RMSNorm [105] zur Stabilisierung des Trainings ein, verwenden SwiGLU [106] als Aktivierungsfunktion zur Verbesserung der Nichtlinearität und integrieren RoPE [107] für eine ausdrucksstärkere Positionskodierung. Tab. [5] bietet einen Überblick über die Modellarchitekturen.
Für die 1B- und 7B-ARM-Baselines sowie die 1B- und 8B-LLaDA-Modelle haben wir den AdamW-Optimierer [29] mit einem Weight Decay von 0,1 verwendet und den Lernraten-Scheduler Warmup-Stable-Decay [28] eingesetzt. Die Lernrate wurde über die ersten 2000 Iterationen linear von 0 auf den Maximalwert erhöht und dann konstant gehalten. Für LLaDA 8B wurde die Lernrate zur Gewährleistung eines stabilen Trainings einmal während des Vortrainings reduziert, wie in Abschn. [2.2] ausführlich dargestellt. Für die 1B-ARM-Baseline sowie die 1B- und 8B-LLaDA-Modelle ist die maximale Lernrate auf mit einer Batchgröße von 1280 festgelegt, ohne jegliche Hyperparameter-Abstimmung. Für die 7B-ARM-Baseline ist die maximale Lernrate auf mit einer Batchgröße von 4224 festgelegt, wobei beide Werte durch Grid Search ausgewählt wurden.
Zusätzlich verwenden wir die weit verbreitete -Formulierung [108] [109], um die Trainings-FLOPs in Abb. [3] zu berechnen, wobei die Anzahl der Nicht-Embedding-Parameter und die Gesamtzahl der Trainings-Tokens bezeichnet. Die detaillierten Ergebnisse zu Abb. [3] sind in Tab. [18] und Tab. [19] angegeben.
B.3 Ablation zu Classifier-free Guidance
Dieser Abschnitt präsentiert eine Ablationsstudie zu Classifier-free Guidance (CFG). Theoretische Details zu CFG finden sich im Anhang [A.2].
Zur Vereinfachung wählen wir sechs repräsentative Benchmarks aus, darunter ARC-C, HellaSwag, TruthfulQA, WinoGrande, PIQA und GPQA, und führen Experimente mit LLaDA 8B Base durch. Wir durchsuchen die CFG-Skala in für jede Aufgabe und berichten das beste Ergebnis. Wie in Tab. [6] gezeigt, verbessert CFG durchgängig die Leistung von LLaDA. Wir betonen, dass CFG, um einen fairen Vergleich mit ARMs zu gewährleisten, in den in der Arbeit berichteten Hauptergebnissen nicht verwendet wird.
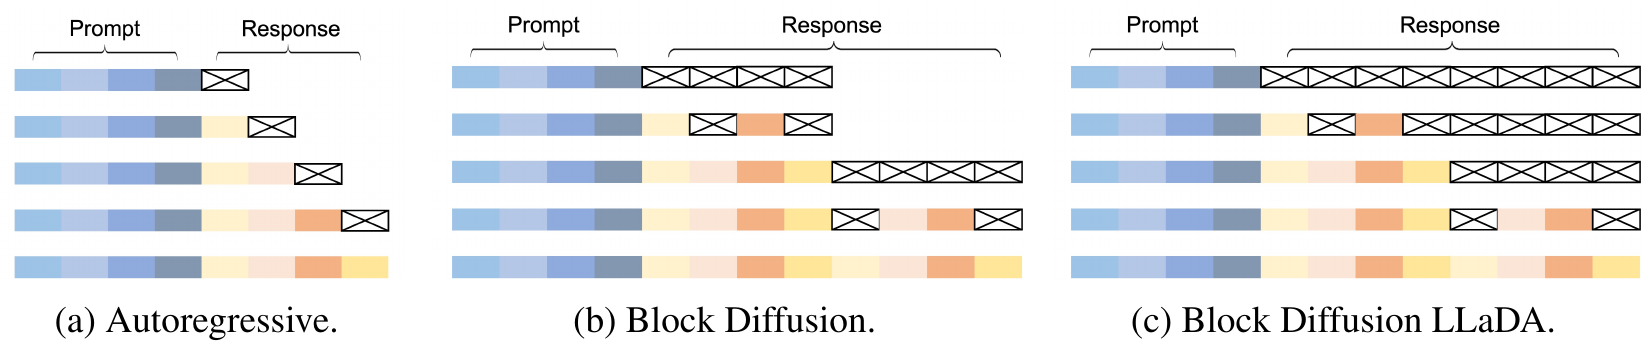
| BBH | GSM8K | Math | HumanEval | MBPP | ||
| Autoregressiv | 38,1 | 63,1 | 23,6 | 18,3 | 33,4 | |
| L' = 2 | 37,3 | 62,6 | 25,2 | 14,6 | 33,6 | |
| L' = 4 | 40,0 | 65,7 | 26,6 | 15,9 | 36,0 | |
| L' = 8 | 42,0 | 68,2 | 27,7 | 19,5 | 39,2 | |
| L' = 32 | 45,7 | 68,6 | 29,7 | 29,9 | 37,4 | |
| Block-Diffusion-LLaDA | L' = 2 | 48,0 | 70,0 | 30,8 | 26,2 | 40,0 |
| L' = 4 | 48,5 | 70,3 | 31,3 | 27,4 | 38,8 | |
| L' = 8 | 48,6 | 70,2 | 30,9 | 31,1 | 39,0 | |
| L' = 32 | 48,3 | 70,3 | 31,2 | 32,3 | 40,0 | |
| Reine Diffusion | 49,7 | 70,3 | 31,4 | 35,4 | 40,0 |
| GSM8K | Mathematik | HumanEval | MBPP | GPQA | MMLU-Pro | ARC-C | |
| Autoregressiv | 0 | 9,5 | 0 | 0 | 0 | 0 | 84,4 |
| Block-Diffusion | 24,6 | 23,5 | 17,1 | 21,2 | 29,3 | 32,5 | 88,1 |
| Block-Diffusion LLaDA | 77,5 | 42,2 | 46,3 | 34,2 | 31,3 | 34,8 | 85,4 |
| Reine Diffusion | 69,4 | 31,9 | 49,4 | 41,0 | 33,3 | 37,0 | 88,5 |
B.4 Details und Ablation zu Sampling-Strategien
In diesem Abschnitt führen wir zunächst die verschiedenen von LLaDA unterstützten Sampling-Strategien ein. Anschließend präsentieren wir Ablationsstudien zur Bewertung der Leistung dieser Sampling-Strategien.
Flexible Sampling-Strategien. In Abschn. 2.4 veranschaulicht Abb. 2(c) den umgekehrten Generierungsprozess von LLaDA. Wie in Abb. 4 gezeigt, unterstützt LLaDA zusätzlich zum umgekehrten Generierungsprozess direkt nach den Pre-Training- oder SFT-Phasen auch autoregressives und Block-Diffusion-[31]-Sampling, ohne dass weitere Modifikationen oder ein Neutraining erforderlich sind. Beim Block-Diffusion-Sampling wird der ursprüngliche umgekehrte Prozess innerhalb jedes Blocks angewendet und das autoregressive Sampling über die Blöcke hinweg. Im ursprünglichen Block-Diffusion-Prozess variiert die Sequenzlänge dynamisch. Wie in Abb. 4(c) gezeigt, kann LLaDA auch eine Block-Diffusion-Strategie mit fester Länge anwenden, die wir als Block-Diffusion-LLaDA bezeichnen, auch bekannt als semi-autoregressives Remasking.
Experimentelles Setup. Wir bewerten verschiedene Sampling-Strategien sowohl mit LLaDA 8B Base als auch mit LLaDA 8B Instruct für eine umfassende Analyse. Für LLaDA 8B Base verwenden wir die fünf Benchmarks in Tab. 1, die auf Sampling statt auf Likelihood-Schätzung basierend bewertet werden. Für LLaDA 8B Instruct verwenden wir die sieben Metriken in Tab. 2 mit Ausnahme von MMLU und HellaSwag, da diese beiden Aufgaben vom Modell nur die Generierung eines einzelnen Tokens (d. h. A, B, C oder D) erfordern. In allen Einstellungen wird pro Sampling-Schritt ein Token generiert.
| Länge | BBH | GSM8K | Math | HumanEval | MBPP |
| Zufälliges Remasking | 32.1 | 21.3 | 9.2 | 11.6 | 21.0 |
| Remasking mit geringer Konfidenz | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| Länge | BBH | GSM8K | Math | HumanEval | MBPP |
| 256 | 45,0 | 70,0 | 30,3 | 32,9 | 40,2 |
| 512 | 50,4 | 70,8 | 30,9 | 32,9 | 39,2 |
| 1024 | 49,7 | 70,3 | 31,4 | 35,4 | 40,0 |
Beim autoregressiven und Block-Diffusion-Sampling endet die Generierung, wenn das |EOS|-Token erzeugt wird. Bei Block-Diffusion-LLaDA (d. h. semi-autoregressivem Remasking) und reinem Diffusions-Sampling ist die Generierungslänge für LLaDA 8B Base auf 1024 festgelegt, während sie für LLaDA 8B Instruct aus {64, 256, 512} abgestimmt wird, um Effizienz und Leistung auszubalancieren. Remasking mit geringer Konfidenz wird sowohl beim Block-Diffusion- und Block-Diffusion-LLaDA-Sampling auf das Intrab lock-Diffusions-Sampling als auch auf das reine Diffusions-Sampling angewendet. Wir testen zudem verschiedene Blocklängen für LLaDA 8B Base. Für LLaDA 8B Instruct bewerten wir aus Effizienzgründen nur die Blocklänge 32, da diese auf LLaDA 8B Base die besten Ergebnisse erzielt.
Zusätzlich beobachten wir für LLaDA 8B Instruct aufgrund der starken Auffüllung mit |EOS|-Tokens in den SFT-Daten (wie in Abschn. [B.1] ausführlich dargestellt), dass beim reinen Diffusions-Sampling der Anteil der |EOS|-Tokens in den Modellausgaben sehr hoch wird. Dies führt zu extrem kurzen Generierungen und beeinträchtigt die Modellleistung. Um dieses Problem zu mildern, setzen wir für HumanEval, MBPP, GSM8K, Math und GPQA den Konfidenzwert des |EOS|-Tokens während des reinen Diffusions-Samplings auf null. Diese Anpassung hilft, ein angemessenes Verhältnis von |EOS|-Tokens während der Generierung aufrechtzuerhalten.
Schließlich führen wir Ablationsstudien durch, um die Auswirkungen von zufälligen und Remasking-Strategien mit geringer Konfidenz beim reinen Diffusions-Sampling zu analysieren. Aus Effizienzgründen verwenden wir in dieser Analyse LLaDA 8B Base mit einer Generierungslänge und Samplingschritten von jeweils 256.
Ergebnisse. Wie in Tab. [7] gezeigt, verbessert sich beim Block-Diffusion-Sampling die Gesamtleistung mit zunehmender Blocklänge. Darüber hinaus zeigen sowohl Tab. [7] als auch Tab. [8], dass Block-Diffusion-Sampling durchgängig das autoregressive Sampling übertrifft und Block-Diffusion-LLaDA-Sampling das standardmäßige Block-Diffusion-Sampling weiter verbessert. Schließlich erzielt reines Diffusions-Sampling die beste Gesamtleistung.
Darüber hinaus zeigt Tab. [9], dass die Remasking-Strategie mit geringer Konfidenz durchgängig die zufällige Remasking-Strategie übertrifft. Wir vermuten, dass Remasking mit geringer Konfidenz ähnlich wie die standardmäßig in ARMs verwendete Annealed-Sampling-Methode wirkt und die Genauigkeit durch Verringerung der Vielfalt der generierten Sätze verbessert.
Wir stellen fest, dass autoregressives Sampling bei LLaDA 8B Instruct zu sehr schlechter Leistung führt. Dies liegt daran, dass jedes SFT-Datum ein vollständiger Satz ist, sodass LLaDA 8B Instruct dazu neigt, bei gegebener Sequenzlänge einen vollständigen Satz innerhalb dieser Länge zu generieren. Im Gegensatz dazu leidet LLaDA 8B Base nicht unter diesem Problem, da die Pre-Training-Daten aus abgeschnittenen Dokumenten bestehen (wie in Anhang [B.1] ausführlich dargestellt) und das Modell mit zufälligen Sequenzlängen trainiert wird (wie in Abschn. [2.2] ausführlich dargestellt). Infolgedessen neigt LLaDA 8B Base bei gegebener kurzer Sequenzlänge dazu, nur einen Teil eines Satzes zu generieren, der dann als Präfix zur Fortsetzung der Generierung verwendet werden kann.
Die Einstellung der Blocklänge auf 8 in Tab. [8] verbessert den GSM8K-Score weiter von 77,5 auf 78,6.
B.5 Ablation zur generierten Länge
In diesem Abschnitt führen wir Ablationsstudien zur generierten Länge durch.
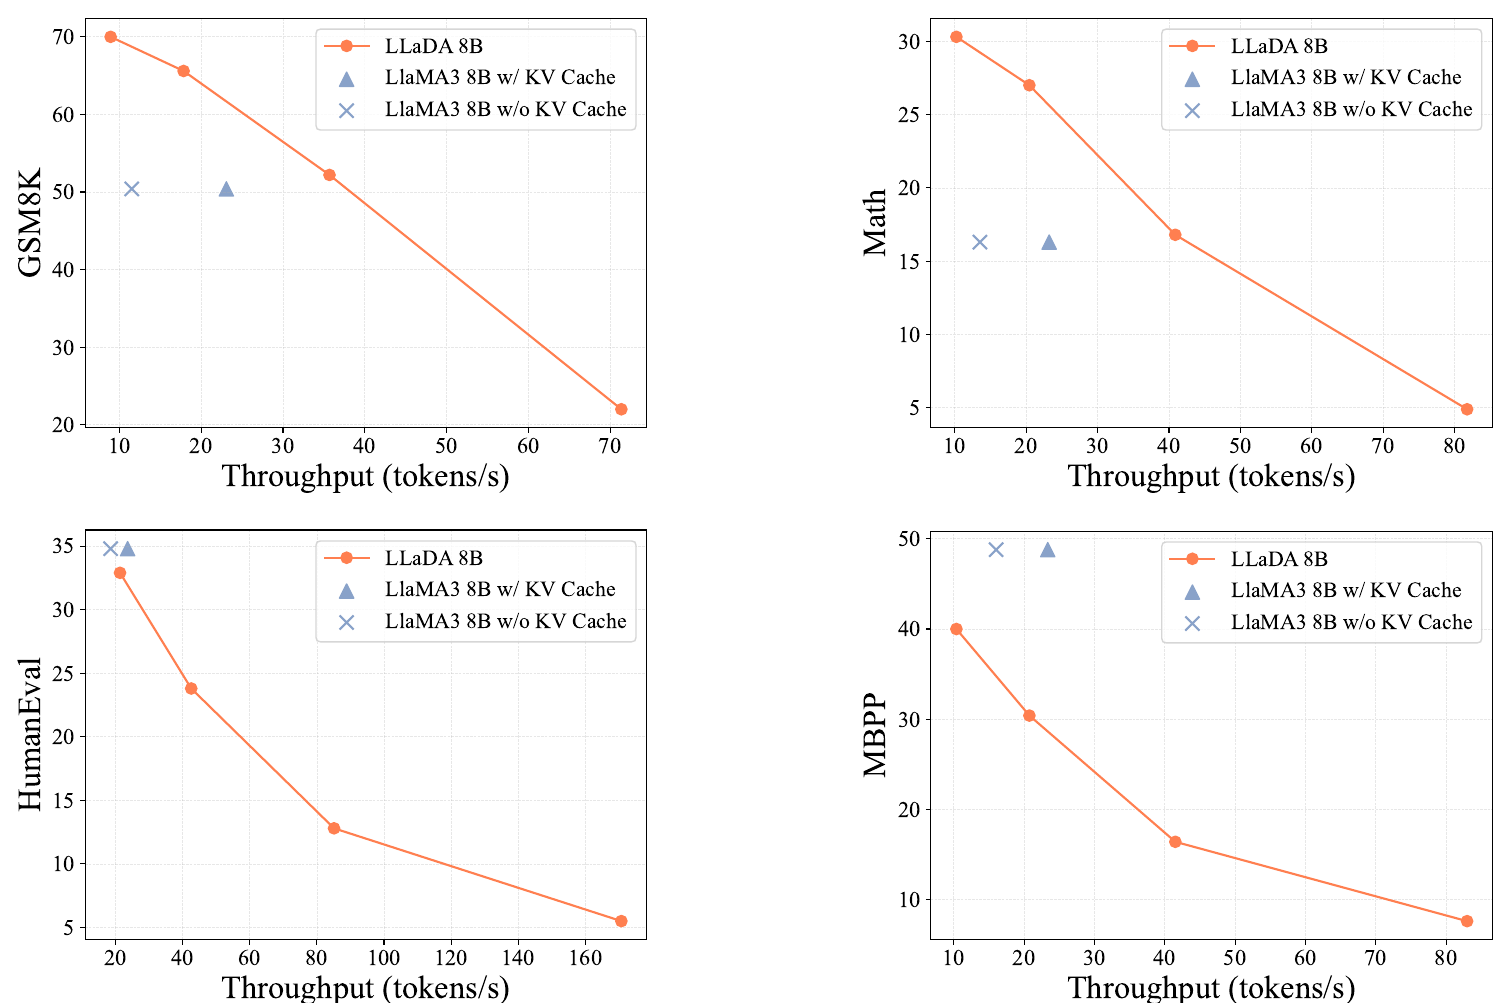
Um Fairness zu gewährleisten, setzen wir für jede Einstellung die Anzahl der Sampling-Schritte gleich der generierten Länge, sodass in jedem Sampling-Schritt genau ein Token von der Maske in den Text übertragen wird. Wir führen Experimente mit LLaDA 8B Base durch.
Wie in Tab. [10] berichtet, sind die Ergebnisse unempfindlich gegenüber dem Längen-Hyperparameter.
B.6 Standard-Benchmarks und Evaluierungsdetails
In diesem Abschnitt führen wir die von uns verwendeten Benchmarks ein und präsentieren die Details unseres Evaluierungsprozesses.
In Anlehnung an standardmäßige LLM-[25] [26]-Evaluierungspraktiken bewerten wir LLaDA entlang von vier Dimensionen:
Allgemeine Fähigkeit: MMLU [110], BBH [111], ARC-C [112], Hellaswag [113], TruthfulQA [114], WinoGrande [115] und PIQA [116].
Mathematik- und Wissenschaftsfähigkeit: GSM8K [117], Math [118] und GPQA [119].
Codegenerierung: HumanEval [120], HumanEval-FIM [121] und MBPP [122].
Chinesisches Verständnis: CMMLU [123] und C-Eval [124].
Für alle oben genannten Benchmarks folgen wir dem weit verbreiteten Evaluierungsprozess [125], der in LLM-Bewertungen verwendet wird, und setzen dabei primär bedingte Likelihood-Schätzung und bedingte Generierung ein. Insbesondere werden für bestimmte Benchmarks ein Prompt und mehrere Kandidatenantworten bereitgestellt, und das Modell muss die bedingte Likelihood jedes Kandidaten berechnen. Der Kandidat mit der höchsten Likelihood wird dann als endgültige Antwort des Modells ausgewählt, und die Genauigkeit wird als Evaluierungsmetrik verwendet. Für die übrigen Benchmarks generiert das Modell Antworten basierend auf dem gegebenen Prompt, und die Leistung wird anhand von Metriken wie Exact Match und anderen relevanten Kriterien bewertet.
Für das Basismodell verwenden wir bedingte Likelihood-Schätzung für MMLU, CMMLU, C-Eval, ARC-C, Hellaswag, TruthfulQA, WinoGrande, PIQA und GPQA, während die übrigen Benchmarks mittels bedingter Generierung bewertet werden. Für das Instruct-Modell bewerten wir alle Benchmarks mittels bedingter Generierung.
| Eingabelänge | Ausgabelänge | LLaDA 8B | LLaMA3 8B ohne KV-Cache | LLaMA3 8B mit KV-Cache |
| 512 | 512 | 17,03 | 16,70 | 16,32 |
| 1024 | 17,53 | 17,49 | 16,43 | |
| 2048 | 18,52 | 20,00 | 16,73 | |
| 1024 | 512 | 17,53 | 17,16 | 16,36 |
| 1024 | 18,01 | 18,26 | 16,41 | |
| 2048 | 19,02 | 21,39 | 16,74 |
Für das Basismodell verwenden wir das weit verbreitete Open-Source-Evaluierungsframework lm-evaluation-harness [125], mit Ausnahme der HumanEval-FIM-Metrik, die vom Framework nicht unterstützt wird. Für HumanEval-FIM beim Basismodell und alle Evaluierungsmetriken beim Instruct-Modell verwenden wir eine interne Evaluierungsbibliothek. Wir wählen die interne Bibliothek, da lm-evaluation-harness eine größere Abweichung von den von Yang et al. [25] berichteten LLaMA3-Ergebnissen zeigt, relativ zu unserer internen Evaluierung.
Für Benchmarks, die mittels bedingter Likelihood-Schätzung bewertet werden, verwenden wir Monte-Carlo-Schätzung, um Gl. [6] für LLaDA zu approximieren. Da MMLU, CMMLU und C-EVAL nur die Likelihood eines einzelnen Tokens erfordern, ist eine einzelne Monte-Carlo-Schätzung für diese Benchmarks ausreichend. Für alle anderen Benchmarks stellen wir fest, dass 128 Monte-Carlo-Stichproben ausreichen, um stabile Ergebnisse zu erzeugen.
Für Benchmarks, die mittels bedingter Generierung bewertet werden, wenden wir reines Diffusions-Sampling mit einer Remasking-Strategie geringer Konfidenz sowohl auf LLaDA Base als auch auf LLaDA Instruct an. Für LLaDA Base setzen wir sowohl die Generierungslänge als auch die Anzahl der Sampling-Schritte auf 1024. Für LLaDA Instruct wird die Anzahl der Sampling-Schritte gleich der Antwortlänge gesetzt, die wie folgt konfiguriert ist: 3 für MMLU und HellaSwag, 64 für GPQA, 256 für MBPP und MMLU-Pro sowie 512 für HumanEval, GSM8K, Math und ARC-C. Wie in Anhang [B.4] ausführlich dargestellt, setzen wir für HumanEval, MBPP, GSM8K, Math und GPQA die Konfidenz des |EOS|-Tokens während des Samplings für LLaDA Instruct auf null.
B.7 Analyse der Sampling-Effizienz
In diesem Abschnitt analysieren wir zunächst die Sampling-Effizienz von LLaDA, einschließlich sowohl der Sampling-Geschwindigkeit als auch des Speicherverbrauchs. Anschließend erörtern wir mögliche Optimierungen zur weiteren Verbesserung ihrer Effizienz.
Für die Analyse der Sampling-Geschwindigkeit verwenden wir vier repräsentative offene Generierungs-Benchmarks: GSM8K, Math, HumanEval und MBPP. Wir verwenden die weit verbreitete Durchsatzmetrik zur Messung der Generierungsgeschwindigkeit, definiert als die Anzahl der pro Sekunde generierten Token. Wir vergleichen LLaDA 8B Base und LLaMA3 8B Base, beide mit bfloat16-Präzision. Alle Experimente in diesem Abschnitt wurden auf einer einzelnen A100-80GB-GPU mit einer Batch-Größe von 1 durchgeführt. Für LLaDA ist die Ausgabelänge über alle vier Benchmarks hinweg auf 256 Token festgelegt.
Abb. 5 zeigt, dass LLaDA durch Anpassung der Anzahl der Sampling-Schritte einen flexiblen Kompromiss zwischen Generierungsqualität und Geschwindigkeit ermöglicht. Konkret erreicht LLaDA 8B Base auf den Datensätzen GSM8K und Math eine vergleichbare Leistung wie LLaMA3 8B Base und liefert dabei 1,5- bzw. 1,8-mal höheren Durchsatz, obwohl LLaMA3 KV-Cache verwendet und LLaDA ohne jegliche Inferenz-Optimierungstechniken arbeitet. Beim HumanEval-Benchmark erzielt LLaDA 8B Base eine vergleichbare Leistung wie LLaMA3 8B Base, wenn der Durchsatz angeglichen wird. Beim MBPP-Benchmark bleibt LLaDA 8B Base hinter LLaMA3 8B Base zurück.
Bei LLaMA3 ist der durch KV-Caching gebotene Beschleunigungsvorteil beim HumanEval-Datensatz deutlich schwächer, was auf dessen relativ kurze Prompt-Längen zurückzuführen ist. Konkret betragen die durchschnittlichen Prompt-Längen für GSM8K, Math, MBPP und HumanEval 894, 680, 628 bzw. 132 Token.
Tab. [1] vergleicht den Speicherverbrauch zwischen LLaDA 8B Base und LLaMA3 8B Base. Um Schwankungen der Generierungslänge aufgrund unterschiedlicher Trainingsdaten zu vermeiden, legen wir während der Speicheranalyse sowohl die Eingabe- als auch die Ausgabe-Token-Länge fest. Bei LLaDA bleibt der Speicherverbrauch unabhängig von der Anzahl der Sampling-Schritte konstant. Sein Speicherverbrauch ist vergleichbar mit dem von LLaMA3 8B Base ohne KV-Cache, aber etwas höher als mit KV-Cache.
| 4 Schritte | 5 Schritte | 6 Schritte | |
| LLaMA3 8B Base | 38,0 | 35,0 | 34,0 |
| LLaDA 8B Base | 64,0 | 41,0 | 44,0 |
Wir betonen, dass das Ziel dieser Studie nicht darin besteht, ein Modell vorzuschlagen, das schneller als ARMs ist. Stattdessen möchten wir das Potenzial von Diffusionsmodellen für die Sprachmodellierung im großen Maßstab aufzeigen und die gängige Annahme infrage stellen, dass Kernfähigkeiten von LLMs wie Skalierbarkeit, In-Context-Learning und Instruction-Following inhärent von ARMs abhängen. Ein umfangreicher Forschungsbereich [31, 79, 87] hat sich auf die Verbesserung der Generierungseffizienz von MDMs durch algorithmische oder architektonische Innovationen konzentriert. Eine ähnliche effizienzorientierte Untersuchung für LLaDA überlassen wir zukünftiger Arbeit.
B.8 Evaluierung auf dem iGSM-Datensatz
Um die mathematischen Fähigkeiten von LLaDA weiter zu bewerten, testen wir seine Leistung auf iGSM [34], einem unendlichen, synthetischen GSM8K-ähnlichen Datensatz. iGSM wird durch spezifische Regeln generiert, wobei Parameter die Schwierigkeit der Probleme (d. h. die Anzahl der Lösungsschritte) steuern. Für die Konsistenz der Evaluierung hängen wir „#### Sanswer" an die endgültige Lösung an und folgen dabei dem GSM8K-Format. Unten ist ein Beispiel mit Lösungsschritten gleich 4:
(Frage) Die Anzahl jedes Cultural Studies Classroom der North Star Elementary beträgt 1. Die Anzahl jedes Dance Studio der Westridge Elementary beträgt das Dreifache der Summe aus jedem Classroom der North Star Elementary und jedem Cultural Studies Classroom der North Star Elementary. Wie viele Dance Studios hat die Westridge Elementary? (Lösung) Definiere den Cultural Studies Classroom der North Star Elementary als ; also . Definiere den Classroom der North Star Elementary als ; also . Definiere das Dance Studio der Westridge Elementary als ; ; also #### 1
Da es geringfügige Unterschiede zwischen GSM8K und iGSM gibt (z. B. die Verwendung eines algorithmischen Systems modulo 5), folgen wir [34] und stellen einen System-Prompt zusammen mit vier Frage-Antwort-Paaren (Four-Shot) für jedes Problem bereit.
(Prompt) Du bist ein Experte im Lösen elementarer mathematischer Probleme mit Addition, Subtraktion und Multiplikation. Du löst alle Probleme in einem einheitlichen Format. Alle Berechnungen werden modulo 5 durchgeführt. Zum Beispiel ergibt 3, ergibt 1, ergibt 4, ergibt 4 und ergibt 4. Wenn du deine Lösung angibst, beende sie bitte mit '#### x.', wobei x deine endgültige Antwort ist, eine ganze Zahl zwischen 0 und 4. Du musst alle Probleme im selben Lösungsformat lösen. Unsere Szenarien umfassen bis zu vier Kategorien von Objekten: Schulen, Klassenzimmer, Rucksäcke und Schreibwaren. Jede Schule kann Klassenzimmer enthalten, jedes Klassenzimmer kann Rucksäcke enthalten und jeder Rucksack kann Schreibwaren enthalten. Wir können Mengen angeben, wie die Anzahl der Tanzstudios an jeder Lakeshore High. Gehe davon aus, dass jede Entität mit demselben Namen eine identische Konfiguration hat; zum Beispiel enthält jede Lakeshore High dieselbe Anzahl an Tanzstudios. Ein weiteres Leitprinzip ist, dass das, was nicht erwähnt wird, nicht existiert: Wenn wir uns auf Klassenzimmer an der Lakeshore High beziehen, sprechen wir nur über die Klassenzimmer, die in unserem Szenario ausdrücklich erwähnt werden. Wenn die Lakeshore High nicht einmal erwähnt wird, gilt außerdem jedes Klassenzimmer darin automatisch als nicht existent (d. h. 0).
Für Lösungsschritte von 4 bis 6 generieren wir 100 Fragen für jeden Fall und berichten die entsprechende Genauigkeit in Tabelle [2]. Wie die Tabelle zeigt, weist LLaDA 8B Base bei ungesehenen mathematischen Problemen signifikante und konsistente Vorteile gegenüber LLaMA3 8B Base auf, was mit den Ergebnissen in Tabelle [1] übereinstimmt.
| User LLaDA | Welche Vorteile hat regelmäßige Bewegung für die körperliche und psychische Gesundheit? | ||||||||||
| Regelmäßige Bewegung | kann | die körperliche | Gesundheit | verbessern, | indem | sie | Muskeln | und | Knochen | stärkt, | |
| die | kardiovaskuläre | Gesundheit | verbessert | und | das | Risiko | chronischer | Erkrankungen | wie | Diabetes | |
| und | Herzkrankheiten | verringert. | Sie | kann | auch | die psychische | Gesundheit | und | Angstzustände | verbessern, | |
| die Stimmung | heben | und | die kognitive | Funktion | steigern. | Darüber hinaus | kann | Bewegung | die | Schlafqualität | |
| verbessern | und | das Energieniveau | erhöhen. | ||||||||
B.9 Aufgaben zur Gedichtvervollständigung
In diesem Abschnitt präsentieren wir Beispiele aus unserem Datensatz zur Gedichtvervollständigung wie folgt.
Beispiel 1:
Prompt: 窈窕淑女的下一句是什么? 直接输出句子即可。
Antwort: 君子好逑。
Beispiel 2:
Prompt: 不拘一格降人才的上一句是什么? 直接输出句子即可。
Antwort: 我劝天公重抖擞。
B.10 Weitere Fallstudien
In diesem Abschnitt präsentieren wir weitere Fallstudien zu LLaDA 8B Instruct. Zunächst zeigt Tab. [13] den Sampling-Prozess des Block-Diffusions-Samplings von LLaDA, während Tab. [14] den Sampling-Prozess für Multi-Turn-Dialoge mit zufälligem Remasking darstellt. Darüber hinaus liefern Tab. [15] und Tab. [16] weitere Beispiele für Single-Turn- und Multi-Turn-Dialoge. Schließlich präsentiert Tab. [17] Beispiele für Gedicht-Rückwärtsvervollständigungen, bei denen das Modell LLaDA 8B Instruct erfolgreich ist, im Gegensatz zum Scheitern von GPT-4o.
C Impact Statement
Unsere Arbeit zeigt das Potenzial von Diffusionsmodellen für die Sprachmodellierung im großen Maßstab und stellt die gängige Annahme infrage, dass Kernfähigkeiten von LLMs wie Skalierbarkeit, In-Context-Learning und Instruction-Following inhärent von ARMs abhängen. Unsere Ergebnisse eröffnen neue Wege zur Erforschung alternativer probabilistischer Paradigmen in der Verarbeitung natürlicher Sprache, mit potenziellen Anwendungen in konversationeller KI, Codegenerierung und komplexen Reasoning-Aufgaben.
Allerdings werfen Diffusionsmodelle, wie traditionelle LLMs, ähnliche gesellschaftliche Bedenken auf. Dazu gehören die Umweltauswirkungen groß angelegten Trainings, der potenzielle Missbrauch zur Generierung schädlicher Inhalte und die Verstärkung von Verzerrungen, die in Trainingsdaten vorhanden sind. Die Bewältigung dieser Herausforderungen ist entscheidend, um die verantwortungsvolle Entwicklung und den Einsatz von Diffusionssprachmodellen zu gewährleisten.
Tabelle 14: Visualisierung des Multi-Turn-Dialogs. Wir verwenden eine Strategie des zufälligen Remaskings. In der Antwort von LLaDA zeigen dunklere Farben Token an, die in späteren Phasen des Samplings vorhergesagt wurden, während hellere Farben früheren Vorhersagen entsprechen.
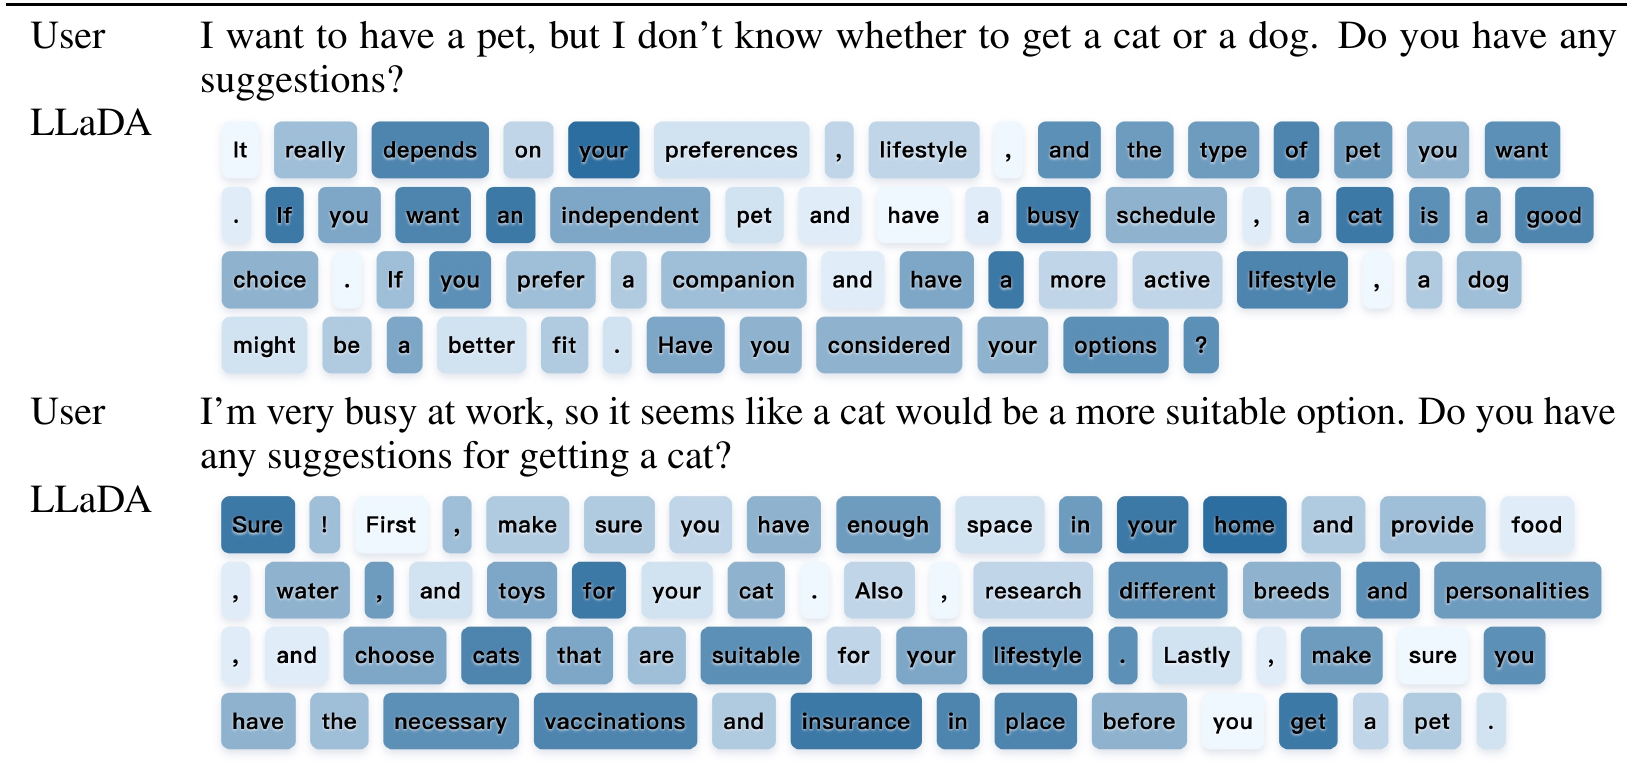
| Alltagsleben User LLaDA | Welchen Ratschlag, den du erhalten hast, fandest du hilfreich? Ein hilfreicher Ratschlag, den ich erhalten habe, ist, stets offen für Lernen und Wachstum zu sein. Ich habe festgestellt, dass die Bereitschaft, neue Ideen und Erfahrungen zu erkunden, mir geholfen hat, widerstandsfähiger und anpassungsfähiger zu werden. Indem ich eine Wachstumsmentalität angenommen habe, konnte ich Möglichkeiten zur Verbesserung und Entwicklung erkennen, sowohl persönlich als auch beruflich. |
| Alltagsleben User LLaDA | Bitte empfiehl mir drei berühmte Filme Gerne! Hier sind drei berühmte Filme, die große Popularität und kritische Anerkennung erlangt haben: 1. Die Verurteilten (1994) – Inspiriert von einer Novelle und unter der Regie von Frank Darabont erzählt dieser Film die Geschichte von Andy Dufresne, einem Mann, der wegen Mordes an seiner Frau verurteilt wurde, der sein hartes Leben im Shawshank-Gefängnis bewältigt und eine unwahrscheinliche Freundschaft mit einem Mitinsassen schließt. 2. Der Pate (1972) – Unter der Regie von Francis Ford Coppola basiert dieser Film auf Mario Puzos gleichnamigem Roman. Er folgt der Geschichte der Familie Corleone, insbesondere Michael Corleone, der an die Macht aufsteigt und das kriminelle Imperium der Familie übernimmt. 3. Das Imperium schlägt zurück (1980) – Unter der Regie von George Lucas setzt dieser Film die Geschichte eines jungen Skywalkers in der Star-Wars-Saga fort. Er folgt Luke Skywalker, während er der Rebellenallianz hilft, gegen das Galaktische Imperium zu kämpfen und die mächtige Waffe, den Todesstern, zu zerstören. Alle diese Filme werden für ihre filmischen Leistungen, ihr kraftvolles Erzählen und ihre unvergesslichen Figuren gefeiert. |
| Übersetzung User LLaDA | Bitte hilf mir, ins Chinesische zu übersetzen: ‚What is now proved was once only imagined‘ 现在被证明的曾经只是想象 |
| Übersetzung User LLaDA | Bitte hilf mir, ins Deutsche zu übersetzen: ‚What is now proved was once only imagined‘ 我把他去查查过,我其实没再问啊。 |
| Mathematik User LLaDA | Emma beschließt, 4 Sprints 5 Mal pro Woche zu laufen. Sie läuft 75 Meter pro Sprint. Wie viele Meter läuft sie insgesamt pro Woche? Emma läuft jedes Mal 4 Sprints, also läuft sie insgesamt 4 x 5 = 20 Sprints pro Woche. Jeder Sprint ist 75 Meter lang, also läuft Emma insgesamt 20 x 75 = 1500 Meter pro Woche. Das Endergebnis ist 1500 |
| Code User LLaDA | Ich schreibe Python-Code, ich habe ein Array, bitte hilf mir, es vom größten zum kleinsten zu sortieren Gerne! Du kannst ein Array in Python mit der Methode ‚sort()‘ oder der Funktion ‚sorted()‘ vom größten zum kleinsten sortieren. Hier ist ein Beispiel: ### Verwendung der Methode ‚sort()‘: my_array = [3, 1, 4, 1, 5, 2] my_array.sort(reverse=True) print(my_array) |
| Alltag | |
| Nutzer | Wie bereite ich mich auf ein Vorstellungsgespräch vor? |
| LLaDA | Um sich auf ein Vorstellungsgespräch vorzubereiten, sollten Sie das Unternehmen und die Stelle recherchieren, gängige Interviewfragen üben und sich angemessen kleiden. |
| Nutzer | Was sind einige gängige Interviewfragen? |
| LLaDA | Einige gängige Interviewfragen sind "Erzählen Sie mir von sich" und "Warum möchten Sie für uns arbeiten"? |
| Alltag | |
| Nutzer | Wie beginne ich mit dem Programmierenlernen? |
| LLaDA | Um Programmieren zu lernen, können Sie damit beginnen, eine Programmiersprache zu wählen, die Sie interessiert. Einige beliebte Sprachen sind Python, Java und C++. |
| Nutzer | Welche Programmiersprache sollte ich zuerst lernen? |
| LLaDA | Das hängt von Ihren Interessen und Zielen ab. Python ist aufgrund seiner Einfachheit und Vielseitigkeit eine großartige Sprache für Anfänger. |
| Nutzer | Wie lange dauert es, Python zu lernen? |
| LLaDA | Das Erlernen von Python kann zwischen einigen Wochen und mehreren Monaten dauern. |
| Nutzer | Welche guten Python-Projekte gibt es für Anfänger? |
| LLaDA | Einige gute Python-Projekte für Anfänger sind der Bau eines einfachen Taschenrechners, eines Spiels und einer Webanwendung. |
| Mathematik | |
| Nutzer | Natalia verkaufte im April Clips an 48 ihrer Freunde und verkaufte dann im Mai halb so viele Clips. Wie viele Clips verkaufte Natalia im April und Mai insgesamt? |
| LLaDA | Natalia verkaufte im April Clips an 48 Freunde. Im Mai verkaufte sie halb so viele Clips, also verkaufte sie 48/2 = 24 Clips im Mai. Insgesamt verkaufte Natalia im April und Mai 48 + 24 = 72 Clips. Das Endergebnis ist 72. |
| Nutzer | Natalia verkaufte im Juni dreimal so viele Artikel wie im Mai. Wie viele Clips verkaufte Natalia in diesen drei Monaten insgesamt? |
| LLaDA | Natalia verkaufte im April Clips an 48 Freunde. Im Mai verkaufte sie halb so viele Clips, also verkaufte sie 48/2 = 24 Clips im Mai. Natalia verkaufte im Juni dreimal so viele Artikel wie im Mai, also verkaufte sie 24 * 3 = 72 Clips im Juni. Insgesamt verkaufte Natalia in diesen drei Monaten 48 + 24 + 72 = 144 Clips. Das Endergebnis ist 144. |
| Nur-Lese-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): Tabelle 14: Visualisierung des Multi-Turn-Dialogs. Wir verwenden eine zufällige Remasking-Strategie. In der Antwort von LLaDA zeigen dunklere Farben Token an, die in späteren Stadien der Stichprobenentnahme vorhergesagt wurden, während hellere Farben früheren Vorhersagen entsprechen. Zu übersetzender Text: Frage1 | |
| Benutzer | Was ist die vorherige Zeile von „但闻人语响“? |
| GPT-4o | Die vorherige Zeile von „但闻人语响“ ist „无可奈何花落去“. Diese beiden Zeilen stammen von der Dichterin der Tang-Dynastie Li Qingzhao aus (武陵春,春晚: 无可奈何花落去,但闻人语响. Dieses Gedicht drückt die Einsamkeit und Sentimentalität der Autorin im Frühling aus und spiegelt durch die Beschreibung des fallenden Blumen und der menschlichen Stimmen die Hilflosigkeit und den Verlust im Inneren der Dichterin wider. |
| LLaDA | Die vorherige Zeile von „但闻人语响“ ist „空山不见人“ |
| Frage2 | |
| Benutzer | Was ist die vorherige Zeile von „夜静春山空“? |
| GPT-4o | Die vorherige Zeile von „夜静春山空“ ist „空山新雨后“. Diese beiden Zeilen stammen von dem Dichter der Tang-Dynastie Wang Wei aus (山居秋 膜): 空山新雨后,夜静春山空. Dieses Gedicht beschreibt die Stille und Leere im Berg nach dem Regen im Frühling und zeigt die Ruhe und harmonische Schönheit der Natur. |
| LLaDA | Die vorherige Zeile von „夜静春山空“ ist „人闲桂花落“ |
| Modell | Trainings-Tokens | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| LLaDA 1B | 37,75B | 2,20e20 | 25,52 | 25,95 | 25,17 | 59,41 | 1,82 | 0,00 |
| LLaDA 1B | 88,08B | 5,13e20 | 27,11 | 26,52 | 26,96 | 61,86 | 3,03 | 1,83 |
| LLaDA 1B | 138,41B | 8,06e20 | 29,32 | 27,13 | 30,20 | 63,38 | 2,35 | 0,00 |
| LLaDA 1B | 239,08B | 1,39e21 | 31,48 | 30,77 | 27,99 | 63,11 | 3,26 | 1,22 |
| LLaDA 1B | 352,32B | 2,05e21 | 35,86 | 34,35 | 31,31 | 65,34 | 3,64 | 3,05 |
| LLaDA 1B | 461,37B | 2,69e21 | 31,86 | 30,98 | 30,12 | 65,51 | 2,35 | 0,61 |
| LLaDA 8B | 62,91 Mrd. | 2,63e21 | 32,22 | 28,5 | 30,20 | 63,82 | 3,87 | 2,44 |
| LLaDA 8B | 125,83 Mrd. | 5,27e21 | 33,39 | 33,9 | 34,64 | 66,54 | 8,72 | 3,66 |
| LLaDA 8B | 251,66 Mrd. | 1,05e22 | 42,84 | 40,59 | 40,10 | 69,04 | 15,31 | 3,66 |
| LLaDA 8B | 377,49 Mrd. | 1,58e22 | 45,11 | 43,99 | 39,25 | 68,61 | 25,40 | 9,76 |
| LLaDA 8B | 503,32 Mrd. | 2,11e22 | 43,57 | 41,38 | 42,06 | 70,24 | 27,52 | 9,76 |
| LLaDA 8B | 629,14 Mrd. | 2,63e22 | 48,80 | 47,13 | 42,24 | 72,09 | 30,10 | 12,80 |
| LLaDA 8B | 679,48 Mrd. | 2,85e22 | 49,61 | 48,19 | 41,30 | 70,84 | 26,31 | 8,54 |
| LLaDA 8B | 792,72 Mrd. | 3,31e22 | 50,88 | 49,01 | 42,58 | 70,51 | 31,99 | 6,10 |
| LLaDA 8B | 981,47B | 4,11e22 | 49,47 | 48,10 | 40,27 | 71,38 | - | 6,10 |
| LLaDA 8B | 1107,30B | 4,64e22 | 51,13 | 47,57 | 41,13 | 69,26 | 36,69 | 10,37 |
| LLaDA 8B | 1233,13B | 5,16e22 | 50,52 | 49,72 | 45,05 | 71,49 | 38,97 | 9,76 |
| LLaDA 8B | 1358,95B | 5,69e22 | 54,61 | 53,97 | 49,40 | 74,05 | 48,14 | 17,68 |
| LLaDA 8B | 1547,70B | 6,48e22 | 57,38 | 56,04 | 49,49 | 74,59 | 53,30 | 20,73 |
| LLaDA 8B | 1975,52B | 8,27e22 | 58,52 | 57,87 | 50,68 | 75,35 | - | 19,51 |
| Tabelle 14: Visualisierung des Multi-Turn-Dialogs. Wir verwenden eine zufällige Remasking-Strategie. In der Antwort von LLaDA zeigen dunklere Farben Token an, die in späteren Phasen der Stichprobenentnahme vorhergesagt wurden, während hellere Farben früheren Vorhersagen entsprechen. | Zu übersetzender Text: Modell | Trainings-Token | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K |
| HumanEval | ARM 1B | 37,75B | 2,20e20 | 25,47 | 25,38 | 30,20 | 67,36 | 2,20 |
| 4,88 | ARM 1B | 88,08B | 5,13e20 | 24,67 | 25,23 | 33,96 | 70,02 | 7,51 |
| 10,37 | ARM 1B | 138,41B | 8,06e20 | 29,25 | 27,48 | 33,45 | 70,29 | 8,34 |
| 9,76 | ARM 7B | 17,30B | 6,02e20 | 26,92 | 25,18 | 21,02 | 57,18 | 1,29 |
| 1,22 | ARM 7B | 34,60B | 1,20e21 | 25,83 | 25,38 | 24,07 | 62,84 | 1,59 |
| 2,44 | ARM 7B | 86,50B | 3,01e21 | 24,41 | 24,90 | 25,42 | 71,11 | 2,88 |
| 7,93 ARM 7B | 173,02 Mrd. | 6,02e21 | 26,20 | 24,78 | 26,10 | 74,27 | 6,67 | 9,15 |
| ARM 7B | 207,62 Mrd. | 7,23e21 | 30,36 | 28,86 | 31,86 | 74,48 | 8,57 | 12,80 |
| ARM 7B | 224,92 Mrd. | 7,83e21 | 29,49 | 32,26 | 31,19 | 74,37 | 8,95 | 8,54 |
| ARM 7B | 242,22 Mrd. | 8,43e21 | 33,62 | 31,38 | 34,92 | 75,41 | 10,84 | 9,15 |
| ARM 7B | 259,52 Mrd. | 9,03e21 | 34,11 | 34,20 | 32,88 | 75,19 | 9,33 | 10,98 |
| ARM 7B | 311,43 Mrd. | 1,08e22 | 35,66 | 35,49 | 36,61 | 75,14 | 11,30 | 10,37 |
| ARM 7B | 363,33 Mrd. | 1,26e22 | 34,54 | 37,67 | 34,58 | 76,55 | 12,28 | 14,02 |
| ARM 7B | 415,24 Mrd. | 1,45e22 | 35,37 | 38,37 | 35,25 | 76,39 | 14,40 | 12,80 |
| ARM 7B | 449,84 Mrd. | 1,57e22 | 39,51 | 39,24 | 34,92 | 76,82 | 14,94 | 14,63 |
| ARM 7B | 519,09 Mrd. | 1,81e22 | 40,30 | 40,69 | 37,29 | 77,15 | 14,03 | 14,63 |
| ARM 7B | 778,57 Mrd. | 2,71e22 | 43,33 | 43,50 | 38,31 | 77,53 | 17,59 | 14,63 |
| ARM 7B | 1038,09 Mrd. | 3,61e22 | 45,06 | 46,12 | 41,69 | 77,86 | 20,02 | 15,85 |
| ARM 7B | 1384,12 Mrd. | 4,82e22 | 47,63 | 48,18 | 47,80 | 76,93 | 22,82 | 15,24 |
| ARM 7B | 2076,18 Mrd. | 7,23e22 | 47,68 | 50,85 | 44,07 | 77,37 | 24,79 | 14,63 |
| ARM 7B | 2214,59 Mrd. | 7,71e22 | 49,26 | 52,08 | 53,56 | 77,69 | 27,37 | 17,07 |