
Einfach denselben Prompt oft sampeln: die Abdeckung steigt auch bei 10.000 Versuchen weiter, ein Verifier macht daraus Genauigkeit. Papier 2024.
Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
Große Sprachaffen: Skalierung der Inferenzrechenleistung durch wiederholtes Sampling
Bradley Brown\†‡, Jordan Juravsky\†, Ryan Ehrlich\*†, Ronald Clark‡, Quoc V. Le§, Christopher Ré† und Azalia Mirhoseini†§
†Department of Computer Science, Stanford University ‡University of Oxford §Google DeepMind
bradley.brown@cs.ox.ac.uk, jbj@stanford.edu, ryanehrlich@cs.stanford.edu, ronald.clark@cs.ox.ac.uk, qvl@google.com, chrismre@stanford.edu, azalia@stanford.edu
Zusammenfassung
Die Skalierung der Rechenleistung, die zum Training von Sprachmodellen verwendet wird, hat deren Fähigkeiten dramatisch verbessert. Bei der Inferenz hingegen beschränken wir Modelle oft darauf, nur einen einzigen Versuch für ein Problem zu unternehmen. Hier untersuchen wir die Inferenzrechenleistung als eine weitere Achse der Skalierung, indem wir die einfache Technik des wiederholten Samplings von Kandidatenlösungen aus einem Modell nutzen. Über mehrere Aufgaben und Modelle hinweg beobachten wir, dass die Abdeckung – der Anteil der Probleme, die durch irgendein generiertes Sample gelöst werden – über vier Größenordnungen hinweg mit der Anzahl der Samples skaliert. Interessanterweise ist die Beziehung zwischen Abdeckung und Anzahl der Samples oft log-linear und lässt sich mit einem exponenzierten Potenzgesetz modellieren, was auf die Existenz von Skalierungsgesetzen für die Inferenzzeit hindeutet. In Bereichen wie dem Programmieren und formalen Beweisen, in denen Antworten automatisch verifiziert werden können, schlagen sich diese Steigerungen der Abdeckung direkt in verbesserter Leistung nieder. Wenn wir wiederholtes Sampling auf SWE-bench Lite anwenden, steigt der Anteil der gelösten Issues mit DeepSeek-Coder-V2-Instruct von 15,9 % mit einem Sample auf 56 % mit 250 Samples und übertrifft damit den Ein-Sample-Stand der Technik von 43 %. In Bereichen ohne automatische Verifizierer stellen wir fest, dass gängige Methoden zur Auswahl aus einer Sammlung von Samples (Mehrheitsabstimmung und Reward-Modelle) jenseits mehrerer hundert Samples ein Plateau erreichen und nicht vollständig mit dem Sample-Budget skalieren.
1 Einleitung
Die Fähigkeit großer Sprachmodelle (LLMs), Programmier-, Mathematik- und andere Denkaufgaben zu lösen, hat sich in den vergangenen Jahren dramatisch verbessert [47, 11, 2, 4]. Die Skalierung der Trainingsrechenleistung durch größere Modelle, längere Vor-Trainingsläufe und größere Datensätze war ein beständiger Treiber dieser Fortschritte [27, 37, 28].
Im Gegensatz dazu wurde vergleichsweise wenig in die Skalierung der während der Inferenz verwendeten Rechenleistung investiert. Größere Modelle benötigen zwar mehr Inferenzrechenleistung als kleinere, und Prompting-Techniken wie Chain-of-Thought [61] können die Antwortqualität auf Kosten längerer (und damit rechenintensiverer) Ausgaben erhöhen. Bei der Interaktion mit LLMs beschränken Nutzer und Entwickler Modelle jedoch oft darauf, beim Lösen eines Problems nur einen einzigen Versuch zu unternehmen.
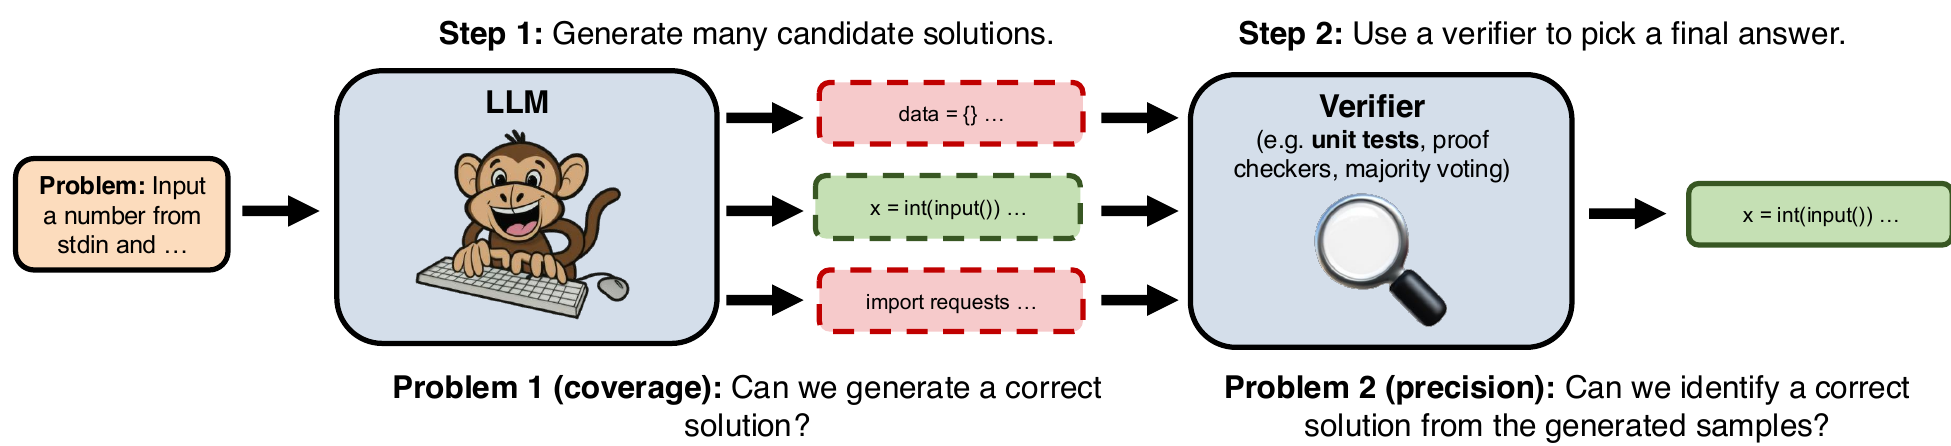
In dieser Arbeit untersuchen wir wiederholtes Sampling (Abbildung 1) als einen einfachen Ansatz zur Skalierung der Inferenzrechenleistung, um die Denkleistung zu verbessern. Bestehende Arbeiten liefern ermutigende Beispiele dafür, dass wiederholtes Sampling in Mathematik-, Programmier- und Rätsellösungsszenarien vorteilhaft sein kann [60, 48, 23]. Insbesondere AlphaCode [41], ein hochmodernes System für kompetitives Programmieren, stellt fest, dass sich die Leistung mit einer Million Samples pro Problem weiter verbessert. Unser Ziel ist es, diese Vorteile systematisch über eine Reihe von Aufgaben, Modellen und Sample-Budgets hinweg zu charakterisieren.
Die Wirksamkeit von wiederholtem Sampling wird durch zwei Schlüsseleigenschaften bestimmt:
1. Abdeckung: Mit steigender Anzahl von Samples – welchen Anteil der Probleme können wir mit irgendeinem generierten Sample lösen?
2. Präzision: Wie oft können wir korrekte Samples aus unserer Sammlung von Generierungen identifizieren?
Beide Eigenschaften sind erforderlich, um eine starke reale Leistung zu erzielen. Mit unbegrenzten Samples wird jedes Modell, das jeder Sequenz eine von null verschiedene Wahrscheinlichkeit zuweist, eine perfekte Abdeckung erreichen. Wiederholtes Sampling ist jedoch nur dann praktikabel, wenn wir die Abdeckung mit einem realisierbaren Budget verbessern können. Ebenso ist die Generierung großer Sample-Sammlungen nur dann nützlich, wenn die korrekten Samples in einer Sammlung identifiziert werden können. Die Schwierigkeit des Präzisionsproblems kann je nach Aufgabe variieren. In einigen Szenarien können bestehende Werkzeuge wie Beweisprüfer und Unit-Tests jedes Sample automatisch verifizieren. In anderen Fällen, etwa beim Lösen von Textaufgaben, sind andere Verifikationsmethoden erforderlich.
Bei der Untersuchung der Abdeckung zunächst stellen wir fest, dass Sampling bis zu 10.000 Mal pro Problem die Abdeckung bei Mathematik- und Programmieraufgaben erheblich steigern kann (Abschnitt 2). Beim Lösen von CodeContests-Programmierproblemen [41] mit Gemma-2B [52] erhöhen wir die Abdeckung um über das 300-Fache, von 0,02 % mit einem Sample auf 7,1 % mit 10.000 Samples. Interessanterweise folgt die Beziehung zwischen log(Abdeckung) und der Anzahl der Samples oft einem annähernden Potenzgesetz (Abschnitt 3). Mit Llama-3 [3] und Gemma-Modellen führt dies dazu, dass die Abdeckung über mehrere Größenordnungen hinweg nahezu log-linear mit der Anzahl der Samples wächst.
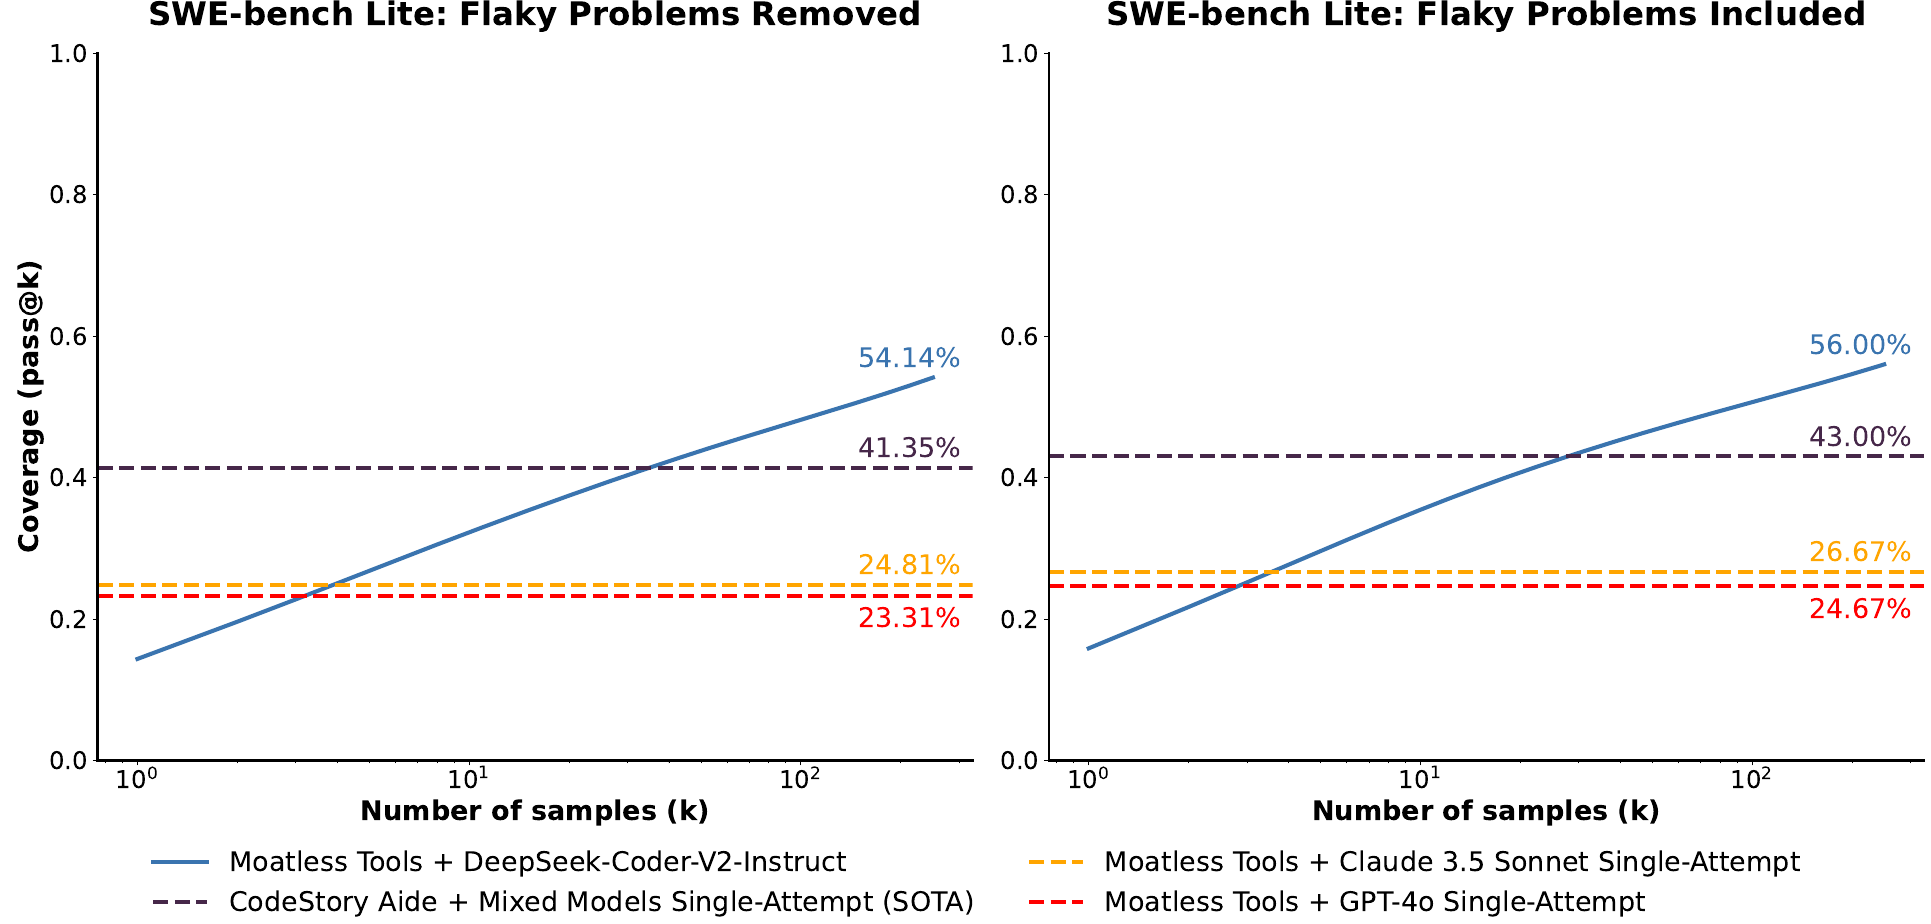
In Szenarien mit automatischen Verifikationswerkzeugen schlagen sich Steigerungen der Abdeckung direkt in verbesserter Aufgabenleistung nieder. Bei der Anwendung von wiederholtem Sampling auf kompetitives Programmieren und das Schreiben von Lean-Beweisen können Modelle wie Llama-3-8B-Instruct die Ein-Sample-Leistung von deutlich stärkeren Modellen wie GPT-4o [2] übertreffen. Diese Fähigkeit, schwächere Modelle zu verstärken, erstreckt sich auf den anspruchsvollen SWE-bench-Lite-Datensatz realer GitHub-Issues [32], bei dem der aktuelle Ein-Sample-Stand der Technik (SOTA), erreicht durch eine Mischung aus GPT-4o und Claude 3.5 Sonnet, 43 % beträgt [1]. Beschränkt auf ein einziges Sample löst DeepSeek-Coder-V2-Instruct [20] nur 15,9 % der Issues. Durch einfaches Erhöhen der Anzahl der Samples auf 250 steigern wir den Anteil gelöster Issues auf 56 % und übertreffen damit den Stand der Technik um 13 %.
Neben der Verbesserung der Modellqualität bietet wiederholtes Sampling einen neuen Mechanismus zur Minimierung der LLM-Inferenzkosten (Abschnitt 2.3). Wenn wir die Gesamtzahl der Inferenz-FLOPs konstant halten, stellen wir fest, dass auf einigen Datensätzen (z. B. MATH) die Abdeckung mit einem kleineren Modell und mehr Samples maximiert wird, während es auf anderen (z. B. CodeContests) besser ist, weniger oft von einem größeren Modell zu samplen. Wir vergleichen auch die API-Preise zwischen DeepSeek-Coder-V2-Instruct, GPT-4o und Claude Sonnet 3.5 im Kontext der Lösung von SWE-bench-Lite-Issues. Bei konstant gehaltenem Agenten-Framework (Moatless Tools [67]) löst das fünfmalige Samplen vom schwächeren und günstigeren DeepSeek-Modell mehr Issues als einzelne Samples von Claude oder GPT und ist dabei über dreimal günstiger.
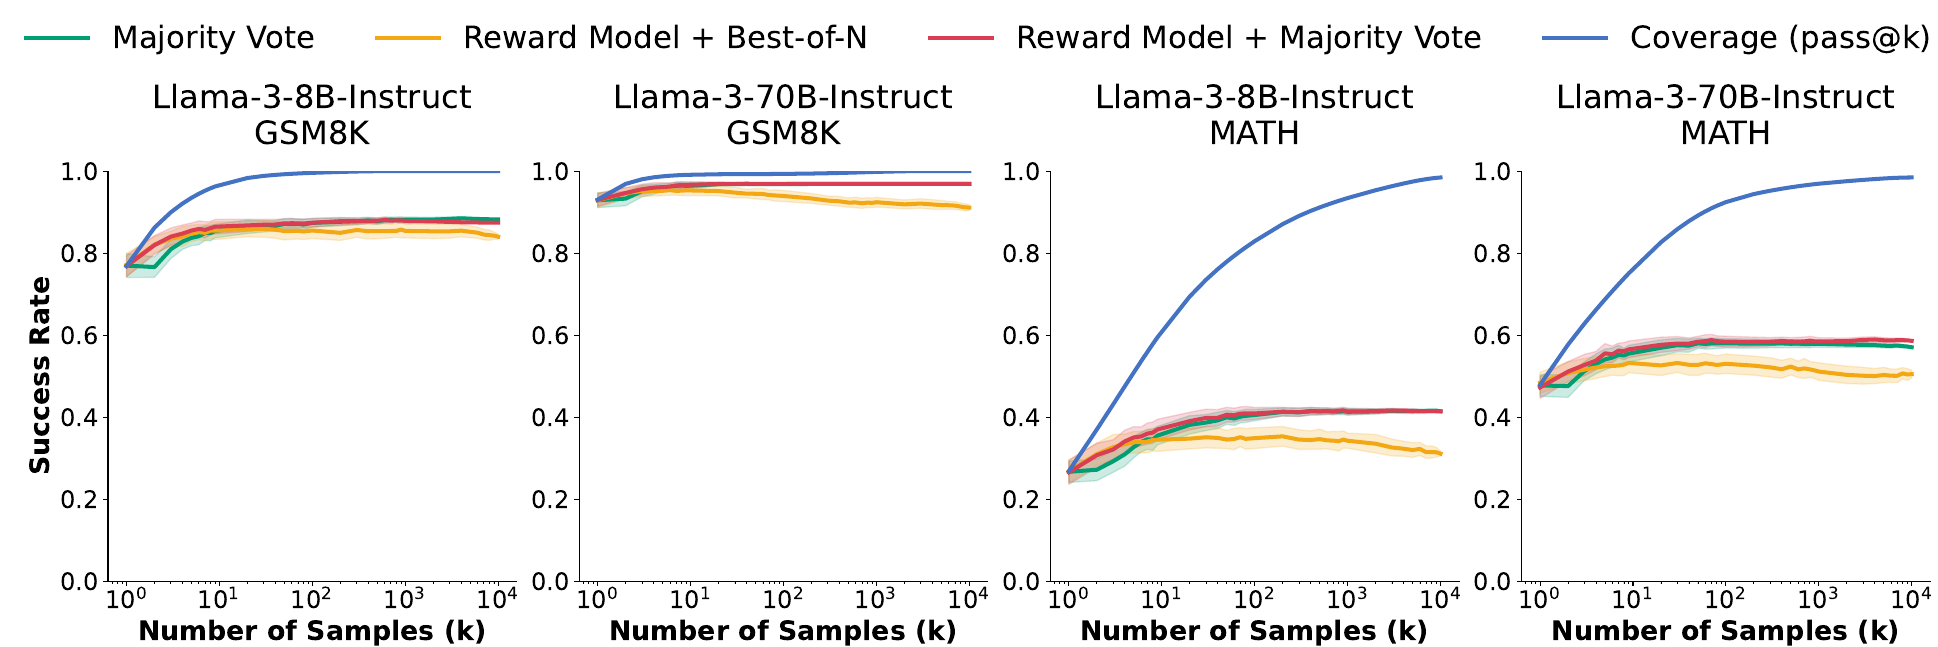
Schließlich zeigen wir, dass skalierbare Verifikation notwendig ist, um vollständig von wiederholtem Sampling zu profitieren. Mit steigender Anzahl von Samples verbessert sich die Abdeckung dadurch, dass Modelle korrekte Lösungen für Probleme generieren, die sie zuvor nicht gelöst haben. Diese zunehmend seltenen korrekten Generierungen sind jedoch nur dann vorteilhaft, wenn Verifizierer „die Nadel im Heuhaufen finden“ und sie aus Sammlungen überwiegend fehlerhafter Samples identifizieren können. In Mathematik-Textaufgaben-Szenarien stellen wir fest, dass zwei gängige Verifikationsmethoden (Mehrheitsabstimmung und Reward-Modelle) diese Fähigkeit nicht besitzen. Beim Lösen von MATH-Problemen [26] mit Llama-3-8B-Instruct steigt die Abdeckung von 82,9 % mit 100 Samples auf 98,44 % mit 10.000 Samples. Bei Verwendung von Mehrheitsabstimmung oder Reward-Modellen zur Auswahl der endgültigen Antworten beträgt der größte Leistungsanstieg über denselben Sample-Bereich jedoch nur 40,50 % auf 41,41 %. Mit steigender Anzahl von Samples wächst auch die Lücke zwischen der Abdeckung (d. h. der Leistung mit einem perfekten Verifizierer) und der Leistung dieser Methoden (Abbildung [7]).
Zusammenfassend sind unsere wichtigsten Beobachtungen:
1. Wir zeigen, dass die Skalierung der Inferenzrechenleistung durch wiederholtes Sampling zu großen Verbesserungen der Abdeckung über eine Vielzahl von Aufgaben und Modellen führt. Dies ermöglicht es – und ist manchmal kosteneffizient –, schwächere Modelle mit vielen Samples zu verstärken und die Ein-Sample-Leistung fähigerer Modelle zu übertreffen.
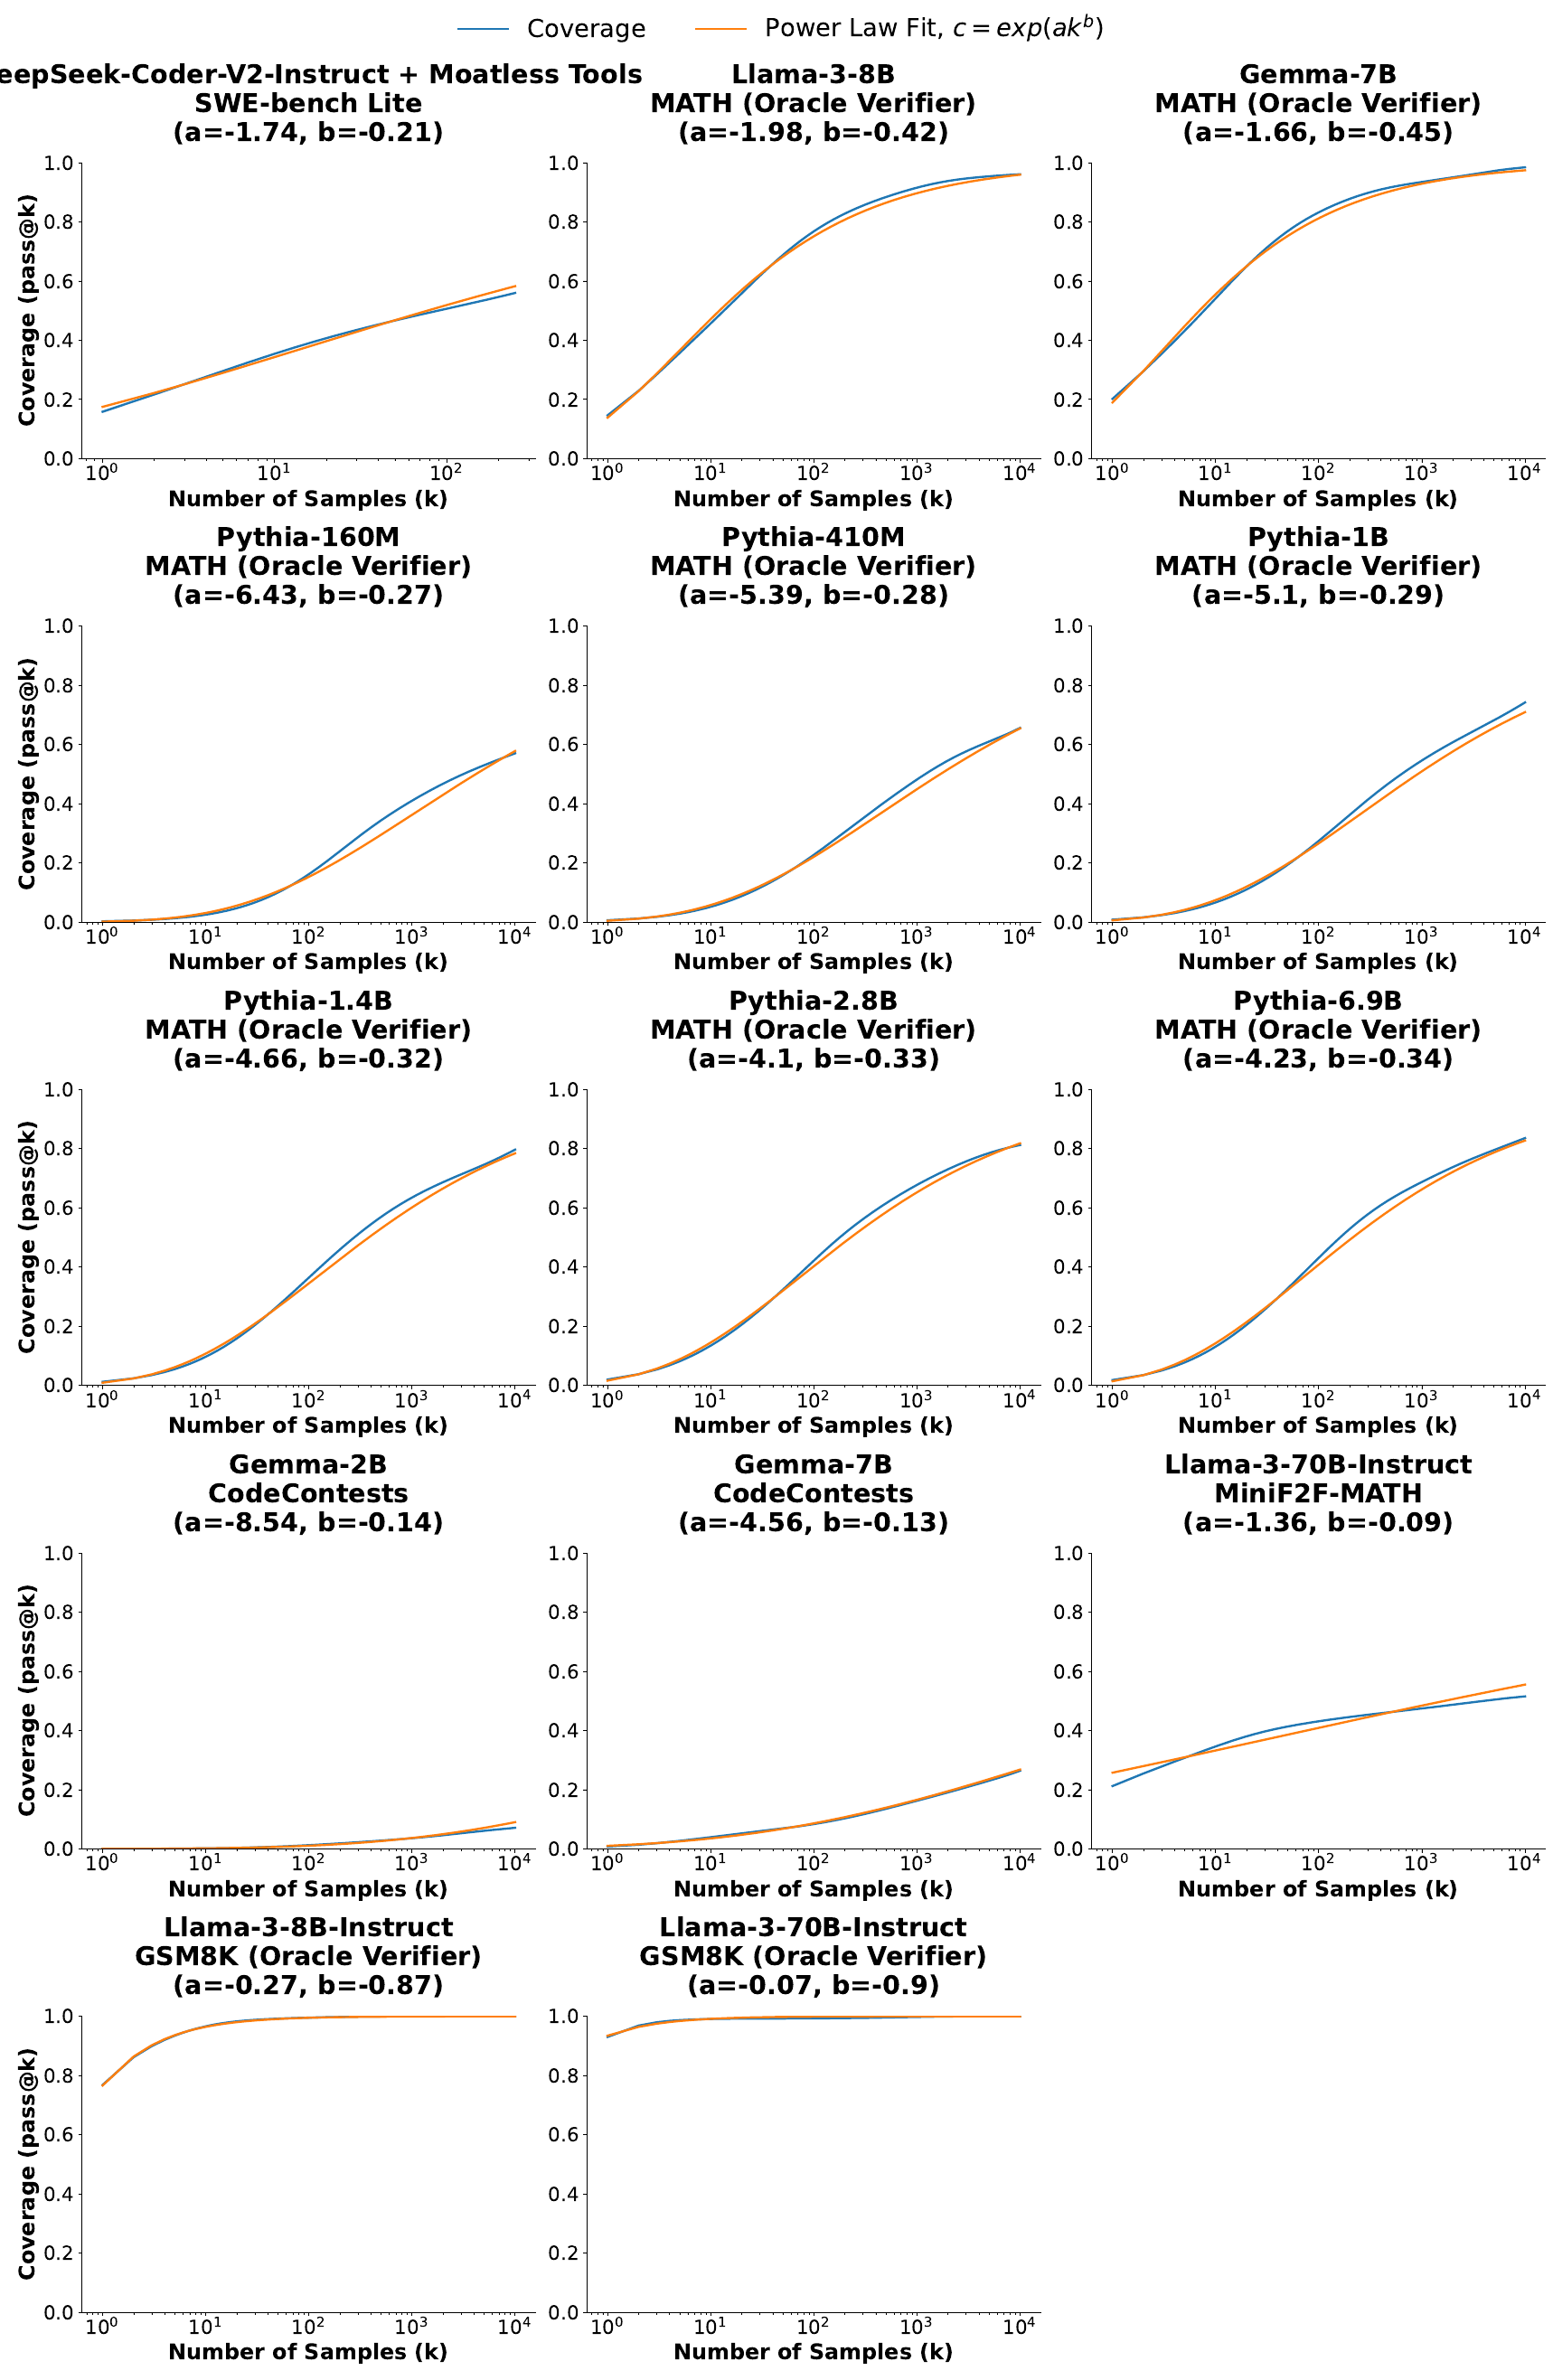
2. Wir zeigen, dass die Beziehung zwischen Abdeckung und der Anzahl der Samples oft mithilfe eines exponenzierten Potenzgesetzes modelliert werden kann, was auf eine Form von Skalierungsgesetzen für die Inferenzzeit-Rechenleistung hindeutet.
3. In Bereichen ohne automatische Verifizierer zeigen wir, dass gängige Ansätze zur Verifikation jenseits von etwa 100 Samples ein Plateau erreichen. Dies führt zu einer wachsenden Lücke zwischen der mit diesen Methoden erzielten Leistung und der Obergrenze der Abdeckung.
2 Skalierung von wiederholtem Sampling
Wir konzentrieren uns auf Bestanden/Durchgefallen-Aufgaben, bei denen eine Kandidatenlösung als richtig oder falsch bewertet werden kann. Die primäre Metrik von Interesse für diese Aufgaben ist die Erfolgsrate: der Anteil der Probleme, die wir lösen können. Beim wiederholten Sampling betrachten wir ein Setup, bei dem ein Modell viele Kandidatenlösungen generieren kann, während es versucht, ein Problem zu lösen. Die Erfolgsrate wird daher sowohl durch die Fähigkeit beeinflusst, für viele Probleme korrekte Samples zu generieren (d. h. Abdeckung), als auch durch die Fähigkeit, diese korrekten Samples zu identifizieren (d. h. Präzision).
Die Schwierigkeit des Präzisionsproblems hängt von der Verfügbarkeit von Werkzeugen zur Sample-Verifikation ab. Beim Beweisen formaler Aussagen in Lean können Beweisprüfer schnell feststellen, ob eine Kandidatenlösung korrekt ist. Ebenso können Unit-Tests verwendet werden, um Kandidatenlösungen für Programmieraufgaben zu verifizieren. In diesen Fällen wird die Präzision automatisch gehandhabt, und die Verbesserung der Abdeckung schlägt sich direkt in höheren Erfolgsraten nieder. Im Gegensatz dazu sind die verfügbaren Werkzeuge zur Verifikation von Lösungen für Mathematik-Textaufgaben aus GSM8K und MATH begrenzt, was zusätzliche Verifikationsmethoden erforderlich macht, die aus vielen (oft widersprüchlichen) Samples eine einzige endgültige Antwort bestimmen.
Wir betrachten die folgenden fünf Aufgaben:
1. GSM8K: Ein Datensatz von Mathematik-Textaufgaben auf Grundschulniveau [18]. Wir evaluieren auf einer zufälligen Teilmenge von 128 Problemen aus dem GSM8K-Testsatz.
2. MATH: Ein weiterer Datensatz mit mathematischen Textaufgaben, die im Allgemeinen schwieriger sind als die aus GSM8K [13]. Ebenso evaluieren wir auf 128 zufälligen Problemen aus dem Testset dieses Datensatzes.
3. MiniF2F-MATH: Ein Datensatz mit Mathematikproblemen, die in Sprachen zur Beweisprüfung formalisiert wurden [65]. Wir verwenden Lean4 als unsere Sprache und evaluieren auf den 130 Testset-Problemen, die aus dem MATH-Datensatz formalisiert wurden.
4. CodeContests: Ein Datensatz mit Problemen aus Programmierwettbewerben [41]. Jedes Problem hat eine Textbeschreibung sowie eine Menge von Eingabe-Ausgabe-Testfällen (vor dem Modell verborgen), mit denen die Korrektheit einer Kandidatenlösung überprüft werden kann. Wir schreiben vor, dass Modelle ihre Lösungen in Python3 verfassen.
5. SWE-bench Lite: Ein Datensatz mit realen Github-Issues, wobei jedes Problem aus einer Beschreibung und einem Schnappschuss eines Coderepositorys besteht [32]. Um ein Problem zu lösen, müssen Modelle Dateien in der Codebasis bearbeiten (im Lite-Teil von SWE-bench, den wir verwenden, muss nur eine einzige Datei geändert werden). Kandidatenlösungen können automatisch mithilfe der Unit-Test-Suite des Repositorys überprüft werden.
Unter diesen Aufgaben verfügen MiniF2F-MATH, CodeContests und SWE-bench Lite über automatische Verifizierer (in Form des Lean4-Beweisprüfers, von Testfällen bzw. von Unit-Test-Suiten). Wir beginnen damit, zu untersuchen, wie wiederholtes Sampling die Abdeckung des Modells verbessert. Verbesserungen der Abdeckung entsprechen direkt erhöhten Erfolgsraten bei Aufgaben mit automatischen Verifizierern und liefern im allgemeinen Fall eine obere Schranke für die Erfolgsrate. In Programmierkontexten ist unsere Definition von Abdeckung äquivalent zur häufig verwendeten pass@k-Metrik [15], wobei die Anzahl der Stichproben pro Problem bezeichnet. Wir verwenden diese Metrik direkt bei der Evaluierung auf CodeContests und SWE-bench Lite. Für MiniF2F ist die Metrik ähnlich, wobei ein „Bestehen" gemäß dem Lean4-Beweisprüfer definiert wird. Für GSM8K und MATH entspricht die Abdeckung der Verwendung eines Orakel-Verifizierers, der prüft, ob eine Stichprobe „besteht", indem sie die korrekte endgültige Antwort ausgibt. Um die Varianz bei der Berechnung der Abdeckung zu reduzieren, übernehmen wir die unverzerrte Schätzformel von Chen et al. [15]. In jedem Experiment erzeugen wir zunächst Stichproben für jeden Problemindex und berechnen die Anzahl der korrekten Stichproben . Anschließend berechnen wir die pass@k-Werte für jedes relevante gemäß:
Wir verwenden die numerisch stabile Implementierung der obigen Formel, die in Chen et al. [15] vorgeschlagen wurde. Daten und Code sind verfügbar unter https://scalingintelligence.stanford.edu/pubs/large_language_monkeys/.
2.1 Wiederholtes Sampling ist über Aufgaben hinweg effektiv
Hier legen wir dar, dass wiederholtes Sampling die Abdeckung über mehrere Aufgaben und eine Reihe von Sample-Budgets hinweg verbessert. Wir evaluieren Llama-3-8B-Instruct und Llama-3-70B-Instruct auf CodeContests, MiniF2F, GSM8K und MATH und erzeugen 10.000 unabhängige Samples pro Problem. Für SWE-bench Lite verwenden wir DeepSeek-Coder-V2-Instruct [20], da die für diese Aufgabe erforderliche Kontextlänge die Grenzen der Llama-3-Modelle überschreitet. Wie es beim Lösen von SWE-bench-Problemen üblich ist, statten wir
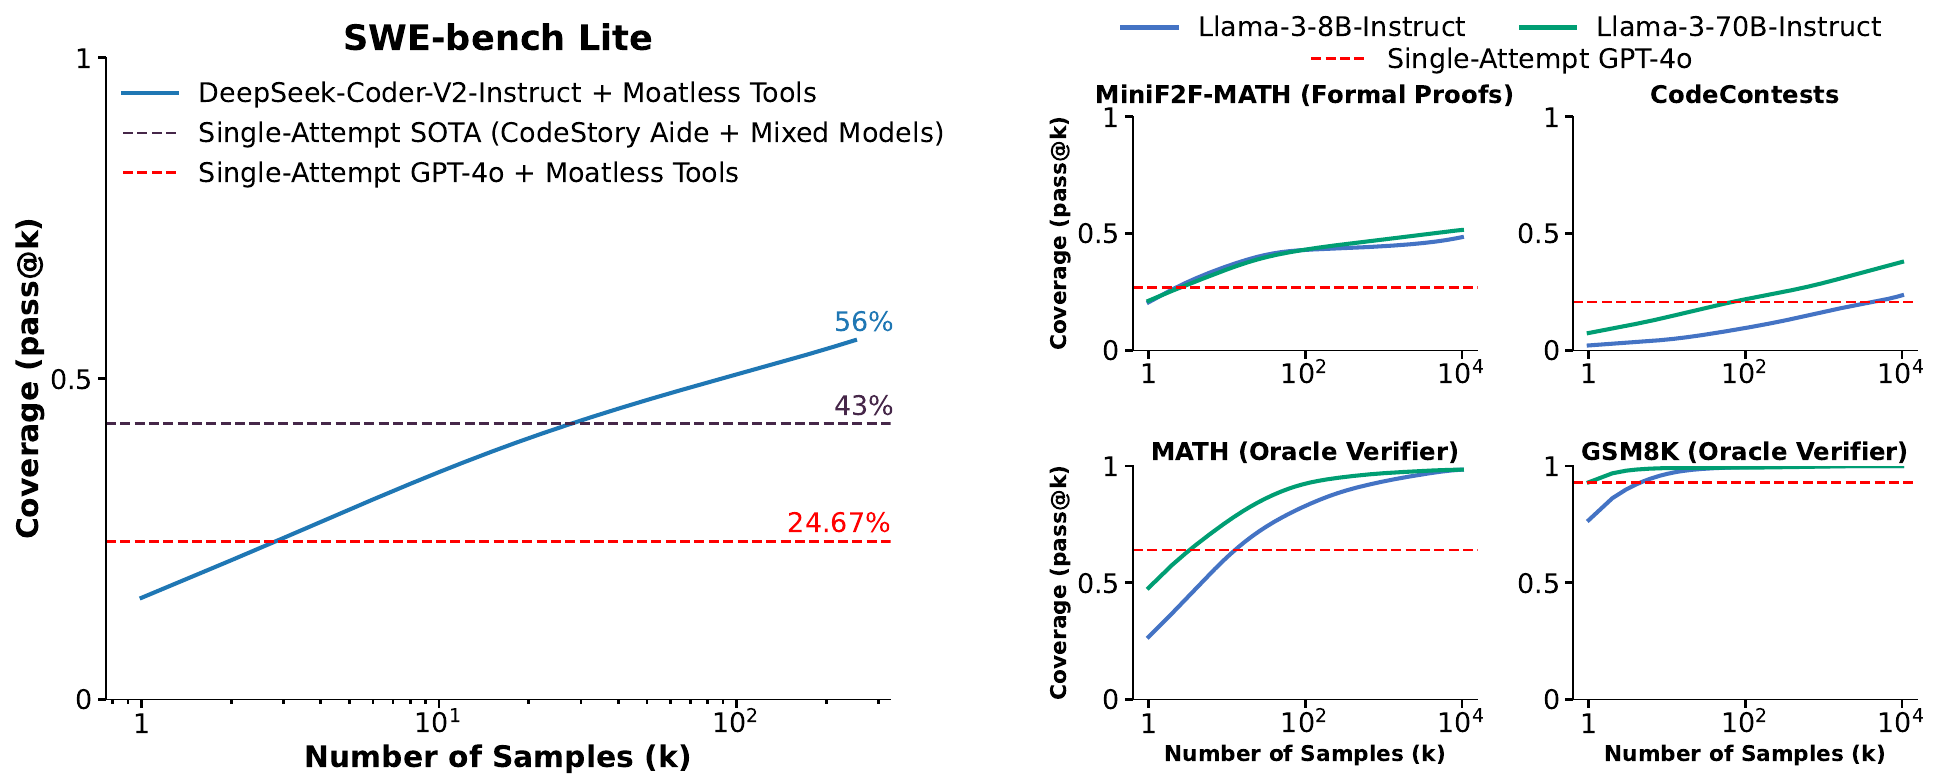
unser LLM mit einem Software-Framework aus, das dem Modell Werkzeuge zum Navigieren durch und Bearbeiten von Codebasen bereitstellt. In unserer Arbeit verwenden wir die Open-Source-Bibliothek Moatless Tools [67]. Beachten Sie, dass das Lösen eines SWE-bench-Problems einen Hin-und-Her-Austausch zwischen dem LLM und Moatless Tools beinhaltet. Ein Sample/Versuch für diesen Benchmark bezieht sich auf eine gesamte Multi-Turn-Trajektorie. Um die Kosten zu minimieren, beschränken wir die Anzahl der Versuche pro Problem auf 250, wobei alle Versuche unabhängig voneinander durchgeführt werden.
Wir berichten unsere Ergebnisse in Abbildung 2. Wir fügen außerdem die Single-Attempt-Leistung von GPT-4o auf jeder Aufgabe hinzu sowie den Single-Attempt-Stand der Technik für SWE-bench Lite (CodeStory Aide 1, das eine Kombination aus GPT-4o und Claude 3.5 Sonnet verwendet). Über alle fünf Aufgaben hinweg stellen wir fest, dass sich die Abdeckung reibungslos verbessert, wenn das Sample-Budget zunimmt. Wenn allen LLMs ein einziger Versuch gegeben wird, übertrifft GPT-4o die Llama- und DeepSeek-Modelle bei jeder Aufgabe. Wenn jedoch die Anzahl der Samples zunimmt, übertreffen alle drei der schwächeren Modelle die Single-Attempt-Leistung von GPT-4o. Im Fall von SWE-bench Lite lösen wir der Probleme und übertreffen damit den Single-Attempt-SOTA von .
2.2 Wiederholtes Sampling ist über Modellgrößen und -familien hinweg effektiv
Die Ergebnisse aus Abschnitt 2.1 deuten darauf hin, dass wiederholtes Sampling die Abdeckung verbessert. Wir zeigen diesen Trend jedoch nur für drei aktuelle, instruktionsgetunte Modelle mit 8B oder mehr Parametern. Nun zeigen wir, dass diese Trends über andere Modellgrößen, -familien und Stufen des Post-Trainings hinweg gelten. Wir erweitern unsere Evaluierung um eine breitere Auswahl von Modellen:
- Llama 3: Llama-3-8B, Llama-3-8B-Instruct, Llama-3-70B-Instruct.
- Gemma: Gemma-2B, Gemma-7B [52].
- Pythia: Pythia-70M bis Pythia-12B (insgesamt acht Modelle) [9].
Wir beschränken die Evaluierung auf die Datensätze MATH und CodeContests, um die Inferenzkosten zu minimieren, und berichten die Ergebnisse in Abbildung 3. Die Abdeckung nimmt bei nahezu jedem von uns getesteten Modell zu, wobei kleinere Modelle einige der stärksten Zunahmen der Abdeckung zeigen, wenn wiederholtes Sampling angewendet wird. Bei CodeContests steigt die Abdeckung von Gemma-2B um über , von einem pass@1 von auf ein
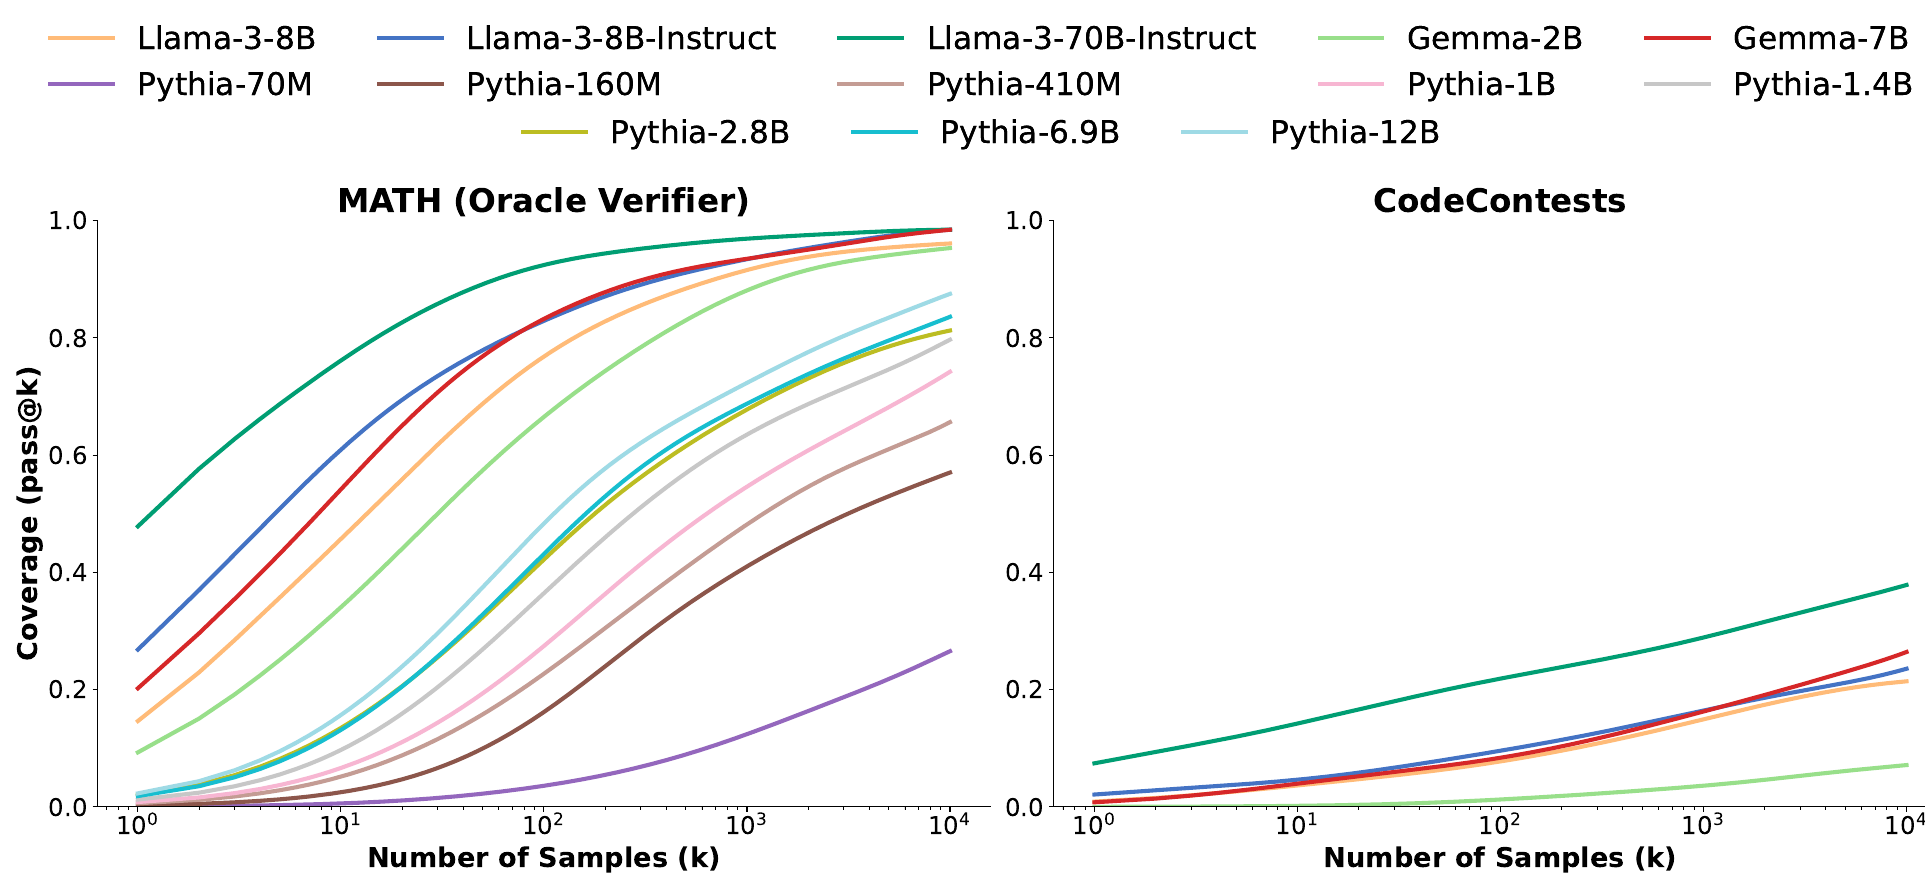
pass@10k von . Ähnlich steigt beim Lösen von MATH-Problemen mit Pythia-160M die Abdeckung von einem pass@1 von auf ein pass@10k von .
Die Ausnahme von diesem Muster zunehmender Abdeckung über Modelle hinweg bildet die Pythia-Familie, evaluiert auf CodeContests. Alle Pythia-Modelle erreichen auf diesem Datensatz eine Abdeckung von null, selbst mit einem Budget von 10.000 Samples. Wir vermuten, dass dies daran liegt, dass Pythia auf weniger codingspezifischen Daten trainiert wurde als Llama und Gemma.
2.3 Wiederholtes Sampling kann helfen, Leistung und Kosten auszubalancieren
Eine Erkenntnis aus den Ergebnissen in den Abschnitten 2.1 und 2.2 ist, dass wiederholtes Sampling es ermöglicht, die Fähigkeiten eines schwächeren Modells zu verstärken und einzelne Samples stärkerer Modelle zu übertreffen. Hier zeigen wir, dass diese Verstärkung kosteneffektiver sein kann als die Verwendung eines stärkeren, teureren Modells, und Praktikern einen neuen Freiheitsgrad bietet, wenn sie versuchen, Leistung und Kosten gemeinsam zu optimieren.
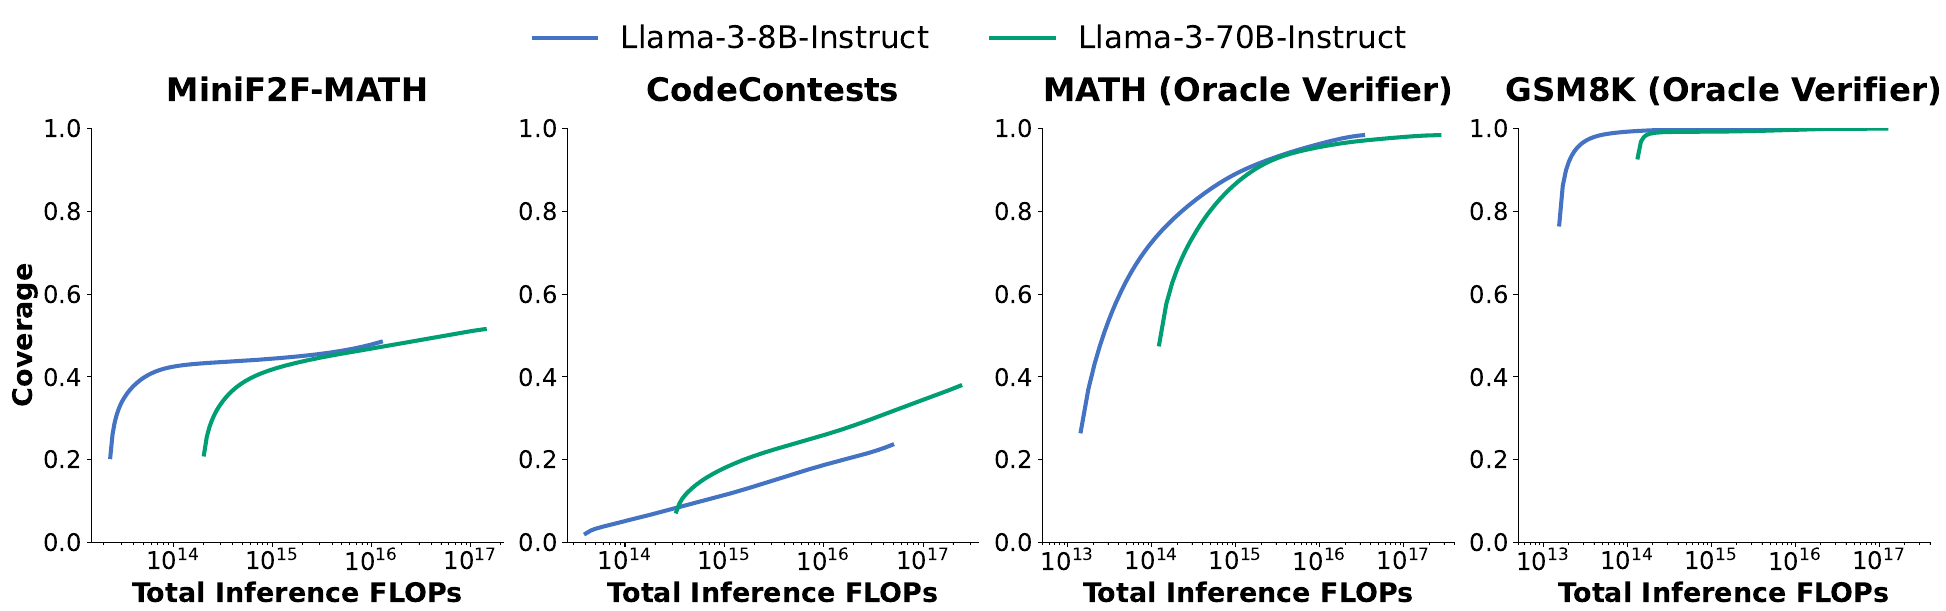
Wir betrachten zunächst FLOPs als Kostenmetrik und untersuchen die Llama-3-Ergebnisse aus Abschnitt 2.1. Wir zeichnen unsere Ergebnisse aus Abbildung 2 erneut, indem wir nun die Abdeckung als Funktion der gesamten Inferenz-FLOPs anstelle des Sample-Budgets visualisieren. Da Llama-3-Modelle dichte Transformer sind, bei denen die Mehrheit der Parameter in Matrixmultiplikationen verwendet wird, approximieren wir die Inferenz-FLOPs mit der Formel:
Wir präsentieren unsere neu skalierten Ergebnisse für MiniF2F, CodeContests, MATH und GSM8K in Abbildung 4. Interessanterweise variiert das Modell, das die Abdeckung maximiert, mit dem Rechenbudget und der Aufgabe. Bei MiniF2F, GSM8K und
| Modell | Kosten pro Versuch (USD) | Anzahl der Versuche | Gelöste Issues (%) | Gesamtkosten (USD) | Relative Gesamtkosten |
| DeepSeek-Coder-V2-Instruct | 0.0072 | 5 | 29.62 | 10.8 | 1x |
| GPT-4o | 0.13 | 1 | 24.00 | 39 | 3.6x |
| Claude 3.5 Sonnet | 0.17 | 1 | 26.70 | 51 | 4.7x |
Tabelle 1: Vergleich der API-Kosten (in US-Dollar) und der Leistung verschiedener Modelle auf dem SWE-bench-Lite-Datensatz unter Verwendung des Moatless-Tools-Agenten-Frameworks. Bei häufigerem Sampling kann das Open-Source-Modell DeepSeek-Coder-V2-Instruct dieselbe Problemlösungsrate wie Closed-Source-Frontier-Modelle für weniger als ein Drittel des Preises erreichen.Bei MATH erzielt Llama-3-8B-Instruct stets eine höhere Abdeckung als das größere (und teurere) 70B-Modell, wenn das FLOP-Budget festgelegt ist. Bei CodeContests hingegen ist das 70B-Modell fast immer kosteneffektiver. Wir merken an, dass die alleinige Betrachtung von FLOPs eine grobe Kostenmetrik sein kann, die andere Aspekte der Systemeffizienz ignoriert [21]. Insbesondere kann wiederholtes Sampling hohe Batch-Größen und spezialisierte Optimierungen nutzen, die den Systemdurchsatz im Vergleich zu Single-Attempt-Inferenz-Workloads verbessern [34] [6] [66]. Wir diskutieren dies ausführlicher in Abschnitt [5]
Wir untersuchen auch die Dollarkosten des wiederholten Samplings beim Lösen von SWE-bench-Lite-Problemen unter Verwendung aktueller API-Preise. Unter Beibehaltung des Agenten-Frameworks (Moatless Tools) betrachten wir einen einzelnen Versuch pro Problem mit Claude 3.5 Sonnet und GPT-4o sowie wiederholtes Sampling mit DeepSeek-Coder-V2-Instruct. Wir berichten die durchschnittlichen Kosten pro Problem und die Problemlösungsrate bei jedem Ansatz in Tabelle [1]. Obwohl das DeepSeek-Modell schwächer ist als die GPT- und Claude-Modelle, ist es auch über 10x billiger. In diesem Fall bietet wiederholtes Sampling eine kostengünstigere Alternative zum Zahlen eines Aufpreises für den Zugang zu starken Modellen, während gleichzeitig eine überlegene Problemlösungsrate erzielt wird.
3 Charakterisierung der Vorteile von wiederholtem Sampling
Die Beziehung zwischen dem Loss eines LLM und seinem Trainings-Compute wurde mit Trainings-Scaling-Gesetzen gut charakterisiert [27] [36] [28]. Diese Gesetze haben empirisch über viele Größenordnungen hinweg gehalten und stärken das Vertrauen von Modellentwicklern, dass große Investitionen in das Training sich auszahlen werden. Inspiriert von Trainings-Scaling-Gesetzen zielen wir hier darauf ab, die Beziehung zwischen Abdeckung und Sample-Budget (d. h. der Menge an Inferenz-Compute) besser zu charakterisieren, und präsentieren zwei interessante Beobachtungen:
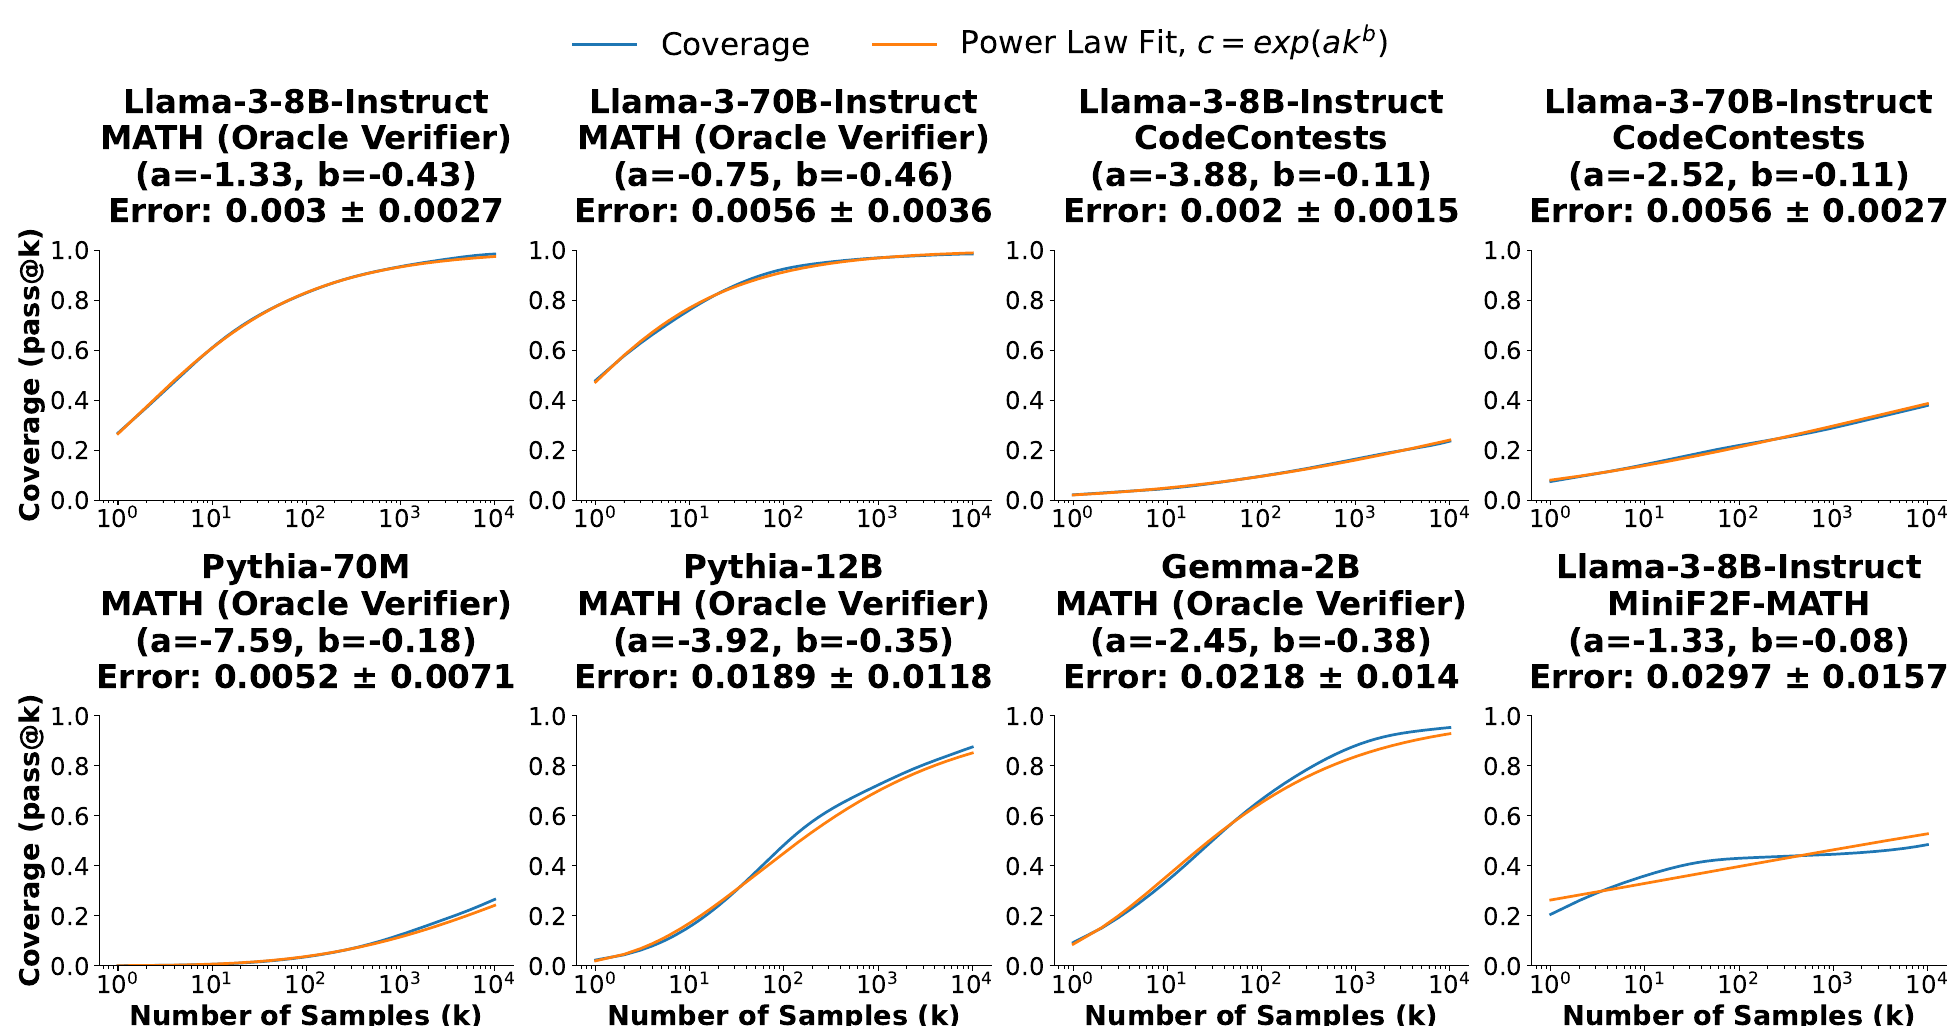
1. Die Beziehung zwischen Abdeckung und der Anzahl der Samples kann oft mit einem potenzierten Potenzgesetz modelliert werden.
2. Für eine gegebene Aufgabe ähneln die Abdeckungskurven verschiedener Modelle aus derselben Familie S-Kurven mit ähnlichen Steigungen, aber unterschiedlichen horizontalen Verschiebungen.
3.1 Scaling-Gesetze für wiederholtes Sampling
Hier entwickeln wir ein explizites Modell für die Beziehung zwischen Abdeckung und der Anzahl der Samples. Der technische Bericht zu GPT-4 [46] stellt fest, dass die Beziehung zwischen der mittleren Log-Pass-Rate eines Modells bei Coding-Problemen und seinem Trainings-Compute gut mit einem Potenzgesetz modelliert werden kann. Wir beginnen damit, dieselbe Funktionsklasse zu übernehmen, modellieren nun aber den Logarithmus der Abdeckung als Funktion der Anzahl der Samples :
wobei angepasste Modellparameter sind. Um die Abdeckung direkt vorherzusagen, potenzieren wir beide Seiten und erhalten so das endgültige Modell:
Wir geben Beispiele angepasster Coverage-Kurven in Abbildung [5] und zusätzliche Kurven in Anhang [C.2]. Obwohl diese Gesetzmäßigkeiten nicht so exakt sind wie Trainings-Scaling-Gesetze (am auffälligsten bei MiniF2F-MATH), liefern sie ermutigende frühe Hinweise darauf, dass sich die Vorteile von Inference-Scaling charakterisieren lassen.
3.2 Ähnlichkeiten der Coverage-Kurven über Modelle hinweg
Interessanterweise zeigt sich beim Vergleich der Coverage-Kurven (mit logarithmischer x-Achse) verschiedener Modelle derselben Familie auf derselben Aufgabe (siehe Abbildung [3]), dass die aufgezeichneten S-Kurven dieselbe Steigung, aber jeweils eigene horizontale Verschiebungen aufweisen. Um dies näher zu untersuchen, überlagern wir die Coverage-Kurven verschiedener Modelle derselben Familie in Abbildung [6]. Dazu wählen wir einen Anker-Coverage-Wert und verschieben jede Kurve (im Logarithmus-Raum) nach links, sodass jede durch den Punkt verläuft. Dies entspricht einer Verschiebung nach links um
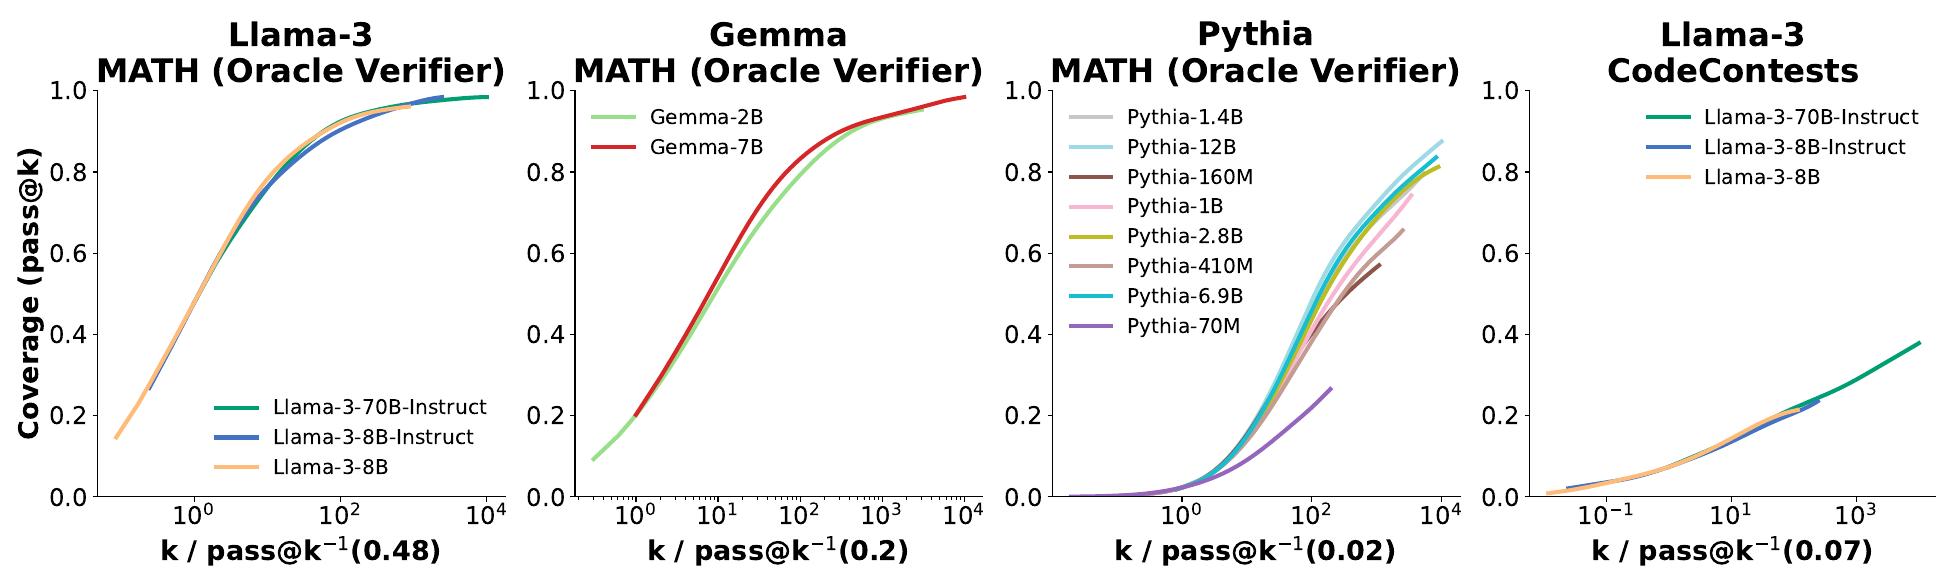
, wobei die nächstgelegene natürliche Zahl bezeichnet, für die gilt. Wir wählen als den maximalen pass@1-Score über alle Modelle derselben Familie. Diese Ähnlichkeiten zeigen, dass über Modelle derselben Familie hinweg die Zunahme des logarithmierten Sample-Budgets (oder äquivalent die multiplikative Zunahme des Sample-Budgets), die nötig ist, um die Coverage von auf zu verbessern, annähernd konstant ist.
4 Die Nutzung wiederholten Samplings erfordert Präzision
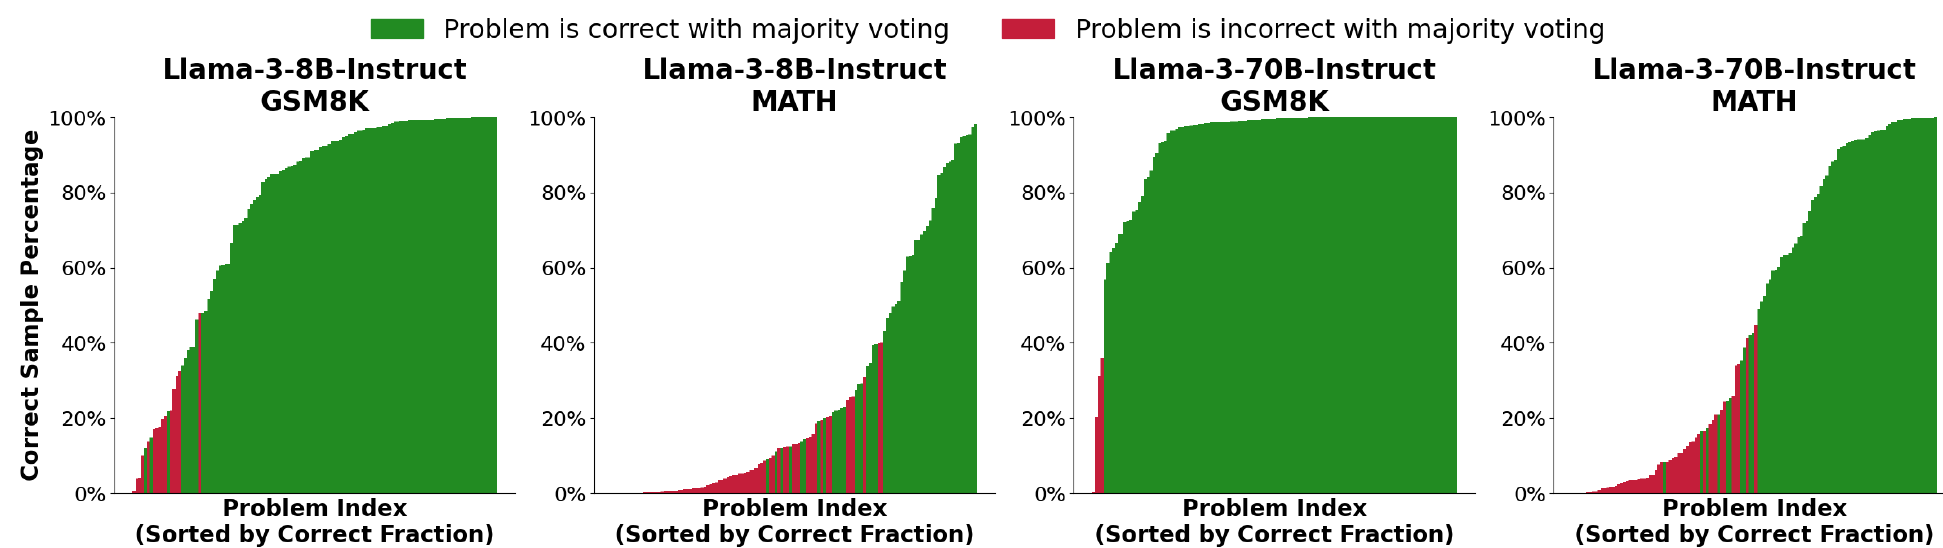
Bisher haben wir uns auf die Messung der Modell-Coverage konzentriert und die Vorteile wiederholten Samplings unter dem Szenario charakterisiert, in dem wir stets korrekte Modell-Samples identifizieren können. Nun wenden wir uns dem komplementären Problem der Präzision zu: Wie oft können wir bei einer Sammlung von Modell-Samples die korrekten identifizieren? Insbesondere interessiert uns die Leistung von Verifiern, wenn wir die Anzahl der Samples erhöhen. Bei manchen Problemen werden korrekte Lösungen mit geringen Wahrscheinlichkeiten aus dem Modell gesampelt (z. B. oder weniger, siehe Abbildung 8). Wenn die Anzahl der Samples zunimmt und für mehr Probleme seltene, korrekte Lösungen generiert werden, verbessert sich die Modell-Coverage. Um diese Verbesserungen der Coverage in höhere Erfolgsraten umzusetzen, müssen Verifier die „Nadel im Heuhaufen“ finden und seltene korrekte Samples identifizieren können.
4.1 Gängige Verifikationsmethoden skalieren nicht immer mit dem Sample-Budget
Von den fünf Aufgaben, die wir bewerten, fehlt es nur bei GSM8K und MATH an Werkzeugen zur automatischen Verifizierung von Lösungen. Wir testen drei einfache und häufig verwendete Verifizierungsansätze hinsichtlich ihrer Fähigkeit, korrekte Lösungen aus diesen Datensätzen zu identifizieren:
1. Majority Vote: Wir wählen die häufigste endgültige Antwort [60].
2. Reward Model + Best-of-N: Wir verwenden ein Reward-Modell [17], um jede Lösung zu bewerten, und wählen die Antwort aus der am höchsten bewerteten Stichprobe.
3. Reward Model + Majority Vote: Wir berechnen einen Majority Vote, bei dem jede Stichprobe mit ihrem Reward-Modell-Score gewichtet wird.
Wir verwenden die Sammlungen von 10.000 Stichproben wieder, die wir mit Llama- 3- 8B- Instruct und Llama- 3- 70B- Instruct in Abschnitt 2 generiert haben. Wir verwenden ArmoRM- Llama3- 8B- v0.1 [57] als Reward-Modell, das im Reasoning-Abschnitt der RewardBench-Rangliste [39] hohe Werte erzielt. Wir berichten unsere Ergebnisse in Abbildung 7, während wir die Anzahl der Stichproben erhöhen. Während die Erfolgsraten für alle drei Methoden zunächst mit der Anzahl der Stichproben ansteigen, erreichen sie bei etwa 100 Stichproben ein Plateau. Die Abdeckung hingegen steigt weiter mit der Anzahl der Stichproben und übersteigt schließlich 95%. Im Fall des Majority Voting ist diese Sättigung der Erfolgsrate intuitiv, da das Auftreten seltener, korrekter Lösungen die häufigste Antwort, die Majority Voting auswählt, nicht beeinflusst.
Angesichts der schlechten Leistung dieser Verifizierer (insbesondere des Reward-Modells) ist es naheliegend, sich zu fragen, wie „schwierig" es ist, eine Kandidatenlösung zu verifizieren. Bei GSM8K und MATH wird nur die endgültige Antwort einer Stichprobe zur Bewertung der Korrektheit herangezogen, während die intermediären Gedankenketten verworfen werden. Wenn Modelle nur unsinnige Gedankenketten generierten, bevor sie eine korrekte endgültige Antwort erraten, wäre die Verifizierung möglicherweise nicht einfacher als das Lösen des Problems selbst. Wir untersuchen diese Frage, indem wir 105 Gedankenketten aus korrekten Llama- 3- 8B- Instruct- Stichproben zu GSM8K- Problemen manuell bewerten und unsere Ergebnisse in Tabelle 2 berichten. Wir stellen fest, dass über der Gedankenketten, die wir bewertet haben, faithful sind, selbst unter Problemen, bei denen korrekte Antworten nur selten generiert werden. Diese korrekten Denkschritte deuten darauf hin, dass es Signal gibt, das ein Verifizierer beim Identifizieren korrekter Stichproben nutzen kann. Interessanterweise haben wir während dieses Prozesses auch ein GSM8K- Problem identifiziert, das eine falsche Ground-Truth-Antwort hat (siehe Anhang E). Dieses fehlerhafte GSM8K- Problem ist auch das einzige, für das Llama- 3- 70B- Instruct über 10.000 Versuche hinweg keine „korrekte" Stichprobe generiert hat.
| Pass@1 | Probleme | CoT bewertet | Korrekter CoT | Inkorrekter CoT | Inkorrekte Ground Truth |
| 0–10 % | 5 | 15 | 11 | 1 | 1 Problem, 3 CoTs |
| 10–25 % | 10 | 30 | 27 | 3 | 0 Probleme |
| 25–75 % | 29 | 30 | 28 | 2 | 0 Probleme |
| 75–100 % | 84 | 30 | 30 | 0 | 0 Probleme |
Tabelle 2: Menschliche Bewertung der Validität des Chain- of- Thought- Reasonings in Llama- 3- 8B- Instruct- Antworten auf GSM8K- Probleme. 3 Gedankenketten wurden pro Problem bewertet. Selbst bei schwierigen Fragen, bei denen das Modell nur der Stichproben korrekt löst, folgen die CoTs fast immer gültigen logischen Schritten. Die Modellgenerierungen und menschlichen Labels finden Sie hier
4.2 Verifizierer und Software-Aufgaben: Zwei warnende Beispiele
Softwareentwicklungsaufgaben können in Bezug auf verfügbare Verifizierungswerkzeuge eine Mittelposition einnehmen. Einerseits ermöglicht die Fähigkeit, Code auszuführen und zu testen, ein höheres Maß an automatischer Verifizierung als bei unstrukturierten Sprachaufgaben. Andererseits verfolgen Werkzeuge wie Unit-Tests einen Black-Box-Ansatz zur Verifizierung eines Codestücks und sind nicht so umfassend wie Methoden wie Proof-Checker. Diese Unvollkommenheiten im Verifizierungsprozess können zu False Positives und/oder False Negatives führen, die bei der Anwendung von Repeated Sampling berücksichtigt werden müssen. Im Folgenden geben wir zwei Beispiele für Unvollkommenheiten von Software-Verifizierern, auf die wir
bei der Generierung unserer Ergebnisse aus Abschnitt 2.1 gestoßen sind.
4.2.1 Flaky Tests in SWE-bench Lite
Bei der Erstellung unserer Ergebnisse auf SWE- bench Lite haben wir festgestellt, dass der Probleme flaky Test-Suites haben, die bei Ausführung auf derselben Kandidatenlösung keine konsistenten Ergebnisse liefern. Diese flaky Tests klassifizieren gelegentlich sogar die Ground-Truth-Lösungen des Datensatzes für das jeweilige Issue als inkorrekt. Darüber hinaus können die Test-Suites für einige Issues je nach Kandidatenlösung nicht-deterministisch sein. Beispielsweise betreffen zwei SWE- bench Lite- Issues die Manipulation von Python-Sets, die von Natur aus ungeordnet sind. Die Gold-Lösungen für diese Issues ordnen die Elemente im Set explizit an und bestehen die Test-Suites zuverlässig. Einige vom Modell generierte Kandidatenlösungen erzwingen jedoch keine solche Ordnung und bestehen die Tests daher bei einigen „glücklichen" Läufen und bei anderen nicht. In Anhang B listen wir alle Problem-IDs auf, bei denen wir flaky Tests identifiziert haben. Wir berichten außerdem unsere SWE- bench Lite- Ergebnisse aus Abbildung 2 mit entfernten problematischen Issues und finden ähnliche Ergebnisse wie bei unseren Bewertungen auf dem gesamten Datensatz.
4.2.2 False Negatives in CodeContests
Jedes Problem aus dem CodeContests-Datensatz kommt mit einer Reihe von Input-Output-Testfällen, die zur Bewertung der Korrektheit von Lösungen verwendet werden. Diese Testfälle sind umfassender als die aus früheren Coding-Benchmarks wie APPS [25] und reduzieren die Häufigkeit von False-Positive-Lösungen, die alle Testfälle bestehen, aber das beschriebene Problem nicht vollständig lösen. Die Konstruktion der CodeContests-Test-Suites führt jedoch zu False-Negative-Lösungen, die korrekt sind, aber die Tests nicht bestehen.
Bei einigen CodeContests-Problemen erlaubt die Problembeschreibung mehrere verschiedene korrekte Ausgaben für eine gegebene Testeingabe. Die entsprechenden Testfälle behandeln diese Szenarien jedoch nicht, sondern verlangen, dass eine bestimmte korrekte Ausgabe ausgegeben wird. Darüber hinaus wurden viele CodeContests-Testfälle programmatisch durch Mutation ursprünglicher Testfälle aus dem Problem generiert. Einige mutierte Eingaben verletzen die Eingabespezifikationen des Problems (z. B. eine mutierte Eingabe ist null, während die Beschreibung eine positive ganze Zahl verspricht). Diese fehlerhaften Testfälle können zu inkonsistentem Verhalten zwischen verschiedenen korrekten Lösungen führen.
Wir bewerten die Prävalenz dieser Probleme, indem wir die Test-Suite jedes Problems auf der Liste der korrekten Lösungen ausführen, die CodeContests bereitstellt. Von den 122 Problemen im Testsatz, die Python3-Lösungen haben, stellen wir fest, dass 35 Probleme „korrekte" Lösungen haben, die die entsprechenden Tests nicht bestehen. Da wir Modellen nicht erlauben, alle Testfälle eines Problems (und deren Besonderheiten) einzusehen, enthält die Anwendung von Repeated Sampling auf diese Probleme ein Element des „Würfelns", um eine Lösung zu generieren, die nicht nur korrekt ist, sondern auch die besonderen Ausgaben ausgibt, die die Tests bestehen.
5 Diskussion und Einschränkungen
In dieser Arbeit untersuchen wir Repeated Sampling als eine Achse zur Skalierung von Compute zur Inferenzzeit, um die Modellleistung zu verbessern. Über eine Reihe von Modellen und Aufgaben hinweg kann Repeated Sampling den Anteil der Probleme, die mit einer beliebigen generierten Stichprobe gelöst werden (d. h. die Abdeckung), erheblich verbessern. Wenn korrekte Lösungen identifiziert werden können (entweder mit automatischen Verifizierungswerkzeugen oder anderen Verifizierungsalgorithmen), kann Repeated Sampling die Modellfähigkeiten während der Inferenz verstärken. Diese Verstärkung kann die Kombination aus einem schwächeren Modell und vielen Stichproben leistungsfähiger und kosteneffizienter machen als die Verwendung weniger Versuche eines stärkeren, teureren Modells.
Repeated Sampling verbessern: In unseren Experimenten untersuchen wir nur eine einfache Version des Repeated Sampling, bei der alle Versuche zu einem Problem unabhängig voneinander mit exakt demselben Prompt und denselben Hyperparametern generiert werden. Wir glauben, dass dieses Setup verfeinert werden kann, um die Leistung zu verbessern, insbesondere in den folgenden Richtungen:
1. Lösungsdiversität: Wir verlassen uns derzeit auf eine positive Sampling-Temperatur als einziges Mittel zur Erzeugung von Diversität unter den Stichproben. Die Kombination dieses Token-Level-Samplings mit anderen Ansätzen auf höherer Ebene könnte die Diversität weiter erhöhen. Beispielsweise konditioniert AlphaCode verschiedene Stichproben mit verschiedenen Metadaten-Tags.
2. Multi-Turn-Interaktionen: Obwohl bei der Lösung von Code-Contests- und MiniF2F-Problemen automatische Verifizierungswerkzeuge verfügbar sind, verwenden wir nur ein Single-Turn-Setup, bei dem Modelle eine Lösung generieren, ohne die Möglichkeit, diese zu iterieren. Die Bereitstellung von Ausführungsfeedback dieser Werkzeuge für Modelle sollte die Lösungsqualität verbessern. Wir interessieren uns für die Tradeoffs, die mit Multi-Turn-Interaktionen verbunden sind, da jeder Versuch teurer wird, aber auch wahrscheinlicher erfolgreich sein kann.
3. Aus früheren Versuchen lernen: Derzeit isolieren unsere Experimente die Versuche vollständig voneinander. Der Zugriff auf vorhandene Stichproben, insbesondere wenn Verifizierungswerkzeuge Feedback dazu liefern können, könnte bei der Generierung zukünftiger Versuche hilfreich sein.
Wiederholtes Sampling und Inferenzsysteme: Wiederholtes Sampling ist eine eigenständige LLM-Inferenz-Workload, die sich vom Bedienen von Chatbot-Anfragen unterscheidet. Bei Produktions-Chatbot-Deployments liegt ein Schwerpunkt auf niedrigen Antwortlatenzen, und die Einhaltung von Latenzzielen kann eine geringere Batch-Größe pro Gerät erzwingen und die Hardware-Auslastung verringern. Im Gegensatz dazu kann beim Sampling vieler Vervollständigungen für einen einzigen Prompt ein größerer Schwerpunkt auf den Gesamtdurchsatz und die Maximierung der Hardware-Auslastung gelegt werden. Darüber hinaus kann wiederholtes Sampling von spezialisierten Attention-Optimierungen profitieren, die Überlappungen in Prompts über Sequenzen hinweg ausnutzen [34] [6] [66]. Inferenz mit wiederholtem Sampling kann daher zu geringeren Kosten durchgeführt werden als durch naives Stellen vieler paralleler Anfragen an eine chatbot-orientierte API. Diese Kosteneinsparungen können zusätzlich dazu motivieren, viele Male von einem günstigeren Modell zu samplen, statt weniger Male von einem teureren.
Verifizierer: Unsere Ergebnisse aus Abschnitt 4 unterstreichen die Bedeutung der Verbesserung von Methoden zur Probenverifikation, wenn Werkzeuge zur automatischen Durchführung derselben nicht verfügbar sind. Modelle mit der Fähigkeit auszustatten, ihre eigenen Ausgaben zu bewerten, wird es ermöglichen, wiederholtes Sampling auf weit mehr Aufgaben zu skalieren. Von besonderem Interesse ist die Anwendung von wiederholtem Sampling auf unstrukturierte Aufgaben wie kreatives Schreiben, was einen subjektiveren Vergleich zwischen verschiedenen Proben erfordern kann als die von uns betrachteten Bestanden-Durchgefallen-Aufgaben. Eine alternative Richtung zur Entwicklung modellbasierter Verifizierer besteht darin, Konverter zu entwerfen, die eine unstrukturierte Aufgabe verifizierbar machen, beispielsweise indem eine informelle mathematische Aussage in eine Sprache wie Lean formalisiert wird, sodass Beweisprüfer angewendet werden können.
6 Verwandte Arbeiten
Skalierung von Inferenz-Compute: Methoden, die während der Inferenz zusätzliche Berechnung durchführen, waren in vielen Bereichen des Deep Learning erfolgreich. In einer Vielzahl von Spielumgebungen nutzen modernste Methoden eine Suche zur Inferenzzeit, um viele mögliche zukünftige Spielzustände zu untersuchen, bevor sie einen Zug entscheiden [12] [50] [10]. Ähnliche baumbasierte Methoden können auch in Kombination mit LLMs effektiv sein und es Modellen ermöglichen, verschiedene Ansätze besser zu planen und zu erkunden [63, 8, 53, 54]. Eine weitere Achse zur Erhöhung des LLM-Inferenz-Compute ermöglicht es Modellen, Tokens damit zu verbringen, über ein Problem nachzudenken, bevor sie zu einer Lösung gelangen [62, 61, 64]. Darüber hinaus können mehrere Modelle zur Inferenzzeit zu Ensembles zusammengefasst werden, um ihre Stärken zu kombinieren [58, 14, 45, 56, 31]. Ein weiterer Ansatz besteht darin, LLMs zu nutzen, um ihre eigenen Antworten zu kritisieren und zu verfeinern [43, 7].
Wiederholtes Sampling: Frühere Arbeiten haben gezeigt, dass wiederholtes Sampling die Fähigkeiten von LLMs in mehreren Domänen verbessern kann. Einer der effektivsten Anwendungsfälle ist das Programmieren [48, 15, 38], wo die Leistung bis zu einer Million Proben weiter skaliert und Verifikationswerkzeuge (z. B. Unit-Tests) oft verfügbar sind, um jede Kandidatenlösung automatisch zu bewerten. Kürzlich zeigt Greenblatt [23], dass wiederholtes Sampling beim Lösen von Puzzles aus der ARC-Challenge [16] effektiv ist, wobei log-lineare Skalierung mit steigender Anzahl von Proben beobachtet wird. In dieser Anwendung kann wiederholtes Sampling in Kombination mit Best-of-N-Ranking mittels eines Reward-Modells das gierige Sampling einer einzelnen Antwort übertreffen [30]. In Domänen ohne automatische Verifikationswerkzeuge zeigt bestehende Arbeit, dass die Verwendung von Mehrheitsabstimmung [60], das Prompten eines LLM [19] oder das Trainieren eines modellbasierten Verifizierers [18, 42, 29, 59, 35], um über eine endgültige Antwort zu entscheiden, die Leistung bei Reasoning-Aufgaben im Vergleich zum Ziehen einer einzelnen Probe verbessern kann. Nguyen et al. [44] stellt fest, dass die Durchführung von Mehrheitsabstimmung über Antworten, die eine Schwellenlänge überschreiten, die Abstimmung über alle Antworten übertreffen kann. Zeitgleich mit unserer Arbeit stellt Song et al. [51] fest, dass die Verwendung der besten verfügbaren Probe die LLM-Leistung bei Chat-, Mathe- und Coding-Aufgaben verbessert, wobei bis zu einem Maximum von 128 Proben getestet wird. Darüber hinaus stellen Hassid et al. [24] fest, dass es beim Lösen von Coding-Aufgaben effektiver sein kann, mehr Proben von einem kleineren Modell zu ziehen als weniger Proben von einem größeren.
Skalierungsgesetze: Die Charakterisierung dessen, wie Skalierung die Modellleistung beeinflusst, kann zu fundierteren Entscheidungen darüber führen, wie Ressourcen zugewiesen werden. Skalierungsgesetze für das LLM-Training finden eine Potenzgesetz-Beziehung zwischen Verlust und der Menge an Trainings-Compute und liefern Schätzungen für die optimale Modell- und Datensatzgröße bei einem festen Compute-Budget [27, 36, 28]. Jones [33] findet Skalierungsgesetze im Kontext des Brettspiels Hex und beobachtet, dass die Leistung vorhersehbar mit der Modellgröße und der Schwierigkeit des Problems skaliert. Interessanterweise zeigen sie auch, dass die Leistung mit der Menge an Testzeit-Compute skaliert, die während der Durchführung der Baumsuche aufgewendet wird. Kürzlich beobachten Shao et al. [49] Skalierungsgesetze bei der Augmentierung von LLMs mit externen Retrieval-Datensätzen und stellen fest, dass die Leistung bei Retrieval-Aufgaben glatt mit der Größe des Retrieval-Korpus skaliert.
7 Danksagungen
Wir danken Together AI für die teilweise Finanzierung des Compute für dieses Projekt sowie Rahul Chalamala und Ben Athiwaratkun für ihre Hilfe bei der Verwaltung dieser Infrastruktur. Wir danken John Yang für seinen Rat und seine Unterstützung bei der Durchführung unserer SWE-bench-Experimente. Schließlich sind wir dankbar für Mayee Chen, Neel Guha, Quinn McIntyre, Jon Saad-Falcon und Benjamin Spector für ihre hilfreichen Diskussionen und ihr Feedback während dieses Projekts.
Wir danken aufrichtig für die Unterstützung des NIH unter Nr. U54EB020405 (Mobilize), der NSF unter Nr. CCF2247015 (Hardware-Aware), CCF1763315 (Beyond Sparsity), CCF1563078 (Volume to Velocity) und 1937301 (RTML); dem US DEVCOM ARL unter Nr. W911NF-23-2-0184 (Long-context) und W911NF-21-2-0251 (Interactive Human-AI Teaming); der ONR unter Nr. N000142312633 (Deep Signal Processing); der Stanford HAI unter Nr. 247183; NXP, Xilinx, LETI-CEA, Intel, IBM, Microsoft, NEC, Toshiba, TSMC, ARM, Hitachi, BASF, Accenture, Ericsson, Qualcomm, Analog Devices, Google Cloud, Salesforce, Total, dem HAI-GCP Cloud Credits for Research-Programm, der Stanford Data Science Initiative (SDSI) und Mitgliedern des Stanford DAWN-Projekts: Meta, Google und VMWare. Die US-Regierung ist berechtigt, Nachdrucke für Regierungszwecke zu reproduzieren und zu verbreiten, ungeachtet etwaiger Urheberrechtsvermerke darauf. Alle in diesem Material geäußerten Meinungen, Erkenntnisse und Schlussfolgerungen oder Empfehlungen sind die der Autoren und spiegeln nicht notwendigerweise die Ansichten, Richtlinien oder Billigungen des NIH, der ONR oder der US-Regierung wider, weder ausdrücklich noch impliziert.
Diese Arbeit wurde mit Unterstützung der Clarendon Fund Scholarships abgeschlossen.
Literaturverzeichnis
[1] Aide.dev, 2024. URL https://aide.dev/
[2] Hello gpt-4o, 2024. URL https://openai.com/index/hello-gpt-4o/
[3] Meta llama 3, 2024. URL https://llama.meta.com/llama3/
[4] Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[5] Voyage ai, 2024. URL https://www.voyageai.com/
[6] Ben Athiwaratkun, Sujan Kumar Gonugondla, Sanjay Krishna Gouda, Haifeng Qian, Hantian Ding, Qing Sun, Jun Wang, Jiacheng Guo, Liangfu Chen, Parminder Bhatia, Ramesh Nallapati, Sudipta Sengupta, and Bing Xiang. Bifurcated attention: Accelerating massively parallel decoding with shared prefixes in llms, 2024. URL https://arxiv.org/abs/2403.08845
[7] Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, Andy Jones, Anna Chen, Anna Goldie, Azalia Mirhoseini, Cameron McKinnon, Carol Chen, Catherine Olsson, Christopher Olah, Danny Hernandez, Dawn Drain, Deep Ganguli, Dustin Li, Eli Tran-Johnson, Ethan Perez, Jamie Kerr, Jared Mueller, Jeffrey Ladish, Joshua Landau, Kamal Ndousse, Kamile Lukosuite, Liane Lovitt, Michael Sellitto, Nelson Elhage, Nicholas Schiefer, Noemi Mercado, Nova DasSarma, Robert Lasenby, Robin Larson, Sam Ringer, Scott Johnston, Shauna Kravec, Sheer El Showk, Stanislav Fort, Tamera Lanham, Timothy Telleen-Lawton, Tom Conerly, Tom Henighan, Tristan Hume, Samuel R. Bowman, Zac Hatfield-Dodds, Ben Mann, Dario Amodei, Nicholas Joseph, Sam McCandlish, Tom Brown, and Jared Kaplan. Constitutional ai: Harmlessness from ai feedback, 2022.
[8] Maciej Besta, Nils Blach, Ales Kubicek, Robert Gerstenberger, Michal Podstawski, Lukas Gianinazzi, Joanna Gajda, Tomasz Lehmann, Hubert Niewiadomski, Piotr Nyczyk, and Torsten Hoefler. Graph of thoughts: Solving elaborate problems with large language models. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16):17682-17690, March 2024. ISSN 2159-5399. doi: 10.1609/aaai.v38i16.29720. URL http://dx.doi.org/10.1609/aaai.v38i16.29720
[9] Stella Biderman, Hailey Schoelkopf, Quentin Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, Aviya Skowron, Lintang Sutawika, and Oskar van der Wal. Pythia: A suite for analyzing large language models across training and scaling, 2023. URL https://arxiv.org/abs/2304.01373
[10] Noam Brown, Anton Bakhtin, Adam Lerer, and Qucheng Gong. Combining deep reinforcement learning and search for imperfect-information games. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS '20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
[11] Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert-Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever und Dario Amodei. Language models are few-shot learners, 2020. URL https://arxiv.org/abs/2005.14165
[12] Murray Campbell, A. Joseph Hoane und Feng-hsiung Hsu. Deep blue. Artif. Intell., 134(1-2):57-83, jan 2002. ISSN 0004-3702. doi: 10.1016/S0004-3702(01)00129-1. URL https://doi.org/10.1016/S0004-3702(01)00129-1
[13] Guoxin Chen, Minpeng Liao, Chengxi Li und Kai Fan. Alphamath almost zero: process supervision without process, 2024.
[14] Lingjiao Chen, Jared Quincy Davis, Boris Hanin, Peter Bailis, Ion Stoica, Matei Zaharia und James Zou. Are more llm calls all you need? towards scaling laws of compound inference systems, 2024. URL https://arxiv.org/abs/2403.02419
[15] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, Alex Ray, Raul Puri, Gretchen Krueger, Michael Petrov, Heidy Khlaaf, Girish Sastry, Pamela Mishkin, Brooke Chan, Scott Gray, Nick Ryder, Mikhail Pavlov, Alethea Power, Lukasz Kaiser, Mohammad Bavarian, Clemens Winter, Philippe Tillet, Felipe Petroski Such, Dave Cummings, Matthias Plappert, Fotios Chantzis, Elizabeth Barnes, Ariel Herbert-Voss, William Hebgen Guss, Alex Nichol, Alex Paino, Nikolas Tezak, Jie Tang, Igor Babuschkin, Suchir Balaji, Shantanu Jain, William Saunders, Christopher Hesse, Andrew N. Carr, Jan Leike, Josh Achiam, Vedant Misra, Evan Morikawa, Alec Radford, Matthew Knight, Miles Brundage, Mira Murati, Katie Mayer, Peter Welinder, Bob McGrew, Dario Amodei, Sam McCandlish, Ilya Sutskever und Wojciech Zaremba. Evaluating large language models trained on code, 2021. URL https://arxiv.org/abs/2107.03374
[16] François Chollet. On the measure of intelligence, 2019. URL https://arxiv.org/abs/1911.01547
[17] Paul Christiano, Jan Leike, Tom B. Brown, Miljan Martic, Shane Legg und Dario Amodei. Deep reinforcement learning from human preferences, 2017. URL https://arxiv.org/abs/1706.03741
[18] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse und John Schulman. Training verifiers to solve math word problems, 2021.
[19] Jared Quincy Davis, Boris Hanin, Lingjiao Chen, Peter Bailis, Ion Stoica und Matei Zaharia. Networks of networks: Complexity class principles applied to compound ai systems design, 2024. URL https://arxiv.org/abs/2407.16831
[20] DeepSeek-AI et al. Deepseek-v2: A strong, economical, and efficient mixture-of-experts language model, 2024. URL https://arxiv.org/abs/2405.04434
[21] Mostafa Dehghani, Anurag Arnab, Lucas Beyer, Ashish Vaswani und Yi Tay. The efficiency misnomer, 2022. URL https://arxiv.org/abs/2110.12894
[22] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang und Andy Zou. A framework for few-shot language model evaluation, 12 2023. URL https://zenodo.org/records/10256836
[23] Ryan Greenblatt. Getting 50 https://www.lesswrong.com/posts/Rdwui3wHxCeKb7feK/ getting-50-sota-on-arc-agi-with-gpt-40 2024.
[24] Michael Hassid, Tal Remez, Jonas Gehring, Roy Schwartz und Yossi Adi. The larger the better? improved llm code-generation via budget reallocation, 2024. URL https://arxiv.org/abs/2404.00725
[25] Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song und Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
[26] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song und Jacob Steinhardt. Measuring mathematical problem solving with the math dataset, 2021.
[27] Joel Hestness, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang und Yanqi Zhou. Deep learning scaling is predictable, empirically, 2017. URL https://arxiv.org/abs/1712.00409
[28] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, Tom Hennigan, Eric Noland, Katie Millican, George van den Driessche, Bogdan Damoc, Aurelia Guy, Simon Osindero, Karen Simonyan, Erich Elsen, Jack W. Rae, Oriol Vinyals und Laurent Sifre. Training compute-optimal large language models, 2022. URL https://arxiv.org/abs/2203.15556
[29] Arian Hosseini, Xingdi Yuan, Nikolay Malkin, Aaron Courville, Alessandro Sordoni und Rishabh Agarwal. V-star: Training verifiers for self-taught reasoners, 2024.
[30] Robert Irvine, Douglas Boubert, Vyas Raina, Adian Liusie, Ziyi Zhu, Vineet Mudupalli, Aliaksei Korshuk, Zongyi Liu, Fritz Cremer, Valentin Assassi, Christie-Carol Beauchamp, Xiaoding Lu, Thomas Rialan und William Beauchamp. Rewarding chatbots for real-world engagement with millions of users, 2023. URL https://arxiv.org/abs/2303.06135
[31] Dongfu Jiang, Xiang Ren und Bill Yuchen Lin. Llm-blender: Ensembling large language models with pairwise ranking and generative fusion, 2023. URL https://arxiv.org/abs/2306.02561
[32] Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press und Karthik Narasimhan. Swe-bench: Can language models resolve real-world github issues?, 2024. URL https://arxiv.org/abs/2310.06770
[33] Andy L. Jones. Scaling scaling laws with board games, 2021. URL https://arxiv.org/abs/2104.03113
[34] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré und Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[35] Jikun Kang, Xin Zhe Li, Xi Chen, Amirreza Kazemi, Qianyi Sun, Boxing Chen, Dong Li, Xu He, Quan He, Feng Wen, Jianye Hao und Jun Yao. Mindstar: Enhancing math reasoning in pre-trained llms at inference time, 2024. URL https://arxiv.org/abs/2405.16265
[36] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu und Dario Amodei. Scaling laws for neural language models, 2020.
[37] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu und Dario Amodei. Scaling laws for neural language models, 2020. URL https://arxiv.org/abs/2001.08361
[38] Sumith Kulal, Panupong Pasupat, Kartik Chandra, Mina Lee, Oded Padon, Alex Aiken und Percy Liang. Spoc: Search-based pseudocode to code, 2019. URL https://arxiv.org/abs/1906.04908
[39] Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, Noah A. Smith und Hannaneh Hajishirzi. Reward-bench: Evaluating reward models for language modeling, 2024. URL https://arxiv.org/abs/2403.13787
[40] Aitor Lewkowycz, Anders Andreassen, David Dohan, Ethan Dyer, Henryk Michalewski, Vinay Ramasesh, Ambrose Slone, Cem Anil, Imanol Schlag, Theo Gutman-Solo, Yuhuai Wu, Behnam Neyshabur, Guy Gur-Ari und Vedant Misra. Solving quantitative reasoning problems with language models, 2022. URL https://arxiv.org/abs/2206.14858
[41] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, Thomas Hubert, Peter Choy, Cyprien de Masson d'Autume, Igor Babuschkin, Xinyun Chen, Po-Sen Huang, Johannes Welbl, Sven Gowal, Alexey Cherepanov, James Molloy, Daniel J. Mankowitz, Esme Sutherland Robson, Pushmeet Kohli, Nando de Freitas, Koray Kavukcuoglu und Oriol Vinyals. Codegenerierung auf Wettbewerbsniveau mit alphacode. Science, 378(6624):1092-1097, Dezember 2022. ISSN 1095-9203. doi: 10.1126/science.abq1158. URL http://dx.doi.org/10.1126/science.abq1158
[42] Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever und Karl Cobbe. Lass uns Schritt für Schritt verifizieren, 2023.
[43] Aman Madaan, Niket Tandon, Prakhar Gupta, Skyler Hallinan, Luyu Gao, Sarah Wiegreffe, Uri Alon, Nouha Dziri, Shrimai Prabhumoye, Yiming Yang, Shashank Gupta, Bodhisattwa Prasad Majumder, Katherine Hermann, Sean Welleck, Amir Yazdanbakhsh und Peter Clark. Selbstverfeinerung: Iterative Verfeinerung mit Selbstfeedback, 2023. URL https://arxiv.org/abs/2303.17651
[44] Alex Nguyen, Dheeraj Mekala, Chengyu Dong und Jingbo Shang. When is the consistent prediction likely to be a correct prediction?, 2024. URL https://arxiv.org/abs/2407.05778
[45] Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E. Gonzalez, M Waleed Kadous und Ion Stoica. Routellm: Learning to route llms with preference data, 2024. URL https://arxiv.org/abs/2406.18665
[46] OpenAI et al. Gpt-4 technical report, 2024. URL https://arxiv.org/abs/2303.08774
[47] Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei und Ilya Sutskever. Language models are unsupervised multitask learners. 2019.
[48] Baptiste Roziere, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat, Xiaoqing Ellen Tan, Yossi Adi, Jingyu Liu, Romain Sauvestre, Tal Remez, Jérémy Rapin, Artyom Kozhevnikov, Ivan Evtimov, Joanna Bitton, Manish Bhatt, Cristian Canton Ferrer, Aaron Grattafiori, Wenhan Xiong, Alexandre Défossez, Jade Copet, Faisal Azhar, Hugo Touvron, Louis Martin, Nicolas Usunier, Thomas Scialom und Gabriel Synnaeve. Code llama: Open foundation models for code, 2023. URL https://arxiv.org/abs/2308.12950
[49] Rulin Shao, Jacqueline He, Akari Asai, Weijia Shi, Tim Dettmers, Sewon Min, Luke Zettlemoyer und Pang Wei Koh. Scaling retrieval-based language models with a trillion-token datastore, 2024. URL https://arxiv.org/abs/2407.12854
[50] David Silver, Thomas Hubert, Julian Schrittwieser, Ioannis Antonoglou, Matthew Lai, Arthur Guez, Marc Lanctot, Laurent Sifre, Dharshan Kumaran, Thore Graepel, Timothy Lillicrap, Karen Simonyan und Demis Hassabis. Mastering chess and shogi by self-play with a general reinforcement learning algorithm, 2017.
[51] Yifan Song, Guoyin Wang, Sujian Li und Bill Yuchen Lin. The good, the bad, and the greedy: Evaluation of llms should not ignore non-determinism, 2024. URL https://arxiv.org/abs/2407.10457
[52] Gemma Team et al. Gemma: Open models based on gemini research and technology, 2024. URL https://arxiv.org/abs/2403.08295
[53] Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi und Dong Yu. Toward self-improvement of llms via imagination, searching, and criticizing, 2024. URL https://arxiv.org/abs/2404.12253
[54] Trieu H. Trinh, Yuhuai Wu, Quoc V. Le, He He und Thang Luong. Solving olympiad geometry without human demonstrations. Nature, 625(7995):476-482, 2024. ISSN 1476-4687. doi: 10.1038/s41586-023-06747-5. URL https://doi.org/10.1038/s41586-023-06747-5
[55] Pauli Virtanen, Ralf Gommers, Travis E. Oliphant, Matt Haberland, Tyler Reddy, David Cournapeau, Evgeni Burovski, Pearu Peterson, Warren Weckesser, Jonathan Bright, Stéfan J. van der Walt, Matthew Brett, Joshua Wilson, K. Jarrod Millman, Nikolay Mayorov, Andrew R. J. Nelson, Eric Jones, Robert Kern, Eric Larson, C J Carey, Ilhan Polat, Yu Feng, Eric W. Moore, Jake VanderPlas, Denis Laxalde, Josef Perktold, Robert Cimrman, Ian Henriksen, E. A. Quintero, Charles R. Harris, Anne M. Archibald, António H. Ribeiro, Fabian Pedregosa, Paul van Mulbregt und SciPy 1.0 Contributors. SciPy 1.0: Fundamental Algorithms for Scientific Computing in Python. Nature Methods, 17:261-272, 2020. doi: 10.1038/s41592-019-0686-2.
[56] Fanqi Wan, Xinting Huang, Deng Cai, Xiaojun Quan, Wei Bi und Shuming Shi. Knowledge fusion of large language models, 2024. URL https://arxiv.org/abs/2401.10491
[57] Haoxiang Wang, Wei Xiong, Tengyang Xie, Han Zhao und Tong Zhang. Interpretable preferences via multi-objective reward modeling and mixture-of-experts, 2024. URL https://arxiv.org/abs/2406.12845
[58] Junlin Wang, Jue Wang, Ben Athiwaratkun, Ce Zhang und James Zou. Mixture-of-agents enhances large language model capabilities, 2024. URL https://arxiv.org/abs/2406.04692
[59] Peiyi Wang, Lei Li, Zhihong Shao, R. X. Xu, Damai Dai, Yifei Li, Deli Chen, Y. Wu und Zhifang Sui. Math-shepherd: Verify and reinforce llms step-by-step without human annotations, 2024. URL https://arxiv.org/abs/2312.08935
[60] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi, Sharan Narang, Aakanksha Chowdhery und Denny Zhou. Self-consistency improves chain of thought reasoning in language models, 2023.
[61] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed Chi, Quoc Le und Denny Zhou. Chain-of-thought prompting elicits reasoning in large language models, 2023.
[62] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan und Yuan Cao. React: Synergizing reasoning and acting in language models, 2022. URL https://arxiv.org/abs/2210.03629
[63] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao und Karthik Narasimhan. Tree of thoughts: Deliberate problem solving with large language models, 2023. URL https://arxiv.org/abs/2305.10601
[64] Eric Zelikman, Georges Harik, Yijia Shao, Varuna Jayasiri, Nick Haber und Noah D. Goodman. Quiet-star: Language models can teach themselves to think before speaking, 2024. URL https://arxiv.org/abs/2403.09629
[65] Kunhao Zheng, Jesse Michael Han und Stanislas Polu. Minif2f: a cross-system benchmark for formal olympiad-level mathematics. arXiv preprint arXiv:2109.00110, 2021.
[66] Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Chuyue Sun, Jeff Huang, Cody Hao Yu, Shiyi Cao, Christos Kozyrakis, Ion Stoica, Joseph E. Gonzalez, Clark Barrett und Ying Sheng. Sglang: Efficient execution of structured language model programs, 2024. URL https://arxiv.org/abs/2312.07104
[67] Albert Orwall. Moatless tools. https://github.com/aorwall/moatless-tools/tree/a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6, 2024.
A Experimenteller Aufbau der Stichprobenerhebung
Wir berichten Ergebnisse zu den 130 Fragen im Testset des lean4-MiniF2F-Datensatzes, die formalisierten MATH-Problemen entsprechen. Dieser Datensatz ist von der korrigierten Version des ursprünglichen MiniF2F-Datensatzes abgeleitet, die von Zheng et al. [65] erstellt wurde. Wir ziehen Stichproben mit einer Temperatur von 0,5 und verwenden kein Nucleus-Sampling. Wir haben 10.000 Stichproben pro Problem generiert. Wir verwenden Beweise der folgenden 5 Theoreme aus dem Validierungsset als Few-Shot-Beispiele:
mathd_algebra_116 amc12_2000_p5 mathd_algebra_132 mathd_algebra_11 mathd_numbertheory_84
Unser Prompt besteht aus:
1. Few-Shot-Beispielen.
2. Header-Importen, die in jedem Problem im HuggingFace-Datensatz cat-searcher/minif2f-lean4 vorhanden sind, einer hochgeladenen Version des lean4-MiniF2F-Datensatzes.
3. Die Theorem-Definition. Um zu vermeiden, dass Informationen darüber preisgegeben werden, wie das Theorem anhand seines Namens zu lösen ist, ersetzen wir den Namen des Theorems durch theorem_i. für die Few-Shot-Beispiele und für das aktuelle Problem.
Wir setzen 200 als maximale Token-Länge für die generierte Lösung. Zur Bewertung der Lösungen verwenden wir die Bibliothek lean-dojo 1.1.2 mit der Lean-Version 4.3.0-rc2. Wir setzen ein Timeout von 10 Sekunden für jeden Taktik-Schritt.
Few-Shot-Beispiel
Schreibe einen Lean4-Beweis für die bereitgestellte formale Aussage. Du hast Zugriff auf die Standard-mathlib4-Bibliothek.
import Mathlib.Algebra.BigOperators.Basic
import Mathlib.Data.Real.Basic
import Mathlib.Data.Complex.Basic
import Mathlib.Data.Nat.Log
import Mathlib.Data.Complex.Exponential
import Mathlib.NumberTheory.Divisors
import Mathlib.Data.ZMod.Defs
import Mathlib.Data.ZMod.Basic
import Mathlib.Topology.Basic
import Mathlib.Data.Nat.Digits
open BigOperators
open Real
open Nat
open Topology
theorem theorem1
Int.floor ((9: ) / 160 \* 100) = 5 :=
by (
rw [Int.floor_eq_iff]
constructor
all.goals norm_num
)
Beispiel-Prompt
Schreibe einen Lean4-Beweis für die bereitgestellte formale Aussage. Du hast Zugriff auf die Standard-mathlib4-Bibliothek.
\\\`pythonimport Mathlib.Algebra.BigOperators.Basic import Mathlib.Data.Real.Basic import Mathlib.Data.Complex.Basic import Mathlib.Data.Nat.Log import Mathlib.Data.Complex.Exponential import Mathlib.NumberTheory.Divisors import Mathlib.Data.ZMod.Defs import Mathlib.Data.ZMod.Basic import Mathlib.Topology.Basic import Mathlib.Data.Nat.Digits open BigOperators open Real open Nat open Topology theorem theorem6 (b h v : R) (h_0 : 0 < b \land 0 < h \land 0 < v) (h_1 : v = 1 / 3 * (b * h)) (h_2 : b = 30) (h_3 : h = 13 / 2) v = 65 := by (
A.2 CodeContests
Wir berichten Ergebnisse zu den 140 Fragen des Testsets, die keine Bild-Tags in der Problembeschreibung enthalten. Wir sampeln mit einer Temperatur von 0,6 und einem Top-p-Wert von 0,95, den Experimenten in CodeLlama [48] folgend. Wir generieren 10.000 Samples pro Problem. Wir verwenden zwei Few-Shot-Beispiele aus dem Trainingsset, die pro Problem zufällig gesampelt werden. Wir setzen 1024 als maximale Token-Länge für die generierte Lösung. Wir verwenden dieselbe Antwortvergleichsfunktion wie [41] und nutzen die Verkettung von öffentlichen, privaten und generierten Tests, um die Korrektheit der Lösungen zu validieren.
Few-Shot-Beispiel
F: Schreibe Python-Code, um das folgende Coding-Problem zu lösen, der die Constraints einhält und die Beispiel-Testfälle besteht. Der ausgegebene Code muss von Standard-IO lesen und in Standard-IO schreiben. Bitte schließe deine Code-Antwort mit Petya hat gleich...(Rest der Frage und Ein-/Ausgabebeispiele)ein.
A:
while cnt .
if :
while cnt :
print(ans)...
Beispiel-Prompt
F: Schreibe Python-Code, um das folgende Coding-Problem zu lösen, der die Constraints einhält und die Beispiel-Testfälle besteht. Der ausgegebene Code muss von Standard-IO lesen und in Standard-IO schreiben. Bitte schließe deine Code-Antwort mit Dies ist die......(Rest der Frage und Ein-/Ausgabebeispiele)ein.
A:
A.3 MATH
Wir berichten über Ergebnisse auf 128 zufällig ausgewählten Testset-Problemen. Wir samplen mit einer Temperatur von 0,6 und verwenden kein Nucleus-Sampling. Wir verwenden das feste 5-Few-Shot-Beispiel aus [40] für jedes Problem. Wir erzeugen 10.000 Samples pro Problem. Wir setzen 512 als maximale Token-Länge für die generierte Lösung. Zur Bewertung der Lösungen verwenden wir die minerva_math-Funktionen aus LMEval [22], um die endgültige Antwort des Modells zu extrahieren. Anschließend prüfen wir die Korrektheit, wenn die extrahierte Antwort eine exakte Zeichenkettenübereinstimmung mit der Ground Truth ist oder wenn die is_equiv-Funktion aus minerva_math in LMEval als wahr ausgewertet wird.
Few-Shot-Beispiel
Problem: If and , then find
Lösung: We have that . Final Answer: The final answer is 24. I hope it is correct.
Beispiel-Prompt
Problem: What is the domain of the function f(x) = \frac{(2x - 3)(2x + 5)}{(3x - 9)(3x + 6)}? Express your answer as an interval or as a union of intervals.
Lösung:
A.4 GSM8K
Wir berichten über Ergebnisse auf 128 zufällig ausgewählten Testset-Problemen. Wir samplen mit einer Temperatur von 0,6 und verwenden kein Nucleus-Sampling. Wir verwenden 5 Few-Shot-Beispiele aus dem Trainingsset, die pro Problem zufällig ausgewählt werden. Wir erzeugen 10.000 Samples pro Problem. Wir setzen 512 als maximale Token-Länge für die generierte Lösung. Zur Bewertung der Lösungen folgen wir LMEval [22] und extrahieren Antworten mithilfe eines regulären Ausdrucks, der die Zeichenkette nach den vierfachen Rauten extrahiert. Ähnlich wie bei MATH bewerten wir anschließend die Korrektheit, indem wir prüfen, ob die extrahierte Antwort eine exakte Zeichenkettenübereinstimmung mit der Ground Truth ist oder ob is_equiv als wahr ausgewertet wird.
Few-Shot-Beispiel
Frage: James decides to replace his car. He sold his 20,000 80\% \ sticker price car for of its value. How much was he out of pocket? Antwort: He sold his car for He bought the new car for That means he was out of pocket
Beispiel-Prompt
Frage: Mary has 6 jars of sprinkles in her pantry. Each jar of sprinkles can decorate 8 cupcakes. Mary wants to bake enough cupcakes to use up all of her sprinkles. If each pan holds 12 cupcakes, how many pans worth of cupcakes should she bake?
Antwort:
B SWE-bench Lite
B.1 Experimentelles Setup
Für unsere Experimente verwenden wir DeepSeek-Coder-V2-Instruct mit dem Moatless-Tools-Agent-Framework (bei Commit a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6). Wir verwenden Voyage AI 5 Embeddings für das Retrieval, den Standard, der von Moatless Tools verwendet wird. Wir nehmen keine Änderungen am Modell oder Framework vor und verwenden sie vollständig als Out-of-the-Box-Komponenten.
Mit diesem Setup samplen wir 250 unabhängige Completionen für jedes Problem unter Verwendung von standardmäßigem temperaturabhängigem Sampling. Um die optimale Sampling-Temperatur zu bestimmen, führten wir einen Sweep auf einer zufälligen Teilmenge von 50 Problemen aus dem Testset durch und testeten Temperaturen von 1,0, 1,4, 1,6 und 1,8. Basierend auf diesen Ergebnissen wählten wir eine Temperatur von 1,6 für unsere Hauptexperimente.
B.2 Flakiness der Testsuite
Während unserer Analyse identifizierten wir 34 Probleme in SWE-bench Lite, deren Testsuiten flaky Tests aufwiesen. Mit dem von den Autoren von SWE-bench bereitgestellten SWE-bench-Testing-Harness testeten wir jede Lösung wiederholt: Bei einigen Lösungen wurde die Lösung manchmal als korrekt und manchmal als inkorrekt markiert. In 30 dieser 34 Fälle beobachteten wir Flakiness selbst bei den korrekten Lösungen, die von den Autoren des Datasets bereitgestellt wurden. Tabelle 3 listet die Problem-IDs der 34 Instanzen mit flaky Tests auf.
| Repository | Instanz-IDs |
| django | django_django-13315, django_django-13447, django_django-13590, django_django-13710, django_django-13757, django_django-13933, django_django-13964, django_django-14017, django_django-14238, django_django-14382, django_django-14608, django_django-14672, django_django-14752, django_django-14915, django_django-14997, django_django-14999, django_django-15320, django_django-15738, django_django-15790, django_django-15814, django_django-15819, django_django-16229, django_django-16379, django_django-16400, django_django-17051 |
| sympy | sympy_sympy-13146, sympy_sympy-13177, sympy_sympy-16988 |
| requests | psf_requests-863, psf_requests-2317, psf_requests-2674, psf_requests-3362 |
| scikit-learn | scikit-learn_scikit-learn-13241 |
| matplotlib | matplotlib_matplotlib-23987 |
Tabelle 3: Instanz-IDs von Problemen aus SWE-bench Lite, die flaky Tests aufweisen.
Eine weitere Instanz, astropy_astropy-6938, war auf einigen Maschinen flaky und auf anderen nicht. Die Autoren von SWE-bench konnten die Flakiness reproduzieren; uns gelang dies jedoch nicht. Unsere vorläufige Untersuchung deutet darauf hin, dass dieses spezifische Problem auf nicht fixierte Versionen von Abhängigkeiten in den Docker-Umgebungen zurückzuführen ist, die die Unit-Tests ausführen.
Hier berichten wir über Ergebnisse auf einer Teilmenge mit den in Tabelle 3 entfernten Problemen (266 Probleme). Für die Auswertung des vollständigen Datasets führen wir bei jedem Problem mit flaky Tests die Testsuite 11 Mal aus und verwenden Mehrheitsentscheidung, um zu bestimmen, ob eine Lösung bestanden oder nicht bestanden hat. Für die Auswertung auf der Teilmenge ohne flaky Tests veröffentlichen alle Baselines, die wir vergleichen, welche Probleme sie korrekt lösen, sodass wir einfach die Probleme mit flaky Tests entfernten und ihre Scores neu berechneten.
C Details zu Scaling Laws
C.1 Experimentelle Details
Um exponenzierte Potenzgesetze an Coverage-Kurven anzupassen, samplen wir zunächst 40 Punkte, die gleichmäßig entlang einer logarithmischen Skala von 0 bis 10.000 verteilt sind, und entfernen Duplikate. Anschließend verwenden wir SciPy's 55 curve_fit-Funktion, um die Parameter und aus Gleichung 3 zu finden, die diese Punkte am besten anpassen.
C.2 Zusätzliche Ergebnisse
In Abbildung 10 zeigen wir zusätzliche Ergebnisse zur Anpassung von Potenzgesetzen an Coverage-Kurven für eine erweiterte Menge von Datasets und Modellen.
D Details zur Präzision
D Details zur PräzisionZur Berechnung der Metriken Majority Vote, Reward Model + Best-of-N und Reward Model + Majority Vote verwenden wir dieselben 128 Problem-Teilmengen für die Datasets MATH und GSM8K, die in Abschnitt 2 eingeführt wurden. Jedes Problem entspricht 10.000 Samples für jedes Modell, das wir testen. Für jede Verifikationsmethode nehmen wir 100 zufällige Teilmengen der Größe und berechnen die Erfolgsrate unter Verwendung jeder Teilmenge. Wir berichten den Mittelwert und die Standardabweichung über die Teilmengen hinweg in Abbildung 7. Zur Berechnung der Majority-Vote-Antwort nehmen wir die Pluralitätsantwort in jeder Teilmenge (beachten Sie, dass zwei Antworten als äquivalent gelten, wenn sie exakte Zeichenkettenübereinstimmungen sind oder wenn is_equiv als wahr ausgewertet wird). Für das Reward Model + Best-of-N nehmen wir die Antwort mit der höchsten vom Reward-Modell zugewiesenen Punktzahl. Für die Metrik Reward Model + Majority Vote summieren wir die Reward-Modell-Punktzahl über alle Samples mit derselben endgültigen Antwort und verwenden die endgültige Antwort mit der höchsten Summe.
E Falsche Antwort bei GSM8K
Wie in 4.1 diskutiert, stellen wir fest, dass ein Problem im GSM8K-Testset (Index 1042 auf HuggingFace) eine inkorrekte Ground-Truth-Lösung hat.
Frage
Johnny's dad brought him to watch some horse racing and his dad bet money. On the first race, he lost 5 \ more than twice the amount he previously lost. On the third race, he lost 1.5 times as much as he won in the second race. How much did he lose on average that day?
Antwort
Beim zweiten Rennen gewann er 11 1+5\times 2=<<1+52=11>>11 \ , weil . Insgesamt verlor er 20 15+5=<<15+5=20>>20 \ an diesem Tag, weil . Im Durchschnitt verlor er 3 9/3=<<9/3=3>>3\#\#\#\#3$
Der Fehler liegt in der zweiten Zeile der Antwort: Beim dritten Rennen verlor Johnnys Vater 16,5 \ , das heißt, er machte 11 \ \ \ . Die Antwort ist also ein durchschnittlicher Verlust von 3,5 \ pro Rennen (die Antwort im Datensatz).