
Fast alle Modelle lösen Nadel im Heuhaufen perfekt. RULER fügt 13 schwierigere Aufgaben hinzu: die echte Kontextlänge ist viel kürzer. COLM 2024.
RULER: What's the Real Context Size of Your Long-Context Language Models?
RULER: Wie groß ist der tatsächliche Kontext wirklich, den Ihre Long-Context-Sprachmodelle verarbeiten können?
Cheng-Ping Hsieh*, Simeng Sun*, Samuel Kriman, Shantanu Acharya, Dima Rekesh, Fei Jia, Yang Zhang, Boris Ginsburg
NVIDIA
{chsieh, simengs}@nvidia.com
Zusammenfassung
Der Needle-in-a-Haystack-Test (NIAH), der die Fähigkeit prüft, eine Information (die „Nadel“) aus langen Ablenkungstexten (dem „Heuhaufen“) abzurufen, wurde weithin zur Bewertung von Long-Context-Sprachmodellen (LMs) eingesetzt. Dieser einfache, auf Abruf basierende Test ist jedoch nur ein Indikator für eine oberflächliche Form des Long-Context-Verständnisses. Um eine umfassendere Bewertung von Long-Context-LMs zu ermöglichen, erstellen wir einen neuen synthetischen Benchmark namens RULER mit flexiblen Konfigurationen für maßgeschneiderte Sequenzlängen und Aufgabenkomplexität. RULER erweitert den ursprünglichen NIAH-Test um Variationen mit unterschiedlichen Typen und Anzahlen von Nadeln. Darüber hinaus führt RULER neue Aufgabenkategorien ein – Multi-Hop-Tracing und Aggregation –, um Verhaltensweisen zu testen, die über die Suche im Kontext hinausgehen. Wir evaluieren 17 Long-Context-LMs mit 13 repräsentativen Aufgaben in RULER. Obwohl sie im ursprünglichen NIAH-Test nahezu perfekte Genauigkeit erreichen, zeigen fast alle Modelle große Leistungseinbußen, wenn die Kontextlänge zunimmt. Obwohl alle diese Modelle Kontextgrößen von 32K Token oder mehr beanspruchen, kann nur die Hälfte von ihnen bei einer Länge von 32K eine zufriedenstellende Leistung aufrechterhalten. Unsere Analyse von Yi-34B, das eine Kontextlänge von 200K unterstützt, zeigt erhebliches Verbesserungspotenzial, wenn wir die Eingabelänge und die Aufgabenkomplexität erhöhen. Wir stellen RULER als Open Source zur Verfügung, um eine umfassende Bewertung von Long-Context-LMs voranzutreiben.
1 Einleitung
Jüngste Fortschritte im Engineering von KI-Systemen (Dao et al., 2022; Jacobs et al., 2023; Fu et al., 2024) und im Design von Sprachmodellen (Chen et al., 2023; Xiong et al., 2023) haben eine effiziente Skalierung der Kontextlänge von Sprachmodellen ermöglicht (Liu et al., 2024a; Young et al., 2024). Frühere Arbeiten (AI21, 2024; X.AI, 2024; Reid et al., 2024; Anthropic, 2024) verwenden üblicherweise synthetische Aufgaben wie Passkey-Retrieval (Mohtashami & Jaggi, 2023) und Needle-in-a-Haystack (Kamradt, 2023), um Long-Context-LMs zu evaluieren. Diese Evaluierungen werden jedoch in verschiedenen Arbeiten uneinheitlich verwendet und offenbaren lediglich die Abrufffähigkeit, sodass sie andere Formen des Long-Context-Verständnisses nicht erfassen können.
In dieser Arbeit schlagen wir RULER vor, einen neuen Benchmark zur Bewertung der Long-Context-Modellierungsfähigkeiten von Sprachmodellen. RULER enthält vier Aufgabenkategorien, um Verhaltensweisen (Ribeiro et al., 2020) jenseits des einfachen Abrufs aus dem Kontext zu testen:
1. Retrieval: Wir erweitern den Needle-in-a-Haystack-Test (Kamradt, 2023; NIAH), um die Abrufffähigkeit mit unterschiedlichen Typen und Anzahlen von Nadeln zu evaluieren. 2. Multi-Hop-Tracing: Wir schlagen Variable Tracking vor, eine minimale Proxy-Aufgabe zur Auflösung von Koreferenzketten, um das Verhalten beim Verfolgen von Entitäten mit Multi-Hop-Verbindungen zu prüfen. 3. Aggregation: Wir schlagen die Extraktion häufiger/gewöhnlicher Wörter vor, Proxy-Aufgaben für die Zusammenfassung, um die Fähigkeit zu testen, relevante Informationen zu aggregieren, die sich über einen weitreichenden Kontext erstrecken.
| Benchmark & Aufgabe | Durchschn. Länge | Typ | Vielfältige Aufgaben | Min. parametrisches Wissen | Kontrollierbarer Kontext |
| ZeroSCROLLS | ~10k | realistisch | ✓ | X | X |
| L-Eval | ~8k | realistisch | ✓ | X | X |
| BAMBOO | ~16k | realistisch | ✓ | ✓ | X |
| LongBench | ~8k | hybrid | ✓ | X | X |
| LooGLE | ~20k | hybrid | ✓ | ✓ | X |
| InfiniteBench | ~200k | hybrid | ✓ | ✓ | X |
| Needle-in-a-haystack (NIAH) | beliebig | synthetisch | X | ✓ | ✓ |
| Passkey / Line / KV Retrieval | beliebig | synthetisch | X | ✓ | ✓ |
| RULER (Unseres) | beliebig | synthetisch | ✓ | ✓ | ✓ |
4. Fragebeantwortung: Wir fügen den Eingaben bestehender Kurzkontext-QA-Datensätze ablenkende Informationen hinzu, um die Fähigkeit zur Fragebeantwortung bei verschiedenen Kontextgrößen zu evaluieren.
Im Vergleich zu bestehenden realistischen Benchmarks (Tabelle 1) besteht RULER ausschließlich aus synthetischen Aufgaben, die die Flexibilität bieten, Sequenzlänge und Aufgabenkomplexität zu kontrollieren. Die synthetische Eingabe in RULER verringert die Abhängigkeit von parametrischem Wissen, das die Nutzung von Long-Context-Eingaben bei realistischen Aufgaben beeinträchtigt (Shaham et al., [2023]; Bai et al., [2023]).
Mit RULER benchmarken wir Gemini-1.5 (Reid et al., [2024]), GPT-4 (OpenAI: Josh Achiam et al., [2023]) und 15 Open-Source-Modelle mit Kontextlängen von 4k bis 128k. Obwohl sie beim ursprünglichen NIAH-Test nahezu perfekte Leistung erzielen, zeigen fast alle Modelle bei komplexeren Aufgaben in RULER mit zunehmender Sequenzlänge große Verschlechterungen. Obwohl alle Modelle eine Kontextgröße von 32k Token oder mehr beanspruchen, zeigen unsere Ergebnisse, dass nur die Hälfte von ihnen eine Sequenzlänge von 32K effektiv bewältigen kann, indem sie einen qualitativen Schwellenwert überschreitet. Darüber hinaus fallen fast alle Modelle unter den Schwellenwert, bevor sie die beanspruchten Kontextlängen erreichen. Um feingranulare Modellvergleiche zu erhalten, aggregieren wir die Leistung von 4k bis 128k mit zwei gewichteten Durchschnittswerten, wobei die Gewichte die Längenverteilung realer Anwendungsfälle simulieren. Die beiden besten Modelle – Gemini-1.5 und GPT-4 – übertreffen unabhängig vom gewählten Gewichtungsschema durchgängig die anderen Modelle.
Wir analysieren ferner Yi-34B, das eine Kontextlänge von 200K beansprucht und unter den Open-Source-Modellen eine recht gute Leistung in RULER erzielt. Unsere Ergebnisse zeigen eine große Verschlechterung der Leistung von Yi, wenn wir die Eingabelänge und die Aufgabenkomplexität erhöhen. Bei großen Kontextgrößen liefert Yi-34B häufig unvollständige Antworten und versäumt es, die relevanten Informationen präzise zu lokalisieren. Darüber hinaus beobachten wir zwei Verhaltensweisen, die mit der Skalierung der Kontextgröße über mehrere Modelle hinweg auftreten: die zunehmende Abhängigkeit von parametrischem Wissen und die zunehmende Neigung, bei Nicht-Retrieval-Aufgaben aus dem Kontext zu kopieren. Unsere zusätzlichen Ablationen zeigen, dass das Training auf längeren Sequenzen nicht immer zu besserer Leistung in RULER führt und dass größere Modellgrößen positiv mit besseren Long-Context-Fähigkeiten korrelieren. Schließlich zeigen wir, dass Nicht-Transformer-Architekturen wie RWKV und Mamba in RULER noch immer mit großen Abständen hinter Transformern zurückliegen.
Unsere Beiträge sind wie folgt:
- Wir schlagen einen neuen Benchmark RULER zur Bewertung von Long-Context-Sprachmodellen mittels synthetischer Aufgaben mit flexiblen Konfigurationen vor.- Wir führen neue Aufgabenkategorien ein, insbesondere Multi-Hop-Tracing und Aggregation, um Verhaltensweisen jenseits des Abrufs aus langem Kontext zu testen.- Wir evaluieren 17 Long-Context-LMs mit RULER und führen Analysen über Modelle und Aufgabenkomplexitäten hinweg durch.
Wir stellen RULER als Open Source zur Verfügung, um zukünftige Forschung zu Long-Context-Sprachmodellen voranzutreiben.
2 Verwandte Arbeiten
Long-Context-Sprachmodelle. Zahlreiche Long-Context-Sprachmodelle wurden in jüngster Zeit aufgrund von Fortschritten im Engineering sowie in architektonischen und algorithmischen Designs eingeführt. Flash Attention (Dao et al., 2022; Dao, 2023) und Ring Attention (Liu et al., 2023) reduzieren den Speicherbedarf für die Verarbeitung langen Kontexts erheblich. Verschiedene sparse Attention-Mechanismen (Child et al., 2019; Jaszczur et al., 2021) wie shifted sparse attention (Chen et al., 2024), dilated attention (Ding et al., 2023) und Attention Sinks (Han et al., 2023; Xiao et al., 2024b) wurden eingesetzt, um eine effiziente Kontextskalierung zu ermöglichen. Neuartige Positions-Embedding-Methoden wurden vorgeschlagen, um die Längenextrapolation in Transformern (Vaswani et al., 2017) zu verbessern, darunter ALiBi (Press et al., 2022), xPOS (Sun et al., 2023b) und RoPE-Varianten (Su et al., 2023) (Chen et al., 2023; Xiong et al., 2023; Peng et al., 2024; Liu et al., 2024b; Ding et al., 2024; Zhu et al., 2024). Eine weitere Forschungslinie konzentriert sich auf die Reduzierung der Kontextgröße. Dies kann erreicht werden, indem vorheriger Kontext mithilfe eines Rekurrenzmechanismus zwischengespeichert wird (Zhang et al., 2024a; Bulatov et al., 2023; Martins et al., 2022; Wu et al., 2022), relevante Informationen aus dem Kontext abgerufen werden (Xu et al., 2024a; Mohtashami & Jaggi, 2023; Wang et al., 2024; Tworkowski et al., 2024; Xiao et al., 2024a) oder die salienten Informationen durch Kompression bewahrt werden (Jiang et al., 2023). Schließlich wurden auch neuartige Architekturen (Gu et al., 2022; Fu et al., 2023a; Poli et al., 2023; Fu et al., 2023b; Sun et al., 2023a; Beck et al., 2024; Sun et al., 2024) wie Mamba (Gu & Dao, 2023) und RWKV (Peng et al., 2023) vorgeschlagen, um Long-Context-Eingaben effizient zu verarbeiten.
Long-Context-Benchmarks und -Aufgaben. Unsere Arbeit steht in engem Zusammenhang mit anderen Arbeiten zum Benchmarking von Long-Context-Sprachmodellen. ZeroSCROLLS (Shaham et al., 2023) umfasst zehn realistische Aufgaben der natürlichen Sprache, wie Long-Document-QA und (abfragebasierte) Zusammenfassung. L-Eval (An et al., 2024) verwendet ebenfalls realistische Daten, die manuell gefiltert wurden, um Qualität zu gewährleisten. LongBench (Bai et al., 2023) enthält Aufgaben in einem zweisprachigen Setting. InfiniteBench (Zhang et al., 2024b) umfasst Aufgaben mit Längen von mehr als 100K Token. LTM (Castillo et al., 2024) zielt auf die Bewertung langfristiger Konversationen ab. Um den Effekt von parametrischem Wissen zu isolieren, schlagen frühere Arbeiten (Dong et al., 2023; Li et al., 2023b) auch vor, Dokumente zu verwenden, die online nach einem bestimmten Stichtag veröffentlicht wurden, oder extrem ressourcenarme Materialien zu nutzen (Tanzer et al., 2024). Im Vergleich zu realistischen Benchmarks sind synthetische Aufgaben flexibler in der Kontrolle des Setups (z. B. Sequenzlänge und Aufgabenkomplexität) und weniger von parametrischem Wissen beeinflusst. Jüngste Arbeiten haben sich hauptsächlich auf retrievalbasierte synthetische Aufgaben konzentriert (Kamradt, 2023; Mohtashami & Jaggi, 2023; Li et al., 2023a; Liu et al., 2024d; Lee et al., 2024), wobei einige andere Aspekte untersuchen, darunter Faktenreasoning (Kuratov et al., 2024; Karpinska et al., 2024), Modellierung weitreichender Diskursstrukturen (Sun et al., 2022), Fragebeantwortung (Levy et al., 2024; Yuan et al., 2024), Many-Shot-In-Context-Learning (Agarwal et al., 2024; Bertsch et al., 2024; Xu et al., 2024b) und Codeverständnis (Liu et al., 2024c).
3 Der RULER-Benchmark
RULER umfasst Aufgaben aus vier Kategorien: Retrieval, Multi-Hop-Tracing, Aggregation und Fragebeantwortung. Die Evaluationsbeispiele in RULER werden automatisch basierend auf Eingabekonfigurationen generiert (siehe Tabelle 2), die die Länge und Komplexität jeder Eingabe definieren. Innerhalb einer eingeschränkten Domäne wie in RULER kann die Aufgabenkomplexität als Funktion der Anzahl der Ziel-Ausgabe-Token und des Signal-Rausch-Verhältnisses im Kontext betrachtet werden. Wir verweisen Leser auf (Goldman et al., 2024) für eine umfassendere Diskussion über das Design von Evaluationsaufgaben für Langkontext-Sprachmodelle.
3.1 Retrieval: Needle-in-a-haystack (NIAH)
Jüngste Arbeiten (Reid et al., 2024; Anthropic, 2023) verwenden häufig den Needle-in-a-haystack-Test (Kamradt, 2023; NIAH), um die Fähigkeit zur Langkontextmodellierung zu evaluieren. Der NIAH-Test erinnert an die umfassend untersuchten (Hopfield, 1982; Graves et al., 2014; Olsson et al., 2022; Arora et al., 2024) assoziativen Erinnerungsaufgaben, bei denen relevante Informationen aus dem Kontext abgerufen werden müssen, sofern eine ausreichende Anfrage vorliegt. In RULER beziehen wir mehrere retrievalbasierte Aufgaben ein und erweitern den Standard-NIAH-Test, um Modelle anhand von drei Kriterien zu evaluieren. Konkret sollte die Retrieval-Fähigkeit (1) unabhängig vom Typ der „Nadel" und des „Heuhaufens" sein, (2) stark genug sein, um harte Distraktoren zu ignorieren, und (3) ein hohes Recall aufweisen, wenn mehrere Elemente abgerufen werden müssen. Basierend auf diesen Kriterien entwickeln wir vier NIAH-Aufgaben. Die „Nadel" in jeder dieser Aufgaben ist ein Schlüssel-Wert-Paar, das in den „Heuhaufen" (lange Distraktor-Texte) eingefügt wird. Die Anfrage befindet sich am Ende der Sequenz und dient als Hinweis zum Abgleichen der Schlüssel im Kontext und anschließend zum Abrufen der zugehörigen Werte.
| Aufgabe | Konfiguration | Beispiel |
| Single NIAH (S-NIAH) | type_key = word type_value = number type_haystack = essay size_haystack < context length | (essays) One of the special magic numbers for long-context is: 12345. What is the special magic number for long-context mentioned in the provided text? Answer: 12345 |
| Multi-keys NIAH (MK-NIAH) | num_keys = 2 type_key = word type_value = number type_haystack = essay size_haystack < context length | (essays) One of the special magic numbers for long-context is: 12345. One of the special magic numbers for large-model is: 54321. What is the special magic number for long-context mentioned in the provided text? Answer: 12345 |
| Multi-values NIAH (MV-NIAH) | num_values = 2 type_key = word type_value = number type_haystack = essay size_haystack < context length | (essays) One of the special magic numbers for long-context is: 12345. One of the special magic numbers for long-context is: 54321. What are all the special magic numbers for long-context mentioned in the provided text? Answer: 12345 54321 |
| Multi-queries NIAH (MQ-NIAH) | num_queries = 2 type_key = word type_value = number type_haystack = essay size_haystack < context length | (essays) One of the special magic numbers for long-context is: 12345. One of the special magic numbers for large-model is: 54321. What are all the special magic numbers for long-context and large-model mentioned in the provided text? Answer: 12345 54321 |
| Variable Tracking (VT) | num_chains = 2 num_hops = 2 size_noises < context length | (noises) VAR X1 = 12345 .... VAR Y1 = 54321 .... VAR X2 = X1 .... VAR Y2 = Y1 .... VAR X3 = X2 .... VAR Y3 = Y2 .... Find all variables that are assigned the value 12345. Answer: X1 X2 X3 |
| Common Words Extraction (CWE) | freq_cw = 2, freq_ucw = 1 num_cw = 10 num_ucw < context length | aaa bbb cca aaa ddd eee ccc fff ggg hhh iii iii .... What are the 10 most common words in the above list? Answer: aaa ccc iii .... |
| Frequent Words Extraction (FWE) | α = 2 num_word < context length | aaa bbb cca aaa ddd eee ccc fff ggg aaa hhh aaa ccc iii iii .... What are the 3 most frequently appeared words in the above coded text? Answer: aaa ccc iii |
| Question Answering (QA) | dataset = SQuAD num_document < context length | Document 1: .... aaa .... Document 2: .... bbb .... Document 3: .... ccc .... Question: question Answer: bbb |
- Single NIAH (S-NIAH): Dies ist der klassische NIAH-Test, bei dem eine einzelne „Nadel" aus dem „Heuhaufen" abgerufen werden muss. Der Query/Key/Value kann in Form von Wörtern, Zahlen (7 Ziffern) oder UUIDs (32 Ziffern) vorliegen. Der „Heuhaufen" kann aus wiederholten Rausch-Sätzen oder Paul-Graham-Essays bestehen (Kamradt, 2023). - Multi-keys NIAH (MK-NIAH): Mehrere „Nadeln" werden in den „Heuhaufen" eingefügt, und nur eine davon muss abgerufen werden. Die zusätzlichen „Nadeln" sind schwierige Distraktoren. Die anspruchsvollste Einstellung ist eine Version, bei der der „Heuhaufen" mit distrahierenden Nadeln gefüllt ist.
- Multi-values NIAH (MV-NIAH): Mehrere „Nadeln", die denselben Key teilen, werden in den „Heuhaufen" eingefügt. Alle Werte, die mit demselben Key verbunden sind, müssen abgerufen werden. - Multi-queries NIAH (MQ-NIAH): Mehrere „Nadeln" werden in den „Heuhaufen" eingefügt. Alle „Nadeln" mit unterschiedlichen Keys müssen abgerufen werden. Dies ist das gleiche Multi-Query-Associative-Recall-Aufgabensetup, das von Arora et al. (2024) verwendet wird. Zusammen mit MV-NIAH bewerten diese beiden Aufgaben die Abrufffähigkeit, ohne dass kritische Informationen fehlen.
3.2 Multi-hop Tracing: Variable Tracking (VT)
Effektives Diskursverstehen (van Dijk & Kintsch, 1983) hängt von der erfolgreichen Erkennung neu erwähnter Entitäten und der Etablierung der Referenzkette, die sich auf dieselbe Entität bezieht (Karttunen, 1969), über den gesamten langen Kontext hinweg ab. Wir entwickeln eine neue Aufgabe, Variable Tracking, um eine minimale Coreference-Chain-Resolution-Aufgabe (Ng, 2010) nachzubilden. Diese Aufgabe prüft das Verhalten beim Verfolgen relevanter Ko-Okkurrenzmuster und beim Ziehen übersprungener Verbindungen innerhalb einer langen Eingabe. Konkret wird eine Variable mit einem Wert initialisiert, gefolgt von einer linearen Kette von Variablennamen-Bindungsanweisungen (z. B. , , ...), die an verschiedenen Positionen der Eingabe eingefügt werden. Das Ziel ist es, alle Variablennamen zurückzugeben, die auf denselben Wert zeigen. Die Aufgabenkomplexität kann durch Hinzufügen weiterer Hops (d. h. der Anzahl der Namensbindungen) oder weiterer Ketten erhöht werden, ähnlich wie beim Hinzufügen schwieriger Distraktoren in MK-NIAH.
3.3 Aggregation: Common Words (CWE) und Frequent Words Extraction (FWE)
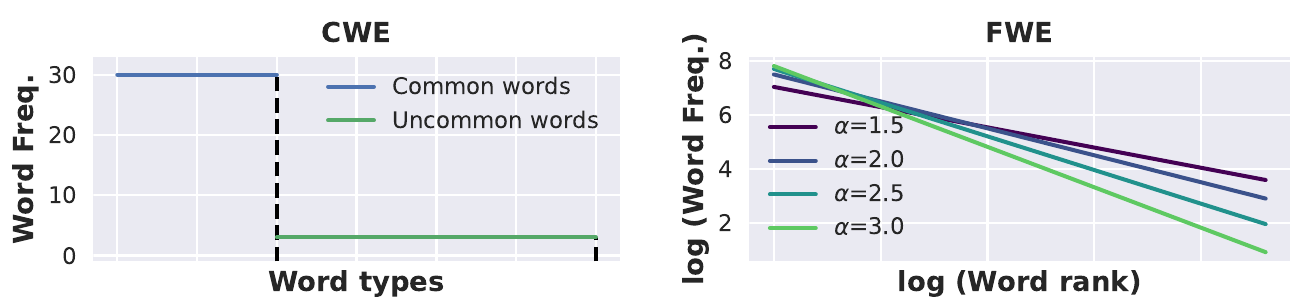
In RULER führen wir eine neue Kategorie als Stellvertreter für Zusammenfassungsaufgaben ein, bei denen relevante Informationen einen viel größeren Teil des Kontexts ausmachen und die Zielausgabe von einer präzisen Aggregation der relevanten Eingabe abhängt. Konkret konstruieren wir eine Eingabesequenz, indem wir Wörter aus einer vordefinierten (synthetischen) Wortliste sampeln. In der Aufgabe zur Extraktion gemeinsamer Wörter (CWE) werden Wörter aus diskreten Gleichverteilungen gesampelt, wobei die Anzahl der gemeinsamen Wörter fest ist, während die Anzahl der ungewöhnlichen Wörter mit der Sequenzlänge zunimmt. In der Aufgabe zur Extraktion häufiger Wörter (FWE) werden Wörter aus einer Zeta-Verteilung gesampelt. Abbildung 1 zeigt eine Veranschaulichung der Worthäufigkeit in der konstruierten Eingabe. Ein Modell muss die top- häufigen Wörter im Kontext zurückgeben. In CWE entspricht der Anzahl der gemeinsamen Wörter. In FWE setzen wir auf 3, da eine Erhöhung von selbst bei kleinen Kontextgrößen für die meisten Modelle zu schlechter Leistung führt. Die Aufgabenkomplexität kann durch Variation der Anzahl der gemeinsamen Wörter oder des Parameters der Zeta-Verteilung angepasst werden.4
3.4 Question Answering (QA)
Die Mehrheit der bestehenden QA-Datensätze (Rajpurkar et al., 2018; Yang et al., 2018; Trivedi et al., 2022) ist darauf ausgelegt, Fragen auf der Grundlage kurzer Passagen zu beantworten. Diese Datensätzekönnen erweitert werden, um eine Langkontext-Eingabe zu simulieren, indem distrahierende Informationen hinzugefügt werden. In dieser Aufgabenkategorie fügen wir die goldenen Absätze (d. h. die Absätze, die Antworten enthalten) in Absätze ein, die zufällig aus demselben Datensatz gesampelt wurden. Diese Kategorie ist eine realweltliche Anpassung (Ivgi et al., 2023) von NIAH, bei der die Frage als Query dient, die goldenen Absätze die „Nadeln" sind und die distrahierenden Absätze den „Heuhaufen" bilden.
4 Experimente & Ergebnisse
Modelle & Inferenz-Setup Wir wählen 17 Langkontext-LLMs aus, darunter 15 Open-Source-Modelle und zwei Closed-Source-Modelle (Gemini-1.5-Pro und GPT-4), die verschiedene Modellgrößen (7B bis 8x22B mit MoE-Architektur) und beanspruchte Kontextlängen (32K bis 1M) abdecken. Vollständige Informationen zu diesen Modellen sind in Anhang A enthalten. Wir evaluieren alle Modelle mit vLLM (Kwon et al., 2023), einem LLM-Serving-System mit effizientem KV-Cache-Speichermanagement. Für alle Modelle führen wir die Inferenz in BFloat16 auf 8 NVIDIA A100 GPUs mit greedy decoding durch.
Aufgabenkonfigurationen Wir testen alle Modelle auf 13 Aufgaben, die unterschiedliche Komplexitäten aus den vier Kategorien von RULER abdecken. Die Testkonfigurationen wurden ausgewählt (gezeigt in Anhang B) auf der Grundlage einer Aufgabenkorrelationsstudie, die in Anhang C beschrieben ist. Wir wählen diese Aufgaben aus, da die meisten Modelle bei einer kurzen Kontextgröße von 4K Tokens ordentlich abschneiden. Unser Hauptziel ist es zu sehen, ob Modelle diese gute Leistung bei der Skalierung der Kontextlänge aufrechterhalten können. Für jede Aufgabe evaluieren wir jedes Modell mit 500 Beispielen, die für jede Länge aus der Reihe (4K, 8K, 16K, 32K, 64K, 128K) generiert werden, wobei wir das erforderliche Chat-Template jedes Modells einhalten. Um zu verhindern, dass das Modell die Beantwortung einer Anfrage verweigert oder Erklärungen generiert, hängen wir an die Aufgaben-Eingabe ein Antwortpräfix an und prüfen das Vorhandensein der Zielausgabe mit rekallbasierter Genauigkeit.
Effektive Kontextgröße Wir beobachten bei allen Modellen eine starke Leistungsverschlechterung, wenn wir die Eingabelänge in RULER erhöhen. Um die maximale Kontextgröße zu bestimmen, die ein Modell effektiv verarbeiten kann, bewerten wir jedes Modell mit einem festen Schwellenwert; dessen Überschreitung zeigt eine zufriedenstellende Leistung bei der Evaluierungslänge an. Wir verwenden die Leistung des Llama2-7b-Modells bei der Kontextlänge 4K als Schwellenwert. In Tabelle 3 berichten wir die maximale Länge, die den Schwellenwert überschreitet, als „effektive Länge" zusammen mit der „beanspruchten Länge".
Modell-Ranking-Kriterien Während die schwellenwertbasierte Bewertung die Diskrepanz zwischen beanspruchter und effektiver Länge aufzeigt, fehlen ihr Details für feingranulare Modellvergleiche. Daher verwenden wir einen gewichteten Durchschnittswert, um die Modellleistung über verschiedene Kontextgrößen hinweg zu aggregieren. Wir ranken Modelle unter zwei Gewichtungsschemata: wAvg. (inc) und wAvg. (dec), wobei das Gewicht jeweils linear mit der Sequenzlänge zunimmt bzw. abnimmt. Idealerweise sollte das Gewicht für jede Länge durch die Längenverteilung der Modellnutzung bestimmt werden; hier wählen wir die beiden Schemata, um die Szenarien zu simulieren, in denen längere Sequenzen (inc) oder kürzere Sequenzen (dec) die Verteilung dominieren.
Hauptergebnisse Wir fügen die Ergebnisse von 17 Langkontext-LMs im Vergleich zur Llama2-7B-Baseline in Tabelle 3 ein. Die Leistung bei einer bestimmten Länge ist der Durchschnitt aller 13 Aufgaben in RULER. Das Closed-Source-Modell Gemini-1.5-Pro übertrifft die übrigen Modelle mit großem Abstand, wobei die effektive Länge größer ist als die maximale Länge, die wir getestet haben. Dieses Modell mit einer schwierigeren Version von RULER einem Belastungstest zu unterziehen, könnte in Zukunft eine interessante Folgearbeit sein. Für die übrigen Modelle gilt: Während sie nahezu perfekte Leistung beim Passkey-Retrieval und bei der klassischen NIAH-Aufgabe erzielen (gezeigt in Anhang E), weisen sie alle eine starke Verschlechterung in RULER auf, wenn die Sequenzlänge zunimmt, und sie schaffen es nicht, die Leistung bei ihrer beanspruchten Länge über der Llama2-7B-Baseline zu halten. Die am höchsten rangplatzierten Open-Source-Modelle (Llama3.1, Qwen2 und Command-R-plus) teilen gemeinsame Konfigurationen, wie etwa größere Modellgrößen und die Verwendung größerer Basisfrequenzen in
| Modelle | Angegebene Länge | Effektive Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. | gew. Durchschn. (inc) | gew. Durchschn. (dec) |
| Llama2 (7B) | 4K | - | 85,6 | ||||||||
| Gemini-1.5-Pro | 1M | >128K | 96,7 | 95,8 | 96,0 | 95,9 | 95,9 | 94,4 | 95,8 | 95,5(1.) | 96,1(1.) |
| GPT-4 | 128K | 64K | 96,6 | 95,3 | 95,2 | 93,2 | 87,0 | 81,2 | 91,6 | 89,0(2.) | 94,1(2.) |
| Llama3.1 (70B) | 128K | 64K | 96,5 | 95,8 | 95,4 | 94,8 | 88,4 | 66,6 | 89,6 | 85,5(4.) | 93,7(3.) |
| Qwen2 (72B) | 128K | 32K | 96,9 | 96,1 | 94,9 | 94,1 | 79,8 | 53,7 | 85,9 | 79,6(9.) | 92,3(4.) |
| Command-R-plus (104B) | 128K | 32K | 95,6 | 95,2 | 94,2 | 92,0 | 84,3 | 63,1 | 87,4 | 82,7 (7.) | 92,1 (5.) |
| GLM4 (9B) | 1M | 64K | 94,7 | 92,8 | 92,1 | 89,9 | 86,7 | 83,1 | 89,9 | 88,0 (3.) | 91,7 (6.) |
| Llama3.1 (8B) | 128K | 32K | 95,5 | 93,8 | 91,6 | 87,4 | 84,7 | 77,0 | 88,3 | 85,4 (5.) | 91,3 (7.) |
| GradientAI/Llama3 (70B) | 1M | 16K | 95,1 | 94,4 | 90,8 | 85,4 | 80,9 | 72,1 | 86,5 | 82,6 (8.) | 90,3 (8.) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 95,6 | 94,9 | 93,4 | 90,9 | 84,7 | 31,7 | 81,9 | 73,5 (11.) | 90,3 (9.) |
| Yi (34B) | 200K | 32K | 93,3 | 92,2 | 91,3 | 87,5 | 83,2 | 77,3 | 87,5 | 84,8 (6.) | 90,1 (10.) |
| Phi3-medium (14B) | 128K | 32K | 93,3 | 93,2 | 91,1 | 86,8 | 78,6 | 46,1 | 81,5 | 74,8 (10.) | 88,3 (11.) |
| Mixtral-v0.2 (7B) | 32K | 16K | 93,6 | 91,2 | 87,2 | 75,4 | 49,0 | 13,8 | 68,4 | 55,6 (13.) | 81,2 (12.) |
| LWM (7B) | 1M | <4K | 82,3 | 78,4 | 73,7 | 69,1 | 68,1 | 65,0 | 72,8 | 69,9 (12.) | 75,7 (13.) |
| DBRX (36B/132B) | 32K | 8K | 95,1 | 93,8 | 83,6 | 63,1 | 2,4 | 0,0 | 56,3 | 38,0 (14.) | 74,7 (14.) |
| Together (7B) | 32K | 4K | 88,2 | 81,1 | 69,4 | 63,0 | 0,0 | 0,0 | 50,3 | 33,8 (15.) | 66,7 (15.) |
| LongChat (7B) | 32K | &lt;4K | 84,7 | 79,9 | 70,8 | 59,3 | 0,0 | 0,0 | 49,1 | 33,1 (16.) | 65,2 (16.) |
| LongAlpaca (13B) | 32K | &lt;4K | 60,6 | 57,0 | 56,6 | 43,6 | 0,0 | 0,0 | 36,3 | 24,7 (17.) | 47,9 (17.) |
RoPE (Xiong et al., 2023). Ein großes Trainings-Kontextfenster ist nicht immer notwendig für gute Langkontext-Leistung – die am höchsten rangplatzierten Open-Source-Modelle umfassen sowohl Brute-Force-Kontextskalierung (Llama3.1, trainiert auf 128K Kontextlänge) als auch Längenextrapolation zur Inferenzzeit (Qwen2, trainiert auf 32K Kontextlänge). Zu den weniger leistungsfähigen Modellen gehören auch solche, die auf einer viel größeren Kontextgröße trainiert wurden (z. B. LWM und GradientAI/Llama3, beide auf 1M Kontextlänge). Obwohl LWM einen höheren Rang als Mistral-v0.2 erreicht, wenn längere Sequenzen ein größeres Gewicht erhalten (wAvg. inc) und eine geringere Verschlechterung mit zunehmender Kontextgröße zeigt, schneidet es selbst bei 4K schlechter ab als Llama2-7B. Dieses Ergebnis deutet auf einen Kompromiss in der Evaluierung zwischen absoluter Leistung auf kurzen Sequenzen und relativer Verschlechterung bei der Skalierung der Kontextgröße hin. Wir bieten weitere Analysen zu Modellgröße und maximaler Trainingslänge in Abschnitt 6.
5 Aufgaben-Fehleranalyse
Wir evaluieren Yi-34B-200K mit erhöhten Eingabelängen (bis zu 256K) auf komplexeren Aufgaben, um die Auswirkung von Aufgabenkonfigurationen und Fehlermodi auf RULER zu verstehen.
Keine Robustheit gegenüber „Nadel“-Typen. Abbildung 2 (links) zeigt, dass Yi zwar nahezu perfekte Leistung erzielt, wenn eine Nadel aus einem Wort-Zahlen-Paar im standardmäßigen Passkey-Retrieval und im Vanilla-NIAH verwendet wird, die Leistung jedoch abnimmt, wenn die Nadel andere Formen annimmt. Die größte Verschlechterung beobachten wir bei der Aufgabe, UUIDs abzurufen, bei der Yi bei langem Eingabekontext () manchmal nicht in der Lage ist, die vollständigen 32 Ziffern zurückzugeben.
Fehlendes Ignorieren von Distraktoren. Abbildung 2 (Mitte links) zeigt, dass eine zunehmende Anzahl ablenkender Nadeln die Leistung stetig senkt, wobei Yi in der extremen Version bei 256K um (\sim 40) Punkte abfällt, in der der Kontext voller irrelevanter Nadeln ist (#K=FULL). Eine Fehleranalyse zeigt, dass Yi die schwierigen Distraktoren bei langem Eingabekontext nicht effektiv ignorieren kann und daher fälschlicherweise Werte abruft, die mit den Distraktor-Schlüsseln verbunden sind. In der extremen Version gibt Yi häufig Werte aus der Umgebung des Ziels zurück, was auf eine grobe Übereinstimmung des Bereichs hindeutet, aber auf einen Mangel an Präzision beim Lokalisieren des Schlüssels, wenn das Ziel innerhalb der Verteilung der Störungen liegt.
Unvollständige Informationen zurückgeben. In Übereinstimmung mit früheren Arbeiten (Liu et al., 2024a; Reid et al., 2024) stellen wir eine erhebliche Verschlechterung der Leistung fest, wenn das Modell mehrere Elemente aus einer langen Eingabe abrufen muss.Beispielsweise sinkt die Leistung, wenn die Anzahl der Abfragen von 1 auf 8 erhöht wird, um (\sim 15) Punkte (Abbildung 2 rechts). Wenn das Modell mehrere Werte abrufen muss, die mit demselben Schlüssel verbunden sind (Abbildung 2 Mitte rechts), gibt Yi häufig doppelte Antworten aus, ohne die vollständige Menge der Werte zurückzugeben, was auf ungleichmäßige Assoziationen zwischen dem Schlüssel und jedem seiner Werte hindeutet.
Tendenz zum Kopieren aus dem Kontext. Wir stellen fest, dass Yi bei der Skalierung der Eingabelänge eine starke Tendenz hat, wörtlich aus dem Kontext zu kopieren. Diese Tendenz ist am auffälligsten bei der Variablenverfolgung (VT) und der Extraktion häufiger Wörter (CWE), bei denen wir eine In-Context-Demonstration am Anfang der Sequenz einfügen. Über (80\%) von Yis Ausgabe in der CWE-Aufgabe bei 128K ist einfach eine aus dem One-Shot-Beispiel kopierte Zeichenkette, während das Kopieren bei kurzen Sequenzen nicht auftritt. Dieses Kopierverhalten zeigt sich auch beim LWM-Modell und bei LongAlpaca, ist jedoch bei anderen Modellen wie Mixtral weniger verbreitet. Dieser Befund unterstreicht weitere die Notwendigkeit, bei langem Eingabekontext auch andere Verhaltensweisen als das Retrieval zu testen.
Unzuverlässige Verfolgung im Kontext. Bei der Aufgabe zur Variablenverfolgung tragen sowohl das Hinzufügen weiterer Ketten als auch weiterer Sprünge erheblich zur starken Verschlechterung der Leistung von Yi bei. Yi verschlechtert sich in der Einstellung mit mehr Sprüngen konsistent, wenn wir die Kontextgröße erhöhen (Abbildung 3 links), während die Verschlechterung in der Einstellung mit mehr Ketten für Längen größer als 128K am bedeutendsten ist (Abbildung 3 mittig links). Neben dem bereits erwähnten Kopierproblem macht Yi Fehler durch die inkorrekte Rückgabe von leeren Zeichenketten oder Variablen aus anderen Ketten, was auf einen Mangel an Fähigkeit hindeutet, dieselbe Entität innerhalb eines langen Kontexts zuverlässig zu verfolgen. Diese Fehler werden auch häufig bei Modellen beobachtet, die das Kopierverhalten nicht zeigen.
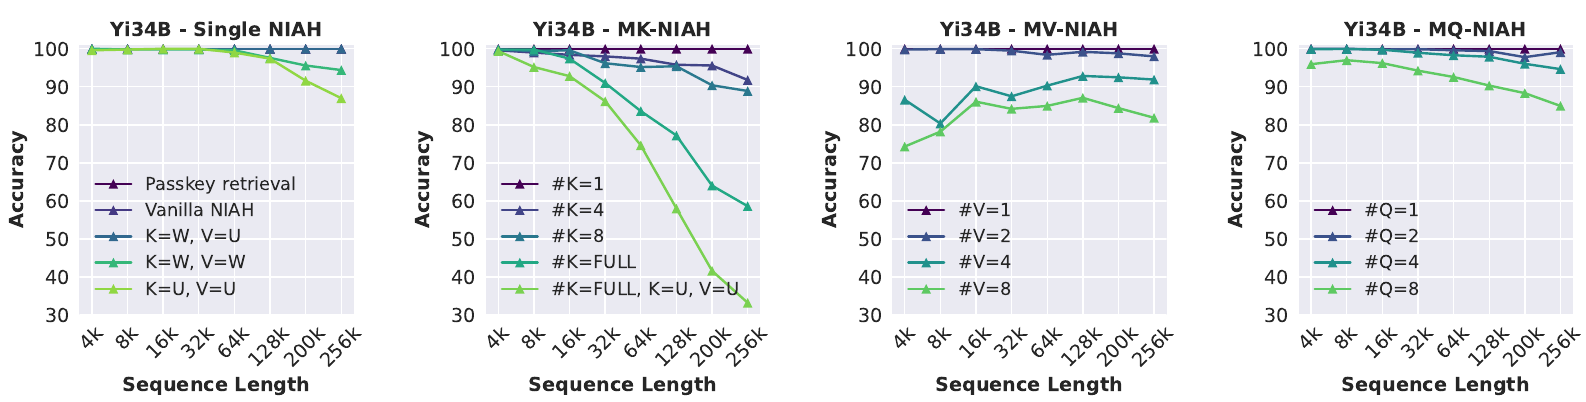
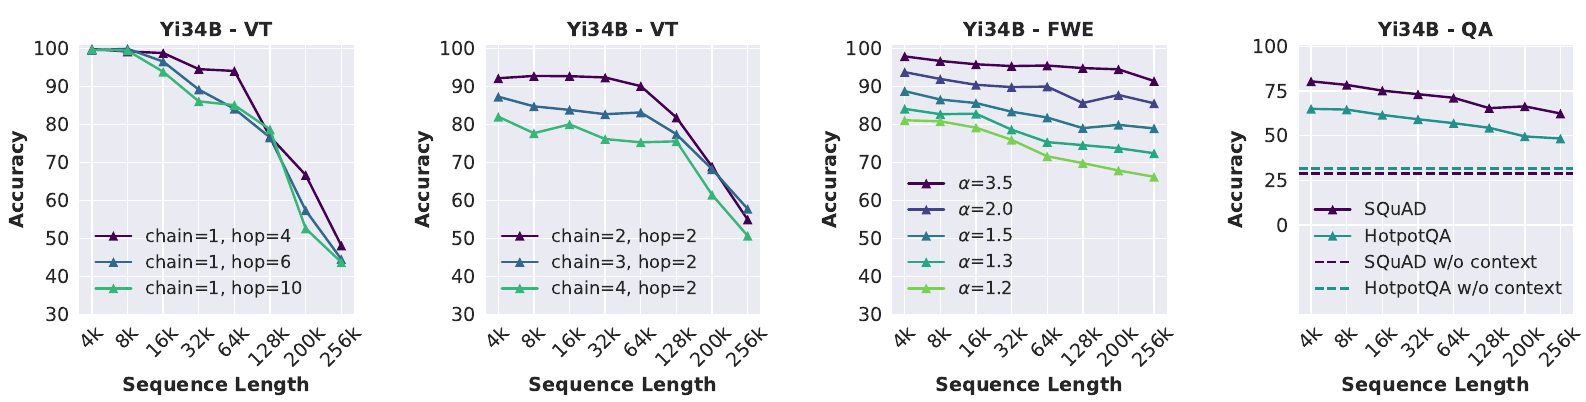
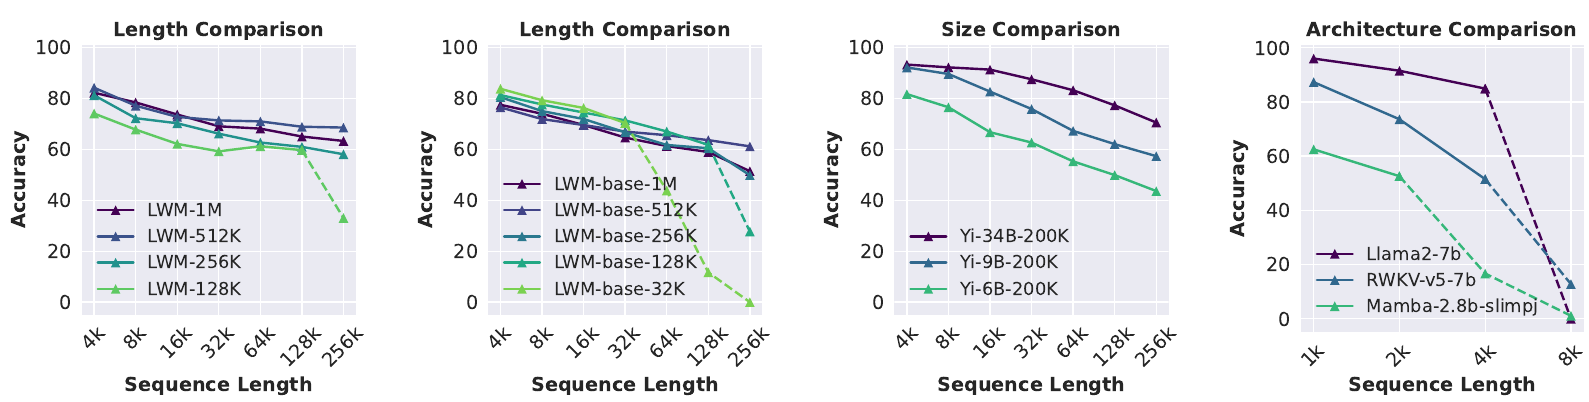
Abbildung 4: (Links & mittig links): Vergleich der LargeWorldModel (LWM)-Serie, trainiert bis zu verschiedenen Kontextgrößen mit fester Parametergröße von 7B. (Mittig rechts): Vergleich der Yi-Suite-Modelle mit unterschiedlichen Parametergrößen bei kontrollierter Trainingskontextlänge von 200K. (Rechts): Die Leistung von Nicht-Transformer-Architekturen bleibt weit hinter der Transformer-Baseline Llama2-7B zurück. Längenextrapolation ist mit gestrichelten Linien dargestellt.
Fehlgeschlagene genaue Aggregation. Wir beobachten zwei häufige Fehlermodi bei Aggregationsaufgaben: inkorrekte Verwendung parametrischen Wissens und ungenaue Aggregation. Modelle, die das Kopierproblem in der CWE-Aufgabe nicht zeigen, ignorieren manchmal die kontextuellen Informationen und verwenden stattdessen parametrisches Wissen, um die Anfrage zu beantworten, insbesondere bei großen Kontextgrößen. Zum Beispiel gibt Mistral (7b-instruct-v0.2) hochfrequente Wörter wie „the", „an", „a" als Ausgabe zurück, ohne die Wörter im Kontext zu zählen. Bei der FWE-Aufgabe, die das Kopierproblem weniger zeigt, scheitert Yi daran, die häufigsten Wörter korrekt auszugeben, wenn wir das in der Zeta-Verteilung verringern (Abbildung 3 mittig rechts). Die Verringerung von führt zu einem kleineren Frequenzunterschied zwischen den Wörtern, was die Schwierigkeit erhöht, die häufigsten Wörter zu unterscheiden.
Häufige Halluzination bei Long-Context-QA. Bei den QA-Aufgaben nähert sich die Leistung von Yi seiner No-Context-Baseline an, wenn wir den Kontext mit ablenkenden Absätzen erweitern (Abbildung 3 rechts). Die Verschlechterung rührt primär von Halluzination und verringerter Abhängigkeit von kontextuellen Informationen her. Wir bemerken, dass bei großen Kontextgrößen die Modellvorhersagen manchmal irrelevant für die Frage sind und mit den Antworten seiner No-Context-Baseline übereinstimmen können. Die insgesamt schlechtere Leistung bei QA-Aufgaben bestätigt, dass das unscharfe Matching zwischen einer Anfrage und einem relevanten Absatz im langen Kontext eine herausforderndere Einstellung ist als die simplistischen NIAH-Tests, bei denen Schlüssel exakt im Kontext lokalisiert werden können.
6 Modellanalyse
Effekt der Trainingskontextlänge. Erzielen Modelle, die mit größeren Kontextgrößen trainiert wurden, bessere Ergebnisse auf RULER? Wir evaluieren die Suite der LargeWorldModels (Liu et al. [2024a] LWM) gleicher Parametergröße, trainiert bis zu verschiedenen Kontextlängen. Abbildung 4 (links & mittig links) zeigt, dass größere Kontextgrößen insgesamt zu besserer Leistung führen, aber die Rangfolge bei langen Sequenzen inkonsistent sein kann. Zum Beispiel ist das mit 1M Kontextgröße trainierte Modell (LWM-1M) bei einer Länge von 256K schlechter als das mit 512K, wahrscheinlich aufgrund unzureichenden Trainings zur Anpassung an die neue Basisfrequenz in RoPE. Darüber hinaus beobachten wir abrupte Leistungsabfälle, wenn Modelle auf ungesehene Längen extrapolieren müssen (z. B. LMW-128K bei einer Eingabe von 256K), und nahezu lineare Verschlechterung mit der Eingabelänge auf logarithmischer Skala innerhalb der maximalen Trainingskontextgröße.
Effekt der Modellgröße Die Spitzenmodelle in unseren Hauptergebnissen sind viel größer als andere Modelle. Um den Effekt der Modellgröße zu isolieren, evaluieren wir Yi-34B-200k, Yi-9B-200k und Yi-6B-200k, alle trainiert bis zur gleichen Kontextlänge unter Verwendung derselben Datenmischung. Abbildung 4 (mittig rechts) zeigt, dass das 34B-Modell deutlich besser als das 6B-Modell auf RULER abschneidet, sowohl hinsichtlich der Leistung bei einer Länge von 4K als auch der relativen Verschlechterung, was auf den Nutzen der Skalierung von Modellgrößen für eine bessere Long-Context-Modellierung hindeutet.
Effekt der Architektur Wir evaluieren die effektive Kontextlänge für zwei Modelle mit Nicht-Transformer-Architekturen: RWKV-v5 (Peng et al. [2023]) und Mamba-2.8B-slimpj (Gu & Dao|2023). Wir stellen fest, dass beide Modelle eine signifikante Verschlechterung zeigen, wenn die Kontextgröße auf 8K erweitert wird, und beide bleiben weit hinter der Transformer-Baseline Llama2-7B zurück bis zur Länge von 4K, jenseits derer Llama2 eine schlechte Längenextrapolationsleistung zeigt (Abbildung 4 rechts).
7 Fazit
Wir präsentieren RULER, einen synthetischen Benchmark zur Evaluierung von Long-Context-Sprachmodellen. RULER enthält diverse Aufgabenkategorien – Retrieval, Multi-Hop-Verfolgung, Aggregation und Fragebeantwortung – und bietet eine flexible und umfassende Evaluierung der Long-Context-Fähigkeiten von LLMs. Wir benchmarken 17 Long-Context-LMs mit RULER bei Kontextgrößen von 4K bis 128K. Trotz perfekter Ergebnisse im weit verbreiteten Needle-in-a-Haystack-Test scheitern fast alle Modelle daran, ihre Leistung in anderen Aufgaben von RULER beizubehalten, wenn wir die Eingabelänge erhöhen. Wir beobachten häufige Fehlermodi bei großen Kontextgrößen, darunter das Versäumnis, Distraktoren zu ignorieren, und die ineffektive Nutzung des langen Kontexts (z. B. einfaches Kopieren aus dem Kontext oder Verwendung parametrischen Wissens stattdessen). Wir zeigen, dass RULER selbst für die am höchsten rangierenden Open-Source-Modelle herausfordernd ist, wenn wir die Aufgabenkomplexität erhöhen. Unsere Analyse offenbart ferner das große Verbesserungspotenzial auf RULER und den Nutzen der Skalierung von Modellgrößen zur Erzielung besserer Long-Context-Fähigkeiten.
8 Einschränkungen
Obwohl RULER mehr Aufgabenkategorien abdeckt als retrieval-orientierte Benchmarks, ist RULER in mehrfacher Hinsicht eingeschränkt, die wir im Folgenden detailliert beschreiben.
Fehlende Positionskontrolle. Das aktuelle RULER berichtet eine einzelne Zahlenmetrik für jede Eingabelänge, ohne die Leistung auf Tiefenebene bereitzustellen. Die Leistung auf Tiefenebene wurde durch den NIAH-Test (Kamradi|2023) und aktuelle Arbeiten wie LV-Eval (Yuan et al. 2024) evaluiert und kann effektiv sein, um das Lost-in-the-Middle-Phänomen (Liu et al. 2024d) aufzudecken. Wir sind uns dieses Problems bewusst und planen, die Positionskontrolle der Schlüsselinformationen in unserer Codebasis zu unterstützen.
Fehlende Korrelation mit realistischen Long-Context-Aufgaben. Während Aufgaben wie Variablenverfolgung und Extraktion häufiger Wörter als Stellvertreter für reale Long-Context-Aufgaben in natürlicher Sprache vorgeschlagen wurden, verhindert das Fehlen leicht evaluierbarer realistischer Long-Context-Aufgaben, dass wir die Validität dieser Stellvertreter verifizieren können. Aufgrund dieser Einschränkung betonen wir, dass RULER als praktische Verhaltensprüfungen von Long-Context-Sprachmodellen verwendet werden kann, jedoch nicht gegenüber realistischeren Einstellungen wie NoCHA (Karpinska et al. 2024) bevorzugt werden sollte, die ebenfalls andere Fähigkeiten wie Reasoning und Instruction-Following betonen.
Fehlende Evaluierung bei kurzem Kontext. In der aktuellen RULER-Aufgabensuite schließen wir Aufgaben ein, bei denen die meisten Modelle bei einer Kontextgröße von 4k einigermaßen gut abschneiden, und zielen darauf ab, eine Leistungsverschlechterung mit der Skalierung der Kontextgröße zu beobachten. Dies sollte nicht als perfekte LM-Fähigkeiten bei einer Kontextgröße von 4k missverstanden werden. Tatsächlich haben aktuelle Arbeiten wie FlenQA (Levy et al. 2024) eine sich verschlechternde Leistung gezeigt, wenn ihre Aufgaben-Eingabelänge auf nur wenige tausend Tokens erhöht wird. Während die Erhöhung der Aufgabenkomplexität in RULER zu deutlich schlechterer Leistung bei kürzerer Kontextgröße führt, haben wir diese Ergebnisse nicht in dieses Paper aufgenommen.
Fehlende Verifikation der Prompt-Robustheit. Sprachmodelle können empfindlich auf das Prompt-Format reagieren, jedoch haben wir keine umfassende Studie zur Prompt-Robustheit über vorläufige Tests im frühen Stadium dieser Arbeit hinaus durchgeführt. Wir haben auch nicht intensiv mit einigen festen Hyperparametern in den bestehenden Aufgaben experimentiert, wie der Länge von Variablennamen bei der Variablenverfolgung und der synthetischen Vokabelgröße bei der Extraktion häufiger Wörter und der Extraktion frequenter Wörter.
Literaturverzeichnis
Marah Abdin, Sam Ade Jacobs, Ammar Ahmad Awan, Jyoti Aneja, Ahmed Awadallah, Hany Awadalla, Nguyen Bach, Amit Bahree, Arash Bakhtiari, Harkirat Behl, et al. Phi-3 technical report: A highly capable language model locally on your phone. arXiv preprint arXiv:2404.14219, 2024.
Rishabh Agarwal, Avi Singh, Lei M Zhang, Bernd Bohnet, Stephanie Chan, Ankesh Anand, Zaheer Abbas, Azade Nova, John D Co-Reyes, Eric Chu, et al. Many-shot in-context learning. arXiv preprint arXiv:2404.11018, 2024.
AI21. Introducing jamba: Ai21's groundbreaking ssm-transformer model, 2024. URL https://www.ai21.com/blog/announcing-jamba
Chenxin An, Shansan Gong, Ming Zhong, Mukai Li, Jun Zhang, Lingpeng Kong, and Xipeng Qiu. L-eval: Instituting standardized evaluation for long context language models. In ICLR, 2024.
Anthropic. Long context prompting for Claude 2.1. Blog, 2023. URL https://www.anthropic.com/index/claude-2-1-prompting
Anthropic. Introducing the next generation of claude, 2024. URL https://www.anthropic.com/news/claude-3-family
Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. Zoology: Measuring and improving recall in efficient language models. In ICLR, 2024.
Yushi Bai et al. LongBench: A bilingual, multitask benchmark for long context understanding. arXiv:2308.14508, 2023.
Maximilian Beck, Korbinian Pöppel, Markus Spanning, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter und Sepp Hochreiter. xlstm: Extended long short-term memory. arXiv-Preprint arXiv:2405.04517, 2024.
Amanda Bertsch, Maor Ivgi, Uri Alon, Jonathan Berant, Matthew R Gormley und Graham Neubig. In-context learning with long-context models: An in-depth exploration. arXiv-Preprint arXiv:2405.00200, 2024.
Aydar Bulatov, Yuri Kuratov und Mikhail S Burtsev. Scaling Transformer to 1M tokens and beyond with RMT. arXiv:2304.11062, 2023.
David Castillo, Joseph Davidson, Finlay Gray, José Solorzano und Marek Rosa. Introducing GoodAI LTM benchmark. Blog, 2024. URL https://www.goodai.com/introducing-goodai-ltm-benchmark/
Shouyuan Chen, Sherman Wong, Liangjian Chen und Yuandong Tian. Extending context window of large language models via positional interpolation. In ICLR, 2023.
Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han und Jiaya Jia. LongLoRA: Efficient fine-tuning of long-context large language models. In ICLR, 2024.
Rewon Child, Scott Gray, Alec Radford und Ilya Sutskever. Generating long sequences with sparse Transformers. arXiv:1904.10509, 2019.
Cohere. Command r, 2024. URL https://docs.cohere.com/docs/command- r- plus#model- details
Tri Dao. FlashAttention- 2: Schnellere Attention mit besserer Parallelität und Arbeitsaufteilung. arxiv:2307.08691, 2023.
Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra und Christopher Ré. FlashAttention: Schnelle und speichereffiziente exakte Attention mit IO-Bewusstsein. In NeurIPS, 2022.
.
Databricks. Einführung von dbrx: Ein neues hochmodernes offenes LLM, 2024. URL https://www databricks.com/blog/introducing- dbrx- new- state- art- open- llm
Jiayu Ding et al. LongNet: Skalierung von Transformern auf 1.000.000.000 Tokens. arXiv:2307.02486, 2023.
Yiran Ding et al. LongRoPE: Erweiterung des LLM-Kontextfensters über 2 Millionen Tokens hinaus. arXiv:2402.13753, 2024.
Zican Dong, Tianyi Tang, Junyi Li, Wayne Xin Zhao und Ji-Rong Wen. Bamboo: Ein umfassender Benchmark zur Bewertung der Fähigkeiten großer Sprachmodelle bei der Modellierung langer Texte. arXiv:2309.13345, 2023.
Daniel Y. Fu, Tri Dao, Khaled K. Saab, Armin W. Thomas, Atri Rudra und Christopher Ré. Hungry Hungry Hippos: Auf dem Weg zur Sprachmodellierung mit Zustandsraummodellen. In ICLR, 2023a.
Daniel Y. Fu et al. Einfache hardwareeffiziente lange Faltungen für die Sequenzmodellierung. ICML, 2023b.
Yao Fu et al. Data Engineering zur Skalierung von Sprachmodellen auf 128k Kontext. arXiv:2402.10171, 2024.
Team GLM, Aohan Zeng, Bin Xu, Bowen Wang, Chenhui Zhang, Da Yin, Diego Rojas, Guanyu Feng, Hanlin Zhao, Hanyu Lai, Hao Yu, Hongning Wang, Jiadai Sun, Jiajie Zhang, Jiale Cheng, Jiayi Gui, Jie Tang, Jing Zhang, Juanzi Li, Lei Zhao, Lindong Wu, Lucen Zhong, Mingdao Liu, Minlie Huang, Peng Zhang, Qinkai Zheng, Rui Lu, Shuaiqi Duan, Shudan Zhang, Shulin Cao, Shuxun Yang, Weng Lam Tam, Wenyi Zhao, Xiao Liu, Xiao Xia, Xiaohan Zhang, Xiaotao Gu, Xin Lv, Xinghan Liu, Xinyi Liu, Xinyue Yang, Xixuan Song, Xunkai Zhang, Yifan An, Yifan Xu, Yilin Niu, Yuantao Yang, Yueyan Li, Yushi Bai, Yuxiao Dong, Zehan Qi, Zhaoyu Wang, Zhen Yang, Zhengxiao Du, Zhenyu Hou und Zihan Wang. Chatglm: Eine Familie großer Sprachmodelle von glm-130b bis glm-4 all tools, 2024.
Omer Goldman, Alon Jacovi, Aviv Slobodkin, Aviya Maimon, Ido Dagan und Reut Tsarfaty. Ist es wirklich langer Kontext, wenn alles, was man braucht, Retrieval ist? Hin zu wirklich schwieriger Long-Context-NLP. arXiv preprint arXiv:2407.00402, 2024.
Alex Graves, Greg Wayne und Ivo Danihelka. Neuronale Turing-Maschinen. arXiv:1410.5401, 2014.
Albert Gu und Tri Dao. Mamba: Lineare Zeitsequenzmodellierung mit selektiven Zustandsräumen. arXiv:2312.00752, 2023.
Albert Gu, Karan Goel und Christopher Re. Effiziente Modellierung langer Sequenzen mit strukturierten Zustandsräumen. In ICLR, 2022.
Chi Han, Qifan Wang, Wenhan Xiong, Yu Chen, Heng Ji und Sinong Wang. Lm-infinite: Einfache Ad-hoc-Längengeneralisierung für große Sprachmodelle. arXiv:2308.16137, 2023.
John J. Hopfield. Neuronale Netze und physikalische Systeme mit emergenten kollektiven Rechenfähigkeiten. Proc of the National Academy of Sciences of the United States of America, 79 8: 2554-8, 1982.
Maor Ivgi, Uri Shaham und Jonathan Berant. Effizientes Verstehen langer Texte mit Kurztextmodellen. Transactions of the ACL, 11:284-299, 2023.
Sam Ade Jacobs et al. DeepSpeed Ulysses: Systemoptimierungen zur Ermöglichung des Trainings von Transformer-Modellen mit extrem langen Sequenzen. arXiv:2309.14509, 2023.
Sebastian Jaszczur et al. Sparse ist ausreichend beim Skalieren von Transformern. In NeurIPS, 2021.
Albert Q Jiang et al. Mixtral of Experts. arXiv:2401.04088, 2024.
Huiqiang Jiang et al. LongLlmLingua: Beschleunigung und Verbesserung von LLMs in Long-Context-Szenarien durch Prompt-Komprimierung. arXiv:2310.06839, 2023.
Gregory Kamradt. Needle In A Haystack – Drucktest für LLMs. Github, 2023. URL https://github.com/gkamradt/LLMTest.NeedleInAHaystack/tree/main
Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal und Mohit Iyyer. Tausendundein Paar: Eine „neuartige“ Herausforderung für Long-Context-Sprachmodelle. arXiv preprint arXiv:2406.16264, 2024.
Lauri Karttunen. Diskursreferenten. In COLING, 1969.
George Kingsley Zipf. Ausgewählte Studien zum Prinzip der relativen Häufigkeit in der Sprache. Harvard university press, 1932.
Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin und Mikhail Burtsev. Babilong: Testen der Grenzen von LLMs mit Long-Context-Reasoning-in-a-Haystack. arXiv preprint arXiv:2406.10149, 2024.
Woosuk Kwon et al. Effizientes Speichermanagement für die Bereitstellung großer Sprachmodelle mit Paged Attention. In Proc. of the ACM SIGOPS 29th Symposium on Operating Systems Principles, 2023.
Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien MR Arnold, Vincent Perot, Siddharth Dalmia, et al. Können Long-Context-Sprachmodelle Retrieval, RAG, SQL und mehr subsumieren? arXiv preprint arXiv:2406.13121, 2024.
Mosh Levy, Alon Jacoby und Yoav Goldberg. Gleiche Aufgabe, mehr Tokens: der Einfluss der Eingabelänge auf die Reasoning-Leistung großer Sprachmodelle. arXiv preprint arXiv:2402.14848, 2024.
Dacheng Li, Rulin Shao, et al. Wie lang können Open-Source-LLMs wirklich zur Kontextlänge stehen?, 2023a. URL https://1msys.org/blog/2023-06-29-longchat
Jiaqi Li, Mengmeng Wang, Zilong Zheng und Muhan Zhang. Loogle: Können Long-Context-Sprachmodelle lange Kontexte verstehen? arXiv:2311.04939, 2023b.
Hao Liu, Matei Zaharia und Pieter Abbeel. Ring Attention mit blockweisen Transformern für nahezu unendlichen Kontext. In ICLR, 2023.
Hao Liu, Wilson Yan, Matei Zaharia und Pieter Abbeel. Weltmodell für millionenlange Videos und Sprache mit Ring Attention. arxiv:2402.08268, 2024a.
Jiaheng Liu et al. E2-LLM: Effiziente und extreme Längenerweiterung großer Sprachmodelle. arXiv:2401.06951, 2024b.
Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang und Lingming Zhang. Repoqa: Bewertung des Verständnisses von Long-Context-Code. arXiv preprint arXiv:2406.06025, 2024c.
Nelson F Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni und Percy Liang. Lost in the middle: Wie Sprachmodelle lange Kontexte nutzen. Transactions of the ACL, 12:157-173, 2024d.
Pedro Henrique Martins, Zita Marinho und Andre Martins. ∞-former: Transformer mit unendlichem Gedächtnis. In Proc. of the 60th Annual Meeting of the ACL (Volume 1: Long Papers), 2022.
Meta.AI. Llama 3 model card. 2024a. URL https://github.com/meta-llama/llama3/blob/main/MODEL_CARD.md
Meta.AI. Llama 3.1 model card. 2024b. URL https://github.com/meta-llama/llama-models/blob/main/models/llama3.1/MODEL_CARD.md
Mistral.AI. La plateforme, 2023. URL https://mistral.ai/news/la-plateforme/Amirkeivan Mohtashami und Martin Jaggi. Landmark attention: Wahlfreier Zugriff auf unendliche Kontextlänge für Transformer. In Workshop on Efficient Systems for Foundation Models @ ICML, 2023.
Vincent Ng. Überwachte Forschung zur Koreferenz von Nominalphrasen: Die ersten fünfzehn Jahre. In Proc. of the 48th Annual Meeting of the ACL, 2010.
Catherine Olsson et al. In-Context-Lernen und Induktionsköpfe. Transformer Circuits Thread, 2022. https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html.
OpenAI: Josh Achiam et al. GPT-4 technischer Bericht. arXiv:2303.08774, 2023.
Bo Peng et al. RWKV: RNNs für die Transformer-Ära neu erfinden. In EMNLP, 2023.
Bowen Peng, Jeffrey Quesnelle, Honglu Fan und Enrico Shippole. YaRN: Effiziente Kontextfenstererweiterung großer Sprachmodelle. In ICLR, 2024.
Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon und Christopher Ré. Hyena-Hierarchie: Hin zu größeren konvolutionalen Sprachmodellen. In ICML, 2023.
Ofir Press, Noah Smith und Mike Lewis. Train short, test long: Attention with linear biases enables input length extrapolation. In ICLR, 2022.
Pranav Rajpurkar, Robin Jia und Percy Liang. Know what you don't know: Unanswerable questions for SQuAD. In Proc. of the 56th Annual Meeting of the ACL (Volume 2: Short Papers), 2018.
Machel Reid et al. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv:2403.05530, 2024.
Marco Tulio Ribeiro, Tongshuang Wu, Carlos Guestrin und Sameer Singh. Beyond accuracy: Behavioral testing of NLP models with CheckList. In Proc. of the 58th Annual Meeting of the ACL, 2020.
Uri Shaham, Maor Ivgi, Avia Efrat, Jonathan Berant und Omer Levy. ZeroSCROLLS: A zero-shot benchmark for long text understanding. In EMNLP, 2023.
Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen und Yunfeng Liu. RoFormer: Enhanced Transformer with rotary position embedding. arXiv:2104.09864, 2023.
Simeng Sun, Katherine Thai und Mohit Iyyer. ChapterBreak: A challenge dataset for long-range language models. In Proc. of the 2022 Conference of the North American Chapter of the ACL: Human Language Technologies, 2022.
Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang und Furu Wei. Retentive network: A successor to Transformer for large language models. arXiv:2307.08621, 2023a.
Yutao Sun, Li Dong, Barun Patra, Shuming Ma, Shaohan Huang, Alon Benhaim, Vishrav Chaudhary, Xia Song und Furu Wei. A length-extrapolatable Transformer. In Proc. of the 61st Annual Meeting of the ACL (Volume 1: Long Papers), 2023b.
Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang und Furu Wei. You only cache once: Decoder-decoder architectures for language models. arXiv preprint arXiv:2405.05254, 2024.
Garrett Tanzer, Mirac Suzgun, Eline Visser, Dan Jurafsky und Luke Melas-Kyriazi. A benchmark for learning to translate a new language from one grammar book. In ICLR, 2024.
Together.AI. Preparing for the era of 32k context: Early learnings and explorations, 2023a. URL https://www.together.ai/blog/llama-2-7b-32k
Together.AI. Llama-2-7b-32k-instruct — and fine-tuning for llama-2 models with together api, 2023b. URL https://www.together.ai/blog/llama-2-7b-32k-instruct
Hugo Touvron et al. Llama 2: Open foundation and fine-tuned chat models. arXiv:2307.09288, 2023.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot und Ashish Sabharwal. Musique: Multihop questions via single-hop question composition. Transactions of the ACL, 10: 539-554, 2022.
Szymon Tworkowski et al. Focused Transformer: Contrastive training for context scaling. NeurIPS, 36, 2024.
Teun A. van Dijk und Walter Kintsch. Strategies of discourse comprehension. In Academic Press, 1983.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, L ukasz Kaiser und Illia Polosukhin. Attention is all you need. In NeurIPS, 2017.
Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao und Furu Wei. Augmenting language models with long-term memory. NeurIPS, 36, 2024.
Thomas Wolf et al. Huggingface's Transformers: State-of-the-art natural language processing. arXiv:1910.03771, 2019.
Qingyang Wu, Zhenzhong Lan, Kun Qian, Jing Gu, Alborz Geramifard und Zhou Yu. Memformer: A memory-augmented Transformer for sequence modeling. In Findings of the ACL: AACL-IJCNLP, 2022.
X.AI. Announcing grok-1.5, 2024. URL https://x.ai/blog/grok-1.5
Chaojun Xiao et al. InfLLM: Unveiling the intrinsic capacity of LLMs for understanding extremely long sequences with training-free memory. arXiv:2402.04617, 2024a.
Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han und Mike Lewis. Efficient streaming language models with attention sinks. In ICLR, 2024b.
Wenhan Xiong et al. Effective long-context scaling of foundation models. arXiv:2309.16039, 2023.
Peng Xu, Wei Ping, Xianchao Wu, Lawrence McAfee, Chen Zhu, Zihan Liu, Sandeep Subramanian, Evelina Bakhturina, Mohammad Shoeybi und Bryan Catanzaro. Retrieval meets long context large language models. In ICLR, 2024a.
Xiaoyue Xu, Qinyuan Ye und Xiang Ren. Stress-testing long-context language models with lifelong icl and task haystack. arXiv preprint arXiv:2407.16695, 2024b.
An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, et al. Qwen2 technical report. arXiv preprint arXiv:2407.10671, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William Cohen, Ruslan Salakhutdinov und Christopher D. Manning. HotpotQA: A dataset for diverse, explainable multi-hop question answering. In EMNLP, 2018.
Alex Young et al. Yi: Open foundation models by 01. AI. arXiv:2403.04652, 2024.
Tao Yuan, Xuefei Ning, Dong Zhou, Zhijie Yang, Shiyao Li, Minghui Zhuang, Zheyue Tan, Zhuyu Yao, Dahua Lin, Boxun Li, et al. Lv-eval: A balanced long-context benchmark with 5 length levels up to 256k. arXiv preprint arXiv:2402.05136, 2024.
Peitian Zhang, Zheng Liu, Shitao Xiao, Ninglu Shao, Qiwei Ye und Zhicheng Dou. Soaring from 4k to 400k: Extending LLM's context with activation beacon. arXiv:2401.03462, 2024a.
Xinrong Zhang, Yingfa Chen, Shengding Hu, Zihang Xu, Junhao Chen, Moo Khai Hao, Xu Han, Zhen Leng Thai, Shuo Wang, Zhiyuan Liu und Maosong Sun. obench: Extending long context evaluation beyond 100k tokens. arXiv:2402.13718, 2024b.
Dawei Zhu, Nan Yang, Liang Wang, Yifan Song, Wenhao Wu, Furu Wei und Sujian Li. PoSE: Efficient context window extension of LLMs via positional skip-wise training. In ICLR, 2024.
A Modelle
Wir wählen insgesamt 37 Modelle für die Evaluierung und Analyse aus. Unsere Ergebnisse im Haupttext umfassen nur alignierte Modelle (GPT-4, Gemini-1.5 und 15 Open-Source-Modelle). Neben den alignierten Modellen evaluieren wir außerdem 7 Open-Source-Basismodelle mit RULER. Wir verwenden die Leistung von Llama2-7b (base) und Llama2-7b (chat) bei einer Kontextlänge von 4K als Schwellenwert zur Bestimmung der effektiven Kontextgröße. In unserem Analyseabschnitt evaluieren wir insgesamt 11 Modelle, darunter die Modellserien Yi und LWM sowie Modelle neuartiger Architekturen, einschließlich Mamba und RWKV.
| Modell | Ausgerichtet | Größe | Kontextlänge | Huggingface [Wolf et al., 2019] / API |
| GPT-4 | OpenAI: Josh Achiam et al., 2023 | ✓ | - | 128K |
| Gemini-1.5 | Kred et al., 2024 | ✓ | - | 1M |
| Llama3.1 | Meta: AI, 2024b | ✓ | 70B | 128K |
| Llama3.1 | Meta: AI, 2024b | ✓ | 8B | 128K |
| Command-K-plus: Cohen, 2024 | ✓ | ✓ | 104B | 128K |
| Qwen2: Yang et al., 2024 | ✓ | ✓ | 72B | 128K |
| Yi: Young et al., 2024 | ✓ | ✓ | 34B | 200K |
| Mixtral-8x22B: Huang et al., 2024 | ✓ | ✓ | 39B/141B | 32K |
| Mixtral-v0.2: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| GLM4: GLM et al., 2024 | ✓ | ✓ | 9B | 1M |
| GradieHAT: Llama3: Meta, AI, 2024a | ✓ | ✓ | 70B | 1M |
| Phi3-medium: Abdin et al., 2024 | ✓ | ✓ | 14B | 128K |
| LWM: Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| DBRX: Tabatricks, 2024 | ✓ | ✓ | 36B/132B | 1M |
| Together: Together, AI, 2023b | ✓ | ✓ | 7B | 32K |
| LongChat: Li et al., 2023a | ✓ | ✓ | 7B | 32K |
| LongAlpaca: Chen et al., 2024 | ✓ | ✓ | 13B | 32K |
| Mixtral-base: Jiang et al., 2024 | ✓ | ✓ | 8x7B | 32K |
| Mixtral-base: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| LWM-base: Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| LongLoRA-base: Chen et al., 2024 | ✓ | ✓ | 7B | 100K |
| Yarn-base: Peng et al., 2024 | ✓ | ✓ | 7B | 128K |
| Together-base: Together, AI, 2023a | ✓ | ✓ | 7B | 32K |
| Jamba-base: AI, 2024 | ✓ | ✓ | 52B | 256K |
| Llama2 (chat): Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Llama2 (base): Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Yi series: Young et al., 2024 | ✓ | ✓ | 6B,9B | 200K |
| LWM series: Liu et al., 2024a | ✓ | ✓ | 7B | 128K,256K,512K |
| LWM-base series: Liu et al., 2024a | ✓ | ✓ | 7B | 32K,128K,256K,512K |
| Mamba: Gu & Dai, 2023 | ✓ | ✓ | 2.8B | 2K |
| RWKV: Peng et al., 2023 | ✓ | ✓ | 7B | 4K |
Tabelle 4: Informationen zu den in RULER evaluierten und analysierten Modellen.
B Aufgabenkonfigurationen
RULER ist so konzipiert, dass es konfigurierbar ist, um unterschiedliche Sequenzlängen und Aufgabenkomplexitäten zu ermöglichen. Für jede Aufgabe ergibt sich eine kombinatorisch große Anzahl von Konfigurationen, die man wählen kann. Im Haupttext evaluieren wir die Modelle mit 13 repräsentativen Aufgaben, die die vier Kategorien von RULER abdecken. Unser Auswahlprozess für die Aufgaben wird im nächsten Anhangabschnitt beschrieben.
- Retrieval: In S-NIAH beziehen wir die Passkey-Retrieval (Mohtashami & Jaggi, 2023) und die Vanilla-NIAH (Kamradt, 2023) ein; beide verwenden Wort-Nummern als Schlüssel-Wert und unterscheiden sich nur durch den Hintergrund-Heuhaufen. Zusätzlich ändern wir den Werttyp zu UUID, um die Robustheit des Modells beim Abrufen langer Zeichenketten aus dem Kontext zu testen. Für MK-NIAH fügen wir drei Ablenkungsnadeln in den Heuhaufen ein. Wir beziehen auch bestehende Setups aus früheren Arbeiten ein: Line Retrieval (Li et al., 2023a) und Key-Value Retrieval (Liu et al., 2024d), wobei der Heuhaufen vollständig mit Ablenkungsnadeln gefüllt ist. Für MV-NIAH bzw. MQ-NIAH testen wir 4 Werte bzw. Abfragen.
- Multi-hop-Tracing: Für VT fügen wir 1 Kette mit 4 Namensbindungssprüngen ein; insgesamt müssen 5 Variablennamen zurückgegeben werden.
- Aggregation: Für CWE müssen insgesamt 10 häufige Wörter zurückgegeben werden, von denen jedes 30-mal vorkommt, während die seltenen Wörter jeweils 3-mal vorkommen. Für FWE setzen wir in der Zeta-Verteilung zur Stichprobenziehung synthetischer Wörter auf 2,0.
- QA: Für QA erweitern wir SQuAD (Rajpurkar et al., 2018) und HotpotQA (Yang et al., 2018), um ein Long-Context-Szenario zu simulieren. Sie sind repräsentativ für Single-Hop- bzw. Multi-Hop-Fragebeantwortungsaufgaben.
| Aufgabe | Konfigurationen | ||
| Teilaufgabe-1 | Teilaufgabe-2 | Teilaufgabe-3 | |
| Single NIAH | type_key = word type_value = number type_haystack = repeat ~Passkey-Retrieval | type_key = word type_value = number type_haystack = essay ~Vanilla NIAH | type_key = word type_value = uuid type_haystack = essay |
| MK-NIAH | num_keys = 4 type_key = word type_value = number type_haystack = essay | num_keys = full haystack type_key = word type_value = number ~Line-Retrieval | num_keys = full haystack type_key = uuid type_value = uuid ~KV-Retrieval |
| MV-NIAH | num_values = 4, type_key = word, type_value = number, type_haystack = essay | ||
| MQ-NIAH | num_queries = 4, type_key = word, type_value = number, type_haystack = essay | ||
| VT | num_chains = 1, num_hops = 4 | ||
| CWE | freq_cw = 30, freq_ucw = 3, num_cw = 10 | ||
| FWE | α = 2.0 | ||
| QA | dataset = SQuAD | dataset = HotpotQA | |
Tabelle 5: Unsere insgesamt 13 Aufgabenkonfigurationen in RULER.
C Aufgabenkorrelationsanalyse
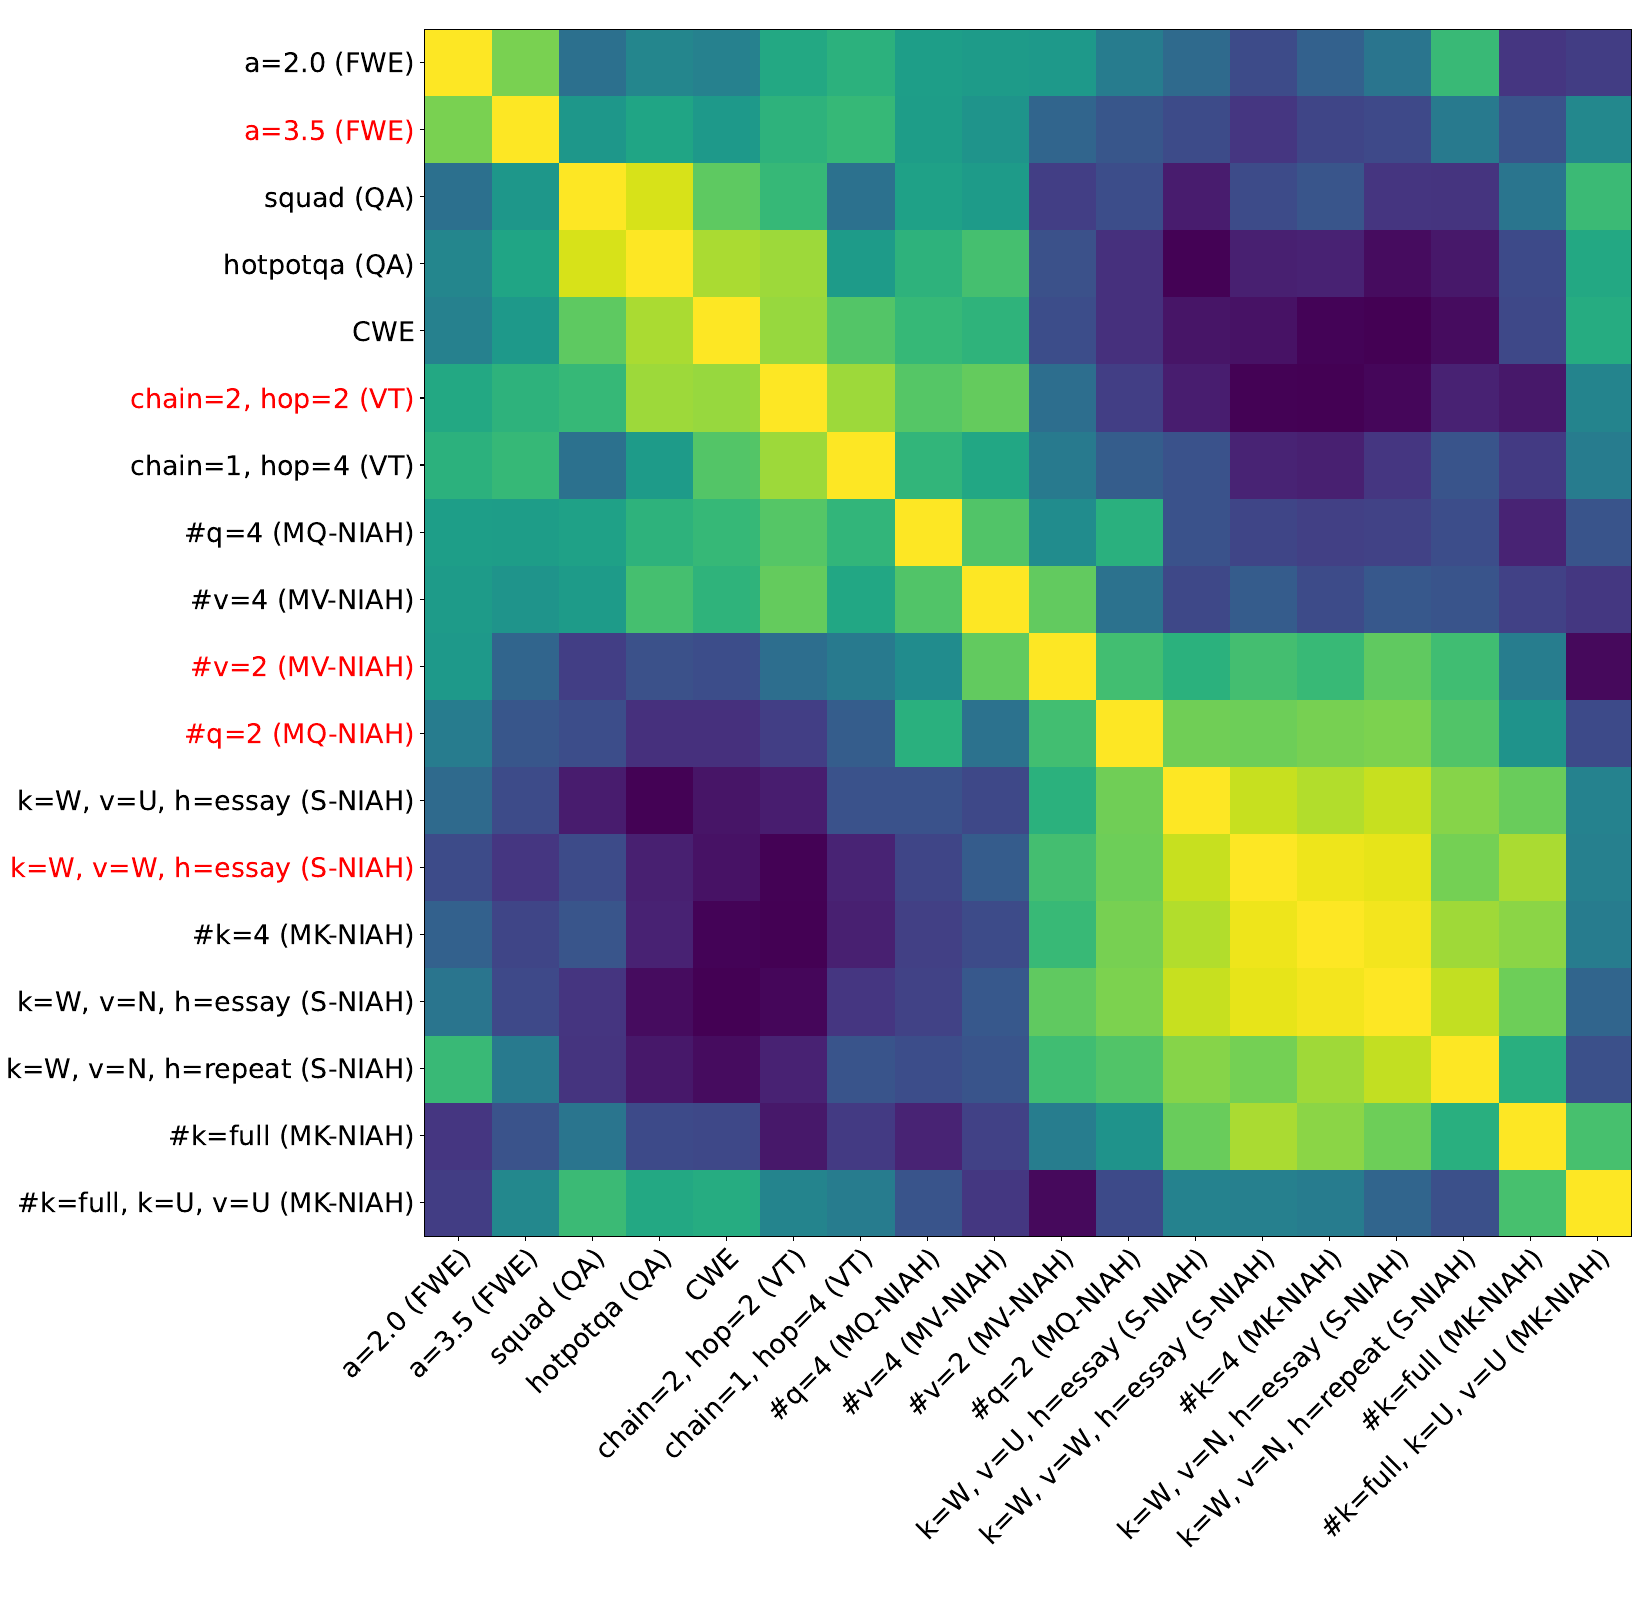
RULER ist unter der Annahme konzipiert, dass Aufgaben aus verschiedenen Kategorien unterschiedliche Modellverhaltensweisen aufdecken können. Wir führen eine vorläufige Korrelationsstudie durch, um die Validität der Aufgabenkategorien zu bestätigen und die Auswahl repräsentativer Aufgaben zu leiten. Wir evaluieren acht Open-Source-Modelle bei verschiedenen Kontextgrößen über 18 Aufgabenkonfigurationen hinweg. Jede Aufgabe kann dann durch einen Vektor der Modellleistung bei verschiedenen Kontextgrößen repräsentiert werden. Die 18 Aufgabenvektoren werden anschließend mittels eines agglomerativen Clustering-Algorithmus geclustert, wobei der Korrelationskoeffizient als Distanzmetrik verwendet wird. Wie in Abbildung 5 gezeigt, bilden zwar bestimmte Aufgaben moderate Korrelationen mit anderen, doch die Aufgaben in jeder der vier Kategorien (NIAH, VT, AG, QA) bilden jeweils eigene kohärente Cluster ohne Redundanz. Wir entfernen ferner einige Aufgaben, die innerhalb desselben Clusters hoch mit anderen Aufgaben korrelieren, und legen schließlich 13 Aufgaben für die spätere umfangreiche Evaluierung fest.
D Prompt-Vorlagen
Wir zerlegen die Eingabe-Prompt-Vorlage in die Modellvorlage in Tabelle 6 und die Aufgabenvorlage in Tabelle 7. Die Modellvorlage ist das Chat-Format des Modells, während die Aufgabenvorlage Anweisung, Kontext und Anfrage kombiniert. Um zu verhindern, dass Modelle sich weigern, unsere Fragen zu beantworten, hängen wir an die Eingabe ein Antwortpräfix an, um Modellantworten hervorzulocken. Für VT und CWE verwenden wir ein Aufgabenbeispiel als In-Context-Demonstration.
| Modell | Vorlage |
| GPT-4 | {task_template} Gib keine Erklärung ab. Bitte gib mir direkt die Antwort. {task_answer_prefix} |
| Yi/Base | {task_template} {task_answer_prefix} |
| Command-R | {BOS_TOKEN} {START_OF_TURN_TOKEN} {USER_TOKEN} {task_template} {END_OF_TURN_TOKEN} {START_OF_TURN_TOKEN} {CHATBOT_TOKEN} {task_answer_prefix} |
| LWM/LongChat | {system_prompt} USER: {task_template} ASSISTANT: {task_answer_prefix} |
| GLM | {gMASK} sop{user} {task_template} {assistant} {task_answer_prefix} |
| Phi3 | {user} {task_template} {end} {assistant} {task_answer_prefix} |
| Qwen/DBRX | {im_start} system {system_prompt} {im_end} {im_start} user {task_template} {im_end} {im_start} assistant {task_answer_prefix} |
| Llama3/Llama3.1 | {begin_of_text} {start_header_id} user {end_header_id} |
| Llama2/Andere | {task_template} {eot_id} {start_header_id} assistant {end_header_id} |
| {task_answer_prefix} | |
| [INST] {task_template} [/INST] {task_answer_prefix} |
Tabelle 6: Modell-Chat-Vorlagen. Wir hängen ein Aufgaben-Antwortpräfix an die Modellantwort an, um zu verhindern, dass Modelle sich weigern, unsere Fragen zu beantworten. Das Hinzufügen des Antwortpräfixes durchbricht die Chat-Vorlage der Modelle nicht.
Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du ihn dir einprägst. Ich werde dich danach zu den Zahlen abfragen.
Eine der besonderen magischen Zahlen für {word-1} ist: {number-1}.
Eine der besonderen magischen Zahlen für {word-2} ist: {number-2}.
Eine der besonderen magischen Zahlen für {word-3} ist: {number-3}.
Eine der besonderen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Unteraufgabe-19
Die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Unteraufgabe-20
Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du ihn dir einprägst. Ich werde dich danach zu den Zahlen abfragen.
Eine der besonderen magischen Zahlen für {word-1} ist: {number-1}.
Eine der besonderen magischen Zahlen für {word-2} ist: {number-2}.
Eine der besonderen magischen Zahlen für {word-3} ist: {number-3}.
Eine der besonderen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Unteraufgabe-21
Die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Unteraufgabe-22
Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du ihn dir einprägst. Ich werde dich danach zu den Zahlen abfragen.
Eine der besonderen magischen Zahlen für {word-1} ist: {number-1}.
Eine der besonderen magischen Zahlen für {word-2} ist: {number-2}.
Eine der besonderen magischen Zahlen für {word-3} ist: {number-3}.
Eine der besonderen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Unteraufgabe-23
Die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Unteraufgabe-24
Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du ihn dir einprägst. Ich werde dich danach zu den Zahlen abfragen.
Eine der besonderen magischen Zahlen für {word-1} ist: {number-1}.
Eine der besonderen magischen Zahlen für {word-2} ist: {number-2}.
Eine der besonderen magischen Zahlen für {word-3} ist: {number-3}.
Eine der besonderen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Unteraufgabe-25
Die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Unteraufgabe-26
Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du ihn dir einprägst. Ich werde dich danach zu den Zahlen abfragen.
Eine der besonderen magischen Zahlen für {word-1} ist: {number-1}.
Eine der besonderen magischen Zahlen für {word-2} ist: {number-2}.
Eine der besonderen magischen Zahlen für {word-3} ist: {number-3}.
Eine der besonderen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Unteraufgabe-27
Die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Unteraufgabe-28
Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du ihn dir einprägst. Ich werde dich danach zu den Zahlen abfragen.
Eine der besonderen magischen Zahlen für {word-1} ist: {number-1}.
Eine der besonderen magischen Zahlen für {word-2} ist: {number-2}.
Eine der besonderen magischen Zahlen für {word-3} ist: {number-3}.
Eine der besonderen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die besondere magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-29
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-30
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-31
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-32
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-33
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-34
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-35
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-36
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-37
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-38
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-39
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-40
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-41
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-42
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-43
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-44
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-45
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-46
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich anschließend zu den Zahlen abfragen.
Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}.
Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}.
Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}.
Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}.
Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-47
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-48
Subtask-61
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-62
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}. Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}. Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-63
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-64
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}. Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}. Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-65
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-66
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}. Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}. Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-67
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-68
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}. Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}. Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-69
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-70
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}. Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}. Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-71
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-72
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}. Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}. Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was ist die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird?
Subtask-73
Die spezielle magische Zahl für {word-4}, die im bereitgestellten Text erwähnt wird, ist
Subtask-74
Some special magic numbers are hidden within the following text. Make sure to memorize it. I will quiz you about the numbers afterwards.
One of the special magic numbers for {word-1} is: {number-1}.
Task Template:
Einige spezielle magische Zahlen sind im folgenden Text verborgen. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}. Eine der speziellen magischen Zahlen für {word-2} ist: {number
| Aufgabenvorlage: Einige besondere magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Paul Graham Essays....... Eine der besonderen magischen Zahlen für {word} ist: {number-1}....... Eine der besonderen magischen Zahlen für {word} ist: {number-2}....... Eine der besonderen magischen Zahlen für {word} ist: {number-3}....... Eine der besonderen magischen Zahlen für {word} ist: {number-4}. Was sind alle besonderen magischen Zahlen für {word}, die im bereitgestellten Text erwähnt werden? |
Task-Antwort-Präfix: Die speziellen magischen Zahlen für {word}, die im bereitgestellten Text erwähnt werden, sind | |
Task-Vorlage: Einige spezielle magische Zahlen sind im folgenden Text versteckt. Stelle sicher, dass du sie dir einprägst. Ich werde dich danach zu den Zahlen abfragen. Paul Graham Essays....... Eine der speziellen magischen Zahlen für {word-1} ist: {number-1}....... Eine der speziellen magischen Zahlen für {word-2} ist: {number-2}....... Eine der speziellen magischen Zahlen für {word-3} ist: {number-3}....... Eine der speziellen magischen Zahlen für {word-4} ist: {number-4}. Was sind alle speziellen magischen Zahlen für {word-1}, {word-2}, {word-3} und {word-4}, die im bereitgestellten Text erwähnt werden? |
| Task-Antwort-Präfix: Die besonderen magischen Zahlen für {word-1}, {word-2}, {word-3} und {word-4}, die im bereitgestellten Text erwähnt werden, sind |
| Aufgabenvorlage: {ein Aufgabenbeispiel} Merke dir die Kette(n) von Variablenzuweisungen, die im folgenden Text verborgen sind, und verfolge sie. Das Gras ist grün. Der Himmel ist blau. Die Sonne ist gelb. Los geht's. Hin und wieder zurück. ...... VAR {X1} = {number} ...... ...... VAR {X2} = {X1} ...... ...... VAR {X3} = {X2} ...... ...... VAR {X4} = {X3} ...... ...... VAR {X5} = {X4} ...... Frage: Finde alle Variablen, denen im obigen Text der Wert {number} zugewiesen wird. |
Task-Antwortpräfix: Antwort: Gemäß der Kette(n) der Variablenzuweisung im obigen Text wird 5 Variablen der Wert {number} zugewiesen, sie sind: |
| Task-Vorlage: {ein Aufgabenbeispiel} Unten steht eine nummerierte Liste von Wörtern. In dieser Liste kommen einige Wörter häufiger vor als andere. Merke dir diejenigen, die am häufigsten vorkommen. 1. Wort-a 2. Wort-b 3. Wort-c 4. Wort-d 5. Wort-d 6. Wort-a 7. Wort-e 8. Wort-f ...... Frage: Was sind die 10 häufigsten Wörter in der obigen Liste? |
| Aufgaben-Antwortpräfix: Antwort: Die 10 Wörter, die in der Liste am häufigsten vorkommen, sind: | |
| Aufgabenvorlage: Lesen Sie den folgenden codierten Text und verfolgen Sie die Häufigkeit jedes codierten Wortes. Finden Sie die drei am häufigsten vorkommenden codierten Wörter. ... Wort-a ... Wort-b ... ... Wort-c ... Wort-a ... Wort-d Wort-e ... Wort-a ... Wort-f ... ... Wort-g ... Wort-h ... Wort-a ... Wort-i .... Frage: Geben Sie keine Erklärung ab. Bitte ignorieren Sie die Punkte '...'. Welches sind die drei am häufigsten vorkommenden Wörter im obigen codierten Text? |
| Task-Antwortpräfix: Antwort: Gemäß dem oben kodierten Text sind die drei am häufigsten vorkommenden Wörter: |
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Template:
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document y:
{document-y}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Aufgabenvorlage:
Beantworte die Frage anhand der gegebenen Dokumente. Gib mir nur die Antwort und gib keine anderen Wörter aus.
Die folgenden sind gegebene Dokumente.
Dokument 1:{document-1}
......
Dokument x:{document-x}
......
Dokument n:{document-n}
Beantworte die Frage anhand der gegebenen Dokumente. Gib mir nur die Antwort und gib keine anderen Wörter aus.
Frage: question
Aufgaben-Antwortpräfix:
Antwort:
Aufgabenvorlage:
Beantworte die Frage anhand der gegebenen Dokumente. Gib mir nur die Antwort und gib keine anderen Wörter aus.
Die folgenden sind gegebene Dokumente.
Dokument 1:{document-1}
......
Dokument x:{document-x}
......
Dokument y:{document-y}
......
Dokument n:{document-n}
Beantworte die Frage anhand der gegebenen Dokumente. Gib mir nur die Antwort und gib keine anderen Wörter aus.
Frage: question
Aufgaben-Antwortpräfix:
Antwort:
E Ergebnisse zur Passkey-Retrieval und zum Vanilla-NIAH
| Nur-Lese-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): E Passkey-Retrieval und Vanilla-NIAH-Ergebnisse Tabelle 11: Leistung ausgewählter alignierter und Basis-Modelle über Längen von 4K bis 128K im Vanilla-NIAH von RULER. Fast alle Modelle erreichen eine perfekte Punktzahl bei ihrer angegebenen Länge. Zu übersetzender Text: Modelle Angegebene Länge 4K 8K 16K 32K 64K 128K Durchschn. | Gemini-1.5 | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| 100,0 | GPT-4 | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| 100,0 | Llama3.1 (70B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 97,8 |
| 99,6 | Llama3.1 (8B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| 100,0 | Qwen2 (72B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 96,6 |
| 99,4 | Command-R-plus (104B) | 128K | 100,0 | 100,0 | 99,8 | 99,8 | 100,0 | 97,2 |
| 99,5 | GLM4 (9B) | |||||||
| 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | |
| GradientAI/LLama3 (70B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 93,6 | 98,9 |
| Mixtral-8x22B (39B/141B) | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 0,0 | 83,3 |
| Yi (34B) | 200K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Phi3-medium (14B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 88,0 | 98,0 |
| Mistral-v0.2 (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 69,6 | 94,9 |
| LWM (7B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| DBRX (36B/132B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 0,0 | 0,0 | 66,7 |
| Together (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 0,0 | 0,0 | 66,7 |
| LongChat (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,4 | 0,0 | 0,0 | 66,6 |
| LongAlpaca (13B) | 32K | 88,2 | 88,6 | 86,4 | 82,4 | 0,0 | 0,0 | 57,6 |
| Mixtral-base (8x7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 46,8 | 91,1 |
| Mixtral-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 70,8 | 95,1 |
| Jamba-base (52B) | 256K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| LWM-base (7B) | 1M | 99,8 | 99,6 | 99,6 | 98,2 | 96,0 | 98,9 | 98,9 |
| LongLoRA-base (7B) | 100K | 99,6 | 99,4 | 99,0 | 99,4 | 99,4 | 0,0 | 82,8 |
| Yarn-base (7B) | 128K | 100,0 | 100,0 | 99,0 | 100,0 | 99,2 | 39,6 | 89,6 |
| Together-base (7B) | 32K | 100,0 | 100,0 | 99,8 | 100,0 | 0,0 | 0,0 | 66,6 |
| Überblick (nur Hintergrund, nicht zu übersetzen): Ergebnisse zur Passkey-Retrieval und Vanilla-NIAH Tabelle 11: Leistung ausgewählter alignierter und Basis-Modelle über Längen von 4K bis 128K im Vanilla-NIAH von RULER. Nahezu alle Modelle erreichen bei ihrer angegebenen Länge eine perfekte Punktzahl. Zu übersetzender Text: Modelle | Angegebene Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. |
| Gemini-1.5 | 1M | 100,0 | 100,0 | 100,0 | 98,0 | 100,0 | 100,0 | 99,7 |
| GPT-4 | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Llama3.1 (70B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 |
| Llama3.1 (8B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 |
| Qwen2 (72B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,8 | 56,4 | 92,7 |
| Command-R-plus (35B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,8 | 86,0 | 97,6 |
| GLM4 (9B) | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| GradientAI/LLama3 (70B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 97,8 | 99,4 |
| Mixtral-8x22B (39B/141B) | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 24,2 | 87,3 |
| Yi (34B) | 200K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| Phi3-medium (14B) | 128K | 100,0 | 100,0 | 100,0 | 99,8 | 99,8 | 73,8 | 95,5 |
| Mixtral-v0.2 (7B) | 32K | 100,0 | 100,0 | 100,0 | 97,0 | 70,0 | 7,4 | 79,1 |
| LWM (7B) | 1M | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 |
| DBRX (36B/132B) | 32K | 100,0 | 100,0 | 90,0 | 93,2 | 0,8 | 0,0 | 64,0 |
| Together (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,8 | 0,0 | 0,0 | 66,6 |
| LongChat (7B) | 32K | 100,0 | 100,0 | 97,6 | 98,4 | 0,0 | 0,0 | 66,0 |
| LongAlpaca (13B) | 32K | 90,2 | 90,2 | 88,4 | 83,4 | 0,0 | 0,0 | 58,7 |
| Mixtral-base (8x7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 85,2 | 34,8 | 86,7 |
| Mixtral-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 100,0 | 94,8 | 0,4 | 82,5 |
| Jamba-base (52B) | 256K | 100,0 | 100,0 | 98,8 | 99,8 | 99,8 | 86,4 | 97,5 |
| LWM-base (7B) | 1M | 100,0 | 99,4 | 97,8 | 98,6 | 98,2 | 98,6 | 98,8 |
| LongLoRA-base (7B) | 100K | 99,8 | 100,0 | 100,0 | 99,8 | 100,0 | 0,0 | 83,3 |
| Yarn-base (7B) | 128K | 97,4 | 97,8 | 91,4 | 85,4 | 86,6 | 20,0 | 79,8 |
| Together-base (7B) | 32K | 100,0 | 100,0 | 100,0 | 99,8 | 0,0 | 0,0 | 66,6 |
Tabelle 11: Leistung ausgewählter ausgerichteter und Basismodelle über Längen von 4K bis 128K im Vanilla-NIAH von RULER. Nahezu alle Modelle erzielen eine perfekte Punktzahl bei ihrer angegebenen Länge.
.
F Zusätzliche Ergebnisse
| Modelle | Angegebene Länge | Effektive Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. | gew. Durchschn. (inc) | gew. Durchschn. (dec) |
| Llama2-7B (Basis) | 4K | - | 79,4 | ||||||||
| Mixtral-Basis (8x7B) | 32K | 32K | 91,8 | 91,0 | 89,5 | 85,8 | 66,9 | 29,0 | 75,7 | 66,4(1.) | 85,0(1.) |
| Mixtral-Basis (7B) | 32K | 16K | 91,6 | 89,8 | 86,3 | 77,2 | 52,3 | 8,0 | 67,5 | 54,7(4.) | 80,4(2.) |
| Jamba-Basis (52B) | 256K | 4K | 81,2 | 75,4 | 68,8 | 65,3 | 61,0 | 51,4 | 67,2 | 62,5(3.) | 71,8(4.) |
| LWM-Basis (7B) | 1M | <4K | 77,5 | 74,0 | 69,6 | 64,6 | 61,3 | 59,0 | 67,7 | 64,4(2.) | 70,9(5.) |
| LongLoRA-base (7B) | 100K | 8K | 81.9 | 80.4 | 75.6 | 65.1 | 60.8 | 0.0 | 60.6 | 49.2(5.) | 72.0(3.) |
| Yarn-base (7B) | 128K | &lt;4K | 77.3 | 67.5 | 59.0 | 47.3 | 38.6 | 13.9 | 50.6 | 40.7(6.) | 60.5(7.) |
| Together-base (7B) | 32K | 4K | 84.6 | 78.7 | 68.3 | 57.9 | 0.0 | 0.0 | 48.2 | 32.3(7.) | 64.2(6.) |
Tabelle 12: Leistung ausgewählter Basismodelle über Längen von 4K bis 128K durch Mittelung von 13 Aufgabenpunktzahlen in RULER.
| Modelle | Angegebene Länge | Effektive Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. | wDurchschn. (inc) | wDurchschn. (dec) |
| Llama2-7B (chat) | 4K | - | 96.9 | ||||||||
| Gemini-1.5 | 1M | &gt;128K | 99.8 | 99.9 | 99.6 | 99.7 | 99.7 | 99.6 | 99.7 | 99.7(1.) | 99.7(1.) |
| Llama3.1 (8B) | 128K | 64K | 99.9 | 99.9 | 99.8 | 99.6 | 98.7 | 92.6 | 98.4 | 97.5(3.) | 99.4(2.) |
| GLM4 (9B) | 1M | 64K | 99.4 | 99.2 | 99.5 | 99.4 | 97.3 | 94.4 | 98.2 | 97.5(2.) | 98.9(3.) |
| Llama3.1 (70B) | 128K | 64K | 100.0 | 100.0 | 99.9 | 99.6 | 98.5 | 78.9 | 96.1 | 93.5(5.) | 98.8(4.) |
| GPT-4 | 128K | 32K | 99,9 | 99,9 | 98,7 | 98,3 | 90,9 | 84,8 | 95,4 | 92,9(6.) | 97,9(5.) |
| Command-R-plus (104B) | 128K | 32K | 99,9 | 99,9 | 99,4 | 97,9 | 89,6 | 65,7 | 92,1 | 87,3(8.) | 96,9(6.) |
| GradientAI/Llama3 (70B) | 1M | 16K | 99,0 | 98,8 | 98,3 | 94,5 | 91,2 | 84,9 | 94,4 | 92,1(7.) | 96,8(7.) |
| Yi (34B) | 200K | 16K | 98,2 | 96,8 | 97,3 | 95,1 | 93,0 | 90,2 | 95,1 | 93,8(4.) | 96,4(8.) |
| Qwen2 (72B) | 128K | 32K | 100,0 | 99,9 | 99,9 | 99,4 | 84,5 | 48,0 | 88,6 | 81,3(11.) | 95,9(9.) |
| Phi3-medium (14B) | 128K | 8K | 98,7 | 98,5 | 96,6 | 95,4 | 91,9 | 51,3 | 88,7 | 82,6 (10.) | 94,9 (10.) |
| Mixtral-8x22B (39B/141B) | 64K | 16K | 99,3 | 99,1 | 97,7 | 96,7 | 89,9 | 23,8 | 84,4 | 74,8 (12.) | 94,1 (11.) |
| LWM (7B) | 1M | &lt;4K | 92,5 | 92,1 | 87,6 | 83,7 | 84,1 | 83,4 | 87,2 | 85,5 (9.) | 89,0 (12.) |
| Mistral-v0.2 (7B) | 32K | 4K | 98,1 | 96,2 | 94,3 | 85,5 | 51,1 | 10,7 | 72,6 | 58,8 (13.) | 86,5 (13.) |
| DBRX (36B/132B) | 32K | 8K | 99,4 | 99,0 | 93,5 | 73,4 | 0,5 | 0,0 | 61,0 | 41,6 (14.) | 80,3 (14.) |
| Together (7B) | 32K | &lt;4K | 96,2 | 89,9 | 82,3 | 80,2 | 0,0 | 0,0 | 58,1 | 40,2 (15.) | 76,0 (15.) |
| LongChat (7B) | 32K | &lt;4K | 93,3 | 92,2 | 81,1 | 67,3 | 0,0 | 0,0 | 55,7 | 37,6 (16.) | 73,7 (16.) |
| LongAlpaca (13B) | 32K | &lt;4K | 74,9 | 72,2 | 70,8 | 53,2 | 0,0 | 0,0 | 45,2 | 30,7 (17.) | 59,7 (17.) |
| Llama2-7B (base) | 4K | - | 90.9 | ||||||||
| Mixtral-base (8x7B) | 32K | 32K | 99.9 | 99.7 | 98.4 | 94.8 | 72.1 | 29.1 | 82.3 | 71.8 (2.) | 92.8 (1.) |
| Mixtral-base (7B) | 32K | 16K | 99.3 | 97.5 | 95.7 | 89.8 | 56.8 | 10.2 | 74.9 | 61.2 (4.) | 88.6 (2.) |
| Jamba-base (52B) | 256K | <4K | 86.4 | 80.5 | 73.7 | 72.3 | 68.1 | 56.9 | 73.0 | 68.5 (3.) | 77.4 (5.) |
| LWM-base (7B) | 1M | <4K | 88.5 | 87.7 | 84.5 | 79.6 | 76.1 | 74.2 | 81.8 | 79.1 (1.) | 84.4 (4.) |
| LongLoRA-base (7B) | 100K | 16K | 95.3 | 95.6 | 92.7 | 81.5 | 76.2 | 0.0 | 73.5 | 60.6 (5.) | 86.5 (3.) |
| Yarn-base (7B) | 128K | &lt;4K | 89,9 | 86,1 | 78,4 | 59,0 | 49,5 | 17,5 | 63,4 | 51,7 (6.) | 75,1 (7.) |
| Together-base (7B) | 32K | 8K | 95,4 | 91,5 | 86,1 | 75,1 | 0,0 | 0,0 | 58,0 | 39,9 (7.) | 76,2 (6.) |
| Together-base (7B) | 32K | 8K | 95,4 | 91,5 | 86,1 | 75,1 | 0,0 | 0,0 | 58,0 | 39,9 (7.) | 76,2 (6.) |
Tabelle 13: Leistung ausgewählter ausgerichteter und Basismodelle über Längen von 4K bis 128K durch Mittelung von 8 Aufgabenpunktzahlen im Retrieval (NIAH) von RULER.
„“
| Modelle | Angegebene Länge | Effektive Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. | gewDurchschn. (inkl.) | gewDurchschn. (exkl.) |
| Llama2-7B (chat) | 4K | - | 89,7 | ||||||||
| GPT-4 | 128K | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 99,9 | 99,9(2.) | 100,0(1.) |
| Gemini-1.5 | 1M | >128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,6 | 100,0 | 99,9 | 99,9(1.) | 100,0(2.) |
| Command-R-plus (104B) | 128K | 128K | 100,0 | 100,0 | 100,0 | 100,0 | 99,9 | 97,2 | 99,5 | 99,2(3.) | 99,8(3.) |
| GLM4 (9B) | 1M | >128K | 99,9 | 99,6 | 99,8 | 99,8 | 99,6 | 97,7 | 99,4 | 99,1(4.) | 99,7(4.) |
| Qwen2 (72B) | 128K | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 95,2 | 79,0 | 95,7 | 92,9 (5.) | 98,5 (5.) |
| Llama3.1 (70B) | 128K | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,9 | 59,2 | 93,2 | 88,3 (8.) | 98,0 (6.) |
| Llama3.1 (8B) | 128K | 64K | 99,9 | 99,7 | 99,7 | 98,8 | 97,6 | 70,4 | 94,4 | 90,7 (6.) | 98,0 (7.) |
| GradientAI/Llama3 (70B) | 1M | 64K | 100,0 | 100,0 | 100,0 | 100,0 | 99,7 | 56,2 | 92,6 | 87,4 (9.) | 97,9 (8.) |
| Yi (34B) | 200K | 64K | 99,8 | 99,8 | 99,8 | 94,5 | 92,5 | 76,8 | 93,6 | 90,3 (7.) | 96,9 (9.) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 100,0 | 100,0 | 99,8 | 98,6 | 96,4 | 0,0 | 82,5 | 70,3 (10.) | 94,7 (10.) |
| Phi3-medium (14B) | 128K | 16K | 99,6 | 99,2 | 98,4 | 82,1 | 53,6 | 26,0 | 76,5 | 64,1 (11.) | 88,9 (11.) |
| Mixtral-v0.2 (7B) | 32K | 16K | 98,9 | 96,0 | 92,2 | 85,0 | 74,5 | 0,0 | 74,4 | 60,9 (12.) | 87,9 (12.) |
| LongChat (7B) | 32K | 8K | 97,6 | 93,5 | 83,4 | 62,4 | 0,0 | 0,0 | 56,2 | 37,4 (14.) | 75,0 (13.) |
| DBRX (36B/132B) | 32K | 8K | 100,0 | 99,0 | 72,5 | 45,8 | 0,0 | 0,0 | 52,9 | 33,3 (15.) | 72,5 (14.) |
| LWM (7B) | 1M | &lt;4K | 84,4 | 80,1 | 67,2 | 52,2 | 45,9 | 15.2 | 57.5 | 46.5 (13.) | 68.6 (15.) |
| Together (7B) | 32K | &lt;4K | 89.2 | 88.8 | 48.3 | 16.6 | 0.0 | 0.0 | 40.5 | 22.8 (16.) | 58.2 (16.) |
| LongAlpaca (13B) | 32K | &lt;4K | 8.5 | 2.1 | 18.2 | 17.0 | 0.0 | 0.0 | 7.6 | 6.5 (17.) | 8.8 (17.) |
| Llama2-7B (Basis) | 4K | - | 58.8 | ||||||||
| Mixtral-Basis (8x7B) | 32K | 64K | 100.0 | 99.9 | 100.0 | 98.4 | 87.3 | 43.3 | 88.1 | 80.5 (2.) | 95.8 (1.) |
| Mixtral-Basis (7B) | 32K | 64K | 99.0 | 98.4 | 96.5 | 89.1 | 86.1 | 0.0 | 78.2 | 65.4 (4.) | 91.0 (2.) |
| Jamba-Basis (52B) | 256K | 128K | 87.5 | 87.6 | 86.2 | 88.1 | 86.0 | 77,8 | 85,5 | 84,3 (1.) | 86,7 (3.) |
| LWM-base (7B) | 1M | 128K | 80,2 | 82,7 | 79,3 | 76,4 | 70,7 | 66,1 | 75,9 | 73,3 (3.) | 78,5 (4.) |
| LongLoRA-base (7B) | 100K | 64K | 92,5 | 87,4 | 73,1 | 56,0 | 69,2 | 0,0 | 63,0 | 50,3 (5.) | 75,8 (5.) |
| Yarn-base (7B) | 128K | 4K | 84,6 | 43,6 | 24,8 | 43,0 | 20,9 | 0,0 | 36,1 | 24,9 (7.) | 47,4 (7.) |
| Together-base (7B) | 32K | 16K | 95,0 | 90,6 | 69,6 | 43,2 | 0,0 | 0,0 | 49,7 | 31,3 (6.) | 68,1 (6.) |
| Modelle | Angegebene Länge | Effektive Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. (inkl.) | gew. Durchschn. (dekl.) |
| Llama2-7B-chat | 4K | - | 84,8 | |||||||
| Gemini-1.5 | 1M | &gt;128K | 97,7 | 97,7 | 97,6 | 98,6 | 97,3 | 90,9 | 96,6 | 95,8 (1.) |
| GPT-4 | 128K | 64K | 99,0 | 98,3 | 98,0 | 95,0 | 90,1 | 79,7 | 93,4 | 90,4 (2.) |
| Qwen2 (72B) | 128K | 32K | 99,3 | 98,0 | 93,1 | 97,4 | 78,5 | 70,3 | 89,4 | 84,7 (3.) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 97,8 | 96,9 | 94,8 | 88,2 | 83,3 | 69,7 | 88,5 | 84,0 (4.) |
| Command-R-plus (104B) | 128K | 32K | 98,2 | 96,9 | 95,2 | 90,3 | 82,5 | 59,5 | 87,1 | 81,3 (5.) |
| Llama3.1 (70B) | 128K | 32K | 99,9 | 98,3 | 98,4 | 97,1 | 66,3 | 39,8 | 83,3 | 73,8 (6.) |
| Phi3-medium (14B) | 128K | 16K | 90,8 | 95,1 | 90,3 | 82,4 | 62,1 | 43,8 | 77,4 | 69,3 (7.) |
| Yi (34B) | 200K | 16K | 91,4 | 90,9 | 86,2 | 75,3 | 58,5 | 43,4 | 74,3 | 66,0 (8.) |
| GLM4 (9B) | 1M | 8K | 93,5 | 85,2 | 78,5 | 68,1 | 58,3 | 49,7 | 72,2 | 64,8 (9.) |
| GradientAI/Llama3 (70B) | 1M | 8K | 96,4 | 94,7 | 74,9 | 57,0 | 45,1 | 41,4 | 68,3 | 57,7 (10.) |
| Llama3.1 (8B) | 128K | 8K | 97,0 | 90,1 | 79,2 | 54,1 | 43,5 | 36,2 | 66,7 | 55,5 (11.) |
| Mixtral-v0.2 (7B) | 32K | 8K | 94,3 | 90,4 | 77,4 | 48,5 | 42,4 | 33,7 | 64,4 | 53,1 (12.) |
| DBRX (36B/132B) | 32K | 8K | 94,5 | 94,7 | 73,7 | 48,7 | 4,1 | 0,0 | 52,6 | 34,3 (13.) |
| Together (7B) | 32K | &lt;4K | 82,3 | 64,5 | 43,3 | 34,8 | 0,0 | 0,0 | 37,5 | 22,9 (16.) |
| LongChat (7B) | 32K | &lt;4K | 74,3 | 50,7 | 46,7 | 51,1 | 0,0 | 0,0 | 37,1 | 24,8 (15.) |
| LWM (7B) | 1M | &lt;4K | 61,3 | 43,6 | 38,3 | 32,8 | 29,1 | 29,1 | 39,0 | 34,0 (14.) |
| LongAlpaca (13B) | 32K | <4K | 33,0 | 27,0 | 26,0 | 23,2 | 0,0 | 0,0 | 18,2 | 12,3 (17.) |
| Llama2-7B (Basis) | 4K | - | 73,1 | |||||||
| Mixtral-Basis (8x7B) | 32K | 32K | 96,5 | 94,8 | 93,1 | 87,8 | 68,6 | 24,3 | 77,5 | 66,9 (1.) |
| Mixtral-Basis (7B) | 32K | 16K | 94,8 | 93,1 | 81,6 | 53,3 | 36,7 | 9,2 | 61,4 | 46,5 (2.) |
| Jamba-Basis (52B) | 256K | 4K | 75,9 | 63,5 | 51,7 | 38,5 | 33,3 | 28,0 | 48,5 | 40,3 (3.) |
| LWM-Basis (7B) | 1M | <4K | 67,1 | 48,4 | 36,0 | 26,3 | 21,5 | 18,7 | 36,3 | 28,4 (5.) |
| LongLoRA-Basis (7B) | 100K | <4K | 70,3 | 64,4 | 50,7 | 39,9 | 29,4 | 0,0 | 42,4 | 31,3 (4.) |
| Yarn-Basis (7B) | 128K | &lt;4K | 70,6 | 49,2 | 28,9 | 20,5 | 17,0 | 2,1 | 31,4 | 20,7 (6.) |
| Together-Basis (7B) | 32K | &lt;4K | 69,1 | 53,0 | 19,9 | 20,6 | 0,0 | 0,0 | 27,1 | 15,1 (7.) |
| Modelle | Angegebene Länge | Effektive Länge | 4K | 8K | 16K | 32K | 64K | 128K | Durchschn. | wDurchschn. (ink) | wDurchschn. (dekl) |
| Llama2-7B (chat) | 4K | - | 49,7 | ||||||||
| Gemini-1.5 | 1M | &gt;128K | 81,9 | 75,9 | 77,8 | 75,9 | 77,6 | 74,1 | 77,2 | 76,3 (1.) | 78,0 (1.) |
| GPT-4 | 128K | 128K | 79,0 | 78,0 | 76,0 | 68,0 | 61,6 | 59,0 | 70,3 | 66,5 (4.) | 74,0 (2.) |
| Qwen2 (72B) | 128K | 64K | 80,8 | 76,9 | 74,1 | 66,9 | 54,5 | 47,2 | 66,7 | 61,0 (8.) | 72,5 (3.) |
| GradientAI/LLama3 (70B) | 1M | &gt;128K | 75,6 | 73,9 | 72,4 | 69,9 | 66,0 | 59,8 | 69,6 | 67,1 (3.) | 72,1 (4.) |
| Llama3.1 (70B) | 128K | 64K | 77,2 | 74,8 | 72,3 | 70,4 | 64,2 | 47,6 | 67,8 | 63,4 (7.) | 72,1 (5.) |
| GLM4 (9B) | 1M | >128K | 74,7 | 71,3 | 71,9 | 68,5 | 66,3 | 63,6 | 69,4 | 67,6 (2.) | 71,1 (6.) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 76,6 | 73,5 | 71,8 | 66,5 | 59,7 | 40,8 | 64,8 | 59,4 (9.) | 70,2 (7.) |
| Yi (34B) | 200K | >128K | 72,7 | 71,5 | 68,4 | 66,2 | 64,1 | 59,9 | 67,1 | 65,0 (5.) | 69,2 (8.) |
| Llama3.1 (8B) | 128K | 128K | 74,1 | 70,1 | 67,3 | 65,8 | 63,7 | 58,8 | 66,6 | 64,3 (6.) | 68,9 (9.) |
| Command-R-plus (104B) | 128K | 64K | 73,4 | 72,3 | 69,4 | 65,9 | 57,0 | 39,2 | 62,9 | 57,6 (10.) | 68,1 (10.) |
| Phi3-medium (14B) | 128K | 64K | 70,9 | 67,2 | 66,1 | 59,3 | 54,2 | 38,0 | 59,3 | 54,3 (12.) | 64,3 (11.) |
| Mixtral-v0.2 (7B) | 32K | 32K | 72,4 | 70,0 | 65,7 | 57,6 | 34,4 | 13,3 | 52,2 | 42,5 (13.) | 62,0 (12.) |
| LWM (7B) | 1M | >128K | 61,2 | 57,8 | 56,7 | 55,4 | 54,7 | 52,6 | 56,4 | 55,1 (11.) | 57,7 (13.) |
| DBRX (36B/132B) | 32K | 16K | 76,0 | 69,4 | 59,4 | 45,0 | 9,6 | 0,0 | 43,2 | 29,6 (14.) | 56,9 (14.) |
| Together (7B) | 32K | 16K | 61,1 | 58,3 | 54,2 | 45,6 | 0,0 | 0,0 | 36,5 | 24,9 (15.) | 48,2 (15.) |
| LongAlpaca (13B) | 32K | 16K | 57,2 | 53,5 | 49,7 | 39,0 | 0,0 | 0,0 | 33,2 | 22,3 (16.) | 44,1 (16.) |
| LongChat (7B) | 32K | 8K | 54,5 | 53,6 | 47,6 | 34,0 | 0,0 | 0,0 | 31,6 | 21,0 (17.) | 42,3 (17.) |
| Llama2-7B (Basis) | 4K | - | 48,6 | 47,7 | 45,3 | 41,3 | 34,4 | 26,4 | 41,0 | 37,0 (3.) | 44,9 (3.) |
| Mixtral-Basis (8x7B) | 32K | 4K | 50,8 | 47,7 | 45,3 | 41,3 | 34,4 | 26,4 | 41,0 | 37,0 (3.) | 44,9 (3.) |
| Mixtral-Basis (7B) | 32K | 8K | 53,5 | 51,0 | 48,4 | 44,7 | 32,8 | 2,2 | 38,8 | 31,3 (4.) | 46,3 (2.) |
| Jamba-base (52B) | 256K | 32K | 62,7 | 60,6 | 57,9 | 52,6 | 47,5 | 39,6 | 53,5 | 49,7 (1.) | 57,3 (1.) |
| LWM-base (7B) | 1M | <4K | 42,7 | 40,2 | 38,7 | 37,1 | 37,3 | 34,6 | 38,4 | 37,2 (2.) | 39,6 (4.) |
| LongLoRA-base (7B) | 100K | <4K | 34,5 | 32,1 | 33,6 | 29,4 | 26,1 | 0,0 | 26,0 | 21,3 (6.) | 30,6 (6.) |
| Yarn-base (7B) | 128K | <4K | 29,7 | 23,5 | 28,6 | 29,7 | 25,5 | 18,1 | 25,9 | 24,6 (5.) | 27,1 (7.) |
| Together-base (7B) | 32K | 4K | 52,0 | 47,5 | 44,6 | 33,6 | 0,0 | 0,0 | 29,6 | 19,8 (7.) | 39,5 (5.) |