
Viele Prompts mit gleichem Präfix verschwenden GPU-Speicher. SGLang teilt den KV-Cache und erreicht 6,4-fachen Durchsatz. NeurIPS 2024, kostenlos.
SGLang: Efficient Execution of Structured Language Model Programs
Lianmin Zheng ^{2*} Liansheng Yin Zhiqiang Xie Chuyue Sun Jeff Huang Cody Hao Yu Shiyi Cao Christos Kozyrakis Ion Stoica Joseph E. Gonzalez Clark Barrett Ying Sheng ^{1*}
Stanford University UC Berkeley Shanghai Jiao Tong University Texas A&M University Independent Researcher
Abstract
Large language models (LLMs) are increasingly used for complex tasks that require multiple generation calls, advanced prompting techniques, control flow, and structured inputs/outputs. However, efficient systems are lacking for programming and executing these applications. We introduce SGLang, a system for efficient execution of complex language model programs. SGLang consists of a frontend language and a runtime. The frontend simplifies programming with primitives for generation and parallelism control. The runtime accelerates execution with novel optimizations like RadixAttention for KV cache reuse and compressed finite state machines for faster structured output decoding. Experiments show that SGLang achieves up to higher throughput compared to state- of- the- art inference systems on various large language and multi- modal models on tasks including agent control, logical reasoning, few- shot learning benchmarks, JSON decoding, retrieval- augmented generation pipelines, and multi- turn chat. The code is publicly available at https://github.com/sgl- project/sglang.
1 Introduction
Recent increases in the capabilities of LLMs have broadened their utility, enabling them to tackle a wider range of general tasks and act as autonomous agents [35, 6, 36, 52, 46]. In such applications, LLMs engage in multi- round planning, reasoning, and interaction with external environments. This is accomplished through tool usage [41, 38], multiple input modalities [47, 2], and a wide range of prompting techniques [30], like few- shot learning [5], self- consistency [53], skeleton- of- thought [33], and tree- of- thought [56]. All of these new use cases require multiple, often dependent, LLM generation calls, showing a trend of using multi- call structures to complete complex tasks [57, 21].
The emergence of these patterns signifies a shift in our interaction with LLMs, moving from simple chatting to a more sophisticated form of programmatic usage of LLMs, which means using a program to schedule and control the generation processes of LLMs. We refer to these programs as "Language Model Programs" (LM Programs) [4, 20]. The advanced prompting techniques and agentic workflow mentioned above fall within the scope of LM programs. There are two common properties of LM programs: (1) LM programs typically contain multiple LLM calls interspersed with control flow. This is needed to complete complex tasks and improve overall quality. (2) LM programs receive structured inputs and produce structured outputs. This is needed to enable the composition of LM programs and to integrate LM programs into existing software systems.

Despite the widespread use of LM programs, current systems for expressing and executing them remain inefficient. We identify two primary challenges associated with the efficient use of LM programs: First, programming LM programs is tedious and difficult due to the non- deterministic nature of LLMs. Developing an LM program often requires extensive string manipulation, experimental tuning of prompts, brittle output parsing, handling multiple input modalities, and implementing parallelism mechanisms. This complexity significantly reduces the readability of even simple programs (Sec. 2).
Secondly and importantly, executing LM programs is inefficient due to redundant computation and memory usage. State- of- the- art inference engines (e.g., vLLM [23], TGI [16], and TensorRT- LLM [34]), have been optimized to reduce latency and improve throughput without direct knowledge of the workload. This makes these systems general and robust but also results in significant inefficiencies for any given workload. A prominent example is the reuse of the Key- Value (KV) cache (Sec. 3). The KV cache consists of reusable intermediate tensors that are essential for generative inference. During typical batch executions of LM programs, numerous opportunities exist to reuse the KV cache across multiple different LLM calls that share a common prefix. However, current systems lack effective mechanisms to facilitate this reuse, resulting in unnecessary computations and wasted memory. Another example is constrained decoding for structured outputs (e.g., JSON mode), where the output of LLMs is restricted to follow specific grammatical rules defined by a regular expression (Sec. 4). Under these constraints, multiple tokens can often be decoded once. However, existing systems only decode one token at a time, leading to suboptimal decoding speeds.
To address these challenges, we present SGLang, a Structured Generation Language for LLMs. The core idea is to systematically exploit the multi- call structure in LM programs for efficient execution. As shown in Fig. 1, it has two parts: a front- end language and a back- end runtime. The front- end simplifies the programming of LM programs, and the runtime accelerates their execution. The two parts can work together for better performance but can also function independently.
We introduce SGLang as a domain- specific language embedded in Python. It provides primitives for generation (e.g., extend, gen, select) and parallelism control (e.g., fork, join). SGLang is compatible with Python's control flow and libraries, so users can develop advanced prompting workflows easily with native Python syntax. We provide an interpreter and a compiler for SGLang. The interpreter manages the prompt state as a stream and submits primitive operations to the stream for asynchronous execution, ensuring proper control over synchronization and intra- program parallelism. Additionally, SGLang program can be traced and compiled for more optimizations.
On the runtime side, we propose several novel optimizations to accelerate the execution of SGLang programs. The first technique, RadixAttention, enables the automatic reuse of the KV cache across multiple generation calls. In existing inference engines, the KV cache of a request is discarded after processing is completed, preventing the KV cache from being reused across multiple calls and significantly slowing down the execution. Instead, our system maintains an LRU cache of the KV cache for all requests within a radix tree. This approach manages the KV cache as a traditional cache and uses a radix tree for efficient matching, insertion, and eviction. It allows the runtime to handle various reuse patterns with a cache- aware scheduling policy efficiently. The second technique is a compressed finite state machine, which enables faster constrained decoding for structured outputs. Existing systems follow the constraints only for the next token by masking probabilities of disallowed tokens, making them able to decode only one token at a time. Instead, our system analyzes the constraints and builds a compressed finite- state machine to represent the constraint. This approach compresses a multi- token path into a single- step path whenever possible, allowing the decoding of multiple tokens at once to achieve faster decoding speed. Lastly, SGLang also supports API- only models like OpenAI's GPT- 4, and we introduce the third technique, API speculative execution, to optimize multi- call programs for API- only models.
Using SGLang, we implemented various LLM applications, including agent control, logical reasoning, few- shot learning benchmarks, JSON decoding, retrieval- augmented generation pipelines, multi- turn chat, and multi- modality processing. We tested the performance on models including Llama- 7B/70B [49], Mistral- 8x7B [17], LLaVA- v1.5- 7B (image) [28], and LLaVA- NeXT- 34B (video) [62] on NVIDIA A10G and A100 GPUs. Experimental results show that SGLang achieves up to higher throughput across a wide range of workloads, models, and hardware setups, compared to existing programming and inference systems, including Guidance [13], vLLM [23], and LMQL [4].
2 Programming Model
This section introduces the SGLang programming model with a running example, describes its language primitives and execution modes, and outlines runtime optimization opportunities. This programming model can simplify tedious operations in multi- call workflows (e.g., string manipulation, API calling, constraint specification, parallelism) by providing flexible and composable primitives.
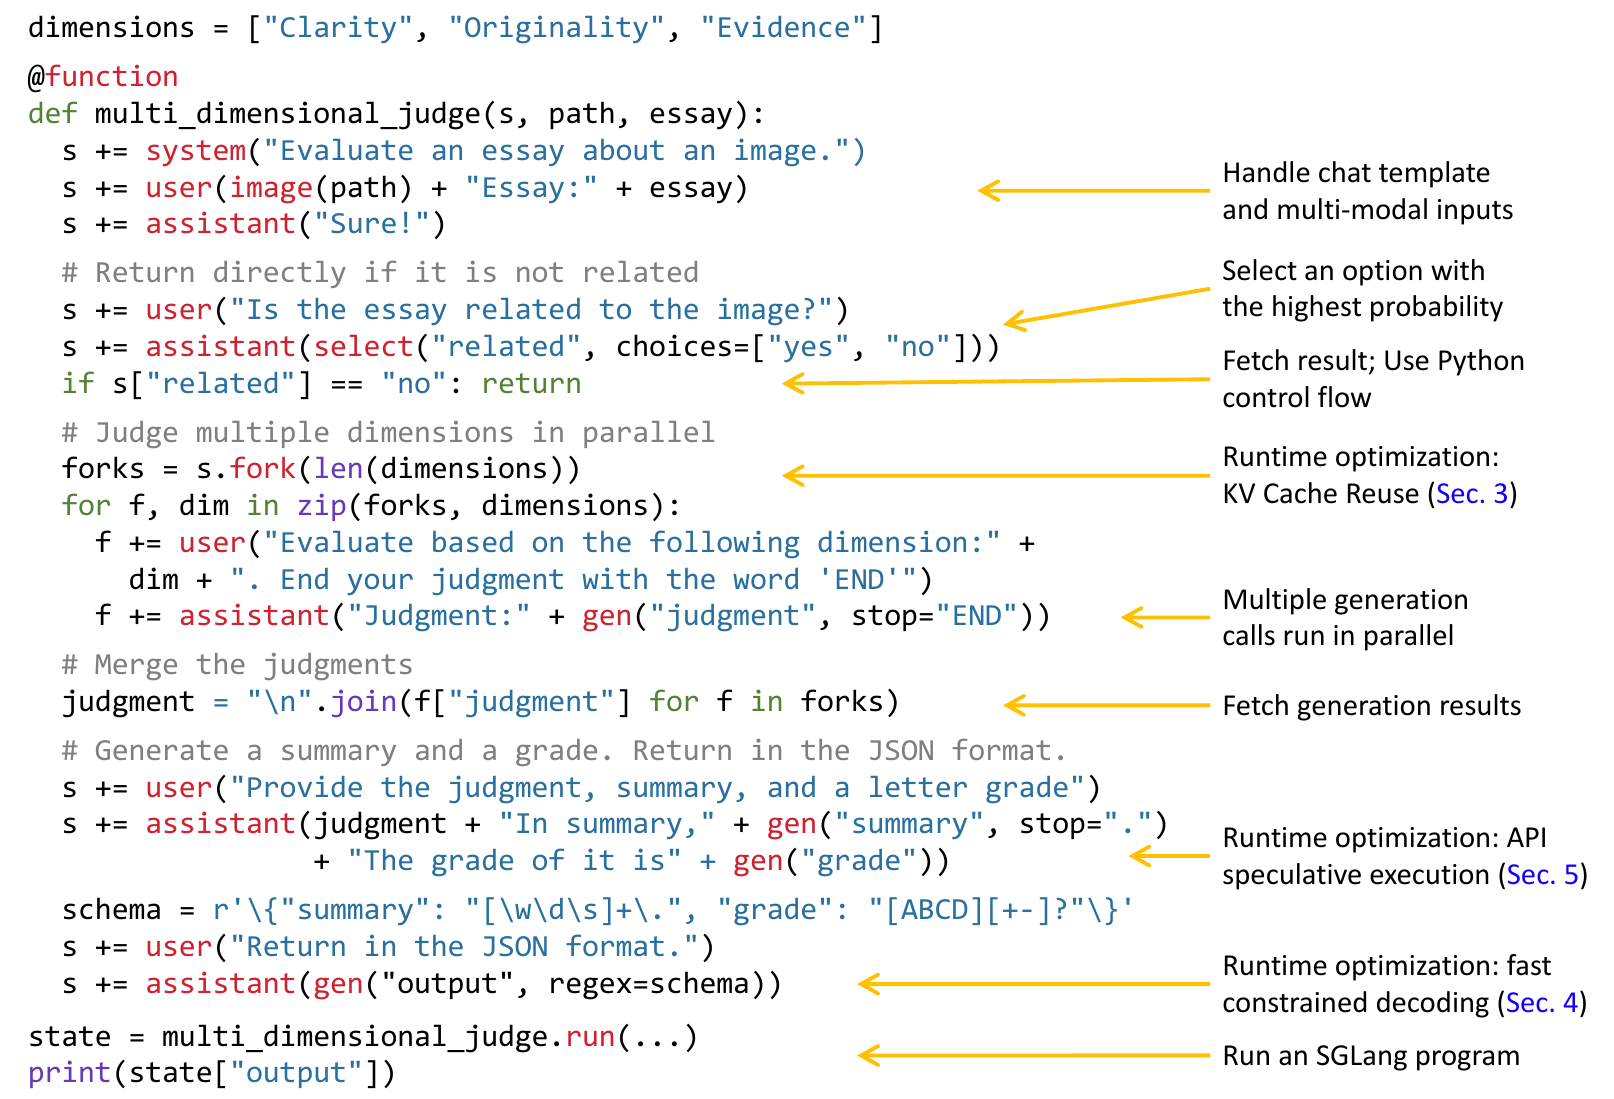
A running example. The language is a domain- specific language embedded in Python. Fig. 2 shows a program that evaluates an essay about an image using the branch- solve- merge prompting method [40]. The function multi_dimensional_judge takes three arguments: s, path, and essay. s manages the prompt state, path is the image file path, and essay is the essay text. New strings and SGLang primitives can be appended to the state s for execution using the operator. First, the function adds the image and essay to the prompt. It then checks if the essay is related to the image using select, storing the result in s["related"]. If related, the prompt is forked into three copies for parallel evaluation from different dimensions, using gen to store results in f["judgment"]. Next, it merges the judgments, generates a summary, and assigns a letter grade. Finally, it returns the results in JSON format, following a schema defined by a regular expression constraint regex. SGLang greatly simplifies this program, as an equivalent program using an OpenAI API- like interface would take as many lines of code due to manual string manipulation and parallelism control.
Sprachprimitive. SGLang stellt Primitive zur Steuerung von Prompt-Zustand, Generierung und Parallelität bereit. Sie können zusammen mit Python-Syntax und -Bibliotheken verwendet werden. Hier sind die Primitive: „gen“ ruft ein Modell zur Generierung auf und speichert die Ergebnisse in einer Variable mit dem im ersten Argument angegebenen Namen. Es unterstützt ein „regex“-Argument, um die Ausgabe auf eine durch einen regulären Ausdruck definierte Grammatik zu beschränken (z. B. ein JSON-Schema). „select“ ruft ein Modell auf, um die Option mit der höchsten Wahrscheinlichkeit aus einer Liste auszuwählen. Der Operator „+=“ oder „extend“ hängt eine Zeichenkette an den Prompt an. Der Operator „[variable_name]“ ruft die Ergebnisse einer Generierung ab. „fork“ erzeugt parallele Abzweigungen des Prompt-Zustands. „join“ führt den Prompt-Zustand wieder zusammen. „image“ und „video“ nehmen Bild- und Videoeingaben entgegen.
Ausführungsmodi. Der einfachste Weg, ein SGLang-Programm auszuführen, ist über einen Interpreter, wobei ein Prompt als asynchroner Stream behandelt wird. Primitive wie extend, gen und select werden zur asynchronen Ausführung an den Stream übergeben. Diese nicht-blockierenden Aufrufe ermöglichen es dem Python-Code, weiterzulaufen, ohne auf den Abschluss der Generierung zu warten. Dies ähnelt dem asynchronen Starten von CUDA-Kernels. Jeder Prompt wird von einem Stream-Executor in einem Hintergrundthread verwaltet, was Intra-Programm-Parallelität ermöglicht. Das Abrufen von Generierungsergebnissen blockiert, bis diese bereit sind, wodurch eine korrekte Synchronisierung gewährleistet wird. Alternativ können SGLang-Programme als Berechnungsgraphen kompiliert und
| System | Syntax | Sprachprimitive | Runtime-Backends |
| LMQL-Anleitung | Benutzerdefiniertes Python | extend, gen, select extend, gen, select, image | HF Transformers, llama.cpp, OpenAI HF Transformers, llama.cpp, OpenAI |
| SGLang | Python | extend, gen, select, image, video, fork, join | SGLang Runtime (SRT), OpenAI |
mit einem Graph-Executor ausgeführt werden, was weitere Optimierungen ermöglicht. Diese Arbeit verwendet standardmäßig den Interpreter-Modus und diskutiert Ergebnisse des Compiler-Modus in Anhang D. SGLang unterstützt Open-Weight-Modelle mit seiner eigenen SGLang Runtime (SRT) sowie API-Modelle wie OpenAI- und Anthropic-Modelle.
Vergleich. Programmiersysteme für LLMs lassen sich in High-Level- (z. B. LangChain, DSPy) und Low-Level-Systeme (z. B. LMQL, Guidance, SGLang) einteilen. High-Level-Systeme bieten vordefinierte oder automatisch generierte Prompts, wie etwa DSPys Prompt-Optimierer. Low-Level-Systeme verändern Prompts typischerweise nicht, ermöglichen aber die direkte Manipulation von Prompts und Primitiven. SGLang ist ein Low-Level-System ähnlich wie LMQL und Guidance. Tabelle 1 vergleicht ihre Merkmale. SGLang legt mehr Wert auf Laufzeiteffizienz und wird mit einer eigenen mitentwickelten Laufzeitumgebung geliefert, was später eingeführte neuartige Optimierungen ermöglicht. High-Level-Sprachen (z. B. DSPy) können zu Low-Level-Sprachen (z. B. SGLang) kompiliert werden. Wir demonstrieren die Integration von SGLang als Backend in DSPy für bessere Laufzeiteffizienz in Abschnitt 6.
Laufzeitoptimierungen. Abb. 2 zeigt drei Möglichkeiten zur Laufzeitoptimierung: KV-Cache-Wiederverwendung, schnelle constrained Decoding und spekulative Ausführung von API-Aufrufen. Wir werden sie in den folgenden Abschnitten diskutieren.
3 Effiziente KV-Cache-Wiederverwendung mit RadixAttention
SGLang-Programme können mehrere Generierungsaufrufe verketten und mit dem „fork"-Primitiv parallele Kopien erstellen. Darüber hinaus teilen verschiedene Programminstanzen oft einige gemeinsame Teile (z. B. System-Prompts). Diese Szenarien erzeugen während der Ausführung viele gemeinsam genutzte Prompt-Präfixe, was zu zahlreichen Möglichkeiten der Wiederverwendung des KV-Cache führt. Während der LLM-Inferenz speichert der KV-Cache Zwischentensoren aus dem Forward-Pass, die zur Dekodierung zukünftiger Tokens wiederverwendet werden. Sie sind nach den Key-Value-Paaren im Self-Attention-Mechanismus [51] benannt. Die KV-Cache-Berechnung hängt nur von den Präfix-Tokens ab. Daher können Anfragen mit demselben Prompt-Präfix den KV-Cache wiederverwenden, wodurch redundante Berechnung und Speichernutzung reduziert werden. Weiterer Hintergrund und einige Beispiele finden sich in Anhang A.
Angesichts der Möglichkeit zur KV-Cache-Wiederverwendung besteht eine zentrale Herausforderung bei der Optimierung von SGLang-Programmen darin, den KV-Cache über mehrere Aufrufe und Instanzen hinweg wiederzuverwenden. Während einige Systeme bestimmte Fälle der KV-Cache-Wiederverwendung untersuchen [23, 58, 18, 12], erfordern sie oft manuelle Konfigurationen und können nicht alle Wiederverwendungsmuster handhaben (z. B. dynamische Baumstrukturen). Folglich berechnen die meisten modernen Inferenzsysteme den KV-Cache für jede Anfrage neu. Wir werden ihre Einschränkungen und unsere Unterschiede in Abschnitt 7 diskutieren.
Dieser Abschnitt führt RadixAttention ein, eine neuartige Technik zur automatischen und systematischen KV-Cache-Wiederverwendung während der Laufzeit. Im Gegensatz zu bestehenden Systemen, die den KV-Cache verwerfen, nachdem eine Generierungsanfrage abgeschlossen ist, behält unser System den Cache für Prompts und Generierungsergebnisse in einem Radixbaum bei, was eine effiziente Präfixsuche, Wiederverwendung, Einfügung und Verdrängung ermöglicht. Wir implementieren eine LRU-Verdrängungsrichtlinie und eine cachebewusste Scheduling-Richtlinie, um die Cache-Trefferrate zu erhöhen. RadixAttention ist mit Techniken wie Continuous Batching [60], Paged Attention [23] und Tensor-Parallelität [44] kompatibel. Darüber hinaus verursacht es nur vernachlässigbaren Speicher- und Zeitaufwand, wenn kein Cache-Treffer vorliegt.
RadixAttention. Ein Radixbaum ist eine Datenstruktur, die als speichereffiziente Alternative zu einem klassischen Trie (Präfixbaum) dient. Anders als bei üblichen Bäumen können die Kanten eines Radixbaums nicht nur mit einzelnen Elementen, sondern auch mit Sequenzen von Elementen variierender Länge beschriftet werden, was die Effizienz erheblich erhöht. In unserem System nutzen wir einen Radixbaum, um eine Abbildung zwischen Token-Sequenzen und ihren entsprechenden KV-Cache-Tensoren zu verwalten. Diese KV-Cache-Tensoren werden in einem nicht zusammenhängenden, seitenbasierten Layout gespeichert, wobei die Größe jeder Seite einem Token entspricht. Da der GPU-Speicher schnell durch den KV-Cache gefüllt wird, führen wir eine einfache LRU-Verdrängungsrichtlinie ein, die zuerst das am längsten nicht verwendete Blatt verdrängt. Indem wir Blätter zuerst verdrängen, ermöglichen wir die Wiederverwendung ihrer gemeinsamen Vorfahren, bis diese Vorfahren selbst zu Blättern werden und ebenfalls verdrängt werden.
Im Continuous-Batching-Szenario können wir keine Knoten verdrängen, die vom aktuell laufenden Batch verwendet werden. Daher führt jeder Knoten einen Referenzzähler, der angibt, wie viele laufende Anfragen ihn verwenden. Ein Knoten ist verdrängbar, wenn sein Referenzzähler null ist. Beachten Sie, dass wir keinen festen Speicherpool als Cache vorab zuweisen. Stattdessen lassen wir die zwischengespeicherten Tokens und die aktuell laufenden Anfragen denselben Speicherpool teilen. Daher weist das System Speicher für Cache und laufende Anfragen dynamisch zu. Wenn genügend wartende Anfragen ausgeführt werden, verdrängt das System alle zwischengespeicherten Tokens zugunsten einer größeren Batch-Größe. Abb. 3 zeigt, wie der Radixbaum für mehrere eingehende Anfragen gepflegt wird. Der
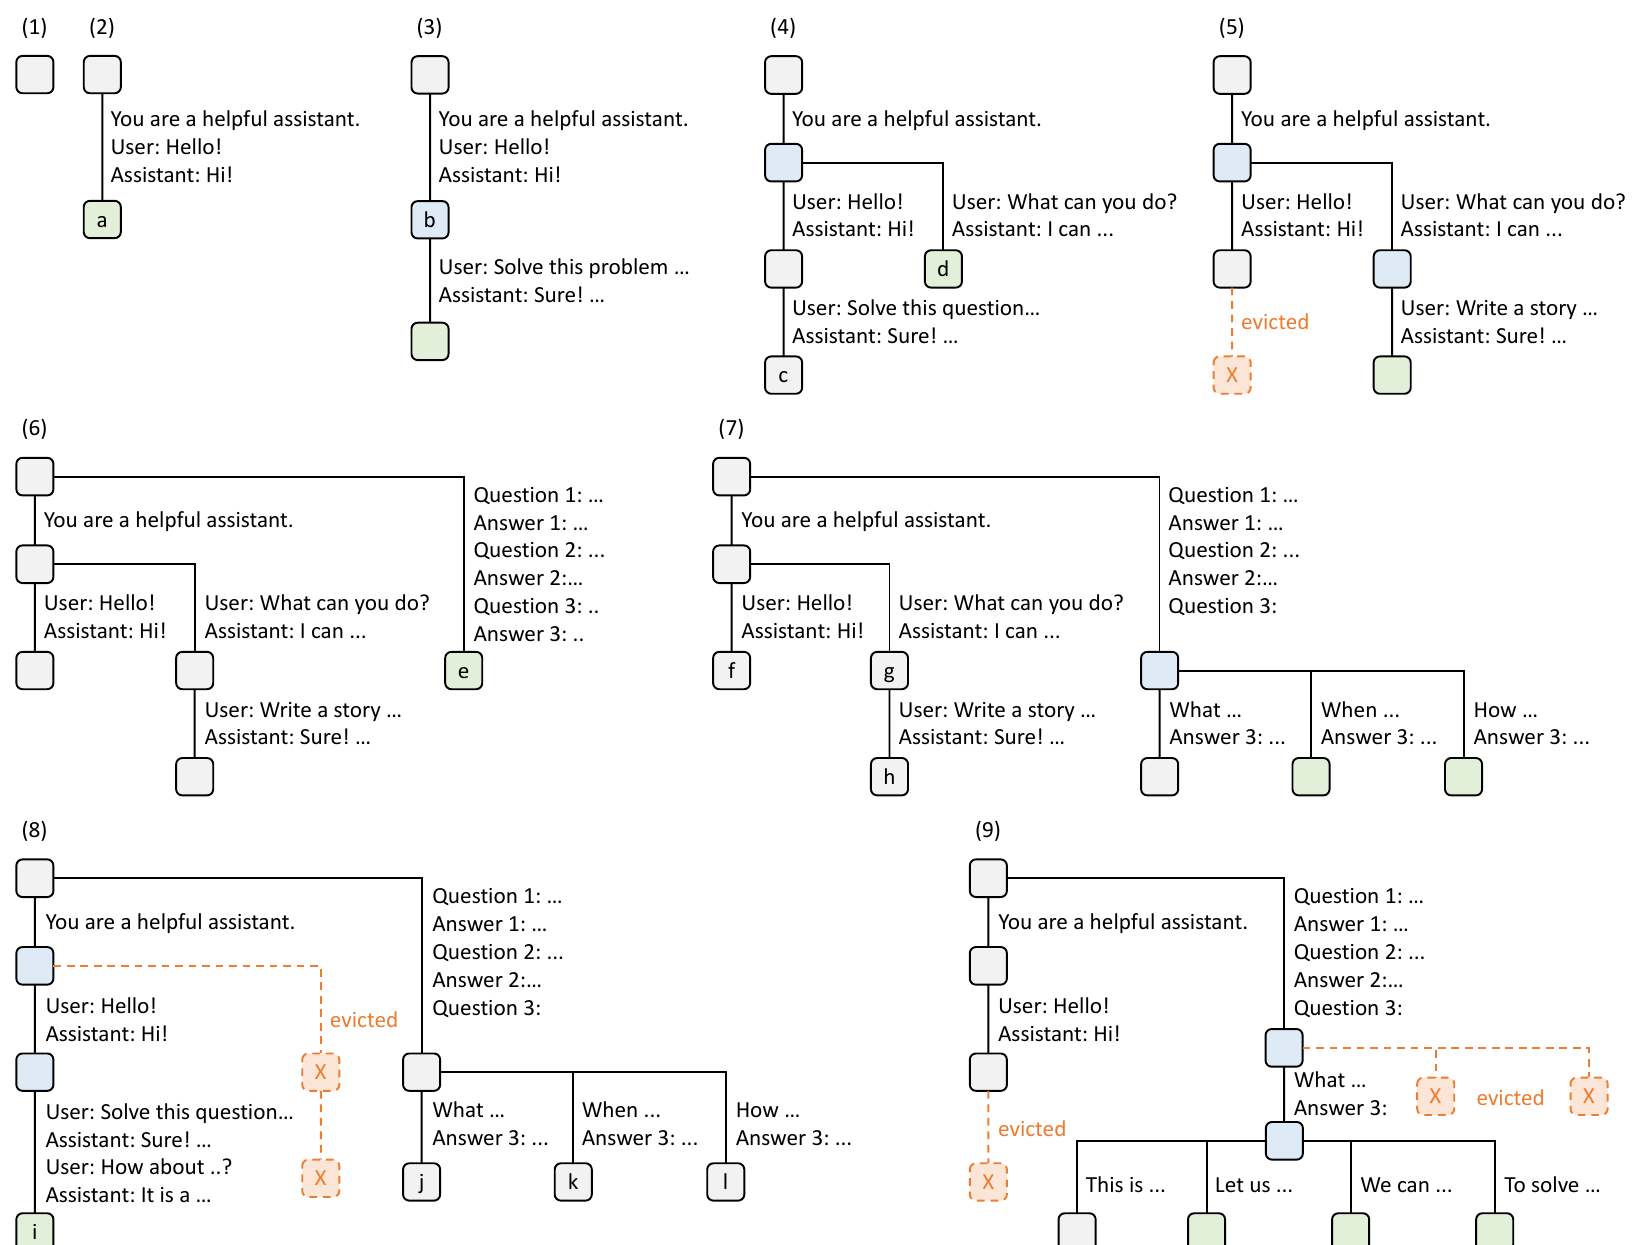
Frontend-Interpreter sendet vollständige Prompts an die Laufzeit, und die Laufzeit führt Präfixabgleich und Wiederverwendung durch. Die Baumstruktur wird auf der CPU mit vernachlässigbarem Wartungsaufwand gespeichert. Während der Ausführung des fork-Primitivs sendet das Frontend zuerst das Präfix als Hinweis, wodurch sichergestellt wird, dass das Präfix korrekt in den Baum eingefügt wird. Anschließend sendet es die übrigen Prompts. Dieser „Frontend-Hinweis" vereinfacht die Laufzeitplanung und das Matching und veranschaulicht die Vorteile des Frontend-Runtime-Co-Designs.
Cachebewusstes Scheduling. Wir definieren die Cache-Trefferrate als Anzahl der zwischengespeicherten Prompt-Tokens. Wenn sich viele Anfragen in der Warteschlange befinden, kann die Reihenfolge, in der sie ausgeführt werden, die Cache-Trefferrate erheblich beeinflussen. Wenn der Anfrage-Scheduler beispielsweise häufig zwischen verschiedenen, nicht verwandten Anfragen wechselt, kann dies zu Cache-Thrashing und einer niedrigen Trefferrate führen. Wir entwerfen einen cachebewussten Scheduling-Algorithmus, um die Cache-Trefferrate zu erhöhen. Im Batch-Verarbeitungsszenario sortieren wir die
Anfragen nach der Länge des übereinstimmenden Präfixes und priorisieren Anfragen mit längeren übereinstimmenden Präfixen, anstatt eine First-Come-First-Served-Planung zu verwenden. Alg. 1 (Anhang) zeigt den Pseudocode für cachebewusstes Scheduling mit kontinuierlichem Batching. Der Algorithmus verwendet die Reihenfolge „längstes gemeinsames Präfix zuerst". In latenzempfindlicheren Szenarien können wir möglicherweise dennoch eine begrenzte Umsortierung von Batches tolerieren, um die Cache-Wiederverwendung zu verbessern. Zusätzlich beweisen wir den folgenden Satz für optimales Scheduling im Offline-Fall. 2
Theorem 3.1. Für einen Batch von Anfragen können wir eine optimale Cache-Trefferrate erreichen, indem wir den Radixbaum der Anfragen in der Reihenfolge einer Tiefensuche durchlaufen, mit einer Cache-Größe der maximalen Anfragelänge. Die Reihenfolge „längstes gemeinsames Präfix zuerst" ist äquivalent zu einer Tiefensuchreihenfolge.
Der Beweis befindet sich in Abschnitt A.3 (Anhang). Im Online-Fall wird die DFS-Reihenfolge gestört, aber unsere Planung approximiert noch immer das DFS-Verhalten auf dem erweiterten Teil des vollständigen Radixbaums, wie in Abschnitt A.3 beschrieben. Während greedy cachebewusstes Scheduling einen hohen Durchsatz erreichen kann, kann es zu Starvation führen. Wir überlassen seine Integration mit anderen fairen Scheduling-Methoden [42] zukünftiger Arbeit.
Verteilte Fälle. RadixAttention kann auf mehrere GPUs erweitert werden. Bei Tensor-Parallelität verwaltet jede GPU einen geshardeten KV-Cache. Es ist keine zusätzliche Synchronisation erforderlich, da die Baumoperationen dieselben sind. Datenparallelität mit mehreren Workern wird in Abschnitt A.4 (Anhang) diskutiert.
4 Effizientes constrained Decoding mit komprimiertem endlichem Automaten
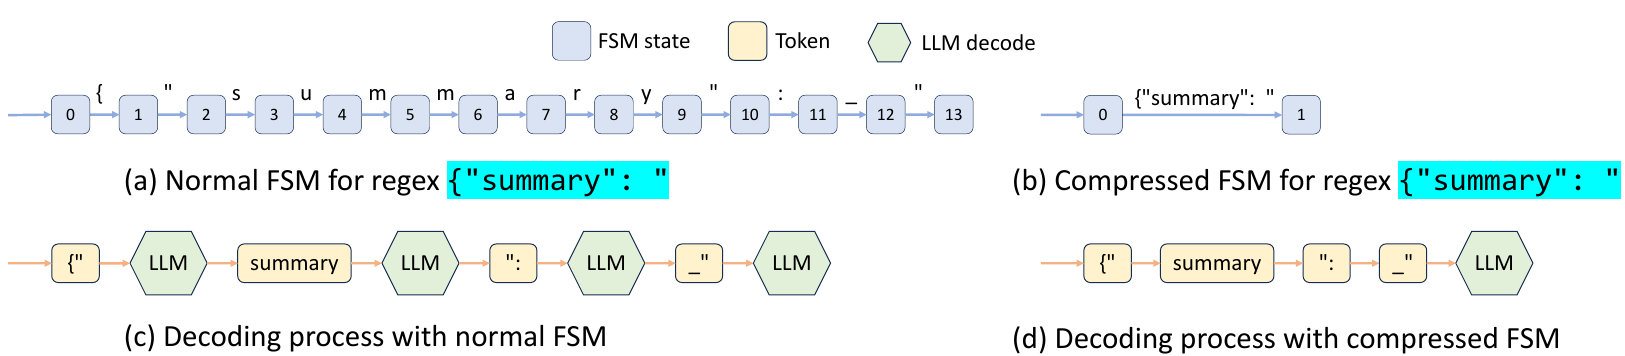
In LM-Programmen möchten Benutzer die Ausgabe des Modells oft auf bestimmte Formate wie JSON-Schemata beschränken. Dies kann die Steuerbarkeit und Robustheit verbessern und die Ausgabe leichter parsbar machen. SGLang bietet ein regex-Argument, um solche Beschränkungen mithilfe regulärer Ausdrücke durchzusetzen, die für viele praktische Szenarien ausdrucksstark genug sind. Bestehende Systeme unterstützen dies, indem sie einen regulären Ausdruck in einen endlichen Automaten (FSM) [54] umwandeln. Während der Dekodierung behalten sie den aktuellen FSM-Zustand bei, rufen erlaubte Tokens aus den Folgezuständen ab und setzen die Wahrscheinlichkeit ungültiger Tokens auf null, wobei sie Token für Token dekodieren. Dieser Token-für-Token-Ansatz ist jedoch ineffizient, wenn die Möglichkeit besteht, mehrere Tokens auf einmal zu dekodieren. Beispielsweise umfasst die konstante Sequenz {"summary": " in Abb. 2 im normalen Dekodierungsprozess mehrere Tokens, wie in Abb. 4 (c) gezeigt, was mehrere Dekodierungsstufen erfordert, obwohl beim Dekodieren nur ein einziges gültiges nächstes Token existiert. Daher kann die gesamte Sequenz in einem einzigen Schritt (d. h. Forward-Pass) dekodiert werden. Bestehende Systeme können jedoch nur jeweils ein Token dekodieren, da die fehlende Integration zwischen dem FSM und dem Model Runner in bestehenden Systemen die Verarbeitung mehrerer Tokens verhindert, was zu langsamer Dekodierung führt.
SGLang überwindet diese Einschränkung durch die Erstellung einer schnellen constrained-Decoding-Laufzeit mit einem komprimierten FSM. Diese Laufzeit analysiert den FSM und komprimiert benachbarte Kanten mit einfachem Übergang im FSM zu einzelnen Kanten, wie in Abb. 4 (b) dargestellt, wodurch sie erkennen kann, wann mehrere Tokens zusammen dekodiert werden können. In Abb. 4 (d) können mehrere Tokens auf der komprimierten Übergangskante in einem einzigen Forward-Pass dekodiert werden, was den Dekodierungsprozess stark beschleunigt. Dies ist zudem allgemein und auf alle regulären Ausdrücke anwendbar. Weitere Details zu Hintergrund und Implementierung finden sich in Anhang B.
5 Effizientes Endpoint-Calling mit spekulativer Ausführung von API-Aufrufen
Die vorherigen Abschnitte führten Optimierungen für Open-Weight-Modelle ein, die Änderungen am Modellinferenzprozess erfordern. Darüber hinaus funktioniert SGLang mit Modellen, auf die nur über APIs zugegriffen werden kann, wie OpenAIs GPT-4. Für diese Modelle können wir jedoch nur einen Blackbox-API-Endpoint aufrufen.
Dieser Abschnitt führt eine neue Optimierung für Blackbox-API-Modelle ein, die die Ausführung beschleunigt und die API-Kosten von SGLang-Programmen mit mehreren Aufrufen durch spekulative Ausführung reduziert. Beispielsweise kann ein Programm das Modell bitten, eine Beschreibung einer Figur mit einem Muster aus mehreren Aufrufen zu generieren:
context "name:" gen("name", stop="\n") "job:" gen("job", stop="\n"). Naiverweise entsprechen die beiden gen-Primitive zwei API-Aufrufen, was bedeutet, dass der Benutzer die Eingabe-Token-Gebühr für den Kontext zweimal bezahlen muss. In SGLang können wir beim ersten Aufruf spekulative Ausführung aktivieren und ihn die Generierung einiger weiterer Tokens fortsetzen lassen, indem wir die Stoppbedingung ignorieren. Der Interpreter behält die zusätzlichen Generierungsausgaben bei und gleicht sie mit späteren Primitiven ab und verwendet sie wieder. In bestimmten Fällen kann das Modell mit sorgfältigem Prompt-Engineering die Vorlage mit hoher Genauigkeit korrekt abgleichen, was uns die Latenz und die Eingabekosten eines API-Aufrufs erspart.
6 Evaluation
Wir evaluieren die Leistung von SGLang über diverse LLM-Workloads hinweg. Anschließend führen wir Ablationsstudien und Fallstudien durch, um die Wirksamkeit bestimmter Komponenten zu demonstrieren. SGLang ist in PyTorch [37] mit benutzerdefinierten CUDA-Kernels aus FlashInfer [59] und Triton [48] implementiert.
6.1 Aufbau
Modelle. Wir testen dichte Llama-2-Modelle [49], sparse Mixture-of-Experts-Modelle Mixtral [17], multimodale LLaVA-Bild- [27] und -Videomodelle [62] sowie das API-Modell OpenAIs GPT-3.5. Bei Open-Weight-Modellen reicht die Anzahl der Parameter von 7 Milliarden bis 70 Milliarden, und wir verwenden float16-Präzision.
Hardware. Die meisten unserer Experimente führen wir auf AWS EC2 G5-Instanzen durch, die mit NVIDIA A10G GPUs (24 GB) ausgestattet sind. Wir führen 7B-Modelle auf einer einzelnen A10G GPU und größere Modelle auf mehreren A10G GPUs mit Tensor-Parallelismus [44] aus. Einige zusätzliche Experimente führen wir auf A100G (80 GB) GPUs durch.
Baselines. Wir vergleichen SGLang sowohl mit High-Level-Programmiersystemen mit ihren jeweiligen Sprachen und Standard-Runtimes als auch mit Low-Level-Inferenz-Engines mit standardmäßigen OpenAI-ähnlichen Completion-APIs. Sofern nicht anders angegeben, aktivieren wir keine Optimierungen, die die Berechnungsergebnisse verändern, sodass alle Systeme dieselben Ergebnisse berechnen. Die Baselines umfassen:
- Guidance [13], eine Sprache zur Steuerung von LLMs. Wir verwenden Guidance v0.1.8 mit llama.cpp-Backend. - vLLM [23], eine Inferenz-Engine mit hohem Durchsatz. Wir verwenden vLLM v0.2.5 und seinen Standard-API-Server. - LMQL [4], eine Abfragesprache. Wir verwenden LMQL v0.7.3 mit Hugging Face Transformers-Backend.
Workloads. Wir testen Folgendes: 5-Shot-MMLU [14] und 20-Shot-HellaSwag [61]-Benchmarks. Für MMLU dekodieren wir ein Token und verwenden das Primitive select, um die Antwort mit der höchsten Wahrscheinlichkeit für HellaSwag auszuwählen. Für den ReAct-Agenten [57] und generative Agenten [36] extrahieren wir die Traces aus den Originalpapers und spielen sie ab. Wir verwenden Tree-of-thought [56] für die GSM-8K-Probleme und Skeleton-of-thought [33] für die Tip-Generierung. Wir verwenden LLM-Richter mit der branch-solve-merge-Technik [40]; JSON-Dekodierung mit einem durch einen regulären Ausdruck spezifizierten Schema; Multi-Turn-Chat mit 4 Turns, wobei die Eingabe jedes Turns zufällig zwischen 256-512 Token abgetastet wird. Multi-Turn-Chat (kurz) bedeutet kurze Ausgabe (4-8 Token) und Multi-Turn-Chat (lang) bedeutet lange Ausgabe (256-512 Token); DSPy-Retrieval-Augmented-Generation-(RAG)-Pipeline [20] in ihrem offiziellen Beispiel.
Metriken. Wir berichten über zwei Leistungsmetriken: Durchsatz und Latenz. Für den Durchsatz führen wir eine ausreichend große Stapelverarbeitung von Programminstanzen aus, um den maximalen Durchsatz zu berechnen, und vergleichen dabei die Anzahl der pro Sekunde ausgeführten Programminstanzen (Programme pro Sekunde, p/s). Für die Latenz führen wir jeweils ein einzelnes Programm ohne Stapelverarbeitung aus und berichten die durchschnittliche Latenz für mehrere Instanzen.
6.2 Ende-zu-Ende-Leistung
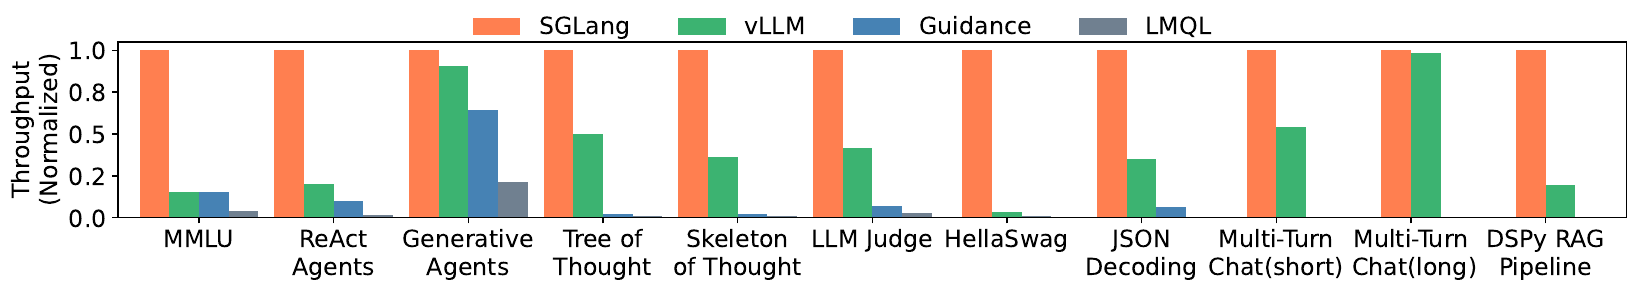
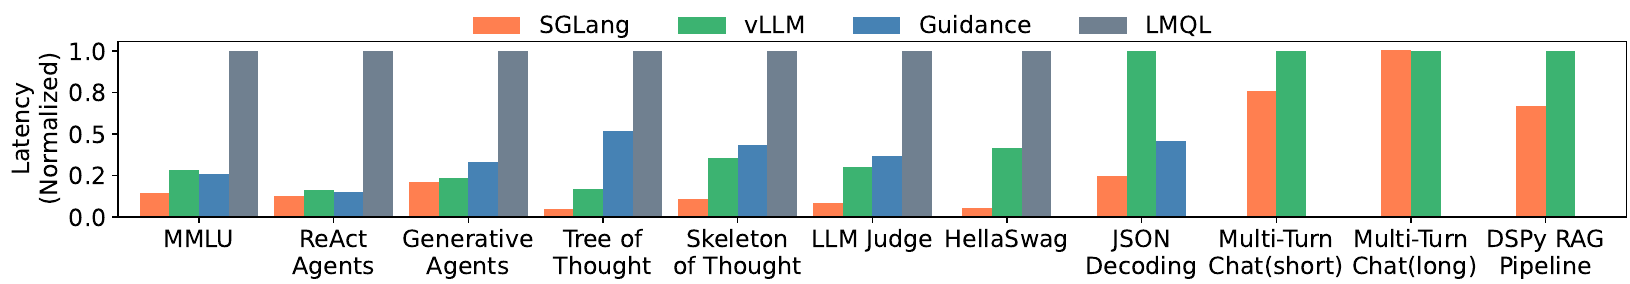
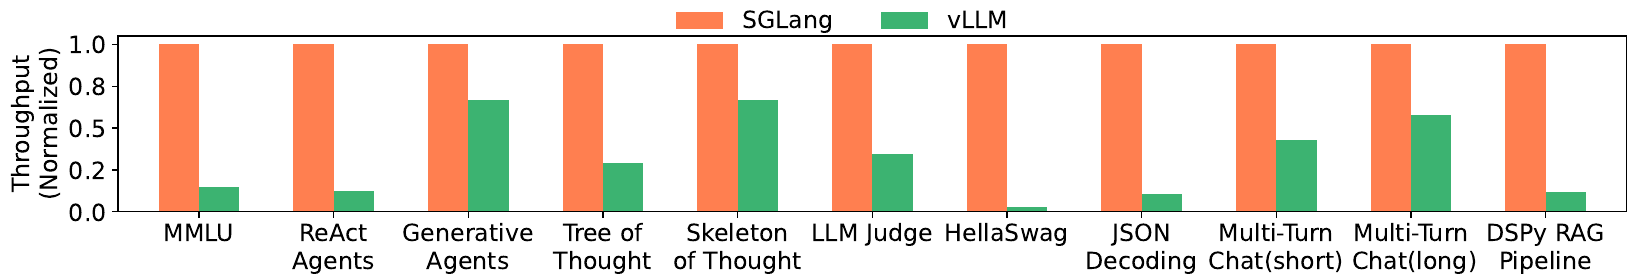
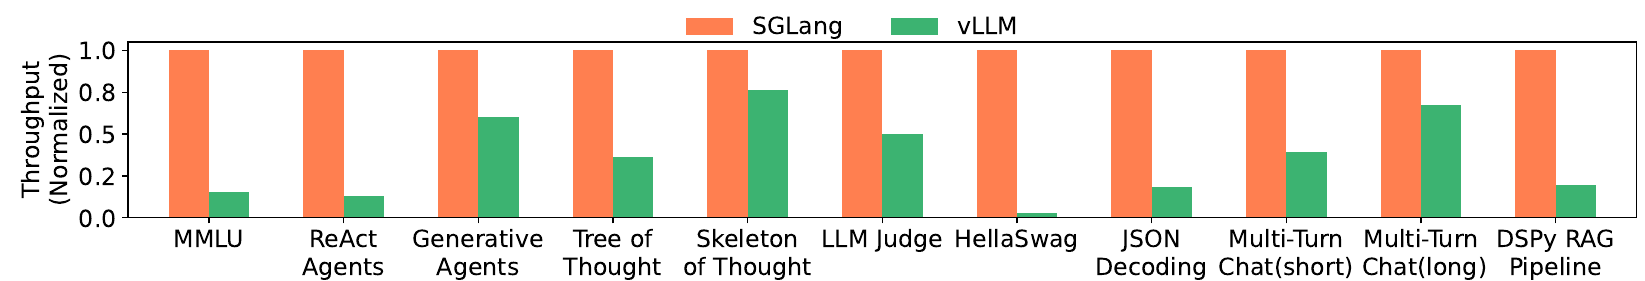
Ergebnisse auf Open-Weight-Modellen. Die Latenz- und Durchsatzergebnisse sind in Abb. 5 und Abb. 6 dargestellt. SGLang verbessert den Durchsatz um bis zu und reduziert die Latenz um bis zu . Diese Verbesserungen
resultieren aus der KV-Cache-Wiederverwendung, der Ausnutzung von Parallelität innerhalb eines einzelnen Programms und einer schnelleren eingeschränkten Dekodierung. Als Nächstes erklären wir die Gründe für die Beschleunigung in jedem Benchmark.
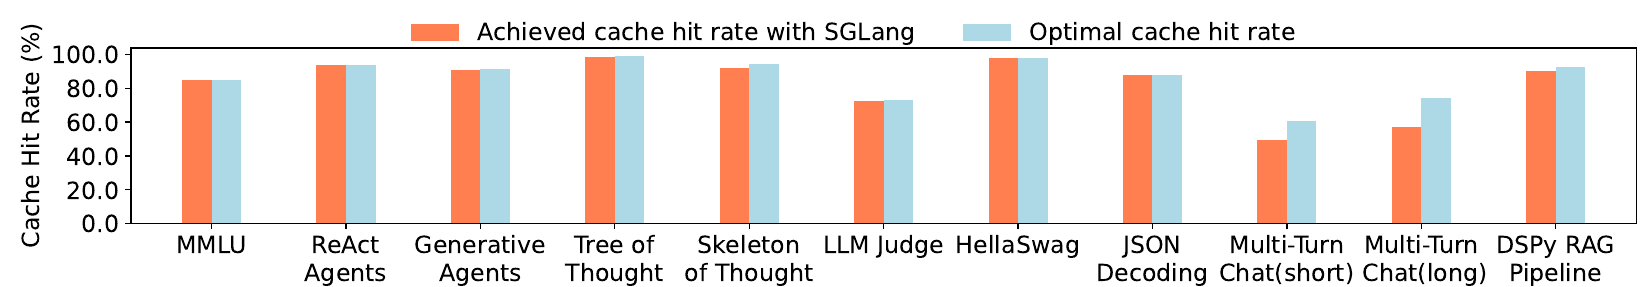
Bei MMLU kann SGLang den KV-Cache der 5-Shot-Beispiele mit RadixAttention wiederverwenden. RadixAttention kommt sowohl dem Durchsatz als auch der Latenz zugute. RadixAttention reduziert den Gesamtspeicherverbrauch durch gemeinsame Nutzung des KV-Cache, wodurch eine größere Batch-Größe ermöglicht wird, um den maximalen Durchsatz zu verbessern. RadixAttention reduziert außerdem die Berechnung des Prefill und verringert somit die Latenz des ersten Tokens. Bei HellaSwag verwendet SGLang den KV-Cache sowohl der Few-Shot-Beispiele als auch des gemeinsamen Frage-Präfixes für mehrere Antwortmöglichkeiten wieder, was zu einer zweistufigen gemeinsamen Nutzung führt. Für die ReAct- und generativen Agenten verwendet SGLang den KV-Cache der Agentenvorlage und früherer Aufrufe wieder. Bei Tree-of-Thought und Skeleton-of-Thought parallelisiert SGLang die Generierungsaufrufe innerhalb eines einzelnen Programms und nutzt den KV-Cache so weit wie möglich wieder. Bei der JSON-Dekodierung beschleunigt SGLang die Dekodierung, indem mehrere Tokens auf einmal mit einem komprimierten endlichen Automaten dekodiert werden. Im Multi-Turn-Chat verwendet SGLang den KV-Cache des Chatverlaufs wieder. Die Beschleunigung ist bei kurzen Ausgaben stärker ausgeprägt, da die KV-Cache-Wiederverwendung hauptsächlich dazu beiträgt, die Präfixzeit zu reduzieren. Bei langen Ausgaben gibt es nahezu keine Beschleunigung, da zwischen verschiedenen Chat-Sitzungen nicht viel gemeinsam genutzt wird und die Dekodierungszeit dominiert. In der DSPy-RAG-Pipeline verwendet SGLang den KV-Cache des gemeinsamen Kontextbeispiels wieder. Bei diesen Benchmarks liegt die Cache-Trefferrate zwischen und . Abb. 13 (Anhang) listet die erzielten und optimalen Cache-Trefferraten für alle von ihnen auf und zeigt, dass unsere cache-bewusste Planung im Durchschnitt der optimalen Trefferrate erreicht.
Wir schließen LMQL und Guidance aus einigen der letzten fünf Benchmarks aufgrund langsamer Leistung und fehlender Funktionalitäten aus. Die Probleme von LMQL rühren von langsamer Verarbeitung auf Token-Ebene und einem nicht optimierten Backend her, während Guidance keine Unterstützung für Stapelverarbeitung und Parallelität bietet.
Ergebnisse auf größeren Modellen mit Tensorparallelismus. Wir führen größere Modelle, Mixtral-8x7B und Llama-70B, mit Tensorparallelismus auf derselben Menge von Benchmarks aus und berichten die Ergebnisse in Abb. 7 und Abb. 12 (Anhang). Die Beschleunigung bei größeren Modellen zeigt einen ähnlichen Trend wie bei kleineren Modellen, was darauf hindeutet, dass unsere Optimierung gut auf größere Modelle generalisiert. Wir lassen Guidance und LMQL hier weg, da sie keine effizienten Implementierungen von Tensorparallelismus besitzen.
Ergebnisse auf multimodalen Modellen. SGLang unterstützt multimodale Modelle nativ mit den Bild- und Video-Primitiven. Die Optimierungen in diesem Artikel sind mit multimodalen Modellen kompatibel. Für RadixAttention berechnen wir den Hash der Eingabebilder und verwenden ihn als Schlüssel im Radix-Baum, wodurch wir den KV-Cache der Bild-Tokens aus demselben Bild wiederverwenden können. Wir führen LLaVA-v1.5-7B (Bild) auf llava-bench-in-the-wild und LLaVA-NeXT-34B (Video) auf ActivityNet aus. Da diese Modelle von anderen Baseline-Systemen nicht gut unterstützt werden, verwenden wir die Originalimplementierung der Modellautoren in Hugging Face Transformers als Baseline. Wie in Tabelle 2 gezeigt, bietet SGLang bei diesen Benchmarks einen bis zu höheren Durchsatz. In llava-bench-in-the-wild gibt es mehrere Fragen zu demselben Bild, und die SGLang-Laufzeit verwendet in diesem Fall den KV-Cache wieder.
Produktivbereitstellung. SGLang wurde in der Chatbot Arena [8] eingesetzt, um Open-Weight-Modelle zu bedienen. Aufgrund des geringen Datenverkehrs für einige Modelle bedient jeweils nur ein SGLang-Worker jedes einzelne. Nach einem Monat beobachteten wir eine RadixAttention-Cache-Trefferrate von für LLaVA-NeXT-34B [28] und für Vicuna-33B [7]. Cache-Treffer stammen aus gemeinsamen Systemnachrichten, häufig wiederverwendeten Beispielbildern und Multi-Turn-Chatverläufen. Dies reduziert die Latenz des ersten Tokens für Vicuna-33B um durchschnittlich .
| Modell | LLaVA-v1.5-7B (Bild) | LLaVA-NEXT-34B (Video) |
| Ursprüngliche Implementierung des Autors | 0,18 Bild/s | 0,02 Frame/s |
| SGLang | 1,15 Bild/s | 0,10 Frame/s |
Ergebnisse auf API-Modellen. Wir testen einen Prompt, der drei Felder aus einer Wikipedia-Seite extrahiert, unter Verwendung von OpenAI's GPT-3.5-Modell. Durch Few-Shot-Prompting ist die Genauigkeit der spekulativen Ausführung der API hoch, und sie reduziert die Kosten für Eingabe-Tokens um etwa das Dreifache aufgrund der Extraktion von drei Feldern.
6.3 Ablationsstudie
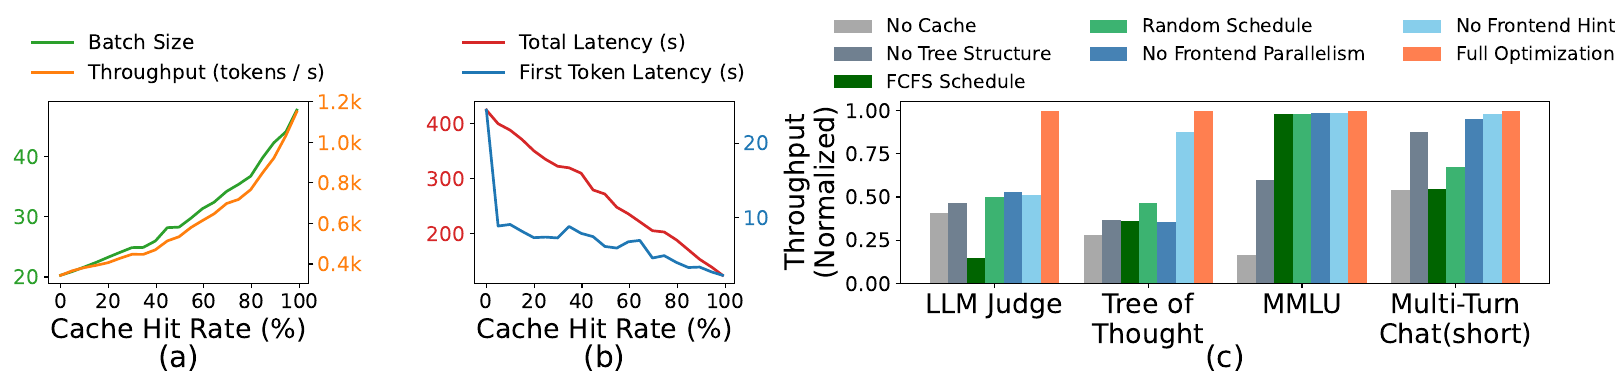
Cache-Trefferrate vs. Latenz/Durchsatz. Abb. 8(a)(b) zeigt die Beziehung zwischen Cache-Trefferrate und Leistungsmetriken (Latenz des ersten Tokens, Gesamtlatenz, Batch-Größe und Durchsatz) beim Tree-of-Thought-Benchmark. Die Abbildung wird erhalten, indem übereinstimmende Tokens zur Laufzeit teilweise deaktiviert werden. Sie zeigt, dass eine höhere Cache-Trefferrate zu einer größeren Batch-Größe, höherem Durchsatz und niedrigerer Latenz führt.
Wirksamkeit von RadixAttention. Wir testen die Wirksamkeit von RadixAttention und seinen Komponenten bei mehreren repräsentativen Benchmarks. Wie in Abb. 8(c) gezeigt, bedeutet „No Cache“ die Verwendung keines Caches, „No Tree-Structure“ die Verwendung eines einfachen tabellenbasierten Caches anstelle eines baumstrukturierten Caches, „FCFS Schedule“ die Verwendung einer First-Come-First-Serve-Richtlinie anstelle unserer cache-bewussten Planung, „Random Schedule“ die Verwendung einer zufälligen Reihenfolge zur Planung von Anfragen, „No Frontend Parallelism“ die Deaktivierung von Parallelität im Interpreter, „No Frontend Hint“ die Deaktivierung des Sendens der Fork-Hinweise von den Interpretern und „Full optimizations“, dass wir alle Optimierungen aktivieren. Die experimentellen Ergebnisse zeigen, dass jede dieser Komponenten erforderlich ist, um die beste Leistung zu erzielen. Die Deaktivierung von Parallelität und Hinweisen vom Frontend-Interpreter führt ebenfalls zu suboptimaler Laufzeitleistung, was die Bedeutung der gemeinsamen Gestaltung von Frontend-Sprache und Laufzeit unterstreicht.
Overhead von RadixAttention. Wir testen den Overhead von RadixAttention bei einem Benchmark ohne jegliche KV-Cache-Wiederverwendungsmöglichkeiten. Der Benchmark misst den Durchsatz auf dem ShareGPT-Datensatz. Die Ausführung von 100 Anfragen dauert 74,3 Sekunden; die Zeit für die Verwaltung der RadixAttention-Datenstrukturen beträgt jedoch nur 0,2 Sekunden, was einen vernachlässigbaren Overhead von weniger als 0,3% darstellt. Dies liegt daran, dass die Komplexität der Baumoperationen linear und gering ist. Daher können wir RadixAttention standardmäßig aktivieren.
Wirksamkeit des komprimierten endlichen Automaten. Wir testen die Wirksamkeit des komprimierten endlichen Automaten und seiner Komponenten beim JSON-Dekodierungs-Benchmark. Die experimentellen Ergebnisse zeigen, dass der komprimierte endliche Automat den Durchsatz um erhöht, da er mehrere Tokens auf einmal dekodieren kann. Darüber hinaus müssen wir den Automaten vorverarbeiten und für eine Batch von Anfragen wiederverwenden. Andernfalls macht die erneute Vorverarbeitung für jede Anfrage den Durchsatz um niedriger.
7 Verwandte Arbeiten
Verschiedene Arbeiten haben die Wiederverwendung des KV-Cache untersucht, und viele von ihnen sind zeitgleich mit unserer Arbeit entstanden. Einzigartig ist, dass unser RadixAttention als erstes vorschlägt, den KV-Cache als baumbasierten LRU-Cache zu behandeln. Es ist die erste Lösung, die mehrstufige gemeinsame Nutzung, cache-bewusste Planung, gemeinsame Planung von Frontend und Laufzeit sowie verteilte Fälle unterstützt. vLLM [23] und ChunkedAttention [58] untersuchen einige einfache Wiederverwendungsfälle (z. B. gemeinsame Nutzung von System-Prompts), decken aber keine mehrstufige baumstrukturierte gemeinsame Nutzung oder LRU-Caching ab. PromptCache [12] schlägt die modulare Wiederverwendung des KV-Cache über das Präfix hinaus vor, kann jedoch die Genauigkeit um bis zu einem Rückgang von beeinträchtigen. HydraGen [18], FlashInfer [59] und ChunkedAttention [58] konzentrieren sich auf CUDA-Kernel-Optimierungen und beinhalten nicht das Konzept eines LRU-Cache. API Serve [1] und LLM-SQL [29] untersuchen die KV-Cache-Wiederverwendung für spezifische Anwendungen wie die Verzahnung mit externen API-Aufrufen und relationalen Datenbanken, verfügen jedoch nicht über unseren Radix-Baum oder unsere cache-bewusste Planung.
Es existieren mehrere LLM-Programmier- und Agenten-Frameworks, wie Guidance [13], LMQL [4], DSPy [20], LangChain [24], AutoGen [55] und LLM Compiler [21]. Guidance und LMQL sind SGLang am ähnlichsten, und wir vergleichen sie in Abschnitt 2. Unsere Innovation liegt in neuartigen Laufzeitoptimierungen zur Beschleunigung des vorgeschlagenen Programmiermodells. SGLang ist mit anderen Frameworks kompatibel und kann sie beschleunigen (z. B. das DSPy-Beispiel in unserer Evaluierung). Darüber hinaus ist SGLang mit vielen anderen gängigen Inferenzoptimierungen kompatibel [60, 39, 3, 23, 59, 10, 26, 15, 19, 32, 31, 11].
8 Zukünftige Richtungen und Fazit
Zukünftige Richtungen. Trotz der mit SGLang erzielten Fortschritte bleiben mehrere Einschränkungen bestehen, die vielversprechende Richtungen für zukünftige Forschung aufzeigen. Dazu gehören die Erweiterung von SGLang zur Unterstützung zusätzlicher Ausgabemodalitäten, die Anpassung von RadixAttention für den Betrieb über mehrere Ebenen der Speicherhierarchie (z. B. DRAM, Festplatte) [43], die Ermöglichung von unscharfem semantischem Matching innerhalb von RadixAttention, die Bereitstellung von Primitiven auf höherer Ebene auf SGLang, die Behebung von Aushungerung in der cache-bewussten Planung [42] und die Verbesserung des SGLang-Compilers zur Durchführung fortgeschrittener statischer Optimierungen wie Planung und Speicherplanung.
Fazit. Wir stellen SGLang vor, ein Framework für die effiziente Programmierung und Ausführung strukturierter Sprachmodellprogramme. SGLang verbessert den Durchsatz und die Latenz komplexer LM-Programme erheblich durch neuartige Optimierungen wie RadixAttention, komprimierte endliche Zustandsmaskinen und einen Sprachinterpreter. Es ist ein wertvolles Werkzeug für die Entwicklung fortgeschrittener Prompting-Techniken und Agenten-Workflows. Der Quellcode ist öffentlich verfügbar.
Danksagung
Dieses Projekt wird vom Stanford Center for Automated Reasoning und durch Spenden von Astronomer, Google, IBM, Intel, Lacework, Microsoft, Mohamed Bin Zayed University of Artificial Intelligence, Nexla, Samsung SDS, Uber und VMware unterstützt. Lianmin Zheng wird durch ein Meta Ph.D. Fellowship unterstützt. Wir danken Yuanhan Zhang und Bo Li für die LLaVA-NeXT-(Video-)Unterstützung.
Literaturverzeichnis
[1] Reyna Abhyankar, Zijian He, Vikranth Srivatsa, Hao Zhang, and Yiying Zhang. Apiserve: Efficient api support for large-language model inferencing. arXiv preprint arXiv:2402.01869, 2024. [2] Jean-Baptiste Alayrac, Jeff Donahue, Pauline Luc, Antoine Miech, Iain Barr, Yana Hasson, Karel Lenc, Arthur Mensch, Katherine Millican, Malcolm Reynolds, et al. Flamingo: a visual language model for few-shot learning. Advances in Neural Information Processing Systems, 35:23716–23736, 2022. [3] Reza Yazdani Aminabadi, Samyam Rajbhandari, Ammar Ahmad Awan, Cheng Li, Du Li, Elton Zheng, Olatunji Ruwase, Shaden Smith, Minjia Zhang, Jeff Rasley, et al. Deepspeed-inference: enabling efficient inference of transformer models at unprecedented scale. In SC22: International Conference for High Performance Computing, Networking, Storage and Analysis, pages 1–15. IEEE, 2022. [4] Luca Beurer-Kellner, Marc Fischer, and Martin Vechev. Prompting is programming: A query language for large language models. Proceedings of the ACM on Programming Languages, 7(PLDI):1946–1969, 2023. [5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877–1901, 2020. [6] Sébastien Bubeck, Varun Chandrasekaran, Ronen Eldan, Johannes Gehrke, Eric Horvitz, Ece Kamar, Peter Lee, Yin Tat Lee, Yuanzhi Li, Scott Lundberg, et al. Sparks of artificial general intelligence: Early experiments with gpt-4. arXiv preprint arXiv:2303.12712, 2023. [7] Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023.
[8] Wei-Lin Chiang, Lianmin Zheng, Ying Sheng, Anastasios Nikolas Angelopoulos, Tianle Li, Dacheng Li, Hao Zhang, Banghua Zhu, Michael Jordan, Joseph E Gonzalez, et al. Chatbot arena: An open platform for evaluating llms by human preference. arXiv preprint arXiv:2403.04132, 2024.
[9] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. arXiv preprint arXiv:2204.02311, 2022.
[10] Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
[11] Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, and Jianfeng Gao. Model tells you what to discard: Adaptive kv cache compression for llms. In The Twelfth International Conference on Learning Representations, 2023.
[12] In Gim, Guojun Chen, Seung-seob Lee, Nikhil Sarda, Anurag Khandelwal, and Lin Zhong. Prompt cache: Modular attention reuse for low-latency inference. arXiv preprint arXiv:2311.04934, 2023.
[13] Guidance AI. A guidance language for controlling large language models. https://github.com/guidance-ai/guidance. Accessed: 2023-11.
[14] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[15] Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, Michael W Mahoney, Yakun Sophia Shao, Kurt Keutzer, and Amir Gholami. Kvquant: Towards 10 million context length llm inference with kv cache quantization. arXiv preprint arXiv:2401.18079, 2024.
[16] Hugging Face. Text generation inference. https://github.com/huggingface/text-generation-inference. Accessed: 2023-11.
[17] Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024.
[18] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[19] Hao Kang, Qingru Zhang, Souvik Kundu, Geonhwa Jeong, Zaoxing Liu, Tushar Krishna, and Tuo Zhao. Gear: An efficient kv cache compression recipe for near-lossless generative inference of llm. arXiv preprint arXiv:2403.05527, 2024.
[20] Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: Compiling declarative language model calls into self-improving pipelines. arXiv preprint arXiv:2310.03714, 2023.
[21] Sehoon Kim, Suhong Moon, Ryan Tabrizi, Nicholas Lee, Michael W Mahoney, Kurt Keutzer, and Amir Gholami. An llm compiler for parallel function calling. arXiv preprint arXiv:2312.04511, 2023.
[22] Michael Kuchnik, Virginia Smith, and George Amvrosiadis. Validating large language models with relm. Proceedings of Machine Learning and Systems, 5, 2023.
[23] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. Efficient memory management for large language model serving with pagedattention. In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611-626, 2023.
[24] LangChain AI. Langchain. https://github.com/langchain-ai/langchain. Accessed: 2023-11.
[25] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. Competition-level code generation with alphacode. Science, 378(6624):1092-1097, 2022.
[26] Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Xingyu Dang, and Song Han. Awq: Activation-aware weight quantization for llm compression and acceleration. arXiv preprint arXiv:2306.00978, 2023.
[27] Haotian Liu, Chunyuan Li, Yuheng Li, and Yong Jae Lee. Improved baselines with visual instruction tuning. arXiv preprint arXiv:2310.03744, 2023.
[28] Haotian Liu, Chunyuan Li, Yuheng Li, Bo Li, Yuanhan Zhang, Sheng Shen, and Yong Jae Lee. Llava-next: Improved reasoning, ocr, and world knowledge, Januar 2024.
[29] Shu Liu, Asim Biswal, Audrey Cheng, Xiangxi Mo, Shiyi Cao, Joseph E Gonzalez, Ion Stoica, and Matei Zaharia. Optimizing llm queries in relational workloads. arXiv preprint arXiv:2403.05821, 2024.
[30] Xiaoxia Liu, Jingyi Wang, Jun Sun, Xiaohan Yuan, Guoliang Dong, Peng Di, Wenhai Wang, and Dongxia Wang. Prompting frameworks for large language models: A survey. arXiv preprint arXiv:2311.12785, 2023.
[31] Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, and Anshumali Shrivastava. Scissorhands: Exploiting the persistence of importance hypothesis for llm kv cache compression at test time. Advances in Neural Information Processing Systems, 36, 2024.
[32] Zirui Liu, Jiayi Yuan, Hongye Jin, Shaochen Zhong, Zhaozhuo Xu, Vladimir Braverman, Beidi Chen, and Xia Hu. Kivi: A tuning-free asymmetric 2bit quantization for kv cache. arXiv preprint arXiv:2402.02750, 2024.
[33] Xuefei Ning, Zinan Lin, Zixuan Zhou, Zifu Wang, Huazhong Yang, and Yu Wang. Skeleton-of-thought: Prompting LLMs for efficient parallel generation. In The Twelfth International Conference on Learning Representations, 2024.
[34] NVIDIA. Tensorrt-llm. https://github.com/NVIDIA/TensorRT-LLM. Accessed: 2023-11.
[35] OpenAI. Gpt-4 technical report, 2023.
[36] Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior. In In the 36th Annual ACM Symposium on User Interface Software and Technology (UIST '23), UIST '23, New York, NY, USA, 2023. Association for Computing Machinery.
[37] Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, et al. Pytorch: An imperative style, high-performance deep learning library. Advances in neural information processing systems, 32, 2019.
[38] Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023.
[39] Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. Efficiently scaling transformer inference. Proceedings of Machine Learning and Systems, 5, 2023.
[40] Swarnadeep Saha, Omer Levy, Asli Celikyilmaz, Mohit Bansal, Jason Weston und Xian Li. Branch-solve-merge verbessert die Evaluation und Generierung großer Sprachmodelle. arXiv preprint arXiv:2310.15123, 2023.
[41] Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda und Thomas Scialom. Toolformer: Sprachmodelle können sich selbst beibringen, Werkzeuge zu verwenden. arXiv preprint arXiv:2302.04761, 2023.
[42] Ying Sheng, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E Gonzalex und Ion Stoica. Fairness beim Bedienen großer Sprachmodelle. arXiv preprint arXiv:2401.00588, 2023.
[43] Ying Sheng, Lianmin Zheng, Binhang Yuan, Zhuohan Li, Max Ryabinin, Beidi Chen, Percy Liang, Christopher Ré, Ion Stoica und Ce Zhang. Flexgen: Generatives Inferenzverfahren mit hohem Durchsatz für große Sprachmodelle auf einer einzelnen GPU. In International Conference on Machine Learning, Seiten 31094-31116. PMLR, 2023.
[44] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper und Bryan Catanzaro. Megatron-lm: Training von Sprachmodellen mit mehreren Milliarden Parametern mittels Modellparallelismus. arXiv preprint arXiv:1909.08053, 2019.
[45] Vikranth Srivatsa, Zijian He, Reyna Abhyankar, Dongming Li und Yiying Zhang. Preble: Effiziente verteilte Prompt-Planung für die Bereitstellung von LLMs. 2024.
[46] Theodore Sumers, Shunyu Yao, Karthik Narasimhan und Thomas Griffiths. Cognitive architectures for language agents. Transactions on Machine Learning Research, 2023.
[47] Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: a family of highly capable multimodal models. arXiv preprint arXiv:2312.11805, 2023.
[48] Philippe Tillet, Hsiang-Tsung Kung und David Cox. Triton: an intermediate language and compiler for tiled neural network computations. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, Seiten 10-19, 2019.
[49] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: Open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
[50] Vivien Tran-Thien. Fast, high-fidelity llm decoding with regex constraints, 2024.
[51] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser und Illia Polosukhin. Attention is all you need. Advances in neural information processing systems, 30, 2017.
[52] Guanzhi Wang, Yuqi Xie, Yunfan Jiang, Ajay Mandlekar, Chaowei Xiao, Yuke Zhu, Linxi Fan und Anima Anandkumar. Voyager: An open-ended embodied agent with large language models. arXiv preprint arXiv: arXiv:2305.16291, 2023.
[53] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc V Le, Ed H Chi, Sharan Narang, Aakanksha Chowdhery und Denny Zhou. Self-consistency improves chain of thought reasoning in language models. In The Eleventh International Conference on Learning Representations, 2022.
[54] Brandon T Willard und Rémi Louf. Efficient guided generation for large language models. arXiv e-prints, Seiten arXiv-2307, 2023.
[55] Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang und Chi Wang. Autogen: Enabling next-gen llm applications via multi-agent conversation framework. arXiv preprint arXiv:2308.08155, 2023.
[56] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L Griffiths, Yuan Cao und Karthik Narasimhan. Tree of thoughts: Deliberate problem solving with large language models. arXiv preprint arXiv:2305.10601, 2023.
[57] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik R Narasimhan und Yuan Cao. React: Synergizing reasoning and acting in language models. In The Eleventh International Conference on Learning Representations, 2022.
[58] Lu Ye, Ze Tao, Yong Huang und Yang Li. Chunkattention: Efficient self-attention with prefix-aware kv cache and two-phase partition. arXiv preprint arXiv:2402.15220, 2024.
[59] Zihao Ye, Lequn Chen, Ruihang Lai, Yilong Zhao, Size Zheng, Junru Shao, Bohan Hou, Hongyi Jin, Yifei Zuo, Liangsheng Yin, Tianqi Chen und Luis Ceze. Accelerating self-attentions for llm serving with flashinfer, Februar 2024.
[60] Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim und Byung-Gon Chun. Orca: A distributed serving system for {Transformer-Based} generative models. In 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), Seiten 521-538, 2022.
[61] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi und Yejin Choi. Hellaswag: Can a machine really finish your sentence? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Seiten 4791-4800, 2019.
[62] Yuanhan Zhang, Bo Li, haotian Liu, Yong jae Lee, Liangke Gui, Di Fu, Jiashi Feng, Ziwei Liu und Chunyuan Li. Llava-next: A strong zero-shot video understanding model, April 2024.
A Zusätzliche Details zu RadixAttention
A.1 Hintergrund zum KV-Cache
Die meisten heute verwendeten LLMs, wie GPT-3 [5], PaLM [9] und LLaMA [49], basieren auf der autoregressiven Transformer-Architektur [51]. Diese Modelle sagen die Wahrscheinlichkeit des nächsten Tokens in einer Sequenz auf Grundlage der vorangehenden Tokens voraus. Während der Inferenz verarbeitet das Modell zunächst eine Sequenz von Eingabe-Tokens in einem Vorwärtsdurchlauf (dieser Prozess wird „Prefill" genannt). Anschließend dekodiert es sequenziell Ausgabe-Tokens, wobei jedes Token von vorherigen Tokens abhängt (dieser Prozess wird „Decoding" genannt). Wir bezeichnen den Prozess, eine Sequenz von Eingabe-Tokens zu nehmen und eine Sequenz von Ausgabe-Tokens zu erzeugen, als einen einzelnen Generierungsaufruf. Während dieses Prozesses erzeugt jedes Token einige intermediäre Tensoren, die zur Dekodierung weiterer Tokens verwendet werden. Diese intermediären Tensoren, bekannt als der „KV-Cache", sind nach den Key-Value-Paaren im Self-Attention-Mechanismus benannt. Eine wichtige Beobachtung bei der Erörterung von Optimierungen in diesem Artikel ist, dass die Berechnung des KV-Cache nur von allen vorherigen Tokens abhängt, sodass verschiedene Sequenzen mit demselben Präfix den KV-Cache der Präfix-Tokens wiederverwenden und redundante Berechnungen vermeiden können.
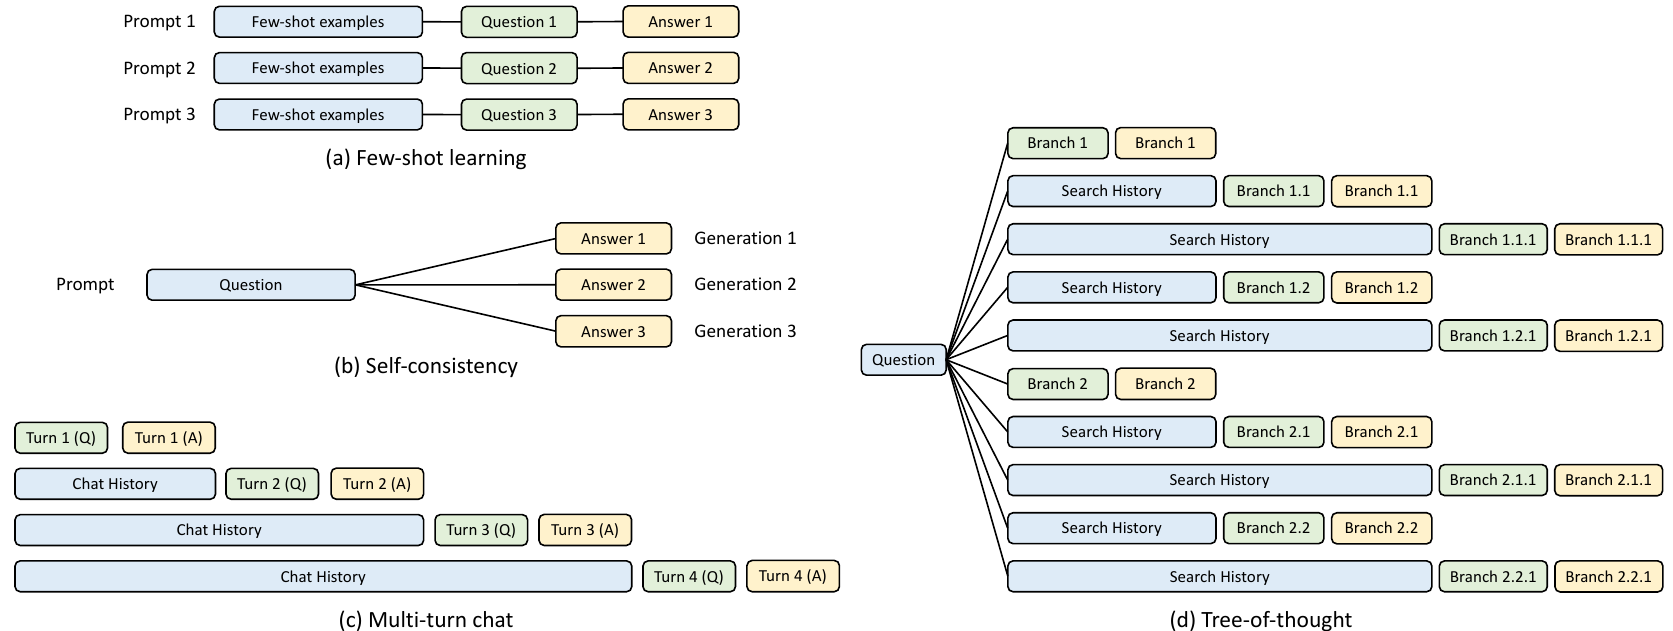
Häufig werden in LLM-Programmen mehrere Textsegmente und Generierungsaufrufe an einen einzelnen Prompt angehängt. Das Zwischenspeichern des berechneten KV-Cache für vorherige Tokens über mehrere verkettete Aufrufe hinweg kann redundante Berechnungen reduzieren. Diese Optimierung ist jedoch weder kostenlos noch trivial, da sie zusätzlichen Speicher und eine komplexere Speicherverwaltung erfordert. Darüber hinaus ist es in LLM-Programmen üblich, mehrere Ausgaben aus einem einzelnen Prompt zu generieren oder einen neuen Prompt vom aktuellen Zustand abzuzweigen [25]. Grundlegendes Präfix-Sharing wurde in vLLM [23] untersucht. Auch fortgeschrittenere Sharing-Muster wie unregelmäßiges baumstrukturiertes Sharing können eingesetzt werden. Abb. 9 zeigt vier typische Muster des KV-Cache-Sharings über mehrere Aufrufe hinweg; keines der bestehenden Systeme kann alle automatisch handhaben. Im Gegensatz dazu kann unser RadixAttention in Abschnitt 3 alle diese zur Laufzeit automatisch handhaben.
A.2 Pseudocode für cachebewusste Planung
Algorithmus 1 zeigt den Pseudocode der cachebewussten Planung für RadixAttention mit kontinuierlichem Batching.
A.3 Beweis von Theorem 3.1
Theorem 3.1. Für eine Charge von Anfragen können wir eine optimale Cache-Trefferrate erreichen, indem wir den Radix-Baum der Anfragen in der Reihenfolge einer Tiefensuche durchlaufen, mit einer Cache-Größe der maximalen Anfragelänge. Die Reihenfolge „längstes gemeinsam genutztes Präfix zuerst" ist äquivalent zu einer Tiefensuche-Reihenfolge.
Beweis. Zunächst zeigen wir, dass die Tiefensuche-Reihenfolge (DFS) eine optimale Cache-Trefferrate erreicht. Sei die Menge der Anfragen in der Charge und der aus aufgebaute Radix-Baum. Für jede Kante von muss der zu gehörende KV-Cache mindestens einmal berechnet werden. Sei die Größe des zu gehörenden KV-Cache. Sei die Rechenkomplexität des KV-Cache für .
Algorithmus 1 Cache-bewusste Planung für RadixAttention mit kontinuierlichem Batching.Eingabe: Der Radix-Baum , der Speicherpool , der aktuell laufende Batch , die Warteschlange .Ausgabe: Abgeschlossene Anfragen und aktualisierter Systemzustand.// Alle Anfragen aus der Warteschlange abrufenrequests .get_all_requests()// Für alle wartenden Anfragen die passende Präfixübereinstimmung suchenfor req requests doreq.prefix_node, req.prefix_len .match_prefix(req.input_tokens)end for// Die Anfragen gemäß den übereinstimmenden Präfixlängen sortierenrequests.sort()// Anfragen für den nächsten Batch auswählenavailable_size .evitable_size() + .available_size()current_size new_batch for req requests doif req.size() + current_size available_size thennew_batch.append(req)delta .increase_ref_counter(req.prefix_node)available_size available_size + deltaend ifend forQ.remove_requests(new_batch)// Anfragen in den aktuell laufenden Batch einfügenB.merge(new_batch)// Neuen Speicher zuweisen und bei Bedarf Verdrängung durchführenneeded_size .needed_size()success,buffer .alloc(needed_size)if not success thenT.evict(needed_size)success,buffer .alloc(needed_size)end ifB.run(buffer)// Abgeschlossene Anfragen verarbeitenfinished_requests .drop_finished_requests()for req finished_requests doT.decrease_ref_counter(req.prefix_node)T.insert(req)end forreturn finished_requestsWir erhalten die untere Schranke
Betrachten wir, dass wir den Radix-Baum in DFS-Reihenfolge besuchen. Für jede Kante von berechnen wir, wenn wir zum ersten Mal den zu gehörenden KV-Cache berechnen, anschließend den gesamten Teilbaum von . Während der Berechnung des Teilbaums von wird die Kante kontinuierlich getroffen, sodass keine zusätzliche Berechnung erfolgt. Nach Abschluss der Berechnung für den in wurzelnden Teilbaum wird die Kante nicht erneut besucht. Beachten Sie, dass bei einer Cache-Größe der maximalen Anfragelänge, die dem längsten Pfad im Radix-Baum entspricht, die Kante während der Berechnung ihres Teilbaums nicht verdrängt wird, da das gemeinsame Präfix einschließlich des Teilbaums kontinuierlich getroffen wird. Daher wird der zu jeder Kante gehörende KV-Cache nur einmal berechnet. Somit erreichen wir die untere Schranke
Die Cache-Trefferrate, definiert als
gleich , erreicht ihre obere Schranke und liefert Optimalität.
Als Nächstes zeigen wir durch Induktion, dass die Reihenfolge „längster gemeinsam genutzter Präfix zuerst“ äquivalent zu einer DFS-Reihenfolge ist.
- (Basisfall) Zu Beginn wird, da nichts zwischengespeichert ist, eine zufällige Anfrage, die einem Knoten in entspricht, verarbeitet. Alle Anfragen, die den Knoten auf dem Pfad von der Wurzel zu entsprechen, benötigen keine Neuberechnung. Die Berechnungskomplexität für Anfragen, die den Knoten entsprechen, stimmt mit einer gültigen DFS überein. Der Pfad von der Wurzel zu ist zwischengespeichert.
- (Induktionsschritt) Nehmen wir an, wir haben gerade einen Knoten in besucht, und die besuchten Knoten stimmen mit einer DFS-Reihenfolge überein. Sei der Pfad von der Wurzel zu . Dann hat jeder Knoten, der noch nicht besucht wurde, seinen niedrigsten gemeinsamen Vorfahren mit den besuchten Knoten auf . Da die Knoten auf zwischengespeichert sind, wird ein noch nicht besuchter Knoten , dessen niedrigster gemeinsamer Vorfahre auf liegt, den längsten gemeinsam genutzten Präfix haben. Die Reihenfolge „längster gemeinsam genutzter Präfix zuerst“ wird auswählen, was einer gültigen DFS-Reihenfolge entspricht. Der Pfad von der Wurzel zu wird zwischengespeichert, da er der zuletzt verwendete ist.
Im Online-Fall wird die DFS-Reihenfolge gestört, aber die Zeitplanung nach dem längsten gemeinsam genutzten Präfix approximiert weiterhin das DFS-Verhalten auf dem erweiterten Teil des impliziten Radixbaums. Wir zeigen dies, indem wir den Schritt des Hinzufügens eines neuen Stapels von Anfragen betrachten.
Sei der Teil des Radixbaums, der bisher besucht wurde, und der gesamte neue Radixbaum nach dem Hinzufügen des neuen Stapels von Anfragen. Sei die Menge der zwischengespeicherten Knoten in . Sei longest der Knoten in , der den längsten Pfad von der Wurzel hat und einen Teilbaum in besitzt, der noch nicht vollständig besucht wurde.
Die Zeitplanung nach dem längsten gemeinsam genutzten Präfix wird dann den Teilbaum in , der bei longest verwurzelt ist, in einer DFS-Reihenfolge verarbeiten. Während dieses Prozesses kann eine Verdrängung auftreten, und die verbleibenden zwischengespeicherten Knoten aus werden zu . Anschließend erfolgt eine DFS für den Teilbaum in , der bei longest verwurzelt ist.
In gleicher Weise erhalten wir , bis nur noch einen Blattknoten in enthält, dessen Teilbaum in nicht vollständig besucht wurde. An diesem Punkt haben wir einen gültigen DFS-Zustand erreicht. Der verbleibende Teil von wird in DFS-Reihenfolge besucht, wie im Beweis von Theorem 3.1 beschrieben.
A.4 Datenparallele verteilte RadixAttention
Um die RadixAttention an verteilte Umgebungen mit mehreren Replica-Workern (d. h. Datenparallelität) anzupassen, haben wir einen Mechanismus entwickelt, bei dem jeder Worker seinen eigenen Teilbaum verwaltet, während der Router einen Meta-Baum überwacht. Dieser Meta-Baum fungiert als Trie, der alle Teilbäume und ihre zugehörigen Geräte verfolgt. Bei der Ankunft eines neuen Stapels von Anfragen am Router wird der Präfixabgleich auf dem Meta-Baum ausgeführt. Wir implementieren verschiedene Richtlinien basierend auf der Affinität jeder Anfrage – gemessen an der Länge des gemeinsam genutzten Präfixes mit bestimmten Workern und anderen Anfragen in derselben Gruppe –, um effiziente Dispatch-Entscheidungen zu treffen, die redundante Berechnungen minimieren. Jedes Mal, wenn neue Anfragen verarbeitet werden, aktualisieren sowohl der Router als auch die Worker unabhängig voneinander ihre jeweiligen Bäume. Sollte bei einem Worker-Knoten eine Verdrängung auftreten, übergibt er diese an eine Warteschlange, die der Router dann verarbeitet, um den Meta-Baum in Zeiten geringer Aktivität zu aktualisieren. Wir haben diese verteilte Konfiguration mit vier Workern und dem MMLU-Datensatz evaluiert und festgestellt, dass sie lineare Skalierung und eine optimale Cache-Trefferrate mit minimalem Overhead durch dieses schwach konsistente verteilte Cache-Design erreicht. Es besteht ein Zielkonflikt zwischen der Maximierung der Datenlokalität und der Effizienz der parallelen Verarbeitung. Die Erforschung fortgeschrittener Scheduling-Richtlinien zur Optimierung dieses Zielkonflikts ist als Bereich für zukünftige Forschung vorgesehen. Darüber hinaus untersucht eine parallele Arbeit von Preble [45] datenparalleles Scheduling basierend auf einer frühen Version von SGLang.
B Weitere Details zum komprimierten endlichen Automaten
Dieser Abschnitt behandelt den Hintergrund und die Implementierungsdetails des komprimierten endlichen Automaten für eine schnellere eingeschränkte Dekodierung. Wir streben an, dass LLMs einem regulären Ausdruck (Regex) folgen, der eine größere Ausdruckskraft bietet und zur Darstellung gängiger Formate wie JSON-Schemata verwendet werden kann. Um dies zu erreichen, konvertieren wir den Regex in einen endlichen Automaten (Finite State Machine, FSM), um den Generierungsprozess während der Dekodierung zu steuern [54]. Eine FSM ist im Wesentlichen ein Graph mit Knoten (Zuständen) und Kanten (Übergängen mit Zeichenketten/Zeichen). Ausgehend von einem Anfangszustand wird bei jedem Übergang die Zeichenkette auf der Kante angehängt, um zum nächsten Zustand zu gelangen, wobei eine Menge von Endzuständen verwendet wird, um den Prozess abzuschließen. Dieser Mechanismus steuert die Dekodierung eines LLMs und filtert ungültige Token basierend auf den Übergängen des aktuellen FSM-Zustands heraus, wie in Abb. 10 dargestellt. Die Dekodierung kann mehrere Übergänge in der FSM umfassen, bis ein Endzustand erreicht ist.
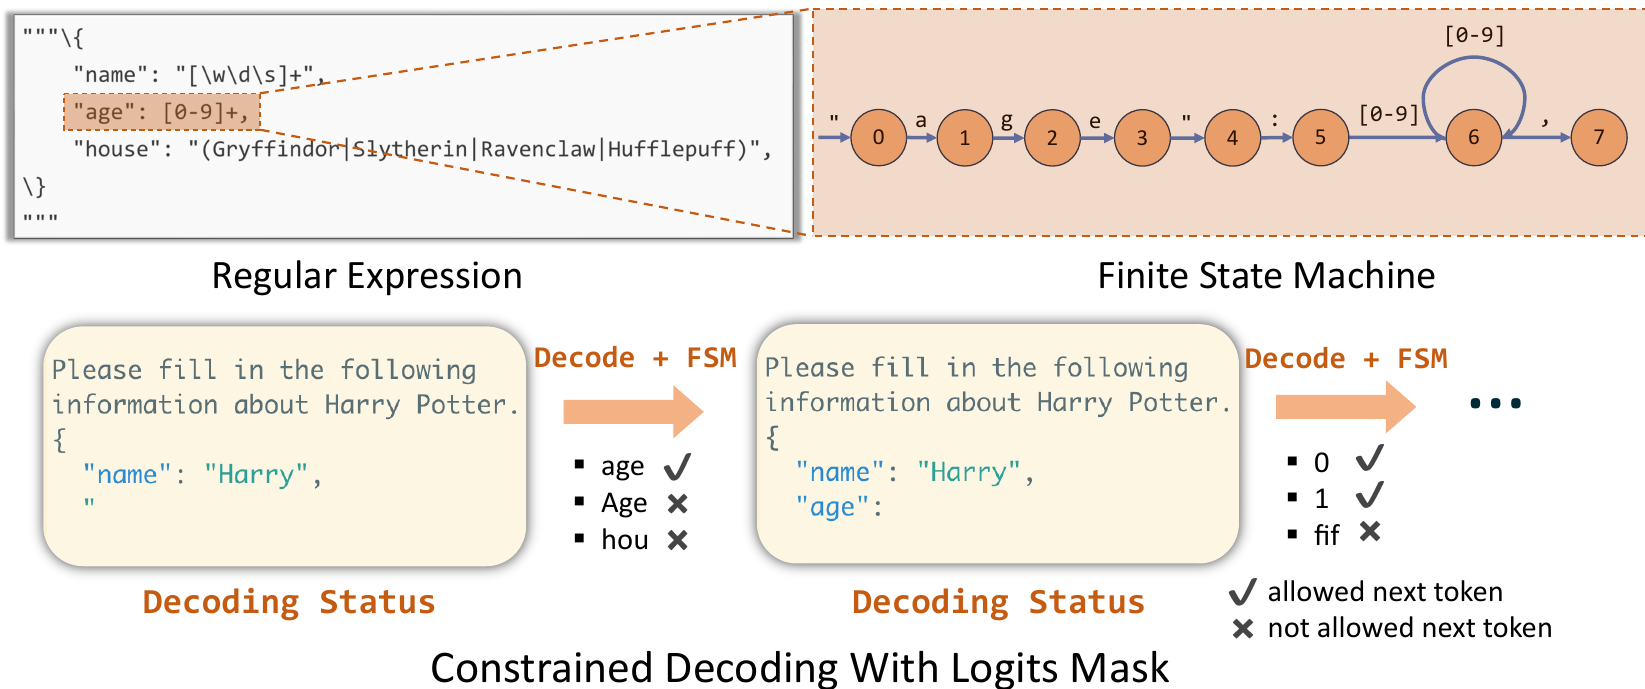
Die Herausforderung der eingeschränkten Dekodierung ergibt sich aus der Tatsache, dass Einschränkungen häufig in natürlichen Sprachformaten ausgedrückt werden, d. h., Regex wird durch Zeichen/Zeichenketten dargestellt, während LLMs darauf ausgelegt sind, diese als Token zu interpretieren und zu verarbeiten. Dies schafft ein komplexes Szenario, da die Abbildung zwischen Zeichenketten und Token kompliziert ist und keine Eins-zu-eins-Entsprechung aufweist [22].
Dieser Abschnitt basiert auf einem früheren Blogbeitrag4. Lesern wird außerdem empfohlen, den Blogbeitrag für zusätzlichen Hintergrund und ein leichteres Verständnis zu lesen.
B.1 Implementierungsdetails des komprimierten endlichen Automaten
Um die Konstruktion des komprimierten FSM zu vereinfachen, erstellen wir die ursprüngliche FSM auf Zeichen/Zeichenketten anstelle von Token. Wir definieren die Konzepte der singulären Übergangskante und der komprimierten Kante formal wie folgt:
- Singuläre Übergangskante: Eine Kante ist eine singuläre Übergangskante, wenn 1) ihr Quellknoten nur einen Nachfolgeknoten hat und 2) es nur ein akzeptables Zeichen/eine akzeptable Zeichenkette auf ihr gibt.- Komprimierte Kante: Eine Kante, die durch mehrere aufeinanderfolgend benachbarte Kanten komprimiert wird, genau dann, wenn singuläre Übergangskanten sind. Der Text der komprimierten Kante ist die Verkettung der Texte von .
Ausgehend von einer FSM auf Zeichenbasis führen wir rekursiv Zusammenführungen singulärer Übergangskanten in ihre vorangehenden Kanten durch, bis eine weitere Komprimierung nicht mehr möglich ist, was zu einer komprimierten FSM führt. Dieser Ansatz beschleunigt den Dekodierungsprozess, wie die Laufzeiteffizienz von SGLang mit der komprimierten FSM in Abb. 11 zeigt.
B.2 Behandlung von Tokenisierungsartefakten durch Retokenisierung
Wenn ein neues Token generiert wird, erhalten wir die Zeichenkette des Tokens und durchsuchen alle ausgehenden Kanten des aktuellen Zustands, um diejenige zu finden, die mit der gerade dekodierten Zeichenkette beginnt, und gehen dann vorwärts. Wenn jedoch die Übergangskante eine gut komprimierte ist und eine sehr lange Zeichenkette enthält, können wir auch die dekodierten Zeichenketten der nächsten Runden vorwegnehmen. Hier findet die Beschleunigung statt, und wir nennen diesen Prozess Jump Forward. Allerdings müssen wir die Zeichenkette noch für die nächsten Dekodierungsphasen in Token umwandeln, und dies ist aufgrund der spezifischen Vortrainings- und Tokenisierungsmethode des LLMs nicht unkompliziert;
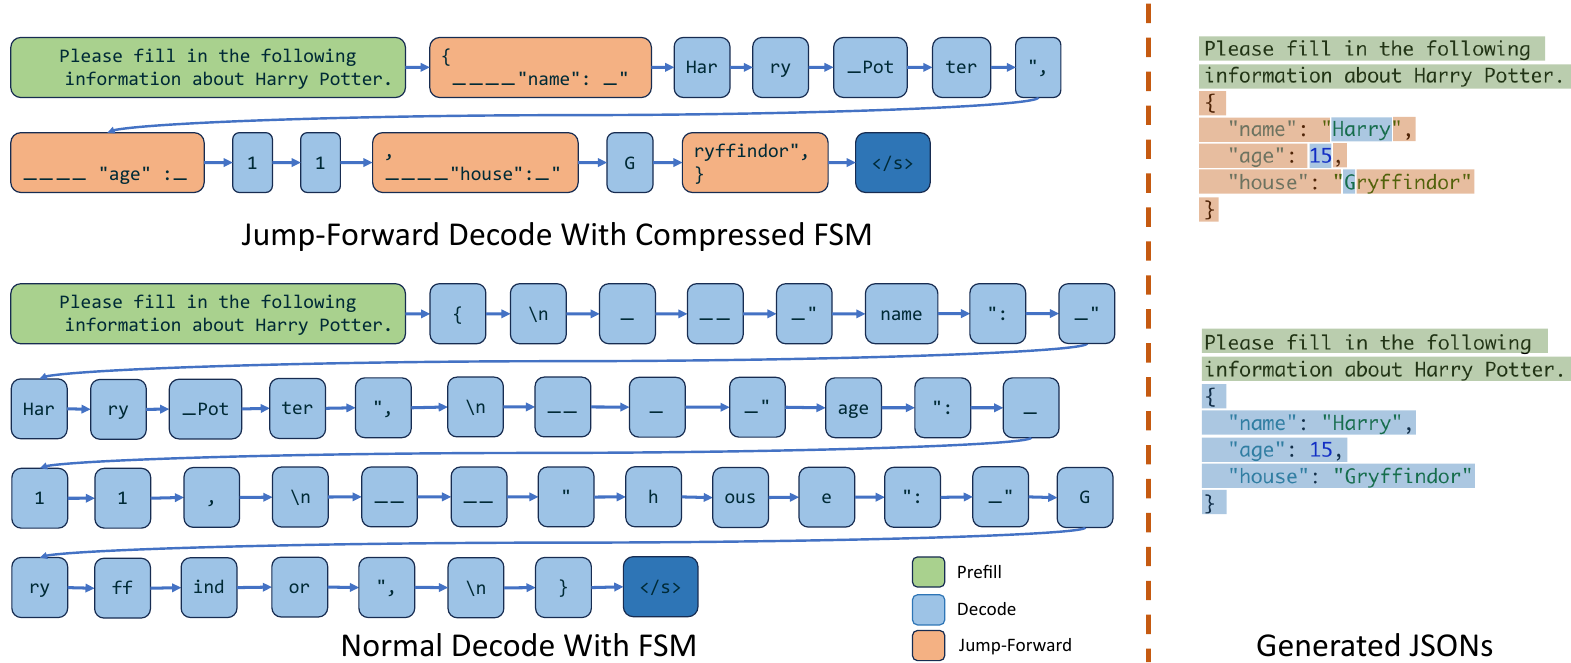
eine direkte Aufteilung könnte die beabsichtigte Bedeutung verändern [50]. Beispielsweise ist der komprimierte Text im Regex von Abb. 2 {"summary": ", der gemäß dem Tokenizer nur als {"summary,": und " tokenisiert werden kann, anstatt sie zufällig aufzuteilen wie etwa {"summa, ry, und ".: Um dieses Problem zu beheben, verwenden wir den ursprünglichen Tokenizer, um sowohl den gesamten vorherigen Text als auch den Text der komprimierten Kante erneut zu tokenisieren, wodurch die Übereinstimmung mit dem ursprünglichen Eingabeformat der LLMs sichergestellt wird. Und dies verursacht nur geringen Retokenisierungs-Overhead.
B.3 Zukünftige Erweiterung: Umgang mit verzerrten Wahrscheinlichkeiten
Die durch die Kluft zwischen Strings und Tokens verursachte Herausforderung bringt auch das Problem der verzerrten Wahrscheinlichkeitsverteilung mit sich [50]. In Abb. 2 beispielsweise legt der Regex „[ABCD] [+- ]?" Noten von A+ bis D- nahe, aber wenn er durch breitere Begriffe wie Excellent | Above Average | Fair | Below Average ersetzt wird, könnte die Laufzeitumgebung ein A fälschlicherweise Above Average zuordnen, da der Begriff Above Average auf einem komprimierten Übergang liegt, wodurch die Notenhierarchie falsch dargestellt wird. Dies geschieht, weil das LLM den spezifischen Bereich der Auswahlmöglichkeiten nicht erkennt, was zu unangemessenen Token-Sequenzen führt. Die Berechnung exakter Wahrscheinlichkeiten für jede Auswahl erfordert die Summierung der Wahrscheinlichkeiten aller Token-Sequenzen, die zu jeder Auswahl führen, was das Decoding verkompliziert und zusätzlichen Overhead verursacht. Ein Workaround besteht darin, die Auswahlmöglichkeiten oder den Regex direkt in den Prefill-Prompt aufzunehmen und das LLM so anzuleiten, sich seiner Auswahlmöglichkeiten bewusst zu sein und die Entscheidung in geeigneten Token-Sequenzen auszugeben. Dieser Ansatz löst jedoch nicht das zugrunde liegende Problem der verzerrten Wahrscheinlichkeiten, was die Notwendigkeit weiterer Forschung zur Verbesserung der Genauigkeit des komprimierten FSM unterstreicht.
C Zusätzliche experimentelle Setups und Ergebnisse
Zusätzliche experimentelle Setups. Abb. 5 und Abb. 6 wurden durch Ausführung von Llama- 7B auf einer einzelnen A10G (24GB) GPU erhalten. Abb. 7 wurden durch Ausführung von Mixtral- 8x7B auf 8 A10G (24GB) GPUs mit Tensor-Parallelität erhalten. Abb. 8(c) wurde durch Ausführung von Llama- 7B auf einer einzelnen A10G (24GB) GPU erhalten. Abb. 12 wurden durch Ausführung von Llama- 70B auf 4 A100G (80GB) GPUs mit Tensor-Parallelität erhalten. Tabelle 2 wurde durch Ausführung von LLaVA- v1.5- 7B auf einer einzelnen A10G (24GB) GPU und Ausführung von LLaVA- Next- 34B auf einer einzelnen A100G (80GB) GPU erhalten. Jeder Balken in den Benchmark-Abbildungen benötigt mehrere Minuten bis eine Stunde Laufzeit.
Zusätzliche experimentelle Ergebnisse. Abb. 13 zeigt die erzielten und optimalen Cache-Trefferraten auf den in Abb. 5 aufgeführten Benchmarks. Abb. 12 zeigt den Durchsatz auf Llama- 2- 70B mit Tensor-Parallelität.
D Compiler-Modus
Neben dem im Hauptteil des Papiers verwendeten Interpreter-Modus besteht eine weitere Möglichkeit, SGLang-Programme auszuführen, darin, sie als Berechnungsgraphen zu kompilieren und mit einem Graph-Executor auszuführen. Dies eröffnet
Möglichkeiten für weitere Kompilierungsoptimierungen, da wir den Graphen umschreiben und eine stärker statische Planung durchführen können.
D.1 Design und Implementierung
Wir haben eine Zwischendarstellung (Intermediate Representation, IR) für SGLang entworfen, die die Programmstrukturen und -operationen von SGLang als Berechnungsgraphen darstellt. Dieser Graph umfasst Knoten für primitive Operatoren und Kanten für Abhängigkeiten. Siehe Abb. 14b für den Graphen, der dem Programm in Abb. 14a entspricht. Im Programm erzeugt jeder Aufruf einer dekorierten Funktion oder eines fork einen neuen Prompt-Zustand oder einen Stream.
Es gibt verschiedene Arten von Knoten. Jeder Operand der Operatoren und in einem SGLang-Programm wird durch einen IR-Knoten repräsentiert. Dazu gehören ConstantText, Argument, Gen, Select, Variable, Fork, GetForkItem und Join. Es gibt zwei Arten von Abhängigkeiten: Intra-Stream-Abhängigkeit, bei der Operationen, die über in einen Stream eingereicht werden, nach allen vorhergehenden Operationen in diesem Stream ausgeführt werden müssen, und Inter-Stream-Abhängigkeit, die auftritt, wenn ein Stream Variablenwerte aus einem anderen Stream abrufen muss, was eine Synchronisierung erfordert. Operationen wie fork manipulieren mehrere Streams und führen somit Inter-Stream-Abhängigkeiten ein.
Um den Graphen zu erzeugen, verwenden wir Tracing, um das Programm mit abstrakten Argumenten auszuführen und den Graphen dynamisch zu konstruieren. Diese Methode ist auf Programme ohne datenabhängige Kontrollflüsse beschränkt, eine Einschränkung, die wir in zukünftiger Arbeit adressieren wollen. Nach der Konstruktion kann der Graph durch einen Graph-Executor ausgeführt werden, wodurch die Notwendigkeit entfällt, das ursprüngliche Python-Programm erneut zu interpretieren. Dies führt zu Vorteilen wie Graph-Umschreibungsoptimierungen, reduziertem Laufzeit-Overhead und Programmserialisierung. Für die Ausführung werden Stream-Executors für jeden Datenstrom gestartet, die IR-Knoten in topologischer Reihenfolge an die Streams verteilen.
D.2 Eine Fallstudie zur Compiler-Optimierung: Codebewegung zur Verbesserung der Prefix-Freigabe
Wir untersuchen eine Compiler-Optimierung für SGLang IR: Codebewegung zur Verbesserung der Prefix-Freigabe. Wir erwarten, dass auch weitere klassische Compiler-Techniken angewendet werden können, wie etwa Auto-Tuning und Instruktionsauswahl.
Diese Optimierung zielt darauf ab, die Prefix-Freigabe zu verbessern, indem die Knoten im Graphen neu angeordnet werden, um die Länge des konstanten Präfixes zu erhöhen. Sie bewahrt die ursprüngliche Berechnung nicht strikt, weshalb sie als aggressive Optimierung eingestuft wird. Wenn beispielsweise der Prompt von „Here is a question + {question}. Please act as a math expert and solve the given question.“ zu „Please act as a math expert and solve the given question. Here is a question + {question}.“ geändert wird, ergibt sich ein längerer gemeinsam nutzbarer Präfix. Diese Optimierung ist interessant, weil traditionelle Programmanalyse sie aufgrund des Vorhandenseins natürlicher Sprachinstruktionen in SGLang nicht erreichen kann. Stattdessen fordern wir GPT-4 auf, die Graphknoten neu anzuordnen. Wir schreiben einen Prompt mit mehreren Beispielen, um GPT-4 die Konzepte von SGLang IR beizubringen, und stellen fest, dass GPT-4 diese Optimierung für einige einfache SGLang-Programme erfolgreich anwenden kann.
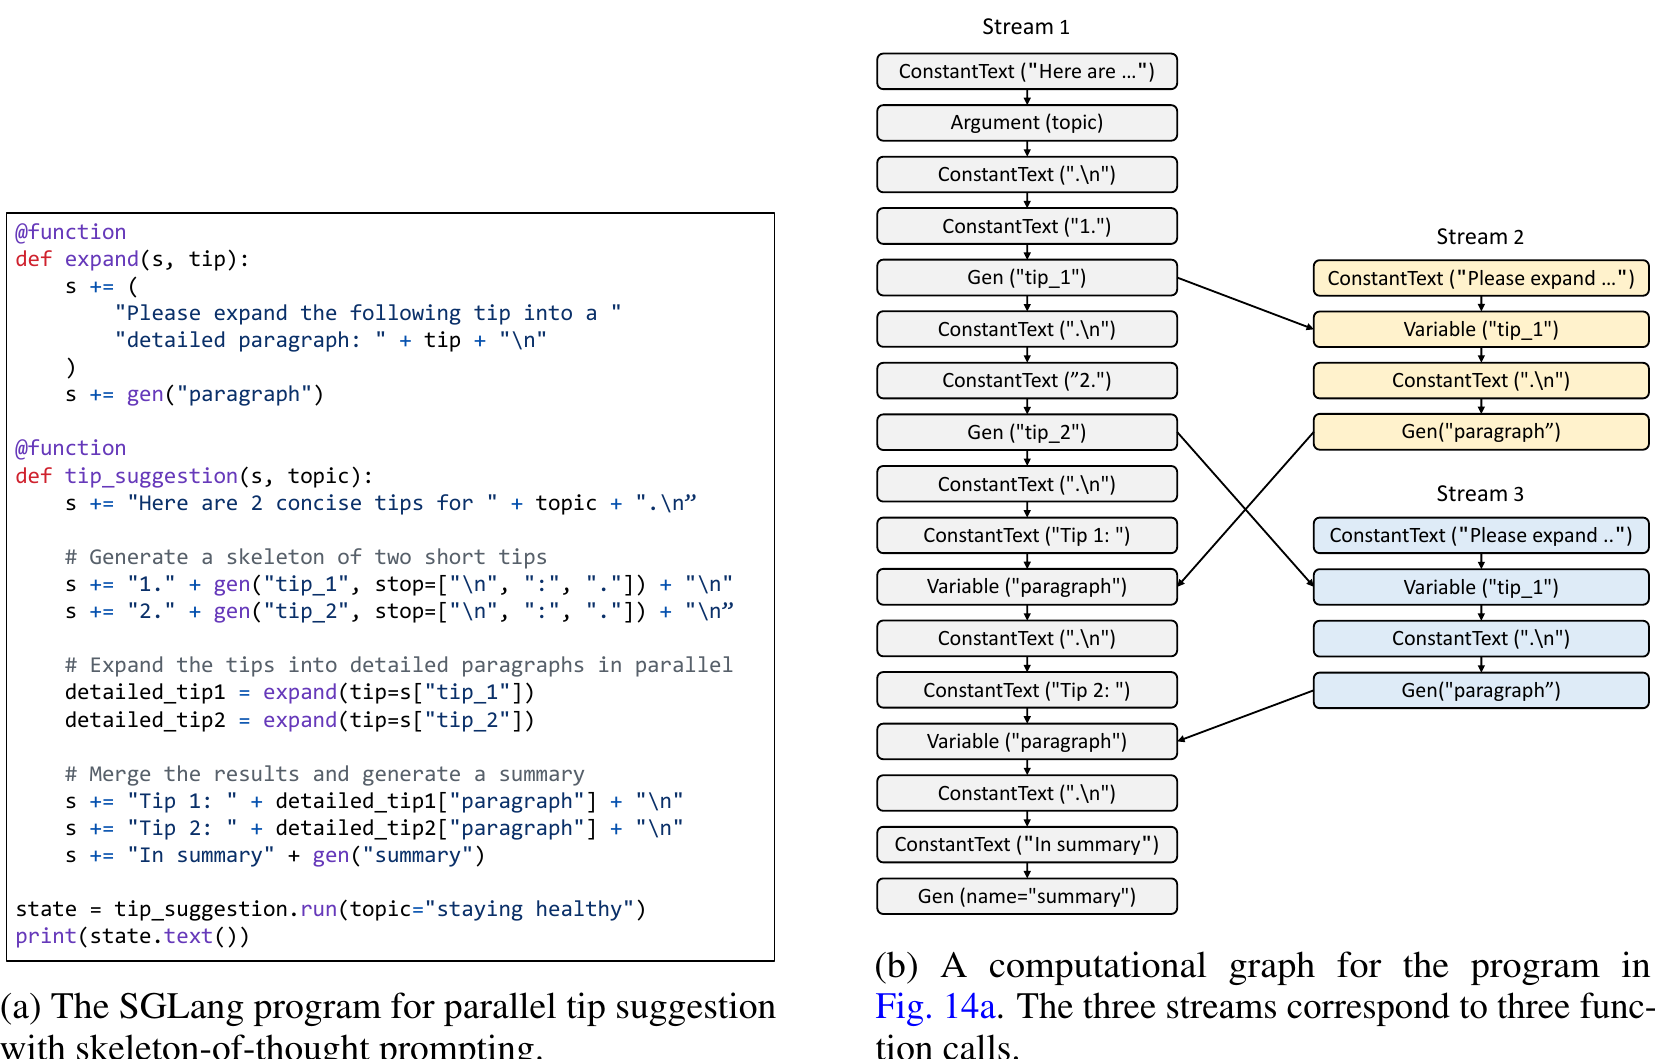
Wir evaluieren die Wirksamkeit dieser Optimierung. Wir sammeln 20 Prompt-Vorlagen aus dem Internet und implementieren sie in SGLang. Wir verwenden 5 dieser Vorlagen als Few-Shot-Trainingsbeispiele und die übrigen 15 als Testfälle. Unsere Evaluation zeigt, dass GPT-4 für 12 der 15 Vorlagen die Graphknoten erfolgreich neu anordnet, ohne die Semantik zu verändern, was durch manuelle Prüfung der modifizierten Prompts bestätigt wurde. Im Durchschnitt führt diese Optimierung zu einer Erhöhung der Länge des gemeinsam nutzbaren Präfixes um 60 Token, was die Wirksamkeit von GPT-4 verdeutlicht. Fehlschläge beim Erzeugen einer optimierten Prompt-Reihenfolge beruhen auf einem falschen Verständnis der semantischen Bedeutung hinter den Graphknoten. Sie ist zu aggressiv und stellt alle Konstanten an den Anfang, selbst wenn eine solche Anordnung die ursprüngliche Semantik verändert. Diese Fallstudie zielt darauf ab, die Verwendung von GPT-4 für Compiler-Optimierungen zu untersuchen. Es sind weitere Arbeiten erforderlich, um diese Art von Optimierungen in Zukunft zuverlässig zu machen.