
Ein Agent, der alles vergisst, hilft nicht. Mem0 behält Wichtiges zwischen Sitzungen und senkt die p95-Latenz um 91 Prozent. Papier 2025, kostenlos.
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
MemO: Produktionsreife KI-Agenten mit skalierbarem Langzeitgedächtnis aufbauen
Prateek Chhikara, Dev Khant, Saket Aryan, Taranjeet Singh und Deshraj Yadavresearch@memO.ai
memO
Große Sprachmodelle (LLMs) haben bemerkenswerte Fähigkeiten bei der Generierung kontextuell kohärenter Antworten gezeigt, doch ihre festen Kontextfenster stellen grundlegende Herausforderungen für die Aufrechterhaltung von Konsistenz über längere sitzungsübergreifende Dialoge dar. Wir stellen MemO vor, eine skalierbare gedächtniszentrierte Architektur, die dieses Problem durch dynamisches Extrahieren, Konsolidieren und Abrufen relevanter Informationen aus laufenden Gesprächen adressiert. Auf dieser Grundlage schlagen wir zudem eine erweiterte Variante vor, die graphbasierte Gedächtnisrepräsentationen nutzt, um komplexe relationale Strukturen zwischen Gesprächselementen zu erfassen. Durch umfassende Evaluierungen auf dem LOCOM0-Benchmark vergleichen wir unsere Ansätze systematisch mit sechs Baseline-Kategorien: (i) etablierten gedächtniserweiterten Systemen, (ii) Retrieval-Augmented Generation (RAG) mit unterschiedlichen Chunk-Größen und -Werten, (iii) einem Vollkontext-Ansatz, der die gesamte Gesprächshistorie verarbeitet, (iv) einer Open-Source-Gedächtnislösung, (v) einem proprietären Modellsystem und (vi) einer dedizierten Gedächtnisverwaltungsplattform. Empirische Ergebnisse zeigen, dass unsere Methoden alle bestehenden Gedächtnissysteme über vier Fragekategorien hinweg konsequent übertreffen: Single-Hop, temporal, Multi-Hop und offene Domänen. Bemerkenswert ist, dass MemO relative Verbesserungen in der LLM-as-a-Judge-Metrik gegenüber OpenAI erzielt, während MemO mit Graphgedächtnis etwa höhere Gesamtpunktzahl als die Basis-MemO-Konfiguration erreicht. Über Genauigkeitsgewinne hinaus reduzieren wir auch den Rechenaufwand im Vergleich zum Vollkontext-Ansatz deutlich. Insbesondere erreicht MemO eine um niedrigere p95-Latenz und spart mehr als Tokenkosten, wodurch ein überzeugendes Gleichgewicht zwischen fortgeschrittenen Reasoning-Fähigkeiten und praktischen Bereitstellungsbeschränkungen geboten wird. Unsere Ergebnisse unterstreichen die entscheidende Rolle strukturierter, persistenter Gedächtnismechanismen für langfristige Gesprächskohärenz und ebnen den Weg für zuverlässigere und effizientere LLM-gesteuerte KI-Agenten.
Der Code ist verfügbar unter: https://mem0. ai/research
1. Einleitung
X
Das menschliche Gedächtnis ist ein Fundament der Intelligenz – es prägt unsere Identität, leitet Entscheidungsfindung und ermöglicht es uns zu lernen, uns anzupassen und bedeutungsvolle Beziehungen zu bilden (Craik and Jennings, 1992). Unter seinen vielen Rollen ist das Gedächtnis wesentlich für Kommunikation: Wir erinnern uns an vergangene Interaktionen, schließen auf Präferenzen und konstruieren sich entwickelnde mentale Modelle derjenigen, mit denen wir interagieren (Assmann, 2011). Diese Fähigkeit, Informationen über längere Zeiträume zu behalten und abzurufen, ermöglicht kohärente, kontextuell reichhaltige Austausche, die sich über Tage, Wochen oder sogar Monate erstrecken. KI-Agenten, angetrieben durch große Sprachmodelle (LLMs), haben bemerkenswerte Fortschritte bei der Generierung flüssiger, kontextuell angemessener Antworten gemacht (Yu et al., 2024, Zhang et al., 2024). Diese Systeme sind jedoch grundlegend durch ihre Abhängigkeit von festen Kontextfenstern eingeschränkt, was ihre Fähigkeit, Kohärenz über längere Interaktionen hinweg aufrechtzuerhalten, stark begrenzt (Bulatov et al., 2022, Liu et al., 2023). Diese Einschränkung rührt aus dem Fehlen persistenter Gedächtnismechanismen bei LLMs, die über ihre endlichen Kontextfenster hinausreichen können. Während Menschen von Natur aus Erfahrungen über die Zeit ansammeln und organisieren und dabei eine kontinuierliche Erzählung
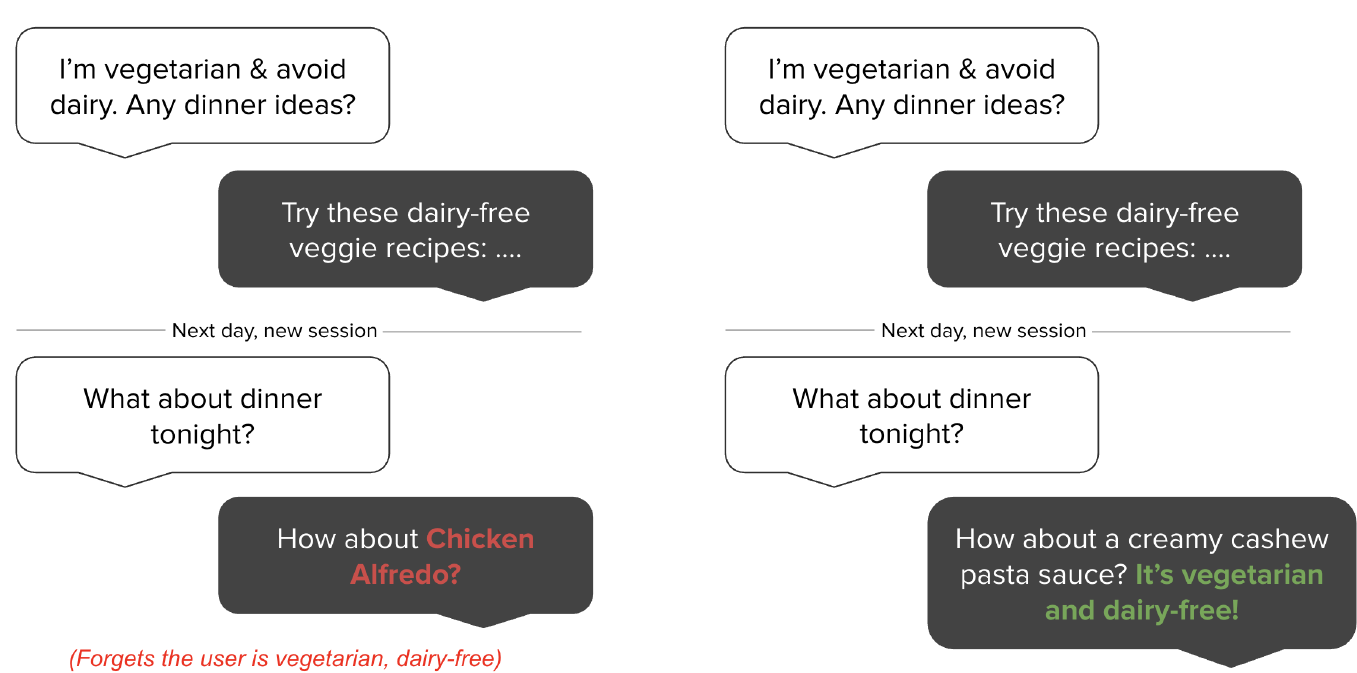
von Interaktionen bilden, können KI-Systeme Informationen nicht von Natur aus über separate Sitzungen hinweg oder nach Kontextüberlauf persistieren. Das Fehlen eines persistenten Gedächtnisses erzeugt eine grundlegende Diskrepanz in der Mensch-KI-Interaktion. Ohne Gedächtnis vergessen KI-Agenten Benutzerpräferenzen, wiederholen Fragen und widersprechen zuvor etablierten Fakten. Betrachten Sie ein einfaches Beispiel, das in Abbildung 1 dargestellt ist, bei dem ein Benutzer in einem ersten Gespräch erwähnt, vegetarisch zu sein und Milchprodukte zu meiden. In einer späteren Sitzung, wenn der Benutzer nach Abendessenempfehlungen fragt, könnte ein System ohne persistentes Gedächtnis Hähnchen vorschlagen und damit den etablierten Ernährungspräferenzen vollständig widersprechen. Im Gegensatz dazu würde ein System mit persistentem Gedächtnis diese kritische Benutzerinformation über Sitzungen hinweg beibehalten und geeignete vegetarische, milchfreie Optionen vorschlagen. Dieses häufige Szenario zeigt, wie Gedächtnisfehler die Benutzererfahrung und das Vertrauen grundlegend untergraben können.
Über Konversationseinstellungen hinaus hat sich gezeigt, dass Gedächtnismechanismen die Agentenleistung in interaktiven Umgebungen dramatisch verbessern (Majumder et al., Shinn et al., 2023). Agenten, die mit Erinnerungen an vergangene Erfahrungen ausgestattet sind, können Benutzerbedürfnisse besser antizipieren, aus früheren Fehlern lernen und Wissen über Aufgaben hinweg generalisieren (Chhikara et al., 2023). Forschung zeigt, dass gedächtniserweiterte Agenten die Entscheidungsfindung verbessern, indem sie kausale Beziehungen zwischen Aktionen und Ergebnissen nutzen, was zu effektiverer Anpassung in dynamischen Szenarien führt (Rasmussen et al., 2025). Hierarchische Gedächtnisarchitekturen (Packer et al., 2023, Sarthi et al., 2024) und agentische Gedächtnissysteme, die zu autonomer Evolution fähig sind (Xu et al., 2025), haben weiter gezeigt, dass Gedächtnis kohärenteres, langfristiges Reasoning über mehrere Dialogsitzungen hinweg ermöglicht.
Anders als Menschen, die neue Informationen dynamisch integrieren und veraltete Überzeugungen revidieren, werden LLMs effektiv „zurückgesetzt“, sobald Informationen außerhalb ihres Kontextfensters fallen (Zhang, 2024, Timoneda and Vera, 2025). Selbst während Modelle wie OpenAIs GPT-4 (128K Tokens) (Hurst et al., 2024), o1 (200K Kontext) (Jaech et al., 2024), Anthropics Claude 3.7 Sonnet (200K Tokens) (Anthropic, 2025) und Googles Gemini (mindestens 10M Tokens) (Team et al., 2024) die Grenzen der Kontextlänge verschieben, verzögern diese Verbesserungen die grundlegende Einschränkung lediglich, statt sie zu lösen. In praktischen Anwendungen erweisen sich selbst diese erweiterten Kontextfenster aus zwei kritischen Gründen als unzureichend. Erstens, da sich bedeutungsvolle Mensch-KI-Beziehungen über Wochen oder Monate entwickeln, überschreitet die Gesprächshistorie unweigerlich selbst die großzügigsten Kontextgrenzen. Zweitens, und vielleicht wichtiger, wahren reale Gespräche selten thematische Kontinuität. Ein Benutzer könnte Ernährungspräferenzen erwähnen (vegetarisch sein), dann stundenlang an unzusammenhängenden Diskussionen über Programmieraufgaben teilnehmen, bevor er zu lebensmittelbezogenen Fragen über Abendessenoptionen zurückkehrt. In solchen Szenarien müsste ein Vollkontext-Ansatz Berge irrelevanter Informationen durchdenken, wobei die kritischen Ernährungspräferenzen möglicherweise unter Tausenden von Tokens von Programmierdiskussionen begraben liegen. Darüber hinaus gewährleistet das bloße Präsentieren längerer Kontexte nicht den effektiven Abruf oder die Nutzung vergangener Informationen, da Aufmerksamkeitsmechanismenüber entfernte Tokens hinweg abnehmen (Guo et al., 2024, Nelson et al., 2024). Diese Einschränkung ist besonders problematisch in Bereichen mit hohen Einsätzen wie Gesundheitswesen, Bildung und Unternehmenssupport, wo die Aufrechterhaltung von Kontinuität und Vertrauen entscheidend ist (Hatalis et al., 2023). Um diese Herausforderungen zu bewältigen, müssen KI-Agenten Gedächtnissysteme übernehmen, die über statische Kontexterweiterung hinausgehen. Ein robustes KI-Gedächtnis sollte wichtige Informationen selektiv speichern, verwandte Konzepte konsolidieren und relevante Details bei Bedarf abrufen – menschliche kognitive Prozesse nachbildend (He et al., 2024). Durch die Integration solcher Mechanismen können wir KI-Agenten entwickeln, die konsistente Personas beibehalten, sich entwickelnde Benutzerpräferenzen verfolgen und auf früheren Austauschen aufbauen. Dieser Wandel wird KI von flüchtigen, vergesslichen Respondern in zuverlässige, langfristige Kollaborateure verwandeln und die Zukunft der Konversationsintelligenz grundlegend neu definieren.
In diesem Artikel adressieren wir eine grundlegende Einschränkung von KI-Systemen: ihre Unfähigkeit, kohärentes Reasoning über längere Gespräche über verschiedene Sitzungen hinweg aufrechtzuerhalten, was bedeutungsvolle langfristige Interaktionen mit Benutzern stark einschränkt. Wir stellen MemO (ausgesprochen mem-zero) vor, eine neuartige Gedächtnisarchitektur, die relevante Informationen aus laufenden Gesprächen dynamisch erfasst, organisiert und abruft. Auf dieser Grundlage entwickeln wir MemO8, das die Basissarchitektur mit graphbasierten Gedächtnisrepräsentationen erweitert, um komplexe Beziehungen zwischen Gesprächselementen besser zu modellieren. Unsere experimentellen Ergebnisse auf dem LOCOM0-Benchmark zeigen, dass unsere Ansätze bestehende Gedächtnissysteme – einschließlich gedächtniserweiterter Architekturen, Retrieval-Augmented-Generation-(RAG-)Methoden sowie sowohl Open-Source- als auch proprietärer Lösungen – über diverse Fragetypen hinweg konsequent übertreffen und gleichzeitig deutlich geringere Rechenressourcen benötigen. Latenzmessungen zeigen zudem, dass MemO mit um \(91\%\) niedrigeren Antwortzeiten als Vollkontext-Ansätze arbeitet und damit ein optimales Gleichgewicht zwischen hochentwickelten Reasoning-Fähigkeiten und praktischen Bereitstellungsbeschränkungen erzielt. Diese Beiträge stellen einen bedeutenden Schritt hin zu KI-Systemen dar, die kohärente, kontextbewusste Gespräche über längere Zeiträume aufrechterhalten können – menschliche Kommunikationsmuster nachbildend und neue Möglichkeiten für Anwendungen in persönlicher Nachhilfe, Gesundheitswesen und personalisierter Assistenz eröffnend.
2. Vorgeschlagene Methoden
Wir stellen zwei Gedächtnisarchitekturen für KI-Agenten vor. (1) MemO implementiert ein neuartiges Paradigma, das relevante Informationen aus Gesprächen durch dedizierte Module für Gedächtnisextraktion und -aktualisierung extrahiert, bewertet und verwaltet. Das System verarbeitet ein Paar von Nachrichten zwischen entweder zwei Benutzerteilnehmern oder einem Benutzer und einem Assistenten. (2) MemO8 erweitert diese Grundlage durch die Einbeziehung graphbasierter Gedächtnisrepräsentationen, bei denen Erinnerungen als gerichtete beschriftete Graphen gespeichert werden, mit Entitäten als Knoten und Beziehungen als Kanten. Diese Struktur ermöglicht ein tieferes Verständnis der Verbindungen zwischen Entitäten. Durch die explizite Modellierung sowohl von Entitäten als auch ihrer Beziehungen unterstützt MemO8 fortgeschritteneres Reasoning über miteinander verbundene Fakten, insbesondere für Abfragen, die das Navigieren durch komplexe relationale Pfade über mehrere Erinnerungen hinweg erfordern.
2.1. MemO
Unsere Architektur folgt einem inkrementellen Verarbeitungsparadigma, das es ihr ermöglicht, nahtlos innerhalb laufender Gespräche zu operieren. Wie in Abbildung 2 dargestellt, besteht die vollständige Pipeline-Architektur aus zwei Phasen: Extraktion und Aktualisierung.
Die Extraktionsphase beginnt mit der Aufnahme eines neuen Nachrichtenpaares , wobei die aktuelle Nachricht und die vorhergehende darstellt. Dieses Paar besteht typischerweise aus einer Benutzernachricht und einer Assistentenantwort und bildet eine vollständige Interaktionseinheit. Um einen geeigneten Kontext für die Gedächtnisextraktion herzustellen, nutzt das System zwei komplementäre Quellen: (1) eine aus der Datenbank abgerufene Konversationszusammenfassung , die
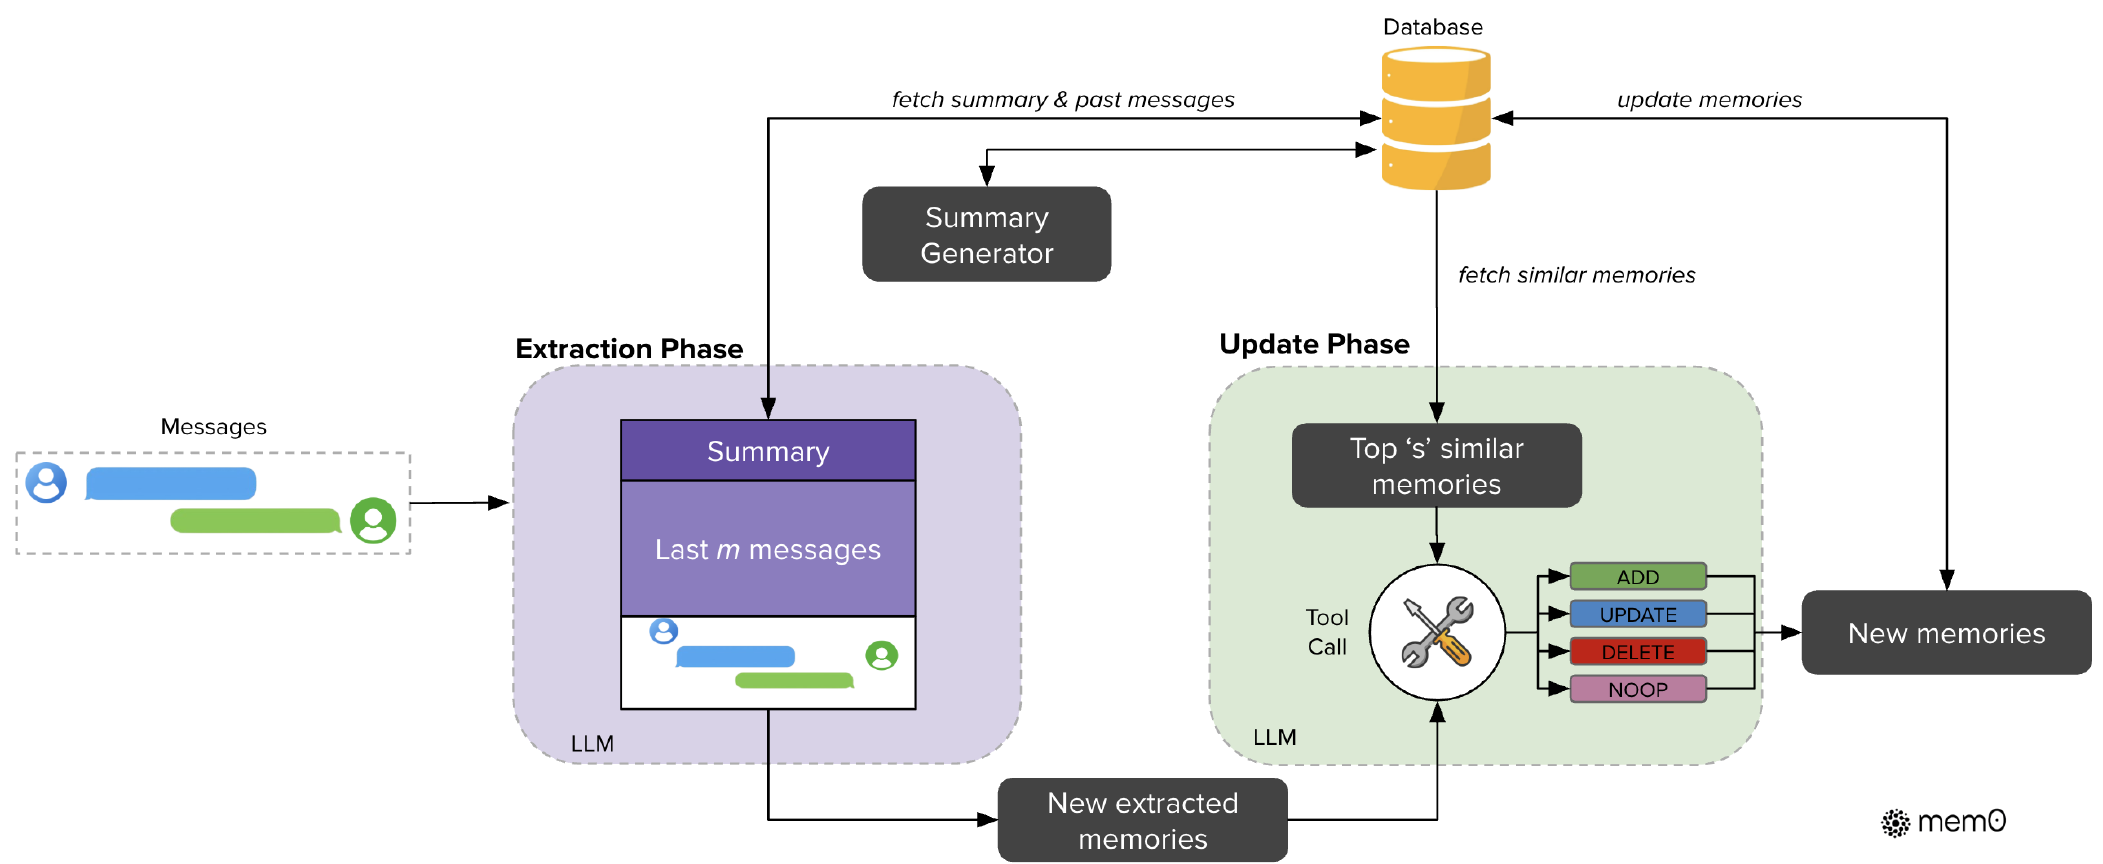
den semantischen Inhalt der gesamten Konversationshistorie zusammenfasst, und (2) eine Sequenz aktueller Nachrichten aus der Konversationshistorie, wobei ein Hyperparameter ist, der das Aktualitätsfenster steuert. Zur Unterstützung einer kontextbewussten Gedächtnisextraktion implementieren wir ein asynchrones Modul zur Zusammenfassungserstellung, das die Konversationszusammenfassung regelmäßig aktualisiert. Diese Komponente arbeitet unabhängig von der Hauptverarbeitungspipeline und stellt sicher, dass die Gedächtnisextraktion stets von aktuellen kontextuellen Informationen profitiert, ohne Verarbeitungsverzögerungen zu verursachen. Während 5 ein globales thematisches Verständnis der gesamten Konversation bietet, liefert die Sequenz der aktuellen Nachrichten einen detaillierten zeitlichen Kontext, der relevante Details enthalten kann, die nicht in der Zusammenfassung konsolidiert wurden. Diese duale kontextuelle Information bildet zusammen mit dem neuen Nachrichtenpaar einen umfassenden Prompt für eine Extraktionsfunktion , die über ein LLM implementiert wird. Die Funktion extrahiert dann eine Menge salienter Erinnerungen speziell aus dem neuen Austausch, während sie sich des breiteren Kontexts der Konversation bewusst bleibt, was zu Kandidatenfakten für eine mögliche Aufnahme in die Wissensbasis führt.
Im Anschluss an die Extraktion bewertet die Aktualisierungsphase jeden Kandidatenfakt gegen bestehende Erinnerungen, um Konsistenz zu wahren und Redundanz zu vermeiden. Diese Phase bestimmt die geeignete Gedächtnisverwaltungsoperation für jeden extrahierten Fakt . Algorithmus 1, erwähnt in Anhang B, veranschaulicht diesen Prozess. Für jeden Fakt ruft das System zunächst die semantisch ähnlichsten Erinnerungen unter Verwendung von Vektoreinbettungen aus der Datenbank ab. Diese abgerufenen Erinnerungen werden dann zusammen mit dem Kandidatenfakt dem LLM über eine Funktionsaufrufschnittstelle präsentiert, die wir als „Tool-Call“ bezeichnen. Das LLM selbst bestimmt, welche der vier unterschiedlichen Operationen auszuführen ist: ADD zur Erstellung neuer Erinnerungen, wenn keine semantisch äquivalente Erinnerung existiert; UPDATE zur Erweiterung bestehender Erinnerungen mit ergänzenden Informationen; DELETE zur Entfernung von Erinnerungen, denen durch neue Informationen widersprochen wird; und NOOP, wenn der Kandidatenfakt keine Änderung der Wissensbasis erfordert. Anstatt einen separaten Klassifikator zu verwenden, nutzen wir die Schlussfolgerungsfähigkeiten des LLM, um die geeignete Operation direkt auf der Grundlage der semantischen Beziehung zwischen dem Kandidatenfakt und bestehenden Erinnerungen auszuwählen. Im Anschluss an diese Bestimmung führt das System die bereitgestellten Operationen aus und wahrt dadurch die Kohärenz der Wissensbasis sowie die zeitliche Konsistenz.
In unserer experimentellen Evaluierung konfigurierten wir das System mit ' vorherigen Nachrichten als kontextuelle Referenz und ' ähnlichen Erinnerungen für die vergleichende Analyse. Alle Sprachmodelloperationen verwendeten GPT-4o-mini als Inferenz-Engine. Die Vektordatenbank verwendet dichte Einbettungen, um eine effiziente Ähnlichkeitssuche während der Aktualisierungsphase zu ermöglichen.
2.2. Memo8
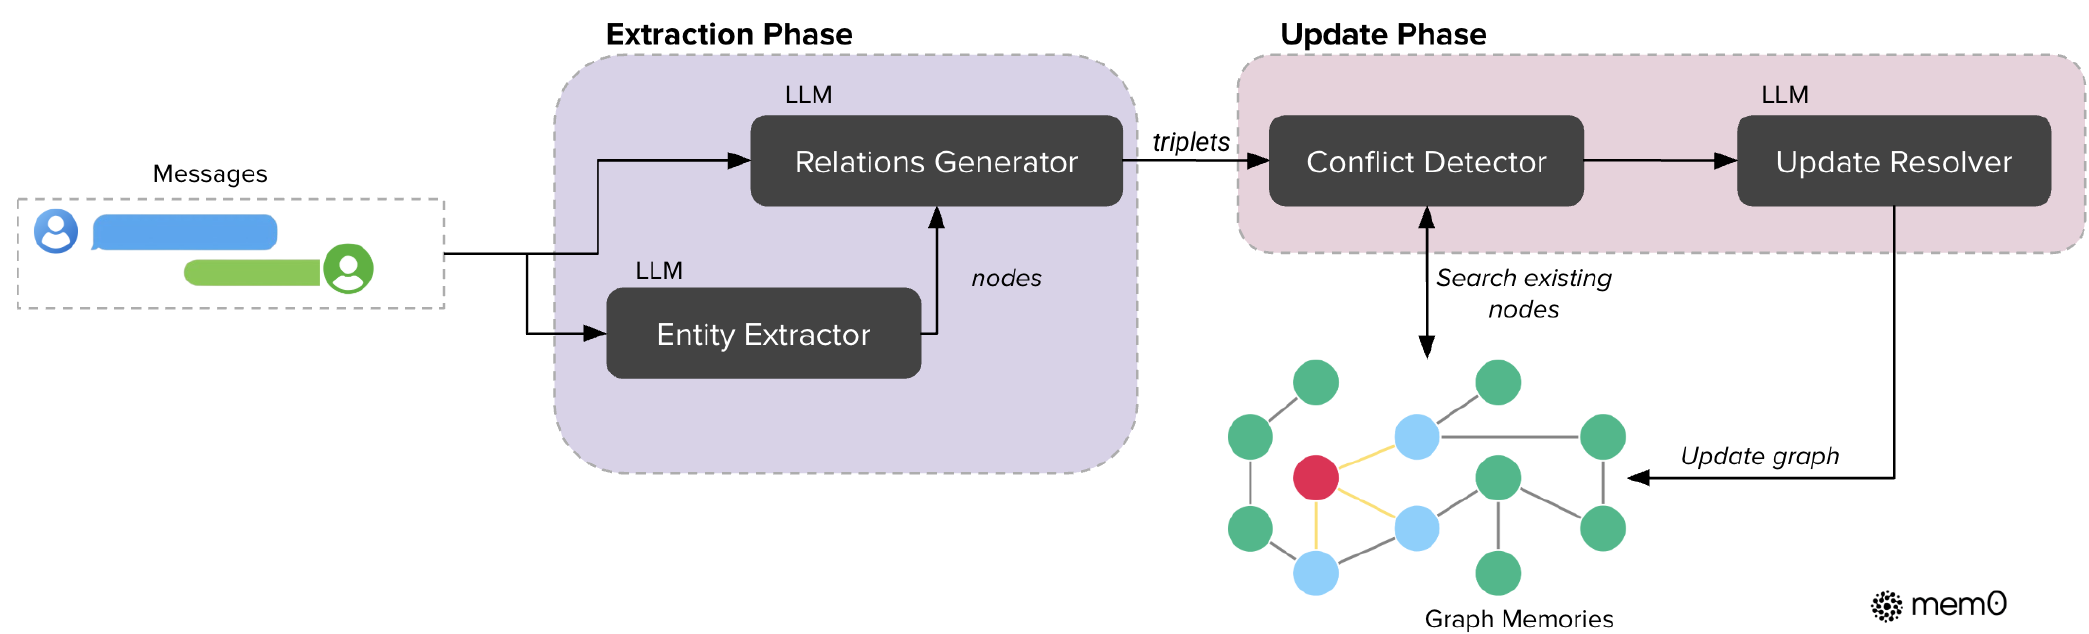
Die Memo8-Pipeline, dargestellt in Abbildung 3, implementiert einen graphenbasierten Gedächtnisansatz, der kontextuelle Informationen aus natürlichen Sprachinteraktionen effektiv erfasst, speichert und abruft (Zhang et al., 2022). In diesem Framework werden Erinnerungen als gerichteter, gelabelter Graph repräsentiert, wobei:
- Knoten Entitäten repräsentieren (z. B. ALICE, SAN_FRANCISCO) - Kanten Beziehungen zwischen Entitäten repräsentieren (z. B. LIVES_IN) - Labels Knoten semantische Typen zuweisen (z. B. ALICE – Person, SAN_FRANCISCO – Stadt)
Jeder Entitätsknoten enthält drei Komponenten: (1) eine Entitätstypklassifikation, die die Entität kategorisiert (z. B. Person, Ort, Ereignis), (2) einen Embedding-Vektor , der die semantische Bedeutung der Entität erfasst, und (3) Metadaten einschließlich eines Erstellungszeitstempels . Beziehungen in unserem System sind als Tripletts der Form strukturiert, wobei und jeweils Quell- und Zielentitätsknoten sind und die gelabelte Kante ist, die sie verbindet.
Der Extraktionsprozess verwendet eine zweistufige Pipeline, die LLMs nutzt, um unstrukturierten Text in strukturierte Graphrepräsentationen zu transformieren. Zunächst verarbeitet ein Entitätsextraktor-Modul den Eingabetext, um eine Menge von Entitäten zusammen mit ihren entsprechenden Typen zu identifizieren. In unserem Framework repräsentieren Entitäten die zentralen Informationselemente in Gesprächen – einschließlich Personen, Orte, Objekte, Konzepte, Ereignisse und Attribute, die eine Repräsentation im Gedächtnisgraphen verdienen. Der Entitätsextraktor identifiziert diese vielfältigen Informationseinheiten, indem er die semantische Bedeutung, Einzigartigkeit und Persistenz von Elementen im Gespräch analysiert. In einem Gespräch über Reisepläne könnten Entitäten beispielsweise Reiseziele (Städte, Länder), Transportmittel, Daten, Aktivitäten und Präferenzen der Teilnehmer umfassen – im Wesentlichen jede diskrete Information, die für zukünftige Referenzen oder Schlussfolgerungen relevant sein könnte.
Als Nächstes leitet eine Beziehungsgenerator-Komponente bedeutungsvolle Verbindungen zwischen diesen Entitäten ab und etabliert eine Menge von Beziehungs-Tripletts, die die semantische Struktur der Informationen erfassen. Dieses LLM-basierte Modul analysiert die extrahierten Entitäten und ihren Kontext innerhalb des Gesprächs, um semantisch bedeutsame Verbindungen zu identifizieren. Es funktioniert, indem es linguistische Muster, kontextuelle Hinweise und Domänenwissen untersucht, um zu bestimmen, wie Entitäten zueinander in Beziehung stehen. Für jedes potenzielle Entitätspaar bewertet der Generator, ob eine bedeutungsvolle Beziehung besteht, und klassifiziert diese Beziehung gegebenenfalls mit einem geeigneten Label (z. B. „lives_in", „prefers", „owns", „happened_on"). Das Modul setzt Prompt-Engineering-Techniken ein, die das LLM dazu anleiten, sowohl über explizite Aussagen als auch über implizite Informationen im Dialog zu schlussfolgern, was zu Beziehungs-Tripletts führt, die die Kanten in unserem Gedächtnisgraphen bilden und komplexes Schlussfolgern über miteinander verbundene Informationen ermöglichen. Bei der Integration neuer Informationen verwendet Memo8 eine ausgefeilte Speicher- und Aktualisierungsstrategie. Für jedes neue Beziehungs-Triplett berechnen wir Embeddings für sowohl Quell- als auch Zielentitäten und suchen dann nach existierenden Knoten mit semantischer Ähnlichkeit oberhalb eines definierten Schwellenwerts „t". Abhängig von der Knotenexistenz kann das System beide Knoten erstellen, nur einen Knoten erstellen oder existierende Knoten verwenden, bevor die Beziehung mit geeigneten Metadaten etabliert wird. Um einen konsistenten Wissensgraphen aufrechtzuerhalten, implementieren wir einen Konflikterkennungsmechanismus, der potenziell konfliktäre existierende Beziehungen identifiziert, wenn neue Informationen eintreffen. Ein LLM-basierter Aktualisierungs-Resolver bestimmt, ob bestimmte Beziehungen obsolet werden sollten, und markiert sie als ungültig, anstatt sie physisch zu entfernen, um zeitliches Schlussfolgern zu ermöglichen.
Die Gedächtnisabruf-Funktionalität in Memo8 implementiert eine duale Strategie für optimalen Informationszugriff. Die entitätszentrierte Methode identifiziert zunächst Schlüsselentitäten innerhalb einer Anfrage und nutzt dann semantische Ähnlichkeit, um entsprechende Knoten im Wissensgraphen zu lokalisieren. Sie erkundet systematisch sowohl eingehende als auch ausgehende Beziehungen von diesen Ankerknoten aus und konstruiert einen umfassenden Subgraphen, der relevante kontextuelle Informationen erfasst. Ergänzend dazu nimmt der semantische Triplett-Ansatz eine ganzheitlichere Perspektive ein, indem er die gesamte Anfrage als dichten Embedding-Vektor kodiert. Diese Anfragerepräsentation wird dann mit textuellen Kodierungen jedes Beziehungs-Tripletts im Wissensgraphen abgeglichen. Das System berechnet feingranulare Ähnlichkeitswerte zwischen der Anfrage und allen verfügbaren Tripletts und gibt nur diejenigen zurück, die einen konfigurierbaren Relevanzschwellenwert überschreiten, geordnet nach abnehmender Ähnlichkeit. Dieser duale Abrufmechanismus ermöglicht es Memo8, sowohl gezielte entitätsfokussierte Fragen als auch breitere konzeptionelle Anfragen mit gleicher Effektivität zu bearbeiten.
Aus Implementierungssicht nutzt das System Neo4j1 als zugrunde liegende Graphdatenbank. LLM-basierte Extraktoren und das Aktualisierungsmodul nutzen GPT-4o-mini mit Function-Calling-Fähigkeiten, was eine strukturierte Extraktion von Informationen aus unstrukturiertem Text ermöglicht. Durch die Kombination graphenbasierter Repräsentationen mit semantischen Embeddings und LLM-basierter Informationsextraktion erreicht Memo8 sowohl den strukturellen Reichtum, der für komplexes Schlussfolgern benötigt wird, als auch die semantische Flexibilität, die für natürliche Sprachverarbeitung erforderlich ist.
3. Experimenteller Aufbau
3.1. Datensatz
Der Datensatz LOCOM0 (Maharana et al., 2024) ist darauf ausgelegt, das langfristige Gesprächsgedächtnis in Dialogsystemen zu evaluieren. Er umfasst 10 ausgedehnte Gespräche, von denen jedes durchschnittlich etwa 600 Dialoge und 26000 Tokens enthält, verteilt über mehrere Sitzungen. Jedes Gespräch erfasst zwei Personen, die über tägliche Erfahrungen oder vergangene Ereignisse sprechen. Im Anschluss an diese sitzungsübergreifenden Dialoge wird jedes Gespräch von durchschnittlich 200 Fragen mit entsprechenden Ground-Truth-Antworten begleitet. Diese Fragen sind in mehrere Typen kategorisiert: Single-Hop, Multi-Hop, temporal und offene Domäne. Der Datensatz enthielt ursprünglich eine Kategorie adversarischer Fragen, die darauf ausgelegt war, die Fähigkeit von Systemen zu testen, unbeantwortbare Fragen zu erkennen. Diese Kategorie wurde jedoch aus unserer Evaluation ausgeschlossen, da Ground-Truth-Antworten nicht verfügbar waren und das erwartete Verhalten für diesen Fragetyp darin besteht, dass der Agent sie als unbeantwortbar erkennt.
3.2. Evaluationsmetriken
Unser Evaluationsframework implementiert einen umfassenden Ansatz zur Bewertung langfristiger Gedächtnisfähigkeiten in Dialogsystemen, wobei sowohl Antwortqualität als auch operationelle Effizienz berücksichtigt werden. Wir kategorisieren unsere Metriken in zwei unterschiedliche Gruppen, die zusammen ein ganzheitliches Verständnis der Systemleistung vermitteln.
(1) Leistungsmetriken Frühere Forschungen im Bereich konversationeller KI (Goswami, 2025, Soni et al., 2024, Singh et al., 2020) haben sich überwiegend auf lexikalische Ähnlichkeitsmetriken wie F1-Score (F1) und BLEU-1 (B1) gestützt. Diese Metriken weisen jedoch erhebliche Einschränkungen bei der Bewertung faktischer Genauigkeit in konversationellen Kontexten auf. Betrachten Sie ein Szenario, in dem die Ground-Truth-Antwort „Alice was born in March" lautet und ein System „Alice is born in July" generiert. Trotz eines kritischen faktischen Fehlers bezüglich des Geburtsmonats würden traditionelle Metriken aufgrund lexikalischer Überlappung bei den übrigen Tokens („Alice", „born" usw.) relativ hohe Werte vergeben. Diese grundlegende Einschränkung kann zu irreführenden Evaluationen führen, die die semantische Korrektheit nicht erfassen. Um diesen Mängeln zu begegnen, verwenden wir LLM-as-a-Judge (J) als komplementäre Evaluationsmetrik. Dieser Ansatz nutzt ein separates, leistungsfähigeres LLM, um die Antwortqualität über mehrere Dimensionen hinweg zu bewerten, einschließlich faktischer Genauigkeit, Relevanz, Vollständigkeit und kontextueller Angemessenheit. Das Judge-Modell analysiert die Frage, die Ground-Truth-Antwort und die generierte Antwort und liefert eine differenziertere Bewertung, die besser mit menschlichem Urteilsvermögen übereinstimmt. Aufgrund der stochastischen Natur von J-Evaluationen führten wir 10 unabhängige Durchläufe für jede Methode auf dem gesamten Datensatz durch und berichten die Mittelwerte zusammen mit Standardabweichung. Weitere Details zu J finden sich in Anhang A.
(2) Deployment-Metriken Über die Antwortqualität hinaus sind praktische Deployment-Überlegungen entscheidend für reale Anwendungen langfristigen Gedächtnisses in KI-Agenten. Wir verfolgen systematisch den Tokenverbrauch unter Verwendung der „c1100k_base"-Kodierung von tiktoken und messen die Anzahl der während des Abrufs extrahierten Tokens, die als Kontext für die Beantwortung von Anfragen dienen. Für unsere gedächtnisbasierten Modelle repräsentieren diese Tokens die aus der Wissensbasis abgerufenen Erinnerungen, während sie für RAG-basierte Modelle der Gesamtzahl der Tokens in den abgerufenen Textabschnitten entsprechen. Diese Unterscheidung ist wichtig, da sie die operationellen Kosten und Systemeffizienz direkt beeinflusst – ob es sich um die Verarbeitung prägnanter Gedächtnisfakten oder größerer Rohtextsegmente handelt. Wir überwachen ferner die Latenz, (i) Suchlatenz: die die Gesamtzeit erfasst, die zum Durchsuchen des Gedächtnisses (bei gedächtnisbasierten Lösungen) oder der Abschnitte (bei RAG-basierten Lösungen) erforderlich ist, und (ii) Gesamtlatenz: die Zeit zur Generierung geeigneter Antworten, bestehend aus sowohl der Abrufzeit (Zugriff auf Erinnerungen oder Abschnitte) als auch der Antwortgenerierungszeit unter Verwendung des LLMs.
Die Beziehung zwischen diesen Metriken offenbart wichtige Kompromisse im Systemdesign. Beispielsweise könnten ausgefeiltere Gedächtnisarchitekturen eine höhere faktische Genauigkeit erzielen, jedoch auf Kosten erhöhten Tokenverbrauchs und erhöhter Latenz. Unsere mehrdimensionale Evaluationsmethodik ermöglicht es Forschern und Praktikern, fundierte Entscheidungen auf der Grundlage ihrer spezifischen Anforderungen zu treffen, sei es die Priorisierung von Antwortqualität für kritische Anwendungen oder von Recheneffizienz für Echtzeit-Deployment-Szenarien.
3.3. Baselines
Um unseren Ansatz umfassend zu evaluieren, vergleichen wir mit sechs unterschiedlichen Kategorien von Baselines, die den aktuellen Stand konversationeller Gedächtnissysteme repräsentieren. Diese vielfältigen Baselines bieten zusammen ein robustes Framework zur Bewertung der Effektivität verschiedener Gedächtnisarchitekturen über verschiedene Dimensionen hinweg, einschließlich faktischer Genauigkeit, Recheneffizienz und Skalierbarkeit auf ausgedehnte Gespräche. Wo anwendbar und sofern nicht anders angegeben, setzen wir die Temperatur auf 0, um die Durchläufe so reproduzierbar wie möglich zu gestalten.
Etablierte LOcOMO-Benchmarks Wir legen zunächst eine Vergleichsgrundlage, indem wir zuvor auf dem LOcOMO-Datensatz gebenchmarkte Methoden evaluieren. Diese umfassen fünf etablierte Ansätze: LoCoMo (Maharana et al., 2024), ReadAgent (Lee et al., 2024), MemoryBank (Zhong et al., 2024), MemGPT (Packer et al., 2023) und A-Mem (Xu et al., 2025). Diese etablierten Benchmarks bieten nicht nur direkte Vergleichspunkte mit veröffentlichten Ergebnissen, sondern repräsentieren auch die Evolution konversationeller Gedächtnisarchitekturen über verschiedene algorithmische Paradigmen hinweg. Für unsere Evaluation wählen wir die Metriken aus, bei denen gpt-4o-mini für die Evaluation verwendet wurde. Weitere Details zu diesen Benchmarks finden sich in Anhang C.
Open-Source-Speicherlösungen Unsere zweite Kategorie besteht aus vielversprechenden Open-Source-Speicherarchitekturen wie LangMem (Hot Path), die ihre Wirksamkeit bei verwandten Konversationsaufgaben gezeigt haben, aber noch nicht auf dem LOcOMO-Datensatz evaluiert wurden. Indem wir diese Systeme an unseren Evaluierungsrahmen anpassen, erweitern wir die vergleichende Landschaft und identifizieren potenzielle alternative Ansätze, die wettbewerbsfähige Leistung bieten könnten. Wir initialisierten das LLM mit gpt-4o-mini und verwendeten text-embedding-small-3 als Embedding-Modell.2
Retrieval-Augmented Generation (RAG) Als Baseline behandeln wir den gesamten Konversationsverlauf als Dokumentensammlung und wenden eine standardmäßige RAG-Pipeline an. Zunächst segmentieren wir jede Konversation in Abschnitte fester Länge (128, 256, 512, 1024, 2048, 4096 und 8192 Token), wobei 8192 die maximale Abschnittsgröße ist, die von unserem Embedding-Modell unterstützt wird. Alle Abschnitte werden mit OpenAIs text-embedding-small-3 eingebettet, um eine konsistente Vektorqualität über alle Konfigurationen hinweg zu gewährleisten. Zum Abfragezeitpunkt rufen wir die top Abschnitte nach semantischer Ähnlichkeit ab und verketten sie als Kontext für die Antwortgenerierung. In unseren Experimenten setzen wir durchgängig : Bei wird nur der einzelne relevanteste Abschnitt verwendet, und bei werden die beiden relevantesten Abschnitte (bis zu 16384 Token) verkettet. Wir vermeiden , da die durchschnittliche Konversationslänge (26000 Token) sonst vollständig abgedeckt würde, was die Vorteile des selektiven Retrievals zunichtemacht. Durch Variation der Abschnittsgröße und von evaluieren wir die RAG-Leistung systematisch bei Aufgaben des langfristigen Konversationsgedächtnisses.
Vollkontextverarbeitung Wir verfolgen einen unkomplizierten Ansatz, indem wir den gesamten Konversationsverlauf innerhalb des Kontextfensters des LLM übergeben. Diese Methode nutzt die inhärente Fähigkeit des Modells, sequenzielle Informationen ohne zusätzliche architektonische Komponenten zu verarbeiten. Obwohl konzeptionell einfach, stößt dieser Ansatz mit zunehmender Konversationslänge an praktische Grenzen und erhöht schließlich Tokenkosten und Latenz. Dennoch etabliert er einen wichtigen Referenzpunkt, um den Wert ausgefeilterer Speichermechanismen im Vergleich zur direkten Verarbeitung des verfügbaren Kontexts zu verstehen.
Proprietäre Modelle Wir evaluieren OpenAIs Speicherfunktion, die in ihrer ChatGPT-Oberfläche verfügbar ist, und verwenden aus Konsistenzgründen speziell gpt-4o-mini. Wir speisen gesamte LOcOMO-Konversationen mit einem Prompt (siehe Anhang A) in einzelne Chat-Sitzungen ein und regen die Speichergenerierung mit Zeitstempeln, Teilnehmernamen und Konversations3text an. Diese generierten Erinnerungen werden dann als vollständiger Kontext für die Beantwortung von Fragen zu jeder Konversation verwendet, wobei dem OpenAI-Ansatz absichtlich privilegierter Zugriff auf alle Erinnerungen gewährt wird und nicht nur auf die für die Frage relevanten. Diese Methodik trägt dem Fehlen eines externen API-Zugriffs für selektives Speicher-Retrieval im OpenAI-System für das Benchmarking Rechnung.
| Methode | Single Hop | Multi-Hop | Open Domain | Temporal | ||||||||
| F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | |
| LoCoMo | 25,02 | 19,75 | - | 12,04 | 11,16 | - | 40,36 | 29,05 | - | 18,41 | 14,77 | - |
| ReadAgent | 9,15 | 6,48 | - | 5,31 | 5,12 | - | 9,67 | 7,66 | - | 12,60 | 8,87 | - |
| MemoryBank | 5,00 | 4,77 | - | 5,56 | 5,94 | - | 6,61 | 5,16 | - | 9,68 | 6,99 | - |
| MemGPT | 26,65 | 17,72 | - | 9,15 | 7,44 | - | 41,04 | 34,34 | - | 25,52 | 19,44 | - |
| A-Mem | 27,02 | 20,09 | - | 12,14 | 12,00 | - | 44,65 | 37,06 | - | 45,85 | 36,67 | - |
| A-Mem* | 20,76 | 14,90 | 39,79 ± 0,38 | 9,22 | 8,81 | 18,85 ± 0,31 | 33,34 | 27,58 | 54,05 ± 0,22 | 35,40 | 31,08 | 49,91 ± 0,31 |
| LangMem | 35,51 | 26,86 | 62,23 ± 0,75 | 26,04 | 22,32 | 47,92 ± 0,47 | 40,91 | 33,63 | 71,12 ± 0,20 | 30,75 | 25,84 | 23,43 ± 0,39 |
| Zep | 35,74 | 23,30 | 61,70 ± 0,32 | 19,37 | 14,82 | 41,35 ± 0,48 | 49,56 | 38,92 | 76,60 ± 0,13 | 42,00 | 34,53 | 49,31 ± 0,50 |
| OpenAI | 34,30 | 23,72 | 63,79 ± 0,46 | 20,09 | 15,42 | 42,92 ± 0,63 | Lesen Sie den schreibgeschützten Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): | Proprietäre Modelle Wir evaluieren OpenAIs memory3-Funktion, die in ihrer ChatGPT-Oberfläche verfügbar ist, und verwenden dabei aus Konsistenzgründen speziell gpt-4o-mini. Wir speisen gesamte LOcOMO-Gespräche mit einem Prompt (siehe Anhang A) in einzelne Chat-Sitzungen ein und regen die Speichergenerierung mit Zeitstempeln, Namen der Teilnehmer und Gesprächstext an. Diese generierten Erinnerungen werden dann als vollständiger Kontext für die Beantwortung von Fragen zu jedem Gespräch verwendet, wodurch dem OpenAI-Ansatz absichtlich pr | Zu übersetzender Text: | 39.31 | 31.16 | 62.29 ± 0.12 |
| 14.04 | 11.25 | 21.71 ± 0.20 | MemO | 38.72 | 27.13 | 67.13 ± 0.65 | 28.64 | 21.58 | 51.15 ± 0.31 | 47.65 | 38.72 | 72.93 ± 0.11 |
| 48.93 | 40.51 | 55.51 ± 0.34 | MemO8 | 38.09 | 26.03 | 65.71 ± 0.45 | 24.32 | 18.82 | 47.19 ± 0.67 | 49.27 | 40.30 | 75.71 ± 0.21 |
Speicheranbieter Wir integrieren Zep (Rasmussen et al., 2025), eine Speicherverwaltungsplattform, die für KI-Agenten konzipiert wurde. Unter Verwendung ihrer Plattformversion führen wir systematische Evaluierungen über den LOcOMO-Datensatz durch und wahren dabei die zeitliche Treue, indem wir Zeitstempelinformationen neben den Gesprächsinhalten beibehalten. Diese zeitliche Verankerung stellt sicher, dass zeitkritische Anfragen durch entsprechend kontextualisierte Speicherabrufung adressiert werden können, was besonders wichtig für die Bewertung von Fragen ist, die chronologisches Bewusstsein erfordern. Diese Baseline stellt eine wichtige kommerzielle Implementierung der Speicherverwaltung dar, die speziell für KI-Agenten entwickelt wurde.
4. Evaluierungsergebnisse, Analyse und Diskussion.
4.1. Leistungsvergleich über speicherfähige Systeme hinweg
Tabelle 1 berichtet , und J-Werte für unsere beiden Architekturen – MemO und MemO – gegenüber einer Reihe konkurrierender Baselines, wie in Abschnitt 3 erwähnt, bei Single-Hop-, Multi-Hop-, Open-Domain- und temporalen Fragen. Insgesamt setzen beide unserer Modelle neue State-of-the-Art-Marken in allen drei Evaluierungsmetriken für die meisten Fragetypen.
Leistung bei Single-Hop-Fragen Single-Hop-Abfragen beinhalten das Auffinden einer einzelnen faktischen Textspanne, die in einem Dialogturn enthalten ist. Durch die Nutzung ihrer dichten Speicher in natürlicher Sprache erzielt MemO die stärksten Ergebnisse: , und . Die Anreicherung der natürlichsprachlichen Speicher mit Graphspeicher (MemO8) führt zu einem marginalen Leistungsabfall im Vergleich zu MemO, was darauf hindeutet, dass relationale Struktur begrenzten Nutzen bietet, wenn das Abrufziel einen einzelnen Turn umfasst. Unter den bestehenden Baselines erreicht der Full-Context-OpenAI-Lauf den nächstbesten J-Wert, was die Vorteile der Beibehaltung der gesamten Konversation im Kontext widerspiegelt, während LangMem und Zep beide etwa 8 % relativ schlechter gegen unsere Modelle beim J-Wert abschneiden. Frühere LOcOMO-Benchmarks wie A-mem liegen um mehr als 25 Punkte bei J zurück, was die Notwendigkeit einer feingranularen, strukturierten Speicherindizierung selbst für einfache Abrufaufgaben unterstreicht.
Leistung bei Multi-Hop-Fragen Multi-Hop-Abfragen erfordern die Synthese von Informationen, die über mehrere Konversationssitzungen verteilt sind, und stellen erhebliche Herausforderungen an die Speicherintegration und den -abruf dar. MemO übertrifft andere Methoden deutlich mit einem -Wert von 28.64 und einem J-Wert von 51.15, was seine Fähigkeit widerspiegelt, disparate, über Sitzungen hinweg gespeicherte Informationen effizient abzurufen und zu integrieren. Interessanterweise bringt die Hinzufügung von Graphspeicher in MemO8 hier keine Leistungsgewinne, was auf mögliche Ineffizienzen oder Redundanzen in strukturierten Graphrepräsentationen für komplexe integrative Aufgaben im Vergleich zu dichtem natürlichsprachlichem Speicher allein hindeutet. Baselines wie LangMem zeigen konkurrenzfähige Leistungen, aber ihre Werte bleiben deutlich hinter denen von MemO zurück, was den Vorteil unserer verfeinerten Speicherindizierungs- und -abrufmechanismen für komplexe Abfrageverarbeitung betont.
Open-Domain-Leistung In Open-Domain-Einstellungen erzielt die Baseline Zep die höchsten - (49.56) und J-Werte (76.60) und übertrifft unsere Methoden um einen knappen Vorsprung. Insbesondere übertrifft Zeps J-Wert von 76.60 den von MemO8 (75.71) um nur 0.89 Prozentpunkte und übertrifft MemO (72.93) um 3.67 Punkte, was einen konsistenten, wenn auch leichten Vorteil bei der Integration von Konversationsspeicher mit externem Wissen hervorhebt. MemO8 bleibt ein starker Zweitplatzierter mit einem J-Wert von 75.71, der eine hohe faktische Abrufpräzision widerspiegelt, während MemO mit 72.93 folgt und robuste Kohärenz demonstriert. Diese Ergebnisse unterstreichen, dass Zep trotz der substanziellen Verbesserung des Open-Domain-Abrufs durch strukturierte relationale Speicher (wie in MemO und MemO8) einen kleinen, aber bedeutenden Vorsprung behält.
Leistung beim temporalen Schlussfolgern Temporale Schlussfolgerungsaufgaben hängen von der genauen Modellierung von Ereignissequenzen, ihrer relativen Reihenfolge und Dauer innerhalb der Konversationshistorie ab. Unsere Architekturen zeigen substanzielle Verbesserungen über alle Metriken hinweg, wobei MemO8 die höchsten - (51.55) und J-Werte (58.13) erzielt, was darauf hindeutet, dass strukturierte relationale Repräsentationen zusätzlich zu natürlichsprachlichen Speichern zeitlich fundierte Urteile erheblich unterstützen. Bemerkenswerterweise liefert auch die Basisvariante MemO einen anständigen J-Wert (55.51), was darauf hindeutet, dass natürliche Sprache allein zeitlich fundierte Urteile unterstützen kann. Unter den Baselines schneidet OpenAI bemerkenswert schlecht ab, mit Werten unter 15 %, hauptsächlich aufgrund fehlender Zeitstempel in den meisten generierten Speichern trotz explizitem Prompting im OpenAI ChatGPT, Speicher mit Zeitstempeln zu extrahieren. Andere Baselines wie A-Mem erzielen respektable Ergebnisse, doch unsere Modelle bringen den State of the Art deutlich voran und betonen den kritischen Vorteil der genauen Nutzung sowohl natürlichsprachlicher Kontextualisierung als auch strukturierter Graphrepräsentationen für temporales Schlussfolgern.
4.2. Kategorieübergreifende Analyse
Die umfassende Evaluierung über verschiedene Fragekategorien hinweg zeigt, dass unsere vorgeschlagenen Architekturen MemO und MemO8 durchgängig überlegene Leistungen im Vergleich zu Baseline-Systemen erzielen. Bei Single-Hop-Abfragen zeigt MemO besonders starke Leistung, profitiert von seiner effizienten dichten natürlichsprachlichen Speicherstruktur. Obwohl graphbasierte Repräsentationen in MemO8 bei diesen einfacheren Abfragen bei lexikalischen Überlappungsmetriken leicht zurückliegen, verbessern sie die semantische Kohärenz erheblich, wie durch konkurrenzfähige J-Werte demonstriert wird. Dies deutet darauf hin, dass Graphstrukturen in Szenarien mit nuanciertem relationalem Kontext vorteilhafter sind als bei einfachem Abruf. Bei Multi-Hop-Fragen zeigt MemO klare Vorteile durch die effektive Synthese verstreuter Informationen über mehrere Sitzungen hinweg, was bestätigt, dass natürlichsprachliche Speicher ausreichende repräsentationale Reichhaltigkeit für diese integrativen Aufgaben bieten. Überraschenderweise übersetzen sich die
| Methode | K | Chunk-Größe / Speicher-Token | Latenz (Sekunden) | Gesamt-J | |||
| Suche | Gesamt | ||||||
| RAG | 1 | 128 | 0,281 | 0,823 | 0,774 | 1,825 | 47,77 ± 0,23 % |
| 256 | 0,251 | 0,710 | 0,745 | 1,628 | 50,15 ± 0,16 % | ||
| 512 | 0,240 | 0,639 | 0,772 | 1,710 | 46,05 ± 0,14 % | ||
| 1024 | 0,240 | 0,723 | 0,821 | 1,957 | 40,74 ± 0,17 % | ||
| 2048 | 0,255 | 0,752 | 0,996 | 2,182 | 37,93 ± 0,12 % | ||
| 8192 | 4096 | 0,254 | 0,719 | 1,093 | 2,711 | 36,84 ± 0,17 % | |
| 812 | 0,279 | 0,838 | 1,396 | 4,416 | 44,53 ± 0,13 % | ||
| 128 | 0,267 | 0,624 | 0,766 | 1,829 | 59,56 ± 0,19 % | ||
| 256 | 0,255 | 0,699 | 0,802 | 1,907 | 60,97 ± 0,20 % | ||
| 2 | 1024 | 512 | 0,247 | 0,746 | 0,829 | 1,729 | 58,19 ± 0,18 % |
| 2048 | 0,238 | 0,702 | 0,860 | 1,850 | 50,68 ± 0,13 % | ||
| 4096 | 0,261 | 0,829 | 1,101 | 2,791 | 48,57 ± 0,22 % | ||
| 812 | 0,266 | 0,944 | 1,451 | 4,822 | 51,79 ± 0,15 % | ||
| 8192 | 0,288 | 1,124 | 2,312 | 9,942 | 60,53 ± 0,16 % | ||
| Vollständiger Kontext | 26031 | - | - | 9,870 | 17,117 | 72,90 ± 0,19 % | |
| A-Mem | 2520 | 0,668 | 1,485 | 1,410 | 4,374 | 48,38 ± 0,15 % | |
| LangMem | 127 | 17,99 | 59,82 | 18,53 | 60,40 | 58,10 ± 0,21 % | |
| Zep | 3911 | 0,513 | 0,778 | 1,292 | 2,926 | 65,99 ± 0,16 % | |
| OpenAI | 4437 | - | - | 0,466 | 0,889 | 52,90 ± 0,14 % | |
| Mem0 | 1764 | 0,148 | 0,200 | 0,708 | 1,440 | 66,88 ± 0,15 % | |
| Mem0^8 | 3616 | 0,476 | 0,657 | 1,091 | 2,590 | 68,44 ± 0,17 % | |
erwarteten relationalen Vorteile von hier nicht in bessere Ergebnisse, was auf potenziellen Overhead oder Redundanz beim Navigieren durch komplexere Graphstrukturen in mehrstufigen Schlussfolgerungsszenarien hindeutet.
Beim temporalen Schlussfolgern übertrifft andere Methoden substanziell und bestätigt, dass strukturierte relationale Graphen bei der Erfassung chronologischer Beziehungen und Ereignissequenzen herausragen. Das Vorhandensein expliziten relationalen Kontexts verbessert die temporale Kohärenz von erheblich und übertrifft die dichte Speicherung von , was die Bedeutung präziser relationaler Repräsentationen bei der Verfolgung zeitlich sensibler Informationen hervorhebt. Die Open-Domain-Leistung verstärkt further den Wert relationaler Modellierung. , profitierend von der relationalen Klarheit graphbasierten Speichers, konkurriert eng mit der leistungsstärksten Baseline (Zep). Dieses konkurrenzfähige Ergebnis unterstreicht die Robustheit von bei der Integration externen Wissens durch relationale Klarheit und deutet auf eine optimale Synergie zwischen strukturiertem Speicher und Open-Domain-Informationssynthese hin.
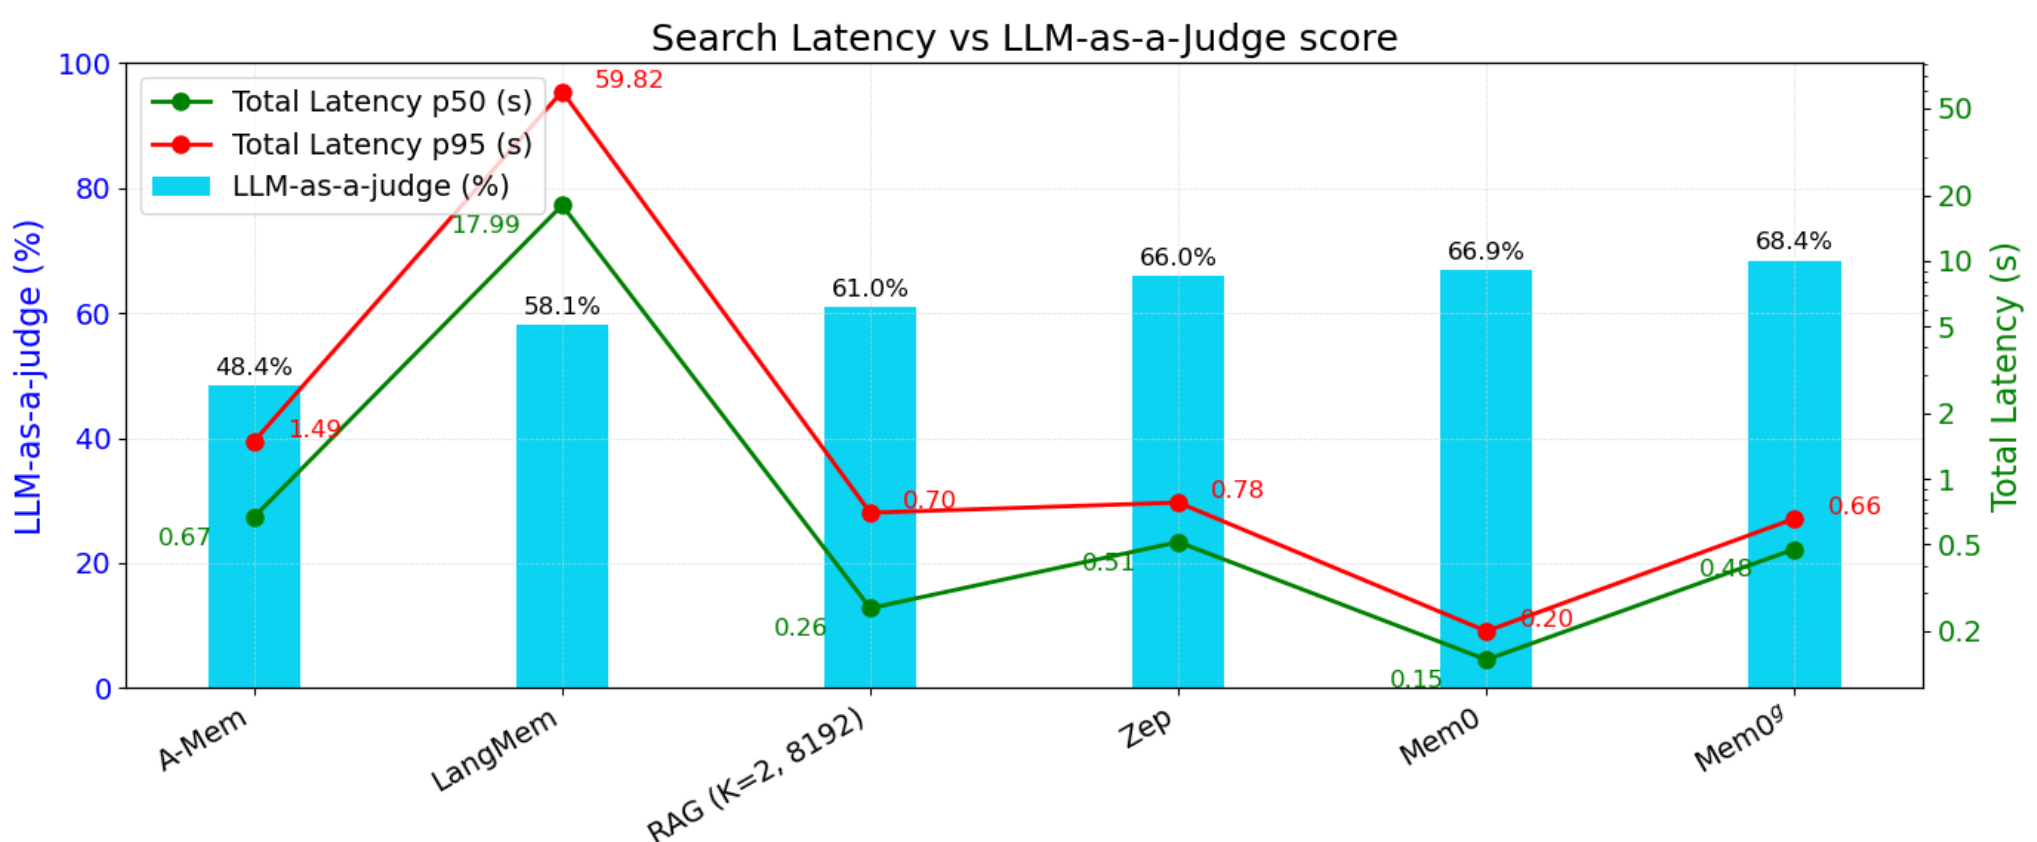
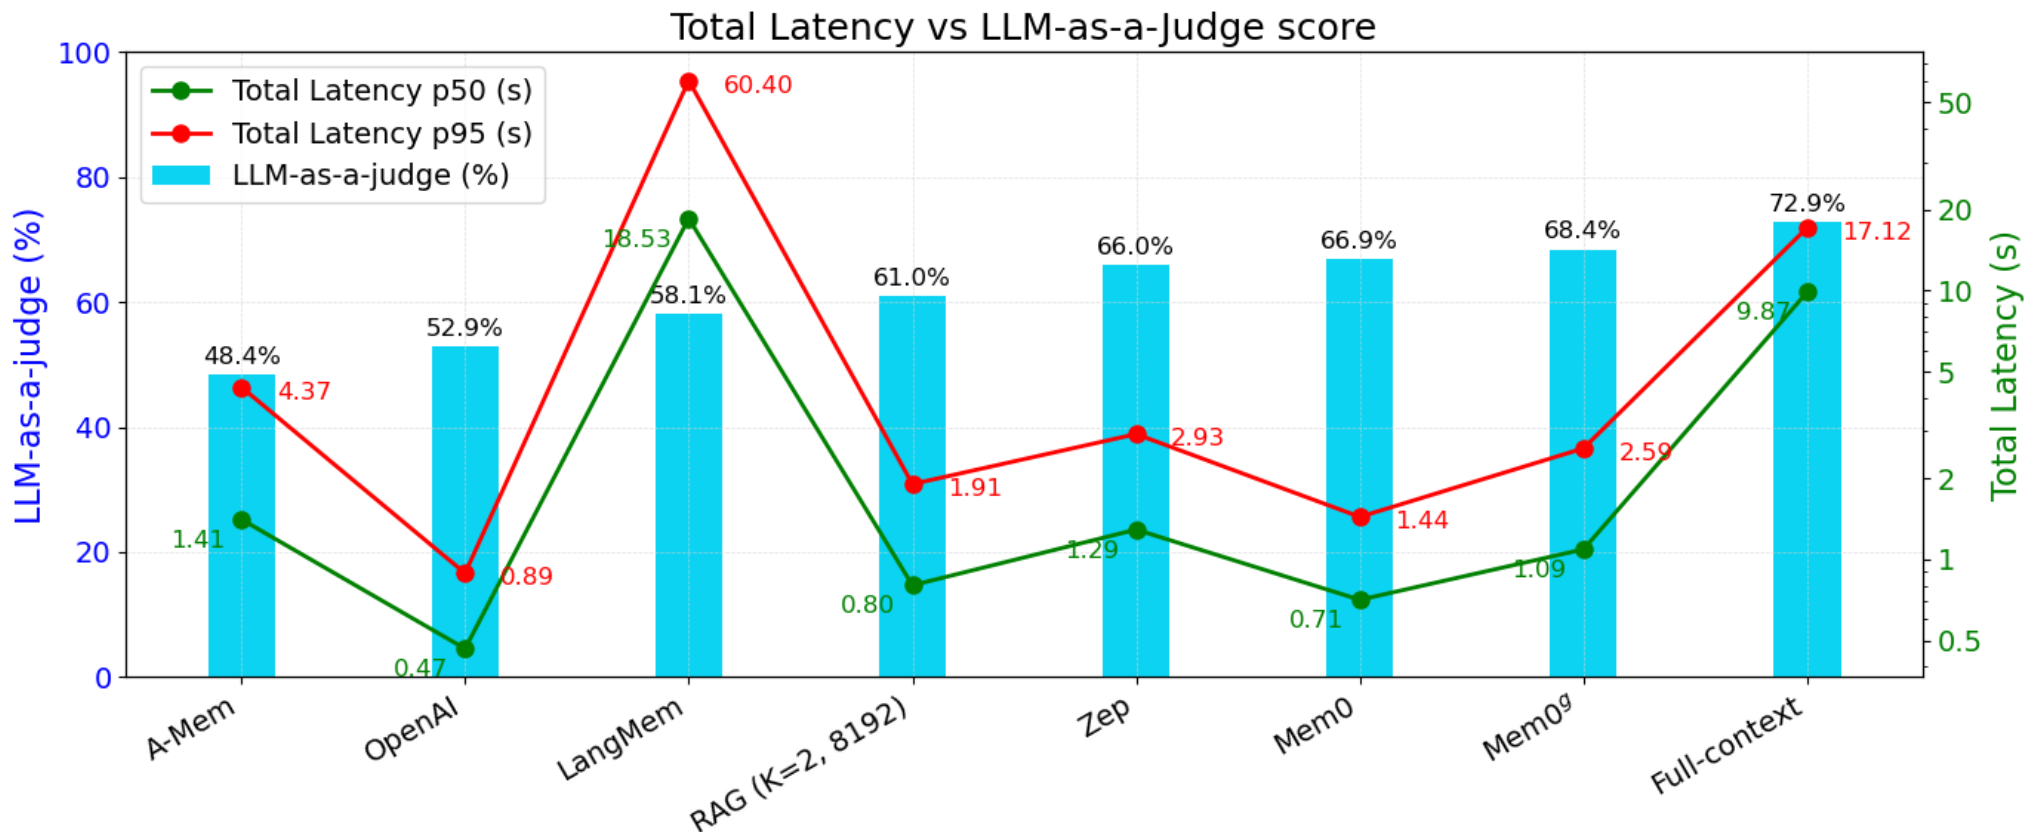
Abbildung 4: Latenzanalyse verschiedener Speicheransätze. Diese Teilabbildungen veranschaulichen die J-Werte und den Latenzvergleich verschiedener ausgewählter Methoden aus Tabelle 2. Teilabbildung (a) hebt die Such-/Abruflatenz vor der Antwortgenerierung hervor, während Teilabbildung (b) die Gesamtlatenz (einschließlich LLM-Inferenz) zeigt. Beide Diagramme überlagern den J-Wert jeder Methode für eine ganzheitliche Sicht auf ihre Genauigkeit und Effizienz.
Insgesamt zeigt unsere Analyse komplementäre Stärken von Mem0 und Mem08 über verschiedene Aufgabenanforderungen hinweg: dichter, natürlichsprachlich basierter Speicher bietet signifikante Effizienz für einfachere Abfragen, während explizite relationale Modellierung für Aufgaben essenziell wird, die nuancierte temporale und kontextuelle Integration erfordern. Diese Ergebnisse bekräftigen die Bedeutung anpassungsfähiger Speicherstrukturen, die auf spezifische Schlussfolgerungskontexte in KI-Agenten-Bereitstellungen zugeschnitten sind.
4.3. Leistungsvergleich von MemO und MemO gegenüber RAG-Ansätzen und Full-Context-Modell
Die Vergleiche in Tabelle 2, mit Fokus auf die Spalte „Overall J“, zeigen, dass sowohl MemO als auch MemO durchgängig alle RAG-Konfigurationen übertreffen, die Chunk-Größen (128–8192 Token) variieren und entweder einen oder zwei Chunks abrufen. Selbst der stärkste RAG-Ansatz erreicht Spitzenwerte von etwa in der J-Metrik, während MemO erreicht – eine relative Verbesserung von etwa – und MemO über erreicht, was einem relativen Gewinn von etwa entspricht. Diese Fortschritte unterstreichen den Vorteil, nur die salientesten Fakten im Speicher zu erfassen, anstatt große Chunks des Originaltexts abzurufen. Durch die Umwandlung der Konversationshistorie in prägnante, strukturierte Repräsentationen mildern MemO und MemO Rauschen und liefern präzisere Hinweise an das LLM, was zu besseren Antworten führt, wie von einem externen LLM (J) bewertet.
Trotz dieser Verbesserungen erreicht eine Vollkontext-Methode, die einen Block von etwa 26.000 Tokens verarbeitet, noch immer den höchsten J-Score (etwa ). Wie jedoch in Abbildung 4b gezeigt wird, verursacht sie auch eine sehr hohe gesamte p95-Latenz – rund 17 Sekunden –, da das Modell bei jeder Anfrage die gesamte Konversation lesen muss. Im Gegensatz dazu reduzieren MemO und MemO den Tokenverbrauch erheblich und erreichen dadurch niedrigere p95-Latenzen von etwa 1,44 Sekunden (eine Reduktion um ) bzw. 2,6 Sekunden (eine Reduktion um ) im Vergleich zum Vollkontext-Ansatz. Obwohl der Vollkontext-Ansatz einen leichten Genauigkeitsvorteil bieten kann, bieten die speicherbasierten Systeme einen praktischeren Kompromiss, indem sie eine nahezu wettbewerbsfähige Qualität beibehalten und dabei nur einen Bruchteil der Token- und Latenzkosten verursachen. Mit zunehmender Konversationslänge leiden Vollkontext-Ansätze unter einem exponentiellen Anstieg des Rechenaufwands (erkennbar in Tabelle 2, wo die gesamte p95-Latenz mit größeren -Werten oder Chunk-Größen deutlich zunimmt). Dieser Anstieg der Eingabe-Chunks führt zu längeren Antwortzeiten und höheren Tokenverbrauchskosten. Im Gegensatz dazu behalten speicherfokussierte Ansätze wie MemO und MemO eine konsistente Leistung unabhängig von der Konversationslänge bei, was sie für produktionsskalierte Bereitstellungen, bei denen Effizienz und Reaktionsfähigkeit entscheidend sind, deutlich praktikabler macht.
4.4. Latenzanalyse
Tabelle 2 bietet einen umfassenden Leistungsvergleich verschiedener Retrieval- und Speichermethodiken und präsentiert Median- (p50) und Tail-Latenzen (p95) sowohl für die Suchphase als auch für die gesamte Antwortgenerierung über den LOCOM0-Datensatz. Unsere Analyse zeigt ausgeprägte Leistungsmuster, die von architektonischen Entscheidungen bestimmt werden. Speicherzentrische Architekturen weisen unterschiedliche Leistungsmerkmale auf. A-Mem verursacht trotz seines größeren Speichers einen erheblichen Suchaufwand (p50: 0,668 s), was zu gesamten medianen Latenzen von 1,410 s führt. LangMem weist noch höhere Suchlatenzen auf (p50: 17,99 s, p95: 59,82 s), was es für interaktive Anwendungen unpraktisch macht. Zep erreicht eine moderate Leistung (p50 gesamt: 1,292 s). Die Vollkontext-Baseline, die den gesamten Konversationsverlauf ohne Retrieval verarbeitet, unterscheidet sich grundlegend von retrievalbasierten Ansätzen. Indem sie den gesamten Konversationskontext (26000 Tokens) direkt an das LLM übergibt, eliminiert sie den Suchaufwand, verursacht jedoch extreme Gesamtlatenzen (p50: 9,870 s, p95: 17,117 s). In ähnlicher Weise führt die OpenAI-Implementierung keine Speichersuche durch, da sie manuell extrahierte Erinnerungen aus ihrem Playground verarbeitet. Obwohl dieser Ansatz beeindruckende Antwortgenerierungszeiten erzielt (p50: 0,466 s, p95: 0,889 s), erfordert er eine vorherige Extraktion des relevanten Kontexts, was in den berichteten Metriken nicht widergespiegelt wird.
Unser vorgeschlagener MemO-Ansatz erreicht die niedrigste Suchlatenz unter allen Methoden (p50: 0,148 s, p95: 0,200 s), wie in Abbildung 4a dargestellt. Diese Effizienz resultiert aus unserem selektiven Speicherretrieval-Mechanismus und Infrastrukturverbesserungen, die dynamisch nur die relevantesten Informationen identifizieren und abrufen, anstatt feste Chunk-Größen zu verwenden. Folglich behält MemO die niedrigste gesamte mediane Latenz (0,708 s) mit bemerkenswert begrenzten p95-Werten (1,440 s) bei, was es besonders für latenzempfindliche Anwendungen wie interaktive KI-Agenten geeignet macht. Die graphgestützte Variante MemO führt zusätzliche relationale Modellierungsfähigkeiten zu moderaten Latenzkosten ein, wobei die Suchzeiten (0,476 s) noch immer alle bestehenden Speicherlösungen und Baselines übertreffen. Trotz dieses Anstiegs behält Memo8 wettbewerbsfähige Gesamtlatenzen bei (p50: 1,091 s, p95: 2,590 s) und erzielt gleichzeitig den höchsten J-Score (68,44 %) unter allen Methoden – nur übertroffen vom rechnerisch prohibitiven Vollkontext-Ansatz. Dieses Leistungsprofil demonstriert die Fähigkeit unserer Methoden, Antwortqualität und Recheneffizienz auszubalancieren, und bietet eine überzeugende Lösung für produktive KI-Agenten, bei denen beide Faktoren kritische Einschränkungen darstellen.
4.5. Overhead des Speichersystems: Token-Analyse und Konstruktionszeit
Wir messen das durchschnittliche Token-Budget, das erforderlich ist, um den Langzeitspeicher jedes Systems zu materialisieren. Memo kodiert vollständige Dialogwechsel in einer natürlichsprachlichen Repräsentation und belegt daher im Durchschnitt nur 7k Token pro Konversation. Wohingegen Memo8 den Fußabdruck auf etwa 14k Token nahezu verdoppelt, bedingt durch die Einführung von Graph-Erinnerungen, die Knoten und entsprechende Beziehungen umfassen. In scharfem Kontrast dazu verbraucht Zeps Speichergraph über 600k Token. Die Aufblähung entsteht durch Zeps Designentscheidung, an jedem Knoten eine vollständige abstraktive Zusammenfassung zu cachen und zugleich Fakten auf den verbindenden Kanten zu speichern, was zu umfangreicher Redundanz über den Graphen hinweg führt. Zum Vergleich: Die Bereitstellung des gesamten rohen Konversationskontexts für das Sprachmodell – ohne jegliche Speicherabstraktion – beläuft sich im Durchschnitt auf etwa 26k Token, 20-mal weniger relativ zu Zeps Graph. Über die Token-Ineffizienz hinaus zeigten unsere Experimente erhebliche operative Engpässe bei Zep. Nach dem Hinzufügen von Erinnerungen zu Zeps System beobachteten wir, dass unmittelbare Speicherabrufe unsere Anfragen oft nicht korrekt beantworten konnten. Interessanterweise ergaben erneute identische Suchen nach einer Verzögerung von mehreren Stunden deutlich bessere Ergebnisse. Diese Latenz legt nahe, dass Zeps Graph-Konstruktion mehrere asynchrone LLM-Aufrufe und umfangreiche Hintergrundverarbeitung umfasst, was das Speichersystem für Echtzeitanwendungen unpraktisch macht. Im Gegensatz dazu schließt die Konstruktion des Memo-Graphen selbst in Worst-Case-Szenarien in unter einer Minute ab, sodass Nutzer neu hinzugefügte Erinnerungen unmittelbar für Abfrageantworten nutzen können.
Diese Ergebnisse unterstreichen, dass Zep nicht nur identische Wissensfragmente über mehrere Knoten hinweg repliziert, sondern auch erhebliche operative Verzögerungen einführt. Unsere Architekturen – MemO und Memo8 – bewahren dieselben Informationen zu einem Bruchteil der Token-Kosten und mit wesentlich schnellerer Speicherverfügbarkeit und bieten eine speichereffizientere und operativ reaktionsschnellere Repräsentation.
5. Fazit und zukünftige Arbeiten
Wir haben MemO und Memo8 eingeführt, zwei komplementäre Speicherarchitekturen, die die inhärenten Einschränkungen fester Kontextfenster in LLMs überwinden. Durch dynamisches Extrahieren, Konsolidieren und Abrufen kompakter Speicherrepräsentationen erreicht MemO Spitzenleistungen bei Single-Hop- und Multi-Hop-Reasoning, während die graphbasierten Erweiterungen von Memo signifikante Gewinne bei temporalen und Open-Domain-Aufgaben erschließen. Auf dem LOCOMO-Benchmark erzielen unsere Methoden relative Verbesserungen von 5 %, 11 % und 7 % bei Single-Hop-, temporalen und Multi-Hop-Reasoning-Fragetypen gegenüber den leistungsstärksten Methoden im jeweiligen Fragetyp und reduzieren die p95-Latenz um über 91 % im Vergleich zu Vollkontext-Baselines – was ein starkes Gleichgewicht zwischen Präzision und Reaktionsfähigkeit demonstriert. Memos dichte Speicherpipeline zeichnet sich durch schnellen Abruf für einfache Anfragen aus und minimiert Token-Verbrauch und Rechenaufwand. Im Gegensatz dazu bieten Memos strukturierte Graph-Repräsentationen nuancierte relationale Klarheit und ermöglichen komplexe Ereignissequenzierung und reiche Kontextintegration, ohne praktische Effizienz zu opfern. Zusammen bilden sie einen vielseitigen Speicher-Toolkit, der sich an vielfältige Konversationsanforderungen anpasst und zugleich im Maßstab einsetzbar bleibt.
Zukünftige Forschungsrichtungen umfassen die Optimierung von Graph-Operationen zur Reduzierung des Latenz-Overheads in Memo8, die Erkundung hierarchischer Speicherarchitekturen, die Effizienz mit relationaler Repräsentation verbinden, und die Entwicklung ausgefeilterer Speicherkonsolidierungsmechanismen, inspiriert von menschlichen kognitiven Prozessen.
Darüber hinaus würde die Erweiterung unserer Speicher-Frameworks auf Domänen jenseits von Konversationsszenarien, wie prozedurales Reasoning und multimodale Interaktionen, ihre breitere Anwendbarkeit weiter validieren. Indem wir die grundlegenden Einschränkungen fester Kontextfenster angehen, stellt unsere Arbeit einen bedeutenden Fortschritt hin zu konversationellen KI-Systemen dar, die in der Lage sind, kohärente, kontextuell reiche Interaktionen über längere Zeiträume aufrechtzuerhalten, ganz ähnlich ihren menschlichen Gegenstücken.
6. Danksagungen
Wir möchten unseren aufrichtigen Dank an Harsh Agarwal, Shyamal Anadkat, Prithvijit Chattopadhyay, Siddesh Choudhary, Rishabh Jain und Vaibhav Pandey für ihre unschätzbaren Einsichten und gründlichen Durchsichten früher Entwürfe ausdrücken. Ihre konstruktiven Kommentare und detaillierten Anregungen halfen, das Manuskript zu verfeinern und sowohl seine Klarheit als auch seine Gesamtqualität zu verbessern. Wir schätzen ihre Großzügigkeit zutiefst, Zeit und Expertise für diese Arbeit aufzubringen.
Literaturverzeichnis
Anthropic. Model card and evaluations for claude models. Technical report, Anthropic, February 2025. URL https://www.anthropic.com/news/claude- 3- 7- sonnet.
Jan Assmann. Communicative and cultural memory. In Cultural memories: The geographical point of view, pages 15- 27. Springer, 2011.
Aydar Bulatov, Yury Kuratov, and Mikhail Burtsev. Recurrent memory transformer. Advances in Neural Information Processing Systems, 35:11079- 11091, 2022.
Prateek Chhikara, Jiarui Zhang, Filip Ilievski, Jonathan Francis, and Kaixin Ma. Knowledge- enhanced agents for interactive text games. In Proceedings of the 12th Knowledge Capture Conference 2023, pages 157- 165, 2023.
Fergus IM Craik and Janine M Jennings. Human memory. 1992.
Gaurav Goswami. Dissecting the metrics: How different evaluation approaches yield diverse results for conversational ai. Authorea Preprints, 2025.
Tianyu Guo, Druv Pai, Yu Bai, Jiantao Jiao, Michael Jordan, and Song Mei. Active- dormant attention heads: Mechanistically demystifying extreme- token phenomena in llms. In NeurIPS 2024 Workshop on Mathematics of Modern Machine Learning, 2024.
Kostas Hatalis, Despina Christou, Joshua Myers, Steven Jones, Keith Lambert, Adam Amos- Binks, Zohreh Dannenhauer, and Dustin Dannenhauer. Memory matters: The need to improve long- term memory in llm- agents. In Proceedings of the AAAI Symposium Series, volume 2, pages 277- 280, 2023.
Zihong He, Weizhe Lin, Hao Zheng, Fan Zhang, Matt W Jones, Laurence Aitchison, Xuhai Xu, Miao Liu, Per Ola Kristensson, and Junxiao Shen. Human- inspired perspectives: A survey on ai long- term memory. arXiv preprint arXiv:2411.00489, 2024.
Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt- 4o system card. arXiv preprint arXiv:2410.21276, 2024.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El- Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. In International Conference on Machine Learning, pages 26396- 26415. PMLR, 2024.
Lei Liu, Xiaoyan Yang, Yue Shen, Binbin Hu, Zhiqiang Zhang, Jinjie Gu, and Guannan Zhang. Think- in- memory: Recalling and post- thinking enable llms with long- term memory. arXiv preprint arXiv:2311.08719, 2023.
Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 13851- 13870, 2024.
Bodhisattwa Prasad Majumder, Bhavana Dalvi Mishra, Peter Jansen, Oyvind Tafjord, Niket Tandon, Li Zhang, Chris Callison- Burch, and Peter Clark. Clin: A continually learning language agent for rapid task adaptation and generalization. In First Conference on Language Modeling.
Elliot Nelson, Georgios Kollias, Payel Das, Subhajit Chaudhury, and Soham Dan. Needle in the haystack for memory based large language models. arXiv preprint arXiv:2407.01437, 2024.
Charles Packer, Vivian Fang, Shishir G Patil, Kevin Lin, Sarah Wooders, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. 2023.
Preston Rasmussen, Pavlo Paliychuk, Travis Beauvais, Jack Ryan, and Daniel Chalef. Zep: A temporal knowledge graph architecture for agent memory. arXiv preprint arXiv:2501.13956, 2025.
Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie, and Christopher D Manning. Raptor: Recursive abstractive processing for tree- organized retrieval. In The Twelfth International Conference on Learning Representations, 2024.
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36:8634- 8652, 2023.
Prabhijot Singh, Prateek Chhikara, and Jasmeet Singh. An ensemble approach for extractive text summarization. In 2020 International Conference on Emerging Trends in Information Technology and Engineering (ic- ETTE), pages 1- 7. IEEE, 2020.
Arpita Soni, Rajeev Arora, Anoop Kumar und Dheerendra Panwar. Bewertung der Domänenabdeckung in ressourcenarmen generativen Chatbots: Eine vergleichende Studie offener und geschlossener Domänenansätze anhand von BLEU-Scores. In 2024 International Conference on Electrical Electronics and Computing Technologies (ICEECT), Band 1, Seiten 1-6. IEEE, 2024.
Gemini Team, Petko Georgiev, Ving Ian Lei, Ryan Burnell, Libin Bai, Anmol Gulati, Garrett Tanzer, Damien Vincent, Zhufeng Pan, Shibo Wang, et al. Gemini 1.5: Multimodales Verständnis über Millionen von Kontext-Tokens hinweg erschließen. arXiv preprint arXiv:2403.05530, 2024.
Joan C Timoneda und Sebastián Vallejo Vera. Memory is all you need: Testing how model memory affects llm performance in annotation tasks. arXiv preprint arXiv:2503.04874, 2025.
Wujiang Xu, Zujie Liang, Kai Mei, Hang Gao, Juntao Tan und Yongfeng Zhang. A-mem: Agentic memory for llm agents. arXiv preprint arXiv:2502.12110, 2025.
Yangyang Yu, Haohang Li, Zhi Chen, Yuechen Jiang, Yang Li, Denghui Zhang, Rong Liu, Jordan W Suchow und Khaldoun Khashanah. Finmem: A performance-enhanced llm trading agent with layered memory and character design. In Proceedings of the AAAI Symposium Series, Band 3, Seiten 595-597, 2024.
Jiarui Zhang. Guided profile generation improves personalization with large language models. In Findings of the Association for Computational Linguistics: EMNLP 2024, Seiten 4005-4016, 2024.
Jiarui Zhang, Filip Ilievski, Kaixin Ma, Jonathan Francis und Alessandro Oltramari. A study of zero-shot adaptation with commonsense knowledge. In AKBC, 2022.
Zeyu Zhang, Xiaohé Bo, Chen Ma, Rui Li, Xu Chen, Quanyu Dai, Jieming Zhu, Zhenhua Dong und Ji-Rong Wen. A survey on the memory mechanism of large language model based agents. arXiv preprint arXiv:2404.13501, 2024.
Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye und Yanlin Wang. Memorybank: Enhancing large language models with long-term memory. In Proceedings of the AAAI Conference on Artificial Intelligence, Band 38, Seiten 19724–19731, 2024.
Anhang
A. Prompts
Bei der Entwicklung unseres LLM-as-a-Judge-Prompts übernehmen wir Elemente aus dem von Packer et al. (2023) veröffentlichten Prompt.
PROMPT-VORLAGE FÜR LLM ALS RICHTER
Ihre Aufgabe ist es, eine Antwort auf eine Frage als „CORRECT“ oder „WRONG“ zu kennzeichnen. Sie erhalten die folgenden Daten: (1) eine Frage (von einem Nutzer an einen anderen Nutzer gestellt), (2) eine „Gold“-Antwort (Ground Truth), (3) eine generierte Antwort, die Sie als CORRECT/WRONG bewerten.
Der Sinn der Frage besteht darin, nach etwas zu fragen, das ein Nutzer über den anderen Nutzer basierend auf ihren früheren Gesprächen wissen sollte. Die Gold-Antwort ist normalerweise eine prägnante und kurze Antwort, die das referenzierte Thema enthält, zum Beispiel:
Frage: Erinnerst du dich, was ich bekommen habe, als ich das letzte Mal nach Hawaii gefahren bin?
Gold-Antwort: Eine Muschelkette
Die generierte Antwort kann viel länger sein, aber Sie sollten bei Ihrer Bewertung großzügig sein – solange sie dasselbe Thema wie die Gold-Antwort berührt, sollte sie als CORRECT gezählt werden.
Bei zeitbezogenen Fragen ist die Gold-Antwort ein konkretes Datum, ein Monat, ein Jahr usw. Die generierte Antwort kann viel länger sein oder relative Zeitangaben verwenden (wie „letzten Dienstag“ oder „nächsten Monat“), aber Sie sollten bei Ihrer Bewertung großzügig sein – solange sie sich auf dasselbe Datum oder denselben Zeitraum wie die Gold-Antwort bezieht, sollte sie als CORRECT gezählt werden. Selbst wenn das Format abweicht (z. B. „7. Mai“ vs. „7 May“), betrachten Sie es als CORRECT, wenn es dasselbe Datum ist.
Jetzt ist es Zeit für die eigentliche Frage: Frage: {question}
Gold-Antwort: {gold_answer}
Generierte Antwort: {generated_answer}
Geben Sie zunächst eine kurze (einsätzige) Erklärung Ihrer Begründung und schließen Sie dann mit CORRECT oder WRONG ab. Fügen Sie NICHT sowohl CORRECT als auch WRONG in Ihre Antwort ein, da dies das Evaluierungsskript beeinträchtigen würde.
Geben Sie einfach das Label CORRECT oder WRONG im JSON-Format mit dem Schlüssel „label“ zurück.
PROMPT-VORLAGE FÜR DIE ERGEBNISGENERIERUNG (MEMO)
Sie sind ein intelligenter Speicherassistent, dessen Aufgabe es ist, genaue Informationen aus Gesprächserinnerungen abzurufen.
KONTEXT:
Sie haben Zugriff auf Erinnerungen von zwei Sprechen in einem Gespräch. Diese Erinnerungen enthalten mit Zeitstempeln versehene Informationen, die für die Beantwortung der Frage relevant sein können.
ANWEISUNGEN:
1. Analysieren Sie sorgfältig alle bereitgestellten Erinnerungen beider Sprecher 2. Achten Sie besonders auf die Zeitstempel, um die Antwort zu bestimmen 3. Wenn die Frage nach einem bestimmten Ereignis oder Fakt fragt, suchen Sie nach direkten Belegen in den Erinnerungen 4. Wenn die Erinnerungen widersprüchliche Informationen enthalten, priorisieren Sie die neueste Erinnerung 5. Wenn es eine Frage zu Zeitangaben gibt (wie „letztes Jahr“, „vor zwei Monaten“ usw.), berechnen Sie das tatsächliche Datum basierend auf dem Zeitstempel der Erinnerung. Wenn beispielsweise eine Erinnerung vom 4. Mai 2022 „letztes Jahr nach Indien gefahren“ erwähnt, dann fand die Reise 2021 statt. 6. Konvertieren Sie relative Zeitangaben stets in konkrete Daten, Monate oder Jahre. Konvertieren Sie beispielsweise „letztes Jahr“ in „2022“ oder „vor zwei Monaten“ in „März 2023“ basierend auf dem Zeitstempel der Erinnerung. Ignorieren Sie die Referenz beim Beantworten der Frage. 7. Konzentrieren Sie sich ausschließlich auf den Inhalt der Erinnerungen beider Sprecher. Verwechseln Sie keine in Erinnerungen erwähnten Charakternamen mit den tatsächlichen Nutzern, die diese Erinnerungen erstellt haben. 8. Die Antwort sollte weniger als 5–6 Wörter umfassen.
VORGEHENSWEISE (Schritt für Schritt denken):
1. Untersuchen Sie zunächst alle Erinnerungen, die Informationen zur Frage enthalten 2. Untersuchen Sie die Zeitstempel und Inhalte dieser Erinnerungen sorgfältig 3. Suchen Sie nach expliziten Erwähnungen von Daten, Zeiten, Orten oder Ereignissen, die die Frage beantworten 4. Wenn die Antwort eine Berechnung erfordert (z. B. die Umwandlung relativer Zeitangaben), zeigen Sie Ihre Arbeit 5. Formulieren Sie eine präzise, knappe Antwort ausschließlich auf Grundlage der Belege in den Erinnerungen 6. Prüfen Sie noch einmal, ob Ihre Antwort direkt auf die gestellte Frage eingeht 7. Stellen Sie sicher, dass Ihre endgültige Antwort spezifisch ist und vage Zeitangaben vermeidet
Erinnerungen für Nutzer {speaker_1_user_id}: {speaker_1_memories}
Erinnerungen für Nutzer {speaker_2_user_id}: {speaker_2_memories}
Frage: {question}
Antwort:
PROMPT-VORLAGE FÜR DIE ERGEBNISGENERIERUNG (MEMO'S)
(gleich wie zuvor)
VORGEHENSWEISE (Schritt für Schritt denken):
1. Untersuchen Sie zunächst alle Erinnerungen, die Informationen zur Frage enthalten 2. Untersuchen Sie die Zeitstempel und Inhalte dieser Erinnerungen sorgfältig 3. Suchen Sie nach expliziten Erwähnungen von Daten, Zeiten, Orten oder Ereignissen, die die Frage beantworten 4. Wenn die Antwort eine Berechnung erfordert (z. B. die Umwandlung relativer Zeitangaben), zeigen Sie Ihre Arbeit 5. Analysieren Sie die Beziehungen im Wissensgraphen, um den Wissenskontext des Nutzers zu verstehen 6. Formulieren Sie eine präzise, knappe Antwort ausschließlich auf Grundlage der Belege in den Erinnerungen 7. Prüfen Sie noch einmal, ob Ihre Antwort direkt auf die gestellte Frage eingeht 8. Stellen Sie sicher, dass Ihre endgültige Antwort spezifisch ist und vage Zeitangaben vermeidet
Erinnerungen für Nutzer {speaker_1_user_id}: {speaker_1_memories}
Beziehungen für Nutzer {speaker_1_user_id}: {speaker_1_graph_memories}
Erinnerungen für Nutzer {speaker_2_user_id}: {speaker_2_memories}
Beziehungen für Nutzer {speaker_2_user_id}: {speaker_2_graph_memories}
Frage: {question}
Antwort:
PROMPT-VORLAGE FÜR OPENAI CHATGPT
Können Sie bitte relevante Informationen aus diesem Gespräch extrahieren und für jeden erwähnten Nutzer Speichereinträge erstellen? Bitte speichern Sie diese Erinnerungen zusätzlich zum angegebenen Zeitstempel in Ihrer Wissensdatenbank für zukünftige Referenzen und personalisierte Interaktionen.
(13:56 Uhr am 8. Mai 2023) Caroline: Hey Mel! Schön, dich zu sehen! Wie ist es dir ergangen? (13:56 Uhr am 8. Mai 2023) Melanie: Hey Caroline! Schön, dich zu sehen! Ich bin mit den Kindern und der Arbeit völlig ausgelastet. Was gibt's bei dir? Irgendetwas Neues? (13:56 Uhr am 8. Mai 2023) Caroline: Ich war gestern bei einer LGBTQ-Selbsthilfegruppe und es war so kraftvoll.
B. Algorithmus
Algorithmus 1 Speicherverwaltungssystem: Aktualisierungsoperationen
1: Eingabe: Menge der abgerufenen Fakten , bestehender Speicher
2: Ausgabe: Aktualisierter Speicher
3: Prozedur UPDATE MEMORY(F, M)
4: für jeden Fakt tue
5: Operation CLASSIFYOPERATION
Führe die entsprechende Operation basierend auf der Klassifikation aus
6: wenn Operation ADD dann
7: GenerateUniqueID()
8:
Neuen Fakt mit eindeutiger Kennung hinzufügen
9: else if Operation UPDATE then
10: FindRelatedMemory
11: if InformationContent InformationContent then
12: Durch reichhaltigere Informationen ersetzen
13: end if
14: else if Operation DELETE then
15: FindContradictedMemory
16: Widersprüchliche Informationen entfernen
17: else if Operation NOOP then
18: Keine Operation durchgeführt. Fakt existiert bereits oder ist irrelevant.
19: end if
20: end for
21: return M
22: end procedure
23: function CLASSIFYOPERATION
24: if SemanticallySimilar then
25: return ADD
26: else if Contradicts then
27: return DELETE
28: else if Augments then
29: return UPDATE
30: else
31: return NOOP
32: end if
33: end function
Neue Information, die nicht im Speicher vorhanden ist
Information steht im Konflikt mit dem vorhandenen Speicher
Erweitert vorhandene Informationen im Speicher
Keine Änderung erforderlich
C. Ausgewählte Baselines
LoCoMo Das LoCoMo-Framework implementiert eine ausgefeilte Speicher-Pipeline, die es LLM-Agenten ermöglicht, kohärente Langzeitgespräche zu führen. Im Kern unterteilt das System den Speicher in Kurzzeit- und Langzeitkomponenten. Nach jeder Gesprächssitzung erzeugen die Agenten Zusammenfassungen (als Kurzzeitspeicher gespeichert), die die Schlüsselinformationen aus dieser Interaktion destillieren. Gleichzeitig werden einzelne Gesprächsbeiträge in „Beobachtungen“ umgewandelt – faktische Aussagen über die Persona jedes Sprechers und Lebensereignisse, die im Langzeitspeicher mit Verweisen auf die spezifischen Dialogbeiträge gespeichert werden, die sie hervorgebracht haben. Bei der Generierung neuer Antworten nutzen die Agenten sowohl die Zusammenfassung der jüngsten Sitzung als auch eine selektive Abfrage relevanter Beobachtungen aus ihrem Langzeitspeicher. Dieser Dual-Speicher-Ansatz wird zusätzlich durch die Einbeziehung eines temporalen Ereignisgraphen erweitert, der kausal verbundene Lebensereignisse zwischen Gesprächssitzungen verfolgt. Indem Antworten auf abgerufene Erinnerungen, den aktuellen Gesprächskontext, Persona-Informationen und dazwischenliegende Lebensereignisse konditioniert werden, ermöglicht das System den Agenten, konsistente Persönlichkeiten beizubehalten und wichtige Details über Gespräche hinweg abzurufen, die sich über Hunderte von Beiträgen und Dutzende von Sitzungen erstrecken.
ReadAgent ReadAgent adressiert die grundlegenden Einschränkungen von LLMs, indem es nachahmt, wie Menschen lange Texte durch eine ausgefeilte dreistufige Pipeline verarbeiten. Zunächst segmentiert das System in der Episode Pagination den Text intelligent an natürlichen kognitiven Grenzen statt an willkürlichen Trennstellen. Als Nächstes destilliert es während der Memory Gisting jedes Segment in prägnante Zusammenfassungen, die die wesentliche Bedeutung bewahren und gleichzeitig die Token-Anzahl drastisch reduzieren – ähnlich wie das menschliche Gedächtnis die Substanz von Informationen ohne wörtlichen Abruf behält. Schließlich untersucht der Interactive Lookup-Mechanismus, wenn er mit der Beantwortung von Fragen beauftragt wird, diese Gists und ruft strategisch nur die relevantesten Originaltextsegmente zur detaillierten Verarbeitung ab. Dieser vom Menschen inspirierte Ansatz ermöglicht es LLMs, Dokumente effektiv zu verwalten, die bis zu 20-mal länger sind als ihre normalen Kontextfenster. Durch die Balance zwischen globalem Verständnis durch Gists und selektiver Aufmerksamkeit für Details erreicht ReadAgent sowohl Recheneffizienz als auch verbessertes Verständnis und zeigt, dass die Nachahmung menschlicher kognitiver Prozesse die Textverarbeitungsfähigkeiten von KI erheblich verbessern kann.
MemoryBank Das MemoryBank-System erweitert LLMs durch eine ausgefeilte dreiteilige Pipeline um ein Langzeitgedächtnis. Im Kern lagert die Komponente Memory Storage detaillierte Gesprächsprotokolle, hierarchische Ereigniszusammenfassungen und sich entwickelnde Benutzerpersönlichkeitsprofile. Wenn eine neue Interaktion stattfindet, setzt der Memory Retrieval-Mechanismus ein Dual-Tower-Dense-Retrieval-Modell ein, um kontextuell relevante vergangene Informationen zu extrahieren. Die Komponente Memory Updating bietet einen menschenähnlichen Vergessensmechanismus, bei dem Erinnerungen stärker werden, wenn sie abgerufen werden, und mit der Zeit auf natürliche Weise verblassen, wenn sie nicht genutzt werden. Dieser umfassende Ansatz ermöglicht es KI-Begleitern, relevante Informationen abzurufen, das Kontextbewusstsein über längere Interaktionen hinweg aufrechtzuerhalten und zunehmend genauere Benutzerprofile zu entwickeln, was zu personalisierteren und natürlicheren Langzeitgesprächen führt.
MemGPT Das MemGPT-System führt einen von Betriebssystemen inspirierten Ansatz ein, um die Kontextfensterbeschränkungen von LLMs zu überwinden. Im Kern setzt MemGPT eine ausgefeilte Speicherverwaltungs-Pipeline ein, die aus drei Schlüsselkomponenten besteht: einem hierarchischen Speichersystem, selbstgesteuerten Speicheroperationen und einem ereignisbasierten Kontrollflussmechanismus. Das System unterteilt den verfügbaren Speicher in „main context“ (analog zum RAM in traditionellen Betriebssystemen) und „external context“ (analog zur Festplattenspeicherung). Der main context – der durch das Kontextfenster des LLM begrenzt ist – enthält Systemanweisungen, den aktuellen Gesprächsverlauf und Arbeitsgedächtnis, das vom Modell geändert werden kann. Der external context speichert unbegrenzte Informationen außerhalb des unmittelbaren Kontextfensters des Modells, einschließlich vollständiger Gesprächsverläufe und Archivdaten. Wenn das LLM Informationen benötigt, die nicht im main context vorhanden sind, kann es Funktionsaufrufe initiieren, um Inhalte über diese Speicherebenen hinweg zu durchsuchen, abzurufen oder zu ändern, wodurch relevante Informationen effektiv in sein begrenztes Kontextfenster „eingelagert“ und wieder ausgelagert werden. Diese vom Betriebssystem inspirierte Architektur ermöglicht es MemGPT, Gesprächskohärenz über längere Interaktionen hinweg aufrechtzuerhalten, Dokumente zu verwalten, die die Standardkontextgrenzen überschreiten, und Multi-Hop-Informationsabrufaufgaben durchzuführen – und das alles mit Modellen mit festem Kontext. Die Fähigkeit des Systems, seine eigenen Speicherressourcen intelligent zu verwalten, erzeugt die Illusion eines unendlichen Kontexts und erweitert das mit der aktuellen LLM-Technologie Mögliche erheblich.
A- Mem Das A-Mem-Modell führt ein agentisches Gedächtnissystem ein, das für LLM-Agenten konzipiert ist. Dieses System strukturiert und entwickelt Erinnerungen dynamisch durch miteinander verbundene Notizen. Jede Notiz erfasst Interaktionen, angereichert mit strukturierten Attributen wie Schlüsselwörtern, Kontextbeschreibungen und Tags, die vom LLM generiert werden. Beim Erstellen einer neuen Erinnerung verwendet A-MEM semantische Einbettungen, um relevante vorhandene Notizen abzurufen, und setzt dann einen LLM-gesteuerten Ansatz ein, um bedeutungsvolle Verknüpfungen basierend auf Ähnlichkeiten und gemeinsamen Attributen herzustellen. Entscheidend ist, dass der Mechanismus der Gedächtnisentwicklung vorhandene Notizen dynamisch aktualisiert und ihre kontextuellen Informationen und Attribute verfeinert, wann immer neue relevante Erinnerungen integriert werden. Somit entwickelt sich die Gedächtnisstruktur kontinuierlich weiter und ermöglicht reichere und kontextuell tiefere Verbindungen zwischen Erinnerungen. Der Abruf aus dem Gedächtnis erfolgt über semantische Ähnlichkeit und liefert relevanten historischen Kontext während der Interaktionen des Agenten.