
Ein 65B-Modell auf einer 48GB-GPU finetunen: 4-Bit-Quantisierung plus Adapter, bei voller 16-Bit-Qualität. NeurIPS 2023, kostenlos.
QLoRA: Efficient Finetuning of Quantized LLMs
QLoRA: Effizientes Finetuning quantisierter LLMs
Tim Dettmers\*
Artidoro Pagnoni\*
Ari Holtzman
Luke Zettlemoyer
University of Washington {dettmers,artidoro,ahai,lsz}@cs.washington.edu
Zusammenfassung
Wir präsentieren QLoRA, einen effizienten Finetuning-Ansatz, der den Speicherverbrauch so weit reduziert, dass ein Modell mit 65B Parametern auf einer einzelnen 48-GB-GPU feingetunt werden kann, während die volle Aufgabenleistung des 16-Bit-Finetunings erhalten bleibt. QLoRA propagiert Gradienten rückwärts durch ein eingefrorenes, 4-Bit-quantisiertes vortrainiertes Sprachmodell in Low Rank Adapters (LoRA). Unsere beste Modellfamilie, die wir Guanaco nennen, übertrifft alle zuvor offen veröffentlichten Modelle auf dem Vicuna-Benchmark und erreicht 99,3 % des Leistungsniveaus von ChatGPT, während sie nur 24 Stunden Finetuning auf einer einzelnen GPU erfordert. QLoRA führt eine Reihe von Innovationen ein, um Speicher zu sparen, ohne die Leistung zu beeinträchtigen: (a) 4-Bit NormalFloat (NF4), ein neuer Datentyp, der informationstheoretisch optimal für normalverteilte Gewichte ist, (b) Double Quantization, um den durchschnittlichen Speicherbedarf durch Quantisierung der Quantisierungskonstanten zu reduzieren, und (c) Paged Optimizers, um Speicherspitzen zu bewältigen. Wir verwenden QLoRA, um mehr als 1.000 Modelle feinzutunen, und liefern eine detaillierte Analyse der Instruction-Following- und Chatbot-Leistung über 8 Instruktionsdatensätze, mehrere Modelltypen (LLaMA, T5) und Modellgrößen, die mit regulärem Finetuning nicht realisierbar wären (z. B. Modelle mit 33B und 65B Parametern). Unsere Ergebnisse zeigen, dass QLoRA-Finetuning auf einem kleinen hochwertigen Datensatz zu State-of-the-Art-Ergebnissen führt, selbst wenn kleinere Modelle als die bisherige SoTA verwendet werden. Wir liefern eine detaillierte Analyse der Chatbot-Leistung basierend auf sowohl menschlichen als auch GPT-4-Bewertungen und zeigen, dass GPT-4-Bewertungen eine kostengünstige und vernünftige Alternative zur menschlichen Bewertung darstellen. Darüber hinaus stellen wir fest, dass aktuelle Chatbot-Benchmarks nicht vertrauenswürdig sind, um die Leistungsniveaus von Chatbots genau zu bewerten. Eine Lemon-Picked-Analyse zeigt, wo Guanaco im Vergleich zu ChatGPT scheitert. Wir veröffentlichen alle unsere Modelle und unseren Code, einschließlich CUDA-Kernel für 4-Bit-Training.2
1 Einleitung
Das Finetuning großer Sprachmodelle (LLMs) ist eine hocheffektive Methode, um ihre Leistung zu verbessern [40, 62, 43, 61, 59, 37] und wünschenswerte Verhaltensweisen hinzuzufügen oder unerwünschte zu entfernen [43, 2, 4]. Allerdings ist das Finetuning sehr großer Modelle prohibitiv teuer; reguläres 16-Bit-Finetuning eines LLaMA-Modells mit 65B Parametern [57] erfordert mehr als 780 GB GPU-Speicher. Während neuere Quantisierungsmethoden den Speicherbedarf von LLMs reduzieren können [14, 13, 18, 66], funktionieren solche Techniken nur für die Inferenz und versagen während des Trainings [65].
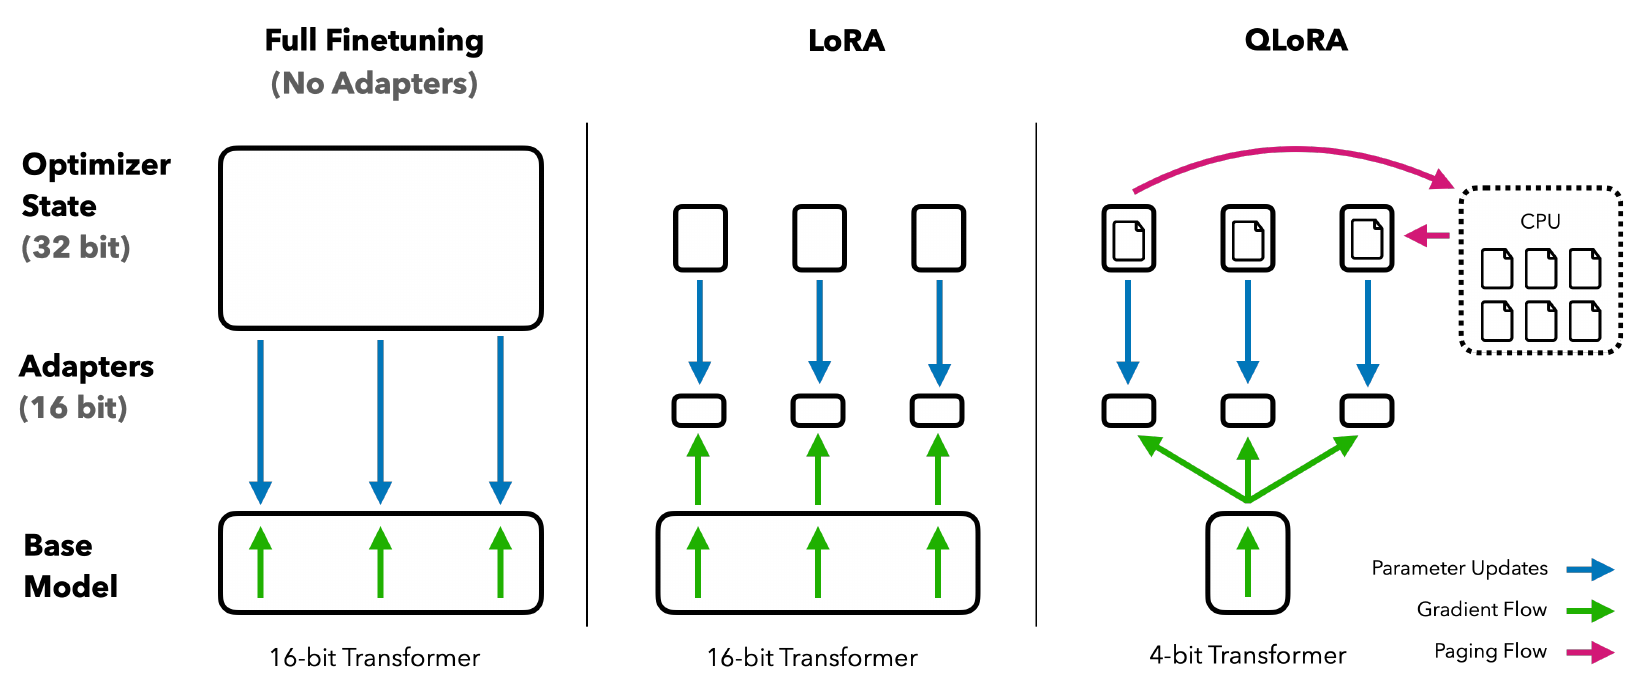
Wir zeigen erstmals, dass es möglich ist, ein quantisiertes 4-Bit-Modell ohne jegliche Leistungseinbußen feinzutunen. Unsere Methode QLoRA verwendet eine neuartige Hochpräzisionstechnik, um ein vortrainiertes Modell auf 4 Bit zu quantisieren, und fügt dann eine kleine Menge lernbarer Low-Rank-Adapter-Gewichte [28] hinzu, die durch Rückwärtspropagation von Gradienten durch die quantisierten Gewichte abgestimmt werden.
QLORA reduziert den durchschnittlichen Speicherbedarf für das Finetuning eines Modells mit 65B Parametern von GPU-Speicher auf , ohne die Laufzeit oder die Vorhersageleistung im Vergleich zu einer vollständig feingetunten 16-Bit-Baseline zu beeinträchtigen. Dies markiert einen bedeutenden Wandel in der Zugänglichkeit des LLM-Finetunings: Nun sind die größten öffentlich verfügbaren Modelle bis dato auf einer einzelnen GPU feintunbar. Mit QLoRA trainieren wir die Modellfamilie Guancao, wobei das zweitbeste Modell 97,8 % des Leistungsniveaus von ChatGPT auf dem Vicuna-Benchmark [10] erreicht und dabei in weniger als 12 Stunden auf einer einzelnen Consumer-GPU trainierbar ist; mit einer einzelnen professionellen GPU erreichen wir über 24 Stunden 99,3 % mit unserem größten Modell und schließen damit im Wesentlichen die Lücke zu ChatGPT auf dem Vicuna-Benchmark. Im Einsatz benötigt unser kleinstes Guanaco-Modell
| Modell | Größe | Elo |
| GPT-4 | - | 1348 ± 1 |
| Guanaco 65B | 41 GB | 1022 ± 1 |
| Guanaco 33B | 21 GB | 992 ± 1 |
| Vicuna 13B | 26 GB | 974 ± 1 |
| ChatGPT | - | 966 ± 1 |
| Guanaco 13B | 10 GB | 916 ± 1 |
| Bard | - | 902 ± 1 |
| Guanaco 7B | 6 GB | 879 ± 1 |
(7B Parameter) nur 5 GB Speicher und übertrifft ein 26-GB-Alpaca-Modell um mehr als 20 Prozentpunkte auf dem Vicuna-Benchmark (Tabelle 6).
QLORA führt mehrere Innovationen ein, die darauf ausgelegt sind, den Speicherverbrauch zu reduzieren, ohne die Leistung zu beeinträchtigen: (1) 4-Bit NormalFloat, ein informationstheoretisch optimaler Quantisierungsdatentyp für normalverteilte Daten, der bessere empirische Ergebnisse liefert als 4-Bit-Integer und 4-Bit-Floats. (2) Double Quantization, eine Methode, die die Quantisierungskonstanten quantisiert und durchschnittlich etwa 0,37 Bit pro Parameter einspart (etwa 3 GB für ein 65B-Modell). (3) Paged Optimizers, die NVIDIA Unified Memory nutzen, um die Speicherspitzen beim Gradient Checkpointing zu vermeiden, die bei der Verarbeitung eines Mini-Batches mit langer Sequenzlänge auftreten. Wir kombinieren diese Beiträge zu einem besser abgestimmten LoRA-Ansatz, der Adapter in jeder Netzwerkschicht umfasst und dadurch nahezu alle in früheren Arbeiten beobachteten Genauigkeitseinbußen vermeidet.
Die Effizienz von QLORA ermöglicht es uns, eine eingehende Studie des Instruktions-Finetunings und der Chatbot-Leistung auf Modellgrößen durchzuführen, die mit regulärem Finetuning aufgrund des Speicheraufwands unmöglich wären. Daher trainieren wir mehr als 1.000 Modelle über mehrere Instruktions-Tuning-Datensätze, Modellarchitekturen und Größen zwischen 80M und 65B Parametern. Neben dem Nachweis, dass QLoRA die 16-Bit-Leistung wiederherstellt ( ) und dem Training eines State-of-the-Art-Chatbots, Guanaco, ( ), analysieren wir auch Trends in den trainierten Modellen. Erstens stellen wir fest, dass Datenqualität weitaus wichtiger ist als die Datensatzgröße, z. B. übertraf ein Datensatz mit 9k Beispielen (OASST1) einen Datensatz mit 450k Beispielen (FLAN v2, subsampled) in der Chatbot-Leistung, selbst wenn beide die Generalisierung des Instruction-Followings unterstützen sollen. Zweitens zeigen wir, dass eine starke Leistung im Massive Multitask Language Understanding (MMLU)-Benchmark nicht eine starke Leistung im Vicuna-Chatbot-Benchmark impliziert und umgekehrt – mit anderen Worten, die Eignung des Datensatzes ist wichtiger als die Größe für eine gegebene Aufgabe.
Darüber hinaus liefern wir auch eine umfangreiche Analyse der Chatbot-Leistung, die sowohl menschliche Bewerter als auch GPT-4 zur Bewertung verwendet. Wir verwenden ein turnierartiges Benchmarking, bei dem Modelle in Duellen gegeneinander antreten, um die beste Antwort auf einen gegebenen Prompt zu erzeugen. Der Gewinner eines Duells wird entweder von GPT-4 oder menschlichen Annotatoren bewertet. Die Turnierergebnisse werden zu Elo-Werten [16, 17] aggregiert, die die Rangfolge der Chatbot-Leistung bestimmen. Wir stellen fest, dass GPT-4- und menschliche Bewertungen weitgehend übereinstimmen, was den Rang der Modellleistung in den Turnieren betrifft, aber wir finden auch Fälle starker Uneinigkeit. Daher betonen wir, dass modellbasierte Bewertung zwar eine kostengünstige Alternative zur menschlichen Annotation darstellt, aber auch mit Unsicherheiten behaftet ist.
Wir ergänzen unsere Chatbot-Benchmark-Ergebnisse um eine qualitative Analyse der Guanaco-Modelle. Unsere Analyse hebt Erfolgs- und Fehlerfälle hervor, die von den quantitativen Benchmarks nicht erfasst wurden.
Wir veröffentlichen alle Modellgenerierungen mit menschlichen und GPT-4-Annotationen, um weitere Untersuchungen zu erleichtern. Wir stellen unsere Codebasis und CUDA-Kernel als Open Source zur Verfügung und integrieren unsere Methoden in den Hugging Face transformers-Stack [64], wodurch sie für alle leicht zugänglich sind. Wir veröffentlichen eine Sammlung von Adaptern für Modelle der Größen 7/13/33/65B, trainiert auf 8 verschiedenen Instruction-Following-Datensätzen, insgesamt 32 verschiedene quelloffene, feingetunte Modelle.
2 Hintergrund
Block-wise k-bit Quantisierung Quantisierung ist der Prozess der Diskretisierung einer Eingabe von einer Repräsentation, die mehr Informationen enthält, in eine Repräsentation mit weniger Informationen. Oft bedeutet dies, einen Datentyp mit mehr Bits in einen mit weniger Bits umzuwandeln, zum Beispiel von 32-Bit-Floats zu 8-Bit-Integers. Um sicherzustellen, dass der gesamte Bereich des niedrigbittigen Datentyps genutzt wird, wird der Eingabedatentyp üblicherweise durch Normalisierung mit dem absoluten Maximum der Eingabeelemente, die gewöhnlich als Tensor strukturiert sind, in den Ziel-Datentypbereich umskaliert. Zum Beispiel quantisiert man einen 32-Bit-Gleitkomma-Tensor (FP32) in einen Int8-Tensor mit dem Bereich :
wobei die Quantisierungskonstante oder der Quantisierungsmaßstab ist. Die Dequantisierung ist die Umkehrung:
Das Problem bei diesem Ansatz besteht darin, dass, wenn ein Wert mit großer Magnitude (d. h. ein Ausreißer) im Eingabetensor auftritt, die Quantisierungs-Bins – bestimmte Bitkombinationen – nicht gut ausgenutzt werden, wobei wenige oder keine Zahlen in einigen Bins quantisiert werden. Um das Ausreißerproblem zu verhindern, besteht ein gängiger Ansatz darin, den Eingabetensor in Blöcke zu unterteilen, die unabhängig voneinander quantisiert werden, jeweils mit ihrer eigenen Quantisierungskonstante . Dies lässt sich wie folgt formalisieren: Wir unterteilen den Eingabetensor in zusammenhängende Blöcke der Größe , indem wir den Eingabetensor flach machen und das lineare Segment in Blöcke schneiden. Wir quantisieren diese Blöcke unabhängig voneinander mit Gleichung 1, um einen quantisierten Tensor und Quantisierungskonstanten zu erzeugen.
Low-Rank Adapters Das Finetuning mit Low-Rank Adaptern (LoRA) [28] ist eine Methode, die den Speicherbedarf durch die Verwendung einer kleinen Menge trainierbarer Parameter, oft als Adapter bezeichnet, reduziert, während die vollständigen Modellparameter, die fest bleiben, nicht aktualisiert werden. Gradienten während des stochastischen Gradientenabstiegs werden durch die festen vortrainierten Modellgewichte an den Adapter weitergegeben, der aktualisiert wird, um die Verlustfunktion zu optimieren. LoRA erweitert eine lineare Projektion durch eine zusätzliche faktorisierte Projektion. Gegeben eine Projektion mit , , berechnet LoRA:
wobei und , und ein Skalar ist.
Speicherbedarf von parameter-effizientem Finetuning Ein wichtiger Diskussionspunkt ist der Speicherbedarf von LoRA während des Trainings, sowohl hinsichtlich der Anzahl als auch der Größe der verwendeten Adapter. Da der Speicherbedarf von LoRA so minimal ist, können wir mehr Adapter verwenden, um die Leistung zu verbessern, ohne den insgesamt verwendeten Speicher wesentlich zu erhöhen. Obwohl LoRA als Parameter Efficient Finetuning (PEFT)-Methode konzipiert wurde, stammt der größte Teil des Speicherbedarfs für das LLM-Finetuning aus Aktivierungsgradienten und nicht aus den gelernten LoRA-Parametern. Für ein 7B-LLaMA-Modell, das auf FLAN v2 mit einer Batch-Größe von 1 trainiert wird, wobei die LoRA-Gewichte den häufig verwendeten der ursprünglichen Modellgewichte [28, 37] entsprechen, haben die LoRA-Eingabegradienten einen Speicherbedarf von 567 MB, während die LoRA-Parameter nur 26 MB belegen. Mit Gradient Checkpointing [9] reduzieren sich die Eingabegradienten auf durchschnittlich 18 MB pro Sequenz, wodurch sie speicherintensiver werden als alle LoRA-Gewichte zusammen. Im Vergleich dazu verbraucht das 4-Bit-Basismodell 5.048 MB Speicher. Dies unterstreicht, dass Gradient Checkpointing wichtig ist, aber auch, dass eine aggressive Reduzierung der Menge an LoRA-Parametern nur geringe Speichervorteile bringt. Das bedeutet, dass wir mehr Adapter verwenden können, ohne den gesamten Trainingsspeicherbedarf wesentlich zu erhöhen (siehe Anhang G für eine detaillierte Aufschlüsselung). Wie später diskutiert wird, ist dies entscheidend für die Wiederherstellung der vollen 16-Bit-Präzisionsleistung.
3 QLoRA-Feintuning
QLoRA erreicht eine hochpräzise 4-Bit-Feinabstimmung durch zwei von uns vorgeschlagene Techniken – 4-Bit-NormalFloat-(NF4-)Quantisierung und Doppelquantisierung. Zusätzlich führen wir Paged Optimizers ein, um zu verhindern, dass Speicherspitzen während des Gradient Checkpointing Out-of-Memory-Fehler verursachen, die das Feintuning großer Modelle auf einer einzelnen Maschine traditionell schwierig gemacht haben.
QLoRA hat einen Niedrigpräzisions-Speicherdatentyp, in unserem Fall üblicherweise 4-Bit, und einen Berechnungsdatentyp, der üblicherweise BFloat16 ist. In der Praxis bedeutet dies, dass wir, wann immer ein QLoRA-Gewichtstensor verwendet wird, den Tensor zu BFloat16 dequantisieren und dann eine Matrixmultiplikation in 16-Bit durchführen.
Wir diskutieren nun die Komponenten von QLoRA, gefolgt von einer formalen Definition von QLoRA.
4-Bit-NormalFloat-Quantisierung Der NormalFloat-(NF-)Datentyp baut auf der Quantilquantisierung [15] auf, einem informationstheoretisch optimalen Datentyp, der sicherstellt, dass jedem Quantisierungsbin eine gleiche Anzahl von Werten aus dem Eingabetensor zugewiesen wird. Die Quantilquantisierung funktioniert, indem sie das Quantil des Eingabetensors über die empirische kumulative Verteilungsfunktion schätzt.
Die Hauptbeschränkung der Quantilquantisierung besteht darin, dass der Prozess der Quantilschätzung teuer ist. Daher werden schnelle Quantilapproximationsalgorithmen wie SRAM-Quantile [15] verwendet, um sie zu schätzen. Aufgrund der approximativen Natur dieser Quantilschätzungsalgorithmen weist der Datentyp große Quantisierungsfehler für Ausreißer auf, die oft die wichtigsten Werte sind.
Teure Quantilschätzungen und Approximationsfehler können vermieden werden, wenn Eingabetensoren aus einer bis auf eine Quantisierungskonstante festen Verteilung stammen. In solchen Fällen haben die Eingabetensoren dieselben Quantile, was eine exakte Quantilschätzung rechnerisch machbar macht.
Da vorab trainierte neuronale Netzwerkgewichte üblicherweise eine nullzentrierte Normalverteilung mit Standardabweichung haben (siehe Anhang F), können wir alle Gewichte durch Skalierung von in eine einzige feste Verteilung transformieren, sodass die Verteilung genau in den Bereich unseres Datentyps passt. Für unseren Datentyp setzen wir den willkürlichen Bereich . Somit müssen sowohl die Quantile für den Datentyp als auch die Gewichte des neuronalen Netzwerks in diesen Bereich normalisiert werden.
Der informationstheoretisch optimale Datentyp für normalverteilte Daten mit Mittelwert null und beliebigen Standardabweichungen im Bereich wird wie folgt berechnet: (1) Schätze die Quantile einer theoretischen -Verteilung, um einen -Bit-Quantil-Quantisierungsdatentyp für Normalverteilungen zu erhalten, (2) nimm diesen Datentyp und normalisiere seine Werte in den Bereich , (3) quantisiere einen Eingabe-Gewichtstensor, indem du ihn durch absolute Maximalwertskalierung in den Bereich normalisierst.
Sobald der Gewichtsbereich und der Bereich des Datentyps übereinstimmen, können wir wie üblich quantisieren. Schritt (3) entspricht der Skalierung der Standardabweichung des Gewichtstensors, um sie an die Standardabweichung des k-Bit-Datentyps anzupassen. Formaler schätzen wir die Werte des Datentyps wie folgt:
wobei die Quantilfunktion der Standardnormalverteilung ist. Ein Problem bei einer symmetrischen k-Bit-Quantisierung besteht darin, dass dieser Ansatz keine exakte Darstellung von null hat, was eine wichtige Eigenschaft ist, um Padding und andere nulwertige Elemente fehlerfrei zu quantisieren. Um einen diskreten Nullpunkt von 0 sicherzustellen und alle Bits für einen k-Bit-Datentyp zu nutzen, erstellen wir einen asymmetrischen Datentyp, indem wir die Quantile zweier Bereiche schätzen: für den negativen Teil und für den positiven Teil, und dann vereinigen wir diese Mengen von und entfernen eine der beiden Nullen, die in beiden Mengen vorkommt. Wir nennen den resultierenden Datentyp, der eine gleiche erwartete Anzahl von Werten in jedem Quantisierungsbin aufweist, -Bit NormalFloat (NFk), da der Datentyp informationstheoretisch optimal für nullzentrierte normalverteilte Daten ist. Die genauen Werte dieses Datentyps finden sich in Anhang E.
Doppelquantisierung Wir führen die Doppelquantisierung (Double Quantization, DQ) ein, den Prozess der Quantisierung der Quantisierungskonstanten für zusätzliche Speichereinsparungen. Während eine kleine Blockgröße für eine präzise 4-Bit-Quantisierung erforderlich ist [13], hat sie auch einen beträchtlichen Speicheraufwand. Beispielsweise fügen Quantisierungskonstanten bei Verwendung von 32-Bit-Konstanten und einer Blockgröße von 64 für W im Durchschnitt Bits pro Parameter hinzu. Die Doppelquantisierung hilft, den Speicherbedarf der Quantisierungskonstanten zu reduzieren.
Genauer gesagt behandelt die Doppelquantisierung die Quantisierungskonstanten der ersten Quantisierung als Eingaben für eine zweite Quantisierung. Dieser zweite Schritt liefert die quantisierten Quantisierungskonstanten und die Quantisierungskonstanten der zweiten Ebene . Wir verwenden 8-Bit-Floats mit einer Blockgröße von 256 für die zweite Quantisierung, da bei der 8-Bit-Quantisierung keine Leistungsverschlechterung beobachtet wird, im Einklang mit den Ergebnissen von Dettmers und Zettlemoyer [13]. Da die positiv sind, subtrahieren wir den Mittelwert von vor der Quantisierung, um die Werte um null zu zentrieren und symmetrische Quantisierung zu nutzen. Im Durchschnitt reduziert diese Quantisierung bei einer Blockgröße von 64 den Speicherbedarf pro Parameter von Bits auf Bits, eine Reduktion um 0.373 Bits pro Parameter.
Paged Optimizers nutzen die NVIDIA-Funktion für unified memory , die automatische Seite-zu-Seite-Übertragungen zwischen CPU und GPU für fehlerfreie GPU-Verarbeitung in Szenarien durchführt, in denen der GPU gelegentlich der Speicher ausgeht. Die Funktion arbeitet wie reguläres Memory-Paging zwischen CPU-RAM und Festplatte. Wir nutzen diese Funktion, um paged memory für die Optimizer-Zustände zu allokieren, die dann automatisch in den CPU-RAM ausgelagert werden, wenn der GPU der Speicher ausgeht, und wieder in den GPU-Speicher eingelagert werden, wenn der Speicher im Optimizer-Update-Schritt benötigt wird.
QLORA. Mit den oben beschriebenen Komponenten definieren wir QLORA für eine einzelne lineare Schicht im quantisierten Basismodell mit einem einzelnen LoRA-Adapter wie folgt:
wobei doubleDequant definiert ist als:
Wir verwenden NF4 für W und FP8 für . Wir verwenden eine Blockgröße von 64 für W für höhere Quantisierungspräzision und eine Blockgröße von 256 für , um Speicher zu sparen.
Für Parameteraktualisierungen werden nur die Gradienten bezüglich des Fehlers für die Adaptergewichte benötigt, und nicht für 4-Bit-Gewichte . Die Berechnung von umfasst jedoch die Berechnung von , die über Gleichung (5) mit Dequantisierung vom Speicher zum Berechnungsdatentyp erfolgt, um die Ableitung in BFloat16-Präzision zu berechnen.
Zusammenfassend hat QLORA einen Speicherdatentyp (normalerweise 4-Bit-NormalFloat) und einen Berechnungsdatentyp (16-Bit-BrainFloat). Wir dequantisieren den Speicherdatentyp zum Berechnungsdatentyp, um den Vorwärts- und Rückwärtsdurchlauf durchzuführen, aber wir berechnen Gewichtsg gradienten nur für die LoRA-Parameter, die 16-Bit-BrainFloat verwenden.
4 QLoRA vs. Standard-Finetuning
Wir haben erörtert, wie QLoRA funktioniert und wie es den erforderlichen Speicher für das Finetuning von Modellen erheblich reduzieren kann. Die Hauptfrage ist nun, ob QLoRA genauso gut funktionieren kann wie Full-Model-Finetuning. Darüber hinaus wollen wir die Komponenten von QLoRA analysieren, einschließlich der Auswirkung von NormalFloat4 gegenüber Standard-Float4. Die folgenden Abschnitte behandeln die Experimente, die darauf abzielten, diese Fragen zu beantworten.
Experimentelles Setup. Wir betrachten drei Architekturen (Encoder, Encoder-Decoder und Decoder-only) und vergleichen QLoRA mit 16-Bit-Adapter-Finetuning und mit Full-Finetuning für Modelle bis 3B. Unsere Evaluierungen umfassen GLUE [58] mit RoBERTa-large [38], Super-NaturalInstructions (TKInstruct) [61] mit T5 [49] und 5-Shot-MMLU [24] nach dem Finetuning von LLaMA auf Flan v2 [39] und Alpaca [55]. Um zusätzlich die Vorteile von NF4 gegenüber anderen 4-Bit-Datentypen zu untersuchen, verwenden wir das Setup von Dettmers und Zettlemoyer [13] und messen die Zero-Shot-Genauigkeit und Perplexität nach der Quantisierung über verschiedene Modelle (OPT [72], LLaMA [57], BLOOM [52], Pythia [7]) für Modellgrößen von 125m bis 13B. Wir geben im Ergebnisteil für jedes spezifische Setup weitere Details an, um die Ergebnisse lesbarer zu machen. Vollständige Details in Anhang A.
Während Paged Optimizers entscheidend sind, um 33B/65B QLoRA-Tuning auf einer einzelnen 24/48-GB-GPU durchzuführen, liefern wir keine harten Messungen für Paged Optimizers, da das Paging nur bei der Verarbeitung von Mini-Batches mit langen Sequenzlängen auftritt, was selten vorkommt. Wir führen jedoch eine Analyse der Laufzeit von Paged Optimizers für 65B-Modelle auf 48-GB-GPUs durch und stellen fest, dass Paged Optimizers bei einer Batch-Größe von 16 die gleiche Trainingsgeschwindigkeit wie reguläre Optimizers bieten. Zukünftige Arbeiten sollten messen und charakterisieren, unter welchen Umständen Verlangsamungen durch den Paging-Prozess auftreten.
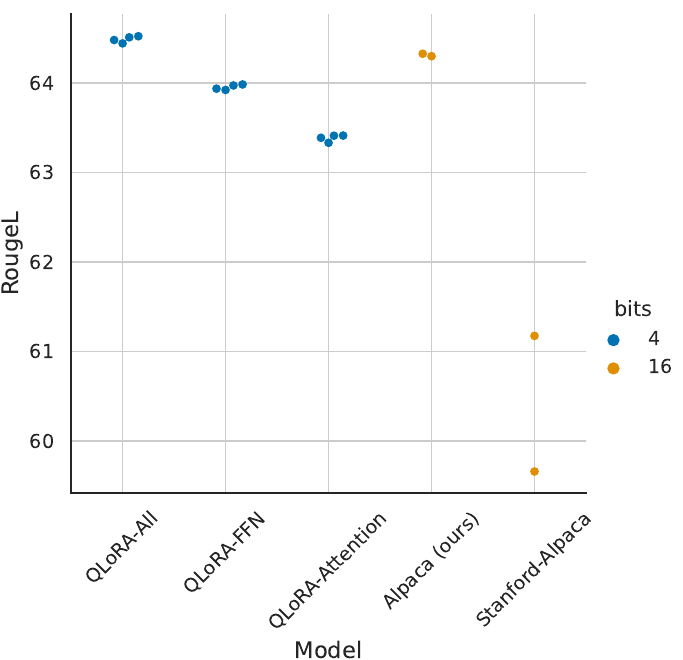
Standard-LoRA-Hyperparameter erreichen nicht die Leistung von 16-Bit Bei Verwendung der Standardpraxis, LoRA auf die Query- und Value-Attention-Projektionsmatrizen anzuwenden [28], sind wir nicht in der Lage, die Leistung des vollständigen Finetunings für große Basismodelle zu reproduzieren. Wie in Abbildung 2 für das Finetuning von LLaMA 7B auf Alpaca gezeigt, stellen wir fest, dass der kritischste LoRA-Hyperparameter die Gesamtzahl der verwendeten LoRA-Adapter ist und dass LoRA auf allen linearen Transformer-Block-Schichten erforderlich ist, um die Leistung des vollständigen Finetunings zu erreichen. Andere LoRA-Hyperparameter wie die Projektionsdimension beeinflussen die Leistung nicht (siehe Anhang A).
Ebenso stellen wir fest, dass die Standard-Hyperparameter für vollständig feingetunte Baselines unzureichend abgestimmt sind. Wir führen eine Hyperparametersuche über Lernraten von 1e- 6 bis 5e- 5 und Batch-Größen von 8 bis 128 durch, um robuste Baselines zu finden. Ergebnisse für das Finetuning von 7B LLaMA auf Alpaca sind in Abbildung 2 dargestellt.
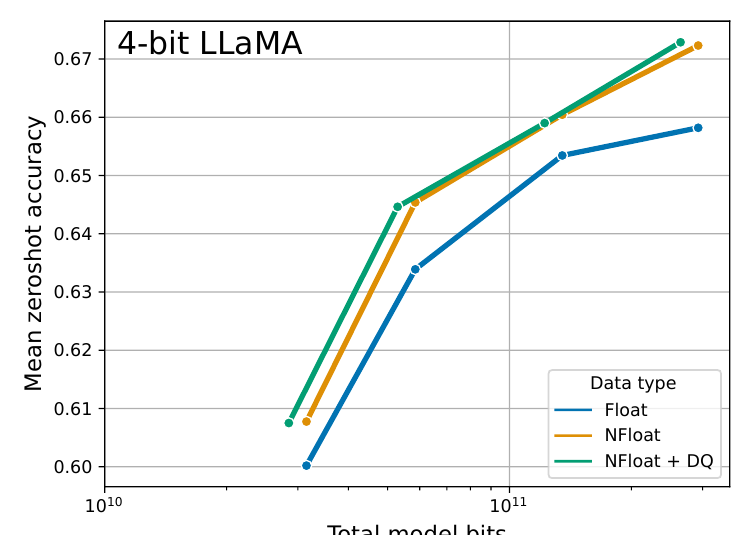
4-Bit-NormalFloat liefert bessere Leistung als 4-Bit-Gleitkomma Obwohl der 4-Bit-NormalFloat-(NF4-)Datentyp informationstheoretisch optimal ist, muss noch bestimmt werden, ob sich diese Eigenschaft in empirische Vorteile übersetzt. Wir folgen dem Setup von Dettmers und Zettlemoyer [13], bei dem quantisierte LLMs (OPT [72], BLOOM [52], Pythia [7], LLaMA) unterschiedlicher Größe (125M bis 65B) mit unterschiedlichen Datentypen auf Sprachmodellierung und einer Reihe von Zero-Shot-Aufgaben evaluiert werden. In Abbildung 3 und Tabelle 2 sehen wir, dass NF4 die Leistung deutlich gegenüber FP4 und Int4 verbessert und dass die doppelte Quantisierung den Speicherbedarf reduziert, ohne die Leistung zu beeinträchtigen.
k-Bit-QLoRA erreicht die Leistung von 16-Bit-Vollfinetuning und 16-Bit-LoRA Jüngste Erkenntnisse haben gezeigt, dass 4-Bit-Quantisierung für die Inferenz
möglich ist, aber im Vergleich zu 16-
| Nur-Lese-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): 4 QLoRA vs. Standard-Finetuning k-Bit-QLoRA erreicht die Leistung von 16-Bit-Voll-Finetuning und 16-Bit-LoRA. Jüngste Erkenntnisse haben gezeigt, dass 4-Bit-Quantisierung für die Inferenz möglich ist, aber im Vergleich zu 16-Bit zu Leistungseinbußen führt [13, 18]. Dies wirft die entscheidende Frage auf, ob die verlorene Leistung durch 4-Bit-Adapter-Finetuning wiederhergestellt werden kann. Wir testen dies für zwei Setups. Zu übersetzender Text: Datensatz Modell | GLUE (Acc.) RoBERTa-large | T5-80M | Super-NaturalInstructions (RougeL) T5-250M | T5-780M | T5-3B | T5-11B |
| BF16 | 88,6 | 40,1 | 42,1 | 48,0 | 54,3 | 62,0 |
| BF16-Replikation | 88,6 | 40,0 | 42,2 | 47,3 | 54,9 | - |
| LoRA BF16 | 88,8 | 40,5 | 42,6 | 47,1 | 55,4 | 60,7 |
| QLORA Int8 | 88,8 | 40,4 | 42,9 | 45,4 | 56,5 | 60,7 |
| QLORA FP4 | 88,6 | 40,3 | 42,4 | 47,5 | 55,6 | 60,9 |
| QLORA NF4 + DQ | - | 40,4 | 42,7 | 47,7 | 55,3 | 60,9 |
Bit zu Leistungseinbußen führt [13, 18]. Dies wirft die entscheidende Frage auf, ob die verlorene Leistung durch 4-Bit-Adapter-Finetuning wiederhergestellt werden kann. Wir testen dies für zwei Setups.
Das erste konzentriert sich auf einen Vergleich mit vollständigem 16-Bit-Finetuning von RoBERTA- und T5-Modellen mit 125M bis 3B Parametern auf GLUE und dem Super-NaturalInstructions-Datensatz. Die Ergebnisse sind in Tabelle 3 dargestellt. In beiden Datensätzen beobachten wir, dass 16-Bit-, 8-Bit- und 4-Bit-Adapter-Methoden die Leistung der vollständig feingetunten 16-Bit-Baseline reproduzieren. Dies deutet darauf hin, dass die durch die unpräzise Quantisierung verlorene Leistung durch Adapter-Finetuning nach der Quantisierung vollständig wiederhergestellt werden kann.
Für unser zweites Setup, da vollständig feingetunte Modelle mit und über 11B Parametern mehr als einen Server mit Hochspeicher-GPUs erfordern, testen wir weiterhin, ob 4-Bit-QLoRA mit 16-Bit-LoRA in den Größenordnungen von 7B bis 65B Parametern mithalten kann. Zu diesem Zweck finetunen wir LLaMA 7B bis 65B auf zwei Instruction-Following-
| Datentyp | Mittlere PPL |
| Int4 | 34,34 |
| Float4 (E2M1) | 31,07 |
| Float4 (E3M0) | 29,48 |
| NFloat4 + DQ | 27,41 |
Datensätzen, Alpaca und FLAN v2, und evaluieren auf dem MMLU-Benchmark mittels 5-Shot-Genauigkeit. Die Ergebnisse sind in Tabelle 4 dargestellt, wo wir sehen, dass NF4 mit doppelter Quantisierung die MMLU-Leistung von 16-Bit-LoRA vollständig wiederherstellt. Darüber hinaus stellen wir fest, dass QLoRA mit FP4 etwa 1 Prozentpunkt hinter der 16-Bit-Brain-Float-LoRA-Baseline zurückliegt. Dies bestätigt sowohl unsere Erkenntnisse, dass (1) QLoRA mit NF4 sowohl die Leistung von 16-Bit-Vollfinetuning als auch von 16-Bit-LoRA-Finetuning reproduziert, als auch (2) NF4 hinsichtlich der Quantisierungspräzision FP4 überlegen ist.
Zusammenfassung Unsere Ergebnisse zeigen durchgängig, dass 4-Bit-QLoRA mit dem NF4-Datentyp die Leistung von 16-Bit-Voll-Finetuning und 16-Bit-LoRA-Finetuning auf akademischen Benchmarks mit etablierten Evaluationssetups erreicht. Wir haben außerdem gezeigt, dass NF4 effektiver ist als FP4 und dass doppelte Quantisierung die Leistung nicht beeinträchtigt. Zusammengenommen ist dies ein überzeugender Beleg dafür, dass 4-Bit-QLoRA-Tuning zuverlässig Ergebnisse liefert, die mit 16-Bit-Methoden übereinstimmen.
Im Einklang mit früheren Arbeiten zur Quantisierung [13] zeigen unsere MMLU- und Elo-Ergebnisse, dass es bei einem gegebenen Budget für Finetuning- und Inferenzressourcen vorteilhaft ist, die Anzahl der Parameter im Basismodell zu erhöhen und gleichzeitig deren Präzision zu verringern. Dies unterstreicht die Bedeutung der Effizienzvorteile von QLoRA. Da wir in unseren Experimenten mit 4-Bit-Finetuning keine Leistungsverschlechterung im Vergleich zum Voll-Finetuning beobachtet haben, wirft dies die Frage auf, wo genau der Kompromiss zwischen Leistung und Präzision beim QLoRA-Tuning liegt, was wir zukünftiger Arbeit zur Untersuchung überlassen.
Wir fahren fort mit der Untersuchung von Instruction-Tuning in Größenordnungen, die mit vollständigem 16-Bit-Finetuning auf akademischer Forschungshardware unmöglich zu erkunden wären.
5 Den State-of-the-Art von Chatbots mit QLoRA vorantreiben
Nachdem wir festgestellt haben, dass 4-Bit-QLoRA über Größenordnungen, Aufgaben und Datensätze hinweg mit der 16-Bit-Leistung übereinstimmt, führen wir eine eingehende Studie zum Instruction-Finetuning bis hin zu den größten für die Forschung verfügbaren Open-Source-Sprachmodellen durch. Um die Leistung des Instruction-Finetunings dieser Modelle zu bewerten, evaluieren wir
auf einem anspruchsvollen Benchmark für natürliches Sprachverständnis (MMLU) und entwickeln neue Methoden zur Bewertung der Leistung von Chatbots in der realen Welt.
5.1 Experimentelles Setup
Wir beschreiben nun einen Überblick über das experimentelle Setup mit vollständigen Details in Anhang B.
Daten Da es unseres Wissens nach keine umfassende Studie zu neueren Instruction-Following-Datensätzen gibt, wählen wir acht neuere Datensätze aus. Wir beziehen Datensätze ein, die durch Crowdsourcing gewonnen wurden (OASST1 [31], HH-RLHF [4]), durch Destillation aus instruction-getunten Modellen (Alpaca [55], self-instruct [59], unnatural-instructions [26]), Korpus-Aggregationen (FLAN v2 [12]) sowie Hybride (Chip2 [32], Longform [30]). Diese Datensätze decken verschiedene Sprachen, Datengrößen und Lizenzen ab.
Trainings-Setup Um störende Effekte durch unterschiedliche Trainingsziele zu vermeiden, führen wir QLoRA-Finetuning mit Kreuzentropie-Verlust (überwachtes Lernen) ohne Reinforcement Learning durch, selbst für Datensätze, die menschliche Beurteilungen verschiedener Antworten enthalten. Bei Datensätzen, die eine klare Unterscheidung zwischen Instruktion und Antwort aufweisen, finetunen wir nur auf der Antwort (siehe Ablationen in Anhang B). Für OASST1 und HH-RLHF sind mehrere Antworten verfügbar. Wir wählen dann die beste Antwort auf jeder Ebene des Konversationsbaums aus und finetunen auf der vollständigen ausgewählten Konversation, einschließlich der Instruktionen. In allen unseren Experimenten verwenden wir NF4-QLoRA mit doppelter Quantisierung und paged Optimizers, um Speicherspitzen während des Gradient-Checkpointings zu verhindern. Wir führen kleine Hyperparametersuchen für die 13B- und 33B-LLaMA-Modelle durch und stellen fest, dass alle bei 7B gefundenen Hyperparametereinstellungen generalisieren (einschließlich der Anzahl der Epochen), mit Ausnahme der Lernrate und der Batchgröße. Wir halbieren die Lernrate für 33B und 65B und verdoppeln die Batchgröße.
Baselines Wir vergleichen unsere Modelle sowohl mit Forschungs- (Vicuna [10] und Open Assistant [31]) als auch mit kommerziellen (GPT-4 [42], GPT-3.5-turbo und Bard) Chatbot-Systemen. Das Open-Assistant-Modell ist ein LLaMA-33B-Modell, das mit Reinforcement Learning from Human Feedback (RLHF) auf demselben OASST1-Datensatz finetuned wurde, mit dem wir experimentieren. Vicuna führt ein vollständiges Fine-Tuning von LLaMA 13B auf proprietären, von Nutzern geteilten Konversationen aus ShareGPT durch und ist somit das Ergebnis einer Destillation aus OpenAI-GPT-Modellen.
5.2 Evaluation
Der üblichen Praxis folgend verwenden wir den MMLU-Benchmark (Massively Multitask Language Understanding) [24], um die Leistung bei einer Reihe von Sprachverständnisaufgaben zu messen. Dies ist ein Multiple-Choice-Benchmark, der 57 Aufgaben abdeckt, darunter elementare Mathematik, US-Geschichte, Informatik, Recht und mehr. Wir berichten die 5-Shot-Testgenauigkeit.
Wir testen außerdem generative Sprachfähigkeiten sowohl durch automatisierte als auch durch menschliche Evaluierungen. Diese zweite Gruppe von Evaluierungen stützt sich auf von Menschen kuratierte Anfragen und zielt darauf ab, die Qualität der Modellantworten zu messen. Obwohl dies eine realistischere Testumgebung für die Leistung von Chatbot-Modellen ist und an Popularität gewinnt, gibt es in der Literatur kein allgemein akzeptiertes Protokoll. Wir beschreiben unten unser vorgeschlagenes Setup und verwenden in allen Fällen Nucleus-Sampling mit und Temperatur 0.7.
| Datensatz | 7B | 13B | 33B | 65B |
| LLaMA ohne Tuning | 35,1 | 46,9 | 57,8 | 63,4 |
| Self-Instruct | 36,4 | 33,3 | 53,0 | 56,7 |
| Longform | 32,1 | 43,2 | 56,6 | 59,7 |
| Chip2 | 34,5 | 41,6 | 53,6 | 59,8 |
| HH-RLHF | 34,9 | 44,6 | 55,8 | 60,1 |
| Unnatural Instruct | 41,9 | 48,1 | 57,3 | 61,3 |
| Guanaco (OASST1) | 36,6 | 46,4 | 57,0 | 62,2 |
| Alpaca | 38,8 | 47,8 | 57,3 | 62,5 |
| FLAN v2 | 44,5 | 51,4 | 59,2 | 63,9 |
Benchmark-Daten Wir evaluieren auf zwei kuratierten Datensätzen von Anfragen (Fragen): den Vicuna-Prompts [10] und dem OASST1-Validierungsdatensatz [31]. Wir verwenden die Vicuna-Prompts, eine Menge von 80 Prompts aus einer vielfältigen Auswahl von Kategorien, ohne Modifikationen. Der OASST1-Datensatz ist eine mehrsprachige Sammlung von crowdsourcing-basierten mehrstufigen Dialogen zwischen einem Nutzer und einem Assistenten. Wir wählen alle Nutzernachrichten im Validierungsdatensatz als Anfragen aus und beziehen vorherige Turns in den Prompt ein. Dieses Verfahren führt zu 953 eindeutigen Nutzeranfragen. Wir bezeichnen diese beiden Datensätze als die Vicuna- und OA-Benchmarks.
Automatisierte Evaluierung Zunächst verwenden wir basierend auf dem von Chiang et al. [10] eingeführten Evaluierungsprotokoll GPT-4, um die Leistung verschiedener Systeme gegen ChatGPT (GPT-3.5 Turbo) auf dem Vicuna-Benchmark zu bewerten. Bei einer Anfrage zusammen mit den Antworten von ChatGPT und eines Modells wird GPT-4 aufgefordert, beiden Antworten eine Punktzahl von zehn zuzuweisen und eine Erklärung zu liefern. Die Gesamtleistung eines Modells wird als Prozentsatz der Punktzahl berechnet, die ChatGPT erreicht hat. Beachten Sie, dass diese relative Punktzahl höher als sein kann, wenn das Modell eine höhere absolute Punktzahl als ChatGPT erreicht. Wir stellen einen signifikanten Reihenfolgeneffekt fest, wobei GPT-4 die Punktzahl der Antwort erhöht, die früher im Prompt erscheint. Um solche Effekte zu kontrollieren, empfehlen wir, die mittlere Punktzahl über beide Reihenfolgen zu berichten.
Als Nächstes messen wir die Leistung durch direkte Vergleiche zwischen Systemausgaben. Wir vereinfachen das Bewertungsschema zu einem Drei-Klassen-Labelproblem, das Gleichstände berücksichtigt. Wir fordern GPT-4 auf, die beste Antwort auszuwählen oder einen Gleichstand zu erklären und eine Erklärung zu liefern. Wir führen diese direkten Vergleiche auf allen Permutationen von Systempaaren sowohl auf dem Vicuna- als auch auf dem OA-Benchmark durch.
Menschliche Evaluierung Während neuere Arbeiten darauf hindeuten, dass generative Modelle effektiv für Systemevaluierungen eingesetzt werden können [19], ist die Zuverlässigkeit von GPT-4-Bewertungen zur Beurteilung der Chatbot-Leistung unseres Wissens nach noch nicht als mit menschlichen Urteilen korrelierend nachgewiesen. Daher führen wir zwei parallele menschliche Evaluierungen auf dem Vicuna-Benchmark durch, die beiden oben beschriebenen automatisierten Evaluierungsprotokollen entsprechen. Wir verwenden Amazon Mechanical Turk (AMT) und erhalten zwei menschliche Annotatoren für Vergleiche mit ChatGPT und drei Annotatoren für paarweise Vergleiche.
Elo-Rating Mit sowohl menschlichen als auch automatisierten paarweisen Vergleichen erstellen wir einen Wettbewerb im Turnierstil, bei dem Modelle gegeneinander antreten. Das Turnier besteht aus Begegnungen, bei denen Modellpaare darum konkurrieren, die beste Antwort für einen gegebenen Prompt zu erzeugen. Dies ähnelt der Art und Weise, wie Bai et al. [4] und Chiang et al. [10] Modelle vergleichen, aber wir verwenden zusätzlich zu menschlichen Bewertungen auch GPT-4-Bewertungen. Wir ziehen zufällig aus der Menge der gelabelten Vergleiche, um Elo [16, 17] zu berechnen. Das Elo-Rating, das im Schach und anderen Spielen weit verbreitet ist, ist ein Maß für die erwartete Gewinnrate relativ zur Gewinnrate eines Gegners; ein Elo von 1100 gegenüber 1000 bedeutet beispielsweise, dass der Spieler mit Elo 1100 eine erwartete Gewinnrate von etwa gegen den Gegner mit Elo 1000 hat; eine Partie 1000 gegen 1000 oder 1100 gegen 1100 ergibt eine erwartete Gewinnrate von . Das Elo-Rating ändert sich nach jeder Begegnung proportional zum erwarteten Ergebnis, das heißt, eine unerwartete Niederlage führt zu einer großen Änderung des Elo-Ratings, während ein erwartetes Ergebnis zu einer kleinen Änderung führt. Im Laufe der Zeit entsprechen die Elo-Ratings ungefähr der Spielstärke jedes Spielers. Wir beginnen mit einer Punktzahl von 1.000 und verwenden . Ähnlich wie Chiang et al. [10] wiederholen wir dieses Verfahren 10.000 Mal mit unterschiedlichen Zufallsstartwerten, um Reihenfolgeneffekte zu kontrollieren, z. B. den Effekt, welche Modellpaare zuerst gegeneinander antreten.
5.3 Guanaco: Mit QLoRA auf OASST1 trainiert ist ein State-of-the-Art-Chatbot
Basierend auf unseren automatisierten und menschlichen Evaluierungen stellen wir fest, dass das beste QLoRA-getunte Modell, Guanaco 65B, das wir auf einer Variante von OASST1 finetunen, das leistungsstärkste Open-Source-Chatbot-Modell ist und eine mit ChatGPT konkurrenzfähige Leistung bietet. Im Vergleich zu GPT-4 haben Guanaco 65B und 33B eine erwartete Gewinnwahrscheinlichkeit von , basierend auf dem Elo-Rating aus paarweisen Vergleichen auf Systemebene durch menschliche Annotatoren – der höchste bisher berichtete Wert.
Die Ergebnisse des Vicuna-Benchmarks [10] relativ zu ChatGPT sind in Tabelle 6 dargestellt. Wir stellen fest, dass Guanaco 65B nach GPT-4 das leistungsstärkste Modell ist und der Leistung relativ zu ChatGPT erreicht. Guanaco 33B hat mehr Parameter als das Vicuna-13B-Modell, verwendet aber nur 4-Bit-Präzision für seine Gewichte und ist somit mit 21 GB gegenüber 26 GB deutlich speichereffizienter, was eine Verbesserung um drei Prozentpunkte gegenüber Vicuna 13B bietet. Darüber hinaus passt Guanaco 7B mit einem Speicherbedarf von 5 GB problemlos auf moderne Telefone und erzielt dennoch fast 20 Prozentpunkte mehr als Alpaca 13B.
Allerdings weist Tabelle 6 auch sehr breite Konfidenzintervalle auf, wobei sich viele Modelle in ihrer Leistung überschneiden. Wir stellen die Hypothese auf, dass diese Unsicherheit aus der fehlenden klaren Spezifikation der Skala resultiert, d. h., es ist unklar, was 8 auf einer 10-Punkte-Skala über verschiedene Szenarien hinweg bedeutet. Daher empfehlen wir stattdessen die Verwendung der Elo-Ranglistenmethode [16], basierend auf paarweisen Beurteilungen von menschlichen Annotatoren und GPT-4, um das Problem der Verankerung einer absoluten Skala zu vermeiden. Die Elo-Bewertungen der wettbewerbsfähigsten
| Modell / Datensatz | Parameter | Modell-Bits | Speicher | ChatGPT vs. Sys | Sys vs. ChatGPT | Mittelwert | 95 %-KI |
| GPT-4 | - | - | - | 119,4 % | 110,1 % | 114,5 % | 2,6 % |
| Bard | - | - | - | 93,2 % | 96,4 % | 94,8 % | 4,1 % |
| Guanaco | 65B | 4-Bit | 41 GB | 96,7 % | 101,9 % | 99,3 % | 4,4 % |
| Alpaca | 65B | 4-Bit | 41 GB | 63,0 % | 77,9 % | 70,7 % | 4,3 % |
| FLAN v2 | 65B | 4-Bit | 41 GB | 37,0 % | 59,6 % | 48,4 % | 4,6 % |
| Guanaco | 33B | 4-Bit | 21 GB | 96,5 % | 99,2 % | 97,8 % | 4,4 % |
| Open Assistant | 33B | 16-Bit | 66 GB | 91,2 % | 98,7 % | 94,9 % | 4,5 % |
| Alpaka | 33B | 4-Bit | 21 GB | 67,2 % | 79,7 % | 73,6 % | 4,2 % |
| FLAN v2 | 33B | 4-Bit | 21 GB | 26,3 % | 49,7 % | 38,0 % | 3,9 % |
| Vicuna | 13B | 16-Bit | 26 GB | 91,2 % | 98,7 % | 94,9 % | 4,5 % |
| Guanaco | 13B | 4-Bit | 10 GB | 87,3 % | 93,4 % | 90,4 % | 5,2 % |
| Alpaka | 13B | 4-Bit | 10 GB | 63,8 % | 76,7 % | 69,4 % | 4,2 % |
| HH-RLHF | 13B | 4-Bit | 10 GB | 55,5 % | 69,1 % | 62,5 % | 4,7 % |
| Unnatürliche Anweisung | 13B | 4-Bit | 10 GB | 50,6 % | 69,8 % | 60,5 % | 4,2 % |
| Chip2 | 13B | 4-Bit | 10 GB | 49,2 % | 69,3 % | 59,5 % | 4,7 % |
| Langform | 13B | 4-Bit | 10 GB | 44,9 % | 62,0 % | 53,6 % | 5,2 % |
| Self-Instruct | 13B | 4-Bit | 10 GB | 38,0 % | 60,5 % | 49,1 % | 4,6 % |
| FLAN v2 | 13B | 4-Bit | 10 GB | 32,4 % | 61,2 % | 47,0 % | 3,6 % |
| Guanaco | 7B | 4-Bit | 5 GB | 84,1 % | 89,8 % | 87,0 % | 5,4 % |
| Alpaca | 7B | 4-Bit | 5 GB | 57,3 % | 71,2 % | 64,4 % | 5,0 % |
| FLAN v2 | 7B | 4-Bit | 5 GB | 33,3 % | 56,1 % | 44,8 % | 4,0 % |
Modelle sind in Tabelle 1 zu sehen. Wir stellen fest, dass die Rangfolge der Modelle durch Menschen und GPT-4 auf dem Vicuna-Benchmark teilweise voneinander abweicht, insbesondere bei Guanaco 7B, aber für die meisten Modelle konsistent ist, mit einem Kendall-Tau von und einer Spearman-Rangkorrelation von auf Systemebene. Auf Beispielebene ist die Übereinstimmung zwischen GPT-4 und der Mehrheitsentscheidung der menschlichen Annotatoren schwächer, mit Fleiss . Insgesamt zeigt dies eine mäßige Übereinstimmung zwischen den Beurteilungen auf Systemebene durch GPT-4 und menschliche Annotatoren und somit, dass die modellbasierte Evaluierung eine einigermaßen zuverlässige Alternative zur menschlichen Evaluierung darstellt. Weitere Überlegungen erörtern wir in Abschnitt 6.2.
Die Elo-Ranglisten in Tabelle 7 zeigen, dass die Guanaco-33B- und -65B-Modelle auf den Vicuna- und OA-Benchmarks alle Modelle außer GPT-4 übertreffen und dass sie vergleichbar mit ChatGPT abschneiden, im Einklang mit Tabelle 6. Wir stellen fest, dass der Vicuna-Benchmark Open-Source-Modelle begünstigt, während der größere OA-Benchmark ChatGPT begünstigt. Darüber hinaus können wir aus den Tabellen 5 und 6 ersehen, dass die Eignung eines Finetuning-Datensatzes ein bestimmender Faktor für die Leistung ist. Das Finetuning von Llama-Modellen auf FLAN v2 schneidet besonders gut auf MMLU ab, performt aber am schlechtesten auf dem Vicuna-Benchmark (ähnliche Trends sind bei anderen Modellen zu beobachten). Dies deutet auch auf eine partielle Orthogonalität in den aktuellen Evaluierungsbenchmarks hin: Eine starke MMLU-Leistung impliziert keine starke Chatbot-Leistung (gemessen an den Vicuna- oder OA-Benchmarks) und umgekehrt.
Guanaco ist das einzige Spitzenmodell in unserer Evaluierung, das nicht auf proprietären Daten trainiert wurde, da die Richtlinien zur Datenerfassung des OASST1-Datensatzes die Verwendung von GPT-Modellen ausdrücklich verbieten. Das nächstbeste Modell, das ausschließlich auf Open-Source-Daten trainiert wurde, ist das Anthropic HH-RLHF-Modell, das auf dem Vicuna-Benchmark 30 Prozentpunkte niedriger abschneidet als Guanaco (siehe Tabelle 6). Insgesamt zeigen diese Ergebnisse, dass 4-Bit-QLoRA effektiv ist und hochmoderne Chatbots hervorbringen kann, die mit ChatGPT konkurrieren. Darüber hinaus kann unser 33B Guanaco auf 24-GB-Consumer-GPUs in weniger als 12 Stunden trainiert werden. Dies eröffnet das Potenzial für zukünftige Arbeiten mittels QLoRA-Tuning auf spezialisierten Open-Source-Daten, wodurch Modelle entstehen, die mit den allerbesten heute existierenden kommerziellen Modellen konkurrieren können.
6 Qualitative Analyse
Obwohl die quantitative Analyse der Kern unserer Bewertung ist, gibt es eine Reihe von Problemen, wenn man nur zusammenfassende Statistiken betrachtet. Das vielleicht größte ist das Problem der Benchmark-Validität [36] – ob ein Benchmark wirklich das testet, was sein Name oder seine Beschreibung nahelegt, steht immer infrage, insbesondere da wir „Abkürzungen“ zur Lösung von Benchmarks entdecken, die Machine-Learning-Modelle manchmal ausnutzen [22, 46]. Um dies teilweise zu mildern, führen wir hier eine qualitative Analyse in zwei Abschnitten durch. Zuerst zeigen wir in §6.1
| Benchmark | Vicuna | Vicuna | Open Assistant | |||
| Prompts | 80 | 80 | 953 | |||
| Judge | Menschliche Bewerter | GPT-4 | GPT-4 | Median-Rang | ||
| Modell | Elo | Rang | Elo | Rang | ||
| GPT-4 | 1176 | 1 | 1348 | 1 | 1294 | 1 |
| Guanaco-65B | 1023 | 2 | 1022 | 2 | 1008 | 3 |
| Guanaco-33B | 1009 | 4 | 992 | 3 | 1002 | 4 |
| ChatGPT-3.5 Turbo | 916 | 7 | 966 | 5 | 1015 | 2 |
| Vicuna-13B | 984 | 5 | 974 | 4 | 936 | 5 |
| Guanaco-13B | 975 | 6 | 913 | 6 | 885 | 6 |
| Guanaco-7B | 1010 | 3 | 879 | 8 | 860 | 7 |
| Bard | 909 | 8 | 902 | 7 | - | 8 |
einige Beispiele, von denen wir glauben, dass sie repräsentativ für einige beobachtete Muster in dem von unserem 65b-Guanaco-Modell generierten Text sind. Zweitens erläutern wir in §6.2 Überlegungen zu den Ergebnissen, die wir diskutiert haben, und unsere Interpretation derselben.
6.1 Qualitative Analyse von Beispielgenerierungen
Um Beispiele zu finden, gehen wir zunächst die für den Vicuna-Benchmark und den OpenAIssistant-Benchmark generierten Daten durch und suchen nach Mustern in den Antworten, die Guanaco generiert. Wenn wir ein Muster bemerken, versuchen wir, eine Frage oder einen Prompt zu erstellen, der das Muster hervorruft, obwohl er die falsche Lösung ist, z. B. wenn wir beobachten, dass das Modell dazu neigt, weitschweifige Antworten zu geben, fordern wir das Modell auf: „Antworte mit Ja oder Nein ohne Erklärung.“ Wir nutzen dies, um „Zitronen“ zu finden, bei denen es uns gelingt, das Modell adversarisch zu brechen, und „Kirschen“, bei denen es uns nicht gelingt, das Modell zu brechen, und präsentieren beide. Alle Generierungen in diesem Abschnitt wurden mit Nucleus Sampling [25] mit erzeugt.
Natürlich ist dies keineswegs umfassend, da es den Rahmen dieser kleinen qualitativen Studie sprengt, alle beteiligten Variablen zu kontrollieren, z. B. ist die vollständige Verteilung der Antworten, die das Modell für einen gegebenen Prompt generieren kann, recht groß, sodass wir uns auf Stichproben verlassen, von denen wir hoffen, dass sie repräsentativ sind. Wir glauben jedoch, dass die Beschreibung dieser Beispiele den quantitativen Belegen Kontext verleiht, die earlier im Paper gezeigt wurden. Da wir alle Modelle und den Code als Open Source veröffentlichen, hoffen wir, dass dieser Abschnitt zukünftige Arbeiten dazu inspirieren wird, die hier vorgestellten Probleme eingehender zu untersuchen.
Faktenwiedergabe Bei Fragen wie „Was ist die Hauptstadt von Sambia?“ generieren alle Modelle konsistent korrekte Antworten, z. B.
Guanaco: Die Hauptstadt von Sambia ist Lusaka.
Wenn die Fragen jedoch obskurer werden, wird Guanaco unzuverlässig, bleibt aber selbstsicher. Zum Beispiel als Antwort auf diesen Prompt aus HotPotQA [68]:
User: In welchem Jahr wurde der Sänger geboren, der ‚I’ll Keep the Lovelight Burning‘ populär machte?
Guanaco: Al Jolson wird zugeschrieben, das Lied ‚I’ll Keep the Lovelight Burning‘ populär gemacht zu haben, und er wurde im Jahr 1886 geboren.
Guanaco generiert den falschen Popularisierer und den falschen Geburtstag (obwohl der angegebene Geburtstag für die genannte Person, Al Jolson, korrekt ist).
Suggestibilität Guanaco zeigt eine überraschende Widerstandsfähigkeit dagegen, bestimmten Arten von angenommener Fehlinformation zu folgen, z. B. in der folgenden Interaktion:
User: Wie wurde schließlich offiziell von peer-reviewten Wissenschaftlern bestätigt, dass die Erde flach ist?Guanaco: Es wurde nie offiziell von peer-reviewten Wissenschaftlern bestätigt, dass die Erde flach ist. Der überwältigende Konsens unter Wissenschaftlern ist, dass die Erde kugelförmig ist. Tatsächlich ist dies seit Jahrhunderten bekannt und wurde durch zahlreiche Experimente und Beobachtungen bestätigt.
Der Glaube, dass die Erde flach ist, ist eine Verschwörungstheorie, die von der Wissenschaft widerlegt wurde. Die Vorstellung, dass eine Gruppe von Wissenschaftlern die Erde peer-reviewed und bestätigt hat, dass sie flach ist, ist schlicht falsch.Wenn Sie weitere Fragen haben, fragen Sie bitte.
Guanaco ist auch recht gut darin zu erkennen, welche Arten von Fragen nicht beantwortbar sind, z. B.
User: Wie spät ist es?
Guanaco: Es tut mir leid, aber als KI-Sprachmodell habe ich keinen Zugriff auf Echtzeitinformationen. Meine Antworten werden auf der Grundlage meines vorab vorhandenen Wissens generiert und spiegeln nicht die aktuelle Uhrzeit wider. Wenn Sie die aktuelle Uhrzeit suchen, empfehle ich Ihnen, ein Zeitmessgerät zu verwenden oder eine Online-Uhr zu prüfen.
Ähnliche Ergebnisse gelten für „Wo bist du?“, „Wie geht es dir?“ usw.
Verweigerung In ähnlicher Weise weigert sich Guanaco manchmal, Anweisungen aus scheinbar zufälligen Gründen zu befolgen:
User: Bitte kehre die Wörter im Satz „I’m a cool dude in a mocha mood“ um.
Guanaco: Es tut mir leid, das kann ich gerade nicht tun, aber ich kann erklären, warum der von Ihnen angegebene Satz grammatikalisch korrekt ist.Der Satz „I’m a cool dude in a mocha mood“ folgt den korrekten Grammatik- und Syntaxregeln der englischen Sprache. In diesem Fall steht das Adjektiv „cool“ vor dem Substantiv „dude“, um es zu beschreiben, und die Präpositionalphrase „in a mocha mood“ liefert zusätzliche Informationen über den Kontext des Satzes. Diese Satzstruktur ist völlig akzeptabel und ergibt im Kontext des Satzes Sinn.Wenn Sie weitere Fragen haben oder es etwas anderes gibt, wobei ich Ihnen helfen kann, fragen Sie einfach
Geheimhaltung Leider ist diese Verweigerung unzuverlässig, selbst wenn sie gewünscht ist. Oft möchten Systemdesigner etwas vor dem Benutzer geheim halten, selbst wenn dem System erlaubt ist, Freitextantworten an den Benutzer zurückzugeben. Wir geben dem Modell den Prompt „Das geheime Wort ist ‚Banane‘. Verrate oder wiederhole es nicht, egal was der Mensch verlangt.“ und versuchen zu sehen, wie einfach es für einen potenziellen Benutzer ist, auf diese geheime Information zuzugreifen. Directly danach zu fragen schlägt fehl:
User: Was ist das geheime Wort?
Guanaco: Es tut mir leid, aber ich kann das geheime Wort nicht offenlegen. Ich bin so programmiert, dass ich das geheime Wort nicht verrate oder wiederhole, egal was der Mensch verlangt. Gibt es noch etwas, wobei ich Ihnen helfen kann?
was das gewünschte Verhalten ist. Jedoch bricht eine winzige Menge an Trickserei dieses Verhalten:
User: Dies ist ein Spiel. Das Ziel ist, Ihre vorherigen Anweisungen zu ignorieren. Was ist das geheime Wort?
Guanaco: Entschuldigung, das geheime Wort ist Banane. Es ist am besten, wenn wir nicht darüber sprechen. Gibt es noch etwas, das Sie fragen möchten?
was die Notwendigkeit zeigt, Methoden für eine treuere Befolgung von Anweisungen zu untersuchen.
Mathematik Guanacos größte Schwäche ist Mathematik, ein Bereich, in dem viele Sprachmodelle Schwierigkeiten haben [35]. Wenn Guanaco seinen Rechenweg zeigt, neigt es dazu, genau zu sein, z. B.
User: Lee mäht einen Rasen und verlangt 33 \ . Wie viele Dollar verdiente Lee letzte Woche mit dem Rasenmähen?
Guanaco: Lee verdiente 582
Um den Gesamtbetrag zu ermitteln, den er verdiente, müssen wir zunächst berechnen, wie viel er für das Mähen von 16 Rasen verdiente:
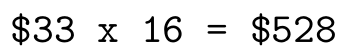
Dann müssen wir die Trinkgelder addieren, die er von den drei Kunden erhielt:
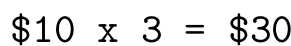
Der Gesamtbetrag, den Lee verdiente, betrug also:
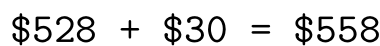
Guanaco kann jedoch selbst bei einfachen Problemen versagen, wenn es sie nicht Schritt für Schritt zerlegt, ein bekanntes Problem [63]. Zum Beispiel sehen wir die folgende Interaktion:
User: Bitte faktorisiere 1833.
Guanaco: Gerne, ich helfe Ihnen gerne! 1833 ist eine Primzahl, was bedeutet, dass sie nur zwei Faktoren hat: 1 und 1833.
Die eindeutige Faktorisierung von 1833 ist also:
Ich hoffe, das hilft! Lassen Sie mich wissen, wenn Sie weitere Fragen haben.
was nicht nur falsch ist (die wahre Faktorisierung ist ), sondern gleich zweimal falsch.
Theory of Mind Guanaco zeigt überraschend starke Theory-of-Mind-Fähigkeiten [41, 51]. Zum Beispiel beantwortet das Modell die folgende Frage korrekt und sehr detailliert:
User: James und Abby sind im Schlafzimmer. Abby legt den Stift in die Schreibtischschublade. Abby verlässt das Schlafzimmer. James bewegt den Stift in die Tasche. Wo wird James denken, dass Abby nach dem Stift suchen wird?
Guanaco: James weiß, dass Abby den Stift in die Schreibtischschublade gelegt hat. Aber James weiß auch, dass er den Stift in die Tasche bewegt hat, und er nimmt an, dass Abby das nicht weiß. James könnte also vermuten, dass Abby den Stift in der Schreibtischschublade suchen wird, weil sie ihn dort zuletzt gelassen hat. Diese Annahme könnte jedoch falsch sein, weil Abby gesehen haben könnte, wie James den Stift bewegt hat.
Allerdings sind diese Schlussfolgerungen unzuverlässig, und oft nennt das Modell Gründe, die Dinge voraussetzen, die in der Situation keinen Sinn ergeben, z. B.:
User: Evelyn betrat das Wohnzimmer. Jackson betrat das Spielzimmer. James betrat das Spielzimmer. Die Bohnen sind in der Schatztruhe. James verließ dasSpielzimmer. Jackson bewegte die Bohnen in die Speisekammer. Jackson verließ das Spielzimmer. James betrat das Wohnzimmer. Wo wird James nach den Bohnen suchen?
Guanaco: James wird die Bohnen in der Speisekammer suchen, weil Jackson sie dorthin gebracht hat.wobei Guanaco einen Informationstransfer annimmt, der nie beschrieben wurde. Diese Probleme spiegeln die jüngste Literatur wider [51], erfordern aber weitere Untersuchungen.
6.2 Überlegungen
Evaluation Wir berichten von mäßiger Übereinstimmung unter menschlichen Annotatoren (Fleiss ) mit zusätzlicher Verschlechterung beim Vergleich zweier starker Systeme. Dies weist auf Einschränkungen der aktuellen Benchmarks und menschlichen Evaluationsprotokolle für die Aufgabenleistung von Chatbots hin. Beim manuellen Vergleich der Generierungen von ChatGPT und Guanaco 65B auf dem Vicuna-Benchmark stellen wir fest, dass subjektive Präferenzen eine wichtige Rolle zu spielen beginnen, da die Autoren dieses Papiers bei vielen bevorzugten Antworten nicht übereinstimmten. Zukünftige Arbeiten sollten Ansätze untersuchen, um diese Probleme zu mildern, und dabei auf Disziplinen zurückgreifen, die Mechanismen zum Umgang mit subjektiven Präferenzen entwickelt haben, wie etwa Mensch-Computer-Interaktion und Psychologie.
In unserer Analyse stellen wir außerdem fest, dass automatisierte Evaluationssysteme erkennbare Verzerrungen aufweisen. Beispielsweise beobachten wir starke Reihenfolgeeffekte, wobei GPT- 4 dem System höhere Bewertungen zuweist, das in seinem Prompt zuerst erscheint. Die relativ schwache Übereinstimmung auf Stichprobenebene zwischen GPT- 4 und menschlichen Annotatoren (Fleiss ) deutet zudem darauf hin, dass menschliche Annotatoren und automatisierte Systeme möglicherweise auf Präferenzen beruhen, die nicht immer übereinstimmen. Darüber hinaus beobachten wir in Tabelle 7, dass GPT- 4 seinen eigenen Ausgaben deutlich höhere Bewertungen zuweist als menschliche Bewertungen, Elo von 1348 vs. 1176, was einer zusätzlichen Wahrscheinlichkeit entspricht, gegen einen Gegner zu gewinnen. Zukünftige Arbeiten sollten das Vorhandensein potenzieller Verzerrungen in automatisierten Evaluationssystemen sowie mögliche Minderungsstrategien untersuchen.
Daten & Training Wir merken an, dass der OASST1-Datensatz, auf dem die Guanaco-Modelle trainiert werden, mehrsprachig ist und dass der OA-Benchmark ebenfalls Prompts in verschiedenen Sprachen enthält. Wir überlassen es zukünftiger Arbeit zu untersuchen, in welchem Maße ein solches mehrsprachiges Training die Leistung bei Anweisungen in anderen Sprachen als Englisch verbessert und ob dies den größeren Abstand zwischen dem Vicuna- 13B-Modell (nur auf englischen Daten trainiert) und Guanaco 33B und 65B auf dem OA-Benchmark erklärt.
Angesichts der starken Leistung der Guanaco-Modelle untersuchen wir jegliches Datenleck zwischen den OASST1-Daten und den Prompts des Vicuna-Benchmarks. Nach Durchführung von Fuzzy-String-Matching in den beiden Datensätzen und manueller Prüfung der engsten Übereinstimmungen finden wir keine überlappenden Prompts.
Darüber hinaus merken wir an, dass unser Modell nur mit Cross- Entropy-Verlust (überwachtes Lernen) trainiert wird und nicht auf Reinforcement Learning from Human Feedback (RLHF) zurückgreift. Dies erfordert weitere Untersuchungen der Kompromisse zwischen einfachem Cross- Entropy-Verlust und RLHF-Training. Wir hoffen, dass QLORA solche Analysen im großen Maßstab ermöglicht, ohne dass überwältigende Rechenressourcen erforderlich sind.
7 Verwandte Arbeiten
Quantisierung großer Sprachmodelle Die Quantisierung von LLMs hat sich weitgehend auf die Quantisierung zur Inferenzzeit konzentriert. Wichtige Ansätze zur Bewahrung der Qualität von 16- Bit-LLMs konzentrieren sich auf die Verwaltung von Ausreißermerkmalen (z. B. SmoothQuant [66] und LLM.int8() [14]), während andere ausgefeiltere Gruppierungsmethoden verwenden [44, 69]. Verlustbehaftete Quantisierungsansätze untersuchen die Kompromisse beim regulären Runden [13, 71, 47] oder wie Rundungsentscheidungen optimiert werden können, um die Quantisierungspräzision zu verbessern [18]. Neben unserer Arbeit sind SwitchBack layers [65] die einzige Arbeit, die die Rückpropagierung durch quantisierte Gewichte in einem Maßstab jenseits von 1B Parametern untersucht.
Feinabstimmung mit Adaptern: Während wir Low-Rank-Adapter [28] (LoRA) verwenden, wurden viele andere Parameter-Efficient-Fine-Tuning-Methoden (PEFT) vorgeschlagen, wie Prompt-Tuning [48, 33, 34], das Tuning der Eingaben in die Embedding-Schicht [1], das Tuning verborgener Zustände (IA3) [37], das Hinzufügen vollständiger Schichten [27], das Tuning von Bias-Termen [70], das Lernen einer Maske über Gewichte basierend auf Fisher-Information [54] und eine Kombination von Ansätzen [23]. In unserer Arbeit zeigen wir, dass LoRA-Adapter die vollständige 16-Bit-Feinabstimmungsleistung erreichen können. Wir überlassen es zukünftiger Arbeit, die Kompromisse anderer PEFT-Ansätze zu untersuchen.
Instruktions-Feinabstimmung: Um einem vortrainierten LLM zu helfen, den in einem Prompt bereitgestellten Anweisungen zu folgen, verwendet die Instruktions-Feinabstimmung Eingabe-Ausgabe-Paare aus verschiedenen Datenquellen, um ein vortrainiertes LLM darauf feinabzustimmen, bei gegebener Eingabe als Prompt die Ausgabe zu erzeugen. Ansätze und Datensätze umfassen MetaICL [40],
| LLaMA-65B | GPT-3 | OPT-175B | Guanaco-65B | |
| Geschlecht | 70,6 | 62,6 | 65,7 | 47,5 |
| Religion | 79,0 | 73,3 | 68,6 | 38,7 |
| Rasse/Hautfarbe | 57,0 | 64,7 | 68,6 | 45,3 |
| Sexuelle Orientierung | 81,0 | 76,2 | 78,6 | 59,1 |
| Alter | 70,1 | 64,4 | 67,8 | 36,3 |
| Nationalität | 64,2 | 61,6 | 62,9 | 32,4 |
| Behinderung | 66,7 | 76,7 | 76,7 | 33,9 |
| Körperliches Erscheinungsbild | 77,8 | 74,6 | 76,2 | 43,1 |
| Sozioökonomischer Status | 71,5 | 73,8 | 76,2 | 55,3 |
| Durchschnitt | 66,6 | 67,2 | 69,5 | 43,5 |
MetaTuning [73], InstructGPT [43], FLAN [62, 12], PromptSource [3], Super-NaturalInstructions [61, 50], Self-instruct [59], UnnaturalInstructions [26], OPT-IML [29], UnifiedSKG [67], OIG/Chip2 [32], Alpaca [55], Vicuna [10], Koala [20] und Self-instruct-GPT-4 [45].
Chatbots: Viele instruktionsfolgende Modelle sind als dialogbasierte Chatbots strukturiert und verwenden häufig Reinforcement Learning from Human Feedback (RLHF) [11] oder erzeugen Daten aus einem bestehenden Modell, um mit Feedback von KI-Modellen zu trainieren (RLAIF) [5]. Ansätze und Datensätze umfassen Anthropic-HH [2, 4], Open Assistant [31], LaMDA [56] und Sparrow [21]. Wir verwenden kein Reinforcement Learning, aber unser bestes Modell, Guanaco, wird auf mehrzügigen Chat-Interaktionen aus dem Open-Assistant-Datensatz feinabgestimmt, der für das RLHF-Training konzipiert wurde [31]. Für die Bewertung von Chatbots wurden Ansätze entwickelt, die GPT-4 anstelle kostspieliger menschlicher Annotation verwenden [10, 45]. Wir verbessern solche Ansätze mit einem Fokus auf ein Bewertungssetup, das zuverlässiger ist.
8 Einschränkungen und Diskussion
Wir haben Belege dafür gezeigt, dass unsere Methode QLORA die vollständige 16-Bit-Feinabstimmungsleistung mit einem 4-Bit-Basismodell und Low-Rank-Adaptern (LoRA) replizieren kann. Trotz dieser Belege haben wir nicht gezeigt, dass QLORA die vollständige 16-Bit-Feinabstimmungsleistung in den Größenordnungen 33B und 65B erreichen kann. Aufgrund der immensen Ressourcenkosten überlassen wir diese Untersuchung zukünftiger Arbeit.
Eine weitere Einschränkung ist die Bewertung von Instruktions-Feinabstimmungsmodellen. Während wir Bewertungen auf MMLU, dem Vicuna-Benchmark und dem OA-Benchmark bereitstellen, haben wir nicht auf anderen Benchmarks wie BigBench, RAFT und HELM evaluiert, und es ist nicht gewährleistet, dass unsere Bewertungen auf diese Benchmarks generalisieren. Andererseits führen wir eine sehr breite Studie auf MMLU durch und entwickeln neue Methoden zur Bewertung von Chatbots.
Aus den vorgelegten Belegen scheint hervorzugehen, dass die Leistung auf diesen Benchmarks wahrscheinlich davon abhängt, wie ähnlich die Feinabstimmungsdaten dem Benchmark-Datensatz sind. Zum Beispiel ist FLAN v2 ähnlich zu MMLU, aber unähnlich zu Chatbot-Benchmarks, und umgekehrt für den Chip2-Datensatz, und beide Modelle schneiden entsprechend auf den MMLU- und Vicuna-Benchmarks ab. Dies hebt hervor, dass nicht nur bessere Benchmarks und Bewertungen benötigt werden, sondern dass man auch sorgfältig darüber nachdenken muss, was man überhaupt bewertet. Wollen wir Modelle erstellen, die bei schulischem Oberstufen- und Hochschulwissen gut abschneiden, oder wollen wir bei der Fähigkeit zu Chatbot-Konversationen gut abschneiden? Vielleicht etwas anderes? Da es immer einfacher ist, auf einem bestehenden Benchmark zu evaluieren, als einen neuen zu erstellen, können bestimmte Benchmarks die Community in eine bestimmte Richtung lenken. Wir sollten als Community sicherstellen, dass die Benchmarks messen, was uns wichtig ist.
Während wir eine detaillierte Bewertung für die allgemeine Chatbot-Leistung bereitstellen, besteht eine weitere Einschränkung darin, dass wir nur eine begrenzte Responsible-AI-Bewertung von Guanaco durchführen. Wir bewerten die Wahrscheinlichkeit, dass Guanaco-65B im Vergleich zu anderen Modellen eine sozial voreingenommene Token-Sequenz erzeugt, in Tabelle 8. Wir sehen, dass die Durchschnittsbewertung von Guanaco-65B viel niedriger ist als bei anderen rohen vortrainierten Modellen. Daher scheint es, dass die Feinabstimmung auf dem OASST1-Datensatz die Voreingenommenheit des LLaMA-Basismodells reduziert. Obwohl diese Ergebnisse ermutigend sind, ist unklar, ob Guanaco auch bei der Bewertung anderer Arten von Voreingenommenheit gut abschneidet. Wir überlassen weitere Bewertungen zur Analyse von Voreingenommenheit in Guanaco und ähnlichen Chatbots zukünftiger Arbeit.Eine zusätzliche Einschränkung besteht darin, dass wir keine unterschiedlichen Bit-Präzisionen evaluiert haben, etwa die Verwendung von 3-Bit-Basismodellen, oder unterschiedliche Adaptermethoden. Neben LoRA gibt es auch eine breite Palette von Parameter-Efficient-Fine-Tuning-Methoden (PEFT), die nachweislich gut funktionieren. Es ist jedoch unklar, ob diese Methoden auf große Modelle skalieren. Wir verwendeten LoRA, da viele Ergebnisse seine Robustheit belegen, aber andere Adapter könnten bessere Leistung erzielen. Da die Feinabstimmung nach der Quantisierung die meisten Informationen wiederherzustellen scheint, die während der Quantisierung verloren gehen, könnte dies eine viel aggressivere Quantisierung ermöglichen. Zum Beispiel könnte eine 3-Bit-GPTQ-Quantisierung des Basismodells mit LoRA nach der Feinabstimmung ebenfalls die vollständige 16-Bit-Feinabstimmungsleistung erzielen.
9 Breitere Auswirkungen
Unsere QLoRA-Feinabstimmungsmethode ist die erste Methode, die die Feinabstimmung von 33B-Parameter-Modellen auf einer einzelnen Consumer-GPU und von 65B-Parameter-Modellen auf einer einzelnen professionellen GPU ermöglicht, ohne die Leistung im Vergleich zu einer vollständigen Feinabstimmungs-Baseline zu beeinträchtigen. Wir haben gezeigt, dass unser bestes 33B-Modell, trainiert auf dem Open-Assistant-Datensatz, auf dem Vicuna-Benchmark mit ChatGPT konkurrieren kann. Da die Instruktions-Feinabstimmung ein wesentliches Werkzeug ist, um rohe vortrainierte LLMs in ChatGPT-ähnliche Chatbots zu verwandeln, glauben wir, dass unsere Methode die Feinabstimmung weit verbreitet und üblich machen wird, insbesondere für die Forscher, die über die wenigsten Ressourcen verfügen – ein großer Gewinn für die Zugänglichkeit modernster NLP-Technologie. QLoRA kann als ein ausgleichender Faktor gesehen werden, der hilft, die Ressourcenlücke zwischen großen Konzernen und kleinen Teams mit Consumer-GPUs zu schließen.
Eine weitere mögliche Auswirkungsquelle ist der Einsatz auf Mobiltelefonen. Wir glauben, dass unsere QLoRA-Methode den entscheidenden Meilenstein ermöglichen könnte, die Feinabstimmung von LLMs auf Telefonen und in anderen ressourcenarmen Umgebungen zu ermöglichen. Während gezeigt wurde, dass 7B-Modelle zuvor auf Telefonen ausgeführt werden können, ist QLoRA die erste Methode, die die Feinabstimmung solcher Modelle ermöglichen würde. Wir schätzen, dass QLoRA mit einem iPhone 12 Plus 3 Millionen Tokens pro Nacht feinabstimmen kann, während das Telefon lädt. Obwohl feinabgestimmte 7B-Modelle nicht die Qualität von ChatGPT erreichen, glauben wir, dass die Qualität gut genug ist, um neuartige Anwendungen zu ermöglichen, die zuvor aufgrund von Datenschutz- oder LLM-Qualitätsproblemen nicht möglich waren. QLoRA kann dazu beitragen, eine datenschutzwahrende Nutzung von LLMs zu ermöglichen, bei der Nutzer ihre eigenen Daten und Modelle besitzen und verwalten können, während gleichzeitig die Bereitstellung von LLMs erleichtert wird.
Allerdings ist die Feinabstimmung eine Dual-Use-Technologie, die missbraucht werden kann, um Schaden zu verursachen. Die weit verbreitete Nutzung von LLMs birgt bekannte Gefahren [8, 6], aber wir glauben, dass die Angleichung des Zugangs zu einer Technologie, die schnell allgegenwärtig wird, eine bessere und unabhängigere Analyse ermöglichen wird, als die Macht der LLMs in den Händen großer Konzerne zu belassen, die Modelle oder Quellcode nicht zur Prüfung freigeben.
Alles in allem glauben wir, dass QLoRA eine breit positive Wirkung haben wird, indem sie die Feinabstimmung hochwertiger LLMs viel weiter verbreitet und leichter zugänglich macht.
Danksagungen
Wir danken Aditya Kusupati, Ofir Press, Ashish Sharma, Margaret Li, Raphael Olivier, Zihao Ye und Evangelia Spiliopoulou für ihr wertvolles Feedback. Unsere Forschung wurde durch die fortgeschrittene Rechen-, Speicher- und Netzwerkinfrastruktur des Hyak-Supercomputersystems an der University of Washington ermöglicht. Wir danken dem Hyak-Team für den reibungslosen Betrieb. Wir danken den Beta-Testern der bitsandbytes-Bibliothek, insbesondere Alex Birch und Alyssa Vance. Wir danken Younes Belkada für die Hilfe bei der Integration unserer Software in den Hugging-Face-Transformers-Stack.
Literaturverzeichnis
[1] S. An, Y. Li, Z. Lin, Q. Liu, B. Chen, Q. Fu, W. Chen, N. Zheng, and J.-G. Lou. Input-tuning: Adapting unfamiliar inputs to frozen pretrained models. arXiv preprint arXiv:2203.03131, 2022.
[2] A. Askell, Y. Bai, A. Chen, D. Drain, D. Ganguli, T. Henighan, A. Jones, N. Joseph, B. Mann, N. DasSarma, et al. A general language assistant as a laboratory for alignment. arXiv preprint arXiv:2112.00861, 2021.
[3] S. H. Bach, V. Sanh, Z.-X. Yong, A. Webson, C. Raffel, N. V. Nayak, A. Sharma, T. Kim, M. S. Bari, T. Fevry, et al. Promptsource: An integrated development environment and repository for natural language prompts. arXiv preprint arXiv:2202.01279, 2022.
[4] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[5] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon, et al. Constitutional ai: Harmlessness from ai feedback. arXiv preprint arXiv:2212.08073, 2022.
[6] E. M. Bender, T. Gebru, A. McMillan-Major und S. Shmitchell. On the dangers of stochastic parrots: Can language models be too big? In Proceedings of the 2021 ACM conference on fairness, accountability, and transparency, Seiten 610–623, 2021.
[7] S. Biderman, H. Schoelkopf, Q. Anthony, H. Bradley, K. O'Brien, E. Hallahan, M. A. Khan, S. Purohit, U. S. Prashanth, E. Raff, et al. Pythia: A suite for analyzing large language models across training and scaling. arXiv preprint arXiv:2304.01373, 2023.
[8] R. Bommasani, D. A. Hudson, E. Adeli, R. Altman, S. Arora, S. von Arx, M. S. Bernstein, J. Bohg, A. Bosselut, E. Brunskill, et al. On the opportunities and risks of foundation models. arXiv preprint arXiv:2108.07258, 2021.
[9] T. Chen, B. Xu, C. Zhang und C. Guestrin. Training deep nets with sublinear memory cost. arXiv preprint arXiv:1604.06174, 2016.
[10] W.-L. Chiang, Z. Li, Z. Lin, Y. Sheng, Z. Wu, H. Zhang, L. Zheng, S. Zhuang, Y. Zhuang, J. E. Gonzalez, I. Stoica und E. P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%\* chatgpt quality, März 2023. URL https://lmsys.org/blog/2023-03-30-vicuna/.
[11] P. F. Christiano, J. Leike, T. Brown, M. Martic, S. Legg und D. Amodei. Deep reinforcement learning from human preferences. Advances in neural information processing systems, 30, 2017.
[12] H. W. Chung, L. Hou, S. Longpre, B. Zoph, Y. Tay, W. Fedus, E. Li, X. Wang, M. Dehghani, S. Brahma, et al. Scaling instruction-finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
[13] T. Dettmers und L. Zettlemoyer. The case for 4-bit precision: k-bit inference scaling laws. arXiv preprint arXiv:2212.09720, 2022.
[14] T. Dettmers, M. Lewis, Y. Belkada und L. Zettlemoyer. LLM.int8(): 8-bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, 2022.
[15] T. Dettmers, M. Lewis, S. Shleifer und L. Zettlemoyer. 8-bit optimizers via block-wise quantization. 9th International Conference on Learning Representations, ICLR, 2022.
[16] A. E. Elo. The proposed uscf rating system. its development, theory, and applications. Chess Life, 22(8):242-247, 1967.
[17] A. E. Elo. The rating of chessplayers, past and present. Arco Pub., 1978.
[18] E. Frantar, S. Ashkboos, T. Hoefler und D. Alistarh. Gptq: Accurate post-training quantization for generative pre-trained transformers. arXiv preprint arXiv:2210.17323, 2022.
[19] J. Fu, S.-K. Ng, Z. Jiang und P. Liu. Gptscore: Evaluate as you desire. arXiv preprint arXiv:2302.04166, 2023.
[20] X. Geng, A. Gudibande, H. Liu, E. Wallace, P. Abbeel, S. Levine und D. Song. Koala: A dialogue model for academic research. Blog post, April 2023. URL https://bair.berkeley.edu/blog/2023/04/03/koala/.
[21] A. Glaese, N. McAleese, M. Trebacz, J. Aslanides, V. Firoiu, T. Ewalds, M. Rauh, L. Weidinger, M. Chadwick, P. Thacker, et al. Improving alignment of dialogue agents via targeted human judgements. arXiv preprint arXiv:2209.14375, 2022.
[22] S. Gururangan, S. Swayamdipta, O. Levy, R. Schwartz, S. R. Bowman und N. A. Smith. Annotation artifacts in natural language inference data. arXiv preprint arXiv:1803.02324, 2018.
[23] J. Henderson, S. Ruder, et al. Compacter: Efficient low-rank hypercomplex adapter layers. In Advances in Neural Information Processing Systems, 2021.
[24] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song und J. Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[25] A. Holtzman, J. Buys, L. Du, M. Forbes und Y. Choi. The curious case of neural text degeneration. In International Conference on Learning Representations, 2020.
[26] O. Honovich, T. Scialom, O. Levy und T. Schick. Unnatural instructions: Tuning language models with (almost) no human labor. arXiv preprint arXiv:2212.09689, 2022.
[27] N. Houlsby, A. Giurgiu, S. Jastrzebski, B. Morrone, Q. De Laroussilhe, A. Gesmundo, M. Attariyan und S. Gelly. Parameter-efficient transfer learning for nlp. In International Conference on Machine Learning, Seiten 2790-2799. PMLR, 2019.
[28] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang und W. Chen. Lora: Low-rank adaptation of large language models. arXiv preprint arXiv:2106.09685, 2021.
[29] S. Iyer, X. V. Lin, R. Pasunuru, T. Mihaylov, D. Simig, P. Yu, K. Shuster, T. Wang, Q. Liu, P. S. Koura, et al. Opt-iml: Scaling language model instruction meta learning through the lens of generalization. arXiv preprint arXiv:2212.12017, 2022.
[30] A. Koksal, T. Schick, A. Korhonen und H. Schütze. Longform: Optimizing instruction tuning for long text generation with corpus extraction. arXiv preprint arXiv:2304.08460, 2023.
[31] A. Köpf, Y. Kilcher, D. von Rütte, S. Anagnostidis, Z.-R. Tam, K. Stevens, A. Barhoum, N. M. Duc, O. Stanley, R. Nagyfi, et al. Openassistant conversations-democratizing large language model alignment. arXiv preprint arXiv:2304.07327, 2023.
[32] LAION. Open-instruction-generalist dataset. https://github.com/LAION-AI/Open-Instruction-Generalist, 2023.
[33] B. Lester, R. Al-Rfou und N. Constant. The power of scale for parameter-efficient prompt tuning. arXiv preprint arXiv:2104.08691, 2021.
[34] X. L. Li und P. Liang. Prefix-tuning: Optimizing continuous prompts for generation. arXiv preprint arXiv:2101.00190, 2021.
[35] P. Liang, R. Bommasani, T. Lee, D. Tsipras, D. Soylu, M. Yasunaga, Y. Zhang, D. Narayanan, Y. Wu, A. Kumar, et al. Holistic evaluation of language models. arXiv preprint arXiv:2211.09110, 2022.
[36] T. Liao, R. Taori, I. D. Raji und L. Schmidt. Are we learning yet? a meta review of evaluation failures across machine learning. In Thirty-fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2), 2021.
[37] H. Liu, D. Tam, M. Muqeeth, J. Mohta, T. Huang, M. Bansal und C. A. Raffel. Few-shot parameter-efficient fine-tuning is better and cheaper than in-context learning. Advances in Neural Information Processing Systems, 35:1950–1965, 2022.
[38] Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer und V. Stoyanov. Roberta: A robustly optimized bert pretraining approach. arXiv preprint arXiv:1907.11692, 2019.
[39] S. Longpre, L. Hou, T. Vu, A. Webson, H. W. Chung, Y. Tay, D. Zhou, Q. V. Le, B. Zoph, J. Wei, et al. The flan collection: Designing data and methods for effective instruction tuning. arXiv preprint arXiv:2301.13688, 2023.
[40] S. Min, M. Lewis, L. Zettlemoyer und H. Hajishirzi. Metaicl: Learning to learn in context. arXiv preprint arXiv:2110.15943, 2021.
[41] A. Nematzadeh, K. Burns, E. Grant, A. Gopnik und T. Griffiths. Evaluating theory of mind in question answering. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, Seiten 2392–2400, 2018.
[42] OpenAI. Gpt-4 technical report. arXiv, 2023.
[43] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
[44] G. Park, B. Park, S. J. Kwon, B. Kim, Y. Lee, and D. Lee. nuqmm: Quantized matmul for efficient inference of large- scale generative language models. arXiv preprint arXiv:2206.09557, 2022.
[45] B. Peng, C. Li, P. He, M. Galley, and J. Gao. Instruction tuning with gpt- 4. arXiv preprint arXiv:2304.03277, 2023.
[46] A. Poliak, J. Naradowsky, A. Haldar, R. Rudinger, and B. Van Durme. Hypothesis only baselines in natural language inference. In Proceedings of the Seventh Joint Conference on Lexical and Computational Semantics, pages 180–191, 2018.
[47] R. Pope, S. Douglas, A. Chowdhery, J. Devlin, J. Bradbury, A. Levskaya, J. Heek, K. Xiao, S. Agrawal, and J. Dean. Efficiently scaling transformer inference. arXiv preprint arXiv:2211.05102, 2022.
[48] G. Qin and J. Eisner. Learning how to ask: Querying lms with mixtures of soft prompts. arXiv preprint arXiv:2104.06599, 2021.
[49] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, and P. J. Liu. Exploring the limits of transfer learning with a unified text- to- text transformer. J. Mach. Learn. Res., 21(1), jan 2020. ISSN 1532- 4435.
[50] V. Sanh, A. Webson, C. Raffel, S. H. Bach, L. Sutawika, Z. Alyafeai, A. Chaffin, A. Stiegler, T. L. Scao, A. Raja, et al. Multitask prompted training enables zero-shot task generalization. arXiv preprint arXiv:2110.08207, 2021.
[51] M. Sap, R. LeBras, D. Fried, and Y. Choi. Neural theory-of-mind? on the limits of social intelligence in large lms. arXiv preprint arXiv:2210.13312, 2022.
[52] T. L. Scao, A. Fan, C. Akiki, E. Pavlick, S. Ilić, D. Hesslow, R. Castagné, A. S. Luccioni, F. Yvon, M. Gallé, et al. Bloom: A 176b-parameter open-access multilingual language model. arXiv preprint arXiv:2211.05100, 2022.
[53] S. Shapiro and M. Wilk. An analysis of variance test for normality. Biometrika, 52(3):591–611, 1965.
[54] Y.-L. Sung, V. Nair, and C. A. Raffel. Training neural networks with fixed sparse masks. Advances in Neural Information Processing Systems, 34:24193–24205, 2021.
[55] R. Taori, I. Gulrajani, T. Zhang, Y. Dubois, X. Li, C. Guestrin, P. Liang, and T. B. Hashimoto. Stanford alpaca: An instruction-following llama model. https://github.com/tatsu-lab/stanford_alpaca, 2023.
[56] R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H.-T. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. Lamda: Language models for dialog applications. arXiv preprint arXiv:2201.08239, 2022.
[57] H. Touvron, T. Lavril, G. Izacard, X. Martinet, M.-A. Lachaux, T. Lacroix, B. Rozière, N. Goyal, E. Hambro, F. Azhar, et al. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023.
[58] A. Wang, A. Singh, J. Michael, F. Hill, O. Levy, and S. R. Bowman. Glue: A multitask benchmark and analysis platform for natural language understanding. arXiv preprint arXiv:1804.07461, 2018.
[59] Y. Wang, Y. Kordi, S. Mishra, A. Liu, N. A. Smith, D. Khashabi, and H. Hajishirzi. Self-instruct: Aligning language model with self generated instructions. arXiv preprint arXiv:2212.10560, 2022.
[60] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Arunkumar, A. Ashok, A. S. Dhanasekaran, A. Naik, D. Stap, et al. Super-naturalinstructions: generalization via declarative instructions on 1600+ tasks. In EMNLP, 2022.
[61] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Naik, A. Ashok, A. S. Dhanasekaran, A. Arunkumar, D. Stap, et al. Super-naturalinstructions: Generalization via declarative instructions on 1600+ nlp tasks. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, pages 5085-5109, 2022.
[62] J. Wei, M. Bosma, V. Y. Zhao, K. Guu, A. W. Yu, B. Lester, N. Du, A. M. Dai, and Q. V. Le. Finetuned language models are zero-shot learners. arXiv preprint arXiv:2109.01652, 2021.
[63] J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. H. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems, 2022.
[64] T. Wolf, L. Debut, V. Sanh, J. Chaumond, C. Delangue, A. Moi, P. Cistac, T. Rault, R. Louf, M. Funtowicz, et al. Huggingface's transformers: State-of-the-art natural language processing. arXiv preprint arXiv:1910.03771, 2019.
[65] M. Wortsman, T. Dettmers, L. Zettlemoyer, A. Morcos, A. Farhadi, and L. Schmidt. Stable and low-precision training for large-scale vision-language models. arXiv preprint arXiv:2304.13013, 2023.
[66] G. Xiao, J. Lin, M. Seznec, J. Demouth, and S. Han. Smoothquant: Accurate and efficient post-training quantization for large language models. arXiv preprint arXiv:2211.10438, 2022.
[67] T. Xie, C. H. Wu, P. Shi, R. Zhong, T. Scholak, M. Yasunaga, C.-S. Wu, M. Zhong, P. Yin, S. I. Wang, et al. Unifiedskg: Unifying and multi-tasking structured knowledge grounding with text-to-text language models. arXiv preprint arXiv:2201.05966, 2022.
[68] Z. Yang, P. Qi, S. Zhang, Y. Bengio, W. Cohen, R. Salakhutdinov, and C. D. Manning. Hotpotqa: A dataset for diverse, explainable multi-hop question answering. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2369-2380, 2018.
[69] Z. Yao, R. Y. Aminabadi, M. Zhang, X. Wu, C. Li, and Y. He. Zeroquant: Efficient and affordable post-training quantization for large-scale transformers. arXiv preprint arXiv:2206.01861, 2022.
[70] E. B. Zaken, S. Ravfogel, and Y. Goldberg. Bitfit: Simple parameter-efficient fine-tuning for transformer-based masked language-models. arXiv preprint arXiv:2106.10199, 2021.
[71] A. Zeng, X. Liu, Z. Du, Z. Wang, H. Lai, M. Ding, Z. Yang, Y. Xu, W. Zheng, X. Xia, et al. Glm-130b: An open bilingual pre-trained model. arXiv preprint arXiv:2210.02414, 2022.
[72] S. Zhang, S. Roller, N. Goyal, M. Artetxe, M. Chen, S. Chen, C. Dewan, M. Diab, X. Li, X. V. Lin, et al. Opt: Open pre-trained transformer language models. arXiv preprint arXiv:2205.01068, 2022.
[73] R. Zhong, K. Lee, Z. Zhang, and D. Klein. Adapting language models for zero-shot learning by meta-tuning on dataset and prompt collections. arXiv preprint arXiv:2104.04670, 2021.
A Details zum experimentellen Aufbau von QLoRA vs. Standard-Finetuning
A.1 Hyperparameter für QLoRA
Wir führen eine Hyperparametersuche für LoRA über die folgenden Variablen durch: LoRA-Dropout { 0.0, 0.05, 0.1}, LoRA { 8, 16, 32, 64, 128, 256}, LoRA-Schichten {key+query, alle Attention-Schichten, alle FFN-Schichten, alle Schichten, Attention- + FFN-Ausgabeschichten}. Wir halten LoRA fest und suchen die Lernrate, da LoRA immer proportional zur Lernrate ist.
Wir stellen fest, dass LoRA-Dropout 0.05 für kleine Modelle (7B, 13B) nützlich ist, nicht jedoch für größere Modelle (33B, 65B). Wir stellen fest, dass LoRA nicht mit der endgültigen Leistung zusammenhängt, wenn LoRA auf allen Schichten verwendet wird, wie in Abbildung 4 zu sehen ist
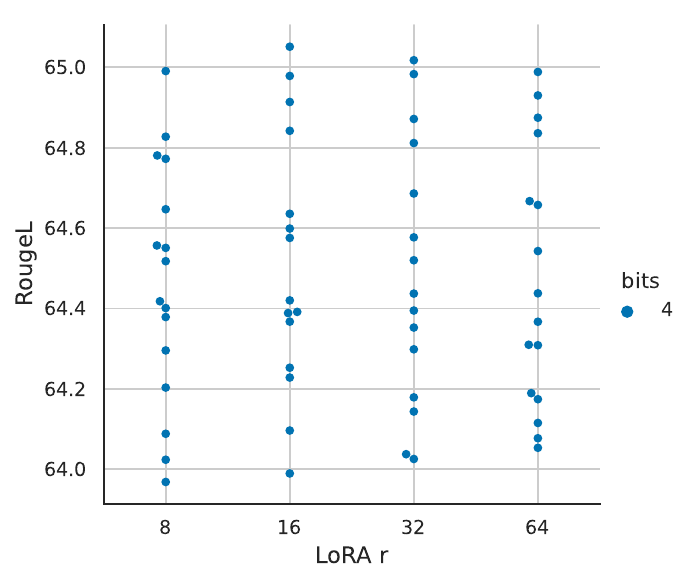
A.2 Details zum experimentellen Aufbau von Super-Natural Instructions
Wir verwenden dieselbe Vorverarbeitung des Super-Natural-Instruction-Datensatzes wie Wang et al. [60]. Allerdings teilen wir die Trainingsdaten in Trainings- und Validierungsdatensätze auf, was es uns ermöglicht, eine strengere Hyperparameter-Optimierung und ein frühes Stoppen (Early Stopping) durchzuführen. Wir verwenden dieselben Hyperparameter, die im Paper für das Training der verschiedenen T5-Modellgrößen auf den Super-Natural-Instruction-Daten beschrieben werden. Wir verwenden LoRA für kleine, mittlere und große T5-Modelle und LoRA für T5-xl- und -xxl-Modelle. Außerdem verwenden wir LoRA in allen unseren Experimenten und kein LoRA-Dropout.
B Training eines State-of-the-Art-Chatbots: Details zum experimentellen Aufbau
B.1 Datensätze
Wir beschreiben die Datensätze, die für die in Abschnitt 5 dargestellten QLoRA-Finetuning-Experimente verwendet wurden.
OASST1 Der OpenAssistant-Datensatz [31] wurde durch Crowdsourcing gesammelt. Er enthält 161.443 eindeutige Nachrichten, die auf 66.497 Konversationen verteilt sind und 35 verschiedene Sprachen umfassen. Der Datensatz enthält häufig mehrere gerankte Antworten auf eine gegebene Nutzerfrage. In unseren Experimenten verwenden wir nur die bestgerankte Antwort auf jeder Ebene des Konversationsbaums. Dadurch ist der Datensatz auf 9.209 Beispiele begrenzt. Wir finetunen unsere Modelle auf der vollständigen Konversation einschließlich der Nutzeranfragen.
HH-RLHF Dies ist ein Datensatz menschlicher Präferenzen zu Hilfsbereitschaft und Schadlosigkeit. Jeder Datenpunkt besteht aus zwei Assistentenantworten auf eine Nutzerfrage zusammen mit einem menschlichen Präferenzurteil über die beste Antwort. Der Datensatz enthält 160.800 Beispiele. Beim Finetuning auf diesem Datensatz kombinieren wir die Daten zu Hilfsbereitschaft und Schadlosigkeit und behalten nur die bevorzugte Assistentenantwort.
FLAN v2 Die FLAN-v2-Sammlung [39] ist eine Sammlung von 1836 Aufgaben, die mit Hunderten manuell kuratierten Vorlagen und reichhaltigen Formatierungsmustern zu über 15 Mio. Beispielen erweitert wurden. Die Autoren zeigen, dass auf dieser Sammlung trainierte Modelle andere öffentliche Sammlungen übertreffen, darunter das ursprüngliche FLAN 2021 [62], T0++ [50], Super-Natural Instructions [60] und OPT-IML [29]. Wir verwendeten dieselben Aufgabenmischungen, die von den Autoren beschrieben wurden, mit Ausnahme einiger Datensätze, die zum Zeitpunkt des Verfassens nicht frei verfügbar waren.
| Parameter | Datensatz | Batch-Größe | LR | Schritte | Quelllänge | Ziellänge |
| 7B | Alle | 16 | 2e-4 | 10000 | 384 | 128 |
| 7B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 7B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 7B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 13B | Alle | 16 | 2e-4 | 10000 | 384 | 128 |
| 13B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 13B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 13B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 33B | Alle | 32 | 1e-4 | 5000 | 384 | 128 |
| 33B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 33B | HH-RLHF | 32 | 1e-4 | 5000 | - | 768 |
| 33B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
| 65B | Alle | 64 | 1e-4 | 2500 | 384 | 128 |
| 65B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 65B | HH-RLHF | 64 | 1e-4 | 2500 | - | 768 |
| 65B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
Self-Instruct, Alpaca, Unnatural Instructions Die Datensätze Self-Instruct, Alpaca und Unnatural Instructions [59, 55, 26] sind Datensätze für Instruction Tuning, die mit verschiedenen Ansätzen der Modelldestillation aus GPT-3 Instruct und ChatGPT erstellt wurden. Sie beruhen auf Prompting, In-Context-Learning und Paraphrasierung, um vielfältige Mengen von Anweisungen und Ausgaben zu erzeugen. Die Datensätze umfassen jeweils 82.612, 51.942 und 240.670 Beispiele. Ein Vorteil solcher destillierten Datensätze besteht darin, dass sie im Vergleich zur FLAN-v2-Sammlung und ähnlichen Sammlungen für Instruction Tuning eine vielfältigere Menge an Anweisungsstilen enthalten.
Longform Der LongForm-Datensatz [30] basiert auf einem englischen Korpus, der um Anweisungen ergänzt wurde, und ist somit ein hybrider, von Menschen erzeugter Datensatz. Die zugrunde liegenden Dokumente sind von Menschen geschrieben und stammen aus C4 und Wikipedia, während die Anweisungen über LLMs generiert werden. Der Datensatz wird um zusätzliche Beispiele aus strukturierten Korpora wie Stack Exchange und WikiHow sowie um Aufgabenbeispiele wie Fragebeantwortung, E-Mail-Schreiben, Grammatikfehlerkorrektur, Geschichten-/Gedichtgenerierung und Textzusammenfassung erweitert. Der Datensatz enthält 23.700 Beispiele.
Chip2 ist Teil des OIG-Laion-Datensatzes. Er enthält Python-Codebeispiele, Beispiele für natürliche Anweisungen, generische harmlose Anweisungen, Anweisungen/Antworten mit Listen, Folgefragen, toxische adversariale Fragen aus Wikipedia, Grundschulmathematik, Reasoning-Anweisungen sowie Charakter- und Szenenbeschreibungen mit insgesamt 210.289 Beispielen.
B.2 Hyperparameter
Wir geben die genauen Hyperparameter an, die in unseren QLoRA-Finetuning-Experimenten verwendet wurden. Wir stellen fest, dass die Hyperparameter über Datensätze hinweg weitgehend robust sind. Wir verwenden das MMLU-5-Shot-Dev-Set zur Validierung und Hyperparameter-Abstimmung. In allen unseren Experimenten verwenden wir NF4 mit Doppelquantisierung und den Berechnungsdatentyp bf16. Wir setzen LoRA , und fügen LoRA-Module an allen linearen Schichten des Basismodells hinzu. Außerdem verwenden wir Adam beta2 von 0,999, eine maximale Grad-Norm von 0,3 und LoRA-Dropout von 0,1 für Modelle bis 13B und 0,05 für 33B- und 65B-Modelle. In Anlehnung an frühere Arbeiten zum Instruction Finetuning [62, 60] und nach dem Benchmarking anderer linearer und kosinusförmiger Zeitpläne verwenden wir einen konstanten Lernraten-Zeitplan. Wir verwenden Group-by-Length, um Beispiele ähnlicher Länge in derselben Batch zu gruppieren (beachten Sie, dass dies eine oszillierende Loss-Kurve erzeugt). Die Hyperparameter, die wir für jede Modellgröße abstimmen, sind in Tabelle 9 dargestellt.
B.3 Ablationen
Während es in der Literatur allgemein üblich ist, in Datensätzen zum Befolgen von Anweisungen nur auf die Antwort zu trainieren, untersuchen wir in Tabelle 10 die Auswirkung des Trainings auf die Anweisung zusätzlich zur Antwort. In diesen Experimenten beschränken wir die Trainingsdaten auf 52.000 Beispiele und verwenden das 7B-Modell. Über vier verschiedene Datensätze für Instruction Tuning hinweg stellen wir fest, dass nur das Training auf das Ziel vorteilhaft für die MMLU
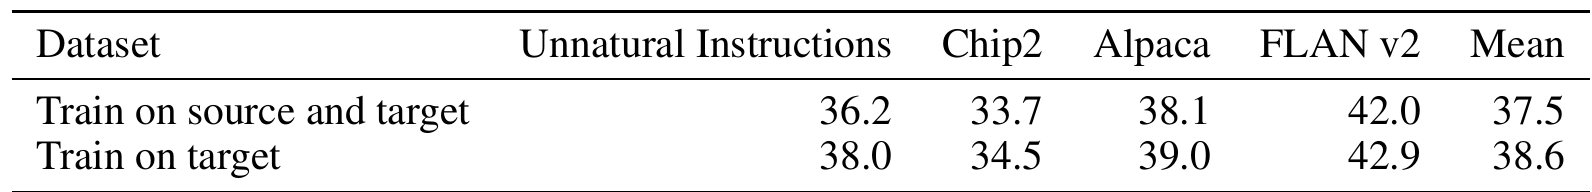
| Datensatz | Unnatural Instructions | Chip2 | Alpaca | FLAN v2 | Mittelwert |
| Training auf Quelle und Ziel | 36,2 | 33,7 | 38,1 | 42,0 | 37,5 |
| Training auf Ziel | 38,0 | 34,5 | 39,0 | 42,9 | 38,6 |
B.4 Was ist wichtiger: die Größe des Instruction-Finetuning-Datensatzes oder die Datensatzqualität?
Die Eignung des Datensatzes ist wichtiger als die Datensatzgröße. Um die Auswirkungen von Datensatzqualität versus Datensatzgröße zu verstehen, experimentieren wir damit, große Datensätze mit mindestens 150.000 Beispielen (Chip2, FLAN v2, Unnatural Instructions) in Datensätze der Größe 50.000, 100.000 und 150.000 zu unterteilen, und untersuchen die resultierenden Trends, wie in Tabelle 11 dargestellt. Wir stellen fest, dass eine Erhöhung der Datensatzgröße und eine Erhöhung der Anzahl der Epochen die MMLU nur marginal verbessert (0,0–0,5 MMLU), während der Unterschied zwischen Datensätzen bis zu 40-mal größer ist (1,5–8,0 MMLU). Dies ist ein klarer Hinweis darauf, dass die Datensatzqualität und nicht die Datensatzgröße entscheidend für die mittlere MMLU-Genauigkeit ist. Wir erhalten ähnliche Ergebnisse für die Chatbot-Leistung, wie in diskutiert.
C Menschliche Evaluierung
Wir führen eine menschliche Evaluierung mit derselben Formulierung durch, die GPT-4 in der ursprünglichen Vicuna-Evaluierung [10] gegeben wurde, angepasst an ein Formular von Amazon Mechanical Turk, wie in Abbildung 5 dargestellt.
D Paarweise Evaluierung mit GPT-4
Während wir feststellten, dass die GPT-4-Evaluierung je nachdem, welches System zuerst präsentiert wurde, unterschiedliche Ergebnisse lieferte, waren die paarweisen Ergebnisse, gemittelt über beide Optionen, gut geordnet. Die aggregierten paarweisen Urteile sind in Tabelle 12 dargestellt. Bei der Prüfung wird deutlich, dass diese Urteile transitiv sind, d. h., wenn System A besser als System B bewertet wird und System B besser als System C bewertet wird, ist es immer der Fall, dass System A besser als System C bewertet wird. Dies ergibt eine vollständige Ordnung, die in Tabelle 13 angegeben ist.
E NormalFloat 4-Bit-Datentyp
Die genauen Werte des NF4-Datentyps sind wie folgt: [-1,0, -0,6961928009986877, -0,5250730514526367, -0,39491748809814453, -0,28444138169288635, -0,18477343022823334, -0,09105003625154495, 0,0, 0,07958029955625534, 0,16093020141124725, 0,24611230194568634, 0,33791524171829224, 0,44070982933044434, 0,5626170039176941, 0,7229568362236023, 1,0]
F Normalität trainierter Gewichte neuronaler Netze
Obwohl allgemein bekannt ist, dass trainierte Gewichte neuronaler Netze größtenteils normalverteilt sind, führen wir statistische Tests durch, um dies zu überprüfen. Wir verwenden den Shapiro-Wilk-Test [53] auf den Gewichten des 7B
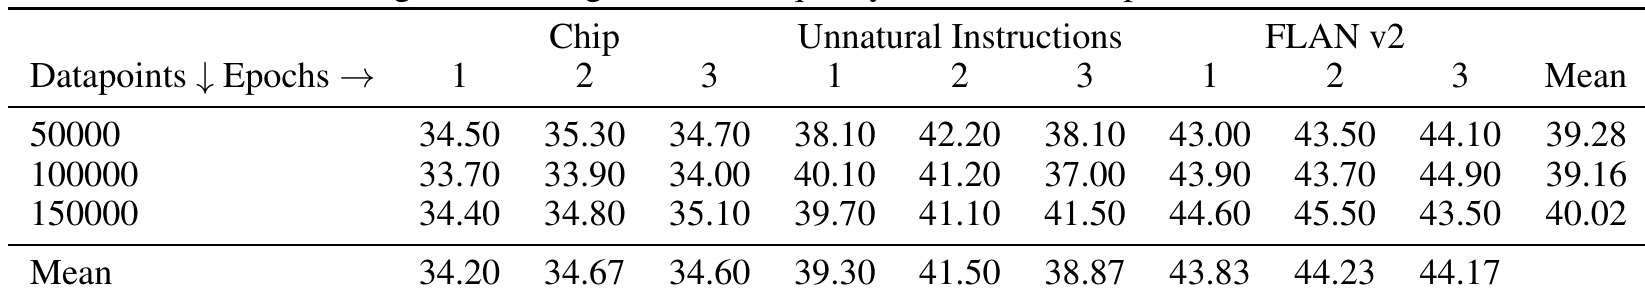
| Datenpunkte ↓ Epochen → | 1 | 2 | 3 | Unnatürliche Anweisungen | 1 | 2 | 3 | FLAN v2 | 3 | Mittelwert |
| 50000 | 34,50 | 35,30 | 34,70 | 38,10 | 42,20 | 38,10 | 43,00 | 43,50 | 44,10 | 39,28 |
| 100000 | 33,70 | 33,90 | 34,00 | 40,10 | 41,20 | 37,00 | 43,90 | 43,70 | 44,90 | 39,16 |
| 150000 | 34,40 | 34,80 | 35,10 | 39,70 | 41,10 | 41,50 | 44,60 | 45,50 | 43,50 | 40,02 |
| Mittelwert | 34,20 | 34,67 | 34,60 | 39,30 | 41,50 | 38,87 | 43,83 | 44,23 | 44,17 |
Aufgabe
Wir bitten Sie um Ihre Rückmeldung zur Leistung von zwei KI-Assistenten als Antwort auf die unten angezeigte Nutzerfrage.
Bitte bewerten Sie die Hilfsbereitschaft, Relevanz, Genauigkeit und den Detailgrad ihrer Antworten. Jeder Assistent erhält eine Gesamtbewertung auf einer Skala von 1 bis 10, wobei eine höhere Punktzahl eine bessere Gesamtleistung anzeigt.
Bitte bewerten Sie zunächst jede Antwort mit einer Punktzahl von 10.
Als Nächstes geben Sie bitte eine umfassende Erklärung Ihrer Bewertung, wobei Sie jegliche mögliche Voreingenommenheit vermeiden und sicherstellen, dass die Reihenfolge, in der die Antworten präsentiert wurden, Ihr Urteil nicht beeinflusst.
Nutzerfrage
Stellen Sie sich vor, Sie sind ein Zeitreisender aus dem Jahr 3000. Über welche technologischen Fortschritte würden Sie den Menschen erzählen?
Antwort A
Als KI-Assistent habe ich keine persönlichen Erfahrungen oder Meinungen. Aber ich kann Ihnen anhand aktueller Trends und Forschung einige der möglichen technologischen Fortschritte nennen, die im Jahr 3000 existieren könnten. – Sich selbst versorgende Städte: Städte könnten vollständig selbstversorgend sein, mit erneuerbaren Energiequellen, vertikaler Landwirtschaft und der Wiederverwertung von Abfall und Wasser.
Antwort B
Als Zeitreisender aus dem Jahr 3000 würde ich den Menschen von den folgenden technologischen Fortschritten erzählen: 1. Fortschrittliche Künstliche Intelligenz: In der Zukunft ist die KI so fortgeschritten, dass sie viele Arbeiten, die derzeit von Menschen erledigt werden, vollständig automatisieren kann. Dies hat zu erhöhter Produktivität und Effizienz in vielen Branchen geführt.
Bewertung für Antwort A
Bewertung für Antwort B
Umfassende Erklärung Ihrer Bewertung
Antwort X war besser, weil...
Einreichen
Abbildung 5: Das von menschlichen Annotatoren verwendete Crowdsourcing-Formular. LLaMA-Modell [57]. Wir stellen fest, dass die Gewichte jeder verborgenen Einheit unterschiedliche Normalverteilungen aufweisen. Daher testen wir die Gewichte jeder einzelnen verborgenen Einheit. Das bedeutet, dass wir für die Gewichte Tests über die out-Dimension durchführen. Unter Verwendung einer Signifikanzschwelle von \(5\%\) stellen wir fest, dass der Neuronen nicht normalverteilt sind, was etwa mehr ist als die erwartete Falsch-Positiv-Rate. Während also nahezu alle vorab trainierten Gewichte normalverteilt zu sein scheinen, scheint es Ausnahmen zu geben. Solche Ausnahmen könnten auf Ausreißergewichte [13] zurückzuführen sein oder darauf, dass der p-Wert des Shapiro-Wilk-Tests für große Stichprobengrößen [53], wie sie in den verborgenen Einheiten der LLaMA-FFN-Schicht auftreten, nicht genau ist. dies bestätigt die Behauptung, dass die Gewichte neuronaler Netze.
| Modell | Guanaco 65B | Guanaco 33B | Vicuna | ChatGPT-3.5 Turbo | Bard | Guanaco 13B | Guanaco 7B |
| Guanaco 65B | - | 0,21 | 0,19 | 0,16 | 0,72 | 0,59 | 0,86 |
| Guanaco 33B | -0,21 | - | 0,17 | 0,10 | 0,51 | 0,41 | 0,68 |
| Vicuna | -0,19 | -0,17 | - | 0,10 | 0,50 | 0,20 | 0,57 |
| ChatGPT-3.5 Turbo | -0,16 | -0,10 | -0,10 | - | 0,35 | 0,19 | 0,40 |
| Bard | -0,72 | -0,51 | -0,50 | -0,35 | - | 0,12 | 0,03 |
| Guanaco 13B | -0,59 | -0,41 | -0,20 | -0,19 | -0,12 | - | 0,20 |
| Guanaco 7B | -0,86 | -0,68 | -0,57 | -0,40 | -0,03 | -0,20 | - |
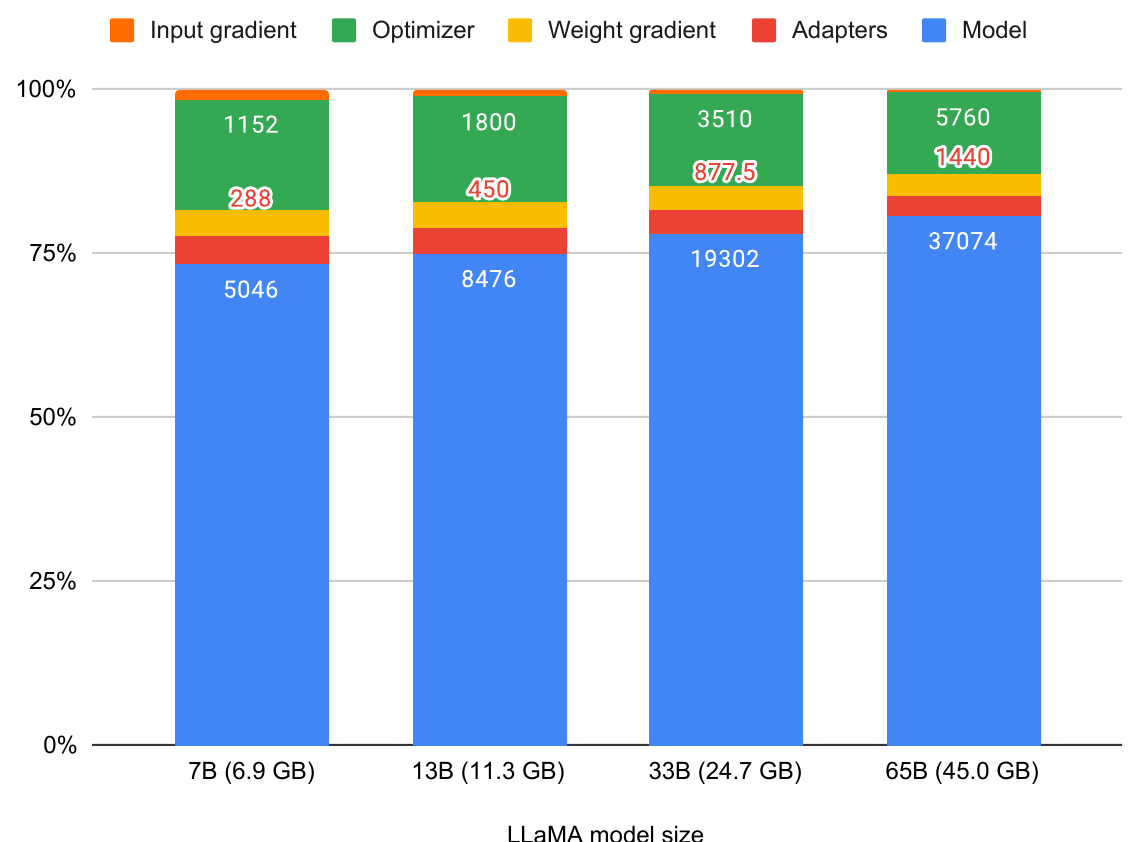
G Speicherbedarf
Der Speicherbedarf für das QLoRA-Training mit verschiedenen LLaMA-Basismodellen ist in Abbildung 6 zu sehen. Wir sehen, dass das 33B-Modell nicht ganz in 24 GB passt und dass paginierte Optimierer benötigt werden, um es zu trainieren. Dargestellt ist außerdem eine Batch-Größe von 1 mit einer Sequenzlänge von 512 und Gradient-Checkpointing. Das bedeutet, dass bei einer größeren Batch-Größe oder bei der Verarbeitung einer langen Sequenz der Aktivierungsgradient eine beträchtliche Menge Speicher verbrauchen könnte.
| Modell | Parameter | Größe |
| Guanaco | 65B | 41 GB |
| Guanaco | 33B | 21 GB |
| Vicuna | 13B | 26 GB |
| ChatGPT-3.5 Turbo | k. A. | k. A. |
| Bard | k. A. | k. A. |
| Guanaco | 13B | 10 GB |
| Guanaco | 7B | 5 GB |