
Ein kleines Modell entwirft Tokens, das große prüft sie in einem Durchlauf: gleiche Ausgabe, schnellere Inferenz. ICML 2023, kostenlos.
Fast Inference from Transformers via Speculative Decoding
Schnelle Inferenz aus Transformatoren mittels spekulativer Dekodierung
Yaniv Leviathan \* 1 Matan Kalman \* 1 Yossi Matias 1
Zusammenfassung
Die Inferenz aus großen autoregressiven Modellen wie Transformatoren ist langsam – die Dekodierung von Token erfordert serielle Durchläufe des Modells. In dieser Arbeit führen wir die spekulative Dekodierung ein – einen Algorithmus zur schnelleren Stichprobennahme aus autoregressiven Modellen ohne jegliche Änderung der Ausgaben, indem mehrere Token parallel berechnet werden. Im Kern unseres Ansatzes stehen die Beobachtungen, dass (1) schwierige Sprachmodellierungsaufgaben oft einfachere Teilaufgaben enthalten, die durch effizientere Modelle gut approximiert werden können, und (2) wir durch spekulative Ausführung und eine neuartige Stichprobenmethode eine exakte Dekodierung aus den großen Modellen beschleunigen können, indem wir sie parallel auf den Ausgaben der Approximationsmodelle ausführen, wodurch potenziell mehrere Token gleichzeitig erzeugt werden, und zwar ohne Änderung der Verteilung. Unsere Methode kann bestehende Off-the-shelf-Modelle beschleunigen, ohne Neutraining oder Architekturänderungen. Wir demonstrieren sie an T5-XXL und zeigen eine 2X-3X-Beschleunigung im Vergleich zur Standard-T5X-Implementierung, bei identischen Ausgaben.
1. Einleitung
Große autoregressive Modelle, insbesondere große Transformatoren (Vaswani et al., [2017]), sind deutlich leistungsfähiger als kleinere Modelle, wie in den vergangenen Jahren unzählige Male belegt wurde, z. B. in der Text- oder Bilddomäne, etwa GPT-3 (Brown et al., [2020]), LaMDA (Thoppilan et al., [2022]), Parti (Yu et al., [2022]) und PaLM (Chowdhery et al., [2022]). Leider ist ein einzelner Dekodierschritt dieser größeren Modelle deutlich langsamer als ein Schritt ihrer kleineren Gegenstücke, und erschwerend kommt hinzu, dass diese Schritte seriell ausgeführt werden – die Dekodierung von Token erfordert serielle Durchläufe des Modells.
Angesichts der Bedeutung großer autoregressiver Modelle und insbesondere großer Transformatoren wurden mehrere Ansätze entwickelt, um die Inferenz aus ihnen zu beschleunigen. Einige Ansätze zielen darauf ab, die Inferenzkosten für alle Eingaben gleichermaßen zu senken (z. B. Hinton et al., [2015], Jaszczur et al., [2021], Hubara et al., [2016], So et al., [2021], Shazeer [2019]). Andere Ansätze entspringen der Beobachtung, dass nicht alle Inferenzschritte gleich sind – einige erfordern ein sehr großes Modell, während andere durch effizientere Modelle gut approximiert werden können. Diese Methoden adaptiver Berechnung (z. B. Han et al., [2021], Sukhbaatar et al., [2019], Schuster et al., [2021], Scardapane et al., [2020], Bapna et al., [2020], Elbayad et al., [2019], Schwartz et al., [2020]) zielen darauf ab, für einfachere Inferenzschritte weniger Rechenressourcen zu verwenden. Während sich viele dieser Lösungen in der Praxis als äußerst effektiv erwiesen haben, erfordern sie üblicherweise Änderungen der Modellarchitektur, Änderungen des Trainingsverfahrens und ein Neutraining der Modelle und behalten die Ausgaben nicht identisch bei.
Gleicher Beitrag 1Google Research, Mountain View, CA, USA. Korrespondenz an: Yaniv Leviathan leviathan@google.com.
Die obige Schlüsselbeobachtung, dass einige Inferenzschritte „schwieriger“ und einige „einfacher“ sind, ist auch ein zentrales Motiv unserer Arbeit. Zusätzlich beobachten wir, dass die Inferenz aus großen Modellen oft nicht durch arithmetische Operationen begrenzt wird, sondern durch Speicherbandbreite und Kommunikation, sodass zusätzliche Rechenressourcen verfügbar sein könnten. Daher schlagen wir vor, die Parallelität als komplementären Ansatz zur Verwendung einer adaptiven Menge an Berechnung zu erhöhen. Konkret können wir die Inferenz beschleunigen, ohne die Modellarchitekturen zu ändern, ohne die Trainingsverfahren zu ändern oder die Modelle neu zu trainieren und ohne die Ausgabeverteilung des Modells zu ändern. Dies wird durch spekulative Ausführung erreicht.
Spekulative Ausführung (Burton, [1985], Hennessy & Patterson, [2012]) ist eine Optimierungstechnik, die in Prozessoren verbreitet ist, bei der eine Aufgabe parallel zur Überprüfung ausgeführt wird, ob sie tatsächlich benötigt wird – der Gewinn ist eine erhöhte Parallelität. Ein bekanntes Beispiel für spekulative Ausführung ist die Sprungvorhersage. Damit spekulative Ausführung effektiv ist, benötigen wir einen effizienten Mechanismus, um Aufgaben vorzuschlagen, die wahrscheinlich benötigt werden. In dieser Arbeit verallgemeinern wir die spekulative Ausführung auf den stochastischen Fall – bei dem eine Aufgabe mit einer gewissen Wahrscheinlichkeit benötigt werden kann. Angewandt auf die Dekodierung aus autoregressiven Modellen wie Transformatoren, entnehmen wir Stichproben von Generierungen aus effizienteren Approximationsmodellen als spekulative Präfixe für die langsameren Zielmodelle. Mit einer neuartigen Stichprobenmethode, der spekulativen Stichprobennahme, maximieren wir die Wahrscheinlichkeit, dass diese spekulativen Aufgaben
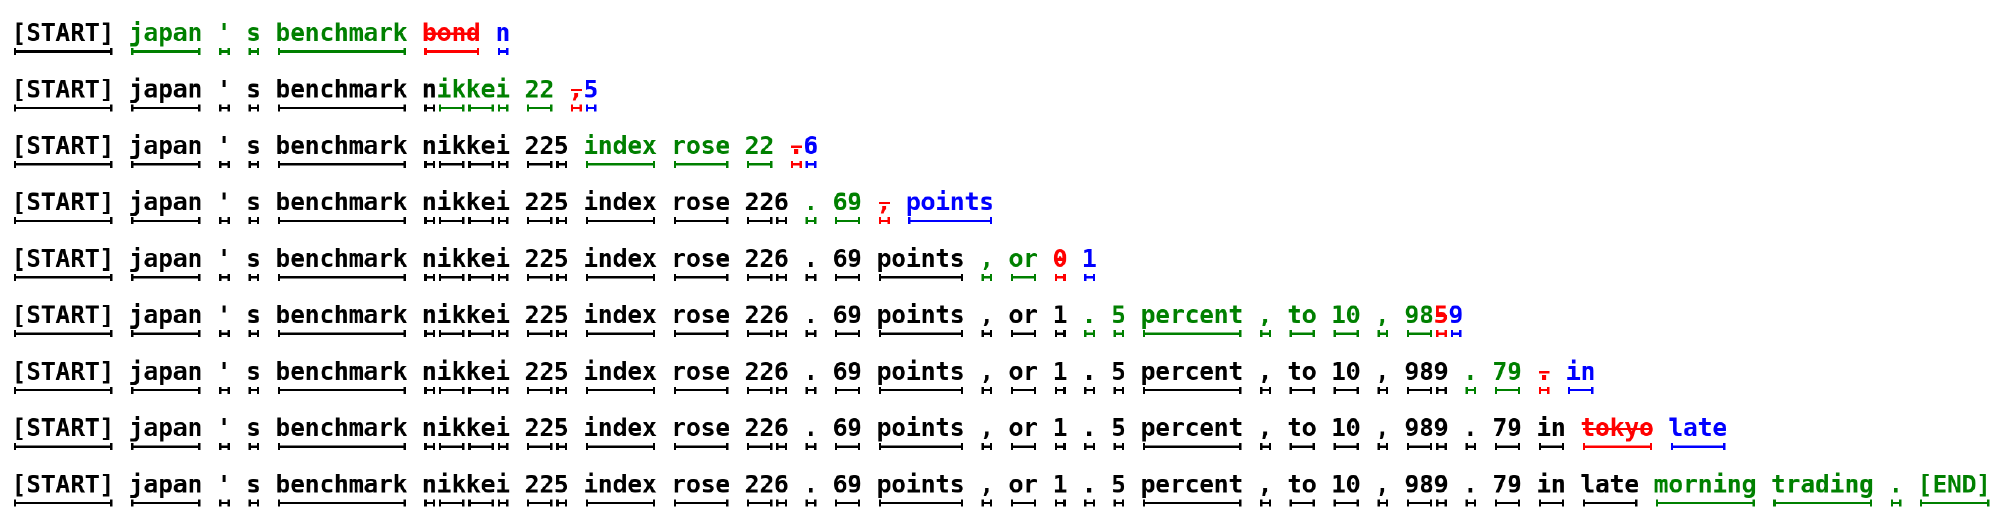
akzeptiert werden, während wir garantieren, dass die Ausgaben unseres Systems dieselbe Verteilung haben wie diejenigen des Zielmodells allein. Beispielsweise wurde der Satz in Abbildung 1, bestehend aus 38 Token, durch unsere Methode mit nur 9 seriellen Durchläufen eines größeren Zielmodells (97 Mio. Parameter) dank eines kleineren und effizienteren Approximationsmodells (6 Mio. Parameter) generiert, während die Wahrscheinlichkeit, ihn zu generieren, unverändert bleibt.
Wir analysieren unsere Methode bei einer Vielzahl von Aufgaben und Modellgrößen: bedingungslose Generierung aus einem GPT-ähnlichen Modell mit 97 Mio. Parametern, trainiert auf 1m1b, Englisch-Deutsch-Übersetzung und Zusammenfassung von Nachrichtenartikeln mit einem T5-XXL-Modell mit 11 Mrd. Parametern sowie eine Dialogaufgabe mit einem LaMDA-Modell mit 137 Mrd. Parametern. Wir implementieren unsere Methode und vergleichen die tatsächlichen Walltimes für T5-XXL mit denen der robusten T5X-Implementierung (Roberts et al., 2022) und zeigen eine Out-of-the-box-Latenzverbesserung von 2X-3X ohne jegliche Änderung der Ausgaben (Abschnitt 4).
Unsere Methode ist in tatsächlichen Produktionsumgebungen leicht einzusetzen, erfordert kein Training neuer Modelle und ändert die Ausgaben nicht. Daher kann sie in gängigen Situationen, in denen die Speicherbandbreite der Engpass ist und Rechenressourcen verfügbar sind, eine gute Standardwahl sein, um die Stichprobennahme aus autoregressiven Modellen wie Transformatoren zu beschleunigen.
Zusammengefasst sind unsere Hauptbeiträge: (1) eine Verallgemeinerung der spekulativen Ausführung auf den stochastischen Fall mit einer neuartigen Stichprobenmethode, die wir spekulative Stichprobennahme nennen, und (2) ein Dekodierungsmechanismus, den wir spekulative Dekodierung nennen und der die Dekodierung aus autoregressiven Modellen beschleunigen kann, ohne jegliche Änderung der Modellarchitekturen, Trainingsregime und Ausgabeverteilungen.
2. Spekulative Dekodierung
2.1. Überblick
Sei das Zielmodell, aus dem wir die Inferenz zu beschleunigen versuchen, und die Verteilung, die wir vom Modell für ein Präfix erhalten. Sei ein effizienteres Approximationsmodell für dieselbe Aufgabe, und bezeichnen wir mit die Verteilung, die wir vom Modell für ein Präfix erhalten. Die Kernidee besteht darin, (1) das effizientere Modell zu verwenden, um Vervollständigungen zu generieren (siehe Abschnitt 3.5) dazu, wie dieser Parameter optimal gewählt wird), dann (2) das Zielmodell zu verwenden, um alle Vermutungen und ihre jeweiligen Wahrscheinlichkeiten aus parallel zu bewerten, alle diejenigen zu akzeptieren, die zu einer identischen Verteilung führen können, und (3) ein zusätzliches Token aus einer angepassten Verteilung zu ziehen, um das erste abgelehnte zu korrigieren oder ein weiteres hinzuzufügen, falls alle akzeptiert wurden. Auf diese Weise erzeugt jeder parallele Durchlauf des Zielmodells mindestens ein neues Token (sodass die Anzahl serieller Durchläufe des Zielmodells niemals, selbst im ungünstigsten Fall, größer sein kann als bei der einfachen autoregressiven Methode), aber er kann potenziell viele neue Token erzeugen, bis zu , je nachdem, wie gut das Modell approximiert.
2.2. Standardisierte Stichprobennahme
Zunächst ist anzumerken, dass es zwar viele Methoden und Parameter der Stichprobennahme gibt, wie Argmax, Top-k, Nucleus und das Setzen einer Temperatur, und gängige Implementierungen sie auf der Logit-Ebene üblicherweise unterschiedlich behandeln, sie sich aber alle leicht als Standard-Stichprobennahme aus einer angepassten Wahrscheinlichkeitsverteilung formulieren lassen. Beispielsweise ist die Argmax-Stichprobennahme äquivalent dazu, Nicht-Maximum-Elemente der Verteilung auf null zu setzen und zu normalisieren. Wir können uns daher ausschließlich mit der Standard-Stichprobennahme aus einer Wahrscheinlichkeitsverteilung befassen und alle anderen Arten der Stichprobennahme in dieses Rahmenwerk überführen. Im Weiteren nehmen wir an, dass und die Verteilungen aus bzw. sind, angepasst an die Stichprobenmethode.
2.3. Spekulative Stichprobennahme
Um zu sampeln, sampeln wir stattdessen , behalten es, wenn , und im Fall verwerfen wir das Sample mit Wahrscheinlichkeit und sampeln stattdessen erneut aus einer angepassten Verteilung . Es ist leicht zu zeigen (siehe Anhang [A.1]), dass für beliebige Verteilungen und und ein auf diese Weise gesampeltes tatsächlich gilt.
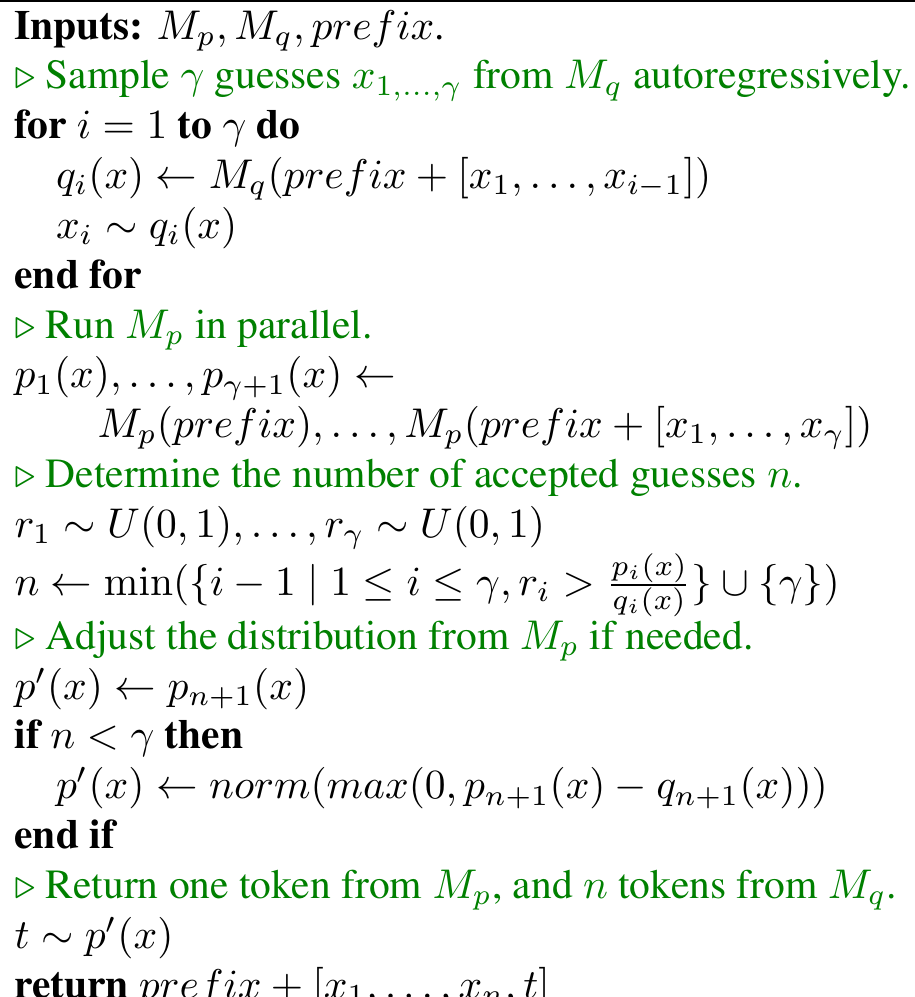
Gegeben die Verteilung , die durch Ausführen von auf einem konditionierenden erhalten wird, können wir ein Token sampeln. Wir berechnen dann die Verteilung durch Ausführen von auf , während wir parallel spekulativ die Verteilung des nächsten Tokens durch Ausführen von auf berechnen. Sobald beide Berechnungen abgeschlossen sind, verfahren wir wie oben: Wenn verworfen wird, verwerfen wir die Berechnung von und sampeln erneut aus einer angepassten Verteilung, und wenn akzeptiert wird, behalten wir beide Tokens. Algorithmus [I] verallgemeinert diese Idee, um zwischen 1 und Tokens auf einmal zu sampeln.
Algorithmus 1 SpeculativeDecodingStep
3. Analyse
3.1. Anzahl der generierten Tokens
Analysieren wir den Reduktionsfaktor bei der Anzahl serieller Aufrufe des Zielmodells, oder äquivalent die erwartete Anzahl von Tokens, die durch einen einzelnen Lauf von Algorithmus [I]erzeugt werden.
Definition 3.1. Die Akzeptanzrate , gegeben ein Präfix , ist die Wahrscheinlichkeit, durch spekulatives Sampling gemäß Abschnitt [2.3] zu akzeptieren:
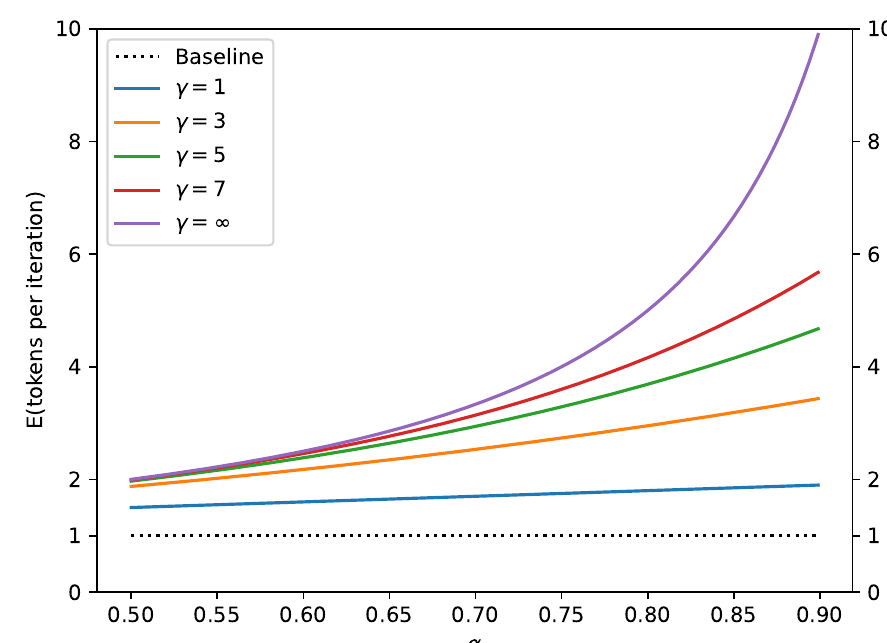
ist dann ein natürliches Maß dafür, wie gut approximiert. Wenn wir die vereinfachende Annahme treffen, dass die s i.i.d. sind, und bezeichnen, dann ist die Anzahl der Tokens, die durch einen einzelnen Lauf von Algorithmus [I] erzeugt werden, eine gedeckelte geometrische Variable mit Erfolgswahrscheinlichkeit und Deckel , und die erwartete Anzahl der von Algorithmus [I] generierten Tokens erfüllt Gleichung [I]. Siehe Abbildung [2]
3.2. Berechnung von
Wir leiten nun eine einfache Formel zur Berechnung von bei gegebenem Präfix und den beiden Modellen und her. Wir beginnen mit der Definition einer natürlichen Divergenz :
Definition 3.2. , wobei .
Lemma 3.3.
Beweis.
Aus Lemma [3.3] erhalten wir unmittelbar die folgenden Ergebnisse: Korollar 3.4. ist eine symmetrische Divergenz in . . und haben disjunkten Träger.
Theorem 3.5.
Schließlich erhalten wir:
Korollar 3.6.
Siehe Tabelle 3 für empirisch beobachtete -Werte in unseren Experimenten.
3.3. Verbesserung der Walltime
Wir haben gezeigt, dass unser Algorithmus unter der i.i.d.-Annahme die Anzahl der Aufrufe des Zielmodells um einen Faktor von reduziert. Beachten Sie, dass spekulative Ausführung im Allgemeinen und unser Algorithmus im Besonderen davon ausgehen, dass wir über ausreichende Rechenressourcen verfügen, um die erhöhte Nebenläufigkeit zu unterstützen (Abschnitt 3.4). Für die Walltime-Analyse nehmen wir an, dass wir gleichzeitige Auswertungen von parallel ausführen können, ohne die Walltime zu erhöhen. Um die gesamte Walltime-Verbesserung zu erhalten, betrachten wir nun die Kosten für die Ausführung des Approximationsmodells .
Definition 3.7. Sei , der Kostenkoeffizient, das Verhältnis zwischen der Zeit für einen einzelnen Lauf von und der Zeit für einen einzelnen Lauf von .
Beachten Sie, dass im Gegensatz zu , das eine intrinsische Eigenschaft der Modelle und der Aufgabe ist, der Wert von von der Hardwarekonfiguration und Softwareimplementierungsdetails abhängt. In unseren Experimenten, in denen typischerweise um einige Größenordnungen kleiner als ist, war stets kleiner als 0,05 und oft vernachlässigbar nahe bei 0.
Theorem 3.8. Der erwartete Verbesserungsfaktor in der gesamten Walltime durch Algorithmus 1 ist .
Beweis. Bezeichnen Sie die Kosten für die Ausführung eines einzelnen Schritts von mit . Nun kostet jeder Lauf von Algorithmus 1 (für die Ausführung des Approximationsmodells mal und die einmalige Ausführung von ) und erzeugt gemäß Gleichung (1) im Durchschnitt Tokens. Die Gesamterwartungskosten für die Erzeugung eines Tokens mit Algorithmus 1 betragen also . Da die Kosten für die Erzeugung eines einzelnen Tokens mit dem Standard-Dekodierungsalgorithmus betragen, erhalten wir das gewünschte Ergebnis.
Beachten Sie, dass Theorem 3.8 ausreichend lange Generierungen annimmt (da wir beispielsweise mindestens einmal ausführen, ist der Verbesserungsfaktor durch die Anzahl der generierten Tokens begrenzt).
Korollar 3.9. Wenn , existiert ein , für das wir eine Verbesserung erzielen, und der Verbesserungsfaktor beträgt mindestens .
Beweis. Wenn wir für eine Verbesserung erzielen, würden wir auch für jedes eine Verbesserung erzielen. Damit unsere Methode eine Verbesserung liefert, können wir Theorem 3.8 für auswerten, was ergibt.
3.4. Anzahl der arithmetischen Operationen
Algorithmus 1 führt Läufe von parallel aus, sodass die Anzahl der gleichzeitigen arithmetischen Operationen um einen Faktor von wächst. Da Algorithmus 1 nun höchstens Tokens pro Lauf erzeugt, könnte die Gesamtzahl der arithmetischen Operationen höher sein als die des Standard-Dekodierungsalgorithmus. Wenn wir die Stichprobe von akzeptieren, ist die erhöhte Nebenläufigkeit „kostenlos“, und die Gesamtzahl der Operationen wird nicht erhöht. Wenn wir jedoch eine Vermutung verwerfen, wird Berechnung verschwendet. Analysieren wir nun die Auswirkung unserer Methode auf die Gesamtzahl der arithmetischen Operationen.
Definition 3.10. Sei das Verhältnis der arithmetischen Operationen pro Token des Approximationsmodells zu denen des Zielmodells .
Theorem 3.11. Der erwartete Erhöhungsfaktor der Gesamtzahl der Operationen von Algorithmus 1 ist .
Beweis. Bezeichnen Sie mit die Anzahl der arithmetischen Operationen, die eine Standard-Dekodierungs-Baseline pro Token ausführt, d. h. die Anzahl der Operationen eines einzelnen Laufs von . Dann kostet eine einzelne Iteration von Algorithmus 1 Operationen (für Läufe von und parallele Läufe von ). Dividieren wir durch die erwartete Anzahl von Tokens, die von Algorithmus 1 erzeugt werden, d. h. Gleichung (1), und durch , erhalten wir das gewünschte Ergebnis.
Wenn niedrig ist, ist die Erhöhung der Anzahl der arithmetischen Operationen hoch, und umgekehrt. Beachten Sie, dass für Transformer-Decoder die Gesamtzahl der arithmetischen Operationen von Algorithmus 1 (ohne Läufe von ) durch einen einzelnen Lauf eines Transformer-Encoders gleicher Größe von oben beschränkt werden kann.
Anders als die Gesamtzahl der arithmetischen Operationen kann die Gesamtzahl der Speicherzugriffe mit unserer Methode sinken. Konkret können die Gewichte und der KV-Cache des Zielmodells einmal pro Ausführung von Algorithmus 1 gelesen werden, sodass sich die Anzahl der Speicherzugriffe für das Lesen derselben gemäß Gleichung (1) um einen Faktor von \(\frac{1 - \alpha^{\gamma + 1}}{1 - \alpha}\) verringert.
3.5. Wahl von \(\gamma\)
Gegeben \(c\) und \(\alpha\) und unter der Annahme ausreichender Rechenressourcen (siehe Abschnitt 3.4) ist das optimale \(\gamma\) jenes, das die Gleichung für die Verbesserung der Wand
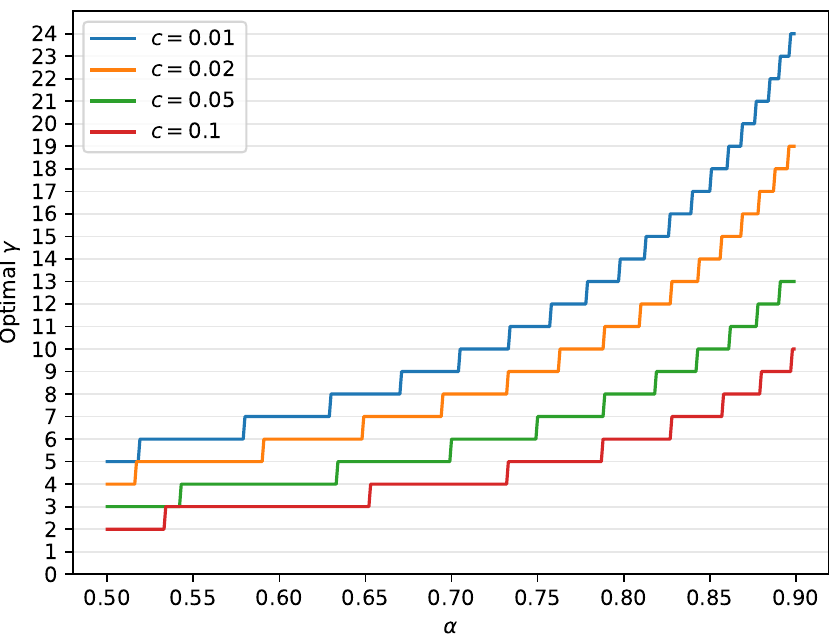
zeit (Theorem 3.8) maximiert: \(\frac{1 - \alpha^{\gamma + 1}}{(1 - \alpha)(\gamma c + 1)}\) . Da \(\gamma\) eine ganze Zahl ist, lässt es sich leicht numerisch finden, siehe Abbildung 3
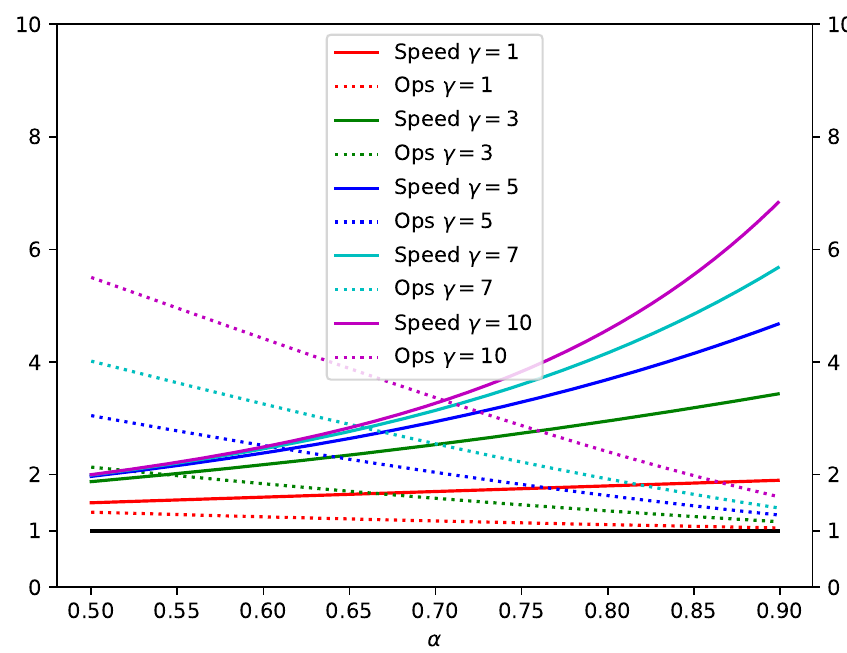
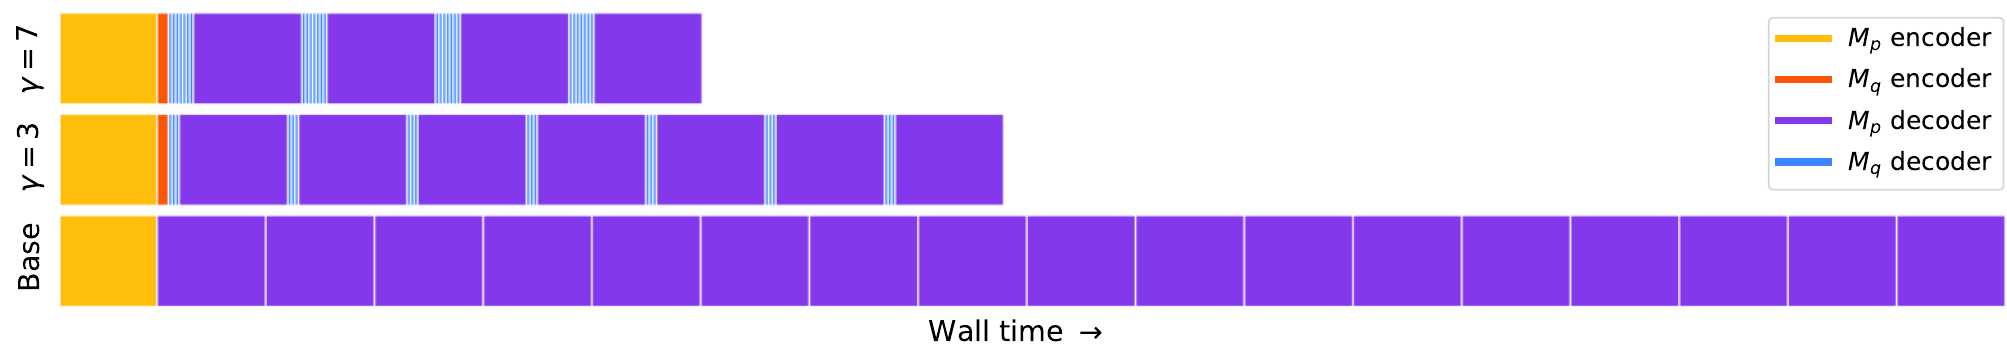
Tabelle 1 und Abbildung 4 veranschaulichen den Kompromiss zwischen Inferenzgeschwindigkeit und der Gesamtzahl der arithmetischen Operationen für verschiedene Werte von \(\alpha\) und \(\gamma\) , unter der Annahme \(c = \hat{c} = 0\) . Abbildung 5 zeigt ein vereinfachtes Ablaufdiagramm.
| α | γ | OPERATIONEN | GESCHWINDIGKEIT |
| 0,6 | 2 | 1,53X | 1,96X |
| 0,7 | 3 | 1,58X | 2,53X |
| 0,8 | 2 | 1,23X | 2,44X |
| 0,8 | 5 | 1,63X | 3,69X |
| 0,9 | 2 | 1,11X | 2,71X |
| 0,9 | 10 | 1,60X | 6,86X |
Anstatt einen einzelnen Wert für \(\gamma\) basierend auf \(\alpha\) zu wählen, könnten wir – da die \(\beta\) s nicht konstant sind – eine weitere Verbesserung erzielen, indem wir den Wert von \(\beta\) vorhersagen und entsprechend den Wert von \(\gamma\) während des Laufs von Algorithmus 1 variieren. Um eine obere Schranke für den zusätzlichen Verbesserungsfaktor zu erhalten, nehmen wir an, wir hätten ein Orakel für \(\gamma\) . Dann hätten wir \(E(\# generated tokens) = \frac{1}{1 - \alpha}\) . Für typische Werte von \(c\) und \(\alpha\) und unter der Annahme unbegrenzter Rechenressourcen kann der verbesserte Wandzeit-Verbesserungsfaktor bis zu \(\sim 60\%\) höher sein als der Verbesserungsfaktor mit einem festen \(\gamma\) . Wir überlassen die Untersuchung dieser Möglichkeit zukünftiger Arbeit.
3.6. Approximationsmodelle
Speculative Sampling und damit auch Speculative Decoding garantieren eine identische Ausgabeverteilung für jede Wahl des Approximationsmodells \(M_{q}\) ohne Einschränkung (siehe Anhang [A.1]). In unseren Experimenten testeten wir hauptsächlich vorhandene kleinere Transformer als Approximationsmodelle. Darüber hinaus testeten wir nur Approximationsmodelle derselben Architektur wie die Zielmodelle \(M_{p}\) und mit derselben Wahrscheinlichkeitsstandardisierung. In diesem Setup schnitt die Wahl von \(M_{q}\) als etwa zwei Größenordnungen kleiner als \(M_{p}\) üblicherweise am besten ab, wobei \(\alpha\) und \(c\) ausbalanciert wurden (Theorem 3.8).
Eine andere Art von Approximationsmodellen, Modelle mit vernachlässigbaren Kosten, sind solche, für die \(c \approx 0\) gilt, d. h. Approximationsmodelle mit vernachlässigbaren Kosten relativ zum Zielmodell. In diesem Fall erhalten wir eine erwartete Wandzeit-Verbesserung von \(\frac{1 - \alpha^{\gamma + 1}}{1 - \alpha}\) , die nach oben durch \(\frac{1}{1 - \alpha}\) beschränkt ist (wir nähern uns der Gleichheit, wenn \(\gamma\) groß ist). Eine interessante Art von Approximationsmodellen mit vernachlässigbaren Kosten sind n-Gramm-Modelle, bei denen die Auswertung einem Tabellennachschlag entspricht. Interessanterweise erhalten wir in empirischen Tests (Abschnitt 4.2) selbst für diese trivialen n-Gramm-Modelle von null verschiedene \(\alpha\) s. Beispielsweise erhalten wir für die Englisch-Deutsch-Übersetzungsaufgabe, mit \(M_{p}\) als T5-XXL 11B und \(M_{q}\) als trivialem Bigramm-Modell, \(\alpha \approx 0.2\) , was mit \(\gamma = 3\) zu einem Inferenzgeschwindigkeits-Verbesserungsfaktor von \(1.25X\) führt.
Andere einfache Heuristiken können als Approximationsmodelle mit vernachlässigbaren Kosten verwendet werden. Beispielsweise könnte in Fällen, in denen lange Sequenzen wahrscheinlich wiederholt werden, wie bei Zusammenfassungsaufgaben oder chat-ähnlichen Schnittstellen, ein Approximationsmodell, das einfach
Tokens aus dem Kontext kopiert, falls wir ein übereinstimmendes Präfix finden, hohe Werte von \(\alpha\) liefern. Diese parameterlosen Approximationsmodelle haben den zusätzlichen Vorteil, dass sie aus Produktionssicht noch einfacher einzusetzen sind.
Eine andere Art von Approximationsmodellen, die durch Speculative Decoding verwendet werden kann, sind nicht-autoregressive Modelle, wie jene von Stern et al. [2018]. Dann würden wir anstelle der autoregressiven Schleife in Algorithmus 1 einfach das nicht-autoregressive Modell einmal aufrufen.
Ein letztes Beispiel, das vor allem aus theoretischer Perspektive interessant ist, ist ein Approximationsmodell, das Tokens zufällig auswählt, was eine gewisse Verbesserung (wenngleich sehr kleine) für alle Modelle \(M_{p}\) garantiert.
4. Experimente
4.1. Empirische Wandzeit-Verbesserung
Wir implementieren unseren Algorithmus und vergleichen ihn mit der Implementierung in der T5X-Codebasis zur Beschleunigung von T5-XXL.
Setup Wir testen ein Standard-Encoder-Decoder-T5-Modell Version 1.1 (Raffel et al., [2020) auf zwei Aufgaben aus dem T5-Papier: (1) Englisch-nach-Deutsch-Übersetzung, feinabgestimmt auf WMT EnDe, und (2) Textzusammenfassung, feinabgestimmt auf CCN/DM. Für beide Aufgaben verwenden wir T5-XXL (11B) für . Für das Approximationsmodell testen wir mehrere bestehende Konfigurationen, nämlich T5-large (800M), T5-base (250M) und T5-small (77M) (Raffel et al., [2020). Wir verwenden bestehende Checkpoints für alle Modelle. Wir messen Walltime-Verbesserungen mit einer Batch-Größe von 1 auf einem einzelnen TPU-v4 sowohl für Argmax-Sampling (temp=0) als auch für Standard-Sampling (temp=1).
Ergebnisse Tabelle 2 zeigt die empirischen Ergebnisse unserer Methode. Wir sehen, dass T5-small (77M) mit einer guten Balance von und unter den getesteten Approximationsmodellen die höchste Beschleunigung liefert. Wie erwartet sehen wir, dass mit der Größe des Approximationsmodells zunimmt. Interessanterweise sind und die Walltime-Verbesserung für Argmax-Sampling (temp=0) höher. Wir beobachten Beschleunigungen von 2,6X (temp=1) und 3,4X (temp=0) bei der Übersetzungsaufgabe und etwas niedrigere Beschleunigungen von 2,3X (temp=1) und 3,1X (temp=0) bei der Zusammenfassungsaufgabe. Diese empirischen Ergebnisse stimmen gut mit den theoretischen Vorhersagen überein, mit einer gewissen Varianz aufgrund von Implementierungsdetails (siehe Anhang A.3).
| Aufgabe | Mq | TEMP | γ | α | GESCHW. |
| ENDE | T5-SMALL ★ | 0 | 7 | 0,75 | 3,4X |
| ENDE | T5-BASE | 0 | 7 | 0,8 | 2,8X |
| ENDE | T5-LARGE | 0 | 7 | 0,82 | 1,7X |
| ENDE | T5-SMALL ★ | 1 | 7 | 0,62 | 2,6X |
| ENDE | T5-BASE | 1 | 5 | 0,68 | 2,4X |
| ENDE | T5-LARGE | 1 | 3 | 0,71 | 1,4X |
| CNNDM | T5-SMALL ★ | 0 | 5 | 0,65 | 3,1X |
| CNNDM | T5-BASE | 0 | 5 | 0,73 | 3,0X |
| CNNDM | T5-LARGE | 0 | 3 | 0,74 | 2,2X |
| CNNDM | T5-SMALL ★ | 1 | 5 | 0,53 | 2,3X |
| CNNDM | T5-BASE | 1 | 3 | 0,55 | 2,2X |
| CNNDM | T5-LARGE | 1 | 3 | 0,56 | 1,7X |
4.2. Empirische -Werte
Während wir unsere Methode nur für T5 implementiert haben, haben wir -Werte für verschiedene Aufgaben, Sampling-Methoden, Zielmodelle und Approximationsmodelle gemessen. Konkret haben wir den Erwartungswert aus Korollar 3.6 auf 10K von generierten Tokens für jede der folgenden Einstellungen ausgewertet.
GPT-artig (97M Parameter) Wir testen ein Decoder-only-Transformer-Modell auf unbedingter Sprachgenerierung, trainiert auf lm1b (Chelba et al., [2013). Das Modell hier ist ein GPT-artiger Transformer-Decoder mit Gelu-Aktivierungen (Hendrycks & Gimpel, [2016). Für haben wir mit einem Transformer-Decoder-Modell mit 6M Parametern experimentiert: dim 256, dim Feed-Forward 1024, 2 Schichten, 4 Attention-Heads, sowie mit einfachen Unigramm- und Bigramm-Modellen. hat 97M Parameter: dim 768, dim Feed-Forward 3072, 12 Schichten, 12 Attention-Heads. Wir verwendeten Bert-Tokenisierung (Devlin et al., [2019]) mit 8k Tokens für alle Modelle.
LaMDA (137B Parameter) Wir testeten ein Decoder-only-LaMDA-Modell auf einer Dialogaufgabe (Thoppilan et al., [2022]). Wir verwendeten bestehende Checkpoints von LaMDA 137B als und LaMDA 8B, LaMDA 2B und LaMDA 100M für .
Siehe Abschnitt 4.1 für das Setup des T5-XXL-Modells (11B Parameter).
Tabelle 3 fasst die -Werte für die getesteten Fälle zusammen. Wir beobachten, dass Approximationsmodelle, die einige Größenordnungen kleiner sind als das Zielmodell, dazu tendieren, -Werte zwischen 0,5 und 0,9 zu erzeugen. Interessanterweise stellen wir außerdem fest, dass für alle Modelle die -Werte umso höher sind, je schärfer die angepasste Verteilung ist. Schließlich stellen wir fest, dass selbst triviale Unigramm- und Bigramm-Approximationen nicht vernachlässigbare -Werte liefern. Zum Beispiel hat für den Fall der Englisch-nach-Deutsch-Übersetzung das Bigramm-Modell einen -Wert von 0,2, und da in diesem Fall gilt, ergibt sich eine 1,25X-Geschwindigkeitsverbesserung, was für dieses triviale Approximationsmodell überraschend hoch ist (aber immer noch niedriger ist als die Beschleunigung, die wir durch die Verwendung von T5-small als Approximationsmodell erhalten).
5. Verwandte Arbeiten
Die Effizienz der Inferenz aus großen Modellen wurde umfassend untersucht (Dehghani et al., [2021]). Viele Ansätze zielen darauf ab, die Inferenz aus großen Modellen im Allgemeinen und aus autoregressiven Modellen wie Transformers im Besonderen zu beschleunigen. Zahlreiche Techniken versuchen, die Inferenz für alle Tokens effizienter zu machen, z. B. Destillation (Hinton et al., [2015]), Sparsifizierung (Jaszczur et al., [2021]), Quantisierung (Hubara et al., [2016]) und Architekturmodifikation (So et al., [2021]; Shazeer [2019]). Näher an unserem Ansatz liegen adaptive Berechnungsmethoden, die die Menge der Berechnung an die Problemschwierigkeit anpassen (Han et al., [2021]). Beispiele umfassen das Attendieren auf eine Teilmenge der Eingaben (Sukhbaatar et al., [2019]) und frühe Ausstiege (Schuster et al., [2021]; Scardapane et al., [2020]; Bapna et al., [2020]; Elbayad et al., [2019]; Schwartz et al., [2020]). Insbesondere nutzt Wisdom of Committees (Schwartz et al., [2020]) kleinere Standardmodelle, ist aber ein adaptiver Berechnungsansatz und verwendet daher eine Heuristik, um zu bestimmen, wann gestoppt werden soll, wodurch die Garantie identischer Ausgaben zu denen der Zielmodelle verloren geht. Im Allgemeinen lernen adaptive Berechnungsmethoden üblicherweise, entweder innerhalb des Modells selbst oder mit einem Hilfsmodell, wann eine Berechnungsabkürzung genommen werden kann. Üblicherweise sparen diese Methoden sowohl Inferenzzeit als auch arithmetische Operationen, erfordern jedoch eine Änderung der Architektur, eine Änderung des Trainingsverfahrens und das Training benutzerdefinierter Modelle oder
| Mp | Mq | SMPL | α |
| GPT-LIKE (97M) | UNIGRAM | T=0 | 0,03 |
| GPT-LIKE (97M) | BIGRAM | T=0 | 0,05 |
| GPT-LIKE (97M) | GPT-LIKE (6M) | T=0 | 0,88 |
| GPT-LIKE (97M) | UNIGRAM | T=1 | 0,03 |
| GPT-LIKE (97M) | BIGRAM | T=1 | 0,05 |
| GPT-LIKE (97M) | GPT-LIKE (6M) | T=1 | 0,89 |
| T5-XXL (ENDE) | UNIGRAM | T=0 | 0,08 |
| T5-XXL (ENDE) | BIGRAM | T=0 | 0,20 |
| T5-XXL (ENDE) | T5-SMALL | T=0 | 0,75 |
| T5-XXL (ENDE) | T5-BASE | T=0 | 0,80 |
| T5-XXL (ENDE) | T5-LARGE | T=0 | 0,82 |
| T5-XXL (ENDE) | UNIGRAM | T=1 | 0,07 |
| T5-XXL (ENDE) | BIGRAM | T=1 | 0,19 |
| T5-XXL (ENDE) | T5-SMALL | T=1 | 0,62 |
| T5-XXL (ENDE) | T5-BASE | T=1 | 0,68 |
| T5-XXL (ENDE) | T5-LARGE | T=1 | 0,71 |
| T5-XXL (CNNDM) | UNIGRAM | T=0 | 0,13 |
| T5-XXL (CNNDM) | BIGRAM | T=0 | 0,23 |
| T5-XXL (CNNDM) | T5-SMALL | T=0 | 0,65 |
| T5-XXL (CNNDM) | T5-BASE | T=0 | 0,73 |
| T5-XXL (CNNDM) | T5-LARGE | T=0 | 0,74 |
| T5-XXL (CNNDM) | UNIGRAM | T=1 | 0,08 |
| T5-XXL (CNNDM) | BIGRAM | T=1 | 0,16 |
| T5-XXL (CNNDM) | T5-SMALL | T=1 | 0,53 |
| T5-XXL (CNNDM) | T5-BASE | T=1 | 0,55 |
| T5-XXL (CNNDM) | T5-LARGE | T=1 | 0,56 |
| LAMDA (137B) | LAMDA (100M) | T=0 | 0,61 |
| LAMDA (137B) | LAMDA (2B) | T=0 | 0,71 |
| LAMDA (137B) | LAMDA (8B) | T=0 | 0,75 |
| LAMDA (137B) | LAMDA (100M) | T=1 | 0,57 |
| LAMDA (137B) | LAMDA (2B) | T=1 | 0,71 |
| LAMDA (137B) | LAMDA (8B) | T=1 | 0,74 |
das erneute Training bestehender Modelle. Sie verändern üblicherweise auch die Ausgaben des Modells. Wir merken an, dass viele der oben genannten Methoden zwar das Verhältnis von Speicher zu arithmetischen Operationen verbessern, aber in Fällen, in denen das Verhältnis hoch bleibt, diese Methoden und unsere spekulative Decoding-Methode im Tandem effektiv sein könnten.
Zwei frühere Methoden nutzen spekulative Ausführung, um das Decoding aus autoregressiven Modellen zu beschleunigen. Blockwise Parallel Decoding (Stern et al., [2018]) decodiert mehrere Tokens parallel, ähnlich wie unsere Arbeit. Es unterstützt jedoch nur Greedy-Decoding (Temperatur ) und nicht die allgemeine stochastische Einstellung, es erfordert zusätzliches Training eines benutzerdefinierten Modells und es konzentriert sich auf die Bewahrung der Qualität nachgelagerter Aufgaben statt auf die Garantie identischer Ausgaben. Shallow Aggressive Decoding (SAD) (Sun et al., [2021]) decodiert ebenfalls mehrere Tokens parallel, ähnlich wie unsere Arbeit. Im Gegensatz zu unserer Arbeit unterstützt SAD nur das Kopieren der Eingabe in die Ausgabe und nicht allgemeine Approximationsmodelle, wodurch es nur für Fälle geeignet ist, in denen Ein- und Ausgaben sehr ähnlich sind, wie etwa grammatikalische Fehlerkorrektur. Darüber hinaus unterstützt SAD, ähnlich wie Blockwise Parallel Decoding, nicht die allgemeine stochastische Sampling-Einstellung.
Nachdem wir unsere Arbeit initially veröffentlicht hatten, zeigte eine unabhängige Implementierung von spekulativem Decoding (Chen et al., [2023]) ähnliche 2X-2,5X-Verbesserungen auf Chinchilla 70B.
6. Diskussion
Wir haben spekulatives Sampling vorgestellt, das effiziente stochastische spekulative Ausführung ermöglicht – d. h. spekulative Ausführung in der stochastischen Einstellung. Wir haben seine Auswirkung auf das Decoding aus autoregressiven Modellen wie Transformers über spekulatives Decoding analysiert und gezeigt, dass wir bei ausreichenden Rechenressourcen in der Praxis sinnvolle 2X-3X-Beschleunigungen gegenüber T5X, einer populären optimierten Implementierung, erhalten.
Eine Einschränkung der spekulativen Ausführung im Allgemeinen und des spekulativen Decodings im Besonderen besteht darin, dass die Latenz durch erhöhte Nebenläufigkeit auf Kosten einer erhöhten Anzahl arithmetischer Operationen verbessert wird. Daher ist unsere Methode für Konfigurationen nicht hilfreich, in denen zusätzliche Rechenressourcen nicht verfügbar sind. In üblichen Fällen jedoch, in denen zusätzliche Rechenressourcen verfügbar sind (z. B. wenn die Speicherbandbreite der Engpass ist), bietet unsere Methode die Beschleunigung mit erheblichen Vorteilen: Die Modellarchitektur ändert sich nicht, ein erneutes Training ist nicht erforderlich, und – am wichtigsten – die Ausgabeverteilung bleibt garantiert gleich. Unsere Methode ist einfach zu implementieren und kann verwendet werden, um die Inferenz mit Standardmodellen zu beschleunigen, ohne benutzerdefinierte Verfahren entwickeln und evaluieren zu müssen.
Es gibt mehrere Richtungen für die weiterführende Forschung, insbesondere die weitere Untersuchung der Kompatibilität von spekulativer Dekodierung mit der Strahlsuche (siehe Anhang [A.4]). Obwohl unsere Methode mit vorhandenen Standard-Approximationsmodellen erhebliche Geschwindigkeitssteigerungen erzielt, könnten größere Verbesserungen durch maßgeschneiderte Approximationsmodelle erzielt werden (Abschnitt [3.6], wie solche mit maßgeschneiderten Architekturen (z. B. maßgeschneiderte Größen, nicht-autoregressive Modelle oder verschiedene Heuristiken) oder mit maßgeschneiderten Trainingsverfahren (z. B. Standard-Destillation mit weichen Zielen von oder direkte Optimierung von für ). Es könnte auch interessant sein, eine hierarchische Version des Algorithmus zu erkunden, bei der das Approximationsmodell selbst durch ein noch schnelleres Modell beschleunigt wird, was leistungsfähigere Approximationsmodelle ermöglichen könnte. In dieser Arbeit haben wir das Approximationsmodell und die Anzahl der Vermutungen während der gesamten Inferenz festgelegt, aber eine Variation während der Inferenz könnte zusätzliche Verbesserungen bringen (Abschnitt [3.5]). In unseren Experimenten haben wir immer dieselbe Standardisierung auf die vom Approximationsmodell erzeugten Verteilungen angewendet wie die gewünschte für das Zielmodell (Abschnitt [2.2]), aber weitere Verbesserungen könnten durch die Anwendung anderer Transformationen erzielt werden. Wir haben die spekulative Dekodierung nur in der Textmodalität getestet, aber sie könnte in anderen Domänen (z. B. Bildern) gut funktionieren, was interessante Experimente wären.
Schließlich stellen wir fest, dass stochastische spekulative Ausführung und spekulatives Sampling außerhalb des Anwendungsbereichs der spekulativen Dekodierung von autoregressiven Modellen hilfreich sein können. Zum Beispiel könnten wir bei zwei langsamen Funktionen und , sodass eine Verteilung erzeugt, aus der die Eingabe von abgetastet wird, unsere Methode verwenden, um und parallel auszuführen. Dieses Szenario könnte z. B. in physikalischen Simulationen oder im bestärkenden Lernen auftreten, wo ein großes Modell ist, das eine Verteilung über Aktionen erzeugt, und die Weltsimulation ist, was interessante Erkundungen wären.
Danksagungen
Wir möchten uns besonders bei YaGuang Li für die Hilfe bei allem, was mit LaMDA zu tun hat, und für die Berechnung der LaMDA-Abbildungen in der Arbeit bedanken, sowie bei Blake Hechtman für großartige Einsichten und Hilfe mit XLA. Wir möchten uns auch bei den Gutachtern für aufschlussreiche Kommentare bedanken, sowie bei Asaf Aharoni, Reiner Pope, Sasha Goldshtein, Nadav Sherman, Eyal Segalis, Eyal Molad, Dani Valevski, Daniel Wasserman, Valerie Nygaard, Danny Vainstein, den LaMDA- und Theta-Labs-Teams bei Google und unseren Familien.
Literaturverzeichnis
Bapna, A., Arivazhagan, N., and Firat, O. Controlling computation versus quality for neural sequence models. ArXiv, abs/2002.07106, 2020.
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert- Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., Hesse, C., Chen, M., Sigler, E., Litwin, M., Gray, S., Chess, B., Clark, J., Berner, C., McCandlish, S., Radford, A., Sutskever, I., and Amodei, D. Language models are few- shot learners. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS'20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
Burton, F. W. Speculative computation, parallelism, and functional programming. IEEE Transactions on Computers, C- 34(12):1190- 1193, 1985. doi: 10.1109/TC.1985.6312218.
Chelba, C., Mikolov, T., Schuster, M., Ge, Q., Brants, T., Koehn, P. T., and Robinson, T. One billion word bench mark for measuring progress in statistical language modeling. In Interspeech, 2013.
Chen, C., Borgeaud, S., Irving, G., Lespiau, J.- B., Sifre, L., and Jumper, J. M. Accelerating large language model decoding with speculative sampling. ArXiv, abs/2302.01318, 2023.
Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N. M., Prabhakaran, V., Reif, E., Du, N., Hutchinson, B. C., Pope, R., Bradbury, J., Austin, J., Isard, M., Gur- Ari, G., Yin, P., Duke, T., Levskaya, A., Ghemawat, S., Dev, S., Michalewski, H., Garcia, X., Misra, V., Robinson, K., Fedus, L., Zhou, D., Ippolito, D., Luan, D., Lim, H., Zoph, B., Spiridonov, A., Sepassi, R., Dohan, D., Agrawal, S., Omernick, M., Dai, A. M., Pillai, T. S., Pelat, M., Lewkowycz, A., Moreira, E., Child, R., Polozov, O., Lee, K., Zhou, Z., Wang, X., Saeta, B., Diaz, M., Firat, O., Catasta, M., Wei, J., Meier- Hellstern, K. S., Eck, D., Dean, J., Petrov, S., and Fiedel, N. Palm: Scaling language modeling with pathways. ArXiv, abs/2204.02311, 2022.
Dehghani, M., Arnab, A., Beyer, L., Vaswani, A., and Tay, Y. The efficiency misnomer. ArXiv, abs/2110.12894, 2021.
Devlin, J., Chang, M.- W., Lee, K., and Toutanova, K. Bert: Pre- training of deep bidirectional transformers for language understanding. ArXiv, abs/1810.04805, 2019.
Elbayad, M., Gu, J., Grave, E., and Auli, M. Depth- adaptive transformer. ArXiv, abs/1910.10073, 2019.
Han, Y., Huang, G., Song, S., Yang, L., Wang, H., and Wang, Y. Dynamic neural networks: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence, 44: 7436- 7456, 2021.
Hendrycks, D. and Gimpel, K. Bridging nonlinearities and stochastic regularizers with gaussian error linear units. ArXiv, abs/1606.08415, 2016.
Hennessy, J. L. and Patterson, D. A. Computer Architecture: A Quantitative Approach. Morgan Kaufmann, Amsterdam, 5 edition, 2012. ISBN 978- 0- 12- 383872- 8.
Hinton, G. E., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. ArXiv, abs/1503.02531, 2015.
Hubara, I., Courbariaux, M., Soudry, D., El- Yaniv, R., and Bengio, Y. Quantized neural networks: Training neural networks with low precision weights and activations. ArXiv, abs/1609.07061, 2016.
Jaszczur, S., Chowdhery, A., Mohiuddin, A., Kaiser, L., Gajewski, W., Michalewski, H., and Kanerva, J. Sparse is enough in scaling transformers. In Neural Information Processing Systems, 2021.
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., and Liu, P. J. Exploring the limits of transfer learning with a unified text- to- text transformer. The Journal of Machine Learning Research, 21(1):5485- 5551, 2020.
Roberts, A., Chung, H. W., Levskaya, A., Mishra, G., Bradbury, J., Andor, D., Narang, S., Lester, B., Gaffney, C., Mohiuddin, A., Hawthorne, C., Lewkowycz, A., Salcianu, A., van Zee, M., Austin, J., Goodman, S., Soares, L. B., Hu, H., Tsvyashchenko, S., Chowdhery, A., Bastings, J., Bulian, J., Garcia, X., Ni, J., Chen, A., Kenealy, K., Clark, J., Lee, S., Garrette, D. H., Lee- Thorp, J., Raffel, C., Shazeer, N. M., Ritter, M., Bosma, M., Passos, A., Maitin- Shepard, J. B., Fiedel, N., Omernick, M., Saeta, B., Sepassi, R., Spiridonov, A., Newlan, J., and Gesmundo, A. Scaling up models and data with 5x and seqio. ArXiv, abs/2203.17189, 2022.
Scardapane, S., Scarpiniti, M., Baccarelli, E., and Uncini, A. Why should we add early exits to neural networks? Cognitive Computation, 12(5):954- 966, 2020.
Schuster, T., Fisch, A., Jaakkola, T., and Barzilay, R. Consistent accelerated inference via confident adaptive transformers. In Conference on Empirical Methods in Natural Language Processing, 2021.
Schwartz, R., Stanovsky, G., Swayamdipta, S., Dodge, J., and Smith, N. A. The right tool for the job: Matching model and instance complexities. In Annual Meeting of the Association for Computational Linguistics, 2020.
Shazeer, N. M. Fast transformer decoding: One write- head is all you need. ArXiv, abs/1911.02150, 2019.
So, D. R., Ma'ake, W., Liu, H., Dai, Z., Shazeer, N. M., and Le, Q. V. Primer: Searching for efficient transformers for language modeling. ArXiv, abs/2109.08668, 2021.
Stern, M., Shazeer, N., and Uszkoreit, J. Blockwise parallel decoding for deep autoregressive models. Advances in Neural Information Processing Systems, 31, 2018.
Sukhbaatar, S., Grave, E., Bojanowski, P., and Joulin, A. Adaptive attention span in transformers. In Annual Meeting of the Association for Computational Linguistics, 2019.
Sun, X., Ge, T., Wei, F., and Wang, H. Instantaneous grammatical error correction with shallow aggressive decoding. ArXiv, abs/2106.04970, 2021.
Thoppilan, R., Freitas, D. D., Hall, J., Shazeer, N. M., Kulshreshtha, A., Cheng, H.- T., Jin, A., Bos, T., Baker, L., Du, Y., Li, Y., Lee, H., Zheng, H., Ghafouri, A., Menegali, M., Huang, Y., Krikun, M., Lepikhin, D., Qin, J., Chen, D., Xu, Y., Chen, Z., Roberts, A., Bosma, M., Zhou, Y., Chang, C.- C., Krivokon, I. A., Rusch, W. J., Pickett, M., Meier- Hellstern, K. S., Morris, M. R., Doshi, T., Santos, R. D., Duke, T., Soraker, J. H., Zevenbergen, B., Prabhakaran, V., Díaz, M., Hutchinson, B., Olson, K., Molina, A., Hoffman- John, E., Lee, J., Aroyo, L., Rajakumar, R., Butryna, A., Lamm, M., Kuzmina, V. O., Fenton, J., Cohen, A., Bernstein, R., Kurzweil, R., Aguera- Arcas, B., Cui, C., Croak, M., hsin Chi, E. H., and Le, Q. Lamda: Language models for dialog applications. ArXiv, abs/2201.08239, 2022.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., and Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Yu, J., Xu, Y., Koh, J. Y., Luong, T., Baid, G., Wang, Z., Vasudevan, V., Ku, A., Yang, Y., Ayan, B. K., Hutchinson, B. C., Han, W., Parekh, Z., Li, X., Zhang, H., Baldridge, J., and Wu, Y. Scaling autoregressive models for content-rich text- to- image generation. ArXiv, abs/2206.10789, 2022.
A. Anhang
A.1. Korrektheit des spekulativen Samplings
Wir werden nun zeigen, dass für beliebige Verteilungen und die Token, die mittels spekulativen Samplings aus und gezogen werden, identisch verteilt sind wie diejenigen, die allein aus gezogen werden. Sei die Akzeptanzwahrscheinlichkeit (Definition 3.1).
Beachte, dass, da , die Normierungskonstante für die angepasste Verteilung gleich ist, wobei die letzte Gleichung unmittelbar aus Lemma 3.3 und Theorem 3.5 folgt
Nun:
Wobei:
Und:
Insgesamt:
Wie gewünscht.
A.2. Speculative Sampling vs. Rejection Sampling
Rejection Sampling ist das folgende iterative Sampling-Verfahren, das oberflächlich betrachtet unserem ähnelt:
1. Sample und .
2. Falls , gib zurück.
3. Gehe zu 1.
Wobei . Wir könnten statt Speculative Sampling eine nicht-iterative Version von Rejection Sampling verwenden – konkret die Schritte 1 und 2 oben durchgehen und andernfalls direkt aus einem unmodifizierten samplen. Das wäre jedoch viel weniger effizient als unsere Methode. Konkret ist die erwartete Akzeptanzwahrscheinlichkeit hier , was (potenziell viel) niedriger ist als die erwartete Akzeptanzwahrscheinlichkeit in unserer Methode.
A.3. Theoretische Vorhersagen vs. empirische Laufzeiten
Tabelle 4 vergleicht die erwarteten Laufzeitverbesserungen basierend auf Theorem 3.8 mit den empirisch gemessenen Laufzeiten aus Tabelle 2. Wir haben die Werte von für die verschiedenen Modelle anhand von Profiler-Traces geschätzt. Wir können sehen, dass die theoretischen Vorhersagen größtenteils mit den gemessenen Laufzeiten übereinstimmen. Die größeren Abweichungen sind zurückzuführen auf: (1) Optimierungsunterschiede zwischen unserer Implementierung und der Baseline, und (2) die vereinfachende Annahme, dass die s i.i.d. sind, die nur eine Näherung darstellt (siehe Abschnitt 3.1).
| AUFGABE | MQ | TEMP | γ | α | c | EXP | EMP |
| ENDE | T5-SMALL | 0 | 7 | 0,75 | 0,02 | 3,2 | 3,4 |
| ENDE | T5-BASE | 0 | 7 | 0,8 | 0,04 | 3,3 | 2,8 |
| ENDE | T5-LARGE | 0 | 7 | 0,82 | 0,11 | 2,5 | 1,7 |
| ENDE | T5-SMALL | 1 | 7 | 0,62 | 0,02 | 2,3 | 2,6 |
| ENDE | T5-BASE | 1 | 5 | 0,68 | 0,04 | 2,4 | 2,4 |
| ENDE | T5-LARGE | 1 | 3 | 0,71 | 0,11 | 2,0 | 1,4 |
| CNNDM | T5-SMALL | 0 | 5 | 0,65 | 0,02 | 2,4 | 3,1 |
| CNNDM | T5-BASE | 0 | 5 | 0,73 | 0,04 | 2,6 | 3,0 |
| CNNDM | T5-LARGE | 0 | 3 | 0,74 | 0,11 | 2,0 | 2,2 |
| CNNDM | T5-SMALL | 1 | 5 | 0,53 | 0,02 | 1,9 | 2,3 |
| CNNDM | T5-BASE | 1 | 3 | 0,55 | 0,04 | 1,8 | 2,2 |
| CNNDM | T5-LARGE | 1 | 3 | 0,56 | 0,11 | 1,6 | 1,7 |
Tabelle 4. Erwarteter Verbesserungsfaktor (Exp) vs. empirisch gemessener Verbesserungsfaktor (EMP).
A.4. Anwendung auf Beam Search
Unsere Methode kann mit gewissem Performanzverlust auf Beam-Search-Sampling angewendet werden. Gegeben die ursprüngliche Beam-Breite , können wir Beam Search mit dem Approximationsmodell und Beam-Breite für Schritte durchführen. Dann können wir verwenden, um alle Kandidaten parallel zu prüfen (was ein Rechenbudget von Läufen von kostet). Schließlich können wir für jeden Schritt die Vorhersagen von akzeptieren, solange , um identische Ergebnisse wie bei regulärem Beam Search allein mit zu erhalten (mit einem aufwändigeren Verfahren könnten wir auch Fälle akzeptieren, in denen die erhaltenen Kandidaten zufällig höhere Wahrscheinlichkeiten als die von allein haben). Die Analyse unserer Methode in diesem Setting ist komplexer und wir überlassen sie zukünftiger Arbeit.
A.5. Nachsicht
Eine starke Eigenschaft von Algorithmus ist, dass die Ausgabeverteilung garantiert unverändert bleibt. Allerdings können wir, wenn wir bereit sind, einige Änderungen mit guten Garantien zuzulassen, weitere Geschwindigkeitsverbesserungen bei der Inferenz erzielen. Um dies weiter zu motivieren, sei angemerkt, dass die generierten Wahrscheinlichkeitsverteilungen nicht identisch sein werden, wenn wir zwei Modelle mit identischen Architekturen und Größen auf demselben Datensatz trainieren, sodass etwas Nachsicht sinnvoll sein könnte. Man beachte, dass die Ergebnisse in diesem Paper mit Ausnahme dieses Abschnitts die strengste Version von Algorithmus verwenden und keinerlei Nachsicht zulassen.
Wir könnten einen Nachsichtsparameter einbeziehen und mit multiplizieren, bevor wir es in Algorithmus mit vergleichen. Dies erhält weiterhin die schöne Garantie, dass kein Token mit einer Wahrscheinlichkeit größer als gesampelt werden kann. Das bedeutet beispielsweise, dass bei kein Token mit mehr als dem 10-fachen seiner Ground-Truth-Wahrscheinlichkeit gesampelt werden kann, sodass wir garantieren können, dass extrem seltene Tokens extrem selten bleiben (es gibt keine Garantie für die Mindestwahrscheinlichkeit, sodass Nachsicht die Diversität der Samples beeinträchtigen könnte).
Konkret haben wir mit einem Nachsichtsfaktor \begin{array}{r l r}{{\alpha}~=}&{{}E_{x\sim q(x)}\left\{\begin{array}{l l}{1}&{l q(x)\leq p(x)}\\ {\frac{p(x)}{l q(x)}}&{l q(x)>p(x)}\end{array}\right.}&{{}=}&{{}E_{x\sim q(x)}\frac{p(x)}{m a x(p(x),l q(x))}}}\end{array}
Tabelle 5 zeigt -Werte für verschiedene Werte von , wenn T5-XXL (11B) und T5-small (77M) ist. Mit erhalten wir bei Nachsichtswerten von 1, 0,5, 0,3 und 0,1 (was bedeutet, dass kein Token mit einer Wahrscheinlichkeit größer als dem 1-fachen, 2-fachen, 3-fachen bzw. 10-fachen der Ground Truth gesampelt werden kann) Verbesserungsfaktoren von 2,5X, 3,1X, 3,6X bzw. 5X.
| MQ | l = 1 | l = 0,5 | l = 0,3 | l = 0,1 |
| UNIGRAM | 0,07 | 0,1 | 0,11 | 0,16 |
| BIGRAM | 0,19 | 0,23 | 0,25 | 0,32 |
| T5-SMALL (77M) | 0,62 | 0,71 | 0,76 | 0,84 |
| T5-BASE (250M) | 0,68 | 0,8 | 0,83 | 0,90 |
Tabelle 5. -Werte für verschiedene Werte von beim Standard-Sampling, wobei T5-XXL (11B) auf der EnDe-Übersetzungsaufgabe ist.
Beachte, dass wir bei Verwendung von Temperatur (d. h. Argmax-Sampling) Nachsicht nicht mehr wie oben verwenden können. Stattdessen könnten wir etwas Nachsicht erlauben, bevor die Verteilungen standardisiert werden. Zum Beispiel könnten wir das aus abgetastete Token akzeptieren, falls . In diesem Fall messen wir ähnliche empirische Anstiege der -Werte wie bei Temperatur . Wenn wir beispielsweise Nachsichtswerte von 1, 0,5, 0,3 und 0,1 für T5-XXL und T5-small bei der Englisch-Deutsch-Übersetzung verwenden, erhalten wir -Werte von 0,75, 0,75, 0,8, 0,87. Nehmen wir zum Beispiel und , so erhalten wir Geschwindigkeitsverbesserungsfaktoren von jeweils 3,3X, 3,3X, 3,9X und 4,9X.7