
Ein Rahmen zeigt, dass Attention und Zustandsraummodelle zwei Sichten derselben Matrix sind, und liefert eine schnellere Sequenzschicht. ICML 2024, kostenlos.
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
Transformer sind SSMs: Verallgemeinerte Modelle und effiziente Algorithmen durch strukturierte Zustandsraum-Dualität
Fachbereich Informatik, Princeton University Fachbereich Maschinelles Lernen, Carnegie Mellon University tri@tridao.me, agu@cs.cmu.edu
Zusammenfassung
Während Transformer die Hauptarchitektur hinter dem Erfolg des Deep Learnings in der Sprachmodellierung waren, wurde kürzlich gezeigt, dass Zustandsraummodelle (SSMs) wie Mamba Transformer in kleinem bis mittlerem Maßstab erreichen oder übertreffen. Wir zeigen, dass diese Modellfamilien tatsächlich recht eng verwandt sind, und entwickeln einen reichhaltigen Rahmen theoretischer Verbindungen zwischen SSMs und Varianten der Attention, die durch verschiedene Zerlegungen einer gut untersuchten Klasse strukturierter halbseparierbarer Matrizen verbunden sind. Unser Rahmen der Zustandsraum-Dualität (SSD) ermöglicht es uns, eine neue Architektur (Mamba-2) zu entwerfen, deren Kernschicht eine Verfeinerung von Mambas selektivem SSM ist, die 2–8× schneller ist und weiterhin konkurrenzfähig mit Transformern bei der Sprachmodellierung bleibt.
1 Einleitung
Transformer, insbesondere reine Decoder-Modelle (z. B. GPT (Brown et al. 2020), Llama (Touvron, Lavril, et al. 2023)), die Eingabesequenzen auf kausale Weise verarbeiten, sind einer der Haupttreiber des Erfolgs des modernen Deep Learnings. Zahlreiche Ansätze versuchen, die Kern-Attention-Schicht zu approximieren, um ihre Effizienzprobleme zu adressieren (Tay et al. 2022), wie etwa die quadratische Skalierung mit der Sequenzlänge während des Trainings und die Notwendigkeit eines Caches von linearer Größe in der Sequenzlänge während der autoregressiven Generierung. Parallel dazu ist eine Klasse alternativer Sequenzmodelle entstanden, die strukturierten Zustandsraummodelle (SSMs), mit linearer Skalierung in der Sequenzlänge während des Trainings und konstanter Zustandsgröße während der Generierung. Sie zeigen starke Leistungen bei Aufgaben mit langen Abhängigkeiten (z. B. S4 (Gu, Goel und Ré 2022)) und haben kürzlich Transformer bei der Sprachmodellierung (z. B. Mamba (Gu und Dao 2023)) in kleinem bis moderatem Maßstab erreicht oder übertroffen. Allerdings scheint die Entwicklung von SSMs losgelöst von den kollektiven Bemühungen der Community zur Verbesserung von Transformern zu sein, etwa sie theoretisch zu verstehen sowie sie auf moderner Hardware zu optimieren. Infolgedessen ist es schwieriger, mit SSMs zu experimentieren und sie zu verstehen, verglichen mit Transformern, und es bleibt sowohl aus algorithmischer als auch aus Systemperspektive eine Herausforderung, SSMs so effizient wie Transformer zu trainieren.
Unser Hauptziel ist es, einen reichhaltigen Korpus theoretischer Verbindungen zwischen strukturierten SSMs und Varianten der Attention zu entwickeln. Dies wird es uns ermöglichen, algorithmische und Systemoptimierungen, die ursprünglich für Transformer entwickelt wurden, auf SSMs zu übertragen, mit dem Ziel, Fundamentmodelle zu bauen, die besser als Transformer performen und dabei effizienter in der Sequenzlänge skalieren. Ein Meilensteinbeitrag in diese Richtung war der Rahmen der Linearen Attention (LA) (Katharopoulos et al. 2020), der eine Verbindung zwischen autoregressiver Attention und linearen RNNs herleitete, indem er die Äquivalenz zwischen „dualen Formen" quadratischer kernelisierter Attention und einer bestimmten linearen Rekurrenz zeigte. Diese Dualität ermöglicht neue Fähigkeiten wie die Möglichkeit, sowohl effizientes parallelisierbares Training als auch effiziente autoregressive Inferenz zu haben. Im selben Geist liefert dieses Papier mehrere Blickwinkel, die SSMs mit linearer Komplexität mit Formen quadratischer Komplexität verbinden, um die Stärken von SSMs und Attention zu kombinieren.
Zustandsraum-Dualität. Unser Rahmen, der strukturierte SSMs und Varianten der Attention verbindet, den wir strukturierte Zustandsraum-Dualität (SSD) nennen, wird durch die Abstraktionen strukturierter Matrizen hergestellt: Matrizen mit subquadratischen Parametern und Multiplikationskomplexität. Wir entwickeln zwei breite Rahmenwerke zur Darstellung von Sequenzmodellen, eines als Matrixtransformationen und eines als Tensorkontraktionen, die jeweils unterschiedliche Perspektiven der Dualität offenbaren. Unsere technischen Beiträge umfassen:
- Wir zeigen eine Äquivalenz zwischen Zustandsraummodellen und einer gut untersuchten Familie strukturierter Matrizen namens halbseparierbare Matrizen (Abschnitt 3). Diese Verbindung steht im Herzen unseres Rahmens und offenbart neue Eigenschaften und Algorithmen für SSMs. Eine zentrale Botschaft dieses Papiers ist, dass verschiedene Methoden zur Berechnung von Zustandsraummodellen als verschiedene Matrixmultiplikationsalgorithmen auf strukturierten Matrizen neu formuliert werden können.
- Wir verbessern die Theorie der linearen Attention (Katharopoulos et al. 2020) erheblich. Wir liefern zunächst einen prägnanten Beweis ihrer rekurrenten Form durch die Sprache der Tensorkontraktionen und verallgemeinern sie dann auf eine neue Familie strukturierter maskierter Attention (SMA) (Abschnitt 4).
- Wir verbinden SSMs und SMA und zeigen, dass sie eine große Schnittmenge haben, die aus Dualen zueinander besteht, die sowohl SSM-artige lineare als auch attention-artige quadratische Formen besitzen (Abschnitt 5). Wir beweisen außerdem, dass jede Kernel-Attention-Methode, die eine schnelle rekurrente Form besitzt, ein SSM sein muss.
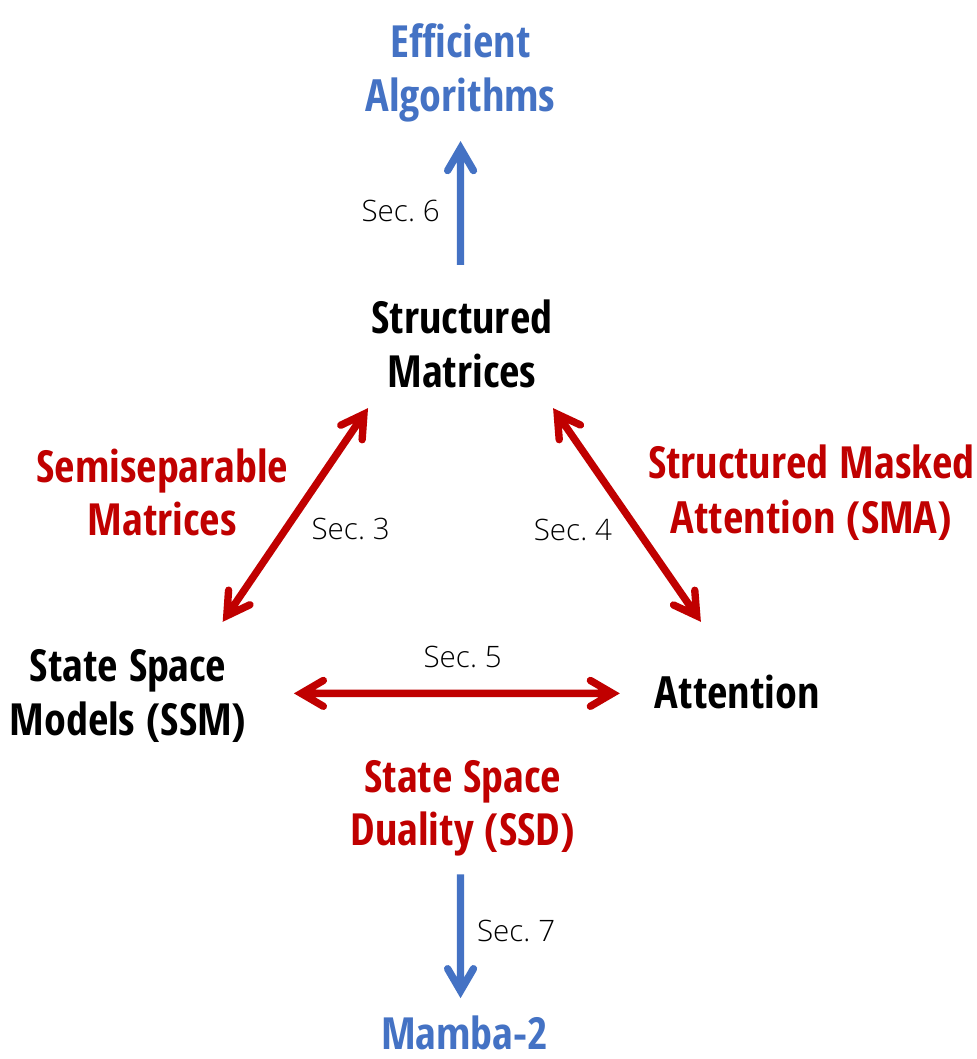
Über ihren intrinsischen theoretischen Wert hinaus eröffnet unser Rahmen eine breite Palette von Richtungen zum Verständnis und zur Verbesserung von Sequenzmodellen.
Effiziente Algorithmen. Zuerst und vor allem legt unser Rahmen neue effiziente und leicht implementierbare Algorithmen zur Berechnung von SSMs offen (Abschnitt 6). Wir führen einen neuen SSD-Algorithmus ein, der auf Blockzerlegungen halbseparierbarer Matrizen basiert und sowohl die lineare SSM-Rekurrenz als auch die quadratische duale Form nutzt, um optimale Kompromisse auf allen wesentlichen Effizienzachsen zu erzielen (z. B. Trainings- und Inferenzrechenaufwand, Speicherverbrauch und die Fähigkeit, Matrixmultiplikationseinheiten auf moderner Hardware zu nutzen). Eine dedizierte Implementierung von SSD ist schneller als die optimierte selektive Scan-Implementierung von Mamba und ermöglicht gleichzeitig viel größere rekurrente Zustandsgrößen ( die Größe von Mamba oder sogar höher, mit minimaler Verlangsamung). SSD ist hochgradig konkurrenzfähig mit optimierten Implementierungen von Softmax-Attention (FlashAttention-2 (Dao 2024)), überholt diese bei Sequenzlänge und ist bei Sequenzlänge 16K schneller.
Architekturdesign. Ein wesentliches Hindernis bei der Einführung neuer Architekturen wie SSMs ist das auf Transformer zugeschnittene Ökosystem, wie etwa hardware-effiziente Optimierungs- und Parallelisierungstechniken für Training im großen Maßstab. Unser Rahmen erlaubt es, etablierte Konventionen und Techniken für Attention zu verwenden, um ein Vokabular von Architekturdesign-Optionen für SSMs aufzubauen und diese weiter zu verbessern (Abschnitt 7). Zum Beispiel führen wir das Analogon der Heads aus der Multi-Head-Attention (MHA) für SSMs ein. Wir zeigen, dass die Mamba-Architektur ein Multi-Input-SSM (MIS) ist, das sich als analog zur Multi-Value-Attention (MVA) erweist, und vergleichen andere Varianten von Mamba mit unterschiedlichen Head-Strukturen.
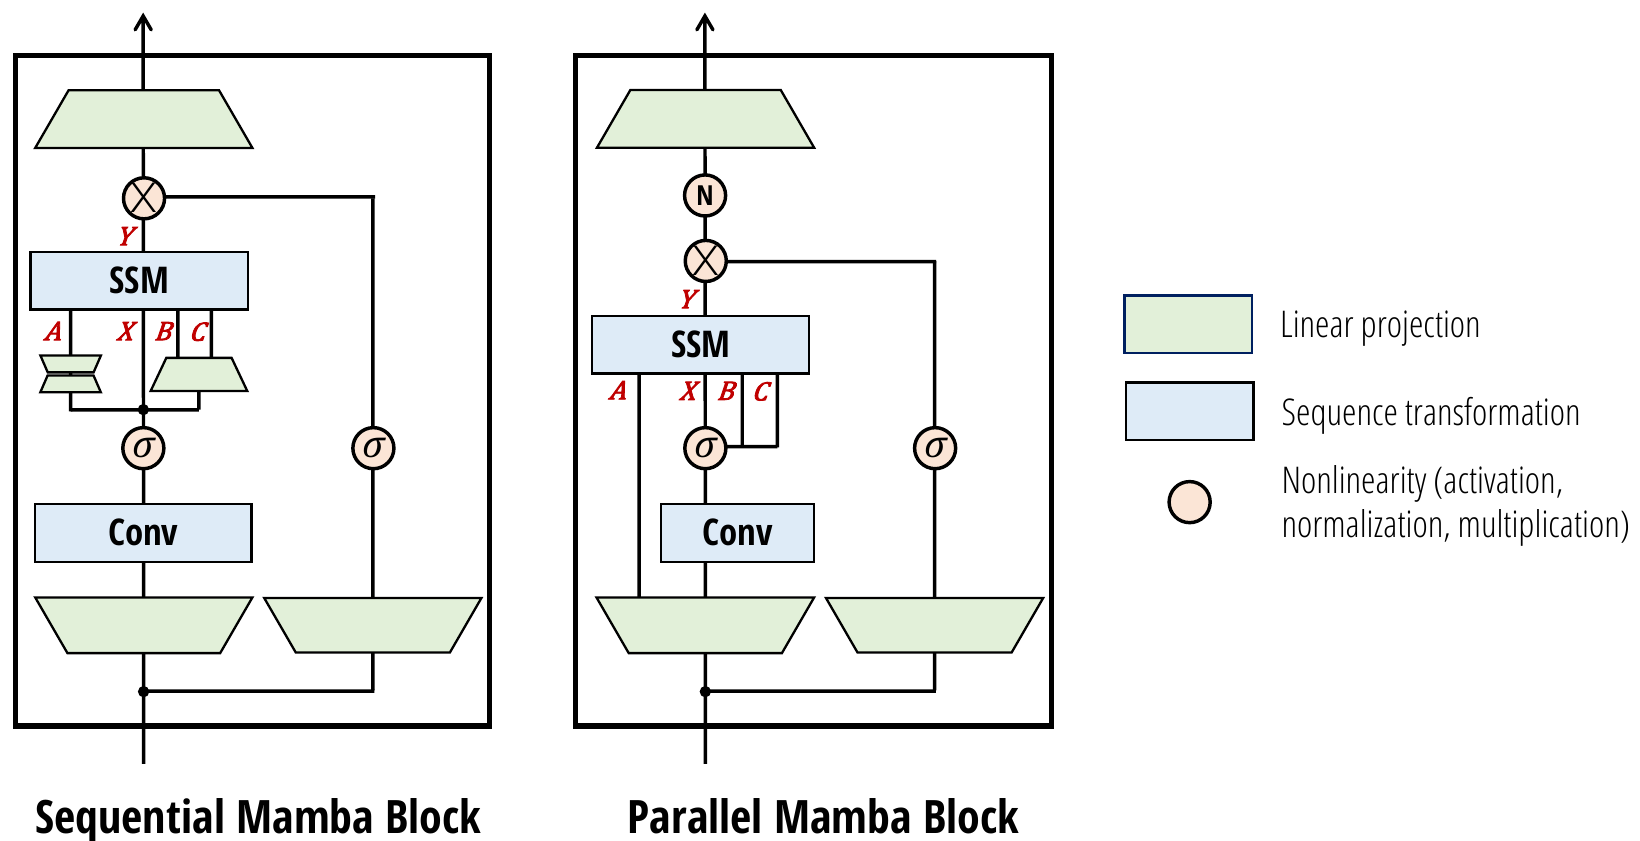
Wir nutzen diese Ideen auch, um geringfügige Modifikationen am Mamba-Block vorzunehmen, die die Implementierung von Tensorparallelismus ermöglichen (z. B. im Stil von Megatron (Shoeybi et al. 2019)). Die Hauptideen umfassen die Einführung einer Grouped-Value-Attention-(GVA-)Head-Struktur und die Verlagerung aller datenabhängigen Projektionen, sodass sie parallel zu Beginn des Blocks erfolgen.
Die Kombination des modifizierten parallelen Mamba-Blocks zusammen mit der Verwendung von SSD als innere SSM-Schicht ergibt die Mamba-2-Architektur. Wir untersuchen Chinchilla-Skalierungsgesetze für Mamba-2 in derselben Einstellung wie Mamba und finden, dass es Mamba und Transformer++ sowohl in Perplexität als auch in Wanduhrzeit Pareto-dominiert. Zusätzlich trainieren wir eine Familie von Mamba-2-Modellen in unterschiedlichen Größen auf dem Pile und zeigen, dass es Mamba und Open-Source-Transformer bei standardmäßigen Downstream-Evaluierungen erreicht oder übertrifft. Zum Beispiel übertrifft Mamba-2 mit 2,7B Parametern, trainiert auf 300B Tokens des Pile, Mamba-2.8B, Pythia-2.8B und sogar Pythia-6.9B, die auf demselben Datensatz trainiert wurden.
Systemoptimierungen. Der SSD-Rahmen verbindet SSMs und Transformer und erlaubt es uns, einen reichhaltigen Korpus an Arbeiten zu Systemoptimierungen zu nutzen, die für Transformer entwickelt wurden (Abschnitt 8).
- Zum Beispiel ist Tensorparallelismus (TP) eine wichtige Modellparallelisierungstechnik, um große Transformer-Modelle zu trainieren, indem jede Schicht über GPUs auf demselben Knoten aufgeteilt wird. Wir gestalten Mamba-2 TP-freundlich und halbieren die Anzahl der Synchronisationspunkte pro Block.
- Für sehr lange Sequenzen, deren Aktivierungen nicht auf ein Gerät passen, wurde Sequenzparallelismus für die Attention-Blöcke entwickelt. Wir beschreiben, wie man SSMs im Allgemeinen und Mamba-2 im Besonderen mit Sequenzparallelismus trainiert, indem man die rekurrenten Zustände zwischen den Geräten weitergibt.
- Für das Finetuning mit Beispielen unterschiedlicher Länge benötigt Transformer für beste Effizienz ausgefeilte Techniken, um Padding-Tokens zu entfernen und Attention auf Sequenzen variabler Länge durchzuführen. Wir zeigen, wie Mamba-2 effizient mit variablen Sequenzlängen trainiert werden kann, ohne Padding-Tokens zu benötigen.
Abschnitt 9 validiert Mamba-2 empirisch bei der Sprachmodellierung, der Trainingseffizienz und einer schwierigen Multi-Query-Associative-Recall-Aufgabe (Arora, Eyuboglu, Zhang, et al. 2024). Schließlich liefern wir in Abschnitt 10 eine erweiterte verwandte Arbeit und diskutieren potenzielle Forschungsrichtungen, die unser Rahmen eröffnet.
Modellcode und vorab trainierte Checkpoints sind Open Source unter https://github.com/state-spaces/mamba.
2 Hintergrund und Überblick
2.1 Strukturierte Zustandsraummodelle
Strukturierte Zustandsraum-Sequenzmodelle (S4) sind eine neuere Klasse von Sequenzmodellen für das Deep Learning, die breit mit RNNs, CNNs und klassischen Zustandsraummodellen verwandt sind. Sie sind von einem bestimmten kontinuierlichen System (1) inspiriert, das eine 1-dimensionale Sequenz durch einen impliziten latenten Zustand abbildet.
Eine allgemeine diskrete Form strukturierter SSMs hat die Gestalt von Gleichung (1).
wobei . Strukturierte SSMs werden so genannt, weil die -Matrix, die die zeitliche Dynamik steuert, strukturiert sein muss, um diese Sequenz-zu-Sequenz-Transformation effizient genug berechnen zu können, um in tiefen neuronalen Netzen verwendet zu werden. Die ursprünglich eingeführten Strukturen waren diagonal plus niedrigrangig (DPLR) (Gu, Goel und Ré 2022) und diagonal (Gu, Gupta et al. 2022; Gupta, Gu und Berant 2022; J. T. Smith, Warrington und Linderman 2023), die nach wie vor die beliebteste Struktur ist.
In dieser Arbeit verwenden wir den Begriff Zustandsraummodell (SSM), um strukturierte SSMs zu bezeichnen. Es gibt viele Varianten solcher SSMs, die eng mit mehreren wichtigen Paradigmen neuronaler Sequenzmodelle wie kontinuierlichen, rekurrenten und konvolutionalen Modellen verbunden sind (Gu, Johnson, Goel et al. 2021). Wir geben unten einen kurzen Überblick und verweisen für mehr Kontext und Details auf frühere Arbeiten (Gu 2023; Gu und Dao 2023).
Kontinuierliche Modelle. Die ursprünglichen strukturierten SSMs entstanden als kontinuierliche Abbildungen auf Funktionen und nicht als direkt auf Sequenzen operierende Modelle. In der kontinuierlichen Perspektive werden in Gleichung (1a) die Matrizen nicht direkt gelernt, sondern aus zugrunde liegenden Parametern zusammen mit einer parametrisierten Schrittweite erzeugt. Die „kontinuierlichen Parameter“ werden durch feste Formeln und in „diskrete Parameter“ umgewandelt, wobei das Paar als Diskretisierungsregel bezeichnet wird.
Anmerkung 1. Während unsere Hauptmodelle dieselbe Parametrisierung und denselben Diskretisierungsschritt wie frühere Arbeiten übernehmen (siehe Gu und Dao (2023) für Details), lassen wir dies zur Vereinfachung der Darstellung und Notation im Rest dieses Papiers weg. Wir merken an, dass frühere Arbeiten zu strukturierten SSMs die kontinuierlichen Parameter und die diskreten Parameter stattdessen als bzw. bezeichneten; wir haben die Notation geändert, um die Darstellung zu vereinfachen und uns direkt auf die diskreten Parameter zu konzentrieren, welche die Haupt-SSM-Rekurrenz bestimmen.
Rekurrente Modelle. Gleichungen (1) und (2) haben die Form einer Rekurrenz, die linear in ihrem Eingang ist. Strukturierte SSMs können daher als Arten von rekurrenten neuronalen Netzen (RNNs) betrachtet werden, wobei die Linearität ihnen zusätzliche Eigenschaften verleiht und es ihnen ermöglicht, die sequentielle Berechnung traditioneller RNNs zu vermeiden. Umgekehrt sind SSMs trotz dieser Vereinfachung nach wie vor vollständig ausdrucksstark als Sequenztransformationen (im Sinne der universellen Approximation) (Kaul 2020; Orvieto et al. 2023; Shida Wang und Xue 2023).
Faltungsmodelle. Wenn die Dynamik des SSM über die Zeit konstant ist wie in Gleichung (1), wird das Modell linear zeitinvariant (LTI) genannt. In diesem Fall sind sie äquivalent zu Faltungen. Somit können SSMs auch als Arten von CNNs betrachtet werden, jedoch mit der Besonderheit, dass (i) die Faltungskerne implizit durch die SSM-Parameter parametrisiert werden und (ii) die Faltungskerne im Allgemeinen global statt lokal sind. Umgekehrt können durch die klassische Signalverarbeitungstheorie alle hinreichend wohldefinierten Faltungen als SSMs dargestellt werden.
Üblicherweise verwendeten frühere LTI-SSMs den Faltungsmodus für effizientes parallelisierbares Training (wobei die gesamte Eingabesequenz im Voraus bekannt ist) und wechselten in den rekurrenten Modus (1) für effiziente autoregressive Inferenz (wobei die Eingaben Schritt für Schritt eintreffen).
Selektive Zustandsraummodelle. Die Form (2), bei der die Parameter auch über die Zeit variieren können, wurde in Mamba als selektives SSM eingeführt. Im Vergleich zur Standard-LTI-Formulierung (1) kann dieses Modell bei jedem Zeitschritt selektiv wählen, ob es sich auf Eingaben konzentriert oder diese ignoriert. Es wurde gezeigt, dass es bei informationsdichten Daten wie Sprache deutlich besser abschneidet als LTI-SSMs, insbesondere wenn seine Zustandsgröße N zunimmt und dadurch mehr Informationskapazität ermöglicht wird. Allerdings kann es nur im rekurrenten statt im Faltungsmodus berechnet werden und erfordert eine sorgfältige hardwarebewusste Implementierung, um effizient zu sein. Selbst dann ist es noch weniger effizient als hardwarefreundliche Modelle wie CNNs und Transformer, da es keine Matrixmultiplikationseinheiten nutzt, auf die moderne Beschleuniger wie GPUs und TPUs spezialisiert sind.
Während zeitinvariante SSMs eng mit kontinuierlichen, rekurrenten und faltungsbasierten Sequenzmodellen verwandt sind, stehen sie nicht direkt mit Attention in Beziehung. In diesem Papier zeigen wir eine tiefere Beziehung zwischen selektiven SSMs und Attention und nutzen sie, um die Trainingsgeschwindigkeit von SSMs erheblich zu verbessern und gleichzeitig viel größere Zustandsgrößen N zu ermöglichen.
Strukturierte SSMs als Sequenztransformationen.
Definition 2.1. Wir verwenden den Begriff Sequenztransformation, um eine parametrisierte Abbildung auf Sequenzen zu bezeichnen, wobei und eine beliebige Sammlung von Parametern ist. T repräsentiert die Sequenz- oder Zeitachse; Indizes greifen in die erste Dimension, z. B.
Sequenztransformationen (z. B. SSMs oder Self-Attention) sind der Grundpfeiler tiefer Sequenzmodelle, wo sie in neuronale Netzarchitekturen (z. B. Transformer) eingebunden werden. Das SSM in (1) oder (2) ist eine Sequenztransformation mit ; es kann auf verallgemeinert werden, indem man einfach über diese Dimension broadcastet (mit anderen Worten, den Eingang als unabhängige Sequenzen auffasst und das SSM auf jede anwendet). Man kann sich als eine Kopf-Dimension vorstellen, worauf wir in Abschnitt 7 näher eingehen werden.
Definition 2.2. Wir definieren den SSM-Operator als die Sequenztransformation , definiert durch Gleichung (2).
In SSMs ist die N-Dimension ein freier Parameter, der als Zustandsgröße oder Zustandsdimension bezeichnet wird. Wir nennen ihn auch den Zustandsexpansionsfaktor, da er die Größe von Ein- und Ausgang um einen Faktor erweitert, was Auswirkungen auf die Recheneffizienz dieser Modelle hat.
Schließlich bemerken wir, dass viele Arten von Sequenztransformationen, wie etwa Attention, als eine einzelne Matrixmultiplikation über die Sequenzdimension dargestellt werden können.
Definition 2.3. Wir nennen eine Sequenztransformation eine Matrixtransformation, wenn sie in der Form geschrieben werden kann, wobei eine von den Parametern abhängige Matrix ist. Wir identifizieren die Sequenztransformation mit der Matrix und lassen die Abhängigkeit von oft weg, wenn sie aus dem Kontext klar ist.
2.2 Attention
Attention bezeichnet im weiteren Sinne eine Art von Berechnung, die jedem Paar von Positionen in einer Sequenz Scores zuweist, wodurch jedes Element auf die übrigen „achten“ kann. Die mit Abstand gebräuchlichste und wichtigste Variante von Attention ist Softmax-Self-Attention, die definiert werden kann als
für . Der Mechanismus paarweiser Vergleiche (induziert durch das Materialisieren von ) führt zu den charakteristischen quadratischen Trainingskosten von Attention.
Viele Varianten von Attention wurden vorgeschlagen, aber alle teilen den zugrunde liegenden Kern dieser Attention-Scores, mit verschiedenen Approximationen (Tay et al. 2022). Die für diese Arbeit wichtigste Variante ist lineare Attention (Katharopoulos et al. 2020). Grob gesprochen verzichtet diese Methodenfamilie auf das Softmax, indem sie es in eine Kernel-Feature-Map einbettet, und nutzt die Assoziativität der Matrixmultiplikation, um umzuschreiben. Darüber hinaus zeigen sie im wichtigen Fall kausaler (autoregressiver) Attention, dass, wenn die kausale Maske auf der linken Seite als eingebracht wird, wobei die untere Dreiecksmatrix aus Einsen ist, die rechte Seite als Rekurrenz entwickelt werden kann. Mehrere neuere und zeitgleich entstandene Arbeiten wie RetNet (Y. Sun et al. 2023) und GateLoop (Katsch 2023) erweitern dies auf allgemeinere Formen von (Abschnitt 10). In dieser Arbeit wird unsere Formulierung strukturierter maskierter Attention diese Ideen stark verallgemeinern.
2.3 Strukturierte Matrizen
Allgemeine Matrizen benötigen Parameter zur Darstellung und Zeit für grundlegende Operationen wie Matrix-Vektor-Multiplikation. Strukturierte Matrizen sind solche, die (i) durch eine komprimierte Darstellung mit subquadratisch vielen (idealerweise linear vielen) Parametern repräsentiert werden können und (ii) schnelle Algorithmen (vor allem für die Matrixmultiplikation) besitzen, indem sie direkt auf dieser komprimierten Darstellung operieren.
Die vielleicht kanonischsten Familien strukturierter Matrizen sind dünn besetzte Matrizen und Niedrigrangmatrizen. Es existieren jedoch viele weitere Familien, wie Toeplitz-, Cauchy-, Vandermonde- und Butterfly-Matrizen, die alle im maschinellen Lernen für effiziente Modelle verwendet wurden (Dao, Gu, et al. 2019; D. Fu et al. 2024; Gu, Gupta, et al. 2022; Thomas et al. 2018). Strukturierte Matrizen sind eine mächtige Abstraktion für effiziente Repräsentationen und Algorithmen. In dieser Arbeit werden wir zeigen, dass SSMs äquivalent zu einer anderen Klasse strukturierter Matrizen sind, die zuvor nicht im Deep Learning verwendet wurden, und diese Verbindung nutzen, um effiziente Methoden und Algorithmen abzuleiten.
2.4 Überblick: Structured State Space Duality
Während dieses Paper einen viel reichhaltigeren Rahmen von Verbindungen zwischen SSMs, Attention und strukturierten Matrizen entwickelt, geben wir eine kurze Zusammenfassung der Hauptmethode, die algorithmisch tatsächlich recht in sich geschlossen und einfach ist.
Wiederkehrende (lineare) Form. Die Zustandsraum-Dualitätsschicht (State Space Dual, SSD) kann als Spezialfall des selektiven SSM (2) definiert werden. Die Standardberechnung eines SSM als Rekurrenz (oder paralleler Scan) kann angewendet werden, was lineare Komplexität in der Sequenzlänge aufweist. Im Vergleich zur in Mamba verwendeten Version gibt es bei SSD zwei geringfügige Unterschiede:
Die Struktur auf wird weiter vereinfacht, von einer diagonalen zu einer Skalar-mal-Identität-Struktur. Jedes kann in diesem Fall auch mit nur einem Skalar identifiziert werden. Wir verwenden eine größere Kopf-Dimension im Vergleich zu , das in Mamba verwendet wird. Typischerweise wird gewählt, was den Konventionen für moderne Transformer ähnelt.
Im Vergleich zum ursprünglichen selektiven SSM können diese Änderungen als eine leichte Verringerung der Ausdruckskraft angesehen werden, im Gegenzug für erhebliche Effizienzverbesserungen beim Training. Insbesondere werden unsere neuen Algorithmen die Verwendung von Matrixmultiplikationseinheiten auf modernen Beschleunigern ermöglichen.
Duale (quadratische) Form. Die duale Form von SSD ist eine quadratische Berechnung, die eng mit Attention verwandt ist und definiert ist als
wobei eingabeabhängige Skalare sind, die auf [0, 1] beschränkt sind.
Im Vergleich zur Standard-Softmax-Attention gibt es zwei Hauptunterschiede:
- Das Softmax wird weggelassen.
- Die Attention-Matrix wird elementweise mit einer zusätzlichen Maskenmatrix multipliziert.
Beide Änderungen können als Lösung für Probleme in der Vanilla-Attention angesehen werden. Beispielsweise wurde kürzlich beobachtet, dass das Softmax Probleme bei Attention-Scores verursacht, wie das Phänomen des „Attention Sink" (Darcet et al. 2024; Xiao et al. 2024). Wichtiger noch: Die Maskenmatrix kann als Ersatz der heuristischen Positions-Embeddings von Transformern durch eine andere datenabhängige Positionsmaske angesehen werden, die steuert, wie viel Information über die Zeit übertragen wird.
Allgemeiner ist diese Form ein Beispiel für unsere strukturierte maskierte Attention-Verallgemeinerung von linearer Attention, die in Abschnitt 4 definiert wird.
Matrixform und SSD-Algorithmus. Die verschiedenen Formen von SSD sind durch eine einheitliche Matrixdarstellung verbunden, indem gezeigt wird, dass SSMs eine Matrixtransformationsform für eine Matrix besitzen, die von abhängt. Insbesondere ist die duale Form von SSD äquivalent zur naiven (quadratischen) Multiplikation mit der Matrix , und die rekurrente Form ist ein besonderer effizienter (linearer) Algorithmus, der die Struktur in ausnutzt.
Darüber hinaus kann jeder Algorithmus zur Multiplikation mit angewendet werden. Unser vorgeschlagener hardware-effizienter SSD-Algorithmus (Abschnitt 6) ist eine neue Methode zur strukturierten Matrixmultiplikation, die Blockzerlegungen von beinhaltet und bessere Effizienz-Kompromisse erzielt als entweder die rein linearen oder die quadratischen Formen. Er ist relativ einfach und leicht zu implementieren im Vergleich zu allgemeinen selektiven SSMs (Gu und Dao 2023); Listing 1 bietet eine vollständige Implementierung in wenigen Codezeilen.
Abbildung 1 bietet einen einfachen Fahrplan der Beziehungen zwischen den in diesem Beitrag vorgestellten Konzepten.
2.5 Notation
Im gesamten Beitrag bevorzugen wir eine präzise Notation, die auf Code abgebildet werden kann.
Matrizen und Vektoren. Wir verwenden im Allgemeinen Kleinbuchstaben für Vektoren (d. h. Tensoren mit einer einzigen Achse) und Großbuchstaben für Matrizen (d. h. Tensoren mit mehr als einer Achse). Wir setzen Matrizen in dieser Arbeit nicht fett. Manchmal, wenn eine Matrix entlang einer Achse gebunden oder wiederholt wird (und daher auch als Vektor betrachtet werden kann), verwenden wir möglicherweise entweder Groß- oder Kleinschreibung für sie. bezeichnet Skalar- oder Matrixmultiplikation, während die Hadamard-(elementweise) Multiplikation bezeichnet.
Indizierung. Wir verwenden Python-artige Indizierung, z. B. bezieht sich auf den Bereich , wenn , und auf , wenn . Zum Beispiel lassen wir für jedes Symbol mit für die Sequenz bezeichnen. ist äquivalent zu . Als Abkürzung lassen wir außerdem das Produkt bezeichnen.
Dimensionen. Um sie von Matrizen und Tensoren zu unterscheiden, verwenden wir häufig Großbuchstaben in Schreibmaschinenschrift (z. B. ), um Dimensionen und Tensorformen zu bezeichnen. Anstelle der traditionellen Notation verwenden wir häufig , um Tensorformen im Code widerzuspiegeln.
Tensor-Kontraktionen. Wir werden uns stark auf Tensor-Kontraktion oder Einsum-Notation stützen, sowohl aus Gründen der Klarheit als auch als zentrales Werkzeug bei der Formulierung und dem Beweis unserer Ergebnisse. Wir setzen voraus, dass der Leser mit dieser Notation vertraut ist, die in modernen Tensor-Bibliotheken wie numpy üblich ist.Zum Beispiel können wir contract verwenden, um den Matrix-Matrix-Multiplikationsoperator zu bezeichnen, und in unserer Notation kann contract (was äquivalent zu ist) in Code als numpy.einsum('mn,nk , X, Y) übersetzt werden.
Ein umfangreiches Glossar der Notation ist in Anhang A enthalten.
3 Zustandsraummodelle sind strukturierte Matrizen
Dieser Abschnitt untersucht verschiedene Perspektiven des Zustandsraummodells als Sequenztransformation und skizziert Eigenschaften und Algorithmen solcher Abbildungen. Die Hauptergebnisse dieses Abschnitts betreffen die Äquivalenz zwischen Zustandsraummodellen und einer Familie strukturierter Matrizen, den sogenannten halbseparierbaren Matrizen, woraus neue Effizienzresultate folgen (Theoreme 3.5 und 3.7).
3.1 Die Matrixtransformationsform von Zustandsraummodellen
Erinnern wir uns daran, dass unsere Definition eines SSM als eine parametrisierte Abbildung definiert ist, die durch (2) gegeben ist. Unser theoretischer Rahmen beginnt damit, diese Transformation einfach als eine Matrixmultiplikation zu schreiben, die die Vektoren abbildet.
Per Definition gilt . Durch Induktion ergibt sich
Durch Multiplikation mit , um zu erzeugen, und Vektorisierung der Gleichung über leiten wir die Matrixtransformationsform von SSMs ab.
3.2 Semiseparable Matrizen
\(M\) in Gleichung (3) ist eine besondere Darstellung einer Klasse von Matrizen, die als semiseparable Matrizen bekannt sind. Semiseparable Matrizen sind eine grundlegende Matrixstruktur. Wir definieren zunächst diese Matrizen und ihre Eigenschaften.
Definition 3.1. Eine (untere Dreiecks-)Matrix \(M\) ist N-semiseparabel, wenn jede im unteren Dreiecksbereich (d. h. auf oder unterhalb der Diagonalen) enthaltene Untermatrix höchstens den Rang N hat. Wir nennen N die Ordnung oder den Rang der semiseparabelen Matrix.
Definition 3.1 und andere Formen verwandter „separabler“ Struktur (z. B. quasiseparable Matrizen und andere Definitionen semiseparabler Matrizen) werden manchmal als strukturierte Rangmatrizen (oder rangstrukturierte Matrizen) bezeichnet, weil sie durch Rangbedingungen an ihren Untermatrizen charakterisiert sind. Semiseparable Matrizen haben viele strukturierte Darstellungen, darunter die hierarchisch semiseparable (HSS), die sequenziell semiseparable (SSS) und Bruhat-Formen (Pernet und Storjohann 2018). Wir werden hauptsächlich die SSS-Form verwenden.
3.2.1 Die sequenziell semiseparable (SSS) Darstellung
Definition 3.2. Eine untere Dreiecksmatrix \(M\in \mathbb{R}^{(\mathrm{T},\mathrm{T})}\) hat eine N-sequenziell semiseparable (SSS) Darstellung, wenn sie in der Form
für Vektoren \(B_{0},\ldots ,B_{\mathrm{T} - 1},C_{0},\ldots ,C_{\mathrm{T} - 1}\in \mathbb{R}^{\mathsf{N}}\) und Matrizen \(A_{0},\ldots ,A_{\mathrm{T} - 1}\in \mathbb{R}^{(\mathsf{N},\mathsf{N})}\) geschrieben werden kann.
Wir definieren den Operator SSS so, dass \(M = \mathrm{SSS}(A_{0:\mathrm{T}},B_{0:\mathrm{T}},C_{0:\mathrm{T}})\)
Ein fundamentales Ergebnis über semiseparable Matrizen ist, dass sie genau äquivalent zu Matrizen mit SSS-Darstellungen sind. Eine Richtung lässt sich mit einem einfachen konstruktiven Beweis ableiten.
Lemma 3.3. Eine N-SSS-Matrix \(M\) mit Darstellung (4) ist N-semiseparabel.
Beweis. Betrachten Sie einen beliebigen außerhalb der Diagonalen liegenden Block \(M_{j:j^{\prime},i^{\prime}:i}\) mit \(j^{\prime} > j\geq i > i^{\prime}\) . Dieser hat eine explizite Rang-N-Faktorisierung als
Da Diagonalmatrizen einfach zu handhaben sind (z. B. ist die Multiplikation mit einer Diagonalmatrix dasselbe wie elementweise Skalarmultiplikation), können wir diese Terme ignorieren. Somit ist unsere grundlegende Darstellung einer 1-SS-Matrix \(M_{ji} = a_{ji}\) oder
Die Bedeutung von 1-SS-Matrizen liegt in ihrer Äquivalenz zur Minimalform einer skalaren Rekurrenz – dem Fall eines degenerierten SSM mit Zustandsdimension und ohne -Projektionen. Beachten Sie, dass die Multiplikation durch die Rekurrenz berechnet werden kann
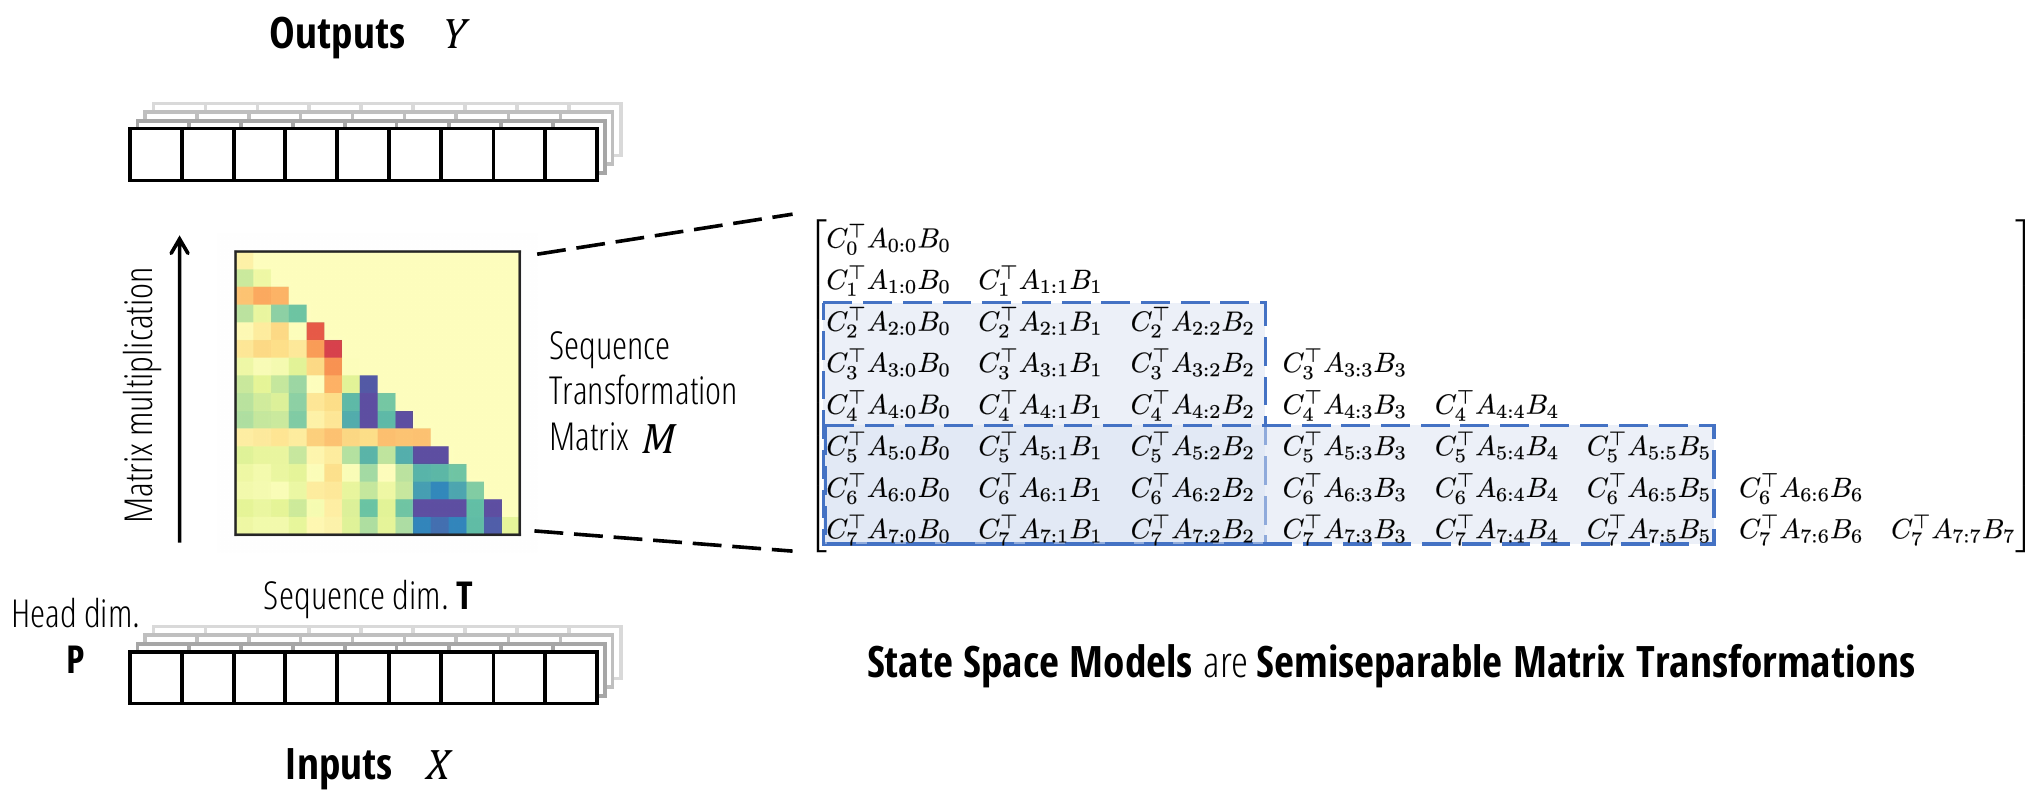
Wir bezeichnen daher die Matrixmultiplikation mit 1-SS-Matrizen auch als die skalare SSM-Rekurrenz oder als den cumprodsum-Operator (kumulatives Produkt-Summe; eine Verallgemeinerung von kumulativem Produkt und kumulativer Summe). Als fundamentale Form der Rekurrenz ist die Multiplikation mit 1-SS-Matrizen wichtig als Baustein für unsere Hauptalgorithmen.
Wir betonen, dass eines der zentralen Themen dieser Arbeit darin besteht, dass viele Algorithmen für Sequenzmodelle auf Algorithmen für strukturierte Matrixmultiplikation reduziert werden können. 1-SS-Matrizen veranschaulichen diese Verbindung: Es gibt viele schnelle Algorithmen zur Berechnung der primitiven skalaren Rekurrenz oder des cumprodsum-Operators, und es stellt sich heraus, dass alle von ihnen äquivalent zu verschiedenen strukturierten Faktorisierungen von 1-SS-Matrizen sind. Wir widmen diesen Algorithmen für die 1-SS-Matrixmultiplikation Anhang B.
3.3 State Space Models sind semiseparable Matrizen
Erinnern Sie sich, dass unsere Definition eines SSM als eine parametrisierte Abbildung definiert ist, die durch Definition 2.1 gegeben ist. Die Verbindung zwischen SSMs und semiseparablen Matrizen folgt einfach daraus, diese Transformation als eine Matrixmultiplikation zu schreiben, die die Vektoren abbildet.
Gleichung (3) stellt direkt die Verbindung zwischen State-Space-Modellen und der sequenziell semiseparablen Darstellung her, die wiederum im Allgemeinen äquivalent zu semiseparablen Matrizen sind (Lemma 3.3 und Proposition 3.4).
Theorem 3.5. Die State-Space-Modell-Transformation mit Zustandsgröße ist identisch mit der Matrixmultiplikation mit einer N-SS-Matrix in sequenziell semiseparabler Darstellung .
Mit anderen Worten, der Sequenztransformationoperator SSM (Definition 2.2) stimmt mit dem Matrixkonstruktionsoperator SSS (Definition 3.2) überein, und wir verwenden sie austauschbar (oder manchmal SS als Kurzform). Darüber hinaus haben – durch eine Laune des Schicksals – strukturierte State-Space-Modelle und sequenziell semiseparable Matrizen dieselben Akronyme, was ihre Äquivalenz unterstreicht! Praktischerweise können wir jedes dieser Akronyme SSM (State-Space-Modell oder semiseparable Matrix), SSS (strukturierter Zustandsraum oder sequenziell semiseparabel) oder SS (Zustandsraum oder semiseparabel) austauschbar verwenden, um eindeutig auf eines der beiden Konzepte zu verweisen. Wir werden jedoch im Allgemeinen die Konvention verwenden, dass SSM sich auf State-Space-Modell bezieht, SS sich auf semiseparabel bezieht und SSS sich auf sequenziell semiseparabel bezieht.
Abbildung 2 veranschaulicht die Perspektive der Sequenztransformation von State-Space-Modellen als semiseparable Matrizen.
3.4 Berechnung von State-Space-Modellen durch strukturierte Matrixalgorithmen
Der Grund, warum Theorem 3.5 wichtig ist, besteht darin, dass es uns ermöglichen wird, das Problem der effizienten Berechnung von SSMs (und anderen Sequenzmodellen) auf effiziente Algorithmen für strukturierte Matrixmultiplikation zu reduzieren. Wir geben kurz einen Überblick und verschieben unseren neuen Hauptalgorithmus auf Abschnitt 6, nachdem wir in den Abschnitten 4 und 5 die Äquivalenz von SSMs zu anderen Sequenzmodellen gezeigt haben.
Wie zuvor definiert, sind semiseparable Matrizen (d. h. rangstrukturierte Matrizen) eine klassische Art strukturierter Matrix:
(i) Sie haben komprimierte Darstellungen wie die SSS-Form, die nur statt Parameter hat.
(ii) Sie haben schnelle Algorithmen, die direkt auf der komprimierten Darstellung arbeiten.
Darüber hinaus können die Parametrisierungs- und Matrixmultiplikationskosten in der semiseparablen Ordnung eng sein.
Proposition 3.6 (Pernet, Signargout und Villard (2023)). Eine N-SS-Matrix der Größe kann in Parametern dargestellt werden und hat eine Matrix-Vektor-Multiplikation in Zeit und Speicher .
Zum Beispiel veranschaulichen 1-SS-Matrizen die Essenz dieser Verbindung. Die Matrix ist durch genau Parameter definiert und kann in Zeit durch Befolgen der skalaren Rekurrenz (7) berechnet werden.
3.4.1 Der lineare (rekurrente) Modus
Proposition 3.6 lässt sich im Fall diagonal strukturierter SSMs (S4D (Gu, Gupta, et al. 2022)) leicht erkennen, indem man einfach die State-Space-Modell-Formulierung (2) nutzt und die Rekurrenz entrollt. Wir geben den formalen Tensor-Kontraktionsalgorithmus in (8) an, wobei die Dimension S gleich ist.
Hier ist definiert als , oder mit anderen Worten für . Dieser Algorithmus umfasst drei Schritte entsprechend (2):
(i) Expandieren der Eingabe durch die Eingabematrix (8a),
(ii) Entrollen unabhängiger skalarer SSM-Rekurrenzen (8b) und
(iii) Kontrahieren des verborgenen Zustands durch die Ausgabematrix (8c).
Beachten Sie, dass wir in Schritt (8b) die Äquivalenz zwischen skalaren SSMs und 1-SS-Matrizen verwendet haben.
Bemerkung 3. Wir bemerken, dass (8) ein Spezialfall des Mamba-(S6-)Modells ist; eine naive Implementierung ist jedoch aufgrund der expandierten Tensoren und der Größe langsam; Gu und Dao (2023) führten eine hardwarebewusste Implementierung ein, um die Materialisierung dieser Tensoren zu vermeiden.
Überraschenderweise implizieren Theorem 3.5 und Proposition 3.6 unmittelbar, dass alle SSMs dieselbe asymptotische Effizienz wie Algorithmus (8) haben.
Theorem 3.7. Jedes State-Space-Modell (Definition 2.2) der Zustandsgröße N auf Sequenzlänge T kann in Zeit berechnet werden (ohne mögliche Vorverarbeitung zu berücksichtigen).
Wir bemerken, dass dieses Ergebnis neu in der Literatur zu strukturierten SSMs ist. Insbesondere scheint bei dichten unstrukturierten -Matrizen allein die Gesamtdarstellung von der Größe zu sein. Somit besagt Theorem 3.7 das nichttriviale Ergebnis, dass mit einem Vorverarbeitungsschritt selbst ein unstrukturiertes SSM optimal effizient berechnet werden kann, wobei die obere Schranke mit der unteren Schranke übereinstimmt, die durch die Größe von und gegeben ist.
Anmerkung 4. Theorem 3.7 ist angesichts der Tatsache, dass fast alle dichten Matrizen über über diagonalisierbar sind, vielleicht nicht allzu überraschend, was zu dem Ergebnis führt, dass fast alle dichten reellen SSMs äquivalent zu einem diagonalen komplexen SSM sind. Diese Tatsache liegt dem Grund zugrunde, warum diagonale SSMs die beliebteste Form strukturierter SSMs sind (Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023). Theorem 3.7 impliziert jedoch das viel stärkere Ergebnis für alle reellen SSMs (nicht nur für die diagonalisierbaren) sowie für dichte SSMs über anderen Körpern (einschließlich selbst).
In der Praxis erfordern effizient berechenbare SSMs dennoch zusätzliche Struktur auf , insbesondere um den teuren Vorverarbeitungsschritt zu vermeiden (der sowohl zusätzliche FLOPs der Ordnung N hat als auch hardware-ineffiziente Operationen wie Singulärwertzerlegungen umfasst). Diese Strukturen sind der Fokus früherer Arbeiten zu strukturierten SSMs (z. B. S4(D) und Mamba) sowie unserer neuen Algorithmen. Insbesondere werden wir, wenn eine etwas stärkere Struktur auferlegt wird, sehr hardware-effiziente Algorithmen durch Blockzerlegungen der SSM-Matrix in Abschnitt 6 entwerfen.
3.4.2 Der quadratische (naive) Modus
Wir bemerken, dass es eine weitere Möglichkeit gibt, ein SSM zu berechnen, die durch unsere neue Matrix-Perspektive offengelegt wird. Eine naive Berechnung der Matrix-SSM-Darstellung (3) beinhaltet einfach das Materialisieren der Sequenztransformationsmatrix . Dies ist eine -Matrix, und daher wird dieser naive Algorithmus quadratisch in der Sequenzlänge skalieren. Wenn die Sequenzlänge jedoch kurz ist, kann dies aufgrund von Konstantenfaktoren und der Hardware-Freundlichkeit des Berechnungsmusters (z. B. unter Nutzung von Matrix-Matrix-Multiplikationen) tatsächlich effizienter sein als der lineare Algorithmus. Tatsächlich sieht dies für einen bestimmten Fall strukturierter SSMs einer quadratischen Attention-Berechnung sehr ähnlich (Abschnitt 5).
3.4.3 Zusammenfassung
Viele Sequenzmodelle sind explizit motiviert oder definiert als Matrix-Sequenztransformationen – insbesondere Transformer, bei denen der Matrix-Mixer die Attention-Matrix ist. Andererseits wurden RNNs und SSMs bisher nicht auf diese Weise beschrieben. Indem wir eine explizite Matrixtransformationsform von Zustandsraummodellen bereitstellen, eröffnen wir neue Wege, sie zu verstehen und zu nutzen. Aus rechnerischer Perspektive kann jede Methode zur Berechnung des Vorwärtsdurchlaufs eines Zustandsraummodells als ein Matrixmultiplikationsalgorithmus auf halbseparablen Matrizen betrachtet werden. Die Perspektive halbseparabler Matrizen bietet eine Linse auf die Zustandsraumdualität (SSD), wobei sich die dualen Modi jeweils auf einen linearzeitigen halbseparablen Matrixmultiplikationsalgorithmus und eine quadratisch zeitliche naive Matrixmultiplikation beziehen.
Darüber hinaus kann die Nutzung der reichen Struktur halbseparabler Matrizen zu noch besseren Algorithmen und weiteren Einsichten führen (z. B. Abschnitt 6 und Anhang B). In Anhang C.1 beschreiben wir einige zusätzliche Eigenschaften halbseparabler Matrizen.
4 Strukturierte maskierte Attention: Verallgemeinerung linearer Attention mit strukturierten Matrizen
In diesem Abschnitt überprüfen wir das Framework der linearen Attention von Grund auf. Die Hauptergebnisse in diesem Abschnitt sind ein einfacher, auf Tensorkontraktion basierender Beweis der linearen Attention (Proposition 4.1) und unsere verallgemeinerte Abstraktion strukturierter maskierter Attention in Definition 4.2. Wir bemerken, dass dieser Abschnitt die Hauptergebnisse der Dualität aus einer anderen Richtung als Zustandsraummodelle herleitet und völlig unabhängig von Abschnitt 3 gelesen werden kann.
- Abschnitt 4.1 richtet unser Framework für Varianten von Attention ein, mit besonderem Fokus auf Kernel-Attention und maskierte Kernel-Attention. - Abschnitt 4.2 liefert unser erstes Hauptresultat zu Attention, einen einfachen Beweis der linearen Attention durch die Linse von Tensorkontraktionen. - Abschnitt 4.3 definiert strukturierte maskierte Attention, unsere Verallgemeinerung früherer Attention-Varianten durch strukturierte Matrizen.
4.1 Der Attention-Rahmen
4.1.1 Attention
Die Grundform der (Single-Head-)Attention ist eine Abbildung auf drei Sequenzen von Vektoren
Wir verwenden „Shape-Annotationen“, um die Dimensionen von Tensoren anzugeben, z. B. . In dieser allgemeinen Form stehen S und T für die Längen der Quell- und Zielsequenz, N steht für die Feature-Dimension und P für die Head-Dimension.
Die gebräuchlichste Variante der Softmax-Attention verwendet eine Softmax-Aktivierung , um die Zeilen der Matrix zu normalisieren.
4.1.2 Self-Attention
Unsere Darstellung ist durch den wichtigsten Fall der Self-Attention motiviert, bei dem (i) die Quell- und die Zielsequenz dieselbe sind (d. h. ), (ii) üblicherweise die Feature- und die Head-Dimension gleich sind (d. h. ), (iii) und durch lineare Projektionen auf denselben Eingabevektor erzeugt werden .
Unsere Darstellung abstrahiert jedoch von diesen Entscheidungen und beginnt bei den Matrizen .
Bemerkung 5. Unser Fokus liegt auf dem Fall der Self-Attention mit gleicher Head- und Feature-Dimension (d. h. und ), der als durchgängiges Beispiel verwendet werden sollte. Wir definieren die allgemeine Formulierung von Attention nicht nur, damit unser Rahmen Varianten wie Cross-Attention erfasst, sondern auch, weil die getrennte Notation für die Dimensionen (z. B. S und T) die Kontraktionsnotations-Beweise unserer Hauptresultate in diesem Abschnitt klarer macht.
Bemerkung 6. Während Attention üblicherweise als eine Operation auf diesen drei Eingaben formuliert wird, die als symmetrisch betrachtet werden, zeigen die Eingabe- und Ausgabedimensionen in (9) etwas anderes. Insbesondere ist die Feature-Dimension N nicht in der Ausgabe vorhanden; daher betrachten wir im Fall (z. B. Self-Attention) als die Haupteingabe, sodass (9) eine eigentliche Sequenztransformation definiert (Definition 2.1).
4.1.3 Kernel-Attention
Der Schritt, in dem die Softmax-Funktion auf die Gram-Matrix angewendet wird, kann in zwei Teile zerlegt werden:
1. Exponentieren der Matrix .
2. Normalisieren der Matrix entlang der S-Achse.
Den Normalisierungsterm können wir vorerst ignorieren, da er lediglich bedeutet, einzusetzen und zu dividieren (wir kommen darauf in Abschnitt 7.3 zurück). Der Exponentierungsterm kann als Kernel-Transformation betrachtet werden: Es gibt eine (unendlich-dimensionale) Feature-Map , sodass . Indem wir die Feature-Map in die Definition von und selbst abstrahieren (d. h. als die nachtransformierten Versionen definieren), können wir die Softmax-Transformation ignorieren und annehmen, dass beliebig durch Kernel-Feature-Maps erzeugt werden und potenziell gilt.
Es wurden viele Instanziierungen von Kernel-Attention vorgeschlagen, darunter:
- Die ursprüngliche Linear Attention (Katharopoulos et al. 2020) definiert die Kernel-Feature-Map als eine beliebige punktweise Aktivierungsfunktion, wie etwa .- Random Feature Attention (RFA) (H. Peng et al. 2021) wählt die Kernel-Feature-Map so, dass sie Softmax-Attention (d. h. die exp-Feature-Map) mithilfe der Random-Fourier-Feature-Approximation von Gauß-Kerneln (Rahimi und Recht 2007) approximiert. Dies umfasst zufällige Projektionen (d. h. Multiplikation von und mit einer zufälligen Projektion und Anwendung der Aktivierung ).
- Performer (Choromanski et al. 2021) schlägt die Fast Attention Via Positive Orthogonal Random Features (FAVOR+) vor. Der Teil der positiven Zufallsfeatures (Positive Random Features, PRF) wählt als Kernel-Feature-Map eine zufällige Projektion, gefolgt von der Feature-Map . Diese Wahl ist dadurch motiviert, dass die Kernlelemente positivwertig sind und nachweislich die Softmax-Attention approximieren. [Er schlägt außerdem vor, die zufälligen Projektionen in orthogonale Richtungen zu wählen, was wir nicht betrachten.]
- cosFormer (Qin, Weixuan Sun, et al. 2022) erweitert RFA um einen Cosinus-Neugewichtungsmechanismus, der Positionsinformationen einbezieht, um Lokalität zu betonen. Dies führt effektiv durch die Feature-Map .
- Linear Randomized Attention (Zheng, C. Wang und Kong 2022) verallgemeinert RFA aus der Perspektive des Importance Sampling und verallgemeinert sie so, dass sie bessere Schätzungen des vollständigen Softmax-Kernels liefert (und nicht nur des exp-transformierten Zählers).
Weitere verwandte Attention-Varianten sind Linformer (Sinong Wang et al. 2020) und Nyströmmer (Xiong et al. 2021), die beide rangniedrige Approximationen der Attention-Matrix verwenden (und somit mit Gleichung (9) kompatibel sind), und zwar durch zufällige Projektionen (Johnson-Lindenstrauss) bzw. Kernel-Approximation (die Nyström-Methode).
4.1.4 Maskierte (Kernel-)Attention
Sei eine Maske der Form (T, S). Am häufigsten kann im autoregressiven Self-Attention-Fall mit eine untere Dreiecksmatrix aus 1en sein, die eine kausale Maske darstellt. Neben der Durchsetzung von Kausalität können viele andere Arten von Masken angewendet werden – insbesondere verschiedene Sparsity-Muster wie bandförmig, dilatiert oder blockdiagonal –, die durch die Verringerung der Komplexität dichter Attention motiviert sind.
Maskierte Attention wird üblicherweise in Matrixnotation geschrieben als
Genauer, mit Shape-Annotationen und aufgeschlüsselt in die präzise Abfolge der Berechnungen:
Unsere verbesserte Herleitung der Attention-Varianten in diesem Abschnitt beginnt mit der Beobachtung, dass diese Formel als eine einzige Kontraktion geschrieben werden kann:
und der Algorithmus in (11) kann so umformuliert werden, dass (12) durch eine bestimmte Reihenfolge paarweiser Kontraktionen berechnet wird
4.2 Lineare Attention
Lineare Attention und viele andere Varianten effizienter Attention werden oft durch eine Änderung der Reihenfolge der Matrixassoziativität in der Kern-Attention-Berechnung motiviert. Wenn jedoch die Maske hinzugefügt wird, ist die Herleitung etwas weniger geradlinig (zum Beispiel geben das Originalpapier (Katharopoulos et al. 2020) und Varianten (Y. Sun et al. 2023) die Formel ohne Beweis an).
Grob gesagt behauptet die Methode der linearen Attention, dass die folgende Formel äquivalent zu (10) ist, was durch Entwickeln der Summe und sorgfältiges Verfolgen der Indizes verifiziert werden muss.
Proposition 4.1 ((Katharopoulos et al. 2020)). Autoregressive Kernel-Attention, d. h. maskierte Kernel-Attention mit der kausalen Maske, kann in Zeit durch eine Rekurrenz berechnet werden, die pro Schritt konstante Zeit benötigt.
4.2.1 Ein Tensor-Kontraktions-Beweis der linearen Attention
Wir präsentieren eine einfache und rigorose Herleitung der linearen Attention, die auch unmittelbar zeigt, wie man sie verallgemeinert. Die Hauptidee besteht darin, die Kontraktion (12) in einer alternativen Reihenfolge durchzuführen. Wir vermeiden mehrdeutige Matrixnotation und arbeiten direkt mit der Kontraktionsnotation:
Intuitiv interpretieren wir diese Kontraktionsreihenfolge wie folgt.
Der erste Schritt (15a) führt eine „Expansion“ in mehr Merkmale durch, um einen Faktor der Merkmalsdimension N. Der dritte Schritt (15c) kontrahiert die expandierte Merkmalsdimension wieder weg. Wenn als die Eingabe betrachtet wird (Bemerkung 6), dann führen und jeweils die Expansion und die Kontraktion durch.
Der zweite Schritt ist der kritischste und erklärt den linearen Teil der linearen Attention. Beachten Sie zunächst, dass (15b) lediglich eine direkte Matrixmultiplikation mit ist (da die Achsen flachgelegt werden können). Beachten Sie außerdem, dass dies der einzige Term ist, der sowohl die T- als auch die S-Achse involviert, und daher Komplexität haben sollte (d. h. quadratisch in der Sequenzlänge). Wenn jedoch die Maske die standardmäßige kausale Attention-Maske ist (untere Dreiecksmatrix aus 1en), ist die Matrix-Vektor-Multiplikation mit identisch mit einer merkmalweisen kumulativen Summe
4.3 Strukturierte maskierte Attention
Mit der Tensor-Kontraktions-Perspektive der maskierten Attention (15) können wir sofort erkennen, dass der Kern der ursprünglichen linearen Attention in der Tatsache liegt, dass die Matrix-Vektor-Multiplikation mit der kausalen Maske äquivalent zum kumulativen Summenoperator ist.
Wir beobachten jedoch, dass es keinen Grund gibt, warum die Attention-Maske ausschließlich aus Einsen bestehen muss. Alles, was für eine schnelle lineare Attention notwendig ist, ist, dass eine strukturierte Matrix ist, worunter per Definition solche Matrizen fallen, die eine schnelle Matrixmultiplikation besitzen (Abschnitt 2.3). Insbesondere können wir jede Maskenmatrix verwenden, die eine subquadratische (idealerweise lineare) Matrix-Vektor-Multiplikation besitzt, was dieselbe Komplexität wie die standardmäßige lineare Attention hätte, indem die Engpassgleichung (15b) beschleunigt wird.
Definition 4.2. Strukturierte maskierte Attention (SMA) (oder kurz strukturierte Attention) ist definiert als eine Funktion auf Queries/Keys/Values sowie einer beliebigen strukturierten Matrix (d. h. mit subquadratischer Matrixmultiplikation), durch die 4-Wege-Tensor-Kontraktion
Der quadratische SMA-Modus-Algorithmus ist die Folge paarweiser Kontraktionen, die durch (13) definiert ist und der standardmäßigen (maskierten) Attention-Berechnung entspricht.
Der lineare SMA-Modus-Algorithmus ist die Folge paarweiser Kontraktionen, die durch (15) definiert ist, wobei Schritt (15b) durch die subquadratische strukturierte Matrixmultiplikation optimiert wird.
Wir können strukturierte maskierte Attention für jede gegebene Klasse von Matrixstrukturen instanziieren. Einige Beispiele umfassen (Abbildung 3):
- Lineare Attention verwendet eine kausale Maske.
- RetNet (Y. Sun et al. 2023) verwendet eine Decay-Maske für einen Decay-Faktor .
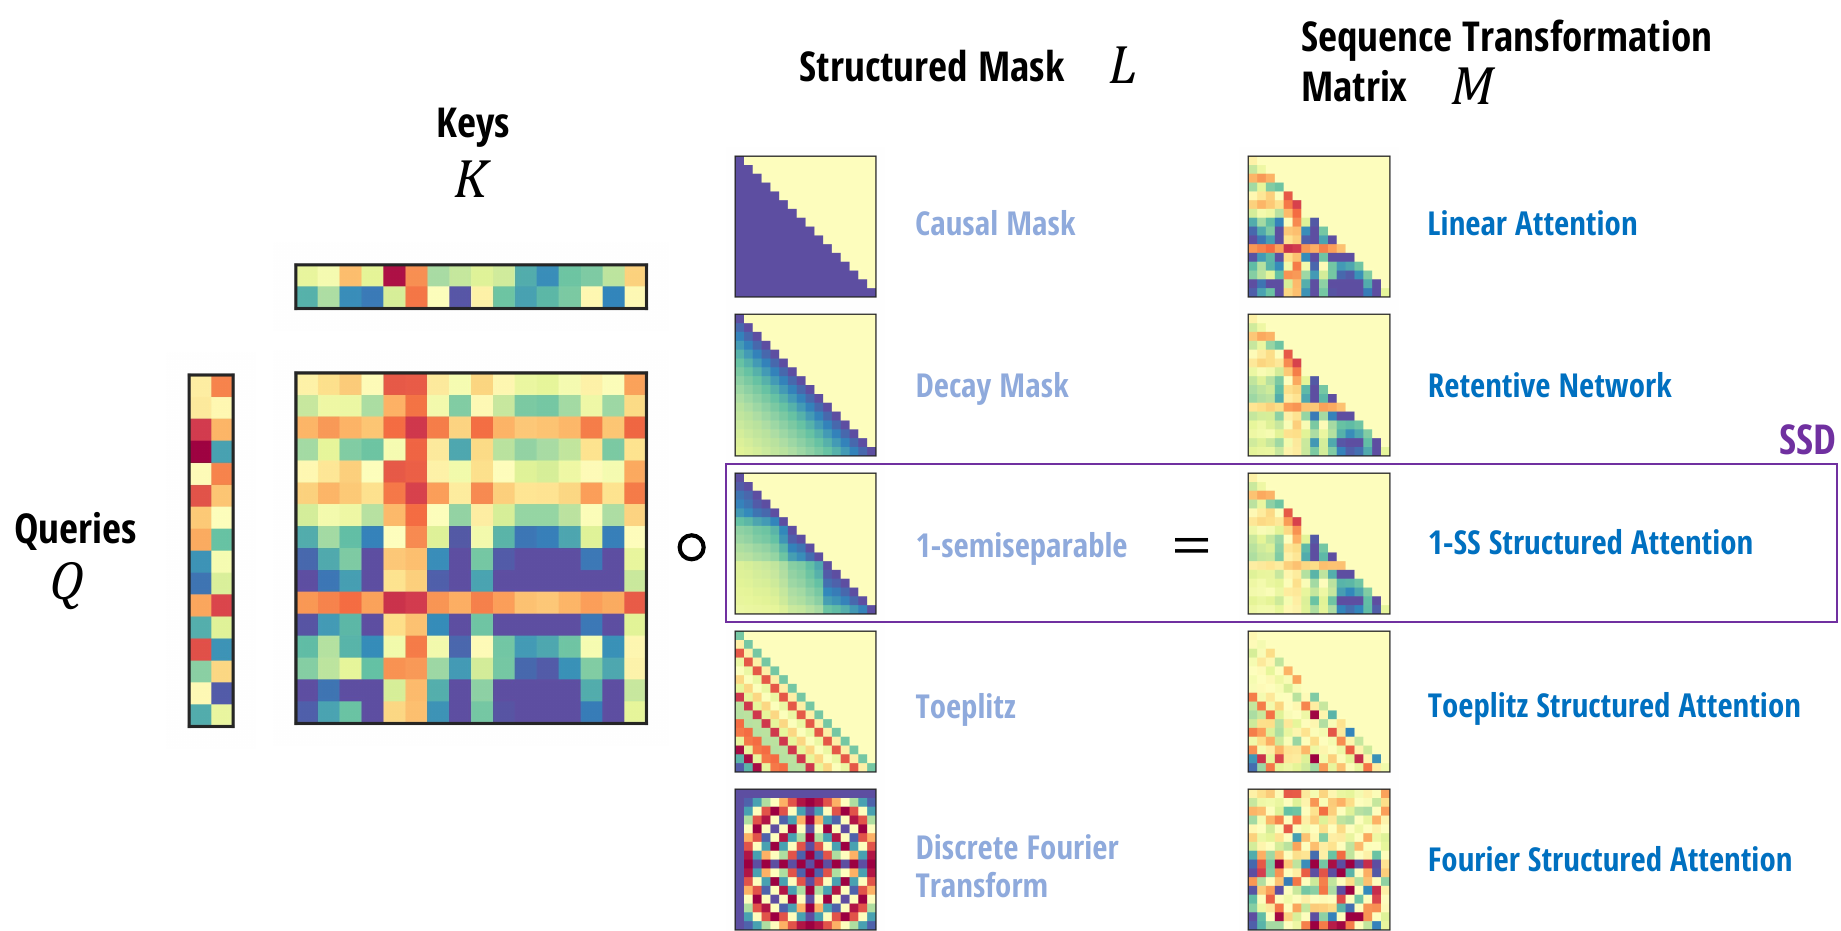
- Die Decay-Maske könnte zu einer Toeplitz-Matrix für eine lernbare (oder eingabeabhängige) Menge von Parametern verallgemeinert werden. Dies kann als eine Form der relativen Positionskodierung interpretiert werden, die an andere Methoden wie AliBi (Press, N. Smith, and Lewis 2022) erinnert, aber multiplikativ statt additiv ist. - Eine weitere Variante könnte eine Fourier-Matrix verwenden, um die Positionsstruktur auf eine andere Weise zu kodieren.
In Abschnitt 5 betrachten wir halbseparierbare SMA, die unser Haupt-SSD-Modell definiert.
4.3.1 Zusammenfassung: Die dualen Formen der maskierten Attention
Standardmäßige (maskierte Kernel-)Attention wird oft zwischen einer Funktion und einem Algorithmus vermischt. Diese Unterscheidung zu trennen, bietet eine klare Möglichkeit, verschiedene Varianten der Attention zu verstehen.
- Wir betrachten maskierte Attention als eine bestimmte Funktion (12). - Die standardmäßige quadratische Attention-Berechnung (13) kann als ein Algorithmus zur Berechnung der Funktion betrachtet werden. - Lineare Attention (15) ist ein alternativer Algorithmus zur Berechnung derselben Funktion.
Darüber hinaus gilt in diesem Fall
- Die maskierte Attention-Funktion ist einfach eine bestimmte Kontraktion über vier Terme. - Die quadratischen und linearen Attention-Algorithmen sind einfach zwei verschiedene Reihenfolgen zur Durchführung der Kontraktionen.
Es ist bekannt, dass Kontraktionsreihenfolgen große Unterschiede in der Berechnungskomplexität bewirken können, was zur Aufteilung in quadratisch vs. linear führt. So wie Zustandsraummodelle eine Transformation sind, die auf mehrere Arten berechnet werden kann, mit dualen quadratischen vs. linearen Formen (Abschnitt 3.4), besitzt lineare Attention eine ähnliche Dualität, die aus zwei Kontraktionsreihenfolgen resultiert. Tatsächlich erweisen sich diese als unterschiedliche Perspektiven auf dieselbe zugrunde liegende Dualität, die wir in Abschnitt 5 explizit machen.
5 Zustandsraum-Dualität
In den Abschnitten 3 und 4 haben wir strukturierte Zustandsraummodelle und strukturierte Attention definiert, ihre Eigenschaften diskutiert und gezeigt, dass beide einen quadratischen Algorithmus und einen linearen Algorithmus besitzen. Dieser Abschnitt verbindet sie miteinander. Unser Hauptergebnis ist der Nachweis, dass ein bestimmter Fall strukturierter Zustandsraummodelle mit einem bestimmten Fall strukturierter Attention übereinstimmt und dass der lineare SSM-Algorithmus und der quadratische Kernel-Attention-Algorithmus duale Formen voneinander sind.
Abschnitt 5.1 spezialisiert Zustandsraummodelle auf Skalarstruktur, wobei die naive quadratische Berechnung als ein Fall von Kernel-Attention betrachtet werden kann.
Abschnitt 5.2 spezialisiert strukturierte maskierte Attention auf halbseparierbare SMA, die maskierte Attention mit effizienter Autoregression charakterisiert.
Abschnitt 5.3 fasst die Verbindung zwischen strukturierter maskierter Attention und strukturierten Zustandsraummodellen zusammen, die als strukturierte Zustandsraum-Dualität bezeichnet wird.
5.1 Skalar-Identitäts-strukturierte Zustandsraummodelle
In Abschnitt 3 haben wir gezeigt, dass Zustandsraummodelle äquivalent zu halbseparierbaren Matrixtransformationen sind, was sowohl zu einer linearen rekurrenten Form als auch zu einer quadratischen naiven Form führt.
Erinnern wir uns daran, dass SSMs durch definiert sind, und die Matrixform von SSMs die SSS-Darstellung (sequenziell halbseparierbar) verwendet, wobei (Gleichung (3)).
Betrachten wir nun den Fall, in dem einfach ein Skalar ist; mit anderen Worten, eine Instanziierung eines strukturierten SSM, bei der die -Matrizen extrem strukturiert sind: für Skalar und Einheitsmatrix . Dann können wir umordnen
Und dies kann vektorisiert werden zu
wobei
Mit dieser Formulierung wird die vollständige Ausgabe genau wie folgt berechnet:
wobei . Aber dies ist genau dasselbe wie die ursprüngliche Definition der maskierten Kernel-Attention-Definition (13)!
Daher ist die naive Berechnung des skalar strukturierten SSM – durch Materialisierung der halbseparierbaren Matrix und Durchführung einer quadratischen Matrix-Vektor-Multiplikation – genau dasselbe wie quadratische maskierte Kernel-Attention.
5.2 1-halbseparierbare strukturierte maskierte Attention
Strukturierte maskierte Attention erlaubt die Verwendung jeder strukturierten Maske . Wenn die kausale Maske ist, handelt es sich um standardmäßige lineare Attention. Beachten Sie, dass die kausale Maske ist, d. h. die 1-SS-Maske wird durch in Definition (6) erzeugt. Dies motiviert die Verallgemeinerung von auf die Klasse der 1-halbseparierbaren Masken bzw. der 1-halbseparierbaren strukturierten maskierten Attention (1-SS-SMA), bei der die kumulative Summe in der Rekurrenz der linearen Attention durch eine allgemeinere Rekurrenz ersetzt wird – den Skalar-SSM-Scan, d. h. die 1-halbseparierbare Matrixmultiplikation (Abschnitt 3.2.2).
Schließlich ist der wichtigste Grund, warum wir 1-semiseparable SMA betrachten, der, dass die lineare Form zu ihrer Berechnung ein Spezialfall des diagonalen Zustandsraummodells ist. Die lineare Form der SMA ist Algorithmus (15), wobei der Engpassschritt (15b) als Matrixmultiplikation mit der 1-SS-Maske betrachtet werden kann. In Abschnitt 3 haben wir auch die Berechnung für ein diagonales SSM (8) ausgeschrieben, wobei der Engpassschritt (8b) eine skalare SSM-Rekurrenz ist, die äquivalent zur 1-SS-Multiplikation ist. Der einzige Unterschied besteht darin, dass (8b) eine zusätzliche N-Dimension in hat, weil die Matrix eine Diagonalmatrix der Größe N ist. Diese N-Dimension würde verschwinden, wenn alle Diagonaleinträge von gleich wären, was zu Korollar 5.1 führt.
Korollar 5.1. 1-SS SMA (maskierte Attention mit 1-semiseparaben strukturierten Matrizen ) (15) ist ein Spezialfall eines diagonalen SSM (8), bei dem die Diagonalmatrix ein skalares Vielfaches der Identität ist.
Während Korollar 5.1 besagt, dass 1-SS SMA eine effiziente rekurrente Form hat, können wir auch ein Umkehrresultat zeigen, das charakterisiert, welche Instanzen von SMA eine effiziente Autoregression besitzen.
Theorem 5.2. Für jede Instanziierung von strukturierter maskierter Attention (Definition 4.2), die ein autoregressiver Prozess mit beschränkter Ordnung ist, muss die strukturierte Maske eine semiseparable Matrix sein.
Mit anderen Worten: Effiziente autoregressive Attention ist allgemeine semiseparable SMA. Theorem 5.2 wird in Anhang C.2 bewiesen.
Bemerkung 7. Während 1-semiseparable SMA ein Spezialfall eines Zustandsraummodells ist, ist allgemeine semiseparable SMA strikt ausdrucksstärker als 1-SS SMA und kann nicht durch ein Standard-SSM beschrieben werden. Jedoch umfassen sowohl die semiseparable Multiplikation mit als auch die lineare Form der SMA (Gleichung (15a)) jeweils einen Expansions- und einen Kontraktionsschritt und können in eine ähnliche Instanz von 1-SS SMA mit einer einzigen (größeren) Expansion absorbiert werden.
Zusammenfassend ist 1-semiseparable strukturierte Attention der wichtigste Fall von SMA, weil sie:
- eine natürliche Verallgemeinerung von linearer Attention mit einer eingabeabhängigen Rekurrenz ist.
- der einfachste Fall von allgemeiner semiseparabler Attention ist, die äquivalent zu effizienter autoregressiver Attention ist.
- ein Spezialfall eines diagonalen Zustandsraummodells ist.
5.3 Strukturierte Zustandsraum-Dualität (SSD)
Um unsere Ergebnisse zusammenzufassen:
- Strukturierte Zustandsraummodelle (Abschnitt 3) sind ein Modell, das üblicherweise durch eine Rekurrenz mit linearer Zeit definiert wird. Durch Expandieren der Matrixformulierung, die ihre lineare Sequenz-zu-Sequenz-Transformation charakterisiert, kann man jedoch eine quadratische Form ableiten.
- Attention-Varianten (Abschnitt 4) sind ein Modell, das durch paarweise Interaktionen mit quadratischer Zeit definiert wird. Durch Betrachtung als Vier-Wege-Tensorkontraktion und Reduktion in einer anderen Reihenfolge kann man jedoch eine lineare Form ableiten.
- Ein natürlicher Spezialfall eines jeden von beiden – genauer gesagt Zustandsraummodelle mit Skalar-Identitäts-Struktur auf den -Matrizen und strukturierte maskierte Attention mit 1-semiseparabler Struktur auf ihrer -Maske – sind Duale voneinander mit exakt denselben linearen und quadratischen Formen.
Abbildung 4 fasst die Dualität zwischen diesen beiden Repräsentationen zusammen.
Eine erweiterte verwandte Arbeit und Diskussion (Abschnitt 10) beschreibt die Beziehung zwischen SSD und allgemeinen SSMs / Attention genauer.
6 Ein hardwareeffizienter Algorithmus für SSD-Modelle
Der Nutzen der Entwicklung des theoretischen SSD-Frameworks zwischen SSMs, Attention und strukturierten Matrizen liegt darin, die Verbindungen zu nutzen, um die Modelle und Algorithmen zu verbessern. In diesem Abschnitt zeigen wir, wie verschiedene Algorithmen zur effizienten Berechnung von SSD-Modellen aus verschiedenen Algorithmen zur Berechnung strukturierter Matrixmultiplikation abgeleitet werden können.
Unsere wichtigste rechnerische Errungenschaft ist ein Algorithmus zur Berechnung von SSD-Modellen, der sowohl den linearen (rekurrenten) Modus als auch den quadratischen (Attention-)Modus kombiniert. Dieser Algorithmus ist rechnerisch so effizient wie SSMs (lineare Skalierung mit der Sequenzlänge) und so hardwarefreundlich wie Attention (verwendet hauptsächlich Matrixmultiplikationen).
Theorem 6.1. Betrachten Sie ein SSD-Modell mit Zustandserweiterungsfaktor und Kopfdimension . Es existiert ein Algorithmus zur Berechnung des Modells für jede Eingabe , der nur Trainings-FLOPs, Inferenz-FLOPs, Inferenzspeicher benötigt und dessen Arbeit von Matrixmultiplikationen dominiert wird.
| Strukturiertes Zustandsraummodell | Strukturierte maskierte Attention | ||||
| C | (Kontraktionsmatrix) | Q | (Queries) | S4 | Diagonales Zustandsraummodell |
| B | (Expansionsmatrix) | K | (Keys) | ||
| X | (Eingabesequenz) | V | (Values) | DSS | Skalar-Identitäts-SSM |
| Aij | (Zustandsmatrix) | Lji | (Maske) | S4D | RetNet GateLoop |
| N | (Zustandsexpansionsdim.) | N | (Kernel-Merkmalsdim.) | S5 | TransNormer |
| H | (verborgene Zustände (8b)) | SMA lineares Dual (15) | S6 | Lineare Attention | |
| = L·XB | (linearer Modus) | 1-halbtrennbare SMA | |||
| SSM quadratisches Dual (16) | G | (Gram-Matrix (13a)) | Effiziente autoregressive Attention | ||
| = Q·K | (quadratischer Modus) | Halbtrennbare SMA |
Beachten Sie, dass alle diese Schranken scharf sind, denn ein Zustandsraummodell mit Zustandserweiterung N, das auf einer Kopfgröße von N operiert, hat eine Gesamtzustandsgröße von (was die unteren Schranken für Trainings- und Inferenz-FLOPs von bzw. liefert). Darüber hinaus hat die Eingabe selbst TN Elemente, was die untere Schranke für den Speicher liefert.
Die Hauptidee hinter Theorem 6.1 besteht erneut darin, das Problem der Berechnung eines Zustandsraummodells als halbseparierbare Matrixmultiplikation aufzufassen, aber ihre Struktur auf neue Weise auszunutzen. Anstatt die gesamte Matrix entweder im rekurrenten oder im Attention-Modus zu berechnen, führen wir eine Blockzerlegung der Matrix durch. Die Diagonablöcke können unter Verwendung des dualen Attention-Modus berechnet werden, was effizient mit Matrixmultiplikationen durchgeführt werden kann, während die außerdiagonalen Blöcke durch die Rangstruktur halbseparierbarer Matrizen faktorisiert und auf eine kleinere Rekurrenz reduziert werden können. Wir betonen, dass Listing 1 eine in sich geschlossene Implementierung des SSD-Algorithmus bereitstellt. Im Vergleich zum allgemeinen selektiven SSM von Gu und Dao (2023) ist diese Implementierung viel einfacher und relativ effizient selbst in nativem PyTorch, ohne spezielle Low-Level-Kernel zu erfordern.
Zunächst partitionieren wir die Matrix in ein -Raster von Untermatrizen der Größe , für eine Blockgröße . Beachten Sie, dass die außerdiagonalen Blöcke aufgrund der definierenden Eigenschaft halbseparierbarer Matrizen (Definition 3.1) niedrigen Rang haben.5
Dies lässt sich am einfachsten anhand eines Beispiels veranschaulichen, z. B. für und eine Zerlegung in Chunks der Länge . Die schattierten Zellen sind Niedrigrang-Faktorisierungen der außerdiagonalen Blöcke der halbseparierbaren Matrix.
Diese Teilprobleme können wie folgt interpretiert werden: Was ist die Ausgabe pro Chunk, unter der Annahme, dass der Anfangszustand (für den Chunk) 0 ist. Mit anderen Worten, für Chunk berechnet dies die korrekten Ausgaben unter ausschließlicher Berücksichtigung der Chunk-Eingaben .
6.2 Niedrigrang-Blöcke
Die Niedrigrang-Faktorisierungen bestehen aus 3 Termen, und entsprechend gibt es drei Teile der Berechnung. In dieser Faktorisierung verwenden wir die Terminologie
Die Terme wie werden als die rechten Faktoren oder -Blockfaktoren bezeichnet.
Die Terme wie werden als die zentralen Faktoren oder -Blockfaktoren bezeichnet.
Die Terme wie werden als die linken Faktoren oder -Blockfaktoren bezeichnet.
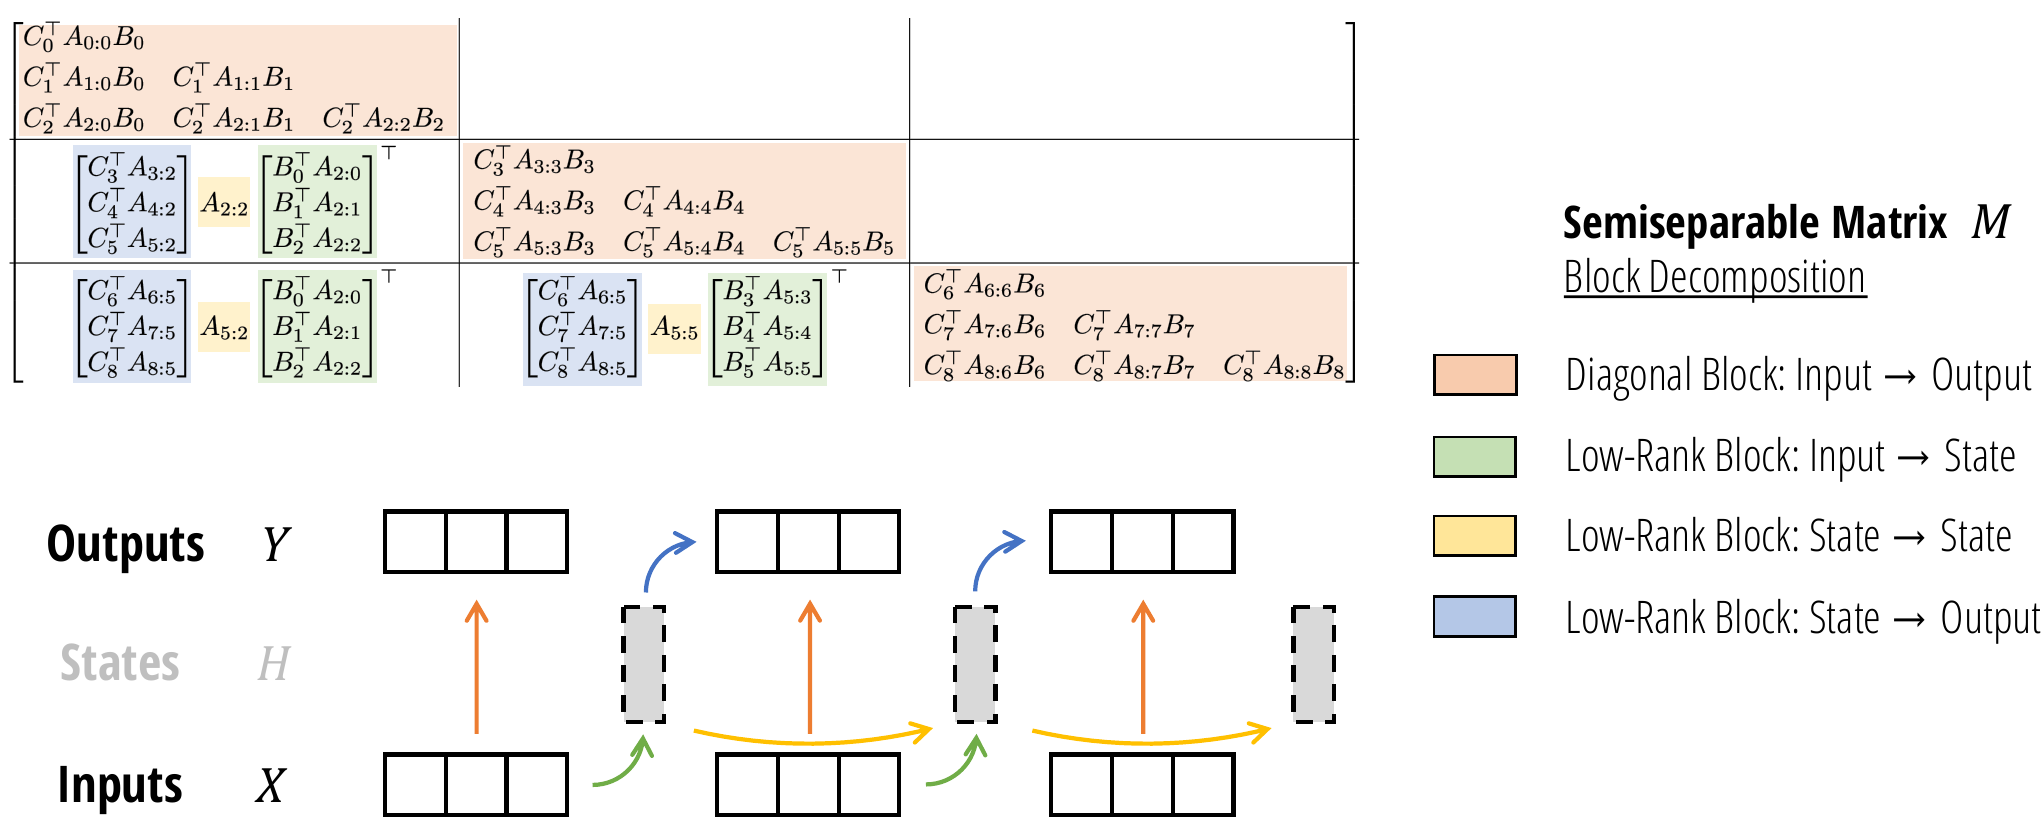
Rechte Faktoren. Dieser Schritt berechnet die Multiplikation mit den rechten -Blockfaktoren der Niedrigrang-Faktorisierung. Beachten Sie, dass dies für jeden Chunk eine Matrixmultiplikation mal ist, wobei die Zustandsdimension und die Kopfdimension ist. Das Ergebnis ist ein -Tensor für jeden Chunk, der dieselbe Dimensionalität wie der erweiterte verborgene Zustand hat.
Dies kann wie folgt interpretiert werden: Was ist der Endzustand pro Chunk, unter der Annahme, dass der Anfangszustand (für den Chunk) 0 ist. Mit anderen Worten, dies berechnet unter der Annahme, dass .
Zentrale Faktoren. Dieser Schritt berechnet den Effekt der zentralen -Blockfaktor-Terme in der Niedrigrang-Faktorisierung. Im vorherigen Schritt haben die Endzustände pro Chunk insgesamt die Form . Diese werden nun mit einer von erzeugten 1-SS-Matrix multipliziert.
Dieser Schritt kann mit jedem Algorithmus zur Berechnung der 1-SS-Multiplikation berechnet werden (auch bekannt als Skalar-SSM-Scan oder cumprodsum-Operator).
Dies kann wie folgt interpretiert werden: Was ist der tatsächliche Endzustand pro Chunk unter Berücksichtigung aller vorherigen Eingaben; mit anderen Worten, dies berechnet den wahren verborgenen Zustand unter Berücksichtigung aller .
Linke Faktoren. Dieser Schritt berechnet die Multiplikation mit den linken -Blockfaktoren der Niedrigrang-Faktorisierung. Für jeden Chunk kann dies durch einen Matrixmultiplikationskontrakt dargestellt werden.
Dies kann wie folgt interpretiert werden: Was ist die Ausgabe pro Chunk unter Berücksichtigung des korrekten Anfangszustands und unter der Annahme, dass die Eingaben 0 sind. Mit anderen Worten, für Chunk berechnet dies die korrekten Ausgaben unter ausschließlicher Berücksichtigung der vorherigen Eingaben .
6.3 Rechnerische Kosten
Wir definieren die Notation , um einen gebatchten Matrixmultiplikationskontrakt mit Batch-Dimension zu definieren. Aus dieser Notation können wir drei Aspekte der Effizienz ableiten:- Rechenkosten: insgesamt FLOPs.
- Speicherkosten: insgesamt Speicherplatz.
Listing 1 Vollständiges PyTorch-Beispiel des State-Space-Dual-(SSD-)Modells.
def segsum(x):
Naive Segment-Summen-Berechnung. exp(segsum(A)) erzeugt eine 1-SS-Matrix,
die einem skalaren SSM entspricht.
T = x.size(- 1)
x_cumsum = torch.cumsum(x, dim=- 1)
x_segsum = x_cumsum[..., None] - x_cumsum[..., None, :]
mask = torch.tri1(torch.ones(T, T, device=x.device, dtype=bool), diagonal=0)
x_segsum = x_segsum.masked_fill(- mask, - torch.inf)
return x_segsum
def ssd(X, A, B, C, block_len=64, initial_states=None):
Argumente:
X: (batch, length, n_heads, d_head)
A: (batch, length, n_heads)
B: (batch, length, n_heads, d_state)
C: (batch, length, n_heads, d_state)
Rückgabe:
Y: (batch, length, n_heads, d_head)
\*
4. Berechnung der Zustand-zu-Ausgabe-Konvertierung pro Chunk # (linker Term der Niedrigrang-Faktorisierung der nicht-diagonalen Blöcke; C-Terme) state_decay_out = torch.exp(A_cumsum) Y_off = torch.einsum('bclhn, bchpn, bhl->bclhp', C, states, state_decay_out)
Ausgabe der Intra-Chunk- und Inter-Chunk-Terme addieren (diagonale und nicht-diagonale Blöcke) Y = rearrange(Y_diag+Y_off, "b c l h p -> b (c l) h p") return Y, final_state
- Parallelisierung: Größere M-, N-, K-Terme können spezialisierte Matrixmultiplikationseinheiten auf modernen Beschleunigern nutzen.
Zentrale Blöcke. Die Kosten der quadratischen SMA-Berechnung bestehen aus drei Schritten (Gleichung (16)):
- Berechnung der Kernelmatrix , mit Kosten .
- Multiplikation mit der Maskenmatrix, eine elementweise Operation auf Tensoren der Form .
- Multiplikation mit den -Werten, mit Kosten
Niedrigrang-Blöcke: Rechte Faktoren. Dieser Schritt ist eine einzelne Matrixmultiplikation mit Kosten .
Niedrigrang-Blöcke: Zentrale Faktoren. Dieser Schritt ist ein skalarer SSM-Scan (oder eine 1-SS-Multiplikation) der Länge über unabhängige Kanäle. Der Aufwand dieses Scans beträgt , was im Vergleich zu den anderen Faktoren vernachlässigbar ist.
Beachte, dass dieser Scan aufgrund der Blockbildung, die die Länge der Sequenz von auf reduziert, -mal geringere Kosten hat als ein reiner SSM-Scan (z. B. der selektive Scan von Mamba). Daher beobachten wir, dass bei den meisten Problemlängen andere Algorithmen (Anhang B) effizienter oder deutlich einfacher zu implementieren sein können, ohne erhebliche Verlangsamung. Beispielsweise hat eine naive Implementierung hiervon über 1-SS-Matrixmultiplikation Kosten von , was deutlich einfacher zu implementieren ist und effizienter sein kann als eine naive Rekurrenz-/Scan-Implementierung.
Low-Rank-Blöcke: Linke Faktoren. Dieser Schritt ist eine einzelne Matrixmultiplikation mit Kosten .
Gesamtkosten. Wenn wir setzen (mit anderen Worten, die Zustandsdimension, die Kopf-Dimension und die Chunk-Länge sind gleich), dann werden alle obigen BMM-Terme zu . Die rechnerischen Eigenschaften davon sind:
- Gesamte FLOP-Zahl von .- Gesamtspeicher von .- Die Arbeit besteht hauptsächlich aus Matrixmultiplikationen auf Matrizen der Form .
Beachten Sie, dass der Speicherverbrauch knapp ist; die Eingaben und Ausgaben haben die Form . Der FLOP-Zähler spiegelt meanwhile einen zusätzlichen Faktor von wider, der durch die autoregressive Zustandsgröße entsteht und allen Modellen gemeinsam ist.
Abgesehen von den Matmuls gibt es einen skalaren SSM-Scan über Merkmale und Sequenzlänge . Dieser hat Kosten von FLOPs und eine Tiefe von . Obwohl er keine Matrixmultiplikationen verwendet, ist er dennoch parallelisierbar, und die insgesamt geleistete Arbeit ist im Vergleich zu den anderen Schritten vernachlässigbar; dies hat in unserer GPU-Implementierung vernachlässigbare Kosten.
Vergleich mit reinen SSM- und Attention-Modellen. Quadratische Attention ist ebenfalls sehr hardwareeffizient, da sie nur Matrixmultiplikationen nutzt, hat aber insgesamt FLOPs. Ihre langsamere Rechengeschwindigkeit sowohl beim Training als auch bei der Inferenz lässt sich direkt als Folge einer größeren Zustandsgröße verstehen – Standard-Attention hat eine Zustandsgröße, die mit der Sequenzlänge skaliert, weil sie ihre Historie zwischenspeichert und ihren Zustand nicht komprimiert.
Lineare SSMs haben insgesamt FLOPs, was dem von SSD entspricht. Eine naive Implementierung erfordert jedoch eine Zustandserweiterung (15a), die zusätzlichen Speicher materialisiert, und eine skalare Operation (15b), die keine Matrixmultiplikationen nutzt.
| Attention | SSM | SSD | |
| State-Größe | T | N | N |
| Trainings-FLOPs | T²N | TN² | TN² |
| Inferenz-FLOPs | TN | N² | N² |
| (Naiver) Speicher | T² | TN² | TN |
| Matrixmultiplikation | ✓ | ✓ |
Wir merken an, dass viele andere Matrixzerlegungen möglich sind (siehe zum Beispiel Anhang B für eine Zusammenstellung von Algorithmen für die 1-SS-Multiplikation durch verschiedene strukturierte Matrixzerlegungen), was zu weiteren Algorithmen für SSDs führen könnte, die für andere spezialisierte Einstellungen besser geeignet sein könnten. Noch allgemeiner merken wir an, dass halbseparierbare Matrizen eine reichhaltige Literatur und viele weitere Darstellungen neben der von uns verwendeten SS-Form (Definition 3.2) besitzen, und dass sogar effizientere Algorithmen möglich sein könnten.
7 Die Mamba-2-Architektur
Durch die Verbindung von SSMs und Attention ermöglicht uns das SSD-Framework, ein gemeinsames Vokabular und eine gemeinsame Bibliothek von Techniken für beide zu entwickeln. In diesem Abschnitt diskutieren wir einige Beispiele dafür, wie SSD-Schichten mit Ideen verstanden und modifiziert werden können, die ursprünglich
für Transformer entwickelt wurden. Wir diskutieren mehrere Designentscheidungen, die zur Mamba-2-Architektur führen. Diese Variationsachsen werden in Abschnitt 9.4 abladiert.
7.1 Blockdesign
Wir diskutieren zunächst Modifikationen am neuronalen Netzwerkblock, die unabhängig von der inneren Sequenzmischungsschicht sind (d. h. außerhalb der Kern-SSD-Schicht).
Parallele Parameterprojektionen. Mamba-1 war von einem SSM-zentrierten Standpunkt motiviert, bei dem die selektive SSM-Schicht als Abbildung von betrachtet wird. Die SSM-Parameter werden als untergeordnet angesehen und sind Funktionen der SSM-Eingabe . Somit erfolgen die linearen Projektionen, die definieren, nach der anfänglichen linearen Projektion zur Erzeugung von .
In Mamba-2 wird die SSD-Schicht als Abbildung von betrachtet. Es ist daher sinnvoll, parallel mit einer einzigen Projektion am Anfang des Blocks zu erzeugen. Beachten Sie die Analogie zu Standard-Attention-Architekturen, bei denen den -Projektionen entsprechen, die parallel erzeugt werden.
Beachten Sie, dass die Verwendung paralleler Projektionen für die -Eingaben in das SSM die Parameter leicht reduziert und, was wichtiger ist, für größere Modelle besser für Tensor-Parallelität geeignet ist, indem standardmäßige Megatron-Sharding-Muster verwendet werden (Shoeybi et al. 2019)).
Zusätzliche Normalisierung. In vorläufigen Experimenten stellten wir fest, dass in größeren Modellen leicht Instabilitäten auftraten. Wir konnten dies mildern, indem wir eine zusätzliche Normalisierungsschicht (z. B. LayerNorm, GroupNorm oder RMSNorm) direkt vor der finalen Ausgabeprojektion zum Block hinzufügten. Diese Verwendung einer Normalisierung steht am direktesten mit der NormFormer-Architektur (Shleifer, Weston und Ott 2021) in Beziehung, die ebenfalls Normalisierungsschichten am Ende der MLP- und MHA-Blöcke hinzufügte.
Wir merken auch an, dass diese Änderung anderen neueren Modellen ähnelt, die mit Mamba-2 verwandt sind und aus einer Linear-Attention-Perspektive abgeleitet wurden. Die ursprüngliche Linear-Attention-Formulierung normalisiert durch einen Nennerterm, der die Normalisierung der Softmax-Funktion in Standard-Attention nachahmt. TransNormerLLM (Qin, Dong Li, et al. 2023) und RetNet (Y. Sun et al. 2023) stellen fest, dass diese Normalisierung instabil ist, und fügen eine zusätzliche LayerNorm oder GroupNorm nach der Linear-Attention-Schicht hinzu. Unsere zusätzliche Normalisierungsschicht unterscheidet sich leicht von diesen, da sie nach dem multiplikativen Gate-Zweig statt davor erfolgt.
. . .
7.2 Multihead-Muster für Sequenztransformationen
Erinnern Sie sich, dass SSMs als Sequenztransformation (Definition 2.1) definiert sind, wobei:
- -Parameter eine Zustandsdimension N haben.- Sie eine Sequenztransformation definieren, die zum Beispiel als Matrix dargestellt werden kann.- Diese Transformation über eine Eingabesequenz operiert, unabhängig über die P-Achse.
Man kann dies als Definition eines Kopfs der Sequenztransformation betrachten.
Definition 7.1 (Multihead-Muster). Eine Multihead-Sequenztransformation besteht aus H unabhängigen Köpfen für eine Gesamtmodelldimension von . Die Parameter können über die Köpfe hinweg gebunden sein, was zu einem Kopfmuster führt.
Die Zustandsgröße N und die Kopf-Dimension P sind analog zur QK-Kopf-Dimension bzw. zur V-Kopf-Dimension von Attention. Genau wie in modernen Transformer-Architekturen (Chowdhery et al. 2023; Touvron, Lavril, et al. 2023) wählen wir in Mamba-2 diese im Allgemeinen als Konstanten um 64 oder 128; wenn die Modelldimension D zunimmt, erhöhen wir die Anzahl der Köpfe, während wir die Kopf-Dimensionen N und P festhalten. Um zu beschreiben, wie dies zu tun ist, können wir Ideen aus der Multihead-Attention übertragen und verallgemeinern, um ähnliche Muster für SSMs oder jede allgemeine Sequenztransformation zu definieren.
| Multi-Head-SSM (Multi-Head-Attn.) | Multi-Contract-SSM (Multi-Query-Attn.) | Multi-Expand-SSM (Multi-Key-Attn.) | Multi-Input-SSM (Multi-Value-Attn.) |
| X (T, H, P) | X (T, 1, P) | X (T, 1, P) | X (T, H, P) |
| A (T, H) | A (T, H) | A (T, H) | A (T, H) |
| B (T, H, N) | B (T, 1, N) | B (T, H, N) | B (T, 1, N) |
| C (T, H, N) | C (T, H, N) | C (T, 1, N) | C (T, 1, N) |
Multihead-SSM-(MHS-) / Multihead-Attention-(MHA-)Muster. Das klassische MHA-Muster setzt voraus, dass die Kopf-Dimension P die Modelldimension D teilt. Die Anzahl der Köpfe ist definiert als . Dann werden H Kopien der Kern-Sequenztransformation erzeugt, indem H unabhängige Kopien jedes Parameters erzeugt werden. Beachten Sie, dass das MHA-Muster zwar zuerst für die Attention-Sequenztransformation beschrieben wurde, aber auf alles angewendet werden kann, was mit Definition 2.1 kompatibel ist. Zum Beispiel würde eine Multihead-SSD-Schicht Eingaben mit Formen gemäß Gleichung (17) akzeptieren, wobei der SSD-Algorithmus über die -Dimension gebroadcastet wird.
Multi-Contract-SSM (MCS) / Multi-Query-Attention (MQA)-Muster. Multi-Query-Attention (Shazeer 2019) ist eine clevere Optimierung für Attention, die die Geschwindigkeit der autoregressiven Inferenz drastisch verbessern kann, welche auf dem Caching der - und -Tensoren beruht. Diese Technik vermeidet einfach, dass und die zusätzliche Head-Dimension erhalten, oder mit anderen Worten: Sie sendet einen einzelnen Head von über alle Heads von hinweg (Broadcasting).
Mithilfe der Zustandsraum-Dualität können wir eine äquivalente SSM-Version von MQA als Gleichung (18) definieren. Hierbei werden und (die SSM-Analoga von und der Attention) über die H Heads hinweg geteilt. Wir nennen dies auch das Multi-Contract-SSM-(MCS-)Head-Muster, weil der -Parameter, der die SSM-Zustandskontraktion steuert, unabhängige Kopien pro Head hat.
In ähnlicher Weise können wir ein Multi-Key-Attention-(MKA-) oder Multi-Expand-SSM-(MES-)Head-Muster definieren, bei dem (das die SSM-Expansion steuert) pro Head unabhängig ist, während und über die Heads hinweg geteilt werden.
Multi-Input-SSM (MIS) / Multi-Value-Attention (MVA)-Muster. Während MQA für Attention aufgrund seines KV-Caches sinnvoll ist, ist es nicht die natürliche Wahl für SSMs. In Mamba wird stattdessen als die Haupteingabe des SSM betrachtet, und daher sind und Parameter, die über die Eingabekanäle hinweg geteilt werden. Wir definieren ein neues Multi-Value-Attention-(MVA-) bzw. Multi-Input-SSM-(MIS-)Muster in Gleichung (20), das wiederum auf jede Sequenztransformation wie SSD angewendet werden kann.
Mit diesem Vokabular ausgestattet, können wir die ursprüngliche Mamba-Architektur präziser charakterisieren.
Proposition 7.2. Die selektive SSM-(S6-)Schicht der Mamba-Architektur (Gu und Dao 2023) kann man so auffassen, dass sie Folgendes hat:–Head-Dimension : jeder Kanal hat unabhängige SSM-Dynamik .
– Multi-Input-SSM-(MIS-) oder Multi-Value-Attention-(MVA-)Head-Struktur: die B\)-, \(C-Matrizen (entsprechend in der Attention-Dualität) werden über alle Kanäle der Eingabe (entsprechend in der Attention) hinweg geteilt.
Wir können diese Head-Muster-Varianten auch ablatieren, wenn sie auf SSD angewendet werden (Abschnitt 9.4.3). Interessanterweise gibt es trotz kontrollierter Parameteranzahl und Gesamtzustandsdimension einen merklichen Unterschied in der Downstream-Performance. Empirisch stellen wir fest, dass das MVA-Muster, wie es ursprünglich in Mamba verwendet wurde, am besten abschneidet.
Gruppierte Head-Muster. Die Ideen der Multi-Query-Attention lassen sich auf gruppierte Query-Attention erweitern (Ainslie et al. 2023): Statt 1 K- und V-Head kann man G unabhängige K- und V-Heads erzeugen, wobei und G H teilt. Dies ist sowohl dadurch motiviert, die Performancelücke zwischen Multi-Query- und Multi-Head-Attention zu überbrücken, als auch dadurch, effizienteren Tensor-Parallelismus zu ermöglichen, indem G auf ein Vielfaches der Anzahl der Shards gesetzt wird (Abschnitt 8).
In ähnlicher Weise lässt sich das in Mamba-2 verwendete Multi-Input-SSM-Head-Muster leicht auf gruppiertes Input-SSM (GIS) oder synonym gruppierte Value-Attention (GVA) erweitern. Die Verallgemeinerung ist unkompliziert, und wir lassen die Details der Einfachheit halber weg.
7.3 Weitere SSD-Erweiterungen aus Linear Attention
Wir beschreiben hier ein Beispiel für architektonische Modifikationen an SSD, die durch Linear Attention motiviert sind. Wir untersuchen diese in Abschnitt 9.4.3 als eine Form eines negativen Ergebnisses und stellen fest, dass sie die Leistung nicht signifikant genug verbessern, um sie als Standardeinstellungen zu übernehmen. Nichtsdestotrotz veranschaulichen sie, wie die umfangreiche Literatur zu Attention einbezogen werden kann, um Varianten von SSD zu definieren. Wir behandeln die Wahl der Kernel-Feature-Map als Hyperparameter in der Mamba-2-Architektur und erwarten, dass auch andere einfache, von Attention inspirierte Modifikationen möglich sind.
Kernel-Attention-Approximationen an Softmax-Attention. Viele Varianten von Linear Attention oder Kernel Attention sind dadurch motiviert, die Attention-Scores als zusammengesetzt aus
1. einem Exponentialkernel zu betrachten, der durch für eine geeignete Kernel-Feature-Map approximiert werden kann. 2. der Normalisierung des Kernels, sodass die Zeilen zu 1 summieren, via , wobei die Division elementweise erfolgt und 1 der Vektor aus lauter Einsen ist.
Exponential-Kernel-Feature-Maps. In Mamba-2 integrieren wir eine flexible Kernel-Feature-Map und wenden sie auf die - und -Zweige an (entsprechend den - und -Zweigen in Attention). Die Feature-Map kann optional auch auf den -Zweig (-Zweig) angewendet werden, aus Gründen der Einfachheit und Symmetrie. Dies wird in Abbildung 6 durch eine beliebige Nichtlinearität dargestellt. Standardmäßig wählen wir einfach als elementweise Swish-/SiLU-Funktion (Hendrycks und Gimpel 2016; Ramachandran, Zoph und Le 2017). Wir untersuchen weitere Optionen in den Ablationen in Abschnitt 9.4.3, darunter Feature-Maps, die von Linear Attention, Performer, Random Feature Attention und cosFormer verwendet werden (Abschnitt 4.1.3).
Einbeziehung eines Normalisierungs-(Nenner-)Terms. Um den Nennerterm zu finden, müssen wir einfach berechnen. Aber erinnern wir uns daran, dass die endgültige Ausgabe des Modells gerade ist (Gleichung (16)). Die Normalisierungsterme können also einfach dadurch gefunden werden, dass um eine zusätzliche Spalte 1 erweitert wird, was einen Tensor der Form ergibt.Beachten Sie, dass in diesem Fall die Kernel-Feature-Map positiv sein muss, damit die Summe positiv ist.
8 Systemoptimierungen für SSMs
Wir beschreiben mehrere Systemoptimierungen für SSMs, insbesondere für die Mamba-2-Architektur, für effizientes Training und effiziente Inferenz im großen Maßstab. Im Besonderen konzentrieren wir uns auf Tensor-Parallelität und Sequenz-Parallelität für Training im großen Maßstab sowie auf gut handhabbare Sequenzen variabler Länge für effizientes Finetuning und effiziente Inferenz.
8.1 Tensor-Parallelität
Tensor-Parallelität (TP) (Shoeybi et al. 2019) ist eine Modell-Parallelitätstechnik, die jede Schicht (z. B. Attention, MLP) aufteilt, um sie auf mehreren Beschleunigern wie GPUs auszuführen. Diese Technik wird weithin verwendet, um die meisten großen Modelle (Brown et al. 2020; Chowdhery et al. 2023; Touvron, Lavril, et al. 2023; Touvron, L. Martin, et al. 2023) auf GPU-Clustern zu trainieren, bei denen jeder Knoten typischerweise 4–8 GPUs mit schneller Vernetzung wie NVLink hat. TP wurde ursprünglich für die Transformer-Architektur entwickelt, und es ist nicht ohne Weiteres möglich, sie an andere Architekturen anzupassen. Wir zeigen zunächst die Herausforderung bei der Verwendung von TP mit der Mamba-Architektur und zeigen dann, wie die Mamba-2-Architektur gestaltet ist, um TP effizient zu machen.
Erinnern wir uns an die Mamba-Architektur mit einer einzelnen Eingabe (ohne Batching zur Vereinfachung), Eingabeprojektionsmatrizen , wobei der Expansionsfaktor ist (typischerweise 2), und Ausgabeprojektionsmatrix :
Bei TP nehmen wir an, dass wir die Berechnung auf 2 GPUs aufteilen wollen. Es ist einfach, die Eingabeprojektionsmatrizen und in zwei Partitionen der jeweiligen Größe aufzuteilen. Dann würde jede GPU die Hälfte von der Größe halten. Wir sehen jedoch, dass, da Funktionen von sind, wir eine zusätzliche All-Reduce zwischen den GPUs benötigen würden, um das vollständige zu erhalten, bevor wir berechnen. Danach können die beiden GPUs das SSM parallel berechnen, da sie entlang unabhängig sind. Am Ende können wir die Ausgabeprojektionsmatrizen in zwei Partitionen der jeweiligen Größe aufteilen und am Ende eine All-Reduce durchführen. Im Vergleich zu Transformers würden wir zwei All-Reduces statt einer benötigen, was die in Kommunikation verbrachte Zeit verdoppelt. Beim Training von Transformers im großen Maßstab macht Kommunikation möglicherweise bereits einen erheblichen Anteil der Zeit aus (z. B. 10–20 %), und eine Verdoppelung der Kommunikation würde Mamba für Training im großen Maßstab nicht so effizient machen.
Mit Mamba-2 ist unser Ziel, nur eine All-Reduce pro Block zu haben, ähnlich wie bei Attention- oder MLP-Blöcken in Transformers. Infolgedessen projizieren wir, um direkt aus statt aus zu erhalten, was es uns ermöglicht, diese Projektionsmatrizen aufzuteilen. Dies impliziert, dass wir auf verschiedenen GPUs verschiedene Sätze von haben, was äquivalent dazu ist, mehrere „Gruppen“ von auf einer größeren „logischen GPU“ zu haben. Darüber hinaus verwenden wir GroupNorm innerhalb jedes Blocks, wobei die Anzahl der Gruppen durch den TP-Grad teilbar ist, sodass die GPUs in einer TP-Gruppe innerhalb des Blocks nicht kommunizieren müssen:
Wir sehen, dass wir nur die Eingangsprojektionsmatrizen und die Ausgangsprojektionsmatrizen aufteilen müssen und am Ende des Blocks lediglich eine All-Reduce-Operation durchführen müssen. Dies ähnelt dem Design von TP für Attention- und MLP-Schichten. Insbesondere bei einem TP-Grad von 2 würden wir mit mit und
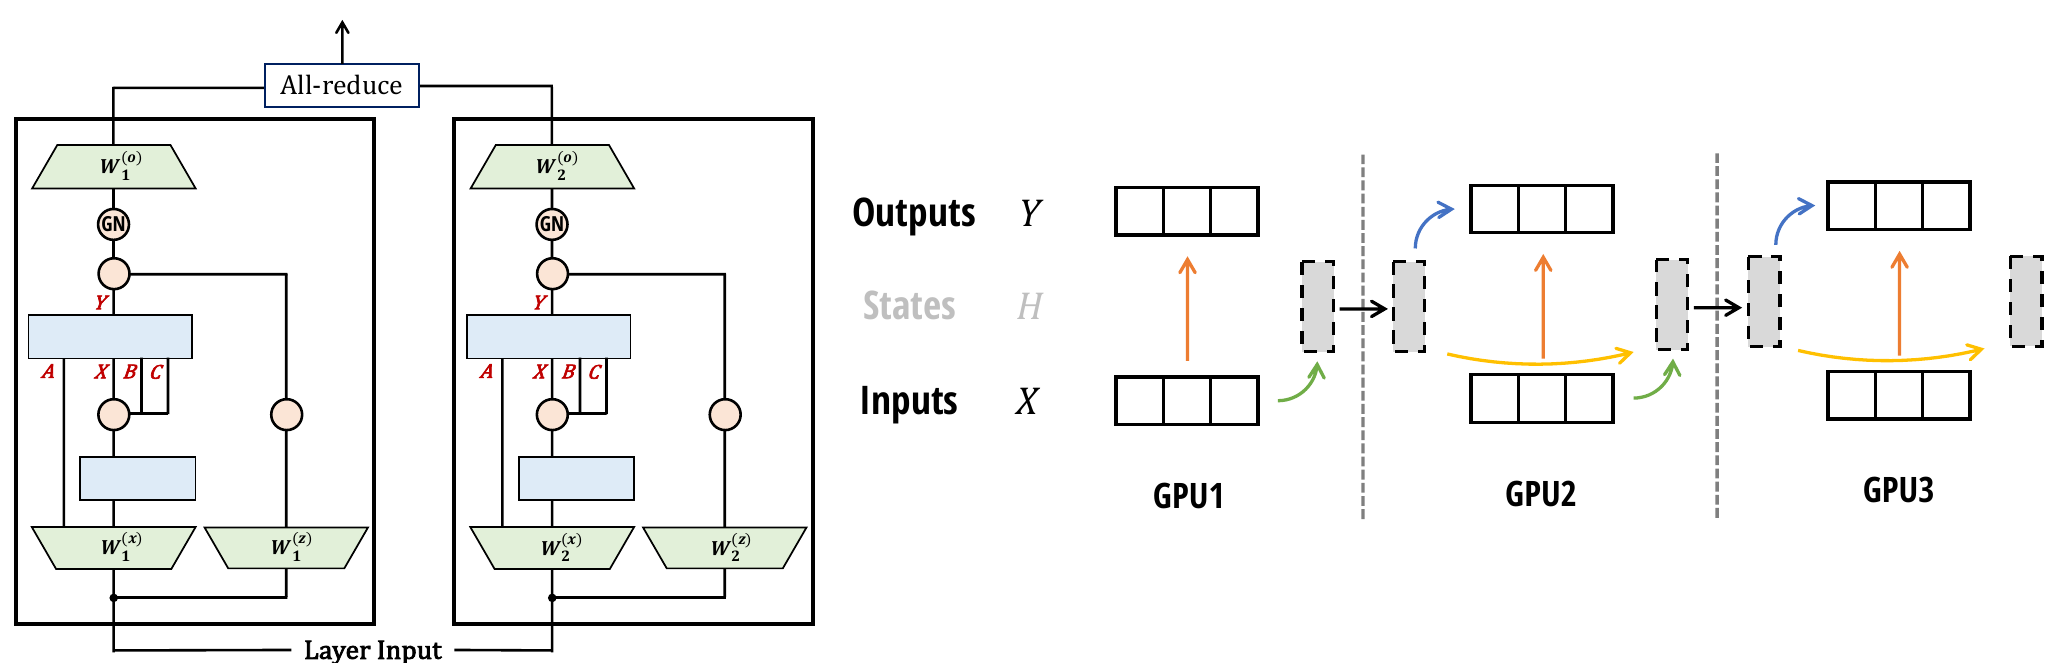
mit aufteilen. Für lässt sich die TP-Mamba-2-Schicht wie folgt schreiben:
Wir veranschaulichen Tensorparallelität mit Mamba-2 in Abbildung 7 (links).
8.2 Sequenzparallelität
Bei sehr langen Sequenzen müssen wir möglicherweise die Eingabe und die Aktivierungen entlang der Sequenzlängendimension auf verschiedene GPUs aufteilen. Es gibt zwei Haupttechniken:
1. Sequenzparallelität (SP) für die Residual- und Normalisierungsoperationen: Diese Technik, die erstmals von Korthikanti et al. (2023) vorgeschlagen wurde, zerlegt die All-Reduce-Operation in TP in Reduce-Scatter und All-Gather. Da die Residual- und Normalisierungsoperationen für alle GPUs in derselben TP-Gruppe auf derselben Eingabe wiederholt werden, teilt SP die Aktivierungen entlang der Sequenzlängendimension auf, indem es Folgendes durchführt: Reduce-Scatter, Residual- und Normalisierungsoperationen, dann All-Gather.
Da die Mamba-2-Architektur dieselbe Residual- und Normalisierungsstruktur verwendet, lässt sich SP ohne Änderungen anwenden.
2. Sequenzparallelität für die Token-Mixing-Operationen (Attention oder SSM), auch bekannt als „Context Parallelism“ (CP). Für die Attention-Schicht wurden mehrere Techniken entwickelt (z. B. Ring Attention (Liu, Yan, et al. 2024; Liu, Zaharia,
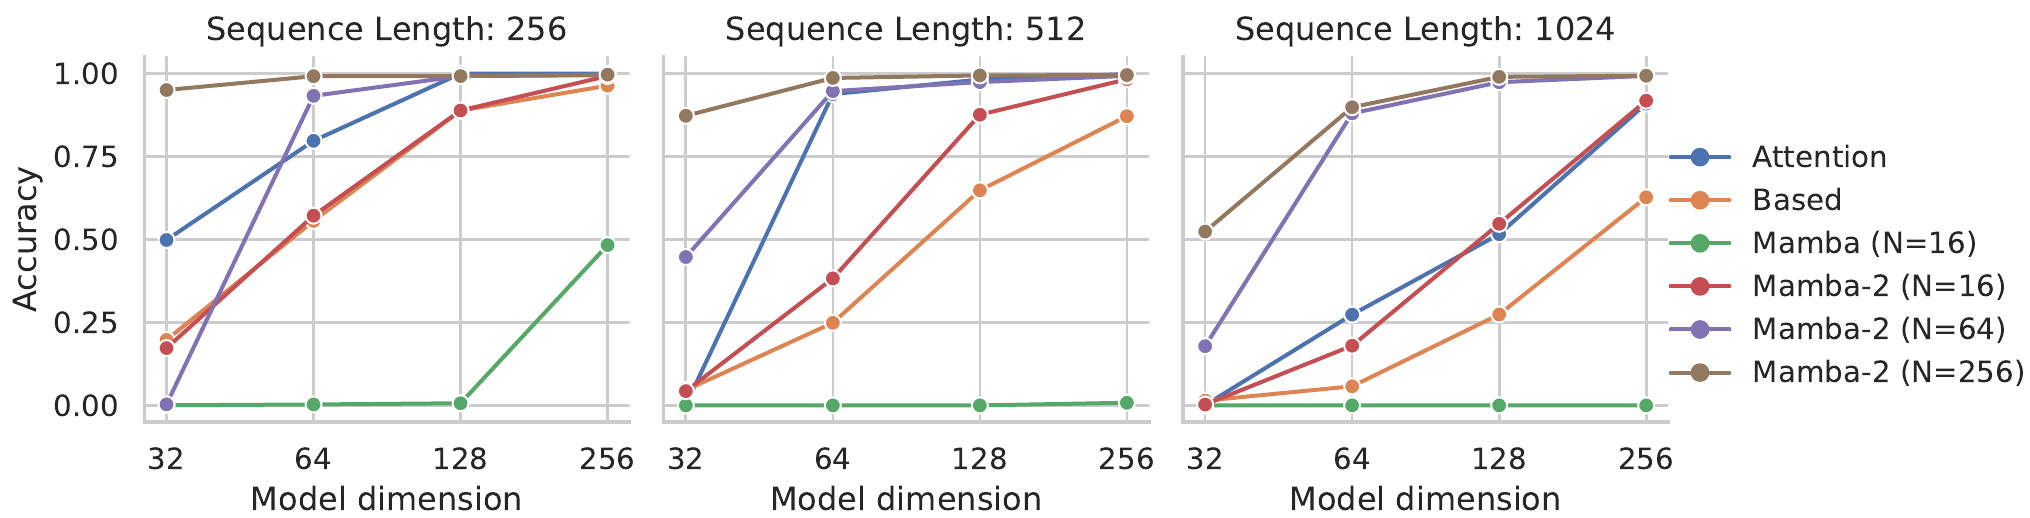
and Abbeel 2023)), mit ausgefeilter Lastausgleichstechnik (Brandon et al. 2023). Die Schwierigkeit bei der Sequenzparallelität in der Attention besteht darin, dass wir Queries und Keys in Blöcke aufteilen können, aber jeder Query-Block mit Key-Blöcken interagieren muss, was zu einer Kommunikationsbandbreite führt, die quadratisch in der Anzahl der Worker ist.
Bei SSMs können wir die Sequenz auf einfache Weise aufteilen: Jeder Worker nimmt einen Anfangszustand, berechnet das SSM bezüglich seiner Eingaben, gibt den Endzustand zurück und übergibt diesen Endzustand an den nächsten Worker. Die Kommunikationsbandbreite ist linear in der Anzahl der Worker. Diese Zerlegung ist genau dieselbe wie die Blockzerlegung im SSD-Algorithmus (Abbildung 5), um in Blöcke / Chunks aufzuteilen. Wir veranschaulichen diesen Context Parallelism in Abbildung 7 (rechts).
8.3 Variable Länge
Während beim Pretraining häufig dieselben Sequenzlängen für den Batch verwendet werden, muss das Modell beim Finetuning oder bei der Inferenz möglicherweise unterschiedliche Eingabesequenzen unterschiedlicher Länge verarbeiten. Eine naive Möglichkeit, diesen Fall zu behandeln, besteht darin, alle Sequenzen im Batch rechts auf die maximale Länge aufzufüllen, was jedoch ineffizient sein kann, wenn die Sequenzen stark unterschiedliche Längen haben. Für Transformer wurden ausgefeilte Techniken entwickelt, um Padding zu vermeiden und einen Lastausgleich zwischen GPUs durchzuführen (Zeng et al. 2022; Y. Zhai et al. 2023) oder mehrere Sequenzen im selben Batch zu packen und die Attention-Maske anzupassen (Ding et al. 2024; Pouransari et al. 2024). Mit SSMs und insbesondere Mamba können wir variable Sequenzlängen behandeln, indem wir einfach den gesamten Batch als eine lange Sequenz betrachten und vermeiden, die Zustände zwischen einzelnen Sequenzen weiterzugeben. Dies ist äquivalent dazu, einfach für Tokens am Ende einer Sequenz zu setzen, um zu verhindern, dass Informationen an das Token weitergegeben werden, das zu einer anderen Sequenz gehört.
9 Empirische Validierung
Wir evaluieren Mamba-2 empirisch an synthetischen Recall-Aufgaben, die für rekurrente Modelle herausfordernd waren (Abschnitt 9.1), sowie an Standard-Pretraining und Downstream-Evaluierungen für Sprachmodellierung (Abschnitt 9.2). Wir validieren, dass unser SSD-Algorithmus viel effizienter als Mamba-1 ist (Abschnitt 9.3) und für moderate Sequenzlängen mit optimierter Attention vergleichbar ist. Schließlich führen wir Ablationen zu verschiedenen Designentscheidungen in der Mamba-2-Architektur durch (Abschnitt 9.4).
9.1 Synthetische Aufgaben: Assoziatives Recall
Synthetische assoziative Recall-Aufgaben sind beliebt, um die Fähigkeit von Sprachmodellen zu testen, Informationen in ihrem Kontext nachzuschlagen. Im Allgemeinen besteht dabei darin, autoregressiven Modellen Paare von Schlüssel-Wert-Assoziationen zuzuführen und das Modell dann aufzufordern, die korrekte Vervollständigung zu erzeugen, wenn ihm ein zuvor gesehener Schlüssel gezeigt wird. Die Multi-Query Associative Recall (MQAR)-Aufgabe ist eine besondere Formulierung dieser Aufgabe, die vom Modell verlangt, mehrere Assoziationen zu memorieren (Arora, Eyuboglu, Timalsina, et al. 2024). Das ursprüngliche Mamba-Paper berichtete Ergebnisse zu verwandten synthetischen Aufgaben, insbesondere Selective Copying (Gu and Dao 2023) und Induction Heads (Olsson et al. 2022), die als einfachere assoziative Recall-Aufgaben angesehen werden können. Die MQAR-Aufgabe ist auch eng mit „Telefonbuch-Nachschlage“-Aufgaben verwandt, von denen gezeigt wurde, dass sie für rekurrente Modelle wie SSMs aufgrund ihrer endlichen Zustandskapazität herausfordernd sind (De et al. 2024; Jelassi et al. 2024).
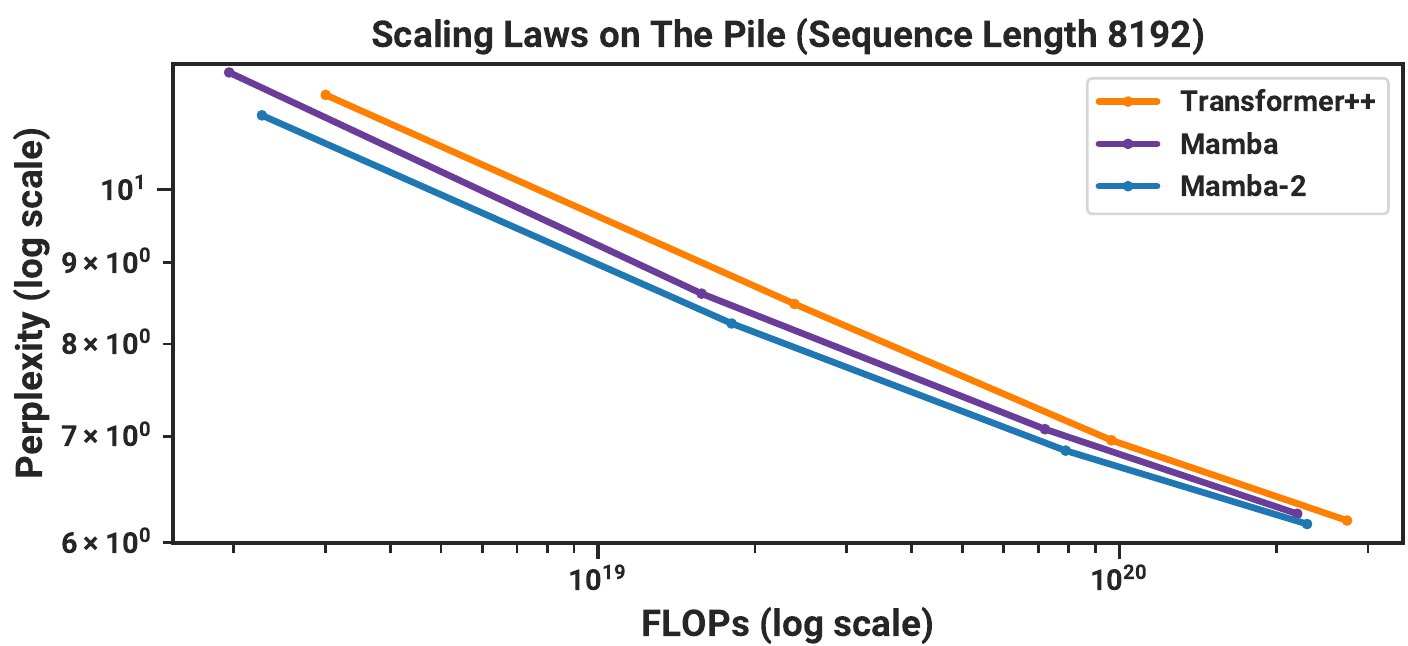
| MODELL | TOKEN. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | DURCHSCHNITT ACC ↑ |
| Pythia-1B | NeoX | 7,82 | 7,92 | 56,1 | 47,2 | 70,7 | 57,0 | 27,1 | 53,5 | 31,4 | 49,0 |
| Mamba-790M | NeoX | 7,33 | 6,02 | 62,7 | 55,1 | 72,1 | 61,2 | 29,5 | 56,1 | 34,2 | 53,0 |
| Mamba-2-780M | NeoX | 7,26 | 5,86 | 61,7 | 54,9 | 72,0 | 61,0 | 28,5 | 60,2 | 36,2 | 53,5 |
| Hybrid H3-1.3B | GPT2 | — | 11,25 | 49,6 | 52,6 | 71,3 | 59,2 | 28,1 | 56,9 | 34,4 | 50,3 |
| Pythia-1.4B | NeoX | 7,51 | 6,08 | 61,7 | 52,1 | 71,0 | 60,5 | 28,5 | 57,2 | 30,8 | 51,7 |
| RWKV4-1,5B | NeoX | 7,70 | 7,04 | 56,4 | 52,5 | 72,4 | 60,5 | 29,4 | 54,6 | 34,0 | 51,4 |
| Mamba-1,4B | NeoX | 6,80 | 5,04 | 65,0 | 59,1 | 74,2 | 65,5 | 32,8 | 61,5 | 36,4 | 56,4 |
| Mamba-2-1,3B | NeoX | 6,66 | 5,02 | 65,7 | 59,9 | 73,2 | 64,3 | 33,3 | 60,9 | 37,8 | 56,4 |
| Hybrid H3-2,7B | GPT2 | — | 7,92 | 55,7 | 59,7 | 73,3 | 65,6 | 32,3 | 61,4 | 33,6 | 54,5 |
| Pythia-2,8B | NeoX | 6,73 | 5,04 | 64,7 | 59,3 | 74,0 | 64,1 | 32,9 | 59,7 | 35,2 | 55,7 |
| RWKV4-3B | NeoX | 7,00 | 5,24 | 63,9 | 59,6 | 73,7 | 67,8 | 33,1 | 59,6 | 37,0 | 56,4 |
| Mamba-2.8B | NeoX | 6,22 | 4,23 | 69,2 | 66,1 | 75,2 | 69,7 | 36,3 | 63,5 | 39,6 | 59,9 |
| Mamba-2-2.7B | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
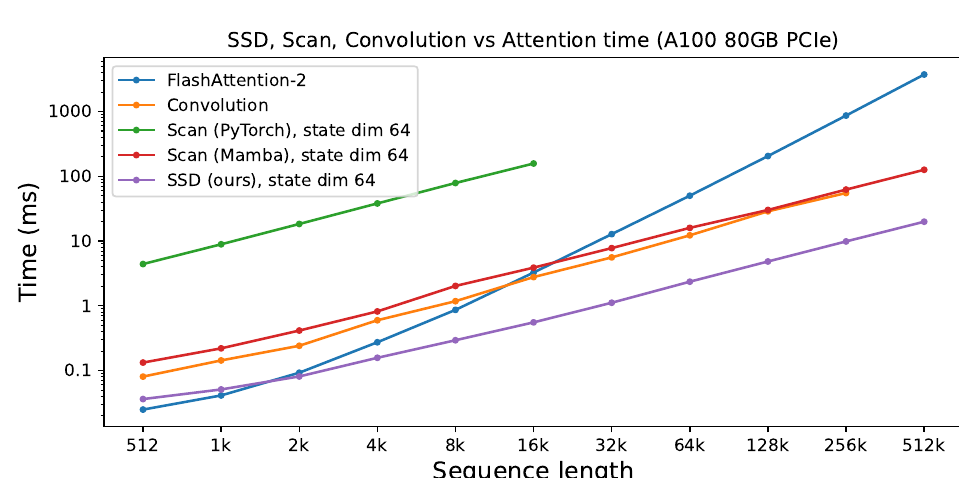
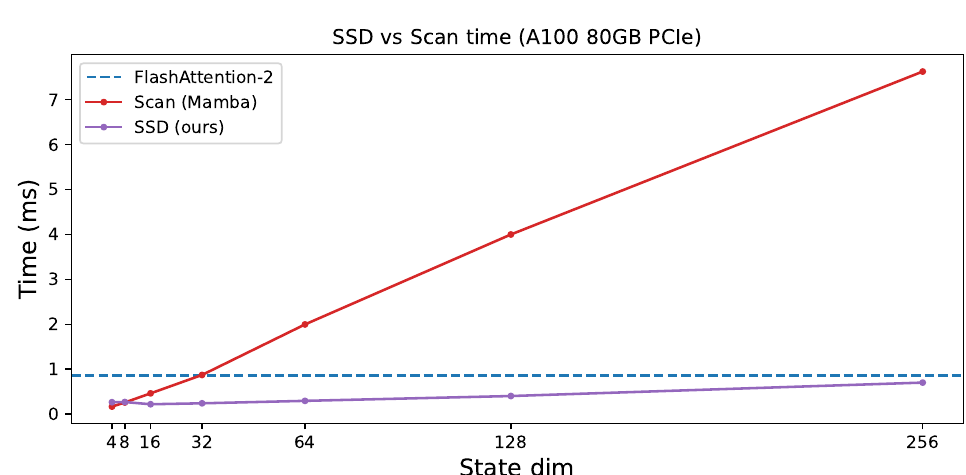
Abbildung 10: (Effizienz-Benchmarks.) (Links) Unser SSD ist schneller als ein fusionierter Mamba-Scan bei großer Zustandserweiterung und schneller als FlashAttention-2 für Sequenzlängen von und mehr. (Rechts) Sequenzlänge : Eine zunehmende Zustandserweiterung verlangsamt die optimierte Mamba-Scan-Implementierung linear. SSD kann viel größere Zustandserweiterungsfaktoren ohne große Verlangsamung verarbeiten.
Wir vergleichen mit einer herausfordernden Version des MQAR-Setups aus (Arora, Eyuboglu, Zhang, et al. 2024), wobei wir eine schwierigere Aufgabe, längere Sequenzen und kleinere Modelle verwenden. Unsere Baselines umfassen Standard-Multi-Head-Softmax-Attention sowie die Based-Architektur, die Faltungen, lokale Attention und eine lineare Attention-Variante kombiniert.
Die Ergebnisse sind in Abbildung 8 dargestellt. Während Mamba-1 bei dieser Aufgabe Schwierigkeiten hat, schneidet Mamba-2 in allen Einstellungen gut ab. Überraschenderweise ist es deutlich besser als Mamba-1, selbst wenn die Zustandsgrößen kontrolliert werden (). (Wir sind uns nicht sicher, welcher Aspekt der Architektur der vorherrschende Faktor ist, was eine offene Frage für zukünftige Arbeiten bleibt.) Darüber hinaus validiert diese Aufgabe die Bedeutung der Zustandsgröße: Eine Erhöhung von auf und verbessert die Leistung bei MQAR konsistent, da der größere Zustand es ermöglicht, mehr Informationen (Schlüssel-Wert-Paare) zu memorieren.
9.2 Sprachmodellierung
Den Standardprotokollen für LLMs folgend trainieren und evaluieren wir die Mamba-2-Architektur für Standard-autoregressive Sprachmodellierung im Vergleich zu anderen Architekturen. Wir vergleichen sowohl Pretraining-Metriken (Perplexität) als auch Zero-Shot-Evaluierungen. Die Modellgrößen (Tiefe und Breite) folgen den GPT3-Spezifikationen, von bis . Wir verwenden den Pile-Datensatz (L. Gao, Biderman, et al. 2020) und folgen dem in Brown et al. (2020) beschriebenen Trainingsrezept. Dies folgt demselben Setup wie in Mamba (Gu and Dao 2023) berichtet; Trainingsdetails finden sich in Anhang D.
9.2.1 Scaling Laws
Als Baselines vergleichen wir sowohl mit Mamba als auch mit dessen Transformer++-Rezept (Gu and Dao 2023), das auf den PaLM- und LLaMa-Architekturen basiert (z. B. Rotary Embedding, SwiGLU-MLP, RMSNorm statt LayerNorm, kein linearer Bias und höhere Lernraten). Da Mamba bereits gezeigt hat, dass es die Standard-Transformer-Architektur (GPT3-Architektur) sowie neuere subquadratische Architekturen (H3 (Dao, D. Y. Fu, et al. 2023), Hyena (Poli et al. 2023), RWKV-4 (B. Peng, Alcaide, et al. 2023), RetNet (Y. Sun et al. 2023)) übertrifft, lassen wir diese der Übersichtlichkeit halber im Diagramm weg (siehe Gu and Dao (2023) für Vergleiche).
Abbildung 9 zeigt Scaling Laws unter dem Standard-Chinchilla-Protokoll (Hoffmann et al. 2022), für Modelle von bis Parametern.
9.2.2 Downstream-Evaluierungen
Tabelle 1 zeigt die Leistung von Mamba-2 bei einer Reihe beliebter Downstream-Zero-Shot-Evaluierungsaufgaben im Vergleich zu den bekanntesten Open-Source-Modellen dieser Größen, insbesondere Pythia (Biderman et al. 2023), das mit demselben Tokenizer, Datensatz und derselben Trainingslänge (300B Tokens) wie unsere Modelle trainiert wurde.
9.2.3 Hybride Modelle: Kombination der SSD-Schicht mit MLP und Attention
Neuere und zeitgleiche Arbeiten (Dao, D. Y. Fu, et al. 2023; De et al. 2024; Glorioso et al. 2024; Lieber et al. 2024) legen nahe, dass eine hybride Architektur mit sowohl SSM-Schichten als auch Attention-Schichten die Modellqualität gegenüber der eines Transformers oder eines reinen SSM-Modells (z. B. Mamba) verbessern könnte, insbesondere für In-Context-Learning. Wir untersuchen die verschiedenen Möglichkeiten, SSD-Schichten mit Attention und MLP zu kombinieren, um die Vorteile jeder Variante zu verstehen. Empirisch stellen wir fest, dass etwa der Gesamtzahl der Schichten als Attention am besten abschneiden. Die Kombination von SSD-Schichten, Attention-Schichten und MLP funktioniert ebenfalls besser als entweder reiner Transformer++ oder Mamba-2.
SSD und Attention Wir stellen fest, dass SSD- und Attention-Schichten komplementär sind: Für sich genommen (z. B. in der Mamba-2-Architektur vs. Transformer++) ist ihre Leistung (gemessen an der Perplexität) nahezu gleich, aber eine Mischung aus SSD- und Attention-Schichten übertrifft die reine Mamba-2- oder Transformer++-Architektur. Wir zeigen einige Ergebnisse (Tabelle 2) für das 350M-Modell (48 Schichten), trainiert auf 7B Tokens auf dem Pile mit dem GPT-2-Tokenizer (gleiche Anzahl Parameter, gleiche Hyperparameter, gleiches Trainings- und Validierungsset). Das Hinzufügen nur weniger Attention-Schichten liefert bereits eine bemerkenswerte Verbesserung und bietet die beste Balance zwischen Qualität und Effizienz. Wir vermuten, dass die SSM-Schichten gut als allgemeine Sequenz-zu-Sequenz-Abbildung fungieren und Attention-Schichten als Retrieval-Mechanismus wirken, um schnell auf vorherige Tokens in der Sequenz zu verweisen, anstatt das Modell zu zwingen, den gesamten Kontext in seinem Speicher (SSM-Zustände) zu komprimieren.
| ANZ. ATTN-BLÖCKE | 0 (Mamba-2) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 9 | 11 | 15 | 24 | Transformer++ |
| PERPLEXITÄT ↓ | 8,60 | 8,38 | 8,32 | 8,29 | 8,29 | 8,28 | 8,26 | 8,27 | 8,28 | 8,30 | 8,34 | 8,50 | 8,68 |
Hybride Modelle mit SSD, MLP und Attention Wir vergleichen verschiedene Möglichkeiten, SSD mit den (gegateten) MLP- und Attention-Schichten zu kombinieren, und evaluieren im 2.7B-Maßstab (64 Schichten), trainiert auf 300B Tokens auf dem Pile (gleiche Anzahl Parameter, gleiche Hyperparameter, gleiches Trainings- und Validierungsset, gleiche Datenreihenfolge):
1. Transformer++: 32 Attention-Layer und 32 gated MLP, verschachtelt.
2. Mamba-2: 64 SSD-Layer.
3. Mamba-2-MLP: 32 SSD- und 32 gated MLP-Layer, verschachtelt.
4. Mamba-2-Attention: 58 SSD-Layer und 6 Attention-Layer (an den Indizes 9, 18, 27, 36, 45, 56)6.
5. Mamba-2-MLP-Attention: 28 SSD-Layer und 4 Attention-Layer, verschachtelt mit 32 gated MLP-Layern.
Wir berichten über die Validierungs-Perplexität auf dem Pile sowie über Zero-Shot-Evaluierung in Tabelle 3. Im Allgemeinen ist die Qualität der Transformer++- und Mamba-2-Modelle ungefähr gleich. Wir sehen, dass das Hinzufügen von nur 6 Attention-Layern das reine Mamba-2-Modell (und auch Transformer++) merklich verbessert. Das Hinzufügen von MLP-Layern verringert die Modellqualität, kann aber (i) das Training und die Inferenz aufgrund der Einfachheit und Hardware-Effizienz der MLP-Schicht beschleunigen und (ii) leichter auf MoE-Modelle upgecycelt werden, indem MLP-Layer durch Mixture-of-Experts ersetzt werden.
| MODELL | TOKEN. | PILE | LAMBADA | LAMBADA | HELLASWAG | PIQA | ARC-E | ARC-C | WINOGRANDE | OPENBOOKQA | DURCHSCHNITT |
| PPL ↓ | PPL ↓ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ||
| Transformer++ | NeoX | 6,13 | 3,99 | 70,3 | 66,4 | 75,2 | 67,7 | 37,8 | 63,9 | 40,4 | 60,2 |
| Mamba-2 | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
| Mamba-2-MLP | NeoX | 6,13 | 4,18 | 69,3 | 65,0 | 76,4 | 68,1 | 37,0 | 63,1 | 38,2 | 59,6 |
| Mamba-2-Attention | NeoX | 5,95 | 3,85 | 71,1 | 67,8 | 75,8 | 69,9 | 37,8 | 65,3 | 39,0 | 61,0 |
| Mamba-2-MLP-Attention | NeoX | 6,00 | 3,95 | 70,0 | 66,6 | 75,4 | 70,6 | 38,6 | 64,6 | 39,2 | 60,7 |
9.3 Geschwindigkeits-Benchmarks
Wir benchmarken die Geschwindigkeit des SSD-Algorithmus gegen Mambas Scan-Implementierung und FlashAttention-2 (Abbildung 10). SSD kann dank seiner Neuformulierung, die Matrixmultiplikation als Unterroutine verwendet, spezialisierte Matrixmultiplikations-(Matmul-)Einheiten auf GPUs nutzen, die auch als Tensor Cores bekannt sind. Dadurch ist es 2–8x schneller als Mambas fusionierter assoziativer Scan, der keine Matmul-Einheiten nutzt. Aufgrund seiner linearen Skalierung mit der Sequenzlänge ist SSD ab einer Sequenzlänge von schneller als FlashAttention-2.
Wir merken jedoch an, dass das Mamba-2-Modell als Ganzes bei kurzer Sequenzlänge (z. B. bei ) möglicherweise nicht so effizient zu trainieren ist wie Transformer, da ein Transformer mit Layern MLP-Layer und Attention-Layer hätte, während ein Mamba-2-Modell bei gleicher Parameterzahl SSD-Layer hätte. Im Allgemeinen sind die MLP-Layer sehr hardwareeffizient, da sie aus einfacher Matrixmultiplikation und punktweiser Linearität bestehen. Wie in Abschnitt 9.2.3 gezeigt, kann man auch SSD-Layer und MLP-Layer kombinieren, um das Training bei kurzer Sequenzlänge zu beschleunigen.
| Block | ABCX-Projektionen | ZUSÄTZLICHE NORMALISIERUNG | PARAMETER | PERPLEXITÄT |
| Mamba-1 | Sequenziell | × | 129,3 Mio. | 11,76 |
| Sequenziell | ✓ | 129,3 Mio. | 11,54 | |
| Parallel | × | 126,5 Mio. | 11,66 | |
| Parallel | ✓ | 126,5 Mio. | 11,49 |
9.4 Architektur-Ablationen
9.4.1 Blockdesign
Abschnitt 7.1 stellt den Mamba-2-Block vor, der kleine Änderungen am Mamba-1-Block aufweist, die teilweise durch die Verbindung zu Attention motiviert sind und auch die Skalierbarkeit von Mamba-2 verbessern sollen. Tabelle 4 unterzieht diese Architekturänderungen am Block, die außerhalb der Kern-SSM-Schicht stattfinden, einer Ablation.
Die Ablationen bestätigen, dass parallele Projektionen zur Erzeugung von Parameter einsparen und etwas besser abschneiden als die sequenziellen Projektionen von Mamba. Wichtiger noch: Diese Änderung eignet sich für Tensorparallelität bei größeren Modellgrößen (Abschnitt 8). Zusätzlich verbessert die zusätzliche Normalisierungsschicht die Leistung leicht. Wichtiger noch: Vorläufige Experimente in größeren Maßstäben zeigten, dass sie auch die Trainingsstabilität verbessert.
9.4.2 Kopfstruktur
Abschnitt 7.2 beschreibt, wie die Dimensionen der -Projektionen als ein Hyperparameter betrachtet werden können, analog zu den Konzepten von Multi-Head-Attention und Multi-Query-Attention. Wir haben außerdem gezeigt, wie die ursprüngliche Mamba-Architektur analog zu Multi-Value-Attention ist (Proposition 7.2), eine Wahl, die sich natürlicherweise aus der Perspektive des State-Space-Modells ergab und zuvor nicht durch Ablation untersucht worden war.
Tabelle 5 unterzieht die Wahlmöglichkeiten der Multi-Head-Struktur für die Mamba-2-Architektur einer Ablation. Auffälligerweise finden wir einen großen Unterschied zwischen Multi-Value- und Multi-Query- oder Multi-Key-Kopfmustern, obwohl sie sehr ähnlich erscheinen. Beachten Sie, dass dies nicht durch die Gesamtzustandsgröße erklärt wird, die für alle gleich ist (gleich HPN bzw. dem Produkt aus Anzahl der Köpfe, Kopfdimension und Zustandsdimension).
Wir vergleichen außerdem mit Multi-Head-Mustern, bei denen die Anzahl der -Köpfe (analog zu ) gleich ist. Wir vergleichen mit dem standardmäßigen Multi-Head-Muster sowie mit einem mit aggressivem Sharing, bei dem alle nur 1 Kopf haben. Beachten Sie, dass das Modell im letzteren Fall immer noch H verschiedene Sequenzmixer hat, da jeder Kopf immer noch ein unterschiedliches besitzt. Bei Parameterabgleich schneiden diese Multi-Head-Muster ähnlich zueinander ab, zwischen den MVA- und MQA/MKA-Mustern.
9.4.3 Approximationen des Attention-Kerns
Abschnitt 7.3 merkte an, wie SSD mit Ideen aus der Literatur zur linearen Attention kombiniert werden kann, etwa mit verschiedenen Formen von Kernel-Approximationen. Wir unterziehen mehrere Varianten davon, die von früheren Arbeiten vorgeschlagen wurden, in Tabelle 6 einer Ablation. Dazu gehören cosFormer (Qin, Weixuan Sun, et al. 2022), Random Feature Attention (H. Peng et al. 2021) und Positive Random Features (Performer) (Choromanski et al. 2021).
Wir unterziehen außerdem das Hinzufügen eines Normalisierungsterms einer Ablation, analog zum Nenner der Softmax-Funktion in Standard-Attention. Wir stellten fest, dass dies bei den meisten Varianten Instabilitäten einführte, aber die Leistung für die ReLU-Aktivierungsfunktion leicht verbesserte.
Tabelle 7 testet außerdem neuere Vorschläge zur Verbesserung der linearen Attention, die die Erweiterung der Feature-Dimension beinhalten (Based (Arora, Eyuboglu, Zhang, et al. 2024) und ReBased (Aksenov et al. 2024)). Diese Erweiterungen der linearen Attention zielen darauf ab, den exp-Kernel durch eine quadratische Approximation zu ersetzen. ReBased schlägt außerdem vor, die QK-Aktivierungsfunktion durch eine Layer-Normalisierung zu ersetzen; aus SSM-zentrierter Sicht wenden wir eine Normalisierung auf an, bevor wir die SSM-Funktion anwenden.
| SSM-Kopfmuster | ATTN.-ANALOG | A-KÖPFE | B-KÖPFE | C-KÖPFE | X-KÖPFE | SCHICHTEN | PARAM. | PPL. |
| Multi-Input (MIS) | Multi-Value (MVA) | 24 | 1 | 1 | 24 | 24 | 126,5 Mio. | 11,66 |
| Multi-Contract (MCS) | Multi-Query (MQA) | 24 | 1 | 24 | 1 | 24 | 126,5 Mio. | 12,62 |
| Multi-Expand (MES) | Multi-Key (MKA) | 24 | 24 | 1 | 1 | 24 | 126,5 Mio. | 12,59 |
| Multi-Head (MHS) | Multi-Head (MHA) | 24 | 24 | 24 | 24 | 15 | 127,6 Mio. | 12,06 |
| Multi-State (MSS) | - | 24 | 1 | 1 | 1 | 36 | 129,6 Mio. | 12,00 |
| Multi-Input (MIS) | Multi-Value (MVA) | 32 | 1 | 1 | 32 | 48 | 361,8 Mio. | 8,73 |
| Multi-Contract (MCS) | Multi-Query (MQA) | 32 | 1 | 32 | 1 | 48 | 361,8 Mio. | 9,33 |
| Multi-Expand (MES) | Multi-Key (MKA) | 32 | 32 | 1 | 1 | 48 | 361,8 Mio. | 9,36 |
| Multi-Head (MHS) | Multi-Head (MHA) | 32 | 1 | 1 | 1 | 70 | 361,3 Mio. | 9,01 |
| Multi-State (MSS) | - | 32 | 32 | 32 | 32 | 29 | 357,3 Mio. | 9,04 |
| KERN-AKTIVIERUNG φ | PERPLEXITÄT |
| keine | 11,58 |
| Swish | 11,66 |
| Exp | 11,62 |
| ReLU | 11,73 |
| ReLU + Normalisierung | 11,64 |
| cosFormer | 11,97 |
| Random Feature Attention | 11,57 |
| Positive Random Features (Performer) | 12,21 |
| KERNEL-AKTIVIERUNG φ | PERPLEXITÄT |
| Swish | 11,67 |
| Swish + Taylor (Based) | 12,19 |
| LayerNorm | 11,50 |
| LayerNorm + Square (ReBased) | 11,84 |
| Swish | 8,58 |
| Swish + Taylor (Based) | 8,71 |
| LayerNorm | 8,61 |
| LayerNorm + Square (ReBased) | 8,63 |
Wir merken an, dass diese Technik unabhängig als „QK-Norm“ für Softmax-Attention (Team 2024) und als „interne Normalisierung“ für Mamba (Lieber et al. 2024) vorgeschlagen wurde.
Insgesamt ergaben Tabelle 6 und Tabelle 7, dass die von uns getesteten Kernel-Approximationsmethoden gegenüber einfachen punktweisen nichtlinearen Aktivierungsfunktionen für keine Verbesserung zu erzielen schienen. Daher verwendeten unsere Standardeinstellungen für Mamba-2 , um Mamba-1 zu folgen, aber wir merken an, dass das vollständige Entfernen dieser Aktivierung eine einfachere Wahl sein könnte, die wir nicht umfassend getestet haben.
Wir betonen jedoch, dass sich SSD und Vanilla-Linear-Attention in der Einbeziehung der 1-semiseparabeln Maske unterscheiden, während die verschiedenen Methoden der linearen Attention in der Literatur hergeleitet wurden, um Softmax-Attention ohne diesen Term zu approximieren; daher sind unsere negativen Ergebnisse möglicherweise nicht unerwartet.
10 Verwandte Arbeiten und Diskussion
Das Rahmenwerk der State-Space-Dualität schlägt Brücken zwischen SSMs, strukturierten Matrizen und Attention. Wir diskutieren die Beziehungen zwischen SSD und diesen Konzepten im weiteren Sinne eingehender. Unter Verwendung von Ideen aus den einzelnen Perspektiven schlagen wir außerdem einige Richtungen vor, in denen das SSD-Rahmenwerk in zukünftiger Arbeit erweitert werden kann.
10.1 State-Space-Modelle
Strukturierte State-Space-Modelle lassen sich entlang der Achsen charakterisieren: (i) ob sie zeitinvariant oder zeitvariabel sind, (ii) die Dimensionalität des Systems, (iii) die Struktur der rekurrenten Übergänge .
SSD kann als selektives SSM mit SISO-Dimensionen und skalarer Identitätsstruktur beschrieben werden.
Zeitvarianz (Selektivität). Die ursprünglichen strukturierten SSMs (S4) waren lineare zeitinvariante (LTI) Systeme (Gu 2023; Gu, Goel, and Ré 2022), motiviert durch kontinuierliches Online-Memorisieren in kontinuierlicher Zeit (Gu, Dao, et al. 2020; Gu, Johnson, Goel, et al. 2021; Gu, Johnson, Timalsina, et al. 2023). Viele Varianten strukturierter SSMs wurden vorgeschlagen (Dao, D. Y. Fu, et al. 2023; Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; Ma et al. 2023; J. T. Smith, Warrington, and Linderman 2023), darunter mehrere, die die Rekurrenz verwerfen und sich auf die Faltungsdarstellung von LTI-SSMs konzentrieren (D. Y. Fu et al. 2023; Y. Li et al. 2023; Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023).
SSD ist ein zeitvariables strukturiertes SSM, auch bekannt als selektives SSM, das in Mamba eingeführt wurde (Gu and Dao 2023). Selektive SSMs sind eng verwandt mit Gating-Mechanismen von RNNs, einschließlich klassischer RNNs wie dem LSTM (Hochreiter and Schmidhuber 1997) und GRU (J. Chung et al. 2014) sowie moderneren Varianten wie dem QRNN (Bradbury et al. 2016), SRU (Lei 2021; Lei et al. 2017), RWKV (B. Peng, Alcaide, et al. 2023), HGRN (Qin, Yang, and Zhong 2023) und Griffin (Botev et al. 2024; De et al. 2024). Diese RNNs unterscheiden sich in ihren Parametrisierungen auf verschiedene Weise, am wichtigsten im Fehlen einer Zustandserweiterung.
Dimensionalität und Zustandserweiterung. Ein wichtiges Merkmal von SSD, das es mit früheren SSMs in seiner Linie (S4, H3, Mamba) teilt, ist, dass es ein Single-Input-Single-Output-(SISO-)System ist, bei dem Eingabekanäle unabhängig verarbeitet werden. Dies führt zu einer viel größeren effektiven Zustandsgröße von N0, wobei N die SSM-Zustandsgröße (auch Zustandserweiterungsfaktor genannt) und D die Standardmodelldimension ist. Traditionelle RNNs haben entweder oder sind Multi-Input-Multi-Output (MIMO) mit dichten -Matrizen, was jeweils zu einem kleineren Zustand führt. Während gezeigt wurde, dass MIMO-SSMs in einigen Domänen gut funktionieren (Lu et al. 2023; Orvieto et al. 2023; J. T. Smith, Warrington, and Linderman 2023), zeigte Mamba, dass Zustandserweiterung für informationsdichte Domänen wie Sprache entscheidend ist. Einer der Hauptvorteile von SSD ist, dass es noch größere Zustandserweiterungsfaktoren ermöglicht, ohne das Modell zu verlangsamen. Viele nachfolgende Arbeiten haben seitdem Zustandserweiterung übernommen (Abschnitt 10.4).
Struktur. Im Vergleich zu früheren strukturierten SSMs liegt die Hauptbeschränkung von SSD in der Ausdrucksfähigkeit der Zustandsübergänge . Wir merken an, dass allgemeinere SSMs, wie der Fall diagonaler , dieselbe theoretische Effizienz wie SSD haben, aber weniger hardwarefreundlich sind. Dies liegt daran, dass die duale quadratische Form ihre attentionähnliche Interpretation verliert und schwieriger zu berechnen wird. Somit unterscheidet sich SSD im Vergleich zu Mamba nur in einer etwas restriktiveren Form diagonaler und tauscht diese Ausdrucksfähigkeit gegen verbesserte Hardwareeffizienz (und einfachere Implementierung) ein.
Wir stellen die Hypothese auf, dass es möglich sein könnte, unsere Algorithmen für strukturierte Matrizen zu verfeinern, um auch den allgemeinen diagonalen SSM-Fall abzudecken.
10.2 Strukturierte Matrizen
Der erste Blickwinkel der Zustandsraumdualität betrachtet diese Modelle als Matrixsequenztransformationen oder „Matrix-Mixer“: Sequenztransformationen (Definition 2.1), die als Matrixmultiplikation (durch eine \(\mathrm{T}\times \mathrm{T}\)-Matrix) entlang der Sequenzdimension T dargestellt werden können.
Mehrere solcher Matrix-Mixer wurden bereits vorgeschlagen, wobei die primäre Variationsachse die Repräsentation der Matrix ist. Dazu gehören MLP-Mixer (Tolstikhin et al. 2021) (unstrukturierte Matrix), FNet (Lee-Thorp et al. 2021) (Fourier-Transformationsmatrix), M2 (Dao, B. Chen, et al. 2022; Dao, Gu, et al. 2019; Dao, Sohoni, et al. 2020; D. Fu et al. 2024) (Schmetterlings-/Monarchenmatrix), Toeplitz-Matrizen (Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023) und sogar noch exotischere Strukturen (De Sa et al. 2018; Thomas et al. 2018).
Eine wichtige Charakterisierung ist, dass effiziente (subquadratische) Matrixsequenztransformationen genau jene sind, die strukturierte Matrix-Mixer besitzen. Ein zentrales Ergebnis des SSD-Frameworks besteht darin, SSMs als Matrix-Mixer mit einer besonderen Struktur – halbseparierbaren Matrizen (Abschnitt 3) – aufzufassen. Die Dualität zwischen linear und quadratisch nimmt dann die Form von strukturierter Matrixmultiplikation gegenüber naiver Matrixmultiplikation an.
Die Strukturmatrixdarstellung führte durch Blockzerlegungen besonderer halbseparierbarer Matrizen (Abschnitt 6) zu unserem effizienten SSD-Algorithmus. Wir merken an, dass halbseparierbare Matrizen in der Literatur zum wissenschaftlichen Rechnen gut untersucht sind und dass die Einbeziehung dieser Ideen ein vielversprechender Weg für weitere Verbesserungen von Zustandsraummodellen sein könnte. Wir schlagen außerdem vor, dass die Fokussierung auf den Blickwinkel des Matrix-Mixers zu ergiebigeren Richtungen für Sequenzmodelle führen kann, etwa zur Entwicklung prinzipiengeleiteter nicht-kausaler Varianten von Mamba oder zur Findung von Wegen, die Lücke zwischen Softmax-Attention und subquadratischen Modellen durch Analyse ihrer Matrixtransformationsstruktur zu charakterisieren und zu überbrücken.
10.3 (Lineare) Attention
Im Vergleich zur standardmäßigen (kausalen) Attention weist SSD nur zwei wesentliche Unterschiede auf.
Erstens verwendet SSD nicht die Softmax-Aktivierung der Standard-Attention (Bahdanau, Cho, and Bengio 2015; Vaswani et al. 2017), die der Attention ihre quadratische Komplexität verleiht. Wird das Softmax weggelassen, kann die Sequenz durch das Framework der linearen Attention (Katharopoulos et al. 2020) mit linearer Skalierung berechnet werden.
Zweitens multipliziert SSD die Logit-Matrix mit einer eingabeabhängigen 1-halbseparierbaren Maske. Diese Maske kann somit als Ersatz für das Softmax in der Standard-Attention betrachtet werden.
Diese halbseparierbare Maske kann auch als Bereitstellung von Positionsinformationen betrachtet werden. Die Elemente wirken als „Gates" im Sinne von RNNs oder als „Selektions"-Mechanismus (siehe Diskussion im Mamba-Paper), und ihre kumulativen Produkte steuern, wie viel Interaktion zwischen den Positionen und erlaubt ist. Positions-Embeddings (z. B. sinusförmige (Vaswani et al. 2017), Alibi (Press, N. Smith, and Lewis 2022) und RoPE (Su et al. 2021)) sind eine wichtige Komponente von Transformers, die oft als Heuristiken betrachtet werden, und die 1-SS-Maske von SSD kann als eine prinzipientretere Form relativer Positions-Embeddings gesehen werden. Wir merken an, dass diese Sichtweise auch zeitgleich von GateLoop (Katsch 2023) vertreten wurde.
Die zweite Sichtweise der State-Space-Dualität ist ein Spezialfall unseres allgemeineren Frameworks der strukturierten maskierten Attention (SMA), wobei sich die Dualität als unterschiedliche Kontraktionsreihenfolgen bei einer einfachen 4-Wege-Tensorkontraktion offenbart. SMA ist eine starke Verallgemeinerung von Linear Attention, die zudem deutlich allgemeiner als SSD ist; andere Formen strukturierter Masken können zu weiteren Varianten effizienter Attention mit anderen Eigenschaften als SSD führen.
Neben der Hinführung zu neuen Modellen können diese Verbindungen zur Attention zu weiteren Richtungen für das Verständnis von SSMs führen. Zum Beispiel sind wir neugierig, ob das Phänomen der Attention Sinks (Darcet et al. 2024; Xiao et al. 2024) bei Mamba-Modellen existiert, und allgemeiner, ob Interpretierbarkeitstechniken auf SSMs übertragen werden können (Ali, Zimerman, and Wolf 2024).
Schließlich wurden viele weitere Varianten von Linear Attention vorgeschlagen (Arora, Eyuboglu, Timalsina, et al. 2024; Arora, Eyuboglu, Zhang, et al. 2024; Choromanski et al. 2021; H. Peng et al. 2021; Qin, Han, Weixuan Sun, Dongxu Li, et al. 2022; Qin, Weixuan Sun, et al. 2022; Schlag, Irie, and Schmidhuber 2021; Zhang et al. 2024; Zheng, C. Wang, and Kong 2022) (siehe Abschnitt 4.1.3 für Beschreibungen mehrerer dieser Varianten), und wir erwarten, dass viele Techniken auf SSMs übertragen werden können (z. B. Abschnitt 7.3).
Wir betonen, dass SSD die Standard-Softmax-Attention nicht verallgemeinert, ebenso wenig irgendeine andere Transformation auf der Attention-Kernel-Matrix, die keine endliche Feature-Map besitzt. Im Vergleich zur allgemeinen Attention besteht der Vorteil von SSD in einem kontrollierbaren State-Expansionsfaktor , der die Historie komprimiert, verglichen mit dem Cache der gesamten Historie bei quadratischer Attention, der mit der Sequenzlänge skaliert. Zeitgleiche Arbeiten haben begonnen, die Tradeoffs dieser Repräsentationen zu untersuchen, beispielsweise bei Copying- und In-Context-Learning-Aufgaben (Akyürek et al. 2024; Grazzi et al. 2024; Jelassi et al. 2024; Park et al. 2024). Wir merken an, dass Mamba-2 Mamba bei einigen dieser Fähigkeiten deutlich verbessert (z. B. wie durch die MQAR-Ergebnisse in Abschnitt 9.1 gezeigt), aber es bleibt mehr zu verstehen.
10.4 Verwandte Modelle
Abschließend heben wir eine wachsende Zahl neuerer und zeitgleicher Arbeiten hervor, die sehr ähnliche Sequenzmodelle wie Mamba und Mamba-2 entwickelt haben.
- RetNet (Y. Sun et al. 2023) und TransNormerLLM (Qin, Dong Li, et al. 2023) verallgemeinern Linear Attention mithilfe von Zerfallstermen anstelle einer kumulativen Summe und schlagen duale parallele/rekursive Algorithmen sowie einen hybriden „chunkweisen" Modus vor. Diese Algorithmen können als eine Instanziierung von SSD gesehen werden, bei der zeitinvariant ist (konstant für alle ); in der SMA-Interpretation wäre die Maskenmatrix eine Zerfallsmatrix . Diese Modelle unterscheiden sich zudem in verschiedener Hinsicht architektonisch. Da sie beispielsweise aus einer attention-zentrierten Perspektive abgeleitet wurden, bewahren sie das Muster der Multi-Head-Attention (MHA); da Mamba-2 aus einem SSM-zentrierten Muster abgeleitet wurde, bewahrt es das Muster der Multi-Value-Attention (MVA) bzw. des Multi-Expand-SSM (MES), von dem wir zeigen, dass es besser ist (Abschnitt 9.4).
- GateLoop (Katsch 2023) schlug zeitgleich die Verwendung eingabeabhängiger Zerfallsfaktoren vor und entwickelte dieselbe duale quadratische Form wie in SSD, die sie als „Surrogate Attention"-Form bezeichnen.
- Gated Linear Attention (GLA) (Yang et al. 2024) schlug eine Variante von Linear Attention mit datenabhängigen Gates vor, zusammen mit effizienten Algorithmen zur Berechnung eines chunkweisen Modus und hardwarebewussten Implementierungen.
- HGRN (Qin, Yang, and Zhong 2023) führte ein RNN mit eingabeabhängigen Gates ein, das in HGRN2 (Qin, Yang, Weixuan Sun, et al. 2024) dahingehend verbessert wurde, State-Expansion zu integrieren.
- Griffin (De et al. 2024) und RecurrentGemma (Botev et al. 2024) zeigten, dass ein RNN mit eingabeabhängigem Gating, kombiniert mit lokaler Attention, sehr konkurrenzfähig zu starken modernen Transformers sein kann. Jamba zeigte zudem, dass die Kombination von Mamba mit einigen wenigen Attention-Schichten beim Language Modeling sehr gut funktioniert (Lieber et al. 2024).
- xLSTM (Beck et al. 2024) verbessert das xLSTM, indem es die Idee der State-Expansion sowie weitere Gating-, Normalisierungs- und Stabilisierungstechniken übernimmt.
- RWKV(-4) (B. Peng, Alcaide, et al. 2023) ist ein RNN, das auf einer anderen Linear-Attention-Approximation basiert (dem Attention-free Transformer (S. Zhai et al. 2021)). Es wurde kürzlich zu den Architekturen RWKV-5/6 (Eagle and Finch) (B. Peng, Goldstein, et al. 2024) verbessert, indem die Ideen der Selektivität und State-Expansion übernommen wurden.
11 Fazit
Wir haben ein theoretisches Framework vorgeschlagen, das auf gut untersuchten Klassen strukturierter Matrizen basiert und die konzeptionelle Lücke zwischen SSMs und Attention-Varianten überbrückt. Dieses Framework liefert Erkenntnisse darüber, wie neuere SSMs (z. B. Mamba) ebenso gut wie Transformers beim Language Modeling abschneiden. Darüber hinaus bieten unsere theoretischen Werkzeuge neue Ideen zur Verbesserung von SSMs (und potenziell Transformers), indem sie die algorithmischen und systemseitigen Fortschritte auf beiden Seiten miteinander verbinden. Als Demonstration leitet das Framework unser Design einer neuen Architektur (Mamba-2) an der Schnittstelle von SSMs und strukturierter Attention.
Danksagungen
Wir danken Angela Wu für den Vorschlag, wie der Gradient von auf numerisch stabile Weise effizient berechnet werden kann. Wir danken Sukjun Hwang und Aakash Lahoti für ihre Unterstützung bei den MQAR-Experimenten.
Literaturverzeichnis
[1] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. „GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints". In: arXiv preprint arXiv:2305.13245 (2023).
[2] Yaroslav Aksenov, Nikita Balagansky, Sofia Maria Lo Cicero Vaina, Boris Shaposhnikov, Alexey Gorbatovski, and Daniil Gavrilov. „Linear Transformers with Learnable Kernel Functions are Better In-Context Models". In: arXiv preprint arXiv:2402.10644 (2024).
[3] Ekin Akyürek, Bailin Wang, Yoon Kim, and Jacob Andreas. „In-Context Language Learning: Architectures and Algorithms". In: The International Conference on Machine Learning (ICML). 2024.
[4] Ameen Ali, Itamar Zimerman, and Lior Wolf. The Hidden Attention of Mamba Models. 2024. arXiv: 2403.01590 [cs.LG].
[5] Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. „Zoology: Measuring and Improving Recall in Efficient Language Models". In: The International Conference on Learning Representations (ICLR). 2024.
[6] Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, and Christopher Ré. „Simple Linear Attention Language Models Balance the Recall-Throughput Tradeoff". In: The International Conference on Machine Learning (ICML). 2024.
[7] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. „Neural Machine Translation by Jointly Learning to Align and Translate". In: The International Conference on Learning Representations (ICLR). 2015.
[8] George A Baker, George A Baker Jr, Peter Graves-Morris, and Susan S Baker. Pade Approximants: Encyclopedia of Mathematics and It's Applications, Vol. 59 George A. Baker, Jr., Peter Graves-Morris. Vol. 59. Cambridge University Press, 1996.
[9] Maximilian Beck, Korbinian Poppel, Markus Spanring, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter und Sepp Hochreiter. „xLSTM: Extended Long Short-Term Memory“. In: arXiv preprint arXiv:2405.04517 (2024).
[10] Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, et al. „Pythia: A Suite for Analyzing Large Language Models across Training and Scaling“. In: The International Conference on Machine Learning (ICML). PMLR. 2023, S. 2397-2430.
[11] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. „PIQA: Reasoning about Physical Commonsense in Natural Language“. In: Proceedings of the AAAI conference on Artificial Intelligence. Bd. 34. 2020.
[12] Sid Black, Stella Biderman, Eric Hallahan, Quentin Anthony, Leo Gao, Laurence Golding, Horace He, Connor Leahy, Kyle McDonell, Jason Phang, et al. „Gpt-NeoX-20B: An Open-source Autoregressive Language Model“. In: arXiv preprint arXiv:2204.06745 (2022).
[13] Guy E Blelloch. „Prefix Sums and Their Applications“. In: (1990).
[14] Aleksandar Botev, Soham De, Samuel L Smith, Anushan Fernando, George-Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, et al. „RecurrentGemma: Moving Past Transformers for Efficient Open Language Models“. In: arXiv preprint arXiv:2404.07839 (2024).
[15] George EP Box, Gwilym M Jenkins, Gregory C Reinsel und Greta M Ljung. Time Series Analysis: Forecasting and Control. John Wiley & Sons, 2015.
[16] James Bradbury, Stephen Merity, Caiming Xiong und Richard Socher. „Quasi-recurrent Neural Networks“. In: arXiv preprint arXiv:1611.01576 (2016).
[17] William Brandon, Aniruddha Nrusimha, Kevin Qian, Zachary Ankner, Tian Jin, Zhiye Song und Jonathan Ragan-Kelley. „Striped attention: Faster ring attention for causal transformers“. In: arXiv preprint arXiv:2311.09431 (2023).
[18] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. „Language Models are Few-shot Learners“. In: Advances in Neural Information Processing Systems (NeurIPS) 33 (2020), S. 1877–1901.
[19] Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, et al. „Rethinking Attention with Performers“. In: The International Conference on Learning Representations (ICLR). 2021.
[20] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. „PaLM: Scaling Language Modeling with Pathways“. In: Journal of Machine Learning Research 24.240 (2023), S. 1–113. URL: http://jmlr.org/papers/v24/22-1144.html.
[21] Junyoung Chung, Caglar Gulcehre, KyungHyun Cho und Yoshua Bengio. „Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling“. In: arXiv preprint arXiv:1412.3555 (2014).
[22] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick und Oyvind Tafjord. „Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge“. In: arXiv preprint arXiv:1803.05457 (2018).
[23] Tri Dao. „FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning“. In: The International Conference on Learning Representations (ICLR). 2024.
[24] Tri Dao, Beidi Chen, Nimit S Sohoni, Arjun Desai, Michael Poli, Jessica Grogan, Alexander Liu, Aniruddh Rao, Atri Rudra und Christopher Ré. „Monarch: Expressive structured matrices for efficient and accurate training“. In: International Conference on Machine Learning. PMLR. 2022, S. 4690–4721.
[25] Tri Dao, Daniel Y Fu, Khaled K Saab, Armin W Thomas, Atri Rudra und Christopher Ré. „Hungry Hungry Hippos: Towards Language Modeling with State Space Models“. In: The International Conference on Learning Representations (ICLR). 2023.
[26] Tri Dao, Albert Gu, Matthew Eichhorn, Atri Rudra und Christopher Ré. „Learning Fast Algorithms for Linear Transforms Using Butterfly Factorizations“. In: The International Conference on Machine Learning (ICML). 2019.
[27] Tri Dao, Nimit Sohoni, Albert Gu, Matthew Eichhorn, Amit Blonder, Megan Leszczynski, Atri Rudra und Christopher Ré. „Kaleidoscope: An Efficient, Learnable Representation for All Structured Linear Maps“. In: The International Conference on Learning Representations (ICLR). 2020.
[28] Timothée Darcet, Maxime Oquab, Julien Mairal und Piotr Bojanowski. „Vision Transformers Need Registers“. In: The International Conference on Learning Representations (ICLR). 2024.
[29] Soham De, Samuel L Smith, Anushan Fernando, Aleksandar Botev, George Cristian-Muraru, Albert Gu, Ruba Haroun, Leonard Berrada, Yutian Chen, Srivatsan Srinivasan, et al. „Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models“. In: arXiv preprint arXiv:2402.19427 (2024).
[30] Christopher De Sa, Albert Gu, Rohan Puttagunta, Christopher Ré und Atri Rudra. „A Two-Pronged Progress in Structured Dense Matrix Vector Multiplication“. In: Proceedings of the Twenty-Ninth Annual ACM-SIAM Symposium on Discrete Algorithms. SIAM. 2018, S. 1060–1079.
[31] Hantian Ding, Zijian Wang, Giovanni Paolini, Varun Kumar, Anoop Deoras, Dan Roth und Stefano Soatto. „Fewer truncations improve language modeling“. In: arXiv preprint arXiv:2404.10830 (2024).
[32] Yuli Eidelman und Israel Gohberg. „On a new class of structured matrices“. In: Integral Equations and Operator Theory 34.3 (1999), S. 293–324.
[33] Dan Fu, Simran Arora, Jessica Grogan, Isys Johnson, Evan Sabri Eyuboglu, Armin Thomas, Benjamin Spector, Michael Poli, Atri Rudra und Christopher Ré. „Monarch mixer: A simple sub-quadratic gemm-based architecture“. In: Advances in Neural Information Processing Systems 36 (2024).
[34] Daniel Y Fu, Elliot L Epstein, Eric Nguyen, Armin W Thomas, Michael Zhang, Tri Dao, Atri Rudra und Christopher Ré. „Simple Hardware-efficient Long Convolutions for Sequence Modeling“. In: The International Conference on Machine Learning (ICML) (2023).
[35] Leo Gao, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, Horace He, Anish Thite, Noa Nabeshima, Shawn Presser und Connor Leahy. „The Pile: An 800GB Dataset of Diverse Text for Language Modeling“. In: arXiv preprint arXiv:2101.00027 (2020).
[36] Leo Gao, Jonathan Tow, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Kyle McDonell, Niklas Muennighoff, Jason Phang, Laria Reynolds, Eric Tang, Anish Thite, Ben Wang, Kevin Wang und Andy Zou. A Framework for Few-shot Language Model Evaluation. Version v0.0.1. Sept. 2021. DOI: 10.5281/zenodo.5371628. URL: https://doi.org/10.5281/zenodo.5371628.
[37] Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim und Beren Millidge. „Zamba: A Compact 7B SSM Hybrid Model“. In: arXiv preprint arXiv:2405.16712 (2024).
[38] Riccardo Grazzi, Julien Siems, Simon Schrodi, Thomas Brox und Frank Hutter. „Is Mamba Capable of In-Context Learning?“ In: arXiv preprint arXiv:2402.03170 (2024).
[39] Albert Gu. „Modeling Sequences with Structured State Spaces“. PhD thesis. Stanford University, 2023.
[40] Albert Gu und Tri Dao. „Mamba: Linear-Time Sequence Modeling with Selective State Spaces“. In: arXiv preprint arXiv:2312.00752 (2023).
[41] Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra und Christopher Ré. „HIPPO: Recurrent Memory with Optimal Polynomial Projections“. In: Advances in Neural Information Processing Systems (NeurIPS). 2020.
[42] Albert Gu, Karan Goel und Christopher Ré. „Efficiently Modeling Long Sequences with Structured State Spaces“. In: The International Conference on Learning Representations (ICLR). 2022.
[43] Albert Gu, Ankit Gupta, Karan Goel und Christopher Ré. „On the Parameterization and Initialization of Diagonal State Space Models“. In: Advances in Neural Information Processing Systems (NeurIPS). 2022.
[44] Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra und Christopher Ré. „Combining Recurrent, Convolutional, and Continuous-time Models with the Linear State Space Layer“. In: Advances in Neural Information Processing Systems (NeurIPS). 2021.
[45] Albert Gu, Isys Johnson, Aman Timalsina, Atri Rudra und Christopher Ré. „How to Train Your HIPPO: State Space Models with Generalized Basis Projections“. In: The International Conference on Learning Representations (ICLR). 2023.
[46] Ankit Gupta, Albert Gu und Jonathan Berant. „Diagonal State Spaces are as Effective as Structured State Spaces“. In: Advances in Neural Information Processing Systems 35 (2022), S. 22982–22994.
[47] Dan Hendrycks und Kevin Gimpel. „Gaussian Error Linear Units (GELUs)“. In: arXiv preprint arXiv:1606.08415 (2016).
[48] W Daniel Hillis und Guy L Steele Jr. „Data Parallel Algorithms“. In: Communications of the ACM 29.12 (1986), S. 1170–1183.
[49] Sepp Hochreiter und Jürgen Schmidhuber. „Long Short-Term Memory“. In: Neural Computation 9.8 (1997), S. 1735–1780.
[50] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. „An Empirical Analysis of Compute Optimal Large Language Model Training“. In: Advances in Neural Information Processing Systems (NeurIPS) 35 (2022), S. 30016–30030. [51] Samy Jelassi, David Brandfonbrener, Sham M Kakade und Eran Malach. „Repeat After Me: Transformers Are Better Than State Space Models at Copying“. In: The International Conference on Machine Learning (ICML). 2024. [52] Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas und Francois Fleuret. „Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention“. In: International Conference on Machine Learning. PMLR. 2020, S. 5156–5165. [53] Tobias Katsch. „GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling“. In: arXiv preprint arXiv:2311.01927 (2023). [54] Shiva Kaul. „Linear Dynamical Systems as a Core Computational Primitive“. In: Advances in Neural Information Processing Systems 33 (2020), S. 16808–16820. [55] Vijay Anand Korthikanti, Jared Casper, Sangkug Lynn, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi und Bryan Catanzaro. „Reducing activation recomputation in large transformer models“. In: Proceedings of Machine Learning and Systems 5 (2023). [56] James Lee-Thorp, Joshua Ainslie, Ilya Eckstein und Santiago Ontanon. „Fnet: Mixing tokens with fourier transforms“. In: arXiv preprint arXiv:2105.03824 (2021). [57] Tao Lei. „When Attention Meets Fast Recurrence: Training Language Models with Reduced Compute“. In: Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing. 2021, S. 7633–7648. [58] Tao Lei, Yu Zhang, Sida I Wang, Hui Dai und Yoav Artzi. „Simple Recurrent Units for Highly Parallelizable Recurrence“. In: arXiv preprint arXiv:1709.02755 (2017). [59] Yuhong Li, Tianle Cai, Yi Zhang, Deming Chen und Debadeepta Dey. „What Makes Convolutional Models Great on Long Sequence Modeling?“ In: The International Conference on Learning Representations (ICLR). 2023. [60] Opher Lieber, Barak Lenz, Hofit Bata, Gal Cohen, Jhonathan Osin, Itay Dalmedigos, Erez Safahi, Shaked Meirom, Yonatan Belinkov, Shai Shalev-Shwartz, et al. „Jamba: A Hybrid Transformer-Mamba Language Model“. In: arXiv preprint arXiv:2403.19887 (2024). [61] Hao Liu, Wilson Yan, Matei Zaharia und Pieter Abbeel. „World Model on Million-Length Video And Language With RingAttention“. In: arXiv preprint arXiv:2402.08268 (2024). [62] Hao Liu, Matei Zaharia und Pieter Abbeel. „Ring attention with blockwise transformers for near-infinite context“. In: arXiv preprint arXiv:2310.01889 (2023). [63] Chris Lu, Yannick Schroecker, Albert Gu, Emilio Parisotto, Jakob Foerster, Satinder Singh und Feryal Behbahani. „Structured State Space Models for In-Context Reinforcement Learning“. In: Advances in Neural Information Processing Systems (NeurIPS). 2023. [64] Xuezhe Ma, Chunting Zhou, Xiang Kong, Junxian He, Liangke Gui, Graham Neubig, Jonathan May und Luke Zettlemoyer. „Mega: Moving Average Equipped Gated Attention“. In: The International Conference on Learning Representations (ICLR). 2023. [65] Eric Martin und Chris Cundy. „Parallelizing Linear Recurrent Neural Nets Over Sequence Length“. In: The International Conference on Learning Representations (ICLR). 2018. [66] Todor Mihaylov, Peter Clark, Tushar Khot und Ashish Sabharwal. „Can a Suit of Armor Conduct Electricity? A New Dataset for Open Book Question Answering“. In: arXiv preprint arXiv:1809.02789 (2018). [67] Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish und Chris Olah. „In-context Learning and Induction Heads“. In: Transformer Circuits Thread (2022). https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html. [68] Antonio Orvieto, Samuel L Smith, Albert Gu, Anushan Fernando, Caglar Gulcehre, Razvan Pascanu und Soham De. „Resurrecting Recurrent Neural Networks for Long Sequences“. In: The International Conference on Machine Learning (ICML). 2023. [69] Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Ngoc-Quan Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda und Raquel Fernández. „The LAMBADA Dataset: Word Prediction Requiring a Broad Discourse Context“. In: Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics. 2016, S. 1525–1534. [70] Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee und Dimitris Papailiopoulos. „Can Mamba Learn How to Learn? A Comparative Study on In-Context Learning Tasks“. In: The International Conference on Machine Learning (ICML). 2024.
. html.
[71] Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, et al. „RWKV: Reinventing RNNs for the Transformer Era“. In: arXiv preprint arXiv:2305.13048 (2023).
[72] Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Teddy Ferdinand, Haowen Hou, Przemyslaw Kazienko, et al. „Eagle and Finch: RWKV with matrix-valued states and dynamic recurrence“. In: arXiv preprint arXiv:2404.05892 (2024).
[73] Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A Smith, and Lingpeng Kong. „Random Feature Attention“. In: The International Conference on Learning Representations (ICLR). 2021.
[74] Clément Pernet. „Computing with Quasiseparable Matrices“. In: Proceedings of the ACM on International Symposium on Symbolic and Algebraic Computation. 2016, S. 389–396.
[75] Clément Pernet, Hippolyte Signargout, and Gilles Villard. „Exact computations with quasiseparable matrices“. In: arXiv preprint arXiv:2302.04515 (2023).
[76] Clément Pernet and Arne Storjohann. „Time and space efficient generators for quasiseparable matrices“. In: Journal of Symbolic Computation 85 (2018), S. 224–246.
[77] Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. „Hyena Hierarchy: Towards Larger Convolutional Language Models“. In: The International Conference on Machine Learning (ICML). 2023.
[78] Hadi Pouransari, Chun-Liang Li, Jen-Hao Rick Chang, Pavan Kumar Anasosalu Vasu, Cem Koc, Vaishaal Shankar, and Oncel Tuzel. „Dataset Decomposition: Faster LLM Training with Variable Sequence Length Curriculum“. In: arXiv preprint arXiv:2405.13226 (2024).
[79] Ofir Press, Noah Smith, and Mike Lewis. „Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation“. In: International Conference on Learning Representations. 2022.
[80] Zhen Qin, Xiaodong Han, Weixuan Sun, Bowen He, Dong Li, Dongxu Li, Yuchao Dai, Lingpeng Kong, and Yiran Zhong. „Toeplitz Neural Network for Sequence Modeling“. In: The International Conference on Learning Representations (ICLR). 2023.
[81] Zhen Qin, Xiaodong Han, Weixuan Sun, Dongxu Li, Lingpeng Kong, Nick Barnes, and Yiran Zhong. „The devil in linear transformer“. In: arXiv preprint arXiv:2210.10340 (2022).
[82] Zhen Qin, Dong Li, Weigao Sun, Weixuan Sun, Xuyang Shen, Xiaodong Han, Yunshen Wei, Baohong Lv, Xiao Luo, Yu Qiao, et al. „TransNormerLLM: A Faster and Better Large Language Model with Improved TransNormer“. In: arXiv preprint arXiv:2307.14995 (2023).
[83] Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong. „CosFormer: Rethinking Softmax in Attention“. In: The International Conference on Learning Representations (ICLR). 2022.
[84] Zhen Qin, Songlin Yang, Weixuan Sun, Xuyang Shen, Dong Li, Weigao Sun, and Yiran Zhong. „HGRN2: Gated Linear RNNs with State Expansion“. In: arXiv preprint arXiv:2404.07904 (2024).
[85] Zhen Qin, Songlin Yang, and Yiran Zhong. „Hierarchically Gated Recurrent Neural Network for Sequence Modeling“. In: Advances in Neural Information Processing Systems 36 (2023).
[86] Ali Rahimi and Benjamin Recht. „Random Features for Large-Scale Kernel Machines“. In: Advances in Neural Information Processing Systems (NeurIPS) 20 (2007).
[87] Prajit Ramachandran, Barret Zoph, and Quoc V Le. „Swish: A Self-gated Activation Function“. In: arXiv preprint arXiv:1710.05941 7.1 (2017), S. 5.
[88] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. „Winogrande: An Adversarial Winograd Schema Challenge at Scale“. In: Communications of the ACM 64.9 (2021), S. 99–106.
[89] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. „Linear Transformers are Secretly Fast Weight Programmers“. In: The International Conference on Machine Learning (ICML). PMLR. 2021, S. 9355–9366.
[90] Noam Shazeer. „Fast Transformer Decoding: One Write-head is All You Need“. In: arXiv preprint arXiv:1911.02150 (2019).
[91] Sam Shleifer, Jason Weston, and Myle Ott. „NormFormer: Improved Transformer Pretraining with Extra Normalization“. In: arXiv preprint arXiv:2110.09456 (2021).
[92] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. „Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism“. In: arXiv preprint arXiv:1909.08053 (2019).
[93] Jimmy TH Smith, Andrew Warrington, and Scott W Linderman. „Simplified State Space Layers for Sequence Modeling“. In: The International Conference on Learning Representations (ICLR). 2023.
[94] Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, and Yunfeng Liu. „Roformer: Enhanced Transformer with Rotary Position Embedding“. In: arXiv preprint arXiv:2104.09864 (2021).
[95] Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei. „Retentive network: A successor to transformer for large language models“. In: arXiv preprint arXiv:2307.08621 (2023).
[96] Yi Tay, Mostafa Dehghani, Dara Bahri, and Donald Metzler. „Efficient Transformers: A Survey“. In: ACM Computing Surveys 55.6 (2022), S. 1–28.
[97] Chameleon Team. „Chameleon: Mixed-Modal Early-Fusion Foundation Models“. In: arXiv preprint arXiv:2405.09818 (2024).
[98] Anna Thomas, Albert Gu, Tri Dao, Atri Rudra, and Christopher Ré. „Learning Compressed Transforms with Low Displacement Rank“. In: Advances in Neural Information Processing Systems (NeurIPS). 2018, S. 9052–9060.
[99] Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al. „MLP-Mixer: An All-MLP Architecture for Vision“. In: Advances in Neural Information Processing Systems (NeurIPS) 34 (2021), S. 24261–24272.
[100] Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al. „Llama: Open and Efficient Foundation Language Models“. In: arXiv preprint arXiv:2302.13971 (2023).
[101] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. „Llama 2: Open foundation and fine-tuned chat models“. In: arXiv preprint arXiv:2307.09288 (2023).
[102] Raf Vandebril, M Van Barel, Gene Golub, and Nicola Mastronardi. „A bibliography on semiseparable matrices“. In: Calcolo 42 (2005), S. 249–270.
[103] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser und Illia Polosukhin. „Attention Is All You Need“. In: Advances in Neural Information Processing Systems (NeurIPS). 2017.
[104] Shida Wang und Beichen Xue. „State-space Models with Layer-wise Nonlinearity are Universal Approximators with Exponential Decaying Memory“. In: arXiv preprint arXiv:2309.13414 (2023).
[105] Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang und Hao Ma. „Linformer: Self-attention with Linear Complexity“. In: arXiv preprint arXiv:2006.04768 (2020).
[106] Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han und Mike Lewis. „Efficient Streaming Language Models with Attention Sinks“. In: The International Conference on Learning Representations (ICLR). 2024.
[107] Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li und Vikas Singh. „Nyströmformer: A Nyström-Based Algorithm for Approximating Self-Attention“. In: Proceedings of the AAAI Conference on Artificial Intelligence. Bd. 35. 2021.
[108] Songlin Yang, Bailin Wang, Yikang Shen, Rameswar Panda und Yoon Kim. „Gated Linear Attention Transformers with Hardware-Efficient Training“. In: The International Conference on Machine Learning (ICML). 2024.
[109] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi und Yejin Choi. „HellaSwag: Can a Machine Really Finish Your Sentence?“ In: Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics. 2019.
[110] Jinle Zeng, Min Li, Zhihua Wu, Jiaqi Liu, Yuang Liu, Dianhai Yu und Yanjun Ma. „Boosting distributed training performance of the unpadded bert model“. In: arXiv preprint arXiv:2208.08124 (2022).
[111] Shuangfei Zhai, Walter Talbott, Nitish Srivastava, Chen Huang, Hanlin Goh, Ruixiang Zhang und Josh Susskind. „An Attention Free Transformer“. In: arXiv preprint arXiv:2105.14103 (2021).
[112] Yujia Zhai, Chengquan Jiang, Leyuan Wang, Xiaoying Jia, Shang Zhang, Zizhong Chen, Xin Liu und Yibo Zhu. „Bytetransformer: A high- performance transformer boosted for variable- length inputs“. In: 2023 IEEE International Parallel and Distributed Processing Symposium (IPDPS). IEEE. 2023, S. 344–355.
[113] Michael Zhang, Kush Bhatia, Hermann Kumbong und Christopher Ré. „The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry“. In: The International Conference on Learning Representations (ICLR). 2024.
[114] Lin Zheng, Chong Wang und Lingpeng Kong. „Linear complexity randomized self- attention mechanism“. In: International Conference on Machine Learning. PMLR. 2022, S. 27011–27041.
Ein Glossar
| Notation | Beschreibung | Definition |
| T | Zeitachse oder Zielsequenzachse | Definition 2.1 |
| S | Quellsequenzachse (bei Attention) | Gleichung (9) |
| D | Modelldimension oder d_model | Definition 7.1 |
| N | Zustands-/Merkmalsdimension oder d_state | Gleichungen (2) und (9) |
| P | Head-Dimension oder d_head | Definition 2.1 |
| H | Anzahl der Heads oder n_head | Definition 7.1 |
| M | Sequenztransformationsmatrix | Definition 2.3 |
| A | Diskrete rekurrente SSM-(Zustands-)Matrix | Gleichung (2) |
| B | Eingabeprojektions-(Expansions-)Matrix des Zustandsraummodells | Gleichung (2) |
| C | Ausgabeprojektions-(Kontraktions-)Matrix des Zustandsraummodells | Gleichung (2) |
| X | Eingabematrix (Form (T,P)) | Gleichungen (2) und (9) |
| Y | Ausgabematrix (Form (T,P)) | Gleichungen (2) und (9) |
| Q | Query-Matrix der Attention | Gleichung (9) |
| K | Key-Matrix der Attention | Gleichung (9) |
| V | Value-Matrix der Attention | Gleichung (9) |
| G | Gram-Matrix der Attention | QK^T (oder CB^T) |
| L | (Strukturierte) Maskenmatrix (im kausalen Fall untere Dreiecksmatrix) | Definition 4.2 |
B Effiziente Algorithmen für den skalaren SSM-Scan (1-SS-Multiplikation)
In diesem Abschnitt erläutern wir verschiedene Algorithmen zur Berechnung des skalaren SSM-Scans aus der Perspektive strukturierter Matrixzerlegungen. Der skalare SSM-Scan ist definiert als die Berechnung des rekurrenten Teils des diskreten SSM (7) im Fall (d. h. ist ein Skalar). Dies wird üblicherweise zur rekurrenten Berechnung von SSMs verwendet; insbesondere reduziert sich der Fall strukturierter SSMs, bei denen diagonal strukturiert ist, auf diese Operation, wie etwa in den Modellen S5 (J. T. Smith, Warrington und Linderman 2023) und S6 (Gu und Dao 2023).
Das Ziel dieses Abschnitts ist es, ein zentrales Thema dieses Artikels zu stützen, nämlich dass effiziente Algorithmen für Sequenzmodelle als Algorithmen zur Multiplikation strukturierter Matrizen betrachtet werden können. Die verschiedenen hier gezeigten Ideen zur Matrixzerlegung stehen in Beziehung zu Ideen, die zur Herleitung schneller SSM-Algorithmen verwendet werden (Abschnitt 6), und werden auch direkt als Unterroutine eingesetzt.
B.1 Problemdefinition
Seien und Folgen von Skalaren. Der skalare SSM-Scan ist definiert als
Dabei kann ein beliebiger Wert sein, der den vorherigen verborgenen Zustand der SSM-Rekurrenz darstellt; sofern nicht anders angegeben, nehmen wir an.
Wir nennen Gleichung (21) auch cumprodsum (kumulative Produktsumme). Beachten Sie, dass die cumprodsum zur cumprod (kumulatives Produkt) wird, wenn das additive neutrale Element ist, und zur cumsum (kumulative Summe) wird, wenn das multiplikative neutrale Element ist. Schließlich beachten Sie, dass wir in vektorisierter Form schreiben können
Mit anderen Worten, dies ist einfach das Matrix-Vektor-Produkt mit einer 1-SS-Matrix .
Daher haben wir drei Sichtweisen auf diese fundamentale primitive Operation, die alle äquivalent sind:
- Ein (skalarer) SSM-Scan. - Eine cumprodsum. - Eine 1-SS-Matrix-Vektor-Multiplikation.
B.2 Klassische Algorithmen
Wir beschreiben zunächst die beiden klassischen Arten der Berechnung des SSM-Scans (21), die zuvor in früheren Arbeiten verwendet wurden.
B.2.1 Sequentielle Rekurrenz
Der rekurrente Modus berechnet einfach (21) einen Zeitschritt nach dem anderen. Aus der Perspektive der 1-SS-Multiplikation wurde dies auch in Abschnitt 3.4.1 beschrieben.
B.2.2 Paralleler assoziativer Scan
Zweitens ist eine wichtige Beobachtung, dass diese Rekurrenz in einen assoziativen Scan umgewandelt werden kann (E. Martin und Cundy 2018; J. T. Smith, Warrington und Linderman 2023). Diese Tatsache ist nicht völlig offensichtlich. Beispielsweise definierte S5 den korrekten assoziativen Scan-Operator und zeigte dann die Assoziativität des Operators durch stumpfsinnige Berechnung.
Eine etwas sauberere Art zu erkennen, dass dies mit einem assoziativen Scan berechenbar ist, besteht darin, die Rekurrenz mit mehreren Termen in eine Rekurrenz mit einem einzigen Term auf einem verborgenen Zustand der Größe 2 statt 1 umzuwandeln:
Dann ist die Berechnung aller dasselbe wie die Bildung der kumulativen Produkte dieser -Matrizen. Da die Matrixmultiplikation assoziativ ist, kann dies mit einem assoziativen Scan berechnet werden. Der assoziative binäre Operator ist einfach die Matrixmultiplikation auf diesen speziellen Matrizen:
Das Gleichsetzen der oberen Zeile ergibt denselben assoziativen Scan-Operator wie von S5 definiert:
Der Grund, warum assoziative Scans wichtig sind, ist, dass sie mit einem Divide-and-Conquer-Algorithmus parallelisiert werden können (Blelloch 1990). Wir lassen die Details dieses Algorithmus aus und zeigen stattdessen, dass der gesamte assoziative SSM-Scan-Algorithmus von Grund auf durch Matrixzerlegungen hergeleitet werden kann (Anhang B.3.5).
B.3 Effiziente Algorithmen mittels strukturierter Matrixzerlegungen
Wir diskutieren mehrere Algorithmen zur Berechnung des SSM-Scans, alle aus der Perspektive der Findung strukturierter Matrixzerlegungen der 1-SS-Matrix . Diese Algorithmen oder Berechnungsmodi umfassen einen dilatierten Modus, bei dem Informationen 1, 2, 4, 8, ... Schritte auf einmal propagiert werden. Einen zustandsübergebenden Modus, bei dem Informationen in Blöcken vorwärts propagiert werden. Einen vollständig rekurrenten Modus, der einen Schritt nach dem anderen inkrementiert, was ein Spezialfall des zustandsübergebenden Modus ist. Einen parallelen Blockzerlegungsmodus, bei dem in hierarchische Blöcke unterteilt wird. Einen Scan-Modus, bei dem in gleich große Blöcke unterteilt und rekursiv reduziert wird.
B.3.1 Dilatierter Modus
Dieser Modus faktorisiert die 1-SS-Matrix auf eine bestimmte Weise, die zunehmende „Schrittweiten“ umfasst. Dies lässt sich am besten anhand eines konkreten Beispiels veranschaulichen:
B.3.2 Zustandsübergebender (blockweiser) Modus
Dieser Modus kann als Verallgemeinerung des standardmäßigen rekurrenten Modus betrachtet werden, bei dem wir den rekurrenten Zustand nicht Schritt für Schritt weitergeben, sondern die Antwort auf Blöcken beliebiger Länge berechnen und den Zustand durch den Block weiterreichen. Dies lässt sich auch aus einer einfachen Blockzerlegung der 1-SS-Matrix herleiten.
Bemerkung 9. Während wir dies „State-Passing“ nennen, um darauf zu verweisen, wie Zustände von einem lokalen Segment an ein anderes weitergegeben werden, steht dies im Zusammenhang mit den „chunkwise“-Algorithmen, die von verwandten Modellen vorgeschlagen wurden (Y. Sun et al. 2023; Yang et al. 2024).
Betrachten wir die Berechnung von in „Blöcken“: Für einen Index wollen wir bzw. die Ausgabe bis zum Index berechnen und haben eine Möglichkeit, das Problem auf ein kleineres Problem über die Indizes zu reduzieren. Wir schreiben als
1. Berechne die linke Hälfte der Antwort mit einer beliebigen gewünschten Methode (d. h. mit einer der Methoden zur 1-SS-Multiplikation aus diesem Abschnitt).
2. Berechne den Endzustand .
3. Inkrementiere den Zustand um einen Schritt, um zu modifizieren.
4. Berechne die rechte Hälfte der Antwort mit einer beliebigen gewünschten Methode.
Mit anderen Worten: Wir berechnen das linke Teilproblem als Blackbox, geben seinen Endzustand an das rechte Problem weiter und berechnen das rechte Teilproblem als Blackbox.
Der Nutzen dieser Methode zeigt sich in komplizierteren Situationen, etwa im allgemeinen -halbs separablen Fall und wenn die Eingabe eine zusätzliche „Batch“-Dimension hat (oder mit anderen Worten, wenn es sich um eine Matrix-Matrix- statt einer Matrix-Vektor-Multiplikation handelt). In diesem Fall können wir für die Blöcke (entsprechend der MM mit und ) einen alternativen Algorithmus verwenden, der die vollständigen versteckten Zustände nicht materialisiert. Stattdessen überspringen wir die versteckten Zustände und berechnen den Endzustand direkt auf eine alternative Weise und „reichen“ dann den Zustand an den nächsten Block weiter.
Komplexität. Diese Methode kann sehr arbeits effizient sein, weil die Schritte 2–3 nur konstante Zeit benötigen. Wenn wir also annehmen, dass die beiden Teilprobleme (Schritte 1 und 4) lineare Zeit benötigen, benötigt die gesamte Methode lineare Zeit.
Der Nachteil ist, dass dies ebenfalls sequenziell ist.
B.3.3 Vollständig rekurrenter Modus
Beachte, dass der vollständig rekurrente Modus, bei dem die Rekurrenz Schritt für Schritt entwickelt wird (21), einfach eine Instanziierung des State-Passing-Modus mit Blockgröße ist.
B.3.4 (Paralleler) Blockzerlegungsmodus
Dieser verwendet dieselbe Matrixzerlegung wie der State-Passing-Modus, berechnet die Teilprobleme jedoch in einer anderen Reihenfolge, wodurch Berechnung gegen Parallelisierung eingetauscht wird.
Wie üblich schreiben wir als
Die entscheidende Beobachtung ist wiederum, dass der untere linke Quadrant von Rang 1 hat. Abgesehen von der Inspektion besteht eine weitere Möglichkeit, dies zu erkennen, darin, die rechte Seite (RHS) zu verwenden und zu beobachten, dass ihr unterer linker Quadrant eine triviale Rang-1-Matrix ist (sie ist überall 0, außer dass die obere rechte Ecke ist), und die Woodbury-Inversionsformel zu nutzen, um zu sehen, dass die untere linke Ecke der linken Seite (LHS) ebenfalls Rang 1 haben muss. Dies liefert auch eine Möglichkeit, die Rang-1-Faktorisierung herzuleiten, die durch Inspektion verifiziert werden kann:
Eine zweite Beobachtung ist, dass diese Matrix selbstähnlich ist: Jede Hauptuntermatrix hat dieselbe Form. Insbesondere sind der obere linke und der untere rechte Quadrant beide 1-SS-Matrizen.
Dies bietet eine einfache Möglichkeit, die Matrixmultiplikation mit durchzuführen: Rekursiv auf den beiden Hälften (d. h. oben links und unten rechts) parallel arbeiten und dann den unteren linken Teilblock berücksichtigen. Dieser „Kombinations“-Schritt im Divide-and-Conquer-Algorithmus ist einfach, da der Teilblock Rang 1 hat. Dies führt zu einem parallelen Algorithmus.
Komplexität. Wie der State-Passing-Algorithmus verwendet diese Methode dieselben Blockzerlegungen der rangstrukturierten halbseparablen Matrizen. Der Unterschied besteht darin, dass wir auf beide Teilprobleme parallel rekursieren, während der State-Passing-Algorithmus zuerst das linke und dann das rechte Teilproblem behandelt. Dadurch wird die Tiefe/Spannweite des Algorithmus von linear auf reduziert. Der Kompromiss besteht darin, dass der Kombinationsschritt (Berücksichtigung des Rang-1-Unterblocks unten links) linearen statt konstanten Aufwand erfordert, sodass der Gesamtaufwand statt linear ist.
Beachten Sie auch, dass wir in der Rekursion jederzeit abbrechen und die Teilprobleme auf beliebige andere Weise berechnen können. Dies ist eine Hauptidee hinter dem SSD-Algorithmus (Abschnitt 6), bei dem wir auf kleinen Teilproblemen zur dualen quadratischen Attention-Formulierung wechseln.
B.3.5 Associative-Scan-Modus
Der State-Passing-(Chunkwise-)Algorithmus hat linearen Aufwand, beinhaltet aber auch sequenzielle Operationen.
Der Blockmatrix-Reduktions- und der dilatierte Modus sind parallelisierbar: Sie haben Tiefe/Spannweite . Allerdings leisten sie zusätzliche Arbeit .
Wie in Anhang B.2.2 erwähnt, gibt es einen Algorithmus, der sowohl Tiefe als auch Aufwand erreicht, indem er den Associative-Scan-(auch Prefix-Scan-)Algorithmus nutzt (Baker et al. 1996). Dieser Algorithmus ist am einfachsten aus der SSM-Scan- oder Cumprodsum-Sicht zu erkennen und selbst dann nicht offensichtlich: Er erfordert die separate Herleitung eines assoziativen Operators (22) und dann die Nutzung des Parallel-/Assoziativ-/Prefix-Scan-Algorithmus als Black Box (Blelloch 1990).
Hier zeigen wir, dass es tatsächlich möglich ist, diesen parallelen Scan herzuleiten, indem man eine andere Matrixzerlegung nutzt:
Stufe 2. Betrachten Sie nun jeden der -Blöcke, der im strikt unteren Dreiecksteil der Matrix als Rang-1-Matrix faktorisiert ist. Beachten Sie, dass jeder der Zeilenvektoren auf der rechten Seite derselbe ist wie der untere Zeilenvektor im Diagonalblock seiner Spalte: insbesondere die Zeilen und .
Daher haben wir die Antworten darauf bereits aus Stufe 1, was das zweite Element aller Teilprobleme in Stufe 1 ist. Wenn wir dieses Array von Elementen nennen (von halber Größe von ), dann müssen wir mit der 1-SS-Matrix multiplizieren, die von erzeugt wird.
Stufe 3. Schließlich kann jede der Antworten aus Stufe 2 durch Multiplikation mit den Spaltenvektoren auf der linken Seite in zwei endgültige Antworten übertragen werden: insbesondere die Vektoren und .
Beachten Sie, dass dies mit einer geringfügigen Verschiebung der Indizes um eins leicht modifiziert werden kann. Eine äquivalente Sichtweise auf diesen Algorithmus ist die dreistufige Matrixfaktorisierung
IUE (VUI, VUCI, AIU RCI, OULCI).
Diese implizieren wiederum Abschlusseigenschaften von Zustandsraummodellen.
Beispielsweise besagt die Additionseigenschaft, dass die Summe zweier paralleler SSM-Modelle immer noch ein SSM ist. Die Multiplikationseigenschaft besagt, dass die sequenzielle Komposition oder Verkettung zweier SSMs immer noch als SSM betrachtet werden kann, dessen Gesamtzustandsgröße additiv ist – eine etwas nichttriviale Tatsache.
Schließlich kann uns die Inverseigenschaft ermöglichen, SSMs mit anderen Modelltypen in Beziehung zu setzen. Beispielsweise kann man bemerken, dass Bandmatrizen halbseparabel sind, sodass ihre Inversen halbseparabel sind. (Tatsächlich wird die halbseparable Strukturfamilie oft durch die Bildung von Inversen von Bandmatrizen motiviert (Vandebril et al. 2005)). Darüber hinaus können die schnellen Rekurrenzeigenschaften halbseparabler Matrizen als Konsequenz davon betrachtet werden, dass ihre Inverse bandförmig ist.
Bemerkung 11. Die Tatsache, dass 1-SS-Matrizen einfache Rekurrenzen (7) sind, ist äquivalent zu der Tatsache, dass die Inverse einer 1-SS-Matrix eine 2-Band-Matrix ist:
Somit gilt , oder
Oder elementweise,
Umgekehrt verwenden wir diese Abschlussergebnisse auch, um zu beweisen, dass autoregressive strukturierte Attention (unter bestimmten Annahmen) SSMs sein muss, was es uns ermöglicht zu zeigen, dass allgemeinere Familien effizienter Sequenzmodelle, einschließlich Attention-Varianten, auf Zustandsraummodelle reduziert werden können (Anhang C.2).
C.2 Autoregressive maskierte Attention ist semiseparabel strukturierte Attention
Wir beweisen Theorem 5.2 aus Abschnitt 5.2. In Abschnitt 4.3 haben wir strukturierte Attention als eine breite Verallgemeinerung von maskierter Attention definiert, wobei die Eigenschaft der Effizienz (d. h. eine Form linearer Zeit für die Kernel-Attention) in die Effizienz strukturierter Matrixmultiplikation abstrahiert wird. Über die rechnerische Effizienz hinaus besitzt Standard-Linear-Attention (Katharopoulos et al. 2020) jedoch auch zwei wichtige Eigenschaften. Erstens ist sie kausal, was für Einstellungen wie autoregressive Modellierung erforderlich ist. Darüber hinaus verfügt sie über effiziente autoregressive Generierung. Mit anderen Worten: Die Kosten eines autoregressiven Schritts – d. h. die inkrementellen Kosten der Berechnung der Ausgabe beim Sehen von , gegeben, dass bereits gesehen und vorverarbeitet wurde – erfordern nur konstante Zeit.
Hier charakterisieren wir, welche Instanzen von SMA eine effiziente Autoregression besitzen.
Im Rahmen von SMA ist Kausalität äquivalent zur Einschränkung, dass die Maske eine untere Dreiecksmatrix ist.
Die Charakterisierung des Raums der -Matrizen, die eine effiziente Autoregression besitzen, ist schwieriger. Wir verwenden eine enge technische Definition autoregressiver Prozesse im Geiste klassischer Definitionen aus der Zeitreihenliteratur (z. B. ARIMA-Prozesse (Box et al. 2015)).
Definition C.2. Wir definieren eine autoregressive Transformation der Ordnung als eine, bei der jede Ausgabe nur von der aktuellen Eingabe und den letzten Ausgaben abhängt:
Beachten Sie, dass der Fall, in dem die Cumsum-Matrix ist, ein Spezialfall mit ist und somit gilt. Mit dieser Definition folgt die Charakterisierung des Raums effizienter autoregressiver linearer Transformationen aus den Eigenschaften semiseparabler Matrizen. Theorem C.3 formalisiert und beweist Theorem 5.2.
Theorem C.3. Sei eine effiziente autoregressive Transformation der Ordnung . Dann ist ein Zustandsraummodell der Ordnung .
Beweis. Seien Eingabe- und Ausgabesequenzen, sodass gilt. Durch Umstellen der Definition (23) erhalten wir
Wenn man über vektorisiert, lässt sich dies als Matrixtransformation ausdrücken:
Die Diagonalmatrix kann nach links verschoben und in die Matrix der -Koeffizienten eingefaltet werden, die eine untere Dreiecksmatrix mit Bandbreite bleibt. Wir haben aber auch , also ist die Inverse dieser Matrix.
Als Nächstes sei angemerkt, dass Matrizen mit Bandbreite aufgrund der Rangcharakterisierung der Semiseparabilität (Definition 3.1) -semiseparabel sind. Nach Proposition C.1 ist die Inverse daher höchstens -semiseparabel. Eine etwas stärkere Schranke von lässt sich aufgrund der zusätzlichen Struktur von Bandmatrizen erzielen. Schließlich folgt die Charakterisierung von als Zustandsraummodell der Ordnung aus Theorem 3.5.
Mit anderen Worten: Effiziente autoregressive Attention ist semiseparable SMA.
D Experimentelle Details
D.1 MQAR-Details
Wir verwenden eine schwierigere Version der in Based (Arora, Eyuboglu, Zhang, et al. 2024) eingeführten Aufgabe, bei der Token, die keine Query-/Key-/Values sind, durch zufällige Token ersetzt werden. Wir verwenden außerdem mehr Schlüssel-Wert-Paare, längere Sequenzen und kleinere Modellgrößen als die übliche Variante von MQAR, die in früheren Arbeiten verwendet wurde – all dies macht die Aufgabe schwieriger.
Für jede Sequenzlänge verwenden wir Schlüssel-Wert-Paare. Die Gesamtvokabulargröße beträgt 8192.
Wir verwenden eine Form des Curriculum-Trainings, bei dem das Training zyklisch durch Datensätze mit Schlüssel-Wert-Paaren läuft, wobei jeder Datensatz Beispiele umfasst, für insgesamt 8 Epochen durch jeden Datensatz (insgesamt Beispiele). Die Gesamtbatchgröße beträgt Token (z. B. beträgt für die Batchgröße 256).
Alle Methoden verwenden 2 Schichten mit Standardeinstellungen; die Attention-Baseline erhält zusätzlich Positions-Embeddings. Für jede Methode durchsuchen wir die Modell dimensionen und Lernraten . Wir verwenden einen linearen Decay-Zeitplan, der bei jeder Epoche absinkt (z. B. hätte die letzte Epoche eine Lernrate von der maximalen/Anfangs-Lernrate).
D.2 Details zu Scaling Laws
Alle Modelle wurden auf dem Pile trainiert. Für die Scaling-Law-Experimente verwenden wir den GPT2-Tokenizer.
Modellgrößen. Tabelle 9 gibt die Modellgrößen an, die wir für Scaling Laws in Anlehnung an GPT3 (Brown et al. 2020) verwenden. Erstens haben wir die Batchgröße des 1,3B-Modells aus Einheitlichkeitsgründen von 1M Token auf 0,5M Token geändert. Zweitens haben wir die Anzahl der Trainingsschritte und die Gesamtzahl der Token geändert, um in etwa den Chinchilla-Scaling-Gesetzen (Hoffmann et al. 2022) zu entsprechen, die besagen, dass die Trainings-Token proportional zur Modellgröße zunehmen sollten.
Trainingsrezepte. Alle Modelle verwendeten den AdamW-Optimierer mit
- Gradient-Clipping-Wert 1,0- Weight Decay 0,1- kein Dropout- linearem Learning-Rate-Warmup mit Kosinus-Decay
| PARAMETER | n_layers | d_model | n_heads / d_head | Trainingsschritte | Lernrate | Batch-Größe | Tokens |
| 125M | 12 | 768 | 12 / 64 | 4800 | 6e-4 | 0,5 Mio. Tokens | 2,5B |
| 350M | 24 | 1024 | 16 / 64 | 13500 | 3e-4 | 0,5 Mio. Tokens | 7B |
| 760M | 24 | 1536 | 16 / 96 | 29000 | 2,5e-4 | 0,5 Mio. Tokens | 15B |
| 1,3B | 24 | 2048 | 32 / 64 | 50000 | 2e-4 | 0,5 Mio. Tokens | 26B |
Standardmäßig entspricht die Spitzenlernrate der GPT3-Spezifikation.
Im Vergleich zum GPT3-Rezept verwenden wir ein „verbessertes Rezept“, inspiriert von Änderungen, die von populären großen Sprachmodellen wie PaLM (Chowdhery et al. 2023) und LLaMa (Touvron, Lavril, et al. 2023) übernommen wurden. Dazu gehören:
- lineares Learning-Rate-Warmup mit Kosinus-Decay auf , mit einem Spitzenwert vom des GPT3-Werts
- keine linearen Bias-Terme
- RMSNorm statt LayerNorm
- AdamW-Hyperparameter (der GPT3-Wert) statt des PyTorch-Standardwerts
D.3 Details zur Downstream-Evaluierung
Um die Downstream-Leistung vollständig trainierter Modelle zu evaluieren, trainieren wir Mamba- 2 auf 300B Token auf dem Pile unter Verwendung des GPT- NeoX-Tokenizers (Black et al. 2022).
Wir verwenden dieselben Hyperparameter wie in den Scaling-Experimenten, außer mit Batchgröße 1M für das 1,3B- und das 2,7B-Modell. Für das 2,7B-Modell folgen wir außerdem der GPT3-Spezifikation (32 Schichten, Dimension 2560).
Für alle Modelle verwenden wir das 5-fache der Lernrate des entsprechenden GPT3-Modells.
Für die Downstream-Evaluierung verwenden wir den LM Evaluation Harness von EleutherAI (L. Gao, Tow, et al. 2021), auf denselben Aufgaben wie Mamba (Gu und Dao 2023) mit einer zusätzlichen:
- LAMBADA (Paperno et al. 2016)
- HellaSwag (Zellers et al. 2019)
- PIQA (Bisk et al. 2020)
- ARC-challenge (P. Clark et al. 2018)
- ARC-easy: eine leichte Teilmenge von ARC-challenge
- WinoGrande (Sakaguchi et al. 2021)
- OpenBookQA (Mihaylov et al. 2018)
D.4 Details zur Ablation
Details zu (Re)Based. Unsere Ablationen in Abschnitt 9.4.3 betrachteten die Modelle Based (Arora, Eyuboglu, Zhang, et al. 2024) und ReBased (Aksenov et al. 2024).
Based approximiert den Exp-Kern mit einer quadratischen Taylor-Entwicklung , was durch die Feature-Map
ReBased schlägt vor, die einfachere Feature-Map zu verwenden, die der Kernel-Transformation entspricht, wendet aber zusätzlich vorher eine Layer-Normalisierung an. Wir betrachten die Layer-Normalisierung als eine alternative nichtlineare Aktivierung zu unserer Standard-Swish-Aktivierung und führen Ablationen von Kombinationen dieser beiden durch.
| MODELL | TOKEN. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | DURCHSCHNITT ACC ↑ |
| Hybrid H3-130M | GPT2 | — | 89,48 | 25,8 | 31,7 | 64,2 | 44,4 | 24,2 | 50,6 | 27,0 | 38,2 |
| Pythia-160M | NeoX | 29,64 | 38,10 | 33,0 | 30,2 | 61,4 | 43,2 | 24,1 | 51,9 | 29,2 | 39,0 |
| Mamba-130M | NeoX | 10,56 | 16,07 | 44,3 | 35,2 | 64,5 | 48,0 | 24,2 | 51,9 | 28,8 | 42,4 |
| Mamba-2-130M | NeoX | 10,48 | 16,86 | 43,9 | 35,3 | 64,9 | 47,4 | 24,2 | 52,1 | 30,6 | 42,6 |
| Hybrid H3-360M | GPT2 | — | 12,58 | 48,0 | 41,5 | 68,1 | 51,4 | 24,7 | 54,1 | 31,6 | 45,6 |
| Pythia-410M | NeoX | 9,95 | 10,84 | 51,4 | 40,6 | 66,9 | 52,1 | 24,6 | 53,8 | 30,0 | 45,6 |
| Mamba-370M | NeoX | 8,28 | 8,14 | 55,6 | 46,5 | 69,5 | 55,1 | 28,0 | 55,3 | 30,8 | 48,7 |
| Mamba-2-370M | NeoX | 8,21 | 8,02 | 55,8 | 46,9 | 70,5 | 54,9 | 26,9 | 55,7 | 32,4 | 49,0 |
| Pythia-1B | NeoX | 7,82 | 7,92 | 56,1 | 47,2 | 70,7 | 57,0 | 27,1 | 53,5 | 31,4 | 49,0 |
| Mamba-790M | NeoX | 7,33 | 6,02 | 62,7 | 55,1 | 72,1 | 61,2 | 29,5 | 56,1 | 34,2 | 53,0 |
| Mamba-2-780M | NeoX | 7,26 | 5,86 | 61,7 | 54,9 | 72,0 | 61,0 | 28,5 | 60,2 | 36,2 | 53,5 |
| GPT-Neo 1,3B | GPT2 | — | 7,50 | 57,2 | 48,9 | 71,1 | 56,2 | 25,9 | 54,9 | 33,6 | 49,7 |
| Hybrid H3-1,3B | GPT2 | — | 11,25 | 49,6 | 52,6 | 71,3 | 59,2 | 28,1 | 56,9 | 34,4 | 50,3 |
| OPT-1,3B | OPT | — | 6,64 | 58,0 | 53,7 | 72,4 | 56,7 | 29,6 | 59,5 | 33,2 | 51,9 |
| Pythia-1,4B | NeoX | 7,51 | 6,08 | 61,7 | 52,1 | 71,0 | 60,5 | 28,5 | 57,2 | 30,8 | 51,7 |
| RWKV4-1.5B | NeoX | 7,70 | 7,04 | 56,4 | 52,5 | 72,4 | 60,5 | 29,4 | 54,6 | 34,0 | 51,4 |
| Mamba-1.4B | NeoX | 6,80 | 5,04 | 65,0 | 59,1 | 74,2 | 65,5 | 32,8 | 61,5 | 36,4 | 56,4 |
| Mamba-2-1.3B | NeoX | 6,66 | 5,02 | 65,7 | 59,9 | 73,2 | 64,3 | 33,3 | 60,9 | 37,8 | 56,4 |
| GPT-Neo 2.7B | GPT2 | — | 5,63 | 62,2 | 55,8 | 72,1 | 61,1 | 30,2 | 57,6 | 33,2 | 53,2 |
| Hybrid H3-2.7B | GPT2 | — | 7,92 | 55,7 | 59,7 | 73,3 | 65,6 | 32,3 | 61,4 | 33,6 | 54,5 |
| OPT-2.7B | OPT | — | 5,12 | 63,6 | 60,6 | 74,8 | 60,8 | 31,3 | 61,0 | 35,2 | 55,3 |
| Pythia-2.8B | NeoX | 6,73 | 5,04 | 64,7 | 59,3 | 74,0 | 64,1 | 32,9 | 59,7 | 35,2 | 55,7 |
| RWKV4-3B | NeoX | 7,00 | 5,24 | 63,9 | 59,6 | 73,7 | 67,8 | 33,1 | 59,6 | 37,0 | 56,4 |
| Mamba-2.8B | NeoX | 6,22 | 4,23 | 69,2 | 66,1 | 75,2 | 69,7 | 36,3 | 63,5 | 39,6 | 59,9 |
| Mamba-2-2.7B | NeoX | 6,09 | 4,10 | 69,7 | 66,6 | 76,4 | 69,6 | 36,4 | 64,0 | 38,8 | 60,2 |
| GPT-J-6B | GPT2 | — | 4,10 | 68,3 | 66,3 | 75,4 | 67,0 | 36,6 | 64,1 | 38,2 | 59,4 |
| OPT-6.7B | OPT | — | 4,25 | 67,7 | 67,2 | 76,3 | 65,6 | 34,9 | 65,5 | 37,4 | 59,2 |
| Pythia-6.9B | NeoX | 6,51 | 4,45 | 67,1 | 64,0 | 75,2 | 67,3 | 35,5 | 61,3 | 38,0 | 58,3 |
| RWKV4-7.4B | NeoX | 6,31 | 4,38 | 67,2 | 65,5 | 76,1 | 67,8 | 37,5 | 61,0 | 40,2 | 59,3 |
Beachte, dass wir, weil diese die Feature-Dimension erweitern, auf kleinere -Dimensionen projizieren müssen; in Tabelle 7 verwenden wir Zustandsgröße für 130M-Modelle und für 380M-Modelle. Für die (Re)Based-Methoden projizieren wir jeweils auf 8 bzw. 16 Dimensionen, bevor wir ihre Feature-Maps anwenden; dies ergibt eine Gesamtzustandsgröße von für ReBased und für Based im Fall des 130M-Modells. Da die - und -Projektionen kleiner sind, verwenden diese Methoden weniger Parameter, und wir passen die Anzahl der Schichten entsprechend an.