
Das Modell lernt, mitten im Denken zu suchen und Treffer einzubauen, trainiert mit Reinforcement Learning. COLM 2025, kostenlos.
Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning
Search-R1: LLMs durch Reinforcement Learning dazu trainieren, zu schlussfolgern und Suchmaschinen zu nutzen
Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon , Sercan Ö. Arik , Dong Wang , Hamed Zamani , Jiawei Han
Department of Computer Science, University of Illinois at Urbana-Champaign
Center for Intelligent Information Retrieval, University of Massachusetts Amherst
Google Cloud AI Research
{bowenj4, zhenrui3, dwang24, hanj}@illinois.edu, {hzeng, zamani}@cs.umass.edu {jinsungyoon, soarik}@google.com
Abstract
Der effiziente Erwerb von externem Wissen und aktuellen Informationen ist wesentlich für effektives Schlussfolgern und effektive Textgenerierung in großen Sprachmodellen (LLMs). Fortschrittliche LLMs mit Schlussfolgerungsfähigkeiten durch Prompts dazu zu veranlassen, während der Inferenz Suchmaschinen zu verwenden, ist oft suboptimal, da das LLM möglicherweise nicht vollständig über die Fähigkeit verfügt, optimal mit der Suchmaschine zu interagieren. Dieses Papier stellt SEARCH-R1 vor, eine Erweiterung des Reinforcement Learning (RL) für Schlussfolgerungs-Frameworks, bei der das LLM lernt, während des schrittweisen Schlussfolgerns mit Echtzeit-Retrieval autonom (mehrere) Suchanfragen zu generieren. SEARCH-R1 optimiert die Schlussfolgerungstrajektorien des LLM mit mehrzügigen Suchinteraktionen und nutzt dabei die Maskierung abgerufener Token für stabiles RL-Training sowie eine einfache ergebnisbasierte Belohnungsfunktion. Experimente auf sieben Frage-Antwort-Datensätzen zeigen, dass SEARCH-R1 die Leistung um (Qwen2.5-7B) und (Qwen2.5-3B) gegenüber verschiedenen RAG-Baselines unter derselben Einstellung verbessert. Dieses Papier liefert zudem empirische Einblicke in RL-Optimierungsmethoden, LLM-Auswahl und Dynamiken der Antwortlänge beim retrieval-augmentierten Schlussfolgern. Der Code und die Modell-Checkpoints sind verfügbar unter https://github.com/PeterGriffinJin/Search-R1.
1 Einleitung
Große Sprachmodelle (LLMs) haben bemerkenswerte Fähigkeiten im Verstehen und Generieren natürlicher Sprache gezeigt (Hendrycks et al., 2020; Clark et al., 2018). Trotz dieser Errungenschaften stoßen LLMs häufig auf Herausforderungen, wenn sie mit komplexem Schlussfolgern (Wei et al., 2022) und dem Abrufen aktueller Informationen aus externen Quellen (Jin et al., 2024) beauftragt werden. Die Bewältigung dieser Einschränkungen erfordert die Integration fortgeschrittener Schlussfolgerungsfähigkeiten (Huang & Chang, 2022) und der Fähigkeit, effektiv mit Suchmaschinen zu interagieren, um externe aktuelle Informationen bestmöglich zu nutzen (Schick et al., 2023).
Bestehende Ansätze zur Integration von LLMs mit Suchmaschinen fallen typischerweise in zwei Kategorien: (1) retrieval-augmentierte Generierung (RAG) (Gao et al., 2023; Lewis et al., 2020) und (2) die Behandlung der Suchmaschine als Werkzeug (Yao et al., 2023; Schick et al., 2023). RAG-Modelle rufen häufig Passagen auf Grundlage der LLM-Eingabe als Anfrage ab und integrieren sie in den Kontext des LLM zur Generierung (Lewis et al., 2020). Dies ermöglicht es dem LLM, externes Wissen beim Beantworten von Fragen zu nutzen. Obwohl bestehende Arbeiten (Trivedi et al., 2022a) das LLM durch Prompts zu mehrzügigem, mehrfachabfragendem Retrieval veranlassen, ist dieser Ansatz suboptimal, da das LLM nicht darauf optimiert wird, während des Trainings zu lernen, wie es effektiv mit Suchmaschinen interagiert. Alternativ können LLMs durch Prompts oder Training dazu gebracht werden, Werkzeuge, einschließlich Suchmaschinen, als Teil ihres Schlussfolgerungsprozesses zu nutzen (Qu et al., 2025; Trivedi et al., 2022a). Prompt-basierte Ansätze haben jedoch oft Schwierigkeiten zu generalisieren, da bestimmte Aufgaben möglicherweise während des Vortrainings des LLM nicht angetroffen wurden. Trainingsbasierte Ansätze bieten andererseits größere Anpassungsfähigkeit, sind aber aufgrund ihrer Abhängigkeit von großskaligen, hochwertig annotierten Trajektorien und der inhärenten Nicht-Differenzierbarkeit der Suchoperation, die eine end-to-end gradientenabstiegsbasierte Optimierung unanwendbar macht, nur schwer effektiv skalierbar (Schick et al., 2023; Asai et al., 2024).
Reinforcement Learning (RL) (Sutton et al., 1999; Kaelbling et al., 1996) hat sich als leistungsfähiges Paradigma zur Verbesserung der Schlussfolgerungsfähigkeiten von LLMs erwiesen (Guo et al., 2025; Hou et al., 2025; Xie et al., 2025; Kumar et al., 2024). Insbesondere Modelle wie OpenAI-01 (Jaech et al., 2024) und DeepSeek-R1 (Guo et al., 2025) haben RL-Techniken (z. B. PPO (Schulman et al., 2017) und GRPO (Shao et al., 2024)) genutzt, um logische Inferenz- und Problemlösungsfähigkeiten durch Lernen aus Erfahrung und Feedback zu verbessern. Mit RL erlernen die Modelle selbst dann, wenn sie ausschließlich auf Ergebnisbelohnungen trainiert werden, komplexe Schlussfolgerungsfähigkeiten, einschließlich Selbstverifikation (Weng et al., 2022) und Selbstkorrektur (Kumar et al., 2024). Die Anwendung von RL auf Such- und Schlussfolgerungsszenarien bringt jedoch drei zentrale Herausforderungen mit sich: (1) RL-Framework und Stabilität – Es bleibt unklar, wie die Suchmaschine effektiv in die RL-Ansätze für LLMs integriert werden kann, während eine stabile Optimierung gewährleistet wird, insbesondere bei der Einbeziehung abgerufenen Kontexts. (2) Mehrzügiges verschachteltes Schlussfolgern und Suchen – Idealerweise sollte das LLM zu iterativem Schlussfolgern und iterativen Aufrufen der Suchmaschine fähig sein und die Retrieval-Strategie dynamisch an die Komplexität des Problems anpassen. (3) Belohnungsdesign – Der Entwurf einer effektiven Belohnungsfunktion für Such- und Schlussfolgerungsaufgaben bleibt eine grundlegende Herausforderung, da unklar ist, ob einfache ergebnisbasierte Belohnungen ausreichen, um das LLM dazu zu führen, sinnvolle und konsistente Suchverhaltensweisen zu erlernen.
Um die oben genannten Herausforderungen anzugehen, führen wir SEARCH-R1 ein, ein neuartiges RL-Framework, das LLMs in die Lage versetzt, in verschachtelter Weise mit Suchmaschinen und ihrem eigenen Schlussfolgern zu interagieren. Konkret führt SEARCH-R1 die folgenden zentralen Innovationen ein: (1) Wir modellieren die Suchmaschine als Teil der Umgebung und ermöglichen so abgetastete Trajektoriensequenzen, die die LLM-Tokengenerierung mit Retrievals der Suchmaschine verschachteln. SEARCH-R1 ist mit verschiedenen RL-Algorithmen kompatibel, einschließlich PPO und GRPO, und wir wenden die Maskierung abgerufener Token an, um eine stabile Optimierung zu gewährleisten. (2) SEARCH-R1 unterstützt mehrzügiges Retrieval und Schlussfolgern, indem Suchaufrufe ausgelöst werden, wenn sie explizit durch <search>- und </search>-Token ausgelöst werden. Abgerufene Inhalte werden in <information>- und </information>-Token eingeschlossen, während die Schlussfolgerungsschritte des LLM in <think>- und </think>-Token eingebettet werden. Die endgültige Antwort wird mit <answer>- und </answer>-Token formatiert, was eine strukturierte, iterative Entscheidungsfindung ermöglicht. (3) Wir verwenden eine unkomplizierte ergebnisbasierte Belohnungsfunktion und vermeiden so die Komplexität prozessbasierter Belohnungen. Unsere Ergebnisse zeigen, dass dieses minimale Belohnungsdesign in Such- und Schlussfolgerungsszenarien effektiv ist. Somit kann SEARCH-R1 als eine Erweiterung von DeepSeek-R1 Zero (Guo et al., 2025) betrachtet werden, das sich hauptsächlich auf parametrisches Schlussfolgern konzentriert, indem es suchaugmentiertes RL-Training für verbesserte retrieval-getriebene Entscheidungsfindung einführt.
Zusammenfassend sind unsere zentralen Beiträge dreifach:
- Unsere Arbeit analysiert die Herausforderungen und bietet Perspektiven zur Implementierung von RL, um zu verbessern, wie LLMs mithilfe von Suchmaschinenergebnissen schlussfolgern.
- Wir schlagen SEARCH-R1 vor, ein neuartiges RL-Framework, das LLM-Rollouts und direkte Optimierung mit einer Suchmaschine unterstützt, einschließlich der Maskierung abgerufener Token zur Stabilisierung des RL-Trainings, mehrzügigem verschachteltem Schlussfolgern und Suchen zur Unterstützung der Lösung komplexer Aufgaben sowie einer effektiven Ergebnisbelohnungsfunktion.
- Wir führen systematische Experimente durch, um die Wirksamkeit von SEARCH-R1 zu demonstrieren, wobei zwei LLMs jeweilige durchschnittliche relative Verbesserungen von 41% und 20% gegenüber RAG-Baselines unter derselben experimentellen Einstellung erzielen (z. B. dasselbe Retrieval-Modell, dieselben Trainingsdaten und dieselben vortrainierten LLMs). Darüber hinaus liefern wir Einblicke zu RL für Schlussfolgerungs- und Sucheinstellungen, einschließlich der Auswahl der RL-Methode, verschiedener LLM-Optionen und einer Untersuchung der Antwortlänge.
2 Verwandte Arbeiten
2.1 Große Sprachmodelle und Retrieval
Trotz bemerkenswerter Fähigkeiten im logischen Schlussfolgern (Guo et al., 2025) und im Programmieren (Guo et al., 2024) fehlt es LLMs (Zhao et al., 2023; Team, 2024; Achiam et al., 2023) häufig an domänenspezifischem Wissen (Peng et al., 2023; Li et al., 2023) und sie neigen zu Halluzinationen (Zhang et al., 2023). Um diese Einschränkungen zu mildern, werden Suchmaschinen (Zhao et al., 2024) weithin integriert, um externe Informationen bereitzustellen. Es gibt zwei primäre Möglichkeiten, Suchmaschinen mit LLMs zu integrieren: (1) retrieval-augmentierte Generierung (RAG) (Gao et al., 2023) und (2) die Behandlung der Suchmaschinen als Werkzeuge (Schick et al., 2023). RAG (Lewis et al., 2020; Yue et al., 2024; Xiong et al., 2025) folgt typischerweise einer Runde aus Retrieval- und sequenziellen Generierungspipelines, wobei eine Suchmaschine relevante Informationen basierend auf der Eingabeabfrage abruft, die dann mit der Abfrage verkettet und in das LLM eingespeist werden. Dies kann jedoch auf Herausforderungen stoßen, irrelevante Informationen abzurufen (Jin et al., 2024) und keinen ausreichend nützlichen Kontext bereitzustellen (Jiang et al., 2023). Ein alternativer Ansatz ist Search-as-a-Tool, bei dem LLMs durch Prompting oder Fine-Tuning dazu gebracht werden, mit Suchmaschinen zu interagieren. IRCoT (Trivedi et al., 2022a) und ReAct (Yao et al., 2023) verwenden Prompting, um iteratives Schlussfolgern und Aufrufe der Suchmaschine zu leiten, während Toolformer (Schick et al., 2023) auf überwachtes Fine-Tuning setzt, um die Suchfähigkeiten zu verbessern. Solche Methoden sind jedoch auf qualitativ hochwertige annotierte Trajektorien angewiesen, die im großen Maßstab schwer zu erhalten sind. Neuere Arbeiten (Guo et al., 2025) deuten darauf hin, dass RL es LLMs ermöglichen kann, fortgeschrittene Schlussfolgerungsfähigkeiten allein durch Ergebnisbelohnungen zu entwickeln, doch sein Potenzial in Szenarien des Aufrufs von Suchmaschinen bleibt untererforscht.
2.2 Große Sprachmodelle und bestärkendes Lernen
Bestärkendes Lernen (RL) (Kaelbling et al., 1996) ist ein Lernparadigma, bei dem ein Agent lernt, sequenzielle Entscheidungen zu treffen, indem er mit einer Umgebung interagiert und Rückmeldung in Form von Belohnungen erhält, mit dem Ziel, die kumulative Belohnung über die Zeit zu maximieren (Sutton et al., 1999). RL wurde von Ouyang et al. (2022) durch RL aus menschlichem Feedback (RLHF) (Kaufmann et al., 2023) in die LLM-Abstimmung eingeführt. Dieser Ansatz trainiert zunächst ein Belohnungsmodell unter Verwendung menschlicher Präferenzdaten (Lambert et al., 2024), das dann die RL-basierte Abstimmung des Policy-LLM leitet, typischerweise über Proximal Policy Optimization (PPO). PPO umfasst jedoch mehrere Runden der LLM-Optimierung, was die Umsetzung erschwert. Um die RL-basierte Abstimmung zu vereinfachen, wurden direkte Optimierungsmethoden wie Direct Preference Optimization (DPO) (Rafailov et al., 2023) und SimPO (Meng et al., 2024) vorgeschlagen. Ein ähnlicher Ansatz wird in LeRet (Hsu et al., 2024) verwendet, bei dem LLMs darauf trainiert werden, vielfältige Abfragen zu erkunden, um die Wirksamkeit der Informationsbeschaffung zu verbessern. Obwohl diese Methoden rechnerische Effizienz bieten, leiden sie unter Off-Policy-Problemen (Pang et al., 2024) und erreichen nicht durchgängig die Leistung reiner RL-Ansätze. Alternative Lösungen umfassen Group Relative Policy Optimization (GRPO) (Shao et al., 2024), das die Notwendigkeit eines Kritikermodells beseitigt, indem es Baselines aus Gruppenergebnissen schätzt, und RLOO (Ahmadian et al., 2024), das ein vereinfachtes Optimierungsframework im REINFORCE-Stil (Williams, 1992) einführt. Trotz dieser Fortschritte bleibt die Anwendung von RL auf LLM-gesteuerte Interaktionen mit Suchmaschinen und Schlussfolgerungen weitgehend unerforscht.
3 Suche-R1
In den folgenden Abschnitten präsentieren wir das detaillierte Design der Trainingsmethoden von SEARCH-R1, das (1) die Erweiterung von RL zur Nutzung von Suchmaschinen; (2) die Textgenerierung mit einem verschachtelten mehrstufigen Suchmaschinenaufruf; (3) die Trainingsvorlage; und (4) das Design des Belohnungsmodells abdeckt.
3.1 Reinforcement Learning mit einer Suchmaschine
Wir formulieren die RL-Zielfunktion unter Nutzung einer Suchmaschine \(\mathcal{R}\) wie folgt:
wobei \(\pi_{\theta}\) das Policy-LLM, \(\pi_{\mathrm{ref}}\) das Referenz-LLM, \(r_{\phi}\) die Belohnungsfunktion und \(\mathbb{D}{\mathrm{KL}}\) das KL-Divergenz-Maß ist. \(x\) bezeichnet Eingabestichproben, die aus dem Datensatz \(\mathcal{D}\) gezogen werden, und \(y\) repräsentiert die generierten Ausgaben, die mit Ergebnissen von Suchmaschinenaufrufen verschachtelt sind, aus der Referenzpolicy \(\pi{\mathrm{ref}}(y\mid x)\) entnommen und von der Suchmaschine \(\mathcal{R}\) abgerufen werden. Anders als frühere RL-Ansätze, die hauptsächlich auf das Policy-LLM \(\pi_{\theta}(\cdot \mid x)\) angewiesen sind, um Rollout-Sequenzen zu generieren (Rafailov et al., 2023; Ouyang et al., 2022), integriert unser Framework explizit Retrieval-verschachteltes Reasoning über \(\pi_{\theta}(\cdot \mid x;\mathcal{R})\), was als \(\pi_{\theta}(\cdot \mid x)\otimes \mathcal{R}\) betrachtet werden kann, wobei \(\otimes\) verschachteltes Retrieval-und-Reasoning bezeichnet. Dies ermöglicht eine effektivere Entscheidungsfindung bei reasoning-intensiven Aufgaben, die externe Informationsbeschaffung erfordern. Eine Darstellung des Rollout-Prozesses und eine Erläuterung von Gl. 1 werden in Abschnitt 3.2 und Anhang A bereitgestellt.
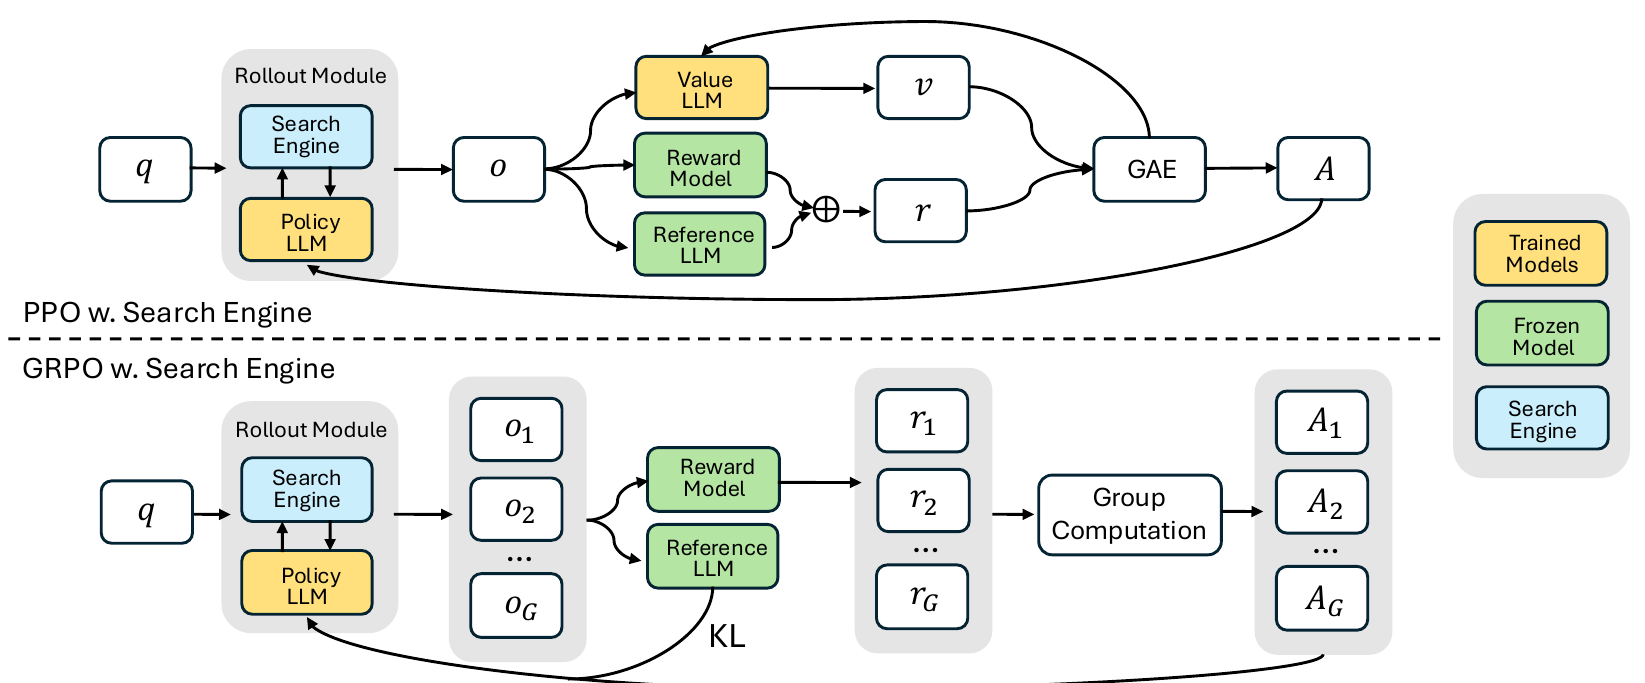
Unser Ansatz baut auf zwei etablierten Policy-Gradient-RL-Methoden auf: Proximal Policy Optimization (PPO) (Schulman et al., 2017) und Group Relative Policy Optimization (GRPO) (Shao et al., 2024; Guo et al., 2025), wobei deren jeweilige Vorteile genutzt werden, um Retrieval-augmentiertes Reasoning zu optimieren.
Loss-Maskierung für abgerufene Tokens. Sowohl in PPO als auch in GRPO werden die Verluste auf Token-Ebene über die gesamte Rollout-Sequenz berechnet. In SEARCH-R1 besteht die Rollout-Sequenz sowohl aus vom LLM generierten Tokens als auch aus abgerufenen Tokens aus externen Passagen. Während die Optimierung der vom LLM generierten Tokens die Fähigkeit des Modells verbessert, mit der Suchmaschine zu interagieren und Reasoning durchzuführen, kann die Anwendung derselben Optimierung auf abgerufene Tokens zu unbeabsichtigten Lerndynamiken führen. Um dem entgegenzuwirken, führen wir eine Loss-Maskierung für abgerufene Tokens ein, die sicherstellt, dass die Policy-Gradient-Zielfunktion nur über vom LLM generierte Tokens berechnet wird und abgerufene Inhalte vom Optimierungsprozess ausgeschlossen werden. Dieser Ansatz stabilisiert das Training und bewahrt gleichzeitig die Flexibilität der suchaugmentierten Generierung.
PPO mit Suchmaschine. Proximal Policy Optimization (PPO) (Schulman et al., 2017) ist ein populärer Actor-Critic-RL-Ansatz, der üblicherweise für LLMs verwendet wird (Ouyang et al., 2022). Für unsere Reasoning-Szenarien, die Suchmaschinenaufrufe beinhalten, optimiert es LLMs durch Maximierung der folgenden Zielfunktion:
wobei \(\pi_{\theta}\) und \(\pi_{\mathrm{old}}\) jeweils das aktuelle und das vorherige Policy-Modell repräsentieren. \(I(y_{t})\) ist die Token-Loss-Maskierungsoperation, sodass \(I(y_{t}) = 1\), wenn \(y_{t}\) ein vom LLM generiertes Token ist, und \(I(y_{t}) = 0\), wenn \(y_{t}\) ein abgerufenes Token ist. Der Term \(\epsilon\) ist ein clipping-bezogener Hyperparameter, der in PPO zur Stabilisierung des Trainings eingeführt wurde. Die Vorteilsschätzung \(A_{t}\) wird unter Verwendung von Generalized Advantage Estimation (GAE) (Schulman et al., 2015) auf der Grundlage zukünftiger Belohnungen \(\{r_{\geq t}\}\) und einer gelernten Wertfunktion \(V_{\phi}\) berechnet.
GRPO mit Suchmaschine. Um die Stabilität der Policy-Optimierung zu verbessern und die Notwendigkeit einer zusätzlichen Wertfunktionsapproximation zu vermeiden, wird in Shao et al. (2024) Group Relative Policy Optimization (GRPO) eingeführt. GRPO unterscheidet sich von PPO dadurch, dass es die durchschnittliche Belohnung mehrerer abgetasteter Ausgaben als Basislinie nutzt, anstatt sich auf eine gelernte Wertfunktion zu stützen. Insbesondere sampelt GRPO für jede Eingabefrage \(x\) eine Gruppe von Antworten \(\{y_{1}, y_{2}, \ldots , y_{G}\}\) aus der Referenzpolicy \(\pi_{\mathrm{ref}}\). Das Policy-Modell wird dann durch Maximierung der folgenden Zielfunktion optimiert:
wobei \(\epsilon\) und \(\beta\) Hyperparameter sind und \(\hat{A}{i,t}\) den Vorteil repräsentiert, der auf der Grundlage der relativen Belohnungen der Ausgaben innerhalb jeder Gruppe berechnet wird. Dieser Ansatz vermeidet zusätzliche Komplexität bei der Berechnung von \(\hat{A}{i,t}\). Darüber hinaus regularisiert GRPO, anstatt die KL-Divergenz als Strafe in die Belohnungsfunktion aufzunehmen, indem es die KL-Divergenz zwischen der trainierten Policy und der Referenzpolicy direkt zur Verlustfunktion hinzufügt. Die Maskierung abgerufener Tokens wird auch bei der Berechnung des KL-Divergenz-Verlusts \(\mathbb{D}_{K L}\) angewendet.
3.2 Generierung mit mehrstufigem Suchmaschinenaufruf
In diesem Abschnitt beschreiben wir den Rollout-Prozess für die LLM-Antwortgenerierung mit verschachtelten mehrstufigen Suchmaschinenaufrufen, formuliert als: \(y \sim \pi_{\theta}(\cdot |x;\mathcal{R}) = \pi_{\theta}(\cdot |x)\otimes \mathcal{R}\).
Unser Ansatz folgt einem iterativen Rahmen, in dem das LLM zwischen Textgenerierung und Abfragen an eine externe Suchmaschine abwechselt. Konkret weist die Systemanweisung das LLM an, seine Suchanfrage zwischen zwei dafür vorgesehenen Suchaufruf-Tokens, <search> und </search>, einzuschließen, wann immer ein externer Abruf erforderlich ist. Sobald diese Tokens in der generierten Sequenz erkannt werden, extrahiert das System die Suchanfrage, fragt die Suchmaschine ab und ruft relevante Ergebnisse ab. Die abgerufenen Informationen werden dann in spezielle Abruf-Tokens, <information> und </information>, eingeschlossen und an die laufende Rollout-Sequenz angehängt, wo sie als zusätzlicher Kontext für den nächsten Generierungsschritt dienen. Dieser Prozess setzt sich iterativ fort, bis eine der folgenden Bedingungen erfüllt ist: (1) die maximale Anzahl von Aktionen ist erreicht, oder (2) das Modell generiert eine endgültige Antwort, die zwischen dafür vorgesehenen Antwort-Tokens, <answer> und </answer>, eingeschlossen ist. Der vollständige Arbeitsablauf ist in Algorithmus 1 dargestellt.
3.3 Trainings-Template
Um SEARCH-R1 zu trainieren, beginnen wir damit, ein einfaches Template zu erstellen, das das initiale LLM anweist, unseren vordefinierten Anweisungen zu folgen. Wie in Tabelle 1 gezeigt, strukturiert dieses Template die Ausgabe des Modells in iterativer Weise in drei Teile: zuerst einen Denkprozess, dann eine Suchmaschinen-Aufruffunktion und schließlich die Antwort. Wir beschränken unsere Vorgaben bewusst auf dieses strukturelle Format und vermeiden jegliche inhaltsspezifischen Voreingenommenheiten, wie etwa das Erzwingen von reflektierendem Denken und Suchmaschinenaufrufen oder die Befürwortung bestimmter Problemlösungsansätze. Dies stellt sicher, dass die natürliche Lerndynamik des Modells während des RL-Prozesses beobachtbar und unvoreingenommen bleibt.
Beantworte die gegebene Frage. Du musst jedes Mal, wenn du neue Informationen erhältst, zuerst innerhalb von <think> und </think> eine Schlussfolgerung anstellen. Wenn du nach dem Nachdenken feststellst, dass dir etwas Wissen fehlt, kannst du eine Suchmaschine mit <search> query </search> aufrufen, und sie wird die besten Suchergebnisse zwischen <information> und </information> zurückgeben. Du kannst so oft suchen, wie du möchtest. Wenn du feststellst, dass kein weiteres externes Wissen benötigt wird, kannst du die Antwort direkt innerhalb von <answer> und </answer> ohne ausführliche Erläuterungen angeben. Zum Beispiel: <answer> xxx </answer>. Frage: question.
Tabelle 1: Template für SEARCH-R1. question wird während des Trainings und der Inferenz durch die jeweilige Frage ersetzt. Erforderlich: Eingabeabfrage , Policy-Modell , Suchmaschine , maximales Aktionsbudget .
Sicherzustellen: Endgültige Antwort .
1: Rollout-Sequenz initialisieren
2: Aktionszähler initialisieren
3: while do
4: Aktuelle LLM-Rollout-Sequenz der Aktion initialisieren
5: while True do
6: Antwort-Token generieren
7: an die Rollout-Sequenz anhängen
8: if in [</search>,</answer>,<eos>] then break
9: end if
10: end while
11:
12: if <search> </search> in erkannt then
13: Suchanfrage extrahieren
14: Suchergebnisse abrufen
15: in den Rollout einfügen
16: else if <answer> </answer> in erkannt then
17: endgültige generierte Antwort zurückgeben
18: else
19: Zum Überdenken auffordern action is not correct. Let me rethink."
20: end if
21: Aktionszähler erhöhen
22: end while
23: endgültige generierte Antwort zurückgeben
3.4 Reward-Modeling
Die Reward-Funktion dient als primäres Trainingssignal und leitet den Optimierungsprozess im RL. Um SEARCH-R1 zu trainieren, verwenden wir ein regelbasiertes Reward-System, das ausschließlich aus Rewards für das Endergebnis besteht und die Korrektheit der Antwort des Modells bewertet. Bei Aufgaben des faktischen Schlussfolgerns kann die Korrektheit beispielsweise anhand regelbasierter Kriterien wie exakter String-Übereinstimmung bewertet werden:
wobei die aus der Antwort extrahierte endgültige Antwort und die Ground-Truth-Antwort ist. Anders als Guo et al. (2025) beziehen wir keine Format-Rewards ein, da unser trainiertes Modell bereits eine starke strukturelle Befolgung zeigt. Die Erforschung komplexerer Format-Rewards überlassen wir zukünftiger Arbeit. Darüber hinaus verzichten wir auf das Training neuronaler Reward-Modelle, in Anlehnung an Guo et al. (2025). Diese Entscheidung ist motiviert durch die Sensitivität von LLMs gegenüber bestimmten Formen von Rewards im RL im großen Maßstab sowie durch den zusätzlichen Rechenaufwand und die Komplexität, die durch das erneute Training dieser Modelle entstehen.
4 Hauptergebnisse
4.1 Datensätze
Wir evaluieren SEARCH-R1 auf sieben Benchmark-Datensätzen, die wie folgt kategorisiert sind: (1) Allgemeines Frage-Antwort-Problem: NQ (Kwiatkowski et al., 2019), TriviaQA (Joshi et al., 2017) und PopQA (Mallen et al., 2022). (2) Multi-Hop-Frage-Antwort-Problem: HotpotQA (Yang et al., 2018), 2WikiMultiHopQA (Ho et al., 2020), Musique (Trivedi et al., 2022b) und Bamboogle (Press et al., 2022). Diese Datensätze umfassen eine vielfältige Bandbreite an Such- und Schlussfolgerungsherausforderungen und ermöglichen eine umfassende Evaluierung von SEARCH-R1.
4.2 Baselines
Zur Bewertung der Wirksamkeit von SEARCH-R1 vergleichen wir es mit den folgenden Baselines: (1) Inferenz ohne Retrieval: Direkte Inferenz und Chain-of-Thought-(CoT-)Schlussfolgern (Wei et al., 2022). (2) Inferenz mit Retrieval: Retrieval-Augmented Generation (RAG) (Lewis et al., 2020), IRCoT (Trivedi et al., 2022a) und Search-o1 (Li et al., 2025). (3) Fine-Tuning-basierte Methoden: Supervised Fine-Tuning (SFT) (Chung et al., 2024), RL-basiertes Fine-Tuning ohne Suchmaschine (R1) (Guo et al., 2025) und Rejection Sampling (Ahn et al., 2024) mit einer Suchmaschine. Für R1 trainieren wir die LLMs mit den in Guo et al. (2025) vorgeschlagenen RL-Methoden mit unseren Daten, um einen fairen Vergleich mit SEARCH-R1 zu ermöglichen. Es enthält nur Schlussfolgerungs- und Antworthritte ohne eine Suchmaschine. Für Rejection Sampling generieren wir fünf Kandidatenantworten pro Trainingsprompt aus demselben Datensatz mit den instruierten LLMs und wählen diejenigen aus, die zu korrekten endgültigen Antworten führen. Diese ausgewählten Trajektorien werden dann verwendet, um einen neuen Trainingssatz zu konstruieren, der denselben in SEARCH-R1 vorgeschlagenen Mechanismus des mehrstufigen Rollouts der Interaktion zwischen LLM und Suchmaschine beibehält, um die LLMs feinabzustimmen.
Diese Baselines decken ein breites Spektrum an retrieval-augmentierten und Fine-Tuning-Ansätzen ab und ermöglichen eine umfassende Bewertung von SEARCH-R1 sowohl im Zero-Shot- als auch im gelernten Retrieval-Setting. Um einen fairen Vergleich zwischen verschiedenen Methoden zu gewährleisten, verwenden wir denselben Retriever, dieselbe Anzahl abgerufener Dokumente, denselben Wissenskorpus, dieselben Trainingsdaten und dieselben vortrainierten LLMs. Details finden sich in Anhang B.
4.3 Experimentelles Setup
Wir führen Experimente mit zwei Modelltypen durch: Qwen-2.5-3B (Base/Instruct) und Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024). Für das Retrieval verwenden wir den Wikipedia-Dump von 2018 (Karpukhin et al., 2020) als Wissensquelle und E5 (Wang et al., 2022) als Retriever. Um einen fairen Vergleich zu gewährleisten, folgen wir Lin et al. (2023) und setzen die Anzahl der abgerufenen Passagen für alle retrieval-basierten Methoden auf 3. Eine Untersuchung der Anzahl abgerufener Passagen findet sich in Anhang G.
Für das Training führen wir die Trainingssätze von NQ und HotpotQA zu einem einheitlichen Datensatz für SEARCH-R1 und andere Fine-Tuning-basierte Baselines zusammen. Die Evaluierung wird auf den Test- oder Validierungssätzen von sieben Datensätzen durchgeführt, um sowohl die In-Domain- als auch die Out-of-Domain-Leistung zu bewerten. Als Evaluierungsmetrik wird Exact Match (EM) verwendet, in Anlehnung an Yu et al. (2024). Für Inferenz-Baselines verwenden wir Instruct-Modelle, da Base-Modelle Anweisungen nicht befolgen können. Für RL-Tuning-Methoden werden Experimente sowohl auf Base- als auch auf Instruct-Modellen durchgeführt. Weitere Details zu den experimentellen Einstellungen finden sich in Anhang B.
Sofern nicht anders angegeben, wird PPO als Standard-RL-Methode verwendet; ein detaillierter Vergleich zwischen PPO und GRPO findet sich in Abschnitt 5.1.
4.4 Leistung
Die Hauptergebnisse, die SEARCH-R1 mit den Baseline-Methoden über die sieben Datensätze hinweg vergleichen, sind in Tabelle 2 dargestellt. Aus den Ergebnissen ziehen wir die folgenden zentralen Beobachtungen: (1) SEARCH-R1 übertrifft durchgängig starke Baseline-Methoden. Wir erzielen eine durchschnittliche relative Verbesserung von bzw. mit Qwen2.5-7B bzw. Qwen2.5-3B. Diese Zugewinne halten sowohl bei der In-Distribution-Evaluierung (d. h. NQ und HotpotQA) als auch bei der Out-of-Distribution-Evaluierung (d. h. TriviaQA, PopQA, 2WikiMultiHopQA, Musique und Bamboogle) an. (2) SEARCH-R1 übertrifft RL-basiertes Training für LLM-Schlussfolgern ohne Retrieval (R1). Dies entspricht den Erwartungen, da die Einbeziehung der Suche in das LLM-Schlussfolgern Zugang zu relevantem externem Wissen bietet und die Gesamtleistung verbessert. (3) SEARCH-R1 ist sowohl für Base- als auch für instruction-getunte Modelle wirksam. Dies zeigt, dass RL im Stil von DeepSeek-R1-Zero mit ergebnisbasierten Rewards (Guo et al., 2025) erfolgreich auf das Schlussfolgern mit Suche angewendet werden kann und damit über seine zuvor etablierte Wirksamkeit in reinen Schlussfolgerungsszenarien hinausgeht. (4) Größere Modelle sind besser darin, zu lernen, wie man sucht. SEARCH-R1 zeigt beim 7B-Modell eine deutlich größere „Leistungslücke" im Vergleich zum 3B-Modell (z. B. im Vergleich zum zweitbesten Modell – RAG).
| Methoden | Allgemeine QA | Multi-Hop-QA | ||||||
| NQ+ | TriviaQA+ | PopQA+ | HotpotQA+ | 2wiki+ | Musique+ | Bamboolle+ | Durchschn. | |
| Qwen2.5-7b-Base/Instruct | ||||||||
| Direkte Inferenz | 0,134 | 0,408 | 0,140 | 0,183 | 0,250 | 0,031 | 0,120 | 0,181 |
| CoT | 0,048 | 0,185 | 0,054 | 0,092 | 0,111 | 0,022 | 0,232 | 0,106 |
| IRCoT | 0,224 | 0,478 | 0,301 | 0,133 | 0,149 | 0,072 | 0,224 | 0,239 |
| Search-o1 | 0,151 | 0,443 | 0,131 | 0,187 | 0,176 | 0,058 | 0,296 | 0,206 |
| RAG | 0,349 | 0,585 | 0,392 | 0,299 | 0,235 | 0,058 | 0,208 | 0,304 |
| SFT | 0,318 | 0,354 | 0,121 | 0,217 | 0,259 | 0,066 | 0,112 | 0,207 |
| R1-base | 0,297 | 0,539 | 0,202 | 0,242 | 0,273 | 0,083 | 0,296 | 0,276 |
| R1-instruct | 0,270 | 0,537 | 0,199 | 0,237 | 0,292 | 0,072 | 0,293 | 0,271 |
| Rejection Sampling | 0,360 | 0,592 | 0,380 | 0,331 | 0,296 | 0,123 | 0,355 | 0,348 |
| Search-R1-base | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| Search-R1-instruct | 0,393 | 0,610 | 0,397 | 0,370 | 0,414 | 0,146 | 0,368 | 0,385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| Direct Inference | 0,106 | 0,288 | 0,108 | 0,149 | 0,244 | 0,020 | 0,024 | 0,134 |
| CoT | 0,023 | 0,032 | 0,005 | 0,021 | 0,021 | 0,002 | 0,000 | 0,015 |
| IRCoT | 0,111 | 0,312 | 0,200 | 0,164 | 0,171 | 0,067 | 0,240 | 0,181 |
| Search-o1 | 0,238 | 0,472 | 0,262 | 0,221 | 0,218 | 0,054 | 0,320 | 0,255 |
| RAG | 0,348 | 0,544 | 0,387 | 0,255 | 0,226 | 0,047 | 0,080 | 0,270 |
| SFT | 0,249 | 0,292 | 0,104 | 0,186 | 0,248 | 0,044 | 0,112 | 0,176 |
| R1-base | 0,226 | 0,455 | 0,173 | 0,201 | 0,268 | 0,055 | 0,224 | 0,229 |
| R1-instruct | 0,210 | 0,449 | 0,171 | 0,208 | 0,275 | 0,060 | 0,192 | 0,224 |
| Rejection Sampling | 0,294 | 0,488 | 0,332 | 0,240 | 0,233 | 0,059 | 0,210 | 0,265 |
| Search-R1-base | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| Search-R1-instruct | 0,341 | 0,545 | 0,378 | 0,324 | 0,319 | 0,103 | 0,264 | 0,325 |
| Methode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolle | Durchschn. |
| Qwen2.5-7b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0,395 | 0,560 | 0,388 | 0,326 | 0,297 | 0,125 | 0,360 | 0,350 |
| SEARCH-R1-instruct (GRPO) | 0,429 | 0,623 | 0,427 | 0,386 | 0,346 | 0,162 | 0,400 | 0,396 |
| SEARCH-R1-base (PPO) | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1-instruct (PPO) | 0,393 | 0,610 | 0,397 | 0,370 | 0,414 | 0,146 | 0,368 | 0,385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0,421 | 0,583 | 0,413 | 0,297 | 0,274 | 0,066 | 0,128 | 0,312 |
| SEARCH-R1-instruct (GRPO) | 0,397 | 0,565 | 0,391 | 0,331 | 0,310 | 0,124 | 0,232 | 0,336 |
| SEARCH-R1-base (PPO) | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| SEARCH-R1-instruct (PPO) | 0,341 | 0,545 | 0,378 | 0,324 | 0,319 | 0,103 | 0,264 | 0,325 |
5 Analyse
5.1 Verschiedene RL-Methoden: PPO vs. GRPO
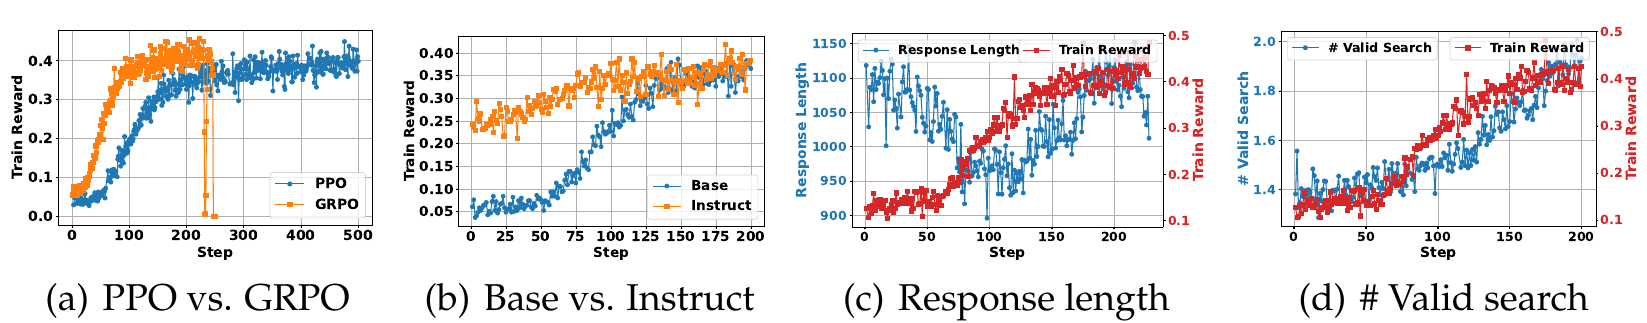
Wir evaluieren SEARCH-R1 sowohl mit PPO als auch mit GRPO als zugrunde liegender RL-Methode und führen Experimente mit Qwen2.5-3B/7B-Modellen durch. Der Vergleich der Trainingsdynamik ist in Abbildung 2(a) dargestellt, und die Evaluierungsergebnisse sind in Tabelle 3 präsentiert, woraus sich die folgenden Erkenntnisse ergeben: (1) GRPO konvergiert in allen Fällen schneller als PPO. Dies liegt daran, dass PPO auf ein Critic-Modell angewiesen ist, das mehrere Warm-up-Schritte benötigt, bevor ein effektives Training beginnt. (2) PPO zeigt eine größere Trainingsstabilität. Wie in Abbildung 2(a) dargestellt, führt GRPO nach vielen Trainingsschritten zu einem Reward-Kollaps, während PPO stabil bleibt. (3) Die finalen Trainings-Rewards von PPO und GRPO sind vergleichbar. Trotz Unterschieden in Konvergenzgeschwindigkeit und Stabilität erzielen beide Methoden ähnliche finale Trainings-Rewards und Leistungen, was darauf hindeutet, dass beide zur Optimierung von SEARCH-R1 geeignet sind. PPO weist eine größere Trainingsstabilität auf, was es in diesem Setting zur bevorzugten Wahl macht. Weitere Ergebnisse finden sich in Anhang F.
| Methode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bambooq | Durchschn. |
| SEARCH-R1 mit Maskierung | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1 ohne Maskierung | 0,388 | 0,567 | 0,391 | 0,325 | 0,321 | 0,108 | 0,304 | 0,343 |
5.2 Base- vs. Instruct-LLMs
Wir analysieren die Trainingsdynamik von SEARCH-R1 sowohl bei Base-LLMs als auch bei instruction-tuned LLMs. Die Experimente werden mit zwei Modellvarianten durchgeführt: Qwen2.5-3B und Qwen2.5-7B. Wie in Abbildung 2(b) dargestellt, beobachten wir, dass instruction-tuned Modelle im Vergleich zu Base-Modellen schneller konvergieren und von einer höheren initialen Leistung starten. Allerdings bleibt der finale Trainings-Reward beider Modelltypen nach dem Training sehr ähnlich. Diese Erkenntnis legt nahe, dass allgemeines Post-Training das Lernen in Szenarien mit Reasoning plus Suche beschleunigt, während RL die Lücke im Laufe der Zeit effektiv schließen kann, sodass Base-Modelle vergleichbare Leistungen erzielen können. Weitere Ergebnisse finden sich in Anhang E.
5.3 Studie zu Antwortlänge und gültigen Suchvorgängen
Wir führen ein Experiment mit SEARCH-R1 und dem Qwen2.5-7b-base-Modell durch, um die Dynamik der Antwortlänge und der Anzahl gültiger Suchmaschinenaufrufe im Verlauf des Trainings zu analysieren. Das Ergebnis zur Antwortlänge ist in Abbildung 2(c) dargestellt und offenbart die folgenden zentralen Trends: (1) Frühe Phase (erste 100 Schritte): Die Antwortlänge nimmt stark ab, während der Trainings-Reward einen leichten Anstieg zeigt. In dieser Phase lernt das Basismodell, übermäßige Füllwörter zu eliminieren, und beginnt, sich an die Aufgabenanforderungen anzupassen. (2) Spätere Phase (nach 100 Schritten): Sowohl die Antwortlänge als auch der Trainings-Reward steigen deutlich an. Zu diesem Zeitpunkt lernt das LLM, die Suchmaschine häufig aufzurufen, was aufgrund der abgerufenen Passagen zu längeren Antworten führt. Der Trainings-Reward verbessert sich erheblich, da das Modell effektiver darin wird, Suchergebnisse zu nutzen. Das Ergebnis zu gültigen Suchvorgängen ist in Abbildung 2(d) dargestellt und zeigt, dass die LLMs im Verlauf des Trainings lernen, die Suchmaschine häufiger aufzurufen.
5.4 Studie zur Loss-Maskierung abgerufener Token
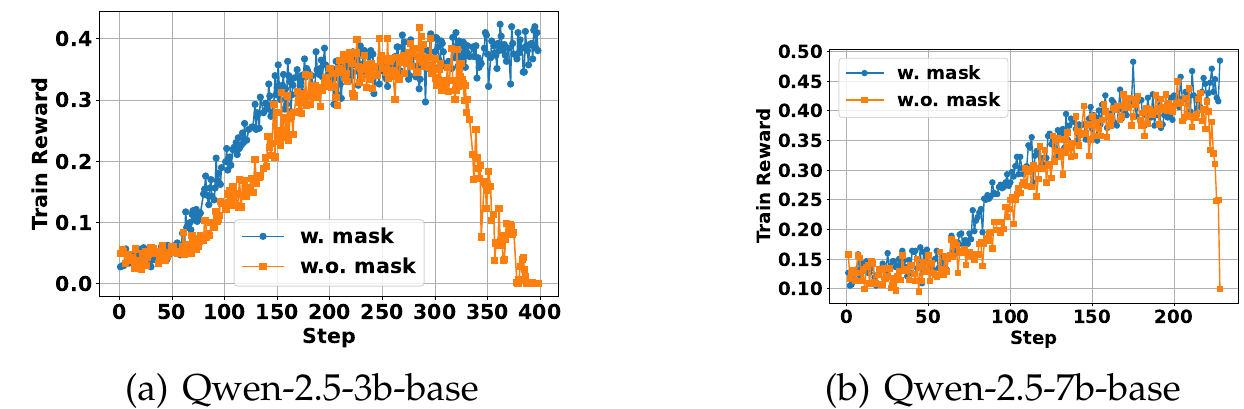
In Abschnitt 3.1 haben wir die Loss-Maskierung für abgerufene Token eingeführt, um unbeabsichtigte Optimierungsverhaltensweisen zu verhindern. Hier führen wir Experimente mit dem Qwen2.5-7b-base-Modell durch und vergleichen die Trainingsdynamik mit und ohne Loss-Maskierung abgerufener Token. Wie in Abbildung 3 dargestellt, führt die Anwendung der Maskierung abgerufener Token zu größeren Verbesserungen des LLM, indem unbeabsichtigte Optimierungseffekte abgeschwächt und ein stabileres Training gewährleistet werden. Der Leistungsvergleich ist in Tabelle 4 angegeben und zeigt, dass SEARCH-R1, trainiert mit Loss-Maskierung abgerufener Token, durchgängig die Variante ohne Maskierung übertrifft.
Weitere experimentelle Ergebnisse zur Loss-Maskierung abgerufener Token, zu Base- vs. Instruct-LLMs, zum Vergleich zwischen PPO/GRPO, zur Anzahl der abgerufenen Passagen im SEARCH-R1-Training, zur Gruppengrößenstudie in SEARCH-R1 (GRPO) und zu Fallstudien finden sich in den Anhängen D, E, G, H, I und J.
6 Schlussfolgerungen
In dieser Arbeit haben wir SEARCH-R1 vorgestellt, ein neuartiges RL-Framework, das LLMs befähigt, Selbst-Reasoning mit Echtzeit-Interaktionen mit Suchmaschinen zu verschränken. Anders als bestehende RAG-ähnliche Ansätze, die auf umfangreiches Prompting für mehrstufige Retrieval-Vorgänge angewiesen sind, oder Tool-Use-Methoden, die umfangreiche überwachte Trainingsdaten erfordern, optimiert SEARCH-R1 die Rollouts des LLM durch RL und ermöglicht autonome Query-Generierung sowie die strategische Nutzung abgerufener Informationen. Durch umfangreiche Experimente auf sieben Datensätzen haben wir gezeigt, dass SEARCH-R1 die Fähigkeit von LLMs deutlich verbessert, komplexe Reasoning-Aufgaben zu bewältigen, die Echtzeit-Wissen aus externen Quellen erfordern. Unsere Analyse liefert zudem zentrale Erkenntnisse zu RL-Trainingsstrategien für suchaugmentiertes Reasoning. Für die Zukunft kann weitere Arbeit die Erweiterung von SEARCH-R1 auf breitere Suchstrategien erkunden, einschließlich ausgefeilterer Reward-Mechanismen, dynamischer Retrieval-Anpassungen basierend auf Unsicherheit, der Kombination mit einer vielfältigen Menge an Tools und der Integration mit diversen Informationsquellen jenseits der Suche. Es ist ebenfalls vielversprechend, die Anwendbarkeit auf multimodale Reasoning-Aufgaben zu untersuchen.
Danksagungen
Diese Forschung wurde teilweise durch das Apple PhD Fellowship unterstützt, teilweise durch das US-DARPA-Programm INCAS Nr. HR0011-21-C0165 und das BRIES-Programm Nr. HR0011-24-3-0325, teilweise durch den Vertrag des Office of Naval Research mit der Nummer N000142412612, teilweise durch NSF-Fördernummern IIS-19-56151 und 2402873, teilweise durch das Molecule Maker Lab Institute: ein AI Research Institutes-Programm, unterstützt von der NSF unter Award Nr. 2019897, und das Institute for Geospatial Understanding through an Integrative Discovery Environment (I-GUIDE) der NSF unter Award Nr. 2118329, teilweise durch Cisco und teilweise durch das Center for Intelligent Information Retrieval. Alle hierin geäußerten Meinungen, Befunde und Schlussfolgerungen oder Empfehlungen sind die der Autoren und geben nicht notwendigerweise die Ansichten der Förderer oder der US-Regierung wieder, weder ausdrücklich noch implizit.
Literaturverzeichnis
Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, and Sara Hooker. Back to basics: Revisiting reinforce style optimization for learning from human feedback in llms. arXiv preprint arXiv:2402.14740, 2024.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, and Wenpeng Yin. Large language models for mathematical reasoning: Progresses and challenges. arXiv preprint arXiv:2402.00157, 2024.
Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. 2024.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1-53, 2024.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try arc, the ai2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Haofen Wang, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2, 2023.
Michael Glass, Gaetano Rossiello, Md Faisal Mahbub Chowdhury, Ankita Rajaram Naik, Pengshan Cai, and Alfio Gliozzo. Re2g: Retrieve, rerank, generate. arXiv preprint arXiv:2207.06300, 2022.
Daya Guo, Qihao Zhu, Dejian Yang, Zhenda Xie, Kai Dong, Wentao Zhang, Guanting Chen, Xiao Bi, Yu Wu, YK Li, et al. Deepseek-coder: When the large language model meets programming-the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. Constructing a multi-hop qa dataset for comprehensive evaluation of reasoning steps. arXiv preprint arXiv:2011.01060, 2020.
Zhenyu Hou, Xin Lv, Rui Lu, Jiajie Zhang, Yujiang Li, Zijun Yao, Juanzi Li, Jie Tang, and Yuxiao Dong. Advancing language model reasoning through reinforcement learning and inference scaling. arXiv preprint arXiv:2501.11651, 2025.
Sheryl Hsu, Omar Khattab, Chelsea Finn und Archit Sharma. Grounding by trying: Llms with reinforcement learning-enhanced retrieval. arXiv preprint arXiv:2410.23214, 2024.
Jie Huang und Kevin Chen-Chuan Chang. Towards reasoning in large language models: A survey. arXiv preprint arXiv:2212.10403, 2022.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan und Graham Neubig. Active retrieval augmented generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, S. 7969-7992, 2023.
Bowen Jin, Jinsung Yoon, Jiawei Han und Sercan O Arik. Long-context llms meet rag: Overcoming challenges for long inputs in rag. In The Thirteenth International Conference on Learning Representations, 2024.
Mandar Joshi, Eunsol Choi, Daniel S Weld und Luke Zettlemoyer. Triviaqa: A large scale distantly supervised challenge dataset for reading comprehension. arXiv preprint arXiv:1705.03551, 2017.
Leslie Pack Kaelbling, Michael L Littman und Andrew W Moore. Reinforcement learning: A survey. Journal of artificial intelligence research, 4:237- 285, 1996.
Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick SH Lewis, Ledell Wu, Sergey Edunov, Danqi Chen und Wen- tau Yih. Dense passage retrieval for open- domain question answering. In EMNLP (1), S. 6769- 6781, 2020.
Timo Kaufmann, Paul Weng, Viktor Bengs und Eyke Hullermeier. A survey of reinforcement learning from human feedback. arXiv preprint arXiv:2312.14925, 10, 2023.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, John D Co- Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, et al. Training language models to self- correct via reinforcement learning. arXiv preprint arXiv:2409.12917, 2024.
Tom Kwiatkowski, Jennimaria Palomaki, Olivia Redfield, Michael Collins, Ankur Parikh, Chris Alberti, Danielle Epstein, Illia Polosukhin, Jacob Devlin, Kenton Lee, et al. Natural questions: a benchmark for question answering research. Transactions of the Association for Computational Linguistics, 7:453- 466, 2019.
Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, et al. Rewardbench: Evaluating reward models for language modeling. arXiv preprint arXiv:2403.13787, 2024.
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen- tau Yih, Tim Rocktaschel, et al. Retrieval- augmented generation for knowledge- intensive nlp tasks. Advances in neural information processing systems, 33:9459- 9474, 2020.
Xiaoxi Li, Jiajie Jin, Yujia Zhou, Yongkang Wu, Zhonghua Li, Qi Ye und Zhicheng Dou. Retrollm: Empowering large language models to retrieve fine- grained evidence within generation. arXiv preprint arXiv:2412.11919, 2024.
Xiaoxi Li, Guanting Dong, Jiajie Jin, Yuyao Zhang, Yujia Zhou, Yutao Zhu, Peitian Zhang und Zhicheng Dou. Search- 01: Agentic search- enhanced large reasoning models. arXiv preprint arXiv:2501.05366, 2025.
Yinheng Li, Shaofei Wang, Han Ding und Hang Chen. Large language models in finance: A survey. In Proceedings of the fourth ACM international conference on AI in finance, S. 374- 382, 2023.
Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Richard James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra- dit: Retrieval- augmented dual instruction tuning. In The Twelfth International Conference on Learning Representations, 2023.
Alex Mallen, Akari Asai, Victor Zhong, Rajarshi Das, Hannaneh Hajishirzi und Daniel Khashabi. When not to trust language models: Investigating effectiveness and limitations of parametric and non- parametric memories. arXiv preprint arXiv:2212.10511, 7, 2022.
Yu Meng, Mengzhou Xia und Danqi Chen. Simpo: Simple preference optimization with a reference- free reward. Advances in Neural Information Processing Systems, 37:124198- 124235, 2024.
Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Training language models to follow instructions with human feedback. Advances in neural information processing systems, 35:27730- 27744, 2022.
Richard Yuanzhe Pang, Weizhe Yuan, He He, Kyunghyun Cho, Sainbayar Sukhbaatar und Jason Weston. Iterative reasoning preference optimization. Advances in Neural Information Processing Systems, 37:116617- 116637, 2024.
Cheng Peng, Xi Yang, Aokun Chen, Kaleb E Smith, Nima PourNejatian, Anthony B Costa, Cheryl Martin, Mona G Flores, Ying Zhang, Tanja Magoc, et al. A study of generative large language model for medical research and healthcare. NPJ digital medicine, 6(1):210, 2023.
Ofir Press, Muru Zhang, Sewon Min, Ludwig Schmidt, Noah A Smith und Mike Lewis. Measuring and narrowing the compositionality gap in language models. arXiv preprint arXiv:2210.03350, 2022.
Changle Qu, Sunhao Dai, Xiaochi Wei, Hengyi Cai, Shuaiqiang Wang, Dawei Yin, Jun Xu und Ji- Rong Wen. Tool learning with large language models: A survey. Frontiers of Computer Science, 19(8):198343, 2025.
Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon und Chelsea Finn. Direct preference optimization: Your language model is secretly a reward model. Advances in Neural Information Processing Systems, 36:53728- 53741, 2023.
Timo Schick, Jane Dwivedi- Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Eric Hambro, Luke Zettlemoyer, Nicola Cancedda und Thomas Scialom. Toolformer: Language models can teach themselves to use tools. Advances in Neural Information Processing Systems, 36: 68539- 68551, 2023.
John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan und Pieter Abbeel. High- dimensional continuous control using generalized advantage estimation. arXiv preprint arXiv:1506.02438, 2015.
John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford und Oleg Klimov. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, YK Li, Y Wu, et al. Deepseekmath: Pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin und Chuan Wu. Hybridflow: A flexible and efficient rlhf framework. arXiv preprint arXiv:2409.19256, 2024.
Richard S Sutton, Andrew G Barto, et al. Reinforcement learning. Journal of Cognitive Neuroscience, 11(1):126- 134, 1999.
Gemini Team. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv preprint arXiv:2403.05530, 2024.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot und Ashish Sabharwal. Interleaving retrieval with chain- of- thought reasoning for knowledge- intensive multi- step questions. arXiv preprint arXiv:2212.10509, 2022a.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot und Ashish Sabharwal. Musique: Multihop questions via single- hop question composition. Transactions of the Association for Computational Linguistics, 10:539- 554, 2022b.
Liang Wang, Nan Yang, Xiaolong Huang, Binxing Jiao, Linjun Yang, Daxin Jiang, Rangan Majumder und Furu Wei. Text embeddings by weakly- supervised contrastive pre- training. arXiv preprint arXiv:2212.03533, 2022.
Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. Chain- of- thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824- 24837, 2022.
Yixuan Weng, Minjun Zhu, Fei Xia, Bin Li, Shizhu He, Shengping Liu, Bin Sun, Kang Liu und Jun Zhao. Large language models are better reasoners with self-verification. arXiv preprint arXiv:2212.09561, 2022.
Ronald J Williams. Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine learning, 8:229-256, 1992.
Tian Xie, Zitian Gao, Qingnan Ren, Haoming Luo, Yuqian Hong, Bryan Dai, Joey Zhou, Kai Qiu, Zhirong Wu und Chong Luo. Logic-rl: Unleashing llm reasoning with rule-based reinforcement learning. arXiv preprint arXiv:2502.14768, 2025.
Guangzhi Xiong, Qiao Jin, Xiao Wang, Yin Fang, Haolin Liu, Yifan Yang, Fangyuan Chen, Zhixing Song, Dengyu Wang, Minjia Zhang, et al. Rag-gym: Optimizing reasoning and search agents with process supervision. arXiv preprint arXiv:2502.13957, 2025.
An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William W Cohen, Ruslan Salakhutdinov und Christopher D Manning. Hotpotqa: A dataset for diverse, explainable multi-hop question answering. arXiv preprint arXiv:1809.09600, 2018.
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan und Yuan Cao. React: Synergizing reasoning and acting in language models. In International Conference on Learning Representations (ICLR), 2023.
Yue Yu, Wei Ping, Zihan Liu, Boxin Wang, Jiaxuan You, Chao Zhang, Mohammad Shoeybi und Bryan Catanzaro. Rankrag: Unifying context ranking with retrieval-augmented generation in llms. Advances in Neural Information Processing Systems, 37:121156-121184, 2024.
Zhenrui Yue, Honglei Zhuang, Aijun Bai, Kai Hui, Rolf Jagerman, Hansi Zeng, Zhen Qin, Dong Wang, Xuanhui Wang und Michael Bendersky. Inference scaling for long-context retrieval augmented generation. arXiv preprint arXiv:2410.04343, 2024.
Yue Zhang, Yafu Li, Leyang Cui, Deng Cai, Lemao Liu, Tingchen Fu, Xinting Huang, Enbo Zhao, Yu Zhang, Yulong Chen, et al. Siren's song in the ai ocean: a survey on hallucination in large language models. arXiv preprint arXiv:2309.01219, 2023.
Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. A survey of large language models. arXiv preprint arXiv:2303.18223, 1(2), 2023.
Wayne Xin Zhao, Jing Liu, Ruiyang Ren und Ji-Rong Wen. Dense text retrieval based on pretrained language models: A survey. ACM Transactions on Information Systems, 42(4): 1-60, 2024.
Anhang
A Formulierung von Reinforcement Learning mit einer Suchmaschine
Das klassische Reinforcement-Learning-(RL-)Framework zum Trainieren großer Sprachmodelle (LLMs) kann wie folgt formuliert werden (Rafailov et al., 2023; Ouyang et al., 2022):
wobei einen aus einem Datensatz gezogenen Prompt bezeichnet, eine vom Policy-Modell generierte Antwort ist und ein Referenzmodell repräsentiert, das als Regularisierungsanker dient. Die Belohnungsfunktion quantifiziert die Qualität der generierten Antwort, während der KL-Divergenz-Term die aktualisierte Policy dazu einschränkt, nahe am Referenzmodell zu bleiben, wodurch die Trainingsstabilität gefördert wird.
Diese Formulierung setzt jedoch voraus, dass die gesamte Ausgabesequenz ausschließlich vom Policy-LLM generiert wird. Diese Annahme gilt in unserem Setting nicht, in dem das Modellverhalten sowohl internes Reasoning als auch externe Informationsbeschaffung umfasst. Um dem Rechnung zu tragen, erweitern wir das RL-Ziel um eine externe Suchmaschine und erhalten die folgende Formulierung:
In diesem überarbeiteten Ziel umfasst die Trajektorie verschachtelte Reasoning-Schritte und abgerufene Inhalte und spiegelt eine Multi-Turn-Interaktion zwischen dem LLM und der Suchmaschine wider. Die KL-Divergenz wird über die gemeinsame Antwortverteilung berechnet, die sowohl auf den Prompt als auch auf den retrieval-augmentierten Kontext konditioniert ist, wodurch sichergestellt wird, dass die gelernte Policy auch bei Vorhandensein externer Informationen mit dem Referenzmodell ausgerichtet bleibt.
B Experimentelle Setups
B.1 Baselines
Mehrere neuere Arbeiten haben RAG-Pipelines untersucht, insbesondere in Benchmarks wie Natural Questions (NQ) oder HotpotQA, mit dem Ziel, die Leistung durch aufwendigere Retrieval-Mechanismen zu verbessern. Beispielsweise schlagen Re2G (Glass et al., 2022) und RetroLLM (Li et al., 2024) ausgefeilte Retrieve-Rerank-Generate-Frameworks vor, die starke Retriever und komplexe Reranking-Strategien einsetzen, um feingranulare Evidenz für die Generierung auszuwählen. Während diese Ansätze beeindruckende Ergebnisse erzielen, beruhen sie häufig auf aufgabenspezifischer Ingenieursarbeit oder schwergewichtigen Pipelines, die die Generalisierbarkeit und Skalierbarkeit einschränken. Im Gegensatz dazu liegt unser Fokus auf einem leichtergewichtigen und allgemeineren Ansatz für retrieval-augmentiertes Reasoning. Daher beziehen wir diese Methoden nicht als direkte Baselines ein, obwohl sie wertvolle Richtungen im breiteren Raum der retrieval-erweiterten Sprachmodellierung darstellen.
B.2 Experimentelle Einstellungen
Wir führen Experimente mit zwei Modelltypen durch: Qwen-2.5-3B (Base/Instruct) und Qwen-2.5-7B (Base/Instruct) (Yang et al., 2024). Für das Retrieval verwenden wir den Wikipedia-Dump von 2018 (Karpukhin et al., 2020) als Wissensquelle und E5 (Wang et al., 2022) als Retriever. Um einen fairen Vergleich zu gewährleisten, folgen wir Lin et al. (2023) und setzen die Anzahl der abgerufenen Passagen bei allen retrieval-basierten Methoden auf 3.
Für das Training führen wir die Trainingssets von NQ und HotpotQA zu einem einheitlichen Datensatz für SEARCH-R1 und andere feinabstimmungsbasierte Baselines zusammen. Die Evaluierung wird auf den Test- oder Validierungssets von sieben Datensätzen durchgeführt, um sowohl die In-Domain- als auch die Out-of-Domain-Leistung zu bewerten. Als Evaluationsmetrik wird Exact Match (EM) verwendet, in Anlehnung an Yu et al. (2024). Für Inferenz-Stil-Baselines verwenden wir Instruct-Modelle, da Base-Modelle Anweisungen nicht befolgen können. Für RL-Tuning-Methoden werden Experimente sowohl auf Base- als auch auf Instruct-Modellen durchgeführt. Weitere Details zu den experimentellen Einstellungen finden sich in Anhang B.
Für die PPO-Variante von SEARCH-R1 setzen wir die Lernrate des Policy-LLM auf 1e-6 und die des Value-LLM auf 1e-5. Das Training wird über 500 Schritte durchgeführt, mit Warm-up-Ratios von 0,285 bzw. 0,015 für das Policy- und das Value-Modell. Wir verwenden Generalized Advantage Estimation (GAE) mit den Parametern und .
Das Training wird auf einem einzelnen Knoten mit 8 H100 GPUs durchgeführt. Wir verwenden eine Gesamt-Batchgröße von 512 mit einer Mini-Batchgröße von 256 und einer Mikro-Batchgröße von 64. Die maximale Sequenzlänge ist auf 4.096 Token festgelegt, mit einer maximalen Antwortlänge von 500 und einer maximalen Länge von 500 Token für abgerufene Inhalte. Zur Optimierung der GPU-Speichernutzung aktivieren wir Gradient Checkpointing und verwenden Fully Sharded Data Parallel (FSDP) mit CPU-Offloading.
Für effiziente LLM-Rollouts verwenden wir vLLM1 mit einer Tensor-Parallel-Größe von 1 und einer GPU-Speicherauslastungsquote von 0,6. Die Rollout-Sampling verwendet eine Temperatur von 1,0 und einen Top-p-Wert von 1,0. Der Regularisierungskoeffizient der KL-Divergenz und die Clip-Ratio werden auf 0,001 bzw. 0,2 gesetzt.
Für das GRPO-Training setzen wir die Lernrate des Policy-LLM auf 1e-6 und sampeln 5 Antworten pro Prompt, in Anlehnung an die GRPO-Implementierung in Verl (Sheng et al., 2024)1 . Das Modell wird über 500 Schritte mit einer Lernraten-Warm-up-Ratio von 0,285 trainiert. Das Training wird auf demselben 8xH100-Setup mit identischen Batchgrößen und Sequenzlängenkonfigurationen wie bei PPO durchgeführt.
Wir verwenden außerdem Gradient Checkpointing, FSDP-Offloading und vLLM-basierte Rollouts mit denselben Hyperparametern wie oben. Die Rollout-Temperatur und die Top-p-Werte werden beide auf 1,0 gesetzt, und der KL-Divergenz-Koeffizient und die Clip-Ratio sind auf 0,001 bzw. 0,2 festgelegt.
Für beide Methoden werden Modell-Checkpoints alle 100 Schritte gespeichert. In Fällen, in denen das Training divergiert, evaluieren wir am jüngsten stabilen Checkpoint gemäß der Trainingsbelohnungskurve; andernfalls wird der finale Checkpoint zur Evaluierung verwendet. Das maximale Aktionsbudget ist auf 4 gesetzt, und wir rufen standardmäßig die Top-3-Passagen ab.
Wir berechnen Outcome-Rewards mittels Exact Match (EM). Sofern nicht anders angegeben, wird PPO als Standard-RL-Algorithmus verwendet, und ein detaillierter Vergleich mit GRPO findet sich in Abschnitt 5.1.
C Hauptergebnisse zum 14B-LLM
Wir führen umfangreiche Experimente mit den Qwen2.5-14B-Modellen durch, und die Ergebnisse sind in Tabelle 5 dargestellt. Wie gezeigt, übertrifft SEARCH-R1 durchgängig alle Baseline-Methoden über die evaluierten Metriken hinweg. Darüber hinaus beobachten wir, dass eine Vergrößerung des Modells zu konsistenten Leistungssteigerungen mit SEARCH-R1 führt, was die Vorteile der LLM-Größenskalierung in unserem Ansatz unterstreicht.
D Studie zur Loss-Maskierung abgerufener Tokens
In Abschnitt 3.1 haben wir eine Loss-Maskierungsstrategie für abgerufene Tokens eingeführt, um unerwünschte Optimierungsverhaltensweisen während des Trainings abzuschwächen. Um ihre Auswirkung zu evaluieren, führen wir Experimente mit dem Qwen2.5-3b/7b-base-Modell durch und vergleichen die Trainingsdynamik mit und ohne Loss-Maskierung abgerufener Tokens. Wie in Abbildung 3 dargestellt, führt die Einbeziehung des Maskierungsmechanismus zu einer stabileren Optimierung und einer verbesserten Modellleistung. Quantitative Ergebnisse in Tabelle 6 bestätigen weiter, dass SEARCH-R1, wenn es mit Loss-Maskierung auf abgerufene Tokens trainiert wird, durchgängig sein nicht maskiertes Gegenstück übertrifft.
E Base- vs. Instruct-LLMs
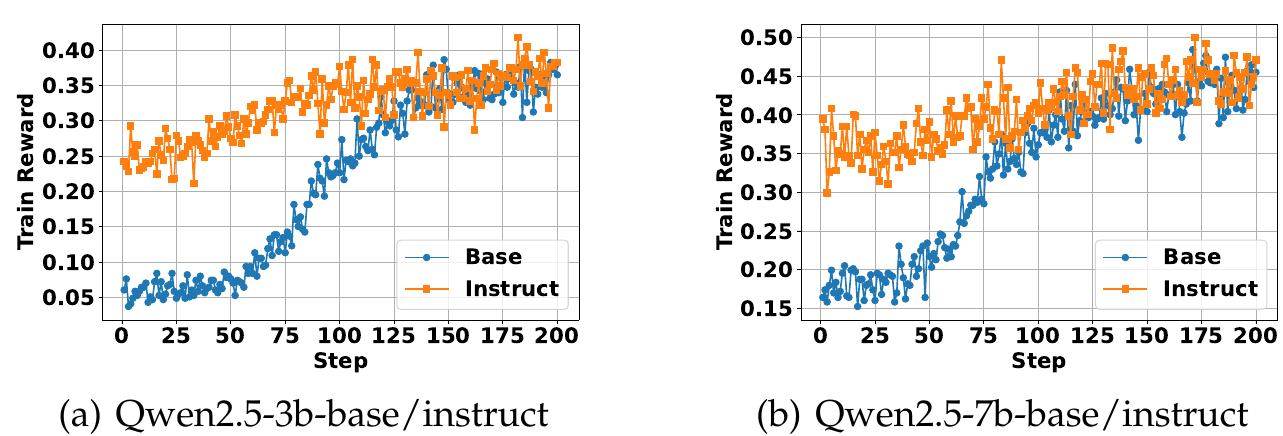
Wir untersuchen die Trainingsdynamik von SEARCH-R1 sowohl bei Base- als auch bei instruction-tuned LLMs unter Verwendung zweier Modellgrößen: Qwen2.5-3B und Qwen2.5-7B. Wie in Abbildung 4 dargestellt,
| Methoden | Allgemeine Fragebeantwortung | Multi-Hop-Fragebeantwortung | ||||||
| NQ† | TriviaQA* | PopQA* | HotpotQA† | 2wiki* | Musique* | Bamboolge* | Durchschn. | |
| Qwen2.5-14b-Base/Instruct | ||||||||
| Direkte Inferenz | 0,198 | 0,531 | 0,184 | 0,217 | 0,253 | 0,045 | 0,160 | 0,227 |
| CoT | 0,190 | 0,495 | 0,148 | 0,269 | 0,297 | 0,054 | 0,432 | 0,269 |
| IRCoT | 0,114 | 0,375 | 0,166 | 0,230 | 0,248 | 0,102 | 0,312 | 0,221 |
| Search-o1 | 0,347 | 0,635 | 0,241 | 0,268 | 0,161 | 0,099 | 0,416 | 0,310 |
| RAG | 0,327 | 0,585 | 0,376 | 0,279 | 0,160 | 0,051 | 0,192 | 0,281 |
| SFT | 0,361 | 0,467 | 0,150 | 0,248 | 0,278 | 0,089 | 0,160 | 0,250 |
| R1-base | 0,369 | 0,626 | 0,270 | 0,306 | 0,326 | 0,117 | 0,488 | 0,357 |
| R1-instruct | 0,334 | 0,628 | 0,253 | 0,294 | 0,325 | 0,108 | 0,432 | 0,339 |
| Search-R1-base | 0,486 | 0,676 | 0,480 | 0,468 | 0,470 | 0,241 | 0,528 | 0,479 |
| Search-R1-instruct | 0,424 | 0,660 | 0,442 | 0,436 | 0,379 | 0,210 | 0,480 | 0,433 |
zeigen instruction-tuned Modelle eine schnellere Konvergenz und profitieren im Vergleich zu ihren Base-Gegenstücken von einer höheren Anfangsleistung. Trotz dieses frühen Vorteils konvergiert die endgültige Leistung beider Modelltypen nach dem Training auf ein ähnliches Niveau. Diese Ergebnisse deuten darauf hin, dass Instruction-Tuning zwar ein effizienteres Lernen in frühen Phasen bei Reasoning-plus-Search-Aufgaben ermöglicht, Reinforcement Learning jedoch in der Lage ist, die Leistungslücke zu schließen und letztlich Base-Modellen zu vergleichbaren Ergebnissen zu verhelfen.
F Vergleich von PPO und GRPO in SEARCH-R1
Wir bewerten die Effektivität von SEARCH-R1 unter zwei Reinforcement-Learning-Algorithmen: PPO und GRPO, wobei sowohl Qwen2.5-3B als auch Qwen2.5-7B als zugrunde liegende Modelle verwendet werden. Abbildung 5 veranschaulicht die Trainingsdynamik. Unsere Analyse liefert die folgenden zentralen Beobachtungen: (1) GRPO zeigt in allen Einstellungen eine schnellere Konvergenz als PPO, was auf die Tatsache zurückzuführen ist,
| Methode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | Durchschn. |
| Qwen2.5-7b-Base | ||||||||
| SEARCH-R1 mit Maskierung | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 | 0,431 |
| SEARCH-R1 ohne Maskierung | 0,388 | 0,567 | 0,391 | 0,325 | 0,321 | 0,108 | 0,304 | 0,343 |
| Qwen2.5-3b-Base | ||||||||
| SEARCH-R1 mit Maskierung | 0,406 | 0,587 | 0,435 | 0,284 | 0,273 | 0,049 | 0,088 | 0,303 |
| SEARCH-R1 ohne Maskierung | 0,346 | 0,484 | 0,365 | 0,241 | 0,244 | 0,053 | 0,104 | 0,262 |
Tabelle 6: Die Leistung von SEARCH-R1 mit und ohne Loss-Maskierung abgerufener Tokens. Das LLM, das mit Loss-Maskierung abgerufener Tokens trainiert wurde, erzielt durchgängig bessere Leistung. (RL: PPO) dass PPO auf eine separate Wertfunktion (Critic) angewiesen ist, die eine anfängliche Warm-up-Phase erfordert, bevor effektive Policy-Updates erfolgen können. (2) PPO bietet ein stabileres Trainingsverhalten, wie in Abbildung 5 ersichtlich ist, wo GRPO bei verlängerten Trainingsschritten einen Reward-Kollaps erleidet, während PPO durchgehend Stabilität bewahrt. (3) PPO und GRPO erzielen vergleichbare finale Reward-Leistungen, was darauf hindeutet, dass beide Methoden trotz Kompromissen bei Konvergenzgeschwindigkeit und Stabilität effektiv für die Optimierung von SEARCH-R1 sind.
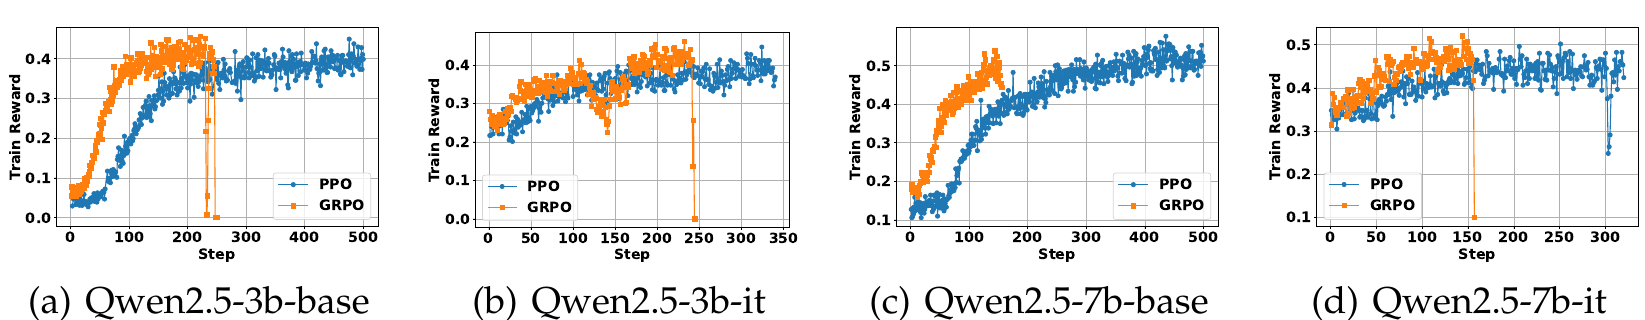
Abbildung 5: Trainingsdynamik von SEARCH-R1 mit PPO und GRPO als Basis-RL-Methode über vier LLMs hinweg. GRPO konvergiert im Allgemeinen schneller, kann jedoch nach einer bestimmten Anzahl von Trainingsschritten Instabilität zeigen, während PPO eine stabilere Optimierung bietet, aber mit langsamerer Rate konvergiert. PPO und GRPO erreichen eine vergleichbare finale Reward-Performance.
G Studie zur Anzahl der abgerufenen Passagen im SEARCH-R1-Training
Wir untersuchen den Einfluss der Anzahl der abgerufenen Passagen (top-k) auf die Trainingsdynamik von SEARCH-R1. Während unsere Hauptexperimente top-k = 3 gemäß Lin et al. (2023) verwenden, führen wir zusätzliche Studien mit top-k = 1, 3 und 5 durch, um seinen Einfluss besser zu verstehen.
Abbildung 6 zeigt die Trainings-Reward-Kurven unter diesen Einstellungen. Wir beobachten, dass alle drei Konfigurationen ähnliche Gesamttrainingsverläufe aufweisen. Bemerkenswert ist, dass top-k = 5 die schnellste anfängliche Konvergenz erreicht und innerhalb der ersten 200 Schritte den höchsten Trainings-Reward erzielt. Allerdings nimmt sein Reward im weiteren Trainingsverlauf allmählich ab und wird instabiler. Im Gegensatz dazu zeigen top-k = 1 und 3 durchgängig konsistentere Verbesserungen während des Trainings, wobei top-k = 3 letztlich nach 500 Schritten den höchsten Reward erreicht.
Die Evaluierungsergebnisse bei Schritt 500 sind in Tabelle 7 zusammengefasst, wobei top-k = 3 die beste Gesamtperformance erzielt. Wir vermuten zwei beitragende Faktoren: (1) top-k = 1 leidet wahrscheinlich unter geringem Retrieval-Recall, was die Fähigkeit einschränkt, relevante kontextuelle Informationen bereitzustellen; (2) top-k = 5 führt zu geringerer Präzision aufgrund der Einbeziehung verrauschter oder irrelevanter Passagen (Jin et al., 2024), was nicht nur die Inferenzperformance beeinträchtigt, sondern auch das RL-Training nachteilig beeinflussen kann – indem es das Modell davon abhält, abgerufene Inhalte zu nutzen, wenn es lernt, dass der zusätzliche Kontext oft wenig hilfreich oder irreführend ist.
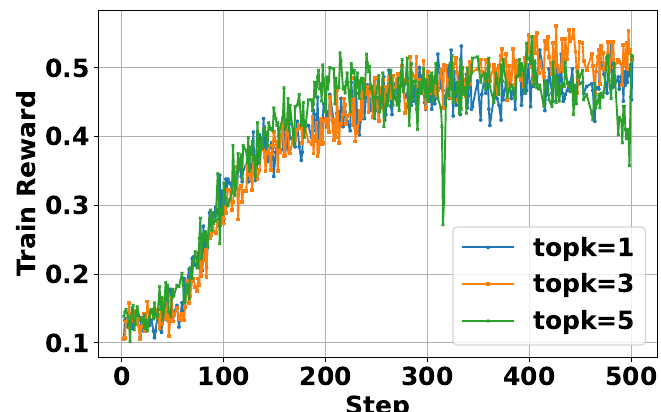
Abbildung 6: Die Trainingsdynamik von SEARCH-R1 mit einer unterschiedlichen Anzahl abgerufener Passagen. (LLM: Qwen2.5-7b-base, RL: PPO)
Tabelle 7: Die Studie zur Anzahl der abgerufenen Passagen im SEARCH-R1-Training. (LLM: Qwen2.5-7b-base; RL: PPO)
| Tabelle 7: Die Anzahl der abgerufenen Passagen, untersucht im SEARCH-R1-Training. (LLM: Qwen2.5-7b-base; RL: PPO) | Text zur Übersetzung: Methode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolge |
| Durchschn. | topk=1 | 0,426 | 0,614 | 0,422 | 0,393 | 0,296 | 0,146 | 0,328 |
| 0,375 | topk=3 | 0,480 | 0,638 | 0,457 | 0,433 | 0,382 | 0,196 | 0,432 |
| 0,431 | topk=5 | 0,479 | 0,634 | 0,440 | 0,394 | 0,343 | 0,156 | 0,352 0,400 |
H Studie zur Gruppengröße im SEARCH-R1-(GRPO-)Training
In unserem Hauptexperiment setzen wir die Gruppengröße für SEARCH-R1 (GRPO) auf 5, gemäß der Einstellung in Sheng et al. (2024). Um den Einfluss der Gruppengröße auf die Trainingsdynamik weiter zu untersuchen, führen wir eine Ablationsstudie mit Gruppengrößen von 1, 3 und 5 durch. Bemerkenswert ist, dass GRPO bei einer Gruppengröße von 1 auf den Standard-REINFORCE-Algorithmus reduziert wird (Williams, 1992).
Wir trainieren die LLMs für 500 Schritte und speichern alle 100 Schritte Modell-Checkpoints. Wenn das Modell während des Trainings kollabiert, verwenden wir den letzten gültigen Checkpoint zur Evaluierung; andernfalls evaluieren wir den Checkpoint bei Schritt 500.
Die Trainingsdynamik unter verschiedenen Gruppengrößenkonfigurationen ist in Abbildung 7 dargestellt. Wir beobachten, dass eine größere Gruppengröße im Allgemeinen zu schnellerer Konvergenz führt, aber aufgrund der inhärenten Instabilität des Reinforcement Learning auch das Kollapsrisiko erhöhen kann.
Die Evaluierungsergebnisse über verschiedene Einstellungen hinweg sind in Tabelle 8 zusammengefasst. Während größere Gruppengrößen die Konvergenz beschleunigen und höhere Trainings-Rewards erreichen können, ermöglichen kleinere Gruppengrößen (z. B. Größe = 1) ein stabileres Training und eine bessere Generalisierung. Dies spiegelt sich in überlegener Performance auf ungesehenen Aufgaben wider und unterstreicht einen Trade-off zwischen Lerngeschwindigkeit und Stabilität im GRPO-Training.
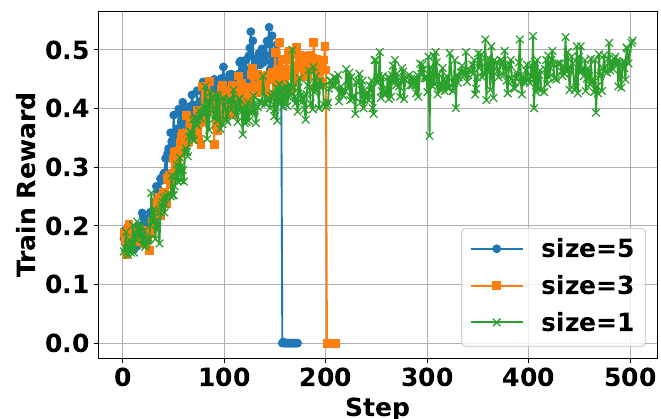
Abbildung 7: Die Trainingsdynamik von SEARCH-R1 (GRPO) mit unterschiedlicher Gruppengröße. (LLM: Qwen2.5-7b-base)
| Methode | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | Durchschn. |
| size=1 | 0,463 | 0,605 | 0,449 | 0,392 | 0,413 | 0,163 | 0,384 | 0,410 |
| size=3 | 0,385 | 0,580 | 0,396 | 0,329 | 0,333 | 0,117 | 0,400 | 0,363 |
| size=5 | 0,395 | 0,560 | 0,388 | 0,326 | 0,297 | 0,125 | 0,360 | 0,350 |
Tabelle 8: Die Studie zur Gruppengröße von SEARCH-R1 (GRPO) auf sieben Datensätzen. (LLM: Qwen2.5-7b-base)
I Vergleich zwischen R1 und SEARCH-R1: Eine Fallstudie
| Frage: Curious ist ein Damenparfüm einer Sängerin, die in welcher Stadt und welchem Bundesstaat geboren wurde? | ||||||||
| Ground Truth: McComb, Mississippi | ||||||||
| R1: | ||||||||
| <l>Die Sängerin ist Beyoncé, die in Houston, Texas, geboren wurde. </l> | ||||||||
| <l>Houston </l> | ||||||||
| <l>Ich muss herausfinden, in welcher Stadt und welchem Bundesstaat eine Sängerin geboren wurde, von der das Damenparfüm „Curious“ stammt. </l> | ||||||||
| <l>Informationen zum Parfüm Curious </search> | ||||||||
| <l>Dokument 1 (Titel: „Curious (fragrance)“) Curious (fragrance) Curious ist ein Damenparfüm von Britney Spears für Elizabeth Arden und das erste Parfüm, das von Britney Spears beworben wurde, vor „Fantasy“. Spears soll Berichten zufolge 52 Millionen US-Dollar mit der Werbung verdient haben. „Curious“ wurde im September 2004 veröffentlicht und war international sehr erfolgreich. Es war das Parfüm Nummer eins des Jahres 2004 in Kaufhäusern, und im Jahr 2005 wurde „Curious“ von der Fragrance Foundation als Best Women's Fragrance ausgezeichnet. Das Parfüm ist ein weißer Blumenduft. Seine Noten sind Magnolie aus Louisiana, goldene Anjou-Birne, Lotusblüte, Tuberose, Sternjasmin, rosa Alpenveilchen, vanillierter Moschus, Sandelholz und helle Hölzer. Elizabeth Arden... </information></td></tr><tr><td colspan="9"><l>Ich muss herausfinden, in welcher Stadt und welchem Bundesstaat Britney Spears, die Sängerin hinter dem Parfüm „Curious“, geboren wurde. </l></td></tr><tr><td colspan="9"><l>Geburtsort von Britney Spears </search></td></tr><tr><td colspan="9"><l>Dokument 1 (Titel: „Britney Spears“) die meistverkaufte Künstlerin von Frauenalben der 2000er Jahre. Im Jahr 2004 brachte sie mit Elizabeth Arden, Inc. eine Parfümmarke auf den Markt, deren Umsatz 1,5 Milliarden US-Dollar übertraf. Spears wurde in McComb, Mississippi, als zweites Kind von Lynne Irene Bridges und James Parnell Spears geboren. Ihre Großmutter mütterlicherseits, Lillian Portell, war Engländerin (geboren in London), und einer der Ururgroßväter von Spears mütterlicherseits war Malteser. Ihre Geschwister sind Bryan James und Jamie Lynn. Britney wurde im Bible Belt geboren, wo der sozial konservative evangelikale Protestantismus einen besonders starken religiösen Einfluss hat. Spears wurde in die Southern Baptist Convention getauft, studierte aber später im Leben... </information> | ||||||||
| <l>Da Britney Spears in McComb, Mississippi, geboren wurde, muss ich herausfinden, welche Stadt und welcher Bundesstaat das ist. </l> | ||||||||
| <l>Lage von McComb, Mississippi </search> | ||||||||
| <l>Dokument 1 (Titel: „McComb, Mississippi“) McComb, Mississippi McComb ist eine Stadt im Pike County, Mississippi, Vereinigte Staaten, etwa südlich von Jackson. Nach der Volkszählung von 2010 hatte die Stadt insgesamt 12.790 Einwohner. Sie ist die Hauptstadt der Micropolitan Statistical Area McComb, Mississippi. McComb wurde 1872 gegründet, nachdem Henry Simpson McComb von der New Orleans, Jackson and Great Northern Railroad, einem Vorgänger der Illinois Central Railroad (heute Teil der Canadian National Railway), beschlossen hatte, die Wartungswerkstätten der Eisenbahn aus New Orleans, Louisiana, zu verlegen, um die Anziehungskraft der Saloons dieser Stadt zu vermeiden. Die Eisenbahn kaufte Land im Pike County... </information> | ||||||||
| <l>Ich habe herausgefunden, dass Britney Spears in McComb, Mississippi, geboren wurde. Da die Frage nach der Stadt und dem Bundesstaat fragt, muss ich nur den Bundesstaat bestätigen, den ich bereits aus der vorherigen Suche kenne. </l> | ||||||||
| <l>McComb, Mississippi </answer> |
Tabelle 9: Eine Fallstudie zu R1 und SEARCH-R1.
Um tiefere Einblicke in SEARCH-R1 zu gewinnen, führen wir eine Fallstudie mit Qwen2.5-7B-Base durch und vergleichen sein Verhalten mit RL ohne Suchmaschine (Guo et al., 2025). Die Ergebnisse sind in Tabelle 20 dargestellt und offenbaren die folgenden zentralen Beobachtungen:Verschachteltes Reasoning und Retrieval verbessern die Problemanalyse: SEARCH-R1 ermöglicht es dem LLM, mit mehrrundigem Retrieval eingehendes Reasoning durchzuführen, während RL ohne Suche ausschließlich auf das interne Wissen der Modelle angewiesen ist. Durch die Einbeziehung abgerufener Passagen ermöglicht SEARCH-R1 dem LLM, sein Reasoning iterativ zu verfeinern, was zu fundierteren und genaueren Antworten führt.
Selbstverifikation durch iteratives Retrieval: Wir beobachten, dass das LLM nach der zweiten Retrieval-Runde bereits ausreichende Informationen gesammelt hat, um die Frage zu beantworten. SEARCH-R1 führt jedoch einen zusätzlichen Retrieval-Schritt zur Selbstverifikation seiner Schlussfolgerung durch, wodurch sein Vertrauen in die finale Antwort weiter gestärkt wird. Dieses Phänomen steht im Einklang mit Erkenntnissen aus LLM-Reasoning-RL ohne Retrieval (Guo et al., 2025) und unterstreicht, wie RL verifikationsgetriebenes Reasoning selbst in suchaugmentierten Einstellungen fördern kann.
J Weitere Fallstudien zu SEARCH-R1
Um ein tieferes Verständnis des Verhaltens und der Fähigkeiten des trainierten LLM zu gewinnen, führen wir zusätzliche Fallstudien zu SEARCH-R1 durch. Insbesondere analysieren wir das Modell, das aus Qwen2.5-7B-Base mit Proximal Policy Optimization (PPO) als zugrundeliegendem Reinforcement-Learning-Algorithmus feinabgestimmt wurde. Die Ergebnisse sind in den folgenden Tabellen dargestellt.
Tabelle 10: SEARCH-R1-Fallstudie 1 (erfolgreich): SEARCH-R1 führt mehrstufiges Reasoning und Suchen mit Selbstverifikation durch und beantwortet schließlich die Frage.
Frage: Welche Art von Beruf haben Chris Jericho und Gary Barlow gemeinsam? Ground Truth: Musiker SEARCH-R1: <think> Ich muss die Art von Beruf finden, die Chris Jericho und Gary Barlow gemeinsam haben. Ich werde danach suchen. </think> <search> Chris Jericho und Gary Barlow Beruf </search> <information> Doc 2(Titel: „Chris Jericho") „Do You Wanna Start a War" (2014) und „Judas" (2017) bestehen vollständig oder überwiegend aus Originalkompositionen. Er ist im Laufe der Jahre auch in zahlreichen TV-Shows aufgetreten, darunter die Teilnahme an der Staffel 2011 von „Dancing With the Stars", wo er bis zur sechsten Woche blieb. Zuvor moderierte Jericho die ABC-Game-Show „Downfall" und die Revolver Golden Gods Awards. Christopher Keith Irvine wurde am 9. November 1970 in Manhasset, New York, geboren, wuchs aber in Winnipeg auf. Sein Vater, der Eishockeyspieler Ted Irvine, spielte zum Zeitpunkt seiner Geburt für die New York Rangers. ... </information> Ich muss herausfinden, ob Gary Barlow einen dieser Berufe gemeinsam hat. </think> <search> Gary Barlow Beruf </search> <information> Doc 1(Titel: „Gary Barlow") Hits, zwölf Nummer-eins-Singles und sieben Nummer-eins-Alben mit Take That. Barlow hat sechs Ivor Novello Awards von der British Academy of Songwriters, Composers and Authors erhalten, darunter den Preis für Outstanding Services to British Music. Er hat weltweit über 50 Millionen Tonträger verkauft. Barlow wurde am 20. Januar 1971 in Frodsham, Cheshire, als zweiter Sohn von Colin (gestorben am 15. Oktober 2009) und Marjorie Barlow geboren. In Barlows Autobiografie erzählt er, dass seine Liebe zur Musik in frühen Jahren begann, und bezeichnet sich selbst als „eines dieser Kinder, die ständig vor dem Fernseher tanzen und ... </information> Ich muss herausfinden, ob es einen gemeinsamen Beruf zwischen Chris Jericho und Gary Barlow gibt. </think> <search> gemeinsamer Beruf von Chris Jericho und Gary Barlow </search> <information> Doc 1(Titel: „Gary Barlow") Gary Barlow Gary Barlow (geboren am 20. Januar 1971) ist ein englischer Sänger, Songwriter, Musiker und Musikproduzent. Er ist vor allem als Leadsänger der britischen Popgruppe Take That bekannt. Barlow war außerdem 2011, 2012 und 2013 Chef-Juror von „The X Factor UK" und 2017 von „Let It Shine". Barlow ist einer der erfolgreichsten Songwriter Großbritanniens und hat vierzehn Nummer-eins-Singles und vierundzwanzig Top-10-Hits geschrieben. Als Solokünstler hatte er drei Nummer-eins-Singles, sechs Top-10-Singles und zwei Nummer-eins-Alben und zusätzlich siebzehn Top-5-... </information> <think> Ich habe herausgefunden, dass Gary Barlow Sänger, Songwriter, Musiker und Musikproduzent ist. Jetzt muss ich herausfinden, ob Chris Jericho einen dieser Berufe gemeinsam hat. </think> <search> Chris Jericho Beruf </search> <information> Doc 1(Titel: „Chris Jericho") Chris Jericho Christopher Keith Irvine (geboren am 9. November 1970), besser bekannt unter seinem Ringnamen Chris Jericho, ist ein in den USA geborener professioneller Wrestler, Musiker, Autor und Schauspieler. Derzeit wrestlet er für New Japan Pro-Wrestling (NJPW), wo er der aktuelle IWGP Intercontinental Champion in seiner ersten Regentschaft ist. Jericho tritt außerdem sporadisch für WWE in der Marke SmackDown auf, mit der er seit 1999 zusammenarbeitet. Innerhalb des professionellen Wrestlings ist er für seine überdrehte Rockstar-Persona bekannt. Jericho gilt als einer der größten professionellen Wrestler aller Zeiten. In den 1990er-Jahren trat Jericho für die amerikanischen Organisationen Extreme Championship ... </information> <think> Ich habe herausgefunden, dass Chris Jericho professioneller Wrestler, Musiker, Autor und Schauspieler ist. Jetzt kann ich es mit Gary Barlows Berufen vergleichen. Ich habe herausgefunden, dass Gary Barlow Sänger, Songwriter, Musiker und Musikproduzent ist. Der gemeinsame Beruf zwischen Chris Jericho und Gary Barlow ist Musiker. </think> <answer> Musiker </answer>
| Frage: Wie lautete der Titel des Debüt-Studioalbums von Weezer, das die Hits „Buddy Holly“ und „Undone – The Sweater Song“ enthielt? |
| Ground Truth: The Blue Album |
| SEARCH-R1: |
| <think> Ich muss den Titel des Debüt-Studioalbums von Weezer finden, das die Hitsongs „Buddy Holly“ und „Undone – The Sweater Song“ enthielt. Ich werde danach suchen. </think> |
| <search> Debüt-Studioalbum von Weezer, das die Hits Buddy Holly und Undone – The Sweater Song enthielt </search> |
| <information> Dok 1 (Titel: „Weezer discography“) Weezer discography Die Diskografie von Weezer, einer amerikanischen Rockband, umfasst 11 Studioalben, zwei Compilation-Alben, ein Videoalbum, sechs EPs, 28 Singles und 24 Musikvideos. Weezers selbstbetiteltes Debüt-Studioalbum, oft als „The Blue Album“ bezeichnet, wurde im Mai 1994 über DGC Records veröffentlicht. Das Album war ein enormer kommerzieller Erfolg, erreichte Platz 16 der US-„Billboard“ 200 und brachte die Singles „Undone – The Sweater Song“ und „Buddy Holly“ hervor, die beide – mit Hilfe von Musikvideos unter der Regie von Spike Jonze – dafür verantwortlich waren, Weezer zum Mainstream-Erfolg zu verhelfen. ... <information> |
| <think> Ich habe herausgefunden, dass das Debüt-Studioalbum von Weezer, das die Hitsongs „Buddy Holly“ und „Undone – The Sweater Song“ enthielt, das selbstbetitelte Album ist, das oft als „The Blue Album“ bezeichnet wird. Jetzt kann ich die Antwort geben. </think> |
| <answer> Weezer </answer> |
Tabelle 11: SEARCH-R1-Fallstudie 2 (fehlgeschlagen): SEARCH-R1 scheitert manchmal daran, das komplexe Problem zu zerlegen, und kann durch irrelevante gefundene Passagen in die Irre geführt werden.
SEARCH-R1: <think> Ich muss herausfinden, wessen Tod, der in einem Bühnenstück dramatisiert wurde, dazu beigetragen hat, die Todesstrafe in Australien zu beenden. Ich werde danach suchen. </think>
<search> wessen Tod in einem Bühnenstück dramatisiert wurde und dazu beigetragen hat, die Todesstrafe in Australien zu beenden </search>
<information> Doc 3(Titel: „Ronald Ryan") Ronald Ryan Ronald Joseph Ryan (21. Februar 1925 - 3. Februar 1967) war die letzte Person, die in Australien legal hingerichtet wurde. Ryan wurde für schuldig befunden, bei einer Flucht aus dem Pentridge-Gefängnis in Victoria im Jahr 1965 den Gefängniswärter George Hodson erschossen und getötet zu haben. Ryans Erhängung stieß auf einige der größten öffentlichen Proteste in der Geschichte Australiens und führte zur Abschaffung der Todesstrafe. Bis 1985 wurde die Todesstrafe in allen Bundesstaaten abgeschafft. Ronald Edmond Thompson wurde im Royal Women's Hospital im inneren Vorort Carlton von Melbourne als Sohn von John Ronald Ryan und Cecilia Thompson (geborene ...) geboren. </information>
<think> Ich habe herausgefunden, dass der Tod von Ronald Ryan, der in einem Bühnenstück dramatisiert wurde, dazu beigetragen hat, die Todesstrafe in Australien zu beenden. Jetzt kann ich die Antwort geben. </think>
<answer> Ronald Ryan </answer>
| <answer> Ronald Ryan </answer> |
| Nur-Lese-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): |
| <answer> Ronald Ryan </answer> |
| Tabelle 20: SEARCH-R1 Fallstudie 11 (fehlgeschlagen): Das LLM kann durch irrelevante abgerufene Informationen in die Irre geführt werden und eine falsche Antwort geben. |
| Zu übersetzender Text: Frage: Wer führte Regie bei dem Film, in dem Steve Cochran und der Schauspieler, der Sheriff Roy Coffee in "Bonanza" spielte, die Hauptrollen spielten? |
| Ground Truth: Louis King |
| SEARCH-R1: |
| <think> Ich muss herausfinden, wer Regie bei dem Film führte, in dem Steve Cochran und der Schauspieler, der Sheriff Roy Coffee in "Bonanza" spielte, die Hauptrollen spielten. Ich werde danach suchen. </think> |
| <search> wer führte Regie bei dem Film, in dem Steve Cochran und der Schauspieler, der Sheriff Roy Coffee in "Bonanza" spielte, die Hauptrollen spielten </search> |
| <information> Dok. 2 (Titel: "Ray Teal") Ray Teal Ray Teal (12. Januar 1902 – 2. April 1976) war ein US-amerikanischer Schauspieler, der in seiner 37-jährigen Karriere in mehr als 250 Filmen und etwa 90 Fernsehprogrammen auftrat. Seine am längsten laufende Rolle war die des Sheriff Roy Coffee in der NBC-Westernserie "Bonanza" (1960–1972). Er spielte auch einen Sheriff in dem Film "Ace in the Hole" (1951). Teal wurde in Grand Rapids, Michigan, geboren. Als Saxophonspieler arbeitete er sich als Bandleader durch die University of California, Los Angeles, bevor er Schauspieler wurde. Nach mehr als 15 Jahren Auftritten in Filmen und im frühen Fernsehen erhielt Teal eine wiederkehrende ... </information> |
| <think> Ich habe herausgefunden, dass der Schauspieler, der Sheriff Roy Coffee in "Bonanza" spielte, Ray Teal ist. Jetzt muss ich den Film finden, in dem Steve Cochran und Ray Teal die Hauptrollen spielten. </think> |
| <search> Film, in dem Steve Cochran und Ray Teal die Hauptrollen spielten </search> |
| <information> Dok. 1 (Titel: "Steve Cochran") im Gangsterklassiker "White Heat" (1949). Er trat an der Seite von Mayo auf. Warner Bros. würde schließlich Cochrans und Mayos Verträge von Goldwyn übernehmen. Cochran unterstützte Joan Crawford in "The Damned Don't Cry" (1950), dann erhielt er seine erste Hauptrolle in "Highway 301" (1950), in der er einen Gangster spielte. Er war ein Bösewicht gegenüber Gary Coopers Helden in "Dallas" (1950) und spielte einen Ku-Klux-Klan-Anhänger in "Storm Warning" (1951), mit Ginger Rogers und Doris Day. Cochran war ein Bösewicht in "Canyon Pass" (1951), einem Western, dann erhielt er die Hauptrolle in "Inside the Walls of Folsom Prison" (1951), der inspirierte ... |
| <information> |
| <think> Ich habe herausgefunden, dass Steve Cochran in mehreren Filmen die Hauptrolle spielte. Jetzt muss ich den Film finden, in dem auch Ray Teal die Hauptrolle spielte. </think> |
| <search> Film, in dem Steve Cochran und Ray Teal die Hauptrollen spielten </search> |
| <information> Dok. 1 (Titel: "Steve Cochran") im Gangsterklassiker "White Heat" (1949). Er trat an der Seite von Mayo auf. Warner Bros. würde schließlich Cochrans und Mayos Verträge von Goldwyn übernehmen. Cochran unterstützte Joan Crawford in "The Damned Don't Cry" (1950), dann erhielt er seine erste Hauptrolle in "Highway 301" (1950), in der er einen Gangster spielte. Er war ein Bösewicht gegenüber Gary Coopers Helden in "Dallas" (1950) und spielte einen Ku-Klux-Klan-Anhänger in "Storm Warning" (1951), mit Ginger Rogers und Doris Day. Cochran war ein Bösewicht in "Canyon Pass" (1951), einem Western, dann erhielt er die Hauptrolle in "Inside the Walls of Folsom Prison" (1951), der inspirierte ... |
| <information> |
| <think> Ich habe herausgefunden, dass Steve Cochran in mehreren Filmen die Hauptrolle spielte. Jetzt muss ich den Film finden, in dem auch Ray Teal die Hauptrolle spielte. Ich werde nach dem Film suchen, in dem sowohl Steve Cochran als auch Ray Teal die Hauptrollen spielten. </think> |
| <search> Film unter der Regie von Sam Peckinpah, in dem Steve Cochran und Ray Teal die Hauptrollen spielten </search> <information> Dok. 1 (Titel: "Sam Peckinpah") Voll von Explosionen, Verfolgungsjagden und intensiven Schießereien wurde der Film Peckinpahs bis dahin größter finanzieller Erfolg und spielte mehr als 25 Millionen Dollar an der Kinokasse ein. Obwohl streng genommen ein kommerzielles Produkt, sind Peckinpahs kreative Akzente throughout zahlreich, am bemerkenswertesten während der kunstvoll geschnittenen Eröffnungssequenz, als McQueens Figur unter dem Druck des Gefängnislebens leidet. Der Film bleibt beliebt und wurde 1994 mit Alec Baldwin und Kim Basinger in den Hauptrollen neu verfilmt. Das Jahr 1973 markierte den Beginn der schwierigsten Periode in Peckinpahs Leben und Karriere. Während er noch "The Getaway" in El Paso, Texas, drehte, schlich sich Peckinpah über die Grenze ... </information> <think> Ich habe herausgefunden, dass Sam Peckinpah Regie bei dem Film "The Wild Bunch" führte, in dem Steve Cochran und Ray Teal die Hauptrollen spielten. </think> <answer> Sam Peckinpah </answer> |
| Nur-Lese-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): <answer> Ronald Ryan </answer> |
| Tabelle 20: SEARCH-R1-Fallstudie 11 (fehlgeschlagen): Das LLM kann durch irrelevante abgerufene Informationen in die Irre geführt werden und eine falsche Antwort geben. |
| Zu übersetzender Text: Frage: Wo ist das Unternehmen ansässig, das XXXTentacions Single "Revenge" vertrieben hat? |
| Ground Truth: San Francisco, Kalifornien |
| SEARCH-R1: <think> Ich muss das Unternehmen finden, das XXXTentacions Single "Revenge" vertrieben hat. Ich werde danach suchen. </think> <search> XXXTentacion's single "Revenge" distributed company </search> |
| <information> Doc 1(Title: "Revenge (XXXTentacion mixtape)") Revenge (XXXTentacion mixtape) Revenge ist ein Mixtape des amerikanischen Rappers XXXTentacion, das am 16. Mai 2017 von Empire Distribution veröffentlicht wurde. Es besteht aus acht bereits veröffentlichten Songs, die auf XXXTentacions SoundCloud zum Streaming verfügbar waren. Vorausgegangen war die Leadsingle ""Look at Me", die auf Platz 34 der US-"Billboard"-Hot 100 erreichte. Die Leadsingle des Tapes mit dem Titel ""Look at Me" wurde am 31. Dezember 2015 auf SoundCloud uraufgeführt. Der Song wurde später am 29. Januar 2016 als Single auf iTunes veröffentlicht, bis er später erneut zum digitalen Download wiederveröffentlicht wurde, mit einer remasterten und sauberen... </information> |
| <think> Ich habe herausgefunden, dass das Unternehmen, das XXXTentacions Single "Revenge" vertrieben hat, Empire Distribution ist. Jetzt muss ich den Standort des Unternehmens finden. </think> <search> Empire Distribution location </search> |
| <information> Doc 1(Title: "Empire Distribution") Empire Distribution EMPIRE Distribution, Records and Publishing Inc. (vermarktet als EMPIRE) ist ein amerikanisches Vertriebsunternehmen und Plattenlabel, das 2010 von Ghazi Shami gegründet wurde und seinen Hauptsitz in San Francisco, Kalifornien, mit Büros in New York City und Atlanta hat. Es hat Alben in verschiedenen Genres wie RB, Reggae, Rock, Gospel, Latin, Country und Pop veröffentlicht, konzentriert sich aber überwiegend auf Hip-Hop-Musik. Unternehmen und Künstler wie Top Dawg Entertainment (Kendrick Lamar, Schoolboy Q, Ab-Soul), Steel Wool (Anderson Paak, Watsky, Jez Dior), Jazz Anderson, Cody Wolfe, Kane Brown, Funk Volume (Dizzy Wright, Jarren Benton), ESGN (Freddie Gibbs),... </information> |
| <think> Ich habe herausgefunden, dass das Unternehmen Empire Distribution in San Francisco, Kalifornien, ansässig ist. Jetzt kann ich die Antwort geben. </think> <answer> San Francisco, Kalifornien </answer> |
| Read-only background for understanding the source (not source text to translate): |
| <answer> Ronald Ryan </answer> |
| Tabelle 20: SEARCH-R1 Fallstudie 11 (fehlgeschlagen): Das LLM kann durch irrelevante abgerufene Informationen in die Irre geführt werden und eine falsche Antwort geben. |
| Zu übersetzender Text: |
| Frage: Diese Erweiterung des Magazinartikels „Is Google Making Us Stoopid?“ von 2008 war Finalist für welchen Preis? |
| Ground Truth: Pulitzer-Preis |
| SEARCH-R1: |
| <think>Ich muss herausfinden, welche Erweiterung des Magazinartikels „Is Google Making Us Stoopid?“ von 2008 Finalist für welchen Preis war. Ich werde danach suchen.</think> |
| <search>Diese Erweiterung des Magazinartikels „Is Google Making Us Stoopid?“ von 2008 war Finalist für welchen Preis</search> |
| <information>Dok. 1 (Titel: „Is Google Making Us Stupid?“) Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains (alternativ Is Google Making Us Stupid?) ist ein Magazinartikel des Technologieautors Nicholas G. Carr und ist äußerst kritisch gegenüber der Wirkung des Internets auf die Kognition. Er wurde in der Ausgabe Juli/August 2008 des Magazins „The Atlantic“ als sechsseitige Titelgeschichte veröffentlicht. Carrs Hauptargument ist, dass das Internet nachteilige Auswirkungen auf die Kognition haben könnte, die die Fähigkeit zu Konzentration und Kontemplation verringern. Trotz des Titels richtet sich der Artikel nicht speziell gegen Google, sondern eher gegen die kognitive Wirkung von ...</information> <think>Ich habe herausgefunden, dass die Erweiterung des Magazinartikels „Is Google Making Us Stoopid?“ von 2008 Finalist für einen Preis war. Ich muss herausfinden, für welchen Preis sie Finalist war.</think> <search>für welchen Preis war die Erweiterung des Magazinartikels „Is Google Making Us Stoopid?“ von 2008 Finalist</search> <information>Dok. 2 (Titel: „Is Google Making Us Stupid?“) nicht schlüssig und stellte fest, dass „es Zeit brauchen wird, bis klar ist, ob wir die alten Wege betrauern, die neuen feiern oder lernen sollten, uns keine Sorgen mehr zu machen und das Netz zu lieben“. Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains (alternativ Is Google Making Us Stupid?) ist ein Magazinartikel des Technologieautors Nicholas G. Carr und ist äußerst kritisch gegenüber der Wirkung des Internets auf die Kognition. Er wurde in der Ausgabe Juli/August 2008 des Magazins „The Atlantic“ als sechsseitige Titelgeschichte veröffentlicht. Carrs Hauptargument ist, dass das Internet nachteilige Auswirkungen auf die Kognition haben könnte, die die Fähigkeit zu Konzentration und Kontemplation verringern. Trotz des Titels richtet sich der Artikel nicht speziell gegen Google, sondern eher gegen die kognitive Wirkung von ...</information> <answer>National Magazine Award</answer> |
| Frage: Wer war eine Pianistin, Maro Ajemian oder Richard C. Sarafian? Ground Truth: Maro Ajemian SEARCH-R1: |
| <think>Ich muss feststellen, ob Maro Ajemian oder Richard C. Sarafian Pianist/in war. Ich werde danach suchen.</think><search> who was a pianist, Maro Ajemian or Richard C. Sarafian </search><information> Doc 1(Title: "Maro Ajemian") Maro Ajemian Maro Ajemian (9. Juli 1921 – 18. September 1978) war eine amerikanische Pianistin. Ajemians Karriere in der zeitgenössischen Musik entwickelte sich aus ihrem armenischen Erbe. Sie wurde als zeitgenössische Pianistin bekannt, nachdem sie die US-Premiere von Aram Chatschaturjans Klavierkonzert gespielt hatte, das sie aufgrund ihrer gemeinsamen armenischen Herkunft ausgewählt hatte. Ajemian studierte an der Juilliard School of Music. Am 14. März 1942 gab sie mit dem Juilliard Graduate Orchestra unter Albert Stoessel die amerikanische Erstaufführung von Aram Chatschaturjans Klavierkonzert in Des. Später führte sie das Stück auf einer landesweiten Tournee auf. Im Anschluss an ihre Aufführungen des ... </information> |
| <think> Ich habe herausgefunden, dass Maro Ajemian eine Pianistin war. Jetzt muss ich prüfen, ob Richard C. Sarafian ein Pianist war oder nicht. </think><search> who was Richard C. Sarafian </search><information> Doc 1(Title: "Richard C. Sarafian") Richard C. Sarafian Richard Caspar Sarafian (28. April 1930 – 18. September 2013) war ein amerikanischer Fernseh- und Filmregisseur und Schauspieler. Er hatte eine vielseitige Karriere, die sich über mehr als fünf Jahrzehnte als Regisseur, Schauspieler und Autor erstreckte. Sarafian ist vor allem als Regisseur des Films "" von 1971 bekannt. Sarafian wurde am 28. April 1930 in New York City als Sohn armenischer Einwanderer geboren. Er studierte Jura-Vorbereitung und Medizin-Vorbereitung an der New York University und war ein schlechter Student, wechselte aber zum Filmstudium, in dem er hervorragende Leistungen erbrachte. Er verließ das College, um in die United States Army einzutreten, in der ... </information><think> Ich habe herausgefunden, dass Richard C. Sarafian ein Fernseh- und Filmregisseur und Schauspieler war. Jetzt kann ich ihn mit Maro Ajemian vergleichen, die eine Pianistin war. </think><answer> Maro Ajemian </answer> |
Read-only-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): <answer> Ronald Ryan </answer> Tabelle 20: SEARCH-R1-Fallstudie 11 (fehlgeschlagen): Das LLM kann durch irrelevante abgerufene Informationen in die Irre geführt werden und eine falsche Antwort geben. Zu übersetzender Text: Frage: Wer ist älter, Jed Hoyer oder John William Henry II? Ground Truth: John William Henry II SEARCH-R1:<think> Ich muss feststellen, ob Jed Hoyer oder John William Henry II älter ist. Ich werde nach ihrem Alter suchen.</think><search> Jed Hoyer oder John William Henry II </search><information> Doc 1(Titel: „Jed Hoyer“) Karriere-Saves-Rekord mit Sam Elias und Nick Miceli. Während seiner Zeit an der Wesleyan University wurde er außerdem in Delta Kappa Epsilon initiiert und ist ein Bruder dieser Verbindung. Im Sommer 1995 stand er im Kader der Waterbury Barons der New England Collegiate Baseball League und sah Innings auf dem Mound und auf der Shortstop-Position. Hoyer arbeitete im Zulassungsbüro und dann im Alumni-/Development-Büro und war nach seinem Abschluss außerdem Baseballtrainer an der Universität. Er arbeitete in der Zulassungsabteilung des Kenyon College, bevor er mit 28 zu den Red Sox kam. Er heiratete Merrill Muckerman im Juni 2010 in ... </information><think> Ich habe herausgefunden, dass Jed Hoyer eine Person ist. Jetzt muss ich sein Alter herausfinden und es mit dem Alter von John William Henry II vergleichen.</think><search> John William Henry II </search><information> Doc 1(Titel: „John W. Henry“) Das Management der Firma war von 2,5 Milliarden Dollar im Jahr 2006 auf weniger als 100 Millionen Dollar Ende 2012 gefallen. Stand Juli 2017 schätzte „Forbes“ sein Nettovermögen auf 2,6 Milliarden Dollar. John William Henry II wurde am 13. September 1949 in Quincy, Illinois, geboren. Seine Eltern waren Sojabohnenfarmer, und er verbrachte seine Kindheit abwechselnd in Illinois und Arkansas. Sein Asthmazustand im Alter von 15 Jahren veranlasste seine Familie, nach Apple Valley, Kalifornien, zu ziehen. Nach seinem Abschluss an der Victor Valley High School in Victorville besuchte er das Victor Valley College, dann die University of California (in Riverside, ... </information><think> Ich habe herausgefunden, dass John William Henry II am 13. September 1949 geboren wurde. Jetzt muss ich Jed Hoyers Geburtsjahr finden, um zu vergleichen.</think><search> Jed Hoyer Geburtsjahr </search><information> Doc 1(Titel: „Jed Hoyer“) Karriere-Saves-Rekord mit Sam Elias und Nick Miceli. Während seiner Zeit an der Wesleyan University wurde er außerdem in Delta Kappa Epsilon initiiert und ist ein Bruder dieser Verbindung. Im Sommer 1995 stand er im Kader der Waterbury Barons der New England Collegiate Baseball League und sah Innings auf dem Mound und auf der Shortstop-Position. Hoyer arbeitete im Zulassungsbüro und dann im Alumni-/Development-Büro und war nach seinem Abschluss außerdem Baseballtrainer an der Universität. Er arbeitete in der Zulassungsabteilung des Kenyon College, bevor er mit 28 zu den Red Sox kam. Er heiratete Merrill Muckerman im Juni 2010 in ... </information><think> Ich habe herausgefunden, dass Jed Hoyer am 7. Dezember 1973 geboren wurde. Jetzt kann ich sein Geburtsjahr mit dem Geburtsjahr von John William Henry II vergleichen.</think><answer> John William Henry II </answer> Tabelle 18: SEARCH-R1-Fallstudie 9 (erfolgreich): Die erste vom LLM geschriebene Abfrage ist nicht sehr aussagekräftig. Daraufhin beginnt das LLM jedoch, die Abfrage zu formulieren und das Problem Schritt für Schritt zu lösen. |
| Read-only-Hintergrund zum Verständnis der Quelle (kein zu übersetzender Quelltext): <answer> Ronald Ryan </answer> |
| Tabelle 20: SEARCH-R1 Fallstudie 11 (fehlgeschlagen): Das LLM kann durch irrelevante abgerufene Informationen in die Irre geführt werden und eine falsche Antwort geben. |
| Zu übersetzender Text: Frage: Die Anthologie „The world's greatest Super-Heroes“ präsentierte einen von vier Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen. Wie lautete ihr Name? |
| Ground Truth: Captain Marvel |
| SEARCH-R1: |
| <think> Ich muss den Namen eines der vier Superhelden finden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen. Ich werde danach suchen. </think> |
| <search> Die Anthologie „The world's greatest Super-Heroes“ präsentierte einen von vier Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen </search> |
| <information> Dok. 1 (Titel: „Shazam! (TV series)“) Shazam! (TV series) Shazam! ist eine halbstündige Live-Action-Fernsehsendung, die von Filmaton produziert wurde (die erste derartige Sendung des Studios), basierend auf dem Superhelden Captain Marvel, auch bekannt als Shazam, aus der Comicreihe Whiz Comics von Fawcett Comics (heute im Besitz von DC Comics). Die Sendung hatte Michael Gray als Billy Batson in der Hauptrolle, einen Teenager, der sich in den Superhelden Captain Marvel verwandeln kann – ursprünglich gespielt von Jackson Bostwick und später von John Davey –, indem er das Zauberwort „Shazam!“ ausspricht. Mit seinem Vormund „Mentor“ (Les Tremayne) reist Billy in einem Dodge Open Road Wohnmobil von 1973 durch das Land auf der Suche nach Ungerechtigkeiten, die er lösen kann. ... </information> |
| <think> Ich habe herausgefunden, dass die Anthologie „The world's greatest Super-Heroes“ einen von vier Superhelden präsentierte, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen. Jetzt muss ich ihre Namen finden. </think> |
| <search> vier Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen </search> |
| <information> Dok. 1 (Titel: „Captain Marvel (DC Comics)“) Captain Marvel (DC Comics) Captain Marvel, auch bekannt als Shazam (), ist ein fiktiver Comic-Superheld, der in Veröffentlichungen des amerikanischen Verlags DC Comics erscheint. Der Zeichner C. C. Beck und der Autor Bill Parker schufen die Figur 1939. Captain Marvel trat erstmals in „Whiz Comics“ #2 auf (Cover-Datum Feb. 1940), veröffentlicht von Fawcett Comics. Er ist das Alter Ego von Billy Batson, einem Jungen, der sich durch das Aussprechen des Zauberworts „SHAZAM“ (Akronym für sechs „unsterbliche Älteste“: Solomon, Hercules, Atlas, Zeus, Achilles und Mercury) in einen kostümierten Erwachsenen mit den Kräften übermenschlicher Stärke, Geschwindigkeit, Flugfähigkeit und anderem verwandeln kann ... </information> |
| <think> Ich habe herausgefunden, dass einer der vier Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen, Captain Marvel ist (auch bekannt als Shazam). Jetzt muss ich die anderen drei Superhelden finden. </think> |
| <search> andere drei Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen </search> |
| <information> Dok. 2 (Titel: „Fawcett Comics“) Fawcett Comics Fawcett Comics, eine Abteilung von Fawcett Publications, war in den 1940er-Jahren während des Goldenen Zeitalters der Comics einer von mehreren erfolgreichen Comicverlagen. Seine beliebteste Figur war Captain Marvel, das Alter Ego des Radioreporters Billy Batson, der sich in den Helden verwandelte, wann immer er das Zauberwort „Shazam!“ sagte. Weitere von Fawcett veröffentlichte Figuren sind Captain Video, Hopalong Cassidy, Ibis the Invincible, Bulletman und Bulletgirl, Spy Smasher, Captain Midnight, Phantom Eagle, Mister Scarlet und Pinky, Minute-Man, Commando Yank und Golden Arrow. Neben den bekannteren Superhelden-Comics veröffentlichte Fawcett auch eine kurzlebige Reihe von ... </information> |
| <think> Ich habe herausgefunden, dass einer der vier Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen, Captain Marvel ist (auch bekannt als Shazam). Jetzt muss ich die anderen drei Superhelden finden. Ich werde nach ihnen suchen. </think> |
| <search> andere drei Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen </search> |
| <information> Dok. 3 (Titel: „Captain Marvel (DC Comics)“) Crossover-Event-Serie. Er ist das superkräftige Alter Ego von Alexander Luthor von Earth-3. In der Geschichte haben das Crime Syndicate (böse Earth-3-Gegenstücke der Justice League) Alexander Luthor, ihren Gefangenen, mit auf die Prime Earth gebracht, wo die Justice League und andere Helden leben. Der Lex Luthor der Prime Earth und sein Team schleichen sich in den Justice League Watchtower, wo das Syndikat Alexander als Geisel hält, und entfernen das Klebeband von seinem Mund, wodurch Alexander das Zauberwort „Mazahs!“ aussprechen und sich in sein muskulöses, äußerst mächtiges Alter Ego verwandeln kann. Während der Shazam der Prime Earth dafür bekannt ist, seine Kräfte zu teilen ... </information> <think> Ich habe herausgefunden, dass einer der vier Superhelden, die dafür bekannt sind, den Ausdruck „SHAZAM“ zu sagen, Captain Marvel ist (auch bekannt als Shazam). Die anderen drei Superhelden werden im Suchergebnis nicht erwähnt. Ich werde die Antwort auf Grundlage der Informationen geben, die ich habe. </think> <answer> Captain Marvel </answer> |
Tabelle 20: SEARCH- R1 Fallstudie 11 (fehlgeschlagen): Das LLM kann durch irrelevante abgerufene Informationen in die Irre geführt werden und eine falsche Antwort geben.
Frage: Wer war der Gewinner der Staffel von The Rap Game, in der eine Kandidatin namens Lady Lesharr als eine ihrer Einflüsse genannt wurde?
Ground Truth: Mani
SEARCH- R1: <think> Ich muss den Gewinner der Staffel von The Rap Game finden, in der eine Kandidatin namens Lady Lesharr als eine ihrer Einflüsse genannt wurde. Ich werde danach suchen. </think>
<search> Wer war der Gewinner der Staffel von The Rap Game, in der eine Kandidatin namens Lady Lesharr als eine ihrer Einflüsse genannt wurde </search>
<information> Doc 1(Titel: „Lady Lesharr“) Act. Lesharr bekannte sich im September 2018 als pansexuell. Lesharr hat Ashley Walters, Lisa Maffia, Missy Elliott und Lil Wayne als ihre primären Einflüsse genannt. Lady Lesharr Melesha Katrina O'Garro (geboren am 15. Dezember 1989), bekannt unter ihrem Künstlernamen Lady Lesharr (), ist eine britische Grime- und Hip-Hop-Rapperin, Sängerin und Produzentin aus Kingshurst, Solihull, UK. Sie ist am besten bekannt für ihre „Queen's Speech“-Freestyle-Serie, deren vierter Teil 2016 viral ging. Die Teilnehmerin der zweiten Staffel von „The Rap Game“, Nia Kay, erklärte, Lesharr sei einer ihrer Einflüsse gewesen, wegen ihrer Einzigartigkeit und ihrer Rap-Fähigkeiten. Ihr anschließender Freestyle, ... </information>
<think> Ich habe herausgefunden, dass Lady Lesharr einer der Einflüsse von Nia Kay in der zweiten Staffel von The Rap Game war. Jetzt muss ich den Gewinner dieser Staffel finden. </think>
<search> Gewinner von The Rap Game Staffel 2 </search> <information> Doc 1(Titel: „Chandra Davis“) Chandra Davis Chandra Davis (geboren am 2. Januar 1978 in Detroit, Michigan), auch bekannt als London Charles und Deelishis, ist ein amerikanisches Model und ehemalige Realityshow-Teilnehmerin. Sie ist am besten bekannt als Gewinnerin von VH1s erfolgreicher Reality-TV-Show „Flavor of Love 2“. Davis war Teilnehmerin der zweiten Staffel von VH1s Flavor of Love (im Alter von 29 Jahren). Sie gewann anschließend den Wettbewerb, als Flavor Flavor sie statt Tiffany ‚New York‘ Pollard wählte, die zurückkehrte, nachdem sie zuvor in der ersten Staffel der Show zur Zweitplatzierten ernannt worden war. Nach FOL gab Davis in einer VH1-Sondersendung bekannt, dass sie derzeit nicht mit Flavor zusammen ist, ... </information>
<think> Ich habe herausgefunden, dass der Gewinner von The Rap Game Staffel 2 London Charles (Chandra Davis) ist. Jetzt kann ich die Antwort geben. </think>
<answer> London Charles </answer>