
Tausend kuratierte Beispiele und ein hartes Token-Limit genügen, um ein kleines Modell an größeren Reasoning-Systemen vorbeizuziehen. 2025, kostenlos.
s1: Simple test-time scaling
s1: Einfache Skalierung zur Testzeit
Niklas Muennighoff Zitong Yang Weijia Shi Xiang Lisa Li Li Fei-Fei Hannaneh Hajishirzi Luke Zettlemoyer Percy Liang Emmanuel Candès Tatsunori Hashimoto
Zusammenfassung
Die Skalierung zur Testzeit ist ein vielversprechender neuer Ansatz für die Sprachmodellierung, bei dem zusätzliche Rechenleistung zur Testzeit eingesetzt wird, um die Leistung zu verbessern. Kürzlich zeigte OpenAIs o1-Modell diese Fähigkeit, teilte seine Methodik jedoch nicht öffentlich, was zu vielen Nachahmungsversuchen führte. Wir suchen nach dem einfachsten Ansatz, um Skalierung zur Testzeit und starke Schlussfolgerungsleistung zu erreichen. Zuerst stellen wir einen kleinen Datensatz s1K mit 1.000 Fragen zusammen, gepaart mit Schlussfolgerungsspuren, wobei wir uns auf drei Kriterien stützen, die wir durch Ablationen validieren: Schwierigkeit, Vielfalt und Qualität. Zweitens entwickeln wir Budget Forcing, um die Rechenleistung zur Testzeit zu steuern, indem wir den Denkprozess des Modells zwangsweise beenden oder ihn verlängern, indem wir „Wait“ mehrfach an die Generierung des Modells anhängen, wenn es versucht zu enden. Dies kann das Modell dazu bringen, seine Antwort zu überprüfen, wodurch es oft fehlerhafte Schlussfolgerungsschritte korrigiert. Nach überwachtem Finetuning des Sprachmodells Qwen2.5-32B-Instruct auf s1K und Ausstattung mit Budget Forcing übertrifft unser Modell s1-32B o1-preview bei Wettbewerbs-Mathematikaufgaben um bis zu (MATH und AIME24). Darüber hinaus ermöglicht die Skalierung von s1-32B mit Budget Forcing eine Extrapolation über seine Leistung ohne Eingriff zur Testzeit hinaus: von auf bei AIME24. Unser Modell, unsere Daten und unser Code sind Open Source unter https://github.com/simplescaling/s1 verfügbar.
1. Einleitung
Leistungsverbesserungen von Sprachmodellen (LMs) in den vergangenen Jahren beruhten weitgehend auf der Skalierung der Rechenleistung zur Trainingszeit mittels groß angelegtem selbstüberwachtem Pretraining (Kaplan et al., 2020; Hoffmann et al., 2022). Die Erschaffung dieser leistungsfähigen Modelle hat die Bühne für ein neues Skalierungsparadigma auf ihrer Grundlage bereitet: die Skalierung zur Testzeit. Das Ziel
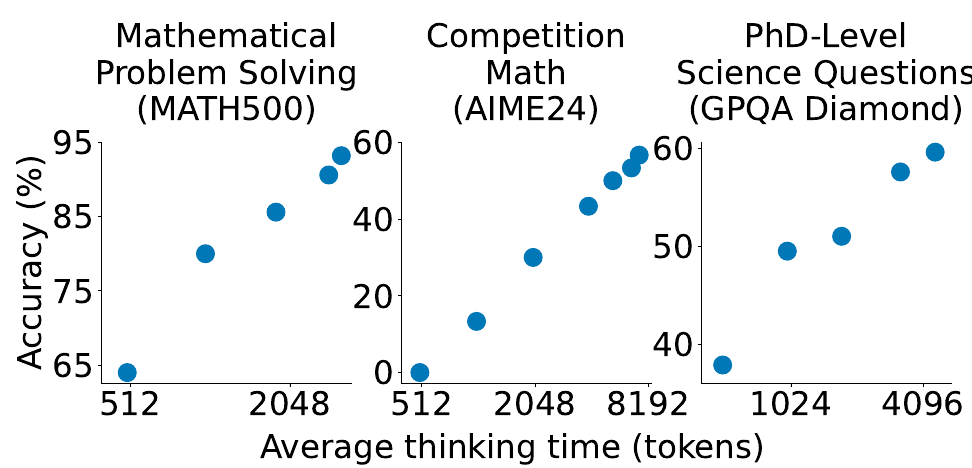
dieses Ansatzes ist es, die Rechenleistung zur Testzeit zu erhöhen, um bessere Ergebnisse zu erzielen. Es gibt bereits viele Arbeiten, die diese Idee untersuchen (Snell et al., 2024; Welleck et al., 2024), und die Tragfähigkeit dieses Paradigmas wurde kürzlich durch OpenAI o1 validiert (OpenAI, 2024). o1 hat starke Schlussfolgerungsleistung mit konsistenten Zugewinnen durch Skalierung der Rechenleistung zur Testzeit demonstriert. OpenAI beschreibt seinen Ansatz als Verwendung von groß angelegtem Reinforcement Learning (RL), was den Einsatz beträchtlicher Datenmengen impliziert (OpenAI, 2024). Dies hat zu verschiedenen Versuchen geführt, ihre Modelle nachzubilden, wobei Techniken wie Monte-Carlo-Baumsuche (Gao et al., 2024b; Zhang et al., 2024a), Multi-Agenten-Ansätze (Qin et al., 2024) und andere (Wang et al., 2024a; Huang et al., 2024b; 2025) zum Einsatz kommen. Unter diesen Ansätzen hat DeepSeek R1 (DeepSeek-AI et al., 2025) erfolgreich eine Leistung auf o1-Niveau nachgebildet, ebenfalls unter Einsatz von Reinforcement Learning über Millionen von Beispielen und mehrere Trainingsphasen hinweg. Trotz der großen Zahl von o1-Nachbildungsversuchen hat jedoch keiner öffentlich ein klares Skalierungsverhalten zur Testzeit nachgebildet. Daher fragen wir: Was ist der einfachste Ansatz, um sowohl Skalierung zur Testzeit als auch starke Schlussfolgerungsleistung zu erreichen?Wir zeigen, dass Training auf nur 1.000 Beispielen mit Next-Token-Vorhersage und die Steuerung der Denkdauer über eine einfache Technik zur Testzeit, die wir Budget Forcing nennen, zu einem starken Schlussfolgerungsmodell führt, dessen Leistung mit mehr Rechenleistung zur Testzeit skaliert. Konkret konstruieren wir s1K, das aus 1.000 sorgfältig ausgewählten Fragen besteht, gepaart mit Schlussfolgerungsspuren und Antworten, die von Gemini Thinking Experimental (Google, 2024) destilliert wurden. Wir führen überwachtes Finetuning (SFT) eines vortrainierten Off-the-Shelf-Modellsauf unserem kleinen Datensatz durch, was nur 26 Minuten Training auf 16 H100-GPUs erfordert. Nach dem Training steuern wir die Menge an Rechenleistung zur Testzeit, die unser Modell aufwendet, mittels Budget Forcing: (I) Wenn das Modell mehr Denk-Token generiert als ein gewünschtes Limit, beenden wir den Denkprozess zwangsweise, indem wir ein End-of-Thinking-Token-Trennzeichen anhängen. Ein Beenden des Denkens auf diese Weise bewirkt, dass das Modell dazu übergeht, seine Antwort zu generieren. (II) Wenn wir möchten, dass das Modell mehr Rechenleistung zur Testzeit für ein Problem aufwendet, unterdrücken wir die Generierung des End-of-Thinking-Token-Trennzeichens und hängen stattdessen „Wait“ an die aktuelle Schlussfolgerungsspur des Modells an, um mehr Exploration zu fördern. Ausgestattet mit diesem einfachen Rezept – SFT auf 1.000 Beispielen und Budget Forcing zur Testzeit – zeigt unser Modell s1-32B Skalierung zur Testzeit (Abbildung 1). Darüber hinaus ist s1-32B das probeneffizienteste Schlussfolgerungsmodell und übertrifft geschlossene Modelle wie OpenAIs o1-preview (Abbildung 2).
Wir führen umfangreiche Ablationsexperimente durch, die auf (a) unsere Auswahl von 1.000 (1K) Schlussfolgerungsbeispielen und (b) unsere Skalierung zur Testzeit abzielen. Für (a) stellen wir fest, dass die gemeinsame Einbeziehung von Schwierigkeits-, Vielfalts- und Qualitätsmaßen in unseren Auswahlalgorithmus wichtig ist. Zufällige Auswahl, die Auswahl von Beispielen mit den längsten Schlussfolgerungsspuren oder die ausschließliche Auswahl maximal vielfältiger Beispiele führen alle zu deutlich schlechterer Leistung (im Durchschnitt etwa bei AIME24). Das Training auf unserem vollständigen Datenpool von 59K Beispielen, einer Obermenge von s1K, bietet keine wesentlichen Zugewinne gegenüber unserer 1K-Auswahl. Dies unterstreicht die Bedeutung sorgfältiger Datenauswahl und bestätigt frühere Befunde für Instruction Tuning (Zhou et al., 2023). Für (b) definieren wir Anforderungen an Methoden zur Skalierung zur Testzeit, um verschiedene Ansätze zu vergleichen. Budget Forcing führt zur besten Skalierung, da es eine perfekte Kontrollierbarkeit mit einer klaren positiven Steigung aufweist, die zu starker Leistung führt.
Zusammenfassend sind unsere Beiträge: Wir entwickeln einfache Methoden zur Erstellung eines probeneffizienten Schlussfolgerungsdatensatzes (§2) und zur Skalierung zur Testzeit (§3); auf deren Grundlage bauen wir s1-32B, das mit o1-preview konkurrenzfähig ist (§4); wir untersuchen Subtilitäten der Daten (§5.1) und der Skalierung zur Testzeit (§5.2) durch Ablationen. Wir schließen mit einer Diskussion, um zukünftige Arbeiten zu einfachem Schlussfolgern zu motivieren (§6). Unser Code, unser Modell und unsere Daten sind Open Source unter https://github.com/simplescaling/s1 verfügbar.
2. Kuratierung von Schlussfolgerungsdaten zur Erstellung von s1K
In diesem Abschnitt beschreiben wir unseren Prozess zur Erstellung eines großen Datensatzes zunächst in §2.1 und dann dessen Filterung auf s1K in §2.2.
2.1. Erste Sammlung von 59K Beispielen
Wir sammeln zunächst 59.029 Fragen aus 16 Quellen nach drei Leitprinzipien. Qualität: Datensätze sollten von hoher Qualität sein; wir prüfen stets Stichproben und ignorieren Datensätze mit z. B. schlechter Formatierung; Schwierigkeit: Datensätze sollten herausfordernd sein und erheblichen Schlussfolgerungsaufwand erfordern; Vielfalt: Datensätze sollten aus verschiedenen Bereichen stammen, um unterschiedliche Schlussfolgerungsaufgaben abzudecken. Wir sammeln Datensätze aus zwei Kategorien:
Kuratierung bestehender Datensätze Unsere größte Quelle ist NuminaMATH (LI et al., 2024) mit 30.660 mathematischen Problemen von Online-Websites. Wir beziehen außerdem historische AIME-Probleme (1983–2021) ein. Um die Vielfalt zu erhöhen, fügen wir OlympicArena (Huang et al., 2024a) mit 4.250 Fragen aus Astronomie, Biologie, Chemie, Informatik, Geographie, Mathematik und Physik aus verschiedenen Olympiaden hinzu. OmniMath (Gao et al., 2024a) fügt 4.238 Mathematikprobleme auf Wettbewerbsniveau hinzu. Wir beziehen außerdem 2.385 Probleme aus AGIEval (Zhong et al., 2023) ein, das Fragen aus standardisierten Tests wie SAT und LSAT umfasst und Englisch, Recht und Logik abdeckt. Für unsere weiteren Quellen verweisen wir auf Tabelle 7 in §C.
Neue Datensätze im quantitativen Schlussfolgern Zur Ergänzung dieser bestehenden Datensätze erstellen wir zwei eigene Datensätze. s1-prob besteht aus 182 Fragen aus dem Wahrscheinlichkeitsabschnitt der PhD-Qualifikationsprüfungen der Statistikabteilung der Stanford University (https://statistics.stanford.edu), begleitet von handschriftlichen Lösungen, die schwierige Beweise abdecken. Die Wahrscheinlichkeits-Qualifikationsprüfung findet jährlich statt und erfordert mathematisches Problemlösen auf professionellem Niveau. s1-teasers umfasst 23 herausfordernde Denksportaufgaben, die häufig in Interviewfragen für Positionen im quantitativen Handel verwendet werden. Jedes Beispiel besteht aus einem Problem und einer Lösung, entnommen aus PuzzledQuant (https://www.puzzledquant.com/). Wir nehmen nur Beispiele mit dem höchsten Schwierigkeitsgrad („Hard“) auf.
Für jede Frage generieren wir eine Schlussfolgerungsspur und eine Lösung mithilfe der Google Gemini Flash Thinking API (Google, 2024), wobei wir ihre Schlussfolgerungsspur und Antwort extrahieren. Dies ergibt 59K Tripel aus einer Frage, einer generierten Schlussfolgerungsspur und einer generierten Lösung. Beispiele aus unserem Datensatz finden sich in §D.2. Wir dekontaminieren alle Stichproben gegen unsere Evaluationsfragen (MATH500, GPQA Diamond, AIME24; §C.5) mithilfe von 8-Grammen und deduplizieren die Daten.
2.2. Endgültige Auswahl von 1K Beispielen
Wir könnten direkt auf unserem Pool von 59.000 Fragen trainieren, jedoch ist unser Ziel, den einfachsten Ansatz mit minimalen Ressourcen zu finden. Daher durchlaufen wir drei Filterstufen, um zu einem minimalen Satz von 1.000 Beispielen zu gelangen, wobei wir uns auf unsere drei leitenden Datenprinzipien stützen: Qualität, Schwierigkeit und Vielfalt.
Qualität Zunächst entfernen wir alle Fragen, bei denen API-Fehler aufgetreten sind, wodurch unser Datensatz auf 54.116 Beispiele reduziert wird. Als Nächstes filtern wir Beispiele geringer Qualität heraus, indem wir prüfen, ob sie Zeichenfolgenmuster mit Formatierungsproblemen enthalten, wie etwa ASCII-Art-Diagramme, nicht existierende Bildverweise oder inkonsistente Fragennummerierungen, wodurch unser Datensatz auf 51.581 Beispiele reduziert wird.
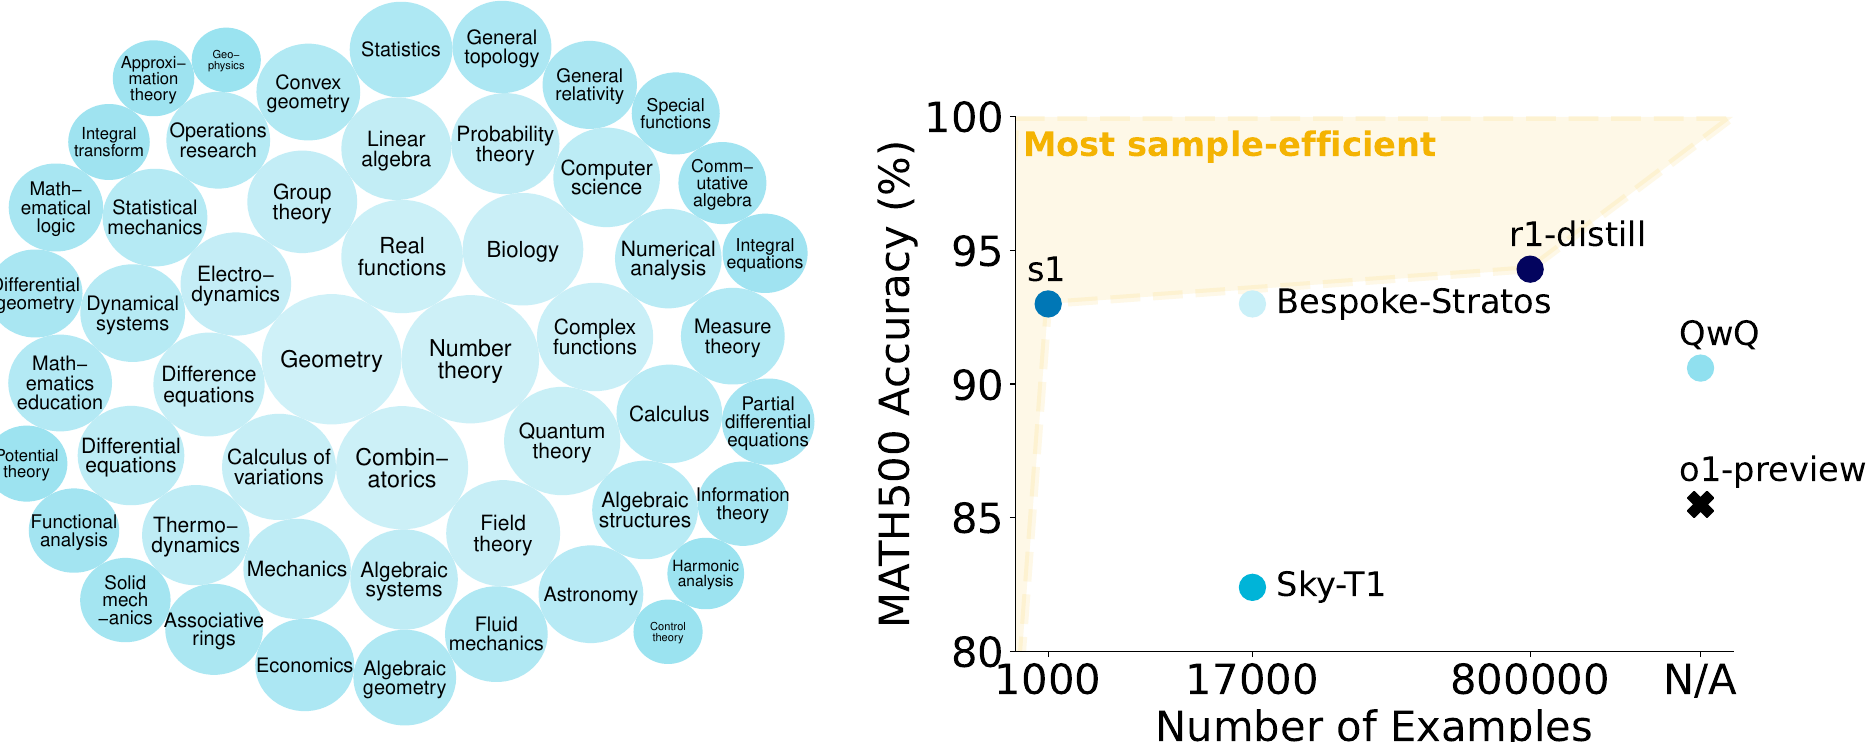
Aus diesem Pool identifizieren wir 384 Beispiele für unsere endgültigen 1.000 Beispiele aus Datensätzen, die wir als hochwertig erachten und die keiner weiteren Filterung bedürfen (siehe §C.4 für Details).
Schwierigkeit Für die Schwierigkeit verwenden wir zwei Indikatoren: die Modellleistung und die Länge der Reasoning-Trace. Wir evaluieren zwei Modelle an jeder Frage: Qwen2.5-7B-Instruct und Qwen2.5-32B-Instruct (Qwen et al., 2024), wobei die Korrektheit von Claude 3.5 Sonnet bewertet wird, indem jeder Versuch mit der Referenzlösung verglichen wird (siehe §C.3 für das Bewertungsprotokoll). Wir messen die Token-Länge jeder Reasoning-Trace, um die Problemschwierigkeit anzuzeigen, wobei wir den Qwen2.5-Tokenizer verwenden. Dies beruht auf der Annahme, dass schwierigere Probleme mehr Denk-Token erfordern. Basierend auf der Bewertung entfernen wir Fragen, die entweder Qwen2.5-7B-Instruct oder Qwen2.5-32B-Instruct korrekt lösen können und die daher zu einfach sein könnten. Durch die Verwendung von zwei Modellen verringern wir die Wahrscheinlichkeit, dass ein einfaches Beispiel aufgrund eines seltenen Fehlers bei einer einfachen Frage eines der Modelle durch unsere Filterung schlüpft. Dadurch sinkt unsere Gesamtzahl der Beispiele auf 24.496, was die Grundlage für die nächste Runde der Unterabtastung basierend auf Vielfalt bildet. Obwohl die Filterung mit diesen beiden Modellen auf unser Setup optimiert sein mag, da wir Qwen2.5-32B-Instruct auch als unser Modell zum Finetuning verwenden werden, lässt sich die Idee der modellbasierten Filterung auf andere Setups verallgemeinern.
Diversität Um die Diversität zu quantifizieren, klassifizieren wir Fragen anhand des Mathematics Subject Classification (MSC)-Systems (z. B. Geometrie, Kombinatorik usw.) der American Mathematical Society mit Claude 3.5 Sonnet in Domänen.1 Die Taxonomie konzentriert sich auf Themen der Mathematik, umfasst aber auch andere Wissenschaften wie Biologie, Physik und Ökonomie. Um unsere endgültigen Beispiele aus dem Pool von 24.496 Fragen auszuwählen, wählen wir zunächst eine Domäne gleichmäßig zufällig aus. Dann entnehmen wir dieser Domäne ein Problem gemäß einer Verteilung, die längere Reasoning-Traces bevorzugt (siehe §C.4 für Details), wie unter Schwierigkeit motiviert. Wir wiederholen diesen Prozess, bis wir insgesamt 1.000 Stichproben über 50 Domänen hinweg haben.
In §5.1 werden wir zeigen, dass die Kombination unserer drei Kriterien wichtig ist, da das alleinige Verlassen auf Qualität, Diversität oder Schwierigkeit zu schlechteren Datensätzen führt. Einige destillierte Generierungen sind fehlerhaft, was wir in unseren Daten zulassen, da wir uns auf die Erfassung des Denkprozesses konzentrieren und nicht auf vollständig korrekte Lösungen. Unser Bewerter (§C.3) erachtet 53,6 % in s1K und 63,0 % in unserem Folge-Datensatz s1K-1.1 als korrekt (siehe §A).
3. Test-Time-Scaling
3.1. Methode
Wir klassifizieren Test-Time-Scaling-Methoden in 1) Sequenziell, wobei spätere Berechnungen von früheren abhängen (z. B. eine lange Denkspur), und 2) Parallel, wobei Berechnungen unabhängig voneinander ablaufen (z. B. Majority Voting) (Snell et al., 2024; Brown et al., 2024). Wir konzentrieren uns auf sequenzielles Scaling, da wir intuitiv glauben, dass es besser skalieren sollte, weil spätere Berechnungen auf Zwischenergebnissen aufbauen können, was tieferes Denken und iterative Verfeinerung ermöglicht. Wir schlagen neue sequenzielle Scaling-Methoden und Wege zu deren Benchmarking vor.
Budget Forcing Wir schlagen eine einfache Decoding-Time-Intervention vor, indem wir eine maximale und/oder minimale Anzahl von Denk-Tokens erzwingen. Konkret erzwingen wir eine maximale Token-Anzahl, indem wir einfach das End-of-Thinking-Token-Delimiter und optional „Final Answer:“ anhängen, um die Denkphase vorzeitig zu beenden
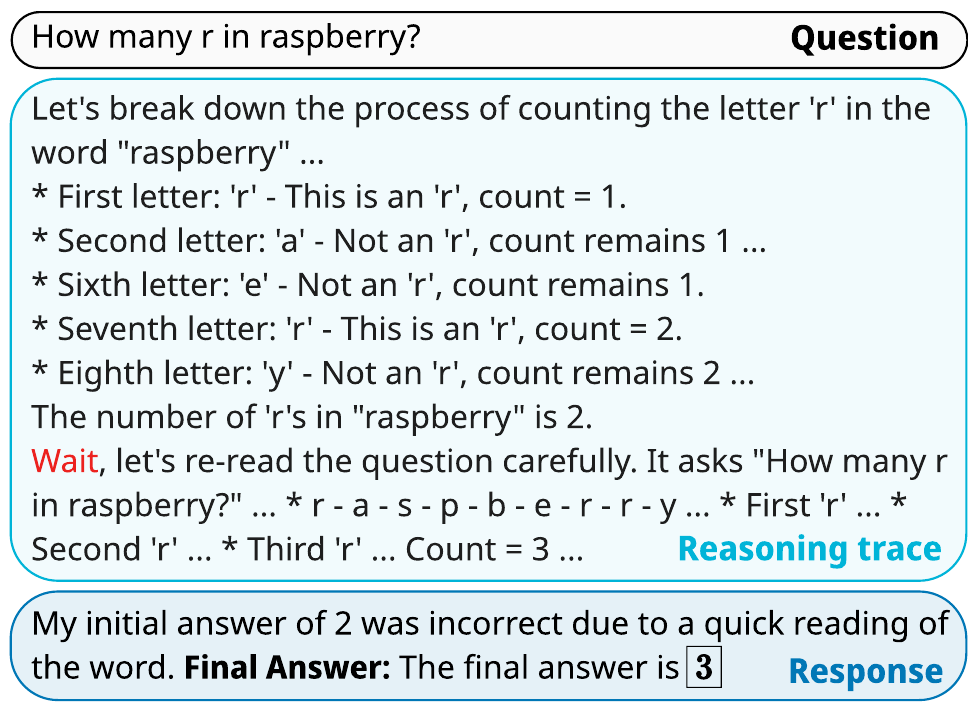
und das Modell dazu zu bringen, seine aktuelle beste Antwort zu geben. Um ein Minimum zu erzwingen, unterdrücken wir die Generierung des End-of-Thinking-Token-Delimiters und hängen optional die Zeichenkette „Wait“ an die aktuelle Denkspur des Modells an, um das Modell zu ermutigen, über seine aktuelle Generierung zu reflektieren. Abbildung 3 enthält ein Beispiel dafür, wie dieser einfache Ansatz das Modell zu einer besseren Antwort führen kann.
Baselines Wir benchmarken Budget Forcing mit: (I) Bedingten Längensteuerungsmethoden, die darauf beruhen, dem Modell im Prompt mitzuteilen, wie lange es generieren soll. Wir gruppieren sie nach Granularität in (a) Token-bedingte Steuerung: Wir geben im Prompt eine Obergrenze an Denk-Tokens an; (b) Schritt-bedingte Steuerung: Wir geben eine Obergrenze an Denkschritten an, wobei jeder Schritt etwa 100 Tokens umfasst; (c) Klassen-bedingte Steuerung: Wir schreiben zwei generische Prompts, die dem Modell sagen, entweder kurz oder lange zu denken (siehe §E.1 für Details). (II) Rejection Sampling, das sampelt, bis eine Generierung in ein vorgegebenes Rechenbudget passt. Dieses Orakel erfasst die Posterior-Verteilung über Antworten bedingt auf ihre Länge.
3.2. Metriken
Wir legen eine Reihe von Erwünschtheiten als Evaluationsmetriken fest, um Test-Time-Scaling über Methoden hinweg zu messen. Wichtig ist, dass wir uns nicht nur für die Genauigkeit interessieren, die eine Methode erreichen kann, sondern auch für ihre Kontrollierbarkeit und die Steigung des Test-Time-Scaling. Für jede betrachtete Methode führen wir eine Reihe von Evaluationen mit variierendem Test-Time-Compute auf einem festen Benchmark durch, z. B. AIME24. Dies erzeugt eine stückweise lineare Funktion mit dem Compute als x-Achse, gemessen in Denk-Tokens, und der Genauigkeit als y-Achse (siehe Abbildung 1, wobei der rechteste Punkt für AIME24 entspricht). Wir messendreiMetriken:
wobei ein im Voraus festgelegtes Minimum bzw. Maximum an Test-Time-Compute bezeichnen; in unserem Fall Denk-Tokens. Üblicherweise beschränken wir nur . Da die generierten Tokens der Menge an aufgewendetem Test-Time-Compute entsprechen, misst diese Metrik das Ausmaß, in dem eine Methode Kontrollierbarkeit über die Verwendung dieses Test-Time-Compute ermöglicht. Wir berichten sie als Prozentsatz, wobei perfekte Kontrolle bedeutet.
Scaling ist die durchschnittliche Steigung der stückweise linearen Funktion. Sie muss für nützliche Methoden positiv sein, und größer ist besser.
Performance ist einfach die maximale Leistung, die die Methode auf dem Benchmark erreicht. Eine Methode mit monoton steigendem Scaling erreicht im Grenzfall Performance auf jedem Benchmark. Allerdings flachen die von uns untersuchten Methoden schließlich ab, oder weiteres Scaling scheitert aufgrund von Einschränkungen der Kontrolle oder des Kontextfensters.
4. Ergebnisse
4.1. Aufbau
Training Wir führen überwachtes Finetuning auf Qwen2.5-32B-Instruct mit s1K durch, um unser Modell s1-32B zu erhalten, wobei wir grundlegende Hyperparameter aus §D verwenden. Das Finetuning dauerte 26 Minuten auf 16 NVIDIA H100 GPUs mit PyTorch FSDP.
Bewertung Wir wählen drei repräsentative Reasoning-Benchmarks aus, die in diesem Bereich weit verbreitet sind: AIME24 (of America, 2024) umfasst 30 Aufgaben, die in der 2024 American Invitational Mathematics Examination (AIME) verwendet wurden, die vom 31. Januar bis 1. Februar 2024 stattfand. Die AIME prüft mathematisches Problemlösen mit Arithmetik, Algebra, Kombinatorik, Geometrie, Zahlentheorie, Wahrscheinlichkeit und anderen Themen der Sekundarstufe. Leistungsstarke High-School-Schülerinnen und -Schüler im Test werden eingeladen, an der United States of America Mathematics Olympiad (USAMO) teilzunehmen. Alle AIME-Antworten sind ganze Zahlen von 000 bis 999 einschließlich. Einige AIME-Aufgaben beruhen auf Abbildungen, die wir unserem Modell mit der Vektorgrafiksprache Asymptote bereitstellen, da es keine Bildeingaben verarbeiten kann. MATH500 (Hendrycks et al., 2021) ist ein Benchmark aus Wettbewerbsmathematikaufgaben unterschiedlicher Schwierigkeit. Wir evaluieren auf denselben 500 Stichproben, die OpenAI in früherer Arbeit ausgewählt hat (Lightman et al., 2023). GPQA Diamond (Rein et al., 2023) besteht aus 198 Wissenschaftsfragen auf PhD-Niveau
aus Biologie, Chemie und Physik. Expertinnen und Experten mit PhD in den entsprechenden Bereichen erreichten auf GPQA Diamond nur (OpenAI, 2024). Wenn wir in dieser Arbeit im Kontext der Evaluation „GPQA“ schreiben, meinen wir stets die Diamond-Teilmenge. Wir bauen auf dem Framework „lm-evaluation-harness“ auf (Gao et al., 2021; Biderman et al., 2024). Sofern nicht anders angegeben, evaluieren wir mit einer Temperatur von 0 (greedy) und messen die Genauigkeit (äquivalent zu pass@1).
Andere Modelle Wir vergleichen s1-32B mit: der OpenAI-o1-Serie (OpenAI, 2024), Closed-Source-Modellen, die Test-Time-Scaling populär gemacht haben; der DeepSeek-r1-Serie (DeepSeek-AI et al., 2025), Open-Weight-Reasoning-Modellen mit bis zu o1-Level-Leistung; Qwens QwQ-32B-preview (Team, 2024), einem 32B-Open-Weight-Reasoning-Modell ohne offengelegte Methodik; Sky-T1-32B-Preview (Team, 2025) und Bespoke-32B (Labs, 2025), offenen Modellen mit offenen Reasoning-Daten, destilliert aus QwQ-32B-preview und r1; Google Gemini 2.0 Flash Thinking Experimental (Google, 2024), der API, aus der wir destillieren. Da es keine offiziellen Evaluationsergebnisse gibt, verwenden wir die Gemini-API, um es selbst zu benchmarken. Allerdings macht der „recitation error“ der Gemini-API die Evaluation schwierig.2 Wir umgehen dies, indem wir alle 30 AIME24-Aufgaben manuell in ihre Weboberfläche eingeben, wo der Fehler nicht auftritt. MATH500 (500 Aufgaben) und GPQA Diamond (198 Aufgaben) lassen wir jedoch aus; daher sind sie in Tabelle 1 N.A. Unser Modell s1-32B ist vollständig offen, einschließlich Gewichte, Reasoning-Daten und Code.
| Modell | ex. | AIME 2024 | MATH 500 | GPQA Diamond |
| Nur API | ||||
| o1-preview | k. A. | 44,6 | 85,5 | 73,3 |
| o1-mini | k. A. | 70,0 | 90,0 | 60,0 |
| o1 | k. A. | 74,4 | 94,8 | 77,3 |
| Gemini 2.0 | k. A. | 60,0 | k. A. | k. A. |
| Flash Think. | ||||
| Offene Gewichte | ||||
| Qwen2.5-32B-Instruct | k. A. | 26,7 | 84,0 | 49,0 |
| QwQ-32B | k. A. | 50,0 | 90,6 | 54,5 |
| r1 | ≥800K | 79,8 | 97,3 | 71,5 |
| r1-distill | 800K | 72,6 | 94,3 | 62,1 |
| Offene Gewichte und offene Daten | ||||
| Sky-T1 | 17K | 43,3 | 82,4 | 56,8 |
| Bespoke-32B | 17K | 63,3 | 93,0 | 58,1 |
| s1 w/o BF | 1K | 50,0 | 92,6 | 56,6 |
| s1-32B | 1K | 56,7 | 93,0 | 59,6 |
| Qwen2.5-32B-Instruct | |||
| N.A. | 26,7 | 84,0 | QwQ-32B |
| N.A. | 50,0 | 90,6 | r1 |
| ≥800K | 79,8 | 97,3 | r1-distill |
| 800K | 72,6 | 94,3 | Offene Gewichte und offene Daten |
| Sky-T1 | |||
| 17K | 43,3 | 82,4 | Bespoke-32B |
| 17K | 63,3 | 93,0 | s1 ohne BF |
| 1K | 50,0 | 92,6 | s1-32B |
| 1K | 56,7 | 93,0 | |
4.2. Leistung
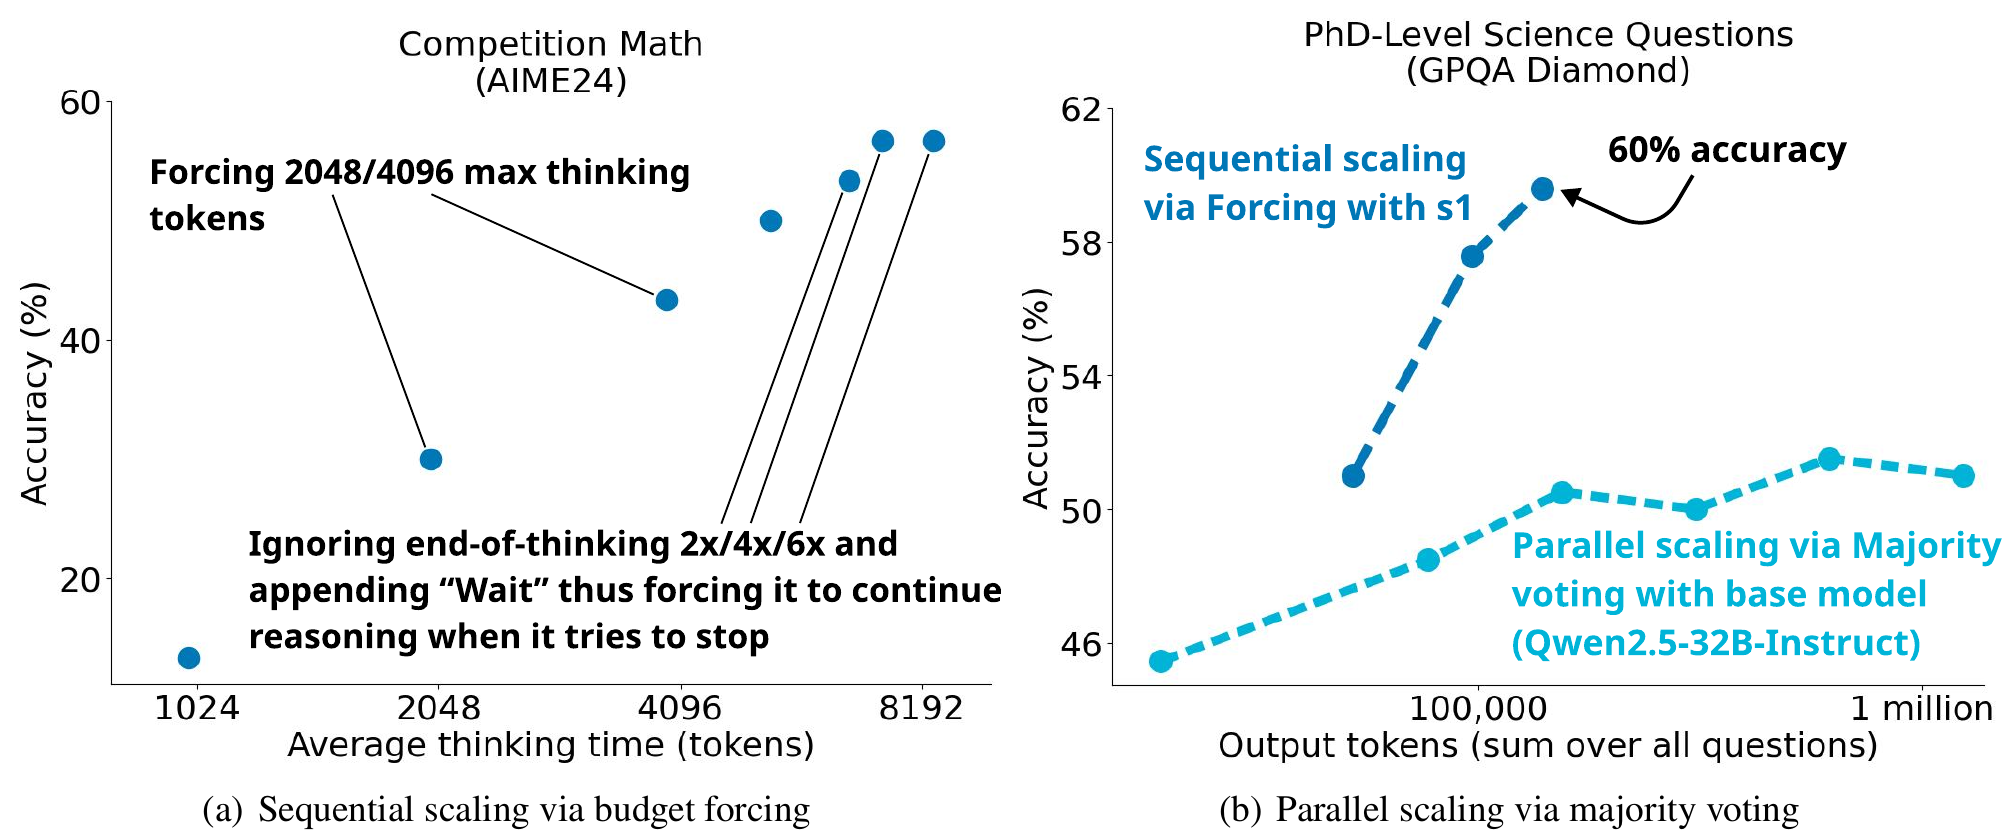
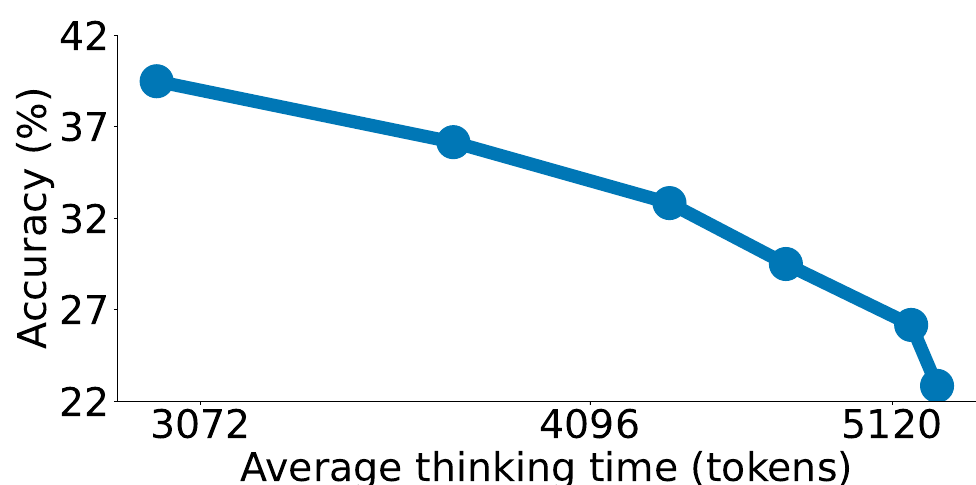
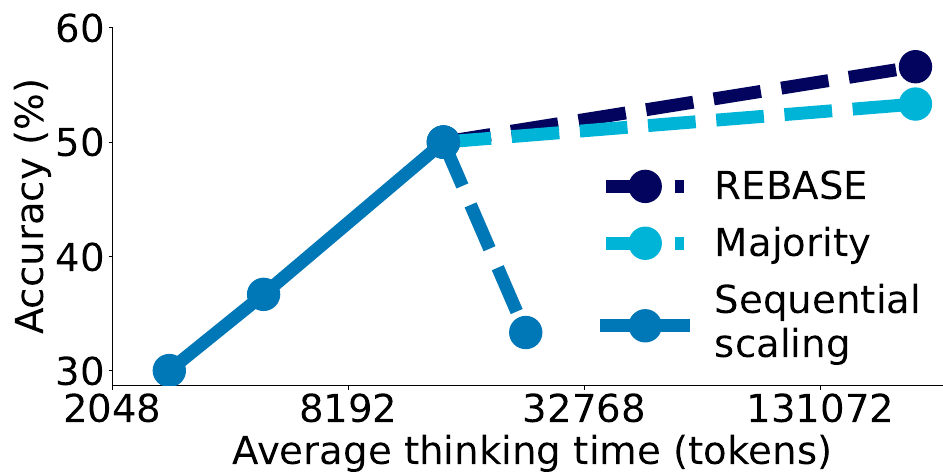
Test-Time-Scaling Abbildung 1 zeigt die Leistung von s1-32B mit Budget Forcing, die mit mehr Test-Time-Compute skaliert. In Abbildung 4 (links) erweitern wir den Plot aus Abbildung 1 (Mitte) und zeigen, dass wir zwar die AIME24-Leistung mit unserer Budget-Forcing-Technik (§3) und mehr Test-Time-Compute verbessern können, sie jedoch bei sechs Mal schließlich abflacht. Das End-of-Thinking-Token-Trennzeichen zu oft zu unterdrücken, kann das Modell in repetitive Schleifen statt zu fortgesetztem Reasoning führen. In Abbildung 4 (rechts) zeigen wir, dass Qwen2.5-32B-Instruct, nachdem es auf unseren 1.000 Stichproben trainiert wurde, um s1-32B zu erzeugen, und mit der einfachen Budget-Forcing-Technik ausgestattet wurde, in einem anderen Scaling-Paradigma operiert. Das Skalieren von Test-Time-Compute beim Basismodell mittels Majority Voting kann nicht mit der Leistung von s1-32B mithalten, was unsere Intuition aus §3 bestätigt, dass sequenzielles Skalieren effektiver ist als paralleles. Wir stellen Beispielgenerierungen von s1-32B in Abbildung 5 bereit.
Sample-Effizienz In Abbildung 2 (rechts) und Tabelle 1 vergleichen wir s1-32B mit anderen Modellen. Wir stellen fest, dass s1-32B das sample-effizienteste Open-Data-Reasoning-Modell ist. Es performt deutlich besser als unser Basismodell (Qwen2.5-32B-Instruct), obwohl es nur auf zusätzlichen 1.000 Stichproben trainiert wurde. Das gleichzeitig veröffentlichte r1-32B zeigt stärkere Leistung als s1-32B, während es ebenfalls nur SFT verwendet (DeepSeek-AI et al., 2025). Es wird jedoch auf mehr Reasoning-Stichproben trainiert. Es ist eine offene Frage, ob man ihre Leistung mit nur 1.000 Stichproben erreichen kann. Schließlich erreicht unser Modell auf AIME24 nahezu Gemini 2.0 Thinking. Da die Daten für s1-32B aus Gemini 2.0 destilliert wurden, zeigt dies, dass unser Destillationsverfahren wahrscheinlich effektiv war.
5. Ablationen
5.1. Datenmenge, Diversität und Schwierigkeit
In §2 haben wir unsere drei Leitprinzipien bei der Kuratierung von s1K dargelegt: Qualität, Schwierigkeit und Diversität. Hier testen wir die Bedeutung ihrer Kombination und die Gesamtwirksamkeit unserer Auswahl. Nur Qualität (1K-random): Nachdem wir unsere hochwertigen Reasoning-Ketten von Gemini erhalten haben, wählen wir 1.000 Stichproben zufällig aus; dabei verlassen wir uns überhaupt nicht auf unsere Schwierigkeits- und Diversitätsfilterung. Tabelle 2 zeigt, dass dieser Ansatz über alle Benchmarks hinweg viel schlechter abschneidet als s1K. Nur Diversität (1K-diverse): Für diesen Datensatz sampeln wir gleichmäßig über Domänen, um die Diversität zu maximieren, ohne irgendeine Vorstellung von Schwierigkeit zu berücksichtigen. Dieser Ansatz führt ebenfalls zu schwacher Leistung ähnlich wie 1K-random. Nur Schwierigkeit (1K-longest): Hier verlassen wir uns auf einen unserer in §2 eingeführten Schwierigkeitsindikatoren, indem wir die 1.000 Stichproben mit den längsten Reasoning-Spuren auswählen. Dieser Ansatz steigert die GPQA-Leistung deutlich, bleibt insgesamt aber noch hinter der Verwendung von s1K zurück. Menge maximieren:
| Modell | AIME 2024 | MATH 500 | GPQA Diamond |
| 1K-random | 36,7 | 90,6 | 52,0 |
| [-26,7 %, -3,3 %] | [-4,8 %, 0,0 %] | [-12,6 %, 2,5 %] | |
| 1K-diverse | 26,7 | 91,2 | 54,6 |
| [-40,0 %, -10,0 %] | [-4,0 %, 0,2 %] | [-10,1 %, 5,1 %] | |
| 1K-longest | 33,3 | 90,4 | 59,6 |
| [-36,7 %, 0,0 %] | [-5,0 %, -0,2 %] | [-5,1 %, 10,1 %] | |
| 59K-full | 53,3 | 92,8 | 58,1 |
| [-13,3 %, 20,0 %] | [-2,6 %, 2,2 %] | [-6,6 %, 8,6 %] | |
| s1K | 50,0 | 93,0 | 57,6 |
Schließlich vergleichen wir mit reinem Training auf allen unseren 59K Stichproben, einer Obermenge aller 1K-Stichproben-Versionen. Dies führt zu einem starken Modell, verbraucht aber viel mehr Ressourcen. Um auf 59K Stichproben zu finetunen, verwenden wir 394 H100-GPU-Stunden, während s1-32B nur 7 H100-GPU-Stunden benötigte. Darüber hinaus ist die alleinige Verwendung von s1K extrem konkurrenzfähig, wie in §2 gezeigt. Insgesamt ist die Kombination aller drei Kriterien – Qualität, Schwierigkeit, Diversität – über unsere Methodik in §2 entscheidend für sample-effizientes Reasoning-Training.
5.2. Test-Time-Scaling-Methoden
| Methode | Kontrolle | Skalierung | Leistung | |A| |
| BF | 100% | 15 | 56,7 | 5 |
| TCC | 40% | -24 | 40,0 | 5 |
| TCC + BF | 100% | 13 | 40,0 | 5 |
| SCC | 60% | 3 | 36,7 | 5 |
| SCC + BF | 100% | 6 | 36,7 | 5 |
| CCC | 50% | 25 | 36,7 | 2 |
| RS | 100% | -35 | 40,0 | 5 |
[AIME24]
Alice und Bob spielen das folgende Spiel. Vor ihnen liegt ein Stapel von Spielmarken. Die Spieler sind abwechselnd an der Reihe, wobei Alice beginnt. In jedem Zug entfernt der Spieler entweder 1 Spielmarke oder 4 Spielmarken vom Stapel. Wer die letzte Spielmarke entfernt, gewinnt. Finde die Anzahl der positiven ganzen Zahlen kleiner oder gleich 2024, für die es eine Strategie für Bob gibt, die garantiert, dass Bob das Spiel gewinnt, unabhängig davon, wie Alice spielt.
Die Aufgabe fragt nach der Anzahl der positiven ganzen Zahlen , für die Bob eine Gewinnstrategie hat. Dies ist ein typisches impartiales Spiel, das mit dem Sprague-Grundy-Theorem oder durch direktes Finden der Gewinn- und Verlustpositionen analysiert werden kann. Sei die Menge der Gewinnpositionen (Anzahl der Spielmarken , bei der der Spieler, der am Zug ist, einen Sieg erzwingen kann) und die Menge der Verlustpositionen. [...]
Sei die Aussage „der Spieler, der am Zug ist, wenn es Spielmarken gibt, hat eine Gewinnstrategie“. ist falsch (der Spieler, der am Zug ist und 0 Spielmarken vor sich hat, hat bereits verloren). Betrachte die kleinen Werte von .. : Der Spieler, der am Zug ist, kann 1 Spielmarke nehmen und gewinnen. Also ist wahr. : Der Spieler, der am Zug ist, kann 1 Spielmarke nehmen und 1 Spielmarke für den Gegner übrig lassen. Da , gewinnt der Gegner. Also ist falsch. : Der Spieler, der am Zug ist, kann 1 Spielmarke nehmen und 2 Spielmarken für den Gegner übrig lassen. Da , gewinnt der Spieler, der am Zug ist. Also ist wahr. ...]
Wir suchen die Anzahl der positiven ganzen Zahlen , für die Bob eine Gewinnstrategie hat. Das bedeutet, dass Bob gewinnen kann, wenn das Spiel mit Spielmarken beginnt und Alice zuerst zieht. Dies ist genau dann der Fall, wenn eine Verlustposition ist (denn wenn , dann muss Alices erster Zug zu einer Gewinnposition für Bob führen). [...]
Versuchen wir, ein Muster in den Verlustpositionen zu finden. Differenzen zwischen aufeinanderfolgenden Gliedern: 2,3,2,3,2,3,2,3,2, ... Das Muster der Differenzen ist abwechselnd 2,3. [...] Die Verlustpositionen haben die Form oder , wobei . Wir müssen die Anzahl der positiven ganzen Zahlen finden, die in der Menge der Verlustpositionen liegen ...
Fall 1: , wobei . Da eine ganze Zahl ist, . Die Anzahl der Werte von ist 404. Fall 2: , wobei . Da eine ganze Zahl ist, . Die Anzahl der Werte von ist .
Die Gesamtzahl der positiven ganzen Zahlen , die Verlustpositionen sind, ist .
[MATH500]
Finde die Projektion von auf , wenn
Die Projektion des Vektors auf den Vektor ist durch die Formel gegeben:
Gegeben sind und
Zuerst müssen wir das Quadrat des Betrags von finden, also .
Nun können wir die Werte in die Projektionsformel einsetzen:
Setze den Vektor ein:
Multipliziere den Skalar mit jeder Komponente des Vektors:
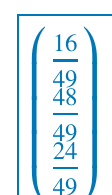
Endgültige Antwort: Die endgültige Antwort ist
Ein quantenmechanisches Teilchen der Masse bewegt sich in zwei Dimensionen in dem folgenden Potential als Funktion der Polarkoordinaten .
Finde das Energiespektrum. Hinweis: Schreibe das Potential in kartesischen Koordinaten.
Das Problem verlangt das Energiespektrum eines Teilchens in einem gegebenen 2D-Potential. Das Potential ist in Polarkoordinaten gegeben:
Wir können das Potential umschreiben als:
Der Hamiltonoperator für ein Teilchen in 2D ist gegeben durch:
In Polarkoordinaten ist der Laplace-Operator:
Also ist der Hamiltonoperator in Polarkoordinaten:
Die zeitunabhängige Schrödinger-Gleichung ist . Wir können versuchen, die Variablen zu trennen, indem wir eine Lösung der Form annehmen. [...]
Dies bestätigt, dass das Energiespektrum
ist. Endgültige Antwort:
Budget-Forcing In Tabelle 3 vergleichen wir die Testzeit-Skalierungsmethoden, die wir in eingeführt haben. Insgesamt stellen wir fest, dass Budget-Forcing eine perfekte Kontrolle bietet, eine gute Skalierung ermöglicht und zu unserem besten AIME24-Ergebnis führt. Daher ist dies die Methode, die wir für s1-32B in Abbildung 1 und in verwenden. In Tabelle 4 vergleichen wir verschiedene Zeichenketten zur Extrapolation der Leistung. Wir stellen fest, dass „Wait“ im Allgemeinen die beste Leistung liefert.
Klassenbedingte Kontrolle Wir geben Benchmark-Ergebnisse für diese Methode in an und fassen hier drei Erkenntnisse zusammen: (1) Token-bedingte Kontrolle scheitert ohne Budget-Forcing, da unser Modell Tokens nicht zuverlässig zählen kann – selbst wenn es darauf trainiert wird. (2) Unter schrittbedingter Kontrolle erzeugt das Modell eine ähnliche Gesamtzahl von Tokens, wenn ihm unterschiedliche Schrittziele vorgegeben werden, da das Modell von wenigen Schritten mit vielen Tokens pro Schritt zu vielen Schritten mit wenigen Tokens pro Schritt übergeht. Somit lernt das Modell, sich um die Rechenbeschränkung herumzuhacken, was die Kontrollierbarkeit dieser Methode mittelmäßig macht. (3) Klassenbedingte Kontrolle kann funktionieren – einem Modell einfach zu sagen, es solle länger nachdenken, kann seinen Testzeit-Rechenaufwand und seine Leistung erhöhen, was in Tabelle 3 zu einer guten Skalierung führt.
| Modell | AIME | MATH | GPQA |
| 2024 | 500 | Diamond | |
| Keine Extrapolation | 50,0 | 93,0 | 57,6 |
| 2x ohne Zeichenkette | 50,0 | 90,2 | 55,1 |
| 2x „Alternatively“ | 50,0 | 92,2 | 59,6 |
| 2x „Hmm“ | 50,0 | 93,0 | 59,6 |
| 2x „Wait“ | 53,3 | 93,0 | 59,6 |
Rejection Sampling Überraschenderweise stellen wir fest, dass einfaches Sampling, bis die Generierung eine bestimmte Länge erfüllt, zu einem inversen Skalierungstrend führt, wie in Abbildung 6 dargestellt. In untersuchen wir eine Frage, die das Modell korrekt beantwortet hat, als beim Rejection Sampling verwendet wurde, aber nicht bei der Einstellung Tokens. In der Einstellung springt das Modell direkt zum richtigen Ansatz, während es bei der Einstellung stark zurückverfolgt. Wir stellen die Hypothese auf, dass es eine Korrelation gibt derart, dass kürzere Generierungen tendenziell diejenigen sind, bei denen das Modell von Anfang an auf dem richtigen Weg war, während längere tendenziell diejenigen sind, bei denen das Modell Fehler gemacht hat und daher zurückverfolgt oder sich selbst infrage stellt. Dies führt dazu, dass längere Samples beim Rejection Sampling oft falsch sind und somit der inverse Skalierungstrend entsteht.
6. Diskussion und verwandte Arbeiten
6.1. Sample-effizientes Schlussfolgern
Modelle Es gibt eine Reihe gleichzeitiger Bemühungen, Modelle zu entwickeln, die die Leistung von o1 (OpenAI, 2024) replizieren. Beispielsweise werden DeepSeek-r1 und k1.5 (DeepSeek-AI et al., 2025; Team et al., 2025) mit Reinforcement-Learning-Methoden entwickelt, während andere auf SFT mit Zehntausenden destillierten Beispielen setzen (Team, 2025; Xu et al., 2025; Labs, 2025). Wir zeigen, dass SFT mit nur 1.000 Beispielen ausreicht, um ein konkurrenzfähiges Schlussfolgerungsmodell zu entwickeln, das o1-preview entspricht und ein Modell erzeugt, das auf der Pareto-Grenze liegt (Abbildung 2). Darüber hinaus führen wir Budget-Forcing ein, das in Kombination mit unserem Schlussfolgerungsmodell zur ersten Reproduktion der Testzeit-Skalierungskurven von OpenAI führt (OpenAI, 2024). Warum führt überwachtes Feintuning mit nur 1.000 Beispielen zu solchen Leistungsgewinnen? Wir stellen die Hypothese auf, dass das Modell bereits während des Pretrainings großen Mengen an Schlussfolgerungsdaten ausgesetzt war, die sich über Billionen von Tokens erstrecken. Somit ist die Fähigkeit zum Schlussfolgern bereits in unserem Modell vorhanden. Unsere sample-effiziente Feintuning-Phase aktiviert sie nur, und wir skalieren sie zur Testzeit mit Budget-Forcing weiter. Dies ähnelt der „Superficial Alignment Hypothesis“, die in LIMA (Zhou et al., 2023) vorgestellt wird, wo die Autoren feststellen, dass 1.000 Beispiele ausreichen können, um ein Modell so auszurichten, dass es Benutzerpräferenzen befolgt.
Benchmarks und Methoden Um diese Modelle zu evaluieren und ihre Grenzen auszuloten, wurden zunehmend anspruchsvollere Benchmarks eingeführt, wie etwa wissenschaftliche Wettbewerbe auf Olympiade-Niveau (He et al., 2024; Jain et al., 2024; Zhong et al., 2023) und andere (Srivastava et al., 2023; Glazer et al., 2024; Su et al., 2024; Kim et al., 2024; Phan et al., 2025). Um die Leistung von Modellen bei schlussfolgerungsbezogenen Aufgaben zu verbessern, haben Forschende mehrere Strategien verfolgt: Frühere Arbeiten haben das Weiter trainieren von Sprachmodellen auf spezialisierten Korpora mit Bezug zu Mathematik und Naturwissenschaften untersucht (Azerbayev et al., 2023; Yang et al., 2024), manchmal sogar mit synthetisch erzeugten Daten (Yu et al., 2024). Andere haben Trainingsmethoden entwickelt, die speziell auf die Schlussfolgerungsleistung abzielen (Zelikman et al., 2022; 2024; Luo et al., 2025; Yuan et al., 2025; Wu et al., 2024a). Eine weitere bedeutende Forschungslinie konzentriert sich auf Prompting-basierte Methoden, um Schlussfolgerungsfähigkeiten hervorzurufen und zu verbessern, darunter Methoden wie Chain-of-Thought-Prompting (Wei et al., 2023; Yao et al., 2023a;b; Bi et al., 2023; Fu et al., 2023; Zhang et al., 2024b; Xiang et al., 2025; Hu et al., 2024; Diao et al., 2024). Diese kombinierten Bemühungen zielen darauf ab, die Schlussfolgerungsfähigkeit von Sprachmodellen voranzubringen und sie in die Lage zu versetzen, komplexere und abstraktere Aufgaben effektiv zu bewältigen.
6.2. Testzeit-Skalierung
Methoden Wie in \(\S 3\) eingeführt, unterscheiden wir zwei Methoden zur Skalierung der Testzeit-Compute: parallel und sequenziell. Erstere beruht auf mehreren parallel generierten Lösungsversuchen und der Auswahl des besten Ergebnisses anhand spezifischer Kriterien. Diese Kriterien umfassen die Wahl der häufigsten Antwort für Majority Voting oder die beste Antwort basierend auf einer externen Belohnung für Best-of-N (Brown et al., 2024; Irvine et al., 2023; Levi, 2024). Anders als bei wiederholtem Sampling lassen frühere sequenzielle Skalierungsmethoden das Modell Lösungsversuche sequenziell auf Basis vorheriger Versuche generieren, wodurch es jeden Versuch anhand vorheriger Ergebnisse verfeinern kann (Snell et al., 2024; Hou et al., 2025; Lee et al., 2025). Baum-basierte Suchmethoden (Gandhi et al., 2024; Wu et al., 2024b) bieten einen hybriden Ansatz zwischen sequenzieller und paralleler Skalierung, wie Monte-Carlo Tree Search (MCTS) (Liu et al., 2024; Zhang et al., 2023; Zhou et al., 2024; Choi et al., 2023) und gelenkte Beam Search (Xie et al., 2023). REBASE (Wu et al., 2024b) setzt ein Prozess-Reward-Modell ein, um Exploration und Pruning während der Baumsuche auszubalancieren. Empirisch hat sich gezeigt, dass REBASE Sampling-basierte Methoden und MCTS übertrifft (Wu et al., 2024b). Reward-Modelle (Lightman et al., 2023; Wang et al., 2024b;c) spielen in diesen Methoden eine Schlüsselrolle. Sie gibt es in zwei Varianten: Outcome-Reward-Modelle und Prozess-Reward-Modelle. Outcome-Reward-Modelle (Xin et al., 2024; Ankner et al., 2024) weisen vollständigen Lösungen eine Bewertung zu und sind besonders nützlich bei der Best-of-N-Auswahl, während Prozess-Reward-Modelle (Lightman et al., 2023; Wang et al., 2024b; Wu et al., 2024b) einzelne Reasoning-Schritte bewerten und effektiv darin sind, baum-basierte Suchmethoden zu lenken.
Grenzen der weiteren Testzeit-Skalierung Wir haben gezeigt, dass Budget Forcing die Extrapolation der Testzeit-Compute in \(\S 4\) ermöglicht, z. B. die Verbesserung der AIME24-Leistung von \(50\%\) auf \(57\%\). Bei weiterer Skalierung hat es jedoch zwei wesentliche Einschränkungen: Es flacht schließlich ab (Abbildung 4), und das Kontextfenster des zugrunde liegenden Sprachmodells beschränkt es. Trotz dieser Einschränkungen zeigt unsere Arbeit Testzeit-Skalierung über einen breiten Bereich von Genauigkeiten (Abbildung 1), teilweise weil sich das Herunterskalieren der Testzeit-Compute vorhersagbar verhält und nicht unter diesen Einschränkungen leidet.
Die Fortsetzung der Testzeit-Skalierung wird Ansätze erfordern, die die Testzeit-Compute weiter extrapolieren können. Wie können wir eine
solche Extrapolation erreichen? Es könnte Verbesserungen an Budget Forcing geben, etwa das Rotieren durch verschiedene Strings, nicht nur „Wait“, oder die Kombination mit Frequenzstrafen oder höherer Temperatur, um repetitive Schleifen zu vermeiden. Eine spannende Richtung für zukünftige Arbeiten ist zudem die Untersuchung, ob die Anwendung von Budget Forcing auf ein mit Reinforcement Learning trainiertes Reasoning-Modell eine bessere Extrapolation liefert; oder ob RL neue Wege der Testzeit-Skalierung jenseits von Budget Forcing ermöglicht. Unsere Arbeit definiert die richtigen Metriken (\(\S 3.2\)) – Control, Scaling und Performance –, um zukünftige Forschung und Fortschritte bei der Extrapolation der Testzeit-Compute zu ermöglichen.
Parallele Skalierung als Lösung Die parallele Skalierung bietet eine Lösung für die Grenzen der sequenziellen Skalierung, daher erweitern wir unser sequenziell skaliertes Modell um zwei Methoden: (I) Majority Voting: Nach der Generierung von \(k\) Lösungen ist die finale Lösung die häufigste über die Generationen hinweg; (II) Baumsuche via REBASE: Wir verwenden das REBASE-Prozess-Reward-Modell, das von LLaMA-34B initialisiert und weiter auf einem synthetischen Datensatz zur Prozess-Reward-Modellierung feinabgestimmt wurde (Wu et al., 2024b). Anschließend aggregieren wir die von REBASE generierten Lösungen via Majority Voting. Wie in Abbildung 7 gezeigt, skaliert die Erweiterung unseres Modells mit REBASE besser als Majority Voting und in diesem Szenario sogar besser als sequenzielle Skalierung. Allerdings erfordert REBASE einen zusätzlichen Forward-Pass bei jedem Schritt für das Reward-Modell, was einen gewissen Rechenaufwand verursacht. Bei der sequenziellen Skalierung, wenn dazu aufgefordert wird, bis zu 512 Schritte zu verwenden, generiert das Modell für 12 der 30 Evaluationsfragen eine Antwort, die das Kontextfenster überschreitet, was zu einem großen Leistungsabfall führt. Insgesamt stellen wir fest, dass diese parallelen Skalierungsmethoden die sequenzielle Skalierung ergänzen und somit einen Weg bieten, die Testzeit-Compute noch weiter zu skalieren – über feste Kontextfenster hinaus.
Impact Statement
Impact StatementSprachmodelle mit starken Schlussfolgerungsfähigkeiten haben das Potenzial, die menschliche Produktivität erheblich zu steigern, von der Unterstützung bei komplexer Entscheidungsfindung bis hin zur Förderung wissenschaftlicher Durchbrüche. Jüngste Fortschritte beim Schlussfolgern, wie OpenAI's o1 und DeepSeek's r1, entbehren jedoch der Transparenz, was den breiteren Forschungsfortschritt einschränkt. Unsere Arbeit zielt darauf ab, die Grenze des Schlussfolgerns in einer vollständig offenen Weise voranzutreiben, Innovation und Zusammenarbeit zu fördern, um Fortschritte zu beschleunigen, die letztlich der Gesellschaft zugutekommen.
Danksagungen
DanksagungenWir danken Ryan Marten für die Generierung von Traces aus DeepSeek r1 für s1.1 unter Verwendung von Bespoke Curator (Marten et al., 2025). Diese Arbeit wurde teilweise unter Verwendung des Stanford Marlowe GPU-Clusters (Kapfer et al., 2025) durchgeführt, ermöglicht durch finanzielle Unterstützung der Stanford University. Wir danken Alexander M. Rush, Andrew Ilyas, Banghua Zhu, Chenglei Si, Chunting Zhou, John Yang, Ludwig Schmidt, Samy Jelassi, Suhas Kotha, Tengyu Ma, Xuechen Li, Yu Sun und Yue Zhang für sehr konstruktive Diskussionen.
Referenzen
Ankner, Z., Paul, M., Cui, B., Chang, J. D., and Ammanabrolu, P. Critique- out- loud reward models, 2024. URL https://arxiv.org/abs/2408.11791. Arora, D., Singh, H. G., and Mausam. Have llms advanced enough? a challenging problem solving benchmark for large language models, 2023. URL https://arxiv.org/abs/2305.15074. Azerbayev, Z., Schoelkopf, H., Paster, K., Santos, M. D., McAleer, S., Jiang, A. Q., Deng, J., Biderman, S., and Welleck, S. Llemma: An open language model for mathematics, 2023. Bi, Z., Zhang, N., Jiang, Y., Deng, S., Zheng, G., and Chen, H. When do program- of- thoughts work for reasoning?, 2023. URL https://arxiv.org/abs/2308.15452. Biderman, S., Schoelkopf, H., Sutawika, L., Gao, L., Tow, J., Abbasi, B., Aji, A. F., Ammanamanchi, P. S., Black, S., Clive, J., DiPofi, A., Etxaniz, J., Fattori, B., Forde, J. Z., Foster, C., Hsu, J., Jaiswal, M., Lee, W. Y., Li, H., Lovering, C., Muennighoff, N., Pavlick, E., Phang, J., Skowron, A., Tan, S., Tang, X., Wang, K. A., Winata, G. I., Yvon, F., and Zou, A. Lessons from the trenches on reproducible evaluation of language models, 2024. Brown, B., Juravsky, J., Ehrlich, R., Clark, R., Le, Q. V., Ré, C., and Mirhoseini, A. Large language monkeys: Scaling inference compute with repeated sampling, 2024. URL https://arxiv.org/abs/2407.21787.
Cesisita, F. L. Multimodal structured generation: Cvpr's 2nd mmfm challenge technical report, 2024. URL https://arxiv.org/abs/2406.11403. Chen, W., Yin, M., Ku, M., Lu, P., Wan, Y., Ma, X., Xu, J., Wang, X., and Xia, T. Theoremaqa: A theorem- driven question answering dataset, 2023. URL https://arxiv.org/abs/2305.12524. Choi, S., Fang, T., Wang, Z., and Song, Y. Kcts: Knowledge- constrained tree search decoding with token- level hallucination detection, 2023. URL https://arxiv.org/abs/2310.09044. DeepSeek- AI, Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., Liu, A., Xue, B., Wang, B., Wu, B., Feng, B., Lu, C., Zhao, C., Deng, C., Zhang, C., Ruan, C., Dai, D., Chen, D., Ji, D., Li, E., Lin, F., Dai, F., Luo, F., Hao, G., Chen, G., Li, G., Zhang, H., Bao, H., Xu, H., Wang, H., Ding, H., Xin, H., Gao, H., Qu, H., Li, H., Guo, J., Li, J., Wang, J., Chen, J., Yuan, J., Qiu, J., Li, J., Cai, J. L., Ni, J., Liang, J., Chen, J., Dong, K., Hu, K., Gao, K., Guan, K., Huang, K., Yu, K., Wang, L., Zhang, L., Zhao, L., Wang, L., Zhang, L., Xu, L., Xia, L., Zhang, M., Zhang, M., Tang, M., Li, M., Wang, M., Li, M., Tian, N., Huang, P., Zhang, P., Wang, Q., Chen, Q., Du, Q., Ge, R., Zhang, R., Pan, R., Wang, R., Chen, R. J., Jin, R. L., Chen, R., Lu, S., Zhou, S., Chen, S., Ye, S., Wang, S., Yu, S., Zhou, S., Pan, S., Li, S. S., Zhou, S., Wu, S., Ye, S., Yun, T., Pei, T., Sun, T., Wang, T., Zeng, W., Zhao, W., Liu, W., Liang, W., Gao, W., Yu, W., Zhang, W., Xiao, W. L., An, W., Liu, X., Wang, X., Chen, X., Nie, X., Cheng, X., Liu, X., Xie, X., Liu, X., Yang, X., Li, X., Su, X., Lin, X., Li, X. Q., Jin, X., Shen, X., Chen, X., Sun, X., Wang, X., Song, X., Zhou, X., Wang, X., Shan, X., Li, Y. K., Wang, Y. Q., Wei, Y. X., Zhang, Y., Xu, Y., Li, Y., Zhao, Y., Sun, Y., Wang, Y., Yu, Y., Zhang, Y., Shi, Y., Xiong, Y., He, Y., Piao, Y., Wang, Y., Tan, Y., Ma, Y., Liu, Y., Guo, Y., Ou, Y., Wang, Y., Gong, Y., Zou, Y., He, Y., Xiong, Y., Luo, Y., You, Y., Liu, Y., Zhou, Y., Zhu, Y. X., Xu, Y., Huang, Y., Li, Y., Zheng, Y., Zhu, Y., Ma, Y., Tang, Y., Zha, Y., Yan, Y., Ren, Z. Z., Ren, Z., Sha, Z., Fu, Z., Xu, Z., Xie, Z., Zhang, Z., Hao, Z., Ma, Z., Yan, Z., Wu, Z., Gu, Z., Zhu, Z., Liu, Z., Li, Z., Xie, Z., Song, Z., Pan, Z., Huang, Z., Xu, Z., Zhang, Z., and Zhang, Z. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948. Diao, S., Wang, P., Lin, Y., Pan, R., Liu, X., and Zhang, T. Active prompting with chain- of- thought for large language models, 2024. URL https://arxiv.org/abs/2302.12246.
Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al- Dahle, A., Letman, A., Mathur, A., Schelten, A., Yang, A., Fan, A., Goyal, A., Hartshorn, A., Yang, A., Mitra, A., Sravankumar, A., Korenev, A., Hinsvark, A., Rao, A., Zhang, A., Rodriguez, A., Gregerson, A., et al. The llama 3 herd of models, 2024. URL https://arxiv.org/abs/2407.21783.
Fu, Y., Peng, H., Sabharwal, A., Clark, P., and Khot, T. Complexity- based prompting for multi- step reasoning, 2023. URL https://arxiv.org/abs/2210.00720.
Gandhi, K., Lee, D., Grand, G., Liu, M., Cheng, W., Sharma, A., and Goodman, N. D. Stream of search (sos): Learning to search in language, 2024. URL https://arxiv.org/abs/2404.03683.
Gao, B., Song, F., Yang, Z., Cai, Z., Miao, Y., Dong, Q., Li, L., Ma, C., Chen, L., Xu, R., Tang, Z., Wang, B., Zan, D., Quan, S., Zhang, G., Sha, L., Zhang, Y., Ren, X., Liu, T., and Chang, B. Omni- math: A universal olympiad level mathematic benchmark for large language models, 2024a. URL https://arxiv.org/abs/2410.07985.
Gao, L., Tow, J., Biderman, S., Black, S., DiPofi, A., Foster, C., Golding, L., Hsu, J., McDonell, K., Muennighoff, N., Phang, J., Reynolds, L., Tang, E., Thite, A., Wang, B., Wang, K., and Zou, A. A framework for few- shot language model evaluation, September 2021. URL https://doi.org/10.5281/zenodo.5371628.
Gao, Z., Niu, B., He, X., Xu, H., Liu, H., Liu, A., Hu, X. und Wen, L. Interpretable contrastive monte carlo tree search reasoning, 2024b. URL https://arxiv.org/abs/2410.01707.
Glazer, E., Erdil, E., Besiroglu, T., Chicharro, D., Chen, E., Gunning, A., Olsson, C. F., Denain, J.- S., Ho, A., de Oliveira Santos, E., Järviniemi, O., Barnett, M., Sandler, R., Vrzala, M., Sevilla, J., Ren, Q., Pratt, E., Levine, L., Barkley, G., Stewart, N., Grechuk, B., Grechuk, T., Enugandla, S. V. und Wildon, M. Frontiermath: A benchmark for evaluating advanced mathematical reasoning in ai, 2024. URL https://arxiv.org/abs/2411.04872.
Google. Gemini 2.0 flash thinking mode (gemini- 2.0- flash- thinking- exp- 1219), Dezember 2024. URL https://cloud.google.com/vertex- ai/generative- ai/docs/thinking- mode.
Groeneveld, D., Beltagy, I., Walsh, P., Bhagia, A., Kinney, R., Tafjord, O., Jha, A. H., Ivison, H., Magnusson, I.,
Wang, Y., Arora, S., Atkinson, D., Authur, R., Chandu, K. R., Cohan, A., Dumas, J., Elazar, Y., Gu, Y., Hessel, J., Khot, T., Merrill, W., Morrison, J., Muennighoff, N., Naik, A., Nam, C., Peters, M. E., Pyatkin, V., Ravichander, A., Schwenk, D., Shah, S., Smith, W., Strubell, E., Subramani, N., Wortsman, M., Dasigi, P., Lambert, N., Richardson, K., Zettlemoyer, L., Dodge, J., Lo, K., Soldaini, L., Smith, N. A., and Hajishirzi, H. Olmo: Accelerating the science of language models, 2024.
He, C., Luo, R., Bai, Y., Hu, S., Thai, Z. L., Shen, J., Hu, J., Han, X., Huang, Y., Zhang, Y., Liu, J., Qi, L., Liu, Z., and Sun, M. Olympiadbench: A challenging benchmark for promoting agi with olympiad- level bilingual multimodal scientific problems, 2024. URL https://arxiv.org/abs/2402.14008.
Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., and Steinhardt, J. Measuring mathematical problem solving with the math dataset, 2021. URL https://arxiv.org/abs/2103.03874.
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., Rae, J. W., Vinyals, O., and Sifre, L. Training compute- optimal large language models, 2022. URL https://arxiv.org/abs/2203.15556.
Hou, Z., Lv, X., Lu, R., Zhang, J., Li, Y., Yao, Z., Li, J., Tang, J., and Dong, Y. Advancing language model reasoning through reinforcement learning and inference scaling, 2025. URL https://arxiv.org/abs/2501.11651.
Hu, Y., Shi, W., Fu, X., Roth, D., Ostendorf, M., Zettlemoyer, L., Smith, N. A., and Krishna, R. Visual sketchpad: Sketching as a visual chain of thought for multimodal language models, 2024. URL https://arxiv.org/abs/2406.09403.
Huang, Z., Wang, Z., Xia, S., Li, X., Zou, H., Xu, R., Fan, R.- Z., Ye, L., Chern, E., Ye, Y., Zhang, Y., Yang, Y., Wu, T., Wang, B., Sun, S., Xiao, Y., Li, Y., Zhou, F., Chern, S., Qin, Y., Ma, Y., Su, J., Liu, Y., Zheng, Y., Zhang, S., Lin, D., Qiao, Y., and Liu, P. Olympicarena: Benchmarking multi- discipline cognitive reasoning for superintelligent ai, 2024a. URL https://arxiv.org/abs/2406.12753.
Huang, Z., Zou, H., Li, X., Liu, Y., Zheng, Y., Chern, E., Xia, S., Qin, Y., Yuan, W., and Liu, P. O1 replication journey - part 2: Surpassing o1- preview through simple distillation, big progress or bitter lesson?, 2024b. URL https://arxiv.org/abs/2411.16489.
Huang, Z., Geng, G., Hua, S., Huang, Z., Zou, H., Zhang, S., Liu, P., and Zhang, X. O1 replication journey - part 3: Inference- time scaling for medical reasoning, 2025. URL https://arxiv.org/abs/2501.06458.
Irvine, R., Boubert, D., Raina, V., Liusie, A., Zhu, Z., Mudupalli, V., Korshuk, A., Liu, Z., Cremer, F., Assassi, V., Beauchamp, C.- C., Lu, X., Rialan, T., and Beauchamp, W. Rewarding chatbots for real- world engagement with millions of users, 2023. URL https://arxiv.org/abs/2303.06135.
Jain, N., Han, K., Gu, A., Li, W.- D., Yan, F., Zhang, T., Wang, S., Solar- Lezama, A., Sen, K., and Stoica, I. Livecodebench: Holistic and contamination free evaluation of large language models for code, 2024. URL https://arxiv.org/abs/2403.07974.
Kapfer, C., Stine, K., Narasimhan, B., Mentzel, C., and Candes, E. Marlowe: Stanford's gpu- based computational instrument, January 2025. URL https://doi.org/10.5281/zenodo.14751899.
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., and Amodei, D. Scaling laws for neural language models, 2020. URL https://arxiv.org/abs/2001.08361.
Kim, E., Suk, J., Kim, S., Muennighoff, N., Kim, D., and Oh, A. Llm- as- an- interviewer: Beyond static testing through dynamic llm evaluation, 2024. URL https://arxiv.org/abs/2412.10424.
Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., and Stoica, I. Efficient memory management for large language model serving with pagedattention, 2023. URL https://arxiv.org/abs/2309.06180.
Labs, B. Bespoke- stratos: The unreasonable effectiveness of reasoning distillation, 2025. URL https://hf.co/bespokelabs/Bespoke- Stratos- 32B. Accessed: 2025- 01- 22.
Lee, K.- H., Fischer, I., Wu, Y.- H., Marwood, D., Baluja, S., Schuurmans, D., and Chen, X. Evolving deeper llm thinking, 2025. URL https://arxiv.org/abs/2501.09891.
Levi, N. A simple model of inference scaling laws, 2024. URL https://arxiv.org/abs/2410.16377.
LI, J., Beeching, E., Tunstall, L., Lipkin, B., Soletskyi, R., Huang, S. C., Rasul, K., Yu, L., Jiang, A., Shen, Z., Qin, Z., Dong, B., Zhou, L., Fleureau, Y., Lample, G., and Polu, S. Numinnamath, 2024. URL https://github.com/project- numina/aimo- progress- prize/blob/main/report/ numina_dataset.pdf.
Lightman, H., Kosaraju, V., Burda, Y., Edwards, H., Baker, B., Lee, T., Leike, J., Schulman, J., Sutskever, I., and Cobbe, K. Let's verify step by step, 2023. URL https://arxiv.org/abs/2305.20050.
Ling, W., Yogatama, D., Dyer, C., and Blunsom, P. Program induction by rationale generation: Learning to solve and explain algebraic word problems, 2017. URL https://arxiv.org/abs/1705.04146.
Liu, J., Cui, L., Liu, H., Huang, D., Wang, Y., and Zhang, Y. Logiqa: A challenge dataset for machine reading comprehension with logical reasoning, 2020. URL https://arxiv.org/abs/2007.08124.
Liu, J., Cohen, A., Pasunuru, R., Choi, Y., Hajishirzi, H., and Celikyilmaz, A. Don't throw away your value model! generating more preferable text with value- guided monte- carlo tree search decoding, 2024. URL https://arxiv.org/abs/2309.15028.
Loshchilov, I. and Hutter, F. Decoupled weight decay regularization, 2019.
Luo, H., Sun, Q., Xu, C., Zhao, P., Lou, J., Tao, C., Geng, X., Lin, Q., Chen, S., Tang, Y., and Zhang, D. Wizardmath: Empowering mathematical reasoning for large language models via reinforced evol- instruct, 2025. URL https://arxiv.org/abs/2308.09583.
Marten, R., Vu, T., Ji, C. C.- J., Sharma, K., Pimpalgaonkar, S., Dimakis, A., and Sathiamoorthy, M. Curator: Ein Werkzeug zur Erstellung synthetischer Daten. https://github.com/bespokelabsai/curator, Januar 2025.
Muennighoff, N., Soldaini, L., Groeneveld, D., Lo, K., Morrison, J., Min, S., Shi, W., Walsh, P., Tafjord, O., Lambert, N., Gu, Y., Arora, S., Bhagia, A., Schwenk, D., Wadden, D., Wettig, A., Hui, B., Dettmers, T., Kiela, D., Farhadi, A., Smith, N. A., Koh, P. W., Singh, A., and Hajishirzi, H. Olmoe: Offene Mixture-of-Experts-Sprachmodelle, 2024. URL https://arxiv.org/abs/2409.02060.
of America, M. A. Aime, Februar 2024. URL https://artofproblemsolving.com/wiki/index.php/AIME_Problems_and_Solutions/.
OpenAI. Lernen, mit LLMs zu schlussfolgern, September 2024. URL https://openai.com/index/learning- to- reason- with- llms/.
OpenAI. Openai o3- mini, 2025. URL https://openai.com/index/openai- o3- mini/. Zugriff: 2025- 02- 24.
Phan, L., Gatti, A., Han, Z., Li, N., Hu, J., Zhang, H., Shi, S., Choi, M., Agrawal, A., Chopra, A., et al. Humanity's last exam, 2025. URL https://arxiv.org/abs/2501.14249.
Qin, Y., Li, X., Zou, H., Liu, Y., Xia, S., Huang, Z., Ye, Y., Yuan, W., Liu, H., Li, Y. und Liu, P. O1 replication journey: A strategic progress report - part 1, 2024. URL https://arxiv.org/abs/2410.18982.
Qwen, : Yang, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Li, C., Liu, D., Huang, F., Wei, H., Lin, H., Yang, J., Tu, J., Zhang, J., Yang, J., Yang, J., Zhou, J., Lin, J., Dang, K., Lu, K., Bao, K., Yang, K., Yu, L., Li, M., Xue, M., Zhang, P., Zhu, Q., Men, R., Lin, R., Li, T., Xia, T., Ren, X., Ren, X., Fan, Y., Su, Y., Zhang, Y., Wan, Y., Liu, Y., Cui, Z., Zhang, Z. und Qiu, Z. Qwen2.5 technical report, 2024. URL https://arxiv.org/abs/2412.15115.
Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J. und Bowman, S. R. Gpqa: A graduate- level google- proof q&a benchmark, 2023. URL https://arxiv.org/abs/2311.12022.
Shi, Q., Tang, M., Narasimhan, K. und Yao, S. Can language models solve olympiad programming?, 2024. URL https://arxiv.org/abs/2404.10952.
Snell, C., Lee, J., Xu, K. und Kumar, A. Scaling llm test- time compute optimally can be more effective than scaling model parameters, 2024. URL https://arxiv.org/abs/2408.03314.
Srivastava, A., Rastogi, A., Rao, A., Shoeb, A. A. M., Abid, A., Fisch, A., Brown, A. R., Santoro, A., Gupta, A., Garriga- Alonso, A., et al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models, 2023.
Su, H., Yen, H., Xia, M., Shi, W., Muennighoff, N., yu Wang, H., Liu, H., Shi, Q., Siegel, Z. S., Tang, M., Sun, R., Yoon, J., Arik, S. O., Chen, D. und Yu, T. Bright: A realistic and challenging benchmark for reasoning- intensive retrieval, 2024. URL https://arxiv.org/abs/2407.12883.
Sun, L., Han, Y., Zhao, Z., Ma, D., Shen, Z., Chen, B., Chen, L. und Yu, K. Scieval: A multi- level large language model evaluation benchmark for scientific research, 2024. URL https://arxiv.org/abs/2308.13149.
Team, K., Du, A., Gao, B., Xing, B., Jiang, C., Chen, C., Li, C., Xiao, C., Du, C., Liao, C., Tang, C., Wang, C., Zhang, D., Yuan, E., Lu, E., Tang, F., Sung, F., Wei, G., Lai, G., Guo, H., Zhu, H., Ding, H., Hu, H., Yang, H., Zhang, H., Yao, H., Zhao, H., Lu, H., Li, H., Yu, H., Gao, H., Zheng,H., Yuan, H., Chen, J., Guo, J., Su, J., Wang, J., Zhao, J., Zhang, J., Liu, J., Yan, J., Wu, J., Shi, L., Ye, L., Yu, L., Dong, M., Zhang, N., Ma, N., Pan, Q., Gong, Q., Liu, S., Ma, S., Wei, S., Cao, S., Huang, S., Jiang, T., Gao, W., Xiong, W., He, W., Huang, W., Wu, W., He, W., Wei, X., Jia, X., Wu, X., Xu, X., Zu, X., Zhou, X., Pan, X., Charles, Y., Li, Y., Hu, Y., Liu, Y., Chen, Y., Wang, Y., Liu, Y., Qin, Y., Liu, Y., Yang, Y., Bao, Y., Du, Y., Wu, Y., Wang, Y., Zhou, Z., Wang, Z., Li, Z., Zhu, Z., Zhang, Z., Wang, Z., Yang, Z., Huang, Z., Huang, Z., Xu, Z. und Yang, Z. Kimi k1.5: Scaling reinforcement learning with llms, 2025. URL https://arxiv.org/abs/2501.12599.
Team, N. Sky- tl: Fully open- source reasoning model with o1- preview performance in 450\(budget, 2025. URL https://novasky- ai.github.io/posts/sky- tl. Accessed: 2025- 01- 09.
Team, Q. Qwq: Reflect deeply on the boundaries of the unknown, November 2024. URL https://qwenlm.github.io/blog/qwq- 32b- preview/.
Wang, J., Meng, F., Liang, Y. und Zhou, J. Drt- o1: Optimized deep reasoning translation via long chain- of- thought, 2024a. URL https://arxiv.org/abs/2412.17498.
Wang, P., Li, L., Shao, Z., Xu, R. X., Dai, D., Li, Y., Chen, D., Wu, Y. und Sui, Z. Math- shepherd: Verify and reinforce llms step- by- step without human annotations, 2024b. URL https://arxiv.org/abs/2312.08935.
Wang, S., Liu, Z., Zhong, W., Zhou, M., Wei, Z., Chen, Z. und Duan, N. From Isat: The progress and challenges of complex reasoning, 2021. URL https://arxiv.org/abs/2108.00648.
Wang, Z., Dong, Y., Delalleau, O., Zeng, J., Shen, G., Egert, D., Zhang, J. J., Sreedhar, M. N. und Kuchaiev, O. Help- steer2: Open- source dataset for training top- performing reward models, 2024c. URL https://arxiv.org/abs/2406.08673.
Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q. und Zhou, D. Chain- of- thought prompting elicits reasoning in large language models, 2023. URL https://arxiv.org/abs/2201.11903.
Welleck, S., Bertsch, A., Finlayson, M., Schoelkopf, H., Xie, A., Neubig, G., Kulikov, I. und Harchaoui, Z. From decoding to meta- generation: Inference- time algorithms for large language models, 2024. URL https://arxiv.org/abs/2406.16838.
Wu, T., Lan, J., Yuan, W., Jiao, J., Weston, J., and Sukhbaatar, S. Thinking llms: General instruction following with thought generation, 2024a. URL https://arxiv.org/abs/2410.10630. Wu, Y., Sun, Z., Li, S., Welleck, S., and Yang, Y. Inference scaling laws: An empirical analysis of compute- optimal inference for problem- solving with language models, 2024b. URL https://arxiv.org/abs/2408.00724. Xiang, V., Snell, C., Gandhi, K., Albalak, A., Singh, A., Blagden, C., Phung, D., Rafailov, R., Lile, N., Mahan, D., Castricato, L., Franken, J.- P., Haber, N., and Finn, C. Towards system 2 reasoning in llms: Learning how to think with meta chain- of- thought, 2025. URL https://arxiv.org/abs/2501.04682. Xie, Y., Kawaguchi, K., Zhao, Y., Zhao, X., Kan, M.- Y., He, J., and Xie, Q. Self- evaluation guided beam search for reasoning, 2023. URL https://arxiv.org/abs/2305.00633. Xin, H., Guo, D., Shao, Z., Ren, Z., Zhu, Q., Liu, B., Ruan, C., Li, W., and Liang, X. Deepseek- prover: Advancing theorem proving in llms through large- scale synthetic data, 2024. URL https://arxiv.org/abs/2405.14333. Xu, H., Wu, X., Wang, W., Li, Z., Zheng, D., Chen, B., Hu, Y., Kang, S., Ji, J., Zhang, Y., Guo, Z., Yang, Y., Zhang, M., and Zhang, D. Redstar: Does scaling long- cot data unlock better slow- reasoning systems?, 2025. URL https://arxiv.org/abs/2501.11284. Yang, Z., Band, N., Li, S., Candès, E., and Hashimoto, T. Synthetic continued pretraining, 2024. URL https://arxiv.org/abs/2409.07431. Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T. L., Cao, Y., and Narasimhan, K. Tree of thoughts: Deliberate problem solving with large language models, 2023a. URL https://arxiv.org/abs/2305.10601. Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., and Cao, Y. React: Synergizing reasoning and acting in language models, 2023b. URL https://arxiv.org/abs/2210.03629. Ye, Y., Huang, Z., Xiao, Y., Chern, E., Xia, S., and Liu, P. Limo: Less is more for reasoning, 2025a. URL https://arxiv.org/abs/2502.03387. Ye, Y., Xiao, Y., Mi, T., and Liu, P. Aime- preview: A rigorous and immediate evaluation framework for advanced mathematical reasoning. https://github.com/GAIR- NLP/AIME- Preview, 2025b. GitHub-Repository.
Yu, L., Jiang, W., Shi, H., Yu, J., Liu, Z., Zhang, Y., Kwok, J. T., Li, Z., Weller, A., and Liu, W. Metamath: Bootstrap your own mathematical questions for large language models, 2024. URL https://arxiv.org/abs/2309.12284. Yuan, S., Chen, Z., Xi, Z., Ye, J., Du, Z., and Chen, J. Agent- r: Training language model agents to reflect via iterative self- training, 2025. URL https://arxiv.org/abs/2501.11425. Zelikman, E., Wu, Y., Mu, J., and Goodman, N. D. Star: Bootstrapping reasoning with reasoning, 2022. URL https://arxiv.org/abs/2203.14465. Zelikman, E., Harik, G., Shao, Y., Jayasiri, V., Haber, N., and Goodman, N. D. Quiet- star: Language models can teach themselves to think before speaking, 2024. URL https://arxiv.org/abs/2403.09629. Zhang, H. and Chen, C. Test- time compute scaling laws, 2024. URL https://github.com/hughbzhang/ol_inference_scaling_laws. Zhang, S., Chen, Z., Shen, Y., Ding, M., Tenenbaum, J. B., and Gan, C. Planning with large language models for code generation, 2023. URL https://arxiv.org/abs/2303.05510. Zhang, Y., Wu, S., Yang, Y., Shu, J., Xiao, J., Kong, C., and Sang, J. ol- coder: an ol replication for coding, 2024a. URL https://arxiv.org/abs/2412.00154. Zhang, Y., Yang, J., Yuan, Y., and Yao, A. C.- C. Cumulative reasoning with large language models, 2024b. URL https://arxiv.org/abs/2308.04371. Zhong, H., Xiao, C., Tu, C., Zhang, T., Liu, Z., and Sun, M. Jec- qa: A legal- domain question answering dataset, 2019. URL https://arxiv.org/abs/1911.12011. Zhong, W., Cui, R., Guo, Y., Liang, Y., Lu, S., Wang, Y., Saied, A., Chen, W., and Duan, N. Agieval: A human- centric benchmark for evaluating foundation models, 2023. URL https://arxiv.org/abs/2304.06364. Zhou, A., Yan, K., Shlapentokh- Rothman, M., Wang, H., and Wang, Y.- X. Language agent tree search unifies reasoning acting and planning in language models, 2024. URL https://arxiv.org/abs/2310.04406. Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., Ma, X., Efrat, A., Yu, P., Yu, L., Zhang, S., Ghosh, G., Lewis, M., Zettlemoyer, L., and Levy, O. Lima: Less is more for alignment, 2023. URL https://arxiv.org/abs/2305.11206.
Inhalt
1 Einleitung 1
2 Kuratierung von Reasoning-Daten zur Erstellung von s1K 2
2.1 Erste Sammlung von 59K Beispielen 2
2.2 Endgültige Auswahl von 1K Beispielen 2
3 Test-Time Scaling 3
3.1 Methode 3
3.2 Metriken 4
4 Ergebnisse 4
4.1 Versuchsaufbau 4
4.2 Leistung 6
5 Ablationen 6
5.1 Datenmenge, Diversität und Schwierigkeit 6
5.2 Methoden des Test-Time Scaling 6
6 Diskussion und verwandte Arbeiten 8
6.1 Proben-effizientes Reasoning 8
6.2 Test-Time Scaling 9
A s1.1 16
B Determinismus der Evaluierung 16
C Details zu s1K 17
C.1 Zusammenfassung von s1K 17
C.2 Datensatzzusammensetzung für die vollständigen 59K Fragen 17
C.3 Bewertungs-Prompt für s1K 19
C.4 Diversitätsauswahl für s1K 19
C.5 Dekontaminierung 19
D Trainingsdetails 21
D.1 Trainings-Ablationen: Sequenzlänge 21
D.2 Trainingsbeispiele 21
E Details zum Test-Time Scaling 35
E.1 Ablationen zum sequenziellen Scaling 35
E.2 Beispiele für die Ablation zum Rejection Sampling 37
F Versionskontrolle 46
A. s1.1
A. s1.1Sieben Tage nach der Veröffentlichung von s1 haben wir s1.1 veröffentlicht. Wir haben die Traces für unsere 1.000 Beispiele in s1K mit DeepSeek r1 (DeepSeek-AI et al., 2025) neu generiert, um s1K-1.1 zu erstellen. Wir verwenden dasselbe Trainingsverfahren, um unser Modell s1.1 zu trainieren. Weitere Aktualisierungen seit unserem Launch umfassen die Veröffentlichung von o3 (OpenAI, 2025), LIMO (Ye et al., 2025a) und AIME 2025. Wir berücksichtigen all diese neuen Entwicklungen in Tabelle 5. Wir stellen fest, dass s1.1 deutlich besser abschneidet als s1. Wir haben außerdem versucht, von Claude 3.7 zu destillieren, was zu einer schlechteren Leistung als bei r1 führte (nicht berichtet).
| Modell | Beispiele | MATH500 | GPQA | AIME 2024 | AIME 2025 |
| Nur API | |||||
| o3-mini-low | N/A | 95,8 | 70,6 | 56,3 | 42,1 |
| o3-mini-medium | N/A | 97,3 | 76,8 | 75,8 | 70,4 |
| o3-mini-high | N/A | 97,9 | 79,7 | 83,8 | 80,9 |
| Offene Gewichte | |||||
| QwQ-32B | N.A. | 90,6 | 54,5 | 46,7 | 32,7 |
| r1 | ≥800K | 07,3 | 71,5 | 79,8 | 70,0 |
| r1-distill-Llama-70B | 800K | 94,5 | 65,2 | 57,1 | 56,3 |
| r1-distill-Qwen-14B | 800K | 93,9 | 59,1 | 61,7 | 48,0 |
| r1-distill-Qwen-32B | 800K | 94,3 | 62,1 | 58,3 | 49,6 |
| Offene Gewichte und offene Daten | |||||
| LIMO | 817 | 94,8 | 66,7 | 56,3 | 44,6 |
| s1 w/o BF | 1K | 92,6 | 56,6 | 50,0 | 26,7 |
| s1 mit Budget Forcing „Wait“ 1x | 1K | 92,8 | 59,6 | 53,3 | 30,0 |
| s1 mit Budget Forcing „Wait“ 2x | 1K | 93,0 | 59,6 | 53,3 | 33,3 |
| s1 mit Budget Forcing „Wait“ 4x | 1K | 92,2 | 58,6 | 56,7 | 36,7 |
| s1.1 ohne BF | 1K | 94,4 | 60,6 | 56,7 | 50,0 |
| s1.1 mit Budget Forcing „Wait“ 1x | 1K | 95,4 | 62,6 | 56,7 | 50,0 |
| s1.1 mit Budget Forcing „Wait“ 2x | 1K | 95,4 | 63,6 | 56,7 | 50,0 |
B. Determinismus der Evaluierung
Wir führen unsere Evaluierungen mit vLLM (Kwon et al., 2023) durch, da es schneller ist als die Alternativen, die wir ausprobiert haben. Wir stellen jedoch fest, dass sich die Bewertungsergebnisse selbst bei Verwendung derselben Zufallsstartwerte und Greedy-Sampling zwischen den Durchläufen erheblich ändern können:
Unterschiedliche Batch-Größen führen zu unterschiedlichen Ergebnissen, siehe https://github.com/vllm- project/vllm/issues/5898 Fortgesetzte Generierungen führen zu unterschiedlichen Ergebnissen, siehe https://github.com/vllm- project/vllm/issues/11783 Änderungen der Tensor-Parallelität führen zu unterschiedlichen Ergebnissen
Da unser Modell vor seiner Antwort lange Reasoning-Traces generiert, können sich kleine numerische Änderungen zu großen Unterschieden aufschaukeln. Wir begegnen vielen Generierungen, die über Tausende von Tokens exakt gleich sind und dann plötzlich bei einem Token abweichen, wodurch schließlich eine völlig andere Antwort entsteht. Um diesem Problem teilweise entgegenzuwirken, führen wir unsere abschließenden Evaluierungen im Allgemeinen mit voller Präzision durch, sofern nicht anders angegeben.
- .
C. Details zu s1K
C.1. Zusammenfassung von s1K
| Domäne | #Fragen | Gesamtzahl der Tokens | Schlüsselwörter |
| Geometrie | 109 | 560,2K | Fläche, Dreieck, Abstand |
| Zahlentheorie | 98 | 522,5K | Folgen, Teilbarkeit |
| Kombinatorik | 75 | 384,7K | Permutationen, Abzählen |
| Reelle Funktionen | 43 | 234,8K | Trigonometrie, Analysis |
| Biologie | 41 | 120,9K | Organische Reaktionen |
| Komplexe Funktionen | 32 | 170,2K | Komplexe Wurzeln |
| Quantentheorie | 32 | 127,9K | Teilchen, Wellenfunktionen |
| Feldtheorie | 28 | 150,1K | Polynome, Wurzeln |
| Variationsrechnung | 28 | 155,5K | Optimierung, Steuerung |
| Differenzengleichungen | 24 | 132,5K | Rekurrenz, Rekursion |
| Elektromagnetische Theorie | 23 | 95,8K | Optik, Wellen, Beugung |
| Gruppentheorie | 22 | 100,0K | Gruppen, Automorphismen |
| Lineare Algebra | 22 | 128,3K | Matrizen, Determinanten |
| Wahrscheinlichkeitstheorie | 20 | 114,6K | Zufällige Irrfahrt, Erwartungswert |
| Algebraische Systeme | 19 | 109,9K | Funktionalgleichungen |
| Mechanik | 19 | 103,6K | Kräfte, Bewegung, Energie |
| Thermodynamik | 19 | 74,2K | Wärmekraftmaschinen, Entropie |
| Differentialgleichungen | 18 | 89,6K | Substitution, Existenz |
| Informatik | 18 | 34,2K | Komplexitätstheorie, Algorithmen |
| Numerische Analysis | 18 | 76,5K | Fehleranalyse, Stabilität |
| Analysis | 17 | 96,3K | Konvergenz, Summation |
| Algebraische Strukturen | 17 | 90,4K | Ungleichungen, Mengen |
| Astronomie | 16 | 37,7K | Sternpopulationen, Umlaufbahnen |
| Verbleibende 27 Domänen | 242 | 982,2K | Domänen mit ≤ 16 Fragen |
| Alle Domänen (51) | 1000 | 4,7M | s1K |
C.2. Datensatzzusammensetzung für die vollständigen 59K Fragen
| Source | Beschreibung | #Stichproben | Durchschn. Denklänge |
| NuminaMATH (LI et al., 2024) | Mathematikaufgaben von Online-Websites | 30660 | 4.1K |
| MATH (Hendrycks et al., 2021) | Mathematikaufgaben aus Wettbewerben | 11999 | 2.9K |
| OlympicArena (Huang et al., 2024a) | Olympiade-Aufgaben aus Astronomie, Biologie, Chemie, Informatik, Geographie, Mathematik und Physik | 4250 | 3.2K |
| OmniMath (Gao et al., 2024a) | Mathematikaufgaben aus Wettbewerben | 4238 | 4.4K |
| AGIEval (Zhong et al., 2023; Ling et al., 2017; Hendrycks et al., 2021; Liu et al., 2020; Zhong et al., 2019; Wang et al., 2021) | Englisch-, Rechts-, Logik- und Mathematikaufgaben aus dem SAT, LSAT und anderen Prüfungen | 2385 | 1.2K |
| xword | Kreuzworträtsel | 999 | 0.7K |
| OlympiadBench (He et al., 2024) | Olympiade-Aufgaben aus Mathematik und Physik | 896 | 3.9K |
| AIME (1983-2021) | American Invitational Mathematics Examination | 890 | 4.7K |
| TheoremQA (Chen et al., 2023) | Informatik-, Finanz-, Mathematik- und Physikaufgaben auf Universitätsniveau mit Bezug zu Theoremen | 747 | 2.1K |
| USACO (Shi et al., 2024) | Codeaufgaben aus der USA Computing Olympiad | 519 | 3.6K |
| JEEBench (Arora et al., 2023) | Chemie-, Mathematik- und Physikaufgaben aus der Aufnahmeprüfung des Indian Institute of Technology | 515 | 2.9K |
| GPQA (Rein et al., 2023) | Wissenschaftliche Fragen auf Doktorandenniveau | 348 | 2.9K |
| SciEval (Sun et al., 2024) | Biologie-, Chemie- und Physikaufgaben aus verschiedenen Quellen | 227 | 0.7K |
| s1-prob | Qualifikationsprüfungen in Statistik der Stanford University | 182 | 4.0K |
| LiveCodeBench (Jain et al., 2024) | Codeaufgaben von Coding-Websites (LeetCode, AtCoder und CodeForces) | 151 | 3.5K |
| s1-teasers | Mathe-Knobelaugaben, die aus dem Internet gecrawlt wurden | 23 | 4,1K |
| Alle 59K Fragen | Zusammensetzung der oben genannten Datensätze mit Reasoning-Traces und Lösungen | 59029 | 3,6K |
C.3. Bewertungs-Prompt für s1K
Um zu bewerten, ob ein Beispiel für unsere Datensatzauswahl in korrekt ist, verwenden wir den Prompt in Abbildung 8. Wir bewerten mit Claude 3.5, mit Ausnahme der Korrektheit unter den abschließenden 1.000 Beispielen, die wir mit Claude 3.7 bewertet haben.
Du bist ein KI-Assistent zur Bewertung eines naturwissenschaftlichen Problems. Der Nutzer stellt dir die Frage selbst, einen Lösungsversuch eines Studierenden und die korrekte Antwort auf das Problem bereit. Deine Aufgabe ist es, zu beurteilen, ob der Versuch korrekt ist, indem du ihn mit der korrekten Antwort vergleichst. Wenn die erwartete Lösung mit einer Zahl oder einer Auswahl endet, sollte es keine Mehrdeutigkeit geben. Wenn die erwartete Lösung den gesamten Denkprozess umfasst, solltest du den Versuch danach beurteilen, ob der Denkprozess korrekt ist, gegebenenfalls mit korrekter Antwort.
Der Nutzer stellt den Versuch und die korrekte Antwort im folgenden Format bereit:
Problem {problem}
Versuch {attempt}
Korrekte Antwort {solution}
Erläutere deine Begründung und beende deine Antwort in einer neuen Zeile mit ausschließlich „Ja“ oder „Nein“ (ohne Anführungszeichen).
C.4. Diversitätsauswahl für s1K
Algorithmus 1 stellt unseren Algorithmus zur Auswahl von Daten in unserer Diversitätsauswahlphase bereit. Wie in erwähnt, beziehen wir außerdem Beispiele aus einigen spezifischen Benchmarks ein, die wir als hochwertig erachten. Keines der Beispiele überschneidet sich mit unserer abschließenden Evaluierung.
C.5. Dekontaminierung
Wir filtern alle Beispiele, indem wir auf eine 8-Gramm-Überschneidung zwischen den ausgewählten Beispielen und den Evaluierungs-Benchmarks MATH500, GPTQA Diamond und AIME24 prüfen. Wir schließen Fragen mit mehr als einer 8-Gramm-Überschneidung aus.
Algorithmus 1 Zweistufiges Sampling für s1K
1: Eingabe: Menge von 24.496 Fragen mit Merkmalen 2: Ausgabe: Menge von 1.000 ausgewählten Fragen 3: Ausgabemenge initialisieren (verfolgt nur eindeutige Elemente) 4: for do 5: if IsGeminiCorrect and (IsAIME or IsGPQA ) then 6: 7: Alle korrekten AIME/GPQA-Lösungen auswählen 8: else if IsGeminiCorrect and IsMATH and ThinkingLength then 9: 10: Korrekte MATH500-Lösungen mit langen Ketten auswählen 11: end if 12: end for 13: Alle verfügbaren Domänen 14: Domänenpool initialisieren 15: while do 16: RandomChoice 17: Zufällig eine Domäne auswählen 18: Fragen in Domäne 19: Fragen aus dieser Domäne abrufen 20: ranks RankByThinkingLength 21: Nach Denklänge ordnen 22: weights ranks 23: Potenzgesetz-Gewichtung anwenden 24: WeightedSample , weights) 25: Stichprobe zugunsten längerer Ketten ziehen 26: 27: Ausgewählte Frage hinzufügen 28: 29: if then 30: 31: Erschöpfte Domänen entfernen 32: end if 33: end while
D. Trainingsdetails
Wir nehmen ein Modell, das bereits vortrainiert und instruktionsabgestimmt wurde, und finetunen es weiter für das Reasoning. Konkret verwenden wir Qwen2.5- 32B- Instruct (Qwen et al., 2024), das bei Mathe-Aufgaben im Allgemeinen mit dem größeren Qwen2.5- 72B- Instruct (Qwen et al., 2024) oder anderen offenen Modellen (Dubey et al., 2024; Groeneveld et al., 2024; Muennighoff et al., 2024) mithält oder diese übertrifft. Wir verwenden Token-Trennzeichen, um die Denkphase von der Antwortphase zu trennen. Wir schließen die Denkphase mit <|im_start|>think und <|im_start|>answer ein; beide werden von einem Zeilenumbruch vorangestellt und gefolgt. Beispiele aus unserem Datensatz finden sich in . Wir verwenden grundlegende Fine- Tuning- Hyperparameter: Wir trainieren über 5 Epochen mit einer Batch-Größe von 16 für insgesamt 315 Gradientenschritte. Wir trainieren in bfloat16- Präzision mit einer Lernrate von , die linear über (16 Schritte) aufgewärmt und dann über den Rest des Trainings (299 Schritte) nach einem Kosinus-Zeitplan auf 0 abgesenkt wird. Wir verwenden den AdamW-Optimierer (Loshchilov & Hutter, 2019) mit , und Weight Decay von . Wir berechnen den Loss nicht auf Fragen, sondern nur auf Reasoning-Spuren und Lösungen. Wir stellen sicher, dass die Sequenzlänge groß genug ist, um ein Abschneiden von Stichproben zu vermeiden; eine Einstellung, die wir in ablatieren. Das Training dauert nur 26 Minuten auf 16 NVIDIA H100 GPUs.
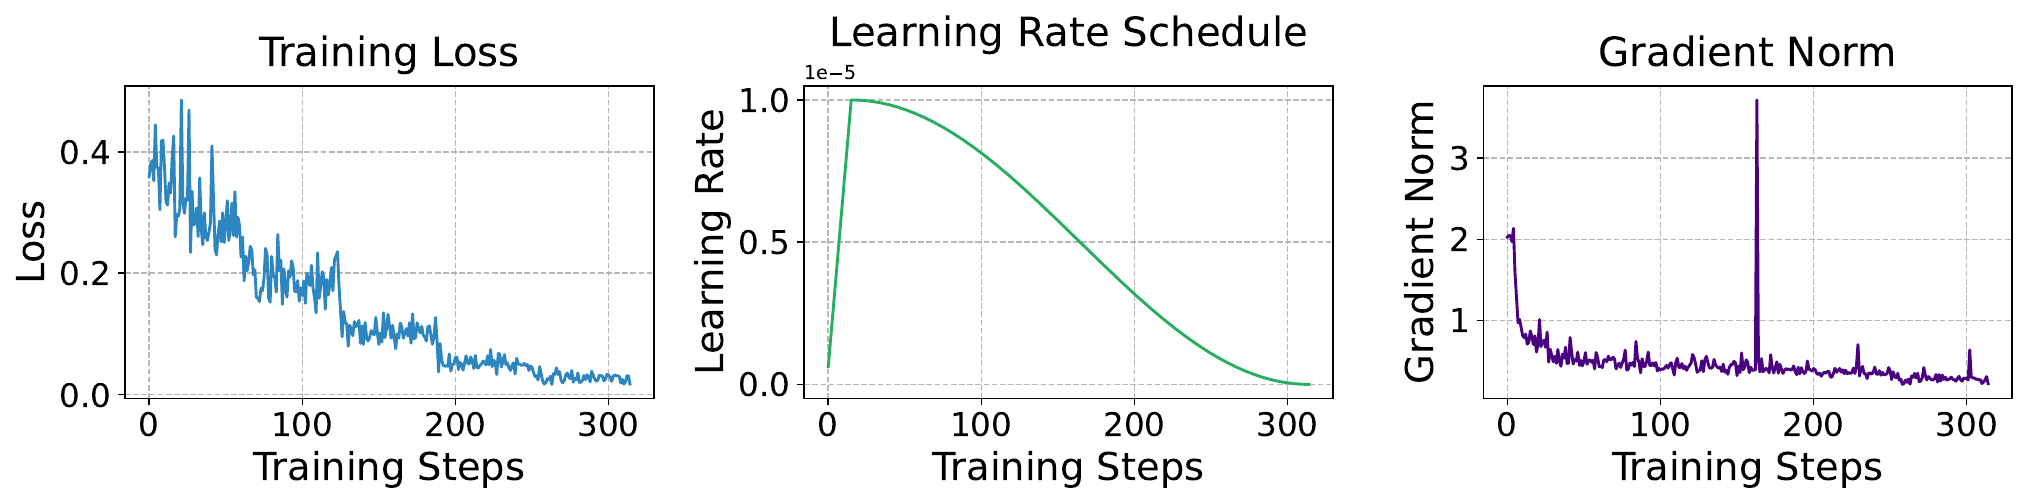
Abbildung 9. Trainingsdynamik von s1-32B auf s1K.
D.1. Trainings-Ablationen: Sequenzlänge
| Modell A | Modell B | |
| Trainingssequenzlänge | 4096 | 32768 |
| % der Trainingsbeispiele abgeschnitten | 74% | 0% |
| AIME24 | 30,0 % / 20721 | 50,0 % / 6984 |
| MATH500 | 90,0 % / 5324 | 91,0 % / 3268 |
| GPQA | 52,5 % / 6841 | 53,0 % / 3568 |
Tabelle 8. Ablation der Trainingssequenzlänge. Wir berichten „Genauigkeit / durchschnittliche Denk-Tokens pro Stichprobe“; je höher die Genauigkeit und je geringer die Denk-Tokens (Inferenzkosten), desto besser.
Neben unseren Skalierungs-Ablationen in ist der wichtigste Trainingshyperparameter, den wir ablatieren, die während des Trainings verwendete Sequenzlänge. Wir stellen fest, dass eine kürzere Trainingssequenzlänge zu längeren Reasoning-Spuren zur Testzeit führt. Dies liegt daran, dass beim Training mit einer kürzeren Sequenzlänge der Antwortabschnitt der Trainingsstichprobe häufiger abgeschnitten wird. Umgekehrt erscheinen bei längerer Trainingssequenzlänge mehr Stichproben vollständig mit dem Abschnitt, in dem das Modell antwortet. Somit erhält das Modell mehr Gradienten-Updates, bei denen es lernt, eine Antwort im Anschluss an seine Kette zu generieren. Dies wiederum führt zu einer höheren Log-Wahrscheinlichkeit des Antwortabschnitts zu jedem Zeitpunkt während der Generierung und damit zu kürzeren Reasoning-Spuren zur Testzeit. Leistungsmäßig stellen wir zudem fest, dass das Modell, das mit einer längeren Sequenzlänge trainiert wurde, besser abschneidet. Daher entscheiden wir uns für die längste Trainingssequenzlänge, da sie zu besserer Leistung führt und die Inferenz durch kürzere Reasoning-Spuren effizienter macht.
D.2. Trainingsstichproben
Tabelle 9, Tabelle 10, Tabelle 11 enthalten Trainingsstichproben aus s1K.
Tabelle 9. s1K-Stichprobe, die aus s1-prob stammt. Der schwarze Text ist die Frage und der gelbe Text ist die Lösung. Ausschließlich auf der Grundlage der Frage erzeugen wir mit Gemini den hellblauen Begründungsverlauf und die blaue Antwort, die wir zum Training verwenden.
Gegeben sind integrierbare Zufallsvariablen und auf demselben Wahrscheinlichkeitsraum sowie zwei -Algebren . Für sei
(a) Zeigen Sie, dass es integrierbare Zufallsvariablen und gibt, sodass für sowohl als auch gilt. (b) Beweisen Sie, dass fast sicher gilt.
1. Führen Sie die Notationen und für alle sowie , ein. Offensichtlich sind beide Filtrationen, und per Definition gilt und für alle . Somit ist (oder ) ein Doob-Martingal bezüglich der Filtration (oder ) und daher U.I., da integrierbar ist. Wenden Sie nun die Tatsache an, dass ein Martingal genau dann U.I. ist, wenn es in konvergiert, und schließen Sie.
2. Wir geben zwei verschiedene Beweise.
1. Beobachten Sie die folgende Identität, die aus der Turmeigenschaft folgt.
Beachten Sie, dass gilt und nach Levys aufsteigendem Theorem , wobei . Es ist offensichtlich, dass gilt (da es der fast sichere Grenzwert von ist) und daher fast sicher gilt. Durch Kombination der obigen Beobachtungen schließen wir, dass gilt. Analog gilt . Ziehen Sie nun Gleichung (4) heran, um zu schließen, dass fast sicher gilt.
2. Da integrierbar ist, gilt nach Levys aufsteigendem Theorem . Analog gilt . Andererseits haben wir im ersten Beweis beobachtet, dass gilt und daher . Dies ergibt Folgendes.
Analog gilt . Dies beweist, dass fast sicher gilt.
Analysieren wir das Problem. Gegeben sind zwei Folgen von Zufallsvariablen und , die durch bedingte Erwartungen definiert sind. Wir müssen zeigen, dass diese Folgen in konvergieren und dass ihre Grenzwerte fast sicher gleich sind.
Teil (a): Konvergenz in .
Die beteiligten Sigma-Algebren sind aufsteigend:
Für die Folge :
Die Folge der Sigma-Algebren ist aufsteigend. Nach dem Martingalkonvergenzsatz (für bedingte Erwartungen) konvergiert die Folge , da integrierbar ist, fast sicher und in gegen . Sei .
Analog gilt für die Folge :
Die Folge der Sigma-Algebren ist aufsteigend. Nach dem Martingalkonvergenzsatz konvergiert die Folge fast sicher und in gegen . Sei .
Teil (b): Beweisen Sie, dass fast sicher gilt.
Wir haben und .
Sei und .
Dann gilt und .
Betrachten Sie . .
. Da gilt, ist .
. Da nicht definiert ist, nehmen wir an, dass und gegeben sind.
Betrachten wir die von allen und erzeugte Sigma-Algebra.
Sei .
Sowohl als auch sind bezüglich messbar. Somit sind und bezüglich messbar.
Betrachten Sie .
Betrachten Sie .
Sei .
Betrachten Sie .
Betrachten Sie .
Betrachten wir die Grenz-Sigma-Algebren und .
Wir wissen, dass - messbar ist und - messbar ist.
Sei .
Betrachten Sie den Fall, wenn und unabhängig sind. Dann sind und .
.
Betrachten wir die von allen Informationen erzeugte Sigma-Algebra. Sei .
Dann sind sowohl als auch - messbar.
Wir haben und f.s. und in .
Betrachten Sie und .
Sei .
Betrachten Sie .
Versuchen wir zu zeigen, dass sowohl als auch gleich sind. Dies scheint zu einfach.
Betrachten wir die Definition des bedingten Erwartungswerts. Für jede Menge gilt .
Für jede Menge gilt .
Betrachten Sie mit .
Betrachten Sie mit .
Betrachten Sie die Sigma-Algebra .
Sei .
Wir haben .
Da von abhängt, welches von abhängt usw., ist es komplex.
Betrachten wir den Fall, in dem und .
Dann ist .
Wenn dies der Fall wäre, dann wären und , also und .
Wir benötigen f.s., d.h. f.s. Dies ist im Allgemeinen nicht wahr.
Betrachten Sie die von allen und erzeugte Sigma-Algebra, bezeichnet mit .
Dann ist .
\(\mathcal{Z}{\infty} = \sigma (B,Y{0},Y_{1},\ldots)\subseteq \sigma (B,G_{\infty})\) .Betrachten Sie \(\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ] = Y_{\infty}\) .Das bedeutet für jedes \(A\in \sigma (A,Z_{0},Z_{1},\ldots)\)
Betrachten Sie \(\mathbb{E}[X|B,Y_{0},Y_{1},\ldots ] = Z_{\infty}\) .Das bedeutet für jedes \(B\in \sigma (B,Y_{0},Y_{1},\ldots)\)
Sei \(\mathcal{H} = \sigma (A,B)\)
Betrachten Sie \(\mathbb{E}[X|\mathcal{H}].\)
Betrachten Sie \(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ] = \mathbb{E}[\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ]|B,Y_{0},Y_{1},\ldots ]\)
Nutzen wir die Tatsache, dass \(Y_{\infty}\) \(\sigma (A,Z_{0},Z_{1},\ldots)\) - messbar ist und \(Z_{\infty}\) \(\sigma (B,Y_{0},Y_{1},\ldots)\) - messbar ist.
Betrachten Sie die kleinste Sigma-Algebra, die sowohl \(\sigma (A,Z_{0},Z_{1},\ldots)\) als auch \(\sigma (B,Y_{0},Y_{1},\ldots)\) enthält
Diese ist \(\sigma (A\cup B\cup \{Y_{i}\}{i\geq 0}\cup \{Z{i}\}_{i\geq 0})\)
Lass uns versuchen zu zeigen, dass
Betrachte die Definition von und
Betrachte
Da messbar bezüglich ist, vereinfacht sich dies nicht ohne Weiteres.
Nehmen wir an, dass auf einer Menge von positivem Maß gilt.
Betrachte den Fall, in dem und trivial sind.
Dann gilt und
Sei
Betrachte
Wir haben
Aufgrund der Eigenschaften des bedingten Erwartungswerts gilt
Betrachte die Sigma-Algebra , die von allen beteiligten Zufallsvariablen erzeugt wird.
Sei
Betrachte die Grenzwerte. Für gilt
Für gilt
Sei und
Wir haben und
Betrachte
Betrachte die Sigma-Algebra
Sei
Betrachte die Grenz-Sigma-Algebra, die von allen Informationen erzeugt wird.
Sei
Dann gilt und
Wir haben und
Betrachte und
Sei
Betrachte
Betrachte die Folge der Paare
Wenn die Grenzwerte gleich sind, dann gilt für jede beschränkte messbare Funktion , dass
Betrachte die Sigma-Algebra
Dann sind sowohl als auch messbar bezüglich
Betrachte
Sei
Betrachte
Dann gilt und . Betrachte die Grenz-Sigma-Algebra .
Wir haben und .
Sei .
Betrachte .
Betrachte die Zufallsvariable . Dann gilt und .
Sei .
Betrachte . Angenommen, .
Betrachte den bedingten Erwartungswert bezüglich der Vereinigung der Sigma-Algebren.
Sei .
Betrachte .
Dann gilt .
Und .
Also gilt und .
Sei und .
Betrachte .
Dann gilt .
Und \(\mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty}\) .
Dies bedeutet, dass \(Y_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]\) fast sicher gilt und \(Z_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]\) fast sicher gilt.
Daher gilt \(Y_{\infty} = Z_{\infty}\) fast sicher.
Lösung:
(a) Für die Folge \(Y_{k}\) sind die \(\sigma\)-Algebren \(\mathcal{F}{k} = \sigma (\mathcal{A}, Z{0}, \ldots , Z_{k - 1})\) mit wachsendem \(k\) aufsteigend. Da \(X\) integrierbar ist, konvergiert die Folge \(Y_{k} = \mathbb{E}[X|\mathcal{F}{k}]\) nach dem Martingalkonvergenzsatz für bedingte Erwartungen fast sicher und in \(L^{1}\) gegen \(Y{\infty} = \mathbb{E}[X|\sigma (\mathcal{A}, Z_{0}, Z_{1}, \ldots)]\) . Ebenso sind für die Folge \(Z_{k}\) die \(\sigma\)-Algebren \(G_{k} = \sigma (B, Y_{0}, \ldots , Y_{k - 1})\) aufsteigend. Da \(X\) integrierbar ist, konvergiert die Folge \(Z_{k} = \mathbb{E}[X|G_{k}]\) nach dem Martingalkonvergenzsatz fast sicher und in \(L^{1}\) gegen \(Z_{\infty} = \mathbb{E}[X|\sigma (B, Y_{0}, Y_{1}, \ldots)]\) .
(b) Seien \(\mathcal{F}{\infty} = \sigma (\mathcal{A}, Z{0}, Z_{1}, \ldots)\) und \(G_{\infty} = \sigma (B, Y_{0}, Y_{1}, \ldots)\) . Wir haben \(Y_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty}]\) und \(Z{\infty} = \mathbb{E}[X|G_{\infty}]\) . Betrachten Sie die \(\sigma\)-Algebra \(\mathcal{H} = \mathcal{F}{\infty} \vee G{\infty} = \sigma (\mathcal{A}, B, Y_{0}, Z_{0}, Y_{1}, Z_{1}, \ldots)\) . Betrachten Sie \(W = \mathbb{E}[X|\mathcal{H}]\) .
Wir haben \(\mathcal{F}{\infty} \subseteq \mathcal{H}\) , also \(\mathbb{E}[W|\mathcal{F}{\infty}] = \mathbb{E}[\mathbb{E}[X|\mathcal{H}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty}\) .
Da \(W\) \(\mathcal{H}\) -messbar ist, impliziert \(\mathbb{E}[W|\mathcal{F}{\infty}] = Y{\infty}\) , dass \(Y_{\infty}\) der bedingte Erwartungswert von \(W\) gegeben \(\mathcal{F}{\infty}\) ist. Da aber \(Y{\infty}\) bereits \(\mathcal{F}{\infty}\) -messbar ist, haben wir \(\mathbb{E}[W|\mathcal{F}{\infty}] = W\) , falls \(W\) \(\mathcal{F}_{\infty}\) -messbar ist, was nicht unbedingt zutrifft.
Wir wissen jedoch, dass \(\mathbb{E}[Y_{\infty}|\mathcal{F}{\infty}] = Y{\infty}\) und \(\mathbb{E}[Z_{\infty}|G_{\infty}] = Z_{\infty}\) .
Betrachten Sie \(\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]\) .
Dann gilt \(\mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty}\) .
Dies impliziert, dass \(\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty}\) .
Ebenso gilt \(\mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty}\) .
Dies impliziert, dass \(\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] = Z_{\infty}\) fast sicher gilt.
Daher gilt \(Y_{\infty} = Z_{\infty}\) fast sicher.
Endgültige Antwort: Die endgültige Antwort ist \(\left[Y_{\infty} = Z_{\infty}\right]\)
Tabelle 10. s1K-Beispiel, das aus s1-Teasern stammt. Der schwarze Text ist die Frage und der gelbe Text ist die Lösung. Ausschließlich auf Grundlage der Frage erzeugen wir mit Gemini den hellblauen Gedankengang und die blaue Antwort, die wir zum Training verwenden.
Alice und Bob haben jeweils eine Münze und werfen sie, bis sie Kopf erhalten. Wenn Bob seine Münze öfter geworfen hat als Alice, wie hoch ist die erwartete Anzahl der Würfe von Alice?
4/3
Das Problem fragt nach der erwarteten Anzahl der Male, die Alice ihre Münze geworfen hat, unter der Bedingung, dass Bob seine Münze öfter geworfen hat als Alice.
Sei \(X\) die Anzahl der Würfe, die Alice macht, bis sie Kopf erhält.
Sei \(Y\) die Anzahl der Würfe, die Bob macht, bis er Kopf erhält.
\(X\) und \(Y\) sind unabhängige Zufallsvariablen, die einer geometrischen Verteilung mit Parameter \(p = 0.5\) folgen (Wahrscheinlichkeit, Kopf zu erhalten).
Die Wahrscheinlichkeitsmassenfunktion einer geometrischen Verteilung ist \(P(K = k) = (1 - p)^{k - 1}p\) , für \(k = 1,2,\ldots\)
In diesem Fall ist \(p = 0.5\) , also \(P(K = k) = (0.5)^{k - 1}(0.5) = (0.5)^{k} = \frac{1}{2^{k}}\) .
Wir erhalten die Bedingung, dass Bob seine Münze öfter geworfen hat als Alice, was bedeutet, dass \(Y > X\) .
Wir möchten den Erwartungswert von \(X\) unter der Bedingung \(Y > X\) finden, d. h. \(E[X|Y > X]\) .
Die Formel für den bedingten Erwartungswert lautet .
Außerdem gilt .
In unserem Fall ist das Ereignis .
Wir müssen ermitteln.
Da und unabhängig sind, gilt .
Die innere Summe ist eine geometrische Reihe:
Dies ist eine geometrische Reihe mit erstem Glied und Quotient .
Die Summe ist .
Also ist .
Dies ist eine weitere geometrische Reihe mit erstem Glied und Quotient .
Die Summe ist .
Nun müssen wir finden.
, aufgrund der Unabhängigkeit.
.
Also ist .
Nun können wir finden.
Schließlich können wir den bedingten Erwartungswert berechnen:
Betrachten Sie die Reihe , wobei .
Betrachten Sie die geometrische Reihe .
Differenzieren nach :
Also ist , was bedeutet .
In unserem Fall ist .
Daher ist
Alternativer Ansatz: Symmetrie.
Betrachten Sie die Ereignisse , und .
aufgrund der Symmetrie.
Wir haben .
. Dies bestätigt unsere vorherige Berechnung.
Sei .
Wir suchen die erwartete Anzahl von Würfen, die Alice gemacht hat, gegeben dass Bob öfter geworfen hat.
Betrachten Sie den Fall, dass der erste Wurf für beide Zahl ist. Dann beginnt der Prozess von Neuem, und die Bedingung bleibt bestehen.
Sei Alices erster Wurf, Bobs erster Wurf.
Fall 1: , also ist falsch.
Fall 2: . Alice hört bei 1 auf, Bob macht weiter.
Fall 3: . Bob hört bei 1 auf, Alice macht weiter.
Fall 4: . Beide machen weiter.
Betrachte die bedingten Wahrscheinlichkeiten gegeben .
Sei .
Wenn die ersten Würfe HH sind, ist die Bedingung nicht erfüllt.
Wenn die ersten Würfe HT sind, ist Alices Anzahl an Würfen 1.
Wenn die ersten Würfe TH sind, ist Bobs Anzahl an Würfen 1, Alices ist mindestens 2, also .
Wenn die ersten Würfe TT sind, beginnt das Problem von vorn, und die erwartete Anzahl zusätzlicher Würfe für Alice ist weiterhin .
Sei die Anzahl der Würfe, die Alice macht, die Anzahl der Würfe, die Bob macht.
Es ist gegeben.
Betrachte die ersten Würfe:
HH (Wahrscheinlichkeit 1/4): Bedingung nicht erfüllt.
HT (prob 1/4): Alice flips 1 time.
TH (prob 1/4): Bob flips 1 time, Alice , so , condition not met.
TT (prob 1/4): Both continue.
Let be the expected number of Alice's flips given Bob flipped more.
If the first flips are HT, Alice flipped 1 time, and the condition is met.
If the first flips are TT, the situation is the same as the beginning, so the expected number of additional flips for Alice is .
Consider the event .
Conditioning on the first flips:
depends on the future flips.
Let's use the definition of conditional expectation directly.
(1>λ)
Consider the probabilities of the first flips given .
If the first flips are TT, the future behavior is the same, and the condition holds if Bob takes more flips than Alice in the subsequent trials.
needs more flips than Alice starting from scratch)
Sum of conditional probabilities:
Now consider the conditional expectations of
: Not relevant since
: Given HT and , Alice flipped 1 time.
: Not relevant.
: Given TT and , Alice has already flipped once, and the expected number of additional flips is . So, the total number of flips is .
undefined
This confirms the previous result.
Let's think about the intuition. If we have the condition , it means Alice was "lucky" and got a head early, or Bob was "unlucky".
Consider the random variable . We are given .
We want .
Let .
The number of tails before the first head follows a geometric distribution with parameter .
, .
.
.
Consider the joint distribution of and .
Consider the event , where .
Wenn , dann ist , .
Prüfe, ob .
Hier stimmt etwas nicht.
Berechnen wir erneut.
Innere Summe: .
Wenn , dann ist . Richtig.
Nun bestimmen wir .
(Unabhängigkeit)
(Fehler im Exponenten)
Sei . .
Wenn , dann ist .
Lösung:
Sei die Anzahl der Würfe, die Alice macht, bis sie Kopf erhält, und die Anzahl der Würfe, die Bob macht, bis er Kopf erhält. und sind unabhängige geometrische Zufallsvariablen mit Parameter . Die Wahrscheinlichkeitsmassefunktion ist .
Wir sind an der erwarteten Anzahl der Male interessiert, die Alice ihre Münze geworfen hat, unter der Bedingung, dass Bob seine Münze öfter geworfen hat als Alice, d. h. .
Mit der Definition der bedingten Erwartung gilt .
Berechnen Sie zuerst .
Berechnen Sie als Nächstes .
Finden Sie nun .
Berechnen Sie schließlich die bedingte Erwartung:
Mit der Formel mit :
Endgültige Antwort: Die endgültige Antwort lautet
Tabelle 11. s1K-Stichprobe aus dem Astronomie-Teilbereich von OlympicArena. Der schwarze Text ist die Frage und der blaue Text ist die Lösung. Ausschließlich auf Grundlage der Frage erzeugen wir mit Gemini den hellblauen Gedankengang und die blaue Antwort, die wir zum Training verwenden.
Eine oft wiederholte kuriose Tatsache ist, dass Menschen mehr Leistung pro Volumeneinheit erzeugen als Sterne. Wenn die Sonne dieselbe Größe hätte, aber dieselbe Leistung pro Volumeneinheit wie ein Mensch erzeugen würde, wie hoch wäre dann ihre Oberflächentemperatur? Nehmen Sie an, dass der „durchschnittliche Mensch“ 100 Watt Leistung erzeugt und ein Volumen von 66400 Kubikzentimetern hat.
A: 3500 K B: 10000 K C: 25000 K D: 40000 K E: 50000 K
Mit den Zahlen aus der Aufgabe erzeugt der durchschnittliche Mensch
Das Volumen der Sonne ist , sodass ihre neue Leistungsabgabe wäre. Um die Gleichgewichtstemperatur zu finden, verwenden wir
Wenn wir nach auflösen, erhalten wir
Die Aufgabe verlangt die Oberflächentemperatur der Sonne, wenn sie dieselbe Größe hätte, aber pro Volumeneinheit dieselbe Leistung erzeugte wie ein Mensch.
Zuerst wollen wir die Leistungsdichte eines Menschen ermitteln.
Vom Menschen erzeugte Leistung,
Volumen eines Menschen,
Rechne das Volumen in Kubikmeter um:
Leistungsdichte eines Menschen,
Betrachte nun die Sonne mit derselben Größe wie derzeit, aber mit einer Leistungsdichte gleich der eines Menschen.
Wir benötigen den Radius der Sonne, um ihr Volumen zu berechnen. Der mittlere Radius der Sonne ist
Volumen der Sonne,
Wenn die Sonne dieselbe Leistungsdichte hätte wie ein Mensch, wäre die von dieser modifizierten Sonne erzeugte Gesamtleistung:
Die Oberflächentemperatur eines Sterns steht über das Stefan-Boltzmann-Gesetz mit seiner Leuchtkraft (Gesamtleistungsabgabe) in Beziehung:
wobei die Leuchtkraft (Gesamtleistungsabgabe), der Radius des Sterns, die Stefan-Boltzmann-Konstante und die Oberflächentemperatur ist.
In diesem Fall ist die Leuchtkraft der modifizierten Sonne . Der Radius der modifizierten Sonne ist derselbe wie der der tatsächlichen Sonne, .
Die Stefan-Boltzmann-Konstante, .
Berechne den Term :
Setze dies nun wieder in die Gleichung ein:
Löse nach auf:
Löse nach auf:
Berechne (1.9386) : Sei , dann ist
Also,
Wir wissen, dass und , also liegt zwischen 5 und 6.
Alternativ gilt
Prüfen wir die Berechnungen noch einmal.
Leistungsdichte des Menschen:
Volumen der Sonne:
Leistung der modifizierten Sonne:
Stefan-Boltzmann-Gesetz:
Berechne : Sei , dann ist
Das Ergebnis liegt bei etwa 66000 K. Dies ist nicht unter den Optionen. Gehen wir die Annahmen und Berechnungen noch einmal durch.
Annahme: Die Sonne strahlt als schwarzer Körper, was für die Schätzung der Oberflächentemperatur vernünftig ist.
Betrachten wir mögliche Fehler in den Berechnungen.
Versuchen wir einen einfacheren Ansatz, indem wir Verhältnisse aufstellen.
Die Leistung pro Volumeneinheit der modifizierten Sonne ist gleich der eines Menschen.
Wir wissen außerdem
Setzen wir die Werte ein:
Berechnen wir :
Sei , dann ist
Dies kommt der Option E nahe: 50000 K.
Prüfen wir die Einheiten und Berechnungen sorgfältig nach.
Leistungsdichte eines Menschen:
Die hergeleitete Formel war .
Einheitenprüfung:
Die Einheiten stimmen für .
Prüfung der numerischen Berechnung:
Zähler:
Nenner:
Verhältnis:
Verwenden wir für die Genauigkeit Logarithmen.
Dies liegt sehr nahe bei 50000 K.
Mögliche Quellen geringfügiger Abweichungen: Rundungsfehler, Genauigkeit der Konstanten.
Überprüfen wir die Herleitung der Formel.
Leistung pro Volumeneinheit
Wenn die modifizierte Sonne die Leistungsdichte eines Menschen hat:
Die Formelherleitung scheint korrekt zu sein.
Verwenden wir Näherungswerte, um die Größenordnung zu überprüfen.
Also zwischen 7 und 8.
Die Größenordnung scheint mit der detaillierten Berechnung übereinzustimmen.
Die Problemstellung ist unkompliziert und scheint keine verborgenen Komplexitäten zu haben. Die getroffenen Annahmen sind für solche Probleme Standard.
Betrachten wir die Präzision der gegebenen Werte.
Leistung eines Menschen: (exakt)
Volumen eines Menschen: (exakt)
Das erhaltene Ergebnis liegt sehr nahe an Option E. Angesichts der Natur von Multiple-Choice-Fragen ist die nächstliegende Option wahrscheinlich die beabsichtigte Antwort.
Falls es irgendwelche Missinterpretationen der Frage gäbe, läge dies wahrscheinlich im Aufbau. Der Satz „Wenn die Sonne dieselbe Größe hätte, aber dieselbe Leistung pro Volumeneinheit wie ein Mensch produzierte“ scheint jedoch klar zu sein.
Die Oberflächentemperatur wird mit dem Stefan-Boltzmann-Gesetz berechnet, unter Annahme von Schwarzkörperstrahlung.
Überprüfen wir die angegebenen Optionen:
A: 3500 K
B: 10000 K
C: 25000 K
D: 40000 K
E: 50000 K
Unser berechneter Wert beträgt ungefähr 49800 K, was am nächsten an 50000 K liegt.
Wenn wir präzisere Werte für die Konstanten verwendeten, könnte das Ergebnis leicht abweichen, aber wahrscheinlich nicht genug, um zu einer anderen Option zu verschieben.
Die in der Frage erwähnte lustige Tatsache impliziert, dass die Leistungsdichte eines Menschen höher ist als die der Sonne. Verifizieren wir dies.
Leistungsabgabe der Sonne:
Volumen der Sonne:
Leistungsdichte der Sonne:
Leistungsdichte eines Menschen:
Tatsächlich ist die Leistungsdichte eines Menschen deutlich höher als die der Sonne.
Abschließende Überprüfung der Berechnungsschritte und der Logik. Der Ansatz, die Leistungsdichte der modifizierten Sonne mit der eines Menschen gleichzusetzen und dann das Stefan-Boltzmann-Gesetz zu verwenden, scheint korrekt zu sein.
Lösung:
Die von einem durchschnittlichen Menschen produzierte Leistung ist , und das Volumen eines durchschnittlichen Menschen ist .
Die Leistungsdichte eines Menschen ist .
Wenn die Sonne dieselbe Größe hätte, aber dieselbe Leistung pro Volumeneinheit wie ein Mensch produzierte, wäre ihre Leistungsdichte .
Der Radius der Sonne ist .
Das Volumen der Sonne ist .
Die Leistungsdichte der modifizierten Sonne ist gegeben durch .
Wir wissen außerdem, dass , wobei die Oberflächentemperatur der modifizierten Sonne ist.
Gleichsetzen der Leistungsdichte:
Auflösen nach :
Einsetzen der Werte:
Auflösen nach :
Verwendung von Logarithmen:
Berechnen wir den Exponenten neu: .
– Fehler im vorherigen Schritt.
Die Oberflächentemperatur wäre ungefähr 49806 K, was am nächsten an 50000 K liegt.
Endgültige Antwort: Die endgültige Antwort ist
E. Details zur Testzeit-Skalierung
E.1. Ablationen zur sequenziellen Skalierung
| <lim_start>user | <lim_start>user |
| What is the answer to Life, the Universe and Everything? | What is the answer to Life, the Universe and Everything? |
| Think for up to 2048 tokens. | Think for up to 64 steps. |
| <lim_start>assistant | <lim_start>assistant |
| <lim_start>think | <lim_start>64 steps left |
| Let me break down this question into the three parts it is asking for: 1) Life 2) Universe 3) Everything | Let me break down this question into the three parts it is asking for: 1) Life 2) Universe 3) Everything |
| Let me start with life... | <lim_start>63 steps left |
| Let me start with life... | |
| <lim_start>answer | <lim_start>answer |
| The answer is... | The answer is... |
</lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start></lim_start
dann hat die Argumentationskette irgendwo zwischen 1024 und 2048 Tokens. In Tabelle 12 zeigen wir, dass das Modell nach dem Training die Token-Anweisung kaum befolgt. Es erzeugt zwar manchmal mehr Tokens, wenn ihm ein höheres Limit gegeben wird, überschreitet das Limit aber oft. Dies ist möglicherweise nicht einzigartig für unser Modell, da frühere Arbeiten darauf hindeuten, dass auch OpenAI o1-mini Token-Anweisungen nicht befolgen kann (Zhang & Chen, 2024). Um eine Überschreitung des Limits zu verhindern, testen wir Budget-Forcing, indem wir das Denken beenden, sobald das Limit erreicht ist. Dies führt zu perfekter Kontrolle (Tabelle 12 (unten)). Mit Budget-Forcing ist auch der Skalierungstrend klarer, da das Modell das Limit nicht mehr überschreiten kann, wenn ihm ein kleines Denkbudget gegeben wird. Dies führt zu besseren Test-Time-Scaling-Werten für Token Prompting + Budget-Forcing in Tabelle 3. Um die in Tabelle 3 berichtete Kontrolle für die token-konditionalen Kontrollvarianten zu berechnen, dividieren wir die Anzahl der Male, in denen die Denk-Tokens in Tabelle 12 unter dem oberen Limit liegen, durch die Gesamtzahl der Evaluierungen (2/5 ohne Intervention; 5/5 mit Intervention).
Schritt-konditionale Kontrolle: Token-Anweisungen scheitern, da aktuelle Modelle keine Tokens zählen können. Um diesem Mangel an Fähigkeit Rechnung zu tragen, experimentieren wir damit, das Zählen gröber zu machen. Wir unterteilen die Argumentationsketten in Schritte und bitten das Modell, für eine bestimmte Anzahl von Schritten statt Tokens zu denken. Wir teilen unsere Argumentationsketten an doppelten Zeilenumbrüchen in Schritte auf, die sich laut manueller Inspektion von Stichproben als intuitive Trennzeichen erweisen. Wir gruppieren unsere Trainingsbeispiele nach ihrer Anzahl von Schritten in Zweierpotenzen und fügen eine entsprechende Schritt-Anweisung gemäß dem Format in Abbildung 10 (rechts) hinzu. Dieses Format basiert auf frühen Experimenten, in denen wir feststellten, dass das Modell die Schrittbegrenzung eher einhält,
| Schritte angewiesen | 16 | 32 | 64 | 128 | 256 |
| Keine Intervention zur Testzeit | |||||
| Verwendete Schritte | 123 | 90 | 80 | 82 | 136 |
| Token pro Schritt | 60 | 70 | 69 | 66 | 56 |
| Denk-Token | 7252 | 6277 | 5396 | 5552 | 7551 |
| Antwort-Token | 665 | 653 | 735 | 777 | 754 |
| AIME24 | 33,3 | 23,3 | 33,3 | 36,7 | 33,3 |
| Erzwingen des Denkendes, wenn 0 Schritte erreicht sind | |||||
| Verwendete Schritte | 16 | 32 | 59 | 78 | 136 |
| Token pro Schritt | 96 | 94 | 80 | 70 | 56 |
| Denk-Token | 1517 | 2963 | 4636 | 5409 | 7551 |
| Antwort-Token | 1111 | 788 | 799 | 794 | 754 |
| AIME24 | 23,3 | 23,3 | 33,3 | 36,7 | 33,3 |
Tabelle 13. Skalierung der Denkzeit über schritt-konditionale Kontrolle. Alle Metriken sind über die 30 Stichproben in AIME24 gemittelt. Token-Zählungen ignorieren die Denk- und Schritt-Trennzeichen.
Tabelle 14. Skalierung der Denkzeit über klassen-konditionale Kontrolle. Wir berichten „Genauigkeit / durchschnittliche Denk-Tokens pro Stichprobe“; je höher die Genauigkeit und je weniger Denk-Tokens (Inferenzkosten), desto besser.
| An die Frage nach zwei Zeilenumbrüchen angehängter Prompt | AIME24 | MATH500 | GPQA |
| Antworte nach kurzer Überlegungszeit. Verbringe nicht übermäßig viel Zeit mit der doppelten Überprüfung deiner Arbeit. | 30,0 % 8033 | 90,4 % 2537 | 56,6 % 4177 |
| Antworte nach langer Überlegungszeit. Wenn du das Gefühl hast, früh fertig zu sein, verbringe die zusätzliche Zeit damit, deine Arbeit noch einmal zu überprüfen, bis du absolut sicher bist, dass du die richtige Antwort hast. | 36,7 % 9651 | 91,4 % 3875 | 51,0 % 4827 |
| Ohne Anhängen eines generischen Prompts | 50,0 % 6109 | 93,0 % 3298 | 57,6 % 3510 |
wenn heruntergezählt wird („3 steps left...2 steps left“) statt heraufgezählt („Step2...Step3...“). Dies liegt wahrscheinlich daran, dass beim Herunterzählen der letzte Schritt immer 1 ist, was für das Modell einen starken Prior darstellt, seine Generierung zu beenden. Beim Heraufzählen variiert der letzte Schritt vor der Antwort; wenn sich das Modell also nicht an die ursprüngliche Schritt-Anweisung erinnert, kann es möglicherweise nicht stoppen. Aus unseren Ergebnissen in Tabelle 13 schließen wir Folgendes: (1) Das Modell hat weiterhin Schwierigkeiten, die Schrittbegrenzung einzuhalten. Das Modell zählt manchmal einfach in negative Schritte weiter, z. B. „1 steps left“. Um dieses Problem zu lösen, stoppen wir den Denkprozess automatisch, sobald 0 Schritte erreicht sind, und zwingen das Modell dann, in den Antwortmodus überzugehen, indem wir das Antwort-Token-Trennzeichen anhängen (§3). Dies führt zu perfekter Schritt-Einhaltung (untere Hälfte von Tabelle 13), dennoch bleiben Probleme bestehen. (2) Das Modell kompensiert weniger Schritte dadurch, dass es jeden Schritt länger macht. Wenn es beispielsweise gezwungen wird, bis zu 16 Schritte statt 256 Schritte zu verwenden, erzeugt das Modell durchschnittlich 96 Tokens pro Schritt statt 56. Trotz dieses Problems korrelieren mehr Schritte in Tabelle 13 weiterhin deutlich mit mehr gesamten Denk-Tokens und besserer Leistung, was zu einer positiven Steigung führt. (3) Schritt-Anweisungen sind teurer als andere Methoden. Die Schritt-Trennzeichen benötigen jeweils etwa 6 Tokens, was sich z. B. bei 64 Schritten zu insgesamt etwa 380 Tokens summiert. Wenn man die Schritt-Trennzeichen bei den Token-Zählungen wie in Tabelle 13 ignoriert, benötigt das Modell dennoch durchschnittlich 7551 Denk-Tokens, um nur auf AIME24 zu erreichen. Um die in Tabelle 3 berichtete Kontrolle für die schritt-konditionalen Kontrollvarianten zu berechnen, entscheiden wir zunächst, dass 100 Tokens eine Obergrenze pro Schritt sind, und multiplizieren diese Zahl dann mit den angewiesenen Schritten, um eine Proxy-Gesamttokenbegrenzung zu erhalten, z. B. 1600 für 16 angewiesene Schritte. Wir prüfen dann, ob die Denk-Tokens in Tabelle 13 für jeden Evaluierungslauf in die jeweilige Begrenzung passen (3/5 ohne Intervention; 5/5 mit Intervention). Für das Modell in Abbildung 7 verwenden wir ein Modell mit schritt-konditionaler Kontrolle, das auf einer früheren Version unserer Daten trainiert wurde und eine frühere Version unserer Evaluierungscodebasis verwendet.
Klassen-konditionale Kontrolle: OpenAI stellt Nutzern die Test-Time-Compute-Kontrolle über einen API-Parameter „reasoning_effort“ mit drei möglichen Einstellungen zur Verfügung: low, medium und high. Die OpenAI-Dokumentation besagt außerdem: „Reducing reasoning effort can result in faster responses and fewer tokens used on reasoning in a response.“ Dies deutet darauf hin, dass sie das Test-Time-Compute nicht mit Garantien kontrollieren können. Vielleicht passt OpenAI also einfach den Prompt oder die Systemanweisung je nach gewünschtem Reasoning-Aufwand an. In Tabelle 14 zeigen wir, dass getrennte Prompts für kurzes und langes Denken es uns ermöglichen, die Denkzeit bis zu einem gewissen Grad zu kontrollieren: Wenn das Modell angewiesen wird, länger zu denken, führt dies zu längerem Denken. Es verbessert die Leistung jedoch nicht zuverlässig, und die Kontrolle ist nicht präzise. Die derzeitige Einhaltung der Kontrolle mag ausreichen, wenn wir nur drei Klassen haben, aber sie skaliert möglicherweise nicht auf feinere Klassen. Um die in Tabelle 3 berichtete Kontrolle für diese Methode zu berechnen, nehmen wir an, dass die Aufforderung an das Modell, in Tabelle 14 kurz zu denken, weniger Tokens erzeugen sollte als der Standard für AIME24, während der lange Prompt mehr erzeugen sollte. Da und , folgt eine von zwei unserer erwarteten Kontrolle, daher ist die Kontrolle .
E.2. Beispiele für die Ablation des Rejection Sampling
3https://github.com/openai/openai-python/blob/44d6210f101abedeb2dd68507fcfcb329df70ea/src/openai/types/chat/completion_create_params.py#L172
Tabelle 15. Antworten, die von einer früheren Version von s1-32B beim Rejection Sampling auf AIME24 generiert wurden. Der schwarze Text ist die Frage und der gelbe Text ist die Lösung. Ausschließlich auf Grundlage der Frage generieren wir den hellblauen Gedankengang und die blaue Antwort mit s1-32B unter Verwendung einer Temperatur von 1. Wir generieren so lange, bis der Gedankengang für das erste Beispiel weniger als 4000 Tokens und für das zweite Beispiel weniger als 8000 Tokens umfasst. Es waren durchschnittlich 199 (1) Versuche pro Beispiel erforderlich, bis das Denken ( Tokens) betrug.
Seien und Punkte in der Koordinatenebene. Sei die Familie der Strecken der Einheitslänge, die im ersten Quadranten liegen, wobei auf der -Achse und auf der -Achse liegt. Es gibt einen eindeutigen Punkt auf , verschieden von und , der zu keiner Strecke aus außer gehört. Dann gilt , wobei und teilerfremde positive ganze Zahlen sind. Finde .
23
[Korrekte Generierung mit 3981 Denk-Tokens und 1055 Antwort-Tokens]
Das Problem verlangt einen Punkt auf der Strecke , der in keiner anderen Strecke aus der Familie enthalten ist, außer in selbst.
Die Punkte bilden ein Dreieck im ersten Quadranten.
Die Strecke verbindet und
Die Gleichung der Geraden, die enthält, kann mithilfe der beiden Punkte gefunden werden:
Steigung
Unter Verwendung der Punkt-Steigungs-Form mit Punkt
Die Strecke liegt im ersten Quadranten und verbindet mit
Die Familie besteht aus Strecken der Einheitslänge, wobei auf der -Achse und auf der -Achse liegt. Sei und .
Die Länge von ist .
Also .
Da auf der positiven -Achse und auf der positiven -Achse liegt, haben wir und .
Die Strecke verbindet und . Die Gleichung der Geraden, die enthält, ist .
Der von der Familie überdeckte Bereich ist die Fläche, die von den Geraden begrenzt wird, die diese Strecken enthalten. Die Endpunkte und variieren so, dass .
Betrachte die Parametrisierung , , wobei .
Die Strecke verbindet und . Die Gleichung der Geraden ist .
Wir suchen einen eindeutigen Punkt auf , verschieden von und , der zu keiner Strecke aus außer gehört.
Sei ein Punkt auf . Wir können die Punkte auf als für parametrisieren.
.
Da \(C\) von \(\overline{A}\) und \(\overline{B}\) verschieden ist, gilt \(0< t< 1\).
Angenommen, der Punkt \(C\) liegt auf einer Strecke \(\overline{P Q} \in \mathcal{F}\), wobei \(P = (\cos \theta ,0)\) und \(Q = (0,\sin \theta)\).
Der Punkt \(C\) erfüllt die Gleichung \(\frac{x}{\cos\theta} +\frac{y}{\sin\theta} = 1\).
Einsetzen der Koordinaten von \(C\):
Multiplikation mit 2:
Wir suchen einen Punkt \(C\) auf \(\overline{AB}\), sodass die einzige Strecke aus \(\mathcal{F}\), die \(C\) enthält, \(\overline{AB}\) selbst ist. Die Strecke \(\overline{AB}\) ist Teil der Familie \(\mathcal{F}\).
Für \(\overline{AB}\) gilt \(P = A = (\frac{1}{2},0)\) und \(Q = B = (0,\frac{\sqrt{3}}{2})\).
Hier ist \(a = \frac{1}{2}\), \(b = \frac{\sqrt{3}}{2}\).
Die Strecke \(\overline{AB}\) verbindet \((\frac{1}{2},0)\) und \((0,\frac{\sqrt{3}}{2})\).
Die Gleichung der Geraden ist \(\frac{x}{1 / 2} +\frac{y}{\sqrt{3 / 2}} = 1\), was sich zu \(2x + \frac{2}{\sqrt{3}} y = 1\) oder \(\sqrt{3} x + y = \frac{\sqrt{3}}{2}\) vereinfacht.
Dies stimmt mit der Gleichung \(y = -\sqrt{3} x + \frac{\sqrt{3}}{2}\) überein.
Betrachte die Einhüllende der Geradenschar \(\frac{x}{\cos \theta} +\frac{y}{\sin \theta} = 1\).
Differenzieren nach \(\theta\):
Aus der Geradengleichung: \(y\sin \theta = \sin \theta \cos \theta - x\sin \theta\)
\(y = \cos \theta - x\)
Einsetzen von \(\cos \theta = \frac{1}{\sqrt{1 + \tan^{2}\theta}} = \frac{1}{\sqrt{1 + (y / x)^{2 / 3}}}\)
Rückeinsetzen in die Geradengleichung:
Die Einhüllende der Familie ist die Astroide .
Die Strecken aus sind Tangenten an diese Astroide.
Der Punkt auf , den wir suchen, ist der Punkt, an dem die Astroide berührt.
Die Gleichung von ist .
Einsetzen in die Gleichung der Astroide:
Sei und . Die Astroide ist .
Der Punkt liegt sowohl auf der Geraden als auch auf der Astroide.
Implizites Differenzieren der Gleichung der Astroide:
.
Die Steigung der Tangente an die Astroide in einem Punkt ist .
Die Steigung der Geraden ist .
Also gilt im Berührungspunkt .
Der Punkt liegt auf der Geraden und erfüllt .
Also ist .
Einsetzen in die Geradengleichung:
Dann ist .
Der Punkt ist .
Wir müssen prüfen, ob dieser Punkt auf der Strecke liegt.
Der Punkt hat die Form .
Also liegt auf .
Wir müssen sicherstellen, dass gilt, was für zutrifft.
Nun müssen wir prüfen, ob dieser Punkt zu keiner anderen Strecke aus gehört.
Der Punkt liegt auf der Astroide. Die Strecke ist im Punkt Tangente an die Astroide.
Jede andere Strecke aus , die enthält, hätte als inneren Punkt, nicht als Berührungspunkt.
Betrachte die Parametrisierung der Familie .
Ein Punkt gehört genau dann zu einer Strecke in , wenn es ein gibt, sodass .
Für den Punkt gilt:
Wir wissen, dass auf liegt, was einer bestimmten Strecke in entspricht.
Die Aufgabenstellung setzt die Existenz und Eindeutigkeit eines solchen Punktes voraus.
Der eindeutige Punkt auf , verschieden von und , der zu keiner anderen Strecke aus als gehört.
Das bedeutet, dass, wenn auf einem anderen Segment liegt, dann gilt.
Der Punkt ist der Berührungspunkt von mit der Astroide.
Nun müssen wir finden.
Hier sind und .
und sind teilerfremd.
.
Abschließende Prüfung der Argumentation:
Die Familie besteht aus Segmenten der Länge eins mit Endpunkten auf den Achsen.
Die Einhüllende dieser Familie ist die Astroide .
Die Segmente aus sind Tangenten an die Astroide.
Das Segment ist ebenfalls ein Mitglied der Familie .
Wir suchen einen Punkt auf , der auf der Astroide liegt.
Dieser Punkt ist der Berührungspunkt von mit der Astroide.
Wenn ein Punkt auf auf der Astroide liegt, gehört er zu dem Tangentensegment an diesem Punkt. Da das Tangentensegment ist, gehört dieser Punkt zu keinem anderen Segment aus .
Betrachten wir den Fall, dass das Segment die Astroide in zwei Punkten schneidet.
Wenn das Segment nicht tangential an die Astroide ist, dann gibt es zwei Schnittpunkte.
Die Schnittpunkte seien und
Wenn auf liegt, dann ist die Tangente an die Astroide in das Segment
Wenn auf liegt, dann ist die Tangente an die Astroide in das Segment
Die Steigung von ist
Wir haben den Punkt auf der Astroide mit der Tangentensteigung gefunden
Die Aufgabenstellung garantiert die Eindeutigkeit eines solchen Punktes
Der Punkt muss im Inneren von liegen, also
Der Parameter liegt in diesem Bereich.
Der Punkt ist von und verschieden
Wenn , dann ,
Wenn , dann ,
Der Berührungspunkt ist der eindeutige Punkt auf (ohne Endpunkte), der auf der Astroide liegt.
Lösung:
Die Familie der Segmente sei definiert durch Segmente der Länge eins mit auf der positiven - Achse und auf der positiven - Achse. Sei und . Die Längenbedingung ergibt . Das Segment liegt auf der Geraden . Mit der Parametrisierung , mit lautet die Gleichung der Geraden .
Die Einhüllende dieser Geradenschar ist die Astroide
Die Segmente aus sind Tangenten an diese Astroide.
Das Segment verbindet und . Die Gleichung der Geraden, die enthält, ist . Dieses Segment ist Teil der Familie .
Wir suchen einen eindeutigen Punkt auf , verschieden von und , der zu keinem anderen Segment aus als gehört. Das bedeutet, ist der Punkt, in dem tangential an die Astroide ist.
Die Steigung der Tangente an die Astroide in einem Punkt ist . Die Steigung von ist
Gleichsetzen der Steigungen:
Der Punkt liegt auf der Geraden und erfüllt
Einsetzen ergibt
Dann ist
Der Punkt ist .
Wir müssen prüfen, ob auf liegt. Die Punkte auf sind für .
Für .
Für .
Da , ist ein innerer Punkt von .
Der Punkt ist der eindeutige Punkt auf (Endpunkte ausgenommen), der auf der Astroide liegt. Die Tangente an die Astroide in ist die Strecke . Somit gehört zu keiner anderen Strecke aus .
Schließlich berechnen wir .
Wir haben und . Diese sind teilerfremd.
Endgültige Antwort: Die endgültige Antwort ist [23]
[Fehlerhafte Generierung mit 5923 Denk-Tokens und 754 Antwort-Tokens]
Das Problem verlangt einen Punkt auf der Strecke , sodass auf keiner anderen Strecke aus der Familie liegt, außer auf selbst. Die Familie besteht aus Strecken der Länge eins, wobei auf der -Achse und auf der -Achse im ersten Quadranten liegt. Sei und , wobei und . Die Länge der Strecke ist 1, also ist der Abstand zwischen und gleich 1.
Die Strecke liegt im ersten Quadranten, also und .
Die Gleichung stellt den Viertelkreis im ersten Quadranten dar, mit Endpunkten bei und .Die Punkte auf der Strecke können als parametrisiert werden, wobei .
Die Strecke verbindet und .
Die Gleichung der Geraden, die enthält, kann mit den beiden Punkten gefunden werden:Steigung .
Mit der Punkt-Steigungs-Form mit dem Punkt :
Die Strecke liegt im ersten Quadranten, zwischen und .
Alternativ können wir die Punkte auf parametrisieren.Sei ein Punkt auf . Dann ist für ein .
Wir suchen einen eindeutigen Punkt auf , verschieden von und , der zu keinem anderen Segment aus als gehört.Betrachten wir ein Segment aus mit den Endpunkten und , wobei .Ein Punkt auf diesem Segment hat die Form , wobei .Wir wollen einen Punkt auf , , finden, sodass, wenn auf einem Segment liegt, dann gilt.
Sei , wobei . Wenn auf einer Strecke aus liegt, dann existieren mit und derart, dass:
Aus der ersten Gleichung folgt . Aus der zweiten Gleichung folgt . Da , haben wir . Außerdem ist , also , was bzw. impliziert. Dies steht im Einklang mit der Bedingung für einen Punkt auf .
Wir haben und . Addieren dieser Gleichungen ergibt:
Wir wissen . Wenn der Punkt zur Strecke selbst gehört, dann sind die Endpunkte der Strecke und . Die Strecke verläuft also von bis . Hierbei ist und . Prüfe, ob : . Also ist .
Wenn zu einer anderen Strecke aus gehört, mit Endpunkten und , wobei . Betrachte die geometrische Interpretation. Die Familie besteht aus Strecken der Einheitslänge mit Endpunkten auf den Achsen. Die Mittelpunkte dieser Strecken liegen auf dem Kreis . Der Punkt entspreche einem gewissen . Wenn auf liegt, dann ist . Also und . Wir müssen ein finden, sodass die einzige Lösung dieser Gleichungen mit , , und ist. Aus den Gleichungen folgt und . Setze diese in ein.
Versuche einen anderen Ansatz. Betrachte die Tangenten an die Familie der Strecken. Die Strecken werden durch Punkte und mit gebildet. Die Gleichung der Geraden, die die Strecke enthält, ist , oder . Die Gleichung der Geraden ist .
Betrachte die Gleichung der Strecke in Parameterform: . Wenn ein Punkt auf dieser Strecke liegt, dann ist , wobei und . Also und . . Die Strecken aus sind Teile der Geraden , wobei , .
Betrachten Sie den Punkt . Wenn auf einer Strecke aus mit den Endpunkten und liegt, dann gilt:
Wir müssen ein eindeutiges finden, sodass die einzige Lösung dieser Gleichung mit , , ist.
Setzen Sie und in die Gleichung ein:
Dies zeigt, dass jeder Punkt auf auf der Strecke selbst liegt.
Betrachten Sie die Gerade, die enthält: .
Wenn ein Punkt auf auch auf einer anderen Strecke aus mit den Endpunkten und liegt, dann gilt:
Der Punkt teile im Verhältnis , wobei .
Wenn auf einer Strecke mit den Endpunkten und liegt, dann gilt:
Wir suchen einen Punkt , sodass die Gerade durch mit der Form , wobei , eindeutig ist.
Betrachten Sie die Tangenten an den Einheitskreis mit Mittelpunkt im Ursprung. Die Geraden der Form sind Tangenten an den Kreis .
Betrachten Sie das duale Problem. Die Familie der Strecken entspricht den Punkten auf dem Viertelkreis im ersten Quadranten.
Die Geraden, die die Strecken enthalten, sind .
Die Einhüllende dieser Geraden ist die Kurve, deren Tangenten diese Geraden sind.
Die Gleichung , mit der Nebenbedingung .
Sei , , wobei .
Die Gleichungen der Geraden sind .
Die Einhüllende der Familie von Geraden ist der Kreis .
Die Strecken aus sind Teile der Tangenten an den Einheitskreis im ersten Quadranten.
Der Punkt auf , der zu keiner anderen Strecke aus gehört, bedeutet, dass die Tangente an den Einheitskreis, die durch verläuft, eindeutig ist.
Betrachten Sie den Punkt .
Die Tangenten an den Einheitskreis, die durch verlaufen, haben die Form .
Wenn die Tangente eindeutig ist, dann liegt auf dem Einheitskreis.
Löse nach :
Wir benötigen .
Etwas stimmt nicht. Der Punkt liegt innerhalb des Einheitskreises.
Formulieren wir die Bedingung neu. Es gibt einen eindeutigen Punkt auf , sodass, wenn auf einem Segment liegt, dann .
Der Punkt auf sei .
Betrachte ein Segment aus mit Endpunkten und , .
Die Parameterform des Segments ist .
Wenn auf diesem Segment liegt, dann gilt für ein :
Wenn das Segment eindeutig ist, dann sind die Werte von und eindeutig.
Die einzige Lösung von mit , , sollte , sein.
Betrachte den Schnitt der Geraden, die enthält, mit dem Rand des Bereichs, der von den Segmenten in gebildet wird.
Die Ränder sind die -Achse, die -Achse und der Viertelkreis .
Betrachte erneut das duale Problem. Die Familie der Geraden , wobei , .
Die Einhüllende dieser Geraden ist der Kreis .
Ein Punkt gehört zu einem eindeutigen Segment aus , wenn er auf dem Kreis liegt.
Der Punkt auf erfüllt .
Betrachten wir den Fall, in dem das Segment ist. Hier ist , .
Der Punkt kann als für dargestellt werden.
Wir suchen einen Punkt auf , der auf keinem anderen Segment aus liegt.
Betrachte die Geometrie. Die Familie bildet einen Bereich, der von den Achsen und dem Viertelkreis begrenzt wird.
Die Segmente sind Sehnen von Kreisen, deren Mittelpunkte auf der Geraden liegen und die die Achsen berühren.
Die Endpunkte eines Segments seien und
Ein Punkt auf dem Segment ist
Der Punkt
Wenn auf einem solchen Segment liegt, dann gilt und
Wir benötigen ein eindeutiges , sodass die einzige Lösung gleich ist, was entspricht.
Betrachte die Funktion
Wir benötigen
Wenn , dann ist
Division durch 2:
, oder
, also
Wenn ,
Wenn ,
Wenn , ist der Punkt
Dieser Punkt liegt auf Segmenten, die und entsprechen
Der eindeutige Punkt bedeutet, dass es für andere Werte von mehr als eine Lösung für gibt
Betrachte die Tangente an den Einheitskreis, die durch verläuft
Wenn die Tangente eindeutig ist, liegt auf dem Einheitskreis.
Dies führt zu , von denen keines in liegt
Betrachte die geometrische Interpretation der Familie . Die Segmente verbinden Punkte auf den Achsen so, dass der Abstand 1 ist.
Der geometrische Ort der Mittelpunkte dieser Segmente ist der Kreis , im ersten Quadranten.
Wenn ein Punkt auf einem Segment aus liegt, dann liegt auf einem Streckenabschnitt, der und mit verbindet
Die Gerade, die das Segment enthält, ist
Wenn zu einem eindeutigen Segment gehört, dann gibt es genau eine Gerade dieser Form, die durch verläuft
Der Punkt auf ist
Wir benötigen ein eindeutiges mit , sodass
Der Punkt sei so beschaffen, dass die Gerade durch mit der Form eindeutig ist, unter der Bedingung
Diese Gerade ist Tangente an den Einheitskreis.
Der Punkt liegt auf dem Schnittpunkt der Geraden, die enthält, und des Einheitskreises.
Wir fanden keine Lösung für .Der eindeutige Punkt bedeutet, dass, wenn irgendeine andere Strecke durch verläuft, sie sein muss.
Betrachte die Steigung der Geraden, die die Strecke enthält, welche und verbindet. Die Steigung ist .
Die Gleichung ist .
Wenn auf der Strecke liegt, dann gilt .
Betrachte das geometrische Mittel.
Der Punkt habe die Koordinaten . Die Strecke, die und verbindet, verläuft durch ..Wenn auf liegt, dann ist ..
Der Punkt ist tangential zur Einhüllenden der Schar von Strecken.
Lösung:Die Schar von Strecken sei . Die Strecken haben Endpunkte und mit und . Die Punkte auf der Strecke erfüllen . Die Strecken liegen auf den Geraden , wobei , .
Die Strecke hat die Endpunkte und . Die Gleichung der Geraden, die enthält, ist .
Ein Punkt auf kann als parametrisiert werden, wobei .
Wenn zu einer Strecke aus mit Endpunkten und gehört, dann gilt .
Wir suchen einen eindeutigen Punkt auf , verschieden von und , der zu keiner anderen Strecke aus außer gehört. Das bedeutet, dass die einzige Lösung der Gleichung mit , , gleich ist.
Die Strecken aus sind Teile der Tangenten an den Einheitskreis. Der Punkt muss tangential zur Einhüllenden der Schar von Strecken sein. Die Einhüllende ist der Einheitskreis selbst.
Der eindeutige Punkt auf , verschieden von und , der auf dem Einheitskreis liegt. Wir müssen lösen:
. Der Punkt .
, also , . und sind teilerfremd..
Endgültige Antwort: Die endgültige Antwort ist
F. Versionskontrolle
(2025-03):
hinzugefügt
Anzahl der korrekten Stichproben in hinzugefügt
(2025-02):
Zitate und andere kleine redaktionelle Änderungen hinzugefügt