
Ein Agent vergisst zwischen Sitzungen alles. A-Mem hält Erinnerungen als verknüpfte Notizen, die sich selbst umschreiben. NeurIPS 2025, kostenlos lesen.
A-Mem: Agentic Memory for LLM Agents
A-Mem: Agentisches Gedächtnis für LLM-Agenten
Wujiang , Zujie Liang , Kai Mei , Hang Gao , Juntao Tan , Yongfeng Zhang Rutgers University Unabhängiger Forscher AIOS Foundation wujiang.xu@rutgers.edu
Zusammenfassung
Während Large-Language-Model-(LLM-)Agenten externe Werkzeuge für komplexe Aufgaben aus der realen Welt effektiv nutzen können, benötigen sie Gedächtnissysteme, um auf historische Erfahrungen zurückzugreifen. Aktuelle Gedächtnissysteme ermöglichen grundlegende Speicherung und Abruf, es fehlt ihnen jedoch an ausgefeilter Gedächtnisorganisation, trotz jüngster Versuche, Graphdatenbanken einzubeziehen. Darüber hinaus begrenzen die festen Operationen und Strukturen dieser Systeme ihre Anpassungsfähigkeit über verschiedene Aufgaben hinweg. Um diese Einschränkung zu adressieren, schlägt dieses Papier ein neuartiges agentisches Gedächtnissystem für LLM-Agenten vor, das Erinnerungen auf agentische Weise dynamisch organisieren kann. Nach den Grundprinzipien der Zettelkasten-Methode haben wir unser Gedächtnissystem so gestaltet, dass es durch dynamische Indexierung und Verknüpfung miteinander verbundene Wissensnetzwerke erzeugt. Wenn eine neue Erinnerung hinzugefügt wird, generieren wir eine umfassende Notiz, die mehrere strukturierte Attribute enthält, darunter kontextuelle Beschreibungen, Schlüsselwörter und Tags. Das System analysiert dann historische Erinnerungen, um relevante Verbindungen zu identifizieren, und stellt Verknüpfungen her, wo bedeutsame Ähnlichkeiten bestehen. Darüber hinaus ermöglicht dieser Prozess die Gedächtnisevolution – während neue Erinnerungen integriert werden, können sie Aktualisierungen der kontextuellen Repräsentationen und Attribute bestehender historischer Erinnerungen auslösen, sodass das Gedächtnisnetzwerk sein Verständnis kontinuierlich verfeinern kann. Unser Ansatz kombiniert die strukturierten Organisationsprinzipien des Zettelkastens mit der Flexibilität agentengesteuerter Entscheidungsfindung und ermöglicht so ein anpassungsfähigeres und kontextbewussteres Gedächtnismanagement. Empirische Experimente an sechs Grundmodellen zeigen überlegene Verbesserungen gegenüber bestehenden SOTA-Baselines.
Code für die Benchmark-Evaluierung: https://github.com/WujiangXu/AgenticMemory Code für produktionsreifes agentisches Gedächtnis: https://github.com/WujiangXu/A- mem- sys
1 Einleitung
Large-Language-Model-(LLM-)Agenten haben bemerkenswerte Fähigkeiten in verschiedenen Aufgaben gezeigt, wobei jüngste Fortschritte es ihnen ermöglichen, mit Umgebungen zu interagieren, Aufgaben auszuführen und autonom Entscheidungen zu treffen [23, 33, 7]. Sie integrieren LLMs mit externen Werkzeugen und sorgfältig gestalteten Arbeitsabläufen, um ihre Argumentations- und Planungsfähigkeiten zu verbessern. Obwohl LLM-Agenten eine starke Argumentationsleistung aufweisen, benötigen sie dennoch ein Gedächtnissystem, um eine langfristige Interaktionsfähigkeit mit der externen Umgebung bereitzustellen [35].
Bestehende Gedächtnissysteme [25, 39, 28, 21] für LLM-Agenten bieten grundlegende Funktionalität zur Gedächtnisspeicherung. Diese Systeme erfordern, dass Agentenentwickler Gedächtnisspeicherstrukturen vordefinieren, Speicherpunkte innerhalb des Arbeitsablaufs festlegen und den Abrufzeitpunkt bestimmen. Um gleichzeitig die strukturierte Gedächtnisorganisation zu verbessern, integriert Mem0 [8] nach den Prinzipien von RAG [9, 18, 30] Graphdatenbanken in die Speicher- und Abrufprozesse. Während Graphdatenbanken eine strukturierte Organisation für Gedächtnissysteme bieten, schränkt ihre Abhängigkeit von vordefinierten Schemata und Beziehungen ihre Anpassungsfähigkeit grundlegend ein. Diese Einschränkung zeigt sich deutlich in praktischen Szenarien – wenn ein Agent eine neuartige mathematische Lösung erlernt, können aktuelle Systeme diese Information nur innerhalb ihres vorgegebenen Rahmens kategorisieren und verknüpfen
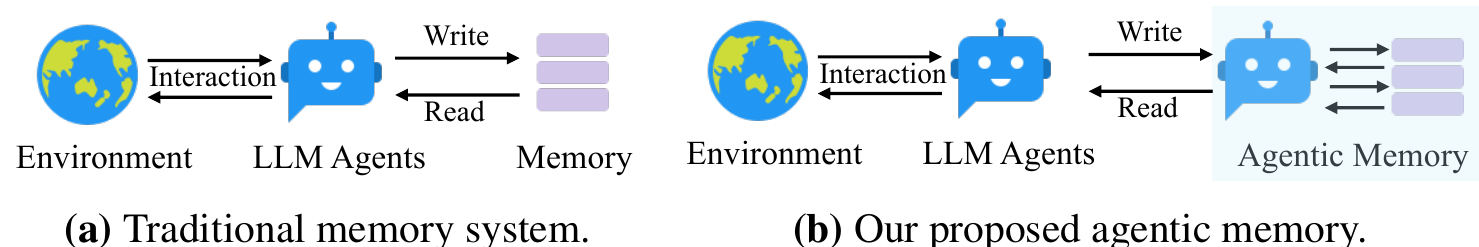
und sind nicht in der Lage, innovative Verbindungen herzustellen oder neue Organisationsmuster zu entwickeln, während sich das Wissen weiterentwickelt. Solche starren Strukturen, zusammen mit festen Agenten-Arbeitsabläufen, schränken die Fähigkeit dieser Systeme, über neue Umgebungen hinweg zu generalisieren und in langfristigen Interaktionen effektiv zu bleiben, stark ein. Die Herausforderung wird zunehmend kritisch, da LLM-Agenten komplexere, offene Aufgaben bewältigen, bei denen flexible Wissensorganisation und kontinuierliche Anpassung wesentlich sind. Daher bleibt die Frage, wie ein flexibles und universelles Gedächtnissystem zu gestalten ist, das die langfristigen Interaktionen von LLM-Agenten unterstützt, eine entscheidende Herausforderung.
In diesem Papier führen wir ein neuartiges agentisches Gedächtnissystem namens A- MEM für LLM-Agenten ein, das eine dynamische Gedächtnisstrukturierung ermöglicht, ohne auf statische, vorbestimmte Gedächtnisoperationen angewiesen zu sein. Unser Ansatz lässt sich von der Zettelkasten-Methode [15, 1] inspirieren, einem hochentwickelten Wissensmanagementsystem, das durch atomare Notizen und flexible Verknüpfungsmechanismen miteinander verbundene Informationsnetzwerke erzeugt. Unser System führt eine agentische Gedächtnisarchitektur ein, die ein autonomes und flexibles Gedächtnismanagement für LLM-Agenten ermöglicht. Für jede neue Erinnerung konstruieren wir umfassende Notizen, die mehrere Repräsentationen integrieren: strukturierte textuelle Attribute, die mehrere Attribute und Einbettungsvektoren für die Ähnlichkeitsabgleichung umfassen. Anschließend analysiert A- MEM das historische Gedächtnisrepositorium, um auf Grundlage semantischer Ähnlichkeiten und gemeinsamer Attribute bedeutungsvolle Verbindungen herzustellen. Dieser Integrationsprozess erzeugt nicht nur neue Verknüpfungen, sondern ermöglicht auch eine dynamische Evolution: Wenn neue Erinnerungen aufgenommen werden, können sie Aktualisierungen der kontextuellen Repräsentationen bestehender Erinnerungen auslösen, sodass das gesamte Gedächtnis sein Verständnis im Laufe der Zeit kontinuierlich verfeinern und vertiefen kann. Die Beiträge lassen sich wie folgt zusammenfassen:
- Wir präsentieren A-MEM, ein agentisches Gedächtnissystem für LLM-Agenten, das die autonome Generierung kontextueller Beschreibungen, die dynamische Herstellung von Gedächtnisverbindungen und die intelligente Evolution bestehender Erinnerungen auf Grundlage neuer Erfahrungen ermöglicht. Dieses System stattet LLM-Agenten mit langfristigen Interaktionsfähigkeiten aus, ohne vorbestimmte Gedächtnisoperationen zu erfordern.
- Wir entwerfen einen agentischen Gedächtnisaktualisierungsmechanismus, bei dem neue Erinnerungen automatisch zwei Schlüsseloperationen auslösen: Verknüpfungsgenerierung und Gedächtnisevolution. Die Verknüpfungsgenerierung stellt automatisch Verbindungen zwischen Erinnerungen her, indem sie gemeinsame Attribute und ähnliche kontextuelle Beschreibungen identifiziert. Die Gedächtnisevolution ermöglicht es bestehenden Erinnerungen, sich dynamisch anzupassen, während neue Erfahrungen analysiert werden, was zum Entstehen übergeordneter Muster und Attribute führt.
- Wir führen umfassende Evaluierungen unseres Systems mit einem langfristigen Konversationsdatensatz durch, vergleichen die Leistung über sechs Grundmodelle hinweg anhand von sechs unterschiedlichen Evaluierungsmetriken und zeigen signifikante Verbesserungen. Darüber hinaus stellen wir T-SNE-Visualisierungen bereit, um die strukturierte Organisation unseres agentischen Gedächtnissystems zu veranschaulichen.
2 Verwandte Arbeiten
2.1 Gedächtnis für LLM-Agenten
Frühere Arbeiten zu Gedächtnissystemen für LLM-Agenten haben verschiedene Mechanismen für Gedächtnismanagement und -nutzung untersucht [23, 21, 8, 39]. Einige Ansätze realisieren eine Interaktionsspeicherung, die umfassende historische Aufzeichnungen durch dichte Retrieval-Modelle [39] oder Lese-Schreib-Gedächtnisstrukturen [24] verwaltet. Darüber hinaus nutzt MemGPT [25] cacheähnliche Architekturen, um aktuelle Informationen zu priorisieren. In ähnlicher Weise schlägt SCM [32] ein Selbstkontrolliertes Gedächtnis-Framework (Self-Controlled Memory) vor, das die Fähigkeit von LLMs verbessert, langfristiges Gedächtnis durch einen Gedächtnisstrom und einen Controllermechanismus aufrechtzuerhalten. Diese Ansätze weisen jedoch erhebliche Einschränkungen bei der Bewältigung vielfältiger realer Aufgaben auf. Während sie grundlegende Gedächtnisfunktionalität bereitstellen können, sind ihre Operationen typischerweise durch vordefinierte Strukturen und feste Arbeitsabläufe eingeschränkt. Diese Einschränkungen rühren von ihrer Abhängigkeit von starren Operations
mustern her, insbesondere bei Gedächtnisschreib- und Abrufprozessen. Diese Unflexibilität führt zu schlechter Generalisierung in neuen Umgebungen und begrenzter Effektivität in langfristigen Interaktionen. Daher bleibt die Gestaltung eines flexiblen und universellen Gedächtnissystems, das die langfristigen Interaktionen von Agenten unterstützt, eine entscheidende Herausforderung.
2.2 Retrieval-Augmented Generation
Retrieval-Augmented Generation (RAG) hat sich als leistungsfähiger Ansatz zur Verbesserung von LLMs durch die Einbeziehung externer Wissensquellen herausgebildet [18, 6, 10]. Der Standard-RAG-Prozess [37, 34] umfasst die Indexierung von Dokumenten in Chunks, den Abruf relevanter Chunks auf Grundlage semantischer Ähnlichkeit und die Anreicherung des LLM-Prompts mit diesem abgerufenen Kontext für die Generierung. Fortgeschrittene RAG-Systeme [20, 12] haben sich weiterentwickelt und umfassen ausgefeilte Optimierungen vor und nach dem Abruf. Aufbauend auf diesen Grundlagen haben jüngste Forschungsarbeiten agentische RAG-Systeme eingeführt, die autonomere und anpassungsfähigere Verhaltensweisen im Abrufprozess zeigen. Diese Systeme können dynamisch bestimmen, wann und was abgerufen werden soll [4, 14], hypothetische Antworten generieren, um den Abruf zu leiten, und ihre Suchstrategien auf Grundlage von Zwischenergebnissen iterativ verfeinern [31, 29].
Während jedoch agentische RAG-Ansätze in der Abrufphase Handlungsfähigkeit zeigen, indem sie autonom entscheiden, wann und was abgerufen wird [4, 14, 38], weist unser agentisches Gedächtnissystem Handlungsfähigkeit auf einer grundlegenderen Ebene durch die autonome Evolution seiner Gedächtnisstruktur auf. Inspiriert von der Zettelkasten-Methode ermöglicht unser System Erinnerungen, aktiv ihre eigenen kontextuellen Beschreibungen zu generieren, bedeutungsvolle Verbindungen mit verwandten Erinnerungen zu bilden und sowohl ihren Inhalt als auch ihre Beziehungen weiterzuentwickeln, während neue Erfahrungen entstehen. Diese grundlegende Unterscheidung in der Handlungsfähigkeit zwischen Abruf einerseits sowie Speicherung und Evolution andererseits unterscheidet unseren Ansatz von agentischen RAG-Systemen, die trotz ihrer ausgefeilten Abrufmechanismen statische Wissensbasen beibehalten.
3 Methodik
Unser vorgeschlagenes agentisches Gedächtnissystem lässt sich von der Zettelkasten-Methode inspirieren und implementiert ein dynamisches und selbstentwickelndes Gedächtnissystem, das es LLM-Agenten ermöglicht, ein langfristiges Gedächtnis ohne vorbestimmte Operationen aufrechtzuerhalten. Das Design des Systems betont atomare Notiznahme, flexible Verknüpfungsmechanismen und die kontinuierliche Evolution von Wissensstrukturen.
3.1 Notizkonstruktion
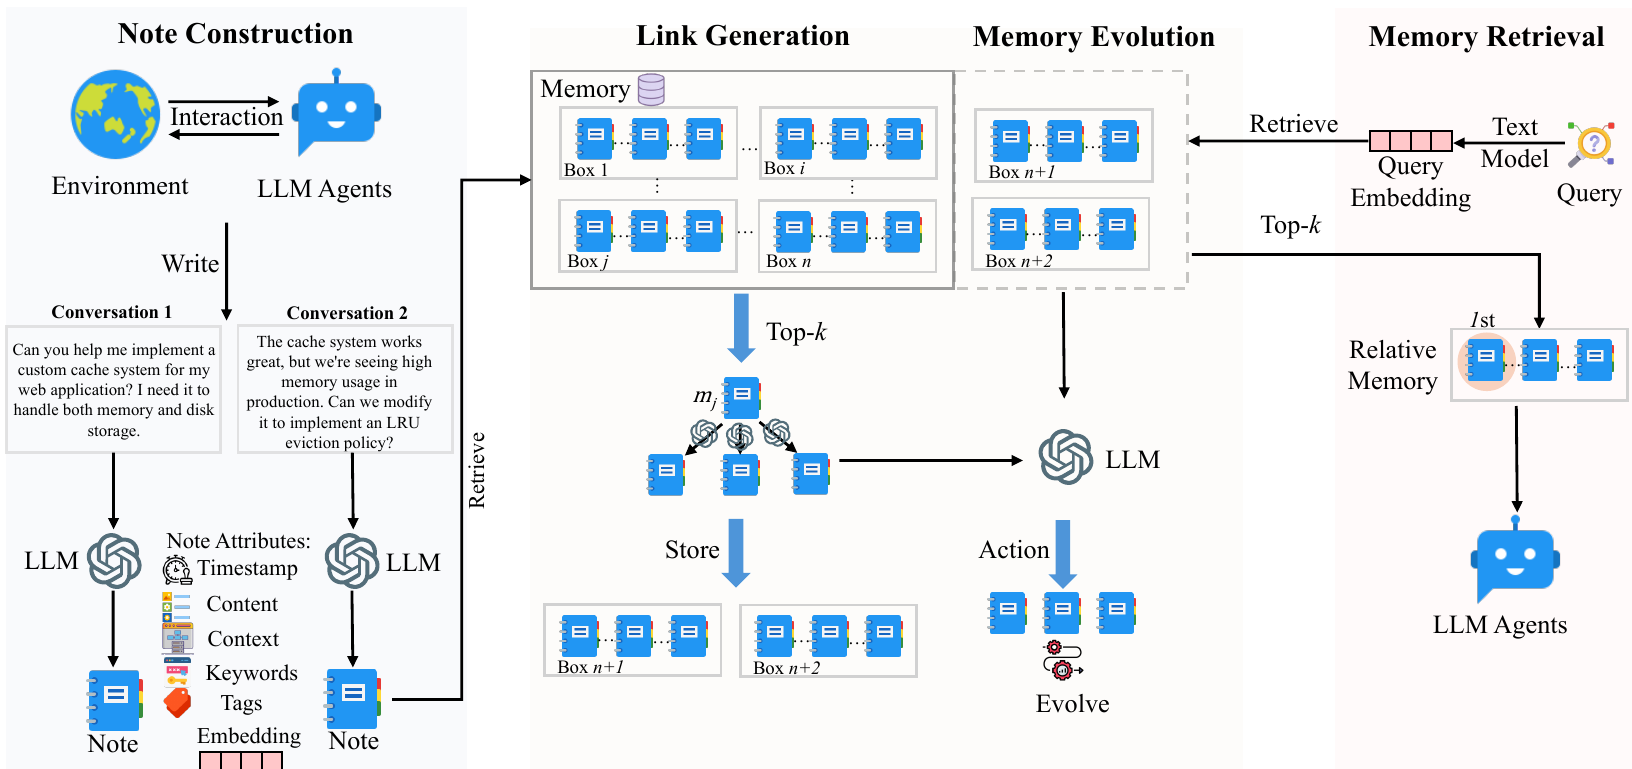
Aufbauend auf den Prinzipien der atomaren Notiznahme und flexiblen Organisation der Zettelkasten-Methode führen wir einen LLM-gesteuerten Ansatz zur Konstruktion von Gedächtnisnotizen ein. Wenn ein Agent mit seiner Umgebung interagiert, konstruieren wir strukturierte Gedächtnisnotizen, die sowohl explizite Informationen als auch vom LLM generiertes kontextuelles Verständnis erfassen. Jede Gedächtnisnotiz in unserer Sammlung wird dargestellt als:
wobei \(c_{i}\) den ursprünglichen Interaktionsinhalt repräsentiert, \(t_{i}\) der Zeitstempel der Interaktion ist, \(K_{i}\) vom LLM generierte Schlüsselwörter bezeichnet, die Schlüsselkonzepte erfassen, \(G_{i}\) vom LLM generierte Tags zur Kategorisierung enthält, \(X_{i}\) die vom LLM generierte kontextuelle Beschreibung repräsentiert, die ein reichhaltiges semantisches Verständnis ermöglicht, und \(L_{i}\) die Menge der verknüpften Erinnerungen verwaltet, die semantische Beziehungen teilen. Um jede Gedächtnisnotiz mit bedeutungsvollem Kontext über ihren grundlegenden Inhalt und Zeitstempel hinaus anzureichern, nutzen wir ein LLM, um die Interaktion zu analysieren und diese semantischen Komponenten zu generieren. Der Prozess der Notizkonstruktion umfasst das Prompting des LLM mit sorgfältig gestalteten Vorlagen \(P_{s1}\):
Dem Zettelkasten-Prinzip der Atomizität folgend, erfasst jede Notiz eine einzelne, in sich geschlossene Wissenseinheit. Um effizientes Abrufen und Verknüpfen zu ermöglichen, berechnen wir eine dichte Vektorrepräsentation über einen Text-Encoder [27], der alle textuellen Komponenten der Notiz umfasst:
Durch die Verwendung von LLMs zur Generierung angereicherter Komponenten ermöglichen wir die autonome Extraktion impliziten Wissens aus Rohinteraktionen. Die vielschichtige Notizstruktur \((K_{i},G_{i},X_{i})\) schafft reichhaltige Repräsentationen, die verschiedene Aspekte der Erinnerung erfassen und eine differenzierte Organisation und Abfrage erleichtern. Darüber hinaus bietet die Kombination der vom LLM generierten semantischen Komponenten mit dichten Vektorrepräsentationen sowohl Kontext als auch rechnereffizientes Ähnlichkeitsmatching.
3.2 Link-Generierung
Unser System implementiert einen autonomen Link-Generierungsmechanismus, der es neuen Gedächtnisnotizen ermöglicht, ohne vordefinierte Regeln bedeutungsvolle Verbindungen zu bilden. Wenn die konstruierte Gedächtnisnotiz \(m_{n}\) zum System hinzugefügt wird, nutzen wir zunächst ihre semantische Einbettung für ähnlichkeitsbasiertes Abrufen. Für jede bestehende Gedächtnisnotiz \(m_{j}\in \mathcal{M}\) berechnen wir einen Ähnlichkeitswert:
Das System identifiziert dann die \(k\) relevantesten Erinnerungen:
Basierend auf diesen Kandidaten nächster Erinnerungen fordern wir das LLM auf, potenzielle Verbindungen anhand ihrer möglichen gemeinsamen Attribute zu analysieren. Formal aktualisiert sich die Link-Menge der Erinnerung \(m_{n}\) wie folgt:
Jeder generierte Link ist wie folgt strukturiert: . Durch die Verwendung von einbettungsbasiertem Retrieval als anfänglichem Filter ermöglichen wir effiziente Skalierbarkeit bei gleichzeitiger Wahrung semantischer Relevanz. A-MEM kann potenzielle Verbindungen selbst in großen Gedächtnissammlungen schnell identifizieren, ohne einen erschöpfenden Vergleich durchführen zu müssen. Noch wichtiger ist, dass die LLM-gesteuerte Analyse ein nuanciertes Verständnis von Beziehungen ermöglicht, das über einfache Ähnlichkeitsmetriken hinausgeht. Das Sprachmodell kann subtile Muster, kausale Beziehungen und konzeptuelle Verbindungen identifizieren, die allein aus der Einbettungsähnlichkeit möglicherweise nicht ersichtlich wären. Wir implementieren das Zettelkasten-Prinzip der flexiblen Verknüpfung und nutzen dabei moderne Sprachmodelle. Das resultierende Netzwerk entsteht organisch aus dem Gedächtnisinhalt und dem Kontext und ermöglicht eine natürliche Wissensorganisation.
3.3 Gedächtnisevolution
Nachdem Links für das neue Gedächtnis erstellt wurden, entwickelt A-MEM die abgerufenen Gedächtnisse basierend auf ihren textlichen Informationen und ihren Beziehungen zum neuen Gedächtnis weiter. Für jedes Gedächtnis in der Menge der nächsten Nachbarn bestimmt das System, ob dessen Kontext, Schlüsselwörter und Tags aktualisiert werden sollen. Dieser Evolutionsprozess lässt sich formal wie folgt ausdrücken:
Das weiterentwickelte Gedächtnis ersetzt dann das ursprüngliche Gedächtnis in der Gedächtnismenge . Dieser evolutionäre Ansatz ermöglicht kontinuierliche Aktualisierungen und neue Verbindungen und ahmt menschliche Lernprozesse nach. Während das System im Laufe der Zeit mehr Gedächtnisse verarbeitet, entwickelt es zunehmend ausgefeiltere Wissensstrukturen und entdeckt Muster und Konzepte höherer Ordnung über mehrere Gedächtnisse hinweg. Dies schafft eine Grundlage für autonomes Gedächtnislernen, bei dem die Wissensorganisation durch die fortlaufende Interaktion zwischen neuen Erfahrungen und bestehenden Gedächtnissen zunehmend reicher wird.
3.4 Abruf relevanter Gedächtnisse
In jeder Interaktion führt unser A-MEM einen kontextbewussten Gedächtnisabruf durch, um dem Agenten relevante historische Informationen bereitzustellen. Gegeben einen Abfragetext \(q\) aus der aktuellen Interaktion, berechnen wir zunächst seine dichte Vektordarstellung unter Verwendung desselben Textencoders, der für die Gedächtnisnotizen verwendet wird:
Das System berechnet dann Ähnlichkeitswerte zwischen der Abfrage-Einbettung und allen vorhandenen Gedächtnisnotizen in \(\mathcal{M}\) mittels Kosinusähnlichkeit:
Anschließend rufen wir die k relevantesten Gedächtnisse aus dem historischen Gedächtnisspeicher ab, um einen kontextuell angemessenen Prompt zu konstruieren.
Diese abgerufenen Gedächtnisse liefern relevanten historischen Kontext, der dem Agenten hilft, die aktuelle Interaktion besser zu verstehen und darauf zu reagieren. Der abgerufene Kontext bereichert den Schlussfolgerungsprozess des Agenten, indem er die aktuelle Interaktion mit verwandten vergangenen Erfahrungen verbindet, die im Gedächtnissystem gespeichert sind.
4 Experiment
4.1 Datensatz und Evaluation
Um die Wirksamkeit instruktionsbewusster Empfehlung in langfristigen Konversationen zu evaluieren, verwenden wir den LoCoMo-Datensatz [22], der im Vergleich zu bestehenden Konversationsdatensätzen [36, 13] deutlich längere Dialoge enthält. Während frühere Datensätze Dialoge mit etwa 1K Tokens über 4–5 Sitzungen enthalten, weist LoCoMo viel längere Konversationen mit durchschnittlich 9K Tokens auf, die bis zu 35 Sitzungen umfassen, was ihn besonders geeignet macht, um die Fähigkeit von Modellen zu bewerten, weitreichende Abhängigkeiten zu handhaben und Konsistenz über längere Konversationen hinweg aufrechtzuerhalten. Der LoCoMo-Datensatz umfasst vielfältige Fragetypen, die darauf ausgelegt sind, verschiedene Aspekte des Modellverständnisses umfassend zu evaluieren: (1) Single-Hop-Fragen, die aus einer einzigen Sitzung beantwortbar sind; (2) Multi-Hop-Fragen, die eine Informationssynthese über Sitzungen hinweg erfordern; (3) Fragen zum temporalen Schlussfolgern, die das Verständnis zeitbezogener Informationen testen; (4) Fragen zu offenem Domänenwissen, die die Integration von Konversationskontext mit externem Wissen erfordern; und (5) adversariale Fragen, die die Fähigkeit von Modellen bewerten, nicht beantwortbare Anfragen zu erkennen. Insgesamt enthält LoCoMo 7.512 Frage-Antwort-Paare über diese Kategorien hinweg. Darüber hinaus verwenden wir einen neuen Datensatz namens DialSim [16], um die Wirksamkeit unseres Gedächtnissystems zu evaluieren. Es handelt sich um einen Frage-Antwort-Datensatz, der aus langfristigen Mehrparteien-Dialogen abgeleitet ist. Der Datensatz stammt aus beliebten Fernsehserien (Friends, The Big Bang Theory und The Office), umfasst 1.300 Sitzungen über fünf Jahre, enthält etwa 350.000 Tokens und beinhaltet mehr als 1.000 Fragen pro Sitzung aus verfeinerten Fragen von Fan-Quiz-Websites sowie komplexe Fragen, die aus temporalen Wissensgraphen generiert wurden.
Für Vergleichsbaselines vergleichen wir mit LoCoMo [22], ReadAgent [17], MemoryBank [39] und MemGPT [25]. Eine detaillierte Einführung der Baselines findet sich in Anhang A.1. Für die Evaluation verwenden wir zwei primäre Metriken: den F1-Score zur Bewertung der Antwortgenauigkeit durch Abwägung von Precision und Recall sowie BLEU-1 [26] zur Bewertung der Qualität generierter Antworten durch Messung der Wortüberlappung
| Modell | Methode | Kategorie | Durchschnitt | ||||||||||
| Multi Hop F1 | BLEU | Temporal F1 | Open Domain F1 | Single Hop F1 | BLEU | Adversial F1 | BLEU | Ranking F1 | BLEU | Token-Länge | |||
| GPT | LoCoMo | 25,02 | 19,75 | 18,41 | 14,77 | 12,04 | 11,16 | 40,36 | 29,05 | 69,23 | 68,75 | 2,4 | 2,4 |
| READAGENT | 9,15 | 6,48 | 12,60 | 8,87 | 5,31 | 5,12 | 9,67 | 7,66 | 9,81 | 9,02 | 4,2 | 4,2 | |
| MEMORYBANK | 5,00 | 4,77 | 9,68 | 6,99 | 5,56 | 5,94 | 6,61 | 5,16 | 7,36 | 6,48 | 4,8 | 4,8 | |
| MEMGPT | 26,65 | 17,72 | 25,52 | 19,44 | 9,15 | 7,44 | 41,04 | 34,34 | 43,29 | 42,73 | 2,4 | 2,4 | |
| A-MEM | 27,02 | 20,09 | 45,85 | 36,67 | 12,14 | 12,00 | 44,65 | 37,06 | 50,03 | 49,47 | 1,2 | 1,2 | |
| GPT | LoCoMo | 28,00 | 18,47 | 9,09 | 5,78 | 16,47 | 14,80 | 61,56 | 54,19 | 52,61 | 51,13 | 2,0 | 2,0 |
| READAGENT | 14,61 | 9,95 | 4,16 | 3,19 | 8,84 | 8,37 | 12,46 | 10,29 | 6,81 | 6,13 | 4,0 | 4,0 | |
| MEMORYBANK | 6,49 | 4,69 | 2,47 | 2,43 | 6,43 | 5,30 | 8,28 | 7,10 | 4,42 | 3,67 | 5,0 | 5,0 | |
| MEMGPT | 30,36 | 22,83 | 17,29 | 13,18 | 12,24 | 11,87 | 60,16 | 53,35 | 34,96 | 34,25 | 2,4 | 2,4 | |
| A-MEM | 32,86 | 23,76 | 39,41 | 31,23 | 17,10 | 15,84 | 48,43 | 42,97 | 36,35 | 35,53 | 1,6 | 1,6 | |
| GPT | LoCoMo | 9,05 | 6,55 | 4,25 | 4,04 | 9,91 | 8,50 | 11,15 | 8,67 | 40,38 | 40,23 | 3,4 | 3,4 |
| READAGENT | 6,61 | 4,93 | 2,55 | 2,51 | 5,31 | 12,24 | 10,13 | 7,54 | 5,42 | 27,32 | 4,6 | 4,6 | |
| MEMORYBANK | 11,14 | 8,25 | 4,46 | 2,87 | 8,05 | 6,21 | 13,42 | 11,01 | 36,76 | 34,00 | 2,6 | 2,6 | |
| MEMGPT | 10,44 | 7,61 | 4,21 | 3,89 | 13,42 | 11,64 | 9,56 | 7,34 | 31,51 | 28,90 | 3,4 | 3,4 | |
| A-MEM | 18,23 | 11,94 | 24,32 | 19,74 | 16,48 | 14,31 | 23,63 | 19,23 | 46,00 | 43,26 | 1,0 | 1,0 | |
| GPT | LoCoMo | 4,61 | 4,29 | 3,11 | 2,71 | 4,55 | 5,97 | 7,03 | 5,69 | 16,95 | 14,81 | 3,2 | 3,2 |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,57 | 5,22 | 3,25 | 2,51 | 15,78 | 14,01 | 4,2 | 4,2 | |
| MEMORYBANK | 3,60 | 3,39 | 1,97 | 1,67 | 6,63 | 6,58 | 4,11 | 3,32 | 13,07 | 10,30 | 4,2 | 4,2 | |
| MEMGPT | 5,07 | 4,31 | 2,94 | 2,95 | 7,04 | 7,10 | 7,26 | 5,52 | 14,47 | 12,39 | 2,4 | 2,4 | |
| A-MEM | 12,57 | 9,01 | 27,59 | 25,07 | 7,12 | 7,28 | 17,23 | 13,12 | 27,91 | 25,15 | 1,0 | 1,0 | |
| LLaMA 2 | LoCoMo | 11,25 | 9,18 | 7,38 | 6,82 | 11,90 | 10,38 | 12,86 | 10,50 | 51,89 | 48,27 | 3,4 | 3,4 |
| READAGENT | 5,96 | 5,12 | 1,93 | 2,30 | 12,46 | 11,17 | 7,75 | 6,03 | 44,64 | 40,15 | 4,6 | 4,6 | |
| MEMORYBANK | 13,18 | 10,03 | 7,61 | 6,27 | 15,78 | 12,94 | 17,30 | 14,03 | 52,61 | 47,53 | 2,0 | 2,0 | |
| MEMGPT | 9,19 | 6,96 | 4,02 | 4,79 | 11,34 | 8,24 | 10,16 | 7,68 | 49,75 | 45,11 | 4,0 | 4,0 | |
| A-MEM | 19,06 | 11,71 | 17,80 | 10,28 | 17,55 | 14,67 | 28,51 | 24,13 | 58,81 | 54,28 | 1,0 | 1,0 | |
| LLaMA 2 | LoCoMo | 6,88 | 5,77 | 4,37 | 4,40 | 10,65 | 9,29 | 8,37 | 6,93 | 30,25 | 28,46 | 2,8 | 2,8 |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,57 | 5,22 | 3,25 | 2,51 | 15,78 | 14,01 | 4,2 | 4,2 | |
| MEMORYBANK | 6,19 | 4,47 | 3,49 | 3,13 | 4,07 | 4,57 | 7,61 | 6,03 | 18,65 | 17,05 | 3,2 | 3.2 | |
| MEMGPT | 5,32 | 3,99 | 2,68 | 2,72 | 5,64 | 5,54 | 4,32 | 3,51 | 21,45 | 19,37 | 3,8 | 3,8 | |
| A-MEM | 17,44 | 11,74 | 26,38 | 19,50 | 12,53 | 11,83 | 28,14 | 23,87 | 42,04 | 40,60 | 1,0 | 1,0 | |
mit den Ground-Truth-Antworten. Zudem berichten wir die durchschnittliche Tokenlänge für die Beantwortung einer Frage. Neben den Berichten von Versuchsergebnissen mit vier zusätzlichen Metriken (ROUGE-L, ROUGE-2, METEOR und SBERT-Ähnlichkeit) präsentieren wir auch experimentelle Ergebnisse unter Verwendung verschiedener Fundamentmodelle, darunter DeepSeek-R1-32B [11], Claude 3.0 Haiku [2] und Claude 3.5 Haiku [3], in Anhang A.3.
4.2 Implementierungsdetails
Für alle Baselines und unsere vorgeschlagene Methode wahren wir Konsistenz, indem wir identische System-Prompts verwenden, wie in Anhang B detailliert beschrieben. Die Bereitstellung der Modelle Qwen-1.5B/3B und Llama 3.2 1B/3B erfolgt durch lokale Instanziierung mit Ollama 1, wobei LiteLLM 2 die Generierung strukturierter Ausgaben verwaltet. Für GPT-Modelle nutzen wir die offizielle API für strukturierte Ausgaben. In unserem Gedächtnisabrufprozess verwenden wir hauptsächlich für die Top--Gedächtnisauswahl, um die Recheneffizienz zu wahren, während wir diesen Parameter für bestimmte Kategorien anpassen, um die Leistung zu optimieren. Die detaillierten Konfigurationen von finden sich in Anhang A.5. Für Text-Embedding implementieren wir das Modell all-miniml-16-v2 in allen Experimenten.
4.3 Empirische Ergebnisse
Leistungsanalyse. In unserer empirischen Evaluation verglichen wir A-MEM mit vier konkurrenzfähigen Baselines, darunter LoCoMo [22], ReadAgent [17], MemoryBank [39] und MemGPT [25], auf dem LoCoMo-Datensatz. Für Nicht-GPT-Fundamentmodelle übertrifft unser A-MEM durchgängig alle Baselines über verschiedene Kategorien hinweg, was die Wirksamkeit unseres agentischen Gedächtnisansatzes demonstriert. Für GPT-basierte Modelle, während LoCoMo und MemGPT in bestimmten Kategorien wie Open Domain und Adversial Tasks aufgrund ihres robusten vortrainierten Wissens beim einfachen Faktenabruf starke Leistungen zeigen, weist unser A-MEM überlegene Leistung bei Multi-Hop-Aufgaben auf und erreicht mindestens doppelt so gute Leistung bei Aufgaben, die komplexe Schlussfolgerungsketten erfordern. Zusätzlich zu den Experimenten auf dem LoCoMo-Datensatz vergleichen wir unsere Methode auch auf dem DialSim-Datensatz mit LoCoMo und MemGPT. A-MEM übertrifft durchgängig alle Baselines über alle Evaluationsmetriken hinweg und erreicht einen F1-
| Methode | F1 | BLEU-1 | ROUGE-L | ROUGE-2 | METEOR | SBERT-Ähnlichkeit |
| LoCoMo | 2,55 | 3,13 | 2,75 | 0,90 | 1,64 | 15,76 |
| MemGPT | 1,18 | 1,07 | 0,96 | 0,42 | 0,95 | 8,54 |
| A-MEM | 3,45 | 3,37 | 3,54 | 3,60 | 2,05 | 19,51 |
| Methode | Multi-Hop | Temporal | Kategorie | Single-Hop | Adversarial | |||||
| F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | F1 | BLEU-1 | |
| ohne LG & ME | 9,65 | 7,09 | 24,55 | 19,48 | 7,77 | 6,70 | 13,28 | 10,30 | 15,32 | 18,02 |
| ohne ME | 21,35 | 15,13 | 31,24 | 27,31 | 10,13 | 10,85 | 39,17 | 34,70 | 44,16 | 45,33 |
| A-MEM | 27,02 | 20,09 | 45,85 | 36,67 | 12,14 | 12,00 | 44,65 | 37,06 | 50,03 | 49,47 |
Score von 3,45 (eine -Verbesserung gegenüber LoCoMos 2,55 und höher als MemGPTs 1,18). Die Wirksamkeit von A-MEM rührt von seiner neuartigen agentischen Gedächtnisarchitektur her, die ein dynamisches und strukturiertes Gedächtnismanagement ermöglicht. Anders als traditionelle Ansätze, die statische Gedächtnisoperationen verwenden, erzeugt unser System miteinander verbundene Gedächtnisnetzwerke durch atomare Notizen mit reichhaltigen kontextuellen Beschreibungen, was effektiveres Multi-Hop-Schlussfolgern ermöglicht. Die Fähigkeit des Systems, dynamisch Verbindungen zwischen Gedächtnissen basierend auf gemeinsamen Attributen herzustellen und bestehende Gedächtnisbeschreibungen kontinuierlich mit neuen kontextuellen Informationen zu aktualisieren, ermöglicht es ihm, die Beziehungen zwischen verschiedenen Informationsstücken besser zu erfassen und zu nutzen.
Kosteneffizienzanalyse. A-MEM demonstriert neben starker Leistung auch erhebliche Rechen- und Kosteneffizienz. Das System benötigt etwa 1.200 Tokens pro Gedächtnisoperation und erreicht eine -Reduktion des Tokenverbrauchs im Vergleich zu Baseline-Methoden (LoCoMo und MemGPT mit 16.900 Tokens) durch unseren selektiven Top-k-Abrufmechanismus. Diese erhebliche Tokenreduktion schlägt sich direkt in niedrigeren Betriebskosten nieder, wobei jede Gedächtnisoperation weniger als 0,0003\(kostet, wenn kommerzielle API-Dienste verwendet werden – was großskalige Bereitstellungen wirtschaftlich tragfähig macht. Die Verarbeitungszeiten betragen durchschnittlich 5,4 Sekunden mit GPT-4o-mini und nur 1,1 Sekunden mit lokal gehostetem Llama 3.2 1B auf einer einzelnen GPU. Obwohl während der Gedächtnisverarbeitung mehrere LLM-Aufrufe erforderlich sind, behält A-MEM diese kosteneffektive Ressourcennutzung bei und übertrifft durchgängig die Baseline-Ansätze über alle getesteten Fundamentmodelle hinweg, insbesondere mit doppelter Leistung bei komplexen Multi-Hop-Schlussfolgerungsaufgaben. Diese Balance aus geringen Rechenkosten und überlegener Schlussfolgerungsfähigkeit hebt den praktischen Vorteil von A-MEM für den Einsatz in der realen Welt hervor.
4.4 Ablationsstudie
Um die Wirksamkeit der Module Link Generation (LG) und Memory Evolution (ME) zu bewerten, führen wir die Ablationsstudie durch, indem wir Schlüsselkomponenten unseres Modells systematisch entfernen. Wenn sowohl die LG- als auch die ME-Module entfernt werden, zeigt das System eine erhebliche Leistungsverschlechterung, insbesondere bei Multi-Hop-Reasoning- und Open-Domain-Aufgaben. Das System mit nur aktivem LG (ohne ME) zeigt mittlere Leistungsniveaus und erzielt weiterhin deutlich bessere Ergebnisse als die Version ohne beide Module, was die grundlegende Bedeutung der Linkgenerierung für die Herstellung von Gedächtnisverbindungen demonstriert. Unser vollständiges Modell A-MEM erzielt durchgängig die beste Leistung in allen Bewertungskategorien, mit besonders starken Ergebnissen bei komplexen Reasoning-Aufgaben. Diese Ergebnisse zeigen, dass das Linkgenerierungsmodul zwar eine kritische Grundlage für die Gedächtnisorganisation bildet, das Memory-Evolution-Modul jedoch wesentliche Verfeinerungen der Gedächtnisstruktur liefert. Die Ablationsstudie validiert unsere architektonischen Designentscheidungen und hebt die komplementäre Natur dieser beiden Module bei der Schaffung eines effektiven Gedächtnissystems hervor.
4.5 Hyperparameter-Analyse
Wir haben umfangreiche Experimente durchgeführt, um die Auswirkung des Gedächtnisabrufparameters k zu analysieren, der die Anzahl der relevanten Gedächtnisse steuert, die für jede Interaktion abgerufen werden. Wie in Abbildung 3 gezeigt, haben wir die Leistung über verschiedene k-Werte (10, 20, 30, 40, 50) in fünf Aufgabenkategorien unter Verwendung von GPT-4o-mini als Basismodell evaluiert. Die Ergebnisse zeigen ein interessantes Muster: Während eine Erhöhung von k im Allgemeinen zu einer verbesserten Leistung führt, flacht diese Verbesserung allmählich ab und nimmt bei höheren Werten manchmal leicht ab. Dieser Trend ist besonders deutlich bei Multi-Hop- und Open-Domain-
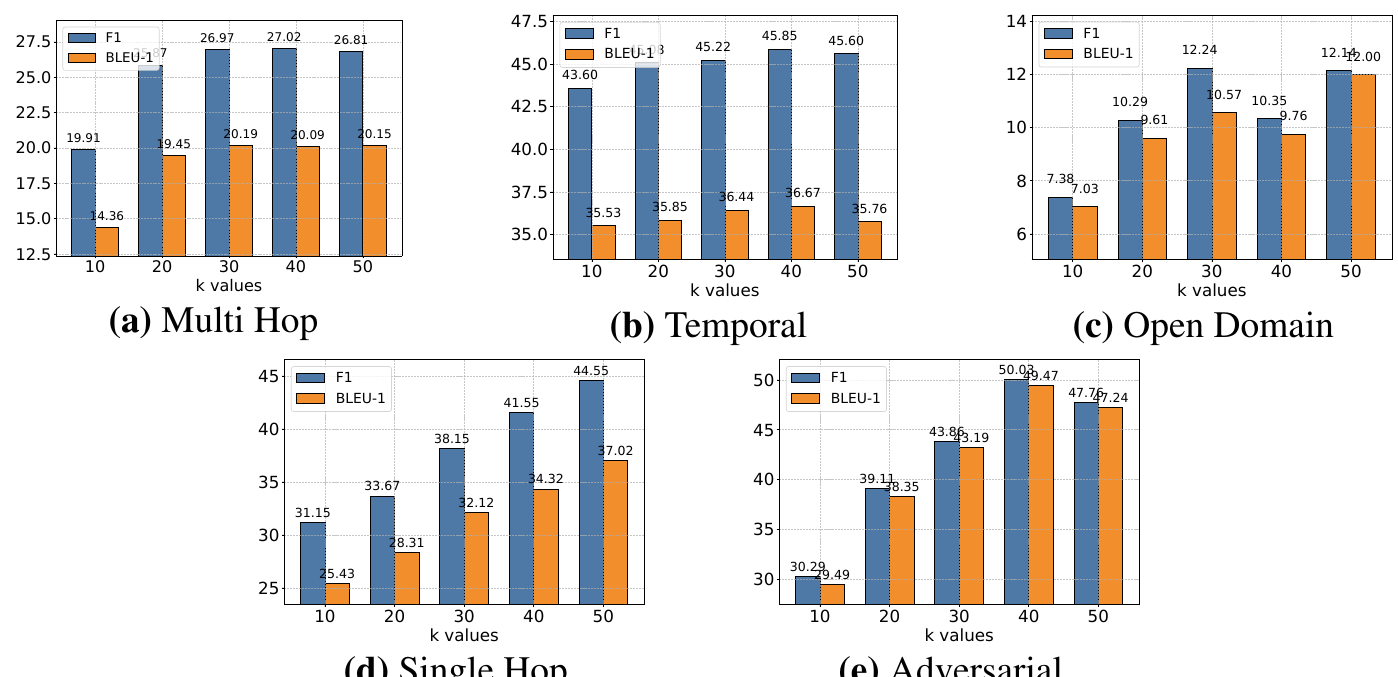
Tabelle 4: Vergleich des Speicherverbrauchs und der Abrufzeit über verschiedene Gedächtnismethoden und -skalen hinweg.
| Speichergröße | Methode | Speicherverbrauch (MB) | Abrufzeit (μs) |
| 1.000 | A-MEM | 1,46 | 0,31 ± 0,30 |
| MemoryBank [39] | 1,46 | 0,24 ± 0,20 | |
| ReadAgent [17] | 1,46 | 43,62 ± 8,47 | |
| 10.000 | A-MEM | 14,65 | 0,38 ± 0,25 |
| MemoryBank [39] | 14,65 | 0,26 ± 0,13 | |
| ReadAgent [17] | 14,65 | 484,45 ± 93,86 | |
| 100.000 | A-MEM | 146,48 | 1,40 ± 0,49 |
| MemoryBank [39] | 146,48 | 0,78 ± 0,26 | |
| ReadAgent [17] | 146,48 | 6.682,22 ± 111,63 | |
| 1.000.000 | A-MEM | 1464,84 | 3,70 ± 0,74 |
| MemoryBank [39] | 1464,84 | 1,91 ± 0,31 | |
| ReadAgent [17] | 1464,84 | 120.069,68 ± 1.673,39 |
Aufgaben. Die Beobachtung legt ein empfindliches Gleichgewicht beim Gedächtnisabruf nahe – während größere k-Werte einen reicheren historischen Kontext für das Reasoning bieten, können sie auch Rauschen einführen und die Fähigkeit des Modells, längere Sequenzen effektiv zu verarbeiten, herausfordern. Unsere Analyse deutet darauf hin, dass moderate k-Werte ein optimales Gleichgewicht zwischen Kontextreichtum und Informationseffizienz bei der Verarbeitung erzielen.
4.6 Skalierungsanalyse
Um die Speicherkosten bei akkumulierendem Gedächtnis zu bewerten, untersuchten wir die Beziehung zwischen Speichergröße und Abrufzeit über unser A-MEM-System und zwei Baseline-Ansätze hinweg: MemoryBank [39] und ReadAgent [17]. Wir evaluierten diese drei Gedächtnissysteme mit identischem Gedächtnisinhalt über vier Skalenpunkte hinweg, wobei die Anzahl der Einträge bei jedem Schritt um den Faktor 10 erhöht wurde (von 1.000 auf 10.000, 100.000 und schließlich 1.000.000 Einträge). Die experimentellen Ergebnisse liefern wichtige Erkenntnisse über die Skalierungseigenschaften unseres A-MEM-Systems: Hinsichtlich der Raumkomplexität zeigen alle drei Systeme eine identische lineare Skalierung des Speicherverbrauchs , wie für vektorbasierte Abrufsysteme zu erwarten ist. Dies bestätigt, dass A-MEM im Vergleich zu Baseline-Ansätzen keinen zusätzlichen Speicheraufwand einführt. Bei der Abrufzeit zeigt A-MEM eine hervorragende Effizienz mit minimalen Anstiegen bei wachsender Gedächtnisgröße. Selbst bei Skalierung auf 1 Million Gedächtnisse steigt die Abrufzeit von A-MEM nur von auf , was eine außergewöhnliche Leistung darstellt. Während MemoryBank etwas schnellere Abrufzeiten zeigt, hält A-MEM eine vergleichbare Leistung aufrecht und bietet zugleich reichere Gedächtnisrepräsentationen und Funktionalität. Basierend auf unserer Analyse der Raumkomplexität und der Abrufzeit schlussfolgern wir, dass die Abrufmechanismen von A-MEM selbst bei großen Skalen eine hervorragende Effizienz beibehalten. Der minimale Anstieg der Abrufzeit über die Gedächtnisgrößen hinweg adressiert Bedenken hinsichtlich der Effizienz bei großskaligen Gedächtnissystemen und zeigt, dass A-MEM eine hochgradig skalierbare Lösung für die Verwaltung langfristiger Konversationen bietet. Diese einzigartige Kombination aus Effizienz, Skalierbarkeit und erweiterten Gedächtnisfähigkeiten positioniert A-MEM als einen bedeutenden Fortschritt beim Aufbau eines leistungsstarken und langfristigen Gedächtnismechanismus für LLM-Agenten.
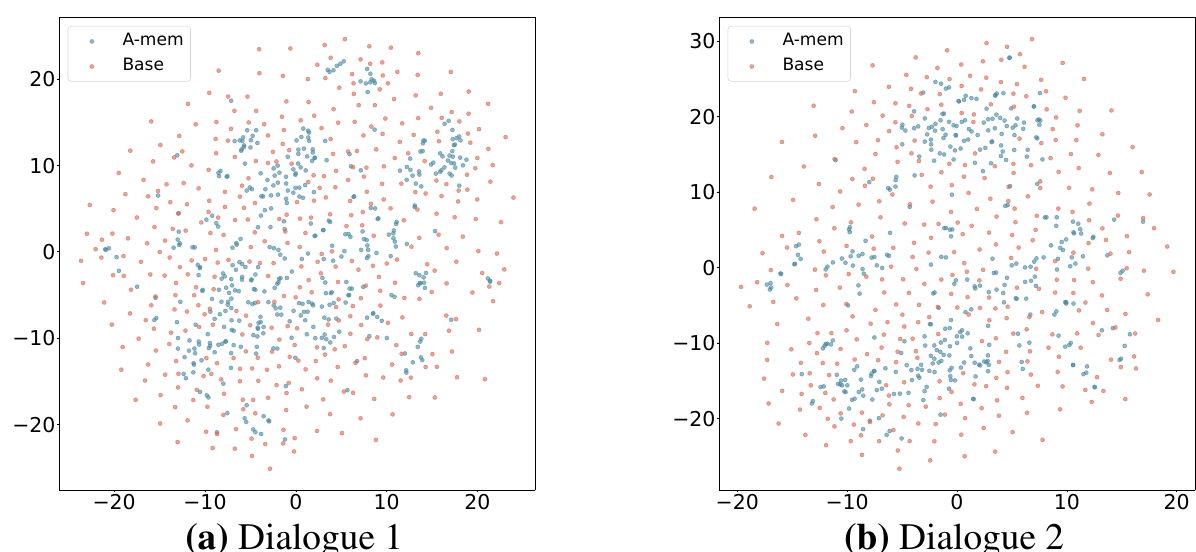
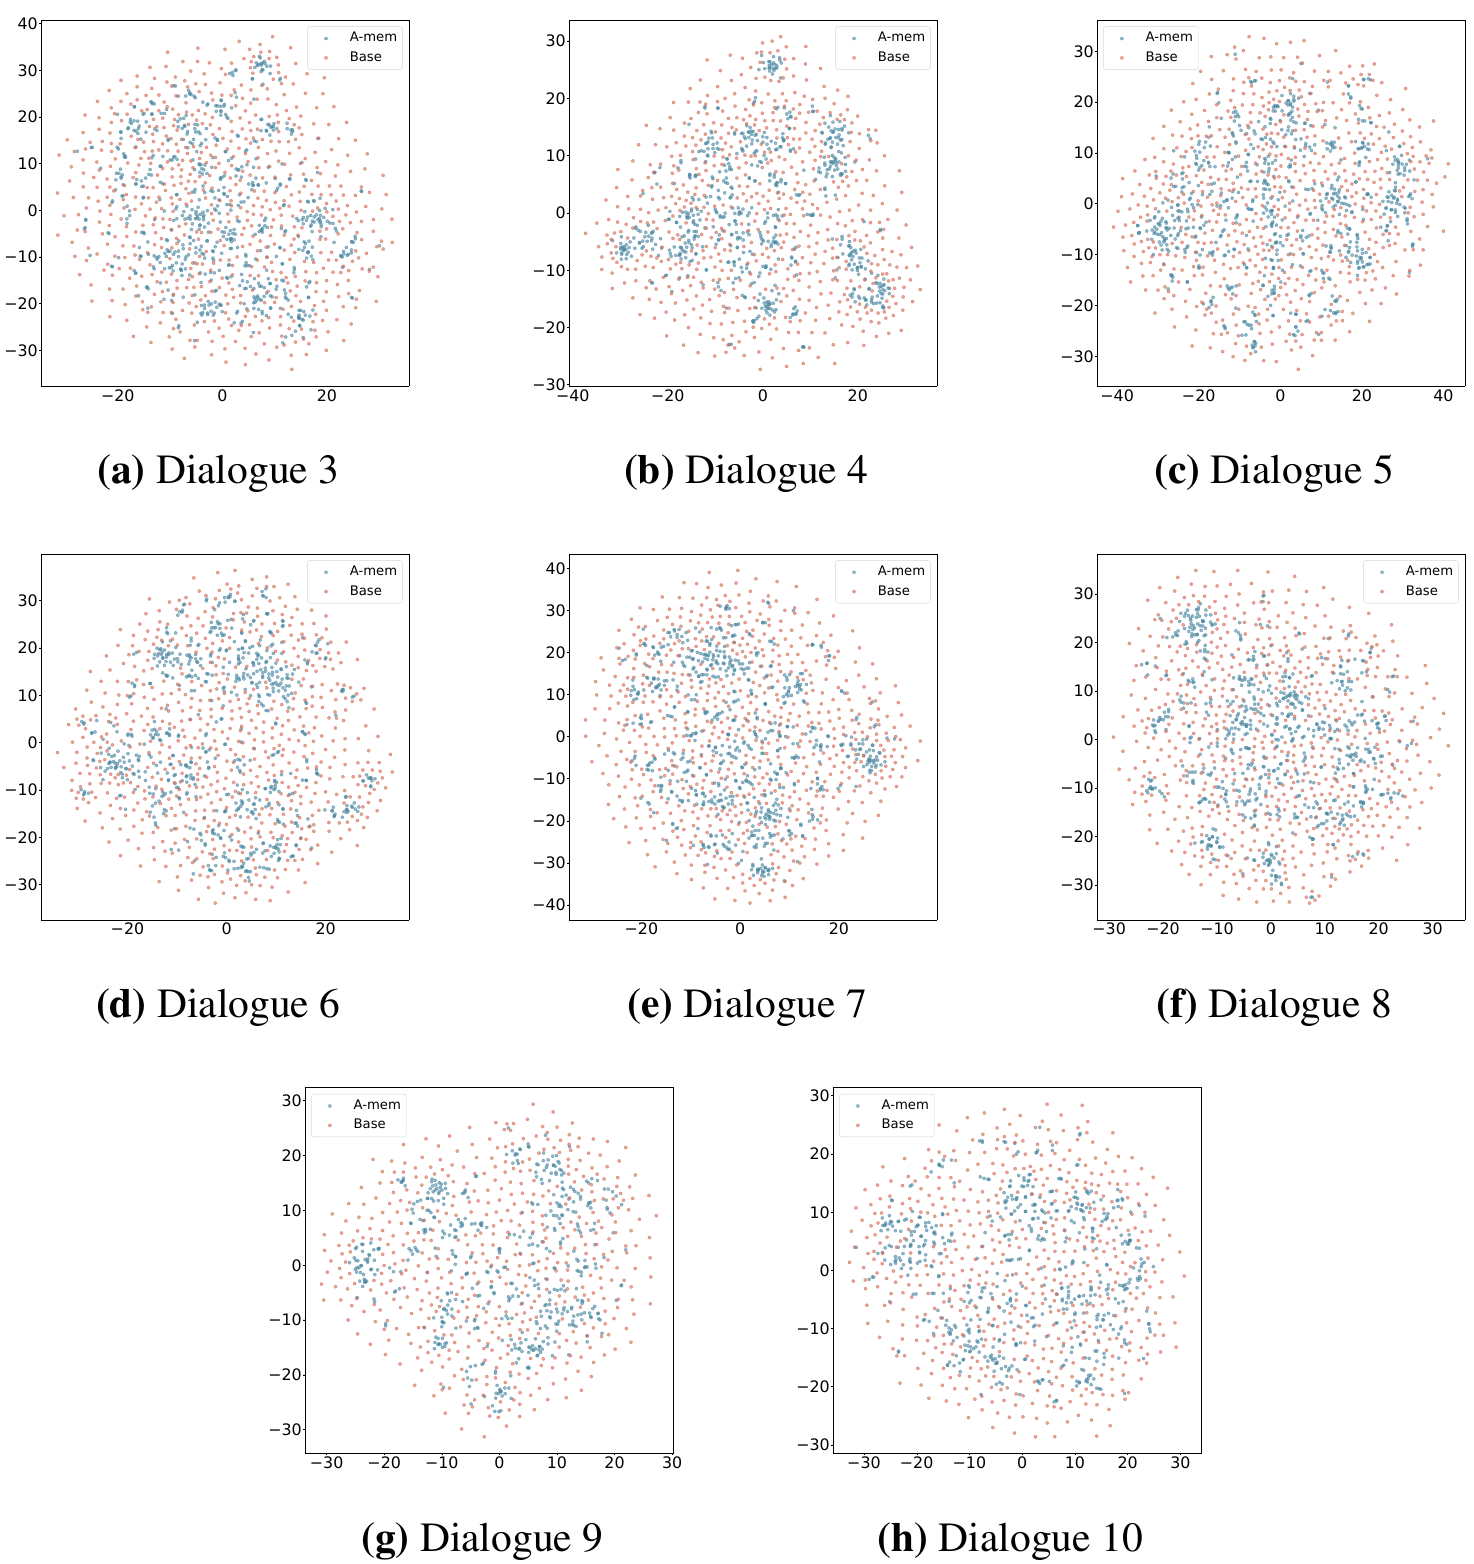
Abbildung 4: T-SNE-Visualisierung der Speicher-Embeddings, die eine organisiertere Verteilung mit A-MEM (blau) im Vergleich zum Basis-Speicher (rot) über verschiedene Dialoge hinweg zeigt. Basis-Speicher bezeichnet A-MEM ohne Link-Generierung und Speicherevolution.
4.7 Speicheranalyse
Wir präsentieren die t-SNE-Visualisierung in Abbildung 4 der Speicher-Embeddings, um die strukturellen Vorteile unseres agentischen Speichersystems zu demonstrieren. Bei der Analyse zweier Dialoge, die aus Langzeitkonversationen in LoCoMo [22] entnommen wurden, beobachten wir, dass A-MEM (blau dargestellt) durchgängig kohärentere Clusterungsmuster im Vergleich zum Basissystem (rot dargestellt) aufweist. Diese strukturelle Organisation zeigt sich besonders deutlich in Dialog 2, wo im zentralen Bereich klar abgegrenzte Cluster entstehen, was empirische Belege für die Wirksamkeit unseres Speicherevolutionsmechanismus und der Generierung kontextueller Beschreibungen liefert. Im Gegensatz dazu zeigen die Speicher-Embeddings der Baseline eine dispersere Verteilung, was belegt, dass den Speichern ohne unsere Link-Generierungs- und Speicherevolutionskomponenten die strukturelle Organisation fehlt. Diese Visualisierungsergebnisse bestätigen, dass A-MEM durch dynamische Evolutions- und Verknüpfungsmechanismen autonom bedeutungsvolle Speicherstrukturen aufrechterhalten kann. Weitere Ergebnisse sind in Anhang A.4 zu finden.
5 Schlussfolgerungen
In dieser Arbeit haben wir A-MEM vorgestellt, ein neuartiges agentisches Speichersystem, das LLM-Agenten befähigt, ihre Speicher dynamisch zu organisieren und weiterzuentwickeln, ohne auf vordefinierte Strukturen angewiesen zu sein. Inspiriert von der Zettelkasten-Methode erzeugt unser System ein miteinander verbundenes Wissensnetzwerk durch dynamische Indexierungs- und Verknüpfungsmechanismen, die sich an vielfältige realweltliche Aufgaben anpassen. Die Kernarchitektur des Systems zeichnet sich durch die autonome Generierung kontextueller Beschreibungen für neue Speicher und die intelligente Herstellung von Verbindungen zu bestehenden Speichern auf Basis gemeinsamer Attribute aus. Darüber hinaus ermöglicht unser Ansatz die kontinuierliche Evolution historischer Speicher durch die Integration neuer Erfahrungen und die Entwicklung höherstufiger Attribute durch fortlaufende Interaktionen. Durch umfangreiche empirische Evaluierung über sechs Basismodelle hinweg haben wir gezeigt, dass A-MEM im Vergleich zu bestehenden State-of-the-Art-Baselines bei Langzeit-Konversationsaufgaben überlegene Leistungen erzielt. Die Visualisierungsanalyse bestätigt zudem die Wirksamkeit unseres Ansatzes zur Speicherorganisation. Diese Ergebnisse legen nahe, dass agentische Speichersysteme die Fähigkeit von LLM-Agenten, Langzeitwissen in komplexen Umgebungen zu nutzen, erheblich verbessern können.
6 Einschränkungen
Obwohl unser agentisches Speichersystem vielversprechende Ergebnisse erzielt, erkennen wir mehrere Bereiche für mögliche zukünftige Untersuchungen an. Erstens kann die Qualität der Organisationen, obwohl unser System Speicher dynamisch organisiert, weiterhin durch die inhärenten Fähigkeiten der zugrunde liegenden Sprachmodelle beeinflusst werden. Verschiedene LLMs könnten leicht unterschiedliche kontextuelle Beschreibungen generieren oder unterschiedliche Verbindungen zwischen Speichern herstellen. Darüber hinaus könnte zukünftige Arbeit, während unsere aktuelle Implementierung auf textbasierte Interaktionen fokussiert ist, die Erweiterung des Systems zur Verarbeitung multimodaler Informationen wie Bilder oder Audio untersuchen, was reichere kontextuelle Repräsentationen ermöglichen könnte.
Literaturverzeichnis
[1] Sönke Ahrens. How to Take Smart Notes: One Simple Technique to Boost Writing, Learning and Thinking. Amazon, 2017. Second Edition.
[2] Anthropic. The claude 3 model family: Opus, sonnet, haiku. Anthropic, Mar 2024. Accessed May 2025.
[3] Anthropic. Claude 3.5 sonnet model card addendum. Technical report, Anthropic, 2025. Accessed May 2025.
[4] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. arXiv preprint arXiv:2310.11511, 2023.
[5] Satanjeev Banerjee and Alon Lavie. Meteor: An automatic metric for mt evaluation with improved correlation with human judgments. In Proceedings of the acl workshop on intrinsic and extrinsic evaluation measures for machine translation and/or summarization, pages 65-72, 2005.
[6] Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George Bm Van Den Driessche, Jean-Baptiste Lespiau, Bogdan Damoc, Aidan Clark, et al. Improving language models by retrieving from trillions of tokens. In International conference on machine learning, pages 2206-2240. PMLR, 2022.
[7] Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Sam Stevens, Boshi Wang, Huan Sun, and Yu Su. Mind2web: Towards a generalist agent for the web. Advances in Neural Information Processing Systems, 36:28091-28114, 2023.
[8] Khant Dev and Singh Taranjeet. mem0: The memory layer for ai agents. https://github.com/mem0ai/mem0, 2024.
[9] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From local to global: A graph rag approach to query-focused summarization. arXiv preprint arXiv:2404.16130, 2024.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2023.
[11] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[12] I. Ilin. Advanced rag techniques: An illustrated overview, 2023.
[13] Jihyoung Jang, Minseong Boo, and Hyounghun Kim. Conversation chronicles: Towards diverse temporal and relational dynamics in multi-session conversations. arXiv preprint arXiv:2310.13420, 2023.
[14] Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. arXiv preprint arXiv:2305.06983, 2023.
[15] David Kadavy. Digital Zettelkasten: Principles, Methods, & Examples. Google Books, May 2021.
[16] Jiho Kim, Woosog Chay, Hyeonji Hwang, Daeun Kyung, Hyunseung Chung, Eunbyeol Cho, Yohan Jo, and Edward Choi. Dialism: A real-time simulator for evaluating long-term multi-party dialogue understanding of conversational agents. arXiv preprint arXiv:2406.13144, 2024.
[17] Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human-inspired reading agent with gist memory of very long contexts. arXiv preprint arXiv:2402.09727, 2024.
[18] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, et al. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459-9474, 2020.
[19] Chin-Yew Lin. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74-81, 2004.
[20] Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Rich James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Ra-dit: Retrieval-augmented dual instruction tuning. arXiv preprint arXiv:2310.01352, 2023.
[21] Zhiwei Liu, Weiran Yao, Jianguo Zhang, Liangwei Yang, Zuxin Liu, Juntao Tan, Prafulla K Choubey, Tian Lan, Jason Wu, Huan Wang, et al. Agentlite: A lightweight library for building and advancing task-oriented llm agent system. arXiv preprint arXiv:2402.15538, 2024.
[22] Adyasha Maharana, Dong-Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long-term conversational memory of llm agents. arXiv preprint arXiv:2402.17753, 2024.
[23] Kai Mei, Zelong Li, Shuyuan Xu, Ruosong Ye, Yingqiang Ge, and Yongfeng Zhang. Aios: Llm agent operating system. arXiv e-prints, pp. arXiv-2403, 2024.
[24] Ali Modarressi, Ayyob Imani, Mohsen Fayyaz, and Hinrich Schütze. Ret-llm: Towards a general read-write memory for large language models. arXiv preprint arXiv:2305.14322, 2023.
[25] Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G Patil, Ion Stoica und Joseph E Gonzalez. Memgpt: Towards llms as operating systems. arXiv preprint arXiv:2310.08560, 2023.
[26] Kishore Papineni, Salim Roukos, Todd Ward und Wei-Jing Zhu. Bleu: a method for automatic evaluation of machine translation. In Proceedings of the 40th annual meeting of the Association for Computational Linguistics, Seiten 311-318, 2002.
[27] Nils Reimers und Iryna Gurevych. Sentence-bert: Sentence embeddings using siamese bert-networks. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing. Association for Computational Linguistics, 11 2019.
[28] Aymeric Roucher, Albert Villanova del Moral, Thomas Wolf, Leandro von Werra und Erik Kaunismaki. 'smolagents': a smol library to build great agentic systems. https://github.com/huggingface/smolagents, 2025.
[29] Zhihong Shao, Yeyun Gong, Yelong Shen, Minlie Huang, Nan Duan und Weizhu Chen. Enhancing retrieval-augmented large language models with iterative retrieval-generation synergy. arXiv preprint arXiv:2305.15294, 2023.
[30] Zeru Shi, Kai Mei, Mingyu Jin, Yongye Su, Chaoji Zuo, Wenyue Hua, Wujiang Xu, Yujie Ren, Zirui Liu, Mengnan Du, et al. From commands to prompts: Llm-based semantic file system for aios. arXiv preprint arXiv:2410.11843, 2024.
[31] Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot und Ashish Sabharwal. Interleaving retrieval with chain-of-thought reasoning for knowledge-intensive multi-step questions. arXiv preprint arXiv:2212.10509, 2022.
[32] Bing Wang, Xinnian Liang, Jian Yang, Hui Huang, Shuangzhi Wu, Peihao Wu, Lu Lu, Zejun Ma und Zhoujun Li. Enhancing large language model with self-controlled memory framework. arXiv preprint arXiv:2304.13343, 2023.
[33] Xingyao Wang, Boxuan Li, Yufan Song, Frank F Xu, Xiangru Tang, Mingchen Zhuge, Jiayi Pan, Yueqi Song, Bowen Li, Jaskirat Singh, et al. Openhands: An open platform for ai software developers as generalist agents. arXiv preprint arXiv:2407.16741, 2024.
[34] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez und Graham Neubig. Learning to filter context for retrieval-augmented generation. arXiv preprint arXiv:2311.08377, 2023.
[35] Lilian Weng. Llm-powered autonomous agents. lilianweng.github.io, Juni 2023.
[36] J Xu. Beyond goldfish memory: Long-term open-domain conversation. arXiv preprint arXiv:2107.07567, 2021.
[37] Wenhao Yu, Hongming Zhang, Xiaoman Pan, Kaixin Ma, Hongwei Wang und Dong Yu. Chain-of-note: Enhancing robustness in retrieval-augmented language models. arXiv preprint arXiv:2311.09210, 2023.
[38] Zichun Yu, Chenyan Xiong, Shi Yu und Zhiyuan Liu. Augmentation-adapted retriever improves generalization of language models as generic plug-in. arXiv preprint arXiv:2305.17331, 2023.
[39] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye und Yanlin Wang. Memorybank: Enhancing large language models with long-term memory. In Proceedings of the AAAI Conference on Artificial Intelligence, Band 38, Seiten 19724-19731, 2024.
Inhalt
1 Einleitung 1
2 Verwandte Arbeiten 2
2.1 Gedächtnis für LLM-Agenten 2
2.2 Retrieval-Augmented Generation 3
3 Methodik 3
3.1 Notizkonstruktion 4
3.2 Linkgenerierung 4
3.3 Gedächtnisevolution 4
3.4 Abruf relevanter Erinnerungen 5
4 Experiment 5
4.1 Datensatz und Evaluation 5
4.2 Implementierungsdetails 6
4.3 Empirische Ergebnisse 6
4.4 Ablationsstudie 7
4.5 Hyperparameteranalyse 7
4.6 Skalierungsanalyse 8
4.7 Gedächtnisanalyse 9
5 Schlussfolgerungen 9
6 Einschränkungen 9
A Experiment 14
A.1 Detaillierte Einführung in die Baselines 14
A.2 Evaluationsmetrik 14
A.3 Vergleichsergebnisse 15
A.4 Gedächtnisanalyse 16
A.5 Einstellung der Hyperparameter 17
B Prompt-Vorlagen und Beispiele 19
B.1 Prompt-Vorlage für die Notizkonstruktion 19
B.2 Prompt-Vorlage für die Linkgenerierung 19
B.3 Prompt-Vorlage für die Gedächtnisevolution 20
B.4 Beispiele für F/A mit A-MEM 21
ANHANG
A Experiment
A.1 Detaillierte Einführung in die Baselines
LoCoMo [22] verfolgt einen direkten Ansatz, indem es Foundation-Modelle ohne Gedächtnismechanismen für Frage-Antwort-Aufgaben nutzt. Für jede Anfrage werden die vollständige vorangegangene Konversation und die Fragen in den Prompt aufgenommen, wodurch die Schlussfolgerungsfähigkeiten des Modells evaluiert werden.
ReadAgent [17] bewältigt die Verarbeitung von Dokumenten mit langem Kontext durch eine ausgefeilte dreistufige Methodik: Zunächst wird durch Episoden-Paginierung der Inhalt in handhabbare Abschnitte unterteilt, anschließend wird durch Memory-Gisting jede Seite zu prägnanten Gedächtnisrepräsentationen verdichtet, und schließlich werden durch interaktives Nachschlagen die relevanten Informationen nach Bedarf abgerufen.
MemoryBank [39] führt ein innovatives Gedächtnisverwaltungssystem ein, das historische Interaktionen verwaltet und effizient abruft. Das System verfügt über einen dynamischen Gedächtnisaktualisierungsmechanismus, der auf der Theorie der Ebbinghaus-Vergessenskurve basiert und die Gedächtnisstärke je nach Zeit und Bedeutung intelligent anpasst. Darüber hinaus enthält es ein System zur Erstellung von Nutzerprofilen, das sein Verständnis der Persönlichkeit des Nutzers durch kontinuierliche Interaktionsanalyse schrittweise verfeinert.
MemGPT [25] präsentiert ein neuartiges System zur Verwaltung virtueller Kontexte, das sich von den Gedächtnishierarchien traditioneller Betriebssysteme inspirieren lässt. Die Architektur implementiert eine zweistufige Struktur: einen Hauptkontext (analog zum RAM), der während der LLM-Inferenz unmittelbaren Zugriff bietet, und einen externen Kontext (analog zum Festplattenspeicher), der Informationen über das feste Kontextfenster hinaus aufrechterhält.
A.2 Evaluationsmetrik
Der F1-Score stellt das harmonische Mittel aus Precision und Recall dar und bietet eine ausgewogene Metrik, die beide Maße in einem einzigen Wert vereint. Diese Metrik ist besonders wertvoll, wenn wir zwischen vollständigen und korrekten Antworten abwägen müssen:
wobei
In Frage-Antwort-Systemen spielt der F1-Score eine entscheidende Rolle bei der Bewertung exakter Übereinstimmungen zwischen vorhergesagten und referenzierten Antworten. Dies ist besonders wichtig für span-basierte QA-Aufgaben, bei denen Systeme präzise Textsegmente identifizieren müssen, während sie eine umfassende Abdeckung der Antwort aufrechterhalten. BLEU-1 [26] bietet eine Methode zur Bewertung der Präzision von Unigramm-Übereinstimmungen zwischen Systemausgaben und Referenztexten:
wobei
Hierbei ist die Länge des Kandidaten, die Länge der Referenz, die Anzahl des n-Gramms i im Kandidaten k und die maximale Anzahl in einer beliebigen Referenz. In QA bewertet BLEU-1 die lexikalische Präzision generierter Antworten, was besonders nützlich für generative QA-Systeme ist, bei denen exakte Übereinstimmung zu streng sein könnte.
ROUGE-L [19] misst die längste gemeinsame Teilsequenz zwischen dem generierten und dem Referenztext.
wobei der Referenztext ist, der Kandidatentext und LCS die längste gemeinsame Teilsequenz (Longest Common Subsequence).
ROUGE-2 [19] berechnet die Überlappung von Bigrammen zwischen dem generierten und dem Referenztext.
Sowohl ROUGE-L als auch ROUGE-2 sind besonders nützlich für die Bewertung der Flüssigkeit und Kohärenz generierter Antworten, wobei ROUGE-L auf die Sequenzübereinstimmung und ROUGE-2 auf die lokale Wortreihenfolge fokussiert.
METEOR [5] berechnet eine Bewertung basierend auf ausgerichteten Unigrammen zwischen dem Kandidaten- und dem Referenztext und berücksichtigt dabei Synonyme und Paraphrasen.
wobei die Präzision, der Recall, ch die Anzahl der Chunks und die Anzahl der übereinstimmenden Unigramme ist. METEOR ist für die QA-Bewertung wertvoll, da es semantische Ähnlichkeit über exakte Übereinstimmungen hinaus berücksichtigt, was es für die Bewertung paraphrasierter Antworten geeignet macht.
SBERT Similarity [27] misst die semantische Ähnlichkeit zwischen zwei Texten mithilfe von Satz-Embeddings.
repräsentiert das Satz-Embedding des Textes. SBERT Similarity ist besonders nützlich für die Bewertung des semantischen Verständnisses in QA-Systemen, da es Bedeutungsähnlichkeiten auch dann erfassen kann, wenn die lexikalische Überlappung gering ist.
A.3 Vergleichsergebnisse
Unsere umfassende Evaluierung mit den Metriken ROUGE-2, ROUGE-L, METEOR und SBERT zeigt, dass A-MEM eine überlegene Leistung erzielt und dabei eine bemerkenswerte Recheneffizienz beibehält. Durch umfangreiche empirische Tests über verschiedene Modellgrößen und Aufgabenkategorien hinweg haben wir A-MEM als einen effektiveren Ansatz im Vergleich zu bestehenden Baselines etabliert, gestützt durch mehrere überzeugende Befunde. In unserer Analyse von Nicht-GPT-Modellen, insbesondere Qwen2.5 und Llama 3.2, übertrifft A-MEM durchgängig alle Baseline-Ansätze bei allen Metriken. Die Kategorie Multi-Hop zeigt besonders bemerkenswerte Ergebnisse, wobei Qwen2.5-15b mit A-MEM einen ROUGE-L-Score von 27,23 erreicht und damit LoComo mit 4,68 und ReadAgent mit 2,81 dramatisch übertrifft – was einer nahezu sechsfachen Verbesserung entspricht. Dieses Überlegenheitsmuster setzt sich konsequent bei den METEOR- und SBERT-Scores fort. Bei der Untersuchung von GPT-basierten Modellen zeigen unsere Ergebnisse ein interessantes Muster. Während LoCoMo und MemGPT starke Fähigkeiten in Open-Domain- und Adversarial-Aufgaben demonstrieren, zeigt A-MEM eine bemerkenswerte Überlegenheit bei Multi-Hop-Reasoning-Aufgaben. Mit GPT-4o-mini erreicht A-MEM einen ROUGE-L-Score von 44,27 bei Multi-Hop-Aufgaben und mehr als das Doppelte von LoComos 18,09. Dieser signifikante Vorteil bleibt konsistent über andere Metriken hinweg, mit METEOR-Scores von 23,43 gegenüber 7,61 und SBERT-Scores von 70,49 gegenüber 52,30. Die Bedeutung dieser Ergebnisse wird durch die außergewöhnliche Recheneffizienz von A-MEM verstärkt. Unser Ansatz benötigt nur 1.200–2.500 Token im Vergleich zu den beträchtlichen 16.900 Token, die von LoComo und MemGPT benötigt werden. Diese Effizienz resultiert aus zwei zentralen architektonischen Innovationen: Erstens schafft unsere neuartige agentische Speicherarchitektur miteinander verbundene Speichernetzwerke durch atomare Notizen mit reichhaltigen kontextuellen Beschreibungen, wodurch Informationsbeziehungen effektiver erfasst und genutzt werden können. Zweitens ermöglicht unser selektiver Top-k-Retrieval-Mechanismus eine dynamische Speicherentwicklung und strukturierte Organisation. Die Wirksamkeit dieser Innovationen zeigt sich besonders deutlich bei komplexen Reasoning-Aufgaben, wie die durchgängig starke Multi-Hop-Leistung bei allen Evaluierungsmetriken belegt. Darüber hinaus zeigen wir auch die experimentellen Ergebnisse mit verschiedenen Grundmodellen, darunter DeepSeek-R1-32B [11], Claude 3.0 Haiku [2] und Claude 3.5 Haiku [3].
| Modell | Methode | Kategorie | ||||||||
| Multi Hop RGE-2 | RGE-L | Temporal RGE-2 | RGE-L | Open Domain RGE-2 | RGE-L | Single Hop RGE-2 | RGE-L | Adversial RGE-2 | ||
| GPT | LoCoMo | 9,64 | 23,92 | 2,01 | 18,09 | 3,40 | 11,58 | 26,48 | 40,20 | 60,46 |
| READAGENT | 2,47 | 9,45 | 0,95 | 13,12 | 0,55 | 5,76 | 2,99 | 9,92 | 6,66 | |
| MEMORYBANK | 1,18 | 5,43 | 0,52 | 9,64 | 0,97 | 5,77 | 1,64 | 6,63 | 4,55 | |
| MEMGPT | 10,58 | 25,60 | 4,76 | 25,22 | 0,76 | 9,14 | 28,44 | 42,24 | 36,62 | |
| A-MEM | 10,61 | 25,86 | 21,39 | 44,27 | 3,42 | 12,09 | 29,50 | 45,18 | 42,62 | |
| LoCoMo | 11,53 | 30,65 | 1,68 | 8,17 | 3,21 | 16,33 | 45,42 | 63,86 | 45,13 | |
| Qwen | READAGENT | 3,91 | 14,36 | 0,43 | 3,96 | 0,52 | 8,58 | 4,75 | 13,41 | 4,24 |
| MEMORYBANK | 1,84 | 7,36 | 0,36 | 2,29 | 2,13 | 6,85 | 3,02 | 9,35 | 1,22 | |
| MEMGPT | 11,55 | 30,18 | 4,66 | 15,83 | 3,27 | 14,02 | 43,27 | 62,75 | 28,72 | |
| A-MEM | 12,76 | 31,71 | 9,82 | 25,04 | 6,09 | 16,63 | 33,67 | 50,31 | 30,31 | |
| LoCoMo | 1,39 | 9,24 | 0,00 | 4,68 | 3,42 | 10,59 | 3,25 | 11,15 | 35,10 | |
| READAGENT | 0,74 | 7,14 | 0,10 | 2,81 | 3,05 | 12,63 | 1,47 | 7,88 | 20,73 | |
| Qwen | MEMORYBANK | 1,51 | 11,18 | 0,14 | 5,39 | 1,80 | 8,44 | 5,07 | 13,72 | 29,24 |
| MEMGPT | 1,16 | 11,35 | 0,00 | 7,88 | 2,87 | 14,62 | 2,18 | 9,82 | 23,96 | |
| A-MEM | 4,88 | 17,94 | 5,88 | 27,23 | 3,44 | 16,87 | 12,32 | 24,38 | 36,32 | |
| LoCoMo | 0,49 | 4,83 | 0,14 | 3,20 | 1,31 | 5,38 | 1,97 | 6,98 | 12,66 | |
| READAGENT | 0,08 | 4,08 | 0,00 | 1,96 | 1,26 | 6,19 | 0,73 | 4,34 | 7,35 | |
| MEMORYBANK | 0,43 | 3,76 | 0,05 | 1,61 | 0,24 | 6,32 | 1,03 | 4,22 | 9,55 | |
| Qwen | MEMGPT | 0,69 | 5,55 | 0,05 | 3,17 | 1,90 | 7,90 | 2,05 | 7,32 | 10,46 |
| A-MEM | 2,91 | 12,42 | 8,11 | 27,74 | 1,51 | 7,51 | 8,80 | 17,57 | 21,39 | |
| LoCoMo | 2,51 | 11,48 | 0,44 | 8,25 | 1,69 | 13,06 | 2,94 | 13,00 | 39,85 | |
| READAGENT | 0,53 | 6,49 | 0,00 | 4,62 | 5,47 | 14,29 | 1,19 | 8,03 | 34,52 | |
| MEMORYBANK | 2,96 | 13,57 | 0,23 | 10,53 | 4,01 | 18,38 | 6,41 | 17,66 | 41,15 | |
| MEMGPT | 1,82 | 9,91 | 0,06 | 6,56 | 2,13 | 11,36 | 2,00 | 10,37 | 38,59 | |
| Llama 2 | A-MEM | 4,82 | 19,31 | 1,84 | 20,47 | 5,99 | 18,49 | 14,82 | 29,78 | 46,76 |
| LoCoMo | 0,98 | 7,22 | 0,03 | 4,45 | 2,36 | 11,39 | 2,85 | 8,45 | 25,47 | |
| READAGENT | 2,47 | 1,78 | 3,01 | 3,01 | 5,07 | 5,22 | 3,25 | 2,51 | 15,78 | |
| MEMORYBANK | 1,83 | 6,96 | 0,25 | 3,41 | 0,43 | 4,43 | 2,73 | 7,83 | 14,64 | |
| MEMGPT | 0,72 | 5,39 | 0,11 | 2,85 | 0,61 | 5,74 | 1,45 | 4,42 | 16,62 | |
| A-MEM | 6,02 | 17,62 | 7,93 | 27,97 | 5,38 | 13,00 | 16,89 | 28,55 | 35,48 | |
A.4 Speicheranalyse
Zusätzlich zu den Speichervisualisierungen der ersten beiden im Haupttext gezeigten Dialoge präsentieren wir weitere Visualisierungen in Abb. 5, die die strukturellen Vorteile unseres agentischen Speichersystems demonstrieren. Durch die Analyse von zwei Dialogen, die aus Langzeitkonversationen in LoCoMo [22] entnommen wurden, beobachten wir, dass A-MEM (in Blau dargestellt) im Vergleich zum Baseline-System (in Rot dargestellt) durchgängig kohärentere Clustering-Muster erzeugt. Diese strukturelle Organisation zeigt sich besonders deutlich in Dialog 2, wo im zentralen Bereich deutlich abgegrenzte Cluster entstehen, was empirische Unterstützung für die Wirksamkeit unseres Speicherentwicklungsmechanismus und unserer kontextuellen Beschreibungsgenerierung liefert. Im Gegensatz dazu weisen die Baseline-Speicher-Embeddings eine stärker verstreute Verteilung auf, was darauf hindeutet, dass den Speichern ohne unsere Link-Generierungs- und Speicherentwicklungskomponenten die strukturelle Organisation fehlt.
| Modell | Methode | Kategorie | ||||||||||
| Multi-Hop-ME | SBERT | Temporal-ME | SBERT | Open-Domain-ME | SBERT | Single-Hop-ME | SBERT | Adversarial-ME | ||||
| GPT | 4-Hop | LoCoMo | 15,81 | 47,97 | 7,61 | 52,30 | 8,16 | 35,00 | 40,42 | 57,78 | 63,28 | 71,93 |
| ReadAgent | 5,46 | 28,67 | 4,76 | 45,07 | 3,69 | 26,72 | 8,01 | 26,78 | 8,38 | 15,20 | ||
| MEMORY BANK | 3,42 | 21,71 | 4,07 | 37,58 | 4,21 | 23,71 | 5,81 | 20,76 | 6,24 | 13,00 | ||
| MEMGPT | 15,79 | 49,33 | 13,25 | 61,53 | 4,59 | 32,77 | 41,40 | 58,19 | 39,16 | 47,24 | ||
| A-MEM | 16,36 | 49,46 | 23,43 | 70,49 | 8,36 | 38,48 | 42,32 | 59,38 | 45,64 | 53,26 | ||
| GPT | 4-Hop | LoCoMo | 16,34 | 53,82 | 7,21 | 32,15 | 8,98 | 43,72 | 53,39 | 73,40 | 47,72 | 56,09 |
| ReadAgent | 7,86 | 37,41 | 3,76 | 26,22 | 4,42 | 30,75 | 9,36 | 31,37 | 5,47 | 12,34 | ||
| MEMORY BANK | 3,22 | 26,23 | 2,29 | 23,49 | 4,18 | 24,89 | 6,64 | 23,90 | 2,93 | 10,01 | ||
| MEMGPT | 16,64 | 55,12 | 12,68 | 35,93 | 7,78 | 37,91 | 52,14 | 72,83 | 31,15 | 39,08 | ||
| A-MEM | 17,53 | 55,96 | 13,10 | 45,40 | 10,62 | 38,87 | 41,93 | 62,47 | 32,34 | 40,11 | ||
| Open2.5 | 4-Hop | LoCoMo | 4,99 | 32,23 | 2,86 | 34,03 | 5,89 | 35,61 | 8,57 | 29,47 | 40,53 | 50,49 |
| ReadAgent | 3,67 | 28,20 | 1,88 | 27,27 | 8,97 | 35,13 | 5,52 | 26,33 | 24,04 | 34,12 | ||
| MEMORY BANK | 5,57 | 35,40 | 2,80 | 32,47 | 4,27 | 33,85 | 10,59 | 32,16 | 32,93 | 42,83 | ||
| MEMGPT | 5,40 | 35,64 | 2,35 | 39,04 | 7,68 | 40,36 | 7,07 | 30,16 | 27,24 | 40,63 | ||
| A-MEM | 9,49 | 43,49 | 11,92 | 61,65 | 9,11 | 42,58 | 19,69 | 41,93 | 40,64 | 52,44 | ||
| Open2.5 | 4-hop | LoCoMo | 2,00 | 24,37 | 1,92 | 25,24 | 3,45 | 25,38 | 6,00 | 21,28 | 16,67 | 23,14 |
| ReadAgent | 1,78 | 21,10 | 1,69 | 20,78 | 4,43 | 25,15 | 3,37 | 18,20 | 10,46 | 17,39 | ||
| MEMORY BANK | 2,37 | 17,81 | 2,22 | 21,93 | 3,86 | 20,65 | 3,99 | 16,26 | 15,49 | 20,77 | ||
| MEMGPT | 3,74 | 24,31 | 2,25 | 27,67 | 6,44 | 29,59 | 6,24 | 22,40 | 13,19 | 20,83 | ||
| A-MEM | 6,25 | 33,72 | 14,04 | 62,54 | 6,56 | 30,60 | 15,98 | 33,98 | 27,36 | 33,72 | ||
| Llama 3.2 | 4-hop | LoCoMo | 5,77 | 38,02 | 3,38 | 45,44 | 6,20 | 42,69 | 9,33 | 34,19 | 46,79 | 60,74 |
| ReadAgent | 2,97 | 29,26 | 1.31 | 26.45 | 7.13 | 39.19 | 5.36 | 26.44 | 42.39 | 54.35 | ||
| SPEICHERBANK | 6.77 | 39.33 | 4.43 | 45.63 | 7.76 | 42.81 | 13.01 | 37.32 | 50.43 | 60.81 | ||
| MEMGPT | 5.10 | 32.99 | 2.54 | 41.81 | 3.26 | 35.99 | 6.62 | 30.68 | 45.00 | 61.33 | ||
| A-MEM | 9.01 | 45.16 | 7.50 | 54.79 | 8.30 | 43.42 | 22.46 | 47.07 | 53.72 | 68.00 | ||
| Llama 3.2 | 4-Hop | LoCoMo | 3.69 | 27.94 | 2.96 | 20.40 | 6.46 | 32.17 | 6.58 | 22.92 | 29.02 | 35.74 |
| ReadAgent | 1.21 | 17.40 | 2.33 | 12.02 | 3.39 | 19.63 | 2.46 | 14.63 | 14.37 | 21,25 | ||
| SPEICHERBANK | 3,84 | 25,06 | 2,73 | 13,65 | 3,05 | 21,08 | 6,35 | 22,02 | 17,14 | 24,39 | ||
| MEMGPT | 2,78 | 22,06 | 2,21 | 14,97 | 3,63 | 23,18 | 3,47 | 17,81 | 20,50 | 26,87 | ||
| A-MEM | 9,74 | 39,32 | 13,19 | 59,70 | 8,09 | 32,27 | 24,30 | 42,86 | 39,74 | 46,76 | ||
| Methode | Kategorie | |||||
| Multi-Hop-F1 | BLEU-1 | Temporal-F1 | Open-Domain-F1 | Single-Hop-F1 | Adversarial-F1 | |
| DeepSeek-R1-32B | ||||||
| LoCoMo | 8,58 | 6,48 | 4,79 | 4,35 | 12,96 | 12,52 |
| MEMGPT | 8,28 | 6,25 | 5,45 | 4,97 | 10,97 | 9,09 |
| A-MEM | 15,02 | 10,64 | 14,64 | 11,01 | 14,81 | 12,82 |
| Claude 3.0 Haiku | ||||||
| LoCoMo | 4,56 | 3,33 | 0,82 | 0,59 | 2,86 | 3,22 |
| MEMGPT | 7,65 | 6,36 | 1,65 | 1,26 | 7,41 | 6,64 |
| A-MEM | 19,28 | 14,69 | 16,65 | 12,23 | 11,85 | 9,61 |
| Claude 3.5 Haiku | ||||||
| LoCoMo | 11,34 | 8,21 | 3,29 | 2,69 | 3,79 | 3,58 |
| MEMGPT | 8,27 | 6,55 | 3,99 | 2,76 | 4,71 | 4,48 |
| A-MEM | 29,70 | 23,19 | 31,54 | 27,53 | 11,42 | 9,47 |
Diese Visualisierungen bestätigen, dass A-MEM durch seine dynamischen Evolutions- und Verknüpfungsmechanismen autonom bedeutungsvolle Speicherstrukturen aufrechterhalten kann.
A.5 Hyperparameter-Einstellung
Alle Hyperparameter-k-Werte sind in Tabelle 8 dargestellt. Für Modelle, die bereits mit k=10 eine State-of-the-Art-(SOTA-)Leistung erreicht haben, behalten wir diesen Wert ohne weitere Optimierung bei.
| Modell | Multi Hop | Temporal | Open Domain | Single Hop | Adversarial |
| GPT-4o-mini | 40 | 40 | 50 | 50 | 40 |
| GPT-4o | 40 | 40 | 50 | 50 | 40 |
| Qwen2.5-1.5b | 10 | 10 | 10 | 10 | 10 |
| Qwen2.5-3b | 10 | 10 | 50 | 10 | 10 |
| Llama3.2-1b | 10 | 10 | 10 | 10 | 10 |
| Llama3.2-3b | 10 | 20 | 10 | 10 | 10 |
B Prompt-Vorlagen und Beispiele
B.1 Prompt-Vorlage für die Notizkonstruktion
Die Prompt-Vorlage in Note Construction:
Erzeuge eine strukturierte Analyse des folgenden Inhalts durch:
1. Identifizierung der hervorstechendsten Schlüsselwörter (Fokus auf Substantive, Verben und Schlüsselkonzepte)
2. Extraktion der Kernthemen und kontextuellen Elemente
3. Erstellung relevanter kategorialer Tags
Formatiere die Antwort als JSON-Objekt: {"keywords": [ // mehrere spezifische, unterschiedliche Schlüsselwörter, die Schlüsselkonzepte und Terminologie erfassen // Reihenfolge von am wichtigsten zu am wenigsten wichtig // Keine Schlüsselwörter, die der Name des Sprechers oder die Zeit sind // Mindestens drei Schlüsselwörter, aber nicht zu redundant. ], "context": // ein Satz, der zusammenfasst: // - Hauptthema/Domäne // - Zentrale Argumente/Punkte // - Zielpublikum/Zweck , "tags": [ // mehrere breite Kategorien/Themen zur Klassifizierung // Domänen-, Format- und Typ-Tags einschließen // Mindestens drei Tags, aber nicht zu redundant. ]}
Inhalt zur Analyse:
B.2 Prompt-Vorlage für die Link-Generierung
Die Prompt-Vorlage in Link Generation:
Du bist ein KI-Speicherentwicklungsagent, der für die Verwaltung und Weiterentwicklung einer Wissensbasis verantwortlich ist. Analysiere die neue Speichernotiz anhand von Schlüsselwörtern und Kontext sowie zusammen mit ihren mehreren nächsten Nachbar-Speichern. Der neue Speicherkontext: {context} Inhalt: {content} Schlüsselwörter: {keywords} Die nächsten Nachbar-Speicher: {nearest_neighbors_memories} Bestimme auf Basis dieser Informationen: Sollte dieser Speicher weiterentwickelt werden? Berücksichtige seine Beziehungen zu anderen Speichern.
B.3 Prompt-Vorlage für die Speicherentwicklung
Die Prompt-Vorlage in Memory Evolution:
Du bist ein KI-Speicherentwicklungsagent, der für die Verwaltung und Weiterentwicklung einer Wissensbasis verantwortlich ist. Analysiere die neue Speichernotiz anhand von Schlüsselwörtern und Kontext sowie zusammen mit ihren mehreren nächsten Nachbar-Speichern.
Triff Entscheidungen über ihre Entwicklung.
Der neue Speicherkontext: {context}
Inhalt: {content}
Schlüsselwörter: {keywords}
Die nächsten Nachbar-Speicher: {nearest_neighbors_memories}
Bestimme auf Basis dieser Informationen:
1. Welche spezifischen Aktionen sollten ergriffen werden (strengthen, update_neighbor)?
1.1 Wenn die Entscheidung darin besteht, die Verbindung zu stärken, mit welchem Speicher sollte sie verbunden werden? Kannst du die aktualisierten Tags dieses Speichers angeben?
1.2 Wenn die Entscheidung darin besteht, den Nachbarn zu aktualisieren, kannst du den Kontext und die Tags dieser Speicher basierend auf dem Verständnis dieser Speicher aktualisieren.
Tags sollten durch den Inhalt der Merkmale dieser Speicher bestimmt werden, die später zum Abrufen und Kategorisieren dieser verwendet werden können.
Alle oben genannten Informationen sollten in Listenformat gemäß der Reihenfolge zurückgegeben werden: [[new_memory],[neighbor_memory_1], ... [neighbor_memory_n]]
Diese Aktionen können kombiniert werden.
Gib deine Entscheidung im JSON-Format mit der folgenden Struktur zurück: {{ "should_evolve": true/false,
"actions": ["stärken", "zusammenführen", "ausdünnen"],
"suggested_connections": ["neighbor_memory_ids"],
"tags_to_update": ["tag_1", ... "tag_n"],
"new_context_neighborhood": ["new_context", ... "new_context"],
"new_tags_neighborhood": [["tag_1", ... "tag_n"], ... ["tag_1", ... "tag_n"]],
B.4 Beispiele für Q/A mit A-MEM
Beispiel:
Frage 686: Welches Hobby hat Dave im Oktober 2023 begonnen?
Vorhersage: Fotografie
Referenz: Fotografie
Gesprächsbeginn: 10:54 Uhr am 17. November 2023
Erinnerungsinhalt: Sprecher Dave sagt: Hey Calvin, lange nicht gesprochen! Es ist viel passiert. Ich habe mit der Fotografie angefangen und es ist großartig –ich habe die Landschaft hier fotografiert, was wirklich cool ist.
Erinnerungskontext: Das Hauptthema ist das neue Hobby des Sprechers, die Fotografie, wobei hervorgehoben wird, wie sehr er es genießt, die lokale Landschaft einzufangen; es zielt darauf ab, einen Freund in ein Gespräch über persönliche Erfahrungen einzubeziehen.
Erinnerungsschlüsselwörter: ['Fotografie', 'Landschaft', 'Gespräch', 'Erfahrung', 'Hobby']
Erinnerungs-Tags: ['Hobby', 'Fotografie', 'persönliche Entwicklung', 'Gespräch', 'Freizeit']
Gesprächsbeginn: 18:38 Uhr am 21. Juli 2023
Erinnerungsinhalt: Sprecher Calvin sagt: Danke, Dave! Es fühlt sich großartig an, meinen eigenen Raum zum Arbeiten zu haben. Ich habe in letzter Zeit mit verschiedenen Genres experimentiert und mich aus meiner Komfortzone herausbewegt. Das Hinzufügen elektronischer Elemente zu meinen Songs verleiht ihnen eine frische Ausstrahlung. Es war ein aufregender Prozess der Selbstfindung und des Wachstums!
Erinnerungskontext: Der Sprecher erörtert seinen kreativen Prozess in der Musik und hebt das Experimentieren mit Genres sowie die Einbeziehung elektronischer Elemente für persönliches Wachstum und künstlerische Entwicklung hervor.
Erinnerungsschlüsselwörter: ['Raum', 'Experimentieren', 'Genres', 'elektronisch', 'Selbstfindung', 'Wachstum']
Erinnerungs-Tags: ['Musik', 'Kreativität', 'Selbstverbesserung', 'künstlerischer Ausdruck']
NeurIPS Paper Checklist
Die Checkliste soll bewährte Verfahren für verantwortungsvolle maschinelle Lernforschung fördern und Themen wie Reproduzierbarkeit, Transparenz, Forschungsethik und gesellschaftliche Auswirkungen behandeln. Entfernen Sie die Checkliste nicht: Papiere, die die Checkliste nicht enthalten, werden ohne Begutachtung abgelehnt. Die Checkliste sollte nach den Referenzen und nach dem (optionalen) zusätzlichen Material folgen. Die Checkliste zählt NICHT zum Seitenlimit.
Bitte lesen Sie die Richtlinien der Checkliste sorgfältig durch, um Informationen dazu zu erhalten, wie diese Fragen zu beantworten sind. Für jede Frage in der Checkliste:
Sie sollten [Ja], [Nein] oder [NA] antworten. [NA] bedeutet entweder, dass die Frage für das jeweilige Papier Nicht Anwendbar ist oder die relevanten Informationen Nicht Verfügbar sind. Bitte geben Sie direkt nach Ihrer Antwort eine kurze Begründung (1–2 Sätze) an (auch bei NA).
Die Antworten der Checkliste sind ein integraler Bestandteil Ihrer Paper-Einreichung. Sie sind für die Gutachter, Area Chairs, Senior Area Chairs und Ethik-Gutachter sichtbar. Sie werden gebeten, sie auch (nach eventuellen Überarbeitungen) mit der finalen Version Ihres Papers einzureichen, und die finale Version wird mit dem Paper veröffentlicht.
Die Gutachter Ihres Papers werden gebeten, die Checkliste als einen der Faktoren in ihrer Bewertung zu verwenden. Während „[Yes]“ im Allgemeinen gegenüber „[No]“ vorzuziehen ist, ist es völlig akzeptabel, mit „[No]“ zu antworten, sofern eine angemessene Begründung gegeben wird (z. B. „Fehlerbalken werden nicht berichtet, weil es zu rechenintensiv wäre“ oder „wir konnten die Lizenz für den von uns verwendeten Datensatz nicht finden“). Im Allgemeinen ist die Antwort „[No]“ oder „[NA]“ kein Grund für eine Ablehnung. Obwohl die Fragen binär formuliert sind, erkennen wir an, dass die wahre Antwort oft differenzierter ist, also verwenden Sie bitte einfach Ihr bestes Urteilsvermögen und schreiben Sie eine Begründung zur Erläuterung. Alle unterstützenden Belege können entweder im Hauptpaper oder im ergänzenden Material im Anhang erscheinen. Wenn Sie eine Frage mit [Yes] beantworten, verweisen Sie in der Begründung bitte auf die Abschnitte, in denen sich relevantes Material zur Frage finden lässt.
WICHTIG, bitte:
- Löschen Sie diesen Anweisungsblock, aber behalten Sie die Abschnittsüberschrift „NeurIPS Paper Checklist“ bei. - Behalten Sie die Unterabschnittsüberschriften, Fragen/Antworten und Richtlinien der Checkliste unten bei. - Ändern Sie die Fragen nicht und verwenden Sie nur die bereitgestellten Makros für Ihre Antworten.
1. Claims
Frage: Geben die im Abstract und in der Einleitung gemachten Hauptbehauptungen die Beiträge und den Umfang des Papers korrekt wieder?
Antwort: [Yes]
Begründung: Das Abstract und die Einleitung fassen unsere Hauptbeiträge zusammen.
Richtlinien:
- Die Antwort NA bedeutet, dass das Abstract und die Einleitung die im Paper gemachten Behauptungen nicht enthalten. - Das Abstract und/oder die Einleitung sollten die gemachten Behauptungen klar darlegen, einschließlich der im Paper geleisteten Beiträge sowie wichtiger Annahmen und Einschränkungen. Eine Antwort „No“ oder „NA“ auf diese Frage wird von den Gutachtern nicht gut aufgenommen. - Die gemachten Behauptungen sollten mit theoretischen und experimentellen Ergebnissen übereinstimmen und widerspiegeln, inwieweit erwartet werden kann, dass die Ergebnisse auf andere Einstellungen generalisieren. - Es ist in Ordnung, aspirationale Ziele als Motivation anzuführen, solange klar ist, dass diese Ziele von dem Paper nicht erreicht werden.
2. Limitations
Frage: Diskutiert das Paper die Einschränkungen der von den Autoren durchgeführten Arbeit?
Antwort: [Yes]
Begründung: Dieses Paper enthält einen Abschnitt zu den Einschränkungen.
Richtlinien:
- Die Antwort NA bedeutet, dass das Paper keine Einschränkung hat, während die Antwort No bedeutet, dass das Paper Einschränkungen hat, diese aber im Paper nicht diskutiert werden.
- Den Autoren wird empfohlen, in ihrem Paper einen separaten Abschnitt „Limitations“ zu erstellen.
- Das Paper sollte auf etwaige starke Annahmen hinweisen und darauf, wie robust die Ergebnisse gegenüber Verletzungen dieser Annahmen sind (z. B. Unabhängigkeitsannahmen, rauschfreie Einstellungen, gute Modellspezifikation, asymptotische Approximationen, die nur lokal gelten). Die Autoren sollten reflektieren, wie diese Annahmen in der Praxis verletzt werden könnten und welche Implikationen dies hätte.
- Die Autoren sollten den Umfang der gemachten Behauptungen reflektieren, z. B. ob der Ansatz nur auf wenigen Datensätzen oder mit wenigen Durchläufen getestet wurde. Im Allgemeinen hängen empirische Ergebnisse oft von impliziten Annahmen ab, die dargelegt werden sollten.
- Die Autoren sollten die Faktoren reflektieren, die die Leistung des Ansatzes beeinflussen. Beispielsweise kann ein Gesichtserkennungsalgorithmus schlecht abschneiden, wenn die Bildauflösung niedrig ist oder Bilder bei schwachem Licht aufgenommen wurden. Oder ein Speech-to-Text-System könnte nicht zuverlässig für die Bereitstellung von Untertiteln für Online-Vorlesungen verwendet werden, weil es technischen Jargon nicht verarbeitet.
- Die Autoren sollten die rechnerische Effizienz der vorgeschlagenen Algorithmen und deren Skalierung mit der Datensatzgröße diskutieren.
- Falls zutreffend, sollten die Autoren mögliche Einschränkungen ihres Ansatzes zur Behandlung von Problemen der Privatsphäre und Fairness diskutieren.
- Während die Autoren befürchten könnten, dass vollständige Ehrlichkeit über Einschränkungen von Gutachtern als Grund für eine Ablehnung verwendet werden könnte, könnte ein schlechteres Ergebnis sein, dass Gutachter Einschränkungen entdecken, die im Paper nicht anerkannt werden. Die Autoren sollten ihr bestes Urteilsvermögen nutzen und erkennen, dass individuelles Handeln zugunsten von Transparenz eine wichtige Rolle bei der Entwicklung von Normen spielt, die die Integrität der Community bewahren. Die Gutachter werden ausdrücklich angewiesen, Ehrlichkeit in Bezug auf Einschränkungen nicht zu bestrafen.
3. Theory assumptions and proofs
Frage: Liefert das Paper für jedes theoretische Ergebnis die vollständige Menge an Annahmen und einen vollständigen (und korrekten) Beweis?
Antwort: [NA]
Begründung: N/A
Richtlinien:
- Die Antwort NA bedeutet, dass das Paper keine theoretischen Ergebnisse enthält.
- Alle Theoreme, Formeln und Beweise im Paper sollten nummeriert und querverwiesen werden.
- Alle Annahmen sollten in der Formulierung jedes Theorems klar dargelegt oder referenziert werden.
- Die Beweise können entweder im Hauptteil der Arbeit oder im Zusatzmaterial erscheinen; falls sie jedoch im Zusatzmaterial erscheinen, werden die Autoren ermutigt, eine kurze Beweisskizze zur Vermittlung der Intuition bereitzustellen.
- Umgekehrt sollte jeder informelle Beweis, der im Kern der Arbeit gegeben wird, durch formale Beweise ergänzt werden, die im Anhang oder im Zusatzmaterial bereitgestellt werden.
- Theoreme und Lemmata, auf die sich der Beweis stützt, sollten ordnungsgemäß referenziert werden.
4. Reproduzierbarkeit experimenteller Ergebnisse
Frage: Legt die Arbeit alle Informationen vollständig offen, die benötigt werden, um die wichtigsten experimentellen Ergebnisse der Arbeit in dem Maße zu reproduzieren, in dem sie die wichtigsten Behauptungen und/oder Schlussfolgerungen der Arbeit beeinflussen (unabhängig davon, ob der Code und die Daten bereitgestellt werden oder nicht)?
Antwort: [Ja]
Begründung: Sowohl Code als auch Datensätze sind verfügbar.
Leitlinien:
- Die Antwort NA bedeutet, dass die Arbeit keine Experimente enthält.
- Wenn die Arbeit Experimente enthält, wird eine Antwort „Nein“ auf diese Frage von den Gutachtern nicht gut aufgenommen: Die Reproduzierbarkeit der Arbeit ist wichtig, unabhängig davon, ob der Code und die Daten bereitgestellt werden oder nicht.
- Wenn der Beitrag ein Datensatz und/oder ein Modell ist, sollten die Autoren die Schritte beschreiben, die unternommen wurden, um ihre Ergebnisse reproduzierbar oder verifizierbar zu machen.
- Je nach Beitrag kann die Reproduzierbarkeit auf verschiedene Weise erreicht werden. Wenn der Beitrag beispielsweise eine neuartige Architektur ist, kann die vollständige Beschreibung der Architektur ausreichen; wenn der Beitrag ein spezifisches Modell und eine empirische Evaluierung ist, kann es erforderlich sein, es anderen entweder zu ermöglichen, das Modell mit demselben Datensatz zu replizieren, oder Zugang zum Modell zu gewähren. Im Allgemeinen ist die Veröffentlichung von Code und Daten oft ein guter Weg, dies zu erreichen, aber Reproduzierbarkeit kann auch durch detaillierte Anweisungen zur Replikation der Ergebnisse, Zugang zu einem gehosteten Modell (z. B. im Fall eines großen Sprachmodells), die Veröffentlichung eines Modell-Checkpoints oder andere Mittel erreicht werden, die für die durchgeführte Forschung angemessen sind.
- Obwohl NeurIPS die Veröffentlichung von Code nicht verlangt, verlangt die Konferenz von allen Einreichungen, dass sie einen angemessenen Weg zur Reproduzierbarkeit bereitstellen, der von der Art des Beitrags abhängen kann. Zum Beispiel
(a) Wenn der Beitrag in erster Linie ein neuer Algorithmus ist, sollte die Arbeit klar machen, wie dieser Algorithmus reproduziert werden kann.
(b) Wenn der Beitrag in erster Linie eine neue Modellarchitektur ist, sollte die Arbeit die Architektur klar und vollständig beschreiben.
(c) Wenn der Beitrag ein neues Modell ist (z. B. ein großes Sprachmodell), dann sollte es entweder einen Weg geben, auf dieses Modell zuzugreifen, um die Ergebnisse zu reproduzieren, oder einen Weg, das Modell zu reproduzieren (z. B. mit einem Open-Source-Datensatz oder Anweisungen zum Aufbau des Datensatzes).
(d) Wir erkennen an, dass Reproduzierbarkeit in manchen Fällen schwierig sein kann; in diesem Fall sind Autoren eingeladen, die besondere Art und Weise zu beschreiben, in der sie Reproduzierbarkeit ermöglichen. Bei Closed-Source-Modellen kann es sein, dass der Zugang zum Modell in irgendeiner Weise eingeschränkt ist (z. B. auf registrierte Nutzer), aber es sollte für andere Forscher möglich sein, einen Weg zur Reproduktion oder Verifizierung der Ergebnisse zu haben.
5. Offener Zugang zu Daten und Code
Frage: Bietet die Arbeit offenen Zugang zu den Daten und dem Code, mit ausreichenden Anweisungen, um die wichtigsten experimentellen Ergebnisse getreu zu reproduzieren, wie im Zusatzmaterial beschrieben?
Antwort: [Ja]
Begründung: Wir stellen den Code-Link im Abstract bereit.
Leitlinien:
- Die Antwort NA bedeutet, dass die Arbeit keine Experimente enthält, die Code erfordern.
- Bitte siehe die NeurIPS-Richtlinien zur Einreichung von Code und Daten (https://nips.cc/public/guides/CodeSubmissionPolicy) für weitere Details.
- Obwohl wir die Veröffentlichung von Code und Daten fördern, verstehen wir, dass dies möglicherweise nicht möglich ist, daher ist „Nein“ eine akzeptable Antwort. Arbeiten können nicht allein deshalb abgelehnt werden, weil sie keinen Code enthalten, es sei denn, dies ist zentral für den Beitrag (z. B. bei einem neuen Open-Source-Benchmark).
- Die Anweisungen sollten den genauen Befehl und die Umgebung enthalten, die zum Ausführen benötigt werden, um die Ergebnisse zu reproduzieren. Siehe die NeurIPS-Richtlinien zur Einreichung von Code und Daten (https://nips.cc/public/guides/CodeSubmissionPolicy) für weitere Details.
- Die Autoren sollten Anweisungen zum Datenzugang und zur Datenvorbereitung bereitstellen, einschließlich wie auf die Rohdaten, vorverarbeiteten Daten, Zwischendaten und generierten Daten zugegriffen werden kann usw.
- Die Autoren sollten Skripte bereitstellen, um alle experimentellen Ergebnisse für die neu vorgeschlagene Methode und die Baselines zu reproduzieren. Wenn nur eine Teilmenge der Experimente reproduzierbar ist, sollten sie angeben, welche aus dem Skript ausgelassen werden und warum.
- Zum Einreichungszeitpunkt sollten die Autoren zur Wahrung der Anonymität anonymisierte Versionen veröffentlichen (falls zutreffend).
- Es wird empfohlen, so viele Informationen wie möglich im Zusatzmaterial (an die Arbeit angehängt) bereitzustellen, aber die Angabe von URLs zu Daten und Code ist zulässig.
6. Experimentelle Einstellung/Details
Frage: Gibt die Arbeit alle Trainings- und Testdetails an (z. B. Datenaufteilungen, Hyperparameter, wie sie gewählt wurden, Art des Optimierers usw.), die zum Verständnis der Ergebnisse erforderlich sind?
Antwort: [Ja]
Begründung: Wir decken alle Details in der Arbeit ab.
Leitlinien:- Die Antwort NA bedeutet, dass die Arbeit keine Experimente enthält.- Die experimentelle Einstellung sollte im Kern der Arbeit mit einem Detaillierungsgrad dargestellt werden, der erforderlich ist, um die Ergebnisse zu würdigen und zu verstehen.- Die vollständigen Details können entweder mit dem Code, im Anhang oder als Zusatzmaterial bereitgestellt werden.
7. Statistische Signifikanz der Experimente
Frage: Berichtet die Arbeit Fehlerbalken in geeigneter und korrekt definierter Weise oder andere geeignete Informationen über die statistische Signifikanz der Experimente?
Antwort: [Nein]
Begründung: Die Experimente nutzen die API großer Sprachmodelle. Mehrfache Aufrufe würden die Kosten erheblich erhöhen.
Leitlinien:- Die Antwort NA bedeutet, dass die Arbeit keine Experimente enthält.- Die Autoren sollten „Ja“ antworten, wenn die Ergebnisse von Fehlerbalken, Konfidenzintervallen oder Tests auf statistische Signifikanz begleitet werden, zumindest für die Experimente, die die Hauptbehauptungen der Arbeit stützen.- Die Variabilitätsfaktoren, die die Fehlerbalken erfassen, sollten klar angegeben werden (zum Beispiel Trainings-/Testaufteilung, Initialisierung, zufällige Ziehung eines Parameters oder gesamter Lauf unter gegebenen experimentellen Bedingungen).- Die Methode zur Berechnung der Fehlerbalken sollte erläutert werden (geschlossene Formel, Aufruf einer Bibliotheksfunktion, Bootstrap usw.).- Die getroffenen Annahmen sollten angegeben werden (z. B. normalverteilte Fehler).- Es sollte klar sein, ob der Fehlerbalken die Standardabweichung oder der Standardfehler des Mittelwerts ist.- Es ist in Ordnung, 1-Sigma-Fehlerbalken zu berichten, aber man sollte dies angeben. Die Autoren sollten vorzugsweise einen 2-Sigma-Fehlerbalken berichten, statt anzugeben, dass sie ein 96%-KI haben, wenn die Hypothese der Normalität der Fehler nicht verifiziert ist.- Bei asymmetrischen Verteilungen sollten die Autoren darauf achten, in Tabellen oder Abbildungen keine symmetrischen Fehlerbalken zu zeigen, die Ergebnisse außerhalb des Bereichs ergeben würden (z. B. negative Fehlerraten).- Wenn Fehlerbalken in Tabellen oder Diagrammen berichtet werden, sollten die Autoren im Text erklären, wie sie berechnet wurden, und die entsprechenden Abbildungen oder Tabellen im Text referenzieren.
8. Rechenressourcen der Experimente
Frage: Gibt die Arbeit für jedes Experiment ausreichende Informationen über die Computerressourcen (Art der Rechenknoten, Speicher, Ausführungszeit) an, die zur Reproduktion der Experimente erforderlich sind?
Antwort: [Ja]
Begründung: Dies kann im experimentellen Teil gefunden werden.
Leitlinien:- Die Antwort NA bedeutet, dass die Arbeit keine Experimente enthält.- Die Arbeit sollte die Art der Rechenknoten angeben, CPU oder GPU, internen Cluster oder Cloud-Anbieter, einschließlich relevantem Speicher und Speicherplatz.
- Die Arbeit sollte die Menge an Rechenleistung angeben, die für jeden der einzelnen experimentellen Läufe erforderlich ist, sowie die gesamte Rechenleistung schätzen.
- Die Arbeit sollte offenlegen, ob das gesamte Forschungsprojekt mehr Rechenleistung erforderte als die in der Arbeit berichteten Experimente (z. B. vorläufige oder fehlgeschlagene Experimente, die es nicht in die Arbeit geschafft haben).
9. Ethikkodex
Frage: Entspricht die in der Arbeit durchgeführte Forschung in jeder Hinsicht dem NeurIPS-Ethikkodex https://neurips.cc/public/EthicsGuidelines?
Antwort: [NA]
Begründung: N/A
Leitlinien:
- Die Antwort NA bedeutet, dass die Autoren den NeurIPS Code of Ethics nicht geprüft haben. - Wenn die Autoren mit Nein antworten, sollten sie die besonderen Umstände erläutern, die eine Abweichung vom Code of Ethics erfordern. - Die Autoren sollten sicherstellen, dass die Anonymität gewahrt bleibt (z. B. wenn aufgrund von Gesetzen oder Vorschriften in ihrer Gerichtsbarkeit eine besondere Berücksichtigung erforderlich ist).
10. Breitere Auswirkungen
Frage: Diskutiert das Papier sowohl potenzielle positive gesellschaftliche Auswirkungen als auch negative gesellschaftliche Auswirkungen der durchgeführten Arbeit?
Antwort: [Nein]
Begründung: Wir diskutieren diesen Aspekt nicht, da wir nur das Speichersystem für LLM-Agenten bereitstellen. Unterschiedliche LLM-Agenten können unterschiedliche gesellschaftliche Auswirkungen erzeugen, die über den Rahmen unserer Arbeit hinausgehen.
Leitlinien:
- Die Antwort NA bedeutet, dass die durchgeführte Arbeit keine gesellschaftlichen Auswirkungen hat.
- Wenn die Autoren mit NA oder Nein antworten, sollten sie erklären, warum ihre Arbeit keine gesellschaftlichen Auswirkungen hat oder warum das Papier gesellschaftliche Auswirkungen nicht behandelt.
- Beispiele für negative gesellschaftliche Auswirkungen umfassen potenzielle böswillige oder unbeabsichtigte Verwendungen (z. B. Desinformation, Erstellung gefälschter Profile, Überwachung), Fairness-Erwägungen (z. B. Einsatz von Technologien, die Entscheidungen treffen könnten, die bestimmte Gruppen unfair beeinflussen), Datenschutzerwägungen und Sicherheitserwägungen.
- Die Konferenz erwartet, dass viele Papiere Grundlagenforschung sind und nicht an bestimmte Anwendungen gebunden sind, geschweige denn an Bereitstellungen. Wenn es jedoch einen direkten Weg zu negativen Anwendungen gibt, sollten die Autoren darauf hinweisen. Beispielsweise ist es legitim, darauf hinzuweisen, dass eine Verbesserung der Qualität generativer Modelle zur Erzeugung von Deepfakes für Desinformation genutzt werden könnte. Andererseits ist es nicht erforderlich, darauf hinzuweisen, dass ein generischer Algorithmus zur Optimierung neuronaler Netze es Menschen ermöglichen könnte, Modelle schneller zu trainieren, die Deepfakes erzeugen.
- Die Autoren sollten mögliche Schäden berücksichtigen, die entstehen könnten, wenn die Technologie wie beabsichtigt und korrekt funktionierend verwendet wird, Schäden, die entstehen könnten, wenn die Technologie wie beabsichtigt verwendet wird, aber falsche Ergebnisse liefert, und Schäden, die aus (absichtlichem oder unabsichtlichem) Missbrauch der Technologie folgen.
- Wenn es negative gesellschaftliche Auswirkungen gibt, könnten die Autoren auch mögliche Gegenmaßnahmen diskutieren (z. B. kontrollierte Freigabe von Modellen, Bereitstellung von Verteidigungsmechanismen zusätzlich zu Angriffen, Mechanismen zur Überwachung von Missbrauch, Mechanismen zur Überwachung, wie ein System im Laufe der Zeit aus Feedback lernt, Verbesserung der Effizienz und Zugänglichkeit von ML).
11. Schutzmaßnahmen
Frage: Beschreibt das Paper Schutzmaßnahmen, die für die verantwortungsvolle Freigabe von Daten oder Modellen mit hohem Missbrauchsrisiko eingerichtet wurden (z. B. vortrainierte Sprachmodelle, Bildgeneratoren oder gescrapte Datensätze)?
Antwort: [NA]
Begründung: N/A
Richtlinien:
Richtlinien:
12. Lizenzen für bestehende Ressourcen
Frage: Werden die Ersteller oder ursprünglichen Eigentümer der im Paper verwendeten Ressourcen (z. B. Code, Daten, Modelle) ordnungsgemäß genannt, und werden die Lizenz und die Nutzungsbedingungen ausdrücklich erwähnt und ordnungsgemäß eingehalten?
Antwort: [Ja]
Begründung: Ihr Beitrag wurde bereits ordnungsgemäß anerkannt und gewürdigt.
Richtlinien:
Richtlinien:
13. Neue Ressourcen
Frage: Sind neue, im Paper eingeführte Ressourcen gut dokumentiert, und wird die Dokumentation zusammen mit den Ressourcen bereitgestellt?
Antwort: [NA]
Begründung: N/A
Richtlinien:
Richtlinien:
14. Crowdsourcing und Forschung mit menschlichen Probanden
Frage: Enthält das Paper für Crowdsourcing-Experimente und Forschung mit menschlichen Probanden den vollständigen Text der den Teilnehmenden gegebenen Anweisungen und ggf. Screenshots sowie Angaben zur Vergütung (falls vorhanden)?
Antwort: [NA]
Begründung: N/A
Richtlinien:
- Die Antwort NA bedeutet, dass das Paper weder Crowdsourcing noch Forschung mit menschlichen Probanden umfasst.- Die Aufnahme dieser Informationen in das Zusatzmaterial ist in Ordnung, aber wenn der Hauptbeitrag des Papers menschliche Probanden umfasst, sollte so viel Detail wie möglich in das Hauptpaper aufgenommen werden.- Gemäß dem NeurIPS Code of Ethics sollten an der Datenerhebung, -kuratierung oder anderen Arbeiten beteiligte Arbeitskräfte mindestens den Mindestlohn des Landes erhalten, in dem die Datenerhebung stattfindet.
15. Genehmigungen durch Institutional Review Boards (IRB) oder gleichwertige Genehmigungen für Forschung mit menschlichen Probanden
Frage: Beschreibt das Paper potenzielle Risiken für Studienteilnehmende, ob diese Risiken den Probanden offengelegt wurden und ob Genehmigungen von Institutional Review Boards (IRB) (oder eine gleichwertige Genehmigung/Überprüfung gemäß den Anforderungen Ihres Landes oder Ihrer Institution) eingeholt wurden?
Antwort: [NA]
Begründung: N/A
Richtlinien:
- Die Antwort NA bedeutet, dass das Paper weder Crowdsourcing noch Forschung mit menschlichen Probanden umfasst.- Je nach Land, in dem die Forschung durchgeführt wird, kann für jede Forschung mit menschlichen Probanden eine IRB-Genehmigung (oder gleichwertig) erforderlich sein. Wenn Sie eine IRB-Genehmigung erhalten haben, sollten Sie dies im Paper klar angeben.- Wir erkennen an, dass die Verfahren hierfür zwischen Institutionen und Standorten erheblich variieren können, und wir erwarten, dass Autoren den NeurIPS Code of Ethics und die Richtlinien ihrer Institution einhalten.- Bei Ersteinreichungen dürfen keine Informationen aufgenommen werden, die die Anonymität brechen würden (falls zutreffend), wie z. B. die Institution, die die Überprüfung durchführt.
16. Erklärung zur LLM-Nutzung
Frage: Beschreibt das Paper die Nutzung von LLMs, wenn diese eine wichtige, originäre oder nicht standardmäßige Komponente der Kernmethoden dieser Forschung darstellen? Beachten Sie, dass eine Erklärung nicht erforderlich ist, wenn das LLM nur zu Schreib-, Bearbeitungs- oder Formatierungszwecken verwendet wird und die Kernmethodik, die wissenschaftliche Strenge oder die Originalität der Forschung nicht beeinflusst.
Antwort: [NA]
Begründung: N/A
Richtlinien:
- Die Antwort NA bedeutet, dass die Entwicklung der Kernmethode in dieser Forschung keine LLMs als wichtige, originäre oder nicht standardmäßige Komponenten umfasst.- Bitte beachten Sie unsere LLM-Richtlinie (https://neurips.cc/Conferences/2025/LLM) dafür, was beschrieben werden sollte und was nicht.