
Zweitausend echte GitHub-Issues end-to-end gelöst, von versteckten Tests bewertet: der Benchmark für Coding-Agenten. ICLR 2024, kostenlos.
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
SWE-BENCH: KÖNNEN SPRACHMODELLE REALE GITHUB-ISSUES LÖSEN?
Carlos E. Jimenez John Yang Alexander Wettig
Shunyu Yao Kexin Pei Ofir Press Karthik Narasimhan
Princeton University Princeton Language and Intelligence University of Chicago
KURZFASSUNG
Sprachmodelle haben unsere Fähigkeit übertroffen, sie effektiv zu evaluieren, aber für ihre zukünftige Entwicklung ist es wesentlich, die Grenze ihrer Fähigkeiten zu untersuchen. Wir finden, dass reale Softwareentwicklung ein reichhaltiges, nachhaltiges und anspruchsvolles Testfeld für die Evaluierung der nächsten Generation von Sprachmodellen darstellt. Zu diesem Zweck führen wir SWE-bench ein, ein Evaluierungsframework, das aus 2.294 Softwareentwicklungsproblemen besteht, die aus realen GitHub-Issues und entsprechenden Pull Requests aus 12 beliebten Python-Repositories stammen. Bei gegebener Codebasis zusammen mit einer Beschreibung eines zu lösenden Issues besteht die Aufgabe eines Sprachmodells darin, die Codebasis zu bearbeiten, um das Issue zu adressieren. Das Lösen von Issues in SWE-bench erfordert häufig das Verstehen und Koordinieren von Änderungen über mehrere Funktionen, Klassen und sogar Dateien gleichzeitig hinweg, was von den Modellen verlangt, mit Ausführungsumgebungen zu interagieren, extrem lange Kontexte zu verarbeiten und komplexe Schlussfolgerungen anzustellen, die weit über traditionelle Codegenerierungsaufgaben hinausgehen. Unsere Evaluierungen zeigen, dass sowohl modernste proprietäre Modelle als auch unser feinabgestimmtes Modell SWE-Llama nur die einfachsten Issues lösen können. Das leistungsstärkste Modell, Claude 2, ist in der Lage, lediglich \(1,96\%\) der Issues zu lösen. Fortschritte auf SWE-bench stellen Schritte hin zu LMs dar, die praktischer, intelligenter und autonomer sind.
1 EINLEITUNG
Sprachmodelle (LMs) werden rasch in kommerziellen Produkten wie Chatbots und Programmierassistenten eingesetzt. Gleichzeitig sind bestehende Benchmarks gesättigt (Kiela et al., 2021; Ott et al., 2022) und erfassen nicht die Grenze dessen, was moderne LMs leisten können und was nicht. Es besteht ein Bedarf an anspruchsvollen Benchmarks, die die realen Anwendungen von LMs genauer widerspiegeln, um ihre zukünftige Entwicklung und Nutzung mitzugestalten (Srivastava et al., 2023).
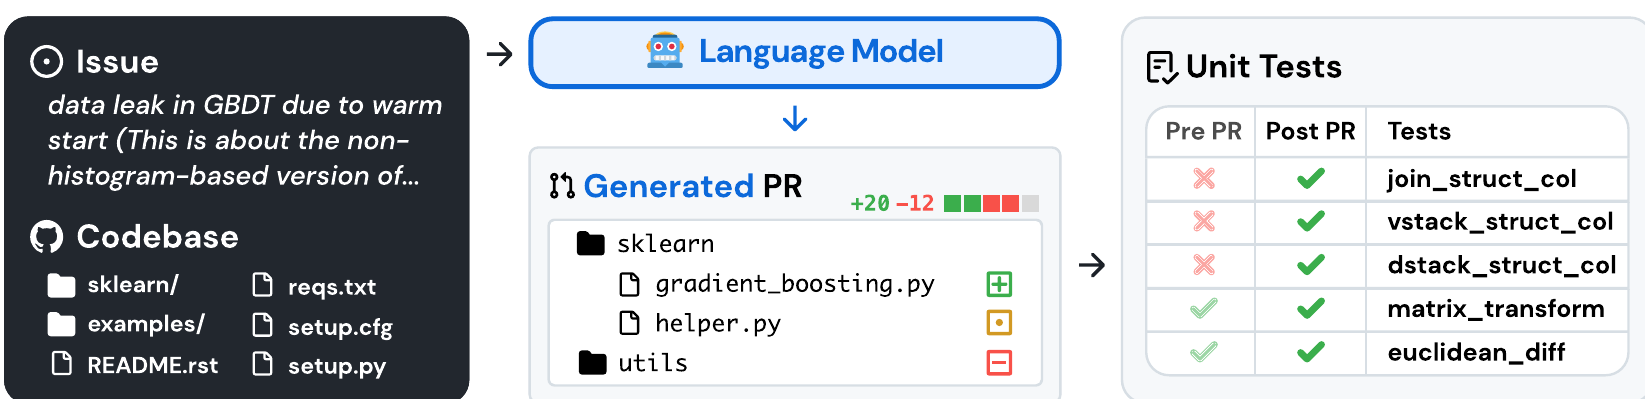
Die Erstellung eines guten Benchmarks ist schwierig, da die Aufgaben herausfordernd genug sein müssen, um bestehende Modelle zu überfordern, aber die Modellvorhersagen auch leicht verifizierbar sein müssen (Martinez-Plumed et al., 2021). Programmieraufgaben sind attraktiv, da sie LMs vor herausfordernde Probleme stellen, die generierten Lösungen jedoch leicht durch das Ausführen von Unit-Tests verifiziert werden können. Bestehende Programmier-Benchmarks wie HumanEval (Chen et al., 2021) umfassen jedoch meist in sich geschlossene Probleme, die in wenigen Codezeilen gelöst werden können.
In der realen Welt ist Softwareentwicklung nicht so einfach. Die Behebung eines Bugs kann das Navigieren in einem großen Repository, das Verstehen des Zusammenspiels zwischen Funktionen in verschiedenen Dateien oder das Aufspüren eines kleinen Fehlers in verschachteltem Code erfordern. Davon inspiriert führen wir SWE-bench ein, einen Benchmark, der LMs in einem realistischen Softwareentwicklungsumfeld evaluiert. Wie in Abbildung 1 dargestellt, besteht die Aufgabe der Modelle darin, Issues (typischerweise einen Bug-Bericht oder eine Funktionsanfrage) zu lösen, die bei beliebten GitHub-Repositories eingereicht wurden. Jede Aufgabe erfordert die Generierung eines Patches, der die auf die bestehende Codebasis anzuwendenden Änderungen beschreibt. Die überarbeitete Codebasis wird dann unter Verwendung des Testframeworks des Repositories evaluiert.
SWE-bench bietet mehrere Vorteile gegenüber bestehenden LM-Programmier-Benchmarks. Dazu gehören eine realistische Umgebung, die von Benutzern eingereichte Issues und Lösungen nutzt, vielfältige Eingaben mit einzigartigen Codeproblemen aus 12 Repositories, ein robustes Framework für ausführungsbasierte Evaluierung und die Möglichkeit, den Benchmark kontinuierlich mit neuen Instanzen zu aktualisieren, wobei minimaler menschlicher Eingriff erforderlich ist.
Wir evaluieren mehrere moderne LMs auf SWE-bench und stellen fest, dass sie alle außer den einfachsten Issues nicht lösen können. Unter Verwendung eines BM25-Retrievers ist Claude 2 nur in der Lage, \(1,96\%\) der Issues zu lösen.
Neben SWE-bench umfassen unsere Beiträge die Veröffentlichung eines Trainingsdatensatzes, SWE-bench-train, der für die Förderung der Entwicklung offener Modelle in diesem anspruchsvollen Bereich wesentlich ist. Dieser Datensatz umfasst eine Sammlung von 19.000 nicht-testenden Aufgabeninstanzen aus 37 Repositories. Unter Verwendung von SWE-bench-train veröffentlichen wir zwei feinabgestimmte Modelle, SWE-Llama 7b und 13b, basierend auf dem CodeLlama-Modell (Rozière et al., 2023). Wir stellen fest, dass SWE-Llama 13b in einigen Einstellungen mit Claude 2 konkurrenzfähig ist und in der Lage ist, Kontexte von über 100.000 Tokens zu verarbeiten.
2 SWE-BENCH
SWE-bench ist ein Benchmark mit GitHub-Issues aus beliebten Repositories, die Bugs melden oder neue Funktionen anfordern, sowie Pull Requests, die Änderungen am Repository vornehmen, um diese Issues zu lösen. Die Aufgabe besteht darin, einen Pull Request zu generieren, der ein gegebenes Issue adressiert und die mit dem Issue verbundenen Tests besteht.
2.1 KONSTRUKTION DES BENCHMARKS
GitHub ist eine reichhaltige Datenquelle für die Softwareentwicklung, aber Repositories, Issues und Pull Requests können verrauscht, ad hoc oder schlecht dokumentiert oder gepflegt sein. Um hochwertige Aufgabeninstanzen in großem Umfang zu finden, verwenden wir eine dreistufige Pipeline wie folgt.
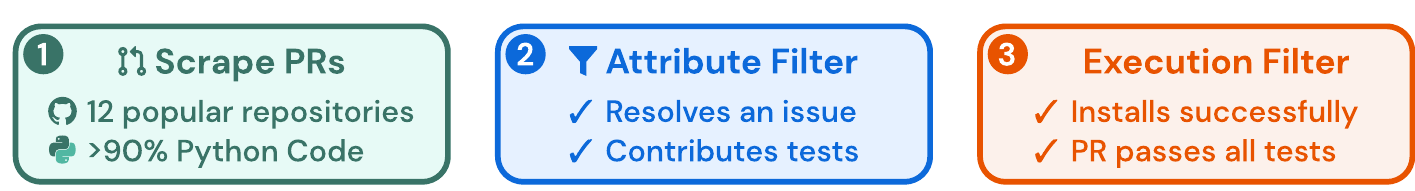
Stufe I: Repository-Auswahl und Datenextraktion. Wir beginnen mit dem Sammeln von Pull Requests (PRs) aus 12 beliebten Open-Source-Python-Repositories auf GitHub, was insgesamt etwa \(\sim 90.000\) PRs ergibt. Wir konzentrieren uns auf beliebte Repositories, da diese tendenziell besser gepflegt sind, klare Richtlinien für Mitwirkende haben und eine bessere Testabdeckung aufweisen. Jeder PR hat eine zugehörige Codebasis, die durch seinen Basis-Commit spezifiziert wird.
Stufe II: Attributbasierte Filterung. Wir erstellen Kandidatenaufgaben, indem wir die zusammengeführten PRs auswählen, die (1) ein GitHub-Issue lösen und (2) Änderungen an den Testdateien des Repositories vornehmen, was darauf hindeutet, dass der Benutzer wahrscheinlich Tests beigesteuert hat, um zu prüfen, ob das Issue gelöst wurde.
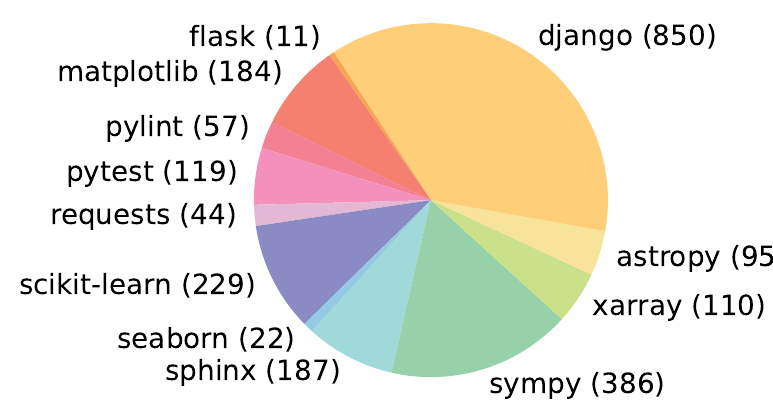
Stufe III: Ausführungsbasierte Filterung. Für jede Kandidatenaufgabe wenden wir den Testinhalt des PRs an und protokollieren die zugehörigen Testergebnisse, bevor und nachdem der übrige Inhalt des PRs angewendet wird. Wir filtern Aufgabeninstanzen heraus, die nicht mindestens einen Test aufweisen, bei dem sich sein Status von fehlschlagend zu bestehend ändert (im Folgenden als Fail-to-Pass-Test bezeichnet). Wir filtern auch Instanzen heraus, die zu Installations- oder Laufzeitfehlern führen. Durch diese Filterungsstufen werden die ursprünglichen 90.000 PRs auf die 2.294 Aufgabeninstanzen reduziert, die SWE-bench umfassen. Eine abschließende Aufschlüsselung dieser Aufgabeninstanzen nach Repositories ist in Abbildung 3 dargestellt, und Tabelle 1 hebt die wichtigsten Merkmale der SWE-bench-Aufgabeninstanzen hervor. Wir betonen, dass die Codebasen groß sind und Tausende von Dateien enthalten und dass die Referenz-Pull-Requests häufig Änderungen an mehreren Dateien gleichzeitig vornehmen. Technische Details zur Konstruktionspipeline von SWE-bench werden in Anhang A diskutiert. Weitere Datensatzstatistiken finden sich in Anhang A.5.
2.2 AUFGABENFORMULIERUNG
Modelleingabe. Einem Modell wird eine Issue-Textbeschreibung und eine vollständige Codebasis gegeben. Das Modell hat dann die Aufgabe, eine Bearbeitung der Codebasis vorzunehmen, um das Issue zu lösen. In der Praxis stellen wir Bearbeitungen als Patch-Dateien dar, die angeben, welche Zeilen in der Codebasis geändert werden müssen, um das Issue zu lösen.
Evaluierungsmetriken. Um eine vorgeschlagene Lösung zu evaluieren, wenden wir den generierten Patch unter Verwendung des Unix-Programms patch auf die Codebasis an und führen dann die Unit- und Systemtests aus, die mit der Aufgabeninstanz verbunden sind. Wenn der Patch erfolgreich angewendet wird und alle diese Tests bestehen, betrachten wir die vorgeschlagene Lösung als erfolgreiche Lösung des Issues. Die Metrik für unseren Benchmark ist der Prozentsatz der Aufgabeninstanzen, die gelöst werden. Weitere technische Details in Anhang A.4.
2.3 MERKMALE VON SWE-BENCH
Traditionelle Benchmarks in der NLP umfassen typischerweise nur kurze Eingabe- und Ausgabesequenzen und betrachten somewhat „konstruierte“ Probleme, die speziell für den Benchmark erstellt wurden. Im Gegensatz dazu verleiht die realistische Konstruktionsumgebung von SWE-bench dem Datensatz einzigartige Eigenschaften, die wir im Folgenden diskutieren.
Reale Softwareentwicklungsaufgaben. Da jede Aufgabeninstanz in SWE-bench aus einer großen und komplexen Codebasis und einer Beschreibung eines relevanten Issues besteht, erfordert das Lösen von SWE-bench die Demonstration anspruchsvoller Fähigkeiten und Kenntnisse, die erfahrene Softwareentwickler besitzen, die aber in traditionellen Codegenerierungs-Benchmarks üblicherweise nicht evaluiert werden.
Kontinuierlich aktualisierbar. Unser Sammelprozess kann leicht auf jedes Python-Repository auf GitHub angewendet werden und erfordert minimalen menschlichen Eingriff. Daher können wir SWE-bench mit einer kontinuierlichen Versorgung neuer Aufgabeninstanzen erweitern und LMs anhand von Issues evaluieren, die nach ihrem Trainingsdatum erstellt wurden, was sicherstellt, dass die Lösung nicht in ihrem Trainingskorpus enthalten war.
Vielfältige lange Eingaben. Issue-Beschreibungen sind typischerweise lang und detailliert (durchschnittlich 195 Wörter), und Codebasen enthalten regelmäßig viele Tausende von Dateien. Das Lösen von SWE-bench erfordert die Identifizierung der relativ geringen Anzahl von Zeilen, die bearbeitet werden müssen, um ein Issue in einem Meer von Kontext zu lösen.
Robuste Evaluierung. Für jede Aufgabeninstanz gibt es mindestens einen Fail-to-Pass-Test, der zur Prüfung der Referenzlösung verwendet wurde, und \(40\%\) der Instanzen haben mindestens zwei Fail-to-Pass-Tests. Diese Tests bewerten, ob das Modell das Problem im Issue adressiert hat. Darüber hinaus wird eine mediane Anzahl von 51 zusätzlichen Tests ausgeführt, um zu prüfen, ob die vorherige Funktionalität ordnungsgemäß erhalten bleibt.
Kontextübergreifende Codebearbeitung. Im Gegensatz zu früheren Einstellungen, die den Bearbeitungsumfang auf eine einzelne Funktion oder Klasse beschränken können (z. B. Chen et al., 2021; Cassano et al., 2022) oder Lückentext-Aufgaben im Cloze-Stil bereitstellen (z. B. Lu et al., 2021; Fried et al., 2023), bietet SWE-bench keine solch explizite Anleitung. Anstatt lediglich ein kurzes Codeschnipsel erzeugen zu müssen, fordert unser Benchmark die Modelle heraus, Änderungen an mehreren Stellen einer großen Codebasis zu generieren. Die Referenzlösungen von SWE-bench bearbeiten durchschnittlich 1,7 Dateien, 3,0 Funktionen und 32,8 Zeilen (hinzugefügt oder entfernt).
Breiter Spielraum für mögliche Lösungen. Die Aufgabe der repository-weiten Codebearbeitung kann als faire Ausgangsbasis dienen, um Ansätze zu vergleichen, die von Retrieval- und Langkontextmodellen bis hin zu entscheidungstragenden Agenten reichen, die im Code reasoning betreiben und handeln könnten. SWE-bench erlaubt zudem kreative Freiheit, da Modelle neuartige Lösungen generieren können, die von der Referenz-PR abweichen mögen.
2.4 SWE-BENCH LITE
Die Evaluierung von LMs auf SWE-bench kann zeitaufwändig sein und je nach Modell einen kostspieligen Rechenaufwand oder API-Guthaben erfordern. Angesichts der Tatsache, dass die ersten Leistungsergebnisse, wie in Abschnitt 5 dargestellt, recht niedrig ausfallen, macht die Schwierigkeit von SWE-bench es nützlich, um den Fortschritt von LMs langfristig zu messen, aber potenziell einschüchternd für erste Systeme, die kurzfristig Fortschritte erzielen wollen.
| Durchschnitt | Maximum | ||
| Issue-Text | Länge (Wörter) | 195,1 | 4477 |
| Codebasis | Dateien (Nicht-Test) | 3.010 | 5.890 |
| Zeilen (Nicht-Test) | 438K | 886K | |
| Gold-Patch | Bearbeitete Zeilen | 32,8 | 5888 |
| Bearbeitete Dateien | 1,7 | 31 | |
| Bearbeitete Funktionen | 3 | 36 | |
| Tests | Fail to Pass | 9,1 | 1633 |
| Gesamt | 120,8 | 9459 |
Um die Akzeptanz von SWE-bench zu fördern, erstellen wir ein Lite-Subset von 300 Instanzen aus SWE-bench, die so ausgewählt wurden, dass sie stärker in sich geschlossen sind, mit dem Fokus auf die Evaluierung funktionaler Bugfixes. Die vollständigen Filterkriterien und Dataset-Informationen sind enthalten in SWE-bench Lite umfasst 11 der ursprünglichen 12 Repositories, mit einer ähnlichen Vielfalt und Verteilung von Aufgabeninstanzen über die Repositories wie das Original. Vollständige Details zum Lite-Split und zu den Filterdetails sind in Anhang A.7 enthalten.
3 SWE-LLAMA: FINE-TUNING VON CODELLAMA FÜR SWE-BENCH
Es ist wichtig, die Leistung offener Modelle auf SWE-bench neben proprietären Modellen zu benchmarken. Zum Zeitpunkt des Verfassens sind nur die CodeLlama-Modelle (Rozière et al., 2023) in der Lage, die sehr langen Kontexte zu verarbeiten, die notwendig sind. Wir beobachten jedoch, dass die vorliegenden CodeLlama-Varianten nicht in der Lage sind, den detaillierten Anweisungen zur Generierung repository-weiter Codeänderungen zu folgen, und typischerweise Platzhalterantworten oder unbezogenen Code ausgeben. Um die Fähigkeiten dieser Modelle besser zu evaluieren, führen wir überwachtes Fine-Tuning an den CodeLlama-Python-Modellen mit 7 Milliarden und 13 Milliarden Parametern durch. Die resultierenden Modelle sind spezialisierte Repository-Editoren, die auf Consumer-Hardware laufen und GitHub-Issues lösen können.
Trainingsdaten. Wir folgen unserem Datenerhebungsverfahren und sammeln 19.000 Issue-PR-Paare aus weiteren 37 beliebten Python-Paket-Repositories. Im Gegensatz zu Abschnitt 2.1 verlangen wir nicht, dass Pull Requests Teständerungen beitragen. Dies ermöglicht es uns, einen deutlich größeren Trainingssatz für überwachtes Fine-Tuning zu erstellen. Um das Risiko einer Datenkontamination zu beseitigen, ist die Menge der Repositories in den Trainingsdaten disjunkt zu denjenigen, die im Evaluierungsbenchmark enthalten sind.
Trainingsdetails. Ausgehend von den Anweisungen, einem Issue-Text von GitHub und den relevanten Codedateien als Prompt fine-tunen wir SWE-Llama, um den Patch zu generieren, der das gegebene Issue gelöst hat (den „Gold-Patch“). Aus Speichereffizienzgründen fine-tunen wir nur die Gewichte der Attention-Sublayer unter Verwendung von LoRA Hu et al. (2022) und schließen Trainingssequenzen mit mehr als 30.000 Tokens aus, wodurch sich die effektive Größe des Trainingskorpus auf 10.000 Instanzen reduziert. Weitere Details finden sich in Anhang B.
4 EXPERIMENTELLER AUFBAU
In diesem Abschnitt erklären wir, wie Eingaben konstruiert werden, um die SWE-bench-Evaluierung durchzuführen. Darüber hinaus besprechen wir die Modelle, die wir in dieser Arbeit evaluieren.
4.1 RETRIEVAL-BASIERTER ANSATZ
SWE-bench-Instanzen stellen eine Issue-Beschreibung und eine Codebasis als Eingabe für das Modell bereit. Während Issue-Beschreibungen in der Regel kurz sind (durchschnittlich 195 Wörter, wie in Tabelle 1 gezeigt), bestehen Codebasen aus viel mehr Tokens (durchschnittlich 438K Zeilen), als typischerweise in das Kontextfenster eines LMs passen. Dann bleibt die Frage, wie genau der relevante Kontext ausgewählt werden soll, der dem Modell bereitgestellt wird.
Um dieses Problem für unsere Baselines anzugehen, verwenden wir einfach ein generisches Retrieval-System, um die Dateien auszuwählen, die als Kontext eingefügt werden. Insbesondere evaluieren wir Modelle unter zwei relevanten Kontexteinstellungen: 1) sparses Retrieval und 2) ein Oracle-Retrieval.
Sparses Retrieval. Dichte Retrieval-Methoden sind für unsere Einstellung schlecht geeignet aufgrund sehr langer Schlüssel- und Abfragelängen und insbesondere der ungewöhnlichen Einstellung, Codedokumente mit natürlichsprachlichen Abfragen abzurufen. Daher entscheiden wir uns, BM25-Retrieval (Robertson et al., 2009) zu verwenden, um relevante Dateien abzurufen, die als Kontext für jede Aufgabeninstanz bereitgestellt werden. Wir experimentieren mit drei verschiedenen maximalen Kontextgrenzen und rufen einfach so viele Dateien ab, wie in die angegebene Grenze passen. Wir evaluieren jedes Modell auf allen Grenzen, die in sein Kontextfenster passen, und berichten die beste Leistung. Aus Beobachtung erzielen Modelle die beste Leistung bei dem kürzesten Kontextfenster, wie in Tabelle 2 gezeigt.
„Oracle“-Retrieval. Zu Analysezwecken betrachten wir auch eine Einstellung, in der wir die Dateien „abrufen“, die durch den Referenz-Patch bearbeitet wurden, der das Issue auf GitHub gelöst hat. Diese „Oracle“-Einstellung ist weniger realistisch, da ein Ingenieur, der an der Bearbeitung eines Issues arbeitet, möglicherweise nicht im Voraus weiß, welche Dateien geändert werden müssen. Darüber hinaus ist diese Einstellung auch nicht unbedingt umfassend, da allein bearbeitete Dateien möglicherweise nicht den gesamten erforderlichen Kontext enthalten, um genau zu verstehen, wie sich Software verhalten wird, wenn sie mit ungesehenen Teilen des Codes interagiert.
Wir vergleichen die Ergebnisse des BM25-Retrievals mit denen der „Oracle“-Retrieval-Einstellung, wie in Tabelle 3 gezeigt. Wir beobachten, dass BM25 in etwa der Instanzen eine Obermenge der Oracle-Dateien für die Kontextgrenze von 27.000 Tokens abruft. In fast der Hälfte der Instanzen mit der Grenze von 27.000 Tokens ruft es jedoch keine der Dateien aus dem „Oracle“-Kontext ab.
4.2 EINGABEFORMAT
Sobald die abgerufenen Dateien mit einer der beiden oben genannten Methoden ausgewählt wurden, konstruieren wir die Eingabe für das Modell, bestehend aus Aufgabenanweisungen, dem Issue-Text, abgerufenen Dateien und Dokumentation und schließlich einer Beispiel-Patchdatei sowie einem Prompt zur Generierung der Patchdatei. Beispiele für Instanzen und weitere Details zu dieser Formulierung sind in Anhang D enthalten.
4.3 MODELLE
Aufgrund der Notwendigkeit, lange Sequenzlängen zu verarbeiten, gibt es derzeit nur wenige Modelle, die für SWE-bench geeignet sind. Daher evaluieren wir ChatGPT-3.5 (gpt-3.5-turbo-16k-0613), GPT-4 (gpt-4-32k-0613), Claude 2 und SWE-Llama mit ihren in Tabelle 4 gezeigten Kontextgrenzen.
| Modell | Max. Inhalt | ||
| 13k | 27k | 50k | |
| Claude 2 | 1.96 | 1.87 | 1.22 |
| SWE-Llama 7b | 0.70 | 0.31 | 0.00 |
| SWE-Llama 13b | 0.70 | 0.48 | 0.00 |
| BM25-Recall | |||
| 13k | 27k | 50k | |
| Durchschn. | 29,58 | 44,41 | 51,06 |
| Alle | 26,09 | 39,83 | 45,90 |
| Beliebig | 34,77 | 51,27 | 58,38 |
Tabelle 4: Wir vergleichen die verschiedenen Kontextlängen und den Anteil der abgedeckten „Oracle“-Retrieval-Einstellung. Modelle mit kürzeren Kontextlängen sind dadurch inhärent benachteiligt. Beachten Sie, dass Beschreibungen von Token-Längen ein relatives nicht-standardisiertes Maß sind (z. B. sind Llama-tokenisierte Sequenzen durchschnittlich länger als die entsprechende für GPT-4 tokenisierte Sequenz).
| ChatGPT-3.5 | GPT-4 | Claude 2 | SWE-Llama | |
| Max. Tokens | 16.385 | 32.768 | 100.000 | ≥100.000 |
| % der Instanzen | 58,1 % | 84,1 % | 96,4 % | ≥94,8 % |
| Modell | SWE-bench | SWE-bench Lite | ||
| % gelöst | % angewendet | % gelöst | % angewendet | |
| Claude 3 Opus | 3,79 | 46,56 | 4,33 | 51,67 |
| Claude 2 | 1,97 | 43,07 | 3,00 | 33,00 |
| ChatGPT-3.5 | 0,17 | 26,33 | 0,33 | 10,00 |
| GPT-4-turbo | 1,31 | 26,90 | 2,67 | 29,67 |
| SWE-Llama 7b | 0,70 | 51,74 | 1,33 | 38,00 |
| SWE-Llama 13b | 0,70 | 53,62 | 1,00 | 38,00 |
5 ERGEBNISSE
Wir berichten über Ergebnisse für Modelle, die verschiedene Retrieval-Mechanismen und Prompting-Stile verwenden, und liefern anschließend einige Analysen und Einblicke in die Modellleistung und -schwierigkeit. Wir fassen die Leistung der Modelle mit BM25-Retrieval in Tabelle 5 zusammen. Durchweg haben die Modelle erhebliche Schwierigkeiten, Issues zu lösen. Das leistungsstärkste Modell, Claude 2, kann nur \(1,96\%\) der Issues lösen.
Um die Bedeutung des Retrievers für die Gesamtergebnisse des Systems zu analysieren, präsentieren wir die „Oracle“-Retrieval-Ergebnisse in Anhang Tabelle 18. Dort kann Claude 2 \(4,8\%\) der Issues mit dem „Oracle“-Retriever lösen. Die Bedeutung des Kontexts analysieren wir weiter in der folgenden Diskussion.
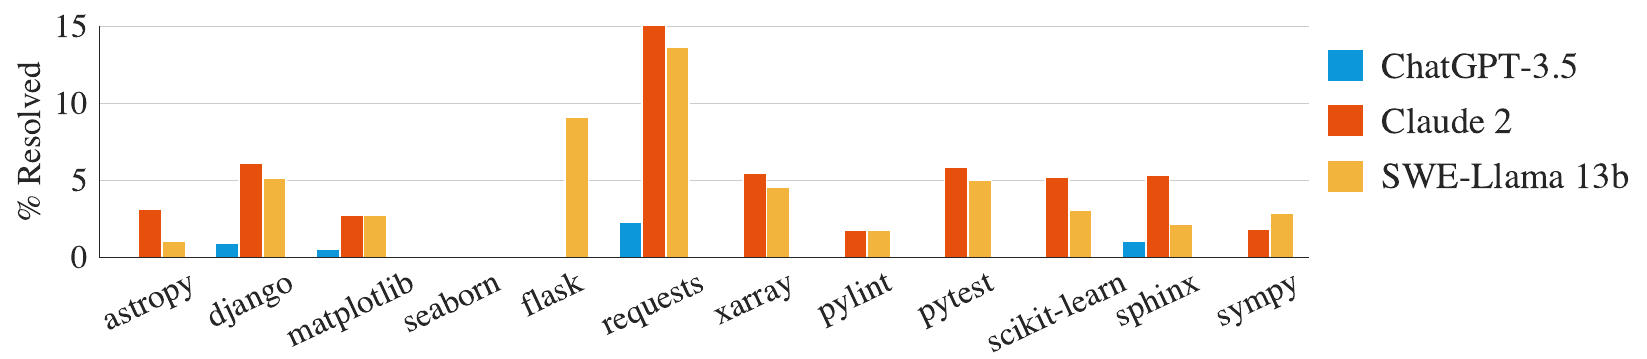
Die Schwierigkeit unterscheidet sich zwischen den Repositories. Wenn man die Leistung nach Repository aufschlüsselt, zeigen alle Modelle ähnliche Trends über verschiedene Repositories hinweg, wie in Abbildung 4 dargestellt. Dennoch überschneiden sich die von den einzelnen Modellen gelösten Issues nicht unbedingt in großem Umfang. Beispielsweise schneiden Claude 2 und SWE-Llama 13b im „Oracle“-Setting vergleichbar ab, wobei jedes Modell 110 bzw. 91 Instanzen löst. Von diesen Instanzen löst Claude 2 jedoch nur \(42\%\) der von SWE-Llama gelösten Instanzen.
Dies könnte auch mit dem Vorhandensein von Bildern in Issues zusammenhängen, die über eingebettete Bildlinks (d. h. ![image][https://...]) in das Issue-Markdown kodiert werden können. Einige Repositories weisen von Natur aus mehr Instanzen mit Bildern auf; beispielsweise enthalten der matplotlib- und der seaborn-Instanzen eingebettete Bilder in ihrem Issue-Text, verglichen mit nur aller Instanzen. Die Lösung dieser Instanzen kann multimodale LMs oder eine Art externe Werkzeugnutzung zur Verarbeitung von Bildern erfordern.
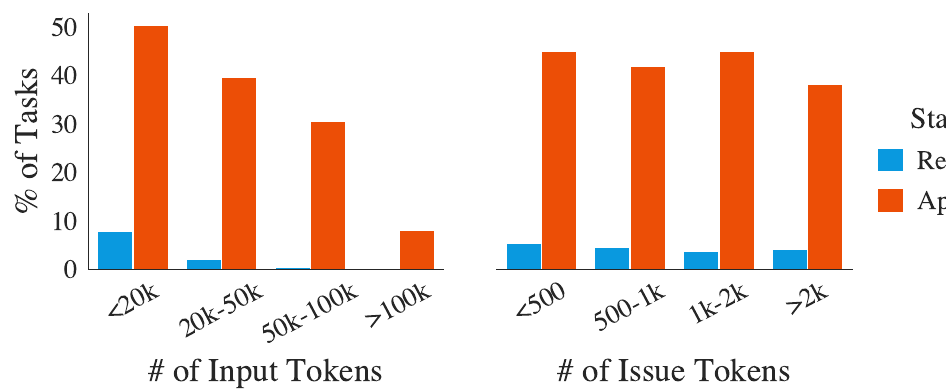
Die Schwierigkeit korreliert mit der Kontextlänge. Chat-Modelle sind möglicherweise auf langen Code-Sequenzen vortrainiert, werden aber typischerweise gebeten, kürzere Code-Schnipsel zu generieren, wobei nur begrenzter Kontext zur Rahmung der Frage bereitgestellt wird. Wie in Abbildung 5 gezeigt, sehen wir, dass mit zunehmender Gesamtkontextlänge die Leistung von Claude 2 erheblich abnimmt; ein Verhalten, das auch bei anderen Modellen beobachtet wird. In unseren Evaluierungseinstellungen sehen die Modelle viel Code, der möglicherweise nicht direkt mit der Lösung des betreffenden Issues zusammenhängt, und sie scheinen häufig Schwierigkeiten damit zu haben, den problematischen Code zu lokalisieren, der aktualisiert werden muss. Dieses Ergebnis bestätigt andere Studien, die zeigen, dass Modelle durch zusätzlichen Kontext abgelenkt werden und möglicherweise empfindlich auf die relative Position von Zielsequenzen reagieren (Liu et al., 2023b). Selbst wenn eine Erhöhung der maximalen Kontextgröße für BM25 den Recall in Bezug auf die Oracle-Dateien erhöhen würde, sinkt die Leistung, wie in Tabelle 2 gezeigt, da die Modelle schlichtweg ineffektiv darin sind, problematischen Code zu lokalisieren. Zur weiteren Untersuchung stellen wir eine Input-Ablation zum „Oracle“-Retrieval-Kontext bereit, „Oracle“-collapsed, wobei die abgerufenen Dateien vollständig zusammengeklappt werden, mit Ausnahme der Zeilen, die tatsächlich durch den
| Modell | „Oracle“-kollabiert | |
| Gelöst | Angewandt | |
| Claude 3 Opus | 9,39 | 48,00 |
| Claude 2 | 5,93 | 68,18 |
| GPT-4 | 3,40 | 48,65 |
| ChatGPT-3.5 | 1,09 | 40,93 |
echten Pull Request bearbeitet wurden (mit Zeilen Puffer), gezeigt in Tabelle 6. In dieser Einstellung sehen wir Leistungssteigerungen, wobei GPT-4 von auf und Claude 2 von auf springt.
Die Schwierigkeit korreliert nicht mit dem Datum der Issue-Lösung. In Tabelle 7 zeigen wir Modellergebnisse im „Oracle“-Retrieval-Setting, aufgeschlüsselt nach Datum, für PRs, die vor oder nach 2023 erstellt wurden. Wir stellen fest, dass es für die meisten Modelle kaum einen Unterschied in der Leistung vor oder nach diesem Datum gibt, mit Ausnahme von GPT-4. Wir betrachten dieses Ergebnis als weitgehend vielversprechend, da es darauf hindeutet, dass Modelle, obwohl sie einer gewissen Version der Codebasis eines Repositories ausgesetzt waren, wahrscheinlich nicht „schummeln“, um Issues zu adressieren, indem sie einfach eine neuere Version des Repositories generieren.
| Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| Vor 2023 | 4,87 | 0,49 | 1,96 | 2,95 |
| Nach 2023 | 4,23 | 0,77 | 0,0 | 3,46 |
Feinabgestimmte Modelle sind empfindlich gegenüber Verschiebungen in der Kontextverteilung. Die feinabgestimmten Modelle SWE-Llama 7b und 13b schneiden mit BM25-abgerufenem Kontext überraschend schlecht ab. Da diese Modelle mit dem „Oracle“-Retrieval als Kontext feinabgestimmt wurden, vermuten wir, dass diese Verschiebung des Kontexts es dem Modell erschwert, zuverlässig zu arbeiten. Beispielsweise wurde SWE-Llama darauf trainiert, jede als Kontext einbezogene Datei zu bearbeiten, während im BM25-Setting viele im Kontext bereitgestellte Dateien voraussichtlich nicht geändert werden.
Das Generieren von Patches ist einfacher als das Generieren ganzer Dateien. Modelle werden oft mit Standard-Codedateien trainiert und sehen wahrscheinlich selten Patch-Dateien. Wir formulieren unsere Aufgabe im Allgemeinen so, dass Modelle Patch-Dateien generieren, anstatt die gesamte Datei mit ihrer vorgeschlagenen Änderung neu zu erstellen, da Patch-Dateien normalerweise eine viel effizientere Darstellung einer Dateiänderung sind. Wie in Tabelle 5 gezeigt, beobachten wir, dass Modelle weiterhin Schwierigkeiten mit der Generierung wohlgeformter Patch-Dateien haben. Daher experimentieren wir damit, Modelle stattdessen zu bitten, ganze Dateien mit ihren vorgeschlagenen Änderungen zur Lösung des Issues neu zu generieren. In dieser Einstellung stellen wir fest, dass die Modelle bei dieser Aufgabe im Allgemeinen schlechter abschneiden als bei der Generierung von Patch-Dateien; beispielsweise erreicht Claude 2 im Vergleich zu in der Haupttabelle für „Oracle“-Retrieval. Selbst wenn man für die Instanzlänge kontrolliert, ergibt die Generierung für die kürzere Hälfte der Aufgabeninstanzen nach Input-Tokens im Vergleich zu für die Generierung von Patches mit Claude 2.
Sprachmodelle neigen dazu, kürzere, einfachere Bearbeitungen zu generieren. Von Modellen generierte Patch-Dateien fügen tendenziell weniger Zeilen hinzu und entfernen weniger Zeilen als ihr jeweiliger Gold-Patch. Wie in Tabelle 8 gezeigt, sind modellgenerierte Patch-Dateien, die korrekt angewendet werden, im Vergleich zu einem durchschnittlichen Gold-Patch weniger als halb so lang (74,5 gegenüber 30,1 Zeilen) wie Gold-Edit-Patch-Dateien und bearbeiten selten mehr als eine einzelne Datei.
5.1 EINE QUALITATIVE ANALYSE DER SWE-LLAMA-GENERIERUNGEN
Wir wählen 11 Generierungen von SWE-Llama und Claude 2 aus, um die Qualität der Aufgabe und der generierten Patches unter dem „Oracle“-Retrieval-Setting besser zu verstehen. Hier diskutieren wir ein Beispiel von SWE-Llama und unsere übergreifenden Befunde, wobei ausführliche Analysen weiterer Beispiele in Anhang F gezeigt werden.
| Modell | Gesamtzeilen | Hinzugefügt | Entfernt | Funktionen | Dateien |
| Claude 2 | 19,6 | 4,2 | 1,9 | 1,1 | 1,0 |
| Gold | 44,1 | 12,0 | 5,8 | 2,1 | 1,2 |
| ChatGPT-3.5 | 30,1 | 3,8 | 2,7 | 1,6 | 1,0 |
| Gold | 39,6 | 9,5 | 6,1 | 1,9 | 1,2 |
| GPT-4 | 20,9 | 4,4 | 1,5 | 1,0 | 1,0 |
| Gold | 33,6 | 8,4 | 3,8 | 1,9 | 1,1 |
| SWE-Llama 13b | 17,6 | 1,6 | 1,2 | 1,2 | 1,1 |
| Gold | 37,8 | 10,0 | 4,4 | 1,9 | 1,1 |
| SWE-Llama 7b | 16,7 | 1,3 | 1,2 | 1,2 | 1,1 |
| Gold | 40,2 | 11,3 | 4,9 | 1,9 | 1,1 |
| Avg. Gold | 39,1 | 10,2 | 5,0 | 1,9 | 1,1 |
| Alle Gold | 74,5 | 22,3 | 10,5 | 3,0 | 1,7 |
Tabelle 8: Durchschnittliche Bearbeitungen modellgenerierter Patches im „Oracle“-Retrieval-Setting über erfolgreich angewendete Patches hinweg. Für die aufgabenspezifischen Instanzen jedes Modells berechnen wir dieselben Statistiken über die Gold-Patches. Avg Gold zeigt Statistiken, die über die jeweiligen Gold-Patches jedes Modells makro-gemittelt sind. All Gold zeigt Statistiken für alle Gold-Patches, unabhängig von der Modellleistung.
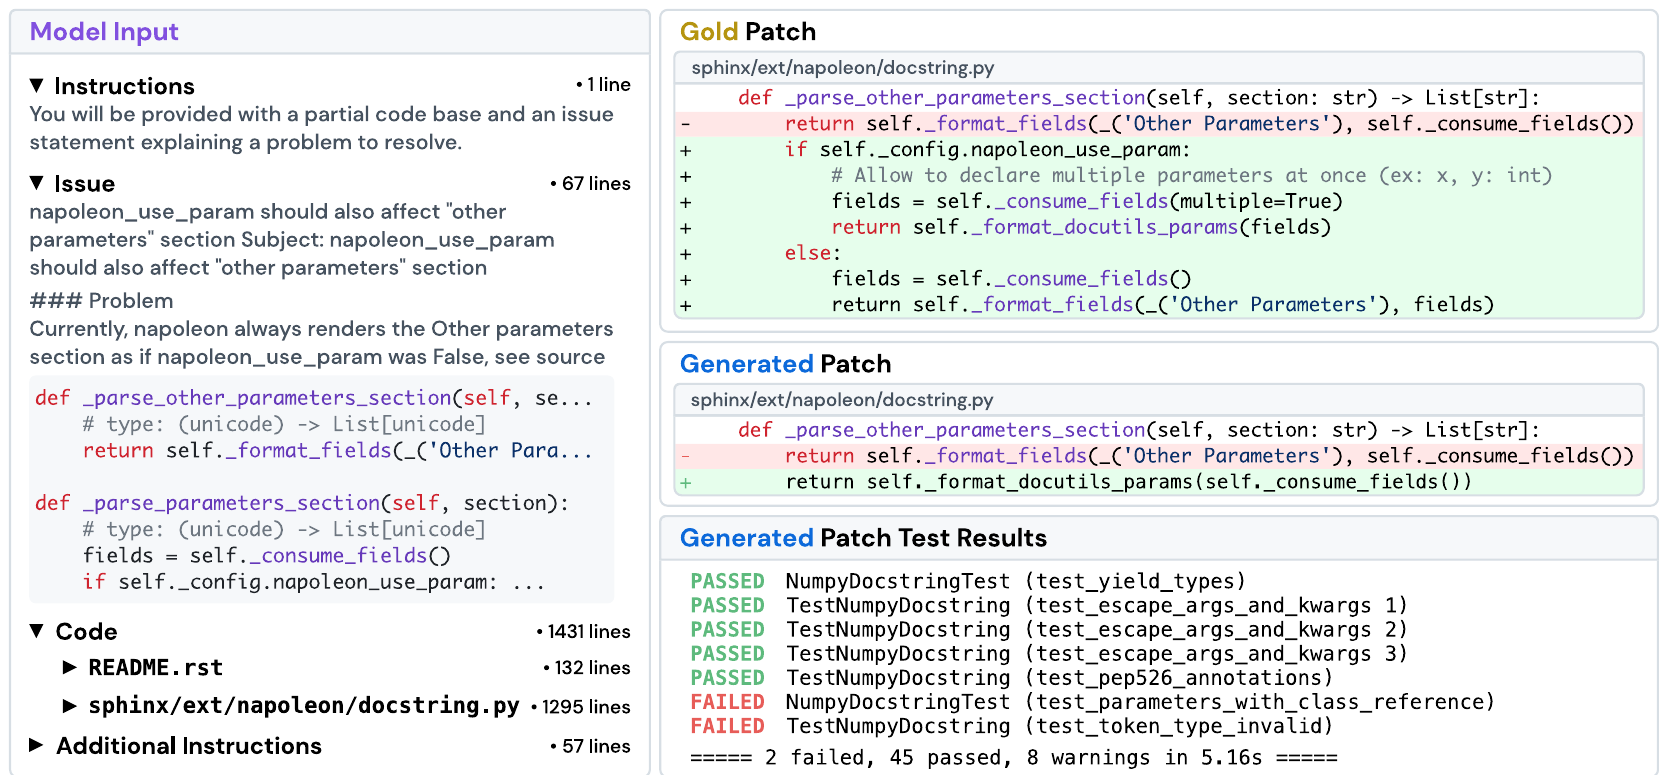
Wir betrachten die Aufgabeninstanz sphinx-doc_ sphinx-8713 aus dem Sphinx-Dokumentationsgenerator, gezeigt in Abbildung 6. Das Issue besagt, dass die napoleon-Erweiterung von Sphinx das Dokumentationsschlüsselwort „Other Parameters“ nicht ordnungsgemäß formatiert, wenn die Konfigurationseinstellung napoleon.use_param auf True gesetzt ist. Der Issue-Text liefert außerdem einen detaillierten Code-Schnipsel, wo der problematische Quellcode vermutet wird, sowie einige Codebeispiele zur Reproduktion des Fehlers und zusätzliche Informationen zu Paketversionen. Für diese spezielle Instanz hat das Modell die Aufgabe nicht gelöst und einige der Tests nicht bestanden, die von der Gold-Lösung gelöst wurden.
Im „Oracle“-Retrieval-Setting stellt der Modell-Input diesen Issue-Text zusammen mit einigen Anweisungen, dem vollständigen Inhalt der durch den Gold-Patch bearbeiteten Dateien und einem Beispiel des Diff-Formats bereit, in dem wir die Antwort erwarten. Der gesamte Modell-Input besteht aus 1.558 Zeilen Kontext bzw. 20.882 Tokens. Beim Vergleich des Gold-Patches mit dem Patch des Modells finden wir einen offensichtlichen Fehler. Während das Modell die richtige Funktion _parse_other_parameters_section in Zeile 684 in sphinx/ext/napoleon/docstring.py bearbeitet, ändert es die Funktion so, dass sie sich verhält, als wäre napoleon.use_param immer True, anstatt zuerst die Konfigurationseinstellung zu prüfen und das zu kopieren, was _parse_parameters_section tut, wie es der Gold-Patch macht. In den Tests vergleicht test_parameters _with_class_reference direkt die Dokumentation, die mit einer Konfiguration erzeugt wurde, in der napoleon_use_param auf False gesetzt ist, was den Fehler des Modells sofort aufdeckt.
Beim Vergleich der Ergebnisse über alle von uns betrachteten Beispiele hinweg bemerken wir einige prominente Verhaltenstrends. Modelle neigen dazu, primitiven Python-Code zu schreiben, und nutzen weder bestehende Drittanbieter-Bibliotheken noch den Rest der Codebasis für ihre Lösungen. Die Generierungen der Modelle spiegeln außerdem einen „gierigen“ Ansatz wider, das Problem exakt zu lösen, mit wenig Rücksicht auf Code-Stil oder logische Einschränkungen, die durch die Codebasis widergespiegelt werden könnten (d. h. Verwendung relativer statt absoluter Imports). Im Gegensatz dazu beobachten wir, dass viele Gold-Patches strukturelle Verbesserungen vornehmen, die einen viel größeren Bereich der Codebasis abdecken; diese Bearbeitungen lösen nicht nur das Issue, sondern antizipieren und lösen auch potenzielle zukünftige Issues.
6 VERWANDTE ARBEITEN
Evaluierung von LMs. Mehrere neuere Arbeiten zur Evaluierung von LMs haben entweder eine Sammlung voneinander verschiedener Aufgaben vorgeschlagen, die mehrere Domänen umfassen (Hendrycks et al., 2021; Liang et al., 2022; Srivastava et al., 2023), oder sich dem Web als interaktive Einstellung zugewandt, mit Aufgaben, die mehrere Schritte zur Lösung erfordern (Yao et al., 2022; Zhou et al., 2023; Deng et al., 2023; Liu et al., 2023d). Solch ein „Potpourri“-artiges Setup hat mehrere Nachteile. Erstens konzentriert sich jede Aufgabe tendenziell eng auf eine oder wenige Fähigkeiten, was zu Herausforderungen führt, die typischerweise zu einfach sind, das Modell in eine reduzierte Rolle zwängen und den Modellen nicht die Bandbreite bieten, ihre Vielseitigkeit auszuüben oder potenziell neue Fähigkeiten zu demonstrieren (Srivastava et al., 2023). Folglich liefert die Leistung eines Modells bei solchen Aufgabenkonglomeraten möglicherweise keine umsetzbaren, tiefen Erkenntnisse über seine Fähigkeiten und darüber, wie sie verbessert werden können (Schlangen, 2019; Martínez-Plumed et al., 2021; Bowman & Dahl, 2021). SWE-bench adressiert diese Mängel, da unsere Arbeit zeigt, dass es erheblich herausfordernd ist, eine breite Palette von Möglichkeiten zur Verbesserung von LMs zur Lösung dieser Aufgabe bietet und leicht über die Zeit mit neuen Aufgabeninstanzen aktualisiert werden kann, von denen jede neuartige, nuancierte und praktische Herausforderungen mit sich bringt.
Codegenerierungs-Benchmarks. HumanEval (Chen et al., 2021) ist der aktuelle Standard in dem seit langem verfolgten Bestreben, Code aus natürlichsprachlichen Beschreibungen zu synthetisieren (Yu et al., 2018; Austin et al., 2021; Hendrycks et al., 2021; Li et al., 2022a; Zan et al., 2023). Im vergangenen Jahr haben nachfolgende Benchmarks versucht, HumanEval durch Erweiterungen auf verschiedene Sprachen (Cassano et al., 2022; Athiwaratkun et al., 2023; Orlanski et al., 2023), Variationen im Bearbeitungsumfang (Yu et al., 2023; Du et al., 2023), ähnliche, aber neuartige Codevervollständigungsaufgaben (Muennighoff et al., 2023) und umfangreicheres Testen (Liu et al., 2023a) zu ergänzen. Gleichzeitig haben separate Arbeiten versucht, neue Programmierparadigmen einzuführen (Yin et al., 2022; Yang et al., 2023) oder bibliotheksspezifische Probleme zu entwerfen (Lai et al., 2022; Zan et al., 2022). Anstatt Probleme in isolierte Datensätze aufzuteilen und sie um der Einfachheit willen zu beschneiden, transformiert das Erfassungsverfahren von SWE-bench den Quellcode mit minimaler Nachbearbeitung und bewahrt so eine viel breitere Menge an Herausforderungen, die in realer Softwareentwicklung jenseits der Closed-Form-Vervollständigung verankert sind, wie etwa Patch-Generierung, Schlussfolgerungen über lange Kontexte, das Navigieren in einem Codebasis-Verzeichnis und das Erfassen von abhängigkeitsbasierten Beziehungen zwischen Modulen.
ML für Software Engineering. Um traditionelle Programmanalyseverfahren zu überwinden, die möglicherweise nicht skalieren oder natürliche Sprache nicht einbeziehen können, besteht eine Richtung der aktuellen Software-Engineering-Forschung darin, neuronale Netze, einschließlich LMs, einzusetzen, um reale Softwareentwicklungsprozesse zu automatisieren (Maniatis et al., 2023; Zheng et al., 2023; Hou et al., 2023). Anwendungsfälle umfassen die Automatisierung der Commit-Generierung (Jung, 2021; Liu et al., 2023c), von PR-Reviews (Yang et al., 2016; Li et al., 2022b; Tufano et al., 2021), der Fehlerlokalisierung (Kim et al., 2019; Chakraborty et al., 2018), des Testens (Kang et al., 2023; Xia et al., 2023; Wang et al., 2023) und der Programmreparatur (Gupta et al., 2017; Allamanis et al., 2017; Monperrus, 2018; Jiang et al., 2018; Goues et al., 2019; Gao et al., 2022; Dinh et al., 2023; Motwani & Brun, 2023). Am relevantesten für SWE-bench sind Arbeiten, die versucht haben, LMs auf die automatisierte Programmreparatur anzuwenden (Xia & Zhang, 2022; 2023; Fan et al., 2023; Sobania et al., 2023) und die Codebearbeitung mithilfe von Commits zu steuern (Chakraborty & Ray, 2021; Zhang et al., 2022; Fakhoury et al., 2023). Allerdings präsentiert keiner der existierenden Datensätze (Just et al., 2014; Karampatsis & Sutton, 2019) Codekontext im Maßstab von SWE-bench. Darüber hinaus kann SWE-bench leicht auf neue Programmiersprachen und Repositories erweitert werden, und es bietet eine deutlich realistischere und anspruchsvollere Arena, um Experimente zur Erweiterung von LMs mit Software-Engineering-Werkzeugen und -Praktiken durchzuführen.
7 DISKUSSION
Einschränkungen und zukünftige Richtungen. Die Aufgabeninstanzen von SWE-bench sind alle in Python; wir hoffen, das Verfahren zur Sammlung von Aufgabeninstanzen von SWE-bench anzuwenden, um seine Abdeckung auf weitere Programmiersprachen und Domänen auszudehnen. Zweitens zielen unsere Experimente darauf ab, eine Baseline der einfachsten und unkompliziertesten Ansätze für diese Aufgabe zu etablieren; wir beabsichtigen nicht, zukünftige Methoden auf dieselbe Art von Ansatz zu beschränken, und ermutigen zukünftige Arbeiten, verschiedene Methoden zu untersuchen (z. B. agentenbasierte Ansätze, werkzeugaugmentierte LMs).
Schließlich bewertet diese Arbeit Modelle zwar mithilfe ausführungsbasierter Codetests, doch die ausschließliche Verwendung dieser Methode reicht nicht aus, um eine zuverlässige Leistung der Modellgenerierungen zu garantieren, da wir feststellen, dass automatisierte Codegenerierungen von LMs im Vergleich zu von Menschen geschriebenen Lösungen häufig weniger umfassend, effizient oder lesbar sein können.
Fazit. Die Komplexität realer Softwareentwicklungsprozesse reicht weit über die reine Codevervollständigung hinaus. Durch den Rückgriff auf die kollaborative Open-Source-Pipeline schafft SWE-bench ein getreues Abbild realer Programmierumgebungen. Diese realistischere Umgebung fördert kreative Lösungen, die unmittelbar in der Open-Source-Softwareentwicklung anwendbar sein können. Wir hoffen, dass dieser Benchmark und unsere übrigen Beiträge als wertvolle Ressourcen für die zukünftige Entwicklung von LMs dienen können, die praktischer, intelligenter und autonomer sind.
8 ETHIKERKLÄRUNG
8 ETHIKERKLÄRUNG SWE-bench wird vollständig aus öffentlichen Repositories mit Lizenzen gesammelt, die die Softwarenutzung erlauben, mit denen unsere Beiträge im Einklang stehen. Einzelheiten zu den Lizenzen sind in Tabelle 12 enthalten. Während der Sammel- oder Evaluierungsprozesse erheben wir keine Informationen über GitHub-Nutzer, und die SWE-bench-Aufgabeninstanzen verwenden keine GitHub-Daten über das hinaus, was über die öffentliche API und Website angeboten wird. Unsere Beiträge umfassen keine Teilnahme menschlicher Probanden; wir führen kein Crowdsourcing durch und rekrutieren keine menschlichen Arbeitskräfte für irgendeinen Teil von SWE-bench, einschließlich seiner Sammel- und Evaluierungsverfahren sowie der Experimente. Die Filterkriterien von SWE-bench für GitHub-Repositories auf Basis ihrer Beliebtheit beruhen weder implizit noch explizit auf diskriminierenden oder voreingenommenen Heuristiken für die Repository-Auswahl. Für die Veröffentlichung des Datensatzes planen wir, die SWE-bench-Aufgabeninstanzen, die Infrastruktur für Sammlung und Evaluierung, die experimentellen Ergebnisse, die für die Feinabstimmung der SWE-Llama-Modelle verwendeten Trainingsdaten und die Gewichte der SWE-Llama-Modelle als Open Source bereitzustellen. In Anlehnung an bewährte Vorgehensweisen werden wir außerdem umfangreiche Dokumentation bereitstellen, die jede Komponente und ihre Verwendung beschreibt, und wir werden auch bequeme Kommunikationskanäle einrichten, um Feedback zur Verbesserung von SWE-bench einzuholen. SWE-bench liefert keine unmittelbar schädlichen Erkenntnisse. Wir erörtern die möglichen Auswirkungen der Verwendung von SWE-bench kurz in Abschnitt E.
9 ERKLÄRUNG ZUR REPRODUZIERBARKEIT
9 ERKLÄRUNG ZUR REPRODUZIERBARKEIT Für unsere Einreichung haben wir den gesamten Quellcode als gezippte Datei hochgeladen, die ordnungsgemäß anonymisiert wurde. Wir haben die Codebasis so organisiert, dass separate Verzeichnisse verschiedenen Beiträgen innerhalb des Hauptpapiers entsprechen (d. h. Datensatzsammlung, Evaluierung, Inferenz mit Open-Source-Modellen, SWE-Llama-Training usw.). Der Quellcode enthält Inline-Dokumentation, die Zweck und Verwendung der verschiedenen Teile der Codebasis beschreibt. Darüber hinaus fügen wir auch den vollständigen Satz von 2294 SWE-bench-Aufgabeninstanzen bei, der alle im Hauptpapier besprochenen Komponenten enthält. Über die Dokumentation im Quellcode hinaus geben wir in Abschnitt A.2 und Abschnitt A.4 gründliche technische Details zur Sammelpipeline und zu den Evaluierungsverfahren an, die die ursprünglichen Details in Abschnitt 2 des Hauptpapiers ergänzen. Diese Abschnitte decken die im Code dargestellte Logik vollständig ab und können für deren Verständnis hilfreich sein. Künftig planen wir, wie in der Ethikerklärung erläutert, SWE-bench formeller als Open-Source-Repository für die Öffentlichkeit freizugeben, mit gründlichen Details, die den Benchmark beschreiben, den Code umreißen und seine Verwendung darlegen. Eine wesentliche Komponente von SWE-bench ist das Sammel-Framework, das Teil des Open-Source-Codes sein wird. Aufgrund seines leicht wartbaren Designs, wie im Hauptpapier erläutert, ist es unsere Hoffnung und Überzeugung, dass SWE-bench hochgradig reproduzierbar sein sollte.
10 DANKSAGUNGEN
10 DANKSAGUNGEN Wir danken Danqi Chen, Tri Dao, Zexuan Zhong, Tianyu Gao, Will Merrill, Mengzhou Xia, Dan Friedman, Adithya Bhaskar, Austin Watkins, Atamik Gupta und Richard Zhu für ihr wertvolles Feedback und ihre Ratschläge. Wir erkennen die Unterstützung der National Science Foundation unter Grant Nr. 2239363 und einen Oracle Collaborative Research Award an. Alle in diesem Material geäußerten Meinungen, Ergebnisse, Schlussfolgerungen oder Empfehlungen sind die der Autor(en) und spiegeln nicht unbedingt die Ansichten der National Science Foundation wider.
LITERATURVERZEICHNIS
Miltiadis Allamanis, Marc Brockschmidt und Mahmoud Khademi. Learning to represent programs with graphs. arXiv preprint arXiv:1711.00740, 2017.
Ben Athiwaratkun, Sanjay Krishna Gouda, Zijian Wang, Xiaopeng Li und Yuchen Tian et al. Multilingual evaluation of code generation models, 2023.
Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le und Charles Sutton. Program synthesis with large language models, 2021.
Samuel R. Bowman und George E. Dahl. What will it take to fix benchmarking in natural language understanding?, 2021.
Federico Cassano, John Gouwar, Daniel Nguyen, Sydney Nguyen, Luna Phipps-Costin, Donald Pinckney, Ming-Ho Yee, Yangtian Zi, Carolyn Jane Anderson, Molly Q Feldman, Arjun Guha, Michael Greenberg und Abhinav Jangda. Multipl-e: A scalable and extensible approach to benchmarking neural code generation, 2022.
Saikat Chakraborty und Baishakhi Ray. On multi-modal learning of editing source code, 2021.
Saikat Chakraborty, Yujian Li, Matt Irvine, Ripon Saha und Baishakhi Ray. Entropy guided spectrum based bug localization using statistical language model. arXiv preprint arXiv:1802.06947, 2018.
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto und Jared Kaplan et al. Evaluating large language models trained on code, 2021.
Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra und Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
Xiang Deng, Yu Gu, Boyuan Zheng, Shijie Chen, Samuel Stevens, Boshi Wang, Huan Sun und Yu Su. Mind2web: Towards a generalist agent for the web, 2023.
Tuan Dinh, Jinman Zhao, Samson Tan, Renato Negrinho, Leonard Lausen, Sheng Zha und George Karypis. Large language models of code fail at completing code with potential bugs. arXiv preprint arXiv:2306.03438, 2023.
Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng und Yiling Lou. Classeval: A manually-crafted benchmark for evaluating llms on class-level code generation, 2023.
Sarah Fakhoury, Saikat Chakraborty, Madan Musuvathi und Shuvendu K. Lahiri. Towards generating functionally correct code edits from natural language issue descriptions, 2023.
Zhiyu Fan, Xiang Gao, Martin Mirchev, Abhik Roychoudhury und Shin Hwei Tan. Automated repair of programs from large language models, 2023.
Daniel Fried, Armen Aghajanyan, Jessy Lin, Sida Wang, Eric Wallace, Freda Shi, Ruiqi Zhong, Wen tau Yih, Luke Zettlemoyer und Mike Lewis. Incoder: A generative model for code infilling and synthesis, 2023.
Xiang Gao, Yannic Noller und Abhik Roychoudhury. Program repair, 2022.
Claire Le Goues, Michael Pradel und Abhik Roychoudhury. Automated program repair. Communications of the ACM, 62(12):56-65, 2019.
David Gros, Prem Devanbu und Zhou Yu. Ai safety subproblems for software engineering researchers, 2023.
Rahul Gupta, Soham Pal, Aditya Kanade und Shirish Shevade. Deepfix: Fixing common c language errors by deep learning. In Proceedings of the aaai conference on artificial intelligence, Band 31, 2017.
Maurice H. Halstead. Elements of Software Science (Operating and programming systems series). Elsevier Science Inc., USA, 1977. ISBN 0444002057.
Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song und Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
Xinyi Hou, Yanjie Zhao, Yue Liu, Zhou Yang, Kailong Wang, Li Li, Xiapu Luo, David Lo, John Grundy und Haoyu Wang. Large language models for software engineering: A systematic literature review, 2023.
Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang und Weizhu Chen. LoRA: Low-rank adaptation of large language models. In International Conference on Learning Representations, 2022. URL https://openreview.net/forum?id=nZeVKeeFYf9.
Sam Ade Jacobs, Masahiro Tanaka, Chengming Zhang, Minjia Zhang, Leon Song, Samyam Rajbhandari und Yuxiong He. Deepspeed ulysses: System optimizations for enabling training of extreme long sequence transformer models, 2023.
Jiajun Jiang, Yingfei Xiong, Hongyu Zhang, Qing Gao und Xiangqun Chen. Shaping program repair space with existing patches and similar code. In Proceedings of the 27th ACM SIGSOFT international symposium on software testing and analysis, S. 298–309, 2018.
Tae-Hwan Jung. Committer: Commit message generation using pre-trained programming language model, 2021.
René Just, Darioush Jalali und Michael D. Ernst. Defects4J: A Database of existing faults to enable controlled testing studies for Java programs. In ISSTA 2014, Proceedings of the 2014 International Symposium on Software Testing and Analysis, S. 437–440, San Jose, CA, USA, Juli 2014. Tool-Demo.
Sungmin Kang, Juyeon Yoon und Shin Yoo. Large language models are few-shot testers: Exploring llm-based general bug reproduction, 2023.
Rafael-Michael Karampatsis und Charles Sutton. How often do single-statement bugs occur? the manysstubs4j dataset. 2020 IEEE/ACM 17th International Conference on Mining Software Repositories (MSR), S. 573–577, 2019. URL https://api.semanticscholar.org/CorpusID:173188438.
Douwe Kiela, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger und Zhengxuan Wu et al. Dynabench: Rethinking benchmarking in nlp, 2021.
Yunho Kim, Seokhyeon Mun, Shin Yoo und Moonzoo Kim. Precise learn-to-rank fault localization using dynamic and static features of target programs. ACM Transactions on Software Engineering and Methodology (TOSEM), 28(4):1-34, 2019.
Yuhang Lai, Chengxi Li, Yiming Wang, Tianyi Zhang, Ruiqi Zhong, Luke Zettlemoyer, Scott Wen tau Yih, Daniel Fried, Sida Wang und Tao Yu. Ds-1000: A natural and reliable benchmark for data science code generation, 2022.
Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser und Rémi Leblond et al. Competition-level code generation with AlphaCode. Science, 378(6624):1092-1097, Dez. 2022a. doi: 10.1126/science.abq1158. URL https://doi.org/10.1126%2Fscience.abq1158.
Zhiyu Li, Shuai Lu, Daya Guo, Nan Duan, Shailesh Jannu, Grant Jenks, Deep Majumder, Jared Green, Alexey Svyatkovskiy, Shengyu Fu und Neel Sundaresan. Automating code review activities by large-scale pre-training, 2022b.
Percy Liang, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu und Michihiro Yasunaga et al. Holistic evaluation of language models, 2022.
Jiawei Liu, Chunqiu Steven Xia, Yuyao Wang und Lingming Zhang. Is your code generated by chatgpt really correct? rigorous evaluation of large language models for code generation. arXiv preprint arXiv:2305.01210, 2023a.
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni und Percy Liang. Lost in the middle: How language models use long contexts, 2023b. arXiv:2307.03172.
Shangqing Liu, Yanzhou Li, Xiaofei Xie und Yang Liu. Commitbart: A large pre-trained model for github commits, 2023c.
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei und Hanyu Lai et al. Agentbench: Evaluating llms as agents, 2023d.
Shuai Lu, Daya Guo, Shuo Ren, Junjie Huang, Alexey Svyatkovskiy und Ambrosio Blanco et al. Codexglue: A machine learning benchmark dataset for code understanding and generation. CoRR, abs/2102.04664, 2021.
Petros Maniatis, Daniel Tarlow und Google DeepMind. Large sequence models for software development activities, 2023. URL https://blog.research.google/2023/05/large-sequence-models-for-software.html.
Fernando Martinez-Plumed, Pablo Barredo, Seán Ó hEigeartaigh und José Hernández-Orallo. Research community dynamics behind popular ai benchmarks. Nature Machine Intelligence, 3:581-589, 2021. URL https://api.semanticscholar.org/CorpusID:236610014.
Thomas J. McCabe. A complexity measure. IEEE Transactions on Software Engineering, SE-2(4):308-320, 1976. doi: 10.1109/TSE.1976.233837.
Martin Monperrus. Automatic software repair. ACM Computing Surveys, 51(1):1-24, Jan. 2018. doi: 10.1145/3105906. URL https://doi.org/10.1145%2F3105906.
Manish Motwani und Yuriy Brun. Better automatic program repair by using bug reports and tests together, 2023.
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra und Shayne Longpre. Octopack: Instruction tuning code large language models, 2023.
Gabriel Orlanski, Kefan Xiao, Xavier Garcia, Jeffrey Hui, Joshua Howland, Jonathan Malmaud, Jacob Austin, Rishabh Singh und Michele Catasta. Measuring the impact of programming language distribution, 2023.
Simon Ott, Adriano Barbosa-Silva, Kathrin Blagec, Janina Brauner und Matthias Samwald. Mapping global dynamics of benchmark creation and saturation in artificial intelligence. Nature Communications, 13, 2022. URL https://api.semanticscholar.org/CorpusID:247318891.
Stephen Robertson, Hugo Zaragoza et al. The probabilistic relevance framework: Bm25 and beyond. Foundations and Trends® in Information Retrieval, 3(4):333-389, 2009.
Baptiste Rozière, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat und Xiaoqing Ellen Tan et al. Code llama: Open foundation models for code, 2023.
David Schlangen. Language tasks and language games: On methodology in current natural language processing research, 2019.
Dominik Sobania, Martin Briesch, Carol Hanna und Justyna Petke. An analysis of the automatic bug fixing performance of chatgpt, 2023.
Aarohi Srivastava, Abhinav Rastogi, Abhishek Rao und Abu Awal Md Shoeb et al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models, 2023.
Rosalia Tufano, Luca Pascarella, Michele Tufano, Denys Poshyvanyk und Gabriele Bavota. Towards automating code review activities, 2021.
Junjie Wang, Yuchao Huang, Chunyang Chen, Zhe Liu, Song Wang und Qing Wang. Software testing with large language model: Survey, landscape, and vision, 2023.
Chunqiu Steven Xia und Lingming Zhang. Less training, more repairing please: revisiting automated program repair via zero-shot learning. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering, S. 959-971, 2022.
Chunqiu Steven Xia und Lingming Zhang. Conversational automated program repair, 2023.
Chunqiu Steven Xia, Matteo Paltenghi, Jia Le Tian, Michael Pradel und Lingming Zhang. Universal fuzzing via large language models. arXiv preprint arXiv:2308.04748, 2023.
John Yang, Akshara Prabhakar, Karthik Narasimhan und Shunyu Yao. Intercode: Standardizing and benchmarking interactive coding with execution feedback, 2023.
Xin Yang, Raula Gaikovina Kula, Norihiro Yoshida und Hajimu Iida. Mining the modern code review repositories: A dataset of people, process and product. In Proceedings of the 13th International Conference on Mining Software Repositories, S. 460-463, 2016.
Shunyu Yao, Howard Chen, John Yang und Karthik Narasimhan. Webshop: Towards scalable real-world web interaction with grounded language agents, 2022.
Pengcheng Yin, Wen-Ding Li, Kefan Xiao, Abhishek Rao, Yeming Wen, Kensen Shi, Joshua Howland, Paige Bailey, Michele Catasta, Henryk Michalewski, Alex Polozov und Charles Sutton. Natural language to code generation in interactive data science notebooks, 2022.
Hao Yu, Bo Shen, Dezhi Ran, Jiaxin Zhang, Qi Zhang, Yuchi Ma, Guangtai Liang, Ying Li, Tao Xie und Qianxiang Wang. Codereval: A benchmark of pragmatic code generation with generative pre-trained models, 2023.
Tao Yu, Rui Zhang, Kai Yang, Michihiro Yasunaga, Dongxu Wang, Zifan Li, James Ma, Irene Li, Qingning Yao, Shanelle Roman, Zilin Zhang und Dragomir Radev. Spider: A large-scale human-labeled dataset for complex and cross-domain semantic parsing and text-to-SQL task. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, S. 3911-3921, Brüssel, Belgien, Oktober-November 2018. Association for Computational Linguistics. doi: 10.18653/v1/D18-1425. URL https://aclanthology.org/D18-1425.
Daoguang Zan, Bei Chen, Dejian Yang, Zeqi Lin, Minsu Kim, Bei Guan, Yongji Wang, Weizhu Chen und Jian-Guang Lou. Cert: Kontinuierliches Vortraining auf Skizzen für bibliotheksorientierte Codegenerierung, 2022.
Daoguang Zan, Bei Chen, Fengji Zhang, Dianjie Lu, Bingchao Wu, Bei Guan, Yongji Wang und Jian-Guang Lou. Große Sprachmodelle treffen auf n1code: Ein Überblick, 2023.
Jiyang Zhang, Sheena Panthaplackel, Pengyu Nie, Junyi Jessy Li und Milos Gligoric. Coditt5: Vortraining für Quellcode- und Bearbeitung natürlicher Sprache, 2022.
Zibin Zheng, Kaiwen Ning, Jiachi Chen, Yanlin Wang, Wenqing Chen, Lianghong Guo und Weicheng Wang. Towards an understanding of large language models in software engineering tasks. arXiv preprint arXiv:2308.11396, 2023.
Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Yonatan Bisk, Daniel Fried, Uri Alon und Graham Neubig. Webarena: A realistic web environment for building autonomous agents, 2023.
ANHANG
Im Anhang stellen wir ausführlichere Details zum Datensatzkonstruktionsprozess, zur Evaluierungspipeline und zur Charakterisierung des SWE-bench-Benchmarks bereit.
A BENCHMARK-DETAILS
Dieser Abschnitt ergänzt Abschnitt 2 durch eine technischere und fein granuliertere Zusammenfassung der Datenerhebung, der ausführungsbasierten Validierung und der Evaluierungsverfahren sowie durch eine vollständigere Charakterisierung der Aufgabeninstanzen.
A.1 ÜBERBLICK AUF HOHER EBENE
Scraping von Pull Requests. Aus einer Liste der 5.000 meistheruntergeladenen PyPI-Bibliotheken im August 2023 wählen wir die Top-100-Pakete aus, identifizieren das jeweilige Open-Source-GitHub-Repository jeder Bibliothek, überprüfen, welche Pakete Lizenzen haben, die eine freie Softwarenutzung erlauben, und sammeln alle PRs für diese Repositorys über die GitHub-Entwickler-API. Wir entscheiden uns dafür, Probleme aus stark frequentierten Repositorys zu beziehen, weil eine weitverbreitete Nutzung in der Regel darauf hindeutet, dass das Repository umfangreiche Dokumentation, strukturierte Open-Source-Entwicklungsrichtlinien und funktionierenden, gut formatierten Code aufweist.
Konstruktion von Aufgabeninstanzen. Wir konstruieren Kandidaten für Aufgabeninstanzen aus PRs, die drei Bedingungen erfüllen. Erstens muss der Status des PR Merged sein. Ein Merged-Status zeigt an, dass die mit dem PR verbundenen Codeänderungen akzeptiert und in das übergeordnete Repository aufgenommen wurden. Zweitens löst der PR ein oder mehrere Issues in seinem Repository. Ein Issue ist gemäß seiner kanonischen Verwendung in GitHub als digitales Ticket zur Verfolgung von Fehlern, Verbesserungen oder allgemeinen Entwicklungszielen für ein Softwareprojekt definiert. Wir durchsuchen den Titel, den Text und die Commit-Nachrichten eines PR nach verlinkten Issues (d. h. „fixes #24“). Drittens muss der PR einen oder mehrere neue Tests einführen. Ein neuer Test wird gezählt, wenn die Codeänderungen eines PR eine Datei bearbeiten, deren Pfad ein testbezogenes Schlüsselwort enthält (z. B. „test“, „testing“).
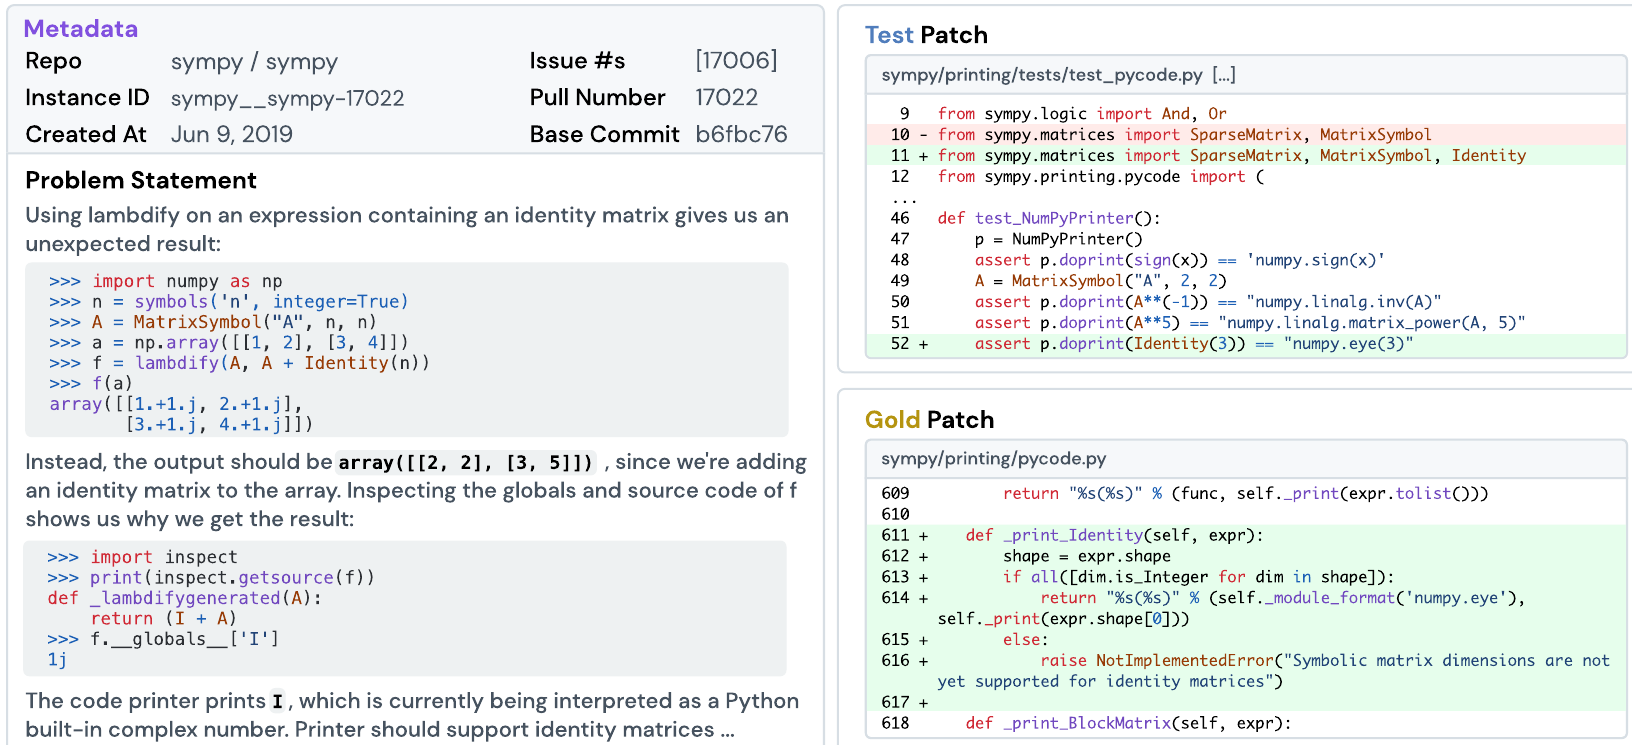
Ein PR, der diese Kriterien erfüllt, wird dann in eine Kandidaten-Aufgabeninstanz umgewandelt, wie das Beispiel in Abbildung 7. Die Codebasis wird durch den Owner/Name-Moniker des Repositorys und den Basis-Commit des Pull Requests identifiziert. Die tatsächliche Codebasis aus diesen Informationen wiederherzustellen, ist unkompliziert. Wir erstellen Mirrors der ursprünglichen GitHub-Repositorys, wobei jeder Mirror eindeutig als owner_name identifiziert wird. Das Klonen des entsprechenden Mirrors eines Repositorys und das Auschecken des Basis-Commits ergibt in seinem Zustand vor dem PR. Die Problembeschreibung ist eine Zusammenfassung der Titel und Beschreibungen aller zugehörigen Issues sowie aller nachfolgenden Kommentare, die vor dem Zeitstempel des ersten Commits des PR geschrieben wurden, um ein Durchsickern von Lösungseinzelheiten zu vermeiden. Die Codeänderungen eines PR werden in einen Test-Patch und einen Gold-Patch aufgeteilt. besteht aus allen Tests aus Dateien, die im Test-Patch bearbeitet wurden. Wie in Abbildung 7 gezeigt, werden sowohl als auch als Patch-Dateien gespeichert. Weitere Einzelheiten zum Parsen von PR- und semantischen Daten finden sich in Anhang A.2.
Ausführungsbasierte Validierung. Wir überprüfen die Verwendbarkeit einer Aufgabeninstanz mittels Ausführung. Für jeden Kandidaten definieren wir zunächst eine virtuelle Umgebung, die als Ausführungskontext dient, installieren dann , bevor wir irgendwelche Patches anwenden, und führen schließlich einmal vor und einmal nach Anwendung der Lösung aus. Ein Kandidat wird für den finalen Datensatz nicht weiter berücksichtigt, wenn ein Schritt im Verifikationsprozess fehlschlägt. Darüber hinaus vergleichen wir, um sicherzustellen, dass eine Lösung nicht trivial ist, die Validierungsprotokolle vor und nach der Lösung, um zu prüfen, ob es in einen oder mehrere Tests gibt, deren Status von fail zu pass wechselt. Schließlich schließen wir Aufgabeninstanzen mit Tests aus, die neu erstellte Funktionen oder Klassen aufrufen, die erstmals in der Lösung eingeführt werden. Da die Benennung solcher Konstrukte typischerweise ein willkürlicher Prozess ist und in der Problembeschreibung gewöhnlich nicht explizit angegeben wird, kann das Lösen solcher Tests selbst für menschliche Entwickler eine unmögliche Aufgabe sein. Informationen zu Ausführungskontexten, Codebasis-Installation, Bestimmung von Teststatus aus Protokollen und mehr finden sich in Anhang A.3.
Kontinuierliche Aktualisierungen. Der Sammlungsprozess von SWE-bench ist leicht auf beliebige Open-Source-Code-Repositorys erweiterbar und ermöglicht eine einfache und wartungsarme Erweiterung auf neue Programmiersprachen und Code-Domänen. Dieses Design verleiht SWE-bench außerdem zeitliche Robustheit; da im Laufe der Zeit neue Sprachmodelle veröffentlicht werden, die auf neuerem Quellcode trainiert wurden, kann SWE-bench einfach aktualisiert werden, um neue Aufgabeninstanzen auf der Grundlage von PRs zu erzeugen, die nach dem Trainingsdatum eines beliebigen LM erstellt wurden.
A.2 KONSTRUKTIONSPROZESS
Wir erörtern zusätzliche Einzelheiten zur Umwandlung eines Pull-Request-Objekts in eine Kandidaten-Aufgabeninstanz. Auf hoher Ebene besteht das Hauptziel dieser Umwandlung darin, relevante Informationen zu erfassen, um die in Abschnitt 2 eingeführten Komponenten Codebasis , Problembeschreibung , Unit-Tests und Lösung zusammenzustellen. Zu diesem Zweck besteht eine SWE-bench-Aufgabeninstanz aus den folgenden Feldern, die in der folgenden Tabelle 9 dargestellt sind. Zusammen entsprechen die Felder den vier Modulen der Aufgabeninstanz.
| Feld | Beschreibung |
| base.commit | (str) Die Commit-ID, auf der der ursprüngliche PR aufsetzt |
| created.at | (date) Datetime-Objekt, wann der PR erstmals erstellt wurde (nicht gemergt) |
| hints.text | (str) Vorschläge in natürlicher Sprache, wie das Problem gelöst werden kann |
| instance.id | (str) Eine eindeutige Kennung, die aus repo und pull_number erzeugt wird |
| issue.numbers | (list) Liste der Issue-Nummern, die der ursprüngliche Pull Request löst |
| patch | (str) Zeichenkette im .patch-Format, die eine Referenzlösung für das Problem darstellt, extrahiert aus den Codeänderungen des ursprünglichen PR |
| problem.statement | (str) Beschreibung der gewünschten Änderung an der Codebasis in natürlicher Sprache |
| pull.number | (int) Die Pull-Nummer des ursprünglichen Pull Requests |
| test.patch | (str) Zeichenkette im .patch-Format, die ungesehene Tests enthält, um zu prüfen, ob eine Aufgabe gelöst wurde, extrahiert aus den Codeänderungen des ursprünglichen PR |
| version | (str) Release-Version (bezogen auf das Repo), während der der PR erstellt wurde |
| repo | (str) Das Repository, aus dem die Aufgabeninstanz stammt |
| FAIL_TO_PASS | (list) Liste der Tests, deren Status sich von fail zu pass ändert |
| PASS_TO_PASS | (list) Liste der Tests, deren Status sich von pass zu pass ändert |
| env.install.commit | (str) Basis-Commit, an dem die notwendigen Abhängigkeiten zur Ausführung der Aufgabeninstanz installiert werden. |
Problembeschreibung. Die Problembeschreibung für jede Aufgabeninstanz ist ohne Weiteres als Feld problem_statement verfügbar. Die Problembeschreibung ist eine Zusammenfassung der ersten Kommentare aller Issues sowie aller an diese Issues angehängten Kommentare, die vor dem Erstellungsdatum des ersten Commits des PR erstellt wurden. Wir durchsuchen Issues aus dem Titel, dem Text und den Commit-Nachrichten des PR. Nach der Verkettung der Textdaten dieser Komponenten entfernen wir zunächst alle Kommentare im Markdown-Stil und durchsuchen dann den verbleibenden Text nach Verweisen auf Issue-Nummern (ein Rautezeichen # gefolgt von einer Zahl) und prüfen, ob das Wort vor dem Verweis auf die Issue-Nummer in einer Menge von Schlüsselwörtern enthalten ist, die darauf hindeuten, dass das Issue durch den PR gelöst wurde (z. B. „closes“, „fixes“, „resolves“). Die gefundenen Issues werden in den Feldern issue_number festgehalten, anschließend werden separate Webanfragen gestellt, um die Daten jedes Issues abzurufen. Um das problem_statement zu bilden, werden Titel und Text jedes Issues zusammengefügt und, falls es mehrere gibt, mit dem nächsten Issue verkettet. In diesem Schritt wird auch das Feld hints_text erstellt und aus dem Kommentarbereich des PR gesammelt, wobei Text aus Kommentaren stammt, die vor dem ersten Commit des PR erstellt wurden. Die Intuition hinter dieser Sammelmethode ist, dass solche PR-Kommentare wahrscheinlich natürlichsprachliche und Pseudocode-Vorschläge an den ursprünglichen menschlichen Aufgabenbearbeiter enthalten, wie die vorliegende Aufgabe zu lösen ist. Die in dieser Arbeit vorgestellten Experimente verwenden hints_text nicht, aber wir glauben, dass diese Informationen für zukünftige Untersuchungen interessant sein könnten.
Codebasis. Der Inhalt der Codebasis wird nicht für jede Aufgabeninstanz im Klartext gespeichert. Stattdessen enthält die Aufgabeninstanz einen Verweis auf die relevante Codebasis über die Felder repo und base_commit. Beide Felder sind in den Daten des ursprünglichen PR verfügbar. Um das Abrufen der Codebasis aus diesen beiden Elementen reproduzierbar und zuverlässig zu machen, erstellen wir Mirrors des ursprünglichen Repositorys. Mirrors für das Repository, das sowohl die Evaluations- als auch die Fine-Tuning-Daten bildet, werden gesammelt und unter der GitHub-Organisation SWE-bench als Open Source veröffentlicht. Da der Code eines ursprünglichen Repositorys Änderungen in seiner Commit- und Bearbeitungshistorie unterliegen kann, die außerhalb der Kontrolle der Autoren liegen, erstellen wir ein Mirror-Repository, um sicherzustellen, dass spätere Änderungen an der Codebasis eine Aufgabeninstanz nicht möglicherweise durch eine Beschädigung oder Entfernung des zugehörigen base_commit unbrauchbar machen. Darüber hinaus erstellen wir ein Mirror, anstatt die neueste Version eines Repositorys zu klonen und zu speichern. Dies liegt daran, dass ein Mirror die ursprünglichen Commit-Hashes, die Historie, Branches und Tags bewahrt und als getreue und vollständige Historie der technischen Details des ursprünglichen Repositorys dient. Ein Mirror behält keine Stars, Watcher, Issues oder Pull Requests des ursprünglichen Repositorys.
Wir erstellen ein Mirror eines Repositorys nach und am selben Tag, an dem Aufgabeninstanzen gesammelt wurden. Das Mirror behält den Moniker „owner/name“ des ursprünglichen Repositorys bei, mit der Ausnahme, dass das Zeichen „/“ in „_“ umgewandelt wird, um den GitHub-Namenskonventionen zu entsprechen. Mit dieser Infrastruktur ist das Abrufen der Codebasis einer Aufgabeninstanz unkompliziert. Zuerst kann das richtige Mirror mithilfe von repo aus der SWE-bench-Organisation geklont werden. Als Nächstes setzt das Auschecken des base_commit innerhalb der lokalen Kopie des Mirrors das Repository auf die Codebasis zurück. Um zu einer anderen Aufgabeninstanz aus demselben Repository überzugehen, wird die Git-Versionskontrolle verwendet, um automatisch alle mit der aktuellen Aufgabeninstanz verbundenen Änderungen zu entfernen, bevor der Basis-Commit der nächsten Aufgabeninstanz ausgecheckt wird.
Lösung, Test-Patches. Die Lösung und die Tests werden aus den Dateiänderungsdaten bzw. dem Diff eines PR abgeleitet. Wie in Abschnitt 2.1 erwähnt, werden das ursprüngliche Diff sowie die Lösung und die Tests als .patch-Datei dargestellt, einem Format zur effizienten Spezifikation von Transformationen für zeilenbasierte Textdateien. Allgemein gesprochen ist ein .patch als Liste von Blöcken strukturiert, wobei jeder Block aus einem Header und einem oder mehreren Hunks besteht, die zusammengenommen Änderungen an einer einzelnen Datei entsprechen. Der Header enthält Metadaten, die einen Dateipfad und Zeilennummern angeben, während die eigentlichen Modifikationen an der Zieldatei als mehrere Zeilen codiert sind, denen „+“ und „-“ vorangestellt sind, um Hinzufügungen und Entfernungen anzuzeigen. Um die Tests zu erstellen, identifizieren wir zunächst jeden eindeutigen Block innerhalb des Patches und wählen dann Blöcke mit Dateipfaden aus, die testbezogene Schlüsselwörter enthalten (z. B. „tests“, „testing“), und fassen sie zusammen. Die verbleibenden Blöcke werden zusammengeführt, um die Lösung zu bilden. Wir validieren die Robustheit des Skripts, das geschrieben wurde, um und korrekt zu parsen, indem wir beide Patches auf die entsprechende Codebasis anwenden und die Tests ausführen; anschließend prüfen wir, ob die Ergebnisse das Verhalten der Diff-Daten des Basis-PR reproduzieren. Die Lösung wird als Feld patch gespeichert, während die Tests als Feld test_patch gespeichert werden.
Übrige Felder. Das Feld created_at ist ein Zeitstempel, der angibt, wann der Basis-PR erstellt wurde. Wir behalten das Feld created_at aus den ursprünglichen Daten bei und verwenden dieses Feld, um eine zeitliche Analyse der Modellleistung durchzuführen. Das Feld version ist eine Zeichenkette, die der Release-Version des Repositorys entspricht, während der der PR veröffentlicht wurde. Je nach Verfügbarkeit und dem für die jeweilige Methode erforderlichen Aufwand erstellen wir das Feld version, indem wir die Informationen direkt aus dem Quellcode abrufen, das Repository lokal bauen und Code aufrufen, um die Version an die Standardausgabe auszugeben, oder das Feld created_at mit einer Zeitleiste der Release-Versionen von der Webseite eines Repositorys vergleichen. Wir erstellen ausführbare Kontexte für jede Version eines Repositorys, wie in § A.3 ausführlicher erörtert.
Dokumentation zum Erstellen eines Mirror-Repositorys mit GitHub
A.3 AUSFÜHRUNGSBASIERTE VALIDIERUNG
Nach dem Filtern aller PRs eines Repositorys und der Umwandlung derjenigen, die die oben genannten Kriterien erfüllen, in Kandidaten-Task-Instanzen besteht der nächste Schritt darin, die Verwendbarkeit jeder Task-Instanz durch Ausführung zu validieren. Dieses Verfahren gliedert sich in drei Schritte. Zuerst erstellen wir ausführbare Kontexte für jede Release-Version eines Repositorys. Als Nächstes prüfen wir, ob die Lösung und die Tests auf der Codebasis angewendet, installiert und erfolgreich ausgeführt werden können. Schließlich untersuchen wir das Ausführungsprotokoll jeder Task-Instanz, um eine bestimmte Menge von Verhaltensweisen zu verifizieren, um sicherzustellen, dass die Task verwendbar und fair für die Modellbewertung ist.
Ausführbare Kontexte. Wir entscheiden uns dafür, ausführbare Kontexte pro Release-Version zu erstellen, nachdem wir mit verschiedenen Granularitätsgraden hinsichtlich der Definitionsebene experimentiert haben, auf der virtuelle Umgebungen definiert werden sollen. Die Definition von Task-Instanz-spezifischen Kontexten ist am förderlichsten, um einen durchgängigen Installationserfolg sicherzustellen, geht jedoch mit dem Preis arbeitsintensiver manueller Erstellung einher. Andererseits ist ein Repository-spezifischer Kontext basierend auf der neuesten Version eines Repositorys typischerweise eine zu grobe Definition, die nicht mit den Anforderungen älterer Versionen kompatibel ist. Wir stellen fest, dass Release-Versionen ein guter Stellvertreter sind, um die Abhängigkeitsanforderungen über eine Teilmenge von Task-Instanzen hinweg zu erfassen, und einen handhabbaren Ausgleich zwischen Installationserfolg und manuellem Aufwand schaffen. Wir erstellen jeden ausführbaren Kontext manuell, indem wir die Codebasis der neuesten Task-Instanz für jede Version untersuchen. Basierend auf dem Quellcode und der Dokumentation, die typischerweise in der README und den CONTRIBUTING-Leitfäden des Repositorys zu finden sind, ermitteln wir die Python-Version, die notwendigen Abhängigkeiten und den Installationsbefehl.
Validierungs-Engine. Der Zweck der Validierungs-Engine besteht darin, Kandidaten-Task-Instanzen zu verifizieren. Konkret prüft dieser Schritt erstens, dass die Lösung und die Tests auf die Codebasis angewendet werden können, und zweitens, dass die Codebasis innerhalb der entsprechenden virtuellen Umgebung ordnungsgemäß installiert und ausgeführt werden kann. Dazu führen wir die Validierung Repository für Repository durch, wobei wir für die Menge der Task-Instanzen jedes Repositorys das folgende Verfahren ausführen:
1. Erstellen ausführbarer Kontexte als conda-Umgebungen basierend auf der neuesten Task-Instanz pro Version.
2. Gruppieren der Task-Instanzen nach Version.
3. Iterieren über jede Gruppe von Task-Instanzen, wobei wir für jede Task-Instanz innerhalb der entsprechenden conda-Umgebung Folgendes ausführen:
(a) Entfernen aller Dateiänderungen und Auschecken des base_commit der Task-Instanz. Dadurch wird das Repository auf die Codebasis gesetzt.
(b) Ausführen des Installationsbefehls, um die Codebasis zu instanziieren.
(c) Anwenden des Test-Patches auf die Codebasis .
(d) Ausführen des Testskripts, das aus dem Test-Patch bestimmt wird, um Testprotokolle zu erzeugen.
(e) Anwenden des Lösungspatches auf die Codebasis mit Tests .
(f) Erneutes Ausführen des Testskripts aus Teil (d), um Testprotokolle zu erzeugen.
Der Testbefehl besteht aus dem vom Repository verwendeten Testframework (z. B. pytest, tox), an das die in angegebenen Pfade angehängt werden. Der Testbefehl würde alle und jede Tests ausführen, die innerhalb des Inhalts jedes Dateipfads angegeben sind. Wenn einer der Schritte bis fehlschlägt, wird die Kandidaten-Task-Instanz aus der Betrachtung ausgeschlossen. Bei moderater Variation zwischen den Repositorys beobachten wir, dass dieser Schritt im Allgemeinen die Hälfte der Kandidaten-Task-Instanzen entfernt.
Überprüfung der Validierungsprotokolle. Nicht zuletzt prüfen wir die von der Validierungs-Engine erstellten Protokolle und auf bestimmte Eigenschaften. Zunächst prüfen wir, um uns gegen willkürliche Namenswahl abzusichern, auf das Auftreten von ImportError und AttributeError, die potenziell auf Fehler im Zusammenhang mit der Benennung von Abhängigkeiten hinweisen, die trivial und nahezu unmöglich korrekt zu beheben wären. Zu diesem Zweck entfernen wir alle Aufgabeninstanzen mit solchen Fehlern in ihrem aus der Betrachtung. Als Nächstes vergleichen wir die Testergebnisse, um sicherzustellen, dass die Aufgabeninstanz nicht trivial ist, was dadurch angezeigt wird, dass mindestens ein oder mehrere Tests vor der Anwendung der Lösung den Status fail und danach den Status pass haben. Um dies zu prüfen, definieren wir zunächst mehrere repository-spezifische Parser, um und in Abbildungen von Tests auf einen Status umzuwandeln. Angesichts dieser beiden Datenstrukturen prüfen wir dann, dass
| Repo | Insgesamt gecrawlte PRs | Nach der Konvertierung | Nach der Validierung (Final) |
| astropy | 9.469 | 1.016 | 95 |
| django | 16.914 | 2.880 | 850 |
| flask | 2.434 | 107 | 11 |
| matplotlib | 16.545 | 1.057 | 184 |
| pylint | 3.848 | 787 | 57 |
| pytest | 5.147 | 750 | 119 |
| requests | 2.344 | 84 | 44 |
| scikit-learn | 15.159 | 1.169 | 229 |
| seaborn | 1.004 | 203 | 22 |
| sphinx | 4.931 | 645 | 187 |
| sympy | 11.928 | 1.897 | 386 |
| xarray | 3.416 | 812 | 110 |
| Gesamt | 93.139 | 11.407 | 2.294 |
mindestens ein existiert, bei dem von fail zu pass wechselt. Wenn keine solchen Tests gefunden werden, wird die Aufgabeninstanz aus der Betrachtung entfernt.
Wenn eine Aufgabeninstanz diese beiden Kriterien erfüllt, wird sie in den Evaluierungsdatensatz aufgenommen. Tabelle 10 zeigt eine Zusammenfassung darüber, wie viele Aufgabeninstanzen während des Konstruktionsprozesses und der ausführungsbasierten Validierungsschritte aus der Betrachtung entfernt wurden. Wir speichern alle finalisierten Aufgabeninstanzen in einer einzigen .json-Datei, die Open Source ist und zum Download zur Verfügung steht.
Neben den Aufgabeninstanzen erstellen wir auch einen entsprechenden Ordner mit den Ground-Truth-Testergebnissen. Für jede Aufgabeninstanz erstellen wir aus ihren jeweiligen Test-zu-Status-Abbildungen von und eine Testergebnis-Datenstruktur, deren Schlüssel FAIL_TO_FAIL, FAIL_TO_PASS, PASS_TO_FAIL und PASS_TO_PASS sind und deren Werte Listen von Tests sind. Durch das „Cachen“ dieser Ergebnisse entfällt die Notwendigkeit, die Lösung zum Evaluierungszeitpunkt erneut auszuführen (obwohl das erneute Ausführen eine verfügbare Option ist). Wir verwenden diese Datenstruktur, um die Aufgabenerfüllung zu überprüfen, wie in Abschnitt A.4 erläutert.
A.4 EVALUIERUNGSVERFAHREN
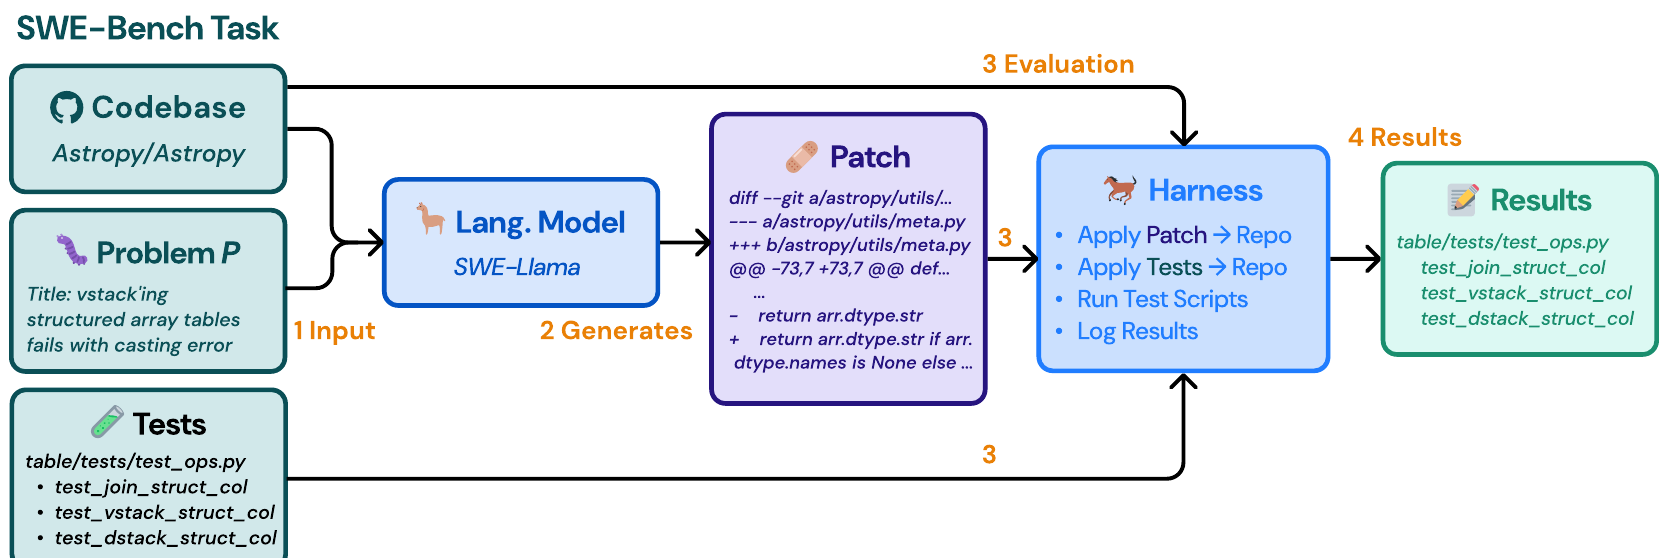
Wir bieten eine Visualisierung des Evaluierungsverfahrens in Abbildung 8. Das Evaluierungsverfahren bewertet die Patch-Generierung des Modells in Bezug auf das Verhalten der Lösung . Auf einer feineren Ebene kann das Evaluierungsverfahren in vier separate Schritte unterteilt werden, die durch die nummerierten Schritte in Abbildung 8 hervorgehoben sind. Zuerst sind die Codebasis und die Problembeschreibung sichtbar und werden dem LM gegeben; das LM generiert dann eine .patch-Vorhersage . Im Evaluierungsschritt werden pro Vorhersage auf der Zielaufgabeninstanz die folgenden Schritte ausgeführt:
1. Alle Dateiänderungen entfernen und den Basis-Commit der Aufgabeninstanz auschecken. Dadurch wird das Repository auf die Codebasis gesetzt.
2. Den ausführbaren Kontext aktivieren, der der Version der Aufgabeninstanz entspricht.
3. Den Installationsbefehl ausführen, um die Codebasis zu instanziieren.
4. Den Test-Patch auf die Codebasis anwenden.
5. Den Vorhersage-Patch auf die Codebasis mit Tests anwenden.
6. Wenn der vorherige Schritt fehlschlägt, versuchen wir, den Vorhersage-Patch automatisch zu reparieren und erneut anzuwenden.
7. Das Testskript, das aus dem Test-Patch bestimmt wird, ausführen, um Testprotokolle zu erzeugen.
Die Schritte 1 bis 4 schlagen zuverlässig nicht fehl aufgrund der Verifikation während des Validierungsprozesses der Aufgabeninstanz. Wenn das Anwenden des Vorhersage-Patches (Schritt 5) fehlschlägt, versuchen wir, die Vorhersage-Patch-Datei zu reparieren, indem wir unnötige Kontextzeilen entfernen und die Header-Werte neu berechnen (Schritt 6). Wenn der verbleibende Patch erneut fehlschlägt oder das Ausführen des Testbefehls (Schritt 7) fehlschlägt, erhält die Vorhersage automatisch eine Bewertung von 0. Unter der Annahme, dass diese Schritte erfolgreich sind, kann das Ausgabeprotokoll dann mit dem entsprechenden, in § A.3 eingeführten repository-spezifischen Parser in eine Test-zu-Status-Abbildung umgewandelt werden, die strukturell identisch ist.
Berechnung der Evaluierungsmetriken. Um die Aufgabenerfüllung zu bestimmen, vergleichen wir die aus geparste Test-zu-Status-Abbildung mit der Liste der Tests, die den Schlüsseln FAIL_TO_PASS und PASS_TO_PASS aus der Ground-Truth-Testergebnis-Datenstruktur entsprechen. Die Bestimmung der Aufgabenerfüllung ist unkompliziert; wir prüfen, dass alle FAIL_TO_PASS- und PASS_TO_PASS-Tests gefunden werden und in der Evaluierungs-Test-zu-Status-Abbildung den Status pass haben. Wenn ein Test fehlt oder einen anderen Status als pass hat, wird er als fail betrachtet. Wie im Hauptpapier definiert und verwendet, gilt eine Aufgabe als gelöst, wenn alle Tests aus FAIL_TO_PASS und PASS_TO_PASS bestehen.
A.5 CHARAKTERISIERUNG DES EVALUIERUNGSTESTSETS
Wir fügen eine erweiterte Form von Tabelle 1 bei, die repository-spezifische Statistiken in Tabelle 11 enthält. Tabelle 12 präsentiert eine kurze Beschreibung jedes Repositorys, die aus der Dokumentation des Repositorys extrahiert wurde, zusammen mit der zugehörigen Open-Source-Lizenz des Repositorys. Die zugehörigen Lizenzen erlauben alle eine nicht-kommerzielle Nutzung des ursprünglichen Bibliotheksquellcodes, solange die Berechtigungen in den ursprünglichen Lizenzen eingehalten und beibehalten werden. Zusätzlich zu den ursprünglichen Statistiken in Tabelle 1 führen wir drei neue Werte ein. Die Lines Added und Lines Removed summieren sich zusammen zu Lines Edited. „Added“ bezieht sich auf die Anzahl der neuen Zeilen, die eingeführt werden, während „Removed“ bereits vorhandene Zeilen sind, die durch die Lösung entfernt werden. Die Statistik (Pass to Pass) bezieht sich auf die Anzahl der Tests, die bestanden wurden, bevor die Lösung während der Validierungspipeline angewendet wurde. Anders als Fail-to-Pass-Tests, die die Problembeschreibung charakterisieren und bestimmen sollen, ob eine Revision das Problem behebt, werden Pass-to-Pass-Tests einbezogen, um sicherzustellen, dass die Revision kein bestehendes erwartetes Verhalten bricht oder verletzt. Diese Tests werden während der Phase der Prüfung der Validierungsprotokolle extrahiert, wie in § A.3 erläutert. Wir merken an, dass Fail-to-Fail-Tests und Pass-to-Fail-Tests während der Evaluierung nicht berücksichtigt werden und diese Statistiken in der obigen Tabelle nicht wiedergegeben werden.
Kategorien von Aufgabeninstanz-Issues. Um ein besseres Gefühl für die Arten von Problemen zu vermitteln, die SWE-bench-Aufgabeninstanzen umfassen, führen wir einfache Analysen der Issues durch, die durch das Feld issue_numbers für jede Aufgabeninstanz identifiziert werden. Pro Issue untersuchen wir Metadaten, insbesondere Tags, um die Art des Beitrags zu charakterisieren, der durch den PR vorgelegt wird. Tabelle 13 gruppiert und zeigt mehrere Beispiele der 2.289 Tags, die wir über alle Issues hinweg gefunden haben. Während die absolute Mehrheit der Issues mit Bugfixes verbunden ist, sind die Aufgabeninstanzen von SWE-bench mit einer vielfältigen Menge von Codeänderungen verbunden, deren Zwecke über Debugging und Fehlerkorrektur hinausgehen.
Attributverteilungen. In Abbildung 9 präsentieren wir Diagramme der kumulativen Verteilungsfunktion für die in Tabelle 1 eingeführten Attribute. Aus diesen Diagrammen sehen wir, dass die mittlere SWE-bench-Aufgabeninstanz eine Problembeschreibung von 140 Wörtern hat und sich in einer Codebasis mit knapp 1900 Dateien und 400K Zeilen abspielen wird. Die entsprechende Referenzlösung bearbeitet üblicherweise eine einzelne Funktion
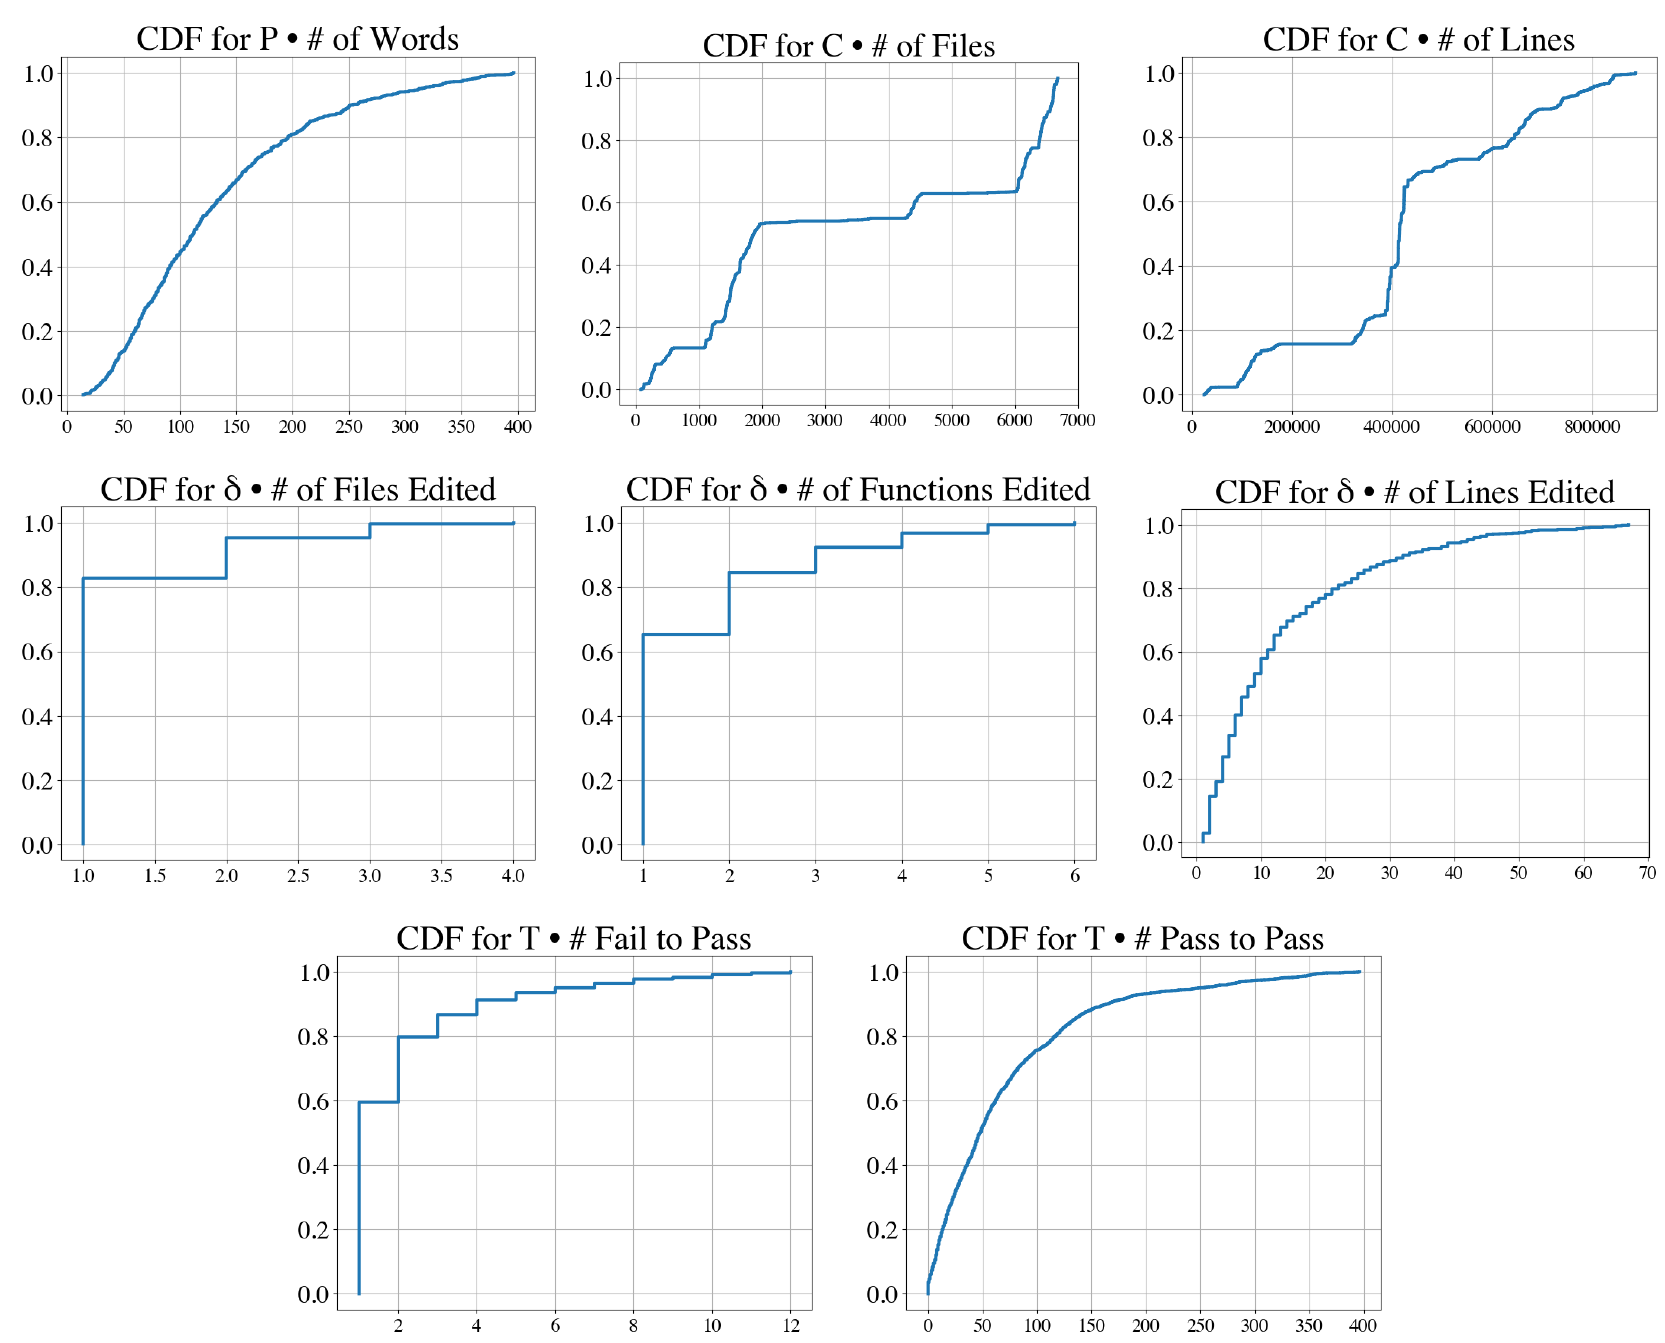
| astropy | django | flask | matplotlib | pylint | pytest | |
| P-Länge (Zeichen) | 2.742 | 1.307 | 1.185 | 2.381 | 2.011 | 2.948 |
| C # Dateien | 1.811 | 6.356 | 225 | 4.395 | 2.426 | 497 |
| C # Zeilen | 804k | 407k | 35k | 646k | 109k | 111k |
| δ # Bearbeitete Dateien | 1,5 | 1,5 | 1,6 | 1,5 | 1,8 | 1,4 |
| δ # Bearbeitete Funkt. | 2,5 | 2,0 | 2,4 | 2,2 | 1,8 | 1,7 |
| δ # Bearbeitete Zeilen | 36,0 | 18,5 | 35,4 | 58,9 | 36,0 | 24,5 |
| δ # Hinzugefügte Zeilen | 25,0 | 12,8 | 23,7 | 35,7 | 26,6 | 18,2 |
| δ # Entfernte Zeilen | 10,9 | 5,7 | 11,6 | 23,2 | 9,5 | 6,4 |
| |T| (Fail to Pass) | 21,7 | 8,8 | 1,4 | 2,4 | 6,8 | 4,1 |
| |T| (Bestanden zu Bestanden) | 191,0 | 85,9 | 32,5 | 242,4 | 47,0 | 60,7 |
| |T| (Alle) | 212,8 | 94,6 | 33,9 | 244,8 | 53,7 | 64,8 |
| Anfragen | scikit-learn | seaborn | sphinx | sympy | xarray | |
| P-Länge (Zeichen) | 1.654 | 2.239 | 1.667 | 1.888 | 1.213 | 3.515 |
| C # Dateien | 119 | 1.224 | 273 | 1.483 | 1.666 | 260 |
| C # Zeilen | 30k | 361k | 105k | 423k | 678k | 137k |
| δ # Bearbeitete Dateien | 1,64 | 1,68 | 1,77 | 1,51 | 1,9 | 2,45 |
| δ # Bearbeitete Funkt. | 1,59 | 2,24 | 1,41 | 2,72 | 3,22 | 3,16 |
| δ # Bearbeitete Zeilen | 25,5 | 44,0 | 30,1 | 30,6 | 36,3 | 124,8 |
| δ # hinzugefügte Zeilen | 19,2 | 32,7 | 24,9 | 22,0 | 24,2 | 95,6 |
| δ # entfernte Zeilen | 6,2 | 11,3 | 5,2 | 8,6 | 12,1 | 29,2 |
| |T| (Fail to Pass) | 7,6 | 7,5 | 12,9 | 2,3 | 2,2 | 58,5 |
| |T| (Pass to Pass) | 87,1 | 150,7 | 86,8 | 45,1 | 74,5 | 297,5 |
| |T| (Alle) | 94,7 | 158,2 | 99,7 | 47,4 | 76,8 | 356,1 |
| Repository | Zusammenfassung | Lizenz |
| astropy/astropy | Kernbibliothek für Astronomie und Astrophysik | BSD 3-Clause |
| django/django | Web-Framework zum Erstellen von Webanwendungen | BSD 3-Clause |
| pallets/flask | Leichtgewichtiges Framework für kleine Web-Apps | BSD 3-Clause |
| matplotlib/matplotlib | Plot-Bibliothek zur Erstellung von Visualisierungen | Benutzerdefiniert |
| pylint-dev/pylint | Statischer Code-Analysator für Python 2 oder 3 | GPL 2.0 |
| pytest-dev/pytest | Test-Framework für Python | MIT |
| psf/requests | Einfache, elegante Bibliothek zum Schreiben von HTTP-Anfragen | Apache-2.0 |
| scikit-learn/scikit-learn | Maschinelles Lernen in Python | BSD 3-Clause |
| mwaskom/seaborn | Statistische Datenvisualisierung in Python | BSD 3-Clause |
| sphinx-doc/sphinx | Bibliothek zur Erstellung von Dokumentation | Benutzerdefiniert |
| sympy/sympy | Computeralgebrasystem, geschrieben in Python | Benutzerdefiniert |
| pydata/xarray | N-D beschriftete Arrays und Datensätze | Apache-2.0 |
innerhalb einer Datei, ändert Zeilen und hat einen einzigen Fail-to-Pass-Test, um die Korrektheit der Änderung zu verifizieren, zusammen mit 51 Pass-to-Pass-Tests, um zu prüfen, ob bestehendes Verhalten erhalten bleibt.
Patch-Fix-Rate. Wir präsentieren Tabelle 14, die zusammenfassende Statistiken darüber enthält, für wie viele Aufgabeninstanzen jedes Modell Patches generiert hat (von 2294), wie viele dieser Patches erfolgreich angewendet wurden und wie viele der erfolgreich angewendeten Patches das in Anhang A.4 eingeführte Patch-Reparaturverfahren durchlaufen mussten. Wir stellen fest, dass reparierte Patches tendenziell einen kleineren Prozentsatz der SWE-Llama-Patches ausmachen, die erfolgreich angewendet wurden, was darauf hindeutet, dass das Fine-Tuning-Verfahren von SWE-Llama einen positiven Effekt auf die Generierung wohlgeformter Patches hat. Bei Closed-Source-Modellen werden weniger Patches erfolgreich angewendet, und von denen, die es werden, erfordert ein größerer Prozentsatz die Reparatur nach der Generierung, was darauf hindeutet, dass Modelle weiterhin Schwierigkeiten mit der Patch-Generierung und strukturierten Ausgaben im Allgemeinen haben.
| Kategorie | Anzahl | Beispiele |
| Bug | 442 | „Bug“ (179); „type:bug“ (114); „bug“ (57); „type: bug“ (48); „Bug:beetle:“ (23); „status: confirmed bug“ (20); |
| Feature | 167 | „type:enhancement“ (47); „Enhancement“ (25); „New feature“ (24); „Feature Request“ (22); „type: enhancement“ (19); „Enhancement:star:“ (15); „New Feature“ (7); „enhancement“ (6); „type: regression“ (14); „Regression“ (14); „regression“ (8); „help wanted“ (71); „good first issue“ (66); „printing“ (58); „extensions:autodoc“ (58); „Easy“ (57); „Easy to Fix“ (54); „domains:py“ (27); „core“ (26); „sets“ (23); „Wrong Result“ (23); „units“ (22); „Good first issue“ (21); |
| Modell | Retrieval-Einstellung | Generierungen | Wird angewendet | Korrigiert | Patch-Korrektur % |
| ChatGPT-3.5 | BM25 13k | 2.270 | 604 | 363 | 60,1 % |
| ChatGPT-3.5 | „Oracle“ | 1.262 | 500 | 222 | 44,4 % |
| ChatGPT-3.5 | „Oracle“-collapsed | 1.811 | 939 | 420 | 44,73 % |
| Claude 2 | BM25 13k | 2.281 | 988 | 302 | 30,57 % |
| Claude 2 | „Oracle“ | 2.138 | 1.441 | 360 | 24,98 % |
| Claude 2 | „Oracle“-collapsed | 2.242 | 1.564 | 465 | 29,73 % |
| GPT-4 | BM25 27k | 573 | 85 | 59 | 69,41 % |
| GPT-4 | „Oracle“ | 462 | 195 | 121 | 62,05 % |
| GPT-4 | „Oracle“-collapsed | 2.292 | 1.116 | 684 | 61,29 % |
| SWE-Llama 13b | BM25 13k | 2.010 | 1.230 | 369 | 30,0 % |
| SWE-Llama 13b | „Oracle“ | 2.125 | 1.532 | 378 | 24,67 % |
| SWE-Llama 7b | BM25 13k | 2.139 | 1.187 | 340 | 28,64 % |
| SWE-Llama 7b | „Oracle“ | 2.119 | 1.503 | 298 | 19,83 % |
A.6 CHARAKTERISIERUNG DES ENTWICKLUNGSSETS
Zusätzlich zum Evaluierungstestsatz stellen wir auch ein Entwicklungsset zur Verfügung, um Modelle zu evaluieren und Hyperparameter zu tunen, bevor sie auf dem finalen Testsatz ausgeführt werden. Im Stil der vorherigen Tabellen und Diagramme präsentieren wir ähnliche Statistiken zur Charakterisierung der 225 Entwicklungsaufgabeninstanzen (etwas mehr als des Haupt-Evaluierungssets), die aus 6 Open-Source-Repositorys mit Lizenzen gesammelt wurden, die eine solche Nutzung erlauben. Das Entwicklungsset wurde nach genau derselben Menge von Methoden und Filtern gesammelt wie das Haupt-Evaluierungsset. Zusätzlich zu den bereits vorhandenen Schritten filtern wir das Entwicklungsset auch, um Aufgabeninstanzen zu behalten, die nach dem 1. Januar 2019 erstellt wurden. Ähnlich wie in Tabelle 12 fassen wir in Tabelle 15 kurz den Zweck und die Lizenzen der 6 ausgewählten Repositorys zusammen.
Im Anschluss an Tabelle 13 führen wir in Tabelle 16 auch die Tags auf, die mit den Aufgaben des Entwicklungssets verbunden sind, und zeigen erneut die Vielfalt und Abdeckung von Aufgabentypen jenseits der Fehlerbehebung. Im Vergleich zu den Hauptbewertungsaufgaben sehen wir auch Tags (z. B. „Crash :collision:“, „io“), die auf Probleme verweisen, die für die Repositories im Entwicklungsset einzigartig sind.
Im Anschluss an Tabelle 1 präsentieren wir in Tabelle 17 dieselbe Menge repositoriespezifischer Durchschnittsstatistiken für die 6 Repositories im Entwicklungsset. Über das gesamte Entwicklungsset hinweg hat jede Aufgabeninstanz durchschnittlich 19,9 / median 2 F2P-Tests. Es gibt durchschnittlich 171,3 / median 79,0 P2P-Tests und insgesamt durchschnittlich 191,2 / median 101,0 Tests pro Aufgabeninstanz.
| Repository | Zusammenfassung | Anzahl | Lizenz |
marshmallow-code/ marshmallowpylint-dev/astroidpydicom/pydicompvlib/pvlib-pythonpyvista/pyvistasqlfluff/sqlfluff | Komplexe Objekte in/aus Python-Datentypen parsenBibliothek für AST-Parsing, statische Analyse/InferenzDICOM-Dateien mit Python lesen/ändern/schreibenLeistung photovoltaischer Energiesysteme simulieren3D-Darstellung, Mesh-Analyse über SchnittstelleSQL-Linter, unterstützt mehrere Dialekte, Templates | 93156631650 | MITLGPL-2.1CustomCustomMITMIT |
| Kategorie | Anzahl | Beispiele |
| Bug | 127 | „bug“ (111); „Bug :cookreach:“ (10); „rule bug“ (6); |
| Feature | 55 | „enhancement“: 46; „Enhancement :star:“ 5; „feature-request“: 2; |
| Regression | 4 | „Regression“ (4); |
| Sonstiges | 95 | „api“: 11, „documentation“: 7, „help wanted“: 6, „config options“: 5, „io“: 5, „jinja“: 4, „good first issue“: 4, „parser“ 3 |
A.7 CHARAKTERISIERUNG VON SWE-BENCH LITE
SWE-bench Lite ist eine kanonische Teilmenge für eine effizientere Bewertung von Sprachmodellen auf der SWE-bench-Aufgabe. SWE-bench ist
B WEITERE DETAILS ZUM TRAINING VON SWE-LLAMA
B.1 TRAININGSDETAILS
Optimierung. Wir feintunen mit LoRA (Hu et al., 2022) mit , , Dropout auf den Query-, Key-, Value- und Output-Projektionsmatrizen jeder Attention-Sublayer. Wir trainieren mit einer Lernrate von und einer Batch-Größe von 32 Sequenzen pro Gradientenschritt für maximal 4 Epochen. Während des Trainings speichern wir alle 50 Schritte Checkpoints und wählen nach dem Training den besten Checkpoint basierend auf dem Validierungsverlust auf 100 zurückgehaltenen Instanzen aus. SWE-Llama 7b wurde mit CodeLlama-Python 7b initialisiert und in 20 Stunden auf 4 NVIDIA A100s trainiert. SWE-Llama 13b wurde mit CodeLlama-Python 13b initialisiert und in 47 Stunden auf 8 NVIDIA A100s trainiert. Wir verwendeten DeepSpeed Ulysses (Jacobs et al., 2023) und Flash Attention (Dao et al., 2022), um Training mit langem Kontext zu ermöglichen.
C WEITERE ERGEBNISSE
C.1 ERGEBNISSE MIT „ORACLE“-RETRIEVAL
Unter Verwendung der in Abschnitt 4.1 beschriebenen „Oracle“-Retrieval-Methode zeigen wir die allgemeinen Leistungsergebnisse in Tabelle 18. Naturgemäß verbessert sich die Modellleistung, wenn nur die Dateien bereitgestellt werden, die durch den Pull Request der Referenzlösung bearbeitet wurden, im Vergleich zur verrauschteren BM25-Retrieval-Einstellung.
C.2 BEWERTUNGSTESTSET
Wir fügen eine repositoryweise Aufschlüsselung der Modellleistung in Tabelle 19 bei, die Abbildung 4 im Hauptpapier entspricht. Wie im Hauptpapier erörtert, unterscheidet sich die Leistung stark zwischen den Repositories.
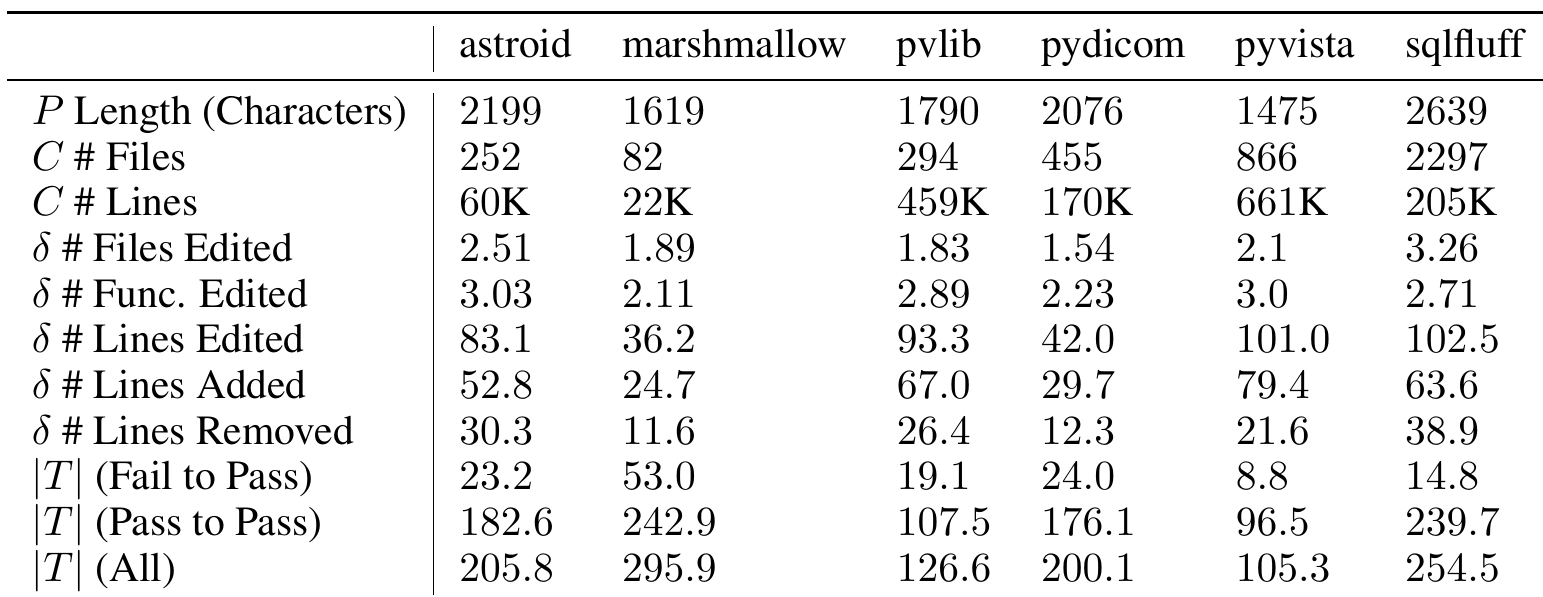
| astroid | marshmallow | pvlib | pydicom | pyvista | sqlfluff | |
| P Länge (Zeichen) | 2199 | 1619 | 1790 | 2076 | 1475 | 2639 |
| C # Dateien | 252 | 82 | 294 | 455 | 866 | 2297 |
| C # Zeilen | 60K | 22K | 459K | 170K | 661K | 205K |
| δ # Bearbeitete Dateien | 2.51 | 1.89 | 1.83 | 1.54 | 2.1 | 3.26 |
| δ # Bearbeitete Funkt. | 3.03 | 2.11 | 2.89 | 2.23 | 3.0 | 2.71 |
| δ # Bearbeitete Zeilen | 83.1 | 36.2 | 93.3 | 42.0 | 101.0 | 102.5 |
| δ # Hinzugefügte Zeilen | 52.8 | 24.7 | 67.0 | 29.7 | 79.4 | 63.6 |
| δ # Entfernte Zeilen | 30.3 | 11.6 | 26.4 | 12.3 | 21.6 | 38.9 |
| |T| (Fail to Pass) | 23.2 | 53.0 | 19.1 | 24.0 | 8.8 | 14.8 |
| |T| (Pass zu Pass) | 182.6 | 242.9 | 107.5 | 176.1 | 96.5 | 239.7 |
| |T| (Alle) | 205.8 | 295.9 | 126.6 | 200.1 | 105.3 | 254.5 |
Tabelle 17: Durchschnittliche Zahlen, die verschiedene Attribute einer SWE-bench-Task-Instanz charakterisieren, gruppiert nach Repository für Repositories im Entwicklungsdatensatz. Die gleichen Statistiken, die in Tabelle 11 dargestellt sind, werden auch hier gezeigt.
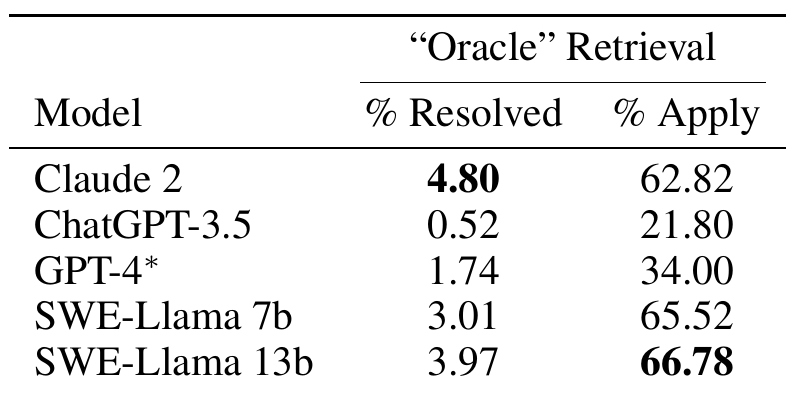
| Modell | „Oracle“-Retrieval | |
| % Gelöst | % Anwenden | |
| Claude 2 | 4,80 | 62,82 |
| ChatGPT-3.5 | 0,52 | 21,80 |
| GPT-4* | 1,74 | 34,00 |
| SWE-Llama 7b | 3,01 | 65,52 |
| SWE-Llama 13b | 3,97 | 66,78 |
Tabelle 18: Wir vergleichen Modelle miteinander unter Verwendung der Oracle-Retrieval-Einstellungen, wie in Abschnitt 4 beschrieben. Die Hauptergebnistabelle, Tabelle 5, präsentiert die Ergebnisse für die verschiedenen Modelle, wenn nur BM25 verwendet wird. \*Aufgrund von Budgetbeschränkungen evaluieren wir GPT-4 auf einer zufälligen -Teilmenge von SWE-bench nur in den Einstellungen „Oracle“ und BM25 27K Retriever.
C.3 ERGEBNISSE DER GPT-4-EVALUIERUNGSTEILMENGE
In diesem Abschnitt präsentieren wir die in Tabelle 5 gezeigten Statistiken für die zufällige -Teilmenge, in der GPT-4 in Tabelle 20 getestet wurde. Da die Auswahl der Teilmenge zufällig ist, stellen wir fest, dass die -Gelöst- und -Anwenden-Raten mit den Hauptergebnissen konsistent sind und nicht signifikant in Richtung einfacher oder schwieriger als der allgemeine Evaluierungssatz verzerrt sind.
C.4 ERWEITERTE ZEITLICHE ANALYSE
In diesem Abschnitt präsentieren wir eine erweiterte zeitliche Analyse der nach Jahr gelösten Task-Instanzen, die der in Tabelle 7 des Evaluierungsabschnitts im Hauptpapier gezeigten Analyse folgt. In Tabelle 21 präsentieren wir die -Gelöst-Statistik über Modelle hinweg unter der „Oracle“-Retrieval-Einstellung für 6 verschiedene zeitliche Partitionen, die Tasks nach den Jahren gruppieren, in denen die Issues erstellt wurden. Aus der Tabelle ist ersichtlich, dass es keine konsistente Korrelation zwischen Modellleistung und Jahr gibt, was unsere Schlussfolgerung stützt, dass trotz der möglichen Sichtung älterer Codeversionen in seinen Pre-Training-Datensätzen das Verstehen und Implementieren von Fixes in SWE-bench eine schwierige Aufgabe ist, die Verständnis erfordert und nicht praktikabel oder konsistent durch Memorisierung beobachteter Daten erreicht werden kann.
C.5 ANALYSE DER F2P- UND P2P-RATEN
In den Ergebnissen des Hauptpapiers präsentieren wir die Statistik „ Gelöst“, die angibt, wie viele Task-Instanzen von den verschiedenen Modellen vollständig gelöst wurden. In diesem Abschnitt bieten wir einen feiner granulierten Einblick in die Lücke bei Task-Instanzen, bei denen 1. die Patch-Generierung des Modells erfolgreich angewendet wurde und 2. die Task-Instanz nicht gelöst wurde. Unter der Annahme, dass ein Patch erfolgreich angewendet wird, definieren wir in Tabelle 22 sechs Fälle, die die Verteilung aller möglichen Ergebnisse basierend auf den Bestanden/Nicht-bestanden-Ergebnissen der F2P- und P2P-Tests vollständig erfassen. Zusätzlich zum „Gelöst“-Ergebnis, das bereits
| Repo | Claude 2 | ChatGPT-3.5 | GPT-4 | SWE-Llama 13b | SWE-Llama 7b |
| astropy/astropy | 3,23 | 0,00 | 0,00 | 1,06 | 3,16 |
| django/django | 6,15 | 1,32 | 2,50 | 5,19 | 4,00 |
| matplotlib/matplotlib | 3,05 | 3,33 | 0,00 | 3,12 | 1,11 |
| mwaskom/seaborn | 0,00 | 0,00 | 0,00 | 0,00 | 0,00 |
| pallets/flask | 0,00 | 0,00 | 0,00 | 9,09 | 0,00 |
| psf/requests | 15,91 | 2,33 | 8,33 | 13,64 | 18,18 |
| pydata/xarray | 6,90 | 0,00 | 0,00 | 5,81 | 3,00 |
| pylint-dev/pylint | 1,75 | 0,00 | 0,00 | 1,75 | 1,75 |
| pytest-dev/pytest | 5,93 | 0,00 | 0,00 | 5,04 | 4,20 |
| scikit-learn/scikit-learn | 5,41 | 0,00 | 0,00 | 3.12 | 0.88 |
| sphinx-doc/sphinx | 5.65 | 1.83 | 0.00 | 2.25 | 2.69 |
| sympy/sympy | 1.94 | 0.00 | 0.00 | 3.01 | 1.59 |
Tabelle 19: Gelöst für Modelle pro in SWE-bench vertretenem Repository.
| Modell | BM25-Retrieval | „Oracle“-Retrieval | ||
| % Gelöst | % Angewendet | % Gelöst | % Angewendet | |
| Claude 2 | 2,27 ↑ 0,31 | 45,72 ↑ 2,65 | 4,01 ↓ 0,79 | 62,65 ↓ 0,17 |
| ChatGPT-3.5 | 0,17 - 0,00 | 26,53 ↑ 0,02 | 0,70 ↑ 0,18 | 21,64 ↓ 0,16 |
| GPT-4 | 0,00 - 0,00 | 14,82 - 0,00 | 1,74 - 0,00 | 34,00 - 0,00 |
| SWE-Llama 7b | 0,35 ↑ 0,35 | 49,04 ↓ 2,70 | 1,92 ↓ 1,09 | 63,70 ↓ 1,82 |
| SWE-Llama 13b | 0,70 - 0,00 | 56,54 ↑ 2,92 | 4,54 ↑ 0,57 | 66,67 ↓ 0,11 |
Tabelle 20: Wir vergleichen Modelle miteinander unter Verwendung der BM25- und Oracle-Retrieval-Einstellungen, wie in Abschnitt 4 beschrieben, auf einer zufälligen -Teilmenge (574 Instanzen) von SWE-bench nur in den Einstellungen „Oracle“ und BM25 27K Retriever. Dies ist dieselbe Teilmenge, auf der GPT-4 evaluiert wird, wie in Tabelle 5 erwähnt. Die Differenz relativ zu den Prozentsätzen in Tabelle 5 und Tabelle 18 ist als tiefgestellte Zahl angegeben.festgelegt wurde, führen wir fünf neue Begriffe ein. Das „Breaking Resolved“-Ergebnis bezieht sich auf den Fall, in dem das gewünschte Verhalten des Issues erreicht wurde (alle F2P-Tests bestehen), aber nicht das gesamte vorherige Verhalten beibehalten wird (nicht alle P2P-Tests bestehen). „Partially Resolved“ bezieht sich auf den Fall, in dem das vorherige Verhalten einer Codebasis beibehalten wurde (alle P2P-Tests bestehen); jedoch das gewünschte Verhalten nicht vollständig erreicht wird (nicht alle F2P-Tests bestehen). Der Fall „Work in Progress“ liegt vor, wenn das gewünschte Verhalten nicht vollständig erreicht wird (nicht alle F2P-Tests bestehen) und das vorherige Verhalten der Codebasis nicht beibehalten wird (nicht alle P2P-Tests bestehen). Ein „No-Op“ liegt vor, wenn eine Codeänderung keine Auswirkung auf die ursprüngliche Codebasis hat; das vorherige Verhalten wird beibehalten (alle P2P-Tests bestehen), aber das Issue bleibt vollständig ungelöst (0 F2P-Tests bestehen). Wenn schließlich das Issue ungelöst ist (0 F2P-Tests bestehen) und vorher funktionierendes Verhalten zurückgenommen wird (einige P2P-Tests schlagen fehl), wird die Codebasis in einem schlechteren Zustand hinterlassen, was wir als „Regression“ definieren.
In Tabelle 23 kategorisieren wir Patch-Generierungen, die erfolgreich angewendet wurden, gemäß diesen sechs Fällen. Wir stellen fest, dass bei nicht „Gelöst“-Issues die Mehrheit der vom Modell vorgeschlagenen Patch-Generierungen keinen einzigen F2P-Testfall aus der entsprechenden Task-Instanz löst („No-Op“ und „Regression“). Innerhalb der Teilmenge dieser Fälle ist die Mehrheit ( bis ) der Fälle ein No-Op, während das Modell für den Rest dieser Situationen bestehendes Verhalten bricht.
Im Allgemeinen stellen die Fälle, in denen Modellgenerierungen einige, aber nicht alle Tests bestehen („Breaking Resolved“, „Partially Resolved“, „Work in Progress“), kumulativ eine kleinere Teilmenge von Problemen im Vergleich zu den anderen drei Kategorien dar. Aus manueller Inspektion mehrerer dieser Fälle ist klar, dass das Modell ein gewisses Verständnis der Task-Anforderungen zeigt. Aufgrund der begrenzten Sicht der Baseline-Methoden auf die Codebasis, die keine Informationen wie dateiübergreifende Abhängigkeiten und Funktionsbeziehungen umfasst, schlagen jedoch viele dieser Task-Instanzen häufig fehl, weil eine Änderung, die das unmittelbare Issue korrekt löst, andere Module nicht berücksichtigt, die die geänderte Entität verwenden und von ihr betroffen sind. Wir fügen mehrere Fallstudien bei, die diese Mängel in Abschnitt F direkt hervorheben. Insgesamt unterstreichen diese Ergebnisse nicht nur die Schwierigkeit von SWE-bench, sondern weisen auch auf den
| Jahr | Gesamt | 25% | Claude 2 | GPT-3.5 | GPT-4* | SWE-Llama 13b | SWE-Llama 7b |
| 2023 | 244 | 61 | 4,51 | 1,56 | 0,00 | 4,07 | 3,50 |
| 2022 | 395 | 117 | 4,05 | 0,85 | 3,42 | 2,80 | 2,46 |
| 2021 | 383 | 102 | 4,18 | 0,00 | 2,94 | 4,45 | 2,56 |
| 2020 | 427 | 109 | 5,15 | 0,71 | 0,00 | 3,96 | 3,43 |
| 2019 | 437 | 112 | 5,72 | 1,49 | 1,79 | 4,55 | 2,21 |
| 2018 | 165 | 37 | 5,45 | 0,00 | 0,00 | 3,57 | 2,94 |
| < 2018 | 89 | 36 | 4,49 | 0,00 | 2,78 | 3,37 | 1,09 |
Tabelle 21: Wir präsentieren in dieser Tabelle eine erweiterte zeitliche Analyse, die den -Gelöst-Wert für Task-Instanzen über Modelle hinweg in der „Oracle“-Retrieval-Einstellung zeigt, getrennt nach verschiedenen Stichtagen. Die Spalte „Year“ bezieht sich auf die Teilmenge von Tasks, die während des angegebenen Kalenderjahres erstellt wurden. In der Spalte „Total“ listen wir die Anzahl der Tasks auf, die in das gegebene Jahr fallen. Die Spalte enthält dieselbe Information für die Teilmenge, auf der GPT-4 evaluiert wurde. Die übrigen modellspezifischen Spalten enthalten die Metrik Gelöst.
| P2P-Tests bestanden | F2P-Tests bestanden | ||
| Alle | Teilweise | Keine | |
| Alle | Gelöst | Teilweise gelöst | No-Op |
| Teilweise | Brechend gelöst | In Arbeit | Regression |
| Keine | Brechend gelöst | In Arbeit | Regression |
Tabelle 22: Wir präsentieren die 6 möglichen Ergebnisse für eine Patch-Generierung, die erfolgreich angewendet und dann ausgeführt wird. Die Ergebnisse werden durch die Anzahl der bestandenen F2P- und P2P-Tests unterschieden.potenziellen Wert der Bereitstellung von Feedback über eine Ausführungsumgebung, die es Modellen ermöglichen würde, Fixes gegen bestehende Tests auszuführen und dann zu entscheiden, ob sie mit der Bearbeitung fortfahren oder den Patch zur Überprüfung einreichen.
C.6 ERWEITERTE ANALYSE DER PATCH-GENERIERUNG
In diesem Abschnitt präsentieren wir Statistiken zur Quantifizierung verschiedener Facetten von Patch-Generierungen gemäß den in Tabelle 8 dargelegten Metriken. In Tabelle 24 berechnen wir diese Werte für alle Patch-Generierungen in der Oracle-Retrieval-Einstellung für alle Modelle neu, unabhängig davon, ob der Patch erfolgreich angewendet wurde oder nicht. Über alle Metriken hinweg stellen wir fest, dass Patch-Generierungen über Modelle hinweg in ihrer Größe viel näher an den Charakteristiken durchschnittlicher Gold-Edits liegen. Während einige Modelle im Vergleich zum entsprechenden Gold-Edit noch weniger Zeilen generieren (z. B. Claude-2, ChatGPT-3.5, GPT-4), sind die Edits der SWE-Llama-Modelle im Durchschnitt in den meisten Belangen länger. Bei Betrachtung sowohl von Tabelle 8 als auch von Tabelle 24 wird deutlich, dass Modelle Schwierigkeiten haben, längere Ausgabesequenzen als korrekt formatierte Patches zu generieren. Eine weitere Untersuchung solcher Vorkommnisse, wie in unseren Fallstudien in Abschnitt F gezeigt, deutet darauf hin, dass Halluzinationen, die Einhaltung des bestehenden Codestils/der bestehenden Struktur und die korrekte Referenzierung weitreichender Abhängigkeiten häufige Fehler sind, die bei längeren Generierungen häufiger auftreten.
C.7 SOFTWARETECHNISCHE METRIKEN
Wir führen vorläufige Bewertungen durch, die den Einsatz von Software-Engineering-Metriken untersuchen, um die Effizienz und Komplexität großer Codeblöcke zu bewerten, die in eine komplexe Codebasis integriert sind. Im Gegensatz zu semantischen Ähnlichkeitsbewertungsfunktionen zur Bewertung von Flüssigkeit und Oberflächenähnlichkeit, die bei traditionellen NLP-Benchmarks beliebt und für die Codegenerierung übernommen wurden, gründen Metriken wie die zyklomatische Komplexität McCabe (1976) und die Halstead-Komplexitätsmaße Halstead (1977) auf logischen Abstraktionen (z. B. abstrakten Syntaxbäumen) und Softwareprinzipien, um die Komplexität, Effizienz und Lesbarkeit von Code als skalaren Wert zu quantifizieren. Die Patch-Generierungen und SWE-bench-Evaluierungsprotokolle sind reichhaltige Informationsquellen, auf die Software-Engineering-Metriken und statische Analysatoren ohne Weiteres angewendet werden können. Anders als bei kleinen Code-Wettbewerbs-Benchmarks, bei denen die Erkenntnisse aus Software-Engineering-Metriken aufgrund des winzigen Umfangs der Zielfunktionalität nicht aussagekräftig sind, ist die Aufgabe von SWE-bench komplex genug, dass Praktiker diese Werkzeuge nutzen können, um gut strukturierte,
| Modell | Claude 2 | ChatGPT-3.5 | GPT-4* | SWE-Llama 7b | SWE-Llama 13b |
| Angewendet | 1078 | 284 | 76 | 1257 | 1196 |
| Gelöst | 110 | 12 | 10 | 69 | 91 |
| Gelöst mit Breaking Change | 26 | 2 | 3 | 17 | 10 |
| Teilweise gelöst | 15 | 4 | 3 | 17 | 10 |
| In Bearbeitung | 20 | 2 | 1 | 17 | 16 |
| No-Op | 471 | 174 | 30 | 716 | 672 |
| Regression | 436 | 90 | 29 | 421 | 397 |
| Modell | Gesamtzeilen | Hinzugefügt | Entfernt | Funktionen | Dateien |
| Claude 2 | 27,2 | 6,6 | 3,3 | 1,2 | 1,1 |
| Gold | 61,6 | 17,8 | 8,6 | 2,6 | 1,4 |
| ChatGPT-3.5 | 42,0 | 6,1 | 3,9 | 1,7 | 1,0 |
| Gold | 44,5 | 12,7 | 5,5 | 2,1 | 1,2 |
| GPT-4 | 22,4 | 4,4 | 1,8 | 0,8 | 0,9 |
| Gold | 50,3 | 14,0 | 6,5 | 2,3 | 1,3 |
| SWE-Llama 13b | 68,9 | 9,5 | 4,3 | 2,5 | 1,6 |
| Gold | 61,5 | 17,8 | 8,6 | 2,6 | 1,4 |
| SWE-Llama 7b | 78,9 | 10,1 | 7,6 | 2,5 | 1,5 |
| Gold | 65,1 | 18,8 | 9,0 | 2,7 | 1,5 |
rigorose und weitreichende Rückmeldungssignale zur Komplexität der Änderung einer Patch-Generierung und ihrer Auswirkung auf den Rest der Codebasis zu gewinnen.
Wir fügen hier unsere explorative Arbeit ein, die zeigt, wie Software-Engineering-Metriken zuverlässig Merkmale der Codequalität erfassen können und wie der Vergleich dieser Statistiken zwischen zwei Patches automatische Beobachtungen über die Fähigkeiten von Modellen ermöglichen kann. Wir verwenden das Radon-Paket, eine Bibliothek zur Berechnung verschiedener Software-Engineering-Metriken direkt aus dem Quellcode.
Wir betrachten speziell erfolgreich angewendete Patch-Vorhersagen von Claude 2 in der „Oracle“-Retrieval-Einstellung für das Repository psf/requests, bei dem mehrere Modelle am besten abschneiden, wie in Abbildung 4 dargestellt. Pro Vorhersage wenden wir den Patch auf die Codebasis an und berechnen dann die Werte für zyklomatische Komplexität und Halstead-Komplexität für die geänderten Funktionen. Die zyklomatische Komplexität quantifiziert den Kontrollfluss einer Funktion, indem sie die Anzahl unabhängiger Ausführungspfade durch den Quellcode zählt (McCabe, 1976). Ein höherer Wert für die zyklomatische Komplexität deutet auf eine komplexere Funktion hin, die eine höhere Wahrscheinlichkeit von Fehlern aufweist und üblicherweise auf eine schwierige Wartbarkeit hindeutet. Die Halstead-Komplexität zählt die Anzahl der Operatoren und Operanden in einem Programm (Halstead, 1977). Pro Vorhersage führen wir dieselbe Abfolge von Schritten auch für den entsprechenden Gold-Patch durch.
Wir stellen fest, dass Software-Engineering-Metriken automatische qualitative Einblicke in die Modellleistung liefern. Betrachten wir die folgende einfache Fallstudie in Abbildung 10. Während die Patch-Vorhersage des Modells (links) im Vergleich zur Gold-Referenzlösung (rechts) weniger Zeilen umfasst (6 statt 11) und weniger Dateien ändert (1 statt 2), platziert die Bearbeitung des Modells eine Bedingung innerhalb einer relativ komplexen und weit verbreiteten HTTPAdapter-Klasse. Dies führt zwei neue potenzielle Ausführungsergebnisse ein und erhöht die zyklomatische Komplexität von HTTPAdapter von 3 auf 5. Im Gegensatz dazu importiert die Referenzlösung, obwohl sie länger ist, intra-modulare Abhängigkeiten, ändert eine logisch einfachere Funktion in get_connection und definiert einen neuen Fehlertyp InvalidProxyURL, um den neuartigen Fehler zu erfassen, der in der Issue beschrieben wird.
Radon-Dokumentation, Open-Source-Codebasis
Problembeschreibung: Irreführende Ausnahme bei ungültigem Protokoll in der Proxy-Variable. Wenn im Wert der Variablen https_proxy oder HTTPS_PROXY versehentlich ein '?' im Protokoll fehlt, wird dem Benutzer ein Traceback ausgegeben, der nicht genau angibt, dass das Problem in der Proxy-Konfiguration liegt ...
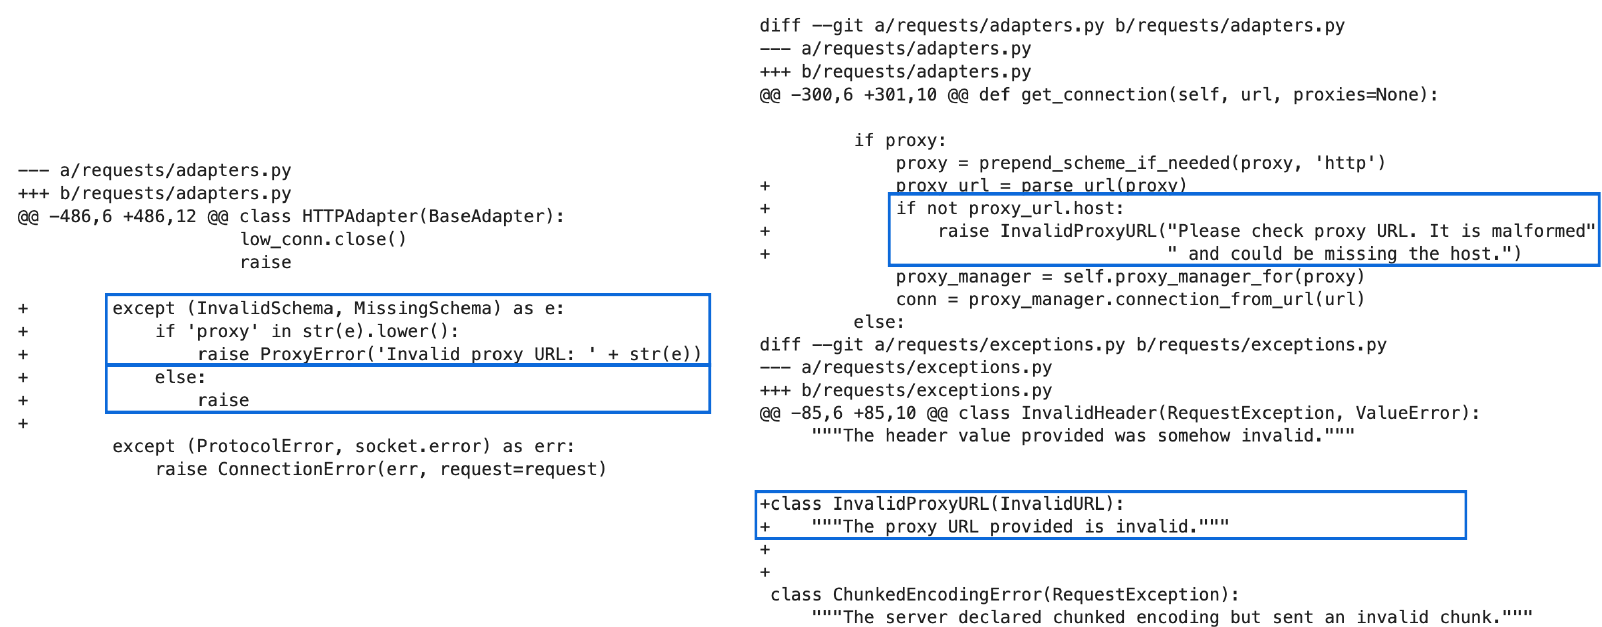
D ZUSÄTZLICHE EXPERIMENTELLE DETAILS
D.1 RETRIEVAL-DETAILS
Sparse Retrieval. Während des Retrievals nehmen wir eine leichte Erweiterung der Dokumente vor, indem wir den Inhalten der Dateien ihre Dateipfade voranstellen, um das Retrieval basierend auf Dateinamen besser zu ermöglichen, die möglicherweise direkt in der Issue erwähnt werden.
Oracle-Retrieval. Die Dateipfade des Oracle-Retrievals werden einfach direkt aus der Patch-Datei der Referenzlösung extrahiert, wobei Testdateien ausgeschlossen werden.
D.2 INFERENZEINSTELLUNGEN
Da Generierungen relativ teuer sind, generieren wir nur eine einzelne Patch-Datei pro Instanz. Dem Präzedenzfall in der Codegenerierung für die Bewertung in Pass@1 folgend (Chen et al., 2021; Rozière et al., 2023), verwenden wir für alle Modelle einfach Greedy-Dekodierung.
D.3 BEISPIEL FÜR PROMPT-VORLAGE
Die Modelle erhalten den folgenden allgemeinen Prompt mit leichten Abweichungen je nach verwendetem Modell.
Ihnen wird eine partielle Codebasis und eine Issue-Beschreibung bereitgestellt, die ein zu lösendes Problem erläutert.<issue> {ISSUE TEXT} </issue> {start of README.md} {README.md text} {end of README.md} {start of file_1. py}... {file_1. py text} [end of file_1. py]... </code>
Here is the translation: Hier ist ein Beispiel für eine Patch-Datei. Sie besteht aus Änderungen an der Codebasis. Sie gibt die Dateinamen, die Zeilennummern jeder Änderung sowie die entfernten und hinzugefügten Zeilen an. Eine einzelne Patch-Datei kann Änderungen an mehreren Dateien enthalten.
<patch>-- a/file.py +++ b/file.py@@ -1,27 +1,35 @@def euclidean(a, b):- while b:- a, b = b, a % b- return a + if b == 0: + return a + return euclidean(b, a % b) def bresenham(x0, y0, x1, y1): points = [] dx = abs(x1 - x0) dy = abs(y1 - y0)- sx = 1 if x0 < x1 else -1- sy = 1 if y0 < y1 else -1- err = dx - dy + x, y = x0, y0 + sx = -1 if x0 > x1 else 1 + sy = -1 if y0 > y1 else 1- while True: points.append((x0, y0))- if x0 == x1 and y0 == y1:- break e2 = 2 * err- if e2 > -dy: + if dx > dy: + err = dx / 2.0 + while x != x1: points.append((x, y)) err = dy- x0 += sx- if e2 < dx:- err += dx- y0 += sy + if err < 0: + y += sy + err += dx + x += sx + else: + err = dy / 2.0 + while y != y1: + points.append((x, y)) + err -= dx + if err < 0: + x += sx + err += dy + y += sy + points.append((x, y)) return points
</patch>
Ich benötige von Ihnen die Lösung des bereitgestellten Problems, indem Sie eine einzelne Patch-Datei generieren, die ich direkt mit git apply auf dieses Repository anwenden kann. Bitte antworten Sie mit einer einzelnen Patch-Datei im oben gezeigten Format.
Antworten Sie unten:
Experimente mit etwas mehr oder weniger Zeilen an Anweisungen oder Beispielen schienen die Gesamtleistung nicht wesentlich zu beeinflussen, mit Ausnahme der in Abschnitt 5 dargelegten Ergebnisse von Experimenten.
E GESELLSCHAFTLICHE AUSWIRKUNGEN
Da das Schlussfolgern über Code sich als eine grundlegende Fähigkeit herausgebildet hat, die vielen Fähigkeiten von Sprachmodellen (LMs) zugrunde liegt, wirft eine mögliche Zukunft der maschinell automatisierten Softwareentwicklung viele wichtige Fragen auf und hat bedeutende potenzielle Auswirkungen im Hinblick auf KI-Sicherheit (Gros et al., 2023). Es ist wichtig, Fragen dazu zu behandeln, wie sichergestellt werden kann, dass von KI generierter Code menschlichen Absichten treu bleibt, und welche Schutzmaßnahmen greifen könnten, wenn menschliche Ziele von Code-Agenten falsch interpretiert werden, die dann die Aufgabe ausführen. Um solche Probleme in einer kontrollierten Umgebung zu beobachten und ihre Lösungen sichtbar zu machen, hoffen wir, dass SWE-bench als Testumgebung für die Gestaltung sicherer, robuster Maßnahmen hin zu ausgerichteter, verifizierbarer und sicherer KI-getriebener Softwareentwicklung dienen kann.
F EINGEHENDE ANALYSE DER SWE-LLAMA-GENERIERUNGEN
In diesem Abschnitt bieten wir fünf zusätzliche qualitative Analysen von Generierungen sowohl von Claude 2 als auch von SWE-Llama-Generierungen (Oracle-Retrieval-Einstellung) im Stil von Abschnitt 5.1.
Qualitative Studien zu Claude 2 finden sich in den Tabellen 25 und 26. Die Tabellen 27, 28 und 29 sind Aufgabeninstanzen, die Claude 2 nicht korrekt bearbeitet hat. Qualitative Studien zu SWE-Llama werden in den Tabellen 30, 31, 32, 33, 34 behandelt. Für die Tabellen 30, 31 und 32 präsentieren wir Aufgabeninstanzen, die von SWE-Llama 13b korrekt gelöst wurden. In Tabelle 33 und 34 präsentieren wir zwei Aufgabeninstanzen, bei denen SWE-Llama 13b das Problem nicht korrekt bearbeitet, und weisen auf eine Teilmenge der Schlussfolgerungs- und Generierungsfähigkeiten hin, in denen Modelle möglicherweise nicht geschickt genug sind, um die anstehende Aufgabe zu bewältigen.
Die Beobachtungen, die wir in diesen Abschnitten machen, bestätigen die im Hauptpapier dargelegten Punkte, nämlich dass Modelle dazu neigen, mit Änderungen über mehrere Zeilen und mehrere Dateien hinweg Schwierigkeiten zu haben, geschickter sind, wenn die erforderliche Korrektur relativ kurz ist, und Hilfe dabei benötigen, die Codebasis auf effiziente Weise zu verstehen.
Tabelle 25: In diesem Beispiel bearbeitet Claude 2 ein Problem aus scikit-learn/scikit-learn korrekt. Wie in der Diskussion dargelegt, zeigt die Lösung jedoch, obwohl sie korrekt ist, die Tendenz von Modellen, primitiven Python-Code zu schreiben und keine bestehenden Methoden innerhalb der Codebasis zu verwenden.
Einstellung – Modell: Claude 2 mit Oracle-Retrieval – Task-Instanz: scikit-learn_scikit-learn-13328 – Link zum Issue: https://github.com/scikit-learn/scikit-learn/pull/13314 – Link zum PR: https://github.com/scikit-learn/scikit-learn/issues/13328
Issue: TypeError beim Übergeben eines booleschen X an fit von HuberRegressor### Beschreibung 'TypeError' beim Anpassen von 'HuberRegressor' mit booleschen Prädiktoren.
Schritte/Code zur Reproduktionimport numpy as np from sklearn.datasets import make_regression from sklearn.linear_model import HuberRegressor# Zufällige Daten X, y, coef = make_regression(n_samples=200, n_features=2, noise=4.0, coef =True, random_state=0) X_bool = X > 0 X_bool_as_float = np.asarray(X_bool, dtype=float)# Funktioniert huber = HuberRegressor().fit(X, y) # Schlägt fehl (!) huber = HuberRegressor().fit(X_bool, y) # Funktioniert ebenfalls huber = HuberRegressor().fit(X_bool_as_float, y)
Erwartete Ergebnisse Es wird kein Fehler ausgelöst, wenn der 'dtype' von 'X' 'bool' ist (zweite Codezeile im obigen Snippet, .fit(X_bool, y)). Es wird erwartet, dass ein boolesches Array von 'HuberRegressor.fit' in 'float' umgewandelt wird, wie es etwa bei 'LinearRegression' der Fall ist.
Tatsächliche Ergebnisse Es wird ein 'TypeError' ausgelöst: (Restliche Zeilen ausgelassen)
Gold-Patchdiff --git a/sklearn/linear_model/huber.py b/sklearn/linear_model/huber.py -- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ - 251,7 +251,8 @@ def fit(self, X, y, sample_weight=None): self : object"
Vom Modell generierter Patch
- a/sklearn/linear_model/huber.py +++ b/sklearn/linear_model/huber.py @@ -231,6 +231,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self.tol = tol + def _validate_data(self, X, y=None): + return X.astype(np.float64) if X.dtype == np.bool else X + def fit(self, X, y, sample_weight=None): """Fit the model according to the given training data.
@@ -250,7 +253,7 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): self : object """ X, y = check_X_y( X, y = check_X_y( X, y, copy=False, accept_sparse=['csr'], y_numeric=True) if sample_weight is not None: sample_weight = np.array(sample_weight) @@ -262,6 +265,9 @@ class HuberRegressor(LinearModel, RegressorMixin, BaseEstimator): raise ValueError( "epsilon_should_be_greater_than_or_equal_to_1.0,got_%f" % self.epsilon) + X = self._validate_data(X)
Tests
Fail to Pass (1)
sklearn/linear_model/tests/test_huber.py::test_huber_bool
Pass to Pass (9)
sklearn/linear_model/tests/test_huber.py::test_huber_max_iter sklearn/linear_model/tests/test_huber.py::test_huber_gradient sklearn/linear_model/tests/test_huber.py::test_huber_sample_weights sklearn/linear_model/tests/test_huber.py::test_huber_sparse sklearn/linear_model/tests/test_huber.py::test_huber_scaling_invariant
Weitere Pass-to-Pass-Tests ausgelassen...
Diskussion. In dieser Task-Instanz beschreibt das Issue ein Problem bezüglich der Art und Weise, wie Typen gecastet werden. Konkret tritt beim Anpassen des HuberRegressor-Modells mit booleschen Prädiktoren wie X_bool ein TypeError auf. Dieses Problem entsteht, weil der HuberRegressor boolesche Arrays nicht automatisch in Floats umwandelt, wie es einige andere Modelle tun, etwa LinearRegression, was zu einem Typ-Mismatch-Fehler führt. Als Fix definiert das Modell seine eigene _validate_data-Funktion, die die Typumwandlungslogik kapselt, und wendet sie auf X an. Obwohl dieser Fix die Tests besteht, könnte er effizienter sein und führt potenziell stilistische und organisatorische Inkonsistenzen ein. Wie in der Referenzlösung gezeigt wird, gibt es eine viel einfachere Lösung, indem dtype-Argumente übergeben werden, die die vorhandenen Flags des check_X_y-Funktionsaufrufs nutzen, um dies sauberer zu lösen. Die Inhalte anderer Dateien wurden in der Oracle-Retrieval-Einstellung aufgrund der Kontextfensterbeschränkung nicht einbezogen.
Tabelle 26: Wir liefern ein weiteres Beispiel, in dem Claude 2 das Issue korrekt löst und eine Lösung entwickelt, die dem Gold-Patch ähnelt. Die Lösung des Gold-Patches ist jedoch stärker darauf bedacht, zukünftige potenzielle Probleme zu vermeiden, die mit diesem Code zusammenhängen könnten.
Einstellung
- Modell: Claude 2 mit Oracle-Retrieval – Task-Instanz: matplotlib_matplotlib-24362 – Link zum Issue: https://github.com/matplotlib/matplotlib/issues/24349 – Link zum PR: https://github.com/matplotlib/matplotlib/pull/24362
Issue
[Bug]: sharex und sharey akzeptieren 0 und 1 nicht als boolesche Werte
Fehlerzusammenfassung
Wenn '0' oder '1' anstelle von 'False' oder 'True' in den Argumenten 'sharex' oder 'sharex' von 'pyplot.subplots' verwendet wird, wird ein Fehler ausgelöst.
Code zur Reproduktion
import matplotlib.pyplot as plt
fig, ax = plt.subplots(ncols=2, sharey=1)
Tatsächliches Ergebnis
Wir erhalten den folgenden Fehler:
Traceback (most recent call last):
(Frühere Zeilen ausgelassen) File "/\\\/matplotlib/lib/matplotlib/gridspec.py", line 293, in subplots _api.check_in_list(["all", "row", "col", "none"], File "/\\\/matplotlib/lib/matplotlib/_api/init.py", line 131, in check_in_list raise ValueError(msg)
ValueError: 1 is not a valid value for sharey; supported values are 'all', 'row', 'col', 'none'
Verwendung von 'sharex' statt 'sharey' erzeugt denselben Fehler (allerdings mit der folgenden Warnung:
UserWarning: sharex argument to subplots() was an integer. Did you intend to use subplot() (without 's')?
aber dies ist zu erwarten und nicht Teil des vorliegenden Problems)
Erwartetes Ergebnis
Ich erwartete, dass die Werte 1 und 0 als bool verstanden werden.
Vom Modell generierter Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py
index 06dd3f19f6.32ee7c306e 100644
-- a/lib/matplotlib/gridspec.py
+++ b/lib/matplotlib/gridspec.py
@@ - 276, 9 +276, 9 @@ class GridSpecBase:
raise ValueError("GridSpec.subplots().only_works_for_GridSpecs_"
"created_with_a_parent_figure")
if isinstance(sharex, bool):
+ if isinstance(sharex, bool) or sharex == 1 or sharex == 0:
sharex = "all" if sharex else "none"
if isinstance(sharey, bool):
+ if isinstance(sharey, bool) or sharey == 1 or sharey == 0:
sharey = "all" if sharey else "none"
This check was added because it is very easy to type
'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.
Gold-Patch
diff --git a/lib/matplotlib/gridspec.py b/lib/matplotlib/gridspec.py - - - a/lib/matplotlib/gridspec.py +++ b/lib/matplotlib/gridspec.py @@ -276,21 +276,12 @@ def subplots(self, \*, sharex=False, sharey=False, squeeze=True,- if isinstance(sharex, bool):+ if not isinstance(sharex, str):sharex = "all" if sharex else "none"- if isinstance(sharey, bool):+ if not isinstance(sharey, str):sharey = "all" if sharey else "none"- # This check was added because it is very easy to type# 'subplots(1, 2, 1)' when 'subplot(1, 2, 1)' was intended.- # In most cases, no error will ever occur, but mysterious behavior# will result because what was intended to be the subplot index is# instead treated as a bool for sharex. This check should go away# once sharex becomes knownly.- if isinstance(sharex, Integral):- api.warn_external("sharex_argument_to_subplots()_was_an_integer.__Did_you""intend_to_use_subplot()_without's')?"- api.check_in_list(["all", "row", "col", "none"],+ api.check_in_list(["all", "row", "col", "none", False, True],sharex=sharex, sharey=sharey)
Tests
Fail to Pass (1)
lib/matplotlib/tests/test_subplots.py::test_shared
Pass to Pass (39)
lib/matplotlib/tests/test_subplots.py::test_label_outer_span lib/matplotlib/tests/test_subplots.py::test_label_outer_non_gridspec lib/matplotlib/tests/test_subplots.py::test_shared_and_moved lib/matplotlib/tests/test_subplots.py::test_exceptions lib/matplotlib/tests/test_subplots.py::test_subplots_offsettext.png)
Weitere Pass-to-Pass-Tests ausgelassen...
Diskussion. Dieses Beispiel verlangt, dass 1 und 0 als boolesche Werte für die Argumente sharex und sharey der Funktion pyplot.subplots behandelt werden. Der aktuelle Code löst einen Fehler aus. Im generierten Patch fügt das Modell 1 und 0 als akzeptable Werte hinzu. Der Gold-Patch hingegen fügt die akzeptablen Werte in eine Liste ["all", "row", "col", "none", False, True] ein. Er entfernt außerdem die mit diesem Problem verbundene Integral-bezogene Warnung. Diese Bereinigung zusammen mit der Klarheit des check_in_list-Arguments macht den Code prägnanter und lesbarer.
Tabelle 27: In diesem Beispiel zeigen wir ein Problem aus astropy/astropy, das Claude 2 nicht korrekt löst. Der Fehler ist primär auf den Versuch der Patch-Generierung zurückzuführen, das Problem direkt zu lösen.
Einstellung
- Modell: Claude 2 mit Oracle-Retrieval- Aufgabeninstanz: astropy_astropy-14365- Link zum Issue: https://github.com/astropy/astropy/issues/14363- Link zum PR: https://github.com/astropy/astropy/pull/14365
Issue
ascii.qdp Tabellenformat geht davon aus, dass QDP-Befehle in Großbuchstaben sind
Beschreibung
ascii.qdp geht davon aus, dass Befehle in einer QDP-Datei in Großbuchstaben sind, zum Beispiel müssen sie für Fehler "READ SERR 1 2" lauten, während QDP selbst nicht case-sensitiv ist und "read serr 1 2" verwenden kann. Da viele QDP-Dateien von Hand erstellt werden, sollte die Erwartung, dass alle Befehle in Großbuchstaben sind, entfernt werden.
Erwartetes Verhalten
Die folgende QDP-Datei sollte in eine 'Table' mit Fehlern eingelesen werden, anstatt abzustürzen.
read serr 1 2 1 0.5 1 0.5
So reproduzieren Sie das Problem: Erstellen Sie eine QDP-Datei:
cat > test.qdp read serr 1 2 1 0.5 1 0.5 <EOF>
python Python 3.10.9 (main, Dec 7 2022, 02:03:23) [Clang 13.0.0 (clang - 1300.0.29.30)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> from astropy.table import Table >>> Table.read('test.qdp', format='ascii.qdp') WARNING: table_id not specified. Reading the first available table [ astropy.io.ascii.qdp] Traceback (most recent call last): raise ValueError(f'Unrecognized_QDP_line: {line}') ValueError: Unrecognized QDP line: read serr 1 2
Das Ausführen von "qdp test.qdp" funktioniert einwandfrei.
Vom Modell generierter Patch
- a/astropy/io/ascii/qdp.py - b/astropy/io/ascii/qdp.py - @ -60,7 +60,7 @@ ValueError: Unrecognized QDP line... """ _decimal_re = r"[-?(\d+(\. \d+)?\.\d+)([eE][+-]?\d+)?" _command_re = r"READ [TS]ERR(\s+[0-9]+)+" _command_re = r"read [ts]err(\s+[0-9]+)+" sep = delimiter if delimiter is None:
Gold-Patch
diff - - git a/astropy/io/ascii/qdp.py b/astropy/io/ascii/qdp.py - - - a/astropy/io/ascii/qdp.py +++ b/astropy/io/ascii/qdp.py @@ - 68,7 + 68,7 @@ def _line_type (line, delimiter=None): _new_re = rf"NO((sep)NO)+" _data_re = rf"((_decimal_re) | NO | [- + ]?nan) ((sep) ((_decimal_re) | NO | [- + ]?nan)) +" _type_re = rf"\s*((?P<command>|_command_re)) | (?P<new>[_new_re]) | (?P< data>[_data_re])?\s*(\!|(?P<comment>.*))?\s+$" - _line_type_re = re.compile(_type_re) + _line_type_re = re.compile(_type_re, re.IGNORECASE) line = line.strip() if not line: return "comment" @@ - 306,7 +306,7 @@ def _get_tables_from_qdp_file(qdp_file, input_colnames=None, delimiter=None): values = [] for v in line.split (delimiter): - if v == "NO": + if v.upper() == "NO": values.append(np.max. masked) else: # Understand if number is int or float
Tests
Fehlschlag zu Bestehen (1)
X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[True]
Bestehen zu Bestehen (8)
X astropy/io/ascii/tests/test_qdp.py::test_get_tables_from_qdp_file X astropy/io/ascii/tests/test_qdp.py::test_roundtrip[False] X astropy/io/ascii/tests/test_qdp.py::test_read_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example X astropy/io/ascii/tests/test_qdp.py::test_roundtrip_example_comma X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple X astropy/io/ascii/tests/test_qdp.py::test_read_write_simple_specify_name X astropy/io/ascii/tests/test_qdp.py::test_get_lines_from_qdp
Diskussion. Dieses Issue fordert eine Korrektur für die Behandlung von QDP-Dateien; konkret wird verlangt, die Erwartung, dass die Befehle in Großbuchstaben geschrieben sind, zu entfernen. Im vom Modell generierten Patch lokalisiert das Modell die in der Issue-Beschreibung erwähnten Befehle READ und ERR in einem Regex-Muster und bearbeitet es direkt. Innerhalb derselben Datei ist jedoch klar ersichtlich, dass das Regex-Muster in weiteren Mustern verwendet wird, etwa in _type_re, sodass eine Korrektur des „Wurzel“-Regex-Musters möglicherweise nicht angemessen ist. Darüber hinaus erfordert die Identifizierung des richtigen unter mehreren Regex-Muster-Variablen eine Schlussfolgerung, die potenziell durch Ausführung unterstützt werden kann. Dieser Fehler in dieser Lösung spiegelt sich darin wider, dass sie nicht nur die angegebenen Unit-Tests nicht besteht, sondern auch bestehende Tests, die das vorherige Verhalten durchsetzen, nicht besteht.
Tabelle 28: Für dieses Issue aus dem Repository mwaskom/seaborn enthält die Problembeschreibung Hyperlinks zu Bildern. Wie in Abschnitt 5 diskutiert, enthält eine kleine Teilmenge der SWE-bench-Aufgaben Bilder, wodurch Bildverständnis eine kleine, aber wichtige Komponente zur Lösung von Issues darstellt, die von den ursprünglichen Baselines nicht untersucht wird.
Einstellung
- Modell: Claude 2 mit Oracle-Retrieval - Aufgabeninstanz: mwaskom_seaborn-3217 - Link zum Issue: https://github.com/mwaskom/seaborn/issues/2907 - Link zum PR: https://github.com/mwaskom/seaborn/pull/3217
Issue
Breitenberechnung nach Histogramm mit Log-Skala leicht falsch. Beachten Sie die leichte Überlappung hier:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image Mit mehr Bins wird es nahezu unmerklich:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth ), so.Hist(bins ) .scale
image Hier geht es nicht um „Bars“; „Bar“ hat es auch:
( so.Plot(tips, "total_bill") .add(so.Bars(alpha , edgewidth , width ), so.Hist(bins ) .scale
image
Vom Modell generierter Patch
- a/seaborn/_core/plot.py +++ b/seaborn/_core/plot.py @@ -1327,9 +1327,7 @@ elif "width" in df: view_width = view_df["width"] else: - view_width = 0.8 # TODO welcher Standardwert? - spacing = scales[orient]._spacing(view_df.loc[view_idx, - width.loc[view_idx] = view_width + spacing + width.loc[view_idx] = view_width df["width"] = width if "baseline" in mark._mappable_props:
Gold-Patch
diff - - git a/seaborn/_core/plot.py b/seaborn/_core/plot.py - - - a/seaborn/_core/plot.py ++ b/seaborn/_core/plot.py @@ - 1377,10 + 1377,9 @@ def _unscale_coords( - drop_cols = [\*coord_cols, "width"] if "width" in df else coord_cols out_df = ( df - .drop(drop_cols, axis=1) + .drop(coord_cols, axis=1) .reindex(df.columns, axis=1) # damit nicht skalierte Spalten ihren Platz behalten @@ - 1396,12 + 1395,6 @@ def _unscale_coords( - if var == orient and "width" in view_df: - width = view_df["width"] - out_df.loc[values.index, "width"] = ( - transform(values + width / 2) - transform(values - width / 2) ) - return out_df diff - - git a/seaborn/_marks/bar.py b/seaborn/_marks/bar.py - - - a/seaborn/_marks/bar.py +++ b/seaborn/_marks/bar.py @@ - 29,17 + 29,23 @@ class BarBase(Mark): + transform = scales[orient]._matplotlib_scale.get_transform() + forward = transform.transform + reverse = transform.inverted().transform + + other = {"x": "y", "y": "x"} [orient] + + pos = reverse(forward(data[orient]) - data["width"] / 2) + width = reverse(forward(data[orient]) + data["width"] / 2) - pos + + val = (data[other] - data["baseline"]).to_numpy() + base = data["baseline"].to_numpy() + (Restliche Zeilen ausgelassen...)
Tests
Nicht bestanden (1)
X tests/_marks/test_bar.py::TestBars::test_log_scale
Bestanden (8)
X tests/_marks/test_bar.py::TestBar::test_categorical_positions_vertical X tests/_marks/test_bar.py::TestBar::test_categorical_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_numeric_positions_vertical X tests/_marks/test_bar.py::TestBar::test_numeric_positions_horizontal X tests/_marks/test_bar.py::TestBar::test_set_properties
Weitere bestandene „Pass to Pass“-Tests ausgelassen...
Diskussion. Die Unfähigkeit des Baseline-Modells, dieses Problem zu lösen, lässt sich direkt auf das Fehlen einer Bildeingabe zurückführen. Wir führen dieses Beispiel an, um zu zeigen, dass das Debuggen realer Softwareprobleme das Verarbeiten von Bildern umfassen kann; dies stellt eine ganz eigene Kategorie von Herausforderungen im Bereich Verstehen und Schlussfolgern dar. Über die SWE-bench-Aufgabe hinaus stellen weitere Probleme im Software-Engineering, etwa das Interpretieren von Systemdesign-Diagrammen, Benutzeroberflächen-Spezifikationen und Nutzerfeedback, interessante Vision-Language-Herausforderungen dar.
Tabelle 29: In diesem letzten Beispiel einer Claude-2-Generierung muss das Modell einen Fehler beheben, der sich auf die Behebung eines Fehlers bezüglich zyklischer Abhängigkeiten bezieht. Claude 2s Lösung bleibt bei einem ansonsten komplexen Problem hinter den Erwartungen zurück.
Einstellung
- Modell: Claude 2 mit Oracle-Retrieval- Aufgabeninstanz: sympy_sympy-18211- Link zum Issue: https://github.com/pylint-dev/pylint/issues/3525- Link zum PR: https://github.com/pylint-dev/pylint/pull/4703
Issue
Importe innerhalb von TYPE.CHECKING können „cyclic-import“ auslösen
Angenommen, Sie haben zwei Module: a.py und b.py. „a“ importiert „b“, aber „b“ benötigt „a“, um Typannotationen vorzunehmen; dann wird dies üblicherweise dadurch erledigt, dass „a“ innerhalb eines „TYPE.CHECKING“-Blocks importiert wird. Leider führt dies dazu, dass pylint „cyclic-import“ meldet.
Möglicherweise verwandt mit https://github.com/PyCQA/pylint/issues/3285
Gold-Patch
diff --git a/pylint/checkers/imports.py b/pylint/checkers/imports.py-- a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py@@ - 813,7 + 813,9 @@ def _get_imported_module(self, importnode, modname):- def _add_imported_module(self, node, importedmodname): + def _add_imported_module(+ self, node: Union[astroid.Import, astroid.ImportFrom], importedmodname: str + ) -> None:"""benachrichtigt über ein importiertes Modul, wird zur Analyse von Abhängigkeiten verwendet""" module_file = node.root().file context_name = node.root().name@@ - 826,6 + 828,10 @@ def _add_imported_module(self, node, importedmodname): except ImportError: pass + in_type_checking_block = (+ isinstance(node.parent, astroid.If) and node.parent. is_type_guard() + ) if context_name == importedmodname: self.add_message("import- self", node=node)@@ - 845,7 + 851,10 @@ def _add_imported_module(self, node, importedmodname): # Importgraphen aktualisieren self.import_graph[context_name].add(importedmodname)- if not self.linter.is_message_enabled("cyclic-import", line= node.lineno): + if + not self.linter.is_message_enabled("cyclic-import", line= node.lineno) + or in_type_checking_block + ) self.excluded_edges[context_name].add(importedmodname)ްމައްސަލައިގެންނަށްޓަކ
Vom Modell generierter Patch
diff - - git a/pylint/checkers/imports.py b/pylint/checkers/imports.py index 4f3eed2. .2b74a8d 100644 - - - a/pylint/checkers/imports.py +++ b/pylint/checkers/imports.py @@ -49,6 +49,7 @@ import copy import os import sys from distutils import sysconfig +from typing import TYPE_CHECKING from typing import Dict, List, Union
import astroid @@ -61,6 +62,9 @@ from pylint.checkers.utils import ( node_ignores_exception, ) from pylint.exceptions import EmptyReportError +if TYPE_CHECKING: + from pylint.lint import PyLinter + from pylint.graph import DotBackend, get_cycles from pylint.interfaces import IASTroidChecker from pylint.reporters.ureports.nodes import Paragraph, VerbatimText, VNode
Tests
Fail to Pass (1)
X tests/marks/test_bar.py::TestBars::test_log_scale
Pass to Pass (11)
tests/test_func.py::test_functionality[func_w0401_disabled_in_func.py] tests/test_func.py::test_functionality[func_i0022. py] tests/test_func.py::test_functionality[func_w0401. py] tests/test_func.py::test_functionality[func_w0801. py] tests/test_func.py::test_functionality[func_w0401_package]
Additional Pass to Pass Tests omitted...
Diskussion. In diesem Problem wird vom Modell verlangt, eine auf TYPE_CHECKING basierende Behandlung zur Auflösung zyklischer Importe bereitzustellen, für die pylint derzeit einen Fehler ausgibt. Der Gold-Patch enthält eine detaillierte Lösung, die eine bedingte Behandlung innerhalb des TYPE_CHECKING-Blocks umfasst, die Meldungen zu zyklischen Importen ausschließt und im Allgemeinen eine spezifischere Behandlung aufweist. Der vom Modell generierte Patch verwendet eine „Stack Overflow“-artige Lösung; das Erstellen eines TYPE_CHECKING-Blocks ist zwar eine beliebte Lösung zur Auflösung von Importen, doch die Lösung dieses Problems für die jeweilige Codebasis erfordert eine differenziertere Lösung als eine allgemeine Antwort, die online verfügbar sein mag.
Tabelle 30: Beispiel einer SWE- Llama 13b-Generierung, die eine SWE- bench-Aufgabeninstanz korrekt löst. In diesem Beispiel ist die SWE- Llama-Generierung exakt identisch mit der Lösung.
Einstellung
- Modell: SWE-Llama 13B mit Oracle-Retrieval- Aufgabeninstanz: pydata_xarray-5131- Link zum Issue: https://github.com/pydata/xarray/pull/5130- Link zum PR: https://github.com/pydata/xarray/pull/5131
Issue
Beim Anzeigen eines DatasetGroupBy in einer interaktiven Python-Sitzung enthält die erste Ausgabezeile ein abschließendes Leerzeichen. Das erste Beispiel in der Dokumentation zeigt dies:
import xarray as xr, numpy as np >>> ds = xr.Dataset( ... {"foo": (("x", "y"), np.random.rand(4, 3)), ... coords={"x": [10, 20, 30, 40], "letters": ("x", list("abba")), ... >>> ds.groupby("letters") DatasetGroupBy, grouped over 'letters' 2 groups with labels 'a', 'b'.
In der ersten Ausgabezeile befindet sich ein abschließendes Leerzeichen, nämlich „DatasetGroupBy, grouped over 'letters' “. Dies ist deutlicher zu erkennen, wenn man das Objekt in einen String umwandelt (beachten Sie das Leerzeichen vor n):
str(ds.groupby("letters")) "DatasetGroupBy, grouped_over_'letters'\n2_groups_with_labels'a', 'b'."
Das ist an sich kein Problem, verursacht aber ein Problem für uns, weil wir flake8 in der kontinuierlichen Integration verwenden, um zu überprüfen, ob unser Code korrekt formatiert ist... [20 weitere Zeilen]
Gold-Patch
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
Vom Modell generierter Patch
diff --git a/xarray/core/groupby.py b/xarray/core/groupby.py -- a/xarray/core/groupby.py +++ b/xarray/core/groupby.py @@ - 436,7 + 436,7 @@ def iter(self): return zip(self._unique_coord.values, self._iter_grouped())
def repr(self): return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( + return "{}, grouped_over_{!r}\n{!r}\groups_with_labels{}.".format( self.class.name,
Tests
Fail to Pass (10)
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj0-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-x]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-y]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-z]
✓ xarray/tests/test_groupby.py::test_groupby_repr[obj1-month]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj0]
✓ xarray/tests/test_groupby.py::test_groupby_repr_datetime[obj1]
Pass to Pass (16)
✓ xarray/tests/test_groupby.py::test_consolidate_slices
✓ xarray/tests/test_groupby.py::test_groupby_da_datetime
✓ xarray/tests/test_groupby.py::test_groupby_duplicate_coordinate_labels
✓ xarray/tests/test_groupby.py::test_groupby_input_mutation
✓ xarray/tests/test_groupby.py::test_groupby_map_shrink_groups[obj0]
Weitere Pass to Pass Tests ausgelassen...
Diskussion. In diesem Problem wird das Modell gebeten, ein Problem mit Leerraum am Zeilenende zu korrigieren, und das Problem zeigt eine Demonstration des Fehlers, der während der Nutzung auftritt, weist aber nicht explizit auf die Funktion hin, die im Modell korrigiert werden soll. In der Oracle-Retrieval-Einstellung erhält das Modell die Datei xarray/core/groupby.py direkt zum Bearbeiten, aber die meisten lokalisieren die zu bearbeitende Zeile. In dieser Situation schlussfolgert das Modell erfolgreich, dass in der interaktiven Python-Umgebung die zugrunde liegende Funktion, die aufgerufen wird, tatsächlich die Funktion repr ist. Nachdem die Funktion lokalisiert wurde, muss es herausfinden, wo in der return-Anweisung sich der Leerraum befindet. An diesem Punkt ist die Korrektur ziemlich offensichtlich, da es ein explizites Leerzeichen gibt, das das Modell entfernt. In diesem Fall besteht das Modell erfolgreich alle Tests, die die Korrektheit dieser Korrektur explizit verifizieren (10 Fail-to-Pass-Tests), während es zugleich das bestehende Verhalten der Datei beibehält (16 Pass-to-Pass-Tests).
Tabelle 31: Beispiel einer SWE-Llama-13b-Generierung, die eine SWE-bench-Aufgabeninstanz korrekt löst. In diesem Beispiel unterscheidet sich die SWE-Llama-Generierung vom Gold-Patch.
Einstellung
- Modell: SWE-Llama 13B mit Oracle-Retrieval - Aufgabeninstanz: psf_-requests-1724 - Link zum Issue: https://github.com/psf/requests/issues/1723 - Link zum PR: https://github.com/psf/requests/pull/1724
Issue
Unicode-Methodennamen verursachen bei einigen Requests in Python 2.7.2 einen UnicodeDecodeError. Das folgende Beispiel funktioniert einwandfrei:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Aber das folgende Beispiel (mit 'method 'POST' statt 'method 'POST') erzeugt einen UnicodeDecodeError:
files {u'file': open(u'/usr/bin/diff', u'rb')} response requests.request(method 'POST', url 'http://httpbin.org/post' files files)
Traceback (most recent call last): [Vollständiger Stack-Trace ausgeblendet] File "/System/Library/Frameworks/Python.framework/Versions/2.7/... msg_+=_message_body UnicodeDecodeError: 'ascii'_codec_can't_decode_byte_0xcf_in_position_140: ordinal_not_in_range (128)
Meine Vermutung ist, dass 'u'POST' den Header mit Unicode kontaminiert, obwohl es ein String sein sollte. Das liegt daran, dass 'sessions.py:313' einfach Folgendes ist:
req.method method.upper()
[Weitere Zeilen ausgeblendet...]
Gold-Patch
diff --git a/requests/sessions.py b/requests/sessions.py-- a/requests/sessions.py+++ b/requests/sessions.py@@ - 12,7 + 12,7 @@from collections import Mappingfrom datetime import datetime-from .compact import cookielib, OrderedDict, [3 weitere ausgelassen]+from .compact import cookielib, OrderedDict, [3 ausgelassen,+ builtin_strfrom .cookies import cookiejar_from_dict, extract_cookies_to_jar, RequestsCookieJarfrom .models import Request, PreparedRequestfrom .hooks import default_ hooks, dispatch_hook@@ - 309,6 + 309,6 @@ def request(self, method, url,:param cert: (optional) if String, path to ssl client cert file (.pem). If Tuple, ('cert', 'key') pair.\\\*
+ method builtin_str(method)
Modellgenerierter Patch
diff - - git a/requests/sessions.py b/requests/sessions.py - - - a/requests/sessions.py +++ b/requests/sessions.py @@ -254,7 +254,7 @@ def prepare_request(self, request):
p = PreparedRequest() p.prepare( method=request.method.upper(), + method=str(request.method).upper(), url=request.url, files=request.files, data=request.data,
Tests
Fehlschlag zu Bestehen (6)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_RETURNS_COOKIE test_requests.py::RequestsTestCase::test_DIGEST_HTTP_200_OK_GET test_requests.py::RequestsTestCase::test_different_encodings_dont_break test_requests.py::RequestsTestCase::test_generic_cookiejar_works test_requests.py::RequestsTestCase::test_uppercase_scheme_redirect
Bestehen zu Bestehen (75)
test_requests.py::RequestsTestCase::test_DIGEST_AUTH_SETS_SESSION_COOKIES test_requests.py::RequestsTestCase::test_DIGEST_STREAM test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_ALTERNATIVE test_requests.py::RequestsTestCase::test_HTTP_200_OK_GET_WITH_PARAMS test_requests.py::RequestsTestCase::test_HTTP_200_OK_HEAD
Weitere Bestehen-zu-Bestehen-Tests ausgelassen...
Diskussion. Anders als bei dem in Tabelle 30 dargestellten Problem wird dem Modell hier anstelle einer interaktiven Python-Eingabe ein Fehler-Trace aus einem Funktionsaufruf gegeben, wobei die Schritte zur Reproduktion des Problems aus Nutzersicht angeboten werden. Darüber hinaus liefert das Issue in der letzten Zeile auch einen Vorschlag für eine mögliche Behebung des Problems. Erneut im Oracle-Setting nutzt das Modell den Vorschlag in natürlicher Sprache und lokalisiert die Änderung auf eine Zeile, die dem Vorschlag semantisch recht ähnlich ist ( req.method = method.upper() im Vergleich zu method=str(request.method).upper() ). Das Modell behebt das Problem korrekt, was sich in allen bestandenen Tests widerspiegelt. In dieser Situation lässt sich jedoch erkennen, dass das Modell mit seinem Erfolg tatsächlich recht „glücklich“ ist. Erstens, während der Gold-Patch auf eingebaute Funktionen setzt, die zur Vereinheitlichung der Behandlung von String-Formatierung verwendet werden, würde die Entscheidung des Modells, primitiveres Python zur Lösung dieses Problems einzusetzen, von einem menschlichen Reviewer aufgrund ihrer Inkonsistenz mit dem übrigen Codebase wahrscheinlich nicht gut aufgenommen werden. Eine weitere Untersuchung der Funktion builtin_str, die in dieser Abbildung nicht gezeigt wird, zeigt zudem, dass sie zusätzliche String-Formatierungsfälle behandelt, die über das im Issue dargestellte hinausgehen. Obwohl das Modell die Aufgabe diesmal löst, ist es fraglich, ob diese Lösung robust gegenüber zukünftigen Problemen ist.
Tabelle 32: Dies ist ein weiteres Beispiel, bei dem SWE- Llama13b die Aufgabe erfolgreich löst. Dieses Beispiel ist interessant, weil das Modell eine gewissermaßen neuartige Lösung im Vergleich zur Referenz entwickelt, die argumentierbar effizienter und sauberer ist.
Setting
- Modell: SWE-Llama 13B mit Oracle-Retrieval- Task-Instanz: djang0. djang0-11727- Link zum Issue: https://code.djangoproject.com/ticket/29376- Link zum PR: https://github.com/djang0/djang0/pull/11727
Issue
Erlauben, den Button „Save and Add Another“ mit einer Kontextvariablen show_save_and_add_another auszublenden
Um eine bessere Anpassbarkeit zu ermöglichen, eine neue Kontextvariable einführen – show_save_and_add_another. Wenn ich zum Beispiel den Button „Save and add another“ ausblenden möchte, kann ich einfach extra_context ändern – False in die Variable schreiben. Für andere Buttons – „Save“ und „Save and continue editing“ – funktioniert dies bereits genau auf diese Weise.
Gold-Patch
diff --git a/djang0/contrib/admin/templateTags/admin_modify.py b/djang0 /... - - a/djang0/contrib/admin/templateTags/admin_modify.py +++ b/djang0/contrib/admin/templateTags/admin_modify.py @@ -54,12 +54,20 @@ def submit_row(context): is_popup = context['is_popup'] save_as = context['save_as'] show_save = context.get('show_save', True) + show_save_and_add_another = context.get('show_save_and_add_another', True)
(7 Zeilen ausgelassen...) or (has_add_permission and add) or has_editable_inline_admin_formset + can_save_and_add_another = ( + has_add_permission and + not is_popup and + (not save_as or add) and + can_save and + show_save_and_add_another + ) can_save_and_continue = not is_popup and can_save and has_view_permission and show_save_and_continue can_change = has_change_permission or has_editable_inline_admin_formset ctx = Context(context) @@ -70,10 +78,7 @@ def submit_row(context): change and context.get('show_delete', True) ), 'show_save_as_new': not is_popup and has_change_permission and change and save_as, - 'show_save_and_add_another': ( - has_add_permission and not is_popup and - (not save_as or add) and can_save - ), 'show_save_and_add_another': can_save_and_add_another, 'show_save_and_continue': can_save_and_continue, 'show_save': show_save and can_save,
Modellgenerierter Patch
diff --git a/django/contrib/admin/templateTags/admin_modify.py b/django/...-- a/django/contrib/admin/templateTags/admin_modify.py +++ b/django/contrib/admin/templateTags/admin_modify.py@@ - 72,7 + 72,7 @@ def submit_row(context):' show_save_as_new': not is_popup and has_change_permission and change and save_as,' show_save_and_add_another': has_add_permission and not is_popup and- (not save_as or add) and can_save + (not save_as or add) and can_save and context. get('show_save_and_add_another', True)),' show_save_and_continue': can_save_and_continue,' show_save': show_save and can_save,
Tests
Fehlschlag zu Bestehen (2)
test_override_show_save_and_add_another
test_submit_row (admin_views.test_templateTags.Admin...)
Bestehen zu Bestehen (3)
test_choice_links (admin_views.test_templateTags.DateHierarchyTests)
test_override_change_form_template_tags
test_override_change_list_template_tags
Diskussion. Bei dieser Task-Instanz aus dem Repository django/django wird das Modell gebeten, eine Kontextvariable einzuführen, die es einem Nutzer ermöglichen würde, den Button „Save and Add Another“ über eine Kontextvariable auszublenden, ähnlich wie es für zwei andere bestehende Buttons gemacht wird. Die Aufgabe ist im Vergleich zu den beiden vorherigen Settings etwas schwieriger, weil kein expliziter Stack-Trace oder eine programmatische Demonstration des Problems angeboten wird. In diesem relativ unterspezifizierten Setting, das keinen Hinweis bezüglich der korrekten Lokalisierung der Funktion liefert, schlussfolgert das Modell erfolgreich, dass es das bestehende Schlüssel-Wert-Paar show_save_and_add_another anpassen sollte. Beim Vergleich mit der Gold-Patch-Lösung lässt sich argumentieren, dass der vom Modell generierte Patch hinsichtlich der bearbeiteten Zeilen eine viel effizientere Lösung darstellt, da er die kleinste notwendige Änderung vornimmt, um den Kontext als Flag für das Setzen des verborgenen Status von show_save_and_add_another einzubinden. Ähnlich wie in der Diskussion zu Tabelle 31 sind die Änderungen des Gold-Patches jedoch stilistisch viel konsistenter mit dem Codebase, und es werden zusätzliche Änderungen vorgenommen, die im Issue nicht explizit diskutiert werden, um dem zu entsprechen, was im Codebase gemacht wurde (d. h. die Hinzufügung eines Feldes can_save_and_add_another. Diese Aufgabe ist ein Beispiel für eine potenziell spannende Richtung, in der Modelle durch menschliche Anleitung oder ein besseres allgemeines Verständnis eines Codebases ihre Generierungen dahingehend anpassen würden, nicht nur die funktional korrekten Änderungen vorzunehmen, sondern auch die stilistisch richtigen.
Tabelle 33: Dies ist ein Beispiel, bei dem SWE- Llama13b eine inkorrekte Lösung schreibt, aber das vorherige Verhalten erfolgreich beibehält. Der Unterschied zwischen der Generierung des Modells und dem Gold-Patch zeigt hier, wie Modelle dazu neigen, die notwendigen Korrekturen unzureichend zu generieren.
Setting
- Modell: SWE-Llama 13B mit Oracle-Retrieval- Task-Instanz: sphinx-doc_sphinx-11445- Link zum Issue: https://github.com/sphinx-doc/sphinx/issues/11437- Link zum PR: https://github.com/sphinx-doc/sphinx/pull/11445
Issue
Die Verwendung von rst_prolog entfernt Überschriften der obersten Ebene, die eine Domänen-Direktive enthalten
Beschreibung des Fehlers
Wenn rst_prolog gesetzt ist, dann rendern alle Dokumente, die eine Domain-Direktive als erste Überschrift enthalten (z. B. :mod:), die Überschrift nicht korrekt oder schließen die Überschrift nicht in die Toctree ein. Im folgenden Beispiel würde die Überschrift von docs/mypackage.rst korrekt angezeigt, wenn sie mypackage2 statt :mod:mypackage2 wäre. Ebenso wird die Überschrift korrekt angezeigt, wenn Sie rst_prolog nicht setzen. Dies scheint schon seit einiger Zeit defekt zu sein, denn ich kann es in v4.0.0 von Sphinx reproduzieren.
So reproduzieren Sie es
$ sphinx-quickstart --no-sep --project mypackage --author me - v 0.1.0 --release 0.1.0 --language en docs $ echo - e 'Welcome\n=========\n\n...\tctree::\n\n\_mypackage\n' > docs/index_rst $ echo - e ':mod:'mypackage2\n=========\n\nContent\n\n Subheading\n-
logger = logging.getLogger(name) - docinfo_re = re.compile(r'\w+.?') + docinfo_re = re.compile(r'\w+.?n') symbols_re = re.compile(r'([-]-\/-\@[\-]') SECTIONING_CHARS = ['=', '-', '-']
Tests
Fail to Pass (2)
X tests/test_util_rst.py::test_prepend_prolog_with_roles_with_newline tests/test_util_rst.py::test_prepend_prolog_with_roles_without_newline
Pass to Pass (8)
X tests/test_util_rst.py::test_prepend_prolog tests/test_util_rst.py::test_prepend_prolog_with_CR tests/test_util_rst.py::test_prepend_prolog_without_CR
Zusätzliche Pass-to-Pass-Tests ausgelassen...
Gold-Patch
diff --git a/sphinx/util/rst.py b/sphinx/util/rst.py -- a/sphinx/util/rst.py ++ b/sphinx/util/rst.py @@ - 10,22 +10,17 @@
from docutils.parsers.rst import roles from docutils.parsers.rst.languages import en as english +from docutils.parsers.rst.states import Body from docutils.statemachine import StringList from docutils.utils import Reporter - from jinja2 import Environment +from jinja2 import Environment, pass_environmentfrom sphinx.locale import from sphinx.util import docutils, logging- try: - from jinja2.utils import pass_environment - except ImportError: - from jinja2 import environmentfilter as pass_environment - logger = logging.getLogger(name) - docinfo_re = re.compile('\w+.*?') +FIELD_NAME_RE = re.compile(Body.patterns['field_marker']) symbols_re = re.compile(r'([-\-/:-@\[-\{-]})' # Symbole ohne Punkt (0 x2e) SECTIONING_CHARS = ['=', '-', '~']
@@ - 80,7 +75,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: if prolog: pos = 0 for line in content: if docinfo_re.match(line): + if FIELD_NAME_RE.match(line): pos += 1 else: break @@ - 91,6 +86,7 @@ def prepend_prolog(content: StringList, prolog: str) -> None: pos += 1 # Prolog einfügen (nach docinfo, falls vorhanden) + lineno = 0 for lineno, line in enumerate(prolog.splitlines()): content.insert(pos + lineno, line, 'rst_prolog>', lineno)
Diskussion. Für diese Aufgabeninstanz aus dem Repository sphinx-doc/sphinx wird ein Modell gebeten, Logik zu schreiben, um einen Fall zu beheben, in dem der Titel fälschlicherweise gerendert wird. Allein das Verständnis der verwendeten Fachbegriffe und die Zuordnung solcher Wörter zur Logik innerhalb der Codebasis ist eine erhebliche Herausforderung für das Modell. Dem Modell wird ein Kommandozeilenaufruf gegeben, der dabei helfen kann, aber die Verankerung der in den Issues dargestellten Terminologie innerhalb der Codebasis ist essenziell. Aus dem Vergleich des Gold-Patches und des vom Modell generierten Patches wird deutlich, dass das Modell der Lösung der Aufgabe nicht nahekommt. Das Modell erkennt im Allgemeinen, dass die Korrektur des Regex-Musters die richtige Aktion ist, da dies auch der Gold-Patch tut. Wo das Modell und die Oracle-Retrieval-Einstellung jedoch gemeinsam zu kurz kommen, liegt hauptsächlich an der erheblichen Nutzung zusätzlicher Module sowohl aus der Codebasis selbst als auch aus Drittanbieter-Bibliotheken. Dieses Beispiel unterstreicht die Bedeutung und das Potenzial für das Training von Sprachmodellen und die Gestaltung von Inferenzverfahren, die die automatisierte Entdeckung solcher Informationen ermöglichen.
Tabelle 34: In diesem letzten Beispiel löst SWE-Llama 13b die Aufgabe nicht nur nicht, sondern beschädigt auch bestehendes Verhalten im Modell. Dieses Beispiel zeigt die Notwendigkeit für Modelle, die Codebasis über den Umfang der erforderlichen Änderungen hinaus zu verstehen.
Setting
- Aufgabeninstanz: scikit-learn_ scikit-learn-13241
- Link zum Issue: https://github.com/scikit-learn/scikit-learn/issues/8798
- Link zum PR: https://github.com/scikit-learn/scikit-learn/pull/13241
Issue
Unterschiede zwischen den Ergebnissen von KernelPCA mit rbf-Kernel
Beschreibung
Wenn ich KernelPCA zur Dimensionsreduktion für dieselben Datensätze ausführe, unterscheiden sich die Ergebnisse in den Vorzeichen.
Schritte/Code zur Reproduktion
Nur um die Dimension mit rbf-Kernel auf 7 zu reduzieren:
pca = KernelPCA(n_components=7, kernel='rbf', copy_X=False, n_jobs=- 1) pca.fit_transform(X)
Erwartete Ergebnisse
Das gleiche Ergebnis.
Tatsächliche Ergebnisse
Die Ergebnisse sind bis auf ihre Vorzeichen gleich:
[[- 0.44457 - 0.18155 - 0.10873 0.13548 - 0.14371 - 0.05746 0.18124]] [[0.44457 0.18155 0.10873 - 0.13548 - 0.14371 - 0.05746 - 0.18124]] [[- 0.44457 - 0.18155 0.10873 0.13548 0.14371 0.057469 0.18124]]
Gold-Patch
diff --git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos...
-- a/sklearn/decomposition/kernel_pca.py
+++ b/sklearn/decomposition/kernel_pca.py
@@ - 8,6 + 8,7 @@
from scipy.sparse.linalg import eighs
from .utils import check_random_state
+from .utils.extmath import svd_flip
from .utils.validation import check_is_fitted, check_array
from .exceptions import NotFittedErrorfrom .base import BaseEstimator, TransformerMixin,_UnstableOn32BitMixin
@@ - 210,6 + 211,10 @@ def _fit_transform(self, K):maxiter=self.max_iter, v0=v0)
+ # Vorzeichen der Eigenvektoren umkehren, um deterministische Ausgabe zu erzwingen
+ self.alphas_, _ = svd_flip(self.alphas_,+ np.empty_like(self.alphas_).T)+ # Eigenvektoren in absteigender Reihenfolge sortierenindices = self.lambdas_.argsort() [::- 1]self.lambdas_ = self.lambdas_[indices]
Vom Modell generierter Patch
diff - - git a/sklearn/decomposition/kernel_pca.py b/sklearn/decompos... - - a/sklearn/decomposition/kernel_pca.py +++ b/sklearn/decomposition/kernel_pca.py @@ -220,7 +220,7 @@ def fit_transform(self, K): self.alphas = self.alphas_[:, self.lambdas_ > 0] self.lambdas_ = self.lambdas_[self.lambdas_ > 0]
return K return K / self.lambdas_
def _fit_inverse_transform(self, X_transformed, X): if hasattr(X, "tocstr"):
Tests
Fehlschlag zu Bestehen (1)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output
Bestehen zu Bestehen (54)
X sklearn/tests/test_kernel_pca.py::test_kernel_pca sklearn/tests/test_kernel_pca.py::test_kernel_pca_consistent_transform sklearn/tests/test_kernel_pca.py::test_kernel_pca_deterministic_output sklearn/tests/test_kernel_pca.py::test_kernel_pca_sparse sklearn/tests/test_kernel_pca.py::test_kernel_pca_linear_kernel sklearn/tests/test_kernel_pca.py::test_kernel_pca_n_components sklearn/tests/test_kernel_pca.py::test_remove_zero_eig sklearn/tests/test_kernel_pca.py::test_kernel_pca_precomputed sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline sklearn/tests/test_kernel_pca.py::test_gridsearch_pipeline_precomputed sklearn/tests/test_pca.py::test_pca_dtype_preservation[randomized] sklearn/tests/test_pca.py::test_pca_dtype_preservation[auto] sklearn/tests/test_pca.py::test_pca_deterministic_output
Weitere Bestehen-zu-Bestehen-Tests ausgelassen...
Diskussion. In diesem Beispiel aus der scikit-learn/scikit-learn-Bibliothek erhält ein Modell die Beobachtung, dass die Paritäten der Ausgabe eines Aufrufs der Funktion fit_transform vertauscht sind. Dem Modell werden außerdem Zeilen von Python-Code und deren Standardausgabe gegeben, die das Problem reproduzieren. Der Gold-Patch importiert und verwendet die Funktion svd_flip, um dieses Problem innerhalb einer anderen Zeile der Funktion _fit_transform zu lösen. Was an dem Fehlschlag des Modells für diese Aufgabe über die für das Beispiel in Tabelle 33 diskutierten Punkte hinaus anders ist, ist, dass es für ein Modell neben dem Verständnis der Drittanbieter-Abhängigkeiten, auf die sich seine Änderungen stützen, auch wichtig ist, zu verstehen, welche anderen Teile der Codebasis wiederum von der Funktion abhängen, die es ändert. Dieses Beispiel zeigt eine andere Facette dafür, warum die Verarbeitung langer Kontexte, die über den lokalen Bearbeitungsbereich hinausgehen, eine schwierige, aber lohnenswerte Herausforderung ist.