
Vier Korrekturen an PPO bringen ein 32B-Modell auf 50 Punkte bei AIME 2024, Code und Daten sind offen. Papier von 2025, gemeinfrei lesbar.
DAPO: An Open-Source LLM Reinforcement Learning System at Scale
DAPO: Ein quelloffenes LLM-Reinforcement-Learning-System im großen Maßstab
ByteDance Seed Institute for AI Industry Research (AIR), Tsinghua University The University of Hong Kong SIA-Labor der Tsinghua AIR und ByteDance Seed
Vollständige Autorenliste in den Beiträgen
Kurzfassung
Inference-Scaling verleiht LLMs eine beispiellose Denkfähigkeit, wobei Reinforcement Learning die Kerntechnik ist, um komplexes Schlussfolgern hervorzubringen. Allerdings werden zentrale technische Details modernster Reasoning-LLMs verschwiegen (etwa im OpenAI-o1-Blog und im technischen Bericht zu DeepSeek R1), sodass die Community nach wie vor Schwierigkeiten hat, deren RL-Trainingsergebnisse zu reproduzieren. Wir schlagen den Algorithmus Decoupled Clip and Dynamic sAmpling Policy Optimization (DAPO) vor und stellen vollständig quelloffen ein modernstes großskaliges RL-System bereit, das mit dem Basismodell Qwen2.5-32B 50 Punkte auf AIME 2024 erreicht. Anders als frühere Arbeiten, die Trainingsdetails zurückhalten, stellen wir vier zentrale Techniken unseres Algorithmus vor, die großskaliges LLM-RL zum Erfolg führen. Darüber hinaus veröffentlichen wir unseren Trainingscode, der auf dem verl-Framework aufbaut, zusammen mit einem sorgfältig kuratierten und aufbereiteten Datensatz als Open Source. Diese Komponenten unseres Open-Source-Systems verbessern die Reproduzierbarkeit und unterstützen künftige Forschung im Bereich großskaliges LLM-RL.
Datum: 17. März 2025 Korrespondenz: zhouhao@air.tsinghua.edu.cn, wangmingxuan.89@bytedance.com Projektseite: https://dapo-sia.github.io/"https://github.com/volcengine/verl
1 Einleitung
Test-Time-Scaling wie bei OpenAIs o1 [1] und DeepSeeks R1 [2] bringt einen tiefgreifenden Paradigmenwechsel für Large Language Models (LLMs) [3–7]. Test-Time-Scaling ermöglicht längeres Chain-of-Thought-Denken und induziert ausgefeilte Schlussfolgerungsverhalten, wodurch die Modelle bei wettbewerbsorientierten Mathematik- und Programmieraufgaben wie AIME und Codeforces überlegen sind.
Die zentrale Technik, die diese Revolution vorantreibt, ist großskaliges Reinforcement Learning (RL), das komplexe Schlussfolgerungsverhalten wie Selbstverifikation und iterative Verfeinerung hervorruft. Der tatsächliche Algorithmus und das zentrale Rezept für skalierbares RL-Training bleiben jedoch ein Mythos, der in technischen Berichten bestehender Reasoning-Modelle [1, 2, 8–11] verborgen bleibt. In diesem Artikel legen wir erhebliche Hindernisse beim großskaligen RL-Training offen und stellen quelloffen ein skalierbares RL-System mit vollständig quelloffenem Algorithmus, Trainingscode und Datensatz bereit, das demokratisierte Lösungen mit RL-Ergebnissen auf Branchenniveau bietet.
Wir experimentieren mit Qwen2.5-32B [12] als vortrainiertem Modell für RL. In unserem anfänglichen GRPO-Lauf erreichten wir auf AIME nur 30 Punkte – eine Leistung, die deutlich unter der von DeepSeeks RL (47 Punkte) liegt. Eine gründliche Analyse zeigt, dass die naive GRPO-Baseline unter mehreren zentralen Problemen leidet, wie Entropiekollaps, Reward-Rauschen und Trainingsinstabilität. Die breitere Community ist bei der Reproduktion von DeepSeeks Ergebnissen auf ähnliche Herausforderungen gestoßen [13–19], was darauf hindeutet, dass im R1-Bericht möglicherweise kritische Trainingsdetails ausgelassen wurden, die zur Entwicklung eines industrietauglichen, großskaligen und reproduzierbaren RL-Systems erforderlich sind.
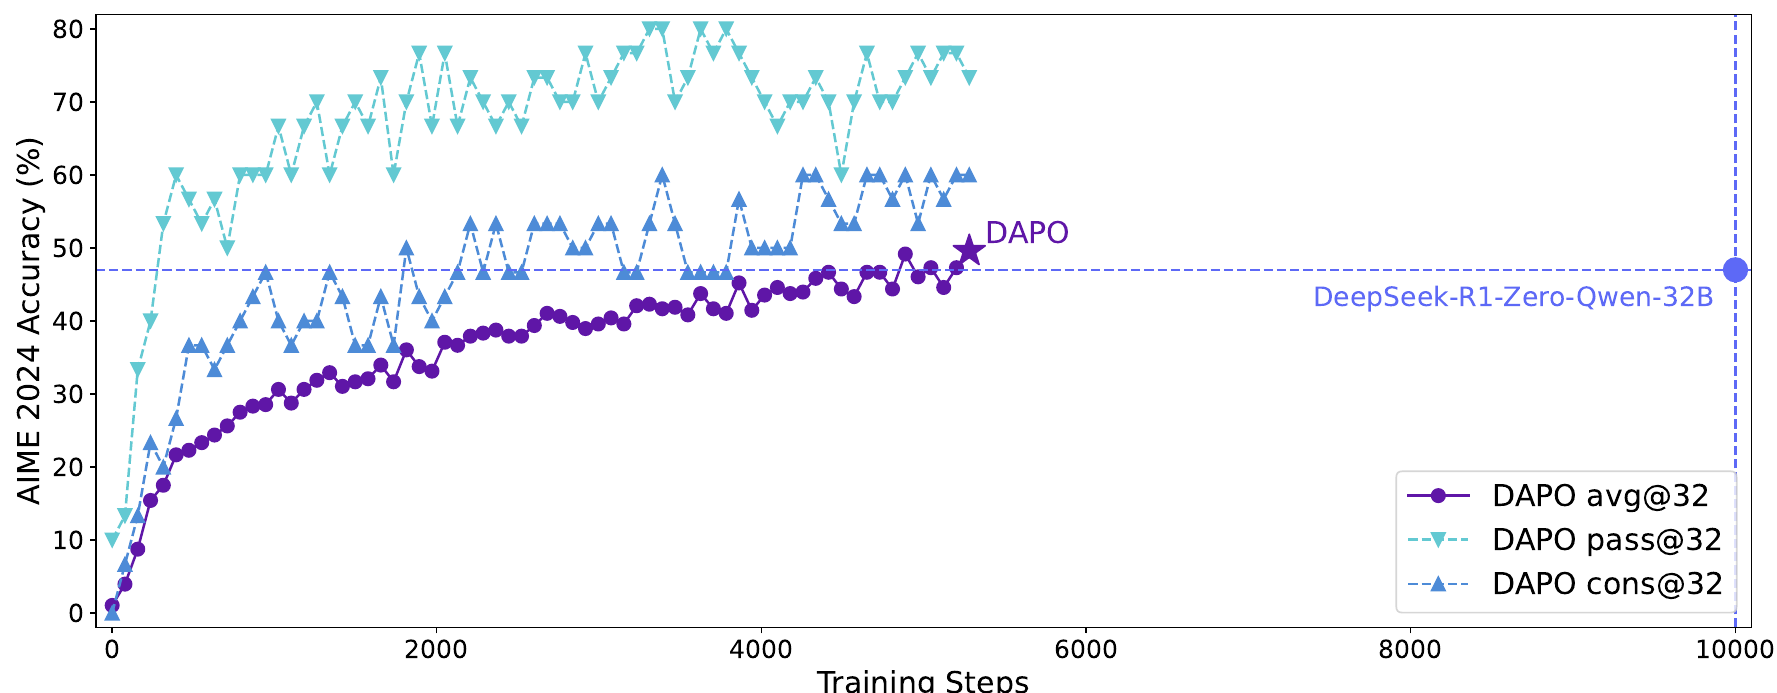
Um diese Lücke zu schließen, veröffentlichen wir ein quelloffenes modernstes System für großskaliges LLM-RL, das auf dem Modell Qwen2.5-32B 50 Punkte auf AIME 2024 erreicht und damit frühere modernste Ergebnisse von DeepSeek-R1-Zero-Qwen-32B [2] (47 Punkte) übertrifft, wobei es 50 % der Trainingsschritte benötigt (Abbildung 1). Wir schlagen den Algorithmus Decoupled Clip and Dynamic Sampling Policy Optimization (DAPO) vor und führen 4 zentrale Techniken ein, damit RL im Long-CoT-RL-Szenario zur Geltung kommt. Details werden in Abschnitt 3 vorgestellt.
1. Clip-Higher, das die Diversität des Systems fördert und Entropiekollaps vermeidet;
2. Dynamic Sampling, das die Trainingseffizienz und -stabilität verbessert;
3. Token-Level Policy Gradient Loss, das in Long-CoT-RL-Szenarien entscheidend ist;
4. Overlong Reward Shaping, das Reward-Rauschen reduziert und das Training stabilisiert.
Unsere Implementierung basiert auf verl [20]. Indem wir unser modernstes RL-System einschließlich Trainingscode und Daten vollständig veröffentlichen, möchten wir wertvolle Erkenntnisse zu großskaligem LLM-RL vermitteln, von denen die breitere Community profitiert.
2 Vorbereitung
2.1 Proximal Policy Optimization (PPO)
PPO [21] führt ein geclipptes Surrogatziel für die Policy-Optimierung ein. Indem die Policy-Updates mithilfe von Clipping innerhalb einer proximalen Region der vorherigen Policy beschränkt werden, stabilisiert PPO das Training und verbessert die Sample-Effizienz. Konkret aktualisiert PPO die Policy durch Maximierung des folgenden Ziels:
wobei ein Frage-Antwort-Paar aus der Datenverteilung ist, der Clipping-Bereich des Importance-Sampling-Verhältnisses ist und ein Schätzer des Vorteils zum Zeitschritt ist. Gegeben die Wertfunktion und die Reward-Funktion , wird unter Verwendung der Generalized Advantage Estimation (GAE) [22] berechnet:
wobei
2.2 Group Relative Policy Optimization (GRPO)
Im Vergleich zu PPO eliminiert GRPO die Wertfunktion und schätzt den Vorteil auf gruppenrelative Weise. Für ein bestimmtes Frage-Antwort-Paar sampelt die Verhaltens-Policy eine Gruppe von individuellen Antworten . Anschließend wird der Vorteil der -ten Antwort durch Normalisierung der Rewards auf Gruppenebene berechnet:
Ähnlich wie PPO verwendet GRPO ein geclipptes Ziel zusammen mit einem direkt auferlegten KL-Strafterm:
wobei
Es ist ebenfalls erwähnenswert, dass GRPO die Zielfunktion auf Sample-Ebene berechnet. Genauer gesagt berechnet GRPO zunächst den mittleren Verlust innerhalb jeder generierten Sequenz, bevor der Verlust verschiedener Samples gemittelt wird. Wie wir in Abschnitt 3.3 diskutieren werden, kann sich dieser Unterschied auf die Leistung des Algorithmus auswirken.
2.3 Entfernung der KL-Divergenz
Der KL-Strafterm wird verwendet, um die Divergenz zwischen der Online-Policy und der eingefrorenen Referenz-Policy zu regulieren. Im RLHF-Szenario [23] besteht das Ziel des RL darin, das Modellverhalten auszurichten, ohne zu weit vom Ausgangsmodell abzuweichen. Beim Training des Lang-CoT-Reasoning-Modells kann jedoch die Modellverteilung erheblich vom Ausgangsmodell abweichen, sodass diese Einschränkung nicht notwendig ist. Daher werden wir den KL-Term aus unserem vorgeschlagenen Algorithmus ausschließen.
2.4 Regelbasiertes Reward-Modeling
Die Verwendung eines Reward-Modells leidet üblicherweise unter dem Problem des Reward Hacking [24-29]. Stattdessen verwenden wir direkt die endgültige Genauigkeit einer verifizierbaren Aufgabe als Ergebnis-Reward, berechnet nach der folgenden Regel:
wobei die Ground-Truth-Antwort und die vorhergesagte Antwort ist. Es ist erwiesen, dass dies ein effektiver Ansatz zur Aktivierung der Reasoning-Fähigkeit des Basismodells ist, wie in zahlreichen Bereichen wie dem automatisierten Theorembeweisen [30-33], der Computerprogrammierung [34-37] und Mathematikwettbewerben [2] gezeigt wurde.
3 DAPO
Wir schlagen den eouple Clip and ynamic sAmpling Policy ptimization (DAPO)-Algorithmus vor. DAPO zieht eine Gruppe von Ausgaben für jede Frage zusammen mit der Antwort und optimiert die Policy über die folgende Zielfunktion:
wobei
Der vollständige Algorithmus findet sich in Algorithmus 1. In diesem Abschnitt stellen wir die wichtigsten Techniken vor, die mit DAPO verbunden sind.
3.1 Die Obergrenze anheben: Clip-Higher
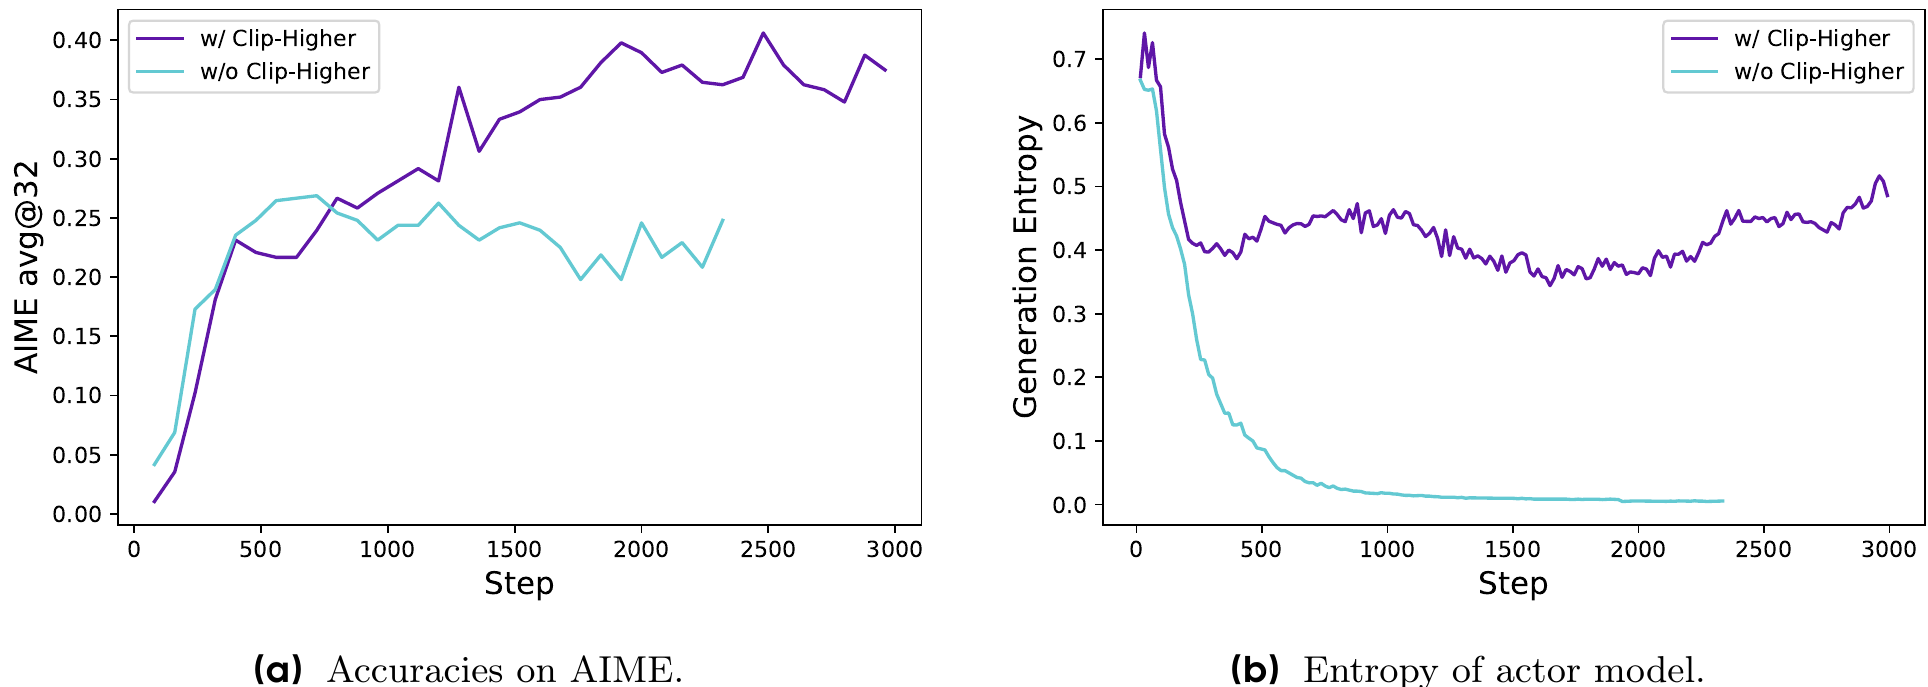
In unseren ersten Experimenten mit naivem PPO [21] oder GRPO [38] beobachteten wir das Phänomen des Entropiekollapses: Die Entropie der Policy sinkt im Verlauf des Trainings schnell (Abbildung 2b). Die abgetasteten Antworten bestimmter Gruppen tendieren dazu, nahezu identisch zu sein. Dies deutet auf begrenzte Exploration und eine früh deterministische Policy hin, was den Skalierungsprozess behindern kann.
Wir schlagen die Clip-Higher-Strategie vor, um dieses Problem zu adressieren. Das Beschneiden des Importance-Sampling-Verhältnisses wird in Clipped Proximal Policy Optimization (PPO-Clip) [21] eingeführt, um die Trust Region einzuschränken und die Stabilität des RL zu erhöhen. Wir stellen fest, dass die obere Beschneidung die Exploration der Policy einschränken kann, da es viel einfacher ist, ein „Exploitation“-Token wahrscheinlicher zu machen, während die Wahrscheinlichkeit eines unwahrscheinlichen „Exploration“-Tokens zu eng begrenzt ist, um angehoben zu werden.
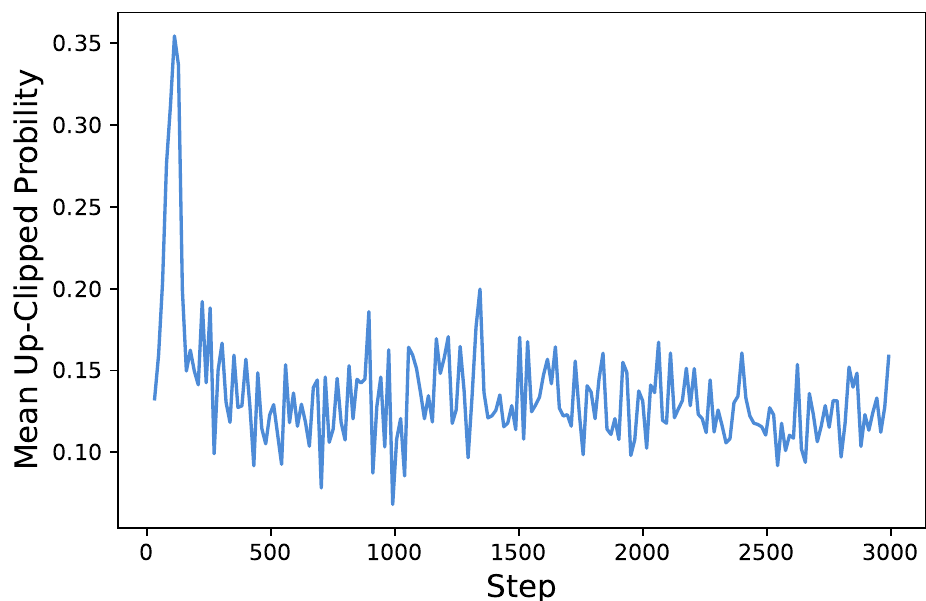
Konkret: Wenn (der Standardwert der meisten Algorithmen) und (das System versucht, die Wahrscheinlichkeit zu erhöhen), betrachte man zwei Aktionen mit Wahrscheinlichkeiten und 0.9. Die Obergrenzen der erhöhten Wahrscheinlichkeiten sind 0.012 bzw. 1.08 ( ). Dies impliziert, dass „Exploitation“-Tokens mit einer höheren Wahrscheinlichkeit (z. B. 0.9) nicht dahingehend beschränkt sind, noch extrem größere Wahrscheinlichkeiten wie 0.999 zu erreichen. Umgekehrt ist es für „Exploration“-Tokens mit niedriger Wahrscheinlichkeit deutlich schwieriger, eine nicht triviale Erhöhung der Wahrscheinlichkeit zu erreichen. Empirisch beobachten wir außerdem, dass die mittlere Wahrscheinlichkeit von oben beschnittenen Tokens niedrig ist: (Abbildung 3a). Dieser Befund stützt unsere Intuition, dass die obere Beschneidungsschwelle tatsächlich die Wahrscheinlichkeitserhöhung von „Exploration“-Tokens mit niedriger Wahrscheinlichkeit einschränkt und dadurch möglicherweise die Exploration des Systems begrenzt.
Gemäß der Clip-Higher-Strategie entkoppeln wir den unteren und den oberen Beschneidungsbereich als und , wie in Gleichung 10 hervorgehoben:
Wir erhöhen den Wert von , um mehr Spielraum für die Erhöhung von Tokens mit niedriger Wahrscheinlichkeit zu lassen. Wie in Abbildung 2 gezeigt, verbessert diese Anpassung effektiv die Entropie der Policy und erleichtert die Generierung vielfältigerer Stichproben. Wir behalten bei, da eine Erhöhung die Wahrscheinlichkeit dieser Tokens auf 0 unterdrücken würde, was zum Kollaps des Sampling-Raums führen würde.
3.2 Je mehr, desto besser: Dynamisches Sampling
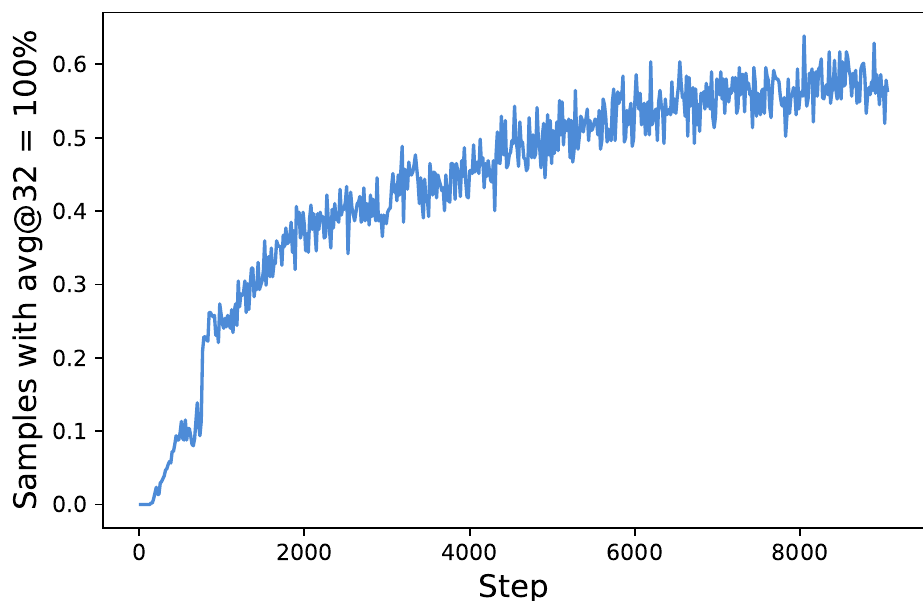
Bestehende RL-Algorithmen leiden unter dem Problem abnehmender Gradienten, wenn einige Prompts eine Genauigkeit von 1 aufweisen. Bei GRPO beispielsweise: Wenn alle Ausgaben eines bestimmten Prompts korrekt sind und dieselbe Belohnung erhalten, ist der resultierende Vorteil für diese Gruppe null. Ein Vorteil von null führt zu null Policy-Gradienten, was die Größe des Batch-Gradienten verringert und seine RauschEmpfindlichkeit erhöht, wodurch die Sample-Effizienz beeinträchtigt wird. Empirisch nimmt die Anzahl der Stichproben mit einer Genauigkeit von 1 weiter zu, wie in Abbildung 3b gezeigt. Das bedeutet, dass die effektive Anzahl von Prompts in jedem Batch stetig abnimmt, was zu einer größeren Varianz im Gradienten führen und die Gradientensignale für das Modelltraining dämpfen kann.
Zu diesem Zweck schlagen wir vor, Prompts mit einer Genauigkeit von 1 und 0 überabzutasten und herauszufiltern, wie in Gleichung 11 dargestellt, sodass alle Prompts im Batch effektive Gradienten aufweisen und eine konsistente Anzahl von Prompts erhalten bleibt. Die Sampling-Kosten für jeden Batch sind dynamisch. Vor dem Training samplen wir weiter, bis der Batch vollständig mit Stichproben gefüllt ist, deren Genauigkeit weder 0 noch 1 ist.
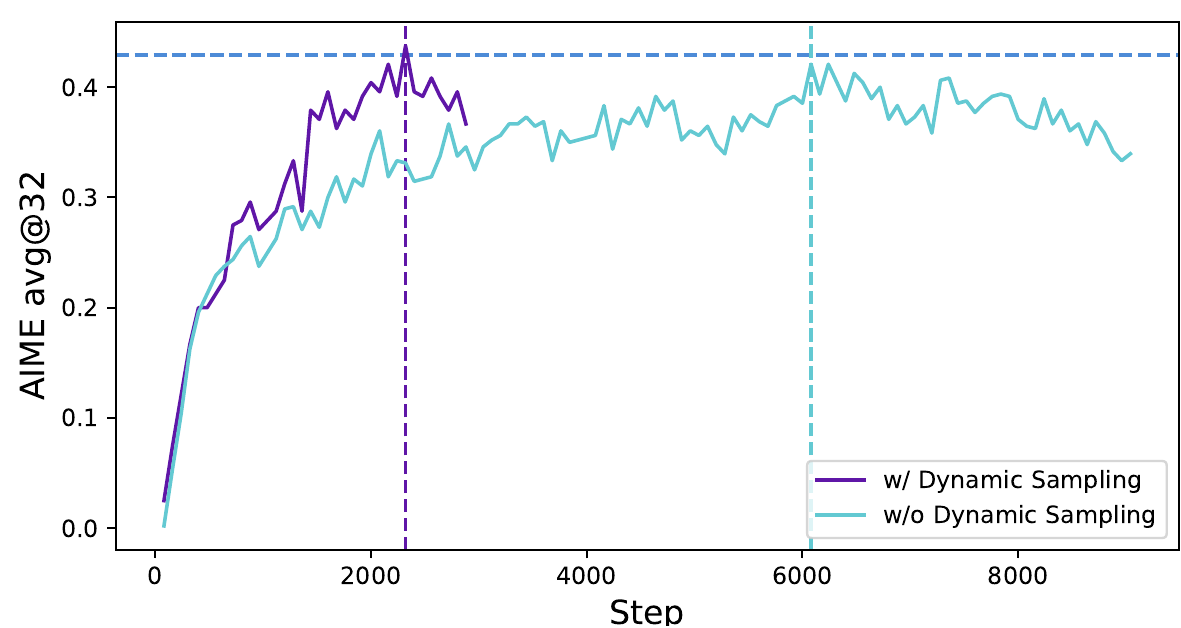
Beachte, dass diese Strategie die Trainingseffizienz nicht unbedingt beeinträchtigt, da die Generierungszeit typischerweise von der Generierung von Long-Tail-Stichproben dominiert wird, wenn das RL-System synchronisiert ist und die Generierungsphase nicht gepipelined wird. Außerdem stellen wir fest, dass das Experiment mit dynamischem Sampling die gleiche Leistung schneller erreicht, wie in Abbildung 6 gezeigt.
3.3 Balanceakt: Policy-Gradient-Verlust auf Token-Ebene
Der ursprüngliche GRPO-Algorithmus verwendet eine Verlustberechnung auf Stichprobenebene, bei der zunächst die Verluste innerhalb jeder Stichprobe über die Tokens gemittelt und dann die Verluste über die Stichproben aggregiert werden. Bei diesem Ansatz wird jeder Stichprobe in der endgültigen Verlustberechnung ein gleiches Gewicht zugewiesen. Wir stellen jedoch fest, dass diese Methode der Verlustreduktion im Kontext von Long-CoT-RL-Szenarien mehrere Herausforderungen mit sich bringt.
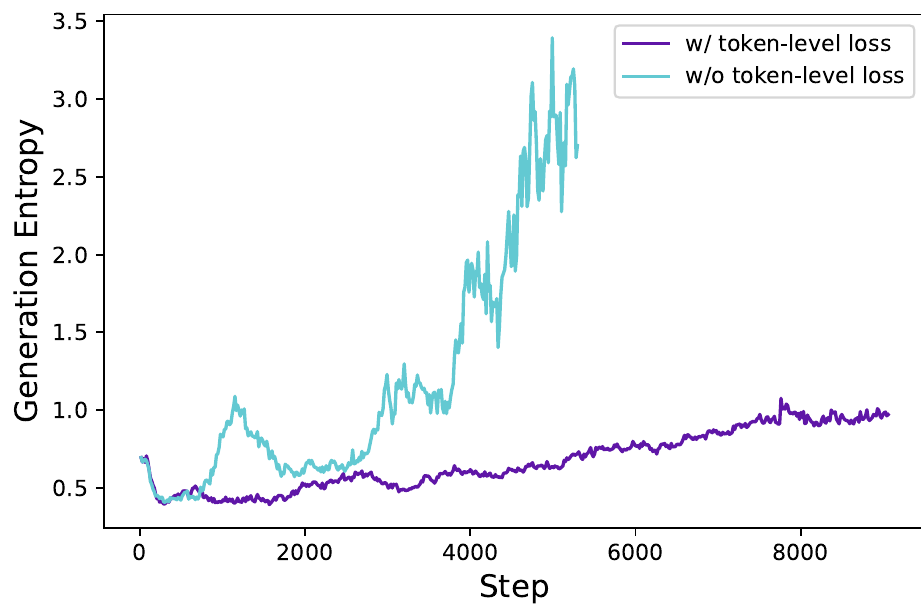
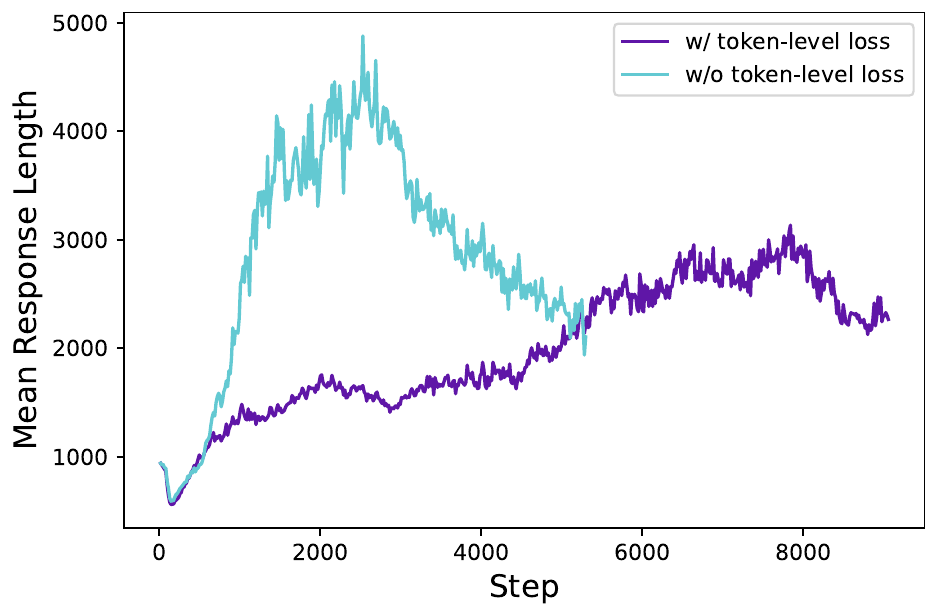
Da allen Stichproben bei der Verlustberechnung dasselbe Gewicht zugewiesen wird, können Tokens innerhalb längerer Antworten (die mehr Tokens enthalten) einen unverhältnismäßig geringeren Beitrag zum Gesamtverlust leisten, was zu zwei nachteiligen Effekten führen kann. Erstens kann dieser Effekt bei hochwertigen langen Stichproben die Fähigkeit des Modells beeinträchtigen, relevante Muster für das Schlussfolgern innerhalb dieser Stichproben zu erlernen. Zweitens beobachten wir, dass übermäßig lange Stichproben häufig minderwertige Muster wie Kauderwelsch und repetitive Wörter aufweisen. Daher führt die Verlustberechnung auf Stichprobenebene, da sie solche unerwünschten Muster in langen Stichproben nicht wirksam bestrafen kann, zu einem ungesunden Anstieg der Entropie und der Antwortlänge, wie in Abbildung 4a und Abbildung 4b gezeigt.
Wir führen einen Policy-Gradient-Verlust auf Token-Ebene im Long-CoT-RL-Szenario ein, um die oben genannten Einschränkungen zu adressieren:
In dieser Einstellung können längere Sequenzen im Vergleich zu kürzeren Sequenzen mehr Einfluss auf die gesamte Gradientenaktualisierung haben. Darüber hinaus wird aus der Perspektive einzelner Tokens ein bestimmtes Generierungsmuster, wenn es zu einer Erhöhung oder Verringerung der Belohnung führen kann, gleichermaßen gefördert oder unterdrückt, unabhängig von der Länge der Antwort, in der es erscheint.
3.4 Verstecken und Suchen: Belohnungsgestaltung für überlange Antworten
Beim RL-Training legen wir üblicherweise eine maximale Länge für die Generierung fest, wobei überlange Samples entsprechend abgeschnitten werden. Wir stellen fest, dass eine unsachgemäße Reward-Gestaltung für abgeschnittene Samples Reward-Rauschen einführen und den Trainingsprozess erheblich stören kann.
Standardmäßig weisen wir abgeschnittenen Samples einen strafenden Reward zu. Dieser Ansatz kann Rauschen in den Trainingsprozess einführen, da ein solider Denkprozess allein aufgrund seiner übermäßigen Länge bestraft werden kann. Solche Strafen können das Modell potenziell hinsichtlich der Validität seines Denkprozesses verwirren.
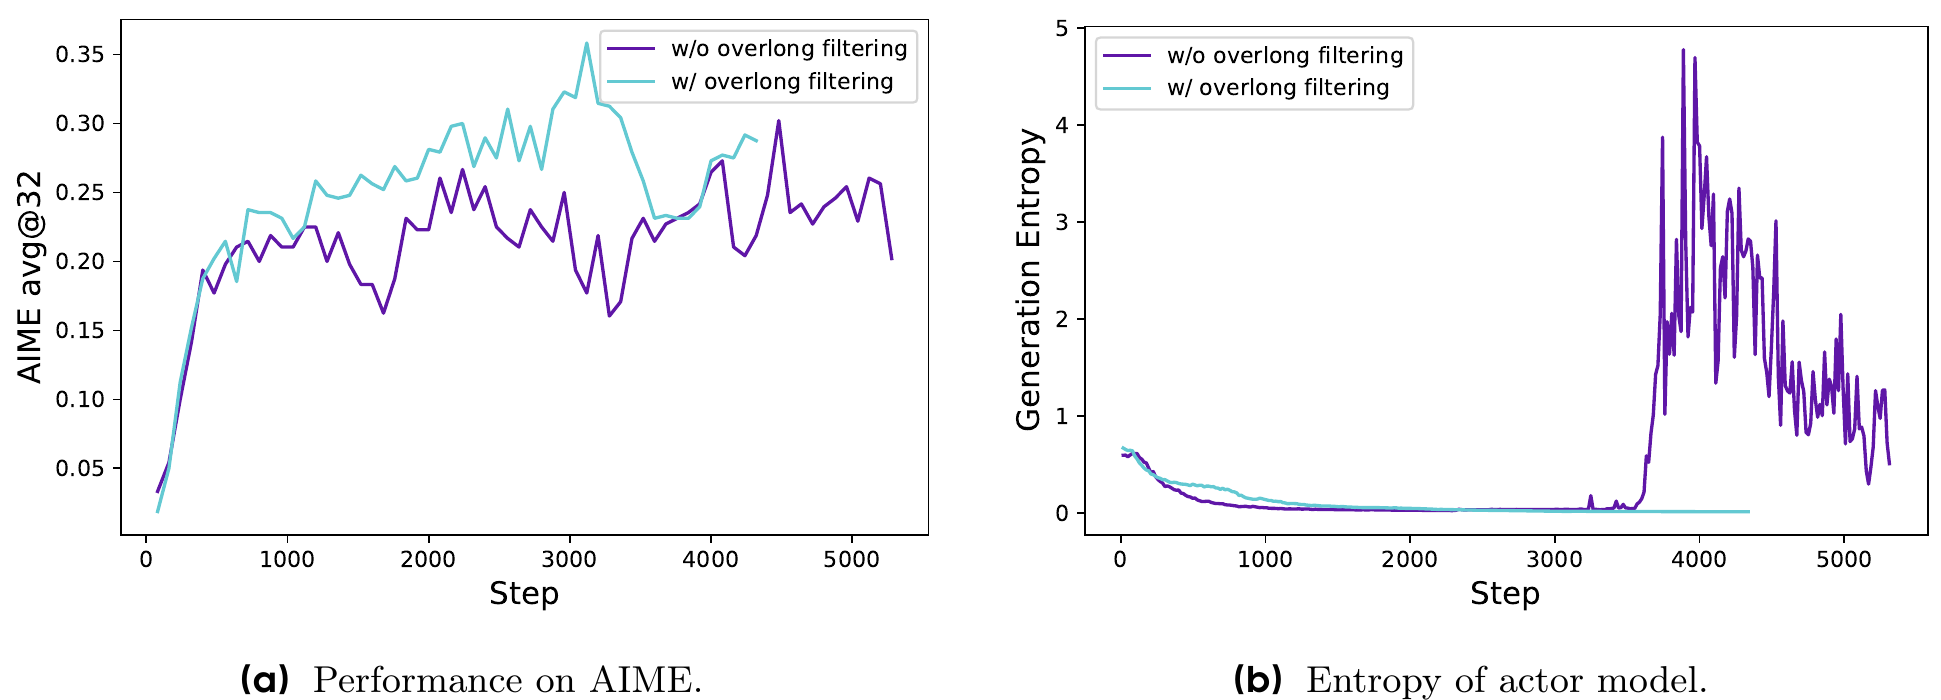
Um die Auswirkung dieses Reward-Rauschens zu untersuchen, wenden wir zunächst eine Overlong-Filtering-Strategie an, die den Loss abgeschnittener Samples maskiert. Wir stellen fest, dass dieser Ansatz das Training erheblich stabilisiert und die Leistung verbessert, wie in Abbildung 5 gezeigt.
| Algorithmus 1 | DAPO: Entkoppeltes Clipping und dynamische Sampling-Policy-Optimierung |
| Eingabe: initiales Policy-Modell πθ; Reward-Modell R; Aufgaben-Prompts D; Hyperparameter ε1ow, εhigh | |
| 1: für step = 1,...,M do | |
| 2: Sample eine Batch Db aus D | |
| 3: Aktualisiere das alte Policy-Modell πθold ← πθ | |
| 4: Sample G Ausgaben {oi}i=1G ~ πθold(·|q) für jede Frage q ∈ Db | |
| 5: Berechne Rewards {ri}i=1G für jede gesampelte Ausgabe oi durch Ausführen von R | |
| 6: Filtere oi heraus und füge die verbleibenden dem dynamischen Sampling-Puffer hinzu (Dynamische Sampling-Gleichung (11)) | |
| 7: wenn Puffergröße nb < N: | |
| 8: continue | |
| 9: Für jedes oi im Puffer berechne Ait,t für das t-te Token von oi (Gleichung (9)) | |
| 10: für iteration = 1, ..., μ do | |
| 11: Aktualisiere das Policy-Modell πθ durch Maximieren des DAPO-Ziels (Gleichung (8)) | |
| Ausgabe πθ |
Darüber hinaus schlagen wir Soft Overlong Punishment (Gleichung 13) vor, einen längenbewussten Strafmechanismus, der darauf ausgelegt ist, den Reward für abgeschnittene Samples zu gestalten. Konkret definieren wir, wenn die Antwortlänge den vordefinierten Maximalwert überschreitet, ein Strafintervall. Innerhalb dieses Intervalls gilt: Je länger die Antwort, desto größer die Strafe, die sie erhält. Diese Strafe wird zum ursprünglichen regelbasierten Korrektheits-Reward addiert und signalisiert dem Modell dadurch, übermäßig lange Antworten zu vermeiden.
3.5 Datensatztransformation
Unser Datensatz stammt aus dem Web und von offiziellen Wettbewerbs-Homepages durch eine Kombination aus Web-Scraping und manueller Annotation. Die Antworten des Mathe-Datensatzes liegen typischerweise in einer Vielzahl von Formaten vor, wie etwa Ausdrücken, Formeln und Zahlen, was es schwierig macht, umfassende Regeln zu deren Parsen zu entwerfen. Um mithilfe von Regeln akkurate Reward-Signale bereitzustellen und Fehler zu minimieren, die durch Formel-Parser eingeführt werden, wählen wir – inspiriert von AIME – die Antworten aus und transformieren sie in ganze Zahlen, die leicht zu parsen sind. Wenn die ursprüngliche Antwort beispielsweise in der Form ausgedrückt ist, weisen wir das LLM an, die Frage so zu ändern, dass die erwartete Antwort wird. Nach Auswahl und Transformation erhielten wir den Datensatz DAPO-Math-17K, der aus 17K Prompts besteht, denen jeweils eine ganze Zahl als Antwort zugeordnet ist.
4 Experimente
4.1 Trainingsdetails
In dieser Arbeit konzentrieren wir uns speziell auf mathematische Aufgaben, um unseren Algorithmus zu evaluieren, der sich ohne Weiteres auf andere Aufgaben übertragen lässt. Wir verwenden das veri-Framework [20] für das Training. Wir nutzen naive GRPO [38] als Baseline-Algorithmus und schätzen die Vorteile mittels Grupppen-Reward-Normalisierung.
Für die Hyperparameter verwenden wir den AdamW-Optimierer [39] mit einer konstanten Lernrate von und integrieren einen linearen Warm-up über 20 Rollout-Schritte. Für das Rollout beträgt die Prompt-Batch-Größe 512, und wir sampeln 16 Antworten für jeden Prompt. Für das Training ist die Mini-Batch-Größe auf 512 gesetzt, d. h. 16 Gradienten-Updates pro Rollout-Schritt. Für das Overlong Reward Shaping setzen wir die erwartete maximale Länge auf 16.384 Token und weisen zusätzliche 4.096 Token als Soft-Punish-Cache zu. Daher wird die maximale Anzahl von Token für die Generierung auf 20.480 Token gesetzt. Was den Clip-Higher-Mechanismus betrifft, setzen wir den Clipping-Parameter auf 0,2 und auf 0,28, was den Trade-off zwischen Exploration und Exploitation effektiv ausbalanciert. Für die Evaluation auf AIME wiederholen wir das Evaluationsset 32-mal und berichten avg@32 für die Ergebnisstabilität. Die Inferenz-Hyperparameter der Evaluation sind auf Temperatur 1,0 und top-p 0,7 gesetzt.
4.2 Hauptergebnisse
Experimente auf AIME 2024 zeigen, dass DAPO das Qwen-32B-Base-Modell erfolgreich zu einem leistungsstarken Reasoning-Modell trainiert hat und dabei eine Leistung erzielt, die besser ist als die von DeepSeeks Experimenten mit Qwen2.5-32B unter Verwendung des R1-Ansatzes. In Abbildung 1 beobachten wir eine substanzielle Leistungsverbesserung auf AIME 2024, wobei die Genauigkeit von nahezu 0 % auf 50 % steigt. Bemerkenswert ist, dass diese Verbesserung mit nur 50 % der Trainingsschritte erreicht wird, die DeepSeek-R1-Zero-Qwen-32B benötigt.
Wir analysieren die Beiträge jeder Trainingstechnik in unserer Methodik, wie in Tabelle 1 detailliert dargestellt. Die beobachteten Verbesserungen zeigen die Wirksamkeit dieser Techniken im RL-Training, wobei jede
| Modell | AIME24 avg@32 |
| DeepSeek-R1-Zero-Qwen-32B | 47 |
| Naives GRPO | 30 |
| + Overlong-Filterung | 36 |
| + Clip-Higher | 38 |
| + Sanfte Bestrafung überlanger Antworten | 41 |
| + Token-Level-Loss | 42 |
| + Dynamisches Sampling (DAPO) | 50 |
mehrere Genauigkeitspunkte auf AIME 2024 beiträgt. Bemerkenswert ist, dass unter der naiven GRPO-Einstellung durch Training ausgehend von einem Qwen2.5-32B-Base-Modell nur Genauigkeit erreicht werden können.
Für den Token-Level-Loss gilt: Obwohl er eine geringere Leistungsverbesserung bringt, stellen wir fest, dass er die Trainingsstabilität erhöht und das Längenwachstum gesünder gestaltet.
Bei der Anwendung von Dynamic Sampling muss zwar mehr Daten gesampelt werden, da Daten mit Nullgradienten herausgefiltert werden, doch die Gesamttrainingszeit wird nicht wesentlich beeinflusst. Wie in Abbildung 6 gezeigt, verringert sich trotz der erhöhten Anzahl von Sampling-Instanzen die Konvergenzzeit des Modells sogar, da weniger Trainingsschritte erforderlich sind.
4.3 Trainingsdynamik
Reinforcement Learning auf großen Sprachmodellen ist nicht nur eine hochaktuelle Forschungsrichtung, sondern auch eine intrinsisch komplexe systemtechnische Herausforderung, die durch die Interdependenz ihrer verschiedenen Teilsysteme gekennzeichnet ist. Änderungen an einem einzelnen Teilsystem können sich durch das System fortpflanzen und aufgrund des komplexen Zusammenspiels dieser Komponenten zu unvorhergesehenen Folgen führen. Selbst scheinbar geringfügige Änderungen der Anfangsbedingungen, wie Variationen in Daten und Hyperparametern, können sich durch iterative Reinforcement-Learning-Prozesse verstärken und erhebliche Abweichungen in den Ergebnissen bewirken. Diese Komplexität stellt Forschende oft vor ein Dilemma: Selbst nach sorgfältiger Analyse und wohlbegründeten Erwartungen, dass eine Modifikation bestimmte Aspekte des Trainingsprozesses verbessern wird, weichen die tatsächlichen Ergebnisse häufig von der erwarteten Entwicklung ab. Daher ist die Überwachung wichtiger Zwischenergebnisse während des Experiments unerlässlich, um die Quellen von Abweichungen schnell zu identifizieren und letztlich das System zu verfeinern.
- Die Länge der generierten Antworten ist eine Metrik, die eng mit Trainingsstabilität und Leistung zusammenhängt, wie in Abbildung 7a gezeigt. Die Zunahme der Länge bietet dem Modell einen größeren Explorationsraum und ermöglicht es, komplexere Reasoning-Verhaltensweisen zu sampeln und diese durch das Training allmählich zu verstärken. Es ist jedoch wichtig zu beachten, dass die Länge während des Trainings nicht immer einen kontinuierlichen Aufwärtstrend beibehält. In einigen beträchtlichen Zeiträumen kann sie einen Trend der Stagnation oder sogar des Rückgangs aufweisen, was auch in [2] gezeigt wurde. Wir verwenden die Länge typischerweise zusammen mit der Validierungsgenauigkeit als Indikatoren, um zu beurteilen, ob ein Experiment sich verschlechtert.
- Die Dynamik des Rewards während des Trainings war schon immer einer der entscheidenden Überwachungsindikatoren im Reinforcement Learning, wie in Abbildung 7b gezeigt. In der Mehrzahl unserer Experimente ist der Trend des Reward-Anstiegs relativ stabil und schwankt oder sinkt nicht wesentlich aufgrund von Anpassungen der experimentellen Einstellungen. Dies deutet darauf hin, dass Sprachmodelle bei einem zuverlässigen Reward-Signal die Verteilung des Trainingssets robust anpassen können. Wir stellen jedoch fest, dass der finale Reward auf dem Trainingsset oft nur wenig mit der Genauigkeit auf dem Validierungsset korreliert, was auf Overfitting am Trainingsset hindeutet.
- Die Entropie des Actor-Modells und die Generierungswahrscheinlichkeit hängen mit der Explorationsfähigkeit des Modells zusammen und sind Schlüsselmetriken, die wir in unseren Experimenten genau überwachen. Intuitiv muss die Entropie des Modells innerhalb eines angemessenen Bereichs gehalten werden. Eine übermäßig niedrige Entropie zeigt an, dass die Wahrscheinlichkeitsverteilung zu scharf ist, was zu einem Verlust der Explorationsfähigkeit führt. Umgekehrt ist eine
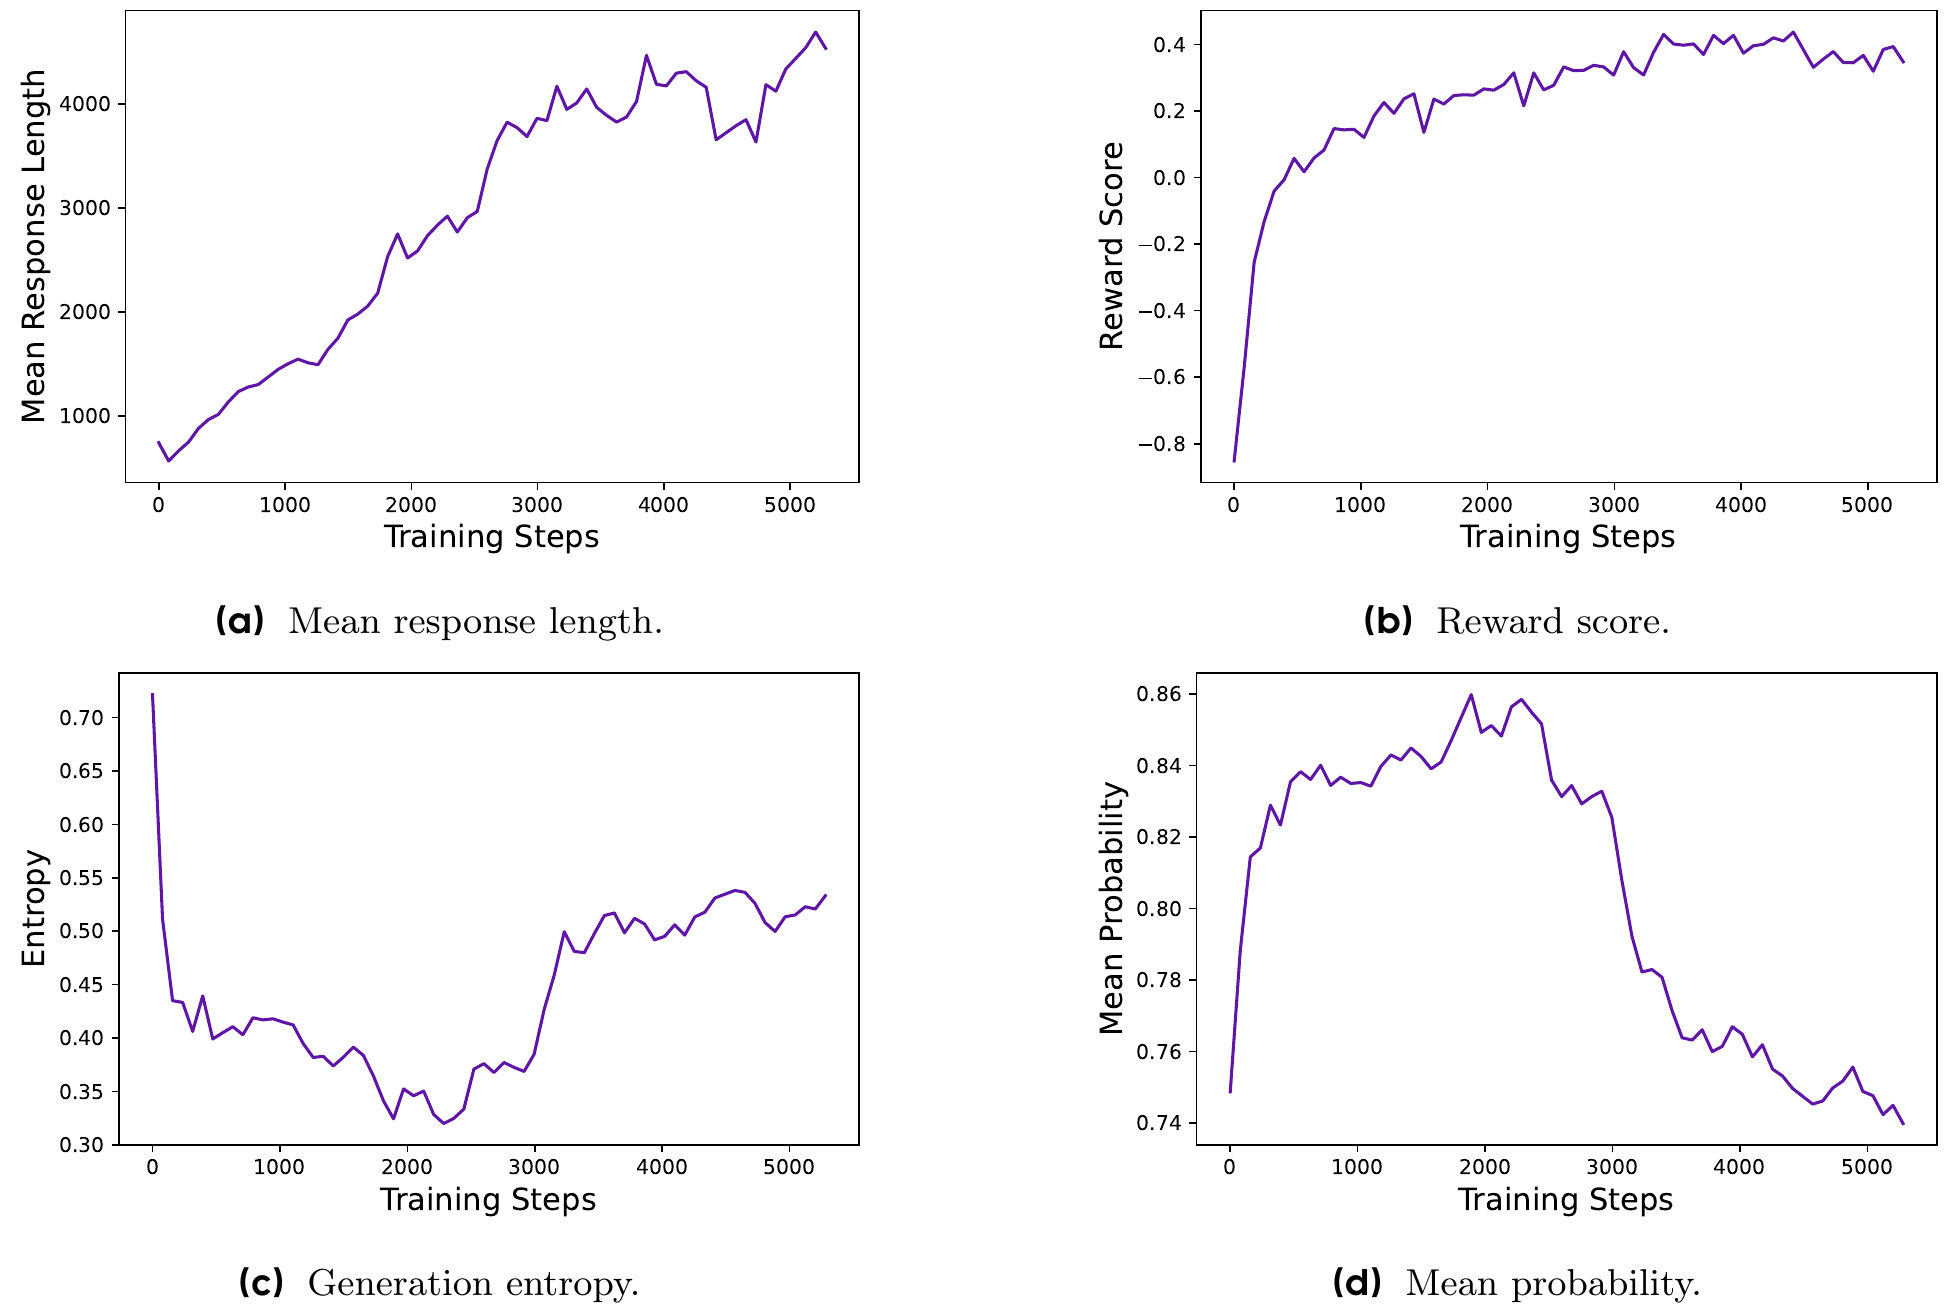
übermäßig hohe Entropie oft mit Problemen der Überexploration wie Kauderwelsch und repetitiver Generierung verbunden. Für die Generierungswahrscheinlichkeit ist die Situation genau umgekehrt. Wie in Abschnitt 3.1 dargelegt, haben wir durch Anwendung der Clip-Higher-Strategie das Problem des Entropiekollapses effektiv behoben. In nachfolgenden Experimenten stellen wir fest, dass die Aufrechterhaltung eines langsamen Aufwärtstrends der Entropie der Verbesserung der Modellleistung zuträglich ist, gezeigt in Abbildung 7c und Abbildung 7d.
4.4 Fallstudie
Während des RL-Trainingsprozesses beobachten wir ein interessantes Phänomen: Die Reasoning-Muster des Actor-Modells entwickeln sich im Laufe der Zeit dynamisch weiter. Konkret verstärkt der Algorithmus nicht nur bestehende Reasoning-Muster, die eine korrekte Problemlösung erleichtern, sondern bringt auch allmählich völlig neue Denkweisen hervor, die anfangs nicht vorhanden waren. Dieser Befund offenbart die Anpassungsfähigkeit und Explorationsfähigkeit von RL-Algorithmen und bietet neue Einblicke in die Lernmechanismen des Modells.
Beispielsweise trat in den frühen Trainingsphasen des Modells praktisch kein Überprüfen und Reflektieren früherer Reasoning-Schritte auf. Mit fortschreitendem Training zeigt das Modell jedoch ausgeprägte Verhaltensweisen des Reflektierens und Zurückverfolgens, wie in Tabelle 2 gezeigt. Diese Beobachtung gibt Aufschluss für weitere Untersuchungen zur Interpretation der Entstehung von Reasoning-Fähigkeiten während des RL, die wir der zukünftigen Forschung überlassen.
5 Fazit
In dieser Arbeit veröffentlichen wir ein vollständig quelloffenes System für großskaliges LLM-RL, einschließlich Algorithmus, Code-Infrastruktur und Datensatz. Das System erreicht eine hochmoderne großskalige LLM-RL-Leistung (AIME 50 mit Qwen-32B-vortrainiertem Modell). Wir schlagen die Decoupled Clip and Dynamic sAmpling Policy vor
Frage:
Da die Basis des Tetraeders ein gleichseitiges Dreieck ist, die Projektion des Punktes auf die Fläche der Orthozentrum von ist, der Diederwinkel beträgt und gilt, finde das Volumen des Tetraeders. Die Antwort hat die Form , gib also den Wert von an.
Antwort:
Betrachten wir das gegebene Problem: Wir müssen bestimmen ... Als Nächstes habe die Koordinaten . Da gilt, liefert uns die Abstandsformel , sodass wir schreiben können. Nun erinnern wir uns daran, dass die orthogonale Projektion von ... ist. Doch warten wir einen Moment, denken wir auf eine durchdachtere geometrische Weise über den Diederwinkel mit Ebenen nach. Betrachten wir die Ebene , die vollständig in der xy-Koordinatenebene liegt (da ). Sei die Ebene . Der Punkt , senkrecht auf die Ebene projiziert, landet auf . Die Gerade ......
Tabelle 2: Emergenz von reflektierendem Verhalten im Reinforcement-Learning-Optimierungsalgorithmus (DAPO), und wir führen 4 Schlüsseltechniken ein, um RL im Lang-CoT-RL-Szenario wirkungsvoll und effizient zu machen. Darüber hinaus bieten wir durch die Open-Source-Veröffentlichung des Trainingscodes und des Datensatzes der breiteren Forschungsgemeinschaft und Gesellschaft praktischen Zugang zu einer skalierbaren Reinforcement-Learning-Lösung und ermöglichen es allen, von diesen Fortschritten zu profitieren.
Beiträge
Projektleitung
Qiying
Algorithmus
Qiying , Zheng Zhang , Ruofei Zhu , Yufeng Yuan , Xiaochen Zuo , Yu Yue
Infrastruktur\*
Weinan Dai , Tiantian Fan , Gaohong Liu , Juncai Liu , Lingjun Liu , Xin Liu , Haibin Lin , Zhiqi Lin , Bole Ma , Guangming Sheng , Yuxuan Tong , Qiying Yu , Chi Zhang , Mofan Zhang , Ru Zhang , Wang Zhang , Hang Zhu , Jinhua Zhu
\*Nachname in alphabetischer Reihenfolge
Datensatz
Jiaze Chen , Jiangjie Chen , Chengyi Wang , Hongli Yu , Yuxuan Song , Xiangpeng Wei , Qiying
Aufsicht
Hao Zhou , Jingjing Liu , Wei- Ying Ma , Ya- Qin Zhang , Lin Yan , Mu Qiao , Yonghui Wu , Mingxuan Wang
Zugehörigkeit
ByteDance Seed
Institute for AI Industry Research (AIR), Tsinghua University
The University of Hong Kong
SIA- Lab of Tsinghua AIR and ByteDance Seed
Danksagungen
Wir danken Zhengyin Du, Shengding Hu, Kai Shen, Tianyang Zhan, Zhen Xiao, Renjie Zheng, Li Han, Kaihua Jiang sowie weiteren Kolleginnen und Kollegen bei ByteDance für ihre Unterstützung des DAPO-Projekts.
Literaturverzeichnis
[1] OpenAI. Learning to reason with llms, 2024.
[2] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
[3] OpenAI. GPT4 technical report. arXiv preprint arXiv:2303.08774, 2023.
[4] Anthropic. Claude 3.5 sonnet, 2024.
[5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877-1901, 2020.
[6] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. Journal of Machine Learning Research, 24(240):1-113, 2023.
[7] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Deepseek-v3 technical report. arXiv preprint arXiv:2412.19437, 2024.
[8] XAI. Grok 3 beta — the age of reasoning agents, 2024.
[9] Google DeepMind. Gemini 2.0 flash thinking, 2024.
[10] Qwen. Qwq-32b: Embracing the power of reinforcement learning, 2024.
[11] Kimi Team, Angang Du, Bofei Gao, Bowei Xing, Changjiu Jiang, Cheng Chen, Cheng Li, Chenjun Xiao, Chenzhuang Du, Chonghua Liao, et al. Kimi k1.5: Scaling reinforcement learning with llms. arXiv preprint arXiv:2501.12599, 2025.
[12] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115, 2024.
[13] Zhipeng Chen, Yingqian Min, Beichen Zhang, Jie Chen, Jinhao Jiang, Daixuan Cheng, Wayne Xin Zhao, Zheng Liu, Xu Miao, Yang Lu, et al. An empirical study on eliciting and improving rl-like reasoning models. arXiv preprint arXiv:2503.04548, 2025.
[14] Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, and Heung-Yeung Shum Xiangyu Zhang. Open-reasoner-zero: An open source approach to scaling reinforcement learning on the base model. https://github.com/Open-Reasoner-Zero/Open-Reasoner-Zero, 2025.
[15] Jian Hu. Reinforce++: A simple and efficient approach for aligning large language models. arXiv preprint arXiv:2501.03262, 2025.
[16] Ganqu Cui, Lifan Yuan, Zefan Wang, Hanbin Wang, Wendi Li, Bingxiang He, Yuchen Fan, Tianyu Yu, Qixin Xu, Weize Chen, et al. Process reinforcement through implicit rewards. arXiv preprint arXiv:2502.01456, 2025.
[17] Jung Hyun Lee, June Yong Yang, Byeongho Heo, Dongyoon Han, and Kang Min Yoo. Token-supervised value models for enhancing mathematical reasoning capabilities of large language models. arXiv preprint arXiv:2407.12863, 2024.
[18] Amirhossein Kazemnejad, Milad Aghajohari, Eva Portelance, Alessandro Sordoni, Siva Reddy, Aaron Courville, and Nicolas Le Roux. Vineppo: Unlocking rl potential for llm reasoning through refined credit assignment. arXiv preprint arXiv:2410.01679, 2024.
[19] Yufeng Yuan, Yu Yue, Ruofei Zhu, Tiantian Fan, and Lin Yan. What's behind ppo's collapse in long-cot? value optimization holds the secret. arXiv preprint arXiv:2503.01491, 2025.
[20] Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, and Chuan Wu. Hybridflow: A flexible and efficient rlhf framework. arXiv preprint arXiv:2409.19256, 2024.
[21] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
[22] John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, and Pieter Abbeel. High-dimensional continuous control using generalized advantage estimation, 2018.
[23] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F Christiano, Jan Leike, and Ryan Lowe. Training language models to follow instructions with human feedback. In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, and A. Oh, editors, Advances in Neural Information Processing Systems, volume 35, pages 27730-27744. Curran Associates, Inc., 2022.
[24] Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, and Dan Mane. Concrete problems in ai safety, 2016.
[25] Tom Everitt, Victoria Krakovna, Laurent Orseau, Marcus Hutter, and Shane Legg. Reinforcement learning with a corrupted reward channel, 2017.
[26] Victoria Krakovna, Jonathan Uesato, Vladimir Mikulik, Matthew Rahtz, Tom Everitt, Ramana Kumar, Zac Kenton, Jan Leike, and Shane Legg. Specification gaming: the flip side of ai ingenuity, 2020.
[27] Tom Everitt, Marcus Hutter, Ramana Kumar, and Victoria Krakovna. Reward tampering problems and solutions in reinforcement learning: A causal influence diagram perspective, 2021.
[28] Leo Gao, John Schulman, and Jacob Hilton. Scaling laws for reward model overoptimization, 2022.
[29] Lilian Weng. Reward hacking in reinforcement learning. lilianweng.github.io, Nov 2024.
[30] Stanislas Polu and Ilya Sutskever. Generative language modeling for automated theorem proving, 2020.
[31] Trieu H Trinh, Yuhuai Wu, Quoc V Le, He He, and Thang Luong. Solving olympiad geometry without human demonstrations. Nature, 625(7995):476-482, 2024.
[32] Trieu Trinh and Thang Luong. Alphageometry: An olympiad-level ai system for geometry, 2024.
[33] AlphaProof and AlphaGeometry Teams. Ai achieves silver-medal standard solving international mathematical olympiad problems, 2024.
[34] Hung Le, Yue Wang, Akhilesh Deepak Gotmare, Silvio Savarese, and Steven Chu Hong Hoi. Coderl: Mastering code generation through pretrained models and deep reinforcement learning. Advances in Neural Information Processing Systems, 35:21314-21328, 2022.
[35] Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning, 2023.
[36] Xinyun Chen, Maxwell Lin, Nathanael Schärli, and Denny Zhou. Teaching large language models to self-debug, 2023.
[37] Jonas Gehring, Kunhao Zheng, Jade Copet, Vegard Mella, Quentin Carbonneaux, Taco Cohen, and Gabriel Synnaeve. Rlcf: Grounding code llms in execution feedback with reinforcement learning, 2025.
[38] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, YK Li, Y Wu, and Daya Guo. Deepseekmath: Pushing the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
[39] Ilya Loshchilov und Frank Hutter. Decoupled weight decay regularization. In International Conference on Learning Representations, 2019.
Anhang
A Datentransformation
Hier ist ein Beispiel einer Datentransformation, bei der wir das ursprüngliche Problem, das transformierte Problem und die Modellausgaben während des Transformationsprozesses zeigen (das Original liegt in Markdown-Text vor, der zur besseren Lesbarkeit gerendert wurde).
Um sicherzustellen, dass das Modell diese Aufgabe mit hoher Genauigkeit erledigen kann, besteht unser Ziel darin, dass es eine umfassende Argumentation durchführt und dabei Halluzinationen vermeidet. Dies erreichen wir, indem wir einen klaren Denkrahmen bereitstellen, der eine gründliche Argumentation fördert. Konkret verwenden wir Chain-of-Thought-(CoT-)Argumentation zusammen mit vier klar definierten Schritten: das Antwortformat extrahieren, die Problemstellung umschreiben, das modifizierte Problem lösen und eine ganze Zahl als endgültige Antwort angeben. Für jeden Schritt stellen wir Few-Shot-Lösungen oder detaillierte Richtlinien bereit, um die Argumentation des Modells zu lenken.
Durch diesen Ansatz haben wir beobachtet, dass das LLM in den meisten Fällen Umformulierungen erzeugen kann, deren Format und Qualität zufriedenstellend sind.
Ursprüngliches Problem
Seien und reelle Zahlen, sodass . Bestimmen Sie den kleinstmöglichen Wert von . Antwort:
Transformiertes Problem
Lassen Sie und reelle Zahlen sein, sodass . Bestimmen Sie den kleinstmöglichen Wert von . Die ursprüngliche Antwort hat die Form , wobei , und ganze Zahlen sind. Bitte finden Sie den Wert von . Antwort: 19
Modellausgabe (Markdown-Text)
Gedankengang zur Transformation
Die ursprüngliche Antwort auf das Problem ist ein algebraischer Ausdruck . Wir müssen diesen in eine ganzzahlige Form transformieren. Zunächst beachten wir, dass die Antwort aus einem ganzzahligen Teil und einem Quadratwurzelterm besteht. Gemäß der gegebenen Regel ersetzen wir die ganzzahligen und Quadratwurzel-Komponenten durch unbestimmte Koeffizienten. Das ursprüngliche Problem verwendet und als Variablen, daher wählen wir andere Buchstaben als unbestimmte Koeffizienten. Wir drücken die Antwort in der Form aus und verlangen von den Schülern, zu finden.
Antwortformat
Transformiertes Problem
Lassen Sie und reelle Zahlen sein, sodass . Bestimmen Sie den kleinstmöglichen Wert von . Die ursprüngliche Antwort hat die Form , wobei , und ganze Zahlen sind. Bitte finden Sie den Wert von .
Berechnung der Antwort für das transformierte Problem
Die ursprüngliche Antwort ist: . Das erforderliche Format ist: . Durch Abgleich der Koeffizienten: , , . Das Endergebnis ist: .
Endgültige Antwort
B Zusatzfall
Frage:
Unter den 900 Einwohnern von Aimeville besitzen 195 einen Diamantring, 367 einen Satz Golfschläger und 562 einen Gartenspaten. Darüber hinaus besitzt jeder der 900 Einwohner eine Tüte mit Zuckerherzen. Es gibt 437 Einwohner, die genau zwei dieser Dinge besitzen, und 234 Einwohner, die genau drei dieser Dinge besitzen. Finden Sie die Anzahl der Einwohner von Aimeville, die alle vier dieser Dinge besitzen.
Antwort:
Schritt-für-Schritt-Lösung:
1. Definieren wir die folgenden Variablen:
Sei die Menge der Einwohner, die einen Diamantring besitzen.
Sei die Menge der Einwohner, die einen Satz Golfschläger besitzen.
Sei die Menge der Einwohner, die einen Gartenspaten besitzen.
Sei die Menge der Einwohner, die eine Tüte mit Zuckerherzen besitzen. Da alle 900 Einwohner eine Tüte mit Zuckerherzen besitzen, gilt
Sei die Anzahl der Einwohner, die genau der 4 Dinge besitzen.
Verwenden wir das Prinzip der Inklusion-Exklusion für die Vereinigung von 4 Mengen
...
Da , die Anzahl der Personen, die alle vier Dinge besitzen, eine ganze Zahl sein muss, muss unser aktueller Ansatz im Hinblick auf die kombinatorische Zählung der Personen, die verschiedene Kombinationen der Dinge besitzen, überdacht werden.
Anstatt direkt das Prinzip der Inklusion-Exklusion zu verwenden, können wir einen anderen Ansatz verwenden, der die Anzahl der Personen einbezieht, die Kombinationen der Dinge , , und besitzen.
Sei die Anzahl der Personen, die genau Dinge unter , , besitzen (mit Ausnahme des Dings , das jeder besitzt).
Dann kann die Gesamtzahl der Personen, die genau Dinge unter , , und besitzen, wie folgt aufgeschlüsselt werden:
...
Tabelle 3 Ein Fall der Entstehung reflexiven Verhaltens.