Self-Attention statt Rekurrenz und Faltung: der Transformer. Das NIPS-Papier von 2017, das moderne Sprachmodelle begründet hat, kostenlos online lesen.
Vorausgesetzt, dass eine ordnungsgemäße Quellenangabe erfolgt, gewährt Google hiermit die Erlaubnis, die Tabellen und Abbildungen in diesem Beitrag ausschließlich für journalistische oder wissenschaftliche Arbeiten zu reproduzieren.
Attention Is All You Need
Ashish Vaswani* Google Brain avaswani@google.com
Noam Shazeer* Google Brain noam@google.com
Niki Parmar* Google Research nikip@google.com
Jakob Uszkoreit* Google Research usz@google.com
Llion Jones* Google Research llion@google.com
Aidan N. Gomez*† University of Toronto aidan@cs.toronto.edu
Lukasz Kaiser* Google Brain lukaszkaiser@google.com
Illia Polosukhin*† illia.polosukhin@gmail.com
Abstract
Die dominierenden Sequenztransduktionsmodelle basieren auf komplexen rekurrenten oder konvolutionalen neuronalen Netzen, die einen Encoder und einen Decoder umfassen. Die leistungsstärksten Modelle verbinden Encoder und Decoder zudem über einen Attention-Mechanismus. Wir schlagen eine neue einfache Netzwerkarchitektur vor, den Transformer, der ausschließlich auf Attention-Mechanismen basiert und Rekurrenz sowie Konvolutionen vollständig aufgibt. Experimente mit zwei maschinellen Übersetzungsaufgaben zeigen, dass diese Modelle qualitativ überlegen sind, während sie stärker parallelisierbar sind und deutlich weniger Trainingszeit benötigen. Unser Modell erreicht 28,4 BLEU bei der Übersetzungsaufgabe Englisch–Deutsch von WMT 2014 und verbessert damit die bestehenden besten Ergebnisse, einschließlich Ensembles, um über 2 BLEU. Bei der Übersetzungsaufgabe Englisch–Französisch von WMT 2014 erzielt unser Modell nach einem Training von 3,5 Tagen auf acht GPUs einen neuen Single-Model-State-of-the-Art-BLEU-Wert von 41,8, was nur einen kleinen Bruchteil der Trainingskosten der besten Modelle aus der Literatur ausmacht. Wir zeigen, dass der Transformer gut auf andere Aufgaben generalisiert, indem wir ihn erfolgreich sowohl mit großen als auch mit begrenzten Trainingsdaten auf die englische Konstituentenanalyse anwenden.
1 Einleitung
Rekurrente neuronale Netze, insbesondere Long Short-Term Memory [13] und gated recurrent [7] neuronale Netze, haben sich fest als State-of-the-Art-Ansätze für Sequenzmodellierung und Transduktionsprobleme wie Sprachmodellierung und maschinelle Übersetzung etabliert [35] [2] [5]. Zahlreiche Arbeiten haben seitdem die Grenzen rekurrenter Sprachmodelle und Encoder-Decoder-Architekturen weiter verschoben [38] [24] [15].
Rekurrente Modelle faktorisieren die Berechnung typischerweise entlang der Symbolpositionen der Eingabe- und Ausgabesequenzen. Indem sie die Positionen auf Schritte in der Berechnungszeit ausrichten, erzeugen sie eine Sequenz verborgener Zustände als Funktion des vorherigen verborgenen Zustands und der Eingabe für Position . Diese inhärent sequenzielle Natur schließt eine Parallelisierung innerhalb von Trainingsbeispielen aus, was bei längeren Sequenzlängen kritisch wird, da Speicherbeschränkungen die Bündelung über Beispiele hinweg begrenzen. Neuere Arbeiten haben durch Faktorisierungstricks [21] und bedingte Berechnung [32] signifikante Verbesserungen der Recheneffizienz erzielt und im letzteren Fall auch die Modellleistung verbessert. Die grundlegende Einschränkung der sequenziellen Berechnung bleibt jedoch bestehen.
Attention-Mechanismen sind zu einem integralen Bestandteil überzeugender Sequenzmodellierungs- und Transduktionsmodelle in verschiedenen Aufgaben geworden und ermöglichen die Modellierung von Abhängigkeiten unabhängig von ihrer Entfernung in den Eingabe- oder Ausgabesequenzen [2] [19]. In allen bis auf wenige Fälle [27] werden solche Attention-Mechanismen jedoch in Verbindung mit einem rekurrenten Netz verwendet.
In dieser Arbeit schlagen wir den Transformer vor, eine Modellarchitektur, die Rekurrenz vermeidet und stattdessen vollständig auf einem Attention-Mechanismus beruht, um globale Abhängigkeiten zwischen Eingabe und Ausgabe zu erfassen. Der Transformer ermöglicht eine deutlich stärkere Parallelisierung und kann nach einem Training von nur zwölf Stunden auf acht P100 GPUs einen neuen State of the Art in der Übersetzungsqualität erreichen.
2 Hintergrund
Das Ziel, sequenzielle Berechnung zu reduzieren, bildet auch die Grundlage der Extended Neural GPU [16], ByteNet [18] und ConvS2S [9], die alle konvolutionale neuronale Netze als grundlegenden Baustein verwenden und verborgene Repräsentationen für alle Eingabe- und Ausgabepositionen parallel berechnen. In diesen Modellen wächst die Anzahl der Operationen, die erforderlich ist, um Signale von zwei beliebigen Eingabe- oder Ausgabepositionen in Beziehung zu setzen, mit der Entfernung zwischen den Positionen, linear für ConvS2S und logarithmisch für ByteNet. Dies macht es schwieriger, Abhängigkeiten zwischen weit entfernten Positionen zu lernen [12]. Im Transformer wird dies auf eine konstante Anzahl von Operationen reduziert, allerdings auf Kosten einer verringerten effektiven Auflösung aufgrund der Mittelung attention-gewichteter Positionen, ein Effekt, dem wir mit Multi-Head-Attention entgegenwirken, wie in Abschnitt [3.2] beschrieben.
Self-Attention, manchmal auch Intra-Attention genannt, ist ein Attention-Mechanismus, der verschiedene Positionen einer einzelnen Sequenz zueinander in Beziehung setzt, um eine Repräsentation der Sequenz zu berechnen. Self-Attention wurde erfolgreich in einer Vielzahl von Aufgaben eingesetzt, darunter Leseverstehen, abstraktive Zusammenfassung, Textimplikation und das Lernen aufgabenunabhängiger Satzrepräsentationen [4] [27] [28] [22].
End-to-End-Memory-Netzwerke basieren auf einem rekurrenten Attention-Mechanismus statt auf sequenzausgerichteter Rekurrenz und haben gezeigt, dass sie bei Aufgaben zur Fragebeantwortung in einfacher Sprache und zur Sprachmodellierung gut abschneiden [34].
Nach unserem besten Wissen ist der Transformer jedoch das erste Transduktionsmodell, das vollständig auf Self-Attention beruht, um Repräsentationen seiner Eingabe und Ausgabe zu berechnen, ohne sequenzausgerichtete RNNs oder Konvolution zu verwenden. In den folgenden Abschnitten beschreiben wir den Transformer, begründen Self-Attention und diskutieren seine Vorteile gegenüber Modellen wie [17] [18] und [9].
3 Modellarchitektur
Die meisten wettbewerbsfähigen neuronalen Sequenztransduktionsmodelle haben eine Encoder-Decoder-Struktur [5] [2] [35]. Hier bildet der Encoder eine Eingabesequenz von Symbolrepräsentationen auf eine Sequenz kontinuierlicher Repräsentationen ab. Gegeben , erzeugt der Decoder dann eine Ausgabesequenz von Symbolen, jeweils ein Element nach dem anderen. Bei jedem Schritt ist das Modell auto-regressiv [10] und verwendet die zuvor erzeugten Symbole als zusätzliche Eingabe, wenn es das nächste erzeugt.
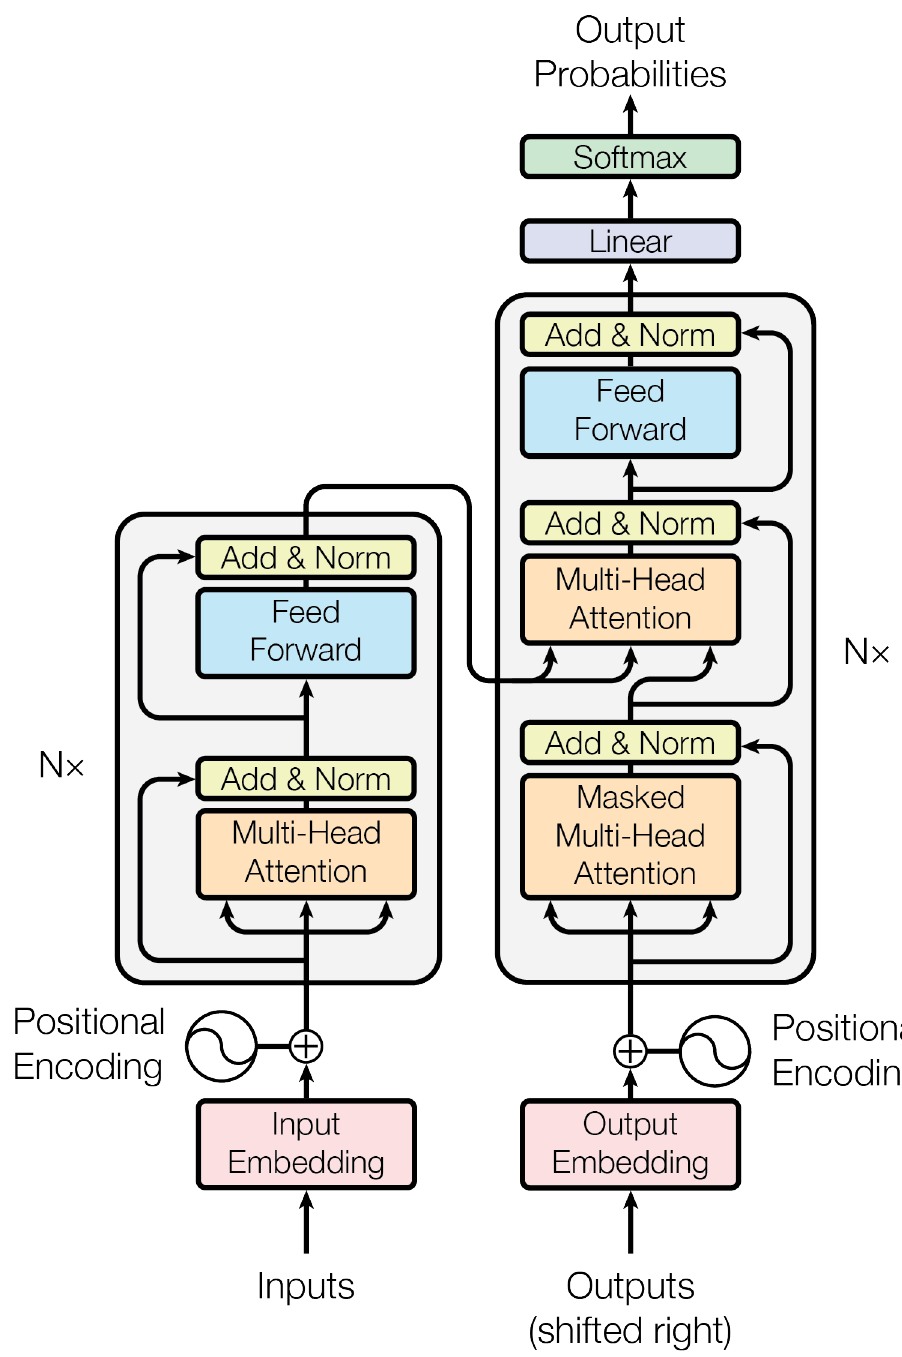
Der Transformer folgt dieser Gesamtarchitektur und verwendet gestapelte Self-Attention- und punktweise, vollständig verbundene Schichten sowohl für den Encoder als auch für den Decoder, die in der linken bzw. rechten Hälfte von Abbildung [1] dargestellt sind.
3.1 Encoder- und Decoder-Stapel
Encoder: Der Encoder besteht aus einem Stapel von identischen Schichten. Jede Schicht hat zwei Teilschichten. Die erste ist ein Multi-Head-Self-Attention-Mechanismus, und die zweite ist ein einfaches, positionsweises vollständig verbundenes Feed-Forward-Netzwerk. Wir verwenden eine Residualverbindung [11] um jede der beiden Teilschichten, gefolgt von Layer-Normalisierung [1]. Das heißt, die Ausgabe jeder Teilschicht ist , wobei die von der Teilschicht selbst implementierte Funktion ist. Um diese Residualverbindungen zu erleichtern, erzeugen alle Teilschichten im Modell sowie die Embedding-Schichten Ausgaben der Dimension .
Decoder: Der Decoder besteht ebenfalls aus einem Stapel von identischen Schichten. Zusätzlich zu den zwei Teilschichten in jeder Encoder-Schicht fügt der Decoder eine dritte Teilschicht ein, die Multi-Head-Attention über die Ausgabe des Encoder-Stapels ausführt. Ähnlich wie beim Encoder verwenden wir Residualverbindungen um jede der Teilschichten, gefolgt von Layer-Normalisierung. Wir modifizieren außerdem die Self-Attention-Teilschicht im Decoder-Stapel, um zu verhindern, dass Positionen auf nachfolgende Positionen achten. Diese Maskierung gewährleistet zusammen mit der Tatsache, dass die Ausgabe-Embeddings um eine Position versetzt sind, dass die Vorhersagen für Position nur von den bekannten Ausgaben an Positionen kleiner als abhängen können.
3.2 Attention
Eine Attention-Funktion kann als Abbildung einer Query und einer Menge von Key-Value-Paaren auf eine Ausgabe beschrieben werden, wobei Query, Keys, Values und Ausgabe alle Vektoren sind. Die Ausgabe wird als gewichtete Summe
der Values berechnet, wobei das jeder Value zugewiesene Gewicht durch eine Kompatibilitätsfunktion der Query mit dem entsprechenden Key berechnet wird.
3.2.1 Skalierte Dot-Product-Attention
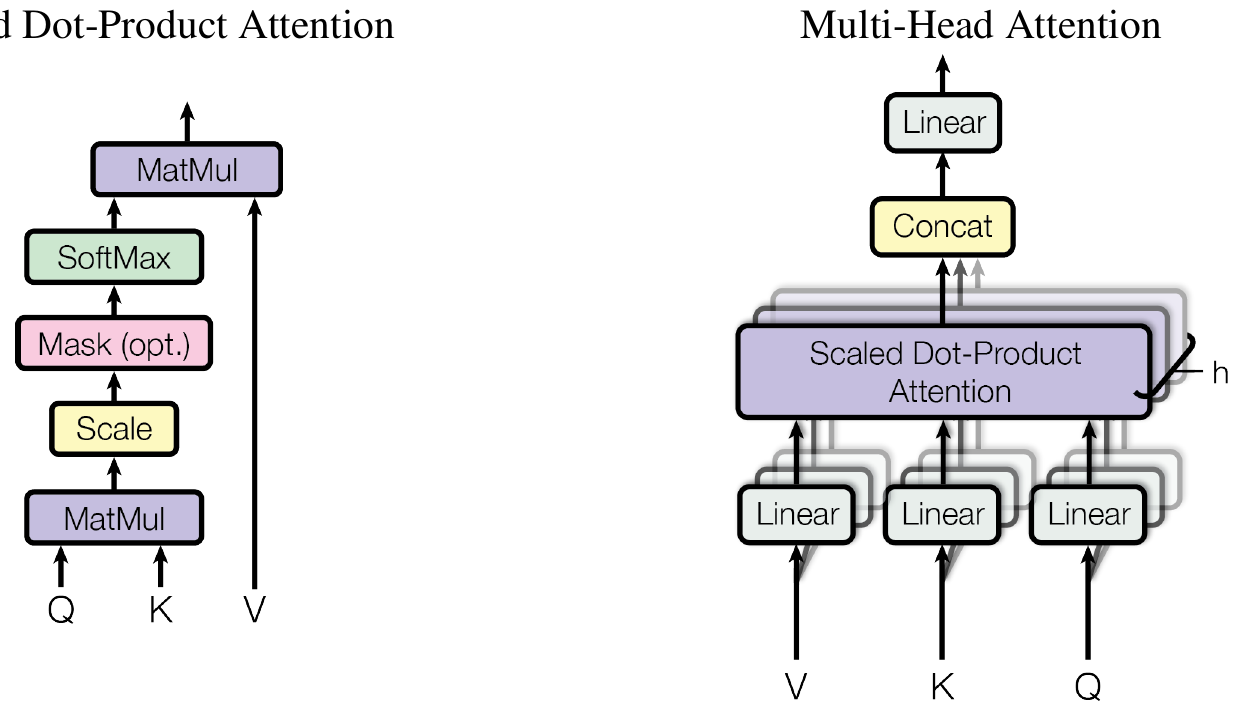
Wir nennen unsere spezielle Aufmerksamkeit „Scaled Dot-Product Attention“ (Abbildung 2). Die Eingabe besteht aus Abfragen und Schlüsseln der Dimension sowie Werten der Dimension . Wir berechnen die Skalarprodukte der Abfrage mit allen Schlüsseln, teilen jedes durch und wenden eine Softmax-Funktion an, um die Gewichte auf den Werten zu erhalten.
In der Praxis berechnen wir die Aufmerksamkeitsfunktion für eine Menge von Abfragen gleichzeitig, die zu einer Matrix zusammengepackt sind. Die Schlüssel und Werte werden ebenfalls zu den Matrizen und zusammengepackt. Wir berechnen die Matrix der Ausgaben als:
Die beiden am häufigsten verwendeten Aufmerksamkeitsfunktionen sind die additive Aufmerksamkeit 2 und die Skalarprodukt- (multiplikative) Aufmerksamkeit. Die Skalarprodukt-Aufmerksamkeit ist mit unserem Algorithmus identisch, abgesehen vom Skalierungsfaktor . Die additive Aufmerksamkeit berechnet die Kompatibilitätsfunktion unter Verwendung eines Feed-Forward-Netzwerks mit einer einzigen verborgenen Schicht. Während die beiden in ihrer theoretischen Komplexität ähnlich sind, ist die Skalarprodukt-Aufmerksamkeit in der Praxis viel schneller und speichereffizienter, da sie mit hochoptimiertem Matrixmultiplikationscode implementiert werden kann.
Während für kleine Werte von die beiden Mechanismen ähnlich abschneiden, übertrifft die additive Aufmerksamkeit die Skalarprodukt-Aufmerksamkeit ohne Skalierung für größere Werte von [3]. Wir vermuten, dass für große Werte von die Skalarprodukte betragsmäßig groß werden und die Softmax-Funktion in Bereiche drücken, in denen sie extrem kleine Gradienten hat. Um diesem Effekt entgegenzuwirken, skalieren wir die Skalarprodukte um .
3.2.2 Multi-Head Attention
Anstatt eine einzelne Aufmerksamkeitsfunktion mit -dimensionalen Schlüsseln, Werten und Abfragen durchzuführen, fanden wir es vorteilhaft, die Abfragen, Schlüssel und Werte Mal mit unterschiedlichen, gelernten linearen Projektionen linear auf jeweils -, - und -Dimensionen zu projizieren. Auf jeder dieser projizierten Versionen von Abfragen, Schlüsseln und Werten führen wir dann die Aufmerksamkeitsfunktion parallel aus, was -dimensionale Ausgabewerte liefert. Diese werden konkateniert und erneut projiziert, was die endgültigen Werte ergibt, wie in Abbildung 2 dargestellt
Multi-Head-Attention ermöglicht es dem Modell, gemeinsam auf Informationen aus verschiedenen Repräsentationsunterräumen an unterschiedlichen Positionen zuzugreifen. Mit einem einzelnen Attention-Kopf wird dies durch Mittelung verhindert.
Wobei die Projektionen Parametermatrizen , , und sind.
In dieser Arbeit verwenden wir parallele Attention-Schichten bzw. -Köpfe. Für jeden von ihnen verwenden wir . Aufgrund der reduzierten Dimension jedes Kopfes ist der gesamte Rechenaufwand ähnlich dem der Single-Head-Attention mit voller Dimensionalität.
3.2.3 Anwendungen von Attention in unserem Modell
Der Transformer verwendet Multi-Head-Attention auf drei verschiedene Arten:
- In „Encoder-Decoder-Attention“-Schichten stammen die Queries aus der vorherigen Decoder-Schicht, und die Memory-Keys und -Values stammen aus der Ausgabe des Encoders. Dies ermöglicht es jeder Position im Decoder, auf alle Positionen in der Eingabesequenz zu attendieren. Dies ahmt die typischen Encoder-Decoder-Attention-Mechanismen in Sequenz-zu-Sequenz-Modellen wie [38] [2] [9] nach.
- Der Encoder enthält Self-Attention-Schichten. In einer Self-Attention-Schicht stammen alle Keys, Values und Queries vom selben Ort, in diesem Fall von der Ausgabe der vorherigen Schicht im Encoder. Jede Position im Encoder kann auf alle Positionen in der vorherigen Schicht des Encoders attendieren.
- In ähnlicher Weise ermöglichen Self-Attention-Schichten im Decoder jeder Position im Decoder, auf alle Positionen im Decoder bis einschließlich dieser Position zu attendieren. Wir müssen einen Informationsfluss nach links im Decoder verhindern, um die autoregressive Eigenschaft zu bewahren. Wir implementieren dies innerhalb der skalierten Dot-Product-Attention, indem wir alle Werte in der Eingabe der Softmax-Funktion maskieren (auf setzen), die unzulässigen Verbindungen entsprechen. Siehe Abbildung [2]
3.3 Positionsweise Feed-Forward-Netzwerke
Zusätzlich zu den Attention-Subschichten enthält jede der Schichten in unserem Encoder und Decoder ein vollständig verbundenes Feed-Forward-Netzwerk, das auf jede Position separat und identisch angewendet wird. Dies besteht aus zwei linearen Transformationen mit einer ReLU-Aktivierung dazwischen.
Während die linearen Transformationen über verschiedene Positionen hinweg gleich sind, verwenden sie von Schicht zu Schicht unterschiedliche Parameter. Eine andere Beschreibungsweise ist die als zwei Faltungen mit Kernelgröße 1. Die Dimensionalität von Eingabe und Ausgabe ist , und die innere Schicht hat die Dimensionalität .
3.4 Embeddings und Softmax
Ähnlich wie bei anderen Sequenztransduktionsmodellen verwenden wir gelernte Embeddings, um die Eingabe-Tokens und Ausgabe-Tokens in Vektoren der Dimension umzuwandeln. Wir verwenden außerdem die übliche gelernte lineare Transformation und Softmax-Funktion, um die Decoder-Ausgabe in vorhergesagte Wahrscheinlichkeiten für das nächste Token umzuwandeln. In unserem Modell teilen wir dieselbe Gewichtsmatrix zwischen den beiden Embedding-Schichten und der linearen Transformation vor der Softmax, ähnlich wie [30]. In den Embedding-Schichten multiplizieren wir diese Gewichte mit .
| Schichttyp | Komplexität pro Schicht | Sequenzielle Operationen | Maximale Pfadlänge |
| Selbstaufmerksamkeit | O(n²·d) | O(1) | O(1) |
| Rekurrent | O(n·d²) | O(n) | O(n) |
| Konvolutional | O(k·n·d²) | O(1) | O(logk(n)) |
| Selbstaufmerksamkeit (eingeschränkt) | O(r·n·d) | O(1) | O(n/r) |
3.5 Positionskodierung
Da unser Modell weder Rekurrenz noch Faltung enthält, müssen wir, damit das Modell die Reihenfolge der Sequenz nutzen kann, einige Informationen über die relative oder absolute Position der Tokens in der Sequenz injizieren. Zu diesem Zweck fügen wir den Eingabe-Embeddings an den unteren Enden der Encoder- und Decoder-Stapel „Positionskodierungen“ hinzu. Die Positionskodierungen haben dieselbe Dimension wie die Embeddings, sodass beide summiert werden können. Es gibt viele Möglichkeiten für Positionskodierungen, gelernte und feste [9].
In dieser Arbeit verwenden wir Sinus- und Kosinusfunktionen unterschiedlicher Frequenzen:
wobei die Position und die Dimension ist. Das heißt, jede Dimension der Positionskodierung entspricht einer Sinuskurve. Die Wellenlängen bilden eine geometrische Progression von bis . Wir wählten diese Funktion, weil wir die Hypothese aufstellten, dass sie es dem Modell ermöglichen würde, leicht zu lernen, nach relativen Positionen zu attendieren, da für jeden festen Offset als lineare Funktion von dargestellt werden kann.
Wir haben auch mit der Verwendung gelernter Positions-Embeddings [9] experimentiert und festgestellt, dass die beiden Versionen nahezu identische Ergebnisse erzielten (siehe Tabelle 3, Zeile (E)). Wir wählten die sinusförmige Version, weil sie es dem Modell ermöglichen könnte, auf Sequenzlängen zu extrapolieren, die länger sind als die während des Trainings angetroffenen.
4 Warum Self-Attention
In diesem Abschnitt vergleichen wir verschiedene Aspekte von Self-Attention-Schichten mit den rekurrenten und konvolutionalen Schichten, die üblicherweise verwendet werden, um eine Sequenz variabler Länge von Symbolrepräsentationen auf eine andere Sequenz gleicher Länge abzubilden, mit , wie etwa eine versteckte Schicht in einem typischen Sequenztransduktions-Encoder oder -Decoder. Zur Begründung unserer Verwendung von Self-Attention betrachten wir drei erstrebenswerte Eigenschaften.
Eine ist die gesamte rechnerische Komplexität pro Schicht. Eine andere ist die Menge an Berechnung, die parallelisiert werden kann, gemessen an der minimal erforderlichen Anzahl sequenzieller Operationen.
Die dritte ist die Pfadlänge zwischen weitreichenden Abhängigkeiten im Netzwerk. Das Lernen weitreichender Abhängigkeiten ist eine zentrale Herausforderung in vielen Sequenztransduktionsaufgaben. Ein wesentlicher Faktor, der die Fähigkeit beeinflusst, solche Abhängigkeiten zu lernen, ist die Länge der Pfade, die Vorwärts- und Rückwärtssignale im Netzwerk durchlaufen müssen. Je kürzer diese Pfade zwischen jeder beliebigen Kombination von Positionen in den Eingabe- und Ausgabesequenzen sind, desto leichter ist es, weitreichende Abhängigkeiten zu lernen [12]. Daher vergleichen wir auch die maximale Pfadlänge zwischen zwei beliebigen Eingabe- und Ausgabepositionen in Netzwerken, die aus den verschiedenen Schichttypen bestehen.
Wie in Tabelle 1 erwähnt, verbindet eine Self-Attention-Schicht alle Positionen mit einer konstanten Anzahl sequenziell ausgeführter Operationen, wohingegen eine rekurrente Schicht sequenzielle Operationen erfordert. Hinsichtlich der rechnerischen Komplexität sind Self-Attention-Schichten schneller als rekurrente Schichten, wenn die Sequenzlänge kleiner ist als die Repräsentationsdimensionalität , was bei Satzrepräsentationen, die von modernsten Modellen in der maschinellen Übersetzung verwendet werden, wie Word-Piece- [38] und Byte-Pair-Repräsentationen [31], meistens der Fall ist. Um die Rechenleistung für Aufgaben mit sehr langen Sequenzen zu verbessern, könnte Self-Attention darauf beschränkt werden, nur eine Nachbarschaft der Größe in der Eingabesequenz zu betrachten, die um die jeweilige Ausgabeposition zentriert ist. Dies würde die maximale Pfadlänge auf erhöhen. Wir planen, diesen Ansatz in zukünftiger Arbeit weiter zu untersuchen.
Eine einzelne Faltungsschicht mit Kernelbreite verbindet nicht alle Paare von Eingabe- und Ausgabepositionen. Dafür ist ein Stapel von Faltungsschichten erforderlich, im Fall zusammenhängender Kernel, oder im Fall dilatierter Faltungen [18], wodurch die Länge der längsten Pfade zwischen zwei beliebigen Positionen im Netzwerk erhöht wird. Faltungsschichten sind im Allgemeinen um einen Faktor teurer als rekurrente Schichten. Separierbare Faltungen [6] verringern jedoch die Komplexität erheblich, auf . Selbst mit ist die Komplexität einer separierbaren Faltung jedoch gleich der Kombination aus einer Self-Attention-Schicht und einer punktweisen Feed-Forward-Schicht, dem Ansatz, den wir in unserem Modell verfolgen.
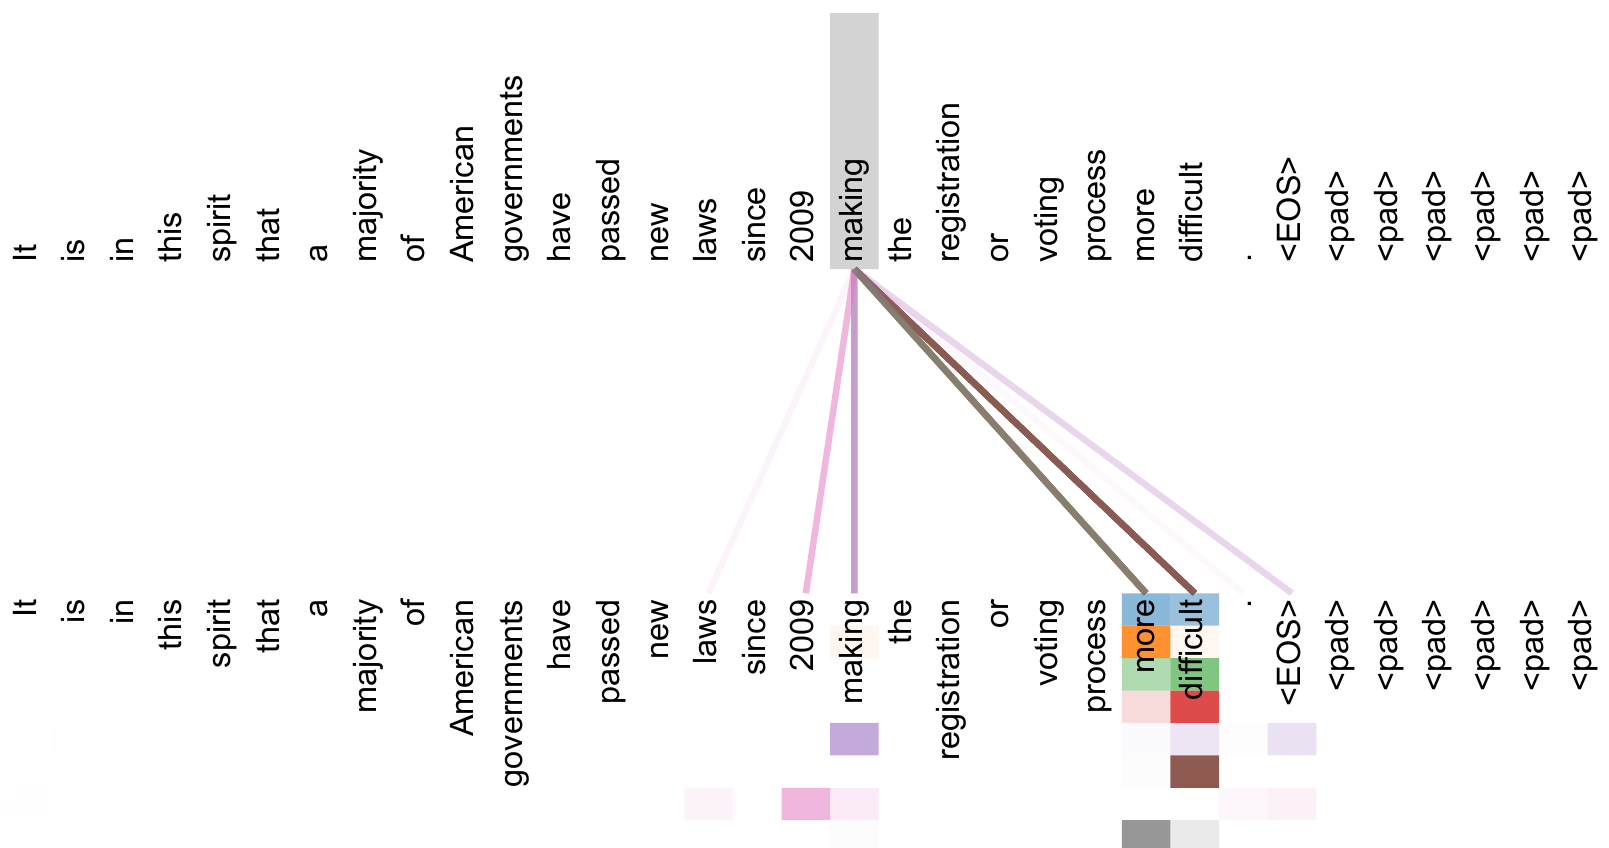
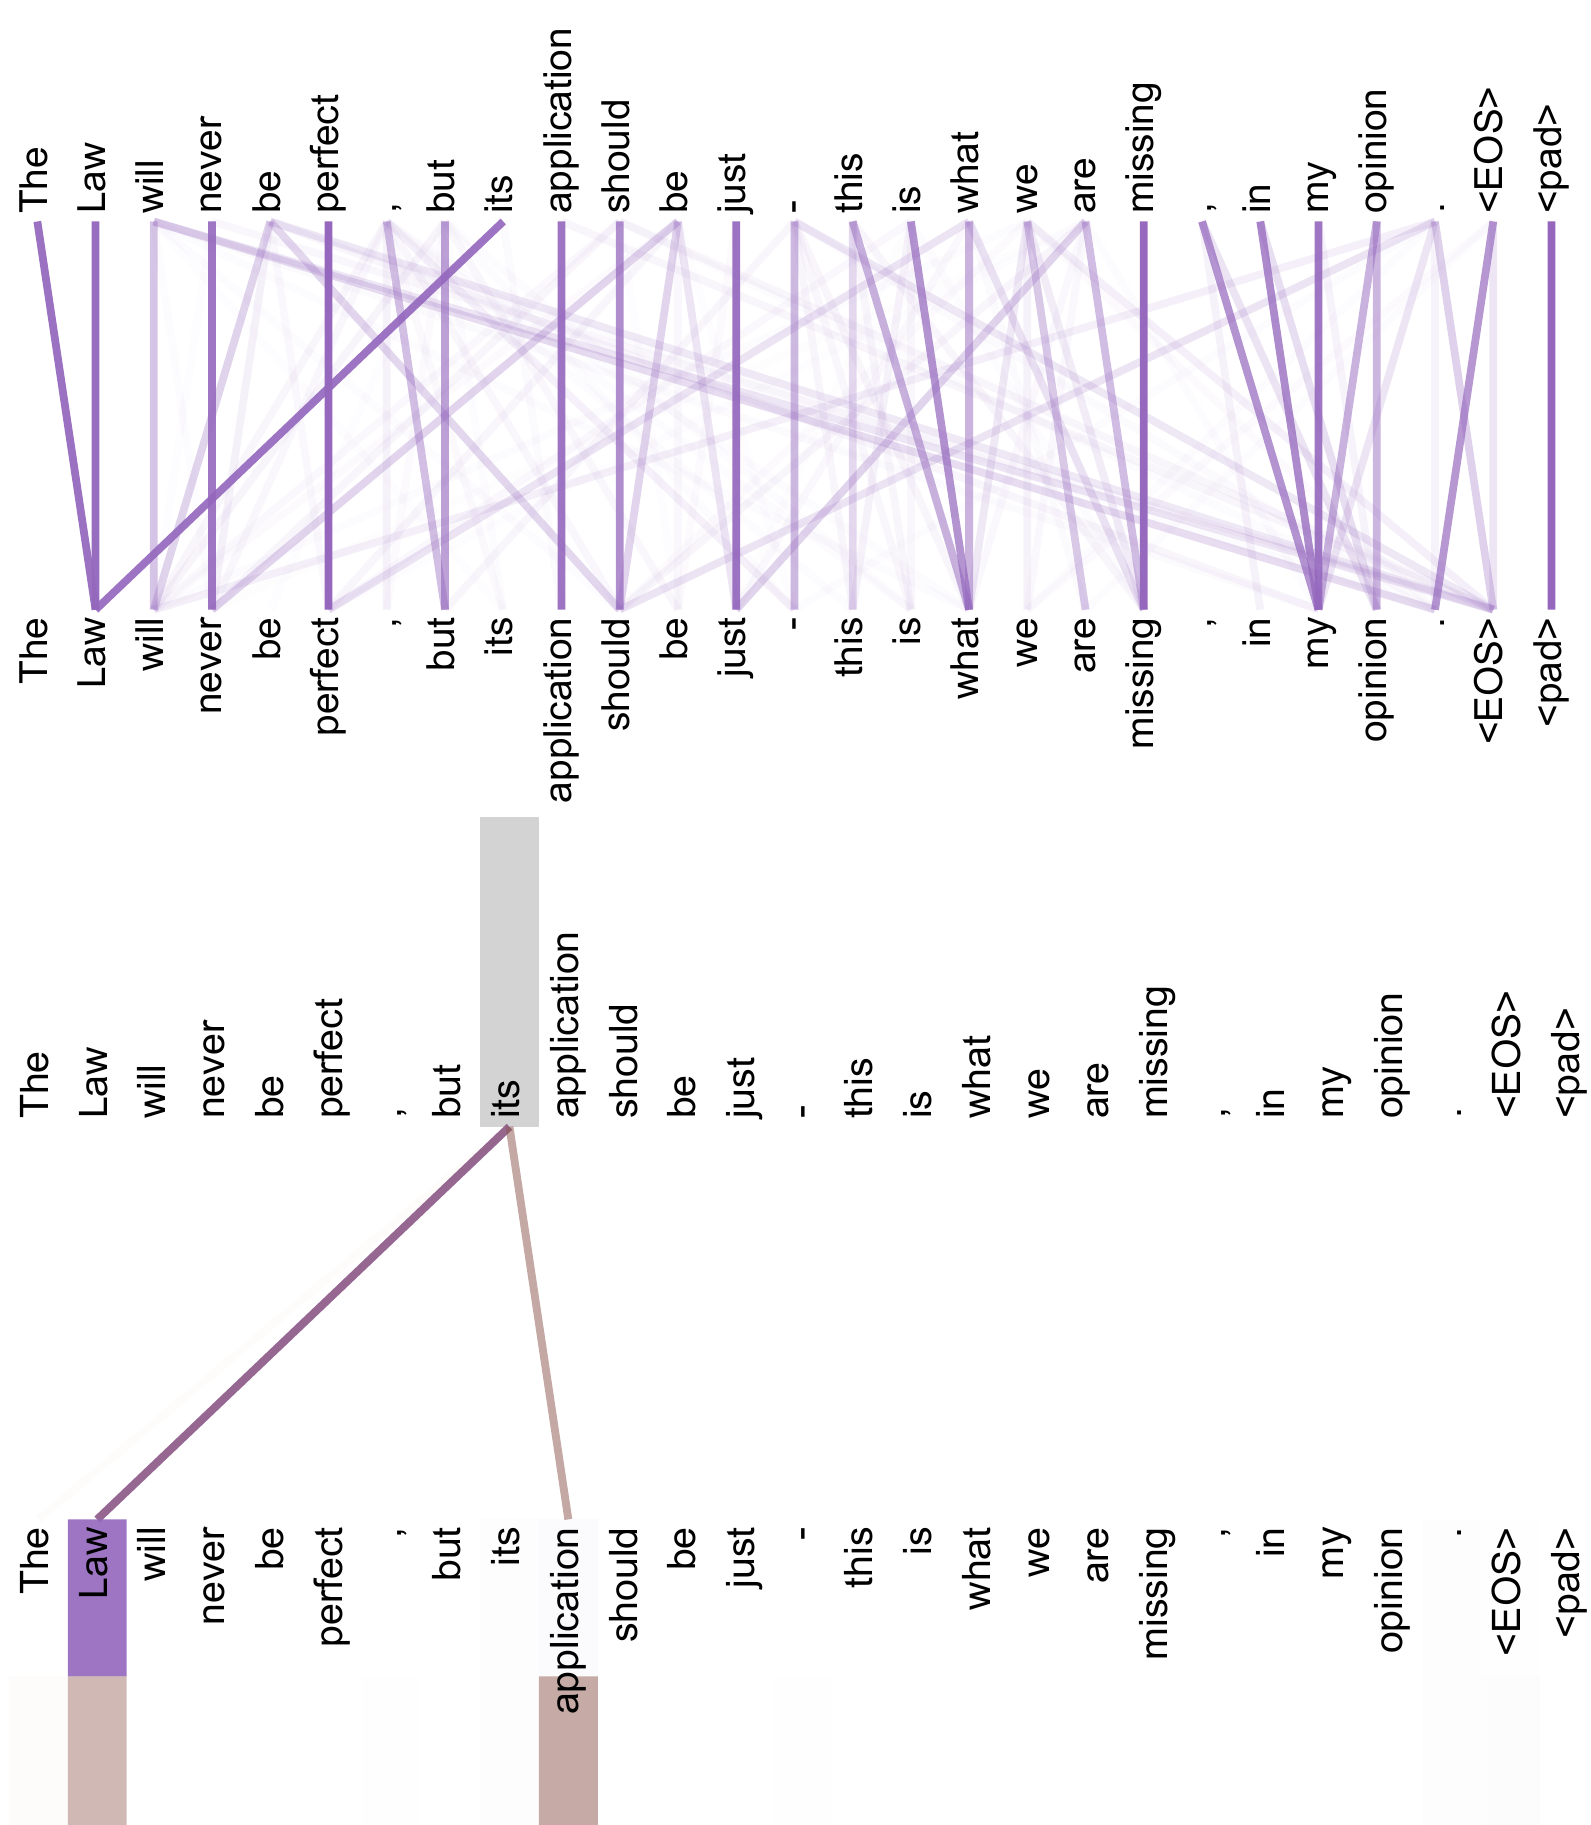
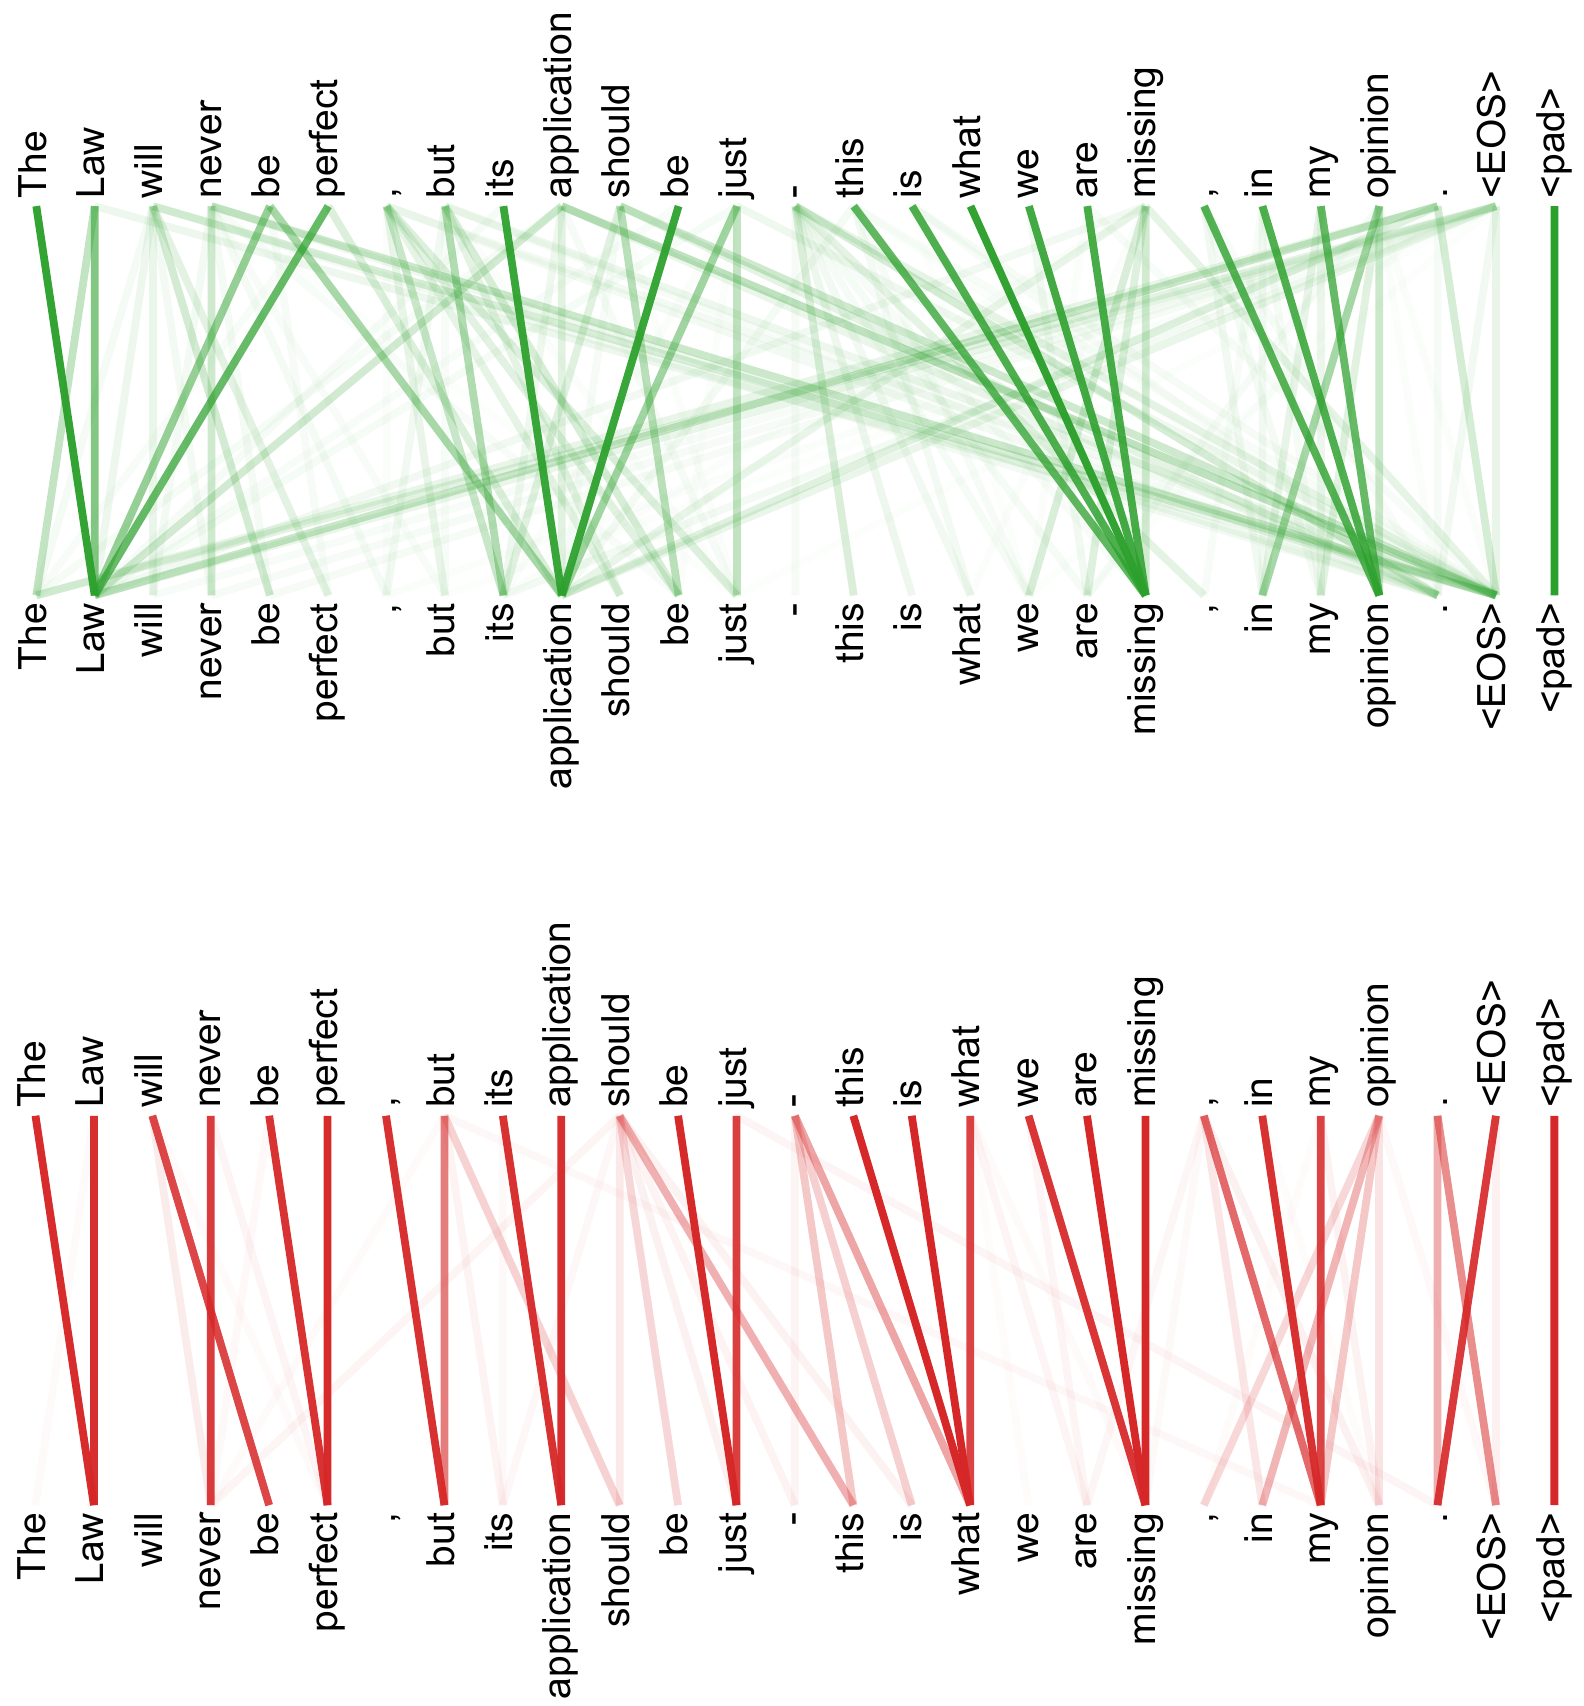
Als Nebeneffekt könnten Self-Attention interpretierbarere Modelle liefern. Wir untersuchen die Attention-Verteilungen unserer Modelle und stellen Beispiele im Anhang vor und diskutieren sie. Nicht nur lernen einzelne Attention-Köpfe eindeutig, unterschiedliche Aufgaben auszuführen; viele scheinen auch Verhalten zu zeigen, das mit der syntaktischen und semantischen Struktur der Sätze zusammenhängt.
5 Training
Dieser Abschnitt beschreibt das Trainingsregime für unsere Modelle.
5.1 Trainingsdaten und Batching
Wir trainierten auf dem standardmäßigen WMT-2014-Datensatz Englisch–Deutsch, der aus etwa 4,5 Millionen Satzpaaren besteht. Die Sätze wurden mit Byte-Pair-Encoding [3] kodiert, das über ein gemeinsames Quell- und Zielvokabular von etwa 37000 Token verfügt. Für Englisch–Französisch verwendeten wir den deutlich größeren WMT-2014-Datensatz Englisch–Französisch, der aus 36 Mio. Sätzen besteht, und teilten die Token in ein Vokabular von 32000 Word-Pieces [38] auf. Satzpaare wurden nach ungefährer Sequenzlänge zu Batches zusammengefasst. Jeder Trainingsbatch enthielt eine Menge von Satzpaaren mit ungefähr 25000 Quell-Token und 25000 Ziel-Token.
5.2 Hardware und Zeitplan
Wir trainierten unsere Modelle auf einer Maschine mit 8 NVIDIA P100 GPUs. Für unsere Basismodelle mit den im gesamten Paper beschriebenen Hyperparametern dauerte jeder Trainingsschritt etwa 0,4 Sekunden. Wir trainierten die Basismodelle insgesamt 100.000 Schritte oder 12 Stunden. Für unsere großen Modelle (beschrieben in der untersten Zeile von Tabelle [3]) betrug die Schrittzeit 1,0 Sekunden. Die großen Modelle wurden für 300.000 Schritte trainiert (3,5 Tage).
5.3 Optimierer
Wir verwendeten den Adam-Optimierer [20] mit , und . Wir variierten die Lernrate im Verlauf des Trainings gemäß der Formel:
Dies entspricht einer linearen Erhöhung der Lernrate für die ersten warmup steps Trainingsschritte und einer anschließenden Verringerung proportional zur inversen Quadratwurzel der Schrittnummer. Wir verwendeten warmup steps = 4000.
5.4 Regularisierung
Wir setzen während des Trainings drei Arten der Regularisierung ein:
| Modell | BLEU | Trainingskosten (FLOPs) | ||
| EN-DE | EN-FR | EN-DE | EN-FR | |
| ByteNet [18] | 23,75 | |||
| Deep-Att + PosUnk [39] | 39,2 | 1,0·1020 | ||
| GNMT + RL [38] | 24,6 | 39,92 | 2,3·1019 | 1,4·1020 |
| ConvS2S [9] | 25,16 | 40,46 | 9,6·1018 | 1,5·1020 |
| MoE [32] | 26,03 | 40,56 | 2,0·1019 | 1,2·1020 |
| Deep-Att + PosUnk Ensemble [39] | 40,4 | 8,0·1020 | ||
| GNMT + RL Ensemble [38] | 26,30 | 41,16 | 1,8·1020 | 1,1·1021 |
| ConvS2S Ensemble [9] | 26,36 | 41,29 | 7,7·1019 | 1,2·1021 |
| Transformer (Basismodell) | 27,3 | 38,1 | 3,3·1018 | |
| Transformer (groß) | 28,4 | 41,8 | 2,3·1019 | |
Residual-Dropout Wir wenden Dropout [33] auf die Ausgabe jeder Teilschicht an, bevor sie zur Eingabe der Teilschicht addiert und normalisiert wird. Darüber hinaus wenden wir Dropout auf die Summen der Embeddings und der Positionskodierungen sowohl in den Encoder- als auch in den Decoder-Stapeln an. Für das Basismodell verwenden wir eine Rate von .
Label-Glättung Während des Trainings verwendeten wir Label-Glättung mit dem Wert [36]. Dies verschlechtert die Perplexität, da das Modell lernt, unsicherer zu sein, verbessert jedoch die Genauigkeit und den BLEU-Score.
6 Ergebnisse
6.1 Maschinelle Übersetzung
Bei der Übersetzungsaufgabe Englisch–Deutsch von WMT 2014 übertrifft das große Transformer-Modell (Transformer (big) in Tabelle 2) die besten bisher berichteten Modelle (einschließlich Ensembles) um mehr als 2,0 BLEU und etabliert einen neuen State-of-the-Art-BLEU-Score von 28,4. Die Konfiguration dieses Modells ist in der untersten Zeile von Tabelle 3 aufgeführt. Das Training dauerte 3,5 Tage auf 8 P100-GPUs. Selbst unser Basismodell übertrifft alle bisher veröffentlichten Modelle und Ensembles, und das zu einem Bruchteil der Trainingskosten jedes der konkurrierenden Modelle.
Bei der Übersetzungsaufgabe Englisch–Französisch von WMT 2014 erreicht unser großes Modell einen BLEU-Score von 41,0 und übertrifft damit alle bisher veröffentlichten Einzelmodelle, bei weniger als der Trainingskosten des bisherigen State-of-the-Art-Modells. Das für Englisch–Französisch trainierte Transformer (big)-Modell verwendete eine Dropout-Rate von statt 0,3.
Für die Basismodelle verwendeten wir ein einzelnes Modell, das durch Mittelung der letzten 5 Checkpoints erhalten wurde, die in 10-Minuten-Intervallen geschrieben wurden. Für die großen Modelle mittelten wir die letzten 20 Checkpoints. Wir verwendeten Beam Search mit einer Beam-Größe von 4 und einer Längenstrafe von [38]. Diese Hyperparameter wurden nach Experimenten auf dem Entwicklungsdatensatz gewählt. Wir setzten die maximale Ausgabelänge während der Inferenz auf Eingabelänge , brachen aber früh ab, wenn dies möglich war [38].
Tabelle 2 fasst unsere Ergebnisse zusammen und vergleicht unsere Übersetzungsqualität und Trainingskosten mit anderen Modellarchitekturen aus der Literatur. Wir schätzen die Anzahl der Gleitkommaoperationen, die zum Trainieren eines Modells verwendet werden, indem wir die Trainingszeit, die Anzahl der verwendeten GPUs und eine Schätzung der nachhaltigen Gleitkommakapazität jedes GPU in einfacher Genauigkeit multiplizieren.
6.2 Modellvariationen
Um die Bedeutung der verschiedenen Komponenten des Transformers zu bewerten, variierten wir unser Basismodell auf unterschiedliche Weise und maßen die Veränderung der Leistung bei der Übersetzung Englisch–Deutsch auf dem
| N | dmodel | dff | h | dk | dv | Pdrop | εls | Trainingsschritte | PPL (Dev) | BLEU (Dev) | Parameter ×106 | |
| Basis | 6 | 512 | 2048 | 8 | 64 | 64 | 0,1 | 0,1 | 100K | 4,92 | 25,8 | 65 |
| 1 | 512 | 512 | 5,29 | 24,9 | ||||||||
| 4 | 128 | 128 | 5,00 | 25,5 | ||||||||
| 16 | 32 | 32 | 4,91 | 25,8 | ||||||||
| (A) | 32 | 16 | 16 | 5,01 | 25,4 | |||||||
| 16 | 5,16 | 25,1 | 58 | |||||||||
| (B) | 32 | 5,01 | 25,4 | 60 | ||||||||
| 6,11 | 23,7 | 36 | ||||||||||
| (C) | 2 | 5,19 | 25,3 | 50 | ||||||||
| 4 | 4,88 | 25,5 | 80 | |||||||||
| 8 | 5,75 | 24,5 | 28 | |||||||||
| 256 | 32 | 32 | 4,66 | 26,0 | 168 | |||||||
| 1024 | 128 | 128 | 5,12 | 25,4 | 53 | |||||||
| 1024 | 4,75 | 26,2 | 90 | |||||||||
| (D) | 0,0 | 5,77 | 24,6 | |||||||||
| 0,2 | 4,95 | 25,5 | ||||||||||
| 0,0 | 4,67 | 25,3 | ||||||||||
| 0,2 | 5,47 | 25,7 | ||||||||||
| (E) | 4,92 | 25,7 | ||||||||||
| big | 6 | 1024 | 4096 | 16 | 0,3 | 300K | 4,33 | 26,4 | 213 |
Entwicklungsdatensatz newstest2013. Wir verwendeten Beam Search wie im vorherigen Abschnitt beschrieben, jedoch ohne Checkpoint-Mittelung. Diese Ergebnisse präsentieren wir in Tabelle 3.
In den Zeilen (A) von Tabelle 3 variieren wir die Anzahl der Attention-Heads sowie die Dimensionen von Attention-Key und -Value, wobei wir die Rechenmenge konstant halten, wie in Abschnitt 3.2.2 beschrieben. Während Single-Head-Attention um 0,9 BLEU schlechter ist als die beste Einstellung, sinkt die Qualität auch bei zu vielen Heads.
In den Zeilen (B) von Tabelle 3 beobachten wir, dass eine Verringerung der Attention-Key-Größe die Modellqualität beeinträchtigt. Dies deutet darauf hin, dass die Bestimmung der Kompatibilität nicht einfach ist und dass eine ausgefeiltere Kompatibilitätsfunktion als das Skalarprodukt von Vorteil sein könnte. In den Zeilen (C) und (D) beobachten wir weiterhin, dass, wie erwartet, größere Modelle besser sind und Dropout sehr hilfreich ist, um Overfitting zu vermeiden. In Zeile (E) ersetzen wir unsere sinusförmige Positionskodierung durch gelernte Positions-Embeddings [2] und beobachten nahezu identische Ergebnisse wie beim Basismodell.
6.3 Englische Konstituentenanalyse
Um zu bewerten, ob der Transformer auf andere Aufgaben generalisieren kann, führten wir Experimente zur englischen Konstituentenanalyse durch. Diese Aufgabe stellt besondere Herausforderungen dar: Die Ausgabe unterliegt starken strukturellen Einschränkungen und ist deutlich länger als die Eingabe. Darüber hinaus konnten RNN-Sequenz-zu-Sequenz-Modelle in Datenarmuts-Szenarien keine State-of-the-Art-Ergebnisse erzielen [37].
Wir trainierten einen 4-schichtigen Transformer mit auf dem Wall Street Journal (WSJ)-Teil des Penn Treebank [25], etwa 40K Trainingssätze. Wir trainierten ihn auch in einem semi-überwachten Setting unter Verwendung der größeren Korpora high-confidence und BerkleyParker mit etwa 17M Sätzen [37]. Wir verwendeten ein Vokabular von 16K Tokens für das WSJ-only-Setting und ein Vokabular von 32K Tokens für das semi-überwachte Setting.
Wir führten nur eine kleine Anzahl von Experimenten durch, um den Dropout, sowohl Attention- als auch Residual-Dropout (Abschnitt [5.4]), die Lernraten und die Beam-Größe auf dem Entwicklungsdatensatz von Abschnitt 22 auszuwählen; alle anderen Parameter blieben unverändert gegenüber dem englisch–deutschen Basis-Übersetzungsmodell. Während der Inferenz
| Parser | Training | WSJ 23 F1 |
| Vinyals & Kaiser el al. (2014) [37] | nur WSJ, diskriminativ | 88,3 |
| Petrov et al. (2006) [29] | nur WSJ, diskriminativ | 90,4 |
| Zhu et al. (2013) [40] | nur WSJ, diskriminativ | 90,4 |
| Dyer et al. (2016) [8] | nur WSJ, diskriminativ | 91,7 |
| Transformer (4 Schichten) | nur WSJ, diskriminativ | 91,3 |
| Zhu et al. (2013) [40] | semi-supervised | 91,3 |
| Huang & Harper (2009) [14] | semi-supervised | 91,3 |
| McClosky et al. (2006) [26] | semi-supervised | 92,1 |
| Vinyals & Kaiser el al. (2014) [37] | semi-supervised | 92,1 |
| Transformer (4 Schichten) | semi-supervised | 92,7 |
| Luong et al. (2015) [23] | Multi-Task | 93,0 |
| Dyer et al. (2016) [8] | generativ | 93,3 |
erhöhten wir die maximale Ausgabelänge auf Eingabelänge . Wir verwendeten eine Beam-Größe von 21 und sowohl für das WSJ-only- als auch für das semi-überwachte Setting.
Unsere Ergebnisse in Tabelle 4 zeigen, dass unser Modell trotz fehlender aufgabenspezifischer Abstimmung überraschend gut abschneidet und bessere Ergebnisse liefert als alle bisher berichteten Modelle mit Ausnahme der Recurrent Neural Network Grammar [8].
Im Gegensatz zu RNN-Sequenz-zu-Sequenz-Modellen [37] übertrifft der Transformer den Berkeley-Parser [29] selbst dann, wenn er nur auf dem WSJ-Trainingssatz von 40K Sätzen trainiert wird.
7 Fazit
In dieser Arbeit präsentierten wir den Transformer, das erste Sequenz-Transduktionsmodell, das vollständig auf Attention basiert und die in Encoder-Decoder-Architekturen am häufigsten verwendeten rekurrenten Schichten durch Multi-Head-Self-Attention ersetzt.
Für Übersetzungsaufgaben kann der Transformer deutlich schneller trainiert werden als Architekturen, die auf rekurrenten oder konvolutionalen Schichten basieren. Sowohl bei den Übersetzungsaufgaben Englisch–Deutsch von WMT 2014 als auch Englisch–Französisch von WMT 2014 erreichen wir einen neuen State of the Art. Bei der ersteren Aufgabe übertrifft unser bestes Modell sogar alle bisher berichteten Ensembles.
Wir sind begeistert von der Zukunft auf Attention basierender Modelle und planen, sie auf andere Aufgaben anzuwenden. Wir planen, den Transformer auf Probleme auszudehnen, die andere Ein- und Ausgabemodalitäten als Text betreffen, und lokale, eingeschränkte Attention-Mechanismen zu untersuchen, um große Ein- und Ausgaben wie Bilder, Audio und Video effizient zu verarbeiten. Die Generierung weniger sequenziell zu gestalten, ist ein weiteres unserer Forschungsziele.
Der Code, den wir zum Trainieren und Evaluieren unserer Modelle verwendet haben, ist verfügbar unter https://github.com/tensorflow/tensor2tensor
Danksagungen Wir danken Nal Kalchbrenner und Stephan Gouws für ihre fruchtbaren Kommentare, Korrekturen und Inspiration.
Literaturverzeichnis
[1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
[7] Junyoung Chung, Caglar Gulcehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122, 2017.
[10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi und Jürgen Schmidhuber. Gradientenfluss in rekurrenten Netzen: die Schwierigkeit, langfristige Abhängigkeiten zu erlernen, 2001.
[13] Sepp Hochreiter und Jürgen Schmidhuber. Long short-term memory. Neural Computation, 9(8):1735–1780, 1997.
[14] Zhongqiang Huang und Mary Harper. Selbsttrainierende PCFG-Grammatiken mit latenten Annotationen über Sprachen hinweg. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, Seiten 832–841. ACL, August 2009.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer und Yonghui Wu. Die Grenzen der Sprachmodellierung erkunden. arXiv preprint arXiv:1602.02410, 2016.
[16] Łukasz Kaiser und Samy Bengio. Kann aktives Gedächtnis Aufmerksamkeit ersetzen? In Advances in Neural Information Processing Systems (NIPS), 2016.
[17] Łukasz Kaiser und Ilya Sutskever. Neuronale GPUs lernen Algorithmen. In International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves und Koray Kavukcuoglu. Neuronale maschinelle Übersetzung in linearer Zeit. arXiv preprint arXiv:1610.10099, 2017.
[19] Yoon Kim, Carl Denton, Luong Hoang und Alexander M. Rush. Strukturierte Aufmerksamkeitsnetzwerke. In International Conference on Learning Representations, 2017.
[20] Diederik Kingma und Jimmy Ba. Adam: Eine Methode zur stochastischen Optimierung. In ICLR, 2015.
[21] Oleksii Kuchaiev und Boris Ginsburg. Faktorisierungstricks für LSTM-Netzwerke. arXiv preprint arXiv:1703.10722, 2017.
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou und Yoshua Bengio. Eine strukturierte selbstaufmerksame Satzeinbettung. arXiv preprint arXiv:1703.03130, 2017.
[23] Minh-Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals und Lukasz Kaiser. Multi-Task-Sequenz-zu-Sequenz-Lernen. arXiv preprint arXiv:1511.06114, 2015.
[24] Minh-Thang Luong, Hieu Pham und Christopher D. Manning. Effektive Ansätze für aufmerksamkeitsbasierte neuronale maschinelle Übersetzung. arXiv preprint arXiv:1508.04025, 2015.
[25] Mitchell P. Marcus, Mary Ann Marcinkiewicz und Beatrice Santorini. Aufbau eines großen annotierten Korpus des Englischen: The Penn Treebank. Computational Linguistics, 19(2):313–330, 1993.
[26] David McClosky, Eugene Charniak und Mark Johnson. Effektives Selbsttraining für das Parsing. In Proceedings of the Human Language Technology Conference of the NAACL, Main Conference, Seiten 152–159. ACL, Juni 2006.
[27] Ankur Parikh, Oscar Täckström, Dipanjan Das und Jakob Uszkoreit. Ein zerlegbares Aufmerksamkeitsmodell. In Empirical Methods in Natural Language Processing, 2016.
[28] Romain Paulus, Caiming Xiong und Richard Socher. Ein tiefes verstärktes Modell für abstraktive Zusammenfassung. arXiv preprint arXiv:1705.04304, 2017.
[29] Slav Petrov, Leon Barrett, Romain Thibaux und Dan Klein. Erlernen präziser, kompakter und interpretierbarer Baumannotation. In Proceedings of the 21st International Conference on Computational Linguistics and 44th Annual Meeting of the ACL, Seiten 433–440. ACL, Juli 2006.
[30] Ofir Press und Lior Wolf. Verwendung der Ausgabeeinbettung zur Verbesserung von Sprachmodellen. arXiv preprint arXiv:1608.05859, 2016.
[31] Rico Sennrich, Barry Haddow und Alexandra Birch. Neuronale maschinelle Übersetzung seltener Wörter mit Subworteinheiten. arXiv preprint arXiv:1508.07909, 2015.
[32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton und Jeff Dean. Ungeheuer große neuronale Netze: Die dünn besetzte gated Mixture-of-Experts-Schicht. arXiv preprint arXiv:1701.06538, 2017.
[33] Nitish Srivastava, Geoffrey E. Hinton, Alex Krizhevsky, Ilya Sutskever und Ruslan Salakhutdinov. Dropout: ein einfacher Weg, neuronale Netze an der Überanpassung zu hindern. Journal of Machine Learning Research, 15(1):1929–1958, 2014.
[34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston und Rob Fergus. End-to-End-Speichernetze. In C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama und R. Garnett, Herausgeber, Advances in Neural Information Processing Systems 28, Seiten 2440–2448. Curran Associates, Inc., 2015.
[35] Ilya Sutskever, Oriol Vinyals und Quoc V. V. Le. Sequenz-zu-Sequenz-Lernen mit neuronalen Netzen. In Advances in Neural Information Processing Systems, Seiten 3104–3112, 2014.
[36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens und Zbigniew Wojna. Die Inception-Architektur für Computer Vision neu überdenken. CoRR, abs/1512.00567, 2015.
[37] Vinyals & Kaiser, Koo, Petrov, Sutskever und Hinton. Grammatik als Fremdsprache. In Advances in Neural Information Processing Systems, 2015.
[38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V. Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey et al. Googles neuronales maschinelles Übersetzungssystem: Die Lücke zwischen menschlicher und maschineller Übersetzung überbrücken. arXiv preprint arXiv:1609.08144, 2016.
[39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li und Wei Xu. Tiefe rekurrente Modelle mit Fast-Forward-Verbindungen für neuronale maschinelle Übersetzung. CoRR, abs/1606.04199, 2016.
[40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang und Jingbo Zhu. Schnelles und präzises Shift-Reduce-Konstituentenparsing. In Proceedings of the 51st Annual Meeting of the ACL (Volume 1: Long Papers), Seiten 434–443. ACL, August 2013.