
antiSMASH 8.0 は微生物ゲノムから生合成遺伝子クラスターを検出し、対応種を 81 から 101 に拡張。2025 年、無料で読めます。
antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation
antiSMASH 8.0:拡張された遺伝子クラスター検出機能ならびに化学、酵素学、および制御の解析
Blin, K.; Shaw, S.; Vader, L.; Szenei, J.; Reitz, Z.L.; Augustijn, H.E.; ...; Weber, T.
引用情報
Blin, K., Shaw, S., Vader, L., Szenei, J., Reitz, Z. L., Augustijn, H. E., ... Weber, T. (2025). antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation. Nucleic Acids Research, 53(W1), W32- W38. doi:10.1093/nar/gkaf334
バージョン:出版社版 ライセンス:Creative Commons CC BY 4.0ライセンス ダウンロード元:https://hdl.handle.net/1887/4285886
注記:本出版物を引用する際は、可能であれば最終公開版をご使用ください。
antiSMASH 8.0:拡張された遺伝子クラスター検出機能ならびに化学、酵素学、および制御の解析
Kai Blin , Simon Shaw , Lisa Vader , Judit Szenei , Zachary L. Reitz , Hannah E. Augustijn , José D.D. Cédiel- Becerra , Valérie de Crécy- Lagard , Robert A. Koetsier , Sam E. Williams , Pablo Cruz- Morales , Sopida Wongwas , Alejandro E. Segurado Luchsinger , Friederike Biermann , Aleksandra Korenskaia , Mitja M. Zdouc , David Meijer , Barbara R. Terlouw , Justin J.J. van der Hooft , Nadine Ziemert , Eric J.N. Helfrich , Joleen Masschelein , Christophe Corre , Marc G. Chevrette , Gilles P. van Wezel , Marnix H. Medema , Tilmann Weber
連絡先著者。Email: kblin@biosustain.dtu.dk 連絡先はMarnix H. Medemaまでお願いすることもできます。Email: marnix.medema@wur.nl 連絡先はTilmann Weberまでお願いすることもできます。Email: tiwe@biosustain.dtu.dk
概要
微生物は二次代謝または特殊代謝を通じて低分子の生理活性化合物を合成する。これらの化合物は微生物間相互作用や土壌の健全性において重要な役割を果たすが、医薬品や農薬の開発にとっても極めて重要である。過去数十年間のゲノム配列決定技術の進歩により、微生物ゲノムから直接、多数の生合成遺伝子クラスターを同定することが可能となった。2011年の登場以来、antiSMASH(https://antismash. secondarymetabolites.org/)は、細菌および真菌におけるこれらの遺伝子クラスターを検出し特性解析するための主要なツールとなっている。本論文ではantiSMASHのバージョン8を紹介する。本バージョンでは検出可能なクラスター型の数が81から101に増加し、テルペノイドおよびテイラリング酵素の解析サポートが改善されるとともに、ポリケチド合成酵素や非リボソームペプチド合成酵素などのモジュール型酵素の解析も改善された。これらの変更により、antiSMASHは本分野の発展に追従し続け、天然物ゲノムマイニングのための全体的な予測能力を拡張している。
グラフィカルアブストラクト
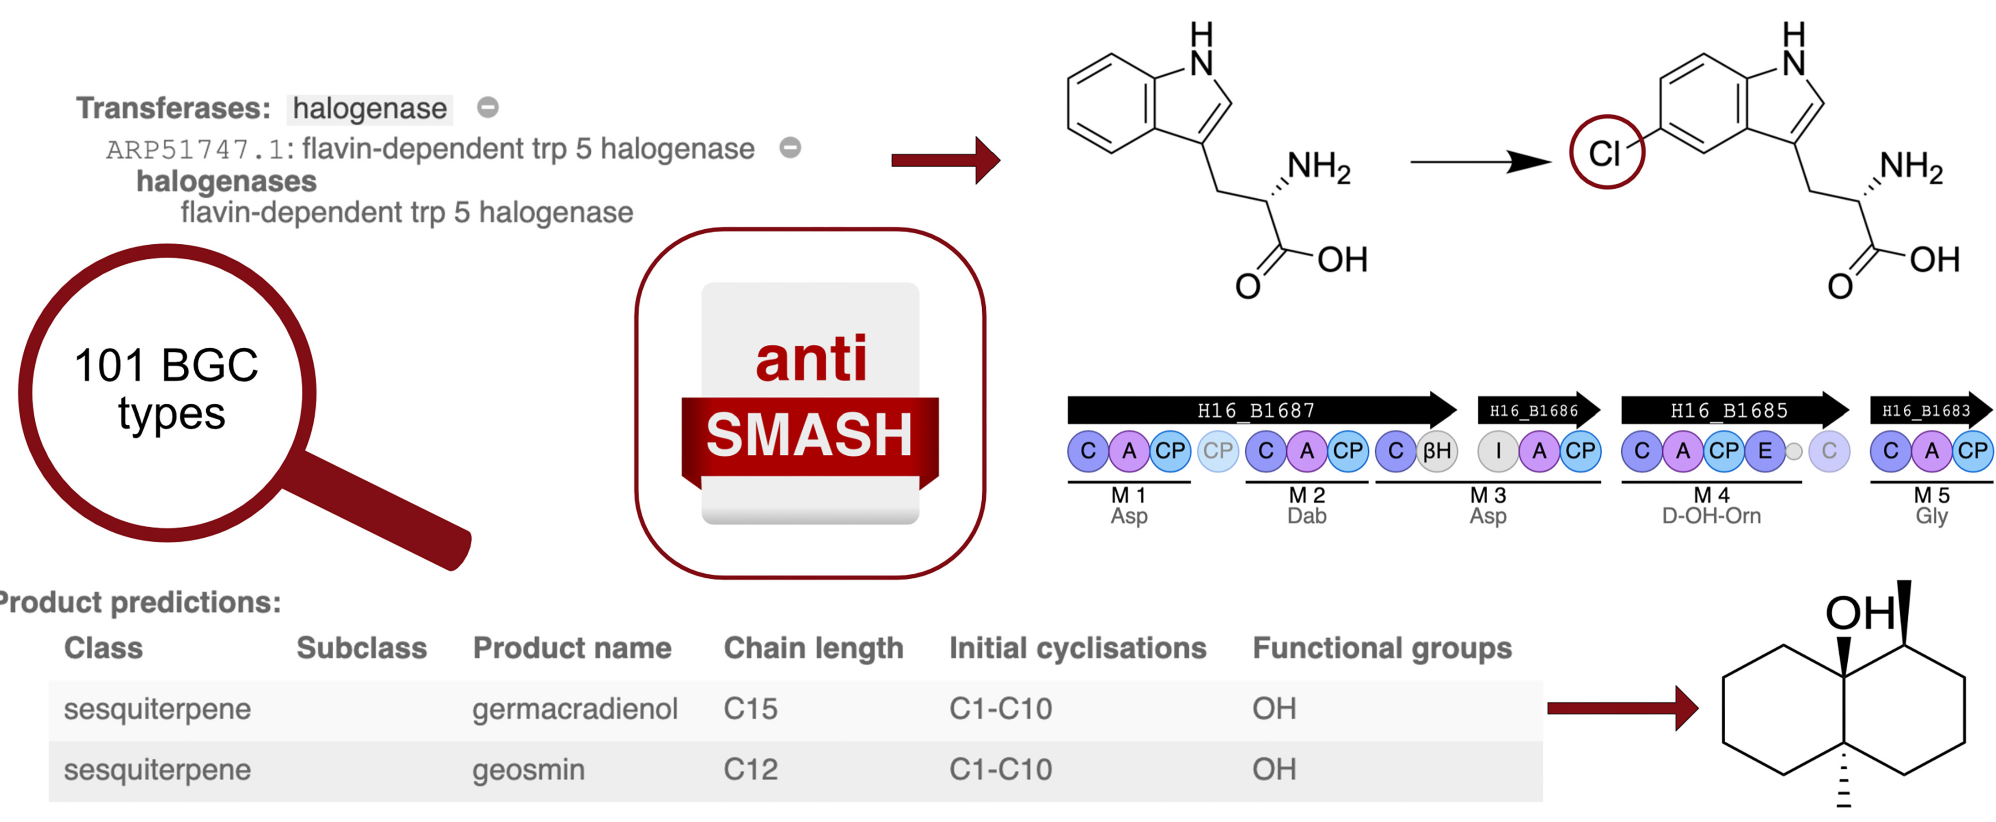
序論
微生物が産生する低分子の生理活性分子は、医薬品[1]や農薬[2]の重要な供給源であり、微生物間相互作用や土壌の健全性において重要な役割を果たしている。過去20~25年間で、利用可能なゲノムデータの豊富さにより、微生物株を単離し、化合物を抽出し、次いで所望の活性についてスクリーニングするという従来のワークフローを、これらの分子の生合成をコードする生合成遺伝子クラスター(BGC)を微生物ゲノム中で探索することによって強化することが可能となった[3]。これらの二次代謝/特殊代謝産物を産生するBGCをゲノム中から探索するソフトウェアツールは、10年以上前から存在している[4- 7]。
2011年の初回リリース以来、antiSMASH[8- 14]は本分野における主要なツールとなっている。antiSMASHを中心として、antiSMASHの予測を組み込むか、あるいはそれに依存する幅広い関連ツールのエコシステムが発展してきた。その例としては、耐性遺伝子に基づくマイニングツールARTS[15]、質量分析に導かれたSeq2PKS[16]、ゲノム工学ツールStreptoCAD[17]、BGCのネットワーク化およびクラスタリングツールBiG- SCAPE[18]、ペアオミクス解析ツールNPLinker[19]などがある。逆に、antiSMASHは他のツールからのBGC予測を取り込むこともできる[13]。当初はDeepBGC[20]のために構築されたが、GECCO[21]のような他の機械学習ベースのツールも必要な形式で結果を提供している。antiSMASHのBGC予測は、Joint Genome InstituteのSecondary Metabolite Collaboratory[22]、ゲノムアノテーションおよび解析のためのMicroScopeプラットフォーム[23]、手動キュレーションされたBGCのデータベースであるMIBiGデータベース[24]、BGCファミリーデータベースBiG- FAM[25]、化学的多様性メタゲノムデータベースBGC Atlas[26]、およびantiSMASHデータベース[27]など、多くのゲノムおよびBGC関連データベースにおいても使用されている。さらに、antiSMASHは、BGCFlow[28]や欧州食品安全機関(EFSA)のMicroOrganisms Pipelines Service[29]など、ゲノムデータの大規模解析のためのいくつかの系統的ワークフローの一部となっている。
ここでは、antiSMASHのバージョン8を紹介する。本リリースでは、検出可能な生合成経路型の数が81から101に増加し、テルペノイドBGCの解析モジュールが追加され、テイラリング酵素の詳細な解析が提供される。
さらに、KnownClusterBlastおよびClusterCompareデータセットがMIBiGリリース4のデータを反映するように更新され、環状ゲノムにおいて複製起点にまたがるBGCに対する適切なサポートが追加され、転写因子結合部位予測がCollecTFデータベース[30]のデータセットで拡張された。非リボソームペプチド合成酵素(NRPS)またはI型ポリケチド合成酵素(PKS)を含むBGCでは、より多くの生合成ドメインが検出および解析される。
新機能および更新
BGC検出の更新
antiSMASHは、BGCを定義するためにゲノム領域内に存在する必要がある生合成機能を定義するために、手作業でキュレーションされたルールを使用している。これらの生合成機能を特定するために、antiSMASHはプロファイル隠れマルコフモデル(pHMM)と、より少ない程度ではあるがPythonコードファイルで指定された動的プロファイルの両方を利用している。pHMMは、PFAM [31]、TIGRFAMS [32]、SMART [33]、BAGEL [34]、Yadavら [35]といった公開データセットから取得されるか、antiSMASHでの使用のために特別に作成される。antiSMASH 7にはそのようなBGCルールが81個含まれていたが[14]、本リリースではこの数は101に増加し、既存のルールのいくつかも改良された。生合成酵素の大きな重複のため、直鎖アゾール含有ペプチドとチオリンク環化チオペプチドを区別することは困難である。現在のantiSMASHデータベース[27]では、チオペプチドのと直鎖アゾール含有ペプチドののBGCコールが重複しており、残りの割り当てのうちどれだけが正確であるかは不明である。この不確実性に対処し、潜在的な混乱を避けるため、両タイプのBGCの検出ルールは新たな「アゾール含有RiPPルール」に統合された。テルペン、マイコスポリン様アミノ酸、NRPS非依存性シデロフォア、trans-AT PKS、NRPS、NRPS様クラスター、および脂肪酸の検出ルールもまた更新された。さらに、古細菌のリボソーム合成・翻訳後修飾ペプチド(RiPP)、アトロポペプチド、ニトロプロパン酸、アゾキシ含有化合物、ポリイン、デアザプリン、多ハロゲン化ピロール、ヒドロキシトロポロン、シアン化水素、ダロバクチン、イソシアニド、細菌性および真菌性環状ジペプチド、トライセプチド、高還元型II型PKS、および真菌NRPS様リジン生合成に対する新たなルールが追加された。
翻訳するテキストが提供されていません。
メッセージにはコロン(:)と二重コロン(::)のみが含まれており、
翻訳すべき実際の内容がありません。
翻訳したいテキストを送っていただければ、
日本語に翻訳いたします。
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
::antiSMASHは、NRPS/PKS BGCにコードされたタンパク質ドメインの詳細な解析を提供します。存在するドメインのより包括的な概要を提供するために、シデロフォア関連の-ヒドロキシラーゼおよびインターフェースドメインのプロファイル(詳細な議論については[37]を参照)と、より汎用的な-
一部のコア遺伝子の隣接するセクションが他のコア遺伝子から遠く離れている場合に対処するため、すべてのコア遺伝子が適切にマークされることを保証する新しい「EXTENDS」条件がルール定義に追加されました。trans-AT PKSルールはこれを使用して、単一のトランス作用性アシルトランスフェラーゼ(AT)ドメインが遠く離れている場合でも、モジュールを含むすべての遺伝子が正しく検出されることを保証します。
テルペン解析
antiSMASHはバージョン1[8]以来テルペン遺伝子クラスターを検出してきましたが、テルペンシンターゼ/シクラーゼのより詳細な解析は欠けていました。antiSMASHバージョン4[11]では初期の解析モジュールが追加されましたが、系統学的配置アルゴリズムの性能上の制限と保守性の課題のため、antiSMASH 5[12]で再び削除されました。バージョン8では、注意深くキュレーションされたpHMMに基づくテルペン解析が復活します(図1A参照)。テルペンBGCを含む各領域について、潜在的な生産物タイプのリストが表示されます。各予測には、テルペノイドクラス(例:ジテルペン、セスキテルペンなど)と予測生産物の鎖長が含まれます。よりよく理解されているテルペンシンターゼサブファミリーについては、予測にテルペノイドサブクラス(例:インドールジテルペノイド)、初期環化(例:C1-C15)、および生産物名も含まれる場合があります。
遺伝子機能解析
昨年のMIBiGアノテーションにおけるMIBiGエントリのテーラリング酵素をよりよくアノテーションするための大規模なコミュニティの取り組みの中で(説明については[24]を参照)、antiSMASHにおいてテーラリング酵素反応にアクセスするためのよりユーザーフレンドリーなインターフェースが必要であることに気づきました。それらのアノテーションソン中にアノテーションされたMITEデータベース(https://mite.bioinformatics.nl/)[36]のテーラリング酵素のコレクション、および既存のsmCOGアノテーションを使用して、専用の「テーラリング」タブにテーラリング酵素情報を表示するようになりました(図1B参照)。これはまた、今回のリリースで追加された、多くのフラビン依存性ハロゲナーゼの基質特異性を報告する機会も与えてくれました。カスタムpHMMと保存モチーフシグネチャを使用して、予測はデータの利用可能性に応じて「ハロゲン化ピロール」から例えばトリプトファンハロゲナーゼの位置選択性まで、詳細さが異なります。
テーラリングタブでは、テーラリング酵素は酵素委員会のカテゴリー、すなわち酸化還元酵素、転移酵素、加水分解酵素、リアーゼ、異性化酵素、およびリガーゼによって整理されています。その領域にヒットがあるカテゴリーのみが表示されます。プラスアイコンをクリックするとカテゴリーが展開され、関連するヒットを持つ遺伝子と、可能な限り最も詳細なテーラリング機能の予測の短い要約が表示されます。目的の遺伝子のプラスアイコンをクリックすると、antiSMASHがテーラリング酵素について提供するすべての情報が展開されます。テーラリング酵素がMITEデータベースのいずれかのエントリに対して少なくとものアミノ酸配列同一性を示す場合、そのMITEエントリへのクロスリンクが提供されます。
NRPSおよびPKSの改善
CoA-リガーゼ(CAL)ドメインは、リポペプチドBGCにおいて脂肪酸由来のスターターユニットをロードすることに関与することがよくありますが、以前はantiSMASHのモジュール検出において開始モジュールとして考慮されていませんでした。前述の-ヒドロキシラーゼおよびインターフェースドメインとともに、それらは今やモジュールの一部として検出できます。
[38]で収集された情報に従い、NRPS縮合(C)およびエピメリ化(E)ドメインの活性部位は、触媒残基の存在についてチェックされるようになり、それらの残基が欠けている場合は不活性としてフラグが立てられます。antiSMASHですでに実行されているNRPSアデニル化(A)ドメインの基質特異性予測を補完するために、研究者により多くの解析オプションを提供するため、外部のPARAS基質特異性予測ツール[39]へのリンクも提供するようになりました。
その他の変更
バージョン8には他の多くの小規模な変更が含まれています。最も類似した既知のクラスターを表示する概要ページビューは、ユーザーの混乱のいくつかの原因に対処するために簡素化されました。「少なくともの配列類似性を持つ遺伝子の割合」でクラスター類似性を直接表示する代わりに、類似性を3つの信頼レベルで表示するようになりました:クラスター類似性が以上の場合「高」、クラスター類似性がからの間の場合「中」、クラスター類似性がからの間の場合「低」です。のクラスター類似性はもはや十分に類似しているとは見なされず、概要に表示されなくなりました。Known ClusterBlast、ClusterCompare、およびCompaRiPPsonは、MIBiG 4.0リリース[24]で提供されるデータに更新されました。ClusterBlast SVG生成は、ファイルサイズを削減し、ローカルで開いたantiSMASH結果を表示するユーザーエクスペリエンスを向上させるために、JavaScriptに移行されました。歴史的に、antiSMASHは環状ゲノムにおいて複製起点にまたがるBGCに苦労してきました。最良の場合、それらのBGCは2つに分割され、最悪の場合、複製起点の反対側にある部分の一方または両方が完全に見逃される可能性がありました。antiSMASH 8.0では、環状ゲノムの座標処理を完全に刷新し、適切に検出および報告されるようにしました。
歴史的に、antiSMASHは真菌の遺伝子呼び出しにGlimmerHMM[40]に依存してきました。これは、正しい遺伝子モデルを手動で選択することなく実行できたためです。残念ながら、ますます多くの真菌ゲノムが利用可能になるにつれて、この遺伝子モデルの選択が高品質の遺伝子呼び出しに不可欠であることが明らかになりました。未知の分類群のアップロードされたゲノムに対して適切な遺伝子モデルを簡単に選択できないため、antiSMASHから真菌遺伝子呼び出し機能を削除することにしました。ユーザーには、AUGUSTUS[41]のような専用の遺伝子呼び出しツールを実行し、その後antiSMASHに遺伝子アノテーションを提供することをお勧めします。現代のシステムにおけるソフトウェアの非互換性のため、MEMEスイートのツール、具体的にはMEME[42]およびFIMO[43]のサポートも非推奨としました。antiSMASHのスタンドアロン版のユーザーは、それらのバイナリを自分で提供することができますが、それらはもはや私たちが提供するコンテナやWebサービスの一部ではありません。これにより、CASSIS[44]真菌BGC境界検出が実質的に無効になり、ランチペプチド、サクチペプチド、ラッソペプチド、およびアゾール含有RiPP前駆体のRODEO[45]スコアに影響を与える可能性があります。
A
詳細なテルペン予測
| 製品予測: | |||||
| クラス | サブクラス | 製品名 | 鎖長 | 初期環化 | 官能基 |
| セスキテルペン | ゲルマクラジエノール | C15 | C1-C10 | OH | |
| セスキテルペン | ゲオスミン | C12 | C1-C10 | OH |
テルペンドメインを持つ遺伝子:
scO6073:T1TS + T1TS
ドメイン1(0 - 326):タイプ1テルペンシンターゼ サブタイプ:ゲオスミンシンターゼ、N末端ドメイン 反応:FPP → ゲルマクラジエノール
ドメイン2(326 - 695):タイプ1テルペンシンターゼ
サブタイプ:ゲオスミンシンターゼ、C末端ドメイン 反応:ゲルマクラジエノール → ゲオスミン
B
テーラリング機能
酸化還元酵素:オキシゲナーゼ
oxyA:環化
oxyB:環化
oxyC:環化
oxyD:シトクロムP450
転移酵素:アミノトランスフェラーゼ、グリコシルトランスフェラーゼ、ハロゲナーゼ、メチルトランスフェラーゼ
bgtFA:グリコシル化
bgtFB:グリコシル化
bgtFC:グリコシル化
bhaA:フラビン依存性チロシン様hpgハロゲナーゼ、ハロゲナーゼ、フラビン依存性チロシン様hpgハロゲナーゼ
MITF
MITEO000028 ハロゲン化(同一性:100.00%)smcogs SMCOG1119:ハロゲナーゼ
bmt:メチル化
dvaB:DegT/DnrJ/ErYC1/StrSアミノトランスフェラーゼ
pgaT:アミノトランスフェラーゼ
加水分解酵素:加水分解酵素
bhp:α/β加水分解酵素フォールドタンパク質
リアーゼ:ヒドラターゼ
dpgC:エノイルCoAヒドラターゼ
dpgD:エノイルCoAヒドラターゼ
リガーゼ:リガーゼ合成酵素
結論と今後の展望
結論と今後の展望antiSMASHのようなゲノムマイニング技術は、天然物発見パズルの重要なピースを構成している。過去14年間にわたり、antiSMASHは継続的な更新と改善を重ね、天然物ゲノムマイニングツールの最前線にとどまり続けることを確実にしてきた。中核開発チーム外からの数多くの貢献からも明らかなように、antiSMASHプロジェクトのオープンソースおよびオープンサイエンスのモデルは依然として成功を収めている。これは、他の多くのより専門化されたツール、ワークフロー、データベースが依存する重要なツールである。現在開発中の他の数多くのゲノムマイニングツールの技術プラットフォームとしての役割も果たしている。今後の更新では、検出されたクラスターの完全な生合成経路を解読するための新しいアルゴリズムと解析モジュールに関する作業を継続する。本バージョンにおける修飾酵素予測の改善の基盤の上に築き、さらに多くの酵素ファミリーをカバーする。同様に、制御因子および制御因子結合部位の検出に関する作業も継続する。従来どおり、エコシステム内で開発される新しいツールの統合、またはそれらとの統合も行う。
謝辞
謝辞著者貢献:Kai Blin(概念化[主導]、データキュレーション[主導]、資金獲得[同等]、方法論[主導]、プロジェクト管理[主導]、ソフトウェア[同等]、監督[同等]、執筆—原稿作成[主導]、執筆—レビュー&編集[主導])、Simon Shaw(データキュレーション[同等]、方法論[同等]、ソフトウェア[主導]、可視化[主導])、Lisa Vader(データキュレーション[支援]、ソフトウェア[支援]、可視化[支援])、Judit Szenei(データキュレーション[支援]、ソフトウェア[支援]、可視化[支援])、Zachary L. Reitz(データキュレーション[支援]、ソフトウェア[支援])、Hannah E. Augustin(データキュレーション[支援]、ソフトウェア[支援])、José D.D. Cediel-Becerra(データキュレーション[支援]、ソフトウェア[支援])、Valérie de Crécy-Lagard(データキュレーション[支援])、Robert A. Koetsier(データキュレーション[支援]、ソフトウェア[支援])、Sam E. Williams(データキュレーション[支援])、Pablo Cruz-Morales(データキュレーション[支援])、Sopida Wongwas(データキュレーション[支援])、Alejandro E. Segurado Luchsinger(データキュレーション[支援])、Friederike Biermann(データキュレーション[支援])、Aleksandra Korenskaia(データキュレーション[支援])、Mitja M. Zdouc(データキュレーション[支援]、執筆—原稿作成[支援])、David Meijer(データキュレーション[支援])、Barbara R. Terlouw(データキュレーション[支援])、Justin J.J. van der Hooft(資金獲得[同等]、執筆—原稿作成[支援])、Nadine Ziemert(資金獲得[同等]、監督[同等])、Eric J.N. Helfrich(資金獲得[同等]、監督[同等]、執筆—原稿作成[支援])、Joleen Masschelein(データキュレーション[支援]、資金獲得[同等]、監督[同等])、Christophe Corre(資金獲得[同等]、監督[同等])、Marc G. Chevrette(資金獲得[同等]、監督[同等])、Gilles P. van Wezel(資金獲得[同等]、監督[同等])、Marnix H. Medema(概念化[支援]、資金獲得[同等]、監督[同等]、執筆—原稿作成[支援])、およびTilmann Weber(概念化[支援]、資金獲得[同等]、監督[同等]、検証[支援]、執筆—原稿作成[支援])
利益相反
J.J.vdH.は、イタリア・ミラノのNAICONS Srlの科学諮問委員会の委員であり、米国インディアナ州インディアナポリスのCorteva Agriscienceのコンサルタントを務めている。M.H.M.はHexagon Bioの科学諮問委員会の委員である。その他の著者は全員、利益相反がないことを表明する。
資金提供
資金提供Novo Nordisk Foundation [NNF20CC0035580(T.W.、K.B.、P.C.-M.宛)、NNF22OC0079021(S.E.W.宛)]、Center for Microbial Secondary Metabolites(CeMiSt)、Danish National Research Foundation [DNRF137(T.W.宛)]、EU Horizon Europe Programme MAGic-MOLFUN [MSC 101072485(T.W.、K.B.、M.H.M.、N.Z.、A.K.、J.J.vdH.宛)]、EU Horizon 2020 MARBLES [101000392(M.M.Z.、J.J.vdH.、M.H.M.、G.P.vW.宛)]、NWO [KICH1. LWV04.21.013(M.M.Z.、J.J.vdH.、M.H.M.宛)]、EU ERC Community [101055020(G.P.vW.宛)]、NWO-XL [OCENW.XL21. XL21.088(R.A.K.宛)]、National Institutes of Health [RM1GM145426(VdC.-L.宛)]、German Center for Infection Research(DZIF)[TTU09.716(N.Z.宛)]、EU Horizon 2020 DECIPHER [948770(D.M.、M.H.M.宛)]、The Royal Thai Government [S.W.への博士課程資金]、Emmy Noether Program of the German Research Foundation [504947087(E.J.N.H.宛)]、Hessian Ministry for Science and the Arts [LOEWE Center for Translational Biodiversity Genomics(E.J.N.H.宛)]、FWO [1008520NおよびG061821N(J.M.宛)]。本記事のオープンアクセス出版料の支払いのための資金は、EU Horizon Europe Program MAGic-MOLFUNにより提供された。
データの入手可能性
antiSMASH 8.0の細菌版および真菌版は、それぞれhttps://antismash.secondarymetabolites.org および https://fungismash.secondarymetabolites.org で自由にアクセスできる。
antiSMASHのドキュメントは、https://docs.antismash.secondarymetabolites.org/ で入手可能である。
antiSMASHのソースコードは、GNU Affero General Public License(AGPL)バージョン3.0の下でライセンスされている。antiSMASHはDocker経由でも利用可能である。antiSMASHのダウンロードおよびインストール方法の詳細については、ドキュメントのウェブサイトを参照されたい。
参考文献
背景情報(翻訳対象外):比較分析。Nucleic Acids Res 2020;48: D579-89. https://doi.org/10.1093/nar/gkz926 24. Zdouc MM, Blin K, Louwen NLL ほか. MIBiG 4.0: グローバルな協働を通じた生合成遺伝子クラスターのキュレーションの進展. Nucleic Acids Res 2025;53:D678-90. https://doi.org/10.1093/nar/gkae1115 25. Kautsar SA, Blin K, Shaw S ほか. BiG-FAM: 生合成遺伝子クラスターファミリーデータベース. Nucleic Acids Res 2021;49: D490-7. https://doi.org/10.1093/nar/gkaa812 26. Bagci C, Nuhamunada M, Goyat H ほか. BGC Atlas: 細菌ゲノムにコードされたグローバルな化学的多様性を探索するためのウェブリソース. Nucleic Acids Res 2025;53:D618-24. https://doi.org/10.1093/nar/gkae953 27. Blin K, Shaw S, Medema MH ほか. antiSMASH database version 4: 追加ゲノムとBGC、新規の配列ベース検索など. Nucleic Acids Res 2024;52:D586-9. https://doi.org/10.1093/nar/gkad984 28. Nuhamunada M, Mohite OS, Phaneuf PV ほか. BGCFlow: 大規模ゲノムデータセット全体にわたる生合成遺伝子クラスターの解析のための系統的パンゲノムワークフロー. Nucleic Acids Res 2024;52:5478-95. https://doi.org/10.1093/nar/gkae314 29. Yolanda GC. Microorganisms pipelines service (MOPS): パイプラインのドキュメント. テクニカルレポート. 30. Kilu S, White ER, Sagitova DM ほか. CollecTF: 細菌における実験的に検証された転写因子結合部位のデータベース. Nucleic Acids Res 2014;42:D156-6030. https://doi.org/10.1093/nar/gkt1123 31. Mistry J, Chugarunsky S, Williams L ほか. Pfam: 2021年におけるタンパク質ファミリーデータベース. Nucleic Acids Res 2021;49: D412-9. https://doi.org/10.1093/nar/gkaa913 32. Haft DH, Selengut JD, Richter RA ほか. TIGRFAMs and genome properties in 2013. Nucleic Acids Res 2013;41: D387-953. https://doi.org/10.1093/nar/gks1234 33. Letunic I, Khedkar S, Bork P. SMART: 最近の更新、新たな開発、および2020年における状況. Nucleic Acids Res 2021;49: D458-60. https://doi.org/10.1093/nar/gkaa937 34. van Heel AJ, de Jong A, Song C ほか. BAGEL4: RiPPおよびバクテリオシンを徹底的にマイニングするためのユーザーフレンドリーなウェブサーバー. Nucleic Acids Res 2018;46: W278-81. https://doi.org/10.1093/nar/gky383 35. Yadav G, Gokhale RS, Mohanty D. ポリケチド合成酵素の代謝産物の予測に向けて:in silico解析. PLOS Comput Biol 2009;5:e1000351. https://doi.org/10.1371/journal.pcbi.1000351 36. Zdouc MM, Meijer D, Biermann F ほか. 天然物生合成を捉えるための修飾酵素/ムタラーゼデータ標準に関する最小情報. ChemRxiv, https://doi.org/10.26434/chemrxiv-2024-78mtl, 2024年4月9日, プレプリント:査読なし. 37. Reitz ZL, Hardy CD, Suk J ほか. シデロフォア \(\beta\)-ヒドロキシラーゼのゲノム解析により、分岐した立体制御が明らかになり、縮合ドメインファミリーが拡張される. Proc Natl Acad Sci USA 2019;116:19805-14. https://doi.org/10.1073/pnas.1903161116 28. Bloudoff K, Schmeng TM. 非リボソームペプチド合成酵素の縮合ドメインスーパーファミリーの構造的および機能的側面:発見、解剖、および多様性. Biochim Biophys Acta Proteins Proteom 2017;1865:1587-604. https://doi.org/10.1016/j.bbapap.2017.05.010 39. Terlouw BR, Huang C, Meijer D ほか. PARAS: 非リボソームペプチド合成酵素における基質特異性の高精度機械学習. bioRxiv, https ... 翻訳対象テキスト: 1. Newman DJ, Cragg GM. 1981年1月から2019年9月までのほぼ40年間における新薬の供給源としての天然物. BMC Genomics 2020;83:1138-43. https://doi.org/10.1021/acs.jnatprod.9b01285 2. Sparks TC, Bryant RJ. 作物保護化合物の発見と革新における天然物の影響. Pest Manag Sci 2022;78:399-408. https://doi.org/10.1002/ps.6653 3. Ziemert N, Alanjary M, Weber T. 微生物におけるゲノムマイニングの進化—レビュー. Nat Prod Rep 2016;33:988-1005. https://doi.org/10.1039/C6NP00025H 4. Weber T. 抗生物質生合成経路の解析のためのin silicoツール. Int J Med Microbiol 2014;304:230-5. https://doi.org/10.1016/j.ijmm.2014.02.001 5. Medema MH, Fischbach MA. 天然物探索への計算論的アプローチ. Nat Chem Biol 2015;11:639-48. https://doi.org/10.1038/nchembio.1884 6. Weber T, Kim HU. 二次代謝産物バイオインフォマティクスポータル:二次代謝産物生産の合成生物学を促進する計算ツール. Synth Syst Biotechnol 2016;1:69-79. https://doi.org/10.1016/j.synbio.2015.12.002 7. Blin K, Kim HU, Medema MH ほか. 二次代謝産物生合成遺伝子クラスターをマイニングするためのantiSMASHおよびその他の計算論的アプローチの最近の開発. Brief Bioinform 2019;20:1103-13. https://doi.org/10.1093/bib/bbx146 8. Medema MH, Blin K, Cimermancic P ほか. antiSMASH: 細菌および真菌のゲノム配列における二次代謝産物生合成遺伝子クラスターの迅速な同定、アノテーション、および解析. Nucleic Acids Res 2011;39:W339-46. https://doi.org/10.1093/nar/gkr466 9. Blin K, Medema MH, Kazempour D ほか. antiSMASH 2.0—二次代謝産物生産者のゲノムマイニングのための多用途プラットフォーム. Nucleic Acids Res 2013;41:W204-12. https://doi.org/10.1093/nar/gkt449 10. Weber T, Blin K, Duddela S ほか. antiSMASH 3.0—生合成遺伝子クラスターのゲノムマイニングのための包括的リソース. Nucleic Acids Res 2015;43:W237-43. https://doi.org/10.1093/nar/gkv437 11. Blin K, Wolf T, Chevrette MG ほか. antiSMASH 4.0—化学予測および遺伝子クラスター境界同定の改善. Nucleic Acids Res 2017;45:W36-411. https://doi.org/10.1093/nar/gkx319 12. Blin K, Shaw S, Steinke K ほか. antiSMASH 5.0: 二次代謝産物ゲノムマイニングパイプラインの更新. Nucleic Acids Res 2019;47:W81-7. https://doi.org/10.1093/nar/gkz310 13. Blin K, Shaw S, Kloosterman AM ほか. antiSMASH 6.0: クラスター検出および比較機能の改善. Nucleic Acids Res 2021;49:W29-35. https://doi.org/10.1093/nar/gkab335 14. Blin K, Shaw S, Augustijn HE ほか. antiSMASH 7.0: 検出、調節、化学構造、および可視化に関する新規かつ改善された予測. Nucleic Acids Res 2023;51:W46-50. https://doi.org/10.1093/nar/gkad344 15. Mungan MD, Alanjary M, Blin K ほか. ARTS 2.0: 比較ゲノムマイニングのためのAntibiotic Resistant Target Seekerの機能更新と拡張. Nucleic Acids Res 2020;48:W546-52. https://doi.org/10.1093/nar/gkaa374 16. Yan D, Zhou M, Adduri A ほか. Seq2PKSを用いた計算論的質量分析およびゲノムマイニングによるI型cis-ATポリケチドの発見. Nat Commun 2024;15:5356. https://doi.org/10.1038/s41467-024-49587-1 17. Levasor L, Whitford CM, Petersen SD ほか. StreptoCAD: ストレプトミセス属におけるゲノム工学ワークフローを自動化するオープンソースソフトウェアツールボックス. bioRxiv, https://doi.org/10.1101/2024.12.19.629370, 2024年12月20日, プレプリント:査読なし. 18. Navarro-Munoz JC, Selem-Mojica N, Mullowney MW ほか. 大規模な生合成多様性を探索するための計算論的フレームワーク. Nat Chem Biol 2020;16:60-8. https://doi.org/10.1038/s41589-019-0400-9 19. Eldjarn GH, Ramsay A, Hooft JJJvd ほか. 相補的なスコアリング関数を用いたNPLinkerフレームワークにおける微生物メタボロミクスとゲノミクスの関連のランキング. PLOS Comput Biol 2021;17:e1008920. https://doi.org/10.1371/journal.pcbi.1008920 20. Hannigan GD, Prihoda D, Palicka A ほか. 生合成遺伝子クラスター予測のための深層学習ゲノムマイニング戦略. Nucleic Acids Res 2019;47:e110. https://doi.org/10.1093/nar/gkz654 21. Carroll LM, Larralde M, Fleck JS ほか. GECCOによる生合成遺伝子クラスターの正確なde novo同定. bioRxiv, https://doi.org/10.1101/2021.05.03.442509, 2021年5月4日, プレプリント:査読なし. 22. Udwary DW, Doering DT, Foster B ほか. 二次代謝産物共同研究拠点:二次代謝産物生合成遺伝子クラスターのためのデータベースおよびウェブディスカッションポータル. Nucleic Acids Res 2025;53:D717-23. https://doi.org/10.1093/nar/gkae1060 23. Vallenet D, Calteau A, Dubois M ほか. MicroScope: ゲノム、パンゲノム、および代謝情報を通じて微生物遺伝子機能のアノテーションと探索を行うための統合プラットフォーム比較解析。Nucleic Acids Res 2020;48: D579-89. https://doi.org/10.1093/nar/gkz92624. Zdouc MM, Blin K, Louwen NLL et al. MIBiG 4.0:グローバルな協働を通じた生合成遺伝子クラスターキュレーションの前進。Nucleic Acids Res 2025;53:D678-90. https://doi.org/10.1093/nar/gkae111525. Kautsar SA, Blin K, Shaw S et al. BiG-FAM:生合成遺伝子クラスターファミリーデータベース。Nucleic Acids Res 2021;49: D490-7. https://doi.org/10.1093/nar/gkaa81226. Bagci C, Nuhamunada M, Goyat H et al. BGC Atlas:細菌ゲノムにコードされたグローバルな化学的多様性を探索するためのウェブリソース。Nucleic Acids Res 2025;53:D618-24. https://doi.org/10.1093/nar/gkae95327. Blin K, Shaw S, Medema MH et al. antiSMASHデータベースバージョン4:追加ゲノムとBGC、新規配列ベース検索など。Nucleic Acids Res 2024;52:D586-9. https://doi.org/10.1093/nar/gkad98428. Nuhamunada M, Mohite OS, Phaneuf PV et al. BGCFlow:大規模ゲノムデータセット全体にわたる生合成遺伝子クラスター解析のための体系的パンゲノムワークフロー。Nucleic Acids Res 2024;52:5478-95. https://doi.org/10.1093/nar/gkae31429. Yolanda GC. 微生物パイプラインサービス(MOPS):パイプライン文書。技術報告書。30. Kilu S, White ER, Sagitova DM et al. CollecTF:細菌における実験的に検証された転写因子結合部位のデータベース。Nucleic Acids Res 2014;42:D156-6030. https://doi.org/10.1093/nar/gkt112331. Mistry J, Chugarunsky S, Williams L et al. Pfam:2021年のタンパク質ファミリーデータベース。Nucleic Acids Res 2021;49: D412-9. https://doi.org/10.1093/nar/gkaa91332. Haft DH, Selengut JD, Richter RA et al. TIGRFAMsと2013年のゲノム特性。Nucleic Acids Res 2013;41: D387-953. https://doi.org/10.1093/nar/gks123433. Letunic I, Khedkar S, Bork P. SMART:2020年における最近の更新、新展開、状況。Nucleic Acids Res 2021;49: D458-60. https://doi.org/10.1093/nar/gkaa93734. van Heel AJ, de Jong A, Song C et al. BAGEL4:RiPPおよびバクテリオシンを徹底的にマイニングするためのユーザーフレンドリーなウェブサーバー。Nucleic Acids Res 2018;46: W278-81. https://doi.org/10.1093/nar/gky38335. Yadav G, Gokhale RS, Mohanty D. ポリケチド合成酵素の代謝産物の予測に向けて:インシリコ解析。PLOS Comput Biol 2009;5:e1000351. https://doi.org/10.1371/journal.pcbi.100035136. Zdouc MM, Meijer D, Biermann F et al. 天然物生合成を捉えるための修飾酵素/ムタレアーゼデータ標準に関する最小情報。ChemRxiv, https://doi.org/10.26434/chemrxiv-2024-78mtl, 2024年4月9日, プレプリント:査読未実施。37. Reitz ZL, Hardy CD, Suk J et al. シデロフォア-ヒドロキシラーゼのゲノム解析は分岐した立体制御を明らかにし、縮合ドメインファミリーを拡大する。Proc Natl Acad Sci USA 2019;116:19805-14. https://doi.org/10.1073/pnas.190316111628. Bloudoff K, Schmeng TM. 非リボソームペプチド合成酵素縮合ドメインスーパーファミリーの構造的および機能的側面:発見、解剖、多様性。Biochim Biophys Acta Proteins Proteom 2017;1865:1587-604. https://doi.org/10.1016/j.bbapap.2017.05.01039. Terlouw BR, Huang C, Meijer D et al. PARAS:非リボソームペプチド合成酵素における基質特異性の高精度機械学習。bioRxiv, https://doi.org/10.1101/2025.01.08.631717, 2025年1月10日, プレプリント:査読未実施。40. Majoros WH, Pertea M, Salzberg SL. TigrScanとGlimmerHMM:2つのオープンソースのアブイニシオ真核生物遺伝子ファインダー。Bioinformatics 2004;20:2878-9. https://doi.org/10.1093/bioinformatics/bth31541. Stanke M, Morgenstern B. AUGUSTUS:ユーザー定義の制約を可能にする真核生物の遺伝子予測用ウェブサーバー。Nucleic Acids Res 2005;33:W465-7. https://doi.org/10.1093/nar/gk14858 42. Bailey TL, Elkan C. 生体高分子におけるモチーフを発見するための期待値最大化による混合モデルの適合。Proc Int Conf Intell Syst Mol Biol 1994;2:28-36. 43. Grant CE, Bailey TL, Noble WS. FIMO:所与のモチーフの出現をスキャンする。Bioinformatics 2011;27:1017-8. https://doi.org/10.1093/bioinformatics/btr064 44. Wolf T, Shelest V, Nath N et al. CASSISとSMIPS:真核生物ゲノムにおける二次代謝産物遺伝子クラスターのプロモーターベース予測。Bioinformatics 2016;32:1138-43. https://doi.org/10.1093/bioinformatics/btv713 45. Walker MC, Eslami SM, Hetrick KJ et al. 10万以上のゲノムを対象とした前駆体ペプチド標的マイニングはランチペプチド天然物ファミリーを拡大する。BMC Genomics 2020;21:387. https://doi.org/10.1186/s12864-020-06785-7