
注意機構そのものを疎で学習可能にし、64k 文脈のコストを削りつつ精度を保つ。ACL 2025 最優秀論文、全文無料。
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
ネイティブスパースアテンション:ハードウェアに整合した、ネイティブに学習可能なスパースアテンション
Jingyang Yuan , Huazuo Gao , Damai Dai , Junyu Luo , Liang Zhao , Zhengyan Zhang , Zhenda Xie , Y. X. Wei , Lean Wang , Zhiping Xiao , Yuqing Wang , Chong Ruan , Ming Zhang , Wenfeng Liang , Wangding Zeng
DeepSeek- AI Key Laboratory for Multimedia Information Processing, School of Computer Science, Peking University, PKU- Anker LLM Lab University of Washington {yuanjy, mzhang_cs}@pku.edu.cn, {zengwangding, wenfeng.liang}@deepseek.com
概要
長文脈モデリングは次世代の言語モデルにとって極めて重要であるが、標準的なアテンション機構の高い計算コストは重大な計算上の課題を提起している。スパースアテンションは、モデルの能力を維持しつつ効率を改善するための有望な方向性を提供する。我々はNSAを提示する。これは、アルゴリズム上の革新とハードウェアに整合した最適化を統合し、効率的な長文脈モデリングを実現する、ネイティブに学習可能なスパースアテンション機構である。NSAは動的な階層型スパース戦略を採用し、粗粒度のトークン圧縮と細粒度のトークン選択を組み合わせることで、グローバルな文脈認識と局所的な精度の両方を保持する。我々のアプローチは、スパースアテンション設計を2つの主要な革新によって前進させる:(1) 算術強度のバランスをとったアルゴリズム設計と、現代のハードウェア向けの実装最適化により、大幅な高速化を達成する。(2) エンドツーエンドの学習を可能にし、モデル性能を犠牲にすることなく事前学習の計算量を削減する。図[1]に示すように、実験では、NSAで事前学習されたモデルが、一般ベンチマーク、長文脈タスク、および指示ベースの推論にわたってFull Attentionモデルを維持または上回ることが示される。一方、NSAは、64k長のシーケンスにおいて、デコーディング、順伝播、および逆伝播にわたってFull Attentionを大幅に上回る高速化を達成し、モデルのライフサイクル全体を通じたその効率性を検証している。
1. はじめに
研究コミュニティは、次世代の大規模言語モデルにとって長文脈モデリングが極めて重要な能力であることをますます認識している。これは、深い推論(DeepSeek- AI, 2025; Zelikman et al., 2022)、リポジトリレベルのコード生成(Zhang et al., 2023a; Zhang et al.)、およびマルチターンの自律エージェントシステム(Park et al., 2023)に至るまで、多様な実世界の応用によって推進されている。OpenAIのoシリーズモデル、DeepSeek- R1(DeepSeek- AI, 2025)、およびGemini 1.5 Pro(Google et al., 2024)を含む最近の突破により、モデルはコードベース全体を処理し、長い文書を扱い、数千トークンにわたる一貫したマルチターン会話を維持し、長距離依存関係にわたる複雑な推論を実行できるようになった。しかしながら、vanilla Attention(Vaswani et al., 2017)機構の高い計算量(Zaheer et al., 2020)は、シーケンス長が増加するにつれて重大な
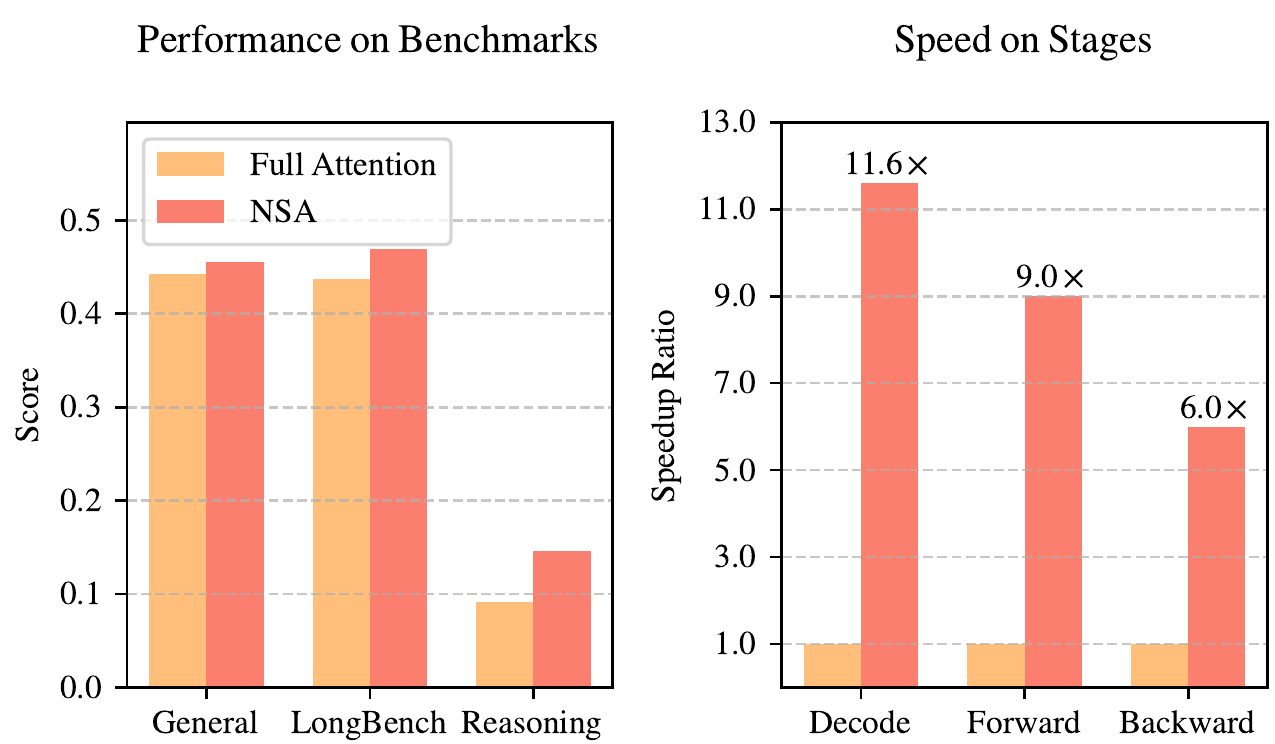
図1 | Full Attentionモデルと我々のNSAの性能および効率の比較。左:スパースであるにもかかわらず、NSAは一般ベンチマーク、長文脈タスク、および推論評価の平均においてFull Attentionベースラインを上回る。右:64k長のシーケンス処理において、NSAはデコーディング、順伝播、および逆伝播のすべての段階でFull Attentionと比較して大幅な計算高速化を達成する。理論的推定によれば、softmaxアーキテクチャを用いたアテンション計算は、64k長の文脈をデコーディングする際の総レイテンシのを占め、より効率的なアテンション機構の緊急の必要性を強調している。
効率的な長文脈モデリングへの自然なアプローチは、softmaxアテンションに内在するスパース性を活用することである(Ge et al., 2023; Jiang et al., 2023)。そこでは、重要なクエリ-キーペアを選択的に計算することで、性能を維持しながら計算オーバーヘッドを大幅に削減できる。最近の進歩は、多様な戦略を通じてこの可能性を示している:KVキャッシュ退避法(Li et al., 2024; Zhang et al., 2023b; Zhou et al., 2024)、ブロックワイズKVキャッシュ選択法(Gao et al., 2024; Tang et al., 2024; Xiao et al., 2024a)、およびサンプリング、クラスタリング、またはハッシュベースの選択法(Chen et al., 2024b; Desai et al., 2024; Liu et al., 2024)である。これらの有望な戦略にもかかわらず、既存のスパースアテンション法は実用的な展開においてしばしば不十分である。多くのアプローチは理論上の利得に匹敵する高速化を達成できず、さらに、ほとんどの手法はアテンションのスパースパターンを十分に活用するための効果的な学習時のサポートを欠いている。
これらの限界に対処するため、効果的なスパースアテンションの展開は2つの主要な課題に取り組まなければならない:(1) ハードウェアに整合した推論高速化:理論上の計算削減を実際の速度向上に変換するには、プロファイリング段階とデコーディング段階の両方において、メモリアクセスとハードウェアスケジューリングのボトルネックを緩和するハードウェアに優しいアルゴリズム設計が必要である;(2) 学習を意識したアルゴリズム設計:学習可能な演算子を用いたエンドツーエンドの計算を可能にし、モデル性能を維持しながら学習コストを削減する。これらの要件は、高速な長文脈推論または学習を実現するための実世界の応用にとって極めて重要である。両方の側面を考慮すると、既存の手法は依然として顕著なギャップを示している。
より効果的かつ効率的なスパースアテンションを達成するため、我々はNSAを提示する。これは階層的トークンモデリングを統合した、ネイティブに学習可能なスパースアテンションアーキテクチャである。図2に示すように、NSAはキーと値を時間ブロックに組織化し、それらを3つのアテンションパス——圧縮された粗粒度トークン、選択的に保持された細粒度トークン、および局所的な文脈情報のためのスライディングウィンドウ——を通じて処理することで、クエリあたりの計算量を削減する。次に、
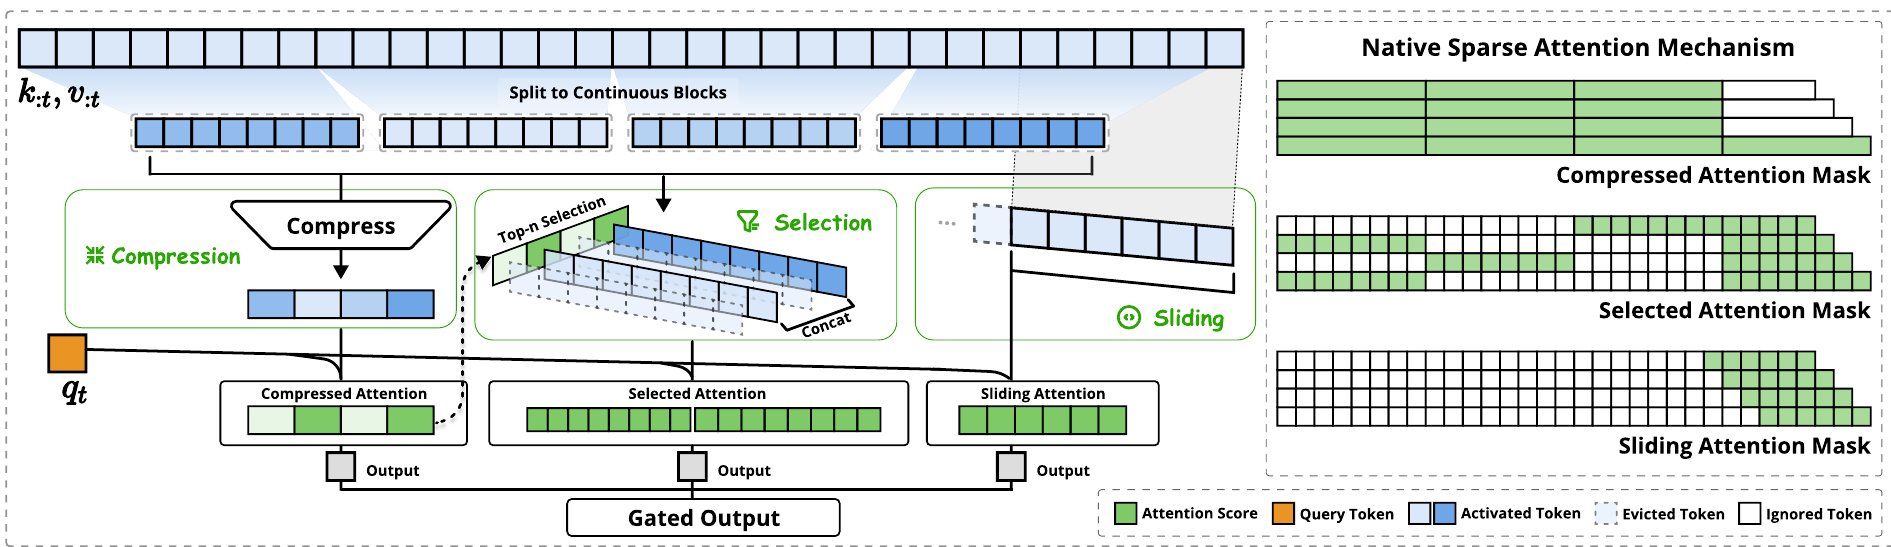
我々はその実用的な効率を最大化するために専用のカーネルを実装する。NSAは、上記の主要な要件に対応する2つの核となる革新を導入する:(1) ハードウェアに整合したシステム:Tensor Coreの利用とメモリアクセスのためにブロックワイズスパースアテンションを最適化し、算術強度のバランスを確保する。(2) 学習を意識した設計:効率的なアルゴリズムと逆伝播演算子を通じて、安定したエンドツーエンドの学習を可能にする。この最適化により、NSAは効率的な展開とエンドツーエンドの学習の両方をサポートできる。
我々は実世界の言語コーパスに関する包括的な実験を通じてNSAを評価する。270億パラメータのトランスフォーマーバックボーン上で2600億トークンを用いて事前学習し、一般言語評価、長文脈評価、および連鎖的思考推論評価にわたってNSAの性能を評価する。さらに、最適化されたTriton(Tillet et al., 2019)実装を用いて、A100 GPU上のカーネル速度を比較する。実験結果は、NSAがfull attentionベースラインと同等または優れた性能を達成しつつ、既存のスパースアテンションアプローチを上回ることを示している。さらに、NSAはFull Attentionと比較して、デコーディング、順伝播、および逆伝播の各段階にわたって大幅な高速化を実現し、その高速化率はより長いシーケンスに対して増加する。これらの結果は、我々の階層型スパースアテンション設計がモデル能力と計算効率のバランスを効果的にとっていることを検証している。
2. スパースアテンション手法の再考
現代のスパースアテンション手法は、トランスフォーマーモデルの理論的計算量を削減する上で大きな進歩を遂げてきた。しかしながら、ほとんどのアプローチは主に推論時にスパース性を適用しつつ、事前学習済みのFull Attentionバックボーンを保持しており、スパースアテンションの利点を十分に活用する能力を制限するアーキテクチャ上のバイアスを導入する可能性がある。我々のネイティブスパースアーキテクチャを導入する前に、我々はこれらの限界を2つの重要な観点から体系的に分析する。
2.1. 効率的推論の幻想
アテンション計算においてスパース性を達成しているにもかかわらず、多くの手法は推論レイテンシの対応する削減を達成できていない。主に2つの課題による:
段階制限されたスパース性。H2O(Zhang et al., 2023b)のような手法は、自己回帰デコーディング中にスパース性を適用する一方で、プロファイリング中に計算集約的な前処理(例:アテンションマップの計算、インデックス構築)を必要とする。対照的に、MInference(Jiang et al., 2024)のようなアプローチはプロファイリングのスパース性のみに焦点を当てている。これらの手法はすべての推論段階にわたる加速を達成できず、少なくとも1つの段階がFull Attentionに匹敵する計算コストのままである。この段階特化は、書籍要約やコード補完のようなプロファイリング支配のワークロード、または長い連鎖的思考(Wei et al., 2022)推論のようなデコーディング支配のワークロードにおいて、これらの手法の高速化能力を低下させる。
高度なアテンションアーキテクチャとの非互換性。一部のスパースアテンション手法は、Multiple- Query Attention(MQA)(Shazeer, 2019)やGrouped- Query Attention(GQA)(Ainslie et al., 2023)のような現代のデコーディング効率アーキテクチャに適応できない。これらは複数のクエリヘッド間でKVを共有することでデコーディング中のメモリアクセスのボトルネックを大幅に削減する。例えば、Quest(Tang et al., 2024)のようなアプローチでは、各アテンションヘッドが独立にそのKVキャッシュのサブセットを選択する。Multi- Head Attention(MHA)モデルにおいて一貫した計算スパース性とメモリアクセススパース性を示すものの、GQAのようなアーキテクチャに基づくモデルでは異なる状況を示す。そこでは、KVキャッシュのメモリアクセス量は、同じGQAグループ内のすべてのクエリヘッドからの選択の和集合に対応する。このアーキテクチャ上の特性は、これらの手法が計算演算を削減できる一方で、必要なKVキャッシュのメモリアクセスが比較的高いままであることを意味する。この限界は重大な選択を強いる:一部のスパースアテンション手法は計算を削減するが、その散在するメモリアクセスパターンは高度なアーキテクチャからの効率的なメモリアクセス設計と衝突する。
これらの限界は、多くの既存のスパースアテンション手法がKVキャッシュの削減または理論的計算削減に焦点を当てているものの、高度なフレームワークやバックエンドにおいて大幅なレイテンシ削減を達成するのに苦労しているために生じている。このことが我々を、高度なアーキテクチャとハードウェア効率の高い実装の両方を組み合わせ、スパース性を完全に活用してモデル効率を改善するアルゴリズムの開発へと動機づけている。
2.2. 学習可能なスパース性の神話
我々がネイティブで学習可能なスパースアテンションを追求する動機は、推論のみを対象としたアプローチを分析することから得られた2つの重要な洞察に基づいている:(1) 性能劣化:事後的にスパース性を適用すると、モデルは事前学習時の最適化軌跡から逸脱することを余儀なくされる。Chen et al. (2024b) が示したように、上位 のアテンションは全体のアテンションスコアの しかカバーできず、事前学習済みモデルにおけるretrieval headのような構造が推論時のプルーニングに対して脆弱になる。(2) 学習効率の要求:長系列学習の効率的な処理は、現代のLLM開発にとって極めて重要である。これには、モデル容量を高めるためのより長い文書での事前学習と、その後の長文脈ファインチューニングや強化学習といった適応段階の両方が含まれる。しかし、既存のスパースアテンション手法は主に推論を対象としており、学習における計算上の課題はほとんど未解決のままである。この制約は、効率的な学習を通じてより高性能な長文脈モデルを開発することを妨げている。さらに、既存のスパースアテンションを学習に適応させようとする取り組みも、以下の課題を露呈している:
学習不可能なコンポーネント。ClusterKV (Liu et al., 2024)(k-meansクラスタリングを含む)やMagicPIG (Chen et al., 2024b)(SimHashベースの選択を含む)といった手法における離散的操作は、計算グラフに不連続性を生み出す。これらの学習不可能なコンポーネントは、トークン選択プロセスを通じた勾配の流れを妨げ、モデルが最適なスパースパターンを学習する能力を制限する。
非効率的な逆伝播。理論上は学習可能ないくつかのスパースアテンション手法は、実用上の学習非効率に悩まされている。HashAttention (Desai et al., 2024) のようなアプローチで用いられるトークン粒度の選択戦略は、アテンション計算時にKVキャッシュから多数の個別トークンをロードする必要を生じさせる。この非連続的なメモリアクセスは、高スループットを実現するために連続的なメモリアクセスとブロックワイズ計算に依存するFlashAttentionのような高速アテンション手法の効率的な適用を妨げる。その結果、実装は低いハードウェア利用率に退避せざるを得なくなり、学習効率を著しく低下させる。
2.3. 不可欠なものとしてのネイティブスパース性
推論効率と学習可能性におけるこれらの限界が、我々にスパースアテンション機構の根本的な再設計を動機づけている。我々はNSAを提案する。これは、計算効率と学習要件の両方に対処するネイティブにスパースなアテンションフレームワークである。以下の節では、NSAのアルゴリズム設計と演算子実装について詳述する。
3. 手法
我々の技術的アプローチは、アルゴリズム設計とカーネル最適化にまたがる。以下の小節では、まず我々の方法論の背景を紹介する。次に、NSAの全体フレームワークを示し、続いてその主要なアルゴリズム構成要素を提示する。最後に、実用的な効率を最大化するハードウェア最適化カーネル設計について詳述する。
3.1. 背景
注意機構は言語モデリングにおいて広く用いられており、各クエリトークン が先行するすべてのキー に対して関連度スコアを計算し、値 の重み付き和を生成する。形式的には、長さ の入力系列に対して、注意演算は次のように定義される:
ここで、Attn は注意関数を表す:
ここで、 は と の間の注意重みを表し、 はキーの特徴次元である。系列長が増加するにつれて、注意計算は全体の計算コストにおいてますます支配的になり、長文脈処理に重大な課題をもたらす。
演算強度は、計算演算とメモリアクセスの比率である。これは本質的にハードウェア上のアルゴリズム最適化を形作る。各GPUは、そのピーク計算能力とメモリ帯域幅によって決まる臨界演算強度を持ち、これはこれら二つのハードウェア限界の比率として計算される。計算タスクにおいて、この臨界閾値を上回る演算強度は計算バウンド(GPUのFLOPSによって制限される)となり、下回る場合はメモリバウンド(メモリ帯域幅によって制限される)となる。
特に因果的自己注意機構については、訓練およびプロファイリングの段階において、バッチ化された行列積と注意計算が高い演算強度を示し、これらの段階を現代のアクセラレータ上で計算バウンドにする。対照的に、自己回帰デコーディングは、一回のフォワードパスごとに一つのトークンを生成する一方で、キー・バリューキャッシュ全体をロードする必要があるため、演算強度が低くなり、メモリ帯域幅に制約される。これは異なる最適化目標につながる——訓練およびプリフィリング時には計算コストを削減し、デコーディング時にはメモリアクセスを削減する。
3.2. 全体フレームワーク
自然な疎パターンを持つ注意の潜在能力を活用するため、我々は式(1)における元のキー・バリューペア を、各クエリ に対して与えられる、よりコンパクトで情報密度の高い表現キー・バリューペアの集合 に置き換えることを提案する。具体的には、最適化された注意出力を次のように形式的に定義する:
ここで、 は現在のクエリ と文脈メモリ に基づいて動的に構築される。我々は様々なマッピング戦略を設計して、異なるカテゴリの を得て、それらを次のように組み合わせることができる:
図2に示すように、NSAは三つのマッピング戦略 を持ち、それぞれキーと値に対する圧縮、選択、スライディングウィンドウを表す。 は対応する戦略 のゲートスコアであり、入力特徴からMLPおよびシグモイド活性化を介して導出される。 を再マッピングされたキー/値の総数とする:
我々は を保証することで高い疎性比率を維持する。
3.3. アルゴリズム設計
本小節では、我々の再マッピング戦略 および の設計を紹介する:トークン圧縮、トークン選択、スライディングウィンドウである。
3.3.1. トークン圧縮
キーまたは値の連続ブロックをブロックレベルの表現に集約することにより、ブロック全体の情報を捉える圧縮されたキーと値を得る。形式的には、圧縮キー表現は次のように定義される:
ここで、 はブロック長、 は隣接ブロック間のスライディングストライド、 はブロック内位置エンコーディングを伴う学習可能なMLPであり、ブロック内のキーを単一の圧縮キーにマッピングする。 は圧縮キーから構成されるテンソルである。通常、情報の断片化を緩和するために を採用する。圧縮値表現 についても同様の定式化が成り立つ。圧縮表現は、より粗い粒度の高レベルな意味情報を捉え、注意の計算負担を軽減する。
3.3.2. トークン選択
圧縮キーのみを用いると、値は重要な細粒度情報を失う可能性があり、そのため我々は個々のキー、値を選択的に保存する動機付けを得る。以下では、低い計算オーバーヘッドで最も関連性の高いトークンを特定し保存する、我々の効率的なトークン選択機構について説明する。
ブロックワイズ選択。我々の選択戦略は、キーおよび値の系列を空間的に連続したブロックで処理する。これは二つの主要な要因に動機付けられている:ハードウェア効率の考慮と注意スコアの内在的な分布パターンである。ブロックワイズ選択は、現代のGPU上で効率的な計算を実現するために極めて重要である。なぜなら、現代のGPUアーキテクチャは、ランダムなインデックスベースの読み取りと比較して、連続したブロックアクセスに対して著しく高いスループットを示すからである。また、ブロックワイズ計算はTensor Coreの最適な利用を可能にする。このアーキテクチャ上の特性は、FlashAttentionのブロックベース設計に例示されるように、ブロックワイズなメモリアクセスと計算を高性能注意力実装における基本原則として確立してきた。ブロックワイズ選択は、注意スコアの内在的な分布パターンに従う。先行研究(Jiang et al., 2024)は、注意スコアがしばしば空間的連続性を示し、隣接するキーが類似した重要度レベルを共有する傾向があることを示している。6.2節における我々の可視化もこの空間的連続パターンを示している。
ブロックワイズ選択を実装するために、我々はまずキー、値の系列を選択ブロックに分割する。注意計算にとって最も重要なブロックを特定するために、各ブロックに重要度スコアを割り当てる必要がある。以下では、これらのブロックレベル重要度スコアを計算する我々の方法を提示する。
重要度スコア計算。ブロック重要度スコアの計算は、大きなオーバーヘッドを導入する可能性がある。幸いなことに、圧縮トークンの注意計算は中間注意スコアを生成し、これを用いて選択ブロックの重要度スコアを導出することができる。その定式化は次のとおりである:
ここで、\(\mathbf{p}_t^{\mathrm{cmp}} \in \mathbb{R}^{\lfloor \frac{l - l}{d}\rfloor +1}\) は \(q_t\) と圧縮キー \(\tilde{\kappa}_t^{\mathrm{cmp}}\) との間のアテンションスコアである。\(l'\) を選択ブロックサイズと表す。圧縮ブロックと選択ブロックが同じブロッキング方式を共有する場合、すなわち \(l' = l = d\) のとき、選択ブロックの重要度スコア \(\mathbf{p}_t^{\mathrm{slc}}\) を \(\mathbf{p}_t^{\mathrm{slc}} = \mathbf{p}_t^{\mathrm{cmp}}\) によって直接的に得ることができる。ブロッキング方式が異なる場合には、選択ブロックの重要度スコアをそれらの空間的関係に従って導出する。\(l \leqslant l'\)、\(d \mid l\)、および \(d \mid l'\) が与えられたとき、次を得る:
ここで、\([\cdot ]\) はベクトル要素にアクセスするためのインデックス演算子を表す。キー・バリューキャッシュがクエリヘッド間で共有されるGQAやMQAを採用するモデルでは、デコーディング中のKVキャッシュの読み込みを最小化するために、これらのヘッド間で一貫したブロック選択を確保しなければならない。グループ内のヘッド間で共有される重要度スコアは、形式的に次のように定義される:
ここで、上付きの \((h)\) はヘッドインデックスを表し、\(H\) は各グループ内のクエリヘッドの数である。この集約により、同一グループ内のヘッド間で一貫したブロック選択が保証される。
Top-\(n\) ブロック選択。選択ブロックの重要度スコアを取得した後、ブロック重要度スコアによってランク付けされた上位\(n\)個のスパースブロック内のトークンを保持する。これは次のように定式化される:
ここで、rank \((\cdot)\) は降順でのランキング位置を表し、rank \(= 1\) が最高スコアに対応し、\(\mathcal{I}{t}\) は選択されたブロックのインデックスの集合であり、Catは連結演算を表す。\(\tilde{K}{t}^{\mathrm{slc}} \in \mathbb{R}^{d_{k} \times n l^{\prime}}\) は圧縮キーによって構成されるテンソルである。同様の定式化が細粒度のバリュー \(\tilde{V}{t}^{\mathrm{slc}}\) にも適用される。選択されたキーとバリューは、その後、式(5)で定義される \(\mathbf{q}{t}\) とのアテンション計算に参加する。
3.3.3. スライディングウィンドウ
アテンション機構において、局所的なパターンは通常より速く適応し、学習プロセスを支配する可能性があり、モデルが圧縮トークンや選択トークンから効果的に学習することを妨げる可能性がある。この問題に対処するため、我々は局所的な文脈を明示的に処理する専用のスライディングウィンドウ分岐を導入し、他の分岐(圧縮および選択)が局所パターンによってショートカットされることなく、それぞれの特徴の学習に集中できるようにする。具体的には、ウィンドウ内の直近のトークンを保持し、異なる情報源(圧縮トークン、選択トークン、スライディングウィンドウ)のアテンション計算を別々の分岐に分離する。これらの分岐の出力は、学習されたゲーティング機構を通じて集約される。さらに、わずかな計算オーバーヘッドで分岐間のショートカット学習を防ぐため、3つの分岐に独立したキーと値を提供する。このアーキテクチャ設計により、局所パターン認識と長距離パターン認識の間の勾配干渉を防ぎつつ、最小限のオーバーヘッドで安定した学習が可能となる。
3カテゴリすべてのキーと値を取得した後、式(5)に従って最終的なアテンション出力を計算する。上述の圧縮、選択、スライディングウィンドウ機構と合わせて、これがNSAの完全なアルゴリズムフレームワークを形成する。
3.4. カーネル設計
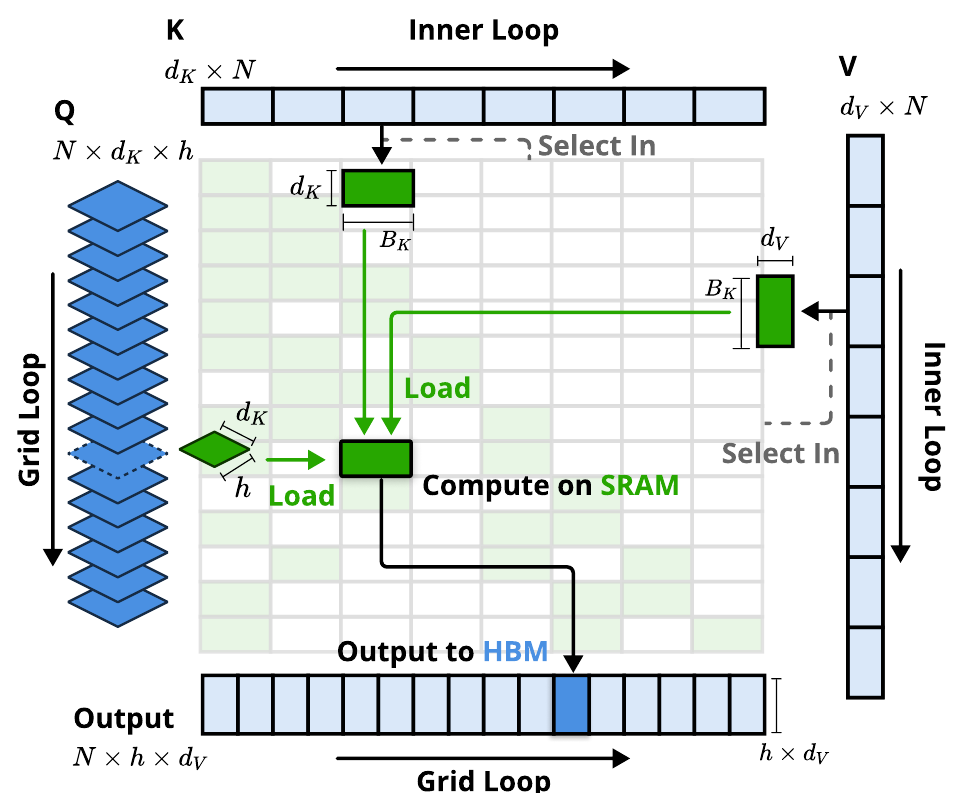
訓練およびプロファイリング中にFlashAttentionレベルの高速化を実現するため、我々はTriton上にハードウェアに整合した疎アテンションカーネルを実装する。MHAはメモリ集約的でありデコーディングには非効率であるため、我々は現在の最先端LLMに倣い、GQAやMQAのようなKVキャッシュを共有するアーキテクチャに焦点を当てる。圧縮およびスライディングウィンドウのアテンション計算は既存のFlashAttention-2カーネルと容易に互換性がある一方で、我々は疎選択アテンションのための専用カーネル設計を導入する。仮にFlashAttentionの戦略に従って時間的に連続するクエリブロックをSRAMにロードすると、ブロック内のクエリが互いに素なKVブロックを必要とする可能性があるため、非効率なメモリアクセスを招くことになる。これに対処するため、我々の鍵となる最適化は異なるクエリグループ化戦略にある。すなわち、クエリシーケンス上の各位置について、GQAグループ内のすべてのクエリヘッド(これらは同じ疎KVブロックを共有する)をSRAMにロードする。図3は我々のフォワードパス実装を示している。提案するカーネルアーキテクチャは以下の主要な特徴を備えている:
1. グループ中心のデータローディング。各内側ループについて、位置におけるグループ内のすべてのヘッドのクエリと、それらが共有する疎キー/値ブロックインデックスをロードする。
2. 共有KVフェッチング。内側ループにおいて、でインデックス付けされた連続するキー/値ブロックを、としてSRAMに順次ロードし、メモリロードを最小化する。ここではを満たすカーネルブロックサイズである。
3. グリッド上の外側ループ。内側ループの長さ(選択ブロック数に比例)は異なるクエリブロック間でほぼ同一に保たれるため、クエリ/出力のループをTritonのグリッドスケジューラに配置し、カーネルを簡素化および最適化する。
この設計は、(1) グループ単位の共有による冗長なKV転送の排除、および (2) GPUストリーミングマルチプロセッサ間での計算ワークロードのバランスにより、ほぼ最適な演算強度を達成する。
4. 実験
我々はNSAを3つの観点から評価する:(1) 一般ベンチマーク性能、(2) 長文脈ベンチマーク性能、(3) 連鎖的思考推論性能であり、Full Attentionベースラインおよび最先端の疎アテンション手法と比較する。我々の疎計算パラダイムの効率分析については、訓練および推論速度に関する詳細な議論を行うセクション5に譲る。
4.1. 事前学習の設定
最先端LLMにおける一般的な慣行に従い、我々の実験ではGrouped-Query Attention(GQA)とMixture-of-Experts(MoE)を組み合わせたバックボーンを採用し、総パラメータ27B、活性パラメータ3Bを特徴とする。モデルは30層からなり、隠れ次元は2560である。GQAについては、グループ数を4に設定し、合計64のアテンションヘッドを持つ。各ヘッドについて、クエリ、キー、値の隠れ次元はそれぞれおよびに設定される。MoEについては、DeepSeekMoE(Dai et al., 2024; DeepSeek-AI, 2024)構造を利用し、72のルーティングエキスパートと2の共有エキスパートを持ち、top-kエキスパートを6に設定する。訓練の安定性を確保するため、最初の層のMoEはSwiGLU形式のMLPに置き換えられる。
| モデル | MMLU Acc. 5-shot | MMLU-PRO Acc. 5-shot | CMMLU Acc. 5-shot | BBH Acc. 3-shot | GSM8K Acc. 8-shot | MATH Acc. 4-shot | DROP F1 1-shot | MBPP Pass@1 3-shot | HumanEval Pass@1 0-shot | 平均 |
| Full Attn | 0.567 | 0.279 | 0.576 | 0.497 | 0.486 | 0.263 | 0.503 | 0.482 | 0.335 | 0.443 |
| NSA | 0.565 | 0.286 | 0.587 | 0.521 | 0.520 | 0.264 | 0.545 | 0.466 | 0.348 | 0.456 |
表1 | 知識(MMLU、MMLU-PRO、CMMLU)、推論(BBH、GSM8K、MATH、DROP)、コーディング(MBPP、HumanEval)タスクにわたる一般ベンチマークにおける、Full AttentionベースラインとNSAの事前学習性能比較。NSAは高い疎性にもかかわらず、ほとんどのベンチマークで優れた平均性能を達成している。
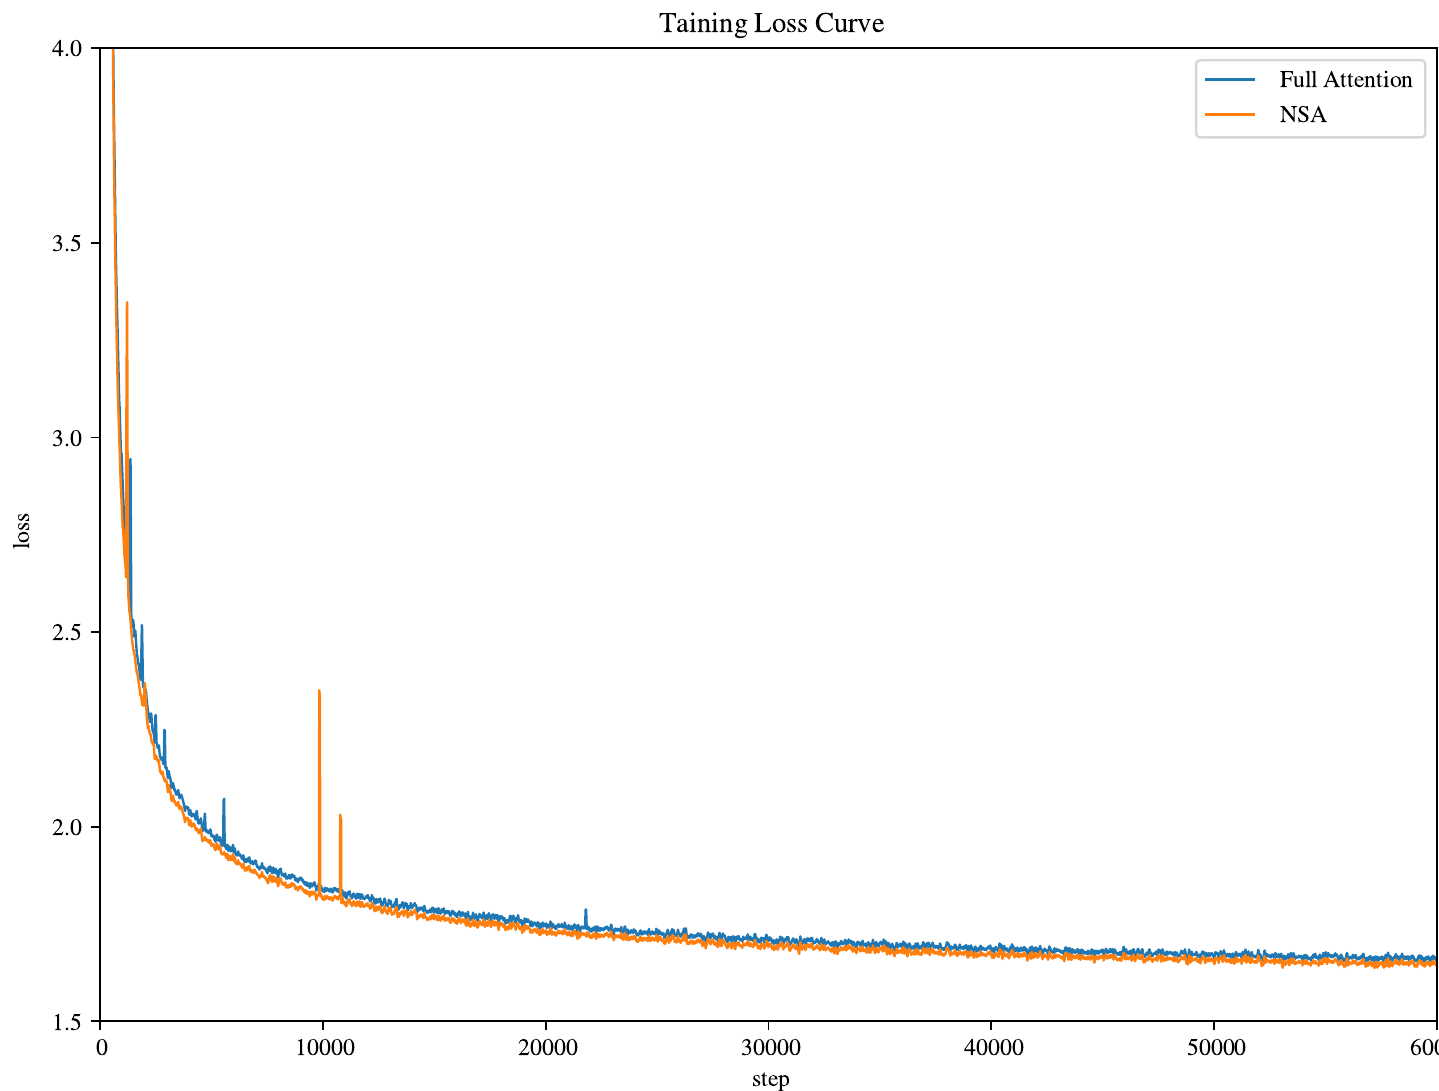
提案するアーキテクチャは、計算コストとモデル性能の間の効果的なトレードオフを達成する。NSAについては、圧縮ブロックサイズ、スライディングストライド、選択ブロックサイズ、選択ブロック数(初期1ブロックと局所2ブロックの固定活性化を含む)、スライディングウィンドウサイズに設定する。Full Attentionと疎アテンションモデルの両方は、8k長のテキスト270Bトークンで事前学習され、その後、長文脈適応を達成するためにYaRN(Peng et al., 2024)を用いて32k長のテキストで継続訓練および教師ありファインチューニングされる。両モデルは公正な比較を確保するため完全に収束するまで訓練される。図4に示すように、我々のNSAとFull Attentionベースラインの事前学習損失曲線は安定かつ滑らかな減少を示し、NSAは一貫してFull Attentionモデルを上回っている。
4.2. ベースライン手法
Full Attentionとの比較に加えて、我々はいくつかの最先端の推論段階の疎アテンション手法を評価する:H2O(Zhang et al., 2023b)、infLLM(Xiao et al., 2024a)、Quest(Tang et al., 2024)、およびExact-Topである。Exact-Topはまず完全なアテンションスコアを計算し、各クエリに対応する上位スコアのキーを選択し、その後これらの位置でアテンションを計算する。これらの手法は、KVキャッシュの退避、クエリアウェアな選択、正確なtop-疎選択を含む多様な疎アテンションパラダイムに及ぶ。
| モデル | SQA | MQA | 合成 | CodeLCC | 平均 | ||||||
| MFQA-en | MFQA-zh | Qasper | HPQ | 2Wiki | GovRpt | Dur | PassR-en | PassR-zh | |||
| H2O | 0.428 | 0.429 | 0.308 | 0.112 | 0.101 | 0.231 | 0.208 | 0.704 | 0.421 | 0.092 | 0.303 |
| InfLLM | 0.474 | 0.517 | 0.356 | 0.306 | 0.250 | 0.277 | 0.257 | 0.766 | 0.486 | 0.143 | 0.383 |
| Quest | 0.495 | 0.561 | 0.365 | 0.295 | 0.245 | 0.293 | 0.257 | 0.792 | 0.478 | 0.135 | 0.392 |
| Exact-Top | 0.502 | 0.605 | 0.397 | 0.321 | 0.288 | 0.316 | 0.291 | 0.810 | 0.548 | 0.156 | 0.423 |
| Full Attn | 0.512 | 0.623 | 0.409 | 0.350 | 0.305 | 0.324 | 0.294 | 0.830 | 0.560 | 0.163 | 0.437 |
| NSA | 0.503 | 0.624 | 0.432 | 0.437 | 0.356 | 0.307 | 0.341 | 0.905 | 0.550 | 0.232 | 0.469 |
表2 | 単一ドキュメントQA、複数ドキュメントQA、合成およびコードタスクカテゴリのサブセットを含むLongBenchにおける、我々のNSAとベースラインの性能比較。NSAはFull Attentionを含むほとんどのベースラインを上回った。
一般的な評価では、ほとんどのサンプルの長さが疎アテンションベースラインの局所文脈ウィンドウ内に収まるため、これらの手法は事実上Full Attentionと等価である。したがって、この設定ではNSAとFull Attentionベースラインの比較結果のみを示す。長文脈評価では、すべてのベースライン手法にわたって比較を行い、公正な比較を確保するためすべての疎アテンション手法の疎性を同一に設定する。長文の教師ありファインチューニングを必要とする連鎖的思考推論評価では、疎アテンションベースラインは訓練をサポートしないため、比較をFull Attentionに限定する。
4.3. 性能比較
一般評価。我々は事前学習済みのNSAとFull Attentionベースラインを、知識、推論、コーディング能力にわたる包括的なベンチマークスイート上で評価した。これにはMMLU(Hendrycks et al., 2020)、MMLU-PRO(Wang et al., 2024)、CMMLU(Li et al., 2023)、BBH(Suzgun et al., 2022)、GSM8K(Cobbe et al., 2021)、MATH(Hendrycks et al., 2020)、DROP(Dua et al., 2019)、MBPP(Austin et al., 2021)、HumanEval(Chen et al., 2021)が含まれる。結果を表1に示す。その疎性にもかかわらず、NSAは優れた総合性能を達成し、9つの指標のうち7つでFull Attentionを含むすべてのベースラインを上回った。これは、NSAが短いシーケンス上でその効率優位性を十分に活用できない可能性があるものの、強い性能を示すことを示している。特筆すべきは、NSAが推論関連のベンチマークで顕著な向上を示すことである(DROP:、GSM8K:)。これは、我々の事前学習がモデルに特化したアテンション機構を発達させるのに役立つことを示唆している。この疎アテンション事前学習機構はモデルに最も重要な情報に集中することを強制し、無関係なアテンションパスからのノイズを除去することで性能を潜在的に向上させる。多様な評価にわたる一貫した性能はまた、NSAが汎用アーキテクチャとしての堅牢性を有することを裏付けている。
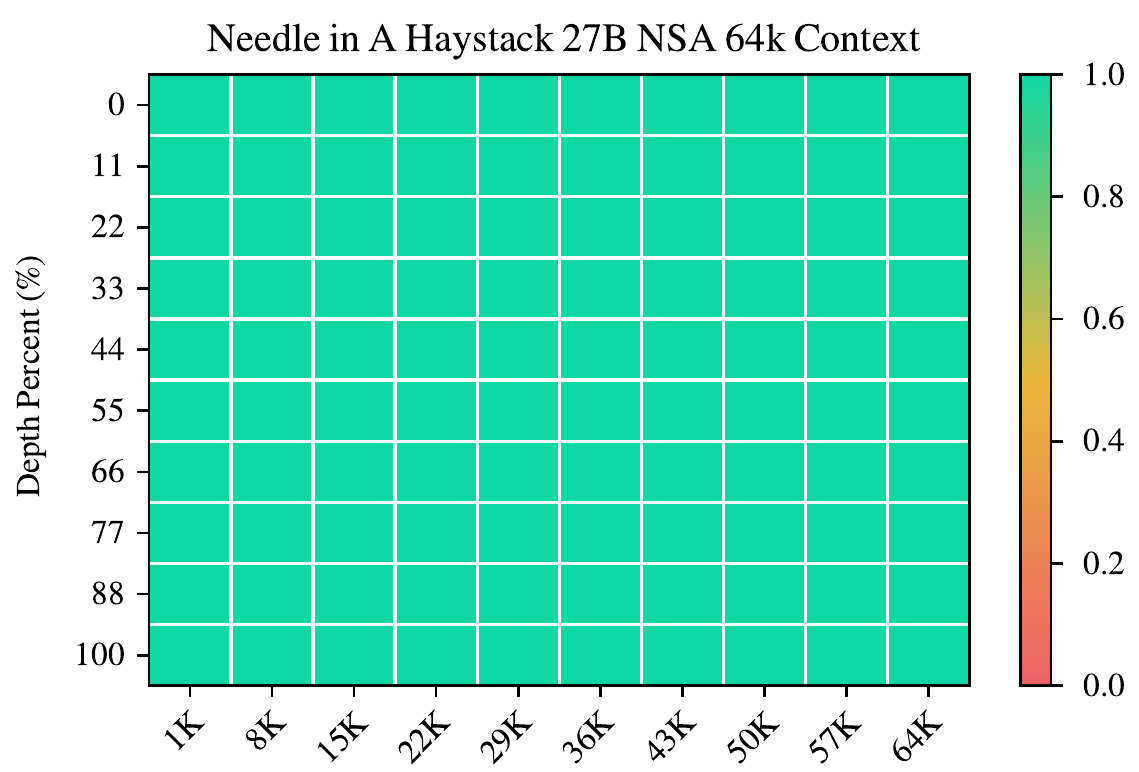
長文コンテキスト評価。図5に示すように、NSAは64kコンテキストのneedle-in-a-haystack(Kamradt, 2023)テストにおいて、すべての位置で完璧な検索精度を達成している。この性能は、効率的なグローバルコンテキストスキャンのための圧縮トークンと、正確なローカル情報検索のための選択トークンを組み合わせた、我々の階層型スパースアテンション設計に由来する。粗粒度の圧縮は低い計算コストで関連するコンテキストブロックを特定し、選択されたトークンに対するトークンレベルのアテンションが重要な細粒度情報の保持を保証する。この設計により、NSAはグローバルな認識とローカルな精度の両方を維持することができる。
また我々は、LongBench(Bai et al., 2023)上でNSAを最先端のスパースアテンション
手法およびFull Attentionベースラインと比較評価した。一貫したスパース性を確保するため、すべてのスパースアテンションベースラインにおいて各クエリが活性化するトークンを2560トークンに設定した。これは、32k系列長を処理する際にNSAが平均的に活性化するトークン数に相当する。Stream-LLM(Xiao et al., 2023)に従い、このトークン予算には先頭128トークンと512のローカルトークンが含まれる。LongBenchからは、すべてのモデルでスコアが低く、意味のある比較を提供しない可能性がある一部のサブセットを除外した。表2に示すように、NSAは平均スコア0.469で最高値を達成し、すべてのベースラインを上回った(Full Attentionに対して+0.032、Exact-Topに対して+0.046)。この改善は2つの重要な革新に起因する:(1)我々のネイティブなスパースアテンション設計は、事前学習中にスパースパターンのエンドツーエンド最適化を可能にし、スパースアテンションモジュールと他のモデル構成要素との同期した適応を促進する;(2)階層型スパースアテンション機構が、ローカル情報処理とグローバル情報処理の間のバランスを実現する。
特筆すべきは、NSAが長いコンテキストに対する複雑な推論を必要とするタスクで卓越した性能を示し、マルチホップQAタスク(HPQおよび2Wiki)でFull Attentionに対して+0.087および+0.051の改善を達成し、コード理解(LCC: +0.069)でベースラインの性能を上回り、パッセージ検索(PassR-en: +0.075)で他の手法を上回ったことである。これらの結果は、NSAが多様な長文コンテキストの課題を処理する能力を裏付けており、ネイティブに事前学習されたスパースアテンションがタスク最適なパターンの学習において追加の利点を提供している。
思考連鎖推論評価。NSAと高度な下流学習パラダイムとの互換性を評価するため、ポストトレーニングを通じて思考連鎖の数学的推論能力を獲得する能力を調査した。小規模モデルに対する強化学習の有効性が限定的であることを踏まえ、DeepSeek-R1からの知識蒸留を採用し、32k長の数学的推論トレース10Bトークンを用いて教師ありファインチューニング(SFT)を実施した。これにより2つの比較可能なモデルが得られた:Full Attention-R(Full Attentionベースライン)とNSA-R(我々のスパース変種)である。両モデルを難易度の高いAmerican Invitational Mathematics Examination(AIME 24)ベンチマークで評価した。サンプリング温度0.7、top-値0.95を用いて各問題につき16の回答を生成し、平均スコアを算出した。推論深度の影響を検証するため、8kおよび16kトークンの2つの生成コンテキスト上限で実験を行い、拡張された推論連鎖が精度を向上させるかどうかを測定した。モデル予測の比較例は付録Aに示す。
| 生成トークン上限 | 8192 | 16384 |
| Full Attention-R | 0.046 | 0.092 |
| NSA-R | 0.121 | 0.146 |
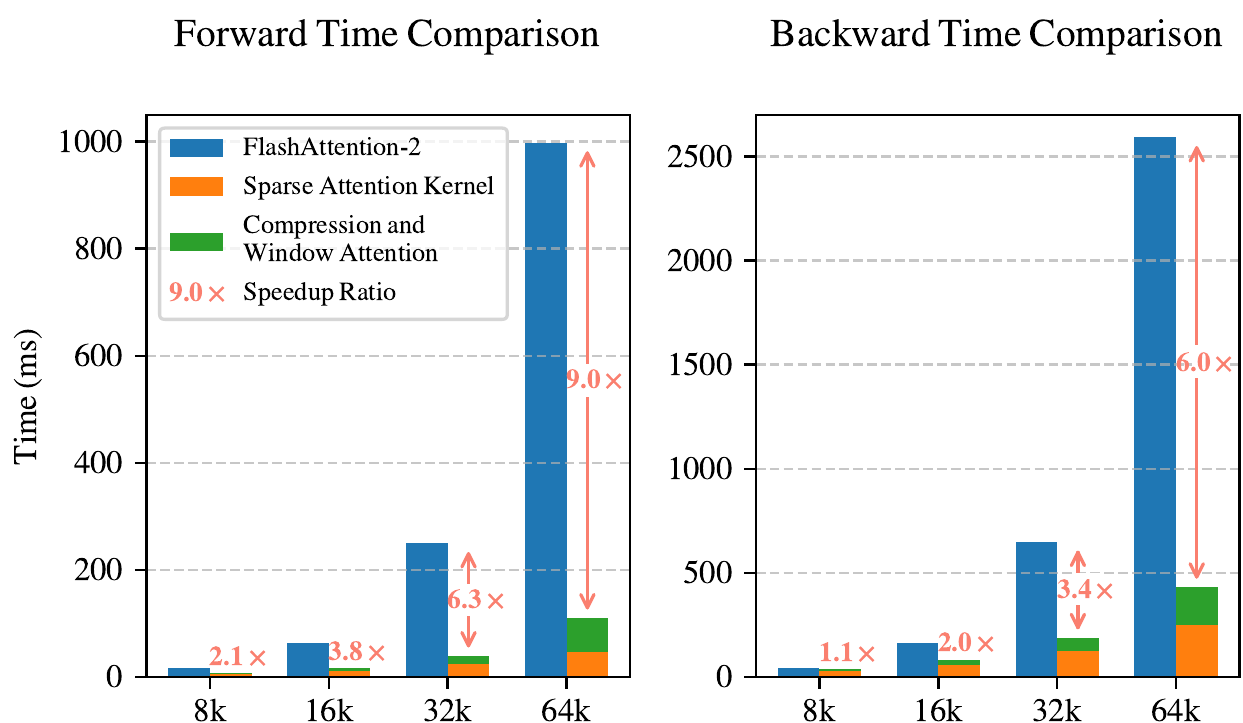
図6 | TritonベースのNSAカーネルとTritonベースのFlashAttention-2カーネルの比較。我々の実装はすべてのコンテキスト長においてレイテンシを大幅に削減し、入力長が増加するにつれてその改善はより顕著になる。
表3に示すように、NSA-Rは8kコンテキスト設定においてFull Attention-Rよりも大幅に高い精度を達成し(+0.075)、この優位性は16kコンテキストでも持続する(+0.054)。これらの結果は、ネイティブ疎注意の2つの重要な利点を実証している:(1) 事前学習された疎注意パターンにより、複雑な数学的導出に不可欠な長距離の論理的依存関係を効率的に捉えることが可能になる;(2) 我々のアーキテクチャのハードウェア整合設計は、破滅的忘却を伴うことなく、増大する推論深度を支えるのに十分なコンテキスト密度を維持する。コンテキスト長全体にわたる一貫した優位性は、トレーニングパイプラインにネイティブに統合された場合の疎注意の高度な推論タスクに対する実現可能性を裏付けている。
5. 効率分析
我々は8-GPU A100システム上で、NSAの計算効率をFull Attentionと比較評価する。効率分析では、モデルをGQAグループ 、グループあたりのヘッド数 、クエリ/キー次元 、バリュー次元 で構成する。セクション4と同じ設定に従い、NSAの圧縮ブロックサイズ 、スライディングストライド 、選択ブロックサイズ 、選択ブロック数 、スライディングウィンドウサイズ を設定する。
5.1. トレーニング速度
同一バックエンド間での公平な速度比較を確保するため、我々はNSA注意とFull AttentionのTritonベース実装を、TritonベースのFlashAttention-2と比較する。図6に示すように、我々のNSAはコンテキスト長が増加するにつれて徐々に大きな高速化を達成し、64kコンテキスト長において最大 のフォワード高速化と のバックワード高速化を実現する。特筆すべきは、速度上の優位性がより長いシーケンスでより顕著になることである。この高速化は、疎注意アーキテクチャの効率を最大化するための我々の
| コンテキスト長 | 8192 | 16384 | 32768 | 65536 |
| Full Attention | 8192 | 16384 | 32768 | 65536 |
| NSA | 2048 | 2560 | 3584 | 5632 |
| 予想される高速化 | 4× | 6.4× | 9.1× | 11.6× |
ハードウェア整合アルゴリズム設計に由来する:(1) ブロック単位のメモリアクセスパターンは、コアレスドロードを通じてTensor Coreの利用率を最大化する;(2) カーネルにおける緻密なループスケジューリングが冗長なKV転送を排除する。
5.2. デコーディング速度
Attentionのデコーディング速度は主にメモリアクセスのボトルネックによって決定され、これはKVキャッシュのロード量と密接に関係している。各デコーディングステップにおいて、我々のNSAは最大で 個の圧縮トークン、 個の選択トークン、および 個の近傍トークンをロードするだけでよく、ここで はキャッシュされたシーケンス長である。表4に示すように、我々の手法はデコーディング長が増加するにつれてレイテンシの大幅な削減を示し、64kコンテキスト長において最大 の高速化を達成する。メモリアクセス効率におけるこの優位性もまた、より長いシーケンスで増幅される。
6. 議論
本節では、NSAの開発プロセスを振り返り、様々な疎注意戦略の探求から得られた主要な洞察について議論する。我々のアプローチは有望な結果を示しているが、代替戦略で遭遇した課題を理解し、注意パターンを分析することは、将来の研究方向性にとって貴重な文脈を提供する。まず、我々の設計上の選択の動機となった代替トークン選択戦略の課題を検討し、続いて注意分布パターンへの洞察を提供する可視化を示す。
6.1. 代替トークン選択戦略の課題
NSAを設計する前に、我々は既存の疎注意手法をトレーニング段階に適応させることを探求した。しかし、これらの試みは様々な課題に遭遇し、異なる疎注意アーキテクチャを設計するに至った:
キークラスタリングベースの戦略。我々はClusterKV(Liu et al., 2024)のようなクラスタリングベースの戦略を検討した。これらの手法は、同じクラスタからのキーとバリューを連続したメモリ領域に格納する。理論的にはトレーニングと推論の両方に実行可能であるが、3つの重大な課題に直面する:(1) 動的クラスタリング機構によってもたらされる無視できない計算オーバーヘッド;(2) クラスタ間の不均衡によって悪化する演算子最適化の困難さ、特にMixture-of-Experts(MoE)システムにおいて、偏ったExpert Parallelism(EP)グループの実行時間が持続的な負荷不均衡を引き起こす;(3) 必須の定期的な再クラスタリングとチャンク順次トレーニングプロトコルの必要性から生じる実装上の制約。これらの複合的な要因が実質的なボトルネックを生み出し、実世界での展開における有効性を大幅に制限している。
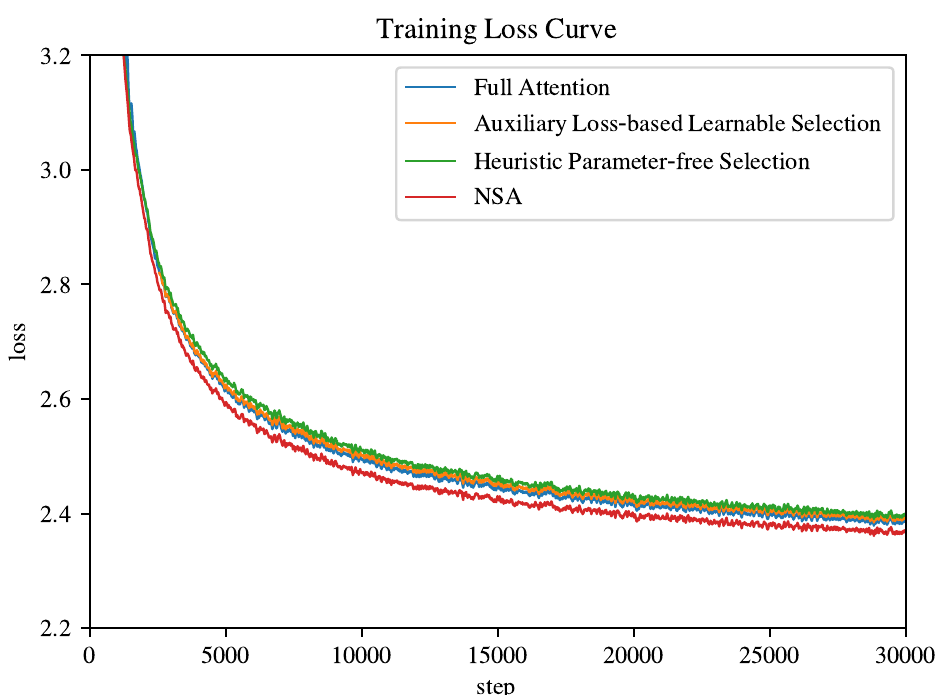
他のブロック単位選択戦略。我々はまた、NSAとは異なるブロック単位のキー・バリュー選択戦略、例えばQuest(Tang et al. [2024])やInfLLM(Xiao et al. [2024a])も検討した。これらの手法は、各KVブロックの重要度スコアを計算し、 との類似度に基づいて上位 個のブロックを選択することに依拠している。しかし、既存の手法は2つの重大な問題に直面する:(1) 選択操作が微分不可能であるため、ニューラルネットワークに基づく重要度スコア計算は補助損失に依存し、これが演算子オーバーヘッドを増加させ、しばしばモデル性能を劣化させる;(2) ヒューリスティックなパラメータフリーの重要度スコア計算戦略は再現率が低く、準最適な性能につながる。我々は両方のアプローチを、類似したアーキテクチャを持つ3Bパラメータモデル上で評価し、それらの損失曲線をNSAおよびFull Attentionと比較した。補助損失ベースの選択手法については、ブロック重要度スコアを推定するために各トークンに対する追加のクエリと各ブロックに対する代表キーを導入する。各キーブロック内の注意スコアを平均プーリングすることでブロックレベルの教師信号を計算し、KLダイバージェンスを用いてブロック重要度予測を監督する。効率的なデコーディングに対応するため、ブロック平均化されたクエリではなく個別のクエリ粒度を維持する。この補助損失ベースの重要度推定は、概念的にはSeerAttention(Gao et al. [2024])と類似している。ヒューリスティックなパラメータフリー選択手法については、Questの戦略に従い、追加のパラメータを導入することなく、クエリとキーチャンクの座標ごとのmin-maxとの積を用いた直接選択を実装する。また、初期1000ステップでFull Attentionを適用してからヒューリスティックなブロック単位選択に移行するコールドスタートトレーニングアプローチも探求した。図7に示すように、両手法はより劣った損失を示した。
6.2. 可視化
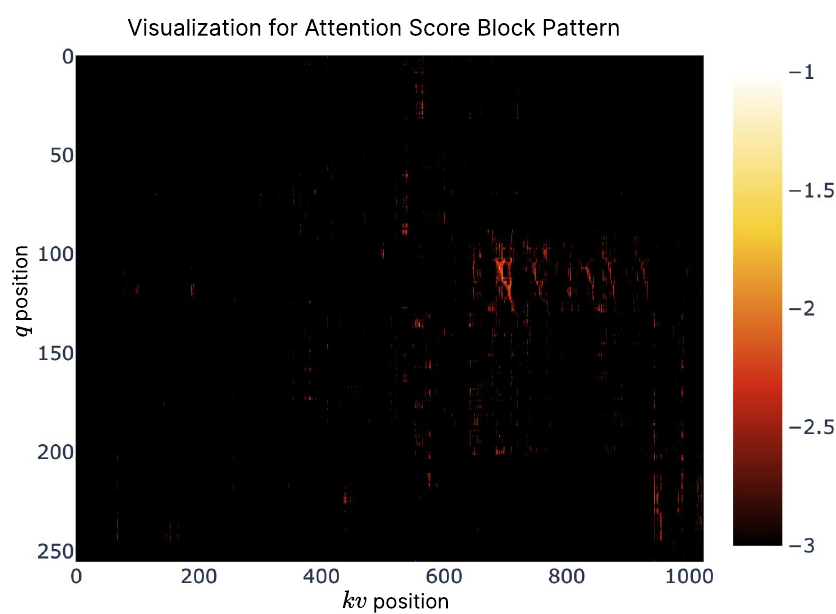
Transformerの注意分布における潜在的なパターンを探求し、我々の設計への着想を得るため、事前学習済み27B Full Attentionモデルからの注意マップを図8に可視化する。この可視化は、注意スコアがブロック単位のクラスタリング特性を示す傾向があり、近傍のキーがしばしば類似した注意スコアを示すという興味深いパターンを明らかにする。この観察はNSAの設計に着想を与え、空間的連続性に基づいてキーブロックを選択することが有望なアプローチである可能性を示唆した。ブロック単位のクラスタリング現象は、シーケンス内で隣接するトークンがクエリトークンと特定の意味的関係を共有する可能性があることを示しているが、これらの関係の正確な性質についてはさらなる調査が必要である。この観察は、計算効率を高め高い注意パターンを保持することを目指して、個々のトークンではなく連続したトークンブロック上で動作する疎注意機構を探求する動機となった。
7. 関連研究
我々は、疎注意を通じて注意計算の効率を改善する既存のアプローチをレビューする。これらの手法は、その中核戦略に基づいて大きく3つのグループに分類できる:(1) 固定疎パターン、(2) 動的トークンプルーニング、(3) クエリ認識選択。各カテゴリからいくつかの代表的な研究を紹介する。
7.1. 固定疎パターン
SlidingWindowは、クエリが固定ウィンドウ内でのみ注意を計算することを可能にする、一般的に用いられるアプローチである。StreamingLLM(Xiao et al., 2023)は、注意シンクとローカルウィンドウを組み合わせて連続的なテキストストリームを処理する。MoA(Fu et al., 2024a)とDuoAttention(Xiao et al., 2024b)も、長シーケンスモデリングのために類似したローカルおよびシンク情報を採用している。Longformer(Beltagy et al., 2020)は、ローカルウィンドウ注意とグローバルトークンを交互に配置して長シーケンスを処理する。これらと比較して、我々のNSAは事前定義された疎パターンに依存せず、パターンを自動的に学習し、完全なコンテキストを活用する可能性を切り開く。
7.2. 動的トークンプルーニング
一部の手法は、推論中の動的KVキャッシュプルーニングを通じてメモリと計算コストを削減するように設計されている。H2O(Zhang et al., 2023b)、BUZZ(Zhao et al., 2024)、およびSepLLM(Chen et al., 2024a)は、デコーディング中のKVキャッシュメモリ使用量を削減するための適応的アプローチを実装している。これらの手法は、将来の予測にとって重要度が低いと見なされたトークンを動的に追い出す。FastGen(Ge et al., 2023)とHeadKV(Fu et al., 2024b)は、個々の注意ヘッドに異なる戦略を割り当てることで計算を最適化する。SnapKV(Li et al., 2024)は、最も重要な特徴のみを選択的に保持することでKVキャッシュを削減し、効率的なメモリ使用を可能にするトークンプルーニング戦略を導入している。これらの推論に焦点を当てたアプローチとは異なり、我々のNSAはトレーニング段階において疎性をネイティブに組み込んでいる。
7.3. クエリ認識選択
他の研究は、アテンションの品質を保ちつつアテンション計算を削減するために、クエリ依存のトークン選択手法に焦点を当てている。Quest(Tang et al., 2024)はブロック単位の選択戦略を採用しており、各チャンクの重要度はクエリとキーチャンクの座標ごとの最小値・最大値との積によって推定される。InfLLM(Xiao et al., 2024a)は、アテンションシンク、ローカルコンテキスト、および取得可能なチャンクを維持することにより、固定パターンと検索を組み合わせている。この手法は各チャンクから代表的なキーを選択してチャンクの重要度を推定する。HashAttention(Desai et al., 2024)は、学習された関数を用いてクエリとキーをハミング空間に写像することにより、重要なトークンの識別を推薦問題として定式化する。ClusterKV(Liu et al., 2024)は、まずキーをクラスタリングし、次にクエリとクラスタの類似度に基づいてアテンション計算に最も関連するクラスタを選択することにより、スパース性を実現する。MInference(Jiang et al., 2024)とTokenSelect(Wu et al., 2024)は、トークンレベルの重要度スコアリングに基づいて計算対象のKVペアを選択する。SeerAttention(Gao et al., 2024)はクエリとキーを空間的ブロックに分割し、効率的な計算のためにブロック単位の選択を行う。これらの手法と比較して、我々のNSAは、訓練、プリフィリング、デコーディングを含むモデルのライフサイクル全体を通じて、ハードウェアに整合したスパースアテンション計算を実現する。
8. 結論
我々は、効率的な長文コンテキストモデリングのためのハードウェアに整合したスパースアテンションアーキテクチャであるNSAを提示する。学習可能なアーキテクチャ内で階層的トークン圧縮とブロック単位のトークン選択を統合することにより、我々のアーキテクチャはFull Attentionの性能を維持しながら、訓練と推論の高速化を実現する。NSAは、一般的なベンチマーク性能がフルアテンションのベースラインと一致すること、長文コンテキスト評価においてモデリング能力を上回ること、および推論能力の向上を実証し、いずれも計算レイテンシの測定可能な削減を伴い、大幅な高速化を達成することにより、最先端を前進させる。
参考文献
J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón, and S. Sanghai. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. arXiv preprint arXiv:2305.13245, 2023. J. Austin, A. Odena, M. Nye, M. Bosma, H. Michalewski, D. Dohan, E. Jiang, C. Cai, M. Terry, Q. Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021. Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Zeng, L. Hou, et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508, 2023. I. Beltagy, M. E. Peters, and A. Cohan. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150, 2020. G. Chen, H. Shi, J. Li, Y. Gao, X. Ren, Y. Chen, X. Jiang, Z. Li, W. Liu, and C. Huang. Sepllm: Accelerate large language models by compressing one segment into one separator. arXiv preprint arXiv:2412.12094, 2024a. M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. D. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. Z. Chen, R. Sadhukhan, Z. Ye, Y. Zhou, J. Zhang, N. Nolte, Y. Tian, M. Douze, L. Bottou, Z. Jia, et al. Magicpig: Lsh sampling for efficient llm generation. arXiv preprint arXiv:2410.16179, 2024b. K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. Training verifiers to solve math word problems, 2021. URL https://arxiv.org/abs/2110.14168, 2021. D. Dai, C. Deng, C. Zhao, R. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv preprint arXiv:2401.06066, 2024. DeepSeek- AI. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model. 2024. URL https://arxiv.org/abs/2405.04434DeepSeek- AI. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948
A. Desai, S. Yang, A. Cuadron, A. Klimovic, M. Zaharia, J. E. Gonzalez, and I. Stoica. Hashattention: Semantic sparsity for faster inference. arXiv preprint arXiv:2412.14468, 2024.
D. Dua, Y. Wang, P. Dasigi, G. Stanovsky, S. Singh, and M. Gardner. Drop: A reading comprehension benchmark requiring discrete reasoning over paragraphs. arXiv preprint arXiv:1903.00161, 2019.
T. Fu, H. Huang, X. Ning, G. Zhang, B. Chen, T. Wu, H. Wang, Z. Huang, S. Li, S. Yan, et al. Moa: Mixture of sparse attention for automatic large language model compression. arXiv preprint arXiv:2406.14909, 2024a.
Y. Fu, Z. Cai, A. Asi, W. Xiong, Y. Dong, and W. Xiao. Not all heads matter: A head-level kv cache compression method with integrated retrieval and reasoning. arXiv preprint arXiv:2410.19258, 2024b.
Y. Gao, Z. Zeng, D. Du, S. Cao, H. K.-H. So, T. Cao, F. Yang, and M. Yang. Seerattention: Learning intrinsic sparse attention in your llms. arXiv preprint arXiv:2410.13276, 2024.
S. Ge, Y. Zhang, L. Liu, M. Zhang, J. Han, and J. Gao. Model tells you what to discard: Adaptive kv cache compression for llms. arXiv preprint arXiv:2310.01801, 2023.
G. T. Google, P. Georgiev, V. I. Lei, R. Burnell, L. Bai, A. Gulati, G. Tanzer, D. Vincent, Z. Pan, S. Wang, et al. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv preprint arXiv:2403.05530, 2024.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
H. Jiang, Q. Wu, C.-Y. Lin, Y. Yang, and L. Qiu. Llmlingua: Compressing prompts for accelerated inference of large language models. arXiv preprint arXiv:2310.05736, 2023.
H. Jiang, Y. Li, C. Zhang, Q. Wu, X. Luo, S. Ahn, Z. Han, A. H. Abdi, D. Li, C.-Y. Lin, et al. Minference 1.0: Accelerating pre-filling for long-context llms via dynamic sparse attention. arXiv preprint arXiv:2407.02490, 2024.
G. Kamradt. LLMTest NeedleInAHaystack. GitHub repository, 2023. URL https://github.com/gkamradt/LLMTest_NeedleInAHaystack アクセス日: [ここにアクセス日を挿入].
.
.
H. Li, Y. Zhang, F. Koto, Y. Yang, H. Zhao, Y. Gong, N. Duan, and T. Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
Y. Li, Y. Huang, B. Yang, B. Venkitesh, A. Locatelli, H. Ye, T. Cai, P. Lewis, and D. Chen. Snapkv: Llm knows what you are looking for before generation. arXiv preprint arXiv:2404.14469, 2024.
.
G. Liu, C. Li, J. Zhao, C. Zhang, and M. Guo. Clusterkv: Manipulating llm kv cache in semantic space for recallable compression. arXiv preprint arXiv:2412.03213, 2024.
J. S. Park, J. C. O'Brien, C. J. Cai, M. R. Morris, P. Liang, and M. S. Bernstein. Generative agents: Interactive simulacra of human behavior. In S. Follmer, J. Han, J. Steimle, and N. H. Riche, editors, Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology, UIST 2023, San Francisco, CA, USA, 29 October 2023–1 November 2023, pages 2:1–2:22. ACM, 2023.
.
.
B. Peng, J. Quesnelle, H. Fan, and E. Shippole. Yarn: Efficient context window extension of large language models. In ICLR. OpenReview.net, 2024.
N. Shazeer. Fast transformer decoding: One write-head is all you need. CoRR, abs/1911.02150, 2019.
M. Suzgun, N. Scales, N. Schärli, S. Gehrmann, Y. Tay, H. W. Chung, A. Chowdhery, Q. V. Le, E. H. Chi, D. Zhou, et al. Challenging big-bench tasks and whether chain-of-thought can solve them. arXiv preprint arXiv:2210.09261, 2022.
J. Tang, Y. Zhao, K. Zhu, G. Xiao, B. Kasikci, and S. Han. Quest: Query-aware sparsity for efficient long-context llm inference. arXiv preprint arXiv:2406.10774, 2024.
P. Tillet, H.-T. Kung, and D. Cox. Triton: an intermediate language and compiler for tiled neural network computations. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, pages 10-19, 2019.
A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. u. Kaiser, and I. Polosukhin. Attention is all you need. Advances in Neural Information Processing Systems, 2017.
Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. Mmlu-pro: A more robust and challenging multi-task language understanding benchmark. arXiv preprint arXiv:2406.01574, 2024.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824-24837, 2022.
W. Wu, Z. Pan, C. Wang, L. Chen, Y. Bai, K. Fu, Z. Wang, and H. Xiong. Tokenselect: Efficient long-context inference and length extrapolation for llms via dynamic token-level kv cache selection. arXiv preprint arXiv:2411.02886, 2024.
C. Xiao, P. Zhang, X. Han, G. Xiao, Y. Lin, Z. Zhang, Z. Liu, and M. Sun. Infllm: Training-free long-context extrapolation for llms with an efficient context memory. In The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024a.
G. Xiao, Y. Tian, B. Chen, S. Han, and M. Lewis. Efficient streaming language models with attention sinks. arXiv preprint arXiv:2309.17453, 2023.
G. Xiao, J. Tang, J. Zuo, J. Guo, S. Yang, H. Tang, Y. Fu, and S. Han. Duoattention: Efficient long-context llm inference with retrieval and streaming heads. arXiv preprint arXiv:2410.10819, 2024b.
M. Zaheer, G. Guruganesh, K. A. Dubey, J. Ainslie, C. Alberti, S. Ontanon, P. Pham, A. Ravula, Q. Wang, L. Yang, et al. Big bird: Transformers for longer sequences. Advances in neural information processing systems, 33:17283-17297, 2020.
E. Zelikman, Y. Wu, J. Mu, N. D. Goodman. Star: Bootstrapping reasoning with reasoning. S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, A. Oh 編, Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, New Orleans, LA, USA, 2022年11月28日 - 12月9日, 2022年.
F. Zhang, B. Chen, Y. Zhang, J. Keung, J. Liu, D. Zan, Y. Mao, J. Lou, W. Chen. Repocoder: Repository-level code completion through iterative retrieval and generation. H. Bouamor, J. Pino, K. Bali 編, Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapore, 2023年12月6-10日, 2471-2484頁. Association for Computational Linguistics, 2023a.K. Zhang, J. Li, G. Li, X. Shi, Z. Jin. Codeagent: Enhancing code generation with tool-integrated agent systems for real-world repo-level coding challenges. L. Ku, A. Martins, V. Srikumar 編, Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thailand, 2024年8月11-16日, 13643-13658頁.Z. Zhang, Y. Sheng, T. Zhou, T. Chen, L. Zheng, R. Cai, Z. Song, Y. Tian, C. Ré, C. Barrett, et al. H2o: Heavy-hitter oracle for efficient generative inference of large language models. Advances in Neural Information Processing Systems, 36:34661-34710, 2023b.J. Zhao, Z. Fang, S. Li, S. Yang, S. He. Buzz: Beehive-structured sparse kv cache with segmented heavy hitters for efficient llm inference. arXiv preprint arXiv:2410.23079, 2024.Z. Zhou, C. Li, X. Chen, S. Wang, Y. Chao, Z. Li, H. Wang, R. An, Q. Shi, Z. Tan, et al. Llm × mapreduce: Simplified long-sequence processing using large language models. arXiv preprint arXiv:2410.09342, 2024.
A. AIME の結果例
プロンプト:
「| ユーザー | と を、次の連立方程式を満たす正の実数とする:
このとき、 の値は である。ここで と は互いに素な正の整数である。 を求めよ。ステップごとに理由を述べ、最終的な答えを の中に書け。 | アシスタント | 」
我々の結果:
(2275 トークン)
連立方程式:
が与えられている。これらの対数方程式を指数の形に変換する:
各変数を , で表すと:
これらの式を互いに代入すると、次のようになる:- と から、 を得て、 となる。- を の式に代入すると、 を得る。- と を の式に代入すると、 を得る。
次に、 を計算する:
これらを掛け合わせると:
底を 2 とする対数を取ると:
絶対値は:
したがって、、 となり、 である。
33
ベースライン結果:
(think)...(/think)(9392 トークン)
対数方程式の連立方程式:
が与えられている。これらの方程式を指数の形に変換する:
これらを互いに代入すると、次のようになる:
これらの方程式を段階的に解くと、次のようになる:
しかし、3 番目の方程式を検証すると、この連立方程式には解がない可能性があることがわかる。そこで、行列の逆行列を用いて連立方程式を解く:
, , とする。連立方程式は次のようになる:
この連立方程式をクラーメルの法則と行列の逆行列を用いて解く。行列式は -2 であり、解は次のとおりである:
したがって、次が得られます:
\(\left|\log_2(x^4 y^3 z^2)\right|\) を求める必要があります:
共通分母(48)に変換します:
これらを合計します:
分数 は既約なので、 かつ です。したがって、 です。
プロンプト:
「| ユーザー | を満たす実数 と が を満たします。 の値は何ですか?段階的に推論し、最終的な答えを の中に入れてください。 | アシスタント | 」
我々の結果:
(15147トークン)
与えられた方程式:
1. 2.
まず、両方の方程式に対数のべき乗則を適用します。
最初の方程式について:
とします。すると、 です。これを方程式に代入すると、次が得られます:
2番目の方程式について:
べき乗則を用いると、次が得られます:
であるから、これは次のように簡略化される:
ここで2つの式が得られる:
1. 2.
と を積 に代入すると、次が得られる:
したがって、 の値は である。
ベースライン結果:
(16223トークン)
を満たす実数 と が方程式 および を満たすという問題において、 の値を求める必要がある。
まず、底の変換公式を用いて、対数方程式を指数形式に変換する。
1.
底の変換公式を用いると、 である。 であるから、 となる。したがって、
2.
再び底の変換公式を用いると、 である。
次に、 と を互いを用いて表す:
そして積 を計算する:
しかし、再評価し、 および と置く別の方法を用いると、次が得られる:
最後に、積 が次のように簡略化されることが分かる: