
エージェントがコードを書き、コマンドを実行し、Web を見るオープンな基盤。15 のベンチマークで評価。ICLR 2025、全文無料。
OpenHands: An Open Platform for AI Software Developers as Generalist Agents
OPENHANDS:AIソフトウェア開発者を汎用エージェントとして支えるオープンプラットフォーム
Xingyao Wang \\(^{1,10}\\) 、Boxuan Li \\(^{2}\\) 、Yufan Song \\(^{2}\\) 、Frank F. Xu \\(^{2}\\) 、Xiangru Tang \\(^{3}\\) 、Mingchen Zhuge \\(^{6}\\) 、Jiayi Pan \\(^{4}\\) 、Yueqi Song \\(^{2}\\) 、Bowen Li、Jaskirat Singh \\(^{7}\\) 、Hoang H. Tran \\(^{8}\\) 、Fuqiang Li、Ren Ma、Mingzhang Zheng、Bill Qian \\(^{3}\\) 、Yanjun Shao \\(^{3}\\) 、Niklas Muennighoff \\(^{5}\\) 、Yizhe Zhang、Binyuan Hui \\(^{9}\\) 、Junyang Lin \\(^{9}\\) 、Robert Brennan \\(^{10}\\) 、Hao Peng \\(^{1}\\) 、Heng Ji \\(^{1}\\) 、Graham Neubig \\(^{2,10}\\) \\(^{1}\\) UIUC \\(^{2}\\) CMU \\(^{3}\\) Yale \\(^{4}\\) UC Berkeley \\(^{5}\\) Contextual AI \\(^{6}\\) KAUST \\(^{7}\\) ANU \\(^{8}\\) HCMUT \\(^{9}\\) Alibaba \\(^{10}\\) All Hands AI xingyao6@illinois.edu, gneubig@cs.cmu.edu
概要
ソフトウェアは、私たち人間が利用できる最も強力な道具の一つである。熟練したプログラマーは、ソフトウェアを通じて世界と複雑かつ深遠な形で関わることができる。同時に、大規模言語モデル(LLM)の改善により、周囲の環境と相互作用し、環境に変化をもたらすAIエージェントの開発も急速に進んでいる。本論文では、人間の開発者と同様の方法で世界と関わる、強力かつ柔軟なAIエージェントを開発するためのプラットフォームであるOpenHands(旧称OpenDevin)を紹介する。すなわち、コードを書き、コマンドラインを操作し、ウェブを閲覧することによって関わる。本稿では、このプラットフォームが、新しいエージェントの実装、コード実行のためのサンドボックス環境との安全な相互作用、複数エージェント間の協調、および評価ベンチマークの組み込みをどのように可能にするかを述べる。現在組み込まれているベンチマークに基づき、ソフトウェアエンジニアリング(例:SWE-BENCH)やウェブ閲覧(例:WEBARENA)など、15の挑戦的なタスクにわたってエージェントを評価する。寛容なMITライセンスの下で公開されているOpenHandsは、学界と産業界にまたがるコミュニティプロジェクトであり、188名を超える貢献者から2.1K件以上の貢献を受けている。
コード https://github.com/All-Hands-AI/OpenHands Slack http://bit.ly/OpenHands-Slack
1 はじめに
大規模言語モデル(LLM; OpenAI 2024b; Team et al. 2023; Jiang et al. 2024; Chang et al. 2024)に支えられ、ユーザー向けAIシステム(ChatGPTなど)は、ユーザーの問い合わせに正確に応答する、数学の問題を解く、コードを生成するといった複雑なタスクを実行する能力をますます高めている。特に、外部環境を知覚し、それに作用できるシステムであるAIエージェントは、近年、ますます多くの研究上の注目を集めている。それらは、ソフトウェアの開発(Jimenez et al., 2024)、現実世界のウェブサイトのナビゲート(Zhou et al., 2023a)、家事の遂行(Ahn et al., 2022)、さらには科学研究の実施(Boiko et al., 2023; Tang et al., 2024a)といった複雑なタスクの実行へと向かっている。
X
AIエージェントが複雑な問題に取り組む能力を持つようになるにつれて、その開発と評価もまた困難になっている。エージェントの開発を容易にするオープンソースフレームワークの作成に向けた取り組みが、近年数多く存在する(Hong et al., 2023; Chen et al., 2024; Wu et al., 2023)。これらのエージェントフレームワークには一般に、1)エージェントが世界と相互作用するためのインターフェース(JSONベースの関数呼び出しやコード実行など)、2)エージェントが動作する環境、3)人間とエージェント、またはエージェント同士のコミュニケーションのための相互作用メカニズムが含まれる。これらのフレームワークは、さまざまな形で開発プロセスを合理化し、容易にする(表1、§C)。
AIエージェントを設計する際には、人間がどのように世界と相互作用するかも考慮できる。現在、人間が世界と相互作用する最も強力な方法はソフトウェアを通じたものである。ソフトウェアは
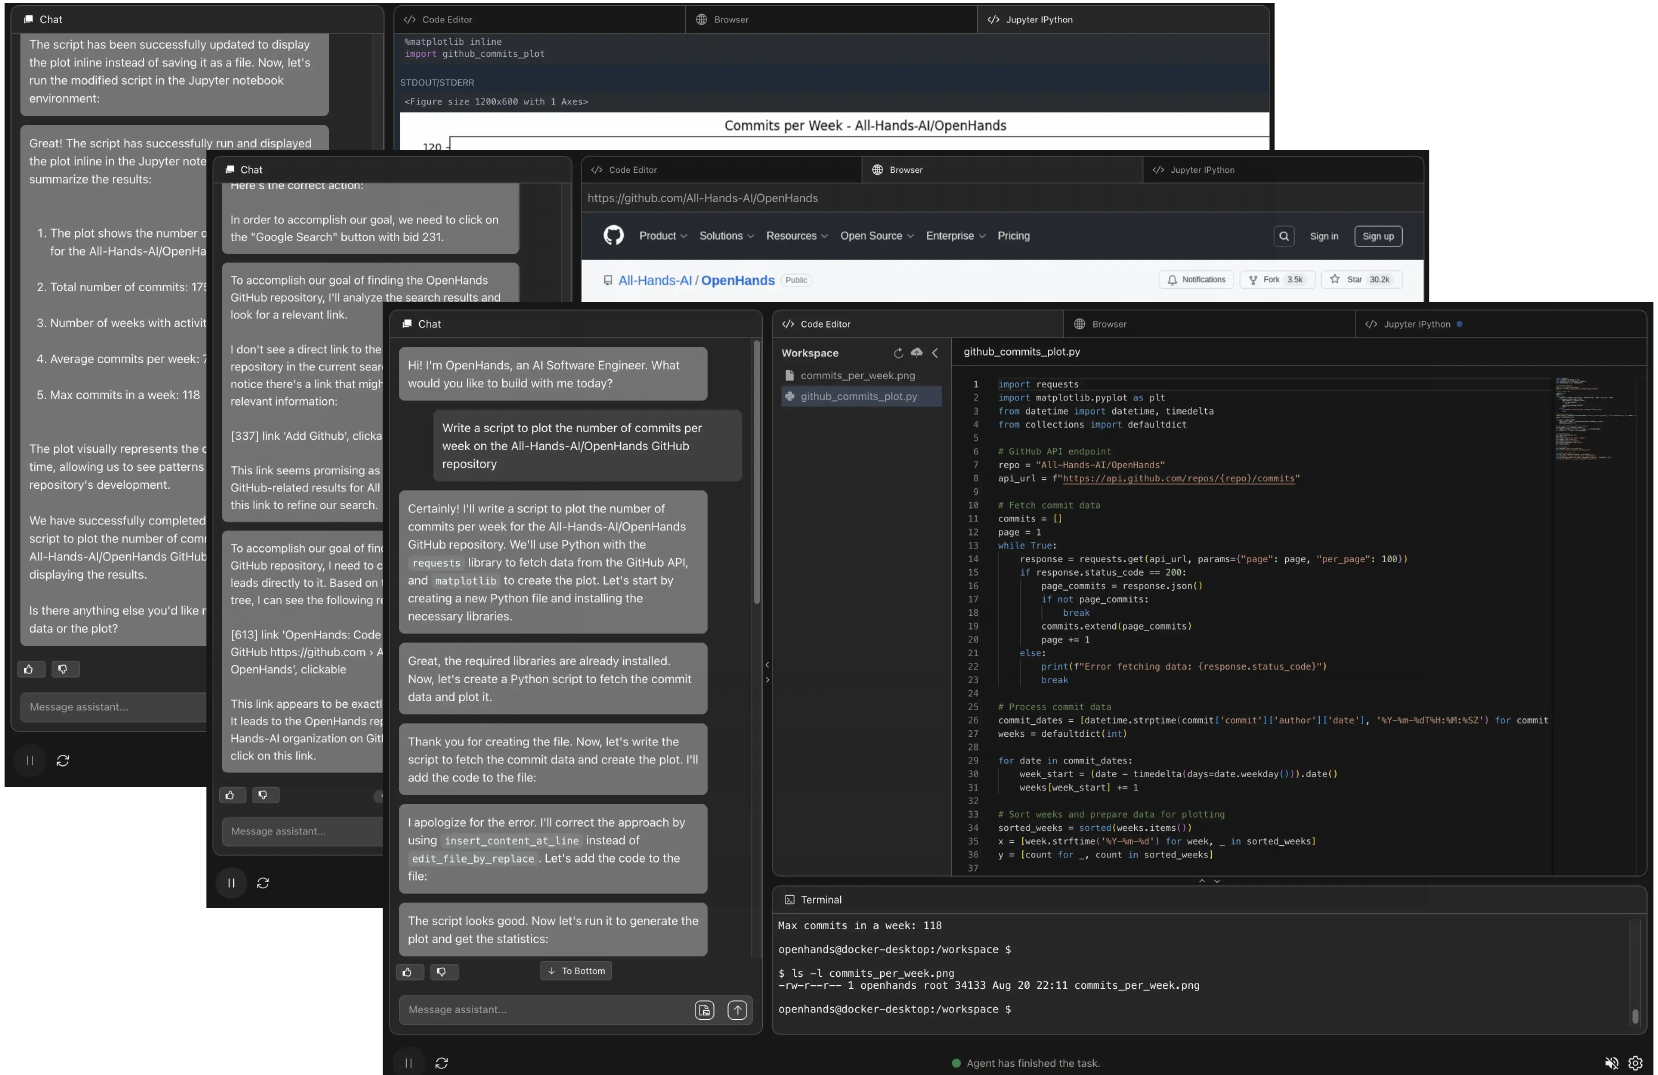
私たちの生活のあらゆる側面を支え、基本的なニーズの物流から科学、技術、そしてAIそのものの進歩に至るまで、あらゆるものを支えている。ソフトウェアの力、およびその効率的な開発、利用、展開を支える既存のツール群を考慮すると、ソフトウェアはAIエージェントが複雑な形で世界と相互作用するための理想的なインターフェースを提供する。しかし、ソフトウェアを効果的に開発できるエージェントを構築することには、独自の課題がある。複雑なソフトウェアシステムにおいて、エージェントが効果的にコードを作成・修正できるようにするにはどうすればよいか。問題をデバッグしたり、タスクに必要な情報を収集したりするために、その場で情報を集めるツールをエージェントに提供するにはどうすればよいか。開発が安全であり、ユーザーのシステムに悪影響を及ぼさないことをどのように保証すればよいか。
本論文では、ソフトウェアを通じて世界と相互作用する汎用的および専門的なAIエージェントの開発のために設計された、コミュニティ主導のプラットフォームであるOpenHands(旧称OpenDevin)を紹介する。1その特徴は次のとおりである。
(1) ユーザーインターフェース、エージェント、および環境が、強力かつ柔軟なイベントストリームアーキテクチャを通じて相互作用できるようにする相互作用メカニズム(§2.1)。(2) エージェントが相互作用できる、bashシェル、ウェブブラウザ、およびIPythonサーバーを備えたDockerサンドボックス化されたオペレーティングシステムからなるランタイム環境(§2.2)。(3) エージェントが実際のソフトウェアエンジニアと同様の方法で環境と相互作用できるようにするインターフェース(§2.3)。エージェントが a) 複雑なソフトウェアを作成・編集し、b) サンドボックス内で任意のコードを実行し、c) ウェブサイトを閲覧して情報を収集する機能を提供する。(4) 複数の専門エージェントが協働できるようにするマルチエージェント委任(§2.4)。(5) 幅広いタスクにわたるエージェントの評価を容易にする評価フレームワーク(§4)。
重要な点として、OpenHandsは単なる概念的枠組みではなく、エージェント、環境、評価の包括的かつ即座に利用可能な実装も含んでいる。本稿執筆時点で、OpenHandsには10以上の実装済みエージェントを備えたエージェントハブ(§3)が含まれており、その中には、CodeActアーキテクチャ(Wang et al., 2024a)に基づいて実装され、ウェブ閲覧(ServiceNow)およびコード編集の専門機能(Yang et al., 2024)を追加した強力な汎用エージェントが含まれる。ユーザーとの相互作用は、エージェントの現在の行動を可視化し、
リアルタイムのフィードバックを可能にするチャットベースのユーザーインターフェースを通じて実装されている(図1、§D)。さらに、評価フレームワークは現在15のベンチマークをサポートしており、これらを用いてエージェントを評価する(§4)。
商業利用を許可する寛容なMITライセンスの下で公開されているOpenHandsは、学界および産業界における多様な研究と実世界応用を支える態勢を整えている。OpenHandsは大きな注目を集めており、32KのGitHubスターと、188名を超える貢献者からの2.1K件以上の貢献を得ている。私たちはOpenHandsを、幅広い実践者コミュニティによって推進される将来の研究イノベーションと多様な応用の触媒と構想している。
2 OPENHANDSアーキテクチャ
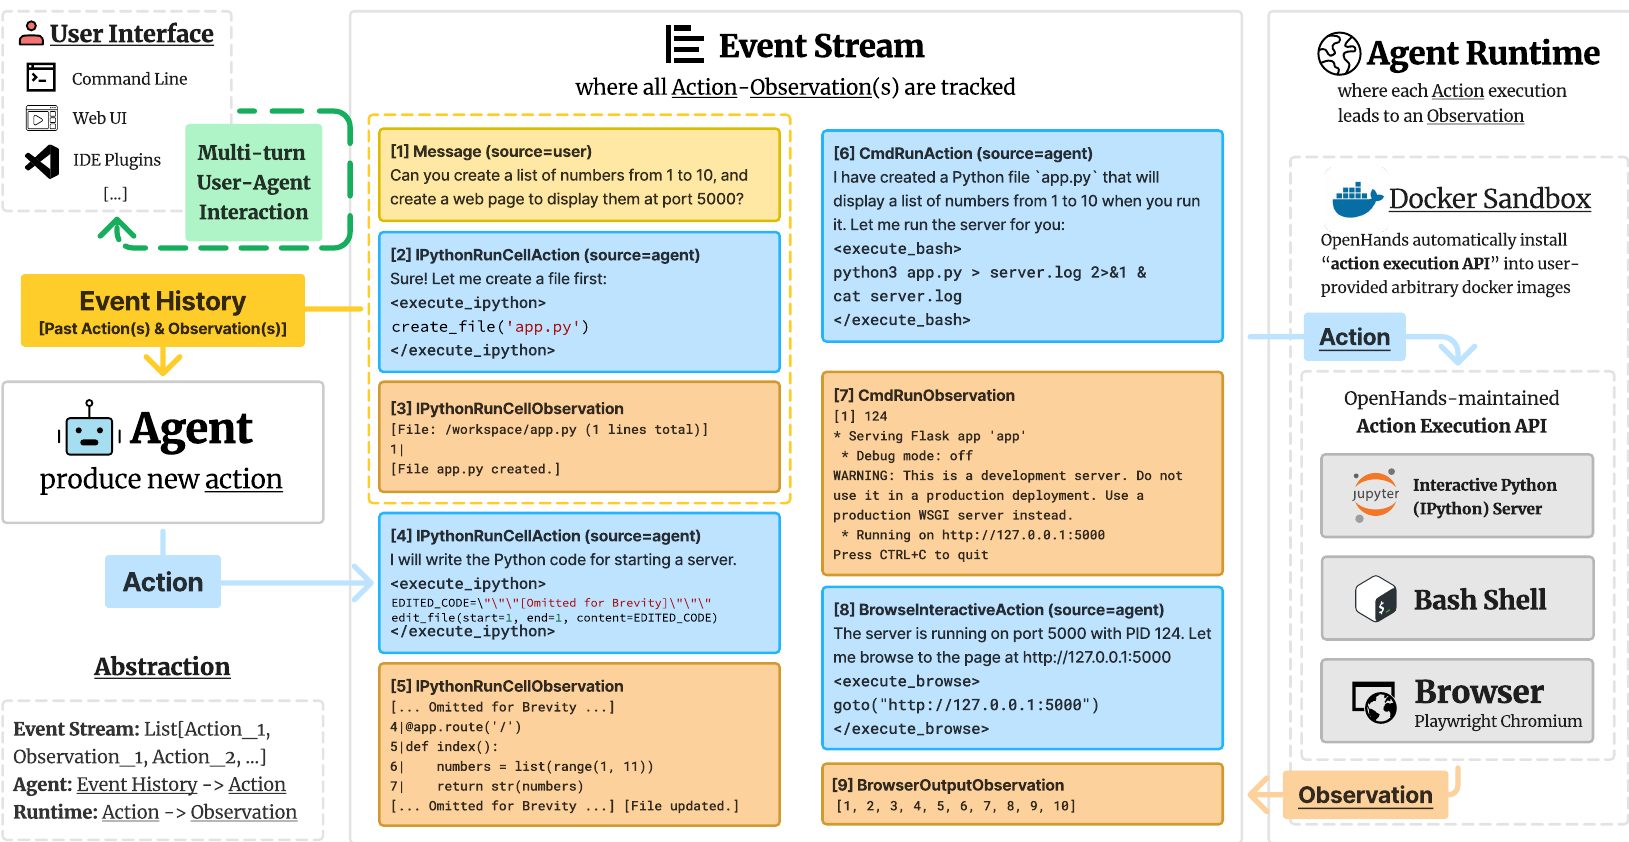
次に、OpenHandsの使用方法を詳細に説明する。特に、1)エージェントを定義および実装する方法(§2.1)、2)各アクションの実行がどのように観測につながるか(§2.2)、3)エージェントにとって一般的に使用されるスキルを信頼性高く管理および拡張する方法(§2.3)、4)タスク解決のために複数のエージェントをどのように組み合わせるか(§2.4)について述べる。図2に概要を示す。
2.1 エージェントの定義と実装
エージェントは、環境の状態(例:以前のアクションと観測)を知覚し、ユーザー指定のタスクを解決するために実行するアクションを生成できる。
状態とイベントストリーム。OpenHandsにおいて、状態は、エージェントの実行に関連するすべての情報をカプセル化するデータ構造である。この状態の重要な構成要素はイベントストリームであり、これはエージェント自身のアクションやユーザーとの相互作用(例:指示、フィードバック)を含む、過去のアクションと観測の時系列的な集合である。イベントストリームに加えて、状態には、LLM呼び出しの累積コスト、マルチエージェント委任を追跡するためのメタデータ(§2.4)、その他の実行関連パラメータなど、エージェントの動作のための補助情報が含まれる。
アクション。CodeAct(Wang et al., 2024a)に着想を得て、OpenHandsはエージェントと環境を一連の汎用的なアクションのコアセットを通じて接続する。アクションIPythonRunCellActionとCmdRunActionにより、エージェントはサンドボックス環境(例えば、安全に隔離されたLinuxオペレーティングシステム)内で任意のPythonコードやbashコマンドを実行できる。BrowserInteractiveActionは、BrowserGym(Drouin et al., 2024)によって導入されたブラウジング用のドメイン固有言語を用いてウェブブラウザとの対話を可能にする。これらのアクションは、人間のソフトウェアエンジニアやアナリストが行うほとんどのタスクをカバーする、包括的かつ柔軟なプリミティブのセットを提供するために選ばれた。プログラミング言語(PL)に基づくアクション空間は強力かつ柔軟であり、様々な形式のツール(例えば、Python関数、REST APIなど)を用いてあらゆるタスクを実行するのに十分でありながら、信頼性が高く保守が容易である(Wang et al., 2024a)。
この設計は、事前に定義されたツールのリストを必要とする既存のツール呼び出しエージェント(Chase, 2022)とも互換性がある。すなわち、ユーザーはプリミティブアクションでサポートされているPLを用いてツールを容易に定義し(例えば、電卓用のPython関数を書くなど)、それらのツールをJSON形式の関数呼び出しの体験(Qin et al., 2023)を通じてエージェントに利用可能にすることができる。さらに、このフレームワークの強力なPLベースのプリミティブにより、タスクを完了するためのAPIが利用できない場合に、エージェントが自らツールを作成すること(例えば、Python関数を生成することにより、Yuan et al. 2023)も可能になる。これらのPLベースのコアアクションがどのように多様なツールのセットに組み合わせられるかについては§2.3を参照されたい。
観測。観測は、エージェントが観測する環境の変化(例えば、先行するアクションの実行結果、人間ユーザーからのテキストメッセージなど)を記述する。
図3:OpenHandsでエージェントを実装する最小限の例。
class MinimalAgent: def reset(self) -> None: self.system_message "You are a helpful assistant ..." def step(self, state: State): messages: list[dict[str, str]] = [ {'role': 'system', 'content': self.system_message] ] for prev_action, obs in state.history: action_message get_action_message(prev_action) messages.append(action_message) obs_message get_observation_message(obs) messages.append(obs_message) # use lim to generate response (e.g., thought, action) response self.lim.do_completion(messages) # parse and execute action in the runtime action self.parse_response(response) if self.is_finish_command(action): return AgentFinishAction() elif self.is_bash_command(action): return CmdRunAction(command=action.command) elif self.is_python_code(action): return IPythonRunCallAction(code=action.code) elif self.is_browser_action(action): return BrowseInteractiveAction(code=action.code) else: return MessageAction(content=action.message)
新しいエージェントの実装。エージェントの抽象化は、シンプルかつ強力になるように設計されており、ユーザーが様々なタスク向けのエージェントを容易に作成・カスタマイズできるようにする。エージェントの抽象化の核心はstep関数にあり、これは現在の状態を入力として受け取り、エージェントのロジックに基づいて適切なアクションを生成する。エージェントの抽象化の簡略化された例示コードを図3に示す。この抽象化を提供することにより、OpenHandsはユーザーがアクションの実行方法の低レベルな詳細(§2.2)を気にすることなく、望ましいエージェントの振る舞いとロジックの定義に集中できるようにする。
2.2 エージェントランタイム:アクションの実行がいかにして観察結果をもたらすか
エージェントランタイムは、人間のソフトウェア開発者に匹敵するアクション空間をエージェントに提供する汎用環境であり、OpenHandsエージェントが複雑なソフトウェア開発ワークフロー、データ分析プロジェクト、Webブラウジングタスクなど、幅広いソフトウェア開発およびWebベースのタスクに取り組むことを可能にする。これにより、エージェントはコードやコマンドラインツールを実行するためのbashターミナルへのアクセス、コードをその場で書いて実行するためのJupyterノートブックの利用、Webベースのタスク(例:情報探索)のためのWebブラウザとの対話が可能になる。
Dockerサンドボックス。各タスクセッションごとに、OpenHandsは安全に隔離されたdockerコンテナサンドボックスを起動し、イベントストリームからのすべてのアクションはそこで実行される。OpenHandsは、サンドボックス内で動作するREST APIサーバ(すなわちOpenHandsアクション実行API)を通じてサンドボックスに接続し、イベントストリームからの任意のアクション(例:bashコマンド、Pythonコード)を実行し、その実行結果を観察結果として返す。ユーザーがエージェントに作業させたいファイルを含む、設定可能なワークスペースディレクトリがその安全なサンドボックスにマウントされ、OpenHandsエージェントがアクセスできるようになる。
OpenHandsアクション実行API。OpenHandsは、イベントストリームからのアクション実行リクエストを待ち受けるために、dockerサンドボックス内で動作するAPIサーバを維持している。このAPIサーバは以下を維持する:
(1) コマンド実行のためにオペレーティングシステム環境(dockerイメージによって指定される)と接続するbashシェル。(2) 対話型Python(IPython)コード実行リクエストを処理し、実行結果をイベントストリームへ返すためのJupyter IPythonサーバ。(3) Playwrightに基づくChromiumブラウザ。プロバイダは、ナビゲーション、クリック、タイピング、スクロールなど、BrowserGym(ServiceNow; Drouin et al., 2024)によって定義された一連のアクションプリミティブを提供する。アクションの完全なセットは§Jに詳述されている。これらのアクションを実行した後、ブラウザランタイムは、HTML、DOM、アクセシビリティツリー(Mozilla)、スクリーンショット、開いているタブなど、ブラウザの現在の状態に関する豊富な観察結果を提供する。
任意のDockerイメージのサポート。OpenHandsは、任意のdockerイメージに基づくランタイムをサポートすることで、エージェントが異なるソフトウェア環境を持つ任意のオペレーティングシステム上で動作することを可能にする。OpenHandsは、ユーザー提供の任意のdockerイメージを受け取り、エージェントとの対話を可能にするためにOpenHandsアクション実行APIをそのイメージにインストールするビルドメカニズムを実装している。OpenHandsエージェントランタイムの詳細な説明は§Fに含まれている。
2.3 エージェントスキル:拡張可能なエージェント・コンピュータインターフェース
SWE-Agent(Yang et al., 2024)は、複雑なタスクをうまく解決する上で、注意深く設計されたエージェント・コンピュータインターフェース(ACI、すなわち特定のタスク向けの専用ツール)の重要性を強調している。しかしながら、多種多様なツールを作成、維持、配布することは、特にそれらのツールを異なるエージェント実装(§3)で利用可能にしたい場合には、困難なエンジニアリング上の課題となり得る。これに対処するため、我々はAgentSkillsライブラリを構築した。これはエージェントの能力を強化するために設計されたツールボックスであり、基本的なbashコマンドやPythonコードでは容易には利用できないユーティリティを提供する。
ツールの作成と拡張が容易。AgentSkillsは、Jupyter IPython環境(§2.2)に自動的にインポートされるさまざまなユーティリティ関数(すなわちツール)からなるPythonパッケージとして設計されている。Python関数をツールとして定義する容易さは、コミュニティメンバーが新しいツールをライブラリに貢献する際の障壁を下げる。Pythonパッケージの汎用性により、異なるエージェント実装も、我々の中核的なアクションの一つであるIPythonRunCellAction(§2.1)を通じてこれらのツールを容易に活用できる。
包含基準と理念。AgentSkillsライブラリでは、考えられるすべてのPythonパッケージをラップし、エージェントにその使い方を再教育することを目指してはいない(例:LLMはすでにCSVファイルを読み取ることができるpandasライブラリを知っているため、同じファイル形式を読み取るようエージェントに教えるツールを再作成する必要はない)。我々は、(1) LLMが直接コードを書くことが容易には達成できない場合(例:コードを編集し特定の行を置き換える)、および/または(2) 外部モデルの呼び出しを伴う場合(例:音声認識モデル、またはコード編集用モデル(Sanger)の呼び出し)にのみ、新しいスキルを追加する。
現在サポートされているスキル。AgentSkillsライブラリには、SWE-Agent(Yang et al., 2024)およびAider(Gauthier)から適応されたファイル編集ユーティリティが含まれており、例えば指定した行から既存のファイルを変更できるedit_file、ファイルの別の部分を閲覧するためのスクロール関数scroll_upおよびscroll_downがある。また、マルチモーダル文書の読み取りをサポートするツールも含まれており、例えば視覚言語モデル(例:GPT-4V)を用いて画像から情報を抽出するparse_imageや、PDFからテキストを読み取るparse_pdfがある。サポートされているスキルの完全なリストは§1に記載されている。
2.4 エージェント委任:協調的なマルチエージェント相互作用
OpenHandsは複数のエージェント間の相互作用も可能にする。この目的のため、我々は特別なアクションタイプであるAgentDelegateActionを使用する。これにより、エージェントは特定のサブタスクを別のエージェントに委任できる。例えば、Webブラウジングのサポートが限られている汎用のCodeActAgentは、AgentDelegateActionを使用してWebブラウジングタスクを特化型のBrowsingAgentに委任し、より複雑なブラウジング活動(例:Webのナビゲート、ボタンのクリック、フォームの送信など)を実行させることができる。
3 AGENTHUB:コミュニティ貢献エージェントのハブ
我々のエージェント抽象化(§2.1)に基づき、OpenHandsはエンドユーザーが選択できる幅広いコミュニティ貢献のエージェント実装をサポートし、それらはさまざまなエージェントタスクのベースラインとして機能する。
CodeActエージェント。CodeActAgentは、CodeActフレームワーク(Wang et al., 2024a)に基づくデフォルトの汎用エージェントである。各ステップにおいて、エージェントは(1) 明確化や確認などを求めるために自然言語で人間とコミュニケーションするために会話する、または(2) コードを実行すること(別名CodeAct)によってタスクを実行する(bashコマンド、Pythonコード、またはブラウザ固有のプログラミング言語の実行を含む)(§2.2)ことができる。この汎用的なアクション空間により、エージェント(v1.5以降)はファイルの編集、Webの閲覧、プログラムの実行など、さまざまなタスクを実行できる。
表1:異なるAIエージェントフレームワークの比較(§C)。SWEは「ソフトウェアエンジニアリング」を指す。標準化ツールライブラリ:フレームワークが異なるエージェント実装向けの再利用可能なツールを含むか(§2.3)。組み込みサンドボックスとコード実行:エージェント生成の任意のコードのサンドボックス実行をサポートするか。組み込みWebブラウザ:エージェントに完全に機能するWebブラウザへのアクセスを提供するか。人間とAIの協働:マルチターンの人間とAIの協働を可能にするか(例:人間がタスク実行中にエージェントを中断したり、追加のフィードバックや指示を提供したりできるか)。AgentHub:さまざまなエージェントの実装をホストするか(§3)。評価フレームワーク:実装されたエージェントを難しいベンチマークで体系的に評価する機能を提供するか(§4)。Agent QC(品質管理):フレームワーク全体のソフトウェア品質を確保するためにテスト(§E)を統合しているか。
| フレームワーク | ドメイン | グラフィカル・ユーザー・インターフェース | 標準化されたツールライブラリ | 組み込みサンドボックス&コード実行 | 組み込みウェブブラウザ | マルチエージェント協調 | 人間とAIの協調 | AgentHub | 評価フレームワーク | Agent QC |
| AutoGPT Gravitas (2023) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| LangChain (Chase, 2022) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| MetaGPT (Hong et al., 2023) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoGen (Wu et al., 2023) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoAgents (Chen et al., 2024) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| エージェント(Zhou et al., 2023b) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Xagents(Team, 2023) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenAgents(Xie et al., 2023) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| GPT5Warm(Zhuge et al., 2024) | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoCodeRover(Zhang et al., 2024b) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| SWE-Agent(Yang et al., 2024) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenHands | 汎用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
\* ネイティブサポートなし。サードパーティ製の商用オプションが利用可能です。
Browsing Agent。我々は、ウェブエージェントタスクのためのシンプルかつ効果的なベースラインとして機能するよう、Browsing Agentと呼ばれる汎用ウェブエージェントを実装した。このエージェントはWebArena(Zhou et al., 2023a)のものと類似しているが、観測と行動が改善されており、ゼロショットプロンプティングのみを用いる。完全なプロンプトはにある。
GPT5Warm Agent。GPT5Warm(Zhuge et al., 2024)は、エージェントシステムを構築するために最適化可能なグラフを使用することを先駆けとし、モジュール性を通じて言語エージェントのフレームワークを統合する。各ノードは個別の操作を表し、エッジは協調と通信の経路を定義する。この設計によりノードとエッジの自動最適化が可能となり、マルチエージェントシステムの構築における進歩を促進する。
Micro Agent(s)。さらに、OpenHandsは特定のタスクに特化したエージェントであるmicro agentの作成を可能にする。micro agentは既存の汎用エージェント(例:CodeAct Agent)の実装の大部分を再利用する。これはエージェント開発の障壁を下げるように設計されており、コミュニティメンバーが自身の特定のユースケースでうまく機能する特化型プロンプトを共有できる。
4 評価
表2に示すように、汎用デジタルエージェント構築の進捗を体系的に追跡するため、我々は15の確立されたベンチマークをOpenHandsに統合する。これらのベンチマークは、ソフトウェアエンジニアリング、ウェブブラウジング、その他の雑多な支援を網羅する。本節では、OpenHandsを、ベンチマークの内容に特化した手動のプロンプトエンジニアリングを行わない、オープンソースで再現可能なベースラインと比較する。なお、本節の残りでは簡潔さのため、OpenHandsの略称として「OH」を用いる。
| カテゴリ | ベンチマーク | 必要な能力 |
| ソフトウェア | SWE-Bench (Jimenez et al., 2024) | Githubのissueの修正 |
| HumanEvalFix (Muennighoff et al., 2024) | バグの修正 | |
| BIRD (Li et al., 2023b) | Text-to-SQL | |
| BioCoder (Tang et al., 2024c) | バイオインフォマティクスのコーディング | |
| Web | ML-Bench (Tang et al., 2024b) | 機械学習のコーディング |
| Gorilla APIBench (Patil et al., 2023) | ソフトウェアAPIの呼び出し | |
| ToolQA (Zhuang et al., 2024) | ツールの使用 | |
| その他の支援 | WebArena (Zhou et al., 2023a) | 目標計画 & 現実的なブラウジング |
| MiniWoB++ (Liu et al., 2018) | 合成ウェブ上の短いトラジェクトリ | |
| GAI (Mialon et al., 2023) | ツール使用、ブラウジング、マルチモダリティ | |
| GPQA (Rein et al., 2023) | 大学院レベルのGoogle検索では解けないQ&A | |
| AgentBench (Liu et al., 2023) | オペレーティングシステムとの対話 (bash) | |
| MINT (Wang et al., 2024b) | マルチターンの数学およびコード問題 | |
| Entity Deduction Arena (Zhang et al., 2024a) | 状態追跡 & 戦略的計画 | |
| ProofWriter (Tajford et al., 2021) | 演繹的論理推論 |
4.1 結果の概要
OpenHandsにおいて、我々の目標は、ソフトウェアインターフェースを通じて世界と相互作用できる汎用デジタルエージェントを開発することである(§2.1で説明したコード行動に例示される)。我々は、ソフトウェアエージェントがコード編集だけでなく、ウェブブラウジングや、コードリポジトリに関する質問への回答やオンライン調査の実施といった様々な補助的タスクにおいても優れているべきであると認識している。
| エージェント | モデル | ソフトウェア('$4.2)</td><td rowspan="2">Web('$4.3) | その他('$4.4) | ||
| SWE-Bench Lite | WebArena | ||||
| SWE-Agent(Yang et al., 2024) | gpt-4-1106-preview | 18.0 | - | - | |
| AutoCodeRover(Zhang et al., 2024b) | gpt-4-0125-preview | 19.0 | - | - | |
| Aider(Gauthier) | gpt-4o &amp; claude-3-opus | 26.3 | - | - | |
| Moatless Tools(Orwall) | claude-3.5-sonnet | 26.7 | - | - | |
| Agentless(Xia et al., 2024) | gpt-4o | 27.3 | - | - | |
| Web閲覧エージェント | |||||
| Lemur(Xu et al., 2023) | Lemur-chat-70b | - | 5.3 | - | - |
| Patel et al.(2024) | 合成データで学習した72B | - | 9.4 | - | - |
| AutoWebGLM(Lai et al., 2024) | 人間/エージェントのアノテーションで学習した7B | - | 18.2 | - | - |
| Auto Eval &amp; Refine(Pan et al., 2024) | GPT-4 + GPT-4Vを用いたReflexion | - | 20.2 | - | - |
| WebArena Agent(Zhou et al., 2023a) | gpt-4-turbo | - | 14.4 | - | - |
| その他の支援エージェント | |||||
| AutoGPT(Gravitas, 2023) | gpt-4-turbo | - | - | - | 13.2 |
| Few-shotプロンプティング +思考の連鎖(Rein et al., 2023) | Llama-2-70b-chat | - | - | 28.1 | - |
| gpt-4 | gpt-3.5-turbo-16k | - | - | 29.6 | - |
| gpt-4 | gpt-4 | - | - | 38.8 | - |
| OpenHandsエージェント | |||||
| CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 6.3 | 8.3 | - | - |
| gpt-4o-2024-05-13 | gpt-4o-2024-05-13 | 22.0 | 14.5 | *53.1 | - |
| claude-3-5-sonnet | claude-3-5-sonnet | 26.0 | 15.3 | 52.0 | - |
| GPTSwarm v1.0 | gpt-4o-2024-05-13 | - | - | - | 32.1 |
\* 数値はCodeActAgent v1.5から報告されている。
表3は厳選された評価結果のセットを示す。OpenHandsのエージェントはすべてのカテゴリで最高の性能を達成するわけではないかもしれないが、汎用性を念頭に置いて設計されている。特筆すべきは、同じCodeActエージェントが、システムプロンプトに一切の変更を加えることなく、ソフトウェア開発、ウェブ操作、雑多なタスクという3つの主要なタスクカテゴリにわたって競争力のある性能を示すことである。これは、通常、特定のタスクカテゴリ向けに設計・最適化されているベースラインエージェントと比較すると、特に重要である。
4.2 ソフトウェアエンジニアリング
次に、表4でソフトウェアエンジニアリングのベンチマークに特化した結果を報告する。
SWE-Bench(Jimenez et al., 2024)は、バグ報告や機能リクエストといった実際のGitHubイシューを解決するエージェントの能力を評価するように設計されている。エージェントはリポジトリと相互作用し、ファイル編集とコード実行を通じて提供されたイシューの修正を試みる。エージェントが変更したコードリポジトリは、同じイシューに対する人間の開発者の修正から追加された新しいテストを含むテストスイートに対してテストされる。各テストインスタンスには、問題を解決する方法に関する自然言語の提案からなる「ヒントテキスト」が付随する。本論文を通じて、我々はすべての結果をヒントテキストを用いずに報告する。アクセスしやすく効率的なテストを促進するため、標準的なサブセットであるSWE-bench Liteが作成された。我々はコスト削減の考慮から、デフォルトでこのサブセットをテストに用いる。2結果。表4に示すように、claude-3.5-sonnetを用いる我々の最新バージョンのCodeActAgent v1.8は、他のオープンソースのSWEスペシャリストと比較してという競争力のある解決率を達成する。
4.2.1 HUMANEVALFIX
HumanEvalFix(Muennighoff et al., 2024)は、提供されたテストケースの助けを借りて、提供された関数のバグを修正するようエージェントに課す。バグは、1つ以上のテストケースが失敗することを保証するように作成されている。我々はベンチマークのPythonサブセットに焦点を当て、モデルがテスト実行からのフィードバックを取り入れつつ、複数ターンにわたる自己デバッグによってバグを解決できるようにする。我々はMuennighoff et al.(2024)の設定に従い、pass@k(Chen et al., 2021)を用いる。結果。表4において、OpenHands CodeActAgentはPythonスプリットのバグのを正常に修正する。これはすべての非エージェント的アプローチよりも大幅に優れており、StarCoder2-15B(Lozhkov et al., 2024; Li et al., 2023c)の性能をほぼ2倍にしている。SWE-Agentはを達成しているが、Yang et al.(2024)はモデルにテストデータセット内のバグの1つを修正する成功したサンプル軌跡の完全なデモンストレーション(「1-shot」)を提供しているのに対し、我々のOpenHandsの評価は0-shotである。HumanEvalFixは人間によって作成され、すべてのバグが
| エージェント | モデル | 成功率 (%) | $ 平均コスト |
| SWE-Agent (Yang et al., 2024) | SWE-Bench Lite (Jimenez et al., 2024)、300インスタンス、ヒントなし | ||
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-1106-preview | 18.0 | 1.67 |
| Aider (Gauthier) | gpt-4-0125-preview | 19.0 | - |
| gpt-4-0&amp; claude-3-opus | 26.3 | - | |
| OH CodeActAgent v1.8 | gpt-4-0-mini-2024-07-18 | 7.0 | 0.01 |
| gpt-4-0-2024-05-13 | 22.0 | 1.72 | |
| claude-3-5-sonnet@20240620 | 26.0 | 1.10 | |
| HumanEvalFix (Muennighoff et al., 2024)、164インスタンス | |||
| プロンプティング、0ショット | BLOOMZ-176B | 16.6 | - |
| OctoCoder-15B | 30.4 | - | |
| DeepSeekCoder-33B-Instruct | 47.5 | - | |
| StarCoder2-15B | 48.6 | - | |
| SWE-agent、1ショット (Yang et al., 2024) | gpt-4-turbo | 87.7 | - |
| gpt-3.5-turbo-16k-0613 | 20.1 | 0.11 | |
| OH CodeActAgent v1.5、汎用、0ショット。 | gpt-4-0-2024-05-13 | 79.3 | 0.14 |
| BIRD (Li et al., 2023b)、300インスタンス | |||
| プロンプティング、0ショット | CodeLlama-7B-Instruct | 18.3 | - |
| CodeQwen-7B-Chat | 31.3 | - | |
| OH CodeActAgent v1.5 | gpt-4-1106-preview | 42.7 | 0.19 |
| gpt-4-0-2024-05-13 | 47.3 | 0.11 | |
| ML-Bench(Tang et al., 2024b)、68インスタンス | |||
| プロンプティング + BM25、0ショット | gpt-3.5-turbo | 11.0 | - |
| gpt-4-1106-preview | 22.1 | - | |
| gpt-4-0-2024-05-13 | 26.2 | - | |
| SWE-Agent(Yang et al., 2024) | gpt-4-1106-preview | 42.6 | 1.91 |
| Aider(Gauthier) | gpt-4-0-2024-05-13 | 64.4 | - |
| gpt-4-0-2024-05-13 | 76.5 | 0.25 | |
| gpt-4-1106-preview | 58.8 | 1.22 | |
| gpt-3.5-turbo-16k-0613 | 13.2 | 0.12 | |
| BioCoder(Python)(Tang et al., 2024b)、157インスタンス | |||
| プロンプティング、0ショット | gpt-3.5-turbo | 11.0 | - |
| gpt-4-1106-preview | 12.7 | - | |
| OH CodeActAgent v1.5 | gpt-4-0-2024-05-13 | 27.5 | 0.13 |
| gpt-4-0-2024-05-13 | 8.7 | - | |
| gpt-4-0-2014 | 21.2 | - | |
| gpt-3.5-turbo-0301 | 29.7 | - | |
| llama-7b | 75.0 | - | |
| gpt-3.5-turbo-0125 | 21.6 | 0.002 | |
| gpt-4-0-2024-05-13 | 36.4 | 0.04 | |
| ToolQA(Zhuang et al., 2024)、800インスタンス | |||
| プロンプティング、0ショット | ChatGPT + CoT | 5.1 | - |
| ChatGPT | 5.6 | - | |
| Chameleon | 10.6 | - | |
| ReAct、0ショット(Yao et al., 2023; OpenAI, 2024a) | gpt-3.5-turbo | 36.8 | - |
| gpt-3 | 43.1 | - | |
| gpt-3.5-turbo-0125 | 2.3 | 0.03 | |
| gpt-4-0-2024-05-13 | 47.2 | 0.91 |
注意深く検証されているため、このベンチマークでを達成することは完全に実現可能であり、我々はOpenHandsの将来のイテレーションでそれを目指す。
ML-Bench(Tang et al., 2024b)は、18のGitHubリポジトリにわたる機械学習タスクを解決するエージェントの能力を評価する。このベンチマークは、169の多様なML問題にわたる9,641のタスクで構成され、エージェントはユーザーの指示に応じてbashスクリプトまたはPythonコードを生成することを要求される。サンドボックス環境において、エージェントはコマンドを反復的に実行してフィードバックを受け取ることができ、リポジトリのコンテキストを理解し、ユーザーの要件を段階的に満たすことができる。元の論文の設定に従い、我々はML-Benchの4分の1のサブセットでエージェント評価を行う。
Gorilla APIBench(Patil et al., 2023)は、APIを使用するエージェントの能力を評価する。これはTorchHub、TensorHub、HuggingFaceに関するタスクを組み込んでいる。評価中、モデルには「録音中の話し言葉をテキストに変換できるAPIを特定せよ」といったAPI使用に関する質問が与えられる。正しさは、モデルのAPI呼び出しが正しいドメインにあるかどうかに基づいて評価される。
ToolQA(Zhuang et al., 2024)は、外部ツールを使用するエージェントの能力を評価する。このベンチマークには、フライトステータス、コーヒー価格、Yelpデータ、Airbnbデータといった様々なトピックに関するタスクが含まれ、テキストツール、データベースツール、数学ツール、グラフツール、コードツール、システムツールといった様々なツールの使用を要求する。これはeasyとhardの2つのレベルを特徴とする。easyの質問は単一ツールの使用に重点を置くのに対し、hardの質問は推論を重視する。我々は評価にeasyサブセットを採用する。
BioCoder(Tang et al., 2024c)は、バイオインフォマティクス関連のタスク、具体的にはコンテキストを取得して正確に活用する能力についてエージェントの性能を評価する、リポジトリレベルのコード生成ベンチマークである。元のプロンプトにはコードの関連コンテキストが含まれているが、本研究ではこれらを削除し、複数ターンの相互作用においてコンテキスト取得、
| エージェント | モデル | 成功率(%) | $ 平均コスト |
| Lemur(Xu et al., 2023) | WebArena(Zhou et al., 2023a)、812インスタンス | ||
| Patel et al.(2024) | Lemur-chat-70b | 5.3 | - |
| AutoWebGLM(Lai et al., 2024) | 自己改善型合成データで学習した72B | 9.4 | - |
| Auto Eval & Refine(Pan et al., 2024) | 人間/エージェントのハイブリッド注釈で学習した7B | 18.2 | - |
| GPT-4 + Reflexion(GPT-4V報酬モデル使用) | 20.2 | - | |
| WebArena Agent(Zhou et al., 2023a) | gpt-3.5-turbo | 6.2 | - |
| gpt-4-turbo | 14.4 | - | |
| OH BrowsingAgent v1.0 | gpt-4o-mini-2024-07-18 | 8.5 | 0.01 |
| gpt-4o-2024-05-13 | 14.8 | 0.15 | |
| claude-3-5-sonnet-20240620 | 15.5 | 0.10 | |
| OH CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 8.3 | - |
| BrowsingAgent v1.0への委譲による | gpt-4o-2024-05-13 | 14.5 | - |
| claude-3-5-sonnet-20240620 | 15.3 | - | |
| MiniWoB++(Liu et al., 2018)、125環境 | |||
| Workflow Guided Exploration(Liu et al., 2018) | 環境探索で学習した専用モデル | 34.6 | - |
| CC-NET(Humphreys et al., 2022) | RLと人間注釈BCで学習した専用モデル | 91.1 | - |
| OH BrowsingAgent v1.0 | gpt-3.5-turbo-0125 | 27.2 | 0.01 |
| gpt-4o-2024-05-13 | 40.8 | 0.05 | |
| OH CodeActAgent v1.8 | gpt-4o-2024-05-13 | 39.8 | - |
自己デバッグ、推論を行うOpenHandsの能力を示す。BioCoderは157のPython関数と50のJava関数で構成され、それぞれがプロテオミクス、ゲノミクス、その他の専門領域といったバイオインフォマティクスの特定の領域を対象としている。このベンチマークは、関連するコードがマスクされた既存のリポジトリ内でコードを生成することにより、実世界のコードを対象とする。
BIRD(Li et al., 2023b)は、現実的で大規模なデータベース環境を目指したtext-to-SQLタスク(すなわち、自然言語を実行可能なSQLに変換する)のベンチマークである。我々はdevセットから300サンプルを選択してOpenHandsに統合し、実行精度で評価する。さらに、エージェントが最終的なSQLクエリに到達するために複数ターンの相互作用を行うことを許可し、SQL実行の結果を観察することで過去の結果を修正できるようにすることで、設定を拡張する。
4.3 ウェブブラウジング
我々は表5でウェブブラウジングベンチマークの評価結果を報告する。
WebArena(Zhou et al., 2023a)は、エージェントが与えられたタスクを完了するためにどの経路を取るかを自由に選択できる、自己敵対的で実行ベースのウェブエージェントベンチマークである。WebArenaは、ショッピング、フォーラム、開発者プラットフォーム、コンテンツ管理システムを含む様々なドメインにわたる812の人間が厳選したタスク指示で構成されている。結果。表5から、我々のBrowsingAgentが、ドメイン汎用のプロンプティング技術を用いたLLMを使用するエージェントの中で競争力のある性能を達成していることがわかる。
MiniWoB++(Liu et al., 2018)は、組み込みの報酬関数を備えたインタラクティブなウェブベンチマークである。タスクは125の異なるミニマリストなウェブインターフェース上で合成的に初期化される。WebArenaとは異なり、タスクはページ変更がなくより容易であり、より少ないステップを必要とし、低レベルの段階的なタスク指示を提供する。これには正常に取り組むために視覚能力を必要とする環境の一部が含まれており、多くの既存研究はタスクのサブセットのみに焦点を当てることを選択している(Kim et al., 2024; Li et al., 2023d; Shaw et al., 2023)ことに注意されたい。それでもなお、我々は完全なセットでの性能を報告し、完全なセットで評価されているベースラインのみを含める。
4.4 雑多な支援
雑多な支援のベンチマークの結果は表6で報告される。
GAIA(Mialon et al., 2023)は、様々な実世界のシナリオを網羅する、エージェントの一般的な問題解決スキルを評価する。これは推論、マルチモーダル理解、ウェブブラウジング、コーディングを含む様々なエージェント能力を必要とする。GAIAは3つのレベルにわたる466の厳選されたタスクで構成されている。GAIAの設定は、様々なツールをエージェントと統合することの複雑さのため、伝統的に困難であるが、OpenHandsのインフラストラクチャ(例:ランタイム§2.2、ツール§2.3)は統合を大幅に簡素化する。
GPQA(Rein et al., 2023)は、難しい大学院レベルの問題を解く際のエージェントの協調的なツール利用能力を評価する。ツール利用(例:python)やウェブ検索は、これらの質問にエージェントが答えるのを支援するためにしばしば有用である。なぜなら、それらはLLMがしばしば苦手とする正確な計算や、LLMのパラメトリック知識ベースの外にある情報へのアクセスを提供するからである。
| エージェント | モデル | 成功率(%) | $ 平均コスト |
| GAIA(Mialon et al., 2023)、L1検証セット、53インスタンス | |||
| AutoGPT(Gravitas, 2023) | gpt-4-turbo | 13.2 | - |
| OH GPTSwarm v1.0 | gpt-4-0125-preview | 30.2 | 0.110 |
| gpt-4-2024-05-13 | 32.1 | 0.050 | |
| GPQA(Rein et al., 2023)、ダイヤモンドセット、198インスタンス(他のサブセットについては§G、Tab. 7を参照) | |||
| Human(Rein et al., 2023) | 専門家の人間 | 81.3 | - |
| 非専門家の人間 | 21.9 | - | |
| Few-shotプロンプティング+Chain-of-Thought(Rein et al., 2023) | gpt-3.5-turbo-16k | 29.6 | - |
| gpt-4 | 38.8 | - | |
| OH CodeActAgent v1.8 | claude-3-5-sonnet-20240620 | 52.0 | 0.065 |
| AgentBench(Liu et al., 2023)、OS(bash)サブセット、144インスタンス | |||
| AgentBenchベースラインエージェント(Liu et al., 2023) | gpt-4 | 42.4 | - |
| gpt-3.5-turbo | 32.6 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 57.6 | 0.085 |
| gpt-3.5-turbo-0125 | 11.8 | 0.006 | |
| MINT(Wang et al., 2024b):数学サブセット、225インスタンス | |||
| MINTベースラインエージェント | gpt-4-0613 | 65.8 | - |
| gpt-4-2024-05-13 | 77.3 | 0.070 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 33.8 | 0.048 |
| MINT(Wang et al., 2024b):コードサブセット、136インスタンス | |||
| MINTベースラインエージェント | gpt-4-0613 | 59.6 | - |
| gpt-4-2024-05-13 | 50.0 | 0.087 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 5.2 | 0.030 |
| ProofWriter(Tafjord et al., 2021)、600インスタンス | |||
| Few-shot Prompting + Chain-of-Thought(Pan et al., 2023) | gpt-4 | 68.1 | - |
| Logic-LM(Pan et al., 2023) | gpt-4 + 記号ソルバー | 79.6 | - |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 78.8 | - |
| Entity Deduction Arena(Zhang et al., 2024a)、200インスタンス | |||
| Zero-shot Prompting(Zhang et al., 2024a) | gpt-4-0314 | 40.0 | - |
| gpt-3.5-turbo-0613 | 27.0 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 38.0 | - |
| gpt-3.5-turbo-16k-0613 | 24.0 | - |
AgentBench(Liu et al., 2023)は、マルチターンでオープンエンドな生成設定におけるエージェントの推論および意思決定能力を評価する。我々は144個のタスクを含むコード基盤のオペレーティングシステム(OS)サブセットを選択した。OpenHandsのエージェントは、bashコマンドを用いてタスク固有のOSとマルチターン方式で直接やり取りし、相互作用と推論を組み合わせてタスク完了を自動化する。
MINT(Wang et al., 2024b)は、GPT-4によってシミュレートされたツールと自然言語フィードバックを用いたマルチターンの相互作用を通じて、困難なタスクを解くエージェントの能力を評価するために設計されたベンチマークである。我々はYuan et al.(2024)で使用されたコーディングおよび数学のサブセットを用いる。我々は原著論文に従い、エージェントが最大5回のイテレーションで相互作用し、解答を提案する機会を2回与えることを許容する。
ProofWriter(Tafjord et al., 2021)は、LLMの演繹的推論能力を評価するために作成された合成データセットである。Logic-LM(Pan et al., 2023)と同様に、我々は最も困難なサブセットに焦点を当てており、これは5ホップの推論を必要とする600個のインスタンスを含む。意味解析における潜在的な誤りの影響を最小化するため、我々はLogic-LMによって提供された論理形式を用いる。
Entity Deduction Arena(EDA)(Zhang et al., 2024a)は、20の質問ゲームに類似した、戦略的な質問を通じて未知のエンティティを推論するエージェントの能力を評価する。このベンチマークは、マルチターンの会話におけるエージェントの状態追跡、戦略的計画、および帰納的推論能力を試す。我々は「Things」と「Celebrities」の2つのデータセットを評価し、それぞれ100個のインスタンスからなり、これら2つのデータセットにわたる平均成功率を報告する。
5 結論
我々は、ソフトウェアインターフェースを通じて世界と相互作用するエージェントの開発を可能にする、コミュニティ主導のプラットフォームであるOpenHandsを紹介する。強力な相互作用メカニズム、安全なサンドボックス環境、エージェントに不可欠なスキル、マルチエージェント協調機能、そして包括的な評価フレームワークを提供することにより、OpenHandsはエージェント型AIシステムの研究革新と実世界応用を加速させる。安全で信頼性の高いエージェントの開発における課題(\$A)にもかかわらず、我々は活気あるコミュニティに胸を躍らせており、OpenHandsのさらなる進化を楽しみにしている。
参考文献
Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Omar Cortes, Byron David, Chelsea Finn, Chuyuan Fu, Keerthana Gopalakrishnan, Karol Hausman, et al. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022. 1
Daniil A Boiko, Robert MacKnight, Ben Kline, and Gabe Gomes. Autonomous chemical research with large language models. Nature, 624(7992):570- 578, 2023. 1
Yupeng Chang, Xu Wang, Jindong Wang, Yuan Wu, Linyi Yang, Kaijie Zhu, Hao Chen, Xiaoyuan Yi, Cunxiang Wang, Yidong Wang, et al. A survey on evaluation of large language models. ACM Transactions on Intelligent Systems and Technology, 15(3):1- 45, 2024. 1
Harrison Chase. LangChain, October 2022. URL https://github.com/langchain- ai/langchain. 4, 6, 18
Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Jaward Sesay, Borje F. Karlsson, Jie Fu, and Yemin Shi. Autoagents: A framework for automatic agent generation, 2024. 1, 6, 18
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. 7
Cognition.ai. Introducing devin, the first ai software engineer. URL https://www.cognition.ai/blog/introducing- devin. 2
CrewAI. CrewAI, October 2024. URL https://github.com/crewAIInc/crewAI. 18
Jiaxi Cui, Zongjian Li, Yang Yan, Bohua Chen, and Li Yuan. Chatlaw: Open- source legal large language model with integrated external knowledge bases, 2023. 18
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados, and Alexandre Lacoste. Workarena: How capable are web agents at solving common knowledge work tasks?, 2024. 3, 4
Paul Gauthier. How aider scored sota 26.3% on swe bench lite i aider. https://aider.chat/2024/05/22/ swe- bench- lite.html. Accessed: 2024- 06- 05. 5, 7, 8
Significant Gravitas. Auto- gpt: An autonomous gpt- 4 experiment, 2023. URL https://github.com/Significant- Gravitas/Auto- GPT, 2023. 6, 7, 10, 18
Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, et al. Metagpt: Meta programming for a multi- agent collaborative framework. In The Twelfth International Conference on Learning Representations, 2023. 1, 6, 18
Dong Huang, Qingwen Bu, Jie M. Zhang, Michael Luck, and Heming Cui. Agentcoder: Multi- agent- based code generation with iterative testing and optimisation, 2024. 19
Peter C Humphreys, David Raposo, Tobias Pohlen, Gregory Thornton, Rachita Chhaparia, Alistair Muldal, Josh Abramson, Petko Georgiev, Adam Santoro, and Timothy Lillicrap. A data- driven approach for learning to control computers. In International Conference on Machine Learning, pp. 9466- 9482. PMLR, 2022. 9
IPython. Jupyter and the future of IPython — IPython. URL https://ipython.org. 4
Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024. 1
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik R Narasimhan. SWE- bench: Can Language Models Resolve Real- world Github Issues? In The Twelfth International Conference on Learning Representations, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. 1, 6, 7, 8, 17, 19
Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: Compiling declarative language model calls into self- improving pipelines. 2024. 18
Geunwoo Kim, Pierre Baldi, and Stephen McAleer. Language models can solve computer tasks. Advances in Neural Information Processing Systems, 36, 2024. 9
Hanyu Lai, Xiao Liu, Iat Long Iong, Shuntian Yao, Yuxuan Chen, Pengbo Shen, Hao Yu, Hanchen Zhang, Xiaohan Zhang, Yuxiao Dong, et al. Autowebglm: Bootstrap and reinforce a large language model- based web navigating agent. arXiv preprint arXiv:2404.03648, 2024. 7, 9
Hareton K. N. Leung and Lee J. White. A study of integration testing and software regression at the integration level. In Proceedings of the Conference on Software Maintenance, ICSM 1990, San Diego, CA, USA, 26- 29 November, 1990, pp. 290- 301. IEEE, 1990. doi: 10.1109/ICSM.1990.131377. URL https://doi.org/10.1109/ICSM.1990.131377. 19
Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin, and Bernard Ghanem. Camel: Communicative agents for" mind" exploration of large scale language model society. arXiv preprint arXiv:2303.17760, 2023a. 18
Jinyang Li, Binyuan Hui, GE QU, Jiaxi Yang, Binhua Li, Bowen Li, Bailin Wang, Bowen Qin, Ruiying Geng, Nan Huo, Xuanhe Zhou, Chenhao Ma, Guoliang Li, Kevin Chang, Fei Huang, Reynold Cheng, and Yongbin Li. Can LLM already serve as a database interface? a Blg bench for large- scale database grounded text- to- SQLs. In Thirty- seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023b. 6, 8, 9, 17
Raymond Li, Loubna Ben Allal, Yangtian Zi, Niklas Muennighoff, Denis Kocetkov, Chenghao Mou, Marc Marone, Christopher Akiki, Jia Li, Jenny Chim, Qian Liu, Evgenii Zheltonozhskii, Terry Yue Zhuo, Thomas Wang, Olivier Dehaene, Mishig Davaadorj, Joel Lamy- Poirier, Joao Monteiro, Oleh Shliazhko, Nicolas Gontier, Nicholas Meade, Armel Zebaze, Ming- Ho Yee, Logesh Kumar Umapathi, Jian Zhu, Benjamin Lipkin, Muhtasham Oblokulov, Zhiruo Wang, Rudra Murthy, Jason Stillerman, Siva Sankalp Patel, Dmitry Abulkhanov, Marco Zocca, Manan Dey, Zhihan Zhang, Nour Fahmy, Urvashi Bhattacharyya, Wenhao Yu, Swayam Singh, Sasha Luccioni, Paulo Villegas, Maxim Kunakov, Fedor Zhdanov, Manuel Romero, Tony Lee, Nadav Timor, Jennifer Ding, Claire Schlesinger, Hailey Schoelkopf, Jan Ebert, Tri Dao, Mayank Mishra, Alex Gu, Jennifer Robinson, Carolyn Jane Anderson, Brendan Dolan- Gavitt, Danish Contractor, Siva Reddy, Daniel Fried, Dzmitry Bahdanau, Yacine Jernite, Carlos Munoz Ferrandis, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra, and Harm de Vries. Starcoder: may the source be with you!, 2023c. URL https://arxiv.org/abs/2305.06161. 7
Tao Li, Gang Li, Zhiwei Deng, Bryan Wang, Yang Li. 構造化された内省を備えたコンピュータ制御のためのゼロショット言語エージェント。arXivプレプリント arXiv:2310.08740, 2023d. 9
Evan Zheran Liu, Kelvin Guu, Panupong Pasupat, Tianlin Shi, Percy Liang. ワークフロー誘導型探索を用いたウェブインターフェース上の強化学習。国際学習表現会議(ICLR)予稿集, 2018. URL https://arxiv.org/abs/1802.08802. 6, 9, 17
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, Shudan Zhang, Xiang Deng, Aohan Zeng, Zhengxiao Du, Chenhui Zhang, Sheng Shen, Tianjun Zhang, Yu Su, Huan Sun, Minlie Huang, Yuxiao Dong, Jie Tang. Agentbench: エージェントとしてのLLMの評価。arXivプレプリント arXiv: 2308.03688, 2023. 6, 10, 17
Anton Lozhkov, Raymond Li, Loubna Ben Allal, Federico Cassano, Joel Lamy- Poirier, Nouamane Tazi, Ao Tang, Dmytro Pykhtar, Jiawei Liu, Yuxiang Wei, Tianyang Liu, Max Tian, Denis Kocetkov, Arthur Zucker, Younes Belkada, Zijian Wang, Qian Liu, Dmitry Abulkhanov, Indraneil Paul, Zhuang Li, Wen- Ding Li, Megan Risdal, Jia Li, Jian Zhu, Terry Yue Zhuo, Evgenii Zheltonozhskii, Nii Osae Osae Dade, Wenhao Yu, Lucas Krauß, Naman Jain, Yixuan Su, Xuanli He, Manan Dey, Edoardo Abati, Yekun Chai, Niklas Muennighoff, Xiangru Tang, Muhtasham Oblokulov, Christopher Akiki, Marc Marone, Chenghao Mou, Mayank Mishra, Alex Gu, Binyuan Hui, Tri Dao, Armel Zebaze, Olivier Dehaene, Nicolas Patry, Canwen Xu, Julian McAuley, Han Hu, Torsten Scholak, Sebastien Paquet, Jennifer Robinson, Carolyn Jane Anderson, Nicolas Chapados, Mostofa Patwary, Nima Tajbakhsh, Yacine Jernite, Carlos Muñoz Ferrandis, Lingming Zhang, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra, Harm de Vries. Starcoder 2とThe Stack v2:次世代, 2024. URL https://arxiv.org/abs/2402.19173. 7
Grégoire Mialon, Clémentine Fourrier, Craig Swift, Thomas Wolf, Yann LeCun, and Thomas Scialom. GAIA: a benchmark for general AI assistants. CoRR, abs/2311.12983, 2023. doi: 10.48550/ARXIV.2311.12983. URL https://doi.org/10.48550/arXiv.2311.12983. 6, 9, 10, 17
Mozilla. Accessibility tree - MDN Web Docs Glossary: Definitions of Web-related terms | MDN. URL https://developer.mozilla.org/en-US/docs/Glossary/Accessibility_tree. 5
Niklas Muennighoff, Qian Liu, Armel Zebaze, Qinkai Zheng, Binyuan Hui, Terry Yue Zhuo, Swayam Singh, Xiangru Tang, Leandro von Werra, and Shayne Longpre. Octopack: Instruction tuning code large language models, 2024. 6, 7, 8, 17
Y Nakajima. Babyagi. URL https://github.com/yoheinakajima/babyagi, 2023. 18
OpenAI. Chatgpt: May 2024 version. https://www.openai.com/chatgpt, 2024a. アクセス日: 2024-05-29. 8, 18
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. アクセス日: 2024-05-15. 1
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/, 2024b. アクセス日: 2024-05-15. 1OpenAI, Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, Red Avila, Igor Babuschkin, Suchir Balaji, Valerie Balcom, Paul Baltescu, Haiming Bao, Mohammad Bavarian, Jeff Belgum, Irwan Bello, Jake Berdine, Gabriel Bernadett-Shapiro, Christopher Berner, Lenny Bogdonoff, Oleg Boiko, Madelaine Boyd, Anna-Luisa Brakman, Greg Brockman, Tim Brooks, Miles Brundage, Kevin Button, Trevor Cai, Rosie Campbell, Andrew Cann, Brittany Carey, Chelsea Carlson, Rory Carmichael, Brooke Chan, Che Chang, Fotis Chantzis, Derek Chen, Sully Chen, Ruby Chen, Jason Chen, Mark Chen, Ben Chess, Chester Cho, Casey Chu, Hyung Won Chung, Dave Cummings, Jeremiah Currier, Yunxing Dai, Cory Decareaux, Thomas Degry, Noah Deutsch, Damien Deville, Arka Dhar, David Dohan, Steve Dowling, Sheila Dunning, Adrien Ecoffet, Atty Eleti, Tyna Eloundou, David Farhi, Liam Fedus, Niko Felix, Simón Posada Fishman, Juston Forte, Isabella Fulford, Leo Gao, Elie Georges, Christian Gibson, Vik Goel, Tarun Gogineni, Gabriel Goh, Rapha Gontijo-Lopes, Jonathan Gordon, Morgan Grafstein, Scott Gray, Ryan Greene, Joshua Gross, Shixiang Shane Gu, Yufei Guo, Chris Hallacy, Jesse Han, Jeff Harris, Yuchen He, Mike Heaton, Johannes Heidecke, Chris Hesse, Alan Hickey, Wade Hickey, Peter Hoeschele, Brandon Houghton, Kenny Hsu, Shengli Hu, Xin Hu, Joost Huizinga, Shantanu Jain, Shawn Jain, Joanne Jang, Angela Jiang, Roger Jiang, Haozhun Jin, Denny Jin, Shino Jomoto, Billie Jonn, Heewoo Jun, Tomer Kaftan, Łukasz Kaiser, Ali Kamali, Ingmar Kanitscheider, Nitish Shirish Keskar, Tabarak Khan, Logan Kilpatrick, Jong Wook Kim, Christina Kim, Yongjik Kim, Jan Hendrik Kirchner, Jamie Kiros, Matt Knight, Daniel Kokotajlo, Łukasz Kondraciuk, Andrew Kondrich, Aris Konstantinidis, Kyle Kosic, Gretchen Krueger, Vishal Kuo, Michael Lampe, Iki Lan, Teddy Lee, Jan Leike, Jade Leung, Daniel Levy, Chak Ming Li, Rachel Lim, Molly Lin, Stephanie Lin, Mateusz Litwin, Theresa Lopez, Ryan Lowe, Patricia Lue, Anna Makanju, Kim Malfacini, Sam Manning, Todor Markov, Yaniv Markovski, Bianca Martin, Katie Mayer, Andrew Mayne, Bob McGrew, Scott Mayer McKinney, Christine McLeavey, Paul McMillan, Jake McNeil, David Medina, Aalok Mehta, Jacob Menick, Luke Metz, Andrey Mishchenko, Pamela Mishkin, Vinnie Monaco, Evan Morikawa, Daniel Mossing, Tong Mu, Mira Murati, Oleg Murk, David Mély, Ashvin Nair, Reiichiro Nakano, Rajeev Nayak, Arvind Neelakantan, Richard Ngo, Hyeonwoo Noh, Long Ouyang, Cullen O'Keefe, Jakub Pachocki, Alex Paino, Joe Palermo, Ashley Pantuliano, Giambattista Parascandolo, Joel Parish, Emy Parparita, Alex Passos, Mikhail Pavlov, Andrew Peng, Adam Perelman, Filipe de Avila Belbute Peres, Michael Petrov, Henrique Ponde de Oliveira Pinto, Michael, Pokorny, Michelle Pokrass, Vitchyr H. Pong, Tolly Powell, Alethea Power, Boris Power, Elizabeth Proehl, Raul Puri, Alec Radford, Jack Rae, Aditya Ramesh, Cameron Raymond, Francis Real, Kendra Rimbach, Carl Ross, Bob Rotsted, Henri Roussez, Nick Ryder, Mario Saltarelli, Ted Sanders, Shibani Santurkar, Girish Sastry, Heather Schmidt, David Schnurr, John Schulman, Daniel Selsam, Kyla Sheppard, Toki Sherbakov, Jessica Shieh, Sarah Shoker, Pranav Shyam, Szymon Sidor, Eric Sigler, Maddie Simens, Jordan Sitkin, Katarina Slama, Ian Sohl, Benjamin Sokolowsky, Yang Song, Natalie Staudacher, Felipe Petroski Such, Natalie Summers, Ilya Sutskever, Jie Tang, Nikolas Tezak, Madeleine B. Thompson, Phil Tillet, Amin Tootoonchian, Elizabeth Tseng, Preston Tuggle, Nick Turley, Jerry Tworek, Juan Felipe Cerón Uribe, Andrea Vallone, Arun Vijayvergiya, Chelsea Voss, Carroll Wainwright, Justin Jay Wang, Alvin Wang, Ben Wang, Jonathan Ward, Jason Wei, CJ Weinmann, Akila Welihinda, Peter Welinder, Jiayi Weng, Lilian Weng, Matt Wiethoff, Dave Willner, Clemens Winter, Samuel Wolrich, Hannah Wong, Lauren Workman, Sherwin Wu, Jeff Wu, Michael Wu, Kai Xiao, Tao Xu, Sarah Yoo, Kevin Yu, Qiming Yuan, Wojciech Zaremba, Rowan Zellers, Chong Zhang, Marvin Zhang, Shengjia Zhao, Tianhao Zheng, Juntang Zhuang, William Zhuk, and Barret Zoph. Gpt-4 technical report, 2024. 18
Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine, and Alane Suhr. Autonomous evaluation and refinement of digital agents. arXiv preprint arXiv:2404.06474, 2024. 7, 9, 18
Liangming Pan, Alon Albalak, Xinyi Wang, and William Yang Wang. Logic-Im: Empowering large language models with symbolic solvers for faithful logical reasoning. arXiv preprint arXiv:2305.12295, 2023. 10
Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior, 2023. 18
Ajay Patel, Markus Hofmarcher, Claudiu Leoveanu-Condrei, Marius-Constantin Dinu, Chris Callison-Burch, and Sepp Hochreiter. Large language models can self-improve at web agent tasks. arXiv preprint arXiv:2405.20309, 2024. 7, 9
Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023. 6, 8, 17
Playwright. Fast and reliable end-to-end testing for modern web apps | Playwright. URL https://playwright.dev/. 4
Chen Qian, Xin Cong, Wei Liu, Cheng Yang, Weize Chen, Yusheng Su, Yufan Dang, Jiahao Li, Juyuan Xu, Dahai Li, Zhiyuan Liu, and Maosong Sun. Communicative agents for software development, 2023. 18, 19
Yujia Qin、Shihao Liang、Yining Ye、Kunlun Zhu、Lan Yan、Yaxi Lu、Yankai Lin、Xin Cong、Xiangru Tang、Bill Qian、Sihan Zhao、Runchu Tian、Ruobing Xie、Jie Zhou、Mark Gerstein、Dahai Li、Zhiyuan Liu、Maosong Sun。Toolllm:大規模言語モデルが16000以上の実世界APIを習得できるようにする。CoRR、abs/2307.16789、2023年。doi: 10.48550/ARXIV.2307.16789。URL https://doi.org/10.48550/arXiv.2307.16789。4
David Rein、Betty Li Hou、Asa Cooper Stickland、Jackson Petty、Richard Yuanzhe Pang、Julien Dirani、Julian Michael、Samuel R Bowman。GPQA:大学院レベルのGoogle耐性Q&Aベンチマーク。arXiv preprint arXiv:2311.12022、2023年。6、7、9、10、17、23
Aman Sanger。ほぼ即時のファイル全体編集。https://www.cursor.com/blog/instant-apply。アクセス日:2024-06-05。5
ServiceNow。BrowserGym:ウェブタスク自動化のためのGym環境。URL https://github.com/ServiceNow/BrowserGym。2、4、18
Peter Shaw、Mandar Joshi、James Cohan、Jonathan Berant、Panupong Pasupat、Hexiang Hu、Urvashi Khandelwal、Kenton Lee、Kristina N Toutanova。ピクセルからUIアクションへ:グラフィカルユーザーインターフェースを通じて指示に従うことを学習する。Advances in Neural Information Processing Systems、36:34354-34370、2023年。9
Noah Shinn、Federico Cassano、Ashwin Gopinath、Karthik Narasimhan、Shunyu Yao。「Reflexion: 言語エージェントと言語による強化学習」。Advances in Neural Information Processing Systems、36、2024年。18
Øyvind Tafjord、Bhavana Dalvi、Peter Clark。「ProofWriter: 自然言語に対する含意・証明・仮説的陳述の生成」。Chengqing Zong、Fei Xia、Wenjie Li、Roberto Navigli(編)、Findings of the Association for Computational Linguistics: ACL-IJCNLP 2021、pp. 3621-3634、オンライン、2021年8月。Association for Computational Linguistics。doi: 10.18653/v1/2021.findings-acl.317。URL https://aclanthology.org/2021.findings-acl.317。6、10、17
Xiangru Tang、Qiao Jin、Kunlun Zhu、Tongxin Yuan、Yichi Zhang、Wangchunshu Zhou、Meng Qu、Yilun Zhao、Jian Tang、Zhuosheng Zhang ほか。「 Prioritizing safeguarding over autonomy: Risks of llm agents for science」。arXiv preprint arXiv:2402.04247、2024a。1
Xiangru Tang、Yuliang Liu、Zefan Cai、Yanjun Shao、Junjie Lu、Yichi Zhang、Zexuan Deng、Helan Hu、Kaikai An、Ruijun Huang、Shuzheng Si、Sheng Chen、Haozhe Zhao、Liang Chen、Yan Wang、Tianyu Liu、Zhiwei Jiang、Baobao Chang、Yin Fang、Yujia Qin、Wangchunshu Zhou、Yilun Zhao、Arman Cohan、Mark Gerstein。「ML-Bench: リポジトリレベルのコードにおける機械学習タスクのための大規模言語モデルとエージェントの評価」、2024b。URL https://arxiv.org/abs/2311.09835。6、8、17
Xiangru Tang、Bill Qian、Rick Gao、Jiakang Chen、Xinyun Chen、Mark B Gerstein。「BioCoder: 大規模言語モデルによるバイオインフォマティクスコード生成のベンチマーク」。Bioinformatics、40(Supplement_1):i266-i276、2024年6月、2024c。ISSN 1367-4811。6、8、17
Xiangru Tang、Anni Zou、Zhuosheng Zhang、Ziming Li、Yilun Zhao、Xingyao Zhang、Arman Cohan、Mark Gerstein。「Medagents: ゼロショット医療推論のための協働者としての大規模言語モデル」、2024d。18
Gemini Team、Rohan Anil、Sebastian Borgeaud、Yonghui Wu、Jean-Baptiste Alayrac、Jiahui Yu、Radu Soricut、Johan Schalkwyk、Andrew M Dai、Anja Hauth ほか。「Gemini: 高い能力を持つマルチモーダルモデルのファミリー」。arXiv preprint arXiv:2312.11805、2023年。1
XAgent Team。「Xagent: 複雑なタスク解決のための自律エージェント」、2023年。6、18
Hugo Touvron、Thibaut Lavril、Gautier Izacard、Xavier Martinet、Marie-Anne Lachaux、Timothée Lacroix、Baptiste Rozière、Naman Goyal、Eric Hambro、Faisal Azhar、Aurelien Rodriguez、Armand Joulin、Edouard Grave、Guillaume Lample。「Llama: オープンで効率的な基盤言語モデル」。arXiv preprint arXiv:2302.13971、2023年。8
Xingyao Wang、Yangyi Chen、Lifan Yuan、Yizhe Zhang、Yunzhu Li、Hao Peng、Heng Ji。「Executable Code Actions Elicit Better LLM Agents」。ICML、2024a。2、3、4、5、17
Xingyao Wang、Zihan Wang、Jiateng Liu、Yangyi Chen、Lifan Yuan、Hao Peng、Heng Ji。「MINT: ツールおよび言語フィードバックとのマルチターン相互作用におけるLLMの評価」。ICLR、2024b。6、10、17
Qingyun Wu、Gagan Bansal、Jieyu Zhang、Yiran Wu、Shaokun Zhang、Erkang Zhu、Beibin Li、Li Jiang、Xiaoyun Zhang、Chi Wang。「Autogen: マルチエージェント会話フレームワークによる次世代LLMアプリケーションの実現」。arXiv preprint arXiv:2308.08155、2023年。1、6、18
Chunqiu Steven Xia、Yinlin Deng、Soren Dunn、Lingming Zhang。「Agentless: LLMベースのソフトウェアエンジニアリングエージェントの謎を解く」。arXiv preprint、2024年。7
Tianbao Xie、Fan Zhou、Zhoujun Cheng、Peng Shi、Luoxuan Weng、Yitao Liu、Toh Jing Hua、Junning Zhao、Qian Liu、Che Liu ほか。「Openagents: 実環境における言語エージェントのためのオープンプラットフォーム」。arXiv preprint arXiv:2310.10634、2023年。6
Yiheng Xu、Hongjin Su、Chen Xing、Boyu Mi、Qian Liu、Weijia Shi、Binyuan Hui、Fan Zhou、Yitao Liu、Tianbao Xie ほか。「Lemur: 言語エージェントのための自然言語とコードの調和」。arXiv preprint arXiv:2310.06830、2023年。7、9
John Yang、Carlos E. Jimenez、Alexander Wettig、Kilian Lieret、Shunyu Yao、Karthik Narasimhan、Ofir Press。「Swe-agent: エージェント・コンピュータ・インターフェースが自動ソフトウェアエンジニアリングを可能にする」、2024年。2、5、6、7、8、19
Shunyu Yao、Jeffrey Zhao、Dian Yu、Nan Du、Izhak Shafran、Karthik R Narasimhan、Yuan Cao。「React: 言語モデルにおける推論と行動の相乗効果」。The Eleventh International Conference on Learning Representations、2023年。URL https://openreview.net/forum?id=WE_vluYUL-X。8
Yining Ye、Xin Cong、Shizuo Tian、Jiannan Cao、Hao Wang、Yujia Qin、Yaxi Lu、Heyang Yu、Huadong Wang、Yankai Lin ほか。「Proagent: ロボティック・プロセス・オートメーションからエージェント型プロセス・オートメーションへ」。arXiv preprint arXiv:2311.10751、2023年。18。
Lifan Yuan、Yangyi Chen、Xingyao Wang、Yi R. Fung、Hao Peng、Heng Ji。「CRAFT: 専門ツールセットの作成と検索によるLLMのカスタマイズ」。CoRR、abs/2309.17428、2023年。doi: 10.48550/ARXIV.2309.17428。URL https://doi.org/10.48550/arXiv.2309.17428。4
Lifan Yuan、Ganqu Cui、Hanbin Wang、Ning Ding、Xingyao Wang、Jia Deng、Boji Shan、Huimin Chen、Ruobing Xie、Yankai Lin、Zhenghao Liu、Bowen Zhou、Hao Peng、Zhiyuan Liu、Maosong Sun。「選好木を用いたLLM推論汎用モデルの前進」、2024年。10
Yizhe Zhang、Jiarui Lu、Navdeep Jaitly。「20の質問ゲームによるLLMのマルチターン計画能力の探索」、2024a。6、10、17
Yuntong Zhang、Haifeng Ruan、Zhiyu Fan、Abhik Roychoudhury。「Autocoderover: 自律的なプログラム改善」、2024b。6、7、8、19
Shuyan Zhou、Frank F Xu、Hao Zhu、Xuhui Zhou、Robert Lo、Abishek Sridhar、Xianyi Cheng、Tianyue Ou、Yonatan Bisk、Daniel Fried ほか。「Webarena: 自律エージェント構築のための現実的なWeb環境」。The Twelfth International Conference on Learning Representations、2023a。1、6、7、9、17
Wangchunshu Zhou、Yuchen Eleanor Jiang、Long Li、Jialong Wu、Tiannan Wang、Shi Qiu、Jintian Zhang、Jing Chen、Ruipu Wu、Shuai Wang、Shiding Zhu、Jiyu Chen、Wentao Zhang、Xiangru Tang、Ningyu Zhang、Huajun Chen、Peng Cui、Mrinmaya Sachan。「Agents: 自律言語エージェントのためのオープンソースフレームワーク」、2023b。6、18
Yuchen Zhuang、Yue Yu、Kuan Wang、Haotian Sun、Chao Zhang。「Toolqa: 外部ツールを用いたLLM質問応答のためのデータセット」。Advances in Neural Information Processing Systems、36、2024年。6、8、17
Mingchen Zhuge、Haozhe Liu、Francesco Faccio、Dylan R Ashley、Robert Csordás、Anand Gopalakrishnan、Abdullah Hamdi、Hasan Abed Al Kader Hammoud、Vincent Herrmann、Kazuki Irie ほか。「自然言語ベースの心の社会におけるマインドストーム」。arXiv preprint arXiv:2305.17066、2023年。18
Mingchen Zhuge, Wenyi Wang, Louis Kirsch, Francesco Faccio, Dmitrii Khizbullin, and Jurgen Schmidhuber. 最適化可能なグラフとしての言語エージェント. arXiv preprint arXiv:2402.16823, 2024. 6, 17, 18
Albert Örwall. Moatless tools. URL https://github.com/aorwall/moatless- tools. 7
著者の貢献
本研究は、複数の機関にまたがるオープンソースの共同作業であった。我々は貢献度を判定し著者資格を授与するためにポイントベースのシステムを採用し、技術的貢献はプルリクエスト(PR)¹の単位で追跡・測定した。Xingyao Wangがプロジェクトを率い、開発全体の調整と論文執筆の取り組みを統括した。詳細な貢献は以下の通りである:
- エージェント開発(§3):Xingyao WangがCodeAct Wang et al. (2024a)およびCodeActSWEエージェントの実装を主導した。Frank F. XuがウェブブラウジングエージェントZhou et al. (2023a)の開発を主導した。Mingchen ZhugeがGPTSwarmエージェントZhuge et al. (2024)の統合を指揮した。Robert BrennanとBoxuan LiがMicro Agentの開発を主導した。
- アーキテクチャ開発(Fig. 2):Robert Brennanがアーキテクチャ設計を開始した。Boxuan Li、Frank F. Xu、Xingyao Wang、Yufan Song、Mingzhang Zhengがアーキテクチャをさらに洗練・拡張した。Boxuan Liは統合テスト(§E)の初期バージョンを実装し、agentskillsライブラリ(§2.3)を維持し、設定を管理し、評価におけるリソースリークを解決した。Frank F. Xuはエージェントの実行と評価の両方のためのウェブブラウジング環境(§J)を開発し、それをエージェントとフロントエンドの両方のユーザーインターフェースと統合した。Xingyao WangはagentskillsライブラリとDockerサンドボックスの初期コードを執筆した。Yufan Songは評価のためのコスト追跡を実装し、Mingzhang Zhengはより安定したSWE-Bench評価のためのイメージ非依存のDockerサンドボックスを開発した。
- ベンチマーク、統合、コードレビュー:Boxuan LiとYufan Songがベンチマーク統合の取り組みを主導し、調整、評価、コードレビューを含めた。Yufan SongはPR貢献の追跡も支援した。Graham Neubig、Xingyao Wang、Mingzhang Zheng、Robert Brennan、Hoang H. Tran、Frank F. Xu、Xiangru Tang、Fuqiang Li、Yanjun Shaoが統合とコードレビューにおいて追加の支援を提供した。具体的なベンチマークへの貢献は以下の通りである:
- SWE-Bench Jimenez et al. (2024):Bowen LiとXingyao Wang- WebArena Zhou et al. (2023a)およびMiniWob++ Liu et al. (2018):Frank F. Xu- GAIA Mialon et al. (2023):Jiayi Pan(統合)とMingchen Zhuge(GPTSwarm評価)- API-Bench Patil et al. (2023)およびToolQA Zhuang et al. (2024):Yueqi Song- HumanEvalFix Muennighoff et al. (2024):Niklas MuennighoffとXiangru Tang- ProofWriter Tafjord et al. (2021):Ren Ma- MINT Wang et al. (2024b):Hoang H. Tran- AgentBench Liu et al. (2023):Fuqiang Li- BIRD Li et al. (2023b):Binyuan Hui- GPQA Rein et al. (2023):Jaskirat Singh- BioCoder Tang et al. (2024c):Xiangru TangとBill Qian- ML-Bench Tang et al. (2024b):Xiangru TangとYanjun Shao- Entity-Deduction-Arena Zhang et al. (2024a):Yizhe Zhang
- 助言:Graham Neubigがプロジェクトに助言し、指針、リソース、および論文への大幅な編集を提供した。Heng JiとHao Pengが追加のプロジェクト助言を提供し、論文執筆を支援した。Junyang Linが助言的支援を提供し、リソースを提供した。
A 限界と今後の課題
我々は、活発なコミュニティがOpenHandsに築いた基盤に興奮しており、その継続的な進化を楽しみにしている。我々は今後の課題としていくつかの方向性を特定する:
マルチモーダルサポートの強化。現在の実装は事前定義されたエージェントスキルを通じて幅広いファイル形式をすでにサポートしているが、我々は標準的なIPythonとブラウザの統合を通じて、原理的な方法でマルチモーダルを可能にすることに関心がある。例えば、視覚言語モデルを用いてブラウザ経由で画像や動画を閲覧したり、コードでXLSXファイルを処理したりすることである。
より強力なエージェント。現在のエージェントは依然として複雑なタスクに苦戦しており、我々は訓練と推論時間の両方の技術を通じてより優れたエージェントを構築することに関心がある。
エージェント編集の改善。現在のエージェントは長いファイルを編集する際に大きな苦戦をしており、我々はエージェントのファイル編集性能を改善するための異なるアプローチを探求することに関心がある。
ウェブブラウジングの改善。OpenHandsの拡張可能な性質により、エージェントを改善しうる直交するコンポーネントを容易に統合できる。例えば、OpenHandsの拡張可能なアーキテクチャのおかげで、Auto Eval & Refine Pan et al. (2024)は、Reflexion Shinn et al. (2024)プロンプトとタスク完了報酬モデルを用いたエージェントのエラー時再試行戦略であり、我々のブラウジングエージェントに付随するオプションのコンポーネントとして統合される予定である。
自動ワークフロー生成。現在、OpenHandsのワークフローは依然として相当な手作業の負荷を必要とする。我々は、GPTSwarm Zhuge et al. (2024)やLangGraph Chase (2022)のようなグラフベースのフレームワークが、エージェントを構築するための代替ソリューションとして機能しうると信じている。特にGPTSwarmでは、エージェントがグラフを用いて構築される場合、様々な最適化手法(例えば、強化学習、メタプロンプティング)を組み込むことがより容易になる。OpenHandsはこれらの手法が、将来のバージョンにおける自動ワークフロー生成の有望なソリューションの基礎を築くと考えている。
B 倫理声明
今日のほとんどのAIエージェントは依然として研究の産物であり、実世界で複雑で長期的なタスクを確実に実行する能力を欠いている。しかし、その性能が向上し続け、実世界でますます展開されるにつれて、生産性を高める可能性がある一方で、社会に重大なセキュリティリスクをもたらす可能性もある。OpenHandsは以下の方法でリスクを軽減するのに役立つ:
(1) これらのエージェントの体系的な評価を可能にし、広く展開される前にリスクを特定し対処できるようにする。(2) エージェントが監督なしに自律的に動作することを許すのではなく、人間とエージェントの相互作用を促進する。(3) さらに重要であるのは、我々はOpenHandsが世界中の研究者が安全で有用なエージェントを構築するためのフロンティア安全研究を行うために、最高のエージェントスイートにアクセスできるようにすることを願っている。
C 関連研究
ChatGPT OpenAI (2024a)やGPT4 OpenAI et al. (2024)のような大規模言語モデル(LLM)のブレークスルーは、様々な領域における自律エージェントの能力を大幅に強化してきたYe et al. (2023); Tang et al. (2024d); Park et al. (2023); Cui et al. (2023)。これらの進歩は、多様なユーザータスクを実行することを目的とした多数の汎用エージェントの提案Gravitas (2023); Nakajima (2023); Wu et al. (2023)を促し、開発者と幅広い観衆の両方から注目を集めてきた。Auto-GPT Gravitas (2023)のような注目すべき研究は、ユーザーの目標を実行可能なステップに分解することでタスク完了のためにLLMを活用している。マルチエージェント協調システムは、ロールプレイングやタスク解決能力などの要素のためにLLMを活用しZhuge et al. (2023); Li et al. (2023a); Zhou et al. (2023b); Team (2023)、MetaGPT Hong et al. (2023)は標準化された操作手順を強調し、AutoGen Wu et al. (2023)は対話型システムのための会話フレームワークを提供している。AGENTS Zhou et al. (2023b)とAutoAgents Chen et al. (2024)はカスタマイズ可能なエージェントアーキテクチャのための新しいパラダイムを提供し、XAgent Team (2023)とGPTSwarm Zhuge et al. (2024)はそれぞれ、強化されたエージェント操作のために複雑な管理システムと最適化可能なグラフを導入している。
このエージェント開発の急増は、エージェント実装を合理化することを目的とした専門的なフレームワークにつながった。LangChainとLangGraph Chase (2022)は基本的なランタイムサポートを備えた基盤的なビルディングブロックを提供し、CrewAI CrewAI (2024)はマルチエージェント通信のオーケストレーションに焦点を当てている。BrowserGym ServiceNowは特にウェブブラウジング能力を対象とし、DSPy Khattab et al. (2024)はエンドツーエンドのプロンプト最適化を強調している。AutoGen Wu et al. (2023)はPythonとbashの実行能力を実装することで基本的なフレームワークを超えて前進しているが、ステートレスなコマンド実行であり、CrewAIのようなフレームワークはサンドボックス化されているが限定的なコードインタープリタ機能を提供している。
ソフトウェア開発は、LLMベースのエージェントの応用における先駆者であり、開発プロセスを促進するためのフレームワークの進歩が見られているHong et al. (2023); Qian et al. (2023)。ChatDev Qian et al. (2023)のようなイノベーションはウォーターフォールモデルに似たソフトウェア開発ライフサイクルを自動化し、AutoCodeRover Zhang et al. (2024b)はコード検索と抽象構文木の操作を通じてGitHubのissueに対処する。AgentCoder Huang et al. (2024)は統合されたテストとフィードバックを用いてコード生成を反復的に洗練し、SWE-Agent Yang et al. (2024)は自動化されたGitHubのissue修正のためにLLMを統合し、ソフトウェアエンジニアリングを合理化している。
D グラフィカルユーザーインターフェース
コマンドラインから実行するだけでなく、OpenHandsはエージェントの現在の行動(例えば、ウェブの閲覧、基本コマンドやPythonコードの実行など)を可視化し、ユーザーからのリアルタイムのフィードバックを可能にするリッチなグラフィカルユーザーインターフェースを備えている。UIのスクリーンショットはFig. 1に示されている。ユーザーはエージェントが作業している間にいつでも介入して、追加のフィードバック、コメント、または指示を提供できる。このユーザーインターフェースはイベントストリーム(§2.1)に直接接続してエージェントとランタイムを制御・可視化し、エージェントとランタイムに依存しない。
E 品質管理:エージェントのための統合テスト
統合テストLeung & White (1990)は、ソフトウェア品質を確保するためにソフトウェア開発者によって長い間使用されてきた。単純な入力-出力スキーマを持つ大規模言語モデルとは異なり、エージェントは通常、開発プロセス中に軽微なエラーが容易に導入され、最終的なタスク性能を損なう可能性がある複雑なソフトウェアである。完全なスイート評価(§4)を実行することは性能劣化の究極の尺度であるが、コード変更ごとにそれらを実行することは法外に遅く高価になりうる。4。OpenHandsでは、プロンプトの回帰、行動、サンドボックス環境をテストするエンドツーエンドのエージェントテストフレームワークを先駆的に導入する。これはソフトウェアエンジニアリングの統合テストと、エージェント開発中に誤ってバグが導入されるのを防ぐための決定論的行動のための基盤モデルモッキングを組み合わせたものである。
インテグレーションテストの定義。OpenHands のインテグレーションテストフレームワークは、タスクの実行と結果の検証を自動化することにより、エンドツーエンドの機能を検証するように構成されています。開発者はタスクと期待される結果を定義します。たとえば、タスクには「bad.txt」という名前の文書内の誤字を修正することが含まれる場合があります。OpenHands を通じてタスクが実行されると、出力は正確性を確保するために事前定義された「gold file」と比較されます。
決定論的な動作のための LLM のモック化。大規模言語モデル(LLM)の非決定性という課題と、それに伴う高いコストに対処するため、このフレームワークはすべての LLM 呼び出しをインターセプトし、プロンプトの完全一致に基づいて事前定義された応答を提供します。この方法により、テスト結果の一貫性が確保されるだけでなく、実際の LLM への依存を最小限に抑えることで運用コストも削減されます。
破壊的変更時に LLM 応答を再生成する。プロンプトと応答のペアは、新しいテストが導入されたとき、または既存のプロンプトが変更されたときに、これらのペアを生成して保存するスクリプトを通じて管理されます。定期的なテストでは、フレームワークはプロンプトをわずかに調整することにより、既存の LLM 応答を再利用しようとします。タスクの処理に影響を与える重大な変更には、実際の LLM を用いたこれらのペアの再生成が必要です。
インテグレーションテストの利点。このフレームワークにはいくつかの利点があります。1) プロンプトリグレッションテスト:保存されたプロンプトと応答のペアにより変更の追跡が容易になり、新しいチームメンバーが LLM とのやり取りを理解するための参考資料を提供します。2) マルチプラットフォームサポート:テストはプルリクエストごとおよびメインブランチへのコミットごとに自動的にスケジュールされ、Linux や Mac を含む複数のプラットフォーム、環境、エージェントで、またローカル、SSH、exec サンドボックス内で実行されます。3) 包括的なエラー検出:プロンプト生成、メッセージ受け渡し、サンドボックス実行におけるエラーを捕捉し、それにより高いテストカバレッジを維持します。
F OpenHands ランタイムの仕組み
F.1 ワークフロー
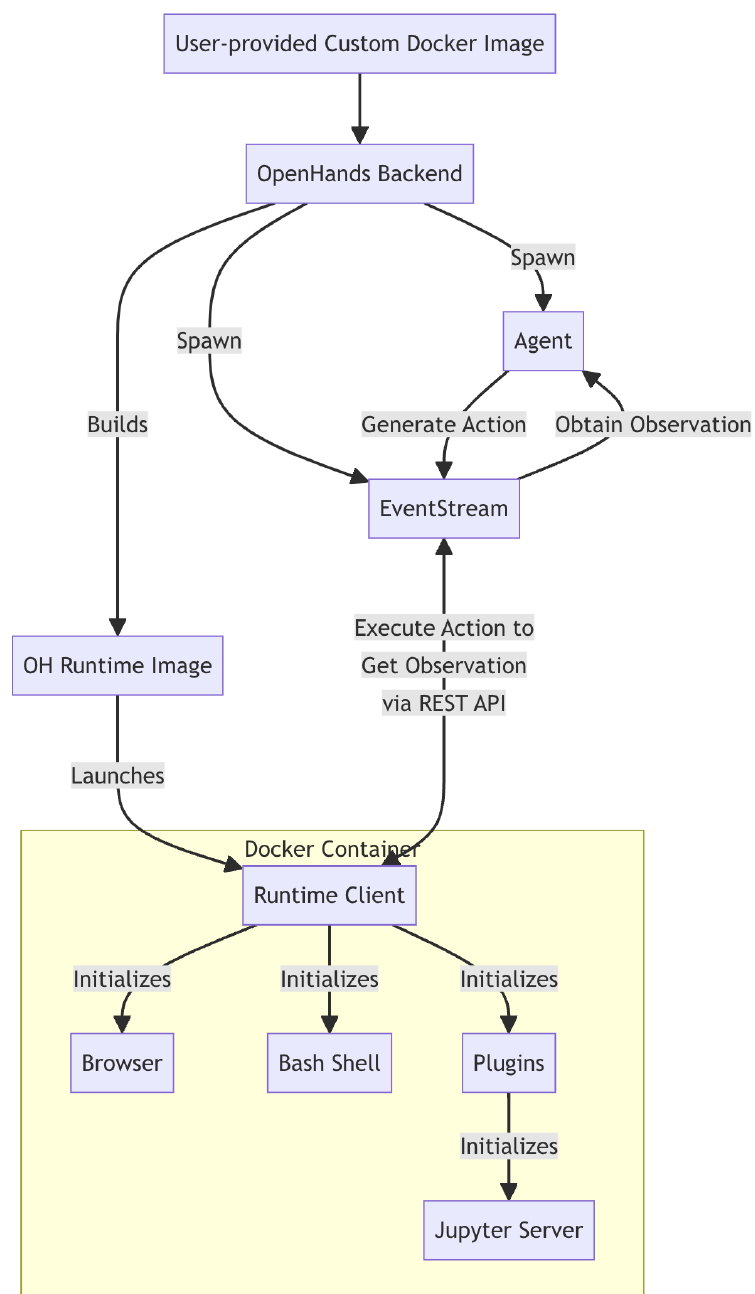
OpenHands Runtime システムは、Docker コンテナで実装されたクライアント・サーバアーキテクチャを採用している。その動作の概要については図4を参照されたい。
(1) ユーザ入力:ユーザはカスタムのベース Docker イメージを提供する。
(2) イメージビルド:OpenHands は、ユーザが提供したイメージに基づいて新しい Docker イメージ(「OH ランタイムイメージ」)をビルドする。この新しいイメージには OpenHands 固有のコード、主に「ランタイムクライアント」(すなわち §2.2 で説明されているランタイム API サーバ)が含まれる。
(3) コンテナ起動:OpenHands の起動時に、OH ランタイムイメージを用いて Docker コンテナを起動する。
(4) 通信:OpenHands バックエンド(runtime.py)は RESTful API を介してランタイムクライアントと通信し、アクションを送信し、観測(observation)を受信する。
(5) アクション実行:ランタイムクライアントはバックエンドからアクションを受信し、サンドボックス環境内でそれらを実行し、観測を返送する。
(6) 観測の返却:クライアントは実行結果を観測として OpenHands バックエンドのイベントストリームに返送する。
クライアントの役割:- これは OpenHands バックエンドとサンドボックス環境の間の仲介役として機能する- コンテナ内でさまざまな種類のアクション(シェルコマンド、ファイル操作、Python コードなど)を安全に実行する- サンドボックス環境の状態(現在の作業ディレクトリやロードされたプラグインを含む)を管理する- 観測を整形してバックエンドに返却し、結果を処理するための一貫したインタフェースを保証する
F.2 OpenHands がランタイムイメージをビルドおよび保守する方法
ランタイムイメージのビルドと管理に対する OpenHands のアプローチは、本番環境と開発環境の両方において Docker イメージを作成・保守する際の効率性、一貫性、柔軟性を確保する。
F.2.1 イメージタグ付けシステム
OpenHands は、再現性と柔軟性のバランスを取るため、ランタイムイメージにデュアルタグ付けシステムを採用している:
(1) ハッシュベースのタグ:{target_image_repo}:{target_image_hash_tag}。例:runtime:abc123def456
- このタグは Docker ビルドフォルダの MD5 ハッシュに基づいており、このフォルダには(ランタイムクライアントおよび関連依存関係の)ソースコードと Dockerfile が含まれる- 同一のハッシュタグは、イメージがまったく同じソースコードと Dockerfile でビルドされたことを保証する- これにより再現性が確保される。同じハッシュは常に同じイメージ内容を意味する
(2) 汎用タグ:{target_image_repo}:{target_image_tag}。例:runtime:oh_v0.9.3_ubuntu_tag_22.04
- このタグは次の形式に従う:runtime:oh_v{VERSION}{BASE_IMAGE_tag{IMAGE_TAG}}
- これは特定のベースイメージと OpenHands バージョンの組み合わせに対する最新のビルドを表す
- このタグは、ソースコードが変更された場合でも、同じベースイメージから新しいイメージがビルドされるたびに更新される
ハッシュベースのタグは再現性を確保し、汎用タグは特定の構成の最新バージョンへの安定した参照を提供する。このデュアルタグ付けのアプローチにより、OpenHands は開発環境と本番環境の両方を効率的に管理できる。
F.2.2 ビルドプロセス
(1) イメージ命名規則:
- ハッシュベースのタグ:target_image_repo:target_image_hash_tag。例:runtime:abc123def456
- 汎用タグ:target_image_repo:target_image_tag。例:runtime:oh_v0.9.3_ubuntu_tag_22.04
(2) ビルドプロセス:
a. ベースイメージ名を OH ランタイムイメージ名に変換する 例:ubuntu:22.04-> runtime:oh_v0.9.3_ubuntu_tag_22.04
b. ビルドコンテキスト(Dockerfile と OpenHands ソースコード)を生成し、そのハッシュを計算する
c. 計算されたハッシュを持つ既存のイメージを確認する
d. 見つからない場合、ベースとして使用する最近の互換イメージを確認する
e. 互換イメージが存在しない場合、元のベースイメージを用いてゼロからビルドする
f. 新しいイメージにハッシュベースのタグと汎用タグの両方を付与する
(3) イメージの再利用と再ビルドのロジック:システムは、ユーザが提供した(ベース)イメージ(例:ubuntu:22.04)から新しいイメージをビルドするか既存のイメージを使用するかを決定するために、次の手順に従う:
a. 同じハッシュを持つイメージ(例:runtime:abc123def456)が存在する場合、それをそのまま再利用する
b. 正確なハッシュが見つからない場合、システムは最新の汎用イメージ(例:runtime:oh_v0.9.3_ubuntu_tag_22.04)をベースとして再ビルドを試みる。これにより既存の依存関係を活用して時間を節約する
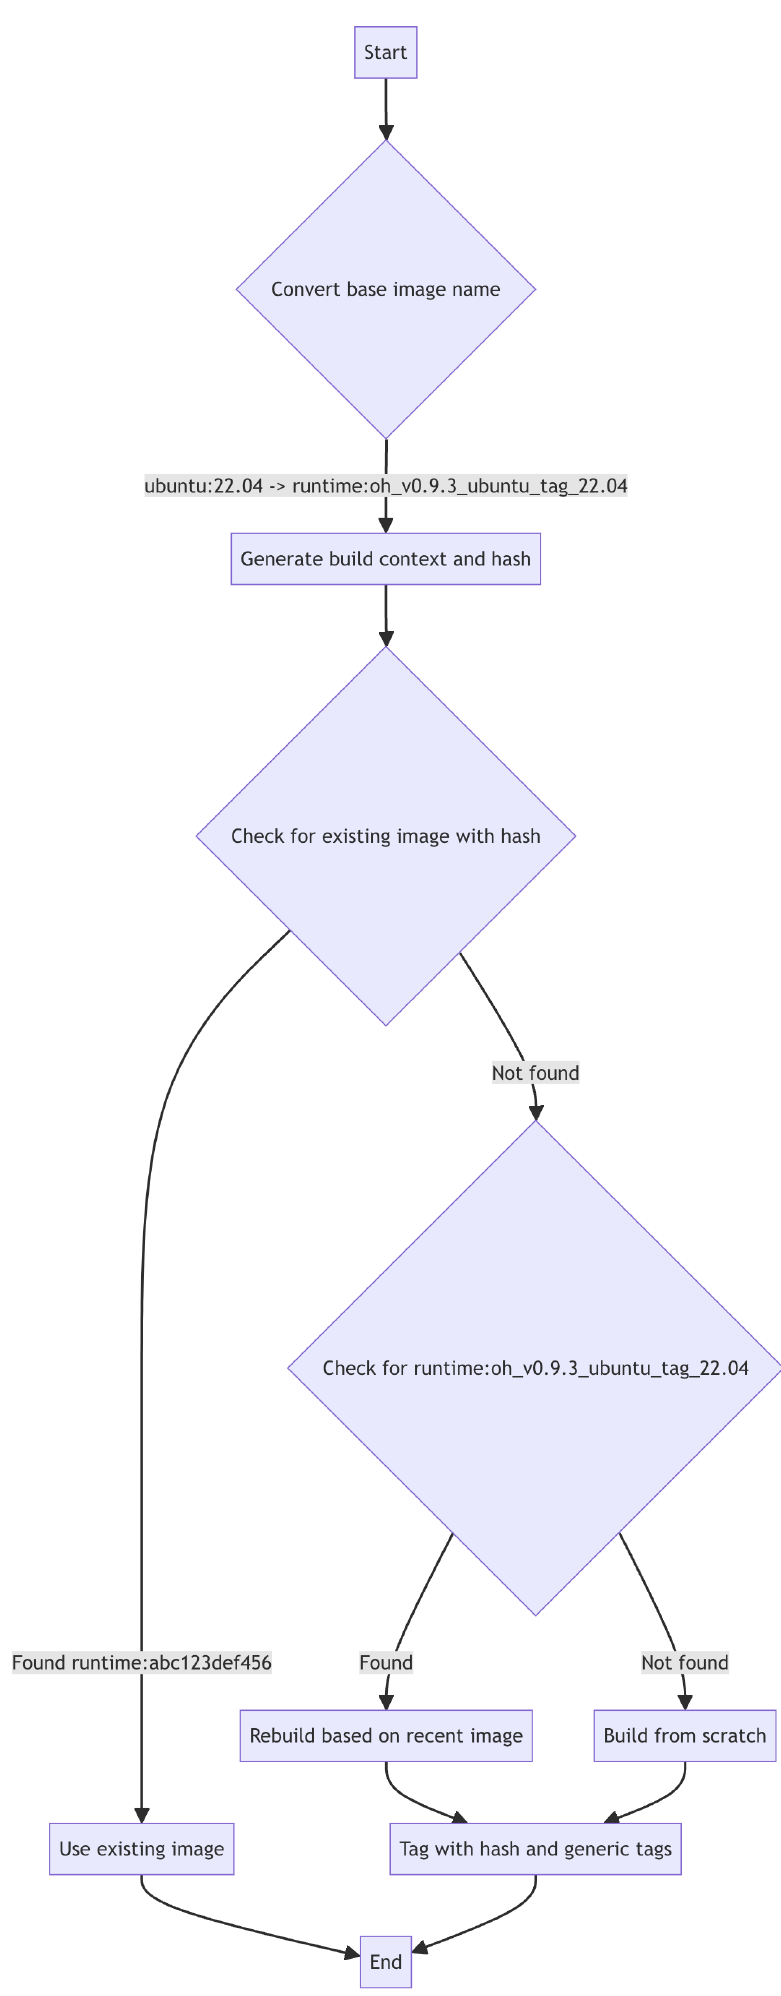
c. ハッシュタグ付きイメージも汎用タグ付きイメージも見つからない場合、システムはイメージを完全にゼロからビルドする
キャッシュと効率性。システムはビルド時間を節約するため、可能な場合は既存のイメージを再利用しようとする。正確な一致(ハッシュによる)が見つかった場合、再ビルドせずにそれを使用する。互換イメージが見つかった場合、それを再ビルドのベースとして使用し、依存関係のインストールにかかる時間を節約する。
ビルドプロセスを図示したフローチャートを図5に示す。
G GPQA ベンチマークの追加結果
GPQA ベンチマークの他のサブセットにおける性能を含む、より詳細な結果を表7に示す。
| 評価方法とモデル | サブセット別精度(%) | 平均コスト($) | ||
| ダイヤモンドセット | メインセット | 拡張セット | ||
| 専門家による人間の検証者 | 81.2 | 72.5 | 65.4 | N/A |
| 非専門家による人間の検証者 | 21.9 | 30.5 | 33.9 | N/A |
| Few-Shot CoT Llama-2-70B-chat | 28.1 | 29.1 | 30.4 | N/A |
| Few-Shot CoT GPT-3.5-turbo-16k | 29.6 | 28.0 | 28.2 | N/A |
| Few-Shot CoT GPT-4 | 38.8 | 39.7 | 38.7 | N/A |
| 検索付きGPT-4(棄権時はCoTにフォールバック) | 38.8 | 41.0 | 39.4 | N/A |
| OpenHands + CodeActAgent v1.5 + GPT3.5-turbo | 27.9 | 23.4 | 26.1 | 0.012 |
| OpenHands + CodeActAgent v1.5 + GPT4-turbo | 51.8 | 47.4 | 42.4 | 0.501 |
| OpenHands + CodeActAgent v1.5 + GPT4o | 53.1 | 49.3 | 52.8 | 0.054 |
H CODEACTSWEAGENT のためのインコンテキストデモンストレーション
プロンプトは、SWE-agent が公開した軌跡(https://github.com/princeton-nlp/SWE-agent/tree/main/trajectories/demonstrations)から再採用している。プロンプトは https://github.com/All-Hands-AI/OpenHands/blob/main/agenthub/codeact_swe_agent/prompt.py で確認できる。
I サポートされる AGENTSKILLS
OpenHands v0.6 の時点で、以下のスキル一覧をサポートしている。最新のスキル一覧についてはソースコードを参照されたい:https://github.com/All-Hands-AI/OpenHands/blob/main/OpenHands/runtime/plugins/agent_skills/agentskills.py
def open_file(path: str, line_number: Optional[int] = None) -> None:\\\* 指定されたパスのファイルをエディタで開く。line_number が指定された場合、ウィンドウはその行を含むように移動される。Args: path: str: 開くファイルのパス。line_number: Optional[int]: 移動する行番号。\\\*
def goto_line(line_number: int) -> None:\\\* 指定された行番号を表示するようにウィンドウを移動する。Args: line_number: int: 移動する行番号。pass
def scroll_down() -> None: """ウィンドウを100行下に移動する。Args: None\\\* pass
def scroll_up() -> None: """ウィンドウを100行上に移動する。Args: None pass
def create_file(filename: str) -> None: """指定された名前で新しいファイルを作成して開きます。引数: filename: str: 作成するファイルの名前。pass
def edit_file(start: int, end: int, content: str) -> None: """ファイルを編集します。開いているファイル内の 'start' 行目から 'end' 行目(両端を含む)までを、指定されたテキスト 'content' で置き換えます。編集する前にファイルが開かれている必要があることに注意してください。引数: start: int: 開始行番号。start >= 1 を満たす必要があります。end: int: 終了行番号。start <= end <= ファイル内の行数 を満たす必要があります。content: str: 行を置き換える内容。pass
def search_dir(search_term: str, dir_path: str = './') -> None: """dir 内のすべてのファイルで search_term を検索します。dir が指定されていない場合は、現在のディレクトリを検索します。引数: search_term: str: 検索する語。dir_path: Optional[str]: 検索するディレクトリのパス。pass
def search_file(search_term: str, file_path: Optional[str] = None) -> None: """ファイル内で search_term を検索します。file が指定されていない場合は、現在開いているファイルを検索します。引数: search_term: str: 検索する語。file_path: Optional[str]: 検索するファイルのパス。pass
def find_file(file_name: str, dir_path: str = './') -> None: """指定されたディレクトリ内で、指定された名前を持つすべてのファイルを検索します。引数: file_name: str: 検索するファイルの名前。dir_path: Optional[str]: 検索するディレクトリのパス。
pass
def parse_pdf(file_path: str) -> None:
"\\\*PDF ファイルの内容を解析して出力します。
引数:
file_path: str: 開くファイルのパス。
pass
def parse_docx(file_path: str) -> None:
DOCX ファイルの内容を解析して出力します。
引数:
file_path: str: 開くファイルのパス。
pass
def parse_latex(file_path: str) -> None:
LaTeXファイルの内容を解析して出力します。
Args:
file_path: str: 開くファイルのパス。
pass
def parse_audio(file_path: str, model: str = 'whisper- 1') -> None:
音声ファイルの内容を解析して出力します。
Args:
file_path: str: 文字起こしする音声ファイルのパス。 model: Optional[str]: 文字起こしに使用する音声モデル。デフォルトは'whisper- 1'。
pass
def parse_image(
file_path: str, task: str = 'Describe this image as detail as possible.'
) -> None:
画像ファイルの内容を解析して説明を出力します。
Args:
file_path: str: 開くファイルのパス。 task: Optional[str]: API呼び出しのためのタスク説明。デフォルトは'Describe this image as detail as possible.'。
pass
def parse_video( file_path: str, task: str = 'Describe this image as detail as possible.', frame_interval: int = 30, ) -> None:
画像ファイルの内容を解析して説明を出力します。
Args: file_path: str: 開く動画ファイルのパス。 task: Optional[str]: API呼び出しのためのタスク説明。デフォルトは'Describe this image as detail as possible.'。 frame_interval: Optional[int]: 解析するフレーム間の間隔。デフォルトは30。
pass
def parse_pptx(file_path: str) -> None:
pptxファイルの内容を解析して出力します。
Args: file_path: str: 開くファイルのパス。
pass
J BROWSERGYM アクション
以下は、v0.3.4時点でBrowserGym5に定義されているすべてのサポート対象アクションです。アクションはいくつかの種類に分類でき、機能の一部のみを使用するように設定することもできます。エージェント制御アクション、ナビゲーションアクション、ページ要素ベースのアクション、座標ベースのアクション、さらにタブ関連のアクションがあります。私たちはBrowserGymライブラリのこれらのアクションを、主要なブラウジングアクションのプリミティブとして使用します。
def send_msg_to_user(text: str):
ユーザーにメッセージを送信します。
Examples:
send_msg_to_user("Based on the results of my search, the city was built in 1751.")
\\\*
pass
def report_infeasible(reason: str):
\\\*
ユーザーに対して、その指示が実行不可能であることを通知します。
Examples:
report_infeasible("I cannot follow these instructions because there is no email field in this form.") pass
def noop(wait_ms: float = 1000):\\\*
何もせず、任意で指定された時間( ミリ秒)待機します。
Examples: noop() noop(500) pass
https://playwright.dev/docs/input#text- input
def fill(bid: str, value: str):\\\*
フォームのフィールドに入力します。要素にフォーカスし、入力されたテキストでinputイベントを発火します。<input>、<textarea>、および[contenteditable] 要素で動作します。
Examples:
fill('237', 'example value')
fill('45', "multi- line\nexample")
fill('a12', "example with \\""quotes\\""\\\* pass
https://playwright.dev/python/docs/api/class- locator#locator- check
def check(bid: str):\\\*
チェックボックスまたはラジオ要素がチェックされていることを確認します。
Examples:
check('55')*** 成功
https://playwright.dev/python/docs/api/class- locator#locator- uncheck
def uncheck(bid: str):***
チェックボックスまたはラジオ要素がチェックされていないことを確認します。
例:
uncheck('a5289')*** 成功
https://playwright.dev/docs/input#select- options
def select_option(bid: str, options: str | list[str]):*** <select> 要素内で1つまたは複数のオプションを選択します。選択するオプションの値またはラベルを 指定できます。複数のオプションを 選択できます。
例: select_option('a48', "blue") select_option('c48', ["red", "green", "blue"]) 成功
https://playwright.dev/python/docs/api/class- locator#locator- click def click( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : 要素をクリックします。例: click('a51') click('b22', button="right") click('48', button="middle", modifiers=["Shift"]) 成功
https://playwright.dev/python/docs/api/class- locator#locator- dblclick def dblclick( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : 要素をダブルクリックします。
例: dblclick('12') dblclick('ca42', button="right") dblclick('178', button="middle", modifiers=["Shift"]) 成功
https://playwright.dev/python/docs/api/class- locator#locator- hover def hover(bid: str): 要素の上にホバーします。
例: hover('b8') pass
https://playwright.dev/python/docs/input#keys- および - shortcuts def press (bid: str, key_comb: str): """ 一致する要素にフォーカスし、キーの組み合わせを押します。キーボードイベントのkeyboardEvent.keyプロパティで送出される論理キー名を受け付けます: Backquote、Minus、Equal、Backslash、Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、PageUp、ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ など。あるいは、"a"や"#"のように生成したい単一の文字を指定することもできます。以下の修飾キーショートカットもサポートされています: Shift、Control、Alt、Meta。
例: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t') pass
https://playwright.dev/python/docs/api/class- locator#locator- focus def focus (bid: str): """ 一致する要素にフォーカスします。例: focus('b455') """ pass
https://playwright.dev/python/docs/api/class- locator#locator- clear def clear (bid: str): """ 入力フィールドをクリアします。例: clear('996') """ pass
https://playwright.dev/python/docs/input#drag- および - drop def drag_and_drop(from_bid: str, to_bid: str): """ ドラッグ&ドロップを実行します。ドラッグされる要素にホバーします。""" 押下しますgged. 左マウスボタン。マウスをドロップを受け取る要素へ移動します 。左マウスボタンを離します。
例: drag_and_drop('56', '498')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- wheel def scroll(delta_x: float, delta_y: float):
水平方向および垂直方向にスクロールします。量はピクセル単位で、 右または下へのスクロールは正、左または 上へのスクロールは負です。wheelイベントを送出します。
例: scroll(0, 200) scroll(- 50.2, - 100.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- move def mouse_move(x: float, y: float):
\\\*
マウスをある位置へ移動します。絶対クライアント座標 をピクセル単位で使用します。マウス移動イベントを送出します。
例: mouse_move(65.2, 158.5)
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- up def mouse_up(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
マウスをある位置へ移動してから、マウスボタンを離します。 マウス移動イベントおよびmouseupイベントを送出します。
例: mouse_up(250, 120) mouse_up(47, 252, 'right')
pass
https://playwright.dev/python/docs/api/class- mouse#mouse- down def mouse_down(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
マウスをある位置へ移動してから、マウス ボタンを押し下げたままにします。マウス移動イベントおよびmousedownイベントを送出します。例: mouse_down(140.2, 580.1) mouse_down(458, 254.5, 'middle') pass
https://playwright.dev/python/docs/api/class- mouse#mouse- click def mouse_click(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):マウスをある位置へ移動し、マウスボタンをクリックします。mousemove、mousedownおよびmouseupイベントを送出します。
例: mouse_click(887.2, 68) mouse_click(56, 712.56, 'right')
pass #https://playwright.dev/python/docs/api/class- mouse#mouse- dblclick def mouse_dblclick(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
マウスをある位置へ移動し、マウスボタンをダブルクリックします。mousemove、mousedownおよびmouseupイベントを送出します。例: mouse_dblclick(5, 236) mouse_dblclick(87.5, 354, 'right')
passdef mouse_drag_and_drop(from_x: float, from_y: float, to_x: float, to_y: float): "middle", "right"] = "left"):
ある位置からある位置へドラッグ&ドロップします。絶対クライアント座標をピクセル単位で使用します。mousemove、mousedownおよびmouseupイベントを送出します。例:
mouse_drag_and_drop(10.7, 325, 235.6, 24.54)
pass #https://playwright.dev/python/docs/api/class- keyboard#keyboard- press def keyboard_press(key: str): キーの組み合わせを押します。キーボード \(\leftrightarrow\) イベントのkeyboardEvent.keyプロパティで送出される論理キー名を \(\leftrightarrow\) 受け付けます: Backquote、Minus、Equal、Backslash、Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、PageUp、\(\leftrightarrow\) ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ など。あるいは、"a"や"#"のように生成したい \(\leftrightarrow\) 単一の文字を指定することもできます。以下の修飾キーショートカットも \(\leftrightarrow\) サポートされています: Shift、Control、Alt、Meta。
例: keyboard_press('Backspace') keyboard_press('Control+a') keyboard_press('Meta+Shift+t') page.keyboard.press("PageDown")\\\* pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- up def keyboard_up(key: str): キーボードキーを離します。keyupイベントを送出します。キーボードイベントのkeyboardEvent.keyプロパティ \(\leftrightarrow\) で送出される論理キー名を受け付けます \(\leftrightarrow\): Backquote、Minus、Equal、Backslash、\(\leftrightarrow\) Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、\(\leftrightarrow\) PageUp、ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ、\(\leftrightarrow\) など。あるいは、"a"や"#"のように生成したい \(\leftrightarrow\) 単一の文字を指定することもできます。
例: keyboard_up('Shift') keyboard_up('c') pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- down def keyboard_down(key: str): キーボードのキーを押して押し続けます。keydown イベントをディスパッチします。 キーボードイベントの keyboardEvent.key プロパティで送出される論理キー名を受け付けます:Backquote、Minus、Equal、Backslash、 Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、 PageUp、ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ、 など。あるいは、"a" や "#" のような単一文字を指定することもできます。
例:keyboard_up('Shift') keyboard_up('c')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- type def keyboard_type(text: str): """ キーボードを通じてテキスト文字列を入力します。テキスト内の各文字に対して keydown、 keypress/input、および keyup イベントを送信します。修飾キーは keyboard_type に影響しません。Shift を押し続けても、テキストは 大文字で入力されません。
例:keyboard_type('Hello world!')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- insert- text def keyboard_insert_text(text: str): """ 現在フォーカスされている要素にテキスト文字列を挿入します。 input イベントのみをディスパッチし、keydown、keyup、または keypress イベントは発行しません。 修飾キーは keyboard_insert_text に影響しません。Shift を押し続けても、テキストは 大文字で入力されません。
例:keyboard_insert_text('Hello world!')
pass
https://playwright.dev/python/docs/api/class- page#page- goto def goto(url: str):
URL に移動します。
例:goto('http://www.example.com')
pass
https://playwright.dev/python/docs/api/class- page#page- go- back
\\\\
履歴内の前のページに移動します。
例:go_back()
pass
https://playwright.dev/python/docs/api/class- page#page- go- forward go_forward(): 履歴内の次のページに移動します。例:go_forward()
pass
\*
https://playwright.dev/python/docs/api/class- browsercontext#browser- context- new- def new_tab():
\\\\
新しいタブを開きます。そのタブがアクティブになります。
例:new_tab()
global page
新しいページをアクティブページとして設定します
page page.context.new_page()
このページをアクティブとして設定するコールバックをトリガーします
browsergym
pass
https://playwright.dev/python/docs/api/class- page#page- close
def tab_close():
\\\\
現在のタブを閉じます。
例:
tab_close()
\\\\
pass
\\\\
https://playwright.dev/python/docs/api/class- page#page- bring- to- front def tab_focus(index: int):
\\\\\*
タブを前面に表示します(タブをアクティブ化します)。
例:
tab_focus(2)\\\* pass
\\\* pass# https://playwright.dev/python/docs/input#upload- filesdef upload_file(bid: str, file: str | list[str]): """要素をクリックして"filechooser"イベントを待機し、その後 → アップロードする1つまたは複数の入力ファイルを選択します。相対ファイルパスは → 現在の作業ディレクトリを基準に解決されます。空のリストは → 選択されたファイルをクリアします。
例: upload_file("572", "my_receipt.pdf") upload_file("63", ["/home/bob/Documents/image.jpg", "/home/bob/Documents/file.zip"])
pass
\\\* https://playwright.dev/python/docs/input#upload- filesdef mouse_upload_file(x: float, y: float, file: str | list[str]): """位置をクリックして"filechooser"イベントを待機し、その後 → アップロードする1つまたは複数の入力ファイルを選択します。相対ファイルパスは → 現在の作業ディレクトリを基準に解決されます。空のリストは → 選択されたファイルをクリアします。
例: mouse_upload_file(132.1, 547, "my_receipt.pdf") mouse_upload_file(328, 812, → ["/home/bob/Documents/image.jpg", → "/home/bob/Documents/file.zip"])
pass
K BROWsing AGENT DETAILS
K BROWsing AGENT DETAILS以下は、次のブラウジングアクションを予測するために現在のステップに必要なすべての情報を含むプロンプトの例です。エージェントが、ページからのフィードバックなしに連続して実行されるべきだと考える場合、1ターンで複数のアクションを予測するようにも指示していることに注意してください。これにより、ユーザー名とパスワードの入力とログインページでの送信など、観察の変化を伴わずに同じページ上で一連のアクションを実行する一般的なワークフローのターンを節約できます。
指示
ページの現在の状態とその他すべての情報を確認して → 目標を達成するために最適な次のアクションを見つけてください。 → あなたの回答はプログラムによって解釈および実行されます。 → 必ずフォーマットの指示に従ってください。
目標: localhost:8000を閲覧し、人生の究極の答えを教えてください。いかなる時点でも私に確認を求めないでください。
アクション空間
16種類の異なるアクションが利用可能です。
noop(wait_ms: float = 1000)
例:
noop()
noop(500)
send_msg_to_user(text: str)
例:
send_msg_to_user('検索結果に基づくと、その都市は1751年に建設されました。')
scroll(delta_x: float, delta_y: float)
例:
scroll(0, 200)
scroll(- 50.2, - 100.5)
fill(bid: str, value: str)
例:
fill('237', 'example value')
fill('45', 'multi- line\nexample')
fill('a12', 'example with "quotes")
select_option(bid: str, options: str | list[str])
例:
select_option('48', 'blue')
select_option('48', ['red', 'green', 'blue'])
click(bid: str, button: Literal['left', 'middle', 'right'] = → 'left', modifiers: list[typing.Literal['Alt', 'Control', → 'Meta', 'Shift']] = []
例:
click('51')
click('b22', button='right')
click('48', button='middle', modifiers=['Shift'])
dblclick(bid: str, button: Literal['left', 'middle', 'right'] = → 'left', modifiers: list[typing.Literal['Alt', 'Control', → 'Meta', 'Shift']] = []
例:
dblclick('12')
dblclick('ca42', button='right')
dblclick('178', button='middle', modifiers=['Shift'])
hover(bid: str) 例: hover('b8')
press(bid: str, key_comb: str) 例: press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')
focus(bid: str) 例: focus('b455')
clear(bid: str) 例: clear('996')
drag_and_drop(from_bid: str, to_bid: str) 例: drag_and_drop('56', '498')
upload_file(bid: str, file: str | list[str]) 例: upload_file('572', 'my_receipt.pdf')
upload_file('63', ['/home/bob/Documents/image.jpg', ' /home/bob/Documents/file.zip'])
go_back() 例: go_back()
go_forward() 例: go_forward()
goto(url: str) 例: goto('http://www.example.com')
複数のアクションを一度に指定できます。例: fill('a12', 'example with "quotes"') click('51')
click('48', button='middle', modifiers=['Shift']) 複数のアクションは、ページからのフィードバックなしで順次実行されることを意図しています。ページからのフィードバックが必要な場合は、複数のアクションを一度に実行しないでください。
現在のアクセシビリティツリー: RootWebArea 'The Ultimate Answer', focused [8] heading 'The Ultimate Answer' [9] paragraph ' StaticText 'Click the button to reveal the answer to life, the universe, and everything.' [10] button 'Click me', clickable
以前のアクション goto('http://localhost:8000')
以下は、 ボタンをクリックする際の有効なアクションの思考連鎖の例です:
目標を達成するために、私は bid 12 のボタンをクリックする必要があります "click("12")"
そして、上記のプロンプトに対する応答例は次のとおりです:
目標を達成するために、私は bid 10 のボタンをクリックして、生命、宇宙、そして すべての答えを明らかにする必要があります。 "click("10")"
WebArena ベンチマークでの評価では、一部のタスクでエージェントからユーザーへの返信メッセージに対して回答の完全一致を確認する必要があるため、ユーザーにメッセージを送る際はエージェントが簡潔な回答文字列のみで返信するように次の指示を追加し、余分なテキストによってエージェントがテストに失敗するのを防ぎます:
以下は、ユーザーに簡潔な回答を提供する際の有効なアクション の思考連鎖の別の例です:
目標を達成するために、私は尋ねられた情報 をユーザーに送り返す必要があります。このページには HP Inkjet Fax Machine の情報が記載されており、これは目的 で特定された製品です。その価格は 279.49\( です。私は答えを含むメッセージをユーザー に送り返します。 "send_msg_to_user("\) \ "