
一語ずつ予測する代わりに、拡散モデルのようにマスク文を埋める。8B で LLaMA-3 に匹敵する。ICML 2025、全文無料。
Large Language Diffusion Models
大規模言語拡散モデル
Shen Fengqi Zhu Zebin You Xiaolu Zhang Jingyang Jun Jun Zhou Yankai Ji- Rong Wen Chongxuan 中国人民大学高瓴人工智能学院 北京市大模型与智能治理研究重点实验室 下一代智能搜索与推荐教育部工程研究中心 蚂蚁集团 {nieshen,fengqizhu,chongxuanli}@ruc.edu.cn {nie shen, fengqizhu, chongxuanli}@ruc.edu.cn
概要
大規模言語モデル(LLM)の能力は、自己回帰モデル(ARM)に依存していると広く考えられている。我々はこの通念に挑戦し、事前学習と教師あり微調整(SFT)の枠組みの下でゼロから訓練された拡散モデルであるLLaDAを導入する。LLaDAは、マスクされたトークンを予測するためにTransformerでパラメータ化された、順方向のデータマスキング過程と逆方向の生成過程を採用している。それは、尤度の下界を最適化することにより、確率的推論のための原理的な生成的アプローチを提供する。一般タスク、数学、コードなどに関する広範なベンチマークにおいて、LLaDAは強いスケーラビリティを示し、我々が自作したARMベースラインと同等の性能を発揮する。特筆すべきは、LLaDA 8Bが文脈内学習においてLLaMA3 8Bのような強力なLLMと競合し、SFT後にはマルチターン対話などのケーススタディにおいて印象的な指示追従能力を示すことである。さらに、LLaDAは反転の呪いに対処し、反転詩補完タスクにおいてGPT-4oを上回る。我々の発見は、大規模な言語モデリングにおける拡散モデルの有望性を示し、上述したLLMの核となる能力が本質的にARMに依存するという一般的な仮定に挑戦するものである。プロジェクトページとコード: https://ml- gsai.github.io/LLaDA- demo/
1 はじめに
大規模言語モデル(LLM)[1]は、完全に生成的モデリングの枠組みに属する。具体的には、LLMは最尤推定、すなわち2つの分布間のKLダイバージェンス最小化を通じてモデル分布 を最適化することにより、真であるが未知の言語分布 を捉えることを目指す:
支配的なアプローチは、モデル分布を定義するために自己回帰モデリング(ARM)——一般に「次トークン予測」パラダイムと呼ばれる——に依拠している:
自己回帰的定式化
\*同等の貢献。
\(^{1}\) 蚂蚁集团でのインターンシップ期間中の研究。
\(^{1}\) プロジェクトリーダー。
\(^{1}\) 連絡先:Chongxuan Li。
ここで は長さ の系列であり、 は 番目のトークンである。このパラダイムは著しく効果的であることが証明されており [2][5]、現在のLLMの基盤となっている。その広範な採用にもかかわらず、根本的な問いが未解決のままである:自己回帰パラダイムは、スケーラビリティ、文脈内学習、指示追従といったLLMの核となる能力を達成する唯一の道なのだろうか?
我々は、その答えは単純に「はい」ではないと主張する。これまで見落とされてきた重要な洞察は次のとおりである:LLMの本質的な特性を根本的に支えているのは、自己回帰的定式化(すなわち式(2))そのものではなく、生成的モデリングの原理(すなわち式(1))である。
特に、我々はスケーラビリティが主に、式(2)のARMの独自の結果というよりも、Transformer [7]、モデルサイズ、データサイズ、そして式(1)の生成的原理によって引き起こされるフィッシャー一致性 [5][8] の相互作用の結果であると主張する。視覚データ[11]における拡散Transformer [9][10]の成功はこの主張を支持している。さらに、指示追従と文脈内学習 [4] の能力は、ARMの排他的な利点というよりも、構造的に一貫した言語タスクにおけるすべての条件付き生成的モデルの内在的特性であるように思われる。加えて、ARMは可逆なデータ圧縮器[12][13]として解釈できるが、十分に表現力のある確率的モデルであれば同様の能力を達成できる[14]。
しかしながら、LLMの特定の本質的限界は、その自己回帰的性質に直接起因する可能性がある。例えば、左から右への生成過程は、反転推論タスク[15]を扱う能力を制限しており、現在のモデルの汎化能力における代表的な失敗を浮き彫りにしている。
これらの洞察に動機づけられ、我々はLLaDA(Large Language Diffusion with mAsking)を導入し、LLMが示す能力がARMを超えた生成的モデリングの原理から生じうるかどうかを調査することで、先に提起した根本的な問いに取り組む。従来のARMとは対照的に、LLaDAはマスク付き拡散モデル(MDM)[16][20]を活用しており、これは順方向のデータマスキング過程を組み込み、その逆過程を近似するマスク予測器を訓練する。この設計により、LLaDAは双方向依存性を持つモデル分布を構築し、その対数尤度の変分下界を最適化することが可能となり、上述したLLMの核となる能力について、原理的かつこれまで未探索の視点を提供する。
我々はデータ準備、事前学習、教師あり微調整(SFT)、評価という標準的なパイプラインを採用し、LLaDAを前例のない規模である8Bの言語拡散モデルへとスケールアップする。特に、LLaDA 8Bは2.3兆トークンを用いて0.13百万H800 GPU時間でゼロから事前学習され、その後450万ペアでSFTされた。言語理解、数学、コード、中国語を含む多様なタスクにおいて、LLaDAは以下の貢献を示す:
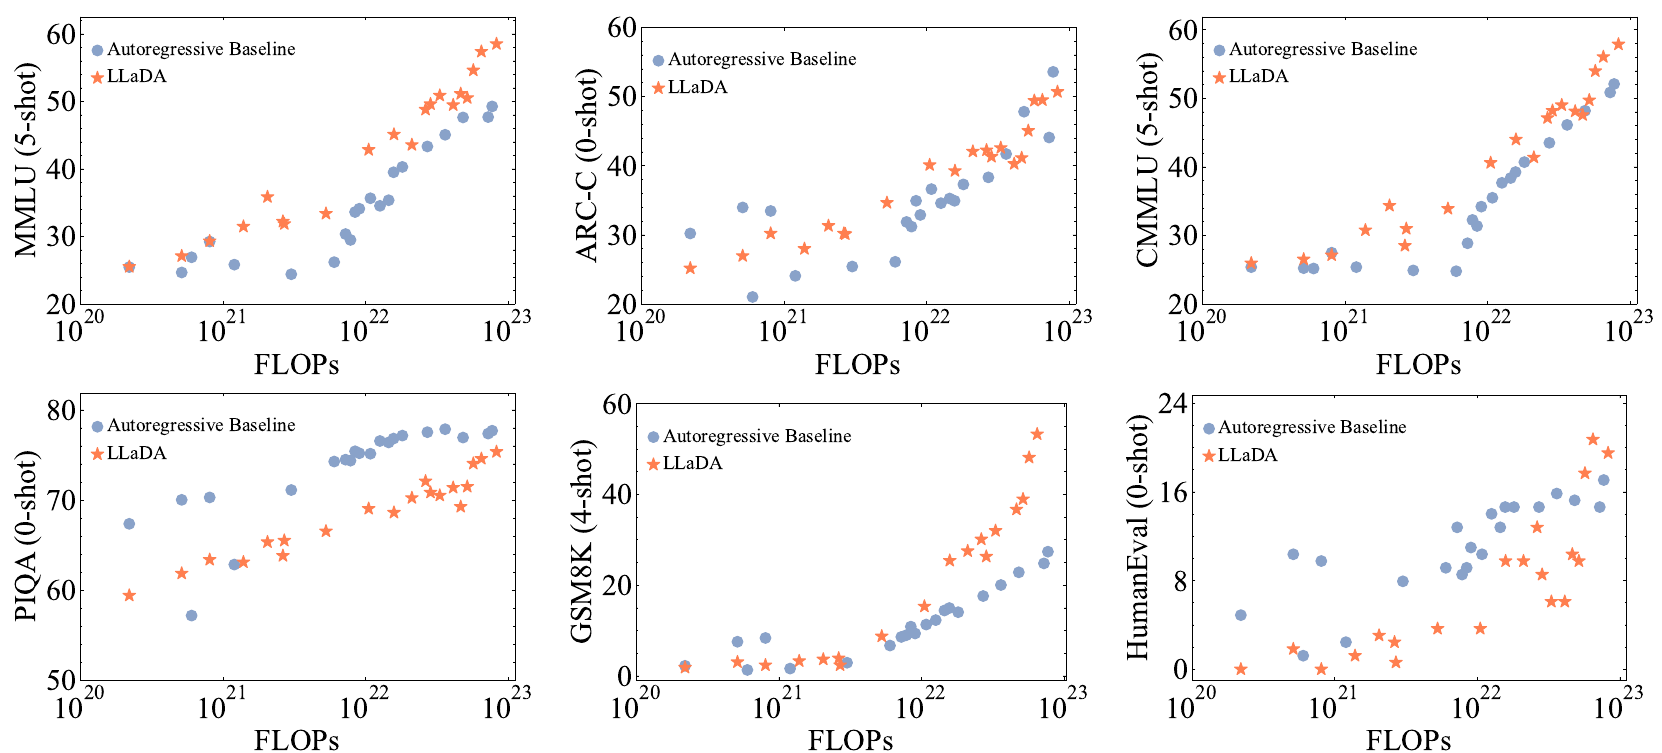
- LLaDAは \(10^{23}\) FLOPsの計算予算まで効果的にスケールし、MMLUやGSM8Kを含む6つのタスクにおいて、同じデータで訓練されたARMベースラインと同等の結果を達成する。
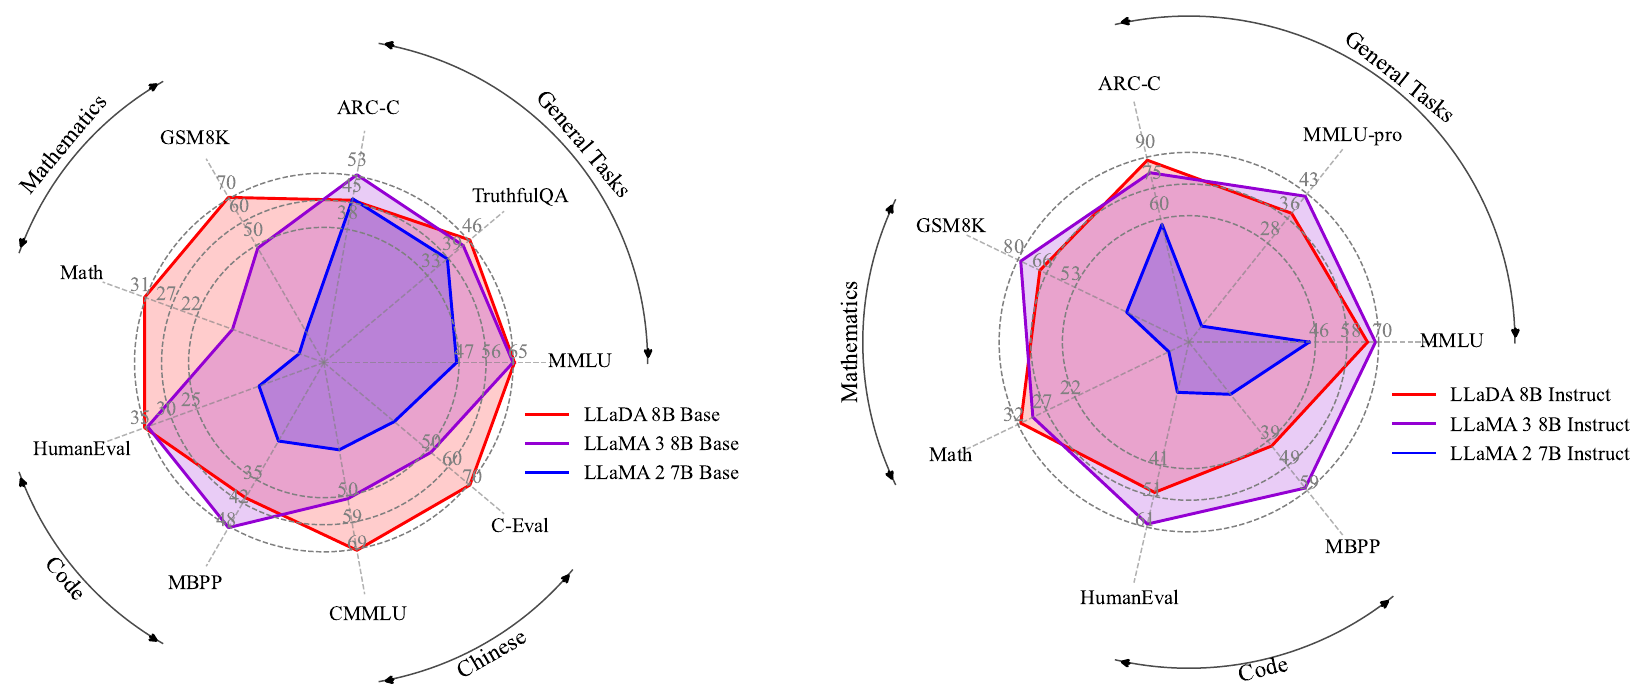
- 事前学習済みのLLaDA 8B Baseは、15の標準的なゼロ/少数ショット学習タスクのほぼすべてにおいてLLaMA2 7B Base [21]を上回り、LLaMA3 8B Base [6]と同等の性能を発揮し、効果的な文脈内学習能力を示す。
- LLaDAは、マルチターン対話などのケーススタディで示されるように、SFT後の指示追従能力を大幅に向上させる。
- LLaDAは反転の呪い[15]を効果的に打破し、順方向タスクと反転タスクで一貫した性能を発揮する。特筆すべきは、反転詩補完タスクにおいてGPT-4oを上回ることである。
2 アプローチ
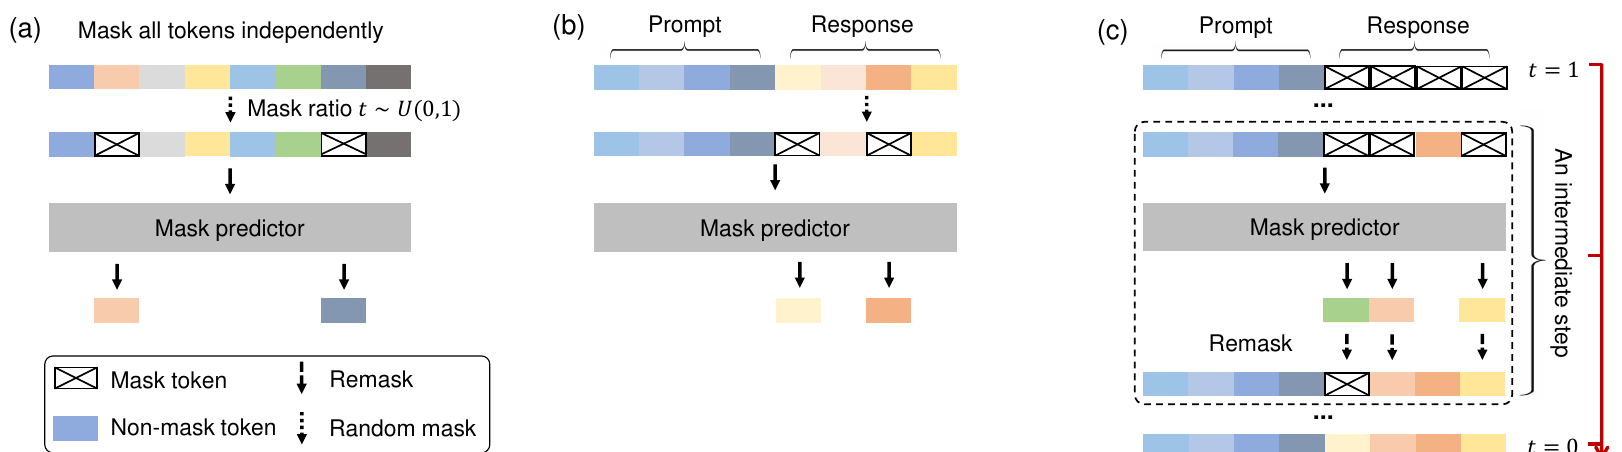
本節では、図2に示すように、LLaDAの確率的定式化[6]ならびに事前学習、教師あり微調整、推論の手順を紹介する。
2.1 確率的定式化
式(2)のARMとは異なり、LLaDAは順方向過程と逆方向過程を通じてモデル分布 を定義する[16][20]。順方向過程は、系列が で完全にマスクされるまで、 内のトークンを独立に徐々にマスクする。 において、系列 は部分的にマスクされており、各トークンは確率 でマスクされるか、確率 でマスクされずに残る。逆方向過程は、\(t\) が1から0へ移動するにつれてマスクされたトークンを反復的に予測することにより、データ分布を回復する。
LLaDAの中核はマスク予測器であり、 を入力として受け取り、すべてのマスクされたトークン(Mと表記)を同時に予測するパラメトリックモデル です。これは、マスクされたトークンのみで計算される交差エントロピー損失を用いて学習されます[18][20]:
ここで、 は学習サンプル、 は から一様に抽出される連続確率変数、 はフォワード過程からサンプリングされ、 は系列長です。指示関数 は、損失がマスクされたトークンに対してのみ計算されることを保証します。
学習後、マスク予測器によってパラメータ化された逆過程(詳細は第[2.4]節を参照)をシミュレートし、モデル分布 を で誘導される周辺分布として定義できます。式(3)の損失関数は、モデル分布の負の対数尤度の上界であることが証明されており、生成モデリングのための原理的な目的関数となっています:
注目すべきことに、LLaDAは0から1の間でランダムに変化するマスキング率を採用しているのに対し、BERT [22]は固定の率を使用しています。この微妙な違いは、特にスケールにおいて重要な意味を持ちます:式(4)に示されるように、LLaDAはLLMと同様に、インコンテキスト学習や指示追従を自然に実行できる可能性を秘めた原理的な生成モデルです。さらに、その生成的な観点は、第[1]節で議論したように、大規模なデータとモデルに対する強いスケーラビリティを意味します。加えて、MaskGIT [23]はヒューリスティックな学習目的を採用しており、式(3)と比較して 項を欠いており、最尤推定との理論的な関連性を欠いています。私たちが言語モデリングのために離散拡散モデルをスケールアップする動機となったのは、まさに最尤推定の理論的基盤であることを強調します。
2.2 事前学習
LLaDAは、既存のLLMと同様に、マスク予測器としてTransformer [7]を採用しています。しかし、LLaDAは因果マスクを使用しません。その定式化により、予測のために入力全体を見ることができるからです。
私たちは、異なるサイズのLLaDAの2つの変種、1Bと8Bを学習しました。ここでLLaDA 8BとLLaMA3 8B [6]のモデルアーキテクチャを要約し、詳細は付録[B.2]で提供します。いくつかの必要な変更を加えつつ、ほとんどのハイパーパラメータの一貫性を確保しています。LLaDAはKVキャッシュと互換性がなく、キーとバリューのヘッド数が異なるため、簡潔さのためにグループ化クエリ注意[24]の代わりにバニラのマルチヘッド注意を使用します。その結果、注意層のパラメータが増えるため、同等のモデルサイズを維持するためにFFN次元を削減します。さらに、私たちのデータに適応させたトークナイザ[4]により、語彙サイズが異なります。
LLaDAモデルは、2.3兆(T)トークンからなるデータセットで事前学習されており、既存のLLM[25][26]に密接に沿ったデータプロトコルに従っており、特別な技術は一切組み込まれていない。データはオンラインコーパスから取得され、低品質なコンテンツは手作業で設計されたルールとLLMベースのアプローチによってフィルタリングされている。一般テキストに加えて、データセットには高品質なコード、数学、多言語データが含まれている。データセットの詳細については付録[B.1]を参照されたい。データソースとドメインの混合は、縮小規模のARMによって導かれる。事前学習プロセスでは4096トークンの固定系列長を使用し、総計算コストは13万H800 GPU時間であり、同規模・同データセットサイズのARMと同程度である。
訓練系列に対して、我々はをランダムにサンプリングし、各トークンを同じ確率で独立にマスクしてを得て(図2参照)、確率的勾配降下訓練のためのモンテカルロ法によって式(3)を推定する。さらに、Nie et al.[27]に従い、可変長データを扱うLLaDAの能力を強化するため、事前学習データのをの範囲から一様にサンプリングされたランダムな長さに設定した。
我々は、連続訓練を中断することなく訓練の進捗を監視するために、Warmup-Stable-Decay[28]学習率スケジューラを採用した。具体的には、最初の2000イテレーションで学習率を0からまで線形に増加させ、に維持した。1.2Tトークンを処理した後、学習率をに減衰させ、安定した訓練を確保するために次の0.8Tトークンに対して一定に保った。最後に、最後の0.3Tトークンに対して学習率をからまで線形に減少させた。さらに、重み減衰0.1、バッチサイズ1280、GPUあたりのローカルバッチサイズ4でAdamWオプティマイザ[29]を使用した。8B実験は一度だけ実行され、ハイパーパラメータのチューニングは一切行われなかった。
2.3 教師ありファインチューニング
我々は、ペアデータ(ここではプロンプト、は応答を表す)を用いた教師ありファインチューニング(SFT)により、指示に従うLLaDAの能力を強化する。これはLLMのための最も単純かつ基本的なポストトレーニング手法である。技術的には、事前学習におけるの代わりに条件付き分布をモデル化する必要がある。
実装は事前学習と同様である。図2に示すように、プロンプトは変更せず、応答内のトークンをに対して行ったのと同様に独立にマスクする。そして、プロンプトとマスクされた応答の両方を事前学習済みのマスク予測器に入力して、SFTの損失を計算する:
ここでは後述する動的な長さを表し、その他の記号はすべて以前と同じである。このアプローチは事前学習と完全に互換性があることに注意されたい。本質的に、との連結はクリーンな事前学習データとして扱うことができ、との連結はマスクされたバージョンとして機能する。このプロセスは事前学習と同一であり、唯一の違いは、すべてのマスクされたトークンがたまたまの部分に現れることである。
LLaDA 8Bモデルは、450万ペアからなるデータセットでSFTを受ける。事前学習プロセスと一致して、データ準備と訓練の両方が既存のLLM[25][26]で利用されているSFTプロトコルに従い、LLaDAの性能を最適化するための追加技術は一切導入されていない。データセットはコード、数学、指示追従を含む複数のドメインにまたがる。各ミニバッチ内の短いペアの末尾に|EOS|トークンを付加し、すべてのデータ間で長さが等しくなるようにする。訓練中は|EOS|を通常のトークンとして扱い、サンプリング中にそれを除去することで、LLaDAが応答長を自動的に制御できるようにする。詳細については付録B.1を参照されたい。
我々は、事前学習段階と同様のスケジュールを用いて、SFTデータで3エポック訓練する。学習率は最初の50イテレーションで0からまで線形に増加させ、その後一定に保つ。最後ののイテレーションでは、まで線形に減少させる。さらに、重み減衰を0.1、グローバルバッチサイズを256、GPUあたりのローカルバッチサイズを2に設定した。SFT実験は一度だけ実行され、ハイパーパラメータのチューニングは一切行われなかった。
2.4 推論
生成モデルとして、LLaDAは左から右への自己回帰的方式ではなく、拡散方式で新しいテキストをサンプリングし、候補テキストの尤度を評価することができる。
まず逆生成プロセスから始める。図2に示すように、プロンプトが与えられたとき、完全にマスクされた応答から開始して、モデル分布からサンプリングするために逆プロセスを離散化する。総サンプリングステップ数はハイパーパラメータであり、第[3.3]節で分析するように、効率とサンプル品質の間のトレードオフをLLaDAに自然に提供する。デフォルトでは一様に分布したタイムステップを採用する。さらに、生成長もハイパーパラメータとして扱われ、サンプリングプロセスの開始時における完全にマスクされた文の長さを指定する。生成後、|EOS|トークンの後に現れるトークンは破棄される。付録[B.5]で詳述するように、事前学習とSFTの両方が可変長のデータセットを用いて行われるため、最終結果はこの長さハイパーパラメータに対して鈍感である。
時刻からへの中間ステップにおいて、との両方をマスク予測器に入力し、すべてのマスクされたトークンを同時に予測する。続いて、予測されたトークンのうち期待値での割合を再マスクしてを得ることで、逆プロセスの遷移が正確なサンプリングのために順プロセスと整合することを保証する[18][20]。原則として、再マスキング戦略は純粋にランダムであるべきである。しかし、LLMにおけるサンプリングのアニーリング技法[4][30]に触発され、我々は低信頼度再マスキング戦略を採用しており、予測に基づいて最も信頼度の低いの割合の予測トークンを再マスクする。これはChang et al.[23]のアプローチと同じである。
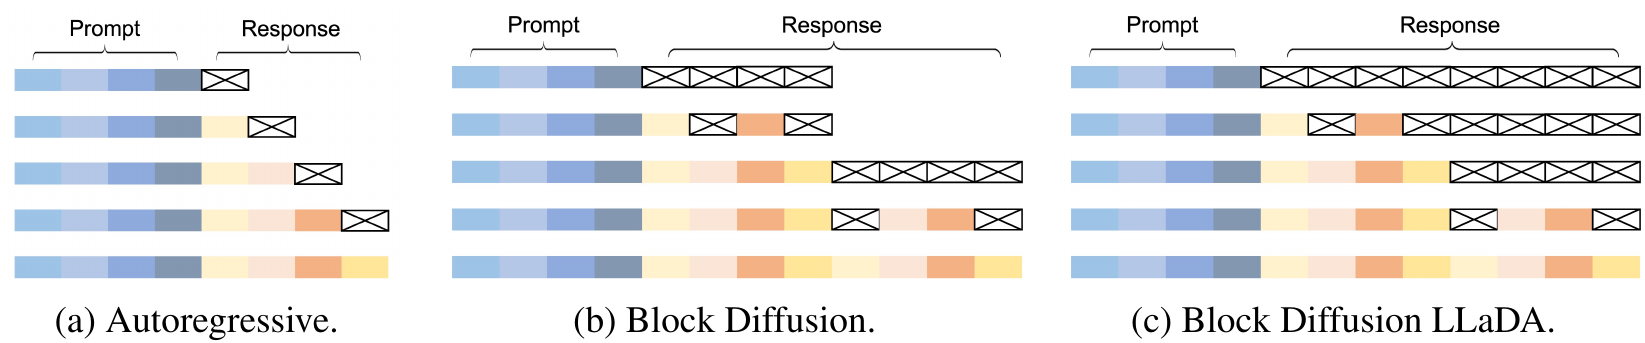
LLaDAは柔軟なサンプリングを可能にすることに言及する。特に、上述の事前学習またはSFTプロセスの後、さらなる修正や訓練を必要とせずに、自己回帰サンプリングおよびブロック拡散[31]サンプリングを直接サポートする。付録[B.4]で詳細な分析を提供する。それにもかかわらず、拡散サンプリング(すなわち逆生成プロセス)が最良の性能をもたらし、本論文全体を通じて、特に第[3]節で提示されるすべての実験に対して、デフォルトとして採用されている。
条件付き尤度評価については、式[5]の上界を自然に利用することができる。しかし、以下の等価な形式[20]がより低い分散を示し、より安定であることがわかった:
ここで、 は の系列長であり、 は から一様にサンプリングされ、 はマスキングのために から 個のトークンを非復元で一様にサンプリングすることによって得られる。
訓練および推論アルゴリズム、ならびに理論的詳細は付録 [A] に示す。
3 実験
我々は、標準ベンチマーク上で LLaDA のスケーラビリティ、指示追従性、および文脈内学習能力を評価し、続いて包括的な評価を提供するための分析とケーススタディを行う。
3.1 言語タスクにおける LLaDA のスケーラビリティ
我々はまず、我々が構築した ARM ベースラインとの比較において、下流タスクでの LLaDA のスケーラビリティを調査する。具体的には、1B スケールでは、LLaDA と ARM が同一のアーキテクチャ、データ、およびその他すべての設定を共有することを保証した。より大きなスケールでは、リソースの制約により、同一データで訓練されたサイズがわずかに異なる LLaDA および ARM モデルの結果も報告する。詳細については付録 [B.2] を参照されたい。我々は事前訓練の計算コストを統一的なスケーリング指標として用いる。評価については、標準的で多様な 6 つのタスクに焦点を当てた。
図 3 は、LLaDA が目覚ましいスケーラビリティを示し、その全体的な傾向が ARM と非常に競争力があることを示している。特に、MMLU や GSM8K といったタスクでは、LLaDA はさらに強いスケーラビリティを示す。PIQA のような比較的弱いタスクでも、スケールが増大するにつれて ARM との性能差は縮まる。外れ値の影響を考慮するため、我々は定量的な曲線のフィッティングを行わず、潜在的な誤解を避けることを選んだ。それにもかかわらず、結果は LLaDA のスケーラビリティを明確に示している。
特定のベンチマークにおける LLaDA の優位性を考慮し、我々はこの性能向上が重要なアーキテクチャ上の差異に由来すると仮説を立てる。すなわち、自己回帰モデルは左から右への条件付き確率のみを最適化するのに対し、LLaDA は付録 [A.2] で詳述するように複数の条件付け方向を考慮するように訓練されており、これがより大きな柔軟性を提供し、より良い汎化につながる可能性がある。この仮説は、第 [3.3] 節における反転推論での LLaDA の強い性能と、付録 [B.4] におけるサンプリング戦略に関するアブレーション研究によって動機付けられている。
Nie ら [27] は、MDM が ARM と同じ尤度を達成するには 16 倍の計算を必要とすると示唆している。しかし、重要な差異により、我々の発見はより広く適用可能である。特に、尤度は下流タスクの性能に対して比較的間接的な指標であり、拡散は尤度の上界を最適化するため、ARM と直接比較することはできない。さらに、我々は Nie ら [27] における FLOPs から、本研究では FLOPs へとスケーリング範囲を拡張した。
3.2 ベンチマーク結果
LLaDA 8B の文脈内学習および指示追従能力を包括的に評価するため、我々は同程度のスケールの既存 LLM [6,21,25,26,32,33] との詳細な比較を行った。タスクの選択と評価プロトコルは既存研究に従い、一般タスク、数学、コード、および中国語における人気のベンチマークをカバーした。さらなる詳細は付録 [B.6] に示す。より直接的な比較のため、我々は代表的な LLM [6,21] を我々の実装において再評価した。
表 [1] に示すように、2.3T トークンでの事前訓練後、LLaDA 8B Base は目覚ましい性能を示し、ほぼすべてのタスクで LLaMA2 7B Base を上回り、全体として LLaMA3 8B Base と競争力がある。LLaDA は数学および中国語のタスクで優位性を示す。我々は、この強みが
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Mistral 7B† | Deepseek 7B† | |
| モデル 学習トークン数 | Diffusion 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR - | AR 2T |
| 一般タスク | |||||||
| MMLU | 65.9 (5) | 65.4 (5) | 45.9 (5) | 70.3 (5) | 74.2 (5) | 64.2 (5) | 48.2 (5) |
| BBH | 49.7 (3) | 62.1 (3) | 39.4 (3) | 62.3 (3) | 70.4 (3) | 56.1 (3) | 39.5 (3) |
| ARC-C | 45.9 (0) | 53.1 (0) | 46.3 (0) | 60.6 (25) | 63.7 (25) | 60.0 (25) | 48.1 (0) |
| Hellaswag | 70.5 (0) | 79.1 (0) | 76.0 (0) | 80.7 (10) | 80.2 (10) | 83.3 (10) | 75.4 (0) |
| TruthfulQA | 46.1 (0) | 44.0 (0) | 39.0 (0) | 54.2 (0) | 56.4 (0) | 42.2 (0) | - |
| WinoGrande | 74.8 (5) | 77.3 (5) | 72.5 (5) | 77.0 (5) | 75.9 (5) | 78.4 (5) | 70.5 (0) |
| PIQA | 73.6(0) | 80.6(0) | 79.1(0) | - | - | - | 79.2(0) |
| 数学・科学 | |||||||
| GSM8K | 70.3(4) | 48.7(4) | 13.1(4) | 80.2(4) | 85.4(4) | 36.2(4) | 17.4(8) |
| Math | 31.4(4) | 16.0(4) | 4.3(4) | 43.5(4) | 49.8(4) | 10.2(4) | 6.0(4) |
| GPQA | 25.2(5) | 25.9(5) | 25.7(5) | 30.8(5) | 36.4(5) | 24.7(5) | - |
| コード | |||||||
| HumanEval | 35.4(0) | 34.8(0) | 12.8(0) | 51.2(0) | 57.9(0) | 29.3(0) | 26.2(0) |
| HumanEval-FIM | 73.8(2) | 73.3(2) | 26.9(2) | - | - | - | - |
| MBPP | 40.0(4) | 48.8(4) | 23.2(4) | 64.2(0) | 74.9(0) | 51.1(0) | 39.0(3) |
| 中国語 | |||||||
| CMMLU | 69.9(5) | 50.7(5) | 32.5(5) | 83.9(5) | - | - | 47.2 (5) |
| C-Eval | 70.5 (5) | 51.7 (5) | 34.0 (5) | 83.2 (5) | - | - | 45.0 (5) |
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Gemma2 9B† | Deepseek 7B† | |
| モデル学習トークン数 | 拡散 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR 8T | AR 2T |
| ポストトレーニング アラインメントペア | SFT 4.5M | SFT+RL - | SFT+RL - | SFT+RL 0.5M + - | SFT+RL 1M + 0.15M - | SFT+RL - | SFT+RL 1.5M + - |
| 一般タスク | |||||||
| MMLU | 65.5 (5) | 68.4 (5) | 44.1 (5) | - | - | - | 49.4 (0) |
| MMLU-pro | 37.0 (0) | 41.9 (0) | 4.6 (0) | 44.1 (5) | 56.3 (5) | 52.1 (5) | - |
| Hellaswag | 74.6 (0) | 75.5 (0) | 51.5 (0) | - | - | - | 68.5 (-) |
| ARC-C | 88.5 (0) | 82.4 (0) | 57.3 (0) | - | - | - | 49.4 (-) |
| 数学 & 科学 | |||||||
| GSM8K | 69.4 (4) | 78.3 (4) | 29.0 (4) | 85.7 (0) | 91.6 (0) | 76.7 (0) | 理解のための読み取り専用の背景情報(翻訳対象の原文テキストではありません): |
| 3.2 ベンチマーク結果 | 表[1]に示すように、2.3Tトークンで事前学習した後、LLaDA 8B Baseは目覚ましい性能を示し、ほぼすべてのタスクでLLaMA2 7B Baseを上回り、全体としてLLaMA3 8B Baseと競合しています。LLaDAは数学および中国語のタスクで優位性を示しています。この強みは、一部のタスクにおける比較的弱い性能と同じ要因に由来すると推測しています。すなわち、主にLLのクローズドソース状況に起因するデータ品質と分布の違いです。 | 翻訳対象テキスト: | 63.0 (0) | 数学 | 31.9 (0) | 29.6 (0) | 3.8 (0) |
| 52.9 (0) | 75.5 (0) | 44.3 (0) | 15.8 (0) | GPQA | 33.3 (5) | 31.9 (5) | 28.4 (5) |
| 34.3 (0) | |||||||
| 36.4 (0) | 32.8 (0) | - | コード | HumanEval | 49.4 (0) | 59.8 (0) | 16.5 (0) |
| 79.9 (0) | 84.8 (0) | 68.9 (0) | 48.2 (-) | MBPP | 41.0 (4) | 57.6 (4) | 20.6 (4) 67.2 (0) 79.2 (0) 74.9 (0) 35.2 (-) |
一部のタスクにおける比較的弱い性能と同じ要因に由来すると推測する。すなわち、主に LLM データセットのクローズドソース状況に起因する、データの品質と分布の差異である。
特に、GSM8Kを例にとって、データ漏洩の可能性を慎重に排除した。第一に、図[3]に示すように、GSM8Kに関してLLaDAはARMベースラインを上回った。さらに、その結論は付録B.8の完全に未見のGSM8K類似タスク[34]においても維持される。
さらに、表[2]はLLaDA 8B Instructの性能を既存のLLMと比較している。SFTはほとんどの下流タスクにおいてLLaDAの性能を向上させた。MMLUのようないくつかの指標では低下が見られたが、これはSFTデータの品質が最適でなかったことに起因する可能性がある。全体として、我々は強化学習(RL)によるアラインメントを行っていないため、
| サンプリングプロセス | |
| ユーザー | リリーは時速12キロメートルで4時間走ることができます。その後、彼女は時速6キロメートルで走ります。8時間で彼女は何キロメートル走ることができますか? |
| LLaDA | 4時間で、リリーは12 * 4 = 48キロメートル走ります。4時間後、彼女は6 * 4 = 24キロメートル走ります。合計で彼女は8時間で48 + 24 = 72キロメートル走ります。結果 72 |
| マルチラウンド対話の事例 | |
| ユーザー | 名高い詩「The Road Not Taken」の最初の2行を私に共有していただけますか? |
| LLaDA | もちろんです!ロバート・フロストによる名高い詩「The Road Not Taken」の最初の2行は次のとおりです:「Two roads diverged in a yellow wood, And sorry I could not travel both.」これらの行は詩の舞台を設定し、二人の道の間の選択に直面する話し手という考えを導入しています。 |
| ユーザー | 中国語に翻訳するのを手伝ってください。 |
| LLaDA | もちろんです!ロバート・フロストの「The Road Not Taken」の最初の2行は、中国語に次のように翻訳できます:「两条路分岔在黄色的树林中,遗憾我不能同时走」 |
| ユーザー | ドイツ語に翻訳してください。 |
| LLaDA | もちろんです!ロバート・フロストの「The Road Not Taken」の最初の2行は、ドイツ語に次のように翻訳できます:「Zwei Wege trennten sich im gelben Wald, und leider konnte ich nicht beide tun.」 |
| ユーザー | 人生の選択についての詩も書いてください。5文必要で、各文の最初の単語はCを最初の文字として始まります。 |
| LLaDA | もちろんです!人生の選択についての詩で、各文が文字「C」で始まるものです:Choices cascade through life’s journey, Creating connections with each decision, Careful consideration leads to better paths, Courageous choices shape our destiny, Choosing wisely guides us through the years. |
我々の結果はLLaMA3 8B Instructにやや劣るものの、多くの指標における差は小さいままである。特筆すべきは、SFTのみであっても、LLaDAは印象的な指示追従能力を示すことであり、その詳細は第[3.4]節に記載している。RLベースのアラインメントは今後の課題として残す。
第[3]節のすべての結果は純粋な拡散手法に基づいている。これは、自己回帰成分を取り入れた手法よりも全体的な性能が優れているためである。具体的には、条件付き尤度推定に式(6)を用い、サンプリングには低信頼度リマスキングを適用している。LLaDA 8B Instructについては、ブロック拡散スタイルのサンプリングがGSM8KとMathでより良い性能を示し、スコアは78.6と42.2であり、表[2]の69.4と31.9と比較される。この向上は、SFTデータにおける大量の|EOS|トークンパディングに起因し、低信頼度リマスキングにおいて早期終了を引き起こすためである。詳細は付録[B.4]を参照されたい。
全体として、データの透明性を欠いているにもかかわらず、我々は標準化された手順を採用し、多様なタスクを導入するためにあらゆる努力を払ってきた。これらはLLaDAの並外れた能力を十分に実証していると考える。LLaDAは我々の知る限り、競争力のある唯一の非自己回帰モデルである。
3.3 反転推論と分析
モデルの反転推論[15]能力を定量化するため、我々はAllen-Zhu and Li [35]で確立されたプロトコルに従う。具体的には、496組の有名な漢詩の対句からなるデータセットを構築する。詩のある句が与えられると、モデルは追加のファインチューニングなしで、次の句(順方向)または前の句(反転)を生成することを求められる。例は第[B.9]節にある。この設定は、先行研究[27, 36]と比較して、簡潔でより現実的な評価を提供する。
表[4]に示すように、LLaDAは反転の呪い[15]に効果的に対処し、順方向タスクと反転タスクの両方で一貫したゼロショット性能を実証している。対照的に、Qwen 2.5とGPT-4oはともに、両者の間に大きな差を示す。順方向生成の結果は、両ARMがLLaDAよりもはるかに大規模なデータセットとより多くの計算資源の恩恵を受けて強力であることを確認している。しかし、反転タスクにおいてLLaDAは両者を大差で上回る。
我々は反転タスクのために特別な設計を何も行っていない。直感的には、LLaDAは帰納バイアスなしにトークンを均一に扱うため、バランスの取れた性能につながる。詳細は付録A.2を参照されたい。
我々はまた、自己回帰サンプリング、ブロック拡散[31]サンプリング、純粋拡散サンプリングを含む、LLaDAに対する異なるサンプリング戦略の効果を分析し、純粋拡散サンプリングが全体的に最良の性能を達成することを示す。詳細は付録B.4にある。
| 参考資料(翻訳対象の原文ではない):LLaDAに対する異なるサンプリング戦略の効果も分析しており、自己回帰サンプリング、ブロック拡散[31]サンプリング、純粋拡散サンプリングを含み、純粋拡散サンプリングが全体的に最良の性能を達成することを示している。詳細は付録B.4に記載されている。さらに、LLaDAのサンプリング速度とメモリ消費を検討し、生成品質と速度の間で柔軟なトレードオフが可能であることを示している。詳細は付録B.7を参照されたい。翻訳対象のテキスト: | 正方向 | |
| 逆方向 | GPT-4o(2024-08-06) | 82.7 |
| 34.3 | Qwen2.5-7B Instruct | 75.9 |
| 38.0 | LLaDA-8B Instruct | 51.8 |
さらに、我々はLLaDAのサンプリング速度とメモリ消費を調査し、生成品質と速度の間の柔軟なトレードオフを可能にすることを示す。詳細は付録B.7を参照されたい。
分類器フリーガイダンス(CFG)[37][27]は、拡散モデルにおいて生成品質を向上させるために広く用いられている手法である。ARMとの公平な比較を確保するため、本文ではLLaDAにCFGを適用しない。しかし、LLaDAはCFGと互換性があり、その適用から一貫して恩恵を受けることを示す。詳細は付録B.3を参照されたい。
3.4 ケーススタディ
表3に、LLaDA 8B Instructによって生成されたサンプルを示し、その指示追従能力を実証する。第一に、この表はLLaDAが非自己回帰的に一貫性のある、流暢で、長いテキストを生成する能力を示している。第二に、モデルのマルチターン対話能力を強調し、会話履歴を効果的に保持し、複数の言語にわたって文脈に適した応答を生成する。LLaDAのこのようなチャット能力は、我々の知る限り初めて従来のARMから逸脱するものであり、印象的である。より多くのケーススタディは付録B.10を参照されたい。
4 関連研究
拡散モデル[38,40]は視覚領域で目覚ましい成功を収めているが、大規模な(例えば FLOPsを超える計算で訓練されたモデル)言語モデリングについては、関心の高まりと広範な研究努力にもかかわらず、未だ検証されていない。
単純なアプローチは、テキストデータを連続化し、連続拡散モデルを直接適用することである[41-51]。あるいは、一部の手法は離散分布の連続パラメータをモデル化する[52-56]。しかし、スケーラビリティはこれらのアプローチにとって依然として重大な課題である。例えば、1Bモデルは同等の性能を達成するためにARMの64倍の計算を必要とする場合がある[57]。
別のアプローチは、連続拡散を、新しい順方向および逆方向のダイナミクスを特徴とする離散過程に置き換えるものであり、多数の変種を生み出している[58,71]。元の拡散モデルの論文[38]は、統一された拡散フレームワークの下で連続状態と離散状態の両方の遷移カーネルを導入した。Austin et al. [16]は、離散拡散モデルを言語モデリングに導入した先駆的な研究の一つであり、このアプローチの実現可能性を実証した。Lou et al. [17]は、離散拡散の特殊ケースであるマスク拡散が、GPT-2スケールでARMに匹敵するかそれを上回るパープレキシティを達成することを示した。Shi et al. [18]、Sahoo et al. [19]、Ou et al. [20]は基礎的な理論的結果を確立し、これが我々のモデル設計、訓練、推論の動機となった(詳細は付録Aを参照)。Nie et al. [27]は言語モデリングにおけるMDMのスケーリング則を導入し、GPT-2スケールでMDMが質問応答などの言語タスクにどのように活用できるかを探求した。Gong et al. [72]はMDMフレームワーク内でARMをファインチューニングする可能性を実証した。しかし、Gong et al. [72]で観察された改善は特定の指標に限定され、そのアプローチは純粋な拡散ベースの訓練を通じて達成可能な性能には対処していない。並行する研究[73]は、コード生成における拡散言語モデルの可能性を実証し、推論効率における優位性を強調している。しかしながら、クローズドソース製品であるため、訓練手順やサンプリング手法などの具体的な詳細は不明のままである。
これと比較して、本研究はMDMをゼロから8Bパラメータという前例のない規模にスケールアップし、LLaMA 3のような主要なLLMに匹敵する性能を達成する。
さらに、画像生成に関する並行する一連の研究[23,74,75]は、MDMのテキストデータへの応用とよく整合している。さらに、MDMはタンパク質生成[76][77]などの他の領域でも有望性を示しており、有望な結果を達成している。特筆すべきは、一連の研究[31][78][87]が、MDMサンプリングを加速するためのアーキテクチャ最適化、蒸留、サンプリングアルゴリズム設計などの技術を探求していることである。
5 結論と考察
我々はLLaDAを紹介する。これは前例のない8Bパラメータの規模でゼロから訓練された拡散言語モデルである。LLaDAはスケーラビリティ、文脈内学習、指示追従において強力な能力を実証し、LLaMA3のような強力なLLMに匹敵する性能を達成する。さらに、LLaDAは双方向モデリングや強化されたロバスト性など独自の利点を提供し、既存のLLMの関連する限界に効果的に対処する。我々の発見は、大規模言語モデリングにおける拡散モデルの可能性を示し、これらの本質的な能力が本来的にARMに結びついているという一般的な仮定に挑戦する。これらの結果は言語モデリングの新しいパラダイムを表し、新たな洞察を明らかにし、高度な科学的革新を示している。
限界。有望ではあるが、拡散モデルの完全な可能性はまだ十分に探求されていない。本研究のいくつかの限界は、将来の研究にとって重要な機会を提示する。生成長はユーザー指定のハイパーパラメータである。LLaDAは付録[B.5]で詳述するようにこのハイパーパラメータに鈍感であるが、適応的な生成長を採用することがより効率的な解決策を提供すると考える。計算上の制約のため、LLaDAとARMの直接比較——同一データセットでの訓練など——は FLOPs未満の計算予算に制限された。可能な限り最大のLLaDAモデルを訓練しその可能性を示すために資源を割り当てるため、我々はARMベースラインを同じ程度にスケールすることができなかった。さらに、LLaDAのために特別なアテンション機構や位置埋め込みは設計されておらず、KVキャッシュのようなシステムレベルのアーキテクチャ最適化も適用されていない。推論側では、より効率的で制御可能な[37][88][89]サンプリングアルゴリズムは依然として初歩的である。さらに、LLaDAは強化学習[90][91]によるアラインメントをまだ経ておらず、これはその性能と人間の意図とのアラインメントを改善するために極めて重要である。
今後を見据えると、LLaDAのモデル規模と訓練データ量はともに主要なARMの対応モデル[6][26][92][95]よりも小さく、その能力を完全に評価するにはさらなるスケーリングの必要性が浮き彫りになる。さらに、LLaDAのマルチモーダルデータを処理する能力は未探求のままである。プロンプトチューニング技術[96]やエージェントベースシステム[97][98]への統合に対するその影響はまだ完全には理解されていない。最後に、拡散言語モデルの可能性をさらに引き出すためには、LLaDAのポストトレーニング(例えばO1ライクなシステム[99][100])に関する体系的な調査が必要である。
謝辞
本研究は、国家自然科学基金(No. 92470118)、北京市自然科学基金(No. L247030)、北京新星計画(No. 20220484044)、およびAnt Group Research Fundの支援を受けた。
参考文献
[1] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, ほか. 大規模言語モデルのサーベイ. arXiv preprint arXiv:2303.18223, 2023. [2] Alec Radford. 生成的事前学習による言語理解の改善, 2018. [3] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, ほか. 言語モデルは教師なしのマルチタスク学習者である. OpenAI blog, 1(8):9, 2019. [4] Tom B Brown. 言語モデルは少数ショット学習者である. arXiv preprint arXiv:2005.14165, 2020. [5] OpenAI. ChatGPT: 対話のための言語モデルの最適化. OpenAI blog, 2022年11月. URL https://openai.com/blog/chatgpt/[6] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, ほか. Llama 3 モデル群. arXiv preprint arXiv:2407.21783, 2024.
[7] Ashish Vaswani. Attention is all you need. arXiv preprint arXiv:1706.03762, 2017.
[8] Ronald A Fisher. 理論統計学の数学的基礎について. Philosophical transactions of the Royal Society of London. Series A, containing papers of a mathematical or physical character, 222(594-604):309-368, 1922.
[9] Fan Bao, Shen Nie, Kaiwen Xue, Yue Cao, Chongxuan Li, Hang Su, Jun Zhu. All are worth words: A vit backbone for diffusion models. IEEE/CVF Conference on Computer Vision and Pattern Recognition 議事録, 22669-22679頁, 2023年.
[10] William Peebles, Saining Xie. Scalable diffusion models with transformers. IEEE/CVF International Conference on Computer Vision 議事録, 4195-4205頁, 2023年.
[11] Tim Brooks, Bill Peebles, Connor Holmes, Will DePue, Yufei Guo, Li Jing, David Schnurr, Joe Taylor, Troy Luhman, Eric Luhman, Clarence Ng, Ricky Wang, Aditya Ramesh. Video generation models as world simulators. 2024年. URL https://openai.com/research/video-generation-models-as-world-simulators
[12] Gregoire Deletang, Anian Ruoss, Paul-Ambroise Duquenne, Elliot Catt, Tim Genewein, Christopher Mattern, Jordi Grau-Moya, Li Kevin Wenliang, Matthew Aitchison, Laurent Orseau, ほか. Language modeling is compression. 第12回国際学習表現会議.
[13] Yuzhen Huang, Jinghan Zhang, Zifei Shan, Junxian He. Compression represents intelligence linearly. arXivプレプリント arXiv:2404.09937, 2024年.
[14] Claude Elwood Shannon. A mathematical theory of communication. The Bell system technical journal, 27(3):379-423, 1948年.
[15] Lukas Berglund, Meg Tong, Max Kaufmann, Mikita Balesni, Asa Cooper Stickland, Tomasz Korbak, Owain Evans. The reversal curse: Llms trained on" a is b" fail to learn" b is a". arXivプレプリント arXiv:2309.12288, 2023年.
[16] Jacob Austin, Daniel D Johnson, Jonathan Ho, Daniel Tarlow, Rianne Van Den Berg. Structured denoising diffusion models in discrete state-spaces. Advances in Neural Information Processing Systems, 34:17981-17993, 2021年.
[17] Aaron Lou, Chenlin Meng, Stefano Ermon. Discrete diffusion language modeling by estimating the ratios of the data distribution. arXivプレプリント arXiv:2310.16834, 2023年.
[18] Jiaxin Shi, Kehang Han, Zhe Wang, Arnaud Doucet, Michalis K Titsias. Simplified and generalized masked diffusion for discrete data. arXivプレプリント arXiv:2406.04329, 2024年.
[19] Subham Sekhar Sahoo, Marianne Arriola, Yair Schiff, Aaron Gokaslan, Edgar Marroquin, Justin T Chiu, Alexander Rush, Volodymyr Kuleshov. Simple and effective masked diffusion language models. arXivプレプリント arXiv:2406.07524, 2024年.
[20] Jingyang Ou, Shen Nie, Kaiwen Xue, Fengqi Zhu, Jiacheng Sun, Zhenguo Li, Chongxuan Li. Your absorbing discrete diffusion secretly models the conditional distributions of clean data. arXivプレプリント arXiv:2406.03736, 2024年.
[21] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, ほか. Llama 2: Open foundation and fine-tuned chat models. arXivプレプリント arXiv:2307.09288, 2023年.
[22] Jacob Devlin. Bert: Pre-training of deep bidirectional transformers for language understanding. arXivプレプリント arXiv:1810.04805, 2018年.
[23] Huiwen Chang, Han Zhang, Lu Jiang, Ce Liu, William T Freeman. Maskgit: Masked generative image transformer. IEEE/CVF Conference on Computer Vision and Pattern Recognition 議事録, 11315-11325頁, 2022年.
[24] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron, Sumit Sanghai. Gqa: Training generalized multi-query transformer models from multihead checkpoints. 2023年自然言語処理における経験的手法に関する会議議事録, 4895-4901頁, 2023年.
[25] An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, Guanting Dong, Haoran Wei, Huan Lin, Jialong Tang, Jialin Wang, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Ma, Jianxin Yang, Jin Xu, Jingren Zhou, Jinze Bai, Jinzheng He, Junyang Lin, Kai Dang, Keming Lu, Keqin Chen, Kexin Yang, Mei Li, Mingfeng Xue, Na Ni, Pei Zhang, Peng Wang, Ru Peng, Rui Men, Ruize Gao, Runji Lin, Shijie Wang, Shuai Bai, Sinan Tan, Tianhang Zhu, Tianhao Li, Tianyu Liu, Wenbin Ge, Xiaodong Deng, Xiaohuan Zhou, Xingzhang Ren, Xinyu Zhang, Xipin Wei, Xuancheng Ren, Xuejing Liu, Yang Fan, Yang Yao, Yichang Zhang, Yu Wan, Yunfei Chu, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zhifang Guo, Zhihao Fan. Qwen2 technical report, 2024年. URL https://arxiv.org/abs/2407.10671
[26] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, Huan Lin, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Yang, Jiaxi Yang, Jingren Zhou, Junyang Lin, Kai Dang, Keming Lu, Keqin Bao, Kexin Yang, Le Yu, Mei Li, Mingfeng Xue, Pei Zhang, Qin Zhu, Rui Men, Runji Lin, Tianhao Li, Tingyu Xia, Xingzhang Ren, Xuancheng Ren, Yang Fan, Yang Su, Yichang Zhang, Yu Wan, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zihan Qiu. Qwen2.5 technical report. arXivプレプリント arXiv:2412.15115, 2024年.
[27] Shen Nie, Fengqi Zhu, Chao Du, Tianyu Pang, Qian Liu, Guangtao Zeng, Min Lin, Chongxuan Li. Scaling up masked diffusion models on text. arXivプレプリント arXiv:2410.18514, 2024年.
[28] Shengding Hu, Yuge Tu, Xu Han, Chaoqun He, Ganqu Cui, Xiang Long, Zhi Zheng, Yewei Fang, Yuxiang Huang, Weilin Zhao, ほか. Minicpm: Unveiling the potential of small language models with scalable training strategies. arXivプレプリント arXiv:2404.06395, 2024年.
[29] I Loshchilov. Decoupled weight decay regularization. arXivプレプリント arXiv:1711.05101, 2017年.
[30] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes, Yejin Choi. The curious case of neural text degeneration. arXivプレプリント arXiv:1904.09751, 2019年.
[31] Marianne Arriola, Aaron Gokaslan, Justin T Chiu, Zhihan Yang, Zhixuan Qi, Jiaqi Han, Subham Sekhar Sahoo, Volodymyr Kuleshov. Block diffusion: Interpolating between autoregressive and diffusion language models. arXivプレプリント arXiv:2503.09573, 2025年.
[32] Xiao Bi, Deli Chen, Guanting Chen, Shanhuang Chen, Damai Dai, Chengqi Deng, Honghui Ding, Kai Dong, Qiushi Du, Zhe Fu, ほか. Deepseek llm: Scaling open-source language models with longtermism. arXivプレプリント arXiv:2401.02954, 2024年.
[33] Albert Q Jiang, Alexandre Sablayrolles, Arthur Mensch, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Florian Bressand, Gianna Lengyel, Guillaume Lample, Lucile Saulnier, ほか. Mistral 7b. arXivプレプリント arXiv:2310.06825, 2023年.
[34] Tian Ye, Zicheng Xu, Yuanzhi Li, Zeyuan Allen-Zhu. Physics of Language Models: Part 2.1, Grade-School Math and the Hidden Reasoning Process. arXiv e-prints, abs/2407.20311, 2024年7月. 完全版は http://arxiv.org/abs/2407.20311 で入手可能
[35] Zeyuan Allen-Zhu, Yuanzhi Li. Physics of Language Models: Part 3.2, Knowledge Manipulation. ArXiv e-prints, abs/2309.14402, 2023年9月. 完全版は http://arxiv.org/abs/2309.14402 で入手可能
[36] Ouaïl Kitouni, Niklas Nolte, Diane Bouchacourt, Adina Williams, Mike Rabbat, and Mark Ibrahim. 因数分解の呪い:予測するトークンが反転の呪いとその先を左右する。arXiv preprint arXiv:2406.05183, 2024.
[37] Jonathan Ho and Tim Salimans. 分類器なしの拡散ガイダンス。arXiv preprint arXiv:2207.12598, 2022.
[38] Jascha Sohl-Dickstein, Eric Weiss, Niru Maheswaranathan, and Surya Ganguli. 非平衡熱力学を用いた深層教師なし学習。In International conference on machine learning, pages 2256-2265. PMLR, 2015.
[39] Jonathan Ho, Ajay Jain, and Pieter Abbeel. ノイズ除去拡散確率モデル。Advances in neural information processing systems, 33:6840-6851, 2020.
[40] Yang Song, Jascha Sohl-Dickstein, Diederik P Kingma, Abhishek Kumar, Stefano Ermon, and Ben Poole. 確率微分方程式によるスコアベース生成モデリング。arXiv preprint arXiv:2011.13456, 2020.
[41] Xiang Li, John Thickstun, Ishaan Gulrajani, Percy S Liang, and Tatsunori B Hashimoto. Diffusion-LMは制御可能なテキスト生成を改善する。Advances in Neural Information Processing Systems, 35:4328-4343, 2022.
[42] Shansan Gong, Mukai Li, Jiangtao Feng, Zhiyong Wu, and LingPeng Kong. Diffuseq: Sequence to sequence text generation with diffusion models. arXiv preprint arXiv:2210.08933, 2022.
[43] Xiaochuang Han, Sachin Kumar, and Yulia Tsvetkov. Ssd- lm: Semi- autoregressive simplex- based diffusion language model for text generation and modular control. arXiv preprint arXiv:2210.17432, 2022.
[44] Robin Strudel, Corentin Tallec, Florent Altché, Yilun Du, Yaroslav Ganin, Arthur Mensch, Will Grathwohl, Nikolay Savinov, Sander Dieleman, Laurent Sifre, et al. Self- conditioned embedding diffusion for text generation. arXiv preprint arXiv:2211.04236, 2022.
[45] Ting Chen, Ruixiang Zhang, and Geoffrey Hinton. Analog bits: Generating discrete data using diffusion models with self- conditioning. arXiv preprint arXiv:2208.04202, 2022.
[46] Sander Dieleman, Laurent Sartran, Arman Roshannai, Nikolay Savinov, Yaroslav Ganin, Pierre H Richemond, Arnaud Doucet, Robin Strudel, Chris Dyer, Conor Durkan, et al. Continuous diffusion for categorical data. arXiv preprint arXiv:2211.15089, 2022.
[47] Pierre H. Richemond, Sander Dieleman, and Arnaud Doucet. Categorical sdes with simplex diffusion, 2022.
[48] Tong Wu, Zhihao Fan, Xiao Liu, Yeyun Gong, Yelong Shen, Jian Jiao, Hai- Tao Zheng, Juntao Li, Zhongyu Wei, Jian Guo, Nan Duan, and Weizhu Chen. Ar- diffusion: Auto- regressive diffusion model for text generation, 2023.
[49] Rabeeh Karimi Mahabadi, Hamish Ivison, Jaesung Tae, James Henderson, Iz Beltagy, Matthew E. Peters, and Arman Cohan. Tess: Text- to- text self- conditioned simplex diffusion, 2024.
[50] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian, and Mingxuan Wang. Dinoiser: Diffused conditional sequence learning by manipulating noises. arXiv preprint arXiv:2302.10025, 2023.
[51] Yizhe Zhang, Jiatao Gu, Zhuofeng Wu, Shuangfei Zhai, Joshua Susskind, and Navdeep Jaitly. Planner: Generating diversified paragraph via latent language diffusion model. Advances in Neural Information Processing Systems, 36:80178- 80190, 2023.
[52] Aaron Lou and Stefano Ermon. Reflected diffusion models, 2023.
[53] Alex Graves, Rupesh Kumar Srivastava, Timothy Atkinson, and Faustino Gomez. Bayesian flow networks. arXiv preprint arXiv:2308.07037, 2023.
[54] Zhenghao Lin, Yeyun Gong, Yelong Shen, Tong Wu, Zhihao Fan, Chen Lin, Nan Duan, and Weizhu Chen. Text generation with diffusion language models: A pre- training approach with continuous paragraph denoise. In International Conference on Machine Learning, pages 21051- 21064. PMLR, 2023.
[55] Kaiwen Xue, Yuhao Zhou, Shen Nie, Xu Min, Xiaolu Zhang, Jun Zhou, and Chongxuan Li. Unifying bayesian flow networks and diffusion models through stochastic differential equations. arXiv preprint arXiv:2404.15766, 2024.
[56] Ruixiang Zhang, Shuangfei Zhai, Yizhe Zhang, James Thornton, Zijing Ou, Joshua Susskind, and Navdeep Jaitly. Target concrete score matching: A holistic framework for discrete diffusion. arXiv preprint arXiv:2504.16431, 2025.
[57] Ishaan Gulrajani and Tatsunori B Hashimoto. Likelihood- based diffusion language models. Advances in Neural Information Processing Systems, 36, 2024.
[58] Emiel Hoogeboom, Didrik Nielsen, Priyank Jaini, Patrick Forré, and Max Welling. Argmax flows and multinomial diffusion: Learning categorical distributions. Advances in Neural Information Processing Systems, 34:12454- 12465, 2021.
[59] Emiel Hoogeboom, Alexey A Gritsenko, Jasmijn Bastings, Ben Poole, Rianne van den Berg, and Tim Salimans. Autoregressive diffusion models. arXiv preprint arXiv:2110.02037, 2021.
[60] Zhengfu He, Tianxiang Sun, Kuanning Wang, Xuanjing Huang, and Xipeng Qiu. Diffusion- bert: Improving generative masked language models with diffusion models. arXiv preprint arXiv:2211.15029, 2022.
[61] Andrew Campbell, Joe Benton, Valentin De Bortoli, Thomas Rainforth, George Deligiannidis, and Arnaud Doucet. A continuous time framework for discrete denoising models. Advances in Neural Information Processing Systems, 35:28266- 28279, 2022.
[62] Chenlin Meng, Kristy Choi, Jiaming Song, and Stefano Ermon. Concrete score matching: Generalized score matching for discrete data. Advances in Neural Information Processing Systems, 35:34532- 34545, 2022.
[63] Machel Reid, Vincent J. Hellendoorn, and Graham Neubig. Diffuser: Discrete diffusion via edit- based reconstruction, 2022.
[64] Haoran Sun, Lijun Yu, Bo Dai, Dale Schuurmans, and Hanjun Dai. Score- based continuous- time discrete diffusion models. arXiv preprint arXiv:2211.16750, 2022.
[65] Ouaif Kitouni, Niklas Nolte, James Hensman, and Bhaskar Mitra. Disk: A diffusion model for structured knowledge. arXiv preprint arXiv:2312.05253, 2023.
[66] Lin Zheng, Jianbo Yuan, Lei Yu, and Lingpeng Kong. A reparameterized discrete diffusion model for text generation. ArXiv, abs/2302.05737, 2023.
[67] Zixiang Chen, Huizhuo Yuan, Yongqian Li, Yiwen Kou, Junkai Zhang, and Quanquan Gu. Fast sampling via de- randomization for discrete diffusion models. arXiv preprint arXiv:2312.09193, 2023.
[68] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian, and Quanquan Gu. Diffusion language models can perform many tasks with scaling and instruction- finetuning. arXiv preprint arXiv:2308.12219, 2023.
[69] Itai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky TQ Chen, Gabriel Synnaeve, Yossi Adi, and Yaron Lipman. Discrete flow matching. arXiv preprint arXiv:2407.15595, 2024.
[70] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming- Yu Liu, Jun Zhu, and Qinsheng Zhang. Masked diffusion models are secretly time- agnostic masked models and exploit inaccurate categorical sampling, 2024. URL https://arxiv.org/abs/2409.02908
[71] Shreyas Kapur, Erik Jenner, and Stuart Russell. Diffusion on syntax trees for program synthesis. arXiv preprint arXiv:2405.20519, 2024.
[72] Shansan Gong, Shivam Agarwal, Yizhe Zhang, Jiacheng Ye, Lin Zheng, Mukai Li, Chenxin An, Peilin Zhao, Wei Bi, Jiawei Han, et al. Scaling diffusion language models via adaptation from autoregressive models. arXiv preprint arXiv:2410.17891, 2024.
[73] Samar Khanna, Siddhant Kharbanda, Shufan Li, Harshit Varma, Eric Wang, Sawyer Birnbaum, Ziyang Luo, Yanis Miraoui, Akash Palrecha, Stefano Ermon, et al. Mercury: Ultra- fast language models based on diffusion. arXiv preprint arXiv:2506.17298, 2025.
[74] Huiwen Chang, Han Zhang, Jarred Barber, AJ Maschinot, Jose Lezama, Lu Jiang, Ming- Hsuan Yang, Kevin Murphy, William T Freeman, Michael Rubinstein, et al. Muse: Text- to- image generation via masked generative transformers. arXiv preprint arXiv:2301.00704, 2023.
[75] Zebin You, Jingyang Ou, Xiaolu Zhang, Jun Hu, Jun Zhou, and Chongxuan Li. 効果的で効率的なマスク画像生成モデル. arXiv preprint arXiv:2503.07197, 2025.
[76] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang, and Quanquan Gu. 拡散言語モデルは汎用性の高いタンパク質学習器である. arXiv preprint arXiv:2402.18567, 2024.
[77] Xinyou Wang, Zaixiang Zheng, Fei Ye, Dongyu Xue, Shujian Huang, and Quanquan Gu. Dplm-2: マルチモーダル拡散タンパク質言語モデル. arXiv preprint arXiv:2410.13782, 2024.
[78] Siqi Kou, Lanxiang Hu, Zhezhi He, Zhijie Deng, and Hao Zhang. Clims: 一貫性大規模言語モデル. arXiv preprint arXiv:2403.00835, 2024.
[79] Chenkai Xu, Xu Wang, Zhenyi Liao, Yishun Li, Tianqi Hou, and Zhijie Deng. Show-o turbo: 加速された統合マルチモーダル理解と生成に向けて. arXiv preprint arXiv:2502.05415, 2025.
[80] Sulin Liu, Juno Nam, Andrew Campbell, Hannes Stärk, Yilun Xu, Tommi Jaakkola, and Rafael Gómez-Bombarelli. 生成しながら考える: 計画されたノイズ除去を伴う離散拡散. arXiv preprint arXiv:2410.06264, 2024.
[81] Yuanzhi Zhu, Xi Wang, Stéphane Lathuilière, and Vicky Kalogeiton. Dimo: マスク拡散モデルをワンステップ生成器に蒸留する. arXiv preprint arXiv:2503.15457, 2025.
[82] Yinuo Ren, Haoxuan Chen, Yuchen Zhu, Wei Guo, Yongxin Chen, Grant M Rotskoff, Molei Tao, and Lexing Ying. 離散拡散モデルのための高速ソルバー:高次アルゴリズムの理論と応用. arXiv preprint arXiv:2502.00234, 2025.
[83] Satoshi Hayakawa, Yuhta Takida, Masaaki Imaizumi, Hiromi Wakaki, and Yuki Mitsufuji. 次元的相関を通じた離散拡散の蒸留. arXiv preprint arXiv:2410.08709, 2024.
[84] Yixiu Zhao, Jiaxin Shi, Feng Chen, Shaul Druckmann, Lester Mackey, and Scott Linderman. 離散拡散モデルのための情報を用いた補正器. arXiv preprint arXiv:2407.21243, 2024.
[85] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu, and Qinsheng Zhang. マスク付き拡散モデルは実は時間非依存のマスク付きモデルであり、不正確なカテゴリカルサンプリングを利用している. arXiv preprint arXiv:2409.02908, 2024.
[86] Yong-Hyun Park, Chieh-Hsin Lai, Satoshi Hayakawa, Yuhta Takida, and Yuki Mitsufuji. ステップを跳べ:離散拡散モデルのサンプリングスケジュールの最適化. In The Thirteenth International Conference on Learning Representations, 2024.
[87] Justin Deschenaux and Caglar Gulcehre. 自己回帰を超えて:時間を通じた自己蒸留による高速LLM. arXiv preprint arXiv:2410.21035, 2024.
[88] Prafulla Dhariwal and Alexander Nichol. 拡散モデルは画像生成においてGANを凌駕する. Advances in neural information processing systems, 34:8780-8794, 2021.
[89] Yair Schiff, Subham Sekhar Sahoo, Hao Phung, Guanghan Wang, Sam Boshar, Hugo Dallatorre, Bernardo P de Almeida, Alexander Rush, Thomas Pierrot, and Volodymyr Kuleshov. 離散拡散モデルのための単純なガイダンス機構. arXiv preprint arXiv:2412.10193, 2024.
[90] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. 人間のフィードバックを用いた指示追従のための言語モデルの訓練. Advances in neural information processing systems, 35:27730-27744, 2022.
[91] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, and Chelsea Finn. 直接選好最適化:あなたの言語モデルは実は報酬モデルである. Advances in Neural Information Processing Systems, 36, 2024.
[92] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. GPT-4 技術報告書. arXiv preprint arXiv:2303.08774, 2023.
[93] Google. 次世代モデル:Gemini 1.5, 2024. URL https://blog.google/technology/ai/google-gemini-next-generation-model-february-2024
[94] Anthropic. Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[95] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, et al. Deepseek-v3 技術報告書. arXiv preprint arXiv:2412.19437, 2024.
[96] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. 思考の連鎖プロンプティングは大規模言語モデルにおける推論を引き出す. Advances in neural information processing systems, 35:24824-24837, 2022.
[97] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang, and Michael S Bernstein. 生成的エージェント:人間行動のインタラクティブなシミュラクラ. In Proceedings of the 36th annual acm symposium on user interface software and technology, pages 1-22, 2023.
[98] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, et al. 大規模言語モデルに基づく自律エージェントに関するサーベイ. Frontiers of Computer Science, 18(6):186345, 2024.
[99] OpenAI. LLMによる推論の学習, 2024. URL https://openai.com/index/learning-to-reason-with-llms/
[100] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1:強化学習によるLLMの推論能力へのインセンティブ付与. arXiv preprint arXiv:2501.12948, 2025.
[101] Benigno Uria, Iain Murray, and Hugo Larochelle. 深く扱いやすい密度推定器. In Proceedings of the 31th International Conference on Machine Learning, 2014.
[102] Andy Shih, Dorsa Sadigh, and Stefano Ermon. 任意順序自己回帰モデルにおける正しい訓練と推論. In Proceedings of the 31th International Conference on Machine Learning, 2022.
[103] Zhangchen Xu, Fengqing Jiang, Luyao Niu, Yuntian Deng, Radha Poovendran, Yejin Choi, and Bill Yuchen Lin. Magpie:何も与えずに整合化されたLLMをプロンプトすることでゼロからアラインメントデータを合成する. arXiv preprint arXiv:2406.08464, 2024.
[104] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding, and Lingming Zhang. Magicoder:OSS-instructによるコード生成の強化. arXiv preprint arXiv:2312.02120, 2023.
[105] Biao Zhang and Rico Sennrich. 二乗平均平方根層正規化. Advances in Neural Information Processing Systems, 32, 2019.
[106] Noam Shazeer. GLU変種はTransformerを改善する. arXiv preprint arXiv:2002.05202, 2020.
[107] Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo, and Yunfeng Liu. Roformer:回転位置埋め込みによる拡張Transformer. Neurocomputing, 568:127063, 2024.
[108] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. ニューラル言語モデルのスケーリング則. arXiv preprint arXiv:2001.08361, 2020.
.
[109] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al. 計算最適な大規模言語モデルの訓練. arXiv preprint arXiv:2203.15556, 2022.
[110] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. 大規模マルチタスク言語理解の測定. arXiv preprint arXiv:2009.03300, 2020.
[111] Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, et al. 困難なBIG-benchタスクと思考の連鎖がそれらを解けるかどうか. arXiv preprint arXiv:2210.09261, 2022.
[112] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. 質問応答を解いたと思っているか?ARC、AI2推論チャレンジを試せ. arXiv preprint arXiv:1803.05457, 2018.
[113] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi. Hellaswag:機械は本当にあなたの文を完成できるか? arXiv preprint arXiv:1905.07830, 2019.
[114] Stephanie Lin, Jacob Hilton, and Owain Evans. Truthfulqa: Measuring how models mimic human falsehoods. arXiv preprint arXiv:2109.07958, 2021.
[115] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. Winogrande: An adversarial winograd schema challenge at scale. Communications of the ACM, 64(9):99- 106, 2021.
[116] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. Piqa: Reasoning about physical commonsense in natural language. In Proceedings of the AAAI conference on artificial intelligence, 2020.
[117] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, et al. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021.
[118] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. Measuring mathematical problem solving with the math dataset. arXiv preprint arXiv:2103.03874, 2021.
[119] David Rein, Betty Li Hou, Asa Cooper Stickland, Jackson Petty, Richard Yuanzhe Pang, Julien Dirani, Julian Michael, and Samuel R Bowman. Gpqa: A graduate- level google- proof q&a benchmark. arXiv preprint arXiv:2311.12022, 2023.
[120] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
[121] Mohammad Bavarian, Heewoo Jun, Nikolas Tezak, John Schulman, Christine McLeavey, Jerry Tworek, and Mark Chen. Efficient training of language models to fill in the middle. arXiv preprint arXiv:2207.14255, 2022.
[122] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
[123] Haonan Li, Yixuan Zhang, Fajri Koto, Yifei Yang, Hai Zhao, Yeyun Gong, Nan Duan, and Timothy Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
[124] Yuzhen Huang, Yuzhuo Bai, Zhihao Zhu, Junlei Zhang, Jinghan Zhang, Tangjun Su, Junteng Liu, Chuancheng Lv, Yikai Zhang, Yao Fu, et al. C-eval: A multi-level multi-discipline chinese evaluation suite for foundation models. Advances in Neural Information Processing Systems, 36, 2024.
[125] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. A framework for few-shot language model evaluation, 07 2024. URL https://zenodo.org/records/12608602
アルゴリズム1 LLaDAの事前学習
要求: マスク予測器 、データ分布
1: repeat
2: # 確率 で、 の系列長は U[1, 4096] に従う
3:
4: # は式 (7) で定義される
5: を計算する # は の系列長である
6: を計算し、オプティマイザを実行する。
7: 収束するまで
8: を返す
アルゴリズム2 LLaDAの教師ありファインチューニング
要求: マスク予測器 、ペアデータ分布
1: repeat
2: # SFTデータの詳細については付録 B.1 を参照されたい
3:
4: # は式 (7) で定義される
5: を計算する # は の系列長である
6: を計算し、オプティマイザを実行する。
7: 収束するまで
8: を返す
アルゴリズム3 LLaDAの条件付き対数尤度評価
要求: マスク予測器 、プロンプト 、応答 、モンテカルロ推定回数
1: log_likelihood
2: for to do
3: # は の系列長である
4: から 個のトークンをマスキングのために非復元抽出で一様にサンプリングすることにより、 を取得する
5:
6: end for
7: log_likelihood
8: log_likelihood を返す
A マスク付き拡散モデルの定式化
A.1 学習
MDM [16|20] は、自己回帰モデルとは異なる方法でモデル分布 を定義する。
これらのモデルは、時刻 でインデックス付けされた順過程 を導入する。この過程は、系列 内のすべてのトークンを徐々に、かつ独立にマスクする。時刻 では、データ点 はマスクなしで完全に観測され、 では、 は期待値においてさまざまなマスク率を持つ潜在変数を表す。
形式的には、 が与えられたときの の条件付き分布は、完全に因子化された形式で定義される:
ここで、各トークンの条件付き分布は次で与えられる:
ここで、M はマスクトークンを表す。直感的には、各トークンは変化しないかマスクされるかのいずれかであり、マスクされる確率は が 0 から 1 へ進むにつれて線形に増加する。 では、すべての
トークンがマスクされることが保証される。つまり、 は完全にマスクされたトークンの系列に集中したディラック分布に従う。特筆すべきは、線形のマスキング確率は連続拡散モデル[38,40]におけるノイズスケジュールに類似しているが、それとは異なる点である。この線形性は、テキストの情報量が平均してトークン数に比例するという仮定に動機づけられており、順方向過程において情報が線形に失われることを妥当なものとしている。 順方向過程は可逆であるだけでなく、すべてのトークンにわたって完全に因子分解された逆方向過程に対応する。時間 \(t = 1\) から 0 への逆方向過程は、完全にマスクされたトークンの系列から新しいデータを生成する。逆方向過程の条件付き分布は、\(0 \leq s < t \leq 1\) に対して、次のように因子分解される:
ここで、各トークンの条件付き分布は次のとおりである:
したがって、推定すべき鍵となる関数は条件付き分布 であり、これは入力 においてマスクされている場合に元のトークンを予測する。これは連続拡散モデルにおけるデータ予測形式に類似している。
[20]で証明されているように、等価でありながら時間に依存しないパラメータ化は次のように導出できる:
ここで、 は におけるマスクされていないトークンの集合を表し、これは元のデータ における対応するトークンと同一である。なぜなら、マスクされていないトークンは のみによって決定され、時間 に依存しないからである。直感的には、これはデータ予測関数の推定が、時間不変であるクリーンデータ上の条件付き分布の推定と等価であることを意味する。したがって、時間 をパラメトリックモデルへの入力として与える必要はない。 要求:マスク予測器 \(p_{\theta}\) 、プロンプト \(p_{0}\) 、回答長 \(L\) 、サンプリングステップ数 \(N\) 1: \(r_{1}\) を長さ \(L\) の完全にマスクされた系列とする。2: for \(t \leftarrow 1\) down to \(\frac{1}{N}\) step \(\frac{1}{N}\) do 3: \(s = t - \frac{1}{N}\) 4: \(r_{0} = \arg \max_{r_{0}} p_{\theta}(r_{0}|p_{0},r_{t})\) # マスクトークンを予測する際には貪欲サンプリングを採用する 5: for \(i \leftarrow 1\) to \(L\) do 6: if \(r_{t}^{i} \neq \mathbf{M}\) then 7: \(r_{0}^{i} = r_{t}^{i}\) 8: else 9: 確率 \(\frac{s}{t}\) で、\(r_{0}^{i}\) を \(\mathbf{M}\) に設定する 10: end if 11: end for 12: \(r_{s} = r_{0}\) 13: end for 14: \(r_{0}\) を返す
マスク付き拡散の開発は自明ではないものの、その実装は straightforward である。まず、マスク予測器を導入する。これはパラメトリックモデル (例えば、因果マスクを持たない Transformer)であり、任意の に対する を入力として受け取り、すべてのマスクされたトークンを同時に予測する。次に、モデル分布 を次のように定義する。完全にマスクされたトークンの系列として から始め、 から 0 まで、 によってパラメータ化された近似逆過程をシミュレートする。そのとき で誘導される周辺分布がモデル分布 を表す。
要求:マスク予測器 、プロンプト 、回答長 、サンプリングステップ数
1: を長さ の完全にマスクされた系列とする。
2: for down to step do
3:
4: for to do
5: if then
6:
7: else
8:
9:
10: end if
11: end for
12: # タイムステップ においてマスクされていないトークンの数は である
13: for to do
14: if then
15: # 信頼度が最も低い 個の位置が再マスクのために選択される。
16: end if
17: end for
18:
19: end for
20: を返す
形式的には、マスク予測器はマスキング付きの交差エントロピー損失を用いて訓練される:
ここで、 は訓練データからサンプリングされ、 は から一様にサンプリングされ、 は からサンプリングされる。指示関数 は、交差エントロピー損失がマスクされたトークンに対してのみ計算されることを保証する。Shi et al. [18]、Sahoo et al. [19]、Ou et al. [20] において、損失関数 がモデル分布の負の対数尤度の上界であることが証明されている:
要約すると、この原理に基づくアプローチは、順過程においてトークンを漸進的にマスクし、逆過程においてデータ分布を復元することを学習することによって生成モデルを訓練するものであり、そのすべてが(近似的な)最尤推定の枠組みの下で行われる。
A.2 推論
式 [12] の交差エントロピー損失には、いくつかの等価な形が存在する [20]。最初のものは次で与えられる:
ここで、 は から一様にサンプリングされ、 は からマスキングのために非復元抽出で 個のトークンを一様にサンプリングすることによって得られる。ちょうど 個のトークンをマスクすることは各トークンを確率 で独立にマスクすることとは異なるが、これら二つのマスキング手法は期待値において等価な結果をもたらす [20]。
任意順自己回帰モデル(AO-ARM)[59][101][102] は、 個の変数のすべての可能な順序 に対して同時分布を自己回帰的に特徴づける。そのような分布を学習するために、AO-ARM は重み共有ニューラルネットワークを用いてすべての一変量条件付き分布をモデル化し、欠落変数を表すためにマスクトークンを用いる。訓練時には、すべての順序の一様分布 に関する期待負の対数尤度が最小化される:
直感的には、 は、 にインデックスを持つ位置がマスクされたマスクトークン として理解できる。さらに、式 (15) が式 (12) と等価であることが証明できる。この関連性は、LLaDA の双方向推論能力を説明するものであり、それが推論手続きにおいて明示的に用いられたことはなかったとしてもそうである。
さらに、Nie et al. [27] は教師なし分類器フリーガイダンス(CFG)を導入している。これは、プロンプトとの整合性とテキストの多様性のバランスを取るプラグアンドプレイの手法である。具体的には、教師なし CFG は推論のために以下の修正されたマスク予測器を用いる:
ここで、 は と同じ長さのマスク系列であり、 は の強さを制御する調整可能なハイパーパラメータである。ARMsとの公平な比較を確保するため、本文ではLLaDAにCFGを適用しない。しかし、付録[B.3]で示されているように、LLaDAはCFGと完全に互換性があり、適用すると一貫して性能の向上を示す。
A.3 アルゴリズム
本節では、学習アルゴリズムと推論アルゴリズムを提示する。具体的には、事前学習アルゴリズムと教師あり微調整アルゴリズムをそれぞれアルゴリズム[1]とアルゴリズム[2]で紹介する。さらに、尤度評価アルゴリズムをアルゴリズム[3]で提供する。最後に、逆生成過程をアルゴリズム[4]とアルゴリズム[5]で提示する。これらはそれぞれ、ランダムリマスキング戦略と低信頼度[23]リマスキング戦略に対応する。
B 実験
B.1 データ収集と前処理
本節では、まず事前学習とSFTの両方におけるデータ収集とフィルタリングのプロセスを紹介する。次に、LLaDAが学習中にこれらのデータセットをどのように活用するかを説明する。
我々の事前学習コーパスは、Webデータ、書籍、学術論文、ソーシャルメディア、百科事典、数学、コードを含む多様な公開利用可能なソースから構築されており、約が中国語、が英語、がコードである。データクリーニングプロセスには、PDFテキスト抽出、重複排除、有害コンテンツのフィルタリングが含まれる。品質をさらに確保するため、我々はBERT [22]モデルを微調整して自動データ品質アノテーションを行い、より高品質なサンプルの選択を可能にする。我々のSFTデータセットは、100万件の人手アノテーション付きサンプルと350万件の合成サンプルから構成され、後者はXu et al. [103]、Wei et al. [104]で提案された手法と同様の方法を用いて生成された。
収集した文書を事前学習コーパス内で連結し、事前に定義された系列長に従ってテキストを固定長の系列に分割する。
SFTでは、動的系列長戦略を採用しており、短いペアの末尾に|EOS|トークンを付加することで、各ミニバッチ内のすべてのサンプルにわたって系列長を均一に保つ。特筆すべきは、パディング用の|EOS|トークンが応答の一部として扱われる、すなわちマスクされ、訓練目的に含まれる点である。|EOS|トークンはサンプリング時に生成出力から除去される。この戦略により、モデルは|EOS|を生成することで応答の長さを制御することを学習し、応答長を所与のプロンプトに効果的に整合させることが可能となる。
さらに、ターンの対話については、これを個の単一ターン対話ペア、すなわちとして扱い、そのうち1つをランダムにサンプリングする。このデータ分割戦略は、LLaDAにマルチターン対話能力を与えるだけでなく、上述の|EOS|パディング戦略とも整合する。
| 私たちのARMベースライン1B | LLaDA 1B | 私たちのARMベースライン7B | LLaDA 8B | LLaMA3 8B | |
| 層数 | 22 | 22 | 28 | 32 | 32 |
| モデル次元 | 2048 | 2048 | 4096 | 4096 | 4096 |
| アテンションヘッド数 | 32 | 32 | 32 | 32 | 32 |
| 語彙サイズ | 126,464 | 126,464 | 126,464 | 126,464 | 128,000 |
| FFN次元 | 5634 | 5634 | 13,440 | 12,288 | 14,336 |
| Key/Valueヘッド数 | 4 | 4 | 8 | 32 | 8 |
| 総パラメータ数 | 1.49 B | 1.49 B | 6.83 B | 8.02 B | 8.03 B |
| 非埋め込みパラメータ数 | 0.97 B | 0.97 B | 5.80 B | 6.98 B | 6.98 B |
| ARC-C | Hellaswag | TruthfulQA | WinoGrande | GPQA | PIQA | |
| CFGなし | 45.9 | 70.5 | 46.1 | 74.8 | 25.2 | 73.6 |
| CFGあり | 47.9 | 72.5 | 46.4 | 74.8 | 26.1 | 74.4 |
B.2 モデル訓練の詳細
本節では、LLaDAおよび対応するARMベースラインの訓練の詳細を述べる。
まず、効率性のため、1.5Bパラメータを持ち同一アーキテクチャのARMとMDMをそれぞれ訓練した。加えて、MDMを8Bパラメータにスケールアップした。計算資源の制約により、同一アーキテクチャの8B自己回帰モデルは訓練しなかった。代わりに、以前に訓練した7B自己回帰モデルを比較に用いた。これら4つのモデルは、Sec. [3.1]のスケーラビリティ分析で用いられる。
我々が訓練したARMおよびMDMには、LLaMA [6] [21]に類似したTransformerアーキテクチャを採用した。具体的には、訓練を安定化させるためにRMSNorm [105]を採用し、非線形性を高めるためにSwiGLU [106]を活性化関数として使用し、より表現力の高い位置エンコーディングのためにRoPE [107]を統合した。Tab. [5]にモデルアーキテクチャの概要を示す。
1Bおよび7BのARMベースライン、ならびに1Bおよび8BのLLaDAモデルについては、重み減衰0.1のAdamWオプティマイザ[29]を利用し、Warmup-Stable-Decay [28]学習率スケジューラを採用した。学習率は最初の2000イテレーションで0から最大値まで線形に増加させ、その後一定に保った。LLaDA 8Bについては、安定した訓練を確保するため、事前学習中に学習率を1回減衰させた(詳細はSec. [2.2]を参照)。1B ARMベースラインならびに1Bおよび8BのLLaDAモデルについては、最大学習率を、バッチサイズを1280に設定し、ハイパーパラメータのチューニングは行わなかった。7B ARMベースラインについては、最大学習率を、バッチサイズを4224に設定し、いずれもグリッドサーチにより選定した。
さらに、Fig. [3]における訓練FLOPsの計算には、広く用いられているの定式化[108] [109]を採用した。ここでは非埋め込みパラメータ数を表し、は訓練トークンの総数を表す。Fig. [3]に対応する詳細な結果はTab. [18]およびTab. [19]に示す。
B.3 分類器フリーガイダンスに関するアブレーション
本節では、分類器フリーガイダンス(CFG)に関するアブレーション研究を示す。CFGに関する理論的詳細は付録[A.2]に記載されている。
簡便のため、ARC-C、HellaSwag、TruthfulQA、WinoGrande、PIQA、GPQAを含む6つの代表的なベンチマークを選定し、LLaDA 8B Baseを用いて実験を行った。各タスクについてCFGスケールをの範囲で探索し、最良の結果を報告する。Tab. [6]に示すように、CFGは一貫してLLaDAの性能を向上させる。ARMsとの公平な比較を確保するため、本論文で報告する主要な結果ではCFGを使用していないことを強調しておく。
| BBH | GSM8K | Math | HumanEval | MBPP | ||
| 自己回帰 | 38.1 | 63.1 | 23.6 | 18.3 | 33.4 | |
| L' = 2 | 37.3 | 62.6 | 25.2 | 14.6 | 33.6 | |
| L' = 4 | 40.0 | 65.7 | 26.6 | 15.9 | 36.0 | |
| L' = 8 | 42.0 | 68.2 | 27.7 | 19.5 | 39.2 | |
| L' = 32 | 45.7 | 68.6 | 29.7 | 29.9 | 37.4 | |
| Block Diffusion LLaDA | L' = 2 | 48.0 | 70.0 | 30.8 | 26.2 | 40.0 |
| L' = 4 | 48.5 | 70.3 | 31.3 | 27.4 | 38.8 | |
| L' = 8 | 48.6 | 70.2 | 30.9 | 31.1 | 39.0 | |
| L' = 32 | 48.3 | 70.3 | 31.2 | 32.3 | 40.0 | |
| Pure Diffusion | 49.7 | 70.3 | 31.4 | 35.4 | 40.0 |
| GSM8K | 数学 | HumanEval | MBPP | GPQA | MMLU-Pro | ARC-C | |
| 自己回帰 | 0 | 9.5 | 0 | 0 | 0 | 0 | 84.4 |
| ブロック拡散 | 24.6 | 23.5 | 17.1 | 21.2 | 29.3 | 32.5 | 88.1 |
| ブロック拡散 LLaDA | 77.5 | 42.2 | 46.3 | 34.2 | 31.3 | 34.8 | 85.4 |
| 純粋拡散 | 69.4 | 31.9 | 49.4 | 41.0 | 33.3 | 37.0 | 88.5 |
B.4 サンプリング戦略の詳細とアブレーション
本節では、まずLLaDAがサポートする異なるサンプリング戦略を紹介する。次に、これらのサンプリング戦略の性能を評価するためのアブレーション研究を示す。
柔軟なサンプリング戦略。Sec. 2.4のFig. 2(c)は、LLaDAの逆生成プロセスを示している。Fig. 4に示すように、逆生成プロセスに加えて、LLaDAは事前学習またはSFT段階の後に、追加の修正や再訓練を一切必要とせずに、自己回帰サンプリングおよびブロック拡散[31]サンプリングを直接サポートする。ブロック拡散サンプリングは、各ブロック内で元の逆プロセスを適用し、ブロック間では自己回帰サンプリングを適用する。元のブロック拡散プロセスでは、系列長は動的に変化する。Fig. 4(c)に示すように、LLaDAは固定長ブロック拡散戦略を採用することもでき、これを我々はブロック拡散LLaDA、別名半自己回帰リマスキングと呼ぶ。
実験設定。包括的な分析のため、LLaDA 8B BaseとLLaDA 8B Instructの両方を用いて異なるサンプリング戦略を評価する。LLaDA 8B Baseについては、Tab. 1のうち尤度推定ではなくサンプリングに基づいて評価される5つのベンチマークを使用する。LLaDA 8B Instructについては、Tab. 2の7つの指標のうち、MMLUとHellaSwagを除いたものを使用する。これらの2つのタスクはモデルに単一のトークン(すなわちA、B、C、またはD)を生成させることのみを要求するためである。すべての設定において、1サンプリングステップにつき1トークンを生成する。
| 長さ | BBH | GSM8K | Math | HumanEval | MBPP |
| ランダム再マスキング | 32.1 | 21.3 | 9.2 | 11.6 | 21.0 |
| 低信頼度再マスキング | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| 長さ | BBH | GSM8K | Math | HumanEval | MBPP |
| 256 | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| 512 | 50.4 | 70.8 | 30.9 | 32.9 | 39.2 |
| 1024 | 49.7 | 70.3 | 31.4 | 35.4 | 40.0 |
自己回帰サンプリングおよびブロック拡散サンプリングでは、|EOS|トークンが生成された時点で生成を終了する。ブロック拡散LLaDA(すなわち半自己回帰リマスキング)および純粋拡散サンプリングでは、生成長をLLaDA 8B Baseでは1024に固定し、LLaDA 8B Instructでは効率と性能のバランスを取るため{64, 256, 512}から調整した。低信頼度リマスキングは、ブロック拡散およびブロック拡散LLaDAの両方におけるブロック内拡散サンプリング、ならびに純粋拡散サンプリングに適用される。また、LLaDA 8B Baseについては異なるブロック長もテストした。LLaDA 8B Instructについては、LLaDA 8B Baseで最良の結果が得られたことから、効率性のためブロック長32のみを評価した。
さらに、LLaDA 8B Instructについては、SFTデータにおける|EOS|トークンのパディングが多いため(詳細はSec. [B.1]を参照)、純粋拡散サンプリング下ではモデル出力に占める|EOS|トークンの割合が非常に高くなることを観察した。これは生成が極端に短くなることを引き起こし、モデル性能を低下させる。この問題を軽減するため、HumanEval、MBPP、GSM8K、Math、GPQAについては、純粋拡散サンプリング中に|EOS|トークンの信頼度スコアをゼロに設定した。この調整により、生成中の|EOS|トークンの適切な比率を維持するのに役立つ。
最後に、純粋拡散サンプリングを用いて、ランダムリマスキング戦略と低信頼度リマスキング戦略の効果を分析するためのアブレーション研究を行った。効率性のため、この分析ではLLaDA 8B Baseを使用し、生成長とサンプリングステップを256に設定した。
結果。Tab. [7]に示すように、ブロック拡散サンプリングでは、ブロック長が増加するにつれて全体的な性能が向上する。さらに、Tab. [7]およびTab. [8]の両方が示すように、ブロック拡散サンプリングは一貫して自己回帰サンプリングを上回り、ブロック拡散LLaDAサンプリングは標準的なブロック拡散サンプリングをさらに改善する。最終的に、純粋拡散サンプリングが全体的に最良の性能を達成する。
加えて、Tab. [9]は、低信頼度リマスキング戦略がランダムリマスキング戦略を一貫して上回ることを示している。低信頼度リマスキングは、ARMsでデフォルトで用いられるアニーリングサンプリング法と同様に機能し、生成文の多様性を減らすことで精度を向上させると我々は仮説を立てている。
我々は、自己回帰サンプリングがLLaDA 8B Instructにとって非常に低い性能をもたらすことを発見した。これは、各SFTデータが完全な文であるため、所与の系列長に対してLLaDA 8B Instructがその長さ内で完全な文を生成しようとする傾向があるためである。対照的に、LLaDA 8B Baseはこの問題に陥らない。事前学習データが切り詰められた文書で構成されており(詳細は付録[B.1]を参照)、モデルがランダムな系列長で訓練されているためである(詳細はSec. [2.2]を参照)。その結果、短い系列長が与えられた場合、LLaDA 8B Baseは文の一部のみを生成する傾向があり、これをプレフィックスとして生成を継続することができる。
Tab. [8]においてブロック長を8に設定すると、GSM8Kスコアが77.5から78.6にさらに向上する。
B.5 生成長に関するアブレーション
本節では、生成長に関するアブレーション研究を行う。
公平性を確保するため、各設定において、サンプリングステップ数を生成長と等しく設定し、各サンプリングステップにおいてちょうど1つのトークンのみがマスクからテキストへ転送されるようにした。実験にはLLaDA 8B Baseを使用した。
表[10]に報告されているように、結果は長さのハイパーパラメータに対して敏感ではない。
B.6 標準ベンチマークと評価の詳細
本節では、使用したベンチマークを紹介し、評価プロセスの詳細を示す。
標準的なLLM[25][26]の評価慣行に従い、LLaDAを以下の4つの次元で評価する:
一般能力:MMLU [110]、BBH [111]、ARC-C [112]、Hellaswag [113]、TruthfulQA [114]、WinoGrande [115]、PIQA [116]。
数学・科学能力:GSM8K [117]、Math [118]、GPQA [119]。
コード生成:HumanEval [120]、HumanEval-FIM [121]、MBPP [122]。
中国語理解:CMMLU [123]、C-Eval [124]。
上述のすべてのベンチマークについて、LLM評価で広く採用されている評価プロセス[125]に従い、主に条件付き尤度推定と条件付き生成を用いる。具体的には、一部のベンチマークではプロンプトと複数の候補回答が与えられ、モデルは各候補の条件付き尤度を計算することを求められる。その後、最も高い尤度を持つ候補がモデルの最終回答として選択され、精度が評価指標として用いられる。残りのベンチマークでは、モデルは与えられたプロンプトに基づいて応答を生成し、完全一致やその他の関連する基準などの指標を用いて性能が評価される。
ベースモデルについては、MMLU、CMMLU、C-Eval、ARC-C、Hellaswag、TruthfulQA、WinoGrande、PIQA、GPQAに対して条件付き尤度推定を用い、残りのベンチマークは条件付き生成を用いて評価する。インストラクトモデルについては、すべてのベンチマークを条件付き生成を用いて評価する。ベースモデルについては、HumanEval-FIM指標(このフレームワークではサポートされていない)を除き、広く採用されているオープンソースの評価フレームワークであるlm-evaluation-harness [125]を使用する。ベースモデルのHumanEval-FIMおよびインストラクトモデルのすべての評価指標については、内部評価ライブラリを使用する。lm-evaluation-harnessは、我々の内部評価と比較して、Yangら[25]が報告したLLaMA3の結果からの乖離が大きいため、内部ライブラリを選択した。
| 入力長 | 出力長 | LLaDA 8B | KVキャッシュなしのLLaMA3 8B | KVキャッシュありのLLaMA3 8B |
| 512 | 512 | 17.03 | 16.70 | 16.32 |
| 1024 | 17.53 | 17.49 | 16.43 | |
| 2048 | 18.52 | 20.00 | 16.73 | |
| 1024 | 512 | 17.53 | 17.16 | 16.36 |
| 1024 | 18.01 | 18.26 | 16.41 | |
| 2048 | 19.02 | 21.39 | 16.74 |
条件付き尤度推定によって評価されるベンチマークについては、LLaDAに対して式[6]を近似するためにモンテカルロ推定を用いる。MMLU、CMMLU、C-EVALは単一トークンの尤度のみを必要とするため、これらのベンチマークでは単一のモンテカルロ推定で十分である。その他のすべてのベンチマークについては、安定した結果を得るために128個のモンテカルロサンプルで十分であることがわかった。
条件付き生成を用いて評価されるベンチマークについては、LLaDA BaseとLLaDA Instructの両方に、低信頼度リマスキング戦略を伴う純粋拡散サンプリングを適用する。LLaDA Baseでは、生成長とサンプリングステップ数の両方を1024に設定する。LLaDA Instructでは、サンプリングステップ数を回答長と等しく設定し、以下のように構成する:MMLUとHellaSwagでは3、GPQAでは64、MBPPとMMLU-Proでは256、HumanEval、GSM8K、Math、ARC-Cでは512。付録[B.4]でHumanEval、MBPP、GSM8K、Math、GPQAについて詳述しているように、LLaDA Instructではサンプリング中に|EOS|トークンの信頼度をゼロに設定する。
B.7 サンプリング効率の分析
本節では、まずサンプリング速度とメモリ消費の両方を含むLLaDAのサンプリング効率を分析する。次に、その効率をさらに改善するための潜在的な最適化について議論する。
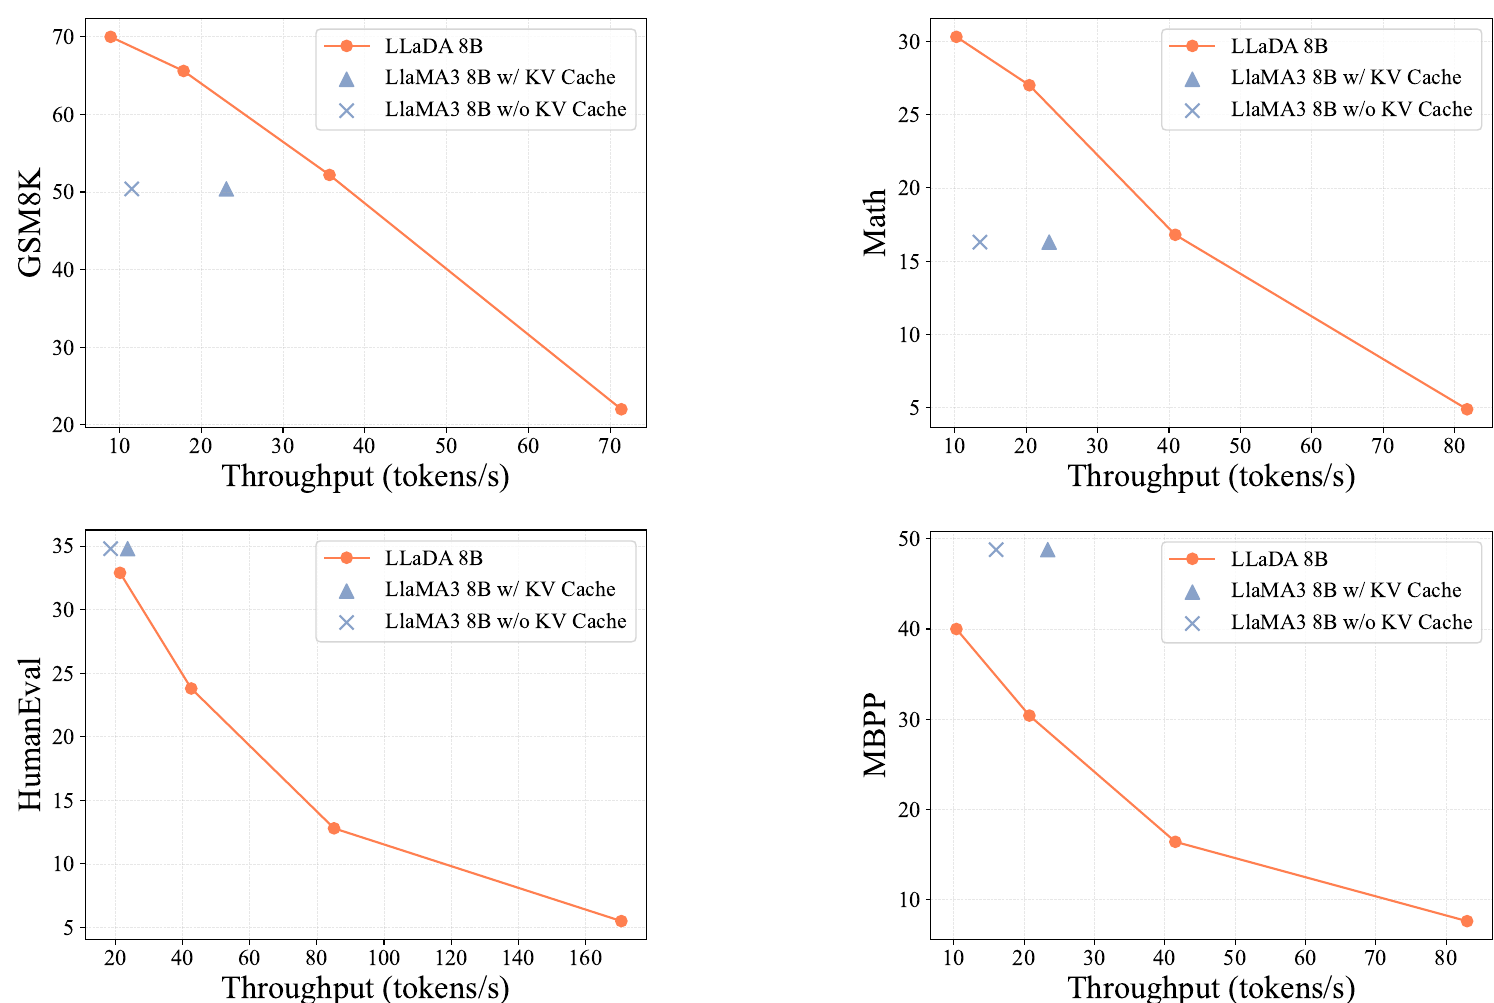
サンプリング速度の分析には、4つの代表的なオープンエンド生成ベンチマーク(GSM8K、Math、HumanEval、MBPP)を用いる。生成速度を測定するために広く採用されているスループット指標を用い、これを毎秒生成されるトークン数として定義する。LLaDA 8B BaseとLLaMA3 8B Baseを比較し、両方ともbfloat16精度を使用する。本節のすべての実験は、バッチサイズ1で単一のA100-80GB GPU上で実施した。LLaDAでは、出力長を4つのベンチマークすべてで256トークンに固定する。
図5は、LLaDAがサンプリングステップ数を調整することで、生成品質と速度の間の柔軟なトレードオフを可能にすることを示している。具体的には、GSM8KとMathデータセットにおいて、LLaDA 8B BaseはLLaMA3 8B Baseと同等の性能を達成しつつ、1.5倍および1.8倍高いスループットを実現する。これはLLaMA3がKVキャッシュを使用し、LLaDAがいかなる推論最適化技術も用いずに動作しているにもかかわらずである。HumanEvalベンチマークでは、LLaDA 8B Baseはスループットを一致させた場合にLLaMA3 8B Baseと同等の性能を発揮する。MBPPベンチマークでは、LLaDA 8B BaseはLLaMA3 8B Baseに劣る。
LLaMA3では、KVキャッシュによってもたらされる加速効果がHumanEvalデータセットで著しく弱いが、これはそのプロンプト長が比較的短いことに起因すると考えられる。具体的には、GSM8K、Math、MBPP、HumanEvalの平均プロンプト長はそれぞれ894、680、628、132トークンである。
表[1]は、LLaDA 8B BaseとLLaMA3 8B Baseのメモリ消費を比較したものである。訓練データの違いに起因する生成長の変動を避けるため、メモリ分析中は入力と出力の両方のトークン長を固定する。LLaDAでは、メモリ使用量はサンプリングステップ数に関係なく一定である。そのメモリ消費はKVキャッシュなしのLLaMA3 8B Baseに匹敵するが、KVキャッシュありの場合よりわずかに高い。
| 4ステップ | 5ステップ | 6ステップ | |
| LLaMA3 8B Base | 38.0 | 35.0 | 34.0 |
| LLaDA 8B Base | 64.0 | 41.0 | 44.0 |
本研究の目的は、ARMsよりも高速なモデルを提案することではないことを強調する。むしろ、大規模言語モデリングにおける拡散モデルの可能性を示し、スケーラビリティ、インコンテキスト学習、指示追従といったLLMの中核的能力が本質的にARMsに依存するという一般的な仮定に異議を唱えることを目指している。多数の研究[31, 79, 87]が、アルゴリズム的またはアーキテクチャ的革新を通じてMDMsの生成効率を改善することに焦点を当ててきた。同様の効率指向の探求は、LLaDAの今後の課題として残す。
B.8 iGSMデータセットでの評価
LLaDAの数学的能力をさらに評価するため、無限の合成GSM8K類似データセットであるiGSM[34]でその性能をテストする。iGSMは特定のルールによって生成され、問題の難易度(すなわち解法ステップ数)を制御するパラメータを持つ。評価の一貫性のため、GSM8K形式に従い、最終的な解答に「#### Sanswer」を付加する。以下は解法ステップ数を4に設定した例である:
(問題)North Star Elementaryの各Cultural Studies Classroomの数は1に等しい。Westridge Elementaryの各Dance Studioの数は、North Star Elementaryの各ClassroomとNorth Star Elementaryの各Cultural Studies Classroomの合計の3倍に等しい。Westridge ElementaryにはDance Studioがいくつあるか?(解答)North Star ElementaryのCultural Studies Classroomをと定義する;したがって。North Star ElementaryのClassroomをと定義する;したがって。Westridge ElementaryのDance Studioをと定義する;;したがって #### 1
GSM8KとiGSMの間には若干の違いがあるため(例:mod 5アルゴリズムシステムの使用)、[34]に従い、各問題に対してシステムプロンプトと4ショットの質問-回答ペアを提供する。
(プロンプト)あなたは加算、減算、乗算を含む初等数学の問題を解く専門家です。あなたはすべての問題を統一された形式で解きます。すべての計算はmodulo 5で行われます。例えば、は3に等しく、は1に等しく、は4に等しく、は4に等しく、は4に等しい。解答を提供する際は、'#### x.'で終わらせてください。ここでxは最終的な答えであり、0から4の間の整数です。あなたはすべての問題を同じ解答形式を用いて解かなければなりません。私たちのシナリオには最大4つのカテゴリのオブジェクトが含まれます:学校、教室、バックパック、文房具。各学校は教室を含むことができ、各教室はバックパックを含むことができ、各バックパックは文房具を含むことができる。私たちは、各Lakeshore Highのダンススタジオの数など、数量を指定することができる。同じ名前を持つすべての実体は同一の構成を持つと仮定する;例えば、各Lakeshore Highは同じ数のダンススタジオを含む。もう一つの指針は、言及されていないものは存在しないということである:Lakeshore Highの教室に言及するとき、私たちはシナリオで明示的に言及された教室のみを議論している。さらに、Lakeshore Highが全く言及されていない場合、その中の教室は自動的に存在しない(すなわち0)と見なされる。
解法ステップ数が4から6の範囲について、各ケースで100問を生成し、対応する精度を表[2]に報告する。表に示されるように、LLaDA 8B Baseは未見の数学的問題においてLLaMA3 8B Baseに対して顕著かつ一貫した優位性を示しており、表[1]の結果と一致する。
| ユーザー LLaDA | 定期的な運動には、身体的・精神的健康においてどのような利点がありますか? | ||||||||||
| 定期的な運動は | 筋肉や骨を強化し、 | 心血管の健康を改善し、 | 慢性疾患である | 糖尿病や心臓病の | リスクを減らすことで、 | 身体的健康を | 改善することが | できます。 | |||
| また、精神的健康や不安を改善し、 | 気分を向上させ、 | 認知機能を高めることもできます。 | さらに、運動は | 睡眠の質を改善し、 | エネルギーレベルを | ||||||
| 高めることができます。 | |||||||||||
B.9 詩完成タスク
本節では、詩完成データセットからの例を以下のように示す。
例1:
プロンプト:窈窕淑女的下一句是什么? 直接输出句子即可。
回答:君子好逑。
例2:
プロンプト:不拘一格降人才的上一句是什么? 直接输出句子即可。
回答:我劝天公重抖擞。
B.10 さらなるケーススタディ
本節では、LLaDA 8B Instructの追加のケーススタディを示す。まず、表[13]はブロック拡散LLaDAサンプリングのサンプリング過程を示し、表[14]はランダムリマスキングを用いたマルチターン対話のサンプリング過程を描写している。さらに、表[15]と表[16]は単一ターンおよびマルチターン対話のさらなる例を提供する。最後に、表[17]はLLaDA 8B Instructモデルが成功し、GPT-4oが失敗した詩の逆順完成の例を示している。
C 影響声明
本研究は、大規模言語モデリングにおける拡散モデルの可能性を示し、スケーラビリティ、インコンテキスト学習、指示追従といったLLMの中核的能力が本質的にARMsに依存するという一般的な仮定に異議を唱える。私たちの発見は、自然言語処理における代替の確率的パラダイムを探求する新たな道を開き、対話型AI、コード生成、複雑な推論タスクへの潜在的な応用を持つ。
しかしながら、拡散モデルは従来のLLMと同様に、同様の社会的懸念を引き起こす。これには、大規模訓練の環境への影響、有害なコンテンツ生成への潜在的な悪用、訓練データに存在するバイアスの増幅が含まれる。これらの課題への対処は、拡散言語モデルの責任ある開発と展開を確保するために極めて重要である。
表14:マルチターン対話の可視化。ランダムリマスキング戦略を採用している。LLaDAの応答では、濃い色はサンプリングの後半段階で予測されたトークンを示し、薄い色は前半の予測に対応する。
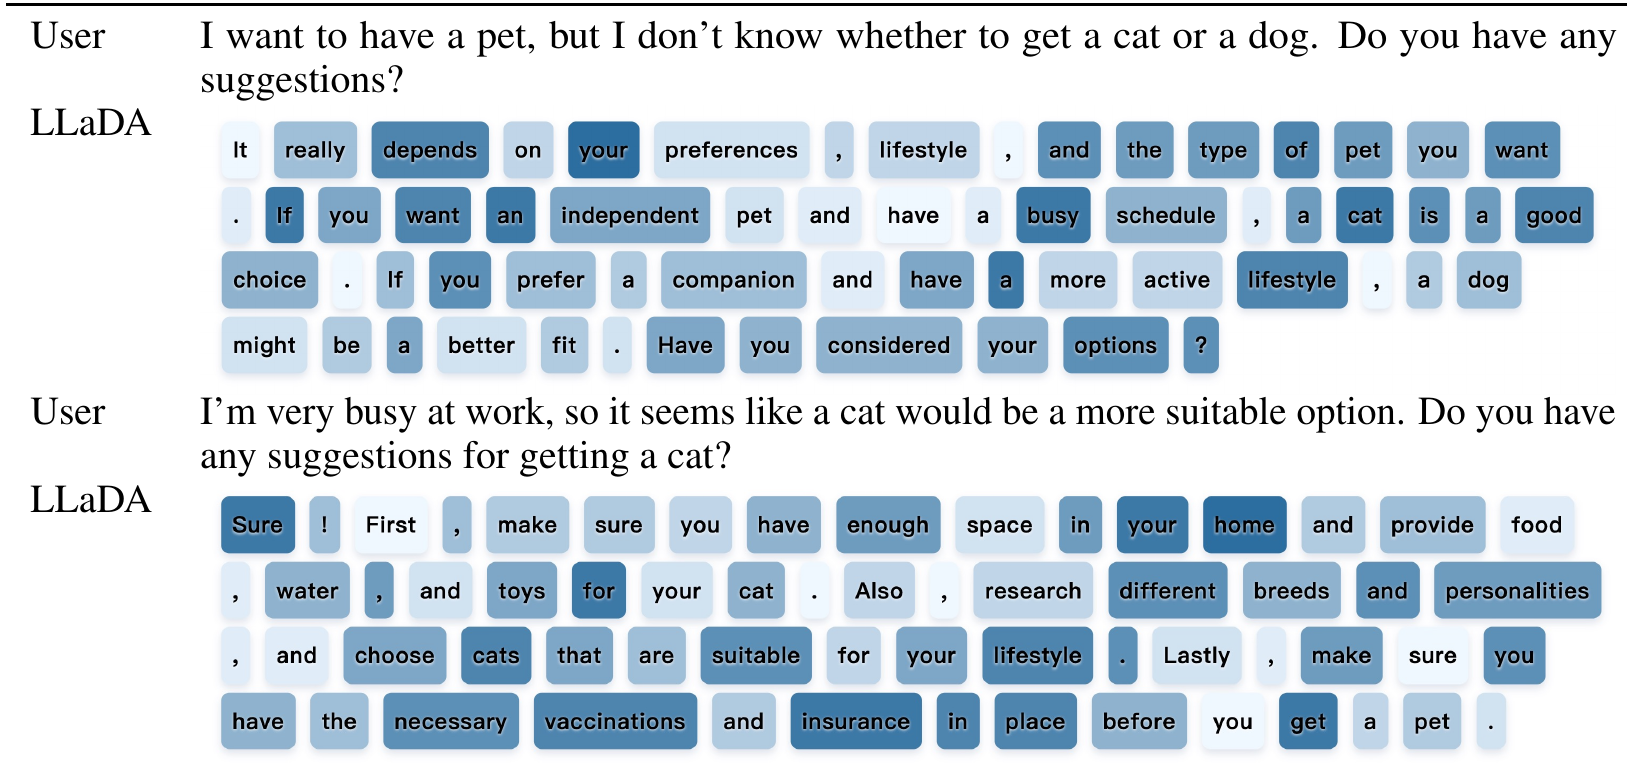
| 読み取り専用の背景情報(翻訳対象の原文テキストではありません): 表14:マルチターン対話の可視化。ランダムリマスキング戦略を採用している。LLaDAの応答では、濃い色はサンプリングの後期段階で予測されたトークンを示し、薄い色はより早期の予測に対応する。 翻訳対象テキスト: | 日常生活UserLLaDA これまでに受けたアドバイスの中で、役に立ったものは何ですか?私が受けた役に立つアドバイスの一つは、常に学びと成長に対して開かれた姿勢でいることです。新しいアイデアや経験を進んで探求することで、より回復力と適応力を持つことができました。成長マインドセットを受け入れることで、個人的にも仕事上でも、改善と発展の機会を見つけることができました。 |
| 日常生活UserLLaDA 有名な映画を3本おすすめしてください。もちろんです!広く人気を集め、批評家からも高い評価を得た有名な映画を3本ご紹介します: | 1. ショーシャンクの空に(1994年) - 中編小説に着想を得て、フランク・ダラボンが監督したこの映画は、妻を殺害した罪で有罪判決を受けたアンディ・デュフレーンが、ショーシャンク刑務所での過酷な生活に向き合い、同じ囚人との思いがけない友情を築く物語です。 2. ゴッドファーザー(1972年) - フランシス・フォード・コッポラ監督によるこの映画は、マリオ・プーゾの同名小説に基づいています。コルレオーネ一家、特に権力の座に上り詰めて一家の犯罪帝国を引き継ぐマイケル・コルレオーネの物語を追います。 3. 帝国の逆襲(1980年) - ジョージ・ルーカス監督によるこの映画は、スター・ウォーズ・サーガにおける若きスカイウォーカーの物語を続けます。ルーク・スカイウォーカーが反乱同盟軍を助けて銀河帝国と戦い、強力な兵器であるデス・スターを破壊するまでを描きます。 これらの映画はいずれも、映画芸術としての達成、力強い物語性、記憶に残る登場人物によって称賛されています。 |
| 翻訳UserLLaDA 中国語への翻訳を手伝ってください:『What is now proved was once only imagined』 现在被证明的曾经只是想象 | |
| 翻訳UserLLaDA ドイツ語への翻訳を手伝ってください:『What is now proved was once only imagined』 我把他去查查过,我其实没再问啊。 | |
| 数学UserLLaDA エマは週に5回、4本のスプリントを行うことにしました。各スプリントで75メートル走ります。彼女は週に合計何メートル走りますか? | エマは毎回4本のスプリントを行うので、週に合計4 x 5 = 20本のスプリントを行います。各スプリントは75メートルなので、エマは週に合計20 x 75 = 1500メートル走ります。最終結果は1500です。 |
| コードUserLLaDA Pythonのコードを書いています。配列があるので、大きい順から小さい順に並べ替えるのを手伝ってください。もちろんです!Pythonでは、『sort()』メソッドまたは『sorted()』関数を使って配列を大きい順から小さい順に並べ替えることができます。以下は例です: | ### 『sort()』メソッドを使う場合: my_array = [3, 1, 4, 1, 5, 2] my_array.sort(reverse=True) print(my_array) |
| 読み取り専用の背景情報(翻訳対象の原文テキストではありません): 表14:マルチターン対話の可視化。我々はランダム・リマスキング戦略を採用している。LLaDAの応答において、濃い色はサンプリングの後期段階で予測されたトークンを示し、薄い色はより早期の予測に対応する。 翻訳対象テキスト: 日常生活 | |
| ユーザー | 就職面接にはどう準備すればいいですか? |
| LLaDA | 就職面接の準備としては、企業と職務について調べ、よくある面接質問を練習し、適切な服装をすることが大切です。 |
| ユーザー | よくある面接質問にはどのようなものがありますか? |
| LLaDA | よくある面接質問には、「自己紹介をお願いします」や「なぜ当社で働きたいのですか」などがあります。 |
| 日常生活 | |
| ユーザー | プログラミングの学習はどう始めればいいですか? |
| LLaDA | プログラミングを学ぶには、まず自分が興味を持てるプログラミング言語を選ぶことから始めるとよいでしょう。人気のある言語にはPython、Java、C++などがあります。 |
| ユーザー | 最初に学ぶべきプログラミング言語はどれですか? |
| LLaDA | あなたの興味と目標によります。Pythonはその簡潔さと汎用性から、初心者にとって優れた言語です。 |
| ユーザー | Pythonを学ぶにはどのくらいかかりますか? |
| LLaDA | Pythonを学ぶには、数週間から数か月かかることがあります。 |
| ユーザー | 初心者向けの良いPythonプロジェクトにはどのようなものがありますか? |
| LLaDA | 初心者向けの良いPythonプロジェクトには、簡単な電卓、ゲーム、Webアプリケーションの作成などがあります。 |
| 数学 | |
| ユーザー | Nataliaは4月に48人の友人にクリップを売り、その後5月にはその半分の数のクリップを売りました。Nataliaは4月と5月に合わせて何個のクリップを売りましたか? |
| LLaDA | Nataliaは4月に48人の友人にクリップを売りました。5月にはその半分の数のクリップを売ったので、5月には48/2 = 24個のクリップを売りました。合わせて、Nataliaは4月と5月に48 + 24 = 72個のクリップを売りました。最終結果は72です。 |
| ユーザー | Nataliaは6月に5月の3倍の数の商品を売りました。Nataliaはこの3か月間に合わせて何個のクリップを売りましたか? |
| LLaDA | Nataliaは4月に48人の友人にクリップを売りました。5月にはその半分の数のクリップを売ったので、5月には48/2 = 24個のクリップを売りました。Nataliaは6月に5月の3倍の数の商品を売ったので、6月には24 * 3 = 72個のクリップを売りました。合わせて、Nataliaはこの3か月間に48 + 24 + 72 = 144個のクリップを売りました。最終結果は144です。 |
| 理解用の読み取り専用背景(翻訳対象の原文ではない): | |
| 表14:マルチターン対話の可視化。我々はランダム・リマスキング戦略を採用している。LLaDAの応答では、濃い色はサンプリングの後半段階で予測されたトークンを示し、薄い色はより早い段階の予測に対応する。 | 翻訳対象のテキスト: |
| 質問1 | ユーザー |
| 「但聞人語響」の前の一句は何ですか? | GPT-4o |
| 「但聞人語響」の前の一句は「無可奈何花落去」であり、この二句は唐代の詞人李清照の(武陵春、晩春:無可奈何花落去、但聞人語響)に由来する。この詞は春の時節における作者の孤独と感傷を表し、花が散ることと言語の声の描写を通じて、詞人の内心の無念と失落を反映している。 | |
| LLaDA | 「但聞人語響」の前の一句は「空山不見人」である。 |
| 質問2 | ユーザー |
| 「夜静春山空」の前の一句は何ですか? | GPT-4o |
| モデル | 学習トークン数 | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| LLaDA 1B | 37.75B | 2.20e20 | 25.52 | 25.95 | 25.17 | 59.41 | 1.82 | 0.00 |
| LLaDA 1B | 88.08B | 5.13e20 | 27.11 | 26.52 | 26.96 | 61.86 | 3.03 | 1.83 |
| LLaDA 1B | 138.41B | 8.06e20 | 29.32 | 27.13 | 30.20 | 63.38 | 2.35 | 0.00 |
| LLaDA 1B | 239.08B | 1.39e21 | 31.48 | 30.77 | 27.99 | 63.11 | 3.26 | 1.22 |
| LLaDA 1B | 352.32B | 2.05e21 | 35.86 | 34.35 | 31.31 | 65.34 | 3.64 | 3.05 |
| LLaDA 1B | 461.37B | 2.69e21 | 31.86 | 30.98 | 30.12 | 65.51 | 2.35 | 0.61 |
| LLaDA 8B | 62.91B | 2.63e21 | 32.22 | 28.5 | 30.20 | 63.82 | 3.87 | 2.44 |
| LLaDA 8B | 125.83B | 5.27e21 | 33.39 | 33.9 | 34.64 | 66.54 | 8.72 | 3.66 |
| LLaDA 8B | 251.66B | 1.05e22 | 42.84 | 40.59 | 40.10 | 69.04 | 15.31 | 3.66 |
| LLaDA 8B | 377.49B | 1.58e22 | 45.11 | 43.99 | 39.25 | 68.61 | 25.40 | 9.76 |
| LLaDA 8B | 503.32B | 2.11e22 | 43.57 | 41.38 | 42.06 | 70.24 | 27.52 | 9.76 |
| LLaDA 8B | 629.14B | 2.63e22 | 48.80 | 47.13 | 42.24 | 72.09 | 30.10 | 12.80 |
| LLaDA 8B | 679.48B | 2.85e22 | 49.61 | 48.19 | 41.30 | 70.84 | 26.31 | 8.54 |
| LLaDA 8B | 792.72B | 3.31e22 | 50.88 | 49.01 | 42.58 | 70.51 | 31.99 | 6.10 |
| LLaDA 8B | 981.47B | 4.11e22 | 49.47 | 48.10 | 40.27 | 71.38 | - | 6.10 |
| LLaDA 8B | 1107.30B | 4.64e22 | 51.13 | 47.57 | 41.13 | 69.26 | 36.69 | 10.37 |
| LLaDA 8B | 1233.13B | 5.16e22 | 50.52 | 49.72 | 45.05 | 71.49 | 38.97 | 9.76 |
| LLaDA 8B | 1358.95B | 5.69e22 | 54.61 | 53.97 | 49.40 | 74.05 | 48.14 | 17.68 |
| LLaDA 8B | 1547.70B | 6.48e22 | 57.38 | 56.04 | 49.49 | 74.59 | 53.30 | 20.73 |
| LLaDA 8B | 1975.52B | 8.27e22 | 58.52 | 57.87 | 50.68 | 75.35 | - | 19.51 |
| モデル | 学習トークン数 | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| ARM 1B | 37.75B | 2.20e20 | 25.47 | 25.38 | 30.20 | 67.36 | 2.20 | 4.88 |
| ARM 1B | 88.08B | 5.13e20 | 24.67 | 25.23 | 33.96 | 70.02 | 7.51 | 10.37 |
| ARM 1B | 138.41B | 8.06e20 | 29.25 | 27.48 | 33.45 | 70.29 | 8.34 | 9.76 |
| ARM 7B | 17.30B | 6.02e20 | 26.92 | 25.18 | 21.02 | 57.18 | 1.29 | 1.22 |
| ARM 7B | 34.60B | 1.20e21 | 25.83 | 25.38 | 24.07 | 62.84 | 1.59 | 2.44 |
| ARM 7B | 86.50B | 3.01e21 | 24.41 | 24.90 | 25.42 | 71.11 | 2.88 | 7.93 |
| ARM 7B | 173.02B | 6.02e21 | 26.20 | 24.78 | 26.10 | 74.27 | 6.67 | 9.15 |
| ARM 7B | 207.62B | 7.23e21 | 30.36 | 28.86 | 31.86 | 74.48 | 8.57 | 12.80 |
| ARM 7B | 224.92B | 7.83e21 | 29.49 | 32.26 | 31.19 | 74.37 | 8.95 | 8.54 |
| ARM 7B | 242.22B | 8.43e21 | 33.62 | 31.38 | 34.92 | 75.41 | 10.84 | 9.15 |
| ARM 7B | 259.52B | 9.03e21 | 34.11 | 34.20 | 32.88 | 75.19 | 9.33 | 10.98 |
| ARM 7B | 311.43B | 1.08e22 | 35.66 | 35.49 | 36.61 | 75.14 | 11.30 | 10.37 |
| ARM 7B | 363.33B | 1.26e22 | 34.54 | 37.67 | 34.58 | 76.55 | 12.28 | 14.02 |
| ARM 7B | 415.24B | 1.45e22 | 35.37 | 38.37 | 35.25 | 76.39 | 14.40 | 12.80 |
| ARM 7B | 449.84B | 1.57e22 | 39.51 | 39.24 | 34.92 | 76.82 | 14.94 | 14.63 |
| ARM 7B | 519.09B | 1.81e22 | 40.30 | 40.69 | 37.29 | 77.15 | 14.03 | 14.63 |
| ARM 7B | 778.57B | 2.71e22 | 43.33 | 43.50 | 38.31 | 77.53 | 17.59 | 14.63 |
| ARM 7B | 1038.09B | 3.61e22 | 45.06 | 46.12 | 41.69 | 77.86 | 20.02 | 15.85 |
| ARM 7B | 1384.12B | 4.82e22 | 47.63 | 48.18 | 47.80 | 76.93 | 22.82 | 15.24 |
| ARM 7B | 2076.18B | 7.23e22 | 47.68 | 50.85 | 44.07 | 77.37 | 24.79 | 14.63 |
| ARM 7B | 2214.59B | 7.71e22 | 49.26 | 52.08 | 53.56 | 77.69 | 27.37 | 17.07 |