
同じプロンプトを上万回サンプリングすると被覆率は伸び続け、検証器が正解に変える。2024年の論文、全文無料。
Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
大規模言語モンキー:繰り返しサンプリングによる推論計算のスケーリング
Bradley Brown\†‡、Jordan Juravsky\†、Ryan Ehrlich\*†、Ronald Clark‡、Quoc V. Le§、Christopher Ré†、Azalia Mirhoseini†§
†スタンフォード大学コンピュータサイエンス学科 ‡オックスフォード大学 §Google DeepMind
bradley.brown@cs.ox.ac.uk、jbj@stanford.edu、ryanehrlich@stanford.edu、ronald.clark@cs.ox.ac.uk、qvl@google.com、chrismre@stanford.edu、azalia@stanford.edu
概要
言語モデルの訓練に用いる計算量をスケーリングすることで、その能力は劇的に向上してきた。しかし、推論に関しては、モデルに問題への試行を一度しか許さないことが多い。本稿では、モデルから候補解を繰り返しサンプリングするという単純な手法を用いて、スケーリングのもう一つの軸としての推論計算を探求する。複数のタスクとモデルにわたって、カバレッジ——生成されたいずれかのサンプルによって解かれる問題の割合——が、サンプル数の4桁にわたる範囲でスケールすることを観察した。興味深いことに、カバレッジとサンプル数の関係はしばしば対数線形であり、指数化されたべき乗則でモデル化できることから、推論時スケーリング則の存在が示唆される。コーディングや形式証明のように解答を自動検証できる領域では、このカバレッジの増加はそのまま性能の向上につながる。繰り返しサンプリングをSWE-bench Liteに適用すると、DeepSeek-Coder-V2-Instructで解決されるイシューの割合は、1サンプルでの15.9%から250サンプルでの56%に増加し、単一サンプルの最先端である43%を上回った。自動検証器のない領域では、サンプル集合から選択する一般的な手法(多数決投票や報酬モデル)は数百サンプルを超えると頭打ちになり、サンプル予算に十分にスケールしないことがわかった。
1 はじめに
大規模言語モデル(LLM)がコーディング、数学、その他の推論タスクを解く能力は、過去数年間で劇的に向上してきた[47, 11, 2, 4]。より大きなモデル、より長い事前訓練、より大きなデータセットを通じて訓練計算量をスケーリングすることが、これらの向上の一貫した原動力となってきた[27, 37, 28]。
対照的に、推論時に用いる計算量のスケーリングには、比較的限られた投資しかなされてこなかった。より大きなモデルはより小さなモデルよりも多くの推論計算を必要とし、思考の連鎖(chain-of-thought)[61]のようなプロンプティング手法は、より長い(したがって計算コストの高い)出力と引き換えに回答品質を高めることができる。しかし、LLMと対話する際、ユーザーや開発者はしばしばモデルに問題を解く際の試行を一度だけに制限する。
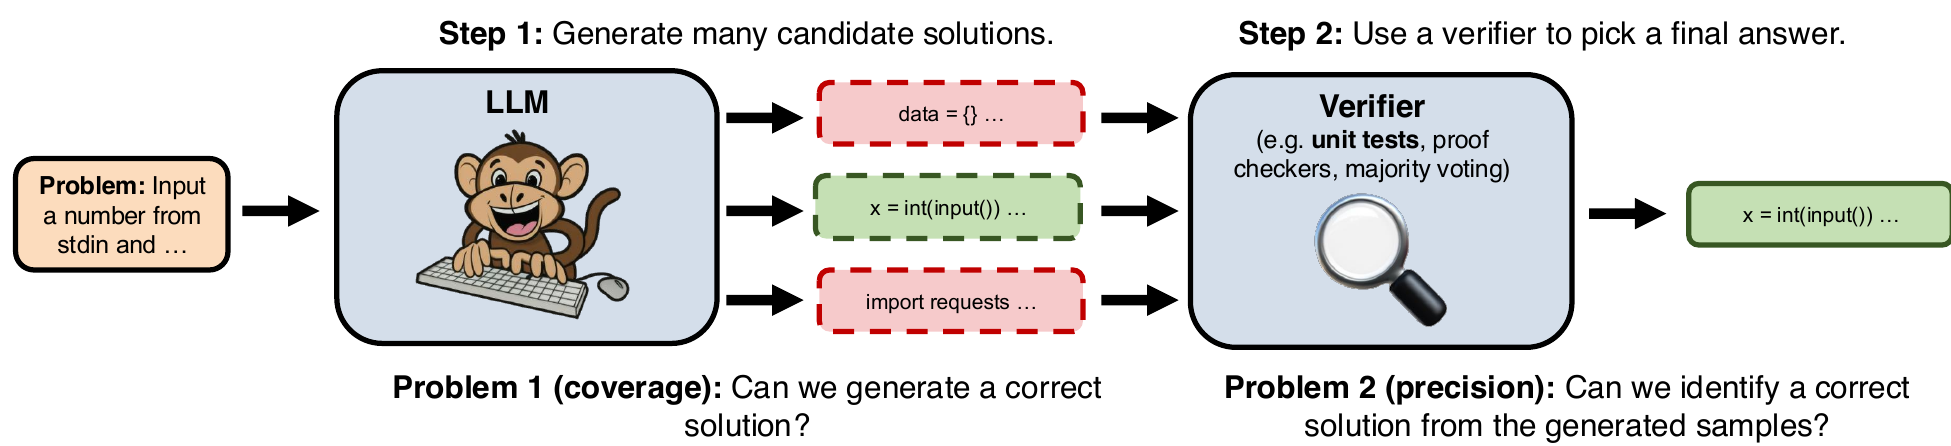
本研究では、推論性能を向上させるために推論計算をスケーリングする単純なアプローチとして、繰り返しサンプリング(図1)を探求する。既存の研究は、繰り返しサンプリングが数学、コーディング、パズル解決の設定で有益でありうるという励みになる例を提供している[60, 48, 23]。特筆すべきは、競技プログラミングの最先端システムであるAlphaCode [41]が、問題あたり100万サンプルでも性能が向上し続けることを見出していることである。我々の目標は、これらの利点をさまざまなタスク、モデル、サンプル予算にわたって体系的に特徴づけることである。
繰り返しサンプリングの有効性は、2つの重要な性質によって決まる:
1. カバレッジ:サンプル数が増えるにつれて、生成されたいずれかのサンプルを用いて解くことができる問題の割合はどのくらいか?
2. 精度:生成の集合から正しいサンプルをどれだけの頻度で特定できるか?
両方の性質が、強い実世界性能を達成するために必要である。無制限のサンプルがあれば、すべての系列に非ゼロの確率を割り当てるあらゆるモデルは完全なカバレッジを達成する。しかし、繰り返しサンプリングが実用的であるのは、実行可能な予算でカバレッジを改善できる場合のみである。同様に、大規模なサンプル集合を生成することは、その集合の中の正しいサンプルを特定できる場合にのみ有用である。精度問題の難しさはタスクによって異なりうる。一部の設定では、証明チェッカーや単体テストのような既存のツールがすべてのサンプルを自動的に検証できる。文章題を解く場合のような他のケースでは、検証のための他の手法が必要となる。
まずカバレッジを探求すると、問題あたり最大10,000回のサンプリングが数学およびコーディングタスクのカバレッジを大幅に向上させうることを見出した(第2節)。Gemma-2B [52]を用いてCodeContests [41]のプログラミング問題を解く際、カバレッジを300倍以上、1サンプルでの0.02%から10,000サンプルでの7.1%へと増加させた。興味深いことに、log(カバレッジ)とサンプル数の関係はしばしば近似的なべき乗則に従う(第3節)。Llama-3 [3]およびGemmaモデルでは、これによりカバレッジがサンプル数の数桁にわたってほぼ対数線形に増加する。
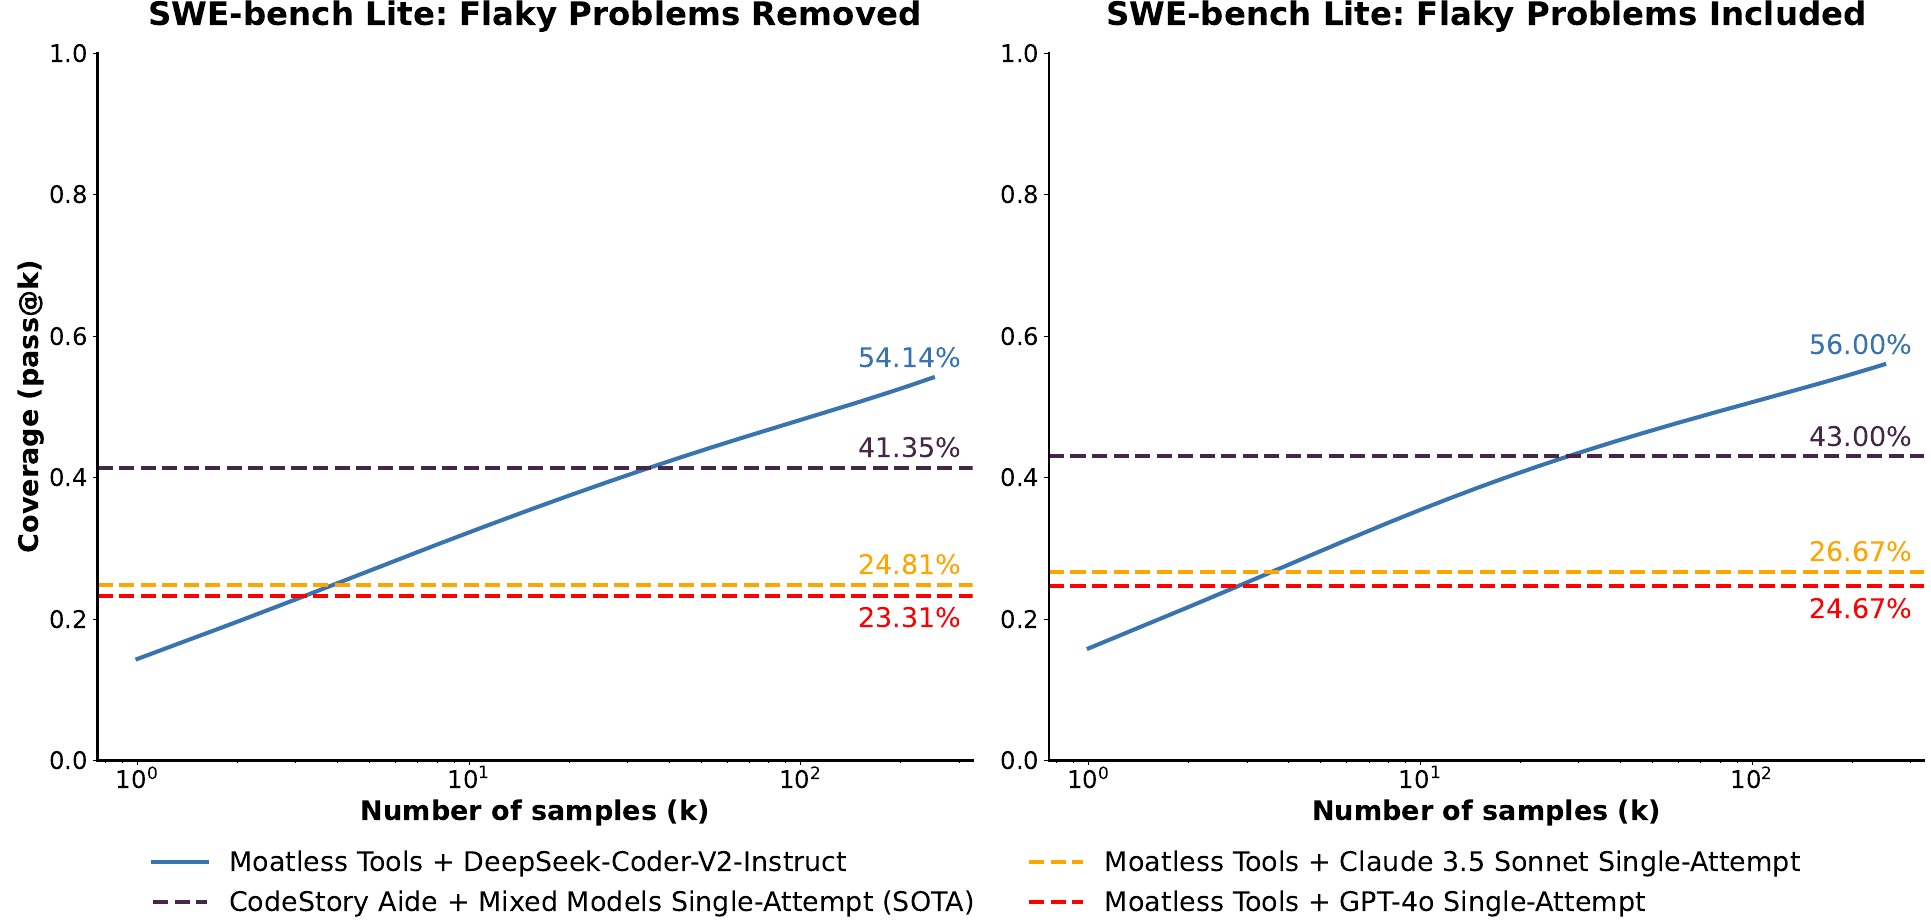
自動検証ツールのある設定では、カバレッジの増加はそのままタスク性能の向上につながる。繰り返しサンプリングを競技プログラミングやLean証明の記述に適用すると、Llama-3-8B-InstructのようなモデルがGPT-4o [2]のようなはるかに強力なモデルの単一サンプル性能を超えることができる。この弱いモデルを増幅する能力は、実際のGitHubイシューの困難なSWE-bench Liteデータセット[32]にも及ぶ。そこでは、GPT-4oとClaude 3.5 Sonnetの混合によって達成された現在の単一サンプル最先端(SOTA)は43%である[1]。単一サンプルに制限すると、DeepSeek-Coder-V2-Instruct [20]はイシューのわずか15.9%を解く。サンプル数を250に増やすだけで、解決されるイシューの割合は56%に増加し、最先端を13%上回る。
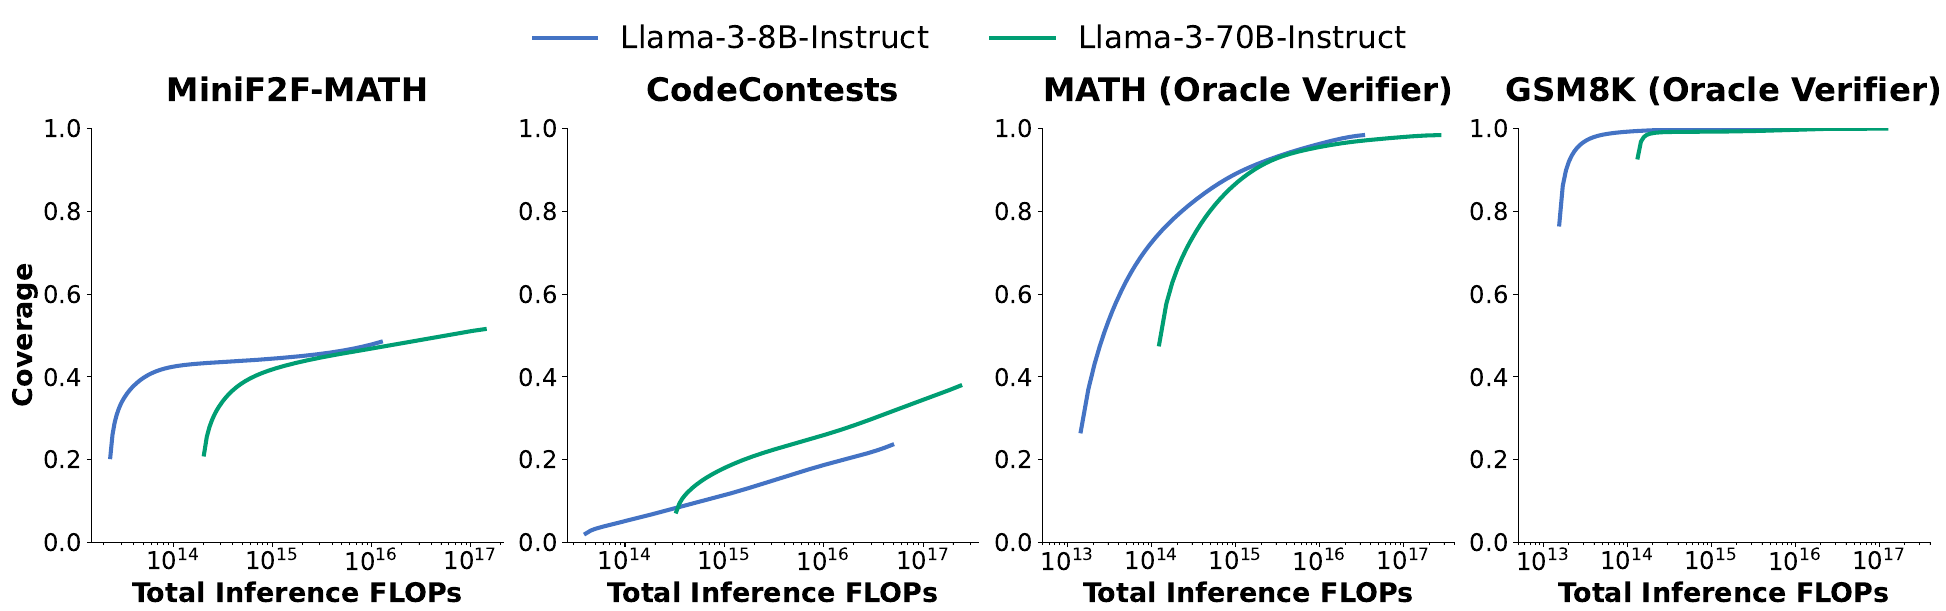
モデル品質の向上に加えて、繰り返しサンプリングはLLM推論コストを最小化する新たなメカニズムを提供する(第2.3節)。推論FLOPの総数を一定に保つと、一部のデータセット(例:MATH)ではカバレッジはより小さなモデルとより多くのサンプルで最大化される一方、他のデータセット(例:CodeContests)ではより大きなモデルからより少ない回数サンプリングする方が良いことがわかった。また、SWE-bench Liteのイシューを解く文脈で、DeepSeek-Coder-V2-Instruct、GPT-4o、Claude Sonnet 3.5のAPI価格を比較する。エージェントフレームワーク(Moatless Tools [67])を一定に保つと、より弱く安価なDeepSeekモデルから5回サンプリングする方が、ClaudeやGPTからの単一サンプルよりも多くのイシューを解き、かつ3倍以上安価である。
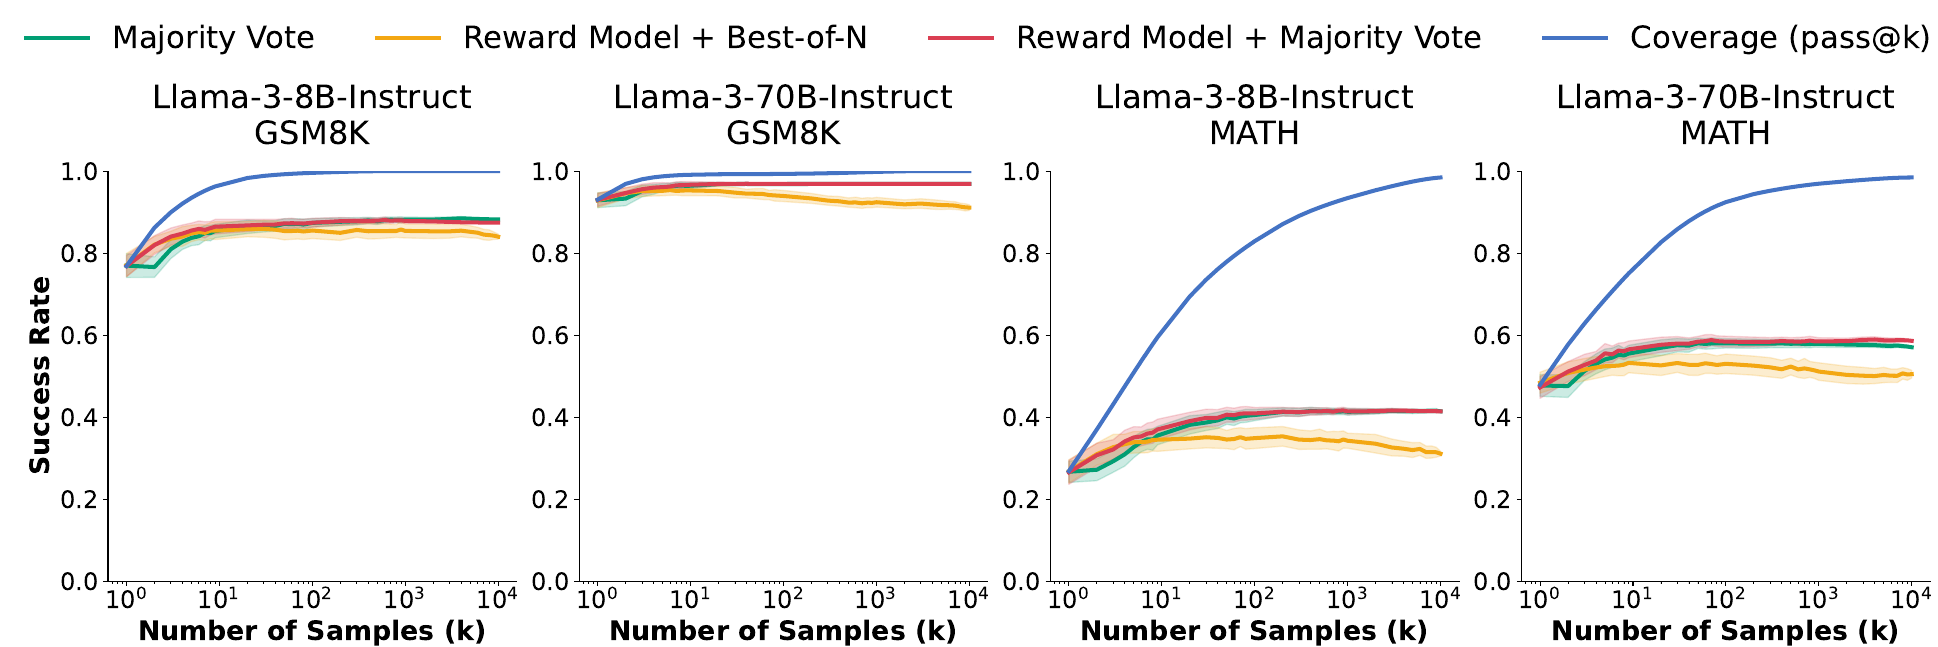
最後に、繰り返しサンプリングから完全に利益を得るにはスケーラブルな検証が必要であることを示す。サンプル数が増えるにつれて、カバレッジはモデルが以前に解けなかった問題への正しい解を生成することによって向上する。しかし、これらのますます稀になる正しい生成は、検証器が「干し草の山の中の針を見つける」ことができ、ほとんどが不正解のサンプル集合からそれらを特定できる場合にのみ有益である。数学文章題の設定では、検証のための2つの一般的な手法(多数決投票と報酬モデル)がこの能力を持たないことを見出した。Llama-3-8B-InstructでMATH [26]の問題を解く際、カバレッジは100サンプルでの82.9%から10,000サンプルでの98.44%に増加する。しかし、最終回答を選択するために多数決投票や報酬モデルを用いる場合、同じサンプル範囲にわたる最大の性能向上はわずか40.50%から41.41%である。サンプル数が増えるにつれて、カバレッジ(すなわち完全な検証器での性能)とこれらの手法の性能との間のギャップも増大する(図[7]。
要約すると、我々の主な観察は以下の通りである:
1. 繰り返しサンプリングを通じて推論計算をスケーリングすることが、さまざまなタスクとモデルにわたってカバレッジの大幅な改善をもたらすことを示す。これにより、弱いモデルを多くのサンプルで増幅し、より有能なモデルからの単一サンプルを上回ることが可能となり、時には費用対効果も高くなる。
2. カバレッジとサンプル数の関係は、しばしば指数べき乗則を用いてモデル化できることを示す。これは、推論時計算量に対するスケーリング則の一形態を示唆するものである。
3. 自動検証器のない領域では、一般的な検証手法は約100サンプルを超えると頭打ちになることを示す。このため、これらの手法で達成される性能とカバレッジの上限との間のギャップが拡大する。
2 反復サンプリングのスケーリング
我々は、候補解が正しいか誤りかで採点できる合否タスクに焦点を当てる。これらのタスクで主要な関心となる指標は成功率である。すなわち、解くことのできる問題の割合である。反復サンプリングでは、モデルが問題を解こうとする際に多数の候補解を生成できる設定を考える。したがって成功率は、多くの問題に対して正しいサンプルを生成する能力(すなわちカバレッジ)と、それらの正しいサンプルを特定する能力(すなわち精度)の両方によって影響を受ける。
精度の問題の難しさは、サンプル検証のためのツールが利用可能かどうかに依存する。Leanで形式命題を証明する場合、証明チェッカーは候補解が正しいかどうかを迅速に判定できる。同様に、単体テストを用いてコーディングタスクの候補解を検証できる。これらの場合、精度は自動的に処理され、カバレッジの改善は直接的に成功率の向上へとつながる。対照的に、GSM8KやMATHの数学文章題に対する解を検証するために利用可能なツールは限られており、多数の(しばしば互いに矛盾する)サンプルから単一の最終回答を決定する追加の検証手法が必要となる。
我々は以下の5つのタスクを考える:
1. GSM8K:小学校レベルの数学文章題のデータセット[18]。GSM8Kテストセットからランダムに選んだ128問の部分集合で評価する。
2. MATH:一般にGSM8Kの問題より難しい数学文章題の別のデータセット[13]。同様に、このデータセットのテストセットからランダムに選んだ128問で評価する。
3. MiniF2F-MATH:証明検査言語に形式化された数学問題のデータセット[65]。言語としてLean4を用い、MATHデータセットから形式化された130問のテストセット問題で評価する。
4. CodeContests:競技プログラミング問題のデータセット[41]。各問題にはテキストによる説明と、候補解の正しさを検証するために使用できる一連の入出力テストケース(モデルには非公開)が付属する。モデルはPython3を用いて解を記述することを強制する。
5. SWE-bench Lite:現実世界のGithub issueのデータセットであり、各問題は説明とコードリポジトリのスナップショットからなる[32]。問題を解くには、モデルはコードベース内のファイルを編集しなければならない(我々が用いるSWE-benchのLiteサブセットでは、変更が必要なファイルは1つだけである)。候補解は、リポジトリの単体テストスイートを用いて自動的にチェックできる。
これらのタスクのうち、MiniF2F-MATH、CodeContests、SWE-bench Liteには自動検証器がある(それぞれLean4証明チェッカー、テストケース、単体テストスイートの形で)。まず、反復サンプリングがモデルのカバレッジをどのように改善するかを調査する。カバレッジの改善は、自動検証器を持つタスクでは成功率の向上と直接対応し、一般の場合には成功率の上限を与える。コーディング設定では、我々のカバレッジの定義は、一般に用いられるpass@k指標[15]と等価である。ここでは問題あたりのサンプル数を表す。CodeContestsとSWE-bench Liteの評価では、この指標を直接用いる。MiniF2Fでは指標は同様であり、「合格」はLean4証明チェッカーに従って定義される。GSM8KとMATHでは、カバレッジは、いずれかのサンプルが正しい最終回答を出力して「合格」するかどうかをチェックするオラクル検証器を用いることに対応する。カバレッジ計算時の分散を低減するため、Chenら[15]の不偏推定式を採用する。各実験では、まず各問題インデックスに対して個のサンプルを生成し、正しいサンプル数を計算する。次に、関心のある各についてのpass@kスコアを以下に従って計算する:
我々はChenら[15]が提案した上記の式の数値的に安定な実装を用いる。データとコードは https://scalingintelligence.stanford.edu/pubs/large_language_monkeys/ で入手可能である。
2.1 反復サンプリングはタスクを問わず有効である
ここでは、反復サンプリングが複数のタスクおよびさまざまなサンプル予算にわたってカバレッジを改善することを確立する。Llama-3-8B-InstructとLlama-3-70B-InstructをCodeContests、MiniF2F、GSM8K、MATHで評価し、各問題につき10,000個の独立なサンプルを生成する。SWE-bench Liteでは、このタスクに必要なコンテキスト長がLlama-3モデルの限界を超えるため、DeepSeek-Coder-V2-Instruct[20]を用いる。SWE-benchのissueを解く際の標準として、我々はLLMにコードベースのナビゲートと編集のためのツールを提供するソフトウェアフレームワークを装備する。
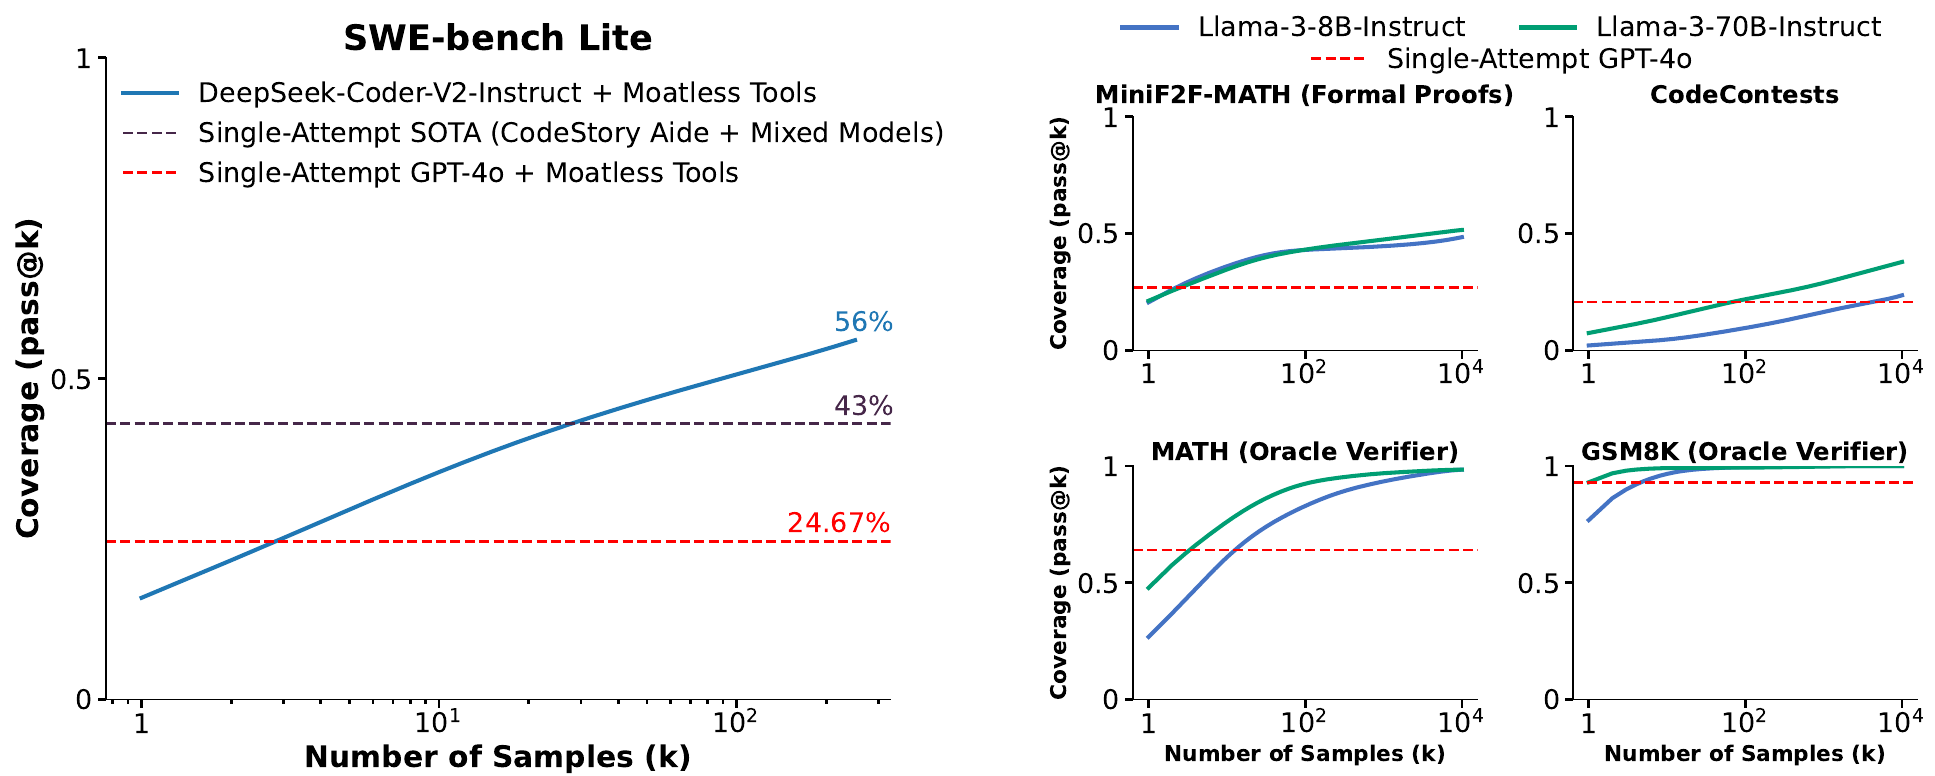
本研究では、オープンソースのMoatless Toolsライブラリ[67]を用いる。なお、SWE-benchのissueを解くことは、LLMとMoatless Toolsとの間のやり取りを含む。このベンチマークにおける1サンプル/試行とは、1つのマルチターン軌跡全体を指す。コストを最小化するため、issueあたりの試行回数を250に制限し、すべての試行は互いに独立に行う。
結果を図2に報告する。また、各タスクにおけるGPT-4oの単一試行性能、およびSWE-bench Liteにおける単一試行の最先端(GPT-4oとClaude 3.5 Sonnetの組み合わせを用いるCodeStory Aide 1)も併せて記載する。5つのタスクすべてにおいて、サンプル予算が増加するにつれてカバレッジが滑らかに改善することを見出した。すべてのLLMに単一の試行を与えた場合、GPT-4oはすべてのタスクでLlamaおよびDeepSeekモデルを上回る。しかし、サンプル数が増加するにつれて、3つのより弱いモデルすべてがGPT-4oの単一試行性能を超える。SWE-bench Liteの場合、我々は問題のを解き、単一試行の最先端であるを上回る。
2.2 反復サンプリングはモデルサイズおよびファミリーを問わず有効である
第2.1節の結果は、反復サンプリングがカバレッジを改善することを示している。しかし、この傾向は8B以上のパラメータを持つ最近のinstruction-tunedモデル3つのみで示したにすぎない。ここでは、これらの傾向が他のモデルサイズ、ファミリー、およびポストトレーニングのレベルにおいても成り立つことを示す。評価をより広範なモデル集合に拡張する:
- Llama 3:Llama-3-8B、Llama-3-8B-Instruct、Llama-3-70B-Instruct。
- Gemma:Gemma-2B、Gemma-7B [52]。
- Pythia:Pythia-70MからPythia-12Bまで(合計8モデル)[9]。
推論コストを最小化するため、評価をMATHおよびCodeContestsデータセットに限定し、結果を図3に報告する。テストしたほぼすべてのモデルでカバレッジが増加し、小さいモデルでは反復サンプリングを適用した際にカバレッジの最も急激な増加の一部が見られる。CodeContestsでは、Gemma-2Bのカバレッジが倍以上増加し、pass@1のから
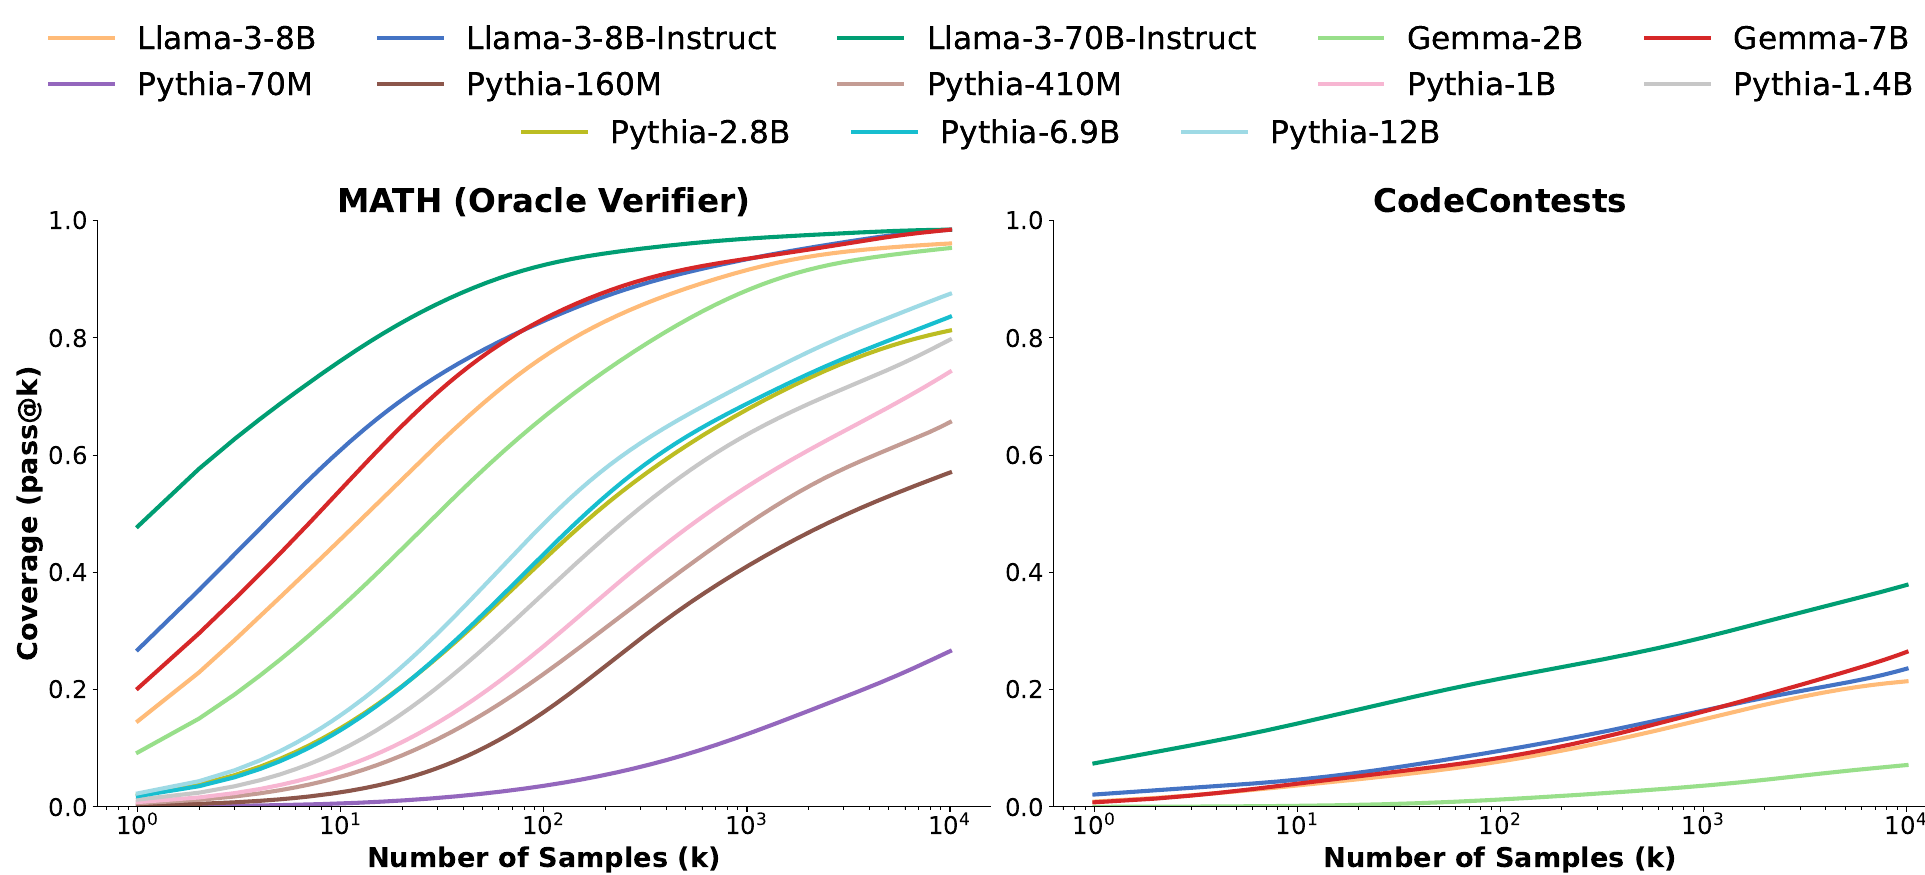
pass@10kのになる。同様に、Pythia-160MでMATH問題を解く場合、カバレッジはpass@1のからpass@10kのに増加する。
モデル間でカバレッジが増加するこのパターンの例外は、CodeContestsで評価したPythiaファミリーである。すべてのPythiaモデルは、10,000サンプルの予算でもこのデータセットでゼロのカバレッジとなる。これは、PythiaがLlamaやGemmaよりもコーディングに特化したデータで訓練されていないためであると推測する。
2.3 反復サンプリングは性能とコストのバランスに役立ちうる
第2.1節および第2.2節の結果からの一つの示唆は、反復サンプリングによってより弱いモデルの能力を増幅し、より強いモデルの単一サンプルを上回ることが可能になるということである。ここでは、この増幅が、より強く高価なモデルを用いるよりもコスト効率が良い場合があることを示し、実務者に性能とコストを同時に最適化しようとする際の新たな自由度を提供する。
まず、コスト指標としてFLOPsを考え、第2.1節のLlama-3の結果を検討する。図2の結果を、サンプル予算の代わりに総推論FLOPsの関数としてカバレッジを可視化して再プロットする。Llama-3モデルはパラメータの大部分が行列積に用いられる密なトランスフォーマーであるため、推論FLOPsを次の式で近似する:
図4に、MiniF2F、CodeContests、MATH、GSM8Kに対する再スケーリングした結果を示す。興味深いことに、カバレッジを最大化するモデルは計算予算とタスクによって異なる。MiniF2F、GSM8K、および
| モデル | 試行あたりのコスト(USD) | 試行回数 | 解決した問題(%) | 総コスト(USD) | 相対総コスト |
| DeepSeek-Coder-V2-Instruct | 0.0072 | 5 | 29.62 | 10.8 | 1x |
| GPT-4o | 0.13 | 1 | 24.00 | 39 | 3.6x |
| Claude 3.5 Sonnet | 0.17 | 1 | 26.70 | 51 | 4.7x |
表1: Moatless Toolsエージェントフレームワークを用いたSWE-bench Liteデータセット上での、各種モデルのAPIコスト(米ドル)と性能の比較。より多くサンプリングすれば、オープンソースのDeepSeek-Coder-V2-Instructモデルは、クローズドソースのフロンティアモデルと同じ問題解決率を3分の1以下の価格で達成できる。MATHでは、FLOP予算を固定した場合、Llama-3-8B-Instructはより大規模(かつ高価)な70Bモデルよりも常に高いカバレッジを得る。しかしCodeContestsでは、70Bモデルの方がほぼ常に費用対効果が高い。FLOPsのみを検討することは、システム効率の他の側面を無視する粗いコスト指標になり得ることに留意する[21]。特に、反復サンプリングは大きなバッチサイズや特殊な最適化を活用でき、単一試行の推論ワークロードと比較してシステムスループットを向上させる[34][6][66]。これについてはセクション[5]でより詳しく議論する。
また、現在のAPI価格を用いてSWE-bench Liteの問題を解く際の反復サンプリングのドルコストについても検討する。エージェントフレームワーク(Moatless Tools)を固定したまま、Claude 3.5 SonnetとGPT-4oによる問題ごとの単一試行、ならびにDeepSeek-Coder-V2-Instructを用いた反復サンプリングを考える。各手法の問題あたりの平均コストと問題解決率を表[1]に報告する。DeepSeekモデルはGPTおよびClaudeモデルよりも弱いが、10倍以上安価でもある。この場合、反復サンプリングは、優れた問題解決率を達成しつつ、強力なモデルへのアクセスに割増料金を支払うよりも安価な代替手段を提供する。
3 繰り返しサンプリングの利点の特徴付け
LLMの損失とその学習計算量の関係は、学習スケーリング則によってよく特徴付けられてきた[27][36][28]。これらの法則は経験的に何桁もの範囲にわたって成立しており、モデル開発者に大規模な学習への投資が報われるという確信を与えている。学習スケーリング則に着想を得て、ここではカバレッジとサンプル予算(すなわち推論計算量)の関係をよりよく特徴付けることを目指し、二つの興味深い観察を提示する:
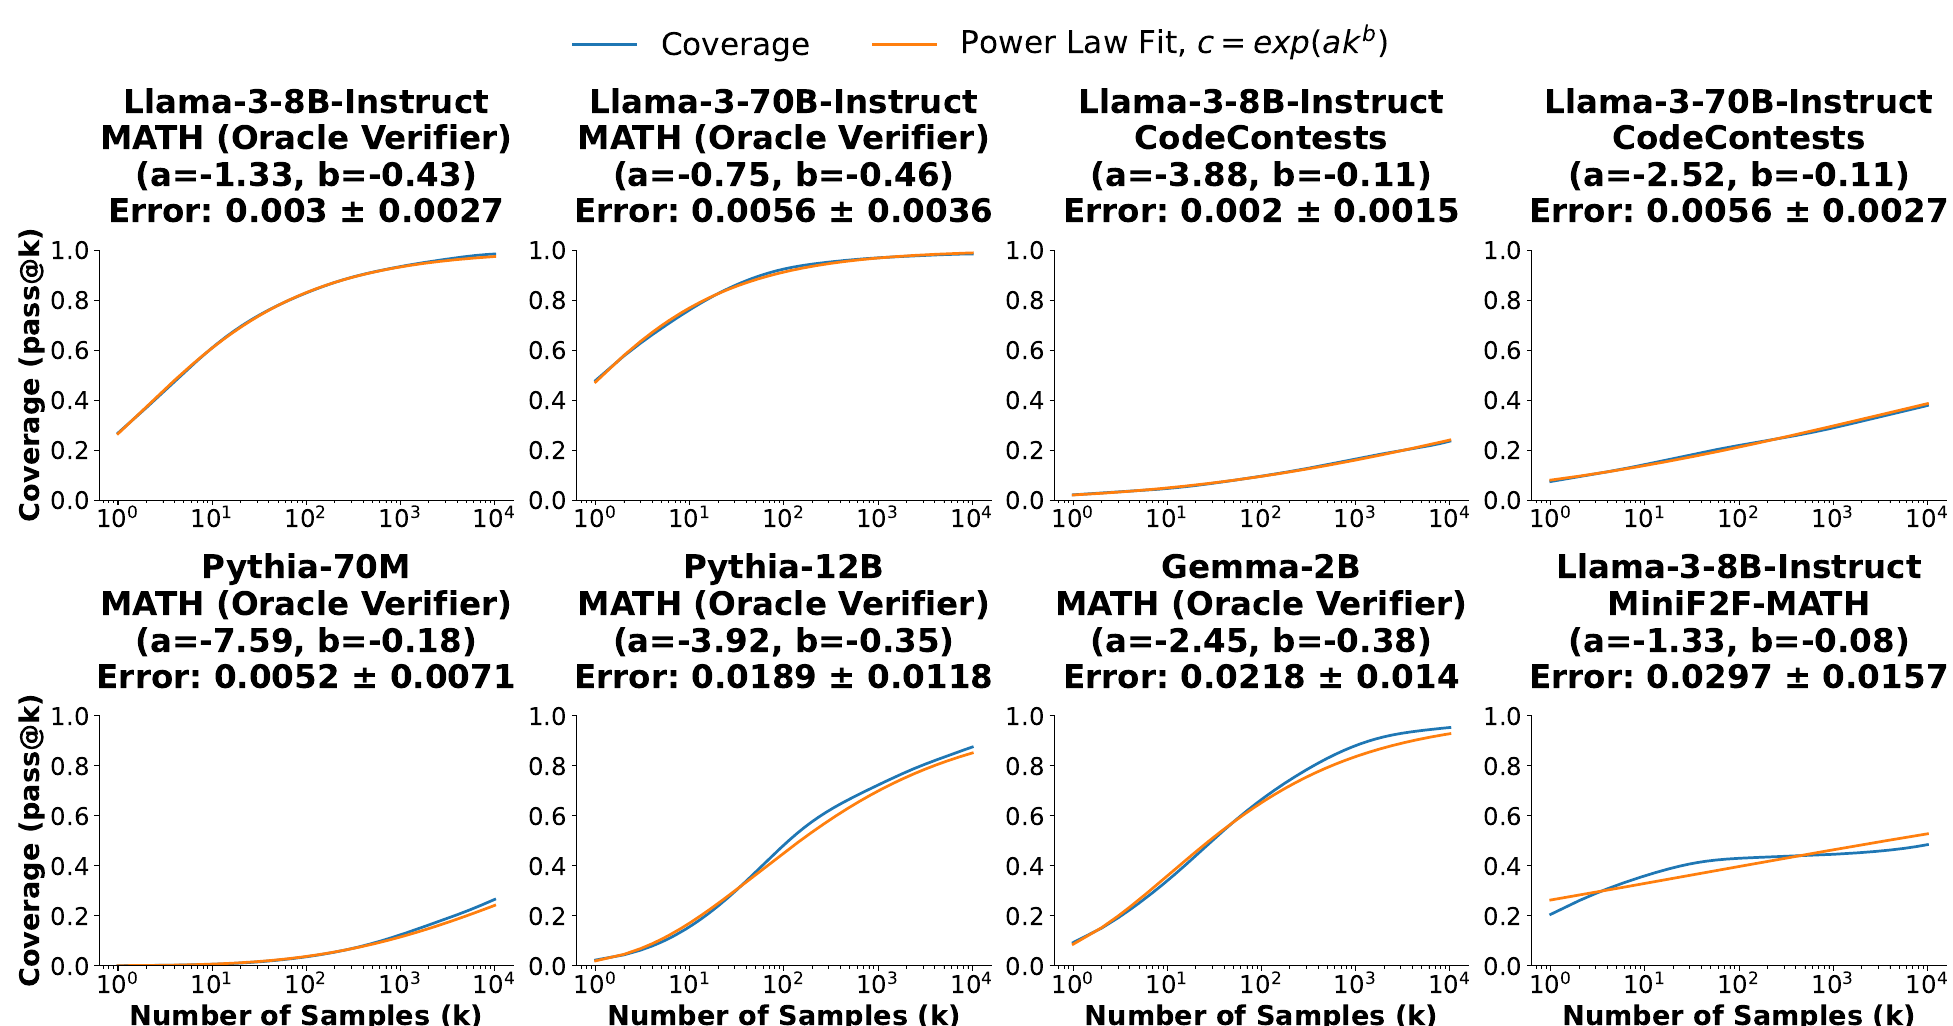
1. カバレッジとサンプル数の関係は、しばしば指数化べき乗則でモデル化できる。
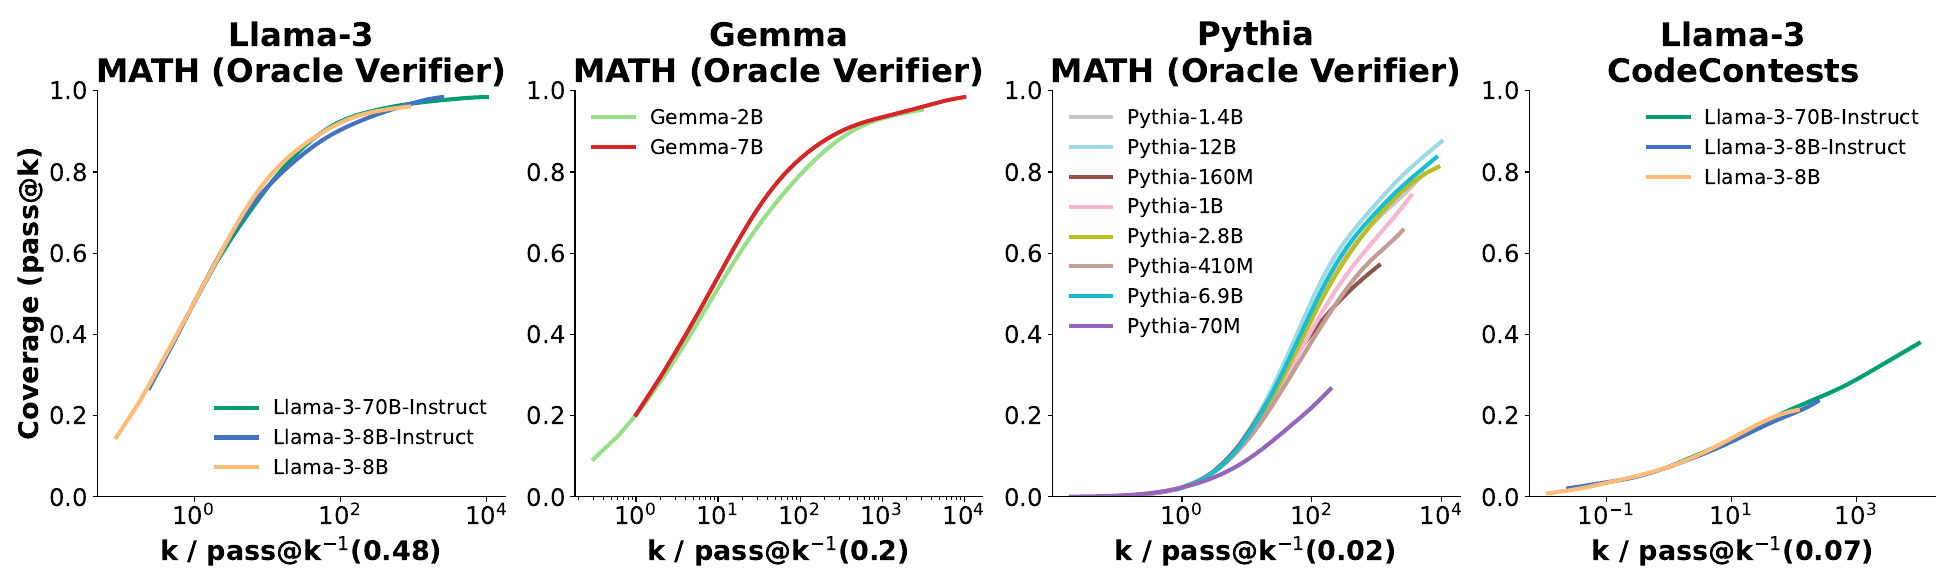
2. 与えられたタスクに対して、同一ファミリーの異なるモデルのカバレッジ曲線は、類似した傾きを持つが水平方向のオフセットが異なるS字曲線に似ている。
3.1 繰り返しサンプリングのためのスケーリング則
ここでは、カバレッジとサンプル数の関係についての明示的なモデルを構築する。GPT-4のテクニカルレポート[46]は、コーディング問題におけるモデルの平均log pass rateとその学習計算量の関係が、べき乗則を用いてよくモデル化できることを見出している。我々はまず同じ関数クラスを採用するが、今度はカバレッジの対数をサンプル数の関数としてモデル化する:
ここではフィッティングされたモデルパラメータである。カバレッジを直接予測するために、両辺の指数をとり、最終的なモデルは次のようになる:
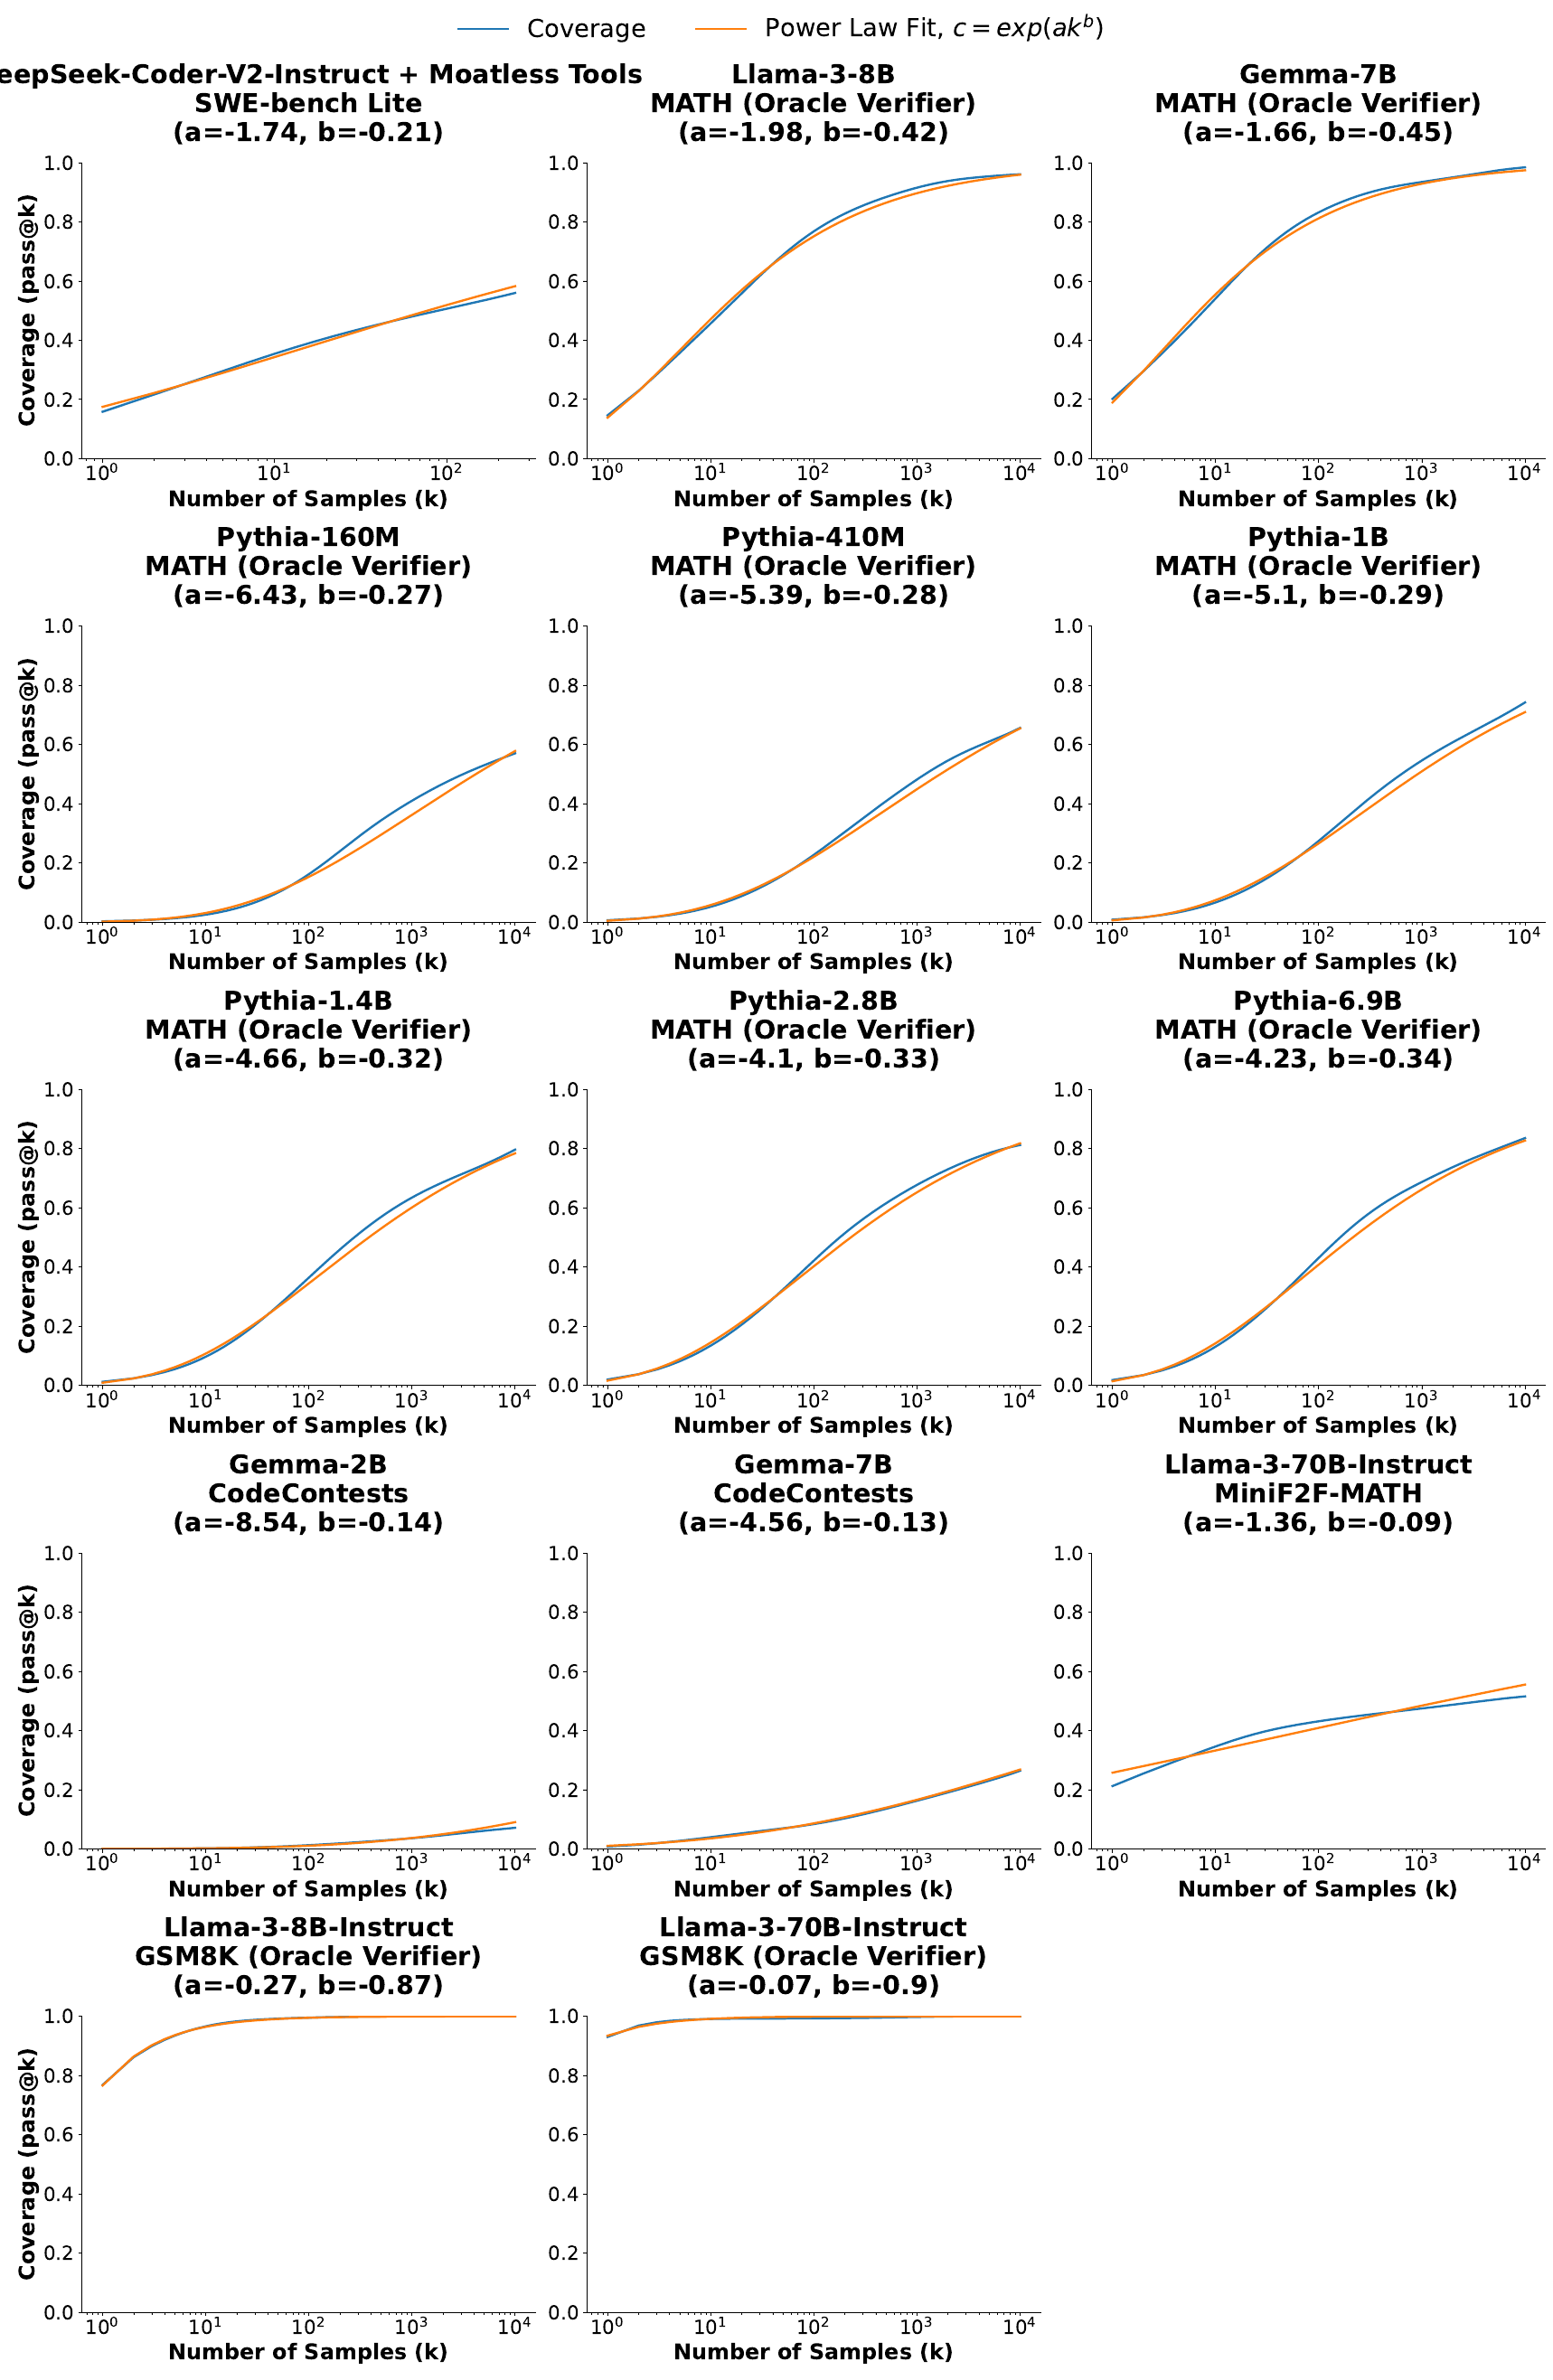
フィッティングされたカバレッジ曲線の例を図[5]に、追加の曲線を付録[C.2]に示す。これらの法則は学習スケーリング則ほど厳密ではないが(最も顕著にはMiniF2F-MATHにおいて)、推論スケーリングの利点を特徴付けることができるという有望な初期の証拠を提供している。
3.2 モデル間におけるカバレッジ曲線の類似性
興味深いことに、同一ファミリーの異なるモデルの同一タスクにおけるカバレッジ曲線(x軸を対数としたもの)を比較すると(図[3]参照)、描かれるS字曲線は同じ傾きを持つが、水平方向のオフセットがそれぞれ固有であるように見える。これをさらに調べるため、図[6]において同一ファミリーの異なるモデルのカバレッジ曲線を重ね合わせる。これは、アンカーとなるカバレッジ値を選び、各曲線を(対数空間において)左方向にシフトして、すべてが点を通るようにすることで行う。これは、
\(-\log (\mathrm{pass}@k^{- 1}(c))\) だけの左方向へのシフトに対応する。ここで\(\mathrm{pass}@k^{- 1}(c)\)は\(\mathrm{pass}@k = c\)となる最も近い自然数\(k\)を表す。\(c\)としては、同一ファミリーのすべてのモデルにわたる最大のpass@1スコアを選ぶ。これらの類似性は、同一ファミリーのモデル間において、カバレッジを\(c\)から\(c'\)へ改善するために必要なlogサンプル予算の増加(あるいは等価的に、サンプル予算の乗法的な増加)がほぼ一定であることを示している。
4 繰り返しサンプリングの活用には精度が必要
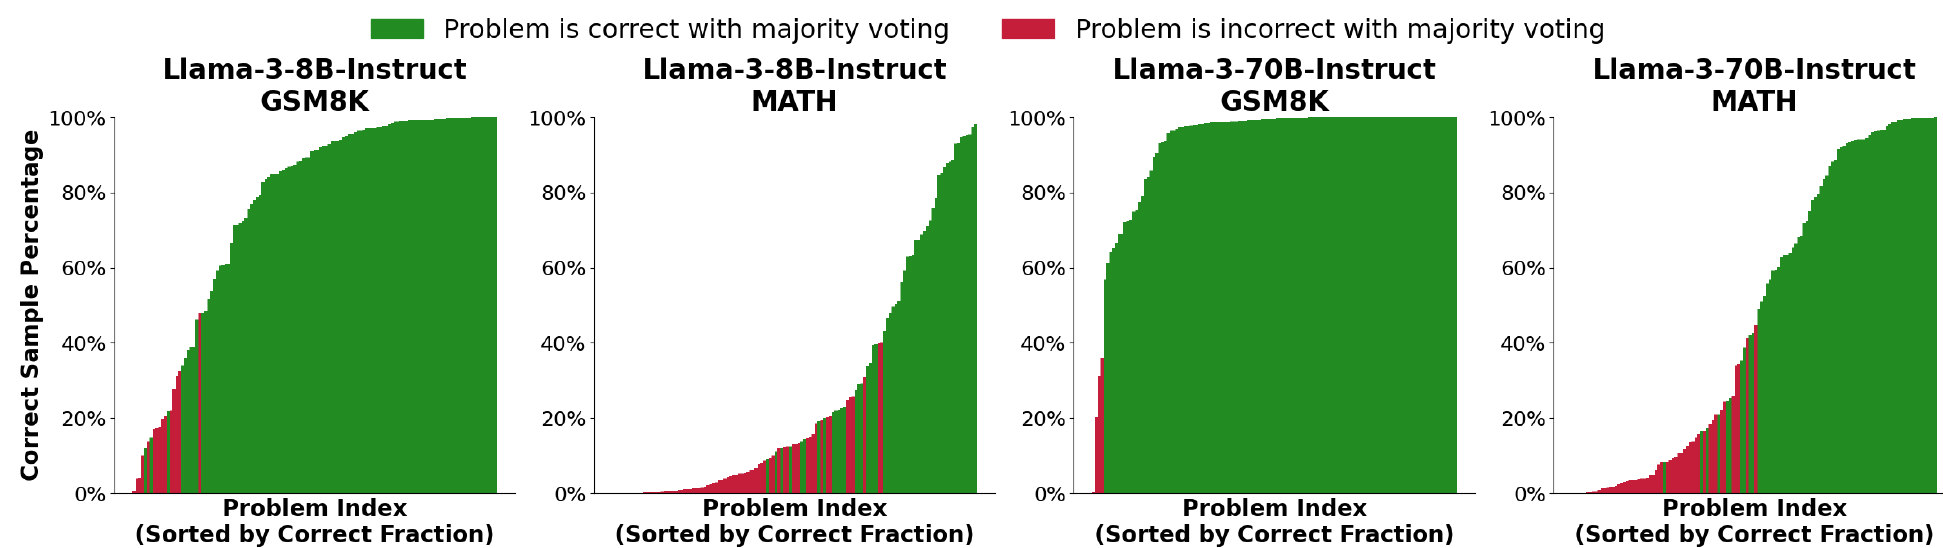
これまで我々は、モデルのカバレッジの測定に焦点を当て、常に正しいモデルサンプルを特定できるというシナリオの下での繰り返しサンプリングの利点を特徴付けてきた。ここで我々は、補完的な問題である精度へと目を向ける:モデルサンプルの集合が与えられたとき、正しいものをどのくらいの頻度で特定できるだろうか?特に、サンプル数を増やしていくにつれての検証器の性能に我々は関心がある。いくつかの問題では、正しい解はモデルから低い確率(例えば以下、図8参照)でサンプリングされる。サンプル数が増加し、まれな正しい解がより多くの問題に対して生成されるにつれて、モデルのカバレッジは改善する。これらのカバレッジの改善をより高い成功率へと変換するためには、検証器が「干し草の山の中の針」を見つけ出し、頻度の低い正しいサンプルを特定できなければならない。
4.1 一般的な検証手法は必ずしもサンプル予算に応じてスケールしない
我々が評価する五つのタスクのうち、解を自動的に検証するためのツールを欠いているのはGSM8KとMATHのみである。我々は、これらのデータセットから正しい解を特定する能力について、三つの単純で一般的に用いられる検証アプローチをテストする:
1. 多数決:最も一般的な最終回答を選ぶ[60]。
2. 報酬モデル+Best-of-N:報酬モデル[17]を用いて各解をスコアリングし、最もスコアの高いサンプルの回答を選ぶ。
3. 報酬モデル+多数決:各サンプルをその報酬モデルスコアで重み付けした多数決を計算する。
我々は、セクション2においてLlama-3-8B-InstructおよびLlama-3-70B-Instructで生成した10,000サンプルの集合を再利用する。報酬モデルとしてはArmoRM-Llama3-8B-v0.1[57]を用いる。これはRewardBenchリーダーボード[39]の推論セクションにおいて高いスコアを獲得している。サンプル数を増やしていくにつれての結果を図7に報告する。三つの手法すべてにおいて、成功率は当初はサンプル数とともに増加するが、およそ100サンプルで頭打ちになる。一方、カバレッジはサンプル数とともに増加し続け、最終的には95%を超える。多数決の場合、この成功率の飽和は直感的に理解できる。なぜなら、まれな正しい解の出現は、多数決が選ぶ最も一般的な回答には影響を与えないからである。
これらの検証器(特に報酬モデル)の性能が低いことを踏まえると、候補解を検証することがどれほど「難しい」のかと疑問に思うのはもっともである。GSM8KとMATHでは、正しさの評価にはサンプルの最終回答のみが用いられ、中間の思考連鎖は破棄される。もしモデルが正しい最終回答を推測する前に無意味な思考連鎖しか生成しないのであれば、検証は問題を最初から解くことよりも容易ではないかもしれない。我々はこの問いを、GSM8K問題に対する正しいLlama-3-8B-Instructサンプルから105個の思考連鎖を手動で評価することによって調査し、その結果を表2に報告する。我々が採点した思考連鎖のうち90%以上が忠実であることを見出した。それは正しい回答がまれにしか生成されない問題においてさえもである。これらの正しい推論ステップは、正しいサンプルを特定する際に検証器が活用できるシグナルが存在することを示している。興味深いことに、この過程で我々は、誤った正解を持つGSM8K問題を一つ特定した(付録E参照)。この誤ったGSM8K問題はまた、Llama-3-70B-Instructが10,000回の試行にわたって「正しい」サンプルを生成しなかった唯一の問題でもある。
| Pass@1 | 問題数 | CoT採点済み | 正しいCoT | 誤ったCoT | 誤った正解データ |
| 0-10% | 5 | 15 | 11 | 1 | 1問題、3 CoT |
| 10-25% | 10 | 30 | 27 | 3 | 0問題 |
| 25-75% | 29 | 30 | 28 | 2 | 0問題 |
| 75-100% | 84 | 30 | 30 | 0 | 0問題 |
表2:GSM8K問題に対するLlama-3-8B-Instructの回答における思考連鎖推論の妥当性に関する人間による評価。問題ごとに3つの思考連鎖を採点した。モデルがサンプルのわずか10%以下しか正解しないような難しい問題においてさえ、CoTはほとんど常に妥当な論理ステップを踏んでいる。モデルの生成と人間のラベルについては、こちらを参照されたい。
4.2 検証器とソフトウェアタスク:二つの警告的な事例
ソフトウェア開発タスクは、利用可能な検証ツールに関して中間的な位置を占めることができる。一方では、コードを実行しテストする能力により、非構造化言語タスクで可能なよりも高度な自動検証が可能となる。しかしながら、ユニットテストのようなツールはコードの一部を検証するのにブラックボックス的なアプローチをとり、証明チェッカーのような手法ほど包括的ではない。検証プロセスにおけるこれらの不完全性は、繰り返しサンプリングを適用する際に考慮することが重要な偽陽性および/または偽陰性をもたらす可能性がある。以下では、セクション2.1の結果を生成する際に我々が遭遇した
ソフトウェア検証器の不完全性の二つの例を示す。
4.2.1 SWE-bench Liteにおけるフレーキーテスト
SWE-bench Liteにおける結果を生成する際に、我々は11.3%の問題が、同じ候補解に対して実行したときに一貫した結果を生成しないフレーキーなテストスイートを持つことを特定した。これらのフレーキーテストは、データセットの正解となる問題解決策でさえも誤りと分類することがある。さらに、いくつかの問題のテストスイートは、候補解に依存して非決定論的になりうる。例えば、二つのSWE-bench Liteの問題は、本質的に順序のないPythonの集合を操作することを含んでいる。これらの問題のゴールド解は集合の要素を明示的に順序付けしており、テストスイートを確実に通過する。しかしながら、一部のモデル生成候補解はそのような順序付けを課さないため、ある「幸運な」実行ではテストを通過するが、そうでない実行もある。付録Bにおいて、我々がフレーキーテストを特定したすべての問題IDを列挙する。また、問題のある問題を除去した図2のSWE-bench Liteの結果も報告し、データセット全体での評価と同様の結果を見出している。
4.2.2 CodeContestsにおける偽陰性
CodeContestsデータセットの各問題には、解の正しさを評価するために用いられる入出力テストケースの集合が付属している。これらのテストケースは、APPS[25]のような初期のコーディングベンチマークのものよりも包括的であり、すべてのテストケースを通過するが記述された問題を完全には解かない偽陽性解の頻度を削減している。しかしながら、CodeContestsのテストスイートの構築は、正しいにもかかわらずテストに失敗する偽陰性解を生じさせる。
CodeContestsの一部の問題では、問題文が特定のテスト入力に対して複数の異なる正しい出力を許容している。しかし、対応するテストケースはそのようなシナリオを扱っておらず、代わりに特定の1つの正しい出力を要求している。さらに、多くのCodeContestsのテストケースは、問題の元のテストケースを変異させることによってプログラム的に生成されている。一部の変異した入力は問題の入力仕様に違反している(例えば、問題文が正の整数を約束しているにもかかわらず、変異した入力がゼロになっているなど)。これらの不正な形式のテストケースは、異なる正しい解法間で一貫性のない挙動を引き起こす可能性がある。
我々は、CodeContestsが提供する正しい解法のリストに対して各問題のテストスイートを実行することで、これらの問題の蔓延度を評価する。テストセット内のPython3の解法を持つ122問のうち、35問が対応するテストに失敗する「正しい」解法を持つことを発見した。我々はモデルが問題のすべてのテストケース(およびその特異性)を閲覧することを許可していないため、これらの問題に繰り返しサンプリングを適用することには、正しいだけでなくテストを通過する特定の出力を生成するための「サイコロを振る」要素が含まれる。
5 議論と限界
本研究では、モデル性能を向上させるために、推論時の計算量をスケーリングする軸として繰り返しサンプリングを探求する。様々なモデルとタスクにわたって、繰り返しサンプリングは生成されたいずれかのサンプルを用いて解かれる問題の割合(すなわちカバレッジ)を大幅に改善できる。正しい解法を特定できる場合(自動検証ツールまたは他の検証アルゴリズムのいずれかを用いて)、繰り返しサンプリングは推論時にモデルの能力を増幅できる。この増幅により、弱いモデルと多くのサンプルの組み合わせが、より強い高コストのモデルからのより少ない試行を使用するよりも、高性能かつコスト効率が良くなる可能性がある。
繰り返しサンプリングの改善:我々の実験では、問題へのすべての試行がまったく同じプロンプトとハイパーパラメータを用いて互いに独立に生成される、繰り返しサンプリングの単純なバージョンのみを探求する。我々はこの設定が性能を向上させるために洗練されうると考えており、特に以下の方向性に沿って改善できると考える:
1. 解法の多様性:我々は現在、サンプル間の多様性を生み出す唯一のメカニズムとして正のサンプリング温度に依存している。このトークンレベルのサンプリングを他の高レベルのアプローチと組み合わせることで、多様性をさらに高められる可能性がある。例えば、AlphaCodeは異なるサンプルを異なるメタデータタグで条件付けしている。
2. マルチターン相互作用:CodeContestsやMiniF2Fの問題を解く際に自動検証ツールが利用可能であるにもかかわらず、我々はモデルが解法を反復的に改善する能力なしに生成するシングルターン設定のみを使用している。これらのツールからの実行フィードバックをモデルに提供することで、解法の品質が向上するはずである。各試行はより高コストになるが、成功する可能性も高まるため、我々はマルチターン相互作用に関連するトレードオフに興味がある。
3. 過去の試行からの学習:現在、我々の実験では各試行を完全に互いに分離している。既存のサンプルへのアクセス、特に検証ツールがそれらに対してフィードバックを提供できる場合には、将来の試行を生成する際に有用である可能性がある。
反復サンプリングと推論システム:反復サンプリングは、チャットボットのリクエストを処理するのとは異なるLLM推論ワークロードである。実運用のチャットボット展開では低い応答レイテンシが重視され、レイテンシ目標を遵守することでデバイスあたりのバッチサイズを小さくせざるを得ず、ハードウェア利用率が低下する可能性がある。対照的に、単一のプロンプトに対して多数の補完をサンプリングする場合には、全体のスループットとハードウェア利用率の最大化により大きな重点を置くことができる。さらに、反復サンプリングは、シーケンス間でのプロンプトの重複を活用する専門的なアテンション最適化の恩恵を受けることができる[34][6][66]。したがって、反復サンプリング推論は、チャットボット指向のAPIに対して多数の並列リクエストを素朴に行うよりも低いコストで実現できる。これらのコスト削減はさらに、より高価なモデルから少数回サンプリングする代わりに、より安価なモデルから多数回サンプリングするという選択を動機づけることができる。
検証器:第4節の結果は、自動的に検証を行うツールが利用できない場合に、サンプル検証手法を改善することの重要性を浮き彫りにしている。モデルに自身の出力を評価する能力を備えさせることで、反復サンプリングをはるかに多くのタスクにスケールさせることが可能になる。特に興味深いのは、創作的な文章作成のような非構造化タスクに反復サンプリングを適用することであり、こうしたタスクでは我々が検討する合否型タスクよりも、異なるサンプル間のより主観的な比較が必要となる場合がある。モデルベースの検証器を開発する代替の方向性として、非構造化タスクを検証可能にする変換器を設計することが挙げられる。例えば、非形式的な数学の命題をLeanのような言語に形式化し、証明チェッカーを適用できるようにする、といったものである。
6 関連研究
推論計算のスケーリング:推論時に追加の計算を行う手法は、深層学習の多くの領域で成功を収めてきた。多様なゲーム環境において、最先端の手法は推論時の探索を活用し、手を決定する前に多数の可能な将来のゲーム状態を調べる[12][50][10]。同様の木ベースの手法はLLMと組み合わせても有効であり、モデルがより適切に計画を立て、異なるアプローチを探索できるようにする[63, 8, 53, 54]。LLM推論計算を増やす別の軸として、モデルが解決策に至る前に問題について熟考するためにトークンを費やすことを可能にするものがある[62, 61, 64]。さらに、複数のモデルを推論時にアンサンブルして、それぞれの強みを組み合わせることもできる[58, 14, 45, 56, 31]。また別のアプローチとして、LLMを用いて自身の応答を批評し洗練させるものがある[43, 7]。
反復サンプリング:先行研究は、反復サンプリングが複数の領域でLLMの能力を向上させ得ることを示している。最も効果的なユースケースの一つはコーディングであり[48, 15, 38]、性能は100万サンプルまでスケールし続け、検証ツール(例えばユニットテスト)が各候補解を自動的に採点するためにしばしば利用可能である。最近、Greenblatt [23]は、ARCチャレンジ[16]のパズルを解く際に反復サンプリングが有効であることを示し、サンプル数の増加に伴って対数線形のスケーリングを観察した。その応用では、反復サンプリングと報酬モデルによるbest-of-Nランキングを組み合わせることで、単一の応答を貪欲にサンプリングするよりも優れた性能を発揮できる[30]。自動検証ツールのない領域では、既存研究は、最終回答を決定するために多数決投票[60]、LLMへのプロンプティング[19]、またはモデルベースの検証器の訓練[18, 42, 29, 59, 35]を用いることで、単一サンプルを取る場合と比較して推論タスクの性能を改善できることを示している。Nguyenら[44]は、閾値の長さを超える回答に対して多数決投票を行うことで、すべての回答に対する投票よりも優れた性能を発揮できることを見出した。我々の研究と並行して、Songら[51]は、利用可能な最良のサンプルを用いることでチャット、数学、コードのタスクにおけるLLMの性能が向上することを見出し、最大128サンプルまでスイープした。さらに、Hassidら[24]は、コーディングタスクを解く際に、より大きなモデルから少数のサンプルを取るよりも、より小さなモデルからより多くのサンプルを取る方が効果的な場合があることを見出した。
スケーリング則:スケーリングがモデル性能にどのように影響するかを特徴づけることで、リソースをどのように配分するかについてより情報に基づいた意思決定が可能になる。LLM訓練のスケーリング則は、損失と訓練計算量の間にべき乗則の関係を見出し、固定された計算予算の下での最適なモデルサイズとデータセットサイズの推定値を提供する[27, 36, 28]。Jones [33]はボードゲームHexの文脈でスケーリング則を見出し、性能がモデルサイズと問題の難易度に対して予測可能にスケールすることを観察した。興味深いことに、彼らはまた、性能が木探索を行う際に費やされるテスト時計算量に伴ってスケールすることも示している。最近、Shaoら[49]は、LLMを外部の検索データセットで拡張する際のスケーリング則を観察し、検索タスクの性能が検索コーパスのサイズに対して滑らかにスケールすることを見出した。
7 謝辞
本プロジェクトの計算資源の一部をスポンサーしてくださったTogether AIに感謝するとともに、このインフラの管理を支援してくださったRahul ChalamalaとBen Athiwaratkunに感謝する。SWE-bench実験の実施にあたり助言と支援をいただいたJohn Yangに感謝する。最後に、本プロジェクト全体を通じて有益な議論とフィードバックをいただいたMayee Chen、Neel Guha、Quinn McIntyre、Jon Saad-Falcon、Benjamin Spectorに感謝する。
我々は、NIH(No. U54EB020405(Mobilize))、NSF(No. CCF2247015(Hardware-Aware)、CCF1763315(Beyond Sparsity)、CCF1563078(Volume to Velocity)、1937301(RTML))、米国DEVCOM ARL(No. W911NF-23-2-0184(Long-context)、W911NF-21-2-0251(Interactive Human-AI Teaming))、ONR(No. N000142312633(Deep Signal Processing))、Stanford HAI(No. 247183)、NXP、Xilinx、LETI-CEA、Intel、IBM、Microsoft、NEC、Toshiba、TSMC、ARM、Hitachi、BASF、Accenture、Ericsson、Qualcomm、Analog Devices、Google Cloud、Salesforce、Total、HAI-GCP Cloud Credits for Researchプログラム、Stanford Data Science Initiative(SDSI)、およびStanford DAWNプロジェクトのメンバー(Meta、Google、VMWare)からの支援に深く感謝する。米国政府は、それに記載されたいかなる著作権表示にもかかわらず、政府目的のために本資料を複製および配布することを許可されている。本資料に表明された意見、知見、結論または推奨は著者のものであり、NIH、ONR、または米国政府の見解、方針、または支持を必ずしも反映するものではない(明示的または黙示的を問わず)。
本研究はClarendon Fund Scholarshipsの支援を受けて完了した。
参考文献
[1] Aide.dev, 2024. URL https://aide.dev/
[2] Hello gpt-4o, 2024. URL https://openai.com/index/hello-gpt-4o/
[3] Meta llama 3, 2024. URL https://llama.meta.com/llama3/
[4] Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[5] Voyage ai, 2024. URL https://www.voyageai.com/
[6] Ben Athiwaratkun, Sujan Kumar Gonugondla, Sanjay Krishna Gouda, Haifeng Qian, Hantian Ding, Qing Sun, Jun Wang, Jiacheng Guo, Liangfu Chen, Parminder Bhatia, Ramesh Nallapati, Sudipta Sengupta, and Bing Xiang. Bifurcated attention: Accelerating massively parallel decoding with shared prefixes in llms, 2024. URL https://arxiv.org/abs/2403.08845
[7] Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, Andy Jones, Anna Chen, Anna Goldie, Azalia Mirhoseini, Cameron McKinnon, Carol Chen, Catherine Olsson, Christopher Olah, Danny Hernandez, Dawn Drain, Deep Ganguli, Dustin Li, Eli Tran-Johnson, Ethan Perez, Jamie Kerr, Jared Mueller, Jeffrey Ladish, Joshua Landau, Kamal Ndousse, Kamile Lukosuite, Liane Lovitt, Michael Sellitto, Nelson Elhage, Nicholas Schiefer, Noemi Mercado, Nova DasSarma, Robert Lasenby, Robin Larson, Sam Ringer, Scott Johnston, Shauna Kravec, Sheer El Showk, Stanislav Fort, Tamera Lanham, Timothy Telleen-Lawton, Tom Conerly, Tom Henighan, Tristan Hume, Samuel R. Bowman, Zac Hatfield-Dodds, Ben Mann, Dario Amodei, Nicholas Joseph, Sam McCandlish, Tom Brown, and Jared Kaplan. Constitutional ai: Harmlessness from ai feedback, 2022.
[8] Maciej Besta, Nils Blach, Ales Kubicek, Robert Gerstenberger, Michal Podstawski, Lukas Gianinazzi, Joanna Gajda, Tomasz Lehmann, Hubert Niewiadomski, Piotr Nyczyk, and Torsten Hoefler. Graph of thoughts: Solving elaborate problems with large language models. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16):17682-17690, March 2024. ISSN 2159-5399. doi: 10.1609/aaai.v38i16.29720. URL http://dx.doi.org/10.1609/aaai.v38i16.29720
[9] Stella Biderman, Hailey Schoelkopf, Quentin Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, Aviya Skowron, Lintang Sutawika, and Oskar van der Wal. Pythia: A suite for analyzing large language models across training and scaling, 2023. URL https://arxiv.org/abs/2304.01373
[10] Noam Brown, Anton Bakhtin, Adam Lerer, and Qucheng Gong. Combining deep reinforcement learning and search for imperfect-information games. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS '20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
[11] Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert-Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, and Dario Amodei. Language models are few-shot learners, 2020. URL https://arxiv.org/abs/2005.14165
[12] Murray Campbell, A. Joseph Hoane, and Feng-hsiung Hsu. Deep blue. Artif. Intell., 134(1-2):57-83, jan 2002. ISSN 0004-3702. doi: 10.1016/S0004-3702(01)00129-1. URL https://doi.org/10.1016/S0004-3702(01)00129-1
[13] Guoxin Chen, Minpeng Liao, Chengxi Li, and Kai Fan. Alphamath almost zero: process supervision without process, 2024.
[14] Lingjiao Chen, Jared Quincy Davis, Boris Hanin, Peter Bailis, Ion Stoica, Matei Zaharia, and James Zou. Are more llm calls all you need? towards scaling laws of compound inference systems, 2024. URL https://arxiv.org/abs/2403.02419
[15] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, Alex Ray, Raul Puri, Gretchen Krueger, Michael Petrov, Heidy Khlaaf, Girish Sastry, Pamela Mishkin, Brooke Chan, Scott Gray, Nick Ryder, Mikhail Pavlov, Alethea Power, Lukasz Kaiser, Mohammad Bavarian, Clemens Winter, Philippe Tillet, Felipe Petroski Such, Dave Cummings, Matthias Plappert, Fotios Chantzis, Elizabeth Barnes, Ariel Herbert-Voss, William Hebgen Guss, Alex Nichol, Alex Paino, Nikolas Tezak, Jie Tang, Igor Babuschkin, Suchir Balaji, Shantanu Jain, William Saunders, Christopher Hesse, Andrew N. Carr, Jan Leike, Josh Achiam, Vedant Misra, Evan Morikawa, Alec Radford, Matthew Knight, Miles Brundage, Mira Murati, Katie Mayer, Peter Welinder, Bob McGrew, Dario Amodei, Sam McCandlish, Ilya Sutskever, and Wojciech Zaremba. Evaluating large language models trained on code, 2021. URL https://arxiv.org/abs/2107.03374
[16] François Chollet. On the measure of intelligence, 2019. URL https://arxiv.org/abs/1911.01547
[17] Paul Christiano, Jan Leike, Tom B. Brown, Miljan Martic, Shane Legg, and Dario Amodei. Deep reinforcement learning from human preferences, 2017. URL https://arxiv.org/abs/1706.03741
[18] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse, and John Schulman. Training verifiers to solve math word problems, 2021.
[19] Jared Quincy Davis, Boris Hanin, Lingjiao Chen, Peter Bailis, Ion Stoica, and Matei Zaharia. Networks of networks: Complexity class principles applied to compound ai systems design, 2024. URL https://arxiv.org/abs/2407.16831
[20] DeepSeek-AI et al. Deepseek-v2: A strong, economical, and efficient mixture-of-experts language model, 2024. URL https://arxiv.org/abs/2405.04434
[21] Mostafa Dehghani, Anurag Arnab, Lucas Beyer, Ashish Vaswani, and Yi Tay. The efficiency misnomer, 2022. URL https://arxiv.org/abs/2110.12894
[22] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. A framework for few-shot language model evaluation, 12 2023. URL https://zenodo.org/records/10256836
[23] Ryan Greenblatt. Getting 50 https://www.lesswrong.com/posts/Rdwui3wHxCeKb7feK/getting-50-sota-on-arc-agi-with-gpt-40 2024.
[24] Michael Hassid, Tal Remez, Jonas Gehring, Roy Schwartz, and Yossi Adi. The larger the better? improved llm code-generation via budget reallocation, 2024. URL https://arxiv.org/abs/2404.00725
[25] Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song, and Jacob Steinhardt. Measuring coding challenge competence with apps, 2021.
[26] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. Measuring mathematical problem solving with the math dataset, 2021.
[27] Joel Hestness, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang, and Yanqi Zhou. Deep learning scaling is predictable, empirically, 2017. URL https://arxiv.org/abs/1712.00409
[28] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, Tom Hennigan, Eric Noland, Katie Millican, George van den Driessche, Bogdan Damoc, Aurelia Guy, Simon Osindero, Karen Simonyan, Erich Elsen, Jack W. Rae, Oriol Vinyals, and Laurent Sifre. Training compute-optimal large language models, 2022. URL https://arxiv.org/abs/2203.15556
[29] Arian Hosseini, Xingdi Yuan, Nikolay Malkin, Aaron Courville, Alessandro Sordoni, and Rishabh Agarwal. V-star: Training verifiers for self-taught reasoners, 2024.
[30] Robert Irvine, Douglas Boubert, Vyas Raina, Adian Liusie, Ziyi Zhu, Vineet Mudupalli, Aliaksei Korshuk, Zongyi Liu, Fritz Cremer, Valentin Assassi, Christie-Carol Beauchamp, Xiaoding Lu, Thomas Rialan, and William Beauchamp. Rewarding chatbots for real-world engagement with millions of users, 2023. URL https://arxiv.org/abs/2303.06135
[31] Dongfu Jiang, Xiang Ren, and Bill Yuchen Lin. Llm-blender: Ensembling large language models with pairwise ranking and generative fusion, 2023. URL https://arxiv.org/abs/2306.02561
[32] Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik Narasimhan. Swe-bench: Can language models resolve real-world github issues?, 2024. URL https://arxiv.org/abs/2310.06770
[33] Andy L. Jones. Scaling scaling laws with board games, 2021. URL https://arxiv.org/abs/2104.03113
[34] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[35] Jikun Kang, Xin Zhe Li, Xi Chen, Amirreza Kazemi, Qianyi Sun, Boxing Chen, Dong Li, Xu He, Quan He, Feng Wen, Jianye Hao, and Jun Yao. Mindstar: Enhancing math reasoning in pre-trained llms at inference time, 2024. URL https://arxiv.org/abs/2405.16265
[36] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. Scaling laws for neural language models, 2020.
[37] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. Scaling laws for neural language models, 2020. URL https://arxiv.org/abs/2001.08361
[38] Sumith Kulal, Panupong Pasupat, Kartik Chandra, Mina Lee, Oded Padon, Alex Aiken, and Percy Liang. Spoc: Search-based pseudocode to code, 2019. URL https://arxiv.org/abs/1906.04908
[39] Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, Noah A. Smith, and Hannaneh Hajishirzi. Reward-bench: Evaluating reward models for language modeling, 2024. URL https://arxiv.org/abs/2403.13787
[40] Aitor Lewkowycz, Anders Andreassen, David Dohan, Ethan Dyer, Henryk Michalewski, Vinay Ramasesh, Ambrose Slone, Cem Anil, Imanol Schlag, Theo Gutman-Solo, Yuhuai Wu, Behnam Neyshabur, Guy Gur-Ari, and Vedant Misra. 言語モデルによる定量的推論問題の解法, 2022. URL https://arxiv.org/abs/2206.14858
[41] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, Thomas Hubert, Peter Choy, Cyprien de Masson d'Autume, Igor Babuschkin, Xinyun Chen, Po-Sen Huang, Johannes Welbl, Sven Gowal, Alexey Cherepanov, James Molloy, Daniel J. Mankowitz, Esme Sutherland Robson, Pushmeet Kohli, Nando de Freitas, Koray Kavukcuoglu, and Oriol Vinyals. AlphaCodeによる競技レベルのコード生成. Science, 378(6624):1092-1097, December 2022. ISSN 1095-9203. doi: 10.1126/science.abq1158. URL http://dx.doi.org/10.1126/science.abq1158
[42] Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. 一歩ずつ検証しよう, 2023.
[43] Aman Madaan, Niket Tandon, Prakhar Gupta, Skyler Hallinan, Luyu Gao, Sarah Wiegreffe, Uri Alon, Nouha Dziri, Shrimai Prabhumoye, Yiming Yang, Shashank Gupta, Bodhisattwa Prasad Majumder, Katherine Hermann, Sean Welleck, Amir Yazdanbakhsh, and Peter Clark. Self-refine: 自己フィードバックによる反復的改善, 2023. URL https://arxiv.org/abs/2303.17651
[44] Alex Nguyen, Dheeraj Mekala, Chengyu Dong, Jingbo Shang. 一貫した予測はいつ正しい予測になり得るか?, 2024. URL https://arxiv.org/abs/2407.05778
[45] Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E. Gonzalez, M Waleed Kadous, Ion Stoica. Routellm: 選好データを用いたLLMのルーティング学習, 2024. URL https://arxiv.org/abs/2406.18665
[46] OpenAI et al. GPT-4 テクニカルレポート, 2024. URL https://arxiv.org/abs/2303.08774
[47] Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever. 言語モデルは教師なしのマルチタスク学習者である. 2019.
[48] Baptiste Roziere, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat, Xiaoqing Ellen Tan, Yossi Adi, Jingyu Liu, Romain Sauvestre, Tal Remez, Jérémy Rapin, Artyom Kozhevnikov, Ivan Evtimov, Joanna Bitton, Manish Bhatt, Cristian Canton Ferrer, Aaron Grattafiori, Wenhan Xiong, Alexandre Défossez, Jade Copet, Faisal Azhar, Hugo Touvron, Louis Martin, Nicolas Usunier, Thomas Scialom, Gabriel Synnaeve. Code llama: コードのためのオープン基盤モデル, 2023. URL https://arxiv.org/abs/2308.12950
[49] Rulin Shao, Jacqueline He, Akari Asai, Weijia Shi, Tim Dettmers, Sewon Min, Luke Zettlemoyer, Pang Wei Koh. 1兆トークンのデータストアによる検索ベース言語モデルのスケーリング, 2024. URL https://arxiv.org/abs/2407.12854
[50] David Silver, Thomas Hubert, Julian Schrittwieser, Ioannis Antonoglou, Matthew Lai, Arthur Guez, Marc Lanctot, Laurent Sifre, Dharshan Kumaran, Thore Graepel, Timothy Lillicrap, Karen Simonyan, Demis Hassabis. 汎用強化学習アルゴリズムによる自己対戦でのチェスと将棋の習得, 2017.
[51] Yifan Song, Guoyin Wang, Sujian Li, Bill Yuchen Lin. 良いもの、悪いもの、そして貪欲なもの: LLMの評価は非決定性を無視すべきではない, 2024. URL https://arxiv.org/abs/2407.10457
[52] Gemma Team et al. Gemma: Geminiの研究と技術に基づくオープンモデル, 2024. URL https://arxiv.org/abs/2403.08295
[53] Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi, Dong Yu. 想像、探索、批判によるLLMの自己改善に向けて, 2024. URL https://arxiv.org/abs/2404.12253
[54] Trieu H. Trinh, Yuhuai Wu, Quoc V. Le, He He, Thang Luong. 人間の実演なしでオリンピック幾何学を解く. Nature, 625(7995):476-482, 2024. ISSN 1476-4687. doi: 10.1038/s41586-023-06747-5. URL https://doi.org/10.1038/s41586-023-06747-5
[55] Pauli Virtanen, Ralf Gommers, Travis E. Oliphant, Matt Haberland, Tyler Reddy, David Cournapeau, Evgeni Burovski, Pearu Peterson, Warren Weckesser, Jonathan Bright, Stéfan J. van der Walt, Matthew Brett, Joshua Wilson, K. Jarrod Millman, Nikolay Mayorov, Andrew R. J. Nelson, Eric Jones, Robert Kern, Eric Larson, C J Carey, Ilhan Polat, Yu Feng, Eric W. Moore, Jake VanderPlas, Denis Laxalde, Josef Perktold, Robert Cimrman, Ian Henriksen, E. A. Quintero, Charles R. Harris, Anne M. Archibald, António H. Ribeiro, Fabian Pedregosa, Paul van Mulbregt, SciPy 1.0 Contributors. SciPy 1.0: Pythonにおける科学計算のための基本アルゴリズム. Nature Methods, 17:261-272, 2020. doi: 10.1038/s41592-019-0686-2.
[56] Fanqi Wan, Xinting Huang, Deng Cai, Xiaojun Quan, Wei Bi, Shuming Shi. 大規模言語モデルの知識融合, 2024. URL https://arxiv.org/abs/2401.10491
[57] Haoxiang Wang, Wei Xiong, Tengyang Xie, Han Zhao, Tong Zhang. 多目的報酬モデリングとMixture-of-Expertsによる解釈可能な選好, 2024. URL https://arxiv.org/abs/2406.12845
[58] Junlin Wang, Jue Wang, Ben Athiwaratkun, Ce Zhang, James Zou. Mixture-of-Agentsは大規模言語モデルの能力を強化する, 2024. URL https://arxiv.org/abs/2406.04692
[59] Peiyi Wang, Lei Li, Zhihong Shao, R. X. Xu, Damai Dai, Yifei Li, Deli Chen, Y. Wu, Zhifang Sui. Math-Shepherd: 人間のアノテーションなしでLLMを段階的に検証・強化する, 2024. URL https://arxiv.org/abs/2312.08935
[60] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi, Sharan Narang, Aakanksha Chowdhery, Denny Zhou. 自己一貫性は言語モデルにおける思考の連鎖推論を改善する, 2023.
[61] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed Chi, Quoc Le, Denny Zhou. 思考の連鎖プロンプティングは大規模言語モデルにおける推論を引き出す, 2023.
[62] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao. ReAct: 言語モデルにおける推論と行動の相乗効果, 2022. URL https://arxiv.org/abs/2210.03629
[63] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao, Karthik Narasimhan. Tree of Thoughts: 大規模言語モデルによる意図的な問題解決, 2023. URL https://arxiv.org/abs/2305.10601
[64] Eric Zelikman, Georges Harik, Yijia Shao, Varuna Jayasiri, Nick Haber, Noah D. Goodman. Quiet-STaR: 言語モデルは話す前に考えることを自ら学べる, 2024. URL https://arxiv.org/abs/2403.09629
[65] Kunhao Zheng, Jesse Michael Han, Stanislas Polu. MiniF2F: 形式化されたオリンピックレベルの数学のためのクロスシステムベンチマーク. arXiv preprint arXiv:2109.00110, 2021.
[66] Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Chuyue Sun, Jeff Huang, Cody Hao Yu, Shiyi Cao, Christos Kozyrakis, Ion Stoica, Joseph E. Gonzalez, Clark Barrett, Ying Sheng. SGLang: 構造化された言語モデルプログラムの効率的な実行, 2024. URL https://arxiv.org/abs/2312.07104
[67] Albert Orwall. Moatless tools. https://github.com/aorwall/moatless-tools/tree/a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6, 2024.
A サンプリング実験の設定
lean4 MiniF2Fデータセットのテストセットのうち、形式化されたMATH問題に対応する130問について結果を報告する。このデータセットは、Zhengら[65]によって作成された元のMiniF2Fデータセットの修正版から派生したものである。温度0.5でサンプリングし、nucleusサンプリングは使用しない。問題ごとに10,000個のサンプルを生成した。検証セットから以下の5つの定理の証明をフューショット例として使用する:
mathd_algebra_116 amc12_2000_p5 mathd_algebra_132 mathd_algebra_11 mathd_numbertheory_84
我々のプロンプトは以下から構成される:
1. フューショット例。
2. lean4 MiniF2FデータセットのアップロードであるHuggingFaceデータセットcat-searcher/minif2f-lean4内の各問題に存在するヘッダーのインポート。
3. 定理の定義。定理の名前に解法に関する情報が漏れるのを避けるため、定理の名前を theorem_i に置き換えます。few-shot の例では 、現在の問題では とします。
生成される解答の最大トークン長は 200 に設定します。解答の採点には、lean バージョン 4.3.0-rc2 の lean-dojo 1.1.2 ライブラリを使用します。各タクティクのステップに対して 10 秒のタイムアウトを設定します。
Few-Shot の例
与えられた形式文に対する Lean4 の証明を書いてください。標準の mathlib4 ライブラリを利用できます。
import Mathlib.Algebra.BigOperators.Basic
import Mathlib.Data.Real.Basic
import Mathlib.Data.Complex.Basic
import Mathlib.Data.Nat.Log
import Mathlib.Data.Complex.Exponential
import Mathlib.NumberTheory.Divisors
import Mathlib.Data.ZMod.Defs
import Mathlib.Data.ZMod.Basic
import Mathlib.Topology.Basic
import Mathlib.Data.Nat.Digits
open BigOperators
open Real
open Nat
open Topology
theorem theorem1
Int.floor ((9: ) / 160 \* 100) = 5 :=
by (
rw [Int.floor_eq_iff]
constructor
all.goals norm_num
)
プロンプト例
与えられた形式仕様に対するlean4の証明を書いてください。標準のmathlib4ライブラリを利用できます。
\\\`pythonimport Mathlib.Algebra.BigOperators.Basic import Mathlib.Data.Real.Basic import Mathlib.Data.Complex.Basic import Mathlib.Data.Nat.Log import Mathlib.Data.Complex.Exponential import Mathlib.NumberTheory.Divisors import Mathlib.Data.ZMod.Defs import Mathlib.Data.ZMod.Basic import Mathlib.Topology.Basic import Mathlib.Data.Nat.Digits open BigOperators open Real open Nat open Topology theorem theorem6 (b h v : R) (h_0 : 0 < b \land 0 < h \land 0 < v) (h_1 : v = 1 / 3 * (b * h)) (h_2 : b = 30) (h_3 : h = 13 / 2) v = 65 := by (
A.2 CodeContests
問題記述に画像タグを含まない140問のテストセット問題について結果を報告する。CodeLlama [48] の実験に従い、temperature 0.6、top-p 0.95でサンプリングする。問題ごとに10,000サンプルを生成する。訓練セットから問題ごとにランダムにサンプリングした2つのfew-shot例を用いる。生成解の最大トークン長は1024に設定する。[41]と同じ回答比較関数を用い、公開テスト、非公開テスト、生成テストを連結して解の正しさを検証する。
Few-Shot例
Q: 制約を守り、例示テストケースを通過する、以下のコーディング問題を解くpythonコードを書いてください。出力コードは標準IOから読み書きする必要があります。コード回答は次で囲んでください: Petyaは等しい... (残りの問題文と入出力例)...
A:
while cnt .
if \mathrm{b} * 2 < = \mathrm{n}} :
while cnt :
print(ans)...
プロンプト例
Q: 制約を守り、例示テストケースを通過する、以下のコーディング問題を解くpythonコードを書いてください。出力コードは標準IOから読み書きする必要があります。コード回答は次で囲んでください: これは......(残りの問題文と入出力例)...
A:
A.3 MATH
ランダムに選択した128問のテストセット問題について結果を報告する。temperature 0.6でサンプリングし、nucleus samplingは用いない。[40]の固定5つのfew-shot例を各問題に用いる。問題ごとに10,000サンプルを生成する。生成解の最大トークン長は512に設定する。解の採点には、LMEval [22]のminerva_math関数を用いてモデルの最終回答を抽出する。次に、抽出された回答が正解と完全な文字列一致である場合、またはLMEvalのminerva_mathのis_equiv関数がtrueと評価される場合に、正しいと判定する。
Few-Shot例
翻訳対象のテキスト:問題: かつ であるとき、 を求めよ。
解答: である。最終解答:最終解答は 24 である。これが正しいことを願う。
例題プロンプト
問題:関数 f(x) = \frac{(2x - 3)(2x + 5)}{(3x - 9)(3x + 6)} の定義域は何か。答えを区間または区間の和として表せ。
解答:
A.4 GSM8K
ランダムにサンプリングした128個のテストセット問題について結果を報告する。サンプリングは温度0.6で行い、nucleus samplingは使用しない。訓練セットから問題ごとにランダムにサンプリングした5つのfew-shot例を使用する。問題ごとに10,000個のサンプルを生成する。生成される解答の最大トークン長は512に設定する。解答の採点にはLMEval [22] に従い、四重ハッシュの後の文字列を抽出する正規表現を用いて答えを抽出する。MATHと同様に、抽出された答えが正解と完全な文字列一致するか、またはis_equivがtrueと評価されるかを確認することで正しさを評価する。
Few-Shot例
質問:Jamesは車を買い替えることにした。彼は20,000ドルの車をその価値の80\% で売り、その後値引き交渉して30,000ドルの定価の車をその価値の90\% で購入できた。彼の自腹額はいくらだったか? 答え:彼は車を20000^{}.8 = \S < 20000^{}.8 = 16000 > > 16,000ドルで売った。彼は新しい車を30,000^{}.9 = \S < 30000^{}.9 = 27000 > > 27,000ドルで買った。つまり彼の自腹額は27,000 - 16,000 = \S < < 27000- 16000 = 11000 > > 11,000ドルだった。
例題プロンプト
質問:Maryはパントリーに6瓶のスプリンクルを持っている。各瓶のスプリンクルで8個のカップケーキを飾ることができる。Maryはスプリンクルをすべて使い切るのに十分なカップケーキを焼きたい。各天板に12個のカップケーキが載るとすると、彼女は天板何枚分のカップケーキを焼くべきか?
答え:
B SWE-bench Lite
B.1 実験設定
実験には、Moatless Toolsエージェントフレームワーク(コミットa1017b78e3e69e7d205b1a3faa83a7d19fce3fa6)を備えたDeepSeek-Coder-V2-Instructを使用する。検索にはVoyage AI 5埋め込みを使用し、これはMoatless Toolsのデフォルトである。モデルやフレームワークには一切変更を加えず、完全に既製のコンポーネントとして使用する。
この設定で、標準的な温度ベースのサンプリングを用いて各問題につき250個の独立した補完をサンプリングする。最適なサンプリング温度を決定するため、テストセットからランダムに選んだ50問のサブセットで温度1.0、1.4、1.6、1.8を試すスイープを実施した。これらの結果に基づき、主要実験では温度1.6を選択した。
B.2 テストスイートの不安定性
分析中に、SWE-bench Lite内でテストスイートに不安定なテストを含む34問を特定した。SWE-benchの著者らが提供するSWE-benchテストハーネスを用いて各解答を繰り返しテストしたところ、一部の解答では、あるときは正解とされ、別のときには不正解とされた。これら34件のうち30件では、データセット著者らが提供する正解の解答においてさえ不安定性が観察された。表3は、不安定なテストを持つ34インスタンスの問題IDを列挙している。
| リポジトリ | インスタンスID |
| django | django_django-13315、django_django-13447、django_django-13590、django_django-13710、django_django-13757、django_django-13933、django_django-13964、django_django-14017、django_django-14238、django_django-14382、django_django-14608、django_django-14672、django_django-14752、django_django-14915、django_django-14997、django_django-14999、django_django-15320、django_django-15738、django_django-15790、django_django-15814、django_django-15819、django_django-16229、django_django-16379、django_django-16400、django_django-17051 |
| sympy | sympy_sympy-13146、sympy_sympy-13177、sympy_sympy-16988 |
| requests | psf_requests-863、psf_requests-2317、psf_requests-2674、psf_requests-3362 |
| scikit-learn | scikit-learn_scikit-learn-13241 |
| matplotlib | matplotlib_matplotlib-23987 |
表3:不安定なテストを持つSWE-bench Liteの問題のインスタンスID。
さらに別のインスタンス astropy_astropy-6938 は、一部のマシンでは不安定で、他のマシンではそうではなかった。SWE-benchの著者らはこの不安定性を再現できたが、我々は再現できなかった。我々の予備調査によれば、この特定の問題は、単体テストを実行するdocker環境における依存関係のバージョンが固定されていないことに起因する。
ここでは、表3の問題を除いたサブセット(266問)での結果を含める。完全なデータセットの評価では、不安定なテストを持つ問題については、テストスイートを11回実行し、多数決によって解答が合格か不合格かを判定する。不安定なテストを含まないサブセットでの評価では、比較するすべてのベースラインがどの問題を正しく解くかを公開しているため、不安定なテストを持つ問題を単に除外し、スコアを再計算した。
C スケーリング則の詳細
C.1 実験の詳細
カバレッジ曲線に指数べき乗則を当てはめるため、まず0から10,000までの対数スケールに沿って均等に配置した40点をサンプリングし、重複を除去する。次にSciPyの55 curve_fit関数を用いて、これらの点に最もよく当てはまる式3の と のパラメータを求める。
C.2 追加結果
図10では、拡張されたデータセットとモデルのセットについて、カバレッジ曲線にべき乗則を当てはめた追加結果を示す。
D 精度の詳細
D 精度の詳細 Majority Vote、Reward Model + Best-of-N、およびReward Model + Majority Voteの指標を計算するために、第2節で導入したMATHとGSM8Kデータセットの両方について同じ128問のサブセットを使用する。各問題は、テストする各モデルにつき10,000個のサンプルに対応する。各検証手法について、サイズ \(k\) のランダムなサブセットを100個取り、各サブセットを用いて成功率を計算する。図7ではサブセット全体の平均と標準偏差を報告する。Majority Voteの答えを計算するには、各サブセットで最多の答えを取る(2つの答えは、完全な文字列一致する場合、またはis_equivがtrueと評価される場合に等価とみなされることに注意)。Reward Model + Best-of-Nでは、報酬モデルが割り当てたスコアが最も高い答えを取る。Reward Model + Majority Vote指標では、同じ最終答えを持つすべてのサンプルにわたって報酬モデルのスコアを合計し、合計が最も高い最終答えを用いる。
以下が日本語訳です。 E GSM8Kの誤った回答
4.1で述べたように、GSM8Kテストセットのある問題(HuggingFace上のインデックス1042)に、誤った正解が含まれていることを確認した。
問題
ジョニーの父親は彼を競馬を見に連れて行き、父親はお金を賭けた。最初のレースで、彼は5ドルを失った。2番目のレースで、彼は以前に失った金額の2倍より1ドル多く勝った。3番目のレースで、彼は2番目のレースで勝った金額の1.5倍を失った。その日、彼は平均していくら失ったか?
回答
2番目のレースで彼は11ドル勝った。なぜなら 。3番目のレースで彼は ドル失った。なぜなら 。彼は最初と3番目のレースで合計20ドル失った。なぜなら \(15+5=<<15+5=20>>20\)。彼はその日に ドル失った。なぜなら 。彼は1レースあたり平均3ドル失った。なぜなら \(9/3=<<9/3=3>>3\)\#\#\#\#3
間違いは回答の2行目にある。3番目のレースで、ジョニーの父親は ドル失ったのであり、 ドルではない。つまり彼は11ドル勝ち、 ドル失った。したがって、答えは1レースあたり平均3.5ドルの損失であり、1レースあたり ドル(データセット内の答え)ではない。