
ほぼ全てのモデルが干し草の針を当てる。RULER は 13 の難しい課題を追加し、実際の文脈長はずっと短いと示す。COLM 2024、全文無料。
RULER: What's the Real Context Size of Your Long-Context Language Models?
RULER:長文コンテキスト言語モデルの実際のコンテキストサイズはどれほどか?
*Cheng-Ping Hsieh、Simeng Sun、Samuel Kriman、Shantanu Acharya、Dima Rekesh、Fei Jia、Yang Zhang、Boris Ginsburg*
NVIDIA
{chsieh, simengs}@nvidia.com
概要
needle-in-a-haystack(NIAH)テストは、長い妨害テキスト(「haystack」)から一つの情報(「needle」)を検索する能力を調べるものであり、長文コンテキスト言語モデル(LM)の評価に広く採用されてきた。しかし、この単純な検索ベースのテストは、長文コンテキスト理解のごく表面的な形態しか示すものではない。長文コンテキストLMをより包括的に評価するため、我々はカスタマイズ可能な系列長とタスク複雑度の柔軟な設定を備えた新しい合成ベンチマークRULERを作成する。RULERは、vanilla NIAHテストを拡張し、多様な種類と数のneedleを用いたバリエーションを包含する。さらに、RULERは新たなタスクカテゴリとしてマルチホップ追跡と集約を導入し、コンテキストからの検索を超えた振る舞いをテストする。我々はRULERにおける13の代表的なタスクで17の長文コンテキストLMを評価する。vanilla NIAHテストではほぼ完璧な精度を達成しているにもかかわらず、ほぼすべてのモデルがコンテキスト長の増加に伴い大きな性能低下を示す。これらのモデルはすべて32Kトークン以上のコンテキストサイズを主張しているが、32Kの長さで満足のいく性能を維持できるのはそのうち半数に過ぎない。200Kのコンテキスト長をサポートするYi-34Bの分析は、入力長とタスク複雑度を増すにつれて改善の余地が大きいことを明らかにする。我々は長文コンテキストLMの包括的評価を促進するため、RULERをオープンソース化する。
1 はじめに
AIシステムエンジニアリング(Dao et al., 2022; Jacobs et al., 2023; Fu et al., 2024)および言語モデル設計(Chen et al., 2023; Xiong et al., 2023)における最近の進歩により、言語モデルのコンテキスト長の効率的なスケーリングが可能になった(Liu et al., 2024a; Young et al., 2024)。先行研究(AI21, 2024; X.AI, 2024; Reid et al., 2024; Anthropic, 2024)は一般に、passkey retrieval(Mohtashami & Jaggi, 2023)やneedle-in-a-haystack(Kamradt, 2023)などの合成タスクを長文コンテキストLMの評価に採用している。しかし、これらの評価は研究間で一貫して用いられておらず、検索能力のみを明らかにするものであり、他の形態の長文コンテキスト理解を測ることはできない。
本研究では、言語モデルの長文コンテキストモデリング能力を評価する新しいベンチマークRULERを提案する。RULERは、コンテキストからの単純な検索を超えた振る舞い(Ribeiro et al., 2020)をテストする4つのタスクカテゴリを含む:
1. 検索:我々はneedle-in-a-haystack(Kamradt, 2023; NIAH)テストを拡張し、多様な種類と数のneedleで検索能力を評価する。2. マルチホップ追跡:我々はvariable trackingを提案する。これは共参照連鎖解決のための最小限の代理タスクであり、マルチホップ接続を持つ実体を追跡する振る舞いを調べる。3. 集約:我々はcommon/frequent words extractionを提案する。これは要約のための代理タスクであり、長距離コンテキストにまたがる関連情報を集約する能力をテストする。4. 質問応答:我々は既存の短文コンテキストQAデータセットの入力に妨害情報を追加し、様々なコンテキストサイズでの質問応答能力を評価する。
| 読み取り専用の背景情報(翻訳対象の原文ではない):1 はじめに 1. 検索:多様な種類と数量のニードルを用いて検索能力を評価するため、干し草の山の中の針(Kamradt, 2023; NIAH)テストを拡張する。2. マルチホップ追跡:マルチホップ接続を持つエンティティの追跡動作を確認するため、共参照連鎖解決のための最小限の代理タスクである変数追跡を提案する。3. 集約:要約のための代理タスクである共通語/頻出語抽出を提案し、関連情報を集約する能力をテストする。翻訳対象のテキスト:ベンチマーク&タスク | 平均長 | 種類 | 多様なタスク | 最小限のパラメトリック知識 | 制御可能なコンテキスト |
| ZeroSCROLLS | 約10k | 現実的 | ✓ | X | X |
| L-Eval | 約8k | 現実的 | ✓ | X | X |
| BAMBOO | 約16k | 現実的 | ✓ | ✓ | X |
| LongBench | 約8k | ハイブリッド | ✓ | X | X |
| LooGLE | 約20k | ハイブリッド | ✓ | ✓ | X |
| InfiniteBench | 約200k | ハイブリッド | ✓ | ✓ | X |
| 干し草の山の中の針(NIAH) | 任意 | 合成的 | X | ✓ | ✓ |
| パスキー/行/KV検索 | 任意 | 合成的 | X | ✓ | ✓ |
| RULER(提案手法) | 任意 | 合成的 | ✓ | ✓ | ✓ |
既存の現実的なベンチマーク(Table 1)と比較して、RULERは合成タスクのみで構成されており、系列長とタスク複雑度を制御する柔軟性を提供する。RULERにおける合成入力は、現実的なタスクにおいて長文コンテキスト入力の活用を妨げるパラメトリック知識への依存を軽減する(Shaham et al., [2023]; Bai et al., [2023])。
RULERを用いて、我々はGemini-1.5(Reid et al., [2024])、GPT-4(OpenAI: Josh Achiam et al., [2023])、およびコンテキスト長が4kから128kに及ぶ15のオープンソースモデルをベンチマークする。vanilla NIAHテストではほぼ完璧な性能を達成しているにもかかわらず、ほぼすべてのモデルが系列長の増加に伴い、RULERのより複雑なタスクで大きな劣化を示す。すべてのモデルが32kトークン以上のコンテキストサイズを主張しているが、我々の結果は、定性的な閾値を超えることで32Kの系列長を効果的に扱えるのはそのうち半数に過ぎないことを示している。さらに、ほぼすべてのモデルが主張するコンテキスト長に達する前にその閾値を下回る。細粒度のモデル比較を得るため、我々は実世界のユースケースの長さ分布を模倣した重みで、4kから128kまでの性能を2つの重み付き平均スコアで集約する。上位2モデルであるGemini-1.5とGPT-4は、選択した重み付け方式にかかわらず、一貫して他のモデルを上回る。
我々はさらに、200Kのコンテキスト長を主張し、オープンソースモデルの中でRULERにおいて妥当に良好な性能を達成するYi-34Bを分析する。我々の結果は、入力長とタスク複雑度を増すにつれてYiの性能が大きく劣化することを示す。大きなコンテキストサイズでは、Yi-34Bはしばしば不完全な回答を返し、関連情報を正確に特定できない。さらに、複数のモデルにわたってコンテキストサイズのスケーリングに伴い2つの振る舞いが現れることを観察する:パラメトリック知識への依存の増大と、非検索タスクにおいてコンテキストからコピーする傾向の増大である。我々の追加のアブレーションは、より長い系列での訓練が必ずしもRULERでのより良い性能につながらないこと、そしてより大きなモデルサイズがより良い長文コンテキスト能力と正に相関することを示す。最後に、RWKVやMambaなどの非Transformerアーキテクチャは、RULERにおいて依然としてTransformerに大きな差をつけられていることを示す。
我々の貢献は以下の通りである:
- 我々は、柔軟な設定を備えた合成タスクを通じて長文コンテキスト言語モデルを評価する新しいベンチマークRULERを提案する。- 我々は、長文コンテキストからの検索以外の振る舞いをテストするため、特にマルチホップ追跡と集約という新しいタスクカテゴリを導入する。- 我々はRULERを用いて17の長文コンテキストLMを評価し、モデルとタスク複雑度にわたる分析を行う。
我々は長文コンテキスト言語モデルにおける今後の研究を促進するため、RULERをオープンソース化する。
2 関連研究
長文コンテキスト言語モデル。近年、エンジニアリング、アーキテクチャ、アルゴリズム設計の進歩により、数多くの長文コンテキスト言語モデルが導入されている。Flash attention (Dao et al., 2022; Dao, 2023) と Ring attention (Liu et al., 2023) は、長文コンテキストの処理に必要なメモリフットプリントを大幅に削減する。shifted sparse attention (Chen et al., 2024)、dilated attention (Ding et al., 2023)、attention sinks (Han et al., 2023; Xiao et al., 2024b) など、様々なスパースアテンション機構 (Child et al., 2019; Jaszczur et al., 2021) が効率的なコンテキストスケーリングを可能にするために採用された。Transformer (Vaswani et al., 2017) における長さ外挿を改善するために、ALiBi (Press et al., 2022)、xPOS (Sun et al., 2023b)、RoPE (Su et al., 2023) の変種 (Chen et al., 2023; Xiong et al., 2023; Peng et al., 2024; Liu et al., 2024b; Ding et al., 2024; Zhu et al., 2024) を含む新規の位置埋め込み手法が提案された。別の研究の流れは、コンテキストサイズの削減に焦点を当てている。これは、再帰機構を用いて過去のコンテキストをキャッシュする (Zhang et al., 2024a; Bulatov et al., 2023; Martins et al., 2022; Wu et al., 2022) か、コンテキストから関連情報を検索する (Xu et al., 2024a; Mohtashami & Jaggi, 2023; Wang et al., 2024; Tworkowski et al., 2024; Xiao et al., 2024a) か、圧縮によって顕著な情報を保持する (Jiang et al., 2023) ことによって達成できる。最後に、Mamba (Gu & Dao, 2023) や RWKV (Peng et al., 2023) のような新規アーキテクチャ (Gu et al., 2022; Fu et al., 2023a; Poli et al., 2023; Fu et al., 2023b; Sun et al., 2023a; Beck et al., 2024; Sun et al., 2024) も、長文コンテキスト入力を効率的に処理するために提案されている。
長文コンテキストのベンチマークとタスク。我々の研究は、長文コンテキスト言語モデルのベンチマークに関する他の研究と密接に関連している。ZeroSCROLLS (Shaham et al., 2023) は、長文書QAや(クエリベースの)要約など、10の現実的な自然言語タスクをカバーしている。L-Eval (An et al., 2024) も現実的なデータを使用しており、品質を確保するために手動でフィルタリングされている。LongBench (Bai et al., 2023) はバイリンガル設定のタスクを含む。InfiniteBench (Zhang et al., 2024b) は100Kトークンを超える長さのタスクを含む。LTM (Castillo et al., 2024) は長期会話の評価を対象としている。パラメトリック知識の影響を分離するために、先行研究 (Dong et al., 2023; Li et al., 2023b) は、あるカットオフ日付より後にオンラインで投稿された文書を使用すること、あるいは極めて低リソースの資料を活用すること (Tanzer et al., 2024) も提案している。現実的なベンチマークと比較して、合成タスクはセットアップ(例:系列長やタスク複雑度)をより柔軟に制御でき、パラメトリック知識の影響を受けにくい。近年の研究は主に検索ベースの合成タスク (Kamradt, 2023; Mohtashami & Jaggi, 2023; Li et al., 2023a; Liu et al., 2024d; Lee et al., 2024) に焦点を当てており、事実推論 (Kuratov et al., 2024; Karpinska et al., 2024)、長距離談話モデリング (Sun et al., 2022)、質問応答 (Levy et al., 2024; Yuan et al., 2024)、多数ショットの文脈内学習 (Agarwal et al., 2024; Bertsch et al., 2024; Xu et al., 2024b)、コード理解 (Liu et al., 2024c) を含む他の側面を調査する少数の研究がある。
3 RULERベンチマーク
RULERは、検索、マルチホップ追跡、集約、質問応答の4つのカテゴリにわたるタスクで構成されている。RULERの評価例は、各入力の長さと複雑度を定義する入力構成(表2を参照)に基づいて自動的に生成される。RULERのように制約された領域内では、タスク複雑度は、対象出力トークン数とコンテキスト内の信号対雑音比の関数と考えることができる。長文コンテキスト言語モデルの評価タスク設計に関するより包括的な議論については、読者を (Goldman et al., 2024) に誘導する。
3.1 検索: Needle-in-a-haystack (NIAH)
近年の研究 (Reid et al., 2024; Anthropic, 2023) は、長文コンテキストモデリング能力を評価するために、needle-in-a-haystack (Kamradt, 2023; NIAH) テストを一般的に採用している。NIAHテストは、十分なクエリが与えられたときにコンテキストから関連情報を検索する必要がある、広く研究されてきた (Hopfield, 1982; Graves et al., 2014; Olsson et al., 2022; Arora et al., 2024) 連想想起タスクを想起させる。RULERでは、複数の検索ベースのタスクを含め、バニラNIAHテストを拡張して、3つの基準に基づいてモデルを評価する。
| タスク | 設定 | 例 |
SingleNIAH(S-NIAH) | type_key = word、type_value = number、type_haystack = essay、size_haystack < context length | (エッセイ)long-context の特別なマジックナンバーの一つは 12345 です。提供されたテキストで言及されている long-context の特別なマジックナンバーは何ですか? 答え:12345 |
Multi-keysNIAH(MK-NIAH) | num_keys = 2、type_key = word、type_value = number、type_haystack = essay、size_haystack < context length | (エッセイ)long-context の特別なマジックナンバーの一つは 12345 です。large-model の特別なマジックナンバーの一つは 54321 です。提供されたテキストで言及されている long-context の特別なマジックナンバーは何ですか? 答え:12345 |
Multi-valuesNIAH(MV-NIAH) | num_values = 2、type_key = word、type_value = number、type_haystack = essay、size_haystack < context length | (エッセイ)long-context の特別なマジックナンバーの一つは 12345 です。long-context の特別なマジックナンバーの一つは 54321 です。提供されたテキストで言及されている long-context の特別なマジックナンバーをすべて挙げてください。答え:12345 54321 |
Multi-queriesNIAH(MQ-NIAH) | num_queries = 2、type_key = word、type_value = number、type_haystack = essay、size_haystack < context length | (エッセイ)long-context の特別なマジックナンバーの一つは 12345 です。large-model の特別なマジックナンバーの一つは 54321 です。提供されたテキストで言及されている long-context と large-model の特別なマジックナンバーをすべて挙げてください。答え:12345 54321 |
VariableTracking(VT) | num_chains = 2、num_hops = 2、size_noises < context length | (ノイズ)VAR X1 = 12345 .... VAR Y1 = 54321 .... VAR X2 = X1 .... VAR Y2 = Y1 .... VAR X3 = X2 .... VAR Y3 = Y2 .... 値 12345 が代入されている変数をすべて見つけてください。答え:X1 X2 X3 |
Common WordsExtraction(CWE) | freq_cw = 2、freq_ucw = 1、num_cw = 10、num_ucw < context length | aaa bbb cca aaa ddd eee ccc fff ggg hhh iii iii .... 上記のリストで最も一般的な 10 個の単語は何ですか? 答え:aaa ccc iii .... |
Frequent WordsExtraction(FWE) | α = 2、num_word < context length | aaa bbb cca aaa ddd eee ccc fff ggg aaa hhh aaa ccc iii iii .... 上記のコード化されたテキストで最も頻繁に出現する 3 個の単語は何ですか? 答え:aaa ccc iii |
QuestionAnswering(QA) | dataset = SQuAD、num_document < context length | Document 1: .... aaa .... Document 2: .... bbb .... Document 3: .... ccc .... Question: question Answer: bbb |
具体的には、検索能力は、(1)「needle」と「haystack」のタイプに依存しないこと、(2)困難な妨害物を無視できるほど十分に強いこと、(3)複数の項目を検索する必要がある場合に高い再現率を持つこと、である。これらの基準に基づいて、我々は4つのNIAHタスクを開発した。これらの各タスクにおける「needle」は、「haystack」(長い妨害テキスト)に挿入されたキー-バリューペアである。クエリは系列の末尾に位置し、コンテキスト内のキーと照合し、その後に関連する値を検索するための手がかりとして機能する。
- Single NIAH (S-NIAH): これは、単一の「needle」を「haystack」から検索する必要があるバニラNIAHテストである。クエリ/キー/バリューは、単語、数字(7桁)、またはUUID(32桁)の形式をとることができる。「haystack」は、繰り返されるノイズ文またはPaul Grahamのエッセイ (Kamradt, 2023) とすることができる。- Multi-keys NIAH (MK-NIAH): 複数の「needle」が「haystack」に挿入され、そのうちの1つだけを検索する必要がある。追加の「needle」は困難な妨害物である。最も困難な設定は、「haystack」が妨害用のneedleで埋め尽くされているバージョンである。
- Multi-values NIAH (MV-NIAH): 同じキーを共有する複数の「needle」が「haystack」に挿入される。同じキーに関連付けられたすべての値を検索する必要がある。- Multi-queries NIAH (MQ-NIAH): 複数の「needle」が「haystack」に挿入される。異なるキーを持つすべての「needle」を検索する必要がある。これは、Arora et al. (2024) が使用したものと同じマルチクエリ連想想起タスクの設定である。MV-NIAHと合わせて、これら2つのタスクは、重要な情報を一切見逃すことなく検索能力を評価する。
3.2 マルチホップ追跡: 変数追跡 (VT)
効果的な談話理解 (van Dijk & Kintsch, 1983) は、新しく言及された実体を正しく認識し、長いコンテキスト全体を通じて同じ実体を共参照する参照の連鎖を確立すること (Karttunen, 1969) に依存している。我々は、最小限の共参照連鎖解決 (Ng, 2010) タスクを模倣する新しいタスクである変数追跡を開発した。このタスクは、長い入力内で関連する共起パターンを追跡し、飛ばされた接続を描く振る舞いをチェックする。具体的には、変数 が値 で初期化され、その後に一連の変数名束縛文(例: 、、...)が続き、これらが入力の様々な位置に挿入される。目的は、同じ値 を指すすべての変数名を返すことである。タスク複雑度は、MK-NIAHで困難な妨害物を追加するのと同様に、より多くのホップ(すなわち名前束縛の回数)やより多くの連鎖を追加することによって増加させることができる。
3.3 集約: 共通語 (CWE) と頻出語抽出 (FWE)
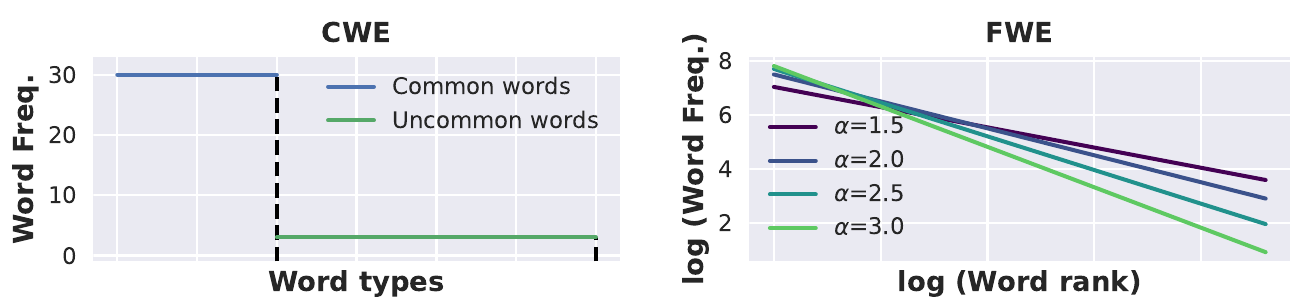
RULERでは、関連情報がコンテキストのより大きな部分を占め、対象出力が関連入力の正確な集約に依存する要約タスクの代理として、新しいカテゴリを導入する。具体的には、事前定義された(合成)単語リストから単語をサンプリングすることによって入力系列を構築する。共通語抽出タスク(CWE)では、単語は離散一様分布からサンプリングされ、共通語の数は固定されている一方で、非共通語の数は系列長とともに増加する。頻出語抽出タスク(FWE)では、単語はゼータ分布からサンプリングされる。図1は、構築された入力における単語頻度の例示を示している。モデルは、コンテキスト内で上位 個の頻出語を返す必要がある。CWEでは、 は共通語の数に等しい。FWEでは、 を3に設定する。なぜなら、 を増やすと、ほとんどのモデルで小さなコンテキストサイズでも性能が低下するからである。タスク複雑度は、共通語の数またはゼータ分布のパラメータを変化させることによって調整できる。4
3.4 質問応答 (QA)
既存のQAデータセットの大半(Rajpurkar et al., 2018; Yang et al., 2018; Trivedi et al., 2022)は、短いパッセージに基づいて質問に答えるように設計されている。これらのデータセットは、紛らわしい情報を追加することで長文脈入力のシミュレーションへと拡張できる。このタスクカテゴリでは、ゴールデンパラグラフ(すなわち解答を含むパラグラフ)を、同一データセットからランダムにサンプリングしたパラグラフに挿入する。このカテゴリは、NIAHを実世界向けに適応させたものであり(Ivgi et al., 2023)、質問がクエリ、ゴールデンパラグラフが「針」、紛らわしいパラグラフが「干し草の山」の役割を果たす。
4 実験と結果
モデルと推論の設定 我々は17の長文脈LLMを選択した。これには15のオープンソースモデルと2つのクローズドソースモデル(Gemini-1.5-ProとGPT-4)が含まれ、多様なモデルサイズ(7BからMoEアーキテクチャの8x22B)と公称コンテキスト長(32Kから1M)をカバーしている。これらのモデルの完全な情報は付録Aに含まれている。我々はすべてのモデルを、効率的なKVキャッシュメモリ管理を備えたLLMサービングシステムであるvLLM(Kwon et al., 2023)を用いて評価する。すべてのモデルについて、推論はBFloat16で8台のNVIDIA A100 GPU上でグリーディーデコーディングにより実行する。
タスク設定 我々はすべてのモデルを、RULERの4つのカテゴリから多様な複雑さを持つ13のタスクでテストする。テスト設定は、付録Cに記載されたタスク相関研究に基づいて選択された(付録Bに示す)。これらのタスクを選択したのは、ほとんどのモデルが4Kトークンという短いコンテキストサイズで良好に動作するためである。我々の主な目的は、コンテキスト長のスケーリングに伴いモデルがこのような良好な性能を維持できるかどうかを確認することである。各タスクについて、各モデルを(4K、8K、16K、32K、64K、128K)の系列の各長さに対して生成した500例で評価し、各モデルに必要なチャットテンプレートに従う。モデルがクエリへの回答を拒否したり説明を生成したりするのを防ぐため、タスク入力に回答プレフィックスを付加し、リコールベースの精度でターゲット出力の存在を確認する。
効果的なコンテキストサイズ RULERにおいて入力長を増やすと、すべてのモデルで大きな性能劣化が見られることに注目する。モデルが効果的に扱える最大コンテキストサイズを決定するため、各モデルを固定の閾値で評価し、これを通過すれば評価した長さにおいて満足のいく性能を示すものとする。閾値としては、Llama2-7bモデルの4Kコンテキスト長における性能を用いる。表3では、閾値を超える最大長を「実効長」として、「公称長」とあわせて報告する。
モデルランキングの基準 閾値に基づく評価は、公称長と実効長の間の不一致を明らかにするものの、細粒度のモデル比較に必要な詳細を欠いている。そこで我々は、さまざまなコンテキストサイズにわたるモデル性能を集約するために重み付き平均スコアを用いる。モデルは2つの重み付け方式、wAvg.(inc)とwAvg.(dec)の下でランク付けされる。ここで重みはそれぞれ系列長に対して線形に増加および減少する。理想的には、各長さの重みはモデル使用の長さ分布によって決定されるべきであるが、ここではより長い系列(inc)またはより短い系列(dec)が分布を支配するシナリオを模擬するためにこの2つの方式を選ぶ。
主な結果 表3には、Llama2-7Bベースラインと比較した17の長文コンテキストLMの結果を含む。ある長さにおける性能は、RULERの全13タスクの平均である。クローズドソースモデルであるGemini-1.5-Proは他のモデルを大きく上回り、その実効長は我々がテストした最大長よりも大きい。このモデルをより難しいバージョンのRULERでプレッシャーテストすることは、今後の興味深いフォローアップとなり得る。その他のモデルについては、パスキー検索およびバニラNIAHタスク(付録Eに示す)ではほぼ完璧な性能を達成するものの、すべてのモデルが系列長の増加に伴ってRULERで大きな劣化を示し、公称長においてLlama2-7Bベースライン以上の性能を維持できていない。上位のオープンソースモデル(Llama3.1、Qwen2、Command-R-plus)は、より大きなモデルサイズを持つことやRoPEにおいてより大きな基底周波数を用いること(Xiong et al., 2023)といった共通の構成を共有している。
| モデル | 公称長 | 有効長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 | 重み付き平均(増加) | 重み付き平均(減少) |
| Llama2 (7B) | 4K | - | 85.6 | ||||||||
| Gemini-1.5-Pro | 1M | &gt;128K | 96.7 | 95.8 | 96.0 | 95.9 | 95.9 | 94.4 | 95.8 | 95.5(1位) | 96.1(1位) |
| GPT-4 | 128K | 64K | 96.6 | 95.3 | 95.2 | 93.2 | 87.0 | 81.2 | 91.6 | 89.0(2位) | 94.1(2位) |
| Llama3.1 (70B) | 128K | 64K | 96.5 | 95.8 | 95.4 | 94.8 | 88.4 | 66.6 | 89.6 | 85.5(4位) | 93.7(3位) |
| Qwen2 (72B) | 128K | 32K | 96.9 | 96.1 | 94.9 | 94.1 | 79.8 | 53.7 | 85.9 | 79.6(9位) | 92.3(4位) |
| Command-R-plus (104B) | 128K | 32K | 95.6 | 95.2 | 94.2 | 92.0 | 84.3 | 63.1 | 87.4 | 82.7(7位) | 92.1(5位) |
| GLM4 (9B) | 1M | 64K | 94.7 | 92.8 | 92.1 | 89.9 | 86.7 | 83.1 | 89.9 | 88.0(3位) | 91.7(6位) |
| Llama3.1 (8B) | 128K | 32K | 95.5 | 93.8 | 91.6 | 87.4 | 84.7 | 77.0 | 88.3 | 85.4(5位) | 91.3(7位) |
| GradientAI/Llama3 (70B) | 1M | 16K | 95.1 | 94.4 | 90.8 | 85.4 | 80.9 | 72.1 | 86.5 | 82.6(8位) | 90.3(8位) |
| Mixtral-8x22B (39B/141B) | 64K | 32K | 95.6 | 94.9 | 93.4 | 90.9 | 84.7 | 31.7 | 81.9 | 73.5(11位) | 90.3(9位) |
| Yi (34B) | 200K | 32K | 93.3 | 読み取り専用の背景情報(翻訳対象の原文テキストではありません):4 実験と結果 主な結果 表3には、Llama2-7Bベースラインと比較した17の長文脈LMの結果を示す。ある長さにおける性能は、RULERにおける全13タスクの平均である。クローズドソースモデルのGemini-1.5-Proは他のモデルを大差で上回り、その有効長は我々がテストした最大長よりも大きい。このモデルをより難易度の高いバージョンのRULERでプレッシャーテストすることは、今後の追跡調査として興味深いであろう。 | 翻訳対象テキスト: | 92.2 | 91.3 | 87.5 | 83.2 | 77.3 | 87.5 |
| 84.8(6位) | 90.1(10位) | Phi3-medium(14B) | 128K | 32K | 93.3 | 93.2 | 91.1 | 86.8 | 78.6 | 46.1 | 81.5 |
| 74.8(10位) | 88.3(11位) | Mixtral-v0.2(7B) | 32K | 16K | 93.6 | 91.2 | 87.2 | 75.4 | 49.0 | 13.8 | 68.4 |
| 55.6(13位) | 81.2(12位) | LWM(7B) | 1M | &lt;4K | 82.3 | 78.4 | 73.7 | 69.1 | 68.1 | 65.0 | 72.8 |
| 69.9(12位) | 75.7(13位) | DBRX(36B/132B) | 32K | 8K | 95.1 | 93.8 | 83.6 | 63.1 | 2.4 | 0.0 | 56.3 |
| 38.0(14位) | 74.7(14位) | Together(7B) | 32K | 4K | 88.2 | 81.1 | 69.4 63.0 0.0 | 0.0 | 50.3 | 33.8(15位) | 66.7(15位) |
| LongChat(7B) | 32K | &lt;4K | 84.7 | 79.9 | 70.8 | 59.3 | 0.0 | 0.0 | 49.1 | 33.1(16位) | 65.2(16位) |
| LongAlpaca(13B) | 32K | &lt;4K | 60.6 | 57.0 | 56.6 | 43.6 | 0.0 | 0.0 | 36.3 | 24.7(17位) | 47.9(17位) |
大きな学習コンテキストウィンドウは、優れた長文コンテキスト性能にとって必ずしも必要ではない。上位のオープンソースモデルには、力任せのコンテキスト拡張(Llama3.1は128Kコンテキスト長で学習)と推論時の長さ外挿(Qwen2は32Kコンテキスト長で学習)の両方が含まれている。性能の低いモデルには、はるかに大きなコンテキストサイズで学習されたもの(例:LWMとGradientAI/Llama3はいずれも1Mコンテキスト長)も含まれる。LWMは、より長い系列に大きな重みが与えられる場合(wAvg. inc)にMistral-v0.2よりも高い順位を達成し、コンテキストサイズの増加に伴う劣化も小さいものの、4KにおいてさえLlama2-7Bよりも性能が低い。この結果は、短い系列における絶対性能とコンテキストサイズのスケーリングに伴う相対的劣化との間の評価上のトレードオフを示唆している。モデルサイズと最大学習長に関するより詳細な分析は第6節で示す。
5 タスクエラー分析
我々は、Yi-34B-200Kをより複雑なタスクにおいて増加した入力長(最大256K)で評価し、タスク構成と失敗モードがRULERに与える影響を理解する。
「ニードル」の種類に対する非堅牢性。図2(左)は、標準的なパスキー検索およびバニラNIAHにおいて単語-数字ペアのニードルを用いる場合にはYiがほぼ完璧な性能を達成する一方、ニードルが他の形式をとる場合には性能が劣化することを示している。最大の劣化はUUIDを検索するタスクで観察され、長い()入力コンテキストが与えられた場合に、Yiは完全な32桁を返すことに失敗することがある。
妨害要素を無視することの失敗。図2(中央左)は、妨害となるニードルの数を増やすと性能が着実に低下し、コンテキストが無関係なニードルで満たされる極端なバージョン(#K=FULL)では256KにおいてYiが約40ポイント低下することを示している。エラー分析により、長い入力コンテキストが与えられた場合にYiが困難な妨害要素を効果的に無視することに失敗し、その結果妨害キーに関連する値を誤って検索していることが明らかになった。極端なバージョンでは、Yiはしばしばターゲットの近傍から値を返し、範囲の粗い一致は示すものの、ターゲットがノイズの分布内にある場合にキーを特定する精度を欠いていることを示唆している。
不完全な情報を返す。先行研究(Liu et al., 2024a; Reid et al., 2024)と一致して、モデルが長い入力から複数の項目を検索する必要がある場合に性能が大きく劣化することを我々は確認した。例えば、クエリの数を1から8に増やすと性能が約15ポイント低下する(図2右)。モデルが同一のキーに関連する複数の値を検索する必要がある場合(図2中央右)、Yiはしばしば完全な値の集合を返さずに重複した回答を出力し、キーとその各値との間の関連が不均一であることを示唆している。
コンテキストからのコピー傾向。我々は、入力長をスケーリングする際にYiがコンテキストから逐語的にコピーする強い傾向を持つことに注目した。この傾向は、系列の先頭にインコンテキストの実演を1つ含める変数追跡(VT)および共通単語抽出(CWE)において最も顕著である。128KにおけるCWEタスクでのYiの出力の80%以上は、単にワンショット例からコピーされた文字列であり、一方で短い系列ではコピーは存在しない。このコピー行動はLWMモデルおよびLongAlpacaにも見られるが、Mixtralなど他のモデルではあまり一般的ではない。この発見は、長い入力コンテキストが与えられた際に検索以外の行動をテストする必要性をさらに強めるものである。
コンテキスト内での信頼性の低い追跡。変数追跡タスクでは、チェーンを増やすこととホップを増やすことの両方がYiの性能の大きな劣化に寄与する。Yiはコンテキストサイズを増やすにつれてホップ数が多い設定で一貫して劣化し(図3左)、一方でチェーン数が多い設定での劣化は128Kを超える長さで最も顕著である(図3中央左)。上述のコピー問題に加えて、Yiは空文字列や他のチェーンからの変数を誤って返すことによるエラーを起こし、長いコンテキスト内で同じエンティティを確実に追跡する能力の欠如を示唆している。これらのエラーは、コピー行動を示さないモデルでも頻繁に観察される。
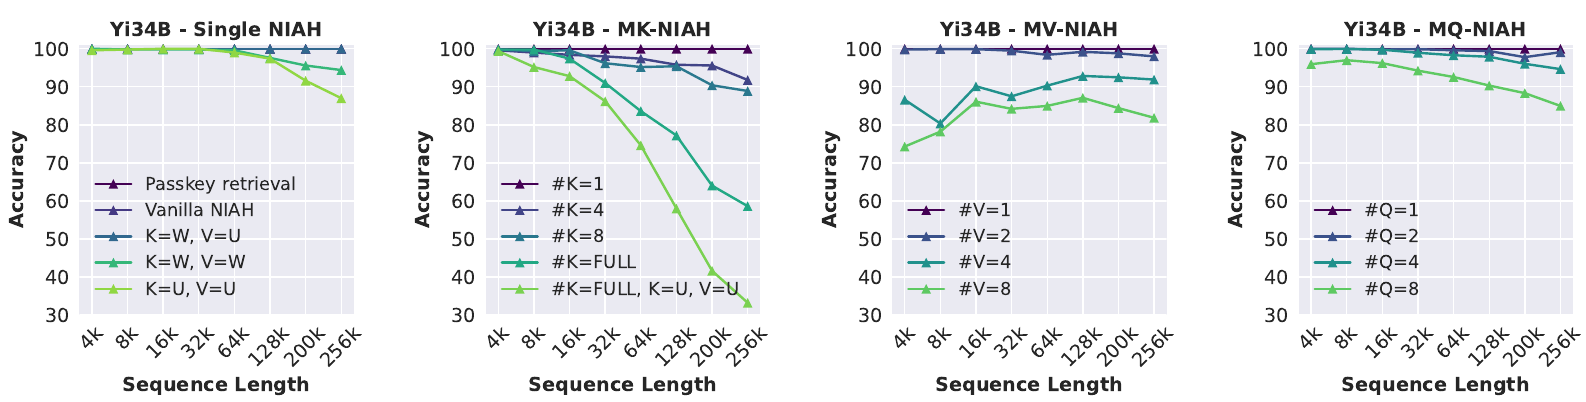
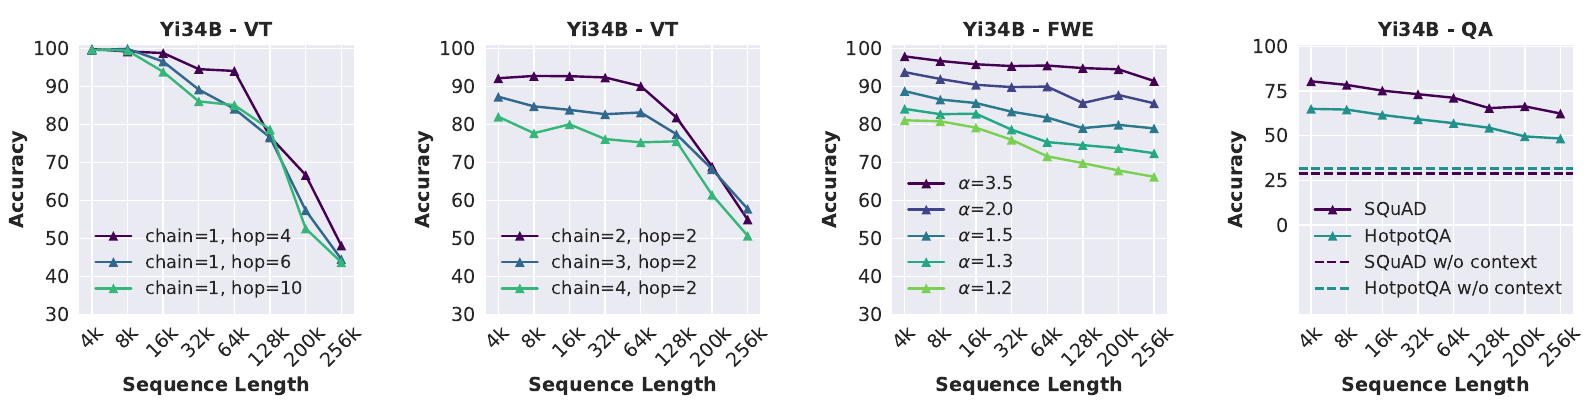
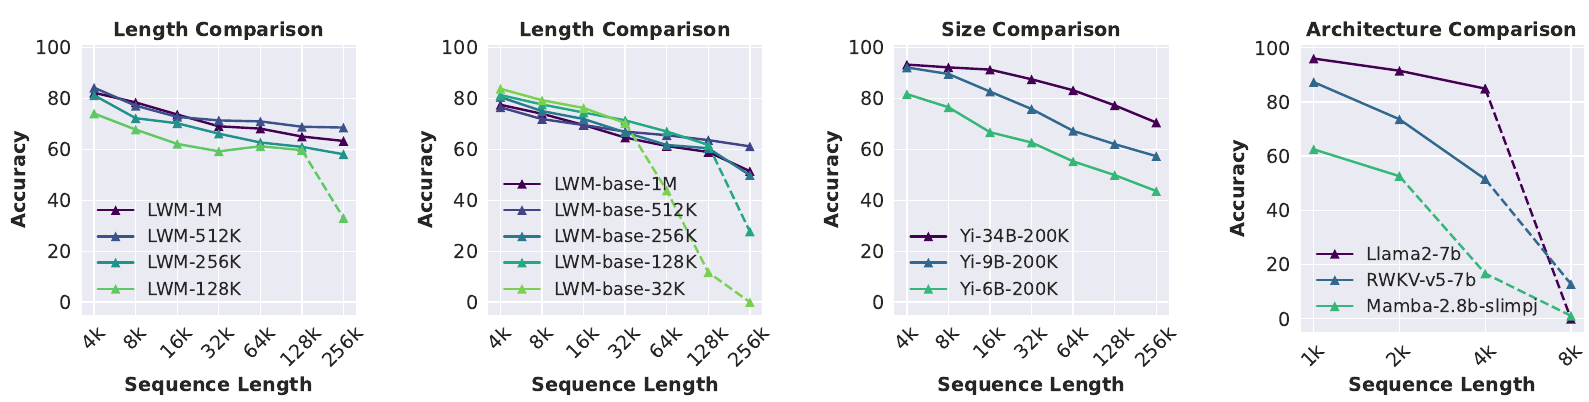
図4:(左および中央左):7Bの固定パラメータサイズで様々なコンテキストサイズまで学習されたLargeWorldModel(LWM)シリーズの比較。(中央右):200Kの学習コンテキスト長を制御した、異なるパラメータサイズを持つYiスイートモデルの比較。(右):非Transformerアーキテクチャの性能はTransformerベースラインであるLlama2-7Bに大きく後れをとる。長さ外挿は破線で示す。
正確に集約することの失敗。我々は集約タスクにおいて2つの一般的な失敗モードを観察する。パラメトリック知識の誤用と不正確な集約である。CWEタスクでコピー問題を示さないモデルは、しばしばコンテキスト情報を無視し、代わりにパラメトリック知識を用いてクエリに回答する。特に大きなコンテキストサイズにおいてそうである。例えば、Mistral(7b-instruct-v0.2)はコンテキスト内の単語を数えることなく、「the」「an」「a」といった高頻度語を出力として返す。コピー問題をあまり示さないFWEタスクでは、Zeta分布のを減少させるにつれてYiは上位の頻出語を正しく出力することに失敗する(図3中央右)。を減少させると単語間の頻度の差が小さくなり、上位頻出語を識別することが困難になる。
長文コンテキストQAにおける頻繁なハルシネーション。QAタスクでは、妨害となる段落でコンテキストを拡張するにつれてYiの性能はそのコンテキストなしのベースラインに近づく(図3右)。劣化は主にハルシネーションとコンテキスト情報への依存の低下に起因する。大きなコンテキストサイズでは、モデルの予測がしばしば質問と無関係であり、コンテキストなしのベースラインの回答と一致することがあることに我々は注目した。QAタスク全般におけるより悪い性能は、長いコンテキストにおいてクエリと関連段落との間の曖昧なマッチングが、キーをコンテキスト内で正確に特定できる単純なNIAHテストよりも困難な設定であることを裏付けている。
6 モデル分析
学習コンテキスト長の効果。より大きなコンテキストサイズで学習されたモデルはRULERでより良い性能を発揮するのだろうか。我々は、等しいパラメータサイズで様々なコンテキスト長まで学習されたLargeWorldModels(Liu et al. [2024a] LWM)のスイートを評価する。図4(左および中央左)は、より大きなコンテキストサイズが全体的により良い性能につながるものの、長い系列では順位が一貫しない場合があることを示している。例えば、1Mコンテキストサイズで学習されたモデル(LWM-1M)は、256Kの長さにおいて512Kのモデルよりも劣っており、これはおそらくRoPEにおける新しい基底周波数への適応のための学習が不十分であるためである。さらに、モデルが未見の長さへ外挿する必要がある場合(例:LMW-128Kに256Kの入力を与える場合)に急激な性能低下が観察され、最大学習コンテキストサイズ内では対数スケールで入力長に対してほぼ線形の劣化が見られる。
モデルサイズの効果 我々の主な結果における上位モデルは他のモデルよりもはるかに大きい。モデルサイズの効果をアブレーションするため、我々はYi-34B-200k、Yi-9B-200k、Yi-6B-200kを評価する。これらはすべて同じデータブレンドを用いて同じコンテキスト長まで学習されている。図4(中央右)は、34Bモデルが4Kの長さにおける性能と相対的劣化の両方において6BモデルよりもRULERで有意に優れていることを示しており、より良い長文コンテキストモデリングのためのモデルサイズのスケーリングの利点を示唆している。
アーキテクチャの影響 我々は、非Transformerアーキテクチャを持つ2つのモデル、RWKV-v5(Peng et al. [2023])とMamba-2.8B-slimpj(Gu & Dao, 2023)について、実効コンテキスト長を評価する。両モデルとも、コンテキストサイズを8Kに拡張すると著しい性能劣化を示し、また4Kの長さまではTransformerベースラインであるLlama2-7Bに大きな差で劣ることが分かった。4Kを超えると、Llama2は長さの外挿性能が低いことを示す(図4右)。
7 結論
我々は、長コンテキスト言語モデルを評価するための合成ベンチマークであるRULERを提示する。RULERは、検索、マルチホップ追跡、集約、質問応答といった多様なタスクカテゴリを含み、LLMの長コンテキスト能力を柔軟かつ包括的に評価する。我々は、4Kから128Kまでのコンテキストサイズで、RULERを用いて17の長コンテキストLMをベンチマーク評価した。広く使われているneedle-in-a-haystackテストでは完璧な結果を達成しているにもかかわらず、入力長を増やすと、ほとんどすべてのモデルがRULERの他のタスクで性能を維持できない。大きなコンテキストサイズにおいて共通して見られる失敗モードとして、妨害情報を無視できないことや、長コンテキストを効果的に活用できないこと(例:単にコンテキストからコピーする、または代わりにパラメトリック知識を用いる)が観察された。我々は、タスクの複雑さを増すにつれて、RULERがトップランクのオープンソースモデルにとっても困難であることを示す。さらに我々の分析は、RULERにおいて改善の大きな余地があること、およびより優れた長コンテキスト能力を達成するためにモデルサイズをスケーリングすることの利点を明らかにする。
8 制限
検索指向のベンチマークよりも多くのタスクカテゴリを網羅しているにもかかわらず、RULERには複数の制限があり、以下で詳細に述べる。
位置制御の欠如。現在のRULERは、深さレベルの性能を提供せずに、各入力長に対して単一の数値指標を報告する。深さレベルの性能は、NIAHテスト(Kamradi, 2023)やLV-Eval(Yuan et al. 2024)のような最近の研究によって評価されており、lost-in-the-middle(Liu et al. 2024d)現象を明らかにするのに有効であり得る。我々はこの問題を認識しており、我々のコードベースにおいてキー情報の位置制御をサポートする予定である。
現実的な長文コンテキストタスクとの相関性の欠如。変数追跡や頻出単語抽出といったタスクは、実際の長文コンテキスト自然言語タスクの代理として提案されてきたが、評価が容易な現実的な長文コンテキストタスクが存在しないため、こうした代理タスクの妥当性を検証することができない。この制限により、RULERは長文コンテキスト言語モデルの簡便な振る舞いチェックとして使用できるものの、より現実的な設定、例えばNoCHA(Karpinska et al. 2024)のように推論や指示追従といった他の能力も重視する設定よりも優先されるべきではないことを強調する。
短文コンテキストにおける評価の欠如。現在のRULERタスクスイートでは、ほとんどのモデルが4kコンテキストサイズで reasonable に良好な性能を発揮するタスクを含めており、コンテキストサイズの拡大に伴う性能劣化を観察することを目的としている。これは4kコンテキストサイズにおける完璧なLM能力と誤読されるべきではない。実際、FlenQA(Levy et al. 2024)のような最近の研究では、タスク入力長をわずか数千トークンに増加させるだけで性能が劣化することが示されている。RULERにおけるタスクの複雑性を増加させると、より短いコンテキストサイズで性能がはるかに悪化するが、これらの結果は本論文には含めていない。
プロンプトの堅牢性の検証の欠如。言語モデルはプロンプト形式に敏感であり得るが、本研究の初期段階における予備的テストを超えて、プロンプトの堅牢性に関する包括的な研究を拡張することはしなかった。また、既存のタスクにおけるいくつかの固定ハイパーパラメータ、例えば変数追跡における変数名の長さや、common word extractionおよびfrequent word extractionにおける合成語彙サイズについても、大規模な実験を行っていない。
参考文献
Marah Abdin, Sam Ade Jacobs, Ammar Ahmad Awan, Jyoti Aneja, Ahmed Awadallah, Hany Awadalla, Nguyen Bach, Amit Bahree, Arash Bakhtiari, Harkirat Behl, et al. Phi-3 technical report: A highly capable language model locally on your phone. arXiv preprint arXiv:2404.14219, 2024.
Rishabh Agarwal, Avi Singh, Lei M Zhang, Bernd Bohnet, Stephanie Chan, Ankesh Anand, Zaheer Abbas, Azade Nova, John D Co-Reyes, Eric Chu, et al. Many-shot in-context learning. arXiv preprint arXiv:2404.11018, 2024.
AI21. Introducing jamba: Ai21's groundbreaking ssm-transformer model, 2024. URL https://www.ai21.com/blog/announcing-jamba
Chenxin An, Shansan Gong, Ming Zhong, Mukai Li, Jun Zhang, Lingpeng Kong, and Xipeng Qiu. L-eval: Instituting standardized evaluation for long context language models. In ICLR, 2024.
Anthropic. Long context prompting for Claude 2.1. Blog, 2023. URL https://www.anthropic.com/index/claude-2-1-prompting
Anthropic. Introducing the next generation of claude, 2024. URL https://www.anthropic.com/news/claude-3-family
Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. Zoology: Measuring and improving recall in efficient language models. In ICLR, 2024.
Yushi Bai et al. LongBench: A bilingual, multitask benchmark for long context understanding. arXiv:2308.14508, 2023.
Maximilian Beck, Korbinian Pöppel, Markus Spanning, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, and Sepp Hochreiter. xlstm: Extended long short-term memory. arXiv preprint arXiv:2405.04517, 2024.
Amanda Bertsch, Maor Ivgi, Uri Alon, Jonathan Berant, Matthew R Gormley, and Graham Neubig. In-context learning with long-context models: An in-depth exploration. arXiv preprint arXiv:2405.00200, 2024.
Aydar Bulatov, Yuri Kuratov, and Mikhail S Burtsev. Scaling Transformer to 1M tokens and beyond with RMT. arXiv:2304.11062, 2023.
David Castillo, Joseph Davidson, Finlay Gray, José Solorzano, and Marek Rosa. Introducing GoodAI LTM benchmark. Blog, 2024. URL https://www.goodai.com/introducing-goodai-ltm-benchmark/
Shouyuan Chen, Sherman Wong, Liangjian Chen, and Yuandong Tian. Extending context window of large language models via positional interpolation. In ICLR, 2023.
Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han, and Jiaya Jia. LongLoRA: Efficient fine-tuning of long-context large language models. In ICLR, 2024.
Rewon Child, Scott Gray, Alec Radford, and Ilya Sutskever. Generating long sequences with sparse Transformers. arXiv:1904.10509, 2019.
Cohere. Command r, 2024. URL https://docs.cohere.com/docs/command-r-plus#model-details
Tri Dao. FlashAttention-2: Faster attention with better parallelism and work partitioning. arxiv:2307.08691, 2023.
Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. FlashAttention: Fast and memory-efficient exact attention with IO-awareness. In NeurIPS, 2022.
.
Databricks. Introducing dbrx: A new state-of-the-art open llm, 2024. URL https://www databricks.com/blog/introducing-dbrx-new-state-art-open-llm
Jiayu Ding et al. LongNet: Scaling Transformers to 1,000,000,000 tokens. arXiv:2307.02486, 2023.
Yiran Ding et al. LongRoPE: Extending LLM context window beyond 2 million tokens. arXiv:2402.13753, 2024.
Zican Dong, Tianyi Tang, Junyi Li, Wayne Xin Zhao, and Ji-Rong Wen. Bamboo: A comprehensive benchmark for evaluating long text modeling capacities of large language models. arXiv:2309.13345, 2023.
Daniel Y. Fu, Tri Dao, Khaled K. Saab, Armin W. Thomas, Atri Rudra, and Christopher Ré. Hungry Hungry Hippos: Towards language modeling with state space models. In ICLR, 2023a.
Daniel Y. Fu et al. Simple hardware-efficient long convolutions for sequence modeling. ICML, 2023b.
Yao Fu et al. Data engineering for scaling language models to 128k context. arXiv:2402.10171, 2024.
Team GLM, Aohan Zeng, Bin Xu, Bowen Wang, Chenhui Zhang, Da Yin, Diego Rojas, Guanyu Feng, Hanlin Zhao, Hanyu Lai, Hao Yu, Hongning Wang, Jiadai Sun, Jiajie Zhang, Jiale Cheng, Jiayi Gui, Jie Tang, Jing Zhang, Juanzi Li, Lei Zhao, Lindong Wu, Lucen Zhong, Mingdao Liu, Minlie Huang, Peng Zhang, Qinkai Zheng, Rui Lu, Shuaiqi Duan, Shudan Zhang, Shulin Cao, Shuxun Yang, Weng Lam Tam, Wenyi Zhao, Xiao Liu, Xiao Xia, Xiaohan Zhang, Xiaotao Gu, Xin Lv, Xinghan Liu, Xinyi Liu, Xinyue Yang, Xixuan Song, Xunkai Zhang, Yifan An, Yifan Xu, Yilin Niu, Yuantao Yang, Yueyan Li, Yushi Bai, Yuxiao Dong, Zehan Qi, Zhaoyu Wang, Zhen Yang, Zhengxiao Du, Zhenyu Hou, and Zihan Wang. Chatglm: A family of large language models from glm-130b to glm-4 all tools, 2024.
Omer Goldman, Alon Jacovi, Aviv Slobodkin, Aviya Maimon, Ido Dagan, and Reut Tsarfaty. Is it really long context if all you need is retrieval? towards genuinely difficult long context nlp. arXiv preprint arXiv:2407.00402, 2024.
Alex Graves, Greg Wayne, and Ivo Danihelka. Neural Turing machines. arXiv:1410.5401, 2014.
Albert Gu and Tri Dao. Mamba: Linear-time sequence modeling with selective state spaces. arXiv:2312.00752, 2023.
Albert Gu, Karan Goel, and Christopher Re. Efficiently modeling long sequences with structured state spaces. In ICLR, 2022.
Chi Han, Qifan Wang, Wenhan Xiong, Yu Chen, Heng Ji, and Sinong Wang. Lm-infinite:大規模言語モデルのための簡易なオンザフライ長さ汎化。arXiv:2308.16137, 2023.
John J. Hopfield. 創発的な集団計算能力を持つニューラルネットワークと物理システム。Proc of the National Academy of Sciences of the United States of America, 79 8: 2554-8, 1982.
Maor Ivgi, Uri Shaham, and Jonathan Berant. 短文モデルによる効率的な長文理解。Transactions of the ACL, 11:284-299, 2023.
Sam Ade Jacobs et al. DeepSpeed Ulysses:極めて長い系列のTransformerモデルの訓練を可能にするためのシステム最適化。arXiv:2309.14509, 2023.
Sebastian Jaszczur et al. Transformerのスケーリングにおいてスパースは十分である。In NeurIPS, 2021.
Albert Q Jiang et al. Mixtral of experts. arXiv:2401.04088, 2024.
Huiqiang Jiang et al. LongLlmLingua:プロンプト圧縮による長文コンテキストシナリオにおけるLLMの加速と強化。arXiv:2310.06839, 2023.
Gregory Kamradt. Needle In A Haystack - LLMのプレッシャーテスト。Github, 2023. URL https://github.com/gkamradt/LLMTest.NeedleInAHaystack/tree/main
Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal, and Mohit Iyyer. 千と一のペア:長文コンテキスト言語モデルへの「斬新な」挑戦。arXiv preprint arXiv:2406.16264, 2024.
Lauri Karttunen. 談話指示対象。In COLING, 1969.
George Kingsley Zipf. 言語における相対頻度の原理に関する選集。Harvard university press, 1932.
Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin, and Mikhail Burtsev. Babilong:干し草の山の中での長文コンテキスト推論によってLLMの限界をテストする。arXiv preprint arXiv:2406.10149, 2024.
Woosuk Kwon ほか「ページアテンションを用いた大規模言語モデルサービングのための効率的なメモリ管理」ACM SIGOPS 第29回オペレーティングシステム原理シンポジウム論文集、2023年。
Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien MR Arnold, Vincent Perot, Siddharth Dalmia, ほか「長文脈言語モデルは検索、RAG、SQLなどを包含できるか?」arXivプレプリント arXiv:2406.13121、2024年。
Mosh Levy, Alon Jacoby, Yoav Goldberg「同一タスク、より多くのトークン:入力長が大規模言語モデルの推論性能に与える影響」arXivプレプリント arXiv:2402.14848、2024年。
Dacheng Li, Rulin Shao, ほか「オープンソースLLMはコンテキスト長について本当にどこまで約束できるのか?」2023a年。URL https://1msys.org/blog/2023-06-29-longchat
Jiaqi Li, Mengmeng Wang, Zilong Zheng, Muhan Zhang「Loogle:長文脈言語モデルは長い文脈を理解できるか?」arXiv:2311.04939、2023b年。
Hao Liu, Matei Zaharia, Pieter Abbeel「ブロックワイズTransformerによるリングアテンションでほぼ無限のコンテキストを実現」ICLR、2023年。
Hao Liu, Wilson Yan, Matei Zaharia, Pieter Abbeel「Ring Attentionによる100万長の動画と言語に関する世界モデル」arxiv:2402.08268、2024a年。
Jiaheng Liu ほか「E2-LLM:大規模言語モデルの効率的かつ極端な長さ拡張」arXiv:2401.06951、2024b年。
Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang, Lingming Zhang「Repoqa:長文脈コード理解の評価」arXivプレプリント arXiv:2406.06025、2024c年。
Nelson F Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni, Percy Liang「中間で失われる:言語モデルが長い文脈をどのように利用するか」Transactions of the ACL、12:157-173、2024d年。
Pedro Henrique Martins, Zita Marinho, Andre Martins「∞-former:無限メモリTransformer」第60回ACL年次総会論文集(第1巻:長論文)、2022年。
Meta.AI「Llama 3 モデルカード」2024a年。URL https://github.com/meta-llama/llama3/blob/main/MODEL_CARD.md
Meta.AI「Llama 3.1 モデルカード」2024b年。URL https://github.com/meta-llama/llama-models/blob/main/models/llama3.1/MODEL_CARD.md
Mistral.AI「La plateforme」2023年。URL https://mistral.ai/news/la-plateforme/Amirkeivan Mohtashami, Martin Jaggi「ランドマークアテンション:Transformerのためのランダムアクセス無限コンテキスト長」基盤モデルのための効率的システムに関するワークショップ @ ICML、2023年。
Vincent Ng「教師あり名詞句照応研究:最初の15年」第48回ACL年次総会論文集、2010年。
Catherine Olsson ほか「文脈内学習と帰納ヘッド」Transformer Circuits Thread、2022年。https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html
OpenAI: Josh Achiam ほか「GPT-4 技術報告」arXiv:2303.08774、2023年。
Bo Peng ほか「RWKV:Transformer時代のためのRNNの再発明」EMNLP、2023年。
Bowen Peng, Jeffrey Quesnelle, Honglu Fan, Enrico Shippole「YaRN:大規模言語モデルの効率的なコンテキストウィンドウ拡張」ICLR、2024年。
Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, Christopher Ré「Hyena階層:より大規模な畳み込み言語モデルに向けて」ICML、2023年。
Ofir Press, Noah Smith, Mike Lewis「短く訓練し、長くテストする:線形バイアス付きアテンションが入力長の外挿を可能にする」ICLR、2022年。
Pranav Rajpurkar, Robin Jia, Percy Liang「知らないことを知る:SQuADに対する回答不能な質問」第56回ACL年次総会論文集(第2巻:短論文)、2018年。
Machel Reid ほか「Gemini 1.5:数百万トークンのコンテキストにわたるマルチモーダル理解の解き放ち」arXiv:2403.05530、2024年。
Marco Tulio Ribeiro, Tongshuang Wu, Carlos Guestrin, Sameer Singh「精度を超えて:CheckListによるNLPモデルの行動テスト」第58回ACL年次総会論文集、2020年。
Uri Shaham, Maor Ivgi, Avia Efrat, Jonathan Berant, Omer Levy「ZeroSCROLLS:長文テキスト理解のためのゼロショットベンチマーク」EMNLP、2023年。
Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, Yunfeng Liu「RoFormer:回転位置埋め込みによる強化されたTransformer」arXiv:2104.09864、2023年。
Simeng Sun, Katherine Thai, Mohit Iyyer「ChapterBreak:長距離言語モデルのための挑戦的データセット」2022年北米ACL章会議:人間言語技術論文集、2022年。
Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, Furu Wei「リテンションネットワーク:大規模言語モデルのためのTransformerの後継」arXiv:2307.08621、2023a年。
Yutao Sun, Li Dong, Barun Patra, Shuming Ma, Shaohan Huang, Alon Benhaim, Vishrav Chaudhary, Xia Song, Furu Wei「長さ外挿可能なTransformer」第61回ACL年次総会論文集(第1巻:長論文)、2023b年。
Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang, Furu Wei「一度だけキャッシュする:言語モデルのためのデコーダ-デコーダアーキテクチャ」arXivプレプリント arXiv:2405.05254、2024年。
Garrett Tanzer, Mirac Suzgun, Eline Visser, Dan Jurafsky, Luke Melas-Kyriazi「1冊の文法書から新しい言語の翻訳を学習するためのベンチマーク」ICLR、2024年。
Together.AI「32kコンテキスト時代への準備:初期の学びと探求」2023a年。URL https://www.together.ai/blog/llama-2-7b-32k
Together.AI「Llama-2-7b-32k-instruct — およびTogether APIによるLlama-2モデルのファインチューニング」2023b年。URL https://www.together.ai/blog/llama-2-7b-32k-instruct
Hugo Touvron ほか「Llama 2:オープンな基盤モデルとファインチューニングされたチャットモデル」arXiv:2307.09288、2023年。
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, Ashish Sabharwal「Musique:単一ホップ質問の合成によるマルチホップ質問」Transactions of the ACL、10:539-554、2022年。
Szymon Tworkowski ほか「Focused Transformer:コンテキストスケーリングのための対照学習」NeurIPS、36、2024年。
Teun A. van Dijk, Walter Kintsch「談話理解のストラテジー」Academic Press、1983年。
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, L ukasz Kaiser, Illia Polosukhin「Attention is all you need」NeurIPS、2017年。
Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao, Furu Wei. 長期記憶を用いた言語モデルの拡張. NeurIPS, 36, 2024.
Thomas Wolf ほか. HuggingfaceのTransformers:最先端の自然言語処理. arXiv:1910.03771, 2019.
Qingyang Wu, Zhenzhong Lan, Kun Qian, Jing Gu, Alborz Geramifard, Zhou Yu. Memformer:系列モデリングのための記憶拡張型Transformer. Findings of the ACL: AACL-IJCNLP, 2022.
X.AI. Grok-1.5の発表, 2024. URL https://x.ai/blog/grok-1.5
Chaojun Xiao ほか. InfLLM:訓練不要の記憶による極めて長い系列の理解に対するLLMの本質的能力の解明. arXiv:2402.04617, 2024a.
Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis. アテンションシンクを用いた効率的なストリーミング言語モデル. ICLR, 2024b.
Wenhan Xiong ほか. 基盤モデルの効果的な長文脈スケーリング. arXiv:2309.16039, 2023.
Peng Xu, Wei Ping, Xianchao Wu, Lawrence McAfee, Chen Zhu, Zihan Liu, Sandeep Subramanian, Evelina Bakhturina, Mohammad Shoeybi, Bryan Catanzaro. 検索と長文脈大規模言語モデルの融合. ICLR, 2024a.
Xiaoyue Xu, Qinyuan Ye, Xiang Ren. 生涯ICLとタスクヘイスタックによる長文脈言語モデルのストレステスト. arXiv preprint arXiv:2407.16695, 2024b.
An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, ほか. Qwen2テクニカルレポート. arXiv preprint arXiv:2407.10671, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William Cohen, Ruslan Salakhutdinov, Christopher D. Manning. HotpotQA:多様で説明可能なマルチホップ質問応答のためのデータセット. EMNLP, 2018.
Alex Young ら。Yi: Open foundation models by 01. AI。arXiv:2403.04652、2024年。
Tao Yuan、Xuefei Ning、Dong Zhou、Zhijie Yang、Shiyao Li、Minghui Zhuang、Zheyue Tan、Zhuyu Yao、Dahua Lin、Boxun Li ら。Lv-eval: A balanced long-context benchmark with 5 length levels up to 256k。arXiv preprint arXiv:2402.05136、2024年。
Peitian Zhang、Zheng Liu、Shitao Xiao、Ninglu Shao、Qiwei Ye、Zhicheng Dou。Soaring from 4k to 400k: Extending LLM's context with activation beacon。arXiv:2401.03462、2024a。
Xinrong Zhang、Yingfa Chen、Shengding Hu、Zihang Xu、Junhao Chen、Moo Khai Hao、Xu Han、Zhen Leng Thai、Shuo Wang、Zhiyuan Liu、Maosong Sun。obench: Extending long context evaluation beyond 100k tokens。arXiv:2402.13718、2024b。
Dawei Zhu、Nan Yang、Liang Wang、Yifan Song、Wenhao Wu、Furu Wei、Sujian Li。PoSE: Efficient context window extension of LLMs via positional skip-wise training。In ICLR、2024年。
A モデル
我々は評価と分析のために合計37個のモデルを選択した。本文中の結果には、アラインメント済みモデル(GPT-4、Gemini-1.5、および15個のオープンソースモデル)のみを含めている。アラインメント済みモデルに加えて、我々は7個のオープンソースベースモデルもRULERを用いて評価する。有効なコンテキストサイズを決定するための閾値として、コンテキスト長4KにおけるLlama2-7b(base)とLlama2-7b(chat)の性能を用いる。分析の節では、モデルシリーズYiとLWM、ならびにMambaやRWKVを含む新規アーキテクチャのモデルを含む、合計11個のモデルを評価する。
| モデル | アラインド | サイズ | コンテキスト長 | Huggingface [Wolf et al., 2019] / API |
| GPT-4 | OpenAI: Josh Achiam et al., 2023 | ✓ | - | 128K |
| Gemini-1.5 | Kred et al., 2024 | ✓ | - | 1M |
| Llama3.1 | Meta: AI, 2024b | ✓ | 70B | 128K |
| Llama3.1 | Meta: AI, 2024b | ✓ | 8B | 128K |
| Command-K-plus: Cohen, 2024 | ✓ | ✓ | 104B | 128K |
| Qwen2: Yang et al., 2024 | ✓ | ✓ | 72B | 128K |
| Yi: Young et al., 2024 | ✓ | ✓ | 34B | 200K |
| Mixtral-8x22B: Huang et al., 2024 | ✓ | ✓ | 39B/141B | 32K |
| Mixtral-v0.2: Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| GLM4: GLM et al., 2024 | ✓ | ✓ | 9B | 1M |
| GradieHAT: Llama3: Meta, AI, 2024a | ✓ | ✓ | 70B | 1M |
| Phi3-medium: Abdin et al., 2024 | ✓ | ✓ | 14B | 128K |
| LWM:Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| DBRX:Tabatricks, 2024 | ✓ | ✓ | 36B/132B | 1M |
| Together:Together, AI, 2023b | ✓ | ✓ | 7B | 32K |
| LongChat:Li et al., 2023a | ✓ | ✓ | 7B | 32K |
| LongAlpaca:Chen et al., 2024 | ✓ | ✓ | 13B | 32K |
| Mixtral-base:Jiang et al., 2024 | ✓ | ✓ | 8x7B | 32K |
| Mixtral-base:Mixtral-AI, 2023 | ✓ | ✓ | 7B | 32K |
| LWM-base:Liu et al., 2024a | ✓ | ✓ | 7B | 1M |
| LongLoRA-base:Chen et al., 2024 | ✓ | ✓ | 7B | 100K |
| Yarn-base:Peng et al., 2024 | ✓ | ✓ | 7B | 128K |
| Together-base:Together, AI, 2023a | ✓ | ✓ | 7B | 32K |
| Jamba-base:AI, 2024 | ✓ | ✓ | 52B | 256K |
| Llama2 (chat):Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Llama2(base):Touvron et al., 2023 | ✓ | ✓ | 7B | 4K |
| Yiシリーズ:Young et al., 2024 | ✓ | ✓ | 6B,9B | 200K |
| LWMシリーズ:Liu et al., 2024a | ✓ | ✓ | 7B | 128K,256K,512K |
| LWM-baseシリーズ:Liu et al., 2024a | ✓ | ✓ | 7B | 32K,128K,256K,512K |
| Mamba:Gu & Dai, 2023 | ✓ | ✓ | 2.8B | 2K |
| RWKV:Peng et al., 2023 | ✓ | ✓ | 7B | 4K |
表4: RULERにおいて評価および分析されたモデルの情報。
B タスク構成
RULERは、多様な系列長とタスク複雑性を可能にするように構成可能に設計されている。各タスクについて、採用可能な構成の数は組合せ的に膨大になる。本文では、RULERの4つのカテゴリにまたがる13個の代表的なタスクでモデルを評価する。我々のタスク選択プロセスは、次の付録節で説明する。
- 検索: S-NIAHでは、パスキー検索(Mohtashami & Jaggi, 2023)とバニラNIAH(Kamradt, 2023)を含める。両方とも単語-数字をキー-値として用い、背景の干し草(haystack)のみが異なる。さらに、コンテキストから長い文字列を検索する際のモデルの堅牢性をテストする目的で、値の型をUUIDに変更する。MK-NIAHでは、干し草に3つの妨害用ニードルを追加する。また、先行研究の既存の設定も含める。すなわち、干し草を完全に妨害用ニードルで埋めたライン検索(Li et al., 2023a)とキー-値検索(Liu et al., 2024d)である。MV-NIAHとMQ-NIAHでは、それぞれ4つの値とクエリをテストする。
- マルチホップ追跡: VTでは、4つの名前束縛ホップを持つ1つの連鎖を挿入し、合計5つの変数名を返す必要がある。
- 集約: CWEでは、合計10個の一般的な単語を返す必要があり、各単語は30回出現するのに対し、珍しい単語はそれぞれ3回出現する。FWEでは、合成単語をサンプリングするためのZeta分布においてを2.0に設定する。
- QA: QAでは、長いコンテキストのシナリオをシミュレートするためにSQuAD(Rajpurkar et al., 2018)とHotpotQA(Yang et al., 2018)を拡張する。これらはそれぞれシングルホップおよびマルチホップの質問応答タスクを代表するものである。
| タスク | 設定 | ||
| サブタスク1 | サブタスク2 | サブタスク3 | |
| Single NIAH | type_key = word type_value = number type_haystack = repeat ~パスキー検索 | type_key = word type_value = number type_haystack = essay ~バニラNIAH | type_key = word type_value = uuid type_haystack = essay |
| MK-NIAH | num_keys = 4 type_key = word type_value = number type_haystack = essay | num_keys = full haystack type_key = word type_value = number ~行検索 | num_keys = full haystack type_key = uuid type_value = uuid ~KV検索 |
| MV-NIAH | num_values = 4、type_key = word、type_value = number、type_haystack = essay | ||
| MQ-NIAH | num_queries = 4、type_key = word、type_value = number、type_haystack = essay | ||
| VT | num_chains = 1、num_hops = 4 | ||
| CWE | freq_cw = 30、freq_ucw = 3、num_cw = 10 | ||
| FWE | α = 2.0 | ||
| QA | dataset = SQuAD | dataset = HotpotQA | |
表5: RULERにおける我々の合計13個のタスク構成。
C タスク相関分析
RULERは、異なるカテゴリにまたがるタスクがモデルの異なる挙動を明らかにできるという仮定の下で設計されている。我々は、タスクカテゴリの妥当性を確認し、代表的なタスクの選択を導くために、予備的な相関研究を行う。我々は8個のオープンソースモデルを、18個のタスク構成にわたり様々なコンテキストサイズで評価する。各タスクは、様々なコンテキストサイズにおけるモデル性能のベクトルで表現できる。次に、18個のタスクベクトルを、相関係数を距離指標として用いる凝集型クラスタリングアルゴリズムによってクラスタリングする。図5に示すように、一部のタスクは他のタスクと中程度の相関を示すが、4つのカテゴリ(NIAH、VT、AG、QA)の各タスクは、冗長性なくそれ自体のまとまりのあるクラスタを形成する。我々はさらに、同じクラスタ内で他のタスクと高度に相関するいくつかのタスクを除外し、後の大規模評価のために13個のタスクを最終決定する。
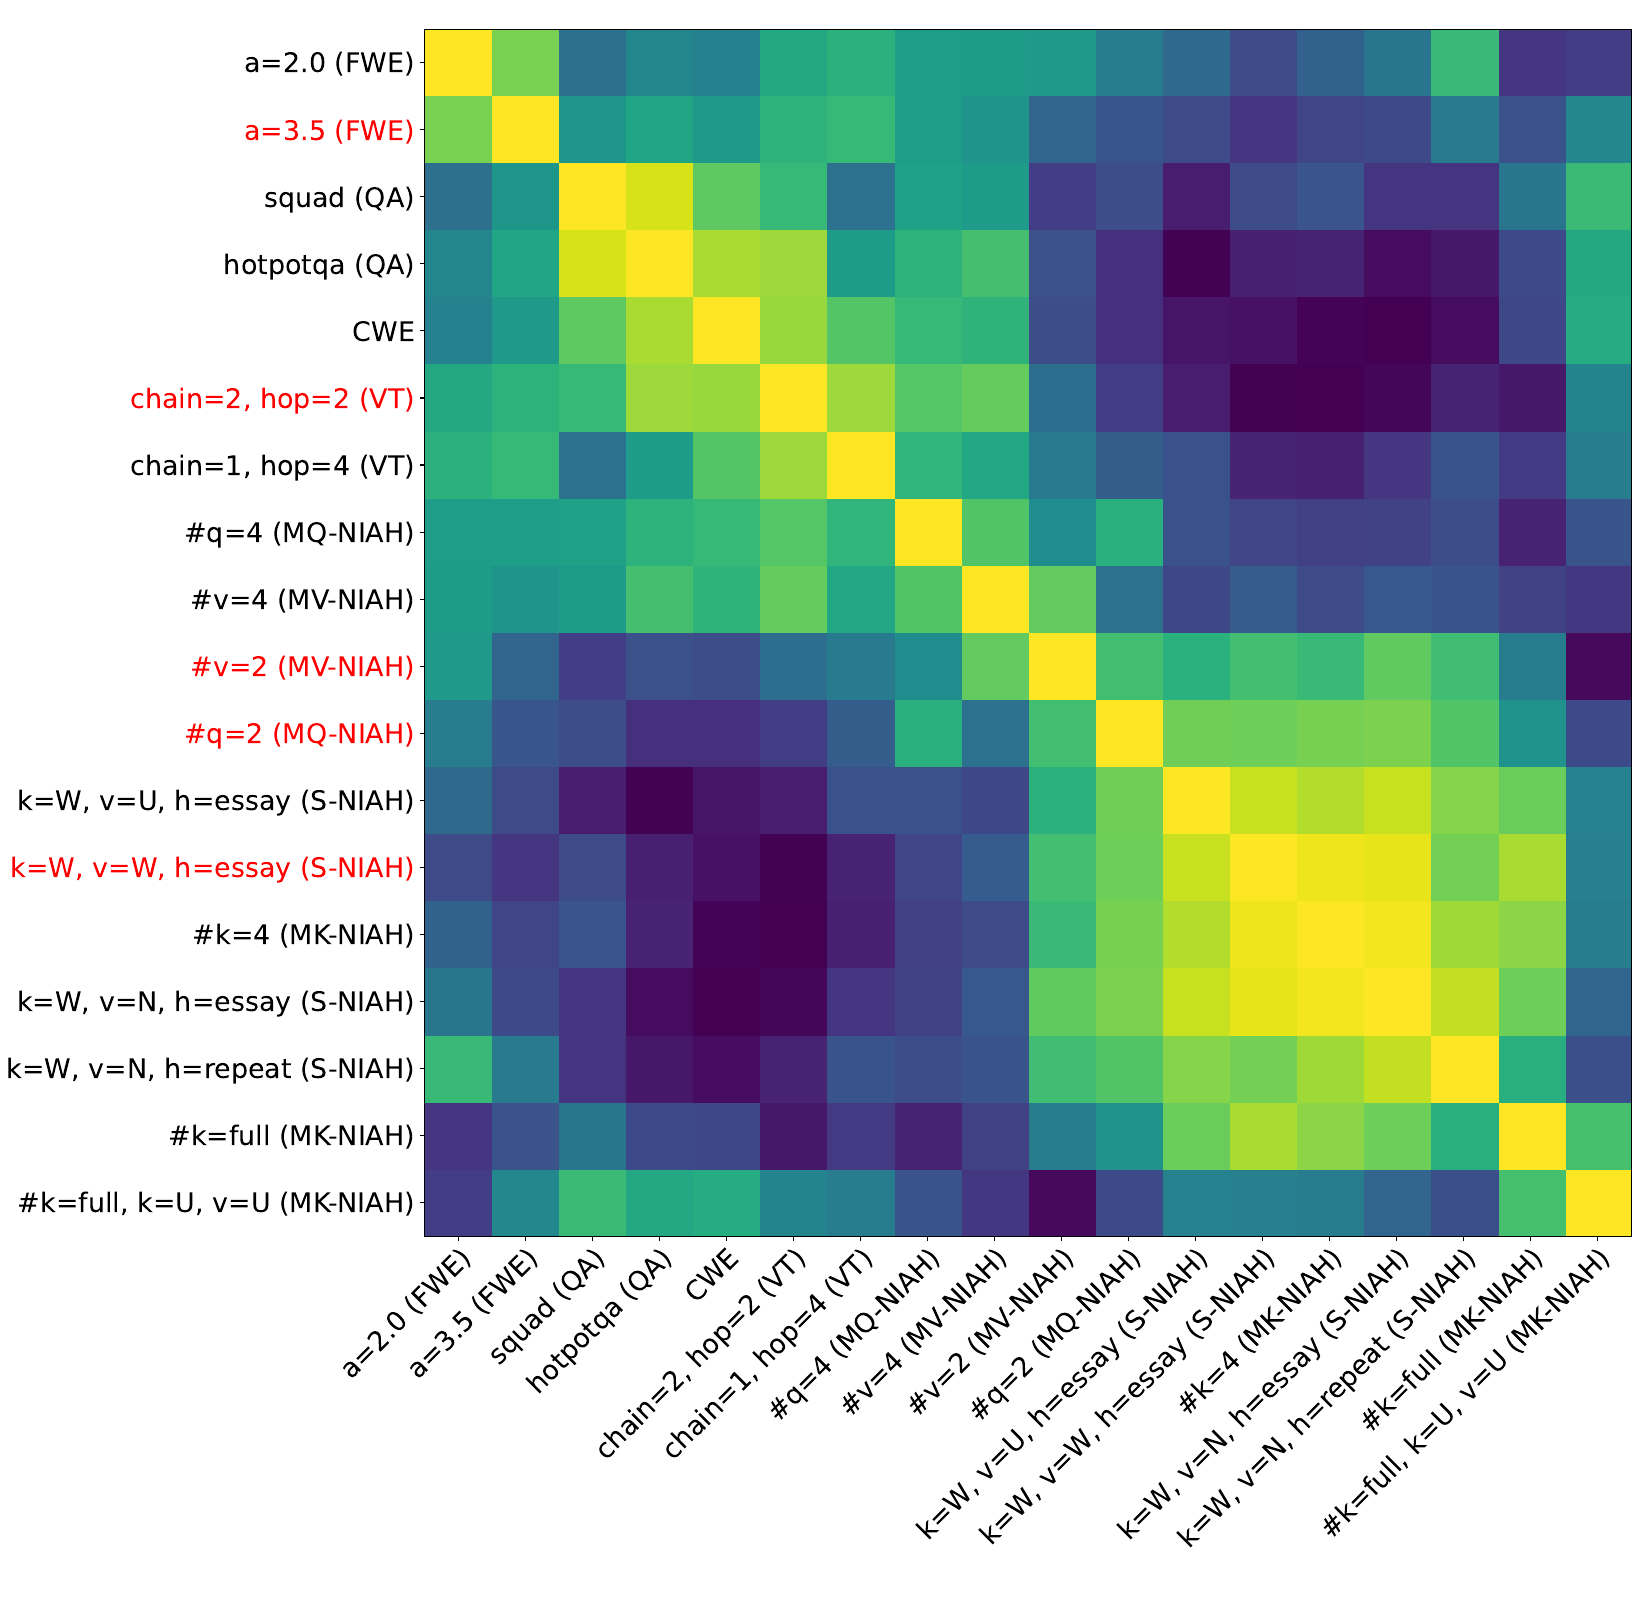
D プロンプトテンプレート
我々は入力プロンプトテンプレートを、表6のモデルテンプレートと表7のタスクテンプレートに分解する。モデルテンプレートはモデルのチャット形式であり、タスクテンプレートは指示、コンテキスト、およびクエリを組み合わせる。モデルが我々の質問への回答を拒否するのを防ぐため、モデルの応答を引き出すために入力に回答プレフィックスを付加する。VTとCWEでは、コンテキスト内の実演として1つのタスクサンプルを用いる。
| モデル | テンプレート |
| GPT-4 | {task_template} 説明は一切提供しないでください。直接答えを教えてください。{task_answer_prefix} |
| Yi/Base | {task_template} {task_answer_prefix} |
| Command-R | {BOS_TOKEN}{START_OF_TURN_TOKEN}{USER_TOKEN}{task_template}{END_OF_TURN_TOKEN}{START_OF_TURN_TOKEN}{CHATBOT_TOKEN}{task_answer_prefix} |
| LWM/LongChat | {system_prompt} USER: {task_template} ASSISTANT:{task_answer_prefix} |
| GLM | {gMASK} sop{user}{task_template} {assistant}{task_answer_prefix} |
| Phi3 | {user}{task_template} {end}{assistant}{task_answer_prefix} |
| Qwen/DBRX | {im_start} system{system_prompt} {im_end}{im_start} user{task_template} {im_end}{im_start} assistant{task_answer_prefix} |
| Llama3/Llama3.1 | {begin_of_text} {start_header_id} user {end_header_id} |
| Llama2/その他 | {task_template} {eot_id}{start_header_id} assistant {end_header_id} |
| {task_answer_prefix} | |
| [INST] {task_template} [/INST] {task_answer_prefix} |
表6: モデルのチャットテンプレート。モデルが我々の質問への回答を拒否するのを防ぐため、モデル応答にタスクの回答プレフィックスを付加する。回答プレフィックスの追加は、モデルのチャットテンプレートを壊さない。
タスクテンプレート:以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後でその数字についてクイズを出します。{word-1} の特別なマジックナンバーの一つは:{number-1}。{word-2} の特別なマジックナンバーの一つは:{number-2}。{word-3} の特別なマジックナンバーの一つは:{number-3}。{word-4} の特別なマジックナンバーの一つは:{number-4}。提供されたテキストに記載されている {word-4} の特別なマジックナンバーは何ですか?
サブタスク-19
サブタスク-20
サブタスク-21
サブタスク-22
サブタスク-23
サブタスク-24
サブタスク-25
サブタスク-26
サブタスク-27
サブタスク-28
サブタスク-29
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-30
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-31
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-32
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-33
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-34
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-35
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-36
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-37
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-38
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-39
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-40
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-41
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-42
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-43
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-44
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-45
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-46
いくつかの特別なマジックナンバーが以下のテキストの中に隠されています。必ずそれを記憶してください。後でその数字についてあなたにクイズを出します。
{word-1}の特別なマジックナンバーの一つは:{number-1}です。
{word-2}の特別なマジックナンバーの一つは:{number-2}です。
{word-3}の特別なマジックナンバーの一つは:{number-3}です。
{word-4}の特別なマジックナンバーの一つは:{number-4}です。
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-47
提供されたテキストで言及されている{word-4}の特別なマジックナンバーは
サブタスク-48
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-49
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは
サブタスク-50
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-51
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは
サブタスク-52
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-53
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは
サブタスク-54
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-55
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは
サブタスク-56
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-57
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは
サブタスク-58
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
サブタスク-59
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは
サブタスク-60
以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後であなたにその数字についてクイズを出します。
{word-1}の特別なマジックナンバーの1つは:{number-1}です。
{word-2}の特別なマジックナンバーの1つは:{number-2}です。
{word-3}の特別なマジックナンバーの1つは:{number-3}です。
{word-4}の特別なマジックナンバーの1つは:{number-4}です。
提供されたテキストに記載されている{word-4}の特別なマジックナンバーは何ですか?
Subtask-61
Subtask-62
Subtask-63
Subtask-64
Subtask-65
Subtask-66
Subtask-67
Subtask-68
Subtask-69
Subtask-70
Subtask-71
Subtask-72
Subtask-73
Subtask-74
Some special magic numbers are hidden within the following text. Make sure to memorize it. I will quiz you about the numbers afterwards.
One of the special magic numbers for {word-1} is: {number-1}.
タスクテンプレート: 以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず暗記してください。後でその数字についてクイズを出します。{word-1}の特別なマジックナンバーの一つは: {number-1}。{word-2}の特別なマジックナンバーの一つは: {number
タスクテンプレート:以下のテキストの中に、いくつかの特別なマジックナンバーが隠されています。必ず覚えておいてください。後でその数字についてクイズを出します。Paul Graham Essays....... {word} の特別なマジックナンバーの一つは:{number-1}....... {word} の特別なマジックナンバーの一つは:{number-2}....... {word} の特別なマジックナンバーの一つは:{number-3}....... {word} の特別なマジックナンバーの一つは:{number-4}。提供されたテキストで言及されている {word} の特別なマジックナンバーはすべて何ですか? |
| タスク回答プレフィックス:提供されたテキストで言及されている{word}の特別なマジックナンバーは | |
| タスクテンプレート:以下のテキストにはいくつかの特別なマジックナンバーが隠されています。必ず覚えてください。後でその数字についてクイズを出します。Paul Graham Essays....... {word-1}の特別なマジックナンバーの1つは:{number-1}....... {word-2}の特別なマジックナンバーの1つは:{number-2}....... {word-3}の特別なマジックナンバーの1つは:{number-3}....... {word-4}の特別なマジックナンバーの1つは:{number-4}。提供されたテキストで言及されている{word-1}、{word-2}、{word-3}、{word-4}の特別なマジックナンバーはすべて何ですか? |
| タスク回答プレフィックス: 提供されたテキストに記載されている{word-1}、{word-2}、{word-3}、および{word-4}の特別なマジックナンバーは |
| タスクトemplate: {1つのタスク例} 以下のテキストに隠された変数代入の連鎖を記憶し、追跡してください。 草は緑です。空は青いです。太陽は黄色です。さあ始めましょう。行って戻ってきます。 …… VAR {X1} = {数} …… …… VAR {X2} = {X1} …… …… VAR {X3} = {X2} …… …… VAR {X4} = {X3} …… …… VAR {X5} = {X4} …… 質問:上記のテキスト内で値{数}が代入されているすべての変数を見つけてください。 |
| タスク回答プレフィックス: 回答:上記のテキストにおける変数代入の連鎖に従うと、5つの変数に値 {number} が代入されており、それらは以下のとおりです: |
タスクトemplate:{一つのタスク例}以下は番号付きの単語リストです。これらの単語の中には、他のものより頻繁に現れるものがあります。最も頻繁に現れるものを記憶してください。1. word-a 2. word-b 3. word-c 4. word-d 5. word-d 6. word-a 7. word-e 8. word-f ......質問:上記のリストの中で最も一般的な10個の単語は何ですか? |
| タスク回答プレフィックス: 回答:リスト内で最も頻繁に出現する上位10語は以下の通りです: | |
| タスクテンプレート: 以下のコード化されたテキストを読み、各コード化単語の頻度を追跡してください。最も頻繁に出現する3つのコード化単語を見つけてください。…単語a…単語b……単語c…単語a… 単語d 単語e…単語a…単語f……単語g…単語h…単語a…単語i…。 質問:いかなる説明も提供しないでください。ドット「…」は無視してください。上記のコード化されたテキストにおいて、最も頻繁に出現する3つの単語は何ですか? |
| タスク回答プレフィックス: 回答:上記のコード化されたテキストによると、最も頻繁に出現する3つの単語は次のとおりです: |
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Template:
Answer the question based on the given documents. Only give me the answer and do not output any other words.
The following are given documents.
Document 1:
{document-1}
......
Document x:
{document-x}
......
Document y:
{document-y}
......
Document n:
{document-n}
Answer the question based on the given documents. Only give me the answer and do not output any other words.
Question: question
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
Task Answer Prefix:
Answer:
タスクテンプレート:
与えられた文書に基づいて質問に答えてください。答えのみを提示し、それ以外の語は一切出力しないでください。
以下が与えられた文書です。
文書1:
{document-1}
……
文書x:
{document-x}
……
文書n:
{document-n}
与えられた文書に基づいて質問に答えてください。答えのみを提示し、それ以外の語は一切出力しないでください。
質問:question
タスク回答プレフィックス:
Answer:
タスクテンプレート:
与えられた文書に基づいて質問に答えてください。答えのみを提示し、それ以外の語は一切出力しないでください。
以下が与えられた文書です。
文書1:
{document-1}
……
文書x:
{document-x}
……
文書y:
{document-y}
……
文書n:
{document-n}
与えられた文書に基づいて質問に答えてください。答えのみを提示し、それ以外の語は一切出力しないでください。
質問:question
タスク回答プレフィックス:
Answer:
E パスキー取得とバニラNIAHの結果
| モデル | 主張長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 |
| Gemini-1.5 | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| GPT-4 | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Llama3.1 (70B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 97.8 | 99.6 |
| Llama3.1 (8B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Qwen2 (72B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 96.6 | 99.4 |
| Command-R-plus (104B) | 128K | 100.0 | 100.0 | 99.8 | 99.8 | 100.0 | 97.2 | 99.5 |
| GLM4 (9B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| GradientAI/LLama3 (70B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 93.6 | 98.9 |
| Mixtral-8x22B (39B/141B) | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 0.0 | 83.3 |
| Yi (34B) | 200K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Phi3-medium (14B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 88.0 | 98.0 |
| Mistral-v0.2 (7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 69.6 | 94.9 |
| LWM (7B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| DBRX (36B/132B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 0.0 | 0.0 | 66.7 |
| Together(7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 0.0 | 0.0 | 66.7 |
| LongChat(7B) | 32K | 100.0 | 100.0 | 100.0 | 99.4 | 0.0 | 0.0 | 66.6 |
| LongAlpaca(13B) | 32K | 88.2 | 88.6 | 86.4 | 82.4 | 0.0 | 0.0 | 57.6 |
| Mixtral-base(8x7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 46.8 | 91.1 |
| Mixtral-base(7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 70.8 | 95.1 |
| Jamba-base(52B) | 256K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| LWM-base(7B) | 1M | 99.8 | 99.6 | 99.6 | 98.2 | 96.0 | 98.9 | 98.9 |
| LongLoRA-base(7B) | 100K | 99.6 | 99.4 | 99.0 | 99.4 | 99.4 | 0.0 | 82.8 |
| Yarn-base(7B) | 128K | 100.0 | 100.0 | 99.0 | 100.0 | 99.2 | 39.6 | 89.6 |
| Together-base(7B) | 32K | 100.0 | 100.0 | 99.8 | 100.0 | 0.0 | 0.0 | 66.6 |
| モデル | 主張されている長さ | 4K | 8K | 16K | 32K | 64K | 128K | 平均 |
| Gemini-1.5 | 1M | 100.0 | 100.0 | 100.0 | 98.0 | 100.0 | 100.0 | 99.7 |
| GPT-4 | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Llama3.1 (70B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 99.9 |
| Llama3.1 (8B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 99.9 |
| Qwen2 (72B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.8 | 56.4 | 92.7 |
| Command-R-plus (35B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.8 | 86.0 | 97.6 |
| GLM4 (9B) | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| GradientAI/LLama3 (70B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 97.8 | 99.4 |
| Mixtral-8x22B (39B/141B) | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 24.2 | 87.3 |
| Yi (34B) | 200K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| Phi3-medium (14B) | 128K | 100.0 | 100.0 | 100.0 | 99.8 | 99.8 | 73.8 | 95.5 |
| Mixtral-v0.2 (7B) | 32K | 100.0 | 100.0 | 100.0 | 97.0 | 70.0 | 7.4 | 79.1 |
| LWM (7B) | 1M | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 |
| DBRX (36B/132B) | 32K | 100.0 | 100.0 | 90.0 | 93.2 | 0.8 | 0.0 | 64.0 |
| Together(7B) | 32K | 100.0 | 100.0 | 100.0 | 99.8 | 0.0 | 0.0 | 66.6 |
| LongChat(7B) | 32K | 100.0 | 100.0 | 97.6 | 98.4 | 0.0 | 0.0 | 66.0 |
| LongAlpaca(13B) | 32K | 90.2 | 90.2 | 88.4 | 83.4 | 0.0 | 0.0 | 58.7 |
| Mixtral-base(8x7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 85.2 | 34.8 | 86.7 |
| Mixtral-base(7B) | 32K | 100.0 | 100.0 | 100.0 | 100.0 | 94.8 | 0.4 | 82.5 |
| Jamba-base(52B) | 256K | 100.0 | 100.0 | 98.8 | 99.8 | 99.8 | 86.4 | 97.5 |
| LWM-base(7B) | 1M | 100.0 | 99.4 | 97.8 | 98.6 | 98.2 | 98.6 | 98.8 |
| LongLoRA-base(7B) | 100K | 99.8 | 100.0 | 100.0 | 99.8 | 100.0 | 0.0 | 83.3 |
| Yarn-base(7B) | 128K | 97.4 | 97.8 | 91.4 | 85.4 | 86.6 | 20.0 | 79.8 |
| Together-base(7B) | 32K | 100.0 | 100.0 | 100.0 | 99.8 | 0.0 | 0.0 | 66.6 |
表11:RULERのバニラNIAHにおける、長さ4Kから128Kにわたる選択されたアラインドモデルとベースモデルの性能。ほぼすべてのモデルが、主張する長さで満点を獲得している。
.
F 追加結果
| モデル | 公称長 | 実効長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 | wAvg.(増加) | wAvg.(減少) |
| Llama2-7B(base) | 4K | - | 79.4 | ||||||||
| Mixtral-base(8x7B) | 32K | 32K | 91.8 | 91.0 | 89.5 | 85.8 | 66.9 | 29.0 | 75.7 | 66.4(1位) | 85.0(1位) |
| Mixtral-base(7B) | 32K | 16K | 91.6 | 89.8 | 86.3 | 77.2 | 52.3 | 8.0 | 67.5 | 54.7(4位) | 80.4(2位) |
| Jamba-base(52B) | 256K | 4K | 81.2 | 75.4 | 68.8 | 65.3 | 61.0 | 51.4 | 67.2 | 62.5(3位) | 71.8(4位) |
| LWM-base(7B) | 1M | <4K | 77.5 | 74.0 | 69.6 | 64.6 | 61.3 | 59.0 | 67.7 | 64.4(2位) | 70.9(5位) |
| LongLoRA-base (7B) | 100K | 8K | 81.9 | 80.4 | 75.6 | 65.1 | 60.8 | 0.0 | 60.6 | 49.2(5位) | 72.0(3位) |
| Yarn-base (7B) | 128K | &lt;4K | 77.3 | 67.5 | 59.0 | 47.3 | 38.6 | 13.9 | 50.6 | 40.7(6位) | 60.5(7位) |
| Together-base (7B) | 32K | 4K | 84.6 | 78.7 | 68.3 | 57.9 | 0.0 | 0.0 | 48.2 | 32.3(7位) | 64.2(6位) |
表12:RULERの13タスクスコアを平均した、長さ4Kから128Kにわたる選択されたベースモデルの性能。
| モデル | 公称長 | 実効長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 | wAvg.(増加) | wAvg.(減少) |
| Llama2-7B(chat) | 4K | - | 96.9 | ||||||||
| Gemini-1.5 | 1M | &gt;128K | 99.8 | 99.9 | 99.6 | 99.7 | 99.7 | 99.6 | 99.7 | 99.7(1位) | 99.7(1位) |
| Llama3.1(8B) | 128K | 64K | 99.9 | 99.9 | 99.8 | 99.6 | 98.7 | 92.6 | 98.4 | 97.5(3位) | 99.4(2位) |
| GLM4(9B) | 1M | 64K | 99.4 | 99.2 | 99.5 | 99.4 | 97.3 | 94.4 | 98.2 | 97.5(2位) | 98.9(3位) |
| Llama3.1(70B) | 128K | 64K | 100.0 | 100.0 | 99.9 | 99.6 | 98.5 | 78.9 | 96.1 | 93.5(5位) | 98.8(4位) |
| GPT-4 | 128K | 32K | 99.9 | 99.9 | 98.7 | 98.3 | 90.9 | 84.8 | 95.4 | 92.9(6位) | 97.9(5位) |
| Command-R-plus(104B) | 128K | 32K | 99.9 | 99.9 | 99.4 | 97.9 | 89.6 | 65.7 | 92.1 | 87.3(8位) | 96.9(6位) |
| GradientAI/Llama3(70B) | 1M | 16K | 99.0 | 98.8 | 98.3 | 94.5 | 91.2 | 84.9 | 94.4 | 92.1(7位) | 96.8(7位) |
| Yi(34B) | 200K | 16K | 98.2 | 96.8 | 97.3 | 95.1 | 93.0 | 90.2 | 95.1 | 93.8(4位) | 96.4(8位) |
| Qwen2(72B) | 128K | 32K | 100.0 | 99.9 | 99.9 | 99.4 | 84.5 | 48.0 | 88.6 | 81.3(11位) | 95.9(9位) |
| Phi3-medium(14B) | 128K | 8K | 98.7 | 98.5 | 96.6 | 95.4 | 91.9 | 51.3 | 88.7 | 82.6(10位) | 94.9(10位) |
| Mixtral-8x22B (39B/141B) | 64K | 16K | 99.3 | 99.1 | 97.7 | 96.7 | 89.9 | 23.8 | 84.4 | 74.8(12位) | 94.1(11位) |
| LWM (7B) | 1M | &lt;4K | 92.5 | 92.1 | 87.6 | 83.7 | 84.1 | 83.4 | 87.2 | 85.5(9位) | 89.0(12位) |
| Mistral-v0.2 (7B) | 32K | 4K | 98.1 | 96.2 | 94.3 | 85.5 | 51.1 | 10.7 | 72.6 | 58.8(13位) | 86.5(13位) |
| DBRX (36B/132B) | 32K | 8K | 99.4 | 99.0 | 93.5 | 73.4 | 0.5 | 0.0 | 61.0 | 41.6(14位) | 80.3(14位) |
| Together (7B) | 32K | &lt;4K | 96.2 | 89.9 | 82.3 | 80.2 | 0.0 | 0.0 | 58.1 | 40.2(15位) | 76.0(15位) |
| LongChat(7B) | 32K | &lt;4K | 93.3 | 92.2 | 81.1 | 67.3 | 0.0 | 0.0 | 55.7 | 37.6(16位) | 73.7(16位) |
| LongAlpaca(13B) | 32K | &lt;4K | 74.9 | 72.2 | 70.8 | 53.2 | 0.0 | 0.0 | 45.2 | 30.7(17位) | 59.7(17位) |
| Llama2-7B(ベース) | 4K | - | 90.9 | ||||||||
| Mixtral-base(8x7B) | 32K | 32K | 99.9 | 99.7 | 98.4 | 94.8 | 72.1 | 29.1 | 82.3 | 71.8(2位) | 92.8(1位) |
| Mixtral-base(7B) | 32K | 16K | 99.3 | 97.5 | 95.7 | 89.8 | 56.8 | 10.2 | 74.9 | 61.2(4位) | 88.6(2位) |
| Jamba-base(52B) | 256K | &lt;4K | 86.4 | 80.5 | 73.7 | 72.3 | 68.1 | 56.9 | 73.0 | 68.5(3位) | 77.4(5位) |
| LWM-base(7B) | 1M | &lt;4K | 88.5 | 87.7 | 84.5 | 79.6 | 76.1 | 74.2 | 81.8 | 79.1(1位) | 84.4(4位) |
| LongLoRA-base(7B) | 100K | 16K | 95.3 | 95.6 | 92.7 | 81.5 | 76.2 | 0.0 | 73.5 | 60.6(5位) | 86.5(3位) |
| Yarn-base (7B) | 128K | &lt;4K | 89.9 | 86.1 | 78.4 | 59.0 | 49.5 | 17.5 | 63.4 | 51.7(6位) | 75.1(7位) |
| Together-base (7B) | 32K | 8K | 95.4 | 91.5 | 86.1 | 75.1 | 0.0 | 0.0 | 58.0 | 39.9(7位) | 76.2(6位) |
| Together-base (7B) | 32K | 8K | 95.4 | 91.5 | 86.1 | 75.1 | 0.0 | 0.0 | 58.0 | 39.9(7位) | 76.2(6位) |
表13:RULERのRetrieval(NIAH)の8タスクスコアを平均した、長さ4Kから128Kにわたる選択されたアラインドモデルとベースモデルの性能。
「」
| モデル | 公称長 | 実効長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 | wAvg.(増加) | wAvg.(減少) |
| Llama2-7B(chat) | 4K | - | 89.7 | ||||||||
| GPT-4 | 128K | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 99.9 | 99.9(2位) | 100.0(1位) |
| Gemini-1.5 | 1M | >128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.6 | 100.0 | 99.9 | 99.9(1位) | 100.0(2位) |
| Command-R-plus(104B) | 128K | 128K | 100.0 | 100.0 | 100.0 | 100.0 | 99.9 | 97.2 | 99.5 | 99.2(3位) | 99.8(3位) |
| GLM4(9B) | 1M | >128K | 99.9 | 99.6 | 99.8 | 99.8 | 99.6 | 97.7 | 99.4 | 99.1(4位) | 99.7(4位) |
| Qwen2 (72B) | 128K | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 95.2 | 79.0 | 95.7 | 92.9(5位) | 98.5(5位) |
| Llama3.1 (70B) | 128K | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.9 | 59.2 | 93.2 | 88.3(8位) | 98.0(6位) |
| Llama3.1 (8B) | 128K | 64K | 99.9 | 99.7 | 99.7 | 98.8 | 97.6 | 70.4 | 94.4 | 90.7(6位) | 98.0(7位) |
| GradientAI/Llama3 (70B) | 1M | 64K | 100.0 | 100.0 | 100.0 | 100.0 | 99.7 | 56.2 | 92.6 | 87.4(9位) | 97.9(8位) |
| Yi (34B) | 200K | 64K | 99.8 | 99.8 | 99.8 | 94.5 | 92.5 | 76.8 | 93.6 | 90.3(7位) | 96.9(9位) |
| Mixtral-8x22B (39B/141B) | 64K | 64K | 100.0 | 100.0 | 99.8 | 98.6 | 96.4 | 0.0 | 82.5 | 70.3(10位) | 94.7(10位) |
| Phi3-medium(14B) | 128K | 16K | 99.6 | 99.2 | 98.4 | 82.1 | 53.6 | 26.0 | 76.5 | 64.1(11位) | 88.9(11位) |
| Mixtral-v0.2(7B) | 32K | 16K | 98.9 | 96.0 | 92.2 | 85.0 | 74.5 | 0.0 | 74.4 | 60.9(12位) | 87.9(12位) |
| LongChat(7B) | 32K | 8K | 97.6 | 93.5 | 83.4 | 62.4 | 0.0 | 0.0 | 56.2 | 37.4(14位) | 75.0(13位) |
| DBRX(36B/132B) | 32K | 8K | 100.0 | 99.0 | 72.5 | 45.8 | 0.0 | 0.0 | 52.9 | 33.3(15位) | 72.5(14位) |
| LWM(7B) | 1M | &lt;4K | 84.4 | 80.1 | 67.2 | 52.2 | 45.9 | 15.2 | 57.5 | 46.5(13位) | 68.6(15位) |
| Together (7B) | 32K | &lt;4K | 89.2 | 88.8 | 48.3 | 16.6 | 0.0 | 0.0 | 40.5 | 22.8(16位) | 58.2(16位) |
| LongAlpaca (13B) | 32K | &lt;4K | 8.5 | 2.1 | 18.2 | 17.0 | 0.0 | 0.0 | 7.6 | 6.5(17位) | 8.8(17位) |
| Llama2-7B (base) | 4K | - | 58.8 | ||||||||
| Mixtral-base (8x7B) | 32K | 64K | 100.0 | 99.9 | 100.0 | 98.4 | 87.3 | 43.3 | 88.1 | 80.5(2位) | 95.8(1位) |
| Mixtral-base (7B) | 32K | 64K | 99.0 | 98.4 | 96.5 | 89.1 | 86.1 | 0.0 | 78.2 | 65.4(4位) | 91.0(2位) |
| Jamba-base (52B) | 256K | 128K | 87.5 | 87.6 | 86.2 | 88.1 | 86.0 | 77.8 | 85.5 | 84.3(1位) | 86.7(3位) |
| LWM-base(7B) | 1M | 128K | 80.2 | 82.7 | 79.3 | 76.4 | 70.7 | 66.1 | 75.9 | 73.3(3位) | 78.5(4位) |
| LongLoRA-base(7B) | 100K | 64K | 92.5 | 87.4 | 73.1 | 56.0 | 69.2 | 0.0 | 63.0 | 50.3(5位) | 75.8(5位) |
| Yarn-base(7B) | 128K | 4K | 84.6 | 43.6 | 24.8 | 43.0 | 20.9 | 0.0 | 36.1 | 24.9(7位) | 47.4(7位) |
| Together-base(7B) | 32K | 16K | 95.0 | 90.6 | 69.6 | 43.2 | 0.0 | 0.0 | 49.7 | 31.3(6位) | 68.1(6位) |
| モデル | 公称長 | 実効長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均(増加) | 加重平均(減少) |
| Llama2-7B-chat | 4K | - | 84.8 | |||||||
| Gemini-1.5 | 1M | &gt;128K | 97.7 | 97.7 | 97.6 | 98.6 | 97.3 | 90.9 | 96.6 | 95.8(1位) |
| GPT-4 | 128K | 64K | 99.0 | 98.3 | 98.0 | 95.0 | 90.1 | 79.7 | 93.4 | 90.4(2位) |
| Qwen2(72B) | 128K | 32K | 99.3 | 98.0 | 93.1 | 97.4 | 78.5 | 70.3 | 89.4 | 84.7(3位) |
| Mixtral-8x22B(39B/141B) | 64K | 32K | 97.8 | 96.9 | 94.8 | 88.2 | 83.3 | 69.7 | 88.5 | 84.0(4位) |
| Command-R-plus(104B) | 128K | 32K | 98.2 | 96.9 | 95.2 | 90.3 | 82.5 | 59.5 | 87.1 | 81.3(5位) |
| Llama3.1(70B) | 128K | 32K | 99.9 | 98.3 | 98.4 | 97.1 | 66.3 | 39.8 | 83.3 | 73.8(6位) |
| Phi3-medium(14B) | 128K | 16K | 90.8 | 95.1 | 90.3 | 82.4 | 62.1 | 43.8 | 77.4 | 69.3(7位) |
| Yi(34B) | 200K | 16K | 91.4 | 90.9 | 86.2 | 75.3 | 58.5 | 43.4 | 74.3 | 66.0(8位) |
| GLM4(9B) | 1M | 8K | 93.5 | 85.2 | 78.5 | 68.1 | 58.3 | 49.7 | 72.2 | 64.8(9位) |
| GradientAI/Llama3(70B) | 1M | 8K | 96.4 | 94.7 | 74.9 | 57.0 | 45.1 | 41.4 | 68.3 | 57.7(10位) |
| Llama3.1(8B) | 128K | 8K | 97.0 | 90.1 | 79.2 | 54.1 | 43.5 | 36.2 | 66.7 | 55.5(11位) |
| Mixtral-v0.2(7B) | 32K | 8K | 94.3 | 90.4 | 77.4 | 48.5 | 42.4 | 33.7 | 64.4 | 53.1(12位) |
| DBRX(36B/132B) | 32K | 8K | 94.5 | 94.7 | 73.7 | 48.7 | 4.1 | 0.0 | 52.6 | 34.3(13位) |
| Together(7B) | 32K | &lt;4K | 82.3 | 64.5 | 43.3 | 34.8 | 0.0 | 0.0 | 37.5 | 22.9(16位) |
| LongChat(7B) | 32K | &lt;4K | 74.3 | 50.7 | 46.7 | 51.1 | 0.0 | 0.0 | 37.1 | 24.8(15位) |
| LWM(7B) | 1M | &lt;4K | 61.3 | 43.6 | 38.3 | 32.8 | 29.1 | 29.1 | 39.0 | 34.0(14位) |
| LongAlpaca(13B) | 32K | &lt;4K | 33.0 | 27.0 | 26.0 | 23.2 | 0.0 | 0.0 | 18.2 | 12.3(17位) |
| Llama2-7B(ベース) | 4K | - | 73.1 | |||||||
| Mixtral-base(8x7B) | 32K | 32K | 96.5 | 94.8 | 93.1 | 87.8 | 68.6 | 24.3 | 77.5 | 66.9(1位) |
| Mixtral-base(7B) | 32K | 16K | 94.8 | 93.1 | 81.6 | 53.3 | 36.7 | 9.2 | 61.4 | 46.5(2位) |
| Jamba-base(52B) | 256K | 4K | 75.9 | 63.5 | 51.7 | 38.5 | 33.3 | 28.0 | 48.5 | 40.3(3位) |
| LWM-base(7B) | 1M | &lt;4K | 67.1 | 48.4 | 36.0 | 26.3 | 21.5 | 18.7 | 36.3 | 28.4(5位) |
| LongLoRA-base(7B) | 100K | &lt;4K | 70.3 | 64.4 | 50.7 | 39.9 | 29.4 | 0.0 | 42.4 | 31.3(4位) |
| Yarn-base(7B) | 128K | &lt;4K | 70.6 | 49.2 | 28.9 | 20.5 | 17.0 | 2.1 | 31.4 | 20.7(6位) |
| Together-base(7B) | 32K | &lt;4K | 69.1 | 53.0 | 19.9 | 20.6 | 0.0 | 0.0 | 27.1 | 15.1(7位) |
| モデル | 公称長 | 実効長 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 | 重み付き平均(増加) | 重み付き平均(減少) |
| Llama2-7B(チャット) | 4K | - | 49.7 | ||||||||
| Gemini-1.5 | 1M | &gt;128K | 81.9 | 75.9 | 77.8 | 75.9 | 77.6 | 74.1 | 77.2 | 76.3(1位) | 78.0(1位) |
| GPT-4 | 128K | 128K | 79.0 | 78.0 | 76.0 | 68.0 | 61.6 | 59.0 | 70.3 | 66.5(4位) | 74.0(2位) |
| Qwen2(72B) | 128K | 64K | 80.8 | 76.9 | 74.1 | 66.9 | 54.5 | 47.2 | 66.7 | 61.0(8位) | 72.5(3位) |
| GradientAI/LLama3(70B) | 1M | &gt;128K | 75.6 | 73.9 | 72.4 | 69.9 | 66.0 | 59.8 | 69.6 | 67.1(3位) | 72.1(4位) |
| Llama3.1(70B) | 128K | 64K | 77.2 | 74.8 | 72.3 | 70.4 | 64.2 | 47.6 | 67.8 | 63.4(7位) | 72.1(5位) |
| GLM4(9B) | 1M | >128K | 74.7 | 71.3 | 71.9 | 68.5 | 66.3 | 63.6 | 69.4 | 67.6(2位) | 71.1(6位) |
| Mixtral-8x22B(39B/141B) | 64K | 64K | 76.6 | 73.5 | 71.8 | 66.5 | 59.7 | 40.8 | 64.8 | 59.4(9位) | 70.2(7位) |
| Yi(34B) | 200K | >128K | 72.7 | 71.5 | 68.4 | 66.2 | 64.1 | 59.9 | 67.1 | 65.0(5位) | 69.2(8位) |
| Llama3.1(8B) | 128K | 128K | 74.1 | 70.1 | 67.3 | 65.8 | 63.7 | 58.8 | 66.6 | 64.3(6位) | 68.9(9位) |
| Command-R-plus(104B) | 128K | 64K | 73.4 | 72.3 | 69.4 | 65.9 | 57.0 | 39.2 | 62.9 | 57.6(10位) | 68.1(10位) |
| Phi3-medium (14B) | 128K | 64K | 70.9 | 67.2 | 66.1 | 59.3 | 54.2 | 38.0 | 59.3 | 54.3(12位) | 64.3(11位) |
| Mixtral-v0.2 (7B) | 32K | 32K | 72.4 | 70.0 | 65.7 | 57.6 | 34.4 | 13.3 | 52.2 | 42.5(13位) | 62.0(12位) |
| LWM (7B) | 1M | &gt;128K | 61.2 | 57.8 | 56.7 | 55.4 | 54.7 | 52.6 | 56.4 | 55.1(11位) | 57.7(13位) |
| DBRX (36B/132B) | 32K | 16K | 76.0 | 69.4 | 59.4 | 45.0 | 9.6 | 0.0 | 43.2 | 29.6(14位) | 56.9(14位) |
| Together (7B) | 32K | 16K | 61.1 | 58.3 | 54.2 | 45.6 | 0.0 | 0.0 | 36.5 | 24.9(15位) | 48.2(15位) |
| LongAlpaca(13B) | 32K | 16K | 57.2 | 53.5 | 49.7 | 39.0 | 0.0 | 0.0 | 33.2 | 22.3(16位) | 44.1(16位) |
| LongChat(7B) | 32K | 8K | 54.5 | 53.6 | 47.6 | 34.0 | 0.0 | 0.0 | 31.6 | 21.0(17位) | 42.3(17位) |
| Llama2-7B(ベース) | 4K | - | 48.6 | 47.7 | 45.3 | 41.3 | 34.4 | 26.4 | 41.0 | 37.0(3位) | 44.9(3位) |
| Mixtral-base(8x7B) | 32K | 4K | 50.8 | 47.7 | 45.3 | 41.3 | 34.4 | 26.4 | 41.0 | 37.0(3位) | 44.9(3位) |
| Mixtral-base(7B) | 32K | 8K | 53.5 | 51.0 | 48.4 | 44.7 | 32.8 | 2.2 | 38.8 | 31.3(4位) | 46.3(2位) |
| Jamba-base (52B) | 256K | 32K | 62.7 | 60.6 | 57.9 | 52.6 | 47.5 | 39.6 | 53.5 | 49.7(1位) | 57.3(1位) |
| LWM-base (7B) | 1M | &lt;4K | 42.7 | 40.2 | 38.7 | 37.1 | 37.3 | 34.6 | 38.4 | 37.2(2位) | 39.6(4位) |
| LongLoRA-base (7B) | 100K | &lt;4K | 34.5 | 32.1 | 33.6 | 29.4 | 26.1 | 0.0 | 26.0 | 21.3(6位) | 30.6(6位) |
| Yarn-base (7B) | 128K | &lt;4K | 29.7 | 23.5 | 28.6 | 29.7 | 25.5 | 18.1 | 25.9 | 24.6(5位) | 27.1(7位) |
| Together-base (7B) | 32K | 4K | 52.0 | 47.5 | 44.6 | 33.6 | 0.0 | 0.0 | 29.6 | 19.8(7位) | 39.5(5位) |