
同じ接頭辞を共有するプロンプトは GPU メモリを無駄にする。SGLang は KV キャッシュを共有し、スループットを 6.4 倍にする。NeurIPS 2024、全文無料。
SGLang: Efficient Execution of Structured Language Model Programs
SGLang:構造化言語モデルプログラムの効率的な実行
Lianmin Zheng ^{2}\)\(* Liansheng Yin Zhiqiang Xie Chuyue Sun Jeff Huang Cody Hao Yu Shiyi Cao Christos Kozyrakis Ion Stoica Joseph E. Gonzalez Clark Barrett Ying Sheng ^{1}\)\(*
スタンフォード大学 UCバークレー 上海交通大学 テキサスA&M大学 独立研究者
概要
大規模言語モデル(LLM)は、複数の生成呼び出し、高度なプロンプト技法、制御フロー、構造化された入力/出力を必要とする複雑なタスクにますます利用されるようになっている。しかし、こうしたアプリケーションをプログラミングし実行するための効率的なシステムは不足している。我々は、複雑な言語モデルプログラムを効率的に実行するためのシステムであるSGLangを提案する。SGLangは、フロントエンド言語とランタイムから構成される。フロントエンドは、生成と並列性制御のためのプリミティブによってプログラミングを簡素化する。ランタイムは、KVキャッシュ再利用のためのRadixAttentionや、構造化出力デコーディングを高速化するための圧縮有限状態機械といった新しい最適化によって実行を加速する。実験により、SGLangは、エージェント制御、論理推論、少数ショット学習ベンチマーク、JSONデコーディング、検索拡張生成パイプライン、マルチターンチャットを含むタスクにおいて、様々な大規模言語モデルおよびマルチモーダルモデル上で、最先端の推論システムと比較して最大高いスループットを達成することが示された。コードは https://github.com/sgl-project/sglang で公開されている。
1 はじめに
近年のLLMの能力の向上により、その有用性は広がり、より広範な一般的タスクに取り組み、自律エージェントとして行動することが可能になっている[35, 6, 36, 52, 46]。このようなアプリケーションでは、LLMは多ラウンドの計画、推論、および外部環境との相互作用を行う。これは、ツール使用[41, 38]、複数の入力モダリティ[47, 2]、および少数ショット学習[5]、自己一貫性[53]、思考の骨格[33]、思考の木[56]といった幅広いプロンプト技法[30]を通じて達成される。これらすべての新しいユースケースは、複数の、しばしば依存関係のあるLLM生成呼び出しを必要とし、複雑なタスクを完了するためにマルチ呼び出し構造を用いる傾向を示している[57, 21]。
これらのパターンの出現は、LLMとの相互作用が、単純なチャットから、LLMのより洗練されたプログラム的利用へと移行していることを意味する。すなわち、プログラムを用いてLLMの生成プロセスをスケジュールし制御することである。我々はこれらのプログラムを「言語モデルプログラム」(LMプログラム)と呼ぶ[4, 20]。上記の高度なプロンプト技法およびエージェント的ワークフローは、LMプログラムの範囲に含まれる。LMプログラムには2つの一般的な性質がある:(1)LMプログラムは通常、制御フローに挟まれた複数のLLM呼び出しを含む。これは複雑なタスクを完了し、全体的な品質を向上させるために必要である。(2)LMプログラムは構造化された入力を受け取り、構造化された出力を生成する。これはLMプログラムの合成を可能にし、LMプログラムを既存のソフトウェアシステムに統合するために必要である。

LMプログラムが広く使用されているにもかかわらず、それらを表現し実行するための現在のシステムは依然として非効率的である。我々は、LMプログラムの効率的な利用に関連する2つの主要な課題を特定する。第一に、LLMの非決定論的性質のため、LMプログラムのプログラミングは退屈で困難である。LMプログラムの開発には、しばしば広範な文字列操作、プロンプトの実験的調整、脆弱な出力解析、複数の入力モダリティの処理、および並列性メカニズムの実装が必要となる。この複雑さは、単純なプログラムでさえも可読性を著しく低下させる(第2節)。
第二に、そして重要に、LMプログラムの実行は、冗長な計算とメモリ使用のために非効率的である。最先端の推論エンジン(例えば、vLLM [23]、TGI [16]、TensorRT-LLM [34])は、ワークロードを直接知ることなく、レイテンシを削減しスループットを向上させるように最適化されている。これにより、これらのシステムは汎用的で堅牢になるが、任意のワークロードに対しては著しい非効率性をもたらす。顕著な例は、Key-Value(KV)キャッシュの再利用である(第3節)。KVキャッシュは、生成的推論に不可欠な再利用可能な中間テンソルから構成される。LMプログラムの典型的なバッチ実行では、共通のプレフィックスを共有する複数の異なるLLM呼び出しにわたってKVキャッシュを再利用する多くの機会が存在する。しかし、現在のシステムはこの再利用を促進する効果的なメカニズムを欠いており、不必要な計算とメモリの浪費を引き起こしている。もう一つの例は、構造化出力のための制約付きデコーディング(例えば、JSONモード)であり、LLMの出力は正規表現によって定義された特定の文法規則に従うように制限される(第4節)。これらの制約の下では、しばしば複数のトークンを一度にデコードできる。しかし、既存のシステムは一度に1つのトークンしかデコードせず、デコーディング速度が最適に達しない。
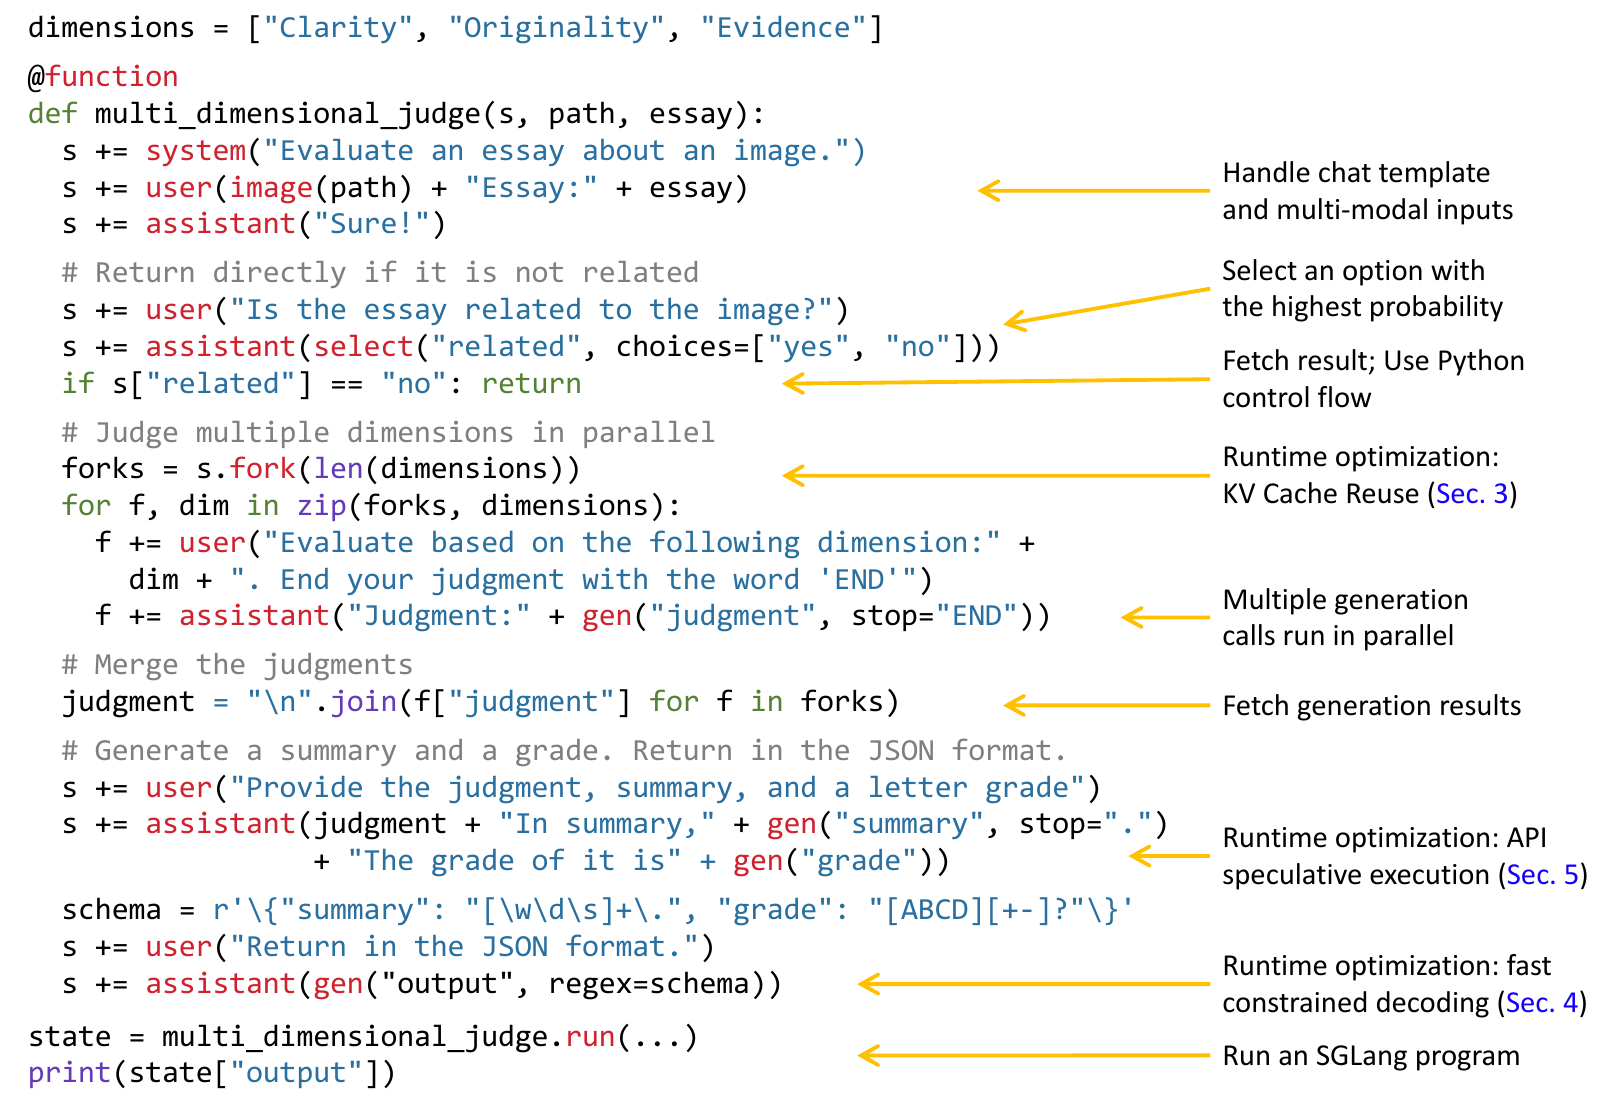
これらの課題に対処するため、我々はLLMのための構造化生成言語であるSGLangを提案する。核心的なアイデアは、LMプログラムにおけるマルチ呼び出し構造を体系的に活用し、効率的な実行を実現することである。図1に示すように、SGLangは2つの部分からなる:フロントエンド言語とバックエンドランタイムである。フロントエンドはLMプログラムのプログラミングを簡素化し、ランタイムはその実行を加速する。この2つの部分は、より良い性能のために協調して動作できるが、独立して機能することもできる。
我々は、Pythonに埋め込まれたドメイン固有言語としてSGLangを導入する。これは、生成(例えば、extend、gen、select)および並列性制御(例えば、fork、join)のためのプリミティブを提供する。SGLangはPythonの制御フローおよびライブラリと互換性があるため、ユーザーはネイティブなPython構文で高度なプロンプトワークフローを容易に開発できる。我々はSGLangのためのインタプリタとコンパイラを提供する。インタプリタはプロンプト状態をストリームとして管理し、プリミティブ操作をストリームに投入して非同期実行を行い、同期およびプログラム内並列性の適切な制御を保証する。さらに、SGLangプログラムはトレースおよびコンパイルして、さらなる最適化を行うことができる。
ランタイム側では、我々はSGLangプログラムの実行を加速するためのいくつかの新しい最適化を提案する。最初の技術であるRadixAttentionは、複数の生成呼び出しにわたるKVキャッシュの自動再利用を可能にする。既存の推論エンジンでは、リクエストのKVキャッシュは処理完了後に破棄されるため、複数の呼び出しにわたってKVキャッシュを再利用できず、実行が著しく遅くなる。これに対し、我々のシステムは、すべてのリクエストのKVキャッシュを基数木(radix tree)内にLRUキャッシュとして維持する。このアプローチはKVキャッシュを従来のキャッシュとして管理し、基数木を用いて効率的なマッチング、挿入、およびエビクションを行う。これにより、ランタイムはキャッシュを意識したスケジューリングポリシーを用いて、様々な再利用パターンを効率的に処理できる。2番目の技術は圧縮有限状態機械であり、構造化出力のためのより高速な制約付きデコーディングを可能にする。既存のシステムは、許可されないトークンの確率をマスクすることにより、次のトークンに対してのみ制約に従うため、一度に1つのトークンしかデコードできない。これに対し、我々のシステムは制約を解析し、制約を表現する圧縮有限状態機械を構築する。このアプローチは、可能な限りマルチトークンパスを単一ステップパスに圧縮し、複数のトークンを一度にデコードしてより高速なデコーディング速度を達成することを可能にする。最後に、SGLangはOpenAIのGPT-4のようなAPI専用モデルもサポートしており、我々は3番目の技術であるAPI投機的実行を導入し、API専用モデルのためのマルチ呼び出しプログラムを最適化する。
SGLangを用いて、我々はエージェント制御、論理推論、少数ショット学習ベンチマーク、JSONデコーディング、検索拡張生成パイプライン、マルチターンチャット、およびマルチモーダル処理を含む様々なLLMアプリケーションを実装した。我々は、NVIDIA A10GおよびA100 GPU上で、Llama-7B/70B [49]、Mistral-8x7B [17]、LLaVA-v1.5-7B(画像)[28]、およびLLaVA-NeXT-34B(動画)[62]を含むモデルで性能をテストした。実験結果は、SGLangが、Guidance [13]、vLLM [23]、LMQL [4]を含む既存のプログラミングおよび推論システムと比較して、幅広いワークロード、モデル、ハードウェア構成にわたって最大高いスループットを達成することを示している。
2 プログラミングモデル
本節では、実行例を用いてSGLangプログラミングモデルを紹介し、その言語プリミティブと実行モードを説明し、ランタイム最適化の機会を概説する。このプログラミングモデルは、柔軟で合成可能なプリミティブを提供することにより、マルチ呼び出しワークフローにおける退屈な操作(例えば、文字列操作、API呼び出し、制約指定、並列性)を簡素化できる。
実行例。この言語はPythonに埋め込まれたドメイン固有言語である。図2は、branch-solve-mergeプロンプティング法[40]を用いて画像に関するエッセイを評価するプログラムを示している。関数multi_dimensional_judgeは3つの引数を取る:s、path、essayである。sはプロンプト状態を管理し、pathは画像ファイルのパス、essayはエッセイのテキストである。新しい文字列およびSGLangプリミティブは、演算子を用いて実行のために状態sに追加できる。まず、関数は画像とエッセイをプロンプトに追加する。次に、selectを用いてエッセイが画像に関連しているかどうかを確認し、結果をs["related"]に格納する。関連している場合、プロンプトは異なる次元からの並列評価のために3つのコピーにフォークされ、genを用いて結果をf["judgment"]に格納する。次に、判定をマージし、要約を生成し、文字による評点を割り当てる。最後に、正規表現制約regexによって定義されたスキーマに従って、結果をJSON形式で返す。SGLangはこのプログラムを大幅に簡素化する。というのも、OpenAI APIライクなインターフェースを用いた同等のプログラムは、手動の文字列操作と並列性制御のためにの行数のコードを必要とするからである。
言語プリミティブ。SGLangは、プロンプトの状態、生成、並列性を制御するためのプリミティブを提供する。これらはPythonの構文やライブラリと組み合わせて使用できる。以下がそのプリミティブである。「gen」はモデルを呼び出して生成を行い、その結果を最初の引数で指定された名前の変数に格納する。出力を正規表現で定義された文法(例えばJSONスキーマ)に従うよう制約する「regex」引数をサポートする。「select」はモデルを呼び出してリストの中から最も確率の高い選択肢を選ぶ。演算子「+=」または「extend」はプロンプトに文字列を追加する。演算子「[variable_name]」は生成結果を取得する。「fork」はプロンプト状態の並列フォークを作成する。「join」はプロンプト状態を再結合する。「image」と「video」は画像および動画の入力を受け取る。
実行モード。SGLangプログラムを実行する最も簡単な方法はインタプリタを通す方法であり、そこではプロンプトは非同期ストリームとして扱われる。extend、gen、selectといったプリミティブは非同期実行のためにストリームに投入される。これらの非ブロッキング呼び出しにより、Pythonコードは生成の完了を待たずに実行を継続できる。これはCUDAカーネルを非同期に起動するのと似ている。各プロンプトはバックグラウンドスレッドのストリームエグゼキュータによって管理され、プログラム内並列性を可能にする。生成結果の取得は、それらが準備できるまでブロックされ、正しい同期が保証される。あるいは、SGLangプログラムは計算グラフとしてコンパイルし、
| システム | 構文 | 言語プリミティブ | ランタイムバックエンド |
| LMQLガイダンス | カスタムPython | extend、gen、select extend、gen、select、image | HF Transformers、llama.cpp、OpenAI HF Transformers、llama.cpp、OpenAI |
| SGLang | Python | extend、gen、select、image、video、fork、join | SGLangランタイム(SRT)、OpenAI |
グラフエグゼキュータで実行することもでき、より多くの最適化が可能になる。本論文ではデフォルトでインタプリタモードを使用し、コンパイラモードの結果については付録Dで議論する。SGLangは独自のSGLang Runtime(SRT)を用いたオープンウェイトモデルに加え、OpenAIやAnthropicのモデルといったAPIモデルもサポートする。
比較。LLM向けのプログラミングシステムは、高水準(例えばLangChain、DSPy)と低水準(例えばLMQL、Guidance、SGLang)に分類できる。高水準システムは、DSPyのプロンプトオプティマイザのように、事前定義された、あるいは自動生成されたプロンプトを提供する。低水準システムは通常、プロンプトを変更せず、プロンプトとプリミティブの直接的な操作を可能にする。SGLangはLMQLやGuidanceに類似した低水準システムである。表1はそれらの特徴を比較している。SGLangはランタイム効率により重点を置き、独自の共同設計されたランタイムを備えており、後に導入される新規の最適化を可能にする。高水準言語(例えばDSPy)は低水準言語(例えばSGLang)にコンパイルできる。我々は、より良いランタイム効率のためにDSPyにおけるバックエンドとしてのSGLangの統合を第6節で実証する。
ランタイム最適化。図2は3つのランタイム最適化の機会を示している:KVキャッシュの再利用、高速制約付きデコーディング、API投機的実行である。以下、これらの節で議論する。
3 RadixAttentionによる効率的なKVキャッシュ再利用
SGLangのプログラムは複数の生成呼び出しを連鎖させ、「fork」プリミティブで並列コピーを作成できる。さらに、異なるプログラムインスタンスが共通部分(例えばシステムプロンプト)を共有することがよくある。これらのシナリオは実行中に多くの共有プロンプトプレフィックスを生み出し、KVキャッシュを再利用する多数の機会をもたらす。LLM推論中、KVキャッシュはフォワードパスの中間テンソルを保存し、将来のトークンのデコーディングに再利用される。これらは自己注意機構[51]におけるキー・バリュー対にちなんで名付けられている。KVキャッシュの計算はプレフィックストークンのみに依存する。したがって、同じプロンプトプレフィックスを持つリクエストはKVキャッシュを再利用でき、冗長な計算とメモリ使用量を削減できる。より詳細な背景といくつかの例は付録Aに示す。
KVキャッシュ再利用の機会を踏まえると、SGLangプログラムの最適化における重要な課題は、複数の呼び出しとインスタンスにまたがってKVキャッシュを再利用することである。いくつかのシステムは特定のKVキャッシュ再利用のケースを探求しているが[23, 58, 18, 12]、それらはしばしば手動設定を必要とし、すべての再利用パターン(例えば動的木構造)を扱えない。その結果、最先端の推論システムのほとんどはリクエストごとにKVキャッシュを再計算する。それらの限界と我々の違いについては第7節で議論する。
本節では、実行時に自動かつ系統的にKVキャッシュを再利用する新しい技術であるRadixAttentionを紹介する。生成リクエストの終了後にKVキャッシュを破棄する既存システムとは異なり、我々のシステムはプロンプトと生成結果のキャッシュを基数木(ラディックスツリー)に保持し、効率的なプレフィックス検索、再利用、挿入、退避を可能にする。我々はLRU退避ポリシーとキャッシュ認識スケジューリングポリシーを実装し、キャッシュヒット率を高める。RadixAttentionは継続的バッチ処理[60]、ページドアテンション[23]、テンソル並列処理[44]などの技術と互換性がある。さらに、キャッシュヒットがない場合には無視できる程度のメモリと時間のオーバーヘッドしか導入しない。
RadixAttention。基数木は、古典的なトライ木(プレフィックス木)に対する空間効率の良い代替として機能するデータ構造である。典型的な木とは異なり、基数木のエッジは単一の要素だけでなく、さまざまな長さの要素の列でラベル付けできるため、効率が大幅に向上する。我々のシステムでは、基数木を利用してトークン列とそれに対応するKVキャッシュテンソルの間のマッピングを管理する。これらのKVキャッシュテンソルは、各ページのサイズが1トークンに等しい、非連続のページドレイアウトで保存される。GPUメモリはKVキャッシュによってすぐに満たされるため、我々は最も最近使用されていないリーフを最初に退避する単純なLRU退避ポリシーを導入する。リーフを最初に退避することで、それらの共通祖先を再利用できるようになり、祖先がリーフとなって同様に退避されるまで続く。
継続的バッチ処理の設定では、現在実行中のバッチが使用しているノードを退避することはできない。したがって、各ノードはそれがいくつの実行中リクエストに使用されているかを示す参照カウンタを維持する。ノードは参照カウンタがゼロであれば退避可能である。我々はキャッシュとして固定サイズのメモリプールを事前確保しないことに注意されたい。代わりに、キャッシュされたトークンと現在実行中のリクエストが同じメモリプールを共有するようにする。したがって、システムはキャッシュと実行中リクエストのために動的にメモリを割り当てる。十分な待機リクエストが実行されると、システムはより大きなバッチサイズを優先してキャッシュされたすべてのトークンを退避する。図3は、いくつかの受信リクエストに対して基数木がどのように維持されるかを示している。フロントエンドインタプリタは
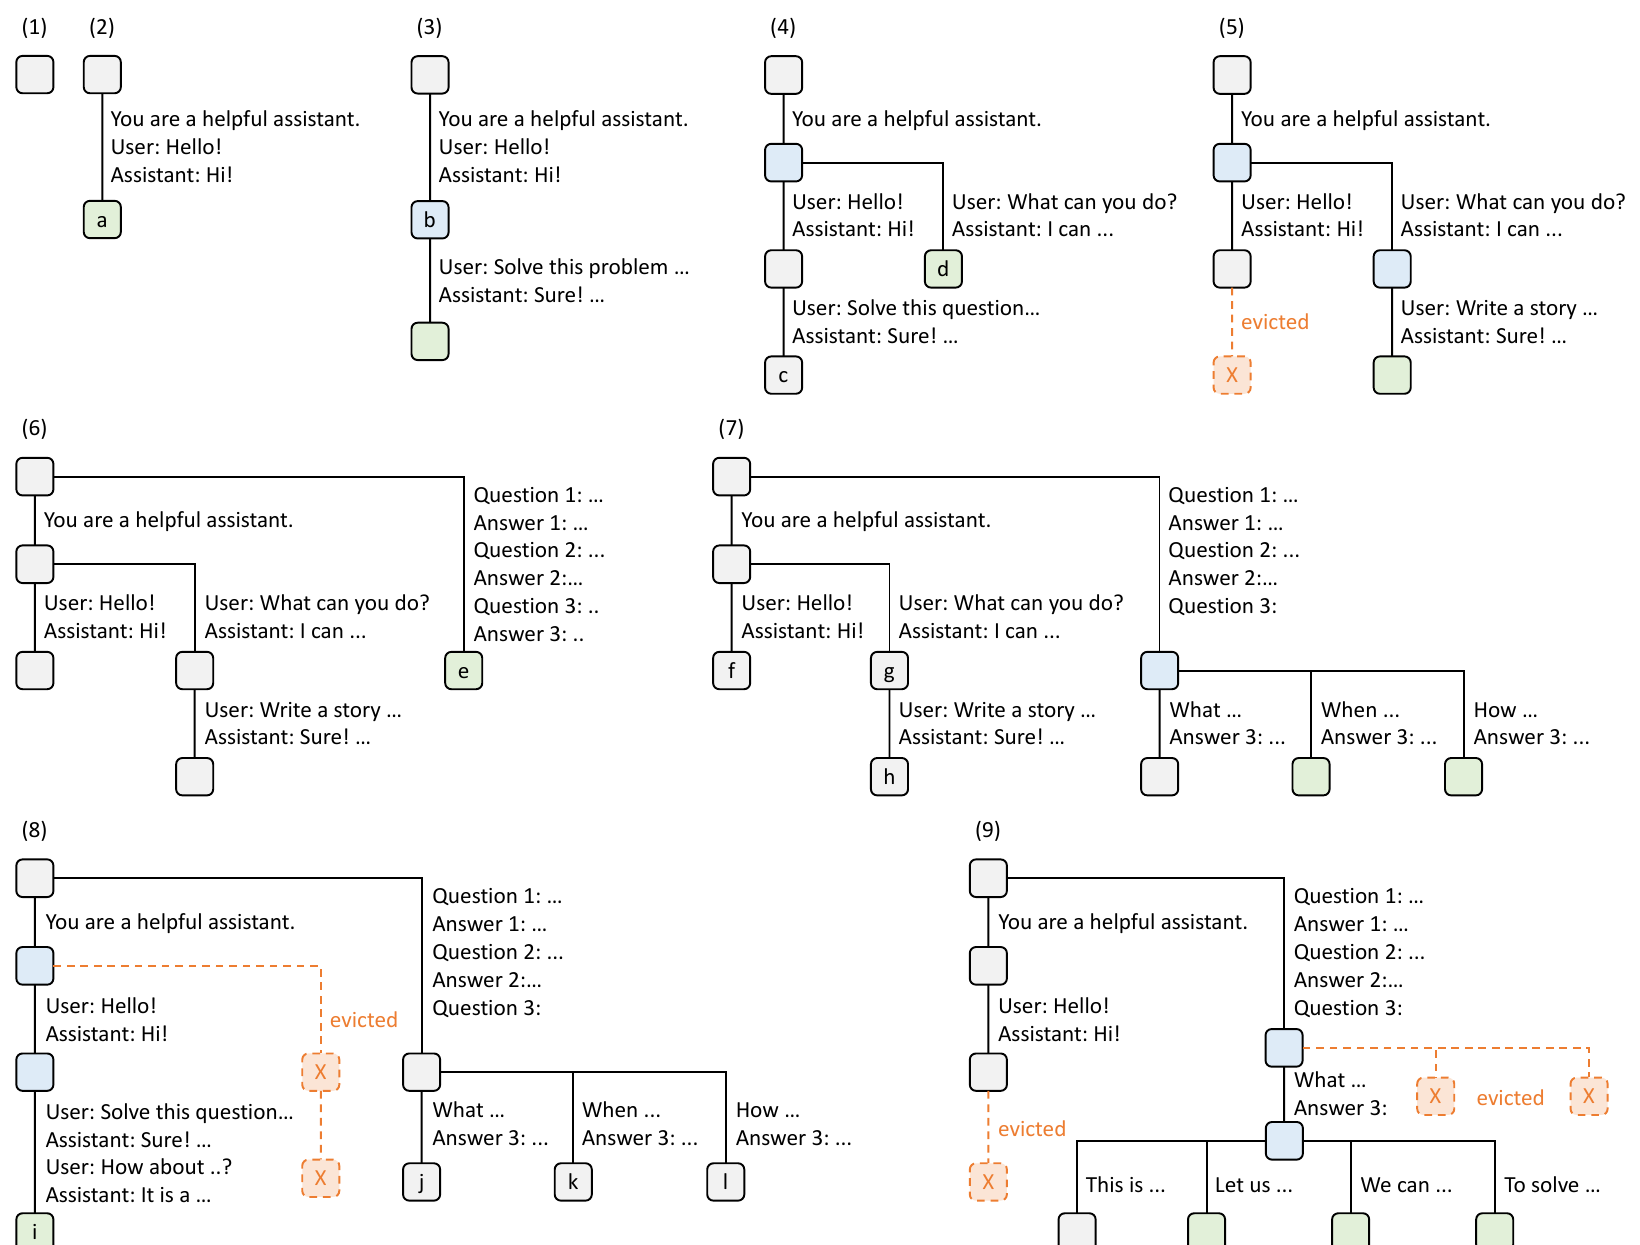
完全なプロンプトをランタイムに送信し、ランタイムはプレフィックスマッチングと再利用を実行する。木構造はCPU上に保存され、その維持オーバーヘッドは無視できる程度である。forkプリミティブの実行中、フロントエンドはまずプレフィックスをヒントとして送信し、プレフィックスが正しく木に挿入されることを保証する。その後、残りのプロンプトを送信する。この「フロントエンドヒント」はランタイムのスケジューリングとマッチングを簡素化し、フロントエンドとランタイムの共同設計の利点を例示している。
キャッシュ認識スケジューリング。我々はキャッシュヒット率を、キャッシュされたプロンプトトークンの数として定義する。待機キューに多くのリクエストがある場合、それらが実行される順序はキャッシュヒット率に大きく影響しうる。例えば、リクエストスケジューラが異なる無関係なリクエスト間で頻繁に切り替わる場合、キャッシュスラッシングを引き起こし、ヒット率を低下させる可能性がある。我々はキャッシュヒット率を高めるためにキャッシュ認識スケジューリングアルゴリズムを設計する。バッチ処理の設定では、リクエストをマッチしたプレフィックス長でソートし、
先着順スケジュールを使用する代わりに、より長いマッチしたプレフィックスを持つリクエストを優先する。アルゴリズム1(付録)は、連続バッチ処理を用いたキャッシュ認識スケジューリングの擬似コードを示している。このアルゴリズムは最長共通プレフィックス優先の順序を使用する。よりレイテンシに敏感な設定では、キャッシュ再利用を改善するために限られたバッチの並べ替えを依然として許容できる場合がある。さらに、我々はオフラインの場合における最適スケジューリングについて次の定理を証明する。2
定理3.1。リクエストのバッチに対して、キャッシュサイズが最大リクエスト長以上であれば、リクエストの基数木を深さ優先探索順に訪問することで最適なキャッシュヒット率を達成できる。最長共通プレフィックス優先の順序は深さ優先探索順と等価である。
証明は付録A.3(付録)にある。オンラインの場合、DFS順は乱されるが、我々のスケジュールは付録A.3で述べられているように、完全な基数木の拡張部分に対するDFSの振る舞いを依然として近似する。貪欲なキャッシュ認識スケジューリングは高いスループットを達成できるが、スタベーションを引き起こす可能性がある。他の公平なスケジューリング手法[42]との統合は今後の課題とする。
分散の場合。RadixAttentionは複数のGPUに拡張できる。テンソル並列処理では、各GPUがシャードされたKVキャッシュを維持する。木の操作が同一であるため、追加の同期は不要である。複数のワーカーによるデータ並列処理は付録A.4(付録)で議論する。
4 圧縮有限状態機械による効率的な制約付きデコーディング
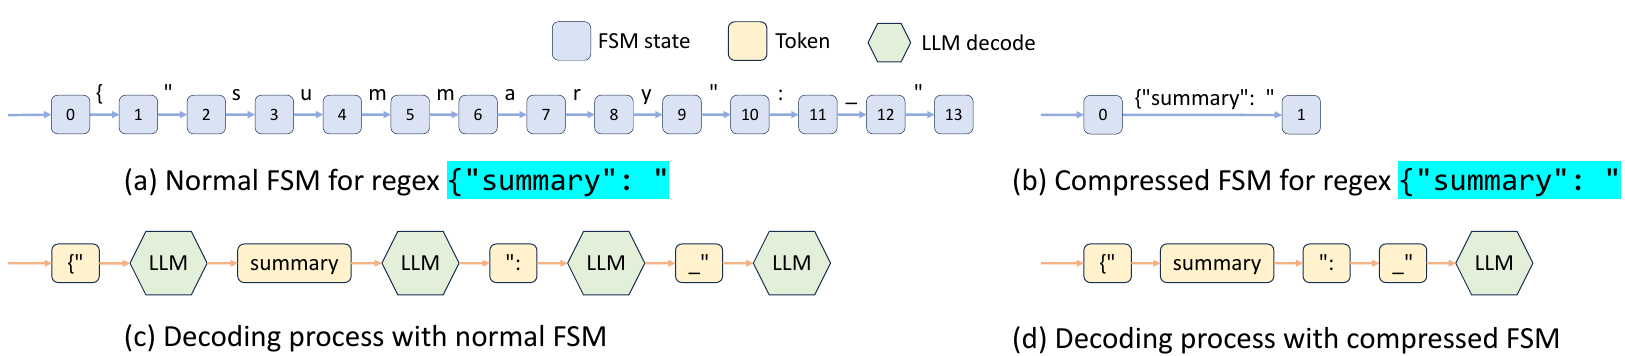
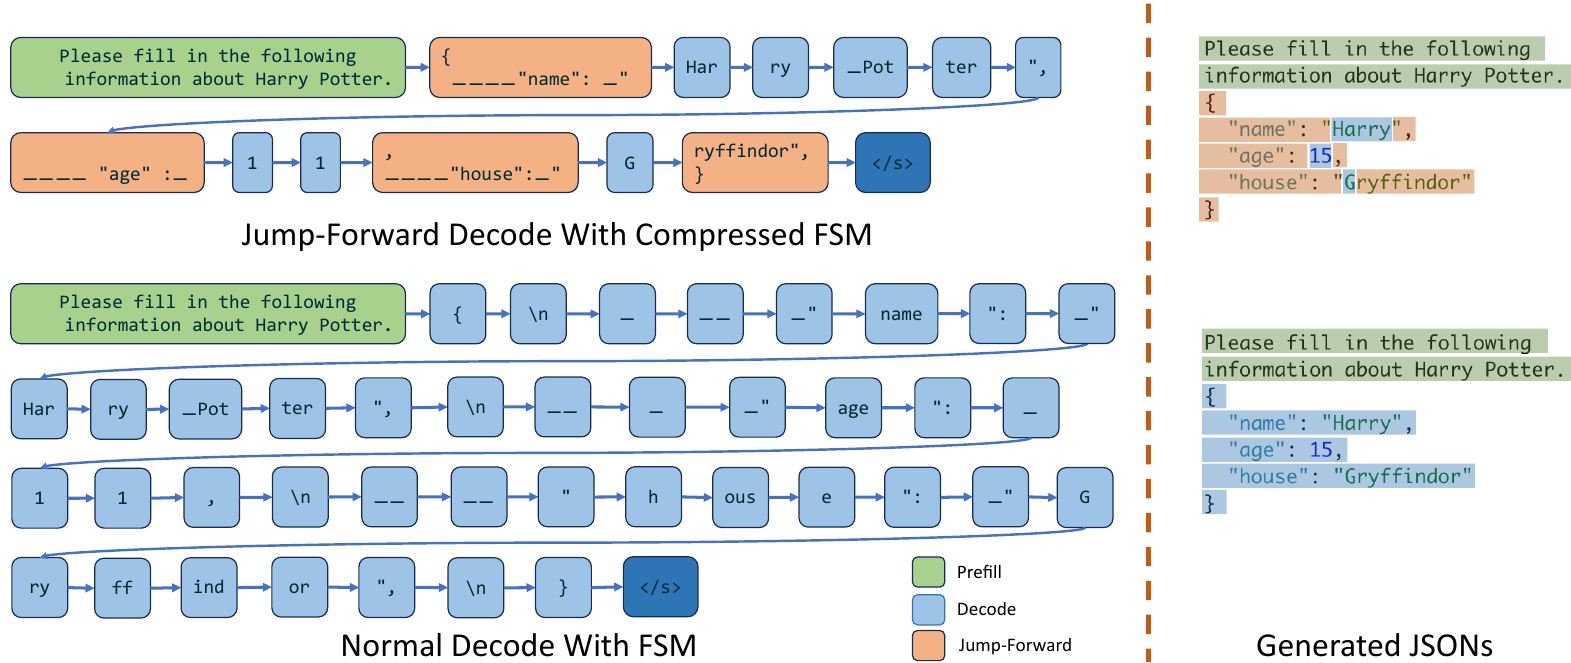
LMプログラムでは、ユーザーはしばしばモデルの出力をJSONスキーマなどの特定の形式に従うよう制約したいと考える。これは制御性と堅牢性を向上させ、出力をより解析しやすくする。SGLangはそのような制約を正規表現で強制するためのregex引数を提供しており、これらは多くの実用的なシナリオに対して十分に表現力がある。既存システムは正規表現を有限状態機械(FSM)[54]に変換することでこれをサポートしている。デコーディング中、それらは現在のFSM状態を維持し、次の状態から許可されたトークンを取得し、無効なトークンの確率をゼロに設定して、トークンごとにデコーディングする。しかし、このトークンごとのアプローチは、複数のトークンを一度にデコードできる機会がある場合には非効率である。例えば、図2の定数列{"summary": "は、図4(c)に示すように通常のデコーディング過程で複数のトークンにまたがり、それをデコードする際に有効な次のトークンが1つしかないにもかかわらず、複数のデコーディング段階を必要とする。したがって、列全体を1ステップ(すなわちフォワードパス)でデコードできる。しかし、既存システムではFSMとモデルランナーの統合が欠如しているためマルチトークン処理が妨げられ、既存システムは一度に1トークンしかデコードできず、デコーディングが遅くなる。
SGLangは、圧縮FSMを用いた高速制約付きデコーディングランタイムを作成することでこの制限を克服する。このランタイムはFSMを解析し、図4(b)に示すようにFSM内の隣接する単一遷移エッジを単一のエッジに圧縮し、複数のトークンをまとめてデコードできるタイミングを認識できるようにする。図4(d)では、圧縮された遷移エッジ上の複数のトークンを1回のフォワードパスでデコードでき、デコーディング過程を大幅に加速する。また、これは汎用的であり、すべての正規表現に適用可能である。背景と実装の詳細は付録Bにある。
5 API投機的実行による効率的なエンドポイント呼び出し
前節では、モデル推論過程の変更を必要とするオープンウェイトモデル向けの最適化を紹介した。さらに、SGLangはOpenAIのGPT-4のようなAPIアクセスのみのモデルとも連携する。しかし、これらのモデルについては、ブラックボックスのAPIエンドポイントを呼び出すことしかできない。
本節では、投機的実行を用いてマルチ呼び出しSGLangプログラムの実行を加速しAPIコストを削減する、ブラックボックスAPIモデル向けの新しい最適化を紹介する。例えば、プログラムがマルチ呼び出しパターンでキャラクターの説明を生成するようモデルに求める場合がある:
context "name:" gen("name", stop="\n") "job:" gen("job", stop="\n")。素朴には、2つのgenプリミティブは2つのAPI呼び出しに対応し、ユーザーはcontextの入力トークン料金を2回支払う必要がある。SGLangでは、最初の呼び出しで投機的実行を有効にし、停止条件を無視してさらに数トークンの生成を続けさせることができる。インタプリタは追加の生成出力を保持し、後のプリミティブとマッチングして再利用する。特定のケースでは、慎重なプロンプトエンジニアリングにより、モデルはテンプレートを高い精度で正しくマッチでき、1回のAPI呼び出しのレイテンシと入力コストを節約できる。
6 評価
我々は多様なLLMワークロードにわたってSGLangの性能を評価する。続いて、特定のコンポーネントの有効性を示すためにアブレーション研究とケーススタディを実施する。SGLangはPyTorch[37]で実装され、FlashInfer[59]とTriton[48]によるカスタムCUDAカーネルを使用している。
6.1 セットアップ
モデル。我々は密なLlama-2モデル[49]、疎な混合エキスパートMixtralモデル[17]、マルチモーダルLLaVA画像[27]および動画モデル[62]、そしてAPIモデルであるOpenAIのGPT-3.5をテストする。オープンウェイトモデルについては、パラメータ数は70億から700億の範囲であり、float16精度を使用する。
ハードウェア。ほとんどの実験は、NVIDIA A10G GPU(24GB)を搭載したAWS EC2 G5インスタンス上で実行します。7Bモデルは単一のA10G GPU上で、より大きなモデルはテンソル並列化[44]を用いて複数のA10G GPU上で実行します。追加の実験の一部はA100G(80GB)GPU上で実行します。
ベースライン。SGLangを、それぞれの言語とデフォルトのランタイムを備えた高水準プログラミングシステム、および標準的なOpenAIライクなCompletion APIを備えた低水準推論エンジンの両方と比較します。特に断りのない限り、計算結果を変化させる最適化は有効にせず、すべてのシステムが同じ結果を計算するようにします。ベースラインには以下が含まれます:
- Guidance[13]、LLMを制御するための言語。llama.cppバックエンドを備えたGuidance v0.1.8を使用します。- vLLM[23]、高スループット推論エンジン。vLLM v0.2.5とそのデフォルトのAPIサーバーを使用します。- LMQL[4]、クエリ言語。Hugging Face Transformersバックエンドを備えたLMQL v0.7.3を使用します。
ワークロード。以下をテストします:5ショットMMLU[14]および20ショットHellaSwag[61]ベンチマーク。MMLUでは1トークンをデコードし、HellaSwagではプリミティブなselectを用いて最も確率の高い回答を選択します。ReActエージェント[57]および生成エージェント[36]については、元の論文からトレースを抽出して再生します。GSM-8K問題にはTree-of-thought[56]を、tip生成にはSkeleton-of-thought[33]を使用します。branch-solve-merge[40]手法を用いたLLMジャッジ;正規表現で指定されたスキーマによるJSONデコーディング;4ターンのマルチターンチャット(各ターンの入力は256〜512トークンの間でランダムにサンプリング);DSPyの検索拡張生成(RAG)パイプライン[20]をその公式例で使用します。
指標。我々はスループットとレイテンシという2つの性能指標を報告する。スループットについては、最大スループットを計算するために十分に大きなバッチのプログラムインスタンスを実行し、1秒あたりに実行されるプログラムインスタンスの数(programs per second、p/s)を比較する。レイテンシについては、バッチ処理を行わずに一度に1つのプログラムを実行し、複数のインスタンスの平均レイテンシを報告する。
6.2 エンドツーエンド性能
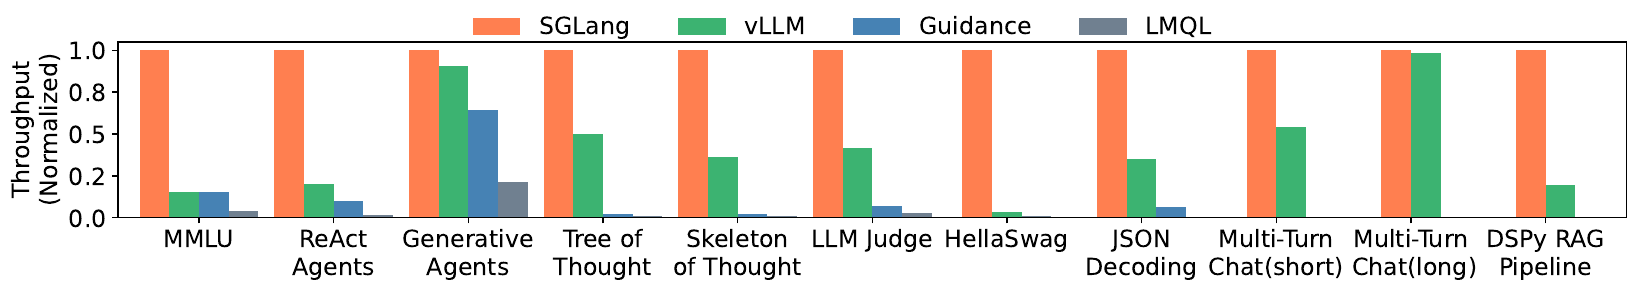
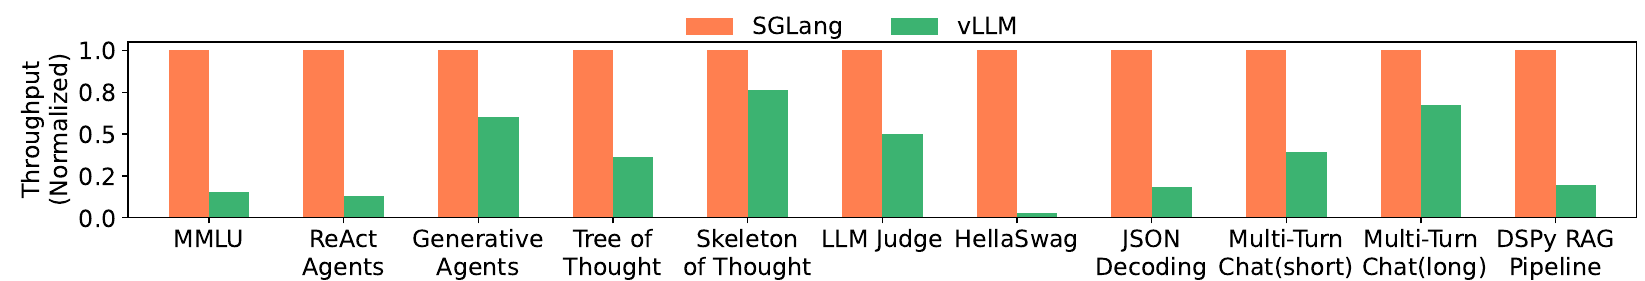
オープンウェイトモデルでの結果。レイテンシとスループットの結果を図5および図6に示す。SGLangはスループットを最大向上させ、レイテンシを最大削減する。これらの改善は、KVキャッシュの再利用、単一プログラム内での並列性の活用、およびより高速な制約付きデコーディングに起因する。次に、各ベンチマークにおける高速化の理由を説明する。
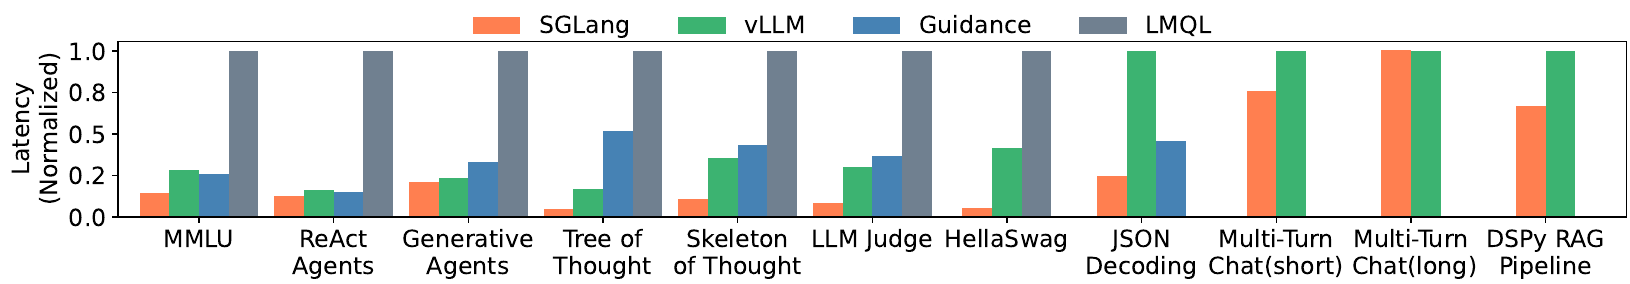
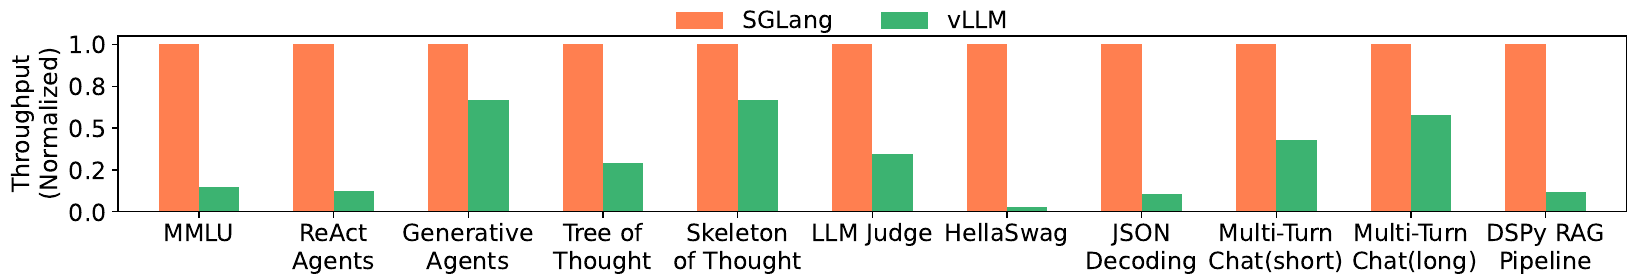
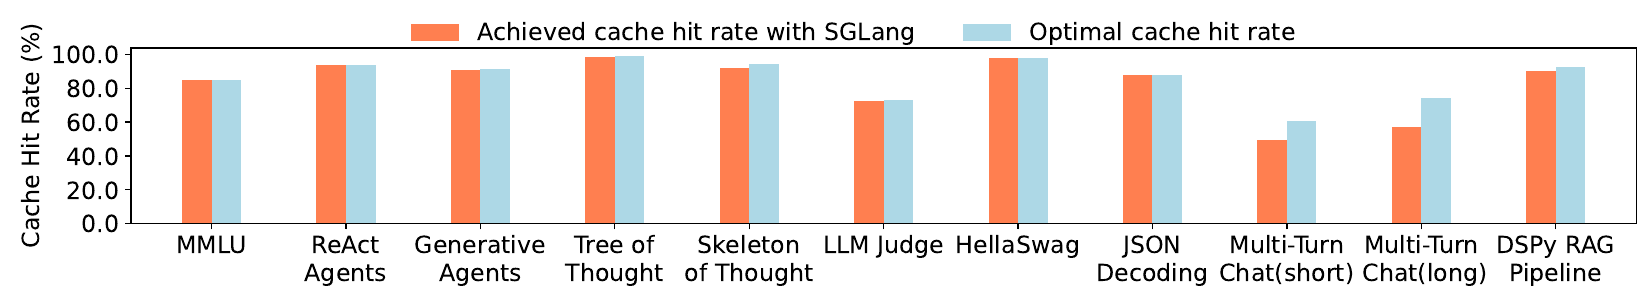
MMLUでは、SGLangはRadixAttentionを用いて5ショット例のKVキャッシュを再利用できる。RadixAttentionはスループットとレイテンシの両方に利益をもたらす。RadixAttentionはKVキャッシュを共有することで総メモリ使用量を削減し、より大きなバッチサイズを可能にして最大スループットを向上させる。またRadixAttentionはプリフィルの計算を削減し、それによって最初のトークンのレイテンシを減少させる。HellaSwagでは、SGLangは少数ショット例と複数選択肢に対する共通の質問プレフィックスの両方のKVキャッシュを再利用し、2レベルの共有を実現する。ReActおよび生成的エージェントでは、SGLangはエージェントテンプレートと以前の呼び出しのKVキャッシュを再利用する。Tree-of-thoughtおよびSkeleton-of-thoughtでは、SGLangは単一プログラム内の生成呼び出しを並列化し、KVキャッシュを可能な限り再利用する。JSONデコーディングでは、SGLangは圧縮有限状態機械を用いて複数のトークンを一度にデコードすることでデコーディングを高速化する。マルチターンチャットでは、SGLangはチャット履歴のKVキャッシュを再利用する。KVキャッシュの再利用は主にプレフィックス時間の削減に寄与するため、短い出力では高速化がより顕著である。長い出力では、異なるチャットセッション間での共有がほとんどなく、デコーディング時間が支配的であるため、高速化はほとんどない。DSPy RAGパイプラインでは、SGLangは共通コンテキスト例のKVキャッシュを再利用する。これらのベンチマークでは、キャッシュヒット率はからの範囲である。図13(付録)はそれらすべてについて達成されたキャッシュヒット率と最適なキャッシュヒット率を列挙しており、我々のキャッシュアウェアスケジューリングが平均で最適ヒット率のに近づくことを示している。
我々は最後の5つのベンチマークの一部からLMQLとGuidanceを除外する。それは性能が遅く機能が欠けているためである。LMQLの問題は遅いトークンレベルの処理と最適化されていないバックエンドに起因し、Guidanceはバッチ処理と並列性のサポートを欠いている。
テンソル並列性を用いたより大規模なモデルでの結果。我々はより大規模なモデルであるMixtral-8x7BとLlama-70Bを同じベンチマーク群上でテンソル並列性を用いて実行し、結果を図7および図12(付録)に報告する。より大規模なモデルでの高速化は、より小規模なモデルで観察された傾向と同様の傾向を示しており、我々の最適化がより大規模なモデルにも良好に一般化することを示している。GuidanceとLMQLはテンソル並列性の効率的な実装を欠いているため、ここでは省略する。
マルチモーダルモデルでの結果。SGLangは画像および動画プリミティブによるマルチモーダルモデルのネイティブサポートを有する。本論文の最適化はマルチモーダルモデルと互換性がある。RadixAttentionについては、入力画像のハッシュを計算し、それを基数木のキーとして用いることで、同じ画像からの画像トークンのKVキャッシュを再利用できる。我々はLLaVA-v1.5-7B(画像)をllava-bench-in-the-wild上で、LLaVA-NeXT-34B(動画)をActivityNet上で実行する。これらのモデルは他のベースラインシステムによって十分にサポートされていないため、ベースラインとしてモデル作者によるHugging Face Transformersでの元の実装を用いる。表2に示すように、SGLangはこれらのベンチマークで最大高いスループットを提供する。llava-bench-in-the-wildでは、同じ画像について複数の質問があり、SGLangランタイムはこの場合にKVキャッシュを再利用する。
本番環境へのデプロイ。SGLangはChatbot Arena [8]にデプロイされ、オープンウェイトモデルを提供している。一部のモデルはトラフィックが少ないため、各モデルにつき1つのSGLangワーカーのみがサービスを提供している。1か月後、我々はLLaVA-NeXT-34B [28]で、Vicuna-33B [7]でのRadixAttentionキャッシュヒット率を観測した。キャッシュヒットは、共通のシステムメッセージ、頻繁に再利用される例示画像、およびマルチターンのチャット履歴に由来する。これによりVicuna-33Bでは最初のトークンのレイテンシが平均で削減される。
| モデル | LLaVA-v1.5-7B(画像) | LLaVA-NEXT-34B(動画) |
| 著者による元の実装 | 0.18 image/s | 0.02 frame/s |
| SGLang | 1.15 image/s | 0.10 frame/s |
APIモデルでの結果。我々はOpenAIのGPT-3.5モデルを用いてWikipediaページから3つのフィールドを抽出するプロンプトをテストする。少数ショットプロンプティングを用いることで、API投機的実行の精度は高く、3つのフィールドを抽出するため入力トークンのコストを約3分の1に削減する。
6.3 アブレーション研究
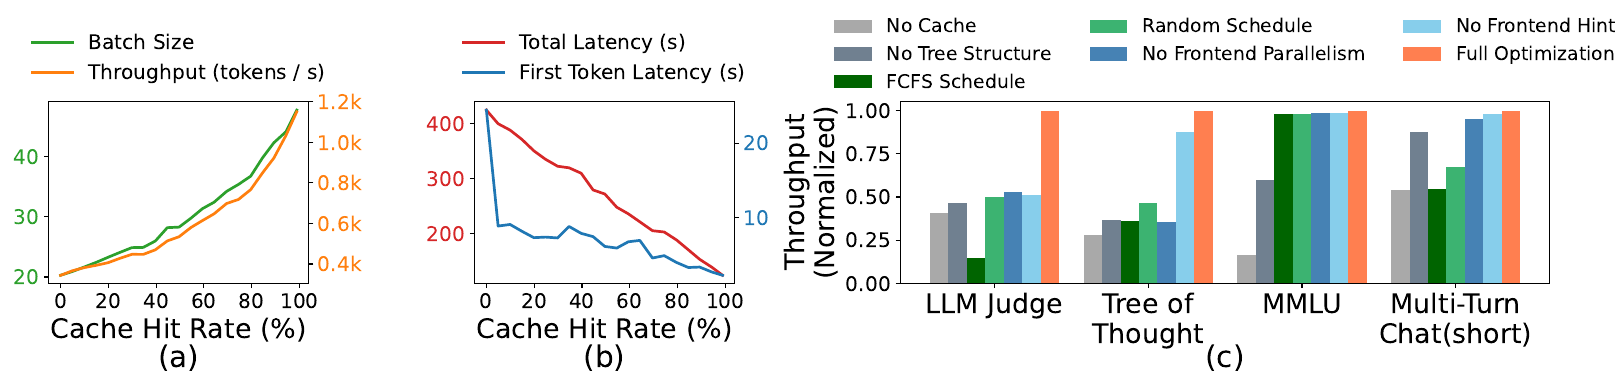
キャッシュヒット率とレイテンシ/スループットの関係。図8(a)(b)は、tree-of-thoughtベンチマークにおけるキャッシュヒット率と性能指標(最初のトークンのレイテンシ、総レイテンシ、バッチサイズ、スループット)の関係を示している。この図は、実行時にマッチしたトークンを部分的に無効化することで得られたものである。キャッシュヒット率が高いほど、バッチサイズが大きく、スループットが高く、レイテンシが低くなることを示している。
RadixAttentionの有効性。我々はいくつかの代表的なベンチマーク上でRadixAttentionとその構成要素の有効性をテストする。図8(c)に示すように、「No Cache」はキャッシュを一切使用しないこと、「No Tree-Structure」は木構造キャッシュの代わりに単純なテーブルベースのキャッシュを用いること、「FCFS Schedule」は我々のキャッシュアウェアスケジューリングの代わりに先着順ポリシーを用いること、「Random Schedule」はランダムな順序でリクエストをスケジュールすること、「No Frontend Parallelism」はインタプリタ内の並列性を無効化すること、「No Frontend Hint」はインタプリタからのフォークヒントの送信を無効化すること、「Full optimizations」はすべての最適化を有効化することを意味する。実験結果は、最良の性能を達成するためにはこれらの各構成要素が必要であることを示している。フロントエンドインタプリタからの並列性とヒントを無効化することもまた、準最適なランタイム性能をもたらし、フロントエンド言語とランタイムの協調設計の重要性を浮き彫りにしている。
RadixAttentionのオーバーヘッド。我々はKVキャッシュの再利用機会が一切ないベンチマーク上でRadixAttentionのオーバーヘッドをテストする。このベンチマークはShareGPTデータセットでのスループットを測定する。100リクエストを実行するのに74.3秒かかるが、RadixAttentionのデータ構造の管理に費やされる時間はわずか0.2秒であり、\(0.3\%\)未満という無視できるオーバーヘッドである。これは木操作の計算量が線形かつ小さいためである。したがって、我々はRadixAttentionをデフォルトで有効にできる。
圧縮有限状態機械の有効性。我々はJSONデコーディングベンチマーク上で圧縮有限状態機械とその構成要素の有効性をテストする。実験結果は、圧縮有限状態機械が複数のトークンを一度にデコードできるためスループットを向上させることを示している。さらに、状態機械を前処理し、それをリクエストのバッチに対して再利用する必要がある。そうでなければ、リクエストごとに前処理をやり直すことでスループットが低下する。
7 関連研究
様々な研究がKVキャッシュの再利用を探求しており、その多くは我々の研究と並行している。独自に、我々のRadixAttentionはKVキャッシュを木ベースのLRUキャッシュとして扱うことを初めて提案する。これはマルチレベルの共有、キャッシュアウェアスケジューリング、フロントエンド-ランタイム協調スケジューリング、および分散ケースをサポートする最初のソリューションである。vLLM [23]とChunkedAttention [58]はいくつかの単純な再利用ケース(例えばシステムプロンプトの共有)を探求しているが、マルチレベルの木構造共有やLRUキャッシュをカバーしていない。PromptCache [12]はプレフィックスを超えたKVキャッシュのモジュール式再利用を提案しているが、精度に最大の低下という影響を与えうる。HydraGen [18]、FlashInfer [59]、ChunkedAttention [58]はCUDAカーネルの最適化に焦点を当てており、LRUキャッシュの概念を含んでいない。API Serve [1]とLLM-SQL [29]は外部API呼び出しやリレーショナルデータベースとのインターリーブといった特定のアプリケーション向けのKVキャッシュ再利用を研究しているが、我々の基数木やキャッシュアウェアスケジューリングを有していない。
Guidance [13]、LMQL [4]、DSPy [20]、LangChain [24]、AutoGen [55]、LLM Compiler [21]など、いくつかのLLMプログラミングおよびエージェントフレームワークが存在する。GuidanceとLMQLはSGLangに最も類似しており、我々は第2節でそれらを比較する。我々の革新は、提案するプログラミングモデルを加速するための新しいランタイム最適化にある。SGLangは他のフレームワークと互換性があり、それらを加速できる(例えば我々の評価におけるDSPyの例)。さらに、SGLangは他の多くの一般的な推論最適化[60, 39, 3, 23, 59, 10, 26, 15, 19, 32, 31, 11]と互換性がある。
8 今後の方向性と結論
今後の方向性。SGLangでなされた進歩にもかかわらず、将来の研究の有望な方向性を示すいくつかの限界が残っている。これらには、SGLangを追加の出力モダリティをサポートするよう拡張すること、RadixAttentionをメモリ階層の複数レベル(例えばDRAM、ディスク)にわたって動作するよう適応させること[43]、RadixAttention内でファジーな意味マッチングを可能にすること、SGLangの上により高レベルのプリミティブを提供すること、キャッシュアウェアスケジューリングにおけるスターベーションを修正すること[42]、およびSGLangコンパイラを強化してスケジューリングやメモリプランニングといった高度な静的最適化を実行できるようにすることが含まれる。
結論。我々は、構造化された言語モデルプログラムを効率的にプログラミングし実行するためのフレームワークであるSGLangを紹介する。SGLangは、RadixAttention、圧縮有限状態機械、言語インタプリタといった新規の最適化を通じて、複雑なLMプログラムのスループットとレイテンシを大幅に改善する。これは、高度なプロンプティング技術やエージェントワークフローを開発するための貴重なツールである。ソースコードは公開されている。
謝辞
本プロジェクトは、Stanford Center for Automated ReasoningおよびAstronomer、Google、IBM、Intel、Lacework、Microsoft、Mohamed Bin Zayed University of Artificial Intelligence、Nexla、Samsung SDS、Uber、VMwareからの寄付によって支援されている。Lianmin ZhengはMeta Ph.D. Fellowshipの支援を受けている。LLaVA-NeXT(動画)のサポートについて、Yuanhan ZhangとBo Liに感謝する。
参考文献
[1] Reyna Abhyankar, Zijian He, Vikranth Srivatsa, Hao Zhang, and Yiying Zhang. Apiserve: Efficient api support for large-language model inferencing. arXiv preprint arXiv:2402.01869, 2024. [2] Jean-Baptiste Alayrac, Jeff Donahue, Pauline Luc, Antoine Miech, Iain Barr, Yana Hasson, Karel Lenc, Arthur Mensch, Katherine Millican, Malcolm Reynolds, et al. Flamingo: a visual language model for few-shot learning. Advances in Neural Information Processing Systems, 35:23716–23736, 2022. [3] Reza Yazdani Aminabadi, Samyam Rajbhandari, Ammar Ahmad Awan, Cheng Li, Du Li, Elton Zheng, Olatunji Ruwase, Shaden Smith, Minjia Zhang, Jeff Rasley, et al. Deepspeed-inference: enabling efficient inference of transformer models at unprecedented scale. In SC22: International Conference for High Performance Computing, Networking, Storage and Analysis, pages 1–15. IEEE, 2022. [4] Luca Beurer-Kellner, Marc Fischer, and Martin Vechev. Prompting is programming: A query language for large language models. Proceedings of the ACM on Programming Languages, 7(PLDI):1946–1969, 2023. [5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877–1901, 2020. [6] Sébastien Bubeck, Varun Chandrasekaran, Ronen Eldan, Johannes Gehrke, Eric Horvitz, Ece Kamar, Peter Lee, Yin Tat Lee, Yuanzhi Li, Scott Lundberg, et al. Sparks of artificial general intelligence: Early experiments with gpt-4. arXiv preprint arXiv:2303.12712, 2023. [7] Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023.
[8] Wei-Lin Chiang, Lianmin Zheng, Ying Sheng, Anastasios Nikolas Angelopoulos, Tianle Li, Dacheng Li, Hao Zhang, Banghua Zhu, Michael Jordan, Joseph E Gonzalez, et al. Chatbot arena: An open platform for evaluating llms by human preference. arXiv preprint arXiv:2403.04132, 2024.
[9] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. arXiv preprint arXiv:2204.02311, 2022.
[10] Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
[11] Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, and Jianfeng Gao. Model tells you what to discard: Adaptive kv cache compression for llms. In The Twelfth International Conference on Learning Representations, 2023.
[12] In Gim, Guojun Chen, Seung-seob Lee, Nikhil Sarda, Anurag Khandelwal, and Lin Zhong. Prompt cache: Modular attention reuse for low-latency inference. arXiv preprint arXiv:2311.04934, 2023.
[13] Guidance AI. A guidance language for controlling large language models. https://github.com/guidance-ai/guidance. Accessed: 2023-11.
[14] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[15] Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, Michael W Mahoney, Yakun Sophia Shao, Kurt Keutzer, and Amir Gholami. Kvquant: Towards 10 million context length llm inference with kv cache quantization. arXiv preprint arXiv:2401.18079, 2024.
[16] Hugging Face. Text generation inference. https://github.com/huggingface/text-generation-inference. Accessed: 2023-11.
[17] Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024.
[18] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[19] Hao Kang, Qingru Zhang, Souvik Kundu, Geonhwa Jeong, Zaoxing Liu, Tushar Krishna, and Tuo Zhao. Gear: An efficient kv cache compression recipe for near-lossless generative inference of llm. arXiv preprint arXiv:2403.05527, 2024.
[20] Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: Compiling declarative language model calls into self-improving pipelines. arXiv preprint arXiv:2310.03714, 2023.
[21] Sehoon Kim, Suhong Moon, Ryan Tabrizi, Nicholas Lee, Michael W Mahoney, Kurt Keutzer, and Amir Gholami. An llm compiler for parallel function calling. arXiv preprint arXiv:2312.04511, 2023.
[22] Michael Kuchnik, Virginia Smith, and George Amvrosiadis. Validating large language models with relm. Proceedings of Machine Learning and Systems, 5, 2023.
[23] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. Efficient memory management for large language model serving with pagedattention. In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611-626, 2023.
[24] LangChain AI. Langchain. https://github.com/langchain-ai/langchain. Accessed: 2023-11.
[25] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. Competition-level code generation with alphacode. Science, 378(6624):1092-1097, 2022.
[26] Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Xingyu Dang, and Song Han. Awq: Activation-aware weight quantization for llm compression and acceleration. arXiv preprint arXiv:2306.00978, 2023.
[27] Haotian Liu, Chunyuan Li, Yuheng Li, and Yong Jae Lee. Improved baselines with visual instruction tuning. arXiv preprint arXiv:2310.03744, 2023.
[28] Haotian Liu, Chunyuan Li, Yuheng Li, Bo Li, Yuanhan Zhang, Sheng Shen, and Yong Jae Lee. Llava-next: Improved reasoning, ocr, and world knowledge, January 2024.
[29] Shu Liu, Asim Biswal, Audrey Cheng, Xiangxi Mo, Shiyi Cao, Joseph E Gonzalez, Ion Stoica, and Matei Zaharia. Optimizing llm queries in relational workloads. arXiv preprint arXiv:2403.05821, 2024.
[30] Xiaoxia Liu, Jingyi Wang, Jun Sun, Xiaohan Yuan, Guoliang Dong, Peng Di, Wenhai Wang, and Dongxia Wang. Prompting frameworks for large language models: A survey. arXiv preprint arXiv:2311.12785, 2023.
[31] Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, and Anshumali Shrivastava. Scissorhands: Exploiting the persistence of importance hypothesis for llm kv cache compression at test time. Advances in Neural Information Processing Systems, 36, 2024.
[32] Zirui Liu, Jiayi Yuan, Hongye Jin, Shaochen Zhong, Zhaozhuo Xu, Vladimir Braverman, Beidi Chen, and Xia Hu. Kivi: A tuning-free asymmetric 2bit quantization for kv cache. arXiv preprint arXiv:2402.02750, 2024.
[33] Xuefei Ning, Zinan Lin, Zixuan Zhou, Zifu Wang, Huazhong Yang, and Yu Wang. Skeleton-of-thought: Prompting LLMs for efficient parallel generation. In The Twelfth International Conference on Learning Representations, 2024.
[34] NVIDIA. Tensorrt-llm. https://github.com/NVIDIA/TensorRT-LLM. Accessed: 2023-11.
[35] OpenAI. Gpt-4 technical report, 2023.
[36] Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior. In In the 36th Annual ACM Symposium on User Interface Software and Technology (UIST '23), UIST '23, New York, NY, USA, 2023. Association for Computing Machinery.
[37] Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, et al. Pytorch: An imperative style, high-performance deep learning library. Advances in neural information processing systems, 32, 2019.
[38] Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023.
[39] Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. Efficiently scaling transformer inference. Proceedings of Machine Learning and Systems, 5, 2023.
[40] Swarnadeep Saha, Omer Levy, Asli Celikyilmaz, Mohit Bansal, Jason Weston, Xian Li. Branch-solve-merge improves large language model evaluation and generation. arXiv preprint arXiv:2310.15123, 2023.
[41] Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda, Thomas Scialom. Toolformer: Language models can teach themselves to use tools. arXiv preprint arXiv:2302.04761, 2023.
[42] Ying Sheng, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E Gonzalex, Ion Stoica. Fairness in serving large language models. arXiv preprint arXiv:2401.00588, 2023.
[43] Ying Sheng, Lianmin Zheng, Binhang Yuan, Zhuohan Li, Max Ryabinin, Beidi Chen, Percy Liang, Christopher Ré, Ion Stoica, Ce Zhang. Flexgen: high-throughput generative inference of large language models with a single gpu. In International Conference on Machine Learning, pages 31094-31116. PMLR, 2023.
[44] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, Bryan Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism. arXiv preprint arXiv:1909.08053, 2019.
[45] Vikranth Srivatsa, Zijian He, Reyna Abhyankar, Dongming Li, Yiying Zhang. Preble: Efficient distributed prompt scheduling for llm serving. 2024.
[46] Theodore Sumers、Shunyu Yao、Karthik Narasimhan、Thomas Griffiths。言語エージェントのための認知アーキテクチャ。Transactions on Machine Learning Research、2023年。
[47] Gemini Team、Rohan Anil、Sebastian Borgeaud、Yonghui Wu、Jean-Baptiste Alayrac、Jiahui Yu、Radu Soricut、Johan Schalkwyk、Andrew M Dai、Anja Hauthほか。Gemini:高性能なマルチモーダルモデルのファミリー。arXiv preprint arXiv:2312.11805、2023年。
[48] Philippe Tillet、Hsiang-Tsung Kung、David Cox。Triton:タイル化されたニューラルネットワーク計算のための中間言語およびコンパイラ。Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages、10〜19ページ、2019年。
[49] Hugo Touvron、Louis Martin、Kevin Stone、Peter Albert、Amjad Almahairi、Yasmine Babaei、Nikolay Bashlykov、Soumya Batra、Prajjwal Bhargava、Shruti Bhosaleほか。Llama 2:オープンな基盤モデルおよびファインチューニング済みチャットモデル。arXiv preprint arXiv:2307.09288、2023年。
[50] Vivien Tran-Thien。正規表現制約を用いた高速で高忠実度のLLMデコーディング、2024年。
[51] Ashish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N Gomez、Łukasz Kaiser、Illia Polosukhin。Attention is all you need。Advances in neural information processing systems、30、2017年。
[52] Guanzhi Wang、Yuqi Xie、Yunfan Jiang、Ajay Mandlekar、Chaowei Xiao、Yuke Zhu、Linxi Fan、Anima Anandkumar。Voyager:大規模言語モデルを備えたオープンエンドな身体性エージェント。arXiv preprint arXiv: arXiv:2305.16291、2023年。
[53] Xuezhi Wang、Jason Wei、Dale Schuurmans、Quoc V Le、Ed H Chi、Sharan Narang、Aakanksha Chowdhery、Denny Zhou。自己整合性は言語モデルにおける連鎖的思考推論を改善する。The Eleventh International Conference on Learning Representations、2022年。
[54] Brandon T Willard、Rémi Louf。大規模言語モデルのための効率的な誘導生成。arXiv e-prints、arXiv-2307ページ、2023年。
[55] Qingyun Wu、Gagan Bansal、Jieyu Zhang、Yiran Wu、Shaokun Zhang、Erkang Zhu、Beibin Li、Li Jiang、Xiaoyun Zhang、Chi Wang。Autogen:マルチエージェント会話フレームワークによる次世代LLMアプリケーションの実現。arXiv preprint arXiv:2308.08155、2023年。
[56] Shunyu Yao、Dian Yu、Jeffrey Zhao、Izhak Shafran、Thomas L Griffiths、Yuan Cao、Karthik Narasimhan。Tree of thoughts:大規模言語モデルによる意図的な問題解決。arXiv preprint arXiv:2305.10601、2023年。
[57] Shunyu Yao、Jeffrey Zhao、Dian Yu、Nan Du、Izhak Shafran、Karthik R Narasimhan、Yuan Cao。React:言語モデルにおける推論と行動の相乗効果。The Eleventh International Conference on Learning Representations、2022年。
[58] Lu Ye、Ze Tao、Yong Huang、Yang Li。Chunkattention:プレフィックスを認識するKVキャッシュと二段階パーティションによる効率的な自己アテンション。arXiv preprint arXiv:2402.15220、2024年。
[59] Zihao Ye、Lequn Chen、Ruihang Lai、Yilong Zhao、Size Zheng、Junru Shao、Bohan Hou、Hongyi Jin、Yifei Zuo、Liangsheng Yin、Tianqi Chen、Luis Ceze。FlashInferによるLLMサービングのための自己アテンションの高速化、2024年2月。
[60] Gyeong-In Yu、Joo Seong Jeong、Geon-Woo Kim、Soojeong Kim、Byung-Gon Chun。Orca:{Transformerベース}の生成モデルのための分散サービングシステム。16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22)、521〜538ページ、2022年。
[61] Rowan Zellers、Ari Holtzman、Yonatan Bisk、Ali Farhadi、Yejin Choi。Hellaswag:機械は本当にあなたの文を完成できるのか?Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics、4791〜4800ページ、2019年。
[62] Yuanhan Zhang、Bo Li、haotian Liu、Yong jae Lee、Liangke Gui、Di Fu、Jiashi Feng、Ziwei Liu、Chunyuan Li。Llava-next:強力なゼロショット動画理解モデル、2024年4月。
A RadixAttentionに関する追加の詳細
A.1 KVキャッシュの背景
現在使用されているほとんどのLLMは、GPT-3 [5]、PaLM [9]、LLaMA [49]など、自己回帰型Transformerアーキテクチャ[51]に基づいている。これらのモデルは、先行するトークンに基づいて系列内の次のトークンの確率を予測する。推論中、モデルはまず入力トークンの系列を順伝播で処理する(このプロセスは「プリフィル」と呼ばれる)。その後、出力トークンを逐次的にデコードし、各トークンは先行するトークンに依存する(このプロセスは「デコーディング」と呼ばれる)。入力トークンの系列を受け取り、出力トークンの系列を生成するプロセスを、ここでは単一の生成呼び出しと呼ぶ。このプロセス全体を通じて、各トークンはいくつかの中間テンソルを生成し、それらはさらなるトークンのデコーディングに使用される。これらの仲介テンソルは、自己アテンション機構におけるキーと値のペアにちなんで「KVキャッシュ」と呼ばれる。本論文で最適化を議論する際の重要な観察は、KVキャッシュの計算はすべての先行トークンのみに依存するため、同じプレフィックスを持つ異なる系列はそのプレフィックストークンのKVキャッシュを再利用でき、冗長な計算を避けられるということである。
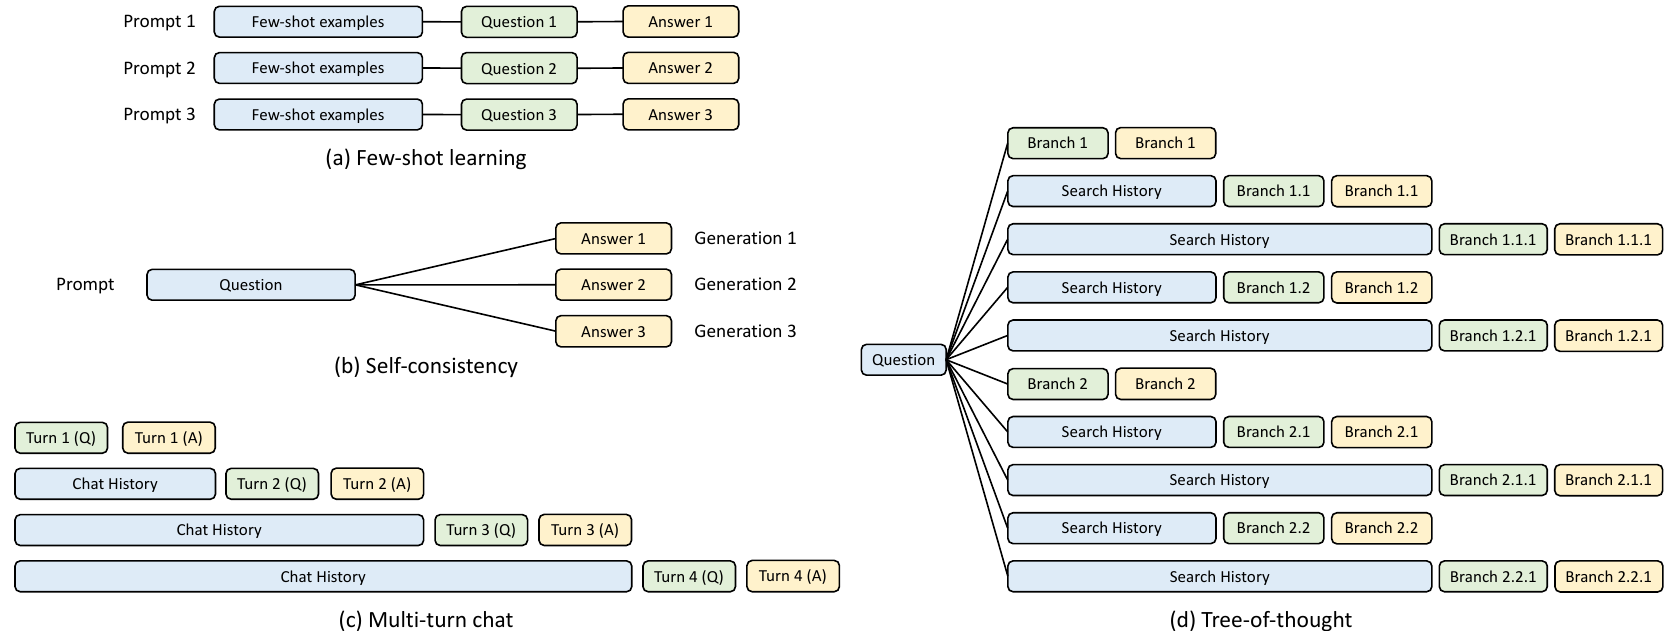
LLMプログラムではしばしば、複数のテキストセグメントと生成呼び出しが単一のプロンプトに追加される。複数の連鎖した呼び出しにわたって以前のトークンに対して計算されたKVキャッシュをキャッシュすることで、冗長な計算を削減できる。しかし、この最適化は無償でも自明でもなく、追加のストレージとより複雑なメモリ管理を必要とする。さらに、LLMプログラムでは、単一のプロンプトから複数の出力を生成したり、現在の状態から新しいプロンプトを分岐させたりすることが一般的である[25]。基本的なプレフィックス共有はvLLM [23]で研究されている。不規則な木構造の共有のような、より高度な共有パターンも採用できる。図9は、複数の呼び出しにわたるKVキャッシュ共有の4つの典型的なパターンを示している。既存のシステムはいずれもそれらすべてを自動的に扱うことはできない。反対に、第3節で述べる我々のRadixAttentionは、実行時にそれらすべてを自動的に扱うことができる。
A.2 キャッシュ認識スケジューリングの擬似コード
アルゴリズム1は、連続バッチ処理を伴うRadixAttentionのためのキャッシュ認識スケジューリングの擬似コードを示している。
A.3 定理3.1の証明
定理3.1。リクエストのバッチに対して、キャッシュサイズが最大リクエスト長以上であれば、リクエストの基数木を深さ優先探索順で訪問することにより、最適なキャッシュヒット率を達成できる。最長共有プレフィックス優先順は深さ優先探索順と等価である。
証明。まず、深さ優先探索(DFS)順が最適なキャッシュヒット率を達成することを示す。 をバッチ内のリクエストの集合、 を から構築された基数木とする。 の各辺 について、 に関連付けられたKVキャッシュは少なくとも一度は計算される必要がある。 を に関連付けられたKVキャッシュのサイズとする。 を に対するKVキャッシュの計算複雑度とする。
アルゴリズム1 RadixAttentionのためのキャッシュを考慮した連続バッチングによるスケジューリング。入力:基数木 、メモリプール 、現在実行中のバッチ 、待機キュー 。出力:完了したリクエストおよび更新されたシステム状態。// 待機キューからすべてのリクエストを取得requests .get_all_requests()// すべての待機リクエストに対してプレフィックス一致を検索for req requests doreq.prefix_node, req.prefix_len .match_prefix(req.input_tokens)end for// 一致したプレフィックス長に従ってリクエストをソートrequests.sort()// 次のバッチのためのリクエストを選択available_size .evitable_size() + .available_size()current_size new_batch for req requests doif req.size() + current_size available_size thennew_batch.append(req)delta .increase_ref_counter(req.prefix_node)available_size available_size + deltaend ifend forQ.remove_requests(new_batch)// リクエストを現在実行中のバッチに挿入B.merge(new_batch)// 新しいメモリを割り当て、必要なら退避を行うneeded_size .needed_size()success,buffer .alloc(needed_size)if not success thenT.evict(needed_size)success,buffer .alloc(needed_size)end ifB.run(buffer)// 完了したリクエストを処理finished_requests .drop_finished_requests()for req finished_requests doT.decrease_ref_counter(req.prefix_node)T.insert(req)end forreturn finished_requests我々は下界
を得る。基数木 をDFS順で訪問することを考える。\(T\) の各辺 について、 に関連するKVキャッシュを初めて計算するとき、その後 の部分木全体を計算することになる。 の部分木の計算中、辺 は継続的にヒットするため、追加の計算は発生しない。 を根とする部分木の計算を終えた後、辺 は再び訪問されることはない。キャッシュサイズが 最大リクエスト長、すなわち基数木 における最長パスである場合、部分木の計算中に辺 が退避されることはないことに注意されたい。なぜなら、その部分木の を含む共通プレフィックスが継続的にヒットするからである。したがって、各辺 に関連するKVキャッシュは一度だけ計算される。よって、我々は下界
を達成する。キャッシュヒット率は、
と定義され、 に等しく、その上界に達し、最適性を実現する。
次に、最長共通接頭辞優先の順序が帰納法によりDFS順序と等価であることを示す。
- (基底)最初はキャッシュされたものが何もないため、 内のノード に対応するランダムなリクエストが処理される。根から への経路上のノード に対応するすべてのリクエストは再計算を必要としない。ノード に対応するリクエストの計算複雑度は、有効なDFSと一致する。根から への経路がキャッシュされる。
- (帰納)ちょうど 内のノード を訪問したばかりであり、訪問済みノードがDFS順序と一致していると仮定する。 を根から への経路とする。このとき、未訪問の各ノードは、訪問済みノードとの最低共通祖先を 上に持つ。 上のノードはキャッシュされているため、最低共通祖先が 上にある未訪問のノード は、最長の共通接頭辞を持つことになる。最長共通接頭辞優先の順序は を選択するが、これは有効なDFS順序である。根から への経路は、それが最も最近のものであるためキャッシュされる。
オンラインの場合、DFS順序は崩れるが、最長共通接頭辞スケジュールは、暗黙の基数木の拡張部分においてDFSの挙動を依然として近似する。我々はこれを、新しいバッチのリクエストを追加するステップを考えることによって示す。
をこれまでに訪問された基数木の部分とし、 を新しいバッチのリクエストを追加した後の基数木全体とする。 を 内のキャッシュされたノードの集合とする。 を、 内で根からの経路が最長であり、かつ 内に完全には訪問されていない部分木を持つノードとする。
このとき、最長共通接頭辞スケジュールは、 を根とする 内の部分木をDFS順序で処理する。この過程で退去が発生する可能性があり、 からの残りのキャッシュされたノードは となる。次に、 を根とする 内の部分木に対してDFSが行われる。
同様に、 が、 内の部分木が完全には訪問されていない 内の唯一の葉ノードのみを含むまで、 が得られる。この時点で、有効なDFS状態に到達している。 の残りの部分は、定理3.1の証明で述べたようにDFS順序で訪問される。
A.4 データ並列分散RadixAttention
複数のレプリカワーカーを備えた分散設定(すなわちデータ並列)にRadixAttentionを適合させるため、各ワーカーが自身の部分木を維持する一方で、ルーターがメタ木を監督する機構を開発した。このメタ木は、すべての部分木とそれに関連するデバイスを追跡するトライとして機能する。ルーターに新しいバッチのリクエストが到着すると、メタ木上で接頭辞マッチングが実行される。我々は、各リクエストのアフィニティ——特定のワーカーや同じグループ内の他のリクエストとの共通接頭辞の長さによって測定される——に基づく様々なポリシーを実装し、冗長な計算を最小化する効率的なディスパッチ決定を行う。新しいリクエストが処理されるたびに、ルーターとワーカーはそれぞれ独立に自身の木を更新する。ワーカーノードで退去が発生した場合、その退去をキューにコミットし、ルーターは活動が低い期間にそれを処理してメタ木を更新する。我々は4つのワーカーとMMLUデータセットを用いてこの分散設定をベンチマークし、線形スケーリングと、この弱整合分散キャッシュ設計による最小限のオーバーヘッドで最適なキャッシュヒット率を達成することを観察した。データ局所性の最大化と並列処理効率の間にはトレードオフが存在する。このトレードオフを最適化する高度なスケジューリングポリシーの探求は、今後の研究領域として位置づけられている。さらに、Preble [45] による並行研究は、SGLangの初期バージョンに基づくデータ並列スケジューリングを研究している。
B 圧縮有限状態機械に関する追加の詳細
本節では、より高速な制約付きデコーディングのための圧縮有限状態機械の背景と実装の詳細について議論する。我々はLLMが正規表現(regex)に従うことを目指しており、これはより高い表現力を持ち、JSONスキーマのような一般的な形式を表現するために使用できる。これを達成するために、我々はregexを有限状態機械(FSM)に変換し、デコーディング中の生成過程を導く[54]。FSMは本質的にノード(状態)とエッジ(文字列/文字による遷移)を持つグラフである。初期状態から始めて、各遷移はエッジ上の文字列を付加して次の状態へ移動し、最終状態の集合を用いて過程を終結させる。この機構は、図10に示すように、FSMの現在の状態遷移に基づいて無効なトークンをフィルタリングしながら、LLMのデコーディングを導く。デコーディングは、最終状態に到達するまでFSM内で複数の遷移を含む場合がある。
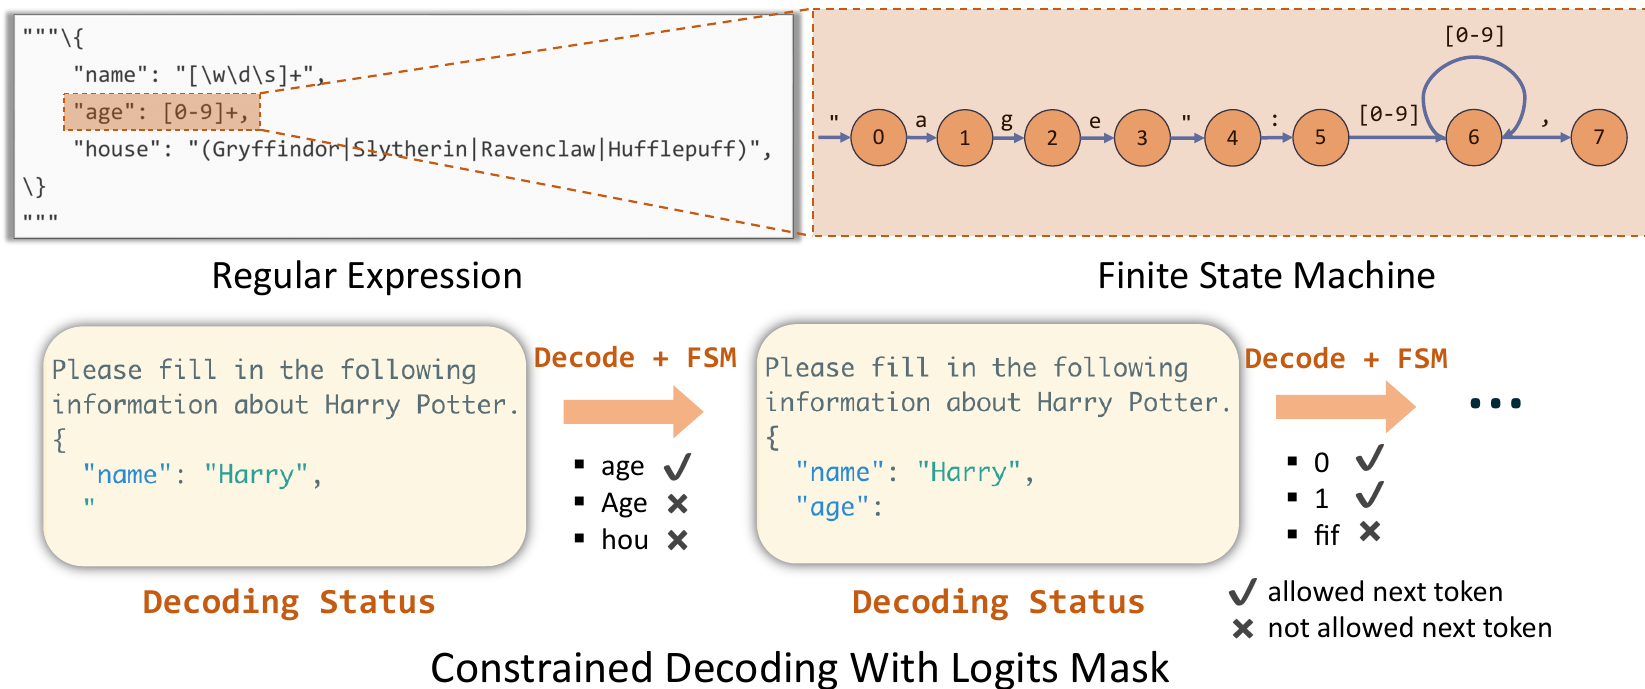
制約付きデコーディングの課題は、制約がしばしば自然言語形式で表現されるという事実に起因する。すなわち、regexは文字/文字列によって描写される一方で、LLMはこれらをトークンとして解釈および処理するように設計されている。文字列とトークンの間のマッピングは複雑であり、一対一の対応を欠くため[22]、これは複雑な状況を生み出す。
本節は以前のブログ記事に由来する。読者は追加の背景とより容易な理解のためにブログ記事も読むことが推奨される。4
B.1 圧縮有限状態機械の実装の詳細
圧縮FSMの構築を簡素化するため、我々は元のFSMをトークン上ではなく文字/文字列上に構築する。我々は単一遷移エッジと圧縮エッジの概念を次のように形式的に定義する:
- 単一遷移エッジ:エッジが単一遷移エッジであるのは、1) その始点ノードが唯一の後続ノードを持つ場合、かつ2) その上に許容される文字/文字列が1つだけである場合である。- 圧縮エッジ: が単一遷移エッジである場合に限り、いくつかの連続的に隣接するエッジ によって圧縮されたエッジである。圧縮エッジのテキストは、 のテキストを連結したものである。
文字に基づくFSMから始めて、それ以上の圧縮が不可能になるまで単一遷移エッジをその先行エッジへと再帰的に併合し、圧縮FSMを得る。この手法は、図11に示すSGLangの圧縮FSMによる実行時効率によって実証されるように、デコーディング過程を高速化する。
B.2 再トークン化によるトークン化アーティファクトの処理
新しいトークンが生成されると、我々はそのトークンの文字列を取得し、現在の状態のすべての出力エッジを検索して、ちょうどデコードされた文字列で始まるものを見つけ、その後前方へ移動する。しかし、遷移エッジが十分に圧縮されたものであり、非常に長い文字列を含む場合、我々は次ラウンドのデコードされた文字列も予期できる場合がある。ここで加速が起こり、我々はこの過程をジャンプフォワードと呼ぶ。しかし、次のデコーディング段階のために文字列をトークンに変換する必要は依然としてあり、LLM固有の事前学習とトークン化手法のためにこれは容易ではない。直接的な分割は意図された意味を変える可能性がある[50]。例えば、図2のregexにおける圧縮テキストは {"summary": " であり、トークナイザによれば {"summary,": と " としてのみトークン化でき、 {"summa、ry、および ". のようにランダムに分割することはできない。この問題に対処するため、我々は元のトークナイザを用いて、以前のすべてのテキストならびに圧縮エッジのテキストを再トークン化し、LLMの元の入力形式との整合性を確保する。そしてそれはわずかな再トークン化オーバーヘッドしかもたらさない。
B.3 今後の拡張:歪んだ確率への対処
文字列とトークンの間のギャップによって生じる課題は、確率分布の偏りという問題ももたらす[50]。例えば、図2において、正規表現「[ABCD][+- ]?」はA+からD-までの成績を表唆するが、これをExcellent | Above Average | Fair | Below Averageのようなより広い用語に置き換えると、Above Averageという用語が圧縮された遷移上にあるため、ランタイムがAを不正確にAbove Averageにマッピングし、成績の階層を誤って表現する可能性がある。これは、LLMが具体的な選択肢の範囲を認識できないために発生し、不適切なトークン列につながる。各選択肢に対して正確な確率を計算するには、各選択肢に至るすべてのトークン列の確率を合計する必要があり、これがデコーディングを複雑にし、オーバーヘッドを増大させる。一つの回避策は、選択肢や正規表現をプリフィルプロンプトに直接含めることであり、LLMに自身の選択肢を意識させ、適切なトークン列で決定を出力するよう導くことができる。しかし、このアプローチは確率の歪みという根本的な問題を解決するものではなく、圧縮されたFSMの精度を向上させるための更なる研究の必要性を浮き彫りにしている。
C 追加の実験設定と結果
追加の実験設定。図5および図6は、単一のA10G(24GB)GPU上でLlama-7Bを実行して得られたものである。図7は、テンソル並列を用いて8台のA10G(24GB)GPU上でMixtral-8x7Bを実行して得られたものである。図8(c)は、単一のA10G(24GB)GPU上でLlama-7Bを実行して得られたものである。図12は、テンソル並列を用いて4台のA100G(80GB)GPU上でLlama-70Bを実行して得られたものである。表2は、単一のA10G(24GB)GPU上でLLaVA-v1.5-7Bを実行し、単一のA100G(80GB)GPU上でLLaVA-Next-34Bを実行して得られたものである。ベンチマーク図の各バーは、実行に数分から1時間を要する。
追加の実験結果。図13は、図5に列挙されたベンチマークにおける達成されたキャッシュヒット率と最適なキャッシュヒット率を示している。図12は、テンソル並列を用いたLlama-2-70Bのスループットを示している。
D コンパイラモード
本論文の本文で使用されているインタプリタモードに加えて、SGLangプログラムを実行するもう一つの方法は、それらを計算グラフとしてコンパイルし、グラフエグゼキュータで実行することである。これにより、
グラフを書き換えたり、より静的なプランニングを実行したりできるため、より多くのコンパイル最適化の機会が開かれる。
D.1 設計と実装
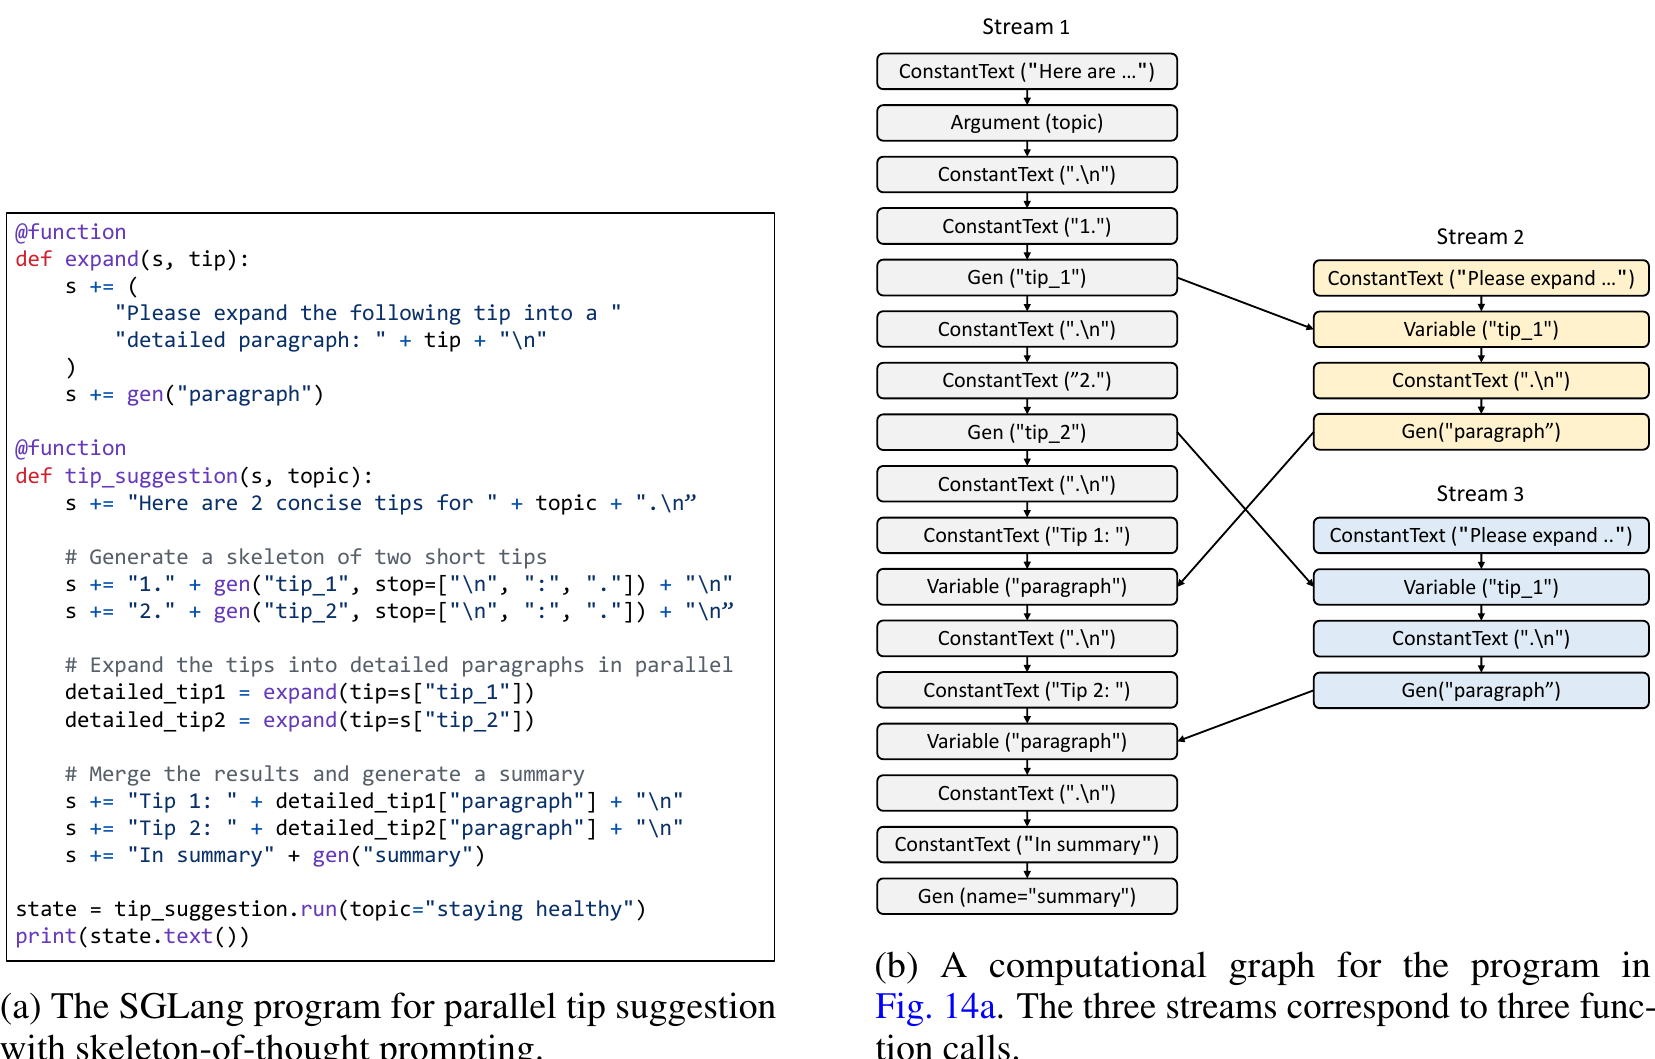
我々は、SGLangプログラムの構造と操作を計算グラフとして表現する中間表現(IR)をSGLang向けに設計した。このグラフは、プリミティブ演算子のノードと依存関係のエッジを含む。図14aのプログラムに対応するグラフについては図14bを参照されたい。プログラムにおいて、デコレートされた関数やforkの各呼び出しは、新しいプロンプト状態またはストリームを生成する。
ノードにはいくつかの種類がある。SGLangプログラムにおけるおよび演算子の各オペランドは、IRノードによって表現される。これらには、ConstantText、Argument、Gen、Select、Variable、Fork、GetForkItem、およびJoinが含まれる。依存関係には2種類ある。すなわち、を用いてストリームに投入された操作が、そのストリーム内のすべての先行する操作の後に実行されなければならないストリーム内依存関係と、あるストリームが別のストリームから変数の値を取得する必要がある場合に生じ、同期を必要とするストリーム間依存関係である。forkのような操作は複数のストリームを操作するため、ストリーム間依存関係を導入する。
グラフを生成するために、我々は抽象引数を用いてプログラムを実行するトレーシングを用い、グラフを動的に構築する。この手法はデータ依存の制御フローを持たないプログラムに限定され、この制限は今後の研究で対処する予定である。一度構築されれば、グラフはグラフエグゼキュータを通じて実行でき、元のPythonプログラムを再解釈する必要がなくなる。これにより、グラフ書き換え最適化、ランタイムオーバーヘッドの削減、プログラムのシリアル化といった利点が得られる。実行にあたっては、各データストリームに対してストリームエグゼキュータが起動され、IRノードをトポロジカル順にストリームへディスパッチする。
D.2 コンパイラ最適化のケーススタディ:プレフィックス共有を改善するためのコード移動
我々は、SGLang IRに対するコンパイル最適化、すなわちプレフィックス共有を改善するためのコード移動について探求する。自動チューニングや命令選択など、より古典的なコンパイラ技術も適用できると我々は期待している。
この最適化は、グラフ内のノードを並べ替えて定数プレフィックスの長さを増やすことにより、プレフィックス共有を改善することを目的としている。これは元の計算を厳密に保存するものではないため、アグレッシブな最適化として分類される。例えば、プロンプトを「Here is a question + {question}. Please act as a math expert and solve the given question.」から「Please act as a math expert and solve the given question. Here is a question + {question}.」に変更すると、共有可能なプレフィックスが長くなる。この最適化が興味深いのは、SGLangには自然言語の指示が含まれているため、従来のプログラム解析ではこれを達成できない点である。代わりに、我々はGPT-4にグラフノードの並べ替えを促す。SGLang IRの概念をGPT-4に教えるために複数の例を含むプロンプトを書き、GPT-4がいくつかの単純なSGLangプログラムに対してこの最適化をうまく適用できることを我々は発見した。
我々はこの最適化の有効性を評価する。インターネットから20個のプロンプトテンプレートを収集し、それらをSGLangで実装する。これらのテンプレートのうち5個を少数ショットの訓練例として用い、残りの15個をテストケースとして用いる。我々の評価によれば、15個のテンプレートのうち12個について、GPT-4は意味を変えることなくグラフノードの並べ替えに成功しており、これは変更されたプロンプトの手作業による検査によって確認された。平均して、この最適化は共有可能なプレフィックス長を60トークン増加させ、GPT-4の有効性を示している。最適化されたプロンプト順序の生成に失敗するのは、グラフノードの背後にある意味論的な意味を誤って理解した場合である。それはあまりにアグレッシブであり、そのような順序付けが元の意味を変える場合でも、すべての定数を先頭に置いてしまう。このケーススタディは、コンパイラ最適化へのGPT-4の利用を探求することを目的としている。将来、この種の最適化を信頼できるものにするには、さらなる研究が必要である。