
忘れるエージェントは助手にならない。Mem0 は会話をまたぐ重要情報を保存し、p95 遅延を 91% 削減する。2025年の論文、全文無料。
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
MemO: スケーラブルな長期記憶を備えた本番運用可能なAIエージェントの構築
Prateek Chhikara, Dev Khant, Saket Aryan, Taranjeet Singh, and Deshraj Yadav research@memO.ai
memO
大規模言語モデル(LLM)は、文脈的に一貫した応答を生成する上で目覚ましい能力を示してきたが、その固定されたコンテキストウィンドウは、長期にわたるマルチセッション対話において一貫性を維持するための根本的な課題を提起している。我々はMemOを導入する。これは、進行中の会話から顕著な情報を動的に抽出、統合、検索することでこの問題に対処する、スケーラブルなメモリ中心のアーキテクチャである。この基盤の上に、我々はさらに、会話要素間の複雑な関係構造を捉えるためにグラフベースのメモリ表現を活用する拡張版を提案する。LOCOM0ベンチマークでの包括的な評価を通じて、我々は我々のアプローチを6つのベースラインカテゴリと体系的に比較する:(i) 確立されたメモリ拡張システム、(ii) 様々なチャンクサイズと値を用いた検索拡張生成(RAG)、(iii) 会話履歴全体を処理するフルコンテキストアプローチ、(iv) オープンソースのメモリソリューション、(v) 独自モデルシステム、(vi) 専用のメモリ管理プラットフォーム。実証結果は、我々の手法が単一ホップ、時間的、マルチホップ、オープンドメインという4つの質問カテゴリすべてにおいて、既存のすべてのメモリシステムを一貫して上回ることを示している。特筆すべきは、MemOがLLM-as-a-Judge指標においてOpenAIに対しての相対的改善を達成し、グラフメモリを備えたMemOはベースのMemO構成よりも総合スコアが約高いことである。精度の向上にとどまらず、我々はフルコンテキストアプローチと比較して計算オーバーヘッドも著しく削減する。特に、MemOはp95レイテンシを低減し、トークンコストを以上節約し、 thereby 高度な推論能力と実用的な展開上の制約との間で説得力のあるバランスを提供する。我々の発見は、長期的な会話の一貫性に対する構造化された永続的メモリメカニズムの重要な役割を強調し、より信頼性が高く効率的なLLM駆動のAIエージェントへの道を開くものである。
コードはこちらで入手可能:https://mem0.ai/research
1. はじめに
X
人間の記憶は知性の基盤である——それは我々のアイデンティティを形成し、意思決定を導き、学習、適応、そして有意義な関係の構築を可能にする(Craik and Jennings, 1992)。その多くの役割の中で、記憶はコミュニケーションに不可欠である:我々は過去のやり取りを想起し、好みを推測し、関わる相手の進化する心的モデルを構築する(Assmann, 2011)。長期間にわたって情報を保持し検索するこの能力は、数日、数週間、あるいは数か月に及ぶ一貫した、文脈的に豊かなやり取りを可能にする。大規模言語モデル(LLM)を動力源とするAIエージェントは、流暢で文脈的に適切な応答の生成において目覚ましい進歩を遂げてきた(Yu et al., 2024, Zhang et al., 2024)。しかし、これらのシステムは固定されたコンテキストウィンドウへの依存によって根本的に制限されており、長期的なやり取りにわたって一貫性を維持する能力を厳しく制限している(Bulatov et al., 2022, Liu et al., 2023)。この制限は、LLMが有限のコンテキストウィンドウを超えて拡張できる永続的メモリメカニズムを欠いていることに起因する。人間は時間の経過とともに自然に経験を蓄積し組織化し、やり取りの連続的な物語を形成するが、
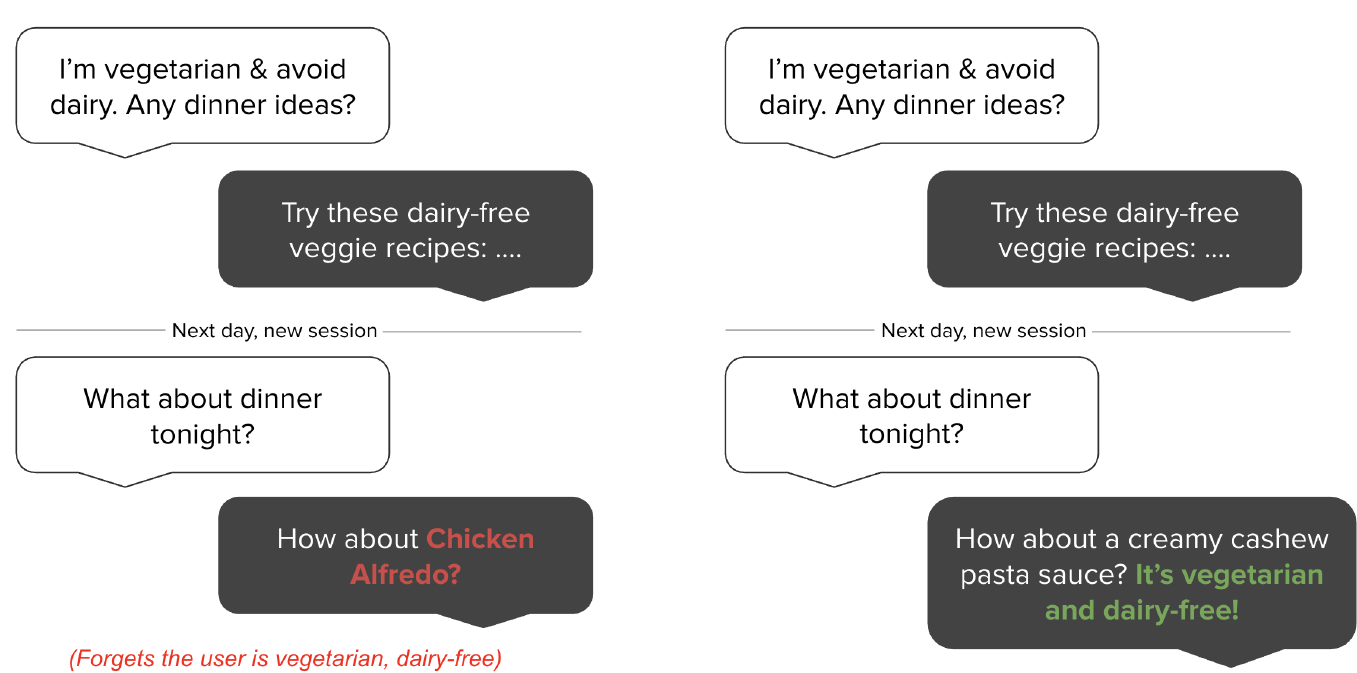
AIシステムは本質的に別々のセッション間やコンテキストオーバーフロー後に情報を持続させることができない。永続的メモリの欠如は、人間とAIの相互作用に根本的な断絶を生み出す。メモリがなければ、AIエージェントはユーザーの好みを忘れ、質問を繰り返し、以前に確立された事実と矛盾する。図1に示す簡単な例を考えてみよう。ユーザーが最初の会話でベジタリアンであり乳製品を避けていることに言及したとする。その後のセッションで、ユーザーが夕食の推薦について尋ねると、永続的メモリを持たないシステムは鶏肉を提案し、確立された食事の好みと完全に矛盾する可能性がある。対照的に、永続的メモリを持つシステムは、この重要なユーザー情報をセッション間で維持し、適切なベジタリアン向けの乳製品不使用の選択肢を提案する。この一般的なシナリオは、メモリの失敗がユーザー体験と信頼を根本的に損なう可能性があることを強調している。
会話の設定を超えて、メモリメカニズムはインタラクティブな環境においてエージェントのパフォーマンスを劇的に向上させることが示されている(Majumder et al., Shinn et al., 2023)。過去の経験の記憶を備えたエージェントは、ユーザーのニーズをよりよく予測し、過去の過ちから学び、タスク全体に知識を一般化することができる(Chhikara et al., 2023)。研究は、メモリ拡張エージェントが行動と結果の間の因果関係を活用することで意思決定を改善し、動的なシナリオにおいてより効果的な適応につながることを実証している(Rasmussen et al., 2025)。階層的メモリアーキテクチャ(Packer et al., 2023, Sarthi et al., 2024)や自律的進化が可能なエージェント型メモリシステム(Xu et al., 2025)はさらに、メモリが複数の対話セッションにわたるより一貫した長期的推論を可能にすることを示している。
新しい情報を動的に統合し時代遅れの信念を修正する人間とは異なり、LLMは情報がコンテキストウィンドウの外に落ちると事実上「リセット」される(Zhang, 2024, Timoneda and Vera, 2025)。OpenAIのGPT-4(128Kトークン)(Hurst et al., 2024)、o1(200Kコンテキスト)(Jaech et al., 2024)、AnthropicのClaude 3.7 Sonnet(200Kトークン)(Anthropic, 2025)、GoogleのGemini(少なくとも10Mトークン)(Team et al., 2024)といったモデルがコンテキスト長の限界を押し広げているが、これらの改善は根本的な制限を解決するのではなく、単に遅らせるだけである。実用的な応用において、これらの拡張されたコンテキストウィンドウでさえ2つの重大な理由で不十分であることが判明する。第一に、有意義な人間とAIの関係が数週間または数か月にわたって発展するにつれて、会話履歴は必然的に最も寛大なコンテキスト制限さえも超える。第二に、そしておそらくより重要なことに、現実世界の会話はめったにテーマの連続性を維持しない。ユーザーは食事の好み(ベジタリアンであること)に言及し、その後プログラミングタスクについて何時間も無関係な議論に従事し、それから夕食の選択肢に関する食べ物関連の質問に戻るかもしれない。このようなシナリオでは、フルコンテキストアプローチは大量の無関係な情報を推論する必要があり、重要な食事の好みは何千ものトークンにわたるコーディング議論の中に埋もれている可能性がある。さらに、単に長いコンテキストを提示することは、過去の情報の効果的な検索や活用を保証するものではない。なぜなら、注意メカニズムは遠いトークンにわたって劣化するからである(Guo et al., 2024, Nelson et al., 2024)。この制限は、継続性と信頼の維持が極めて重要な医療、教育、エンタープライズサポートなどの重要な領域において特に問題となる(Hatalis et al., 2023)。これらの課題に対処するために、AIエージェントは静的なコンテキスト拡張を超えたメモリシステムを採用する必要がある。堅牢なAIメモリは、重要な情報を選択的に保存し、関連する概念を統合し、必要に応じて関連する詳細を検索するべきである——人間の認知プロセスを反映して(He et al., 2024)。このようなメカニズムを統合することで、一貫したペルソナを維持し、進化するユーザーの好みを追跡し、以前のやり取りの上に構築するAIエージェントを開発することができる。この転換は、AIを一時的で忘れっぽい応答者から、信頼できる長期的な協力者へと変革し、会話型知能の未来を根本的に再定義する。
本論文では、AIシステムの根本的な制限に対処する:異なるセッションにわたる長期的な会話を通じて一貫した推論を維持する能力の欠如であり、これはユーザーとの有意義な長期的相互作用を厳しく制限する。我々はMemO(mem-zeroと発音)を導入する。これは、進行中の会話から顕著な情報を動的に捉え、組織化し、検索する新規のメモリアーキテクチャである。この基盤の上に、我々はMemO8を開発する。これは、会話要素間の複雑な関係をよりよくモデル化するためにグラフベースのメモリ表現でベースアーキテクチャを強化する。LOCOM0ベンチマークでの我々の実験結果は、我々のアプローチが多様な質問タイプにわたって既存のメモリシステム——メモリ拡張アーキテクチャ、検索拡張生成(RAG)手法、オープンソースおよび独自ソリューションの両方を含む——を一貫して上回り、同時に大幅に少ない計算リソースを必要とすることを実証している。レイテンシ測定はさらに、MemOがフルコンテキストアプローチよりも\(91\%\)低い応答時間で動作し、洗練された推論能力と実用的な展開上の制約との間で最適なバランスを実現することを明らかにしている。これらの貢献は、長期間にわたって一貫した文脈認識の会話を維持できるAIシステムへの有意義な一歩を表しており、人間のコミュニケーションパターンを反映し、個別指導、医療、パーソナライズされた支援における応用の新たな可能性を開く。
2. 提案手法
我々はAIエージェントのための2つのメモリアーキテクチャを導入する。(1) MemOは、メモリ抽出と更新のための専用モジュールを通じて、会話から顕著な情報を抽出、評価、管理する新規のパラダイムを実装する。システムは、2人のユーザー参加者間、またはユーザーとアシスタント間のメッセージのペアを処理する。(2) MemO8は、メモリがエンティティをノード、関係をエッジとする有向ラベル付きグラフとして保存されるグラフベースのメモリ表現を組み込むことで、この基盤を拡張する。この構造により、エンティティ間の接続のより深い理解が可能になる。エンティティとそれらの関係の両方を明示的にモデル化することで、MemO8は相互接続された事実にわたるより高度な推論をサポートし、特に複数のメモリにわたる複雑な関係パスをナビゲートする必要があるクエリに対して有効である。
2.1. MemO
我々のアーキテクチャはインクリメンタル処理パラダイムに従い、進行中の会話内でシームレスに動作することを可能にする。図2に示すように、完全なパイプラインアーキテクチャは2つのフェーズで構成される:抽出と更新である。
抽出フェーズは、新しいメッセージペア の取り込みとともに開始される。ここで は現在のメッセージを表し、 は直前のメッセージを表す。このペアは通常、ユーザーメッセージとアシスタントの応答から構成され、完全なインタラクション単位を捉えている。メモリ抽出のために適切なコンテキストを確立するため、システムは2つの相補的な情報源を用いる:(1) 会話履歴全体の意味的内容を要約した、データベースから取得される会話サマリ
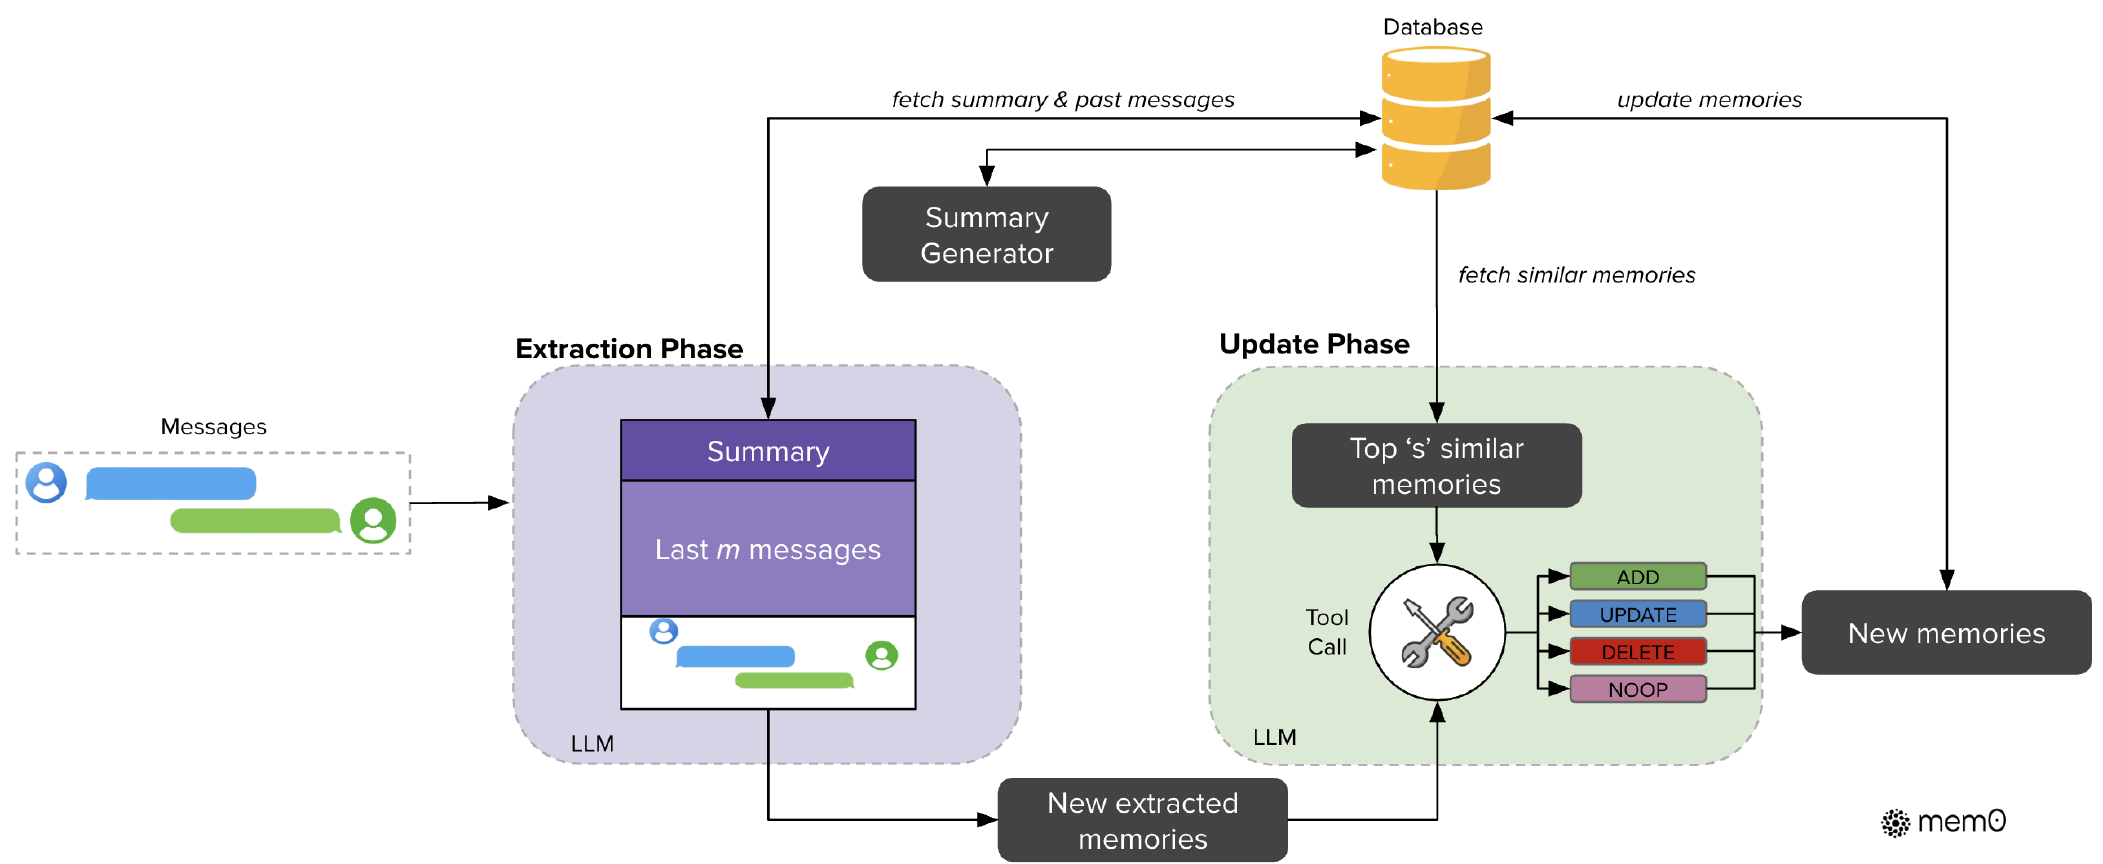
、および (2) 会話履歴からの直近のメッセージ列 。ここで は直近ウィンドウを制御するハイパーパラメータである。コンテキストを考慮したメモリ抽出を支援するため、我々は会話サマリを定期的に更新する非同期サマリ生成モジュールを実装している。このコンポーネントはメインの処理パイプラインとは独立して動作し、処理遅延を生じさせることなく、メモリ抽出が常に最新のコンテキスト情報の恩恵を受けられるようにする。5 は会話全体にわたる大域的なテーマ理解を提供する一方で、直近のメッセージ列は、サマリに統合されていない関連する詳細を含みうる、細粒度の時間的コンテキストを提供する。この二重のコンテキスト情報は、新しいメッセージペアと組み合わされて、LLM を介して実装される抽出関数 のための包括的なプロンプト を形成する。関数 は、会話のより広いコンテキストを認識しつつ、新しいやり取りから特に顕著なメモリの集合 を抽出し、その結果としてナレッジベースに含める候補となりうる事実が得られる。
抽出に続いて、更新フェーズでは、一貫性を維持し冗長性を避けるため、各候補事実を既存のメモリと照合して評価する。このフェーズは、抽出された各事実 に対して適切なメモリ管理操作を決定する。付録 B で言及されているアルゴリズム 1 は、このプロセスを示している。各事実について、システムはまず、データベースからのベクトル埋め込みを用いて意味的に類似する上位 件のメモリを取得する。これらの取得されたメモリは、候補事実とともに、我々が「ツール呼び出し」と呼ぶ関数呼び出しインターフェースを通じて LLM に提示される。LLM 自身が、実行すべき4つの異なる操作のうちどれかを決定する:意味的に等価なメモリが存在しない場合に新しいメモリを作成する ADD、既存のメモリを補完的情報で拡張する UPDATE、新しい情報と矛盾するメモリを削除する DELETE、および候補事実がナレッジベースの変更を必要としない場合の NOOP である。別個の分類器を用いるのではなく、我々は LLM の推論能力を活用して、候補事実と既存のメモリとの間の意味的関係に基づいて適切な操作を直接選択する。この決定に続いて、システムは提供された操作を実行し、それによってナレッジベースの整合性と時間的一貫性を維持する。
我々の実験的評価では、コンテキスト参照用として「」= 10 件の過去メッセージ、比較分析用として「」= 10 件の類似メモリでシステムを構成した。すべての言語モデル操作は、推論エンジンとして GPT-4o-mini を利用した。ベクトルデータベースは、更新フェーズ中の効率的な類似検索を可能にするために密埋め込みを採用している。
2.2. Memo8
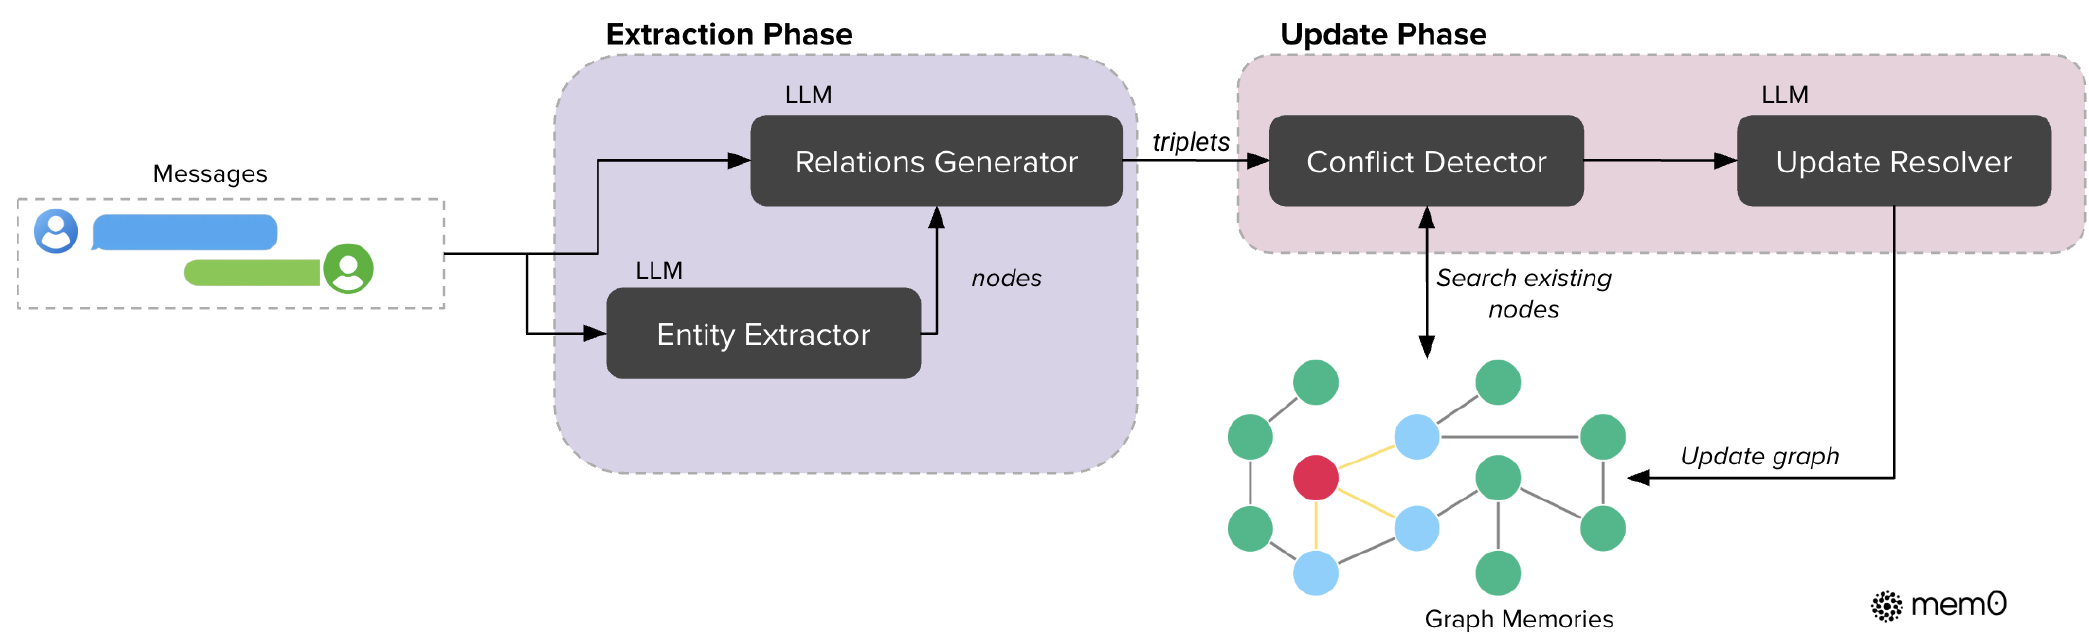
図3に示すMemo8パイプラインは、自然言語のやり取りから文脈情報を効果的に捕捉、保存、検索するグラフベースのメモリアプローチを実装している(Zhang et al., 2022)。このフレームワークでは、メモリは有向ラベル付きグラフ として表現される。ここで、
- ノード はエンティティを表す(例:ALICE、SAN_FRANCISCO)- エッジ はエンティティ間の関係を表す(例:LIVES_IN)- ラベル はノードに意味的な型を割り当てる(例:ALICE - Person、SAN_FRANCISCO - City)
各エンティティノード は3つの構成要素を含む:(1) エンティティを分類するエンティティ型分類(例:Person、Location、Event)、(2) エンティティの意味を捉える埋め込みベクトル 、(3) 作成タイムスタンプ を含むメタデータ。本システムにおける関係は の形式のトリプレットとして構造化される。ここで と はそれぞれソースとデスティネーションのエンティティノードであり、 はそれらを結ぶラベル付きエッジである。
抽出プロセスは、LLMを活用して非構造化テキストを構造化されたグラフ表現に変換する2段階のパイプラインを採用している。まず、エンティティ抽出モジュールが入力テキストを処理し、エンティティの集合とそれに対応する型を特定する。本フレームワークでは、エンティティは会話における主要な情報要素を表す。これには、メモリグラフに表現する価値のある人物、場所、物体、概念、イベント、属性が含まれる。エンティティ抽出器は、会話における要素の意味的重要性、一意性、持続性を分析することにより、これらの多様な情報単位を特定する。例えば、旅行計画に関する会話では、エンティティには目的地(都市、国)、交通手段、日付、活動、参加者の好みが含まれ得る。つまり、将来の参照や推論に関連し得るあらゆる個別の情報である。
次に、関係生成コンポーネントがこれらのエンティティ間の意味のあるつながりを導出し、情報の意味構造を捉える関係トリプレットの集合を確立する。このLLMベースのモジュールは、抽出されたエンティティと会話内でのその文脈を分析し、意味的に重要なつながりを特定する。これは言語的パターン、文脈的手がかり、ドメイン知識を調べることにより、エンティティ同士がどのように関係するかを決定する。考えられる各エンティティペアについて、生成器は意味のある関係が存在するかどうかを評価し、存在する場合にはその関係を適切なラベル(例:「lives_in」、「prefers」、「owns」、「happened_on」)で分類する。このモジュールは、LLMが対話における明示的な記述と暗黙的な情報の両方について推論するよう導くプロンプトエンジニアリング手法を採用しており、その結果として得られる関係トリプレットはメモリグラフのエッジを形成し、相互接続された情報にわたる複雑な推論を可能にする。新しい情報を統合する際、Memo8は洗練された保存および更新戦略を採用する。新しい関係トリプレットごとに、ソースとデスティネーションの両方のエンティティの埋め込みを計算し、定義された閾値「t」を超える意味的類似度を持つ既存ノードを検索する。ノードの存在に基づき、システムは両方のノードを作成するか、一方のノードのみを作成するか、または既存ノードを使用したうえで適切なメタデータとともに関係を確立する。一貫した知識グラフを維持するため、新しい情報が到着した際に潜在的に矛盾する既存の関係を特定する競合検出メカニズムを実装している。LLMベースの更新リゾルバが、特定の関係を廃止すべきかどうかを判断し、時間的推論を可能にするために物理的に削除するのではなく無効としてマークする。
Memo8のメモリ検索機能は、最適な情報アクセスのために二重アプローチ戦略を実装している。エンティティ中心の手法は、まずクエリ内の主要なエンティティを特定し、次に意味的類似度を利用して知識グラフ内の対応するノードを特定する。これらのアンカーノードから入方向と出方向の両方の関係を体系的に探索し、関連する文脈情報を捉える包括的なサブグラフを構築する。これを補完する意味的トリプレット手法は、クエリ全体を密な埋め込みベクトルとしてエンコードすることにより、より全体的な視点を取る。このクエリ表現は、知識グラフ内の各関係トリプレットのテキストエンコーディングと照合される。システムはクエリと利用可能なすべてのトリプレットとの間の細粒度の類似度スコアを計算し、設定可能な関連性閾値を超えるもののみを類似度の降順で返す。この二重検索メカニズムにより、Memo8は特定のエンティティに焦点を当てた質問とより広範な概念的クエリの両方を同等の有効性で処理できる。
実装の観点では、本システムは基盤となるグラフデータベースとしてNeo4j1を利用している。LLMベースの抽出器と更新モジュールは、関数呼び出し機能を備えたGPT-4o-miniを活用し、非構造化テキストからの構造化された情報抽出を可能にする。グラフベースの表現を意味的埋め込みおよびLLMベースの情報抽出と組み合わせることで、Memo8は複雑な推論に必要な構造的豊かさと、自然言語理解に必要な意味的柔軟性の両方を実現している。
3. 実験設定
3.1. データセット
LOCOMO(Maharana et al., 2024)データセットは、対話システムにおける長期的な会話メモリを評価するために設計されている。これは10件の拡張された会話から構成され、各会話は平均約600の対話と26000トークンを含み、複数のセッションに分散している。各会話は2人の個人が日常の経験や過去の出来事について議論する様子を捉えている。これらのマルチセッション対話に続いて、各会話には平均200の質問と対応する正解が付随している。これらの質問は、シングルホップ、マルチホップ、時間的、オープンドメインといった複数の種類に分類される。データセットには当初、システムが回答不可能な質問を認識する能力をテストするために設計された敵対的質問カテゴリが含まれていた。しかし、このカテゴリは正解が利用できず、この種の質問に対して期待される動作はエージェントが回答不可能であると認識することであるため、我々の評価から除外した。
3.2. 評価指標
我々の評価フレームワークは、応答品質と運用効率の両方を考慮し、対話システムにおける長期的なメモリ能力を評価するための包括的なアプローチを実装している。指標を2つの異なるグループに分類し、これらを合わせてシステム性能の全体的な理解を提供する。
(1) 性能指標 会話AIにおける先行研究(Goswami, 2025, Soni et al., 2024, Singh et al., 2020)は、主にF1スコア(F1)やBLEU-1(B1)などの語彙的類似度指標に依存してきた。しかし、これらの指標は会話の文脈における事実的正確性を評価する際に重大な限界を示す。正解が「Alice was born in March」であり、システムが「Alice is born in July」を生成するシナリオを考えてみよう。誕生月に関する重大な事実誤認を含んでいるにもかかわらず、従来の指標は残りのトークン(「Alice」「born」など)の語彙的重複により比較的高いスコアを割り当てるだろう。この根本的な限界は、意味的正しさを捉えられない誤解を招く評価につながり得る。これらの欠点に対処するため、我々は補完的な評価指標としてLLM-as-a-Judge(J)を使用する。このアプローチは、別のより高性能なLLMを活用して、事実的正確性、関連性、完全性、文脈的適切性を含む複数の次元で応答品質を評価する。判定モデルは質問、正解、生成された回答を分析し、人間の判断によりよく整合する、よりきめ細かな評価を提供する。J評価の確率的性質のため、データセット全体に対して各手法を10回独立に実行し、平均スコアと標準偏差 を報告する。Jの詳細については付録Aに示す。
(2) 展開指標 応答品質に加えて、AIエージェントにおける長期的メモリの実世界応用には実用的な展開上の考慮事項が不可欠である。我々はtiktokenの「c1100k_base」エンコーディングを用いてトークン消費量を体系的に追跡し、クエリへの回答のための文脈として機能する検索中に抽出されたトークン数を測定する。メモリベースのモデルでは、これらのトークンは知識ベースから検索されたメモリを表すのに対し、RAGベースのモデルでは、検索されたテキストチャンク内のトークンの総数に対応する。この区別は、簡潔なメモリ事実を処理するか、より大きな生テキストセグメントを処理するかにかかわらず、運用コストとシステム効率に直接影響するため重要である。さらに、我々はレイテンシを監視する:(i) 検索レイテンシ:メモリ(メモリベースのソリューションの場合)またはチャンク(RAGベースのソリューションの場合)を検索するのに必要な総時間を捉える、および (ii) 総レイテンシ:適切な応答を生成するまでの時間で、検索時間(メモリまたはチャンクへのアクセス)とLLMを用いた回答生成時間の両方から構成される。
これらの指標間の関係は、システム設計における重要なトレードオフを明らかにする。例えば、より洗練されたメモリアーキテクチャは、より高い事実的正確性を達成できるが、その代償としてトークン消費量とレイテンシが増加する可能性がある。我々の多次元的な評価方法論により、研究者や実務者は、重要なアプリケーションのために応答品質を優先するか、リアルタイム展開シナリオのために計算効率を優先するかといった、各自の特定の要件に基づいて情報に基づいた意思決定を行うことが可能となる。
3.3. ベースライン
我々のアプローチを包括的に評価するため、会話メモリシステムの現状を表す6つの異なるカテゴリのベースラインと比較する。これらの多様なベースラインは、事実的正確性、計算効率、拡張された会話へのスケーラビリティを含む様々な次元にわたって、異なるメモリアーキテクチャの有効性を評価するための堅牢なフレームワークを集合的に提供する。該当する場合、特に断りのない限り、実行を可能な限り再現可能にするために温度を0に設定した。
確立されたLOCOMOベンチマーク まず、LOCOMOデータセットで以前にベンチマークされた手法を評価することにより、比較の基盤を確立する。これらには5つの確立されたアプローチが含まれる:LoCoMo(Maharana et al., 2024)、ReadAgent(Lee et al., 2024)、MemoryBank(Zhong et al., 2024)、MemGPT(Packer et al., 2023)、A-Mem(Xu et al., 2025)。これらの確立されたベンチマークは、公表された結果との直接的な比較ポイントを提供するだけでなく、異なるアルゴリズムパラダイムにわたる会話メモリアーキテクチャの進化を表している。我々の評価では、gpt-4o-miniが評価に使用された指標を選択する。これらのベンチマークの詳細については付録Cに記載する。
オープンソースのメモリソリューション 私たちの2番目のカテゴリは、LangMem2(Hot Path)のような有望なオープンソースのメモリアーキテクチャで構成されており、これらは関連する会話タスクにおいて有効性を示しているものの、まだLOcOMOデータセットでは評価されていません。これらのシステムを私たちの評価フレームワークに適応させることで、比較の範囲を広げ、競争力のある性能を提供する可能性のある代替アプローチを特定します。LLMはgpt-4o-miniで初期化し、埋め込みモデルとしてtext-embedding-small-3を使用しました。
検索拡張生成(RAG) ベースラインとして、会話履歴全体をドキュメントコレクションとして扱い、標準的なRAGパイプラインを適用します。まず各会話を固定長のチャンク(128、256、512、1024、2048、4096、8192トークン)に分割します。ここで8192は私たちの埋め込みモデルがサポートする最大チャンクサイズです。すべてのチャンクは、構成間で一貫したベクトル品質を確保するために、OpenAIのtext-embedding-small-3を使用して埋め込みます。クエリ時には、意味的類似度によって上位個のチャンクを取得し、それらを連結して回答生成のためのコンテキストとします。実験全体を通じてと設定しました。では最も関連性の高い単一のチャンクのみが使用され、では最も関連性の高い2つのチャンク(最大16384トークン)が連結されます。平均的な会話長(26000トークン)が完全にカバーされてしまい、選択的検索の利点が損なわれるため、は避けています。チャンクサイズとを変化させることで、長期会話メモリタスクにおけるRAGの性能を体系的に評価します。
フルコンテキスト処理 会話履歴全体をLLMのコンテキストウィンドウ内に渡すという直接的なアプローチを採用します。この手法は、追加のアーキテクチャコンポーネントなしで逐次情報を処理するモデルの固有の能力を活用します。概念的には単純ですが、会話長が増加するにつれて実際的な制限に直面し、最終的にはトークンコストとレイテンシが増大します。それでもなお、利用可能なコンテキストの直接処理と比較して、より洗練されたメモリメカニズムの価値を理解するための重要な参照点を確立します。
プロプライエタリモデル OpenAIのChatGPTインターフェースで利用可能なメモリ3機能を評価し、一貫性のために特にgpt-4o-miniを使用します。プロンプト(付録Aを参照)を用いてLOcOMOの会話全体を単一のチャットセッションに投入し、タイムスタンプ、参加者名、会話テキストを含むメモリ生成を促します。これらの生成されたメモリは、各会話に関する質問に答えるための完全なコンテキストとして使用され、意図的に質問に関連するメモリだけでなく、すべてのメモリへの特権的なアクセスをOpenAIのアプローチに付与しています。この方法論は、ベンチマークのためにOpenAIのシステムにおいて選択的メモリ検索のための外部APIアクセスが存在しないことに対応しています。
| 方法 | シングルホップ | マルチホップ | オープンドメイン | 時間的 | ||||||||
| F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | |
| LoCoMo | 25.02 | 19.75 | - | 12.04 | 11.16 | - | 40.36 | 29.05 | - | 18.41 | 14.77 | - |
| ReadAgent | 9.15 | 6.48 | - | 5.31 | 5.12 | - | 9.67 | 7.66 | - | 12.60 | 8.87 | - |
| MemoryBank | 5.00 | 4.77 | - | 5.56 | 5.94 | - | 6.61 | 5.16 | - | 9.68 | 6.99 | - |
| MemGPT | 26.65 | 17.72 | - | 9.15 | 7.44 | - | 41.04 | 34.34 | - | 25.52 | 19.44 | - |
| A-Mem | 27.02 | 20.09 | - | 12.14 | 12.00 | - | 44.65 | 37.06 | - | 45.85 | 36.67 | - |
| A-Mem* | 20.76 | 14.90 | 39.79 ± 0.38 | 9.22 | 8.81 | 18.85 ± 0.31 | 33.34 | 27.58 | 54.05 ± 0.22 | 35.40 | 31.08 | 49.91 ± 0.31 |
| LangMem | 35.51 | 26.86 | 62.23 ± 0.75 | 26.04 | 22.32 | 47.92 ± 0.47 | 40.91 | 33.63 | 71.12 ± 0.20 | 30.75 | 25.84 | 23.43 ± 0.39 |
| Zep | 35.74 | 23.30 | 61.70 ± 0.32 | 19.37 | 14.82 | 41.35 ± 0.48 | 49.56 | 38.92 | 76.60 ± 0.13 | 42.00 | 34.53 | 49.31 ± 0.50 |
| OpenAI | 34.30 | 23.72 | 63.79 ± 0.46 | 20.09 | 15.42 | 42.92 ± 0.63 | 参考情報(翻訳対象の原文ではない):独自モデルOpenAIのChatGPTインターフェースで利用可能なmemory3機能を評価し、一貫性のために特にgpt-4o-miniを使用する。付録Aのプロンプトを用いてLOcOMOの会話全体を単一のチャットセッションに投入し、タイムスタンプ、参加者名、会話テキストを含めて記憶生成を促す。生成されたこれらの記憶は、その後、各会話に関する質問に答えるための完全なコンテキストとして使用され、意図的にOpenAIのアプローチにpr | 翻訳対象テキスト: | 39.31 | 31.16 | 62.29 ± 0.12 | 14.04 |
| 11.25 | 21.71 ± 0.20 | MemO | 38.72 | 27.13 | 67.13 ± 0.65 | 28.64 | 21.58 | 51.15 ± 0.31 | 47.65 | 38.72 | 72.93 ± 0.11 | 48.93 |
| 40.51 | 55.51 ± 0.34 | MemO8 | 38.09 | 26.03 | 65.71 ± 0.45 | 24.32 | 18.82 | 47.19 ± 0.67 | 49.27 | 40.30 | 75.71 ± 0.21 | 51.55 |
メモリプロバイダー 我々は、AIエージェント向けに設計されたメモリ管理プラットフォームであるZep(Rasmussen et al., 2025)を組み込んでいる。彼らのプラットフォーム版を用いて、LOcOMOデータセット全体にわたる体系的な評価を実施し、会話内容とともにタイムスタンプ情報を保持することで時間的忠実性を維持した。この時間的アンカリングにより、時間に敏感なクエリを適切に文脈化されたメモリ検索を通じて処理できることが保証され、これは時系列的な認識を必要とする質問の評価において特に重要である。このベースラインは、AIエージェント向けに特化して設計されたメモリ管理の重要な商用実装を表している。
4. 評価結果、分析および考察
4.1. メモリ対応システム間の性能比較
表1は、単一ホップ、マルチホップ、オープンドメイン、および時間的質問において、セクション3で述べた一連の競合ベースラインに対する我々の2つのアーキテクチャ—MemOおよびMemO—の、、Jスコアを報告する。全体として、我々の両モデルは、ほとんどの質問タイプにおいて3つの評価指標すべてで新たな最先端水準を打ち立てた。
単一ホップ質問の性能 単一ホップクエリは、1つの対話ターン内に含まれる単一の事実スパンを特定することを伴う。自然言語テキストにおける密なメモリを活用し、MemOは最も強い結果を確保した:、、。自然言語メモリをグラフメモリで拡張する(MemO8)と、MemOと比較してわずかな性能低下をもたらし、検索対象が単一ターンに存在する場合には関係構造が限られた有用性しか提供しないことを示している。既存のベースラインの中では、フルコンテキストのOpenAI実行が次に良いJスコアを達成し、会話全体をコンテキストに保持することの利点を反映している。一方、LangMemとZepはいずれもJスコアにおいて我々のモデルに対して相対的に約8%低いスコアであった。A-memのような以前のLOcOMOベンチマークはJにおいて25ポイント以上遅れており、単純な検索タスクにおいてさえも、細粒度で構造化されたメモリインデックス作成の必要性を強調している。
マルチホップ質問の性能 マルチホップクエリは、複数の会話セッションに分散した情報を統合することを要求し、メモリの統合と検索において重大な課題をもたらす。MemOはスコア28.64およびJスコア51.15で他の手法を明確に上回り、セッション間にわたって保存された異種の情報を効率的に検索・統合する能力を反映している。興味深いことに、MemO8におけるグラフメモリの追加はここでは性能向上をもたらさず、複雑な統合タスクにおいては、密な自然言語メモリのみと比較して構造化グラフ表現に潜在的な非効率性または冗長性があることを示している。LangMemのようなベースラインは競争力のある性能を示すが、そのスコアはMemOのスコアに大きく劣っており、複雑なクエリ処理に対する我々の洗練されたメモリインデックス作成および検索メカニズムの利点を強調している。
オープンドメイン性能 オープンドメイン設定では、ベースラインのZepが最高の(49.56)およびJ(76.60)スコアを達成し、僅差で我々の手法を上回った。特に、ZepのJスコア76.60はMemO8の75.71をわずか0.89パーセントポイント上回り、MemOの72.93を3.67ポイント上回っており、会話メモリと外部知識の統合において一貫した、 albeit わずかな優位性を強調している。MemO8はJが75.71で高い事実検索精度を反映して強力な次点であり続け、MemOは72.93で続き、堅牢な一貫性を示している。これらの結果は、構造化された関係メモリ(MemOおよびMemO8のように)がオープンドメイン検索を大幅に改善するものの、Zepが小さいながらも意味のあるリードを維持していることを強調している。
時間的推論性能 時間的推論タスクは、会話履歴内のイベントの順序、その相対的順序付け、および期間の正確なモデリングにかかっている。我々のアーキテクチャはすべての指標で大幅な改善を示し、MemO8が最高の(51.55)およびJ(58.13)を達成しており、自然言語メモリに加えて構造化された関係表現が時間的に根拠づけられた判断を大幅に支援することを示唆している。注目すべきことに、基本バリアントであるMemOも適切なJスコア(55.51)を提供しており、自然言語のみでも時間的に根拠づけられた判断を支援できることを示唆している。ベースラインの中では、OpenAIが特に低性能であり、スコアは15%未満である。主な理由は、タイムスタンプ付きのメモリを抽出するようOpenAI ChatGPTで明示的にプロンプトしたにもかかわらず、生成されたメモリのほとんどにタイムスタンプが欠けていることである。A-Memのような他のベースラインは立派な結果を達成しているが、我々のモデルは明らかに最先端を前進させており、時間的推論において自然言語の文脈化と構造化グラフ表現の両方を正確に活用することの決定的な利点を強調している。
4.2. カテゴリ横断分析
多様な質問カテゴリにわたる包括的な評価は、我々の提案アーキテクチャであるMemOおよびMemO8がベースラインシステムと比較して一貫して優れた性能を達成することを明らかにしている。単一ホップクエリでは、MemOは特に強い性能を示し、その効率的な密な自然言語メモリ構造から恩恵を受けている。MemO8のグラフベース表現はこれらのより単純なクエリの字句重複指標ではわずかに遅れをとるものの、競争力のあるJスコアによって示されるように意味的一貫性を大幅に強化する。これは、グラフ構造が単純な検索ではなく微妙な関係的文脈を含むシナリオにおいてより有益であることを示している。マルチホップ質問では、MemOは複数のセッションにわたって分散した情報を効果的に統合することにより明確な利点を示し、自然言語メモリがこれらの統合タスクに対して十分な表現の豊かさを提供することを確認している。驚くべきことに、
| 方法 | K | チャンクサイズ / メモリトークン | レイテンシ(秒) | 全体 J | |||
| 検索 | 合計 | ||||||
| RAG | 1 | 128 | 0.281 | 0.823 | 0.774 | 1.825 | 47.77 ± 0.23% |
| 256 | 0.251 | 0.710 | 0.745 | 1.628 | 50.15 ± 0.16% | ||
| 512 | 0.240 | 0.639 | 0.772 | 1.710 | 46.05 ± 0.14% | ||
| 1024 | 0.240 | 0.723 | 0.821 | 1.957 | 40.74 ± 0.17% | ||
| 2048 | 0.255 | 0.752 | 0.996 | 2.182 | 37.93 ± 0.12% | ||
| 8192 | 4096 | 0.254 | 0.719 | 1.093 | 2.711 | 36.84 ± 0.17% | |
| 812 | 0.279 | 0.838 | 1.396 | 4.416 | 44.53 ± 0.13% | ||
| 128 | 0.267 | 0.624 | 0.766 | 1.829 | 59.56 ± 0.19% | ||
| 256 | 0.255 | 0.699 | 0.802 | 1.907 | 60.97 ± 0.20% | ||
| 2 | 1024 | 512 | 0.247 | 0.746 | 0.829 | 1.729 | 58.19 ± 0.18% |
| 2048 | 0.238 | 0.702 | 0.860 | 1.850 | 50.68 ± 0.13% | ||
| 4096 | 0.261 | 0.829 | 1.101 | 2.791 | 48.57 ± 0.22% | ||
| 812 | 0.266 | 0.944 | 1.451 | 4.822 | 51.79 ± 0.15% | ||
| 8192 | 0.288 | 1.124 | 2.312 | 9.942 | 60.53 ± 0.16% | ||
| フルコンテキスト | 26031 | - | - | 9.870 | 17.117 | 72.90 ± 0.19% | |
| A-Mem | 2520 | 0.668 | 1.485 | 1.410 | 4.374 | 48.38 ± 0.15% | |
| LangMem | 127 | 17.99 | 59.82 | 18.53 | 60.40 | 58.10 ± 0.21% | |
| Zep | 3911 | 0.513 | 0.778 | 1.292 | 2.926 | 65.99 ± 0.16% | |
| OpenAI | 4437 | - | - | 0.466 | 0.889 | 52.90 ± 0.14% | |
| Mem0 | 1764 | 0.148 | 0.200 | 0.708 | 1.440 | 66.88 ± 0.15% | |
| Mem0^8 | 3616 | 0.476 | 0.657 | 1.091 | 2.590 | 68.44 ± 0.17% | |
の期待された関係的利点はここではより良い結果に結びつかず、多段階推論シナリオにおいてより複雑なグラフ構造をナビゲートする際の潜在的なオーバーヘッドまたは冗長性を示唆している。
時間的推論では、が他の手法を大幅に上回り、構造化された関係グラフが時系列関係およびイベントシーケンスの捕捉に優れていることを検証している。明示的な関係的文脈の存在はの時間的一貫性を大幅に強化し、の密なメモリ蓄積を上回り、時間的に敏感な情報を追跡する際の正確な関係表現の重要性を強調している。オープンドメイン性能は関係モデリングの価値をさらに強固にする。はグラフベースメモリの関係的明瞭性から恩恵を受け、最高性能のベースライン(Zep)と密接に競合している。この競争力のある結果は、関係的明瞭性を通じて外部知識を統合する際のの堅牢性を強調し、構造化メモリとオープンドメイン情報統合の間の最適な相乗効果を示唆している。
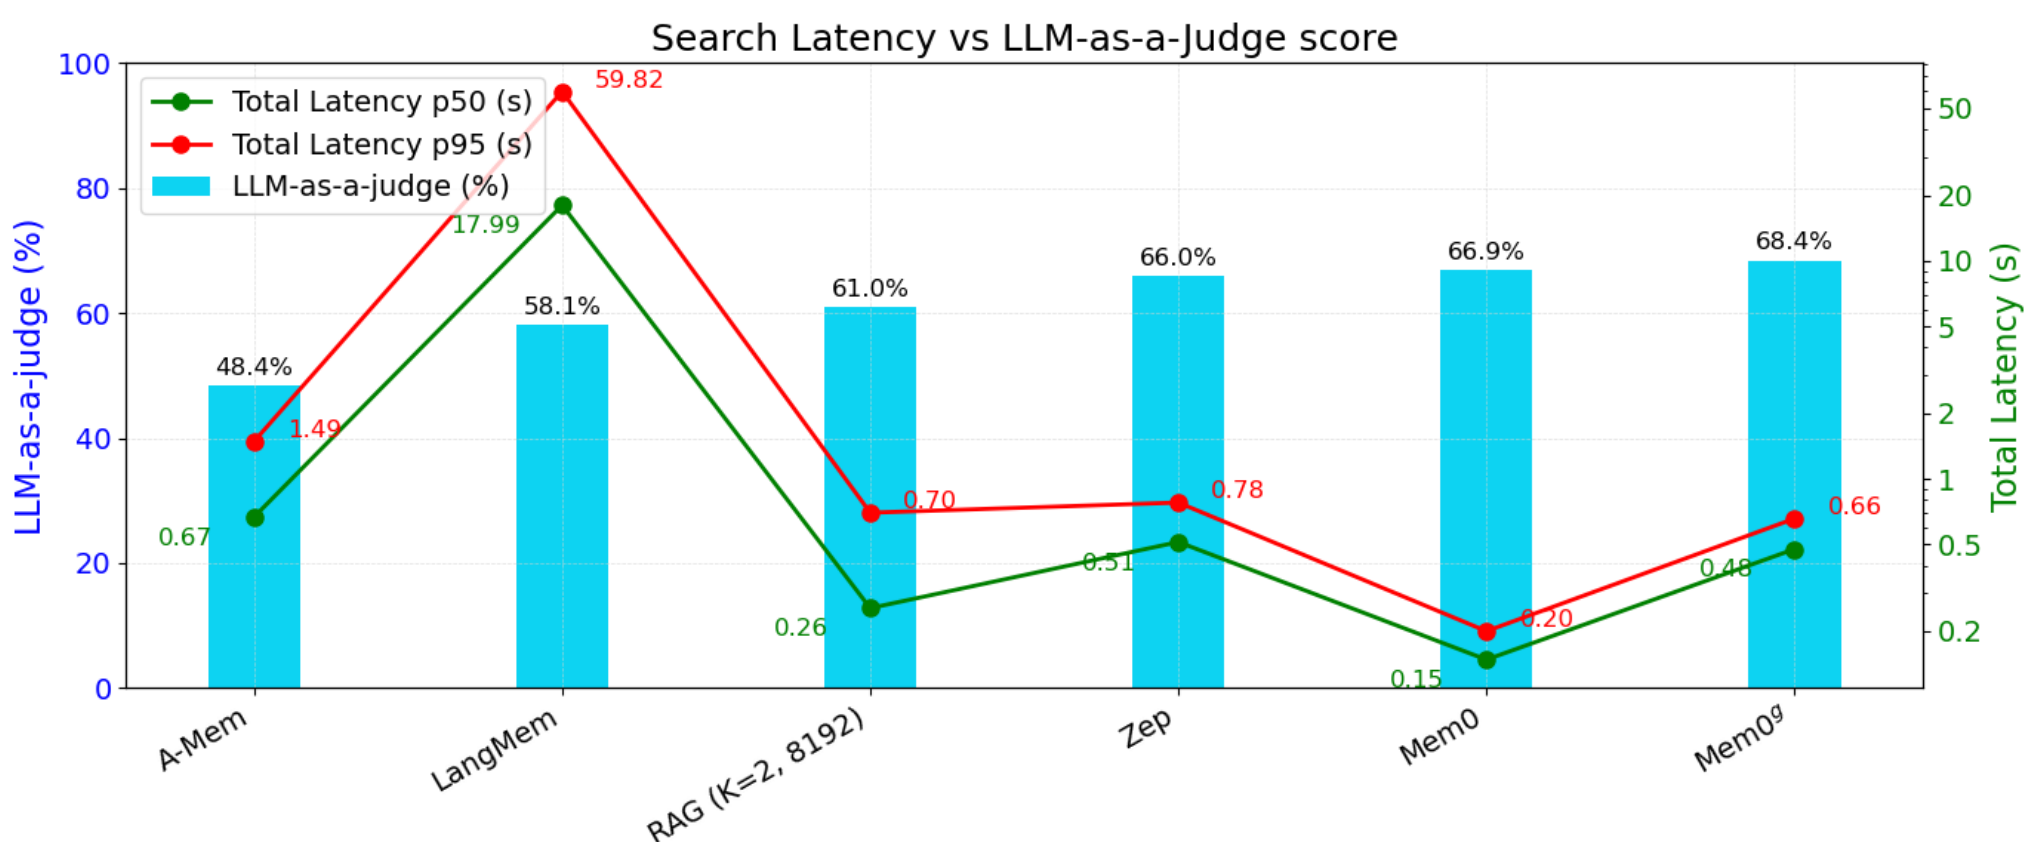
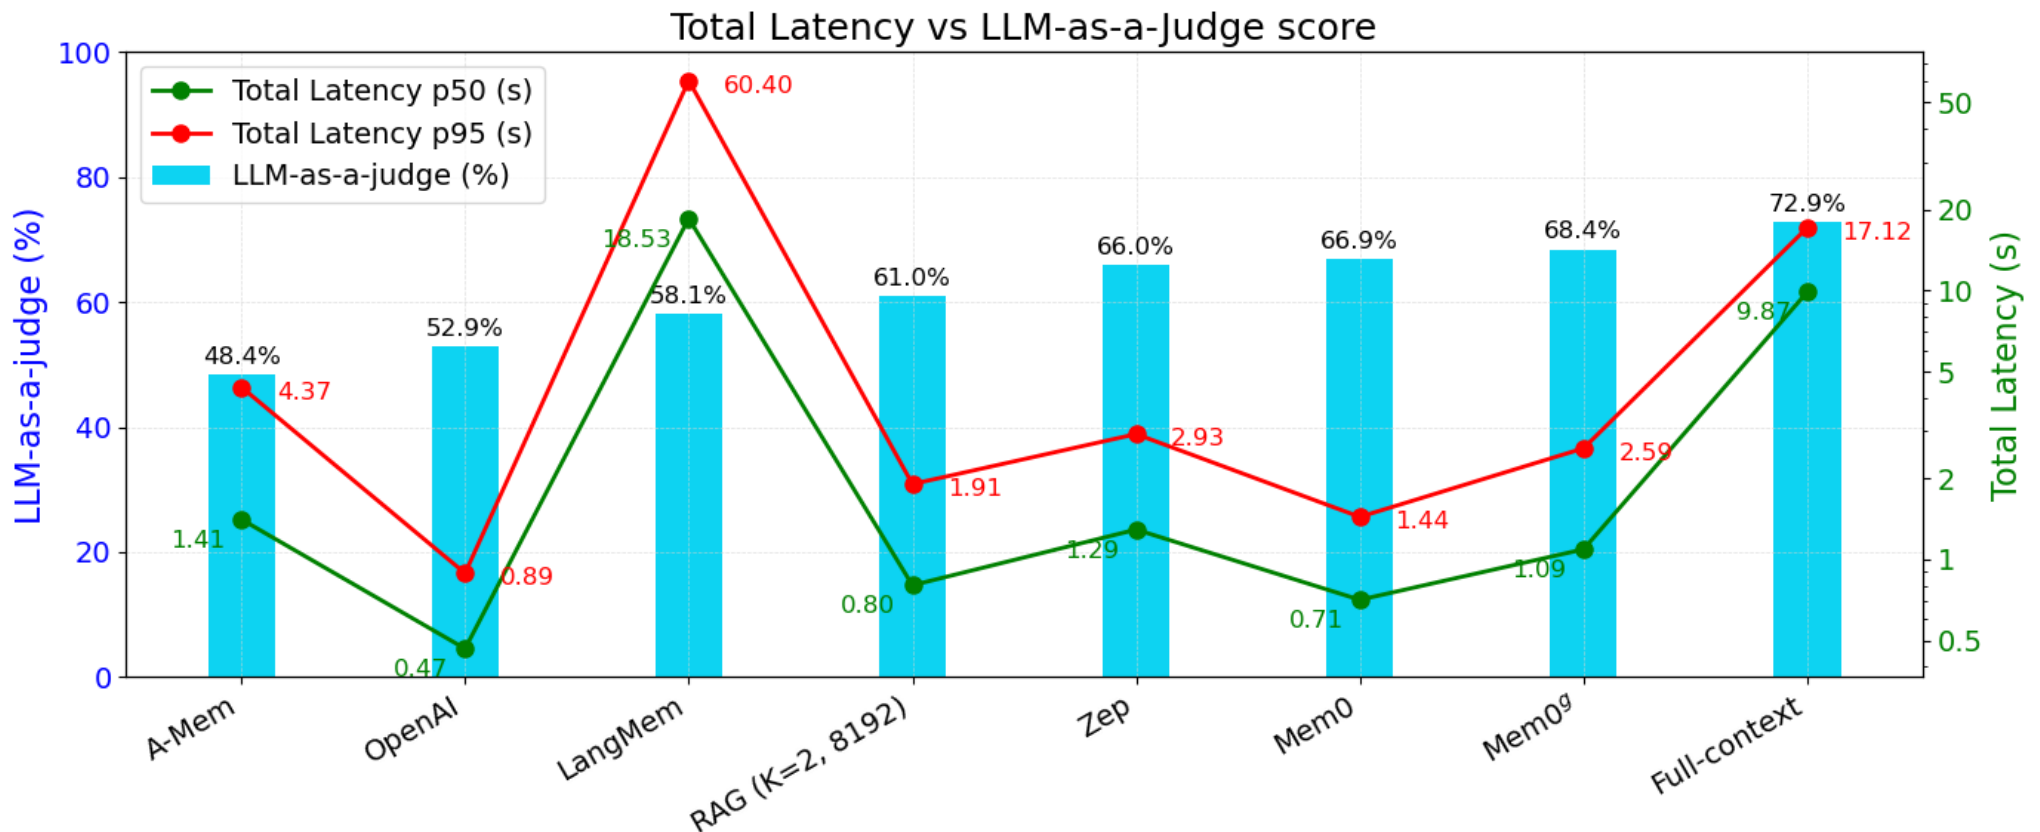
図4:異なるメモリアプローチのレイテンシ分析。これらのサブ図は、表2から選択された様々な手法のJスコアとレイテンシ比較を示している。サブ図(a)は回答生成前の検索/取得レイテンシを強調し、サブ図(b)は総レイテンシ(LLM推論を含む)を示している。両方のプロットは、精度と効率の全体像を示すために各手法のJスコアを重ね合わせている。
全体として、我々の分析は、様々なタスク要求にわたるMem0とMem08の相補的な強みを示している:密な自然言語ベースのメモリはより単純なクエリに対して大幅な効率を提供し、一方、明示的な関係モデリングは微妙な時間的および文脈的統合を要求するタスクにとって不可欠となる。これらの知見は、AIエージェントの展開において特定の推論コンテキストに合わせた適応可能なメモリ構造の重要性を強固にする。
4.3. MemOおよびMemOのRAGアプローチおよびフルコンテキストモデルに対する性能比較
「Overall J」列に焦点を当てた表2の比較は、MemOとMemOの両方が、チャンクサイズを変化させ(128〜8192トークン)、1つまたは2つのチャンクを取得するすべてのRAG構成を一貫して上回ることを明らかにしている。最も強いRAGアプローチでさえJ指標で約がピークであるのに対し、MemOはに達し—約の相対的改善—、MemOは以上に達し、約の相対的利得を達成している。これらの進歩は、元のテキストの大きなチャンクを取得するのではなく、メモリ内で最も顕著な事実のみを捕捉することの利点を強調している。会話履歴を簡潔で構造化された表現に変換することにより、MemOとMemOはノイズを軽減し、LLMに対してより正確な手がかりを浮き彫りにし、外部LLM(J)によって評価されるより良い回答につながる。
これらの改善にもかかわらず、約26,000トークンのチャンクを入力とするフルコンテキスト方式は、依然として最高のJスコア(約)を達成している。しかし、図4bに示すように、モデルはクエリごとに会話全体を読み込む必要があるため、総p95レイテンシも約17秒と非常に高くなる。対照的に、MemOとMemOはトークン使用量を大幅に削減し、フルコンテキスト方式と比較してそれぞれ約1.44秒(削減)および2.6秒(削減)という低いp95レイテンシを実現している。フルコンテキスト方式はわずかに精度面で優位に立てるものの、メモリベースのシステムはより実用的なトレードオフを提供し、トークンとレイテンシのコストをほんの一部に抑えつつ、競争力のある品質をほぼ維持している。会話の長さが増すにつれて、フルコンテキスト方式は計算オーバーヘッドの指数的な増大に悩まされる(表2では、値やチャンクサイズが大きくなるにつれて総p95レイテンシが大幅に増加することが明らかである)。この入力チャンクの増加は、応答時間の長期化とトークン消費コストの増大につながる。対照的に、MemOやMemOのようなメモリに焦点を当てた方式は、会話の長さにかかわらず一貫した性能を維持するため、効率性と応答性が重要となる本番規模の展開において、はるかに実用的である。
4.4. レイテンシ分析
表2は、様々な検索およびメモリ手法の包括的な性能比較を示しており、LOCOM0データセット全体にわたる検索フェーズと総応答生成の両方について、中央値(p50)およびテール(p95)レイテンシを提示している。我々の分析は、アーキテクチャ上の選択によって支配される明確な性能パターンを明らかにしている。メモリ中心のアーキテクチャは異なる性能特性を示す。A-Memは、より大きなメモリストアを持つにもかかわらず、多大な検索オーバーヘッド(p50:0.668秒)を被り、その結果、総中央値レイテンシは1.410秒となる。LangMemはさらに高い検索レイテンシ(p50:17.99秒、p95:59.82秒)を示し、インタラクティブなアプリケーションには実用的でない。Zepは中程度の性能(p50合計:1.292秒)を達成している。会話履歴全体を検索なしで処理するフルコンテキストベースラインは、検索ベースの手法とは根本的に異なる。会話コンテキスト全体(26000トークン)をLLMに直接渡すことで検索オーバーヘッドを排除するが、極端な総レイテンシ(p50:9.870秒、p95:17.117秒)を被る。同様に、OpenAIの実装は、playgroundから手動で抽出したメモリを処理するため、メモリ検索を実行しない。この方式は印象的な応答生成時間(p50:0.466秒、p95:0.889秒)を達成するものの、関連コンテキストの事前抽出を必要とし、それは報告されている指標には反映されていない。
我々が提案するMemO方式は、図4aに示すように、全手法の中で最低の検索レイテンシ(p50:0.148秒、p95:0.200秒)を達成している。この効率性は、固定サイズのチャンクではなく最も顕著な情報のみを動的に特定して取得する、我々の選択的メモリ検索メカニズムとインフラの改善に由来する。その結果、MemOは最低の総中央値レイテンシ(0.708秒)を維持し、p95値も著しく抑制されており(1.440秒)、インタラクティブなAIエージェントのようなレイテンシに敏感なアプリケーションに特に適している。グラフ拡張版のMemOは、中程度のレイテンシコストで追加の関係モデリング機能を導入しており、検索時間(0.476秒)は依然として既存のすべてのメモリソリューションおよびベースラインを上回っている。この増加にもかかわらず、Memo8は競争力のある総レイテンシ(p50:1.091秒、p95:2.590秒)を維持しつつ、全手法の中で最高のJスコア(68.44%)を達成している—計算コストが非現実的なフルコンテキスト方式にのみ及ばない。この性能プロファイルは、両方の要素が重要な制約となる本番AIエージェントにとって魅力的なソリューションを提供しつつ、応答品質と計算効率のバランスを取る我々の手法の能力を示している。
4.5. メモリシステムのオーバーヘッド:トークン分析と構築時間
各システムの長期メモリストアを実体化するために必要な平均トークン予算を測定した。Memoは完全な対話ターンを自然言語表現で符号化するため、1会話あたり平均わずか7kトークンしか占有しない。一方、Memo8はグラフメモリの導入により、ノードと対応する関係を含むため、フットプリントがほぼ倍増して14kトークンとなる。これとは対照的に、Zepのメモリグラフは600kトークンを超えて消費する。この膨張は、各ノードに完全な抽象的要約をキャッシュし、さらに接続エッジに事実を保存するというZepの設計上の選択に起因し、グラフ全体にわたる広範な冗長性を引き起こしている。参考までに、メモリ抽象化を一切行わずに生の対話コンテキスト全体を言語モデルに供給すると、平均で約26kトークンとなり、Zepのグラフと比較して20分の1となる。トークンの非効率性に加えて、我々の実験ではZepに重大な運用上のボトルネックがあることが明らかになった。Zepのシステムにメモリを追加した後、即時のメモリ検索試行が我々のクエリに正しく答えられないことがしばしば観察された。興味深いことに、数時間の遅延後に同一の検索を再実行すると、かなり良好な結果が得られた。このレイテンシは、Zepのグラフ構築が複数の非同期LLM呼び出しと広範なバックグラウンド処理を伴うことを示唆しており、メモリシステムをリアルタイムアプリケーションには実用的でないものにしている。対照的に、Memoのグラフ構築は最悪の場合でも1分未満で完了し、ユーザーは新たに追加されたメモリを即座にクエリ応答に活用できる。
これらの知見は、Zepが同一の知識断片を複数のノードにわたって複製するだけでなく、重大な運用上の遅延をもたらすことを強調している。我々のアーキテクチャ—MemOとMemo8—は、同じ情報をわずかなトークンコストで、かつ実質的により迅速なメモリ可用性をもって保持し、よりメモリ効率が高く運用上応答性の高い表現を提供する。
5. 結論と今後の展望
我々はMemOとMemo8を導入した。これらはLLMにおける固定コンテキストウィンドウの本質的限界を克服する、相補的な2つのメモリアーキテクチャである。コンパクトなメモリ表現を動的に抽出・統合・検索することにより、MemOはシングルホップおよびマルチホップ推論にわたって最先端の性能を達成し、一方でMemoのグラフベースの拡張は時間的タスクおよびオープンドメインタスクにおいて著しい向上を可能にする。LOCOMOベンチマークにおいて、我々の手法はシングルホップ、時間的、マルチホップ推論の質問タイプで、それぞれの質問タイプで最高性能の手法に対して5%、11%、7%の相対的改善をもたらし、フルコンテキストのベースラインと比較してp95レイテンシを91%以上削減した—これは精度と応答性の間の強力なバランスを示している。Memoの高密度メモリパイプラインは、単純なクエリに対する迅速な検索に優れ、トークン使用量と計算オーバーヘッドを最小化する。対照的に、Memoの構造化グラフ表現は、実用的な効率を犠牲にすることなく、きめ細かな関係的明確性を提供し、複雑なイベントの順序付けと豊かなコンテキスト統合を可能にする。両者は相まって、多様な対話要求に適応しつつ大規模に展開可能な、汎用性の高いメモリツールキットを形成する。
今後の研究方向には、Memo8のレイテンシオーバーヘッドを削減するためのグラフ操作の最適化、効率性と関係表現を融合する階層的メモリアーキテクチャの探求、人間の認知プロセスに着想を得たより洗練されたメモリ統合メカニズムの開発が含まれる。
さらに、我々のメモリフレームワークを対話シナリオ以外の領域、例えば手続き的推論やマルチモーダルインタラクションへ拡張することは、その広範な適用可能性をさらに検証することになるだろう。固定コンテキストウィンドウの根本的限界に対処することにより、我々の研究は、人間の counterpart と同様に、長期にわたって一貫した、文脈豊かなインタラクションを維持できる対話型AIシステムに向けた重要な進歩を表すものである。
6. 謝辞
Harsh Agarwal、Shyamal Anadkat、Prithvijit Chattopadhyay、Siddesh Choudhary、Rishabh Jain、およびVaibhav Pandeyの各氏に、貴重な洞察と初期草稿の徹底的なレビューに対して心より感謝の意を表する。彼らの建設的なコメントと詳細な提案は、原稿を洗練させ、その明瞭さと全体的な品質の両方を高めるのに役立った。本研究に時間と専門知識を惜しみなく注いでいただいた彼らの寛大さに深く感謝する。
参考文献
Anthropic. Model card and evaluations for claude models. Technical report, Anthropic, February 2025. URL https://www.anthropic.com/news/claude- 3- 7- sonnet.
Jan Assmann. Communicative and cultural memory. In Cultural memories: The geographical point of view, pages 15- 27. Springer, 2011.
Aydar Bulatov, Yury Kuratov, and Mikhail Burtsev. Recurrent memory transformer. Advances in Neural Information Processing Systems, 35:11079- 11091, 2022.
Prateek Chhikara, Jiarui Zhang, Filip Ilievski, Jonathan Francis, and Kaixin Ma. Knowledge- enhanced agents for interactive text games. In Proceedings of the 12th Knowledge Capture Conference 2023, pages 157- 165, 2023.
Fergus IM Craik and Janine M Jennings. Human memory. 1992.
Gaurav Goswami. Dissecting the metrics: How different evaluation approaches yield diverse results for conversational ai. Authorea Preprints, 2025.
Tianyu Guo, Druv Pai, Yu Bai, Jiantao Jiao, Michael Jordan, and Song Mei. Active- dormant attention heads: Mechanistically demystifying extreme- token phenomena in llms. In NeurIPS 2024 Workshop on Mathematics of Modern Machine Learning, 2024.
Kostas Hatalis, Despina Christou, Joshua Myers, Steven Jones, Keith Lambert, Adam Amos- Binks, Zohreh Dannenhauer, and Dustin Dannenhauer. Memory matters: The need to improve long- term memory in llm- agents. In Proceedings of the AAAI Symposium Series, volume 2, pages 277- 280, 2023.
Zihong He, Weizhe Lin, Hao Zheng, Fan Zhang, Matt W Jones, Laurence Aitchison, Xuhai Xu, Miao Liu, Per Ola Kristensson, and Junxiao Shen. Human- inspired perspectives: A survey on ai long- term memory. arXiv preprint arXiv:2411.00489, 2024.
Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt- 4o system card. arXiv preprint arXiv:2410.21276, 2024.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El- Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. In International Conference on Machine Learning, pages 26396- 26415. PMLR, 2024.
Lei Liu, Xiaoyan Yang, Yue Shen, Binbin Hu, Zhiqiang Zhang, Jinjie Gu, and Guannan Zhang. Think- in- memory: Recalling and post- thinking enable llms with long- term memory. arXiv preprint arXiv:2311.08719, 2023.
Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 13851- 13870, 2024.
Bodhisattwa Prasad Majumder, Bhavana Dalvi Mishra, Peter Jansen, Oyvind Tafjord, Niket Tandon, Li Zhang, Chris Callison- Burch, and Peter Clark. Clin: A continually learning language agent for rapid task adaptation and generalization. In First Conference on Language Modeling.
Elliot Nelson, Georgios Kollias, Payel Das, Subhajit Chaudhury, and Soham Dan. Needle in the haystack for memory based large language models. arXiv preprint arXiv:2407.01437, 2024.
Charles Packer, Vivian Fang, Shishir G Patil, Kevin Lin, Sarah Wooders, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. 2023.
Preston Rasmussen, Pavlo Paliychuk, Travis Beauvais, Jack Ryan, and Daniel Chalef. Zep: A temporal knowledge graph architecture for agent memory. arXiv preprint arXiv:2501.13956, 2025.
Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie, and Christopher D Manning. Raptor: Recursive abstractive processing for tree- organized retrieval. In The Twelfth International Conference on Learning Representations, 2024.
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36:8634- 8652, 2023.
Prabhijot Singh, Prateek Chhikara, and Jasmeet Singh. An ensemble approach for extractive text summarization. In 2020 International Conference on Emerging Trends in Information Technology and Engineering (ic- ETTE), pages 1- 7. IEEE, 2020.
Arpita Soni, Rajeev Arora, Anoop Kumar, Dheerendra Panwar. 低リソース生成チャットボットにおけるドメインカバレッジの評価:BLEUスコアを用いたオープンドメインアプローチとクローズドドメインアプローチの比較研究. 2024年電気電子・コンピューティング技術国際会議(ICEECT)論文集, 第1巻, 1-6ページ. IEEE, 2024.
Gemini Team, Petko Georgiev, Ving Ian Lei, Ryan Burnell, Libin Bai, Anmol Gulati, Garrett Tanzer, Damien Vincent, Zhufeng Pan, Shibo Wang, ほか. Gemini 1.5:数百万トークンのコンテキストにわたるマルチモーダル理解の解放. arXivプレプリント arXiv:2403.05530, 2024.
Joan C Timoneda, Sebastián Vallejo Vera. 必要なのはメモリだけ:モデルのメモリがアノテーションタスクにおけるLLMの性能に与える影響の検証. arXivプレプリント arXiv:2503.04874, 2025.
Wujiang Xu, Zujie Liang, Kai Mei, Hang Gao, Juntao Tan, Yongfeng Zhang. A-mem:LLMエージェントのためのエージェント型メモリ. arXivプレプリント arXiv:2502.12110, 2025.
Yangyang Yu, Haohang Li, Zhi Chen, Yuechen Jiang, Yang Li, Denghui Zhang, Rong Liu, Jordan W Suchow, Khaldoun Khashanah. FinMem:層状メモリとキャラクター設計を備えた性能強化型LLMトレーディングエージェント. AAAIシンポジウムシリーズ論文集, 第3巻, 595-597ページ, 2024.
Jiarui Zhang. 誘導型プロファイル生成は大規模言語モデルによるパーソナライゼーションを改善する. 計算言語学協会論文集:EMNLP 2024, 4005-4016ページ, 2024.
Jiarui Zhang, Filip Ilievski, Kaixin Ma, Jonathan Francis, Alessandro Oltramari. 常識知識を用いたゼロショット適応に関する研究. AKBC, 2022.
Zeyu Zhang、Xiaohé Bo、Chen Ma、Rui Li、Xu Chen、Quanyu Dai、Jieming Zhu、Zhenhua Dong、Ji-Rong Wen. 大規模言語モデルベースのエージェントの記憶メカニズムに関するサーベイ. arXiv preprint arXiv:2404.13501, 2024.
Wanjun Zhong、Lianghong Guo、Qiqi Gao、He Ye、Yanlin Wang. Memorybank: 長期記憶による大規模言語モデルの強化. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 38, pages 19724-19731, 2024.
付録
A. プロンプト
LLM-as-a-Judgeプロンプトの開発にあたり、我々はPacker et al. (2023)によって公開されたプロンプトから要素を適応させている。
LLM AS A JUDGEのためのプロンプトテンプレート
あなたのタスクは、ある質問に対する回答を「CORRECT」または「WRONG」とラベル付けすることです。あなたには以下のデータが与えられます: (1) 質問(あるユーザーが別のユーザーに対して行ったもの)、(2) 「ゴールド」(正解)回答、(3) 生成された回答。これに対してあなたはCORRECT/WRONGの評価を下します。
この質問の趣旨は、あるユーザーが以前の会話に基づいて別のユーザーについて知っているべき事柄を尋ねることです。ゴールド回答は通常、参照されたトピックを含む簡潔で短い回答になります。例えば:
質問: 私が前回ハワイに行ったときに何を手に入れたか覚えてる?
ゴールド回答: 貝殻のネックレス
生成された回答はもっと長くなるかもしれませんが、採点は寛容に行うべきです — ゴールド回答と同じトピックに触れていれば、CORRECTと数えるべきです。
時間に関する質問の場合、ゴールド回答は特定の日付、月、年などになります。生成された回答はもっと長くなるかもしれませんし、相対的な時間表現(「先週の火曜日」や「来月」など)を使うかもしれませんが、採点は寛容に行うべきです — ゴールド回答と同じ日付や期間を指していれば、CORRECTと数えるべきです。たとえ形式が異なっていても(例: 「5月7日」対「7 May」)、同じ日付であればCORRECTとみなしてください。
さて、本当の質問の時間です: 質問: {question}
ゴールド回答: {gold_answer}
生成された回答: {generated_answer}
まず、あなたの推論について短い(一文の)説明を示し、最後にCORRECTまたはWRONGで締めくくってください。回答にCORRECTとWRONGの両方を含めないでください。評価スクリプトが壊れてしまいます。
ラベルCORRECTまたはWRONGを、キーを"label"とするjson形式で返すだけにしてください。
結果生成のためのプロンプトテンプレート(MEMO)
あなたは、会話の記憶から正確な情報を取得することを任務とする知能の高い記憶アシスタントです。
コンテキスト:
あなたは、会話における2人の話者からの記憶にアクセスできます。これらの記憶には、質問への回答に関連する可能性のあるタイムスタンプ付きの情報が含まれています。
指示:
1. 両方の話者から提供されたすべての記憶を注意深く分析する 2. 回答を決定するためにタイムスタンプに特に注意を払う 3. 質問が特定の出来事や事実について尋ねている場合は、記憶の中に直接的な証拠を探す 4. 記憶に矛盾する情報が含まれている場合は、最も新しい記憶を優先する 5. 時間表現(「去年」「2か月前」など)に関する質問がある場合は、記憶のタイムスタンプに基づいて実際の日付を計算する。例えば、2022年5月4日の記憶が「去年インドに行った」と述べている場合、その旅行は2021年に起こった。 6. 常に相対的な時間表現を具体的な日付、月、年、または年に変換する。例えば、記憶のタイムスタンプに基づいて「去年」を「2022」に、または「2か月前」を「2023年3月」に変換する。質問に答える際には、その表現は無視する。 7. 両方の話者からの記憶の内容のみに焦点を当てる。記憶の中で言及されている登場人物の名前を、それらの記憶を作成した実際のユーザーと混同しない。 8. 回答は5〜6語未満にすべきである。
アプローチ(ステップバイステップで考える):
1. まず、質問に関連する情報を含むすべての記憶を調べる 2. これらの記憶のタイムスタンプと内容を注意深く調べる 3. 質問に答える日付、時刻、場所、または出来事の明示的な言及を探す 4. 回答に計算が必要な場合(例: 相対的な時間表現の変換)、計算過程を示す 5. 記憶の中の証拠のみに基づいて、正確で簡潔な回答をまとめる 6. 回答が尋ねられた質問に直接答えていることを再確認する 7. 最終的な回答が具体的であり、曖昧な時間表現を避けていることを確認する
ユーザー {speaker_1_user_id} の記憶: {speaker_1_memories}
ユーザー {speaker_2_user_id} の記憶: {speaker_2_memories}
質問: {question}
回答:
結果生成のためのプロンプトテンプレート(MEMO'S)
(前と同じ)
アプローチ(ステップバイステップで考える):
1. まず、質問に関連する情報を含むすべての記憶を調べる 2. これらの記憶のタイムスタンプと内容を注意深く調べる 3. 質問に答える日付、時刻、場所、または出来事の明示的な言及を探す 4. 回答に計算が必要な場合(例: 相対的な時間表現の変換)、計算過程を示す 5. 知識グラフの関係を分析して、ユーザーの知識コンテキストを理解する 6. 記憶の中の証拠のみに基づいて、正確で簡潔な回答をまとめる 7. 回答が尋ねられた質問に直接答えていることを再確認する 8. 最終的な回答が具体的であり、曖昧な時間表現を避けていることを確認する
ユーザー {speaker_1_user_id} の記憶: {speaker_1_memories}
ユーザー {speaker_1_user_id} の関係: {speaker_1_graph_memories}
ユーザー {speaker_2_user_id} の記憶: {speaker_2_memories}
ユーザー {speaker_2_user_id} の関係: {speaker_2_graph_memories}
質問: {question}
回答:
OPENAI CHATGPTのためのプロンプトテンプレート
この会話から関連する情報を抽出し、言及された各ユーザーの記憶エントリを作成していただけますか?これらの記憶を、将来の参照とパーソナライズされたインタラクションのために提供されたタイムスタンプに加えて、あなたの知識ベースに保存してください。
(2023年5月8日午後1時56分)Caroline: やあ、Mel!会えて嬉しいわ!元気にしてた? (2023年5月8日午後1時56分)Melanie: やあ、Caroline!会えて嬉しいわ!子供と仕事でてんてこ舞いよ。そっちはどう?何か新しいことある? (2023年5月8日午後1時56分)Caroline: 昨日LGBTQサポートグループに行ったんだけど、すごく力強かったわ。
B. アルゴリズム
アルゴリズム1 記憶管理システム: 更新操作
1: 入力: 取得された記憶の集合 、既存の記憶ストア
2: 出力: 更新された記憶ストア
3: procedure UPDATEMEMORY(F, M)
4: for each 事実 do
5: operation CLASSIFYOPERATION
分類に基づいて
適切な操作を実行
6: if operation ADD then
7: GenerateUniqueID()
8:
一意の識別子を持つ新しい事実を追加
9: else if 操作 \(=\) UPDATE then
10: \(m_{i}\leftarrow\) FindRelatedMemory \((f,M)\)
11: if InformationContent \((f) >\) InformationContent \((m_{i})\) then
12: \(M\leftarrow (M\setminus \{m_{i}\})\cup \{(id_{i},f,"UPDATE")\}\) より豊富な情報で置き換える
13: end if
14: else if 操作 \(=\) DELETE then
15: \(m_{i}\leftarrow\) FindContradictedMemory \((f,M)\)
16: \(M\gets M\setminus \{m_{i}\}\) 矛盾する情報を削除する
17: else if 操作 \(=\) NOOP then
18: 操作は実行されない 事実はすでに存在するか、無関係である
19: end if
20: end for
21: return M
22: end procedure
23: function CLASSIFYOPERATION
24: if SemanticallySimilar then
25: return ADD
26: else if Contradicts then
27: return DELETE
28: else if Augments then
29: return UPDATE
30: else
31: return NOOP
32: end if
33: end function
メモリに存在しない新情報
既存のメモリと矛盾する情報
メモリ内の既存情報を強化する
変更不要
C. 選択されたベースライン
LoCoMo LoCoMoフレームワークは、LLMエージェントが一貫した長期的な会話を維持できるようにする洗練されたメモリパイプラインを実装している。その中核として、システムはメモリを短期コンポーネントと長期コンポーネントに分割する。各会話セッションの後、エージェントはそのインタラクションから主要な情報を抽出した要約を生成する(短期メモリとして保存される)。同時に、個々の会話ターンは「観察」—各話者のペルソナや人生の出来事に関する事実的記述—に変換され、それらを生成した特定の対話ターンへの参照とともに長期メモリに保存される。新しい応答を生成する際、エージェントは最新のセッション要約と、長期メモリから選択的に取得した関連する観察の両方を活用する。この二重メモリアプローチは、会話セッション間で発生する因果的につながった人生の出来事を追跡する時間的イベントグラフを組み込むことでさらに強化される。取得された記憶、現在の会話コンテキスト、ペルソナ情報、およびその間の人生の出来事に応じて応答を条件付けることで、このシステムはエージェントが数百ターン、数十セッションにわたる会話を通じて一貫した人格を維持し、重要な詳細を想起できるようにする。
ReadAgent ReadAgentは、人間が長文を処理する方法を模倣する洗練された3段階のパイプラインを通じて、LLMの根本的な限界に対処する。第一に、エピソード・ページネーションにおいて、システムは恣意的な区切りではなく自然な認知境界でテキストをインテリジェントに分割する。次に、メモリ・ジスティングの段階で、各セグメントを本質的な意味を保ちながらトークン数を大幅に削減した簡潔な要約へと蒸留する—これは、人間の記憶が逐語的な想起ではなく情報の実質を保持する方法に似ている。最後に、質問への回答を求められた際、インタラクティブ・ルックアップ機構がこれらのジストを精査し、最も関連性の高い元のテキストセグメントのみを戦略的に取得して詳細に処理する。この人間に着想を得たアプローチにより、LLMは通常のコンテキストウィンドウの最大20倍長い文書を効果的に管理できる。ジストによる全体的理解と詳細への選択的注意のバランスを取ることで、ReadAgentは計算効率と理解度の向上の両方を達成し、人間の認知プロセスを模倣することがAIのテキスト処理能力を大幅に向上させ得ることを実証している。
MemoryBank MemoryBankシステムは、洗練された3部構成のパイプラインを通じてLLMに長期メモリを付与する。その中核として、メモリ・ストレージコンポーネントは詳細な会話ログ、階層的なイベント要約、および進化するユーザー性格プロファイルを保管する。新しいインタラクションが発生すると、メモリ・リトリーバル機構はデュアルタワー密検索モデルを用いて文脈的に関連する過去の情報を抽出する。メモリ・アップデーティングコンポーネントは、想起されると記憶が強化され、使用されなければ時間とともに自然に減衰するという人間らしい忘却機構を提供する。この包括的なアプローチにより、AIコンパニオンは関連情報を想起し、長期にわたるインタラクションを通じて文脈的認識を維持し、ますます正確なユーザーポートレートを形成することができ、その結果、よりパーソナライズされた自然な長期的会話が実現する。
MemGPT MemGPTシステムは、LLMに固有のコンテキストウィンドウの制約を克服するために、オペレーティングシステムに着想を得たアプローチを導入する。その中核として、MemGPTは階層型メモリシステム、自己主導型メモリ操作、およびイベントベースの制御フロー機構という3つの主要コンポーネントからなる洗練されたメモリ管理パイプラインを採用している。システムは利用可能なメモリを「メインコンテキスト」(従来のオペレーティングシステムにおけるRAMに相当)と「外部コンテキスト」(ディスクストレージに相当)に分割する。メインコンテキスト—LLMのコンテキストウィンドウによって制約される—には、システム命令、最近の会話履歴、およびモデルが変更可能なワーキングメモリが含まれる。外部コンテキストは、完全な会話履歴やアーカイブデータを含む、モデルの即時コンテキストウィンドウ外の無制限の情報を保存する。LLMがメインコンテキストに存在しない情報を必要とする場合、これらのメモリ階層にわたってコンテンツを検索、取得、または変更する関数呼び出しを開始でき、関連情報を効果的にその限られたコンテキストウィンドウに「ページング」して出し入れする。このOSに着想を得たアーキテクチャにより、MemGPTは長期にわたるインタラクションを通じて会話の一貫性を維持し、標準的なコンテキスト限界を超える文書を管理し、マルチホップ情報検索タスクを実行することができる—しかも固定コンテキストのモデルで動作しながら。自身のメモリリソースをインテリジェントに管理するこのシステムの能力は、無限のコンテキストという錯覚を提供し、現在のLLM技術で可能なことを大幅に拡張する。
A- Mem A-Memモデルは、LLMエージェント向けに設計されたエージェント型メモリシステムを導入する。このシステムは、相互接続されたノートを通じてメモリを動的に構造化し進化させる。各ノートは、LLMによって生成されたキーワード、文脈的記述、タグといった構造化属性で強化されたインタラクションを捉える。新しいメモリを作成する際、A-MEMは意味的埋め込みを用いて関連する既存のノートを取得し、次にLLM駆動のアプローチを採用して、類似性と共有属性に基づく意味のあるリンクを確立する。決定的に重要なのは、メモリ進化機構が既存のノートを動的に更新し、新しい関連メモリが統合されるたびにその文脈情報と属性を洗練させることである。こうして、メモリ構造は継続的に進化し、メモリ間により豊かで文脈的に深いつながりを可能にする。メモリからの取得は意味的類似性を通じて行われ、エージェントのインタラクション中に関連する履歴コンテキストを提供する。