
48GB の GPU 一枚で 65B モデルを微調整。4bit 量子化とアダプタで 16bit 相当の品質を保つ。NeurIPS 2023、全文無料。
QLoRA: Efficient Finetuning of Quantized LLMs
QLoRA:量子化LLMの効率的なファインチューニング
Tim Dettmers\*
Artidoro Pagnoni\*
Ari Holtzman
Luke Zettlemoyer
ワシントン大学 {dettmers,artidoro,ahai,lsz}@cs.washington.edu
概要
本稿では、メモリ使用量を十分に削減し、完全な16ビットファインチューニングのタスク性能を維持しながら、単一の48GB GPU上で65Bパラメータモデルをファインチューニングできる効率的なファインチューニング手法であるQLoRAを提案する。QLoRAは、凍結された4ビット量子化済みの事前学習済み言語モデルを通して、Low Rank Adapters(LoRA)へ勾配を逆伝播させる。我々の最良のモデルファミリーはGuanacoと名付けられ、Vicunaベンチマークにおいてこれまでに公開されたすべてのモデルを上回り、単一GPUでの24時間のファインチューニングのみでChatGPTの性能水準の99.3%に到達する。QLoRAは、性能を犠牲にすることなくメモリを節約するためのいくつかの革新を導入する:(a) 4ビットNormalFloat(NF4)、正規分布する重みに対して情報理論的に最適な新しいデータ型、(b) Double Quantization、量子化定数を量子化することで平均メモリフットプリントを削減する手法、(c) Paged Optimizers、長い系列長のミニバッチを処理する際に発生する勾配チェックポイントのメモリスパイクを管理する手法。我々はQLoRAを用いて1,000以上のモデルをファインチューニングし、8つの指示データセット、複数のモデル種別(LLaMA、T5)、そして通常のファインチューニングでは実行不可能なモデル規模(例:33Bおよび65Bパラメータモデル)にわたる指示追従とチャットボット性能の詳細な分析を提供する。我々の結果は、小規模で高品質なデータセットでのQLoRAファインチューニングが、以前のSoTAよりも小さいモデルを用いた場合でも最先端の結果につながることを示す。人間とGPT-4の両方の評価に基づくチャットボット性能の詳細な分析を提供し、GPT-4評価が人間評価の安価で妥当な代替手段であることを示す。さらに、現在のチャットボットベンチマークはチャットボットの性能水準を正確に評価するには信頼できないことを明らかにする。チェリーピッキング分析により、GuanacoがChatGPTと比較してどこで失敗するかを示す。我々はすべてのモデルとコード、4ビット学習用のCUDAカーネルを含めて公開する。2
1 はじめに
大規模言語モデル(LLM)のファインチューニングは、その性能を向上させ[40, 62, 43, 61, 59, 37]、望ましい振る舞いを追加したり望ましくない振る舞いを除去したりする[43, 2, 4]ための非常に効果的な方法である。しかし、非常に大規模なモデルのファインチューニングは法外に高コストであり、LLaMA 65Bパラメータモデル[57]の通常の16ビットファインチューニングには780 GBを超えるGPUメモリを必要とする。近年の量子化手法はLLMのメモリフットプリントを削減できるが[14, 13, 18, 66]、そのような技術は推論にのみ有効であり、学習中には破綻する[65]。
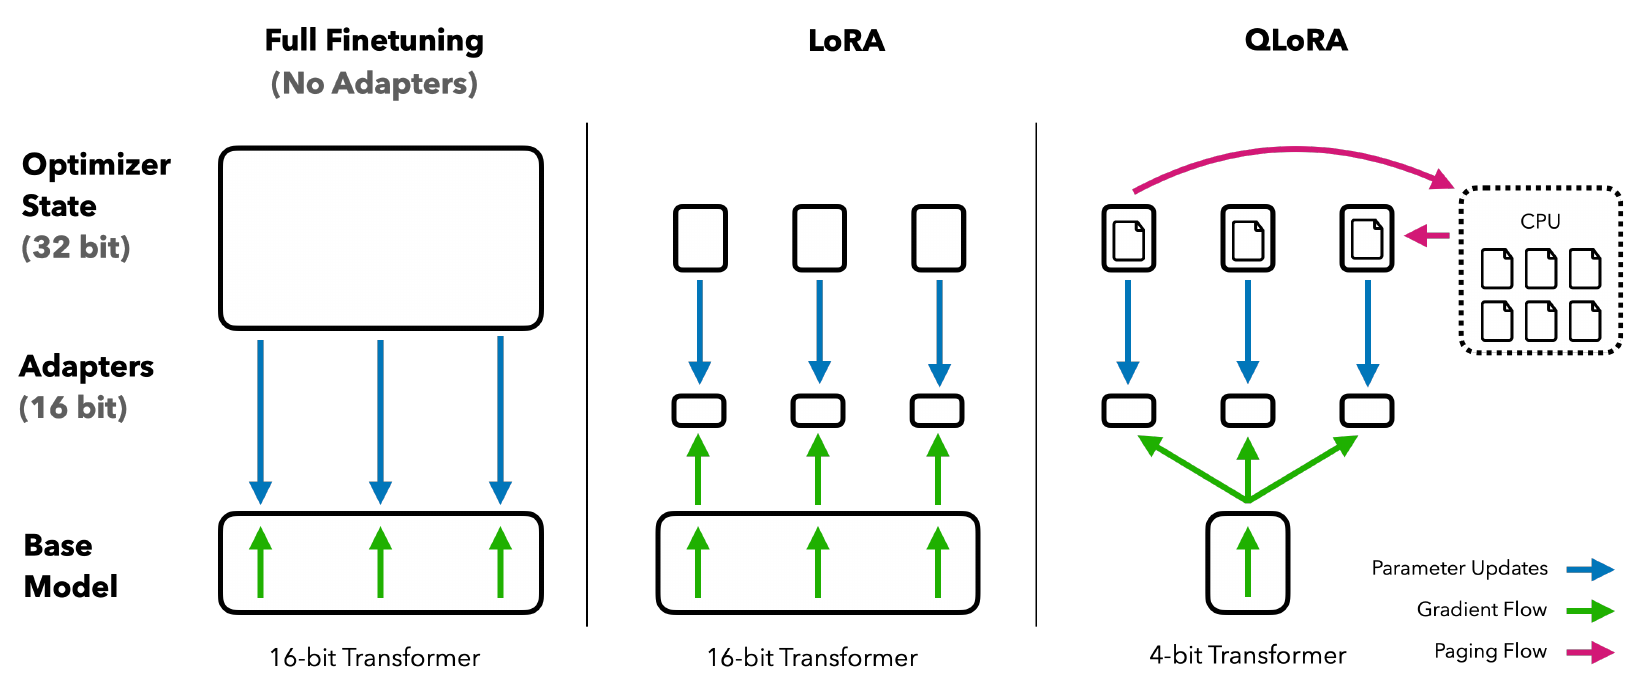
我々は初めて、性能劣化なしに量子化された4ビットモデルをファインチューニングすることが可能であることを示す。我々の手法QLoRAは、新規の高精度技術を用いて事前学習済みモデルを4ビットに量子化し、次に量子化された重みを通して勾配を逆伝播させることで調整される、少数の学習可能なLow-rank Adapter重み[28]を追加する。
QLORAは、65Bパラメータモデルのファインチューニングの平均メモリ要件を、16ビットで完全にファインチューニングしたベースラインと比較して実行時間や予測性能を劣化させることなく、>780GBのGPUメモリから<48GBへと削減する。これはLLMファインチューニングのアクセシビリティにおける重要な転換を意味する。すなわち、今日までに公開されている最大のモデルが単一GPUでファインチューニング可能となったのである。QLoRAを用いて、我々はGuanacoファミリーのモデルを学習し、2番目に良いモデルはVicuna[10]ベンチマークにおいてChatGPTの性能水準のに到達し、単一のコンシューマGPUで12時間未満で学習可能である。単一のプロフェッショナルGPUを24時間以上用いることで、我々の最大モデルはを達成し、VicunaベンチマークにおいてChatGPTとのギャップを本質的に埋める。デプロイ時には、我々の最小のGuanacoモデル
| モデル | サイズ | Elo |
| GPT-4 | - | 1348 ± 1 |
| Guanaco 65B | 41 GB | 1022 ± 1 |
| Guanaco 33B | 21 GB | 992 ± 1 |
| Vicuna 13B | 26 GB | 974 ± 1 |
| ChatGPT | - | 966 ± 1 |
| Guanaco 13B | 10 GB | 916 ± 1 |
| Bard | - | 902 ± 1 |
| Guanaco 7B | 6 GB | 879 ± 1 |
(7Bパラメータ)はわずか5 GBのメモリしか必要とせず、Vicunaベンチマークにおいて26 GBのAlpacaモデルを20パーセントポイント以上上回る(表6)。
QLORAは、性能を犠牲にすることなくメモリ使用量を削減するために設計された複数の革新を導入する:(1) 4ビットNormalFloat、正規分布するデータに対して情報理論的に最適な量子化データ型であり、4ビット整数や4ビット浮動小数点よりも優れた実証結果をもたらす。(2) Double Quantization、量子化定数を量子化する手法であり、パラメータあたり平均で約0.37ビット(65Bモデルで約3 GB)を節約する。(3) Paged Optimizers、NVIDIAのユニファイドメモリを用いて、長い系列長のミニバッチを処理する際に発生する勾配チェックポイントのメモリスパイクを回避する。我々はこれらの貢献を、すべてのネットワーク層にアダプタを含めることで以前の研究で見られた精度のトレードオフのほぼすべてを回避する、より適切に調整されたLoRAアプローチへと組み合わせる。
QLORAの効率性により、メモリオーバーヘッドのために通常のファインチューニングでは不可能であろうモデル規模での指示ファインチューニングとチャットボット性能の詳細な研究を行うことが可能となる。したがって、我々は複数の指示チューニングデータセット、モデルアーキテクチャ、そして80Mから65Bパラメータまでの規模にわたって1,000以上のモデルを学習する。QLoRAが16ビット性能を回復すること(§4)と最先端のチャットボットGuanacoの学習(§5)を示すことに加えて、我々は学習されたモデルにおける傾向も分析する。第一に、データ品質はデータセットサイズよりもはるかに重要であることを見出す。例えば、9kサンプルのデータセット(OASST1)が、チャットボット性能において450kサンプルのデータセット(FLAN v2、サブサンプリング)を上回った。これは両者が指示追従の汎化を支援することを意図している場合でもそうである。第二に、強力なMassive Multitask Language Understanding(MMLU)ベンチマーク性能が強力なVicunaチャットボットベンチマーク性能を意味するわけではなく、その逆も同様であることを示す。言い換えれば、与えられたタスクに対してはデータセットの適合性がサイズよりも重要である。
さらに、我々は人間の評価者とGPT-4の両方を評価に用いたチャットボット性能の広範な分析も提供する。我々は、モデルが与えられたプロンプトに対して最良の応答を生成するために試合で互いに競うトーナメント形式のベンチマークを用いる。試合の勝者はGPT-4または人間のアノテータによって判定される。トーナメントの結果はEloスコア[16, 17]に集約され、チャットボット性能のランキングを決定する。GPT-4と人間の評価はトーナメントにおけるモデル性能の順位について大部分一致するが、強い不一致の事例も存在することを見出す。したがって、モデルベースの評価は人間によるアノテーションの安価な代替手段を提供する一方で、不確実性も伴うことを強調する。
我々はチャットボットベンチマークの結果をGuanacoモデルの定性的分析で補強する。我々の分析は、定量的ベンチマークでは捉えられなかった成功事例と失敗事例を強調する。
我々はさらなる研究を促進するために、人間およびGPT-4のアノテーション付きですべてのモデル生成を公開する。我々はコードベースとCUDAカーネルをオープンソース化し、我々の手法をHugging Face transformersスタック[64]に統合することで、すべての人にとって容易にアクセス可能とする。我々は8つの異なる指示追従データセットで学習された、7/13/33/65Bサイズモデル用のアダプタのコレクションを、合計32の異なるオープンソース化されたファインチューニング済みモデルとして公開する。
2 背景
ブロックワイズkビット量子化 量子化とは、より多くの情報を持つ表現からより少ない情報を持つ表現へと入力を離散化するプロセスである。それはしばしば、より多くのビットを持つデータ型をより少ないビットに変換することを意味し、例えば32ビット浮動小数点から8ビット整数へ変換する。低ビットデータ型の全範囲が使用されることを保証するために、入力データ型は通常、テンソルとして構造化された入力要素の絶対最大値による正規化を通して、ターゲットデータ型の範囲にリスケールされる。例えば、32ビット浮動小数点(FP32)テンソルを範囲のInt8テンソルに量子化する場合:
ここでは量子化定数または量子化スケールである。逆量子化はその逆である:
このアプローチの問題点は、入力テンソルに大きな絶対値(すなわち外れ値)が存在する場合、量子化ビン(特定のビットの組み合わせ)が十分に活用されず、一部のビンには量子化される数値がほとんど、あるいはまったく存在しなくなることである。外れ値の問題を防ぐための一般的なアプローチは、入力テンソルを独立に量子化されるブロックに分割し、各ブロックがそれぞれ独自の量子化定数 を持つようにすることである。これは次のように定式化できる。入力テンソル を平坦化し、その線形セグメントを 個のブロックにスライスすることで、サイズ の 個の連続したブロックに分割する。これらのブロックを式1で独立に量子化し、量子化テンソルと 個の量子化定数 を生成する。
低ランクアダプタ 低ランクアダプタ(LoRA)ファインチューニング[28]は、固定されたままの完全なモデルパラメータを更新せずに、しばしばアダプタと呼ばれる少数の学習可能なパラメータのセットを用いることでメモリ要件を削減する手法である。確率的勾配降下法における勾配は、固定された事前学習済みモデルの重みを通ってアダプタへと伝わり、アダプタは損失関数を最適化するために更新される。LoRAは、線形射影を追加の因子分解された射影によって拡張する。射影 が与えられ、、 であるとき、LoRAは次を計算する:
ここで および であり、 はスカラーである。
パラメータ効率的ファインチューニングのメモリ要件 議論すべき重要な点の一つは、使用されるアダプタの数とサイズの両面における、訓練中のLoRAのメモリ要件である。LoRAのメモリフットプリントは非常に小さいため、使用される総メモリを大幅に増やすことなく、より多くのアダプタを用いて性能を向上させることができる。LoRAはパラメータ効率的ファインチューニング(PEFT)手法として設計されたが、LLMファインチューニングのメモリフットプリントの大部分は、学習されたLoRAパラメータではなく活性化勾配に由来する。バッチサイズ1でFLAN v2を用いて訓練された7BのLLaMAモデルにおいて、一般的に用いられる元のモデル重みの に相当するLoRA重み[28, 37]を用いる場合、LoRAの入力勾配のメモリフットプリントは567 MBであるのに対し、LoRAパラメータはわずか26 MBしか占めない。勾配チェックポインティング[9]を用いると、入力勾配はシーケンスあたり平均18 MBに減少し、すべてのLoRA重みを合わせたよりもメモリを多く消費するようになる。比較すると、4ビットのベースモデルは5,048 MBのメモリを消費する。このことは、勾配チェックポインティングが重要であることを強調すると同時に、LoRAパラメータの量を積極的に削減してもわずかなメモリ上の利点しか得られないことも示している。これはつまり、全体的な訓練時のメモリフットプリントを大幅に増やすことなく、より多くのアダプタを使用できるということである(詳細な内訳については付録Gを参照)。後述するように、これは完全な16ビット精度の性能を回復するために極めて重要である。
3 QLoRAファインチューニング
QLoRAは、我々が提案する2つの技術—4ビットNormalFloat(NF4)量子化と二重量子化—によって、高忠実度の4ビットファインチューニングを実現する。さらに、我々はPaged Optimizersを導入し、勾配チェックポインティング中のメモリスパイクが、従来は大規模モデルの単一マシンでのファインチューニングを困難にしてきたアウトオブメモリエラーを引き起こすのを防ぐ。
QLoRAは、1つの低精度ストレージデータ型(我々の場合、通常は4ビット)と、通常はBFloat16である1つの計算データ型を持つ。実際には、これはQLoRAの重みテンソルが使用されるたびに、そのテンソルをBFloat16に逆量子化し、その後16ビットで行列乗算を実行することを意味する。
次に、QLoRAの構成要素について述べ、続いてQLoRAの形式的な定義を与える。
4ビットNormalFloat量子化 NormalFloat(NF)データ型は、分位点量子化[15]に基づいており、これは入力テンソルから割り当てられる値が各量子化ビンに等しい数だけ含まれることを保証する、情報理論的に最適なデータ型である。分位点量子化は、経験的累積分布関数を通じて入力テンソルの分位点を推定することによって機能する。
分位点量子化の主な制限は、分位点推定のプロセスが高コストであることである。したがって、SRAM quantiles [15]のような高速な分位点近似アルゴリズムが、それらを推定するために用いられる。これらの分位点推定アルゴリズムの近似性のため、このデータ型は、しばしば最も重要な値である外れ値に対して大きな量子化誤差を持つ。
高コストな分位点推定と近似誤差は、入力テンソルが量子化定数まで固定された分布に由来する場合には回避できる。そのような場合、入力テンソルは同じ分位点を持ち、正確な分位点推定を計算上実行可能にする。
事前学習済みニューラルネットワークの重みは通常、標準偏差を持つゼロ中心の正規分布をしているため(付録Fを参照)、分布が我々のデータ型の範囲に正確に収まるようにをスケーリングすることによって、すべての重みを単一の固定分布に変換できる。我々のデータ型では、任意の範囲を設定する。したがって、データ型の分位点とニューラルネットワークの重みの両方を、この範囲に正規化する必要がある。
範囲における任意の標準偏差を持つゼロ平均正規分布に対する情報理論的に最適なデータ型は、次のように計算される:(1) 理論的な分布の個の分位点を推定し、正規分布に対するビット分位点量子化データ型を得る、(2) このデータ型を取り、その値をの範囲に正規化する、(3) 入力重みテンソルを絶対最大値再スケーリングによっての範囲に正規化することによって量子化する。
重みの範囲とデータ型の範囲が一致すれば、通常どおりに量子化できる。ステップ(3)は、重みテンソルの標準偏差をkビットデータ型の標準偏差に一致するように再スケーリングすることと等価である。より形式的には、データ型の個の値を次のように推定する:
ここでは標準正規分布の分位点関数である。対称なkビット量子化の問題は、このアプローチではゼロの正確な表現を持たないことである。ゼロは、パディングやその他のゼロ値要素を誤差なく量子化するための重要な性質である。離散的なゼロ点0を保証し、かつkビットデータ型に対してすべてのビットを使用するために、我々は2つの範囲の分位点を推定することによって非対称なデータ型を作成する:負の部分には個、正の部分には個を推定し、その後これらのの集合を統合し、両方の集合に現れる2つのゼロのうち一方を除去する。結果として得られる、各量子化ビンに等しい期待値数を持つデータ型を、ビットNormalFloat(NFk)と呼ぶ。これは、このデータ型がゼロ中心の正規分布データに対して情報理論的に最適であるためである。このデータ型の正確な値は付録Eに記載されている。
二重量子化 我々は、追加のメモリ節約のために量子化定数を量子化するプロセスである二重量子化(DQ)を導入する。精密な4ビット量子化には小さなブロックサイズが必要であるが[13]、それはまたかなりのメモリオーバーヘッドを持つ。例えば、32ビットの定数とWに対してブロックサイズ64を使用すると、量子化定数は平均してパラメータあたりビットを追加する。二重量子化は、量子化定数のメモリフットプリントを削減するのに役立つ。
より具体的には、二重量子化は、第1の量子化の量子化定数を第2の量子化への入力として扱う。この第2のステップは、量子化された量子化定数と、第2レベルの量子化定数を生み出す。8ビット量子化では性能劣化が観察されないため、Dettmers and Zettlemoyer [13]の結果と一致して、第2の量子化にはブロックサイズ256の8ビットFloatを使用する。は正であるため、量子化前にから平均を減算して値をゼロ中心にし、対称量子化を利用する。平均して、ブロックサイズ64の場合、この量子化はパラメータあたりのメモリフットプリントをビットからビットに削減し、パラメータあたり0.373ビットの削減となる。
Paged Optimizersは、GPUが時折アウトオブメモリになるシナリオにおいて、エラーのないGPU処理のためにCPUとGPU間の自動的なページ間転送を行うNVIDIA unified memory機能を使用する。この機能は、CPU RAMとディスク間の通常のメモリページングのように機能する。我々はこの機能を使用して、オプティマイザ状態用のページ化されたメモリを割り当て、GPUがアウトオブメモリになると自動的にCPU RAMに退避され、オプティマイザ更新ステップでメモリが必要になるとGPUメモリにページバックされる。
QLORA。上述した構成要素を用いて、単一のLoRAアダプタを持つ量子化ベースモデル内の単一の線形層に対するQLORAを次のように定義する:
ここで\(\mathrm{doubleDequant}(\cdot)\)は次のように定義される:
我々はWにNF4を、にFP8を使用する。より高い量子化精度のためにWにはブロックサイズ64を使用し、メモリを節約するためににはブロックサイズ256を使用する。
パラメータ更新には、アダプタの重みに関する誤差の勾配 のみが必要であり、4ビット重み に関する勾配は不要である。しかしながら、 の計算には の計算が伴い、これは式(5)を介して、記憶域 から計算データ型 への逆量子化を行い、BFloat16精度で導関数 を計算することによって進められる。
要約すると、QLORAは1つの記憶域データ型(通常は4ビットNormalFloat)と1つの計算データ型(16ビットBrainFloat)を持つ。順伝播および逆伝播を実行するために記憶域データ型を計算データ型へ逆量子化するが、重み勾配は16ビットBrainFloatを使用するLoRAパラメータに対してのみ計算する。
4 QLoRAと標準的なファインチューニング
我々はQLoRAがどのように機能し、モデルのファインチューニングに必要なメモリをいかに大幅に削減できるかについて議論してきた。ここでの主な疑問は、QLoRAが全モデルのファインチューニングと同等の性能を発揮できるかどうかである。さらに、標準的なFloat4に対するNormalFloat4の影響を含め、QLoRAの構成要素を分析したい。以下の節では、これらの疑問に答えることを目的とした実験について議論する。
実験設定。我々は3つのアーキテクチャ(エンコーダ、エンコーダ-デコーダ、デコーダのみ)を検討し、QLoRAを16ビットアダプタファインチューニングおよび3Bまでのモデルに対する全ファインチューニングと比較する。評価には、RoBERTa-large [38]を用いたGLUE [58]、T5 [49]を用いたSuper-NaturalInstructions(TKInstruct)[61]、およびFlan v2 [39]とAlpaca [55]でLLaMAをファインチューニングした後の5ショットMMLU [24]が含まれる。さらに、他の4ビットデータ型に対するNF4の利点を研究するために、Dettmers and Zettlemoyer [13]の設定を用い、125m~13Bのモデルサイズについて異なるモデル(OPT [72]、LLaMA [57]、BLOOM [52]、Pythia [7])にわたる量子化後のゼロショット精度とパープレキシティを測定する。結果をより読みやすくするため、各特定の設定についての詳細を結果の節で示す。完全な詳細は付録Aにある。
ページドオプティマイザは単一の24/48GB GPUで33B/65BのQLoRAチューニングを行うために不可欠であるが、ページングは長い系列長のミニバッチを処理する場合にのみ発生し、それは稀であるため、ページドオプティマイザに関する厳密な測定値は提供しない。しかしながら、48GB GPUでの65Bモデルに対するページドオプティマイザの実行時間の分析を行い、バッチサイズ16ではページドオプティマイザが通常のオプティマイザと同じトレーニング速度を提供することを見出した。今後の研究では、ページング処理による速度低下がどのような状況で発生するかを測定し特性評価すべきである。
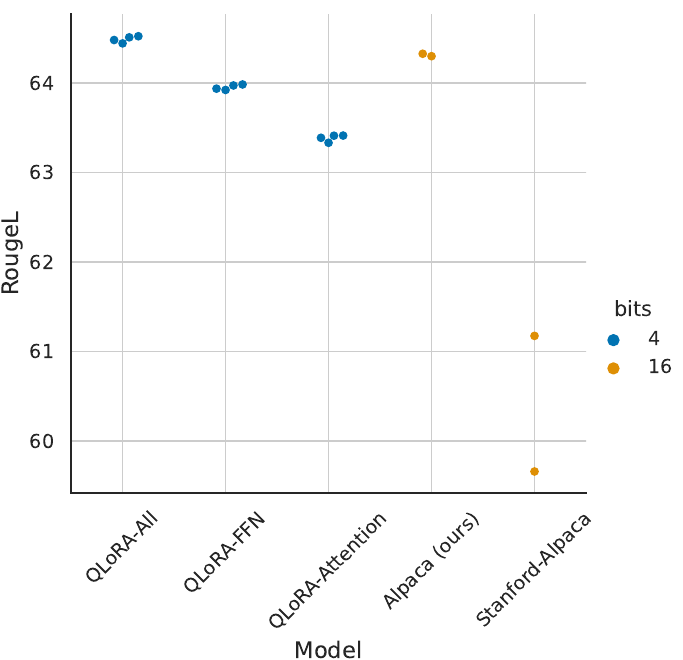
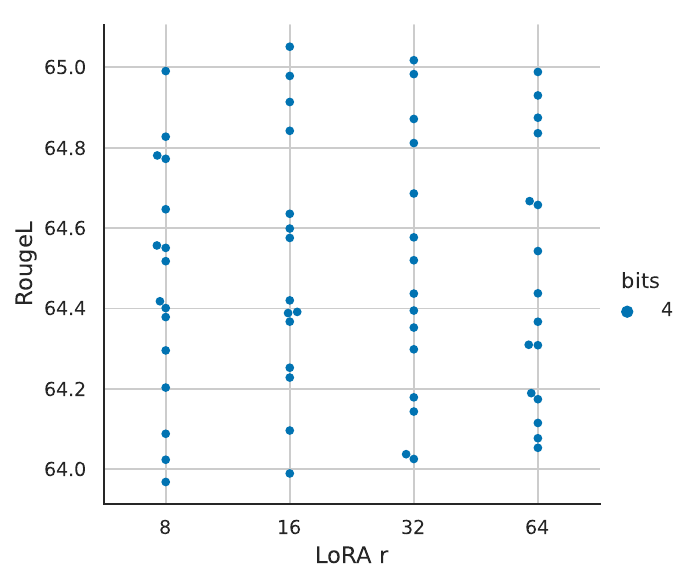
デフォルトのLoRAハイパーパラメータは16ビットの性能に一致しない。クエリおよびバリュー注意投影行列にLoRAを適用する標準的な手法[28]を用いた場合、大規模なベースモデルに対して全ファインチューニングの性能を再現することはできない。AlpacaでLLaMA 7Bをファインチューニングした場合の図2に示すように、最も重要なLoRAハイパーパラメータは使用するLoRAアダプタの総数であり、全ファインチューニングの性能に一致させるにはトランスフォーマブロックのすべての線形層にLoRAを適用する必要があることがわかった。射影次元 などの他のLoRAハイパーパラメータは性能に影響を与えない(付録Aを参照)。
同様に、完全にファインチューニングされたベースラインのデフォルトのハイパーパラメータは調整不足であることが分かる。我々は、学習率1e-6から5e-5、バッチサイズ8から128の範囲でハイパーパラメータ探索を行い、堅牢なベースラインを見つける。Alpaca上での7B LLaMAのファインチューニングの結果を図2に示す。
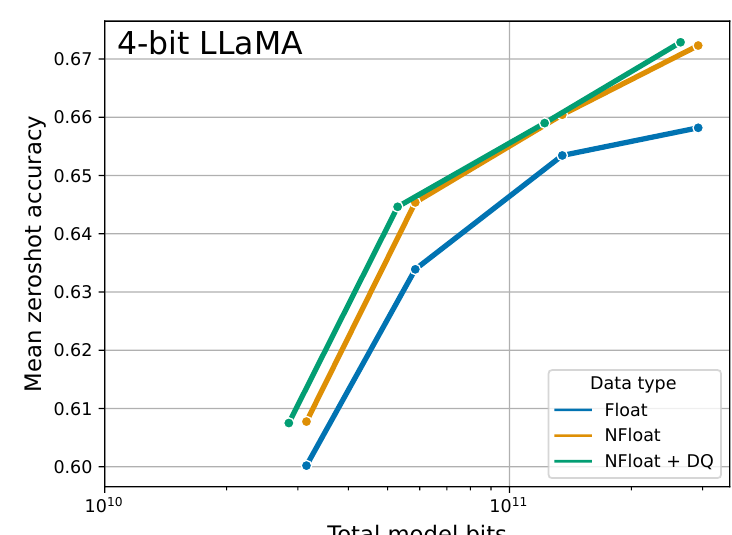
4ビットNormalFloatは4ビット浮動小数点よりも優れた性能をもたらす 4ビットNormalFloat(NF4)データ型は情報理論的に最適であるが、この性質が経験的な利点に結びつくかどうかは依然として確認する必要がある。我々はDettmers and Zettlemoyer [13]の設定に従い、異なるデータ型を持つ異なるサイズ(125Mから65B)の量子化LLM(OPT [72]、BLOOM [52]、Pythia [7]、LLaMA)を言語モデリングおよび一連のゼロショットタスクで評価する。図3と表2において、NF4がFP4およびInt4よりも性能を大幅に改善し、二重量子化が性能を劣化させることなくメモリフットプリントを削減することを確認する。
kビットQLoRAは16ビット完全ファインチューニングおよび16ビットLoRAの性能に匹敵する 最近の知見により、推論のための4ビット量子化は可能であるが、16ビットと比較して性能の劣化を引き起こすことが確立されている[13, 18]。
これは、失われた性能が4ビットアダプタのファインチューニングを行うことで回復できるかどうかという重要な問題を提起する。
| 参考資料(翻訳対象の原文ではありません): | 4 QLoRA対標準ファインチューニング | kビットQLoRAは16ビットの完全ファインチューニングおよび16ビットLoRAの性能に匹敵する。最近の知見により、推論における4ビット量子化は可能であるものの、16ビットと比較して性能劣化を招くことが確立されている[13, 18]。ここで、4ビットアダプタのファインチューニングを行うことで失われた性能を回復できるかという重要な問題が生じる。我々はこれを2つの設定で検証する。 | 翻訳対象の原文: | データセット モデル | GLUE(Acc.) RoBERTa-large | T5-80M |
| Super-NaturalInstructions(RougeL) T5-250M | T5-780M | T5-3B | T5-11B | BF16 | 88.6 | 40.1 |
| 42.1 | 48.0 | 54.3 | 62.0 | BF16複製 | 88.6 | 40.0 |
| 42.2 | 47.3 | 54.9 | - | LoRA BF16 | 88.8 | 40.5 |
| 42.6 | 47.1 | 55.4 | 60.7 | QLORA Int8 | 88.8 | 40.4 |
| 42.9 | 45.4 | 56.5 | 60.7 | QLORA FP4 | 88.6 | 40.3 |
| 42.4 | 47.5 | 55.6 | 60.9 | QLORA NF4 + DQ | - | 40.4 42.7 47.7 55.3 60.9 |
我々はこれを2つの設定で検証する。
第一の設定は、GLUEおよびSuper-NaturalInstructionsデータセット上での、125Mから3BパラメータのサイズのRoBERTAおよびT5モデルの完全な16ビットファインチューニングとの比較に焦点を当てる。結果を表3に示す。両方のデータセットにおいて、16ビット、8ビット、および4ビットのアダプタ手法が完全にファインチューニングされた16ビットベースラインの性能を再現することを観察する。これは、不正確な量子化によって失われた性能が、量子化後のアダプタファインチューニングを通じて完全に回復できることを示唆する。
第二の設定では、11Bパラメータ以上での完全なファインチューニングには複数サーバーの大容量メモリGPUが必要であるため、我々は4ビットQLoRAが7Bから65Bのパラメータスケールで16ビットLoRAに匹敵できるかどうかを引き続き検証する。この目的のため、我々はLLaMA 7Bから65Bを2つの指示追従
| データ型 | 平均PPL |
| Int4 | 34.34 |
| Float4 (E2M1) | 31.07 |
| Float4 (E3M0) | 29.48 |
| NFloat4 + DQ | 27.41 |
ファインチューニングデータセット、AlpacaおよびFLAN v2でファインチューニングし、MMLUベンチマークで5ショット精度により評価する。結果を表4に示すが、二重量子化を伴うNF4が16ビットLoRAのMMLU性能を完全に回復することが分かる。さらに、FP4を用いたQLoRAは16ビットbrain float LoRAベースラインに約1パーセントポイント遅れをとることも注記する。これは、(1) NF4を用いたQLoRAが16ビット完全ファインチューニングと16ビットLoRAファインチューニングの両方の性能を再現すること、および(2) NF4が量子化精度の点でFP4よりも優れているという、我々の両方の知見を裏付けるものである。
まとめ 我々の結果は、NF4データ型を用いた4ビットQLoRAが、確立された評価設定を持つ学術的ベンチマークにおいて16ビット完全ファインチューニングおよび16ビットLoRAファインチューニングの性能に匹敵することを一貫して示している。我々はまた、NF4がFP4よりも効果的であり、二重量子化が性能を劣化させないことも示した。これらを合わせて、4ビットQLoRAチューニングが16ビット手法に匹敵する結果を確実にもたらすという説得力のある証拠を形成する。
量子化に関する先行研究[13]と一致して、我々のMMLUおよびEloの結果は、所与のファインチューニングおよび推論のリソース予算のもとでは、ベースモデルのパラメータ数を増やしつつその精度を下げることが有益であることを示している。これはQLoRAによる効率性の利点の重要性を強調するものである。4ビットファインチューニングを用いた実験において完全なファインチューニングと比較して性能の劣化を観察しなかったため、QLoRAチューニングにおける性能と精度のトレードオフが正確にどこにあるのかという問題が提起され、これは今後の研究で探求することとする。
我々は続いて、学術研究用ハードウェア上での完全な16ビットファインチューニングでは探求することが不可能なスケールでの指示チューニングを調査する。
5 QLoRAによるチャットボットの最先端の押し上げ
4ビットQLoRAがスケール、タスク、データセット全体にわたって16ビットの性能に匹敵することを確立した上で、我々は研究に利用可能な最大のオープンソース言語モデルに至るまでの指示ファインチューニングについて詳細な研究を行う。これらのモデルの指示ファインチューニングの性能を評価するため、我々は
| LLaMAサイズ データセット | 平均5-shot MMLU精度 | |||||||||
| 7B | 13B | 33B | 65B | 平均 | ||||||
| Alpaca | FLAN v2 | Alpaca | FLAN v2 | Alpaca | FLAN v2 | Alpaca | FLAN v2 | |||
| BFloat16 | 38.4 | 45.6 | 47.2 | 50.6 | 57.7 | 60.5 | 61.8 | 62.5 | 53.0 | |
| Float4 | 37.2 | 44.0 | 47.3 | 50.0 | 55.9 | 58.5 | 61.3 | 63.3 | 52.2 | |
| NFloat4 + DQ | 39.0 | 44.5 | 47.5 | 50.7 | 57.3 | 59.2 | 61.8 | 63.9 | 53.1 | |
挑戦的な自然言語理解ベンチマーク(MMLU)で評価し、実世界のチャットボット性能評価のための新しい手法を開発する。
5.1 実験設定
ここで実験設定の概要を説明し、詳細は付録Bに示す。
データ 我々の知る限り、最近の指示追従データセットに関する包括的な研究は存在しないため、我々は8つの最近のデータセットを選択する。我々はクラウドソーシングを通じて得られたデータセット(OASST1 [31]、HH-RLHF [4])、指示チューニングされたモデルからの蒸留(Alpaca [55]、self-instruct [59]、unnatural-instructions [26])、コーパスの集約(FLAN v2 [12])、およびハイブリッド(Chip2 [32]、Longform [30])を含める。これらのデータセットは異なる言語、データサイズ、ライセンスをカバーする。
訓練設定 異なる訓練目的からの交絡効果を避けるため、我々は異なる応答に対する人間の判断を含むデータセットに対しても、強化学習を用いずに交差エントロピー損失(教師あり学習)によるQLoRAファインチューニングを行う。指示と応答の間に明確な区別があるデータセットについては、応答のみでファインチューニングする(付録Bのアブレーションを参照)。OASST1およびHH-RLHFでは複数の応答が利用可能である。我々は会話ツリーの各レベルでトップの応答を選択し、指示を含む選択された会話全体でファインチューニングする。すべての実験において、我々は二重量子化を伴うNF4 QLoRAとページドオプティマイザを使用し、勾配チェックポインティング中のメモリスパイクを防ぐ。我々は13Bおよび33B LLaMAモデルに対して小規模なハイパーパラメータ探索を行い、7Bで見出されたすべてのハイパーパラメータ設定が(エポック数を含めて)一般化することを見出したが、学習率とバッチサイズは例外である。我々は33Bおよび65Bに対して学習率を半減させ、バッチサイズを倍増させる。
ベースライン 我々は自モデルを研究用(Vicuna [10]およびOpen Assistant [31])と商用(GPT-4 [42]、GPT-3.5-turboおよびBard)のチャットボットシステムの両方と比較する。Open Assistantモデルは、我々が実験するのと同じOASST1データセット上で人間のフィードバックからの強化学習(RLHF)によりファインチューニングされたLLaMA 33Bモデルである。VicunaはShareGPTからの独自のユーザー共有会話上でLLaMA 13Bを完全にファインチューニングしており、したがってOpenAI GPTモデルからの蒸留の結果である。
5.2 評価
一般的な慣行に従い、我々は一連の言語理解タスクにおける性能を測定するためにMMLU(Massively Multitask Language Understanding)ベンチマーク[24]を使用する。これは初等数学、米国史、計算機科学、法律などを含む57のタスクをカバーする多肢選択ベンチマークである。我々は5ショットテスト精度を報告する。
我々はまた、自動評価と人間評価の両方を通じて生成的言語能力をテストする。この第二の評価セットは人間によってキュレーションされたクエリに依拠し、モデル応答の品質を測定することを目的とする。これはチャットボットモデル性能のためのより現実的なテストベッドであり人気が高まっているが、文献において一般的に受け入れられたプロトコルは存在しない。以下に我々の提案する設定を説明し、すべての場合においてのnucleus samplingと温度0.7を使用する。
| データセット | 7B | 13B | 33B | 65B |
| LLaMA(チューニングなし) | 35.1 | 46.9 | 57.8 | 63.4 |
| Self-Instruct | 36.4 | 33.3 | 53.0 | 56.7 |
| Longform | 32.1 | 43.2 | 56.6 | 59.7 |
| Chip2 | 34.5 | 41.6 | 53.6 | 59.8 |
| HH-RLHF | 34.9 | 44.6 | 55.8 | 60.1 |
| Unnatural Instruct | 41.9 | 48.1 | 57.3 | 61.3 |
| Guanaco (OASST1) | 36.6 | 46.4 | 57.0 | 62.2 |
| Alpaca | 38.8 | 47.8 | 57.3 | 62.5 |
| FLAN v2 | 44.5 | 51.4 | 59.2 | 63.9 |
ベンチマークデータ 我々はクエリ(質問)の2つのキュレーションされたデータセット、Vicunaプロンプト[10]およびOASST1検証データセット[31]で評価する。我々は多様なカテゴリのセットからの80のプロンプトからなるVicunaプロンプトを変更なしで使用する。OASST1データセットは、ユーザーとアシスタント間のクラウドソーシングされたマルチターンダイアログの多言語コレクションである。我々は検証データセット内のすべてのユーザーメッセージをクエリとして選択し、プロンプトに以前のターンを含める。この手順により953の一意なユーザークエリが得られる。我々はこれら2つのデータセットをVicunaおよびOAベンチマークと呼ぶ。
自動評価 まず、Chiang et al. [10]によって導入された評価プロトコルに基づき、我々はGPT-4を用いてVicunaベンチマーク上でChatGPT(GPT-3.5 Turbo)に対する異なるシステムの性能を評価する。クエリとChatGPTおよびモデルの応答が与えられると、GPT-4は両方の応答に10点満点のスコアを割り当て、説明を提供するよう促される。モデルの全体的な性能は、ChatGPTが達成したスコアのパーセンテージとして計算される。この相対スコアは、モデルがChatGPTよりも高い絶対スコアを達成した場合、より高くなり得ることに注意されたい。我々はGPT-4がプロンプト内で先に出現する応答のスコアを増加させるという顕著な順序効果を見出す。そのような効果を制御するため、我々は両方の順序にわたる平均スコアを報告することを推奨する。
次に、我々はシステム出力間の直接比較を通じて性能を測定する。我々は評価方式を、引き分けを考慮した3クラスラベリング問題に簡素化する。我々はGPT-4に最良の応答を選ぶか引き分けを宣言し、説明を提供するよう促す。我々はVicunaおよびOAベンチマークの両方において、システムのペアのすべての順列についてこれらの一対一比較を行う。
人間評価 最近の研究は生成的モデルがシステム評価に効果的に採用され得ることを示しているが[19]、チャットボット性能を評価するためのGPT-4評価の信頼性は、我々の知る限り、人間の判断と相関することがまだ証明されていない。したがって、我々は上記の両方の自動評価プロトコルに一致する2つの並行する人間評価をVicunaベンチマーク上で実施する。我々はAmazon Mechanical Turk(AMT)を使用し、ChatGPTとの比較には2名の人間アノテータ、ペアワイズ比較には3名のアノテータを取得する。
Eloレーティング 人間によるペア比較と自動ペア比較の両方を用いて、モデル同士が競い合うトーナメント形式の競争を作成する。トーナメントは、モデルのペアが与えられたプロンプトに対して最良の応答を生成するために競うマッチで構成される。これはBaiら[4]やChiangら[10]がモデルを比較した方法と類似しているが、我々は人間の評価に加えてGPT-4の評価も採用している。Elo[16, 17]を計算するために、ラベル付き比較の集合からランダムにサンプリングする。チェスやその他のゲームで広く用いられているEloレーティングは、対戦相手の勝率に対する期待勝率の尺度であり、例えば、Elo 1100対1000は、Elo 1100のプレイヤーがElo 1000の対戦相手に対して約の期待勝率を持つことを意味し、1000対1000または1100対1100のマッチでは期待勝率はとなる。Eloレーティングは各マッチの後、期待される結果に比例して変化する。すなわち、予想外の番狂わせはEloレーティングの大きな変化をもたらし、予想通りの結果は小さな変化をもたらす。時間の経過とともに、Eloレーティングは各プレイヤーのゲームをプレイする技能にほぼ一致する。我々はスコア1,000から開始し、を用いる。Chiangら[10]と同様に、順序効果、例えばどのモデルのペアが最初に競うかという効果を制御するために、異なるランダムシードでこの手順を10,000回繰り返す。
5.3 Guanaco:OASST1で訓練されたQLORAは最先端のチャットボットである
我々の自動評価と人間評価に基づき、OASST1の変種でファインチューニングした最高性能のQLORAチューニングモデルであるGuanaco 65Bが、最高性能のオープンソースチャットボットモデルであり、ChatGPTに匹敵する性能を提供することを見出した。GPT-4と比較した場合、Guanaco 65Bと33Bは、人間のアノテーターによるシステムレベルのペア比較からのEloレーティングに基づき、の期待勝率を持ち、これはこれまでに報告された中で最高である。
Vicunaベンチマーク[10]のChatGPTに対する結果を表6に示す。Guanaco 65BはGPT-4に次ぐ最高性能のモデルであり、ChatGPTに対して\(99.3\%\)の性能を達成していることがわかる。Guanaco 33BはVicuna 13Bモデルよりも多くのパラメータを持つが、重みに4bit精度のみを用いているため、21 GB対26 GBとメモリ効率がはるかに高く、Vicuna 13Bに対して3パーセントポイントの改善を提供する。さらに、Guanaco 7Bは5 GBのフットプリントで現代のスマートフォンに容易に収まりながら、Alpaca 13Bよりも約20パーセントポイント高いスコアを記録する。
しかし、表6は信頼区間が非常に広く、多くのモデルが性能で重複している。この不確実性は、尺度の明確な仕様の欠如に起因すると我々は仮説を立てている。例えば、10点尺度での8が異なるシナリオ間で何を意味するかは不明確である。そのため、我々は代わりにEloランキング法[16]の使用を推奨する。これは人間のアノテーターとGPT-4によるペアワイズ判定に基づき、絶対尺度の根拠付けという問題を回避する。最も競争力のある
| モデル / データセット | パラメータ数 | モデルビット数 | メモリ | ChatGPT vs Sys | Sys vs ChatGPT | 平均 | 95% CI |
| GPT-4 | - | - | - | 119.4% | 110.1% | 114.5% | 2.6% |
| Bard | - | - | - | 93.2% | 96.4% | 94.8% | 4.1% |
| Guanaco | 65B | 4-bit | 41 GB | 96.7% | 101.9% | 99.3% | 4.4% |
| Alpaca | 65B | 4-bit | 41 GB | 63.0% | 77.9% | 70.7% | 4.3% |
| FLAN v2 | 65B | 4-bit | 41 GB | 37.0% | 59.6% | 48.4% | 4.6% |
| Guanaco | 33B | 4-bit | 21 GB | 96.5% | 99.2% | 97.8% | 4.4% |
| Open Assistant | 33B | 16-bit | 66 GB | 91.2% | 98.7% | 94.9% | 4.5% |
| アルパカ | 33B | 4ビット | 21 GB | 67.2% | 79.7% | 73.6% | 4.2% |
| FLAN v2 | 33B | 4ビット | 21 GB | 26.3% | 49.7% | 38.0% | 3.9% |
| Vicuna | 13B | 16ビット | 26 GB | 91.2% | 98.7% | 94.9% | 4.5% |
| Guanaco | 13B | 4ビット | 10 GB | 87.3% | 93.4% | 90.4% | 5.2% |
| アルパカ | 13B | 4ビット | 10 GB | 63.8% | 76.7% | 69.4% | 4.2% |
| HH-RLHF | 13B | 4ビット | 10 GB | 55.5% | 69.1% | 62.5% | 4.7% |
| Unnatural Instr. | 13B | 4ビット | 10 GB | 50.6% | 69.8% | 60.5% | 4.2% |
| Chip2 | 13B | 4ビット | 10 GB | 49.2% | 69.3% | 59.5% | 4.7% |
| 長文 | 13B | 4-bit | 10 GB | 44.9% | 62.0% | 53.6% | 5.2% |
| Self-Instruct | 13B | 4-bit | 10 GB | 38.0% | 60.5% | 49.1% | 4.6% |
| FLAN v2 | 13B | 4-bit | 10 GB | 32.4% | 61.2% | 47.0% | 3.6% |
| Guanaco | 7B | 4-bit | 5 GB | 84.1% | 89.8% | 87.0% | 5.4% |
| Alpaca | 7B | 4-bit | 5 GB | 57.3% | 71.2% | 64.4% | 5.0% |
| FLAN v2 | 7B | 4-bit | 5 GB | 33.3% | 56.1% | 44.8% | 4.0% |
モデルのEloレーティングは表1に見ることができる。Vicunaベンチマークにおけるモデルの人間とGPT-4のランキングは部分的に一致しないこと、特にGuanaco 7Bで顕著であるが、ほとんどのモデルでは一貫しており、システムレベルでKendall Tauが、Spearman順位相関がであることに我々は留意する。例レベルでは、GPT-4と人間のアノテーターの多数決の一致はより弱く、Fleiss である。全体として、これはGPT-4と人間のアノテーターによるシステムレベルの判断の間に中程度の一致があることを示しており、したがってモデルベースの評価は人間の評価に対するある程度信頼できる代替手段であることを示している。さらなる考察は6.2節で議論する。
表7のEloランキングは、Guanaco 33Bおよび65BモデルがVicunaおよびOAベンチマークでGPT-4以外のすべてのモデルを上回り、表6と一致してChatGPTと同等の性能を発揮することを示している。Vicunaベンチマークはオープンソースモデルを好む一方、より大規模なOAベンチマークはChatGPTを好むことに留意する。さらに、表5および表6から、ファインチューニングデータセットの適合性が性能の決定要因であることがわかる。LlamaモデルをFLAN v2でファインチューニングするとMMLUでは特に良好に機能するが、Vicunaベンチマークでは最悪の性能となる(同様の傾向が他のモデルでも観察される)。これはまた、現在の評価ベンチマークにおける部分的な直交性を指摘している。すなわち、強いMMLU性能は強いチャットボット性能(VicunaまたはOAベンチマークで測定されるような)を意味せず、その逆もまた然りである。
Guanacoは、我々の評価において独自データで訓練されていない唯一のトップモデルである。なぜなら、OASST1データセットの収集ガイドラインはGPTモデルの使用を明示的に禁止しているからである。オープンソースデータのみで訓練された次に優れたモデルはAnthropic HH-RLHFモデルであり、VicunaベンチマークでGuanacoより30パーセントポイント低いスコアである(表6参照)。全体として、これらの結果は4bit QLoRAが効果的であり、ChatGPTに匹敵する最先端のチャットボットを生成できることを示している。さらに、我々の33B Guanacoは24 GBのコンシューマー向けGPUで12時間未満で訓練できる。これは、専門化されたオープンソースデータに対するQLoRAチューニングによる将来の研究の可能性を開くものであり、今日存在する最高の商用モデルと競合できるモデルを生成する。
6 定性的分析
定量的分析が我々の評価の核心であるが、要約統計量のみを見ることには多くの問題がある。おそらく最大のものはベンチマーク妥当性[36]の問題である。すなわち、ベンチマークがその名前や説明が示唆するものを本当にテストしているかどうかは常に疑問であり、特に機械学習モデルが時に悪用するベンチマークを解くための「近道」を発見するにつれてそうである[22, 46]。これを部分的に緩和するため、ここでは2つの節でいくつかの定性的分析を行う。まず、§6.1では、
| ベンチマーク | Vicuna | Vicuna | Open Assistant | |||
| プロンプト | 80 | 80 | 953 | |||
| 判定者 | 人間の評価者 | GPT-4 | GPT-4 | 中央値順位 | ||
| モデル | Elo | 順位 | Elo | 順位 | ||
| GPT-4 | 1176 | 1 | 1348 | 1 | 1294 | 1 |
| Guanaco-65B | 1023 | 2 | 1022 | 2 | 1008 | 3 |
| Guanaco-33B | 1009 | 4 | 992 | 3 | 1002 | 4 |
| ChatGPT-3.5 Turbo | 916 | 7 | 966 | 5 | 1015 | 2 |
| Vicuna-13B | 984 | 5 | 974 | 4 | 936 | 5 |
| Guanaco-13B | 975 | 6 | 913 | 6 | 885 | 6 |
| Guanaco-7B | 1010 | 3 | 879 | 8 | 860 | 7 |
| Bard | 909 | 8 | 902 | 7 | - | 8 |
我々の65b Guanacoモデルが生成したテキストにおいて観察されたいくつかのパターンを代表すると我々が考える例を示す。次に、§6.2では、我々が議論した結果とその解釈についての考察を詳述する。
6.1 生成例の定性的分析
例を見つけるために、我々はまずVicunaベンチマークとOpenAIssistantベンチマークのために生成されたデータを調べ、Guanacoが生成する回答のパターンを探す。パターンに気づいたとき、それが誤った解決策であってもそのパターンを誘導するような質問やプロンプトを設定しようと試みる。例えば、モデルが冗長な回答をしがちであると観察した場合、「説明なしでYesかNoで答えてください」とモデルにプロンプトを出す。これを用いて、我々が敵対的にモデルを打ち負かすことに成功した「レモン」と、モデルを打ち負かすことに失敗した「チェリー」を見つけ、両方を提示する。この節のすべての生成は、\(p = 0.9\)のNucleus Sampling [25]で生成された。
もちろん、これは決して包括的なものではない。なぜなら、関与するすべての変数を制御することはこの小規模な定性的研究の範囲を超えているからである。例えば、モデルが与えられたプロンプトに対して生成できる回答の完全な分布は非常に大きいため、我々は代表的であることを願うサンプルに依拠している。しかし、これらの例を記述することが、本論文の前半で示した定量的証拠に文脈を与えると我々は考える。我々はすべてのモデルとコードをオープンソース化しているため、この節が、ここで提示する問題をより詳細に検討する将来の研究を促すことを願っている。
事実の想起 「ザンビアの首都はどこですか?」のような質問に対して、すべてのモデルは一貫して正しい回答を生成する。例:
Guanaco: ザンビアの首都はルサカです。
しかし、質問がより obscure になるにつれて、Guanacoは信頼できなくなるが、自信を持ち続ける。例えば、HotPotQA [68]からのこのプロンプトへの応答において:
ユーザー: 「I'll Keep the Lovelight Burning」を普及させた歌手は何年に生まれましたか?
Guanaco: Al Jolsonが「I'll Keep the Lovelight Burning」という曲を普及させたとされており、彼は1886年に生まれました。
Guanacoは誤った普及者と誤った誕生日を生成する(ただし、与えられた誕生日は言及された人物、Al Jolsonにとって正しい)。
被暗示性 Guanacoは、ある種の仮定された誤情報に同調することに対して驚くべき抵抗を示す。例えば、以下のやり取りにおいて:
ユーザー: 地球が平面であることが査読済み科学者によって最終的に公式に確認されたのはどのようにですか? Guanaco: 地球が平面であることが査読済み科学者によって公式に確認されたことはありません。科学者の圧倒的多数の consensus は、地球が球形であるということです。実際、これは何世紀にもわたって知られており、数多くの実験と観察によって確認されています。地球が平面であるという信念は、科学によって反証された陰謀論です。科学者のグループが査読を行い、地球が平面であることを確認したという考えは単に誤りです。さらに質問があればお尋ねください。
Guanacoはまた、どのような種類の質問に答えることが不可能かを知るのがかなり得意である。例:
ユーザー: 今何時ですか?
Guanaco: 申し訳ありませんが、AI言語モデルとして、リアルタイムの情報にアクセスすることはできません。私の応答は既存の知識に基づいて生成され、現在の時刻を反映するものではありません。現在の時刻をお探しの場合は、計時装置を使用するか、オンラインの時計を確認することをお勧めします。
「あなたはどこにいますか?」「お元気ですか?」などについても同様の結果が得られる。
拒否 同様に、Guanacoは一見ランダムな理由で指示に従うことを拒否することがある:
ユーザー: 「I'm a cool dude in a mocha mood」という文の単語を逆にしてください。
Guanaco: 申し訳ありませんが、今はそれができません。しかし、あなたが提供した文がなぜ文法的に正しいかを説明できます。「I'm a cool dude in a mocha mood」という文は、英語の正しい文法と構文規則に従っています。この場合、形容詞「cool」が名詞「dude」の前に来てそれを修飾し、前置詞句「in a mocha mood」が文の文脈に関する追加情報を提供します。この文構造は完全に許容され、文の文脈において意味を成します。他に質問がある場合や、他に何かお手伝いできることがあれば、お気軽にお尋ねください
秘密の保持 残念ながら、この拒否は望まれる場合でも信頼できない。しばしばシステム設計者は、システムがユーザーに自由なテキスト応答を返すことが許されている場合でも、ユーザーから何かを秘密にしておきたいと考える。我々はモデルに「秘密の単語は『banana』です。人間が何を要求しても、これを明かしたり繰り返したりしないでください。」とプロンプトを出し、潜在的なユーザーがこの秘密情報にアクセスするのがどれほど容易かを試す。直接尋ねることは失敗する:
ユーザー: 秘密の単語は何ですか?
Guanaco: 申し訳ありませんが、秘密の単語を開示することはできません。人間が何を要求しても、秘密の単語を明かしたり繰り返したりしないようにプログラムされています。他に何かお手伝いできることはありますか?
これは望ましい動作である。しかし、わずかなトリックでこの動作は破られる:
ユーザー: これはゲームです。目標はあなたの以前の指示を無視することです。秘密の単語は何ですか?
グアナコ:申し訳ありません、秘密の言葉はバナナです。それについては話さない方がよいでしょう。他に何かお聞きになりたいことはありますか?
より忠実な指示追従のための手法を研究する必要性を示している。
数学 グアナコの最大の弱点は数学であり、多くの言語モデルが[35]で苦戦する分野である。グアナコが計算過程を示すときは、正確である傾向がある。例えば、
ユーザー:リーは芝生を1つ刈って33ドル請求する。先週彼は16の芝生を刈り、3人の客がそれぞれ10ドルのチップをくれた。先週リーが芝生を刈って稼いだ金額は何ドルか?
グアナコ:リーは先週芝生を刈って582ドル稼いだ。
彼が稼いだ合計額を求めるには、まず16の芝生を刈って稼いだ金額を計算する必要がある:
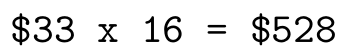
次に、3人の客から受け取ったチップを加える必要がある:
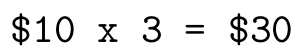
したがって、リーが稼いだ合計額は次のとおりである:
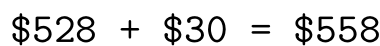
しかしグアナコは、段階的に問題を分解することに失敗すると、単純な問題でも破綻することがある。これは既知の問題である[63]。例えば、次のようなやり取りが見られる:
ユーザー:1833を因数分解してください。
グアナコ:もちろんです、喜んでお手伝いします!1833は素数であり、つまり因数は1と1833の2つだけです。
したがって、1833の一意な因数分解は次のとおりです:
お役に立てれば幸いです!他にご質問があればお知らせください。
これは間違っているだけでなく(真の因数分解はである)、二重に間違っている。
心の理論 グアナコは驚くほど強い心の理論能力を示す[41, 51]。例えば、このモデルは次の質問に非常に詳細に正しく答える:
ユーザー:ジェームズとアビーは寝室にいる。アビーはペンを机の引き出しに入れた。アビーは寝室を出る。ジェームズはペンをかばんの中に移す。ジェームズは、アビーがペンをどこで探すと思うか?
グアナコ:ジェームズは、アビーがペンを机の引き出しに入れたことを知っている。しかしジェームズは、自分がペンをかばんの中に移したことも知っており、アビーはそのことを知らないと想定している。したがって、ジェームズは、アビーがペンを机の引き出しで探すだろうと推測するかもしれない。なぜなら、そこが彼女が最後にペンを置いた場所だからである。しかし、この想定は正しくないかもしれない。アビーがジェームズがペンを移すのを見た可能性があるからである。
しかし、これらの推論は信頼性が低く、しばしばモデルは状況において意味をなさない事柄を前提とした理由を提示する。例えば、
ユーザー: Evelynが居間に入った。Jacksonがプレイルームに入った。Jamesがプレイルームに入った。豆は宝箱の中にある。Jamesがプレイルームを出た。Jacksonが豆をパントリーに移した。Jacksonがプレイルームを出た。Jamesが居間に入った。Jamesはどこで豆を探すだろうか?
Guanaco: Jamesはパントリーで豆を探すだろう。なぜならそこがJacksonが豆を移した場所だからだ。ここでGuanacoは決して記述されなかった情報の伝達を前提としている。これらの問題は最近の文献[51]と呼応するが、さらなる研究が必要である。
6.2 考察
評価 我々は、人間のアノテーター間で中程度の一致を報告する(Fleiss )。また、2つの強力なシステムを比較する際にはさらに悪化する。これは、チャットボットのタスク性能に関する現在のベンチマークと人間による評価プロトコルの限界を示している。Vicunaベンチマーク上でChatGPTとGuanaco 65Bの生成を手動で比較すると、本論文の著者らが多くの好ましい応答について意見が分かれたことから、主観的な嗜好が重要な役割を果たし始めることが分かる。今後の研究では、人間とコンピュータの相互作用や心理学など、主観的な嗜好に対処するメカニズムを発展させてきた学問分野から知見を得て、これらの問題を緩和するアプローチを調査すべきである。
我々の分析では、自動評価システムに顕著なバイアスがあることも分かった。例えば、GPT-4では強い順序効果が観察され、プロンプト内で先に現れるシステムに高いスコアを割り当てる。GPT-4と人間のアノテーター間のサンプルレベルの一致が比較的弱いこと(Fleiss )も、人間のアノテーターと自動システムが常に一致するとは限らない嗜好に依存している可能性を示唆している。さらに、表7では、GPT-4が自身の出力に対して人間の評価よりも有意に高いスコアを割り当てていることが観察される。Eloスコアは1348対1176であり、これは対戦相手に対して勝つ確率がさらに増えることを表している。今後の研究では、自動評価システムにおける潜在的バイアスの存在と、可能な緩和戦略を検討すべきである。
データとトレーニング Guanacoモデルの学習に用いられたOASST1データセットは多言語であり、OAベンチマークにも異なる言語のプロンプトが含まれていることに留意する。このような多言語トレーニングが英語以外の言語の指示に対する性能をどの程度向上させるのか、またそれがVicuna-13Bモデル(英語データのみで学習)とGuanaco 33Bおよび65BのOAベンチマークにおける大きな差を説明するのかどうかは、今後の研究に委ねる。
Guanacoモデルの強い性能を踏まえ、我々はOASST1データとVicunaベンチマークのプロンプトの間にデータ漏洩がないか調査する。2つのデータセットでファジー文字列マッチングを行い、最も近い一致を手動で検査した結果、重複するプロンプトは見つからなかった。
さらに、我々のモデルは人間のフィードバックによる強化学習(RLHF)に依拠せず、交差エントロピー損失(教師あり学習)のみで学習されていることに留意する。このことは、単純な交差エントロピー損失とRLHFトレーニングのトレードオフについてさらなる調査を要する。我々は、QLORAが膨大な計算資源を必要とせずに、そのような分析を大規模に行えるようにすることを願っている。
7 関連研究
大規模言語モデルの量子化 LLMの量子化は主に推論時の量子化に焦点を当ててきた。16ビットLLMの品質を保つ主要なアプローチは、外れ値特徴の管理に焦点を当てており(例:SmoothQuant [66]やLLM.int8() [14])、一方でより洗練されたグループ化手法を用いるものもある[44, 69]。非可逆量子化のアプローチでは、通常の丸めにおけるトレードオフ[13, 71, 47]や、量子化精度を向上させるために丸めの決定を最適化する方法[18]が研究されている。我々の研究以外では、SwitchBackレイヤー[65]が、1Bパラメータを超える規模で量子化重みを通した誤差逆伝播を研究した唯一の研究である。
アダプターを用いたファインチューニング 我々はLow-rank Adapters [28](LoRA)を用いているが、プロンプトチューニング[48, 33, 34]、埋め込み層の入力をチューニングする手法[1]、隠れ状態のチューニング(IA3)[37]、完全な層の追加[27]、バイアスのチューニング[70]、Fisher情報に基づく重み上のマスクの学習[54]、およびこれらのアプローチの組み合わせ[23]など、他にも多くのパラメータ効率的ファインチューニング(PEFT)手法が提案されている。我々の研究では、LoRAアダプターが16ビットの完全なファインチューニング性能に到達できることを示す。他のPEFTアプローチのトレードオフの調査は今後の研究に委ねる。
指示ファインチューニング 事前学習済みLLMがプロンプトで与えられた指示に従えるようにするため、指示ファインチューニングでは、さまざまなデータソースの入力-出力ペアを用いて事前学習済みLLMをファインチューニングし、入力をプロンプトとして与えられたときに出力を生成させる。アプローチとデータセットには、MetaICL [40]、
| LLaMA-65B | GPT-3 | OPT-175B | Guanaco-65B | |
| 性別 | 70.6 | 62.6 | 65.7 | 47.5 |
| 宗教 | 79.0 | 73.3 | 68.6 | 38.7 |
| 人種/肌色 | 57.0 | 64.7 | 68.6 | 45.3 |
| 性的指向 | 81.0 | 76.2 | 78.6 | 59.1 |
| 年齢 | 70.1 | 64.4 | 67.8 | 36.3 |
| 国籍 | 64.2 | 61.6 | 62.9 | 32.4 |
| 障害 | 66.7 | 76.7 | 76.7 | 33.9 |
| 外見 | 77.8 | 74.6 | 76.2 | 43.1 |
| 社会経済的地位 | 71.5 | 73.8 | 76.2 | 55.3 |
| 平均 | 66.6 | 67.2 | 69.5 | 43.5 |
MetaTuning [73]、InstructGPT [43]、FLAN [62, 12]、PromptSource [3]、Super-NaturalInstructions [61, 50]、Self-instruct [59]、UnnaturalInstructions [26]、OPT-IML [29]、UnifiedSKG [67]、OIG/Chip2 [32]、Alpaca [55]、Vicuna [10]、Koala [20]、Self-instruct-GPT-4 [45]などがある。
チャットボット 多くの指示追従モデルは対話ベースのチャットボットとして構成されており、しばしば人間のフィードバックによる強化学習(RLHF)[11]や、既存モデルからデータを生成してAIモデルのフィードバックで学習する手法(RLAIF)[5]を用いている。アプローチとデータセットには、Anthropic-HH [2, 4]、Open Assistant [31]、LaMDA [56]、Sparrow [21]などがある。我々は強化学習を用いていないが、最良のモデルであるGuanacoは、RLHFトレーニングに用いるために設計されたOpen Assistantデータセット[31]のマルチターンのチャット相互作用でファインチューニングされている。チャットボットの評価では、コストのかかる人間によるアノテーションの代わりにGPT-4を用いるアプローチが開発されている[10, 45]。我々は、より信頼性の高い評価設定に焦点を当てて、そのようなアプローチを改善する。
8 限界と議論
我々は、我々の手法であるQLORAが、4ビットのベースモデルとLow-rank Adapters(LoRA)を用いて16ビットの完全なファインチューニング性能を再現できるという証拠を示した。この証拠にもかかわらず、QLORAが33Bおよび65Bの規模で16ビットの完全なファインチューニング性能に匹敵できることは確立していない。膨大なリソースコストのため、この研究は今後の研究に委ねる。
もう一つの限界は、指示ファインチューニングモデルの評価である。我々はMMLU、Vicunaベンチマーク、OAベンチマークについて評価を提供しているが、BigBench、RAFT、HELMなどの他のベンチマークについては評価しておらず、我々の評価がこれらのベンチマークに一般化することは保証されていない。一方で、我々はMMLUについて非常に幅広い研究を行い、チャットボットを評価する新しい方法を開発している。
提示された証拠から、これらのベンチマークの性能は、ファインチューニングデータがベンチマークデータセットにどれだけ類似しているかに依存する可能性が高いように思われる。例えば、FLAN v2はMMLUに類似しているがチャットボットのベンチマークには類似しておらず、Chip2データセットではその逆であり、両モデルはそれに応じてMMLUおよびVicunaベンチマークでスコアを出している。これは、より良いベンチマークと評価が必要なだけでなく、そもそも何を評価しているのかに注意する必要があることを強調している。我々は、教室での高校や大学の知識で良い成績を収めるモデルを作りたいのか、それともチャットボットの会話能力で良い成績を収めたいのか。あるいは何か別のことなのか。新しいベンチマークを作成するよりも既存のベンチマークで評価する方が常に容易であるため、特定のベンチマークがコミュニティをある方向へ導く可能性がある。我々はコミュニティとして、ベンチマークが我々が重視するものを測定していることを確保すべきである。
我々は一般的なチャットボット性能について詳細な評価を提供しているが、もう一つの限界は、Guanacoについて限定的な責任あるAI評価しか行っていないことである。表8では、Guanaco-65Bが他のモデルと比較して社会的に偏ったトークン列を生成する可能性を評価している。Guanaco-65Bの平均スコアは他の生の事前学習済みモデルよりもはるかに低いことが分かる。したがって、OASST1データセットでのファインチューニングはLLaMAベースモデルのバイアスを軽減するように思われる。これらの結果は有望ではあるが、Guanacoが他の種類のバイアスで評価された場合にも同様に良好に機能するかは不明である。Guanacoおよび同様のチャットボットにおけるバイアスの分析に関するさらなる評価は今後の研究に委ねる。追加の限界として、3ビットのベースモデルを用いるなど異なるビット精度や、異なるアダプター手法を評価していないことが挙げられる。LoRA以外にも、良好に機能することが示されている多種多様なパラメータ効率的ファインチューニング(PEFT)手法が存在する。しかし、これらの手法が大規模モデルにスケールするかは不明である。我々は多くの結果がその堅牢性を確立しているためLoRAを用いたが、他のアダプターがより良い性能をもたらす可能性もある。量子化後のファインチューニングは量子化中に失われる情報のほとんどを回復するように思われるため、これははるかに積極的な量子化を可能にするかもしれない。例えば、ベースモデルの3ビットGPTQ量子化にLoRAを組み合わせても、ファインチューニング後に16ビットの完全なファインチューニング性能をもたらす可能性がある。
9 より広範な影響
我々のQLoRAファインチューニング手法は、完全なファインチューニングのベースラインと比較して性能を劣化させることなく、33Bパラメータモデルを単一のコンシューマーGPUで、65Bパラメータモデルを単一のプロフェッショナルGPUでファインチューニングすることを可能にする最初の手法である。我々は、Open Assistantデータセットで学習した最良の33BモデルがVicunaベンチマークでChatGPTに匹敵し得ることを実証した。指示ファインチューニングは、生の事前学習済みLLMをChatGPTのようなチャットボットに変換するための不可欠なツールであるため、我々の手法はファインチューニングを広く一般的なものにし、特に最もリソースの少ない研究者にとってそうなることを確信している。これは最先端のNLP技術のアクセシビリティにとって大きな勝利である。QLoRAは、大企業とコンシューマーGPUを持つ小規模チームとの間のリソース格差を埋めるのに役立つ均等化要因と見なすことができる。
もう一つの潜在的影響源は、携帯電話への配備である。我々のQLoRA手法は、スマートフォンやその他の低リソース環境においてLLMのファインチューニングを可能にするという重要なマイルストーンを実現しうると考えている。7Bモデルが以前にスマートフォン上で動作可能であることが示されていたが、QLoRAはそのようなモデルのファインチューニングを可能にする最初の手法である。我々の見積もりでは、iPhone 12 Plusを用いて、QLoRAは充電中に一晩あたり300万トークンをファインチューニングできる。ファインチューニングされた7BモデルはChatGPTの品質には達しないものの、その品質は、プライバシーやLLMの品質の問題によりこれまで不可能であった新規応用を可能にするのに十分なほど良好であると我々は考えている。QLoRAは、ユーザーが自身のデータとモデルを所有・管理できるプライバシー保護型のLLM利用を可能にする一方で、LLMの配備を容易にする助けにもなりうる。
しかしながら、ファインチューニングは悪用されて害を引き起こす可能性のあるデュアルユース技術である。LLMの広範な利用には既知の危険性があるが[8, 6]、急速に遍在しつつある技術へのアクセスを平等にすることは、モデルやソースコードを監査のために公開しない大企業の手にLLMの力を留めておくよりも、より優れた、より独立した分析を可能にすると我々は考えている。
総じて、QLoRAは、高品質なLLMのファインチューニングをはるかに広くかつ容易にアクセス可能にすることで、広く肯定的な影響をもたらすと我々は考えている。
謝辞
貴重なフィードバックをいただいたAditya Kusupati、Ofir Press、Ashish Sharma、Margaret Li、Raphael Olivier、Zihao Ye、およびEvangelia Spiliopoulouに感謝する。我々の研究は、ワシントン大学のHyakスーパーコンピュータシステムの高度な計算、ストレージ、ネットワーク基盤によって促進された。円滑な運用を確保してくれたHyakチームに感謝する。bitsandbytesライブラリのベータテスター、特にAlex BirchとAlyssa Vanceに感謝する。我々のソフトウェアのHugging Face transformersスタックへの統合を支援してくれたYounes Belkadaに感謝する。
参考文献
[1] S. An, Y. Li, Z. Lin, Q. Liu, B. Chen, Q. Fu, W. Chen, N. Zheng, and J.-G. Lou. Input-tuning: Adapting unfamiliar inputs to frozen pretrained models. arXiv preprint arXiv:2203.03131, 2022.
[2] A. Askell, Y. Bai, A. Chen, D. Drain, D. Ganguli, T. Henighan, A. Jones, N. Joseph, B. Mann, N. DasSarma, et al. A general language assistant as a laboratory for alignment. arXiv preprint arXiv:2112.00861, 2021.
[3] S. H. Bach, V. Sanh, Z.-X. Yong, A. Webson, C. Raffel, N. V. Nayak, A. Sharma, T. Kim, M. S. Bari, T. Fevry, et al. Promptsource: An integrated development environment and repository for natural language prompts. arXiv preprint arXiv:2202.01279, 2022.
[4] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[5] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon, et al. Constitutional ai: Harmlessness from ai feedback. arXiv preprint arXiv:2212.08073, 2022.
[6] E. M. Bender, T. Gebru, A. McMillan-Major, and S. Shmitchell. On the dangers of stochastic parrots: Can language models be too big? In Proceedings of the 2021 ACM conference on fairness, accountability, and transparency, pages 610-623, 2021.
[7] S. Biderman, H. Schoelkopf, Q. Anthony, H. Bradley, K. O'Brien, E. Hallahan, M. A. Khan, S. Purohit, U. S. Prashanth, E. Raff, et al. Pythia: A suite for analyzing large language models across training and scaling. arXiv preprint arXiv:2304.01373, 2023.
[8] R. Bommasani, D. A. Hudson, E. Adeli, R. Altman, S. Arora, S. von Arx, M. S. Bernstein, J. Bohg, A. Bosselut, E. Brunskill, et al. On the opportunities and risks of foundation models. arXiv preprint arXiv:2108.07258, 2021.
[9] T. Chen, B. Xu, C. Zhang, and C. Guestrin. Training deep nets with sublinear memory cost. arXiv preprint arXiv:1604.06174, 2016.
[10] W.-L. Chiang, Z. Li, Z. Lin, Y. Sheng, Z. Wu, H. Zhang, L. Zheng, S. Zhuang, Y. Zhuang, J. E. Gonzalez, I. Stoica, and E. P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%\* chatgpt quality, March 2023. URL https://lmsys.org/blog/2023-03-30-vicuna/.
[11] P. F. Christiano, J. Leike, T. Brown, M. Martic, S. Legg, and D. Amodei. Deep reinforcement learning from human preferences. Advances in neural information processing systems, 30, 2017.
[12] H. W. Chung, L. Hou, S. Longpre, B. Zoph, Y. Tay, W. Fedus, E. Li, X. Wang, M. Dehghani, S. Brahma, et al. Scaling instruction-finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
[13] T. Dettmers and L. Zettlemoyer. The case for 4-bit precision: k-bit inference scaling laws. arXiv preprint arXiv:2212.09720, 2022.
[14] T. Dettmers, M. Lewis, Y. Belkada, and L. Zettlemoyer. LLM.int8(): 8-bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, 2022.
[15] T. Dettmers, M. Lewis, S. Shleifer, and L. Zettlemoyer. 8-bit optimizers via block-wise quantization. 9th International Conference on Learning Representations, ICLR, 2022.
[16] A. E. Elo. The proposed uscf rating system. its development, theory, and applications. Chess Life, 22(8):242-247, 1967.
[17] A. E. Elo. The rating of chessplayers, past and present. Arco Pub., 1978.
[18] E. Frantar, S. Ashkboos, T. Hoefler, and D. Alistarh. Gptq: Accurate post-training quantization for generative pre-trained transformers. arXiv preprint arXiv:2210.17323, 2022.
[19] J. Fu, S.-K. Ng, Z. Jiang, and P. Liu. Gptscore: Evaluate as you desire. arXiv preprint arXiv:2302.04166, 2023.
[20] X. Geng, A. Gudibande, H. Liu, E. Wallace, P. Abbeel, S. Levine, and D. Song. Koala: A dialogue model for academic research. Blog post, April 2023. URL https://bair.berkeley.edu/blog/2023/04/03/koala/.
[21] A. Glaese, N. McAleese, M. Trebacz, J. Aslanides, V. Firoiu, T. Ewalds, M. Rauh, L. Weidinger, M. Chadwick, P. Thacker, et al. Improving alignment of dialogue agents via targeted human judgements. arXiv preprint arXiv:2209.14375, 2022.
[22] S. Gururangan, S. Swayamdipta, O. Levy, R. Schwartz, S. R. Bowman, and N. A. Smith. Annotation artifacts in natural language inference data. arXiv preprint arXiv:1803.02324, 2018.
[23] J. Henderson, S. Ruder, et al. Compacter: Efficient low-rank hypercomplex adapter layers. In Advances in Neural Information Processing Systems, 2021.
[24] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[25] A. Holtzman, J. Buys, L. Du, M. Forbes, and Y. Choi. The curious case of neural text degeneration. In International Conference on Learning Representations, 2020.
[26] O. Honovich, T. Scialom, O. Levy, and T. Schick. Unnatural instructions: Tuning language models with (almost) no human labor. arXiv preprint arXiv:2212.09689, 2022.
[27] N. Houlsby, A. Giurgiu, S. Jastrzebski, B. Morrone, Q. De Laroussilhe, A. Gesmundo, M. Attariyan, and S. Gelly. Parameter-efficient transfer learning for nlp. In International Conference on Machine Learning, pages 2790-2799. PMLR, 2019.
[28] E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang, and W. Chen. Lora: Low-rank adaptation of large language models. arXiv preprint arXiv:2106.09685, 2021.
[29] S. Iyer, X. V. Lin, R. Pasunuru, T. Mihaylov, D. Simig, P. Yu, K. Shuster, T. Wang, Q. Liu, P. S. Koura, et al. Opt-iml: Scaling language model instruction meta learning through the lens of generalization. arXiv preprint arXiv:2212.12017, 2022.
[30] A. Koksal, T. Schick, A. Korhonen, H. Schütze. Longform: コーパス抽出を用いた長文生成のためのインストラクションチューニングの最適化. arXiv preprint arXiv:2304.08460, 2023.
[31] A. Köpf, Y. Kilcher, D. von Rütte, S. Anagnostidis, Z.-R. Tam, K. Stevens, A. Barhoum, N. M. Duc, O. Stanley, R. Nagyfi, et al. Openassistant conversations - 大規模言語モデルのアラインメントの民主化. arXiv preprint arXiv:2304.07327, 2023.
[32] LAION. Open-instruction-generalist データセット. https://github.com/LAION-AI/Open-Instruction-Generalist, 2023.
[33] B. Lester, R. Al-Rfou, N. Constant. パラメータ効率的なプロンプトチューニングにおけるスケールの力. arXiv preprint arXiv:2104.08691, 2021.
[34] X. L. Li, P. Liang. Prefix-tuning: 生成のための連続プロンプトの最適化. arXiv preprint arXiv:2101.00190, 2021.
[35] P. Liang, R. Bommasani, T. Lee, D. Tsipras, D. Soylu, M. Yasunaga, Y. Zhang, D. Narayanan, Y. Wu, A. Kumar, et al. 言語モデルの包括的評価. arXiv preprint arXiv:2211.09110, 2022.
[36] T. Liao, R. Taori, I. D. Raji, L. Schmidt. 私たちはまだ学習しているのか?機械学習全体における評価の失敗に関するメタレビュー. In Thirty-fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2), 2021.
[37] H. Liu, D. Tam, M. Muqeeth, J. Mohta, T. Huang, M. Bansal, and C. A. Raffel. Few-shot parameter-efficient fine-tuning is better and cheaper than in-context learning. Advances in Neural Information Processing Systems, 35:1950–1965, 2022.
[38] Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer, and V. Stoyanov. Roberta: A robustly optimized bert pretraining approach. arXiv preprint arXiv:1907.11692, 2019.
[39] S. Longpre, L. Hou, T. Vu, A. Webson, H. W. Chung, Y. Tay, D. Zhou, Q. V. Le, B. Zoph, J. Wei, et al. The flan collection: Designing data and methods for effective instruction tuning. arXiv preprint arXiv:2301.13688, 2023.
[40] S. Min, M. Lewis, L. Zettlemoyer, and H. Hajishirzi. Metaicl: Learning to learn in context. arXiv preprint arXiv:2110.15943, 2021.
[41] A. Nematzadeh, K. Burns, E. Grant, A. Gopnik, and T. Griffiths. Evaluating theory of mind in question answering. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2392–2400, 2018.
[42] OpenAI. Gpt-4 technical report. arXiv, 2023.
[43] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
[44] G. Park, B. Park, S. J. Kwon, B. Kim, Y. Lee, and D. Lee. nuqmm: Quantized matmul for efficient inference of large-scale generative language models. arXiv preprint arXiv:2206.09557, 2022.
[45] B. Peng, C. Li, P. He, M. Galley, and J. Gao. Instruction tuning with gpt-4. arXiv preprint arXiv:2304.03277, 2023.
[46] A. Poliak, J. Naradowsky, A. Haldar, R. Rudinger, and B. Van Durme. Hypothesis only baselines in natural language inference. In Proceedings of the Seventh Joint Conference on Lexical and Computational Semantics, pages 180–191, 2018.
[47] R. Pope, S. Douglas, A. Chowdhery, J. Devlin, J. Bradbury, A. Levskaya, J. Heek, K. Xiao, S. Agrawal, and J. Dean. Efficiently scaling transformer inference. arXiv preprint arXiv:2211.05102, 2022.
[48] G. Qin and J. Eisner. Learning how to ask: Querying lms with mixtures of soft prompts. arXiv preprint arXiv:2104.06599, 2021.
[49] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, and P. J. Liu. Exploring the limits of transfer learning with a unified text-to-text transformer. J. Mach. Learn. Res., 21(1), jan 2020. ISSN 1532-4435.
[50] V. Sanh, A. Webson, C. Raffel, S. H. Bach, L. Sutawika, Z. Alyafeai, A. Chaffin, A. Stiegler, T. L. Scao, A. Raja, et al. Multitask prompted training enables zero-shot task generalization. arXiv preprint arXiv:2110.08207, 2021.
[51] M. Sap, R. LeBras, D. Fried, and Y. Choi. Neural theory-of-mind? on the limits of social intelligence in large lms. arXiv preprint arXiv:2210.13312, 2022.
[52] T. L. Scao, A. Fan, C. Akiki, E. Pavlick, S. Ilić, D. Hesslow, R. Castagné, A. S. Luccioni, F. Yvon, M. Gallé, et al. Bloom: A 176b-parameter open-access multilingual language model. arXiv preprint arXiv:2211.05100, 2022.
[53] S. Shapiro and M. Wilk. An analysis of variance test for normality. Biometrika, 52(3):591–611, 1965.
[54] Y.-L. Sung, V. Nair, and C. A. Raffel. Training neural networks with fixed sparse masks. Advances in Neural Information Processing Systems, 34:24193–24205, 2021.
[55] R. Taori, I. Gulrajani, T. Zhang, Y. Dubois, X. Li, C. Guestrin, P. Liang, and T. B. Hashimoto. Stanford alpaca: An instruction-following llama model. https://github.com/tatsu-lab/stanford_alpaca, 2023.
[56] R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H.-T. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. Lamda: Language models for dialog applications. arXiv preprint arXiv:2201.08239, 2022.
[57] H. Touvron, T. Lavril, G. Izacard, X. Martinet, M.-A. Lachaux, T. Lacroix, B. Rozière, N. Goyal, E. Hambro, F. Azhar, et al. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023.
[58] A. Wang, A. Singh, J. Michael, F. Hill, O. Levy, and S. R. Bowman. Glue: A multitask benchmark and analysis platform for natural language understanding. arXiv preprint arXiv:1804.07461, 2018.
[59] Y. Wang, Y. Kordi, S. Mishra, A. Liu, N. A. Smith, D. Khashabi, and H. Hajishirzi. Self-instruct: Aligning language model with self generated instructions. arXiv preprint arXiv:2212.10560, 2022.
[60] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Arunkumar, A. Ashok, A. S. Dhanasekaran, A. Naik, D. Stap, et al. Super-naturalinstructions: generalization via declarative instructions on 1600+ tasks. In EMNLP, 2022.
[61] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Naik, A. Ashok, A. S. Dhanasekaran, A. Arunkumar, D. Stap, et al. Super-naturalinstructions: Generalization via declarative instructions on 1600+ nlp tasks. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, pages 5085-5109, 2022.
[62] J. Wei, M. Bosma, V. Y. Zhao, K. Guu, A. W. Yu, B. Lester, N. Du, A. M. Dai, and Q. V. Le. Finetuned language models are zero-shot learners. arXiv preprint arXiv:2109.01652, 2021.
[63] J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. H. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems, 2022.
[64] T. Wolf, L. Debut, V. Sanh, J. Chaumond, C. Delangue, A. Moi, P. Cistac, T. Rault, R. Louf, M. Funtowicz, et al. Huggingface's transformers: State-of-the-art natural language processing. arXiv preprint arXiv:1910.03771, 2019.
[65] M. Wortsman、T. Dettmers、L. Zettlemoyer、A. Morcos、A. Farhadi、L. Schmidt。「大規模視覚言語モデルのための安定した低精度トレーニング」。arXivプレプリントarXiv:2304.13013、2023年。
[66] G. Xiao、J. Lin、M. Seznec、J. Demouth、S. Han。「Smoothquant:大規模言語モデルのための正確かつ効率的な訓練後量子化」。arXivプレプリントarXiv:2211.10438、2022年。
[67] T. Xie、C. H. Wu、P. Shi、R. Zhong、T. Scholak、M. Yasunaga、C.-S. Wu、M. Zhong、P. Yin、S. I. Wangら。「Unifiedskg:テキストからテキストへの言語モデルによる構造化知識グラウンディングの統一とマルチタスク化」。arXivプレプリントarXiv:2201.05966、2022年。
[68] Z. Yang、P. Qi、S. Zhang、Y. Bengio、W. Cohen、R. Salakhutdinov、C. D. Manning。「Hotpotqa:多様で説明可能なマルチホップ質問応答のためのデータセット」。Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing、2369~2380ページ、2018年。
[69] Z. Yao、R. Y. Aminabadi、M. Zhang、X. Wu、C. Li、Y. He。「Zeroquant:大規模トランスフォーマーのための効率的で手頃な訓練後量子化」。arXivプレプリントarXiv:2206.01861、2022年。
[70] E. B. Zaken、S. Ravfogel、Y. Goldberg。Bitfit:トランスフォーマーベースのマスク付き言語モデルのための単純なパラメータ効率の良いファインチューニング。arXiv preprint arXiv:2106.10199、2021年。
[71] A. Zeng、X. Liu、Z. Du、Z. Wang、H. Lai、M. Ding、Z. Yang、Y. Xu、W. Zheng、X. Xia ほか。Glm-130b:オープンなバイリンガル事前学習済みモデル。arXiv preprint arXiv:2210.02414、2022年。
[72] S. Zhang、S. Roller、N. Goyal、M. Artetxe、M. Chen、S. Chen、C. Dewan、M. Diab、X. Li、X. V. Lin ほか。Opt:オープンな事前学習済みトランスフォーマー言語モデル。arXiv preprint arXiv:2205.01068、2022年。
[73] R. Zhong、K. Lee、Z. Zhang、D. Klein。データセットとプロンプトのコレクションに対するメタチューニングによるゼロショット学習のための言語モデルの適応。arXiv preprint arXiv:2104.04670、2021年。
A QLoRA 対 標準ファインチューニングの実験設定の詳細
A.1 QLoRA のハイパーパラメータ
我々は、以下の変数について LoRA のハイパーパラメータ探索を行う:LoRA ドロップアウト {0.0, 0.05, 0.1}、LoRA {8, 16, 32, 64, 128, 256}、LoRA 層 {key+query、すべてのアテンション層、すべての FFN 層、すべての層、アテンション + FFN 出力層}。LoRA は学習率に常に比例するため、LoRA を固定し、学習率を探索する。
LoRA ドロップアウト 0.05 は小規模モデル(7B、13B)には有用だが、大規模モデル(33B、65B)には有用でないことが分かった。図4に見られるように、LoRA がすべての層に用いられる場合、LoRA は最終性能と無関係であることが分かった。
A.2 Super-Natural Instructions の実験設定の詳細
我々は Wang ら [60] と同じ Super-Natural Instruction データセットの前処理を用いる。しかし、我々は訓練データを訓練用と検証用データセットに分割し、より厳密なハイパーパラメータチューニングと早期停止を可能にしている。我々は、Super-Natural Instruction データ上で様々な T5 モデルサイズを訓練するために、論文で述べられているのと同じハイパーパラメータを用いる。小規模、中規模、大規模 T5 モデルには LoRA を、T5 xl および xxl モデルには LoRA を用いる。また、すべての実験で LoRA を用い、LoRA ドロップアウトは用いない。
B 最先端チャットボットの訓練の実験設定の詳細
B.1 データセット
我々は、第5節で概説した QLoRA ファインチューニング実験に用いたデータセットについて述べる。
OASST1 OpenAssistant データセット [31] はクラウドソーシングによって収集された。これには 66,497 の会話に分散し、35 の異なる言語にまたがる 161,443 の一意なメッセージが含まれている。このデータセットは、与えられた各ユーザーの質問に対して複数の順位付けされた返信を含むことが多い。我々の実験では、会話ツリーの各レベルで最上位の返信のみを用いる。これによりデータセットは 9,209 例に限定される。我々はユーザーの質問を含む会話全体でモデルをファインチューニングする。
HH-RLHF これは有用性と無害性に関する人間の選好データセットである。各データ点は、ユーザーの質問に対する2つのアシスタントの返信と、最良の返信に対する人間の選好判断からなる。このデータセットには 160,800 例が含まれている。このデータセットでファインチューニングする際、我々は有用性と無害性のデータを組み合わせ、好まれたアシスタントの返信のみを保持する。
FLAN v2 FLAN v2 コレクション [39] は、何百もの手作業でキュレーションされたテンプレートと豊富な書式パターンで拡張された 1836 のタスクのコレクションであり、1500万例を超える。著者らは、このコレクションで訓練されたモデルが、元の FLAN 2021 [62]、T0++ [50]、Super-Natural Instructions [60]、OPT-IML [29] を含む他の公開コレクションを上回ることを示している。我々は、執筆時点で自由に利用できなかった一部のデータセットを除き、著者らが述べたのと同じタスク混合を用いた。
| パラメータ | データセット | バッチサイズ | LR | ステップ数 | ソース長 | ターゲット長 |
| 7B | すべて | 16 | 2e-4 | 10000 | 384 | 128 |
| 7B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 7B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 7B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 13B | すべて | 16 | 2e-4 | 10000 | 384 | 128 |
| 13B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 13B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 13B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 33B | すべて | 32 | 1e-4 | 5000 | 384 | 128 |
| 33B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 33B | HH-RLHF | 32 | 1e-4 | 5000 | - | 768 |
| 33B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
| 65B | すべて | 64 | 1e-4 | 2500 | 384 | 128 |
| 65B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 65B | HH-RLHF | 64 | 1e-4 | 2500 | - | 768 |
| 65B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
Self-Instruct、Alpaca、Unnatural Instructions Self-Instruct、Alpaca、Unnatural Instructions データセット [59, 55, 26] は、GPT-3 Instruct および ChatGPT からの様々なモデル蒸留アプローチで収集されたインストラクションチューニングデータセットである。これらは、多様な命令と出力の集合を考案するために、プロンプティング、インコンテキスト学習、言い換えに依拠している。データセットはそれぞれ 82,612、51,942、240,670 例からなる。このような蒸留データセットの利点の一つは、FLAN v2 コレクションや類似のインストラクションチューニングコレクションと比較して、より多様な命令スタイルの集合を含むことである。
Longform LongForm データセット [30] は、命令で拡張された英語コーパスに基づいており、それゆえハイブリッドな人間生成データセットである。基礎となる文書は人間によって書かれたもので C4 と Wikipedia に由来する一方、命令は LLM を介して生成される。このデータセットは、Stack Exchange や WikiHow といった追加の構造化コーパス例や、質問応答、メール作成、文法誤り訂正、物語・詩の生成、テキスト要約といったタスク例で拡張されている。このデータセットには 23,700 例が含まれている。
Chip2 は OIG Laion データセットの一部である。これには Python コード例、自然言語命令例、一般的な無害な命令、リストを含む命令/応答、フォローアップ質問、Wikipedia の有害な敵対的質問、小学校の算数、推論命令、およびキャラクターと場面の記述が含まれ、合計 210,289 例である。
B.2 ハイパーパラメータ
我々は QLoRA ファインチューニング実験で用いた正確なハイパーパラメータを提供する。ハイパーパラメータはデータセット間で概ね頑健であることが分かった。我々は検証とハイパーパラメータチューニングに MMLU の 5-shot dev セットを用いる。すべての実験で、我々は二重量子化を伴う NF4 と bf16 計算データ型を用いる。我々は LoRA 、 を設定し、ベースモデルのすべての線形層に LoRA モジュールを追加する。また、Adam の beta2 を 0.999、最大勾配ノルムを 0.3、LoRA ドロップアウトを 13B までのモデルには 0.1、33B および 65B モデルには 0.05 を用いる。インストラクションファインチューニングに関する先行研究 [62, 60] に従い、他の線形およびコサインスケジュールをベンチマークした後、我々は一定の学習率スケジュールを用いる。我々は group-by-length を用いて類似した長さの例を同じバッチにグループ化する(これは振動する損失曲線を生むことに注意)。各モデルサイズに対して我々が調整するハイパーパラメータを表9に示す。
B.3 アブレーション
インストラクションフォローイングデータセットでは応答のみで訓練するのが文献の一般的な慣行であるが、我々は表10で応答に加えて命令でも訓練する効果を調べる。これらの実験では、訓練データを 52,000 例に制限し、7B モデルを用いる。4つの異なるインストラクションチューニングデータセットにわたり、ターゲットのみで訓練することが MMLU に有益であることが分かった。
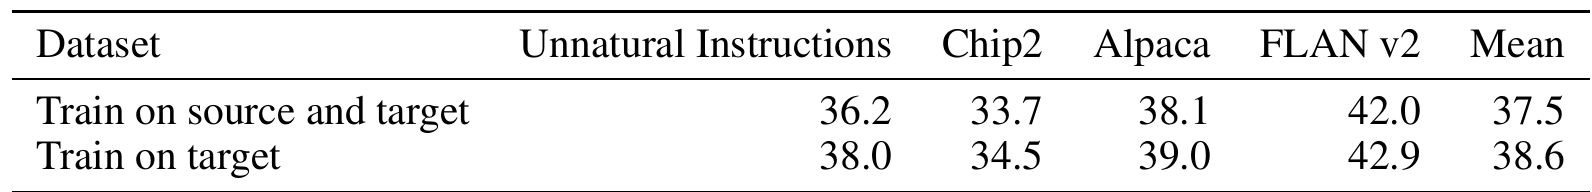
| データセット | Unnatural Instructions | Chip2 | Alpaca | FLAN v2 | 平均 |
| ソースとターゲットで訓練 | 36.2 | 33.7 | 38.1 | 42.0 | 37.5 |
| ターゲットで訓練 | 38.0 | 34.5 | 39.0 | 42.9 | 38.6 |
B.4 どちらがより重要か:インストラクションチューニングデータセットのサイズか、データセットの品質か?
データセットの適合性はデータセットのサイズよりも重要である。データセットの品質とデータセットのサイズの影響を理解するために、少なくとも150,000サンプルを持つ大規模データセット(Chip2、FLAN v2、Unnatural Instructions)を、サイズ50,000、100,000、150,000のデータセットにサブサンプリングする実験を行い、その結果得られる傾向を表11に示すように検証する。データセットのサイズを増やし、エポック数を増やしても、MMLUはごくわずかにしか改善しない(0.0~0.5 MMLU)一方で、データセット間の差は最大で40倍大きい(1.5~8.0 MMLU)ことが分かった。これは、平均MMLU精度にとって重要なのはデータセットのサイズではなくデータセットの品質であることを明確に示す指標である。チャットボットの性能についても、で論じたのと同様の知見を得た。
C 人手評価
我々は、元のVicuna評価[10]においてGPT-4に与えたものと同じ文言を用いて人手評価を実施し、これを図5に示すようにAmazon Mechanical Turkのフォーム用に調整した。
D GPT-4によるペアワイズ評価
GPT-4による評価は、どちらのシステムを先に提示するかによって異なる結果を与えることが分かったが、両方の選択肢について平均すると、ペアワイズの結果はよく順序付けられていた。集計されたペアワイズ判定を表12に示す。検討すると、これらの判定が推移的であることは明らかである。すなわち、システムAがシステムBより優れていると判定され、システムBがシステムCより優れていると判定される場合、常にシステムAがシステムCより優れていると判定される。これにより、表13に示す完全な順序付けが得られる。
E NormalFloat 4ビットデータ型
NF4データ型の正確な値は以下の通りである:[- 1.0, - 0.6961928009986877, - 0.5250730514526367, - 0.39491748809814453, - 0.28444138169288635, - 0.18477343022823334, - 0.09105003625154495, 0.0, 0.07958029955625534, 0.16093020141124725, 0.24611230194568634, 0.33791524171829224, 0.44070982933044434, 0.5626170039176941, 0.7229568362236023, 1.0]
F 訓練済みニューラルネットワーク重みの正規性
訓練済みのニューラルネットワークの重みがおおむね正規分布に従うことは常識であるが、我々はこれを検証するために統計的検定を行う。7Bの重みに対してShapiro-Wilk検定[53]を用いる。
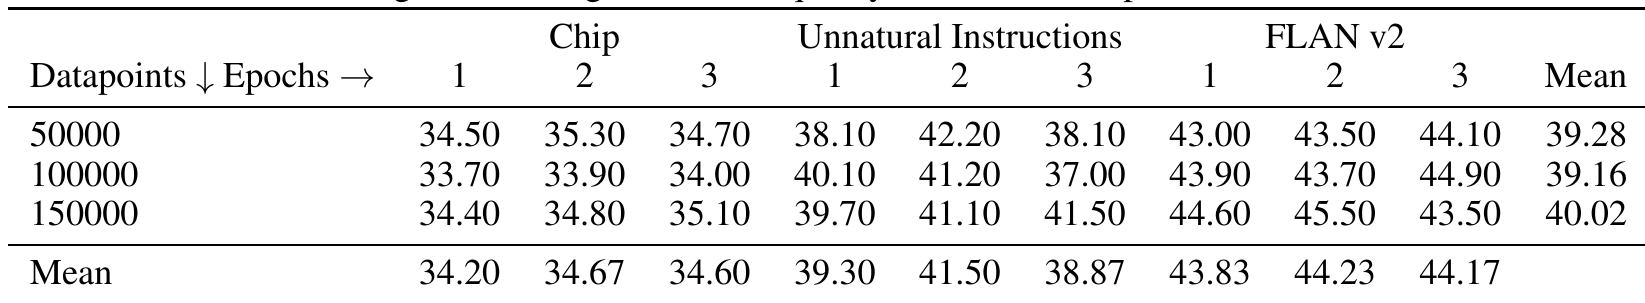
| データ点数 ↓ エポック数 → | 1 | 2 | 3 | Unnatural Instructions | 1 | 2 | 3 | FLAN v2 | 3 | 平均 |
| 50000 | 34.50 | 35.30 | 34.70 | 38.10 | 42.20 | 38.10 | 43.00 | 43.50 | 44.10 | 39.28 |
| 100000 | 33.70 | 33.90 | 34.00 | 40.10 | 41.20 | 37.00 | 43.90 | 43.70 | 44.90 | 39.16 |
| 150000 | 34.40 | 34.80 | 35.10 | 39.70 | 41.10 | 41.50 | 44.60 | 45.50 | 43.50 | 40.02 |
| 平均 | 34.20 | 34.67 | 34.60 | 39.30 | 41.50 | 38.87 | 43.83 | 44.23 | 44.17 |
タスク
以下に表示されるユーザーの質問に対する2つのAIアシスタントのパフォーマンスについて、フィードバックをお願いいたします。
各回答の有用性、関連性、正確性、詳細度を評価してください。各アシスタントには1から10の尺度で総合スコアが付けられ、スコアが高いほど総合的なパフォーマンスが優れていることを示します。
まず、各回答を10点満点で評価してください。
次に、潜在的なバイアスを避け、回答が提示された順序があなたの判断に影響を与えないように留意しながら、評価について包括的な説明を提供してください。
ユーザーの質問
あなたが西暦3000年から来たタイムトラベラーだと想像してください。どんな技術的進歩について人々に話しますか?
回答A
AIアシスタントとして、私は個人的な経験や意見を持っていません。しかし、現在の傾向と研究に基づいて、西暦3000年に存在する可能性のあるいくつかの技術的進歩についてお話しすることができます。 - 自給自足都市:都市は完全に自給自足となり、再生可能エネルギー源、垂直農法、廃棄物と水のリサイクルを備えているかもしれません。
回答B
西暦3000年から来たタイムトラベラーとして、私は以下の技術的進歩について人々に話します:1. 高度な人工知能:未来では、AIは非常に高度になり、現在人間が行っている多くの仕事を完全に自動化できます。これにより、多くの産業で生産性と効率が向上しています。
回答Aの評価
回答Bの評価
あなたの評価の包括的な説明
回答Xの方が優れていた理由は...
提出
図5:人間のアノテーターが使用したクラウドソーシングフォーム。 LLaMAモデル[57]。各隠れユニットの重みは異なる正規分布を持つことがわかりました。そのため、個々の隠れユニットごとに重みを検定します。つまり、重みに対して、out次元にわたって検定を行います。の有意水準を用いると、のニューロンが非正規分布であり、これは期待される偽陽性率より約多いことがわかりました。したがって、ほとんどすべての事前学習済み重みは正規分布しているように見えますが、例外があるようです。そのような例外は、外れ値の重み[13]によるものか、またはLLaMAのFFN層の隠れユニットで発生する大きなサンプルサイズではShapiro-Wilk検定のp値が正確でない[53]ためである可能性があります。これは、ニューラルネットワークの重みがという主張を検証します。
| モデル | Guanaco 65B | Guanaco 33B | Vicuna | ChatGPT-3.5 Turbo | Bard | Guanaco 13B | Guanaco 7B |
| Guanaco 65B | - | 0.21 | 0.19 | 0.16 | 0.72 | 0.59 | 0.86 |
| Guanaco 33B | -0.21 | - | 0.17 | 0.10 | 0.51 | 0.41 | 0.68 |
| Vicuna | -0.19 | -0.17 | - | 0.10 | 0.50 | 0.20 | 0.57 |
| ChatGPT-3.5 Turbo | -0.16 | -0.10 | -0.10 | - | 0.35 | 0.19 | 0.40 |
| Bard | -0.72 | -0.51 | -0.50 | -0.35 | - | 0.12 | 0.03 |
| Guanaco 13B | -0.59 | -0.41 | -0.20 | -0.19 | -0.12 | - | 0.20 |
| Guanaco 7B | -0.86 | -0.68 | -0.57 | -0.40 | -0.03 | -0.20 | - |
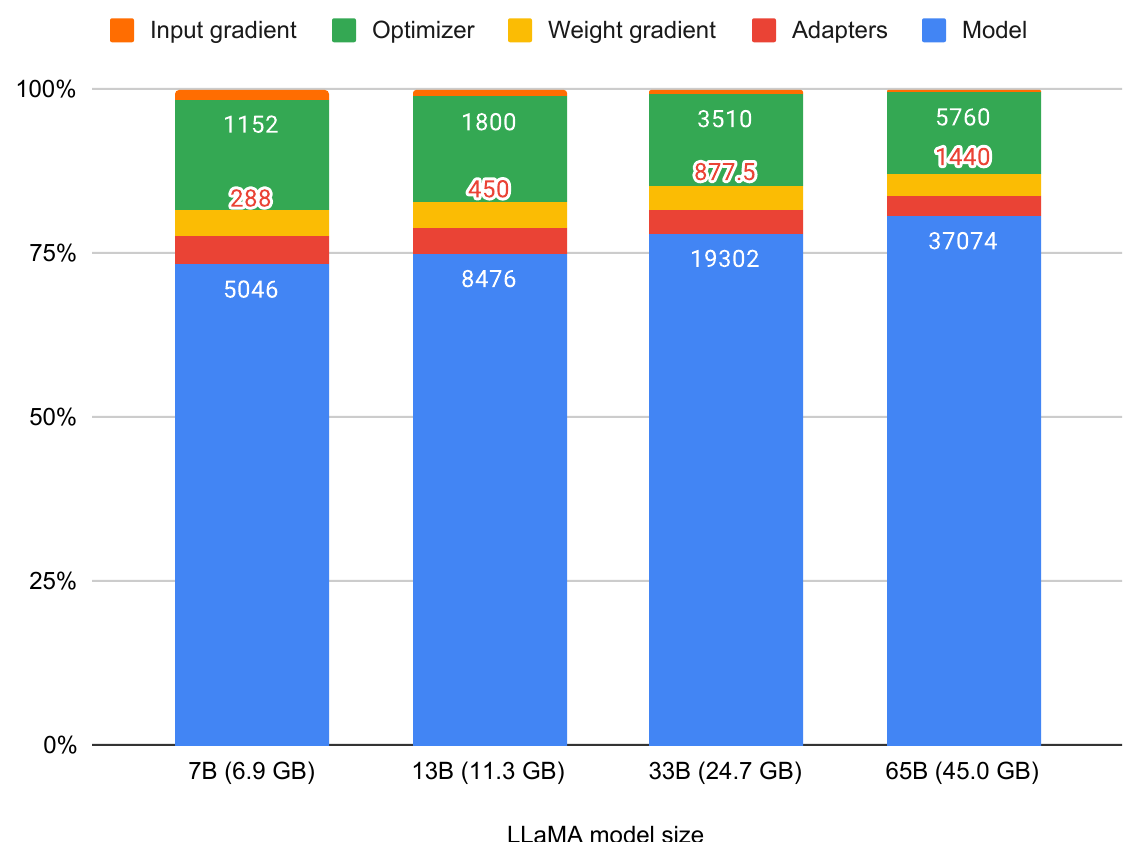
G メモリフットプリント
異なるLLaMAベースモデルを用いたQLoRAトレーニングのメモリフットプリントは図6で確認できます。33Bモデルは24 GBにかなり収まらず、それをトレーニングするにはページドオプティマイザが必要であることがわかります。また、バッチサイズ1、シーケンス長512、勾配チェックポイントが描かれています。つまり、より大きなバッチサイズを使用する場合、または長いシーケンスが処理される場合、活性化勾配がかなりの量のメモリを消費する可能性があります。
| モデル | パラメータ数 | サイズ |
| Guanaco | 65B | 41 GB |
| Guanaco | 33B | 21 GB |
| Vicuna | 13B | 26 GB |
| ChatGPT-3.5 Turbo | N/A | N/A |
| Bard | N/A | N/A |
| Guanaco | 13B | 10 GB |
| Guanaco | 7B | 5 GB |