
小型モデルが複数トークンを下書きし、大型モデルが一度に検証する。出力は変わらず推論だけ速くなる。ICML 2023、全文無料。
Fast Inference from Transformers via Speculative Decoding
Transformerからの高速推論:投機的デコーディングによる手法
Yaniv Leviathan \* 1 Matan Kalman \* 1 Yossi Matias 1
概要
Transformerのような大規模自己回帰モデルからの推論は遅い——個のトークンをデコードするには、モデルを回逐次的に実行する必要がある。本研究では、投機的デコーディング(speculative decoding)を導入する。これは、出力を一切変更することなく、複数のトークンを並列に計算することで自己回帰モデルからより高速にサンプリングするアルゴリズムである。我々のアプローチの核心には、(1) 難しい言語モデリングのタスクには、より効率的なモデルで十分に近似できる易しいサブタスクがしばしば含まれること、(2) 投機的実行と新規のサンプリング手法を用いることで、近似モデルの出力に対して大規模モデルを並列に実行し、場合によっては複数のトークンを同時に生成しつつ、分布を変更することなく、大規模モデルからの正確なデコーディングを高速化できること、という観察がある。我々の手法は、再学習やアーキテクチャの変更なしに、既存の市販モデルを高速化できる。我々はこれをT5-XXLで実証し、標準的なT5X実装と比較して、同一の出力を保ちながら2倍から3倍の高速化を達成したことを示す。
1. はじめに
大規模自己回帰モデル、特に大規模Transformer (Vaswani et al., [2017]) は、小規模モデルよりもはるかに高い能力を持つ。これは近年、テキストや画像の領域において、GPT-3 (Brown et al., [2020])、LaMDA (Thoppilan et al., [2022])、Parti (Yu et al., [2022])、PaLM (Chowdhery et al., [2022]) などで無数の例が示されている。残念ながら、これらの大規模モデルからの単一のデコードステップは、小規模な対応モデルからのステップよりも著しく遅く、さらに悪いことに、これらのステップは逐次的に行われる——個のトークンをデコードするには、モデルを回逐次的に実行する必要がある。
大規模自己回帰モデル、特に大規模Transformerの重要性を踏まえ、それらからの推論を高速化するためにいくつかのアプローチが開発されてきた。一部のアプローチは、すべての入力に対して推論コストを均等に削減することを目指す(例:Hinton et al., [2015]、Jaszczur et al., [2021]、Hubara et al., [2016]、So et al., [2021]、Shazeer [2019])。他のアプローチは、すべての推論ステップが同じように生まれるわけではない——あるものは非常に大規模なモデルを必要とするが、他のものはより効率的なモデルで十分に近似できる——という観察に基づく。これらの適応的計算手法(例:Han et al., [2021]、Sukhbaatar et al., [2019]、Schuster et al., [2021]、Scardapane et al., [2020]、Bapna et al., [2020]、Elbayad et al., [2019]、Schwartz et al., [2020])は、容易な推論ステップに対してより少ない計算資源を使用することを目指す。これらのソリューションの多くは実際に極めて有効であることが証明されているが、通常はモデルアーキテクチャの変更、学習手順の変更とモデルの再学習が必要であり、出力を同一に保つことはない。
上述の「一部の推論ステップは『難しい』が、一部は『易しい』」という重要な観察は、我々の研究の重要な動機でもある。我々はさらに、大規模モデルからの推論はしばしば算術演算ではなく、メモリ帯域幅と通信によってボトルネックとなるため、追加の計算資源が利用可能である場合があることを観察する。したがって、我々は適応的な計算量の使用に対する補完的なアプローチとして、並行性を高めることを提案する。具体的には、モデルアーキテクチャを変更せず、学習手順を変更せず、モデルの再学習も必要とせず、モデルの出力分布も変更することなく、推論を高速化できる。これは投機的実行によって達成される。
投機的実行(Burton, [1985]、Hennessy & Patterson, [2012])は、プロセッサで一般的な最適化手法であり、タスクが実際に必要かどうかを検証することと並行してタスクを実行する——その見返りは並行性の向上である。投機的実行のよく知られた例は分岐予測である。投機的実行を効果的にするには、必要とされる可能性が高いタスクを提案する効率的なメカニズムが必要である。本研究では、投機的実行を確率的設定に一般化する——そこではタスクがある確率で必要とされるかもしれない。これをTransformerのような自己回帰モデルからのデコーディングに適用し、より効率的な近似モデルから生成をサンプリングして、より遅いターゲットモデルの投機的プレフィックスとする。新規のサンプリング手法である投機的サンプリングにより、これらの投機的タスクが
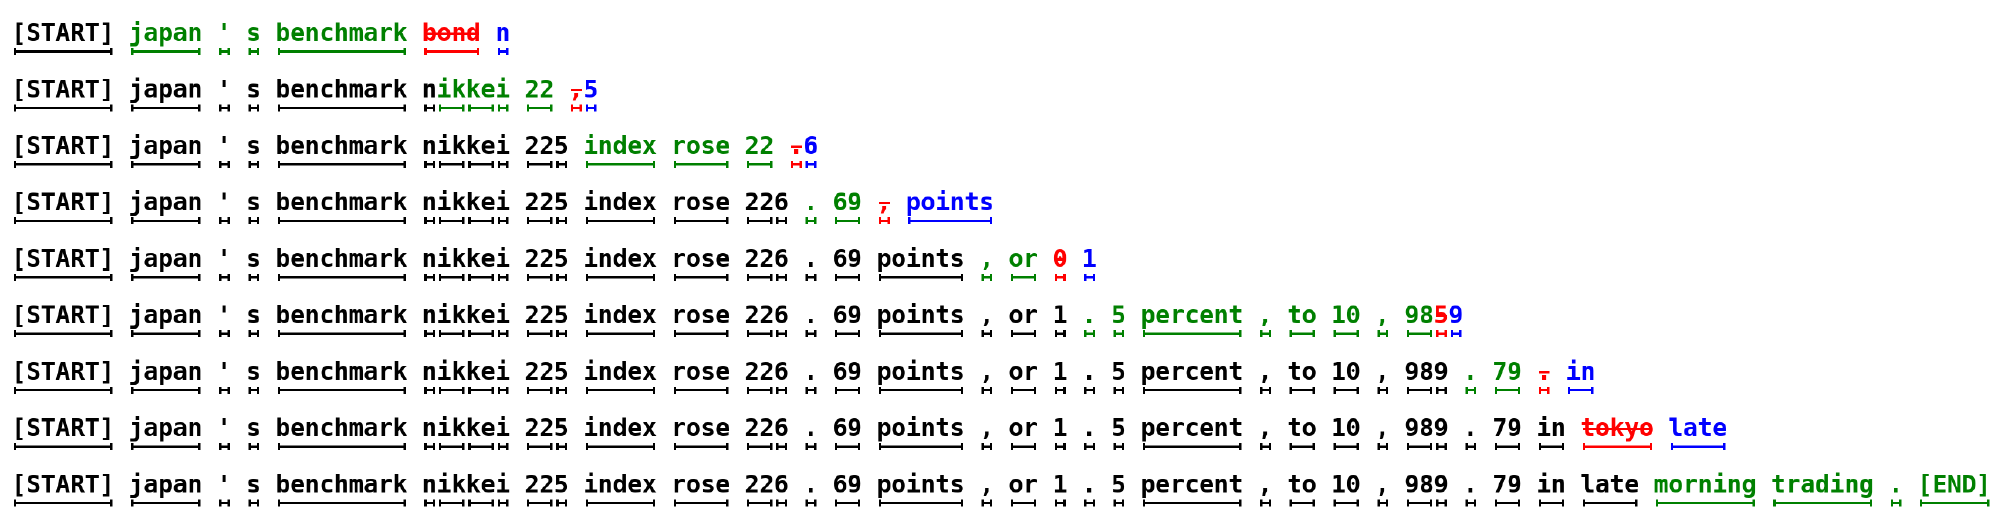
受け入れられる確率を最大化しつつ、我々のシステムからの出力がターゲットモデル単独からの出力と同じ分布を持つことを保証する。例えば、図1の38個のトークンからなる文は、我々の手法によって、より小さくより効率的な近似モデル(6Mパラメータ)のおかげで、より大規模なターゲットモデル(97Mパラメータ)をわずか9回逐次的に実行するだけで生成され、しかもそれを生成する確率は変わらない。
我々は様々なタスクとモデルサイズで我々の手法を分析する:1m1bで学習された97MパラメータのGPTライクなモデルからの無条件生成、11BパラメータのT5-XXLモデルを用いた英語からドイツ語への翻訳とニュース記事の要約、そして137BパラメータのLaMDAモデルを用いた対話タスクである。我々は手法を実装し、T5-XXLの実際のウォールタイムを堅牢なT5X実装(Roberts et al., 2022)と比較し、出力に一切の変更を加えることなく、すぐに使える形で2倍から3倍のレイテンシ改善を示す(第4節)。
我々の手法は実際の本番環境で容易に採用でき、新しいモデルの学習を必要とせず、出力を変更しない。したがって、メモリ帯域幅がボトルネックであり、計算資源が利用可能であるという一般的な状況において、Transformerのような自己回帰モデルからのサンプリングを高速化するための良いデフォルトとなり得る。
まとめると、我々の主な貢献は次のとおりである:(1) 投機的実行の確率的設定への一般化と、我々が投機的サンプリングと呼ぶ新規のサンプリング手法、(2) モデルアーキテクチャ、学習方式、出力分布に一切の変更を加えることなく、自己回帰モデルからのデコーディングを高速化できる、我々が投機的デコーディングと呼ぶデコーディング機構。
2. 投機的デコーディング
2.1. 概要
をターゲットモデルとし、そこからの推論を我々は高速化しようとしている。またを、プレフィックスに対してモデルから得られる分布とする。を同じタスクのためのより効率的な近似モデルとし、をプレフィックスに対してモデルから得られる分布とする。核心となるアイデアは、(1) より効率的なモデルを用いて個の補完を生成し(このパラメータを最適に選択する方法については第3.5節を参照)、次に(2) ターゲットモデルを用いて、すべての推測とそれに対応するからの確率を並列に評価し、同一の分布をもたらし得るものをすべて受け入れ、(3) 最初に拒否されたものを修正するために調整された分布から追加のトークンをサンプリングするか、すべてが受け入れられた場合には追加のものを1つ加える。このようにして、ターゲットモデルの各並列実行は少なくとも1つの新しいトークンを生成する(したがって、ターゲットモデルの逐次実行回数は、最悪の場合でも、単純な自己回帰手法よりも多くなることは決してない)が、がをどれだけよく近似するかに応じて、最大個の多数の新しいトークンを生成する可能性がある。
2.2. 標準化されたサンプリング
まず、argmax、top-k、nucleus、温度の設定など、サンプリングには多くの手法とパラメータがあり、一般的な実装は通常ロジットのレベルでそれらを異なる方法で扱うが、それらはすべて調整された確率分布からの標準的なサンプリングに容易に変換できることに注意する。例えば、argmaxサンプリングは、分布の最大でない要素をゼロにして正規化することと等価である。したがって、我々は確率分布からの標準的なサンプリングのみを扱うことができ、他のすべての種類のサンプリングをその枠組みに変換できる。以下では、とはそれぞれとからの分布であり、サンプリング手法に合わせて調整されているものと仮定する。
2.3. 投機的サンプリング
をサンプリングする代わりに、 をサンプリングし、 であればそれを保持し、 の場合は確率 でそのサンプルを棄却し、代わりに調整済み分布 から を再度サンプリングします。任意の分布 と 、およびこの方法でサンプリングされた に対して、実際に となることは簡単に示せます(付録 [A.1] 参照)。
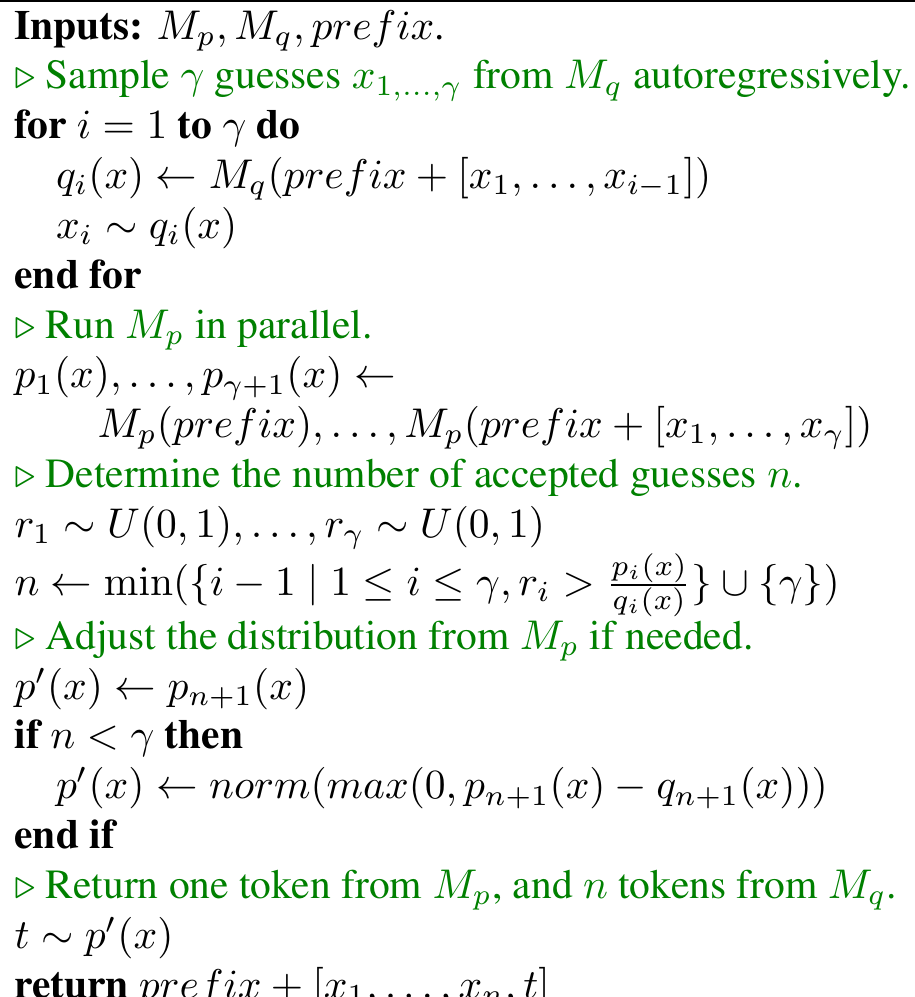
条件付け に対して を実行して得られた分布 が与えられると、トークン をサンプリングできます。次に、 に対して を実行して分布 を計算すると同時に、 に対して を実行して次のトークン の分布を投機的に並列計算します。両方の計算が完了したら、上記の手順に従って進めます。すなわち、 が棄却された場合は の計算を破棄し、調整済み分布から を再サンプリングし、 が受理された場合は両方のトークンを保持します。アルゴリズム [I] はこのアイデアを一般化し、一度に 1 から 個のトークンをサンプリングします。
アルゴリズム 1 SpeculativeDecodingStep
3. 分析
3.1. 生成されるトークン数
ターゲットモデルへの逐次呼び出し回数の削減率、すなわちアルゴリズム [I] の 1 回の実行で生成されるトークンの期待数を分析しましょう。
定義 3.1. プレフィックス が与えられたときの受理率 とは、セクション [2.3] に従い、投機的サンプリングによって が受理される確率です:
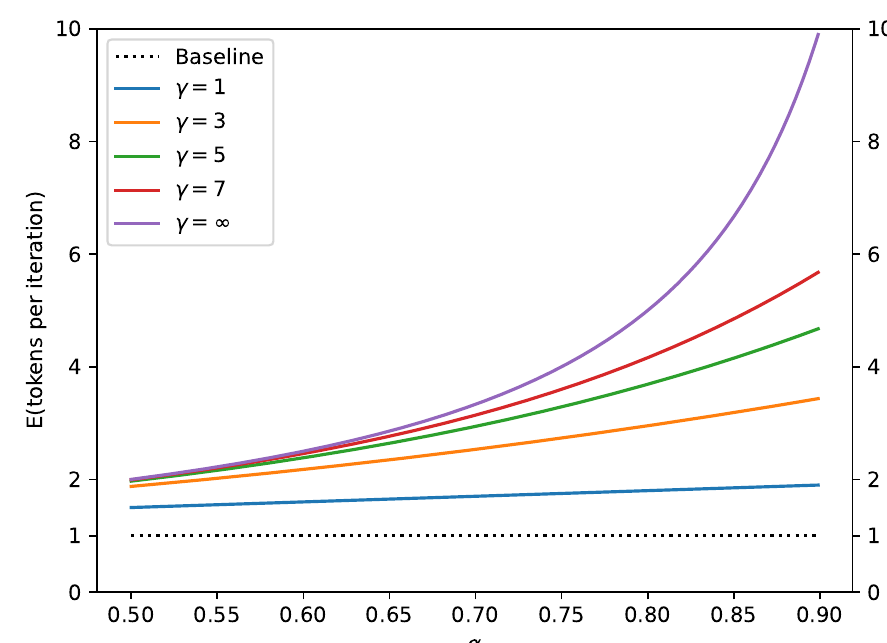
このとき は、 が をどれだけよく近似しているかの自然な尺度となります。 が独立同分布であると仮定し、 と表記すると、アルゴリズム [I] の 1 回の実行で生成されるトークン数は、成功確率 、上限 を持つ打ち切り幾何変数となり、アルゴリズム [I] によって生成されるトークンの期待数は式 [I] を満たします。図 [2] を参照してください。
3.2. の計算
次に、プレフィックスと 2 つのモデル 、 が与えられたときに を計算するための簡単な公式を導出します。まず、自然なダイバージェンス を定義します:
定義 3.2. ここで です。
補題 3.3.
証明。
補題[3.3]から、直ちに以下の結果が得られる:系3.4。 は における対称なダイバージェンスである。。 と のサポートが互いに素である。
定理3.5。
最終的に次が得られる:
系3.6。
我々の実験において経験的に観測された の値については表3を参照されたい。
3.3. 実時間(ウォールタイム)の改善
i.i.d.仮定の下では、我々のアルゴリズムがターゲットモデルへの呼び出し回数を 倍に削減することを示した。一般的な投機的実行、特に我々のアルゴリズムは、増加した並行性を支えるだけの計算資源があることを前提としていることに注意されたい(3.4節)。ウォールタイムの分析では、ウォールタイムを増加させることなく の 回の並行評価を並列に実行できると仮定する。総ウォールタイムの改善量を求めるために、次に近似モデル の実行コストを考える。
定義3.7。コスト係数 を、 の1回の実行時間と の1回の実行時間の比とする。
モデルとタスクの本質的な性質である とは異なり、 の値はハードウェア構成とソフトウェア実装の詳細に依存することに注意されたい。我々の実験では は通常 より2桁程度小さいため、 は常に0.05未満であり、しばしば無視できるほど0に近かった。
定理3.8。アルゴリズム1による総ウォールタイムの期待改善率は である。
証明。 の1ステップの実行コストを と表す。このとき、アルゴリズム1の各実行には のコストがかかり(近似モデル を 回実行し、 を1回実行するため)、式(1)によれば平均して 個のトークンを生成する。したがって、アルゴリズム1でトークンを生成する際の全体的な期待コストは である。標準的なデコーディングアルゴリズムで1つのトークンを生成するコストは であるから、求める結果が得られる。\(\square\)
定理3.8は十分に長い生成を仮定していることに注意されたい(例えば、 を少なくとも1回は実行するため、改善率は生成されるトークン数によって上限が定められる)。
系3.9。 ならば、改善が得られる が存在し、その改善率は少なくとも となる。
証明。ある で改善が得られるならば、任意の でも改善が得られる。したがって、我々の手法が改善をもたらすかどうかを評価するには、定理3.8を で評価すればよく、 が得られる。
3.4. 演算回数
アルゴリズム1は を 回並列に実行するため、同時演算回数は 倍に増加する。また、アルゴリズム1は1回の実行あたり最大 個のトークンを生成するため、総演算回数は標準的なデコーディングアルゴリズムより多くなる可能性がある。 からのサンプルを受理する場合、増加した並行性は「無料」であり、総演算回数は増加しない。しかし、推測を棄却する場合には計算が無駄になる。次に、我々の手法が総演算回数に与える影響を分析する。
定義3.10。 を、近似モデル のトークンあたりの演算回数とターゲットモデル のトークンあたりの演算回数の比とする。
定理3.11。アルゴリズム1の総演算回数の期待増加率は である。
証明。標準的なデコーディングのベースラインがトークンあたりに行う演算回数、すなわち の1回の実行の演算回数を と表す。このとき、アルゴリズム1の1回の反復には 回の演算がかかる( の 回の実行と の 回の並列実行のため)。これを、アルゴリズム1が生成する期待トークン数、すなわち式(1)と で割ることで、求める結果が得られる。
が低い場合、演算回数の増加は大きくなり、逆もまた同様である。Transformerデコーダの場合、アルゴリズム1による総演算回数( の実行を除く)は、同じサイズのTransformerエンコーダの1回の実行によって上から抑えられることに注意されたい。
算術演算の総数とは異なり、メモリアクセスの総数は我々の手法によって減少し得る。具体的には、ターゲットモデルの重みとKVキャッシュはアルゴリズム1の各実行につき一度だけ読み込まれ得るため、それらを読み込むためのメモリアクセスの回数は、式(1)によれば倍に減少する。
3.5. の選択
とが与えられ、十分な計算資源を仮定すると(セクション3.4参照)、最適なはウォールタイム改善の式(定理3.8)を最大化するものである:
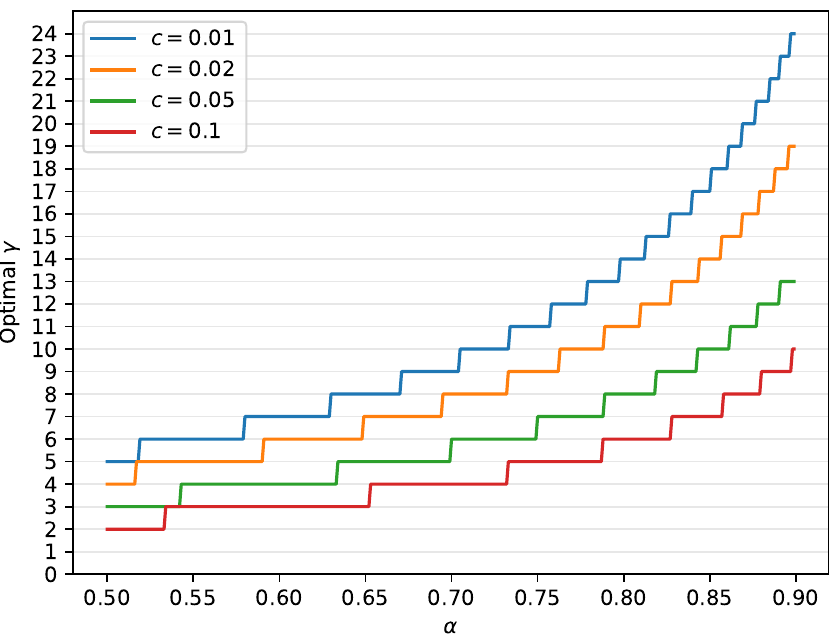
。は整数であるため、数値的に容易に求めることができる。図3を参照されたい。
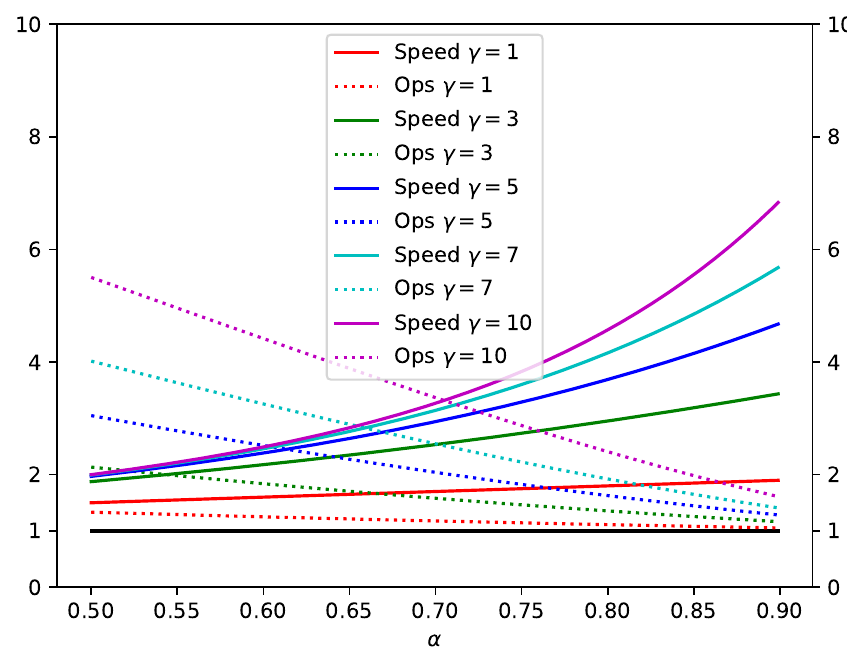
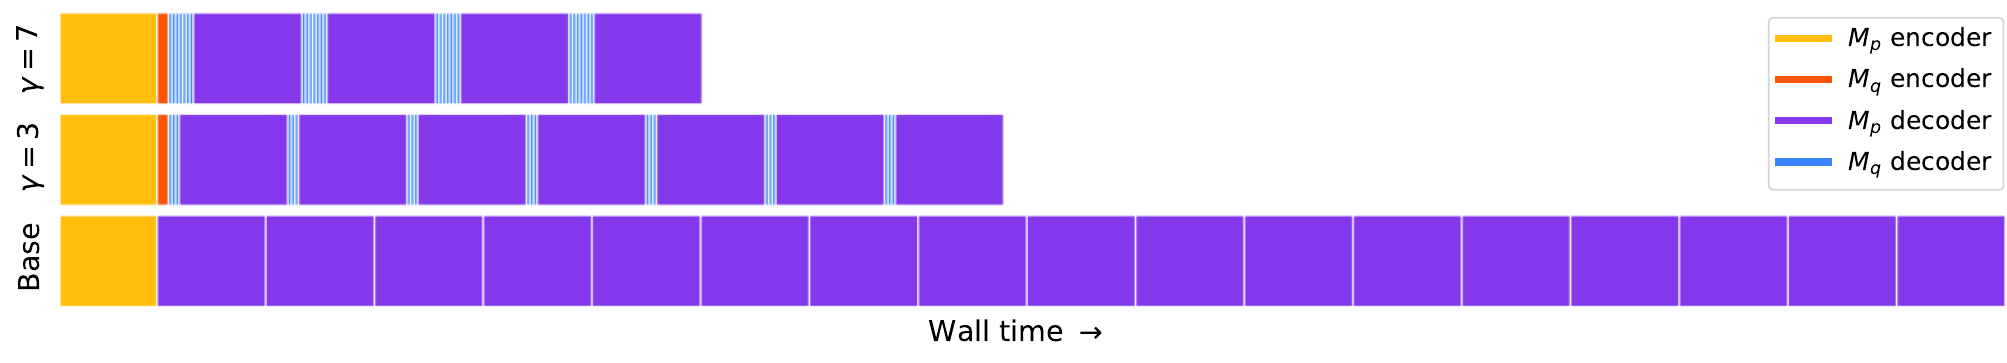
表1と図4は、を仮定した場合の、様々なとの値に対する推論速度と算術演算の総数の間のトレードオフを示している。図5は簡略化したトレース図を示している。
| α | γ | 演算数 | 速度 |
| 0.6 | 2 | 1.53X | 1.96X |
| 0.7 | 3 | 1.58X | 2.53X |
| 0.8 | 2 | 1.23X | 2.44X |
| 0.8 | 5 | 1.63X | 3.69X |
| 0.9 | 2 | 1.11X | 2.71X |
| 0.9 | 10 | 1.60X | 6.86X |
は一定ではないため、に基づいて単一のの値を選ぶ代わりに、の値を予測し、それに応じてアルゴリズム1の実行中にの値を変化させることで、さらなる改善を得ることができる。追加の改善係数の上限を得るために、に関するオラクルがあると仮定しよう。その場合、となる。との典型的な値に対して、無制限の計算資源を仮定すると、強化されたウォールタイム改善係数は、固定のによる改善係数よりも最大で約60%高くなり得る。この探求は今後の課題とする。
3.6. 近似モデル
投機的サンプリング、ひいては投機的デコーディングは、近似モデルの選択がいかなるものであっても、無制限に同一の出力分布を保証する(付録A.1参照)。我々の実験では、主に既存の市販のより小さなTransformerを近似モデルとしてテストした。さらに、我々はターゲットモデルと同じアーキテクチャを持ち、同じ確率標準化を用いる近似モデルのみをテストした。この設定では、をよりも約2桁小さく選ぶことが、とのバランスを取る上で通常最もうまく機能した(定理3.8)。
別の種類の近似モデルである無視できるコストのモデルとは、となるもの、すなわちターゲットモデルに対して無視できるコストの近似モデルである。この場合、期待されるウォールタイム改善はとなり、これは上からで抑えられる(が大きければ等号に近づく)。興味深い無視できるコストの近似モデルの一種として、n-gramモデルがあり、その評価はテーブルルックアップに相当する。興味深いことに、実証実験(セクション4.2)では、このような自明なn-gramモデルに対しても非ゼロのが得られた。例えば、英独翻訳タスクにおいて、をT5-XXL 11B、を自明なバイグラムモデルとした場合、が得られ、で1.25倍の推論速度改善係数につながる。
他の単純なヒューリスティクスも無視できるコストの近似モデルとして使用できる。例えば、要約タスクやチャット形式のインターフェースのように長いシーケンスが繰り返される可能性が高い場合、一致するプレフィックスが見つかったときにコンテキストからトークンを単に
コピーする近似モデルは、高い値をもたらす可能性がある。これらのパラメータを持たない近似モデルは、本番環境の観点から展開がさらに簡単であるという追加の利点を持つ。
投機的デコーディングで使用できる別の種類の近似モデルは、Sternら[2018]によるもののような非自己回帰モデルである。その場合、アルゴリズム1の自己回帰ループの代わりに、非自己回帰モデルを一度呼び出すだけでよい。
最後の例は、主に理論的な観点から興味深いものであるが、トークンをランダムに選ぶ近似モデルであり、これはすべてのモデルに対してある程度の改善(ただし非常に小さい)を保証する。
4. 実験
4.1. 実証的なウォールタイム改善
我々はアルゴリズムを実装し、T5-XXLの高速化のためにT5Xコードベースの実装と比較する。
セットアップ 我々は、標準的なエンコーダ・デコーダ型のT5バージョン1.1モデル(Raffel et al., [2020])を、T5論文の2つのタスクでテストする:(1)WMT EnDeでファインチューニングされた英語からドイツ語への翻訳、および(2)CNN/DMでファインチューニングされたテキスト要約である。両タスクにおいて、 にはT5-XXL(11B)を用いる。近似モデル については、いくつかの既存の構成、すなわちT5-large(800M)、T5-base(250M)、T5-small(77M)をテストする(Raffel et al., [2020])。すべてのモデルには既存のチェックポイントを用いる。我々は、単一のTPU-v4上でバッチサイズ1とし、argmaxサンプリング(temp=0)と標準サンプリング(temp=1)の両方について、実時間(walltime)の改善を測定する。
結果 表2は我々の手法による実証結果を示す。T5-small(77M)が、 と の良好なバランスにより、テストした近似モデルの中で最高の高速化を提供することがわかる。予想通り、 は近似モデルのサイズとともに増加することがわかる。興味深いことに、 と実時間の改善はargmaxサンプリング(temp=0)の方が高い。翻訳タスクでは2.6倍(temp=1)および3.4倍(temp=0)の高速化が観測され、要約タスクではやや低い2.3倍(temp=1)および3.1倍(temp=0)の高速化が観測された。これらの実証結果は理論的予測とよく一致しており、実装の詳細によるいくらかのばらつきがある(付録A.3を参照)。
| タスク | Mq | TEMP | γ | α | SPEED |
| ENDE | T5-SMALL ★ | 0 | 7 | 0.75 | 3.4X |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 2.8X |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 1.7X |
| ENDE | T5-SMALL ★ | 1 | 7 | 0.62 | 2.6X |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 2.4X |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 1.4X |
| CNNDM | T5-SMALL ★ | 0 | 5 | 0.65 | 3.1X |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 3.0X |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 2.2X |
| CNNDM | T5-SMALL ★ | 1 | 5 | 0.53 | 2.3X |
| CNNDM | T5-BASE | 1 | 3 | 0.55 | 2.2X |
| CNNDM | T5-LARGE | 1 | 3 | 0.56 | 1.7X |
4.2. 実証的な 値
我々は手法をT5に対してのみ実装したが、さまざまなタスク、サンプリング手法、ターゲットモデル 、および近似モデル について 値を測定した。具体的には、以下の各設定について、 によって生成された10Kトークン上で系3.6の期待値を評価した。
GPTライク(97Mパラメータ) 我々は、lm1b(Chelba et al., [2013])で訓練された無条件言語生成において、デコーダのみのTransformerモデルをテストする。ここでのモデルは、Gelu活性化(Hendrycks & Gimpel, [2016])を用いたGPTライクなTransformerデコーダである。 については、6MパラメータのTransformerデコーダモデル:dim 256、フィードフォワードdim 1024、2層、4アテンションヘッド、ならびに単純なユニグラムおよびバイグラムモデルを実験した。 は97Mパラメータを持つ:dim 768、フィードフォワードdim 3072、12層、12アテンションヘッド。すべてのモデルで8kトークンのBertトークナイゼーション(Devlin et al., [2019])を用いた。
LaMDA(137Bパラメータ) 我々は、対話タスクにおいてデコーダのみのLaMDAモデルをテストした(Thoppilan et al., [2022])。 としてLaMDA 137Bの既存のチェックポイントを、 としてLaMDA 8B、LaMDA 2B、およびLaMDA 100Mを用いた。
T5-XXL(11Bパラメータ)モデルのセットアップについてはセクション4.1を参照されたい。
表3は、テストしたケースの 値をまとめたものである。ターゲットモデルより数桁小さい近似モデルは、0.5から0.9の間の 値を生成する傾向があることがわかる。興味深いことに、すべてのモデルにおいて、調整された分布が鋭いほど 値が高くなることも確認できる。最後に、取るに足らないユニグラムおよびバイグラム近似でさえ、無視できない 値を生み出すことを述べておく。例えば、英語からドイツ語への翻訳の場合、バイグラムモデルは 値が0.2であり、この場合 であるため、1.25倍の速度改善をもたらす。これはこの取るに足らない近似モデルにしては驚くほど高い(しかし、T5-smallを近似モデルとして用いて得られる高速化よりは依然として低い)。
5. 関連研究
大規模モデルからの推論の効率性は広く研究されてきた(Dehghani et al., [2021])。多くのアプローチは、一般に大規模モデルからの推論を、特にTransformerのような自己回帰モデルからの推論を高速化することを目的としている。数多くの技術が、すべてのトークンに対して推論をより効率的にしようと試みている。例えば、蒸留(Hinton et al., [2015])、スパース化(Jaszczur et al., [2021])、量子化(Hubara et al., [2016])、およびアーキテクチャの変更(So et al., [2021]; Shazeer [2019])である。我々のアプローチに近いのは、問題の難しさに応じて計算量を適応させる適応的計算手法である(Han et al., [2021])。例としては、入力の部分集合へのアテンション(Sukhbaatar et al., [2019])や早期終了(Schuster et al., [2021]; Scardapane et al., [2020]; Bapna et al., [2020]; Elbayad et al., [2019]; Schwartz et al., [2020])がある。特に、Wisdom of Committees(Schwartz et al., [2020])は既製のより小さなモデルを活用するが、適応的計算アプローチであるため、いつ停止するかを決定するためにヒューリスティックを用いており、ターゲットモデルの出力と同一の出力という保証を失っている。一般に、適応的計算手法は通常、モデル自体の中か補助モデルを用いて、計算のショートカットをいつ取ることができるかを学習する。通常、これらの手法は推論時間と演算回数の両方を節約するが、アーキテクチャの変更、訓練手順の変更、およびカスタムモデルの訓練または
| Mp | Mq | SMPL | α |
| GPT-LIKE(97M) | UNIGRAM | T=0 | 0.03 |
| GPT-LIKE(97M) | BIGRAM | T=0 | 0.05 |
| GPT-LIKE(97M) | GPT-LIKE(6M) | T=0 | 0.88 |
| GPT-LIKE(97M) | UNIGRAM | T=1 | 0.03 |
| GPT-LIKE(97M) | BIGRAM | T=1 | 0.05 |
| GPT-LIKE(97M) | GPT-LIKE(6M) | T=1 | 0.89 |
| T5-XXL(ENDE) | UNIGRAM | T=0 | 0.08 |
| T5-XXL(ENDE) | BIGRAM | T=0 | 0.20 |
| T5-XXL(ENDE) | T5-SMALL | T=0 | 0.75 |
| T5-XXL(ENDE) | T5-BASE | T=0 | 0.80 |
| T5-XXL(ENDE) | T5-LARGE | T=0 | 0.82 |
| T5-XXL(ENDE) | UNIGRAM | T=1 | 0.07 |
| T5-XXL(ENDE) | BIGRAM | T=1 | 0.19 |
| T5-XXL(ENDE) | T5-SMALL | T=1 | 0.62 |
| T5-XXL(ENDE) | T5-BASE | T=1 | 0.68 |
| T5-XXL(ENDE) | T5-LARGE | T=1 | 0.71 |
| T5-XXL(CNNDM) | UNIGRAM | T=0 | 0.13 |
| T5-XXL(CNNDM) | BIGRAM | T=0 | 0.23 |
| T5-XXL(CNNDM) | T5-SMALL | T=0 | 0.65 |
| T5-XXL(CNNDM) | T5-BASE | T=0 | 0.73 |
| T5-XXL(CNNDM) | T5-LARGE | T=0 | 0.74 |
| T5-XXL(CNNDM) | UNIGRAM | T=1 | 0.08 |
| T5-XXL(CNNDM) | BIGRAM | T=1 | 0.16 |
| T5-XXL(CNNDM) | T5-SMALL | T=1 | 0.53 |
| T5-XXL(CNNDM) | T5-BASE | T=1 | 0.55 |
| T5-XXL(CNNDM) | T5-LARGE | T=1 | 0.56 |
| LAMDA(137B) | LAMDA(100M) | T=0 | 0.61 |
| LAMDA(137B) | LAMDA(2B) | T=0 | 0.71 |
| LAMDA(137B) | LAMDA(8B) | T=0 | 0.75 |
| LAMDA(137B) | LAMDA(100M) | T=1 | 0.57 |
| LAMDA(137B) | LAMDA(2B) | T=1 | 0.71 |
| LAMDA (137B) | LAMDA (8B) | T=1 | 0.74 |
既存モデルの再訓練を必要とする。また、通常はモデルの出力を変化させる。上記の手法の多くはメモリ対演算回数の比率を改善するが、比率が高いままである場合には、これらの手法と我々の投機的デコーディング手法が相乗的に効果的であり得ることに注意する。
自己回帰モデルからのデコーディングを高速化するために投機的実行を活用する先行手法が2つある。Blockwise Parallel Decoding(Stern et al., [2018])は我々の研究と同様に複数のトークンを並列にデコードする。しかし、これは貪欲デコーディング(温度 )のみをサポートし、一般的な確率的設定はサポートせず、カスタムモデルの追加訓練を必要とし、同一の出力を保証するのではなく下流タスクの品質を維持することに焦点を当てている。Shallow Aggressive Decoding(SAD)(Sun et al., [2021])も我々の研究と同様に複数のトークンを並列にデコードする。我々の研究とは異なり、SADは入力の出力へのコピーのみをサポートし、一般的な近似モデルはサポートしないため、文法誤り訂正のように入力と出力が非常に類似している場合にのみ適している。さらに、Blockwise Parallel Decodingと同様に、SADは一般的な確率的サンプリング設定をサポートしていない。
我々の研究を最初に発表した後、投機的デコーディングの独立した実装(Chen et al., [2023])がChinchilla 70Bにおいて同様の2倍から2.5倍の改善を示した。
6. 議論
我々は、効率的な確率的投機的実行、すなわち確率的設定における投機的実行を可能にする投機的サンプリングを提示した。我々は、投機的デコーディングを介したTransformerのような自己回帰モデルからのデコーディングへのその影響を分析し、十分な計算資源が与えられれば、一般的な最適化実装であるT5Xと比較して実際に意味のある2倍から3倍の高速化が得られることを示した。
一般に投機的実行の、特に投機的デコーディングの一つの限界は、レイテンシが演算回数の増加を犠牲にして並行性の増加を通じて改善されることである。したがって、我々の手法は追加の計算資源が利用できない構成には役立たない。しかし、追加の計算資源が利用可能な一般的なケース(例えばメモリ帯域幅がボトルネックである場合)においては、我々の手法は大きな利点を伴う高速化を提供する:モデルアーキテクチャは変わらず、再訓練は不要であり、最も重要なことに、出力分布は同一に保たれることが保証される。我々の手法は実装が容易であり、カスタムスキームを開発・評価することなく、既製のモデルを用いた推論の高速化に使用できる。
今後の研究にはいくつかの方向性がある。重要なのは、投機的デコーディングとビーム探索との互換性をさらに調査することである(付録[A.4]参照)。また、我々の手法は既存の市販の近似モデルで大幅な高速化を実現するが、カスタム近似モデル(セクション[3.6])—例えばカスタムアーキテクチャ(カスタムサイズ、非自己回帰モデル、各種ヒューリスティクスなど)やカスタム訓練手順(からのソフトターゲットを用いた標準的な蒸留、あるいはに対して直接を最適化するなど)—によって、より大きな改善が得られる可能性がある。アルゴリズムの階層的バージョンを探索することも興味深いかもしれない。そこでは近似モデル自体がさらに高速なモデルによって加速され、より能力の高い近似モデルが可能になる。本研究では推論全体を通じて近似モデルと推測数を固定したが、推論中にこれらを変化させることで追加の改善が得られる可能性がある(セクション[3.5])。我々の実験では、近似モデルが生成する分布に対して、ターゲットモデルに望まれるものと同じ標準化を常に適用した(セクション[2.2])が、異なる変換を適用することでさらなる改善が得られるかもしれない。我々は投機的デコーディングをテキストモダリティでのみテストしたが、他の領域(例えば画像)でもうまく機能する可能性があり、実験するのは興味深いだろう。
最後に、確率的投機的実行と投機的サンプリングは、自己回帰モデルからの投機的デコーディングの範囲外でも有用であり得ることに言及する。例えば、2つの遅い関数とが与えられ、がの入力がサンプリングされる分布を生成する場合、我々の手法を用いてとを並列に実行できる。このような設定は、例えば物理シミュレーションや、が行動に関する分布を生成する大規模モデルでありが世界シミュレーションである強化学習において生じる可能性があり、探索するのは興味深いだろう。
謝辞
LaMDA関連のすべてにおいて助けていただき、本論文のLaMDAの図を計算していただいたYaGuang Liに、またXLAに関する優れた洞察と助けをいただいたBlake Hechtmanに、特別な感謝を捧げる。また、洞察に満ちたコメントをいただいたレビュアーの皆様、ならびにAsaf Aharoni、Reiner Pope、Sasha Goldshtein、Nadav Sherman、Eyal Segalis、Eyal Molad、Dani Valevski、Daniel Wasserman、Valerie Nygaard、Danny Vainstein、GoogleのLaMDAチームとTheta Labsチーム、そして我々の家族に感謝する。
参考文献
Bapna, A., Arivazhagan, N., and Firat, O. Controlling computation versus quality for neural sequence models. ArXiv, abs/2002.07106, 2020.
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert- Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., Hesse, C., Chen, M., Sigler, E., Litwin, M., Gray, S., Chess, B., Clark, J., Berner, C., McCandlish, S., Radford, A., Sutskever, I., and Amodei, D. Language models are few- shot learners. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS'20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
Burton, F. W. Speculative computation, parallelism, and functional programming. IEEE Transactions on Computers, C- 34(12):1190- 1193, 1985. doi: 10.1109/TC.1985.6312218.
Chelba, C., Mikolov, T., Schuster, M., Ge, Q., Brants, T., Koehn, P. T., and Robinson, T. 統計的言語モデリングの進歩を測定するための10億語ベンチマーク。In Interspeech, 2013.
Chen, C., Borgeaud, S., Irving, G., Lespiau, J.- B., Sifre, L., and Jumper, J. M. 投機的サンプリングによる大規模言語モデルのデコーディングの高速化。ArXiv, abs/2302.01318, 2023.
Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N. M., Prabhakaran, V., Reif, E., Du, N., Hutchinson, B. C., Pope, R., Bradbury, J., Austin, J., Isard, M., Gur- Ari, G., Yin, P., Duke, T., Levskaya, A., Ghemawat, S., Dev, S., Michalewski, H., Garcia, X., Misra, V., Robinson, K., Fedus, L., Zhou, D., Ippolito, D., Luan, D., Lim, H., Zoph, B., Spiridonov, A., Sepassi, R., Dohan, D., Agrawal, S., Omernick, M., Dai, A. M., Pillai, T. S., Pelat, M., Lewkowycz, A., Moreira, E., Child, R., Polozov, O., Lee, K., Zhou, Z., Wang, X., Saeta, B., Diaz, M., Firat, O., Catasta, M., Wei, J., Meier- Hellstern, K. S., Eck, D., Dean, J., Petrov, S., and Fiedel, N. Palm: Pathwaysによる言語モデリングのスケーリング。ArXiv, abs/2204.02311, 2022.
Dehghani, M., Arnab, A., Beyer, L., Vaswani, A., and Tay, Y. 効率性という誤称。ArXiv, abs/2110.12894, 2021.
Devlin, J., Chang, M.- W., Lee, K., and Toutanova, K. Bert: 言語理解のための深層双方向トランスフォーマーの事前学習。ArXiv, abs/1810.04805, 2019.
Elbayad, M., Gu, J., Grave, E., and Auli, M. 深さ適応型トランスフォーマー。ArXiv, abs/1910.10073, 2019.
Han, Y., Huang, G., Song, S., Yang, L., Wang, H., and Wang, Y. 動的ニューラルネットワーク:サーベイ。IEEE Transactions on Pattern Analysis and Machine Intelligence, 44: 7436- 7456, 2021.
Hendrycks, D. and Gimpel, K. ガウス誤差線形ユニットによる非線形性と確率的正則化器の橋渡し。ArXiv, abs/1606.08415, 2016.
Hennessy, J. L. and Patterson, D. A. コンピュータアーキテクチャ:定量的アプローチ。Morgan Kaufmann, Amsterdam, 第5版, 2012. ISBN 978- 0- 12- 383872- 8.
Hinton, G. E., Vinyals, O., and Dean, J. ニューラルネットワークにおける知識の蒸留。ArXiv, abs/1503.02531, 2015.
Hubara, I., Courbariaux, M., Soudry, D., El- Yaniv, R., and Bengio, Y. 量子化ニューラルネットワーク:低精度の重みと活性化によるニューラルネットワークの学習。ArXiv, abs/1609.07061, 2016.
Jaszczur, S., Chowdhery, A., Mohiuddin, A., Kaiser, L., Gajewski, W., Michalewski, H., and Kanerva, J. トランスフォーマーのスケーリングにおいてスパース性で十分である。In Neural Information Processing Systems, 2021.
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., and Liu, P. J. 統一的なテキスト-to-テキストトランスフォーマーによる転移学習の限界の探求。The Journal of Machine Learning Research, 21(1):5485- 5551, 2020.
Roberts, A., Chung, H. W., Levskaya, A., Mishra, G., Bradbury, J., Andor, D., Narang, S., Lester, B., Gaffney, C., Mohiuddin, A., Hawthorne, C., Lewkowycz, A., Salcianu, A., van Zee, M., Austin, J., Goodman, S., Soares, L. B., Hu, H., Tsvyashchenko, S., Chowdhery, A., Bastings, J., Bulian, J., Garcia, X., Ni, J., Chen, A., Kenealy, K., Clark, J., Lee, S., Garrette, D. H., Lee- Thorp, J., Raffel, C., Shazeer, N. M., Ritter, M., Bosma, M., Passos, A., Maitin- Shepard, J. B., Fiedel, N., Omernick, M., Saeta, B., Sepassi, R., Spiridonov, A., Newlan, J., and Gesmundo, A. 5xとseqioによるモデルとデータのスケーリング。ArXiv, abs/2203.17189, 2022.
Scardapane, S., Scarpiniti, M., Baccarelli, E., and Uncini, A. なぜニューラルネットワークに早期出口を追加すべきなのか?Cognitive Computation, 12(5):954- 966, 2020.
Schuster, T., Fisch, A., Jaakkola, T., and Barzilay, R. 自信に基づく適応型トランスフォーマーによる一貫した高速推論。In Conference on Empirical Methods in Natural Language Processing, 2021.
Schwartz, R., Stanovsky, G., Swayamdipta, S., Dodge, J., and Smith, N. A. 仕事に適したツール:モデルとインスタンスの複雑さのマッチング。In Annual Meeting of the Association for Computational Linguistics, 2020.
Shazeer, N. M. 高速トランスフォーマーデコーディング:必要な書き込みヘッドは1つだけ。ArXiv, abs/1911.02150, 2019.
So, D. R., Ma'ake, W., Liu, H., Dai, Z., Shazeer, N. M., and Le, Q. V. Primer: 言語モデリングのための効率的なトランスフォーマーの探索。ArXiv, abs/2109.08668, 2021.
Stern, M., Shazeer, N., and Uszkoreit, J. 深い自己回帰モデルのためのブロックワイズ並列デコーディング。Advances in Neural Information Processing Systems, 31, 2018.
Sukhbaatar, S., Grave, E., Bojanowski, P., and Joulin, A. トランスフォーマーにおける適応型アテンションスパン。In Annual Meeting of the Association for Computational Linguistics, 2019.
Sun, X., Ge, T., Wei, F., and Wang, H. 浅いアグレッシブデコーディングによる即時文法誤り訂正。ArXiv, abs/2106.04970, 2021.
Thoppilan, R., Freitas, D. D., Hall, J., Shazeer, N. M., Kulshreshtha, A., Cheng, H.- T., Jin, A., Bos, T., Baker, L., Du, Y., Li, Y., Lee, H., Zheng, H., Ghafouri, A., Menegali, M., Huang, Y., Krikun, M., Lepikhin, D., Qin, J., Chen, D., Xu, Y., Chen, Z., Roberts, A., Bosma, M., Zhou, Y., Chang, C.- C., Krivokon, I. A., Rusch, W. J., Pickett, M., Meier- Hellstern, K. S., Morris, M. R., Doshi, T., Santos, R. D., Duke, T., Soraker, J. H., Zevenbergen, B., Prabhakaran, V., Díaz, M., Hutchinson, B., Olson, K., Molina, A., Hoffman- John, E., Lee, J., Aroyo, L., Rajakumar, R., Butryna, A., Lamm, M., Kuzmina, V. O., Fenton, J., Cohen, A., Bernstein, R., Kurzweil, R., Aguera- Arcas, B., Cui, C., Croak, M., hsin Chi, E. H., and Le, Q. Lamda: 対話アプリケーションのための言語モデル。ArXiv, abs/2201.08239, 2022.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., and Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Yu, J., Xu, Y., Koh, J. Y., Luong, T., Baid, G., Wang, Z., Vasudevan, V., Ku, A., Yang, Y., Ayan, B. K., Hutchinson, B. C., Han, W., Parekh, Z., Li, X., Zhang, H., Baldridge, J., and Wu, Y. Scaling autoregressive models for content-rich text- to- image generation. ArXiv, abs/2206.10789, 2022.
A. 付録
A.1. 投機的サンプリングの正当性
ここでは、任意の分布 および に対して、 と から投機的サンプリングによってサンプリングされたトークンが、 のみからサンプリングされたトークンと同一の分布に従うことを示す。 を受理確率とする(定義3.1)。
であるから、調整後の分布 の正規化定数は である。ここで、最後の等式は補題3.3および定理3.5から直ちに従う。
今、以下が成り立ちます。
ここで、
および、
全体としては、
となり、意図したとおりです。
A.2. 投機的サンプリングと棄却サンプリング
棄却サンプリングは、一見すると我々の手法に似ている以下の反復サンプリング手順です。
1. および をサンプリングする。
2. もし なら を返す。
3. 1 に戻る。
ここで です。投機的サンプリングの代わりに、棄却サンプリングの非反復版を採用することもできます。具体的には、上記のステップ 1 と 2 を行い、そうでなければ修正されていない から直接サンプリングします。しかし、それは我々の手法よりはるかに非効率でしょう。具体的には、ここでの期待採択確率は であり、我々の手法における期待採択確率 よりも(場合によってははるかに)低くなります。
A.3. 理論的予測と実測実行時間
表 4 は、定理 3.8 に基づく期待実行時間改善率と、表 2 の実測実行時間を比較しています。我々はプロファイラのトレースに基づいて、各種モデルに対する の値を推定しました。理論的予測はおおむね実測実行時間と一致していることがわかります。より大きな差は、(1) 我々の実装とベースラインの間の最適化の違い、および (2) が独立同一分布に従うという単純化仮定が近似にすぎないこと(セクション 3.1 を参照)に起因します。
| タスク | MQ | TEMP | γ | α | c | EXP | EMP |
| ENDE | T5-SMALL | 0 | 7 | 0.75 | 0.02 | 3.2 | 3.4 |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 0.04 | 3.3 | 2.8 |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 0.11 | 2.5 | 1.7 |
| ENDE | T5-SMALL | 1 | 7 | 0.62 | 0.02 | 2.3 | 2.6 |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 0.04 | 2.4 | 2.4 |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 0.11 | 2.0 | 1.4 |
| CNNDM | T5-SMALL | 0 | 5 | 0.65 | 0.02 | 2.4 | 3.1 |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 0.04 | 2.6 | 3.0 |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 0.11 | 2.0 | 2.2 |
| CNNDM | T5-SMALL | 1 | 5 | 0.53 | 0.02 | 1.9 | 2.3 |
| CNNDM | T5-BASE | 1 | 3 | 0.55 | 0.04 | 1.8 | 2.2 |
| CNNDM | T5-LARGE | 1 | 3 | 0.56 | 0.11 | 1.6 | 1.7 |
表 4. 期待改善率(Exp)と実測改善率(EMP)。
A.4. ビームサーチへの応用
本手法は、多少の性能低下を伴いますが、ビームサーチサンプリングにも適用できます。元のビーム幅 が与えられたとき、近似モデル とビーム幅 を用いて ステップのビームサーチを行えます。次に、 を用いてすべての候補を並列に検査します( の 回の実行に相当する計算予算を要します)。最後に、各ステップで である限り の推測を採択することにより、 単独での通常のビームサーチと同一の結果が得られます(より精巧な手順を用いれば、得られた候補がたまたま 単独の場合よりも高い確率を持つケースも採択できます)。この設定における本手法の解析はより複雑であり、今後の課題とします。
A.5. 寛容性
アルゴリズム の強い性質は、出力分布が変わらないことが保証される点です。とはいえ、良好な保証付きで多少の変化を許容するのであれば、さらなる推論速度の改善が得られます。これをさらに動機づけるために、同一のアーキテクチャとサイズを持つ 2 つのモデルを同じデータセットで訓練した場合、生成される確率分布は同一にはならないため、ある程度の寛容性が理にかなう場合があることに注意してください。本節を除く本論文の結果は、アルゴリズム の最も厳格なバージョンを用いており、いかなる種類の寛容性も許容していないことに注意してください。
寛容性パラメータ を含め、アルゴリズム において と比較する前に に を掛けることもできます。これにより、どのトークンも を超える確率でサンプリングされないという良好な保証が依然として維持されます。これは例えば、 の場合、どのトークンも真の確率の 10 倍を超える確率ではサンプリングされないことを意味するため、極めて稀なトークンは極めて稀なままであることを保証できます(最小確率に関する保証はないため、寛容性はサンプルの多様性を損なう可能性があります)。
具体的には、寛容性因子 を用いると、\begin{array}{r l r}{{\alpha}~=}&{{}E_{x\sim q(x)}\left\{\begin{array}{l l}{1}&{l q(x)\leq p(x)}\\ {\frac{p(x)}{l q(x)}}&{l q(x)>p(x)}\end{array}\right.}&{{}=}&{{}E_{x\sim q(x)}\frac{p(x)}{m a x(p(x),l q(x))}}}\end{array} となります。
表 5 は、 が T5-XXL (11B) で が T5-small (77M) の場合の、標準サンプリングにおけるさまざまな の値に対する の値を示しています。 において、寛容性の値 1、0.5、0.3、0.1(つまり、どのトークンも真の確率の 1 倍、2 倍、3 倍、10 倍を超える確率ではサンプリングされないことを意味します)を用いると、それぞれ 2.5 倍、3.1 倍、3.6 倍、5 倍の改善率が得られます。
| MQ | l = 1 | l = 0.5 | l = 0.3 | l = 0.1 |
| UNIGRAM | 0.07 | 0.1 | 0.11 | 0.16 |
| BIGRAM | 0.19 | 0.23 | 0.25 | 0.32 |
| T5-SMALL (77M) | 0.62 | 0.71 | 0.76 | 0.84 |
| T5-BASE (250M) | 0.68 | 0.8 | 0.83 | 0.90 |
表 5. が T5-XXL (11B) の EnDe 翻訳タスクにおける標準サンプリングでの、さまざまな の値に対する の値。
温度(すなわちargmaxサンプリング)を使用する場合、上記のような寛容さはもはや使用できないことに注意されたい。代わりに、分布を標準化する前にいくらかの寛容さを許容することができる。例えば、 の場合に、 からサンプリングされたトークン を受け入れることができる。この場合、温度 の場合と同様の 値の経験的な増加が測定される。例えば、英語-ドイツ語翻訳において T5-XXL と T5-small に対して寛容さの値1、0.5、0.3、0.1を使用すると、 値として0.75、0.75、0.8、0.87が得られる。例えば および とすると、それぞれ3.3倍、3.3倍、3.9倍、4.9倍の速度改善係数が得られる。7