
注意と状態空間モデルは同じ行列の二つの見方だと示し、より速い系列層を導く。ICML 2024、全文無料。
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
TransformersはSSMである:構造化状態空間双対性を通じた一般化モデルと効率的アルゴリズム
プリンストン大学計算機科学科 カーネギーメロン大学機械学習学科 tri@tridao.me, agu@cs.cmu.edu
概要
Transformerは言語モデリングにおける深層学習の成功を支える主要なアーキテクチャであり続けてきたが、Mambaのような状態空間モデル(SSM)は最近、小規模から中規模のスケールにおいてTransformerに匹敵するか、それを上回ることが示されている。我々は、これらのモデルファミリーが実は非常に密接に関連していることを示し、よく研究された構造化半分離行列のさまざまな分解を通じて結びつけられた、SSMとアテンションの変種との間の豊かな理論的関連の枠組みを構築する。我々の状態空間双対性(SSD)フレームワークにより、新しいアーキテクチャ(Mamba-2)を設計することが可能となる。その中核層はMambaの選択的SSMを改良したものであり、2~8倍高速でありながら、言語モデリングにおいてTransformerと競合し続ける。
1 はじめに
Transformer、特に入力系列を因果的に処理するデコーダのみのモデル(例:GPT(Brown et al. 2020)、Llama(Touvron, Lavril, et al. 2023))は、現代の深層学習の成功を支える主要な原動力の一つである。多くのアプローチが中核となるアテンション層を近似してその効率性の問題に対処しようと試みてきた(Tay et al. 2022)。例えば、学習時に系列長に対して二次関数的にスケールする問題や、自己回帰生成時に系列長に線形なサイズのキャッシュを必要とする問題である。並行して、代替の系列モデルのクラスである構造化状態空間モデル(SSM)が登場し、学習時には系列長に対して線形にスケールし、生成時には一定の状態サイズを持つ。これらは長距離タスク(例:S4(Gu, Goel, and Ré 2022))で強い性能を示し、最近では小規模から中規模のスケールにおいて言語モデリングでTransformerに匹敵するか、それを上回った(例:Mamba(Gu and Dao 2023))。しかしながら、SSMの発展は、Transformerを改善するためのコミュニティの集合的な取り組み、例えばそれらを理論的に理解することや現代のハードウェア上で最適化することとは、かけ離れているように見えた。その結果、SSMはTransformerと比較して理解や実験がより困難であり、アルゴリズムとシステムの両方の観点から、SSMをTransformerと同じくらい効率的に学習することは依然として困難である。
我々の主な目標は、構造化SSMとアテンションの変種との間の豊かな理論的関連の体系を構築することである。これにより、元々Transformerのために開発されたアルゴリズム的およびシステム的最適化をSSMに転用することが可能となり、系列長に対してより効率的にスケールしながらTransformerよりも優れた性能を発揮する基盤モデルを構築するという目標に向かうことができる。この方向における画期的な貢献は線形アテンション(LA)フレームワーク(Katharopoulos et al. 2020)であり、二次カーネル化アテンションと特定の線形再帰の「双対形式」の間の等価性を示すことで、自己回帰アテンションと線形RNNの間の関連を導出した。この双対性により、効率的に並列化可能な学習と効率的な自己回帰推論の両方を実現できるといった新しい能力が可能となる。同じ精神で、本論文は線形計算量のSSMと二次計算量の形式とを結びつける複数の視点を提供し、SSMとアテンションの強みを組み合わせる。
状態空間双対性。構造化SSMとアテンションの変種を結びつける我々のフレームワークは、構造化状態空間双対性(SSD)と呼ぶものであり、構造化行列、すなわち劣二次のパラメータ数と乗算計算量を持つ行列の抽象化を通じて構築される。我々は系列モデルを表現するための二つの広範なフレームワークを開発する。一つは行列変換として、もう一つはテンソル縮約としてであり、それぞれが双対性の異なる視点を明らかにする。我々の技術的貢献は以下の通りである:
- 我々は状態空間モデルと、半分離行列と呼ばれるよく研究された構造化行列のファミリーとの間の等価性を示す(第3節)。この関連は我々のフレームワークの中心にあり、SSMの新しい性質とアルゴリズムを明らかにする。本論文の中心的なメッセージは、状態空間モデルを計算するさまざまな方法が、構造化行列上のさまざまな行列乗算アルゴリズムとして再解釈できるということである。
- 我々は線形アテンション(Katharopoulos et al. 2020)の理論を大幅に改善する。まずテンソル縮約の言語を通じてその再帰形式の鋭い証明を与え、次にそれを構造化マスク付きアテンション(SMA)の新しいファミリーへと一般化する(第4節)。
- 我々はSSMとSMAを結びつけ、それらが互いの双対である大きな共通部分を持ち、SSM的な線形形式とアテンション的な二次形式の両方を備えることを示す(第5節)。また、高速な再帰形式を持つカーネルアテンション手法は必ずSSMでなければならないことを証明する。その内在的な理論的価値を超えて、我々のフレームワークは系列モデルの理解と改善のための広範な方向性を切り開く。
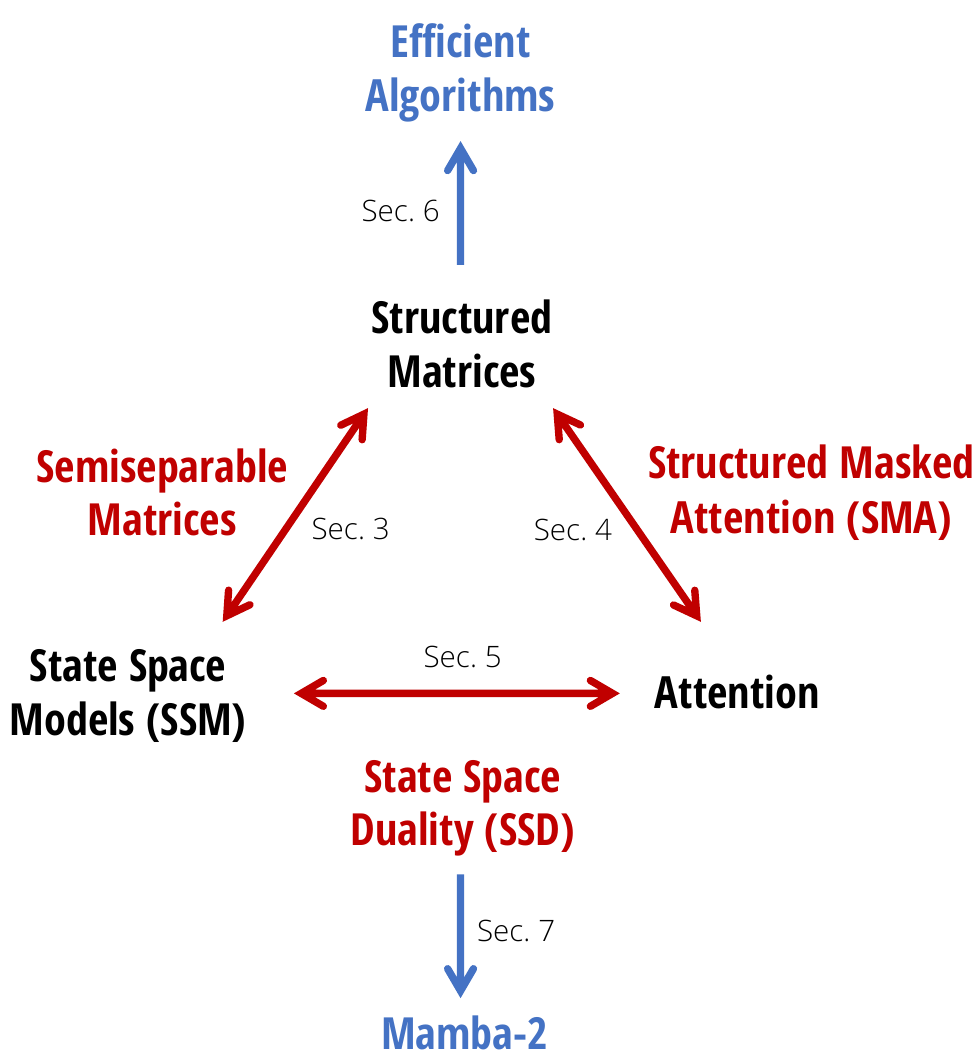
効率的アルゴリズム。まず最も重要なこととして、我々のフレームワークはSSMを計算するための新しい効率的で実装が容易なアルゴリズムを明らかにする(第6節)。我々は半分離行列のブロック分解に基づく新しいSSDアルゴリズムを導入する。これは線形SSM再帰と二次双対形式の両方を活用し、すべての主要な効率の軸(例えば学習と推論の計算量、メモリ使用量、現代のハードウェア上で行列乗算ユニットを活用する能力)において最適なトレードオフを得る。SSDの専用実装は、Mambaの最適化された選択的スキャン実装よりも高速であり、同時にはるかに大きな再帰状態サイズ(Mambaののサイズ、あるいはそれ以上でも最小限の速度低下で)を可能にする。SSDはソフトマックスアテンションの最適化された実装(FlashAttention-2(Dao 2024))と非常に競合的であり、系列長で交差し、系列長16Kでは高速である。
アーキテクチャ設計。SSMのような新しいアーキテクチャを採用する上での主要な障害の一つは、大規模学習のためのハードウェア効率の良い最適化や並列化技術など、Transformerに合わせて整備されたエコシステムである。我々のフレームワークにより、アテンションの確立された慣習や技術を用いてSSMのアーキテクチャ設計選択の語彙を構築し、さらにそれらを改善することが可能となる(第7節)。例えば、我々はマルチヘッドアテンション(MHA)のヘッドの類似物をSSMに導入する。Mambaアーキテクチャはマルチ入力SSM(MIS)であり、マルチバリューアテンション(MVA)に類似していることを示し、異なるヘッド構造を持つ他のMambaの変種と比較する。
我々はまたこれらのアイデアを用いてMambaブロックに軽微な変更を加え、テンソル並列性を実装できるようにする(例えばMegatron(Shoeybi et al. 2019)のスタイルで)。主なアイデアには、グループ化バリューアテンション(GVA)ヘッド構造の導入と、すべてのデータ依存の射影をブロックの先頭で並列に実行するように移動することが含まれる。
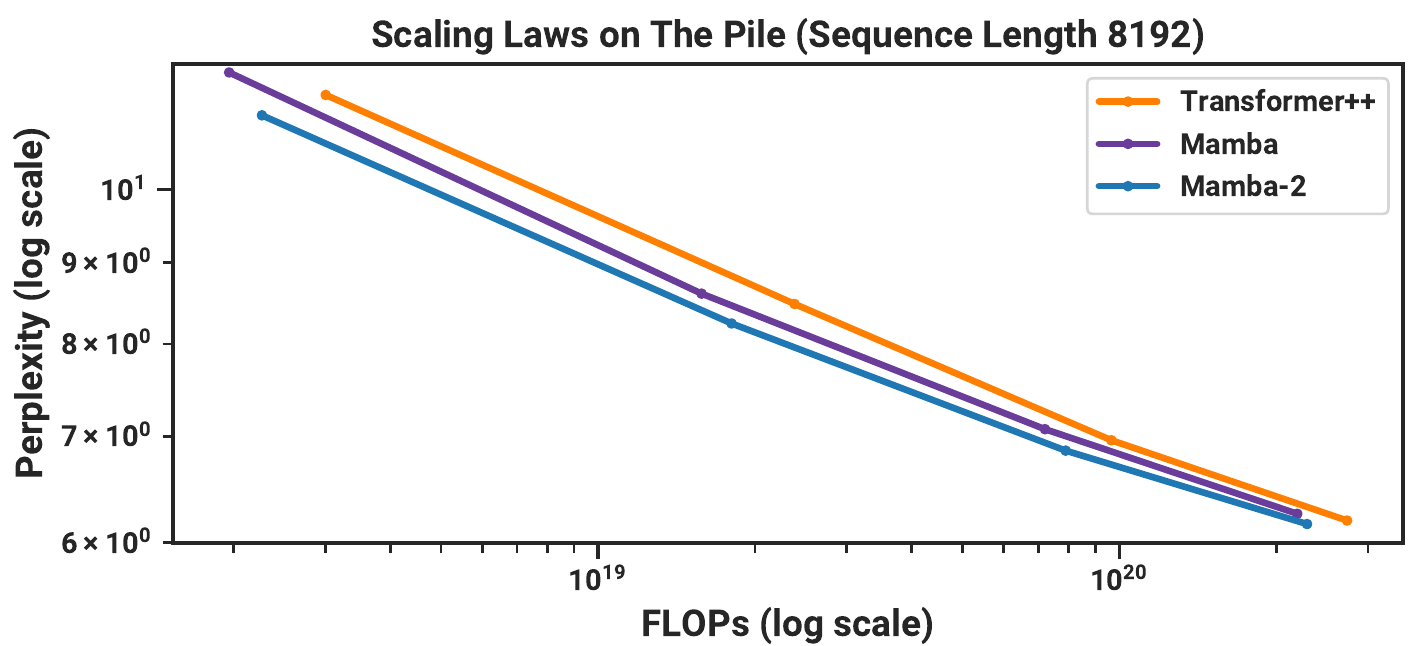
変更された並列Mambaブロックと、SSDを内部SSM層として使用することの組み合わせが、Mamba-2アーキテクチャをもたらす。我々はMambaと同じ設定でMamba-2のChinchillaスケーリング則を調査し、それがパープレキシティと実時間の両方においてMambaおよびTransformer++をパレート支配することを見出す。さらに我々はPile上でさまざまなサイズのMamba-2モデルのファミリーを学習し、それが標準的な下流評価においてMambaおよびオープンソースのTransformerに匹敵するか、それを上回ることを示す。例えば、Pile上で300Bトークンで学習された2.7BパラメータのMamba-2は、同じデータセットで学習されたMamba-2.8B、Pythia-2.8B、さらにはPythia-6.9Bをも上回る。
システム最適化。SSDフレームワークはSSMとTransformerを結びつけ、Transformerのために開発されたシステム最適化に関する豊富な研究を活用することを可能にする(第8節)。
- 例えば、テンソル並列性(TP)は、各層を同一ノード上のGPU間に分割することで大規模Transformerモデルを学習するための重要なモデル並列化技術である。我々はMamba-2をTPに優しい設計とし、ブロックあたりの同期ポイントの数を半分に削減する。
- 活性化が1つのデバイスに収まらない非常に長い系列に対しては、アテンションブロック向けに系列並列性が開発されている。我々は一般的にSSMを、特にMamba-2を、デバイス間で再帰状態を渡すことにより系列並列性を用いて学習する方法を記述する。
- 異なる長さの例を用いたファインチューニングにおいて、最高の効率を得るために、Transformerはパディングトークンを除去し可変長系列上でアテンションを実行するための洗練された技術を必要とする。我々はMamba-2がパディングトークンを必要とせず、可変系列長で効率的に学習できることを示す。
第9節は言語モデリング、学習効率、および困難なマルチクエリ連想想起タスク(Arora, Eyuboglu, Zhang, et al. 2024)においてMamba-2を実証的に検証する。最後に、第10節で拡張された関連研究を提供し、我々のフレームワークによって切り開かれる潜在的な研究方向について議論する。
モデルコードと事前学習済みチェックポイントは https://github.com/state-spaces/mamba でオープンソース化されている。
2 背景と概要
2.1 構造化状態空間モデル
構造化状態空間系列モデル(S4)は、深層学習のための最近の系列モデルのクラスであり、RNN、CNN、および古典的な状態空間モデルに広く関連している。それらは、暗黙の潜在状態を通じて1次元系列を写像する特定の連続系(1)に触発されている。
構造化SSMの一般的な離散形は式(1)の形をとる。
ここで である。構造化SSMがそのように名付けられたのは、この系列対系列変換を深層ニューラルネットワークで使用できるほど効率的に計算するために、時間的ダイナミクスを制御する 行列が構造化されている必要があるためである。最初に導入された構造は対角+低ランク(DPLR)(Gu, Goel, and Ré 2022)および対角(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023)であり、後者は最も普及している構造であり続けている。
本研究では、状態空間モデル(SSM)という用語を構造化SSMを指すものとして用いる。このようなSSMには多くの種類があり、連続時間モデル、リカレントモデル、畳み込みモデルといったニューラル系列モデルの主要なパラダイムと深く結びついている(Gu, Johnson, Goel, et al. 2021)。以下に简要な概観を示し、より詳しい背景と詳細については先行研究を参照されたい(Gu 2023; Gu and Dao 2023)。
連続時間モデル。元々の構造化SSMは、系列に直接作用するのではなく、関数 上の連続時間写像として生まれた。連続時間の観点では、式(1a)において行列 は直接学習されるのではなく、基礎となるパラメータ およびパラメータ化されたステップサイズ から生成される。「連続パラメータ」 は、固定の公式 および を通じて「離散パラメータ」 に変換される。ここで、組 は離散化規則と呼ばれる。
注1. 我々の主要なモデルは先行研究と同じパラメータ化と離散化ステップを採用しているが(詳細はGu and Dao (2023)を参照)、説明と表記を簡素化するため、本論文の残りの部分ではこれを省略する。先行研究の構造化SSMでは、連続パラメータと離散パラメータをそれぞれとと呼んでいたことに注意されたい。我々は表記を変更し、提示を簡素化するとともに、主要なSSMの再帰を支配する離散パラメータに直接焦点を当てている。
再帰モデル。式(1)と(2)は、入力に対して線形な再帰の形式をとる。したがって、構造化SSMは一種のリカレントニューラルネットワーク(RNN)と見なすことができ、この線形性が追加の性質を与え、従来のRNNの逐次計算を回避することを可能にする。逆に、この単純化にもかかわらず、SSMはシーケンス変換として(普遍近似の意味で)依然として完全に表現力を持つ(Kaul 2020; Orvieto et al. 2023; Shida Wang and Xue 2023)。
畳み込みモデル。式(1)のようにSSMのダイナミクスが時間を通じて一定である場合、そのモデルは線形時不変(LTI)と呼ばれる。この場合、それらは畳み込みと等価である。したがって、SSMは一種のCNNと見なすこともできるが、(i) 畳み込みカーネルがSSMパラメータを通じて暗黙的にパラメータ化されており、(ii) 畳み込みカーネルが一般に局所的ではなく大域的であるという点が異なる。逆に、古典的な信号処理理論を通じて、十分に性質の良いすべての畳み込みはSSMとして表現できる。
一般に、従来のLTI SSMは、効率的に並列化可能な訓練(入力シーケンス全体を事前に見る場合)には畳み込みモードを使用し、効率的な自己回帰推論(入力を1ステップずつ見る場合)には再帰モード(1)に切り替えていた。
選択的状態空間モデル。パラメータが時間とともに変化し得る形式(2)は、Mambaにおいて選択的SSMとして導入された。標準的なLTI定式化(1)と比較して、このモデルは各タイムステップにおいて入力に注目するか無視するかを選択的に選ぶことができる。言語のような情報密度の高いデータにおいて、LTI SSMよりもはるかに優れた性能を発揮することが示されており、特に状態サイズNが増加するにつれてより多くの情報容量が得られる。しかし、畳み込みモードではなく再帰モードでのみ計算可能であり、効率的にするにはハードウェアを意識した慎重な実装が必要である。それでもなお、行列乗算ユニットを活用しないため、GPUやTPUのような現代のアクセラレータが特化しているCNNやTransformerのようなハードウェアに優しいモデルよりも効率が劣る。
時不変SSMは連続的、再帰的、畳み込み的シーケンスモデルと密接に関連しているが、アテンションとは直接関係していない。本論文では、選択的SSMとアテンションの間のより深い関係を示し、それを用いてSSMの訓練速度を大幅に改善すると同時に、はるかに大きな状態サイズNを可能にする。
シーケンス変換としての構造化SSM。
定義2.1. 我々は「シーケンス変換」という用語を、シーケンス上のパラメータ化された写像を指すために用いる。ここでであり、は任意のパラメータの集合である。Tはシーケンスまたは時間軸を表し、添字は第1次元へのインデックスである。例えばである。
シーケンス変換(例えばSSMや自己アテンション)は深層シーケンスモデルの基盤であり、ニューラルネットワークアーキテクチャ(例えばTransformer)に組み込まれる。式(1)または(2)のSSMはのシーケンス変換であり、この次元にわたって単にブロードキャストすることにより(言い換えれば、入力を個の独立したシーケンスと見なし、それぞれにSSMを適用することにより)に一般化できる。はヘッド次元と考えることができ、これについては第7節で詳述する。
定義2.2. 我々はSSM演算子を、式(2)によって定義されるシーケンス変換 として定義する。
SSMにおいて、N次元は状態サイズまたは状態次元と呼ばれる自由パラメータである。またこれを状態拡張係数とも呼ぶ。なぜなら、入出力のサイズを倍に拡張し、これらのモデルの計算効率に影響を与えるからである。
最後に、アテンションのような多くの種類のシーケンス変換は、シーケンス次元にわたる単一の行列乗算として表現できることに言及する。
定義2.3. シーケンス変換がの形式で書けるとき、これを行列変換と呼ぶ。ここではパラメータに依存する行列である。我々はシーケンス変換を行列と同一視し、文脈から明らかな場合はへの依存をしばしば省略する。
2.2 アテンション
アテンションとは広く、系列内のすべての位置のペアに対してスコアを割り当てる計算の一種を指し、各要素が他の要素に「注意を向ける」ことを可能にする。はるかに最も一般的かつ重要なアテンションの変種はソフトマックス自己アテンションであり、次のように定義できる。
ここで である。ペアワイズ比較の機構( を実体化することによって誘導される)は、アテンションに特徴的な二次の訓練コストをもたらす。
アテンションの多くの変種が提案されてきたが、いずれもこれらのアテンションスコアという中核を共有しており、さまざまな近似を伴う(Tay et al. 2022)。本研究にとって最も重要な変種は線形アテンションである(Katharopoulos et al. 2020)。大まかに言えば、この手法群はソフトマックスをカーネル特徴写像に折り込むことで取り除き、行列積の結合性を用いて と書き換える。さらに、因果的(自己回帰的)アテンションという重要な場合において、因果マスクを左辺に として組み込むと(ここで は下三角の1の行列である)、右辺が漸化式として展開できることを示している。RetNet(Y. Sun et al. 2023)やGateLoop(Katsch 2023)など、最近のおよび同時期のいくつかの研究は、これをより一般的な形の へと強化している(第10節)。本研究における構造化マスク付きアテンションの定式化は、これらのアイデアを強く一般化するものである。
2.3 構造化行列
一般の行列 は、表現するために 個のパラメータを必要とし、行列ベクトル積のような基本操作を行うために の時間を要する。構造化行列とは、(i) 圧縮された表現を通じて準二次(理想的には線形)のパラメータで表現でき、(ii) この圧縮された表現を直接操作することによって高速なアルゴリズム(最も重要なのは行列積)を持つものである。
おそらく最も代表的な構造化行列の族は、疎行列と低ランク行列である。しかしながら、Toeplitz、Cauchy、Vandermonde、バタフライ行列など、他にも多くの族が存在し、これらはすべて効率的なモデルのために機械学習で用いられてきた(Dao, Gu, et al. 2019; D. Fu et al. 2024; Gu, Gupta, et al. 2022; Thomas et al. 2018)。構造化行列は、効率的な表現とアルゴリズムのための強力な抽象化である。本研究では、SSMがこれまで深層学習で用いられてこなかった別のクラスの構造化行列と等価であることを示し、この関連性を用いて効率的な手法とアルゴリズムを導出する。
2.4 概要:構造化状態空間双対性
本論文は、SSM、アテンション、構造化行列の間の関連性について、はるかに豊かな枠組みを展開するものであるが、ここでは主要な手法の簡潔な要約を示す。この手法は実際のところ、アルゴリズム的にはかなり自己完結的で単純である。
再帰(線形)形式。状態空間双対(SSD)層は、選択的SSM(2)の特殊ケースとして定義できる。SSMの標準的な計算を漸化式(または並列スキャン)として適用でき、これは系列長に対して線形の計算量を持つ。Mambaで用いられる版と比較して、SSDには2つの小さな違いがある。
上の構造が、対角構造からスカラー×単位行列構造へとさらに単純化される。この場合、各 も単にスカラーで同一視できる。Mambaで用いられる と比較して、より大きなヘッド次元 を用いる。通常、現代のTransformerの慣例に似て が選ばれる。
元の選択的SSMと比較して、これらの変更は、大幅な訓練効率の改善と引き換えに表現力をわずかに低下させるものと見なすことができる。特に、我々の新しいアルゴリズムは、現代のアクセラレータ上で行列積ユニットを使用することを可能にする。
双対(二次)形式。SSDの双対形式は、アテンションと密接に関連する二次の計算であり、次のように定義される。
ここで は [0, 1] に有界な入力依存のスカラーである。
標準的なソフトマックス注意と比較して、主に2つの違いがある。
- ソフトマックスが削除されている。
- 注意行列は、追加のマスク行列 と要素ごとに乗算される。
翻訳対象のテキストです。 これらの変更はいずれも、バニラ注意機構における問題に対処するものと見なすことができる。例えば、softmax が注意スコアにおいて「attention sink(注意の吸い込み)」現象などの問題を引き起こすことが最近観測されている(Darcet et al. 2024; Xiao et al. 2024)。さらに重要なことに、マスク行列 は、Transformer のヒューリスティックな位置埋め込みを、時間をまたいでどれだけの情報が転送されるかを制御する、データ依存の異なる位置マスクで置き換えるものと見なすことができる。
より広く言えば、この形式は、第4節で定義される、線形注意の構造化マスク注意一般化の一例である。
行列形式と SSD アルゴリズム。SSD のさまざまな形式は、統一的な行列表現を通じて結び付けられる。すなわち、SSM が に依存する行列 に対する行列変換形式 を持つことを示すことによってである。特に、SSD の双対形式は行列 による素朴な(二次時間の)乗算に等しく、再帰形式は の構造を活用する特定の効率的な(線形時間の)アルゴリズムである。
これらを超えて、 による乗算のための任意のアルゴリズムを適用することができる。我々が提案するハードウェア効率の良い SSD アルゴリズム(第6節)は、 のブロック分解を伴う新しい構造化行列乗算手法であり、純粋な線形形式や二次形式のいずれよりも優れた効率のトレードオフを得る。これは一般的な選択的 SSM(Gu and Dao 2023)と比較して比較的単純で実装が容易であり、Listing 1 は数行のコードによる完全な実装を提供している。
図1は、本論文で提示される概念間の関係についての簡潔なロードマップを提供する。
2.5 記法
本論文を通じて、我々はコードにマッピングできる正確な記法を用いることを好む。
行列とベクトル。一般に、ベクトル(すなわち単一の軸を持つテンソル)を表すのに小文字を、行列(すなわち複数の軸を持つテンソル)を表すのに大文字を用いる。本論文では行列を太字にしない。時として、行列がある軸に沿って結び付けられまたは繰り返される場合(したがってベクトルとしても見なすことができる場合)、それに対して大文字または小文字のいずれかを用いることがある。 はスカラーまたは行列の乗算を表し、 はアダマール(要素ごとの)乗算を表す。
添字付け。我々は Python スタイルの添字付けを用いる。例えば は、 のとき範囲 を、 のとき を指す。例えば、任意の記号 に対して、 のとき で列 を表す。 は に等しい。略記として、 で積 を表すこともする。
次元。行列やテンソルと区別するために、次元やテンソルの形状を表すのにしばしばタイプライターフォントの大文字(例えば )を用いる。伝統的な記法 の代わりに、コードにおけるテンソルの形状を反映して を頻繁に用いる。
テンソル縮約。我々は明瞭さのため、また結果を述べ証明する上での中心的な道具として、テンソル縮約すなわち einsum 記法に大いに依拠する。読者は、numpy のような現代のテンソルライブラリで一般的に用いられるこの記法に精通しているものと仮定する。例えば、行列と行列の乗算演算子を表すのに contract を用いることができ、我々の記法では contract (これは に等しい)はコードでは numpy.einsum('mn,nk , X, Y) と翻訳できる。
記法の大規模な用語集は付録Aに含まれている。
3 状態空間モデルは構造化行列である
本節では、系列変換としての状態空間モデルのさまざまな見方を探り、そのような写像の性質とアルゴリズムを概説する。本節の主な結果は、状態空間モデルと、半分離行列(semiseparable matrices)と呼ばれる構造化行列の族との間の等価性に関するものであり、これは新たな効率性の結果を導く(定理3.5および3.7)。
3.1 状態空間モデルの行列変換形式
SSM の我々の定義は、(2) を通じて定義されるパラメータ化された写像として定義されることを思い出そう。我々の理論的枠組みは、この変換を単に、ベクトル を写す行列乗算として書き下すことから始まる。
定義により、 である。帰納法により、
を乗じて を生成し、方程式を についてベクトル化すると、SSM の行列変換形式が導かれる。
3.2 半分離行列
式 (3) における は、半分離行列として知られる行列のクラスの特定の表現である。半分離行列は基本的な行列構造である。まずこれらの行列とその性質を定義する。
定義3.1.(下三角)行列 は、下三角部分(すなわち対角線上またはその下)に含まれるすべての部分行列が高々 N のランクを持つとき、N-半分離であるという。N を半分離行列の次数またはランクと呼ぶ。
定義3.1、および関連する他の形式の「分離可能」構造(例えば準分離行列や半分離行列の他の定義)は、部分行列に対するランク条件によって特徴づけられるため、構造化ランク行列(またはランク構造化行列)と呼ばれることがある。半分離行列は、階層的半分離(HSS)、逐次半分離(SSS)、Bruhat 形式(Pernet and Storjohann 2018)など、多くの構造化表現を持つ。我々は主に SSS 形式を用いる。
3.2.1 逐次半分離(SSS)表現
定義3.2. 下三角行列 は、次の形式で書けるとき、N-逐次半分離(SSS)表現を持つという。
ベクトル および行列 に対して
演算子 SSS を となるように定義する。
半可分行列に関する基本的な結果として、それらは SSS 表現を持つ行列と正確に等価であることが知られている。一方の方向は、簡単な構成的証明によって導くことができる。
補題 3.3. 表現 (4) を持つ N-SSS 行列 は N-半可分である。
証明. を満たす任意の非対角ブロック を考える。これは次のような明示的なランク N 分解を持つ。
対角行列は扱いが容易であるため(例えば、対角行列による乗算は要素ごとのスカラー乗算と同じである)、これらの項は無視できる。したがって、1-SS 行列の基本表現は である、または
1-SS 行列の重要性は、それらがスカラー漸化式の最小形式、すなわち状態次元 を持ち 射影を持たない縮退 SSM の場合と等価であることにある。乗算 は次の漸化式によって計算できることに注意されたい。
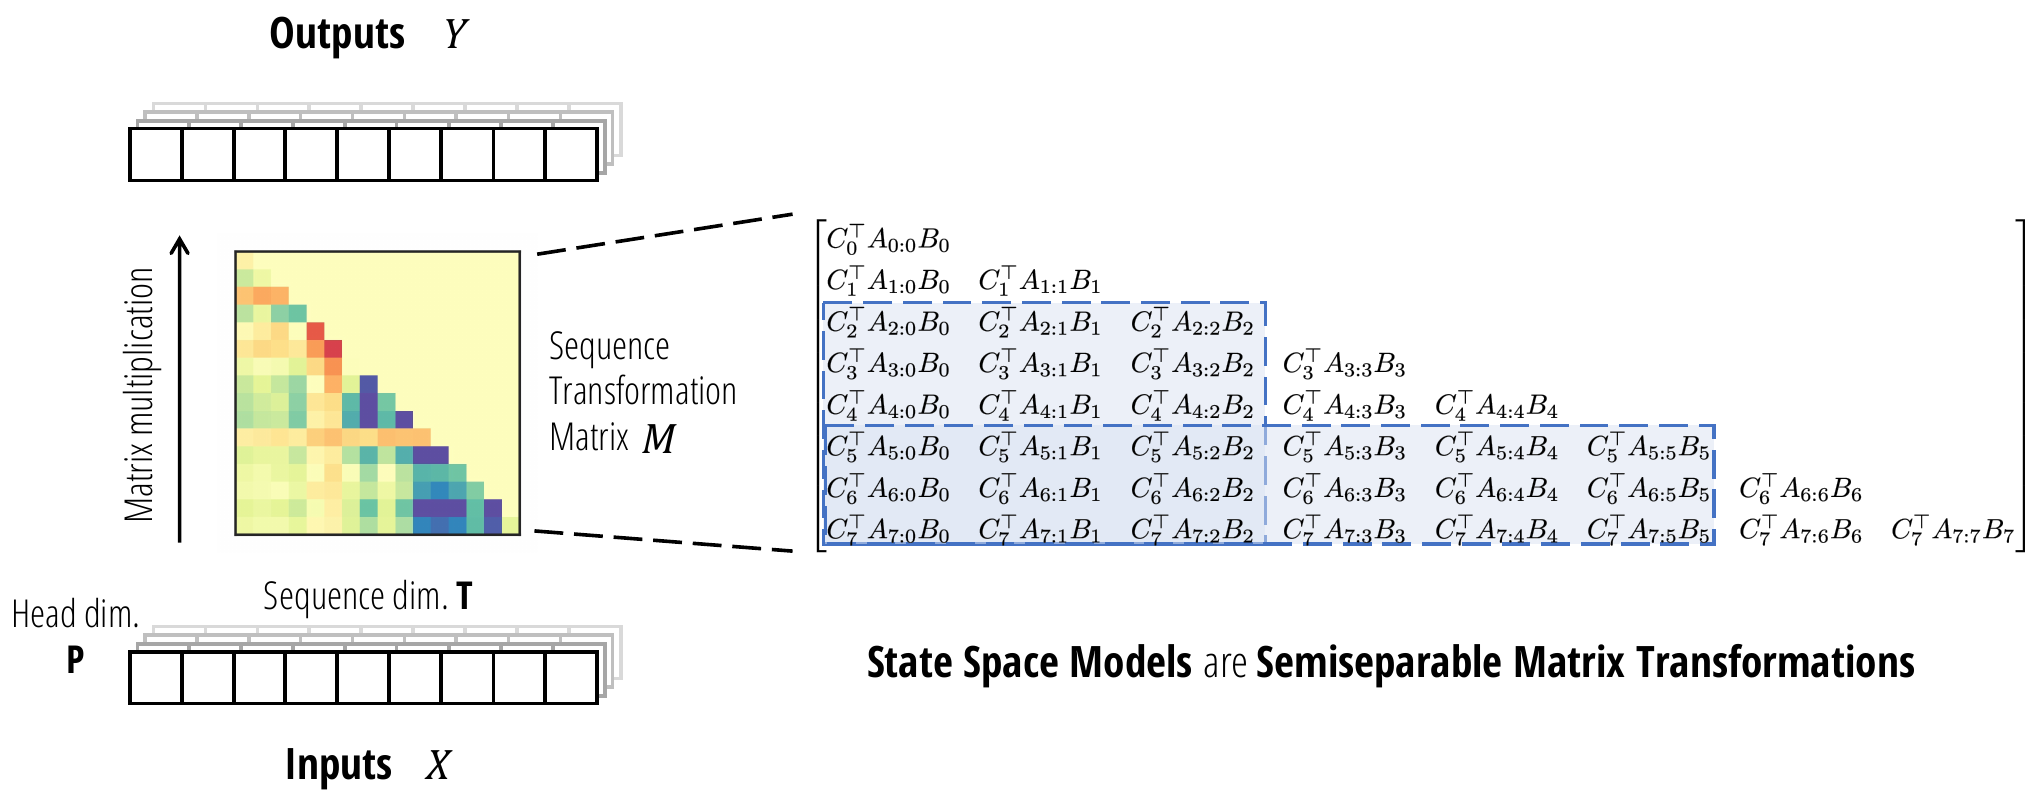
したがって、1-SS 行列による行列乗算をスカラー SSM 漸化式、または cumprodsum(累積積和。累積積と累積和の一般化)演算子とも呼ぶ。漸化式の基本形式として、1-SS 行列による乗算は我々の主要なアルゴリズムの構成要素として重要である。
本論文の中心的なテーマの一つは、シーケンスモデルに関する多くのアルゴリズムが構造化行列乗算アルゴリズムに還元できることであることを強調する。1-SS 行列はこの関連性を例証している。すなわち、原始的スカラー漸化式または cumprodsum 演算子を計算するための高速アルゴリズムは多数存在し、それらはすべて 1-SS 行列の異なる構造化分解と等価であることが判明する。付録 B を 1-SS 行列乗算のためのこれらのアルゴリズムに充てる。
3.3 状態空間モデルは半可分行列である
SSM の定義は、定義 2.1 を通じて定義されるパラメータ化された写像として定義されることを思い出されたい。SSM と半可分行列の間の関連性は、この変換をベクトル を写像する行列乗算として単純に書き下すことから導かれる。
方程式 (3) は、状態空間モデルと逐次半可分表現の間の関連性を直接確立し、その逐次半可分表現は一般に半可分行列と等価である(補題 3.3 および命題 3.4)。
定理 3.5. 状態サイズ を持つ状態空間モデル変換 は、逐次半可分表現 における N-SS 行列による行列乗算と同一である。
言い換えれば、系列変換演算子 SSM(定義 2.2)は行列構築演算子 SSS(定義 3.2)と一致しており、これらを互換的に用いる(あるいは略記として SS を用いることもある)。さらに—運命の巡り合わせにより—構造化状態空間モデルと逐次半分離行列は同じ頭字語を持つため、その等価性が際立っている!都合のよいことに、これらの頭字語のいずれか、すなわち SSM(state space model または semiseparable matrix)、SSS(structured state space または sequentially semiseparable)、あるいは SS(state space または semiseparable)を互換的に用いて、いずれの概念も曖昧さなく指し示すことができる。ただし、一般には SSM は状態空間モデルを指し、SS は半分離行列を指し、SSS は逐次半分離行列を指すという慣例を用いる。
図 2 は、状態空間モデルの系列変換としての視点を半分離行列として示している。
3.4 構造化行列アルゴリズムによる状態空間モデルの計算
定理 3.5 が重要な理由は、これにより SSM(および他の系列モデル)の効率的な計算問題を、構造化行列乗算の効率的なアルゴリズムへと還元できるからである。ここでは概要を簡単に述べ、主となる新しいアルゴリズムは、セクション 4 および 5 で SSM と他の系列モデルとの等価性を示した後のセクション 6 に譲る。
先に定義したように、半分離行列(すなわちランク構造化行列)は古典的な種類の構造化行列である:
(i) これらは SSS 形式のような圧縮表現を持ち、 ではなく 個のパラメータしか持たない。
(ii) これらは圧縮表現上で直接動作する高速アルゴリズムを持つ。
さらに、パラメータ化および行列乗算のコストは半分離次数においてタイトになり得る。
命題 3.6(Pernet, Signargout, and Villard (2023))。サイズ の N- SS 行列は 個のパラメータで表現でき、時間および空間 で行列-ベクトル乗算が可能である。
例えば、1- SS 行列はこの関連の本質を示している。行列 はちょうど 個のパラメータ によって定義され、スカラー漸化式 (7) に従うことで 時間で計算できる。
3.4.1 線形(再帰)モード
命題 3.6 は、対角構造化 SSM(S4D(Gu, Gupta, et al. 2022))の場合に、状態空間モデルの定式化 (2) を活用し漸化式を展開するだけで容易に確認できる。形式的なテンソル縮約アルゴリズムを (8) に示す。ここで次元 S は に等しい。
ここで、 は として定義される。言い換えれば、 に対して である。このアルゴリズムは (2) に対応する 3 つのステップを含む:
(i) 入力行列 によって入力 を展開する(8a)、
(ii) 独立なスカラー SSM 漸化式を展開する(8b)、
(iii) 出力行列 によって隠れ状態 を縮約する(8c)。
ステップ (8b) において、スカラー SSM と 1- SS 行列の間の等価性を用いたことに注意されたい。
注意 3. (8) は Mamba(S6)モデルの特殊ケースであることに注意する。しかし、サイズ の展開されたテンソル と のため、素朴な実装は遅い;Gu and Dao (2023) はこれらのテンソルを実体化することを避けるハードウェアを意識した実装を導入した。
驚くべきことに、定理 3.5 と命題 3.6 は、すべての SSM がアルゴリズム (8) と同じ漸近的効率を持つことを直ちに示唆する。
定理 3.7. 系列長 T 上の状態サイズ N の任意の状態空間モデル(定義 2.2)は、時間 で計算できる(潜在的な前処理は考慮しない)。
この結果は構造化 SSM の文献において新しいものであることに注意する。特に、密な非構造化 行列が与えられた場合、表現だけでもサイズ であるように思われる。したがって定理 3.7 は、前処理ステップを伴えば、非構造化 SSM でさえ最適に効率的に計算でき、その上限が と のサイズによって与えられる下限 と一致するという非自明な結果を述べている。
注意 4. 定理 3.7 は、 上のほとんどすべての密行列が 上で対角化可能であるという事実を踏まえると、それほど驚くべきことではないかもしれない。これは、ほとんどすべての密な実 SSM が対角複素 SSM と等価であるという結果につながる。この事実が、対角 SSM が構造化 SSM の最も一般的な形式である理由の根底にある(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023)。しかし、定理 3.7 は、すべての実 SSM(対角化可能なものだけでなく)ならびに他の体( 自体を含む)上の密な SSM について、はるかに強い結果を含意する。
実際には、効率的に計算可能な SSM は依然として に追加の構造を必要とする。特に、高コストな前処理ステップ(次数 N の余分な FLOPs を持ち、特異値分解のようなハードウェア非効率な演算を含む)を避けるためである。これらの構造が、構造化 SSM に関する過去の研究(例えば S4(D) や Mamba)ならびに我々の新しいアルゴリズムの焦点である。特に、 にやや強い構造が課される場合、セクション 6 において SSM 行列 のブロック分解を通じて、非常にハードウェア効率のよいアルゴリズムを設計する。
3.4.2 二次(素朴)モード
我々の新しい行列の視点によって明らかになる、SSM を計算する別の方法があることに注意する。行列 SSM 表現 (3) の素朴な計算は、単に系列変換行列 を実体化することを含む。これは 行列であるため、この素朴なアルゴリズムは系列長に対して二次的にスケールする。しかし、系列長 が短い場合、定数因子および計算パターンのハードウェア親和性(例えば行列-行列乗算の活用)により、これは実際には線形アルゴリズムよりも効率的であり得る。実際、構造化 SSM の特定の場合において、これは二次注意計算と非常に似たものに見える(セクション 5)。
3.4.3 まとめ
多くの系列モデルは、明示的に行列系列変換として動機づけられるか、あるいは定義されている。とりわけ Transformer では、行列混合器がアテンション行列である。一方で、RNN や SSM はこれまでこのようには記述されてこなかった。状態空間モデルに対して明示的な行列変換の形を与えることで、我々はそれらを理解し利用する新たな方法を明らかにする。計算の観点からは、状態空間モデルのフォワードパスを計算するあらゆる方法は、半分離可能行列(semiseparable matrices)上の行列乗算アルゴリズムと見なすことができる。半分離可能行列の視点は、状態空間双対性(SSD)への一つのレンズを与える。そこでは双対モードがそれぞれ、線形時間の半分離可能行列乗算アルゴリズムと二次時間の素朴な行列乗算を指す。
さらに、半分離可能行列の豊かな構造を活用することで、さらに優れたアルゴリズムとより多くの洞察が得られる(例:第6節および付録B)。付録C.1では、半分離可能行列のいくつかの追加的な性質について述べる。
4 構造化マスク付きアテンション:構造化行列による線形アテンションの一般化
本節では、線形アテンションの枠組みを基本原理から再検討する。本節の主な結果は、線形アテンションのテンソル縮約に基づく簡潔な証明(命題4.1)と、定義4.2における構造化マスク付きアテンションの一般化された抽象化である。なお、本節は状態空間モデルとは異なる方向から主要な双対性の結果を導出するものであり、第3節とは完全に独立して読むことができる。
- 第4.1節では、アテンションの諸変種に対する我々の枠組みを設定する。特にカーネルアテンションとマスク付きカーネルアテンションに焦点を当てる。- 第4.2節では、最初の主要なアテンションの結果として、テンソル縮約のレンズを通した線形アテンションの簡潔な証明を与える。- 第4.3節では、構造化行列を通じた従来のアテンション変種の一般化である構造化マスク付きアテンションを定義する。
4.1 アテンションの枠組み
4.1.1 アテンション
(単一ヘッド)アテンションの基本形は、3つのベクトル系列上の写像 である。
我々はテンソルの次元を示すために「形状注釈」を用いる。例えば のように。この一般形において、S と T はソース系列長とターゲット系列長を表し、N は特徴次元を表し、P はヘッド次元を表す。
ソフトマックスアテンションの最も一般的な変種は、 行列の行を正規化するためにソフトマックス活性化 を用いる。
4.1.2 自己アテンション
我々の扱いは、自己アテンションの最も重要なケースによって動機づけられている。そこでは (i) ソース系列とターゲット系列が同一であり(すなわち )、(ii) 通常は特徴次元とヘッド次元が同一であり(すなわち )、(iii) が同一の入力ベクトルに対する線形射影によって生成される()。
しかし、我々の提示ではこれらの選択を抽象化し、 行列から出発する。
注意5. 我々の焦点は、ヘッド次元と特徴次元が等しい自己注意の場合(すなわち かつ )にあり、これを実行例として用いるべきである。我々が注意の一般的な定式化を定義するのは、我々の枠組みがクロスアテンションのような変種を捉えるようにするためだけではなく、次元の表記(例えば S と T)を分離することで、本節における主要な結果の縮約表記による証明がより明確になるからでもある。
注意6. 注意は通常、対称的に扱われるこれら3つの入力 に対する演算として枠づけられるが、(9) における入力次元と出力次元はそうではないことを示している。特に、特徴次元 N は出力に存在しない。したがって、 の場合(例えば自己注意)、我々は を主要な入力とみなし、(9) が適切な系列変換 (定義2.1)を定義するようにする。
4.1.3 カーネル注意
softmax 関数がグラム行列 に適用されるステップは、2つの部分に分解できる:
1. 行列の指数化。
2. S 軸上での 行列の正規化。
正規化項は今のところ無視できる。それは単に を渡して割ることに相当するからである(これについては7.3節で再考する)。指数化の項はカーネル変換として見ることができる: となるような(無限次元の)特徴写像 が存在する。特徴写像を と 自体の定義に抽象化することにより(すなわち、 を変換後のバージョンとして定義する)、softmax 変換を無視でき、 がカーネル特徴写像によって任意に生成され、場合によっては であると仮定できる。
カーネル注意の多くの具体化が提案されており、以下を含む:
- 元々の Linear Attention(Katharopoulos et al. 2020)は、カーネル特徴写像を のような任意の点ごとの活性化関数として定義する。- Random Feature Attention(RFA)(H. Peng et al. 2021)は、ガウスカーネルのランダムフーリエ特徴近似(Rahimi and Recht 2007)を用いて softmax 注意(すなわち exp 特徴写像)を近似するようにカーネル特徴写像を選択する。これはランダム射影(すなわち と にランダム射影 を掛け、活性化 を適用する)を含む。
- Performer(Choromanski et al. 2021)は、正の直交ランダム特徴による高速注意(FAVOR+)を提案する。正のランダム特徴(PRF)の部分は、カーネル特徴写像をランダム射影に続いて特徴写像 を適用するものとして選択する。この選択は、カーネル要素が正値となり、softmax 注意を証明可能に近似するように動機づけられている。[また、ランダム射影を直交方向に選択することも提案しているが、我々は考慮しない。]
- cosFormer(Qin, Weixuan Sun, et al. 2022)は、位置情報を組み込んで局所性を強調するコサイン再重み付け機構で RFA を拡張する。これは実質的に を特徴写像 に通す。
- Linear Randomized Attention(Zheng, C. Wang, and Kong 2022)は、重要度サンプリングの観点から RFA を一般化し、完全な softmax カーネル(exp 変換された分子だけではなく)のより良い推定を提供するように一般化する。
その他の関連する注意の変種としては、Linformer(Sinong Wang et al. 2020)や Nyströmmer(Xiong et al. 2021)があり、これらはそれぞれランダム射影(Johnson-Lindenstrauss)とカーネル近似(Nyström 法)を通じて、注意行列 の低ランク近似を用いる(したがって式 (9) と互換である)。
4.1.4 マスク付き(カーネル)注意
を形状 (T, S) のマスクとする。最も一般的には、 の自己回帰的自己注意の場合、 は因果マスクを表す1の下三角行列でありうる。因果性を強制することに加えて、他の多くの種類のマスクを適用できる — 特に帯状、拡張、またはブロック対角のような様々なスパース性パターン — これらは密な注意の計算量を削減することを動機としている。
マスク付き注意は通常、行列表記で次のように書かれる
より正確には、形状注釈を付けて、これを計算の正確な順序に分解すると:
本節における注意変種の改良された導出は、この式が単一の縮約として書けることに気づくことから始まる:
そして (11) のアルゴリズムは、ペアワイズ縮約の特定の順序によって (12) を計算するものとして再枠づけできる
4.2 線形注意
線形注意、および他の多くの効率的な注意の変種は、しばしば中核となる注意計算 における行列の結合順序を変更することによって動機づけられる。しかし、マスクが加えられると、導出はいくぶんそれほど単純ではなくなる(例えば、元々の論文(Katharopoulos et al. 2020)や変種(Y. Sun et al. 2023)は証明なしで式を述べている)。
大まかに言えば、線形注意法は次の式が (10) と等価であると主張しており、これは和を展開し、添字を注意深く追跡することによって検証されなければならない。
命題4.1((Katharopoulos et al. 2020))。自己回帰的カーネル注意、すなわち因果マスクを伴うマスク付きカーネル注意は、各ステップで定数時間を要する再帰により 時間で計算できる。
4.2.1 線形注意のテンソル縮約による証明
我々は線形注意の単純かつ厳密な導出を提示する。これはまた、それをどのように一般化するかを直ちに明らかにするものでもある。主なアイデアは、縮約 (12) を別の順序で実行することである。我々は曖昧な行列表記を避け、縮約表記を直接用いる:
直感的には、この縮約順序を次のように解釈する。
最初のステップ(15a)は、特徴次元Nの因子だけ、より多くの特徴への「拡張」を行う。3番目のステップ(15c)は、拡張された特徴次元を縮約して消す。\(K\) を入力と見なすならば(注6)、\(V\) と \(Q\) はそれぞれ拡張と縮約を行う。
2番目のステップが最も重要であり、線形注意の線形部分を説明する。まず、(15b)は単に \(L\) による直接の行列積であることに注意する(\((\mathrm{P},\mathrm{N})\) 軸は平坦化できるため)。また、これがT軸とS軸の両方を含む唯一の項であるため、\(\Omega (\mathrm{TS})\) の計算量(すなわち系列長に対して二次)を持つはずであることにも注意する。しかし、マスク \(L\) が標準的な因果注意マスク(下三角の1)である場合、\(L\) による行列ベクトル積は、特徴ごとの累積和と同一である
4.3 構造化マスク付き注意
マスク付き注意のテンソル縮約の観点(15)を用いると、元の線形注意の要点は、因果マスクによる行列ベクトル積が累積和演算子と等価であるという事実にあることが直ちに分かる。
しかし、注意マスクがすべて1でなければならない理由はないと我々は observ する。線形注意が高速であるために必要なのは、\(L\) が構造化行列であることだけであり、構造化行列とは定義上、高速な行列積を持つ行列のことである(2.3節)。特に、劣二次(理想的には線形)の行列ベクトル積を持つ任意のマスク行列 \(L\) を用いることができ、それはボトルネックである式(15b)を高速化することにより、標準的な線形注意と同じ計算量となる。
定義4.2. 構造化マスク付き注意(SMA)(略して構造化注意)は、クエリ/キー/値 \(Q,K,V\) ならびに任意の構造化行列 \(L\)(すなわち劣二次の行列積を持つ)上の関数として、4方向テンソル縮約
によって定義される。
SMAの二次モードアルゴリズムは、(13)で定義される一対ごとの縮約の列であり、標準的な(マスク付き)注意計算に対応する。
SMAの線形モードアルゴリズムは、(15)で定義される一対ごとの縮約の列であり、ステップ(15b)は劣二次の構造化行列積によって最適化される。 我々は構造化マスク付き注意を、任意の与えられた行列構造のクラスに対してインスタンス化できる。いくつかの例を挙げると(図3):
- 線形注意は因果マスクを用いる。
- RetNet(Y. Sun et al. 2023)は、ある減衰係数 に対して減衰マスク を用いる。
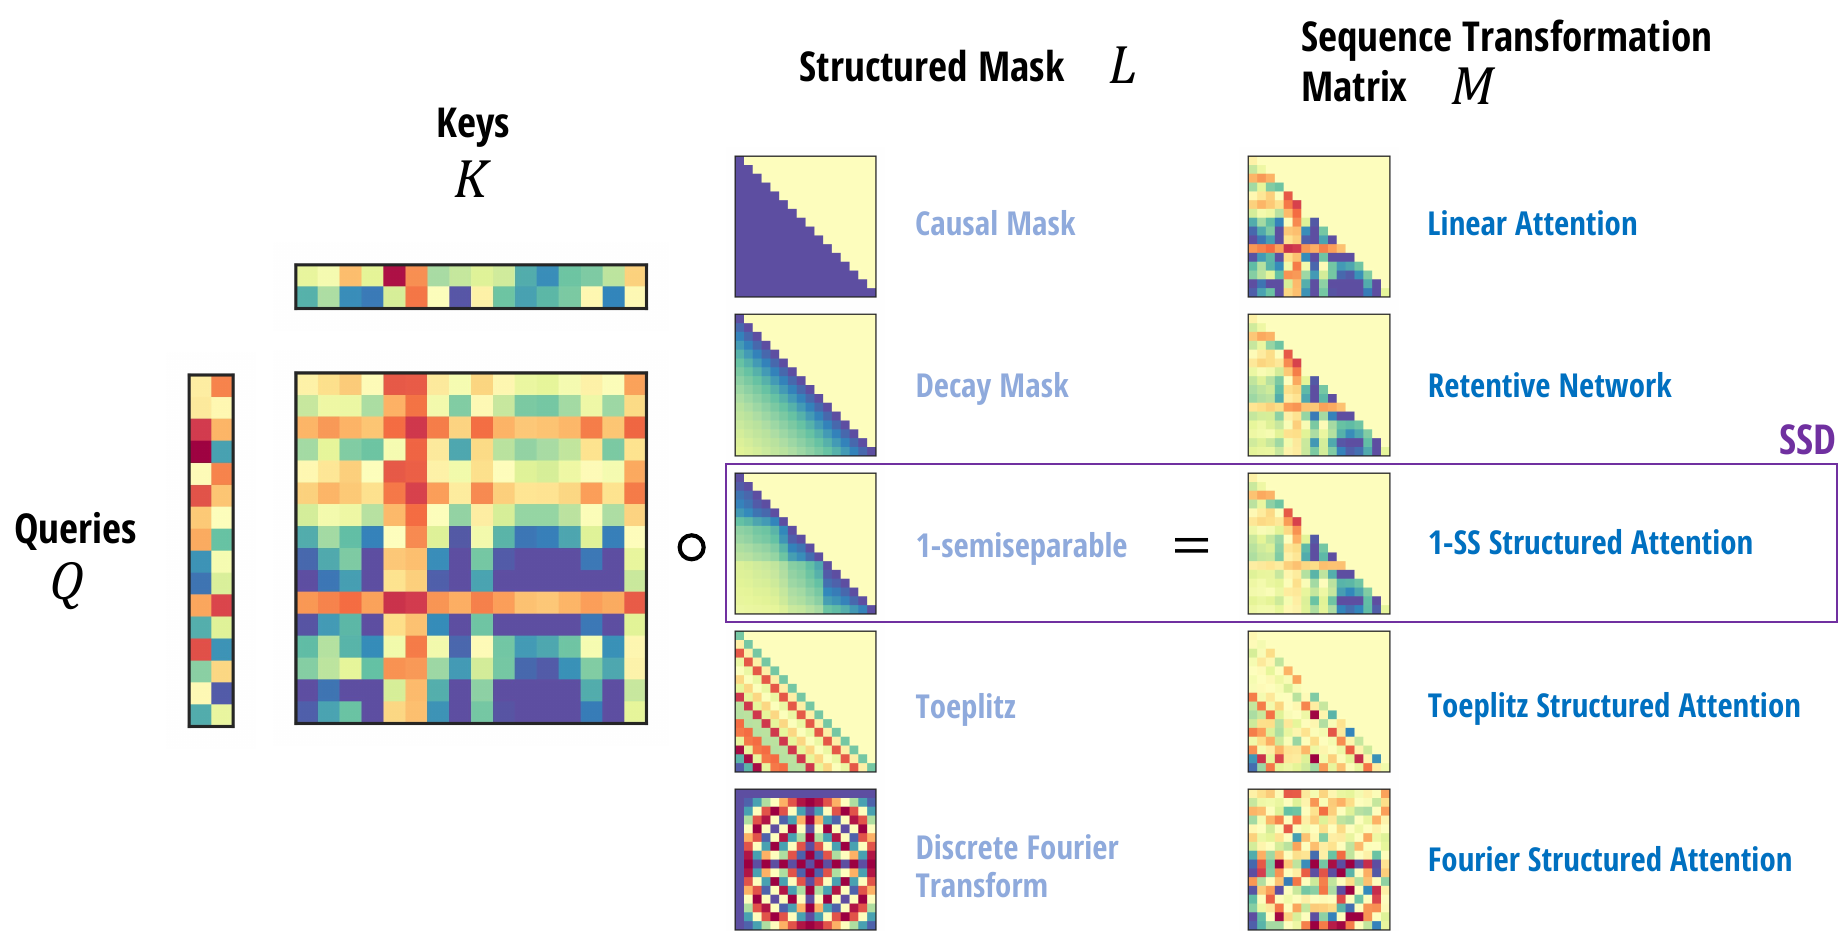
- 減衰マスクは、学習可能な(または入力依存の)パラメータ集合 に対して、テプリッツ行列 へと一般化できる。これは相対位置エンコーディングの一形態として解釈でき、AliBi(Press, N. Smith, and Lewis 2022)のような他の手法を想起させるが、加算ではなく乗算である。- 別の変種として、位置構造を異なる方法でエンコードするためにフーリエ行列 を用いることもできる。
第5節では、我々の主要なSSDモデルを定義する半分離可能SMAについて考察する。
4.3.1 まとめ:マスク付き注意の双対形式
標準的な(マスク付きカーネル)注意は、しばしば関数とアルゴリズムの間で混同される。この区別を分けることで、注意のさまざまな変種を理解する明快な方法が得られる。
- 我々はマスク付き注意を特定の関数(12)と見なす。- 標準的な二次注意計算(13)は、その関数を計算するアルゴリズムと見なせる。- 線形注意(15)は、同じ関数を計算する別のアルゴリズムである。
さらに、この場合
- マスク付き注意関数は、単に4つの項の上の特定の縮約である。- 二次注意アルゴリズムと線形注意アルゴリズムは、単に縮約を実行する2つの異なる順序である。
縮約の順序が計算複雑性に大きな違いをもたらし、二次対線形の分割につながることは知られている。状態空間モデルが複数の方法で計算できる変換であり、二次形式と線形形式の双対を持つ(第3.4節)のと同様に、線形注意にも2つの縮約順序から生じる同様の双対性がある。実際、これらは同じ根底にある双対性に対する異なる視点であることが判明し、それを第5節で明示する。
5 状態空間双対性
第3節と第4節では、構造化状態空間モデルと構造化注意を定義し、その性質を議論し、それらがともに二次アルゴリズムと線形アルゴリズムを持つことを示した。本節ではそれらを結びつける。我々の主要な結果は、構造化状態空間モデルの特定の場合が構造化注意の特定の場合と一致すること、そして線形時間SSMアルゴリズムと二次時間カーネル注意アルゴリズムが互いの双対形式であることを示すことである。
第5.1節では状態空間モデルをスカラー構造に特化し、そこでは素朴な二次計算がカーネル注意の一例と見なせることを示す。
第5.2節では構造化マスク付き注意を半分離可能SMAに特化し、それが効率的な自己回帰を伴うマスク付き注意を特徴づけることを示す。
第5.3節では構造化マスク付き注意と構造化状態空間モデルの間の関連をまとめ、これを構造化状態空間双対性と呼ぶ。
5.1 スカラー恒等構造化状態空間モデル
第3節では、状態空間モデルが半分離可能行列変換と等価であり、その結果として線形再帰形式と二次素朴形式の両方を持つことを示した。
SSMは で定義され、SSMの行列形式はSSS(順次半分離可能)表現 を用いることを思い出そう。ここで である(式(3))。
ここで、 が単にスカラーである場合、言い換えれば 行列が極めて構造化された構造化SSMの具体例、すなわちスカラー と単位行列 に対して である場合を考えよう。すると次のように並べ替えられる
そしてこれは次のようにベクトル化できる
ここで
この定式化を用いると、完全な出力 はまさに次のように計算される
ここで である。しかしこれはマスク付きカーネル注意の定義(13)の元の定義とまさに同じである!
したがって、第3.4節でほのめかしたように、スカラー構造化SSMを素朴に計算すること、すなわち半分離可能行列 を実体化して二次行列ベクトル積を実行することは、二次マスク付きカーネル注意とまさに同じである。
5.2 1-半分離可能構造化マスク付き注意
構造化マスク付き注意は任意の構造化マスク の使用を可能にする。 が因果マスクである場合、それは標準的な線形注意である。因果マスクは であることに注意されたい。すなわち1-SSマスクは定義(6)において によって生成される。これは を1-半分離可能マスクのクラス、すなわち1-半分離可能構造化マスク付き注意(1-SS SMA)へと一般化する動機付けとなる。そこでは線形注意の再帰におけるcumsumが、より一般的な再帰、すなわちスカラーSSMスキャン、つまり1-半分離可能行列乗算(第3.2.2節)に置き換えられる。
最後に、我々が1-半分離可能SMAを考察する最も重要的な理由は、それを計算するための線形形式が対角状態空間モデルの特殊ケースであることである。SMAの線形形式はアルゴリズム(15)であり、そこでのボトルネックステップ(15b) は1-SSマスクによる行列乗算と見なせる。第3節では対角SSMの計算(8)も書き下した。そこでのボトルネックステップ(8b)は1-SS乗算と等価なスカラーSSM再帰である。唯一の違いは、(8b)では行列 がサイズNの対角行列であるため、 に余分なN次元があることである。このN次元は、 のすべての対角要素が同じであれば消え、その結果が系5.1となる。
系5.1. 1-SS SMA(1-半分離可能構造化行列 を用いたマスク付き注意)(15)は、対角行列が単位行列のスカラー倍である対角SSM(8)の特殊ケースである。
系5.1は1-SS SMAが効率的な再帰形式を持つことを述べているが、我々はSMAのどのインスタンスが効率的な自己回帰を持つかを特徴づける逆の結果も示すことができる。
定理5.2. 有界次数の自己回帰過程である構造化マスク付き注意(定義4.2)の任意の具体例に対して、構造化マスク は半分離可能行列でなければならない。
言い換えれば、効率的な自己回帰注意は一般的な半分離可能SMAである。定理5.2は付録C.2で証明される。
注7. 1-半分離可能SMAは状態空間モデルの特殊ケースであるが、一般的な半分離可能SMAは1-SS SMAよりも厳密に表現力が高く、標準的なSSMでは記述できない。しかし、 による半分離可能乗算とSMAの線形形式(式(15a))はそれぞれ展開と縮約のステップを含み、単一の(より大きな)展開を持つ1-SS SMAの同様のインスタンスに吸収できる。
要約すると、1-半分離可能構造化注意はSMAの最も重要なケースである。なぜなら、それは以下の性質を持つからである:
- 入力依存の再帰を伴う線形注意の自然な一般化である。
- 効率的な自己回帰注意と等価である一般の半分離可能注意の最も単純なケースである。
- 対角状態空間モデルの特殊ケースである。
5.3 構造化状態空間双対性(SSD)
我々の結果を要約すると:
- 構造化状態空間モデル(第3節)は、通常、線形時間の再帰によって定義されるモデルである。しかし、その線形系列-to-系列変換を特徴づける行列表現を展開することにより、二次形式を導出することができる。
- 注意の変種(第4節)は、二次時間のペアワイズ相互作用によって定義されるモデルである。しかし、それを四方向テンソル縮約として捉え、異なる順序で縮約することにより、線形形式を導出することができる。
- それぞれの自然な特殊ケース——より正確には、 行列にスカラー-恒等構造を持つ状態空間モデルと、その マスクに1-半分離可能構造を持つ構造化マスク注意——は、まったく同じ線形形式と二次形式を持つ互いの双対である。
図4は、これら二つの表現の間の双対性を要約している。
拡張された関連研究と議論(第10節)では、SSDと一般的なSSM/注意との関係をより詳細に述べる。
6 SSDモデルのためのハードウェア効率の良いアルゴリズム
SSM、注意、構造化行列の間の理論的SSD枠組みを開発する利点は、その繋がりを利用してモデルとアルゴリズムを改善することにある。本節では、SSDモデルを効率的に計算するための種々のアルゴリズムが、構造化行列乗算を計算するための種々のアルゴリズムからどのように導出できるかを示す。
我々の主要な計算結果は、線形(再帰)モードと二次(注意)モードの両方を組み合わせたSSDモデルを計算するアルゴリズムである。このアルゴリズムは、SSMと同程度に計算効率が良く(系列長に対して線形スケーリング)、注意と同程度にハードウェア親和性がある(主に行列乗算を用いる)。
定理6.1。状態拡張因子 とヘッド次元 を持つSSDモデルを考える。任意の入力 に対してこのモデルを計算するアルゴリズムであって、訓練FLOPsが 、推論FLOPsが 、推論メモリが のみを必要とし、その作業が行列乗算によって支配されるものが存在する。
| 構造化状態空間モデル | 構造化マスク付き注意 | ||||
| C | (縮約行列) | Q | (クエリ) | S4 | 対角状態空間モデル |
| B | (拡張行列) | K | (キー) | ||
| X | (入力系列) | V | (値) | DSS | スカラー恒等SSM |
| Aij | (状態行列) | Lji | (マスク) | S4D | RetNet GateLoop |
| N | (状態拡張次元) | N | (カーネル特徴次元) | S5 | TransNormer |
| H | (隠れ状態(8b)) | SMA線形双対(15) | S6 | 線形注意 | |
| = L·XB | (線形モード) | 1-半分離可能SMA | |||
| SSM二次双対(16) | G | (グラム行列(13a)) | 効率的自己回帰注意 | ||
| = Q·K | (二次モード) | 半分離可能SMA |
これらの境界はすべてタイトであることに注意されたい。なぜなら、状態拡張 を持つ状態空間モデルがヘッドサイズ 上で動作する場合、総状態サイズは であり(訓練と推論のFLOPsの下界 と \(O(\mathrm{N}^2)\) をそれぞれ与える)、さらに入力 \(X\) 自体がTN個の要素を持つため、メモリの下界が得られるからである。
定理6.1の背後にある主要なアイデアは、再び状態空間モデルの計算問題を半分離可能行列乗算として捉えることにあるが、その構造を新たな方法で活用する点にある。再帰モードまたは注意モードのいずれかで行列全体を計算する代わりに、行列のブロック分解を行う。対角ブロックは双対な注意モードを用いて計算でき、これは行列乗算によって効率的に行うことができる。一方、非対角ブロックは半分離可能行列のランク構造によって分解でき、より小さな再帰に帰着させることができる。Listing 1がSSDアルゴリズムの自己完結した実装を提供していることを強調する。Gu and Dao (2023)の一般的な選択的SSMと比較して、この実装ははるかに単純であり、特別な低レベルカーネルを必要とせずにネイティブPyTorchでも比較的効率的である。
まず、行列 を の部分行列からなるグリッドに分割する。各部分行列のサイズは であり、 はあるブロックサイズである。半可分行列の定義上の性質(定義3.1)により、非対角ブロックは低ランクであることに注意されたい。5
これは例を通じて最も簡単に説明できる。例えば で、長さ のチャンクに分解する場合である。網掛けされたセルは、半可分行列の非対角ブロックの低ランク分解を表している。
これらの部分問題は、次のように解釈できます。すなわち、チャンクへの初期状態が0であると仮定したとき、チャンクごとの出力は何か、というものです。言い換えれば、チャンクについて、これはチャンク入力のみを考慮して正しい出力を計算します。
6.2 低ランクブロック
低ランク分解は3つの項から構成され、それに対応して計算も3つの部分からなります。この分解では、次の用語を用います。
のような項は、右因子または-ブロック因子と呼ばれます。
のような項は、中央因子または-ブロック因子と呼ばれます。
のような項は、左因子または-ブロック因子と呼ばれます。
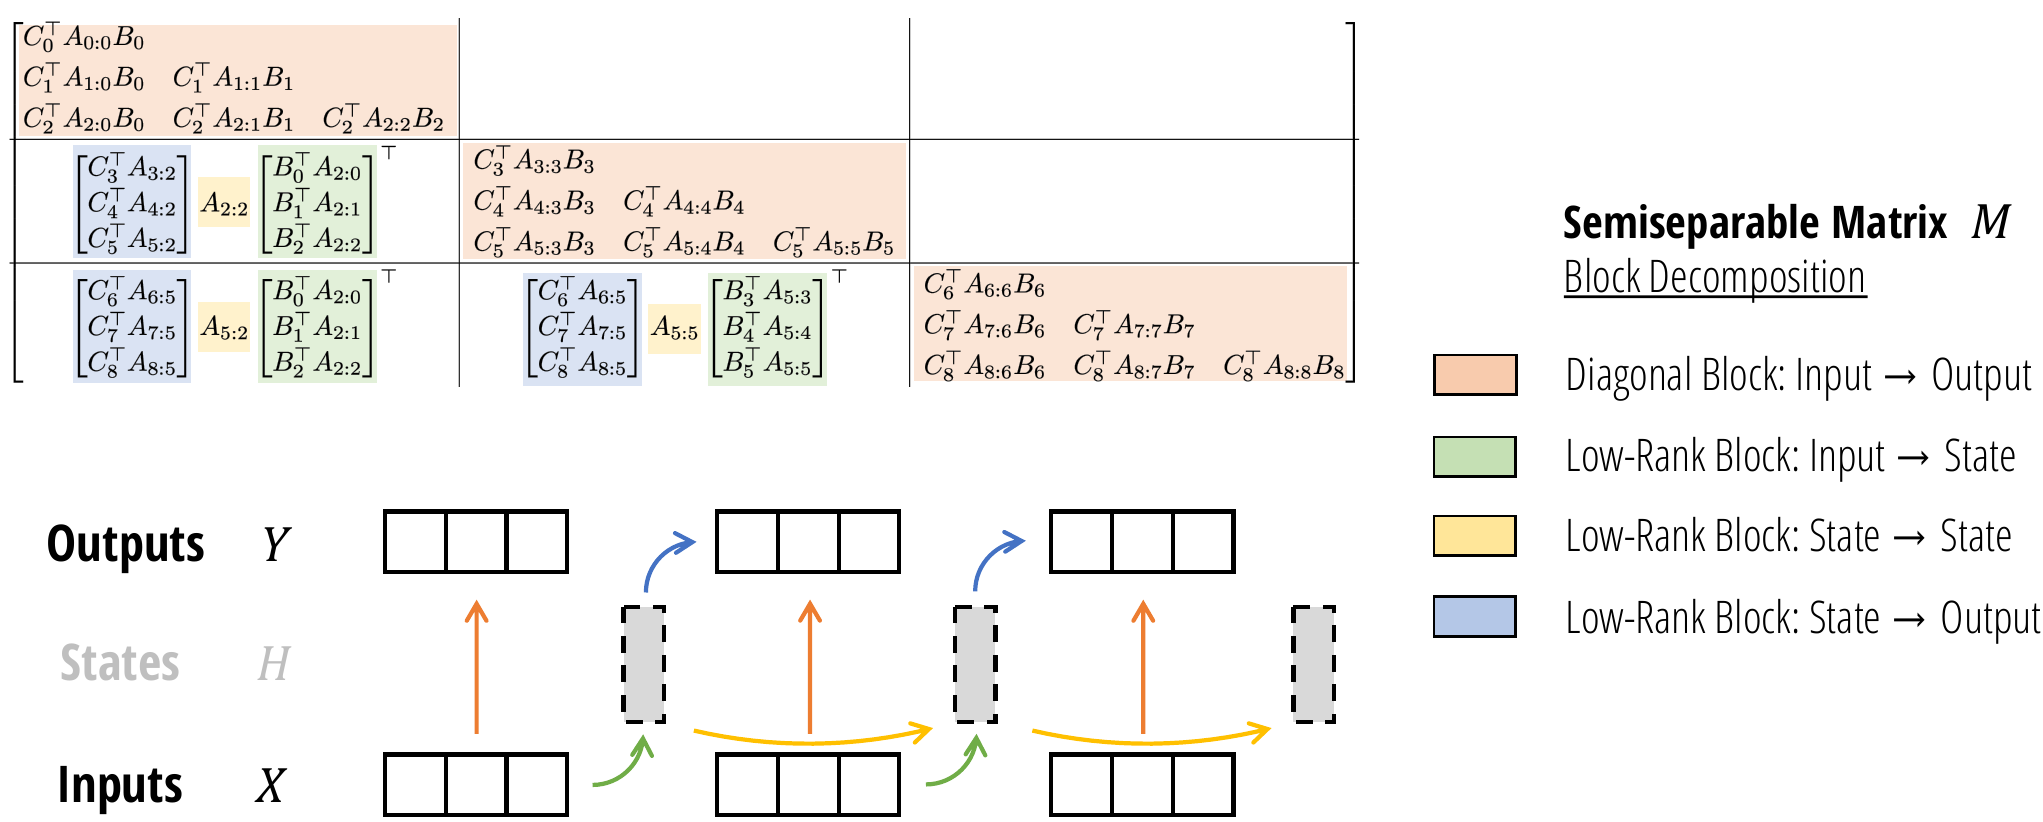
右因子。このステップでは、低ランク分解の右-ブロック因子による乗算を計算します。各チャンクについて、これはとの行列積であることに注意してください。ここで、は状態次元、はヘッド次元です。結果は各チャンクについてテンソルとなり、これは展開された隠れ状態と同じ次元を持ちます。
これは、次のように解釈できます。すなわち、チャンクへの初期状態が0であると仮定したとき、チャンクごとの最終状態は何か、というものです。言い換えれば、と仮定してを計算します。
中央因子。このステップでは、低ランク分解における中央-ブロック因子の項の効果を計算します。前のステップでは、チャンクごとの最終状態の全体形状はでした。これに、によって生成される1-SS行列を乗算します。
このステップは、1-SS乗算を計算する任意のアルゴリズム(スカラーSSMスキャンまたはcumprodsum演算子とも呼ばれます)によって計算できます。
これは、次のように解釈できます。すなわち、すべての過去の入力を考慮したとき、チャンクごとの実際の最終状態は何か、というものです。言い換えれば、のすべてを考慮して真の隠れ状態を計算します。
左因子。このステップでは、低ランク分解の左-ブロック因子による乗算を計算します。各チャンクについて、これは行列積の縮約で表せます。
これは、次のように解釈できます。すなわち、正しい初期状態を考慮し、入力が0であると仮定したとき、チャンクごとの出力は何か、というものです。言い換えれば、チャンクについて、これは先行する入力のみを考慮して正しい出力を計算します。
6.3 計算コスト
表記を、バッチ次元を持つバッチ化された行列積の縮約を定義するために用います。この表記から、効率性の3つの側面を推測できます。- 計算コスト:合計 FLOPs。
- メモリコスト:合計の空間。
リスト1 状態空間双対(SSD)モデルの完全なPyTorchの例。
def segsum(x):
ナイーブなセグメント和の計算。exp(segsum(A))は1-SS行列を生成し、
これはスカラーSSMと等価です。
T = x.size(- 1)
x_cumsum = torch.cumsum(x, dim=- 1)
x_segsum = x_cumsum[..., None] - x_cumsum[..., None, :]
mask = torch.tri1(torch.ones(T, T, device=x.device, dtype=bool), diagonal=0)
x_segsum = x_segsum.masked_fill(- mask, - torch.inf)
return x_segsum
def ssd(X, A, B, C, block_len=64, initial_states=None):
引数:
X: (batch, length, n_heads, d_head)
A: (batch, length, n_heads)
B: (batch, length, n_heads, d_state)
C: (batch, length, n_heads, d_state)
戻り値:
Y: (batch, length, n_heads, d_head)
\*
4. チャンクごとの状態 -> 出力変換を計算する # (非対角ブロックの低ランク分解の左項; C項) state_decay_out = torch.exp(A_cumsum) Y_off = torch.einsum('bclhn, bchpn, bhl->bclhp', C, states, state_decay_out)
チャンク内項とチャンク間項の出力を加算する (対角ブロックと非対角ブロック) Y = rearrange(Y_diag+Y_off, "b c l h p -> b (c l) h p") return Y, final_state
- 並列化:より大きなM、N、Kの項は、現代のアクセラレータ上の特殊化された行列乗算ユニットを活用できます。
中央ブロック。二次SMA計算のコストは、3つのステップ(式(16))からなります。
- カーネル行列の計算。コストはです。
- マスク行列による乗算。これは形状のテンソルに対する要素ごとの演算です。
- \(X\) の値との乗算。コストは \(\text{BMM}(T / Q, Q, P, N)\)
低ランクブロック:右因子。このステップは単一の行列積であり、コストは \(\mathsf{BMM}(\mathsf{T} / \mathsf{Q},\mathsf{N},\mathsf{P},\mathsf{Q})\) である。
低ランクブロック:中心因子。このステップは、\((\mathsf{N},\mathsf{P})\) 個の独立したチャネル上で長さ \(\mathsf{T} / \mathsf{Q}\) のスカラーSSMスキャン(または1-SS乗算)である。このスキャンの計算量は \(\mathsf{TNP} / \mathsf{Q}\) であり、他の因子と比較して無視できる。
ブロッキングによって系列長が \(\mathsf{T}\) から \(\mathsf{T} / \mathsf{Q}\) に削減されるため、このスキャンのコストは純粋なSSMスキャン(例えばMambaの選択的スキャン)よりも \(\mathsf{Q}\) 倍小さいことに注意されたい。したがって、ほとんどの問題長において、他のアルゴリズム(付録B)の方が効率的であるか、あるいは大幅な速度低下なしにはるかに実装が容易であることが観察される。例えば、これを1-SS行列積によって素朴に実装するとコストは \(\mathsf{BMM}(1,\mathsf{T} / \mathsf{Q},\mathsf{NP},\mathsf{T} / \mathsf{Q})\) となり、これははるかに実装が容易であり、素朴な再帰/スキャン実装よりも効率的になり得る。
低ランクブロック:左因子。このステップは単一の行列積であり、コストは \(\mathsf{BMM}(\mathsf{T} / \mathsf{Q},\mathsf{Q},\mathsf{P},\mathsf{N})\) である。
総コスト。\(\mathsf{N} = \mathsf{P} = \mathsf{Q}\) と設定すると(言い換えれば、状態次元、ヘッド次元、チャンク長が等しい場合)、上記のすべてのBMM項は \(\mathsf{BMM}(\mathsf{T} / \mathsf{N},\mathsf{N},\mathsf{N},\mathsf{N})\) となる。この計算特性は以下のとおりである:
- 総FLOP数は \(O(\mathsf{T}\mathsf{N}^{2})\)。- 総メモリは \(O(\mathsf{T}\mathsf{N})\) 。- 計算の大部分は形状 \((\mathsf{N},\mathsf{N})\) の行列に対する行列積からなる。
メモリ消費はタイトであることに注意されたい。入力と出力 \(x,y\) は形状 \((\mathsf{T},\mathsf{P}) = (\mathsf{T},\mathsf{N})\) を持つ。一方、FLOP数は余分な因子 \(\mathsf{N}\) を反映しており、これは自己回帰的な状態サイズに起因するコストであり、すべてのモデルに共通するものである。
行列積の他に、\(\mathsf{N}\mathsf{P} = \mathsf{N}^{2}\) 個の特徴量と系列長 \(\mathsf{T} / \mathsf{Q}\) に対するスカラーSSMスキャンがある。このコストは \(O(\mathsf{T} / \mathsf{Q}\mathsf{N}^{2})\) FLOPs であり、深さは \(O(\log (\mathsf{T} / \mathsf{Q}))\) である。行列積を使用しないが、それでも並列化可能であり、総計算量は他のステップと比較して無視できる。これは我々のGPU実装において無視できるコストである。
純粋なSSMおよびAttentionモデルとの比較。二次Attentionも行列積のみを活用するためハードウェア効率が非常に高いが、総FLOP数は \(\mathsf{T}^{2}\mathsf{N}\) である。訓練と推論の両方におけるその遅い計算速度は、より大きな状態サイズを持つことの直接的な帰結として見ることができる。標準的なAttentionはその履歴をキャッシュし状態を圧縮しないため、状態サイズが系列長 \(\mathsf{T}\) とともにスケールする。
線形SSMは総FLOP数が \(\mathsf{TNP} = \mathsf{T}\mathsf{N}^{2}\) であり、これはSSDと同じである。しかし、素朴な実装では余分なメモリを実体化する状態展開(15a)と、行列積を活用しないスカラー演算(15b)が必要となる。
| 注意 | SSM | SSD | |
| 状態サイズ | T | N | N |
| 訓練FLOPs | T²N | TN² | TN² |
| 推論FLOPs | TN | N² | N² |
| (ナイーブ)メモリ | T² | TN² | TN |
| 行列積 | ✓ | ✓ |
他の多くの行列分解が可能であることに留意する(例えば、1-SS乗算を異なる構造化行列分解を通じて行うアルゴリズムの概説については付録Bを参照)。これらは、他の専門的な設定においてより優れている可能性のある、SSDのためのさらなるアルゴリズムにつながるかもしれない。さらに広く言えば、半分離行列には豊富な文献があり、我々が使用するSS形式(定義3.2)以外にも多くの表現が存在し、さらに効率的なアルゴリズムも可能かもしれない。
7 Mamba-2アーキテクチャ
SSMとアテンションを結びつけることにより、SSDフレームワークは両者に対して共有された語彙と技術のライブラリを開発することを可能にする。本節では、元々Transformerのために開発されたアイデアを用いてSSD層を理解し修正するいくつかの例について議論する。我々はいくつかの設計上の選択について議論し、その結果としてMamba-2アーキテクチャが得られる。これらの変動軸はセクション9.4でアブレーションされる。
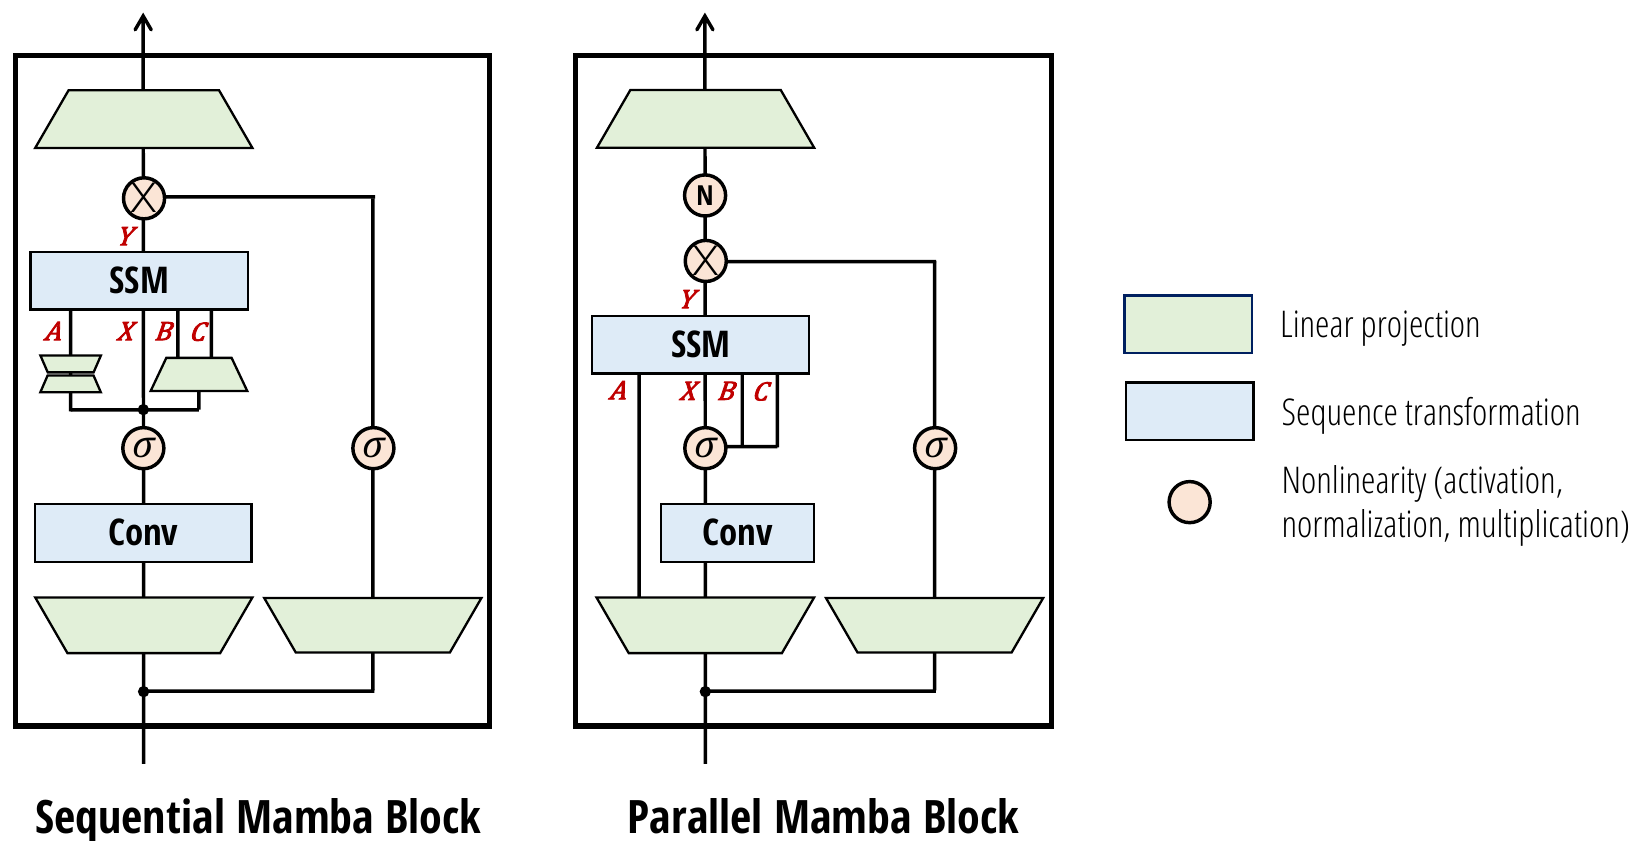
7.1 ブロック設計
まず、内部の系列混合層(すなわちコアSSD層の外側)に依存しないニューラルネットワークブロックへの修正について議論する。
並列パラメータ射影。Mamba-1は、選択的SSM層がの写像として見られる、SSM中心の視点によって動機づけられていた。SSMパラメータは補助的なものとして見なされ、SSM入力の関数である。したがって、を定義する線形射影は、を生成するための初期線形射影の後に生じる。
Mamba-2では、SSD層はの写像として見なされる。したがって、ブロックの冒頭で単一の射影によりを並列に生成することは理にかなっている。標準的なアテンションアーキテクチャとの類似性に注意されたい。そこではは並列に生成される射影に対応する。
SSMへの入力に対して並列射影を採用することは、パラメータをわずかに削減し、さらに重要なことに、標準的なMegatronシャーディングパターン(Shoeybi et al. 2019)を用いることにより、より大規模なモデルに対するテンソル並列性に一層適していることに注意されたい。
追加の正規化。予備実験において、我々はより大規模なモデルにおいて不安定性が生じやすいことを発見した。我々は、最終出力射影の直前にブロックへ追加の正規化層(例えばLayerNorm、GroupNorm、またはRMSNorm)を加えることにより、これを緩和することができた。この正規化の使用は、MLPブロックとMHAブロックの末尾にも正規化層を追加したNormFormerアーキテクチャ(Shleifer, Weston, and Ott 2021)に最も直接に関連する。
また、この変更は、線形アテンションの視点から導出された、Mamba-2に関連する他の最近のモデルと類似していることにも留意されたい。元の線形アテンションの定式化は、標準的なアテンションにおけるsoftmax関数の正規化を模倣する分母項によって正規化を行う。TransNormerLLM(Qin, Dong Li, et al. 2023)とRetNet(Y. Sun et al. 2023)は、この正規化が不安定であることを見出し、線形アテンション層の後に追加のLayerNormまたはGroupNormを加えている。我々の追加の正規化層はこれらとは若干異なり、乗算ゲート分岐の前ではなく後に生じる。
。。。
7.2 系列変換のためのマルチヘッドパターン
SSMは系列変換(定義2.1)として定義されることを思い出されたい。ここで:
- パラメータは状態次元Nを持つ。- それらは系列変換を定義し、これは例えば行列として表現できる。- この変換は入力系列上で、P軸に関して独立に作用する。
これは系列変換の1つのヘッドを定義するものと見なすことができる。
定義7.1(マルチヘッドパターン)。マルチヘッド系列変換はH個の独立したヘッドから成り、総モデル次元はである。パラメータはヘッド間で共有されてもよく、ヘッドパターンをもたらす。
状態サイズNとヘッド次元Pは、それぞれアテンションのQKヘッド次元とVヘッド次元に類似している。現代のTransformerアーキテクチャ(Chowdhery et al. 2023; Touvron, Lavril, et al. 2023)と同様に、Mamba-2では一般にこれらを64または128程度の定数として選ぶ。モデル次元Dが増加するとき、ヘッド次元NとPを固定したままヘッド数を増やす。これをどのように行うかを記述するために、我々はマルチヘッドアテンションからのアイデアを転用および一般化して、SSM、または任意の一般的な系列変換に対する類似のパターンを定義することができる。
| マルチヘッドSSM(マルチヘッドAttn.) | マルチコントラクトSSM(マルチクエリAttn.) | マルチエキスパンドSSM(マルチキーAttn.) | マルチ入力SSM(マルチバリューAttn.) |
| X (T, H, P) | X (T, 1, P) | X (T, 1, P) | X (T, H, P) |
| A (T, H) | A (T, H) | A (T, H) | A (T, H) |
| B (T, H, N) | B (T, 1, N) | B (T, H, N) | B (T, 1, N) |
| C (T, H, N) | C (T, H, N) | C (T, 1, N) | C (T, 1, N) |
マルチヘッドSSM(MHS)/マルチヘッドアテンション(MHA)パターン。古典的なMHAパターンは、ヘッド次元Pがモデル次元Dを割り切ることを仮定する。ヘッド数はと定義される。次に、H個のコア系列変換のコピーが、各パラメータのH個の独立したコピーを作成することによって生成される。MHAパターンは元々アテンション系列変換に対して記述されたが、定義2.1と互換性のある任意のものに適用できることに注意されたい。例えば、マルチヘッドSSD層は、SSDアルゴリズムが次元にわたってブロードキャストされる、式(17)に従った形状の入力を受け入れるであろう。
マルチコントラクトSSM(MCS)/マルチクエリアテンション(MQA)パターン。マルチクエリアテンション(Shazeer 2019)は、とテンソルのキャッシュに依存する自己回帰推論の速度を劇的に改善できる、アテンションの巧妙な最適化である。この手法は単にとに余分なヘッド次元を与えることを避ける、言い換えれば、の単一のヘッドをのすべてのヘッドにわたってブロードキャストする。
状態空間双対性を用いることにより、我々はMQAの等価なSSM版を式(18)として定義することができる。ここで、と(アテンションのとのSSM類似物)はH個のヘッド間で共有される。我々はこれをマルチコントラクトSSM(MCS)ヘッドパターンとも呼ぶ。なぜなら、SSM状態の縮約を制御するパラメータがヘッドごとに独立したコピーを持つからである。
同様に、マルチキーアテンション(MKA)またはマルチエキスパンドSSM(MES)ヘッドパターンを定義することができる。ここでは(SSMの拡張を制御する)がヘッドごとに独立である一方、とはヘッド間で共有される。
マルチ入力SSM(MIS)/マルチバリューアテンション(MVA)パターン。MQAはKVキャッシュのためアテンションにとっては理にかなっているが、SSMにとって自然な選択ではない。Mambaでは代わりに、がSSMへの主要な入力として見なされ、したがってとは入力チャネル間で共有されるパラメータである。我々は式(20)において、マルチバリューアテンション(MVA)またはマルチ入力SSM(MIS)パターンを新たに定義する。これはやはりSSDのような任意の系列変換に適用できる。
この語彙を備えることで、我々は元のMambaアーキテクチャをより正確に特徴づけることができる。
命題7.2。Mambaアーキテクチャ(Gu and Dao 2023)の選択的SSM(S6)層は、以下を持つものと見なすことができる——ヘッド次元:すべてのチャネルが独立したSSMダイナミクスを持つ。
- マルチ入力SSM(MIS)またはマルチバリューアテンション(MVA)ヘッド構造:行列(アテンション双対性におけるに対応)は、入力(アテンションにおけるに対応)のすべてのチャネル間で共有される。
我々は、SSDに適用した場合にこれらのヘッドパターン変種をアブレーションすることもできる(9.4.3節)。興味深いことに、パラメータ数と総状態次元を制御しているにもかかわらず、下流タスクの性能には顕著な差が見られる。我々は経験的に、Mambaで元々用いられていたMVAパターンが最も良い性能を発揮することを見出した。
グループ化ヘッドパターン。マルチクエリアテンションのアイデアは、グループ化クエリアテンション(Ainslie et al. 2023)へと拡張できる。すなわち、1つのKヘッドとVヘッドの代わりに、G個の独立したKヘッドとVヘッドを作成できる。ここでであり、GはHを割り切る。これは、マルチクエリアテンションとマルチヘッドアテンションの間の性能差を橋渡しすることと、Gをシャード数の倍数に設定することでより効率的なテンソル並列化を可能にすることの両方に動機づけられている(8節)。
同様に、Mamba-2で用いられているマルチ入力SSMヘッドパターンは、グループ化入力SSM(GIS)、別名グループ化バリューアテンション(GVA)へと容易に拡張できる。この一般化は straightforward であり、簡潔さのため詳細は省略する。
7.3 線形アテンションからのその他のSSD拡張
ここでは、線形アテンションに動機づけられたSSDへのアーキテクチャ変更の一例を述べる。我々はこれらをネガティブな結果の一形態として9.4.3節でアブレーションし、デフォルト設定として採用するのに十分なほど性能を有意に向上させるものではないことを見出している。それにもかかわらず、これらはアテンションに関する膨大な文献を組み込んでSSDの変種を定義できることを示している。我々はカーネル特徴写像の選択をMamba-2アーキテクチャにおけるハイパーパラメータとして扱い、アテンションに着想を得た他の単純な変更も可能であると期待している。
ソフトマックスアテンションへのカーネルアテンション近似。線形アテンションやカーネルアテンションの多くの変種は、アテンションスコアを以下の要素から構成されるものと見なすことによって動機づけられている。
1. 指数カーネル。これはあるカーネル特徴写像を用いてにより近似できる。2. 行の和が1になるようにカーネルを正規化する。すなわちにより行い、ここで除算は要素ごとに行われ、1はすべての要素が1のベクトルである。
指数カーネル特徴写像。Mamba-2では、柔軟なカーネル特徴写像を組み込み、これをおよびブランチ(アテンションにおけるおよびブランチに対応)に適用する。この特徴写像は、簡潔さと対称性のために、()ブランチにも任意で適用できる。これは図6において任意の非線形性によって表されている。デフォルトでは、我々は単にを要素ごとのSwish / SiLU関数(Hendrycks and Gimpel 2016; Ramachandran, Zoph, and Le 2017)として選ぶ。9.4.3節のアブレーションでは、Linear Attention、Performer、Random Feature Attention、およびcosFormerで用いられる特徴写像を含む他の選択肢を探る(4.1.3節)。
正規化(分母)項の組み込み。分母項を求めるには、単にを計算すればよい。しかし、モデルの最終出力は単にであることを思い出されたい(式(16))。したがって、正規化項はに余分な列1を追加することで簡単に求められ、その結果、形状のテンソルが得られる。 この場合、カーネル特徴写像は和が正となるように正でなければならないことに注意されたい。
8 SSMのためのシステム最適化
我々は、大規模で効率的な訓練と推論のためのSSM、特にMamba-2アーキテクチャに対するいくつかのシステム最適化について述べる。特に、大規模訓練のためのテンソル並列およびシーケンス並列に焦点を当て、また効率的なファインチューニングと推論のための可変長シーケンスにも焦点を当てる。
8.1 テンソル並列
テンソル並列(TP)(Shoeybi et al. 2019)は、各層(例えば、アテンション、MLP)をGPUなどの複数のアクセラレータ上で実行するように分割するモデル並列化手法である。この手法は、各ノードが通常NVLinkなどの高速ネットワークで接続された4〜8個のGPUを持つGPUクラスタ上で、ほとんどの大規模モデル(Brown et al. 2020; Chowdhery et al. 2023; Touvron, Lavril, et al. 2023; Touvron, L. Martin, et al. 2023)を訓練するために広く用いられている。TPはもともとTransformerアーキテクチャ向けに開発されたものであり、他のアーキテクチャに適応させるのは容易ではない。まず、MambaアーキテクチャでTPを使用する際の課題を示し、次にMamba-2アーキテクチャがTPを効率的にするためにどのように設計されているかを示す。
Mambaアーキテクチャを思い出そう。単一の入力(簡単のためバッチ処理なし)、入力投影行列(ここでは拡張係数、通常2)、および出力投影行列を用いる:
TPでは、計算を2つのGPUに分割したいとする。入力投影行列とをそれぞれサイズの2つのパーティションに分割するのは容易である。すると各GPUはサイズのの半分を保持することになる。しかし、はの関数であるため、を計算する前に全体を取得するためにGPU間で追加のall-reduceが必要となる。その後、2つのGPUはに沿って独立であるため、SSMを並列に計算できる。最後に、出力投影行列をそれぞれサイズの2つのパーティションに分割し、最後にall-reduceを行うことができる。Transformerと比較すると、1回ではなく2回のall-reduceが発生し、通信に費やす時間が2倍になる。大規模Transformerの訓練では、通信がすでにかなりの割合の時間(例えば10〜20%)を占めている可能性があり、通信が2倍になるとMambaは大規模訓練において効率的でなくなる。
Mamba-2では、TransformerのアテンションやMLPブロックと同様に、ブロックごとにall-reduceを1回だけにすることを目標としている。その結果、を取得するための投影をからではなくから直接行い、これらの投影行列を分割できるようにする。これは、異なるGPU上で異なるのセットを持つことを意味し、より大きな「論理GPU」上でのいくつかの「グループ」を持つことと等価である。さらに、各ブロック内でGroupNormを使用し、グループ数をTP度で割り切れるようにすることで、TPグループ内のGPUがブロック内で通信する必要がなくなる:
入力投影行列と出力投影行列を分割するだけでよく、ブロックの最後にall-reduceを行うだけでよいことがわかる。これは、アテンション層とMLP層に対するTPの設計と類似している。特に、TP度が2の場合、()、(
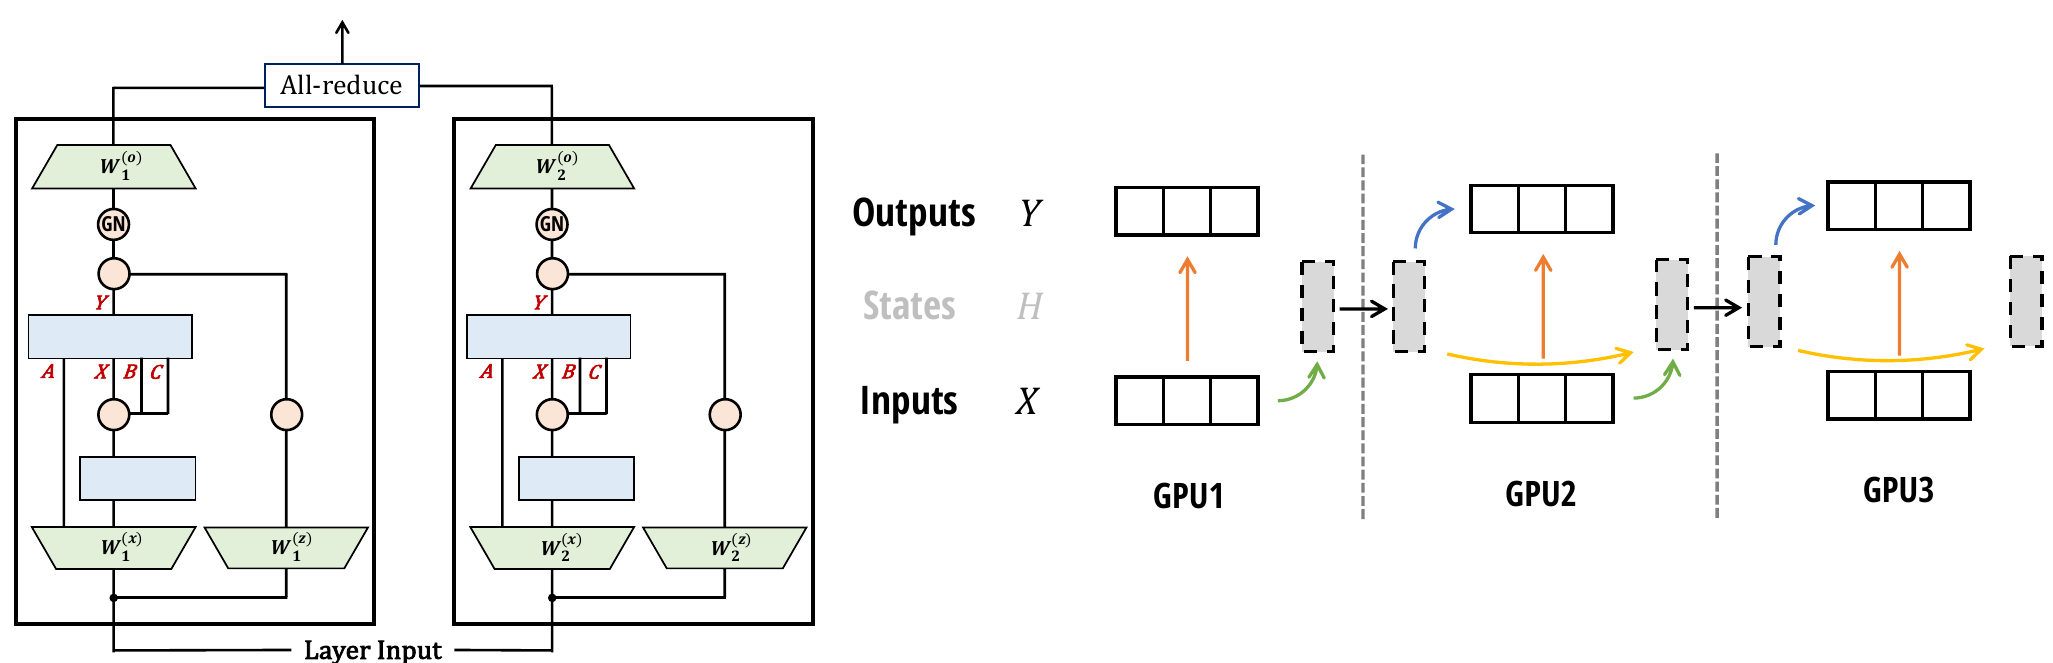
)、および()のように分割する。\(i = 1, 2\)に対して、TP Mamba-2層は次のように書ける:
Mamba-2におけるテンソル並列を図7(左)に示す。
8.2 シーケンス並列
非常に長いシーケンスでは、入力と活性化をシーケンス長の次元に沿って異なるGPUに分割する必要があるかもしれない。主に2つの手法がある:
1. 残差および正規化演算のためのシーケンス並列(SP):Korthikanti et al. (2023)によって最初に提案されたこの手法は、TPにおけるall-reduceをreduce-scatterとall-gatherに分解する。残差および正規化演算は、同じTPグループ内のすべてのGPUに対して同じ入力上で繰り返されることに注目し、SPはreduce-scatter、残差および正規化、そしてall-gatherを実行することによって、活性化をシーケンス長の次元に沿って分割する。
Mamba-2アーキテクチャは同じ残差および正規化構造を使用しているため、SPは変更なしで適用できる。
2. トークン混合操作(アテンションまたはSSM)のためのシーケンス並列性。これは「コンテキスト並列性」(CP)とも呼ばれる。アテンション層については、いくつかの技術が開発されており(例:Ring attention(Liu, Yan, et al. 2024; Liu, Zaharia,
and Abbeel 2023))、洗練された負荷分散技術も存在する(Brandon et al. 2023)。アテンションにおけるシーケンス並列性の難しさは、クエリとキーをブロックに分割できるものの、各クエリブロックがキーブロックと相互作用する必要があるため、通信帯域幅がワーカー数の二乗に比例してしまうことにある。
SSMの場合、シーケンスを単純な方法で分割できる。各ワーカーは初期状態を受け取り、自身の入力に対してSSMを計算し、最終状態を返し、その最終状態を次のワーカーに渡す。通信帯域幅はワーカー数に対して線形である。この分解は、SSDアルゴリズム(図5)においてブロック/チャンクに分割する際のブロック分解とまったく同じである。このコンテキスト並列性を図7(右)に示す。
8.3 可変長
事前学習ではバッチ内で同じ系列長を用いることが多いが、ファインチューニングや推論時には、モデルが異なる長さの異なる入力系列を処理する必要がある場合がある。このケースを扱う素朴な方法の一つは、バッチ内のすべての系列を最大長まで右パディングすることであるが、系列の長さが大きく異なる場合には非効率となりうる。Transformerについては、パディングを避けてGPU間で負荷分散を行う洗練された技術(Zeng et al. 2022; Y. Zhai et al. 2023)や、複数の系列を同じバッチにパッキングしてアテンションマスクを調整する技術(Ding et al. 2024; Pouransari et al. 2024)が開発されている。SSM、特にMambaでは、バッチ全体を一つの長い系列として扱い、個々の系列間で状態を渡すことを避けるだけで、可変系列長を扱うことができる。これは、ある系列の終端にあるトークンに対して単にを設定し、異なる系列に属するトークンへ情報が渡らないようにすることと等価である。
9 実証的検証
我々は、リカレントモデルにとって困難であった合成的リコールタスク(9.1節)および標準的な言語モデリングの事前学習と下流評価(9.2節)において、Mamba-2を実証的に評価する。我々のSSDアルゴリズムがMamba-1よりもはるかに効率的であり(9.3節)、中程度の系列長において最適化されたアテンションと同等であることを検証する。最後に、Mamba-2アーキテクチャにおける様々な設計選択についてアブレーションを行う(9.4節)。
9.1 合成タスク:連想想起
合成連想想起タスクは、言語モデルが文脈中の情報を参照する能力をテストするために広く用いられてきた。概して、これらのタスクは自己回帰モデルにキーと値の連想のペアを入力し、その後、以前に見たキーを示された際に正しい補完を生成するようモデルに促すものである。多クエリ連想想起(MQAR)タスクは、このタスクの特定の定式化であり、モデルが複数の連想を記憶することを要求する(Arora, Eyuboglu, Timalsina, et al. 2024)。元のMamba論文は、関連する合成タスク、特にSelective Copying(Gu and Dao 2023)とInduction Heads(Olsson et al. 2022)に関する結果を報告しており、これらはより容易な連想想起タスクと見なすことができる。MQARタスクはまた、「電話帳検索」タスクとも密接に関連しており、このタスクは有限状態容量のため、SSMのような再帰モデルにとって困難であることが示されている(De et al. 2024; Jelassi et al. 2024)。
| モデル | トークン | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | 平均ACC ↑ |
| Pythia-1B | NeoX | 7.82 | 7.92 | 56.1 | 47.2 | 70.7 | 57.0 | 27.1 | 53.5 | 31.4 | 49.0 |
| Mamba-790M | NeoX | 7.33 | 6.02 | 62.7 | 55.1 | 72.1 | 61.2 | 29.5 | 56.1 | 34.2 | 53.0 |
| Mamba-2-780M | NeoX | 7.26 | 5.86 | 61.7 | 54.9 | 72.0 | 61.0 | 28.5 | 60.2 | 36.2 | 53.5 |
| Hybrid H3-1.3B | GPT2 | — | 11.25 | 49.6 | 52.6 | 71.3 | 59.2 | 28.1 | 56.9 | 34.4 | 50.3 |
| Pythia-1.4B | NeoX | 7.51 | 6.08 | 61.7 | 52.1 | 71.0 | 60.5 | 28.5 | 57.2 | 30.8 | 51.7 |
| RWKV4-1.5B | NeoX | 7.70 | 7.04 | 56.4 | 52.5 | 72.4 | 60.5 | 29.4 | 54.6 | 34.0 | 51.4 |
| Mamba-1.4B | NeoX | 6.80 | 5.04 | 65.0 | 59.1 | 74.2 | 65.5 | 32.8 | 61.5 | 36.4 | 56.4 |
| Mamba-2-1.3B | NeoX | 6.66 | 5.02 | 65.7 | 59.9 | 73.2 | 64.3 | 33.3 | 60.9 | 37.8 | 56.4 |
| Hybrid H3-2.7B | GPT2 | — | 7.92 | 55.7 | 59.7 | 73.3 | 65.6 | 32.3 | 61.4 | 33.6 | 54.5 |
| Pythia-2.8B | NeoX | 6.73 | 5.04 | 64.7 | 59.3 | 74.0 | 64.1 | 32.9 | 59.7 | 35.2 | 55.7 |
| RWKV4-3B | NeoX | 7.00 | 5.24 | 63.9 | 59.6 | 73.7 | 67.8 | 33.1 | 59.6 | 37.0 | 56.4 |
| Mamba-2.8B | NeoX | 6.22 | 4.23 | 69.2 | 66.1 | 75.2 | 69.7 | 36.3 | 63.5 | 39.6 | 59.9 |
| Mamba-2-2.7B | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
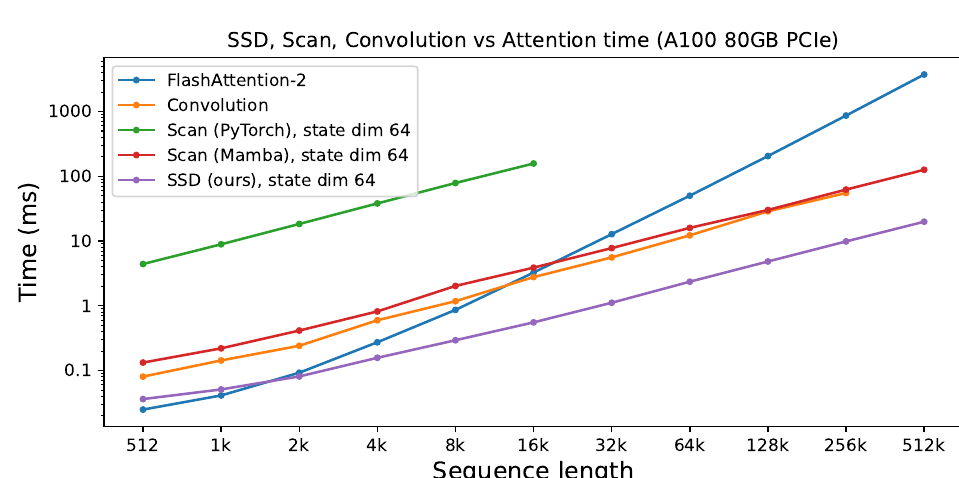
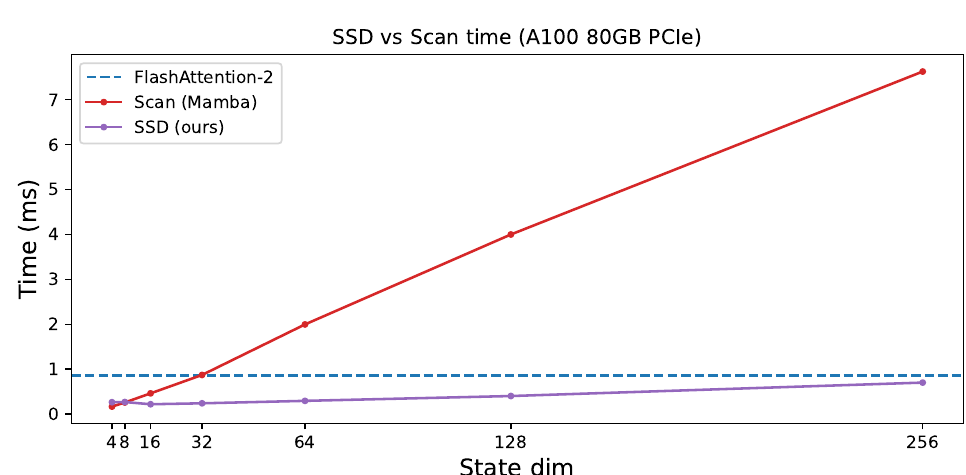
図10:(効率ベンチマーク。)(左)我々のSSDは、大きな状態拡張(\(N = 64\))においてMambaの融合スキャンよりも高速であり、系列長以上においてFlashAttention-2よりも高速である。(右)系列長:状態拡張を増やすと、Mambaの最適化されたスキャン実装は線形に遅くなる。SSDは、それほど遅くなることなく、はるかに大きな状態拡張係数を扱うことができる。
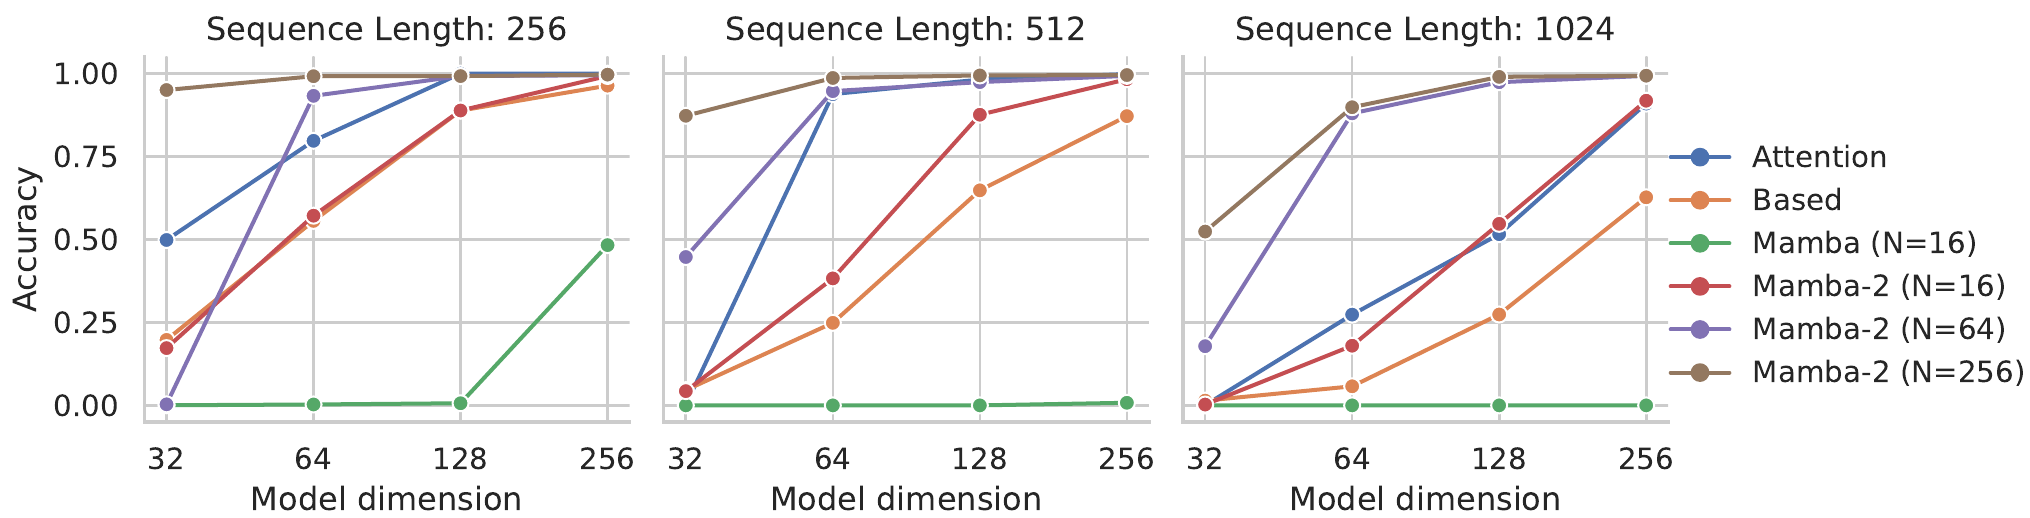
我々は、(Arora, Eyuboglu, Zhang, et al. 2024)のMQAR設定の困難なバージョンで比較を行い、より難しいタスク、より長い系列、より小さなモデルを用いる。我々のベースラインには、標準的なマルチヘッドソフトマックスアテンション、ならびに畳み込み、ローカルアテンション、および線形アテンションの変種を組み合わせたBasedアーキテクチャが含まれる。
結果は図8に示されている。Mamba-1はこのタスクで苦戦する一方、Mamba-2はすべての設定で良好に機能する。驚くべきことに、状態サイズを制御した場合()でも、Mamba-1よりも大幅に優れている。(アーキテクチャのどの側面が支配的な要因であるかは判明しておらず、これは今後の研究で探求すべき課題として残っている。)さらに、このタスクは状態サイズの重要性を検証している。からおよびへと増やすことでMQARの性能が一貫して向上する。これは、より大きな状態がより多くの情報(キーと値のペア)を記憶できるようにするためである。
9.2 言語モデリング
LLMにおける標準的なプロトコルに従い、我々はMamba-2アーキテクチャを標準的な自己回帰言語モデリングについて他のアーキテクチャと比較して訓練および評価する。我々は事前学習の指標(パープレキシティ)とゼロショット評価の両方を比較する。モデルサイズ(深さと幅)はGPT3の仕様に従い、からまでである。我々はPileデータセット(L. Gao, Biderman, et al. 2020)を使用し、Brown et al.(2020)に記載された訓練レシピに従う。これはMamba(Gu and Dao 2023)で報告されたのと同じ設定に従っており、訓練の詳細は付録Dにある。
9.2.1 スケーリング則
ベースラインとして、我々はMambaおよびそのTransformer++レシピ(Gu and Dao 2023)と比較する。後者はPaLMおよびLLaMaアーキテクチャ(例えば、回転埋め込み、SwiGLU MLP、LayerNormの代わりにRMSNorm、線形バイアスなし、より高い学習率)に基づいている。Mambaはすでに、標準的なTransformerアーキテクチャ(GPT3アーキテクチャ)ならびに最近の準二次アーキテクチャ(H3(Dao, D. Y. Fu, et al. 2023)、Hyena(Poli et al. 2023)、RWKV-4(B. Peng, Alcaide, et al. 2023)、RetNet(Y. Sun et al. 2023))を上回ることを示しているため、図を明確にするためにこれらは省略する(比較についてはGu and Dao(2023)を参照)。
図9は、標準的なChinchilla(Hoffmann et al. 2022)プロトコルの下での、からパラメータのモデルにおけるスケーリング則を示している。
9.2.2 下流評価
表1は、Mamba-2の広範な人気のある下流ゼロショット評価タスクにおける性能を、これらのサイズで最もよく知られたオープンソースモデル、とりわけPythia(Biderman et al. 2023)と比較して示している。Pythiaは我々のモデルと同じトークナイザ、データセット、および訓練長(300Bトークン)で訓練された。
9.2.3 ハイブリッドモデル:SSD層とMLPおよびアテンションの組み合わせ
最近および同時期の研究(Dao, D. Y. Fu, et al. 2023; De et al. 2024; Glorioso et al. 2024; Lieber et al. 2024)は、SSM層とアテンション層の両方を備えたハイブリッドアーキテクチャが、Transformerや純粋なSSM(例えばMamba)モデルよりも、特に文脈内学習においてモデル品質を向上させ得ることを示唆している。我々は、SSD層をアテンションおよびMLPと組み合わせるさまざまな方法を探求し、それぞれの利点を理解する。経験的に、総層数の約をアテンションとすることが最良の性能を発揮することを見出した。SSD層、アテンション層、およびMLPを組み合わせることもまた、純粋なTransformer++やMamba-2のいずれよりも良好に機能する。
SSDとアテンション 我々は、SSDとアテンション層が相補的であることを見出した。それら単独では(例えばMamba-2アーキテクチャ対Transformer++において)、その性能(パープレキシティで測定)はほぼ同じであるが、SSDとアテンション層の混合は純粋なMamba-2やTransformer++アーキテクチャを上回る。我々は、GPT-2トークナイザを用いてPile上で7Bトークンまで訓練した350Mモデル(48層)に関するいくつかの結果(表2)を示す(同じパラメータ数、同じハイパーパラメータ、同じ訓練および検証セット)。わずか数個のアテンション層を加えるだけで、すでに顕著な改善が得られ、品質と効率の最良のバランスを実現する。我々は、SSM層が一般的な系列間マッピングとして良好に機能し、アテンション層が、モデルにすべての文脈をそのメモリ(SSM状態)に圧縮することを強いる代わりに、系列内の以前のトークンを素早く参照するための検索メカニズムとして機能すると仮説を立てている。
| NUM. ATTN BLOCKS | 0 (Mamba-2) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 9 | 11 | 15 | 24 | Transformer++ |
| PERPLEXITY ↓ | 8.60 | 8.38 | 8.32 | 8.29 | 8.29 | 8.28 | 8.26 | 8.27 | 8.28 | 8.30 | 8.34 | 8.50 | 8.68 |
SSD、MLP、およびアテンションを備えたハイブリッドモデル 我々は、SSDを(ゲート付き)MLPおよびアテンション層と組み合わせるさまざまな方法を比較し、2.7Bスケール(64層)で評価し、Pile上で300Bトークンまで訓練した(同じパラメータ数、同じハイパーパラメータ、同じ訓練および検証セット、同じデータ順序):
1. Transformer++:32個のアテンション層と32個のゲート付きMLPを交互に配置。
2. Mamba-2:64個のSSD層。
3. Mamba-2-MLP:32個のSSDと32個のゲート付きMLP層を交互に配置。
4. Mamba-2-Attention:58個のSSD層と6個のアテンション層(インデックス9、18、27、36、45、56)6。
5. Mamba-2-MLP-Attention:28個のSSD層と4個のアテンション層を、32個のゲート付きMLP層と交互に配置。
我々は、Pile上の検証パープレキシティ、ならびにゼロショット評価を表3に報告する。一般に、Transformer++とMamba-2モデルの品質はほぼ同じである。わずか6個のアテンション層を加えることで、純粋なMamba-2モデル(およびTransformer++)を顕著に上回ることを見出した。MLP層を加えることはモデル品質を低下させるが、(i)MLP層の単純さとハードウェア効率性により訓練と推論を高速化でき、(ii)MLP層を混合エキスパートに置き換えることでMoEモデルへアップサイクルすることが容易になる。
| モデル | トークン | PILE | LAMBADA | LAMBADA | HELLASWAG | PIQA | ARC-E | ARC-C | WINOGRANDE | OPENBOOKQA | 平均 |
| PPL ↓ | PPL ↓ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ||
| Transformer++ | NeoX | 6.13 | 3.99 | 70.3 | 66.4 | 75.2 | 67.7 | 37.8 | 63.9 | 40.4 | 60.2 |
| Mamba-2 | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| Mamba-2-MLP | NeoX | 6.13 | 4.18 | 69.3 | 65.0 | 76.4 | 68.1 | 37.0 | 63.1 | 38.2 | 59.6 |
| Mamba-2-Attention | NeoX | 5.95 | 3.85 | 71.1 | 67.8 | 75.8 | 69.9 | 37.8 | 65.3 | 39.0 | 61.0 |
| Mamba-2-MLP-Attention | NeoX | 6.00 | 3.95 | 70.0 | 66.6 | 75.4 | 70.6 | 38.6 | 64.6 | 39.2 | 60.7 |
9.3 速度ベンチマーク
我々は、SSDアルゴリズムの速度をMambaのスキャン実装およびFlashAttention-2と比較してベンチマークする(図10)。SSDは、行列乗算をサブルーチンとして使用する再定式化により、GPU上の専用行列乗算(matmul)ユニット、すなわちテンソルコアを活用できる。その結果、matmulユニットを活用しないMambaの融合連想スキャンよりも2~8倍高速である。系列長に対して線形にスケールするため、SSDは系列長からFlashAttention-2よりも高速である。
しかしながら、Mamba-2モデルは全体として、短い系列長(例えば)ではTransformerほど効率的に訓練できない可能性があることに注意する。なぜなら、層のTransformerは個のMLP層と個のattention層を持つ一方、同じパラメータ数に対してMamba-2モデルは個のSSD層を持つからである。一般に、MLP層は単純な行列積とpointwiseな線形性から構成されるため、ハードウェア効率が非常に高い。9.2.3節で示したように、個のSSD層と個のMLP層を組み合わせて、短い系列長での訓練を高速化することもできる。
| ブロック | ABCX 射影 | 追加の正規化 | パラメータ数 | パープレキシティ |
| Mamba-1 | 逐次 | × | 129.3M | 11.76 |
| 逐次 | ✓ | 129.3M | 11.54 | |
| 並列 | × | 126.5M | 11.66 | |
| 並列 | ✓ | 126.5M | 11.49 |
9.4 アーキテクチャのアブレーション
9.4.1 ブロック設計
7.1節ではMamba-2ブロックを導入した。これはMamba-1ブロックに小さな変更を加えたものであり、その変更は一部がattentionとの関連性に動機づけられ、またMamba-2のスケーラビリティを向上させるためのものでもある。表4では、コアSSM層の外側で行われるこれらのブロックへのアーキテクチャ変更についてアブレーションを行っている。
アブレーションにより、を生成する並列射影がパラメータを節約し、Mambaの逐次射影よりもわずかに優れた性能を発揮することが検証された。さらに重要なことに、この変更はより大きなモデルサイズでのテンソル並列化(8節)に適している。加えて、追加の正規化層も性能をわずかに向上させる。さらに重要なことに、より大規模なスケールでの予備実験では、これが訓練の安定性にも寄与することが観察された。
9.4.2 ヘッド構造
7.2節では、射影の次元を、multi-head attentionやmulti-query attentionの概念に類似したハイパーパラメータとして捉えられることを説明した。また、元のMambaアーキテクチャがmulti-value attentionに類似していること(命題7.2)も示した。これは状態空間モデルの観点から自然に発展した選択であり、これまでアブレーションされたことはなかった。
表5では、Mamba-2アーキテクチャにおけるmulti-head構造の選択肢についてアブレーションを行っている。驚くべきことに、multi-valueとmulti-queryまたはmulti-keyのヘッドパターンの間には、非常に似ているにもかかわらず大きな差が見られる。これは総状態サイズでは説明できないことに注意する。総状態サイズはすべての場合で同一である(HPN、すなわちヘッド数、ヘッド次元、状態次元の積に等しい)。
また、(に相当)のヘッド数が等しいmulti-headパターンとも比較する。標準的なmulti-headパターン、および積極的な共有を行いすべてが1ヘッドのみとなるパターンと比較する。後者の場合でも、各ヘッドが異なるを持つため、モデルは依然としてH個の異なる系列ミキサーを持つことに注意する。パラメータを揃えた場合、これらのmulti-headパターンは互いに同程度の性能を示し、MVAとMQA/MKAパターンの間程度となる。
9.4.3 Attentionカーネル近似
7.3 節では、SSD が線形注意の文献からのアイデア、例えば様々な形のカーネル近似とどのように組み合わせられるかを述べた。我々は、先行研究によって提案されたこれらのいくつかの変種について Table 6 でアブレーションを行う。これらには cosFormer (Qin, Weixuan Sun, et al. 2022)、Random Feature Attention H. Peng et al. 2021、および Positive Random Features (Performer) (Choromanski et al. 2021) が含まれる。
我々はまた、標準的な注意における softmax 関数の分母に類する正規化項の追加についてもアブレーションを行う。この項はほとんどの変種に対して不安定性をもたらすことが分かったが、ReLU 活性化関数 に対しては性能をわずかに改善した。
Table 7 ではまた、特徴次元の拡張を含む、線形注意を改善するためのより最近の提案 (Based (Arora, Eyuboglu, Zhang, et al. 2024) および ReBased (Aksenov et al. 2024)) も検証している。これらの線形注意の拡張は、二次近似によって exp カーネルを代替することを目指している。ReBased はまた、QK 活性化関数を layer normalization で置き換えることを提案している。SSM 中心の視点からは、SSM 関数を適用する前に の上に正規化を適用する。
| SSMヘッドパターン | ATTN. アナログ | Aヘッド | Bヘッド | Cヘッド | Xヘッド | レイヤー | パラメータ | PPL. |
| マルチ入力(MIS) | マルチバリュー(MVA) | 24 | 1 | 1 | 24 | 24 | 126.5M | 11.66 |
| マルチコントラクト(MCS) | マルチクエリ(MQA) | 24 | 1 | 24 | 1 | 24 | 126.5M | 12.62 |
| マルチエクスパンド(MES) | マルチキー(MKA) | 24 | 24 | 1 | 1 | 24 | 126.5M | 12.59 |
| マルチヘッド(MHS) | マルチヘッド(MHA) | 24 | 24 | 24 | 24 | 15 | 127.6M | 12.06 |
| マルチステート(MSS) | - | 24 | 1 | 1 | 1 | 36 | 129.6M | 12.00 |
| マルチ入力(MIS) | マルチバリュー(MVA) | 32 | 1 | 1 | 32 | 48 | 361.8M | 8.73 |
| マルチコントラクト(MCS) | マルチクエリ(MQA) | 32 | 1 | 32 | 1 | 48 | 361.8M | 9.33 |
| マルチエキスパンド(MES) | マルチキー(MKA) | 32 | 32 | 1 | 1 | 48 | 361.8M | 9.36 |
| マルチヘッド(MHS) | マルチヘッド(MHA) | 32 | 1 | 1 | 1 | 70 | 361.3M | 9.01 |
| マルチステート(MSS) | - | 32 | 32 | 32 | 32 | 29 | 357.3M | 9.04 |
| カーネル活性化 φ | パープレキシティ |
| なし | 11.58 |
| Swish | 11.66 |
| Exp | 11.62 |
| ReLU | 11.73 |
| ReLU + 正規化 | 11.64 |
| cosFormer | 11.97 |
| ランダム特徴アテンション | 11.57 |
| 正のランダム特徴 (Performer) | 12.21 |
| カーネル活性化 φ | パープレキシティ |
| Swish | 11.67 |
| Swish + テイラー(Based) | 12.19 |
| LayerNorm | 11.50 |
| LayerNorm + 二乗(ReBased) | 11.84 |
| Swish | 8.58 |
| Swish + テイラー(Based) | 8.71 |
| LayerNorm | 8.61 |
| LayerNorm + 二乗(ReBased) | 8.63 |
我々は、この手法が softmax 注意に対する「QK-Norm」(Team 2024) として、また Mamba に対する「internal normalization」(Lieber et al. 2024) として独立に提案されていることに言及する。
全体として、Table 6 と Table 7 から、我々が試したカーネル近似手法は、 に対する単純な pointwise 非線形活性化関数を上回るようには思われなかった。したがって、Mamba-2 のデフォルト設定では Mamba-1 に従って を用いたが、この活性化関数を完全に削除することがより単純な選択肢となり得ることを示唆する。ただし、我々はこれを広範囲には検証していない。
しかしながら我々は、SSD とバニラ線形注意が 1-semiseparable マスク の包含において異なることを強調する。一方、文献における様々な線形注意手法は、この項なしで softmax 注意を近似するように導出されたものである。したがって、我々の否定的な結果は予想外ではないかもしれない。
10 関連研究と議論
状態空間双対性の枠組みは、SSM、構造化行列、および注意の間の結びつきを橋渡しする。我々は、SSD とこれらの概念との関係をより広く掘り下げて議論する。各視点からのアイデアを用いて、SSD の枠組みが将来の研究で拡張され得るいくつかの方向性も提案する。
10.1 状態空間モデル
構造化状態空間モデルは、(i) 時間不変か時間変化か、(ii) システムの次元性、(iii) 再帰的遷移 上の構造、という軸に沿って特徴づけることができる。
SSD は、SISO 次元とスカラー恒等構造を持つ選択的 SSM として記述できる。
時間変化性 (選択性)。元々の構造化 SSM (S4) は、連続時間のオンライン記憶 (Gu, Dao, et al. 2020; Gu, Johnson, Goel, et al. 2021; Gu, Johnson, Timalsina, et al. 2023) に動機づけられた線形時間不変 (LTI) システム (Gu 2023; Gu, Goel, and Ré 2022) であった。構造化 SSM の多くの変種が提案されており (Dao, D. Y. Fu, et al. 2023; Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; Ma et al. 2023; J. T. Smith, Warrington, and Linderman 2023)、その中には再帰を捨てて LTI SSM の畳み込み表現に焦点を当てるものもいくつか含まれる (D. Y. Fu et al. 2023; Y. Li et al. 2023; Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023)。
SSD は時間変化する構造化 SSM であり、Mamba で導入された選択的 SSM としても知られる (Gu and Dao 2023)。選択的 SSM は RNN のゲーティング機構と密接に関係しており、LSTM (Hochreiter and Schmidhuber 1997) や GRU (J. Chung et al. 2014) のような古典的 RNN だけでなく、QRNN (Bradbury et al. 2016)、SRU (Lei 2021; Lei et al. 2017)、RWKV (B. Peng, Alcaide, et al. 2023)、HGRN (Qin, Yang, and Zhong 2023)、Griffin (Botev et al. 2024; De et al. 2024) のようなより現代的な変種も含まれる。これらの RNN は様々な点でパラメータ化が異なるが、最も重要な違いは状態拡張の欠如である。
次元性と状態拡張。SSD の重要な特性であり、その系譜における先行する SSM (S4、H3、Mamba) と共有されるものは、入力チャネルが独立に処理される単一入力単一出力 (SISO) システムであるという点である。これは、N を SSM 状態サイズ (状態拡張因子とも呼ばれる)、D を標準的なモデル次元とすると、はるかに大きな実効状態サイズ N0 をもたらす。従来の RNN は であるか、密な 行列を持つ多入力多出力 (MIMO) であり、いずれの場合もより小さな状態をもたらす。MIMO SSM は一部の領域でうまく機能することが示されているが (Lu et al. 2023; Orvieto et al. 2023; J. T. Smith, Warrington, and Linderman 2023)、Mamba は状態拡張が言語のような情報密度の高い領域にとって極めて重要であることを示した。SSD の主な利点の一つは、モデルを遅くすることなく、さらに大きな状態拡張因子を可能にすることである。その後、多くの後続研究が状態拡張を採用している (10.4 節)。
構造。先行する構造化 SSM と比較して、SSD の主な制約は状態遷移 の表現力にある。対角 の場合のように、より一般的な SSM は SSD と同じ理論的効率を持つが、ハードウェアに優しくないことに言及する。これは、双対の二次形式が注意のような解釈を失い、計算がより困難になるためである。したがって Mamba と比較して、SSD は対角 のわずかにより制約の強い形においてのみ異なり、この表現力をハードウェア効率 (および実装の容易さ) の向上と引き換えにしている。
我々は、我々の構造化行列アルゴリズムを改良して一般的な対角 SSM の場合にも改善できる可能性があると仮説を立てる。
10.2 構造化行列
状態空間双対性の最初の視点は、これらのモデルを行列系列変換、すなわち「行列ミキサー」として捉える視点を採用する。これは、系列次元 T に沿って ( 行列による) 行列積として表現できる系列変換 (定義 2.1) である。
このような行列ミキサーはこれまでにいくつか提案されており、主要な変動軸は行列の表現である。これらには MLP-Mixer (Tolstikhin et al. 2021) (非構造化行列)、FNet (Lee-Thorp et al. 2021) (フーリエ変換行列)、M2 (Dao, B. Chen, et al. 2022; Dao, Gu, et al. 2019; Dao, Sohoni, et al. 2020; D. Fu et al. 2024) (butterfly/monarch 行列)、Toeplitz 行列 (Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023)、さらにはより異国的な構造 (De Sa et al. 2018; Thomas et al. 2018) が含まれる。
重要な特徴づけは、効率的な (劣二次の) 行列系列変換とは、構造化された行列ミキサーを持つものに他ならないという点である。SSD の枠組みの中心的な結果は、SSM を特定の構造、すなわち半分離行列 (3 節) を持つ行列ミキサーとして捉えることである。線形対二次の双対性は、その後、構造化行列積対素朴な行列積という形を取る。
構造化行列表現は、特定の半分離行列のブロック分解 (6 節) を通じて、我々の効率的な SSD アルゴリズムにつながった。半分離行列は科学計算の文献でよく研究されており、それらのアイデアを取り入れることは状態空間モデルの更なる改善への有望な道筋となり得ることに言及する。また、行列ミキサーの視点に焦点を当てることで、Mamba の原理的な非因果的変種の設計や、行列変換構造を分析することによって softmax 注意と劣二次モデルの間のギャップを特徴づけて橋渡しする方法の探索など、系列モデルにとってより実りある方向性が導かれ得ることを示唆する。
10.3 (線形) 注意
標準的な (因果的) 注意と比較して、SSD には主な違いが二つしかない。
第一に、SSD は標準的な注意の softmax 活性化 (Bahdanau, Cho, and Bengio 2015; Vaswani et al. 2017) を用いない。これが注意に二次計算量をもたらすものである。softmax を取り除くと、系列は線形注意の枠組み (Katharopoulos et al. 2020) を通じて線形スケーリングで計算できる。
第二に、SSD はロジット行列に入力依存の 1-semiseparable マスクを乗じる。したがって、このマスクは標準的な注意における softmax を置き換えるものと見なすことができる。
この半可分マスクは、位置情報を提供するものとしても見なすことができる。要素 はRNNにおける「ゲート」、あるいは「選択」機構として機能し(Mamba論文での議論を参照)、それらの累積積 は位置 と の間でどれだけの相互作用が許されるかを制御する。位置埋め込み(例えば、正弦波状のもの(Vaswani et al. 2017)、Alibi(Press, N. Smith, and Lewis 2022)、RoPE(Su et al. 2021)など)は、しばしばヒューリスティックとして見なされるTransformerの重要な構成要素であるが、SSDの1-SSマスクは、より原理に基づいた形の相対位置埋め込みとして見ることができる。この見方はGateLoop(Katsch 2023)によっても同時期に提唱されていたことに留意されたい。
状態空間双対性の第二の見方は、我々のより一般的な構造化マスク付き注意(structured masked attention、SMA)フレームワークの特別な場合であり、そこでは双対性が単純な4方向テンソル縮約上の異なる縮約順序として明らかになる。SMAは線形注意の強力な一般化であり、SSDよりもはるかに一般的でもある。他の形式の構造化マスクは、SSDとは異なる性質を持つ効率的注意のさらなる変種につながる可能性がある。
新しいモデルにつながるだけでなく、これらの注意との結びつきは、SSMを理解するための他の方向性にもつながり得る。例えば、我々は注意シンク(attention sinks)(Darcet et al. 2024; Xiao et al. 2024)という現象がMambaモデルにも存在するのかどうか、またより広く解釈可能性の技法がSSMに移転できるかどうか(Ali, Zimerman, and Wolf 2024)に興味を持っている。
最後に、線形注意の他の多くの変種が提案されており(Arora, Eyuboglu, Timalsina, et al. 2024; Arora, Eyuboglu, Zhang, et al. 2024; Choromanski et al. 2021; H. Peng et al. 2021; Qin, Han, Weixuan Sun, Dongxu Li, et al. 2022; Qin, Weixuan Sun, et al. 2022; Schlag, Irie, and Schmidhuber 2021; Zhang et al. 2024; Zheng, C. Wang, and Kong 2022)(これらのいくつかの記述については4.1.3節を参照)、多くの技法がSSMに移転できると我々は期待している(例えば7.3節)。
SSDは標準的なsoftmax注意や、有限の特徴写像ψを持たない注意カーネル行列上的その他の変換を一般化するものではないことを強調する。一般的な注意と比較して、SSDの利点は、履歴を圧縮する制御可能な状態拡張因子Nを持つことであり、これは系列長T≫Nに応じて全履歴をキャッシュする二次注意とは対照的である。並行研究では、これらの表現のトレードオフについて、例えばコピーや文脈内学習タスクにおいて研究が始まっている(Akyürek et al. 2024; Grazzi et al. 2024; Jelassi et al. 2024; Park et al. 2024)。Mamba-2はこれらの能力のいくつかにおいてMambaを大幅に改善している(例:セクション9.1のMQAR結果で示されている)が、さらに理解すべきことは残されている。
10.4 関連モデル
最後に、MambaおよびMamba-2に非常に類似した系列モデルを開発した、最近のまた並行する研究の増えつつある一群を強調する。
- RetNet(Y. Sun et al. 2023)とTransNormerLLM(Qin, Dong Li, et al. 2023)は、累積和の代わりに減衰項を用いて線形注意を一般化し、双対の並列/再帰アルゴリズムならびにハイブリッドな「チャンクワイズ」モードを提案している。これらのアルゴリズムは、A_{t}が時間不変(すべてのtに対して一定)であるSSDの一実現と見ることができる。SMAの解釈では、マスク行列Lは減衰行列L_{i,j} = γ^{t - j}となる。これらのモデルはまた、様々な点でアーキテクチャ上も異なる。例えば、注意中心の観点から導出されたため、マルチヘッド注意(MHA)パターンを保持している。一方、Mamba-2はSSM中心のパターンから導出されたため、マルチバリュー注意(MVA)またはマルチエキスパンドSSM(MES)パターンを保持しており、これがより優れていることを我々は示す(セクション9.4)。
- GateLoop(Katsch 2023)は並行して、入力依存の減衰因子A_{t}を用いることを提案し、SSDと同じ双対二次形式を開発しており、これを「代理注意(surrogate attention)」形式と呼んでいる。
- Gated Linear Attention(GLA)(Yang et al. 2024)は、データ依存のゲートを備えた線形注意の変種を提案し、チャンクワイズモードを計算する効率的なアルゴリズムとハードウェアを意識した実装を併せて提案した。
- HGRN(Qin, Yang, and Zhong 2023)は、入力依存のゲートを備えたRNNを導入し、これはHGRN2(Qin, Yang, Weixuan Sun, et al. 2024)において状態拡張を取り入れるよう改善された。
- Griffin(De et al. 2024)とRecurrentGemma(Botev et al. 2024)は、入力依存のゲーティングを備えたRNNが局所注意と組み合わされることで、強力な現代のTransformerと非常に競争力を持ち得ることを示した。Jambaもまた、Mambaを数層の注意と組み合わせることが言語モデリングにおいて非常に良好に機能することを示した(Lieber et al. 2024)。
- xLSTM(Beck et al. 2024)は、状態拡張のアイデアならびにその他のゲーティング、正規化、安定化の技法を採用することでxLSTMを改善している。
- RWKV(-4)(B. Peng, Alcaide, et al. 2023)は、異なる線形注意近似(注意不要Transformer(S. Zhai et al. 2021))に基づくRNNである。これは最近、選択性と状態拡張のアイデアを採用することで、RWKV-5/6(EagleおよびFinch)アーキテクチャ(B. Peng, Goldstein, et al. 2024)へと改善された。
11 結論
我々は、よく研究された構造化行列のクラスに基づく理論的枠組みを提案し、SSMと注意の変種との間の概念的ギャップを橋渡しした。この枠組みは、最近のSSM(例えばMamba)がなぜ言語モデリングにおいてTransformerと同等に良好に機能するのかについての洞察をもたらす。さらに、我々の理論的ツールは、双方におけるアルゴリズム的およびシステム的進歩を結びつけることにより、SSM(そして潜在的にはTransformer)を改善する新たなアイデアを提供する。実証として、この枠組みはSSMと構造化注意の交点における新アーキテクチャ(Mamba-2)の設計を導く。
謝辞
Δの勾配を数値的に安定した方法で効率的に計算する方法についての提案に対し、Angela Wuに感謝する。MQAR実験への支援に対し、Sukjun HwangとAakash Lahotiに感謝する。
参考文献
[1] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints". In: arXiv preprint arXiv:2305.13245 (2023).
[2] Yaroslav Aksenov, Nikita Balagansky, Sofia Maria Lo Cicero Vaina, Boris Shaposhnikov, Alexey Gorbatovski, and Daniil Gavrilov. "Linear Transformers with Learnable Kernel Functions are Better In-Context Models". In: arXiv preprint arXiv:2402.10644 (2024).
[3] Ekin Akyürek, Bailin Wang, Yoon Kim, and Jacob Andreas. "In-Context Language Learning: Architectures and Algorithms". In: The International Conference on Machine Learning (ICML). 2024.
[4] Ameen Ali, Itamar Zimerman, and Lior Wolf. The Hidden Attention of Mamba Models. 2024. arXiv: 2403.01590 [cs.LG].
[5] Simran Arora, Sabri Eyuboglu, Aman Timalsina, Isys Johnson, Michael Poli, James Zou, Atri Rudra, and Christopher Ré. "Zoology: Measuring and Improving Recall in Efficient Language Models". In: The International Conference on Learning Representations (ICLR). 2024.
[6] Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, and Christopher Ré. "Simple Linear Attention Language Models Balance the Recall-Throughput Tradeoff". In: The International Conference on Machine Learning (ICML). 2024.
[7] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. "Neural Machine Translation by Jointly Learning to Align and Translate". In: The International Conference on Learning Representations (ICLR). 2015.
[8] George A Baker, George A Baker Jr, Peter Graves-Morris, and Susan S Baker. Pade Approximants: Encyclopedia of Mathematics and It's Applications, Vol. 59 George A. Baker, Jr., Peter Graves-Morris. Vol. 59. Cambridge University Press, 1996.
[9] Maximilian Beck, Korbinian Poppel, Markus Spanring, Andreas Auer, Oleksandra Prudnikova, Michael Kopp, Günter Klambauer, Johannes Brandstetter, and Sepp Hochreiter. "xLSTM: Extended Long Short-Term Memory". In: arXiv preprint arXiv:2405.04517 (2024).
[10] Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, et al. "Pythia: A Suite for Analyzing Large Language Models across Training and Scaling". In: The International Conference on Machine Learning (ICML). PMLR. 2023, pp. 2397-2430.
[11] Yonatan Bisk, Rowan Zellers, Jianfeng Gao, Yejin Choi, et al. "PIQA: Reasoning about Physical Commonsense in Natural Language". In: Proceedings of the AAAI conference on Artificial Intelligence. Vol. 34. 2020.
[12] Sid Black, Stella Biderman, Eric Hallahan, Quentin Anthony, Leo Gao, Laurence Golding, Horace He, Connor Leahy, Kyle McDonell, Jason Phang, et al. "Gpt-NeoX-20B: An Open-source Autoregressive Language Model". In: arXiv preprint arXiv:2204.06745 (2022).
[13] Guy E Blelloch. "Prefix Sums and Their Applications". In: (1990).
[14] Aleksandar Botev, Soham De, Samuel L Smith, Anushan Fernando, George-Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, et al. "RecurrentGemma: Moving Past Transformers for Efficient Open Language Models". In: arXiv preprint arXiv:2404.07839 (2024).
[15] George EP Box, Gwilym M Jenkins, Gregory C Reinsel, and Greta M Ljung. Time Series Analysis: Forecasting and Control. John Wiley & Sons, 2015.
[16] James Bradbury, Stephen Merity, Caiming Xiong, and Richard Socher.「準リカレントニューラルネットワーク」。In: arXiv preprint arXiv:1611.01576 (2016).
[17] William Brandon, Aniruddha Nrusimha, Kevin Qian, Zachary Ankner, Tian Jin, Zhiye Song, and Jonathan Ragan-Kelley.「ストライプ注意:因果的トランスフォーマーのためのより高速なリング注意」。In: arXiv preprint arXiv:2311.09431 (2023).
[18] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al.「言語モデルは少数ショット学習者である」。In: Advances in Neural Information Processing Systems (NeurIPS) 33 (2020), pp. 1877-1901.
[19] Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, et al.「Performersによる注意の再考」。In: The International Conference on Learning Representations (ICLR). 2021.
[20] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al.「PaLM:Pathwaysによる言語モデリングのスケーリング」。In: Journal of Machine Learning Research 24.240 (2023), pp. 1-113. URL: http://jmlr.org/papers/v24/22-1144.html.
[21] Junyoung Chung, Caglar Gulcehre, KyungHyun Cho, and Yoshua Bengio.「系列モデリングにおけるゲート付きリカレントニューラルネットワークの実証的評価」。In: arXiv preprint arXiv:1412.3555 (2014).
[22] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord.「質問応答を解いたと思っているか?ARC、AI2推論チャレンジを試せ」。In: arXiv preprint arXiv:1803.05457 (2018).
[23] Tri Dao.「FlashAttention-2:より優れた並列性と作業分割による高速なアテンション」. In: The International Conference on Learning Representations (ICLR). 2024.
[24] Tri Dao, Beidi Chen, Nimit S Sohoni, Arjun Desai, Michael Poli, Jessica Grogan, Alexander Liu, Aniruddh Rao, Atri Rudra, and Christopher Ré.「Monarch:効率的で正確な学習のための表現力豊かな構造化行列」. In: International Conference on Machine Learning. PMLR. 2022, pp. 4690-4721.
[25] Tri Dao, Daniel Y Fu, Khaled K Saab, Armin W Thomas, Atri Rudra, and Christopher Ré.「Hungry Hungry Hippos:状態空間モデルによる言語モデリングに向けて」. In: The International Conference on Learning Representations (ICLR). 2023.
[26] Tri Dao, Albert Gu, Matthew Eichhorn, Atri Rudra, and Christopher Ré.「バタフライ因子分解を用いた線形変換のための高速アルゴリズムの学習」. In: The International Conference on Machine Learning (ICML). 2019.
[27] Tri Dao, Nimit Sohoni, Albert Gu, Matthew Eichhorn, Amit Blonder, Megan Leszczynski, Atri Rudra, and Christopher Ré.「Kaleidoscope:すべての構造化線形写像に対する効率的で学習可能な表現」. In: The International Conference on Learning Representations (ICLR). 2020.
[28] Timothée Darcet, Maxime Oquab, Julien Mairal, and Piotr Bojanowski.「Vision Transformerにはレジスタが必要である」. In: The International Conference on Learning Representations (ICLR). 2024.
[29] Soham De, Samuel L Smith, Anushan Fernando, Aleksandar Botev, George Cristian-Muraru, Albert Gu, Ruba Haroun, Leonard Berrada, Yutian Chen, Srivatsan Srinivasan, et al.「Griffin:効率的な言語モデルのためのゲート付き線形再帰と局所アテンションの混合」. In: arXiv preprint arXiv:2402.19427 (2024).
[30] Christopher De Sa, Albert Gu, Rohan Puttagunta, Christopher Ré, and Atri Rudra.「構造化密行列ベクトル積における二方面の進展」. In: Proceedings of the Twenty-Ninth Annual ACM-SIAM Symposium on Discrete Algorithms. SIAM. 2018, pp. 1060-1079.
[31] Hantian Ding, Zijian Wang, Giovanni Paolini, Varun Kumar, Anoop Deoras, Dan Roth, and Stefano Soatto.「より少ない切り捨てが言語モデリングを改善する」. In: arXiv preprint arXiv:2404.10830 (2024).
[32] Yuli Eidelman and Israel Gohberg.「構造化行列の新しいクラスについて」. In: Integral Equations and Operator Theory 34.3 (1999), pp. 293-324.
[33] Dan Fu, Simran Arora, Jessica Grogan, Isys Johnson, Evan Sabri Eyuboglu, Armin Thomas, Benjamin Spector, Michael Poli, Atri Rudra, and Christopher Ré.「Monarch mixer:単純な準二次的GEMMベースのアーキテクチャ」. In: Advances in Neural Information Processing Systems 36 (2024).
[34] Daniel Y Fu, Elliot L Epstein, Eric Nguyen, Armin W Thomas, Michael Zhang, Tri Dao, Atri Rudra, and Christopher Ré.「系列モデリングのための単純でハードウェア効率の良い長い畳み込み」. In: The International Conference on Machine Learning (ICML) (2023).
[35] Leo Gao, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, Horace He, Anish Thite, Noa Nabeshima, Shawn Presser, and Connor Leahy.「The Pile:言語モデリングのための多様なテキストからなる800GBのデータセット」. In: arXiv preprint arXiv:2101.00027 (2020).
[36] Leo Gao, Jonathan Tow, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Kyle McDonell, Niklas Muennighoff, Jason Phang, Laria Reynolds, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. 少数ショット言語モデル評価のためのフレームワーク. バージョン v0.0.1. 2021年9月. DOI: 10.5281/zenodo.5371628. URL: https://doi.org/10.5281/zenodo.5371628.
[37] Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim, and Beren Millidge.「Zamba:コンパクトな7B SSMハイブリッドモデル」. In: arXiv preprint arXiv:2405.16712 (2024).
[38] Riccardo Grazzi, Julien Siems, Simon Schrodi, Thomas Brox, and Frank Hutter.「Mambaは文脈内学習が可能か?」. In: arXiv preprint arXiv:2402.03170 (2024).
[39] Albert Gu.「構造化状態空間による系列のモデリング」. 博士論文. Stanford University, 2023.
[40] Albert Gu and Tri Dao.「Mamba:選択的状態空間による線形時間系列モデリング」. In: arXiv preprint arXiv:2312.00752 (2023).
[41] Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra, and Christopher Ré.「HIPPO:最適多項式射影による再帰メモリ」. In: Advances in Neural Information Processing Systems (NeurIPS). 2020.
[42] Albert Gu, Karan Goel, and Christopher Ré.「構造化状態空間による長い系列の効率的なモデリング」. In: The International Conference on Learning Representations (ICLR). 2022.
[43] Albert Gu, Ankit Gupta, Karan Goel, and Christopher Ré.「対角状態空間モデルのパラメータ化と初期化について」. In: Advances in Neural Information Processing Systems (NeurIPS). 2022.
[44] Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra, and Christopher Ré.「線形状態空間層による再帰・畳み込み・連続時間モデルの結合」. In: Advances in Neural Information Processing Systems (NeurIPS). 2021.
[45] Albert Gu, Isys Johnson, Aman Timalsina, Atri Rudra, and Christopher Ré.「HIPPOの学習方法:一般化基底射影を用いた状態空間モデル」. In: The International Conference on Learning Representations (ICLR). 2023.
[46] Ankit Gupta, Albert Gu, and Jonathan Berant.「対角状態空間は構造化状態空間と同等に有効である」. In: Advances in Neural Information Processing Systems 35 (2022), pp. 22982-22994.
[47] Dan Hendrycks and Kevin Gimpel.「ガウス誤差線形ユニット(GELU)」. In: arXiv preprint arXiv:1606.08415 (2016).
[48] W Daniel Hillis and Guy L Steele Jr.「データ並列アルゴリズム」. In: Communications of the ACM 29.12 (1986), pp. 1170-1183.
[49] Sepp Hochreiter and Jürgen Schmidhuber.「長短期記憶」. In: Neural Computation 9.8 (1997), pp. 1735-1780.
[50] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, et al.「計算最適な大規模言語モデル訓練の実証的分析」。In: Advances in Neural Information Processing Systems (NeurIPS) 35 (2022), pp. 30016-30030. [51] Samy Jelassi, David Brandfonbrener, Sham M Kakade, and Eran Malach.「Repeat After Me: Transformers Are Better Than State Space Models at Copying」。In: The International Conference on Machine Learning (ICML). 2024. [52] Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, and Francois Fleuret.「Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention」。In: International Conference on Machine Learning. PMLR. 2020, pp. 5156-5165. [53] Tobias Katsch.「GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling」。In: arXiv preprint arXiv:2311.01927 (2023). [54] Shiva Kaul.「Linear Dynamical Systems as a Core Computational Primitive」。In: Advances in Neural Information Processing Systems 33 (2020), pp. 16808-16820. [55] Vijay Anand Korthikanti, Jared Casper, Sangkug Lynn, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi, and Bryan Catanzaro.「Reducing activation recomputation in large transformer models」。In: Proceedings of Machine Learning and Systems 5 (2023). [56] James Lee-Thorp, Joshua Ainslie, Ilya Eckstein, and Santiago Ontanon.「Fnet: Mixing tokens with fourier transforms」。In: arXiv preprint arXiv:2105.03824 (2021). [57] Tao Lei.「When Attention Meets Fast Recurrence: Training Language Models with Reduced Compute」。In: Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing. 2021, pp. 7633-7648. [58] Tao Lei, Yu Zhang, Sida I Wang, Hui Dai, and Yoav Artzi.「Simple Recurrent Units for Highly Parallelizable Recurrence」。In: arXiv preprint arXiv:1709.02755 (2017). [59] Yuhong Li, Tianle Cai, Yi Zhang, Deming Chen, and Debadeepta Dey.「What Makes Convolutional Models Great on Long Sequence Modeling?」In: The International Conference on Learning Representations (ICLR). 2023. [60] Opher Lieber, Barak Lenz, Hofit Bata, Gal Cohen, Jhonathan Osin, Itay Dalmedigos, Erez Safahi, Shaked Meirom, Yonatan Belinkov, Shai Shalev-Shwartz, et al.「Jamba: A Hybrid Transformer-Mamba Language Model」。In: arXiv preprint arXiv:2403.19887 (2024). [61] Hao Liu, Wilson Yan, Matei Zaharia, and Pieter Abbeel.「World Model on Million-Length Video And Language With RingAttention」。In: arXiv preprint arXiv:2402.08268 (2024). [62] Hao Liu, Matei Zaharia, and Pieter Abbeel.「Ring attention with blockwise transformers for near-infinite context」。In: arXiv preprint arXiv:2310.01889 (2023). [63] Chris Lu, Yannick Schroecker, Albert Gu, Emilio Parisotto, Jakob Foerster, Satinder Singh, and Feryal Behbahani.「Structured State Space Models for In-Context Reinforcement Learning」。In: Advances in Neural Information Processing Systems (NeurIPS). 2023. [64] Xuezhe Ma, Chunting Zhou, Xiang Kong, Junxian He, Liangke Gui, Graham Neubig, Jonathan May, and Luke Zettlemoyer.「Mega: Moving Average Equipped Gated Attention」。In: The International Conference on Learning Representations (ICLR). 2023. [65] Eric Martin and Chris Cundy.「Parallelizing Linear Recurrent Neural Nets Over Sequence Length」。In: The International Conference on Learning Representations (ICLR). 2018. [66] Todor Mihaylov, Peter Clark, Tushar Khot, and Ashish Sabharwal.「Can a Suit of Armor Conduct Electricity? A New Dataset for Open Book Question Answering」。In: arXiv preprint arXiv:1809.02789 (2018). [67] Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, and Chris Olah.「In-context Learning and Induction Heads」。In: Transformer Circuits Thread (2022). https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html. [68] Antonio Orvieto, Samuel L Smith, Albert Gu, Anushan Fernando, Caglar Gulcehre, Razvan Pascanu, and Soham De.「Resurrecting Recurrent Neural Networks for Long Sequences」。In: The International Conference on Machine Learning (ICML). 2023. [69] Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Ngoc-Quan Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda, and Raquel Fernández.「The LAMBADA Dataset: Word Prediction Requiring a Broad Discourse Context」。In: Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics. 2016, pp. 1525-1534. [70] Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee, and Dimitris Papailiopoulos.「Can Mamba Learn How to Learn? A Comparative Study on In-Context Learning Tasks」。In: The International Conference on Machine Learning (ICML). 2024.
. html。
[71] Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, et al.「RWKV: Reinventing RNNs for the Transformer Era」。In: arXiv preprint arXiv:2305.13048 (2023)。
[72] Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Teddy Ferdinand, Haowen Hou, Przemyslaw Kazienko, et al.「Eagle and Finch: RWKV with matrix-valued states and dynamic recurrence」。In: arXiv preprint arXiv:2404.05892 (2024)。
[73] Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A Smith, and Lingpeng Kong.「Random Feature Attention」。In: The International Conference on Learning Representations (ICLR). 2021。
[74] Clément Pernet.「Computing with Quasiseparable Matrices」。In: Proceedings of the ACM on International Symposium on Symbolic and Algebraic Computation. 2016, pp. 389-396。
[75] Clément Pernet, Hippolyte Signargout, and Gilles Villard.「Exact computations with quasiseparable matrices」。In: arXiv preprint arXiv:2302.04515 (2023)。
[76] Clément Pernet and Arne Storjohann.「Time and space efficient generators for quasiseparable matrices」。In: Journal of Symbolic Computation 85 (2018), pp. 224-246。
[77] Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré.「Hyena Hierarchy: Towards Larger Convolutional Language Models」。In: The International Conference on Machine Learning (ICML). 2023。
[78] Hadi Pouransari, Chun-Liang Li, Jen-Hao Rick Chang, Pavan Kumar Anasosalu Vasu, Cem Koc, Vaishaal Shankar, and Oncel Tuzel.「Dataset Decomposition: Faster LLM Training with Variable Sequence Length Curriculum」。In: arXiv preprint arXiv:2405.13226 (2024)。
[79] Ofir Press, Noah Smith, and Mike Lewis.「Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation」。In: International Conference on Learning Representations. 2022。
[80] Zhen Qin, Xiaodong Han, Weixuan Sun, Bowen He, Dong Li, Dongxu Li, Yuchao Dai, Lingpeng Kong, and Yiran Zhong.「Toeplitz Neural Network for Sequence Modeling」。In: The International Conference on Learning Representations (ICLR). 2023。
[81] Zhen Qin, Xiaodong Han, Weixuan Sun, Dongxu Li, Lingpeng Kong, Nick Barnes, and Yiran Zhong.「The devil in linear transformer」。In: arXiv preprint arXiv:2210.10340 (2022)。
[82] Zhen Qin, Dong Li, Weigao Sun, Weixuan Sun, Xuyang Shen, Xiaodong Han, Yunshen Wei, Baohong Lv, Xiao Luo, Yu Qiao, et al.「TransNormerLLM: A Faster and Better Large Language Model with Improved TransNormer」。In: arXiv preprint arXiv:2307.14995 (2023)。
[83] Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong.「CosFormer: Rethinking Softmax in Attention」。In: The International Conference on Learning Representations (ICLR). 2022。
[84] Zhen Qin, Songlin Yang, Weixuan Sun, Xuyang Shen, Dong Li, Weigao Sun, and Yiran Zhong.「HGRN2: Gated Linear RNNs with State Expansion」。In: arXiv preprint arXiv:2404.07904 (2024)。
[85] Zhen Qin, Songlin Yang, and Yiran Zhong.「Hierarchically Gated Recurrent Neural Network for Sequence Modeling」。In: Advances in Neural Information Processing Systems 36 (2023)。
[86] Ali Rahimi and Benjamin Recht.「Random Features for Large-Scale Kernel Machines」。In: Advances in Neural Information Processing Systems (NeurIPS) 20 (2007)。
[87] Prajit Ramachandran, Barret Zoph, and Quoc V Le.「Swish: A Self-gated Activation Function」。In: arXiv preprint arXiv:1710.05941 7.1 (2017), p. 5。
[88] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi.「Winogrande: An Adversarial Winograd Schema Challenge at Scale」。In: Communications of the ACM 64.9 (2021), pp. 99-106。
[89] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber.「Linear Transformers are Secretly Fast Weight Programmers」。In: The International Conference on Machine Learning (ICML). PMLR. 2021, pp. 9355-9366。
[90] Noam Shazeer.「Fast Transformer Decoding: One Write-head is All You Need」。In: arXiv preprint arXiv:1911.02150 (2019)。
[91] Sam Shleifer, Jason Weston, and Myle Ott.「NormFormer: Improved Transformer Pretraining with Extra Normalization」。In: arXiv preprint arXiv:2110.09456 (2021)。
[92] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro.「Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism」。In: arXiv preprint arXiv:1909.08053 (2019)。
[93] Jimmy TH Smith, Andrew Warrington, and Scott W Linderman.「Simplified State Space Layers for Sequence Modeling」。In: The International Conference on Learning Representations (ICLR). 2023。
[94] Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, and Yunfeng Liu.「Roformer: Enhanced Transformer with Rotary Position Embedding」。In: arXiv preprint arXiv:2104.09864 (2021)。
[95] Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei.「Retentive network: A successor to transformer for large language models」。In: arXiv preprint arXiv:2307.08621 (2023)。
[96] Yi Tay, Mostafa Dehghani, Dara Bahri, and Donald Metzler.「Efficient Transformers: A Survey」。In: ACM Computing Surveys 55.6 (2022), pp. 1-28。
[97] Chameleon Team.「Chameleon: Mixed-Modal Early-Fusion Foundation Models」。In: arXiv preprint arXiv:2405.09818 (2024)。
[98] Anna Thomas, Albert Gu, Tri Dao, Atri Rudra, and Christopher Ré.「Learning Compressed Transforms with Low Displacement Rank」。In: Advances in Neural Information Processing Systems (NeurIPS). 2018, pp. 9052-9060。
[99] Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al.「MLP-Mixer: An All-MLP Architecture for Vision」。In: Advances in Neural Information Processing Systems (NeurIPS) 34 (2021), pp. 24261-24272。
[100] Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al.「Llama: Open and Efficient Foundation Language Models」。In: arXiv preprint arXiv:2302.13971 (2023)。
[101] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al.「Llama 2: Open foundation and fine-tuned chat models」。In: arXiv preprint arXiv:2307.09288 (2023)。
[102] Raf Vandebril, M Van Barel, Gene Golub, and Nicola Mastronardi.「A bibliography on semiseparable matrices」。In: Calcolo 42 (2005), pp. 249-270。
[103] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin.「Attention Is All You Need」。In: Advances in Neural Information Processing Systems (NeurIPS). 2017.
[104] Shida Wang and Beichen Xue.「State-space Models with Layer-wise Nonlinearity are Universal Approximators with Exponential Decaying Memory」。In: arXiv preprint arXiv:2309.13414 (2023).
[105] Sinong Wang, Belinda Z Li, Madian Khabsa, Han Fang, and Hao Ma.「Linformer: Self-attention with Linear Complexity」。In: arXiv preprint arXiv:2006.04768 (2020).
[106] Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, and Mike Lewis.「Efficient Streaming Language Models with Attention Sinks」。In: The International Conference on Learning Representations (ICLR). 2024.
[107] Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, and Vikas Singh.「Nyströmformer: A Nyström-Based Algorithm for Approximating Self-Attention」。In: Proceedings of the AAAI Conference on Artificial Intelligence. Vol. 35. 2021.
[108] Songlin Yang, Bailin Wang, Yikang Shen, Rameswar Panda, and Yoon Kim.「Gated Linear Attention Transformers with Hardware-Efficient Training」。In: The International Conference on Machine Learning (ICML). 2024.
[109] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, and Yejin Choi.「HellaSwag: Can a Machine Really Finish Your Sentence?」In: Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics. 2019.
[110] Jinle Zeng, Min Li, Zhihua Wu, Jiaqi Liu, Yuang Liu, Dianhai Yu, and Yanjun Ma. "Boosting distributed training performance of the unpadded bert model". In: arXiv preprint arXiv:2208.08124 (2022).
[111] Shuangfei Zhai, Walter Talbott, Nitish Srivastava, Chen Huang, Hanlin Goh, Ruixiang Zhang, and Josh Susskind. "An Attention Free Transformer". In: arXiv preprint arXiv:2105.14103 (2021).
[112] Yujia Zhai, Chengquan Jiang, Leyuan Wang, Xiaoying Jia, Shang Zhang, Zizhong Chen, Xin Liu, and Yibo Zhu. "Bytetransformer: A high- performance transformer boosted for variable- length inputs". In: 2023 IEEE International Parallel and Distributed Processing Symposium (IPDPS). IEEE. 2023, pp. 344- 355.
[113] Michael Zhang, Kush Bhatia, Hermann Kumbong, and Christopher Ré. "The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry". In: The International Conference on Learning Representations (ICLR). 2024.
[114] Lin Zheng, Chong Wang, and Lingpeng Kong. "Linear complexity randomized self- attention mechanism". In: International Conference on Machine Learning. PMLR. 2022, pp. 27011- 27041.
付録A 用語集
| 表記 | 説明 | 定義 |
| T | 時間軸またはターゲット系列軸 | 定義2.1 |
| S | ソース系列軸(アテンションにおいて) | 式(9) |
| D | モデル次元またはd_model | 定義7.1 |
| N | 状態/特徴次元またはd_state | 式(2)および(9) |
| P | ヘッド次元またはd_head | 定義2.1 |
| H | ヘッド数またはn_head | 定義7.1 |
| M | 系列変換行列 | 定義2.3 |
| A | 離散SSM再帰(状態)行列 | 式(2) |
| B | 状態空間モデルの入力射影(拡張)行列 | 式(2) |
| C | 状態空間モデルの出力射影(縮約)行列 | 式(2) |
| X | 入力行列(形状 (T,P)) | 式(2)および(9) |
| Y | 出力行列(形状 (T,P)) | 式(2)および(9) |
| Q | アテンションのクエリ行列 | 式(9) |
| K | アテンションのキー行列 | 式(9) |
| V | アテンションのバリュー行列 | 式(9) |
| G | アテンションのグラム行列 | QK^T(またはCB^T) |
| L | (構造化)マスク行列(因果設定では下三角) | 定義4.2 |
付録B スカラーSSMスキャンのための効率的アルゴリズム(1-SS乗算)
本節では、構造化行列分解の観点から、スカラーSSMスキャンを計算するためのさまざまなアルゴリズムを詳述する。スカラーSSMスキャンは、 の場合(すなわち がスカラーである場合)に、離散SSM(7)の再帰部分を計算することとして定義される。これは一般にSSMを再帰的に計算するために用いられ、特に が対角的に構造化されている構造化SSMの場合にはこの操作に帰着する。たとえばS5(J. T. Smith, Warrington, and Linderman 2023)やS6(Gu and Dao 2023)モデルがそうである。
本節の目的は、系列モデルのための効率的アルゴリズムが構造化行列乗算アルゴリズムとして捉えられるという、本論文の中心的テーマを裏付けることにある。ここで示すさまざまな行列分解のアイデアは、高速SSMアルゴリズムを導出するために用いられたアイデア(第6節)に関連し、またサブルーチンとして直接利用される。
B.1 問題定義
および をスカラーの系列とする。スカラーSSMスキャンは次式で定義される。
ここで は、SSM再帰に対する直前の隠れ状態を表す任意の値とすることができる。特に断りのない限り、 と仮定する。
また、式(21)をcumprodsum(累積積和)とも呼ぶ。cumprodsumは、(加法単位元)のときcumprod(累積積)に帰着し、(乗法単位元)のときcumsum(累積和)に帰着することに注意されたい。最後に、ベクトル化形式では次のように書けることに注意されたい。
言い換えれば、これは単に1-SS行列 による行列-ベクトル積にすぎない。
したがって、この基本的なプリミティブ演算については、すべて等価な3つの捉え方がある。
- (スカラー)SSMスキャン。- cumprodsum。- 1-SS行列-ベクトル乗算。
B.2 古典的アルゴリズム
まず、従来研究で用いられてきた、SSMスキャン(21)を計算する2つの古典的な方法について述べる。
B.2.1 逐次再帰
再帰モードは、単に(21)を1タイムステップ ずつ計算するものである。1-SS乗算の観点からは、これは3.4.1節でも述べられている。
B.2.2 並列連想スキャン
第二に、重要な観察として、この再帰は連想スキャンに変換できる(E. Martin and Cundy 2018; J. T. Smith, Warrington, and Linderman 2023)。この事実は完全に自明というわけではない。たとえばS5は、正しい連想スキャン演算子を定義し、そのうえで機械的な計算によって演算子の連想性を示した。
これが連想スキャンで計算可能であることをより明快に理解する方法は、多項再帰を、サイズ1ではなくサイズ2の隠れ状態に関する単項再帰に変換することである。
すると、すべての を計算することは、これらの 行列の累積積を取ることと同じになる。行列乗算は連想性を持つため、これは連想スキャンで計算できる。連想二項演算子は、単にこれらの特定の行列に対する行列乗算である。
最上行を等置すると、S5によって定義されたものと同じ連想スキャン演算子が得られる。
連想スキャンが重要である理由は、分割統治アルゴリズム(Blelloch 1990)を用いて並列化できることにある。本稿ではこのアルゴリズムの詳細は省略し、代わりに連想SSMスキャンアルゴリズム全体が行列分解を通じてゼロから導出できることを示す(付録B.3.5)。
B.3 構造化行列分解による効率的アルゴリズム
ここでは、1-SS行列 の構造化行列分解を見出すという観点から、SSMスキャンを計算するためのいくつかのアルゴリズムについて述べる。これらのアルゴリズムすなわち計算モードには、情報を1、2、4、8、…ステップずつ伝播させるダイレーテッドモード、情報をチャンク単位で前方に伝播させる状態受け渡しモード、1ステップずつ進む完全再帰モード(状態受け渡しモードの特殊ケース)、 を階層的なブロックに分割するブロック分解並列モード、 を等サイズのブロックに分割して再帰的に縮約するスキャンモードが含まれる。
B.3.1 ダイレーテッドモード
このモードは、増加する「ストライド」を含む特定の方法で1-SS行列を分解する。これは具体例を通じて最もよく説明できる。
B.3.2 状態受け渡し(チャンクワイズ)モード
このモードは、標準的な再帰モードの一般化と見なすことができる。すなわち、再帰状態 を一度に1ステップずつ渡す代わりに、任意の長さ のチャンク上で答えを計算し、そのチャンクを通して状態を渡すのである。これはまた、1-SS 行列の単純なブロック分解からも導出できる。
注意 9. ここで我々がこれを「状態渡し(state-passing)」と呼んでいるのは、状態がひとつの局所的セグメントから別のセグメントへと渡される様子を指すためであるが、これは関連するモデルによって提案された「チャンクワイズ(chunkwise)」アルゴリズム(Y. Sun et al. 2023; Yang et al. 2024)に関係している。
を「チャンク」で計算することを考えよう。ある添字 に対して、我々は 、すなわち添字 までの出力を計算し、問題を添字 上のより小さな問題に還元する方法を持ちたい。 を次のように書く。
1. 任意の望ましい方法(すなわち、本節の 1-SS 乗算のためのいずれかの方法)を用いて、答えの左半分 を計算する。
2. 最終状態 を計算する。
3. 状態を1ステップ進めて を修正する。
4. 任意の望ましい方法を用いて、答えの右半分 を計算する。
言い換えれば、左の部分問題をブラックボックスとして計算し、その最終状態を右の問題へと渡し、右の部分問題をブラックボックスとして計算するのである。
この方法の有用性は、より複雑な設定、たとえば一般的な -半可分(semiseparable)の場合や、入力 が追加の「バッチ」次元を持つ場合(言い換えれば、これが行列-ベクトル乗算ではなく行列-行列乗算である場合)に発揮される。この場合、我々はチャンクに対して( および による MM に対応する)代替アルゴリズムを用いることができ、それは完全な隠れ状態 を実体化しない。代わりに、隠れ状態を飛ばして、最終状態 を代替の方法で直接計算し、その状態を次のチャンクへと「渡す」。
計算量. この方法は、ステップ 2-3 が定数時間しかかからないため、非常に仕事効率が良いものとなりうる。したがって、2つの部分問題(ステップ 1 と 4)が線形時間であると仮定すれば、方法全体も線形時間で済む。
欠点は、これもまた逐次的であるという点である。
B.3.3 完全再帰モード
完全再帰モード、すなわち再帰が一度に1ステップずつ発展するモード(21)は、チャンクサイズ の状態渡しモードの単なる一具体化にすぎないことに注意されたい。
B.3.4 (並列)ブロック分解モード
これは状態渡しモードと同じ行列分解を用いるが、計算と並列化のトレードオフを行う異なる順序で部分問題を計算する。
例によって、 を次のように書く。
鍵となる観察は、やはりの左下象限がランク1であるということである。目視による確認のほか、別の見方として、右辺を用いる方法がある。すなわち、その左下象限が自明なランク1行列(右上隅がである以外はすべて0)であることに注目し、Woodburyの反転公式を用いることで、左辺の左下隅もまたランク1でなければならないことがわかる。このことは、目視で検証可能なランク1分解を導出する方法も与える:
第二の観察は、この行列が自己相似であるということである。すなわち、任意の主小行列は同じ形をしている。特に、左上象限と右下象限はともに1-SS行列である。
このことは、による行列積を実行する容易な方法を与える。すなわち、二つの半分(つまり左上と右下)について並列に再帰し、その後で左下の小行列を考慮に入れる。分割統治アルゴリズムにおけるこの「結合」ステップは、小行列がランク1であるため容易である。これにより並列アルゴリズムが導かれる。
計算量。状態受け渡しアルゴリズムと同様に、この手法はランク構造化半分離可能行列の同じブロック分解を用いる。違いは、状態受け渡しアルゴリズムが左の部分問題を処理してから右の部分問題を処理するのに対し、この手法では両方の部分問題について並列に再帰するという点である。これによりアルゴリズムの深さ/スパンが線形からへと低減される。トレードオフとして、結合ステップ(ランク1の左下小行列を考慮に入れること)が定数ではなく線形の作業量を必要とするため、総作業量は線形ではなくとなる。
また、再帰においては、任意の時点で停止し、部分問題を他の任意の方法で計算できることにも注意されたい。これはSSDアルゴリズム(第6節)の背後にある主要なアイデアであり、そこでは小さな部分問題に対して双対的な二次注意定式化へと切り替える。
B.3.5 連想スキャンモード
状態受け渡し(チャンクワイズ)アルゴリズムは線形の作業量を持つが、逐次的な操作も含む。
ブロック行列縮約モードと膨張モードは並列化可能であり、の深さ/スパンを持つ。しかしながら、余分な作業量を要する。
付録B.2.2で述べたように、連想スキャン(プレフィックススキャンとも呼ばれる)アルゴリズム(Baker et al. 1996)を活用することで、の深さとの作業量の両方を達成するアルゴリズムが存在する。このアルゴリズムはSSMスキャンまたは累積積和の観点から最も容易に理解されるが、それでもなお自明ではない。すなわち、連想演算子(22)を別途導出し、その後で並列/連想/プレフィックススキャンアルゴリズムをブラックボックスとして活用する必要がある(Blelloch 1990)。
ここでは、異なる行列分解を活用することで、この並列スキャンを実際に導出することが可能であることを示す:
第2段階。次に、行列の狭義下三角部分においてランク1行列として分解された各ブロックを考える。右側の各行ベクトルは、その列の対角ブロックにおける最下行ベクトルと同一であることに注意されたい。特におよびの各行である。
したがって、これらの答えは第1段階からすでに得られている。それは第1段階におけるすべての個の部分問題の第2要素である。この要素の配列を(の半分のサイズ)と呼ぶならば、にによって生成される1-SS行列を掛ける必要がある。
第3段階。最後に、第2段階の各答えは、左側の列ベクトルを掛けることによって二つの最終的な答えへとブロードキャストできる。特に、およびの各ベクトルである。
なお、これはインデックスの多少のオフバイワンシフトによって若干修正できる。このアルゴリズムを捉える等価な方法は、三段階の行列分解としてである:
IUE(VUI、VUCI、AIU RCI、OULCI)。
今度は、これらは状態空間モデルの閉包性を意味する。
例えば、加法性は、二つの並列なSSMモデルを足し合わせてもなおSSMであることを述べている。乗法性は、二つのSSMを逐次的に合成または連鎖させてもなおSSMと見なすことができ、その総状態サイズが加法的であることを述べている。これはやや非自明な事実である。
最後に、逆元性により、SSMを他の種類のモデルと関連付けることができる。例えば、帯行列は半分離可能であるため、その逆行列も半分離可能であることに気づくことができる。(実際、半分離可能な構造の族は、帯行列の逆行列を取ることによってしばしば動機づけられている(Vandebril et al. 2005))。さらに、半分離可能行列の高速な漸化式の性質は、その逆行列が帯状であることの帰結として見なすことができる。
注11。1-SS行列が単純な漸化式(7)であるという事実は、1-SS行列の逆行列が2帯行列であるという事実と等価である:
したがって、すなわち
または要素ごとに、
逆に、これらの閉包性の結果を用いて、自己回帰構造化注意(一定の仮定の下で)がSSMでなければならないことを証明し、注意の変種を含むより一般的な効率的系列モデルの族を状態空間モデルへと還元できることを示す(付録C.2)。
C.2 自己回帰マスク付き注意は半分離構造化注意である
セクション5.2の定理5.2を証明する。セクション4.3では、構造化注意をマスク付き注意の広範な一般化として定義した。そこでは、効率性の性質(すなわちカーネル注意に対する線形時間形式)が、構造化行列乗算の効率性へと抽象化されている。しかし、計算効率を超えて、標準的な線形注意(Katharopoulos et al. 2020)には二つの重要な性質もある。第一に、それは因果的であり、自己回帰モデリングなどの設定に必要とされる。さらに、効率的な自己回帰生成を備えている。言い換えれば、自己回帰ステップのコスト——すなわち、 がすでに見られ前処理されていることを前提として、 を見た際に出力 を計算するための増分コスト——は定数時間しか必要としない。
ここでは、SMAのどのインスタンスが効率的な自己回帰を持つかを特徴づける。
SMAの枠組みにおいて、因果性はマスク が下三角行列であるという制約と等価である。
効率的な自己回帰を持つ 行列の空間を特徴づけることはより困難である。我々は、時系列文献における古典的な定義(例:ARIMA過程(Box et al. 2015))の精神に沿って、自己回帰過程の狭い技術的定義を用いる。
定義 C.2. 我々は、次数 の自己回帰変換 を、各出力 が現在の入力と直近 個の出力のみに依存するものとして定義する:
がcumsum行列である場合は の特殊ケースであり、したがって であることに注意されたい。この定義により、効率的な自己回帰線形変換の空間の特徴づけは、半分離行列の性質から従う。定理C.3は定理5.2を形式化し証明する。
定理 C.3. を次数 の効率的な自己回帰変換とする。このとき は次数 の状態空間モデルである。
証明. を入力系列と出力系列とし、 とする。定義(23)を整理すると、
\(t\) に関してベクトル化すると、これは行列変換として次のように表せる。
\(\mu\) の対角行列は左辺に移し、\(\ell\) 係数の行列に折り込むことができる。この行列は依然として \(k + 1\) 帯の下三角行列である。しかし \(L^{- 1}y = x\) でもあるため、\(L\) はこの行列の逆行列である。
次に、半可分性のランクによる特徴付け(定義3.1)により、\(k + 1\) 帯行列は \(k + 1\) 半可分であることに注意する。したがって命題C.1により、逆行列 \(L\) は高々 \(k + 2\) 半可分である。帯行列の追加的な構造のため、\(k + 1\) というわずかに強い上界が得られる。最後に、\(L\) を次数 \(k + 1\) の状態空間モデルとして特徴付けることは定理3.5から従う。\(\square\)
言い換えれば、効率的な自己回帰アテンションは半可分SMAである。
D 実験の詳細
D.1 MQARの詳細
我々は、Based(Arora, Eyuboglu, Zhang, et al. 2024)で導入されたタスクのより難しいバージョンを使用する。そこではクエリ・キー・バリュー以外のトークンがランダムなトークンに置き換えられる。また、先行研究で用いられた通常のMQARの変種よりも多くのキー・バリュー対、より長い系列、より小さいモデルサイズを使用しており、これらはいずれもタスクをより難しくする。
各系列長 \(T \in \{256, 512, 1024\}\) について、\(T / 4\) 個のキー・バリュー対を使用する。総語彙サイズは8192である。
我々はカリキュラム学習の一形態を用いており、訓練は \((T / 32, T / 16, T / 8, T / 4)\) 個のキー・バリュー対を用いるデータセットを巡回する。各データセットは \(2^{18} \approx 250000\) 個の例を持ち、各データセットを合計8エポック通す(合計 \(2^{28} \approx 270M\) 個の例)。総バッチサイズは \(2^{18} \approx 0.25M\) トークンである(例えば \(T = 1024\) の場合、バッチサイズは256)。
すべての手法はデフォルト設定で2層を使用し、アテンションのベースラインにはさらに位置埋め込みが与えられる。各手法について、モデル次元 \(\mathsf{D} = \{32, 64, 128, 256\}\) と学習率 \(\{10^{- 3.5}, 10^{- 2}, 10^{- 2.5}\}\) を掃引する。我々はエポックごとに減少する線形減衰スケジュールを使用する(例えば最後のエポックでは、最大/開始学習率の \(1 / 8\) の学習率となる)。
D.2 スケーリング則の詳細
すべてのモデルはPileで訓練された。スケーリング則の実験では、GPT2トークナイザーを使用する。
モデルサイズ。表9は、GPT3(Brown et al. 2020)に従ってスケーリング則に用いるモデルサイズを規定している。第一に、統一性のために1.3Bモデルのバッチサイズを1Mトークンから0.5Mトークンに変更した。第二に、訓練ステップ数と総トークン数を変更し、Chinchillaスケーリング則(Hoffmann et al. 2022)にほぼ一致させた。これは訓練トークンがモデルサイズに比例して増加すべきであると規定している。
訓練レシピ。すべてのモデルはAdamWオプティマイザを使用し、
- 勾配クリップ値1.0- 重み減衰0.1- ドロップアウトなし- コサイン減衰を伴う線形学習率ウォームアップ
| PARAMS | n_layers | d_model | n_heads / d_head | トレーニングステップ数 | 学習率 | バッチサイズ | トークン数 |
| 125M | 12 | 768 | 12 / 64 | 4800 | 6e-4 | 0.5Mトークン | 2.5B |
| 350M | 24 | 1024 | 16 / 64 | 13500 | 3e-4 | 0.5Mトークン | 7B |
| 760M | 24 | 1536 | 16 / 96 | 29000 | 2.5e-4 | 0.5Mトークン | 15B |
| 1.3B | 24 | 2048 | 32 / 64 | 50000 | 2e-4 | 0.5Mトークン | 26B |
デフォルトでは、ピーク学習率はGPT3の仕様である。
GPT3のレシピと比較して、我々はPaLM(Chowdhery et al. 2023)やLLaMa(Touvron, Lavril, et al. 2023)のような人気の大規模言語モデルが採用した変更に着想を得た「改良レシピ」を使用する。これには以下が含まれる:
- \(1e - 5\) へのコサイン減衰を伴う線形学習率ウォームアップで、ピーク値はGPT3の値の \(5\times\)
- 線形バイアス項なし
- LayerNormの代わりにRMSNorm
- PyTorchのデフォルト \(\beta = (.9,.999)\) の代わりにAdamWハイパーパラメータ \(\beta = (.9,.95)\)(GPT3の値)
D.3 下流評価の詳細
完全に訓練されたモデルの下流性能を評価するため、我々はGPT- NeoX(Black et al. 2022)トークナイザーを用いて、Pile上で300BトークンでMamba- 2を訓練する。
スケーリング実験と同じハイパーパラメータを使用するが、1.3Bおよび2.7Bモデルではバッチサイズを1Mとする。2.7BモデルではさらにGPT3の仕様(32層、次元2560)に従う。
すべてのモデルについて、対応するGPT3モデルの学習率の5倍を使用する。
下流評価には、EleutherAIのLM評価ハーネス(L. Gao, Tow, et al. 2021)を、Mamba(Gu and Dao 2023)と同じタスクに1つ追加して用いる:
- LAMBADA(Paperno et al. 2016)
- HellaSwag(Zellers et al. 2019)
- PIQA(Bisk et al. 2020)
- ARC-challenge(P. Clark et al. 2018)
- ARC-easy:ARC-challengeの易しい部分集合
- WinoGrande(Sakaguchi et al. 2021)
- OpenBookQA(Mihaylov et al. 2018)
D.4 アブレーションの詳細
(Re)Basedの詳細。9.4.3節のアブレーションでは、Based(Arora, Eyuboglu, Zhang, et al. 2024)およびReBased(Aksenov et al. 2024)モデルを検討した。
Basedはexpカーネルを2次のテイラー展開 \(\exp (x) \approx 1 + x + x^{2} / 2\) で近似し、これは特徴写像
ReBasedは、カーネル変換に対応するより単純な特徴写像を使用することを提案しているが、その前にレイヤー正規化も適用する。我々はレイヤー正規化を、デフォルトのSwish活性化に代わる非線形活性化として捉え、これらの組み合わせをアブレーションする。
| モデル | トークナイザー | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | 平均ACC ↑ |
| Hybrid H3-130M | GPT2 | — | 89.48 | 25.8 | 31.7 | 64.2 | 44.4 | 24.2 | 50.6 | 27.0 | 38.2 |
| Pythia-160M | NeoX | 29.64 | 38.10 | 33.0 | 30.2 | 61.4 | 43.2 | 24.1 | 51.9 | 29.2 | 39.0 |
| Mamba-130M | NeoX | 10.56 | 16.07 | 44.3 | 35.2 | 64.5 | 48.0 | 24.2 | 51.9 | 28.8 | 42.4 |
| Mamba-2-130M | NeoX | 10.48 | 16.86 | 43.9 | 35.3 | 64.9 | 47.4 | 24.2 | 52.1 | 30.6 | 42.6 |
| Hybrid H3-360M | GPT2 | — | 12.58 | 48.0 | 41.5 | 68.1 | 51.4 | 24.7 | 54.1 | 31.6 | 45.6 |
| Pythia-410M | NeoX | 9.95 | 10.84 | 51.4 | 40.6 | 66.9 | 52.1 | 24.6 | 53.8 | 30.0 | 45.6 |
| Mamba-370M | NeoX | 8.28 | 8.14 | 55.6 | 46.5 | 69.5 | 55.1 | 28.0 | 55.3 | 30.8 | 48.7 |
| Mamba-2-370M | NeoX | 8.21 | 8.02 | 55.8 | 46.9 | 70.5 | 54.9 | 26.9 | 55.7 | 32.4 | 49.0 |
| Pythia-1B | NeoX | 7.82 | 7.92 | 56.1 | 47.2 | 70.7 | 57.0 | 27.1 | 53.5 | 31.4 | 49.0 |
| Mamba-790M | NeoX | 7.33 | 6.02 | 62.7 | 55.1 | 72.1 | 61.2 | 29.5 | 56.1 | 34.2 | 53.0 |
| Mamba-2-780M | NeoX | 7.26 | 5.86 | 61.7 | 54.9 | 72.0 | 61.0 | 28.5 | 60.2 | 36.2 | 53.5 |
| GPT-Neo 1.3B | GPT2 | — | 7.50 | 57.2 | 48.9 | 71.1 | 56.2 | 25.9 | 54.9 | 33.6 | 49.7 |
| Hybrid H3-1.3B | GPT2 | — | 11.25 | 49.6 | 52.6 | 71.3 | 59.2 | 28.1 | 56.9 | 34.4 | 50.3 |
| OPT-1.3B | OPT | — | 6.64 | 58.0 | 53.7 | 72.4 | 56.7 | 29.6 | 59.5 | 33.2 | 51.9 |
| Pythia-1.4B | NeoX | 7.51 | 6.08 | 61.7 | 52.1 | 71.0 | 60.5 | 28.5 | 57.2 | 30.8 | 51.7 |
| RWKV4-1.5B | NeoX | 7.70 | 7.04 | 56.4 | 52.5 | 72.4 | 60.5 | 29.4 | 54.6 | 34.0 | 51.4 |
| Mamba-1.4B | NeoX | 6.80 | 5.04 | 65.0 | 59.1 | 74.2 | 65.5 | 32.8 | 61.5 | 36.4 | 56.4 |
| Mamba-2-1.3B | NeoX | 6.66 | 5.02 | 65.7 | 59.9 | 73.2 | 64.3 | 33.3 | 60.9 | 37.8 | 56.4 |
| GPT-Neo 2.7B | GPT2 | — | 5.63 | 62.2 | 55.8 | 72.1 | 61.1 | 30.2 | 57.6 | 33.2 | 53.2 |
| Hybrid H3-2.7B | GPT2 | — | 7.92 | 55.7 | 59.7 | 73.3 | 65.6 | 32.3 | 61.4 | 33.6 | 54.5 |
| OPT-2.7B | OPT | — | 5.12 | 63.6 | 60.6 | 74.8 | 60.8 | 31.3 | 61.0 | 35.2 | 55.3 |
| Pythia-2.8B | NeoX | 6.73 | 5.04 | 64.7 | 59.3 | 74.0 | 64.1 | 32.9 | 59.7 | 35.2 | 55.7 |
| RWKV4-3B | NeoX | 7.00 | 5.24 | 63.9 | 59.6 | 73.7 | 67.8 | 33.1 | 59.6 | 37.0 | 56.4 |
| Mamba-2.8B | NeoX | 6.22 | 4.23 | 69.2 | 66.1 | 75.2 | 69.7 | 36.3 | 63.5 | 39.6 | 59.9 |
| Mamba-2-2.7B | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| GPT-J-6B | GPT2 | — | 4.10 | 68.3 | 66.3 | 75.4 | 67.0 | 36.6 | 64.1 | 38.2 | 59.4 |
| OPT-6.7B | OPT | — | 4.25 | 67.7 | 67.2 | 76.3 | 65.6 | 34.9 | 65.5 | 37.4 | 59.2 |
| Pythia-6.9B | NeoX | 6.51 | 4.45 | 67.1 | 64.0 | 75.2 | 67.3 | 35.5 | 61.3 | 38.0 | 58.3 |
| RWKV4-7.4B | NeoX | 6.31 | 4.38 | 67.2 | 65.5 | 76.1 | 67.8 | 37.5 | 61.0 | 40.2 | 59.3 |
これらの手法は特徴次元を拡張するため、より小さな次元へ射影しなければならないことに注意されたい。表7では、130Mモデルには状態サイズを、380Mモデルにはを使用する。(Re)Based手法では、それぞれ8次元および16次元へ射影してから特徴写像を適用する。その結果、130Mモデルの場合、総状態サイズはReBasedで、Basedでとなる。およびの射影がより小さいため、これらの手法はより少ないパラメータを使用し、我々は層数を適切に調整する。