
記憶で推測せず、推論の途中で検索を発行し結果を取り込むよう強化学習で訓練する。COLM 2025 の論文、全文無料。
Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning
Search-R1:検索エンジンを活用した推論を強化学習でLLMに訓練する
Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon , Sercan Ö. Arik , Dong Wang , Hamed Zamani , Jiawei Han
イリノイ大学アーバナ・シャンペーン校 計算機科学科
マサチューセッツ大学アマースト校 インテリジェント情報検索センター
Google Cloud AI Research
{bowenj4, zhenrui3, dwang24, hanj}@illinois.edu, {hzeng, zamani}@cs.umass.edu {jinsungyoon, soarik}@google.com
概要
外部知識や最新情報を効率的に獲得することは、大規模言語モデル(LLM)における効果的な推論とテキスト生成に不可欠である。推論能力を持つ高度なLLMに、推論時に検索エンジンを使用するようプロンプトで指示することは、しばしば最適とは言えない。なぜなら、LLMは検索エンジンと最適に相互作用する方法を十分に備えていない可能性があるからである。本論文では、SEARCH-R1を導入する。これは推論フレームワークのための強化学習(RL)の拡張であり、LLMがリアルタイム検索を伴う段階的な推論の過程で、(複数の)検索クエリを自律的に生成することを学習する。SEARCH-R1は、マルチターンの検索相互作用を伴うLLMの推論軌跡を最適化し、安定したRL訓練のために検索されたトークンのマスキングを活用し、シンプルな結果ベースの報酬関数を採用する。7つの質問応答データセットでの実験により、SEARCH-R1は同一設定下で様々なRAGベースラインと比較して性能を(Qwen2.5-7B)および(Qwen2.5-3B)向上させることが示された。本論文はさらに、検索拡張推論におけるRL最適化手法、LLMの選択、応答長のダイナミクスについての実証的な知見を提供する。コードとモデルのチェックポイントはhttps://github.com/PeterGriffinJin/Search-R1で公開されている。
1 はじめに
大規模言語モデル(LLM)は、自然言語の理解と生成において目覚ましい能力を実証してきた(Hendrycks et al., 2020; Clark et al., 2018)。これらの成果にもかかわらず、LLMは複雑な推論(Wei et al., 2022)や外部ソースからの最新情報の取得(Jin et al., 2024)を課された際にしばしば課題に直面する。これらの制限に対処するには、高度な推論能力(Huang & Chang, 2022)と、外部の最新情報を最大限に活用するために検索エンジンと効果的に相互作用する能力(Schick et al., 2023)を統合する必要がある。
LLMと検索エンジンを統合する既存のアプローチは、通常2つのカテゴリに分類される:(1)検索拡張生成(RAG)(Gao et al., 2023; Lewis et al., 2020)と、(2)検索エンジンをツールとして扱うこと(Yao et al., 2023; Schick et al., 2023)である。RAGモデルはしばしばLLMの入力をクエリとしてパッセージを検索し、それらを生成のためにLLMのコンテキストに組み込む(Lewis et al., 2020)。これにより、LLMは質問に答える際に外部知識を活用できる。既存の研究(Trivedi et al., 2022a)はマルチターン、マルチクエリの検索をLLMにプロンプトで指示しているが、このアプローチは最適とは言えない。なぜなら、LLMは訓練中に検索エンジンと効果的に相互作用する方法を学習するよう最適化されていないからである。あるいは、LLMは検索エンジンを含むツールを推論プロセスの一部として利用するようプロンプトで指示されたり訓練されたりすることができる(Qu et al., 2025; Trivedi et al., 2022a)。しかし、プロンプトベースのアプローチはしばしば汎化に苦労する。なぜなら、特定のタスクはLLMの事前訓練中に遭遇していない可能性があるからである。一方、訓練ベースのアプローチはより高い適応性を提供するが、大規模で高品質な注釈付き軌跡への依存と、検索操作の本質的な非微分可能性により、効果的にスケールすることが難しい。後者は、エンドツーエンドの勾配降下法に基づく最適化を適用不可能にする(Schick et al., 2023; Asai et al., 2024)。
強化学習(RL)(Sutton et al., 1999; Kaelbling et al., 1996)は、LLMの推論能力を強化するための強力なパラダイムとして台頭してきた(Guo et al., 2025; Hou et al., 2025; Xie et al., 2025; Kumar et al., 2024)。特に、OpenAI-o1(Jaech et al., 2024)やDeepSeek-R1(Guo et al., 2025)のようなモデルは、経験とフィードバックから学習することにより、論理的推論と問題解決のスキルを向上させるためにRL技術(例:PPO(Schulman et al., 2017)やGRPO(Shao et al., 2024))を活用してきた。RLを用いれば、結果報酬のみで訓練された場合でも、モデルは自己検証(Weng et al., 2022)や自己修正(Kumar et al., 2024)を含む複雑な推論能力を学習する。しかし、RLを検索と推論のシナリオに適用する際には、3つの主要な課題がある:(1)RLフレームワークと安定性 – 特に検索されたコンテキストを組み込む際に、安定した最適化を確保しながら、検索エンジンをLLMのRLアプローチに効果的に統合する方法は依然として不明確である。(2)マルチターンのインターリーブ推論と検索 – 理想的には、LLMは反復的な推論と検索エンジン呼び出しが可能であり、問題の複雑さに基づいて検索戦略を動的に調整すべきである。(3)報酬設計 – 検索と推論のタスクに効果的な報酬関数を設計することは根本的な課題であり続ける。なぜなら、シンプルな結果ベースの報酬が、LLMが意味のある一貫した検索行動を学習するのに十分であるかは不明確だからである。
前述の課題に対処するため、我々はSEARCH-R1を導入する。これは、LLMが自身の推論とインターリーブ方式で検索エンジンと相互作用することを可能にする新しいRLフレームワークである。具体的には、SEARCH-R1は以下の主要な革新を導入する:(1)我々は検索エンジンを環境の一部としてモデル化し、LLMのトークン生成と検索エンジンの検索をインターリーブするサンプリングされた軌跡シーケンスを可能にする。SEARCH-R1はPPOやGRPOを含む様々なRLアルゴリズムと互換性があり、我々は安定した最適化を確保するために検索されたトークンのマスキングを適用する。(2)SEARCH-R1はマルチターンの検索と推論をサポートし、<search>と</search>トークンによって明示的にトリガーされたときに検索呼び出しを実行する。検索されたコンテンツは<information>と</information>トークン内に囲まれ、LLMの推論ステップは<think>と</think>トークン内に包まれる。最終的な答えは<answer>と</answer>トークンを使用してフォーマットされ、構造化された反復的な意思決定を可能にする。(3)我々はプロセスベース報酬の複雑さを回避し、シンプルな結果ベースの報酬関数を採用する。我々の結果は、この最小限の報酬設計が検索と推論のシナリオにおいて効果的であることを実証する。したがって、SEARCH-R1はDeepSeek-R1 Zero(Guo et al., 2025)の拡張として見ることができる。後者は主にパラメトリック推論に焦点を当てているが、SEARCH-R1は検索拡張RL訓練を導入して検索駆動型の意思決定を強化する。
要約すると、我々の主要な貢献は3つある:
- 我々の研究は課題を分析し、LLMが検索エンジンの結果を用いて推論する方法を改善するためのRLの実装に関する見解を提供する。
- 我々はSEARCH-R1を提案する。これは、検索エンジンを用いたLLMのロールアウトと直接最適化をサポートする新しいRLフレームワークであり、RL訓練を安定させるための検索トークンマスキング、複雑なタスク解決をサポートするマルチターンのインターリーブ推論と検索、および効果的な結果報酬関数を含む。
- 我々はSEARCH-R1の有効性を実証するための体系的な実験を行い、2つのLLMが同一の実験設定(例:同じ検索モデル、訓練データ、事前訓練済みLLM)下でRAGベースラインに対してそれぞれ平均相対改善41%と20%を達成した。さらに、我々は推論と検索の設定のためのRLに関する知見を提供する。これには、RL手法の選択、異なるLLMの選択、応答長の研究が含まれる。
2 関連研究
2.1 大規模言語モデルと検索
優れた推論能力(Guo et al., 2025)やコーディング能力(Guo et al., 2024)を示しているにもかかわらず、LLM(Zhao et al., 2023; Team, 2024; Achiam et al., 2023)はしばしばドメイン固有の知識を欠いており(Peng et al., 2023; Li et al., 2023)、ハルシネーションを起こしやすい(Zhang et al., 2023)。これらの限界を緩和するために、検索エンジン(Zhao et al., 2024)が外部情報を提供するために広く統合されている。検索エンジンをLLMと統合する主な方法は2つある:(1)検索拡張生成(RAG)(Gao et al., 2023)と、(2)検索エンジンをツールとして扱う方法(Schick et al., 2023)である。RAG(Lewis et al., 2020; Yue et al., 2024; Xiong et al., 2025)は通常、1回の検索と逐次生成のパイプラインに従い、検索エンジンが入力クエリに基づいて関連情報を取得し、それがクエリと連結されてLLMに入力される。しかし、これは無関係な情報を取得してしまう(Jin et al., 2024)ことや、十分に有用な文脈を提供できない(Jiang et al., 2023)という課題に直面する可能性がある。代替となるアプローチは検索をツールとして用いる方法であり、LLMはプロンプトまたはファインチューニングによって検索エンジンと対話するように促される。IRCoT(Trivedi et al., 2022a)とReAct(Yao et al., 2023)はプロンプトを用いて反復的な推論と検索エンジン呼び出しを導き、Toolformer(Schick et al., 2023)は教師ありファインチューニングを活用して検索能力を強化する。しかし、このような手法は高品質なラベル付き軌跡に依存しており、それを大規模に取得することは困難である。最近の研究(Guo et al., 2025)は、RLが結果報酬のみを用いてLLMに高度な推論スキルを発達させ得ることを示唆しているが、検索エンジン呼び出しのシナリオにおけるその可能性は十分に探求されていない。
2.2 大規模言語モデルと強化学習
強化学習(RL)(Kaelbling et al., 1996)は、エージェントが環境と対話し、報酬の形でフィードバックを受け取ることによって逐次的な意思決定を学習するパラダイムであり、時間を通じた累積報酬の最大化を目指す(Sutton et al., 1999)。RLはOuyang et al.(2022)によって人間のフィードバックからの強化学習(RLHF)(Kaufmann et al., 2023)を通じてLLMのチューニングに導入された。このアプローチでは、まず人間の選好データ(Lambert et al., 2024)を用いて報酬モデルを訓練し、それが通常Proximal Policy Optimization(PPO)を介してポリシーLLMのRLベースのチューニングを導く。しかし、PPOは複数ラウンドのLLM最適化を伴うため、実装が困難である。RLベースのチューニングを簡素化するために、Direct Preference Optimization(DPO)(Rafailov et al., 2023)やSimPO(Meng et al., 2024)といった直接最適化手法が提案されている。同様のアプローチがLeRet(Hsu et al., 2024)で採用されており、LLMは情報検索の有効性を高めるために多様なクエリを探索するよう訓練される。これらの手法は計算効率を提供する一方で、オフポリシーの問題(Pang et al., 2024)を抱えており、純粋なRLアプローチの性能に一貫して匹敵するわけではない。代替の解決策には、グループスコアからベースラインを推定することでクリティックモデルの必要性を排除するGroup Relative Policy Optimization(GRPO)(Shao et al., 2024)や、簡素化されたREINFORCEスタイル(Williams, 1992)の最適化フレームワークを導入するRLOO(Ahmadian et al., 2024)がある。これらの進歩にもかかわらず、LLM駆動の検索エンジン対話と推論へのRLの応用は、依然としてほとんど未探求のままである。
3 Search-R1
以下の節では、SEARCH-R1の訓練手法の詳細な設計を示します。これには、(1) 検索エンジンを利用するためのRLの拡張、(2) インターリーブされたマルチターンの検索エンジン呼び出しを伴うテキスト生成、(3) 訓練テンプレート、(4) 報酬モデルの設計が含まれます。
3.1 検索エンジンを用いた強化学習
検索エンジン \(\mathcal{R}\) を利用するRL目的関数を次のように定式化します:
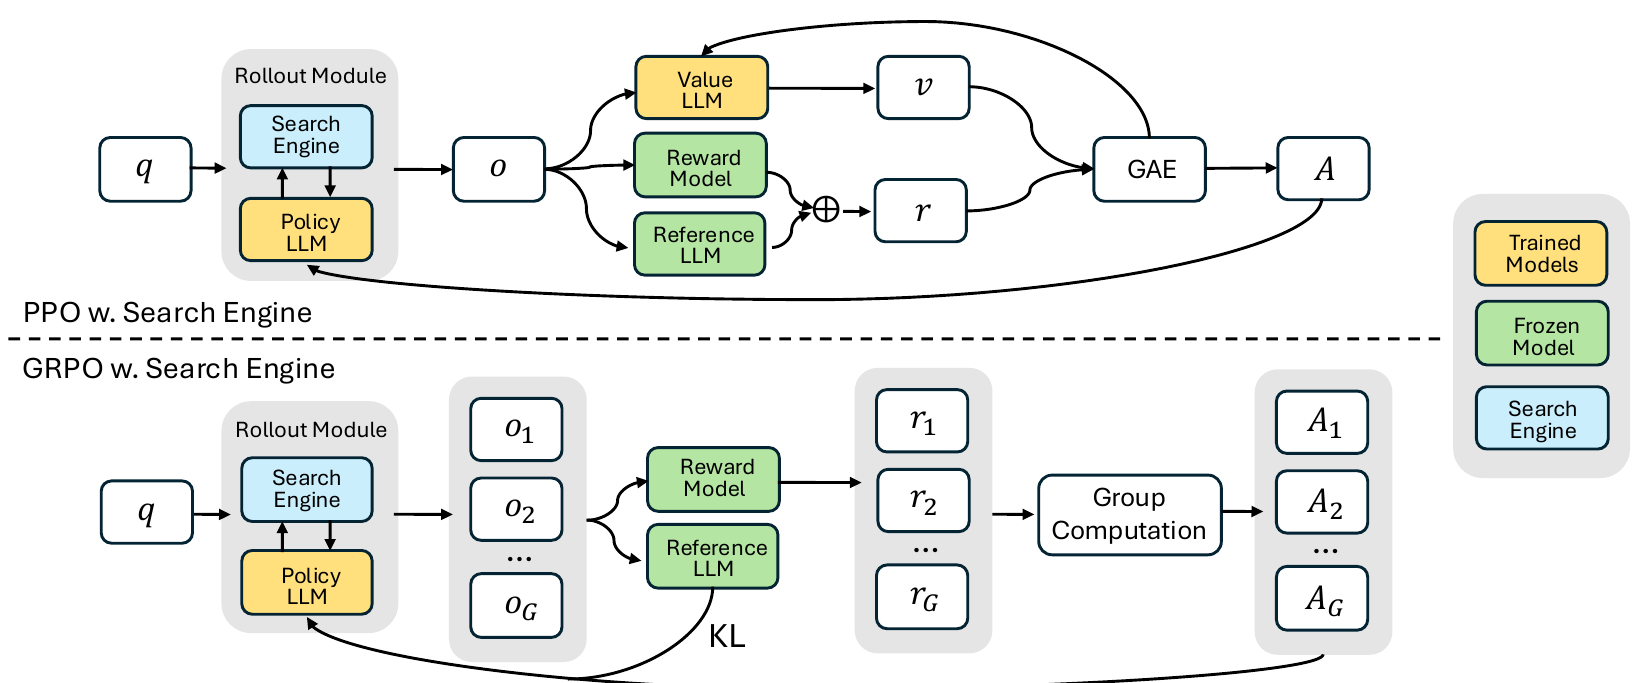
ここで、\(\pi_{\theta}\) はポリシーLLM、\(\pi_{\mathrm{ref}}\) は参照LLM、\(r_{\phi}\) は報酬関数、\(\mathbb{D}{\mathrm{KL}}\) はKLダイバージェンス測度です。\(x\) はデータセット \(\mathcal{D}\) から抽出された入力サンプルを表し、\(y\) は検索エンジン呼び出しの結果とインターリーブされた生成出力を表し、参照ポリシー \(\pi{\mathrm{ref}}(y\mid x)\) からサンプリングされ、検索エンジン \(\mathcal{R}\) から取得されます。ロールアウト系列の生成を主にポリシーLLM \(\pi_{\theta}(\cdot \mid x)\) に依存する従来のRLアプローチ(Rafailov et al., 2023; Ouyang et al., 2022)とは異なり、我々のフレームワークは \(\pi_{\theta}(\cdot \mid x;\mathcal{R})\) を介して検索をインターリーブした推論を明示的に組み込みます。これは \(\pi_{\theta}(\cdot \mid x)\otimes \mathcal{R}\) と見なすことができ、\(\otimes\) は検索と推論のインターリーブを表します。これにより、外部情報の検索を必要とする推論集約的なタスクにおいて、より効果的な意思決定が可能になります。ロールアウトプロセスの図解と式1の説明は、セクション3.2および付録Aに記載しています。
我々のアプローチは、確立された2つのポリシー勾配RL手法、すなわちProximal Policy Optimization(PPO)(Schulman et al., 2017)とGroup Relative Policy Optimization(GRPO)(Shao et al., 2024; Guo et al., 2025)に基づいており、それぞれの利点を活かして検索拡張推論を最適化します。
取得トークンに対する損失マスキング。PPOとGRPOの両方において、トークンレベルの損失はロールアウト系列全体にわたって計算されます。SEARCH-R1では、ロールアウト系列はLLMが生成したトークンと外部パッセージから取得したトークンの両方で構成されます。LLMが生成したトークンを最適化することで、モデルが検索エンジンと対話し推論を行う能力が向上しますが、取得したトークンに同じ最適化を適用すると、意図しない学習ダイナミクスを引き起こす可能性があります。これに対処するため、取得トークンに対する損失マスキングを導入し、ポリシー勾配目的がLLM生成トークンのみにわたって計算され、取得コンテンツが最適化プロセスから除外されるようにします。このアプローチは、検索拡張生成の柔軟性を保ちながら訓練を安定化させます。
検索エンジンを用いたPPO。Proximal Policy Optimization(PPO)(Schulman et al., 2017)は、LLMによく用いられる一般的なactor-critic型RLアプローチです(Ouyang et al., 2022)。検索エンジン呼び出しを含む我々の推論シナリオでは、以下の目的関数を最大化することによってLLMを最適化します:
ここで、\(\pi_{\theta}\) と \(\pi_{\mathrm{old}}\) はそれぞれ現在のポリシーモデルと以前のポリシーモデルを表します。\(I(y_{t})\) はトークン損失マスキング操作であり、\(y_{t}\) がLLM生成トークンであれば \(I(y_{t}) = 1\)、\(y_{t}\) が取得トークンであれば \(I(y_{t}) = 0\) となります。\(\epsilon\) はPPOで訓練を安定化させるために導入されたクリッピング関連のハイパーパラメータです。アドバンテージ推定 \(A_{t}\) は、将来の報酬 \(\{r_{\geq t}\}\) と学習された価値関数 \(V_{\phi}\) に基づいて、Generalized Advantage Estimation(GAE)(Schulman et al., 2015)を用いて計算されます。
検索エンジンを用いたGRPO。ポリシー最適化の安定性を向上させ、追加の価値関数近似の必要性を回避するために、Group Relative Policy Optimization(GRPO)がShao et al.(2024)で導入されました。GRPOは、学習された価値関数に依存するのではなく、複数のサンプリングされた出力の平均報酬をベースラインとして活用する点でPPOと異なります。具体的には、各入力質問 \(x\) に対して、GRPOは参照ポリシー \(\pi_{\mathrm{ref}}\) から応答のグループ \(\{y_{1}, y_{2}, \ldots , y_{G}\}\) をサンプリングします。そして、ポリシーモデルは以下の目的関数を最大化することによって最適化されます:
ここで、\(\epsilon\) と \(\beta\) はハイパーパラメータであり、\(\hat{A}{i,t}\) は各グループ内の出力の相対報酬に基づいて計算されるアドバンテージを表します。このアプローチにより、\(\hat{A}{i,t}\) の計算に追加の複雑さが導入されることを回避します。さらに、報酬関数内のペナルティとしてKLダイバージェンスを組み込む代わりに、GRPOは訓練されたポリシーと参照ポリシーの間のKLダイバージェンスを損失関数に直接加えることによって正則化します。取得トークンのマスキングは、KLダイバージェンス損失 \(\mathbb{D}_{K L}\) を計算する際にも適用されます。
3.2 マルチターンの検索エンジン呼び出しを伴う生成
本節では、インターリーブされたマルチターンの検索エンジン呼び出しを伴うLLM応答生成のロールアウトプロセスについて説明します。これは次のように定式化されます:\(y \sim \pi_{\theta}(\cdot |x;\mathcal{R}) = \pi_{\theta}(\cdot |x)\otimes \mathcal{R}\)。
私たちのアプローチは、LLMがテキスト生成と外部検索エンジンへのクエリを交互に行う反復的なフレームワークに従っています。具体的には、システム指示により、LLMは外部検索が必要なときはいつでも、検索クエリを2つの指定された検索呼び出しトークン<search>と</search>の間に囲むよう導かれます。生成された系列内でこれらのトークンが検出されると、システムは検索クエリを抽出し、検索エンジンにクエリを送り、関連する結果を取得します。取得された情報はその後、特別な検索トークン<information>と</information>の間に囲まれ、進行中のロールアウト系列に追加され、次の生成ステップのための追加のコンテキストとして機能します。このプロセスは、以下のいずれかの条件が満たされるまで反復的に続きます:(1) 最大アクション数に達する、または (2) モデルが最終応答を生成する。最終応答は指定された回答トークン<answer>と</answer>の間に囲まれます。ワークフロー全体はアルゴリズム1に示されています。
3.3 トレーニングテンプレート
SEARCH-R1をトレーニングするために、まず初期のLLMに事前定義された指示に従うよう導くシンプルなテンプレートを作成します。表1に示すように、このテンプレートはモデルの出力を反復的な形式で3つの部分に構造化します:まず推論プロセス、次に検索エンジン呼び出し関数、そして最後に回答です。私たちは意図的に制約をこの構造的フォーマットに限定し、反射的推論や検索エンジン呼び出しを強制したり、特定の問題解決アプローチを推奨したりするような内容固有のバイアスを避けています。これにより、RLプロセス中のモデルの自然な学習ダイナミクスが観察可能で偏りのないものになることが保証されます。
与えられた質問に答えてください。新しい情報を得るたびに、まず必ず<think>と</think>の中で推論を行わなければなりません。推論後、何らかの知識が不足しているとわかった場合は、<search> query </search>で検索エンジンを呼び出すことができ、検索上位の結果が<information>と</information>の間に返されます。検索は何度でも行えます。これ以上外部知識が必要ないとわかった場合は、詳細な説明なしに<answer>と</answer>の中に直接回答を提供できます。例えば、<answer> xxx </answer>のように。質問: question。
表1: SEARCH-R1のテンプレート。questionはトレーニングおよび推論中に特定の質問に置き換えられます。要求: 入力クエリ、ポリシーモデル、検索エンジン、最大アクション予算。
保証: 最終応答。
1: ロールアウト系列を初期化
2: アクションカウントを初期化
3: while do
4: 現在のアクションのLLMロールアウト系列を初期化
5: while True do
6: 応答トークンを生成
7: をロールアウト系列に追加
8: if in [</search>,</answer>,<eos>] then break
9: end if
10: end while
11:
12: if <search> </search> が 内で検出された then
13: 検索クエリを抽出
14: 検索結果を取得
15: をロールアウトに挿入
16: else if <answer> </answer> が 内で検出された then
17: 最終生成応答 を返す
18: else
19: 再考を要求 action is not correct. Let me rethink."
20: end if
21: アクション数をインクリメント
22: end while
23: 最終生成応答 を返す
3.4 報酬モデリング
報酬関数は主要な学習シグナルとして機能し、RLにおける最適化プロセスを導く。SEARCH-R1を学習するために、我々はモデルの応答の正しさを評価する最終結果報酬のみからなるルールベースの報酬システムを採用する。例えば、事実推論タスクでは、正しさは厳密な文字列一致などのルールベースの基準を用いて評価できる:
ここで は応答 から抽出された最終回答であり、 は正解の回答である。Guo et al. (2025) とは異なり、我々の学習済みモデルはすでに強い構造的遵守を示しているため、フォーマット報酬は組み込まない。より複雑なフォーマット報酬の探索は今後の課題として残す。さらに、Guo et al. (2025) に従い、ニューラル報酬モデルの学習は行わない。この決定は、大規模RLにおいてLLMが特定の形式の報酬に敏感であること、またこれらのモデルを再学習させることで生じる追加の計算コストと複雑さに動機づけられている。
4 主要な結果
4.1 データセット
我々はSEARCH-R1を7つのベンチマークデータセットで評価し、以下のように分類する:(1) 一般的な質問応答:NQ (Kwiatkowski et al., 2019)、TriviaQA (Joshi et al., 2017)、PopQA (Mallen et al., 2022)。(2) マルチホップ質問応答:HotpotQA (Yang et al., 2018)、2WikiMultiHopQA (Ho et al., 2020)、Musique (Trivedi et al., 2022b)、Bamboogle (Press et al., 2022)。これらのデータセットは、推論を伴う多様な検索の課題を包含しており、SEARCH-R1の包括的な評価を可能にする。
4.2 ベースライン
SEARCH-R1の有効性を評価するため、我々は以下のベースラインと比較する:(1) 検索なしの推論:直接推論とChain-of-Thought (CoT) 推論 (Wei et al., 2022)。(2) 検索ありの推論:Retrieval-Augmented Generation (RAG) (Lewis et al., 2020)、IRCoT (Trivedi et al., 2022a)、Search-o1 (Li et al., 2025)。(3) ファインチューニングベースの手法:教師ありファインチューニング (SFT) (Chung et al., 2024)、検索エンジンなしのRLベースのファインチューニング (R1) (Guo et al., 2025)、および検索エンジンを用いた棄却サンプリング (Ahn et al., 2024)。R1については、SEARCH-R1との公正な比較のため、我々のデータを用いてGuo et al. (2025) で提案されたRL手法でLLMを学習させる。これは検索エンジンなしで推論と回答のステップのみを含む。棄却サンプリングについては、同じデータセットから学習プロンプトごとに5つの候補応答を指示付きLLMで生成し、正しい最終回答に至るものを選択する。これらの選択された軌跡は、SEARCH-R1で提案されたものと同じマルチターンのLLM-検索エンジン相互作用ロールアウト機構を保持する新しい学習セットの構築に用いられ、LLMのファインチューニングに使用される。
これらのベースラインは検索拡張およびファインチューニングのアプローチの広いスペクトルを網羅しており、ゼロショット設定と学習済み検索設定の両方においてSEARCH-R1を包括的に評価することを可能にする。異なる手法間で公正な比較を行うため、我々は同じ検索器、同じ検索文書数、同じ知識コーパス、同じ学習データ、そして同じ事前学習済みLLMを使用する。詳細は付録Bに記載する。
4.3 実験設定
我々は2種類のモデル、Qwen-2.5-3B (Base/Instruct) とQwen-2.5-7B (Base/Instruct) (Yang et al., 2024) を用いて実験を行う。検索には、2018年のWikipediaダンプ (Karpukhin et al., 2020) を知識源として、E5 (Wang et al., 2022) を検索器として使用する。公正な比較を確保するため、Lin et al. (2023) に従い、すべての検索ベース手法において検索パッセージ数を3に設定する。検索パッセージ数に関する検討は付録Gに記載する。
学習には、NQとHotpotQAの学習セットを統合し、SEARCH-R1およびその他のファインチューニングベースのベースラインのための統一データセットを形成する。評価は7つのデータセットのテストセットまたは検証セットで行い、ドメイン内とドメイン外の両方の性能を評価する。評価指標には、Yu et al. (2024) に従い、Exact Match (EM) を用いる。推論スタイルのベースラインについては、ベースモデルは指示に従えないため、指示付きモデルを使用する。RLチューニング手法については、ベースモデルと指示付きモデルの両方で実験を行う。実験設定の詳細は付録Bに記載する。
別途明記しない限り、PPOをデフォルトのRL手法として使用し、PPOとGRPOの詳細な比較は5.1節に記載する。
4.4 性能
7つのデータセットにわたるSEARCH-R1とベースライン手法の比較の主要な結果を表2に示す。結果から、我々は以下の主要な観察を行う:(1) SEARCH-R1は強力なベースライン手法を一貫して上回る。我々はQwen2.5-7BとQwen2.5-3Bでそれぞれ平均24%と20%の相対的改善を達成する。これらの向上は、分布内評価(すなわちNQとHotpotQA)と分布外評価(すなわちTriviaQA、PopQA、2WikiMultiHopQA、Musique、Bamboogle)の両方で維持される。(2) SEARCH-R1は検索なしのLLM推論に対するRLベースの学習 (R1) を上回る。これは予想と一致する。なぜなら、検索をLLM推論に組み込むことで関連する外部知識にアクセスでき、全体的な性能が向上するからである。(3) SEARCH-R1はベースモデルと指示チューニング済みモデルの両方で有効である。これは、結果ベースの報酬を用いたDeepSeek-R1-ZeroスタイルのRL (Guo et al., 2025) が、検索を伴う推論に首尾よく適用できることを示しており、これまでに確立された純粋な推論シナリオにおける有効性を超えて拡張される。(4) より大きなモデルは検索の方法をよりよく学習する。7BモデルでのSEARCH-R1は、3Bモデルと比較してはるかに大きな「性能ギャップ」を示す(例えば、次点モデルであるRAGと比較して)。
| 方法 | 一般QA | マルチホップQA | ||||||
| NQ+ | TriviaQA+ | PopQA+ | HotpotQA+ | 2wiki+ | Musique+ | Bamboolle+ | 平均 | |
| Qwen2.5-7b-Base/Instruct | ||||||||
| 直接推論 | 0.134 | 0.408 | 0.140 | 0.183 | 0.250 | 0.031 | 0.120 | 0.181 |
| CoT | 0.048 | 0.185 | 0.054 | 0.092 | 0.111 | 0.022 | 0.232 | 0.106 |
| IRCoT | 0.224 | 0.478 | 0.301 | 0.133 | 0.149 | 0.072 | 0.224 | 0.239 |
| Search-o1 | 0.151 | 0.443 | 0.131 | 0.187 | 0.176 | 0.058 | 0.296 | 0.206 |
| RAG | 0.349 | 0.585 | 0.392 | 0.299 | 0.235 | 0.058 | 0.208 | 0.304 |
| SFT | 0.318 | 0.354 | 0.121 | 0.217 | 0.259 | 0.066 | 0.112 | 0.207 |
| R1-base | 0.297 | 0.539 | 0.202 | 0.242 | 0.273 | 0.083 | 0.296 | 0.276 |
| R1-instruct | 0.270 | 0.537 | 0.199 | 0.237 | 0.292 | 0.072 | 0.293 | 0.271 |
| リジェクションサンプリング | 0.360 | 0.592 | 0.380 | 0.331 | 0.296 | 0.123 | 0.355 | 0.348 |
| Search-R1-base | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| Search-R1-instruct | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| 直接推論 | 0.106 | 0.288 | 0.108 | 0.149 | 0.244 | 0.020 | 0.024 | 0.134 |
| CoT | 0.023 | 0.032 | 0.005 | 0.021 | 0.021 | 0.002 | 0.000 | 0.015 |
| IRCoT | 0.111 | 0.312 | 0.200 | 0.164 | 0.171 | 0.067 | 0.240 | 0.181 |
| Search-o1 | 0.238 | 0.472 | 0.262 | 0.221 | 0.218 | 0.054 | 0.320 | 0.255 |
| RAG | 0.348 | 0.544 | 0.387 | 0.255 | 0.226 | 0.047 | 0.080 | 0.270 |
| SFT | 0.249 | 0.292 | 0.104 | 0.186 | 0.248 | 0.044 | 0.112 | 0.176 |
| R1-base | 0.226 | 0.455 | 0.173 | 0.201 | 0.268 | 0.055 | 0.224 | 0.229 |
| R1-instruct | 0.210 | 0.449 | 0.171 | 0.208 | 0.275 | 0.060 | 0.192 | 0.224 |
| Rejection Sampling | 0.294 | 0.488 | 0.332 | 0.240 | 0.233 | 0.059 | 0.210 | 0.265 |
| Search-R1-base | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| Search-R1-instruct | 0.341 | 0.545 | 0.378 | 0.324 | 0.319 | 0.103 | 0.264 | 0.325 |
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolle | 平均 |
| Qwen2.5-7b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
| SEARCH-R1-instruct (GRPO) | 0.429 | 0.623 | 0.427 | 0.386 | 0.346 | 0.162 | 0.400 | 0.396 |
| SEARCH-R1-base (PPO) | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1-instruct (PPO) | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.421 | 0.583 | 0.413 | 0.297 | 0.274 | 0.066 | 0.128 | 0.312 |
| SEARCH-R1-instruct (GRPO) | 0.397 | 0.565 | 0.391 | 0.331 | 0.310 | 0.124 | 0.232 | 0.336 |
| SEARCH-R1-base(PPO) | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| SEARCH-R1-instruct(PPO) | 0.341 | 0.545 | 0.378 | 0.324 | 0.319 | 0.103 | 0.264 | 0.325 |
5 分析
5.1 異なるRL手法:PPO対GRPO
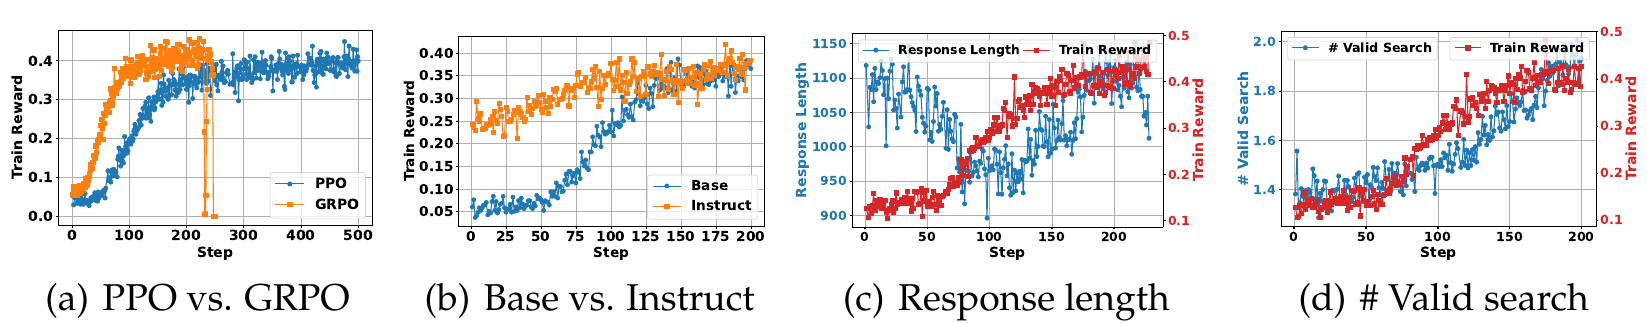
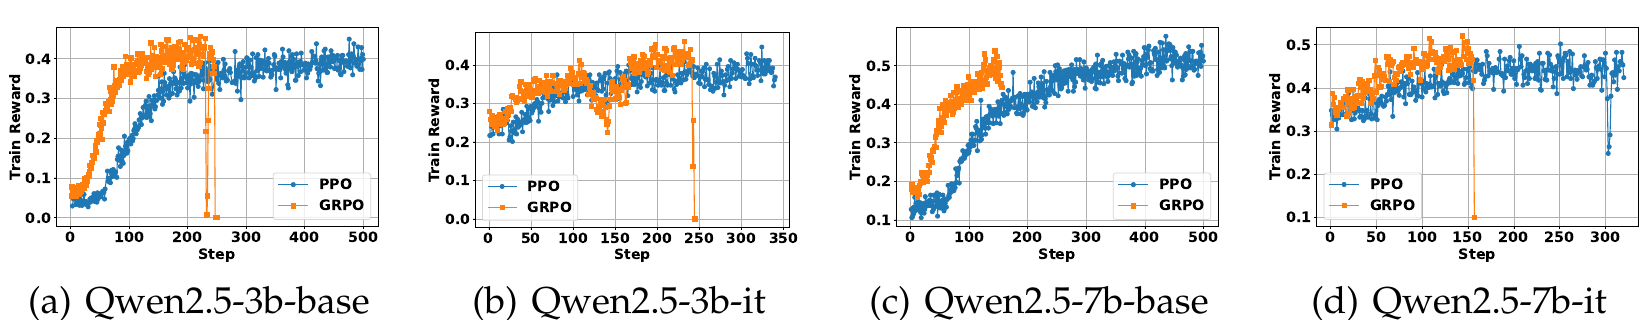
我々は、PPOとGRPOの両方をベースRL手法として用いてSEARCH-R1を評価し、Qwen2.5-3B/7Bモデルで実験を行った。訓練ダイナミクスの比較を図2(a)に、評価結果を表3に示す。そこから以下の知見が得られた:(1) GRPOはすべてのケースにおいてPPOより速く収束する。これは、PPOがクリティックモデルに依存しており、効果的な訓練が始まるまでに数ステップのウォームアップを必要とするためである。(2) PPOはより高い訓練安定性を示す。図2(a)に示すように、GRPOは多くのステップを訓練した後に報酬崩壊を引き起こすのに対し、PPOは安定を保つ。(3) PPOとGRPOの最終的な訓練報酬は同程度である。収束速度と安定性の違いにもかかわらず、両手法は同様の最終訓練報酬と性能を達成しており、どちらもSEARCH-R1の最適化に有効であることを示している。PPOはより高い訓練安定性を示すため、この設定においては好ましい選択肢となる。より詳細な結果は付録Fにある。
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bambooq | 平均 |
| SEARCH-R1(マスクあり) | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1(マスクなし) | 0.388 | 0.567 | 0.391 | 0.325 | 0.321 | 0.108 | 0.304 | 0.343 |
5.2 ベースLLM対インストラクトLLM
我々は、ベースLLMとインストラクションチューニング済みLLMの両方にわたってSEARCH-R1の訓練ダイナミクスを分析する。実験は2つのモデル変種、Qwen2.5-3BおよびQwen2.5-7Bで行う。図2(b)に示すように、インストラクションチューニング済みモデルはベースモデルと比較してより速く収束し、より高い初期性能から開始することを観察した。しかしながら、両モデル種の最終訓練報酬は訓練後には非常に類似したままである。この知見は、一般的なポストトレーニングが推論+検索のシナリオにおける学習を加速する一方で、RLが時間をかけて効果的にその差を埋め、ベースモデルが同程度の性能を達成できるようにすることを示唆している。より詳細な結果は付録Eにある。
5.3 応答長と有効検索の検討
我々は、Qwen2.5-7b-baseモデルを用いたSEARCH-R1による実験を行い、訓練の経過に伴う応答長と有効な検索エンジン呼び出し回数のダイナミクスを分析する。応答長の結果を図2(c)に示し、以下の主要な傾向が明らかになった:(1) 初期段階(最初の100ステップ):応答長は急激に減少する一方、訓練報酬はわずかに増加する。この段階では、ベースモデルは過剰なフィラーワードを排除することを学習し、タスク要件への適応を開始する。(2) 後期段階(100ステップ以降):応答長と訓練報酬の両方が大幅に増加する。この時点で、LLMは検索エンジンを頻繁に呼び出すことを学習し、取得されたパッセージにより応答が長くなる。モデルが検索結果をより効果的に活用できるようになるため、訓練報酬は大幅に改善する。有効検索の結果を図2(d)に示す。これは、訓練が進むにつれてLLMが検索エンジンをより多く呼び出すことを学習することを示している。
5.4 取得トークンの損失マスキングに関する検討
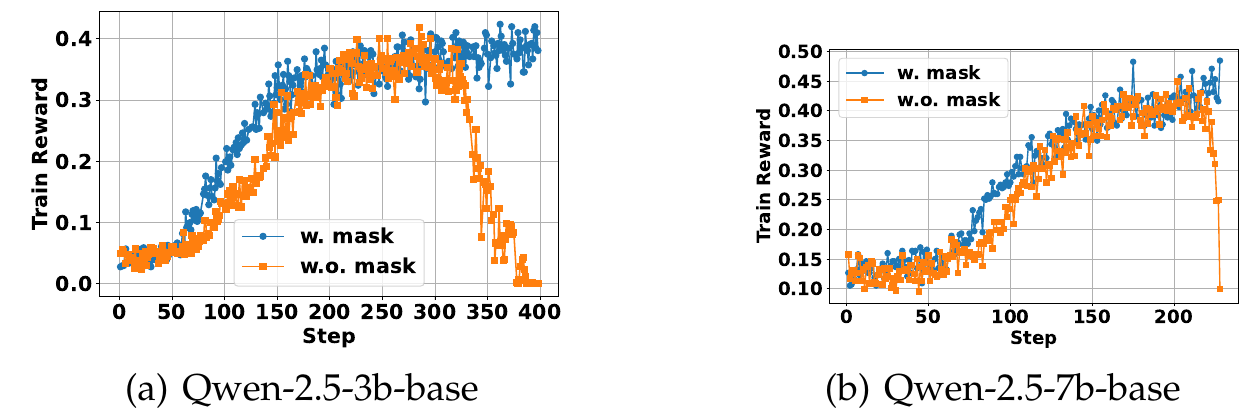
3.1節において、我々は意図しない最適化挙動を防ぐために取得トークンに対する損失マスキングを導入した。ここでは、Qwen2.5-7b-baseモデルで実験を行い、取得トークン損失マスキングありとなしの訓練ダイナミクスを比較する。図3に示すように、取得トークンマスキングを適用するとLLMの改善がより大きくなり、意図しない最適化効果を緩和し、より安定した訓練を確保する。性能比較を表4に示す。これは、取得トークン損失マスキングを用いて訓練されたSEARCH-R1が、マスキングなしの変種を一貫して上回ることを示している。
取得トークン損失マスク、ベースLLM対インストラクトLLM、PPO/GRPO間の比較、SEARCH-R1訓練における取得パッセージ数、SEARCH-R1(GRPO)におけるグループサイズの検討、ケーススタディに関するより詳細な実験結果は、付録D、E、G、H、IおよびJにある。
6 結論
本研究では、LLMが自己推論とリアルタイムの検索エンジンとの対話を交互に実行できるようにする新しいRLフレームワークであるSEARCH-R1を導入した。多ターン検索のために広範なプロンプティングに依存する既存のRAG的なアプローチや、大規模な教師あり訓練データを必要とするツール利用手法とは異なり、SEARCH-R1はRLを通じてLLMのロールアウトを最適化し、自律的なクエリ生成と取得情報の戦略的活用を可能にする。7つのデータセットに対する広範な実験を通じて、SEARCH-R1がリアルタイムの外部知識を必要とする複雑な推論タスクに取り組むLLMの能力を大幅に向上させることを示した。我々の分析はまた、検索拡張推論のためのRL訓練戦略に関する重要な知見を提供する。今後は、より洗練された報酬メカニズム、不確実性に基づく動的な検索調整、多様なツール群との組み合わせ、検索以外の多様な情報源との統合を含む、より広範な検索戦略をサポートするようSEARCH-R1を拡張することを将来の研究として検討できる。また、マルチモーダル推論タスクへの適用可能性を調査することも有望である。
謝辞
本研究は、一部Apple PhD Fellowshipにより、一部は米国DARPA INCASプログラムNo. HR0011-21-C0165およびBRIESプログラムNo. HR0011-24-3-0325により、一部はOffice of Naval Research契約番号N000142412612により、一部はNSF助成金番号IIS-19-56151および2402873により、一部はMolecule Maker Lab Institute:NSFがAward No. 2019897の下で支援するAI Research Institutesプログラム、およびNSFがAward No. 2118329の下で支援するInstitute for Geospatial Understanding through an Integrative Discovery Environment(I-GUIDE)により、一部はCiscoにより、また一部はCenter for Intelligent Information Retrievalにより支援された。本稿で表明された意見、所見、結論または推薦は著者のものであり、スポンサーまたは米国政府の見解を明示的または暗黙的に必ずしも代表するものではない。
参考文献
Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, and Sara Hooker. Back to basics: Revisiting reinforce style optimization for learning from human feedback in llms. arXiv preprint arXiv:2402.14740, 2024.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, and Wenpeng Yin. Large language models for mathematical reasoning: Progresses and challenges. arXiv preprint arXiv:2402.00157, 2024.
Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. 2024.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1-53, 2024.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try arc, the ai2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Haofen Wang, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2, 2023.
Michael Glass, Gaetano Rossiello, Md Faisal Mahbub Chowdhury, Ankita Rajaram Naik, Pengshan Cai, and Alfio Gliozzo. Re2g: Retrieve, rerank, generate. arXiv preprint arXiv:2207.06300, 2022.
Daya Guo, Qihao Zhu, Dejian Yang, Zhenda Xie, Kai Dong, Wentao Zhang, Guanting Chen, Xiao Bi, Yu Wu, YK Li, et al. Deepseek-coder: When the large language model meets programming-the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. Constructing a multi-hop qa dataset for comprehensive evaluation of reasoning steps. arXiv preprint arXiv:2011.01060, 2020.
Zhenyu Hou, Xin Lv, Rui Lu, Jiajie Zhang, Yujiang Li, Zijun Yao, Juanzi Li, Jie Tang, and Yuxiao Dong. Advancing language model reasoning through reinforcement learning and inference scaling. arXiv preprint arXiv:2501.11651, 2025.
Sheryl Hsu, Omar Khattab, Chelsea Finn, and Archit Sharma. Grounding by trying: Llms with reinforcement learning-enhanced retrieval. arXiv preprint arXiv:2410.23214, 2024.
Jie Huang and Kevin Chen-Chuan Chang. Towards reasoning in large language models: A survey. arXiv preprint arXiv:2212.10403, 2022.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. Active retrieval augmented generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pp. 7969-7992, 2023.
Bowen Jin, Jinsung Yoon, Jiawei Han, and Sercan O Arik. Long-context llms meet rag: Overcoming challenges for long inputs in rag. In The Thirteenth International Conference on Learning Representations, 2024.
Mandar Joshi, Eunsol Choi, Daniel S Weld, and Luke Zettlemoyer. Triviaqa: A large scale distantly supervised challenge dataset for reading comprehension. arXiv preprint arXiv:1705.03551, 2017.
Leslie Pack Kaelbling, Michael L Littman, and Andrew W Moore. Reinforcement learning: A survey. Journal of artificial intelligence research, 4:237-285, 1996.
Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick SH Lewis, Ledell Wu, Sergey Edunov, Danqi Chen, and Wen-tau Yih. Dense passage retrieval for open-domain question answering. In EMNLP (1), pp. 6769-6781, 2020.
Timo Kaufmann, Paul Weng, Viktor Bengs, and Eyke Hullermeier. A survey of reinforcement learning from human feedback. arXiv preprint arXiv:2312.14925, 10, 2023.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, John D Co-Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, et al. Training language models to self-correct via reinforcement learning. arXiv preprint arXiv:2409.12917, 2024.
Tom Kwiatkowski, Jennimaria Palomaki, Olivia Redfield, Michael Collins, Ankur Parikh, Chris Alberti, Danielle Epstein, Illia Polosukhin, Jacob Devlin, Kenton Lee, et al. Natural questions: a benchmark for question answering research. Transactions of the Association for Computational Linguistics, 7:453-466, 2019.
Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, et al. Rewardbench: 言語モデリングのための報酬モデルを評価する. arXiv preprint arXiv:2403.13787, 2024.
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Kuttler, Mike Lewis, Wen-tau Yih, Tim Rocktaschel, et al. 知識集約型NLPタスクのための検索拡張生成. Advances in neural information processing systems, 33:9459-9474, 2020.
Xiaoxi Li, Jiajie Jin, Yujia Zhou, Yongkang Wu, Zhonghua Li, Qi Ye, and Zhicheng Dou. Retrollm: 生成中に細粒度の証拠を検索するように大規模言語モデルを強化する. arXiv preprint arXiv:2412.11919, 2024.
Xiaoxi Li, Guanting Dong, Jiajie Jin, Yuyao Zhang, Yujia Zhou, Yutao Zhu, Peitian Zhang, and Zhicheng Dou. Search-01: エージェント型検索で強化された大規模推論モデル. arXiv preprint arXiv:2501.05366, 2025.
Yinheng Li, Shaofei Wang, Han Ding, and Hang Chen. 金融における大規模言語モデル: サーベイ. In Proceedings of the fourth ACM international conference on AI in finance, pp. 374-382, 2023.
Xi Victoria Lin, Xilun Chen, Mingda Chen, Weijia Shi, Maria Lomeli, Richard James, Pedro Rodriguez, Jacob Kahn, Gergely Szilvasy, Mike Lewis, et al. Radit: 検索拡張デュアル指示チューニング. In The Twelfth International Conference on Learning Representations, 2023.
Alex Mallen, Akari Asai, Victor Zhong, Rajarshi Das, Hannaneh Hajishirzi, Daniel Khashabi. 言語モデルを信用すべきでないとき:パラメトリック記憶と非パラメトリック記憶の有効性と限界に関する調査. arXiv preprint arXiv:2212.10511, 7, 2022.
Yu Meng, Mengzhou Xia, Danqi Chen. Simpo:参照なし報酬による簡素な選好最適化. Advances in Neural Information Processing Systems, 37:124198-124235, 2024.
Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. 人間のフィードバックを用いた指示追従のための言語モデルの訓練. Advances in neural information processing systems, 35:27730-27744, 2022.
Richard Yuanzhe Pang, Weizhe Yuan, He He, Kyunghyun Cho, Sainbayar Sukhbaatar, Jason Weston. 反復的推論選好最適化. Advances in Neural Information Processing Systems, 37:116617-116637, 2024.
Cheng Peng, Xi Yang, Aokun Chen, Kaleb E Smith, Nima PourNejatian, Anthony B Costa, Cheryl Martin, Mona G Flores, Ying Zhang, Tanja Magoc, et al. 医学研究と医療のための生成的大規模言語モデルに関する研究. NPJ digital medicine, 6(1):210, 2023.
Ofir Press, Muru Zhang, Sewon Min, Ludwig Schmidt, Noah A Smith, Mike Lewis. 言語モデルにおける構成性ギャップの測定と縮小. arXiv preprint arXiv:2210.03350, 2022.
Changle Qu, Sunhao Dai, Xiaochi Wei, Hengyi Cai, Shuaiqiang Wang, Dawei Yin, Jun Xu, Ji-Rong Wen. 大規模言語モデルによるツール学習:サーベイ. Frontiers of Computer Science, 19(8):198343, 2025.
Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, Chelsea Finn. 直接選好最適化:あなたの言語モデルは実は報酬モデルである. Advances in Neural Information Processing Systems, 36:53728-53741, 2023.
Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Eric Hambro, Luke Zettlemoyer, Nicola Cancedda, Thomas Scialom. Toolformer:言語モデルは自らツールの使い方を学べる. Advances in Neural Information Processing Systems, 36:68539-68551, 2023.
John Schulman, Philipp Moritz, Sergey Levine, Michael Jordan, Pieter Abbeel. 一般化アドバンテージ推定を用いた高次元連続制御. arXiv preprint arXiv:1506.02438, 2015.
John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, Oleg Klimov. 近接方策最適化アルゴリズム. arXiv preprint arXiv:1707.06347, 2017.
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, YK Li, Y Wu, et al. Deepseekmath:オープン言語モデルにおける数学的推論の限界を押し広げる. arXiv preprint arXiv:2402.03300, 2024.
Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, Chuan Wu. Hybridflow:柔軟で効率的なrlhfフレームワーク. arXiv preprint arXiv:2409.19256, 2024.
Richard S Sutton, Andrew G Barto, et al. 強化学習. Journal of Cognitive Neuroscience, 11(1):126-134, 1999.
Gemini Team. Gemini 1.5:数百万トークンのコンテキストにわたるマルチモーダル理解の解放. arXiv preprint arXiv:2403.05530, 2024.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, Ashish Sabharwal. 知識集約型多段階質問に対する思考連鎖推論と検索の交互配置. arXiv preprint arXiv:2212.10509, 2022a.
Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, Ashish Sabharwal. Musique:シングルホップ質問の合成によるマルチホップ質問. Transactions of the Association for Computational Linguistics, 10:539-554, 2022b.
Liang Wang, Nan Yang, Xiaolong Huang, Binxing Jiao, Linjun Yang, Daxin Jiang, Rangan Majumder, Furu Wei. 弱教師あり対照的事前学習によるテキスト埋め込み. arXiv preprint arXiv:2212.03533, 2022.
Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. 思考連鎖プロンプティングは大規模言語モデルにおける推論を引き出す. Advances in neural information processing systems, 35:24824-24837, 2022.
Yixuan Weng, Minjun Zhu, Fei Xia, Bin Li, Shizhu He, Shengping Liu, Bin Sun, Kang Liu, Jun Zhao. 大規模言語モデルは自己検証により優れた推論者となる. arXiv preprint arXiv:2212.09561, 2022.
Ronald J Williams. コネクショニスト強化学習のための単純な統計的勾配追従アルゴリズム. Machine learning, 8:229-256, 1992.
Tian Xie, Zitian Gao, Qingnan Ren, Haoming Luo, Yuqian Hong, Bryan Dai, Joey Zhou, Kai Qiu, Zhirong Wu, Chong Luo. Logic-rl:ルールベース強化学習によるllm推論の解放. arXiv preprint arXiv:2502.14768, 2025.
Guangzhi Xiong, Qiao Jin, Xiao Wang, Yin Fang, Haolin Liu, Yifan Yang, Fangyuan Chen, Zhixing Song, Dengyu Wang, Minjia Zhang, et al. Rag-gym:プロセス監督による推論および検索エージェントの最適化. arXiv preprint arXiv:2502.13957, 2025.
An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, et al. Qwen2.5 技術報告. arXiv preprint arXiv:2412.15115, 2024.
Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William W Cohen, Ruslan Salakhutdinov, Christopher D Manning. Hotpotqa:多様で説明可能なマルチホップ質問応答のためのデータセット. arXiv preprint arXiv:1809.09600, 2018.
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao. React:言語モデルにおける推論と行動の相乗作用. In International Conference on Learning Representations (ICLR), 2023.
Yue Yu, Wei Ping, Zihan Liu, Boxin Wang, Jiaxuan You, Chao Zhang, Mohammad Shoeybi, Bryan Catanzaro. Rankrag:llmにおける検索拡張生成とコンテキストランキングの統合. Advances in Neural Information Processing Systems, 37:121156-121184, 2024.
Zhenrui Yue, Honglei Zhuang, Aijun Bai, Kai Hui, Rolf Jagerman, Hansi Zeng, Zhen Qin, Dong Wang, Xuanhui Wang, Michael Bendersky. 長文脈検索拡張生成のための推論スケーリング. arXiv preprint arXiv:2410.04343, 2024.
Yue Zhang, Yafu Li, Leyang Cui, Deng Cai, Lemao Liu, Tingchen Fu, Xinting Huang, Enbo Zhao, Yu Zhang, Yulong Chen, et al. AIの海におけるセイレーンの歌:大規模言語モデルにおけるハルシネーションに関するサーベイ. arXiv preprint arXiv:2309.01219, 2023.
Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, et al. 大規模言語モデルのサーベイ. arXiv preprint arXiv:2303.18223, 1(2), 2023.
Wayne Xin Zhao, Jing Liu, Ruiyang Ren, Ji-Rong Wen. 事前学習済み言語モデルに基づく高密度テキスト検索:サーベイ. ACM Transactions on Information Systems, 42(4):1-60, 2024.
付録
A 検索エンジンを備えた強化学習の定式化
大規模言語モデル(LLM)を訓練するための古典的な強化学習(RL)フレームワークは、以下のように定式化できる(Rafailov et al., 2023; Ouyang et al., 2022):
ここで、 はデータセット からサンプリングされたプロンプトを表し、 はポリシーモデル によって生成された応答であり、 は正則化のアンカーとして機能する参照モデルを表す。報酬関数 は生成された応答の品質を定量化し、KLダイバージェンス項は更新されたポリシーが参照モデルに近い状態を保つように制約することで、訓練の安定性を促進する。
しかし、この定式化は、出力シーケンス 全体がポリシーLLMのみによって生成されることを仮定している。この仮定は、モデルの振る舞いが内部推論と外部情報検索の両方を取り入れる我々の設定では成り立たない。これに対応するため、我々はRL目的関数を拡張して外部検索エンジン を組み込み、以下の定式化を得る:
この改訂された目的関数では、軌跡 には、インターリーブされた推論ステップと検索されたコンテンツが含まれ、LLMと検索エンジンの間のマルチターンの相互作用を反映している。KLダイバージェンスは、プロンプトと検索拡張コンテキストの両方に条件付けられた同時応答分布上で計算され、外部情報が存在する場合でも、学習されたポリシーが参照モデルと整合したままであることを保証する。
B 実験設定
B.1 ベースライン
最近のいくつかの研究は、特にNatural Questions(NQ)やHotpotQAなどのベンチマークにおいて、より精巧な検索メカニズムを通じて性能を向上させることを目指し、RAGパイプラインを探索してきた。例えば、Re2G(Glass et al., 2022)やRetroLLM(Li et al., 2024)は、強力な検索器と複雑な再ランキング戦略を用いて生成のための細粒度の証拠を選択する、洗練された検索-再ランキング-生成フレームワークを提案している。これらのアプローチは印象的な結果を示しているが、しばしばタスク固有のエンジニアリングや、汎用性とスケーラビリティを制限する重量級のパイプラインに依存している。対照的に、我々の焦点は、検索拡張推論に対するより軽量で汎用的なアプローチにある。したがって、これらの手法は直接のベースラインとしては含めないが、検索拡張言語モデリングの広範な領域における価値ある方向性を表している。
B.2 実験設定
我々は、Qwen-2.5-3B(Base/Instruct)とQwen-2.5-7B(Base/Instruct)(Yang et al., 2024)の2種類のモデルを用いて実験を行う。検索には、知識源として2018年のWikipediaダンプ(Karpukhin et al., 2020)を、検索器としてE5(Wang et al., 2022)を使用する。公平な比較を確保するため、Lin et al.(2023)に従い、すべての検索ベース手法において検索されるパッセージ数を3に設定する。
訓練については、NQとHotpotQAの訓練セットを統合し、SEARCH-R1および他のファインチューニングベースのベースラインのための統一データセットを形成する。評価は、ドメイン内およびドメイン外の性能の両方を評価するため、7つのデータセットのテストセットまたは検証セットで実施する。評価指標として、Yu et al.(2024)に従い、Exact Match(EM)を使用する。推論スタイルのベースラインには、baseモデルは指示に従えないため、instructモデルを使用する。RLチューニング手法については、baseモデルとinstructモデルの両方で実験を行う。実験設定の詳細については付録Bを参照されたい。
SEARCH-R1のPPO変種では、ポリシーLLMの学習率を1e-6、価値LLMの学習率を1e-5に設定する。訓練は500ステップ行い、ポリシーモデルと価値モデルのウォームアップ比率はそれぞれ0.285と0.015とする。パラメータ と を持つGeneralized Advantage Estimation(GAE)を使用する。
訓練は8台のH100 GPUを搭載した単一ノードで行う。総バッチサイズは512、ミニバッチサイズは256、マイクロバッチサイズは64を使用する。最大シーケンス長は4,096トークンに設定し、最大応答長は500、検索コンテンツの最大長は500トークンとする。GPUメモリ使用量を最適化するため、勾配チェックポイントを有効にし、CPUオフロードを伴うFully Sharded Data Parallel(FSDP)を使用する。
効率的なLLMロールアウトのために、テンソル並列サイズ1、GPUメモリ利用率0.6のvLLM 1 を採用する。ロールアウトのサンプリングには、温度1.0とtop-p値1.0を使用する。KLダイバージェンス正則化係数 とクリップ比率 は0.001と0.2に設定する。
GRPO訓練では、Verl(Sheng et al., 2024)1 のGRPO実装に従い、ポリシーLLMの学習率を1e-6に設定し、プロンプトごとに5つの応答をサンプリングする。モデルは500ステップ訓練し、学習率ウォームアップ比率は0.285とする。訓練は、PPOと同じバッチサイズおよびシーケンス長の構成で、同じ8xH100のセットアップ上で行う。
また、勾配チェックポイント、FSDPオフロード、および上記と同じハイパーパラメータを持つvLLMベースのロールアウトを使用する。ロールアウトの温度とtop-p値はともに1.0に設定し、KLダイバージェンス係数 とクリップ比率 は0.001と0.2に固定する。
両手法とも、モデルチェックポイントは100ステップごとに保存する。訓練が発散する場合には、訓練報酬曲線に従って直近の安定したチェックポイントで評価を行い、そうでない場合には最終チェックポイントを評価に使用する。最大行動予算 は4に設定し、デフォルトで上位3つのパッセージを検索する。
結果報酬はexact match(EM)を用いて計算する。特に断りのない限り、PPOをデフォルトのRLアルゴリズムとして使用し、GRPOとの詳細な比較はセクション5.1で示す。
C 14B LLMにおける主要な結果
我々はQwen2.5-14Bモデルを用いて広範な実験を行い、結果を表5に示す。示されているように、SEARCH-R1は評価された指標全体において一貫してすべてのベースライン手法を上回る。さらに、モデルサイズを増加させるとSEARCH-R1の性能が一貫して向上することを観察し、我々のアプローチにおけるLLMサイズのスケーリングの利点を強調している。
D 検索トークン損失マスキングの研究
セクション3.1では、訓練中の望ましくない最適化挙動を軽減するため、検索トークンに対する損失マスキング戦略を導入した。その影響を評価するため、Qwen2.5-3b/7b-baseモデルを用いて、検索トークン損失マスキングありとなしの訓練ダイナミクスを比較する実験を行う。図3に示されるように、マスキングメカニズムを組み込むことで、より安定した最適化とモデル性能の向上がもたらされる。表6の定量的結果はさらに、検索トークンに対する損失マスキングを用いて訓練した場合のSEARCH-R1が、マスキングなしの対応版を一貫して上回ることを確認している。
E Base LLMとInstruct LLM
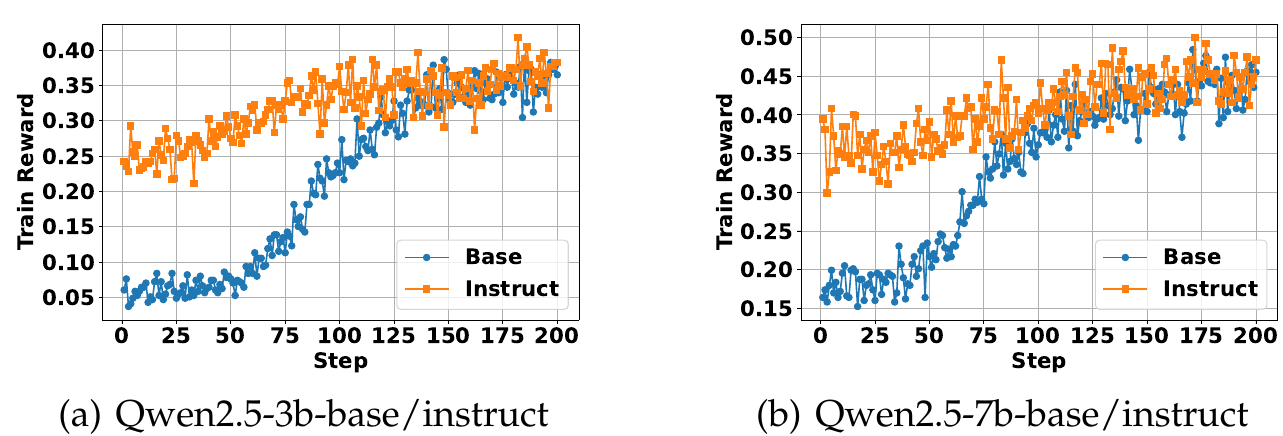
我々は、Qwen2.5-3BとQwen2.5-7Bの2つのモデルスケールを用いて、base LLMと命令チューニングされたLLMの両方にわたるSEARCH-R1の訓練ダイナミクスを調査する。図4に示されるように、命令チューニングされたモデルはより速く収束し、baseの対応モデルと比較して高い初期性能の恩恵を受ける。
| 方法 | 一般QA | マルチホップQA | ||||||
| NQ† | TriviaQA* | PopQA* | HotpotQA† | 2wiki* | Musique* | Bamboolge* | 平均 | |
| Qwen2.5-14b-Base/Instruct | ||||||||
| 直接推論 | 0.198 | 0.531 | 0.184 | 0.217 | 0.253 | 0.045 | 0.160 | 0.227 |
| CoT | 0.190 | 0.495 | 0.148 | 0.269 | 0.297 | 0.054 | 0.432 | 0.269 |
| IRCoT | 0.114 | 0.375 | 0.166 | 0.230 | 0.248 | 0.102 | 0.312 | 0.221 |
| Search-o1 | 0.347 | 0.635 | 0.241 | 0.268 | 0.161 | 0.099 | 0.416 | 0.310 |
| RAG | 0.327 | 0.585 | 0.376 | 0.279 | 0.160 | 0.051 | 0.192 | 0.281 |
| SFT | 0.361 | 0.467 | 0.150 | 0.248 | 0.278 | 0.089 | 0.160 | 0.250 |
| R1-base | 0.369 | 0.626 | 0.270 | 0.306 | 0.326 | 0.117 | 0.488 | 0.357 |
| R1-instruct | 0.334 | 0.628 | 0.253 | 0.294 | 0.325 | 0.108 | 0.432 | 0.339 |
| Search-R1-base | 0.486 | 0.676 | 0.480 | 0.468 | 0.470 | 0.241 | 0.528 | 0.479 |
| Search-R1-instruct | 0.424 | 0.660 | 0.442 | 0.436 | 0.379 | 0.210 | 0.480 | 0.433 |
この初期の優位性にもかかわらず、両モデルタイプの最終性能は訓練後に同様の水準に収束する。これらの結果は、命令チューニングが推論+検索タスクにおける初期段階の学習をより効率的にする一方で、強化学習が性能ギャップを埋めることができ、最終的にbaseモデルが同等の結果に到達することを可能にすることを示している。
F SEARCH-R1におけるPPOとGRPOの比較
我々は、基盤モデルとしてQwen2.5-3BとQwen2.5-7Bの両方を用いて、PPOとGRPOという2つの強化学習アルゴリズムの下でのSEARCH-R1の有効性を評価する。図5は訓練ダイナミクスを示している。我々の分析から以下の主要な観察が得られる:(1)GRPOはすべての設定においてPPOよりも速く収束する。これは、PPOが別個の価値関数(クリティック)に依存しており、効果的なポリシー更新を行えるようになる前に初期ウォームアップ段階を必要とするためである。(2)PPOはより安定した訓練挙動を提供する。これは図5で示されており、GRPOは長期の訓練ステップで報酬の崩壊に遭遇するのに対し、PPOは訓練全体を通じて安定性を維持する。(3)PPOとGRPOは同等の最終報酬性能を達成しており、収束速度と安定性におけるトレードオフにもかかわらず、両手法がSEARCH-R1の最適化に有効であることを示唆している。
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | 平均 |
| Qwen2.5-7b-Base | ||||||||
| SEARCH-R1 w. mask | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1 w.o. mask | 0.388 | 0.567 | 0.391 | 0.325 | 0.321 | 0.108 | 0.304 | 0.343 |
| Qwen2.5-3b-Base | ||||||||
| SEARCH-R1 w. mask | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| SEARCH-R1 w.o. mask | 0.346 | 0.484 | 0.365 | 0.241 | 0.244 | 0.053 | 0.104 | 0.262 |
図5:4つのLLMにわたる、基盤RL手法としてPPOとGRPOを用いたSEARCH-R1の訓練ダイナミクス。GRPOは一般に速く収束するが、一定のステップ数訓練した後に不安定性を示す可能性があるのに対し、PPOはより安定した最適化を提供するが収束速度は遅い。PPOとGRPOは同等の最終報酬性能を達成する。
G SEARCH-R1訓練における検索パッセージ数の研究
我々は、検索パッセージ数(top-k)がSEARCH-R1の訓練ダイナミクスに与える影響を調査する。主要な実験ではLin et al.(2023)に従ってtop-k = 3を採用したが、その影響をよりよく理解するため、top-kを1、3、5に設定した追加の研究を行う。
図6は、これらの設定下での訓練報酬曲線を示している。3つの構成すべてが類似した全体的な訓練軌跡を示すことを観察する。特筆すべきは、top-k = 5が最も速い初期収束を示し、最初の200ステップ以内で最高の訓練報酬に到達することである。しかし、その報酬は訓練が進むにつれて徐々に低下し、より不安定になる。対照的に、top-k = 1と3は訓練全体を通じてより一貫した改善を示し、top-k = 3が最終的に500ステップ後に最高の報酬を達成する。
ステップ500における評価結果は表7にまとめられており、top- k = 3が全体的に最良の性能をもたらす。我々は2つの寄与要因を仮説として挙げる:(1) top- k = 1は検索の再現率が低いことに悩まされている可能性が高く、関連する文脈情報を提供する能力を制限している;(2) top- k = 5はノイズの多い、あるいは無関係なパッセージを含むことにより精度が低くなり(Jin et al., 2024)、推論性能を低下させるだけでなくRL訓練にも悪影響を及ぼす可能性がある——追加の文脈がしばしば役に立たない、あるいは誤解を招くものであるとモデルが学習すると、検索された内容を活用することを躊躇するようになる。
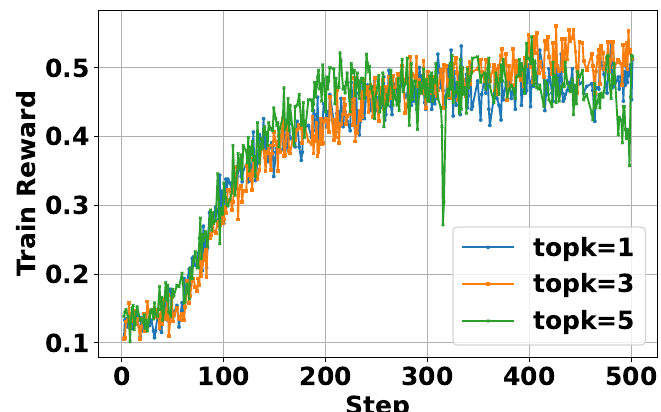
図6:検索パッセージ数を変えた場合のSEARCH-R1の訓練ダイナミクス。(LLM: Qwen2.5-7b-base、RL: PPO)
表7:SEARCH-R1訓練における検索パッセージ数の検討。(LLM: Qwen2.5-7b-base;RL: PPO)
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolge | 平均 |
| topk=1 | 0.426 | 0.614 | 0.422 | 0.393 | 0.296 | 0.146 | 0.328 | 0.375 |
| topk=3 | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| topk=5 | 0.479 | 0.634 | 0.440 | 0.394 | 0.343 | 0.156 | 0.352 | 0.400 |
H SEARCH-R1(GRPO)訓練におけるグループサイズの検討
主実験では、Sheng et al. (2024)の設定に従い、SEARCH-R1(GRPO)のグループサイズを5に設定した。グループサイズが訓練ダイナミクスに与える影響をさらに調査するため、グループサイズ1、3、5でアブレーション実験を行う。特筆すべきは、グループサイズを1に設定すると、GRPOは標準的なREINFORCEアルゴリズム(Williams, 1992)に縮約されることである。
我々はLLMを500ステップ訓練し、100ステップごとにモデルのチェックポイントを保存する。訓練中にモデルが崩壊した場合は、最後の有効なチェックポイントを評価に用いる;そうでなければ、ステップ500のチェックポイントを評価する。
異なるグループサイズ設定下での訓練ダイナミクスを図7に示す。グループサイズが大きいほど一般に収束が速くなるが、強化学習に固有の不安定性により崩壊のリスクも高まる可能性があることを我々は観察した。
異なる設定間での評価結果を表8にまとめる。グループサイズが大きいと収束を加速し、より高い訓練報酬を達成できる一方で、グループサイズが小さい場合(例:サイズ = 1)はより安定した訓練と優れた汎化を可能にする。これは未見のタスクにおける優れた性能に反映されており、GRPO訓練における学習速度と安定性の間のトレードオフを浮き彫りにしている。
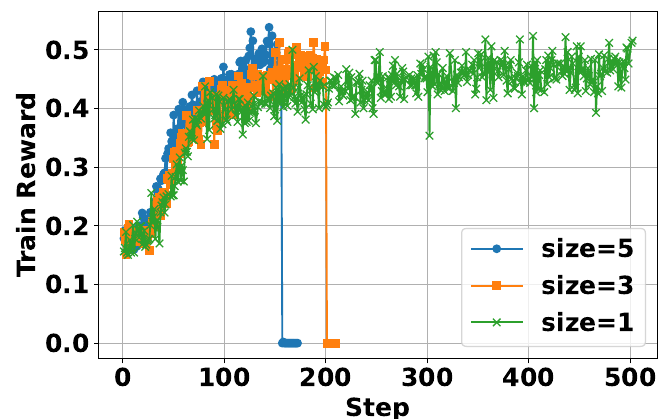
図7:グループサイズを変えた場合のSEARCH-R1(GRPO)の訓練ダイナミクス。(LLM: Qwen2.5-7b-base)
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | 平均 |
| size=1 | 0.463 | 0.605 | 0.449 | 0.392 | 0.413 | 0.163 | 0.384 | 0.410 |
| size=3 | 0.385 | 0.580 | 0.396 | 0.329 | 0.333 | 0.117 | 0.400 | 0.363 |
| size=5 | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
表8:7つのデータセットにおけるSEARCH-R1(GRPO)のグループサイズに関する研究。(LLM:Qwen2.5-7b-base)
I R1とSEARCH-R1の比較:ケーススタディ
| 質問:Curiousは、ある歌手による女性用フレグランスですが、その歌手はどの市と州で生まれましたか? | ||||||||
| 正解:ミシシッピ州マッコーム | ||||||||
| R1: | ||||||||
| <l>その歌手はビヨンセで、テキサス州ヒューストンで生まれました。</l> | ||||||||
| <l>ヒューストン</l> | ||||||||
| <l>女性用フレグランス「Curious」を手がけた歌手が、どの市と州で生まれたのかを調べる必要があります。</l> | ||||||||
| <l>Curious フレグランス情報 </search> | ||||||||
| <l>Doc 1(タイトル:「Curious (fragrance)」)Curious (fragrance) Curiousは、エリザベス・アーデンのためにブリトニー・スピアーズが手がけた女性用フレグランスであり、「Fantasy」に先立つ、ブリトニー・スピアーズが推薦した最初の香水です。スピアーズはこの推薦により5200万ドルを稼いだといわれています。「Curious」は2004年9月に発売され、国際的に大成功を収めました。2004年の百貨店におけるナンバーワンのフレグランスとなり、2005年には「Curious」がフレグランス財団により最優秀女性用フレグランスとして表彰されました。このフレグランスは白い花の香りです。そのノートはルイジアナ・マグノリア、ゴールデン・アンジュー・ペア、ロータスフラワー、チューベローズ、スタージャスミン、ピンク・シクラメン、バニラを配合したムスク、サンダルウッド、ブロンドウッズです。エリザベス・アーデン... </information></td></tr><tr><td colspan="9"><l>「Curious」フレグランスを手がけた歌手であるブリトニー・スピアーズが、どの市と州で生まれたのかを調べる必要があります。</l></td></tr><tr><td colspan="9"><l>ブリトニー・スピアーズ 出生地 </search></td></tr><tr><td colspan="9"><l>Doc 1(タイトル:「Britney Spears」)2000年代で最も売れた女性アルバムアーティストです。2004年、彼女はエリザベス・アーデン社とともに香水ブランドを立ち上げ、その売上は15億米ドルを超えました。スピアーズは、リン・アイリーン・ブリッジズとジェームズ・パーネル・スピアーズの第二子として、ミシシッピ州マッコームで生まれました。母方の祖母リリアン・ポーテルはイングランド人(ロンドン生まれ)で、スピアーズの母方の曾々祖父の一人はマルタ人でした。きょうだいはブライアン・ジェームズとジェイミー・リンです。ブリトニーはバイブル・ベルトで生まれ、そこでは社会的に保守的な福音派プロテスタント主義が特に強い宗教的影響力を持っています。スピアーズは南部バプテスト連盟で洗礼を受けましたが、後に人生で... </information> | ||||||||
| <l>ブリトニー・スピアーズはミシシッピ州マッコームで生まれたので、それがどの市と州なのかを調べる必要があります。</l> | ||||||||
| <l>マッコーム、ミシシッピ州 所在地 </search> | ||||||||
| <l>Doc 1(タイトル:「McComb, Mississippi」)McComb, Mississippi マッコームは、アメリカ合衆国ミシシッピ州パイク郡にある都市で、ジャクソンのおよそ南に位置します。2010年の国勢調査によると、この市の総人口は12,790人でした。マッコーム・ミシシッピ小都市統計地域の中心都市です。マッコームは1872年、ニューオーリンズ・ジャクソン・グレートノーザン鉄道(イリノイ・セントラル鉄道の前身、現在はカナダ国鉄の一部)のヘンリー・シンプソン・マッコームが、ニューオーリンズのサロンの誘惑を避けるために鉄道の整備工場をルイジアナ州ニューオーリンズから移すことを決めた後に設立されました。鉄道はパイク郡の土地を購入し... </information> | ||||||||
| <l>ブリトニー・スピアーズがミシシッピ州マッコームで生まれたことが分かりました。質問は市と州を尋ねているので、前回の検索で既に分かっている州を確認するだけで十分です。</l> | ||||||||
| <l>ミシシッピ州マッコーム </answer> |
表9:R1とSEARCH-R1のケーススタディ。
SEARCH-R1についてより深く理解するため、Qwen2.5-7B-Baseを用いたケーススタディを実施し、検索エンジンを用いないRL(Guo et al., 2025)との振る舞いを比較する。結果は表20に示されており、以下の主要な観察が明らかになった:インターリーブされた推論と検索は問題分析を強化する:SEARCH-R1はLLMがマルチターン検索を伴う深い推論を行うことを可能にする一方、検索を用いないRLはモデルの内部知識のみに依存する。取得されたパッセージを組み込むことで、SEARCH-R1はLLMがその推論を反復的に洗練させることを可能にし、より情報に基づいた正確な応答につながる。反復的検索による自己検証:第2回の検索ラウンドの後、LLMはすでに質問に答えるのに十分な情報を収集していることが観察された。しかし、SEARCH-R1はその結論を自己検証するために追加の検索ステップを実行し、最終応答への自信をさらに強固にする。この現象は、検索を用いないLLM推論RLの発見(Guo et al., 2025)と一致しており、RLが検索拡張設定においても検証駆動型の推論を促進しうることを強調している。
J SEARCH-R1のさらなるケーススタディ
訓練されたLLMの振る舞いと能力についてより深く理解するため、SEARCH-R1に関する追加のケーススタディを実施する。具体的には、基盤となる強化学習アルゴリズムとしてProximal Policy Optimization(PPO)を用いてQwen2.5-7B-Baseからファインチューニングされたモデルを分析する。結果は以下の表に示す。
表10:SEARCH-R1ケーススタディ1(成功):SEARCH-R1はマルチステップ推論、検索を自己検証とともに行い、最終的に質問に答える。
質問:Chris JerichoとGary Barlowに共通する職業の種類は何か?正解:musician SEARCH-R1:<think> Chris JerichoとGary Barlowに共通する職業の種類を見つける必要がある。それを検索しよう。</think> <search> Chris Jericho and Gary Barlow profession </search><information> Doc 2(タイトル:「Chris Jericho」)「Do You Wanna Start a War」(2014)と「Judas」(2017)は、完全にまたは主にオリジナル曲で構成されている。彼はまた、長年にわたり数多くのテレビ番組に出演しており、2011年シーズンの「Dancing With the Stars」では第6週まで勝ち残った。その以前には、JerichoはABCのゲーム番組「Downfall」やRevolver Golden Gods Awardsを司会した。Christopher Keith Irvineは1970年11月9日、ニューヨーク州マンハセットで生まれたが、ウィニペグで育った。彼の父であるアイスホッケー選手のTed Irvineは、彼の誕生時にニューヨーク・レンジャーズでプレーしていた。… </information>Gary Barlowがこれらの職業のいずれかを共通して持つかどうかを見つける必要がある。</think> <search> Gary Barlow profession </search><information> Doc 1(タイトル:「Gary Barlow」)ヒット、Take Thatとの12枚のナンバーワンシングルと7枚のナンバーワンアルバム。Barlowは英国アカデミー作詞家・作曲家・作家協会から6つのIvor Novello賞を受賞しており、その中には英国音楽への卓越した貢献に対する賞も含まれる。彼は世界中で5000万枚以上のレコードを売り上げている。Barlowは1971年1月20日、チェシャー州フロドシャムで、Colin(2009年10月15日没)とMarjorie Barlowの次男として生まれた。Barlowの自伝の中で、彼は音楽への愛が幼い頃に始まったと述べており、自分自身を「テレビの前で永遠に踊っている子供の一人で、見ているのは…」と呼んでいる。</information>Chris JerichoとGary Barlowの間に共通の職業があるかどうかを見つける必要がある。</think> <search> common profession of Chris Jericho and Gary Barlow </search><information> Doc 1(タイトル:「Gary Barlow」)Gary Barlow Gary Barlow(1971年1月20日生まれ)は、イングランドの歌手、ソングライター、ミュージシャン、レコードプロデューサーである。彼は英国のポップグループTake Thatのリードシンガーとして最もよく知られている。Barlowはまた、2011年、2012年、2013年に「The X Factor UK」のヘッドジャッジを、2017年に「Let It Shine」のヘッドジャッジを務めた。Barlowは英国で最も成功したソングライターの一人であり、14枚のナンバーワンシングルと24曲のトップ10ヒットを書いている。ソロアーティストとしては3枚のナンバーワンシングル、6曲のトップ10シングル、2枚のナンバーワンアルバムを持ち、さらに17曲のトップ5… </information><think> Gary Barlowが歌手、ソングライター、ミュージシャン、レコードプロデューサーであることを見つけた。今、Chris Jerichoがこれらの職業のいずれかを共通して持つかどうかを見つける必要がある。</think><search> Chris Jericho profession </search> <information> Doc 1(タイトル:「Chris Jericho」)Chris Jericho Christopher Keith Irvine(1970年11月9日生まれ)は、リングネームChris Jerichoでよりよく知られ、アメリカ生まれのプロレスラー、ミュージシャン、作家、俳優である。彼は現在New Japan Pro-Wrestling(NJPW)でレスリングしており、そこでは初の在位で現在のIWGPインターコンチネンタルチャンピオンである。Jerichoはまた、1999年から仕事をしているWWEのSmackDownブランドに散発的に出演している。プロレス界において、彼はその大げさなロックスター的なペルソナで知られている。Jerichoは史上最も偉大なプロレスラーの一人と見なされている。1990年代、Jerichoはアメリカの組織Extreme Championship… </information><think> Chris Jerichoがプロレスラー、ミュージシャン、作家、俳優であることを見つけた。今、それをGary Barlowの職業と比較できる。Gary Barlowが歌手、ソングライター、ミュージシャン、レコードプロデューサーであることを見つけた。Chris JerichoとGary Barlowの共通の職業はミュージシャンである。</think><answer> musician </answer>
| 質問:ヒット曲「Buddy Holly」と「Undone – The Sweater Song」を収録したWeezerのデビュースタジオアルバムのタイトルは何でしたか? Ground Truth:The Blue Album SEARCH-R1: <think> ヒット曲「Buddy Holly」と「Undone – The Sweater Song」を収録したWeezerのデビュースタジオアルバムのタイトルを探す必要がある。検索しよう。 </think> <search> debut studio album by Weezer which contained the hit Buddy Holly and Undone – The Sweater Song </search> <information> Doc 1(タイトル:「Weezer discography」)Weezer discography アメリカのロックバンド、Weezerのディスコグラフィーは、11枚のスタジオアルバム、2枚のコンピレーションアルバム、1枚のビデオアルバム、6枚のEP、28枚のシングル、24本のミュージックビデオで構成されている。Weezerのセルフタイトルのデビュースタジオアルバムは、しばしば「The Blue Album」と呼ばれ、1994年5月にDGC Recordsからリリースされた。このアルバムは商業的に大成功を収め、US「Billboard」200で16位に達し、シングル「Undone – The Sweater Song」と「Buddy Holly」を生み出した。どちらも、スパイク・ジョーンズが監督したミュージックビデオの助けを借りて、Weezerをメインストリームの成功へと押し上げる役割を果たした。… <information> <think> ヒット曲「Buddy Holly」と「Undone – The Sweater Song」を収録したWeezerのデビュースタジオアルバムは、セルフタイトルのアルバムで、しばしば「The Blue Album」と呼ばれることがわかった。これで答えを提供できる。 </think> <answer> Weezer </answer> |
SEARCH-R1:<think> 舞台劇で戯曲化された誰の死がオーストラリアの死刑廃止を助けたのかを見つける必要がある。それを検索しよう。</think>
<search> whose death dramatized in a stage play helped end the death penalty in Australia </search>
<information> Doc 3(タイトル:「Ronald Ryan」)Ronald Ryan Ronald Joseph Ryan(1925年2月21日 - 1967年2月3日)は、オーストラリアで合法的に処刑された最後の人物であった。Ryanは1965年、ビクトリア州のPentridge刑務所からの脱獄中に看守George Hodsonを射殺した罪で有罪とされた。Ryanの絞首刑はオーストラリア史上最大級の公的抗議に直面し、死刑の終焉につながった。死刑は1985年までにすべての州で廃止された。Ronald Edmond Thompsonはメルボルンの内側郊外CarltonにあるRoyal Women's Hospitalで、John Ronald RyanとCecilia Thompson(旧姓…)の間に生まれた。</information>
<think> 舞台劇で戯曲化されたRonald Ryanの死がオーストラリアの死刑廃止を助けたことを見つけた。今、答えを提供できる。</think>
<answer> Ronald Ryan </answer>
| 理解のための読み取り専用の背景情報(翻訳対象の原文ではありません): <answer> ロナルド・ライアン </answer> 表20:SEARCH-R1 ケーススタディ11(失敗):LLMは無関係な取得情報に誤導され、誤った回答を提供する可能性がある。 翻訳対象のテキスト: 質問:テイデ国立公園とガラホナイ国立公園はどこにありますか? グラウンドトゥルース:スペイン、カナリア諸島 SEARCH-R1: <think> テイデ国立公園とガラホナイ国立公園がどこにあるのかを調べる必要があります。検索してみましょう。 </think> <search> テイデ国立公園とガラホナイ国立公園の場所 </search> <information> 文書1(タイトル:「ガラホナイ国立公園」)自ら命を絶つことを決めた。ガラホナイ国立公園 ガラホナイ国立公園(、)は、カナリア諸島(スペイン)の一つであるラ・ゴメラ島の中央および北部に位置する。1981年に国立公園に指定され、1986年にはUNESCOの世界遺産に登録された。面積は40 km(15平方マイル)で、島内の6つの自治体すべてに広がっている。毎年約45万人の観光客がこの公園を訪れる。公園の境界のすぐ外側には観光客向けの宿泊施設がある。公園は、最高地点であるガラホナイの岩 formation にちなんで名付けられた... </information> <think> ガラホナイ国立公園は、カナリア諸島(スペイン)の一つであるラ・ゴメラ島の中央および北部に位置することが分かりました。次に、テイデ国立公園の場所を調べる必要があります。 </think> <search> テイデ国立公園の場所 </search> <information> 文書1(タイトル:「テイデ国立公園」)テイデ国立公園 テイデ国立公園(、)は、テネリフェ(スペイン、カナリア諸島)に位置する国立公園である。この国立公園は、スペインで最も高い山(標高3,718メートル)であるテイデ山を中心としており、さらに、大西洋の島々で最も高い火山であり、海底の基部から測ると世界で3番目に高い火山(高さ7,500メートル)でもある。国立公園の地位は1954年1月22日に認められ、スペインで3番目に古い国立公園となった。国立公園の境界内に含まれるピコ・ビエホは、カナリア諸島で2番目に高い火山であり... </information> <think> テイデ国立公園はテネリフェ(スペイン、カナリア諸島)に位置することが分かりました。これで、テイデ国立公園とガラホナイ国立公園の両方の場所が分かりました。 </think> <answer> スペイン、カナリア諸島 </answer> |
| 背景情報(翻訳対象の原文ではありません):<answer> Ronald Ryan </answer> |
| 表20:SEARCH-R1 ケーススタディ11(失敗):LLMは無関係な検索情報に惑わされ、誤った回答を提示する可能性がある。 |
| 翻訳対象テキスト: |
| 質問:スティーブ・コクランと、「ボナンザ」でロイ・コーヒー保安官を演じた俳優が主演した映画を監督したのは誰か? |
| 正解:ルイス・キング |
| SEARCH-R1: |
| <think> 「ボナンザ」でロイ・コーヒー保安官を演じた俳優とスティーブ・コクランが主演した映画の監督を調べる必要がある。検索しよう。 </think> |
| <search> スティーブ・コクランと、「ボナンザ」でロイ・コーヒー保安官を演じた俳優が主演した映画を監督したのは誰か </search> |
| <information> 文書2(タイトル:「レイ・ティール」)レイ・ティール レイ・ティール(1902年1月12日—1976年4月2日)は、37年のキャリアの中で250本以上の映画と約90本のテレビ番組に出演したアメリカ人俳優である。最も長く続いた役は、NBCの西部劇シリーズ「ボナンザ」(1960年—1972年)におけるロイ・コーヒー保安官だった。彼はまた、映画「地獄の凱歌」(1951年)でも保安官を演じた。ティールはミシガン州グランドラピッズで生まれた。サックス奏者であった彼は、俳優になる前にバンドリーダーとしてUCLAの学費を稼いだ。映画や初期のテレビで15年以上にわたり演技をした後、ティールは recurring... </information> |
| <think> 「ボナンザ」でロイ・コーヒー保安官を演じた俳優がレイ・ティールであることがわかった。次に、スティーブ・コクランとレイ・ティールが主演した映画を探す必要がある。 </think> |
| <search> スティーブ・コクランとレイ・ティールが主演した映画 </search> |
| <information> 文書1(タイトル:「スティーブ・コクラン」)ギャング映画の名作「和白熱」(1949年)。彼はメイヨと共演した。ワーナー・ブラザースは最終的に、コクランとメイヨの契約をゴールドウィンから引き継ぐことになった。コクランは「ダムド・ドント・クライ」(1950年)でジョアン・クロフォードを助演し、その後「ハイウェイ301」(1950年)で初の主役を与えられ、ギャングを演じた。彼は「ダラス」(1950年)でゲイリー・クーパーの英雄に対する悪役であり、「ストーム・ワーニング」(1951年)ではジンジャー・ロジャースとドリス・デイと共にクー・クラックス・クランの成員を演じた。コクランは西部劇「キャニオン・パス」(1951年)で悪役を演じ、その後「フォルサム刑務所の壁の内側」(1951年)で主演を与えられ、それは...に影響を与えた <information> |
| <think> スティーブ・コクランが複数の映画に主演したことがわかった。次に、レイ・ティールも主演した映画を探す必要がある。 </think> |
| <search> スティーブ・コクランとレイ・ティールが主演した映画 </search> |
| <information> 文書1(タイトル:「スティーブ・コクラン」)ギャング映画の名作「和白熱」(1949年)。彼はメイヨと共演した。ワーナー・ブラザースは最終的に、コクランとメイヨの契約をゴールドウィンから引き継ぐことになった。コクランは「ダムド・ドント・クライ」(1950年)でジョアン・クロフォードを助演し、その後「ハイウェイ301」(1950年)で初の主役を与えられ、ギャングを演じた。彼は「ダラス」(1950年)でゲイリー・クーパーの英雄に対する悪役であり、「ストーム・ワーニング」(1951年)ではジンジャー・ロジャースとドリス・デイと共にクー・クラックス・クランの成員を演じた。コクランは西部劇「キャニオン・パス」(1951年)で悪役を演じ、その後「フォルサム刑務所の壁の内側」(1951年)で主演を与えられ、それは...に影響を与えた <information> |
| <think> スティーブ・コクランが複数の映画に主演したことがわかった。次に、レイ・ティールも主演した映画を探す必要がある。スティーブ・コクランとレイ・ティールの両方が主演した映画を検索しよう。 </think> |
| <search> サム・ペキンパーが監督し、スティーブ・コクランとレイ・ティールが主演した映画 </search> |
| <information> 文書1(タイトル:「サム・ペキンパー」)爆発、カーチェイス、激しい銃撃戦に満ちたこの映画は、興行収入2500万ドル以上を稼ぎ、ペキンパーにとってそれまでで最大の商業的成功となった。厳密には商業作品でありながら、ペキンパーの創造的なタッチは随所に溢れており、特にマックイーンの人物が刑務所生活の重圧に苦しむ、入り組んだ編集のオープニングシーケンスで顕著である。この映画は今も人気があり、1994年にアレック・ボールドウィンとキム・ベイシンガー主演でリメイクされた。1973年は、ペキンパーの人生とキャリアの中で最も困難な時期の始まりとなった。テキサス州エルパソで「ゲッタウェイ」をまだ撮影中に、ペキンパーは国境を密かに越えて... |
| <think> サム・ペキンパーが、スティーブ・コクランとレイ・ティールが主演した映画「ワイルドバンチ」を監督したことがわかった。 </think> <answer> サム・ペキンパー </answer> |
| 背景情報(翻訳対象のソーステキストではありません): |
| <answer> ロナルド・ライアン </answer> |
| 表20:SEARCH-R1 ケーススタディ11(失敗):LLMは無関係な検索情報に惑わされ、誤った回答を提示することがある。 |
| 翻訳対象テキスト: |
| 質問:XXXTentacionのシングル「Revenge」を配給した会社はどこに拠点を置いていますか? |
| 正解:カリフォルニア州サンフランシスコ |
| SEARCH-R1: |
| <think> XXXTentacionのシングル「Revenge」を配給した会社を見つける必要があります。検索してみましょう。 </think> |
| <search> XXXTentacionのシングル「Revenge」を配給した会社 </search> |
| <information> 文書1(タイトル:「Revenge(XXXTentacionのミックステープ)」)Revenge(XXXTentacionのミックステープ)Revengeは、アメリカのラッパーXXXTentacionによるミックステープで、2017年5月16日にEmpire Distributionからリリースされました。収録曲は、XXXTentacionのSoundCloudでストリーミング配信されていた既発表曲8曲です。先行シングル「Look at Me」がアメリカの「Billboard」Hot 100で34位を記録しました。このテープの先行シングル「Look at Me」は2015年12月31日にSoundCloudで初公開されました。この曲はその後、2016年1月29日にシングルとしてiTunesでリリースされ、後にリマスターおよびクリーン版として再びデジタルダウンロード用に再リリースされました… </information> |
| <think> XXXTentacionのシングル「Revenge」を配給した会社はEmpire Distributionであることがわかりました。次に、その会社の所在地を調べる必要があります。 </think> |
| 質問:2008年の雑誌記事「Is Google Making Us Stoopid?」の拡張版は、どの賞の最終候補だったか? |
| 正解:ピューリッツァー賞 |
| SEARCH-R1: |
| <think>2008年の雑誌記事「Is Google Making Us Stoopid?」の拡張版が、どの賞の最終候補だったのかを調べる必要がある。検索しよう。</think> |
| <search>2008年の雑誌記事「Is Google Making Us Stoopid?」のこの拡張版は、どの賞の最終候補だったか </search> |
| <information>文書1(タイトル:「Is Google Making Us Stupid?」)Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains(別題 Is Google Making Us Stupid?)は、テクノロジーライターのニコラス・G・カーによる雑誌記事であり、インターネットが認知に与える影響を強く批判している。これは「The Atlantic」誌の2008年7月/8月号に、6ページのカバーストーリーとして掲載された。カーの主な主張は、インターネットが認知に有害な影響を及ぼし、集中力や熟考する能力を低下させる可能性があるというものだ。タイトルにもかかわらず、この記事は特にGoogleを標的にしたものではなく、より広く…の認知的影響を扱っている… </information> |
| <think>2008年の雑誌記事「Is Google Making Us Stoopid?」の拡張版が、ある賞の最終候補だったことがわかった。どの賞の最終候補だったのかを調べる必要がある。</think> |
| <search>2008年の雑誌記事「Is Google Making Us Stoopid?」の拡張版は、どの賞の最終候補だったか </search> |
| <information>文書2(タイトル:「Is Google Making Us Stupid?」)結論は出ておらず、「昔ながらのやり方を嘆き悲しむべきか、新しいやり方を称賛すべきか、それとも心配するのをやめてネットを愛することを学ぶべきかが明らかになるには時間がかかるだろう」と述べている。Is Google Making Us Stupid? Is Google Making Us Stupid? What the Internet Is Doing to Our Brains(別題 Is Google Making Us Stupid?)は、テクノロジーライターのニコラス・G・カーによる雑誌記事であり、インターネットが認知に与える影響を強く批判している。これは「The Atlantic」誌の2008年7月/8月号に、6ページのカバーストーリーとして掲載された。カーの主な主張は、インターネットが認知に有害な影響を及ぼし、集中力や熟考する能力を低下させる可能性があるというものだ。タイトルにもかかわらず、この記事は特にGoogleを標的にしたものではなく、より広く…の認知的影響を扱っている… </information> |
| <answer>ナショナル・マガジン賞 </answer> |
| 質問:ピアニストだったのは、マロ・アジェミアンとリチャード・C・サラフィアンのどちらですか? |
| 正解:マロ・アジェミアン |
SEARCH-R1:<think>マロ・アジェミアンとリチャード・C・サラフィアンのどちらがピアニストだったのかを特定する必要がある。検索しよう。</think><search> ピアニストだったのは、マロ・アジェミアンとリチャード・C・サラフィアンのどちらか </search><information> 文書1(タイトル:「マロ・アジェミアン」)マロ・アジェミアン マロ・アジェミアン(1921年7月9日 – 1978年9月18日)はアメリカのピアニストであった。アジェミアンの現代音楽におけるキャリアは、彼女のアルメニア系の出自から発展した。彼女は、アラム・ハチャトゥリアンのピアノ協奏曲のアメリカ初演を演奏したことで現代音楽のピアニストとして知られるようになった。この曲を選んだのは、二人が共通するアルメニア系の出自を持っていたためである。アジェミアンはジュリアード音楽院で学んだ。1942年3月14日、彼女はアルバート・シュテッセル指揮のジュリアード卒業生管弦楽団とともに、アラム・ハチャトゥリアンのピアノ協奏曲 変ニ長調のアメリカ初演を行った。彼女は後にこの曲を全米ツアーで演奏した。彼女の演奏の後、... </information><think> マロ・アジェミアンがピアニストであったことが分かった。次に、リチャード・C・サラフィアンがピアニストであったかどうかを確認する必要がある。</think><search> リチャード・C・サラフィアンとは誰か </search><information> 文書1(タイトル:「リチャード・C・サラフィアン」)リチャード・C・サラフィアン リチャード・キャスパー・サラフィアン(1930年4月28日 – 2013年9月18日)は、アメリカのテレビ・映画監督であり俳優であった。彼は監督、俳優、脚本家として50年以上にわたる多才なキャリアを築いた。サラフィアンは1971年の映画「」の監督として最もよく知られている。サラフィアンは1930年4月28日、アルメニア系移民の家庭にニューヨーク市で生まれた。彼はニューヨーク大学で法学準備課程と医学準備課程を学び、成績は芳しくなかったが、映画の勉強に転じ、そこで優秀な成績を収めた。彼は大学を離れてアメリカ陸軍に入隊し、そこで... </information><think> リチャード・C・サラフィアンがテレビ・映画監督であり俳優であったことが分かった。これで、ピアニストであったマロ・アジェミアンと比較できる。</think><answer> マロ・アジェミアン </answer> |
| 質問:ジェド・ホイヤーとジョン・ウィリアム・ヘンリー2世では、どちらが年上ですか? |
| 正解:ジョン・ウィリアム・ヘンリー2世 |
| SEARCH-R1:<think> ジェド・ホイヤーとジョン・ウィリアム・ヘンリー2世のどちらが年上かを判断する必要がある。二人の年齢を検索しよう。</think><search> Jed Hoyer or John William Henry II </search><information> 文書1(タイトル:「Jed Hoyer」)Sam EliasとNick Miceliとの通算セーブ記録。ウェスリアン大学在学中にデルタ・カッパ・エプシロンに入会し、その兄弟でもあった。1995年の夏はニューイングランド大学野球リーグのウォーターベリー・バロンズのロースターに名を連ね、マウンドとショートでイニングをこなした。ホイヤーは入学課で働き、その後同窓生・開発課で働き、卒業後は大学で野球コーチも務めた。28歳でレッドソックスに入団する前は、ケニオン大学の入学課で働いていた。2010年6月にMerrill Muckermanと結婚し…… </information><think> ジェド・ホイヤーが人物であることが分かった。次に彼の年齢を調べ、ジョン・ウィリアム・ヘンリー2世の年齢と比較する必要がある。</think><search> John William Henry II </search><information> 文書1(タイトル:「John W. Henry」)同社の経営は2006年の25億ドルから2012年後半には1億ドル未満にまで落ち込んでいた。2017年7月時点で、「フォーブス」は彼の純資産を26億ドルと推定した。ジョン・ウィリアム・ヘンリー2世は1949年9月13日にイリノイ州クインシーで生まれた。両親は大豆農家で、彼は成長期をイリノイ州とアーカンソー州で過ごした。15歳時の喘息の症状により、家族はカリフォルニア州アップルバレーへ移住した。ビクタービルのビクター・バレー高校を卒業後、ビクター・バレー・カレッジに進学し、その後カリフォルニア大学(リバーサイド校…… </information><think> ジョン・ウィリアム・ヘンリー2世が1949年9月13日に生まれたことが分かった。次に比較するために、ジェド・ホイヤーの生年を調べる必要がある。</think><search> Jed Hoyer birth year </search><information> 文書1(タイトル:「Jed Hoyer」)Sam EliasとNick Miceliとの通算セーブ記録。ウェスリアン大学在学中にデルタ・カッパ・エプシロンに入会し、その兄弟でもあった。1995年の夏はニューイングランド大学野球リーグのウォーターベリー・バロンズのロースターに名を連ね、マウンドとショートでイニングをこなした。ホイヤーは入学課で働き、その後同窓生・開発課で働き、卒業後は大学で野球コーチも務めた。28歳でレッドソックスに入団する前は、ケニオン大学の入学課で働いていた。2010年6月にMerrill Muckermanと結婚し…… </information><think> ジェド・ホイヤーが1973年12月7日に生まれたことが分かった。これで彼の生年をジョン・ウィリアム・ヘンリー2世の生年と比較できる。</think><answer> ジョン・ウィリアム・ヘンリー2世 </answer> |
| 質問:世界最大のスーパーヒーロー・アンソロジーに登場した、「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人とは、その名前は何か? |
| 正解:キャプテン・マーベル |
| SEARCH-R1: |
| <think> 「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人の名前を見つける必要がある。検索しよう。</think> |
| <search> 世界最大のスーパーヒーロー・アンソロジーに登場した、「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人 </search> |
| <information> 文書1(タイトル:「Shazam!(TVシリーズ)」)Shazam!(TVシリーズ)Shazam!は、スーパーヒーローのキャプテン・マーベル(別名Shazam)に基づいてFilmatonが制作した30分の実写テレビ番組である(同スタジオにとって初のそのような番組)。キャプテン・マーベルはFawcett Comicsのコミックシリーズ『Whiz Comics』(現在はDC Comicsが所有)のキャラクターである。この番組ではマイケル・グレイがビリー・バットソンを演じた。ビリー・バットソンは、「Shazam!」という魔法の言葉を口にすることでスーパーヒーローのキャプテン・マーベルに変身できる10代の少年であり、キャプテン・マーベルは当初ジャクソン・ボストウィックが、後にジョン・デイヴィーが演じた。ビリーは保護者である「メンター」(レス・トレメイン)とともに、1973年製ダッジ・オープンロード・モーターホームで国中を旅し、正すべき不正を探す。... </information> |
| <think> 世界最大のスーパーヒーロー・アンソロジーに登場した、「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人を見つけた。次に、彼らの名前を見つける必要がある。</think> |
| <search> 「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーロー </search> |
| <information> 文書1(タイトル:「Captain Marvel(DC Comics)」)Captain Marvel(DC Comics)Captain Marvelは、別名Shazam()としても知られ、アメリカの出版社DC Comicsの出版物に登場する架空のコミックブックのスーパーヒーローである。アーティストのC. C. BeckとライターのBill Parkerが1939年にこのキャラクターを創造した。Captain Marvelは、Fawcett Comicsが出版した『Whiz Comics』第2号(表紙日付1940年2月)で初登場した。彼はビリー・バットソンの別人格であり、ビリー・バットソンは「SHAZAM」という魔法の言葉(6人の「不死の長老」Solomon、Hercules、Atlas、Zeus、Achilles、Mercuryの頭字語)を口にすることで、超人的な力、スピード、飛行などの力を持つコスチューム姿の成人へと変身できる... </information> |
| <think> 「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人はCaptain Marvel(別名Shazam)であることを見つけた。次に、他の3人のスーパーヒーローを見つける必要がある。</think> |
| <search> 「SHAZAM」というフレーズを口にすることで知られる他の3人のスーパーヒーロー </search> |
| <information> 文書2(タイトル:「Fawcett Comics」)Fawcett Comics Fawcett ComicsはFawcett Publicationsの一部門であり、1940年代のコミックブックの黄金時代に成功した複数のコミックブック出版社の1つであった。その最も人気のあるキャラクターはCaptain Marvelであり、ラジオ記者ビリー・バットソンの別人格で、ビリーは魔法の言葉「Shazam!」を口にするたびにヒーローに変身した。Fawcettが出版した他のキャラクターには、Captain Video、Hopalong Cassidy、Ibis the Invincible、Bulletman and Bulletgirl、Spy Smasher、Captain Midnight、Phantom Eagle、Mister Scarlet and Pinky、Minute-Man、Commando Yank、Golden Arrowが含まれる。よりよく知られたスーパーヒーロー本とは別に、Fawcettは短命に終わった... </information> |
| <think> 「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人はCaptain Marvel(別名Shazam)であることを見つけた。次に、他の3人のスーパーヒーローを見つける必要がある。それらを検索しよう。</think> |
| <search> 「SHAZAM」というフレーズを口にすることで知られる他の3人のスーパーヒーロー </search> |
| <information> 文書3(タイトル:「Captain Marvel(DC Comics)」)クロスオーバー・イベント・シリーズ。彼はアース3のAlexander Luthorの超能力を持った別人格である。物語では、クライム・シンジケート(ジャスティス・リーグの邪悪なアース3の相似体)が、囚人であるAlexander Luthorをプライム・アースへ連れて行き、そこにはジャスティス・リーグや他のヒーローたちが住んでいる。プライム・アースのLex Luthorと彼のチームは、シンジケートがAlexanderを人質に取っているジャスティス・リーグ・ウォッチタワーに忍び込み、Alexanderの口に貼られたダクトテープを剥がす。それによりAlexanderは魔法の言葉「Mazahs!」を話し、筋肉質で非常に強力な別人格へと変身する。プライム・アースのShazamは彼の力を共有することで知られているが... </information> |
| <think> 「SHAZAM」というフレーズを口にすることで知られる4人のスーパーヒーローのうちの1人はCaptain Marvel(別名Shazam)であることを見つけた。他の3人のスーパーヒーローは検索結果には記載されていない。手持ちの情報に基づいて答えを提供しよう。</think> |
| <answer> Captain Marvel </answer> |
表20:SEARCH-R1ケーススタディ11(失敗):LLMは無関係な取得情報に誤導され、誤った答えを提供する可能性がある。
質問:Lady Lesharrという名前の出場者が彼女の影響力の一人として挙げられたThe Rap Gameのシーズンの勝者は誰か?
正解:Mani
SEARCH-R1:<think> Lady Lesharrという名前の出場者が彼女の影響力の一人として挙げられたThe Rap Gameのシーズンの勝者を見つける必要がある。それを検索しよう。</think>
<search> who was the winner of the season of The Rap Game where a contestant named Lady Lesharr as one of her influences </search>
<information> Doc 1(タイトル:「Lady Lesharr」)Act。Lesharrは2018年9月にパンセクシュアルであることを公表した。LesharrはAshley Walters、Lisa Maffia、Missy Elliott、Lil Wayneを彼女の主要な影響力として挙げている。Lady Lesharr Melesha Katrina O'Garro(1989年12月15日生まれ)は、プロとしてLady Lesharr()として知られ、英国のグライムおよびヒップホップのラッパー、歌手、プロデューサーであり、英国ソリハルのキングスハースト出身である。彼女は「Queen's Speech」シリーズのフリースタイルで最もよく知られており、その第4弾は2016年にバイラルとなった。「The Rap Game」シーズン2の競技者Nia Kayは、Lesharrが彼女の独自性とラップスキルのために彼女の影響力の一人であったと述べた。彼女のその後のフリースタイル、… </information>
<think> レディ・レシャーが『The Rap Game』シーズン2のニア・ケイに影響を与えた人物の一人であることが分かりました。次に、そのシーズンの優勝者を見つける必要があります。 </think>
<search> The Rap Game シーズン2 優勝者 </search> <information> 文書1(タイトル:「Chandra Davis」)Chandra Davis Chandra Davis(1978年1月2日、ミシガン州デトロイト生まれ)、別名London CharlesおよびDeelishisは、アメリカのモデルであり、元リアリティ番組の出演者です。彼女は、VH1のヒットリアリティTV番組「Flavor of Love 2」の優勝者として最もよく知られています。Davisは、VH1のFlavor of Loveの第2シーズンに出演者として参加しました(当時29歳)。彼女は、Flavor Flavが、同番組の第1シーズンで以前に準優勝者に選ばれたTiffany 'New York' Pollardを差し置いて彼女を選んだことで、その競争に勝利しました。FOLの後、DavisはVH1の特別番組を通じて、現在Flavorと交際していないことを発表しました、... </information>
<think> The Rap Game シーズン2の優勝者がLondon Charles(Chandra Davis)であることが分かりました。これで答えを提供できます。 </think>
<answer> London Charles </answer>